


TensorRT-LLM 源码完全拆解(十六):P/D 分离与 KV 传输——控制面、数据面与拓扑异构的对齐
系列进度与本篇定位
这是「四个推理框架源码系统学习」系列的第四站 TensorRT-LLM,也是本站 TensorRT-LLM 系列的第十六篇。前十五篇的路线是先摸地形、再走执行闭环、再进模型执行、再下到 KV 池的内部账本与读写路径,最后补上分布式与显存预算:
- 地形与执行闭环:整体架构与模块全景、PyExecutor 装配线与单步闭环、调度器内部;
- KV 账本:KVCacheManager 与块管理、KV Cache 的内存布局与量化存储、KV Cache 的写入与读取路径、KV Cache 压缩框架;
- 模型执行:PyTorchModelEngine 与输入组装、Attention Backend 的 prepare() 内部;
- 分布式与执行细节:并行拓扑与通信、注意力层的张量并行、MoE 层前向执行、量化全链路、投机解码;
- 显存预算:显存与缓冲管理。
到这里,一台单实例推理机器已经被完整拆过一遍:请求怎么进来、怎么被调度、KV 落在哪、一次前向怎么拼出来、显存怎么算预算。但所有这些篇目都有一个共同的隐含前提——context 阶段和 generation 阶段跑在同一批 GPU 上。本篇拆掉这个前提,进入 TensorRT-LLM 的 P/D 分离(disaggregated serving)实现:两个阶段的请求如何被配对,KV 缓存如何跨实例搬过去,以及当两侧的并行策略不一样时,谁来保证搬过去的数据是正确的。
本篇要回答的问题具体到源码级:
- 编排层(
trtllm-serve disaggregated)如何把一次客户端请求拆成「context-only」和「generation-only」两段,这两段之间靠什么参数接头? - 传输通道由哪些模块组成,控制面和数据面为什么必须分开,谁在什么时候注册内存、谁负责算地址?
- 当 context 用 TP4、generation 用 PP2 时,哪个 rank 搬哪一段 KV?这套
(src_ptrs, dst_ptrs, sizes)的对齐算法在哪? - KV 传输是怎么接进
PyExecutor执行循环的:什么时候发起、什么时候等待、什么时候能安全释放源侧缓存? - 站在 SGLang 那篇 SGLang 源码完全拆解(十二):Disaggregation 的对照面上,两个框架在同一件事上做了哪些不同的选择。
选这个题目有一个直接理由:P/D 分离是目前长上下文、高并发线上服务里争议最大、也最容易踩坑的一块工程结构。它同时牵动调度器、KV 管理器、通信库和部署拓扑四条线,而把这四条线在一个框架里打通读一遍,比分别读四篇各自领域的文章更有价值。
为什么把 Prefill 和 Decode 拆开
两个阶段的硬件性格完全不同
Transformer 推理的两段计算有本质差异。用「算术强度」这个尺度看更清楚:算术强度指每读一个字节的数据能顺带做多少次浮点运算。
Context(prefill)阶段一次前向要处理整段提示词的全部 token,每层都要做 QKV 投影、输出投影、FFN 两个大矩阵乘。这些矩阵乘的权重是复用的,激活是「一大堆 token × 隐藏维」的形状,数据复用率高,算术强度可达几百甚至上千 FLOP/Byte。这种形状的负载吃算力,硬件利用率容易打满。
Generation(decode)阶段每次只处理一个新 token。权重矩阵还是那么大,激活却只是一行向量,算术强度掉到个位数 FLOP/Byte——GPU 大部分时间在等 HBM 把权重搬进 SM,算力单元空转。这种形状的负载吃带宽。
prefill: [num_tokens, hidden] × [hidden, hidden] -> 矩阵乘,算力受限decode: [1, hidden] × [hidden, hidden] -> 矩阵向量乘,带宽受限这就解释了为什么同一台机器上这两个阶段的最优配置完全不同:prefill 希望尽可能大的批、尽可能高的算力密度、对延迟不敏感;decode 希望尽可能多的并发序列来摊薄权重读取、对每一步的延迟极其敏感(TPOT 直接决定用户看到的出字速度)。
混在一起会互相伤害
把两段放在同一批 GPU 上跑(业界叫 in-flight batching,IFB),就是 TensorRT-LLM 官方文档里说的 aggregated serving。它的执行时间线如图 1 所示:一个长 prompt 的 context 计算会占满 GPU 若干毫秒甚至几十毫秒,期间所有正在 decode 的序列都得排队等——它们的 TPOT 被这一段长 prefill 直接拉长。
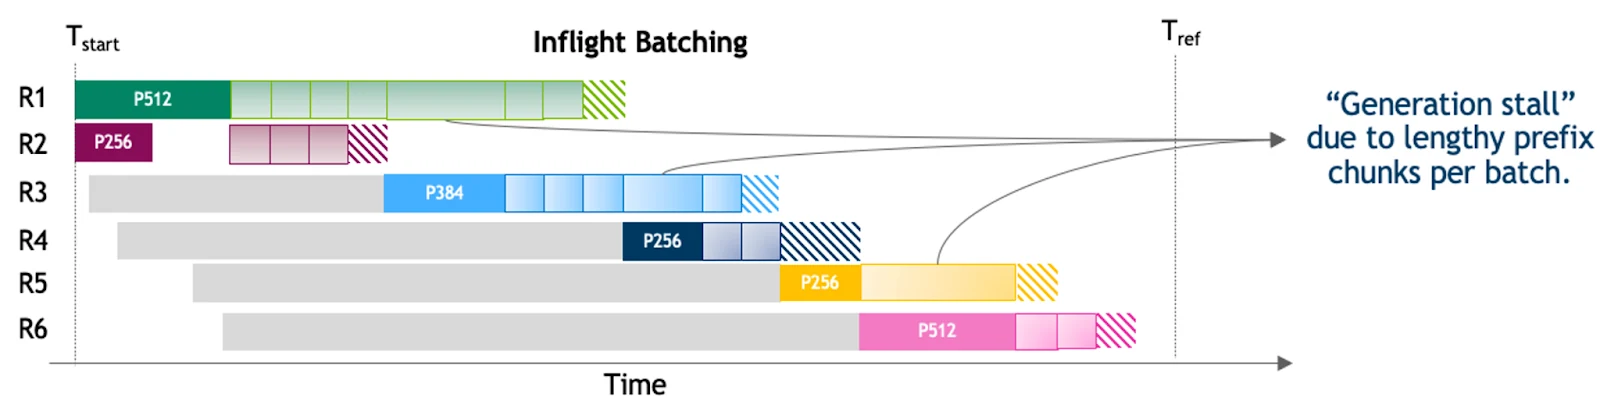
图:aggregated serving 的执行时间线。图中每个色块是一次前向;可以看到 context 块与 decode 块交替占用同一批 SM,decode 的步间隔被 prefill 撑开。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/blogs/media/tech_blog5_Picture1.png)
把两段拆到不同 GPU 池上,就是 disaggregated serving,时间线如图 2:context 池只跑 prefill,generation 池只跑 decode,两边的节奏互不干扰,TTFT 和 TPOT 可以各自调优。
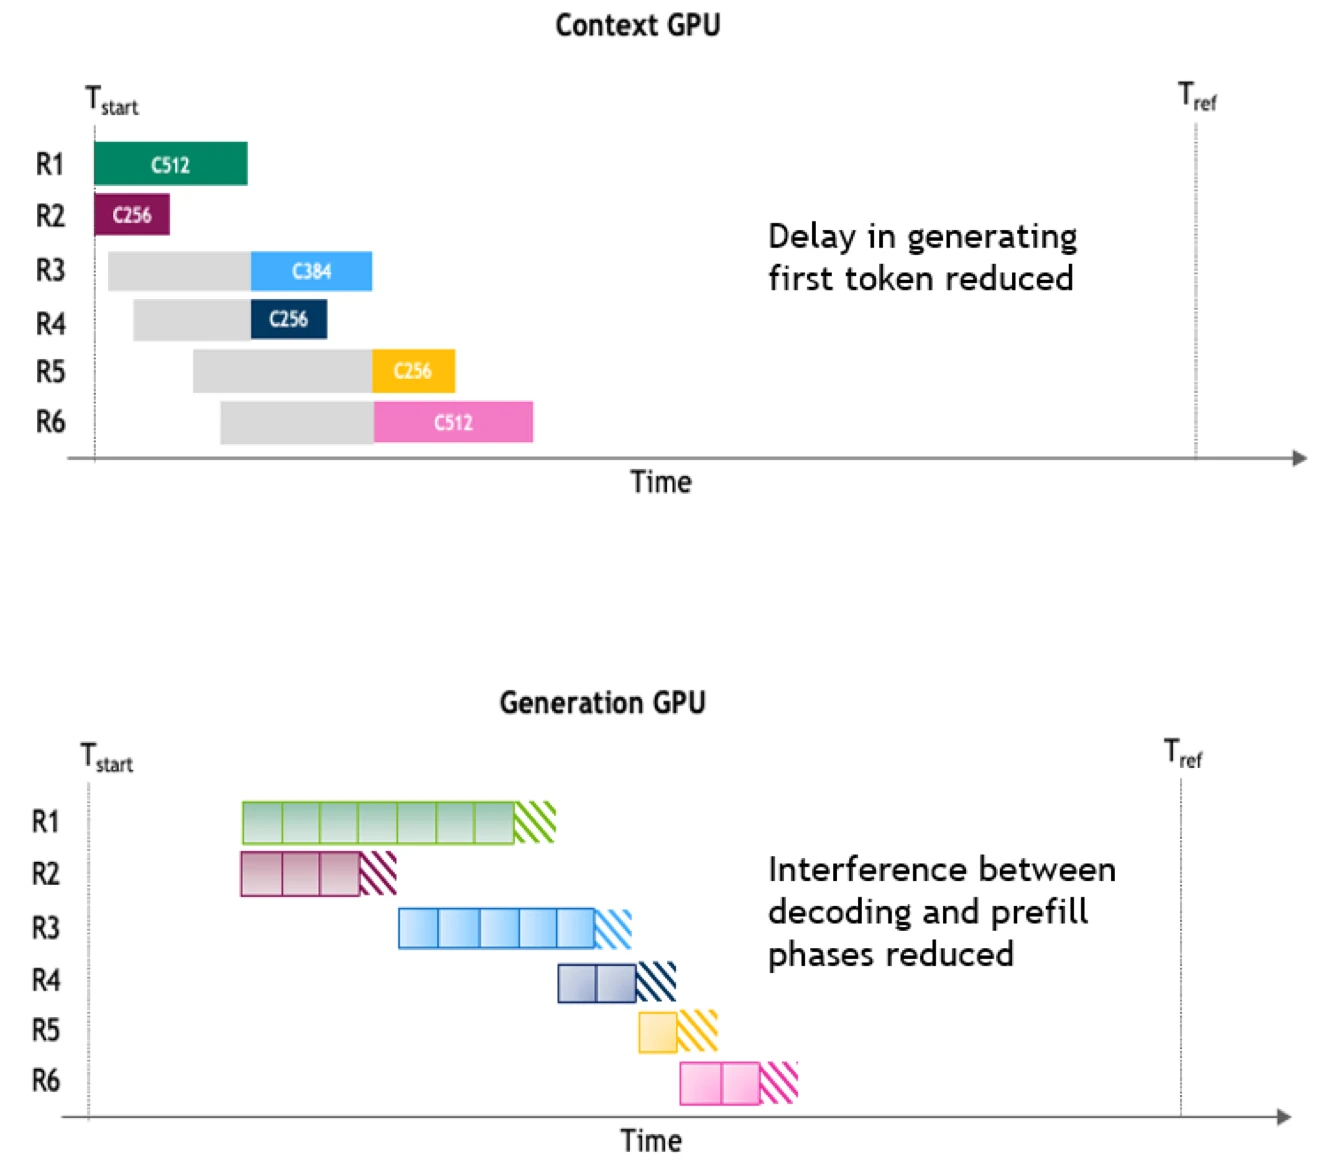
图:disaggregated serving 的执行时间线。两侧各自把同类工作连成一串,唯一的耦合点是 KV 缓存从 context 侧搬到 generation 侧的那一次传输。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/blogs/media/tech_blog5_Picture2.png)
收益与代价的账
拆开不是免费的。代价有三项:
- KV 传输开销:prompt 的 KV 缓存必须从 context 侧的显存搬到 generation 侧的显存。这段数据量是
2 × num_layers × prompt_len × num_kv_heads × head_dim × dtype_bytes。对 70B 级模型、8K prompt,这是几百 MB 到 GB 级的数据,跨节点走 RDMA 也要几毫秒到几十毫秒。 - 额外一跳延迟:客户端请求要先经编排服务器,再分发给 context、再跳到 generation,链路变长。
- 部署复杂度:两类实例、两套并行配置、两套显存预算、一个编排层,监控和排障面都变大。
收益则集中在一种负载形态上:长输入、中等输出。prompt 越长,prefill 占用的时间越长,对 decode 的干扰越严重,拆开的收益越大;输出越短,KV 传输可以摊薄的 decode 步数越少,拆开的相对代价越高。反过来说,对「短 prompt + 超长输出」这种负载,拆开往往不划算,因为一次传输的开销要靠大量 decode 步才能摊回来。
TensorRT-LLM 官方文档明确把这一点写成收益边界:「advantage can be substantial—particularly for workloads with long input sequences and moderate output lengths where interference is most severe」。这条经验规则可以作为是否上 P/D 分离的第一道判断。
还有一个不那么显眼的收益:两侧可以各用各的并行策略
这是很多人第一次读 P/D 分离时容易忽略的点。context 和 generation 的算力/带宽性格不同,它们的最优并行策略本来就不该一样:
- context 阶段算力受限、激活巨大,张量并行(TP)能把一次大矩阵乘横切到多卡上,缩短单次前向时间;同时它对显存的需求集中在激活而非 KV。
- decode 阶段带宽受限、每步只处理一个 token,TP 每层都要插一次 all-reduce,通信与计算的比例恶化得很快;流水并行(PP)反而更划算,因为每卡只需要装一部分层的权重,通信只发生在层边界。
所以一个很自然的部署是「context 用 TP、generation 用 PP」。官方文档给出的例子就是 context 用 TP2、generation 用 PP2(图 5,后面会详细拆)。这个自由度一旦放开,就立刻带来本篇最核心的技术问题:两侧的 KV 缓存切法不一样,搬过去的数据该怎么重新对齐? 这不是一个网络层问题,而是一个索引算术问题,也是 TensorRT-LLM 在这块代码里花最多篇幅的地方。
编排层:客户端请求怎么变成两段配对请求
三种部署形态
TensorRT-LLM 的 P/D 分离有两种落地方式。第一种是接 Dynamo——NVIDIA 的数据中心级推理服务器,它自带前处理/后处理 worker、智能路由、Kubernetes 部署与监控。第二种是框架自带的 trtllm-serve disaggregated,即用一个额外的「编排服务器」把客户端请求分发给 context 与 generation 服务器。
第二种形态的分工如图 6:编排服务器对外暴露一个 OpenAI 兼容端点(默认 :8000),它同时持有 context 实例列表与 generation 实例列表的 URL,把请求按角色分发出去。
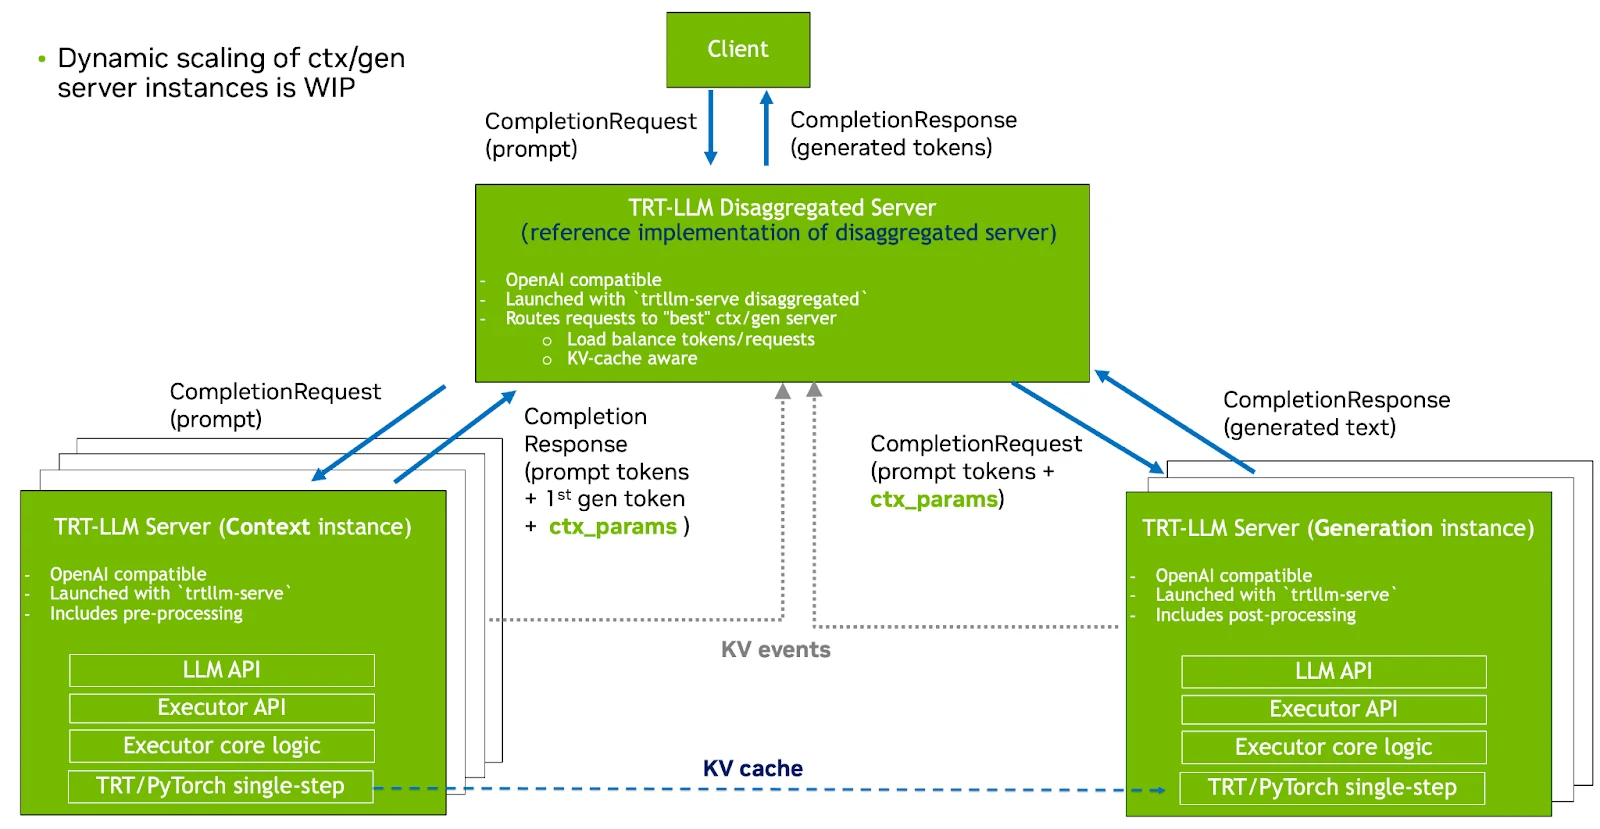
图:trtllm-serve 的分离式部署形态。编排服务器扮演唯一对外的 OpenAI 兼容端点,内部维护 ctx 与 gen 两组实例;context 实例回传的 ContextPhaseParams 是两段请求的接头凭证。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/blogs/media/tech_blog5_Picture3.png)
启动方式在文档里写得很直白:每个 context/gen 实例都是一台独立的 trtllm-serve,用 CUDA_VISIBLE_DEVICES 决定它占哪几张卡:
# context 实例的配置:关掉 overlap scheduler,并把 transceiver 打开echo -e "disable_overlap_scheduler: True\ncache_transceiver_config:\n backend: NIXL" > context_config.yml
CUDA_VISIBLE_DEVICES=0 trtllm-serve TinyLlama/TinyLlama-1.1B-Chat-v1.0 \ --host localhost --port 8001 --backend pytorch --config ./context_config.yml &> log_ctx_0 &CUDA_VISIBLE_DEVICES=1 trtllm-serve TinyLlama/TinyLlama-1.1B-Chat-v1.0 \ --host localhost --port 8002 --backend pytorch --config ./context_config.yml &> log_ctx_1 &
# generation 实例的配置echo -e "cache_transceiver_config:\n backend: NIXL" > gen_config.ymlCUDA_VISIBLE_DEVICES=2 trtllm-serve TinyLlama/TinyLlama-1.1B-Chat-v1.0 \ --host localhost --port 8003 --backend pytorch --config ./gen_config.yml &> log_gen_0 &
# 编排服务器trtllm-serve disaggregated -c disagg_config.yamldisagg_config.yaml 里写清楚两组实例的地址:
hostname: localhostport: 8000backend: pytorchcontext_servers: num_instances: 2 urls: - "localhost:8001" - "localhost:8002"generation_servers: num_instances: 1 urls: - "localhost:8003"有一个细节值得单独指出来:cache_transceiver_config.backend 没有默认值。如果 worker 的配置文件里不写这一行,worker 照样能启动,但它不会创建 cache transceiver,随后被路由过来的分离式请求会被直接拒绝。而且两个 worker 之间的传输参数不做协商——配置不匹配不会被报成配置错误,而是在传输失败时才暴露。文档给出的自检方式是:
grep -E "Using KvCacheTransceiverV2|cache_transceiver is disabled" log_ctx_0 log_gen_0这条设计反映了一个更大的原则:传输通道的两端必须显式对齐,框架不做隐式兜底。这个原则在后面讲 mapper 匹配时会反复出现。
请求怎么被拆成两段:request_type 与 ContextPhaseParams
编排服务器不会把原始请求原样转发两次。它做的是:
- 对 context 实例:把请求标记为 context-only(
REQUEST_TYPE_CONTEXT_ONLY),让它在算完 prefill 之后跳过生成。 - 对 generation 实例:把请求标记为 generation-only(
REQUEST_TYPE_GENERATION_ONLY),让它跳过 prefill,直接从 KV 接收开始。
这两个标记定义在 tensorrt_llm/disaggregated_params.py 的 DisaggregatedParams 里,取值是字符串 "context_only" / "generation_only" / "context_and_generation",再由 get_request_type() 映射到 C++ binding 的枚举。同时存在的还有一个 schedule_style,取值 context_first 或 generation_first——这是「先调度哪一侧」的问题,我们放到时序那一节讲。
两段请求之间靠什么接头?靠 context 实例返回的 ContextPhaseParams。它由 DisaggregatedParams.get_context_phase_params() 构造:
def get_context_phase_params(self) -> tllme.ContextPhaseParams: # Prefer disagg_request_id over ctx_request_id request_id = ( self.disagg_request_id if self.disagg_request_id is not None else self.ctx_request_id ) first_gen_tokens = self.first_gen_tokens if self.first_gen_tokens is not None else [] return tllme.ContextPhaseParams( first_gen_tokens, request_id, self.opaque_state, self.draft_tokens, self.ctx_dp_rank, self.ctx_info_endpoint, )这六个字段每一个都在解决一个具体的工程问题:
first_gen_tokens:context 阶段算完最后一段 prompt 之后,实际上已经顺带算出了「下一个 token」的 logits。把这个 token 一并发给 generation 侧,generation 侧就不用再算一次首 token 的前向——省掉一次完整的 prefill 尾部计算。文档里说,context 实例的响应包含 prompt tokens、第一个生成的 token 以及 context 请求的元数据,这三样合起来才够 generation 侧接着往下跑。request_id:两段请求共用的全局唯一 ID。这是整条传输链路的主键,两个在途请求 ID 撞车就会把传输内容串到一起。文档明确写了这一点:「a collision (two in-flight requests with the same ID) corrupts the transfer」。opaque_state/draft_tokens:任意需要在两侧之间传递的状态,以及投机解码的草稿 token(如果 context 侧已经算过草稿)。ctx_dp_rank:context 侧的注意力数据并行 rank。这个字段在注册阶段是None——因为 context 调度器还没把请求分配到某个 DP rank 上;只有 prefill 被调度之后,respond_and_send_async()才把它写进ContextPhaseParams。它的用途是告诉 generation 侧「去哪个 ctx DP rank 取 KV」,None的含义是「广播给所有 ctx DP rank」。ctx_info_endpoint:context 实例可以被打到的地址。这是 generation 侧建立连接的唯一入口。
全局请求 ID:snowflake 与 ID 空间切分
两段请求共用一个 ID,那这个 ID 从哪来?如果用共享计数器,就需要一次跨进程协调;如果用 UUID,就要处理字符串与整数之间的转换。TensorRT-LLM 选的是 snowflake ID:一个自洽的 64 位正整数,不需要任何跨进程协调就能保证唯一。
[ 0 (1 bit) | timestamp_ms (39 bits) | node_id (8 bits) | process_id (6 bits) | counter (10 bits) ]各段的含义:
node_id(0–255):节点标识,默认取 MAC 地址哈希再模 256,也可以用配置里的node_id手动覆盖。文档特意写了一句「Assuming only one disagg-server is running on a machine, modulo 256」,说明这是概率性的唯一性假设。process_id(0–63):该节点上的编排进程编号。在 coordinator + worker fleet 形态下,launcher 会给每个 fleet worker 分配一个不同的值,所以同机多个 worker 在同一毫秒内也不会撞 ID。counter(10 bits):每毫秒最多 1024 个 ID。timestamp_ms(39 bits):注意源码用的是time.monotonic(),不是墙钟,所以不受时间回拨影响。
代码里还有一手「空间切分」:
# Rotate into [MIN_GLOBAL_ID, MAX_INT64); [0, MIN_GLOBAL_ID) is local-id space.global_id_int64 = global_id % (MAX_INT64 - MIN_GLOBAL_ID) + MIN_GLOBAL_ID全局分离式 ID 被强制落在 [1 << 40, 2**63) 区间,而 worker 本地的请求 ID(包括预热请求)落在 [0, 1 << 40)。两个区间不相交,于是「本地 ID」和「全局 ID」永远不会互相污染。文档把这一点写成了明确的分工:如果客户端自己传了正的 disagg_request_id,服务端就原样使用(客户端必须保证全局唯一);没传就现场铸一个 snowflake。
编排层自己也会成为瓶颈:coordinator + fleet
一个 trtllm-serve disaggregated 进程本身是单线程编排器。它要终止每一条客户端连接、跑路由、代理 ctx→gen 那一跳,高并发下自己就成了吞吐瓶颈。
TensorRT-LLM 的解法是把编排层拆成两个角色:
- Coordinator:一个进程,独占所有集群状态——ctx/gen 路由器、worker 就绪状态,以及(对 KV 缓存感知路由器)唯一的 ZMQ 事件接收端点。它暴露内部协调 API:
/select、/finish、/cluster_info、/health。 - Fleet workers:
num_workers个无状态的编排服务器进程,通过SO_REUSEPORT共享同一个对外端口。每个 worker 自己就是一个进程、绑同一个端口,内核按四元组哈希把进来的连接分摊到它们上面。
关键设计在于worker 不持有路由状态。每个 worker 只在本地算路由键(比如块哈希),然后把「放哪里」这个决策委托给 coordinator;这样无论哪条连接落在哪个 worker 上,路由结果都是全局一致的。三种拓扑由两个字段决定:
num_workers | disagg_coordinator_url | 行为 |
|---|---|---|
1 | 未设置 | 单进程自洽服务器,coordinator 在进程内(默认) |
> 1 | 未设置 | 本进程内启动一个隐式 coordinator(监听 port - 1),public 端口上跑 num_workers 个委托 worker |
| 任意 | 已设置 | 本进程不启动 coordinator,worker 全部指向外部 disagg_coordinator_url |
有一处细节很能说明工程成熟度:fleet worker 在启动时会先探测 coordinator 的 /cluster_info,带界重试到 --server_start_timeout 秒;探测不通就直接带错误退出,而不是「先起来、然后对每个请求都返回 Cluster is not ready」。这是快速失败而非降级服务的选择。
路由策略:从轮询到 KV 感知
编排层的路由不是简单的负载均衡。src/router.py 里定义了一族路由器:
| 路由器 | 决策依据 |
|---|---|
RoundRobinRouter | 轮询,不往返 coordinator |
LoadBalancingRouter | 按在途负载选最轻的实例 |
KvCacheAwareRouter | 按块哈希集合判断哪台实例已经有了这段前缀的 KV |
ConversationRouter | 按会话亲和性固定实例,多轮对话复用前缀 |
KvCacheAwareRouter 继承了一个混入类 BlockHashMixin,其 KvCacheAwareServerState 维护每个实例的 _block_table(块哈希集合),并通过 update_with_events(events) 消费实例上报的 KV 事件来持续更新。也就是说,context 实例算完一个 prompt 之后,它产生的块哈希会被上报到编排层,后续同类请求就能被路由到「已经持有这段 KV」的实例上,直接命中前缀复用。
这里有一条容易被忽略的配置语义:fleet 会把 load_balancing、kv_cache_aware、conversation 三种路由委托给 coordinator 以保证全局一致,而 round_robin 保留在本地、不做 coordinator 往返。原因很直接:轮询不需要全局状态,多一跳 HTTP 纯属浪费。
控制面与数据面:为什么必须分开
总览:两张网
整套 KV 传输的骨架可以一句话概括:控制面用 ZeroMQ,数据面用 NIXL 单向写,两者从不共用通道。
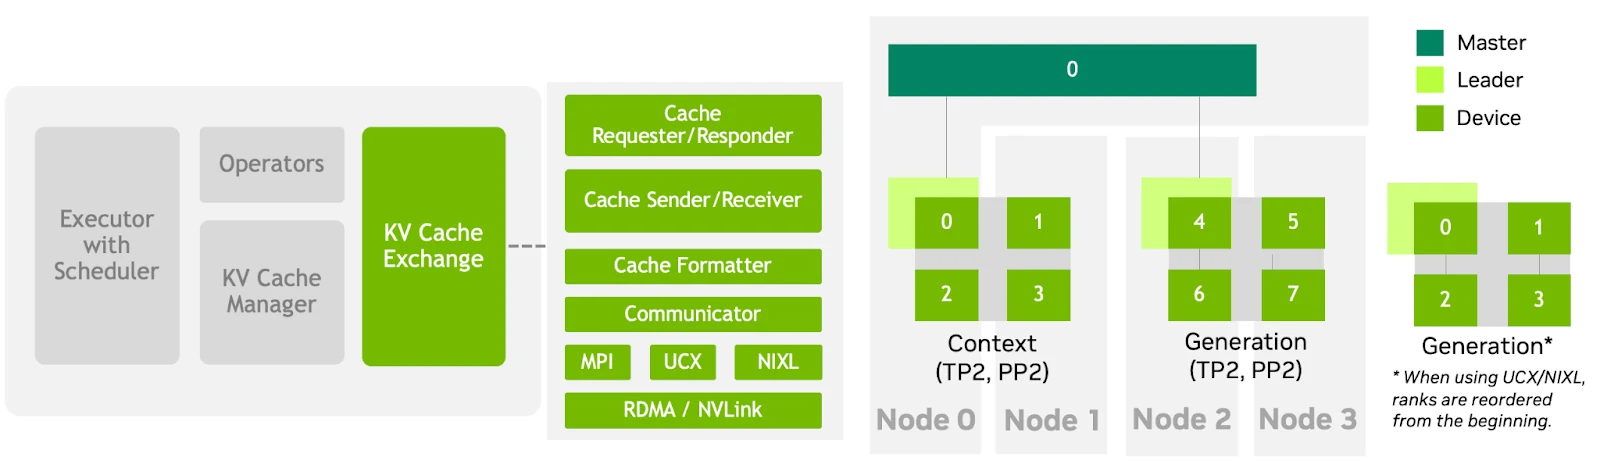
图:KV cache exchange 的模块解耦。传输模块不直接依赖某个 cache manager 的存储格式,也不直接依赖某个通信库;布局转换发生在交换过程之中。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/blogs/media/tech_blog5_Picture6.png)
官方文档把这条分工写得很清楚:
The control plane — discovery, per-request metadata, and completion notices — is ZeroMQ. The data plane is one-sided NIXL writes issued by the context worker into memory the generation worker has registered. The two never share a channel.
为什么必须分开?因为两类消息的性格完全不同:
- 控制消息体积小(几十字节到几 KB)、延迟敏感、必须可靠有序。它们是「我要这几块」「我发完了」这类语义,一旦乱序或丢失,状态机立刻错乱。
- 数据消息体积大(MB 到 GB 级)、带宽敏感、理想情况下完全不需要 CPU 参与。它们应该由网卡直接从源显存搬到目标显存,CPU 只在两端算地址。
把大块的显存搬运塞进控制通道,控制通道的队头阻塞会直接毁掉延迟;把控制语义塞进 RDMA 传输,又失去了可靠有序的语义保证。两张网各自解决自己那类问题,是这件事唯一合理的设计。
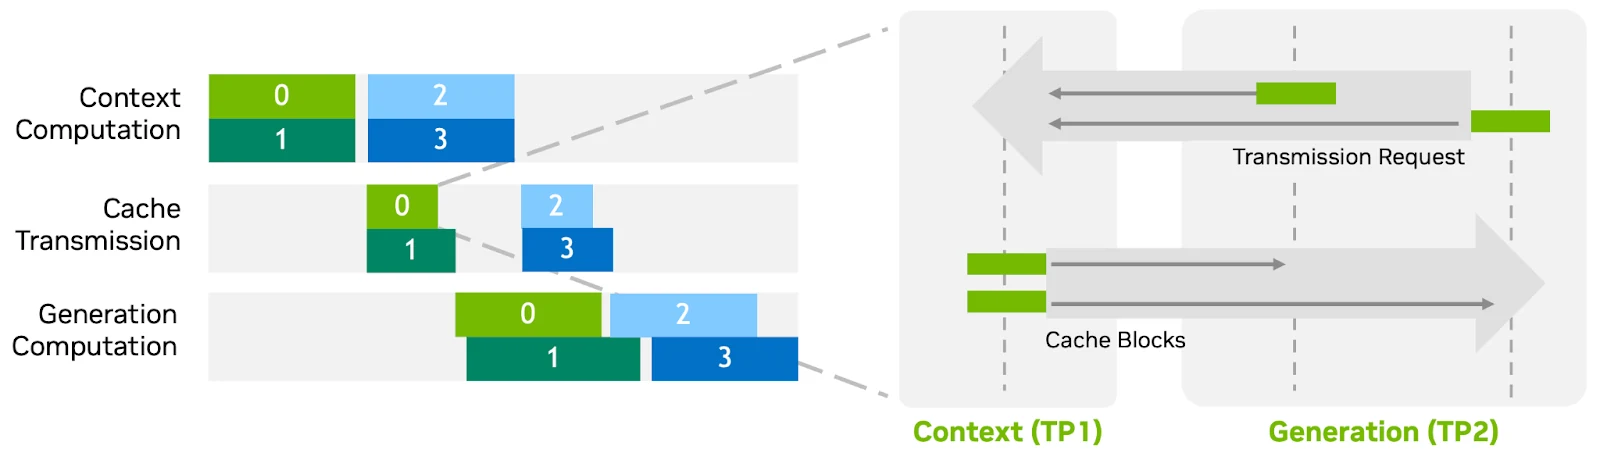
图:KV cache 交换的时序。传输与计算不串行——一个请求在收发 KV 时,其它请求继续做前向;多卡实例下不同 GPU 组之间的传输还可以并行。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/blogs/media/tech_blog5_Picture7.png)
这张图还解释了另一个容易被忽略的部署结论:传输的重叠对象是「其它请求」,不是「同一个请求」。要让重叠真正发生,编排层就必须把足够多的请求同时留在 generation 侧——如果并发度太低,一个请求在等 KV,池子里没有别的请求可以算,重叠就退化成串行。这也是为什么文档专门给了一个基准填谷的开关 TLLM_BENCHMARK_REQ_QUEUES_SIZE,以及配套的 TRTLLM_GPU_KEEPALIVE:后者让等待填谷的 generation worker 在每块 SM 上保留一个常驻 warp(按约 100 ms 一段),这样 GPU 活动指标不会在等待期间读成「空闲」。源码注释强调这份工作「is drained when the gate opens and never overlaps a forward pass」——保活工作与前向计算严格互斥,不会污染测量。
六步工作流
把 docs/source/developer-guide/kv-transfer.md 里的工作流展开,一次完整的 KV 交接分六步:
第一步:context 阶段算完,KV 留在显存里等传输。 context worker 此时只发布一件事——它可以在哪个端点被找到,写在 ContextPhaseParams.disagg_info_endpoint 上。
第二步:generation worker 首次接触该 context 实例时,先交换 RankInfo。 它从 context 的 rank 0 取回该实例的 RankInfo——拓扑、注意力几何、序列化后的页表、传输 agent 的描述符;然后把它自己的 RankInfo 注册到 context 的每一个 rank 上。这个结果按端点缓存,所以只有第一个请求要付这次往返。
这一步是整个方案里最容易被低估的设计:两个实例在传输第一字节之前,先交换彼此「KV 长什么样」的完整描述。因为两侧的 TP/PP 配置可能不同,KV 的切法可能完全不同,所以必须先把几何信息摆到桌面上,后面的地址算术才有可能。
第三步:generation 阶段请求特定 token 的 KV。 它把目的块 ID 发给每一个与它有层重叠的 context rank。
第四步:context 侧本地算出源地址和目的地址,提交一次单向 NIXL 传输。 注意这句原文:
Context computes both source and destination addresses locally and submits a one-sided NIXL transfer. … All address arithmetic happens on the context side; the generation worker’s CPU is not involved.
地址算术全部发生在发送侧,接收侧的 CPU 完全不参与。这一条的收益很实在:一次传输涉及成千上万个子区域,如果每个子区域都要接收侧 CPU 算一次地址再下指令,接收侧的 CPU 就会成为传输带宽的上限。把算术压到一侧,接收侧只需要暴露自己的地址描述符,然后什么都不用做。
第五步:context 通过控制面上报完成。 接收会话在所有预期写入者都上报之后才算完成。
第六步:generation 恢复计算,context 释放 KV。 原文特别强调:
Both sides run an allgather first, so every rank agrees on the outcome before any state transition.
两侧在状态迁移前都要先跑一次 allgather,确保所有 rank 对结果有一致认知。这条约束的存在说明作者踩过「部分 rank 认为成功、部分 rank 认为失败」这类不一致的坑——在这种情况下,一侧已经释放了 KV 而另一侧还在读,就会读到已被复用的显存。
关键组件
| 组件 | 文件 | 职责 |
|---|---|---|
| Transceiver | transceiver.py 的 KvCacheTransceiverV2 | 协调一个 executor 内部各 rank 的收发;暴露 PyExecutor 驱动的那套接口;所有方法都跑在 executor 主循环上 |
| Messenger | native/messenger.py | 封装 ZeroMQ 的 ROUTER/DEALER socket,每个 socket 一个监听线程 |
| Transfer / Fetch / Publish | native/transfer.py、native/fetch.py、native/publish.py | 在 messenger 之上构建实际端点:context 侧是 Sender,generation 侧是 Receiver,rank 0 上还有会合服务器 |
| Peer Registrar | native/peer.py | 解析「哪些 peer rank 持有相同的层」,并为每个目的端选出一个唯一的 owner |
| Mappers | native/mixers/ | 每个架构的布局策略,把一对匹配的池翻译成 (src_ptrs, dst_ptrs, sizes) |
| Page Table | resource/page.py | 与具体 cache manager 无关地描述一个 rank 的 KV 存储 |
| KV Extractor | resource/kv_extractor.py | 从两代 cache manager 构建页表,并把块 ID 翻成 slot 指针 |
| Transfer Agent | base/agent.py 的 BaseTransferAgent | 内存注册、远端 agent 加载、传输请求提交 |
关于 messenger 有一条重要约束:监听线程的处理器只改会话状态并入队工作,绝不在传输上阻塞。它是唯一能让「控制面保持低延迟」落地的实现细节——一旦监听线程被某个慢传输堵住,后续请求的控制消息全部排队。
还有一句原文值得抄下来:
native/transfer.pybuilds the actual endpoints on top:Senderon the context side,Receiveron the generation side, and a rendezvous server on rank 0.
Sender / Receiver 的不对称命名本身就说明了所有权:发送侧是主动方,接收侧是被动方。
Transfer Agent:把「传输能力」抽象成一个可替换部件
base/agent.py 定义了一个纯虚基类:
class BaseTransferAgent(ABC): @abstractmethod def register_memory(self, descs: RegMemoryDescs) -> None: ... @abstractmethod def deregister_memory(self, descs: RegMemoryDescs) -> None: ... @abstractmethod def load_remote_agent(self, name: str, agent_desc: bytes) -> None: ... @abstractmethod def get_local_agent_desc(self) -> bytes: ... @abstractmethod def invalidate_remote_agent(self, name: str) -> None: ... @abstractmethod def submit_transfer_requests(self, request: TransferRequest) -> TransferStatus: ... @abstractmethod def notify_sync_message(self, name: str, sync_message: str) -> None: ... @abstractmethod def check_remote_descs(self, name: str, memory_descs: MemoryDescs) -> bool: ... @abstractmethod def shutdown(self) -> None: ...这九个方法就是「一方能单边写另一方已注册内存」所需的全部能力。请求对象也很简洁:
@dataclassclass TransferRequest: op: TransferOp # READ 或 WRITE src_descs: MemoryDescs # 源区域:一串 (ptr, size, device_id) dst_descs: MemoryDescs # 目的区域 remote_name: str # 对端 agent 名 sync_message: Optional[str] = NoneMemoryDescs 用一个 type 字段(DRAM/VRAM/BLK/OBJ/FILE)标注这批区域的内存类型,加一串 (ptr, size, device_id) 三元组。READ/WRITE 用普通字符串而不是枚举,源码注释给了理由:这样成员直接等价于字符串本身,序列化时不需要转换。
框架提供两条实现路径:nanobind 的 C++ binding(tensorrt_llm_transfer_agent_binding,等待期间释放 GIL)和纯 Python 的 nixl 包(用 TRTLLM_USE_PY_NIXL_KVCACHE=1 强制启用)。模块加载时会做一次能力探测:
required_attributes = [ "MemoryType", "TransferOp", "MemoryDesc", "MemoryDescs", "TransferRequest", "TransferStatus", "BaseTransferAgent",]if all(hasattr(_cpp_binding, attr) for attr in required_attributes): return _cpp_binding逐个检查必需属性再决定采用,而不是「import 成功就用」——这是对版本漂移的防御。
自定义传输的接入点讲得也很坦白:任何能对已注册远端内存做单向写的传输都可以继承 BaseTransferAgent;但 agent 的选择目前硬编码在 nixl/agent.py 和 TransferWorker._setup_transfer_engine,还没有配置驱动的 agent 注册表,所以接新后端需要在这两处加钩子。
拓扑异构:谁和谁对齐、谁负责搬哪一段
这一节是整篇的技术核心。前面铺垫的「两侧可以用不同并行策略」一旦成立,就必须回答三个问题:
- 层:context 的第 12 层 KV,对应 generation 的哪一层?
- rank:source 的哪个 rank 负责搬这段数据,目的端的哪个 rank 接收?
- 字节:一段层内的 KV 缓存里,哪些字节对应哪些字节?
三个问题分别由 get_pool_mapping、get_peer_overlap/should_send_pool、以及 mapper 家族回答。
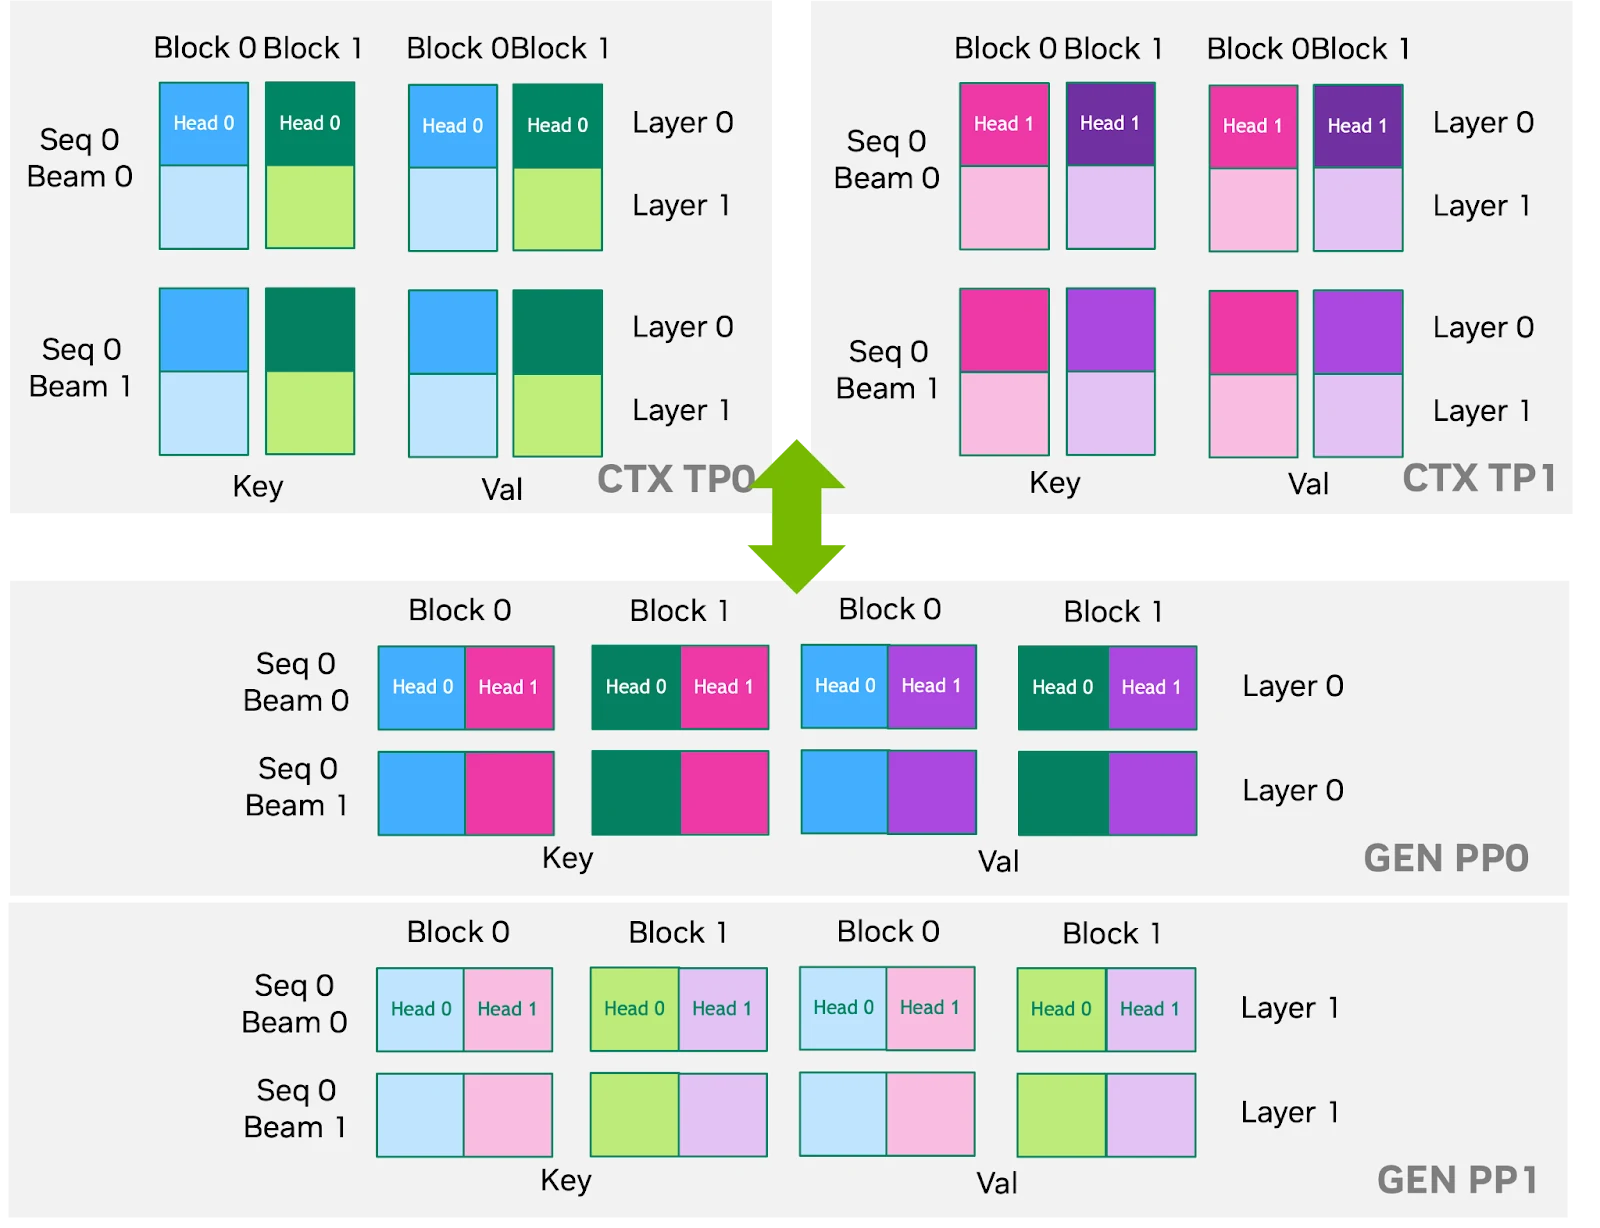
图:context 用 TP2、generation 用 PP2 时的布局转换。左侧每个 rank 持有全部层的一半 KV 头,右侧每个 rank 持有全部 KV 头的若干层;KV 块在两侧的归属关系完全不同,必须靠映射表逐段搬运。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/blogs/media/tech_blog5_Picture8.png)
这张图值得逐块读一遍,因为它是后面所有算法的可视化版本。TP2 的 context 侧:两张卡各持一半 KV 头,但每张卡都有全部层。PP2 的 generation 侧:两张卡各持一半层,但每张卡都有全部 KV 头。所以
- gen rank 0 需要的第 0–N/2 层 KV,要从 ctx rank 0 和 ctx rank 1 两边各取一半头;
- ctx rank 0 持有的第 0 层的半个头,要送给 gen rank 0;它持有的第 N/2 层的半个头,要送给 gen rank 1。
一个源 rank 要扇出到多个目的 rank,一个目的 rank 要从多个源 rank 扇入。这就是整个映射问题的形状。
第一层:层组与物理池的配对
TensorRT-LLM 没有按「层」逐层配对,而是先配对层组(layer group)与物理池(physical pool)。
先看 resource/page.py 里的数据结构。PhysicalPool 是「物理池的仿射视图」:
@dataclassclass PhysicalPool: """Affine view of a physical pool over logical layers and slots.
The payload address is ``base_address + layer * layer_stride_bytes + slot * slot_stride_bytes``. """ base_address: int # uint64 slot_bytes: int num_slots: int slot_stride_bytes: Optional[int] = None layer_stride_bytes: Optional[int] = None一个池里任何一个 (layer, slot) 的地址都可以用两个 stride 算出来:base_address + layer * layer_stride_bytes + slot * slot_stride_bytes。这是整条地址算术链的基石——后面所有 mapper 都只需要在这个公式上做加法,而不需要遍历真实内存。
注意两个 stride 是可选的,默认值描述「稠密、层主序」的存储(slot_stride_bytes == slot_bytes、layer_stride_bytes == num_slots * slot_stride_bytes)。V2 的 Mamba 池会显式给出两者,因为它的池是 slot 主序、并且不同角色在层间交错。默认值 + 显式覆盖这个设计让「常见布局零配置、特殊布局精确控制」同时成立。
PoolView 是「某个层组在某个物理池里的视图」,它的核心字段是 buffer_entries:
BUFFER_ENTRY_DTYPE = np.dtype([ ("local_layer_id", np.uint32), # 64-bit: layer-major recurrent-state pools address a layer at # layer_index * num_slots * slot_bytes, which exceeds 4 GiB. ("offset", np.uint64), ("size", np.uint32),])每个 entry 记录「这一层的这块 buffer,在池 slot 里偏移多少、有多大」。源码注释解释了为什么 offset 用 64 位而 size 用 32 位:层主序的循环状态池里,一层的地址是 layer_index * num_slots * slot_bytes,会超过 4 GiB。这是被真实模型规模逼出来的字段宽度选择。
PoolView.pool_role 是配对用的等价标签,注释里写得很明确:
Used as the equivalence label for peer-to-peer pool matching: two pools match iff their
pool_rolefrozensets are equal. Disagg never enumerates the role-name vocabulary — adding a new role on the manager side requires no disagg change.
也就是说,传输层不认识任何角色名("key"、"value"、"deepseek_v4_swa" 这些都只是字符串),它只做集合相等比较。cache manager 新增一种角色,传输层不需要改一行代码。这是一个典型的依赖倒置:把易变的词汇表留给上层,把稳定的比较逻辑留给自己。
真正的配对算法在 PeerRegistrar.get_pool_mapping 里,注释把两步匹配写成了清晰的两段:
Two-step matching:1. Find peer layer_group via layer_to_layer_group (global_layer_id -> lg_idx).2. Within the matched peer layer_group, find the unique peer pool whose ``PoolView.pool_role`` equals self's and whose global_layer_ids overlap.第一步:按全局层 ID 找对端的层组。 这里有一个关键不变量被反复强调:
A self layer group never matches multiple peer layer groups… A multi-LG hit therefore means the two peers group layers differently (unsupported topology), and we fail loudly instead of silently transferring only the first LG’s overlap.
如果一次匹配命中了多个对端层组,说明两侧的层分组方式不一致——这是不支持的拓扑,代码直接抛异常而不是悄悄只传第一个。为什么这么激进?因为静默地只传一部分,会导致 generation 侧的前向在缺少部分层 KV 的情况下算出看似正常、实则错误的结果,这种 bug 极难定位;而抛异常至少定位得到。
第二步:在同角色的池里,用层重叠做筛。 这里有一个很精细的细节:pool_role 在同一个对端层组里不保证唯一——V2 可能按 buffer 大小把同一个层组拆成多个同角色池(例如 VSWA)。所以匹配条件是「角色相等 且 层集合有交集」:
for peer_pi, peer_pv in enumerate(peer_lg.pool_views): if peer_pv.pool_role != self_pv.pool_role: continue peer_global_ids = get_pool_view_global_layer_ids(peer_pv, peer_lg) if not set(peer_global_ids) & self_layer_set: continue if peer_pv.mapper_kind != self_pv.mapper_kind: raise ValueError(...) matched_peer_pi = peer_pi break「零层重叠的池不是匹配」——两层覆盖完全不相交的池之间没有任何可传的东西。这个约束把「同角色多池」这个复杂情况化简成了唯一的匹配。
顺带注意 mapper_kind 不匹配时的处理:直接 raise,不做兜底。
第二层:谁拥有这次传输
配对解决了「传哪一段」,接下来是「谁来传」。get_peer_overlap 计算两侧在 PP/TP/CP 三个维度上的重叠:
# compute pp overlap and target layersself_start_layer = sum(self._ri.layer_num_per_pp[: self._ri.pp_rank])self_end_layer = self_start_layer + self._ri.layer_num_per_pp[self._ri.pp_rank]
for p in range(peer_ri.pp_size): peer_start_layer = pre peer_end_layer = peer_start_layer + peer_ri.layer_num_per_pp[p] if self_start_layer < peer_end_layer and self_end_layer > peer_start_layer: tgt_pp_ranks.append(p) pre += peer_ri.layer_num_per_pp[p]这是标准的区间重叠判定:本 rank 持有的层区间 [self_start, self_end) 与对端第 p 个 PP rank 的区间 [peer_start, peer_end) 有交集,就把 p 收进目标列表。因为两侧的 PP 切分可能不同(比如本侧 PP2 而对面 PP4),一个本侧 rank 的层区间可以横跨多个对端 PP rank,所以 overlap_pp_size 是「重叠了几个对端 PP rank」。
然后是 rank 号的展开。这里有一段注释很值得看:
ranks: List[int] = []for pp in range(peer_start_pp, peer_end_pp): for tp in range(peer_start_tp, peer_end_tp): for cp in range(peer_start_cp, peer_end_cp): # CP-minor flat rank (ppRank*(TP*CP) + tpRank*CP + cpRank), # matching Mapping and the C++ transceiver; a TP-minor formula # mis-routes when tp > 1 and cp > 1. ranks.append(pp * peer_ri.tp_size * peer_ri.cp_size + tp * peer_ri.cp_size + cp)注释明确点出:CP 是最内层维度(ppRank*(TP*CP) + tpRank*CP + cpRank),这必须与 Mapping 和 C++ transceiver 保持一致;如果写成 TP 最内层,当 tp > 1 且 cp > 1 时会路由错目标。这是那种「参数都大于 1 时才现形」的 bug,所以注释把它固化下来。
接下来是扇出/扇入的选举,也就是「谁负责传」。这部分逻辑分两层。
第一层在 AttentionPolicy.should_send:
def should_send(self, peer_overlap, peer_rank_info, *, mapper_kind=None) -> "bool | None": """Attention uses head-duplication routing.
REPLICATED views (index-key side caches) hold identical bytes on every TP rank, so they return None to defer to fan-in election instead. """ if mapper_kind == MapperKind.REPLICATED: return None dup = peer_overlap.duplicate_head_factor if dup <= 1: return True tp_rank = self._ri.tp_rank % self._ri.tp_size_per_dp_group return (peer_rank_info.dp_rank % dup) == (tp_rank % dup)头复制路由的逻辑是:当本侧的 TP 度数大于对侧(duplicate_head_factor > 1),说明好几个本侧 rank 持有相同的 KV 头(典型例子是 GQA 模型在 num_kv_heads < tp_size 时,KV 头会在 TP rank 间复制)。这时如果每个持有副本的 rank 都往对端发一遍,对端就会收到重复数据。should_send 用 (peer_dp_rank % dup) == (tp_rank % dup) 从每个复制组里选出一个发送者。
注意选举里掺进了 peer_rank_info.dp_rank——选举结果按目的端的 DP rank 轮转。这样在 generation 侧有多个 DP 组时,额外的复制流量会分散到本侧不同的 rank 上,而不是永远压在每组第一个 rank。
返回 None 表示「本策略不决定,交给扇入选举」。第二层在 PeerRegistrar._owns_tp_fan_in:
def _owns_tp_fan_in(self, peer_rank_info: RankInfo) -> bool: """Elect one owner when replicated bytes fan in across TP ranks.""" ratio = max(1, self._ri.tp_size_per_dp_group // peer_rank_info.tp_size_per_dp_group) self_tp_rank = self._ri.tp_rank % self._ri.tp_size_per_dp_group return self_tp_rank % ratio == peer_rank_info.dp_rank % ratio这里处理的是复制数据的扇入选主:对端 TP 分片更少时,多个本侧 rank 会送同一份数据过去,必须选一个 owner,避免目的端收到多份。
最后 should_send_pool 把两者串起来:
policy = self._get_policy(layer_group.kind)result = policy.should_send(peer_overlap, peer_rank_info, mapper_kind=pool_view.mapper_kind)return self._owns_tp_fan_in(peer_rank_info) if result is None else result「owner 唯一」这件事被强调了两次:peer.py 的模块注释说「elects exactly one owner per destination so nothing is transferred twice」,docs/source/developer-guide/kv-transfer.md 说「elects exactly one owner per destination so nothing is transferred twice」。重复写两遍说明它是个硬约束——多传一份不只是浪费带宽,还可能覆盖目的端已经被别人写好的正确数据。
第三层:字节级的 mapper 家族
配对和选举解决完「传哪段、谁传」,剩下的是最难的一层:一段层内的 KV 缓存里,源字节和目标字节怎么对应。
MapperKind 是一个四值闭集(外加一个 Mamba 用的 SECTIONED):
class MapperKind(IntEnum): """Transfer semantics of one physical pool's bytes.""" INDEXED = 0 HND = INDEXED REPLICATED = 1 NHD = 2 SECTIONED = 3 # Sectioned layout: [Sec0|Sec1|...], each section independently TP-sharded三个值的含义(源码注释逐条抄下来):
- INDEXED / HND:头主序布局,即「TRTLLM 注意力内核写出的布局、V1 与标准 V2 manager 的默认布局」。异构头传输时,每个 K/V buffer 里选一个连续的头区间。
- REPLICATED:池里的字节在每个 TP rank 上都相同(MiniMax M3 的 index-key、DSA 的 indexer K)。不做 KV 头重映射,按每层 stride 整段拷贝;由扇入路由选举唯一的发送者,保证对端只收到一份。
- NHD:普通 K/V,但每个 buffer 的存储是 token 主序
[token, head, dim]。异构头传输必须在每一个 token 内部选出对应的头切片,而不是头主序意义下的一整个连续区间。
HND 与 NHD 的区别是整件事的技术关键,值得展开。假设一个块里有 16 个 token、每 rank 4 个 KV 头、每头 128 维:
HND(头主序)布局: [head0: t0 t1 ... t15][head1: t0 t1 ... t15][head2: ...][head3: ...] → 选 head0..head1 是「开头 2/4 的连续字节」→ 1 个 fragment
NHD(token 主序)布局: [t0: h0 h1 h2 h3][t1: h0 h1 h2 h3]...[t15: h0 h1 h2 h3] → 选 head0..head1 在每个 token 里都只占前 2/4 → 需要在每个 token 内部切一刀 → 16 个 fragment这个差异直接决定了一份 NIXL 传输里有多少个描述符。PeerRegistrar.register 里有一段为此写的告警,读起来相当有信息量:
if nhd_fragments_per_token: logger.warning_once( "NHD head-mismatched disaggregated KV transfer has no " "contiguous staging path and will emit approximately " f"{nhd_fragments_per_token} NIXL descriptors per transferred " "token per peer, excluding block-level replicated pools " f"(local_kv_heads={local_heads}, peer_kv_heads={peer_heads}). " "Long-context TEP/DEP transfers may have high latency.", ... )「每个传输的 token、每个 peer,大约要发 N 个 NIXL 描述符」——这是把片段数量的爆炸直接换成延迟预测量写进日志。文档在 Limitations 里也说了同一件事的另一面:默认路径上「that transfer carries one descriptor per cache fragment」,只有可选 bounce 路径才会把一次请求合并成单个连续缓冲区和单次写入。
mapper 的选择在 AttentionPolicy.build_mapper,if/elif 链的每个分支都对应一个语义差异:
if mapper_kind == MapperKind.REPLICATED: return ReplicatedMapper(...) # 头数无关,直接整层拷
head_match, _ = self.head_match(peer_ri)if head_match: return IntactMapper(...) # 头数一致,退化成一整段拷贝
if mapper_kind == MapperKind.NHD: return NHDHeadMismatchMapper(...) # 头数不一致 + token 主序,逐 token 切
return HNDHeadMismatchMapper(...) # 头数不一致 + 头主序,整段头区间切头数一致时,四种布局全部塌缩成 IntactMapper——这是最重要的一层简化。
IntactMapper:把连续段合并成「一趟」
class IntactMapper(RegionMapperBase): """ src slot: [ base ]--+off(L2)--> [L2 region] --+off(L3)--> [L3 region] ... dst slot: [ base ]--+off'(L2)-> [L2 region] --+off'(L3)--> [L3 region] ...
Layers whose regions are contiguous on BOTH sides are merged into one fragment, so a fully contiguous class (e.g. K/V in a dedicated pool) degrades to a single whole-region copy per block. """核心是 _merge_contiguous:
@staticmethoddef _merge_contiguous(src, dst, bytes_per_layer): runs = [] run_start = 0 for i in range(1, src.size + 1): if (i == src.size or src[i] != src[i - 1] + bytes_per_layer or dst[i] != dst[i - 1] + bytes_per_layer): run_layers = i - run_start runs.append((int(src[run_start]), int(dst[run_start]), run_layers * bytes_per_layer)) run_start = i return runs合并条件是两个同时成立:源侧相邻层的偏移差正好等于一层大小,目的侧也一样。这样一段连续区域就可以用「起始地址 + 总字节数」一次搬完。
为什么值得为这个写一个静态函数?因为它把描述符数量从「每层一个」压到「每连续段一个」。对标准模型,一个层组的 K/V 在池里通常是连续的,于是每个块只剩一次拷贝。这个合并对传输性能的影响是数量级的,不是常数因子。
map() 最后只是把合并后的 runs 展开成指针数组:
pairs = [ SpecRegionPair( src=SpecRegion( memory=MemRegionGroup(ptrs=src_group.ptrs + src_off, bytes_per_region=run_bytes), spec=src_regions.spec, ), dst=SpecRegion( memory=MemRegionGroup(ptrs=dst_group.ptrs + dst_off, bytes_per_region=run_bytes), spec=dst_regions.spec, ), ) for src_off, dst_off, run_bytes in self._runs]return pairs[0] if len(pairs) == 1 else pairs注意 ptrs + src_off 是 numpy 数组的整体加法:一次 np.add 就把「所有块的基址」平移到了这一段的起始位置,没有 Python 循环。这就是「地址算术」的真实形态——不是逐个算,而是把每个块的基址向量整体平移。
HNDHeadMismatchMapper:头数不同时怎么从头主序里切
class HNDHeadMismatchMapper(RegionMapperBase): """ Fine-grained mapping when head counts or TP/DP partitioning differ. Split layers into per-head (or contiguous-heads) fragments and map them individually.
Source (layers x heads): L0: [S00 S01] [S02 S03] ... L1: [S10 S11] [S12 S13] ...
Mapping (each arrow = copy cont_heads_frag): [S00 S01] -> [D00] [S02 S03] -> [D01] [S10 S11] -> [D02] """这里有一个非常值得称道的细节:字节几何是从存储注册的每层区域大小反推的,而不是用 element_bytes × dims 算出来的:
# Byte geometry is derived from the per-layer region size registered# by storage (always whole bytes) rather than element_bytes x dims# arithmetic, so sub-byte dtypes (e.g. NVFP4) stay exact-integer.为什么必须这样?因为 NVFP4 这类亚字节数据类型(一个元素不足 8 位)根本没法用「元素数 × 每元素字节数」表达。如果按元素算术,除以 2 就会得到 0.5 字节,浮点误差会在偏移计算里累积成错位的拷贝。用整数字节反推,再用整除校验兜底,是这个问题的干净解法:
@staticmethoddef _bytes_per_head(layer_kv_bytes: int, heads: int, *, side: str) -> int: if heads <= 0 or layer_kv_bytes % heads != 0: raise ValueError( f"HND head slicing is not byte-aligned ({side}): " f"layer_kv_bytes={layer_kv_bytes}, kv_heads={heads}" ) return layer_kv_bytes // heads「头切片必须字节对齐」被一个整除检查显式保证,不对齐就抛异常,而不是做小数运算。
最难的一段是头偏移的推算,因为 TP 度数不同意味着「源侧的第 3 个头」和「目的侧的第 3 个头」根本不是同一个头:
@staticmethoddef _compute_head_offsets( self_tp_per_dp, peer_tp_per_dp, self_tp_rank, peer_tp_rank, self_kv_heads, peer_kv_heads, bytes_per_head,) -> tuple[int, int]: if self_tp_per_dp == peer_tp_per_dp: return 0, 0 # total_unique = total KV heads in model; head_idx via integer division # handles head duplication (total_kv_heads < tp_per_dp) correctly. if self_tp_per_dp < peer_tp_per_dp: total_unique = self_kv_heads * self_tp_per_dp src_head_idx = (peer_tp_rank * total_unique) // peer_tp_per_dp % self_kv_heads return src_head_idx * bytes_per_head, 0 else: total_unique = peer_kv_heads * peer_tp_per_dp dst_head_idx = (self_tp_rank * total_unique) // self_tp_per_dp % peer_kv_heads return 0, dst_head_idx * bytes_per_head逐行拆解这个推导,因为它是全篇最需要「讲透」的地方:
self_tp_per_dp == peer_tp_per_dp时返回(0, 0):两侧 TP 度数相同时,「第 k 个头」在两侧是同一个头,偏移为零。(这假设两侧的kv_heads_per_rank相同,而这一点由 mapper 构造时的其他检查保障。)total_unique = kv_heads × tp_per_dp:按每个 rank 持有的头数乘以 TP 度数,反推出模型里 KV 头的总数。注意这个式子对「头复制」也成立——当total_kv_heads < tp_per_dp时,每个 rank 只持有 1 个头(或其他小数),乘积仍然是模型总头数。注释明确写了这一点:「head_idx via integer division handles head duplication correctly」。src_head_idx = (peer_tp_rank * total_unique) // peer_tp_per_dp % self_kv_heads:这是「把目的端的 rank 编号换算成源端的头编号」。peer_tp_rank * total_unique // peer_tp_per_dp算出对端 rank 在全局头序列里覆盖的起始全局头号(对端 rank 0 从 0 开始,rank 1 从total/peer_tp开始……),再取模self_kv_heads得到它落在本侧哪个 local 头上,最后乘以每头字节数变成字节偏移。- 反向分支对称:
dst_head_idx = (self_tp_rank * total_unique) // self_tp_per_dp % peer_kv_heads,用于本侧 TP 度数更大的情形。
取模运算是头复制的关键:在对端 TP 度数更大时,total_unique // peer_tp_per_dp 可能小于 self_kv_heads,多个对端 rank 会映射到同一个源头——这正是「多个目的 rank 共用同一份源数据」的表达方式,不需要写任何特判。
再看片段数量的下界:self._bytes_cont_heads = min(self_kv_heads, peer_kv_heads) * bytes_per_head。一次能连续搬走的字节数,受限于两侧较小的那个头数——因为对端一次最多只能接收这么多头。
偏移数组的展开是纯 numpy 广播:
@staticmethoddef _build_flat_offsets(*, layer_offsets, buffers_per_layer, buffer_bytes, head_offset): ...其思想是:每个 (layer, buffer) 的偏移 = 层偏移 + buffer 索引 × buffer 字节数 + 头偏移,用 np.add.outer(bases, flat_offsets) 在 map() 时一次性展开到所有块。
NHDHeadMismatchMapper:逐 token 切
class NHDHeadMismatchMapper(HNDHeadMismatchMapper): """Map heterogeneous KV heads stored token-major as ``[N, H, D]``.
``HNDHeadMismatchMapper`` selects one contiguous head range per K/V buffer, which is correct for HND storage. In NHD storage, the selected head range is contiguous only within one token, so this mapper emits one fragment per ``(layer, K/V, token)``. """它刻意不调用父类构造函数,注释写得很坦率:
# Deliberately do not call HNDHeadMismatchMapper.__init__: its offsets# assume HND-contiguous heads. Initialize the three attributes consumed# by the inherited map() with NHD token-granular geometry instead.只重写偏移预计算,继承父类的 map()。还多了一条硬约束:
if self_tpb != peer_tpb: raise ValueError( "NHDHeadMismatchMapper requires equal tokens_per_block; " f"local={self_tpb}, peer={peer_tpb}" )NHD 要求两侧 tokens_per_block 严格相等。原因很直观:NHD 布局下「一个块里第 t 个 token 的第 h 个头」这个地址依赖块内的 token 数,两侧块大小不同时,「第几个 token」这个索引本身就无法对齐。而 HND 和 REPLICATED 也有同样的要求,理由是「它们要按块内字节寻址」。AttentionPolicy._tpb_check 把这条约束写成了集中的判定:
@staticmethoddef _uses_exact_tpb_mapper(ri: RankInfo) -> bool: """NHD / replicated pools address bytes inside a block, so their geometry only lines up when both sides use the same tokens_per_block."""而 tokens_per_block 不同的处理分两种情况:如果任一侧用了需要块内寻址的 mapper,直接判不兼容;否则只要大的能被小的整除就允许继续,并打一条警告「KV transfer proceeds — ensure block boundaries align during transfer」。这说明除 NHD/REPLICATED 之外的布局在 tokens_per_block 不同时仍可能勉强工作(因为搬的是整块),但作者选择打警告而不是假装没问题。
ReplicatedMapper 则是 IntactMapper 的子类,只把 mapper_name 换成 "Replicated",并注明「no head slicing applies」——因为它拷贝的是 TP 复制的字节(MiniMax M3 index-key、DSA indexer K)。
_get_buffers_per_layer:为什么不能用总数除层数
配对和切片之间还有一道校验,写法很有代表性:
entries = pool_view.buffer_entriesif len(entries) == 0: return 1counts = Counter(int(e["local_layer_id"]) for e in entries)distinct = set(counts.values())if len(distinct) != 1: raise ValueError( "PoolView buffer entries are not evenly distributed across layers: ..." )注释解释了为什么不做「总数 ÷ 层数」这种更省事的检查:
e.g. 1 + 3 entries over two layers passes
total % layers == 0yet would make head-slicing mappers split every layer at wrong offsets.
两层分别有 1 个和 3 个 buffer 时,总数 4 能被层数 2 整除,但头切片会按每层 2 个 buffer 去算偏移,结果每层都错。所以必须逐层统计再比较。这是一个很典型的「用便宜检查代替精确检查会引入静默错误」的例子。
页表与 KV 提取:如何与两代 Cache Manager 解耦
为什么需要中间层
TensorRT-LLM 的 KV 管理器有两代:V1(KVCacheManager,块表结构)与 V2(KVCacheManagerV2,按 life cycle 分层的块基数树)。两代的内部结构完全不同。如果 KV 传输直接读某一代的数据结构,就会写死在一代上。
TensorRT-LLM 的做法是插一层页表(page table):一个只描述「一个 rank 的 KV 存储长什么样」的中间表示,与哪一代管理器产生它无关。
resource/page.pydescribes a rank’s KV storage independently of which cache manager produced it, which is what lets a V1 context worker talk to a V2 generation worker.
V1 context worker 与 V2 generation worker 可以互通——这句话是这一层存在的全部理由。上一节讲的 PhysicalPool / PoolView / LayerGroup / KVCachePageTable 就是这层中间表示。
从管理器到页表的统一入口是 build_page_table_from_manager:
def _is_kv_cache_manager_v2(obj) -> bool: return hasattr(obj, "impl") and hasattr(obj.impl, "layer_grouping")
def build_page_table_from_manager(manager) -> KVCachePageTable: """Unified entry point: build a KVCachePageTable from any manager type.
Supports KVCacheManager (V1) and KVCacheManagerV2. """ if _is_kv_cache_manager_v2(manager): return _build_page_table_v2(manager) else: return build_page_table(manager)判定方式是鸭子类型探测(有没有 impl.layer_grouping),不是 isinstance——这样跨版本、跨绑定的管理器对象都能被识别。
从块 ID 到指针:extract
页表建好之后,真正的地址算术只有一处:把块 ID 数组变成指针数组。
@nvtx_range("KVRegionExtractorV1.extract")def extract(self, region_ids: np.ndarray, layer_group_id: int = 0, pool_idx: int = 0) -> SpecRegion: """ For KV cache: each ptr = base_address + slot_id * slot_bytes, pointing to the start of a full slot. Sub-slot selection (layers, role classes, heads) is the mappers' responsibility; logical views carry that geometry in their buffer entries. """ ... # KV cache: filter out invalid block_ids (BAD_PAGE_INDEX = -1) valid = region_ids >= 0 ptrs = base_ptr + block_stride * region_ids[valid] memory = MemRegionGroup(ptrs=ptrs, bytes_per_region=block_size) return SpecRegion(memory=memory)三行核心代码值得逐行看:
valid = region_ids >= 0:过滤掉无效块 ID。BAD_PAGE_INDEX = -1是「这个位置还没有分配物理块」的标记,直接从指针数组里剔除。只对有效块生成传输描述符,而不是生成一个指向非法地址的描述符再指望传输层容忍。ptrs = base_ptr + block_stride * region_ids[valid]:一次 numpy 广播,把所有有效块 ID 一次性变成所有块的首地址。没有 Python 循环,没有逐个查块表。bytes_per_region=block_size:这里只标出一个 slot 的总字节数,不做层内切分。
第三点是分工的核心。注释把它写得很清楚:
Sub-slot selection (layers, role classes, heads) is the mappers’ responsibility; logical views carry that geometry in their buffer entries.
提取器只负责「哪个块」;mapper 负责「块内的哪些字节」。 这个分工让两边的复杂度各自可控:提取器只需要知道块的地址公式,mapper 只需要知道层内几何。
另一条路径:extract_slot(循环状态用)
Mamba / KDA 这类循环层的状态不是一个「块」的概念,而是每个序列一个 slot。所以另有一个入口:
@nvtx_range("KVRegionExtractorV1.extract_slot")def extract_slot(self, slot_id: int, layer_group_id: int = 0, pool_idx: int = 0) -> SpecRegion: """Extract per-layer pointers for a single slot (used for mamba state).
Returns a SpecRegion with one pointer per layer: ptr[i] = base + view_offset[i] + slot_id * slot_stride """每个层一个指针,而不是每层一个起始地址再靠 bytes_per_region 自动展开。原因注释也给了:「a recurrent role may exist on only a subset of layers or be interleaved with another role in a V2 pool」——循环状态可能只存在于部分层,或者与别的角色在同一个 V2 池里交错。这时层的地址不是等差列,必须逐层显式给出。
CacheReuseAdapter:前缀复用也统一
除了存储布局,还有一件事两代不一致:前缀复用的记账方式。V1 用块表命中,V2 用块基数树命中,两者报告「缓存了多长的前缀」的方式不同。
CacheReuseAdapter 就是为此存在的抽象基类:
class CacheReuseAdapter(ABC): """Uniform prefix-reuse API over KVCacheManager V1/V2."""它的 get_cached_token_count_per_layer_group 有一点注释非常关键:
Returns the reuse-hit prefix only; SWA stale-region handling lives at the transfer call site (it is a transport concern, not a cache one).
滑动窗口注意力的「陈旧区域」处理被划归传输侧,而不是缓存侧。这个边界划分是有道理的:缓存管理器只知道「这些块还挂着引用」,它不知道接收方的窗口把哪些块视为过期;而传输侧知道接收方的 sliding_window_size,所以由它决定哪些块不传。文档在介绍 resource/cache_reuse.py 时也强调了同一件事:
resource/cache_reuse.pyreports the cached prefix length uniformly, so context-side reuse, generation-side reuse, and sliding-window stale prefixes all resolve without a special case.
context 侧复用、generation 侧复用、滑动窗口陈旧前缀三种情况被统一处理,没有特例分支——这是把差异收敛到一层抽象里之后才可能达到的效果。
滑动窗口与分块传输:_build_prefill_extent
前面讲的都是「一次传完」。但 TensorRT-LLM 支持流水线传输(pipelined transfer),也就是把长 prompt 的 KV 分块边算边传。这个能力集中在 _build_prefill_extent:
def _build_prefill_extent(self, req: LlmRequest) -> Optional[CacheExtent]: """Build an extent for completed prefill blocks, or None.""" assert req.py_beam_width == 1, "beam_width > 1 is not supported for chunked KV transfer" ... chunk_start_pos, chunk_end_pos = req.py_last_context_chunk tpb = self._kv_cache_manager.tokens_per_block
# Include any reused prefix in the first transferred chunk. is_first_chunk = chunk_start_pos == req.prepopulated_prompt_len is_last_chunk = req.context_remaining_length == 0 # Defer partial blocks except at the prompt's final chunk. chunk_start = 0 if is_first_chunk else chunk_start_pos // tpb chunk_end = (chunk_end_pos + tpb - 1) // tpb if is_last_chunk else chunk_end_pos // tpb逐条解读这段算术:
is_first_chunk:本次 chunk 的起点是否等于「预填充长度」。若相等说明这是第一个 chunk,把复用命中的前缀一并算进这个 chunk——因为前缀的 KV 可能已经在池里,必须随第一批一起送出去,否则接收方永远收不到这部分。chunk_start:第一个 chunk 从块 0 开始;其它 chunk 从chunk_start_pos // tpb开始(向下取整到块边界)。chunk_end:最后一个 chunk 向上取整((chunk_end_pos + tpb - 1) // tpb),其它 chunk 向下取整。注释解释了原因:「Defer partial blocks except at the prompt’s final chunk」——中间 chunk 的半个块不传,留到后面凑齐;但最后一个 chunk 即使只有半个块也必须传,否则这部分 KV 永远送不出去。- 还有一条兜底:「The final chunk is sent even when it contains no complete block」——最后一个 chunk 哪怕一个完整块都没有,也要发。
滑动窗口的处理单独有一段:
for lg, block_ids in zip(self._page_table.layer_groups, all_block_ids): window_size = getattr(lg, "sliding_window_size", None) if window_size is not None and window_size < req.prompt_len: # SWA pages can leave the active window between chunks. Defer # the group and send its complete final active window at once. chunk_block_ids.append(block_ids if is_last_chunk else np.full_like(block_ids, -1)) else: # Positional: keep the chunk's ordinals, blank everything else. chunk = np.full_like(block_ids, -1) chunk[chunk_start:chunk_end] = block_ids[chunk_start:chunk_end] chunk_block_ids.append(chunk)滑动窗口层组不在中间 chunk 传输,而是等到最后一个 chunk 一次性发完整的活动窗口。 原因是滑动窗口的页会在 chunk 之间滑出活动窗口——如果中间就发了,发出去的页在接收方看来已经过期,白传。这个优化把 SWA 组的数据量从「整段 prompt」压到了「一个窗口」。
np.full_like(block_ids, -1) 是「本次不传」的表达方式:用 -1 填满整个块 ID 数组,再由 extract() 的 region_ids >= 0 过滤掉。「不传」和「传」用同一个数据结构表达,靠一个哨兵值区分,不需要额外的条件分支——这是把过滤逻辑压进地址算术里的一种写法。
最后返回的 CacheExtent 里带了一个精确的 token 范围:
# The block window is rounded up; the span this piece delivers is not. Every reader below# rounds back to blocks, and a recurrent-state group reads the end as an exact checkpoint.chunk_end_token = min(chunk_end * tpb, req.prompt_len) if is_last_chunk else chunk_end * tpb块窗口向上取整了,但这一段真正交付的 token 跨度没有。这个区别重要在哪?对循环状态(Mamba/KDA)组来说,token_range.end 被当作一个精确的检查点读取——如果这里填的是向上取整后的块边界,循环状态就会取到一个不存在的检查点。所以块的对齐和 token 的对齐必须分开表达。
Bounce Buffer:什么时候把碎片攒成一整块
问题的形状
前面几节反复出现一个数字:描述符数量。默认路径下「一次传输的每个 cache fragment 带一个描述符」。当头数不匹配且是 NHD 布局时,这个数量会爆炸到「每个 token、每个 peer 一个描述符」。一次 8K prompt 的传输会产生几十万个描述符。
NIXL 的每次 write 都有固定的提交与完成开销。几万个描述符的提交开销会盖过数据本身。bounce buffer 就是针对这个问题的机制:把碎片先攒到一块连续的本地缓冲里(gather),再一次写过去(scatter)。
两种实现,一个开关
cache_transceiver_config.agent_bounce_buffer_enable 决定走哪条路:
- 默认
false→ Python 侧 bounce:每个方向一块连续缓冲(kv_cache_bounce_size_mbMiB),一次请求一次 NIXL write。文档说它「is designed for fabric (MNNVL) memory」。 true→ C++ transfer-agent 的 bounce v2:收发共用一块kv_cache_bounce_size_mbMiB 的缓冲,写入分块。文档注明「prefer a power of two; the usable capacity rounds down to one」。
源码里这两个尺寸被显式地互斥赋值:
bounce=bounce_config_from_size( 0 if cache_transceiver_config.agent_bounce_buffer_enable else cache_transceiver_config.kv_cache_bounce_size_mb),agent_buffer_size_mb=( cache_transceiver_config.kv_cache_bounce_size_mb if cache_transceiver_config.agent_bounce_buffer_enable else 0),一个开关切换时,把另一条路的尺寸置 0,避免两条路同时被激活。这种「显式互斥」的写法比条件分支里到处 if 更不容易出错。
什么时候启用:两道闸门
bounce 不是无条件启用的——它自身有 gather + scatter 两次设备内拷贝的开销。所以有两道闸门,按载荷类型选:
@dataclassclass Config: sizing: Sizing = field(default_factory=FixedSizing) # 预留多少内存(可插拔) chunk_mb: int = 32 # 物理 chunk 大小;大 chunk 让写入只用一个描述符 min_bytes: int = DEFAULT_MIN_BYTES # 循环状态载荷的字节闸门 min_blocks: int = 96 # 普通 KV 载荷的块数闸门默认值分别是 2 MiB 和 96 个块。源码里有一段很长的注释解释这两个数字怎么来的,其中包含一个真实踩坑记录:
The cost this gate guards scales with BYTES, not blocks: the block-count gate (96 blocks, calibrated for 128-token blocks) silently skipped a 433 MiB Kimi-K3 transfer (67 blocks of 32 tokens plus the non-paged KDA state) and dropped it onto the ~0.4 GB/s host-staged fallback, a ~1000x cliff.
块数闸门在遇到块变大或变小的模型时会失效:96 个块在 128-token 块时是 12k token,但在 32-token 块、且混入非分页 KDA 状态时,67 个块可能就是 433 MiB。这个传输因为「块数不够」绕过了 bounce,掉进了只有约 0.4 GB/s 的主机中转路径——约 1000 倍的性能悬崖。
这段注释的价值不止在于修复了一个 bug,更在于它把闸门该按什么量纲这件事讲清楚了:成本随字节数增长,闸门就应该按字节数。新闸门被设为 2 MiB,注释算了盈亏平衡:
bounce adds one gather plus one scatter copy (device-local, ~hundreds of GB/s) and ~0.1 ms of fixed launch/reservation overhead, while the in-place path can be as slow as ~0.4 GB/s inter-node — 2 MiB in-place at that rate is ~5 ms vs well under 1 ms bounced. Below 2 MiB the fixed overhead dominates and arena slots are better kept for large transfers.
翻译成判断规则:原路传输 2 MiB 在 0.4 GB/s 的跨节点速率下要 5 ms,而 bounce 路径(两次设备内拷贝几百 GB/s + 约 0.1 ms 固定开销)远低于 1 ms。低于 2 MiB 时固定开销占主导,缓冲区槽位留给大传输更划算。
启用条件还有一层:描述符形状
C++ 那一路(agent_bounce_buffer_enable: true)的闸门更细。文档写:
By default it engages only for KV writes with many small descriptors (at least 1024, averaging at most 16 KiB), i.e. head-mismatch layouts such as context TP != generation TP or DP; head-matched layouts (MLA, symmetric TP) stay on the standard NIXL path unless
agent_bounce_paramsrelaxes the gate.
两条判据都指向同一个事实:只有「描述符很多、每个都很小」时才值得 bounce。
- 「至少 1024 个描述符」——描述符太少,提交开销本来就不大。
- 「平均不超过 16 KiB」——每个描述符都很大时,gather/scatter 的两次拷贝反而纯属浪费。
文档也点出了典型场景:头不匹配的布局(context TP ≠ generation TP,或者用了 DP),因为 NHD 逐 token 切会造出海量小描述符;而头匹配的布局(MLA、对称 TP)留在标准 NIXL 路径,根本不需要 bounce。
一个容易踩的坑:两端必须参数一致
文档里有一段很长的警告,讲的是 C++ bounce 的参数一致性:
Set it consistently on the context and generation workers; in particular
request_timeout_msand the effective chunk cap must match on both sides, otherwise the pair falls back to standard NIXL with a WARNING when the peer is loaded (transfers are then routed silently).
而「有效的 chunk 上限」的定义还有点绕:
The compared chunk cap is the effective one, min(
max_chunk_size, the arena’s usable capacity):kv_cache_bounce_size_mbmatters only when its usable capacity (rounded down to a power of two) is belowmax_chunk_size; both sides must then clamp to the same chunk cap.
拆开说:
- 真正参与比较的「chunk 上限」是
min(max_chunk_size, 缓冲池可用容量)。 - 缓冲池容量向下取整到 2 的幂作为可用容量——所以你配 384 MiB,实际可用是 256 MiB。
- 只有这个可用容量小于
max_chunk_size时,它才会影响 chunk 上限;此时两侧必须都夹到同一个值。
为什么两端要一致?因为 bounce 的写入是分块发过去的,接收方要按同样的块大小来落位。两端 chunk 上限不同,写入的切片方式就对不上。而框架的处理方式是回退到标准 NIXL 并打 WARNING——注意这里的措辞「transfers are then routed silently」,警告之后传输仍然会走,只是走了另一条路。这意味着性能可能悄悄下降一个档次,所以部署时必须把两侧配置对齐并检查日志。
接进执行循环:overlap、完成通知与释放
前面五节讲的是「一次传输怎么做对」。这一节讲「传输怎么接进那台一直在转的推理机器」。这是最容易被忽略、但在生产上最要命的部分——传输做对不难,做对的同时不阻塞调度循环、不泄漏显存、不在取消时留下不一致状态,才是难点。
接口:PyExecutor 驱动的那五个方法
KvCacheTransceiver 是一个抽象基类(kv_cache_transceiver.py),定义了 PyExecutor 需要的全部能力:
class KvCacheTransceiver(ABC): def pipeline_transfer_enabled(self) -> bool: ... def has_inflight_transfer(self, req: LlmRequest) -> bool: ... def has_retired_send_session(self, req: LlmRequest) -> bool: ... def consumes_transfer_buffer(self) -> bool: ... def respond_and_send_async(self, req: LlmRequest) -> None: ... # context 侧发送 def request_and_receive_sync(self, req: LlmRequest) -> None: ... # gen 侧阻塞接收 def request_and_receive_async(self, req: LlmRequest) -> None: ... # gen 侧异步接收 def check_context_transfer_status(self, ...) -> CtxTransferStatus: ... def check_gen_transfer_status(self, at_least_request_num) -> GenTransferStatus: ... def check_gen_transfer_complete(self) -> bool: ... def cancel_request(self, req: LlmRequest) -> bool: ... def prepare_context_requests(self, requests: List[LlmRequest]) -> None: ... def get_disaggregated_params(self) -> Dict[str, Any]: ... def commit_blocks_for_reuse(self, req: LlmRequest) -> None: ... def shutdown(self) -> None: ...同步和异步两个接收入口并存,这是接口设计里最值得琢磨的一处。request_and_receive_sync 用 session.wait_complete(blocking=True) 原地等;request_and_receive_async 提交后立刻返回,进度靠 check_gen_transfer_status 轮询。注释说明了为什么异步版本才是主流:
def request_and_receive_async(self, req: LlmRequest) -> None: """Start background KV cache receive from the context server.
The receiver always uses a single monolithic slice. Chunking is sender-only: the sender splits its source blocks into chunks and slices the receiver's destination blocks to match each chunk. """最后这句是本章最重要的一条设计决策:接收方永远只用一个整体切片,分块只发生在发送方。发送方把源块切成若干 chunk,同时把接收方的目的块也切成对应的若干份。
为什么这么切分责任?因为发送方是算地址的那一方(第四步工作流:所有地址算术都在 context 侧)。只有发送方知道自己打算怎么切,所以也只有它能把接收方的目的区间同步切开。如果让接收方也参与切片,两侧就要协商切片方案——多一轮协调、多一份分歧风险,而收益为零。
context 侧的发送:respond_and_send_async
@nvtx_range("KvCacheTransceiverV2.respond_and_send_async")def respond_and_send_async(self, req: LlmRequest) -> None: """Send the request's next KV slice to the generation server.""" if not self._validate_bridge_req(req): return self._ever_had_send_session = True req.set_kv_cache_transfer_start(tensorrt_llm.bindings.global_steady_clock_now()) rid = get_unique_rid(req) session = self._get_or_create_send_session(req) if session is None: return try: if self.pipeline_transfer_enabled: extent = self._build_prefill_extent(req) if extent is None: return else: extent = self._create_cache_extent(req) chunk = extent.local # The handle that comes back is the contract's answer about this piece. What retires # the request is the sweep over the session tables, as it was before. PeerPublish(session, req).publish(extent) if chunk.is_last: self._finalize_send(req, session) ... except Exception as error: ... raise几个要点:
- 方法名里的
async指的是「提交后不等」:它在 executor 主循环上跑,提交完描述符就返回,不等传输完成。真正的等待发生在状态轮询那一步。 pipeline_transfer_enabled决定切片方式:开启时每调用一次发送「下一个 chunk」(所以可以每个调度步都调),关闭时一次性发整个 extent。- 状态迁移在
is_last时才发生:注释解释了为什么中间 chunk 不迁移状态——「Preserve the legacy pipelined-transfer state boundary: intermediate chunks must remain schedulable for prefill」。中间 chunk 发完之后,请求还必须保持「可被调度继续 prefill」的状态,否则后续 chunk 就没得算了。
生命周期:谁在管会话表
KvCacheTransceiverV2.__init__ 里的四个字典就是全部状态:
self._send_sessions: Dict[int, TxSessionBase] = {}self._recv_sessions: Dict[int, RxSessionBase] = {}self._send_reqs = {}self._recv_reqs = {}self._wait_reqs = {}check_gen_transfer_complete 的实现简单到不能再简单:
def check_gen_transfer_complete(self): return len(self._recv_sessions) == 0「接收会话表为空」就是「接收全部完成」的定义。 一个整数长度判断代替了遍历与聚合,因为会话的创建与关闭恰好就是传输的开始与结束。
接收侧注册目的请求的时机有一处很讲究的注释:
req.state = LlmRequestState.DISAGG_GENERATION_TRANS_IN_PROGRESS# Root the destination before publication can escape. Registering only on success leaves a# failed publication as a session the sweep can see but cannot pair with a request.self._recv_reqs[rid] = req先把请求登记进 _recv_reqs,再去做发布。如果只在成功后登记,那么发布失败时会留下一个「清扫逻辑看得见、但配不到请求」的孤儿会话——清扫逻辑会试图回收一个它无法关联到任何请求的会话,这就是泄漏的来源。这个顺序选择是有理由的、也是正确的。
失败路径上的清理同样对称:
except Exception: # No session means no publication and nothing the sweep could ever pair the request # with, so the registration made here is undone here and the request goes terminal. if self._legacy_session(fetches) is None: del self._recv_reqs[rid] req.state = LlmRequestState.DISAGG_TRANS_ERROR raise「没有会话」就撤销登记并把请求置为终态;「有会话」就留给清扫逻辑。两种失败形态各自有明确的归属,不留模糊地带。
轮询:一个真实的性能 bug 及其修法
接收进度靠轮询推进,轮询函数里藏着一段非常精彩的注释:
def _poll_sessions_for_interval(self, sessions, reqs, wait_num, poll_interval_ms) -> None: # The exit condition can only ever count in-flight sessions, so a # target above len(sessions) is unsatisfiable and the loop would sleep # out the whole interval for nothing. The idle executor loop hits # exactly that: check_context_transfer_status(1) with no in-flight # sends burns a full kv_transfer_sender_future_timeout_ms per # iteration and delays scheduling of newly arrived requests # (nvbugs 6647405). Clamping is safe under rank-divergent session # counts because this helper is purely local (no collectives). wait_num = min(wait_num, len(sessions)) if wait_num <= 0: return拆解这个 bug:
- 调用方传
wait_num=1,意思是「至少等到 1 个会话完成」。 - 但退出条件只能数在途会话。当
len(sessions) == 0时,「1 个完成」永远不可能达成。 - 于是循环会一直睡到整个轮询间隔结束——而空闲时这个间隔等于
kv_transfer_sender_future_timeout_ms。 - 结果:空转的执行循环每轮白白烧掉一个完整超时,新到达的请求被推迟调度(bug 编号 nvbugs 6647405)。
修法是一行 min(wait_num, len(sessions))。注释还额外论证了「夹取在 rank 间会话数不一致时也是安全的」,理由是「this helper is purely local (no collectives)」——这个 helper 不做集合通信,所以各 rank 夹取到不同的数字也不会导致死锁。这句话点出了一个非常重要的前提:如果把这段逻辑放进集合通信路径,rank 间的分支差异就会变成死锁。
完成判定:把「没有在途传输」写进条件
PyExecutor 在主循环里驱动 disagg 子系统:
if self.kv_cache_transceiver: wait_for_disagg_gen_transfer_progress = False admitted_disagg_gen_init_requests, wait_for_disagg_gen_transfer_progress = ( self.disagg.admit(scheduler_fitting_disagg_gen_init_requests)) # Prepare KV cache manager resources only for requests admitted # into the transfer window this iteration. self.disagg.receive_gen_init(admitted_disagg_gen_init_requests)
self.disagg.poll_progress_when_idle()注意调用顺序:先 admit(准入)→ 再 receive_gen_init(为被准入的请求准备 KV 资源)→ 最后 poll_progress_when_idle(推进在途传输)。三步的顺序表达了因果链:只有被准入的请求才配得到资源,只有配了资源才谈得上进度。
这里的 self.disagg 是 PyExecutor 持有的一层薄适配器(_torch/pyexecutor/disagg_adapter.py),它把「准入、准备资源、推进进度」这三件事从 executor 主循环的其余逻辑里隔出来。适配器的存在让主循环保持在原来的形状——PyExecutor 的 _schedule()、_pad_empty_attention_dp_batch()、can_queue() 这些既有步骤一行不改,只多出三个调用点。把新功能塞进一个适配器而不是散进主循环,是这类增量改造里最好用的手法。
admit 这一步本身就是一个独立的调度窗口——不是所有 generation_init 状态的请求都能一次性进入传输窗口,而是按配置逐次放行。这和第零篇讲的 CapacityScheduler 的准入算术是同一个思想:把「想做的」和「这一步做的」分开。
结束判定:两侧的 allgather 与状态一致
第一步工作流里提到的「两侧都要先跑 allgather」在代码里的体现是 _allgather_model_parallel_status:
local_ok = int(local_all_fetched and local_all_past_transfer and local_no_inflight)local_status = (local_ok, bool(local_transfer_progress))
all_rank_status = self._allgather_model_parallel_status(local_status)all_ranks_ok = [status[0] for status in all_rank_status]global_ok = min(all_ranks_ok) == 1三个条件合成本地判定:
local_all_fetched:所有请求的 KV 都已取到;local_all_past_transfer:所有请求都已越过传输状态;local_no_inflight:transceiver 的异步接收记账已清空(check_gen_transfer_complete())。
注意第三个条件的注释:
# Also require the transceiver's async receive bookkeeping to be# drained before opening the fill gate.然后 min(all_ranks_ok) == 1——取最小,也就是所有 rank 都 OK 才 OK。这是「全局与」的标准写法,但值得指出的是:它必须建立在 allgather 本身也成功的前提上。
取消:为什么返回 False 而不是抛异常
def cancel_request(self, req: LlmRequest) -> bool: """Cancel the transfer for the given request.
Returns False if any task is mid-write (TRANSFERRING); caller must retry next iteration. Returns True when safe to free KV memory. """ rid = get_unique_rid(req) # Not yet started (generation-first wait queue). self._wait_reqs.pop(rid, None)
has_transferring = False
if rid in self._send_sessions: self._send_sessions[rid].cancel() if self._send_sessions[rid].has_transferring_tasks(): has_transferring = True elif self._send_sessions[rid].close() is False: has_transferring = True else: self._retire_send_session(rid, req, outcome="cancelled", session_already_closed=True) ... if has_transferring: return False return True这个返回值语义是整个取消机制的关键:True 表示「可以安全释放 KV 显存了」,False 表示「有任务正在写,调用方下一轮再试」。
为什么不能用异常表达同一件事?因为“暂时不行”不是错误。取消请求时恰好碰上传输正在写,是一件完全正常的事——传输一旦提交就不能中止(文档在 Limitations 里明确写了「Submitted NIXL operations cannot be aborted. Cancellation is cooperative: an operation already handed to the transfer agent runs to completion」)。所以框架的选择是:等它写完再释放,而不是粗暴地打断。
注释还精确地区分了三种状态:has_transferring_tasks() 为真 → 还在写;close() 返回 False → 资源没能全部收回;两者都不成立 → 可以退场。「有没有在写」和「能不能关上」是两件事,必须分开判断。
在 PyExecutor 侧的调用形式则是一个「带重试的释放」:
is_cancelled = self._try_cancel_request(request)配合一个 has_inflight_transfer 判断:
return (self.kv_cache_transceiver is not None and self.kv_cache_transceiver.has_inflight_transfer(request))has_inflight_transfer 用来回答另一个问题:这个请求的传输还没落地,所以不能在别处释放它的显存。它和 cancel_request 的 False 返回值是同一个约束的两种查询方式。
一个被显式检查的不变量:历史长度必须预声明
_assert_disagg_history_declared 是一处很有意思的防御性检查:
def _assert_disagg_history_declared(self, req: LlmRequest) -> None: """Verify the V2 scheduler pre-declared prompt_len as history.
Call right before the TRANS_COMPLETE state transition. The V2 scheduler's ``_try_schedule_disagg_gen_init`` calls ``prepare_disagg_gen_init``, which sets ``kv_cache.history_length`` to ``prompt_len`` at allocation time so SWA stale computation skips pre-window blocks. If that contract is violated, SWA / sparse-attn pools may fill with pre-window prompt blocks and the V2 scheduler can deadlock under high concurrency (e.g., benchmark fill-phase). """ ... if history < prompt_len: raise RuntimeError( f"req {req.py_request_id}: kv_cache.history_length={history} " f"< prompt_len={prompt_len} at TRANS_COMPLETE boundary. " f"V2 scheduler must call prepare_disagg_gen_init() in " f"_try_schedule_disagg_gen_init." )这条不变量把三个模块绑在了一起:V2 调度器在分配 KV 时必须先把 history_length 预声明为 prompt_len(这样 SWA 的陈旧计算会跳过窗口之前的块)。如果这个契约被破坏,后果是「SWA / 稀疏注意力池被窗口前的 prompt 块填满,V2 调度器在高并发下死锁」。
检查时机也很讲究:在 TRANS_COMPLETE 状态迁移之前。此时接收已经成功、KV 已经在池里,正是最容易发现「池被填错」的位置;放到迁移之后检查,请求已经进入正常解码流程,错误就会被掩盖成「输出质量变差」而不是崩溃。
这条检查是「契约检查前置到状态迁移边界」的一个范例:与其在结果出错之后回溯,不如在状态跃迁的那一瞬间断言。
冷启动的一个可解释现象
文档的 FAQ 里有一条值得单独抄出来,因为它解释了很多人第一次跑 P/D 分离 benchmark 时会看到的怪现象:
Q. What causes the substantial bandwidth fluctuations in kvCache transfers, especially during the first few requests following service initialization?
A. The communication for kvCache transfer between executors are established dynamically. The connection establishment process incurs significant overhead, which explains the apparently lower kvCache transfer bandwidth observed during the initial requests after service startup. … When conducting benchmarks, it is recommended to perform a warm-up phase to ensure accurate performance measurements.
执行器之间的通信连接是动态建立的,连接建立的开销被算进了那几次传输里,所以前几个请求看起来带宽很低。这不是 bug,是记账口径。benchmark 必须先热身,否则测出来的传输带宽是被建连开销稀释过的数字。
与 SGLang P/D 分离的横向对照
两个框架都在做 P/D 分离,但把同一件事拆成了不同的形状。把它们并排看,能分清哪些是问题本身的性质、哪些是框架各自的选择。
关联键:snowflake ID vs bootstrap_room
SGLang 用 bootstrap_room 作为整套协议的关联键:一个整数,由 router 在分派请求时生成,prefill 侧与 decode 侧共用同一个 room 号。所有「这个 KV 该发给谁」「这个请求传输到哪一步」的判断都以 room 号为索引。
TensorRT-LLM 用 disagg_request_id——编排层那节讲过的 snowflake ID。
两者的区别不在实现,而在生成位置与语义负担:
SGLang bootstrap_room | TensorRT-LLM disagg_request_id | |
|---|---|---|
| 生成者 | router 分派请求时 | 服务端现场铸造(或客户端提供) |
| 唯一性保障 | 由 router 的分配逻辑保证 | 自洽的位段布局(时间戳+节点+进程+计数器) |
| 额外职责 | 兼做负载均衡分派键(room % num_dp_ranks 决定落在哪个 DP rank) | 只做身份标识,路由交给 src/router.py 的路由器族 |
| 跨进程协调 | 需要 router 参与分发 | 不需要任何协调 |
SGLang 把「身份」和「分派」压在同一个整数上,好处是路由与关联天然一致——同一个 room 一定落在同一个 DP rank;代价是这个整数必须由唯一的分派点集中生成。
TensorRT-LLM 把两件事拆开:ID 自洽,任何进程都能本地铸(这直接支撑了 fleet worker 形态——每个 worker 单独铸 ID 也不会撞),而路由决策交给独立的 coordinator 与路由器。代价是编排层要维护集群状态(KvCacheAwareServerState._block_table、负载计数),复杂度从「一个整数」转移到了「一个状态服务」。
这更像是集中 vs 分布的取舍,而不是优劣之分:SGLang 集中分派换来简单关联,TensorRT-LLM 分布铸造换来编排层可横向扩展。
传输引擎抽象:谁把代码写到哪里为止
SGLang 的传输引擎是可插拔后端:disaggregation_transfer_backend 支持 mooncake(默认)、nixl、mori、ascend、fake。其中 fake 是一个不发真实数据的假后端——它保留全部握手路径但跳过数据搬运,用于在没有 RDMA 的机器上跑通协议逻辑。这类假后端本身就是一种可测试性设计。
TensorRT-LLM 的对应是 BaseTransferAgent 抽象基类,但它当前的状态不同:agent 的选择硬编码在 nixl/agent.py 与 TransferWorker._setup_transfer_engine,还没有配置驱动的 agent 注册表。而且 Python 版 transceiver 目前只支持 NIXL——文档 Limitations 第一条就是「NIXL only. MPI, UCX, and Mooncake deployments stay on the C++ transceiver」,而那个 C++ transceiver 已被标记为 deprecated、将来会移除。
两条路线的差异很清楚:
- SGLang 的做法是先把抽象做出来、再填多个后端(代价是抽象层要足够通用,且要维护多个后端的兼容性)。
- TensorRT-LLM 的做法是先把一条路径做对做透,再把抽象补上(代价是抽象完备之前,非 NIXL 路径被冻结在旧实现上)。
异构 TP:暂存缓冲的位置不同
两侧都遇到了同一个问题:prefill 用 TP4、decode 用 TP1 时,KV 头的归属完全不同。解法也都是「先攒成连续缓冲再传」。但攒在哪里、由谁攒、放不下时怎么办,三家不一样。
SGLang 在 disaggregation/common/staging_buffer.py 里做了一对 gather/scatter kernel,配一个固定大小的暂存池(SGLANG_DISAGG_STAGING_POOL_SIZE_MB 默认 4096 MB),并且:
fits()判断放不下时,chunk 会被延后到下一次——传输的节拍由缓冲区水位控制,而不是单纯由计算进度控制。get_gather_stream()让 gather 跑在独立 CUDA stream 上,与计算流重叠。- 官方给出的收益口径是高并发下 2–5 倍吞吐提升,且与同构 TP 基线相差在 5% 以内。
TensorRT-LLM 的对应机制是上一节讲的 bounce buffer,闸门规则明显不同:
| SGLang 暂存缓冲 | TensorRT-LLM bounce | |
|---|---|---|
| 启用条件 | 两侧 attention TP size 不同即启用 | 按载荷量纲过闸门(普通 KV ≥96 块,循环状态 ≥2 MiB);C++ 路径另有描述符形状闸门(≥1024 个且平均 ≤16 KiB) |
| 容量 | 固定池(默认 4096 MB) | kv_cache_bounce_size_mb,默认 0(关闭) |
| 放不下时 | chunk 延后(水位控制节拍) | 按闸门决定走不走 bounce,不延后 |
| 缓冲归属 | 显式的 gather/scatter kernel | Python 路径 per-region;C++ 路径收发共享一块 arena 并分块写入 |
| MLA | 文档明确不适用 MLA | 有专门的 MLA 头匹配判断(头匹配走标准路径) |
最值得注意的差异是默认状态:SGLang 的暂存池默认开启且默认 4 GB;TensorRT-LLM 的 bounce 默认关闭。这反映了两边对「默认配置偏向什么」的不同判断——一个偏向「异构部署开箱即用」,一个偏向「不为可能用不上的机制预留显存」。
再往下一层看,两边对缓冲的定位也不同:SGLang 把暂存池当一个资源池做水位调度(放不下就延后,节拍跟着水位走);TensorRT-LLM 把 bounce 当一个可选的传输加速器(按量纲与描述符形状过闸门,不过闸门就维持原路径)。同一个物理机制,一个被纳入调度节拍,一个被保持为纯优化。
失败与回收:都在处理「传输不能中止」
两个框架都被同一个物理事实约束:已提交的 RDMA 传输不能中止。SGLang 的处理是「推迟释放:等 abort 真的排空」(BaseKVManager 上有 per-backend 开关,注释是「set True once the prefill acks a drained abort」);TensorRT-LLM 的处理是 cancel_request 返回 True/False 的协作式取消。
形状不同,内核一致:释放必须等传输真正落地,而「等」必须由一个明确的、可查询的状态来表达——不能靠时间猜测,也不能靠异常传递。
部署形态:轻量注册中心 vs coordinator + fleet
SGLang 的形态是「prefill 实例 + decode 实例 + 一个轻量 bootstrap server」。CommonKVBootstrapServer 基于 aiohttp,只暴露四个路由,prefill 侧每个 TP/PP/CP/DP rank 启动时 PUT 一次自己的坐标;decode 侧查询带连接池缓存,避免同一个 prefill rank 被无数请求反复查询。
TensorRT-LLM 的形态更重:每个 context/gen 实例是一台完整的 trtllm-serve,编排层本身还能再拆成 coordinator + worker fleet(用 SO_REUSEPORT 共享端口的无状态 worker)。
差别在于编排层承担多少:SGLang 的 bootstrap server 只做「坐标查询」,路由与分派在 router 侧;TensorRT-LLM 的编排服务器要终止每一条客户端连接、跑路由、代理 ctx→gen 那一跳——正因为它承担得多,才需要再用 fleet 把它横向摊开。
两边都有的那道窄门
对照到这里可以收一句:两家都在「默认路径简单、异构路径昂贵」这个结构上收敛。SGLang 的默认路径是 per-token slice,异构才走暂存;TensorRT-LLM 的默认路径是每 fragment 一个描述符,碎片多才走 bounce。
原因一样:同构拓扑下 KV 搬运可以退化成「整块拷贝」,而任何异构(TP 不同、PP 不同、头数不同、块大小不同)都会把它变成「大量小片段」。所有的工程投入,都在把后一种情况重新拉回「少而大」的形状。
限制与坑
把文档与源码里明确写下的限制收拢成一份上线前的检查清单。
硬性限制
- 只支持 decoder-only 模型。 而且各层的 KV 缓存必须同构——相同数据类型、相同注意力头数。两侧的并行策略可以不同(TP、PP 都能不同),框架会处理 KV 缓存的异构性;但模型自身的 KV 布局必须在层间一致。
- Python transceiver 只支持 NIXL。 MPI、UCX、Mooncake 部署留在 C++ transceiver 上,而那个实现已经 deprecated、将来会移除。
- 流水线传输与 PP 不兼容。
enable_pipelined_transfer在 context worker 上要求pipeline_parallel_size == 1,并且要求开启 chunked prefill、beam_width == 1、schedule_style == 'generation_first'。这四条被写成一条连续的校验链:
if not self.model_engine.attn_runtime_features.chunked_prefill: raise ValueError("enable_chunked_prefill is required when enable_pipelined_transfer is set.")if request.py_beam_width != 1: raise ValueError(f"enable_pipelined_transfer requires beam_width == 1, got {request.py_beam_width}.")if disagg_params.schedule_style != DisaggScheduleStyle.GENERATION_FIRST: raise ValueError("enable_pipelined_transfer requires schedule_style='generation_first' on the request.")if self.dist.pp_size != 1: raise ValueError(f"enable_pipelined_transfer is not supported with pipeline_parallel_size={self.dist.pp_size} on context workers.")- 一次请求一个 KV 切片(非流水线时)。 文档原话:「The whole prompt moves in a single transfer after prefill completes. The session machinery is multi-slice capable and
KVSlice.layer_rangeexists, but no producer sets it — there is no layer-wise or chunked transfer overlapping compute yet.」会话机制本身已支持多切片,但还没有生产者去设置它——这句话把「设计已就位、实现未接线」的状态说得很坦白。 - 两侧必须同 build、同 transceiver runtime。
RankInfo逐字段序列化且不带版本标签,没有可协商的东西。把一个 C++ context worker 配一个 Python generation worker,会在第一个请求上失败——因为 C++ worker 根本不发布disagg_info_endpoint。 - 已提交的 NIXL 操作不能中止,取消是协作式的。 文档还补了一句更重的:「Lifecycle ownership is not complete either — safe retirement of a session after an ambiguous failure or a cancellation is not fully enforced, so do not assume the KV pages are reclaimed at a well-defined point on those paths.」——在模糊失败或取消路径上,不要假设 KV 页会在一个明确的时间点被回收。
- 混跑 context-only 与 generation-only 不推荐。 文档原话:「TRT-LLM does not implement optimal scheduling for the case where the instance handles mixed context-only requests and generation-only requests.」
配置层面的坑
cache_transceiver_config.backend没有默认值。 不设也能启动,但不创建 transceiver,随后被路由过来的分离式请求会被拒绝。而且两侧的传输配置不做协商,不一致不会被报成配置错误。- bounce 参数两端必须一致,否则静默回退到标准 NIXL(有 WARNING,但传输照走)。特别是
request_timeout_ms与有效 chunk 上限。 max_tokens_in_buffer最好别设。 文档明确说「is best left unset」——它约束 generation worker 并发接纳多少 KV 传输,内置默认值是从模型最大序列长度推出来的,手写一个小值只会把传输路径掐住。- 首几个请求的带宽统计偏低是正常的,因为执行器之间的通信连接是动态建立的。benchmark 必须先热身。
- 跨 NVLink 域会挂或变慢。 用
nvidia-smi -q的Fabric.ClusterUUID字段确认 NVLink 域;跨域时需要调 UCX 变量:UCX_CUDA_IPC_ENABLE_MNNVL=n(同时能减少cuMemImportFromShareableHandle failed这类报错)、检查UCX_NET_DEVICES、在 GB200 上把UCX_RNDV_SCHEME设为get_zcopy或put_zcopy。 - TEP 场景下的网卡争用。
UCX_MAX_RNDV_RAILS默认为 2,意味着 UCX 会尝试给每张 GPU 用两个 IB 网卡做 RNDV 传输;两侧都开张量+专家并行时多个 TP rank 会并发传 KV,每个 rank 最多占两个网卡,于是网卡被多张 GPU 共享、产生争用。设UCX_MAX_RNDV_RAILS=1可以缓解。 - NCCL graph mixing 默认关闭。 TensorRT-LLM 现在默认以
NCCL_GRAPH_MIXING_SUPPORT关闭的方式初始化常见 NCCL 通信器,以减少 CUDA Graph 捕获的 NCCL 操作启动开销。这个假设是「该通信器不被并行图启动使用、也不在有图未完成时被未捕获的 NCCL 调用使用」——负载需要原行为时要显式设回1。
三条设计原则(比单条限制更重要)
把上面的限制归纳一下,这套实现有三条贯穿始终的原则,读懂它们比记住具体限制更有用:
- 显式对齐优于隐式兜底。
mapper_kind不匹配直接抛异常、「一个层组命中多个对端层组」直接抛异常、tokens_per_block不一致时至少打警告、backend没有默认值、bounce 参数不匹配时打 WARNING——全部是「宁可响也不能默默传错」。因为静默传错的数据会让 generation 侧算出一个看起来正常、实际错误的结果,这类 bug 的成本远高于一次崩溃。 - 地址算术集中在一侧。 所有源地址与目的地址都在 context 侧算,接收侧 CPU 不参与。这不只是省 CPU:它把「两侧算法不一致」这个失败模式从根上消掉了——只有一个实现,就没法不一致。
- 契约检查前置到状态边界。
_assert_disagg_history_declared在TRANS_COMPLETE迁移前断言history_length >= prompt_len;_validate_bridge_req在读 back session 之前校验;request_and_receive_async在发布之前登记请求。每一个状态跃迁点上都有一个断言或登记动作,错误因此在它发生的位置暴露,而不是在几步之后以「输出不对」的形式暴露。
小结
把本篇的事实收拢成一张清单:
- 分离的动机是算术强度差异:prefill 算力受限、decode 带宽受限,混跑时 prefill 会把 decode 的 TPOT 顶开。收益集中在「长输入、中等输出」的负载上;额外收益是两侧可以各用各的并行策略(典型是 context 用 TP、generation 用 PP)。
- 编排层把一次请求拆成 context-only 与 generation-only 两段,靠
ContextPhaseParams接头,六个字段分别承载首 token、全局请求 ID、不透明状态、草稿 token、ctx DP rank 与可打到的端点。 - 全局请求 ID 是 snowflake:
[0 | timestamp_ms(39) | node_id(8) | process_id(6) | counter(10)],用time.monotonic()保证不受时钟回拨影响;全局 ID 被强制落在[1<<40, 2**63),与本地 ID 空间互不污染。 - 编排服务器可以再拆成 coordinator + fleet:无状态 worker 用
SO_REUSEPORT共享端口,路由决策委托给 coordinator 以保证全局一致;round_robin留在本地(不需要全局状态);worker 探测不通 coordinator 时快速失败而不是降级服务。 - 控制面走 ZeroMQ、数据面走单边 NIXL 写,两者从不共用通道;所有地址算术在 context 侧完成,generation 侧 CPU 不参与。
- 六步工作流:发布端点 → 交换
RankInfo(首次接触才付这次往返)→ 请求特定 token 的 KV → context 侧算地址并提交 → 控制面上报完成 → 两侧 allgather 后才做状态迁移。 - 拓扑异构的解耦分三层:
get_pool_mapping配对层组与物理池(同角色 + 层重叠,命中多个层组就抛异常);get_peer_overlap/should_send_pool算重叠并选举唯一 owner;mapper 家族把一对池翻译成(src_ptrs, dst_ptrs, sizes)。 - HND 与 NHD 是整件事的技术关键:头主序下选一段头是一个连续区间;token 主序下选同一段头要在每个 token 内部各切一刀。这直接决定一份 NIXL 传输里有多少描述符,也是 bounce buffer 存在的理由。
- 头偏移推算靠整数除法取模:
total_unique = kv_heads × tp_per_dp反推模型总头数,(peer_tp_rank * total_unique) // peer_tp_per_dp % self_kv_heads把对端 rank 编号换算成本侧头编号;取模天然表达了头复制,不需要特判。 - 字节几何从存储注册的每层大小反推,不做元素算术——这是 NVFP4 这类亚字节类型能正确传输的前提,配合整除校验保证头切片字节对齐。
- 页表是两代 KV 管理器的公共中间表示,让 V1 context worker 与 V2 generation worker 互通;
extract只负责「哪个块」,mapper 负责「块内的哪些字节」。 - bounce buffer 的两道闸门按载荷量纲设:普通 KV 用 96 块、循环状态用 2 MiB——块数闸门曾经让一次 433 MiB 的 Kimi-K3 传输绕过 bounce,掉进约 1000 倍慢的主机中转路径。
- 接进执行循环靠五个方法:接收方永远只用一个整体切片(分块只发生在发送方);轮询用
min(wait_num, len(sessions))夹取修掉了空闲循环白烧一整个超时的 bug;结束判定用 allgather 取全局与;取消用返回值区分「可以释放」与「下一轮再试」而不是抛异常。 - 与 SGLang 的对照给出三处结构性差异:关联键(集中分派的
bootstrap_roomvs 自洽铸造的 snowflake ID)、传输抽象(多后端可插拔 vs 单路径做透)、异构策略(水位控制的暂存池 vs 量纲闸门控制的 bounce)。
一句话概括:P/D 分离的难点不在「怎么搬 KV」,而在「两侧的 KV 布局不一样时怎么保证搬对、搬完怎么在正确的时间点释放」。TensorRT-LLM 把这件事拆成「页表描述几何 → 配对找对应 → mapper 算字节偏移 → 单边 NIXL 写」,再用一套会话表与协作式取消把生命周期管起来。整套设计反复回到同一个判断:宁可抛异常,也不要静默传错。
参考资料
- Disaggregated Serving(TensorRT-LLM 官方文档)
- Introduction to KV Cache Transmission(TensorRT-LLM 开发者指南)
- Disaggregated Serving in TensorRT-LLM(官方技术博客 blog05)
- TensorRT-LLM 仓库:
tensorrt_llm/_torch/disaggregation/ - TensorRT-LLM 仓库:
tensorrt_llm/_torch/disaggregation/native/peer.py - TensorRT-LLM 仓库:
tensorrt_llm/_torch/disaggregation/native/mixers/attention/peer.py - TensorRT-LLM 仓库:
tensorrt_llm/_torch/disaggregation/resource/page.py - TensorRT-LLM 仓库:
tensorrt_llm/_torch/disaggregation/transceiver.py - TensorRT-LLM 仓库:
tensorrt_llm/disaggregated_params.py - TensorRT-LLM 仓库:
tensorrt_llm/serve/router.py - NVIDIA Dynamo 仓库(数据中心级推理服务器)
- NIXL(NVIDIA Inference Xfer Library)仓库
- DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving
- Splitwise: Efficient Generative LLM Inference Using Phase Splitting
- Towards Efficient Large Language Model Serving: A Survey on Disaggregated Systems
- NCCL 环境变量文档:
NCCL_GRAPH_MIXING_SUPPORT
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



