


SGLang 源码完全拆解(十二):Disaggregation——Prefill 与 Decode 如何拆到两台机器、KV 如何跨实例传输
承接前文:从「一个调度器管到底」到「两个进程各管一段」
这个系列的前十一篇都在拆解一个前提:一个 SGLang 实例从请求进来到 token 出去,全部由同一个 Scheduler 完成。调度器既跑 prefill 批次,又跑 decode 批次,KV 内存池、RadixCache、CUDA Graph、投机解码都长在同一个进程里。前面讲解的每一个不变量——请求状态不丢、KV 所有权不重叠、batch 预算不越界——都是在这个「统一引擎」的假设下成立的。
本篇处理的是这个假设被打破之后的世界。PD 分离(Prefill-Decode Disaggregation)把计算密集的 prefill 阶段和访存密集的 decode 阶段放到两个不同的服务实例上,请求的 KV Cache 必须从 prefill 实例跨网络搬到 decode 实例。这会一次性推翻前面好几条不变量:KV 内存池不再由单一进程独占,一块 KV 会被「写入方」和「读取方」两个进程先后持有;调度器的记账需要新增一列「正在传输」的状态;前缀缓存的命中判断要在两个实例之间保持语义一致,否则复用就会算错。
具体来说,本篇回答五个问题:
- 为什么统一调度会把 decode 的延迟搞坏,PD 分离从原理上解决了什么?
- 一个节点如何声明自己是 prefill 还是 decode,两边怎么在启动时就互相发现?
- 一段 KV 从 prefill 写到 decode 的完整握手协议是什么,中间经过哪些 HTTP/ZMQ 跳?
- KV 传输引擎(Mooncake / NIXL)在 SGLang 的抽象里被封装成什么样,SGLang 自己的代码到哪一层为止?
- 分离之后,调度器的记账、内存所有权、失败与回收发生了哪些变化?
一句话概括本篇的核心:PD 分离的本质不是「把两个阶段分开跑」,而是「把一次请求拆成两个进程各自持有半条生命周期」——前半条生命周期(prefill 计算 + KV 发送)属于 prefill 实例,后半条(KV 接收 + 逐 token 解码)属于 decode 实例,两者靠一套以 bootstrap_room 为主键的握手协议对接。
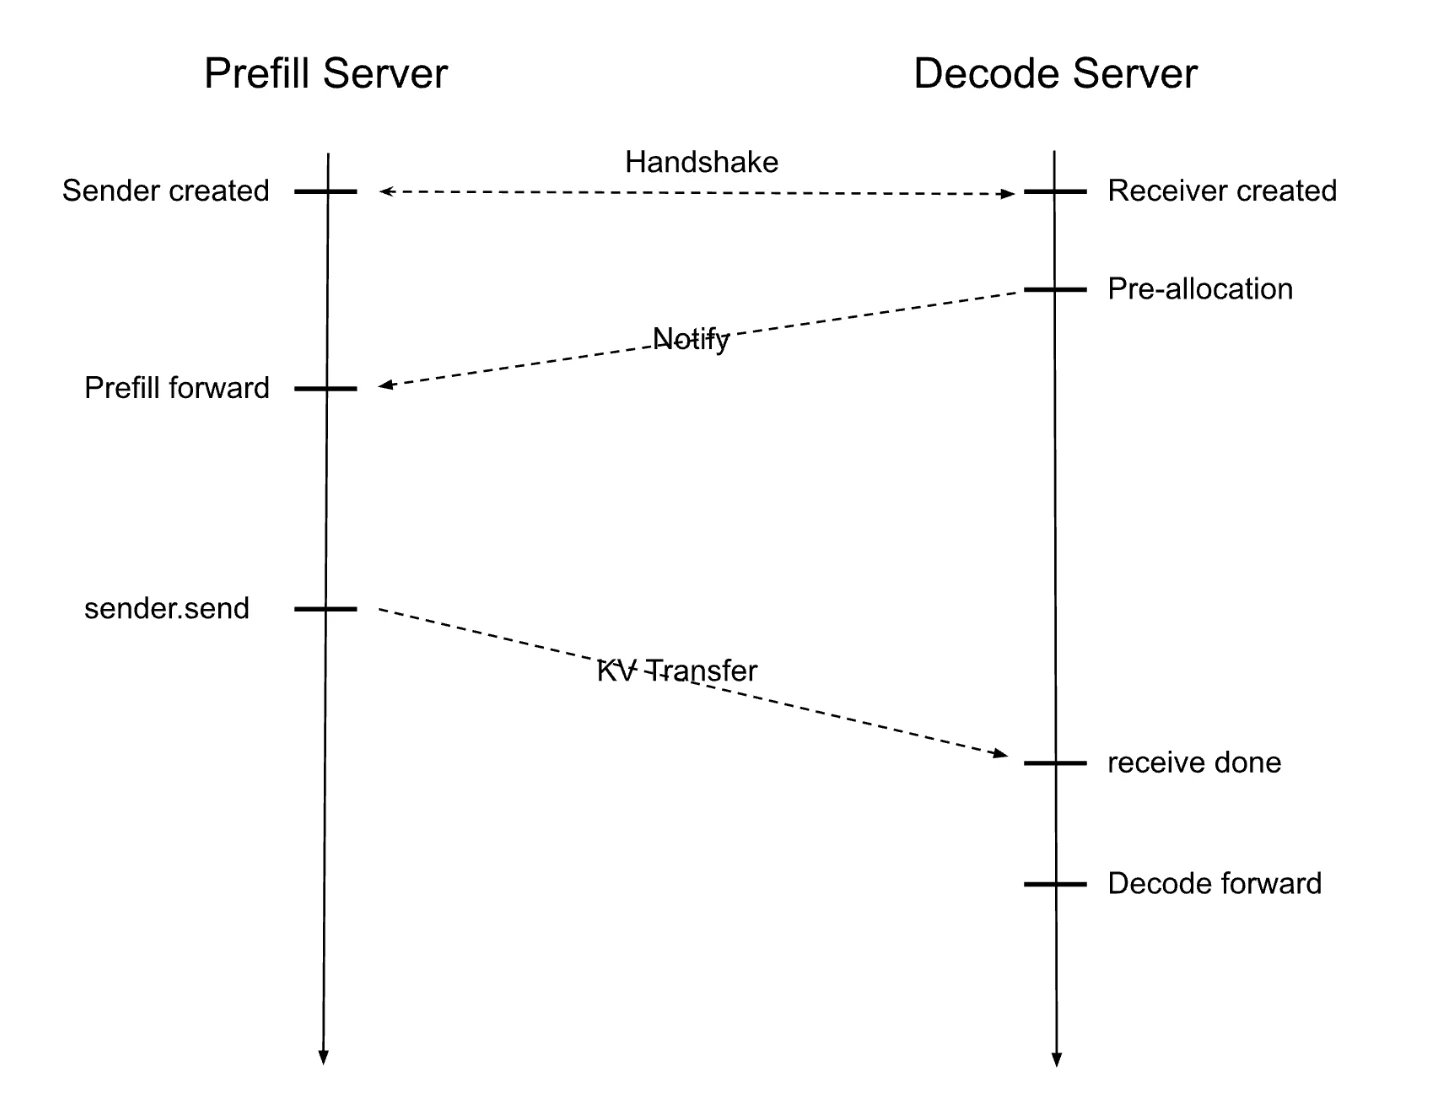
图源:LMSYS 官方博客 Deploying DeepSeek with PD Disaggregation and Large-scale Expert Parallelism on 96 H100 GPUs。图中把 prefill 组与 decode 组画成两排独立实例,中间那条跨组连线就是本篇的主题——KV Cache 传输通道。注意它把「请求先经过 router」这件事也画出来了:router 负责把同一个请求的两段分派给两个组,而这个分派必须携带足够信息让两边能对上号。
背景:统一调度为什么伤害 decode
要理解 PD 分离的动机,先要看清统一引擎里 prefill 与 decode 是怎么互相拖累的。
两个阶段的资源画像完全不同
Transformer 推理的两个阶段在硬件上的瓶颈是错开的:
- Prefill 处理整段 prompt,把所有输入 token 一次性过一遍。它的计算量正比于输入长度,矩阵乘规模大,GPU 的计算单元(Tensor Core)基本打满,是算力瓶颈。
- Decode 每次只处理一个新生成的 token,但对每个新 token 都要读取全部历史 KV。它的计算量很小(一个 token 的一次前向),访存量巨大(整个 KV Cache),是显存带宽瓶颈。
同一个 GPU 执行这两种负载时,最优的 batch 组织、最优的 kernel 配置、最优的切分策略都不一样。更关键的是它们在时间上的干扰。
干扰一:prefill 会打断正在跑的 decode
在统一调度里,一个 prefill 批次的计算时间通常是 decode 批次的几十倍。当调度器决定这一轮先跑 prefill 再跑 decode 时,正在 decode 的那些请求的下一个 token 要等到 prefill 算完才能出来。这在在线服务里直接表现为尾延迟尖峰:一个长 prompt 的请求进来,所有在线用户的输出都会卡一下。
这个现象在连续批处理(continuous batching)里已经被部分缓解——调度器可以限制单个批次的 token 预算。但预算控制只能减小尖峰的幅度,不能消除它,因为 prefill 的计算终究要占据 GPU 时间,而 decode 是串行敏感的:它每生成一个 token 都要等上一轮前向结束。
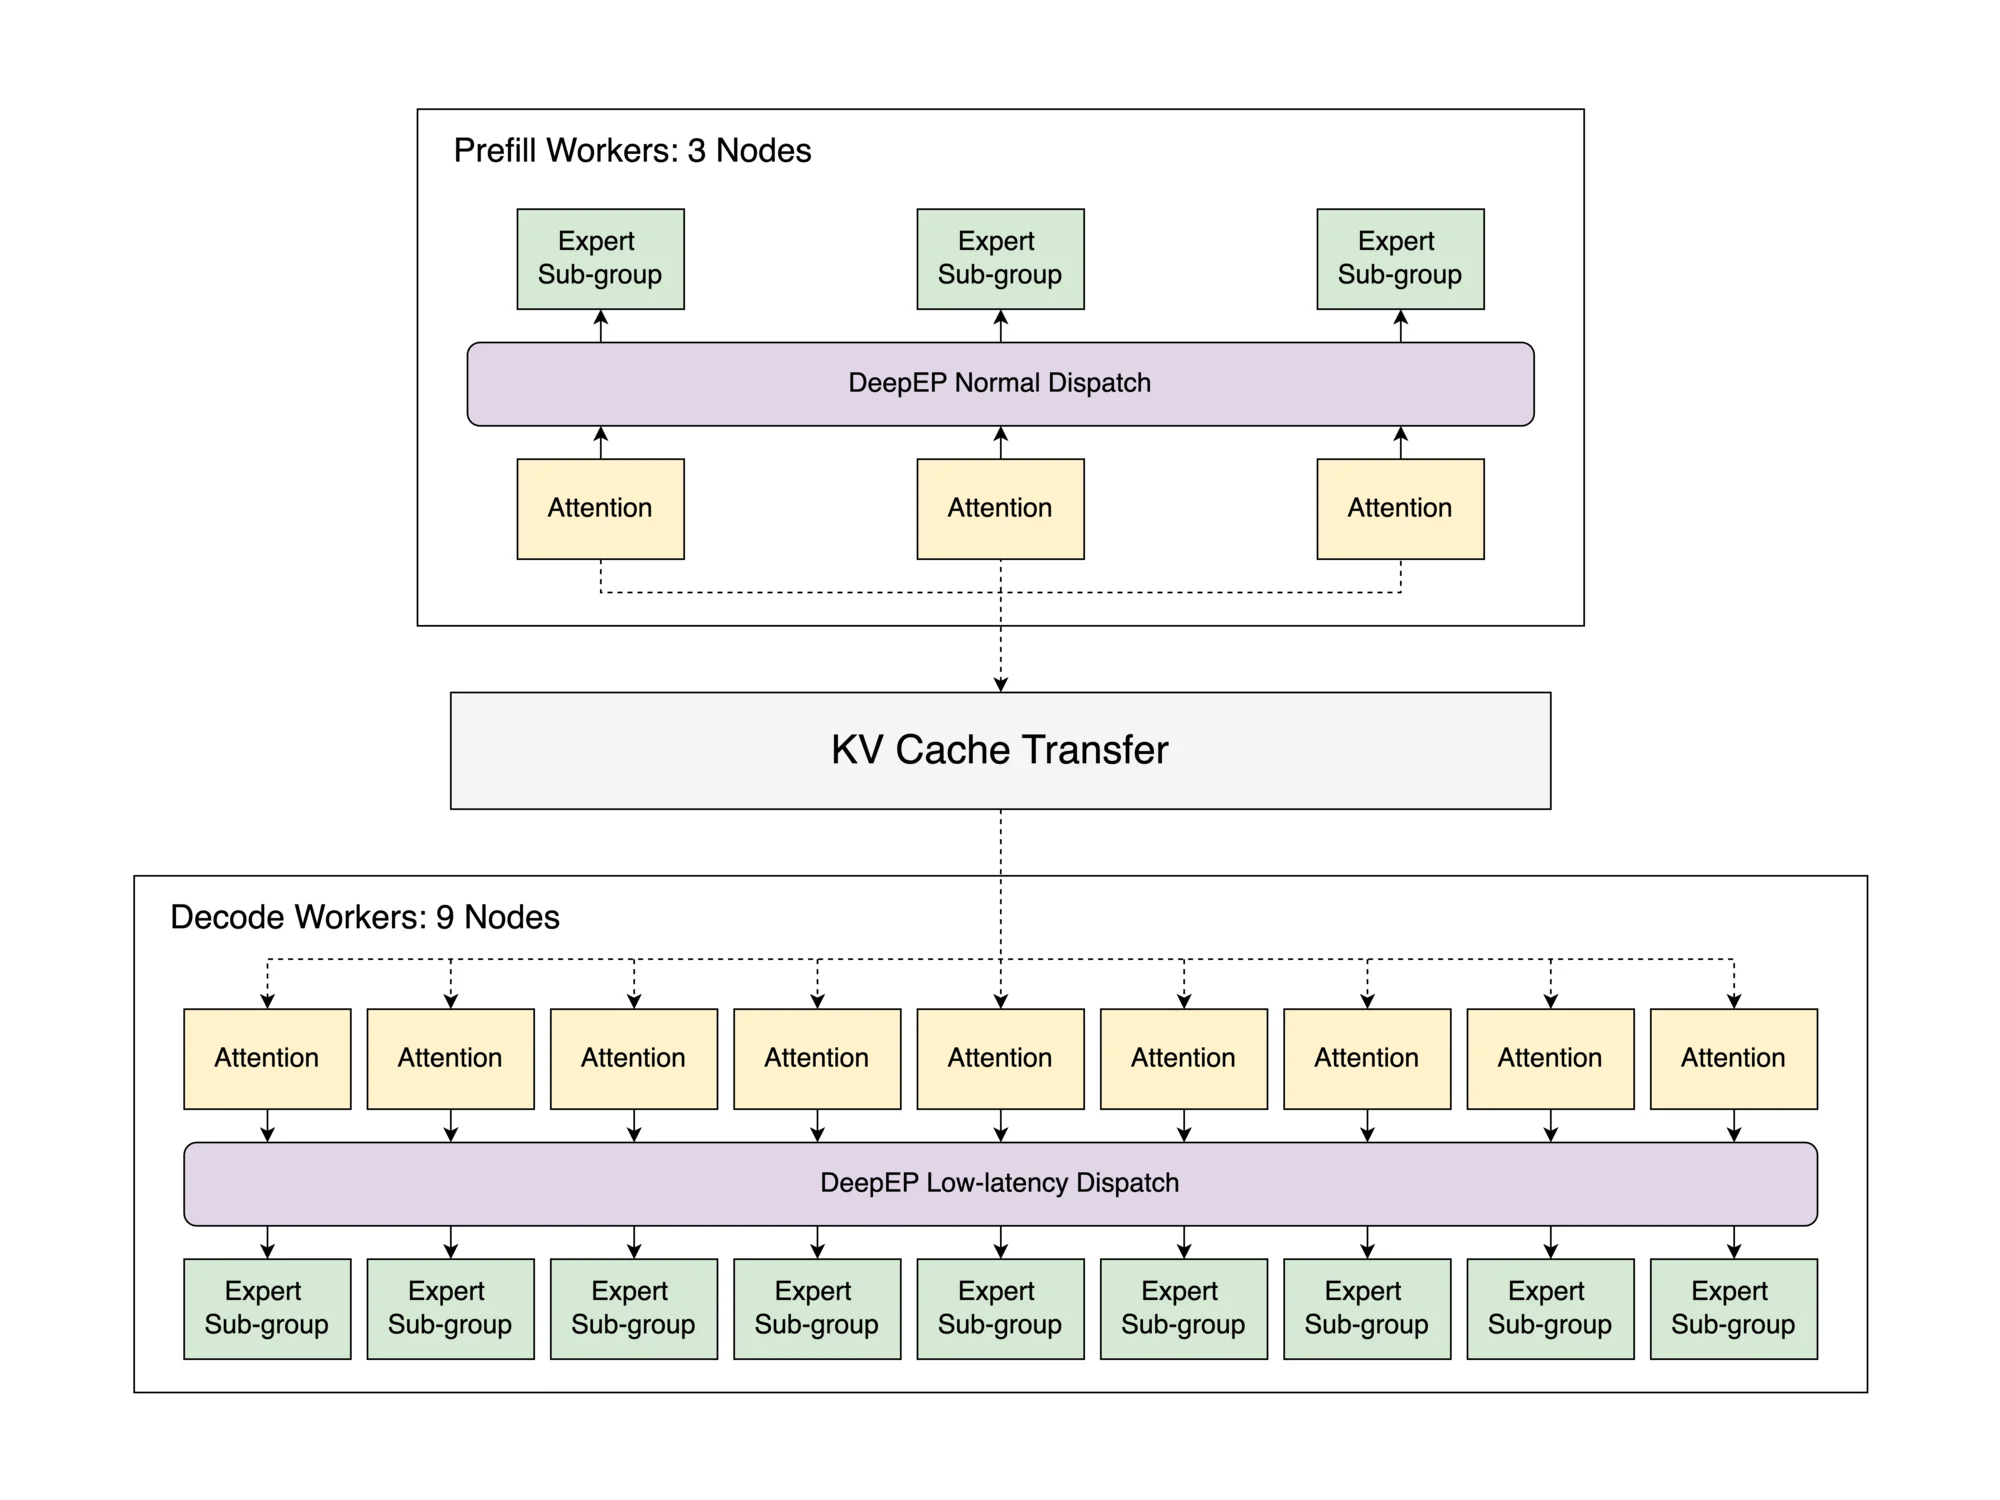
图源:LMSYS 官方博客 Deploying DeepSeek with PD Disaggregation and Large-scale Expert Parallelism on 96 H100 GPUs。这张图把大 EP 场景的整体架构画出来,可以看到 prefill 侧与 decode 侧的并行策略本身就是分开设计的。PD 分离的深层动机就在这里:两个阶段的硬件最优配置不同,强行放在一个引擎里意味着一定有一侧要妥协。
干扰二:DP Attention 的负载失衡
当 attention 用数据并行(DP)时,多个 DP worker 各自处理一部分请求。统一调度下,可能出现「DP worker 0 正在跑一个 prefill 批次、DP worker 1 正在跑 decode 批次」的局面。这一方面让两个 worker 的负载严重不均,另一方面 attention 层如果需要跨 DP 通信(MoE 场景常见),就会被迫等待最慢的那个 worker——也就是在跑 prefill 的那个。结果就是 decode 延迟被拉长。
SGLang 官方文档把这两条总结为统一引擎的两个问题:Prefill Interruption(prefill 打断 decode)与 DP Attention Imbalance(DP attention 失衡)。PD 分离通过让两个阶段各跑各的、互不干扰来消除它们。
分离之后能各自优化
一旦两个阶段分属不同实例,就可以分别做针对性的优化:
- Prefill 实例可以配很强的算力、较少的 KV 容量(prefill 是算力瓶颈,KV 算完就能发走);decode 实例可以配很大的 KV 容量、较低的算力(decode 是带宽瓶颈)。
- Prefill 实例可以用大 TP、大 batch 追求吞吐;decode 实例可以用小 TP、大 batch、更长 CUDA Graph 捕获追求延迟稳定。
- 两者甚至可以用不同的 TP 大小(heterogeneous TP),前提是 KV 传输能处理两侧的内存布局差异。
这正是官方配置示例里 prefill 与 decode 分别指定 --max-running-requests、不同并行度的原因。
代价是什么? 分离引入了三样统一引擎里不存在的东西:一次跨机网络传输(KV 从 prefill 内存搬到 decode 内存)、一套两进程握手协议(两边要能对上同一个请求、同一个 KV 区间)、一份更复杂的所有权账本(传输中、已接收、已消费、失败回收)。本篇文章剩下的部分就在讲 SGLang 怎么处理这三样东西。
角色的划分:一个枚举决定进程的所有行为
SGLang 里「这个进程是 prefill 还是 decode」由一个三元枚举决定,定义在 disaggregation/utils.py:
class DisaggregationMode(Enum): NULL = "null" # 未启用 PD 分离,统一引擎 PREFILL = "prefill" # 只做 prefill,算完把 KV 发出去 DECODE = "decode" # 只做 decode,收 KV 后逐 token 生成
@staticmethod def to_engine_type(mode: str) -> str: if mode == DisaggregationMode.PREFILL.value: return "prefill" elif mode == DisaggregationMode.DECODE.value: return "decode" return "unified"这个枚举来自启动参数 --disaggregation-mode。to_engine_type 把它翻译成给外部(router、监控、注册中心)用的字符串,统一引擎报 unified。
把这个枚举放大了看,它是一个贯穿全进程的分叉开关。Scheduler 会在构造时读它,然后选择不同的 mixin、不同的队列、不同的事件循环:
| 角色 | 关键差异 |
|---|---|
| 统一引擎(NULL) | 单个 waiting_queue,prefill 与 decode 混在同一批里调度 |
| PREFILL | 增加 PrefillBootstrapQueue(等待握手的请求)与 disagg_prefill_inflight_queue(等待发送完成的请求);事件循环拆成 event_loop_normal_disagg_prefill / event_loop_overlap_disagg_prefill |
| DECODE | 增加 DecodePreallocQueue(等待 KV 到达的请求)与 DecodeTransferQueue(正在接收 KV 的请求);decode 侧的 running batch 只在 KV 就绪后才接纳请求 |
源码里这些差异通过 mixin 组织,SchedulerDisaggregationPrefillMixin 与 decode 侧的对应 mixin 分别挂在 Scheduler 上。这是 SGLang 一贯的组织方式:主循环的骨架不变,角色相关的行为以 mixin 形式插入,避免为两种角色维护两套 Scheduler。
启动参数:一个角色的完整配置面
PD 相关的参数集中在 arg_groups/fields/disagg.py 里,命名空间是 disagg:
disaggregation_mode: A[ # --disaggregation-mode {null,prefill,decode} 'Only used for PD disaggregation. "prefill" for prefill-only server, ' 'and "decode" for decode-only server. If not specified, it is not PD disaggregated',]disaggregation_decode_allocation_policy: A[ # early | prefill_complete "When to reserve per-request decode KV in disaggregated serving. "]disaggregation_transfer_backend: A[ # mooncake | nixl | mori | ascend | fake help="The backend for disaggregation transfer. Default is mooncake.",]disaggregation_enable_kv_checksum: A[...] # 传输后校验 KV 是否一致disaggregation_bootstrap_port: A[...] # 握手服务端口disaggregation_ib_device: A[ # RDMA 网卡设备 'The InfiniBand devices for disaggregation transfer. ...']disaggregation_decode_enable_radix_cache: A[ # decode 侧启用前缀缓存 "Enable radix cache on decode server (PD mode). Caches KV prefixes to " "avoid redundant transfers. Incompatible with --enable-hisparse, " "speculative decoding, and --disaggregation-transfer-backend fake.",]几个值得一提的设计点:
disaggregation_transfer_backend把传输引擎抽象成可插拔后端,默认mooncake,可选nixl、mori、ascend、fake。fake是一个不发真实数据的假后端,用于在没有 RDMA 的机器上跑通协议逻辑——这一点对理解代码非常有用,因为它把所有握手路径保留下来但跳过了实际数据搬运。disaggregation_ib_device支持多种写法:单个设备名、逗号分隔的设备列表、按 GPU 映射的 JSON('{"0": "mlx5_0,mlx5_1", "1": "mlx5_2"}')或指向该 JSON 的文件路径。默认 None 时在 mooncake 后端下自动探测。这说明多 GPU 机器上每张卡的 RDMA 出口可能不同,需要显式绑定。disaggregation_decode_enable_radix_cache让 decode 侧也维护前缀缓存,从而避免重复传输相同前缀的 KV。它的互斥列表(不兼容 HiSparse、投机解码、fake 后端)本身就是一条重要线索:前缀缓存复用与「KV 来自远端」这件事在语义上有冲突,后面会展开。
两端如何发现彼此:bootstrap server 与 rank 拓扑注册
PD 分离的第一个工程问题是寻址:prefill 实例和 decode 实例是两组独立进程,它们怎么知道对方在哪,怎么知道对方内部的并行结构?
SGLang 用的是一个轻量注册中心,叫 bootstrap server。它的实现是 disaggregation/common/conn.py 里的 CommonKVBootstrapServer,基于 aiohttp,只暴露四个路由:
def _setup_routes(self): self.app.router.add_route("*", "/route", self._handle_route) self.app.router.add_post("/register_dp_rank", self._handle_register_dp_rank) self.app.router.add_post("/query_dp_ranks", self._handle_query_dp_ranks) self.app.router.add_get("/health", self._handle_health_check)注册:每个 prefill rank 上报自己的坐标
prefill 侧每个 TP/PP/CP/DP rank 启动时都要向 bootstrap server 做一次 PUT。上报的字段(_handle_route_put 里逐条读出)构成了一份完整的坐标:
attn_tp_size, attn_tp_rank # attention 张量并行规模与自己的 rankattn_cp_size, attn_cp_rank # attention context 并行attn_dp_size, attn_dp_rank # attention 数据并行pp_size, pp_rank # 流水线并行system_dp_size, system_dp_rank # 系统级 DPrank_ip, rank_port # 这个 rank 的 ZMQ 监听地址(KV 传输握手用)page_size, kv_cache_dtype # KV 页大小与数据类型prefill_http_port # prefill 的 HTTP 端口(供重算/回退使用)这套坐标之所以需要这么细,是因为 decode 侧必须精确知道「我要的 KV 在哪几个 rank 上、每个 rank 的内存布局是什么」。KV Cache 在 prefill 实例内部是按 TP rank 切分的:如果 prefill 的 attention TP size 是 8,那么完整的一段 KV 分散在 8 个 rank 各自的显存里,传输时必须分别从 8 个源取。decode 侧收到这份拓扑后,才能构造出正确的「源 rank 列表」。
服务器在 _handle_route_put 里顺手做了一致性校验,这一点很关键:
if self._registered_count and self.dsv41_spec_layout != dsv41_spec_layout: return web.Response( text="DeepSeek-V4.1 DSpark PD layout differs across prefill ranks", status=400, )policy = data.get("decode_allocation_policy", "early")if self._registered_count and self.decode_allocation_policy != policy: return web.Response(text="Inconsistent prefill allocation policies", status=400)也就是说,同一个 prefill 组里的所有 rank 必须在两件事上完全一致:投机解码的 KV 布局(dsv41_spec_layout)、decode 分配策略(decode_allocation_policy)。不一致就直接 400 拒绝注册。这类校验的价值在于把错误暴露在启动阶段,而不是等到运行时一个请求传输失败才去排查。
就绪判断:按 DP × CP × TP × PP 的乘积清点
注册中心什么时候算「完整」?代码里写得很直白:
def _is_ready(self) -> bool: if (self.attn_tp_size is None or self.attn_cp_size is None or self.pp_size is None or self.dp_size is None): return False expected = self.dp_size * self.attn_cp_size * self.attn_tp_size * self.pp_size return self._registered_count >= expected期望的注册数是四个并行维度的乘积。decode 侧来查询拓扑时,如果还没注册满,会收到 503(Prefill server not fully registered yet),而不是一份残缺的拓扑。这样做避免了「拓扑不完整导致传输目标错漏」这类难查的 bug。
查询:一次 GET 拿回整份并行信息
decode 侧查询时走 _handle_route_get。当四个查询参数都是 -1 时,表示「我要整份服务器信息」,服务器返回一个 PrefillServerInfo:
info = PrefillServerInfo( attn_tp_size=self.attn_tp_size, attn_cp_size=self.attn_cp_size, dp_size=self.dp_size, pp_size=self.pp_size, page_size=self.page_size, kv_cache_dtype=self.kv_cache_dtype, dsv41_spec_layout=self.dsv41_spec_layout, follow_bootstrap_room=..., enable_dsa_cache_layer_split=bool(self.enable_dsa_cache_layer_split), prefill_http_port=self.prefill_http_port, decode_allocation_policy=self.decode_allocation_policy,)带具体参数时则返回某个特定 rank 的连接信息({bootstrap_addr}_{prefill_dp_rank}_{target_cp_rank}_{target_tp_rank} 为键,带 pp rank 遍历)。这套查询在 decode 侧由 CommonKVReceiver._setup_bootstrap_infos 调用,并带有一个连接池缓存:
bootstrap_key = f"{self.bootstrap_addr}_{self.prefill_dp_rank}_{target_cp_rank}_{self.target_tp_rank}"with self.kv_mgr.connection_lock: cached_bootstrap_infos = self.kv_mgr.connection_pool.get(bootstrap_key)同一个 prefill rank 会被无数个请求反复查询,缓存避免每次都走一次 HTTP。注意 for target_pp_rank in reversed(self.target_pp_ranks) 这个细节——注释说明「让更高的 PP rank 更早被 bootstrap,使 PP PD 请求更健壮」。原因是 PP 模式下 KV 是分层的,高 PP rank 持有后段层的 KV,让它先建立连接可以掩盖流水线启动的气泡。
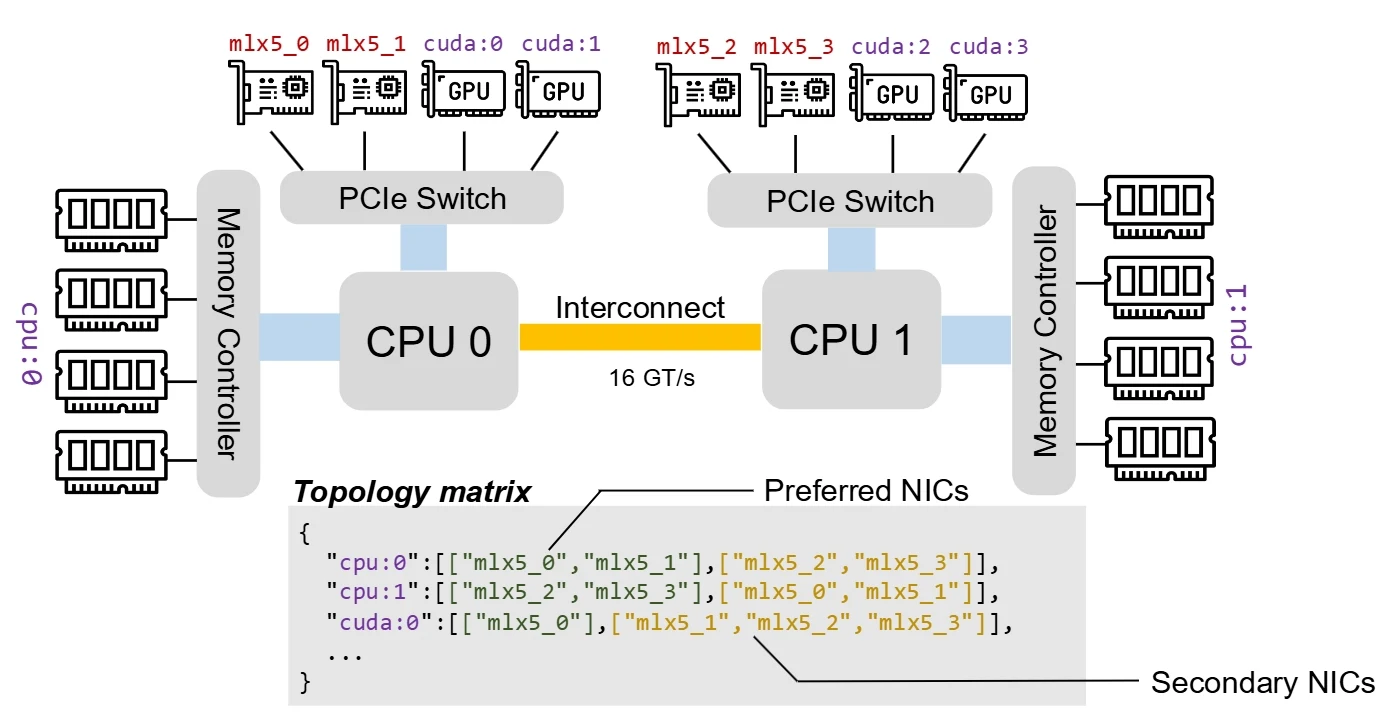
图源:Mooncake 官方仓库 kvcache-ai/Mooncake。KV 传输的性能高度依赖物理拓扑——同一台机器内的 GPU 之间走 NVLink,跨机走 RDMA,某些方向甚至没有直连。这张拓扑矩阵刻画的就是「谁到谁有多快」,它决定了 PD 部署时 prefill 组与 decode 组该怎么摆放。
握手协议:一个请求从 prefill 到 decode 的完整时序
这是本篇最核心的部分。一个开启了 PD 分离的请求,从进入 prefill 到 decode 开始生成,要经过一条精确的时序。我们按时间顺序走一遍。
主键:bootstrap_room
整套协议用 bootstrap_room 作为关联键。它是一个整数,由 router(或请求入口)在分派请求时生成,同一个请求在 prefill 侧和 decode 侧使用的是同一个 room 号。整个系统里所有「这个 KV 该发给谁」「这个请求的传输进行到哪一步了」的判断,全部以 room 号为索引:
# CommonKVManager 里的状态表self.request_status: Dict[int, KVPoll] = {} # room -> 传输状态self.addr_to_rooms_tracker: Dict[str, Set[int]] = {} # 地址 -> 该地址上活跃的 room 集合room % num_dp_ranks 这类算术在源码里频繁出现(比如 self.bootstrap_room % get_parallel().num_dp_ranks),说明 room 号还承担了负载均衡的分派职责——请求落在哪个 DP rank 可以由 room 号直接决定,这就是 follow_bootstrap_room 策略的来源。
状态机:KVPoll 的五个状态
传输状态是一个小状态机,定义在 disaggregation/base/conn.py:
class KVPoll: Failed = 0 Bootstrapping = 1 WaitingForInput = 2 Transferring = 3 Success = 4这五个状态的语义需要仔细区分,因为它们对应的是协议的不同阶段,而不是「传输进行到百分之几」:
- Bootstrapping:接收方已创建,正在向 bootstrap server 查询拓扑、建立连接。此时还不知道对端在哪。
- WaitingForInput:接收方已就绪,但发送方还没拿到「往哪写」(目标 KV 页索引)的信息。之所以叫 WaitingForInput,是因为 decode 侧必须先在自己的 KV 池里分配好目标页,把页索引告诉 prefill,prefill 才能开始写。
- Transferring:源地址与目标地址都已确认,RDMA 引擎正在搬运数据。
- Success / Failed:终态。
为什么要有 WaitingForInput 这个中间态? 这是 PD 分离与统一引擎最本质的差别之一。在统一引擎里,KV 写在本地,写哪个页由本地分配器决定,不需要跟任何人协商。而 PD 分离下,KV 的落点是 decode 实例的显存,这个落点只能由 decode 侧决定(只有它知道自己的 KV 池哪个页空闲、以及前缀缓存命中了哪些页)。于是产生了「decode 分配 → 通知 prefill → prefill 写入」的依赖:prefill 在收到目标索引之前,只能等。
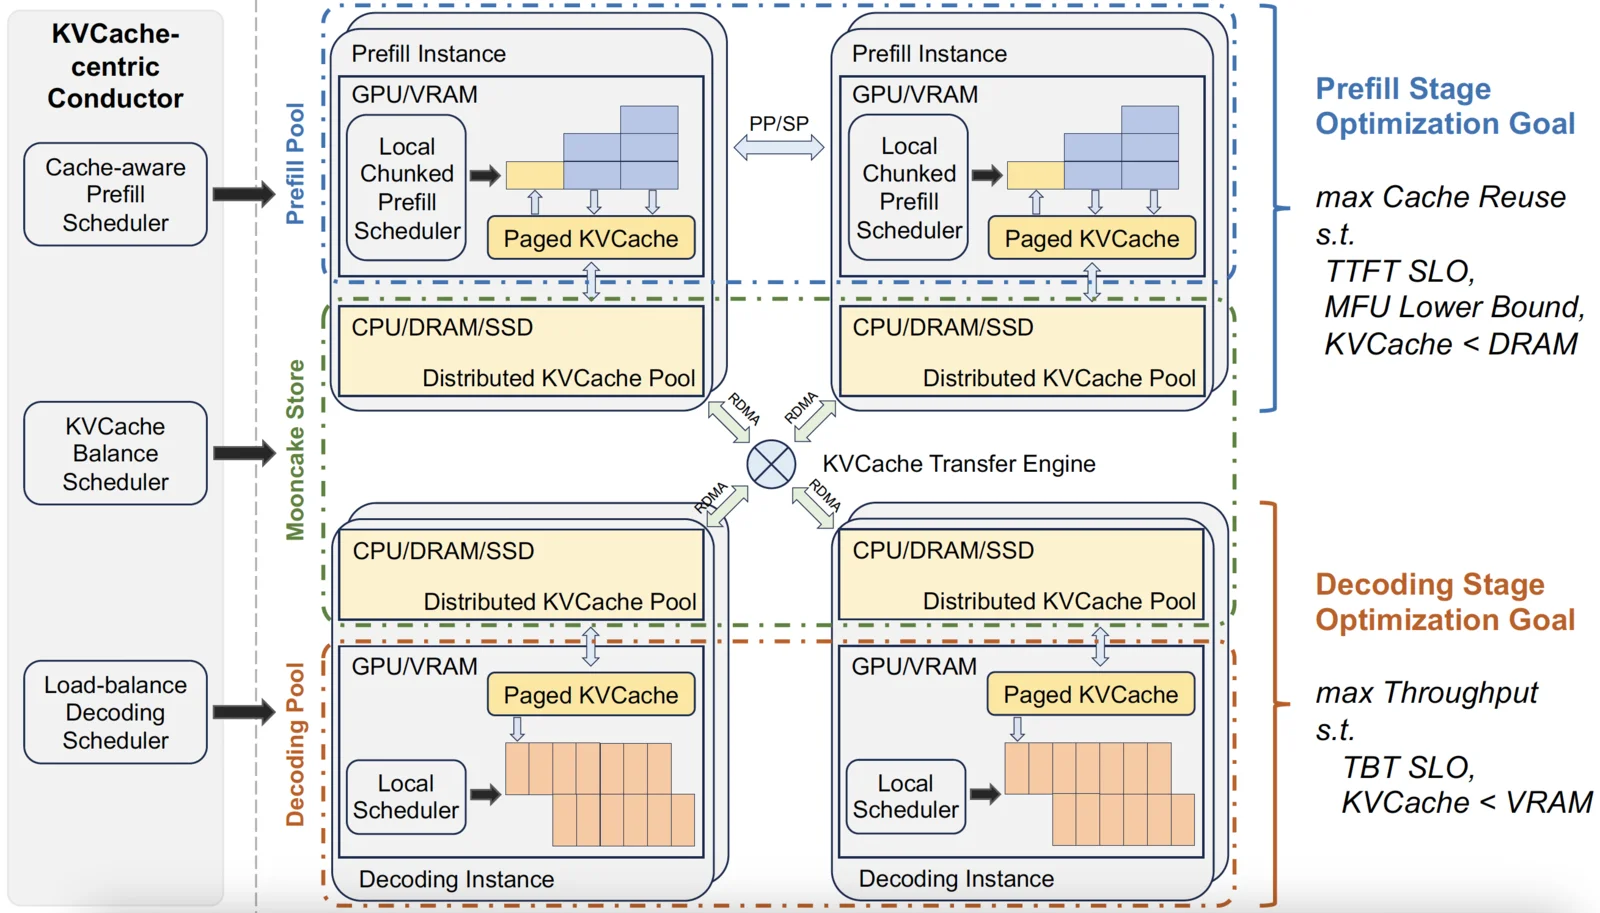
图源:Mooncake 官方仓库 kvcache-ai/Mooncake。Mooncake 把「谁要传什么、传到哪里」的控制信息与「实际搬字节」的数据面分开:控制信息走普通网络(在 SGLang 里是 ZMQ 与 HTTP),数据面走 RDMA/NVLink。理解这个分层是理解握手协议的前提——上层的握手协议只负责协商地址,不负责搬数据。
发送方:CommonKVSender 的三步
disaggregation/common/conn.py 里的 CommonKVSender 是 prefill 侧的发送句柄,一个请求一个。它的生命周期是三步:
第一步,构造与认领 room。 构造函数里会通过 deferred_bootstrap.open(room, self) 认领这个 room:
if mgr.deferred_bootstrap is not None: room_state = mgr.deferred_bootstrap.open(bootstrap_room, self) self._owns_bootstrap_room = room_state is not None mgr.update_status(bootstrap_room, KVPoll.Bootstrapping) if room_state is None or room_state.failed: mgr.record_failure(bootstrap_room, "Duplicate or cancelled bootstrap room") mgr.update_status(bootstrap_room, KVPoll.Failed) self.conclude_state = KVPoll.Failed return_owns_bootstrap_room 这个布尔量很值得留意。它的含义是「这个 room 是我第一个认领的吗」——如果是重复 room(router 重试导致同一 room 被处理两次,或者 room 已被取消),就立刻标记失败并停止。这是一个幂等性保护:传输协议里最怕的就是两个请求同时往同一个 room 里写 KV,造成数据错乱。
紧接着还有一段 DP 相关的检查:
if get_parallel().num_dp_ranks > 1 and not req_has_disagg_prefill_dp_rank: if (get_parallel().load_balance_method != "follow_bootstrap_room" or envs.SGLANG_DISAGGREGATION_FORCE_QUERY_PREFILL_DP_RANK.get()): self._register_prefill_dp_rank() elif self.kv_mgr.attn_dp_rank != self.bootstrap_room % get_parallel().num_dp_ranks: # follow_bootstrap_room was overridden by external routed_dp_rank self.kv_mgr.record_failure( self.bootstrap_room, f"follow_bootstrap_room conflict: dispatched to dp_rank " f"{self.kv_mgr.attn_dp_rank} but bootstrap_room " f"{self.bootstrap_room} implies dp_rank " f"{self.bootstrap_room % get_parallel().num_dp_ranks}. ...", ) self.kv_mgr.update_status(self.bootstrap_room, KVPoll.Failed) return如果负载均衡策略是 follow_bootstrap_room,那么「这个请求该在哪个 DP rank 上处理」完全由 room % num_dp_ranks 决定;如果外部 router 把一个 room 分派给了「wrong」的 DP rank,这里会直接判定失败。这条规则的存在,是为了让 decode 侧能够不查表就推断出 KV 在哪个 prefill DP rank 上——只要它知道 room 号,取模就能算出 rank。这是用一条纪律换掉一次远程查询的设计。
第二步,init:声明这次要传多少索引。
def init(self, num_kv_indices: int, aux_index: Optional[int] = None): self.num_kv_indices = num_kv_indices self.aux_index = aux_indexnum_kv_indices 是要传输的 KV 页数量,aux_index 是辅助数据的槽位(比如 Mamba 状态、或者某些模型的额外状态)。这一步只是本地记账,不涉及网络。
第三步,mark_prefill_complete:通知对端「我算完了」。
def mark_prefill_complete(self) -> None: if self.kv_mgr.deferred_bootstrap is None: return # Give decode admission a fresh budget, excluding prefill queue/compute. if self._prefill_complete_time is None: self._prefill_complete_time = time.time() self.kv_mgr._notify_bootstrap(self.bootstrap_room, ...)这个方法只在 deferred_bootstrap 存在时(即 prefill_complete 分配策略下)生效,它做的是给 decode 侧发一个「prefill 完成」的信号,让 decode 开始分配目标 KV 槽。注释写得很清楚:「给 decode 一个全新的预算,排除 prefill 排队与计算时间」——这对应了官方文档里说的超时预算划分。
接收方:CommonKVReceiver 的初始化与轮询
decode 侧的接收句柄是 CommonKVReceiver。它的 init(prefill_dp_rank) 方法做几件重要的事:
def init(self, prefill_dp_rank: int): if self.conclude_state == KVPoll.Failed: return if self.bootstrap_addr not in self.kv_mgr.prefill_info_table: self.kv_mgr.record_failure( self.bootstrap_room, f"Prefill server with bootstrap_addr: {self.bootstrap_addr} is healthy " f"before, but now it is down. Request (bootstrap_room: {self.bootstrap_room}) " f"has been marked as failed.", ) ...注意这里检查的是 prefill_info_table ——一份由心跳线程维护的「prefill 服务器健康表」。这引出 PD 分离的另一个工程必需件:心跳。
心跳:为什么必须先知道对端活着
分离之后,decode 实例可能在 prefill 实例已经挂掉的时候还在尝试建连。如果每次都要等 TCP 超时才能发现,请求的失败延迟会非常长。SGLang 的做法是让 decode 侧起一个心跳检查线程(CommonKVManager._start_heartbeat_checker_thread),周期性探测每个 prefill bootstrap server 的 /health:
def _handle_health_check(self, request): return web.Response(text="OK", status=200)心跳的参数在官方文档里有明确默认值:SGLANG_DISAGGREGATION_HEARTBEAT_INTERVAL 默认 5.0 秒,SGLANG_DISAGGREGATION_HEARTBEAT_MAX_FAILURE 默认 2 次——连续 2 次心跳失败就把该 prefill server 标记为离线,此后 init 里的那个检查就会立刻让请求失败,而不必等网络超时。这是一个典型的「用主动探测把长尾失败变短」的工程手法。
分配策略:early 与 prefill_complete
init 里还有一段直接决定协议时序的代码:
policy = get_disagg().disaggregation_decode_allocation_policyreason = Noneif info.decode_allocation_policy != policy: reason = ("Disaggregation decode allocation policy mismatch: " f"prefill={info.decode_allocation_policy}, decode={policy}. ...")elif policy == "prefill_complete" and ( info.attn_tp_size != 1 or info.attn_cp_size != 1 or info.pp_size != 1): reason = "prefill_complete requires peer attention TP1/CP1/PP1"if reason is not None: self.kv_mgr.record_failure(self.bootstrap_room, reason) ... return...if policy == "early": self.kv_mgr.update_status(self.bootstrap_room, KVPoll.WaitingForInput) returnself._prefill_wait_start = time.time()try: for info in self.bootstrap_infos: sock, lock = self._connect_to_bootstrap_server(info) with lock: sock.send_multipart([ b"BOOTSTRAP", str(self.bootstrap_room).encode("ascii"), self.kv_mgr.local_ip.encode("ascii"), str(self.kv_mgr.rank_port).encode("ascii"), ])except zmq.ZMQError: self.abort()这段代码把两种策略的差别表达得很清楚:
early(默认):decode 在 prefill 还没算完时就预分配目标 KV 槽,然后立刻进入WaitingForInput,把「我这边准备好了」的信息通过 ZMQ 的BOOTSTRAP消息发给 prefill。优点是 KV 一算出来就能立刻开始传,重叠度高;缺点是长 prefill 会长时间占着 decode 的目标槽,可能挤占其他正在 decode 的请求的容量。prefill_complete:decode 先不分配,等 prefill 发来「算完了」的信号(就是前面mark_prefill_complete)之后再分配。这缓解了「长 prefill 占着 decode 容量」的问题,但它牺牲了重叠,并且有严格的约束(要求 attention TP=CP=PP=1,因为多 rank 情况下「全部算完」的信号语义复杂)。
b"BOOTSTRAP" 这条 ZMQ 消息携带四段:魔数、room 号、decode 的 IP、decode 的 ZMQ 端口。这就是 decode 把自己的联系方式告诉 prefill 的时刻——在 early 策略下,这条消息与「目标 KV 索引」是分开的(索引后面再发),因为目标索引可能要等 prefill 算完一部分才逐步确定。
传输就绪后:poll 的推进
decode 侧用一个 poll() 轮询状态机:
def _poll(self) -> KVPoll: if self.conclude_state is not None: return self.conclude_state status = self.kv_mgr.check_status(self.bootstrap_room) if status in (KVPoll.Success, KVPoll.Failed): self.conclude_state = status elif status == KVPoll.Bootstrapping and self._prefill_wait_start is not None: if time.time() - self._prefill_wait_start >= self.kv_mgr.waiting_timeout: self.abort() self.kv_mgr.record_failure( self.bootstrap_room, "Timed out waiting for prefill completion") return KVPoll.Failed elif status == KVPoll.WaitingForInput: # Observe readiness before evaluating the old compute deadline. # send_metadata starts the transfer timeout using this same clock. if self._prefill_wait_start is not None: self._prefill_wait_start = None self.init_time = time.time() timeout = self._check_waiting_timeout() if timeout is not None: return timeout return status这里有两个精巧的设计:
-
超时预算会重置。
Bootstrapping阶段用的是「等待 prefill 完成」的超时(waiting_timeout),一旦进入WaitingForInput,就切换成一个新的时钟init_time = time.time(),并改用传输超时(_check_waiting_timeout)。注释点明:「send_metadata 用同一个时钟开始传输超时」。也就是说,等待 prefill 计算 与 等待 KV 传输 用的是两段独立的预算,而不是一段被共享的总预算。这对长 prompt 场景至关重要——否则一个 prefill 很慢的请求会因为「计算时间」吃掉了「传输时间」的配额而误判失败。 -
conclude_state的粘性。 一旦走到 Success 或 Failed,就锁存在conclude_state里,之后所有poll都返回它,不再查表。这避免了状态回退的歧义,也让终态可以被反复读取。
传输引擎抽象:SGLang 的代码到哪一层为止
一个很自然的问题是:KV 传输到底是谁在做?SGLang 自己有没有实现 RDMA?
答案是没有——SGLang 把数据面委托给外部传输引擎,自己只负责控制面(协商地址、分批、记账)。抽象层在 disaggregation/base/conn.py 里:
class BaseKVManager(ABC): """Base class for managing transfer states""" enable_deferred_decode_kv_release: bool = False supports_host_destination: bool = False
@abstractmethod def register_to_bootstrap(self): """Register prefill server info to the bootstrap server.""" ...
supports_role_switch: bool = False supports_deferred_decode_kv_release: bool = False
def teardown(self) -> None: raise NotImplementedError(...)
class BaseKVSender(ABC): @abstractmethod def init(self, num_kv_indices: int, aux_index: Optional[int] = None): ... @abstractmethod def send(self, ...): ...KVArgs:描述「要传什么」的完整清单
真正定义了「数据面需要知道什么」的是 KVArgs 这个类。它是一份很长的字段清单,我们挑关键的看:
class KVArgs: engine_rank: int kv_data_ptrs: List[int] # 每个 KV 张量的显存起始地址 kv_data_lens: List[int] # 每个张量的长度 kv_item_lens: List[int] # 每一项(一页)的长度 kv_layer_ids: List[int] # 每个张量属于哪一层 kv_cache_dtype_str: str aux_data_ptrs: List[int] # 辅助数据缓冲 aux_data_lens: List[int] aux_item_lens: List[int] state_types: List[StateType] # 各种模型额外状态的类型 state_data_ptrs: List[List[int]] state_data_lens: List[List[int]] state_item_lens: List[List[int]] state_layer_ids: List[List[int]] state_dim_per_tensor: List[List[int]] # 每个张量的 TP 切分维度 state_slice_outer_counts: List[List[int]] is_hybrid_mla_backend: bool ib_device: str gpu_id: int kv_head_num: int total_kv_head_num: int page_size: int system_dp_rank: int pp_rank: int prefill_start_layer: int prefill_end_layer: Optional[int] mla_compression_ratios: Optional[List[int]]这份清单直接揭示了数据面的接口形态:传输引擎不认「KV Cache」这个概念,它只认「一组显存地址 + 每组里每一项的长度 + 页大小」。SGLang 把「KV Cache 里哪一段需要传」翻译成「哪些地址、哪些索引」交给引擎,引擎负责把源地址上按索引挑选的数据搬到目标地址的对应索引上。
几个字段值得单独说明:
kv_data_ptrs/kv_data_lens/kv_item_lens是三个平行的列表。这个三元组的设计允许「多个不同形状的 KV 张量」共用一个传输通道:第 i 个张量的基地址是kv_data_ptrs[i],第 j 项(第 j 页)的地址是kv_data_ptrs[i] + j * kv_item_lens[i]。这样引擎不需要知道「K 和 V」「不同层」的区别,只要按项搬运。state_types:StateType枚举列出了所有非标准 KV 的额外状态。 从源码可以看到它已经覆盖了相当多的前沿模型结构:
class StateType(str, enum.Enum): MAMBA = "mamba" # Mamba 卷积/SSM 状态 QSA_PENDING = "qsa_pending" QSA_COMPRESSED = "qsa_compressed" SWA = "swa" # 滑窗注意力的窗口状态 DSA = "dsa" # DeepSeek 稀疏注意力的索引 DSA_TAIL = "dsa_tail" # DSA kpool-compress 尾部环行槽 MINIMAX_INDEX_K = "minimax_index_k" MINIMAX_DENSE_KV = "minimax_dense_kv" SWA_RING = "swa_ring" # DeepSeek-V4 unified_kv SWA 环形槽 DSV4_REQUEST_STATE = "c128_state" # 请求级压缩状态 BLOCK_SCALE = "block_scale" # 块缩放量化的 per-block scale BLOCK_SCALE_SWA = "block_scale_swa"这份枚举是「PD 分离必须传递的不只是 KV」的最好证据。 现代模型的推理状态早已不限于 K/V 两个张量:Mamba 的 SSM 状态、滑窗注意力的环形缓冲、稀疏注意力的索引结构、量化 KV 的 per-block scale——这些都是「这个请求继续 decode 所必需的状态」。如果 PD 分离只传 K/V,那么任何非纯 attention 的模型都会在 decode 侧算错。注释里对 DSV4_REQUEST_STATE 的一条尤其说明问题:「DeepSeek-V4 request-scoped compression state; preserve the legacy wire value」——连 wire 值(枚举字符串)都不能随便改,因为它是跨版本兼容协议的一部分。
is_hybrid_mla_backend与mla_compression_ratios:MLA 的后端在 KV 布局上有特殊性(压缩后的 latent 表示),混合 MLA(部分层用 MLA、部分层用标准注意力)需要额外的布局信息。mla_compression_ratios的注释给了取值范围线索:「entries are 0/4/128」,这对应 DeepSeek-V4 的压缩比例,0 表示该层不做压缩。state_dim_per_tensor/state_slice_outer_counts:这两个字段的存在理由是异构 TP——当 prefill 的 attention TP size 与 decode 不同时,一个张量的切分维度也不同,需要显式告诉传输层该怎么切片。
分块传输:一次请求不是一次搬完
长 prompt 的 KV 可能非常大(几十 GB 的量级),不可能等全部算完再一次性搬。SGLang 的做法是按 chunk 分批传,common/utils.py 里的 TransferKVChunk 就是传输的工作单元:
@dataclasses.dataclassclass TransferKVChunk: """Work unit for KV cache transfer from prefill to decode.""" room: int prefill_kv_indices: npt.NDArray[np.int32] index_slice: slice is_last_chunk: bool prefill_aux_index: Optional[int] state_indices: Optional[List] chunk_id: Optional[int] = None num_kv_tokens: Optional[int] = None trace_ctx: ... staging_counted: bool = False wait_event: Optional[object] = None这份结构里藏着几个工程细节:
index_slice:这个 chunk 在整段 KV 索引里占的区间。分块传输意味着「索引数组」也是分片的,每个 chunk 处理prefill_kv_indices[index_slice]。is_last_chunk:最后一块的语义特殊——辅助状态(aux/state)只在最后一块传。这一点在 prefill 的_send_kv_chunk里能看得很清楚:只有在last_chunk=True时才调用self.disagg_metadata_buffers.set_buf(req)并构造各种state_indices。wait_event:注释说是「Early-send: GPU event to synchronize before reading KV」——一个 GPU 事件,用来确保 KV 真的写完了再读。这是异步场景下的正确性保护:SGLang 的 overlap 调度让 CPU 的发送与 GPU 的计算重叠,如果不加这个事件,RDMA 引擎可能在 GPU 还没把 KV 写进显存时就去读,读到脏数据。staging_counted:注释说明「Set when the staging worker first counts this chunk toward the per-room outstanding count; stays set across re-enqueue on a watermark defer」。意思是:这块 chunk 是否已经被计入「本 room 未完成传输数」。因为在暂存(staging)路径下,chunk 可能因为缓冲区水位而被重新入队,重新入队时不能重复计数,否则「传输全部完成」的判断会永远不成立。
prefill 侧的索引构造:从 token 池翻译成页索引
_send_kv_chunk 里最有信息量的是它构造 state_indices 的部分。以「完整 KV 页」为例:
def _full_kv_pages_payload(): kv_indices_full = self.req_to_token_pool.req_to_token[ req.kv.req_pool_idx, :seq_len ] return kv_to_page_indices(kv_indices_full, page_size)这里的思路是:请求在 KV 池里的位置记录在 req_to_token 表里(这正是第五篇 SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环 讲过的映射表),从表里取出前 seq_len 个 token 对应的物理槽位,然后用 kv_to_page_indices 折叠成页索引。传输的粒度是页而不是 token,与 PagedAttention 的内存组织一致。
滑窗注意力则是另一个 payload:
def _swa_payload(): window_size = self.sliding_window_size window_start = max(req.disagg_decode_prefix_len, seq_len - window_size) window_start = (window_start // page_size) * page_size window_kv_indices_full = self.req_to_token_pool.req_to_token[ req.kv.req_pool_idx, window_start:seq_len ] window_kv_indices_swa = ( self.token_to_kv_pool_allocator.translate_swa_indices_for_transfer( window_kv_indices_full) ) return kv_to_page_indices(window_kv_indices_swa, page_size)这段代码把「SWA 只需要窗口内 KV」这件事落到了传输层面:窗口外的 KV 根本不传。window_start 先取 max(前缀长度, seq_len - window_size),再向下对齐到页边界。这既是带宽优化,也是正确性要求——SWA 的 decode 只需要窗口内的历史。
同一段代码里还有 Mamba、DSA tail、QSA pending、SWA ring 等各自的 payload 构造函数。每一种模型架构的额外状态,都有自己的索引翻译逻辑,这正是 StateType 枚举存在的配套实现。
decode 侧的接收与确认
decode 侧的 DecodeTransferQueue(disaggregation/decode.py)负责把 KV 到场的事件接回请求生命周期,其中的 _commit_transfer_to_req 把传输结果提交到请求对象上。真正决定「这个请求能不能进入 running batch」的是 pop_preallocated,它会检查:
if not decode_req.waiting_for_input: continue以及容量约束。这段代码里有一段注释非常重要,它说明了 PD 分离下最棘手的内存问题:
# We need to make sure that the sum of inflight tokens and allocatable tokens# is greater than maximum input+output length of each inflight request# Otherwise it is possible for one request running decode out of memory, while# all other requests are in the transfer queue that cannot be retracted.翻译过来:在途 token 与可分配 token 之和,必须大于每个在途请求的最大输入+输出长度。否则会出现一种死锁式的 OOM——一个请求正在 decode,而其他所有请求都卡在传输队列里无法被抢占回收(因为它们还没真正开始 decode,回收它们没有意义),结果正在 decode 的那个请求需要更多 KV 却无处可要。
这是 PD 分离新引入的一类失败模式。在统一引擎里,内存不足可以通过抢占(retract)一个已有请求来缓解;但在分离架构下,被抢占的请求如果要重新 prefill,代价是重新走一遍跨实例的 KV 传输,成本远高于统一引擎中的本地重算。所以 decode 侧的准入必须更保守:它要预留足够的余量,保证已有请求不会在传输批量到场时被挤爆。
异构 TP 与暂存缓冲:当两侧的布局对不上
前面提到 state_dim_per_tensor 是为了异构 TP 准备的。这一节把这件事展开。
问题:TP 切分不同,目标地址算不出来
当 prefill 用 TP=4、decode 用 TP=1(或 attention DP + TP=1)时,两侧的 KV 内存布局不同。假设 KV head 数是 32:
- prefill 侧每个 rank 持有 8 个 head 的 KV,四张卡各存一段。
- decode 侧由单张卡持有全部 32 个 head。
如果按「prefill 的 rank i 把它的 8 个 head 写到 decode 的对应位置」来做,那么 decode 侧要接收 4 次传输,每次只写入 head 区间的一部分。这是「per-token slice」的朴素做法,在高并发下效率很低:每次传输的数据块小、次数多、目标地址不连续。
方案:GPU 暂存缓冲(staging buffer)
SGLang 的解法是引入一个 GPU 上的暂存缓冲:prefill 侧把各 head 切片先聚合成一整块连续缓冲,做一次大块 RDMA 传输,decode 侧再把这块缓冲散射回正确的 KV 页。
对应实现是 disaggregation/common/staging_buffer.py,里面有成对的 gather/scatter kernel:
def _fused_gather_to_staging_kernel(...): ...def _fused_scatter_from_staging_kernel(...): ...
class StagingBuffer: def get_ptr(self) -> int: ... def get_size(self) -> int: ... def fits(self, required_bytes: int) -> bool: ... def get_gather_stream(self) -> torch.cuda.Stream: ...
class StagingAllocator: def assign(self, required_bytes: int) -> Optional[Tuple[int, int, int]]: ... def free(self, alloc_id: int): ... def get_watermark(self) -> Tuple[int, int]: ...
def gather_kv_head_slices(...): ...def scatter_kv_head_slices(...): ...def gather_all_layers_to_staging(...): ...几个设计点值得注意:
fits与get_watermark:暂存缓冲是一个固定大小的池(官方文档里SGLANG_DISAGG_STAGING_POOL_SIZE_MB默认 4096 MB),不保证每次请求都放得下。fits判断放不下时,chunk 会被延后到下一次(这就是前文staging_counted提到的「watermark defer」的来源)。也就是说,暂存路径下传输的节拍由缓冲区水位控制,而不是单纯由计算进度控制。get_gather_stream:gather 是一个 GPU kernel,跑在独立的 CUDA stream 上,从而与计算流重叠。- 官方文档给出的收益口径:暂存缓冲在高并发下相比默认的 per-token slice 方式有 2–5 倍吞吐提升,并且与同构 TP 基线相差在 5% 以内。这个数据的意义在于:异构 TP 不再是一个「为了省显存而牺牲性能」的妥协方案,它可以在性能基本持平的前提下获得部署灵活性。
- 使用边界:官方文档明确指出暂存缓冲只适用于非 MLA 模型(GQA/MHA),MLA 模型(DeepSeek-V2/V3)不应开启;且两侧 TP 相同时会自动跳过(即使开关打开)。
什么时候会走暂存路径
decode 侧在 init 里决定:
if self.kv_mgr.enable_staging: self.require_staging = ( self.prefill_info.attn_tp_size != 0 and self.prefill_info.attn_tp_size != self.kv_mgr.attn_tp_size )只有两侧 attention TP size 不同才需要暂存——这行判断就是「异构 TP 才用暂存」这条规则的落地。!= 0 的额外条件说明 attn_tp_size 为 0 是一个特殊的哨兵值(可能代表未知或未初始化),需要排除。
失败、回收与所有权:分离架构下最脏的部分
统一引擎里,「释放一个请求的 KV」就是调一次分配器的 free。分离之后,释放变成一个跨进程的两阶段协议,而且中间还有一堆「传输中」的状态需要处理。这一节讲 SGLang 怎么处理。
推迟释放:等 abort 真的排空
BaseKVManager 上有一个开关:
# Opt-in per backend: set True once the prefill acks a drained abort# (ABORT_ACK carrying the sender rank). Without it a hold only ends on timeout.supports_deferred_decode_kv_release: bool = False注释说得很清楚:只有当 prefill 侧确认「这个 abort 已经排空」并回一个 ABORT_ACK 之后,KV 才可以释放;如果不支持这种确认,那么这个「持有」(hold)只能靠超时结束。
为什么需要这个机制?因为一个 abort 到达时,prefill 侧可能有正在传输中的 RDMA 操作。如果 decode 立刻释放了目标 KV 槽,而 RDMA 还在往里写,就会写坏已分配给别人的内存。所以顺序必须是:abort 通知 → prefill 停止发送并排空队列 → prefill 回 ACK → decode 释放。
源码里这套逻辑由三个结构承载:
class AbortNotification(msgspec.Struct, frozen=True): ... # abort 通知class AbortAck(msgspec.Struct, frozen=True): ... # prefill 的确认class DeferredAbortAckState(msgspec.Struct): ...以及一组方法:
def register_deferred_abort_room(self, bootstrap_room: int) -> int: ...def note_abort_ack(self, ...): ...def handle_abort_ack_message(self, msg: List[bytes]) -> bool: ...def is_abort_release_safe(self, bootstrap_room: int, required_acks: int) -> bool: ...def clear_deferred_abort_state(self, bootstrap_room: int) -> None: ...def _send_abort_ack(self, room: int, target: AckTarget) -> None: ...def _maybe_ack_drained_abort(self, room: int) -> None: ...注意 is_abort_release_safe 的签名里有一个 required_acks: int——需要的 ACK 数量不是一个固定值。原因是一个请求的 KV 可能来自多个 prefill rank(TP>1 或 CP>1 时),必须等每一个源 rank 都确认排空,释放才是安全的。这个参数把「多源传输」这件事显式化了。
AckTarget 这个 NamedTuple 与 _prefill_unique_rank、_send_abort_acks 的存在,进一步说明 ACK 是多播的:prefill 侧要把 ACK 发给所有关心这个 room 的 decode rank。
一个请求的 KV 可能分布在多个源
这一点值得单独强调,因为它是理解整个协议复杂度的关键。我们回看 CommonKVReceiver._setup_bootstrap_infos 的结构:
for target_cp_rank in self.target_cp_ranks: ... for target_tp_rank in self.target_tp_ranks: for target_pp_rank in reversed(self.target_pp_ranks): bootstrap_info = self._get_bootstrap_info_from_server( self.prefill_dp_rank, target_cp_rank, target_tp_rank, target_pp_rank)三层嵌套循环:CP × TP × PP。一次请求的 KV 会从这么多个 prefill rank 上分别收取。这解释了为什么:
required_dst_info_num与required_prefill_response_num是数量而不是布尔——decode 侧要清点「多少个源都应该响应我」。- MLA 后端下有一段特殊的
is_dummy标记逻辑:
if self.kv_mgr.is_mla_backend: # For MLA: target_tp_rank is the selected real rank, others are dummy ranks bootstrap_info["is_dummy"] = not bool( target_tp_rank == self.target_tp_rank or self.target_tp_rank is None)else: # For non-MLA: all target_tp_ranks are selected real ranks bootstrap_info["is_dummy"] = FalseMLA 的 KV 是压缩后的 latent,按 head 切分没有意义(MLA 的 KV 已经降维),所以只有一个 TP rank 持有真正的数据,其他 rank 是 dummy 参与者(只参与集合通信、不参与数据搬运)。而非 MLA(GQA/MHA)下每个 TP rank 都持有一部分真实 KV,全部是 real rank。这是 MLA 与标准注意力在 PD 传输上最本质的区别,也是为什么 KVArgs 里会有 is_hybrid_mla_backend 这个字段。
传输失败与重算回退
CommonKVManager 里有一段很特殊的机制:
def _ensure_prefill_recompute_executor(self, ...): ...def _get_prefill_recompute_session(self) -> requests.Session: ...def _resolve_rebootstrap_prefill_url(self, ...): ...def submit_prefill_recompute(self, ...): ...def _fail_prefill_recompute(self, ...): ...def _run_prefill_recompute(self, ...): ...「prefill recompute」——当 KV 传输失败、或者 decode 侧的某种恢复路径需要重新拿到 KV 时,decode 可以请求 prefill 重新算一遍。这就是 KVArgs 里 prefill_http_port 字段的用途:decode 拿着这个端口,向 prefill 的 HTTP 接口提交一个重算请求。
对应地,prefill 侧在 _init_kv_manager 里会启动一个 HTTP 服务来接收这类请求。这套机制的存在意味着:PD 分离把「本地重算」这样一个廉价操作,变成了一个跨实例的远程调用。这也是前面讲 decode 侧准入要保守的原因——回退路径比统一引擎贵得多,所以要尽量避免走到回退。
角色切换:不重启进程就能改变身份
disaggregation/role_switch.py 提供了另一个有意思的能力:
class PdRoleSwitchRestart(Exception): ...def run_event_loop_supervisor(...): ...def handle_pd_role_switch(...): ...def _reject_reason(scheduler: Scheduler, new_role: str) -> Optional[Tuple[str, bool]]: ...def _current_kv_manager(scheduler: Scheduler): ...def teardown_disaggregation(scheduler: Scheduler) -> None: ...def _release_prefix_cache_for_role_switch(scheduler: Scheduler) -> None: ...运行时角色切换指的是:一个实例原本是 prefill,可以在运行时切换成 decode(或反过来),而不需要重启进程。它的实现方式是:
- 检查当前状态是否允许切换(
_reject_reason返回拒绝原因)。 - 拆掉当前的 disaggregation 资源(
teardown_disaggregation)——这就是BaseKVManager.teardown()与supports_role_switch标志的用途,注释明确说「release transfer resources; the scheduler owns the KV pool」——只释放传输资源,KV 池归调度器管,不动。 - 释放前缀缓存(
_release_prefix_cache_for_role_switch)——因为角色变了,缓存的所有权语义也变了。 - 抛出
PdRoleSwitchRestart让事件循环重启到一个新角色。
这个能力的运维价值很直观:流量潮汐。白天 prefill 压力大、夜里 decode 压力大时,可以动态调整两组的实例比例,而不是固定配置。代价是切换期间实例不可用,且对传输资源与缓存的处理必须干净。
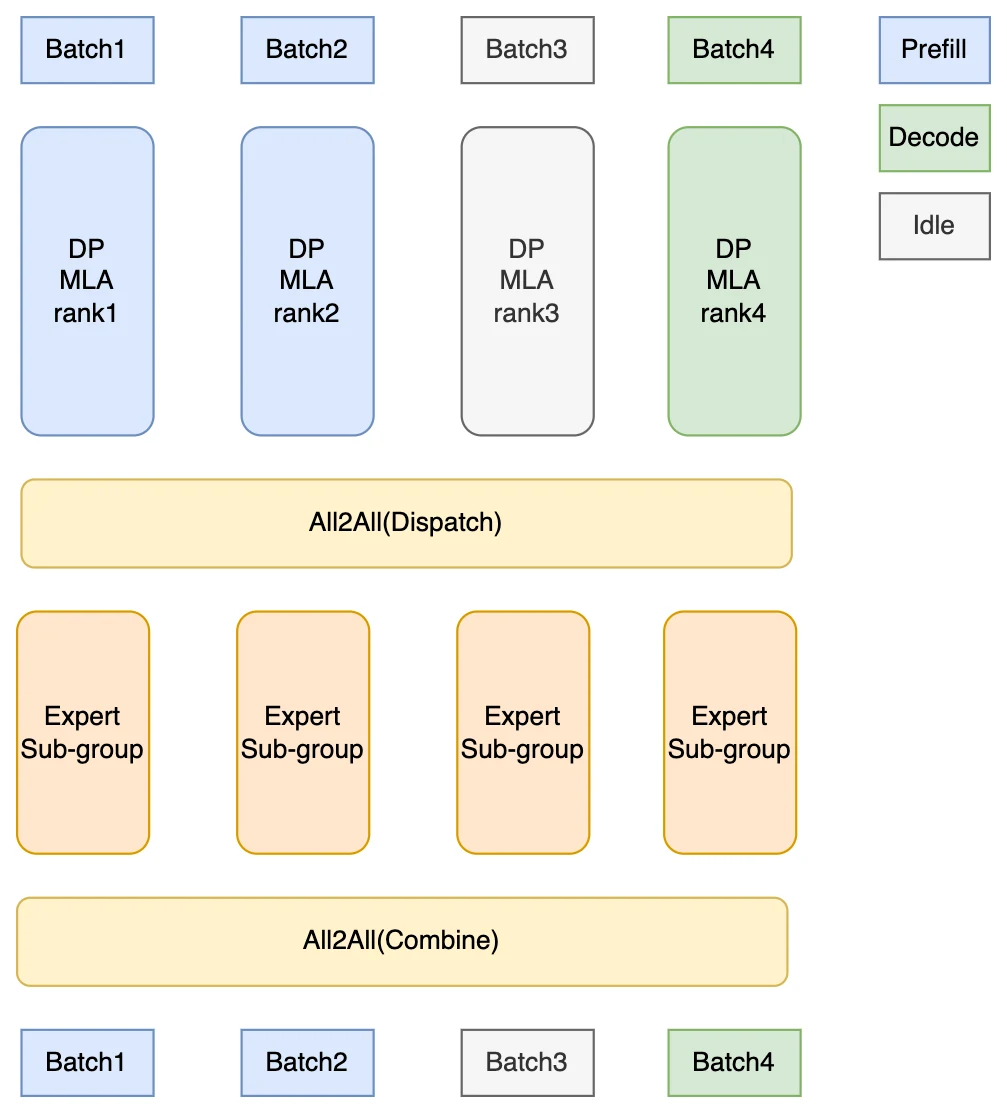
图源:SGLang 官方仓库 docs/images。DP Attention 是 PD 分离要解决的第二个问题(DP imbalance)的来源。这张图展示 attention 在数据并行下如何切分——当不同 DP rank 的负载不同时,跨 rank 的同步会拖慢整个批次,这正是把两个阶段拆开后能消除的干扰。
与投机解码、前缀缓存的交互
PD 分离不是孤立特性,它与本系列前面讲过的模块有交叉。这一节梳理这些交叉点,因为它们往往是实际部署出错的地方。
与投机解码:额外的 KV 状态
第十一篇 SGLang 源码完全拆解(十一):投机解码——草稿生成、批量验证与 token 接受如何接进同一条前向 讲过的草稿 KV,在 PD 分离下也要传输。源码里为此准备了专门的路径:eagle_disaggregation.py、dflash_disaggregation.py 的存在说明每种投机算法都有自己的分离适配。KVArgs 里的 num_draft_entries、hidden_kv_layers、draft_kv_layers 字段就是为草稿 KV 准备的:
# Only used of npu, for decode total kv layershidden_kv_layers: intdraft_kv_layers: intnum_draft_entries: int = 0而 dsv41_spec_layout 的一致性校验(前面注册时看到的)说明:投机解码的 KV 布局必须在 prefill 组内一致,否则 decode 无法正确解析收到的数据。
与前缀缓存:命中的部分不再传
disaggregation_decode_enable_radix_cache 让 decode 侧也维护 RadixAttention 前缀树。逻辑是:如果这次请求的前缀在 decode 侧已经有缓存(比如另一个用户问过同样的问题),那这部分 KV 根本不需要从 prefill 传——decode 侧已经有现成的。这直接节省了网络带宽。
但它的互斥列表很有信息量:不兼容 HiSparse、投机解码、fake 后端。原因是这几者都会改变 KV 的布局或所有权语义,使得「命中的前缀对应的 KV 页」与「传输的目标页」之间的映射不再简单。这提醒我们:PD 分离下的前缀缓存不是加一个缓存那么简单,它要求整套页映射在两个实例间保持一致。
KV 校验:传输是否真的对
disaggregation/checksum.py 与 --disaggregation-enable-kv-checksum 提供了传输正确性校验。前文 send_kv_chunk 里的这段就是它的调用点:
computer: Optional[KvChecksumComputer] = self.kv_checksum_computerif last_chunk and computer is not None: if is_health_check_req(req): value = 0 else: if end_idx is None: end_idx = min(req.extend_end, len(req.origin_input_ids)) page_indices_gpu = page_indices_for_request(self, req, end_idx) state_indices = state_indices_for_request(self, req, end_idx) value = computer.compute(page_indices_gpu, state_indices) self.disagg_metadata_buffers.set_kv_checksum(req, value)只在最后一块计算校验值,然后通过 metadata buffer 传给 decode。decode 侧收到后可以重算并比对。这是一个「默认关闭、出问题才开」的诊断开关——因为校验本身要读一遍全部 KV,有成本。
传输指标
KVTransferMetric 提供了可观测量:
@dataclasses.dataclassclass KVTransferMetric: # Backends that cannot isolate transfer latency can leave this as None. transfer_latency_s: Optional[float] = None # Backends that cannot isolate allocation wait latency can leave this as None. alloc_latency_s: Optional[float] = None transfer_total_bytes: Optional[int] = None三个指标对应三段可独立优化的时间:传输延迟(网络)、分配等待延迟(decode 侧容量竞争)、总字节数(数据量本身)。字段可以是 None——注释说明「无法隔离该延迟的后端可以留空」,这是一个诚实的接口设计:承认不是所有后端都能提供完整指标,而不是用 0 假装。
部署要点与工程取舍
把官方文档里的部署建议与源码对照,可以提炼出几条实操结论。
单机 Llama 的最小部署
官方给出的单机最小示例(三个进程:prefill、decode、router):
python -m sglang.launch_server \ --model-path meta-llama/Llama-3.1-8B-Instruct \ --disaggregation-mode prefill \ --port 30000 \ --disaggregation-ib-device mlx5_roce0
python -m sglang.launch_server \ --model-path meta-llama/Llama-3.1-8B-Instruct \ --disaggregation-mode decode \ --port 30001 \ --base-gpu-id 1 \ --disaggregation-ib-device mlx5_roce0
python -m sglang_router.launch_router --pd-disaggregation \ --prefill http://127.0.0.1:30000 --decode http://127.0.0.1:30001 \ --host 0.0.0.0 --port 8000三个要点:两边的 --disaggregation-ib-device 必须指向同一张 RDMA 网卡(这里都是 mlx5_roce0);--base-gpu-id 1 把 decode 放到第二张卡上;router 用 --pd-disaggregation 模式,分别指定 prefill 与 decode 的地址。router 是必需的——客户端只跟 router 说话,router 决定每个请求走哪对实例。
多机 DeepSeek:并行度可以分开配
多机示例里 prefill 与 decode 都配了 --tp-size 16 --attn-dp-size 8 --moe-a2a-backend deepep,但 decode 侧额外指定了 --max-running-requests 128。这个差别印证了前面的分析:decode 侧的内存管理更保守、更受 KV 容量约束,所以要显式限制并发请求数来保证不会 OOM。而 --dist-init-addr 让每个实例组内部用各自的分布式初始化地址——prefill 组和 decode 组是两个独立的分布式作业。
NVLink 传输:同一台机器内不必走 RDMA
官方文档给出了几组环境变量:
# NVL72 部署(推荐)export SGLANG_MOONCAKE_CUSTOM_MEM_POOL=NVLINKexport MC_FORCE_MNNVL=True
# 单机 A100/H20/H100 等(推荐)export SGLANG_MOONCAKE_CUSTOM_MEM_POOL=INTRA_NODE_NVLINKexport MC_INTRANODE_NVLINK=trueSGLANG_MOONCAKE_CUSTOM_MEM_POOL 支持 NVLINK、BAREX、INTRA_NODE_NVLINK。同一台机器内用 NVLink 传 KV,比绕一圈 RDMA 快得多——但文档也诚实注明「auxiliary data transfer will still use TCP as a temporary workaround」,即辅助数据暂时还走 TCP。这是「主路径优化了、边角路径还没优化」的真实工程状态。
传输队列与线程池
两个关键的可调参数:
SGLANG_DISAGGREGATION_THREAD_POOL_SIZE:每个 TP rank 的传输工作线程总数。默认是int(0.75 * os.cpu_count()) // 8,并被限制在 [4, 12] 之间。这个默认值的设计逻辑很直接:从 CPU 核数估算一个既能压满网卡又不会线程打架的规模。SGLANG_DISAGGREGATION_QUEUE_SIZE(默认 4):并行传输队列数。解释原文是「来自多个 decode 实例的 KV 传输请求会被分片到这些队列里,从而共享线程与传输带宽;如果设为 1,则按 FCFS 逐个传」。这直接说明了一个潜在的公平性问题:多个 decode 实例同时要 KV 时,prefill 侧的传输资源是共享的,队列数决定了并发度与公平性。
分块传输的上限
SGLANG_MOONCAKE_MAX_TRANSFER_BATCH_INDICES(默认 0,关闭):限制一次同步全层传输所表示的 KV 索引数。设为正值时,会把大索引数组切成有序的子批,再形成连续地址区间。注释里那句「The custom-memory-pool layerwise path is unchanged」说明这个开关只对非 custom-memory-pool 的路径生效。它的用途是控制单次传输的粒度——太大则一次传输时间长、阻塞别的请求,太小则次数多、开销大。
小结
这一篇把 SGLang 的 PD 分离拆完了。核心结论有六条:
-
动机是两个阶段资源画像不同,且互相干扰。 Prefill 是算力瓶颈、Decode 是带宽瓶颈;统一调度会造成 prefill 打断 decode(Prefill Interruption)与 DP attention 失衡。分离后两侧可以各自选择最优并行度与容量配比。代价是引入了跨机传输、跨进程握手与更复杂的所有权账本。
-
DisaggregationMode是一个贯穿全进程的角色开关。 它决定 Scheduler 挂哪个 mixin、有哪些队列、跑哪个事件循环。角色相关行为以 mixin 形式插入,主循环骨架不变。传输后端可插拔(mooncake/nixl/mori/ascend/fake),fake后端用于无 RDMA 环境下跑通协议。 -
bootstrap server 是寻址中心,注册的是完整并行拓扑。 每个 prefill rank 上报 TP/CP/DP/PP 坐标、IP、ZMQ 端口、page_size、kv dtype;就绪判断是四个维度规模的乘积。注册时做一致性校验(投机 KV 布局、分配策略),不一致直接 400——把错误暴露在启动期而非运行期。
-
握手协议以
bootstrap_room为主键,状态机是五态的KVPoll。WaitingForInput这个中间态是分离架构特有的:decode 必须先在自己的 KV 池里分配目标页并把页索引告诉 prefill,prefill 才能写。_owns_bootstrap_room提供幂等性保护,room % num_dp_ranks让 decode 不查表就能推断源 rank。等待 prefill 与等待传输用的是两段独立的超时预算。 -
数据面委托给外部引擎,SGLang 只做控制面。
KVArgs用「地址 + 长度 + 项长 + 页大小」描述传输目标,引擎不认识 KV 概念。StateType枚举证明要传的不只是 K/V——Mamba 状态、SWA 滑窗、DSA 索引、量化 block scale 都是必需的推理状态。长 prompt 按TransferKVChunk分块传,辅助状态只在最后一块传;wait_event保证 GPU 写完再读;staging_counted防止重新入队时重复计数。 -
失败回收是跨进程两阶段协议。 abort 要等 prefill 回
ABORT_ACK才能释放目标 KV,required_acks的数量取决于源 rank 数(TP×CP×PP 三层嵌套)。MLA 只有一个真实 TP rank(其余 dummy),非 MLA 全部是 real rank。prefill recompute提供远程重算回退——这也解释了为什么 decode 准入必须保守:pop_preallocated里那条「在途 + 可分配 token 之和必须大于最大输入输出长度」的约束,防的是传输队列不可抢占导致的死锁式 OOM。
从系列视角看,这一篇把「单实例内部」的讨论推进到了「多实例之间」。第十二篇之后,SGLang 待讲的模块里与分离架构关系最近的是 LoRA 与多 LoRA 批处理(多 LoRA 请求在分离下如何分组、adapter 如何在各实例间同步)、多模态与 VLM 输入链路(encoder 本身就是第三条可分离的流水线,disaggregation/encoder/ 目录下已有 grpc/http 两种 server 实现),以及 权重加载与量化后端。
下一篇将进入「LoRA 与多 LoRA 批处理」这条线:多 LoRA 请求如何在同一个批次里共存、adapter 的内存如何组织、以及它与 PD 分离、前缀缓存、CUDA Graph 这些模块的相互作用。
参考资料
- SGLang 官方 GitHub 仓库
- SGLang 官方文档:PD Disaggregation
- SGLang 分离传输基础抽象源码(disaggregation/base/conn.py,固定提交)
- SGLang 分离公共连接与 bootstrap server 源码(disaggregation/common/conn.py,固定提交)
- SGLang 分离工具与角色枚举源码(disaggregation/utils.py,固定提交)
- SGLang 分离传输工作单元源码(disaggregation/common/utils.py,固定提交)
- SGLang prefill 侧分离调度源码(disaggregation/prefill.py,固定提交)
- SGLang decode 侧分离调度源码(disaggregation/decode.py,固定提交)
- SGLang GPU 暂存缓冲源码(disaggregation/common/staging_buffer.py,固定提交)
- SGLang PD 角色切换源码(disaggregation/role_switch.py,固定提交)
- SGLang Mooncake 分离后端源码(disaggregation/mooncake/conn.py,固定提交)
- SGLang 分离配置字段源码(arg_groups/fields/disagg.py,固定提交)
- LMSYS 博客:Deploying DeepSeek with PD Disaggregation and Large-scale Expert Parallelism on 96 H100 GPUs
- Mooncake 官方仓库:面向 LLM 推理的分离式 KV Cache 传输引擎
- DistServe 论文:把 Prefill 与 Decode 拆开、按 Goodput 调度(arXiv:2401.09670)
- SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环
- SGLang 源码完全拆解(六):Overlap Scheduler 如何重叠 CPU 调度与 GPU 执行
- SGLang 源码完全拆解(十一):投机解码——草稿生成、批量验证与 token 接受如何接进同一条前向
- DistServe 完全拆解:拆开 Prefill 与 Decode,按 Goodput 调度大模型推理
- KV Cache Offloading 完全拆解:把显存装不下的历史塞进 CPU、SSD 与远端内存
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



