


TensorRT-LLM 源码完全拆解(七):KV Cache 的内存布局与量化存储——NHD/HND、FP8 scale 与 MLA latent 池如何决定内核访存
系列进度与本篇定位
前六篇把 TensorRT-LLM 的推理路径从服务入口一路读到了注意力内核门口。第一篇建立仓库地形;第二篇走完 create_py_executor 装配线与 PyExecutor 的单步闭环;第三篇钻进调度器的准入算术与微批选择;第四篇打开 KV 账本,讲清 KVCacheManager 的两级池、块表构造与前缀复用树;第五篇讲 PyTorchModelEngine 如何把动态请求拼成静态形状的输入缓冲;第六篇进入注意力后端,看 AttentionMetadata.prepare() 如何把块句柄翻成各后端要的块表、页索引与块偏移数组。
第六篇结尾留下一个明确的口子:那一篇讲的所有索引数组——paged_kv_indices、kv_cache_block_offsets、kv_block_ids_per_seq——都只是块的编号或偏移,它们最终都要乘上 stride 才能变成显存地址。而 stride 从哪来?取决于块池在显存里到底怎么排。这一篇补的就是这一段:KV 池的物理布局、K/V 分池还是合池、NHD 与 HND 两种维序的 stride 差异如何决定内核的访存模式、量化缓存(FP8/INT8)的数值怎么存、scale 因子放在哪里、以及 MLA 的 latent 池为什么只有一份张量却要同时满足 K 和 V 的读取。
这里要回答五个问题:
- 第四篇说块是”固定大小的页”,那这一页在显存里到底是几个张量、几维、什么维序?为什么同一个模型在 Hopper 和 Blackwell 上可能用不同的维序?
- FP8/INT8 的 KV 缓存,一个 token 的 K 向量只占原来一半甚至四分之一的空间,那 scale 因子(缩放系数)存在哪?为什么不能简单地”存 int8 再乘回来”?
- 常量缩放(per-tensor scale)与逐 token / 逐头缩放(per-token-head scale)在精度和访存上各付什么代价?内核要不要为它们走不同的路径?
- 滑动窗口与多池(VSWA)下,块池是怎么切分的?为什么 Gemma 这类模型必须分池?
- MLA(Multi-head Latent Attention)的 KV 缓存为什么只有一份 latent 张量,却能同时扮演 K 和 V?它和普通 GQA 的缓存布局差在哪?
池的形状:一个张量装下所有层
第六篇结尾的那个”乘法”的答案藏在 C++ 侧的 KVCacheBlockPool 结构里。先把它的字段读出来:
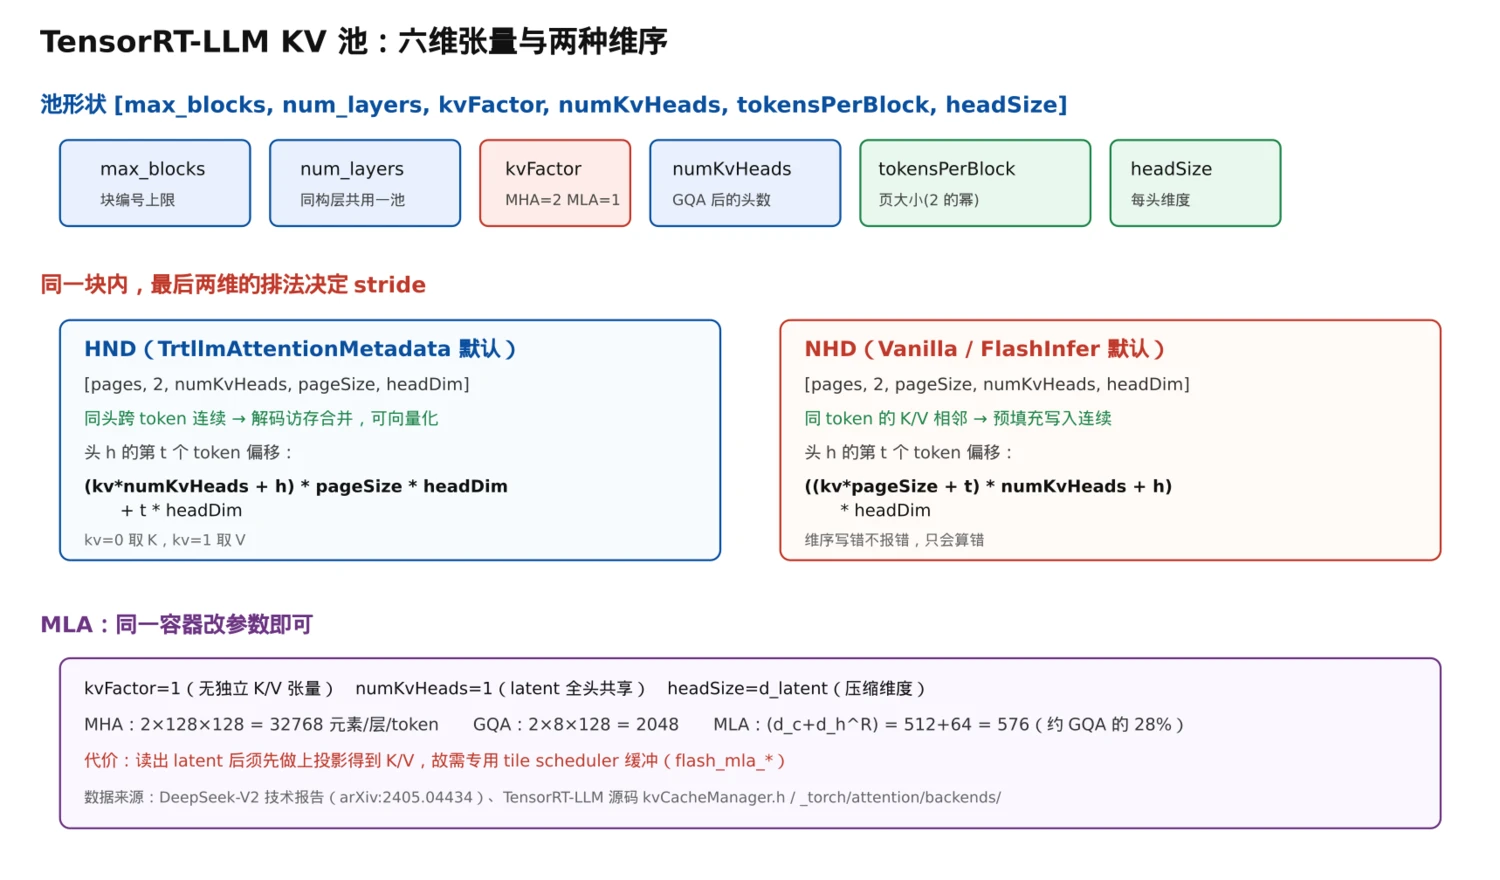
上图把本篇的核心要素画在一起:池的六个维度各代表什么、HND 与 NHD 下同一个头的第 个 token 偏移如何换算、以及 MLA 如何只靠改三个参数就复用同一套容器。数据来源:TensorRT-LLM 源码 cpp/include/tensorrt_llm/batch_manager/kvCacheManager.h(池形状与 KVCacheBlockPool 注释)与 DeepSeek-V2 技术报告(MLA 的 取值)。
class KVCacheBlockPool{public: SizeType32 numLayers; // 共享这个池的层数 SizeType32 kvFactor; // K/V 因子:通常 2,MLA 为 1 SizeType32 numKvHeads; // 该池的 KV 头数(GQA 之后) SizeType32 sizePerHead; // 每头维度 head_dim SizeType32 tokensPerBlock;// 一个块装多少 token(页大小,2 的幂) SizeType32 blockSize; // = numKvHeads * sizePerHead * tokensPerBlock
runtime::ITensor::SharedPtr primaryPtr; // 快存储(显存) runtime::ITensor::SharedPtr secondaryPtr; // 慢存储(宿主,用于卸载)
bool containsBlockScales; // FP4 缓存的第二级 scale 池 bool containsIndexerKCache; // 稀疏注意力的索引器 K 缓存(DSA 这类) bool layerFirstLayout; // 线性注意力的循环状态用 {layers, blocks, ...} 排布};这个结构本身就是一篇文章的提纲。先看最反直觉的一条:一个池张量装下了所有层。WindowBlockManager 的注释写得很清楚:
Each pool has shape [max_blocks, num_layers, 2, num_kv_heads, tokens_per_block, head_size],where num_layers refers to the number of layers with the same num_kv_heads that share that pool.也就是说,池张量是六维的,第二维是层。为什么会这样设计?
原因是:块的元数据是所有层共享的。注释里接着说:“The metadata of KVCacheBlocks is shared between layers, so each block spans all of the managed pool”。第四篇讲的块句柄(block id)是一个全局整数,它不对应某一层,而对应每个池里的同一段偏移。当你为一条请求分配块 17,意味着第 0 层、第 1 层……第 numLayers-1 层的这个位置都归你了。这样前缀复用树、空闲队列、引用计数只需要维护一套块编号,而不是每层一套——账本复杂度从 降到 。
代价是分池的粒度必须由层间差异决定:只有 KV 头数相同、注意力窗口大小相同的层,才能塞进同一个池。一旦某个模型的层不满足这个条件,就必须拆池。
为什么 GQA 的池会更小
numKvHeads 这个字段直接对应 MQA/GQA 的内存收益。把池张量的每块字节数算出来:
以 Llama-3-8B 为例:32 个 query 头、GQA 后 8 个 KV 头、head_dim=128、tokens_per_block=64、BF16(2 字节)。每块每层:
32 层就是 8 MiB 一块(用 BF16)。如果换成 MHA(32 个 KV 头),这个数字直接乘 4 变成 32 MiB。所以官方文档里那句”KV cache will create blocks with only enough space to store state for the discrete query head groups”不是修辞——池的宽度就是按 KV 头数开的,MQA 只有一组,GQA 是折中,MHA 每头一组。省下的显存是实打实的四倍。
分池:VSWA 与”窗口大小决定池边界”
官方文档给了一句很关键的话:
A separate pool is created for each combination of attention window size and number of heads to support variable attention window size and optimization techniques like GQA. If more than one pool is created, available memory is divided among the pools. The fraction to assign to each pool is determined during initialization and is static.
把块池的切分规则总结成一句话:池的键是(注意力窗口大小,KV 头数)这个二元组。Gemma 这类”每隔一层用滑动窗口、每隔一层用全局注意力”的模型(VSWA,Variable Sliding Window Attention),滑窗层和全注意力层的窗口不同,因此必然落进不同的池。GPT-OSS 也是同样的结构(sliding window on every other layer)。
这里有一条工程上要注意的静态分配问题:池之间的显存比例在初始化时就定死,运行中不能调整。文档坦率地承认了这一点:
This is not optimal and we are working on providing a better solution.
为什么不能动态调?因为池张量是一整块连续显存,CUDA Graph 捕获的是它的基址;要改比例就得重新分配张量、重新捕获图。这和第五篇讲的”地址必须稳定”是同一条约束的延伸。新版管理器(V2)引入了 pool_ratio 参数,为每个层组配一个归一化的配额权重,但仍然要求权重在创建时给定。对运维的启示很直接:如果你知道自己的负载里长上下文占比高、滑窗层命中率低,就得在启动时把权重往全注意力池倾斜,事后改不了。
池的初始化:块数是怎么算出来的
块数不是凭经验拍的,而是从两个输入反推出来的:显存预算与块大小。文档给出的规则是:
Property
free_gpu_memory_fractionis a ratio > 0 and < 1 that specifies how much of free GPU memory should be allocated to KV cache. The default is 90% (ratio of 0.9). Ifmax_tokensis also set, KV cache will determine how much memory is needed to holdmax_tokensand will allocate the lesser ofmax_tokensandfree_gpu_memory_fraction.
翻译成计算过程:
其中 bytesPerBlock 就是前面算过的每块字节数(层数 × K/V 因子 × KV 头数 × 页大小 × 每头维度 × 每元素字节)。Python 侧的实现是一个直白的整除:
blocks_in_primary_pool = int(max_tokens // tokens_per_block)一个常见误解是”max_tokens 设多大就真的会占那么多显存”。不是——两个上限取较小者。把 max_tokens 设成 100 万而显存只够 20 万 token 时,框架不会 OOM,而是安静地按 20 万分配;反过来显存很富裕而 max_tokens 很小,则按 max_tokens 分配。这条规则的含义是:max_tokens 是一个”不超过”约束,不是”至少要”约束。想验证实际分配了多少,应该去看启动日志里池的块数,而不是相信自己设的数字。
还有两条容易踩的约束:
tokens_per_block必须是大于 1 的 2 的幂(文档原文:It must be a power of two greater than 1)。原因和第六篇讲过的”形状分桶”同源:块大小是显存分配与地址计算的基本粒度,取非 2 的幂会让乘法/移位优化失效,也会让前缀复用树的键(按块哈希)边界变得难以对齐。- 块的驱逐不是纯 LRU,而是”优先级 + LRU”:每个块带一个 0 到 100 的优先级(100 最重要),必须先把最低优先级的块全部驱逐完,才轮到下一个优先级;同一优先级内才按最近最少使用排序。默认优先级是 35,而
TokenRangeRetentionConfig允许对指定 token 区间(例如”第 10 到第 61 个 token”)单独指定优先级与生效时长。这条机制的设计意图很直白:系统提示词与文档开头的部分几乎每轮都被复用,理应比结尾的闲聊内容更难被驱逐——而纯 LRU 无法表达”这段比其他段重要”。
明白了块数怎么来、优先级怎么定,回头再看”池间比例静态分配”就不会觉得是偷懒了:初始化时一次性把显存按预算切块、建树、发布地址,之后运行期只做”分配/回收/改内容”三件事——所有会改变张量元信息的操作都被推到启动阶段。这条原则贯穿 TensorRT-LLM 的整个 KV 子系统。
NHD 与 HND:同一个池的两种维序
池张量里还有一个维度没讲:tokens_per_block 和 head_dim 谁在前。interface.py 把这个选择显式暴露成 kv_layout:
# Paged KV-cache block layout:# NHD: [max_num_pages, 2, page_size, num_kv_heads, head_dim]# HND: [max_num_pages, 2, num_kv_heads, page_size, head_dim]kv_layout: Literal["NHD", "HND"] = "HND"注意默认值是 HND。N 是 token 数(page size 那一维),H 是 KV 头数,D 是 head_dim。两种排法意味着同一个块的字节内容在显存里以完全不同的顺序排列。
要理解这个差异为什么重要,得回到内核的访存模式。注意力内核在解码阶段做的是:对当前这一个 query token,遍历 KV 序列里所有历史 token,逐个算 。它会以头为单位切分工作:每个 warp / 每个线程块负责若干个头,沿着序列方向滑动。
- HND 布局下,同一个头的连续 token 在显存里是相邻的(
[head, token, dim])。内核处理某个头时,读出来的是一段连续内存,天然满足合并访存(coalesced access),L2 命中率高,还可以直接向量化读取(一次读 16 字节 = 8 个 BF16 元素)。 - NHD 布局下,连续 token 之间隔着
num_kv_heads × head_dim个元素([token, head, dim])。同一个头跨 token 读的时候,步长是散的。
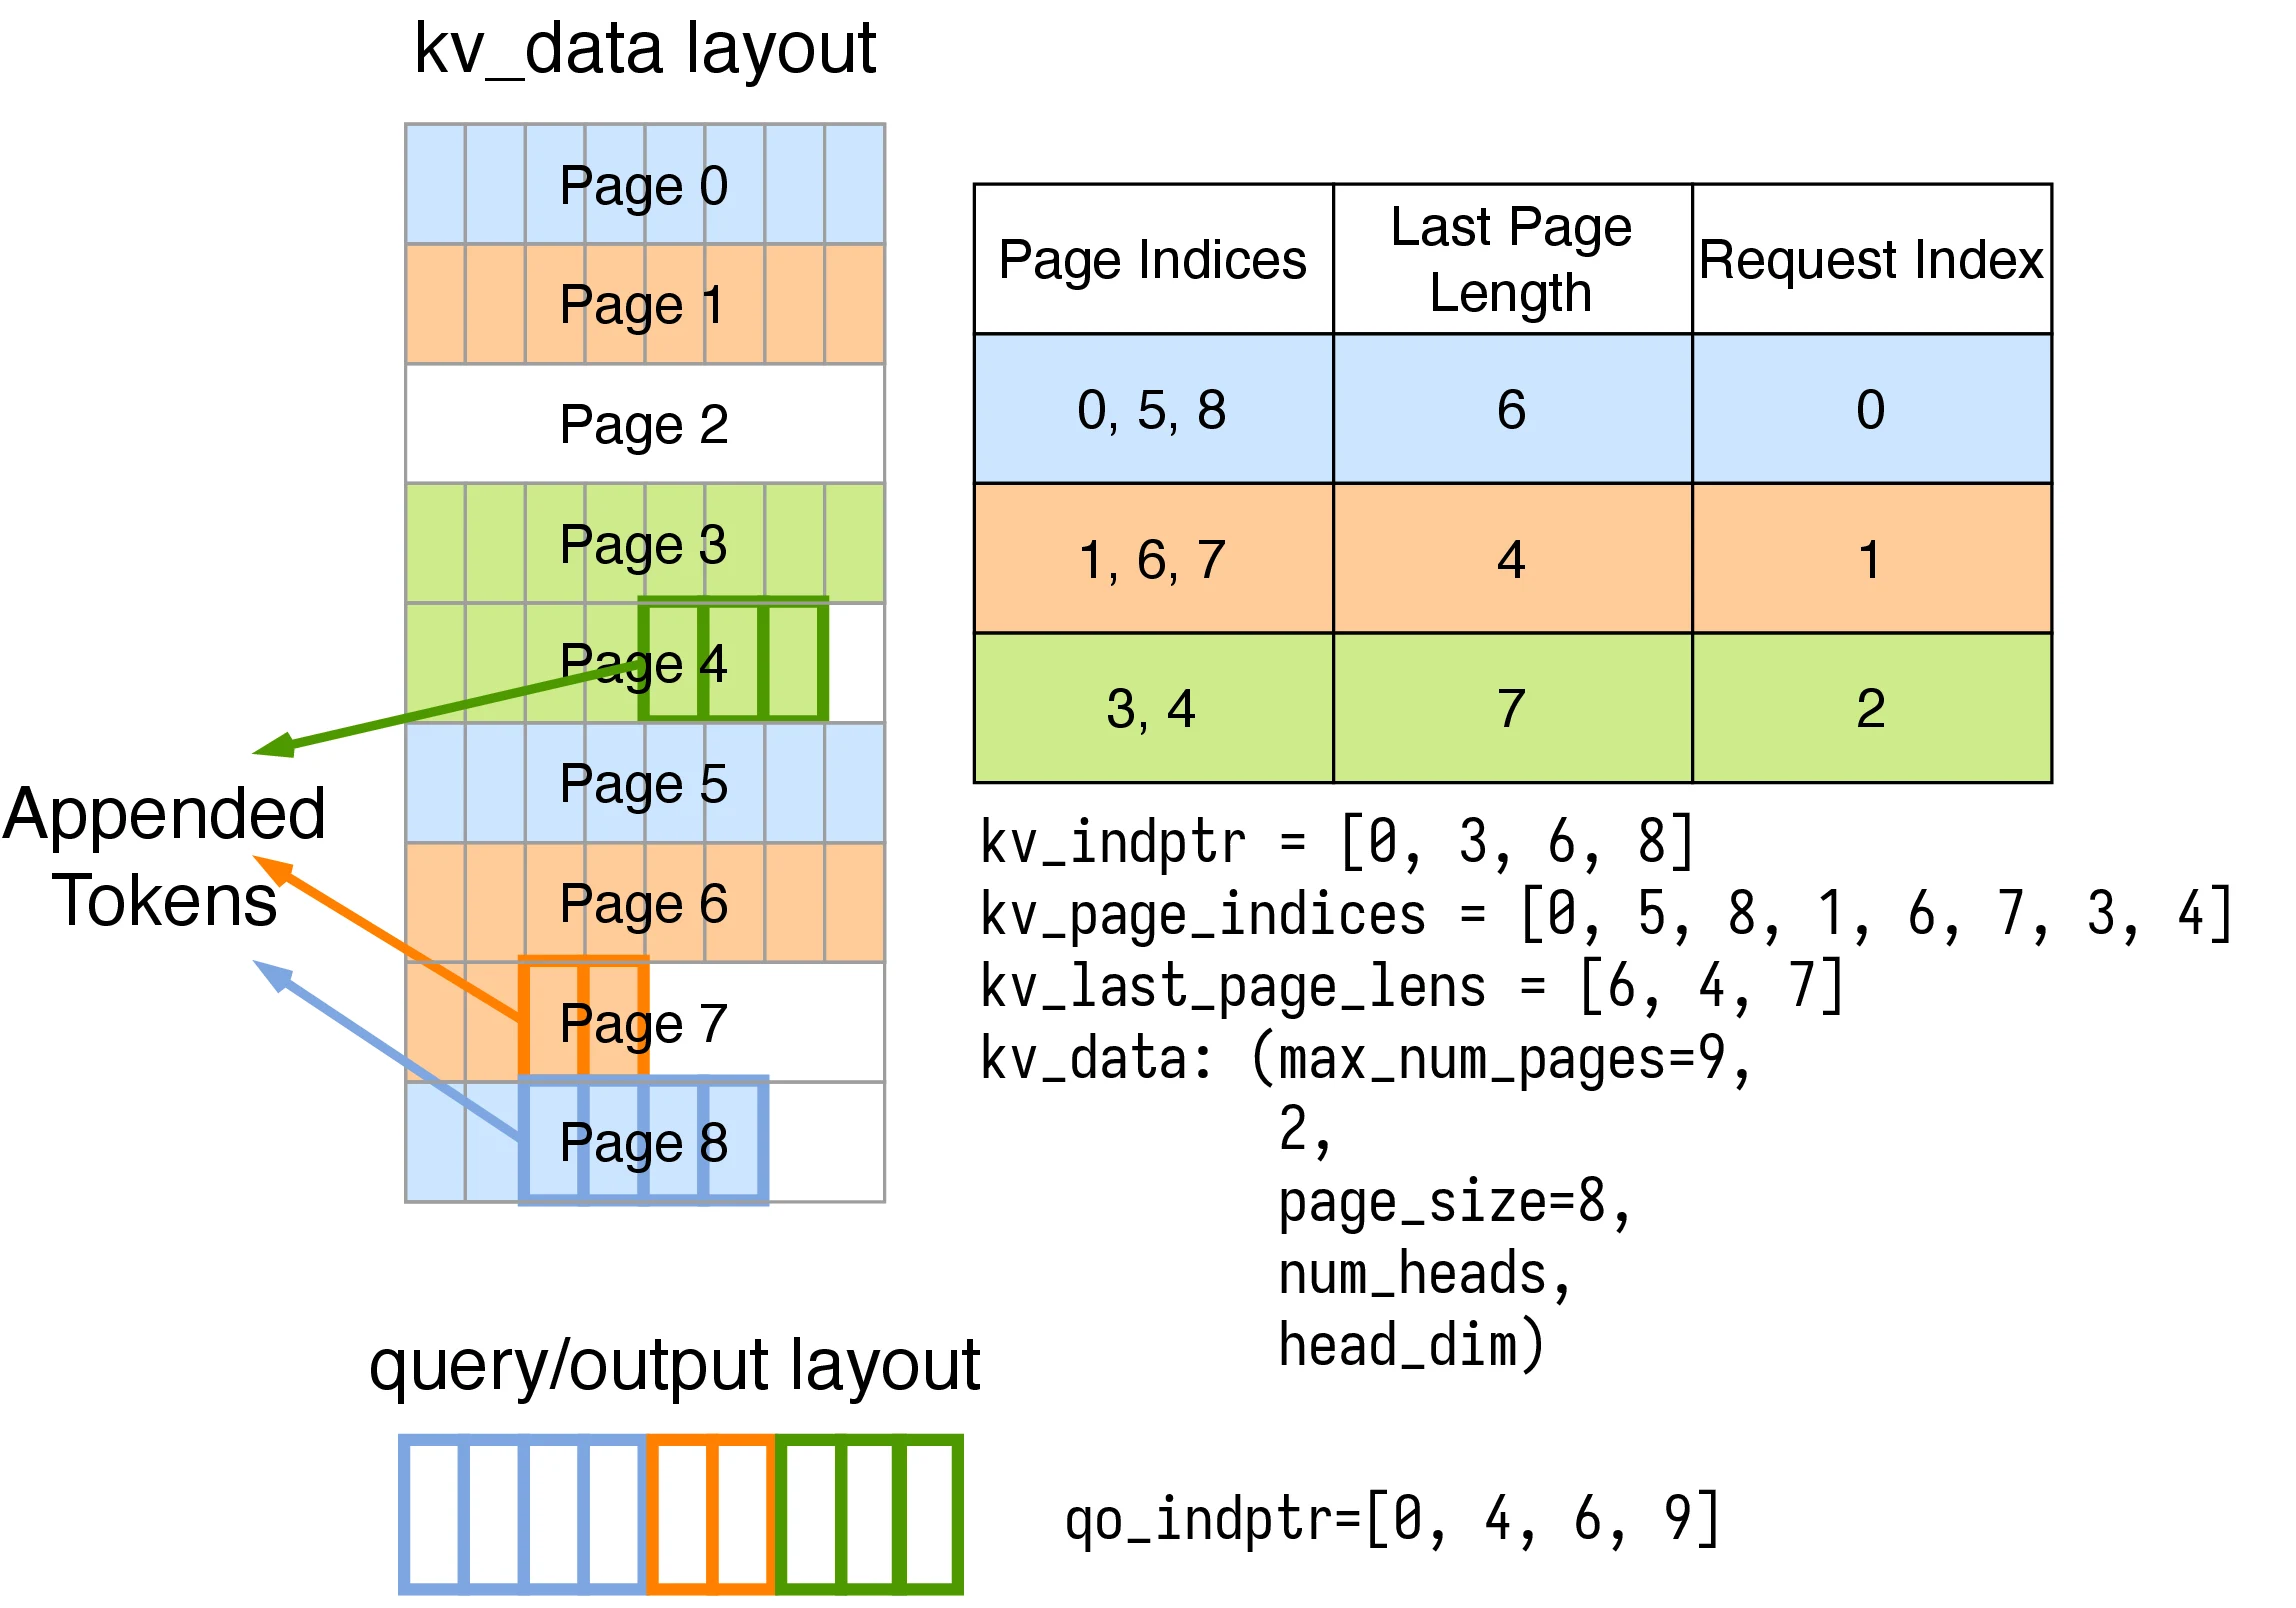
上图是 FlashInfer 官方教程给出的分页 KV 布局示意。它画的是逻辑页到物理页的映射这一层——也就是第六篇讲的页表三件套(paged_kv_indices / paged_kv_indptr / paged_kv_last_page_len)承担的工作;而本篇要补的是再往下一层:一个物理页内部的元素如何排列。两者叠起来才构成完整的地址换算。图片来源:FlashInfer 官方文档 KV-Cache Layout。
那为什么还要保留 NHD?两个原因。第一,prefill 阶段的访存模式相反:预填充要处理整段序列的 token,写 KV 时是按 token 顺序生成的,NHD 让”一条 token 的 K 和 V 挨在一起”,写入更连续;许多 FlashAttention 风格的内核与 FlashInfer 的页表约定就是按 NHD 组织的。第二,兼容性与历史:早期内核、部分量化内核、以及 MLA 的 latent 表示是按 NHD 写就的。所以这不是”哪个更先进”,而是哪个更匹配当前内核的访存模式。
第六篇讲过 VanillaAttention 后端把 kv_layout 写死成 "NHD"(vanilla_attn.py 第 68 行:self.kv_layout = "NHD")。FlashInfer 后端则两种都支持,并且把差异表达成一行”轴位置”判断——这是整个代码库里对维序语义最短的注释:
def _slice_paged_kv_cache_heads( paged_kv_cache, start, end, kv_layout,): if kv_layout == "HND": head_axis = 2 elif kv_layout == "NHD": head_axis = 3 else: raise ValueError(f"Unsupported kv_layout: {kv_layout}") ...同一个语义(“切出前 个头”)在两种维序下对应张量的不同轴:HND 是第 2 轴,NHD 是第 3 轴。这个函数在解析布局时必须两个分支都写,因为它拿到的是运行期才知道的 metadata.kv_layout(第 2710 行传的就是这个值)。而 TrtllmAttentionMetadata 契约里的默认值是 "HND",FlashInfer 侧若干辅助函数的签名默认则是 "NHD"。同一个框架里两种默认值并存,说明维序是后端内核的选择而非框架强制的约定——换个后端,池的维序契约就跟着换,而所有按轴索引的辅助函数都得跟着分叉。
把两种维序的 stride 列在一起,可以看出它们各自服务于谁:
| 元素 | HND 下的 stride | NHD 下的 stride |
|---|---|---|
| 相邻 token(同头) | headDim | numKvHeads × headDim |
| 相邻头(同 token) | pageSize × headDim | headDim |
| 相邻页 | 2 × numKvHeads × pageSize × headDim | 同左 |
表里最重要的一行是第一行:HND 下”下一个 token”只隔 headDim 个元素,NHD 下要隔 numKvHeads × headDim 个。以 8 个 KV 头、headDim = 128 为例,前者步长 128 个元素(256 字节 @BF16),后者步长 1024 个元素(2048 字节)。注意力是”沿序列方向反复读”的循环,步长越小,cache line 利用率越高、预取越有效——这就是解码阶段 HND 占优的算术原因。而第二行反过来:NHD 下”同一个 token 的不同头”是相邻的,内核按 token 组织写入(一次写整条 K 和 V)时更连续。
没有一种布局对所有人最优,只有”匹配当前内核访存模式”的布局。 这也是为什么这篇反复强调维序是契约字段:它把一个纯性能决策提升成了正确性接口。
这里有一个非常容易踩的坑:kv_layout 一变,第六篇里的所有索引数组的含义都要重解释。paged_kv_indices 给出的块编号本身不变(它指向哪个块),但”块内第 i 个 token 在哪”要乘的 stride 变了。如果后端和池的维序不一致,读到的就不是同一个 token 的 KV——不会报错,只会算错。这也是为什么维序必须作为契约字段显式声明,而不能由各方”约好”。
量化存储:FP8 / INT8 / NVFP4 缓存怎么放
前面两节讲的都是布局。现在讲存什么类型。官方文档把这一步的重要性说得很直白:
Perhaps the most important property is
dtypewhich specifies what data type is held in KV cache.
在 KvCacheConfig 里把 dtype 设成 'fp8' 或 'nvfp4' 就能切换缓存的数值类型。这里必须讲清楚一个容易被误解的点:KV 缓存量化与权重/激活量化是三条独立的线。模型权重可以是 FP8 而 KV 缓存仍是 BF16;反过来一个没有做量化感知训练的 checkpoin,也可以手动把 KV 缓存设成 FP8(文档专门加了一条 Note 说明这件事)。
量化一个 KV 向量:为什么必须做 per-token 缩放
一个 KV 缓存向量(比如某个 token 的 K)是一串浮点数。要把它压成 FP8(E4M3)或 INT8,最朴素的做法是整池共用一个 scale(per-tensor):
其中 是原始浮点值, 是量化后的低精度码位, 是缩放系数, 是反量化回来的近似值。
问题在于,不同 token 的 KV 向量数值范围差异极大。一个 token 的 K 向量里元素绝对值可能集中在 ,另一个 token 可能有一个 outlier 冲到 (LLM 的激活 outlier 是有名的现象,对应少量”attention sink”式的 token)。
- 用整池统一 scale: 必须由全局最大值决定。比如 (FP8 E4M3 的可表示范围约 ),那么一个正常 token 里取值 0.5 的元素,量化后是 ,取整成 7 —— 有效比特从 8 位掉到了个位数,精度被 outlier token 吃掉了。
- 用逐 token 缩放(per-token / per-token-head):每个 token 的 KV 向量有自己的 ,正常 token 的元素也能用满动态范围。
这就是为什么文档里同时列了 FP8 Per Tensor 和 FP8 KV Cache 两条不同的 recipe。前者是激活量化里的粗粒度方案,后者是 KV 缓存专用的方案,二者的数值行为完全不同。
要理解 FP8 的精度,得先看清它怎么分配比特。E4M3 把 8 位拆成”4 位指数 + 3 位尾数 + 1 位符号”:
3 位尾数意味着每个数量级内只有 8 个可表示值——相对精度约 。这就是”逐 token 缩放”的全部意义:它不是在提高格式本身的精度,而是让每个 token 的数据落在格式最擅长的那个数量级里。E5M2(5 位指数 + 2 位尾数)动态范围更大但精度更差,所以 KV 缓存这种”已经做过缩放、数值集中”的场景用 E4M3,而不是 E5M2。
scale 从哪里来:写入路径上的一次规约
scale 不是离线标定的常量,而是在 KV 写入时现算的。每当一个新 token 的 K/V 被写进池,写入内核必须先对这个向量的绝对值做一次规约(求 ),得到 ,再把 量化后写进池、把 写进对应的 scale 位置。
这一步的代价常被忽略:它意味着每个写入的 token 都多一次跨 head_dim 的归约和一次除法。好处是它把误差控制在单 token 内,不会随上下文长度累积——这正是 KV 量化和”把整个缓存压成一个文件”的本质区别:逐 token 的 scale 让误差保持局部,而精度损失不会随着序列变长而放大。
NVFP4 的两级 scale:为什么注释里写的是 “second level”
官方文档把 NVFP4 缓存单列为一条 recipe(KvCacheConfig(dtype='nvfp4'),并且必须先用 ModelOpt 做离线量化)。NVFP4 的格式是 E2M1——2 位指数、1 位尾数,每 4 位只表示 之间的 16 个离散值。这么窄的动态范围不可能靠单一 scale 撑住,所以它用了两级缩放:
- 第一级:块内 scale。每 16 个元素共享一个 FP8 的 scale。C++ 注释里”the last dim is head_size / N where N … is 16 for NVFP4”说的就是这一级——
head_dim = 128时,一个头的 scale 数是 个。 - 第二级:张量级 scale。整池再乘一个 FP32 的全局缩放因子。
两级乘起来才把 E2M1 码位映射回真实数值。这就是 C++ 结构里 containsBlockScales 那个布尔字段和”第二级 scale 池”名称的来历:KV 主池存 E2M1 码位,scale 池存第一级 FP8 因子,而第二级的 FP32 张量级因子则作为池的属性存在别处。三层结构各司其职,任何一层缺失都会让反量化结果整体偏一个常数倍——这类错误不会崩溃,只会让注意力输出悄悄变差,是调试中最难定位的一类。
还有一处容器的细节值得单独点出来:4 位数据在显存里按”容器”打包,而不是一个元素一个字节。C++ 里有一个专门的访问器:
[[nodiscard]] SizeType32 getNumEltsPerContainer() const{#ifdef ENABLE_FP4 return mDataType == tensorrt_llm::DataType::kFP4 ? 2 : 1;#else return 1;#endif}FP8 时返回 1(一个元素一个字节容器),FP4 时返回 2(两个 4 位元素挤进一个字节容器)。这意味着凡是按”容器数”计算最后一维的代码——索引计算、形状推导、偏移换算——遇到 FP4 缓存时都要按折半处理。同一个 head_dim,在 FP8 池里占 128 个容器,在 FP4 池里只占 64 个。这类”元素数”与”容器数”的换算如果漏掉,算出来的地址会整体偏一倍,读到的就是别人的 KV。
scale 因子放在哪:containsBlockScales 与第二级 scale 池
答案就在前面读过的 KVCacheBlockPool 里:还有第二条实现路径。看注释:
// FP4 KV caches allocate additional pools for block scale factors. These pools have the same// shape as the regular KV pools, except that the last dim is head_size / N where N is determined// by the precise FP4 format being used (16 for NVFP4). There is one block scale pool per normal pool.拆开讲:
- FP4 缓存会额外分配一个 scale 池(
containsBlockScales = true)。 - scale 池的形状和 KV 池一样,唯一的差别是最后一维变成
head_size / N。对 NVFP4 来说 —— 因为 NVFP4 是块缩放(block scaling)格式:每 16 个元素共享一个 FP8 的 scale 因子。 - “There is one block scale pool per normal pool”:每个 KV 池配一个 scale 池,一一对应。
为什么不是把 scale 附在每个向量后面?因为那会破坏块的自然对齐。块的大小是按 tokensPerBlock × numKvHeads × headDim × bytesPerElem 算好的、必须对齐到显存页边界的整块;如果每个向量尾部再挂几个字节的 scale,块就被撑成了不规则长度,分配、复用、前缀匹配全部要跟着改。把 scale 拆成独立的池,让两个池共用同一套块编号,是最小侵入的做法:块 17 的 KV 数据在主池的第 17 段,它的 scale 在 scale 池的第 17 段。
代价也很明显:内核现在要读两个张量。注意力内核每读一块 KV,就得同时读对应的 scale 块,且要在流水线里把两路数据合到同一个 tile 上算反量化。这是 containsBlockScales 这条路只在 Blackwell 上开放的原因——它需要内核专门为”主数据 + scale 双流”设计流水线。
一个 KV 头的读取路径:把 stride 串起来
把这一篇的所有要素串起来看内核的一次访存。假设 HND 布局、FP8 缓存、块大小 64、8 个 KV 头、head_dim = 128:
- 第六篇给出的块偏移数组告诉我们”第 3 个请求的第 17 个块”的块偏移是
blk_offset。 - 池基址 +
blk_offset得到这个块在池张量里的起点。 - HND 下同一头内 token 连续,所以”该块第 5 个 token、第 2 个头”的 K 元素地址是:
(第一个 1 是 K/V 维度上的索引,取 K 用 0、取 V 用 1;这里为体现 stride 的乘法结构把它显式写出。)
- 读到 FP8 码位后,还要去 scale 池用同一个
blkOffset取对应的 scale 做反量化。 - 反量化后的 FP32/BF16 值进入 的乘加。
四次乘法全部来自 stride——这正是第六篇结尾说的”索引数组最终都要乘上 stride 才能变成地址”。布局(HND/NHD)决定后两步的 stride,量化格式(FP8/FP4/INT8)决定要不要走第 4 步,块大小决定 64 这个乘数。三者共同定死了内核的访存模式,也因此必须在内核编译期就知道。
稀疏与索引器缓存:在同一个池体系里多挂一条
C++ 结构里还有一个字段:containsIndexerKCache,以及构造参数里的 indexerKCacheQuantBlockSize、indexerKCacheIndexHeadDim、indexerKCacheUseFp4、indexerKCacheLayerMask。这对应 DeepSeek-V3.2 的 DSA(DeepSeek Sparse Attention)那类两级注意力:先用一个轻量的索引器(indexer)算出每个历史 token 的分数,选出 Top-K,再用真正的注意力只在选中的 token 上算。
问题是:索引器要打分,就得自己有一份 K(通常是低维、低精度的投影)。如果索引器每次重算这份 K,开销就抵消了稀疏带来的收益。所以 TensorRT-LLM 把索引器的 K 缓存也做成了一个池,挂在同一套块管理下。
注意它的参数配置很讲究:
indexerKCacheQuantBlockSize = 128:索引器 K 自己的量化块大小(和主池的tokensPerBlock是两回事)。indexerKCacheIndexHeadDim:索引器 K 的维度,独立配置,通常远小于主head_dim。indexerKCacheUseFp4:索引器 K 是否用 FP4 —— 打分只需要相对大小,精度要求低。indexerKCacheLayerMask:哪些层需要索引器 K。这是个vector<bool>,因为稀疏注意力往往只加在部分层上,没必要为全模型都开这条池。
这四件事合起来说明一个设计取向:索引器缓存是”独立但共池”的。独立,是指维度、精度、量化块大小都能单独配;共池,是指它仍然复用 WindowBlockManager 的块编号体系,从而能让前缀复用、卸载、引用计数这些机制原封不动地覆盖它。如果另起一套管理器,前缀复用时”主 KV 命中了但索引器 K 没命中”就会成为一个要单独处理的错误状态。
为什么索引器需要自己的一份 K?因为它的打分逻辑和主注意力不一样。以 DeepSeek-V3.2 的 DSA 为例,索引器是一个轻量打分器:它用一个小的投影把 query 和 key 压到低维(其 index head dim 远小于主 head_dim),算出的分数只用来排序选 Top-K,随后真正的注意力只在这 K 个 token 上做。既然只用来排序,它就只需要”相对大小正确”,不需要数值绝对精确——这正是 indexerKCacheUseFp4 敢把它压到 FP4 的理由:排序对量化误差的容忍度远高于数值计算。
而 indexerKCacheLayerMask 说明了另一件事:稀疏注意力通常只加在部分层上。全模型都挂索引器意味着每层都要多维护一条池、多跑一次打分,而实验上通常只有一部分层对长上下文的贡献最大。把这个选择做成一个 vector<bool> 的层掩码,等于把”稀疏加在哪几层”从代码里的硬编码变成了配置项——换模型不必改内核。
索引器的量化块大小(indexerKCacheQuantBlockSize = 128)和主池的 tokensPerBlock 是两个独立的量:前者是”打分时多少个 token 共用一个 scale”,后者是”一个物理页装多少 token”。把它们分开配,是因为二者的约束来源不同——前者由打分精度决定,后者由显存分配粒度决定。同名的”块”在这两处含义并不相同,读代码时混起来是很容易犯的错误。
站内 DSA 稀疏注意力完全拆解:从 DeepSeek-V3.2 的闪电索引器到 vLLM 的算子实现 详细讲过索引器本身的算法与在 vLLM 里的算子实现;这里补的是它在缓存侧的内存归属——索引器 K 不是临时变量,而是一份和主 KV 同生命周期、同样要记账、同样可复用的持久数据。
MLA 的 latent 池:一份张量同时当 K 和 V
最后一个问题:MLA(Multi-head Latent Attention)的缓存为什么只有一份张量。
普通 MHA/GQA 的注意力是”每个头有自己的 K 和 V”,所以池里 kvFactor = 2,K 和 V 各占一半。MLA 换了做法:它把 K 和 V 共同压缩到一个低维 latent 向量 里存储,注意力计算时再用上投影矩阵把这个 latent 分别展开成 K 和 V。
于是:
kvFactor变成 1——池里只有一份 latent 张量,没有分开的 K 和 V。numKvHeads变成 1——MLA 的 latent 是所有头共享的,不存在”每头的 KV”。sizePerHead变成 latent 维度 ,而不是原来的head_dim。
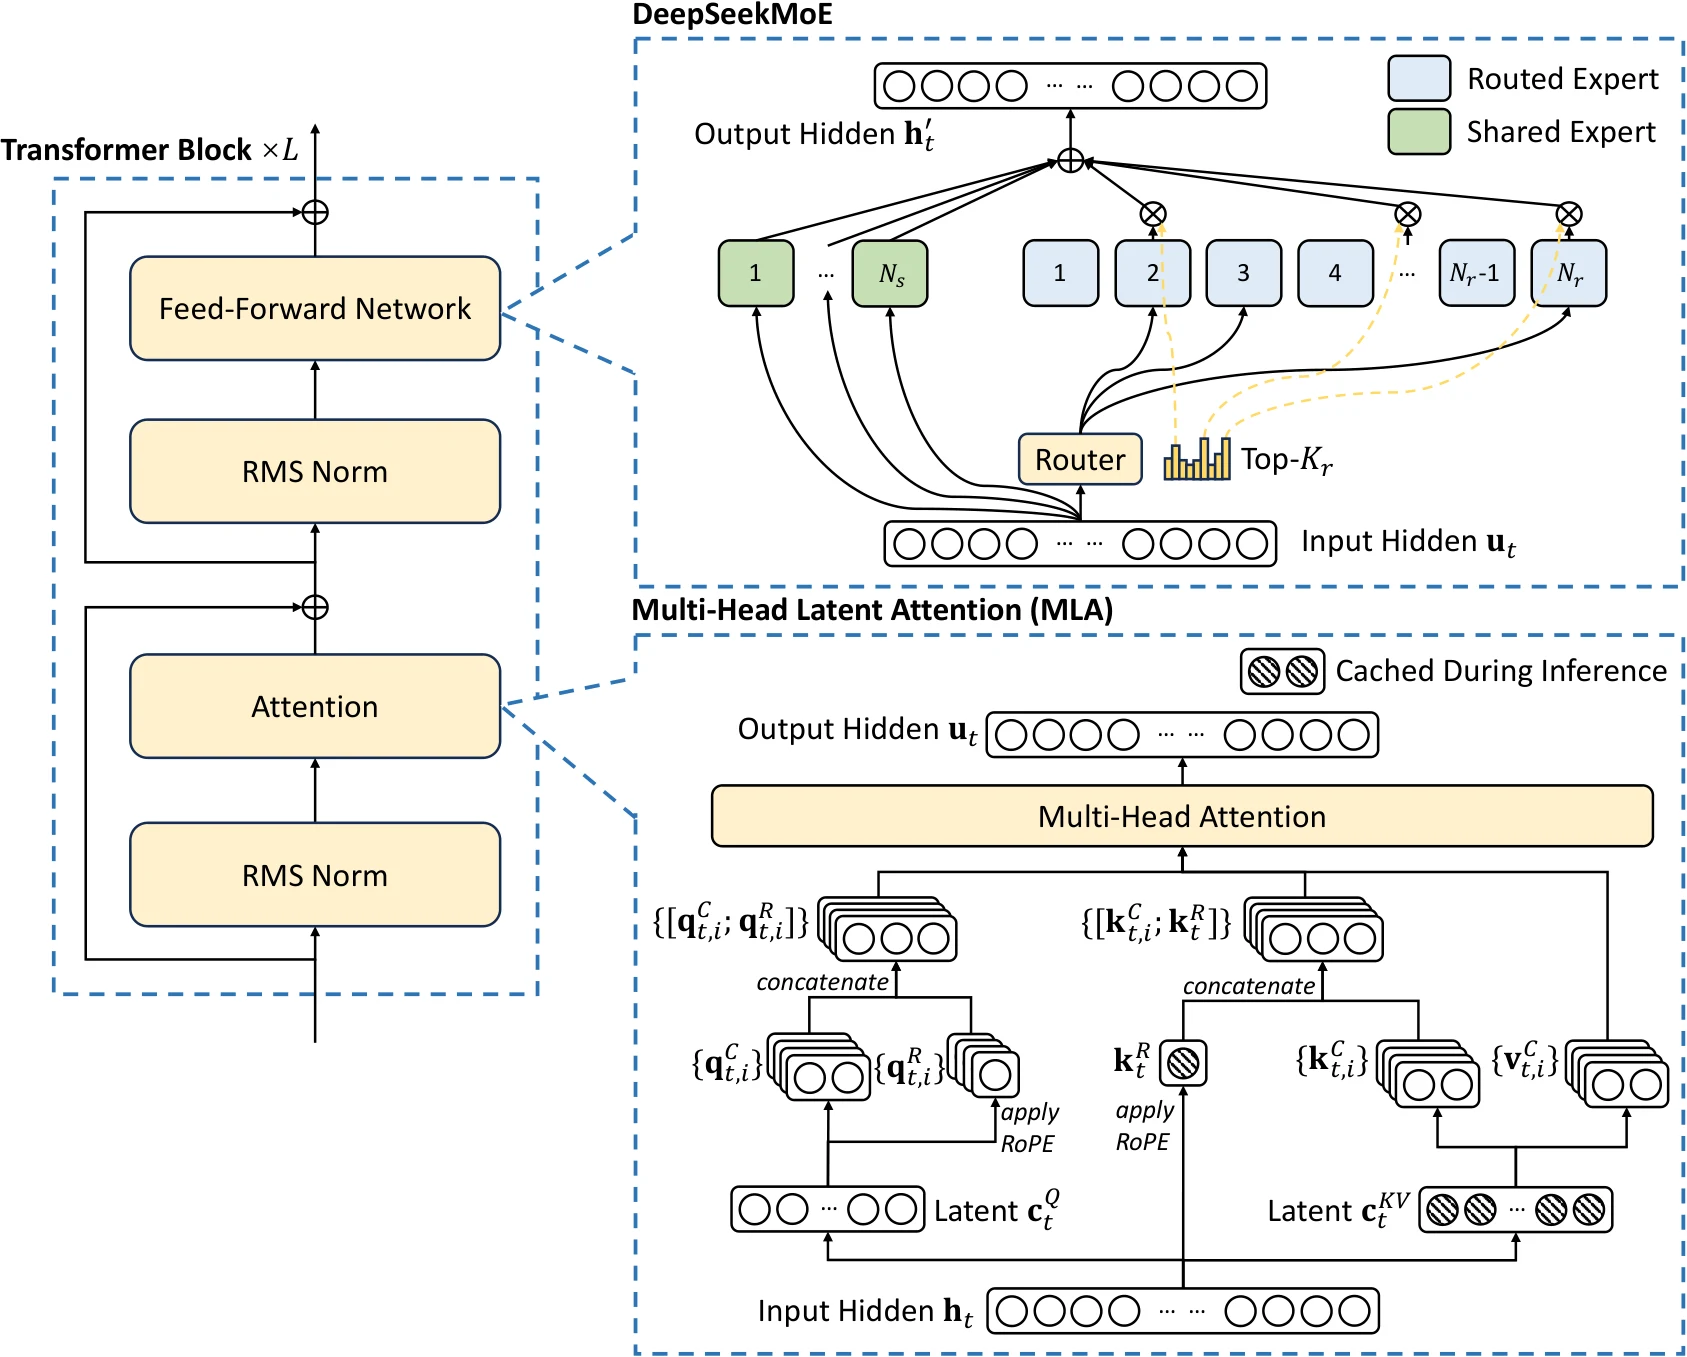
上图出自 DeepSeek-V2 技术报告(arXiv:2405.04434)的 Figure 3,并列画出 MHA、GQA、MQA 与 MLA 四种形态。关键在第四格的箭头方向:MLA 不是”少存一些头”,而是先用下投影把 K/V 压成一个 latent 向量存起来,读取时再用上投影还原——这就是本篇说的 kvFactor=1、numKvHeads=1 的来源。图片来源:DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model。
这里有一个很容易搞错的细节:MLA 缓存的不只是那个 latent 向量。因为 MLA 用的是”解耦 RoPE”(decoupled RoPE)策略——位置信息由一组额外的、带 RoPE 的共享 key 承担,它没法被折进 latent 里,必须单独缓存。所以论文给出的缓存量是:
其中 是层数, 是解耦 query/key 的每头维度。以 DeepSeek-V2 为例,、,所以每 token 每层实际缓存 个元素。论文表格里把它写作 ,并按这个口径给出四种方案的对比:
| 方案 | 每 token 每层缓存元素数 | 以 、、 折算 |
|---|---|---|
| MHA | 32768(= 64 KiB @BF16) | |
| GQA | 2048(= 4 KiB @BF16) | |
| MQA | 256 | |
| MLA | 576(= 1.125 KiB @BF16) |
按这个口径,MLA 的缓存约是 GQA 的 576/2048 ≈ 28%,不到三成(如果漏掉解耦 key、只算 ,会得到”四分之一”这个偏乐观的数)。把 加回去之后结论不变、量级更准确:MLA 依然明显胜过 GQA,而且这还不是靠”少存点信息”换来的——它是靠给 KV 加了一个可训练的低秩压缩,压缩质量由模型自己学会。论文把这一点总结得很直白:MLA 同时拿到了 MHA 的”强表达能力”和 MQA 的”小缓存”。
这个结论在 TensorRT-LLM 的源码里能找到逐字对应。flashinfer.py 对 MLA 缓存的形状有这样一段注释:
# with kv_factor=1 and head_dim = kv_lora_rank + qk_rope_head_dim.# [num_pages, 1, page_size, 1, kv_lora_rank + qk_rope_head_dim].紧接着的代码就是把它切成两段:
ckv_cache = combined[..., :self.kv_lora_rank] # 压缩 latentkpe_cache = combined[..., self.kv_lora_rank:] # 解耦 RoPE keyhead_dim = kv_lora_rank + qk_rope_head_dim 这一行就是论文里 的工程写法;DeepSeek 系列上它是 。所以当你看到一个 MLA 池的 sizePerHead 是 576 而不是 512 时,多出来的 64 正是解耦 key——它不是冗余,是同一条记录里必须一起分配、一起搬运、一起量化的另一段数据。漏掉它,位置信息就没了。
但这份省下来的访存要在内核侧还回去:内核读出一个 latent 向量后,必须先做上投影才能得到 K 和 V,再进入注意力计算。这是一次额外的矩阵乘,代价在计算侧。所以 MLA 的取舍是:用计算换缓存,与 GQA 的”用精度换缓存”是两条不同的路。
这解释了为什么前面看到的 MLA 相关代码会有那么多专门的缓冲:mla_cu_q_rows(累计 query 行数,因为 MLA 里 query 行数 = cumsum(q_lens) * num_heads)、mla_cu_kv_seqlens(累计 KV 长度)、mla_ctx_cu_q_seqlens,以及 flash_mla_tile_scheduler_metadata 和 flash_mla_num_splits 这一对调度缓冲。这些都不是”通用注意力”需要的——它们是 MLA 特有的:因为 latent 只有一份,内核无法像普通注意力那样按头并行地独立调度,必须用一个专门的 tile scheduler 把”读 latent → 上投影 → 算注意力”这条链编排起来。
VanillaAttention 里的 MLA 读取路径
第六篇讲过 VanillaAttention 是那个”什么优化都不做”的后端,用 gather 把分页 KV 拉成连续张量。它对 MLA 有专门的处理,vanilla_attn.py 里有一个独立函数:
def _gather_paged_mla_latent(kv_cache, block_ids, kv_len): # NHD [num_pages, 1, tokens_per_block, 1, d_latent] # A single block ... tokens_per_block = kv_cache.shape[2]注意这个形状注释:[num_pages, 1, tokens_per_block, 1, d_latent]。和 NHD 的 [pages, 2, pageSize, numKvHeads, headDim] 逐维对比:
- 第二维是
1(不是2)——kvFactor = 1,只有一份 latent。 - 第四维是
1(不是numKvHeads)——latent 全头共享。 - 第五维是
d_latent(不是headDim)——存的是压缩后的维度。
同一套张量结构,只靠三个维度的取值就同时表达了 MHA、GQA、MQA 和 MLA。这正是前面讲”池的键是(窗口大小,KV 头数)“的延伸:布局是参数化的,不同模型只是参数不同。理解了这一点,TensorRT-LLM 的 KV 缓存就不再是一堆特例,而是一个带六个可调维度的通用容器。
三个维度上的取舍如何组合
这篇讲了三组独立的选择——池的分法、维序、量化格式。它们并不是各自的”最优解”然后拼在一起,而是必须组合出一个自洽的配置。把组合关系列出来:
| 选择 | 选项 | 主要约束来自 | 组合影响 |
|---|---|---|---|
| 池分法 | 单池 / 按(窗口,头数)分池 | 层间头数与窗口是否一致 | 分池后比例静态、不可运行期改 |
| 维序 | HND / NHD | 后端内核的访存模式 | 决定所有按轴索引辅助函数的分支 |
| 量化 | BF16 / FP8 / NVFP4 | 精度容忍度与内核是否支持双流 | FP4 需要额外 scale 池与容器折半 |
三者的耦合点有两个,都很实际:
耦合点一:量化格式必须被后端内核支持,而内核是按维序编译的。 选了 NVFP4 缓存,就要走”主数据 + FP8 scale 双流”的内核;这个内核又必须在某个确定的维序下工作。格式和维序不能各自独立选——它们是同一个 kernel variant 的两个参数。这就是为什么文档里的支持矩阵是按”模型 × 量化方法”列的:矩阵里每个 Y 背后都对应一组已经编译好的、维序确定的内核。
耦合点二:分池会增加池数量,而每个池都要有自己的量化配置与 scale 池。 一个两池的 VSWA 模型若都用 FP4 缓存,就有 4 个张量(2 个 KV 池 + 2 个 scale 池);如果模型还是混合 Mamba,还要再加 Mamba 状态池。文档提到 V2 管理器会把这些池放在一起按比例定尺寸(“Attention KV and Mamba state pools must be sized together”),正是为了防止某一类池分得过大而另一类饿死。
所以”怎么配”没有单点最优答案,只有在给定模型结构、给定后端内核、给定精度预算下的一个自洽组合。文档给出的默认策略其实是一条很实用的经验规则:
- 小批次(batch ≤ 4)瓶颈在显存带宽,权重占主导,KV 缓存量化收益相对小,优先权重侧量化。
- 大批次(batch ≥ 16)同时受带宽和算力约束,KV 缓存与激活量化才开始显著收益。
- 量化方法先试 FP8——文档的措辞是”we typically see it offers the best performance and accuracy”,只有在 FP8 精度不达标时才退到 INT8 SmoothQuant、AWQ/GPTQ 等更激进的方案。
这条”先 FP8、不达标再降”的顺序值得记住:FP8 是当前精度-性能比最稳的一档,而 NVFP4 属于”显存真的不够时才动用”的手段——它换来的显存收益最大,但需要额外的 scale 池、双流内核和更严格的校准流程。
小结
这一篇补上了第六篇留下的那个乘法:索引数组乘上 stride 变成地址,而 stride 来自池的布局。
- 池是六维张量,
[max_blocks, num_layers, kvFactor, numKvHeads, tokensPerBlock, headSize],一个池装下所有同构的层,因为块的元数据是层间共享的。账本因此只需一套块编号。 - 池的键是(注意力窗口大小,KV 头数)。VSWA 模型(Gemma、GPT-OSS)必然分池;池间显存比例静态分配、运行时不可改,因为池基址被 CUDA Graph 记录。运维上必须在启动时就按负载特征配好权重。
numKvHeads直接换算成tokensPerBlock × headDim × 2 × dtype的每块字节数,GQA 相对 MHA 省 4 倍,且这个省法不损失任何精度——它只是不给重复的 KV 头分配空间。- NHD 与 HND 是同一个池的两种维序:HND(
[head, token, dim])让同头跨 token 的访存连续,适合解码;NHD([token, head, dim])让同 token 的 K/V 相邻,适合预填充写入与部分既有内核。TrtllmAttentionMetadata默认 HND、FlashInfer 后端默认 NHD、VanillaAttention写死 NHD——维序是后端契约,不是框架约定。 - 量化缓存必须逐 token/逐头缩放,否则少量 outlier token 会把整池的动态范围吃掉。per-tensor scale 是激活量化的方案,不是 KV 缓存的方案。
- FP4 的 scale 因子放在独立的 scale 池(
containsBlockScales),形状与 KV 池相同、最后一维变成head_size / N(NVFP4 是 16),与主池共用块编号。代价是内核必须走”主数据 + scale 双流”的流水线。 - 索引器 K 缓存(DSA 这类)同样是一个池(
containsIndexerKCache),维度、量化块大小、精度、层掩码都可单独配置,但复用主池的块编号体系,因此前缀复用与卸载机制能原封不动覆盖它。 - MLA 的 latent 池是
kvFactor=1、numKvHeads=1、sizePerHead=d_latent,一份张量同时当 K 和 V;收益是缓存压到 GQA 的约三成(DeepSeek-V2 每 token 每层 元素,对 GQA 的 2048),代价是读出来之后要做上投影,因此需要flash_mla_tile_scheduler_metadata这类专用调度缓冲。 - 同一套六维容器靠参数取值就覆盖了 MHA/GQA/MQA/MLA;差别不在结构,只在参数。
把这一篇和第六篇合起来看:第六篇讲的是逻辑账(哪些块属于哪条请求),这一篇讲的是物理账(那些块在显存里长什么样、每个元素在哪个偏移)。两本账之间只隔着一层 stride 乘法,而所有”为什么这么设计”的答案都指向同一条约束:内核要能无条件地、以编译期已知的步长访存。布局、量化格式、块大小全部因此必须在创建时就定死,运行中只允许改内容、不允许改形状。
下一篇进入 KV 缓存的写入与读取路径:一次前向里新 token 的 K/V 究竟由哪个内核写进池(reshape_and_cache 这类 scatter 操作的索引从哪里来)、变长序列的 ragged 写入如何按 kv_indptr 分段、块边界跨越时一次写入怎么拆成两段、以及读取侧的分页 gather 如何与这篇讲的 stride 拼成最终地址。这一篇把”池长什么样”讲完了,下一篇讲”数据怎么进出这个池”。
参考资料
- TensorRT-LLM 官方仓库(NVIDIA/TensorRT-LLM)
- TensorRT-LLM 官方文档:KV Cache System(池结构、分池规则、保留策略与驱逐)
- TensorRT-LLM 官方文档:Quantization(FP8 / NVFP4 KV Cache 配置与模型支持矩阵)
- TensorRT-LLM 官方博客:Speed up inference with SOTA quantization techniques in TRT-LLM
- TensorRT-LLM
_torch/attention/backends/interface.py:kv_layout 契约与 KVCacheParams - TensorRT-LLM
cpp/include/tensorrt_llm/batch_manager/kvCacheManager.h:KVCacheBlockPool 与池形状注释 - TensorRT-LLM
cpp/tensorrt_llm/batch_manager/kvCacheManager.cpp:WindowBlockManager 与块分配实现 - TensorRT-LLM
_torch/attention/backends/vanilla.py:NHD 布局与 MLA latent gather - TensorRT-LLM
_torch/attention/backends/flashinfer.py:kv_layout 分支与页表构造 - FlashInfer 官方文档:KV-Cache Layout(NHD/HND 与页表三件套)
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model(MLA 的出处,、)
- DeepSeek-V3.2 技术报告(DSA 稀疏注意力与索引器)
- FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving
- PyTorch 官方文档:CUDA Graph 语义与捕获前置要求
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



