


vLLM 源码完全拆解(十七):KV Connector——P/D 分离中 KV 缓存如何跨实例传输与接管调度
从第十六篇接上
前十六篇把 vLLM 的「单实例内部」拆完了:请求怎么进来、调度器怎么分配 token 预算、KVCacheManager 怎么记账、GPUModelRunner 怎么把动态请求拼成一次前向、注意力后端怎么执行、采样怎么出 token,以及投机解码、张量并行、多模态、结构化输出、编译与 CUDA Graph。
这些机制有一个共同前提:prefill 与 decode 在同一个进程里、同一份 KV 池里完成。而线上大模型服务早就分开了——prefill 算力密集、batch 大,decode 显存带宽密集、batch 小,混在一起会互相伤害(这一矛盾我们在 DistServe 完全拆解:拆开 Prefill 与 Decode,按 Goodput 调度大模型推理 里从系统角度讲过)。
拆开之后,一个新问题浮出水面:prefill 实例算出来的 KV,要怎样进入另一台机器上 decode 实例的分页显存? 而且不只是搬字节——decode 那边的调度器必须知道「这个请求的前缀 KV 在别处算过、我可以跳过多少 token」,它才知道这一步该给这个请求派多少任务。
本篇就拆 vLLM V1 里负责这件事的抽象:KV Connector。它不只是一个传输库的封装,而是一套把调度器、KV 管理器、注意力层与外部存储/远端实例缝在一起的接口契约。我们按以下顺序推进:
- 为什么要「连接器」而不是写死一条传输路径;
KVConnectorBase_V1的两侧(scheduler side / worker side)各有哪些方法,每一步在请求生命周期的哪个位置被调用;- NIXL、LMCache、P2P NCCL、SharedStorage、Multi 这几种实现各自解决什么问题,源码里怎么落地;
- 以 NIXL 为例走一遍 P/D 分离的完整时序:KVP 异步拉取、
WAITING_FOR_REMOTE_KVS状态、通知回传与块释放; - 工程边界:TP 异构、前缀命中、分块 prefill、异步加载与 KV 池覆盖的时序陷阱。
说明:本篇的源码依据是 vLLM 仓库
vllm/distributed/kv_transfer/目录(V1 连接器体系),版本约为 0.9.x。该目录仍在快速演进,函数名与字段命名可能变化,但「两侧分工 + 元数据下发」的结构是稳定的。
为什么需要一个「连接器」抽象
传输这件事,三套不同的问题
把 KV 从 A 搬到 B,至少涉及三类互相纠缠的问题。
第一类是物理传输:用什么链路(NVLink、IB/RDMA、TCP、共享文件系统)、用什么协议(NCCL、NIXL 的 RDMA 读写、ZMQ 控制通道)、怎么注册显存地址、怎么保证搬完。
第二类是语义拼接:源端 KV 是按源端分页池的 block 编号摆放的,目标端有自己的 block 表;MLA 模型只有一份 latent KV,GQA 模型是 K/V 两份;FlashInfer 后端把 [2, num_blocks, ...] 和 [num_blocks, 2, ...] 的维度顺序交换过;源端 TP=4、目标端 TP=8 时,每个目标 rank 要读的部分不一样。搬运必须懂「分页布局 + 并行拓扑」。
第三类是调度语义:decode 端调度器要知道「哪些 token 不必本地算、正在从远端拉、拉完没有」,并且要处理拉取期间的请求状态、失败时的降级、请求结束时远端块何时可以释放。
如果让每个传输后端自己把三类问题都做一遍,结果就是每个后端各写一套调度钩子、各自改 KV 管理器,互相不兼容。vLLM 的选择是把第三类问题收进统一的接口,第二类问题收进连接器实现内部的「描述符/元数据」逻辑,第一类问题交给具体传输库。
两个进程、两个角色
V1 引擎的进程结构决定了这套接口的形状。回顾 vLLM 源码完全拆解(一):整体架构与模块全景 中的进程拓扑:调度器运行在 EngineCore 进程里,模型执行发生在 Worker 进程里(TP>1 时每个 rank 一个 worker,或按 executor 组织)。
KV Connector 因此被显式拆成两个角色:
KVConnectorRole.SCHEDULER:与调度器同进程,只做「查询与记账」——判断某请求能从外部拿多少 token、记录哪些请求要拉 KV、在每步结束时把「这一步要搬什么」整理成一份元数据;KVConnectorRole.WORKER:与模型执行同进程,只做「执行搬运」——接收元数据、发起/等待异步传输、回答「哪些请求搬完了」。
两侧之间只有一种通信方式:元数据对象。它在每步调度结束时由调度器侧构造,随 SchedulerOutput.kv_connector_metadata 一路下发到 worker,worker 在执行前绑定它:
def maybe_setup_kv_connector(scheduler_output: "SchedulerOutput"): if has_kv_transfer_group(): kv_connector = get_kv_transfer_group() assert isinstance(kv_connector, KVConnectorBase_V1) assert scheduler_output.kv_connector_metadata is not None kv_connector.bind_connector_metadata( scheduler_output.kv_connector_metadata) # Background KV cache transfers happen here. kv_connector.start_load_kv(get_forward_context())这段代码来自 vllm/v1/worker/gpu_model_runner.py。注意注释里的 Background KV cache transfers:拉取是「后台」的,它可以在这一步的模型执行期间并发进行;而且元数据里描述的请求,不一定是本步正在计算的那些请求——异步加载的请求此时还在排队。
工厂的注释把这种分工说得更直接:
# NOTE(Kuntai): v1 connector is explicitly separated into two roles.# Scheduler connector:# - Co-locate with scheduler process# - Should only be used inside the Scheduler class# Worker connector:# - Co-locate with worker process# - Should only be used inside the forward context & attention layer# We build separately to enforce strict separationreturn connector_cls(config, role)「严格分离」是有意为之。现实中很多 P/D 分离的 bug 都来自两侧对同一件事的理解不一致:调度器以为「已经分配好了」,worker 以为「还没到」,结果读到未初始化的 KV。角色拆分 + 元数据契约,把这类不一致压缩成一个可以审计的接口。
接口全貌:每一步对应生命周期上的哪个位置
KVConnectorBase_V1(vllm/distributed/kv_transfer/kv_connector/v1/base.py)的类文档把方法分成了两侧,这里按执行顺序展开。
调度器侧:五个方法
| 方法 | 被谁调用 | 职责 |
|---|---|---|
get_num_new_matched_tokens(request, num_local) | 调度器为新请求做准入 | 返回「本地前缀缓存之外,还有多少 token 可以从外部拿到」,以及「这次加载是否异步」 |
update_state_after_alloc(request, blocks, num_external) | 调度器完成块分配之后 | 记住这个请求要从哪里拉、拉到哪些本地块;也可能什么都不做 |
build_connector_meta(scheduler_output) | 每步调度结束、发出 SchedulerOutput 之前 | 把本步要执行的传输整理成元数据;同时清空内部状态 |
request_finished(request, block_ids) | 请求结束、释放块之前 | 决定块现在释放,还是等异步发送完成后释放;顺带返回要附加到输出里的传输参数 |
get_finished 的调度器侧入口(见 worker 侧) | 由 runner 触发 | 调度器读取「这一步结束时哪些请求搬完了」 |
第一个方法的签名值得逐字看:
@abstractmethoddef get_num_new_matched_tokens( self, request: "Request", num_computed_tokens: int,) -> tuple[int, bool]: """... Returns: - The number of tokens that can be loaded from the external KV cache beyond what is already computed. - `True` if external KV cache tokens will be loaded asynchronously (between scheduler steps). Must be 'False' if the first element is 0. """两个返回值共同决定调度器怎么处理这个请求。num_computed_tokens 参数名虽然叫「已计算」,实际传入的是调度器刚刚从本地前缀缓存里 get_computed_blocks 拿到的命中长度:
# Get locally-cached tokens.new_computed_blocks, num_new_local_computed_tokens = \ self.kv_cache_manager.get_computed_blocks(request)
# Get externally-cached tokens if using a KVConnector.if self.connector is not None: num_external_computed_tokens, load_kv_async = ( self.connector.get_num_new_matched_tokens( request, num_new_local_computed_tokens))
# Total computed tokens (local + external).num_computed_tokens = (num_new_local_computed_tokens + num_external_computed_tokens)这是 v1/core/sched/scheduler.py 中 schedule() 里处理新请求的片段。外部命中是叠加在本地命中之上的:本地前缀缓存先尽量命中,剩下的部分再由连接器声明「远端有」。这避免了两个来源重复计算同一段 token。
异步加载如何改变调度行为
load_kv_async=True 时,调度器不会给这个请求派新的计算任务,只给它分配 KV 块:
# KVTransfer: loading remote KV, do not allocate for new work.if load_kv_async: assert num_external_computed_tokens > 0 num_new_tokens = 0随后分配阶段会调用 allocate_slots 时传入 num_new_tokens + num_external_computed_tokens,并用 delay_cache_blocks=load_kv_async 告诉 KV 管理器:这些块的内容还没到位,先别当成可缓存前缀。分配完成后:
if load_kv_async: # If loading async, allocate memory and put request # into the WAITING_FOR_REMOTE_KV state. skipped_waiting_requests.prepend_request(request) request.status = RequestStatus.WAITING_FOR_REMOTE_KVS continue请求被放回等待队列头部(保持顺序),状态切到 WAITING_FOR_REMOTE_KVS,然后 continue 去处理下一个请求。它「占着块,但不占 token 预算」。
worker 侧:六个方法
| 方法 | 调用时机 | 职责 |
|---|---|---|
register_kv_caches(kv_caches) | 启动时、KV 池建好后 | 把分页 KV 张量注册给传输库、计算每个块的字节布局 |
bind_connector_metadata(meta) | 每步执行前 | 接收调度器下发的元数据 |
start_load_kv(forward_context) | 模型执行之前 | 为元数据里的请求发起(可能异步的)拉取;该阶段的加载可与本步计算重叠 |
wait_for_layer_load(layer_name) | 每个注意力层的 forward 里 | 等到当前层所需的 KV 已到位,再计算这一层 |
save_kv_layer(layer_name, kv_layer, attn_metadata) | 注意力层计算完成后 | 为当前层发起(可能异步的)对外发送/保存 |
wait_for_save() | 模型执行结束后 | 等所有保存完成,防止分页池被覆盖 |
get_finished(finished_req_ids) | 每步执行结束后 | 返回「发送完成」与「接收完成」两组请求 ID |
wait_for_layer_load 与 save_kv_layer 是按层的,这是为了逐层流水:prefill 端第 0 层算完就开始传第 0 层,第 1 层在算的时候,第 0 层的传输可能已经完成。Mooncake 论文里明确写了这一点:prefill 实例「逐层且与 prefill 计算并行地加载/存储 KVCache,以缓解传输开销」。
注意力层里的两个钩子
注意力层里调用这两个钩子的位置很关键。vllm/attention/layer.py 中,unified_attention 在调用后端实现之前插入等待:
def wait_for_kv_layer_from_connector(layer_name: str): ... connector = get_kv_transfer_group() forward_context: ForwardContext = get_forward_context() attn_metadata = forward_context.attn_metadata if attn_metadata is None: return assert isinstance(attn_metadata, dict) connector.wait_for_layer_load(layer_name)在执行完后端计算之后插入保存:
def unified_attention(...): ... output = self.impl.forward(self, query, key, value, kv_cache, attn_metadata) maybe_save_kv_layer_to_connector(layer_name, kv_cache) return outputattn_metadata is None 就返回,是为了兼容前向上下文缺失的场景(例如预热、纯解码无注意力元数据的情形);assert isinstance(attn_metadata, dict) 则说明 V1 采用按层名索引的元数据字典——这也是连接器能实现「逐层等待」的前提。
同步与异步:三档加载模式
从接口语义能看出三种加载模式:
- 同步、立即:在
start_load_kv里阻塞地搬完,后续各层直接可用。实现最简单,但完全堵住 GPU。 - 异步、跨步:
load_kv_async=True时,请求进入WAITING_FOR_REMOTE_KVS,调度器这一步不计算它。传输在后台进行,通常在若干步之后完成,get_finished报告后请求回到等待队列。 - 异步、层间流水:
start_load_kv只发起传输,wait_for_layer_load在每层前等待。需要传输库支持「按描述符批量的非阻塞读写 + 完成查询」。
不同连接器实现覆盖的模式不同,这决定了它们的适用场景。NIXL 属于第 2、3 类;P2P NCCL 属于第 1 类的变体(get_num_new_matched_tokens 返回 False,即同步加载)。
完成与释放:get_finished 的语义
@abstractmethoddef get_finished( self, finished_req_ids: set[str]) -> tuple[Optional[set[str]], Optional[set[str]]]: """ ... Returns: ids of requests that have finished asynchronous transfer (requests that previously returned True from request_finished()), tuple of (sending/saving ids, recving/loading ids). """两组 ID 的用途在调度器里被明确分开:
def _update_from_kv_xfer_finished(self, model_runner_output): for req_id in (model_runner_output.finished_recving or ()): self.finished_recving_kv_req_ids.add(req_id) for req_id in (model_runner_output.finished_sending or ()): self._free_blocks(self.requests[req_id])- 接收完成:记进
finished_recving_kv_req_ids,等待中的请求会在下次调度时检查并转回WAITING(见下文「远端 KV 到位」小节); - 发送完成:这个请求的块此时才能真正回收。之前
request_finished返回delay_free_blocks=True,块被「挂起」不释放,就是为了防止传输读到已被覆盖的分页。
这套「延迟释放」是连接器正确性的核心约定之一:KV 池是复用的,谁要读它,谁就得让它多活一会儿。它与 vLLM 源码完全拆解(四):KVCacheManager 如何分配、复用与回收物理 Block 里的引用计数与 free queue 是同一套内存生命周期思想,区别在于「使用者」变成了一个异步的远端读取者。
请求的完整生命周期:把连接器嵌进一张时序图
把上面的散点拼成时序(以 NIXL + 标准 P/D 分离为例):
客户端 --------- route ----------> D 实例 (decode) | | get_num_new_matched_tokens | => (n_ext, True) [do_remote_prefill] | allocate_slots(n_ext + 0, delay_cache=True) | status = WAITING_FOR_REMOTE_KVS | update_state_after_alloc -> _reqs_need_recv | build_connector_meta -> NixlConnectorMetadata vworker: bind metadata -> start_load_kv | 首次与 P 实例握手(ZMQ 交换 NIXL agent 元数据) | NIXL READ:从 P 的 KV 池直接读进本地 block | 若干步后 get_finished -> finished_recving vscheduler: _update_waiting_for_remote_kv | 命中完成,cache_blocks,num_computed_tokens = n_ext | status = WAITING -> 正常调度 | 第一步只解码最后一个 prompt token(见下)P 实例一侧则在 request_finished 时返回 kv_transfer_params,其中携带 remote_block_ids / remote_engine_id / remote_host / remote_port / tp_size,这些参数随请求输出回到客户端,再由路由层转交给 D 实例。也就是说,P 与 D 之间的连接信息通过请求输出传递,而不是连接器之间约定全局地址。这让连接器无需知道集群拓扑,也能支持任意 P/D 配对。
远端 KV 到位之后:为什么要减一
def _update_waiting_for_remote_kv(self, request: Request) -> bool: assert self.connector is not None if request.request_id not in self.finished_recving_kv_req_ids: return False
# Now that the blocks are ready, actually cache them. (block_ids, ) = self.kv_cache_manager.get_block_ids(request.request_id) num_computed_tokens = len(block_ids) * self.block_size # Handle the case where num request tokens less then one block. num_computed_tokens = min(num_computed_tokens, request.num_tokens) if num_computed_tokens == request.num_tokens: num_computed_tokens -= 1 # This will cache the blocks iff caching is enabled. self.kv_cache_manager.cache_blocks(request, num_computed_tokens)
request.num_computed_tokens = num_computed_tokens self.finished_recving_kv_req_ids.remove(request.request_id) return True这段 _update_waiting_for_remote_kv 有几处设计值得解释。
为什么按块数换算 token 数,而不是直接用远端声明的长度? 因为拉取是按块粒度做的:目标是「把 n_ext 个 token 以整块对齐的数量拉进来」,实际拉进来的 token 数可能比 n_ext 略多(也可能略少——见下文前缀命中时 NIXL 的块选择)。最终「计算到哪」必须由实际拥有的完整块决定,否则最后一个 token 的 KV 可能是不完整的。这与前缀缓存只发布完整块是同一条规则。
为什么 num_computed_tokens == request.num_tokens 时要减一? 如果整段 prompt 的 KV 都已在池里,还需要一个「query 位置」去生成第一个输出 token:模型的最后一步前向必须以最后一个 prompt token 为输入,拿到它的 logits 才能解码。把最后一个位置标为「未计算」,调度器就会为它安排一次计算——输出的是下一个 token 的 logits,而不是重复计算前缀。
cache_blocks 做什么? 它把刚刚拉进来的块「正式发布」为可被后续请求前缀复用的块。注意 NIXL 拉取之前给这些块传了 delay_cache_blocks=True,所以拉取期间它们不会被其他请求命中——防止别人读到一半的数据。
request_finished:谁该等下再释放
NIXL 调度器的实现:
if (not params.get("do_remote_decode") or request.status != RequestStatus.FINISHED_LENGTH_CAPPED): return False, None
# Get computed blocks.all_full = request.num_computed_tokens % self.block_size == 0computed_block_ids = block_ids if all_full else block_ids[:-1]
# If prompt < block_size, no xfer so free blocks immediately.delay_free_blocks = len(computed_block_ids) > 0
return delay_free_blocks, dict( do_remote_prefill=True, do_remote_decode=False, remote_block_ids=computed_block_ids, remote_engine_id=self.engine_id, remote_host=self.side_channel_host, remote_port=self.side_channel_port, tp_size=self.vllm_config.parallel_config.tensor_parallel_size)几个细节:
- 只处理「首 token 即长度截断」这一种结束。P 实例在 P/D 分离下只跑 prefill,然后很快以
FINISHED_LENGTH_CAPPED结束(max_tokens=1 之类的设定),这是唯一需要交接的场景;如果用户在 P 实例上要求继续生成,那就没有「交给 D」这一步。 - 非整块时去掉末尾块。最后一个块可能只装了部分 token,它的内容不完整,对远端没有复用价值;而且远端也只能按完整块对齐读取。
- prompt 不足一块就不延迟释放:没有可传的内容,直接回收。
还有一个「未调度就结束」的防御:如果请求在 update_state_after_alloc 之前就被中止(do_remote_prefill 仍为 True),它会往 _reqs_need_recv 里塞一条空块记录,让 worker 侧给 P 实例发一个「我不需要了」的通知,避免 P 端块被永久占住:
if params.get("do_remote_prefill"): # ... the request must have been aborted before it was scheduled. # To avoid stranding the prefill blocks in the prefill instance, # we must add empty block_ids to _reqs_need_recv so that our # worker side will notify and free blocks in the prefill instance. self._reqs_need_recv[request.request_id] = (request, []) params["do_remote_prefill"] = False return False, NoneNIXL:以「读我想要的块」为核心的传输路径
NIXL(NVIDIA Inference Xfer Library)是 vLLM 生产级 P/D 分离主要依赖的点对点传输后端。它的设计思想与 Mooncake 一脉相承:由需要数据的一侧直接远端读取,而不是由源端主动推送。本篇以它为主要分析对象。
注册:把分页 KV 变成一组可寻址的块
worker 初始化时调用 register_kv_caches。代码先判断 KV 布局:
use_mla = len(first_kv_cache.shape) == 3assert use_mla == self.use_mlaif use_mla: # MLA case. self.num_blocks = first_kv_cache.shape[0] block_rank = 2 # [block_size, latent_dim] block_shape = first_kv_cache.shape[-block_rank:] block_size, kv_latent_dim = block_shape self.slot_size_bytes = kv_elem_size * kv_latent_dimelse: # [2 (k and v), num_blocks, ...] if self._use_flashinfer: # FlashInfer swaps 2<->num_blocks dimensions. self.num_blocks = first_kv_cache.shape[0] block_rank = 4 # [2, block_size, kv_heads, head_dim] else: self.num_blocks = first_kv_cache.shape[1] block_rank = 3 # [block_size, kv_heads, head_dim]这揭示了一个容易忽略的事实:「一个 block 在显存里有多大」取决于后端。MLA 的每层 KV 只有一个张量、末尾两维是 [block_size, latent_dim];GQA 的每层是两个张量(K 与 V),非 FlashInfer 后端第一维是 2;FlashInfer 把维度交换成了 [num_blocks, 2, ...]。连接器必须按后端实际的布局计算每个块的字节数,才能为每个块构造正确的描述符。
普通 GQA 模型(每层 K、V 各一份)的块字节数是
MLA 模型只有一个压缩后的 latent KV:
其中 是分页粒度(每块 token 数), 是 KV 头数, 是每头维度, 是 MLA 的 latent 维度, 是单个元素的字节数(FP16 为 2、FP8 为 1)。以 V4.1-Flash 量级的 MLA 配置为例,、 约 500 多、FP8 存储时一个块只有几十 KB;而同样块大小的普通 GQA 模型(、、FP16)会到 256 KB 量级。同样叫「一块」,传输成本差一个数量级,这直接决定了 P/D 传输是「可以藏在计算背后」还是「成为 TTFT 的主要项」。
一次传输的下界可以写成
是握手与提交的固定开销, 是本次要搬的块数;分母取链路带宽与显存带宽的较小值——因为源端从 HBM 读、目标端往 HBM 写,任何一侧都可能先饱和。这也解释了 Mooncake 为什么强调「逐层传输」:把 拆成每层一小批, 会略增,但传输可以和该层之后的计算重叠,端到端关键路径上只剩下最后一层的传输。
注册被拆成两级:
- 区域(region)注册:每个 cache 张量(MLA 每层 1 个、普通每层 2 个)作为一段
(base_addr, region_len, device_index),交给nixl_wrapper.get_reg_descs(caches_data, "VRAM")并register_memory。注释解释了为什么 K/V 要作为两个区域:这样 MLA(只有一份 KV)与 K/V 非连续的情形都能统一处理,代价是元数据更大(约 8KB 而非 5KB)。 - 块级描述符(xfer descs):对每个区域里的每个块编号构造
(addr + block_id * block_len, block_len, tp_rank),用get_xfer_descs注册成传输描述符。每个描述符有一个全局编号,编号规则在_get_block_descs_ids里:
for reg_id in region_ids: for block_id in block_ids: descs_ids.append(reg_id * num_blocks + block_id)于是「本地块 b 的第 l 层」对应编号 l * num_blocks + b(MLA)或 (2l + {0,1}) * num_blocks + b(普通 GQA 的 K/V)。传输时只需要给出两组编号列表——本地侧的一串和远端侧的一串——按位置配对搬运。
握手:一次交换 agent 元数据
两实例第一次需要传输时,D 端 worker 不知道 P 端的显存地址与 agent 名称。NIXL 用 ZMQ 做一次握手:
self._nixl_handshake_listener_t = threading.Thread(...)self._handshake_initiation_executor = ThreadPoolExecutor( # NIXL is not guaranteed to be thread-safe, limit 1 worker. max_workers=1, thread_name_prefix="vllm-nixl-handshake-initiator",)初始化线程池只有一个 worker,注释写明原因:NIXL 不保证线程安全。握手监听端在 base_port + tp_rank 上起 ROUTER socket,把 NixlAgentMetadata(agent 名称、KV base 地址、块数、块大小等)msgspec 编码后返回给对方;发起端拿到后建立 _remote_agents[engine_id][rank] = agent_name。
两个设计要记下来:
- DP rank 有自己的端口段:
side_channel_port = VLLM_NIXL_SIDE_CHANNEL_PORT + dp_rank * tp_size,同一 DP 组内每个 TP rank 用base_port + tp_rank,避免端口冲突。 - 握手与传输解耦:
start_load_kv遇到未握手的 engine,会把请求挂到_ready_requests队列后立即返回,握手的 future 完成回调再把请求放回队列。这样「第一次连接」也不会阻塞整个 step。
拉取:前缀命中的块选择与 TP 异构
start_load_kv 依次处理元数据里的请求:
for req_id, meta in metadata.requests.items(): ... if remote_engine_id not in self._remote_agents: with self._handshake_lock: if remote_engine_id not in self._remote_agents: self._background_nixl_handshake(req_id, remote_engine_id, meta) continue self._read_blocks_for_req(req_id, meta)while not self._ready_requests.empty(): self._read_blocks_for_req(*self._ready_requests.get_nowait())真正构造传输的是 _read_blocks,其中有几处非平凡逻辑:
# Number of D TP workers that will read from dst P. Propagate tp_ratio# on notification so that dst worker can wait before freeing blocks.tp_ratio = self._tp_size[self.engine_id] // self._tp_size[dst_engine_id]notif_id = f"{request_id}:{tp_ratio}".encode()
num_local_blocks = len(local_block_ids)if num_local_blocks == 0: remote_rank = self.tp_rank // tp_ratio agent_name = self._remote_agents[dst_engine_id][remote_rank] self.nixl_wrapper.send_notif(agent_name, notif_msg=notif_id) return
num_remote_blocks = len(remote_block_ids)assert num_local_blocks <= num_remote_blocksif num_local_blocks < num_remote_blocks: remote_block_ids = remote_block_ids[-num_local_blocks:]要点:
- D 端本地前缀已经全命中时,
local_block_ids为空。此时不需要读任何东西,但仍要发通知——否则 P 端以为自己还有读者,块永不释放。通知里带上tp_ratio,因为 P 端需要知道有多少个 D 的 TP worker 会来读它,全部读完才能释放。 - 部分命中的对齐:D 端已有前
num_remote_blocks - num_local_blocks个块的内容,只需要远端块的末尾num_local_blocks个。所以remote_block_ids = remote_block_ids[-num_local_blocks:]。这是一条不易发现的细节——如果按前缀对齐读取,就会把已命中的块再读一遍,甚至读到位置错配的数据。 - TP 异构映射:一个 D rank 对应
tp_ratio = D_tp // P_tp个 P rank 中的某一个(remote_rank = self.tp_rank // tp_ratio),一个 D worker 只从一个 P worker 拉。这是「异构 TP」下 vLLM 采取的一种简化映射,后续版本中有更完整的分片读取逻辑。
用一个具体例子把「取末尾块」讲清楚。设块大小 ,prompt 有 8 个完整块(128 token),D 端本地前缀缓存已经命中前 2 个块(32 token)。调度器传入 num_computed_tokens=32,NIXL 的 get_num_new_matched_tokens 算出 count = round_down(128,16) - 32 = 96,即还需要 6 个块。update_state_after_alloc 拿到本地新分配的 6 个块编号,_read_blocks 里 local_block_ids 长度是 6,而远端 remote_block_ids 长度是 8。它执行 remote_block_ids[-6:],也就是取远端第 2 到第 7 块,和本地 6 个块按顺序配对。
为什么不能取前 6 块?因为本地已经有第 0、1 块的内容,真正缺的是第 2 到第 7 块。如果按前缀取,会把第 0、1 块再读一遍,同时漏掉最后两块;更糟的是,目标端会把远端第 0 块写进本地「第 2 个新块」的位置,块表与内容整体错位,decode 时读到的是错位的历史。分页 KV 的传输是按块编号配对的,不是按字节流拼接的,这是连接器实现里最容易写错的一处。
传输描述符的编号也随之确定:远端第 2 块在 MLA 的第 层对应编号 l * num_blocks + 2;本地新块(假设编号 40)对应 l * num_blocks + 40。make_prepped_xfer 接收两个等长的编号列表,NIXL 按索引配对,逐层搬完。
最后,按区域组装描述符编号并提交一次 READ 传输:
handle = self.nixl_wrapper.make_prepped_xfer( "READ", local_xfer_side_handle, local_block_descs_ids, remote_xfer_side_handle, remote_block_descs_ids, notif_msg=notif_id,)self.nixl_wrapper.transfer(handle)self._recving_transfers[request_id].append(...)notif_msg 随传输一起发出,意味着通知是在数据完成时由传输层发出的,不由本端代码手动触发。这避免了「通知先到、数据未到」的竞态。
完成:跨 TP rank 的完成计数
get_finished 需要解决一个问题:TP=8 时,8 个 rank 都在收,调度器只应该看到 rank 0 的结果。代码的处理:
if self.tp_rank == 0: for req_id in done_sending: self._done_sending_count[req_id] += 1 for req_id in done_recving: self._done_recving_count[req_id] += 1 other_ranks_finished_ids = [] for i in range(1, self.world_size): other_ranks_finished_ids.extend(self.tp_group.recv_object(src=i)) ... for req_id in list(self._done_recving_count.keys()): if self._done_recving_count[req_id] == self.world_size: ...每个 rank 完成时把自己完成的 ID 发给 rank 0(tp_group.send_object(finished_req_ids, dst=0)),rank 0 计数,所有 rank 都完成后才返回给调度器。这里有个隐含顺序:rank 0 先处理自己的完成集合,再收其他 rank 的消息,因此其他 rank 报来的 ID 可能是「已完成但因某原因未在 rank 0 集合里」的,代码通过「在 _done_recving_count 或 _recving_transfers 里」来区分收发方向。
其他连接器:同一接口下的不同取舍
KVConnectorFactory 注册了多个实现,它们覆盖的场景不同:
| 连接器名 | 实现文件 | 传输性质 | 典型用途 |
|---|---|---|---|
P2pNcclConnector | v1/p2p/p2p_nccl_connector.py | 同步,P 主动 send、D 主动 recv(NCCL + ZMQ) | 教学/调试、小规模 P/D |
NixlConnector | v1/nixl_connector.py | 异步,D 端 READ 远端显存 | 生产级 P/D 分离(Mooncake、Dynamo 等) |
LMCacheConnectorV1 | v1/lmcache_connector.py | 薄封装,逻辑全部在 LMCache 侧 | CPU/磁盘/远端 KV 层、前缀缓存卸载 |
SharedStorageConnector | v1/shared_storage_connector.py | 文件系统 safetensors 读写 | 功能验证、跨进程不共享网络时的权宜之计 |
MultiConnector | v1/multi_connector.py | 组合:从一个 load、向所有 save | 本地缓存 + P/D 传输同时启用 |
旧版 PyNcclConnector / MooncakeConnector / MooncakeStoreConnector | kv_connector/*.py(非 v1) | V0 接口 | 历史兼容 |
LMCache:把逻辑推给外部引擎
先看工厂如何实例化它。V1 连接器既可以来自内置注册表,也可以来自外部模块路径,后者是 LMCache 这类第三方后端接入的标准方式:
connector_name = kv_transfer_config.kv_connectorif connector_name in cls._registry: connector_cls = cls._registry[connector_name]()else: connector_module_path = kv_transfer_config.kv_connector_module_path if connector_module_path is None: raise ValueError( f"Unsupported connector type: {connector_name}") connector_module = importlib.import_module(connector_module_path) connector_cls = getattr(connector_module, connector_name)assert issubclass(connector_cls, KVConnectorBase_V1)kv_connector_module_path 不是事后补的逃生通道,而是与注册表并列的一等入口:内置实现走注册表,外部实现走模块路径,两者在创建前都要通过 issubclass(..., KVConnectorBase_V1) 的类型检查。注册表的注册被刻意集中在一个文件(factory.py)里,注释解释原因——希望只加载当前连接器对应的文件,而不是把所有传输库都 import 进来。对一个同时支持 NCCL、NIXL、sglang 风格存储后端的框架来说,这一点很实际:import 即链接,链接不上的库会让进程起不来。
LMCacheConnectorV1 自身几乎只是转发:
def __init__(self, vllm_config, role): super().__init__(vllm_config=vllm_config, role=role) self._lmcache_engine = LMCacheConnectorV1Impl(vllm_config, role, self)
def start_load_kv(self, forward_context, **kwargs): self._lmcache_engine.start_load_kv(forward_context, **kwargs)这不是偷懒,而是接口设计的副产品:只要连接器接口足够完整,外部项目就可以完全接管 KV 的存储、淘汰与传输策略。LMCache 借此实现了 CPU 内存、本地磁盘、远端存储的分层,并在调度器侧提供自己的前缀查询。对读源码的人来说,它是一个好例子:一个连接器不需要自己写任何 GPU kernel,只要把「多少个 token 命中」「在哪里」「何时搬完」三件事回答清楚。
SharedStorage:最小可用的参考实现
class SharedStorageConnector(KVConnectorBase_V1): # NOTE: This is Simple debug implementation of the KV connector. # It save / load the KV cache to / from the disk. # It does extra work which will overwrite the existing prefix-cache in GPU它用请求的 token_ids 与槽位映射构造文件名和偏移,把 KV 层存成 safetensors,再读回。它的价值在于给出一个「把接口所有方法都实现」的骨架:ReqMeta.make_meta 里从 block_ids 与 block_size 算出 slot_mapping 的那段代码,是理解「分页块 ↔ 连续 token」映射最直观的例子:
block_offsets = torch.arange(0, block_size)slot_mapping = block_offsets.reshape((1, block_size)) + \ block_ids_tensor.reshape((num_blocks, 1)) * block_sizeslot_mapping = slot_mapping.flatten()[:valid_num_tokens]MultiConnector:一次命中、多处保存
class MultiConnector(KVConnectorBase_V1): """ The current logic is: - Load KV from the first connector that advertises available tokens from get_num_new_matched_tokens(), based on the order in the config. - Save to all connectors. """加载时只从第一个能提供内容的连接器读(避免重复读取同一段 KV),保存时向所有成员分发。实现上的难点在「异步保存计数」:多个成员可能各自异步保存,request_finished 需要等到所有成员的保存都完成才能释放块,所以它用 extra_async_saves 把「除一个之外的额外保存数」随元数据下发到 worker,由 worker 侧统计:
if async_saves > 1: self._extra_async_saves[request.request_id] = async_saves - 1并且只允许一个成员返回 kv_transfer_params(否则 P/D 信息会冲突):
if kv_txfer_params is not None: raise RuntimeError( "Only one connector can produce KV transfer params")P2P NCCL:同步模式下的显式分工
P2pNcclConnector 用 is_producer / is_consumer 区分实例角色。生产者侧在 build_connector_meta 里把已完成的 prompt 打包发送,并专门处理分块 prefill:块还没凑齐时先记在 self.chunked_prefill 里,等所有块齐了再发。消费者侧先 recv_tensor,再按 slot_mapping 把数据写进分页池:
dst_kv_cache_layer[slot_mapping, ...] = src_kv_cache注意这是按 token 槽位写入而非按块拷贝,所以能兼容「目标端块表与源端块编号不同」的情况,但也意味着它是逐层、逐请求的显式拷贝,无法走 RDMA 直写。
它的调度器侧实现更能说明「同步」模式的含义。消费者端(decode)的 get_num_new_matched_tokens 直接返回差量且 False:
if self.is_producer: return 0, Falsenum_external_tokens = (len(request.prompt_token_ids) - 1 - num_computed_tokens)if num_external_tokens < 0: num_external_tokens = 0return num_external_tokens, False因为返回 False,请求不会进入 WAITING_FOR_REMOTE_KVS,而是正常进入本步调度;update_state_after_alloc 把请求放进 _requests_need_load,build_connector_meta 再为它构造 ReqMeta。于是同一步里:start_load_kv 阻塞 recv_tensor,注意力层计算读到的就是完整的 KV。代价很直接——拉取时间全额落在 TTFT 的关键路径上,且它只支持「一次性全部拉完」,没有层间流水。它适合单机多卡、带宽充足且请求长度可控的实验环境;上线到跨机 RDMA 时,通常会换成 NIXL 或 Mooncake 一类支持异步读的后端。
生产者端(prefill)则多了一层 chunked_prefill 记账:只有当本请求的 prompt 全部块被调度执行过(num_tokens >= len(prompt_token_ids))才发 add_request,否则把已分配的块与完整 prompt token 列表存在 self.chunked_prefill[req_id] 里,等下一次调度接着累积。这段逻辑直观地展示了一个事实:连接器必须理解「一次 prefill 可能被切成多步」,否则会把半截 KV 发出去。
ReqMeta.make_meta 里还有一处值得记下的取舍:它把连续的 token 列表映射为「块偏移 + 块号」的槽位映射,align_to_block_size 把长度向上对齐到块边界,然后 slot_mapping = block_offsets + block_ids * block_size 展开再截断到有效 token 数。槽位映射就是注意力内核写 KV 时用的那张表,P2P 连接器在接收端构造同一张表,把收到的连续 [num_tokens, ...] 张量按槽位散写进分页池。「块表」和「槽位映射」是两件事:前者描述块与块的顺序,后者描述每个 token 落在哪一块的哪个位置,这一点在 vLLM 源码完全拆解(四):KVCacheManager 如何分配、复用与回收物理 Block 也专门对比过。它的 get_num_new_matched_tokens 返回 (len(prompt) - 1 - num_computed, False)——同步:请求不会进入 WAITING_FOR_REMOTE_KVS,而是一边收一边算。
横向对照:SGLang 与 TensorRT-LLM 把职责放在了哪一层
同一个问题,三个框架的切法不同。对照它们的职责边界,比单独读某一家的源码更容易看清「哪些事必须由框架做,哪些可以外置」。
| 关注点 | vLLM V1 KV Connector | SGLang Disaggregation | TensorRT-LLM Disaggregated Serving |
|---|---|---|---|
| 配对谁来做 | 框架外:请求输出携带 kv_transfer_params,由 router/proxy 转交 | 框架内:bootstrap server + bootstrap_room 注册与查询 | 框架内:orchestrator 层拆请求、配对 P/D |
| 调度语义 | 连接器基类的 5 个调度器侧方法 | KVPoll 五状态机 + CommonKVSender/KVReceiver | 调度器 + CacheReuseAdapter,控制面/数据面分离 |
| 传输后端 | 可插拔:NIXL / LMCache / P2P NCCL / 自定义模块 | 可插拔:Mooncake / NIXL / MORI 等 BaseKVManager 子类 | 可插拔:TransferAgent 抽象 |
| 层间流水 | wait_for_layer_load / save_kv_layer | 按 chunk 传输,TransferKVChunk 表达分块 | 层组配对 + mapper,支持不均衡 TP |
| 异构 TP | tp_ratio + 描述符选择(仍在演进) | 由 KVArgs 与后端 manager 处理 | 专门的三层拓扑对齐与 mapper 家族 |
本站在 SGLang 源码完全拆解(十二):Disaggregation——Prefill 与 Decode 如何拆到两台机器、KV 如何跨实例传输 里拆过 SGLang 的完整时序:它在框架内起 bootstrap server,prefill rank 注册自己的并行拓扑,decode 侧按 bootstrap_room 查询后建立 KVSender/KVReceiver,传输本身交给 Mooncake/NIXL。相比之下,vLLM 把「配对」外置给路由层,连接器只关心「拿到远端地址之后怎么搬、怎么记账」——这让 vLLM 的连接器更小,但也意味着生产部署必须自带一个会读 kv_transfer_params 的路由器。
TensorRT-LLM 的选择又不一样。TensorRT-LLM 源码完全拆解(十六):P/D 分离与 KV 传输——控制面、数据面与拓扑异构的对齐 里可以看到它在 orchestrator 层做请求拆分与配对,控制面负责「谁和谁配对、页表怎么对齐」,数据面由 TransferAgent 执行;遇到 TP 不均衡时,它用层组与字节级 mapper 解决「每个 rank 该搬哪一段」。这是一种把拓扑异构当作一等公民的设计,复杂度也最高。
三种切法的共同点是:调度器必须先知道「要搬哪些块」,传输层才知道「搬到哪」。区别只在于这份「搬家清单」由谁生成、由谁持有。vLLM 把它压缩成每步一份的 KVConnectorMetadata,这是三者中最轻的一种表达。
读连接器源码时最容易误读的几行
源码里有些写法初看平平,细看藏着约定。挑几条对理解整体结构最有帮助的。
第一,「按层名索引的 attn_metadata 字典」不是可选项。 连接器逐层等待与逐层保存,都依赖 attn_metadata[layer_name] 能定位到当前层。若某后端把元数据聚合成单一对象,逐层流水就无法实现,只能整模型等待。所以「支持层间流水」这件事,一半取决于连接器,一半取决于注意力后端的元数据组织方式。
第二,get_num_new_matched_tokens 被注释为「可能被多次调用」。 基类文档写道 Might be called multiple times for a given request and should be side-effect free。调度器在预算不足、块分配失败、编码器输入裁剪等情况下可能把请求挂起后重新尝试准入。如果连接器在这个方法里偷偷改状态(比如「第一次查询时登记到待拉列表」),就会重复登记或漏登记。正确的分担方式是:查询只读,登记放到 update_state_after_alloc。
第三,build_connector_meta 文档说它「会重置连接器状态」。 这意味着 _reqs_need_recv 这类队列是「一次性」的:本步构造完元数据就清空,下一步重新累积。对异步加载来说,元数据只是「本步发起哪些拉取」的指令,并不表示这些拉取会在本步完成;完成状态走另一条通道(get_finished)。
第四,finished_req_ids 参数告诉你「哪些请求已经结束」,但连接器不该据此立即释放远端块。 远端块的释放要靠「通知」——由读到数据的一方(或其读完后发出的通知)驱动。结束的请求如果还挂着 do_remote_prefill,NIXL 反而要往 _reqs_need_recv 里塞一条空记录,目的就是让通知发出去。这再一次说明:KV 的生命周期由「谁在用」决定,而不是由「请求是否结束」决定。
第五,连接器实例有两个,不是一个。 is_kv_transfer_group() 为假时,注意力层里的两个钩子直接返回;为真时,worker 进程里持有的是 WORKER 角色的连接器,调度器进程里持有的是 SCHEDULER 角色的连接器。两个实例各自维护状态,状态不一致就是 bug 的来源,而这正是元数据要显式下发的原因。
从单实例到集群:vLLM 与生产级 KV 系统
vLLM 的连接器抽象只负责「一次配对传输」。线上系统在它之上还要解决更多问题,这些正好可以从同一条发展线上理解:
- Mooncake(2024 年由月之暗面团队公开,arXiv:2407.00079):以 KVCache 为中心重新组织集群。它有一个 CPU 内存里的大 KVCache 池(下图),块带哈希、按前缀去重;prefill 实例把 KV 逐层写入池,decode 实例按需异步读取。vLLM 的
MooncakeConnector就是接入这套传输的早期实现。
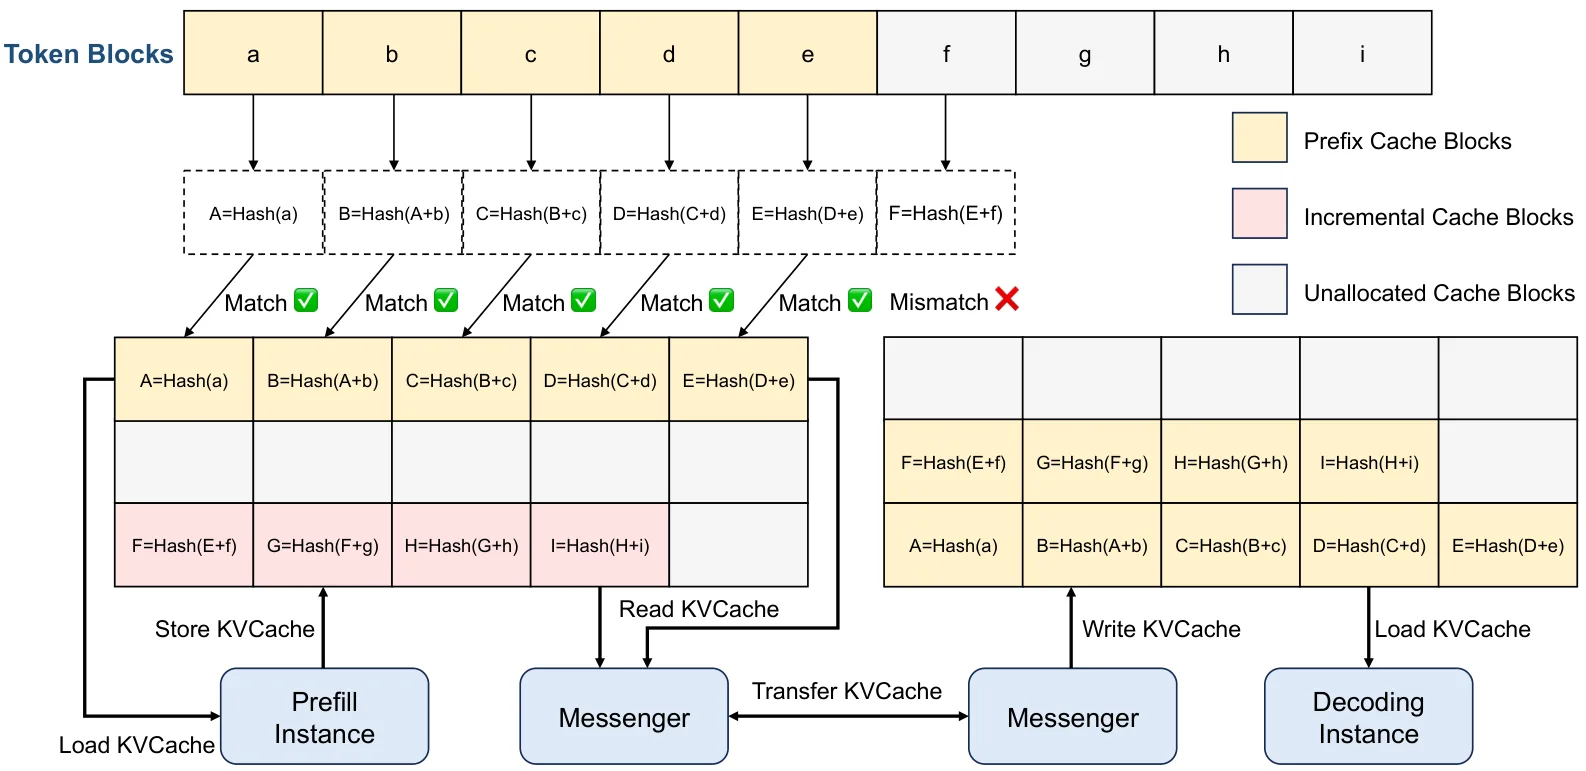
(图源:Mooncake 论文 Figure 3,arXiv:2407.00079v5)
- KVCache 中心调度:Mooncake 的论文里还有一张架构图,把「KVCache 池作为一等公民」摆在整个集群的中央,prefill、decode、存储机群围绕它组织。
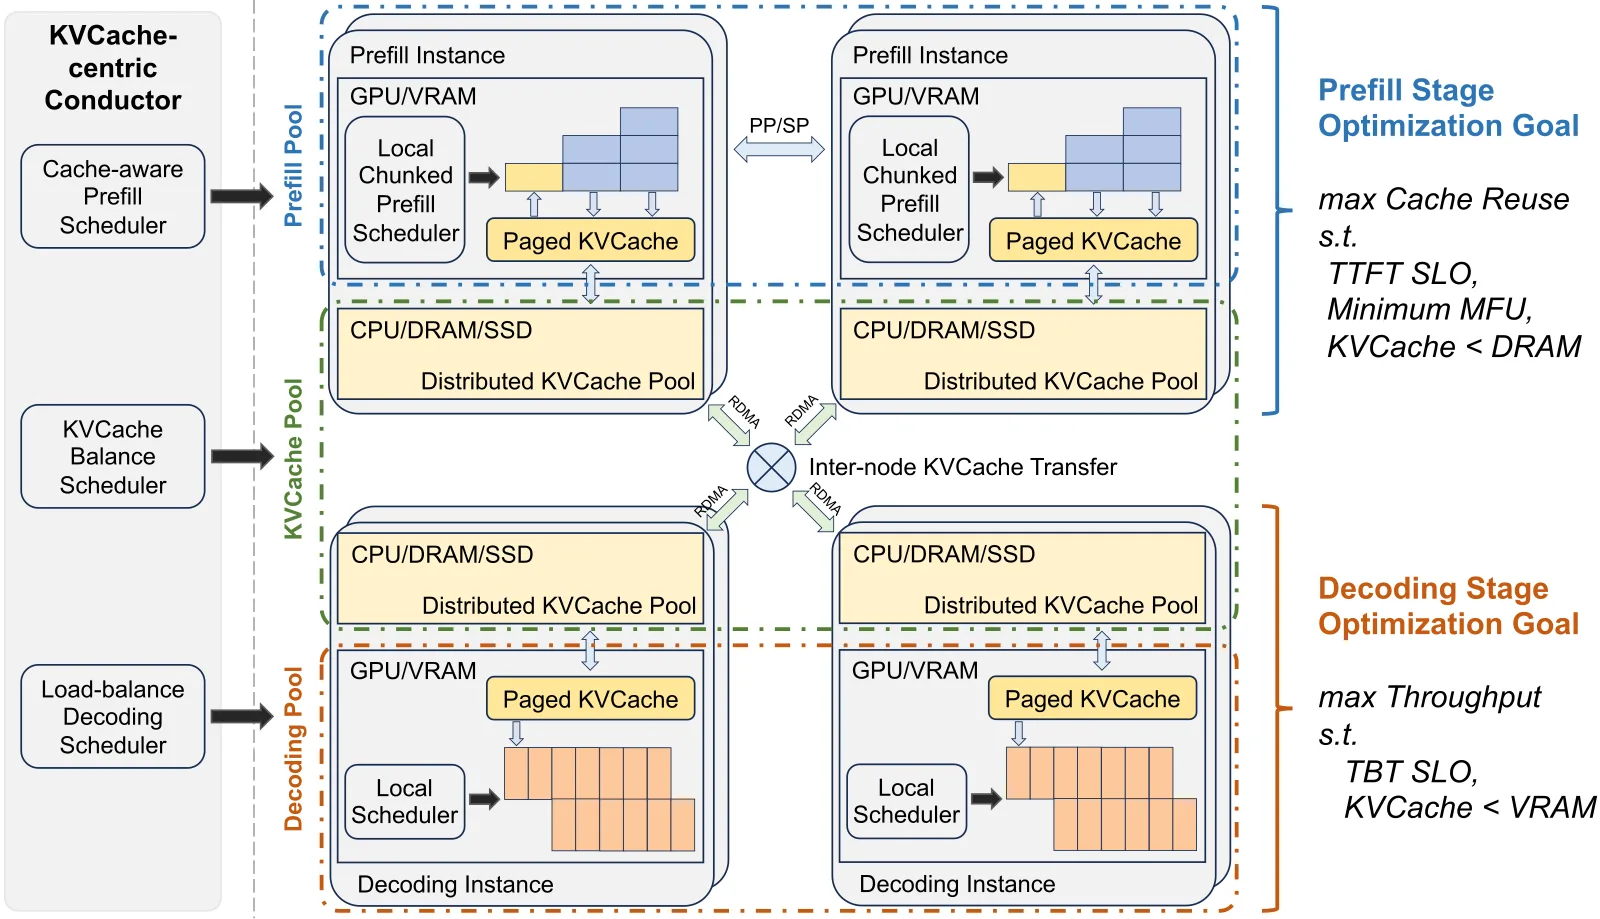
(图源:Mooncake 论文 Figure 1,arXiv:2407.00079v5)
- 推理实例的工作流:prefill 端逐层加载/写入池并与计算并行,decode 端异步加载与解码并行。这张图解释了为什么连接器接口要提供「按层等待」而不是「整模型等待」。
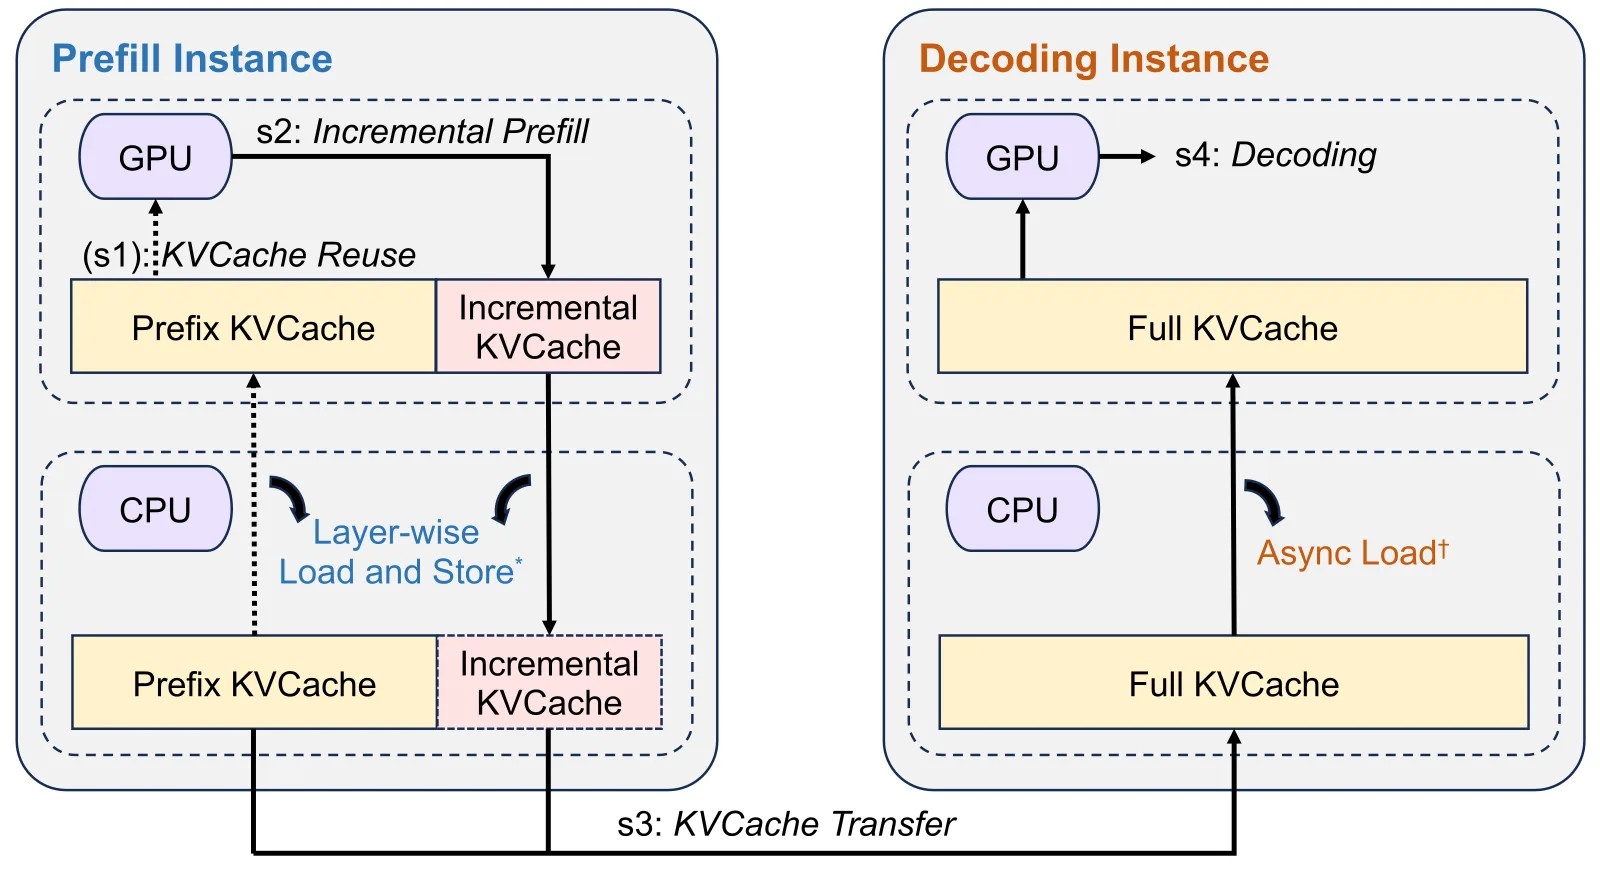
(图源:Mooncake 论文 Figure 4,arXiv:2407.00079v5)
- DeepInfer 的选择:DeepSeek 开源的推理引擎把「KV Cache Store」放在框架之外,与内部基础设施耦合的 KVCache 管理与负载均衡部分不随框架开源(见其部署问答)。它采用「VE / Prefill / Decode + 专门存储节点」的分离架构,并设置了超过 72 小时的缓存保留窗口。对比来看:vLLM 提供的是可插拔的传输接口,存储层与全局调度留给外部系统;DeepInfer 则把存储层当成自身基础设施的一部分。两种选择对应用户形态不同——前者适合自建,后者适合已拥有大规模存储与编排能力的服务商。
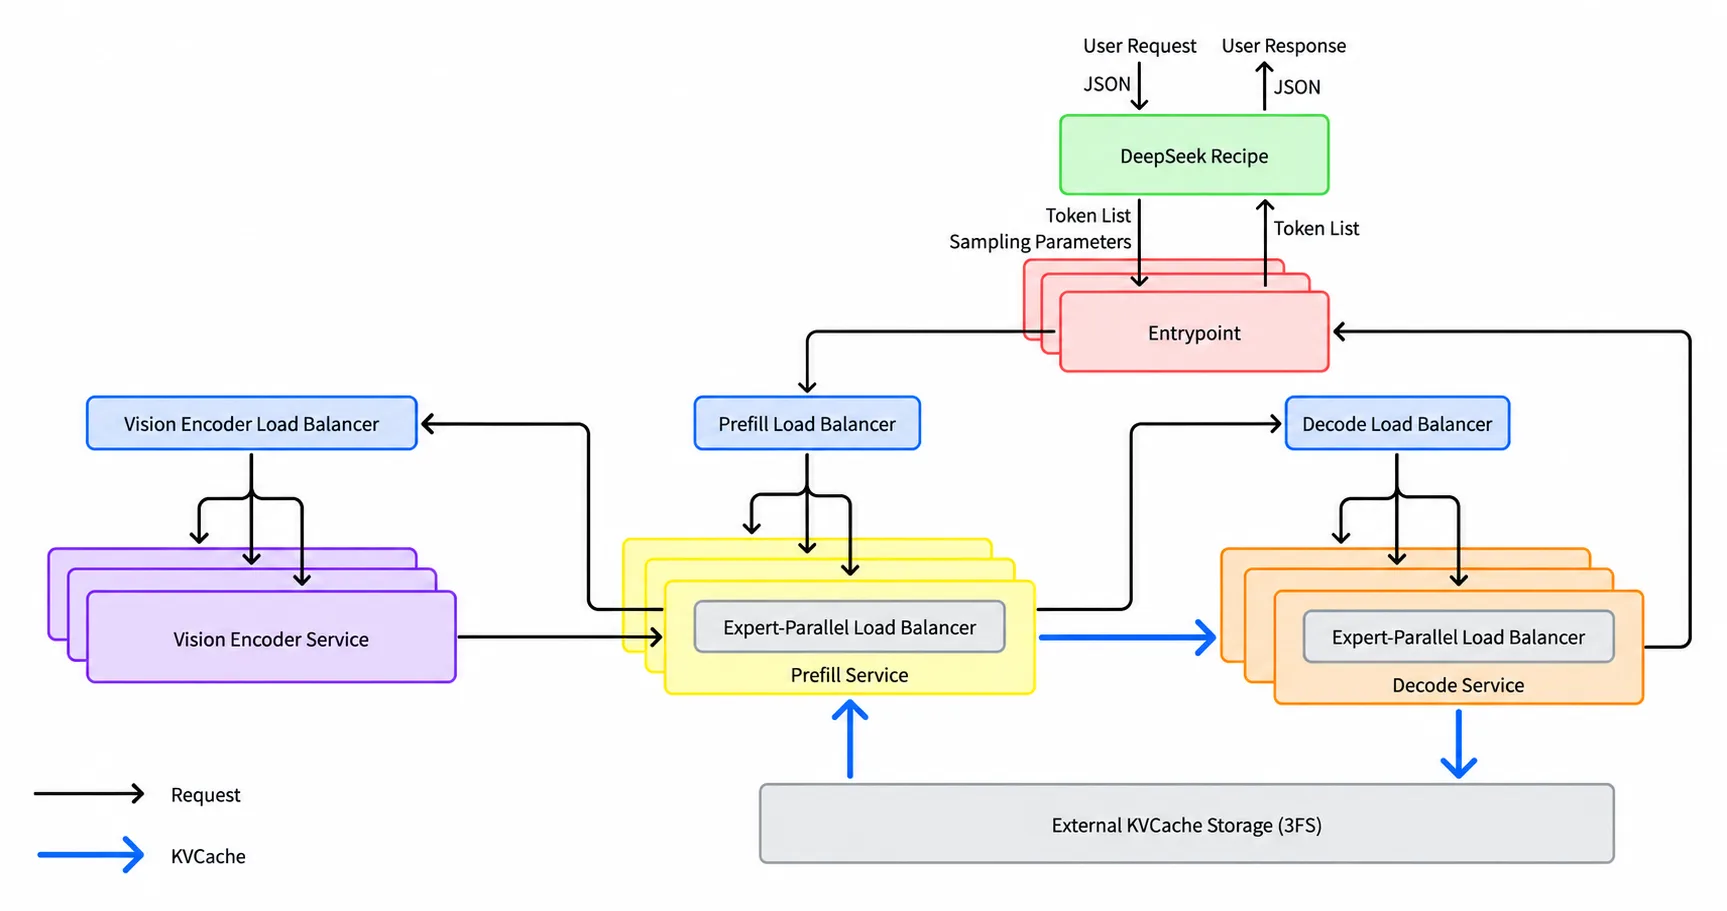
(图源:DeepSeek V4.1 Flash 推理部署问答,DeepInfer 仓库 doc/images/architecture_overview.png)
工程边界:那些读过源码才会注意的细节
前缀命中与「外部命中」的叠加顺序
调度器先本地后外部,这个顺序决定了 get_num_new_matched_tokens 的实现必须考虑本地已命中的部分:NIXL 从 num_computed_tokens 开始算差量,LMCache 会查它自己的缓存并跳过本地前缀。如果连接器忽略了 num_computed_tokens,同一个前缀会被计算两遍,块表也会错位。
分块 prefill 下的延迟交接
P 端若开了分块 prefill,一次 schedule 只算 prompt 的一段。request_finished 只在请求结束时触发,因此只有在最后一段完成时 num_computed_tokens 才是 round_down(prompt_len, block_size)。P2P 连接器为此单独维护 chunked_prefill,NIXL 则依赖「结束时取块」,本质上都是「等凑齐再交」。
更麻烦的是 D 端:get_num_new_matched_tokens 里对 num_computed_tokens % block_size != 0 直接断言,因为 NIXL 按块拉取,D 端本地命中必然是整块。
ZOS 与异步调度下的时序
DeepInfer 用延后一拍的 ZOS 把 CPU 后处理移出关键路径;vLLM V1 没有这个名字,但它的调度器一样「先发这一步的执行,再处理上一步的输出」。连接器要适应这种时序:build_connector_meta 生成的是本步要搬的内容,而 get_finished 报告的是上步及之前的搬完状态。任何依赖「本步发起的传输在本步就完成」的假设都会错。
张量并行与异构
- TP 组内每个 rank 独立传输自己负责的头;
rank 0汇总完成情况,调度器只看一份结果;- 异构 TP 需要额外的
tp_ratio通知与「一个 D rank 对多个 P rank」的映射,这是 NIXL 实现里最复杂的部分之一,也在快速演进; - 每层的 KV 布局因后端而异(NHD/HND、K/V 分离、MLA),注册与描述符构造都必须按后端实际
shape走。
失败处理目前仍是薄弱点
NIXL 的握手回调里有一条 TODO:
# TODO: handle failure state of future in the# callback, we want to fail the request in this case.def request_ready(_f: Future[Any], entry=(req_id, meta)): self._ready_requests.put(entry)握手失败时请求会一直停在 WAITING_FOR_REMOTE_KVS(除非另有超时机制),不会自动降级成本地 prefill。生产部署需要在上层编排层(router / proxy)设置超时与重试,或在连接器里补上失败降级。这是 KV Connector 作为「实验性 API」——KVConnectorBase_V1.__init__ 里那句 This API is experimental and subject to change——的真实含义。
与批次不变性、确定性共享的「同一份 KV」
值得一提的是一个容易被忽视的耦合:vLLM 的 NixlConnector 在读取时按块整块搬运,而 D 端计算时读的仍是自己分页池里的数据——KV 的数值只取决于源端如何计算它,不取决于 D 端 batch。这也意味着,如果 D 端启用了批不变算子,源端也必须启用,否则同一段前缀在不同 P 实例上算出的 KV 会有数值差异。Thinking Machines 实验室 2025 年的博客《Defeating Nondeterminism in LLM Inference》实验展示了同一请求在 batch=1 与 batch=768 下 logprob 可相差约 0.6,并因此让同一 1000 次运行的 completions 产生 18 种类别;他们的 batch_invariant_ops 库通过 set_batch_invariant_mode() 替换 matmul、RMSNorm、注意力等算子实现批不变。两幅对比图直观地展示了「相同输入、不同批次组成」如何分出多条轨迹:
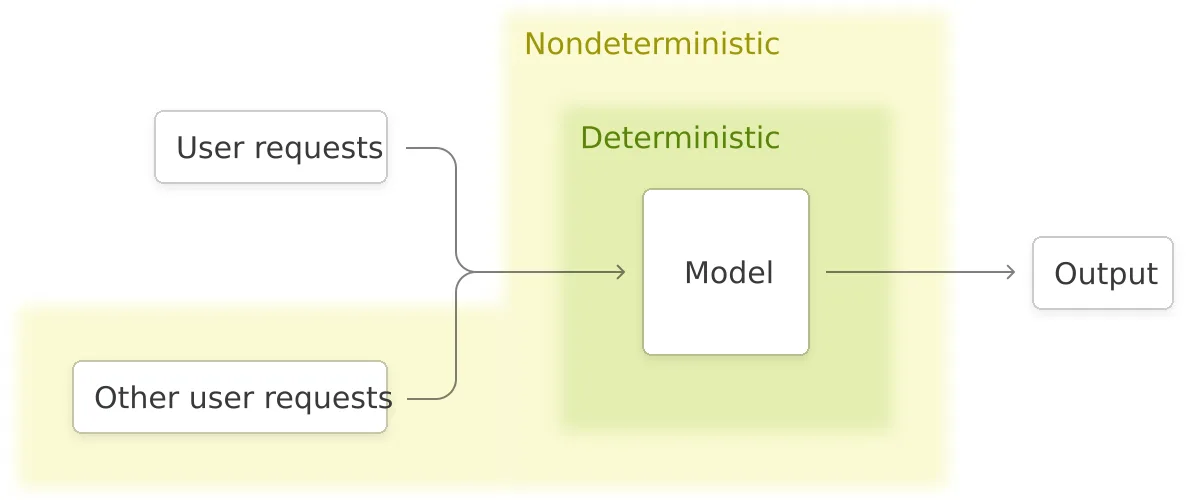
(图源:Thinking Machines Lab 博客 Figure,svgs/nondeterministic.svg)
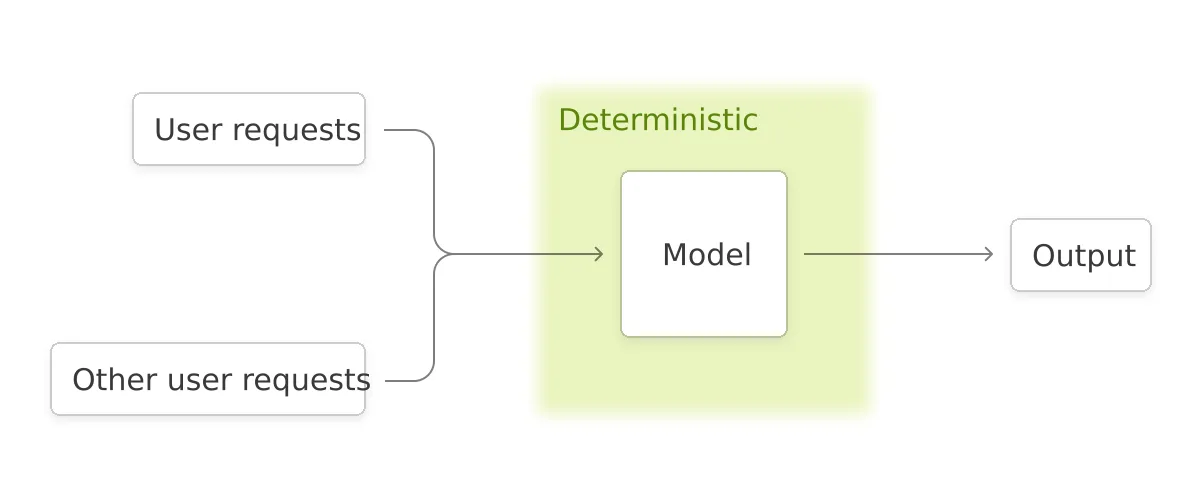
(图源:Thinking Machines Lab 博客 Figure,svgs/deterministic.svg)
对 P/D 分离而言,这条约束会被放大:同一个请求的 KV 来源可能换了一个 P 实例,如果两实例的算子路径不一致,前缀复用就会产生不可复现的数值漂移。
一次异步加载的逐步时序:把「占块不占预算」拆开看
设 D 实例在第 步的调度中遇到请求 R:本地命中 0 token,NIXL 报告远端有 96 token(6 个块),异步加载。
- 第 步:调度器分配 6 个块给 R,标记
delay_cache_blocks=True;R 进入WAITING_FOR_REMOTE_KVS,不进入本步的 token 预算。update_state_after_alloc把 R 放进_reqs_need_recv。 - 第 步末:
build_connector_meta生成一条ReqMeta,包含本地块编号、远端块编号、远端 engine 地址;同时清空_reqs_need_recv。元数据随SchedulerOutput下发。 - 第 步执行前:worker 绑定元数据,
start_load_kv发起 NIXL READ(若首次还要握手,先挂起)。 - 第 到 步:R 一直在等待队列,调度器每步都会调用
_update_waiting_for_remote_kv检查;未完成就继续跳过它。注意:此时它的 6 个块已经被占用,其他请求无法使用,但也没人读取它们。 - 第 步末:
get_finished返回 R;调度器把 R 转回WAITING,num_computed_tokens=96(若 prompt 恰好 96 token 则减一,变成 95)。 - 第 步:R 被正常调度,计算最后一个 prompt token 并解码第一个输出 token。
这条时序解释了「异步」的真实代价:它没有阻塞 GPU,但占用了 KV 容量。如果大量请求同时等待远端 KV,分页池会被「占着但不可用」的块迅速吃满,触发其他请求的抢占。生产系统需要根据远端传输的 P99 延迟和并发量预留容量,或者限制同时处于 WAITING_FOR_REMOTE_KVS 的请求数。这是连接器接口之外、部署层必须补的策略。
上线前的检查清单
- 远端与本地块大小一致:
block_size是连接器、KV 管理器、注意力后端共享的常量;改分页粒度会同时改变两端布局。 - 并行拓扑写进传输参数:
tp_size必须随kv_transfer_params传给 D 端,否则tp_ratio算错,读到的块会缺头或少尾。 - KV 布局按后端校准:FlashInfer 的维度交换、MLA 的 3D 张量、FP8 的
slot_size_bytes,任何一项不一致都会让描述符越界或错位。 - 完成通知必须送达:全命中时也要发
send_notif,否则 P 端块泄漏;这是 P/D 分离最常见的「显存慢漏」来源。 - 失败要能降级:握手失败、传输超时、对端重启,都应该让请求回退到本地 prefill;当前 NIXL 实现里这条路径还不完整。
- 两侧的数值路径一致:如果启用批不变算子,P 与 D 必须同时启用;前缀复用的前提是「同一段 token 算出的 KV 相同」。
小结
本篇从接口出发拆了 vLLM 的 KV Connector:
- 它解决的是三类问题的缝合:物理传输、分页布局与并行拓扑的语义、调度语义;vLLM 把第三类收进统一接口,并显式拆成 scheduler / worker 两个角色。
- 调度器侧五个方法构成一条线:查询外部命中 → 分配后记录待拉请求 → 构造元数据 → 结束时决定块是否延迟释放;worker 侧六个方法负责注册、绑定、按层发起/等待/保存、以及汇报完成。
- NIXL 是「目标端按描述符列表 READ 远端显存」:以区域 + 块级描述符把分页 KV 变成可寻址对象,ZMQ 握手交换 agent 元数据,传输完成由传输层发出通知,TP 组内 rank 0 汇总完成计数。
- LMCache、SharedStorage、P2P NCCL、Multi 展示了同一接口在存储层、同步传输、组合场景下的不同取舍。
- 工程边界集中在:前缀命中叠加、分块 prefill、异步调度的时序、异构 TP 与布局差异、失败降级。
如果把 vLLM 的源码当成一套「推理操作系统」,KV Connector 就是它的「设备驱动层」:上层的调度器不需要知道 KV 是在本地显存、远端显存、CPU 池还是文件系统里,只需要通过一个窄接口问三件事——有多少、在哪、何时可用。
下一篇计划讨论 vLLM 的 metric 与可观测性体系:StatsLogger 如何从每个 step 的原始计数聚合出吞吐、前缀缓存命中率、投机解码接受率与显存水位,以及这些指标在 P/D 分离部署下如何分别观测两侧实例。
参考资料
- vLLM: Easy, Fast, and Cheap LLM Serving with PagedAttention(Kwon et al., SOSP 2023,分页 KV 与共享前缀的背景)
- Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving(arXiv:2407.00079,KVCache 池、逐层传输与以 KV 为中心的调度)
- NIXL: NVIDIA Inference Xfer Library(vLLM 生产级 P/D 传输所用的点对点传输库)
- LMCache: KV cache layer for LLM inference(CPU/磁盘/远端分层 KV 缓存与 vLLM 集成)
- vLLM 仓库:
vllm/distributed/kv_transfer/kv_connector/v1/base.py(KVConnectorBase_V1 接口文档) - vLLM 仓库:
vllm/distributed/kv_transfer/kv_connector/v1/nixl_connector.py(NIXL 连接器的调度器侧与 worker 侧实现) - Defeating Nondeterminism in LLM Inference(Thinking Machines Lab, 2025,批不变算子与确定性推理)
- batch_invariant_ops 仓库(批不变算子的参考实现)
- SGLang Deterministic Inference 文档(基于批不变算子的确定性推理配置与后端兼容性)
- DeepSeek V4.1 Flash 推理部署问答(DeepInfer 的 VE/Prefill/Decode 分离架构与 KVCache 存储设计)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



