


TensorRT-LLM 源码完全拆解(十):投机解码——one-model 统一 worker、KV 回滚与验收流水线
从这一篇开始补上 TensorRT-LLM 的投机解码
这个系列走完了 TensorRT-LLM 的调度器、KV Cache 管理与注意力后端(可参考 TensorRT-LLM 源码完全拆解(九):KV Cache 压缩框架),接下来要看的是推理引擎里另一个大模块:投机解码(speculative decoding)。
投机解码的通用原理在本站已经讲过不止一遍——vLLM 的实现见 vLLM 源码完全拆解(十):投机解码,SGLang 的实现见 SGLang 源码完全拆解(十一):投机解码,算法侧的 EAGLE-3、MTP、Medusa、Lookahead 也各有专文。这一篇不再重复讲”什么是草稿、什么是验证”,而是回答一个更具体的问题:在 TensorRT-LLM 的代码里,投机解码是怎么落地的,它和 vLLM、SGLang 的做法在结构上差在哪里。
先建立直觉:投机解码的两个时间账
投机解码的全部收益来自一个非常朴素的事实:一次前向可以并行算很多个位置的 logits,但只能按顺序确定下一个 token。
具体到生成阶段,目标模型一次前向读入 个位置,输出 组 logits。如果这 个位置恰好是”上一步已经确定的那 1 个 token,加上草稿模型猜出来的 个 token”,那么这 组 logits 一次性就把 个候选位置全部验证完了。验证规则(来自投机采样原始论文):
- 草稿 token 是否被接受,取决于目标分布在位置 处给它的概率与草稿分布在位置 处给它的概率之比;
- 若 被接受,继续验证 ;一旦被拒绝,从这里截断,并用一个修正分布采样出一个 token 作为替代;
- 无论接受几个,位置 处(草稿序列之外,由前向自然多出来的那一行 logits)总能再白送一个”奖励 token”(bonus token)。
以草稿长度 为例,一步前向最多推进 个 token。设真实接受长度为 (acceptance length,即”这一步实际吐出了几个 token”),那么:
其中 是”草稿模型相对目标模型的单次前向成本比”。 越小(草稿模型越小)、 越大,收益越高。这条式子也解释了投机解码的所有工程取舍:
- 草稿要便宜:MTP、EAGLE-3 这类”寄生在目标模型里的草稿头”只多跑一两个小模块, 天然很小;
- 草稿要准: 对内容极度敏感,代码、重复文本能到 4–6,自由创作可能只有 1.2;
- 批次要小:大 batch 下目标前向本身已经是 compute-bound,多算几行 logits 不再”免费”,而草稿开销照样要付。
第三点正是 TensorRT-LLM 文档里那句”speed ups are only observable at low batch sizes”(加速只在小批量下可见)的来源。
TensorRT-LLM 的投机解码模式全景
TensorRT-LLM 的 PyTorch 后端把投机解码抽象成一个枚举 SpeculativeDecodingMode,位于 tensorrt_llm/_torch/speculative/interface.py:
class SpeculativeDecodingMode(IntEnum): MTP = 1 MTP_EAGLE_ONE_MODEL = 3 EAGLE3_ONE_MODEL = 5 NGRAM = 6 SA = 7 DRAFT_TARGET_ONE_MODEL = 9 USER_PROVIDED = 10 SAVE_HIDDEN_STATES = 11 PARD = 12 DFLASH = 13 DSPARK = 14 NONE = 15 AUTO = 16源码里对这个枚举有一句注释值得单独拎出来:这些数值必须保持稳定,因为它出现在跨进程序列化白名单里(llmapi/serialization.py),另一个 build 产出的整数配置可能被当前进程读到;重新编号会让旧值解码成另一种模式。这也解释了为什么列表中 2、4、8 是”退役”编号而不是被复用。
枚举本身只是标签,真正表达”这类模式怎么跑”的是它上面挂的一组谓词。把这组谓词读一遍,TensorRT-LLM 投机解码的整体骨架就出来了:
| 谓词 | 含义 | 谁为真 |
|---|---|---|
use_one_engine() | 草稿与目标是否跑在同一个模型引擎里 | MTP、MTP-Eagle、EAGLE3、SA、以及所有外部草稿(PARD/DFlash/DSpark/DraftTarget) |
needs_kv_cache_rewind() | 是否需要把被拒绝的草稿 token 从 KV Cache 里回滚 | 上述全部 |
support_overlap_scheduler() | 能否与重叠调度器共存 | 同上 |
without_logits() | 目标前向是否不需要输出 logits | 同上 |
has_spec_decoder() | 是否由模型内的 worker 完成草稿+验证+接受 | one-model 全部 |
has_spec_drafter() | 是否由一个独立的 drafter 对象只负责产出草稿 token | NGram、USER_PROVIDED |
is_parallel_draft() | 是否一次前向并行产出全部草稿 token | PARD、DFlash、DSpark |
这组谓词直接决定代码走哪条路,是读这份源码时最该先记住的一张表。下面几节就是沿着它展开。
one-model 架构:为什么草稿逻辑进了目标模型的 forward
在 vLLM 和 SGLang 里,投机解码大致是这样一个形状(详见 vLLM 源码完全拆解(十) 与 SGLang 源码完全拆解(十一)):
- 草稿阶段:调用草稿模型(或草稿头)跑 次前向,攒出 个 token;
- 验证阶段:把这 个 token 拼进目标模型的输入,跑一次目标前向;
- 接受阶段:在 Python 侧比较概率,决定接受几个,回滚 KV,攒下一轮输入。
TensorRT-LLM 走的是另一条路。它把 1–3 全部塞进目标模型的单次 forward() 里,由一个 SpecWorkerBase 的子类接管:
class SpecWorkerBase(nn.Module, ABC): def __init_subclass__(cls, **kwargs): super().__init_subclass__(**kwargs) if "forward" in cls.__dict__: raise TypeError( f"{cls.__name__} must not override SpecWorkerBase.forward; " f"implement _forward_impl instead. ...")
def forward(self, *args, **kwargs): attn_metadata = kwargs.get("attn_metadata") spec_metadata = kwargs.get("spec_metadata") ... try: return self._forward_impl(*args, **kwargs) finally: self._ensure_spec_dec_state_restored(attn_metadata, spec_metadata)两个细节值得注意:
__init_subclass__里显式禁止子类覆写forward,只能实现_forward_impl。这不是风格洁癖,而是为了保证finally里的_ensure_spec_dec_state_restored一定执行——源码引用了内部 bug 号 nvbugs/6442074,说明历史上真的出现过”草稿阶段改坏了 attention metadata 却没有恢复,导致后续每一次前向都在配对断言上失败”的事故。SpecWorkerBase继承自nn.Module,也就是说它本身就在模型的 module tree 里,forward由模型代码在合适的层次调用。
为什么要把草稿塞进目标前向?理由有三条:
第一,隐藏状态不用搬出显存。 EAGLE-3 这类草稿头需要目标模型中间层的 hidden states(本站有专文:EAGLE-3 完全拆解)。如果草稿模型是独立引擎,这些 hidden states 要么落盘、要么走进程间通信;而在 one-model 里它就存在同一块显存里,直接切片喂给草稿头。
第二,草稿 KV 可以先写进目标 KV Cache 池,验证失败再回滚。 这比”草稿阶段单独维护一份 KV、验证通过后再拷进目标池”要省一次拷贝。代价是必须有一套准确的回滚逻辑(下一节详述)。
第三,省掉一次 kernel 启动与调度往返。 草稿前向和目标前向在同一次 forward() 调用里、同一张 CUDA Graph 内完成,Python 侧只做零散的状态更新。
代价同样明确:这套机制高度依赖设备侧的融合算子。草稿采样、批量验证、接受判定都被压进 custom op 里,Python 侧只看结果张量;一旦你的模型结构或采样参数落在算子覆盖范围之外,就只能报错拒绝(下一节会看到一整张”不支持清单”)。
模式分发:get_spec_worker 与 get_spec_drafter
模型引擎在构造时通过 tensorrt_llm/_torch/speculative/utils.py 里的工厂函数决定挂哪个 worker:
def get_spec_worker(spec_config, model_config, mapping, use_separate_draft_kv_cache: bool = False): spec_dec_mode = spec_config.spec_dec_mode if spec_dec_mode.is_mtp_vanilla(): return MTPWorker(spec_config, model_config, use_separate_draft_kv_cache, mapping=mapping) if spec_dec_mode.is_eagle3_one_model(): if _is_effective_dynamic_tree(spec_config): return Eagle3OneModelDynamicTreeWorker(...) return Eagle3OneModelWorker(...) if spec_dec_mode.is_pard(): return PARDWorker(...) if spec_dec_mode.is_dflash(): return DFlashWorker(...) if spec_dec_mode.is_dspark(): if spec_config.draft_is_embedded_in_target: return DSv4DSparkWorker(...) return DSparkWorker(...) if spec_dec_mode.is_sa(): return SAWorker(spec_config, model_config) if spec_dec_mode.is_draft_target_one_model(): return DraftTargetOneModelWorker(...) return None对应的还有两个工厂:
def get_spec_drafter(model_engine, draft_model_engine, sampler, spec_resource_manager, guided_decoder=None): if spec_config.spec_dec_mode.is_user_provided(): return spec_config.drafter if spec_config.spec_dec_mode.is_ngram(): return NGramDrafter(spec_config, spec_resource_manager) return Noneget_spec_worker 只对 has_spec_decoder() 的模式返回对象,get_spec_drafter 只对 has_spec_drafter() 的模式返回对象——两条路互斥,这正是那张谓词表的代码形态。
NGram 走的是 drafter 路线:它不需要模型内融合算子,只需要在 Python 侧”查表”出候选 token,填进 request.py_draft_tokens,之后由目标模型的多 token 查询 kernel 完成验证。这解释了 Drafter 抽象基类里那个有点奇怪的接口——它只有一个抽象方法 prepare_draft_tokens,其余全是 @final 的公共逻辑:
class Drafter(ABC): @abstractmethod def prepare_draft_tokens(self, scheduled_requests, resource_manager=None) -> None: ...
@final def pad_draft_tokens_for_cuda_graph(self, scheduled_requests, resource_manager=None) -> None: pad_to = self._static_max_total_draft_tokens for req in scheduled_requests.generation_requests: num_draft_tokens = get_draft_token_length(req) req.py_draft_tokens_effective_len = num_draft_tokens req.py_draft_tokens.extend(0 for _ in range(pad_to - num_draft_tokens)) ...pad_draft_tokens_for_cuda_graph 里的两行很关键:先把真实草稿数记进 py_draft_tokens_effective_len,再把 py_draft_tokens 补齐到静态最大值。 原因是 CUDA Graph 重放要求张量形状固定,所以缓冲区必须按最大草稿长度分配;但”这次到底提出了几个草稿 token”是验收率的分母,绝不能把补零算进去。这个”真实值 / 缓冲长度”分离的设计在整份代码里反复出现,后面还会碰到两次。
验收流水线:SpecSampler 如何把融合算子的输出搬回请求
为什么 one-model 只需要一个采样器
先看 get_spec_decoder:
def get_spec_decoder(sampler_args: TorchSampler.Args, spec_config): spec_dec_mode = spec_config.spec_dec_mode if spec_dec_mode.use_one_engine(): penalty_supported = not _is_effective_dynamic_tree(spec_config) fused_sampling = (spec_config.advanced_sampling_mode.is_fused) return SpecSampler(sampler_args, enable_penalty=spec_config.enable_penalty, penalty_supported=penalty_supported, fused_sampling=fused_sampling) raise ValueError(...)注释写得很直白:one-model 的所有模式共用一个采样器,因为”草稿 + 验证 + 接受”已经在 worker 的融合 kernel 里做完了,采样器只剩下搬运工作。spec_sampler_base.py 的文件头注释也是同一个意思:
Every one-model speculative mode (MTP, Eagle3, SA, DraftTarget, PARD, DFlash, DSpark) shares a single sampler: the worker’s fused kernel already performs drafting, target verification and acceptance, so the sampler only scatters that output into slot-indexed buffers, starts the async D2H copy, and updates requests host-side.
SpecSampler 的 buffer 形状完全由 TorchSampler.Args 推导,其中 draft_len = args.max_total_draft_tokens,即”目标每步输入宽度减一”——正好是各个模式以前各自算一遍的那个草稿长度。这个统一化不是美化代码,而是让增删一种投机模式不再需要动采样器。
第一步:sample_async 把结果按 slot 散列
worker 的 forward 返回一个 dict:
{ 'logits': raw_logits, 'new_tokens': accepted_tokens, # [batch, draft_len+1] 'new_tokens_lens': num_accepted_tokens, # [batch] 'next_draft_tokens': next_draft_tokens, # [batch, draft_len] 'next_new_tokens': next_new_tokens, # [batch, draft_len+1]}第一个关键设计是:这些张量按 batch 行排列,而请求是按 slot 驻留的。sample_async 用 index_copy_ 把它们散列进以 seq slot 为索引的固定缓冲区:
slots = torch.as_tensor([r.py_seq_slot for r in sampling_requests], dtype=torch.long)self.store.new_tokens.squeeze(-1).T.index_copy_(0, slots, o_new_tokens)self.store.next_new_tokens.squeeze(-1).T.index_copy_(0, slots, o_next_new_tokens)self.store.new_tokens_lens.index_copy_(0, slots, o_new_tokens_lens)self.store.next_draft_tokens.index_copy_(0, slots, o_next_draft_tokens)为什么要绕这一圈?因为重叠调度器:当 CPU 还在处理第 步的结果时,GPU 上已经在跑第 步了,而这两步的 batch 组成可能完全不同(有的请求完成、有的新请求进来)。按 slot 存、按 slot 取,才能让”第 步的 batch 布局”与”第 步的请求状态”解耦。缓冲区本身是钉住内存(pinned memory),随后 _copy_to_host 发起异步 D2H 拷贝。
散列之后还有一段对齐逻辑:worker 输出的宽度跟着 runtime_draft_len 走,而缓冲区是按静态最大宽度分配的,于是要先 pad 或 truncate 再 index_copy_:
if o_next_draft_tokens.shape[1] < draft_tokens_width: o_next_draft_tokens = torch.nn.functional.pad( o_next_draft_tokens, (0, draft_tokens_width - o_next_draft_tokens.shape[1]))elif o_next_draft_tokens.shape[1] > draft_tokens_width: o_next_draft_tokens = o_next_draft_tokens[:, :draft_tokens_width]runtime_draft_len 是本步实际使用的草稿长度(可被 draft_len_schedule 按 batch size 动态调整),它缩小到静态最大值以下时,超出部分必须显式截掉,否则会读到上一轮的陈旧行。
第二步:update_requests 推导 rewind 长度
sample_async 结束时会返回一份 SampleStateSpec,其中携带一个容易被忽略的字段:
draft_lens = [ min(r.py_draft_tokens_effective_len, get_draft_token_length(r)) if r.py_draft_tokens_effective_len is not None else get_draft_token_length(r) for r in sampling_requests]这就是前面 pad_draft_tokens_for_cuda_graph 埋下的伏笔:在补零之前快照真实草稿数。注释解释了为什么不能在 update_requests 里现取:update_requests 自己会把 py_draft_tokens 换成下一步的草稿,取到的是”未来”,不是”本步”。
然后 update_requests 里这段是整个投机解码流水线的枢纽:
req.py_num_accepted_draft_tokens = num_new_tokens - 1verified_len = ( token_windows[req_idx] - 1 if token_windows is not None else runtime_draft_len)drafted_len = state.draft_lens[req_idx] if state.draft_lens is not None else 0req.py_num_draft_tokens_verified = min(drafted_len, verified_len)req.py_rewind_len = verified_len - req.py_num_accepted_draft_tokensself._request_common_handling(req, next_draft_tokens_list, runtime_draft_len)逐行拆:
num_new_tokens是这一步实际写入序列的 token 数(含奖励 token),所以接受的草稿数 = 写入数 − 1;verified_len是本步被验证的窗口长度。默认等于runtime_draft_len;若走 ragged verification(每个请求有自己的验证窗口),则由设备侧上报的verify_lens决定;py_num_draft_tokens_verified取两者较小值——这是验收率的分母,且必须排除 CUDA Graph 补零;py_rewind_len = verified_len - 接受数,即需要从 KV Cache 里回滚的位置数。如果全部接受,rewind 为 0;如果全部拒绝,rewind 等于整个验证窗口;- 最后
_request_common_handling把下一步的草稿 token 装回请求:
request.py_draft_tokens = next_draft_tokens[request.py_seq_slot][:runtime_draft_len]request.py_decoding_iter += 1注意这里的先后顺序:先用本步的真实草稿数算 rewind,再覆盖 py_draft_tokens。顺序颠倒会让分母变成下一步的值,验收率统计直接失真。
第三步:统计口径
PyExecutor 每步结束后会汇总投机统计(py_executor.py):
stats.specdec_stats.acceptance_length = float( total_accepted_tokens + num_requests_with_draft) / float(num_requests_with_draft)注释里给出了公式本身:——每个请求至少产出 1 个目标 token,所以分子加上请求数。同一处还记录了 draft_overhead = 草稿延迟 / 迭代延迟,用来回答”这一步里草稿到底占了多久”。这两个数字是做投机解码性能归因时最先要看的东西: 上不去说明草稿质量差,draft_overhead 高说明草稿开销吃掉了收益。
拒绝采样:可选但更严格的接受路径
上面描述的是严格接受:草稿 token 在目标分布下的概率必须”够格”才被接受。TensorRT-LLM 还提供了另一条可选路径——拒绝采样(rejection sampling),由 use_rejection_sampling 配置开启。它对每条请求维护草稿分布 draft_probs [batch, D, vocab] 和目标分布 target_probs [batch, D+1, vocab],交给一个融合 kernel:
def rejection_sampling_one_model(draft_probs, draft_token_ids, target_probs, seed, offset): """Verify each request's linear draft against the target distribution.""" return torch.ops.trtllm.chain_speculative_sampling( draft_probs, draft_token_ids, target_probs, seed, offset)其中 seed, offset 是每条请求独立的 Philox 随机数状态——注释说明 offset 用来把某个请求的随机流与其它所有请求(同一请求的其它行、其它未设种子请求的过去与现在)区分开,这样 seed 可以是一个常量,而整轮运行的随机性仍然互不干扰。返回值 accepted_tokens [batch, D+1](接受的草稿 token、修正或奖励 token、然后是 -1 填充)与每条请求的产出长度。
这条路径的安全性由两个”失败即降级”的设计保证:
def _can_use_rejection_sampling(self, spec_metadata) -> bool: return (spec_metadata.use_rejection_sampling and not spec_metadata.is_all_greedy_sample)- 全贪心批次直接走基础路径:贪心下拒绝采样与 argmax 的结果完全一致,没必要付两份概率计算的代价;
_rejection_buffers_valid是 fail-closed 的形状守卫:只有当所有槽位索引缓冲区存在且形状正确时才启用拒绝路径,否则退化为严格接受。源码明确写了这个守卫只看 host 侧张量形状、不读 CUDA 张量数值(不用.item()),因此在 CUDA Graph 捕获期间也安全。
还有一个不显眼但很致命的约束写在注释里:
The target distribution the acceptance test divides by. It must be filtered exactly as the draft probs were …, which is why both use the same backend selection on the same mode — a mismatch here corrupts acceptance silently rather than raising.
意思是:目标侧的采样过滤(temperature、top-k、top-p、min_p)与草稿侧的过滤必须走同一套后端与同一套参数。如果两边不一致,接受判定会静默变错——不报错、不崩溃,只是接受率莫名其妙地不对。这是很典型的”正确性藏在对称性里”的设计。
融合采样的代价:一张不支持清单
因为 one-model 的采样走设备侧融合算子,Python 侧的 LogitsProcessor 就没有落点了。SpecSampler.validate_request 于是变成一张拒绝清单:
| 被拒绝的能力 | 原因 |
|---|---|
return_context_logits / prompt_logprobs | 融合路径不返回 context logits |
return_generation_logits | 同上 |
logprobs | 同上 |
min_length | 依赖采样前改写 logits,one-model 无此钩子 |
bad_words | 同上 |
no_repeat_ngram_size | 同上 |
embedding_bias | 同上 |
top_p_decay / top_p_min | 同上 |
min_p | 仅当配置了融合采样后端(advanced_sampling_mode: full)才支持 |
repetition_penalty / presence_penalty / frequency_penalty | 需要 enable_penalty: true,且树形投机尚不支持 |
最后一条的原因值得展开:occurrence penalty 的前提是”一行 logits 的前缀就是它前面的那些行”。线性草稿里这个前提成立;树形草稿里每一行的前缀是它到根的路径,兄弟分支之间不该互相惩罚,所以树模式宁可报错也不静默算错:
if not self._penalty_supported: raise ValueError( "repetition_penalty / presence_penalty / frequency_penalty are not " "supported with tree speculative decoding (dynamic tree) yet. ...")源码还解释了为什么这些检查存在两处:一处是执行器侧的 SpecSampler.validate_request,另一处是 LLM._check_arguments 在流打开前的预检。原因是 OpenAI 前端此时已经回过 200 并打开了响应流,如果只剩执行器侧检查,客户端收到的会是一个看起来像网络故障的断流(ClientPayloadError / TransferEncodingError),无法与真实网络问题区分。两份检查共享同一批错误消息常量,就是为了防止两处慢慢漂移。
被拒绝的草稿 token 从哪里回滚:KV Cache 的预留与归还
投机解码最容易出错的地方不是接受判定,而是 KV Cache 的记账。原因很直接:草稿 token 在生成阶段是先写进 KV Cache 再验证的——否则目标前向就没有办法在这些位置上做注意力。验证一旦失败,那部分 KV 必须被抹掉,否则后续位置的注意力会读到”不存在的历史”。
TensorRT-LLM 把这个过程拆成三步:多预留 → 先写入 → 再归还。
第一步:prepare_resources 多写几个 token
resource_manager.py 的 prepare_resources 里,每条生成请求在分配 KV 容量时是这样做的:
for req in scheduled_batch.generation_requests: ... draft_len = get_draft_token_length(req) self.impl.add_token(req.py_request_id) for _ in range(max(draft_len, self._kv_reserve_draft_tokens)): self.impl.add_token(req.py_request_id)第一句 add_token 是”本步真实产出的那 1 个 token”占的位置;后面循环是为草稿预留的位置数,取 draft_len(本轮实际草稿数)与 _kv_reserve_draft_tokens(容量上限)的较大值。
_kv_reserve_draft_tokens 的取值在构造函数里定:
self._kv_reserve_draft_tokens = self.max_total_draft_tokensif (self.is_draft and spec_config is not None and getattr(spec_config, 'use_dynamic_tree', False) and getattr(spec_config, 'dynamic_tree_max_topK', 0) > 0): draft_loop_tokens = spec_config.dynamic_tree_max_topK * spec_config.max_draft_len self._kv_reserve_draft_tokens = max(self.max_total_draft_tokens, draft_loop_tokens)也就是说,动态树模式的草稿池要按 预留,因为草稿循环一层可能展开 K 个候选节点;目标池则保留 max_total_draft_tokens 这个精确值。注释写明了这个差别:draft manager 需要为”循环可能写入的最大量”留容量,target manager 只需要精确值。
除此之外还有一类”额外 KV token”,来自 get_num_extra_kv_tokens:
def get_num_extra_kv_tokens(spec_config): if spec_config is None: return 0 if getattr(spec_config, "_use_shared_kv_cache", False): return 0 if spec_config.spec_dec_mode.use_one_engine(): return spec_config.max_draft_len - 1 return 0为什么 one-model 需要 max_draft_len - 1 个额外 slot?因为 one-model 的草稿循环在同一次前向内连续写入 个位置,而第一次写入发生在 add_sequence_batch 阶段——那时还没人知道这轮会接受几个。与其在每一步精细地按需扩容量,不如一次性预留 个富余位,让写入永远有地方落。注意 _use_shared_kv_cache 为真时返回 0:草稿与目标共享同一份 KV 视图时,这笔额外开销由共享结构承担。
第二步:update_resources 归还
一步生成结束后,update_resources 做两件事:
def update_resources(self, scheduled_batch, attn_metadata=None, kv_cache_dtype_byte_size=None): if self.kv_cache_type != CacheTypeCpp.CROSS: if not self.is_draft: from .kv_cache.kv_cache_manager_v2 import _update_kv_cache_draft_token_location _update_kv_cache_draft_token_location(self, scheduled_batch, attn_metadata, kv_cache_dtype_byte_size)
for request in scheduled_batch.generation_requests: if request.state in (LlmRequestState.GENERATION_COMPLETE, LlmRequestState.CONTEXT_INIT): continue if request.py_rewind_len > 0: self.rewind_kv_cache(request, request.py_rewind_len) # Symmetric companion to prepare_resources's reserve_slack # add_token loop: when _kv_reserve_draft_tokens (e.g. dynamic # tree's K*max_draft_len) exceeds the runtime draft length, # those extra slots must also be rewound, otherwise the draft # KV cache leaks reserve_slack tokens per generation iteration # and eventually overflows mCacheBlockIndices. runtime_draft_len = (request.py_rewind_len + request.py_num_accepted_draft_tokens) extra_rewind = self._kv_reserve_draft_tokens - runtime_draft_len if extra_rewind > 0: self.rewind_kv_cache(request, extra_rewind)两个 rewind 各自解决一个问题:
- 第一个 rewind 归还被拒绝的草稿位置。
py_rewind_len = verified_len - accepted,正是”验证过但没被接受”的那一段; - 第二个 rewind 归还”预留了但本轮根本没用到”的位置。
runtime_draft_len = rewind_len + accepted恰好等于本步实际用掉的窗口长度,用_kv_reserve_draft_tokens减去它就得到富余量。注释把后果写得很清楚:如果不补这一刀,草稿池每步泄漏reserve_slack个 token,最终撑爆mCacheBlockIndices。
注意 for 循环开头的两个 continue:GENERATION_COMPLETE 的请求已经结束,CONTEXT_INIT 的请求是被暂停后重置状态的,二者都不该再回滚。第二个条件还牵涉重叠调度器——调度器在第 步暂停某请求并释放 KV 时,第 步的批次可能还在往回改 KV Cache。
第三步:分页池的 rewind 到底做了什么
rewind_kv_cache 本身只是一层转发:
def rewind_kv_cache(self, request: LlmRequest, rewind_len: int): self.impl.rewind_kv_cache(request.py_request_id, rewind_len)到了分页池实现里(rewind_cache),逻辑就变成一次块的尾部归还:
def rewind_cache(self, request: LlmRequest, rewind_len: int): if rewind_len == 0: return request_id = request.py_request_id self.num_sequences[request_id] -= rewind_len updated_token_num = max(self.num_sequences[request_id], 0) block_count_needed = self.compute_block_count(updated_token_num, self.tokens_per_block) num_rewind_pages = len(self.block_ids[request_id]) - block_count_needed if num_rewind_pages > 0: self._free_blocks(self.block_ids[request_id][-num_rewind_pages:]) self.block_ids[request_id] = self.block_ids[request_id][:-num_rewind_pages]三行核心动作:逻辑长度减去 rewind_len;按 tokens_per_block 重算需要几个块;只把多出来的整块归还,块内不做清零。
最后一点是这套设计的关键取舍:rewind 只改”逻辑长度”,不改”物理内容”。 保留下来的那些块里,尾部可能还残留着被拒绝 token 的 K/V。它们之所以不会影响正确性,是因为:
- 后续写入按新的逻辑长度覆盖它们;
- 注意力只按逻辑长度取数,超出的行不参与计算。
换句话说,这里的 rewind 不是”擦除”,而是”把游标退回去,让后面的写覆盖掉垃圾”。用块粒度归还而不是逐 token 清零,是为了让回滚成本与”退还的块数”成正比——而块数通常只有 0 或 1。
第四步:还有一次”搬到正确位置”的整理
对 KV Cache V2 管理器,update_resources 之前还会跑一次 _update_kv_cache_draft_token_location:
def _update_kv_cache_draft_token_location(cache_manager, scheduled_batch, attn_metadata, kv_cache_dtype_byte_size): run_kv_cache_relocation = False for request in scheduled_batch.generation_requests: if request.state != LlmRequestState.GENERATION_COMPLETE: if (request.py_num_accepted_draft_tokens > 0 and len(request.py_num_accepted_draft_tokens_indices) > 0): run_kv_cache_relocation = True if not run_kv_cache_relocation: return (accepted_draft_token_offsets, packed_accepted_draft_tokens_indices, rewind_draft_token_separate_adjustments) = _locate_accepted_draft_tokens(requests) ...它做的事情和 rewind 恰好相反:rewind 是把没接受的丢掉,relocation 是把接受的那些行搬到正确的物理位置上。 触发条件是”本步至少有一条请求接受了草稿,且记录了接受 token 的下标”(py_num_accepted_draft_tokens_indices)——注意这是一个快速路径判断:全批次都没接受任何草稿时直接返回,不做任何搬运。
为什么需要搬?因为在草稿循环里, 个草稿 token 是连续写进 KV 池的,而它们各自对应的逻辑位置取决于”前面接受了几个”。假设草稿序列 只有 被接受,那么原本写在位置 的三行,只有前两行是有效的,且它们确实就落在 ——线性草稿下搬运量常常为零。但一旦涉及树形草稿(一个位置可能对应多个候选节点)或者 per-head 的草稿布局,接受的那些行就可能散落在不连续的位置上,必须显式 gather 到紧凑布局,后续注意力才能按连续逻辑位置读取。
源码在这里还给了两条硬约束:
assert use_paged_kv_cache, "Only paged kv cache is supported"assert len(set(cache_manager.max_attention_window_vec)) == 1, ( "Currently, only one max attention window size is supported.")assert len(set(cache_manager.num_kv_heads_per_layer)) == 1, ( "update_kv_cache_draft_token_location requires uniform num_kv_heads across all layers, ...")即:必须分页、必须是单一注意力窗口、各层 KV 头数必须一致。这三条不是保守,而是搬运 kernel 的索引算术前提——窗口不一致时”逻辑位置”与”物理页”的映射不再是一套公式。
与前缀缓存的冲突:一个需要特别说明的例外
投机解码与前缀缓存(本站有专文讲SGLang 的 RadixAttention)天然冲突:被拒绝的草稿 token 一旦进了前缀树,就会污染缓存。TensorRT-LLM 的处理方式是在启用投机解码时直接拒绝带 KV Cache Connector 的配置:
if is_kv_cache_manager_v2 and self.max_draft_len > 0: raise ValueError( "KV Cache Connector is not supported with speculative " "decoding. Rejected draft tokens ..." "Disable speculative decoding to run a connector.")但”命中前缀缓存的请求”还有另一个更隐蔽的问题,源码里给了专门的正则化机制——spec recompute tail:
def _maybe_rewind_reused_context(self, batch_llm_requests): """Recompute a tail of reused prompt tokens for drafter capture.
Hidden-state-conditioned drafters (DFlash/DSpark) capture target hidden states only for tokens that physically pass through a target forward. A prefix-cache hit skips the reused tokens, so the drafter's cross-attention context never sees them and acceptance length drops (measured -15% AL at a 100% prefix-hit rate). Rewinding the context position after ``add_sequence_batch`` keeps the blocks reused ... while restoring the drafter's inputs. """这段注释值得单独记住:前缀缓存命中率 100% 时,DFlash/DSpark 这类依赖隐藏状态的草稿器接受长度会掉约 15%。原因是这些草稿器要从目标前向的中间层取 hidden states 做 cross-attention 上下文,而被复用的 prompt token 根本没经过目标前向,草稿器”看不见”它们。修法是把上下文游标回退一段,强制重算窗口大小的尾部,同时保留块的复用(重算写回的是相同数值,分配与去重的收益不丢):
- 由
context_recompute_tail配置驱动,默认 0(关闭),显式设为None时从草稿模型配置解析; - 对窗口化的草稿上下文(如 DFlash2 的
swa_window_size),退一个窗口大小即可精确复现”无复用时”的草稿输入; -1表示强制整段重新 prefill。
这个机制还带两个前置开关,缺一不可:
if any(window is not None and 0 < window < self.max_seq_len for window in self.max_attention_window_vec): logger.warning("context_recompute_tail is unsupported with sliding-window " "attention layers on this KV cache manager: ...") self._spec_recompute_tail = 0 returnif not self.enable_chunked_prefill: logger.warning("context_recompute_tail requires chunked prefill: ...") self._spec_recompute_tail = 0 return- 滑窗注意力下不可用:回退后的游标会跨越”页表已经摘掉的窗口外块”,那些 slot 是占位符,读写会落空;
- 必须开启分块 prefill:调度器是按”复用折扣后的 token 成本”接纳缓存命中请求的,回退之后这批请求的真实 token 数会超过
max_num_tokens,只有分块 prefill 的fit_token_budget能把它重新切回预算内。
这两条约束其实是同一件事的两面:重算尾部把”省下来的计算”又加回去了一部分,收益必须由调度器重新配平。
worker 怎么跑:从 MTP 的三层草稿循环看 one-model 的执行形态
前面几节讲的是骨架,这一节看肌肉。选 MTP 是因为它的 forward 注释写得最完整——源码里直接用一段 ASCII 图把”上下文阶段 + 两次生成阶段”的 token 与 hidden state 流水画了出来,照着讲一遍,one-model 的执行形态就清楚了。
MTP 的机制背景
MTP(Multi-Token Prediction,多 token 预测)是 DeepSeek-V3 提出的结构:在主干之外挂若干顺序预测模块,第 个模块吃”主干第 个位置的 hidden state + 第 个 token 的 embedding”,输出第 个 token 的预测。本站有专文拆过它的训练侧设计(MTP 完全拆解),这里只看它在推理时怎么当草稿引擎用。
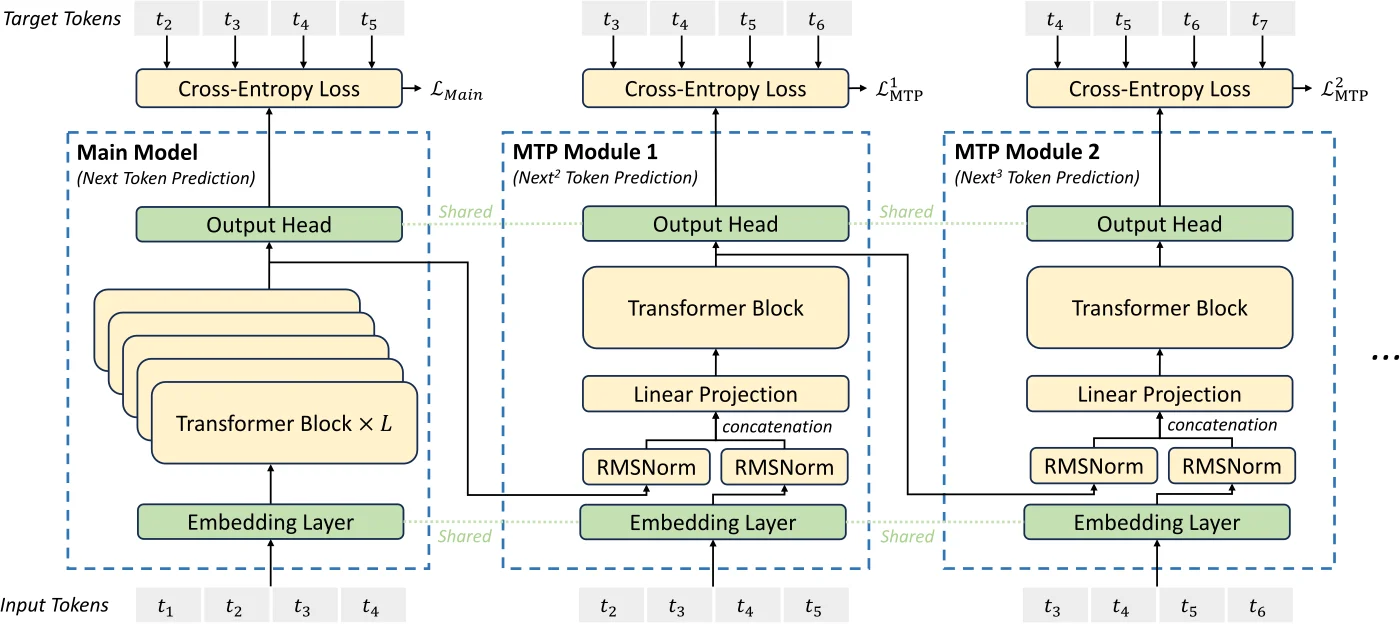
图:DeepSeek-V3 论文 Figure 3,MTP 的因果链结构。来源:DeepSeek-V3 Technical Report
源码里的那段注释
mtp.py 的 MTPWorker._forward_impl 开头有一段 100 行的 docstring,把三层 MTP 的完整流程走了一遍。核心约定是:
- 记 为目标模型在位置 产出的 hidden state, 为草稿模型(MTP 层)产出的 hidden state;
- 以 prompt
ABCD为例,上下文阶段目标模型采样出E,因此目标前向覆盖的 KV 是ABCD,产出的 hidden state 是 ; - MTP1 的输入是
BCDE(prompt[1:] 加上新生成的 token,即”向后错一位”),配上 ,输出 draft tokenF; - MTP2 的输入是
CDEF,hidden state 用 ——注意最后一个位置已经换成了 MTP1 自己产出的 ,这是”顺序模块”的本义; - MTP3 同理,输出
H。
三轮下来拿到草稿 FGH,目标模型下一次前向就吃 E + FGH 五个位置,一次验证完。
生成阶段第一次前向的注释更值得细读:
Generation phase 1: accept partial draft tokensTarget model: - input tokens: E + FGH - sampling tokens: FGXY - accepted tokens: FGX - KV cache: (ABCD) + EFGH (H's KV cache is invalid) - hidden states: H_E, H_F, H_G, H_H (H_H is invalid)这段把三件事讲透了:
sampling tokens: FGXY——目标前向在 5 个位置上各给出一组 logits,验证结果是”F 接受、G 接受、H 拒绝”,于是第三个位置从目标分布里重采一个 X,第五个位置(草稿之外的位置)再送一个 Y。accepted tokens: FGX就是”两条草稿 + 一条修正”;KV cache: (ABCD) + EFGH,且注明H's KV cache is invalid——这就是第四节讲的 rewind:H 是草稿 token,它的 KV 已经写进去了,但被拒绝,所以这一份 KV 必须作废;hidden states: H_E, H_F, H_G, H_H,同样注明H_H is invalid——hidden state 也需要按接受长度回滚。这正是_commit_target_mamba_states那个方法存在的原因:
def _commit_target_mamba_states(self, attn_metadata, num_accepted_tokens, batch_size): """Promote the target state at each generation request's accepted depth.
Target verification writes intermediate GDN/Mamba states for every candidate position. The next draft pass must start from the accepted candidate, rather than the last (possibly rejected) position. """注释里说的”target verification writes intermediate GDN/Mamba states for every candidate position”,指的是混合线性注意力模型(GDN = Gated Delta Net,Mamba 系)的循环状态:这类架构的状态不是按 token 存的 KV,而是一条随时间递推的向量,验证时它同样会为每个候选位置写出一份中间状态。所以回滚不能只回滚 KV,还得把循环状态一并”提拔”到被接受的那个深度上。
草稿循环的代码
_forward_impl 的主循环很朴素:
with self.draft_kv_cache_context(attn_metadata, draft_kv_cache_manager): for i, mtp_layer in enumerate(draft_model.mtp_layers[:runtime_draft_len]): hidden_states = mtp_layer(embed_tokens=draft_model.embed_tokens, **draft_inputs) logits = mtp_layer.shared_head(hidden_states, draft_model.lm_head, attn_metadata).float() new_draft_token = self.sample_draft_tokens(logits, spec_metadata, batch_size, draft_step=i) next_draft_tokens.append(new_draft_token) # shift input_ids and hidden_states input_ids = draft_inputs["input_ids"] input_ids[:-1] = input_ids[1:].clone() input_ids[last_tokens_idx] = new_draft_token draft_hidden_states = draft_inputs["hidden_states"] draft_hidden_states[:-1] = draft_hidden_states[1:].clone() draft_hidden_states[last_tokens_idx] = hidden_states[last_tokens_idx, :] draft_inputs = {...}注意那个 input_ids[:-1] = input_ids[1:].clone():这是就地左移,把”向后错一位”的输入在每个草稿步上前进一格——前一步刚采样出的新 token 被写到序列末尾,原来的位置整体左移。这是 MTP 顺序模块的本质:它消费的不是完整序列,而是一个长度为 的滑动窗口。
EAGLE-3:同样一个 worker,换掉草稿来源
EAGLE-3 的 worker 是 Eagle3OneModelWorker,它的结构跟 MTPWorker 几乎一模一样(都是”接受 → 回滚 → 草稿循环 → 恢复元数据”),差别在三处:
第一,草稿来源不同。 MTP 用模型自带的 MTP 层,EAGLE-3 用一个独立的草稿头;后者需要目标模型中间若干层的 hidden states 作为输入。
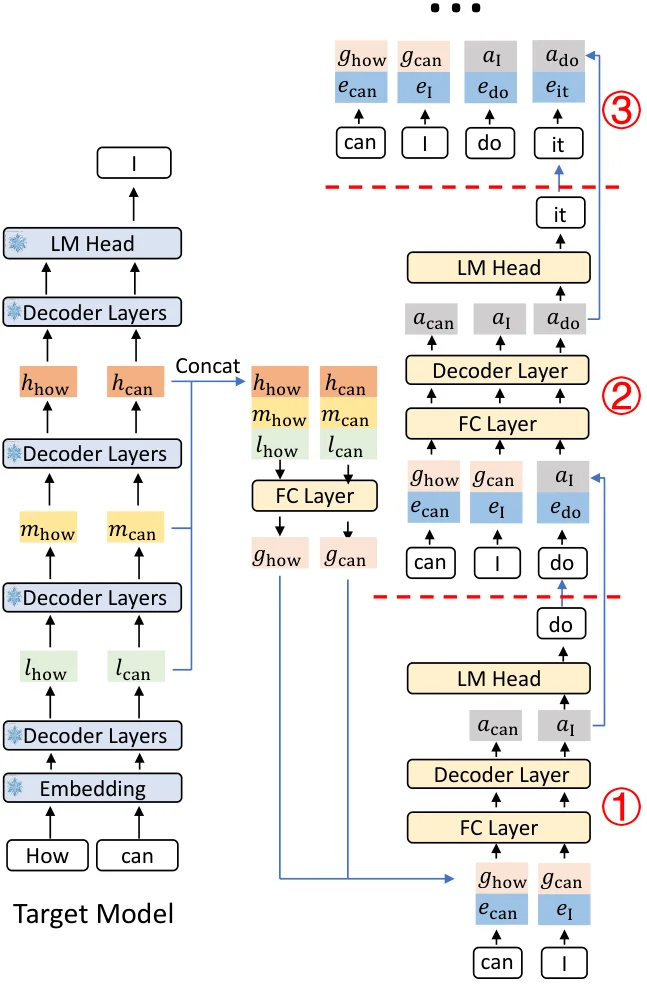
图:EAGLE-3 论文 Figure 5,推理流水线的三个阶段。来源:EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test
第二,捕获哪些层是可配的。 Eagle3OneModelSpecMetadata.__post_init__ 里有这样的默认:
def _get_eagle3_default_capture_layers(num_layers: int): return (1, num_layers // 2 - 1, num_layers - 4)即默认抓第 1 层、中间层、倒数第 4 层三层。这来自 EAGLE-3 论文的结论:低层特征偏词汇/局部模式,中层特征偏语义,高层特征偏预测分布,三层拼接的效果最好。源码还对层数不足的情况直接报错:
if self.num_layers <= 5: raise ValueError("Not enough hidden layers for default EAGLE3 capture")捕获本身是挂在解码层的一个钩子:
def maybe_capture_hidden_states(self, layer_id, hidden_states, residual=None): for i, captured_layer_id in enumerate(self.layers_to_capture): if captured_layer_id == layer_id: num_tokens = self.num_capture_tokens to_save = hidden_states[:num_tokens] if residual is not None: to_save = to_save + residual[:num_tokens] inplace_slice_copy(self.hidden_states, to_save, i * self.hidden_size, (i + 1) * self.hidden_size) break两个细节:
to_save + residual:捕获的是”层归一化之后的残差”,即hidden_states与residual之和。因为maybe_capture_hidden_states挂在归一化之前的位置,此时hidden_states是层内输出,residual是流经的残差——两者相加才是真正的中间层表示;num_capture_tokens而不是self.num_tokens:注释解释了原因——prepare()会把num_tokens减到 attention-DP 的子序列形状,而捕获必须按真实调度到的 token 数做边界,否则 CUDA Graph 的 padding 会让捕获越界。
还有一个不太起眼但影响很大的开关:
if self.spec_dec_mode.is_mtp_eagle_one_model(): # MTP Eagle one-model feeds the target model's hidden_states # directly to the MTP layer ... It never reads spec_metadata.hidden_states, # so leave layers_to_capture empty: this makes is_layer_capture() # return False everywhere and avoids the post-MLP/MoE fusion # disable side effect in modeling_deepseekv3 / glm / etc. self.layers_to_capture = ()MTP-Eagle 模式(复用 MTP 层当草稿头)把 layers_to_capture 设为空集,从而让 is_layer_capture() 恒为假。注释点明了副作用:一旦模型知道”有层要被捕获”,DeepSeek-V3 / GLM 这些实现会关掉 MLP/MoE 的融合优化(因为融合后会拿不到中间的激活)。把捕获列表清空,就避免了为一条用不上的路径付性能代价。
第三,草稿循环多一步 gather 计算。 EAGLE-3 的线性草稿循环里,第一步需要从扁平化的 token 序列里”挑出每条请求最后一个被接受的 token”:
if i == 0: start_ids_gen = (spec_metadata.batch_indices_cuda[:num_gens] * (runtime_draft_len + 1)).long() gather_ids_gen = (start_ids_gen + num_accepted_tokens[num_contexts:] - 1 + attn_metadata.num_ctx_tokens) gather_ids = torch.concat([last_tokens_idx[:num_contexts], gather_ids_gen], dim=0)else: gather_ids = slice(0, batch_size)第一步的批次里,每条生成请求占 行(1 个输入 token + 个草稿位置),而”接受长度”各不相同,所以要按 batch_indices * (D+1) + accepted - 1 算出每条请求的真实起始行;从第二步开始每请求只贡献一行,于是直接取前缀切片即可。这段逻辑和前面 update_requests 里的 verify_lens 是同一件事的两种表示。
一个共享的工具:并行草稿与串行草稿
PARD、DFlash、DSpark 属于另一类:它们一次前向并行产出全部草稿 token,而不是像 MTP/EAGLE-3 那样一步步递推。枚举里的 is_parallel_draft() 就是为它们准备的。
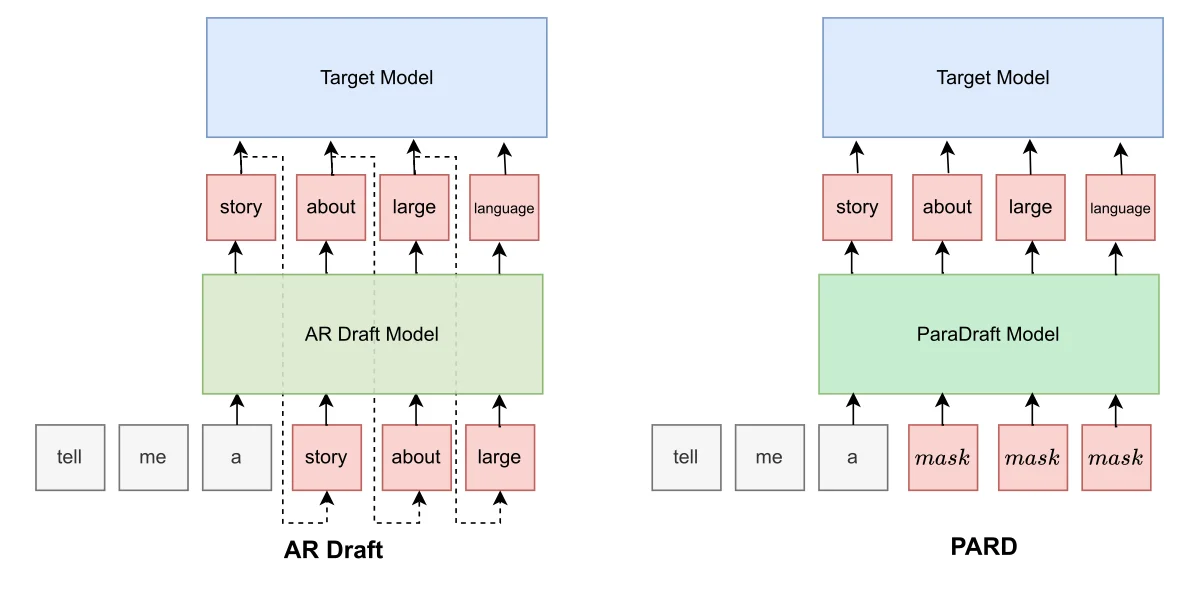
图:PARD 论文 Figure 3,并行草稿与自回归草稿的对比。来源:PARD: Parallel Drafting for Speculative Decoding
PARD(Parallel Drafting)的做法是把 个 mask token 一次性喂进草稿模型,让它在一次前向里同时预测所有位置——代价是草稿质量通常低于自回归草稿,收益是草稿开销降到 量级。resolve_draft_len 里对 PARD 有一段专门的缓冲区处理,原因写在注释里:
if spec_config is not None and spec_config.spec_dec_mode.is_pard(): # PARD carries K proposals followed by K-1 placeholders. buffer_width = spec_config.get_runtime_tokens_per_gen_step(draft_len) - 1 current_draft_len = ((current_num_draft_tokens + 1) // 2 if current_num_draft_tokens > 0 else 0) draft_tokens = request.py_draft_tokens[:min(current_draft_len, draft_len)] draft_tokens.extend([draft_buffer_pad] * (draft_len - len(draft_tokens))) request.py_draft_tokens = draft_tokens + [draft_buffer_pad] * (buffer_width - len(draft_tokens))也就是说 PARD 的草稿缓冲区里, 个真实提案后面跟着 个占位符,宽度是 ——因为这些 mask token 也要经过目标前向,等于把验证宽度又撑大了将近一倍。SpecSampler 里对应地写了一句:
PARD sets it to 2K-1 because it also feeds mask tokens through the target.
这是”并行草稿”要付的真实代价:省了草稿的串行步数,却在目标侧多验证了一倍的宽度。
三个跨模式的工程问题
前面各节都是”某种模式内部怎么跑”。这一节收三个所有模式都会撞上的横向问题:延迟到底花在哪、Acceptance 掉了怎么办、以及为什么”外部草稿”其实是另一条路。
动态草稿长度:按 batch size 决定猜几个
草稿长度 不是一个固定超参。第 1 节那条加速公式已经说明:batch 越大,目标前向自身越接近 compute-bound,“多算几行 logits”就越不免费。所以 TensorRT-LLM 允许配置 draft_len_schedule,按运行时的 batch size 决定这一步草稿几个:
def get_draft_len_for_batch_size(self, batch_size: int) -> int: thresholds = list(self.draft_len_schedule.keys()) idx = bisect_right(thresholds, batch_size) if idx == 0: logger.warning(f"get_draft_len_for_batch_size called with batch_size={batch_size} < 1. ...") return 0 threshold = thresholds[idx - 1] return self.draft_len_schedule[threshold]配置形如 ——batch 为 1 时草稿 8 个,batch 到 4 时降到 4,到 16 时干脆不猜。bisect_right 找”不超过当前 batch 的最大阈值”,取对应的草稿长度;退化为 0 时直接关闭本轮投机。
源码在这段上留了一处很实在的注释,解释缓冲区为什么要补齐:
def update_max_total_draft_tokens(self, new_max_total_draft_tokens): self.max_total_draft_tokens = new_max_total_draft_tokens self.max_draft_len = new_max_total_draft_tokens配合 Drafter.pad_draft_tokens_for_cuda_graph 里”先记真实值、再补零到静态最大值”的做法,形成一对约束:运行时草稿长度可以变,缓冲区宽度必须恒定。这是 CUDA Graph 重放的基本要求,也是前面 draft_lens 快照存在的原因。
验收率太低就永久关掉:SpeculationGate
投机解码在”草稿猜得不准”的内容上(比如自由创作、随机性强的对话)不但没有收益,还会拖慢——因为每个被拒绝的草稿都白付了一份验证成本。TensorRT-LLM 用一个很直接的门控处理这件事:
class SpeculationGate: """Tracks a rolling average of true acceptance-rate samples over the last N speculation-enabled decoding iterations.
Permanently disables speculation when the rolling average falls below the configured threshold."""
def record_acceptance_rate(self, acceptance_rate, sample_id=None): ... self.acceptance_rate_history.append(acceptance_rate) self.acceptance_rate_sum += acceptance_rate if len(self.acceptance_rate_history) > self.window: removed = self.acceptance_rate_history.popleft() self.acceptance_rate_sum -= removed self.num_recorded_samples += 1 if self.num_recorded_samples >= self.window: avg_acceptance_rate = self.acceptance_rate_sum / len(self.acceptance_rate_history) if avg_acceptance_rate < self.threshold: self.disabled = True logger.info("[SpeculationGate] Speculative decoding disabled: " f"rolling acceptance rate avg {avg_acceptance_rate:.3f} " f"< threshold {self.threshold} over last {self.window} iterations") return True, avg_acceptance_rate这是一个 的滑动窗口均值:deque 存最近 window 次的真实接受率,进出各加减一次和。关键是”永久”(permanently):一旦滚动均值掉到阈值以下,就 disabled = True 且不再恢复。
为什么是永久而不是”过一阵再试”?因为接受率的高低主要由内容类型决定,而请求一旦进入某类内容(比如长段自由发挥的散文),接下来的若干步大概率还是同类;反复试探只会持续付出”草稿 + 验证”两份成本换回”什么都没接受”的结果。代码里还有一个细节值得注意:
def record_acceptance_rate(self, acceptance_rate, sample_id=None): if self.disabled or self.window is None or self.window <= 0 or self.threshold is None: return False, None if acceptance_rate is None: return False, None acceptance_rate = float(acceptance_rate) if acceptance_rate < 0.0 or acceptance_rate > 1.0: raise ValueError("acceptance_rate must be in the range [0.0, 1.0], " f"got {acceptance_rate}")传进来的必须是真实接受率(0 到 1 之间),越界直接抛异常。这与前面 py_num_draft_tokens_verified 的设计是配套的:分母必须是真实提出的草稿数,不能把 CUDA Graph 的补零算进去,否则算出来的”接受率”是假的,门控就会基于错误信号做决定。
另外 PyExecutor 里保存了这个门控的决策结果:
self.speculation_permanently_disabled = Falseself.speculation_gate = Nonespec_config = getattr(self.model_engine, 'spec_config', None)if spec_config is not None: window = getattr(spec_config, 'acceptance_rate_window_size', None) threshold = getattr(spec_config, 'acceptance_rate_threshold', None) if ...: self.speculation_gate = SpeculationGate(window, threshold)而 resolve_draft_len 的第一段就是它:
def resolve_draft_len(spec_config, scheduled_batch, *, max_draft_len, static_draft_len, draft_len=None, speculation_permanently_disabled=False): if speculation_permanently_disabled: for request in scheduled_batch.generation_requests: request.py_draft_tokens = [] return 0关掉之后,草稿 token 列表被清空,runtime_draft_len 返回 0,worker 走 skip_drafting 分支——正式退化成普通解码。
外部草稿:save_hidden_states 与跨进程草稿
枚举里有一个模式叫 SAVE_HIDDEN_STATES,名字看不出用途。它的真实语义是:这一个引擎只负责跑目标模型并保存中间层 hidden states,不自己做草稿——草稿由外部的草稿引擎完成,两个引擎通过某种通道交换 hidden states。
这就是 one-model 与”两模型”的边界所在。当草稿模型大到无法塞进目标模型的同一份显存预算,或者需要用完全不同的并行策略(比如草稿用小 TP、目标用大 TP)时,可以把 save_hidden_states 模式的引擎当成”特征供应器”:
class SaveHiddenStatesSpecMetadata(SpecMetadata): ...class SaveHiddenStatesResourceManager(ResourceManager): ...SpecWorkerBase 里还专门给这种情况留了钩子:
def register_auxiliary_state_handler(self, handler): """Register one model-owned state handler without re-parenting the module.""" if not any(registered is handler for registered in self._auxiliary_state_handlers): self._auxiliary_state_handlers.append(handler)
def commit_auxiliary_speculative_states(self, num_accepted_tokens, state_indices, num_contexts): """Promote registered model-side states using accepted token counts.""" for handler in self._auxiliary_state_handlers: handler.commit_speculative_states(num_accepted_tokens, state_indices, num_contexts)注意注释里的”without re-parenting the module”——handler 只是被登记进一个列表,不会改变它自己在 module tree 里的归属。这样做的原因是:辅助状态可能属于目标模型自己(比如 Mamba 的循环状态、稀疏注意力的索引器缓存),把它们从原模型上”摘下来”挂到 worker 上会破坏 state_dict、影响权重加载与并行切分。用一个注册表做回调,是侵入性最小的做法。
分层的代价:这套设计牺牲了什么
把 one-model 的架构说完整,还得说清它的代价。除了前面提到的”不支持清单”,还有三条更结构性的:
第一,采样器被绑定到 flashinfer。 因为 one-model 的采样走 sample_from_logits_op,SpecWorkerBase.__init__ 里直接硬校验:
if not IS_FLASHINFER_AVAILABLE or Version(flashinfer.__version__) < Version("0.6.4"): raise ImportError("Speculative decoding requires flashinfer>=0.6.4, " "please install the version pinned in requirements.txt.")注释说明了为什么要在构造时就失败而不是推理中途崩溃:“Fail at construction with a clear error instead of crashing mid-inference on the first non-greedy sampling step.” 这是一个很务实的取舍:投机解码的收益只有在”开启之后”,而一旦某个非贪心请求触发了缺失的算子,失败点会离配置点非常远,排查成本高。
第二,动态草稿长度与 CUDA Graph 互相拉扯。 前面看到的所有 pad / snapshot / extend 逻辑,都是这两者冲突的产物。pad_draft_tokens_for_cuda_graph 的 docstring 甚至专门解释了为什么某些 drafter 需要额外的 KV 扩容:
Drafters that use TorchSampler (NGram, two-model) compute
py_rewind_lenfromlen(py_draft_tokens), which includes padding. They must set this to True so thatextend_capacity_for_tokensis called after padding. One-model drafters (MTP / Eagle3 / SA) use SpecSampler which computes rewind fromruntime_draft_len, so padding is harmless.
也就是说”补零是否会污染 rewind 长度”取决于采样器怎么算——这是一个必须由代码作者逐模式确认的不变量,而不是靠框架统一保证的。
第三,每加一种模式都要重新回答一遍这些不变量。 枚举里那组谓词(needs_kv_cache_rewind、without_logits、support_overlap_scheduler、penalty_supported……)之所以必须逐个模式手写,就是因为每个模式的答案都不同。这是把草稿塞进目标前向这条路线的固有成本。
小结
把这一篇的内容收拢成几条可以直接记住的结论:
- TensorRT-LLM 的投机解码是”one-model”主导的:MTP、MTP-Eagle、EAGLE-3、SA、PARD、DFlash、DSpark、DraftTarget 全部走同一个
SpecSampler,草稿 + 验证 + 接受在同一次目标前向内由融合算子完成;只有NGram和用户自定义草稿走独立的Drafter路线。 SpeculativeDecodingMode那组谓词是读这份源码的钥匙:use_one_engine()、needs_kv_cache_rewind()、has_spec_decoder()、has_spec_drafter()、is_parallel_draft()直接把代码分成了几条互斥的路径。- 验收流水线的枢纽是
py_rewind_len:先用本步真实草稿数(py_draft_tokens_effective_len快照)算分母与回滚长度,再覆盖py_draft_tokens装下一步草稿;顺序颠倒会同时污染统计与 KV 账本。 - KV 回滚是”多预留 → 先写入 → 再归还”:
prepare_resources多写max(draft_len, _kv_reserve_draft_tokens)个位置,update_resources归还py_rewind_len与_kv_reserve_draft_tokens - runtime_draft_len两笔,缺任何一笔都会泄漏。 - 前缀缓存与投机解码有真实冲突,代价是隐藏状态草稿器在 100% 命中时掉约 15% 的接受长度;
context_recompute_tail用”回退游标、重算窗口尾部”来换回草稿质量,代价是必须开分块 prefill。 - 拒绝采样是可选路径,且 fail-closed:全贪心批次直接跳过;缓冲区形状不合规时降级为严格接受;草稿侧与目标侧的采样过滤必须走同一套后端,否则接受判定会静默出错。
- 工程上最容易被忽视的两个开关:
draft_len_schedule按 batch size 动态降草稿长度,SpeculationGate在滚动接受率低于阈值时永久关闭投机——前者解决”大 batch 不划算”,后者解决”内容不适合猜”。
下一篇会回到 TensorRT-LLM 的通信与并行主线:从 Mapping 与 DistConfig 出发,看张量并行、流水并行与注意力 DP 如何在一次前向里组织,以及 Communicator/allreduce 这类集合通信原语是怎么被调度器与模型引擎接进去的。
参考资料
- Fast Inference from Transformers via Speculative Decoding —— Leviathan 等,ICML 2023,投机采样原始论文
- Accelerating Large Language Model Decoding with Speculative Sampling —— Chen 等,DeepMind 2023,拒绝采样版本的投机解码
- EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test
- PARD: Parallel Drafting for Speculative Decoding
- DeepSeek-V3 Technical Report —— MTP 模块与推理系统部分
- TensorRT-LLM 官方文档:Speculative Decoding
- TensorRT-LLM GitHub 仓库 —— 本文所有代码引用来自
tensorrt_llm/_torch/speculative/与tensorrt_llm/_torch/pyexecutor/
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



