


TensorRT-LLM 源码完全拆解(二):PyExecutor 装配线与单步闭环——从 LLM 参数到一次可重叠的 GPU 前向
系列进度与本篇定位
这是「四个推理框架源码系统学习」系列的第四站第二篇。上一篇 TensorRT-LLM 源码完全拆解(一):整体架构与模块全景 已经摸清了地形,结论可以压缩成四句话:
- TensorRT engine 后端已被彻底移除,PyTorch 是唯一执行后端,
trtllm-build、convert_checkpoint.py与tensorrtpip 依赖都不再需要,模型直接由tensorrt_llm/_torch/models/modeling_*.py里的原生 PyTorch 模块定义。 - 框架是「Python 编排层 + 厚重 C++ 运行时」:调度与 KV Cache Manager 的实现在
cpp/tensorrt_llm/batch_manager/,接口留在 Python 侧并通过 nanobind 绑定,因此两者都能用 Python 定制。 PyExecutor的单步流程是五动作:取新请求 → 调度部分请求 → 跑模型前向 → 跑 Decoder → 追加输出并处理完成。ResourceManager用prepare/update/free三个钩子把「一个请求需要的资源」抽象出来,其中最重要的是 KV Cache Manager。- 调度是两级:
CapacityScheduler做容量准入,MicroBatchScheduler做本步选择,SimpleScheduler串联两者;paused_requests显式建模「暂停」,PyTorch 流程不支持流水线并行。
那篇的最后留了一个悬念:LLM 对象比 vLLM 的重,因为它要在初始化阶段就把 KV Cache 池、调度器、模型引擎、显存缓冲全部建好,而不是留到第一次请求。
本篇就沿着这个悬念往下走,回答两个问题:
- 装配线:
LLM(model=...)这一行代码背后,create_py_executor到底按什么顺序、把哪些部件装成一台推理机器?特别是那个其他框架都没有的动作——KV Cache 容量估算,为什么它需要把执行器建两遍。 - 单步闭环:装好之后,一次
step从「取请求」到「回响应」要经过哪些函数,中间的状态在哪一刻被改写;两个循环(普通与重叠)的差别究竟在哪一行代码。
第一篇给的是地图,本篇给的是装配图与流水线。读完之后再去看 py_executor.py 那九千多行,你应该能一眼认出每一段代码属于装配、调度、执行还是收尾。
装配线全景:create_py_executor 做六件事
入口在 tensorrt_llm/llmapi/llm.py。LLM.__init__ 做的是参数解析与容器搭建,真正的装配发生在 tensorrt_llm/_torch/pyexecutor/py_executor_creator.py。外层函数 create_py_executor 很短,它的价值在于包了两层保护:
@functools.wraps(_create_py_executor_impl)def create_py_executor( llm_args: TorchLlmArgs, checkpoint_dir: Optional[str] = None, tokenizer: Optional[TokenizerBase] = None, profiling_stage_data: Optional[dict] = None, resource_governor_queue=None,) -> PyExecutor: """Create a PyExecutor and roll back a partially initialized DWDP runtime.""" previous_dwdp_manager = get_global_dwdp_manager() try: with monitor_executor_initialization(), _StartupTimer( "executor_creation") as startup_timer: return _create_py_executor_impl(...) except BaseException: # 构造失败时回滚 DWDP(DeepSeek 式宽专家并行的管理对象) ... raise两件事值得注意:_StartupTimer 给整条装配线打上了分阶段计时(后面每个 with _startup_timer.phase("...") 都是一个可观测的装配阶段),而异常分支会检查并回滚 DWDP 全局管理器——装配到一半失败时,已经建立起来的分布式状态必须收干净,否则下一次重试会撞上残留的进程组与通信句柄。
_create_py_executor 本体按顺序做六件事,这张表可以先记住,后面逐站展开:
| 阶段 | 主要动作 | 关键对象 |
|---|---|---|
| 1. 配置与加载 | 读模型配置、应用模型默认值、建检查点加载器 | TorchLlmArgs、checkpoint_loader |
| 2. 模型引擎 | 定义 PyTorch 模块并加载权重,必要时同时建草稿引擎 | PyTorchModelEngine |
| 3. KV Cache 容量估算 | 用一轮「假执行」测出显存余量,再据测定容量重建管理器 | KvCacheCreator |
| 4. 调度器与资源 | 绑定容量/微批调度器,组装资源字典 | BindCapacityScheduler、ResourceManager |
| 5. 执行器实例化 | 造 PyExecutor,装配采样器、投机草稿、引导解码 | create_py_executor_instance |
| 6. 启动工作线程 | start_worker() 让执行循环跑起来 | PyExecutor |
整条链路的调用关系是:
LLM.__init__ └─ create_py_executor # 保护壳:计时 + DWDP 回滚 └─ _create_py_executor # 装配主体 ├─ _load_config_and_create_checkpoint_loader ├─ PyTorchModelEngine(...) # 主模型引擎 ├─ KvCacheCreator(...) # KV 容量估算与两代管理器 │ ├─ try_prepare_estimation() │ ├─ build_managers(resources, estimating=True) │ ├─ configure_kv_cache_capacity(py_executor) │ ├─ teardown_managers(resources) │ └─ build_managers(resources, estimating=False) ├─ create_py_executor_instance(...) # 建资源管理器与调度器 │ ├─ ResourceManager(resources) │ ├─ BindCapacityScheduler / BindMicroBatchScheduler │ └─ PyExecutor(...) └─ py_executor.start_worker()这份链路图里,第 3 阶段是 TensorRT-LLM 独有的,也是最容易读晕的一段:同一个执行器会被构造两次。先解释为什么。
为什么 KV Cache 要「估」而不是「算」
其他框架确定 KV Cache 容量的做法通常是算出来的:给定 num_layers、num_kv_heads、head_dim、dtype,再乘上你想支持的 token 数,就是一个静态公式。问题在于公式算的是「KV Cache 该占多少显存」,而工程上真正紧的约束是「装完权重和激活工作区之后还剩多少显存」。后者依赖的东西太多:权重实际占了多少(量化方式不同差一倍)、CUDA Graph 捕获时张量要预留多少、注意力后端的 workspace 有多大、通信缓冲(NVLS、DeepEP)要多少。
TensorRT-LLM 的选择是:先按一个保守的小容量把执行器完整建起来(含 CUDA Graph 捕获、工作区分配),跑一轮前向收集显存账目,再用实测余量反推 KV Cache 的最终容量,然后把旧执行器拆掉、按新容量重建一个。这就是 KvCacheCreator 的存在理由。
要理解这一步在算什么,先把静态公式写出来。给定测得的「可用于 KV Cache 的空闲字节数」,模型单层的 KV 存储开销是:
其中 是 KV 头数, 是单头维度, 是每个元素的字节数(FP16/BF16 为 2、FP8 为 1、FP4 为 0.5),系数 表示 K 与 V 各一份。于是整个池能容纳的 token 总数是:
是层数。分页存储下,再把它折成块数 , 就是 tokens_per_block。
这个公式里每一项都值得注意,因为它解释了「为什么估比算更靠谱」:
- 与 是模型结构决定的,读配置即可,唯一需要小心的是 MLA 这类压缩注意力——它的 KV 不是「每头一份」,而是一个压缩 latent(本站 MLA 完全拆解:DeepSeek 低秩 KV 压缩注意力的原理与全部实现细节 里有完整推导),此时 且 是压缩维度,公式依然成立但取值完全不同。
- 来自
kv_cache_dtype,可以与模型权重的精度不同。第一篇里我们看到KVCacheManager的构造函数直接接收dtype=kv_cache_dtype,而前向之后的update_resources还要把kv_cache_dtype_byte_size传进来按真实精度记账——同一份 KV,存 FP8 与存 FP16 的容量账差一倍。 - 是唯一无法从配置推出来的量,而它往往是最小的一项。权重受量化影响、工作区受后端与形状影响、通信缓冲受拓扑与并行策略影响、CUDA Graph 还要求预留固定地址的显存——这些量叠起来可能吃掉几百 MB 到数 GB。用一个静态公式去猜 ,本质是在猜别人的实现细节,所以框架选择实测。
try_prepare_estimation 决定「要不要估」,以及给出估算时使用的假负载。它返回一个布尔值,True 表示接下来会走两轮构造:
def try_prepare_estimation(self) -> bool: """Prepare for possible KV cache capacity estimation.
This updates `kv_cache_config` and returns a boolean indicating whether KV cache estimation is to be performend. """ if self._skip_est: return False ...它会在几种情况下直接放弃估算,每一条都有具体的物理原因:
- 上下文并行(CP):估算用的假请求是单条长序列,而 CP 恰恰是把一条序列切开跑,估算出来的每 rank 余量没有意义。
- Vanilla 注意力后端:这个后端是参考实现,用线性 KV Cache 而不是分页 KV,它的工作区形态与生产后端不同,估出来的数字不可用。
- Encoder-Decoder 模型:估算用的假请求是纯文本的,而 cross-attention 的 KV 块记账需要编码器输出长度,
getEncoderOutputLen在假请求上会直接抛异常。
三条禁用条件合起来说明一件事:估算不是「测个数字」这么简单,它依赖假负载能真实复现生产路径的显存形态。任何让假负载偏离生产形态的配置,都会让估算结果失真,此时框架宁可退回到用户显式指定的容量。
估算阶段的另一个细节在注释里写得很直白:
# User-provided pool sizing can underprovision the temporary# estimation cache and cause warmup to hang or fail. Override it# for estimation, then restore it in configure_kv_cache_capacity().self._kv_cache_config.pool_ratio = Noneself._kv_cache_config.avg_seq_len = self._max_seq_len用户给的 pool_ratio(KV 池占剩余显存的比例)与 avg_seq_len(平均序列长度)会影响池的划分方式。估算阶段把它们临时清空并改成最保守的形态,估完再恢复。原因是:如果按用户给的参数去建估算池,池可能太小,warmup 阶段要跑的假请求会直接卡住或者失败——一个用来「测容量」的池不该依赖被测对象本身的参数。
两轮构造的完整时序如下:
轮 1(估计轮) build_managers(resources, estimating_kv_cache=True) └─ 按估算容量建 KV Cache Manager,挂进 resources create_py_executor_instance(..., start_worker=False) # 不起线程 └─ 建调度器、资源管理器、CUDA Graph 捕获、warmup configure_kv_cache_capacity(py_executor) └─ 读实测显存账,写回 kv_cache_config 的最终容量 拆轮 1 ├─ kv_cache_transceiver.shutdown() # 先注销 NIXL 注册的 pinned 显存 ├─ kv_cache_creator.teardown_managers(resources) ├─ 清空 attn_metadata └─ del py_executor; gc.collect(); torch.cuda.empty_cache()
轮 2(最终轮) build_managers(resources, estimating_kv_cache=False) create_py_executor_instance(..., start_worker=False) start_worker()拆轮 1 的顺序有一段注释值得抄下来,因为它解释了一个很容易踩的坑:
# Shut down the transceiver before tearing down KV cache managers so# that NIXL-registered (pinned) GPU memory is deregistered first;# otherwise the old KV cache memory stays pinned and the subsequent# KV cache allocation will OOM.KV Cache 的显存可能被传输层(NIXL)注册成了 pinned 内存,P/D 分离场景下这是常态。如果先拆管理器再关传输层,那块显存仍然处于「被注册」状态,CUDA 不会把它还给分配器,第二轮分配就会 OOM。这是一个典型的「释放顺序即正确性」问题。
configure_kv_cache_capacity 里还顺手做了一件事:它把最后测得的容量与注意力工作区之间的关系固化下来,例如 fp8 上下文 MLA 工作区能覆盖的「上下文累计 KV 长度上限」会被算出来并交给 KV 管理器,让调度器直接读这个值,而不是每步自己从池布局再推一遍。
为什么要重建而不是就地改容量?因为 CUDA Graph。第一篇里我们强调过:CUDA Graph 把一段 kernel 序列连同所有地址录制成一张可重放的图,一旦重放前重新分配了图中的任何张量,录下来的地址就失效了。KV Cache 池地址变了,录下来的注意力 kernel 参数就全错了。所以「改容量」这件事在图捕获过的执行器上无法增量完成,只能整机重建。这也解释了 start_worker=False 这个参数:估计轮的 PyExecutor 是一个完整的、但从未启动过的执行器——它要捕获图、要跑 warmup,但不该真的去接请求。
模型引擎:装配线的第二站
模型引擎(PyTorchModelEngine)是执行侧的核心,它的构造在装配线中占的比重最大,因为它要做三件重活:
- 确定模型结构:从 HuggingFace 配置构造出原生 PyTorch 模块(
tensorrt_llm/_torch/models/modeling_*.py),并根据attn_backend决定注意力后端的类型、根据moe_backend决定 MoE 的执行方式。 - 加载权重:通过检查点加载器把 HF 命名映射到内部命名(
hf_parameter_utils.py),按并行策略切分后放到对应设备上。 - 决定 warmup 的目的:装配线里有一段代码专门在改这个字段:
for engine in (model_engine, draft_model_engine): if engine is not None: engine._warmup_timer.purpose = "memory_profiling" if estimating_kv_cache else "final_executor"purpose 是一个字符串,但它把两轮构造的区别写在明面上:估计轮的模型引擎是为了「测显存」而 warmup,最终轮的模型引擎是为了「跑服务」而 warmup。同一个类、同一份权重,两次预热的目的完全不同,因此图上要捕哪些形状、工作区要留多少都不同。这是一个很实用的读码提示:看到 _warmup_timer.purpose 就知道自己处在哪一轮。
投机解码在装配线里有自己的分支:get_spec_resource_manager 与 get_spec_drafter 会在模型引擎之后构造草稿相关的资源管理器与草稿器。注意草稿模型可以是一个独立的 draft_model_engine(独立权重)也可以是一个挂在主模型上的草稿头(EAGLE 形态),这两种情况下 KV Cache 的归属不同,KvCacheCreator 要分别处理,所以它的构造函数同时接收 model_engine 与 draft_model_engine 两个参数。关于投机解码在框架里的完整链路,本站有 vLLM 源码完全拆解(十):投机解码——草稿模型、批量验证与 token 接受流水线 与 SGLang 源码完全拆解(十一):投机解码 两篇可以横向对照。
调度器装配:同一个接口,三种实现
装配线的第四站要做的事是:从三种调度器形态里挑一个。这段代码在 _util.py 的 create_py_executor_instance 里,判断逻辑按优先级层层下落:
if 使用 KVCacheManager V2: scheduler = KVCacheV2Scheduler(...) # V2 交错式:容量与预算一起算elif scheduler_config.use_python_scheduler: scheduler = SimpleUnifiedScheduler(...) # Python 单级统一调度else: capacity_scheduler = BindCapacityScheduler(..., kv_cache_manager.impl, ...) mb_scheduler = BindMicroBatchScheduler(...) scheduler = SimpleScheduler(capacity_scheduler, mb_scheduler) # 两级 C++ 绑定三种形态对应三种设计取向,把它们的差别说清楚,比记住类名更重要:
SimpleScheduler(默认):两级结构,CapacityScheduler决定「哪些请求放得下」,MicroBatchScheduler决定「这一步选哪些」。前者的核心输入是get_needed_resource_to_completion与get_max_resource_count,后者的核心输入是 token 预算与 batch 上限。两级的好处是决策可分:准入是资源问题,选择是策略问题,两者可以各自替换。SimpleUnifiedScheduler:use_python_scheduler=True时启用,把两级合成一级。它的意义在源码注释里交代得很清楚——V2 调度器用scheduler_capacity作为「每迭代请求数」;而传统的分离设计需要CapacityScheduler按pp_size * max_batch_size来持有跨 PP 阶段的请求。也就是说,两级结构下容量必须是流水线深度的倍数,因为它要同时容纳各阶段在途的请求;合成一级之后这个约束就消失了。KVCacheV2Scheduler:配合新版分块 KV 管理(kv_cache_manager_v2/)的交错式调度。它接收scheduler_policy(容量策略)与enable_prefix_aware_scheduling(前缀感知调度)等参数,把「容量准入 + 预算分配」在一个对象内完成。
绑定 C++ 实现的那两个调用,参数表本身就是一张设计说明:
capacity_scheduler = BindCapacityScheduler( scheduler_capacity, kv_cache_manager.impl if kv_cache_manager is not None else None, peft_cache_manager.impl if peft_cache_manager is not None else None, scheduler_config.capacity_scheduler_policy, cross_kv_cache_manager=cross_kv_cache_manager.impl if cross_kv_cache_manager is not None else None, two_step_lookahead=mapping.has_pp(), no_schedule_until_state=no_schedule_until_state, enable_prefix_aware_scheduling=enable_prefix_aware_scheduling,)
mb_scheduler = BindMicroBatchScheduler( max_batch_size, max_num_tokens, ctx_chunk_config, no_schedule_until_state=no_schedule_until_state,)逐项解释:
scheduler_capacity:调度器能同时持有的请求数上限,赋值是max_batch_size * mapping.pp_size。乘上流水线深度,是因为流水线并行下同一时刻不同阶段各自持有不同的请求集合,调度器必须能同时看到它们。kv_cache_manager.impl:传入的是绑定对象的.impl,也就是 C++ 侧实例。Python 侧的KVCacheManager是包装层,真正的块分配在 C++ 里,调度器要问容量必须直接问 C++。peft_cache_manager.impl:LoRA 适配器缓存也是一个容量受限的资源,因此也是准入条件之一。多 LoRA 场景下「KV 够但 adapter 缓存不够」同样会导致请求无法被接纳。capacity_scheduler_policy:容量策略枚举。文档里明确出现的两个值是MAX_UTILIZATION(默认)与GUARANTEED_NO_EVICT。前者在容量允许时尽可能多接纳请求,代价是可能触发驱逐/暂停;后者宁可少接也不驱逐已接纳的请求——上一篇我们看过它的 Python 参考实现GuaranteedNoEvictScheduler,它先无条件保住已在生成阶段的请求,再按剩余块数接纳新的上下文请求,遇到第一个放不下的新请求就 break,用 FIFO 顺序避免大请求被小请求无限插队。cross_kv_cache_manager:跨注意力(encoder-decoder)KV 的独立管理器,只在需要时非空。这说明编码解码模型的 cross-KV 与自注意力 KV 是分开记账的:cross-KV 的长度由编码器输出决定,一旦写入就不再增长,因此可以与自回归增长的 self-KV 用不同的池与不同的准入逻辑。two_step_lookahead=mapping.has_pp():只有流水线并行时才打开两阶段预看。原因是 PP 下这一阶段看到的 batch 未必是下一阶段的输入,需要额外一步才能判断容量是否真的够。no_schedule_until_state:状态门槛,规定「请求进入哪个状态之后才允许被调度」。Encoder-Decoder 场景要放宽这个门槛,因为编码器请求必须更早被接纳,编码循环才有活干。max_num_tokens与ctx_chunk_config:微批调度的两个核心预算量,前者是单批 token 上限,后者是分块上下文(chunked context)的切分配置。下一篇会专门展开这两个预算怎么决定一次前向的规模。
有一个常量关系值得先在这里记住,因为它决定了显存预算怎么分:
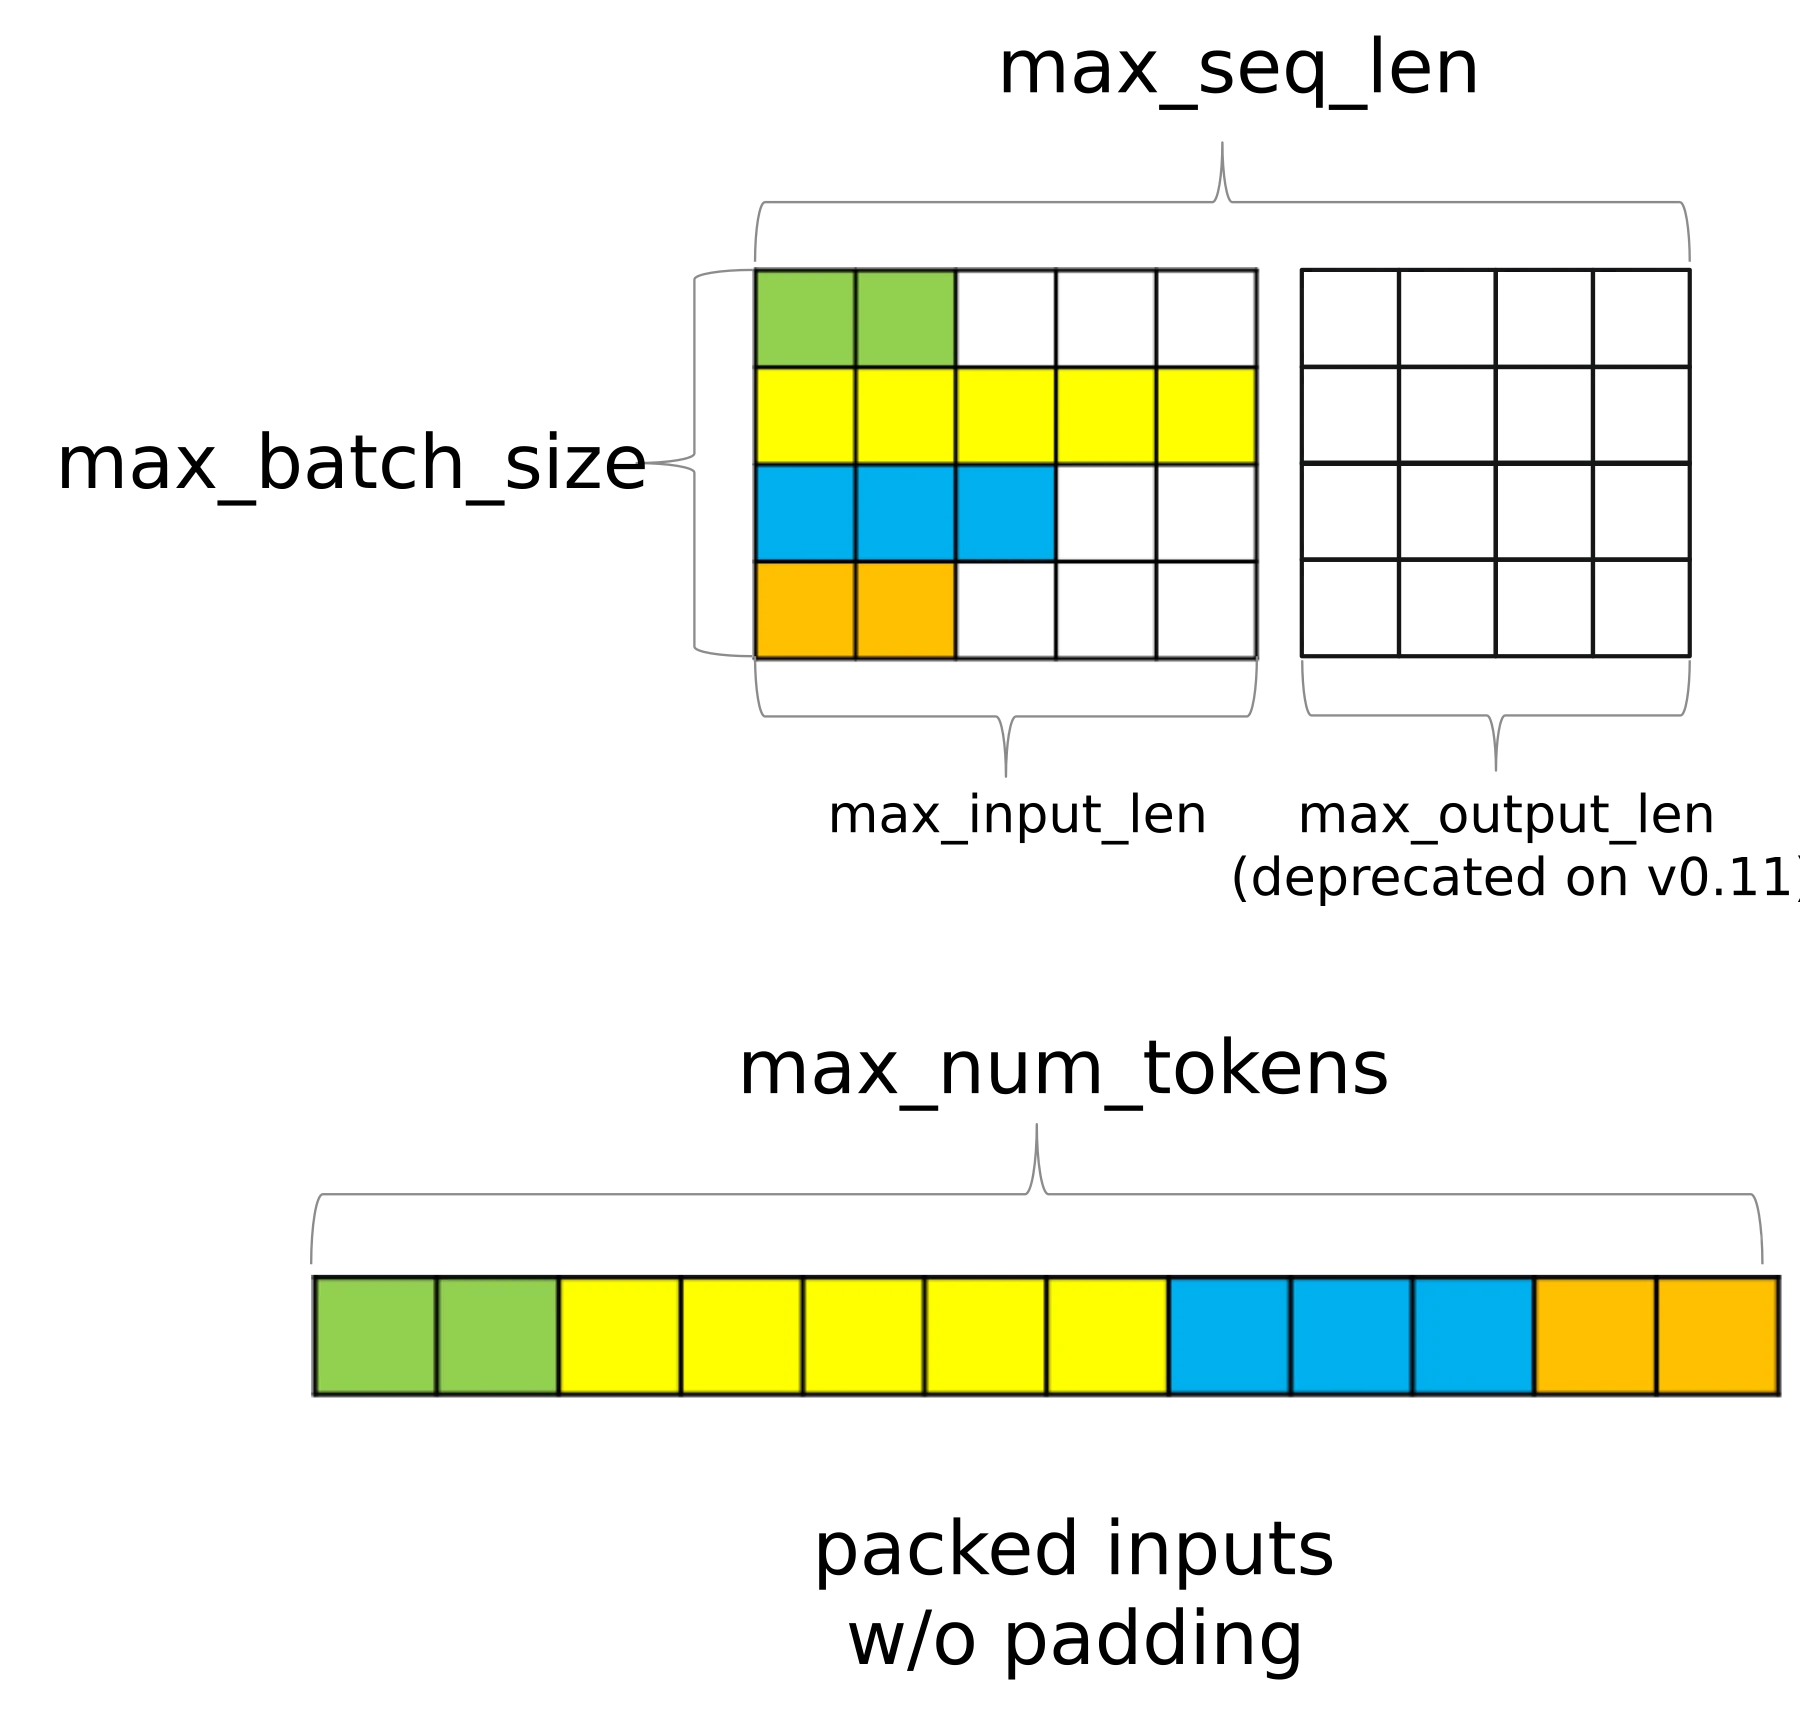
图:TensorRT-LLM 文档给出的长度/批次预算关系。max_input_len、max_output_len、max_seq_len 是单条序列的长度上限,max_batch_size 是并发序列数上限,而 max_num_tokens 是一次前向里所有序列 token 数的总和上限——官方在这一版里把旧路径标成 deprecated,说明现在真正约束显存的是「打包后的 token 总量」而不是「批次里的序列条数」。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/media/max_bs_toks_len.svg)
这张图解释了一个常见困惑:为什么 max_batch_size 与 max_num_tokens 要同时存在? 因为内存预算分两块:一块是「同时存活的序列状态」(请求槽位、beam 宽度、采样状态),由 max_batch_size 约束;另一块是「一次前向要处理的激活与工作区」,由 max_num_tokens 约束。两者不能互相推导——可以有很多条极短的序列(batch 大、token 少),也可以只有一条极长的序列(batch 小、token 多)。
ResourceManager:一个装资源的容器
调度器装好之后,装配线把资源管理器建起来:
resource_manager = ResourceManager(resources)ResourceManager 本身很短,它是一个以 ResourceManagerType 为键的字典,加上一组生命周期方法。构造之后的几行代码在做排序:
resource_manager.resource_managers.move_to_end(...)OrderedDict.move_to_end 决定了资源管理器被遍历的顺序,而顺序在这里是有语义的:钩子按序调用。KV Cache Manager 必须排在能影响 KV 显存分配的那些管理器之前(例如投机解码的资源管理器会额外申请草稿 KV 块),否则「先算容量再分配」的账目会对不上。
BaseResourceManager 定义三个钩子,第一篇文章里列过,这里给出它们在代码里的真实调用点:
| 钩子 | 调用位置 | 语义 |
|---|---|---|
prepare_resources | _forward_step 之前,can_queue 成立时 | 为当前 batch 分配本步所需资源(首次上下文按整段分配,生成阶段按下一步分配) |
update_resources | 本步收尾,_handle_responses 之后 | 更新本步消耗的资源计数(V1 下通常空操作) |
free_resources | 请求结束 | 释放该请求占用的资源 |
update_resources 的签名里有两个额外参数,它们暴露了「为什么要更新」:
self.resource_manager.update_resources(scheduled_batch, attn_metadata, kv_cache_dtype_byte_size)注意力元数据与 KV 精度字节数被传进来,说明这一步的更新是按真实存储形态记账的:同样的 token 数,KV 存 FP8 还是 FP16 占用差一倍,KV Cache 的统计量必须按实际 dtype 折算。这与「按块分配」的 PagedAttention 逻辑一致,本站 PagedAttention 完全拆解:操作系统分页思想如何拯救 LLM 推理的内存利用率 讲过块粒度分配的代价与收益。
PyExecutor 实例化:把执行器交给工作线程
最后一步是 PyExecutor(...) 的构造。它的签名有三十多个参数,但真正必填的只有五个,其余都是可选能力:
def __init__( self, resource_manager, scheduler: RequestScheduler, model_engine: ModelEngine, sampler: Sampler, dist: Distributed, max_num_sequences: int, drafter: Optional[Drafter] = None, disable_overlap_scheduler: bool = False, ... kv_cache_transceiver: Optional[KvCacheTransceiver] = None, guided_decoder: Optional[GuidedDecoder] = None, start_worker: bool = True, ...):这五个必填项正好是上一篇说的「三个关键组件」加两个环境依赖:资源管理器、调度器、模型引擎、采样器、分布式环境。剩下的参数几乎都是「接哪些可选能力」:drafter 管投机解码、kv_cache_transceiver 管 P/D 分离的 KV 传输、guided_decoder 管结构化输出、disable_overlap_scheduler 管重叠开关。
构造里有两处与线程/流有关的准备,值得单独看:
self.execution_stream = execution_stream if execution_stream is not None else torch.cuda.Stream()# Encoder-decoder requests use a dedicated encoder stream so the# encoder forward does not serialize the decoder forward when the# two operate on disjoint request sets.self.encoder_stream = torch.cuda.Stream()执行流(execution stream)与编码器流(encoder stream)是两条独立的 CUDA 流。执行流承载模型前向,这样它可以与 KV 传输管理器(onboard/offload)用事件做正确同步,而不必把默认流拉下水;编码器流承载多模态/编码器前向,理由是注释里那句「两者的请求集合本就不相交」——既然不相交,就没有理由让编码器前向把解码前向串行化。这是用请求集合的不相交性换取并行度的一个干净例子。
start_worker() 最后把工作线程拉起来。线程入口是 _event_loop_wrapper,它要在几个循环之间选一个:
_event_loop_wrapper ├─ _executor_loop # 普通循环:前向与后处理严格串行 ├─ _executor_loop_overlap # 重叠循环:本步 GPU 工作与上一步 CPU 后处理重叠 └─ _executor_loop_pp # 流水线并行循环:按阶段交替执行至此装配完成。接下来进入本篇的第二个重点:循环体内部到底发生了什么。
循环入口:三种循环与它们的共同骨架
start_worker 拉起的线程跑的是 _event_loop_wrapper,它本身不含推理逻辑,只负责「选循环 + 兜底」。三行关键代码:
with host_profiler_context(enable=enable_profiler), \ customized_gc_thresholds(self.garbage_collection_gen0_threshold): self.event_loop()以及异常分支里那句注释,它解释了这里为什么不能顺手调用通用的错误处理:
# We do NOT call _handle_errors / _enqueue_responses here: they trigger# tp_gather / allgather collectives that would deadlock when# only this rank crashed.错误处理里含集合通信,因此只在单 rank 崩溃时调用它会死锁——其余 rank 还在跑,等不到这个 gather。所以这一层只做两件事:把原始异常存进 _event_loop_error(让本地的等待者能拿到真正的错误而不是干等),然后在本 rank 确定无法继续时触发整作业终止,而不是让对端在自己下一次集合通信里被 HangDetector 拖到 300 秒后才失败。
customized_gc_thresholds 是一个容易被忽略但很务实的细节:Python 的垃圾回收触发阈值是可调的,推理服务的对象生命周期极长且分配模式稳定,把 gen0 阈值调大可以避免 GC 在热路径里频繁扫描。装配线里 garbage_collection_gen0_threshold 是作为参数一路传下来的,说明这是一个被显式承认的性能调项。
event_loop 就是循环分发(_executor_loop / _executor_loop_overlap / _executor_loop_pp)。三个循环共享同一套骨架,差别只在「CPU 后处理放在哪里」。先把普通循环的骨架拆成七个动作。
普通循环 _executor_loop 的七件事
去掉所有可选分支(P/D 分离、投机解码、多模态编码器、引导解码),_executor_loop 的每一轮迭代是这样一条线:
while True: 1. 准备并调度 scheduled_batch = self._prepare_and_schedule_batch() ├─ 取新请求并激活(_fetch_and_activate_new_requests) ├─ 处理已取消/控制请求 ├─ 更新投机草稿长度(draft_len_schedule) └─ self._schedule() → scheduler.schedule_request(active_requests, inflight_req_ids) 2. 处理暂停 self._pause_requests(scheduled_batch.paused_requests) 3. 准备资源 self.resource_manager.prepare_resources(scheduled_batch) 4. 前向 batch_outputs = self._forward_step(scheduled_batch) 5. 采样 sample_state = self._sample_async(scheduled_batch, batch_outputs) 6. 更新状态与资源 self._update_request_states(...) self._update_requests(sample_state, ...) self.resource_manager.update_resources(...) 7. 收尾 finished_requests = self._handle_responses()这里的顺序不是随便排的,每一处相邻关系都有原因:
「暂停」必须排在第 2 步、即资源准备之前。 被暂停的请求本步不执行,它的 KV 块要归还给池子,而第 3 步的 prepare_resources 恰好要按「池子里还有多少空块」来分配。如果顺序反了,就会出现「先按旧的池子分配、再归还」的账目错位。
前向与采样用同一个 scheduled_batch。 采样要处理的是这一批刚算出来的 logits,它需要知道每个请求的 logits 前缀和(num_context_logits_prefix_sum)、beam 宽度、以及上下文阶段的 token 数。这段代码在 _sample_async 里:
num_context_logits_prefix_sum = [0]prefix_sum = 0for request in scheduled_batch.context_requests: context_chunk_size = request.context_chunk_size prefix_sum += context_chunk_size if request.py_return_context_logits else 1 num_context_logits_prefix_sum.append(prefix_sum)py_return_context_logits 这个开关决定了上下文阶段的每条请求到底产生多少个 logits:默认情况下只有最后一个 token 需要 logits(用于生成第一个输出 token),所以每个上下文请求对前缀和的贡献是 1;如果打开了返回上下文 logits,则整段上下文都要保留 logits。这直接决定采样侧要处理的张量有多大,因此在服务里默认是关的。
HandleLogits() 与 HandleAdditionalOutputs() 是两个函数对象,它们把「logits 从哪一段切给哪条请求」和「额外输出(如 hidden states、spec token 的中间结果)该发给谁」的规则内聚成两个可调用对象,避免在采样主路径里堆一大段索引计算。
状态更新与资源更新是两件不同的事。 _update_request_states 推进的是请求的状态机(例如 GENERATION_IN_PROGRESS → GENERATION_TO_COMPLETE),_update_requests 处理的是采样结果落到请求对象上(追加 token、判断是否要停),而 update_resources 则回写资源计数。三者分开的原因在重叠循环里会看得更清楚:它们在不同的时刻才有数据可用。
_handle_responses() 是唯一创建输出的地方。 它返回这一步完成的请求列表,同时把增量 token 通过响应队列推到上层(_enqueue_responses)。响应推送与请求终止的顺序也有讲究,源码里在两处留了注释互相呼应:
finished_requests = self._handle_responses()# Complete ctx send sessions AFTER responses are created so# _handle_responses sees the request before it is terminated.self.disagg.reap_context_sends(0)先产响应、再终止请求:终止会释放 KV 并标记请求状态,而 _handle_responses 需要读取请求的完整信息(如已生成的 token 数、是否命中停止条件)。顺序反了,响应就少了一个字段。
_schedule:一次调度要做四次过滤
第 1 步里的 _schedule 值得单独拆,因为它不是一个「调用调度器就完事」的函数。它的主体是:
def _schedule(self): if hasattr(self.kv_cache_manager, "prepare_expect_snapshot_points"): self.kv_cache_manager.prepare_expect_snapshot_points(self.active_requests)
scheduler_output = self.scheduler.schedule_request( self.active_requests, self.inflight_req_ids) ...真实源码里 self.scheduler.schedule_request(...) 返回的是一个复合结构(上下文请求、生成请求、编码器请求、暂停请求、被选中的多模态编码项、重算暂停请求),我们把它统一记成 scheduled_batch。调度结果拿到之后,_schedule 还要做四次过滤,每次过滤都对应一类具体的资源或语义约束:
第一次:编码器批等待。 当模型是 encoder-decoder、没有开注意力 DP、且开了批等待(enable_batch_waiting)时,编码器请求要跟上下文和生成请求一起等——否则编码器先跑完,解码器阶段的上下文请求却还没凑齐,白白多一次循环。
第二次:注意力 DP 的请求均衡。 开了注意力数据并行且 attention_dp_enable_balance 时,上下文请求会按生成请求的分布重新分配,目的是让各 DP rank 的负载均衡。这一步的位置很关键:它在调度之后、批组装之前,也就是说均衡是在「已准入的请求」内部重排,不会推翻准入决策。
第三次:批等待的再检查。 这段注释指出了 V2 内存管理带来的一个副作用:
# With KV cache manager V2, scheduling has already grown context request KV cache capacity.# Requests dropped for batch waiting still occupy KV cache and may reduce the batch# size available for generation requests.V2 调度在准入时就已经把上下文请求的 KV 容量「长出来了」(预留),因此即便一个请求因为批等待被丢弃,它占的 KV 也不会自动还给生成请求——预留与占用在 V2 里是不同的账目,生成请求能用的批大小因此被压低。这条注释是理解 V1/V2 差异的一个入口。
第四次:把累计上下文 KV 长度封顶。
# Cap summed context attended-KV length so the context-MLA attention workspace stays within the# headroom the estimator reserved for it (a no-op for unaffected models).scheduled_context_requests = self._cap_context_by_total_kv_len(scheduled_context_requests)这条对应前面提过的「fp8 上下文 MLA 工作区预留上限」:估算阶段为 MLA 注意力工作区留了一块固定显存,这块工作区的大小取决于本步所有上下文请求的「参与注意力的 KV 总长度」之和。如果调度器一次性放进来太多长上下文请求,工作区就会不够,因此这里按估算时定下的上限做一次裁剪。这又是一个「装配期测出的数字,在运行期变成硬约束」的例子。
前向与采样:两条流之间的交接
_forward_step 做的是三件事:构造输入、把前向放到执行流上跑、把结果交回默认流。核心几步:
self.execution_stream.wait_stream(torch.cuda.current_stream())self._attach_encoder_output_to_execution_stream(scheduled_requests)with torch.cuda.stream(self.execution_stream): outputs = forward(scheduled_requests, self.resource_manager, new_tensors_device, cache_indirection_buffer)torch.cuda.current_stream().wait_stream(self.execution_stream)四行流操作可以读成一句工程原则:前向在生产者的流上跑,消费者在默认流上等。wait_stream 是「让本流等待目标流的当前进度」——第一句保证执行流不会在输入拷贝完成之前抢跑,最后一句保证后续任何用输出的操作(采样、量化、传输)不会在 kernel 完成前读到半成品。
注意 cache_indirection_buffer 是采样器提供的(self.sampler.get_cache_indirection()),它被传进模型前向。这是投机解码/beam search 场景下「一个槽位可能要回看多个 token 位置」的间接寻址表——采样侧的元数据要提前交给前向,因为注意力 kernel 需要它来构造 K/V 索引。
_forward_step 的输入是 scheduled_batch 与可选的 new_tensors_device,输出是 batch_outputs(一个字典,含 logits 与可能的额外输出)。注意它不负责「等 GPU 算完」:返回时前向只完成了下发,真正的完成点由采样侧或重叠循环的下一轮显式同步。这正是重叠调度得以成立的前提。
重叠循环 _executor_loop_overlap:把 CPU 后处理挪到 GPU 忙的时候
disable_overlap_scheduler=False(默认)时用的是重叠循环。它和普通循环的差别可以用一句话概括:本步的 GPU 前向与上一步的 CPU 后处理同时进行。官方文档给出的形态是:
# Schedule and launch GPU work for the current step (n)scheduled_batch, _, _ = self._schedule()batch_outputs = self._forward_step(scheduled_batch, previous_tensors_device)sample_state = self._sample_async(scheduled_batch, batch_outputs)
# While the GPU is busy, process the CPU-bound results from the previous step (n-1)if self.previous_batch is not None: self._process_previous_batch()而 _process_previous_batch 的内容正好是普通循环后半段的那几件事:
def _process_previous_batch(self): self._handle_canceled_requests() finished_requests = self._handle_responses( emit_first_iter=not self.enable_early_first_token_response) scheduled_requests = self.previous_batch.scheduled_requests attn_metadata = getattr(self.model_engine, 'attn_metadata', None) kv_cache_dtype_byte_size = getattr(self.model_engine, 'kv_cache_dtype_byte_size', None) self.resource_manager.update_resources(scheduled_requests, attn_metadata, kv_cache_dtype_byte_size) ...也就是说,重叠循环把「更新资源」与「产出响应」这两件纯 CPU 的事,从本步挪到了下一步的 GPU 时间窗口里。这就是为什么 ResourceManager 的 update_resources 被单独拆出来,而不是混在 prepare_resources 的对称位置上——为了能被挪走。
挪走它需要付出两个额外代价,这也是理解这段代码的关键:
代价一:CPU 侧要保存上一批的输入缓冲区,且不能在拷贝完成前改写它。 循环开头有一句专门的等待:
# Need to wait for the copy of previous iteration before# modifying any host memory copied to GPU. Scheduler V2# modifies the host page table, so wait before scheduling.self._wait_for_model_engine_input_copy()上一轮的输入是从 host 内存拷到 GPU 的,如果这一轮马上改写那块 host 内存,而拷贝还没完成,GPU 读到的就是新旧混合的数据。所以「调度之前必须先等拷贝完成」不是性能优化,而是正确性要求。V2 调度器改写 host 页表,让这个问题变得更尖锐——它改的正是被拷过去的那份描述。
代价二:多一个解码步的延迟。 官方文档的表述是「The optimization introduces one extra decoding step but significantly improves throughput」。原因很直观:第一步的请求要等到第二步的 _process_previous_batch 才会收到自己的第一个 token,因为它的后处理被推迟了一轮。这是典型的「延迟换吞吐」,默认开启说明在多数服务场景下这笔交易划算——吞吐收益来自 CPU 后处理不再占用 GPU 空闲窗口,延迟代价是每个请求固定多一个迭代。
重叠循环里还有一个必须处理的边界,就是各 rank 的批次可能不一致:
# If the batch is not empty on this rank, but empty on other ranks,# we need to delay the update of the previous batch's sample state,# and let the later iteration to update it.should_process_previous_batch = can_queue or not can_queue_this_rank注意力 DP 下各 rank 收到的请求数不同,某些 rank 这一步可能没有任何请求可跑(can_queue 为假)。这时它不能擅自去处理上一批——因为上一批的样本状态在注意力 DP 下需要跨 rank 的集合通信才能对齐,单独一个 rank 提前处理会破坏集合通信的顺序。条件写成 can_queue or not can_queue_this_rank 而不是简单的 can_queue,正是为了覆盖「所有 rank 都没活干」这种必须一起推进的情况。
配合这一点,重叠循环里所有跨 rank 的同步动作都被要求按相同顺序进入,源码里反复出现类似注释:
# non-fatal errors can be buffered on an idle pass, and every ADP rank# must enter the tp_gather in the same order. Keep it after all per-pass# error handling so a response is not needlessly delayed to the next pass.self._flush_pending_transfer_responses()空转的一轮也必须走完同样的集合通信序列,否则 rank 之间会错位并最终互相等待。
单步里的 KV 与资源:一条时间线
把上面这些拼成一条时间线,可以看清「一个 token 的生命周期」在一次迭代里被切成了哪几段:
迭代 n 开始 ├─ 等上一轮输入拷贝完成 (_wait_for_model_engine_input_copy) ├─ 取新请求 → 调度 → 得到 scheduled_batch ├─ 处理暂停请求 (归还 KV 块) ├─ prepare_resources (为首次上下文分配整段 KV;生成阶段按下一步分配) ├─ 前向下发到执行流 (_forward_step,不等完成) ├─ 采样下发 (_sample_async) └─ 处理上一批 (_process_previous_batch) ├─ 创建响应 / 推送增量 token ├─ 终止完成的请求 (free_resources → 回收 KV 块) └─ update_resources (按真实 dtype 回写 KV 统计)迭代 n+1 开始两个观察:
- KV 块的分配发生在
prepare_resources,回收发生在_process_previous_batch(或普通循环的_handle_responses之后),两者之间隔着整整一轮。也就是说,重叠调度下「已经完成但还没被回收」的块会比普通循环多存在一轮。这对容量规划有直接影响:调度器看到的空闲块数比实际空闲的少一轮的量,配置池容量时必须把这块「在途」显存算进去。 - 请求状态在整条链路上被改写了三次:调度阶段(是否能被调度由
no_schedule_until_state门槛决定)、前向之后(状态推进到「待完成」)、收尾阶段(完成或继续生成)。重叠循环里_update_request_states被放在采样之后、_process_previous_batch之前,这个插入点是精心选的:它要在下一轮调度看到正确状态之前完成推进,又不能早于采样结果落地。
Chunked Context:微批调度的核心预算
前面提到 MicroBatchScheduler 的输入里有 ctx_chunk_config,这里把它讲清楚,因为它决定了「一次前向到底多大」。
不做分块时,一条长提示词的上下文阶段必须整条跑完才能进入生成阶段:一条 32K token 的提示词会在一次前向里吃掉 32K token 的预算。如果服务器同时来三条这样的请求,前两条就已经把预算占满,第三条只能等——而更糟的是,等待期间 GPU 可能在生成阶段变得很空,因为生成阶段的每条请求每步只要 1 个 token。
分块上下文(chunked context,TensorRT-LLM 里的开关叫 enable_chunked_prefill)把一条长提示词切成若干块,每轮只处理一块:
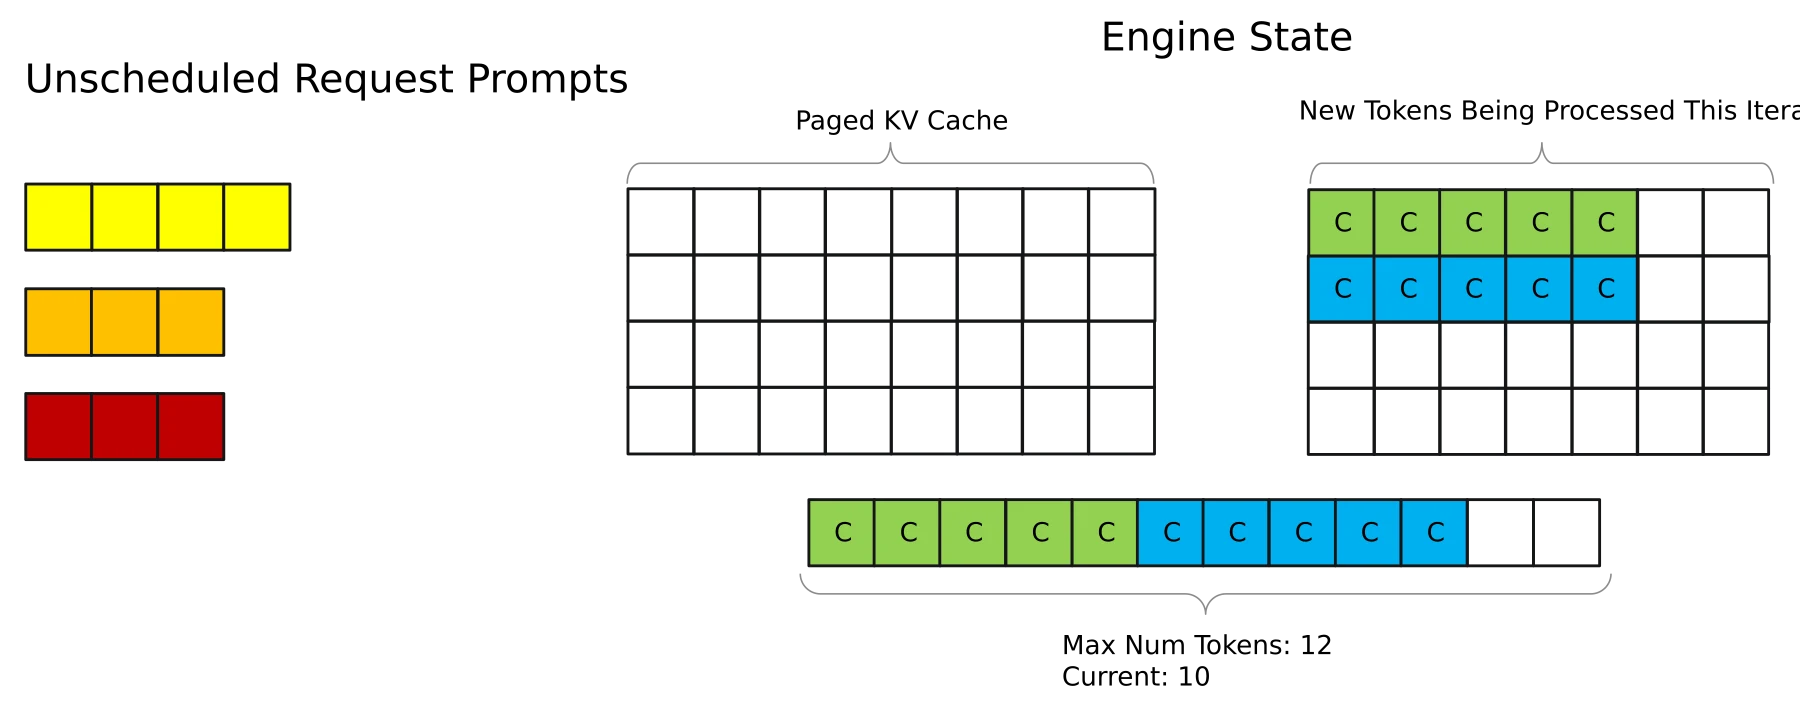
图:TensorRT-LLM 官方调度器示意(带 Max Num Tokens: 12 / Current: 10 的预算计数)。可以看到「本轮处理的 token」是被显式计数的,未调度的请求提示词留在队列里等待下一轮——这正是分块上下文所需的记账方式:max_num_tokens 是每轮的硬预算,调度器按这个预算把上下文块与生成请求拼进同一批。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/media/TRTLLM_Scheduler_Vis_2.svg)
分块带来三个直接后果:
- 首 token 延迟变差:一条提示词被切成 N 块就要跑 N 轮,第一块跑完才有第一个 token,因此 TTFT 会变大。这里的取舍与 Sarathi-Serve 完全一致,本站 Sarathi-Serve 完全拆解:分块 Prefill 与无停顿批处理如何兼顾吞吐和尾延迟 用「无停顿批处理」这个词描述了同一种权衡,可以对照阅读。
- 批内混杂度上升:同一轮里既有「还没做完上下文的请求」也有「正在生成 token 的请求」,所以
AttentionMetadata才会同时维护num_contexts与num_generations两个计数。这也是为什么上下文阶段的 token 数要单独记成num_ctx_tokens、上下文长度张量的形状是(num_contexts)而不是(batch_size)。 - KV 分配模式变化:一条提示词分块进入时,
prepare_resources不再「首次为整段上下文分配」,而是每次为当前块扩展容量。第一篇里引用的那句官方描述——「块内有剩余空间时可能根本不发生实际分配」——在分块场景下出现的频率更高。
调度器示意图里还有一个值得记住的形态:「引擎状态」与「本轮正在处理的 token」被画成两个独立的带。
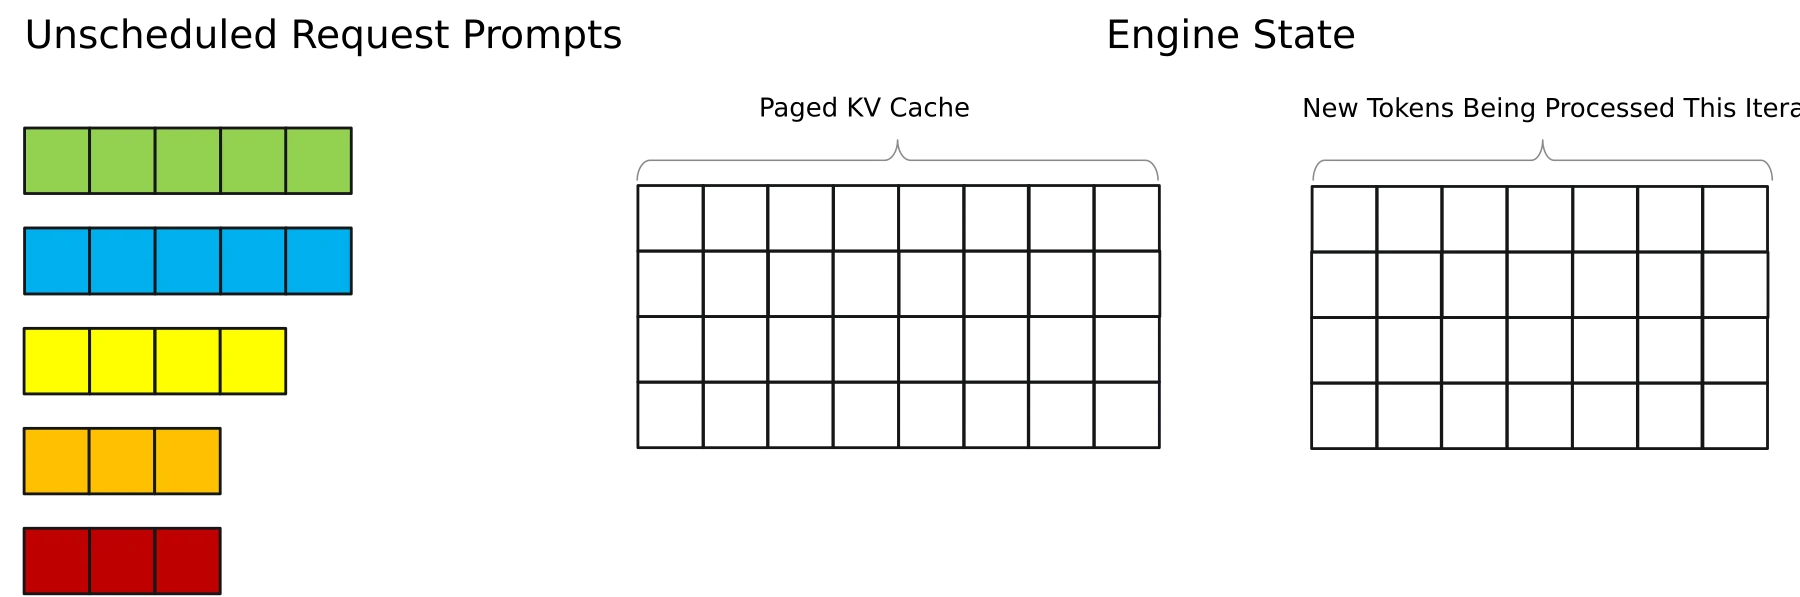
图:TensorRT-LLM 官方调度器示意的整体形态。自上而下分成 Paged KV Cache(已分配的分页缓存)、Engine State(已接纳但尚未完成的历史)、本轮正在处理的新 token 与尚未调度到的新请求提示词四层。理解这张图的关键是第三层:每轮真正产生计算量的只有「本轮正在处理的 token」,其余三层是记账与排队。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/media/TRTLLM_Scheduler_Vis_1.svg)
最后一层「未调度的请求提示词」对应代码里的等待队列。PyExecutor.__init__ 有一个 waiting_queue_policy 参数,默认是 WaitingQueuePolicy.FCFS——先来先服务。这个策略与 GuaranteedNoEvictScheduler 里「遇到放不下的请求就 break」是同一种公平性选择:不做重排序,避免大请求被无限插队。
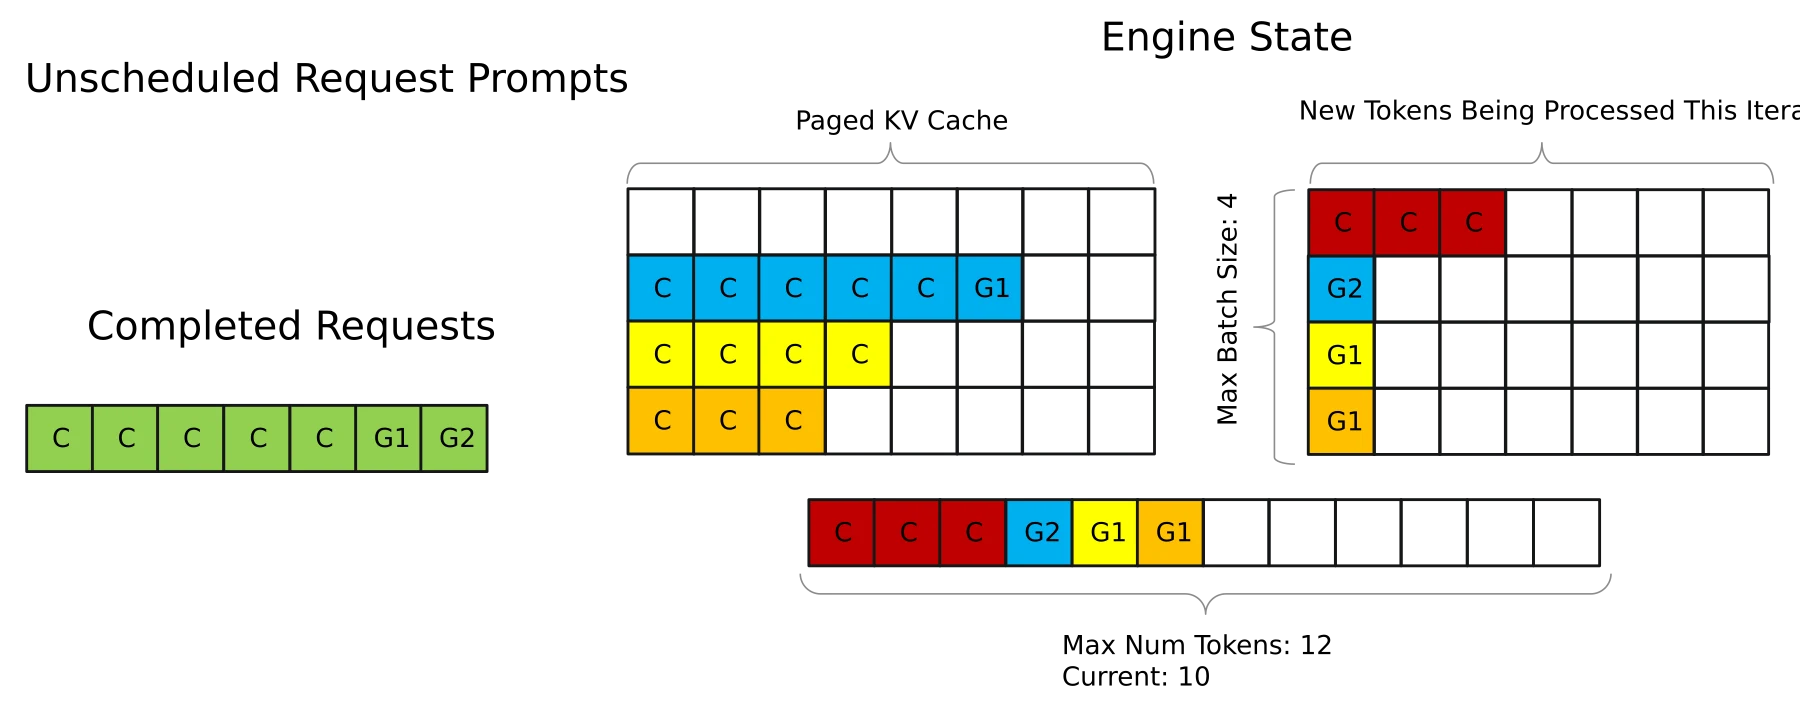
图:TensorRT-LLM 官方调度器示意的进一步形态,出现了 Max Batch Size: 4、Max Num Tokens: 12 与 Completed Requests 三组标记。它把两重约束并置:batch 数上限与 token 总量上限同时生效,且完成的请求会从「引擎状态」里移除、其占用的分页 KV 块随之回到可用池。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/media/TRTLLM_Scheduler_Vis_4.svg)
把它和 BindMicroBatchScheduler(max_batch_size, max_num_tokens, ctx_chunk_config, ...) 的参数对照,可以确认这三件事就是微批调度的全部输入:序列条数上限、token 总量上限、分块方式。
一次完整请求的源码路径速查
把本篇讲到的函数按「请求到达 → 输出返回」的顺序串起来,作为读码时的路标:
LLM.generate / LLM.enqueue_request # API 层入队 └─ PyExecutor.enqueue_request(s) # 进入待激活队列 └─ _prepare_and_schedule_batch # 每轮迭代的第一步 ├─ _fetch_and_activate_new_requests # 新请求进入 active_requests ├─ _pad_attention_dp_dummy_request # ADP 下用假请求补齐张量形状 ├─ _prefetch_for_context_requests # 上下文请求的预取 ├─ _prepare_draft_requests # 投机:给已有请求挂上草稿 token 位 └─ _schedule # 四级过滤 → scheduled_batch ├─ resource_manager.prepare_resources ├─ _forward_step → model_engine.forward ├─ _sample_async → sampler.sample_async ├─ _update_request_states / _update_requests └─ _handle_responses → _enqueue_responses_fetch_and_activate_new_requests 这一步的价值容易被低估:新请求不是「调度时才发现」的,而是要先被激活成 active_requests 的一员。激活意味着它获得了请求槽位、状态机起点、以及(如果开了投机)草稿 token 的初始占位。_prepare_draft_requests 里有一段注释解释了一个具体的坑:
# Skip DISAGG_GENERATION_INIT: snapshotting the dummy py_draft_tokens leaks stale state# into the first real draft.P/D 分离下,生成实例在等到远端上下文之前会挂着一批「占位草稿 token」。如果在那个状态就把它快照成「上次草稿」,第一份真正的草稿就会继承这批假数据。状态机上的每一个中间态都要显式排除在快照之外,这是异步系统里常见的正确性细节。
局限与工程取舍
这套设计有几处代价,值得在部署前想清楚:
- 装配期长且必须是确定性的。KV 容量估算要求假负载能复现生产路径的显存形态,因此「配置改了 → 估算结果变了 → 容量变了」是连锁反应。更麻烦的是两轮构造会让启动时间显著变长(要捕获两次 CUDA Graph),而启动失败往往发生在估算轮里,那时用户看到的错误信息可能来自一个「最终并未投入使用」的执行器。
TRTLLM_SKIP_KV_CACHE_ESTIMATION=1是官方给出的逃生舱,代价是容量必须由用户自己算准。 - 重叠调度多一个迭代的延迟。对延迟敏感的场景(例如要求极低 TTFT 的交互式服务)需要评估这个固定开销,
disable_overlap_scheduler=True是回退路径。 - 注意力 DP 下的形状对齐开销。
_pad_attention_dp_dummy_request用假请求把各 rank 的张量形状补齐,这样集合通信才能对齐;代价是部分 rank 会跑一些「无用的 token」。这是用一点点冗余计算换取集合通信的可执行性,与 vLLM/SGLang 在 DP attention 上的处理思路一致。 - 一票否决式的容量与状态门槛。
no_schedule_until_state、enable_prefix_aware_scheduling、capacity_scheduler_policy三者共同决定准入,任何一个配错都会表现为「吞吐上不去」或「已接纳的请求被反复暂停」,而错误信息不会直接指向配置项。读到这一层时,建议的做法是先用GuaranteedNoEvictScheduler这类 Python 参考实现对照一遍预期行为。
小结
create_py_executor是一条六段装配线:配置加载 → 模型引擎 → KV 容量估算 → 调度器与资源 → 执行器实例化 → 启动工作线程。外层还包了启动计时与 DWDP 失败回滚。- KV Cache 容量是「估」出来的:因为真正的约束是「装完权重、工作区、通信缓冲后还剩多少显存」,只能靠一轮完整构造 + 假负载 warmup 实测。为此同一台执行器会被构造两次,中间要把 KV 管理器、传输层、注意力元数据按正确顺序拆掉(先关传输层再拆 KV 管理器,否则 NIXL 注册的显存会让第二轮 OOM)。
- 调度器有三种形态:V2 交错调度
KVCacheV2Scheduler、Python 单级SimpleUnifiedScheduler、默认的两级SimpleScheduler(BindCapacityScheduler+BindMicroBatchScheduler)。capacity_scheduler_policy在MAX_UTILIZATION与GUARANTEED_NO_EVICT之间选择取舍方向,scheduler_capacity = max_batch_size × pp_size。 _schedule在调用调度器之后还要做四次过滤:编码器批等待、注意力 DP 均衡、批等待再检查(V2 下被丢弃的请求仍占 KV)、以及按估算上限裁剪累计上下文 KV 长度。- 单步闭环有七个动作,顺序不可调换:暂停必须在资源准备之前(要归还 KV 块),响应必须在终止之前(要读到完整请求信息)。
- 重叠循环把「更新资源 + 产出响应」挪到下一步的 GPU 时间窗口,代价是必须等待上一轮 host 输入拷贝完成(否则改写到一半的 host 内存会让 GPU 读到混合数据),以及每个请求固定多一个迭代的延迟。
- 分块上下文是微批调度的核心预算:
max_batch_size(序列条数)与max_num_tokens(token 总量)是两重独立约束,ctx_chunk_config决定长提示词怎么切;切得越细 TTFT 越差、批内混杂度越高。
下一篇进入 CapacityScheduler 与 MicroBatchScheduler 的内部:C++ 绑定里准入逻辑究竟怎么算、paused_requests 如何被暂停与恢复、two_step_lookahead 在流水线并行下怎么做两阶段预看,以及前缀感知调度如何把「前缀命中」变成准入决策的一部分。
参考资料
- TensorRT LLM 官方架构总览(PyTorch 后端)
- TensorRT LLM Scheduler 文档
- TensorRT LLM KV Cache Manager 文档
- PyExecutor 源码(tensorrt_llm/_torch/pyexecutor/py_executor.py)
- Executor 装配源码(tensorrt_llm/_torch/pyexecutor/py_executor_creator.py)
- KvCacheCreator 与 create_py_executor_instance(tensorrt_llm/_torch/pyexecutor/_util.py)
- Overlap Scheduler 文档
- NVIDIA/TensorRT-LLM GitHub 仓库
- Continuous Batching 原始工作 Orca(迭代级调度背景)
- Efficient Memory Management for Large Language Model Serving with PagedAttention
- Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



