


Groq LPU 完全拆解(一):确定性执行与流式架构,为什么 TSP 不需要乱序执行
背景与问题定义
GPU 的性能为什么「不可预测」
如果只看纸面参数,现代 GPU 是一台恐怖的算力机器:A100 提供 19.5 TFLOPS 的 FP32 稠密算力,数千个流处理器通过 SIMT 模型同时执行成千上万个线程,HBM 提供 ~2 TB/s 的显存带宽。但真正部署过在线推理服务的工程师都遇到过同一个问题——延迟不稳定。
同一个模型、同一批输入,第一次推理 30 ms,紧接着一次 220 ms,P99 延迟可能是平均值的 3 倍以上。这些尖刺(spike)的来源几乎都是 GPU 的「运行时仲裁」机制:
- 缓存层次的不确定性。GPU 依赖多级缓存(L1/L2)来掩盖 DRAM 延迟,一次访存可能命中 L2 只要几十纳秒,也可能击穿缓存直达 HBM 花费数百纳秒。缓存命中与否取决于运行时的数据局部性,硬件无法提前告诉你答案。
- 调度的不确定性。SM 内的 warp 调度器、线程块分发器都要在运行时决定「下一个周期执行谁」。当多个 kernel、多个 context 抢占同一块 GPU 时,任何一个算子都可能被别人挡住。
- 频率与功耗墙。GPU 的睿频行为受温度、功耗窗口影响,同一个 kernel 在冷机和满载降频时的延迟可以差出 20% 以上。
对于离线批量处理,这些波动无关紧要——吞吐量才是关键。但对于实时系统(语音对话、在线搜索、自动驾驶、推荐召回),尾部延迟(tail latency)就是产品体验本身:用户不在乎「平均 80 ms 能回话」,他只在乎「第 1000 次对话是不是等了 1 秒」。
Groq——这家由 Jonathan Ross(谷歌 TPU 的项目负责人之一)于 2016 年离开谷歌后创立的公司——给出的方案相当激进:干脆放弃运行时硬件调度,把每一次执行都变成可以提前算好的确定性问题。它 2020 年发表在 ISCA 的论文 Think Fast: A Tensor Streaming Processor (TSP) for Accelerating Deep Learning Workloads(Dennis Abts 等,Groq Inc.)描述了这颗芯片的完整设计。
一个可以提前预知的例子
这套思路的价值用一个数字就能说明。Groq 团队在后续的 BERT 工作里报告了一个令人印象深刻的事实:他们在实现模型映射之前,先用编译器的调度模型预测了整个程序的执行时间,硬件真跑起来之后,实测延迟与预测值的偏差在 1% 以内。
这件事在 GPU 上是完全不可能的——你甚至无法准确预测一个 kernel 的启动开销。它背后是 TSP 架构最核心的取舍:把「如何执行」的全部决定权从硬件移交给编译器。汇编器与功能模拟器(functional simulator)在编译期就把程序里的每一条指令、每一次数据搬运、每一个周期固定下来。
这样的确定性不是免费的。它意味着:
- 没有硬件缓存。缓存是运行时行为,天然不可预测。TSP 用软件显式管理的 SRAM 替代它。
- 没有乱序执行、没有分支预测。所有控制流都会被编译器展开成确定的空间排列。
- 没有运行时内存仲裁。所有内存访问通道在编译期就被分配好,两个操作争抢同一个 SRAM bank 的情况在编译期就被拒绝。
- 没有动态负载均衡。一次编译生成的可执行文件在哪个周期的哪条数据通路上会是什么数据,全部固定。
代价是任何「数据依赖的分摊」都会让预排的流水线作废——所以 TSP 天然不适合训练中频繁出现的动态稀疏模式,而把它定位成推理专用的加速器,恰好与 LLM 推理「静态计算图 + 海量规则数据流」的特征匹配。
核心思想:空间并行 + 流式流水线
理解 TSP 最快的方式,是把它和 GPU 做一个方向性的对比。
GPU 是一种以「计算」为中心组织硬件的架构:把尽可能多的 ALU 堆进芯片,然后构建复杂的内存层次(寄存器、共享内存、L1、L2、HBM)与调度机制(warp scheduler、occupancy 机制、异步拷贝)来持续喂饱这些 ALU。GPU 的强大在于通用性,它的复杂度也来自这里。
TSP 属于以「数据流」为中心组织硬件(dataflow architecture)的一支:把不同类型的计算单元横向排成一条线,让数据像流水线上的传送带一样流经这些单元——数据从内存出来,依次路由到矩阵单元、向量单元、后处理单元,最后写回内存。计算单元不动,数据在动。它的执行模型不是「跑一段程序」,而是「把数据推过一条装配线」。
这就引出了 Groq 官方文档对 LPU 的三个标志性描述:
- 软件优先(software-first):芯片设计前先设计编译器,硬件只负责忠实执行编译器的任何时间安排。
- 可编程装配线(programmable assembly line architecture):函数单元像装配线工位,指令与数据通过流水线式寄存器在工位之间流转,全软件控制。
- 确定性计算与网络(deterministic compute and networking):任何执行步骤都可以在编译期以时钟周期精度预测,芯片内与芯片间都不存在运行时仲裁。
这三条对应到芯片上就是三种设计决策:所有调度交给编译器、所有数据经过统一的流式寄存器阵列、所有内存放片上用 SRAM 而非 HBM。TSP 没有任何一块「等数据来的空闲算力」——因为它在编译期就知道数据何时到达。
原理详解 I:TSP 的空间组织
六条横向通带
TSP 第一代是一颗 725 mm²、14 nm 工艺、268 亿晶体管、275 W TDP 的大芯片。它的布局不按「核」划分,而是按功能通带横向排列——从西到东依次是:
- MEM(West memory):西半区的 SRAM memory blocks
- MXM(matrix execution modules):矩阵乘法单元(西)
- SXM(switch execution modules):开关/转置/置换单元(西)
- VXM(vector execution modules):向量处理单元,位于芯片正中央
- SXM(East switch execution modules):开关/转置/置换单元(东)
- MXM:矩阵乘法单元(东)
- MEM(East memory):东半区的 SRAM memory blocks
对称的关键在于:SXM 是矩阵单元与内存之间的枢纽,矩阵单元从两侧的 MEM 读取数据,经过 SXM 的置换/旋转/分发后进入 MXM 进行乘加;中央的 VXM 负责非线性算子(softmax、layernorm、GELU)与逐元素运算。整个芯片的布局刻意做成左右对称,让访存请求可以同时从两侧并行发起。
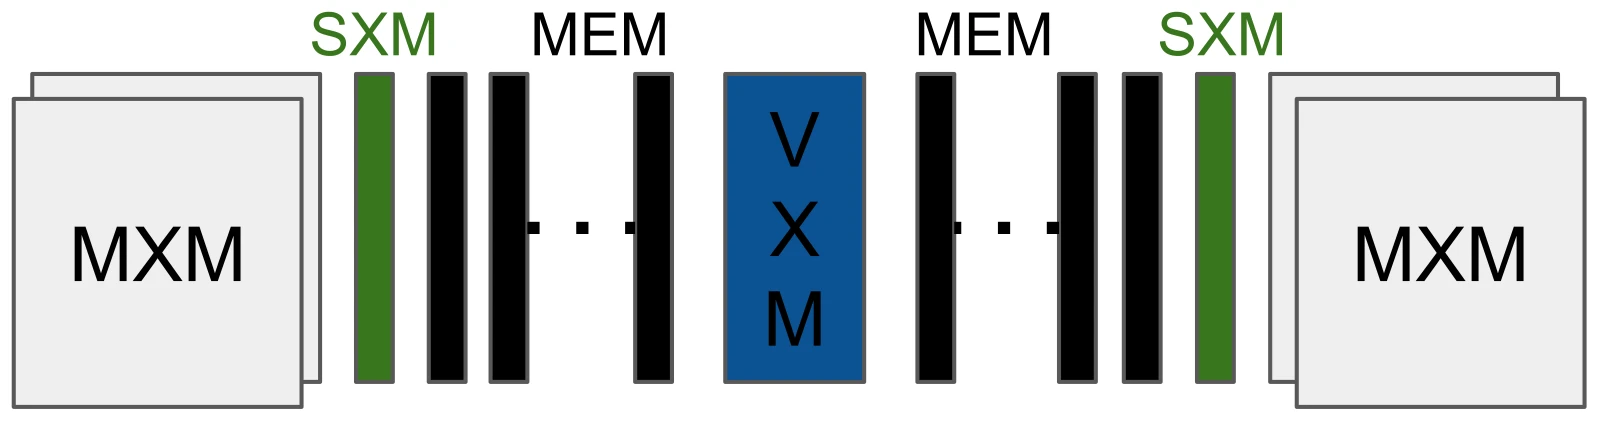
图源:Groq 论文 Answer Fast(arXiv:2206.11062)Fig. 1,简化版 TSP 架构示意图。可以看到 MEM、MXM、SXM、VXM 在芯片上是按功能横向分带的,数据沿东西方向流动。
芯片内数据流:流式寄存器阵列(SRF)
TSP 内部没有 NoC(片上网络),也没有多级缓存。它用一个更激进、也更简单的方式来传递数据:流式寄存器文件(Streaming Register Files, SRF)。
- SRF 由若干条物理连线的流通道组成,每条流通道的宽度是 320 字节的物理向量(对应 fp16 下 160 个元素、int8 下 320 个元素)。
- 数据在这些通道上沿一个固定方向匀速流动(想象一条流水线传送带),每个函数单元在数据「流过自己」的那一个周期读取或写入。
- 一次操作的时间点(第几个周期)完全由编译器决定——所以数据不会「到早」或「到晚」,函数单元在正确的周期上取走它。
这和 GPU 的执行模型有本质区别。GPU 的计算单元是主动去缓存/内存里取数(load/compute 模式),取数时机由 warp 调度器在运行时决定;TSP 的计算单元则是被动站在自己的工位上等数据流过(stream/compute 模式),取数时机被编译器写死。
Abts 等人在 ISCA 论文中给出的量化描述是:TSP 内部维持着 64 条连续流动的数据流(32 条向东、32 条向西),每条每周期搬运一个 320 字节向量,合计约 20 TiB/s 的流带宽。数据流不是「需要时才建立」,而是常开的——即使某一段流水线暂时没有有效数据,流本身也在 CLOCK 边沿上不断推移,编译器只需要决定「哪个周期往流里放什么东西」。
一个具体数字:带宽为什么是几十 TiB/s
把「流式」翻译成带宽语言:TSP 拥有 4 个 MXM plane,每个 plane 是一个 320×320 的 MACC 阵列。这些阵列要持续满负荷运转,需要源源不断的操作数供给。支撑它们的是三个带宽量:
片上带宽对比(TSP 第一代,900 MHz 级别时钟)TSP 片上 SRAM : ~55 TiB/s (88 个独立 bank,每周期每个 bank 一个 320 字节向量)TSP SRF 流带宽 : ~20 TiB/s (64 条流 × 320 字节/时钟)VXM-MEM 边界 : ~40 TiB/s (保证 VXM 的 16 组 ALU 喂得饱)A100 HBM2e : ~1.6-2 TB/s (外部带宽,且需经过 L2 缓存仲裁)这个带宽差距就是 TSP 敢说「推理吞吐碾压 GPU」的底气。在 A100 上跑 Transformer,矩阵单元经常喂不饱——很多时候不是算力不够,是数据搬运不够快。TSP 用片上 SRAM 直接缓解了这个问题:数据一旦从外部 DRAM 装载进片上,之后无论读写多少遍都不再走外部总线。
一次矩阵乘法在通带间的完整旅程
以一个权重矩阵 与激活流 的矩阵乘为例,一次大 GEMM 在 TSP 上的数据流是:
- MEM:权重矩阵的列向量(320 字节一条)从某个 SRAM bank 读出,进入 SRF。
- SXM:对向量做必要的重排、分发或转置。这一步在 Transformer 里主要用于把多头注意力的 QKV 重新按 head 归位,TSP 可以把这个变换融合到数据搬运的过程中(on-the-fly),不占独立的计算步骤。
- MXM:数据进入 320×320 的 MACC 阵列,每一拍完成一次「320 元素向量 × 权重列」的点积累加,产生一个 320 元素的输出向量。
- VXM 或 MEM:累加结果被推回 SRF,如果后面紧跟非线性算子(softmax、layernorm、GELU),就直接流入 VXM 的 ALU 链,否则写回 MEM。
注意第 4 步的灵活性:中间结果可以选择落盘(写 MEM)或者不落盘(直接流进 VXM 或下一个 MXM plane)。这个「不落盘」的能力,就是后面讲非线性算子融合的物理基础。
此外,4 个 MXM plane 可以并行执行多个独立的 GEMM——比如多头注意力里 12 个 head 的 batched-GEMM 可以分摊到 4 个 plane 上同时进行;当一个 GEMM 的权重超过 320 行/列需要多个 pass 时,编译器还可以在执行 pass 的同时预装 pass 的权重,让 MXM 没有任何空转周期。
原理详解 II:确定性执行的机制
静态调度与时间确定性
普通处理器的程序语义是「按逻辑顺序执行」,但物理时间上的执行顺序会在运行时被各种机制改变:乱序引擎重排指令、warp 调度器交错发射、缓存 miss 与命中耗时不同。这些机制让代码「平均更快」,但让「具体的某次执行」不可预测。
TSP 把执行模型彻底改写:编译器生成一条固定的时间表(schedule),明确写出「第 周期 MEM 流出第 列 → 第 周期 MXM 开始累加 → 第 周期结果流出到 VXM」这种粒度的计划。硬件只负责按表执行,不需要任何「决策」。
用 ISCA 论文的话说:TSP 是一个 statically scheduled 的 SIMD 架构,所有函数单元在编译期就被分配了固定的指令,指令流本身也像数据一样通过流水线寄存器在芯片上流动——每个函数单元在正确的周期从自己的「指令传送带」上取到属于它的指令。也就是说,TSP 连指令的投递都是确定性的:指令不再需要被「发射」,而是在编译期就被铺在自己的位置上。
这就是为什么前文那个数字能够成立——Groq 团队用编译器直接推算延迟,硬件实测只偏差 1%。对在线服务而言,这个特性可以进一步把 p99/p95 延迟做扎实:不存在「某次推理恰好遇上缓存抖动」这种事,所有推理的延迟就是同一个数。
确定性带来的尾部延迟优势
在 Groq 团队的 BERT 工作中(ASAP 2022,「Answer Fast」)实测过一组数据,非常直观地说明确定性执行在延迟分布上意味着什么。在 batch-1、sequence length 128 的 BERT-base(int8 量化)上,测量 4000 次端到端推理:
| 指标 | NVIDIA T4(TensorRT int8) | NVIDIA A100(TensorRT int8) | Groq TSP(900 MHz) |
|---|---|---|---|
| 平均延迟 | 1330 µs | 630 µs | 128.9 µs |
| 95th percentile | 1550 µs | 780 µs | 129.1 µs |
| 99th percentile | 1570 µs | 790 µs | 129.5 µs |
| p99 / 平均 | 1.18× | 1.25× | 1.005× |
单看平均值,TSP 比 A100 快约 4.9 倍;但更有意义的是分布形状。A100 的 p99 延迟比平均值高出 25%(630 → 790 µs),这 160 µs 的尖刺来自缓存不确定性:某次推理恰好在 L2 cache 里拿不到数据,多花的时间只能干等。TSP 的 p99 只比平均高 0.4%(129.5 vs 128.9 µs),而剩余的那一点抖动甚至不是芯片本身造成的——论文把残余偏差归因到 PCIe Gen4 链路对损坏包的重放(replay)机制,也就是芯片外部的问题。
对实时系统而言,这意味着 GPU 与 TSP 的差距不体现在平均值上,而是体现在「最坏情况」上。GPU 需要预留 1.25 倍的平均延迟才能保证尾部 SLA,TSP 只需要预留 0.5%。
延迟分布图同样直观。4000 次推理的直方图在 TSP 上收拢成一根细窄的尖峰:
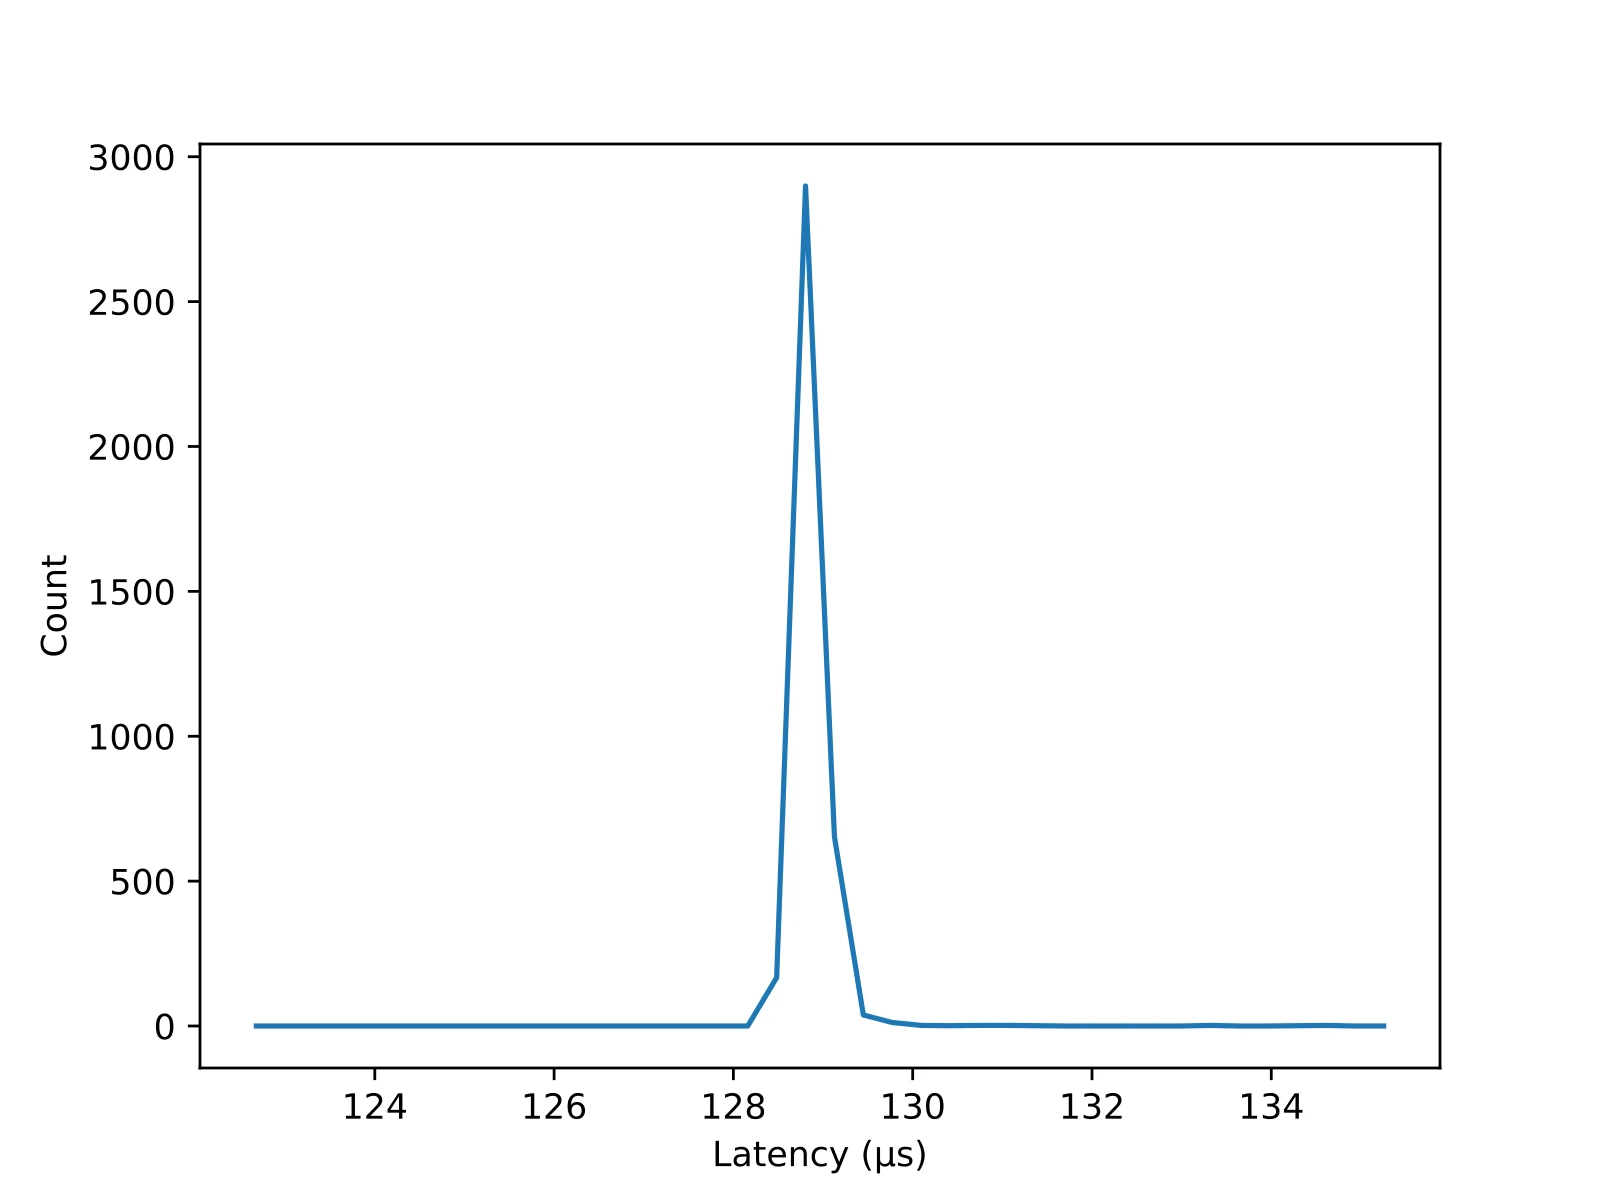
图源:Answer Fast 论文 Fig. 9。确定性执行让延迟分布收窄到以 µs 计的区间,而同样测量在 GPU 上会拖出一条长尾。
把端到端延迟按阶段拆开(embedding、12 层自注意力、12 层前馈、输出层、主机-芯片通信),还有第二个结论:83% 的延迟花在编码器栈上,且这部分时间在 p1 与 p99 两个分位点上的分解几乎完全一致——唯一有差异的只有 Host-TSP 通信部分。也就是说,芯片内部的执行时间在多次推理之间是「同一个数」,唯一的方差来源在芯片外的主机接口上。
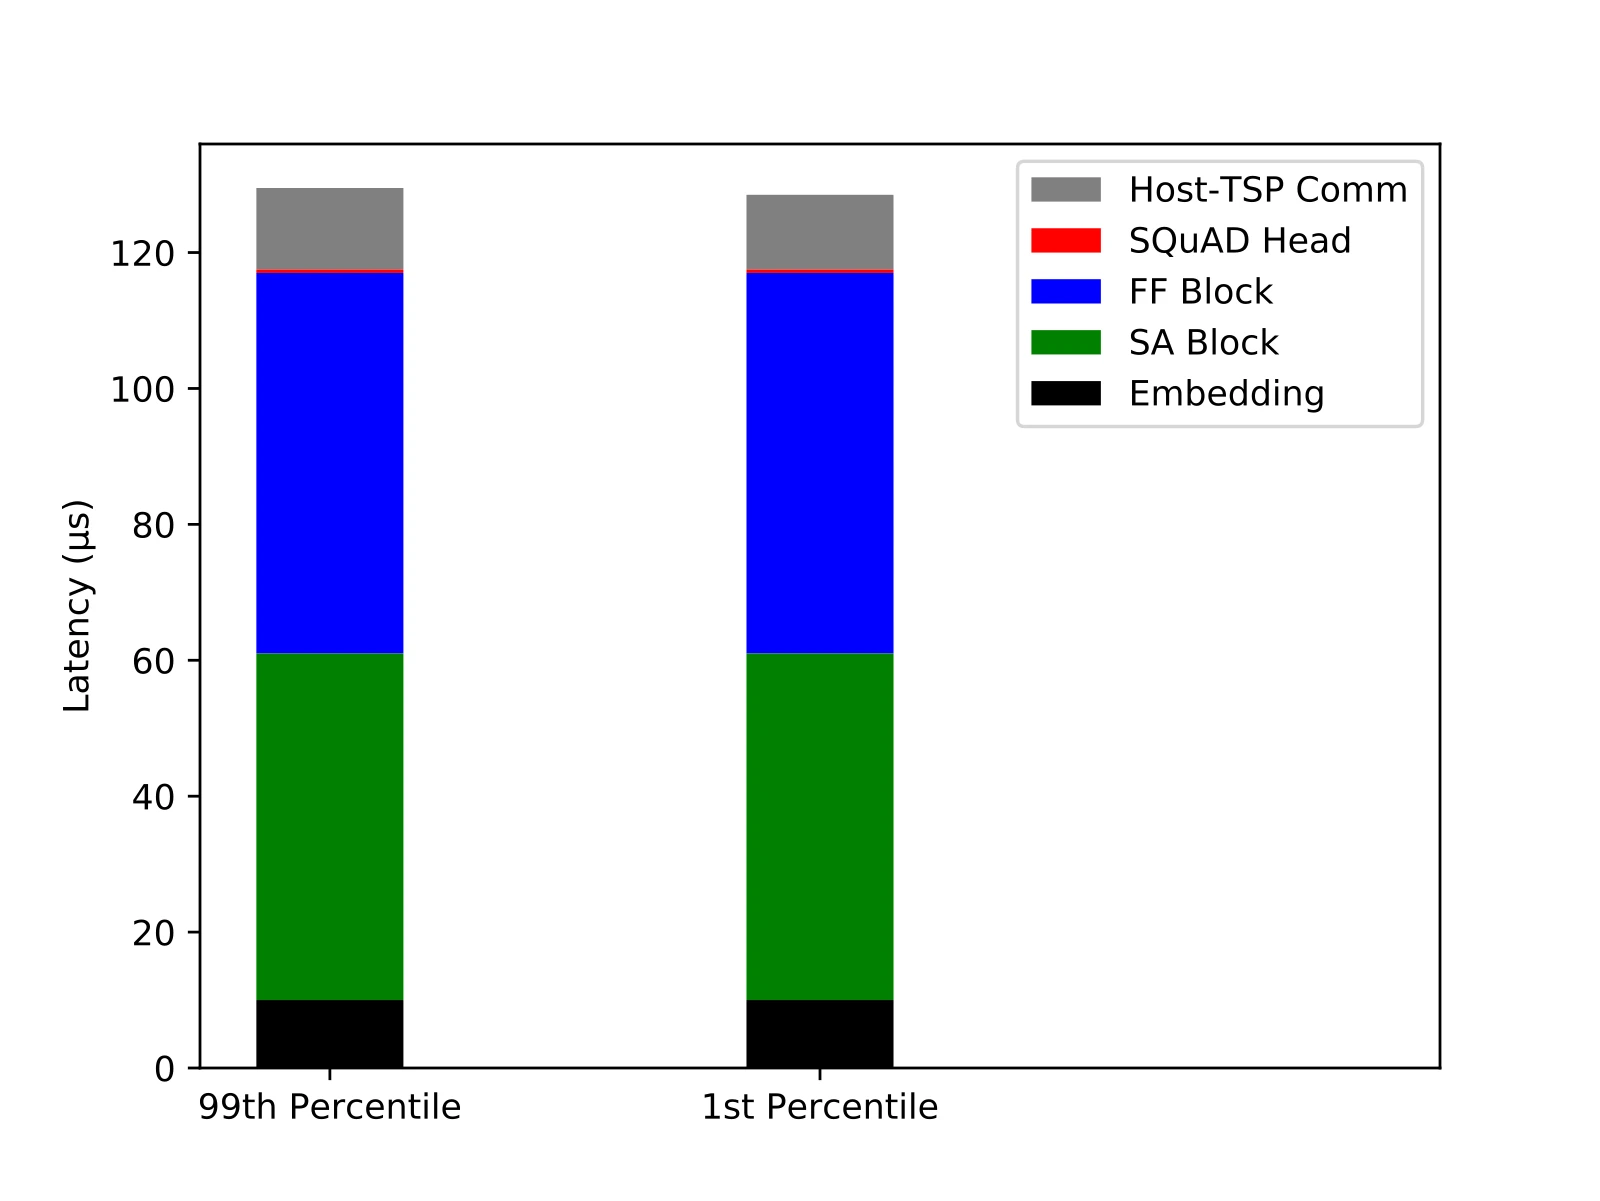
图源:Answer Fast 论文 Fig. 10,99th 与 1st 分位延迟的分解对比。
确定性的代价
「确定性」不是免费的午餐,它有两个工程代价:
- 编译时间。生成最终可执行文件要经过严格的编译期规划,切换模型或改配置都要重新编译。这套开销对在线服务的模型固定场景可以接受,但对「频繁改模型」的探索型负载不友好。
- 数据相关分支。任何依赖运行时数据才能确定的控制流或访问模式,都会让预排的时间表失效。编译器的对策通常是展开成并集再掩码——把所有可能的路径都算出来,用 mask 留下需要的那部分。这在 MoE 这类离散路由模型上是可控的(所有专家的计算照做,mask 掉未激活的),但在「每个 query 选不同 KV 子集」这类连续稀疏模式下,并集就退化为全量计算。
这也是 TSP 把自己定位成推理加速器的原因之一:训练侧的动态性(稀疏梯度、动态 batch、条件计算)太多了。
原理详解 III:分层 SRAM 与软件管理
没有 cache,没有 HBM,只有显式控制的 SRAM
TSP 的存储策略可以概括成三个「彻底」:
- 彻底取消硬件缓存。前面说过,缓存的不可预测性是延迟尖刺的主因。TSP 干脆不放 cache,所有 SRAM 都是软件显式寻址的。
- 彻底上片。TSP 把权重、激活、临时数据都放片上 SRAM,片外 DRAM 只用于在开始时一次性把模型「灌」进来,以及最后把结果取走。
- 彻底消灭动态仲裁。SRAM 的每个 bank 在编译期就被规划好「在每个周期服务哪个读/写请求」,两个操作抢同一个 bank 的情况会被编译器重新调度错开。
这是 TSP 最不像 GPU 的地方。GPU 的 L2 缓存大约 40 MB(A100),且它对软件是透明的——你写代码时不需要(也无法精确)知道数据是否在缓存里。TSP 的片上 SRAM 对软件是完全可见、完全可控的:编译器知道每个权重的第几个字节落在哪个 bank 的哪个地址,并把这个信息编进调度表。
这套设计里有一个容易被误解的点:SRAM 容量并不是「拿来当大缓存用」的。BERT 实验的实测内存分解相当能说明问题——在 int8 量化的 BERT-base 上,真正用作中间结果暂存(scratchpad)的部分只占片上总容量的 5.5%;权重与常量占用了 58%–71%(取决于 embedding 用 int8 还是 int16);指令只占不到 1%。也就是说,绝大部分片上容量是「模型本体」,小部分是「工作台」。深度流水让中间结果大多不落盘——它们还没写进 SRAM 就被下游单元消费掉了,或者只临时住在函数单元边的浅 FIFO 里。
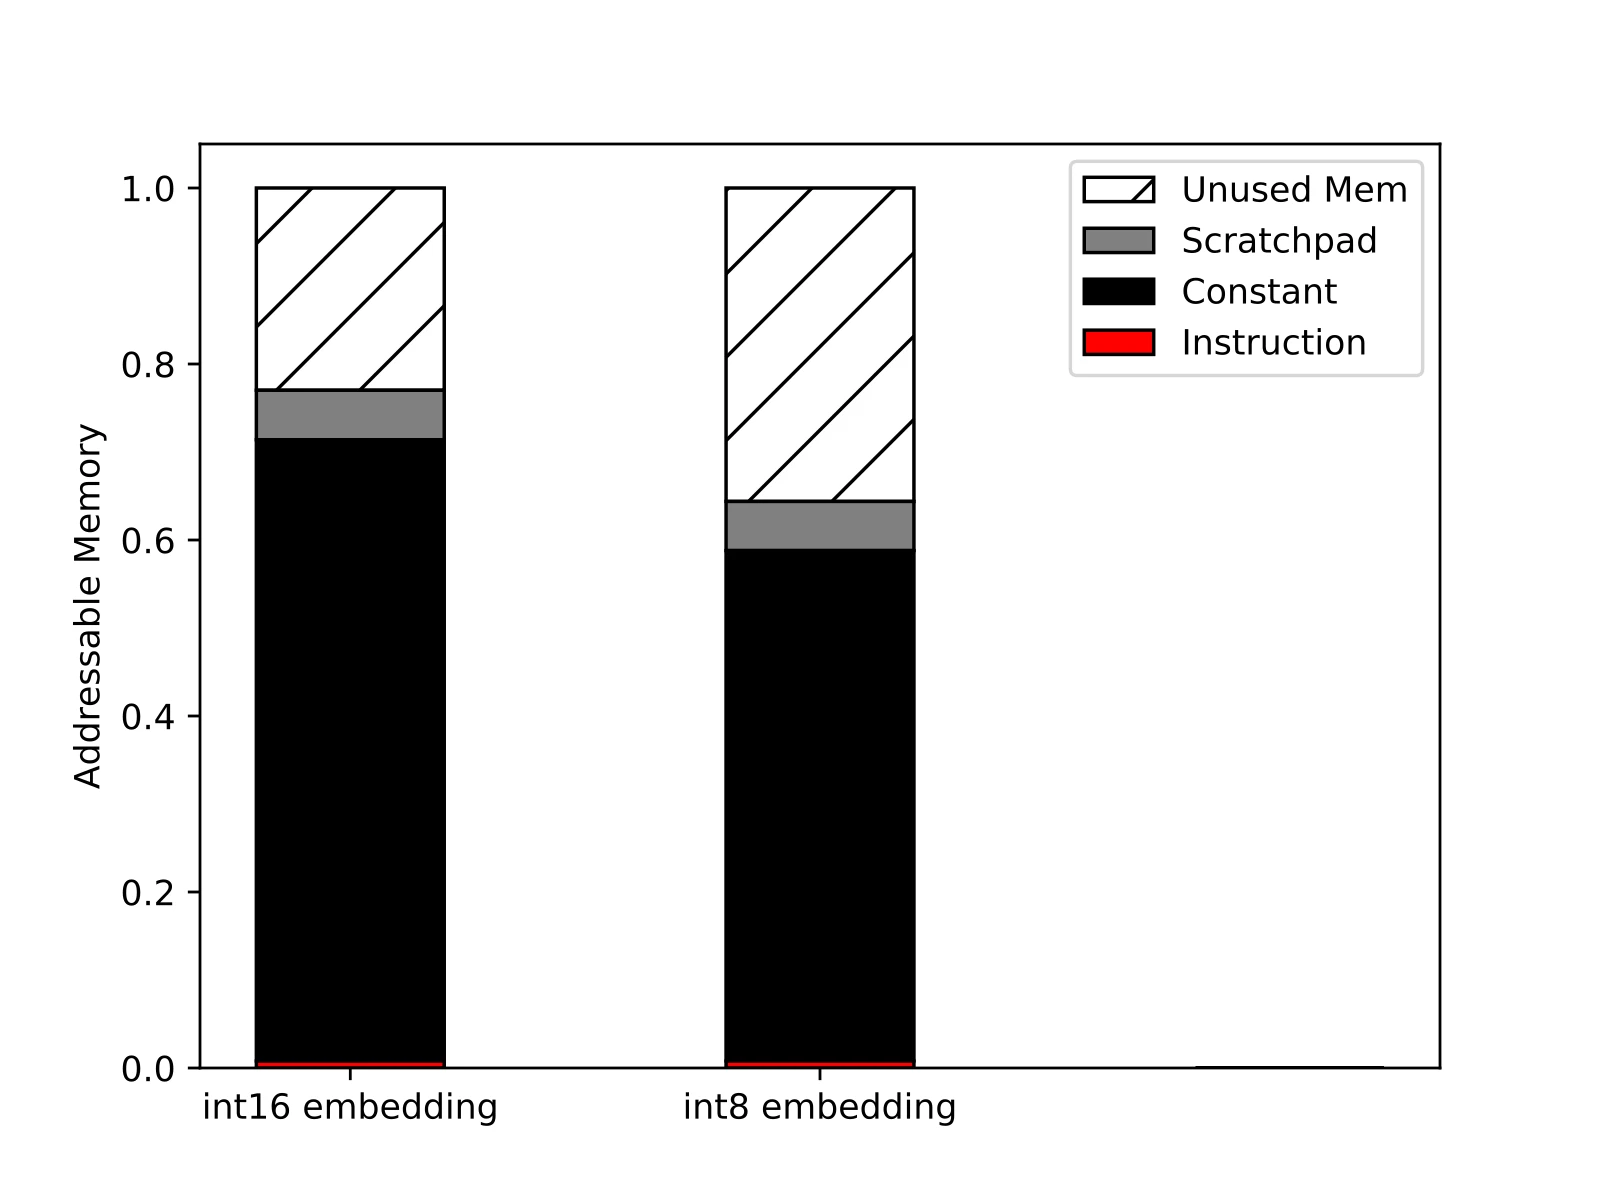
图源:Answer Fast 论文 Fig. 11,BERT-base 随 embedding 精度变化的片上可寻址内存利用分解。
片上访存的结构:88 个 bank 与伪双端口
支撑 55 TiB/s 带宽的不是「单块更快的 SRAM」,而是极度的 bank 化。TSP 的 MEM 由 88 个独立的 on-chip memory blocks 组成(东西半球各一半),每个 block 内部是伪双端口的 SRAM 单元——可以在同一周期里对两个 bank 分别执行一次读和一次写。每个读写操作每周期产出或消费一个 320 字节向量。
论文里给出的另一个关键数字是最多 176 路访存并发(memory concurrency):任意时刻可以有 176 个 320 字节的访存同时在流水线里飞行。这个「并发飞行」能力配合编译期的 bank 冲突检查,就是 55 TiB/s 的来源——它不是靠单 bank 快,而是靠大量 bank 同时服役。
分层存储:数据按生命周期住在不同的地方
把 TSP 的片上存储抽象出来,是一个按数据生命周期分层的三层结构:
- SRF(流式寄存器):函数单元正在消费/生产的数据,容量最小的「传送带」,带宽最高。
- 激活缓冲:短期存储,容纳一层计算内部的中间结果(比如 softmax 的两遍扫描之间需要记住的统计量)。
- 常量与权重池:88 个 bank 组成的大容量池,容纳权重、偏置、查表等常量数据。
区别于 GPU 的 L1/L2/HBM 层次:这里的边界不是硬件按访问模式自动决定,而是编译器按生命周期显式决定。一个 fp32 中间值(生命周期只是一个算子内部)绝不会占用权重池的容量;一个下一层才会用的权重则被提前从池里预取进激活缓冲。
预取:把外部访存延迟藏进时间表
TSP 不是完全没有外部访存。批数据进片、结果出片,以及初始的模型装载都要走 PCIe。传统架构会在这条路上布置 DMA + 预取逻辑 + 缓存来隐藏延迟。TSP 的做法更直接:把 PCIe 访存也算进编译期的全局调度里。编译器知道 PCIe 的带宽与延迟特征,所以它在生成时间表时,会把下一块需要的数据加载提前排在当前计算的同时。
这一点可以和本站的 TPU v1 完全拆解(一) 互相印证:TPU v1 用「权重 FIFO + 双缓冲」把 DDR3 的延迟藏在推理流水线之外,而 TSP 把同样的思想做到了编译期对全片所有通路的统一调度上,粒度从「层」细化到「列向量」。
原理详解 IV:编译器与编程模型
编译器是唯一的执行规划者
TSP 软件栈的核心设计原则是:软件优先(software-first)。Groq 反复强调的一个事实是:他们先设计编译器的架构,再去碰芯片设计。编译器接受标准 ML 框架(PyTorch、TensorFlow、ONNX)导出的计算图,然后完成以下事情:
- 图优化:算子融合、常量折叠、死代码消除——这些与主流编译器无异。
- 时间-空间映射:决定每一个算子放在哪个函数单元(MXM/VXM/SXM/MEM)上执行,以及在什么时刻执行。这是 TSP 编译器最独特的一步——它实际上是在解一个带资源约束的调度问题:给定所有算子的依赖关系,给每个算子分配(空间位置,时间周期)二元组,优化总周期数,约束是任意时刻每个单元只能执行一条指令、每个 SRAM bank 一个周期只能服务一个请求、每条流通道容量有限。
- 物理布局:决定每个张量落在哪个 SRAM bank 的哪个地址,包括权重驻留和激活临时区。
- 发射代码:生成一个 VLIW 风格的超长指令序列,控制四类单元在各自通带上的动作。
背后的工程哲学是:与其在硬件里做毫秒级的运行时优化决策,不如在编译期用秒级甚至分钟级的搜索时间把它做完。同样的思想在 AI 编译器开发工程师:一条计算图如何变成 GPU Kernel 里讨论过——把优化决策前移是近几年整个行业的趋势,TSP 只是这条趋势上走得最彻底的架构代表。
编程模型给开发者的体验
在 Groq 的软件栈上,一次推理的流程是:
- 编译阶段:吃进计算图(如 ONNX),输出一个静态调度的可执行文件。针对新模型编译,布局与调度由编译器自动完成,无需用户手写 kernel。
- 运行阶段:CPU 侧把输入 tensor 送进 LPU 系统,LPU 按时间表执行,CPU 不参与中间过程。
值得注意的是 CPU 在整个过程中的角色极其边缘:它只负责在开头把数据送进、在结尾把结果取出,中间的神经网络完全不消耗 CPU。Groq 在后续的系统演进里甚至进一步把 CPU 请出了关键路径——本站拆解过的 Blink:把 CPU 请出推理关键路径 一文讨论的正是这个方向:让 NIC 直连 GPU、常驻内核接管调度,消除 CPU 干扰。TSP 在架构层面把这件事做到了极致:不但调度不经过 CPU,连芯片间数据的转发也不经过任何主机侧网络栈。
原理详解 V:把多条芯片连成一条装配线
RealScale:装配线向芯片间延伸
前面提到了一个限制:单芯片的片上 SRAM 装不下现代 LLM 的权重(即便 int8 量化,70B 模型也有 ~70 GB)。TSP 的解法极具特色——用芯片间互连把多条装配线串起来,形成一个更大的逻辑芯片。
Groq 把这套芯片间互连称为 RealScale 技术,关键设计是:
- 每个芯片边缘有专用的高速串行通道(南北方向的 lane 是 chip-to-chip 通路),构成大量双向链路。
- 无控制器、无路由器、无数据包:芯片间的数据传输像 SRF 一样直接流过。编译器在全局调度时把「数据从 LPU #3 流到 LPU #7」也算成时间表里的一条搬运,每个 LPU 在正确的周期把数据接进或转发出去。
- 硬件里没有 credit 流控、没有路由表、没有拥塞仲裁——因为一切都已经编译期排好。
这个设计非常纯粹地体现了「装配线」哲学:片内与片外的边界被抹平了。数据在两个 LPU 之间的传送,跟数据在同一个 LPU 内两个 MXM 之间的传送,在编译器的视角里是同一件事(都是带确定时延的流通道)。芯片规模的上限由此不再由单 die 的 SRAM 容量决定,而由「编译器能否处理一个巨型调度问题」决定。
一个具体的产品形态:Groq 把 8 个 LPU 加 1 个 x86 主机组成一个 GroqNode,多个 GroqNode 可以继续级联。由于无交换即无握手开销,数十甚至数百个 LPU 可以表现为一个具有确定性聚合带宽的虚拟处理器。在 Groq 公开的部署描述里,Llama 3 70B 这样的模型会使用数百个 LPU 组成一个推理单元,而 LPU 之间互连的延迟与吞吐依然是编译期确定的。
这套互连放到 LLM 推理上意味着什么
LLM 解码阶段是典型的「访存带宽吃紧」场景:每个 token 的生成都要把全部权重读一遍——batch 越小,算力越闲置,带宽越成为瓶颈。把模型摊到一组 LPU 上后,每个 LPU 的 SRAM 只承担模型的一部分,但所有 LPU 的 SRAM 在逻辑上是一个统一的大内存,读写它的总带宽也就变成了单个芯片带宽的 倍——而且这个聚合是每一比特都确定时延的聚合,不经过任何交换芯片。
这与 GPU 集群形成了对比:GPU 的张量并行要在 AllReduce/AllGather 里穿过 NVSwitch 或 InfiniBand,通信路径会随拥塞变化,延迟抖动直接进入单步解码时间。而在 LPU 的方案里,「第 周期,第 个数据块从这条链路经过」是编译期就写死的。本站拆解过的 TokenWeave:粗粒度 Token 切分与融合 AllReduce-RMSNorm 与 DeepSeek-V3/R1 推理系统完全拆解 都在讨论如何用软件工程手段缓解 GPU 集群里通信的代价,而 TSP 的回答是:从架构上把「通信」这个概念本身消掉,让它退化为确定性数据流。
推理/部署中的表现
小模型:单芯片内摊平所有算子
BERT 实验是展现「空间并行 + 深度流水」价值的最佳案例。BERT-base 有 12 层编码器,每层的计算可以粗略分为 GEMM(矩阵乘)与非线性算子(softmax、GELU、layernorm)两大类。在 GPU 上:
- 非线性算子的计算强度低,几乎都是访存限速,跑它们时 SM 利用率惨不忍睹;
- 因此一个 Transformer 层的耗时 = 一堆 GEMM 时间 + 一堆「GPU 几乎空转地跑非线性算子」的时间 + 一个个 kernel 之间的空隙(launch gap)。
以自注意力一个 block 为例,Answer Fast 论文给出了它被编译器摊开后的执行时间表:GEMM、softmax、置换与非线性的每一个子步骤都被分配到明确的通带与明确的时间窗口,形成一条首尾相接的流水线。
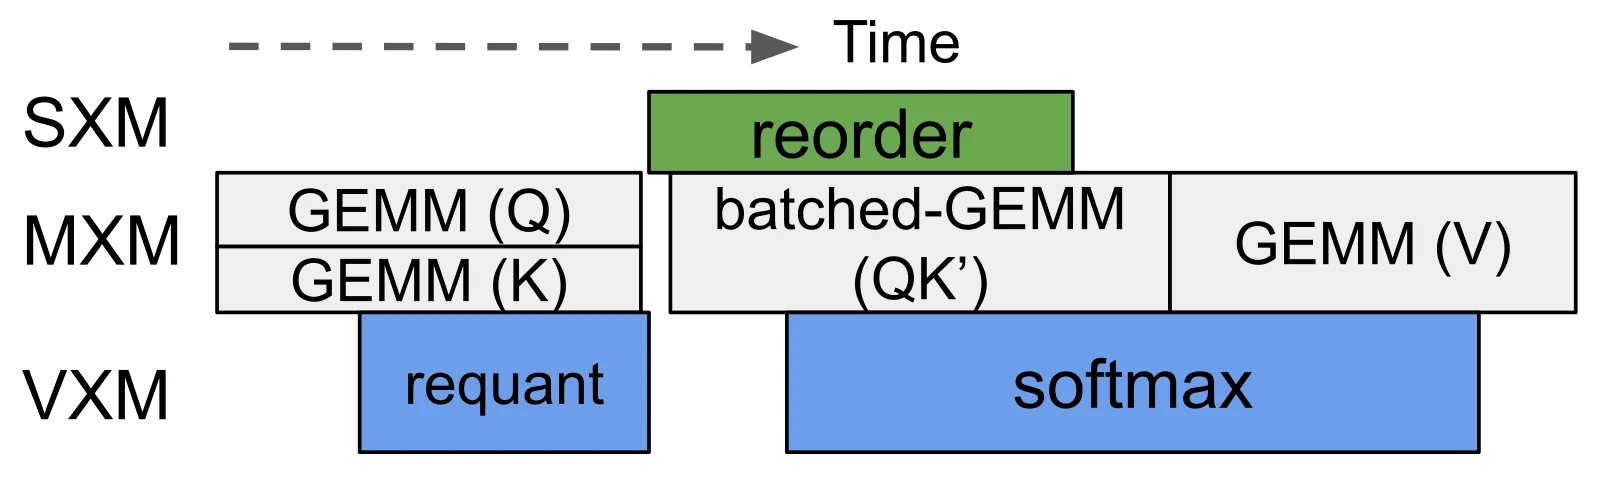
图源:Answer Fast 论文 Fig. 8。每个色块对应一个函数单元在某段时间窗口内的动作,整个 block 的执行顺序在编译期就完全固定。
TSP 的解法是把非线性算子空间上摊给 VXM,让它们与 MXM 里正在跑的 GEMM 时间上重叠。由于编译器全局调度,无需任何运行时同步,VXM 里的 layernorm 可以与 MXM 里的下一个 GEMM 完美流水。实测下来,BERT-base 的单层在 TSP 上达到了接近 MXM 满利用率的水平,非线性算子的延迟几乎被完全隐藏——这也是它把 batch-1 端到端延迟压到 130 µs 以下、比 TensorRT/A100 的 SOTA 快 6 倍的主要来源(99 分位是 6.1 倍)。
两个具体的调度片段能让「重叠」这件事看得更清楚。第一处是 GELU:前馈层的 GELU 需要的 16 组 ALU 链被排在紧随 GEMM 输出流的时刻,它执行的那段时间里,MXM 并没有停下来等,而是在算下一个 GEMM pass——图里的两色横条几乎完全错开又无缝衔接。
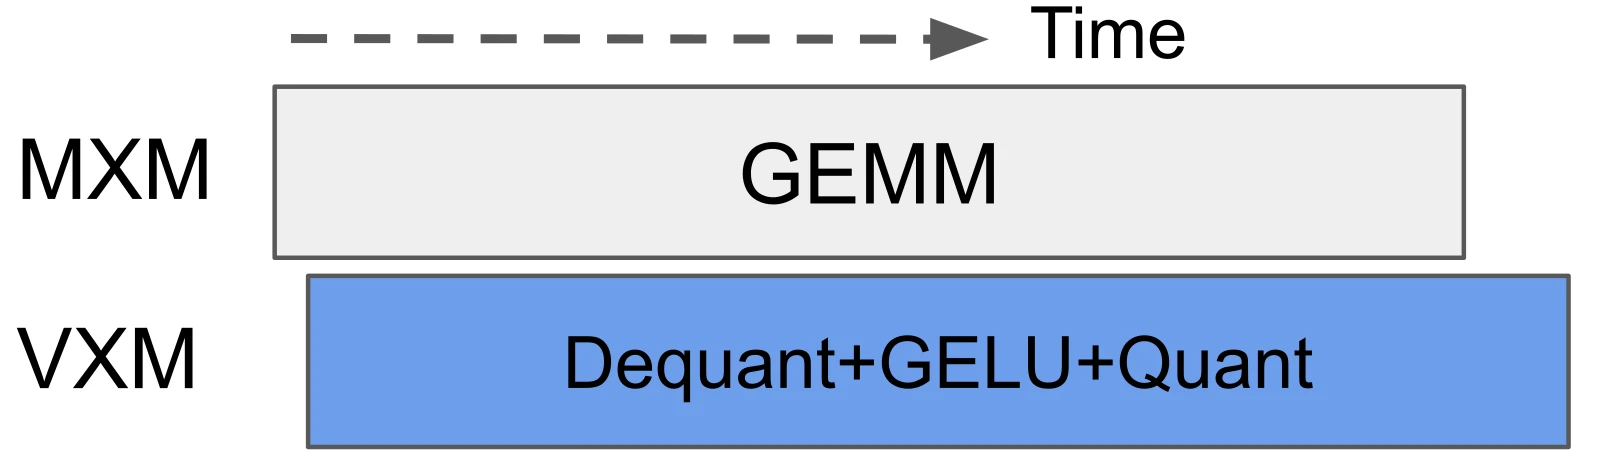
图源:Answer Fast 论文 Fig. 2,GELU 执行与 batched-GEMM 在 MXM 上的时间重叠示意。
第二处是 LayerNorm,它的流水化难度更高:layernorm 要先对整行求均值和方差、才能做归一化,天然是「先全局统计、后逐元素变换」的两阶段模式。TSP 编译器的做法是用四条并行 ALU 链分段扫描累加,把统计阶段切成小段流水起来,与相邻的投影 GEMM 重叠。
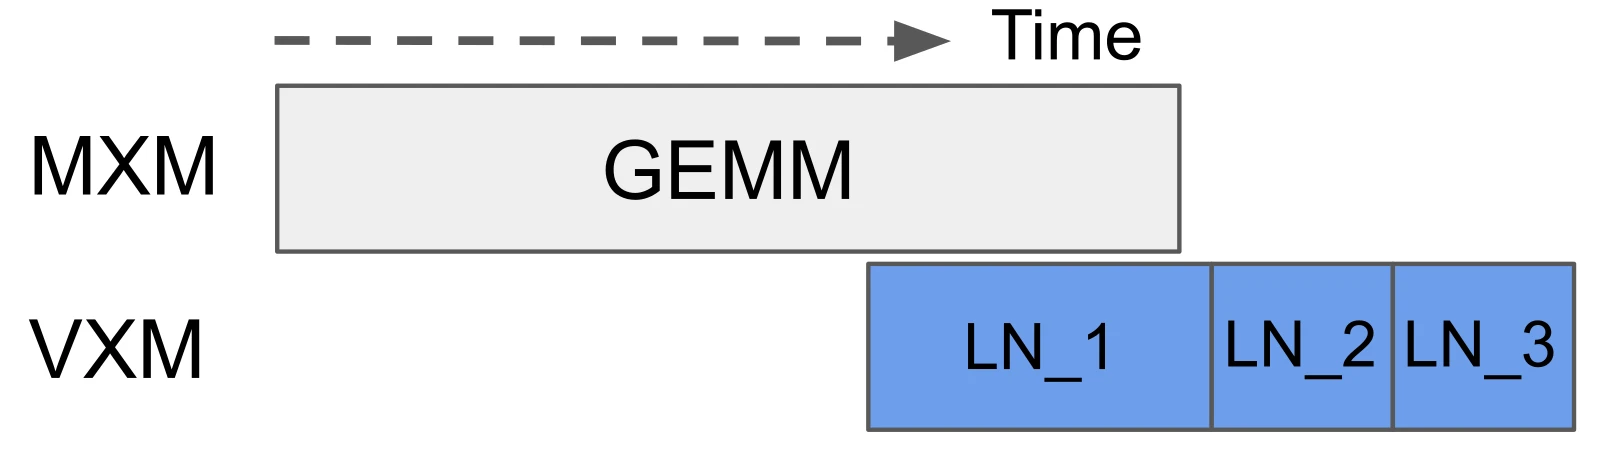
图源:Answer Fast 论文 Fig. 6,LayerNorm 统计、归一化与 GEMM 的编译期时间安排。
大模型:多个 LPU 组成的确定性集群
LLM 时代,TSP 的打法是「把大量 LPU 组成一个 SRAM 池,让模型在池上摊开」。具体的部署形态可以分成三层看:
- 单 GroqNode(8 LPU + 1 CPU host):跑中小规模量化模型,LPU 之间走 RealScale 专用通道。
- 多 GroqNode:几十到几百个 LPU 聚合,跑 70B 级别乃至更大的量化模型。
- GroqCloud:跨机房对外提供的推理 API。
从架构设计的角度,第二层是关键:当模型大于单芯片 SRAM 时,权重必须跨芯片分布。在 GPU 集群里,这个分布通过「tensor parallel + 集合通信」完成,通信要经过交换机并产生不可预测的延迟。在 LPU 集群里,这个分布通过「把 RealScale 通道当作 SRF 的延伸」完成——跨芯片的数据移动是全局时间表的一部分,不存在「网络」这个抽象层。直接的好处是:把模型摊到上百个 LPU 上之后,整体仍然是一个确定性系统。
能效为什么高
在 Groq 的产品设计叙述中,LPU 的能效优势来自一个物理事实:片上 SRAM 访存的能量远小于片外 HBM 访存(SRAM 访问在 pJ 量级,HBM 访问在 nJ 量级,差两到三个数量级),再加上省去了 cache/路由/交换这些「不直接产生算力」的硅面积与功耗。
需要指出,这是一个架构的收益,不是芯片工艺的收益。TSP 第一代用的是 14 nm 工艺,比同期 A100 的 7 nm 落后两代,晶体管数量也只有 A100 的一半(268 亿 vs 542 亿)。在工艺落后的前提下,TSP 凭借更简洁的芯片(少缓存、少交换、少运行时控制)与高带宽 SRAM 追平并在小 batch 推理上超过了 GPU 的效率。
与其他推理架构的对照
把 TSP 放进一个更宽的坐标系里看会更清楚。以下对照综合了前面几节的机制与公开规格:
| 维度 | NVIDIA GPU(A100/H100) | Google TPU v1 | Groq TSP/LPU |
|---|---|---|---|
| 内存 | HBM(多级缓存透明管理) | 片外 DDR3(权重 FIFO 双缓冲) | 片上 SRAM(编译期显式分配) |
| 计算单元 | 通用 SIMT 核,warp 调度 | 脉动阵列 MXU,固定数据流 | 函数单元分带 + 流式寄存器 |
| 执行模型 | 运行时硬件调度,乱序 | 硬件同步,确定性 | 编译期静态调度,确定到周期 |
| 延迟可预测性 | 低(p99 比均值高 25%+) | 中 | 极高(p99 ≈ 均值) |
| 扩展方式 | NVLink/IB,带交换与流控 | PCIe/ICI | RealScale 直连,无路由 |
| 定位 | 训练 + 推理通吃 | 训练为主,兼顾推理 | 推理专用 |
这个对照里最值得琢磨的一列是「延迟可预测性」。以延迟与确定性为主要设计目标的加速器其实一直存在——比如很多 FPGA 方案(本站拆解过 FPGA 加速器完全拆解(一) 与 (二),FPGA 的优势正是无缓存且时序可控)——但 FPGA 用大量硅面积换来「可预测」,单位面积的算力远低于 ASIC。TSP 的价值在于它用 ASIC 的效率实现了 FPGA 级别的确定性,把「可预测的推理」变成一个大规模商用产品的核心特征。
另一个值得对照的对象是本站拆解过的 OpenAI Jalapeño 与 Jalapeño 的系统协同设计:Jalapeño 的关键论断之一是推理芯片应该按推理的三个阶段(prefill、decode、注意力)暴露不同的瓶颈,用「统一异构芯片 + 带宽上限反推架构」的思路做设计。TSP 走的是同一种「按瓶颈反推」的推理侧路线,只是它选择把宝押在「确定性 + 片上 SRAM」上,而 Jalapeño 押在「阶段专业化」上。
对确定性架构的辩证理解
TSP 不是「更快的 GPU」,它是一个不同的约束求解目标。把它与 GPU 的取舍放在一张表上看:
| TSP 放弃的 | TSP 获得的 | |
|---|---|---|
| 运行时缓存 | 自动缓存命中 | 编译期确定的访存时序 |
| 动态分支 | 数据相关的分支(需编译器展开) | 无 pipeline 冒险,时钟精确 |
| 通用性 | 通用计算、训练侧动态算子 | 推理特化的极致吞吐 |
| 单芯片容量 | 片外大容量 HBM | 数十 TiB/s 片上带宽 |
| 多芯片聚合 | 以太网交换机式的可扩展网络 | 无交换、无路由的直连流 |
这个取舍表里第二行尤其值得展开——确定性架构最难处理的就是分支。GPU 遇到分支,warp 内可以分别执行不同路径(虽然有 divergence 损耗),程序语义不受影响;TSP 遇到分支,只能靠编译器把分支展开成所有可能路径的并集:既计算 path A 也计算 path B,然后用 mask 把不需要的输出抹掉。
这里隐含着一个深层的架构判断:对于推理侧的绝大多数负载,「所有可能路径的并集」其实并不比单条路径大多少。Transformer 的每一层是固定结构,只有 MoE 路由和少数条件计算引入动态性;只要动态性不是连续分布(MoE 是离散的 top-k 选择),展开并集的代价就是可控的。一旦负载变成连续分布——比如稀疏注意力里每个 query 选不同的 KV 集合,参见本站 Quest 完全拆解 或 DoSA 完全拆解——并集就退化为全量计算,确定性架构就失去了意义。这类「数据相关的稀疏性」恰恰是 GPU 依然占据主导的领域。
顺带一提,Groq 自己也意识到了 MoE 的重要性:它在官方技术博客里专门讨论过 LPU 如何服务 MoE 架构,并把芯片间的确定性互连(RealScale)描述成「天然适合专家并行」的基础设施——因为专家分布在不同芯片上时,token 在芯片间的搬运依然走编译期确定的流通道,这与 GPU 集群里 All-to-All 通信的不可预测性形成对比。
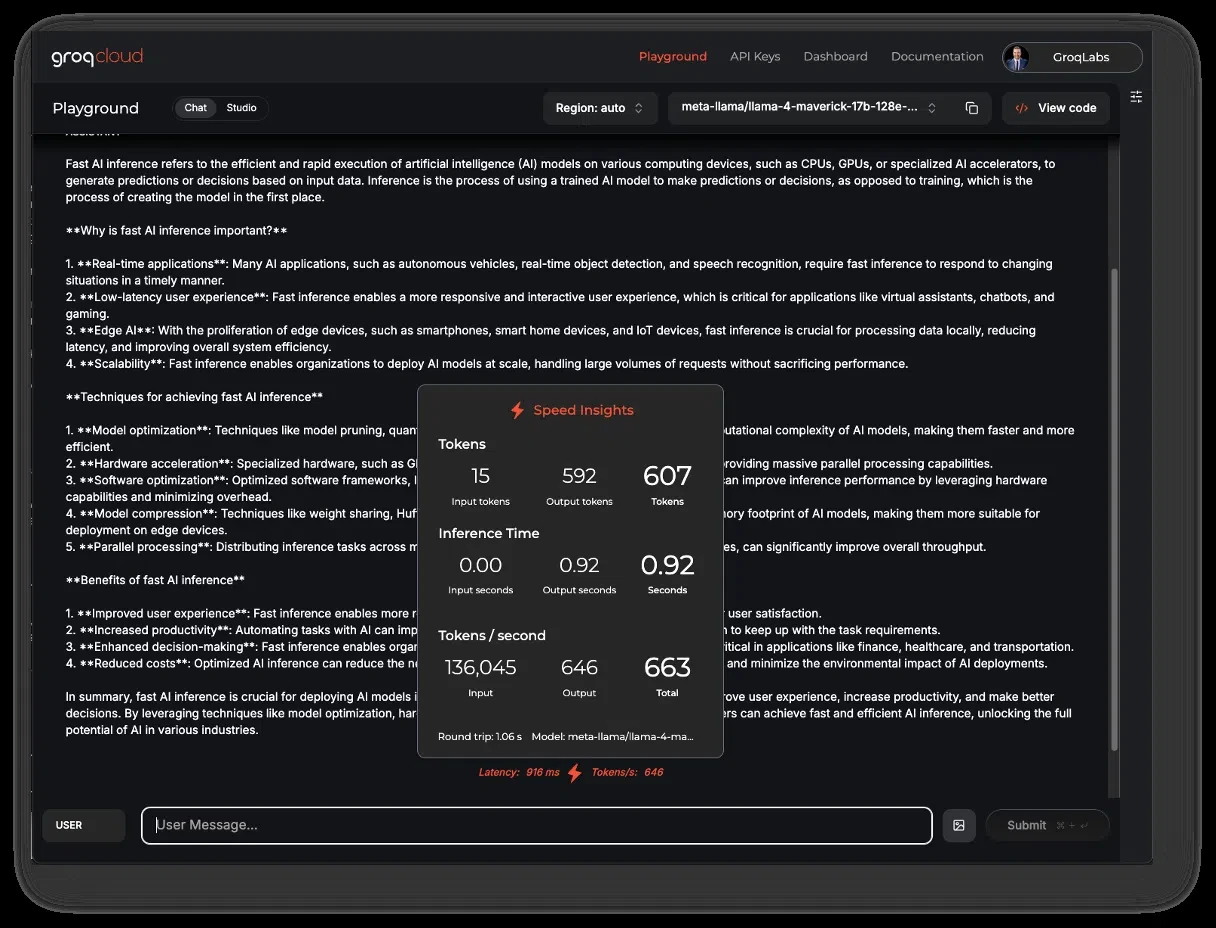
图源:Groq 官方博客 From Speed to Scale(2025)配图,展示专家并行的 LPU 组网形态。
小结
用一个思路总结整篇:TSP 把传统处理器在运行时完成的每一项「优化决策」,全部搬到了编译期。
- 运行时调度 → 编译期时间表
- 硬件缓存 → 编译期显式管理的 SRAM
- 运行时内存仲裁 → 编译期 bank 冲突消除
- 片上 NoC 路由 → 编译期流通道规划
- 芯片间网络交换 → 芯片间直连流
这些替换的共同代价是灵活性,共同收益是确定性。LLM 推理负载恰好处于「计算结构静态、数据规模巨大、延迟敏感」的位置上,这让 TSP 的取舍第一次在大规模商用上成立。
下一篇将讨论 TSP 在执行模型层面最独特的一套机制——流式寄存器(SRF)与 320 元素向量流水线的具体运作,以及 Groq 的实际 kernel 如何用这套机制隐藏 softmax、layernorm、GELU 等非线性算子的延迟。
参考资料
- Think Fast: A Tensor Streaming Processor (TSP) for Accelerating Deep Learning Workloads(ISCA 2020)
- Answer Fast: Accelerating BERT on the Tensor Streaming Processor(ASAP 2022, arXiv:2206.11062)
- What is a Language Processing Unit?(Groq 官方平台文档)
- Why AI Requires a New Chip Architecture(Groq Research Blog,2019)
- From Speed to Scale: How Groq Is Optimized for MoE & Other Large Models(Groq Research Blog,2025)
- AI Hardware Accelerators for Large Language Models: Architectures and the Memory Wall(arXiv:2608.28048)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



