


TensorRT-LLM 源码完全拆解(六):Attention Backend 的 prepare() 内部——块句柄如何变成块表、页表与块偏移
系列进度与本篇定位
前五篇把 TensorRT-LLM 在 CPU 侧的账算完了。第一篇建立仓库地形,确认整条推理路径已由 PyTorch 后端接管;第二篇沿 create_py_executor 走完装配线,看清 PyExecutor 一次 step 的五个动作与重叠执行骨架;第三篇钻进调度器,读完 CapacityScheduler 的准入算术、MicroBatchScheduler 的微批选择与 paused_requests 的暂停-重算语义;第四篇打开 KV 账本,讲清 KVCacheManager 的两级池、块表构造与前缀复用树;第五篇走到 CPU 侧的最后一站——PyTorchModelEngine 如何把动态请求打包成静态形状的输入缓冲,以及 AttentionMetadata.prepare() 在这条流水线里被调用的位置。
第五篇结束时留下一个明确的口子:AttentionMetadata 是一份元数据契约,它声明了 kv_cache_manager、kv_lens、seq_lens、block_ids_per_seq 这些字段,也声明了这些字段必须是稳定地址(因为 CUDA Graph 记录的是设备指针)。但契约只说了”有哪些字段”,没说”这些字段在每种注意力后端里被翻译成什么形状、什么布局、什么内核参数”。这一篇补的就是这一段:同一份元数据进入 TrtllmAttentionMetadata、FlashInferAttentionMetadata、VanillaAttentionMetadata 三条路径后,各自如何把它变成块表(block table)、页索引数组(paged KV indices)、indptr 数组与块偏移张量,以及这些数组最终如何被内核消费。
这里要回答四个问题:
- 为什么第四篇的
KVCacheManager里存的是块句柄(block id 的整数编号),而内核要读的是物理地址偏移?这两者之间的翻译在哪一层完成? copy_batch_block_offsets里的[num_pools, max_batch, 2, max_blocks_per_seq]四维张量,每个维度各代表什么?为什么 K 和 V 要单独占一维?- FlashInfer 后端为什么要额外构造
paged_kv_indices/paged_kv_indptr/paged_kv_last_page_len这三件套(page table 三件套)?它和 TRT-LLM 原生后端的块表有什么本质不同? VanillaAttention这个”什么优化都不做”的后端存在的意义是什么?它怎么用 gather 把分页 KV 拉成连续张量?
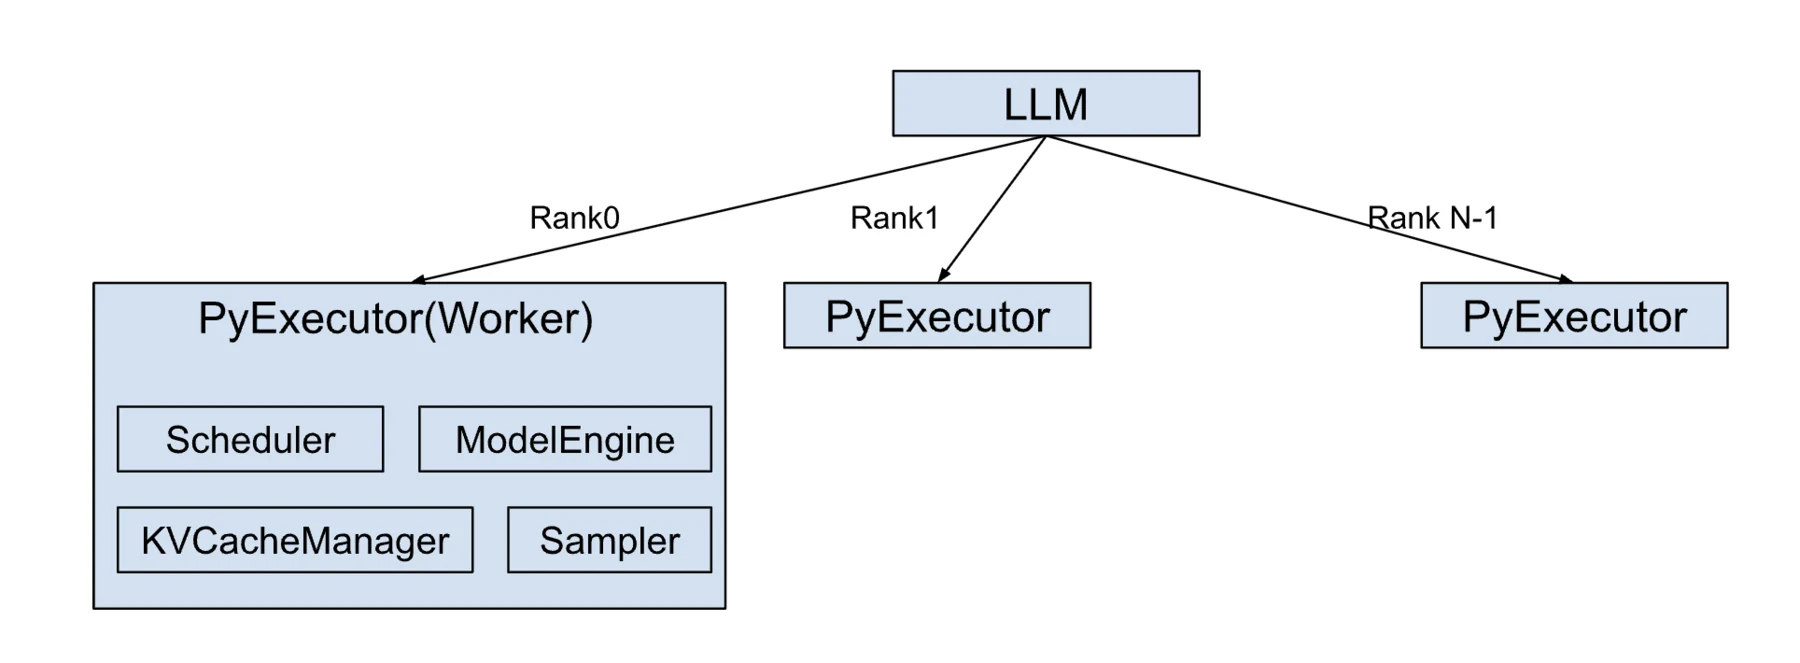
上图是 TensorRT-LLM 官方文档给出的整体架构总览。本篇涉及的 AttentionMetadata.prepare() 位于图中最靠近设备的那一层:上游是第五篇讲过的输入组装流水线,下游就是注意力内核本身。图片来源:TensorRT-LLM 官方文档 media/TRTLLM_Architecture_Overview.png。
从块句柄到块偏移:为什么中间必须有一层翻译
第四篇留下的账面结构
回顾第四篇的核心结论:TensorRT-LLM 的 KV 缓存由 KVCacheManager(Python 侧包装,内部实现是 C++ 的 KVCacheManager)管理,它把显存切成固定大小的块(page,默认 32 或 64 个 token 一块),每个块有两个属性:
- 块句柄(block id):一个整数编号,全局唯一,是这个块在池子里的”学号”。调度器、前缀复用树、
free_blocks队列只认这个编号。 - 物理位置:这个块在显存池里的实际地址,由池的基址加上
block_id × 块字节数得到偏移。
上层逻辑(前缀匹配、复用、回收、beam 分叉)全部在块句柄的层面工作——句柄是逻辑概念,不涉及地址;这样池可以换、布局可以变,逻辑不用改。但内核不行:内核要算出”第 3 个请求的第 17 个 KV 块在显存里的哪个位置”,它必须拿到地址偏移或者能换算成偏移的编号。
块偏移张量的四维布局
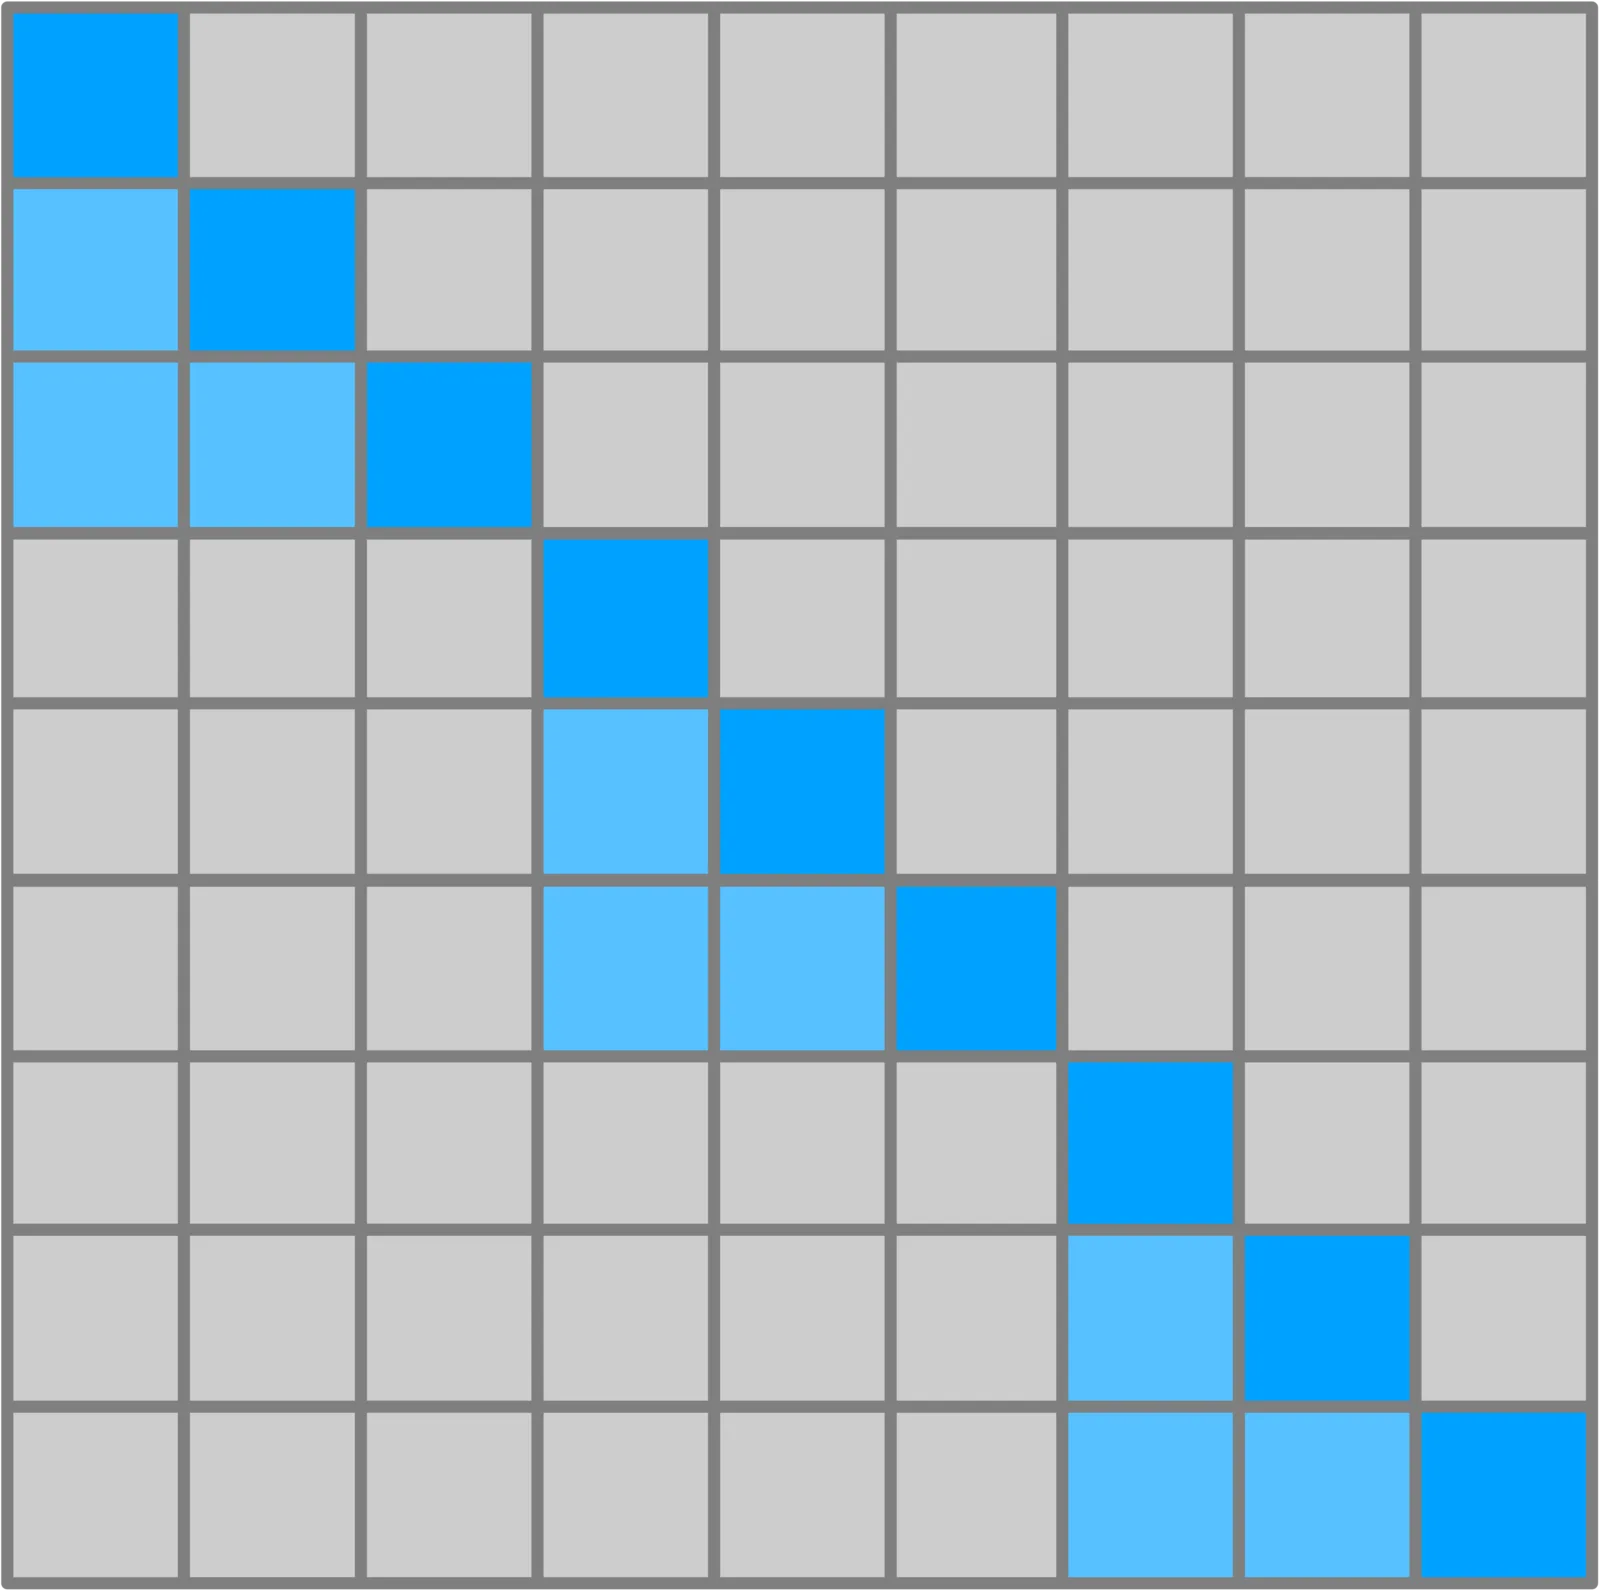
上图是 TensorRT-LLM 官方文档里分块上下文(chunked context)注意力的示意图:一条长提示被切成多段依次执行,每段产生的 KV 依次写进缓存。账本必须按”块”而不是按”步”记账,正是因为它要跨多步持续持有这些物理页——这也是本节四维张量存在的理由。图片来源:TensorRT-LLM 官方文档 media/feat_long_seq_chunked_attention.png。
这个翻译就发生在 KVCacheManager.copy_batch_block_offsets() 里。先看它填充的目标张量的形状:
[num_pools, max_num_requests, 2, max_blocks_per_seq]四个维度逐一拆开:
num_pools:池的数量。绝大多数模型只有一个池;但可变滑动窗口注意力(VSWA,Variable Sliding Window Attention)会按窗口大小分池,每种窗口一个池,这样不同层可以用不同粒度的块管理。Gemma 系列这类”层间窗口大小不同”的模型就会走这条路。max_num_requests:行数按最大批大小预分配,而不是按当前批大小。原因和第五篇讲过的一样:CUDA Graph 捕获的是地址,缓冲区的行数必须在捕获时就固定,运行中只能覆写前num_seqs行。2:K 与 V。多数现代模型(MHA/GQA/MLA 的 KV 合并存储除外)把 K 和 V 分成两块独立的池,或者在同一池里按因子 2 排列,所以这个维度是2,索引0拿 K、索引1拿 V。max_blocks_per_seq:每序列最多多少个块,由max_seq_len / tokens_per_block决定,向上取整。同样是预分配的上限值。
注意这里的 dtype:int32。块偏移不需要 64 位,因为块偏移是”第几个块”而不是”第几字节”,池的块数是 2 的 30 次方级别就够用了,int32 省一半带宽——这是个大批场景下真实影响性能的决策,因为每次前向都要把这些表从主机搬到设备。
句柄到偏移的物理含义
关键问题是:块偏移张量里存的到底是”块句柄”还是”字节偏移”?
答案是两者在数值上可以统一,而且 TensorRT-LLM 正是这么设计的。在分页 KV 池里,物理地址 = 池基址 + 块编号 × 块步长;而”每序列第 i 个块的编号”既可以直接当索引(内核自己做 base + idx * stride),也可以由主机侧预乘成字节偏移。TensorRT-LLM 选择了让张量里存块编号,由内核用块步长换算,理由是:
- 块编号是布局无关的。同一个编号,在 NHD 布局和 HND 布局里对应的字节位置不同,但如果张量里存字节偏移,换布局就得重算整张表。
- 池可以重映射。启用显存整理或跨实例 KV 传输时,块编号不变但物理位置会变;只存编号就不会出现”表里的地址已经过期”的问题。
所以 copy_batch_block_offsets 里 self.impl.copy_batch_block_offsets(...) 调用的是 C++ 实现——它在 C++ 侧直接遍历前綴复用树的节点,把每个请求持有一串块编号铺进行里。名字里的 “offsets” 指的是”这个请求的块序列在块池里的偏移序列”,而不是字节地址。
下面是一段最小化的伪代码,展示这层翻译在概念上做了什么:
# 输入:request_ids(本批请求 id 列表)、beam_width、num_context、num_seqsfor row, rid in enumerate(request_ids): # 1) 从请求状态里取出它持有的块序列(这是一个块句柄列表) blocks = blocks_held_by(rid) # 长度 = ceil(kv_len / tokens_per_block)
# 2) context 段(预填充请求)与 generation 段(解码请求)分开处理: # context 段只用 1 个 beam,因为它还没有分叉 # generation 段要按 beam_width 复制行 —— beam search 时每条请求有多个 beam for b in range(1 if row < num_context else beam_width): dst_row = row_idx_for(row, b) dst[0, dst_row, 0, :len(blocks)] = blocks # K 池 dst[1, dst_row, 1, :len(blocks)] = blocks # V 池(或同一池的 V 因子)这段伪代码里有两个细节值得展开,它们在真实代码里都有对应的注释:
第一,context 与 generation 分开调用。 真实实现里是两次调用:
self.impl.copy_batch_block_offsets(self.host_kv_cache_block_offsets, request_ids[:num_context], 1, 0)self.impl.copy_batch_block_offsets(self.host_kv_cache_block_offsets, request_ids[num_context:], beam_width, num_context)第一次传 beam_width=1、num_context=0,处理预填充请求;第二次传真实的 beam_width 与 num_context,处理解码请求。为什么预填充段强制 beam_width=1?因为预填充阶段还没有分叉:一条新请求进入时只有一个序列,beam search 的分叉发生在它开始逐 token 生成之后。如果在预填充行上就按 beam 展开,会凭空多出几行指向同一个块序列的假 beam,浪费带宽也浪费内核的序列槽位。
第二,cross attention 的展开逻辑正好相反。 交叉注意力(编码器-解码器模型的 decoder 读 encoder 的 K/V)里,多条请求可能共享同一份编码器输出吗?不一定,但同一条请求的多个 beam 一定共享同一份 cross K/V——因为 cross K/V 由编码器一次性写出,解码器的每个 beam 读的是同一份。所以 cross 路径的逻辑是”每请求填一行,然后把 generation 行按 beam 复制(repeat_interleave)”:
gen_block_offsets = host_block_offsets[ pool_idx, num_context:num_context + num_gen_requests]dst_tensor[pool_idx, num_context:num_seqs].copy_( gen_block_offsets.repeat_interleave(beam_width, dim=0), non_blocking=True)repeat_interleave(beam_width, dim=0) 把 [num_gen_requests, ...] 展开成 [num_gen_requests * beam_width, ...],第 i 条请求的 beam_width 个 beam 拿到完全相同的一行。同一份代码里还有一条断言在守着这个语义:
num_gen_requests = len(request_ids) - num_contextexpected_num_seqs = num_context + num_gen_requests * beam_widthassert num_seqs == expected_num_seqs, ( f"Cross KV cache block offsets expected {expected_num_seqs} " f"decoder rows, got {num_seqs}.")它把”元数据张量的行数必须等于 context 行数 + generation 行数 × beam 宽度”写成了硬性契约。这类断言在 TensorRT-LLM 里到处都是,因为行数的错位不会立刻崩溃,只会让内核读到另一个批次(或者另一条请求)的块——这类错误极难排查,所以宁可断言失败也不要静默出错。
一个真实踩过的坑:异步拷贝的源被覆写
copy_batch_block_offsets 的代码里有一段长注释,讲的是一个真实的回归(内部编号 nvbug 6293536),值得完整讲一遍,因为它是理解”重叠调度 + 异步 H2D + 持久缓冲区”三者相互作用的最好例子。
设想的朴素实现是这样的:
# 错误写法(曾经的真实代码)self.impl.copy_batch_block_offsets(self.host_kv_cache_block_offsets, request_ids, beam_width, num_context)dst_tensor.copy_(self.host_kv_cache_block_offsets, non_blocking=True)主机侧先把本批的块编号铺进那块持久的主机缓冲区(它是 max_batch 大小的,跨步复用),然后异步拷到设备。看起来没问题:先写源、再拷。
问题出在重叠调度(第六篇前的第五篇提过,SGLang 侧在SGLang 源码完全拆解(六):Overlap Scheduler 里详细讲过同一类机制)。开启重叠后,CPU 会提前一个迭代准备下一批的输入:当第 t 步的 H2D 拷贝还在流里排队时,CPU 线程已经在为第 t+1 步往同一块持久缓冲区里写数据了。于是第 t 步那次还没执行的异步拷贝,读到的源已经被第 t+1 步覆写了——注意力内核拿到了另一个批次的块表。
修法是把源改成”每次调用新分配一块 pinned 主机缓冲,把持久缓冲区的前 num_rows 行快照进去”:
def _stage_block_offsets_for_copy(self, num_rows, max_blocks=None): if max_blocks is None: width = self.max_blocks_per_seq else: width = min(max(max_blocks, 1), self.max_blocks_per_seq) host_block_offsets = torch.empty(self.num_pools, num_rows, 2, width, dtype=torch.int32, pin_memory=prefer_pinned(), device='cpu') host_block_offsets.copy_(self.host_kv_cache_block_offsets[:, :num_rows, :, :width]) return host_block_offsets新分配的缓冲区不会被下一迭代碰,non_blocking=True 的 H2D 就安全了。注释里还提到:“缓存式主机分配器会把它一直持有到消费它的拷贝完成”——即释放不是靠 Python 引用计数,而是靠 CUDA 缓存分配器的流语义。
而原来那块持久缓冲区不能删,因为有三类 CPU 侧读者直接读它,且依赖它”跨调用持久、行数固定为 max_batch”:
- DSA 稀疏注意力(DeepSeek Sparse Attention,站内 DSA 稀疏注意力完全拆解 讲过这个算法本身):索引器要按块粒度打分,需要读到块表。
- 投机解码的 draft/target 缓冲区交换:草稿模型与目标模型的前向交替使用同一份元数据对象,交换时需要读原表。
- KV 缓存重定位路径:启用显存整理或弹性伸缩时,块的物理位置要搬,搬运逻辑按块编号读表。
注释里那句 “Reassigning this attribute to a per-call, num_seqs-sized buffer broke those readers (nvbug 6293536 regression)” 说明一开始的修法可能是把属性直接指向新缓冲——那会把这些读者的视野从 max_batch 行缩成 num_seqs 行,同样是错的。正确修法是”两份缓冲并存”:持久的那份给同步的 CPU 读者,新的那份给异步的 H2D。 这是一个很典型的工程结论:当一个数据结构同时被”需要稳定视图的读者”和”需要瞬时快照的读者”使用时,共用一个实例迟早出事。
元数据契约:AttentionMetadata 到底声明了什么
在进入三条后端路径之前,先把共同的契约看清楚。AttentionMetadata 是 tensorrt_llm/_torch/attention/backends/interface.py 里的一个 dataclass,它是所有注意力后端的基类,也是模型前向层与调度器之间唯一的握手对象。
三类字段
把它的几十个字段按用途归类,会看得清楚得多:
第一类:容量上限(构造时确定,终身不变)
max_num_requests: int # 单批最多多少条请求max_num_tokens: int # 单批最多多少 tokenmax_num_sequences: int # 单批最多多少序列(beam 展开后)这三个数字是预分配的依据。所有按行索引的缓冲区——seq_lens、kv_lens、块偏移表、块表——都按这三个上限之一来分配行数,运行中只填前 num_seqs 行。第五篇讲过:这是 CUDA Graph 的硬性要求,因为图里记录的是设备地址,缓冲区不能换。
第二类:本步的实际形状(每步都变)
seq_lens: torch.Tensor # (batch_size),本步每条序列的 query 长度seq_lens_kv: torch.Tensor # 交叉注意力专用,KV 侧长度num_contexts: int # 本批里有多少条是 context(预填充)请求seq_lens 有一个很关键的细节——它有两个副本:
_seq_lens: torch.Tensor # 固定在 CPU(pinned)_seq_lens_cuda: torch.Tensor # 同一份数据的设备副本为什么要有两份?代码注释解释了:seq_lens_cuda “被 logits processor 使用”,而且”保留两份副本可以避免 FlashInfer 的 prepare() 实现里大量多余的拷贝”。真实的因果链是这样:采样阶段要在设备上做 logits 处理,需要 per-sequence 长度;注意力后端的内核也需要它。 如果只有一份设备张量,采样侧每次想读就要 D2H 同步——而 D2H 同步会打断重叠调度(第五篇讲的”CPU 提前跑一个迭代”正是靠避免同步才能成立的)。两份副本的分工是:CPU 侧那份给调度与元数据构造用(CPU 需要直接算数,不需要同步),设备侧那份给内核与采样用。
seq_lens 的 setter 里还有一行很值得看的保护:
if self.is_cuda_graph and self._seq_lens_cuda is not None: # Very important: do not reallocate if we are using CUDA graphs. self._seq_lens_cuda.copy_(self._seq_lens, non_blocking=True)else: self._seq_lens_cuda = self._seq_lens.cuda(non_blocking=True)注释里那句 “Very important” 是重点:CUDA Graph 模式下必须原地 copy_,绝不重新分配。 一旦走了 else 分支(新建张量),_seq_lens_cuda 的地址就变了,而捕获的图里写死了旧地址——重放时会读到一块已经释放或被复用的显存。
顺带还能看到一个反直觉的性质:CUDA Graph 模式下批大小不变。注释说 “This copy is safe because the batch size is guaranteed to not change in the CUDA graph case”。因为解码图是按批大小分桶捕获的,某个桶对应的图只在那个批大小下重放,所以 _seq_lens_cuda 的 shape 恒定,原地拷贝永远装得下。但序列长度本身可以变(投机解码时草稿 token 数不同),所以值要每步更新——这才需要 copy_。这正好呼应了第五篇讲的结论:TensorRT-LLM 用”形状固定”换”稳态确定性”,而序列长度这种”形状不变但值变”的东西就落在可更新的那一侧。
第三类:KV 账本接口(跨越到第四篇的世界)
kv_cache_manager: KVCacheManager | KVCacheManagerV2 | Nonekv_cache_params: KVCacheParams # 含 num_cached_tokens_per_seqkv_lens: torch.Tensor # 本步之后每条序列的 KV 长度request_ids: List[int] # 本批请求 id,用于向 manager 查块这里最关键的是 request_ids——元数据本身不持有块表,它只持有”向谁要块表”的钥匙。真正的块在第四篇的 KVCacheManager 里,元数据每次 prepare() 时拿着 request_ids 去问一次。这个设计的好处是:块表天然跟着账本走,不存在”元数据里的块表已经和账本不一致”的窗口。
还有一个隐藏的强约束:is_cross 属性。
@propertydef is_cross(self) -> bool: return self.seq_lens is not self.seq_lens_kv交叉注意力的判定用的是 is not——对象身份比较,不是值比较。 自注意力时 seq_lens_kv 的 getter 直接返回 seq_lens(同一个对象),所以 is not 为假;交叉注意力时两者被显式设为不同张量,is not 为真。为什么不用值比较?因为一行 if 判断省下的开销无所谓,但这个约定把”两者是不是同一份数据”这件事变成了对象身份问题,于是任何重新分配 seq_lens 的代码都会立刻破坏判定。这跟第五篇讲的”元数据必须是同一对象(is 而非 ==)“是同一种设计语言——用对象身份编码语义,因为身份不会撒谎。
prepare() 的两个入口
基类里的 prepare() 短得几乎不像个钩子:
def prepare(self): """Hook to be called before the forward step of the model.""" self._prepare_mamba_metadata()它只做一件事:如果这个模型带 Mamba 层(混合架构,如 Jamba、Mamba2 混合模型),顺便准备一下 Mamba 的元数据。真正的注意力元数据准备全部由子类覆写。这是一条很清晰的分层:基类负责跨注意力机制共用的部分,子类负责把 KV 账本翻译成自己内核要的形状。
此外还有一个专为编码器设计的旁路:
def prepare_encoder_only(self) -> None: """Hook for encoder-only (no-KV-cache) forward setup.
Defaults to the full ``prepare()``; backends with a leaner encoder-only path override this.""" self.prepare()编码器(比如 BERT 类或 Whisper 的编码器部分)不需要 KV 缓存,块表、块偏移、前缀复用全都不存在。如果硬走完整的 prepare(),会白白做一堆”向 manager 要块表”的工作——而 manager 是 None,只能靠分支绕开。所以给了个专门入口,让后端提供一个”什么账都不用算”的快路径。
TRT-LLM 原生后端的 prepare_encoder_only 实现里有一段注释,讲了一个具体的坑:
# `host_request_types` is allocated with `torch.empty_like` (not zeroed),# and the full `prepare()` is what normally fills it. This fast path skips# `prepare()`, so explicitly mark every request as a context request (type 0)# here -- otherwise the FMHA reads whatever garbage the buffer happened to# hold and may treat a context segment as a generation step.n = self.num_seqsself.host_request_types[:n].fill_(0)host_request_types 是一个 per-sequence 的类型标记数组(0 = context,1 = generation),它的用途是告诉内核”这一行是预填充还是解码”。它用 torch.empty_like 分配——未清零。完整 prepare() 会把它填满,而快路径跳过了 prepare(),于是这个数组里全是上一次留下的垃圾值。垃圾值恰好是 1 的话,内核会把一条预填充请求当成解码请求处理:只对最后一个 token 算注意力输出,其余 token 的输出全是垃圾。这就是”快路径”的典型代价——你省掉的每一步初始化,都得自己补回来。
一个被刻意”提前算好”的数字
基类里有一组字段,注释很直白:
# These fields are set when changing seq_lens and _num_contexts to avoid computation# during execution. If the calculation happens during execution, torch compile treats it# as DDS and fails to compile._num_generations: int = field(init=False, default=0, repr=False)_num_ctx_tokens: int = field(init=False, default=0, repr=False)_num_tokens: int = field(init=False, default=0, repr=False)DDS 是 Dynamo 的 “data-dependent shape” 缩写。含义是:如果一个张量的形状依赖运行时的数据值,torch.compile 就无法为它生成静态形状的代码,只能放弃编译(graph break)。 num_contexts 是每步从调度器传进来的一个 Python int,seq_lens 是张量;如果在前向函数体里现算 seq_lens[:num_contexts].sum().item(),就产生了”形状依赖数据”。
解法是在 setter 里算好:
@seq_lens.setterdef seq_lens(self, value): ... self.on_update()
def on_update(self): if (self._seq_lens is not None and self._seq_lens.shape[0] >= self.num_contexts and self.num_contexts >= 0): self._num_ctx_tokens = self._seq_lens[:self.num_contexts].sum().item() self._num_generations = self._seq_lens.shape[0] - self.num_contexts if self._seq_lens_kv is not None: self._num_tokens = self._seq_lens_kv.sum().item() elif self._seq_lens is not None: self._num_tokens = self._seq_lens.sum().item().item() 是同步操作——它强制 CPU 等 GPU 上的 sum() 算完。把它放在 setter 里(调度阶段,CPU 本来就闲着)而不是前向体里(GPU 正在跑,CPU 等就是浪费),既避开了 DDS,又把同步藏到了不心疼的地方。注意 on_update 在 seq_lens、num_contexts、seq_lens_kv 三个 setter 里都被调用,因为这些量互相依赖——改任何一个,三个派生值都要重算。 这种”在 setter 里维护不变式”的写法在 TensorRT-LLM 里反复出现,第五篇的 InputBuffers 也是同一套路数。
稀疏后端的旁路入口
契约里还有一个稀疏注意力的挂载点:
# Sparse settings for metadata allocation/update; dense metadata leaves it None.sparse_metadata_params: Optional[SparseMetadataParams] = None默认是 None,稠密注意力完全不受影响。稀疏算法(第 next 节详述)通过它注入自己的元数据参数——比如”这次的稀疏粒度是 token 还是 block""索引器的 Top-K 是多少”。这种”默认 None + 可选协议”的写法,是 TensorRT-LLM 给同一个元数据类挂载十来种注意力变体(MLA、MHA、稀疏、VSWA、FP4)的通用手法:契约不膨胀,扩展靠旁路。
三条路径之一:VanillaAttention——最朴素的那条
VanillaAttentionMetadata.prepare() 只有四行有效代码:
def prepare(self) -> None: super().prepare() # indices of used cache blocks for each sequence assert self.request_ids is not None self.block_ids_per_seq = self.kv_cache_manager.get_batch_cache_indices( self.request_ids) if self.kv_cache_manager is not None else None它调 get_batch_cache_indices(),拿到一个 List[List[int]]——外层每条请求一个元素,内层是该请求持有的块编号列表。就这些。没有设备张量、没有 pinned 缓冲、没有 indptr。块表以最原始的 Python 嵌套列表形式交到内核手里。
为什么这么设计?先看 VanillaAttention 是怎么用它的:
@staticmethoddef _gather_paged_kv(kv_cache_tensor, block_ids, kv_idx, num_tokens, tokens_per_block): """Materialize the first ``num_tokens`` logical K (``kv_idx=0``) or V (``kv_idx=1``) tokens from the paged pool as a contiguous ``[num_tokens, num_kv_heads, head_dim]`` tensor (NHD view)."""这个函数的功能是:把分页池里散落的 K(或 V)按逻辑顺序 gather 成一块连续张量,形状 [num_tokens, num_kv_heads, head_dim]。之后注意力就能在一个连续的 KV 上做普通的矩阵乘,完全不需要分页内核。
VanillaAttentionMetadata.__post_init__ 里还有一行:
def __post_init__(self) -> None: super().__post_init__() self.kv_layout = "NHD"它强制 NHD 布局。 基类默认是 “HND”(kv_layout: Literal["NHD", "HND"] = "HND"),Vanilla 改成了 NHD。这不是随意选的:_gather_paged_kv 的目标形状是 [num_tokens, num_kv_heads, head_dim](即 [token, head, dim]),正好是 NHD 的排列顺序;而 HND 是 [head, token, dim]。gather 出来的连续块要直接当作标准注意力输入用,就必须是 token-major 的。
那 Vanilla 存在的意义是什么?答案是它是一条”绝对正确但很慢”的兜底路径,服务三个具体场景:
- 开发新算法时做数值基准。 稀疏注意力、MLA 变体、FP4 路径算得对不对?拿 Vanilla 的输出当 ground truth。它没有花哨的内核,逻辑直白,出错概率最低。
- 小 batch / 短序列。 gather 的代价是”搬运 KV token”,约等于
num_tokens × num_kv_heads × head_dim。当序列很短(比如几百 token)、batch 很小时,这次搬运的总量小,而分页内核启动的固定开销(准备页表、启动 tile 调度)反而更贵。在这个区间里,朴素实现可能真的更快。 - 稀疏注意力的承载路径。 稀疏算法要先选出”哪些 KV 重要”,然后只对这些 KV 算注意力。选出来的 KV 集合既不连续、也不规则,用分页内核反而别扭;而 gather 这个动作天然能”按任意块列表取”。稀疏前向
_single_request_sparse_attn_predict在基类里抛NotImplementedError,正是留给具体稀疏算法覆写的钩子。
它的路径选择(后端注册)不在这里展开;重点是理解它在整张图里的位置:Vanilla 是”正确性锚点 + 小规模快路径 + 稀疏承载”三重角色,不是过时的遗留代码。
三条路径之二:FlashInferAttentionMetadata——page table 三件套
FlashInfer 是伯克利团队出的注意力内核库,它的分页 KV 接口约定的不是”块表”,而是三件套:
paged_kv_indices:所有用到的块编号,扁平拼在一起(不是二维表)。paged_kv_indptr:每条序列在扁平数组里的起止位置,长度batch + 1,首元素为 0。paged_kv_last_page_len:每条序列最后一个块里有效 token 数。
这三件套叫 ragged page table(不规则页表)。“ragged”(参差不齐)指的是每条序列的块数不一样——这正是 indptr 存在的理由。
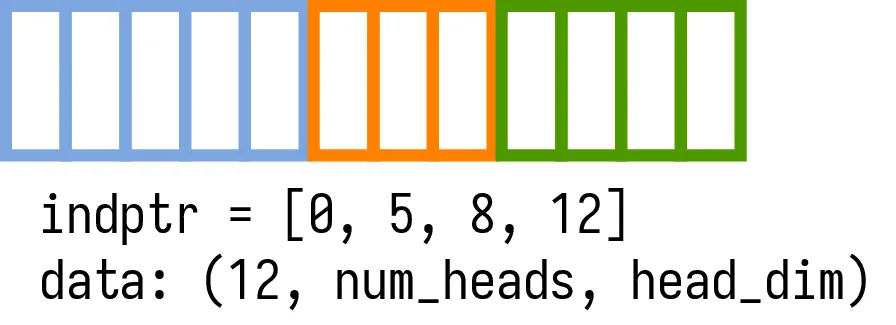
上图是 FlashInfer 官方教程里的 ragged 布局示意:多条长度不同的序列被首尾相接拼成一个扁平张量,用 indptr 记录每条的分界。page table 三件套用的是同一套结构,只不过被拼接的元素是”块编号”而不是 token。图片来源:FlashInfer 官方文档 kv_layout 教程。
为什么 FlashInfer 用 flat + indptr 而不是二维表?
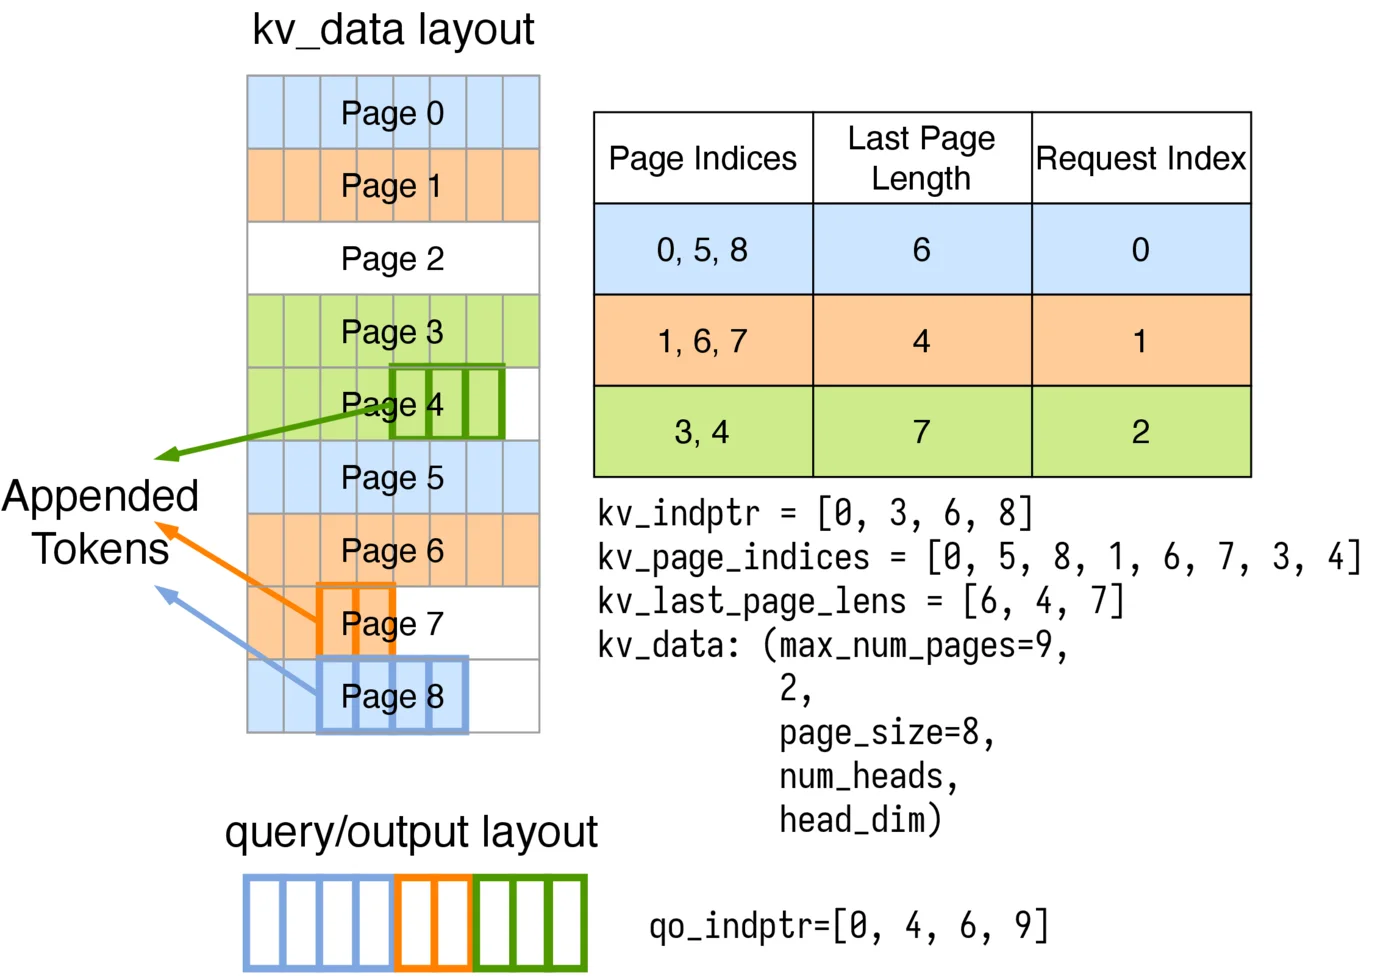
上图是 FlashInfer 官方教程给出的 paged KV 数据布局。图中下半部分就是 ragged page table 的示意:kv_indices 是一串块编号,kv_indptr 把它们按序列切开,kv_last_page_len 标记每段尾巴上的有效长度。图片来源:FlashInfer 官方文档 kv_layout 教程。
答案是避免空洞。二维表 [batch, max_blocks_per_seq] 里,如果某条请求只用 3 个块而表宽是 500 列,那 497 列是纯浪费。解码阶段通常 batch 大、每条请求的块数少而接近,二维表还算合适;但当 batch 里有长有短(混合 chunked prefill 就是典型:一个批里可能既有 20 token 的短请求,也有 8000 token 的长请求),flat 布局省下的空间是数量级的。更进一步,flat 布局让”第 i 条序列的第 j 个块”变成一个纯索引运算 indices[indptr[i] + j],内核里不需要二维的 stride 计算,indptr 天然给了每条序列的边界,这正是 varlen(变长)内核最喜欢的输入形式。
prepare() 逐段拆解
FlashInfer 的 prepare() 是整个文件里最长的一段,按顺序拆开看:
步骤一:qo_indptr(query 侧的 ragged 边界)
assert self.seq_lens_cuda is not Nonetorch.cumsum(self.seq_lens_cuda, dim=0, dtype=torch.int32, out=self._qo_indptr[1:self.seq_lens_cuda.size(0) + 1])注意这是设备上的 cumsum,且 out= 指向预分配缓冲。两个细节各有原因:设备上算是因为要用 seq_lens_cuda;用 out= 是因为 CUDA Graph 要求地址稳定。cumsum 天然给出 prefix sum,配合 _qo_indptr[0] = 0(预分配时已置零),indptr 就成形了。
步骤二:无 KV 缓存的早退分支
if self.kv_cache_manager is None: assert self.request_ids is not None assert self.num_generations == 0, ( "FlashInfer without a KV cache manager only supports context-only " "batches (num_generations == 0) in TRT-LLM.") ... self.kv_cache_params = KVCacheParams(use_cache=False) n = self.num_seqs self._cached_token_lens[:n].zero_() self.num_ctx_cached_tokens = 0 self._clean_cached_plans(defer_plan=False) return没有 KV 缓存的 FlashInfer 只支持 context-only 批。原因很直白:解码阶段的每步都要读写 KV 缓存,没有缓存就没有东西可读,解码无从进行。所以这个分支必须断言 num_generations == 0,并且把”已缓存 token 数”全部清零——不清零的话,内核会以为这些序列已经有一堆历史 KV(实际没有),把后续 token 写到错误位置。
步骤三:从账本取缓存长度,算出本步 KV 长度
num_cached_tokens_per_seq = self.kv_cache_params.num_cached_tokens_per_seq...kv_lens_host = np.asarray(num_cached_tokens_per_seq, dtype=np.int64) + self.seq_lens_kv.numpy()logical_num_blocks = ((kv_lens_host + self.page_size - 1) // self.page_size)这一段有两条设计要点。
其一,全程在主机侧用 NumPy 算。 注释写得很清楚:
# Kept on the host: every consumer below needs host values, so a device-side computation# would force a sync per step.每次算完如果留在设备上,下游要用就得 D2H 一次;而下游有十来个消费者,就是十几次同步。一次性在主机上算完,只做一次 H2D(拷贝设备侧要用的那几份),总同步次数降到零。
其二,logical_num_blocks 是”逻辑块数”,不是”已分配块数”。 注释强调:
# These logical block counts describe committed history, not# all pages that the KV manager has reserved for fixed-width speculative appends.区别在哪?投机解码时,KV manager 会预先把草稿阶段的块也分配好(因为草稿长度是固定的,可以提前占位)。但这些块在草稿 token 被接受之前,里面的数据是未提交的。如果按”已分配的块数”来算,内核就会去读这些未提交的槽位——读到的是上一轮的残值,等于把无效 KV 混进注意力计算。所以必须用”已经真正写入的历史长度”来算逻辑块数。
步骤四:预留宽度与”全页表”
use_full_generation_page_table = ( self.kv_cache_params.use_full_generation_page_table)self._uses_full_generation_page_table = use_full_generation_page_tableif use_full_generation_page_table: # Generation rows need every reserved page to keep a speculative append addressable # across a page boundary. Treating that wider table as the logical sequence would make # FlashInfer attend to uncommitted draft slots, so plans and positions use the separate # device logical lengths populated below. assert self.request_ids is not None num_blocks = np.asarray( _get_page_table_num_blocks( self.kv_cache_manager, self.request_ids, logical_num_blocks.tolist(), self.num_contexts), dtype=np.int64)self.num_blocks = num_blocks.tolist()这里出现了两个不同的块数:logical_num_blocks(真实历史)和 num_blocks(页表宽度)。为什么要分开?
_get_page_table_num_blocks 的实现回答了这个问题:
def _get_page_table_num_blocks(kv_cache_manager, request_ids, logical_num_blocks: list[int], num_contexts: int) -> list[int]: """Keep context rows logical and expose every reserved generation page.""" generation_request_ids = request_ids[num_contexts:] reserved_num_blocks = [ len(block_ids) for block_ids in kv_cache_manager.get_batch_cache_indices(generation_request_ids) ] return list(logical_num_blocks[:num_contexts]) + [ max(logical, reserved) for logical, reserved in zip( logical_num_blocks[num_contexts:], reserved_num_blocks) ]context 行保持逻辑块数,generation 行取”逻辑块数”与”预留块数”的较大者。
对 context(预填充)行:它们每一步都在追加新 token,没有”预留给还没生成的 token”这回事,所以逻辑块数就是真实块数。
对 generation(解码)行:投机解码要跨页边界可寻址。设某条序列已经写了 33 个 token,页大小 32,那么逻辑上它占了 2 页(第 2 页只用了 1 个 slot)。现在草稿阶段要一次追加 8 个 token。如果页表只暴露 2 页,第 3 页根本不在表里——草稿 token 写到一半需要跨页时,内核会去查一个不存在的页,结果是写到别处或直接越界。所以页表必须暴露预留的全部页。
但页表变宽又带来新问题,代码注释点破了:
Treating that wider table as the logical sequence would make FlashInfer attend to uncommitted draft slots如果内核把”页表覆盖的全部页”当成”序列的逻辑长度”,它就会去 attend 那些还没被接受、内容是残值的草稿槽位——等于把垃圾 KV 参加进注意力计算,输出直接错。 所以解法是把两件事拆开:页表用宽版(保证可寻址),而位置计算与 plan 用另一份单独维护的”逻辑长度”张量:
if use_full_generation_page_table: logical_kv_lens = _to_int32_tensor(kv_lens_host) self._logical_kv_lens[:logical_kv_lens.numel()].copy_( logical_kv_lens, non_blocking=True) position_kv_lens = self._logical_kv_lens[:self.num_seqs]else: position_kv_lens = flashinfer.get_seq_lens( self.paged_kv_indptr, self.paged_kv_last_page_len, self.page_size)这是一条很值得记住的工程原则:当”可寻址范围”和”有效数据范围”必须不一致时,用两个显式的量分别表示它们,绝不用一个量兼任两个含义。 同一个数字承担两重语义,迟早会在某个边界条件下出错——而且这种错误往往表现为”结果略微不对”,极难定位。
步骤五:块索引与 page table indptr
paged_kv_indices = self.kv_cache_manager.get_batch_cache_indices_flat( self.request_ids, self.num_blocks, layer_idx=primary_layer_idx)self._paged_kv_indices[:paged_kv_indices.size(0)].copy_( paged_kv_indices, non_blocking=True)get_batch_cache_indices_flat 的实现(第四篇讲过 get_batch_cache_indices,这是它的扁平版):
def get_batch_cache_indices_flat(self, request_ids, num_blocks, layer_idx=None): """Concatenated per-request block tables, trimmed to real widths.
Equivalent to concatenating ``get_batch_cache_indices(request_ids, layer_idx)[i][:num_blocks[i]]`` over all requests into one CPU int32 tensor; matches the interface of ``KVCacheManagerV2.get_batch_cache_indices_flat``.""" block_ids_per_seq = self.get_batch_cache_indices( request_ids, layer_idx=layer_idx, num_blocks_per_seq=num_blocks) indices_list = [] for block_ids, n in zip(block_ids_per_seq, num_blocks): indices_list.extend(block_ids[:n]) return torch.tensor(indices_list, dtype=torch.int32)注意 num_blocks_per_seq=num_blocks 这个参数——它把每条序列的块数裁到我们上一步算出的宽度。裁掉的部分是”该请求持有但本次不需要暴露的块”。这就解释了为什么不能像 Vanilla 那样用 len(block_ids) 当块数,第四篇的注释也提过同一件事:“len(block_ids) 会给你一个太大的数,因为 chunked prefill / KV 复用会提前把所有块都分配好。”
紧接着构造 indptr:
paged_kv_indptr_decode = _to_int32_tensor( np.concatenate([[0], np.cumsum(num_blocks[self.num_contexts:])]))self.paged_kv_indptr_decode[:...].copy_(paged_kv_indptr_decode, non_blocking=True)self._host_paged_kv_indptr_decode = paged_kv_indptr_decode解码段和预填充段各自一个 indptr,因为两段用的内核不同(decode 走 split-K 或 tensor-core 解码内核,prefill 走 paged-prefill 内核),各自的 varlen 边界不一样。
而两段混合时(mixed batch)又要造第三个:
else: assert not self.is_cuda_graph, "Cannot mix decode/prefill with CUDA graphs" # Accumulate on the host and stage through pinned memory: .cuda() # on an unpinned tensor is a synchronous H2D that stalls # the executor thread behind in-flight kernels on every mixed step. self.paged_kv_indptr = _to_int32_tensor( np.concatenate([[0], np.cumsum(num_blocks)])).to(device='cuda', non_blocking=True)两个信息:其一,混合批不能配 CUDA Graph。 因为图必须捕获静态形状,而”混了多少 context、多少 generation”是每步变的,形状定不下来。其二,非 pinned 张量的 .cuda() 是同步的。 这是一个容易被忽略的性能细节:PyTorch 的 .cuda() 在源不是 pinned 内存时,会先隐式做一次同步 H2D,执行线程得等在那里;而 pinned 内存允许 true async。所以这里刻意绕道 _to_int32_tensor(内部用 maybe_pin_memory)。
步骤六:位置与 batch 索引
batch_indices, positions = flashinfer.get_batch_indices_positions( self.kv_indptr, position_kv_lens, self.num_tokens)这两个数组是 FlashInfer 的 append 内核要的:新算出的 K/V 要写进分页池,需要知道”第 i 个新 token 属于哪条序列(batch_index)""它在该序列里是第几个位置(position)“。因为新 token 在批里是紧凑排列的,而它们在各自序列里的位置是跳着的,这个”从紧凑索引到逻辑位置”的映射必须显式算出来。
步骤七:plan 的重新规划
# Re-plan MLA wrappers outside of forward/capture using the params# cached by prior warmup forwards.self._mla_ragged_planned = Falseself._mla_context_planned = Falseself._mla_decode_planned = Falseif (self.num_contexts > 0 and self._mla_ragged_plan_params is not None and self._ragged_prefill_wrapper is not None): ragged_indptr = self.qo_indptr[:self.num_contexts + 1] self._do_plan_ragged(ragged_indptr, ragged_indptr, self._mla_ragged_plan_params)FlashInfer 的 wrapper 有一个”plan”阶段(选内核、算 tile 划分),它本身可能触发同步或设备操作。在 prepare() 里做(图捕获之前),而不是在前向体里做——因为前向体被捕获进 CUDA Graph 之后,任何不该固定的东西都会被冻进图里。这段代码的三次 _do_plan_* 分别对应 ragged prefill、MLA context、MLA decode 三种 wrapper。
步骤八:VSWA 的多池索引切换
if self._vswa_layer_to_pool is not None: unique_pools = set(self._vswa_layer_to_pool.values()) ... for pool_id in unique_pools: if pool_id == primary_pool_id: continue rep_layer = self._vswa_pool_to_rep_layer[pool_id] pool_indices = self.kv_cache_manager.get_batch_cache_indices_flat( self.request_ids, self.num_blocks, layer_idx=rep_layer) ... buf = getattr(self, f'_vswa_pool_buf_{pool_id}') buf[:pool_indices.size(0)].copy_(pool_indices, non_blocking=True)可变滑动窗口(VSWA)时,不同层用不同窗口,也就落在不同的块池里。每层要用属于自己池的那份块索引,所以 prepare() 为每个池各准备一份索引张量,存在 _vswa_pool_indices_cache 里;前向时每层按 layer_to_pool 映射去取对应那份,并把它拷回 _paged_kv_indices(forward_impl 里的 copy_(),代码注释说明这是为了 device-to-device 且可被 CUDA Graph 捕获)。
步骤九:自检
self._debug_validate_page_table(kv_lens_host, logical_num_blocks, num_blocks)把”逻辑块数""页表块数""真实 KV 长度”三者交叉核对一遍。这类自检默认只报有限次数:
_page_table_check_budget = _PAGE_TABLE_CHECK_REPORTS...if cls._page_table_check_budget <= 0:用一个类级别的预算计数器,报告若干次后就不再报告,避免在长期运行的服务里把日志刷爆。这是个很务实的细节:调试信息的价值随时间衰减,但成本(字符串拼接、D2H 取值)是持续的。
三条路径之三:TrtllmAttentionMetadata——块偏移的四维张量
TRT-LLM 原生后端走的是完全不同的路。它不构造三件套,而是填那张第 2 节讲过的四维块偏移张量 [num_pools, max_batch, 2, max_blocks_per_seq]。
prepare() 的骨架(省去 helix、FP4 等分支):
def prepare(self) -> None: super().prepare() self._invalidate_mla_scheduler_buffers() ... prompt_lens = torch.as_tensor(self.prompt_lens, dtype=torch.int, device='cpu') self.prompt_lens_cpu[:self.num_seqs].copy_(prompt_lens) self.prompt_lens_cuda[:self.num_seqs].copy_( self.prompt_lens_cpu[:self.num_seqs], non_blocking=True)
cached_token_lens = torch.tensor( self.kv_cache_params.num_cached_tokens_per_seq, dtype=torch.int, device='cpu' ) if self.kv_cache_params.use_cache else None ... kv_lens = cached_token_lens + self.seq_lens_kv if cached_token_lens is not None else self.seq_lens_kv
# self.kv_lens is the valid kv cache length, while the self.kv_lens_cuda is # the sequence length including the cached tokens and the input tokens. self.kv_lens[:self.num_seqs].copy_(kv_lens + self.kv_cache_params.num_extra_kv_tokens) self.kv_lens_cuda[:self.num_seqs].copy_(maybe_pin_memory(kv_lens[:self.num_seqs]), non_blocking=True) ... self.host_total_kv_lens[0] = kv_lens[:self.num_contexts].sum().item() self.host_total_kv_lens[1] = kv_lens[self.num_contexts:self.num_seqs].sum().item() self.host_request_types[:self.num_contexts].fill_(0) self.host_request_types[self.num_contexts:self.num_seqs].fill_(1)几个要点:
kv_lens 与 kv_lens_cuda 的分工。 注释写得很明确:前者是”有效的 KV 缓存长度”,后者是”包含缓存 token 与输入 token 的序列长度”。区别就是那个 num_extra_kv_tokens——投机解码时,草稿 token 要写进 KV 缓存,但它们还不算”有效历史”(可能被拒绝)。所以设备侧看到的长度包含了草稿(内核需要知道写到哪),而”有效长度”要单独给出去。这正是 FlashInfer 那边”逻辑块数 vs 页表块数”的同一问题的另一种解法。
host_total_kv_lens 分两段累加。 [0] 是 context 段的总 KV token 数,[1] 是 generation 段。这个分段统计后面会被内核用来判定”这次前向是纯预填充、纯解码,还是混合”,也用于 FMHA 的 workspace 大小计算。
host_request_types 用 fill_ 分段写。 和 FlashInfer 那边一样,这是一个 per-sequence 的 0/1 标记数组,而这里是它唯一被正确填充的地方——这就是为什么 prepare_encoder_only 必须自己补一个 fill_(0)。
接下来是最关键的一段:向 manager 要块偏移。
if self.kv_cache_manager is not None: max_kv_len = int(self.kv_lens[:self.num_seqs].max()) assert max_kv_len <= self.kv_cache_manager.max_seq_len, (...) spec_active = (self.draft_kv_cache_manager is not None or self.is_spec_decoding_enabled or bool(self.kv_cache_params.num_extra_kv_tokens) or (self.runtime_features is not None and self.runtime_features.has_speculative_draft_tokens)) max_blocks = None if not spec_active and self.kv_cache_manager.tokens_per_block: max_blocks = ceil_div(max_kv_len, self.kv_cache_manager.tokens_per_block) self.kv_cache_manager.copy_batch_block_offsets( self.kv_cache_block_offsets, self.request_ids, self.beam_width, self.num_contexts, self.num_seqs, max_blocks=max_blocks)这里有一个必须讲透的宽度决策,它的注释解释得很完整:
# On the non-speculative path the host kv_lens snapshot bounds# every block-table access, so the staged/H2D width can be capped# at the batch's maximum instead of max_seq_len's worth of# columns. Speculative decoding must stage the full width:# draft/tree sub-steps and the overlap scheduler advance# kv_lens_cuda on device past the host snapshot, and their# kernels dereference block columns a host-derived cap would# leave unstaged (uninitialized in this buffer).拆开说。非投机路径上,主机侧的 kv_lens 快照能约束所有块表访问——因为内核用的每个块索引都来自这个快照算出的长度,快照之外的列永远不会被读到。所以拷贝宽度可以裁到”本批的最大块数”(max_blocks),而不是”max_seq_len 对应的完整宽度”。当 max_seq_len 是 32K、tokens_per_block 是 64 时,完整宽度是 512 列;而实际批里最长序列如果只有 2K token,只需 32 列。从 512 列裁到 32 列,H2D 拷贝量降 16 倍。 在一个每步都要搬这张表的服务里,这是实打实的收益。
投机解码路径上不能裁。为什么?注释给了两个原因:
- 草稿/树子步骤会在设备上推进
kv_lens_cuda,越过主机快照记录的值。 - 重叠调度也会在设备侧推进它(CPU 提前一步准备下一批,设备侧的长度已经走到前面去了)。
这两条路都让”内核实际访问的块列”超出”主机快照能界定的范围”。如果按主机派生的宽度裁剪,超出部分的列在缓冲区里是未初始化的——内核解引用到它们,读到的是垃圾块编号,然后去访存一个不存在的块。所以投机路径必须搬完整宽度。
这是一个 “优化必须知道自己的前提条件” 的教科书例子。max_blocks 这个裁剪只在”主机快照是权威”时成立;一旦有另一条路径能在设备侧独立推进状态,前提就破了。代码没有选择”把裁剪做得更聪明”(比如按设备侧可能的最大值裁),而是直接退化成不裁——因为正确性优先于这点带宽。
prepare_flash_mla:块表怎么喂给 FlashMLA
启用 FlashMLA(DeepSeek 系 MLA 模型的高性能解码内核)时,块偏移还不够,要另外准备块 id 表:
def prepare_flash_mla(self) -> None: self._flash_mla_metadata_valid = False # Request-specific fills and H2D copies must happen before replay, not # become fixed operations in the captured graph. if torch.cuda.is_current_stream_capturing(): return
block_ids_per_seq = maybe_pin_memory( self.kv_cache_manager.get_block_ids_per_seq(self.request_ids)) num_blocks = block_ids_per_seq.shape[1] self.kv_block_ids_per_seq.fill_(0) self.kv_block_ids_per_seq[:self.num_seqs, :num_blocks].copy_( block_ids_per_seq, non_blocking=True) self.block_ids_per_seq.fill_(0) self.block_ids_per_seq[:self.num_generations, :num_blocks].copy_( block_ids_per_seq[self.num_contexts:], non_blocking=True)get_block_ids_per_seq 是二维表版本:
def get_block_ids_per_seq(self, request_ids: List[int]) -> torch.Tensor: block_ids_per_seq = self.get_batch_cache_indices(request_ids) block_ids_per_seq_tensors = [ torch.tensor(sublist, dtype=torch.int) for sublist in block_ids_per_seq ] padded_tensor = torch.nn.utils.rnn.pad_sequence( block_ids_per_seq_tensors, batch_first=True, padding_value=0) return padded_tensor注意 padding_value=0——短的那些行用块编号 0 填充。所以块编号 0 必须是”可以安全读到”的(通常是一个永远预留的空块),否则被 padding 的行会让内核访存到脏数据。这是一个隐含的全局约定:编号 0 的块是”垃圾但合法”的哨兵块。
这个实现里有三处值得记的设计:
其一,if torch.cuda.is_current_stream_capturing(): return。 这是整个文件里最直白的一行防御:如果当前正在捕获 CUDA Graph,就不要做这些带 H2D 的准备工作。 原因写在注释里——“请求相关的填充和 H2D 拷贝必须发生在重放之前,不能变成捕获进图里的固定操作”。如果被捕获,那么图里就固定了”拷贝某一次特定批次的块表”这个动作,重放时永远拷同一份数据,后面的批次全用错表。
其二,fill_(0) 再 copy_ 的固定套路。 先清零整个缓冲区,再覆写前 num_blocks 列。清零是为了让”本步没用到的列”保持哨兵值 0——如果不清零,那些列里留着上一步的块编号,而内核在某些分支下可能访问到它们(比如 padding 行),就会读到上一批的块。
其三,两份块表 + 精确的行切片。
self.kv_block_ids_per_seq[:self.num_seqs, :num_blocks] # 全部序列self.block_ids_per_seq[:self.num_generations, :num_blocks] # 只解码序列kv_block_ids_per_seq 装全批(context + generation),block_ids_per_seq 只装 generation 段——用 block_ids_per_seq[self.num_contexts:] 切片,然后写进第 0 行开始的位置。为什么?因为MLA 的注意力计算只发生在解码序列上(预填充的 attention 走另一条路径)。让块表的第 0 行对应第一条解码请求,可以让内核直接按 generation 索引,不必再做 - num_contexts 的偏移修正。把偏移藏在准备阶段,而不是让内核每层都算一次——这是在多层的模型里能省下可观指令数的选择。
把三条路径并排放在一起
现在可以把同一份 AttentionMetadata 在三种后端里的”翻译结果”摆在一张表里:
| 维度 | VanillaAttentionMetadata | FlashInferAttentionMetadata | TrtllmAttentionMetadata |
|---|---|---|---|
| 块表形态 | List[List[int]](Python 嵌套列表) | paged_kv_indices(扁平 int32 设备张量) | kv_cache_block_offsets(4 维 int32 张量 [pools, batch, 2, blocks]) |
| 序列边界 | 无(逐请求处理) | paged_kv_indptr(batch+1) | 隐式(每行一条序列) |
| 尾块有效长度 | 无(靠 gather 长度) | paged_kv_last_page_len | 无(靠 kv_lens 逐行给出) |
| KV 布局 | 强制 NHD | 两者皆可,kv_layout 指定 | 两者皆可,kv_layout 指定 |
| 设备张量数量 | 0 | ~10(indices/indptr/last_page_len/qo_indptr/batch_indices/positions…) | 3–4(kv_lens、kv_lens_cuda、block_offsets、块 id 表) |
| 是否上设备 | 否 | 是(H2D 异步) | 是(H2D 异步) |
| 消费方式 | gather 成连续张量后走普通注意力 | FlashInfer paged 内核直接吃三件套 | FMHA/XQA 内核直接吃块偏移 |
| 适用场景 | 小 batch、短序列、稀疏承载、数值基准 | 混合批、长上下文、需要 varlen 内核 | 稳态解码、整图重放、极致 CPU 开销 |
读这张表的正确方式是:它们不是”三代实现”,而是三种对同一个问题的不同取舍。
- Vanilla 赌的是”搬运量小”。把分页 KV gather 成连续块,让后续变得极其简单(普通注意力、无页表、无 indptr)。代价是搬运本身。序列短时搬运量小,它就赢。
- FlashInfer 赌的是”稀疏的块表最省带宽”。ragged 三件套没有空洞,混合批下比二维表省一个数量级,而且 indptr 天然是 varlen 内核的输入格式。代价是张量多、构造步骤多(
prepare()里九个步骤)。 - TRT-LLM 原生赌的是”稳态解码下 CPU 开销趋近于零”。块偏移是一张定宽四维表,宽度可以按批裁剪,格式固定因而能被 CUDA Graph 整图重放。代价是形状必须分桶、混合批不能配图,灵活性最差。
三者共享同一份契约,共享同一份 KV 账本,差别只在”最后一次翻译”的形状。
稀疏注意力如何在同一契约下插入
TensorRT-LLM 的稀疏注意力不是”另一套元数据”,而是在同一份契约上挂载。文档里对这件事的分工描述得很清楚:
- An algorithm selects tokens or blocks, or decides which kernel tiles can be skipped.
- An attention implementation consumes that sparse pattern and computes the output.
“选谁”和”算谁”被明确拆成两件事。 文档还强调这个区分对支持范围很重要:“一个能算稀疏 MQA/GQA 的内核,本身并不定义模型怎么选 token,因此它不构成一个面向用户的独立算法。“这句话是对”内核能力 ≠ 算法”的清晰划界。
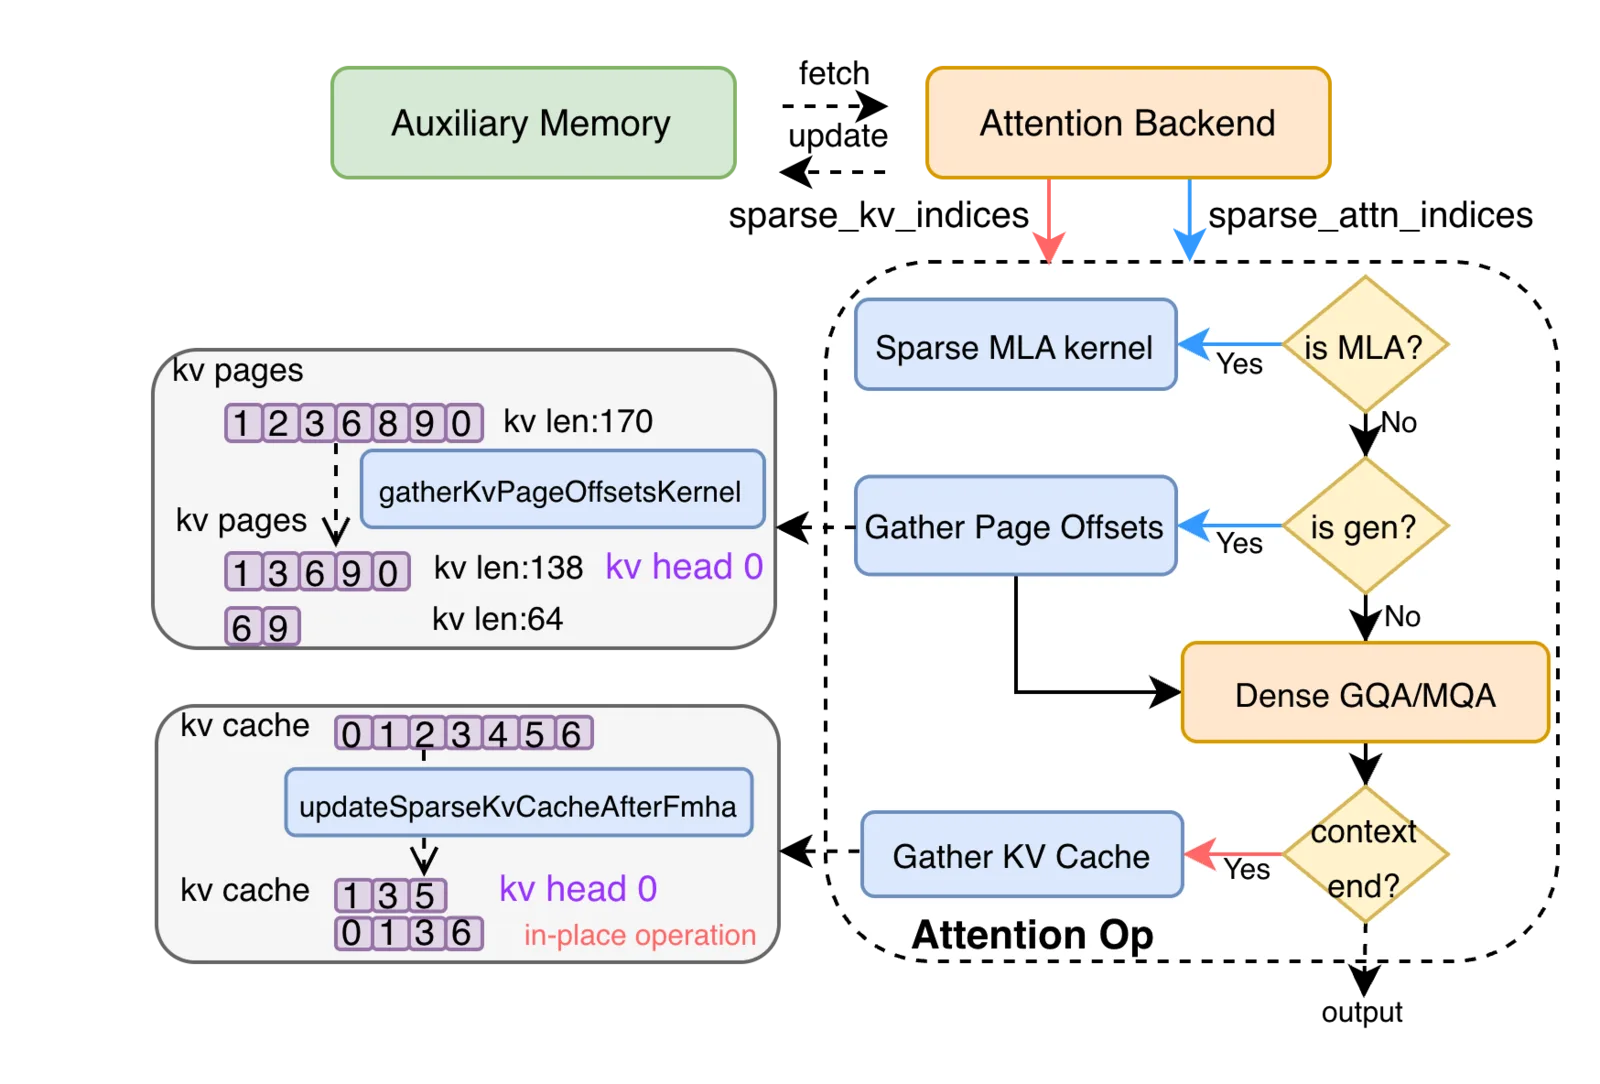
上图是 TensorRT-LLM 官方文档给出的稀疏注意力算子框架示意:上半部分是”选择”(哪些 token / 块 / tile 要算),下半部分是”消费”(内核如何按这份选择结果计算输出)。图中体现的正是本篇强调的那条边界——索引数组是两侧之间的唯一接口。图片来源:TensorRT-LLM 官方文档 media/sparse_attention_op.png。
在代码里,这个挂载点是 AttentionMetadata 里的两个字段:
# Sparse settings for metadata allocation/update; dense metadata leaves it None.sparse_metadata_params: Optional[SparseMetadataParams] = None...sparse_runtime_params: SparseRuntimeParams = field(default_factory=SparseRuntimeParams)SparseRuntimeParams 承载每次注意力调用要消费的运行时状态:
# Sparse index inputs shared by multiple algorithms.sparse_kv_indices: Optional[torch.Tensor] = Nonesparse_kv_offsets: Optional[torch.Tensor] = Nonesparse_attn_indices: Optional[torch.Tensor] = None# Per-query offsets, or backend-specific secondary sparse indices# (DeepSeek-V4 fp8_ds_mla compressed-pool indices).sparse_attn_offsets: Optional[torch.Tensor] = Nonesparse_attn_indices_block_size: int = 0sparse_attn_kv_lens: Optional[torch.Tensor] = Noneaux_kv_cache_pool_ptr: Optional[int] = None注意 sparse_kv_indices 与 sparse_attn_indices 是两个不同的索引数组,名字的区别揭示了稀疏注意力的两层结构:
sparse_kv_indices是”KV 侧的稀疏索引”——哪些 KV 块/位置被选中。它的长度取决于选中了多少。sparse_attn_indices是”query 侧的稀疏索引”——哪些 query 要走稀疏路径。长度是 query 数。
两者通过 sparse_attn_offsets(per-query 偏移)关联起来。设某条 query 选中了 k 个 KV,那么它在 sparse_kv_indices 里的片段由 sparse_attn_offsets 界定——这又是一种 ragged 结构,和 FlashInfer 的 indptr 是同一种想法:用 offset 数组把扁平数组切成变长的段。
还有一个值得注意的字段:
aux_kv_cache_pool_ptr: Optional[int] = None这是一个裸指针(Python int 形式的地址)。 它的用途是让稀疏算法访问”辅助 KV 池”——比如 DSA 的场景下,主池存的是完整的 MLA latent,而索引器(indexer)另有一份专门给打分用的、量化过的 KV 副本(文档里叫 KT cache)。两份池布局不同、由不同的 manager 管理,于是稀疏路径需要同时持有两个池的地址。用裸指针传递是”绕过 PyTorch 张量系统、直接给内核用”的做法,因为它不需要被 autograd 或 dispatcher 处理。
六种稀疏算法与它们的粒度
文档列出的公开算法,按”选择粒度”排序很有启发:
algorithm | 稀疏机制 | 选择粒度 |
|---|---|---|
rocket | 预填充时驱逐 prompt KV,解码时做页级 Top-K | token 驱逐 + 页 |
dsa | 学习到的 token 级索引器 + 稀疏 MLA | token |
deepseek_v4 | 滑窗 + 4 倍压缩历史(稀疏选择)+ 128 倍压缩历史(稠密) | 压缩条目 |
csa2 | 滑窗 + 压缩历史,共享 KV/索引来源 | 压缩条目 |
minimax_m3 | 学习到的块选择 + 稀疏 GQA | 块 |
skip_softmax | 在 FMHA 内核内部动态跳过符合条件的 softmax 计算 | 内核 tile |
粒度从细到粗:token → 块 → 压缩条目 → 内核 tile。粒度越细,稀疏率可以越高,选择和索引的开销越大。token 级要维护一个 per-token 的打分与 Top-K,索引数组很长;块级(128 token 一格)的选择粒度换来的是索引数组短了 128 倍、内核更好向量化,代价是最小稀疏单位变大——即使一个块里只有一个重要 token,整块也不能丢。
而 skip_softmax 是另一类:它不选任何东西,而是在 FMHA 内核内部判断”这一块 tile 的 softmax 贡献是否可忽略”,可忽略就整块跳过计算。它的”选择”发生在最内层,连索引数组都不需要。这也解释了它为什么不需要 model-trained selector——它不依赖模型学出来的重要性,只依赖 softmax 本身的数值分布。
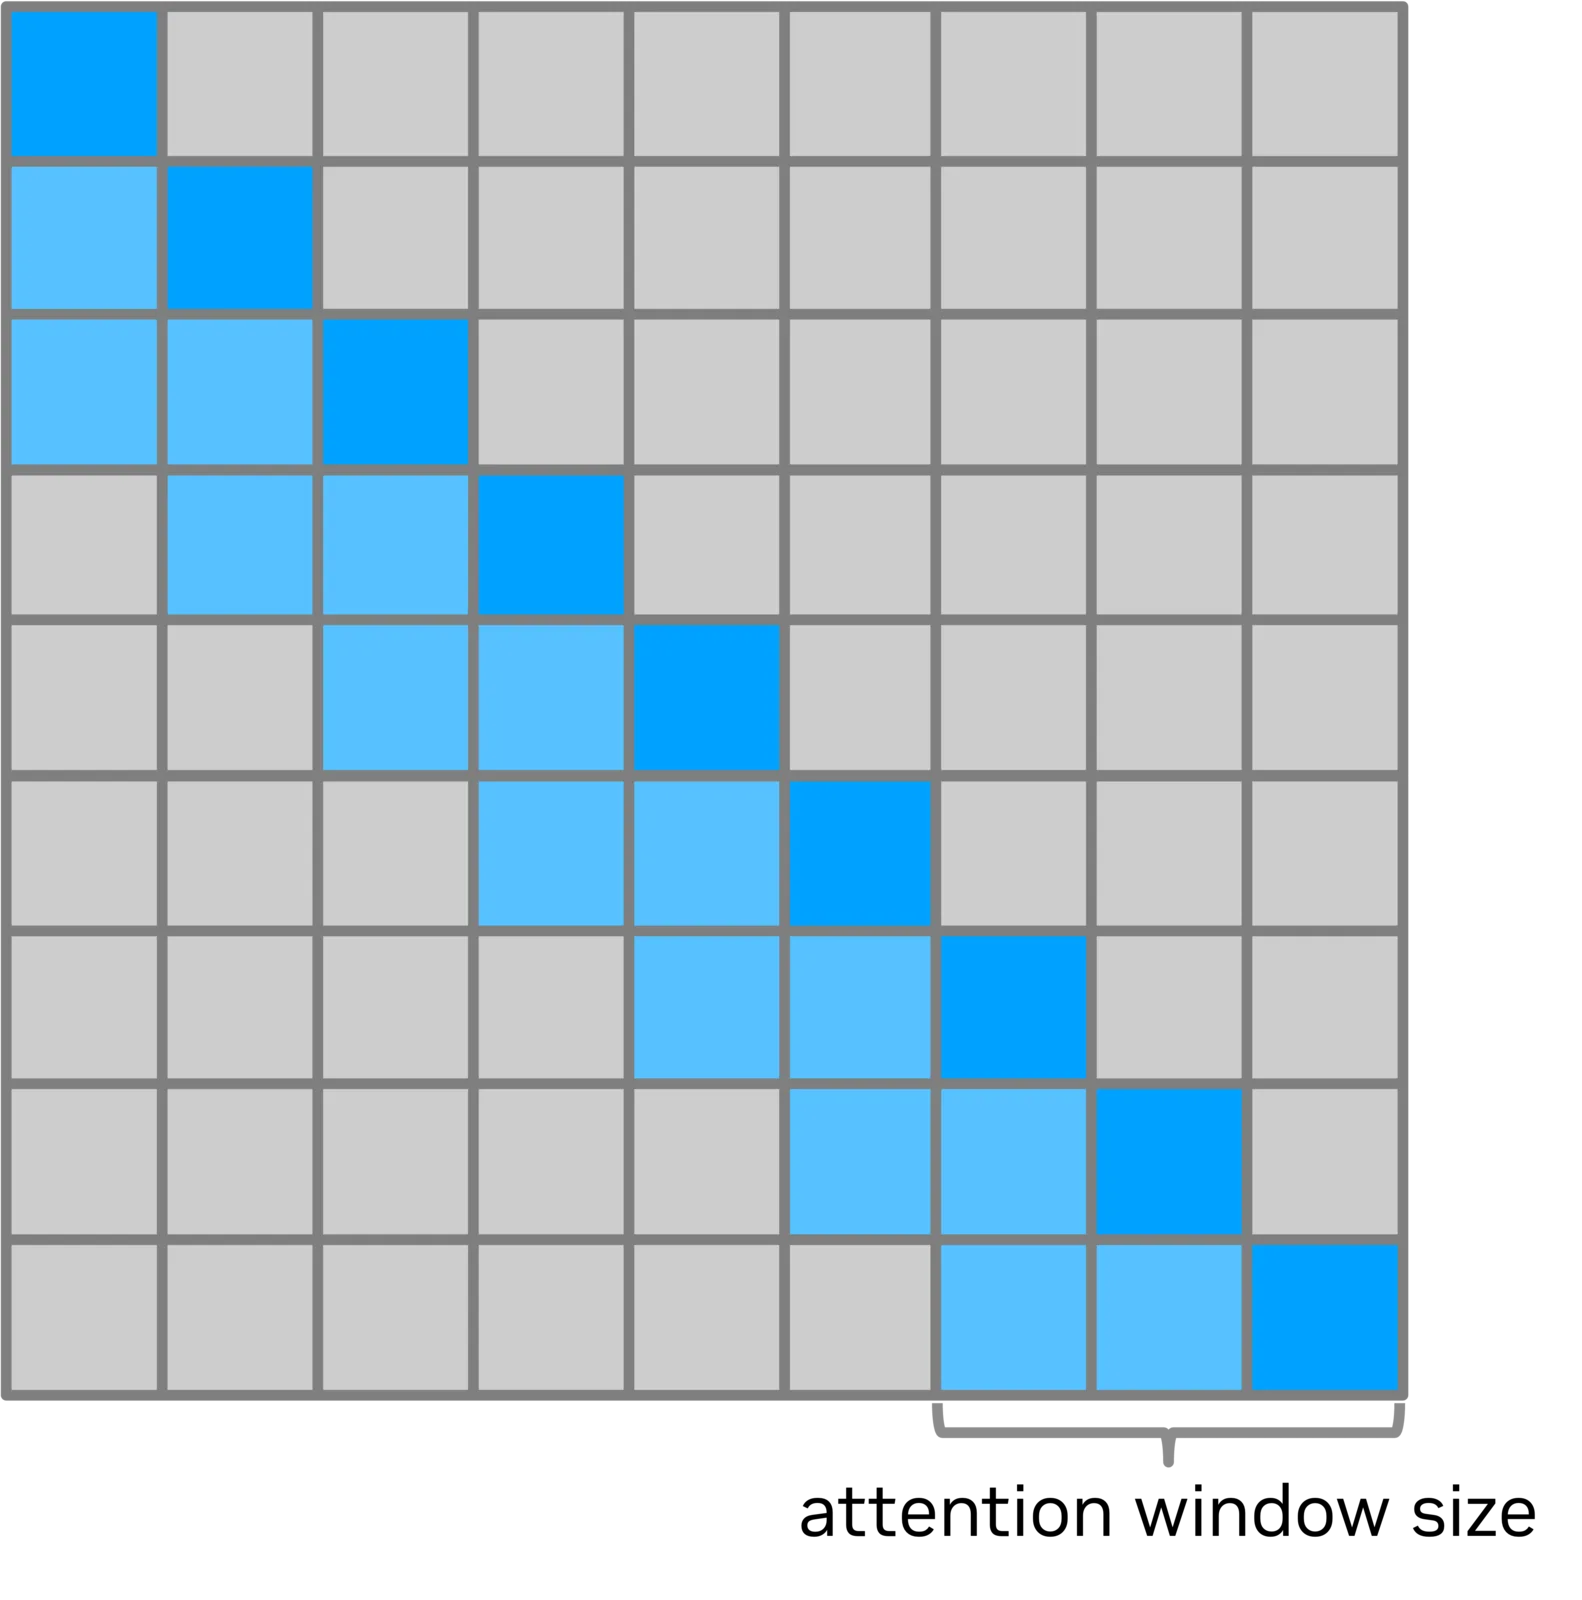
上图是 TensorRT-LLM 官方文档的滑动窗口注意力示意。deepseek_v4、csa2 这类算法的”滑窗分支”就是它:最近的 raw token 走稠密滑窗,更远的历史交给压缩后的稀疏/稠密分支。它对块表的要求与全注意力不同——窗口滑走后,早期块可能整块不再需要暴露在页表里,这也是第四篇讲的 VSWA 会按窗口大小分池的原因。图片来源:TensorRT-LLM 官方文档 media/feat_long_seq_sliding_win_attn.png。
GVR:Top-K 的三级替换路径
DSA 的文档里还提到一个值得注意的实现细节:
On supported Blackwell configurations, Guess-Verify-Refine (GVR) can replace the regular decode Top-K dispatcher. The current implementation accepts
index_topkvalues512,1024, and2048, and indexer compression ratios1and4. Unsupported combinations fall back to the production insertion/radix Top-K path.
这段对应 sparse/params.py 里的一个函数:
def use_self_sampling_gvr(*, enable_heuristic_topk, use_self_sampling_topk, index_topk, compress_ratio, is_cute_dsl_available, sm_version) -> bool: """Return whether the two-level dispatch picks the self-sampling engine.
Shared by the indexer (per-layer TopK construction) and the attention metadata (prior-state allocation and warmup) so both sides of the dispatch agree.""" return (enable_heuristic_topk and use_self_sampling_topk and is_cute_dsl_available and sm_version in (100, 103) and index_topk in (512, 1024, 2048) and compress_ratio in (1, 4))这个函数的存在意义比它的逻辑更重要。注释说明它”被索引器与注意力元数据共享,让 dispatch 的两侧达成一致”。
这是个很容易踩的坑:索引器要在每层构造 Top-K,需要知道走哪条路径;注意力元数据要做”prior-state 分配与 warmup”,也需要知道走哪条路径(因为两条路径需要的辅助缓冲不同)。如果两侧各自实现一遍判定条件,那么一旦条件写得不一样(比如一边漏了 sm_version 判断),就会出现”索引器按 GVR 路径构造了索引,而元数据按常规路径分配了缓冲”——缓冲大小对不上,直接越界。
所以作者把判定抽成一个函数,两侧调用同一个。“让两侧独立推导出同一结论”是这个代码库里反复出现的模式——第十八篇讲弹性 EP 时,joiner 与主部署各自算 join_effective_ep_size 然后核对,也是同一个思路。
注意 use_self_sampling_gvr 里还有一个隐藏的一致性风险,被显式点名了:sm_version(GPU 架构版本)与 is_cute_dsl_available(CuTe DSL 是否可用)都是环境相关的量。同一台机器上、同一个进程里它们不变,所以”两侧算出同一结论”是安全的;但如果把判定结果跨进程或跨实例共享(比如缓存到某个配置文件里),环境一变就会失效。这类”环境派生量”必须在使用点现算,不能缓存。
小结
这一篇补上了第五篇留下的口子:一份 AttentionMetadata 如何变成内核能读的一堆数组。把要点收拢:
- 契约三分类。
AttentionMetadata的字段分成三类:容量上限(max_num_requests等,构造时定终身不变)、本步形状(seq_lens、num_contexts,每步变)、KV 账本接口(kv_cache_manager+request_ids)。元数据不持有块表,只持”向谁要块表”的钥匙,因此永远不会与账本不一致。 - 两份副本与原地更新。
seq_lens分 CPU/设备两份,因为采样侧与内核侧都要设备值,只留一份就要每步 D2H 同步,破坏重叠调度。CUDA Graph 模式下设备那份必须copy_而非重新分配——图里写死了地址。 - 派生量在 setter 里算完。
_num_tokens、_num_ctx_tokens、_num_generations都在 setter 里预计算,因为在前向体里现算会产生 data-dependent shape,让torch.compile放弃编译。同步操作被藏在 CPU 空闲的调度阶段。 - 对象身份编码语义。
is_cross用seq_lens is not seq_lens_kv判定,意味着任何重新分配seq_lens都会破坏判定;AttentionMetadata的 CUDA Graph 约束也用is而非==。身份不会撒谎,值会。 - 块句柄到块偏移的翻译在
copy_batch_block_offsets。 目标张量[num_pools, max_batch, 2, max_blocks_per_seq]四维各有所指;context 段强制beam_width=1(还没分叉),cross 路径反过来把 generation 行按 beamrepeat_interleave。行数契约被写死成断言。 - 异步拷贝的源必须私有。 持久缓冲区不能直接当异步 H2D 的源,因为重叠调度会在拷贝执行前覆写下一次迭代的数据(nvbug 6293536)。修法是”持久缓冲给同步 CPU 读者 + 新 pinned 快照给异步 H2D”两份并存。
- 可寻址范围与有效范围必须分开表示。 FlashInfer 用
num_blocks(页表宽度,含预留页)与logical_num_blocks(真实历史)两个量;TRT-LLM 用kv_lens_cuda(含草稿)与kv_lens(有效)两个量。让一个数字兼任两重含义,迟早会在边界条件上出错。 - 宽度裁剪要知道自己的前提。
max_blocks裁剪只在”主机快照是权威”时成立;投机解码与重叠调度都能在设备侧独立推进长度,前提破了就必须搬完整宽度。正确性优先于带宽。 - 三条路径是三种取舍,不是三个代际。 Vanilla 赌搬运量小(短序列赢);FlashInfer 赌 ragged 布局最省带宽(混合批赢);TRT-LLM 原生赌定宽表能整图重放(稳态解码赢)。三者共享契约与账本,差别只在最后一次翻译的形状。
- 稀疏在同一契约上挂载。 “选谁”(算法)与”算谁”(内核)明确拆开,通过
sparse_metadata_params/sparse_runtime_params注入,默认None不影响稠密路径。粒度从 token 到内核 tile 共五档,粒度越细稀疏率越高但索引开销越大。GVR 判定被抽成共享函数,确保 dispatch 两侧算出同一结论。
回到第五篇那个”元数据契约”的比喻:契约声明的是有哪些字段、这些字段有什么保证;这一篇讲的是每种后端如何兑现这些保证。而契约里那些看起来过分严格的约束——地址必须稳定、对象身份必须不变、可寻址范围必须与有效范围分开——全部来自两个源头:CUDA Graph 记录的是地址,以及设备侧会有另一条路径独立推进状态。理解了这两条,TensorRT-LLM 注意力层里大多数”为什么这么写”的疑问都能自己回答。
下一篇将进入 KV Cache 的内存布局与量化存储:块池在显存里到底怎么排、NHD 与 HND 的 stride 差异如何影响内核访存、FP8 缓存的 scale 因子放在哪里、以及 MLA 的 latent 池为什么只有一份张量却能同时供 K 和 V 用。这一篇讲的所有索引数组——paged_kv_indices、kv_cache_block_offsets、kv_block_ids_per_seq——最终都要乘上 stride 才能变成地址,下一篇会把这层乘法的细节讲清楚。
参考资料
- TensorRT-LLM 官方仓库(NVIDIA/TensorRT-LLM)
- TensorRT-LLM 稀疏注意力官方文档:算法、内核契约与支持矩阵
- TensorRT-LLM
_torch/attention/backends/interface.py:AttentionMetadata 契约与 prepare 钩子 - TensorRT-LLM
_torch/attention/backends/trtllm.py:TrtllmAttentionMetadata 与块偏移准备 - TensorRT-LLM
_torch/attention/backends/flashinfer.py:page table 三件套与计划缓存 - TensorRT-LLM
_torch/attention/backends/vanilla.py:gather 式分页 KV 注意力 - TensorRT-LLM
_torch/attention/backends/sparse/params.py:稀疏参数类型与 GVR 共享判定 - TensorRT-LLM
_torch/pyexecutor/resource_manager.py:copy_batch_block_offsets 与块偏移暂存 - FlashInfer 官方文档:KV cache 布局与 page table 三件套
- PyTorch 官方文档:CUDA Graph 语义与捕获前置要求
- PyTorch 官方文档:torch.compile 与动态形状(dynamic shape / graph break)
- RocketKV: Accelerating Long-Context LLM Inference via Two-Stage KV Cache Compression
- FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving
- DeepSeek-V3.2 技术报告(DSA 稀疏注意力的出处)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



