


TensorRT-LLM 源码完全拆解(四):KVCacheManager 与块管理——两级池、块表构造与前缀复用树如何记物理账
前三篇把 TensorRT-LLM 的骨架搭完了:第一篇建立仓库地形与模块地图,确认了「TensorRT engine 后端已移除、PyTorch 后端接管推理」这一最重要的事实;第二篇沿 create_py_executor 走完装配线,看清了 PyExecutor 单步五动作与重叠执行;第三篇钻进调度器,把 CapacityScheduler 的准入算术、MicroBatchScheduler 的微批选择和 paused_requests 的暂停-重算语义逐行读完。
调度器篇结尾留下了一个明确的悬念:调度器所有的容量判断,价格标签都来自 KV Cache 的账本。resourceManager.get_max_resource_count() 报出的是块数、get_needed_resource_to_completion() 报出的也是块数、前缀感知调度的 beneficialToSkip 判据还是块数——但这本账是怎么记的,第三篇只讲到接口层。本篇把账本翻开:KVCacheManager 如何把显存切成一池一池的块、块的生命周期如何被引用计数与事件驱动、前缀复用树如何在不复制 KV 数据的前提下让两条请求共享同一份物理块、以及「逻辑块号 → 物理索引」的块表最终如何变成注意力内核能吃下的张量。
覆盖范围对应 C++ 侧 cpp/tensorrt_llm/batch_manager/kvCacheManager.{h,cpp}、blockKey.h、radixBlockTree.h、evictionPolicy.h、kvCacheEventManager.h,以及 Python 侧 tensorrt_llm/_torch/pyexecutor/resource_manager.py。这些文件加起来近万行,本篇按「结构 → 分配 → 复用 → 接口 → 块表 → 预算」的顺序推进,每个设计决策都回答「为什么这样做、替代方案是什么」。
账本的三层结构:Manager、BlockManager、WindowBlockManager
官方文档给出了 KV Cache 层次的第一层定义:块(Block)是分配的最小单位,只持有元数据,不持有数据本身;池(Pool)才是真正装 KV 数据的内存缓冲;池分为主池(primary,GPU 显存)与次池(secondary,通常是锁页的 host 内存)。源码里的实现再往下细分出三个类,职责边界非常清楚。
KVCacheManager(继承 BaseKVCacheManager)是对外的总账房。它维护 mSequences(请求 ID → GenerationRequest 的映射)、调用 mBlockManager 完成实际分配、对外提供 addSequenceBatch、storeContextBlocks、storeNewBlock、removeSequence、getCacheBlockIds、commitAndGetBlockHashesForRequest 等接口。调度器看到的 getNeededBlocksOneStep、getRemainingBlocksToCompletion 也挂在它身上。
BlockManager 是「按注意力窗口分仓」的管理者。它内部持有一个 std::map<SizeType32, WindowBlockManager>——每个不同的 attention window size 一个仓。这个设计直接来自 TensorRT-LLM 支持的两种复杂模型结构:
- VGQA(Variable Group-Query Attention):不同层有不同数量的 KV head;
- VSWA(Variable Sliding Window Attention):不同层有不同的注意力窗口大小。
窗口大小不同的层,历史长度上限不同,能装的 token 数也不同,如果塞进同一个池,出池的块该按谁的上限算?所以按窗口分仓:BlockManager 用窗口大小做键,每个仓(WindowBlockManager)内部再按 KV head 数量分池(对应 VGQA)。对于最常见的模型——所有层同一个 KV head 数、同一个窗口——整条链路只会创建一个仓、一个池,但代码路径仍按多仓多池写。
WindowBlockManager 是真正管块的人:它持有 mAllBlocksById(线性块号 → 块句柄)、mAllocatedBlocksPerSeq(请求 → 已分配块列表)、mFreeBlocks(空闲队列)、驱逐策略 mEvictionPolicy、传输管理器 mTransferManager、事件管理器 mEventManager,以及一个指向共享前缀树的指针。分配、复用、驱逐、换出、换入、块表偏移全部在这一层完成。
KVCacheManager 总账:请求生命周期、对外接口、预算估算 └── BlockManager 按 attention window size 分仓(VSWA) └── WindowBlockManager 每仓:多池(VGQA) + 块表 + 空闲队列 + 驱逐/传输/事件 ├── KVCacheBlockPool 真实内存缓冲(primary / secondary) └── KVCacheBlock 每块的元数据句柄有一个贯穿全篇的设计原则值得提前指出:元数据与数据分离。块句柄里的 mBlockId 是「线性号」,与具体池无关;mMemoryPoolBlockIndex 才是「这个块当前落在哪个池的第几个槽位」。两者分开的直接收益是换出/换入不需要动句柄——把主池的块搬到 host 内存,只需交换两个块的池索引(swapMemoryPoolBlockOffset),所有指向该句柄的请求、树节点、引用计数原地不动。这与 vLLM 里「前缀缓存块与物理块绑定」的写法不同,可参考站内 PagedAttention 完全拆解对比两种分页哲学的差异。
块句柄:KVCacheBlock 的每个字段都在解决一个问题
KVCacheBlock 是本篇第一个要逐字段读的结构。它继承 std::enable_shared_from_this,代码里到处用 BlockPtr(shared_ptr)传递——因为块会被多个请求、多个树节点同时引用,生命周期必须用引用计数管理,而不是所有权移动。
| 字段 | 类型 | 作用 | 为什么需要它 |
|---|---|---|---|
mBlockId | int32 | 池无关的线性块号 | 对外接口、事件、日志都用它寻址 |
mMemoryPoolBlockIndex | KVCacheIndex | 池内物理槽位(带池选择信息) | 块表构造的最终产物 |
mRefCount | int32 | 被多少个运行中请求引用 | 为 0 才允许复用或驱逐 |
mSchedulingRefCount | int32 | 本调度周期内被预定的次数 | 准入与提交之间的「占位」计数 |
mBlockKey | BlockKey | 该块代表的 token 前缀 | 前缀复用树按它做键 |
mLookupNode | LookupNodePtr | 在共享前缀树里的节点 | 支持从块反查树、链式回收 |
mWindowSize | int | 挂在节点的哪个 value 槽位 | 多仓共享一棵树的关键 |
mIsPlaceholder | bool | 占位块,无物理显存 | 线性注意力/Mamba 的状态块 |
mPrevBlockInSeq | BlockPtr | 物理分配顺序上的前一块 | 与树上的父块含义不同 |
mFreeBlockIterator | 迭代器 | 指向空闲队列中的位置 | O(1) 从队列摘除 |
mIsFull | bool | 块是否已写满 | 只有满块可以被多条请求共享 |
mPriority / mDurationMs / mExpirationTime | 优先级三元组 | 决定谁先被驱逐 | 支持「先缓存后淘汰」的保留策略 |
mHash | size_t | 事件系统用的稳定哈希 | 外部监控与缓存感知路由 |
几个细节值得展开。
为什么需要两个引用计数。 mRefCount 记录「有多少条运行中的请求正在用这个块算注意力」,mSchedulingRefCount 记录「本调度周期里有多少次分配预定」。第三篇讲过调度是「先预测、后提交」的两阶段:准入阶段探测需要多少块,提交阶段才真正分配。如果只有一个计数,探测阶段的占用会污染运行中的账;如果探测不记账,两个请求在同一步里可能都以为某个空闲块可用。两个计数把「已承诺」和「正在承诺」分开,hasRefs() 与 hasSchedulingRefs() 分别对应两种回收门槛。
mPrevBlockInSeq 与树上的 getPrevBlock() 是两条不同的链。 前者是物理分配顺序——按 token 顺序逐块分配的链,用于尾块回收(releaseLastBlock)这类顺序操作;后者是前缀树上的父块,通过 mLookupNode->getParentNode()->getValue(mWindowSize) 现场计算,用于复用匹配。同一块在两个坐标系里有不同的邻居,分开存是对的。
占位块(placeholder)。Mamba / 线性注意力层只在快照点保存循环状态,中间位置没有可缓存的 KV。为了让前缀链在树里保持完整,这些位置用 createPlaceholder 造出的「无显存块」占位:getCacheBlockIndex 返回空索引、驱逐池忽略它,但块号在请求的块列表里保留。SWA 场景还有一个专用哨兵块号 kPlaceholderBlockId(取 int32 最小值加一),用于把滑出窗口的块原地换成占位——注释里写明这个取值是为了「万一被意外归一化也能安全取负,且任何按 ID 查表都会明显越界失败,而不是悄悄命中别的块」。这种防御式设计在 GPU 系统的 C++ 代码里很常见:错误宁可爆炸,不要静默。
优先级三元组对应 KvCacheRetentionConfig。 用户在请求里可以声明:某些块的保留优先级是 HIGH、MEDIUM 还是 LOW,并附带生效时长(durationMs)或绝对过期时间(expirationTime)。驱逐策略据此决定牺牲谁——例如系统提示词对应的块优先级更高,长对话历史优先级更低。这是「按语义定制缓存经济学」的入口,后文驱逐策略一节还会回到它。
两级池与驱逐:一个空闲块从哪来,又去了哪
分配一个新块的入口是 WindowBlockManager::getFreeBlock。它的完整流程是「先向驱逐策略要块,再决定要不要把旧数据换出到次池,最后清理前缀树上的登记」。
BlockPtr WindowBlockManager::getFreeBlock(GenerationRequest& sequence, executor::RetentionPriority priority, std::optional<std::chrono::milliseconds> durationMs, executor::KvCacheTransferMode mode, std::string const& directory, bool wantPlaceholder){ std::lock_guard<std::recursive_mutex> lock(mLookupTree->getMutex()); // 1) 向驱逐策略要一个空闲的主池块 auto [block, canOffload] = mEvictionPolicy->getFreeBlock(kPrimaryLevel, wantPlaceholder); if (block->getUniqueTokens().empty()) { ++mAllocNewBlocks; } ++mAllocTotalBlocks;
// 2) 若块里有「状态」(曾装过 token)、策略允许换出、次池有空位 → 换出而不是销毁 if (!wantPlaceholder && !block->getUniqueTokens().empty() && canOffload && mEvictionPolicy->getNumFreeBlocks(kSecondaryLevel) > 0) { auto offloadBlock = std::get<0>(mEvictionPolicy->getFreeBlock(kSecondaryLevel)); mEvictionPolicy->claimBlock(block); // 先从主池队列认领 mEvictionPolicy->claimBlock(offloadBlock); // 再从次池队列认领 mTransferManager->offload(block, offloadBlock, mPools, 0, mode, directory); block->swapMemoryPoolBlockOffset(offloadBlock); // 交换池索引:数据在 host,句柄不变 // ... 事件:cacheLevelUpdated(primary -> secondary) mEvictionPolicy->releaseBlock(block); // 换出后的块归还次池队列 block = offloadBlock; // offloadBlock 成为新的主池块 }
// 3) 真正驱逐:只把「这一个块」从查找树摘掉,后代独立处置 { std::lock_guard<std::recursive_mutex> treeLock(mLookupTree->getMutex()); if (mEventManager && blockInRadixTree(block)) { mEventManager->enqueueRemovedEvent(block, mWindowSize); } block->detachFromLookupNode(); } mEvictionPolicy->claimBlock(block, priority, durationMs); return block;}这段代码里有三个决策点值得逐个展开。
决策一:要块之前先问「能不能换出」。 主池块被选中时,如果它携带历史 token(getUniqueTokens() 非空)、驱逐策略认为可以换出、次池还有空位,那么这块的 KV 数据先被拷到 host 内存里的某个次池块,然后两个块的池索引互换。对请求、树、引用计数而言什么都没发生——只有 mMemoryPoolBlockIndex 变了。这就是「元数据与数据分离」的兑现:换出零改动复用链。
代价写在传输上:mTransferManager->offload 是同步拷贝(后续版本有异步路径),拷贝耗时会体现在这一次分配里。官方文档对收益边界给了明确的说法:换出能显著延长 KV 状态的可复用时间,在 Grace-Hopper 这类 GPU-CPU 高带宽互联的机器上成本可忽略;在 x86 + Hopper 的组合上多数场景仍有净收益;更老的平台(PCIe 带宽相对更低)则未必划算。站内 KV Cache Offloading 完全拆解从系统角度讲过整个卸载栈的瓶颈归因,这里的次池只是那个栈在框架内的落点。
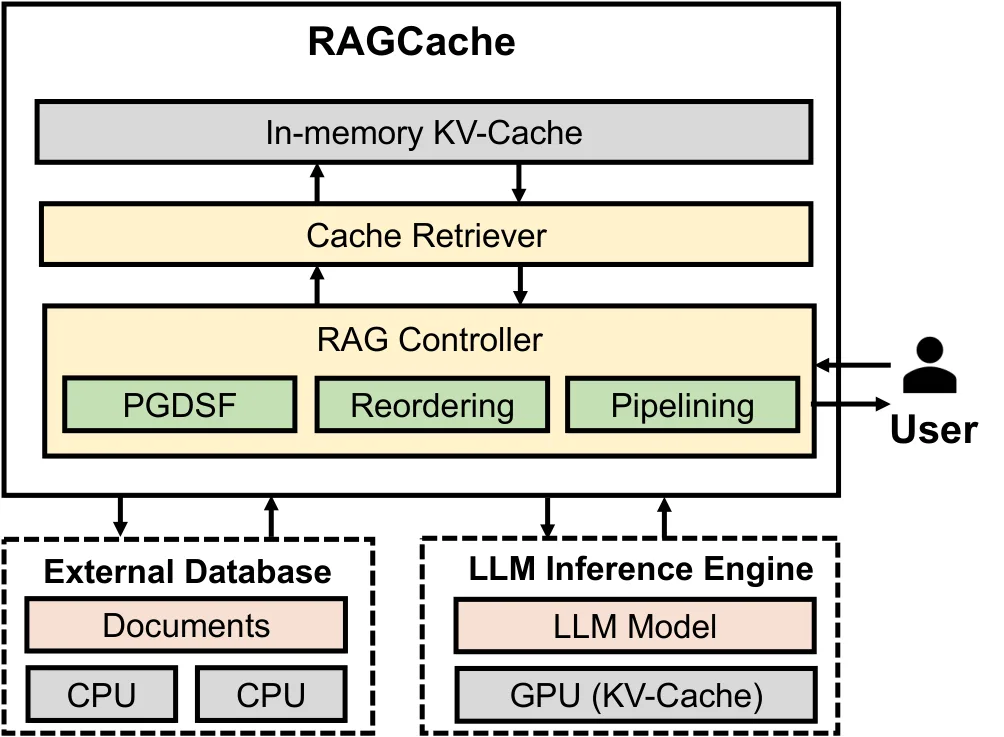
图:RAGCache 论文中的多级 KV 缓存层级(来源:arXiv:2404.12457)。TensorRT-LLM 的 primary/secondary 两级池对应其中「GPU/CPU」两级,TRT-LLM 在 KV 传输层还接 cache_transmission 模块通往远端,相当于图中第三级。
决策二:驱逐时只摘「这一个块」。 注释里记录了这里曾经的写法——freeChildren() 会把整棵子树都摘掉;现在的实现只摘当前块,后代留在树上按各自的优先级被独立驱逐。为什么改?因为旧写法下「高优先级的内层块会被低优先级的叶子后代拖累」:只要叶子被选中驱逐,父块连带出局。改动本身很小,语义差异很大:优先级从「子树属性」变成了「节点属性」,KvCacheRetentionConfig 里声明的优先级终于能精确到单块。
决策三:认领顺序先于交换。 换出路径里的两个 claimBlock 必须在 swapMemoryPoolBlockOffset 之前调用,源码注释解释了原因:claimBlock 内部按块当前的 getCacheLevel() 决定从哪个队列摘除。如果先交换再认领,就会从错误的队列里摘块、并扣错一级的空闲计数——这正是曾经导致 getNumFreeBlocks() 超过 getMaxNumBlocks()(预填充/分离式场景下的计数穿帮)的根因(GitHub #11879)。这类「顺序敏感的记账 bug」是资源管理系统里最典型的一类缺陷:单看每一行都对,错在行序。
驱逐策略:LRU 队列与两级队列的一致性
BaseEvictionPolicy 的接口只有五个:getFreeBlock(cacheLevel, wantPlaceholder)、claimBlock(block[, priority, durationMs])、releaseBlock(block[, toFront])、getNumFreeBlocks(cacheLevel)。主实现是 LRUEvictionPolicy,为每个缓存层级(primary/secondary)各维护一条空闲队列——注意队列里放的是「有空闲内存的块」,不是「空闲内存」,回收块就是把它归还到对应层级的队列。
优先级如何进入 LRU?claimBlock 的重载带 priority/durationMs 参数,块被认领时记录保留信息;releaseBlock 归还时把块放到队列的尾部(或按 toFront 放头部)。块被驱逐的先后因此由「队列位置 + 优先级 + 过期时间」共同决定,而 secondaryOffloadMinPriority 这个构造参数给出了一条明确的边界:优先级低于该阈值的块不值得换出——直接销毁,换个新块进来更划算。这个阈值把「换出的固定成本」与「复用概率」放在一起权衡,是工程上非常务实的折中。
队列的完整性有专门的自检:WindowBlockManager::verifyQueueIntegrity() 与 BlockManager::verifyQueueIntegrity()。在调试构建下,它会验证「块的 mFreeBlockIterator 指向的队列位置与块自身的状态一致」「队列里没有重复块」「认领过的块不在队列里」。资源管理器最怕的不是分配失败,而是账实不符——某个块既不在任何队列、也没被任何请求引用,就永远漏出了账本。自检函数就是「账实相符」的断言层。
换入:块回来了,数据在 host
换入路径是 onboardBlock(BlockManager::onboardBlock → WindowBlockManager::onboardBlock)。当一个被换出的块在前缀树上被匹配命中时,它需要先回到主池才能被请求使用:分配一个主池目标块、mTransferManager->onboard(source, target, ...) 把 host 数据拷回显存、交换池索引,最后发一条 cacheLevelUpdated(secondary -> primary) 事件。换入同样要成对地认领两个层级的块,syncTransferManagerWithBufferManager 负责让传输管理器与缓冲管理器对池的布局保持同一视图。
为什么换入是按需的而不是预取? 源码路径里换入只在「复用确实发生」时触发:前缀树匹配到块、且该块当前在次池。这样做的理由是预取需要预测「哪些前缀即将被用到」,而框架把预测责任交给了上层——调度器的前缀感知调度(第三篇的 beneficialToSkip)只是调整准入顺序(让可能命中的请求先进来),真正触发换入的是执行路径上的匹配。分离「调度排序」与「数据搬运」,各自复杂度都更低。
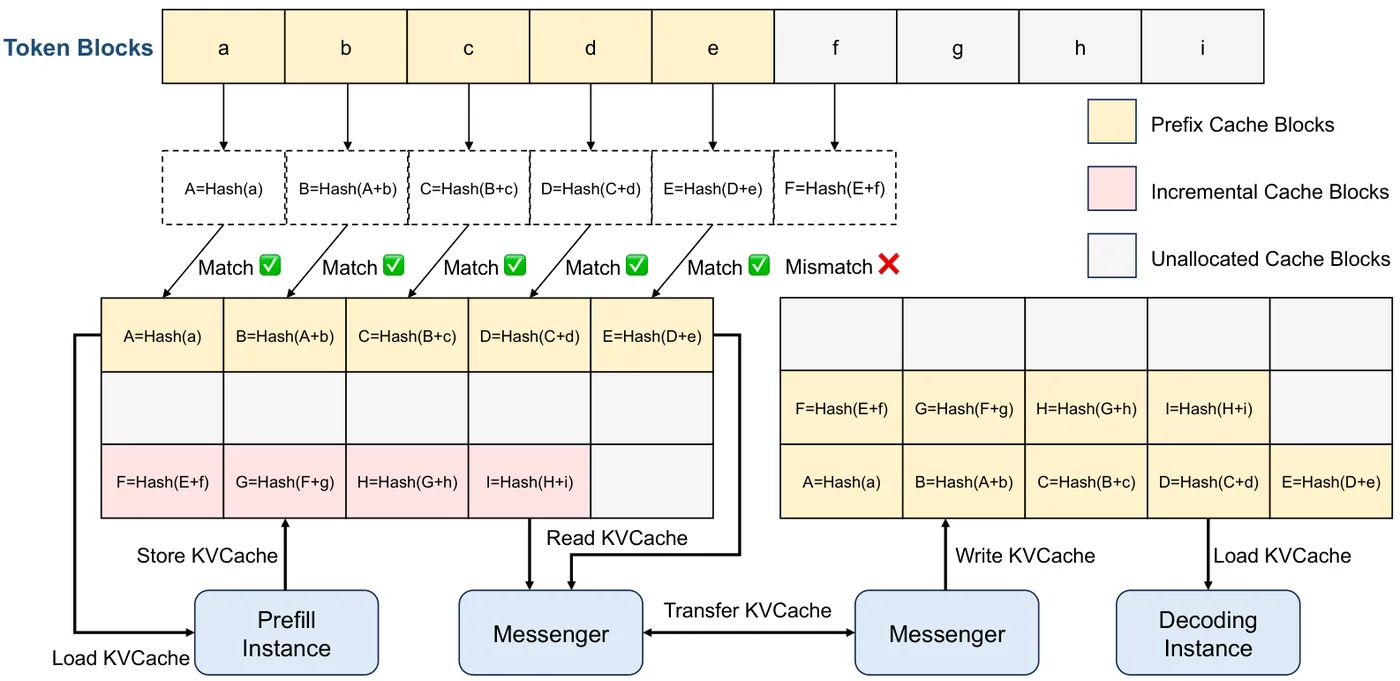
图:Mooncake 论文的以 KVCache 为中心的分离式架构(来源:arXiv:2407.00079)。TensorRT-LLM 的两级池是这套思想在单机框架内的最小实现,而跨实例的 KV 传输则由 cache_transmission 与 P/D 分离模块完成。
前缀复用:BlockKey 与一棵全仓共享的查找树
前缀复用的目标一句话说得清:两条请求若开头有相同的一串 token,第二条不该重算这段 KV。实现它要回答三个问题:拿什么做键?在哪查?命中之后块的所有权怎么处理?
键:BlockKey 比「一串 token ID」复杂得多
BlockKey 的字段揭示了「什么条件下两块 KV 可以互相顶替」:
struct BlockKey { bool usesExtraIds = false; std::optional<LoraTaskIdType> loraTaskId = std::nullopt; VecUniqueTokens uniqueTokens; // 去重后的 token 序列(含 extra id) std::vector<MmKey> extraKeys; // 多模态内容哈希 + 块内偏移 std::optional<std::string> cacheSalt = std::nullopt; // 缓存盐,隔离不同命名空间};uniqueTokens不是原始 token,而是UniqueToken{token, extraId}的序列。extra id 解决的正是p-tuning / prompt embedding 场景:不同请求可能带着相同的假 token ID(数值大于词表)却对应不同的 embedding 表。若只比 ID,两条用不同 embedding 的请求会错误复用彼此的 KV——这是正确性问题,不是性能问题,官方文档专门给了 extra id 的用法示例。loraTaskId:不同 LoRA adapter 的同一段文本,KV 完全不同(站内 SGLang 多 LoRA 服务一篇讲过适配器如何在批内共存),所以 LoRA 任务号必须进键。cacheSalt:多租户场景的命名空间隔离——同一段系统提示词,在租户 A 与租户 B 之间不应互相看见。盐值像密码学里的盐一样把哈希空间切开。extraKeys(多模态):图像等内容的哈希与块内偏移,同样是为了让「token 序列相同但图像不同」的请求不误命中。注意supportsPartialMatching()对多模态键直接返回 false——键里含内容哈希时,前缀截断没有意义,干脆禁用部分匹配。
numMatchingTokens 的实现是一个教科书式的「先比约束字段、再比 token」:
int BlockKey::numMatchingTokens(BlockKey const& other) const noexcept { SizeType32 numMatched{0}; if (usesExtraIds == other.usesExtraIds && loraTaskId == other.loraTaskId && extraKeys == other.extraKeys && cacheSalt == other.cacheSalt) { auto [matchEnd, otherMatchEnd] = std::mismatch( uniqueTokens.begin(), uniqueTokens.end(), other.uniqueTokens.begin(), other.uniqueTokens.end()); numMatched = std::distance(uniqueTokens.begin(), matchEnd); } return numMatched;}约束字段不一致时直接返回 0——「要么整体可比、要么不可比」,避免了「按 token 部分匹配但盐不同」这种半吊子状态。
树:一棵树服务所有窗口仓
查找结构是 UnifiedBlockTree,注释说得很直白:它是「统一树」,单实例服务所有 WindowBlockManager,通过把窗口大小当作 value key 实现。也就是说树上每个节点(对应一段 token 前缀)可以挂多个值:窗口 4096 的仓挂一个块、窗口 32768 的仓挂另一个块,互不干扰。
为什么合一棵树而不是每仓一棵?三个理由在源码注释与实现里都能读到:
- 前缀是同一段 token 序列,按 token 前缀建树是自然键;不同窗口仓对同一前缀各存各的块,只是值不同。
- 线性注意力仓(Mamba)用特殊的 value key:
kRecurrentStates = -1(见radixBlockTree.h)。负值刻意区别于所有合法窗口(>= 1),于是循环状态的快照块能和全注意力块共存于同一棵前缀链上——混合模型(如 Mamba + 全注意力层交错)的复用语义因此保持完整。 - 锁只有一把:
UnifiedBlockTree持有一个std::recursive_mutex,所有树操作(插入、lookup、detachFromLookupNode)都在其保护下。递归锁是刻意选择的:BlockManager::addSequenceBatch的两阶段认领本身持有树锁,而它调用的getFreeBlock/detachFromLookupNode也要拿锁——用普通互斥量会自锁死。
块的树侧接口把「双向布线」写得很清楚:attachToLookupNode(node, windowSize) 把块挂到节点的某个窗口槽位,若块原本挂在别处,会先清除旧槽位并向上级联剪枝;detachFromLookupNode() 反向操作,空节点由自底向上、遇到第一个非空祖先即停的剪枝逻辑回收。根块(mCachedBlocksRoot)通过 setAsRoot(rootNode, windowSize) 挂在根节点上,供直接子块的 getPrevBlock() 查到。
站内 RadixAttention 完全拆解与 SGLang RadixCache 内部讲过 SGLang 的前缀树实现,可以对照阅读:SGLang 的树节点直接持有 token 片段与锁引用;TensorRT-LLM 的树是「节点 + 多窗口槽位 + 块句柄」的三层结构,且键是带盐与多模态哈希的 BlockKey。两边的相似处在于都把「满块」定义为可共享单位,差别在于 TensorRT-LLM 把多租户、多模态、LoRA 这些隔离维度直接编进了键。
查:findReusableBlockMatches 的三道闸门
匹配入口是 WindowBlockManager::findReusableBlockMatches(blockKeys, enablePartialReuse, copyOnPartialReuse, maxMatchedTokens)。它沿树自根向下逐块走,每步都有闸门:
闸门一:token 预算。 candidateMatchedTokens + numMatchedTokens > maxMatchedTokens 就停止——调用方传来的上限是「本请求当前可复用的最大 token 数」(预算口径细节见后文)。为什么不匹配了再说?因为匹配结果影响准入判断,必须受限匹配。
闸门二:SWA 的安全前缀截断。 这是这段代码里最微妙的部分。滑窗注意力下,一个块即使前缀匹配上,也可能因为窗口已滑过而不再覆盖当前需要的 K/V。代码用 updateSafePrefix 与 latestMissingAnchorEndToken 跟踪「最后一个缺块的锚点」:
auto updateSafePrefix = [&]() { if (!mIsSWA || latestMissingAnchorEndToken == 0 || candidateMatchedTokens >= latestMissingAnchorEndToken + mWindowSize) { safeMatchCount = candidateMatches.size(); safeMatchedTokens = candidateMatchedTokens; }};含义是:只有当匹配跨度已经超过「缺失锚点 + 一个窗口」时,整段才算安全可复用;否则把匹配列表截断到上一个安全点(candidateMatches.resize(safeMatchCount))。直觉是:窗口大小为 W 的块只保证覆盖它自己往后 W 个位置;若中间有一段没有块(traversal-only 匹配,只沿树走但值槽为空),那么「缺失点到当前点」的距离必须至少有一个完整窗口,才有块真正覆盖当前需要的范围。
闸门三:部分匹配与写时复制。 若开启 enablePartialReuse,精确匹配失败后还会找 findPartiallyMatchingNodes——键是某已缓存块的前缀。部分命中时,块里只有前若干 token 有效,不能直接共享(后段数据属于另一条请求的上下文),于是要么复制(copyOnPartialReuse 为真),要么仅当块「无引用且是叶子」时才敢原地转用。两个开关的默认值与取舍在后文「工程取舍」里再展开。
匹配的输出是 ReuseMatchResult:匹配列表(每项含块指针、匹配 token 数、是否部分匹配、是否仅遍历即 traversal-only)、总匹配 token 数,以及 firstNewBlock——第一个没在树里找到的满块键。这个字段是给调度器用的:第三篇讲过 PrefixReuseSummary.firstNewBlock 决定「是否推迟这条请求」;此处正是它的产地。
认领:claimMatchingBlocks 的批内协调
匹配只是「找到」,认领(claim)才是「占住」。claimMatchingBlocks 要处理三个真实世界的麻烦:
麻烦一:beam search 的共享。 beam 宽度大于 1 时,同一请求的多条 beam 共享上下文块:isShareLastContextBlock = (mCacheType == kCROSS || inputLength % mTokensPerBlock == 0),据此计算 numSharedContextBlocks——共享的前缀块只认领一次,最后一块在 beam 之间按需分配。CacheType::kCROSS(编码器-解码器跨注意力)的 KV 一次分配、永不增长,所以它天然可全共享。
麻烦二:同批多请求抢同一个块。 一个微批里可能有五条请求都命中同一段系统提示词的前缀块。这些块是「空闲队列里的叶子块」,如果每条请求各复制一份,复用收益瞬间归零。源码用 PartialClaimTracker 做批内仲裁:
// 命中同一个叶子块的多个请求里,只有当「没有更强者」的请求才原地复用,// 其余的标记 needsCopy;若后续出现完整匹配,先前的复用承诺被降级为复制。if (tIt != tracker.map.end()) { if (tIt->second.fullyMatched) { claimed.needsCopy = true; } // 前者已完整匹配 → 我必须复制 else { // 前者只是打算复用 → 让它改复制,我复用 claimResults[tIt->second.requestIdx].claimedBlocks[tIt->second.claimedIdx].needsCopy = true; claimed.needsCopy = false; tIt->second.requestIdx = requestIdx; tIt->second.claimedIdx = result.claimedBlocks.size(); }} else { claimed.needsCopy = false; // 第一个部分匹配的请求 → 原地复用 tracker.map[blockId] = {requestIdx, result.claimedBlocks.size(), /*fullyMatched=*/false};}这段逻辑可以概括成一句话:「一个块只能有一个原地复用者,其余人复制」;部分匹配的复用者可以被后面出现的完整匹配者顶掉(完整匹配更强),复制者则要承担 shouldReleaseCopySource 的责任——若源块是被「无引用非叶」这类边缘状态借来的,最后一个拷贝者负责在复制完成后把它释放回账本。
麻烦三:认领即保护。 所有被匹配到的块立即 mEvictionPolicy->claimBlock(...)——从空闲队列摘除,防止驱逐策略在认领期间把它换出或销毁。这个「先占位再干活」的模式和内核里的 cp.async 预取一样:先预定资源,再执行操作,避免中间态被并发路径截胡。
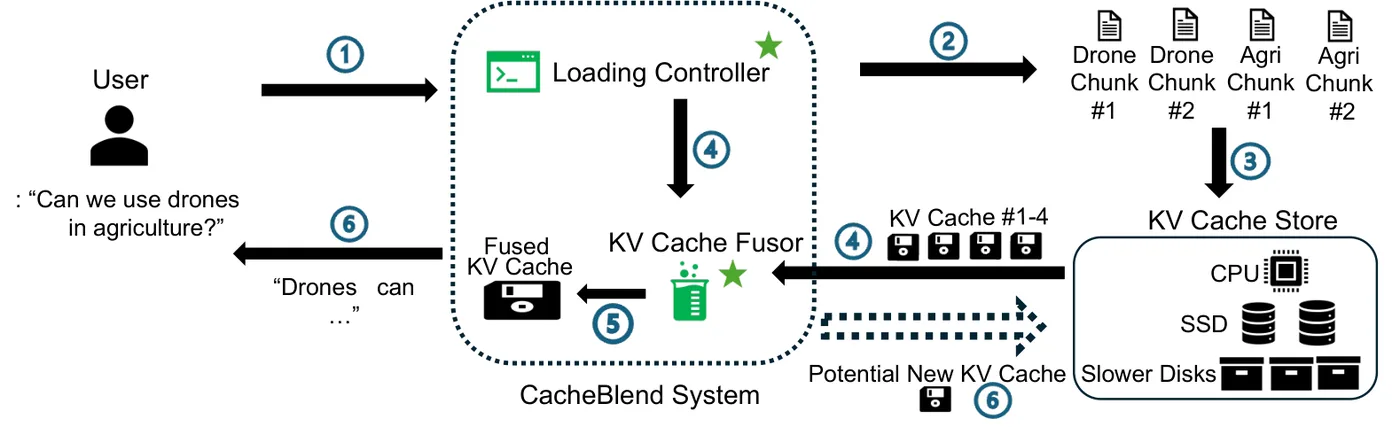
图:CacheBlend 给出的复用与选择性重算思路(来源:arXiv:2405.16444)。TensorRT-LLM 的复用建立在「严格前缀一致」之上(含盐、LoRA、多模态哈希的全部隔离维度),不涉及跨请求的近似复用;两条路线的精度-收益边界正好互为参照。
存货与回收:storeBlocks、releaseBlocks、releaseLastBlock
复用链的另一半是「把算好的块登记进树」。
storeBlocks(WindowBlockManager::storeBlocks) 在请求推进到满块边界时调用:取该块的BlockKey,把块挂到树上(attachToLookupNode),必要时置mIsFull = true,并把mPrevBlockInSeq链续上;返回(prepopulatedLen, blockIds)供上层记账。只有满块才允许跨请求共享,原因在官方文档里:块内最后一个 token 的 KV 在「它自己」被算出来之前不完整,未满块的复用会导致缺 token。storeBlocksForReuse/storeNewBlock是请求结束(或到达某个复用检查点)时对尾块的补登记:把最后一段已算 KV 的块也放进树,让后续请求可以少算这一段。注释口径与getNeededBlocksOneStep里那句「序列插入忽略最后一个 prompt token,因为它的 KV 无法恢复」呼应——最后一个 token 的 KV 永远不可复用,这是自回归结构决定的硬边界,不是实现懒省。releaseBlocks/releaseLastBlock/schedulingReleaseBlocks负责反向操作:请求结束时若块仍被引用则只减引用;引用归零时把块归还空闲队列(releaseBlock),树上的登记按块的新状态刷新——若是叶子且无引用,它留在树上等复用(这就是「已缓存但空闲」的块);若需要腾位则被驱逐时再摘树。
一个统计口径值得记住:KvCacheStats 里的 cacheHitRate = reusedBlocks / (reusedBlocks + missedBlocks),并且区分了 allocNewBlocks(从未承载过 token 的全新块)与 allocTotalBlocks。这条口径是「复用收益」的可观测来源,也是事件系统对外报数的分母。
与调度器的接口:三个钩子与一份共享的复用摘要
startScheduling / commit / schedulingRemoveSequence
KVCacheManager::startScheduling() 转发到每个仓的 startScheduling(),后者遍历空闲队列上每个块的 startScheduling()——把 mSchedulingRefCount 清零并重置调度期状态。这是「预测-提交」两阶段的分界点:调度器开始新一轮准入前,先把上一轮探测留下的临时占位全部清干净。
与之配套的是:
schedulingRemoveSequence(requestId):调度阶段的「移除序列」——不动树、不动引用,只释放调度期占位。第三篇讲过的MAX_UTILIZATION暂停-重试路径就走这条:先调度期移除,再决定是否重算。removeSequence(requestId):运行期的真正移除——返回「最后一个块的降级块号」std::optional<KVCacheBlock::IdType>,供上层更新输出缓冲的映射(KV 被重算后,最后一块可能被释放重建)。commitAndGetBlockHashesForRequest(llmRequest, windowSize):提交阶段。把本次分配涉及的块哈希化并返回给调用方(Python 侧对应commit_and_get_block_hashes),让事件系统与外部观测拿到「这条请求现在持有哪些块的哈希」。这条接口也是第三篇所说「先预测、后提交」的提交端——预测阶段无副作用,提交阶段才落账。
analyzePrefixReuse:一份摘要服务三个消费者
KVCacheManager::analyzePrefixReuse 转发到 BlockManager → WindowBlockManager,对指定 token 序列做只读的树遍历,产出 PrefixReuseSummary:
struct PrefixReuseSummary { SizeType32 reusableBlocksAllocated{0}; // 已被引用(refCount > 0)的前缀块数:块预算用 SizeType32 reusableBlocksAll{0}; // 树上有登记的前缀块总数(含空闲缓存块):token 预算用 std::optional<BlockKey> firstNewBlock{std::nullopt}; // 第一个未命中的满块键};三个字段对应三个消费者,第三篇已经讲过用法,这里补上「为什么分成两个计数」:
- 块预算(capacity / 分配侧)只认
reusableBlocksAllocated。注释解释得直白:一个「空闲但有缓存」的块被复用时,仍要从空闲池里借出一个块(它只是从「空闲缓存态」转为「被引用态」),所以不能把它当成「不需要池容量」;只有已被引用的块(多条请求共享)才真正减少空闲池需求。记账如果混用两者,会与驱逐策略的空闲计数双重计算,导致超额准入。 - token 预算(compute / 计算侧)认
reusableBlocksAll。因为无论块当前是什么状态,命中前缀都会让引擎通过prepopulatedPromptLen跳过这段重算——省的是算力,不是容量。 firstNewBlock供调度器的跳过检查判断「要不要推迟这条请求」;std::nullopt表示「满前缀全命中」或「还没有可探测的满块」。
预算侧还有一处极细的边界:maxRecoverableSharedBlocks = (promptInputLen - 1) / tokensPerBlock——减一是因为最后一个 prompt token 的 KV 不可恢复。当 prompt 恰好落在块边界上时,按全部 unique token 数去数可复用满块,会多认一个块;减一把这个 off-by-one 修掉。这类「差一」在分页系统里普遍存在(块内最后一个 token 的 KV 依赖前向计算),把它写进公式而不是靠调用方自觉,是源码值得学的地方。
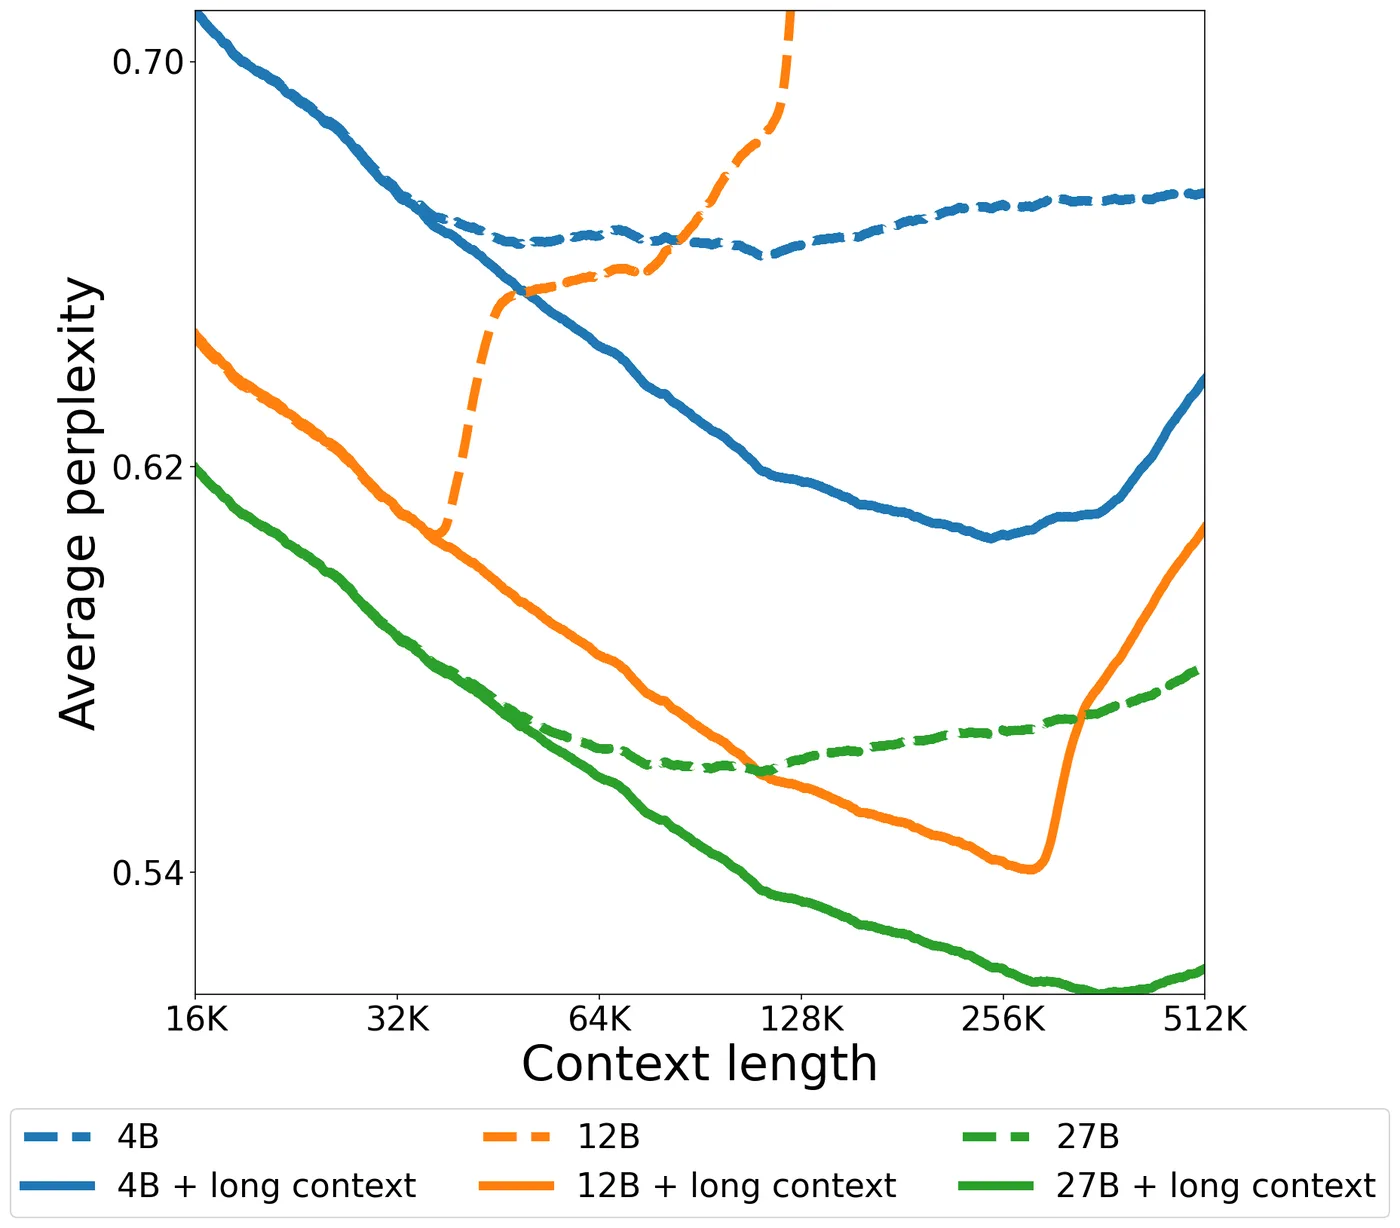
图:Gemma 3 技术报告给出的滑窗(local)与全注意力(global)层配比对质量的影响(来源:arXiv:2503.19786)。VSWA 模型里不同层窗口不同,正是 BlockManager 按窗口分仓、并让各仓在共享树上各占槽位的根本原因。
块表构造:从逻辑块号到内核能读的物理索引
账本记到最后要交付一个产物:注意力内核读得懂的地址表。Python 侧文档给出的接口形状是 get_batch_cache_indices(requests) -> Dict[List[int]](块 ID 列表)与 get_buffers(layer)(KV 池缓冲,形状 [num_blocks, 2, num_tokens_per_block, num_kv_heads, head_dim])。C++ 侧的翻译发生在 WindowBlockManager::setOffsets 与 KVCacheManager::copyBlockOffsets。
setOffsets:两级翻译与三种布局
void WindowBlockManager::setOffsets(tk::KVCacheIndex* offsetsPtr, tensorrt_llm::Dims const& offsetsShape, SizeType32 beamIdx, SizeType32 blockIdx, KVCacheBlock::IdType blockId) const{ auto const& block = getBlockById(blockId); bool const isSwaPlaceholder = blockId == KVCacheBlock::kPlaceholderBlockId; for (poolIdx...) { const auto& pool = mPools.at(poolIdx); for (auto const xIdx : {kIdx, vIdx}) { // K 与 V 各写一次 auto const offsetIndex = flat_index(offsetsShape.d, poolIdx, beamIdx, xIdx, blockIdx); auto const fieldIdx = (mCacheType == CacheType::kSELFKONLY || isRecurrentState()) ? 0 : xIdx; auto const blockIndex = [&]() -> tk::KVCacheIndex { if (isSwaPlaceholder || block->isPlaceholder()) { return tk::KVCacheIndex::nullIndex; } if (pool.layerFirstLayout) { // {numLayers, numBlocks, kvFactor, blockSize} return tk::KVCacheIndex{common::flat_index3( layerIdx, block->getMemoryPoolBlockIndex(), fieldIdx, mNumPrimaryBlocks, mKVFactor)}; } return tk::KVCacheIndex{common::flat_index3( block->getMemoryPoolBlockIndex(), layerIdx, fieldIdx, pool.numLayers, mKVFactor)}; }(); offsetsPtr[offsetIndex] = blockIndex; } }}逐行读下来的要点:
- 两级寻址。表里的条目不是「块号」,而是
KVCacheIndex——一个能把「池归属 + 池内槽位」编码进同一个整数的封装。内核拿到索引后,用高位选择池、低位寻址槽位;分离式部署时同一份索引结构还能跨实例解释。 - 三种布局。
layerFirstLayout决定池内维度序:层优布局是{numLayers, numBlocks, kvFactor, blockSize},块优布局是{numBlocks, numLayers, kvFactor, blockSize}。为什么两种都要?同一池被多层共享(同 KV head 配置的层放一个池),层优布局让「按层切图」的后端(如逐层执行的 CUDA Graph 捕获)拿到连续地址;块优布局让「按块寻址」的常规 FMHA 内核实现更直。这是一个纯性能取向的布局开关,不影响语义,值就藏在每一层对内核访存模式的实测里。 fieldIdx对kSELFKONLY恒为 0。自注意力-仅-K 的缓存只有 K 没有 V(或 V 与 K 同址),写表时只写一份。- 占位块写空索引。SWA 占位块与线性注意力占位块都映射到
nullIndex,内核读到它就知道「这块没有可见 KV」。
copyBlockOffsets:把表搬进张量
KVCacheManager::copyBlockOffsets(ITensor& output, SizeType32 outputSlotOffset, RequestIdType requestId) 把某请求的块列表逐块调用 setOffsets 写进设备张量的指定槽位;getBlockOffsetsOfBatch 遍历整批。getCacheBlockIds(requestId, windowSize) 则返回 vector<vector<vector<SizeType32>>>——per-beam 的块号列表再嵌套 per-pool,与 getBatchCacheBlockIds 一起构成「批-请求-beam-池」四维寻址。Python 侧对应 get_cache_indices,而 groupLayersByWindowSize 把层按窗口分组,保证每个仓只处理自己那些层的表项。
这里能看出这套设计与 vLLM 块表的异同:两者都是「逻辑位置→物理块」的翻译表,但 vLLM 的实现是单层映射(逻辑块号列表),TensorRT-LLM 的表同时携带池选择、层布局与 beam 维度——因为它的池结构本身就是多仓多池的。复杂度不是凭空来的,每一维都对应一个真实功能(VSWA / VGQA / beam search)。
跨 rank 一致性:账本不能各记各的
并行部署下每个 rank 都有自己的 KV 分片,但「总共能装多少块」必须一致——否则调度器在不同 rank 上会算出不同的准入结果,出现「rank 0 答应、rank 1 拒绝」的裂脑。两处保护:
synchronizeBlockCountsAcrossRanks:在calculateMaxNumBlocks末尾对每个窗口的块数做 allreduce(取最小值,见 Python 侧dist.allreduce(max_tokens, op=ReduceOp.MIN)),保证所有 rank 用同一套块数起步。isSortedVectorIdenticalAcrossAllRanks:检查各 rank 的窗口序列一致,不一致直接报错。
Python 侧的 calculate_max_num_blocks 还处理了一个工程细节:free_mem_fraction 默认 0.9,用户若同时设置了 max_tokens,取两者较小值并给出警告——「显存比例」与「token 上限」双配置的一致性由框架兜底,避免用户以为自己配的是上限、实际被另一个约束压掉。
容量估算:两个预算、一次探测、一条差一路径
现在回答第三篇留下的最后一问:调度器手里的「需要多少块」是怎么算出来的。
calculateMaxNumBlocks:一个池的块数从哪来
BaseKVCacheManager::calculateMaxNumBlocks 的输入是一组显存预算(allottedPrimaryMemBytes / allottedSecondaryMemBytes)与窗口映射表,流程是:
- 每个窗口算「每 token 缓存字节数」:
cacheSizePerToken = kvFactor * Σ(numKvHeads) * sizePerHead,再乘 dtype 大小;池配置(PoolConfiguration{windowSize, sizePerHead, dtype})可覆盖管理器级默认值——这就是「同一模型不同层 head_dim 不同」(如 Gemma4 的 SWA 层 256 维 + 全注意力层 512 维)能各自成池的原因。 - 窗口间分预算:
computeWindowSizeShares默认按窗口数均分(注释坦承「更合理的做法是按窗口大小比例分配,但当前为了让各层性能一致,先均分」),可用环境变量TRTLLM_WINDOW_SIZE_SHARES覆盖,例如0.4,0.6给窗口 512 与 32768 分别 40% 与 60%。框架把「不均分」留成显式开关,而不是悄悄做启发式——默认保守、优化留给人。 - 块数 = 预算 / (每 token 字节 × tokensPerBlock),向上取整。
kv_cache_config.max_tokens若非空且非 VSWA,作为额外上限被取 min(源码里有条注释直接提醒:在 VSWA 下设置maxTokens「是个很奇怪的概念」,因为它限制的是每个窗口各自的 token 上限)。 - 次池同理,来自
host_cache_size;若块复用被禁用而次池仍非零,会打印「禁用复用时分配次池内存没有意义」的警告。 - 线性注意力/Mamba 混合模型特例:只有两种「窗口」(
max_seq_len与kRecurrentStates)、且禁用复用时,循环状态按max_batch_size静态分配(每 batch 一个状态块);否则按内存预算动态算。这解释了为什么混合模型的容量口径与纯 Transformer 不同。 - 最后跨 rank 同步块数(上节)。
getNeededBlocksOneStep:两种预算各算一次
这是全篇最该逐行读的函数之一。它对一次前向「新需要多少块」的估算分三种请求状态:
状态一:上下文初始化 + 首个分块(或分离式的生成初始化)。 先算 prompt 覆盖长度:
auto const maxDraftTokensToAdd = std::min(req.getNumDraftTokens(), req.mMaxNewTokens);auto const promptCacheLen = std::min((isCrossKv() ? req.getEncoderOutputLen() : req.mPromptLen) + maxDraftTokensToAdd, windowSize + mChunkSize) + mSinkBubbleLength;三个加项各有一句可解释的理由:
maxDraftTokensToAdd:投机解码的草稿 token 也会写入 KV(站内 SGLang 投机解码一篇讲过草稿-验证链路),必须计入容量;取min(numDraftTokens, mMaxNewTokens)防止「草稿数超过剩余生成长度」这种配置下的虚高。min(..., windowSize + mChunkSize):滑窗注意力下历史只保留一个窗口;分块预填充一次最多推进mChunkSize。取两者之和是「本次前向可能新增的 KV 上界」。mSinkBubbleLength:attention sink 相关的气泡长度。实现是sinkTokensInLastBlock = sinkTokenLen % tokensPerBlock ? tokensPerBlock - sinkTokensInLastBlock : 0——sink token 占不满一个块时,为它保留一个整块的气泡。注释写明这是为 StreamingLLM 式的 sink 保底(TODO 里还有「为 streamLLM 完善」的条目)。
然后按块拆分:numSharedBlocks(满块,可跨 beam 共享)+ numUnSharedBlocks(尾块 × beam 宽),得 numRequiredBlocks。最后——复用折扣,这是与第三篇的接缝处:
if (mEnableBlockReuse && !mBlockManager.isVariableWindow() && !isCrossKv() && !req.isDisaggGenerationInitState()){ auto const summary = cachedSummary.has_value() ? cachedSummary.value() : analyzePrefixReuse(req.getUniqueTokens(0), req); auto const promptInputLen = std::min(req.mPromptLen, windowSize + mChunkSize); auto const maxRecoverableSharedBlocks = (promptInputLen - 1) / getTokensPerBlock(); // 块预算:只有「已被引用」的可复用块才真正减少空闲池需求 auto const reusableAllocatedBlocks = std::min({summary.reusableBlocksAllocated, numSharedBlocks, maxRecoverableSharedBlocks}); numRequiredBlocks -= reusableAllocatedBlocks; // token 预算:所有命中前缀都省算力,记在请求对象上供微批调度器计价 auto const reusableAllBlocks = std::min({summary.reusableBlocksAll, numSharedBlocks, maxRecoverableSharedBlocks}); req.setEstimatedReusableTokens(reusableAllBlocks * getTokensPerBlock());}四个守卫条件把「折扣不适用的场景」全部排除:未开块复用、VSWA(多窗口下前缀语义复杂,第三篇讲过可变窗口下前缀感知整体失效)、跨 KV、分离式生成初始化(该状态只搬 KV 不算上下文)。然后两个计数各自受限、各自记账,最后 setEstimatedReusableTokens 把估算挂到请求上——微批调度器用 reuse_adjusted_compute 折价计价时读的就是它。
状态二:生成中。 算的是「接下来的若干 token 会不会跨块」:
auto const tokensPerStep = req.getNumDraftTokens() + 1;auto const maxTokensToAdd = std::min((twoStepsLookAhead ? 2 : 1) * tokensPerStep, maxTokensToAddToKVCache);auto const numNextTokens = numCurrTokens + maxTokensToAdd;// 若越过该窗口的最大 token 数 → 返回 0(滑窗下不再增长)auto const numRequiredBlocks = (ceilDiv(numNextTokens, tpb) - ceilDiv(numCurrTokens, tpb)) * beamWidth;两个细节:tokensPerStep = draft + 1(草稿 + 被验证的目标 token);twoStepsLookAhead 是给「两阶段预看」的选项——第三篇里 GUARANTEED_NO_EVICT 的到完成预留走一步展望,微批侧会按需做两步展望,避免「这一步刚好不跨块、下一步就跨块」的漏算。
状态三:其他状态返回 0。 不增长就不需要。
getRemainingBlocksToCompletion:到完成的预留口径
getRemainingBlocksToCompletion(req, windowSize, cachedSummary) 与上面成对,回答「这条请求跑完还要多少块」。它对跨 KV、上下文初始化、生成中分别给出「已完成部分之外的余量」;GUARANTEED_NO_EVICT 调度策略(第三篇讲过)在准纳入口用它做整生命周期预留。Python 侧对此有一条诚实得罕见的 TODO 注释:C++ 的 get_remaining_blocks_to_completion 与 Python 版本的语义不一致(C++ 排除已分配块、Python 包含),目前 Python 调度器用自己那版并显式注明 beam_width=1 「保持历史行为」。账本跨语言实现的分裂被写进注释而不是被掩盖——读源码时看到这种注释,应当把它当作「此处口径有坑」的路标。
Python 侧 KVCacheManager:三个钩子与一条补救路径
PyTorch 后端的 resource_manager.py 里,KVCacheManager 继承 BaseResourceManager,兑现四个接口:
prepare_resources(scheduled_batch):每步前向之前按批分配。文档口径是「首次进入上下文的请求按整个上下文分配;生成中的请求按下一步分配;块式组织且块内有余量时可能不实际分配」。源码里交叉 KV 走独立路径(一次分配、永不增长),上下文请求按首块/尾块分流。update_resources:官方文档承认「KV 不需要更新,此函数当前不做操作」——但留下一条明确接口位:「若 Python 侧支持 KV 复用,Radix 树管理在这里更新」。这是为「Python 实现的一等公民复用管理器」预留的扩展点。free_resources(request, pin_on_release=False):请求结束回收;pin_on_release允许把块钉住不回收(供外部复用/传输),默认关闭。get_max_resource_count/get_needed_resource_to_completion:给调度器的容量口径,后者显式注明 beam 口径与 C++ 不一致。
此外就是本篇开头提到的 get_request_kv_block_budget:返回「到完成所需块数 vs 主池容量」的一对值,允许 PyExecutor 直接拒绝不可能完成的请求。它有一条极严的适用性守卫(kv_block_budget_applies):仅当「恰好是基类 KVCacheManager」且「非 VSWA、非线性注意力、所有窗口等于 max_seq_len、且非 CROSS 或 CROSS 特批」才生效——注释解释了原因:稀疏/压缩 KV 管理器(RocketKV、DSA 缓存)保留的 token 少于全序列,按稠密口径估会误杀请求;Mamba 混合把容量分给额外的状态缓存,单个「需要/容量」对表达不了。「估不准就别估」被写成了类型判断,这段守卫本身就是「预算接口的适用边界」最好的教材。
最后是那条值得单独讲的补救路径 fit_token_budget:
微批调度器准入时按估计的可复用 token 折价计价(
reuse_adjusted_compute用estimated_reusable_tokens);真实复用数要到addSequence里才算出来(prepopulated_prompt_len)。若实际比估计少,前向就会多物化 token,撞上total_num_tokens <= max_num_tokens断言(GitHub #13318)。
补救发生在 prepare_resources 之后:此时块已分配、序列已加入,请求不能退出批——但也不必退出。函数从批尾部(先剪「尾块请求」,因为只有尾块请求享受了复用折扣与草稿 token 计价)开始裁剪上下文 chunk,把被剪的请求变回分块状态,多出来的 token 下一轮再算。源码注释把「为什么只能在此刻、只能剪不能踢」讲得很透:剪枝不动批成员,因此不会破坏注意力 DP 的投票、在途集合或其它管理器的每请求状态。估算-实测裂口靠「延后计算」而不是「回滚分配」来弥补——这是资源管理里非常典型的「以时间换一致性」。
顺带的产物:显存布局与索引器缓存
容量核算与块表构造之间还有两块值得点到的实现:
- FP4 KV 的块级缩放池:NVFP4 缓存会为每个普通池再建一个「块缩放因子池」,形状相同、最后一维是
head_size / 16,由createBlockScalePools建立、_merge_kv_cache_pool_pointers在 Python 侧把紧凑缩放行对齐到物理池序。量化 KV 的元数据也走同一套「池-块」账本,这是量化推理类文章里常被忽略的工程细节。 - DSA 索引器 K 缓存池:
createIndexerKCachePools为 DeepSeek 稀疏注意力的闪电索引器单独建池(可 FP4、块大小默认 128),并有按层的掩码indexerKCacheLayerMask。站内 DSA 稀疏注意力完全拆解讲过索引器在算法层做什么;在块管理层,它只是「又一个带特殊布局的池」。
事件系统:让账本对外可见
KVCacheEventManager 是账本的「公告板」,四类事件覆盖块的一生:
| 事件 | 触发点 | 载荷要点 |
|---|---|---|
| Created | 池/块创建与分配 | 各缓存层级的块数、窗口大小 |
| Stored | 块被登记进复用树 | 块列表(含哈希、窗口) |
| Removed | 块被驱逐/释放 | 块哈希、窗口 |
| Updated | 块状态变化 | 优先级变更、层级迁移(primary ↔ secondary) |
实现细节有三个:enqueueCreatedEvent/StoredEvent/RemovedEvent/UpdatedEvent 全部是无阻塞入队(事件写入 mEvents 队列,由消费者 getEvents(timeout) 拉取);队列容量由 maxKVEventEntries 限定;attentionDpRank/Size 与 attentionDpEventsGatherPeriodMs(默认 5ms)参数说明注意力数据并行下各 rank 的事件会被收集合并。块的 mHash(setHash() 由块键与序列前块推算)就是事件里的稳定标识。
为什么事件系统值得写进「完全拆解」?因为它解释了 probe_prefix_match_length 的存在意义:KVCacheAwareADPRouter 这类缓存感知路由需要在不真正执行请求的前提下知道「这个 rank 上这段前缀命中了多少 token」,于是它构造一个 dummy 请求(max_new_tokens=0)调用 analyze_prefix_reuse,返回 reusable_blocks_all * tokens_per_block。这条路径的注释里还有两处工程边角:getattr(self.impl, 'is_variable_window', False) 的防御式取属性(VSWA 下直接返回 0),以及 cache_salt 必须与真实创建路径一致、否则路由会看到错误命名空间的命中长度。观测、路由与调度共用同一份复用摘要——这是「一本账服务多个消费者」的最终形态。
工程取舍与局限
把全篇读到的设计决策收拢成一张取舍表:
- 块大小的两难。块大 → 内核效率高、表项少;块小 → 复用命中率高(末块浪费少)、跨请求共享粒度细。官方文档给出的默认是 128 token、必须是 2 的幂,并明确说「部分匹配可以复用,但会为每个序列复制一份」。TensorRT-LLM 的答案是「默认 + 可配 + 部分匹配兜底」,而不是二选一。
- 部分匹配的两个开关。
enablePartialReuse(要不要做前缀部分命中)与copyOnPartialReuse(部分命中时是否总是复制)是独立开关。真值组合的含义:都不开 = 只共享满块;开复用不开复制 = 叶子且无引用时原地转用、否则放弃;全开 = 一律复制(安全但多吃一份显存)。原地方案省内存但有并发风险(块可能正被别的请求读),复制方案安全但多占块——选择取决于并发形态。 - 换出的成本可见性。换出把「驱逐」变成「搬运」,收益期是后续请求的复用,成本期是这一次拷贝。
secondaryOffloadMinPriority正是这条成本线的表达。更老平台上 PCIe 带宽不足时,换出可能纯亏——这一点官方文档讲得比源码注释更直白。 - VSWA 下的功能缺口。可变窗口模型在调度侧拿不到前缀复用收益(第三篇的
analyzePrefixReuseassert 与跳过逻辑关闭),在容量侧拿不到maxTokens的直观口径,块预算接口也明确排除 VSWA。这是「多仓 + 共享树」设计的代价:语义正确性保住了,但最短路复用路径要绕远。 FORCE_CHUNK与线性注意力的硬约束。循环状态只能在快照点保存(statesSnapshotInterval必须是块大小的整数倍,初始化时校验),因此线性注意力仓享受不到「任意前缀折扣」,这是模型结构决定的边界。- 估算与实测的裂口。第三篇的估计(
estimated_reusable_tokens)与提交期的真实值(prepopulated_prompt_len)必然存在偏差,fit_token_budget是框架给出的补救,但它是「事后裁剪」——批规模越大、复用估计越不准,这类补救被触发的次数越多。要减少补救,就要让估算更准:analyzePrefixReuse的缓存摘要(cachedSummary参数)正是为此存在——一次遍历、多处复用,避免同一请求被反复探测。 - 锁粒度。树操作全部串行在一把递归互斥量上。好处是语义简单(任何树不变式在锁内都成立),代价是分配路径在锁内包含
offload数据传输的认领段(虽然拷贝本身在锁外调用)。高并发小批场景下,这是观察到的热点之一;源码里对「认领先于交换」等顺序的注释,多半就来自这类并发 bug 的修复记录。
小结
本篇把 TensorRT-LLM 的 KV 账本从块句柄读到了预算公式,可验证的结论收拢如下:
- 三层职责:
KVCacheManager管请求与对外口径、BlockManager按窗口分仓(VSWA)、WindowBlockManager管池/块/队列/树;「元数据与数据分离」使换出换入零改动复用链。 - 块句柄的关键字段:双引用计数分离「运行中」与「调度占位」;
mPrevBlockInSeq(物理链)与树上的getPrevBlock()(前缀链)是两套坐标;占位块让 Mamba/SWA 的链完整而无显存开销。 - 分配三决策:先问可否换出(
getFreeBlock内),驱逐时只摘单块(优先级精确到节点),认领必须先于池索引交换(否则队列计数穿帮,GitHub #11879)。 - 复用键的隔离维度:
BlockKey把 LoRA 任务、缓存盐、多模态哈希与 extra id 全部编入键;numMatchingTokens对约束字段「全同才比」。 - 统一树:一棵树用窗口大小作 value key 服务所有仓,线性注意力用
-1作特殊槽位,一把递归锁守住全部树操作。 - 匹配三道闸门:token 预算、SWA 安全前缀截断(
latestMissingAnchorEndToken + windowSize)、部分匹配的复制/原地转用判定;claimMatchingBlocks用批内 tracker 保证「一个块只有一个原地复用者」。 - 调度接缝:
startScheduling清调度占位、commitAndGetBlockHashesForRequest落账、analyzePrefixReuse产出双计数摘要(块预算只认已引用块、token 预算认全部命中块),(promptLen - 1) / tpb修掉末 token 的差一。 - 块表三级信息:池选择、层布局(层优/块优)与 beam 维度全部编进
KVCacheIndex与flat_index3;跨 rank 用 min-allreduce 与序列一致性检查守住同一本账。 - 预算与补救:
getNeededBlocksOneStep对上下文/生成两态分别估算(草稿 token、chunk 上限、sink 气泡逐项计入);Python 侧fit_token_budget以「裁剪延后」而非「回滚」弥补估计与实测的裂口;get_request_kv_block_budget用严格守卫声明自己的适用边界。 - 事件与观测:四类无阻塞事件 + 块哈希构成外部可见的账本视图,
probe_prefix_match_length用同一份摘要服务缓存感知路由。
下一篇进入模型执行侧:PyTorchModelEngine 如何把动态请求拼成静态形状的输入、AttentionMetadata 的 prepare 构造细节,以及块表与页表如何最终写进注意力后端的元数据、与 CUDA Graph 的静态形状约束相遇。账本已经记清,接下来看它如何被消费。
参考资料
- TensorRT LLM KVCacheManager 文档(PyTorch 后端)
- KV Cache Management: Pools, Blocks, and Events(官方文档)
- KV cache reuse(官方文档)
- KVCacheManager 源码(cpp/tensorrt_llm/batch_manager/kvCacheManager.cpp)
- KVCacheManager 头文件(cpp/include/tensorrt_llm/batch_manager/kvCacheManager.h)
- BlockKey 定义(cpp/include/tensorrt_llm/batch_manager/blockKey.h)
- UnifiedBlockTree(cpp/include/tensorrt_llm/batch_manager/radixBlockTree.h)
- 驱逐策略接口(cpp/include/tensorrt_llm/batch_manager/evictionPolicy.h)
- KVCacheEventManager(cpp/include/tensorrt_llm/batch_manager/kvCacheEventManager.h)
- Python 侧资源管理器(tensorrt_llm/_torch/pyexecutor/resource_manager.py)
- Efficient Memory Management for Large Language Model Serving with PagedAttention(vLLM)
- RAGCache: Efficient Knowledge Caching for Retrieval-Augmented Generation
- CacheBlend: Fast Large Language Model Serving for RAG with Cached Knowledge Fusion
- Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving
- Gemma 3 Technical Report
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



