


TensorRT-LLM 源码完全拆解(十二):注意力层的张量并行——head 怎么切、MLA 为什么不能照切
上一篇沿 Mapping、DeviceMesh 与 Communicator 走完了 TensorRT-LLM 的并行拓扑与通信层,弄清了 rank 坐标系、组划分和集合通信原语。但那一篇始终站在”通信基础设施”这一侧:我们知道 AllReduce 会融合残差和 RMSNorm,知道 workspace 怎么分配,却没有回答一个更靠近模型本体的问题——给定一个 tp_size,注意力层里的权重到底被切成了什么形状?
这一篇从通信层往上走一层,进入 tensorrt_llm/_torch/attention/ 目录下的两个核心模块:通用注意力 Attention 和 MLA 注意力 MLA。这两个类的 __init__ 前两百行几乎全部在做同一件事:把”逻辑上的注意力层”翻译成”本 rank 实际持有的那一片”。翻译的过程包含三组算术:head 数怎么分、QKV 权重矩阵怎么切、输出投影 o_proj 的输入维度为什么和 q_size 不一样。而 MLA 又在这个基础上多了一层纠葛——它的 K/V 根本不是按 head 组织的。
为什么张量并行要从注意力层讲起
先交代背景。张量并行(Tensor Parallelism,TP)把单个矩阵乘的大权重按列或按行切开,多个 GPU 各算一部分,再通过集合通信把结果拼回来。Megatron-LM 在 2019 年的论文里给出的方案是:Transformer 的每个 block 内放两个 all-reduce,一个在注意力输出之后,一个在 MLP 输出之后,其余部分完全不需要通信。
为什么是两个而不是更多?因为注意力层可以被拆成”列并行 GEMM → 局部注意力 → 行并行 GEMM”这样一个天然的三段结构:
qkv_proj是列并行(COLUMN):权重按输出维度切,每个 rank 拿到自己那几组 head 对应的 Q/K/V 投影行,输出的 Q/K/V 是”本 rank 的 head”,不需要任何通信。- 注意力计算本身是 head 独立的:第 个头只和第 个头算注意力,head 之间没有任何耦合。所以只要每个 rank 拿到完整的一组 head,它就能独立算完自己那部分注意力,仍然不需要通信。
o_proj是行并行(ROW):权重按输入维度切,每个 rank 只算自己那部分 head 贡献的部分和,最后必须做一次 all-reduce 把它们加起来。
这个结构的美妙之处在于:通信只发生在行并行的输出端,而且是”必须发生”的——因为 o_proj 的输出 是一个跨 head 的求和,物理上就无法在单个 rank 内完成。
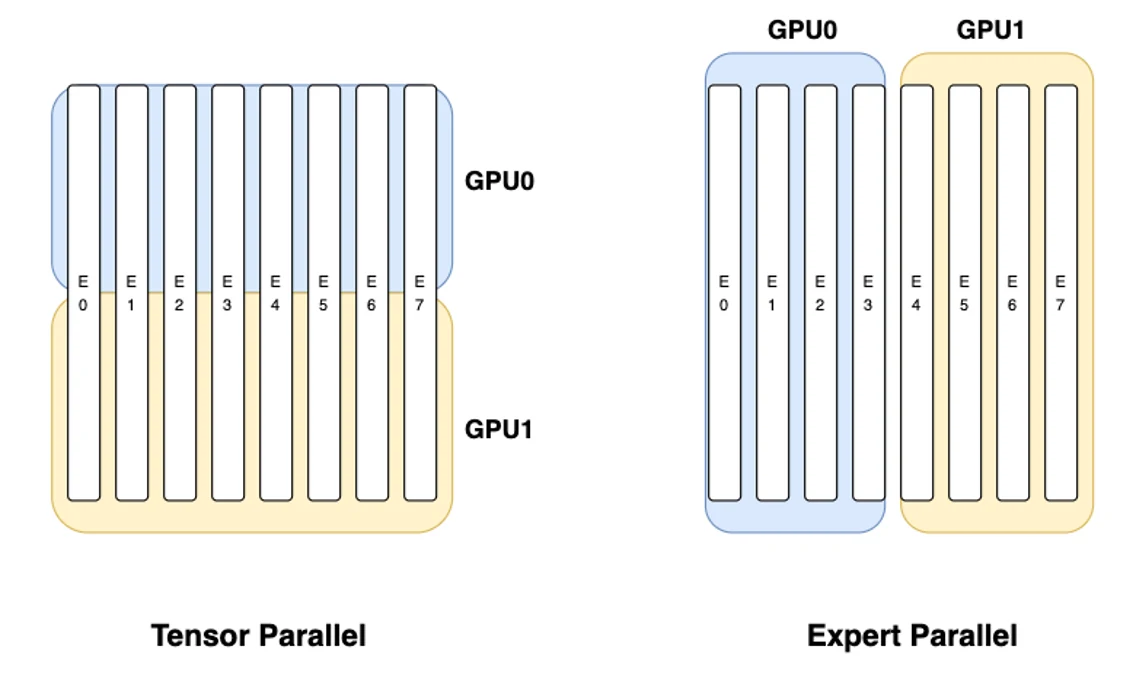
图源:TensorRT-LLM 官方技术博客的并行策略图示(docs/source/blogs/media/tp_ep.png)。左边是张量并行:同一个权重矩阵被切成多份,每张卡只持有自己那一片;右边是专家并行:不同的专家模块被放到不同的卡上。本文要拆的是左侧这一条线在注意力层内部的落点。
理解了这个骨架,再看 TensorRT-LLM 的代码就是”骨架 + 工程细节”。而 MLA 之所以值得单独讲,是因为它打破了这个骨架的第二段:head 独立性。
Attention 的 __init__:把逻辑层翻译成本 rank 的形状
第一步:确认并行度
tp_size = self.mapping.tp_sizepp_size = self.mapping.pp_sizecp_size = self.mapping.cp_sizedp_size = 1if self.mapping.enable_attention_dp: dp_size = tp_size tp_size = 1开头这段代码有个容易被忽略的转折:开了 attention DP,就把 tp_size 折叠成 1,把 dp_size 设成原来的 tp_size。
原因是这样。在纯 TP 模式下,所有 rank 持有同一个请求的不同 head 切片,算完要 all-reduce;在 attention DP 模式下,每个 rank 独立处理不同的请求,注意力层根本不并行,自然也不需要通信——原来那组 TP rank 被重新解释成一组数据并行副本。这也是为什么上一篇里 DP Attention 与专家并行必须”错开”:注意力侧用 DP,MoE 侧用 EP,两者在同一个进程组里的划分方式不同。
注意这里还构造了一个新的 Mapping 对象,而不是复用 self.mapping:
mapping = Mapping( world_size=dp_size * tp_size * pp_size * cp_size, tp_size=tp_size, pp_size=pp_size * dp_size, cp_size=cp_size, ...)world_size 不变,但 tp_size 已经是从 DP 里剥出来的那个,pp_size 则乘上了 dp_size。这是一个”重新解释坐标系”的操作:同一个物理进程组,用另一套数学约定去看它。后面所有 Linear 构造都传这个 mapping,它们才会认为”我的 TP 组是这么多卡”。这个技巧在后面讲 MLA 的 mapping_o 时会再用一次。
第二步:head 数的除法,以及一个不对齐的取整
assert self.num_heads % (tp_size * cp_size) == 0self.num_heads = self.num_heads // tp_sizeself.num_heads_tp_cp = self.num_heads // cp_sizeself.num_key_value_heads = (self.num_key_value_heads + tp_size - 1) // tp_size三行代码,三种处理方式,各有各的道理。
Q head 用整除,并且断言必须整除。 这是硬约束:如果 num_heads 不能被 tp_size 整除,注意力就无法均匀分配工作,框架直接拒绝启动。以 DeepSeek-V3 为例,num_attention_heads = 128,配 tp_size = 8 时每个 rank 拿 16 个 Q head。
num_heads_tp_cp 是 TP 切完再 CP 切。 HELIX 上下文并行会把每个 rank 的 head 再按 CP 组切一次——注意这个变量在非 CP 场景下就等于 num_heads,代码里那句注释说明了这一点:
# note: if we do not have CP, then num_heads_tp_cp == num_heads_tpKV head 用向上取整,不整除也不报错。 这个差异值得展开。GQA(Grouped-Query Attention)下 num_key_value_heads 通常远小于 num_heads——比如 Llama-3-70B 是 64 个 Q head 配 8 个 KV head。当 tp_size 大于 KV head 数时(例如 tp_size=16、num_key_value_heads=8),整除是不可能的:8 个 KV head 分不到 16 张卡上。
向上取整的语义是”允许多个 rank 重复持有同一个 KV head”。8 个头分到 16 张卡,结果是每个 rank 拿到 1 个 KV head,但实际只有 8 个不同的 head,剩下 8 个 rank 持有的是重复的。这看起来浪费,但在注意力层里是可以接受的——KV head 的重复持有只影响权重加载(多读一点)和 KV Cache 分配(每个 rank 多存一份),不影响计算正确性,因为每个 rank 的 Q head 仍然只和它本地的那份 KV 算注意力,结果在 o_proj 的 all-reduce 中合并。
代价是 KV Cache 的显存有冗余。这就是为什么 resource_manager.py 里 KV 显存估算也用了同一个公式:
self.num_kv_heads_per_layer = [ (num_kv_heads + tp_size - 1) // tp_size ...]估算公式和模块的切分公式必须严格一致,否则会算错池子大小——这是这类”两处独立实现同一个除法”的地方最容易出的 bug。
第三步:导出本 rank 的形状
self.q_size = self.num_heads * self.head_dimself.kv_size = self.num_key_value_heads * self.head_dim到这里,self.num_heads 已经是本 rank 的 head 数(__init__ 里被改写过了),所以 q_size 和 kv_size 都是”本 rank 的 Q/KV 投影输出宽度”。用 DeepSeek-V3(128 head、head_dim=128、tp_size=8)算:本 rank 的 q_size = 16 × 128 = 2048,kv_size 因为 num_key_value_heads 也是 128,按向上取整得 16,所以 kv_size = 16 × 128 = 2048。
第四步:构造 QKV 融合权重
qkv_shard_indices_mapping = { "q": (0, self.q_size * (2 if self.attn_output_gate else 1)), "k": (self.q_size * (2 if self.attn_output_gate else 1), self.kv_size), "v": (self.q_size * (2 if self.attn_output_gate else 1) + self.kv_size, self.kv_size),}
self.qkv_proj = Linear( self.hidden_size, tp_size * self.q_size * (2 if self.attn_output_gate else 1) + 2 * tp_size * self.kv_size, bias=bias, dtype=dtype, mapping=mapping, tensor_parallel_mode=TensorParallelMode.COLUMN, weights_loading_config=WeightsLoadingConfig( weight_mode=WeightMode.FUSED_QKV_LINEAR), ... fused_weight_shard_indices_mapping=qkv_shard_indices_mapping, ...)这里有三个关键点。
输出维度是 tp_size × 全局尺寸,不是本 rank 尺寸。 Linear 的 out_features 参数描述的是全局形状(tp_size * q_size + 2 * tp_size * kv_size),Linear 内部再按 COLUMN 模式把它切成 tp_size 份。这一点如果读错,会以为每个 rank 分配了一大堆用不到的权重。q_size 是本 rank 的,乘上 tp_size 就还原成全局的了。
attn_output_gate 让 Q 的宽度翻倍。 带输出门的注意力(如 Qwen3)在 Q 投影后额外产出一个 gate,用于对注意力输出做 out * sigmoid(gate) 的调制。所以 Q 部分的宽度是 2 × q_size,qkv_shard_indices_mapping 里三处 2 if self.attn_output_gate else 1 就是在处理这个。
qkv_shard_indices_mapping 解决的是”融合权重的加载切分”问题。 这是整个 __init__ 里最容易被跳过、但实际最容易出错的部分。回忆一下上一篇讲过的:Mapping 决定进程组,而这里决定的是权重加载时从 checkpoint 的哪个片段取数据。
COLUMN 模式下 Linear 会沿输出维度(第 0 维)切片,切片边界由 _calc_shard 算出:
@staticmethoddef _calc_shard(total, tp_size, rank): return (total // tp_size) * rank + min(total % tp_size, rank)但当权重模式是 FUSED_QKV_LINEAR 时,这个自动切分不能用。原因很直白:checkpoint 里存的是分开的 q_proj.weight、k_proj.weight、v_proj.weight 三个张量,而模块持有的是一个融合后的大权重。切”融合后的张量”和切”三个独立张量再拼接”得到的是不同的结果——除非每一段的宽度都恰好能被 tp_size 整除,且段边界与 rank 边界对齐。
fused_weight_shard_indices_mapping 就是来声明这件事的。load_shard 里对它的处理是:
if isinstance(self.tp_sharding, dict): slice_start, slice_end = self.tp_sharding[name]name 就是 load_weights_fused_qkv_helper 里分别传入的 'q'、'k'、'v':
q_weight = module.load_shard(weights[0], 'weight', device=device, name='q', elm_packing=elm_packing)k_weight = module.load_shard(weights[1], 'weight', device=device, name='k', elm_packing=elm_packing)v_weight = module.load_shard(weights[2], 'weight', device=device, name='v', elm_packing=elm_packing)于是三个独立张量各自被切到 qkv_shard_indices_mapping 声明的区间,再写进融合权重的对应位置。bias 的处理更直接,用 copy_weight_shard 做原地分段拷贝:
def copy_weight_shard(dst: Parameter, src: torch.Tensor, shard_offset: int, shard_size: int): if dst.dtype != src.dtype: src = src.to(dst.dtype) dst[shard_offset:shard_offset + shard_size].data.copy_(src)shard_offset/shard_size 直接来自同一张映射表。这段代码解释了为什么 GQA 下必须显式声明 shard 边界:q_size 和 kv_size 不相等,自动均分必然错位。
第五步:o_proj,以及一个”额外一套 mapping”
mapping_o = Mapping( world_size=dp_size * tp_size * pp_size * cp_size, tp_size=tp_size * cp_size, pp_size=pp_size * dp_size, cp_size=1, ...)self.mapping_o = mapping_o
self.o_proj = Linear( tp_size * self.q_size, self.hidden_size, bias=self.dense_bias, dtype=dtype, mapping=mapping_o, tensor_parallel_mode=TensorParallelMode.ROW, ...)o_proj 是全篇最值得停下来想的地方,因为它同时出现两种形状。
输入维度写的是 tp_size * self.q_size——这又是”全局”尺寸。因为 self.q_size = num_heads × head_dim,而 num_heads 是本 rank 的 head 数,所以 tp_size * self.q_size 等于全局的 Q 宽度,也就是 o_proj 真正的输入维度。ROW 模式下 Linear 会沿输入维度(第 1 维)把它切成 tp_size 份,每个 rank 正好拿到 q_size——和它输出的注意力张量宽度严丝合缝对上。
但传进去的 mapping 是 mapping_o 而不是 mapping。 mapping_o 的 tp_size 是 tp_size * cp_size,cp_size 是 1。也就是说:从 o_proj 的视角看,TP 组变大了,包含了原本的 CP 组。
这就是 HELIX 上下文并行的核心安排。回到 __init__ 里的注释:
# For Helix CP, combine TP and CP for the output projection so each# rank's o_proj input is num_heads_tp_cp * head_dim.在 HELIX 模式下,注意力侧每个 rank 只持有 num_heads_tp_cp = num_heads / tp_size / cp_size 个 head,算出的注意力张量宽度是 num_heads_tp_cp × head_dim。但对 o_proj 来说,“我应该切多少份”必须和新加入的 CP 维度一起算——否则会有 cp_size 个 rank 认为自己持有同一段权重,all-reduce 的结果就错了。把 tp_size * cp_size 作为 o_proj 的 TP 度,恰好让每个 rank 的输入宽度对上。
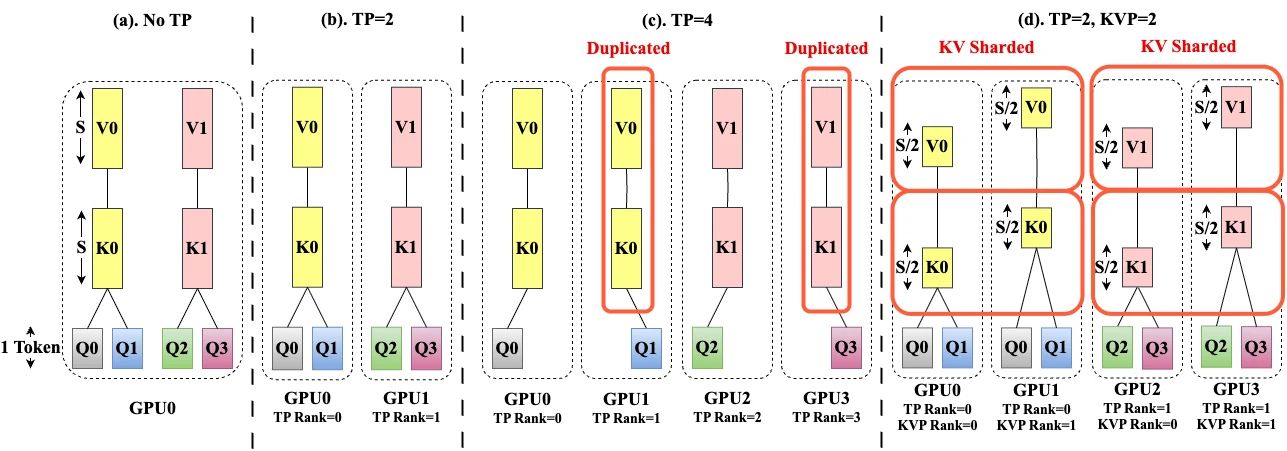
图源:TensorRT-LLM 官方技术博客 Helix Parallelism 的分片示意(docs/source/blogs/media/tech_blog22_attention_sharding.png)。图中展示的是 HELIX 对注意力的双重切分:head 维按 TP/CP 分给不同 rank,序列(token)维也按 CP 切开。这正是 mapping_o 要把 tp_size × cp_size 合并成一个 TP 度的原因——o_proj 必须同时容纳这两条切分线。
这里可以对照上一篇结尾提到的层内模式:“all-gather → 注意力 → o_proj → reduce-scatter”。Attention.forward 的两端就是这两个操作的落点:
def _helix_cp_allgather_input(hidden_states, attn_metadata, mapping, layer_idx): """AllGather hidden states from CP group for layers after the first.
The first layer already has the full input from the embedding. Subsequent layers need to undo the previous layer's reduce-scatter. """ if (mapping.has_cp_helix() and mapping.enable_attention_dp and layer_idx > 0): hidden_states = cp_allgather(hidden_states, mapping, dim=0) hidden_states = hidden_states[:attn_metadata.num_tokens] return hidden_states注意 layer_idx > 0 这个条件:第一层的输入直接来自 embedding,本来就是完整的;只有第二层及以后,输入是上一层 reduce-scatter 之后的token 片段,才需要先 all-gather 拼回完整序列。
另一端:
def _helix_cp_output_projection(o_proj, attn_output, attn_metadata, all_reduce_params, mapping, mapping_o, layer_idx, lora_params=None): """Apply output projection with reduce-scatter when Helix CP+DP is active.
Reduce-scatter sums partial sums across the CP group and scatters the result so each CP rank processes a distinct token chunk through the MLP. Falls back to the standard AllReduce path otherwise. """ if mapping.has_cp_helix() and mapping.enable_attention_dp: attn_output = o_proj( attn_output, all_reduce_params=AllReduceParams(enable_allreduce=False), lora_params=lora_params, layer_idx=layer_idx)
attn_output, _ = _helix_cp_pad(attn_output, attn_metadata.num_tokens, mapping.cp_size) attn_output = reducescatter(attn_output, mapping_o, dim=0) else: attn_output = o_proj(attn_output, all_reduce_params=all_reduce_params, lora_params=lora_params, layer_idx=layer_idx) return attn_outputenable_allreduce=False 这行是上一篇里见过的技巧,现在它有了具体的语境:不是关掉通信,而是把 all-reduce 换成 reduce-scatter。all-reduce 让所有 rank 拿到相同的完整结果;reduce-scatter 求和之后把结果按 token 段切开,每个 rank 只拿一段——正好接上 MLP 需要”每个 rank 处理不同 token”的 DP 语义。
_helix_cp_pad 是补齐操作。reduce-scatter 要求 token 总数能被 cp_size 整除,否则切片边界不整齐。
forward 路径:QKV 从融合张量到 attention kernel
构造讲完了,看一次真实前向怎么用这些形状。
def forward(self, position_ids, hidden_states, attn_metadata, ...): hidden_states = _helix_cp_allgather_input(hidden_states, attn_metadata, self.mapping, self.layer_idx) ... qkv = self.qkv_proj(hidden_states) ... q, k, v, gate = self.preprocess_qkv(qkv, position_ids) q, k, v = self.convert_qkv(q, k, v) ... attn_output = self.forward_impl(q, k, v, attn_metadata, ...) ... attn_output = _helix_cp_output_projection(self.o_proj, attn_output, ...) return attn_output中间那两个函数——preprocess_qkv 和 convert_qkv——处理的是一个容易被忽视的接口分歧:“融合 QKV”和”分离 QKV”两种表示,谁来决定用哪种?
def split_qkv(self, q, k=None, v=None): if k is None and v is None: q, k, v = q.split([self.q_size, self.kv_size, self.kv_size], dim=-1) return q, k, v
def convert_qkv(self, q, k, v): if k is None and v is None and not self.support_fused_qkv: q, k, v = self.split_qkv(q) elif k is not None and v is not None and self.support_fused_qkv: qkv = torch.concat([q, k, v], dim=-1) q, k, v = qkv, None, None return q, k, v判决权在注意力后端手里:self.support_fused_qkv = self.attn.support_fused_qkv()。TRTLLM 和 FlashInfer 这类后端可以直接吃融合 QKV(一次读连续内存更快),Vanilla 后端需要分离的三个张量。convert_qkv 就是这个转换的开关。
s preprocess_qkv 负责另一件事——输出门:
gate = Noneif self.attn_output_gate: q_gate, k, v = qkv.split( [self.q_size * 2, self.kv_size, self.kv_size], dim=-1) orig_shape = q_gate.shape[:-1] # Single line: view -> chunk -> reshape both q and gate q, gate = [ t.reshape(*orig_shape, -1) for t in torch.chunk( q_gate.view(*orig_shape, self.num_heads, -1), 2, dim=-1) ]else: q, k, v = qkv, None, Noneq, k, v = self.apply_rope(q, k, v, position_ids)return q, k, v, gateq_gate.view(*orig_shape, self.num_heads, -1) 然后 chunk(2, dim=-1)——这个 reshape 再切分的顺序是必要的。如果直接对扁平的 Q 段按宽度切一半,得到的会是”前一半 token 的 Q”和”后一半 token 的 gate”,语义完全错。先 reshape 成 [..., num_heads, 2*head_dim],再沿最后一维切,得到的才是”每个 head 的 Q”和”每个 head 的 gate”。
apply_rope 里还有一条分支:融合 RoPE 的后端在 kernel 内部做旋转,Python 侧就不做了。
def apply_rope(self, q, k, v, position_ids): # If RoPE is fused into the attention OP, do not apply RoPE here. if not self.rope_fusion and position_ids is not None: q, k, v = self.split_qkv(q, k, v) q, k = self.rotary_emb(position_ids, [q, k]) return q, k, v注意它先调用 split_qkv 分开 q 和 k——rotary_emb 只旋转 Q 和 K,V 不参与。而 split_qkv 的切片宽度正是本 rank 的 q_size/kv_size,与前面 __init__ 的结论闭环。
MLA:当 K/V 不再按 head 组织
到这里通用注意力的故事讲完了。现在换到 MLA(Multi-head Latent Attention),这是 DeepSeek-V2 在 2024 年提出的注意力结构——它不是”把普通注意力切一切”,而是彻底换了一套 K/V 的表示。
先看传统 MHA/GQA 的 KV Cache 是怎么长的
普通注意力的 KV Cache 每一层存什么?对每个 head,存一份 K 和一份 V。形状是 [num_kv_heads, seq_len, head_dim],再乘 2(K 和 V 各一份)。
GQA 已经省了一层:多个 Q head 共享一个 KV head,num_kv_heads 从 num_heads 降到 num_kv_heads。但每个 KV head 仍要存完整的 head_dim 维 K 和 V。
MLA 的做法完全不同:它不缓存 K 和 V,而是缓存一个低秩的 latent 向量。DeepSeek-V3 的配置里 kv_lora_rank = 512,而按传统方式算的话,每层每 token 要存 128 heads × 128 dim × 2 (K,V) = 32768 个元素;MLA 只存 512 + 64 = 576 个元素(512 维的 compressed KV latent,加上 64 维的 RoPE key)。压缩率超过 50 倍。
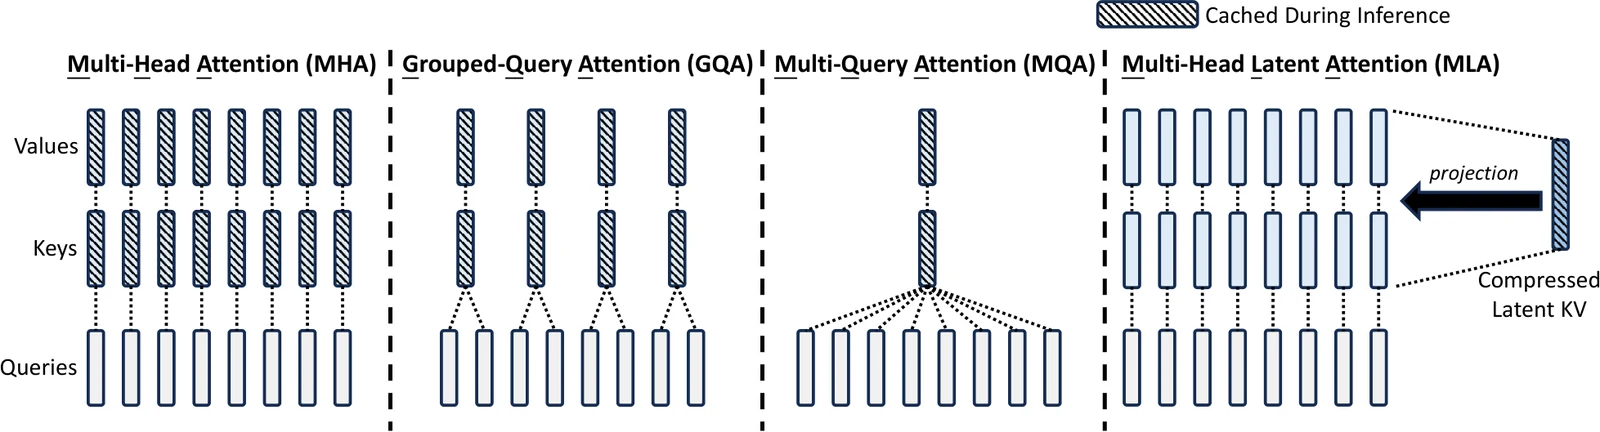
图源:DeepSeek-V2 论文(arXiv:2405.04434)中的注意力结构对比图。自左向右依次是 MHA、GQA 与 MLA。前两者的 KV Cache 随 head 数线性增长,MLA 则把 K/V 压进一个与 head 数无关的低秩 latent —— 这正是它改变张量并行布局的根本原因:缓存里的东西不再有 head 维度。
代价是:K 和 V 要从 latent 现场”展开”出来。这就是 MLA 的张量并行必须重新设计的原因。
MLA 的权重全景
MLA.__init__ 里构造的模块比 Attention 多得多:
if not self.is_lite: kv_a_out_features = self.kv_lora_rank + self.qk_rope_head_dim if self.fuse_qkv_a_proj: kv_a_out_features += self.q_lora_rank self.kv_a_proj_with_mqa = Linear( hidden_size, kv_a_out_features, ...) # 注意:没有 mapping! ... self.q_a_layernorm = RMSNorm(hidden_size=self.q_lora_rank, ...)
self.q_b_proj = Linear( self.q_lora_rank, self.num_heads * self.qk_head_dim, mapping=mapping, tensor_parallel_mode=TensorParallelMode.COLUMN, ...)再往下:
self.kv_b_proj = Linear( self.kv_lora_rank, self.num_heads * (self.qk_nope_head_dim + self.v_head_dim), bias=bias, dtype=dtype, mapping=mapping, tensor_parallel_mode=TensorParallelMode.COLUMN, ...)self.v_b_proj = nn.Parameter( torch.empty( (self.num_heads_tp_cp, self.v_head_dim, self.kv_lora_rank), dtype=dtype, ), requires_grad=False,)以及两个注意力后端:
self.mqa = create_attention( config.attn_backend, self.layer_idx, self.num_heads_tp, head_dim=self.kv_lora_rank + self.qk_rope_head_dim, num_kv_heads=1, ...)...self.mha = create_attention( config.attn_backend, self.layer_idx, self.num_heads_tp, head_dim=self.qk_head_dim, num_kv_heads=self.num_key_value_heads_tp, ...)把这几段摆在一起,MLA 的张量并行全景就出来了:
| 模块 | 并行方式 | 切分维度 | 为什么 |
|---|---|---|---|
kv_a_proj_with_mqa | 不切 | — | 输出是 latent,与 head 无关 |
q_a_proj / q_a_layernorm | 不切 | — | 输出是 q_lora_rank 维的压缩 Q,与 head 无关 |
q_b_proj | COLUMN | 输出维(head) | 从 latent 展开到 per-head Q |
kv_b_proj | COLUMN | 输出维(head) | 从 latent 展开到 per-head K_nope/V |
mqa | TP + CP | head | latent 上的注意力 |
mha | TP + CP | head | 展开后的注意力 |
第一行的”不切”是理解 MLA 张量并行的钥匙。
为什么 kv_a_proj_with_mqa 不能切
看这个 Linear 的构造参数:它没有 mapping= 参数。
self.kv_a_proj_with_mqa = Linear( hidden_size, kv_a_out_features, bias=bias, dtype=dtype, quant_config=quant_config, skip_create_weights_in_init=config.skip_create_weights_in_init, use_custom_cublas_mm=True, force_dynamic_quantization=config.force_dynamic_quantization, use_cute_dsl_blockscaling_mm=self.use_cute_dsl_blockscaling_mm, use_cute_dsl_bf16_gemm=self.use_cute_dsl_bf16_gemm,)不传 mapping,Linear 就走 tp_size = 1 的路径,权重在每个 rank 上完整复制一份。
这是必须的,不是偷懒。kv_a_proj_with_mqa 的输出是 kv_lora_rank + qk_rope_head_dim(+ q_lora_rank,如果融合)维的 latent 向量。这个 latent 向量没有 head 的概念——它是所有 head 共享的一份压缩表示。如果按 COLUMN 模式把它切开,每个 rank 只会拿到 latent 的一部分维度,而后续的 kv_b_proj 需要完整的 latent 才能展开出本 rank 的 head,直接从数学上就错了。
所以 MLA 的并行分界线画在这里:latent 空间之前的投影不切,latent 空间之后的展开切。同样的道理也适用于 q_a_proj 和 q_a_layernorm——它们都在 q_lora_rank 这个压缩空间里工作。
kv_b_proj 的切分:COLUMN 模式为什么是对的
kv_b_proj 从 kv_lora_rank 维的 latent 展开到 num_heads * (qk_nope_head_dim + v_head_dim)。COLUMN 模式沿输出维度切,切出来的是”本 rank 的 head 对应的那段权重”。
正确性论证:展开后的 K_nope 和 V 都是 per-head 的,第 个 head 的展开只依赖权重矩阵的第 段行和完整的 latent。每个 rank 都有完整的 latent(因为上一步没切),所以每个 rank 都能独立完成自己那段的展开。这正好复刻了普通注意力”head 独立、无需通信”的性质。
_get_kvbproj_head_weights 展示了这个”按 head 分段”的物理布局:
def _get_kvbproj_head_weights(self): """Per-head views into kv_b_proj.weight, layout [H, N, K] (contiguous).
kv_b_proj.weight rows are [H*qk_nope (k_nope block) | H*v_head (v block)] with K = kv_lora_rank, so both blocks reshape to head-major [H, N, K] without any copy. """ w = self.kv_b_proj.weight nope_rows = self.num_heads_tp * self.qk_nope_head_dim w_k = w[:nope_rows].view(self.num_heads_tp, self.qk_nope_head_dim, self.kv_lora_rank) w_v = w[nope_rows:].view(self.num_heads_tp, self.v_head_dim, self.kv_lora_rank) return w_k, w_v权重矩阵的行被分成两段:前 num_heads_tp * qk_nope_head_dim 行是 K_nope 的展开权重,后 num_heads_tp * v_head_dim 行是 V 的展开权重。每段都能直接 reshape 成 head-major 的 [H, N, K],不需要任何拷贝——这意味着这个 per-head 视图可以被真正当成一个 batched GEMM 来跑。
这种”零拷贝 reshape”能成立的前提是权重加载时按 head-major 顺序排列。回到 modeling_deepseekv3.py 里的反例,能看到另一种布局:
k_nope_weight.reshape(local_num_heads * local_qk_nope_head_dim, local_kv_lora_rank),v_weight.reshape(local_num_heads * local_v_head_dim, local_kv_lora_rank)这是另一种拆分方式——把 K_nope 和 V 各自 reshape 成 [H * N, K],也就是保持 [head, dim] 的嵌套顺序。两种布局在数学上都对,但影响后续能否直接 view 成 batched GEMM 的输入。
吸收(Absorption):把 kv_b_proj 从推理路径上删掉
MLA 最反直觉的优化是吸收。
标准 MLA 推理流程:缓存 latent → 展开成 K_nope/V → 算注意力。但展开这一步本身有计算量,而且是每步都要做的重复劳动。
吸收的想法是:把展开矩阵乘进 Q 和输出投影里,让注意力直接在 latent 上算。
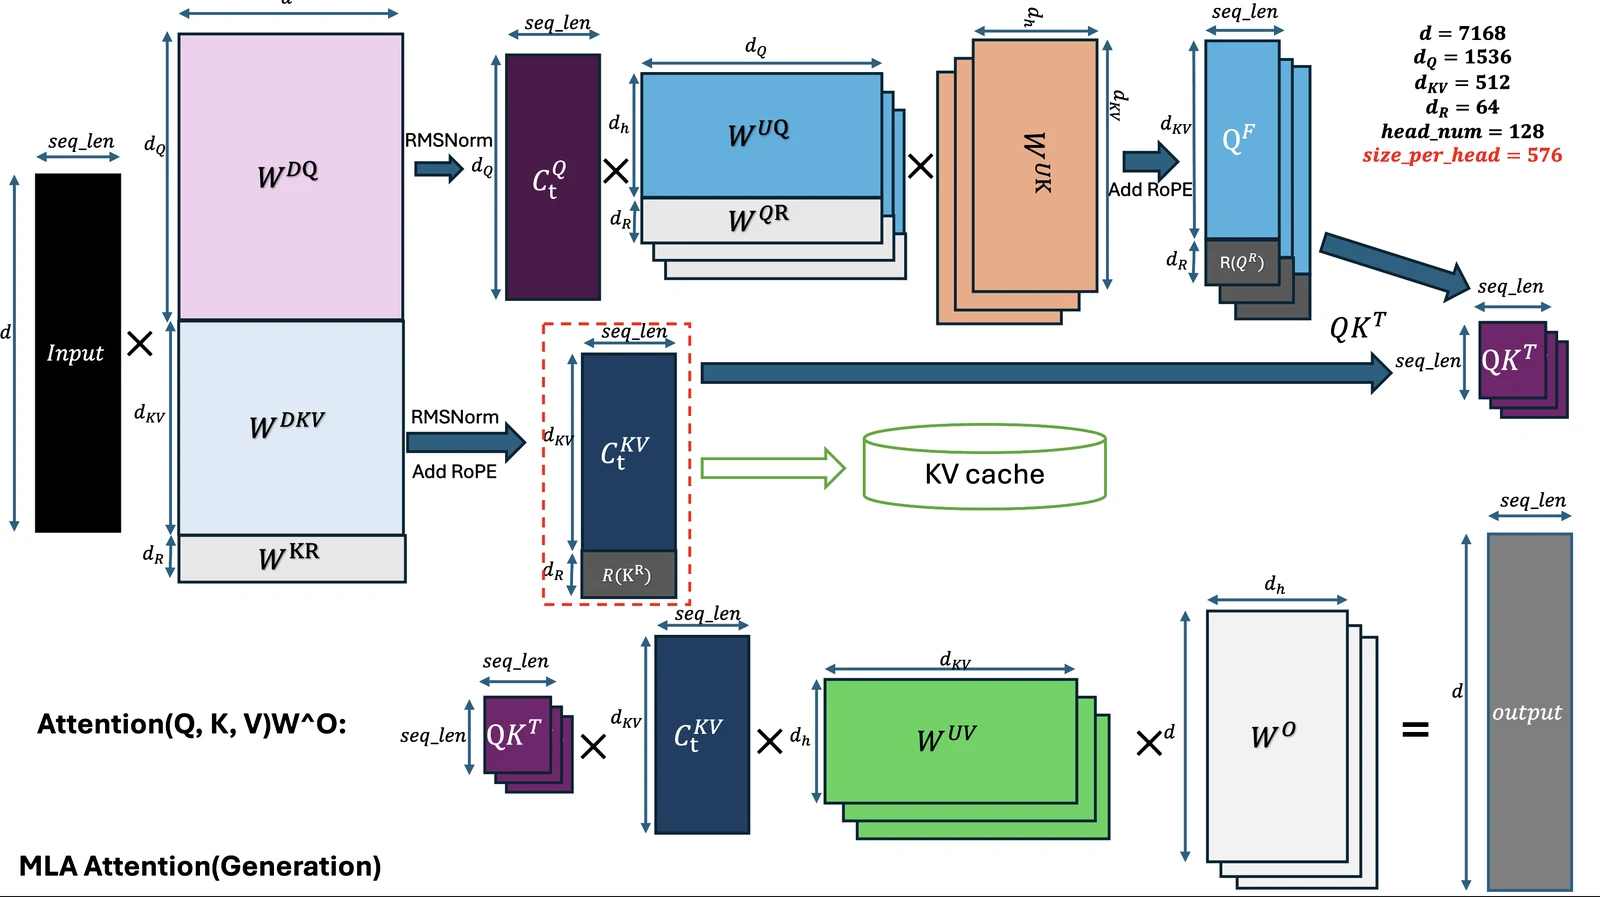
图源:TensorRT-LLM 官方技术博客的 MLA 吸收图示(docs/source/blogs/media/tech_blog3_mla_absorb.png)。图中把吸收拆成两步:第一步把 kv_b_proj 的 K 半段权重转置后提前乘到 Q 上,注意力因此在 latent 空间做内积;第二步把 V 半段权重挪到注意力输出之后,一次性把 latent 维度的注意力结果抬回 v_head_dim。这两步对应的正是代码里的 k_b_proj_trans 和 v_b_proj。
对 Q 侧,注意力内积是 ,其中 ( 是 latent)。于是:
右边把 乘到 上,得到一个和 latent 同维的向量,再和 latent 做内积。这就是代码里的 k_b_proj_trans。
对 V 侧同理:输出是 ,把 移到注意力输出之后,注意力输出保持 latent 维度,最后一次性做 per-head BMM 抬回 v_head_dim。
forward_absorption_generation 就是这条吸收路径:
def forward_absorption_generation(self, q, compressed_kv, k_pe, attn_metadata, output, position_ids=None, latent_cache=None, **kwargs): num_tokens = q.shape[0] q_nope, q_pe = q.view([-1, self.num_heads_tp, self.qk_head_dim]).split( [self.qk_nope_head_dim, self.qk_rope_head_dim], dim=-1) ... if hasattr(self, "k_b_proj_trans"): fused_q = torch.empty( [num_tokens, self.num_heads_tp, (self.kv_lora_rank + self.qk_rope_head_dim)], dtype=q.dtype, device=q.device)fused_q 的形状是 [num_tokens, num_heads_tp, kv_lora_rank + qk_rope_head_dim]——注意第二维仍是本 rank 的 head 数,num_heads_tp。head 并行的结构没有被动摇,被压缩的只是每个 head 的向量宽度:从 qk_head_dim 变成 latent 宽度。
吸收后的 Q 用 BMM 算出来:
if self.k_b_proj_trans.dtype == torch.bfloat16: # [num_heads, num_tokens, self.qk_nope_head_dim] q_nope_t = q_nope.transpose(0, 1) # [num_heads, num_tokens, self.kv_lora_rank] q_nope_out = fused_q[..., : self.kv_lora_rank].transpose(0, 1)
# [num_heads, num_tokens, qk_nope_head_dim] x [num_heads, kv_lora_rank, qk_nope_head_dim] # -> [num_heads, num_tokens, kv_lora_rank] -> [num_tokens, num_heads, kv_lora_rank] # The output of bmm is written directly into fused_q maybe_execute_in_parallel( lambda: self._bmm_bf16_out( q_nope_t, self.k_b_proj_trans, self.k_b_proj_trans.transpose(1, 2), q_nope_out, self._locality_domain_k_b_proj_trans_shards), _mla_gen_rope, self.ln_events[0], self.ln_events[1], rope_stream)逐行读这段:q_nope 是 [tokens, heads, qk_nope_head_dim],转置成 [heads, tokens, qk_nope_head_dim]。k_b_proj_trans 的形状是 [heads, kv_lora_rank, qk_nope_head_dim]——正是 的 head-major 堆叠。两者做 batched matmul,得到 [heads, tokens, kv_lora_rank],再转置回 [tokens, heads, kv_lora_rank] 直接写进 fused_q 的前段。
bmm 的第一维是 head,而且 k_b_proj_trans 的第 0 维是 num_heads_tp——每个 rank 的 batched GEMM 只用自己那份 head 权重。这就是吸收路径下张量并行的具体形态:head 维同时是并行维和 batch 维。
_has_full_absorption_weights 里的形状断言把这一点钉死了:
def _has_full_absorption_weights(self): if getattr(self, "kv_lora_rank", None) != 512 or \ getattr(self, "v_head_dim", None) != 128: return False # The Rubin BF16 BMM requires its K dimension to be 16-byte aligned. # qk_nope_head_dim is K for the absorbed K projection. if getattr(self, "qk_nope_head_dim", 0) % 8 != 0: return False ... expected_k_shape = (self.num_heads_tp, self.kv_lora_rank, self.qk_nope_head_dim) expected_v_shape = (self.num_heads_tp_cp, self.v_head_dim, self.kv_lora_rank) return (...)k_b_proj_trans 的第 0 维是 num_heads_tp,v_b_proj 的第 0 维是 num_heads_tp_cp。这两个变量的差别不是笔误——它精确反映了 TP 和 CP 在两个吸收矩阵上的不同处理,和前面 Attention.__init__ 里 num_heads_tp / num_heads_tp_cp 的划分是同一套逻辑。
再看 v_b_proj 的构造位置:
self.v_b_proj = nn.Parameter( torch.empty( (self.num_heads_tp_cp, self.v_head_dim, self.kv_lora_rank), dtype=dtype, ), requires_grad=False,)它是从 kv_b_proj.weight 里视图出来的参数,不是独立权重——_bind_v_b_proj_weight 做这件事。这解释了为什么它会出现在 need_absorption 分支里:只有走吸收路径时,才需要这个 per-head 的 V 展开视图。
mqa 和 mha:两个后端,分别对应两条路径
最后看那两个注意力后端实例的构造参数差异:
self.mqa = create_attention(..., head_dim=self.kv_lora_rank + self.qk_rope_head_dim, num_kv_heads=1, is_mla_enable=True, ...)self.mha = create_attention(..., head_dim=self.qk_head_dim, num_kv_heads=self.num_key_value_heads_tp, ...)mqa(Multi-Query Attention 后端)的 head_dim 是 kv_lora_rank + qk_rope_head_dim,num_kv_heads=1。这两个参数一起说明:它处理的正是吸收后的表示——latent 维度的 head,所有 head 共享同一份 latent(所以是”1 个 KV head”,即 MQA 式的共享)。
mha 的 head_dim 是 qk_head_dim = qk_nope_head_dim + qk_rope_head_dim,num_kv_heads 是本 rank 的 KV head 数。这是展开后的标准注意力表示。
mqa 永远被创建(if self.mqa is None: raise RuntimeError(...)),mha 则可能为 None:
create_dense_mha = (self.sparse_attn_hooks is None or self.sparse_attn_hooks.need_dense_mha)if create_dense_mha: self.mha = create_attention(...)else: self.mha = None这说明吸收路径(走 mqa)是主路径。上下文阶段需要展开到 mha 走标准 FlashAttention,而生成阶段走 mqa 的吸收路径——这也符合”上下文阶段算一次、生成阶段每步都算”的收益结构:吸收省下的是每步都要付的展开开销。
小结
把这一篇的结论收拢成可以直接记住的几条:
- 张量并行的三段结构:
qkv_proj列并行(不通信)→ head 独立的注意力(不通信)→o_proj行并行(必须 all-reduce)。head 独立性是中间那一段不需要通信的唯一原因,也是 MLA 打破它之后必须重新设计的根由。 Linear的out_features是全局尺寸:tp_size * self.q_size看着像重复计算,实际是把”本 rank 的 head 数”还原成”全局的投影宽度”,再由Linear内部按TensorParallelMode切回去。读这类代码时要时刻区分”参数里的尺寸”和”本 rank 实际持有的尺寸”。- KV head 用向上取整,Q head 用整除 + 断言:GQA 下
tp_size > num_key_value_heads时允许重复持有 KV head,代价是 KV Cache 显存冗余。resource_manager.py的估算公式必须与模块切分公式严格一致。 fused_weight_shard_indices_mapping是融合权重的加载契约:checkpoint 里存的 Q/K/V 是分开的三份,融合权重的 shard 边界必须显式声明,否则 GQA 下q_size ≠ kv_size会自动均分错位。mapping_o是第二套坐标系:HELIX CP 下o_proj的 TP 度是tp_size × cp_size,让每个 rank 的输入宽度恰好是num_heads_tp_cp × head_dim。同一个进程组,两套数学约定。- MLA 的并行分界线画在 latent 空间:
kv_a_proj_with_mqa、q_a_proj、q_a_layernorm都在压缩空间里工作,不切(构造时不传mapping);q_b_proj、kv_b_proj是从 latent 展开到 per-head 的,用 COLUMN 模式切。latent 之前的维度没有 head 语义,切了就无法还原。 - MLA 用 latent 换掉了 per-head KV Cache:DeepSeek-V3 配置下每层每 token 从
128 × 128 × 2 = 32768个元素降到512 + 64 = 576个。这是 MLA 存在的全部理由。 - 吸收把展开从推理路径上删掉:,把
kv_b_proj的吸收矩阵乘进 Q 侧;V 侧同理推后到注意力输出之后。省下的是生成阶段每步都要付的展开开销。 - 吸收矩阵的第一维就是并行维:
k_b_proj_trans形状[num_heads_tp, kv_lora_rank, qk_nope_head_dim],v_b_proj形状[num_heads_tp_cp, v_head_dim, kv_lora_rank]——head 既是 batched GEMM 的 batch,又是 TP 的切分维。 mqa对应吸收路径,mha对应展开路径:mqa的head_dim是 latent 宽度、num_kv_heads=1;mha的head_dim是完整的qk_head_dim。前者永远存在,后者在稀疏注意力接管时可为 None。
下一篇继续沿注意力主线往下走:注意力后端的 create_attention 分派——TRTLLM、FlashInfer、Vanilla、FlashMLA 这些后端各自要求什么样的 Q/K/V 形状,support_fused_qkv 和 support_fused_rope 这类能力查询如何影响模块构造顺序,以及稀疏注意力 hooks 如何在同一个 Attention 类上外挂出另一条完全不同的执行路径。
参考资料
- TensorRT-LLM GitHub 仓库 —— 本文代码引用来自
tensorrt_llm/_torch/attention/attention.py、tensorrt_llm/_torch/attention/mla.py、tensorrt_llm/_torch/modules/linear.py、tensorrt_llm/_torch/models/modeling_deepseekv3.py与tensorrt_llm/_torch/pyexecutor/resource_manager.py - Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism —— 张量并行两段式结构的原始论文,列并行/行并行与两个 all-reduce 的来源
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model —— MLA(Multi-head Latent Attention)的原始论文,低秩 KV 压缩的定义
- DeepSeek-V3 Technical Report —— MLA 在 DeepSeek-V3 上的配置与吸收形式的推导
- TensorRT-LLM 官方文档:Parallelism —— TP/PP/CP/EP 的官方配置说明
- TensorRT-LLM 官方技术博客:Helix Parallelism —— HELIX 的注意力分片图示与执行流程
- TensorRT-LLM 官方技术博客:Optimizing DeepSeek R1 Throughput on NVIDIA Blackwell GPUs —— MLA 吸收形式的官方图示
- Efficient Memory Management for Large Language Model Serving with PagedAttention —— vLLM 的 PagedAttention,KV Cache 分页管理的来源
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



