


TensorRT-LLM 源码完全拆解(九):KV Cache 压缩框架——冷页 NVFP4 编码、TriAttention 驱逐与物理压实
前八篇把 TensorRT-LLM 的 KV 通路从账本一路讲到了字节:第一篇给出仓库地形与模块地图,第二篇沿 create_py_executor 走完装配线,第三篇钻进 CapacityScheduler 与 MicroBatchScheduler 的准入算术,第四篇打开 KVCacheManager 的块池与前缀复用树,第五篇看 PyTorchModelEngine 如何把动态请求拼成静态形状的一次前向,第六篇拆开 AttentionMetadata.prepare() 把块句柄翻成块表与页表,第七篇讲透 NHD/HND stride、FP8 scale 与 MLA latent 池的物理布局,第八篇跟着一个 token 的 K/V 走完了写进分页池、再被注意力内核取回的全过程,可参考 TensorRT-LLM 源码完全拆解(八):KV Cache 的写入与读取路径。
到这里,一条完整的因果链已经闭合:谁决定写什么(调度器)、写到哪(prepare 的索引数组)、怎么落盘(融合写入内核)、怎么取回(内联页表的注意力内核)。但这八篇讲的都是”KV 在被使用时的样子”。而现实中,一个 KV Cache 的一生里,被注意力内核读取的时间只是很小一部分:它在分块预填充的两块之间等待、在工具调用期间停驻、在请求结束后为下一轮对话保留、在显存装不下时被搬到主机内存甚至磁盘。这些时刻没有任何东西在读它。
第九篇要讲的就是这些时刻。TensorRT-LLM 在 2026 年引入了一套 KV Cache 压缩框架(KvCacheCompressionConfig),把”KV 不在前向路径上”的每一段生命周期都变成定义良好的挂载点,让压缩方法按需插入。框架今天挂了两条真实的方法:NVFP4 冷页量化(Storage-bound,页在 GPU 与主机/磁盘之间搬运时做编解码)与 TriAttention(Iteration-driven,生成过程中周期性评分、驱逐、并把缓存物理压实)。
这一篇的组织方式与前八篇一致:先说框架为什么必须存在、它选择在哪些边界插入;再把两条方法的机制、内核、准确性与代价拆开;最后回到与前八篇的接口契约——压缩从不修改注意力内核,也从不改变块的所有权。
问题:KV Cache 的绝大部分寿命不在前向路径上
先量化一下”为什么值得为这些不在前向路径上的时刻专门做设计”。
在第八篇里我们已经知道,一次前向只有两种形态:预填充(一次算完一整段提示的所有 K/V)与解码(一次只算一个新 token 的 K/V)。解码的注意力内核每一层都要读整条历史,所以缓存越大,每步越慢;同时缓存的字节数直接决定能同时容纳多少条序列。这两个约束在长上下文与智能体负载下同时被拉满:
- 一条长对话的 KV 很容易到几十 GB 量级;
- 智能体每一轮都把”到目前为止的全部对话”重新发一遍,提示几乎整段都是系统见过的前缀;
- 前缀在几分钟内就会再来一次。
也就是说,服务系统的收益结构变了:每省下一个字节的 KV,都会在命中率上反复还款——缓存更小意味着更多轮次能常驻、更多前缀能被复用而不是重算、更多显存能留给并发的请求。同一个前缀复用问题的另一面(同一前缀的并发请求同时涌入时账怎么记)可以参考站内的 前缀共享的扇出难题。
TensorRT-LLM 在框架之前已经有两条压缩路径,但它们都发生在前向计算内部:
| 路径 | 配置入口 | 何时生效 | 改变了什么 |
|---|---|---|---|
| 活跃 KV 量化 | KvCacheConfig(dtype=...) | 每个前向步的读写 | GPU 上活跃 KV 的数值精度 |
| 稀疏注意力 | SparseAttentionConfig | 预填充/生成的注意力计算内 | 注意力保留或处理哪些 KV 条目 |
| KV Cache 压缩框架 | KvCacheCompressionConfig | 前向之外的稳定边界 | 冷存表示、或保留的 token 集合 |
前两条路径解决的问题是”算得更少”,第三条路径解决的问题是”存得更小、搬得更快、留得更久”。它们并不冲突:一个实例可以同时开启活跃 KV 量化和压缩方法,因为它们作用在缓存生命周期的不同阶段。唯一的硬限制是同一实例只能启用一个压缩方法(Only one KV cache compression method can be enabled for each LLM instance)——原因后面会讲到,两个会话驱动的驱逐策略会互相破坏对方的记账。
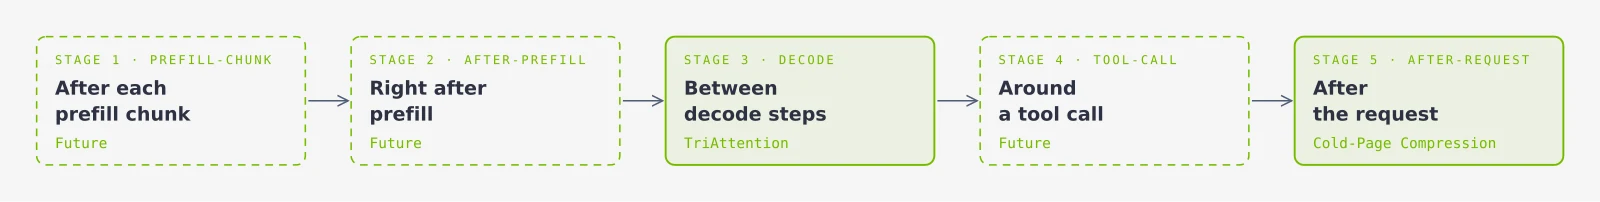
框架把 KV Cache 的一生切成五个阶段,其中三个在一请求运行期间,两个在请求之外:
- 预填充分块阶段:每个预填充分块之后;
- 预填充结束阶段:预填充刚做完、第一次解码之前;
- 解码阶段:解码步与解码步之间;
- 工具调用阶段:请求在等工具返回时;
- 请求结束阶段:请求结束后,KV 为复用而留在 GPU / 主机 / 磁盘。
阶段 1–3 归 Iteration-driven(迭代驱动):方法挂在执行器循环的阶段边界上,在下一次读缓存之前改写保留下来的 KV 状态。阶段 4–5 归 Storage-bound(存储绑定):此时没有请求在跑,缓存管理器持有 KV、跨请求保留它、并在 GPU/主机/磁盘之间搬运它;方法在页发生搬运时对页做变换。
这套划分不是命名习惯,而是所有权划分:阶段 1–3 里页仍然属于某个活跃请求,方法的改动必须让下一次前向读到自洽的状态;阶段 4–5 里页已经回到缓存管理器手上,方法的产物是一个”冷表示”,随时可能被另一个请求取回。
框架设计:配置、管理器与两条接线
框架的目标只有两条:用户用一个配置块打开一个方法,开发者用普通 Python 加自己的内核加一个方法,运行时其余部分不动。
三个部件
整个设计拆成三部分,不修改任何已有运行时组件:
- Compression config:一个配置块选择方法、携带方法自己的参数;一个工厂在模型跑起来之前根据它构造方法。
- Compression manager:方法继承的类。它已经坐在执行器循环的每个钩子上以及缓存管理器的页迁移路径里;方法只需要覆写它需要的那些函数。
- Method-specific kernels:方法自带的内核;既可以是新算法,也可以是与运行时已有部分的融合。
执行器和 KV 缓存管理器都是已存在的组件——框架不替换它们,只在钩子处与它们相遇,把调度和内存所有权留在原地。
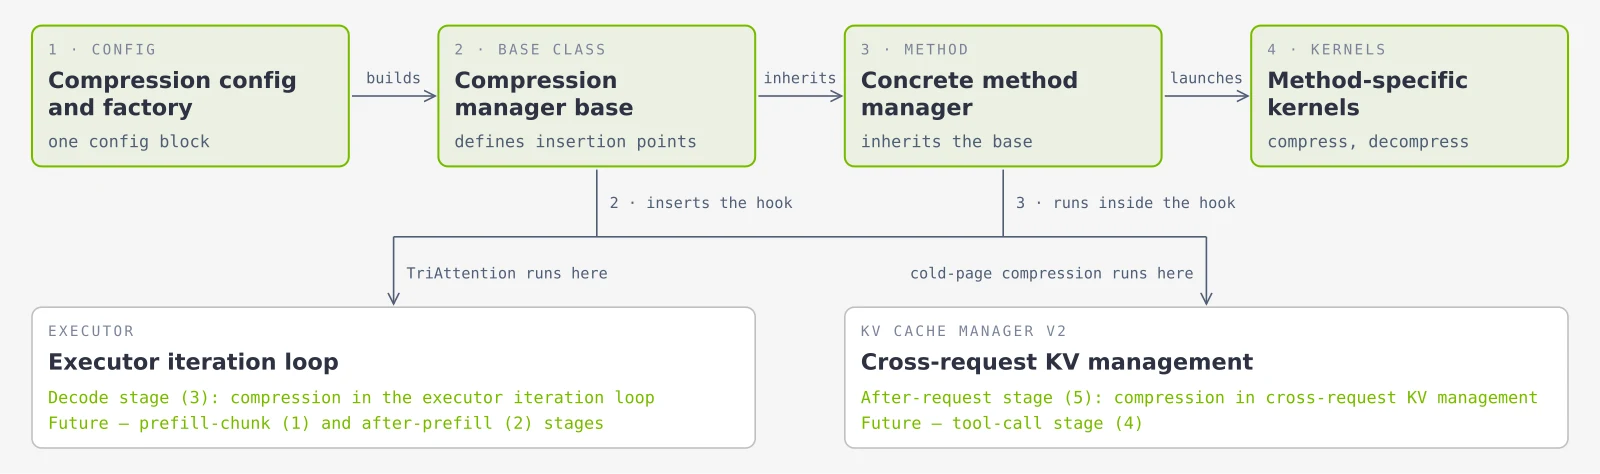
图里把整条装配线画得很清楚,值得逐格读:配置先构造管理器(1);管理器向执行器插一个钩子、向 KV 缓存管理器插一个钩子(2);具体方法继承管理器并在这些钩子里运行(3),启动自己的内核(4)。高亮的方框是框架部件,白色方框是已有系统组件。两条路径的接线方式不同,这是一个容易忽略但很关键的设计细节:
- Iteration-driven 管理器:在工厂阶段注册给生命周期回调;如果它需要访问 KVCM,就通过
bind_kv_cache_managers()在 KVCM 构造之后绑定。 - Storage-bound 管理器:在 KVCM 构造期间提供一个
NativeColdPageCodec,并且不注册迭代回调。
工厂必须跑在 KVCM 构造之前,正是因为 storage-bound 方法要在 KVCM 建冷布局时就已经就位。
配置与准入
kv_cache_compression_config 块里有两个东西:algorithm(选哪个方法)和方法自己的参数(例如 TriAttention 的 token budget、驱逐周期、eviction_mode 与校准文件)。公开的方法配置继承自 tensorrt_llm/llmapi/llm_args.py 里的 KvCacheCompressionConfig,方法特有字段留在具体子类上而不是公共基类。
create_kv_cache_compression_manager()(在 tensorrt_llm/_torch/pyexecutor/_util.py)在模型执行或存储迁移之前校验配置并构造具体管理器。为了支持构造与兼容性检查,压缩配置暴露以下契约:
| 成员 | 类型 | 作用 |
|---|---|---|
changes_physical_kv_length | 类属性 | 告诉 KVCM 压缩是否自己负责物理历史长度的对齐 |
supports_block_reuse() | 方法 | 块复用是否仍然有效 |
supports_speculative_decoding() | 方法 | 当前配置是否支持投机解码(方法自身的模式检查仍然生效) |
这里有一个很容易误判的语义,值得单独说清楚:changes_physical_kv_length 与 supports_block_reuse() 不冲突。它们描述的是两个独立性质。一个方法完全可以只压缩/压实”生成侧的后缀”,同时完整保留可复用的提示词前缀块及其身份——这样的方法可以设 changes_physical_kv_length = True,同时 supports_block_reuse() 返回 True。只有当方法无法保留可复用前缀或其映射契约时,才应该把块复用报为不支持。
兼容性方法是准入谓词,不是运行时回退:不支持的组合在构造阶段用明确信息拒绝,而不是跑起来之后悄悄降级。这与下一篇会讲的”压缩管理器不得在可见状态半更新时静默回退”是同一条原则的两个面。
所有权与失败边界
框架把职责切得很硬,这张表实际上是整套设计的”宪法”:
| 组件 | 拥有 | 不拥有 |
|---|---|---|
KvCacheCompressionConfig / create_kv_cache_compression_manager() | 方法选择与组合准入 | 页、内核、请求映射 |
KVCacheCompressionManager | 算法节奏、请求状态、决策、格式元数据、算法启动 | KVCM 分配策略、注意力运行时状态 |
NativeColdPageCodec | KVCM 布局解析、provider 路由、回退路由、Python/原生生命周期桥 | 格式相关的量化策略 |
KVCacheManagerV2 | 页、槽位、池、映射、迁移流、事件、发布、释放、回滚、冷存储 | 算法打分或量化决策 |
AttentionBackend | 消费已发布的活跃 GPU 表示 | 冷存储与迁移 |
两条规则值得拎出来独立记:
- 在物理改动之前,方法可以拒绝、推迟或执行一个合法的 no-op;
- 在提交工作或移动字节之后,必须遵守框架的完成与失败契约:不得在留下部分更新的可见状态时静默回退。
这条契约的存在,是因为压缩的产物往往被别的东西引用:块表、页表、前缀复用树的哈希、以及调度器的容量账。半更新的状态不会崩溃,只会让数值和容量悄悄偏掉——和第八篇结尾说写入路径错误模式时的结论完全一致。
为什么校准必须离线
框架还划了一条”推理平台不做训练/拟合”的界线,这条界线比它看起来更重要。
有些压缩方法需要校准或其它离线产物(TriAttention 就需要一份按注意力头采集的查询统计校准文件)。TensorRT-LLM 是推理平台,因此压缩方法不得在推理关键路径上做模型校准、语料收集、参数拟合或校准文件生成。用户应当在服务之前用自己的工具链、NVIDIA ModelOpt 或其它有文档的离线流程产出这些产物。
运行时的行为是:配置接受一个产物路径,管理器或模型初始化期间加载并校验它;一旦请求开始执行,生命周期钩子和冷页 encode()/decode() 只能消费已经就绪且不可变的状态。缺产物、与模型不兼容或格式损坏,要在初始化时快速失败。
这条界线有一个精确的例外:在编码一个页时现算的每块 scale,是运行时变换状态,不是模型校准——它数学上是每次压缩操作的一部分,所以允许在 encode() 里算。
Iteration-driven:五个钩子如何挂进执行器循环
迭代驱动方法的接入点,是 TensorRT-LLM 执行器本来就有的请求循环。每个 iteration 都是同一套:调度器挑一批请求;每个资源管理器为该批准备资源(prepare_resources);模型跑一次前向;每个管理器更新自己的状态(update_resources);请求结束时释放资源(free_resources)。
这三个回调恰好就是”没有东西在读缓存”的时刻。KVCacheCompressionManager 继承 BaseResourceManager,并被注册为最后一个资源管理器——这一点很重要:作为最后一个,它看到的缓存已经被更新过,所以它的钩子拿到的是最新的 KV 状态。
| 钩子 | 精确触发点 | 适合做什么 |
|---|---|---|
on_request_init(request) | 请求第一个预填充分块之前 | 初始化请求级压缩状态 |
on_context_step_end(requests) | 请求最后一个预填充分块之后 | 在生成开始前压缩已完成的上下文 |
on_generation_step_begin(scheduled_batch) | 每个被调度的前向迭代之前 | 准备一次迭代级压缩动作 |
on_generation_step_end(scheduled_batch) | 每个前向迭代与 KV 更新之后 | 在下一次迭代前压缩更新后的 KV 状态 |
on_request_finish(request) | 请求完成或中止时 | 释放请求级压缩状态 |
五个钩子默认全是 no-op。例子很直白:一个能在生成结束时推导出所有轮次输入的算法,就不需要 generation-begin 的快照钩子。框架负责注册与回调接线,开发者只需继承 KVCacheCompressionManager 并实现自己用到的钩子。
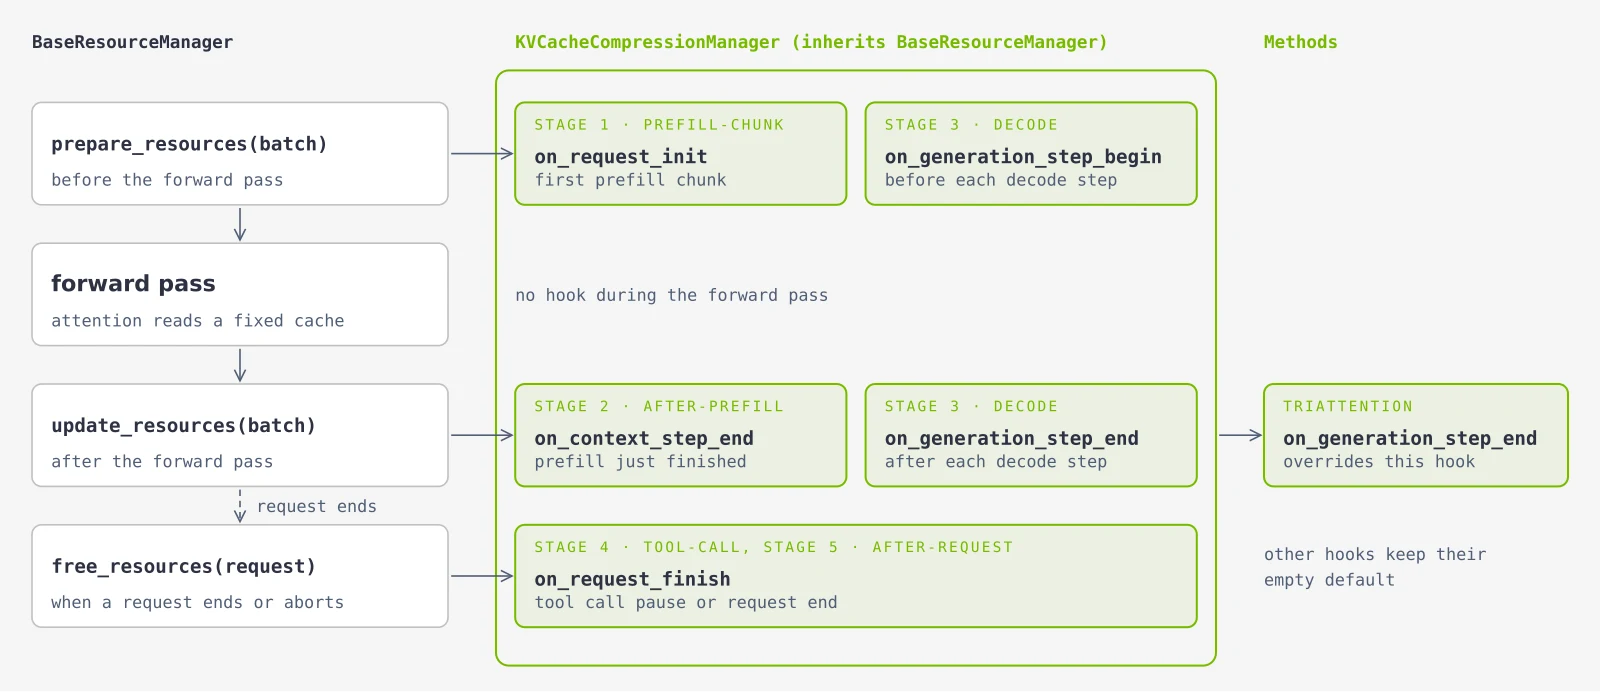
钩子在整条请求生命周期上的展开是:
请求初始化 -> 准备方法状态
预填充 / 分块预填充 -> 最后一个上下文分块完成 -> 可选的上下文终局压缩
每个解码迭代 -> 迭代开始 -> 模型前向与 KVCM 更新 -> 下一次迭代前的可选压缩
请求完成或中止 -> 释放方法状态这里藏着框架最重要的一条”无缝插入”约束:压缩的 GPU 工作必须在下一次前向读缓存之前完成,而决策侧的开销必须藏在执行器自己的回调里,不额外暴露 CPU 侧延迟。
共享的压实内核:只决定”留谁”,不决定”怎么搬”
框架里最有意思的一处工程切分,是把”保留策略”与”压实动作”彻底分开。
在钩子里,方法在自己的内核上跑;然后调用一个共享的、算法无关的压实内核(compaction)把保留的 token 打包、把释放的页还回去。所以方法只决定留谁。两条规则:保留策略与压实分离;GPU 工作必须在任何页被收缩或释放之前完成。
这个压实器的实现值得细看。tensorrt_llm/_torch/kv_cache_compression/compaction.py 的模块注释把这个 mover 的角色写得很清楚:
"""Batched physical KV-cache compaction: an algorithm-neutral mover.
``build_compaction_params`` pre-binds one cache's launch parameters;each round the caller writes its keep decision into the agreed rows and``compact`` packs every cache's move sources and fires its native launches."""它的接口被设计成两段式:build_compaction_params() 一次性预绑定一个缓存的启动参数;之后每一轮,调用方把自己的保留决策写进约定好的行,compact(params, request_count) 负责打包所有缓存的搬运源并触发原生启动。
打包发生在 Triton 侧,_pack_move_sources_kernel 的 docstring 一句话说清了语义:
Pack one decision row into one family's move sources: dense rows emit thekept tokens then the protected tail; SWA rows emit the latest window(ascending order: the native copy moves in place).也就是说,一个请求的搬运源是两段拼接的:先是被判定保留的 token 序号,然后是受保护的尾部(保留窗口尾部 / SWA 的最新窗口)。内核里对应的算术就一行:
dense_source = tl.where(move < KEEP_COUNT, kept, valid_len + move - KEEP_COUNT)move < KEEP_COUNT 的部分从保留列表里取,剩下的部分从 valid_len 往前推——这就是”保护尾部”在索引层面的实现。内核还处理一个广播分支:当 DECISION_ROWS == 1 时,每个请求的一行决策要喂给所有 KV 头的打包行(for head in tl.static_range(0, NUM_KV_HEADS))——因为保留决策通常是按请求全局做出的,而物理缓存是按 (层, 头) 分开存放的。
打包完之后,compact() 对每个 (缓存, 池组) 各发射一次原生算子:
torch.ops.trtllm.sparse_kv_cache_compact_layers(*args)注意最后一段注释里的边界划分:request_count 只用来决定 Triton 打包网格的大小;原生算子从页表视图的行数取 batch,并拿这个行数去校验配套张量。这是一个典型的”主机侧参数与设备侧真相必须对得上”的契约——对不上就应该报错,而不是默默按主机侧的数字处理。
Storage-bound:热页到冷页的 codec
存储绑定方法的接入点是 KVCM V2 的页迁移。这里要先建立 KVCM V2 对”一个页”的两套表示,这是理解冷页压缩的前提。
热表示:一页摊在多个池上;冷表示:一页是一个不透明块
- 热表示在 GPU 上:一个页摊在多个面向内核的池上。这正是第七篇讲过的布局——主池、索引器 K 池、MLA latent 池、以及混合模型里那些非注意力的 state 池,它们各有各的 stride,因为注意力内核要按各自的访存模式去读。
- 冷表示在 GPU 之外:一页是一个固定大小的不透明 blob(opaque blob)。
两者之间的变换由 IKvCacheColdPageCodec 完成:
Hot representation Cold representationmultiple kernel-facing pools <--------> one opaque blob per page codec接口名用的是 “Codec” 而不是 “Compressor”,原因文档里明说了:它定义的是一个表示变换,不一定是压缩算法。默认 codec 把所有热池的数据拼接进冷 blob,不减小尺寸;压缩型 codec 产生更小的冷页。两种情况共用同一套 KVCM 的分配、迁移与事件管理路径。
这个”默认 codec 不压缩”的设计非常关键,它让冷页机制本身(KVCM 侧的记账、事件、暂存)可以独立于压缩算法先落地并验证,压缩只是换了一个更小的 queryColdPageBytes 实现。
冷页布局换来的是实打实的工程收益:磁盘存储的文件数与 I/O 次数下降。原本要按”每个热池每页一次操作”发起,现在变成”每个编码后的冷页一次操作”。
Codec 的 ABI
enum class PageIndexLocation : int{ kBadLocation = -1, kHost, kDevice,};
struct alignas(8) PageIndexPair{ int32_t dst; int32_t src;};
class IKvCacheColdPageCodec{public: virtual bool configure( PoolGroupDesc const* gpuDescs, PoolGroupIndex numGpuDescs) noexcept = 0;
// Zero indicates failure. [[nodiscard]] virtual size_t queryColdPageBytes(LayerGroupId layerGroupId) const noexcept = 0;
[[nodiscard]] virtual LayerGroupId getBatchingLayerGroupId( LayerGroupId layerGroupId) const noexcept;
[[nodiscard]] virtual PageIndexLocation queryPageIndexLocation( LayerGroupId layerGroupId) const noexcept = 0;
virtual bool encode(LayerGroupId layerGroupId, void* dstBasePtr, PageIndexPair const* pageIndices, size_t numBasePages, cudaStream_t stream) noexcept = 0; virtual bool decode(LayerGroupId layerGroupId, void const* srcBasePtr, PageIndexPair const* pageIndices, size_t numBasePages, cudaStream_t stream) noexcept = 0;};几个契约值得逐条解释:
queryColdPageBytes()返回每个生命周期固定的冷页载荷大小,不支持变长输出。固定大小是”base + slot × size”寻址的前提,也是”磁盘一次 I/O 一页”的前提。configure()一次调用就把所有热 GPU 池的布局与基地址交出去,描述符按PoolGroupIndex连续排列;KVCM 只调用一次,返回false表示整个配置被拒绝。getBatchingLayerGroupId(lifecycle)返回同一 codec 等价类里最小的生命周期 ID。相同 ID 是一个承诺:算法、参数、冷页大小、编码后的表示都相同;额外的必要前提是它们属于同一个已配置的 GPU 池组。默认实现返回入参本身,即禁用跨生命周期批处理。这解释了表格里那句”只有等价的页才允许合并成一次 codec 调用”。queryPageIndexLocation()显式选择encode()/decode()用的指针位置。压缩型 codec 通常选kDevice;而一个同步消费索引来构造批量 DMA 描述符、逐页cudaMemcpyAsync调用或内核参数的 codec 可以选kHost。- KVCM 可以把同一 batching ID 下任意子集生命周期的索引对拼起来,用代表 ID 调一次
encode()/decode();KVCM 不承诺这个等价类里的每个成员都出现。 - encode/decode 在给定 CUDA 流上入队工作,不做同步;返回的
bool报告的是同步校验或提交是否成功,不是异步 CUDA 工作已完成。
最后两条指针生命周期规则是 ABI 里最容易写错的地方:
kHost:索引指针只在 codec 调用返回之前有效,异步工作不得保留或解引用它们;kDevice:索引指针在所有在该流上入队的 codec 工作完成之前有效,codec 只能在那个流上使用它们,且不得在工作之外保留。
PageIndexPair 的数组结构体(AoS)布局是刻意的:一个 GPU 工作项可以用一次对齐的 64 位加载同时取到 dst 与 src,而主机侧 codec 可以遍历同一个数组逐页发起拷贝。这就是为什么它是 alignas(8) 且 sizeof == 8 并带 static_assert。
布局等价类:LifeCycleId 与 PoolGroup
KVCM 用两个不同层次的概念管理映射:LifeCycleId 是稳定的语义键,池组(PoolGroup) 是物理分配的等价类,且具体属于某一种存储表示。
LifeCycleId ----> hotPoolGroup(lifecycle): multi-pool hot layout +---> coldPoolGroup(lifecycle): one-pool cold layout热与冷的生命周期到池组的映射互相独立。举个文档里的例子:两个生命周期可以共享一个 GPU 池组(因为未编码布局完全相同),却映射到不同的冷池组(因为编码后大小不同)。反过来,每个非热池组恰好包含一个物理池;冷页 stride 兼容的生命周期可以共享一个冷池组,而它们的编码内容可能不同——因为传给 decode() 的 lifecycle 会选择正确的解释方式。
这里有一个对整个分层存储都生效的简化:所有冷层使用同一套逻辑编码表示和同一套 lifecycle→冷池组映射。这使得主机与磁盘之间的原始 blob 拷贝无需解码再编码。物理层仍然可以按自己的分配粒度或 padding 包在逻辑载荷外面。
内存切分的口径也随之从”按热池组”改成”按层组”。KVCM 先为每个公开层组推导一个正的归一化热层字节配额权重(来源可以是 initial_pool_ratio、典型 batch 或约束);热初始化把映射到同一热池组的生命周期字节权重加起来;冷初始化先把每个热字节权重转成隐含的槽位计数权重,再用该生命周期的冷页大小转成冷字节,最后加进冷池组。这一步转换的目的很具体:当热与冷的页大小不同(或者池组映射不同)时,仍然保持层组之间的槽位计数比例。
于是 initial_pool_ratio 与更高层的 KvCacheConfig.pool_ratio 里每个层组恰好有一个热层字节比例,按层组 ID 顺序排列,而不是每个热池组一个。热层约束仍作为可行性下界,可能钳制最终的热分配;它们不会被投影到冷存储——冷池组只使用其分配器所需的结构性最小值。
迁移时,源与目的池组独立地从页的生命周期与缓存层级解析出来。文档里有一句警告必须记住:池组索引不得跨表示比较,仿佛它们标识同一个物理布局。
事务性:批处理代表如何被校验
在构造阶段,KVCM 会校验每个 batching 代表:已被配置、不大于每个成员、映射到自身、与每个成员属于同一组已配置的 GPU 池组与冷池组、且冷页大小与页索引位置相同。
对一次热/冷转换,迁移键包含物理源池组、物理目的池组与 batching 代表;KVCM 随后拼接已经排好序的索引对,做一次 codec 调用。热/热与冷/冷拷贝不使用 codec batching ID——它们不需要表示变换,直接拷字节。
内存契约:谁拥有内存、事件怎么保护字节
这一节是 C++ 侧最”硬”的部分,但理解它对判断一个压缩方法是否可行很关键。
- KVCM 拥有所有热、冷与暂存分配。冷存储不暴露给 codec 用户;除冷存储外只有 GPU 存储通过既有 KVCM API 暴露。
- KVCM 保证传给 codec 的每个热/冷数据基地址都是 GPU 可访问的(GPU 内存或 pinned mapped 主机内存)。磁盘地址永远不会传给 codec。当没有主机层时,KVCM 用临时 pinned 主机暂存缓冲做 GPU↔磁盘迁移。
- 索引的搬运路径有一个精巧设计:KVCM 先在获取稀缺暂存资源之前构造一个 packed 的
thread_local std::vector<PageIndexPair>。主机索引就直接传这个 vector,codec 在返回前消费完;设备索引则获取设备暂存,并提交一条 H2D 的cuMemcpyBatchAsync,带CU_MEMCPY_SRC_ACCESS_ORDER_DURING_API_CALL。 这条 flag 的含义是:CUDA 必须在 API 返回前完成对可分页主机 vector 的每一次访问,而 H2D 传输仍在 codec 流上异步进行。于是 KVCM 可以立即复用主机 vector,不需要 pinned 主机索引环。上传还带CU_MEMCPY_FLAG_PREFER_OVERLAP_WITH_COMPUTE,在平台支持时优先走拷贝引擎。 CUDA 12.8 之前没有cuMemcpyBatchAsync,KVCM 改用版本门控的分段内核上传可分页主机索引,其参数在启动期间被消费。 - 暂存设施与
CopyEngine解耦。当任一冷层既不是 GPU 也不是主机内存时,StorageManager独占一个 pinned 页环;在查询并校验每个生命周期的冷页大小后,把它定容成max(64 MiB, 3 * maxColdPageBytes)(带检查的乘法)。纯 GPU/主机冷存储不分配页环。 - 暂存管理器刻意不做内部线程安全:每个属于一个 KVCM 实例,而该实例的 API 目前串行化访问。文档还给出了将来的做法:如果 KVCM 日后支持并发公开调用,同步应当放在 KVCM 边界(每实例一把互斥锁),而不是放进每个暂存管理器内部。
分配器本身用的是字节精确的 next-fit 游标 + 空间有序的区间划分:live range 表示当前租约,retired range 保留这些字节上一个时间所有者的完成事件。分配从游标到物理末尾扫描连续的 retired 区段(跳过 live 区段),然后至多再从开头扫一遍;只有成功分配后游标才移动。如果没有区段满足最小请求,分配失败而不是等待——理由写得很直接:等待一个”不能在同一线程 retirement 的 live 租约”是死锁。
第八篇结尾留的伏笔在这里落地了:压缩必须在写入时决定”要不要写、写多少位”,在读取时决定”读出来怎么还原”。冷页 codec 就是这两个决定的实现位置。
冷页机制与”把 KV 放到更远的层级”是同一带宽预算下的两种走法:一个往”装得更小”走,一个往”放得更远”走。后者在站内 KV Cache Offloading 完全拆解 里已经拆过,包括分层放置、异步流水与跨机调度;两者的交汇点正是这里说的冷页表示——它决定了同一块主机内存在同样的带宽下能装下多少页、一次搬运要花多少字节。
NVFP4 冷页压缩:把量化藏进拷贝里
第一条真实方法:NVFP4 冷页压缩。它的出发点是一句很朴素但很有效的话——一页离开 GPU 的那一刻是压缩它的最佳位置。理由有三:这页本来就要被拷贝;它在冷的时候没有任何人读;只有被内存压力挤出去的页才会被处理。所以压缩近乎免费,并且恰好落在容量短缺的地方。它还只在压力下发生、从不作用于整块缓存,这让它对准确性的影响远小于”每一步都压所有页”的方案。
结果是:一个冷页缩到 FP16 的约四分之一、FP8 的一半——NVFP4 是每个值 4.5 bit(含 scale),也就是 0.5625 字节/值,对比 FP16/BF16 的 2 字节/值。
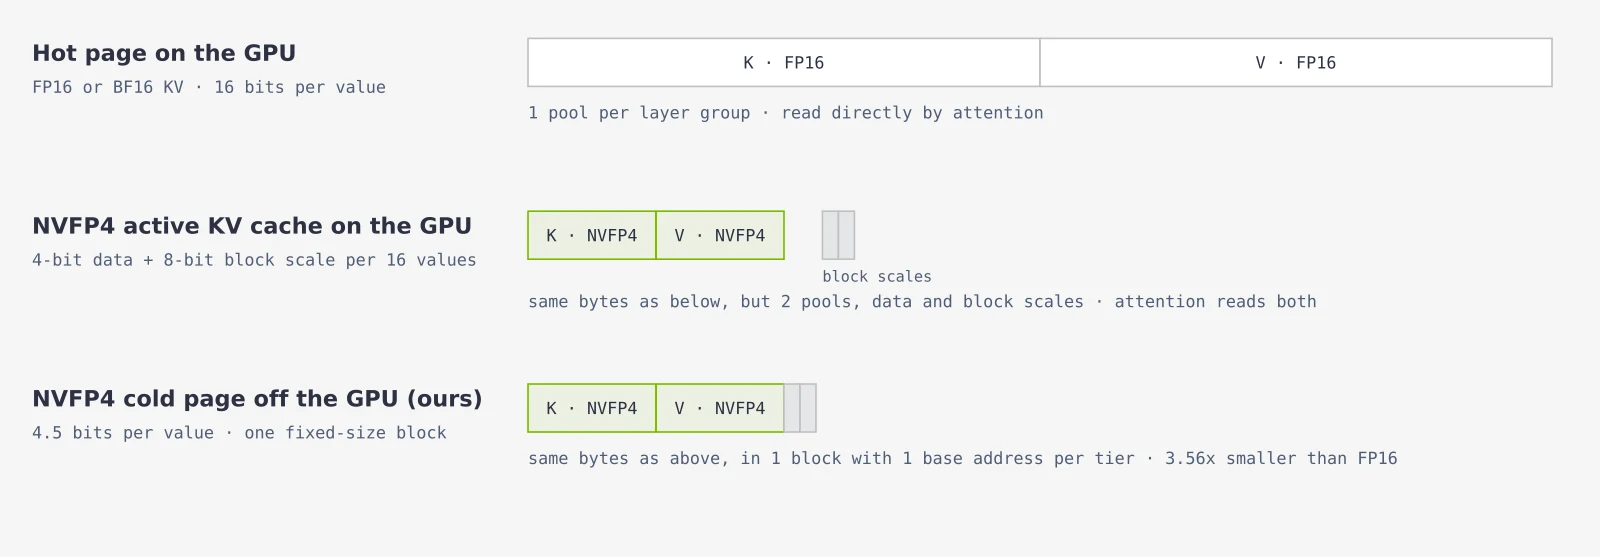
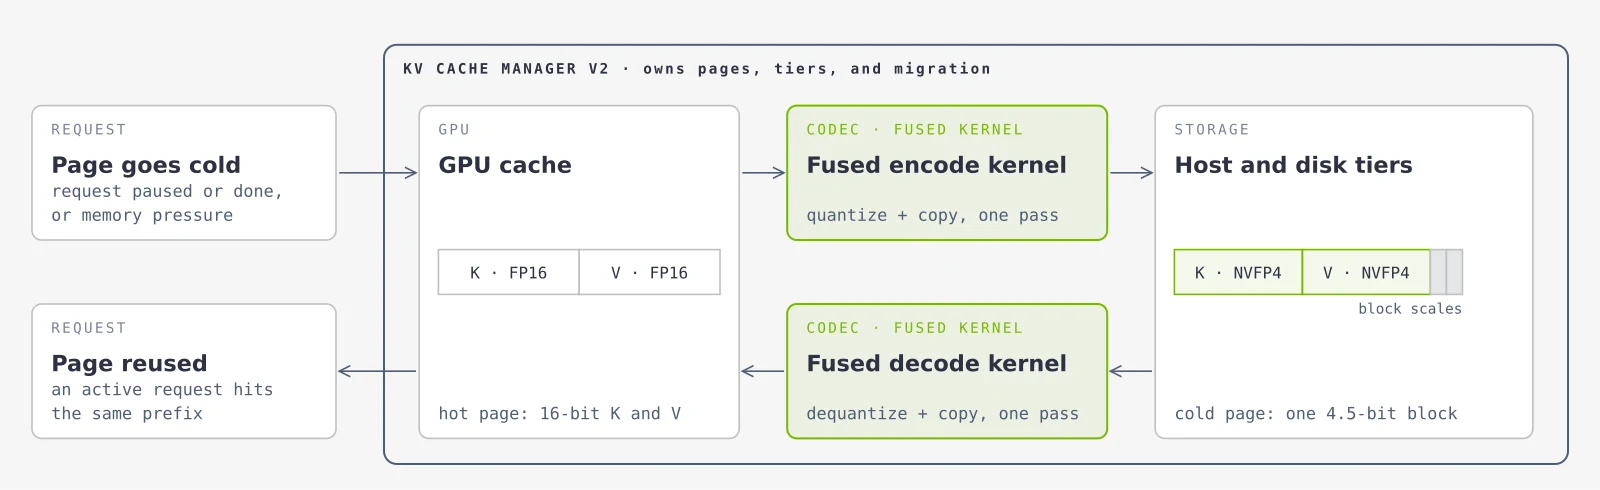
这张图值得逐块读,因为它同时解释了三个概念:
- 热页(左):GPU 上,16 bit/值,放在一个池里——注意力读的就是它;
- 活跃 NVFP4 缓存(中):字节数与冷页相同(4-bit 数据 + 每 16 个值一个 8-bit block scale),但放在两个池里,注意力要把它们一起读;
- NVFP4 冷页(右):同样的字节数,但打包进一个固定大小块,只有一个基地址。
“冷页和活跃 NVFP4 缓存字节数一样、布局不同”这件事,正是前面说的”表示变换不一定是压缩算法”的具体体现:活跃量化改变的是注意力读什么,冷页量化改变的是不在 GPU 上时怎么存。二者互不替代——文档里明确说了,冷页 NVFP4 与 KvCacheConfig(dtype="nvfp4") 的活跃 NVFP4 是两回事,前者只在冷层存 NVFP4、注意力读之前恢复成运行时类型。
融合的 encode/decode
当 KVCacheManagerV2 卸出一批页时,一个融合内核把它们量化并直接写进主机槽位;页回来时,它的 counterpart 在注意力读之前把它们反量化回 GPU 池。文档中对这套内核形态的描述很具体:
The kernels build on the NVFP4 conversion path TensorRT LLM already uses, so no calibration is needed, and they are shaped like the cache manager’s own copy kernel, streaming the page through shared memory and storing directly into host memory, so quantization rides the transfer instead of adding a pass.
三件事同时出现在这句话里:
- 不引入新的数值格式——复用已有的 NVFP4 转换路径,因此不需要校准。这直接消掉了框架里”校准产物”那条约束对这个方法的要求。
- 内核形状照抄缓存管理器自己的拷贝内核:把页流经共享内存、直接存进主机内存。这是性能上的关键——量化骑在传输的带宽上,而不是与之竞争。
- 只量化注意力的 K 与 V;页里其它东西(例如混合层里的递归 state)在同一次启动里原样拷贝。
目标缓存与草稿缓存都被覆盖,所以投机解码在 codec 开启时仍然可用。这在实现上不是小事:投机解码有独立的草稿缓存,两者都要有各自的冷页生命周期与 codec 映射。
冷页的”一页一块”
热页摊在多个池上是因为那是注意力读取的布局;冷页没有任何人读,所以它的布局纯粹为存储与传输选择:一个固定大小块,装着 NVFP4 数据、scale 以及那些无损缓冲。
由此得到一串连锁的简化:主机和磁盘用”base + slot × size”寻址;一次拷贝搬走一整页而不是每个缓冲一次;磁盘每页一次 I/O 而不是每个池一次;主机与磁盘之间的搬运原样拷字节、不需要解码再编码。这正是 KVCM 对 codec 提出的契约,也正是它能”不改缓存管理器就插进去”的原因。
K 向量里被位置编码(RoPE)的那一段
这是 NVFP4 冷页压缩里唯一需要精细权衡的地方:K 向量里带位置信息(RoPE)的部分对量化最敏感,压缩比与准确性在这里互相拉扯。
- 默认(
skip_rope_quantization: false):整条向量都量化,压缩比最好。DeepSeek-V4 遵循它自己的原生方案,把 RoPE 部分存成两个 FP4 分量(2FP4),第二个分量保存第一个的舍入误差——在这个压缩比下把准确性保住。nvfp4_residual_dim默认64,即 64 个 RoPE 值走 2FP4;设成0就整行单一 NVFP4(只支持0和64)。 - 另一侧(
skip_rope_quantization: true):RoPE 部分按热缓存精度原样拷进冷页(FP8 或 BF16),其余值走 NVFP4。代价是冷缓存存储更大。
开发指南把”K/V 向量的哪些数字变成 NVFP4”讲成了内核必须能表达的形状约束:
For each row the kernel turns one contiguous piece into NVFP4 (4-bit values plus one scale per 16 numbers) and copies everything before and after that piece unchanged.
也就是说,每行只有一段连续区间可以被量化,前后原样拷贝;压缩缓冲用 quantized_range_start 与 quantized_range_elements 记录这段区间。codec 会拒绝内核表达不了的情形:整条向量都是 RoPE(没有东西可量化)、RoPE 在向量中间(会变成两段)、或者这段区间的起点/长度不是 16 的倍数(scale 组的大小)。
RoPE 的位置从哪里找?文档给了三条模型特定的规则:MLA 层每 token 只存一个 576 数字的向量(其唯一缓冲是 key),RoPE 是最后 qk_rope_head_dim 个数字;GQA 头若只旋转前导数字(Qwen3.5),是前 head_dim * partial_rotary_factor 个;DeepSeek-V4 压缩条目是 512 个数字里的最后 64 个。V 向量不携带位置,永远整条变 NVFP4。
还有一个实现层面的开关范围约束:skip_rope_quantization 只对 _SKIP_ROPE_QUANTIZATION_MODEL_TYPES 里的模型类型生效(其 RoPE 布局是 codec 知道的);其它模型会打警告并量化整条向量。而草稿模型的冷页忽略两个 RoPE 选项,一律用单一 NVFP4。
开发指南顺带说了一条新增模型的陷阱,值得写给以后要扩展的人:只加一个 model_type 是不够的。对于交错旋转维度、或者 MLA 缓存同时暴露了 value 缓冲的情况,必须实现显式的放置规则并测试,然后才能把模型加进支持列表。另外,RoPE 宽度取自 rotary-width 字段或 partial rotary factor,绝不能从 theta 或 rotary_emb_base 推。
TriAttention:在生成过程中评分、驱逐、压实
第二条真实方法走的是完全不同的路径。它的观察是:在长生成里,绝大部分 KV 是生成出来的 token,而它们中的大多数对将来的查询并不重要。
TriAttention(ICML 2026)从一次性离线采集的每头查询统计里预测哪些 token 重要,每若干 token 就驱逐其余并把缓存压实,于是解码读的是更短的缓存、更多序列能塞进 GPU。
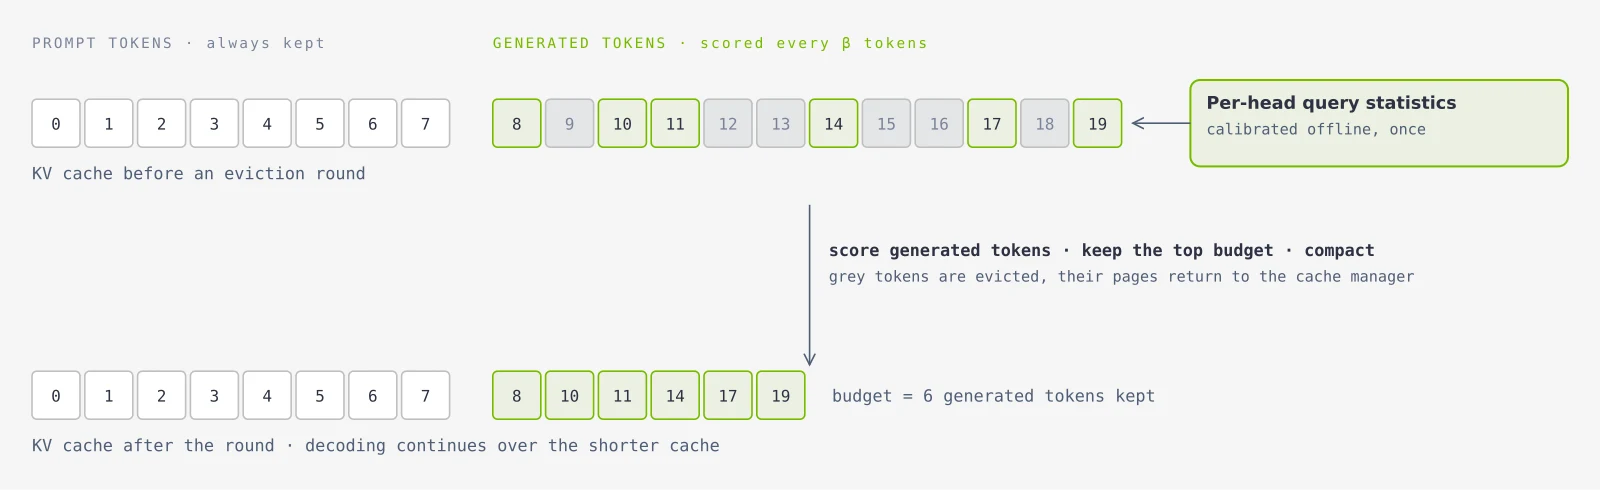
一轮的语义是:提示词保持完整不动,驱逐的是生成出来的 token。每 β 个新 token,用每个头校准好的查询统计给生成 token 打分;budget 个得分最高的留下,其余被驱逐;缓存被压实,解码继续在更短的缓存上跑。
一轮里的每个内核
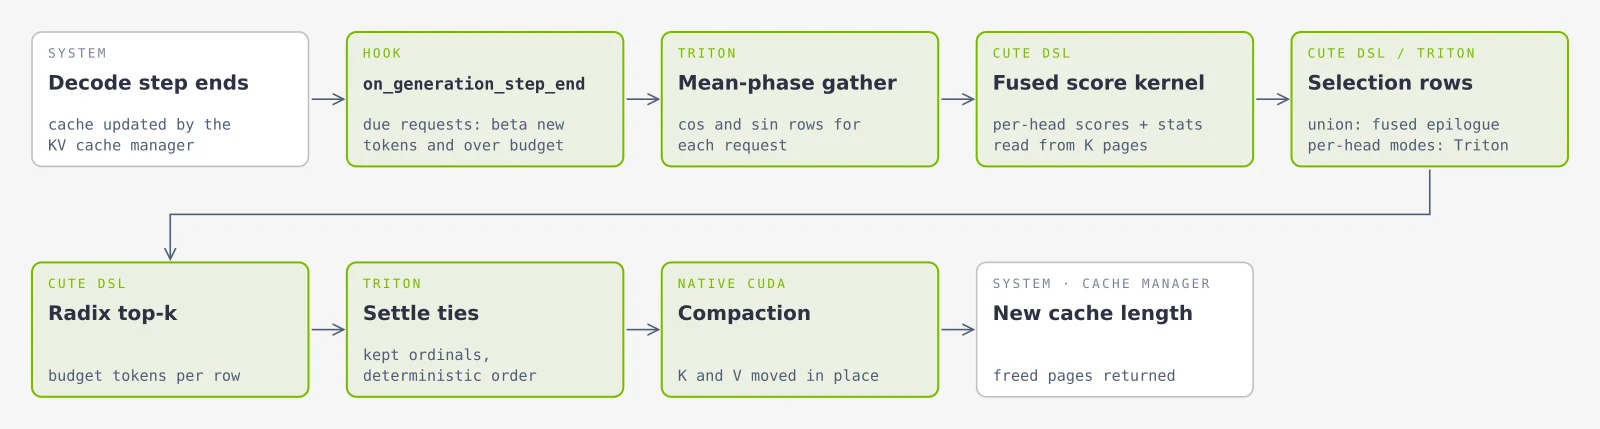
这张图是这一节的主干,一个方框一个内核:
on_generation_step_end钩子挑出到期(due)的请求——注意是”到期”而不是”全部”,一轮每beta个生成 token 才跑一次,且只在序列超过budget之后;- 一个 Triton 内核收集 mean-phase 行;
- 一个融合的 CuTe DSL 内核从 K 页给每个生成 token 打分;
union模式下同一内核里直接产生选择行,per-head 模式下则由一个 Triton 归约产生; - CuTe DSL 的 radix top-k 加一个 Triton 的 tie-settling 段选出保留的 token;
- 一个原生 CUDA 内核压实 K 与 V;
- 缓存管理器接收新的长度与被释放的页。
三个实现决策值得点出来:
- 打分与选择用 CuTe DSL,压实用原生 CUDA。理由是每一段用最适合的内核路径:打分/选择是头维小、token 维大的规约型计算,适合 tile 化的 DSL;压实是在分页缓存上原地搬移,需要精确的地址算术与块边界处理,用原生 CUDA 更直接。
- 整轮驱动来自执行器自己的回调,所以CPU 侧开销也不暴露。文档说得很直接:这些内核把 GPU 时间压到解码步的一个小分数,而轮次是从执行器的回调里驱动的。
- 注入点是
on_generation_step_end,TriAttention 唯一覆写的钩子。时序要求是:一轮必须在某次解码步写完它的 token 之后、下一次步读缓存之前运行。还有一个边界条件:一次确认了多个 token 的投机步最多触发一次。
物理压实与”保留策略分离”
TriAttention 在钩子里用自己的内核打分并选择 token,然后调用共享的压实器。这就是前面 compaction 那节讲的机制:决策行由方法写,搬运由框架做。
压实器的设计动机在代码注释里交代得很清楚——它要同时处理几类缓存结构:
- dense 行:搬运源 = 保留 token + 受保护尾部;
- SWA 行:搬运源 = 最新窗口,且按升序给出,因为原生拷贝是原地移动的;
- 每层共享的 SWA 行:
PER_LAYER分支里,只有第一个层的决策行写它(decision_row < NUM_KV_HEADS),头号由decision_row % NUM_KV_HEADS得到。
原地搬移要求源序号升序,这是一个很典型的”物理压实”约束:压缩后的缓存要占据同一块内存的前缀,所以搬移必须从低序号往高序号做,否则会覆盖还没搬走的源数据。
校准放在哪
TriAttention 需要一份模型特定的离线校准文件。配置里给的是 calibration_path,运行时不生成它。这与前面”校准必须离线”的框架约束一致,也是这个方法在部署上的主要额外步骤。配置形态是:
llm = LLM( model="<path_or_hf_id>", kv_cache_config=KvCacheConfig(use_kv_cache_manager_v2=True), kv_cache_compression_config=TriAttentionKvCacheCompressionConfig( budget=2048, beta=128, eviction_mode="union", calibration_path="/path/to/model-calibration.pt", ),)两条方法的支持边界
框架是共享的,但两个方法支持的缓存结构不同。两张表合起来其实是一份”能力矩阵 + 平台前置条件”:
先交代一句背景:驱逐类做法并不新鲜,站内已经拆过按注意力分数保留重 token 的 H2O、按观察窗口投票的 SnapKV、以及查询感知做页级选择的 Quest。TriAttention 与它们的区别不在打分思想,而在它把”选谁”与”怎么搬”分开,并把搬的动作交给框架里那个共享的 mover——这也是它能在不改注意力内核的前提下接进一个新推理框架的原因。
| 缓存结构 | NVFP4 冷页量化 | TriAttention |
|---|---|---|
| MHA / MQA / GQA 注意力 KV | 支持 | 支持 |
| MLA 注意力 KV | 支持 | 不支持 |
| GDN、SSM 与 Conv 状态 | 量化跳过并无损保留 | 不支持 |
| DSA 等注意力旁路缓冲 | 无损保留 | 不支持 |
| DeepSeek-V4 CSA 缓存 | 支持(NoPE 走 NVFP4,RoPE 默认 2FP4,或 skip_rope_quantization: true 时保持原精度;索引器缓存无损保留) | 不支持 |
| DeepSeek-V4 SWA、HCA 与 compressor 状态 | 无损保留 | 不支持 |
两边的共性平台要求是:PyTorch 后端、KVCM V2、以及 SM100 / SM103 / SM107(Blackwell 及更新)的 NVIDIA GPU。
三处细节值得单独解释:
- 为什么 TriAttention 不支持 MLA:它要按 (层, 头) 对 token 打分并保留,而 MLA 的缓存是低秩 latent,一个 token 只有一个压缩条目、同时供 K 与 V 使用(第七篇讲过 latent 池的存在)。驱逐 token 依然可行,但方法本身是在 KV 头的语义上定义的,与 MLA 的共享 latent 布局不对应。
- 为什么”无损保留”要和量化并存:一个页里除了注意力 KV 还有别的状态——混合层的递归 state、DSA 的索引器缓存、DeepSeek-V4 的 SWA/HCA/compressor 状态。这些要么被量化跳过、要么原样保留,因为它们的数值语义与”每 token 一个 K/V 向量”完全不同,量化它们不会带来好处,只会带来风险。表格里”preserved losslessly”出现的每一格,都是 codec 必须显式处理的分支。
- DeepSeek-V4 的两条限制:它要求
tokens_per_block为 128 或 256(其缓存管理器的约束),并且冷页压缩不覆盖 FP8fp8_ds_mla底部 scale 的 KV 布局——要用普通的 FP8 或 BF16 运行时 KV 布局。如果scale_checkpoint_path提供了 ModelOpt 的 KV scale,只有 per-layer 的 K scale 会应用到 CSA 缓存,V scale 不用。
已在测试范围内的模型族:NVFP4 冷页量化测过 Qwen3、Qwen3.5、GLM(含 GLM-5.2)、DeepSeek-R1、DeepSeek-V4;TriAttention 测过 Qwen3、GPT-OSS、Llama 3。文档强调这是测试清单而不是穷尽的支持清单。
代价与收益:从数据看这套设计值不值
方法的价值最终要落在端到端的服务指标上。这里的数字都来自同一硬件、同一软件构建、同一服务配置下的 A/B 对比,只有压缩设置不同;而且每一条结果被接受之前,都用 /metrics 上的 offload/onboard 字节计数器与 Nsight Systems trace 确认页确实在测量窗口内被压缩过——这一点很重要,“配置解析成功”从来不是”压缩生效”的证据。
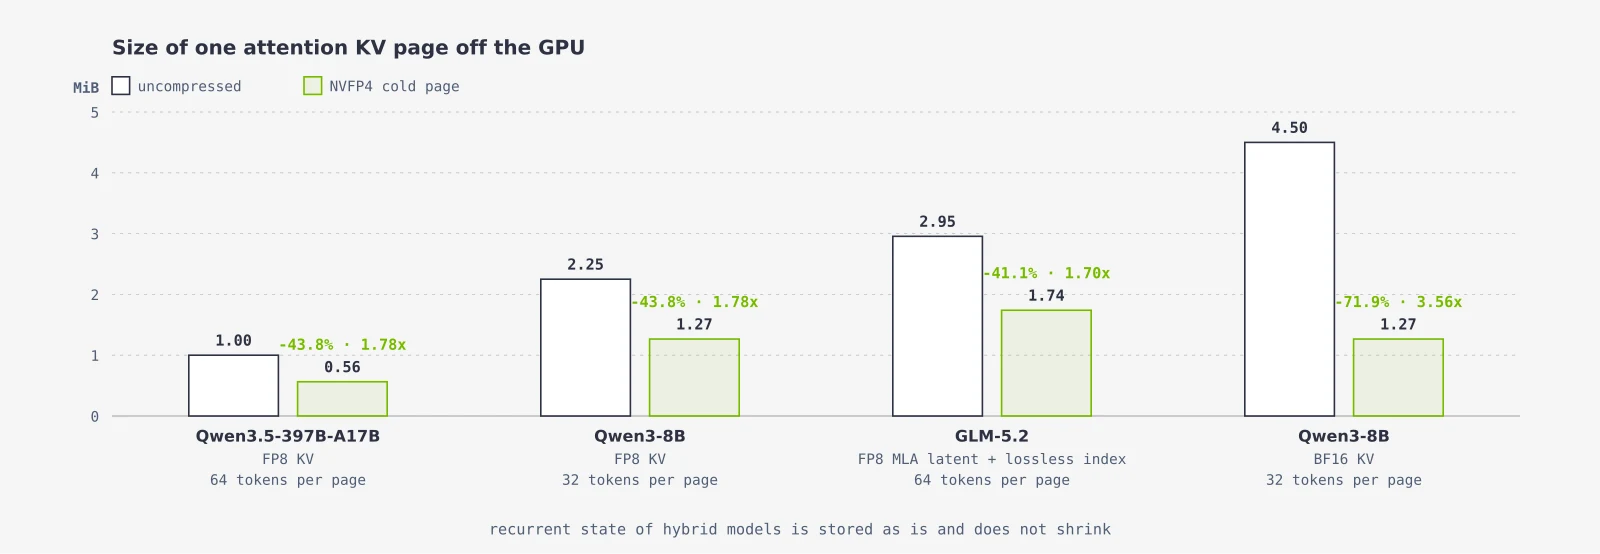
冷页大小:一个注意力 KV 页在 GPU 之外的实测大小,未压缩 vs NVFP4 冷页。页大小取决于模型(Qwen3.5-397B-A17B 与 GLM-5.2 是 64 token/页,Qwen3-8B 是 32 token/页)。FP8 页缩 43.75%,BF16 页缩 71.9%;GLM-5.2 的 MLA 页缩得略少,因为它的索引缓冲保持无损。
服务前沿:在一个大模型、复杂智能体负载上(GLM-5.2 服务 AgentX 轨迹,跨多个 GPU 数与并发度),取 NVFP4 冷页前沿上吞吐最高的十个点,为每个点再跑一遍未压缩 FP8 主机缓存的同一配置:
- 收益最大处达到每 GPU 吞吐 +84%、P90 交互性 4 倍;在最不缺命中的地方收益归零;
- 十个点平均 +21% 吞吐、+92% 交互性。
收益的两条来源,这是整节里最值得记住的分析:
- 命中率上升。当主机层装不下工作集时,更小的冷页意味着下一轮到来时更多前缀还在。文档给出的量级是命中率上升 5 到 34 个百分点。在一个受 GPU 限制的部署里,未压缩层只能读到一半多点的前缀;NVFP4 在每个磁盘层大小上都命中更多、完成更多、答复更快,峰值处多完成 64% 请求、TTFT 低 48%。
- 命中从磁盘移到主机。即使命中率已经饱和,冷页依然有收益:一次从磁盘服务的命中远比从主机内存服务的命中贵,而单看命中率无法区分二者。TensorRT-LLM 现在按服务命中的层来计数。在 GPU 缓存被封顶的例子里,命中率几乎不变,但磁盘服务的命中占比从 31% 降到 19%(GLM-5.2)、从 14% 降到 0%(Qwen3.5-397B-A17B),尾部 TTFT 大约减半,同一窗口内多完成 40% 到 50% 的请求。
第二条尤其值得琢磨:它说明 “命中率”这个指标本身是有误导性的,服务系统真正的收益来自”命中被哪一层满足”。压缩把一个命中从昂贵的层搬到便宜的层,即使总命中率不动,端到端指标也会大幅改变。
准确性:QDQ 往返不累积误差。 页只在离开 GPU 时被量化,所以准确性问题变成”反复的量化-反量化往返会不会累积误差”。答案是不会:把每一个可表示的 FP8、FP16、BF16 值经过最多四次往返测量,到原始值的距离就是一次性的量化误差,不随往返次数变化;到上一次往返的距离从第二次起为零。端到端上,Qwen3-8B 在 AIME24/AIME25 上第二次往返复现第一次往返的每一个输出。
到大模型、难推理任务、且卸载页占比差异很大的场景下,准确性与未压缩基线无法区分:Qwen3.5-397B-A17B 在 AIME25 上,28% 的复用页被压缩时是 90.0%,61% 被压缩时是 90.2%;MATH-500 无论 9% 还是 23% 的页被压缩,波动都在 0.4 分以内。
TriAttention 的性能:Qwen3-8B、单张 B200、每请求 1024 输入与 16384 输出 token。batch size 32 时,压实后的缓存解码快 27% 到 60%(取决于 budget);dense 缓存在 batch size 64 时耗尽显存,而 TriAttention 继续扩到 128,达到 dense 峰值吞吐的 2.7 倍。
TriAttention 的准确性与 budget:驱逐按设计就是有损的,budget 就是那个旋钮。Qwen3-8B 与 GPT-OSS-120B 上,从 8192 token 起,准确性在噪声范围内等同于 dense,而解码 KV 仍然缩小 2 到 4 倍;在 4096(也就是上面那组吞吐数字用的 budget),下降约 5 分,换来解码 KV 小 7.9 倍。
这两组数据合起来给出的工程结论是:冷页压缩基本是”白拿”的容量(只在被挤出去的页上生效、往返不累积误差),而驱逐是”明码标价”的容量(budget 直接对应一个已知的准确性代价)。选择哪一个,取决于你的负载是卡在”装不下”还是卡在”读得慢”。
与前八篇的接口:压缩为什么不该碰注意力内核
把这一篇接回前八篇,可以看清框架设计里的三条硬边界:
第一条:注意力内核永远看不到压缩页。 冷页只存在于 GPU 之外的层级,页回到 GPU 之前 decode 就把运行时类型恢复好了。活跃 GPU 表示不变、页身份不变、token 身份不变、块复用不变。这是”一个框架服务所有模型”的前提——不需要为每种压缩方法在注意力里加分支。
第二条:页的所有权始终在 KVCM。 压缩管理器不拥有任何页,因此从不触碰准入或内存记账。这一点与 llama.cpp 那个系列里 llama_context 与记忆系统 的写法对照起来看很有意思:llama.cpp 把 KV 的组织与 slot 序列操作都压在 llama_memory_i 抽象里,而 TensorRT-LLM 选择把”表示变换”单独抽成 codec,让缓存管理器只管所有权与搬运。文档里的说法是:KVCM 保持对页、槽位、缓存层级、分配、迁移、复用、完成顺序与映射发布的权威。压缩方法改变的是”一页在冷的时候长什么样”或者”缓存里保留哪些 token”,而不是”谁拥有它”。
第三条:两条路径不互相越界。 开发指南专门写了一句纪律:不要把迁移策略加到迭代钩子里,也不要让冷页 provider 去分配或发布 KVCM 页。原因回到前面那张所有权表——一旦越界,记账就会出现两个来源,而第八篇讲过的结论在这里同样成立:不会被发现的错误只会让数值和容量悄悄偏掉。
从”一次前向”的视角看,第八篇把 KV 通路概括为”调度器决定写什么、prepare 决定往哪写、写入内核决定怎么落盘、注意力内核决定怎么取回”。第九篇补上的是这条链外面的两层:压缩决定”不在前向路径上时它长什么样”(冷页表示)与”它还剩多少”(保留集合)。四层契约之上又加了两组:codec ABI(冷页大小、索引位置、批处理等价类) 与 生命周期钩子契约(何时可以改、改完谁负责完成)。
下一篇进入 TensorRT-LLM 的显存与缓冲管理:PyExecutor 里那套 BufferManager / KVCacheManager 的显存预算如何在初始化时被算出来、KV 池之外的 workspace 与 CUDA Graph 缓冲如何共享同一份显存、以及 max_num_tokens、max_batch_size 这些参数如何一路约束到池的几何形状。这一篇讲的压缩会改变冷层的容量需求,而冷层的容量最终仍然要落进同一个显存预算里——两条线索会在那里合上。
小结
- 压缩的动机不是”算得更少”,而是 KV Cache 大部分寿命不在前向路径上:它在分块之间等、在工具调用期间停、在请求之后保留、在显存不够时被搬走。框架把这些时刻变成挂载点。
- 五个生命周期阶段分成两条接入路径:迭代驱动(阶段 1–3,挂进执行器循环的
prepare_resources/update_resources/free_resources三个回调,组成五个钩子)与存储绑定(阶段 4–5,挂进 KVCM 的页迁移)。一个方法可以只用其中一条或两条都用。 KVCacheCompressionManager被注册为最后一个资源管理器,所以每个钩子看到的缓存已经更新过;五个钩子默认全是 no-op。- 保留策略与物理压实彻底分离:方法只写”保留决策行”,共享的
compaction.py负责打包搬运源并触发原生算子。_pack_move_sources_kernel的语义是”dense 行 = 保留 token + 受保护尾部;SWA 行 = 最新窗口按升序”,而内核里就是一行tl.where。 - 冷页 codec 的接口叫
IKvCacheColdPageCodec而不是 Compressor,因为它定义的是表示变换:热表示是一页摊在多个面向内核的池上,冷表示是一页一个固定大小的不透明块。默认 codec 只拼接、不缩小,让冷页机制可以独立于压缩算法落地。 - codec 的 ABI 契约里最关键的三条:
queryColdPageBytes固定大小(支持 base + slot × size 寻址与一页一次 I/O);getBatchingLayerGroupId用”最小的等价生命周期 ID”表达批处理合并的承诺;queryPageIndexLocation明确索引指针在主机还是设备,并对应两套不同的生命周期规则。 - 布局等价类分两层:
LifeCycleId是语义键,池组是物理分配等价类且属于某种表示;池组索引不得跨表示比较。内存切分从”按热池组”改为”按层组”,冷初始化走”字节权重 → 槽位计数权重 → 冷字节”的两步换算,从而在热冷页大小不同时仍保持层组间的槽位比例。 - 索引搬运用
CU_MEMCPY_SRC_ACCESS_ORDER_DURING_API_CALL换来”不需要 pinned 索引环”:CUDA 必须在 API 返回前消费完可分页主机 vector,而 H2D 传输保持异步。暂存管理器刻意不做内部线程安全,未来的并发同步应放在 KVCM 边界。 - NVFP4 冷页压缩的出发点是”一页离开 GPU 的那一刻是最好的压缩位置”:这页本来就要拷贝、冷的时候没人读、只有被挤出去的页才处理——所以近乎免费,且只在容量短缺处生效。融合 encode/decode 复用了已有 NVFP4 转换路径因而不需要校准,内核形状照抄拷贝内核,把量化骑在传输带宽上。
- RoPE 那一段是压缩比与准确性的拉锯点:默认整条量化(DeepSeek-V4 用 2FP4 保住准确性),或
skip_rope_quantization: true把 RoPE 按热精度原样拷入。内核只能表达一段连续区间,所以 codec 会拒绝”整条都是 RoPE""RoPE 在中间""区间不是 16 的倍数”三类形状。 - TriAttention 的核心是”提示词不动、只驱逐生成 token”,每 β 个 token 一轮、只在序列超过 budget 后触发;打分与选择走 CuTe DSL,压实走原生 CUDA;唯一覆写的钩子是
on_generation_step_end,且投机步最多触发一轮。 - 支持矩阵里的每一格”无损保留”都是一个必须显式处理的分支:混合层的递归 state、DSA 索引器缓存、DeepSeek-V4 的 SWA/HCA/compressor 状态都不是”每 token 一个 K/V 向量”的语义。TriAttention 不支持 MLA,因为 MLA 的共享 latent 与”KV 头”的语义不对应。
- 校准必须离线:TensorRT-LLM 是推理平台,不得在推理关键路径做拟合;运行时只加载并校验产物。唯一例外是编码时现算的每块 scale——它是每次压缩操作的数学组成部分,属于运行时变换状态。
- 端到端收益里最有价值的一条观察是”命中率会骗人”:NVFP4 冷页把命中从磁盘搬到主机(31%→19%、14%→0%),命中率几乎不变而尾部 TTFT 减半、同窗口多完成 40%–50% 请求。
- 两类方法的代价性质完全不同:冷页压缩只在被挤出去的页上生效、QDQ 往返不累积误差,基本是”白拿”的容量;驱逐是明码标价的容量(budget 4096 时准确率降约 5 分、解码 KV 小 7.9 倍)。
- 框架的三条硬边界:注意力内核永远看不到压缩页、页所有权始终在 KVCM、两条路径不互相越界(不把迁移策略塞进迭代钩子,不让冷页 provider 分配页)。
参考资料
- TensorRT-LLM 官方仓库(NVIDIA/TensorRT-LLM)
- TensorRT-LLM KV Cache Compression 功能文档(框架、两条路径、方法支持矩阵与前置条件)
- KV Cache Compression in TensorRT LLM(官方技术博客:设计哲学、五个阶段、两条方法的工作原理与评测)
- KV Cache Compression Development Guide(框架架构、生命周期钩子、所有权边界、新增方法与验证流程)
- KVCacheManagerV2 Cold-Page Codec Design(
IKvCacheColdPageCodecABI、布局分组与暂存/事件契约) - TensorRT-LLM
tensorrt_llm/_torch/kv_cache_compression/compaction.py:算法无关的批量物理压实器 - TensorRT-LLM
cpp/tensorrt_llm/batch_manager/kv_cache_compression/nativeColdPageCodec.h:NativeColdPageCodec适配器 - TensorRT-LLM
tensorrt_llm/_torch/kv_cache_compression/quantization_for_cold_page/:冷页量化的管理器与布局策略 - TensorRT-LLM
tensorrt_llm/_torch/kv_cache_compression/triattention/triattention.py:TriAttention 的评分、选择与压实调度 - TensorRT-LLM
tensorrt_llm/_torch/pyexecutor/resource_manager.py:KVCacheCompressionManager与资源管理器回调 - TensorRT-LLM
tensorrt_llm/llmapi/llm_args.py:KvCacheCompressionConfig与方法配置 - TensorRT-LLM 冷页压缩示例:NVFP4 单机与分离式部署配置
- TensorRT-LLM TriAttention 示例:校准、配置参数与当前要求
- Mao et al., TriAttention(ICML 2026)
- TensorRT-LLM 官方文档:KV Cache System(池结构、分池规则与保留策略)
- TensorRT-LLM 官方文档:Sparse Attention(token 驱逐、token 选择与掩码)
- FlashInfer 官方文档:KV-Cache Layout(NHD/HND、页表三件套与 last_page_len)
- RocketKV: Accelerating Long-Context LLM Inference via Two-Stage KV Cache Compression(ICML 2025)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



