


TensorRT-LLM 源码完全拆解(十四):量化全链路——checkpoint 怎么读、权重怎么量化、Linear 怎么选方法
TensorRT-LLM 是一套以「把推理压到硬件极限」为目标的推理栈。前面十三篇沿着调度器、KV Cache、注意力后端、并行通信与 MoE 逐层往下走,但一直绕开了一个对性能影响同样巨大的子系统:量化。这不是可以顺带一提的话题——一个 70B 模型用 FP8 还是 NVFP4 加载,决定的是权重能不能装进显存、显存带宽够不够喂满 Tensor Core、以及一个 decode step 是 10 ms 还是 5 ms。本篇文章按数据在系统里的真实流向,把量化拆成三段:读到什么(checkpoint 与显存占用)、怎么量化(离线量化流程与 scale 约定)、怎么用(运行时 Linear 方法选择与 kernel 落地)。
问题定义:量化在推理栈里到底改变了什么
量化常被描述成「把权重从 16 位压到 4 位」,这只是表象。真正被量化改变的是四件事:显存容量、显存带宽需求、Tensor Core 的输入格式,以及数值精度。前两项决定了模型能不能加载、一个 decode step 要花多少时间,后两项决定了要写多少额外的 kernel 代码。
容量:权重和 KV 缓存是两笔独立的账
以一个 70B 稠密模型为例( 个参数):
- BF16 权重: GB;
- FP8 权重:约 70 GB;
- NVFP4(4-bit)权重:约 35 GB,再加缩放因子开销。
权重是静态的,第二笔账 KV 缓存则是随序列长度线性增长的动态开销。对于采用 MLA 或者 GQA 的模型,单个 token 的 KV 缓存大小可以写成:
其中 是层数, 是 KV 头数(GQA 下远小于注意力头数), 是每头维度, 是每个元素的字节数,系数 2 来自 K 和 V 两份。把 从 2(BF16)换成 1(FP8)或 0.5(NVFP4),KV 缓存的容量上限直接翻倍或翻四倍。这两笔账都直接决定「这张卡能不能装下这个模型、这个上下文」。
带宽:解码阶段的真正瓶颈
自回归解码每生成一个 token 都要把全部权重从 HBM 读进 SM 一次。于是单 token 的解码时间是:
是显存带宽。这个式子说明:在 batch 不够大、算力没被喂满的解码阶段,推理速度与每次前向要搬运的字节数成正比。权重从 FP16 压到 FP8,理论解码吞吐直接翻倍;压到 FP4 再翻一倍。这就是量化在推理侧最直接的收益,与「算力省不省」无关。
Kernel:量化把「乘加」换成了「解码 + 乘加」
代价在第三层。Tensor Core 的 FP8/FP4 指令不是通用的:mma 系列在 FP8 下要求 e4m3 输入、要求缩放因子以特定布局铺在内存里,Blackwell 的 FP4 指令更要求把 e2m1 的两两打包和 E4M3 的 block scale 交错(interleave)成固定块结构。于是「权重怎么摆、scale 怎么存、激活什么时候量化」全部变成 kernel 级的设计问题——这部分正是 TensorRT-LLM 量化子系统在源码层面要解决的事。
一个真实的权衡表:
| 方案 | 权重大小 | 激活 | 解码带宽(相对 BF16) | 内核复杂度 | 精度 |
|---|---|---|---|---|---|
| BF16 | 16 bit | 不量化 | 1× | 低 | 基准 |
| INT8 权重(W8A16) | 8 bit | 不量化 | 2× | 中 | 近无损 |
| FP8(W8A8,per-tensor) | 8 bit | FP8 | 2× | 中 | 近无损 |
| FP8(block scales,1×128) | 8 bit | FP8 | 2× | 高 | 近无损,长上下文更稳 |
| NVFP4(W4A4,16 元素块) | 4 bit | FP4 | 4× | 高 | 精度损失小到可忽略 |
这张表里最值得记住的是最后一行与「内核复杂度」这一列的关系:收益越大,需要写的 kernel 越多。
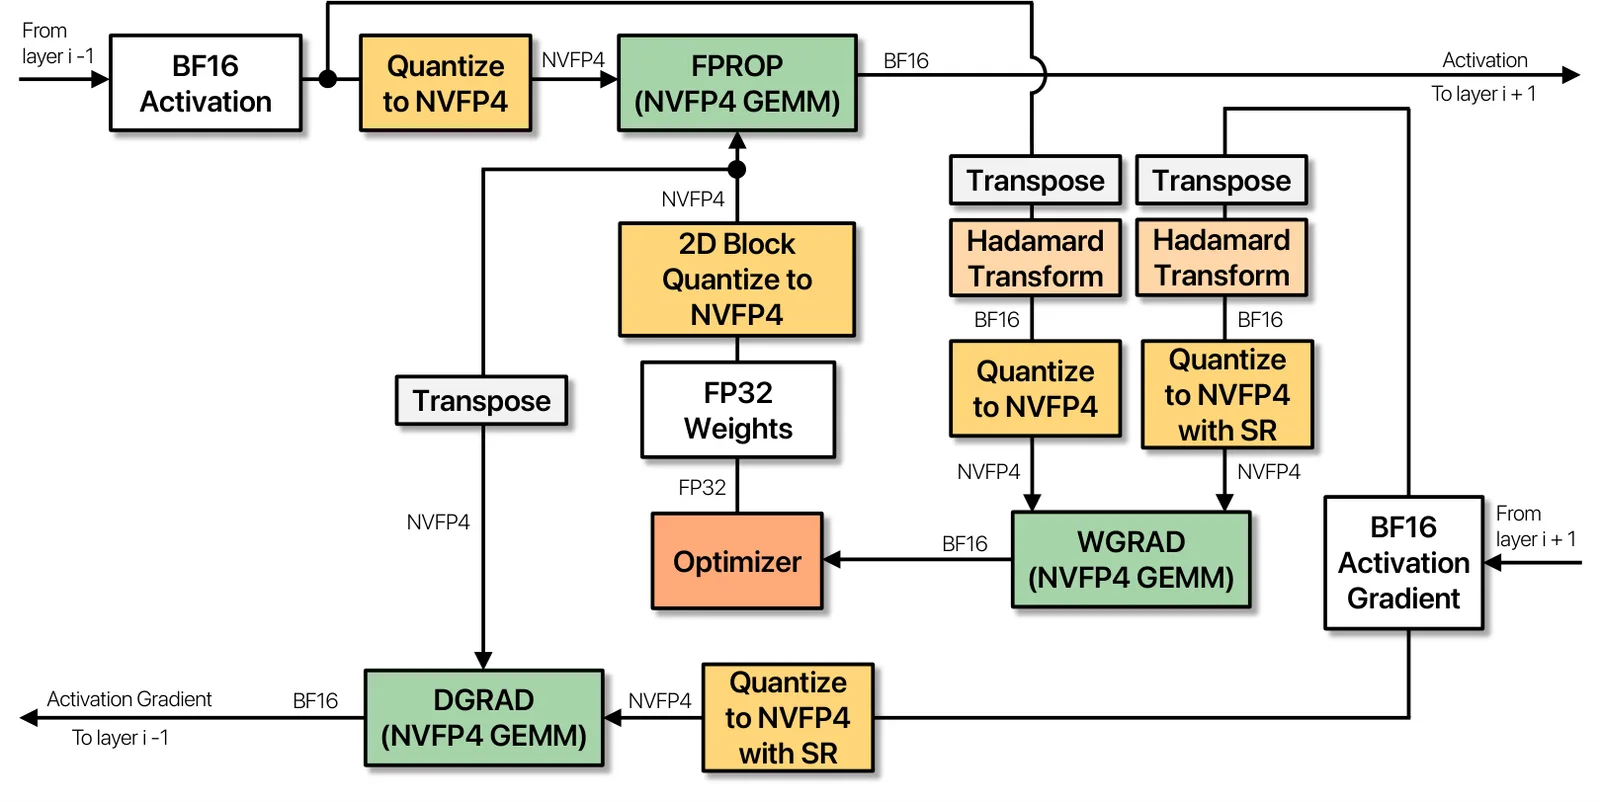
全链路全景:三段流水
TensorRT-LLM 的量化不是一个函数,而是一条三段流水,每段的输入输出都不同:
- 读:从 checkpoint 里读出
hf_quant_config.json/quant_cfg.json,翻译成QuantConfig与逐层配置,再按张量名把权重、scale 搬到设备上。这一段决定「系统认为自己拿到的是一份什么样的量化模型」。 - 量化:如果是未量化的 BF16 checkpoint,先用 NVIDIA ModelOpt 离线量化,产出带 scale 的 checkpoint 与描述文件;如果是已量化的 checkpoint(ModelOpt / compressed-tensors / DeepSeek 自研 recipe),走读取路径。这一段决定「量化参数是怎么被计算出来的」。
- 用:运行时由
Linear模块根据QuantConfig选出LinearMethodBase的具体子类,由子类决定权重张量的物理布局、激活的量化时机与最终的 GEMM 算子。这一段决定「量化在 kernel 层面怎么落地」。
三个段之间靠一组约定串起来:scale 的名字(weight_scale / weight_scale_inv)、scale 的粒度(per-tensor / per-channel / per-group / per-block)、scale 的数据类型(fp32 / e4m3 / UE8M0)、以及 block 的对齐(NVFP4 的 16、FP8 block scales 的 128)。这些约定一旦在任一段错位,表现不是「算错」,而是加载时报 input_scale mismatch across shards 或者 GEMM 结果悄悄偏掉。
第一段:checkpoint 怎么读
QuantAlgo:一串把算法名与位宽绑在一起的枚举
读取路径的终点是一个 QuantConfig,它的 quant_algo 字段取自 tensorrt_llm/quantization/mode.py 里的 QuantAlgo 枚举。这个枚举不只是名字列表,每一项都隐含了「权重位宽、激活位宽、缩放粒度」三元组:
class QuantAlgo(StrEnum, metaclass=BaseEnumMeta): W8A16 = auto() W4A16 = auto() W4A16_AWQ = auto() W4A8_AWQ = auto() W8A16_GPTQ = auto() W4A16_GPTQ = auto() W8A8_SQ_PER_CHANNEL = auto() W8A8_SQ_PER_TENSOR_PLUGIN = auto() W8A8_SQ_PER_CHANNEL_PER_TOKEN_PLUGIN = auto() W8A8_SQ_PER_CHANNEL_PER_TENSOR_PLUGIN = auto() W8A8_SQ_PER_TENSOR_PER_TOKEN_PLUGIN = auto() W4A8_QSERVE_PER_GROUP = auto() W4A8_QSERVE_PER_CHANNEL = auto() FP8 = auto() FP8_PER_CHANNEL_PER_TOKEN = auto() FP8_BLOCK_SCALES = auto() NVFP4 = auto() W4A8_NVFP4_FP8 = auto() W4A8_MXFP4_FP8 = auto() W4A8_MXFP4_MXFP8 = auto() W4A16_MXFP4 = auto() MXFP8 = auto() W4A16_NVFP4 = auto() NVFP4_AWQ = auto() NVFP4_ARC = auto() NO_QUANT = auto()命名规则是 W<bits>A<bits> 加算法后缀:NVFP4 表示权重与激活都是 FP4,W4A16_NVFP4 表示权重 FP4、激活不量化(也就是常说的「weight-only」),W4A8_NVFP4_FP8 表示权重 FP4、激活 FP8。后缀是量化算法的来源:_AWQ 表示用 AWQ 的按通道缩放选显著权重,_GPTQ 表示 GPTQ 的二阶误差补偿,_SQ 表示 SmoothQuant 的等价平滑迁移,_MXFP4 / _MXFP8 表示 OCP microscaling 格式。这些算法的原理在本站已有专门文章拆解,例如 AWQ 完全拆解、GPTQ 完全拆解 与 SmoothQuant 完全拆解。
kv_cache_quant_algo 是另一条独立的枚举,只有 FP8、INT8、NVFP4 三个可选值——KV 缓存的量化粒度与权重完全不同,它是 per-head 或 per-tensor 的,不参与权重那套 per-group 讨论。
QuantMode:位标志如何把枚举翻译成执行条件
QuantAlgo 是给人看的名字,QuantMode 则是给代码看的位掩码。它是一个 IntFlag,每一位代表一个执行条件:
class QuantMode(IntFlag): INT4_WEIGHTS = auto() INT8_WEIGHTS = auto() ACTIVATIONS = auto() PER_CHANNEL = auto() PER_TOKEN = auto() PER_GROUP = auto() INT8_KV_CACHE = auto() FP8_KV_CACHE = auto() FP8_QDQ = auto() FP8_ROWWISE = auto() FP8_1x128_128x128 = auto() NVFP4 = auto() NVFP4_KV_CACHE = auto() W4A8_NVFP4_FP8 = auto() W4A8_MXFP4_FP8 = auto() W4A8_MXFP4_MXFP8 = auto() W4A16_MXFP4 = auto() MXFP8 = auto() COUNT = auto()注意注释里那句 KEEP BELOW DEFINITION IN SYNC WITH cpp/tensorrt_llm/common/quantization.h:这个位掩码同时被 Python 与 C++ 两侧解读,因为最终执行 GEMM 的是 C++/CUDA 侧。这就是量化子系统最容易出问题的地方——一份解释在两处实现,任何一边加位都要同步。
QuantMode.from_quant_algo() 负责把枚举翻成掩码,它的逻辑本身就说明了每类算法的确切含义。摘几段关键分支:
if quant_algo == QuantAlgo.FP8: mode = QuantMode.use_fp8_qdq()elif quant_algo == QuantAlgo.FP8_PER_CHANNEL_PER_TOKEN: mode = QuantMode.use_fp8_rowwise()elif quant_algo == QuantAlgo.FP8_BLOCK_SCALES: mode = QuantMode.use_fp8_block_scales()elif quant_algo == QuantAlgo.NVFP4: mode = QuantMode.use_nvfp4()elif quant_algo == QuantAlgo.W4A16_NVFP4: mode = QuantMode.use_w4a16_nvfp4()elif quant_algo == QuantAlgo.W4A8_NVFP4_FP8: mode = QuantMode.use_w4a8_nvfp4_fp8()elif quant_algo == QuantAlgo.MXFP8: mode = QuantMode.use_mxfp8()再看 from_description 的约束,它把「哪些组合在数学上讲不通」写成了断言式的早期报错:
# We must quantize weights when we quantize activations.if quantize_activations and not quantize_weights: raise_error()
# If we set per_token or per_channel, we must quantize both weights and activations.if (per_token or per_channel) and not (quantize_weights and quantize_activations): raise_error()第一条约束看起来是约定,其实是实现限制:没有哪块 Tensor Core 支持「权重 FP16、激活 FP8」的混合输入,所以「激活量化必然伴随权重量化」。第二条则来自 per-channel 与 per-token 缩放因子的定义——它们是绑在 GEMM 的某一维上的,只有当权重和激活都被量化成同一种定点/浮点格式时才有意义。
值得单独看的是 FP8 rowwise 这一支:
if use_fp8_rowwise: mode = mode | QuantMode.FP8_ROWWISE | QuantMode.PER_TOKEN | QuantMode.PER_CHANNEL一行代码同时点亮三个位:FP8 rowwise 的本质就是「权重按输出通道给 scale(per-channel)、激活按 token 给 scale(per-token)」,也就是 DeepSeek 那套 1×128 与 128×128 缩放之外的另一种常见形态。位掩码在这里的好处是可以直接用 has_fp8_rowwise() 这种查询函数做判断,而不用去记忆枚举之间的映射。
三类 checkpoint 描述文件
读了什么文件决定走哪条解析分支。TensorRT-LLM 至少支持四种来源:
- ModelOpt 的
hf_quant_config.json(或 legacy 的quant_cfg.json),里面是一个quantization字典,字段包括quant_algo、kv_cache_quant_algo、group_size、exclude_modules,AWQ 系还额外带has_zero_point与pre_quant_scale。 - llm-compressor / compressed-tensors 的
config_groups格式,用weights.strategy与input_activations.strategy描述粒度。 - HuggingFace 原生 FP8 checkpoint,靠
quant_method: "fp8"与weight_block_size识别。 - MXFP4 / MXFP8 的
quant_method标记。
ModelOpt 分支:字段逐一对应到 QuantConfig
ModelConfig._build_modelopt_quant_config 就是这段翻译:
quant_config.quant_algo = ( QuantAlgo(canonicalize_quant_algo(json_quant_configs['quant_algo'])) if json_quant_configs.get('quant_algo') is not None else None)quant_config.kv_cache_quant_algo = ( QuantAlgo(json_quant_configs['kv_cache_quant_algo']) if json_quant_configs.get('kv_cache_quant_algo') is not None else None)quant_config.group_size = json_quant_configs.get('group_size', None)quant_config.exclude_modules = json_quant_configs.get('exclude_modules', None)if 'has_zero_point' in json_quant_configs: quant_config.has_zero_point = json_quant_configs['has_zero_point']if 'pre_quant_scale' in json_quant_configs: quant_config.pre_quant_scale = json_quant_configs['pre_quant_scale']group_size 是这里最容易被忽略的字段:对 NVFP4 它应当是 16,对 FP8 block scales 它应当是 128。代码里专门有个 _validate_nvfp4_group_size 做校验,因为同名字段在不同算法下含义不同——如果 checkpoint 声明 quant_algo=NVFP4 却带 group_size=128,那不是「放宽的 NVFP4」,而是格式错误,直接报错比悄悄跑错更安全。
MIXED_PRECISION:一份 checkpoint、多套配置
有一类 checkpoint 的 quant_algo 是 MIXED_PRECISION,意思是不同层用不同算法——典型场景是对注意力与 MoE 专家用不同策略,或者对敏感层保留高精度。这段代码走的是 quant_cfg.json 分支:
if quant_config.quant_algo == QuantAlgo.MIXED_PRECISION: ... mixed_quant_configs = json_quant_configs.get('quantized_layers', None) ... for layer in mixed_quant_configs: layer_cfg = mixed_quant_configs[layer] config = QuantConfig() config.kv_cache_quant_algo = kv_cache_quant_algo config.quant_algo = QuantAlgo(canonicalize_quant_algo(layer_cfg['quant_algo'])) config.group_size = layer_cfg.get('group_size', None) ModelConfig._validate_nvfp4_group_size(config, layer) ... layer_quant_config = mixed_quant_configs结果是一个 Dict[str, QuantConfig],挂在 ModelConfig.per_layer_quant_configs 上,后续通过 get_quant_config(name) 按层名查表。这里有一个必须注意的不变量:KV 缓存的量化算法是全局的。代码显式检查了两份 JSON 的 kv_cache_quant_algo 是否一致:
if kv_quant_lhs != kv_quant_rhs: raise RuntimeError( f"The kvcache config in 'quant_cfg.json', {kv_quant_lhs}," f"is different from 'hf_quant_config.json', {kv_quant_rhs}!" )原因很直接:KV 缓存池是全局分配的一整块张量,它的 dtype 只可能有一个。逐层的 QuantConfig 可以不同,因为它们各自对应独立的权重张量;KV 缓存不行。
FP8_BLOCK_SCALES:默认 exclude 名单里的工程智慧
FP8 block scales 分支有一段默认排除列表,注释写得很清楚:
# Set default exclude_modules for FP8_BLOCK_SCALES# kv_b_proj must always be excluded: FP8 128x128 block boundaries# don't necessarily align with per-head dim boundaries (e.g. GLM-5# has qk_nope_head_dim=192), so the scale tensor cannot be cleanly# reshaped per-head. The dequant path handles this correctly.default_exclude = ["*kv_b_proj*", "*k_b_proj*", "*eh_proj"]这是整篇最值得记住的一条工程细节。MLA 类模型里 kv_b_proj 把低秩 latent 投影成多头 K、V,它的输出维度是 num_heads × head_dim 的拼接。如果 head_dim 不是 128 的整数倍,那么按 128 元素一块铺下来的 FP8 scale 张量就跨头边界落在同一块里——反量化时没法按头重新切分出正确的 scale,数值就会错。解决办法不是「想办法对齐」,而是干脆把这几个投影排除在块量化之外,让它们走反量化路径。这种「宁可多留一层高精度,也不让布局错位」的取舍,是量化工程里非常典型的决定。
compressed-tensors 与 HF 原生格式
compressed-tensors 分支的翻译规则更直白,基本是把 num_bits 与 strategy 组合映射过去:
weights num_bits | weights strategy | input_activations strategy | 映射到的 QuantAlgo | group_size |
|---|---|---|---|---|
| 8 | channel | token | FP8_PER_CHANNEL_PER_TOKEN | 无 |
| 8 | block | group | FP8_BLOCK_SCALES | 必须为 128 |
| 4(type=float) | tensor_group | tensor_group | NVFP4 | 必须为 16 |
| 4(type=float,weight-only) | group | 无 | W4A16_MXFP4 | 必须为 32 |
这里每个 group_size 的硬校验(if group_size != 128: raise ValueError)都在传递同一个信息:group_size 不是自由参数,它由硬件指令的 block 宽度决定,checkpoint 只能声明成那个值,声明错了就没法执行。代码里还有一条提前处理的 KV 缓存分支,注释说明它放在权重分支之前是为了让 early-return 的路径(比如 MXFP4 pack-quantized)也能带上 KV 量化配置。
权重张量名与 scale 名:约定在哪
读取的最后一步是「按名字找张量」。这一步依赖约定,而约定分散在几处:
params_map = dict(FUSED_MODULE_COMPONENTS):把 checkpoint 里的独立张量名(如q_proj、k_proj、v_proj)映射到运行时融合模块的组件名,用于FUSED_QKV模式。_get_scale_name:FP8 block scales 的 scale 张量在不同 recipe 下可能叫weight_scale_inv(DeepSeek recipe)或weight_scale(ModelOpt recipe):
def _get_scale_name(self, weights: List[Dict]): # `weight_scale_inv` for DS recipe and `weight_scale` for ModelOpt recipe. # Actually they hold identical values of data_amax / 448. for w in weights: if "weight_scale_inv" in w: return "weight_scale_inv" return "weight_scale"注释指出了关键事实:两个名字的数值含义相同(都是 data_amax / 448,即「原始值除以最大值」,反量化时相乘),只是历史命名不同。理解这一点,读其他框架的 FP8 checkpoint 时就不会被名字误导。
tie_word_embeddings与lm_head的跳过逻辑:共享词表时lm_head与embed_tokens是同一份权重,只能加载一次。_resolve_lm_head_quant_config则处理「lm_head 是否量化」这个细节问题——很多 checkpoint 的 lm_head 保持高精度,因为它直接决定输出分布。
第二段:权重是怎么被量化出来的
TensorRT-LLM 自己不实现校准算法,它把这一步交给 NVIDIA TensorRT Model Optimizer(ModelOpt)。QuantAlgo 里有一个集合专门标记「ModelOpt 流程支持的量化」:
MODELOPT_FLOW_QUANTIZATIONS = { QuantAlgo.W4A16_AWQ, QuantAlgo.FP8, QuantAlgo.W8A8_SQ_PER_CHANNEL, QuantAlgo.W4A8_AWQ}这四项是最经典的一组,覆盖了「仅权重量化」「FP8 W8A8」「SmoothQuant 平滑后的 W8A8」与「AWQ 4-bit 权重 + FP8 激活」。
ModelOpt 的量化流程可以拆成三步,每一步解决一个具体问题:
第一步:选粒度。 对每个权重矩阵,先要把「多少个数共享一个 scale」定下来。粒度越小精度越好,但 scale 张量越大、kernel 读取 scale 的访存开销越高:
- per-tensor:一个张量一个 scale,最简单,但对权重分布差异大的张量不够用;
- per-channel:每行(输出通道)一个 scale,是 INT8 权重量化的默认选择;
- per-group:每 个连续元素一个 scale(INT4 常用 ,NVFP4 用 );
- per-block(1x128 / 128x128):FP8 块量化,激活用 1x128(每 128 个连续元素一个 scale),权重用 128x128(二维块)。
第二步:算 scale。 用一批校准数据(calibration data)跑前向,统计每个粒度内张量的绝对值最大值,再换算成 scale。对 FP8 目标格式,取 amax / 448,其中 448 是 e4m3 能表示的最大有限值(e4m3 的指数 4 位、尾数 3 位,最大规格化值恰为 448)。
第三步:量化与误差补偿。 直接四舍五入到最近的 FP8/FP4 值会带来误差。ModelOpt 默认走最朴素的 RTN(round-to-nearest),而 AWQ、GPTQ 这类算法则在权重量化前后加入额外的补偿:AWQ 先按激活的显著性对权重按通道缩放(放大显著通道、缩小不显著通道再量),GPTQ 用 Hessian 的二阶信息逐列补偿已经量化的误差。它们产出的 checkpoint 会在描述文件里带上额外字段——这就是前面 _build_modelopt_quant_config 里 has_zero_point 与 pre_quant_scale 两个字段的来历:
has_zero_point:量化把权重映射到 的整数区间时,是否使用零点偏移(非对称量化)。INT4 权重常用非对称量化以保住分布偏斜的权重矩阵;pre_quant_scale:也就是 AWQ 的按通道缩放因子。它在运行时被用来在量化激活之前先乘上去,作用等价于「把激活的离群通道先压小、再把权重对应通道放大」。
NVFP4:两层 scale 的设计与那个 448x6
NVFP4 是 Blackwell 引入的 4-bit 浮点格式,它的量化方案不是「一个 scale 走天下」,而是两层:
- 每 16 个元素一个 FP8 (e4m3) 的 block scale()。之所以是 16 而不是 32,来自硬件指令 block scaling 的粒度选择;
- 整个张量再加一个 FP32 的 per-tensor global scale。
代码里 NVFP4LinearMethod.create_weights 的注释把这两个数字的含义直接写了出来:
# FP32 per-tensor global scaling factor = 448*6/amax_inputmodule.input_scale = Parameter(torch.empty([1], dtype=torch.float32), ...)
# (amax_input * amax_weight) / (448*6 * 448*6)module.alpha = Parameter(torch.empty([1], dtype=torch.float32), ...)
# Global weight scale: amax_weight / (448*6)module.weight_scale_2 = Parameter(torch.empty([1], dtype=torch.float32), ...)三个常数要一起看:
- 448 是 e4m3 的最大值(FP8 block scale 的编码范围);
- 6 是 e2m1 的最大值(FP4 权重/激活能表示的绝对值上限:e2m1 的 );
- 就是「FP8 scale 乘 FP4 元素」这个二级结构能覆盖的整体动态范围上限。
alpha 这个名字容易让人困惑,它的物理含义是「这次 GEMM 输出相对于输入的总放缩倍数」。前向计算时激活被量化成 FP4,乘上 input_scale = 2688/amax_input(把激活归一化到 FP4 范围),权重同样按 weight_scale_2 = amax_weight/2688 归一化,两者相乘后必须再乘回 alpha 才能还原数值:
FP8_MAX, E2M1_MAX = 448.0, 6.0amax_input = torch.amax(torch.abs(input)).float()input_scale = FP8_MAX * E2M1_MAX / amax_inputalpha = (amax_input / (FP8_MAX * E2M1_MAX)) * module.weight_scale_2动态模式(force_dynamic_quantization 为真或静态 scale 缺失)下,input_scale 与 alpha 在每次前向时现算,因为激活的最大值随 batch 与 token 变化;静态模式下二者在加载完成后由 _finalize_nvfp4_scales 固化下来,省掉一次全张量 amax 归约。这就是 NVFP4 的「静态/动态激活量化」开关,也是实测中精度与延迟的调节旋钮。
还有一个容易踩的约束:input_scale 与 weight_scale_2 是标量(shape 为 [1] 的 FP32),在 TP 切分后各 rank 的这两个值必须一致。_finalize_nvfp4_scales 里为此做了断言:
for s in input_scale_list[1:]: assert torch.allclose(input_scale_list[0], s), \ f"input_scale mismatch across shards: {input_scale_list}"如果某个 rank 的激活 amax 统计不一致,这里会直接报错而不是悄悄给出偏差结果。
weight_scale 的物理布局:为什么必须 interleave
NVFP4 的 block scale 在内存里不是简单地按行铺开。load_weight_scales 在 vanilla 路径下做了一次转换:
ws = module.load_shard(w["weight_scale"], device=device, scale_span=scale_span).contiguous()ws = ws.view(fp4_utils.float4_sf_dtype)ws = torch.ops.trtllm.block_scale_interleave(ws)copy_weight(module.weight_scale, ws)block_scale_interleave 是硬件要求:FP4 GEMM 的 Tensor Core 指令以固定的 tile(例如 128 行 x 4 列 scale)为单位读取 scale 张量,如果不做交错,指令取到的 scale 与它正在计算的元素块就对不上。同时 create_weights 里对 scale 张量的尺寸做了补零:
nrows = fp4_utils.pad_up(out_features, 128)ncols = fp4_utils.pad_up(in_features // module.scaling_vector_size, 4)module.weight_scale = Parameter(torch.empty([nrows * ncols], dtype=fp4_utils.float4_sf_dtype), ...)pad_up(x, y) 是把 x 向上取整到 y 的倍数。补零的原因同样来自硬件:tile 尺寸是 128x4,若张量尺寸不是它的整数倍,最后一块会读越界,所以必须补齐。get_fp4_shape 里的 scale_shape = pad_up(m, 128) * pad_up(K // sf_vec_size, 4) 是同一个公式的另一种写法。这类「先补零再交错」的操作在 FP4 kernel 里是标配,也是为什么 FP4 权重的显存占用不是精确的 0.5 byte/元素。
fp4_utils 里还有一个值得看的函数——reorder_rows_for_gated_act_gemm:
def get_reorder_rows_for_gated_act_gemm_row_indices(x) -> torch.Tensor: # Reorders rows in the gemm/MOE_gemm weight matrix for min-latency # [r0, r1, r2, ..., rN/2, r(N/2+1), .. r(N-1)] # to # [r0, rN/2, r1, rN/2+1, ..., r(N/2-1), r(N-1)]这是 SwiGLU 融合 GEMM 的需求:gate 与 up 两个投影的权重在 checkpoint 里是「gate 的全部行、up 的全部行」顺序拼接,但融合 kernel 希望两者交错排列,这样同一个线程块可以同时算出 gate(x) 与 up(x) 并立刻做逐元素相乘。这种「加载时重排权重行」的做法,把布局转换的开销从每次前向挪到了加载阶段——量化子系统里反复出现这个思路。
第三段:运行时怎么用——LinearMethodBase 的方法选择
一个 Linear 模块的三段生命周期
TensorRT-LLM 的 Linear 模块不是简单地持有 nn.Parameter 然后做矩阵乘。它的生命周期分成三段,每段都可能被量化方法改写:
- 构造(
create_weights_impl):调self.quant_method = self.get_quant_method(self.quant_config),再让方法分配权重张量。此时张量是空的,只是按量化格式决定了形状与 dtype; - 加载(
load_weights与post_load_weights):从 checkpoint 读进数据,可能做重排与交错; - 前向(
apply_linear):调quant_method.apply(module, input, bias)。
这个设计的好处是:量化差异被压缩进一个方法对象里,Linear 本身不用知道自己是 FP8 还是 FP4。代价是方法的构造必须发生在权重分配之前,因为张量的形状由它决定——这也解释了为什么 create_weights 里会有断言:
assert in_features % module.scaling_vector_size == 0, \ f"in_features {in_features} must be divisible by scaling_vector_size {module.scaling_vector_size}"如果输入维度不是 16 的倍数,NVFP4 的块划分就无法整齐覆盖整个 K 维,直接拒绝加载比运行时报错好。
get_quant_method:一张决策表
方法选择的全部逻辑在一个函数里:
def get_quant_method(quant_config: Optional[QuantConfig] = None): if quant_config is None or not quant_config.layer_quant_mode.has_any_quant(exclude_kv_cache=True): return UnquantizedLinearMethod() if quant_config.layer_quant_mode.has_fp8_qdq(): return FP8QDQLinearMethod() if quant_config.layer_quant_mode.has_fp8_rowwise(): return FP8RowwiseLinearMethod() if quant_config.layer_quant_mode.has_fp8_block_scales(): return FP8BlockScalesLinearMethod() if quant_config.quant_algo == QuantAlgo.W4A16_NVFP4: return W4A16NVFP4LinearMethod() if quant_config.layer_quant_mode.has_nvfp4(): if quant_config.quant_algo == QuantAlgo.NVFP4_ARC: return NVFP4ARCLinearMethod() return NVFP4LinearMethod() if quant_config.layer_quant_mode.has_w4a8_nvfp4_fp8(): return W4A8NVFP4FP8LinearMethod() if quant_config.layer_quant_mode.has_w4a8_mxfp4_fp8(): return W4A8MXFP4FP8LinearMethod() if quant_config.layer_quant_mode.has_mxfp8(): return MXFP8LinearMethod() if quant_config.layer_quant_mode.is_weight_only() and not quant_config.layer_quant_mode.has_per_group_scaling(): return WeightOnlyQuantLinearMethod() if quant_config.layer_quant_mode.is_int4_weight_only_per_group() and quant_config.quant_algo == QuantAlgo.W4A16_AWQ: return W4A16_AWQ_LinearMethod() if quant_config.layer_quant_mode.is_int4_weight_only_per_group() and quant_config.quant_algo == QuantAlgo.W4A8_AWQ: return W4A8_AWQ_LinearMethod() if quant_config.layer_quant_mode.has_w4a8_mxfp4_mxfp8(): return W4A8MXFP4MXFP8LinearMethod() raise ValueError(f'unsupported quant mode: {quant_config.quant_mode}')三点需要留意:
第一,KV 缓存的量化被排除在方法选择之外(exclude_kv_cache=True)。KV 量化不影响 Linear 的张量布局,它属于注意力后端的事,本站已有 TensorRT-LLM 源码完全拆解(七):KV Cache 的内存布局与量化存储 专门讲这条线。量化子系统与 KV 子系统在这里正交分离。
第二,判断顺序是「格式优先、特例随后」。 FP8 的三种粒度(QDQ、rowwise、block scales)先判,因为它们互斥且由 QuantMode 位直接区分;NVFP4 之后则是按 quant_algo 再细分出 W4A16_NVFP4、NVFP4_ARC 等变体。最后一行 raise ValueError 而不是返回默认方法,是因为「没匹配上」意味着 QuantMode 与 QuantAlgo 不一致,属于配置错误,静默降级会掩盖问题。
第三,INT4 权重量化的分支结构说明:方法选择先看「是否 per-group」,per-group 之下再按 quant_algo 区分 AWQ 与非 AWQ。 这是因为 AWQ 的 checkpoint 多带一个 pre_quant_scale,需要专门的加载与激活预处理路径。
硬件相关的二次选择
选出方法之后还有一层硬件相关覆盖,在 Linear.get_quant_method 里:
def get_quant_method(self, quant_config: Optional[QuantConfig] = None): quant_method = get_quant_method(quant_config) method_type = type(quant_method) if method_type is W4A16NVFP4LinearMethod: # Marlin by default on SM120/121, explicit opt-in elsewhere. if MarlinNVFP4LinearMethod.is_enabled(self): return MarlinNVFP4LinearMethod() elif method_type is NVFP4LinearMethod: if _uses_marlin_nvfp4_backend(self): return MarlinNVFP4LinearMethod() return quant_method这段代码回答了一个自然的问题:同一份 checkpoint 在不同 GPU 上要用不同的 kernel 吗? 答案是会。Marlin 是一套 W4A16 的权重专用 kernel(原理见 Marlin 完全拆解),它在 SM120/121(消费级 Blackwell)上是默认选择,在其他架构上需要显式开启。注释里特别强调方法选择与 uses_marlin_nvfp4 属性必须用同一个判断函数,否则「选出来的方法」与「对外声明的能力」可能不一致,上游就会按 A4 的假设去调一个 A16 的 kernel。
还有一个细节:create_weights_impl 开头会根据是否存在 NVFP4 激活量化来决定是否关闭融合路径:
if not quant_config_has_nvfp4_activation_quantization(self.quant_config): self.use_fused_gemm_allreduce = FalseGEMM 加 AllReduce 的融合要求输出 buffer 是一个特定的对称内存窗口,而只有激活也被量化的路径才支持这种写法。这类「量化方式决定融合能不能做」的耦合,是量化子系统与并行通信子系统之间的接口,本站 TensorRT-LLM 源码完全拆解(十一):并行拓扑与通信 讲了另一半。
WeightMode:同一份权重的三种摆放
load_weights 会按 WeightMode 分派到三个不同的加载函数:
if weight_mode == WeightMode.VANILLA: load_fn = self.load_weights_vanillaelif weight_mode == WeightMode.FUSED_QKV_LINEAR: load_fn = self.load_weights_fused_qkv_linearelif weight_mode == WeightMode.FUSED_GATE_UP_LINEAR: load_fn = self.load_weights_fused_gate_up_linearVANILLA:checkpoint 里 q/k/v 是三个独立张量,运行时也保留三块权重;FUSED_QKV_LINEAR:q/k/v 融合成一块,由一个 GEMM 一次算出,减少 kernel 启动次数与重复读取激活;FUSED_GATE_UP_LINEAR:gate/up 融合,对应前面reorder_rows_for_gated_act_gemm的行重排。
融合带来的收益是访存与启动开销,代价是量化的 shard 对齐变得复杂。NVFP4 的 load_weight_scales 就写明了这一点:
scale_span = (module.scaling_vector_size if module.tp_mode == TensorParallelMode.ROW else 1)在行并行(ROW)下,权重沿 K 维切分,而 NVFP4 的 scale 是每 16 个 K 元素一个,所以切分时必须按 16 个元素为最小单位,否则每个 rank 都会拿到半截 block。scale_span 这个变量就是在告诉 load_shard:「你在 K 维每移动一个单位,scale 张量走多远」。TP 切分与量化粒度的这个交点,在任何框架里都是 bug 高发区。
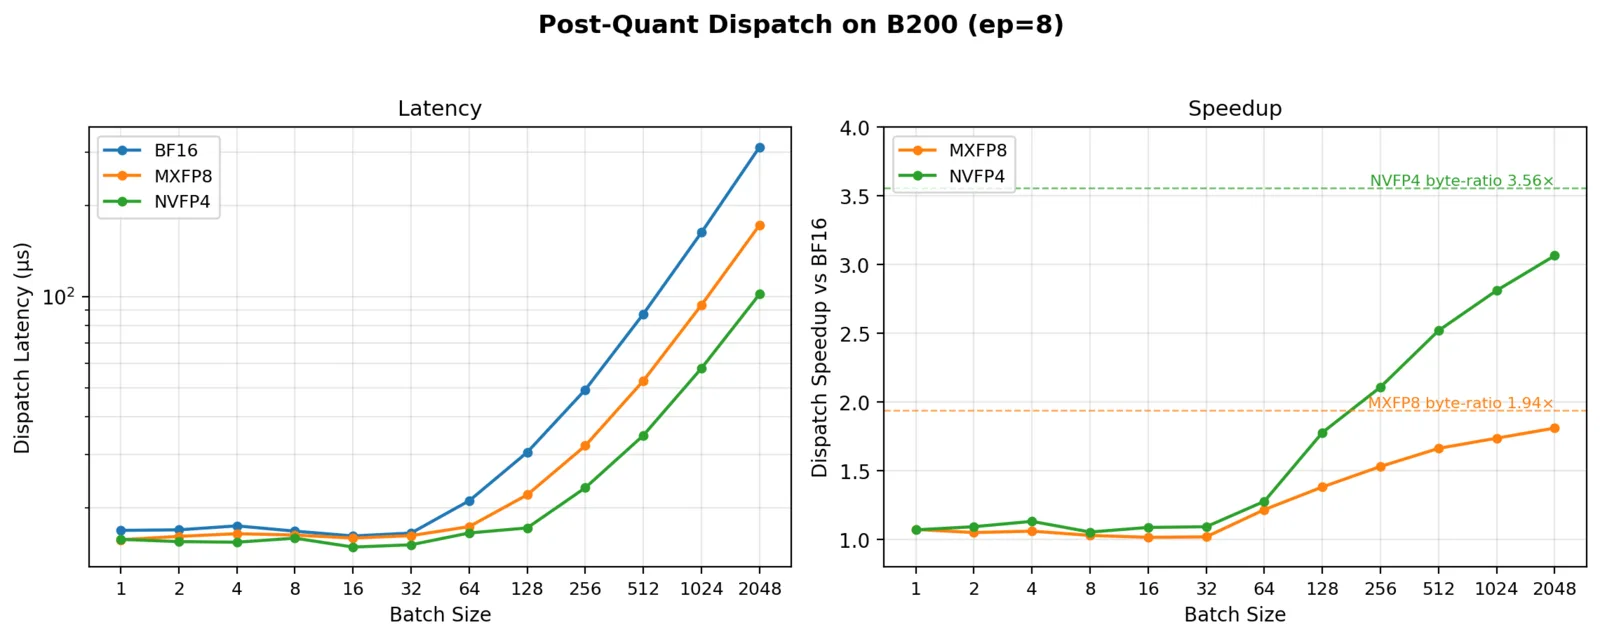
前向:一次 FP8 QDQ GEMM 的完整调用
以 FP8QDQLinearMethod.apply 为例,看一次量化 GEMM 在运行时做了什么:
static_input_scale = self.get_static_input_scale(module)cur_input_scale = module.input_scaleif input.dtype != torch.float8_e4m3fn: if static_input_scale is not None: # Static quantization qinput, _ = torch.ops.tensorrt_llm.static_quantize_e4m3_per_tensor( input, static_input_scale) else: # Dynamic quantization qinput, cur_input_scale = torch.ops.tensorrt_llm.quantize_e4m3_per_tensor(input) cur_input_scale = cur_input_scale.to(torch.float32)else: qinput = input三件事依次发生:
- 判断输入是否已经被量化。如果上一个算子已经输出了 FP8(前一层的量化输出被直接复用,或者注意力输出已经是 FP8),就跳过量化。这是消除冗余量化的关键优化——
if input.dtype != torch.float8_e4m3fn这一句省掉的是整个张量的一次读写。 - 静态与动态量化的分流。静态用 checkpoint 里存的
input_scale,动态则调quantize_e4m3_per_tensor现算 amax 得到 scale。 - 选 GEMM 后端:
if _fp8_per_tensor_uses_cute_dsl_sm107(): output = torch.ops.trtllm.cute_dsl_fp8_per_tensor_gemm_rubin(...)elif module.enable_cuda_core and qinput.shape[0] <= 8: # use cuda core for small m dimension output = torch.ops.trtllm.cuda_scaled_mm(...)else: output = torch.ops.trtllm.cublas_scaled_mm(...)第二支是按 M 维大小分流:解码阶段 M 很小(batch 乘 1 个 token),Tensor Core 的 tile 利用率低,改用 CUDA Core 的 cuda_scaled_mm 反而更快。这条经验在很多框架的量化 kernel 里都能看到。
FP8 block scales:布局转换发生在加载期
FP8BlockScalesLinearMethod 展示了 block 量化的完整形态:
scale_shape = (math.ceil(out_features / 128), math.ceil(in_features / 128))module.weight_scale = Parameter(torch.empty(scale_shape, dtype=torch.float32), ...)scale 是二维的 128x128 块网格,每个块一个 fp32 值。前向时激活的量化与 GEMM 后端也按 SM 版本分流:fp8_swap_ab_gemm(DeepGEMM 路线)、fp8_block_scaling_gemm(trtllm-gen 路线)、cute_dsl_fp8_gemm_blackwell(SM100/103 的 CuTe DSL 路线),以及 SM107 上用 UE8M0 编码 scale 的 cute_dsl_mxfp8_gemm_rubin。
其中一个容易被忽略的类型细节是 scale 的类型:激活 scale 的 dtype 决定了走哪条路:
uses_cute_dsl_rubin = (activation_scale.dtype == torch.uint8 and sm_version == 107 and IS_CUTLASS_DSL_RUBIN_AVAILABLE and (...))elif (activation_scale.dtype == torch.int32 and is_sm_100f() and not module.disable_deep_gemm): output = torch.ops.trtllm.fp8_prequantized_swap_ab_gemm(...)uint8 意味着 scale 被编码成 UE8M0(无符号 8 位纯指数),int32 意味着 scale 被打包成 int32 以便被 DeepGEMM 风格的内核读取。同一份数学量、不同的内存编码,对应的后端完全不同。这解释了为什么 transform_weights 里有一句注释说「把 weight_scale 重新铺成 UE8M0 K32 R128c4」——布局转换被挪到加载阶段完成,前向时只需按 dtype 分派。
MXFP8 的参考实现:十几行讲完一种格式
mxfp8_utils.py 提供了 MXFP8 的 PyTorch 参考路径,注释特别说明它不是生产路径,而是作为 CUTLASS kernel 的数值对照:
def quant_bf16_to_mxfp8(w: torch.Tensor, block_size: int = 32): # [O, K] bf16/fp32 -> (e4m3 [O,K], ue8m0 uint8 [O, K//block]) wb = w.float().view(o, k // block_size, block_size) amax = wb.abs().amax(dim=-1).clamp_min(1e-12) E4M3_MAX = 448.0 exp = torch.ceil(torch.log2(amax / E4M3_MAX)) scale_ue8m0 = (exp + UE8M0_BIAS).clamp(0, 255).to(torch.uint8) scale = torch.exp2(exp).unsqueeze(-1) w_e4m3 = (wb / scale).to(torch.float8_e4m3fn).view(o, k) return w_e4m3, scale_ue8m0.view(o, k // block_size)这段十几行的代码把 MXFP8 的全部数学讲完了:每 32 个元素取 amax,用 求出最近的 2 的幂指数 ,把 加上偏置 127 存成 uint8(这就是 UE8M0:只存指数、尾数固定为 1),然后元素除以 再转成 e4m3。MX 格式的核心是「scale 必须是 2 的幂」,好处是缩放可以用指数加减实现、无需乘法器,代价是 scale 只能近似到最近的 2 的幂,精度略低于自由的 FP32 scale。对照 NVFP4 用 e4m3(有 3 位尾数)做 block scale,可以看到两条格式路线在「scale 表达能力与硬件开销」上的不同取舍。
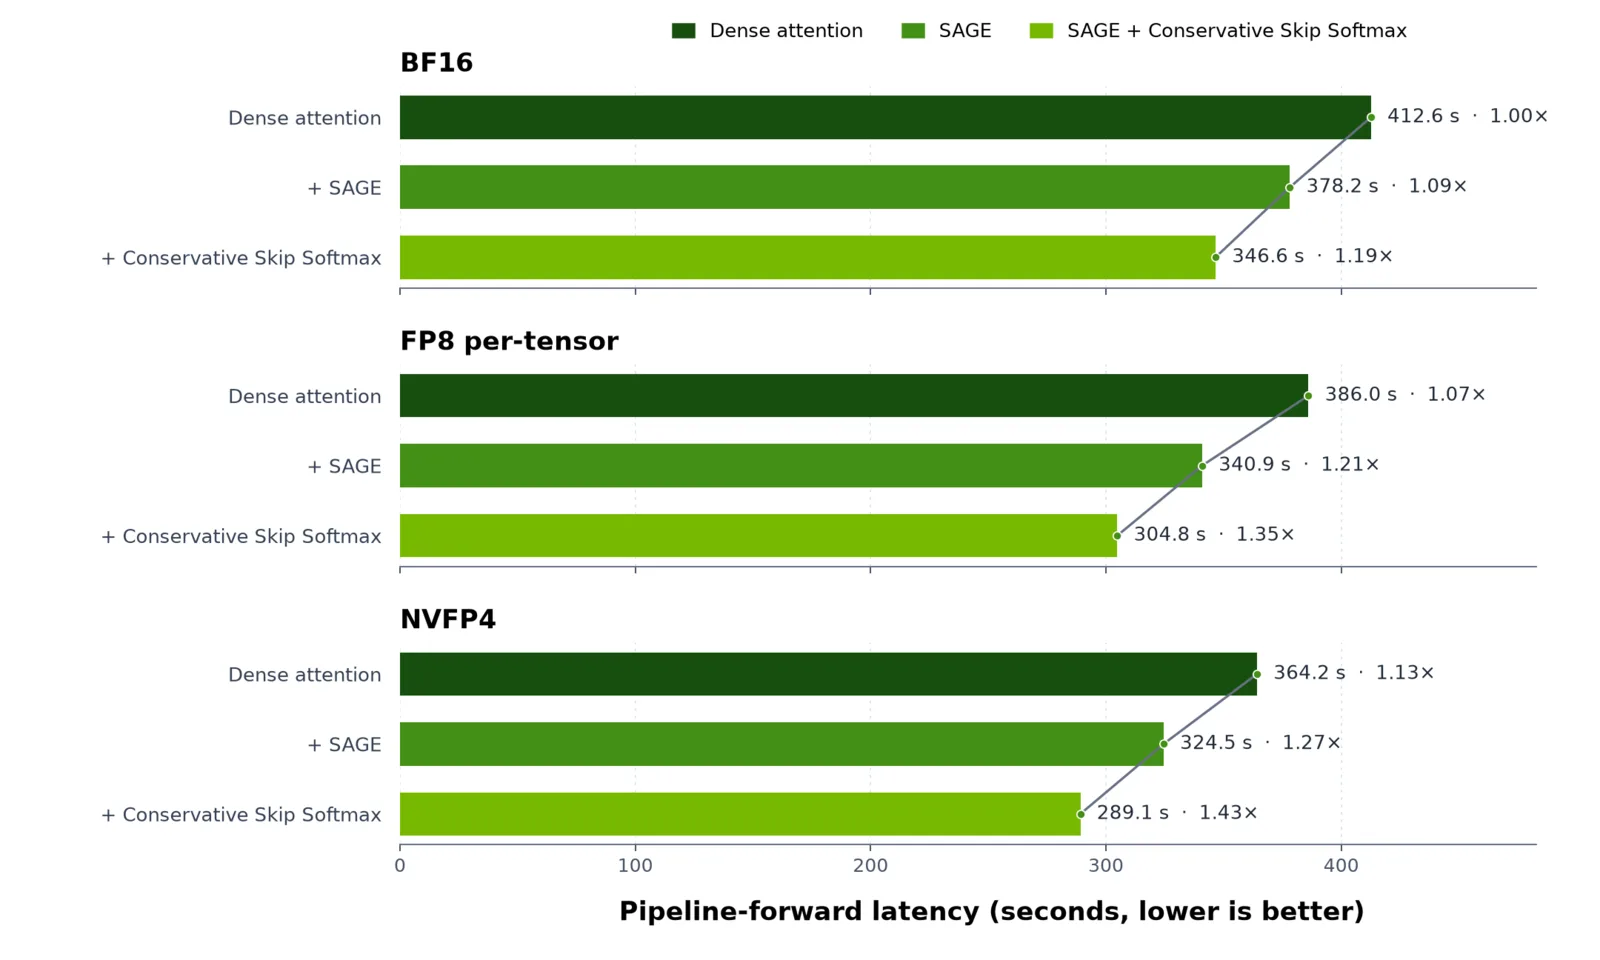
三段流水如何咬合:一个 NVFP4 加载的完整时序
把上面散落的点串起来,NVFP4 checkpoint 从文件到第一次前向的完整时序是:
ModelConfig.load_hf_quant_config读出quant_algo = NVFP4、group_size = 16、kv_cache_quant_algo,构造QuantConfig;若有quant_cfg.json则为每层建一份配置;Linear构造时create_weights_impl调NVFP4LinearMethod.create_weights:把weight分配成[out, in//2]的uint8,weight_scale分配成补零后的扁平 FP8 张量,并建出input_scale、inv_input_scale、alpha、weight_scale_2四个标量;- 加载时
load_weight_scales按WeightMode分派:vanilla 直接交错并拷贝;fused 则先存进tmp_nvfp4_weight_scales字典,等所有 shard 到齐; _finalize_nvfp4_scales校验各 shard 的input_scale、weight_scale_2一致,算出最终的alpha;transform_weights阶段把weight_scale转成 kernel 需要的 UE8M0 布局(若走 CuTe DSL 路径);- 首次前向
apply:_input_prepare决定激活是复用上游量化结果、走动态量化还是走静态 scale,得到(act_fp4, act_sf, alpha);然后调torch.ops.trtllm.nvfp4_gemm,一次性传入量化激活、量化权重、两套 scale 与alpha。
第 6 步的 nvfp4_gemm 调用参数值得完整看一眼,因为它把 NVFP4 的全部约定都体现在签名里:
output = torch.ops.trtllm.nvfp4_gemm( act_fp4, # 量化激活,uint8 打包的 e2m1 module.weight, # 量化权重,同格式 act_sf, # 激活的 block scale module.weight_scale, # 权重的 block scale alpha, # 全局放缩倍数 module.dtype, # 输出 dtype output_buffer_kind=output_buffer_kind, allowed_backends=allowed_backends_str, group=group, bias=bias if fuse_bias_in_gemm else None)allowed_backends 是这套设计的精髓:调用者只是「建议」一个后端偏好(marlin 或一组 NVFP4 后端),实际由 op 内部按当前 SM 与张量形状决定。这让同一份模型代码可以在 Hopper、Blackwell、消费级 Blackwell 上跑出不同的 kernel,而不需要模型层写一堆按架构分支的 if。
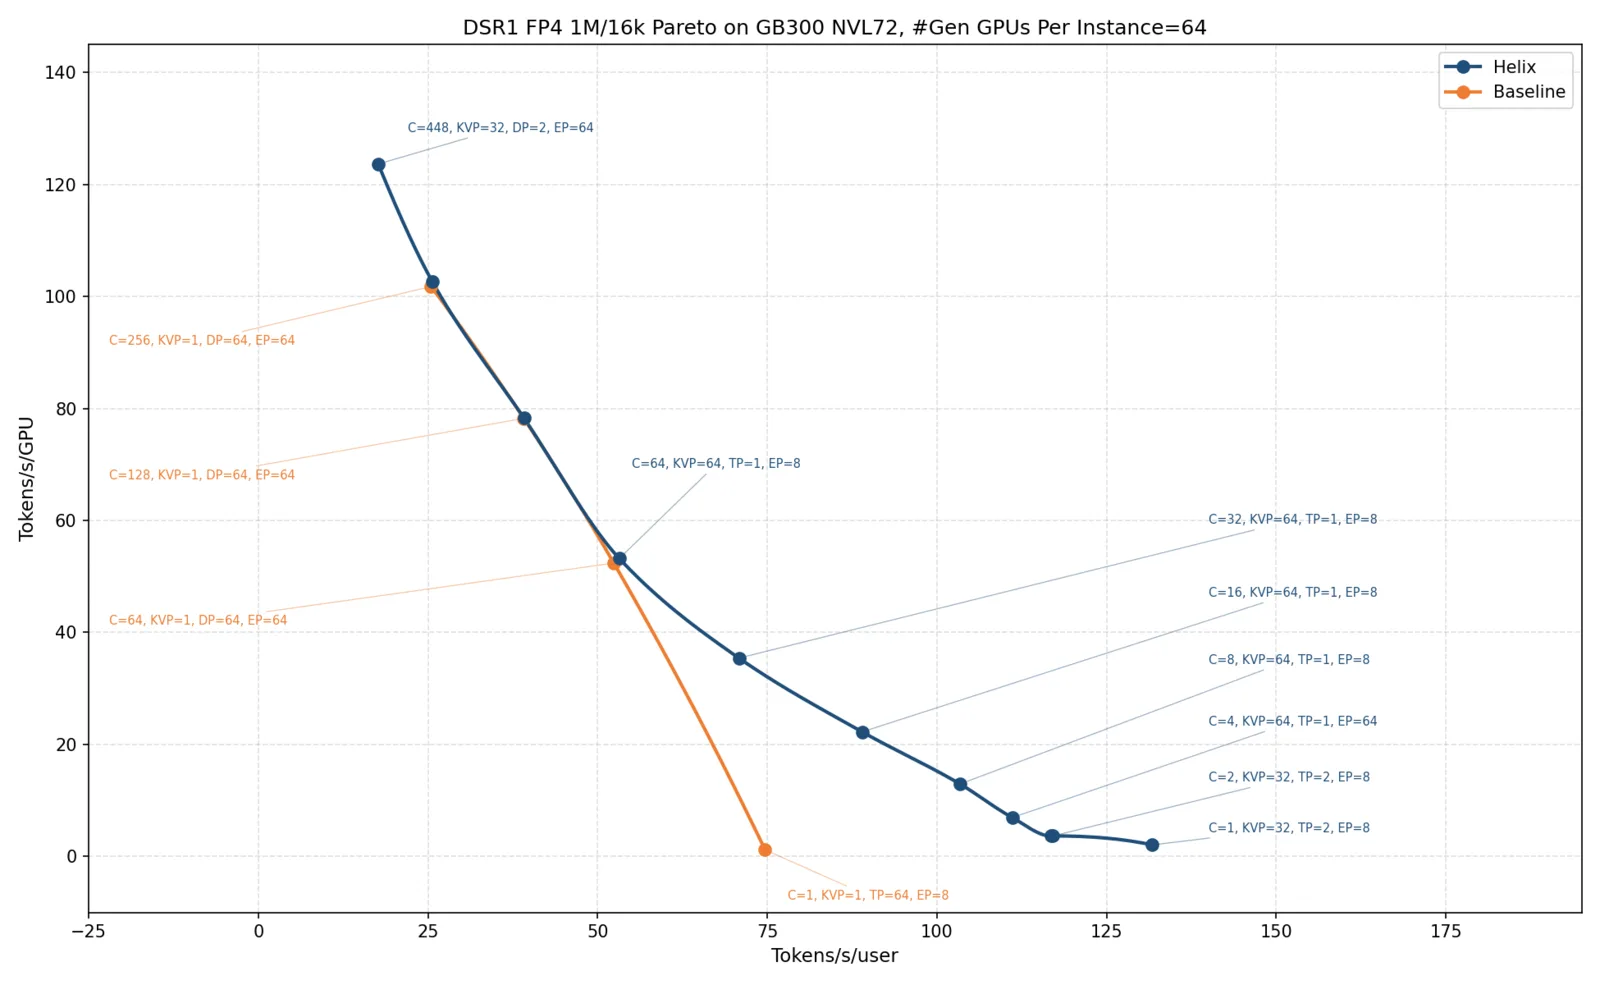
局限与仍然棘手的地方
几个在源码里能直接读到的局限:
其一,KV 缓存量化与权重量化完全分离,且 KV 的算法必须全局统一。 前面那个 kv_quant_lhs != kv_quant_rhs 检查是硬约束。这意味着「部分层 KV 用 FP8、部分层用 NVFP4」在当前实现下不可行,除非为不同层分配不同的 KV 池——那是另一套设计。
其二,group_size 的取值空间被硬件指令钉死。 NVFP4 只能是 16、MXFP4 只能是 32、FP8 block scales 只能是 128。checkpoint 侧「更细粒度量化精度更好」的直觉在这里没有自由度,粒度是硬件的属性而非算法参数。
其三,融合路径与量化方式互相限制。 use_fused_gemm_allreduce 需要激活量化支持对称内存窗口输出,而 FP8 block scales 明确声明 supports_nccl_symmetric_memory_window_output: ClassVar[bool] = False。也就是说,越激进的量化越可能与通信融合冲突,选择需要整体权衡而不是逐项最优。
其四,exclude_modules 的存在说明量化不是全或无。 kv_b_proj、k_b_proj、eh_proj 因为块对齐问题被默认排除;lm_head 常被排除以保住输出分布。一个生产 checkpoint 的量化方案往往是一份「哪些层留下高精度」的清单,这比整体位宽数字更能解释实际精度表现。
工程实践:这套设计给使用者的几条约束
把源码里的机制翻译成使用层面的注意点,有六条值得记住:
其一,hf_quant_config.json 与 quant_cfg.json 必须与权重文件配套。 前者描述全局算法,后者在 MIXED_PRECISION 下描述逐层算法。两者的 kv_cache_quant_algo 必须一致,否则加载阶段直接抛 RuntimeError。这意味着更换 KV 缓存量化方案时,要同时改两份描述文件,而不是只改推理时的一个开关。
其二,group_size 写错不会被纠正,只会被拒绝。 NVFP4 必须是 16、MXFP4 必须是 32、FP8 block scales 必须是 128。这些值对应硬件指令的 block 宽度,代码里是硬断言而不是「向上取整」的柔性处理。
其三,量化粒度会改变 TP 切分的对齐要求。 FP8 block scales 的 get_tp_alignment 返回 128,意味着张量并行切分时输出维必须是 128 的整数倍;NVFP4 在行并行下必须按 16 个元素切。手写自定义模型或者调整并行度时,如果某个投影的输出维度不是对齐值的倍数,得到的不是精度下降而是加载失败。
其四,exclude_modules 里的条目是「不可量化」而不是「不重要」。 kv_b_proj、k_b_proj、eh_proj 被排除是因为块边界与头维度边界不对齐——即使强行量化,反量化阶段的 scale 取回也会错位。这类排除项通常会随模型结构变化(例如换了 MLA 的头维度配置),所以在支持一个新模型时,第一件事是确认排除名单是否需要调整。
其五,激活量化的静态与动态选择影响两件事,不只是延迟。 静态激活 scale 来自离线校准数据的 amax,如果线上输入的分布与校准集偏离(例如长 prompt、特殊语种、极端温度采样),静态 scale 会把大量激活元素压进 FP4 的少数可表示值上,误差放大。所以当线上精度表现与离线评测不一致时,第一件该怀疑的事就是激活量化是否应该切回动态。
其六,量化方案的收益要按阶段分开算。 预填充阶段 M 大、算力是瓶颈,FP4 的收益主要来自 Tensor Core 的更高吞吐;解码阶段 M 小、带宽是瓶颈,收益来自权重字节数的减少与「小 M 走 CUDA Core」的分流。同一份量化方案在两个阶段的收益比例可以差很多,benchmark 时必须分开报告——本站 LLM 推理 Benchmark 完全指南 讲了这两类指标的测量口径。
下一步可以往哪看
量化子系统还有几块本文没有展开,它们是这条线的自然延续:
- 量化后的 MoE 前向:
ConfigurableMoE在量化 checkpoint 下如何选择专家 GEMM 后端、NVFP4 专家的激活量化在哪一步完成,与本站 TensorRT-LLM 源码完全拆解(十三):MoE 层前向执行 是同一模块的另一半; - 注意力输出的量化衔接:注意力 kernel 输出 FP8 时,如何把「已量化」这个状态沿
Fp4QuantizedTensor/ 预量化 FP8 tuple 传递到下游 Linear,省掉重复量化; - 低 M 专用路径:
low_m_gemm.py在小 batch 解码下的分流策略,以及它与 CUDA Graph 静态形状约束的配合; - 逐层混合精度策略:MIXED_PRECISION checkpoint 里「哪些层用哪种算法」是怎么被选择的,以及它与精度评测闭环的关系。
小结
TensorRT-LLM 的量化全链路可以压缩成三句话:读的时候把描述文件翻译成 QuantConfig 与逐层的 QuantMode 位掩码;量化的时候由 ModelOpt 用校准数据算出每个粒度的 scale,NVFP4 额外加一层全局 scale;用的时候由 get_quant_method 选出一个 LinearMethodBase 子类,由它决定张量布局、激活量化时机与最终 GEMM 算子。 三个环节靠 scale 的名字、粒度、dtype 与对齐这四个约定咬合,任何一个错位都会在加载期报错,或者在数值上悄悄偏移。
如果只记一条工程结论:量化在推理栈里真正的工作量不在「算出 scale」,而在「让 scale 与硬件指令的布局、切分、融合约束相符」。 那部分代码占了量化子系统的大半,也解释了这个子系统为什么会长成现在这样。
参考资料
- TensorRT-LLM 源码仓库(NVIDIA/TensorRT-LLM)
- TensorRT-LLM 量化模块源码:tensorrt_llm/_torch/modules/linear.py
- TensorRT-LLM QuantAlgo 与 QuantMode 定义:tensorrt_llm/quantization/mode.py
- TensorRT-LLM NVFP4 工具函数:tensorrt_llm/quantization/utils/fp4_utils.py
- TensorRT-LLM MXFP8 参考实现:tensorrt_llm/_torch/modules/mxfp8_utils.py
- TensorRT-LLM 量化配置解析:tensorrt_llm/_torch/model_config.py
- TensorRT-LLM 权重加载与量化流程:tensorrt_llm/_torch/models/modeling_utils.py
- NVIDIA TensorRT Model Optimizer 仓库
- Introducing NVFP4 for Efficient and Accurate Low-Precision Inference(NVIDIA 技术博客)
- QServe: W4A8KV4 Quantization and System Co-design for Efficient LLM Serving
- AWQ: Activation-aware Weight Quantization for On-Device LLM Compression and Acceleration
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers
- SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models
- Pretraining LLMs with NVFP4(NVFP4 量化配方与逐层数据流)
- TensorRT-LLM 量化示例:examples/quantization
- Quantization in TensorRT-LLM(官方文档)
站点延伸阅读
- TensorRT-LLM 源码完全拆解(一):整体架构与模块全景
- TensorRT-LLM 源码完全拆解(七):KV Cache 的内存布局与量化存储
- TensorRT-LLM 源码完全拆解(九):KV Cache 压缩框架
- TensorRT-LLM 源码完全拆解(十一):并行拓扑与通信
- TensorRT-LLM 源码完全拆解(十二):注意力层的张量并行
- AWQ 完全拆解:只保护 1% 的显著权重
- GPTQ 完全拆解:二阶信息驱动的权重量化
- SmoothQuant 完全拆解:数学等价迁移如何实现无损 W8A8
- Marlin 完全拆解:4-bit 权重如何喂满 GPU Tensor Core
- GGUF 完全拆解:一个文件里的张量布局、k-quants 块量化与元数据字典
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



