


TensorRT-LLM 源码完全拆解(二十七):序列槽位与资源管理器——一个请求的座位、它背后的块,以及一次释放的回收顺序
一个请求进入执行器时,究竟占用了什么
在看 TensorRT-LLM 的 PyTorch 后端源码时,KV Cache 管理器往往最先吸引注意力:它管着成百上千个 KV 块,负责分页、共享、前缀复用、P/D 分离传输,代码长、逻辑重。但一个能被调度的请求真正占用的资源并不只有 KV 块。打开 tensorrt_llm/_torch/pyexecutor/resource_manager.py,在 3000 多行的文件里,除了上千行的 KVCacheManager,还有几个几十行的小类:SlotManager、SeqSlotManager、BlockManager、PeftCacheManager、KVCacheCompressionManager。它们看上去不起眼,却决定了三件事:
- 一条请求在采样器、mRoPE 这一类「按序列编号寻址的池」里占了哪一行;
- 这条请求被释放时,释放按什么顺序发生;
- CUDA Graph 的补齐行(padding row)为什么必须有自己一行不属于任何请求的「座位」。
本篇沿着执行器每个迭代的 prepare_resources / update_resources / free_resources 三次调用,把这个「座位系统」拆开。前二十五篇讲过的内容里,KV 块怎么算、块表怎么建、调度器怎么准入已经讲过,本篇不再复述;这里专门回答「座位从哪来、谁发、什么时候还、为什么这么还」。KV 块与块表的完整映射可参考 KV 块的三张映射表;调度器内部的准入算术见 TensorRT-LLM 源码完全拆解(三):调度器内部;执行器的单步闭环见 TensorRT-LLM 源码完全拆解(二):PyExecutor 装配线与单步闭环。
源码基线为 TensorRT-LLM 主分支(2026 年 11 月)的 tensorrt_llm/_torch/pyexecutor/resource_manager.py、seq_slot_manager.py、_util.py、py_executor.py 与 sampler/sampler.py,以及 C++ 侧的 cpp/tensorrt_llm/batch_manager/kvCacheManager.cpp。
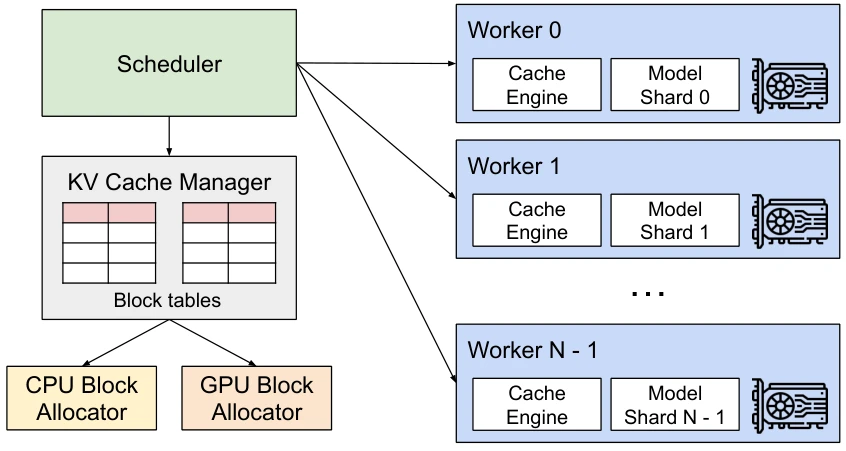
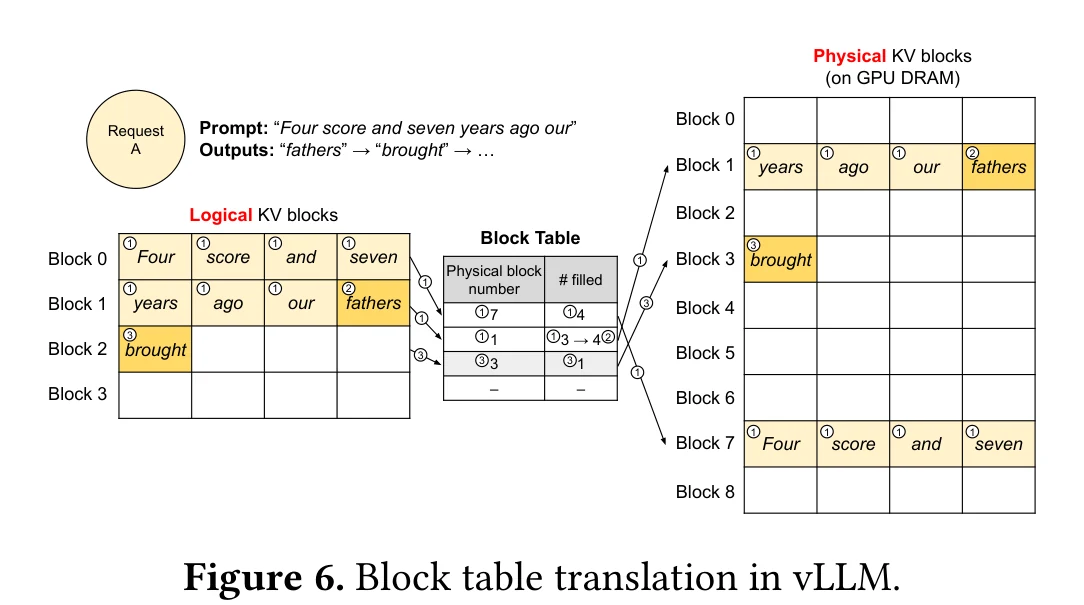
这张图来自 vLLM 的 PagedAttention 论文(arXiv 2309.06180),画的是另一套框架,但把「一条请求到底占几样东西」表达得很清楚:调度器里有它的请求对象,KV 缓存里有一组逻辑页到物理页的映射,采样侧有它的输出槽位。TensorRT-LLM 的资源管理器把这三类东西拆成了不同的 manager,本篇要讲的就是其中最容易被忽略的第一类——座位。
资源管理器的接口:四件事与一个复合容器
BaseResourceManager 的六个钩子
执行器不直接和 KVCacheManager 或 SeqSlotManager 打交道,它只认识抽象基类 BaseResourceManager。基类里有两个抽象方法和四个可选的钩子:
class BaseResourceManager(ABC): @abstractmethod def get_max_resource_count(self) -> int: """Return the maximum number of real requests this manager can admit.""" raise NotImplementedError
@abstractmethod def get_needed_resource_to_completion(self, request: LlmRequest) -> int: raise NotImplementedError
def get_request_kv_block_budget(self, request): ... # 默认 None def kv_block_budget_applies(self) -> bool: ... # 默认 False def add_dummy_requests(self, request_ids): pass def prepare_resources(self, scheduled_batch): pass def update_resources(self, scheduled_batch): pass def free_resources(self, request): pass def shutdown(self): pass这两个抽象方法的语义差异很关键。get_max_resource_count 回答的是「我最多能同时容纳多少条请求」,对 KV 管理器它返回的是块数(self.impl.max_num_blocks),因为它是按「块」这个资源计量;对 SeqSlotManager 它返回的是座位数。get_needed_resource_to_completion 回答的是「跑完这条请求我还需要多少资源」,调用方是调度器做准入判断。
KVCacheManager.get_needed_resource_to_completion 的实现值得单独看一眼,因为它暴露了 Python 调度器与 C++ 调度器的一个历史分歧:
def get_needed_resource_to_completion(self, request: LlmRequest) -> int: # TODO: the C++ implementation of this method can be used, but the # Python and C++ schedulers currently do not agree on what "needed # resource to completion" means. The C++ one excludes already allocated # blocks; the Python one includes them. # ... This intentionally uses beam_width=1 to preserve the historical # beam-unaware value the Python scheduler expects. return self._num_blocks_to_completion(request.orig_prompt_len, request.max_new_tokens, beam_width=1)注释说得很清楚:C++ 口径是「还需要多少」,Python 调度器期望的是「总共多少」,两者对同一字段的解释不同,所以这里固定用 beam_width=1,保持 Python 调度器熟悉的「不考虑 beam 的旧口径」。这提醒我们:读执行器源码时,不能把「资源管理器提供数字」误当成「数字含义在所有路径上都一致」,同一个接口名在不同后端里可以有不同的语义约定。
至于 add_dummy_requests,它只在 KV 管理器与 speculative 资源管理器上被真正实现;SeqSlotManager 没有覆盖它,也就是座位池不为 dummy 预热。这个细节后面会用到。
ResourceManager:一个有序字典
所有具体管理器被装进一个 ResourceManager 复合对象,内部是一个 OrderedDict[ResourceManagerType, BaseResourceManager]。类型枚举一共七个:
class ResourceManagerType(enum.Enum): KV_CACHE_MANAGER = "KV_CACHE_MANAGER" DRAFT_KV_CACHE_MANAGER = "DRAFT_KV_CACHE_MANAGER" CROSS_KV_CACHE_MANAGER = "CROSS_KV_CACHE_MANAGER" PEFT_CACHE_MANAGER = "PEFT_CACHE_MANAGER" SEQ_SLOT_MANAGER = "SEQ_SLOT_MANAGER" SPEC_RESOURCE_MANAGER = "SPEC_RESOURCE_MANAGER" KV_CACHE_COMPRESSION_MANAGER = "KV_CACHE_COMPRESSION_MANAGER"复合对象本身不实现业务逻辑,只负责按顺序遍历。prepare_resources 是正序遍历,free_resources 是 reversed(...) 反序遍历:
def prepare_resources(self, scheduled_batch, *, publish_connector_output=True): for _, resource_manager in self.resource_managers.items(): resource_manager.prepare_resources(scheduled_batch) # After every manager, so context_current_position / context_chunk_size # are final. See maybe_fit_token_budget. self.maybe_fit_token_budget(scheduled_batch) ...
def free_resources(self, request: LlmRequest): for resource_type, resource_manager in reversed(self.resource_managers.items()): resource_manager.free_resources(request)正着申请、反着释放,是资源管理里最常见的纪律,原因在「释放顺序」一节展开。这里先记住一点:OrderedDict 的次序不是构造时随手写的,构建函数 create_py_executor_resources 在最后显式把 KV 管理器、cross-KV 管理器、压缩管理器 move_to_end 到队尾,确保它们在 prepare 里最后跑、在 free 里最先跑。
为什么 KV 管理器必须最后 prepare
prepare_resources 在所有管理器跑完之后还有两步,这两步解释了「KV 管理器为什么排最后」:
self.maybe_fit_token_budget(scheduled_batch) # Strictly after the trim: the connector is told how many tokens the # forward pass will compute, which is only settled once the trim has run. if publish_connector_output and hasattr(kv_cache_manager, "report_batch_to_connector"): kv_cache_manager.report_batch_to_connector(scheduled_batch)maybe_fit_token_budget 在 KVCacheManager 里实现,作用是把超出 max_num_tokens 的 context chunk 当场裁短。它必须等到所有管理器都跑完才有意义,原因是微批调度器准入时用的 token 数是「估算的可复用 token」(estimated_reusable_tokens,来自前缀树的猜测),而真正复用了多少要等 addSequence 执行时才确定(prepopulated_prompt_len)。两者不一致的典型场景,就是估算说「这一段前缀能复用」,实际块表里只命中了一部分,于是本批真实前向的 token 数比预算多。只有在 prepare_resources 末尾,context_current_position 与 context_chunk_size 都是最终值,才能算出差额并裁短。
裁短安全的前提是「只缩不放」:没有任何请求被移出批次,所以此前各管理器为这条请求记录的 per-request 状态、attention-DP 的 _can_queue 投票、PP 的 inflight 集合都仍然与批次一致。如果这里改成「把超预算的请求踢出去」,那些已经为它分配了座位的管理器就必须回滚,复杂度会高一个量级。这也是一个值得记住的设计取舍:在流水线的末端做「缩小」比在末端做「移除」便宜得多。
report_batch_to_connector 则把最终要前向的 token 数告诉 KV connector(P/D 分离场景下负责跨实例搬运 KV 的组件)。它同样必须等裁剪结束,否则传输侧会按裁剪前的数字做预算。
SlotManager:一个整数座位和它的三种边界
SlotManager 是整个「座位系统」里最底层的一层,四十来行,核心就是一个 dict 和一个 set:
class SlotManager: def __init__(self, max_num_requests: int): self.max_num_requests = max_num_requests self.slot_mapping = dict() # request_id -> slot self.free_slots = set(range(max_num_requests)) # 空闲座位集合
def get_slot(self, request_id: int): return self.slot_mapping.get(request_id, None)
def add_slot(self, request_id: int): if request_id in self.slot_mapping: # CUDA graph dummy request could be added for different batches, # but we only need to reserve slot for it once. from .cuda_graph_runner import CUDA_GRAPH_DUMMY_REQUEST_ID assert request_id == CUDA_GRAPH_DUMMY_REQUEST_ID return self.slot_mapping[request_id] if len(self.free_slots) == 0: raise NoFreeSlotsError("No free slots") slot = self.free_slots.pop() self.slot_mapping[request_id] = slot return slot
def remove_slot(self, request_id: int): if request_id in self.slot_mapping: slot = self.slot_mapping.pop(request_id) self.free_slots.add(slot)分配方式是 set.pop(),因此座位号没有顺序语义。先来的请求未必拿 0 号座位,释放后最先被复用的座位号也不确定。这一点和 KV 块分配(deque.popleft(),先进先出)刻意不同:KV 块号会进入块表、进入页索引,顺序影响访存局部性,所以用 FIFO 保持稳定;而座位号只被用来索引几个几 MB 的数组,拿哪一行都无所谓,用 set.pop() 实现 O(1) 且不需要额外数据结构。
边界一:重复申请只有 dummy 能例外
add_slot 遇到已经存在的 request_id,只有当它是 CUDA Graph 的 dummy 请求时才允许「幂等返回」,其余情况直接断言失败。这个例外来自一种真实的调用模式:同一个 dummy id 会在不同批次、不同 draft 长度的补齐路径上被反复申请,每次都新建映射就会把座位号泄漏,因为 remove_slot 只能移除一次。断言则是反向的保护:如果一条真实请求被重复申请座位,说明执行器在释放前又调度了它,这必然是状态机的 bug,与其静默覆盖映射,不如立刻崩掉。
边界二:没有空闲座位时抛 NoFreeSlotsError 而不是返回 None
NoFreeSlotsError 是 ValueError 的子类,名字是「seat」语义的直接延续(源码里的 NoFreeSlotsError 注释写的是 A slot-backed resource manager has no capacity for another request.)。它被 CUDA Graph 补齐路径专门捕获:
try: ... spec_res_mgr.add_dummy_requests([dummy_request_id]) ...except NoFreeSlotsError: rollback() return Noneexcept Exception: rollback() raise补齐 dummy 需要 KV 块,也需要 speculative 资源管理器的槽位;如果槽位不够,补齐应该「放弃补齐」,让这一步退回 eager 模式,而不是让整个执行器挂掉。rollback() 会对所有已登记的管理器反向 free_resources(dummy_request),把已经分配出去的那部分资源还回去。这种「分配失败必须能整体回滚」的模式,与数据库事务是同一个思路:一个请求横跨多个资源管理器,只要有一个拒绝,前面成功的都得撤销,否则会留下半截状态。
边界三:shutdown 的断言是记账自检
def shutdown(self): req_ids_list = list(self.slot_mapping.keys()) for rid in req_ids_list: self.remove_slot(rid) assert len(self.slot_mapping) == 0 and len(self.free_slots) == self.max_num_requests最后那行断言等价于「所有座位都回到了空闲集合」。它在进程退出时运行,是座位池记账的自检:如果之前某条路径把座位取走了却忘了还,这里会直接暴露,而不是等到下一次复用同一个请求 id 时才出现莫名其妙的采样错乱。对这类薄记账结构,退出时做一次守恒检查成本几乎为零,收益却很高。
SeqSlotManager:把座位挂到请求上
SlotManager 本身不知道请求是什么,SeqSlotManager 负责把它接进执行器的生命周期。整个类只有四十来行:
class SeqSlotManager(BaseResourceManager): def __init__(self, max_num_sequences: int): self.slot_manager = SlotManager(max_num_sequences)
def get_max_resource_count(self) -> int: return self.slot_manager.max_num_requests
def get_needed_resource_to_completion(self, request: LlmRequest) -> int: return 1
def prepare_resources(self, scheduled_batch: ScheduledRequests) -> None: for llm_req in scheduled_batch.all_requests(): if llm_req.is_disagg_generation_init_state: logger.info( "Skip assigning sequence slot for DISAGG_GENERATION_INIT " f"request {llm_req.request_id}.") continue if llm_req.seq_slot is None or llm_req.is_disagg_generation_transmission_complete: llm_req.seq_slot = self.slot_manager.add_slot(llm_req.request_id) llm_req.py_seq_slot = llm_req.seq_slot if llm_req.return_perf_metrics: llm_req.set_first_scheduled_time()
def free_resources(self, request: LlmRequest) -> None: self.slot_manager.remove_slot(request.request_id)发放条件:只在「还没有座位」时发
prepare_resources 对批次里每条请求检查 seq_slot is None,只在请求还没有座位时调用 add_slot。这个条件不是性能优化,而是正确性要求:同一条请求会在很多个迭代里被重复调度(每解码一个 token 就是一个迭代),prepare_resources 每个迭代都会对整批请求跑一遍。如果每轮都无条件申请,第二次就会撞上 add_slot 的重复申请断言。
seq_slot 和 py_seq_slot 是两个字段。seq_slot 是绑定到 LLMEngine 那一侧的编号,py_seq_slot 是 PyTask/PyExecutor 这一侧的镜像。分配时两者同时写,正是为了让两条路径在第一个迭代就一致。两者也会出现分歧,最典型的是 P/D 分离:py_executor.py 里有三处注释写着「init_disagg_gen_requests 必须在引擎前向之前执行,因为前向会更新 prev_seq_slot」,意思是生成侧第一次前向会把引擎侧的 prev_seq_slot 换成新的座位号,而 PyTask 一侧的 py_seq_slot 不会自动跟着变。如果采样器在同步完成之前就按 py_seq_slot 去读 new_tokens,读到的就是旧的(甚至是上一条请求的)那一行。这也是生成侧初始化时先不发座位、等传输完成标记置位再发的原因之一:让发号与首次使用尽可能贴近。
get_needed_resource_to_completion 返回常数 1,含义是「一条请求永远只占一个座位」。这让调度器可以非常简单地把座位当作「一个人一个位子」的约束来计算,不必像 KV 那样按 prompt 长度和生成长度估块数。
第一个分支处理的是 P/D 分离场景下的 DISAGG_GENERATION_INIT 状态:这是一个「生成侧初始化、但还没真正拿到 KV」的中间态,此时不给它分配座位,等 KV 传输完成的标记 is_disagg_generation_transmission_complete 置位后再发。这样做的动机是座位需要索引采样器的持久状态(见下文),而传输完成前生成行还不存在,提前占座只会让座位在等待网络传输的这段时间里被白白锁住。
副作用:第一条排进队的请求在这里打时间戳
if llm_req.return_perf_metrics: llm_req.set_first_scheduled_time() 这行容易被忽略。first_scheduled_time 是性能指标里「请求从进入执行器到第一次被调度」的延迟,它的起点正是「拿到了座位」这一刻。把打点放在这里,比放在调度器出口更准确,因为调度器出口还有 _can_queue 投票、connector 预留等可能把本批撤销的步骤;座位发放发生在 prepare_resources 里,而 prepare_resources 只在 can_queue 为真时才被调用(_step 里先是 _can_queue,通过了才准备资源)。也就是说,「拿到座位」与「这一批确实会执行」在同一时刻发生,用它作为延迟指标起点,不会把被撤销的批次计入。
座位被谁使用:采样器里那些「按座位寻址」的数组
座位号到底进了哪些数组?在 sampler/sampler.py 的 TorchSampler 里可以找到最直观的答案。构造函数里有这样一组合约:
self.max_num_sequences = args.max_num_sequencesself.dummy_slot_row = self.max_num_sequencesself.NEW_TOKENS_SHAPE = (self.max_tokens, self.max_num_sequences + 1, self.max_beam_width)self.CACHE_INDIRECTION_SHAPE = (self.max_num_sequences, self.max_beam_width, self.max_seq_len)self.LOGPROBS_SHAPE = (self.max_num_sequences, self.max_beam_width, self.max_tokens)new_tokens 的形状是 (max_tokens, max_num_sequences + 1, max_beam_width),多出来的那一行就是 dummy_slot_row。源码给出的理由是:
# One row past the real sequence slots. CUDA graph padding rows own no# slot, but the captured graph scatters a token for every row it# replays, so they need a destination that belongs to nobody: every# index in range(max_num_sequences) is owned by some request, and the# overlap scheduler reads a slot's row back as that request's next input# token. Mirrors the spec path's dummy_slot_row.这里把两个边界叠在了一起。第一,CUDA Graph 捕获的采样步骤会「对每一行都散写一个 token」,补齐出来的行也不可避免。第二,在 overlap scheduler 下,采样(第 i 步)发生在 update_requests(第 i-1 步)之前,主机侧还没把采样结果折回请求,于是它会把 new_tokens[slot] 这一行直接当作该请求的下一步输入 token 读回来。如果补齐行落在某个真实座位号上,就会把一条真实请求的下一输入悄悄篡改。所以必须留一行「谁都不拥有」的 scratch 行。
随座位号一起分配的持久状态还有:self._pending_steps = [0] * self.max_num_sequences(每个座位上有几个采样步还没折回)、TopPDecayHandler(self.max_num_sequences)、SlotSamplingParams(self.max_num_sequences + 1)、FinishReasonsHandler(max_num_sequences=...)。它们共同满足一条不变量:除了 new_tokens 多一行 scratch,其它数组的座位维必须完全一致。构造函数里有一行断言专门守住它:
assert ( new_tokens_shape[0] == finish_reasons_shape[0] and new_tokens_shape[1] == finish_reasons_shape[1] + 1 and new_tokens_shape[2] == finish_reasons_shape[2]), f"{new_tokens_shape} is not {finish_reasons_shape} plus a scratch slot row"如果把座位池想成「一排寄存柜」,那么每个柜子里预置了采样器要用的本子(待折回的步数、Top-P 衰减状态、采样参数、结束原因);KV 块则是另一套按块租用的大仓库。座位池的尺寸就是柜子数,而柜子数不对,先坏掉的往往是采样而不是注意力。
另一个按座位寻址的池:mRoPE 的 delta 缓存
多模态模型 Qwen2-VL / Qwen3-VL 使用 mRoPE,位置被拆成时间、高、宽三个轴。每个请求需要一个「位置增量 delta」,执行的时候要按座位号把 delta 读出来。CUDA Graph 捕获时不能读一个真实请求的 delta,所以 cuda_graph_runner.py 为它准备了专门的座位:
def get_mrope_dummy_seq_slot(max_num_tokens: int, pp_size: int) -> int: """Cache slot index reserved for MRoPE dummy/no-delta requests.""" return max_num_tokens * pp_size这个号是 max_num_tokens * pp_size,也就是「座位池之外的第一行」。为什么它能放在池外?因为 mRoPE 的 delta 缓存本身不是按 compute_max_num_sequences 分配的,它按 max_num_tokens * pp_size + 1 分配、按 py_seq_slot 索引,依赖 max_batch_size <= max_num_tokens 才能保证真实座位号不越过它。这直接引出了下一节的核心问题:座位池的尺寸到底按什么算。
座位池的尺寸:max_batch_size 为什么要乘上微批数
座位池的大小在 _util.py 里由 compute_max_num_sequences 决定:
def compute_max_num_sequences(mapping: Mapping, max_batch_size: int, disable_overlap_scheduler: bool, enable_overlap_headroom: bool = False) -> int: """Size the sequence-slot pool (and the sampler state it indexes).
``enable_overlap_headroom`` is intentionally opt-in; see ``should_enable_overlap_headroom``. Pipeline parallelism already sizes the pool by ``pp_size``. """ if mapping.has_pp(): num_micro_batches = mapping.pp_size else: num_micro_batches = (2 if enable_overlap_headroom and not disable_overlap_scheduler else 1) return max_batch_size * num_micro_batches公式只有一行:
其中 是调度器的 max_batch_size, 是流水并行度。
为什么 PP 要乘 pp_size
流水并行把模型层切成 段,同一时刻每一段上都有不同的微批在跑。一个批次在某一 rank 上做前向时,前一个微批可能还在下一段上执行,后一个微批已经在上游被组装。座位号是全局编号,采样器、mRoPE 缓存等池在每个 rank 上都按同一套编号分配,因此池必须能同时容纳「所有可能同时在飞的微批」里的请求。乘 pp_size 是把这段流水里的最大重数算进去。
注意这里没有用 max_batch_size * pp_size 之外的额外系数,也没有把 attention-DP 的复制算进去:attention DP 的每个 rank 各自有独立的座位池,编号在 rank 内自洽,不需要跨 rank 唯一。只有 PP 不同——PP 切的是层,不是请求,请求会穿过所有 PP rank,所以座位编号必须在 rank 间是同一套。
overlap headroom:为什么普通场景下要额外多一倍的座位
默认 enable_overlap_headroom=False,非 PP 时座位池就是 max_batch_size。但开启 overlap scheduler 后会有一个微妙的问题,should_enable_overlap_headroom 的 docstring 讲得很清楚:
True only where a retiring request and the replacement that took its placecan own a seat at the same time: non-PP, overlap-on, V2 and non-hybrid.
Under the overlap scheduler a request that emitted its last token keeps itsseat until the next iteration's ``_process_previous_batch``, which runsafter that iteration has already admitted new work. Admission excludes suchretiring requests whenever this gate is on (``ADPRouter`` on theattention-DP path, ``_fetch_new_requests`` otherwise), so the replacementcohort needs seats of its own. Without the extra micro-batch, a workloadwhose requests retire after one iteration -- a context server, where everyrequest finishes in its prefill step -- can only refill the seats theprevious iteration did not use, and runs at roughly half its batch.把这段话拆成时序会更容易理解。设第 个迭代:
- 调度器挑出新请求,
prepare_resources给它们发座位; - 前向执行;
- 采样得到 token;
_process_previous_batch处理第 批的采样结果,把已经产出结束 token 的请求标记完成。
overlap 的含义是「第 3 步和第 4 步不互相等待」:第 步的采样在 _process_previous_batch 之前就跑了。于是第 批里一条已经结束的请求,它的座位要到第 步末尾才被释放,但第 步开始时调度器已经又放进了一批新请求。如果座位池刚好只有 max_batch_size 个,新请求就只能填「上一轮没用到的那些座位」,而那些「已经结束但还没被回收」的座位仍然被占着。
对一个 context server(每条请求在 prefill 这一步就结束)这种极端负载,结果就是每轮只能填一半的座位,批大小掉到约一半。这正是源码注释里 runs at roughly half its batch 的来源。多留一个微批的座位(2 倍),等于是给「退役中」和「新上任」两个群体各留一套座位,重叠才真正生效。
为什么两类模型不能加这个 headroom
should_enable_overlap_headroom 的返回值是三个条件的与:
if is_hybrid or has_mrope_delta_cache or not kv_cache_manager_is_v2: return Falsereturn not mapping.has_pp() and not disable_overlap_scheduleris_hybrid 指混合模型(注意力层 + Mamba/RWKV 之类的线性注意力层)。原因是 MambaCacheManager 自己按 max_batch_size * pp_size 推容量,并不读 compute_max_num_sequences;座位池翻倍后,Mamba 的状态池仍按旧尺寸分配,第一批多出来的座位就会越界。
has_mrope_delta_cache 指 Qwen2/2.5-VL 与 Qwen3-VL。它们按 py_seq_slot 索引一块 max_num_tokens * pp_size + 1 大小的 delta 缓存,依赖 max_batch_size <= max_num_tokens 保证真实座位号不越界;多出来的那一行是预留的 dummy 槽位。座位池翻倍后,先会「别名」到那一行 dummy(补齐请求读到了真实请求的 delta),再往后就直接越过数组末尾。
这两个例子说明一件事:座位池并不是一个孤立数组,它是若干「按座位号索引的池」的共同长度契约。只要有一个池的容量不是由同一个公式推出来的,放大座位池就会破坏不变量。 因此 headroom 做成了显式开关,并且由启动期检查兜底:
def validate_seq_slot_pool_covers_admission(max_num_sequences: int, kv_cache_manager) -> None: """Fail at startup if the KV index pool cannot cover the seat pool.
The check is one-sided on purpose: an index pool narrower than the seat pool silently defers admitted requests, while a wider one is legitimate. """ admissible = getattr(kv_cache_manager, "max_admissible_sequences", None) if not isinstance(admissible, int): return if admissible >= max_num_sequences: return raise ValueError( f"... can lease KV cache indices for {admissible} concurrent sequences " f"but the executor's sequence-slot pool holds {max_num_sequences}: ... " "(nvbug 6627795). The seat pool must come from " "_util.compute_max_num_sequences and the index pool must cover it; a " "shortfall means one of them was re-derived from max_batch_size.")检查是单向的:索引池比座位池大是合法的(浪费一点内存),比座位池小则一定是 bug。原因写在报错信息里——如果索引池更小,准入时「通过了座位检查、却拿不到 KV 索引」的请求会被一条条静默延后(每次调度都只能退回队列),表现为吞吐诡异下降而不是明确报错。启动期直接失败,比线上慢慢劣化好得多。报错文案最后一句还点出了根因模式:两个池里有一个是从 max_batch_size 重新推导的,而不是统一走 compute_max_num_sequences。
座位池与调度器容量:那个 +1
构建资源时还有一段相关代码:
scheduler_capacity = max_batch_size * mapping.pp_sizeif scheduler_capacity == 1 and mapping.enable_attention_dp and kv_cache_manager: scheduler_capacity += 1这是调度器的容量,不是座位池的容量。容量为 1 且开启 attention DP 时,需要给 attention-DP 的 dummy 请求留一个额外的调度位置,否则 DISAGG_GENERATION_INIT 状态的请求会一直卡在调度器里:唯一的调度位被 dummy 占了,真正的请求永远排不进来。注意它加的是调度器容量,而座位池并不为 dummy 发号——dummy 在采样器里用的是 dummy_slot_row,不占真实座位。这两个数字容易混淆,但服务的是不同对象。
座位池尺寸进了哪些下游
max_num_sequences 会被传给 TorchSampler 的 Args、FinishReasonsHandler、TopPDecayHandler、SlotSamplingParams;模型引擎在 _init_from_model 里也按同一个公式算出 max_num_seq_slots,并把它作为 num_seq_slots 交给 C++ 侧的 DecoderRunnerConfig。create_py_executor_resources 里的 resolve_max_num_sequences 则遵循「显式参数优先、其次读引擎已公布的 max_num_seq_slots、最后才重新计算」的顺序,避免两处各算一遍算出不同数字。换句话说,座位池尺寸一变,采样器、执行器资源、解码 runner 几处都要同时跟上;这也是为什么改这个公式时必须同时看 should_enable_overlap_headroom 里的两个排除项。
释放顺序:为什么 free_resources 要反着走
一次释放其实分两层:先采样器,再资源管理器
执行器释放一条请求的执行资源,走的是 _free_request_resources:
def _free_request_resources(self, request: LlmRequest) -> None: """Release execution resources without removing response routing.""" connector = getattr(self, "kv_connector_manager", None) if (self.enable_attention_dp and connector is not None and connector.has_pending_transfers(request.request_id)): self._kv_connector_fail(...) self.sampler.release_request(request) self.resource_manager.free_resources(request) self._prefetched_request_ids.discard(request.py_request_id) self.disagg.forget_request(request.py_request_id) for engine in (self.model_engine, self.draft_model_engine): release = getattr(getattr(engine, "model", None), "release_request_state", None) if release is not None: release(request.py_request_id)采样器先于资源管理器释放,Sampler.release_request 的 docstring 一句话点明顺序:
"""Release sampler-owned state before the request's slot is returned."""这是「反向依赖」的典型写法。座位号本身只是整数,被 FinishReasonsHandler、TopPDecayHandler 之类按座位索引的状态对象使用。释放顺序必须保证:当座位号被归还、可能立刻被另一个请求用掉时,没有任何旧状态还挂在这个号上。 想象先还座位、后清理采样器状态:新请求拿到同一个号,采样器里属于旧请求的结束原因、Top-P 衰减计数还没清掉,新请求的第一步就会读到脏数据。先清状态、再还号,座位号在被重新发放时一定是干净的。
release_request 在 TorchSampler 里只做一件事:self._finish_reasons_handler.release_request(request);基类里其它子类可以有不同实现。这样一个「先清谁」的纪律被写进了基类接口,而不是散落在执行器各个分支里。
复合对象的反向遍历
资源管理器内部的顺序是 reversed(...)。为什么需要反着?看构建函数里的排序就能理解:
# KV cache manager runs last (others may depend on it), except the# compression manager which reconciles after it (below).if kv_cache_manager is not None: resource_manager.resource_managers.move_to_end( ResourceManagerType.KV_CACHE_MANAGER, last=True)if cross_kv_cache_manager is not None: resource_manager.resource_managers.move_to_end( ResourceManagerType.CROSS_KV_CACHE_MANAGER, last=True)if ResourceManagerType.KV_CACHE_COMPRESSION_MANAGER in resource_manager.resource_managers: resource_manager.resource_managers.move_to_end( ResourceManagerType.KV_CACHE_COMPRESSION_MANAGER, last=True)prepare 的正序是「先轻后重」:座位、LoRA、speculative 这些便宜的先拿到,KV 管理器最后跑,因为它要等前面所有管理器确定这一批的真实形状;压缩管理器排更后,因为它依赖 KV 管理器已经分配好物理页,才能做「冷页编码」这类事后处理。
free 的反序于是变成「先重后轻」:压缩管理器先归还页级状态,KV 管理器再释放块,最后才轮到 SeqSlotManager 把座位还回去。这个顺序保证了一件很实际的事——在 KV 块被释放、块表被改写的那一刻,请求的座位号仍然有效,于是任何需要「按座位号找到这条请求」的清理逻辑(比如日志、性能打点、按 request id 做映射的回调)都不会拿到一个已经被复用给别人的座位号。
抢占路径上的一条注释:不能只暂停
V2 KV 管理器的抢占(preemption)有一条特殊路径:
if not self.kv_cache_manager.try_complete_preemption(request): return False# The same teardown an immediate recompute pause does. Pausing alone# would clear py_seq_slot while SeqSlotManager still owned the slot,# and the next schedule would trip its assertion.self._free_request_resources(request)self._pause_recompute_request(request)return True注释里描述了一个很具体的 bug 形态:抢占时如果只做「暂停」(把请求挂起、清空 py_seq_slot,等待稍后重新 prefill),座位并没有被 SeqSlotManager 收回;下一次调度这条请求时,prepare_resources 看到 seq_slot is None,就会再次向 SlotManager.add_slot 申请同一个 request_id。add_slot 对非 dummy 的重复申请会断言失败——因为映射里已经有这个 id,而代码只允许 CUDA Graph dummy 幂等。于是整个执行器崩溃。
修法是「走完整的释放路径」:先 _free_request_resources(采样器状态 + 资源管理器,含座位归还),再 _pause_recompute_request。这里有个顺序细节:如果先 pause 把 py_seq_slot 清掉,再走释放,SeqSlotManager.free_resources 仍然按 request_id 去 remove_slot,能正确归还;但如果在别处先清 seq_slot(引擎侧的编号),采样器就会在释放前读到 None,assert request.py_seq_slot is not None 之类的地方会先炸。所以「先释放、后暂停」不是风格问题,而是字段生命周期决定的唯一安全顺序。
一条请求从进队到回收的完整资源时序
把上面几节串起来,一条普通解码请求的资源账大致是:
| 时刻 | 动作 | 座位 | KV 块 | 采样器状态 |
|---|---|---|---|---|
进入 _step | _can_queue 投票 | 无 | 无 | 无 |
prepare_resources | SeqSlotManager 发号 | 拿到 | — | — |
| 同一函数后段 | KVCacheManager 分配块 | 拿到块表 | — | |
| 末尾 | maybe_fit_token_budget 裁 chunk | 可能追加块 | — | |
| 前向+采样 | 写 new_tokens[s] | 写入 KV | 写入结束原因 | |
| 下一步调度 | 仍 seq_slot != None | 复用/追加 | 累积 | |
_free_request_resources | sampler.release_request | — | 清空 | |
| 紧随其后 | resource_manager.free_resources | 归还 | 块归还 | — |
这张表的重点是第二列与第四列的先后:座位先于 KV 块拿到,后于 KV 块归还。座位是「这条请求存在过」的最早证据,也是「这条请求已经结束」的最后证据。
顺带一提,update_resources 这一步会把本批各请求新分配的块写进注意力元数据,并给 KV 管理器一个机会在不跳过的前提下更新。ResourceManager.update_resources 里对 KV 管理器做了特殊处理:
if resource_type == ResourceManagerType.KV_CACHE_MANAGER: if skip_kv_cache_manager: continue resource_manager.update_resources(scheduled_batch, attn_metadata, kv_cache_dtype_byte_size)else: resource_manager.update_resources(scheduled_batch)skip_kv_cache_manager 的用途是某些路径(例如已经单独更新过 KV 元数据的场景)不重复跑一遍。其它管理器比如 speculative 资源管理器只收 scheduled_batch,因为它们的更新内容不依赖注意力元数据。这种「只有需要元数据的管理器才收元数据」的签名差异,是读执行器时需要留意的细节:接口形状本身就编码了依赖关系。
块管理器:与座位并列的另一半
resource_manager.py 里还有一个 BlockManager,和 KVCacheManager 并列存在。它只有几十行,是一个不带前缀复用、不带共享的极简分页分配器:
class BlockManager: def __init__(self, num_blocks: int, tokens_per_block: int): self.block_ids = dict() # request_id -> [block_id, ...] self.num_sequences = dict() # request_id -> 已占用 token 数 self.free_blocks = deque(range(num_blocks))
def add_tokens(self, request_id: int, num_tokens: int): ... block_count_needed = self.compute_block_count( self.num_sequences[request_id], self.tokens_per_block) if len(self.block_ids[request_id]) < block_count_needed: new_blocks = self._allocate_blocks( block_count_needed - len(self.block_ids[request_id])) self.block_ids[request_id].extend(new_blocks)它值得一读,不是因为它在生产路径上承担了主要工作,而是因为它把「块分配」这件事的最小骨架暴露了出来,方便对照理解 KVCacheManager 多出来的东西:
compute_block_count用的是向上取整:(token_count + tokens_per_page - 1) // tokens_per_page。注意文件里还有一个compute_page_count,写法是(token_count + tokens_per_page) // tokens_per_page,两者刚好相差一页。它们服务的是不同调用点,用哪个取决于「是否要为下一批 token 预留下一个页」这个语义;读代码时如果看到同一概念出现两个差一的公式,先确认调用方的口径,而不是挑一个顺眼的用。free_blocks是deque,分配用popleft,释放用extend。FIFO 让块号在反复分配释放后仍然大致有序,块表里的物理块号不会无规律地跳动。copy_block_offsets里有一句关键注释:# Block ids are the page offsets directly; no lookup table needed.在 KV 池是[num_blocks, tokens_per_block, ...]这种「块号即第一维下标」的布局下,块号可以直接当页偏移用;一旦池子做了分层(比如 K/V 分开池、窗口大小分池),块号到池内偏移就需要一张真正的映射表。KVCacheManager的复杂度很大一部分就来自这张表。rewind_cache处理投机解码被拒绝的草稿 token:把num_sequences减回去,再按新的 token 数算出需要的页数,多出来的尾部页直接_free_blocks。这个动作必须「只从尾部裁」,不能从中间挖洞,否则块表就不再是一条连续前缀。
KVCacheManager 则在这个骨架上加了:前缀树(相同前缀的块共享)、引用计数(一块被多条请求引用时不能释放)、分池(不同窗口/不同 head_dim 的层用不同池)、事件与 connector(P/D 传输)、以及块哈希。这些机制在前面的篇目里已经展开,本篇只需要记住:座位管「谁」,块管「多少」。 两者都以 request_id 为键,但一个的上限是并发请求数,另一个的上限是显存能装下的 token 数。
与其它框架的座位概念对照
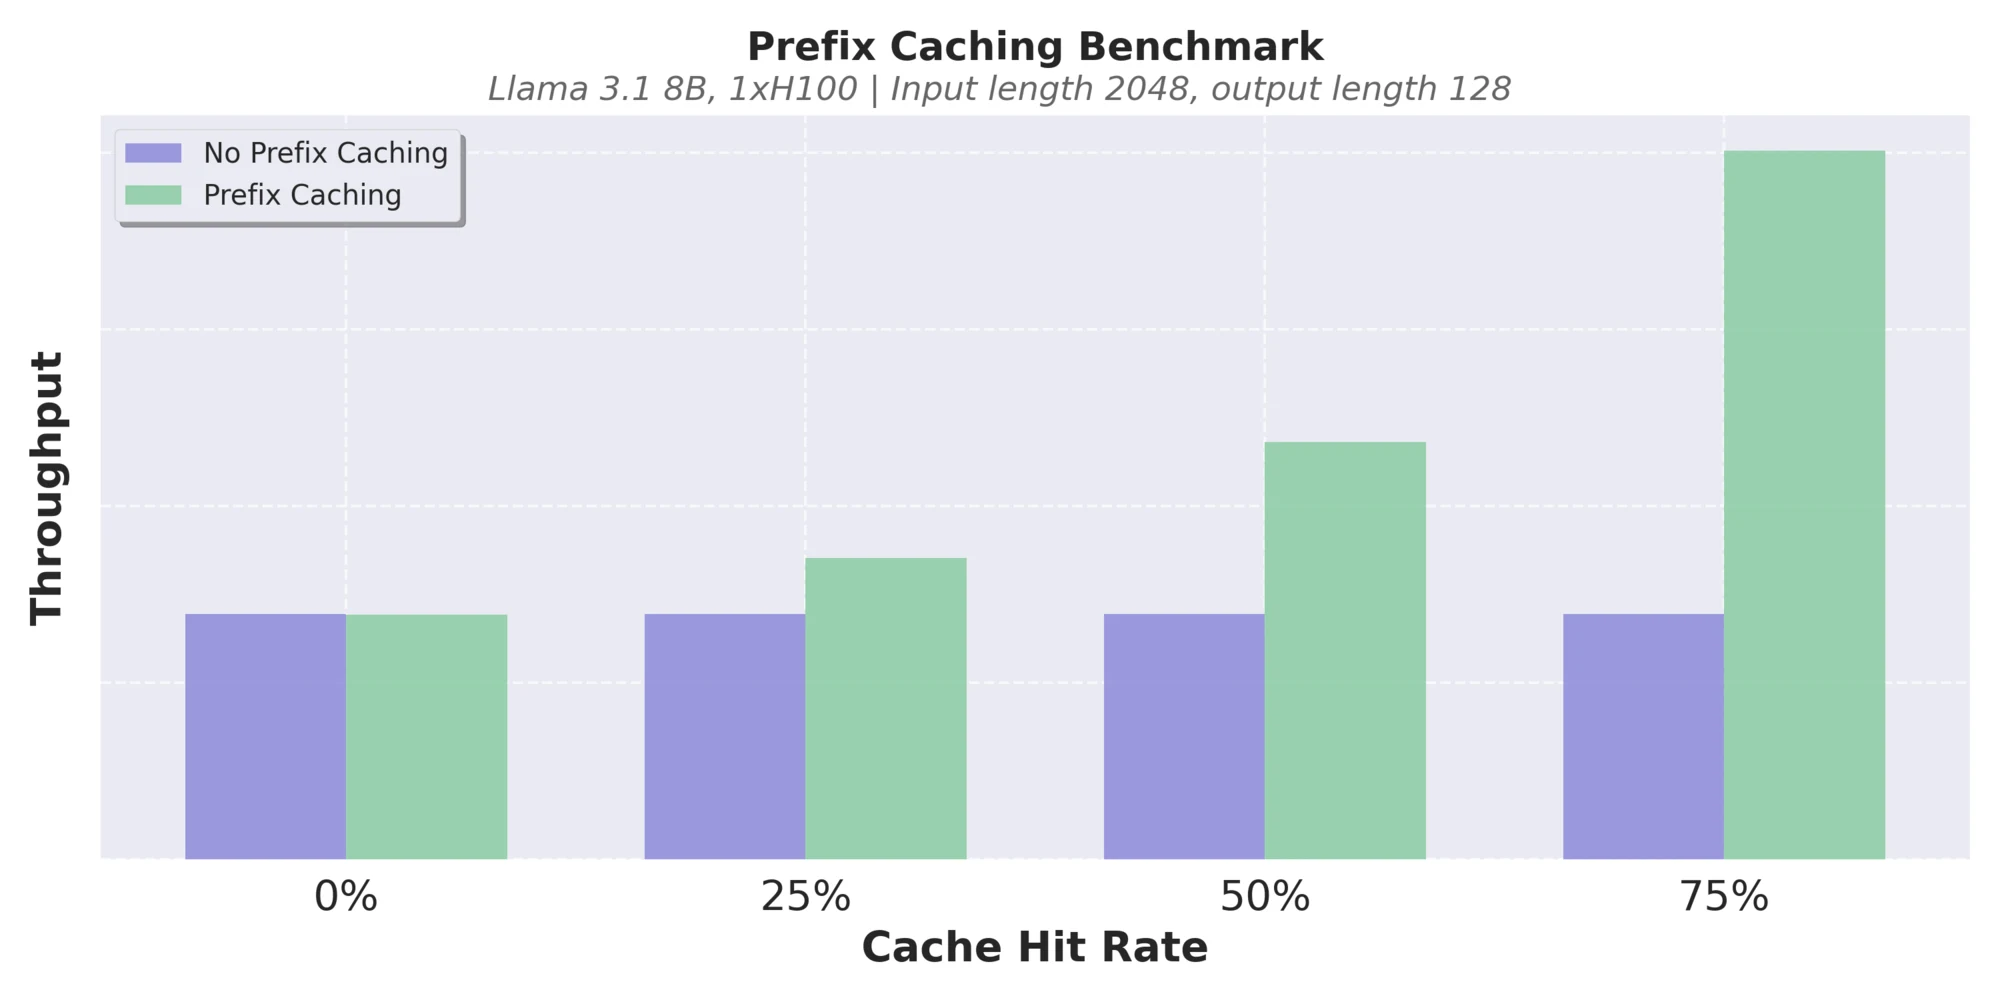
把五个框架放在一起看,「座位」这件事的抽象层级差别很大:
| 框架 | 座位/序列编号的载体 | 分配时机 | 谁按它索引 |
|---|---|---|---|
| TensorRT-LLM | seq_slot / py_seq_slot(独立管理器发号) | prepare_resources 首次调度 | 采样器状态、mRoPE delta、解码 runner |
| vLLM | req_index / 批内行号,以及 slot_mapping | 每个批次重新编排 | 采样器按批内行号;注意力按 slot mapping |
| SGLang | req_pool_idx(请求池下标) | 请求进入 ReqToTokenPool 时 | KV 池、输出缓冲、grammar 状态 |
| llama.cpp | slot(server 层的会话槽) | 请求分配到某个 slot 时 | slot 的 KV、prompt cache、采样链 |
| DeepInfer | 请求行号 + 输入元数据行 | 构造 InputMetadata 时 | 变长验证的行布局、KV 槽映射 |
四列里最值得注意的是「分配时机」这一列。TensorRT-LLM 的座位是跨迭代持久的:一条请求在第 1 个迭代拿到座位,直到结束才归还;vLLM 的批内行号是每批重排的,同一条请求在这一批可能是第 3 行,下一批可能是第 0 行;SGLang 的 req_pool_idx 是池内持久的,但语义更接近「请求对象住在池子的哪一格」,而不只是采样器状态的行号;llama.cpp 的 slot 是会话级持久的,甚至跨请求(slot 可以保留上一条请求的 prompt cache)。
持久性不同,带来的工程后果也不同:
- 持久座位让 TensorRT-LLM 可以在座位号上挂大块状态(采样参数、结束原因、mRoPE delta),不需要每步重排;代价是座位成为稀缺资源,必须精确计算池大小(这正是
compute_max_num_sequences存在的理由)。 - 批内行号让 vLLM 的批组装更自由(请求可以任意重排、抢占后重新入批),代价是任何跨步状态都不能挂在行号上,只能挂在请求对象上,或者每步重新 gather。
- SGLang 的池下标在两者之间:池子本身有固定容量,请求对象常驻池内,所以状态可以挂在池槽上,但池槽的回收必须走引用计数。
- llama.cpp 的 slot 更偏「会话」,一个 slot 可以跨多条请求,因此它的回收语义是「重置会话」而不是「归还座位」。
这四种设计没有优劣,只有「状态挂在哪」这个问题的不同答案。读框架源码时,先找到这条主轴,后面的调度、采样、KV 管理都会顺很多。
补齐行为什么没有座位
回到 TensorRT-LLM。CUDA Graph 补齐会构造一条 dummy 请求,它要拿 KV 块,却不拿座位:SeqSlotManager 没有实现 add_dummy_requests,所以 dummy 的 seq_slot 始终是 None。这不是遗漏,而是有意为之:
- 采样器为补齐行准备了
dummy_slot_row = max_num_sequences这一行 scratch,所有补齐行都写到同一行,写脏了也无所谓; - mRoPE 有自己预留的
max_num_tokens * pp_size号 dummy 座位,同样在真实座位池之外; - 如果 dummy 也占一个真实座位,那么在「座位刚好用满」的边界上,补齐就会因为
NoFreeSlotsError失败,进而让整个解码步骤退回 eager——而补齐本来就是为了避免 eager。
所以规则是:真实请求占真实座位,补齐行走池外的 scratch 行。 两者的生命周期完全不同:真实座位随请求走,scratch 行随进程走,只分配一次,永不归还。
工程坑与调试方法
这一节把源码里能直接对应到「座位系统」的故障形态整理一遍,都是可以在日志或断言里看到的。
坑一:座位泄漏表现为「越跑越慢,最后拒绝服务」
如果某条路径取走座位却没有归还,free_slots 会单调变少。由于座位池大小等于 max_batch_size 乘以微批数,泄漏几个座位不会立刻出错,只会让调度器可用的并发上限缓慢下降;等到空闲集合耗尽,add_slot 开始抛 NoFreeSlotsError。从外部看,就是吞吐逐步下滑、最后新请求全部失败。
定位方法是看 SlotManager.slot_mapping 的大小是否等于「当前活跃请求数」。这个映射本身是纯 Python 的 dict,可以直接打日志;更省事的办法是在 shutdown 之前打印一次,和 max_num_requests - len(free_slots) 对照。源码在 shutdown 里已经做了守恒断言,但那只在进程退出时触发,线上更常见的是「泄漏但不退出」。
坑二:重复发号触发断言,多半是暂停/抢占路径漏了释放
add_slot 对非 dummy 的重复申请直接断言。线上如果真的崩在这里,通常不是 SlotManager 的问题,而是某条「把请求挂起、稍后重来」的路径只清了 py_seq_slot 却没有走 free_resources。前面引用过的那条注释就是这类 bug 的修复记录。排查时可以顺着 _pause_recompute_request 与 try_complete_preemption 的分支看,确认每条「暂停」路径都配了一次 _free_request_resources。
坑三:座位池比 KV 索引池大,表现为「准入成功但一直不执行」
这正是 validate_seq_slot_pool_covers_admission 要防的情况。V2 KV 管理器如果按 max_batch_size 重新推导了自己的 max_admissible_sequences,而座位池按 compute_max_num_sequences 算出了更大的值(比如开启了 overlap headroom),那么两者之间就有一条「座位有、KV 索引没有」的缝隙。落在这条缝隙里的请求会被准入、然后在拿 KV 索引时被一条条延后,看起来像调度器卡住。启动期的 ValueError 会把这种问题在第一时间暴露出来。
坑四:把 dummy_slot_row 当成真实座位读
采样器的 new_tokens 有 max_num_sequences + 1 行,最后一行是 scratch。任何新增的代码如果按「行号 < new_tokens.shape[1]」去遍历,就会把 scratch 行算进去;如果又恰好按行号去某张按座位大小的表里取值,就会越界。源码用一行断言把「new_tokens 只比 finish_reasons 多一行」这个不变式钉死,新增按座位索引的缓冲时,最好也把它加进这行断言。
坑五:在 P/D 生成侧过早使用 py_seq_slot
DISAGG_GENERATION_INIT 状态下不发座位,等 is_disagg_generation_transmission_complete 置位后才发。如果自定义代码在传输完成前就按 py_seq_slot 去访问采样器状态,读到的会是 None 或上一轮的旧号。调试这类问题时,打印 request.seq_slot、request.py_seq_slot、request.is_disagg_generation_init_state 三个字段,往往比读完整条链路更快定位。
怎么验证自己的理解
如果想动手验证「座位池尺寸」这条主线,可以做一个很小的实验:把 max_batch_size 固定为 8,分别运行 disable_overlap_scheduler=True 与 False,打印 max_num_seq_slots 与采样器的 NEW_TOKENS_SHAPE。前者应该看到 8,后者在满足 headroom 条件时应该看到 16。再换一个 Mamba 混合模型,会看到即使开了 overlap,座位池仍然停在 8——因为 is_hybrid 把 headroom 关掉了。三个数字对照,就能把本节讲的「公式 + 三个排除条件」落到具体输出上。
与前后篇的关系
本篇拆的是「座位」这一层,属于执行器资源管理的主干。KV 块的详细账本见 TensorRT-LLM 源码完全拆解(四):KVCacheManager 与块管理;采样器的完整管线见 TensorRT-LLM 源码完全拆解(十七):Sampler;CUDA Graph 的补齐机制见 TensorRT-LLM 源码完全拆解(二十):CUDA Graph 与编译路径;执行器释放请求的完整状态机则与前一篇 TensorRT-LLM 源码完全拆解(二十五):GenerationExecutor 的三根队列 相衔接。
下一篇将讨论 TensorRT-LLM 的 speculative 资源管理器:草稿模型的 KV 池如何与目标模型的座位池共享同一套编号,以及一条请求在被拒绝草稿后如何只回滚尾部而不重建整个座位。
从迭代级调度说起:座位为什么必须跨步存在
TensorRT-LLM 的调度器采用迭代级批处理(iteration-level batching),这套机制最早由 Orca 在 OSDI 2022 上系统提出。它和「按请求批处理」的根本区别在于:批的成员在每个解码迭代都可以变化——新的请求在任何一个迭代里都可以被加进来,完成的请求在任何一个迭代里都可以离开。下图是 Orca 论文中的选择性批处理示意:一条注意力层的输入被拆成各个请求自己的 token 段分别做注意力,再拼接回去做非注意力层的矩阵乘。
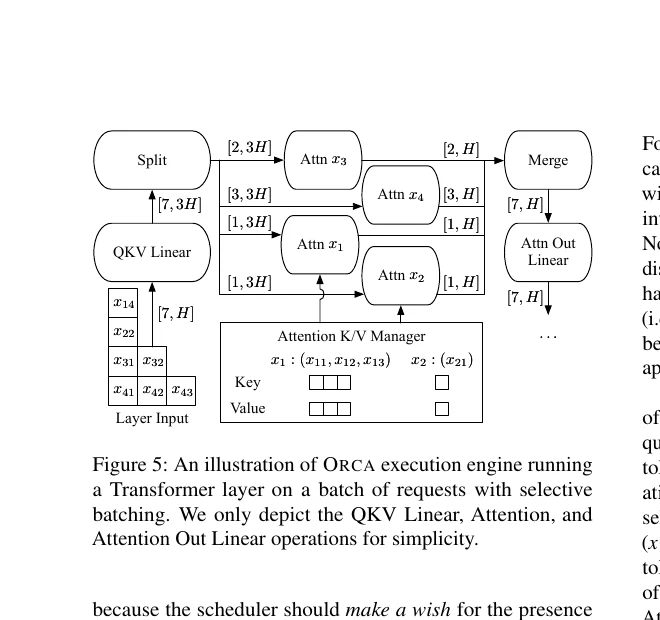
这张图对理解「座位」很关键。图里每一列 x1、x2……就是一条请求;它们在同一层里被拼成一个 [7, H] 的扁平张量去算 QKV 投影和线性层,但在注意力那一步又被拆开,各自用自己的 K/V。执行器每一迭代都在重新组装这个扁平张量,而组装所需的信息(每条请求的 token 数、K/V 在哪、采样参数是什么)都必须能从某个「请求句柄」里查到。TensorRT-LLM 的选择是:给每条请求一个跨迭代不变的座位号,把需要按请求查的状态挂在座位上,再把每个迭代的组装结果交给注意力内核。
这个选择的直接后果,就是本篇反复出现的几条规则:
- 座位必须在请求第一次被调度时分配,在请求彻底结束时回收。 迭代级调度意味着一条请求会跨越几十到上千个迭代,中途不受调度,但状态不能丢。
- 座位号必须在整个生命周期里稳定。 如果每迭代重新编号,采样器里那些「哪个座位上有几步没折回」的计数器、mRoPE 的 delta 缓存就都得每步重组,代价很大。
- 座位池的容量要按「同时可能存活的最大请求数」算,而不是按「单批大小」算。 单批大小是稳态吞吐的指标,同时在飞的数量还要加上正在退役、正在通信、正在被拆成微批的那些请求,这正是
compute_max_num_sequences里那些乘法的来源。
把这三条和 PagedAttention 系统的分层图对照着看,就能理解为什么 vLLM 用「每批重排的批内行号 + slot mapping」而 TensorRT-LLM 用「跨步持久的座位」:两者的调度器都能做迭代级批处理,但 vLLM 把状态挂在请求对象上、每步重新 gather,TensorRT-LLM 则把状态放进按座位索引的定长数组里,用空间换掉了每步的 gather。后者在 CUDA Graph 与 in-graph sampling 场景下更有优势,因为图里捕获的地址必须是固定的——座位号不变,数组地址就不变,图才能稳定复用。
小结
- 一条请求在 TensorRT-LLM 的执行器里至少占用两类资源:一个序列座位(
seq_slot)和一组 KV 块。座位管「谁」,块管「多少」。 SlotManager是纯记账:dict 做 id 到座位的映射,set 做空闲池,分配用set.pop()因此座位号无顺序语义;重复申请只对 CUDA Graph dummy 幂等,座位耗尽抛NoFreeSlotsError,退出时用守恒断言自检。SeqSlotManager把座位挂进请求生命周期:只在seq_slot is None时发号,跳过 P/D 分离的DISAGG_GENERATION_INIT状态,在发号时打第一次调度的时间戳。- 座位号是若干「按座位索引」状态池的共同长度:采样器的
new_tokens、结束原因、Top-P 衰减、mRoPE delta、解码 runner 配置,都以max_num_sequences为准。new_tokens多出的那一行是补齐专用的 scratch。 - 座位池尺寸是
max_batch_size乘以微批数(PP 时为pp_size,overlap 且满足条件时为 2)。多出的一个微批是为了让「退役中」和「新上任」的请求同时有座位;混合模型与带 mRoPE delta 缓存的多模态模型不能加这个 headroom,因为它们有自己的池容量推导。 - 释放顺序有严格方向:采样器状态先于座位归还,资源管理器内部反序遍历,KV 与压缩管理器在 prepare 中排最后、在 free 中排最前。抢先释放座位会让新请求读到旧状态;只暂停不释放则会让下一次调度撞上重复发号断言。
- CUDA Graph 补齐行不占真实座位,用池外 scratch 行承接;
NoFreeSlotsError在补齐路径上被捕获并回滚,使补齐失败退化为 eager,而不是让执行器崩溃。
参考资料
- TensorRT-LLM 源码:resource_manager.py
- TensorRT-LLM 源码:seq_slot_manager.py
- TensorRT-LLM 源码:_util.py(compute_max_num_sequences 与 should_enable_overlap_headroom)
- TensorRT-LLM 源码:sampler/sampler.py
- TensorRT-LLM 源码:py_executor.py
- TensorRT-LLM 源码:cuda_graph_runner.py
- TensorRT-LLM 源码:C++ kvCacheManager.cpp
- TensorRT-LLM 官方文档:PyTorch 后端与执行器
- PagedAttention 论文(arXiv:2309.06180)
- Orca:基于迭代级调度的 Transformer 生成式服务系统(OSDI 2022)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



