


TensorRT-LLM 源码完全拆解(十三):MoE 层前向执行——路由、Fused Kernel 与专家并行的三段拼装
前十二篇把 TensorRT-LLM 的请求入口、调度器、KV 块管理、输入组装、注意力后端、KV 布局与压缩、投机解码、并行拓扑和注意力层的张量并行都走了一遍。那些内容有一条共同的隐含前提:每一层都是”一个 token 进去、一组权重乘一下、一个 token 出来”。MoE 打破了这个前提——同一个 token 在同一层里要经过若干个不同的权重矩阵,而且走哪几个是数据相关的。
这一篇进入 tensorrt_llm/_torch/moe/ 目录。和 vLLM、SGLang 那一侧不同的是,TensorRT-LLM 已经在 2026 年把 MoE 从”每个后端自己写一遍 forward”重构成了一个显式的三段式装配:一个编排者类(ConfigurableMoE)+ 一个纯计算后端(Backend)+ 一个前向执行策略(MoEScheduler)+ 一个可插拔的通信策略(Communication),再外挂一个可选的专家负载均衡器(EPLB)。这个拆法本身就是这一篇最值得讲的东西:它把一个”看起来只能写成一坨”的模块,拆成了四个可以独立替换、且组合数被显式论证过的部件。
MoE 在推理侧到底特殊在哪里
先把问题说清楚。稠密 Transformer 的一层 FFN 可以写成
权重是固定的,所有 token 走同一条路。MoE 层则换成了
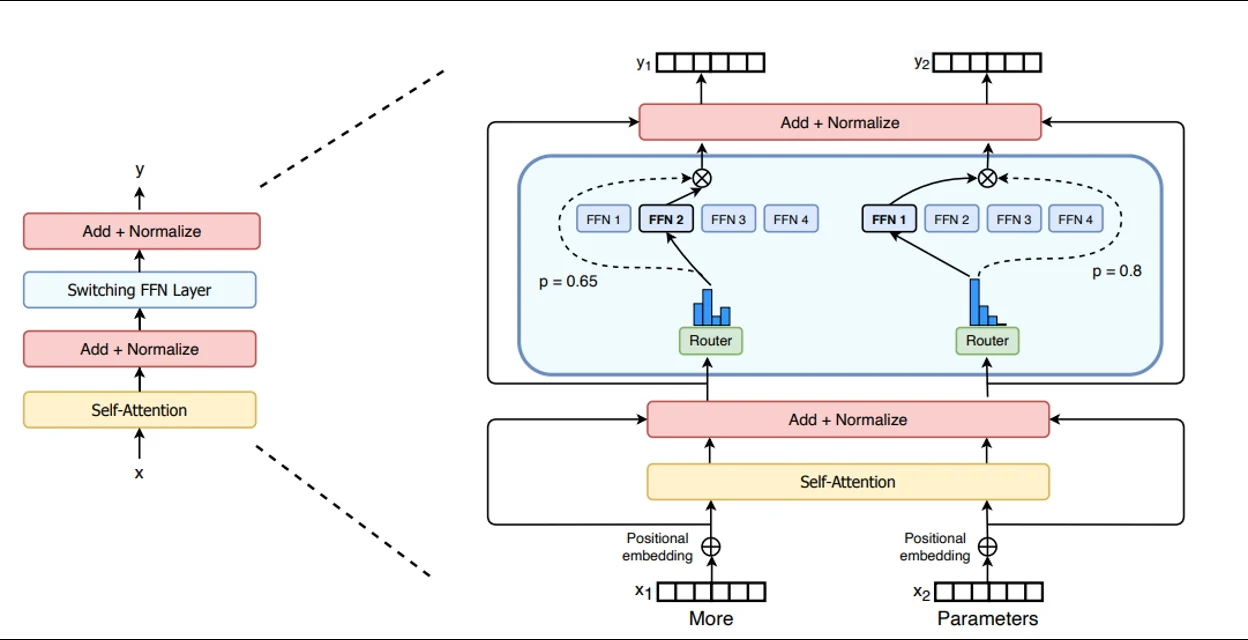
其中 是第 个专家(本身就是一个小 FFN), 是路由给出的权重, 是这批 token 各自选中的专家集合。以 DeepSeek-V3 为例,每层 256 个路由专家、每个 token 选 8 个,再加 1 个所有 token 都走的共享专家。
这条公式带来三个稠密层没有的麻烦:
第一,计算量变成数据相关的。 稠密层一次前向的 FLOPs 是固定的;MoE 层取决于这批 token 实际选中了哪些专家,以及每个专家分到多少行。一个 batch 里如果有 512 个 token、每人选 8 个专家,就产生 4096 个 (token, expert) 对,但要分给 256 个专家去做,每个专家分到多少行完全随机。GPU 最讨厌的就是这种事——它喜欢形状固定的 GEMM,最擅长处理”所有行乘同一个矩阵”。
第二,权重不再能被所有 token 复用。 稠密层的 FFN 权重一次读进 L2/寄存器,服务整批 token;MoE 层里每个专家只服务选中它的那一小撮 token,专家权重读一次可能只用几十行——算术强度低,memory-bound 严重。这就是为什么 MoE 推理的 kernel 几乎全部围绕”把 token 按专家分组、让每个专家一次吃到尽可能多的行”来设计。
第三,专家本身要被切开放到不同 GPU 上。 256 个专家的权重不可能塞进一张卡的可接受显存预算里(V3 每层专家的总参数量是稠密部分的很多倍),于是有了专家并行(Expert Parallelism,EP):每张卡只持有 个专家,token 通过 all-to-all 被”寄”到持有目标专家的卡上算,算完再寄回来。这一步通信是 MoE 推理最大的新增开销,也是所有工程优化的主战场。
TensorRT-LLM 的 MoE 模块,本质上就是在回答”怎么把上面三件事拼成一次高效的设备执行”。
图源:TensorRT-LLM 官方 MoE 开发者文档(MOE_DEVELOPER_GUIDE.md)中的层结构示意。输入 hidden states 同时走向三条路:上方的 fc_gate 路由器、右侧可选的共享专家(shared expert,所有 token 都走,用来兜住那些不该被稀疏化掉的通用能力),以及中间那个”融合 MoE”方框——它内部依次是 routing、MoE backends(FC1→激活→FC2)和 apply weights,最后三条路的输出相加成 final hidden states。这一篇拆的就是中间那个方框,以及它和另外两条路的边界在哪里。
ConfigurableMoE:为什么用组合而不是继承
旧路径的问题
重构之前,TensorRT-LLM 的 MoE 是”一个后端一个类”:CutlassFusedMoE 是一种实现,TritonFusedMoE 是另一种,每个类自己写 forward,自己管理权重加载、自己调通信。这种做法在只有两三个后端时还行,但仓库里的后端数量涨到了十几个:CUTLASS、TRTLLM-Gen、DeepGEMM、CuTe DSL、DenseGEMM、Marlin……而且每个后端还要和”EP 开不开""EPLB 开不开""用哪种通信策略”交叉组合。
继承体系在这种维度下会迅速失控。假设有 10 个后端、4 种通信策略、2 种 EPLB 状态,如果每一种组合都要一个类或者一层 if-else,代码就会变成组合爆炸。更糟的是,通信逻辑和对权重加载、量化的处理本来就没有关系,混在一个类里以后没法单独测试。
新的拆法
TensorRT-LLM 的答案是把”编排”和”计算”分开。官方开发者文档 MOE_DEVELOPER_GUIDE.md 里给的职责划分是这样的:
ConfigurableMoE├── Backend (纯计算: routing → quantize → FC1 → act → FC2)├── Communication (分布式, 可选: dispatch tokens → compute → combine)├── EPLB (可选: 专家在 GPU 间动态迁移)├── DWDP (可选: 绑定 composite-VA 权重; 不做 EP 通信)└── MoEScheduler (前向执行策略: 分块、EPLB 钩子顺序、通信编排; 由 backend.scheduler_kind 选择)这张图是理解整个模块的关键,逐项说:
Backend 是纯计算。 它只负责”给我一批 token 和它们的路由结果,我把专家算完”。它不做任何跨卡通信,也不知道 EPLB 的存在。这条约束在文档里被反复强调,因为它带来一个非常重要的性质:后端的实现可以脱离分布式去单元测试。
Communication 是可插拔的。 dispatch(把 token 送到专家所在的卡)和 combine(把结果收回来)由独立的策略类实现,后端不感知。CommunicationFactory 在运行时根据硬件和配置选一个策略出来。
Scheduler 是前向执行策略。 它决定”要不要把这一批 token 切成几块分别算""EPLB 的统计钩子插在哪个位置""会不会用第二条 stream 重叠”。注意 Scheduler 是无状态的——它只持有对 ConfigurableMoE 的反向引用,读包装器的状态但不写。状态都在包装器上。
EPLB 是可选的专家迁移器。 它解决的是”路由器学出来的专家分布天然不均,冷的卡闲着、热的卡排队”这个问题,需要动态地把专家从热卡搬到冷卡上。
组合的边界:为什么必须是”任意 Backend × 任意 Communication”
文档里列了五条核心设计原则,其中第二条是:
Any Backend × Any Communication × EPLB On/Off —— 所有合法组合都应该能工作(受
can_implement和scheduler_kind约束)。
这条原则听起来像口号,但它有非常具体的工程含义:当一个后端加进来时,它不需要为每一种通信策略各写一遍适配。通信策略的接口(dispatch / combine)是统一的,后端只负责算。反过来说,一个新的通信策略(比如某个硬件厂商的自定义 all-to-all)加进来时,也不需要动任何一个后端。
这个组合空间不是免费的。下面几节会看到,正是这个”任意组合”的要求,逼出了 can_implement 的纯函数约束、MoEResolutionReport 这样的可解释选择机制,以及”降级允许、静默不允许”这条规则。
forward_impl 有多薄
编排者自己的 forward_impl 被压缩到了极薄的一层,文档里给的原样是这样的:
def forward_impl(self, x, router_logits, ...): if self.enable_dwdp: self.dwdp_manager.wait_and_bind(self.backend, self.layer_idx) outputs = self.scheduler.forward(x, router_logits, ...) if self.enable_dwdp: self.dwdp_manager.record_compute_and_prefetch_next(self.layer_idx) self.repeat_idx = (self.repeat_idx + 1) % self.repeat_count return outputs真正的活全在 self.scheduler.forward 里。包装器只做三件事:DWDP 的绑定与记账(一个把跨卡共享的专家权重页映射到本卡地址空间的机制,只在特定硬件路径上启用)、repeat_idx 的推进(EPLB 用到的”同一份权重被连续用了几次”的计数)、以及返回值的搬运。
这么薄的代价是 forward_impl 里看不出任何技术细节;好处是任何新的执行策略都只需要写一个 Scheduler 子类,不需要碰权重加载、量化、EPLB 的生命周期代码。这就是”组合优于继承”在真实代码里的样子。
路由:从 logits 到 (expert_id, weight) 对
MoE 的第一步是把路由器的打分变成”这个 token 走哪几个专家、各占多少权重”。这一步在 TensorRT-LLM 里被抽成了独立的路由方法体系,位于 fused_moe/routing.py。
路由方法枚举
每个模型用的路由算法都不一样,代码里用 RoutingMethodType 枚举把它们编码下来:
class RoutingMethodType(IntEnum): # Default: Softmax -> TopK Default = 0, # Renormalize: TopK -> Softmax Renormalize = 1, # DeepSeekV3: Sigmoid -> RoutingBiasAdd -> Top2 in group -> Top4 groups -> Top8 experts DeepSeekV3 = 2, # Llama4: Top1 -> Sigmoid Llama4 = 3, # Qwen3: Softmax -> TopK -> Renormalize RenormalizeNaive = 4, # MiniMaxM2: Sigmoid -> RoutingBiasAdd -> TopK -> Renormalize(without bias) MiniMax2 = 5, # SigmoidRenorm: Sigmoid -> TopK -> Renormalize SigmoidRenorm = 6, # DeepSeek-V4 DeepSeekV4 = 7, # Unspecified Unspecified = 8,枚举上方的注释就是算法本身,这比写成散文更容易核对:Default 是”先 softmax 再取 top-k”,Renormalize 是”先取 top-k 再在选中的专家上归一化”,两者的差别只在归一化的分母包含哪些专家。
BaseMoeRoutingMethod 是所有路由方法的基类,它的核心接口是 apply:
def apply(self, _router_logits, _input_ids) -> tuple[torch.Tensor, torch.Tensor]: """ 返回 (token_selected_experts: int32, token_final_scales: float32) """返回的两张张量形状都是 [num_tokens, top_k]:前者是专家 ID,后者是对应的权重系数。路由方法在文档里被明确要求是 nn.Module 的纯计算,不碰通信——路由结果只告诉”该去哪些专家”,至于那些专家在本卡还是别的卡上,是通信层的事。
DeepSeek-V3 的 noaux_tc:分组路由的算术
看一个最有代表性的实现。DeepSeek-V3 的路由叫 noaux_tc(No Auxiliary Loss, Top-K with Correction bias),它和”softmax + top-k”完全不是一回事。
打分不用 softmax 用 sigmoid:
@staticmethod@torch.compile(options={"max-autotune": True})def get_scores(logits, e_score_correction_bias): scores = F.sigmoid(logits) scores_with_bias = scores + e_score_correction_bias return scores, scores_with_bias注意这里产生了两份分数:scores 是纯粹的 sigmoid 输出,scores_with_bias 是加上偏置之后的。偏置只用来决定”选谁”,不用来算权重——这一点是 noaux_tc 的核心设计(下面会解释为什么)。
接着是分组选择。256 个专家分成 n_group 组,每组内先取分数最高的 2 个求和作为组分数,然后从组分数里取 topk_group 个组,只在这些组里选最终的 top_k 个专家:
group_scores = torch.sum(torch.topk( scores_with_bias.view(scores_shape[:-1] + [n_group, scores_shape[-1] // n_group]), k=2, dim=-1, largest=True, sorted=True)[0], dim=-1)_, group_idx = torch.topk(group_scores, k=self.topk_group, dim=-1, largest=True, sorted=True)group_mask = torch.zeros_like(group_scores)group_mask.scatter_(-1, group_idx, 1)组外专家的分数被置成负无穷,之后的 top-k 就不可能选中它们:
scores_with_bias = torch.where(score_mask.bool(), scores_with_bias, torch.tensor(float('-inf'), ...))_, topk_idx = torch.topk(scores_with_bias, k=self.top_k, dim=-1, largest=True)最后一步是权重计算,也是最能体现设计意图的地方:
new_mask = torch.zeros_like(scores)new_mask.scatter_(-1, topk_idx, 1)scores = scores * new_mask # 用无偏置分数,靠 mask 筛出选中的专家score_sum = torch.sum(scores, dim=-1, keepdim=True) + 1e-20scores = scores / score_sum * self.routed_scaling_factor为什么选择用带偏置的分数、而权重用不带偏置的分数? 因为 e_score_correction_bias 是一个负载均衡手段:训练时它被调整成让冷门专家更容易被选中(不需要额外的辅助损失项,这就是 “noaux” 的含义)。如果这个偏置进入了权重计算,那么一个被偏置”抬进”top-k 的专家会同时拿到虚高的权重,输出的语义就被污染了。所以偏置只做”入场券”,权重仍由模型原本学出来的 sigmoid 分数决定。这是整个 noaux_tc 里最容易写错的地方。
融合算子与回退阈值
上面这段 PyTorch 逻辑只在”形状不受支持”时才会跑。正常路径是调一个融合算子:
topk_values, topk_indices = torch.ops.trtllm.noaux_tc_op( logits, e_score_correction_bias, n_group, self.topk_group, self.top_k, self.routed_scaling_factor)融合与否则由一个明确的阈值决定:
if self.n_group > 1: experts_per_group = num_experts // n_group if (self.top_k > 8 or num_experts > 256 or experts_per_group > 32 or experts_per_group * self.topk_group > 256): self.is_fused = False也就是说,融合 kernel 只在”top_k ≤ 8、专家数 ≤ 256、每组 ≤ 32 个专家、且参与最终选择的专家总数 ≤ 256”时才可用。超过这些边界就退回 PyTorch 实现并打一条 warning。为什么要设这些阈值?因为融合 kernel 的分组选择通常是把专家的候选集合放进 shared memory 或寄存器里做一次归约,容量是硬约束;超过容量就必须走通用实现。这类”融合版有形状上限、超了静默降级”的模式在 TensorRT-LLM 里到处都是,理解它比记住具体数字更重要。
路由与后端的解耦:requires_separated_routing
对绝大多数后端,路由是”贴着”专家计算的——因为路由结果本来就要按专家重新排列 token,这个重排操作顺手就做了。但对某些后端不行,比如某个 kernel 要求输入已经按专家排好序、或者要求路由分两阶段做。代码里用一个属性表达这件事:
class DeepSeekV4MoeRoutingMethod(BaseMoeRoutingMethod): @property def requires_separated_routing(self) -> bool: ...它和 TLLM_TRTLLMGEN_FORCE_SEPARATED_ROUTING 这个环境变量配合,让”路由是否必须和计算分开”成为一个可以由后端声明、也可以由用户强制的事实。这是”任意后端都能和任意路由方法配对”这一目标的必要补丁:解耦不能只靠接口统一,还得给那些有特殊约束的成员留一个诚实的声明位置。
后端的三种形态与两个调度器家族
后端是真正做算术的地方。fused_moe/ 目录下的后端多达十几种,但它们并不是并列的十几个独立实现,而是按”量化格式 + 硬件代际 + 延迟/吞吐倾向”组织的若干族。
官方文档给出的后端表里,几个有代表性的成员是:
| 后端 | 硬件 | 定位 |
|---|---|---|
CutlassFusedMoE | SM80+ | 高吞吐,量化支持最全,老一代主力 |
TrtllmGenFusedMoEBase 及其叶子 | SM100/SM103/SM107 | Blackwell/Rubin 上的最小延迟与高吞吐,也通过 FlashInfer 服务未量化 BF16 |
CutlassFusedMoE 的 CuTe DSL 版本 CuteDslFusedMoE | SM100/SM103/SM107 | NVFP4 高吞吐,一般快于 CUTLASS |
TrtllmCutedslFusedFc12Nvfp4Impl(CuteDslFc12FusedMoE) | SM107(Rubin) | NVFP4 下把 FC1+FC2 融成一个 kernel,中间结果留在片上 |
DeepgemmCudaW4a8Mxfp4Mxfp8Impl(MegaMoEDeepGemm) | SM100/SM103/SM107 | 通信与 GEMM 全融合的 MegaMoE |
TrtllmCutedslMegaMoeNvfp4Impl(MegaMoECuteDsl) | SM100/SM103/SM107 | NVFP4 的 dispatch+FC1+act+FC2+combine 全融合 |
MarlinFusedMoEBase 的两个叶子 | SM89-SM99 | Ada/Hopper 上的 W4A16 NVFP4 |
VanillaMoE | 所有设备 | 参考实现/调试用,不用于生产 |
这张表的重点在最后三类的分野,它对应下一节的调度器家族划分。
后端还承担一件容易被忽略的事:声明自己的能力。每个后端的 can_implement 是一个纯函数:
@classmethod@abstractmethoddef can_implement(cls, p: MoEProblem, d: MoEDeployment) -> MoEEligibility: """Purely evaluate ``p`` and ``d`` without probing runtime state.
Abstain rather than reject when a required problem field is unknown. """为什么必须”纯”? 因为选择机制要能解释自己的决定。如果 can_implement 内部去读 os.environ 或者探测 GPU,那么同一个配置在两台机器上会得到不同的选择结果,而调用方拿不到原因。文档里把这条单列成节(can_implement must be pure),并配了一条同源的规则:“降级是允许的,静默是不允许的”——一个后端因为形状不支持而放弃了某条快路径,这个事实必须写进 MoEResolutionReport 里,而不是悄悄换一条慢路。这样线上性能掉了一半时,你能从报告里读出”因为 hidden_size 不是 512 的倍数所以退回了通用后端”。
环境探测被单独收进 impl_environment.py,它是唯一去探测机器(SM 版本、可选 wheel、环境变量)的地方,并冻结结果。别的代码读它,而不是自己再探一遍。这个”唯一探测点”的设计让”同一次运行里不同模块看到不同硬件事实”这类诡异 bug 从结构上消失。
MoEScheduler:两条执行路径,两套相反的约定
调度器只有两个实现,但它们代表的是两种根本不同的执行哲学。
选择依据是”通信在哪”
后端通过 scheduler_kind 类属性声明自己属于哪一类,默认是 EXTERNAL_COMM:
class MoESchedulerKind(Enum): """ - EXTERNAL_COMM: comm 在 MoE kernel 边界之外; 调度器从 host 发起 Communication.dispatch / Communication.combine, 支持 per-chunk EPLB 钩子 与可选的多 stream 分块重叠 (Cutlass, DeepGemm, CuteDSL, DenseGEMM, TRTLLMGen). - FUSED_COMM: comm 通过 NVLink SymmBuffer 融进后端的融合 kernel (DeepGEMM fp8_fp4_mega_moe). 无 host 通信; lockstep 分块启动; EPLB 统计更新用 ignore_allreduce=False. """
EXTERNAL_COMM = "external_comm" FUSED_COMM = "fused_comm"两个调度器的完整执行序列,文档里是这么写的:
ExternalCommMoEScheduler._forward_chunk_impl 每个 chunk 执行:[EPLB start_wait_gpu] → routing → [EPLB done_wait_gpu + update_statistic + route] → [comm.prepare_dispatch (NVLink2-sided)] → quantize/dispatch (自适应顺序) → backend.run_moe → [EPLB start_set_cpu] → [unfinalized_combine_fn] → comm.combine → [EPLB done_set_cpu]
FusedCommMoEScheduler._forward_chunk 每个 chunk 执行:[EPLB start_wait_gpu] → routing → [EPLB done_wait_gpu + update_statistic + route] → backend.quantize_input → backend.run_moe (融合 dispatch+GEMM+act+GEMM+combine) → [EPLB start_set_cpu + done_set_cpu]差别很清楚:外部通信版里,dispatch 和 combine 是 host 上发起的两次独立调用,中间夹着 run_moe;融合版里这三步都在 kernel 内部完成,host 侧只看到一次 run_moe 调用。
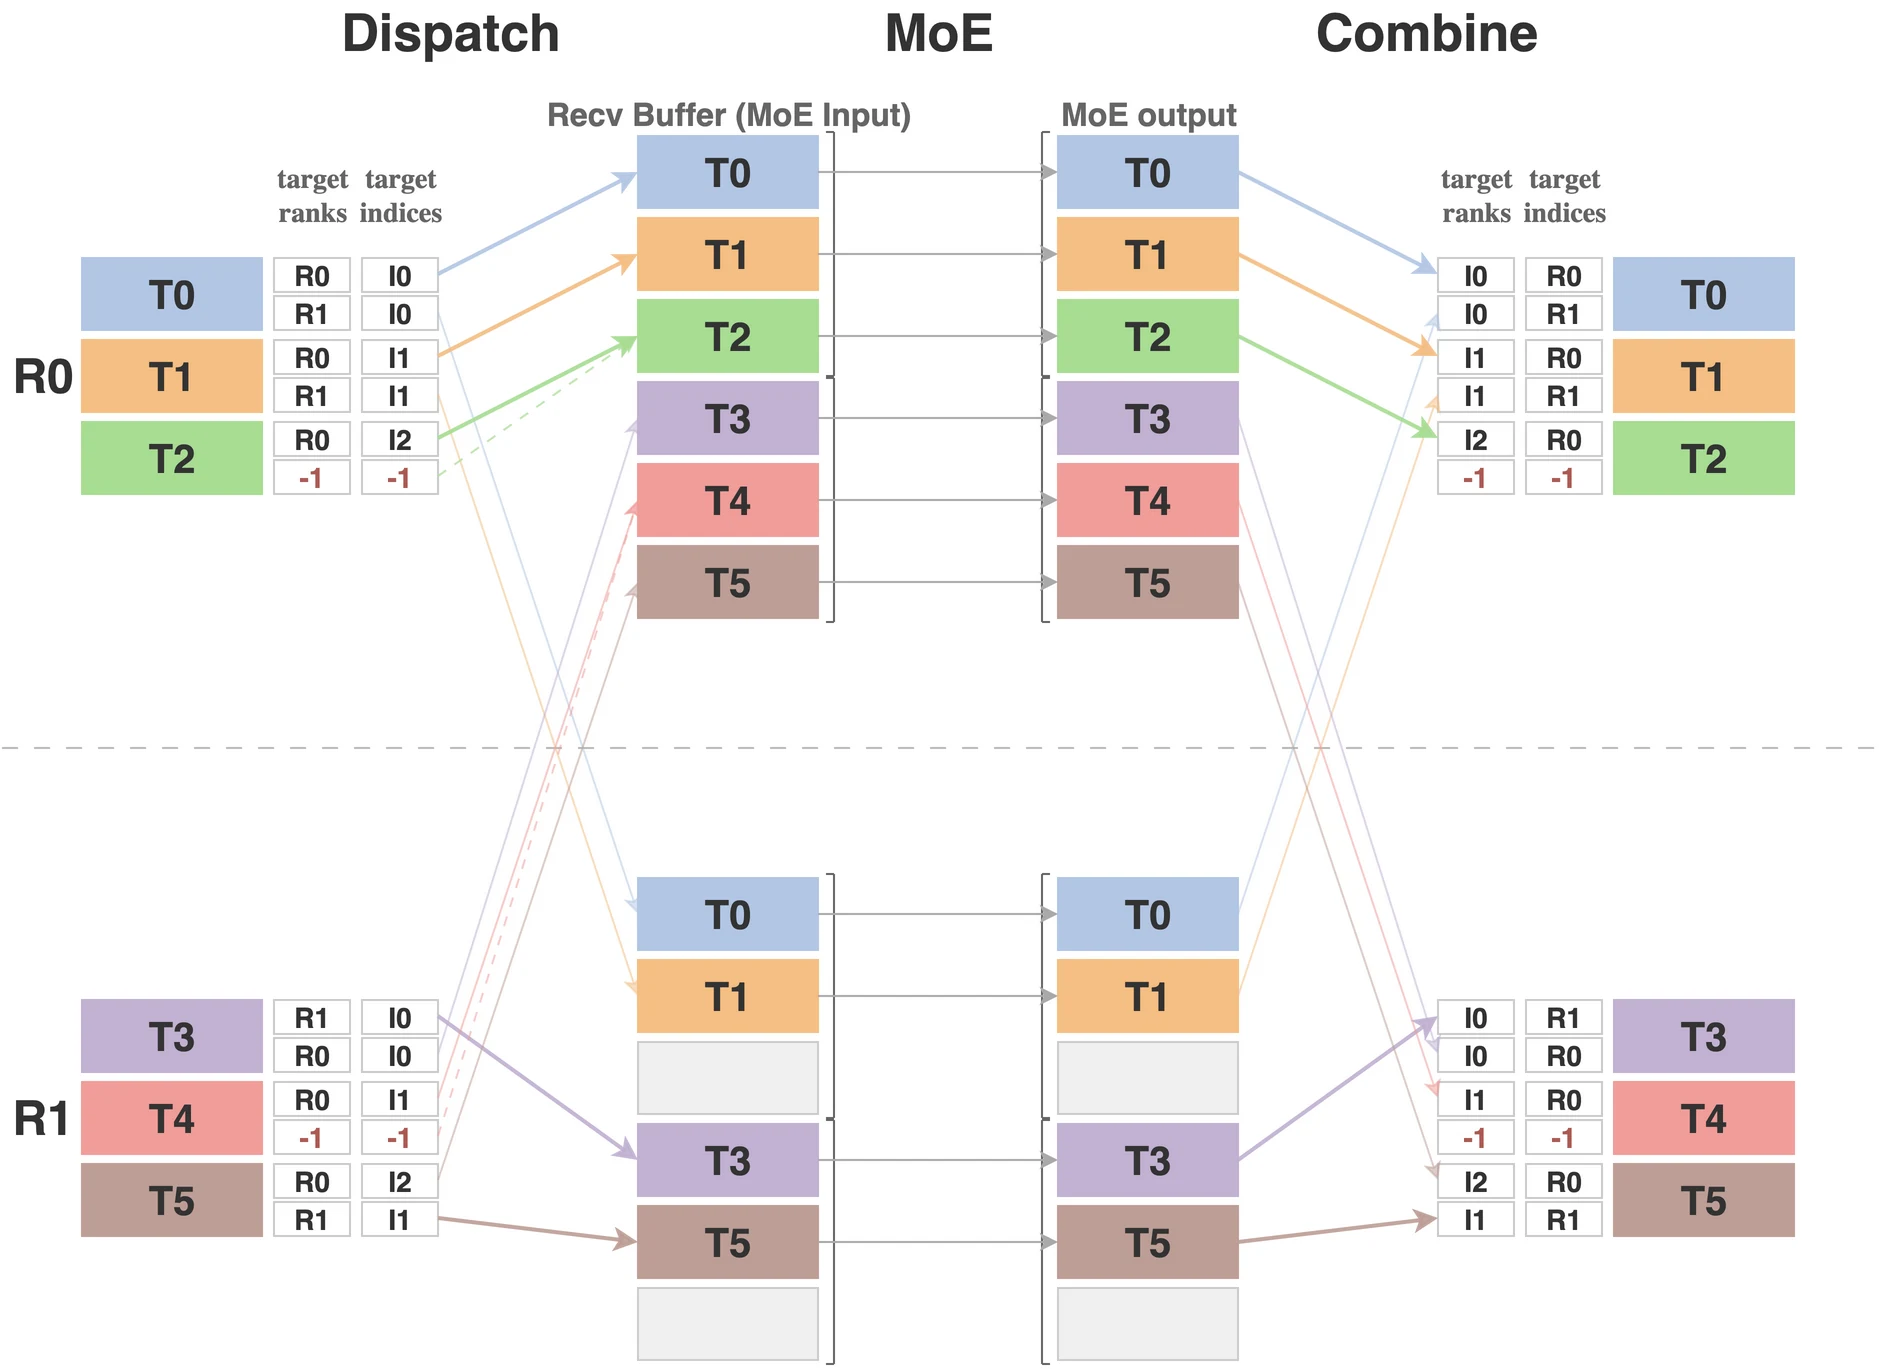
图源:TensorRT-LLM 官方技术博客的 MoE 数据流图(docs/source/blogs/media/tech_blog18_dispatch_moe_combine.png)。图里把”一次 MoE 前向”拆成三段:dispatch 把 token 按目标专家送到各 rank,MoE 段在本卡持有的专家上完成 FC1→激活→FC2,combine 再把每个专家产出的 partial 结果送回 token 的原属 rank 并按路由权重相加。本文反复提到的”通信与计算的分界”,指的就是这两个虚线边界——EXTERNAL_COMM 后端把边界做成 host 发起的真实通信调用,FUSED_COMM 后端则把整张图塞进一个 kernel。
“自适应顺序”里的一个细节
上面序列里那句 “quantize/dispatch (自适应顺序)” 值得展开:
Adaptive quantize/dispatch order (gated by comm.supports_post_quant_dispatch()): Post-quant flow: quantize_input() → comm.dispatch() (发送量化后的数据) Pre-quant flow: comm.dispatch() → quantize_input() (发送原始数据, 本地量化)为什么会有两种顺序? 直觉上应该先量化再发——量化后数据量小 4 到 8 倍,通信量跟着降。但这不是无条件成立的:dispatch 要求发送方把数据写成接收方期望的内存布局,如果量化本身就要做布局变换(比如 NVFP4 要配 scale factor 的 swizzle 布局),那么”先量化再 dispatch”意味着量化 kernel 得按远端布局写;反过来”先 dispatch 原始 BF16、到达后再本地量化”则让量化 kernel 只需面对本卡布局。
选择哪一种,取决于通信策略的 supports_post_quant_dispatch() 和量化方法的实现代价。这是典型的”哪个 kernel 更贵就让它少做事”权衡,而不是一条普遍规则。
两条路径的约定是刻意相反的
这是全篇最反直觉的一段。文档里明确写着:
两条路径有刻意相反的不变量(
use_dp_padding被遵守 vs 被忽略、ADP padding 保留 vs 剥离、空 chunk 被替换 vs 零 token kernel 启动、多 stream 重叠允许 vs 禁止)。
逐条理解:
DP padding(注意力数据并行下的 token 数对齐)。 开了 attention DP 以后,不同 rank 上的 token 数不一样;做集合通信前必须把它们补齐到相同长度。外部通信路径尊重调用方传进来的 use_dp_padding 语义;融合通信路径则忽略它——因为融合 kernel 里的通信是 lockstep 的,每个 rank 都必须在同一个时刻进入 kernel 里的 NVLink barrier,padding 与否由 kernel 内部的协议决定。
空 chunk 的处理方式相反,是这类差异里最有趣的一条。 外部通信路径遇到某个 rank 在某一块上一个 token 都没有时,会用”替代”手法:给这个 rank 塞一个零 token 的占位,让它在集合通信里仍然参与,从而不会把别的 rank 卡住。融合通信路径则相反——它会照样启动 kernel,哪怕一个 token 都没有。为什么?因为融合 kernel 里有一个 in-kernel 的 NVLink barrier,如果这个 rank 不启动 kernel,别的 rank 会在 barrier 上永远等下去。文档里这句话把原因说得很直白:
Zero-token chunks still launch the kernel so peer EP ranks can cross the in-kernel NVLink barrier.
多 stream 重叠允许 vs 禁止。 外部通信路径可以在 enable_alltoall 关闭且存在 aux stream 时开启分块重叠——第 块的 GEMM 和第 块的 dispatch 跑在不同的 stream 上。融合路径不行:通信已经进了 kernel,分块必须 lockstep 地顺序启动。
这组”相反的不变量”提示了一个更普遍的道理:当两个实现共享同一个抽象接口,但底层同步模型完全不同时,不要为了接口好看而把差异藏起来。TensorRT-LLM 的做法是把差异诚实写进各自的类文档字符串(moe_scheduler.py 的 class docstring 和 MOE_SCHEDULER_DESIGN.md),让后来者一眼能看出”这里的行为和那边不一样,而且是故意的”。
外部通信调度器的真实前向:先把 padding 修好
看 ExternalCommMoEScheduler.forward 的真实代码,它的步骤编号在 docstring 里就写清楚了:
def forward(self, x, router_logits, *, do_finalize, output_dtype, all_rank_num_tokens, use_dp_padding, input_ids=None, lora_params=None, routing_aux=None, input_ready_event=None): moe = self.moe
# ========== Step 1: 处理 padding ========== if all_rank_num_tokens is None: all_rank_num_tokens = [x.shape[0]] all_rank_max_num_tokens = max(all_rank_num_tokens) if use_dp_padding: all_rank_num_tokens_padded = [all_rank_max_num_tokens] * len(all_rank_num_tokens) else: all_rank_num_tokens_padded = all_rank_num_tokens接着有一个零 token 死锁修复,注释写得很详细:
# ========== 0-token rank deadlock fix ==========# 当某些 rank 在单 chunk 前向里 0 token 时, 这些 rank 会在# moe.comm.dispatch() 之前就卡在 CUDA kernel 里 (例如 0 行的 NVFP4# quantize_input), 导致非零 rank 在 NCCL AllGather 上死锁。# 修复: 在所有 rank 上统一打开 DP padding, 让每个 rank 都用 sizes=None# (统一 allgather) 并把 x/router_logits 补齐到 max_tokens。if (moe.comm is not None and moe.use_dp and all_rank_max_num_tokens > 0 and not use_dp_padding and any(t == 0 for t in all_rank_num_tokens_padded)): use_dp_padding = True all_rank_num_tokens_padded = [all_rank_max_num_tokens] * len(all_rank_num_tokens) local_n = x.shape[0] if local_n < all_rank_max_num_tokens: input_ready_event = _wait_input_ready(input_ready_event) pad = all_rank_max_num_tokens - local_n x = torch.cat([x, x.new_zeros((pad, x.shape[1]))], dim=0) router_logits = torch.cat([router_logits, router_logits.new_zeros((pad, router_logits.shape[1]))], dim=0)这段代码的价值在于它暴露了一个真实世界里非常常见的死锁模式:一个 rank 提前死在 kernel 里,另一个 rank 在集合通信上等它。注意死锁不是发生在通信里,而是发生在通信之前——0 行的量化 kernel 本身就把 rank 卡住了。修复办法是让所有 rank 的输入形状一致,让”0 行”这种特殊形状彻底不出现。
还有一段关于 stream 同步的设计:
"""``input_ready_event``: ``x`` 是在另一条 stream 上写好的。 把 join 推迟到第一个真正读 ``x`` 的 kernel 上, 这样路由可以与之重叠。"""也就是说,调度器不会一进门就 wait_event,而是把等待推迟到路由算完之后——路由只需要 router_logits,不需要 x。这是流水线重叠里很典型的一个手法:把同步点尽量往后压,压到最后一个还不读数据的算子之后。
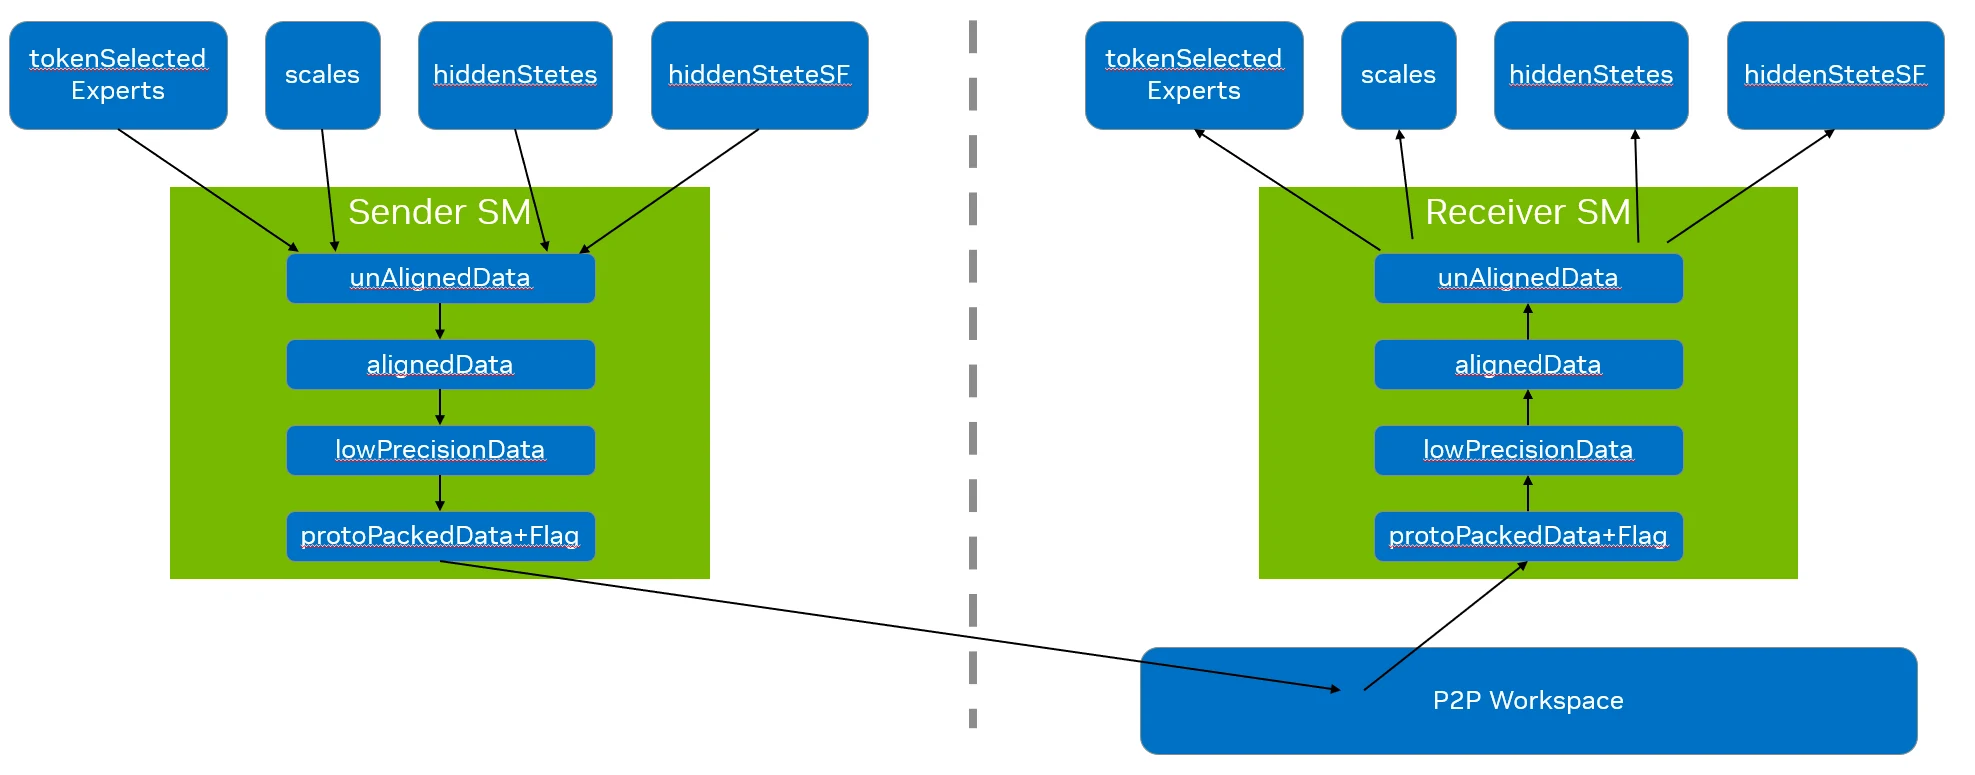
图源:TensorRT-LLM 官方技术博客的 all-to-all 数据流图(docs/source/blogs/media/tech_blog14_alltoall_dataflow.png)。这张图解释了为什么 MoE 的通信记账不能只看”本 rank 有多少 token”:开了 attention DP 以后,dispatch 会把所有 DP rank 的 token 汇总过来,所以一次前向实际要处理的 token 行数是 ,而不是本地的 。本文后面 calculate_num_chunks 里那个 num_rows 就是按这个口径算的。
分块:calculate_num_chunks 与并行策略的分工
单块还是多块,由 moe.calculate_num_chunks(all_rank_num_tokens_padded) 决定;多块走 _forward_multiple_chunks。这个函数的真实实现把”要处理多少行 token”算得很讲究:
def calculate_num_chunks(self, all_rank_num_tokens: List[int]) -> int: if self.use_dp and self.comm is not None: num_rows = self._dp_padded_num_rows(all_rank_num_tokens) elif self.enable_dwdp: num_rows = max(all_rank_num_tokens) else: assert len(all_rank_num_tokens) == 1 num_rows = all_rank_num_tokens[0] return (num_rows + self.moe_max_num_tokens - 1) // self.moe_max_num_tokens三种情形对应三种”这批到底有多少行”的口径:DP 通信开着时是 len(rank) * max(tokens)(所有 DP rank 的 token 会被汇总过来);DWDP 模式不搬 token 只预取权重,所以只按本卡自己的行数算;其余情况就是本地行数。最后向上取整除以 moe_max_num_tokens——分块的动机不是”把大 batch 拆小”,而是把每个块的 token 行数压在一个配置上限内,因为 fused kernel 的 workspace、路由的分组归约容量、以及量化 kernel 的 scale 布局都是按这个上限设计的。
分块的第二个收益才是重叠:多块时不同块的 dispatch/GEMM/combine 可以并行推进。
通信策略的兜底也在这一步发生。 调度器算完块数后调 determine_communication_method,它只做两件事:问当前策略”这个负载你能不能干”,不能干就换成 AllGather:
def determine_communication_method(self, all_rank_num_tokens, num_chunks) -> None: if self.comm is None or isinstance(self.comm, AllGatherReduceScatter): return
feasible_workload = self.comm.is_workload_feasible(all_rank_num_tokens, num_chunks)
if not feasible_workload: logger.info( f"Communication strategy {self.comm.__class__.__name__} " f"cannot be used (num_chunks={num_chunks}, max_num_tokens={...}). " f"Falling back to AllGatherReduceScatter.") self.comm.destroy() self.comm = AllGatherReduceScatter(mapping=self.mapping)注意两点:它不负责创建策略,只负责校验和降级(创建在别处惰性发生),以及旧的策略要先 destroy() 再换新的——通信策略可能持有 DeepEP buffer、symm memory 之类的原生资源,直接丢弃会泄漏。ConfigurableMoE 对此还有一段专门的析构说明:DeepEP 的 Buffer.__del__ 内部有一个集合通信式的 barrier,如果各 rank 的 GC 时机不一致,就会出现一部分 rank 进了 barrier、另一部分继续跑,结果是无限挂起。所以策略必须显式、同步地销毁,ConfigurableMoE 也因此实现了上下文管理器协议(with 语句)来保证这一点。
有一处值得留意的约束:
if num_chunks > 1 and moe.backend.capabilities.supports_moe_lora and moe.backend._moe_lora_active(lora_params): raise_moe_lora_multichunk_unsupported(num_chunks)开了 MoE LoRA 就不允许分块。原因是 LoRA adapter 的选择是 per-request 的,分块以后 adapter 与块的对应关系会变得需要额外记账;框架的选择是直接拒绝并给出明确错误,而不是实现一套复杂的记账。这类”明确拒绝优于默默降级”的取舍在 MoE 模块里出现频率很高——它和前面 can_implement 必须纯、“降级要写进报告”是同一种工程哲学:宁可让调用方看到一条清晰的失败,也不要让它在性能上悄悄差一半。
专家并行:权重的账本,与”允许重复”的除法
EP 的 rank 坐标系
MoE 层需要一套和 TP 不同的并行坐标。代码里从 mapping 上取的是专门的一组字段:
self.cluster_rank = model_config.mapping.moe_cluster_rankself.cluster_size = model_config.mapping.moe_cluster_sizeself.smart_router = True if self.cluster_size > 1 else False
self.tp_rank = model_config.mapping.moe_tp_rankself.tp_size = model_config.mapping.moe_tp_size
self.ep_size = model_config.mapping.moe_ep_sizeself.ep_rank = model_config.mapping.moe_ep_rank上一篇讲注意力层的张量并行时提到过:注意力侧用的是 tp_size,MoE 侧用的是 moe_tp_size / moe_ep_size,两者在同一组进程上可以被解释成不同的划分。moe_cluster_* 是更外一层的概念(多机集群层级),smart_router 表示当存在多个集群时路由器需要感知拓扑。
_compute_ep_partition:整除之外的分布
每张卡分几个专家?最朴素的答案是 num_experts / ep_size。但 256 个专家配 6 张卡呢?代码里的回答是:
def _compute_ep_partition(num_experts: int, ep_size: int, ep_rank: int) -> tuple: """计算本 rank 的专家数与槽位边界。
用 ceil/floor 分布: rank 0..remainder-1 持有 (base+1) 个专家, 其余 rank 持有 base 个。即使 num_experts % ep_size != 0 也能覆盖全部专家。
Returns: (expert_size, slot_start, slot_end) """ if num_experts < ep_size: raise ValueError( f"num_experts ({num_experts}) must be >= ep_size ({ep_size}); " f"configurations producing ranks with zero local experts are not supported.") base = num_experts // ep_size remainder = num_experts % ep_size expert_size = base + (1 if ep_rank < remainder else 0) slot_start = ep_rank * base + min(ep_rank, remainder) return expert_size, slot_start, slot_start + expert_size三件事值得说:
向上不向下。 num_experts < ep_size 直接报错,而不是让某些卡分到 0 个专家。理由是”零专家 rank 没有任何后端和通信策略能端到端支持”——一个持有 0 个专家的卡在 dispatch 时收不到任何 token,在 combine 时也没有东西可发,各种集合通信的语义都会变成特例。注释里还提到下游的 all-to-all 算子本来有个 numExperts >= epSize 的兜底检查,但 AllGatherReduceScatter 回退路径绕过了它,所以必须在这里提前拦住。
用 ceil/floor 而不是整除。 slot_start = ep_rank * base + min(ep_rank, remainder) 这一行把前 remainder 个 rank 各自多拿一个专家的偏移算得干干净净。这保证了专家槽位是连续且无重叠的一段,槽位边界可以直接用来算指针偏移。
“非整除 EP”是一项后端要自己认领的能力。 前面 _init_load_balancer 里有这段:
if (self.num_experts % self.ep_size != 0 and not type(self)._supports_non_divisible_ep): raise ValueError( f"{type(self).__name__} does not support non-divisible EP: " f"num_experts ({self.num_experts}) must be divisible by ep_size ({self.ep_size}). " f"Enable EPLB with num_slots divisible by ep_size, or override " f"`_supports_non_divisible_ep = True` on the subclass after verifying " f"the kernel/comm path handles ceil/floor partitioning.")注意错误信息本身就是一个决策树:要么开 EPLB(它有统一的 slot 划分),要么在后端上显式声明”我验证过我的 kernel 和通信路径能处理 ceil/floor 划分”。它不给你一条”自动帮你对齐”的路——因为对齐意味着 pad 或 reshape,那是对正确性的改动,必须由后端的作者确认。
EPLB 路径下为什么反而要求整除
对照一下 EPLB 打开时的检查:
if moe_load_balancer_config.num_slots % self.ep_size != 0: raise ValueError( f"{type(self).__name__}: with EPLB enabled, num_slots " f"({moe_load_balancer_config.num_slots}) must be divisible by ep_size ({self.ep_size}) " f"so each rank holds the same number of slots.")也就是说,非整除 EP 在 EPLB 下变成了硬性禁止。原因是 EPLB 引入了”槽位”(slot)这个比”专家”更抽象的概念:一张卡持有 num_slots / ep_size 个槽位,每个槽位里放哪个专家是可以动态换的。所有后端 kernel 看到的都是”本卡的槽位数”这个统一形状,专家数是否整除 ep_size 对 kernel 来说已经不可见了。所以要求从”专家数整除”降级成了”槽位数整除”——约束更弱、更好满足,代价是需要 num_slots >= num_experts 的额外显存(多出来的槽位用来做迁移的缓冲)。
这是一个很漂亮的设计:EPLB 不只是个性能开关,它同时改写了并行划分的算术基础。
允许重复的除法与 KV 显存估算的联动
回到上一篇里出现过的一条对照。注意力层里 KV head 用的是向上取整:
self.num_key_value_heads = (self.num_key_value_heads + tp_size - 1) // tp_sizeMoE 侧的专家切分在没有 EPLB 且后端声明支持非整除时用 ceil/floor,在其余情况下用整除。两者形式不同,但背后的动机一致:框架宁可在少量 rank 上重复持有,也不肯让某张卡空着。
这里的”重复持有”在 MoE 里有一个更实质的含义。当 ep_size > num_experts(比如 4 个专家配 8 张卡)时,向上取整会让多张卡持有同一个专家。这时 token 的 dispatch 需要决定”把 token 发给哪一个副本”——多集群拓扑就是为了处理”同一专家在多个位置上都有副本时该去哪边”的问题。
smart_router 正是这个场景的开关。它的定义只有一处、语义也很直白:
self.smart_router = True if self.cluster_size > 1 else False当 moe_cluster_size > 1(例如一个 GB200 NVL72 被划成多个机柜级集群)时,框架要求路由器”感知拓扑”——它能按集群就近度排序候选专家,尽量把 token 留在本集群内,避免跨集群的远端流量。代价是所有后端都必须实现这条路径:参考实现 VanillaMoE 在 can_implement 里明确以 TOPOLOGY_UNSUPPORTED 拒绝了 smart_router 的部署,理由写在错误信息里——“VanillaMoE has no smart-router path”。这是”后端声明能力、选择器按能力筛选”这套机制的一个真实用例:一条只对多集群拓扑成立的硬约束,通过纯函数的拒绝理由暴露出来,而不是等到运行时算错。
还有一条相关的约束藏在负载均衡器的创建处:maybe_create_moe_load_balancer 只在”模型架构受支持、EP > 1、且没有使用 smart router”时才真正创建 EPLB。也就是说,多集群拓扑下的 MoE 走的是另一条均衡路线,EPLB 的开与关并不是完全独立的开关,而是和拓扑选择绑在一起的。
权重加载:两个 mixin 与槽位布局
MoE 层的权重不是一个 nn.Linear,而是每个专家一组 w1 / w2 / w3(gate、down、up),外加路由器权重、可选偏置、可选共享专家。加载这件事在重构后的架构里被抽成 MoEWeightOwnerMixin,由完整的 MoE 层和只做计算的 MoEImplBase 共享:
class MoE(MoEExecutionContractMixin, MoEWeightOwnerMixin, MoEEplbWeightLayoutMixin, nn.Module):三个 mixin 各管一件事,从基类列表就能读出来:执行契约(面向调度器的声明 + forward_fake)、权重所有权(create_weights / load_weights / _check_configs)、以及 EPLB 权重布局。把它们抽成 mixin 而不是写两遍,是为了保证”完整的 MoE 层”和”只做计算的执行单元”在权重语义上不会漂移——这正好呼应了前面那条设计原则:生命周期代码保持通用,前向路径保持特化。
权重加载模式用一个枚举表达:
class MoEWeightLoadingMode(Enum): # Gate 和 up 投影不融合 VANILLA = 0 # Gate 和 up 投影融合 FUSED_GATE_UP_PROJ = 1 # 来自 examples/quantization/quantize_mixed_precision_moe.py 的自定义 W4A8 权重 W4A8_CUSTOM = 2这个枚举解释了一个容易被忽略的 kernel 细节:MoE 的 FC1 通常是”gate 投影 + up 投影”两个矩阵,很多 kernel 把它们拼成一个矩阵以提高算术强度(一次读入、两个输出)。所以权重在文件里的布局到底是两个独立张量还是一个拼接张量,必须显式声明——选错模式会直接把结果算错,而不是慢一点。
还有一个和缩放因子相关的细节,在 MoE.__init__ 里:
# 注意:# - 对 gated 激活, 应该有 gate 和 up 两个投影, 所以 intermediate size 要乘 2.# - 对非 gated 激活, 只有一个 up 投影 (没有 gate), intermediate size 不用乘.self.is_gated_activation = is_gated_activation(activation.kind)self.intermediate_size_expand_ratio = 2 if self.is_gated_activation else 1SwiGLU 这类门控激活需要两个投影,所以专家的中间维度实际是 intermediate_size * 2。把它写成 expand_ratio 而不是散落各处的 * 2,是为了让所有分配 workspace、算权重偏移的地方都读同一个数。
激活值的”语义常数 → kernel 寄存器”
激活函数这块有一个特别值得学的抽象。模型构建时给的是一个语义描述:
self.activation = activation# ActivationType, 而不是裸 int: 作为 IntEnum 它仍然能被 op schema 和# tuning key 当 int 读, 而拒绝信息里可以用 .name.self.activation_type = ActivationType(activation.kind)而”具体 kernel 需要哪几个寄存器/哪个常量”这件事被推迟到一个专门的转换点。文档里对 activation.py 的描述是:
激活词汇表——模型构建的
MoEActivation载体、后端声明的MoEActivationSupport,以及install_activation_params/materialize_activation_params,这是语义常数变成 kernel 寄存器的唯一地方。
为什么要把这一步单拎出来? 因为不同后端的融合 kernel 对激活的支持方式完全不同:有的在 kernel 里硬编码了 SwiGLU 的 epilogue,有的支持一个可配置的 clamp 参数(比如 SiTU 的边界),有的只支持几种固定组合。如果让每个后端自己从 activation.kind 翻译,就会出现”同一个模型在不同后端上激活参数含义不同”的隐蔽 bug。把它收成唯一的转换点,并让后端通过 MoEActivationSupport 声明”我支持哪些、我接受哪几个参数”,语义就只在一个地方落地。
通信策略:五种以上的 all-to-all 变体
fused_moe/communication/ 目录下是一组可插拔的通信策略,由 CommunicationFactory 在运行时根据硬件和配置选择:
| 策略文件 | 名字暗示的机制 |
|---|---|
allgather_reducescatter.py | AllGather + ReduceScatter 的经典替代路径 |
nccl_ep.py | NCCL 的 EP 组通信 |
deep_ep.py / deep_ep_low_latency.py | DeepEP 的正常模式与低延迟模式 |
nvlink_two_sided.py | NVLink 双向(发送方 push、接收方 pull 的两端配合) |
nvlink_one_sided.py | NVLink 单向(只由一方发起) |
nvlink_two_sided_flashinfer.py | 与 FlashInfer 组合的变体 |
这个列表本身就说明了 MoE 通信的复杂度:同样的 all-to-all 语义,在不同硬件和延迟要求下需要完全不同的实现。DeepEP 的低延迟模式是为解码阶段的小 batch 优化的(每个 rank 只发几十行 token),而高吞吐模式是为预填充阶段的大 batch 优化的;NVLink 单向模式利用的是”同一机箱内 GPU 可以互相读写对方显存”这一能力,省掉一端的显式拷贝。
看一个具体策略是怎么把”我什么负载能干”表达出来的。DeepEPLowLatency 把约束全部写成类常量加一个纯判断函数:
class DeepEPLowLatency(Communication): """DeepEP Low Latency strategy supporting both pre-quant and post-quant"""
SUPPORTED_HIDDEN_SIZES = frozenset({2048, 2560, 3584, 4096, 5120, 6144, 7168}) SUPPORTED_HIDDEN_SIZES_EXTENSION = frozenset({4096, 6144, 7168}) MAX_TOP_K: int = 16这三个常量分别对应三类硬约束,注释里连出处都标了:SUPPORTED_HIDDEN_SIZES 来自低延迟 kernel 的 SWITCH_HIDDEN(hidden size 是一个编译期模板参数,不是运行时变量,所以只能取预先实例化过的那些值);SUPPORTED_HIDDEN_SIZES_EXTENSION 来自 NVFP4 后量化/低精度 combine 的扩展 kernel;MAX_TOP_K = 16 对应 device 端 kNumMaxTopK 的断言——低延迟 kernel 用 per-thread 寄存器数组存 top-k 候选,容量写死在编译期,超过就在第一次 dispatch 时直接 abort。
def is_workload_feasible(self, all_rank_num_tokens: List[int], num_chunks: int) -> bool: if num_chunks > 1: return False all_rank_max_num_tokens = max(all_rank_num_tokens) if all_rank_max_num_tokens > self.deep_ep_max_num_tokens: return False if self.weight_dtype != torch.bfloat16: return False return True这三条判据就是”为什么低延迟模式只适合解码”的源码级答案。 分块数必须为 1(低延迟 kernel 的同步协议不支持多块流水);单 rank token 数有一个上限(默认 1024 行,因为它把数据按 slot 摆进固定大小的缓冲区);权重 dtype 必须是 BF16(低延迟路径不做权重量化)。反过来说,预填充阶段那种动辄几千行的 batch 一定会在第二条上被拒——然后 determine_communication_method 记录一条 info 日志、把策略降级成 AllGather,降级原因直接写在日志里。
还有两个能力位值得一并理解,它们解释了前面”自适应量化顺序”和”finalize 放在 combine 之前还是之后”为什么可以是能力查询而不是硬编码:
supports_post_quant_dispatch():策略支不支持”发量化后的数据”。supports_finalize_before_combine():策略支不支持把 top-k 加权求和放到 combine 之前(即在已 dispatch 的行上先做 partial finalize)。
后者的注释里写得很清楚:多数 combine 是对 per-token 稠密张量做无权重行求和,此时”先 finalize 再 combine”和”先 combine 再 finalize”数学等价(因为每一项只依赖自己那一行,非本地槽位贡献的是精确的 0);但 DeepEPLowLatency.combine 不是这种 combine——它消费的是 expert-major 的行布局、并且自己施加路由权重,所以顺序不能换。这段推理把”为什么需要这样一个能力位”讲透了:它不是风格差异,而是某个具体 combine 实现的数据布局决定的。
框架还对这类”顺序可交换性”做了构造期校验:ConfigurableMoE.validate_backend 会在装配时拒绝三种组合——后端没声明 supports_unfinalized_output()、通信策略没声明 supports_finalize_before_combine()、以及 apply_router_weight_on_input。也就是说,一个不支持未 finalize 输出的后端配上一条不支持提前 finalize 的策略,根本装不起来,而不是等到运行时在通信层里炸掉。
框架层面的两个重要设计:
第一,通信策略的选择是有序候选而非单一判断。 CommunicationFactory.create_strategy 会先解析超时预算(解析失败就直接报错,而不是当成”这个后端不可用”),然后依次试各个候选。
第二,需要参与 executor 睡眠/唤醒的策略要实现一个显式协议:
原生 workspace 必须参与 executor sleep/wakeup 的通信策略,实现
communication/base.py里运行时可检查的CheckpointableCommunication协议。公开的checkpoint_resource_key()标识共享同一底层 workspace 的包装器,以便 executor 对每个资源只调用一次checkpoint_prepare()和checkpoint_restore()。
这段设计针对的是一个真实的坑:多张卡上的 MoE 通信可能共享同一块 workspace(比如同一个 SymmBuffer),如果每个策略各自保存/恢复一遍,就会重复拷贝甚至互相破坏。用 checkpoint_resource_key() 把”共享同一资源”显式表达出来,让 executor 去重,这是把”资源身份”上升为协议的做法。
通信超时:为什么要有专门的守卫
MoE 的几类通信 kernel 有一个共性——它们会在 kernel 内部等待对端,等待超时后直接 trap(陷入),而 trap 是一个粘性 CUDA 错误:一旦触发,所有在等的 rank 一起死。文档里的原话是”the trap is a sticky CUDA error, so every waiting rank dies”。
问题在于 warmup 阶段:JIT 编译、自动调优、模块加载这些每 rank 只做一次的工作可能让一个健康的 rank 延迟好几分钟,而这期间没有任何集合通信。如果超时是固定的,正常启动就会被判成故障。
moe_comm_timeout_guard.py 就是解决这个的:
MoECommTimeoutGuard解析两个预算:TRTLLM_MOE_COMM_WARMUP_TIMEOUT_SEC(默认 1800 秒)与TRTLLM_MOE_COMM_TIMEOUT_SEC(默认取各库原生超时),每次切换时把当前值推给所有注册的MoECommTimeoutProxy。
各后端的原生超时差别很大,文档列了一张表:
| 后端 | 超时通过什么生效 | 原生服务超时 |
|---|---|---|
| NVLinkOneSided | torch.ops.trtllm.moe_a2a_set_timeout,拷进启动参数 | 300 s |
| DeepGEMM MegaMoE | deep_gemm.set_barrier_timeout_seconds,作为 kernel 参数 | 60 s,或 DG_JIT_BARRIER_TIMEOUT_SECONDS |
| DeepEP 正常 kernel | deep_ep.set_timeout_seconds,设备端在运行时读取的变量 | 约 100 s |
| NcclEP | nccl.ep.Group.set_timeout_ns,每组一个 proxy | 取自配置,否则约 100 s |
还有一个非常容易出错的细节:
超时是名义值:NVLinkOneSided、DeepGEMM 和 DeepEP 按假定的 2 GHz SM 时钟把秒换算成周期,而 NcclEP 用的是设备实际时钟频率。
为什么这个细节重要? 因为”把 30 秒换算成 cycle 数”这件事依赖时钟频率假设。如果 kernel 里用的是固定假设,而实际硬件降频或超频,真实的墙钟超时就会偏离配置值。这是一个典型的需要读源码才能发现的坑:你在环境变量里写了 60,实际生效的可能是 40 或 90。
另外,CUDA Graph 捕获期间必须冻结超时:
模型引擎的
is_warmupsetter 调用set_moe_comm_warmup。捕获运行的 CUDA-graph pass 在moe_comm_serving_timeouts()里进行,因为被捕获的图会保留捕获时刻的超时值。捕获过程中切换会抛异常。
原因很直接:CUDA Graph 把 kernel 启动参数录进图里,超时值就是参数之一。如果捕获时用的是 warmup 的 1800 秒,那么重放的时候每一次都会带 1800 秒——线上真出事时你要等半小时才看到报错。所以在捕获时切到服务态的值,并在捕获期间拒绝切换。
EPLB 与权重记账:repeat_idx 从哪来
前面反复出现的 repeat_idx / repeat_count 值得单独交代,因为它是 EPLB 记账的关键。
在 MoE.__init__ 里它们的默认值是:
self.repeat_idx = 0self.repeat_count = 1而一旦 EPLB 启用,repeat_count 就变成由负载均衡器给的:
self.layer_load_balancer = moe_load_balancer.add_layer( self.num_experts, top_k, self.expert_size_per_partition, aux_stream=aux_stream)self.repeat_count = self.layer_load_balancer.get_repeat_count()repeat_count 是什么? 是”同一份权重在第 步之前最多被连续使用几次”。EPLB 想在运行中动态迁移专家,但迁移意味着权重在显存里移动,而 GPU 上可能有正在执行的、使用这批权重的 kernel。所以 EPLB 需要把时间切成”权重代”(generation):在一个代内权重不动,代与代之间才允许搬。repeat_idx 就是这个代内的计数器,包装器每前向一次就推进一格:
self.repeat_idx = (self.repeat_idx + 1) % self.repeat_countEPLB 的钩子只在”第一个 repeat_idx 的第一块”和”最后一个 repeat_idx 的最后一块”触发——这正是文档里写的:
EPLB hooks fire only at the first/last chunk of the first/last
repeat_idx.
对上了前面执行序列里的 EPLB start_wait_gpu / done_wait_gpu / start_set_cpu / done_set_cpu 四类钩子:wait_gpu 是”等设备侧把上一轮统计写完”,set_cpu 是”把新的专家分配下发到设备侧”。两侧分工的原因是统计信息要跨 rank 汇总(一次 all-reduce),而重排结果要写回每张卡的权重存储。
统计本身也有一个优化选项:
def _load_balancer_update_statistic(self, token_selected_experts, is_first_call: bool, is_last_call: bool, ignore_allreduce: bool = False): """ ignore_allreduce: 如果为 True, 只更新本地统计, 需要调用 _load_balancer_get_local_statistic_tensor 拿到本地统计张量, 再在外部 allgather, 然后调用 _load_balancer_update_statistic_with_gathered_statistic 更新全局统计。NVLINKTwoSided 支持这条路径。 """为什么要把 all-reduce 从钩子里拆出来? 因为 NVLinkTwoSided 通信策略自己已经有一次集合通信的机会,可以把统计信息搭车带过去,省掉一次独立的 all-reduce。这和前面”自适应量化和 dispatch 顺序”是同一类优化思路:能搭车的通信就不要单独发一趟。
通信与计算融合的方向:MegaMoE
前面 FUSED_COMM 那一类的两个后端,代表了 MoE 推理优化的一条明确路线:把 dispatch、FC1、激活、FC2、combine 全部融进一个 kernel。
以 TrtllmCutedslMegaMoeNvfp4Impl 为例,文档里对它的描述包含几个要点:NVFP4 融合了 dispatch+FC1+act+FC2+combine;内部按架构选 kernel 变体;要求 CUDA 13 的 Cutlass DSL 和一个对称内存(symmetric memory)提供者;对 DeepSeek-V4 在 FC2 量化之前应用路由权重,对其他模型在 FC2 之后应用。
最后这条差异很值得注意。路由权重 到底应该在专家的第二个 GEMM 之前乘(即作用在中间激活上)还是之后乘(作用在输出上),在数学上对单个专家是等价的——都是线性缩放。但在量化语境下不等价:如果在 FC2 之前把输出缩小,那么 FP4 量化时用到的 scale 就要覆盖一个更小的动态范围,精度表现会不一样;反过来在之后乘则中间激活保持原样。DeepSeek-V4 和其他模型在这里选了不同的方案,说明这不是纯粹的数学选择,而是和量化误差分布一起调出来的。
融合带来的收益是明确的:省掉全局内存的一次往返(FC1 的中间结果不用写回再读出来)、省掉一次 kernel 启动、省掉 dispatch/combine 的显式内存中转。代价同样明确:kernel 变得极其复杂且和硬件强绑定——文档里对 DeepGEMM MegaMoE 有一条硬约束 hidden_size % 512 == 0,还有”in-kernel barrier 在某个对端迟到时会 trap,warmup 期间要放宽超时”这类只在融合形态下才存在的问题。
还有一条架构上的代价,就是前面已经讲过的 FUSED_COMM 那套相反的不变量:多 stream 重叠被禁止、零 token chunk 必须照样启动 kernel、DP padding 语义被忽略。融合不是免费的,它换来的是通信与计算之间没有空隙,付出的是灵活性。
选择机制:为什么要有一份”决策报告”
这篇里反复出现一个东西:MoEResolutionReport。它由 moe_resolution.py 里的唯一选择入口 resolve_moe_impl 产生——这个文件在文档里被标注为 “The one selection entry point”:
moe_resolution.py:唯一的选择入口(resolve_moe_impl)——给候选排序、问每个候选的can_implement、返回一个MoEResolutionReport。
配套的词汇表在 impl_contract.py:MoEProblem(问题是什么:专家数、top-k、hidden size、量化格式)、MoEDeployment(部署约束:EP 大小、attention DP、集群拓扑)、MoEEnvironment(环境事实:SM 版本、装了哪些 wheel、环境变量)、MoEEligibility(某个候选的答复)、MoERejectReason(为什么拒绝)、MoEResolutionReport(最终决定和理由链)。
为什么要把一个”选后端”的动作做成这么重的机制? 因为在一个有十几种后端、每种后端支持不同的量化格式和硬件代际的仓库里,“为什么这次跑的是这个后端”是一个每天都有人问的问题。如果选择逻辑是散落的 if-else,答案只能靠读代码推。把它们收成一个纯函数式的候选评审 + 一份可打印的报告,答案就成了一个数据结构。
文档里给了两条配套的纪律,都很值得抄:
can_implement必须是纯函数。降级是允许的,静默是不允许的。
第二条尤其重要。MoE 后端之间确实存在真实的降级关系——比如 MarlinFusedMoEBase 的说明里写着”非 NVFP4 的层(例如未量化的 MTP 草稿层)在 resolve_moe_impl 里降级到 Cutlass,记录在该层的 MoEResolutionReport 中”。降级发生了,但它被记录下来了。这样做的直接收益是:当你发现某个模型的 MoE 层比预期慢,可以去查报告,看到”这个层退回了 Cutlass,因为量化格式不是 NVFP4”。如果降级是静默的,你只会在 profiling 的时候看到一大堆诡异的 kernel 名字而不知道它们从哪来。
还有一条关于跨 rank 一致性的纪律,标题是 “Cross-rank agreement”。它要防的是这类灾难:rank 0 上的选择逻辑和 rank 3 上不一样,结果两张卡用了不同的后端,跑起来在集合通信上死锁或者算出错的结果。解决办法是让选择和 rank 无关的事实(MoEProblem、MoEDeployment)来决定结果,环境事实则由唯一的探测点冻结——只要所有 rank 探测到的是同一份冻结结果,选择就必然一致。
小结:一次 MoE 前向的完整拼装
把前面所有部件按执行顺序串起来,一次 MoE 层前向在 TensorRT-LLM 里是这样的:
第一步,路由。 路由器 Linear 输出 router_logits,路由方法(DefaultMoeRoutingMethod、DeepSeekV3MoeRoutingMethod、MiniMaxM2MoeRoutingMethod 等)把它变成 (token_selected_experts, token_final_scales) 两张 [num_tokens, top_k] 张量。容量超出阈值时,融合算子(如 torch.ops.trtllm.noaux_tc_op)退回 PyTorch 实现。
第二步,调度器接管。 ConfigurableMoE.forward_impl 调 self.scheduler.forward(...)。调度器先补齐 DP padding、修掉零 token 死锁、算分块数、让通信策略兜底,然后按 scheduler_kind 走两条路径之一。
第三步,通信与计算的编排。 EXTERNAL_COMM 路径由 host 发起 dispatch → quantize → run_moe → combine,顺序可自适应,配合 EPLB 的四类钩子和可选的多 stream 分块重叠;FUSED_COMM 路径把这些全压进一次 run_moe,用 lockstep 分块和 in-kernel barrier 换取融合收益。
第四步,专家计算。 后端(CUTLASS / TRTLLM-Gen / CuTe DSL / DeepGEMM / Marlin)在已经按专家排好序的 token 上跑 FC1 → 激活 → FC2,权重按 ep_rank 从本卡持有的槽位里取。
第五步,收尾。 combine 把结果送回原卡并按路由权重求和,调度器截掉 padding,包装器推进 repeat_idx、处理 DWDP 记账,返回 [num_tokens, hidden_size]。
这条链路里每一段都可以单独替换:换量化格式就是换后端,换硬件代际就是换后端族,换互连就是换通信策略,换延迟/吞吐偏好就是换调度器家族,换负载均衡策略就是换 EPLB——而这些替换彼此不要求对方跟着改。这正是把 MoE 拆成”编排者 + 纯计算后端 + 执行调度器 + 可插拔通信 + 可选负载均衡”这五个部件换来的东西。
参考资料
- TensorRT-LLM 仓库(MoE 模块源码位于 tensorrt_llm/_torch/moe/)
- MoE Developer Guide(TensorRT-LLM 官方架构文档)
- attention.md:TensorRT-LLM PyTorch 后端注意力实现文档
- DeepSeek-V3 Technical Report(noaux_tc 分组路由的出处)
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
- DeepEP:面向专家并行的通信库
- DeepGEMM:面向 Hopper/Blackwell 的 FP8 GEMM 库
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity
- GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding
- vLLM 源码完全拆解(八):MoE 层的前向执行
- SGLang 源码完全拆解(十七):DP Attention 与专家并行
- TensorRT-LLM 源码完全拆解(十一):并行拓扑与通信
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



