


TensorRT-LLM 源码完全拆解(五):PyTorchModelEngine 与输入组装——动态请求如何拼成静态形状的一次前向
系列进度与本篇定位
前四篇把 TensorRT-LLM 在 CPU 侧的账算完了。第一篇建立仓库地形,确认了整条推理路径已经由 PyTorch 后端接管,TensorRT engine 那条老路在运行时已被移除;第二篇沿 create_py_executor 走完装配线,看清 PyExecutor 一次 step 的五个动作与重叠执行的骨架;第三篇钻进调度器,把 CapacityScheduler 的准入算术、MicroBatchScheduler 的微批选择和 paused_requests 的暂停-重算语义逐行读完;第四篇打开 KV 账本,讲清了 KVCacheManager 的两级池、块表构造与前缀复用树。
这四篇结束时留下一个明确的口子:调度器已经决定”这次要跑哪些请求、每条请求跑到哪一步”,KV 账本也已经把”这些请求占哪些物理块”记清楚了,但没人把这些抽象翻译成 GPU 能读的一堆张量。这一篇补的就是这一段:PyTorchModelEngine 如何把一份 ScheduledRequests(调度的输出)变成一次可执行的、形状固定的设备前向。
这里要回答三个问题:
- 调度输出的
ScheduledRequests是一种动态的、每步都不同的结构,GPU 前向却要求张量形状尽量固定。这两者之间的翻译在哪里做、怎么做? - 为什么 TensorRT-LLM 要把输入准备做成”持久缓冲区 + 原地写入”而不是每步新建张量?这和 CUDA Graph 的关系是什么?
AttentionMetadata.prepare()到底准备了什么?块表、序列长度、KV 长度这些数字如何在最后一步进入注意力后端?
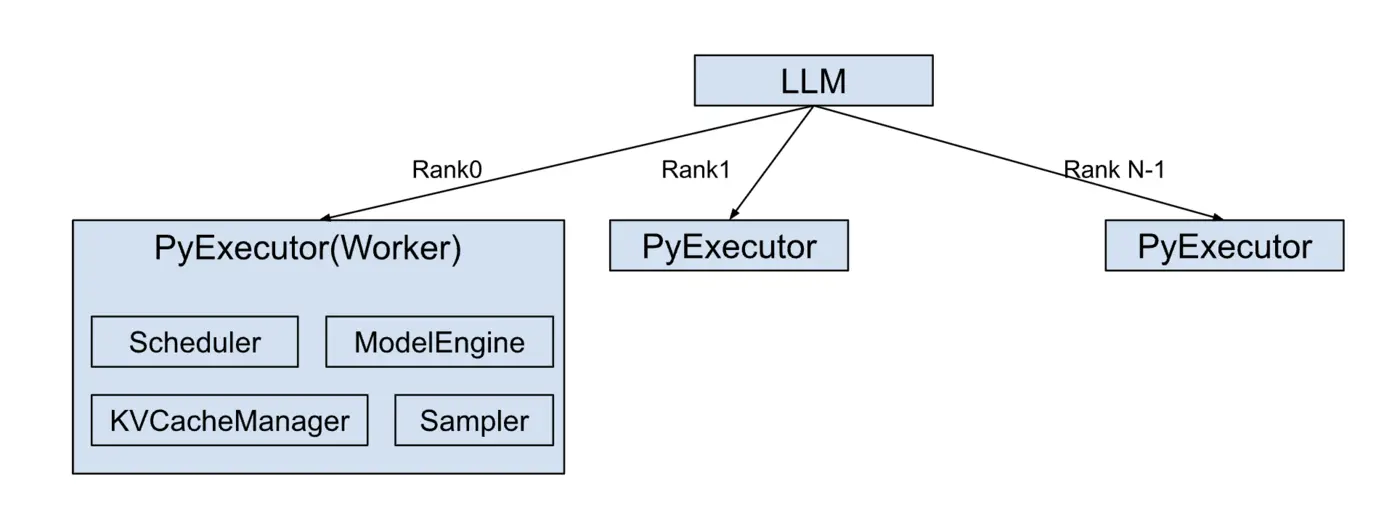
上图是 TensorRT-LLM 官方文档给出的整体架构总览,本篇涉及的 PyTorchModelEngine、ModelRunner 与 AttentionMetadata 位于图中最靠近设备的一层:上游是 LLM 对象与 PyExecutor 的调度闭环,下游就是 GPU 上的注意力内核与 GEMM。图片来源:TensorRT-LLM 官方文档 media/TRTLLM_Architecture_Overview.png。
理解这一段的价值在于:它是 vLLM/SGLang/TensorRT-LLM 三个框架里最不相似的一块。vLLM 的 InputBatch 与 SGLang 的 ForwardBatch 都是”调度完再构造一次批对象”,而 TensorRT-LLM 走的是”固定容器 + 原地覆盖 + 图捕获”的路子。把它读透,才能理解为什么 TensorRT-LLM 在解码阶段能靠整图重放把 CPU 开销压到接近零,也才能理解这条路子带来的具体约束(形状必须分桶、padding 请求必须真的存在、metadata 必须是稳定地址)。
从调度输出到模型输入:这一段为什么难
先把输入和输出说清楚。
调度器交给模型引擎的是一个 ScheduledRequests 对象,它的核心字段是两组请求列表:context_requests(本步要做的预填充,可能是完整提示词,也可能是分块预填充的一段)与 generation_requests(本步要做的一步解码)。每条请求是一个 LlmRequest,带着自己的 py_prompt_len、context_current_position、py_draft_tokens、max_beam_num_tokens、py_batch_idx 等状态。这些字段的类型是 Python 整数和列表,长度随本步调度结果变化。
模型引擎要产出的,是一次 model.forward(...) 调用所能接受的参数集合:input_ids、position_ids、attn_metadata,以及可能的 spec_metadata、lora_params。这些必须是 CUDA 上的张量,而且——这是 TensorRT-LLM 的关键设计——这些张量的存储地址必须在整个进程生命周期里保持稳定。
为什么地址要稳定?因为 CUDA Graph。解码阶段每个 step 的计算图是完全一样的:同一批 kernel、同样的形状、同样的依赖关系。区别只在输入张量的内容(哪些 token、哪些位置、KV 写到哪里)。CUDA Graph 的捕获记录的是设备指针,一旦捕获完成,重放时它只会去读那些固定地址上现在的内容,不会重新解析任何一个 Python 对象。所以只要地址不变、形状不变,就可以在重放前把新内容”拷进”这些地址,然后一次 graph.replay() 把整个解码 step 发到 GPU 上,中间不经过任何 CPU 侧 kernel launch 逻辑。
这条设计路线直接决定了输入准备的形态:持久缓冲区(persistent buffers)。InputBuffers 就是这套思想的载体,它由 runner 持有,在模型加载后、图捕获前一次性按最大容量分配,之后只被切片和原地写入,永不被替换。
@dataclass(frozen=True)class InputBuffers: input_ids_cuda: torch.Tensor position_ids_cuda: torch.Tensor cache_indirection: torch.Tensor | None = None gather_ids_cuda: torch.Tensor | None = None draft_tokens_cuda: torch.Tensor | None = None分配动作在 InputBuffers.allocate 里,容量全部来自配置上限:
return cls( input_ids_cuda=torch.empty(max_num_tokens, dtype=torch.int, device="cuda"), position_ids_cuda=torch.empty(max_num_tokens, dtype=torch.int, device="cuda"), cache_indirection=( torch.zeros((max_batch_size, max_beam_width, max_seq_len), ...) if use_cache_indirection and max_beam_width > 1 else None ), gather_ids_cuda=( torch.empty(max_num_tokens, dtype=torch.int, device="cuda") if max_num_draft_tokens is not None else None ), draft_tokens_cuda=( torch.empty(max_num_draft_tokens, dtype=torch.int, device="cuda") if max_num_draft_tokens is not None else None ),)这里有一个值得停下来想的取舍:用内存换稳定性。input_ids_cuda 按 max_num_tokens 分配(max_num_tokens 是这一步允许的最大 token 数,通常几千到上万),而一次解码步实际用到的往往只有几十个 token。剩下的空间是浪费的,但换来了”地址固定、可以放进图”的性质。解码阶段一步省下的那几十微秒 CPU 时间,乘上每秒上百步、乘上并发请求数,才是 TensorRT-LLM 真正在意的东西。
DecoderInputBuffers 在此基础上追加了推理解码专有的缓冲区:beam search 的 previous_batch_indices_cuda、投机解码用的 gather_ids_cuda 与 num_accepted_draft_tokens_cuda、以及 overlap scheduler 稳态复用的 previous_pos_indices_cuda 等。它们同样是按上限分配、只切片不重建。
三类 runner:输入长什么样,由模型形状决定
在深入准备逻辑之前,必须先理解 ModelRunner 的三种契约。因为”输入准备”这件事本身不是一套代码,而是三套,取决于模型是解码器、编码器,还是根本没有 KV 缓存。
ModelEngine 是一个只有三个方法的抽象类(get_max_num_sequences、forward、warmup),真正的实现是 PyTorchModelEngine。它内部持有一个 ModelRunner,并按模型类型在初始化时选定具体类:
_initialize_decoder_runner—— 标准自回归解码器(含投机解码、chunked prefill、beam search)_initialize_encoder_runner/_initialize_encoder_decoder_runner—— 编码器与编码-解码模型_initialize_no_kv_cache_runner—— 无 KV 缓存的模型(如纯编码/池化路径)
ModelRunner 又分成两个互斥的子契约,由引擎在初始化时判断自己持有哪一个:
class ModelRunner(ABC): def release_graphs(self) -> None: ... def wait_for_input_copy(self) -> None: ...
class ScheduledModelRunner(ModelRunner): @abstractmethod def forward(self, inputs: ScheduledInputs, *, resource_manager: ResourceManager, is_dummy: bool = False) -> dict[str, Any]: ...
class PackedModelRunner(ModelRunner): @abstractmethod def forward(self, inputs: PackedInputs) -> dict[str, Any]: ...两者的差别不在实现细节,而在谁来定义批次边界。ScheduledModelRunner 走的是常规路径:批次由调度器定义,runner 只是把它翻译成张量,所以它需要 resource_manager(拿 KV 管理器、LoRA 管理器等资源)和 is_dummy(区分真实请求与 warmup/显存探测用的假批次)。PackedModelRunner 走的是”批次已经在别处打包好”的路径:PackedInputs 自带 input_ids 列表、sequence_lengths 列表、以及 multi_item_part_lens,不需要调度协作对象。池化、纯编码这类模型属于后者——它们的”批”就是一组待编码的序列,没有 KV、没有逐步推进的概念。
ModelEngine.forward 是这个分岔的入口,它按 batch 的实际类型分派:
def forward(self, batch, resource_manager=None, new_tensors_device=None, cache_indirection_buffer=None): if isinstance(batch, PackedInputs): assert isinstance(self._runner, PackedModelRunner), \ "a packed batch requires a packed-batch runner" return self._runner.forward(batch) assert resource_manager is not None, \ "scheduled execution requires a resource manager" inputs = make_scheduled_inputs(batch, new_tensors_device, cache_indirection_buffer, enable_spec_decode=self.enable_spec_decode, runtime_draft_len=self.runtime_draft_len) outputs = self._forward_scheduled(inputs, resource_manager=resource_manager, is_dummy=self.is_warmup) if isinstance(outputs, dict): self.runtime_draft_len = outputs.pop("runtime_draft_len", inputs.runtime_draft_len) return outputs注意最后三行:
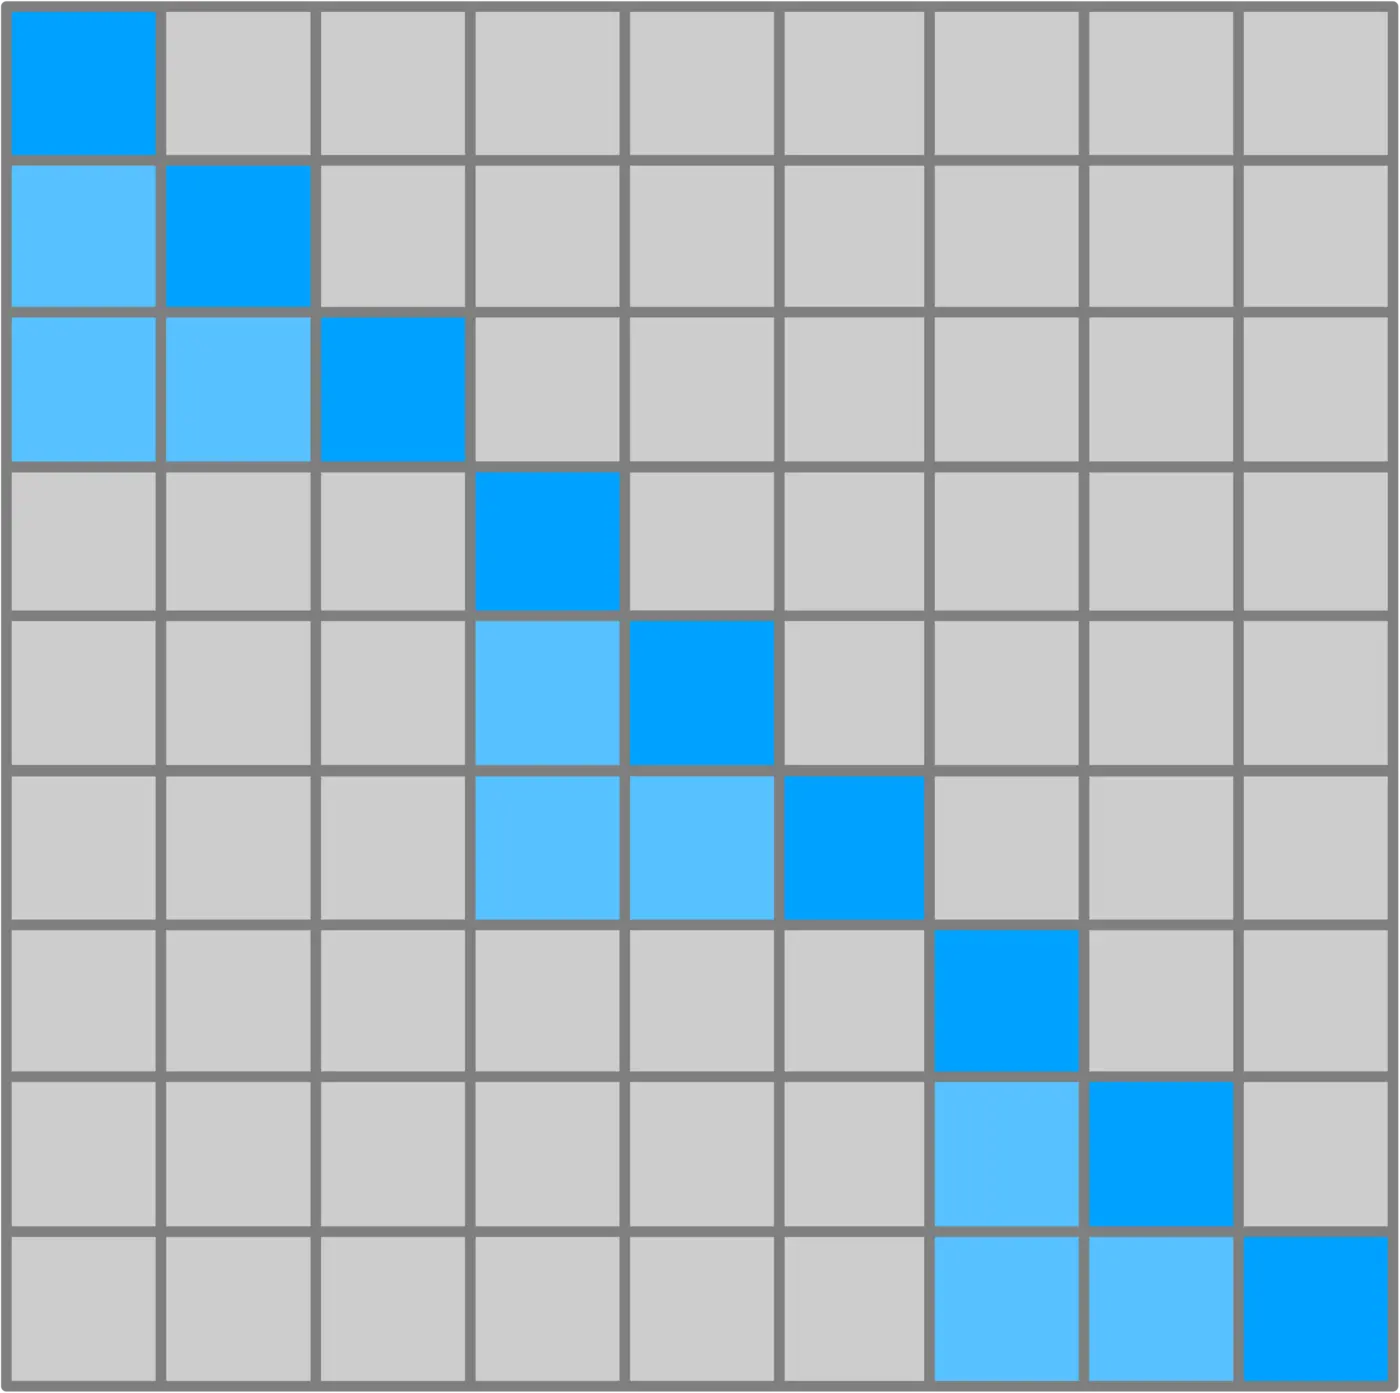
上下文阶段之所以形状多变,根源在于长提示词不会一次算完,而是被切成固定大小的块逐步推进(上图即官方文档对分块上下文注意力的示意)。每一块的 query 数由 context_chunk_size 决定,而同一批里所有上下文请求的 chunk 大小必须一致——这正是后面图键会检查的那条约束。图片来源:TensorRT-LLM 官方文档 media/feat_long_seq_chunked_attention.png。
runtime_draft_len 是由模型前向反向告知引擎的。投机解码里每步实际生成的草稿 token 数可能变化(尤其是动态树草稿),引擎不能预先假设一个固定值,只能让 runner 在前向里算出真实值再回填。这就是 ScheduledInputs 与 PreparedInputs 两个 dataclass 里都带 runtime_draft_len 字段的原因——它们是这条回传链路的两个中转站。
ScheduledInputs 本身定义得很克制,只有批次引用加上几个控制开关:
@dataclass(frozen=True)class ScheduledInputs: batch: ScheduledRequests new_tensors_device: SampleStateTensors | None = None cache_indirection_buffer: torch.Tensor | None = None gather_context_logits: bool = False enable_spec_decode: bool = False runtime_draft_len: int = 0注释里那句”batch and tensors are borrowed”很重要:这个对象不拥有数据,它只是在这一步内把借用关系串起来。真正持有持久存储的是 runner 内部的 DecoderInputBuffers,这也是为什么 release_graphs 和 wait_for_input_copy 这两个生命周期方法定义在 ModelRunner 基类上——图引用了缓冲区地址,输入拷贝是异步的,这两件事决定了缓冲区什么时候才能被安全替换。
一次解码步的输入准备:七步流水线
现在进入主体:DecoderInputPreparer.prepare_inputs。这是整个输入组装的中枢,它把一条 ScheduledRequests 变成一份 PreparedInputs。函数很长,但它的骨架只有七步,而且其中前三步是”能抄近路就抄近路”的快路径判断。
第一步:注册与前置钩子
进入准备前有两个前置动作。一是 _register_suffix_automaton_requests,为需要用后缀自动机做约束解码的请求登记状态(这是结构化输出的一条旁路,与采样侧的语法约束呼应);二是模型自己注册的 prepare_request_inputs 钩子,让模型类有机会在标准流程之外追加自己的每请求准备:
prepare_request_inputs = getattr(self.model, "prepare_request_inputs", None)if prepare_request_inputs is not None: prepare_request_inputs(scheduled_requests, attn_metadata, promoted_context_request_ids)这个钩子的存在说明了一件事:输入准备不是”一个固定函数”,而是”一条标准流水线 + 模型可插入的扩展点”。多模态模型、特殊位置编码模型会在这里挂自己的逻辑。
第二步:解析上一步的采样结果
输入准备需要知道上一步解码出来的 token,因为它是本步 input_ids 的来源。这个数据来自 new_tensors_device——由采样器写进设备缓冲、再由 overlap scheduler 传过来的张量:
new_tokens_device = new_tensors_device.new_tokens # [batch] 或 [batch, 1+draft_len]if isinstance(new_tensors_device, SampleStateTensorsSpec): assert enable_spec_decode new_tokens_lens_device = new_tensors_device.new_tokens_lens # [batch] next_draft_tokens_device = new_tensors_device.next_draft_tokens # [batch, draft_len]普通解码时 new_tokens 是每请求一个 token;投机解码时它是 [batch, 1 + draft_len] 的形状,把”目标模型验证后接受的 token”和”下一轮草稿 token”一起带过来。这里的形状差异解释了为什么投机解码的 AttentionMetadata 与普通解码不同——KV 长度要额外容纳草稿 token 的位置。
第三步:三条快路径
准备逻辑里最反直觉、也最能说明工程取舍的一段,是它有三条快路径,命中哪一条取决于批次的形态:
_prepare_inputs_fast_path—— 针对形状完全可预测的批次(典型是纯解码批次)跳过逐请求打包,直接复用已有 metadata;_can_use_steady_gen_fast_prepare/_apply_steady_gen_fast_prepare—— “稳态解码”复用。当连续多步都是同一批请求在做纯解码时,input_ids、position_ids的增量是有规律的(每请求 +1),于是不必每步重新构造整个列表,只需在上一步的缓冲上做增量更新;- 完整路径 —— 上面两条都不命中时,老老实实逐请求打包。
第三条路径的入口就是那一长串 _pack_* 调用:
host = HostInputs( use_mrope=self._config.use_mrope, mrope_dummy_seq_slot=get_mrope_dummy_seq_slot(...), extra_inputs=self._new_extra_inputs(), context_prompt_lookahead=([] if ... else None),)self._pack_context_requests(host, scheduled_requests)self._classify_generation_requests(host, scheduled_requests, promoted_context_request_ids, next_draft_tokens_device, enable_spec_decode)self._prepare_helix_state(host, kv_cache_manager)...self._pack_extend_requests(host, promoted_context_request_ids, ...)self._pack_generation_requests(host, promoted_context_request_ids, new_tokens_device)这里的 HostInputs 是”主机侧中间态”:所有列表(input_ids、position_ids、sequence_lengths、gather_ids、draft_lens 等)先在 CPU 上按请求顺序拼好,之后统一搬上设备。为什么要有这个中间态? 因为把 N 个 Python 整数逐个 copy_ 到设备是 N 次小拷贝,而先把它们攒成一个 pinned host 列表、再用一次 to(device, non_blocking=True) 搬过去,可以把 N 次同步拷贝压成一次异步传输。这是典型的”主机侧聚合、设备侧一次搬运”模式,也是 prefer_pinned() 在整个文件里反复出现的原因。
逐请求打包:预填充、扩展与解码三个世界
打包阶段最需要讲清楚的,是它按请求类型分成三组,而这三组对应三种不同的”token 语义”。
_pack_context_requests 处理预填充(context)请求。对每一条请求,它把本步要算的提示词片段——注意可能只是分块预填充的一段——的 token 和位置写进 host 列表。这里有两个细节值得记住:分块预填充的 chunk 边界由 context_chunk_size 决定,同一步里所有 context 请求的 chunk 大小必须一致(否则 get_graph_key 会返回 None,拒绝走图路径);以及最后一块预填充的”后续 token 前瞻”(context_prompt_lookahead)只在投机解码需要时收集。
_pack_extend_requests 处理”扩展”请求,这是投机解码与树解码引入的第三类语义。它位于预填充与解码之间:一条请求的上下文已经算完,本步要对多个草稿 token做一次并行验证前向。所以它的 token 数不是 1 也不是 chunk 长度,而是 runtime_tokens_per_gen_step:
runtime_tokens_per_gen_step = self.get_runtime_tokens_per_gen_step(runtime_draft_len)self._pack_extend_requests(host, promoted_context_request_ids, next_draft_tokens_device, runtime_tokens_per_gen_step, spec_config, enable_spec_decode=enable_spec_decode)_pack_generation_requests 处理普通解码:本步每请求一个 token(beam search 下是 beam_width 个)。它写入的 input_ids 来源是上一步采样出的 new_tokens_device——对刚做完预填充的请求,则来自预填充的最后一段。
三组打包完成后的动作是统一的:先把 token 搬上设备,再搬位置,再把投机解码的 gather_ids 搬过去。
self._copy_token_ids_to_device(host, scheduled_requests, new_tokens_device, new_tokens_lens_device, next_draft_tokens_device, runtime_draft_len)self._copy_position_ids_to_device(host)if enable_spec_decode: self._buffers.gather_ids_cuda[: len(host.lists.gather_ids)].copy_( torch.tensor(host.lists.gather_ids, dtype=torch.int, pin_memory=prefer_pinned()), non_blocking=True, )gather_ids 是投机解码的专属输入:验证完成后需要把”实际被接受的那些位置的隐状态”收集出来送给采样器。它不是按请求分布的,而是按”被接受了多少个 token”分布,所以它必须等前向跑到一半、验证结果出来之后才能确定——这正是它在图上需要单独处理的根本原因。
AttentionMetadata.prepare():把账本翻译成内核参数
输入张量搬完,还剩最后一件事:把调度器和 KV 账本的数字翻译成注意力内核能读的元数据。这件事在 _prepare_attn_metadata 里做,是整个准备流程里信息密度最高的一段。
先看清楚 AttentionMetadata 是什么角色。它是注意力后端的输入契约:不同的后端(TRT-LLM 原生、FlashInfer、Vanilla)共享同一个 AttentionMetadata 基类,各自实现自己的 prepare() 把这份元数据转成自己的内核参数。第一篇讲过注意力后端的三种实现,这里的 prepare() 就是它们与框架其余部分的接缝。
_prepare_attn_metadata 填的字段可以分成四类。
第一类是序列长度与请求身份:
if not attn_metadata.is_cuda_graph: attn_metadata.seq_lens = torch.tensor(host.lists.sequence_lengths, dtype=torch.int, pin_memory=prefer_pinned())...attn_metadata.request_ids = host.lists.request_idsattn_metadata.prompt_lens = host.lists.prompt_lengthsattn_metadata.num_contexts = scheduled_requests.num_context_requests注意 if not attn_metadata.is_cuda_graph 这个条件。在图内执行时,seq_lens 不在这里写——因为图捕获时地址已经固定,运行时只能原地改内容,而原地改内容这件事由图内的 kernel 自己完成(例如在 preprocess_inputs 里更新 kv_lens_cuda)。这是一个反复出现的模式:图内路径用设备侧原地更新替代主机侧重建。
第二类是KV 账本的入口,也就是第四篇讲的那些数字如何流到这里:
attn_metadata.kv_cache_params = KVCacheParams( use_cache=True, num_cached_tokens_per_seq=num_cached_tokens_per_seq, num_extra_kv_tokens=get_num_extra_kv_tokens(spec_config), use_full_generation_page_table=( self._should_use_full_generation_page_table(spec_config, attn_metadata) ),)attn_metadata.kv_cache_manager = kv_cache_managernum_cached_tokens_per_seq 是”每条请求已经缓存的 KV 长度”,前缀复用的收益就体现在这个数上——它越大,本步要算的新 token 越少。num_extra_kv_tokens 是投机解码要额外预留的 KV 槽位数。use_full_generation_page_table 则是一个优化开关:overlap 调度下投机解码需要一块更宽的页表,让解码步骤一次读写到完整的保留页。
而 attn_metadata.kv_cache_manager = kv_cache_manager 这一行是最关键的一笔:元数据持有的是管理器对象的引用,不是拷贝出来的块表。块表的真正构造发生在 prepare() 里,由后端按需从管理器取当前步的块映射。这解释了第四篇末尾那句”块表如何最终写进注意力后端的元数据”——它走的不是数据拷贝,而是引用传递。
第三类是beam search 的缓存间接层。beam search 会让多条 beam 共享同一棵前缀树,所以 KV 读取要经过一层间接寻址:
if self.use_beam_search and num_generation_requests > 0: if cache_indirection_buffer is not None: gen_request_seq_slots_tensor = torch.tensor( gen_request_seq_slots, dtype=torch.long, pin_memory=prefer_pinned() ).to(device="cuda", non_blocking=True) self._buffers.cache_indirection[:num_generation_requests].copy_( cache_indirection_buffer[gen_request_seq_slots_tensor] ) if cache_indirection_buffer is not None or is_dummy: attn_metadata.beam_width = self._config.max_beam_widthelse: attn_metadata.beam_width = 1那个 if cache_indirection_buffer is not None or is_dummy 里的 is_dummy 分支不是笔误:warmup 与显存探测用的假批次也必须按最大 beam width 配置元数据,否则捕获出来的图只对 beam width = 1 成立,真实请求一来就要重捕。这是”图捕获必须按最大配置来”这条原则的一个具体落点。
第四类是分块预填充的记账。num_chunked_ctx_requests 记录本步有几个请求是”扩展上下文”(而非从零开始的预填充),这样 kv_lens_cuda 才能在 preprocess_inputs 里被正确更新:
attn_metadata.num_chunked_ctx_requests = 0if (enable_spec_decode and spec_config.spec_dec_mode.extend_ctx(...) and spec_config.is_linear_tree): attn_metadata.num_contexts += len(extend_requests) attn_metadata.num_chunked_ctx_requests = len(extend_requests)这段注释里给出的理由很直白:树解码要用 XQA(一种面向解码的注意力内核)处理草稿 token,所以草稿 token 不能被当成”分块上下文”来对待。元数据的一个字段取值,直接决定了后面会走哪个注意力内核——这就是元数据层与内核层的耦合点。
最后,所有字段填完后统一调用一次:
attn_metadata.prepare()这一次调用把上面这些主机侧字段转成后端自己的内核参数(块表、页表、序列长度数组的最终形态)。它被放在一个精心选择的位置:在 padding 之前、在投机元数据的 spec_metadata.prepare() 之前。注释里给出的理由是 RocketKV 这类稀疏后端会在 prepare() 里原地裁剪 num_cached_tokens_per_seq,而 KVCacheParams 持有的是列表引用——所以要在 prepare() 之前 list(num_cached_tokens_per_seq) 快照一份”真实值”,供稳态复用记录使用。这类”先快照再原地修改”的手法,是当一份数据同时被”本步计算”和”下一步复用”两条路径引用时的标准防御。
Padding:为什么必须往批次里塞假请求
准备流程的最后一步是 padding(_pad_inputs → pad_tokens → pad_input_tokens)。这是 TensorRT-LLM 输入组装里最容易被误读的一块——直觉上 padding 是”浪费算力”,为什么要主动做?
答案藏在 CUDA Graph 的形状约束里。图在捕获时就固定了张量形状,重放时形状不能变。但调度器每步选出的请求数是变化的:这一步可能是 7 条解码请求,下一步可能是 9 条。如果为每个可能的请求数都捕获一张图,图的数量会爆炸(还要乘以 beam width、草稿长度等维度)。工程上的解法是分桶:只为一组预先选定的”支持批次大小”(cuda_graph_batch_sizes)捕获图,比如 1、2、4、8、16、32……实际批次落在哪个区间,就补齐到那个桶的上界。这就是 cuda_graph_padding_enabled 的作用。
补齐的方式是往批次里塞假请求(dummy request),这不是”多算一点”。假请求必须是一条结构完整的 LlmRequest:要有请求 ID、要有 KV 槽位、要能通过调度器的记账。CUDAGraphRunner 为此维护了一个假请求池:
self.padding_dummy_requests: Dict[int, LlmRequest] = {}在 preallocate_padding_dummies 阶段一次性造好,之后按需取用。假请求的 token 行会被显式清零——_zero_fill_row_spans 就是干这个的,它的注释把原因说得很清楚:CUDA graph 和 attention-DP 的 padding 请求,其 input-id 行既不由主机拷贝写、也不由设备拷贝写,所以必须单独清零,否则图会读到上一轮的残留数据。
padding 有两种触发源,get_padding_params 把它们的优先级写得很明确。
第一种是预填充图的 token 分桶。prefill_cuda_graph_num_tokens 是一组预先捕获的 token 数档位,实际 token 数按 bisect_left 向上取档:
def get_padded_prefill_tokens(tokens: int) -> int: return prefill_cuda_graph_num_tokens[ bisect.bisect_left(prefill_cuda_graph_num_tokens, tokens) ]bisect_left 给出的是”第一个不小于实际值”的档位,也就是向上取整到最近的桶。这个函数只在 prefill_cuda_graph_backend != DISABLED 时启用——预填充图是可选项,因为预填充的 token 数变化范围比解码大得多(从几十到上万),捕获成本也高得多。
第二种是 attention DP 的跨 rank 对齐。当注意力做数据并行(attention DP)时,每个 rank 上的 token 数不同,而所有 rank 必须同时进入同一次集合通信。所以要让所有 rank 的 token 数统一到本组最大值:
if attn_all_rank_num_tokens is not None: can_run_prefill_cuda_graph = ( has_ctx_requests and max(attn_all_rank_num_tokens) <= max_captured_num_tokens ) if can_run_prefill_cuda_graph: padded_num_tokens = get_padded_prefill_tokens(max(attn_all_rank_num_tokens)) return padded_num_tokens, True, [padded_num_tokens] * len(attn_all_rank_num_tokens) else: logger.debug("Not all ranks can run prefill CUDA graph, disable prefill CUDA graph") return total_num_tokens, False, attn_all_rank_num_tokens第三个返回值 [padded_num_tokens] * len(attn_all_rank_num_tokens) 就是”统一口径”的表达:所有 rank 都跑同样的 token 数。而 else 分支的语义同样重要——只要有一个 rank 的 token 数超过最大档位,全体 rank 一起退回 eager。这不是保守,而是必需:集合通信是全体参与的,不可能让一半 rank 跑图、一半 rank 跑 eager。
pad_input_tokens 在填完这些参数后做最后两件事:把 padded_num_tokens 记进元数据(attn_metadata.padded_num_tokens,注意只在真的发生 padding 时才记),以及清零被补齐的行:
if attn_metadata.padded_num_tokens is None: return num_tokensinput_ids[num_tokens:padded_num_tokens].fill_(0)position_ids[..., num_tokens:padded_num_tokens].fill_(0)return padded_num_tokens注意 position_ids[..., num_tokens:padded_num_tokens] 里的省略号。MRoPE 模型的 position_ids 是 (3, 1, N) 形状,位置在最后一维,所以用省略号对齐最后一维对两种形状都成立。这是一个很小的细节,但它说明这套代码在支持多种位置编码形态时,选择用统一的索引表达式而不是分支。
attn_metadata.padded_num_tokens 还有一个下游用途:注意力后端要靠它决定 padding 的 KV 行怎么处理——padding 请求的 KV 必须被标记为”无效”,否则 decode 时会读到假请求的块。这个”标记无效”的动作由后端的 prepare() 完成,因为只有后端知道自己用的是什么表示(页表还是块表)。
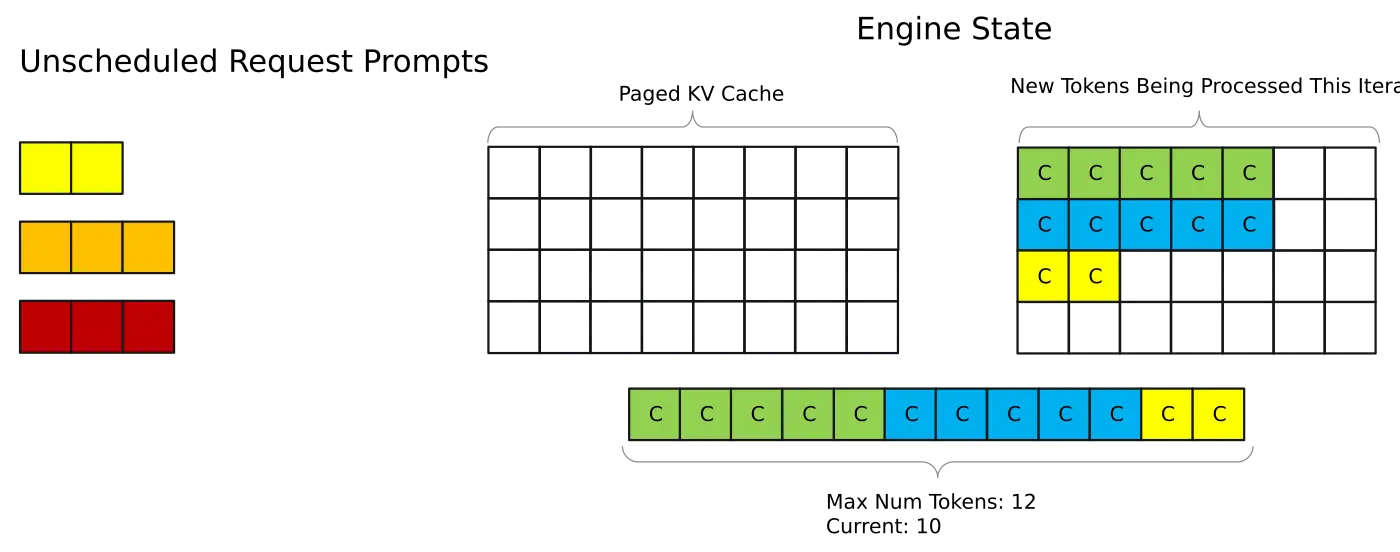
官方的调度可视化图很直观地展示了 padding 的上下文:图里 Max Num Tokens: 12 是这一步的 token 预算上限,Current: 10 是实际要处理的 token 数,差额部分就是被补齐的容量——Paged KV Cache 中未使用的槽位、Engine State 里排队的请求,都对应着”预算没用满但必须按预算形状执行”这件事。图片来源:TensorRT-LLM 官方文档 media/TRTLLM_Scheduler_Vis_Chunked_Context_1.svg。
稳态解码快路径:把”每步重新打包”换成”原地加一”
前面提到 _can_use_steady_gen_fast_prepare 是一条重要快路径,值得单独拆开,因为它是整个输入准备里”省 CPU”最彻底的一招。
先看它的适用条件,这些条件本身就是对”什么情况下输入有规律”的精确刻画:
cache = self._steady_gen_cacheif cache is None or is_dummy: return Falseif new_tokens_device is None or next_draft_tokens_device is not None or spec_metadata is not None: return Falseif scheduled_requests.num_context_requests > 0: return Falsegeneration_requests = scheduled_requests.generation_requestsif len(generation_requests) != cache["num_requests"]: return Falsereturn cache["request_ids"] == [request.py_request_id for request in generation_requests]逐条读:必须有上一步记录的缓存;不能是假批次;必须有上一步的采样结果;不能有下一轮草稿 token(即不能是投机解码的草稿阶段);不能有预填充请求;请求数量必须和上一步一样;而且请求 ID 的列表必须逐位相同。最后一条是核心——只有当”同一批请求、同样顺序、每请求只前进一个 token”时,输入的所有结构才与上一步完全相同,唯一变化的是内容。
命中之后,准备工作被压缩成三个”原地加一”外加一次 index_select:
positions = self._buffers.steady_gen_positions_pinned[:num_requests]positions.add_(1)if use_mrope: self._buffers.mrope_position_ids_cuda[:, :, :num_requests].add_(1)else: self._buffers.position_ids_cuda[:num_requests].add_(1)num_cached_tokens_per_seq = positions.tolist()
previous_slots = self._buffers.previous_batch_indices_cuda[:num_requests]torch.index_select( new_tensors_device.new_tokens[0, :, : self._config.max_beam_width], 0, previous_slots, out=self._buffers.input_ids_cuda[: num_requests * self._config.max_beam_width].view( num_requests, self._config.max_beam_width ),)第一段是位置原地加一:上一步把位置写进了 position_ids_cuda,本步每个请求的位置恰好 +1,所以直接 add_(1) 即可,不需要重新构造列表。注意注释里点明的一个微妙之处——设备侧的位置缓冲区之所以能原地加一,是因为”它仍持有上一步的位置,因为只有 prepare_inputs 写它,而缓存有效性不变量保证了上一轮写的就是同样的行”。这是”不变量换性能”的典型:代码不重新校验内容,而是依赖一个被严格维护的前置条件。
而主机侧的 steady_gen_positions_pinned(pinned 内存里的一个计数器)单独加一,用来算 num_cached_tokens_per_seq。注释解释了为什么设备缓冲和主机计数器要分开维护(提到了 nvbug 6293536 这类隐患):在 overlap 调度下,上一步的异步 H2D 拷贝可能还没完成,如果拿一个正在被异步拷贝读的 pinned 缓冲区当”本步的源”,就会读到半路状态。所以设备侧原地改、主机侧只做簿记,两边不互相当源。这个细节很能说明 overlap 调度给输入准备带来的额外约束——任何跨步复用的缓冲区都必须明确”谁是源、谁是目标”。
第二段的 index_select 是本步唯一的”真拷贝”:要从上一步的采样输出 new_tokens[batch, 1, beam_width] 里,按 previous_batch_indices_cuda 给出的槽位映射,把每请求的 token 抽出来写进 input_ids_cuda。用 index_select 而不是 Python 循环,是把”按槽位重排”这件工作在设备上一次性完成。
命中稳态路径后,元数据的刷新仍然保留——它无法省略,因为 num_cached_tokens_per_seq 每步都在变:
attn_metadata.seq_lens = cache["seq_lens_ones"]attn_metadata.beam_width = 1attn_metadata.request_ids = cache["request_ids"]attn_metadata.prompt_lens = cache["prompt_lens"]attn_metadata.num_contexts = 0attn_metadata.num_chunked_ctx_requests = 0attn_metadata.kv_cache_params = KVCacheParams( use_cache=True, num_cached_tokens_per_seq=num_cached_tokens_per_seq, num_extra_kv_tokens=get_num_extra_kv_tokens(None),)attn_metadata.kv_cache_manager = kv_cache_managerwith nvtx_range("steady_gen_metadata_prepare"): attn_metadata.prepare()seq_lens 用的是缓存下来的 seq_lens_ones(纯解码批次里每条请求本步正好是 1 个 query token,所以这个张量是常量,可以跨步复用),request_ids 与 prompt_lens 同理。唯一必然变化的是 num_cached_tokens_per_seq,它来自前面那个加过一的计数器。
这段代码在性能上的意义可以量化:完整路径要遍历所有请求、构造多个 Python 列表、把它们转成张量再拷贝;稳态路径对每请求只做几次整数加法和一次 index_select。当解码步频率达到每秒几十到上百步、且批次稳定时,前者是纯粹的 CPU 开销,后者几乎没有。这就是 TensorRT-LLM 能在解码阶段把 CPU 时间压到很低的第二个原因(第一个原因当然是整图重放)。
一次前向的执行编排:先选图,再决定 eager 还是 replay
输入准备好、元数据填好之后,剩下的问题是:这一步到底是跑图还是跑 eager?跑哪张图? 这个决策在 DecoderRunner._forward_decoder 里做,它的流程本身就是一篇浓缩的架构说明。
开头几行先解决资源获取:从 resource_manager 拿出 KV 管理器(注意第一行 assert 的口径——“legacy runner 需要 KV cache manager”,这句话暗示存在不需要 KV 管理器的 runner 变体,比如无 KV 缓存的编码路径),再拿稠密/草稿两套管理器:
kv_cache_manager = resource_manager.get_resource_manager(self.kv_cache_manager_key)draft_kv_cache_manager = get_draft_kv_cache_manager( self._config.spec_config, resource_manager)attn_metadata = self._metadata.setup_attention(kv_cache_manager, draft_kv_cache_manager)然后是投机解码的元数据准备,以及一个容易忽略但很关键的动作——把最后一段上下文请求”提升”进解码批次:
graph_requests, promoted_context_request_ids = self._graphs.promote_final_contexts( scheduled_requests, kv_cache_manager, enable_spec_decode=enable_spec_decode, runtime_draft_len=runtime_draft_len, ced_enabled=ced_enabled,)为什么不直接把最后一块预填充当上下文跑完、下一步再解码?因为上下文与解码的张量形状不同(上下文是 chunk 长度的 query,解码是 1 个 query),如果分开跑,就多了一次 kernel 边界和多一次元数据准备。把”最后一个上下文 token”直接用解码形状执行,可以让它和其他解码请求一起进入同一张图。代价是这行请求的记账要特殊处理:它出现在解码批次里,但它的 py_batch_idx 等状态描述的是上一批(预填充批),所以在选择图键时必须用权威的上下文游标而不是这批的簿记——这就是 _get_seq_len_mode 里那段关于 promoted_context_request_ids 的注释所说的内容。
接下来是 padding 与图键选择:
with self._graphs.pad_batch(graph_requests, resource_manager, runtime_draft_len) as padded_graph_requests: ... selection = self._graphs.select( padded_graph_requests, resource_manager, enable_spec_decode=enable_spec_decode, attn_metadata=attn_metadata, spec_metadata=spec_metadata, draft_tokens_cuda=..., new_tensors_device=new_tensors_device, spec_resource_manager=spec_resource_manager, promoted_context_request_ids=promoted_context_request_ids, ) key = selection.keypadding 是一个 context manager,说明补齐进来的假请求会在退出时被清理——它们只在这一个 step 内有效。
图键(KeyType)是这一步决策的全部依据。回到 get_graph_key,它把批次的”形状身份”编码成一个元组:
return KeyType(batch_size=batch_size, draft_len=draft_len, short_seq_len_mode=short_seq_len_mode, is_all_greedy_sample=is_all_greedy_sample, ...)这些字段的选择揭示了三层约束:
batch_size与draft_len—— 张量形状维度。draft_len由批次里所有请求的草稿 token 数最大值决定,而且代码里有一句断言:assert len(set(draft_len_list)) == 1, "All draft lengths must be the same"。混合不同草稿长度的请求会使张量形状无法统一,所以直接拒绝。context_query_len—— 上下文批的 chunk 大小。同一步里所有 context 请求的 chunk 必须一致,否则get_graph_key返回None(退回 eager):
if num_contexts: context_query_len = int(context_requests[0].context_chunk_size) if any(int(request.context_chunk_size) != context_query_len for request in context_requests[1:]): return Noneshort_seq_len_mode与is_all_greedy_sample—— 语义分支,这是最有意思的一类。前者来自稀疏注意力的需求:DSA 这类算法对短序列可以跳过索引器的 MQA 与 Top-K(站内 DSA 稀疏注意力完全拆解 讲过索引器与 Top-K 的机制),所以短序列和长序列需要各自的图,键里就必须带上”本次是短序列模式还是长序列模式”。后者来自采样器:投机解码的单引擎采样器有贪心快路径(argmax)与高级采样内核两条代码路径,两者捕获出的图不同,所以键里要区分。
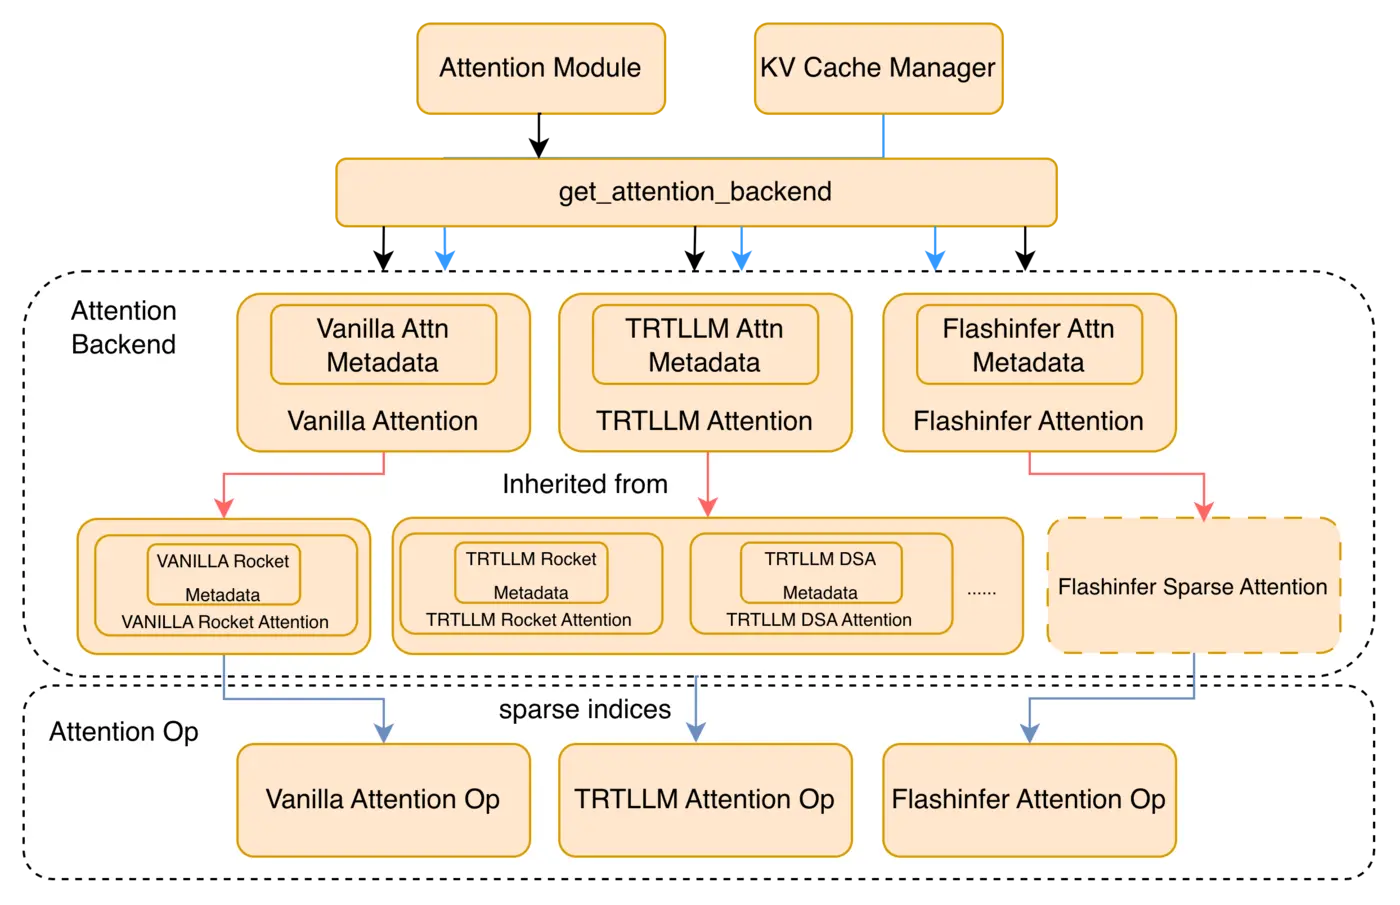
稀疏注意力是”语义分支进入图键”的另一个来源。上图是官方文档对稀疏注意力框架的拆解:算法层(选择哪些 KV 参与计算)与执行层(标准注意力内核)被显式分开,框架负责把稀疏决策落到统一的后端接口上。正因为如此,短序列与长序列可能走完全不同的稀疏路径,图键里必须带上 short_seq_len_mode 这一位。图片来源:TensorRT-LLM 官方文档 media/sparse_attention_framework.png。
is_all_greedy_sample 还有一个执行顺序上的坑,代码注释写得很清楚:这个标志必须在构造图键之前刷新,因为它由 spec_metadata.populate 填充,而 populate 发生在输入准备之后。如果用上一轮的值构造键,就可能拿”高级采样图”去重放一个只填了贪心缓冲的批次,导致运行挂住(注释举了 MTP nextn≥2 的例子)。键的字段必须在键被使用之前处于最终状态——这是一条在复杂流水线里很容易被违反、违反后又极难定位的规则。
选完键之后就是两个世界:
can_run_graph = key is not None and not ( ced_enabled and scheduled_requests.num_context_requests > 0)if can_run_graph: attn_metadata = selection.attn_metadata spec_metadata = selection.spec_metadata execution_requests = padded_graph_requests execution_promoted_context_ids = promoted_context_request_idselse: attn_metadata = self._metadata.attn_metadata if enable_spec_decode: spec_metadata = self._metadata.spec_metadata else: spec_metadata = None execution_requests = scheduled_requests execution_promoted_context_ids = frozenset()注意 else 分支里元数据的来源不同:走图时用 selection 里的元数据,退回 eager 时用 self._metadata 里的元数据。原因是元数据对象本身可能与图绑定(捕获时记录的是那个对象的地址),所以两条路径各有一套。同时 execution_requests 也换了:图路径用补齐后的 padded_graph_requests,eager 路径用未补齐的 scheduled_requests(eager 不需要形状固定,没必要为 padding 多算 token)。
最后落到 DecoderCudaGraphs.run,它把整个决策收束成一个 if:
def run(self, key, inputs, run_model, postprocess_inputs, *, ...): with with_shared_pool(self.cuda_graph_runner.get_graph_pool()): if self.captures_model_body(key): return self.breakable_cuda_graph_runner.capture_model_body( lambda: run_model(inputs)) return self._run(key, inputs, run_model, postprocess_inputs, ...)_run 里是三条分支:没有键 → 试可断图(breakable graph)覆盖,否则 eager;有键但未捕获过 → 先捕获再重放;有键且已捕获 → 直接重放。
needs_capture = self.cuda_graph_runner.needs_capture(key)if needs_capture: def capture_model(model_inputs): with self._torch_compile_bypass(): return run_model(model_inputs) capture_outputs = self.cuda_graph_runner.capture( key, capture_model, inputs, enable_spec_decode=enable_spec_decode, postprocess_fn=postprocess_inputs)if self.cuda_graph_runner.is_warmup_only: outputs = capture_outputselif needs_capture: ... outputs = self.cuda_graph_runner.replay(key, inputs, position_id_offsets=position_id_offsets)else: with MoeLoadBalancerIterContext(moe_load_balancer): outputs = self.cuda_graph_runner.replay(key, inputs, position_id_offsets=position_id_offsets)三个细节值得停下来看。
其一,capture_model 外面套了 self._torch_compile_bypass()。原因很直接:torch.compile 会生成新的 kernel,而图捕获必须在 kernel 集合固定之后进行。捕获时绕过编译,等到重放时模型是已编译好的版本——这是”编译产物与图捕获谁先谁后”这个顺序问题的具体处理,与 vLLM 里 torch.compile 与 CUDA Graph 的配合属于同一类问题(可参考 vLLM 源码完全拆解(十):torch.compile 与 CUDA Graph)。
其二,重放前后有一对 prepare_attn_metadata_for_draft_replay / restore_attn_metadata_after_draft_replay。这处理的是投机解码下草稿 KV 与目标 KV 的关系:重放前要把元数据切到草稿缓存的那一套,重放后恢复。用 try/finally 包住说明这个切换必须是异常安全的。
其三,MoeLoadBalancerIterContext(moe_load_balancer) 只在”已经捕获过”那条分支里出现。MoE 负载均衡器需要在每一步迭代开始时更新专家布点,而捕获阶段不需要(图里已经固定了当次的布点)。站内 SGLang 源码完全拆解(十七):DP Attention 与专家并行 讲过 EPLB 动态重排专家的机制,TensorRT-LLM 这里的 IterContext 就是”重排边界”在框架里的落点:重排必须发生在图重放之前,且不能让重排结果改变图的形状。
图捕获与重放的硬边界
前面反复出现”地址必须稳定”这条约束,它到底有多硬?看 CUDAGraphRunner 捕获阶段的 _record_strict_buffer_snapshot 与重放阶段的 _check_strict_buffer_stability 就明白了。
捕获时,在捕获完成、后处理执行之前,先对一批关键缓冲区打一次快照:
with torch.cuda.graph(graph, pool=self.memory_pool): output = forward_fn(capture_inputs)# Snapshot before postprocessing so the check compares against# the addresses the graph actually baked in.self._record_strict_buffer_snapshot(key)if postprocess_fn is not None: postprocess_fn(capture_inputs)重放时先校验:
stored_meta = self.graph_metadata[key]assert current_inputs["attn_metadata"] is stored_meta["attn_metadata"]if stored_meta["spec_metadata"] is not None: assert current_inputs.get("spec_metadata") is stored_meta["spec_metadata"]self._check_strict_buffer_stability(stored_meta)注意这里的 is,不是 ==:元数据对象必须是同一个对象,不是”内容相同的新对象”。这是图捕获路线的根本约束——图里记录的是元数据内部张量的设备指针,如果换一个”内容一样”的新元数据对象,那些指针就指向了别处。
同样硬的还有 token 数校验:
input_ids = current_inputs["input_ids"]seqlen = input_ids.shape[0]expected_num_tokens = self._get_num_tokens_for_key(key)if seqlen != expected_num_tokens: raise ValueError( f"replay() got {seqlen} tokens for key {key}, but the graph was " f"captured for {expected_num_tokens} tokens. A shorter input_ids " "leaves the tail of the static input buffer stale.")这句话点出了最隐蔽的失效模式:短输入不会报错,只会让缓冲区尾部残留上一轮的数据。因为重放做的是 static_tensors["input_ids"][:seqlen].copy_(input_ids)——只覆盖前 seqlen 行,后面的行保持原样。如果 seqlen 小于图捕获时的长度,那些”后面”的行就会被当成真实输入参与计算。所以这里宁可直接抛异常也不容忍。
位置张量的形状校验同理,而且注释里给出了更细的理由:
expected_position_ids_shape = (1, seqlen)if tuple(position_ids.shape) != expected_position_ids_shape: raise ValueError( f"replay() got position_ids of shape {tuple(position_ids.shape)} " f"for key {key}, but expected {expected_position_ids_shape}. " "torch.Tensor.copy_() silently broadcasts mismatched shapes, " "which would corrupt the static input buffer.")copy_() 会静默广播形状不匹配的张量。这是 PyTorch 的一个友好特性,在这里却是一个危险特性:一个 (1, seqlen) 对 (1, seqlen+1) 的广播拷贝不会报错,但会留下错位的输入。
最后是 replay 里那段关于 mrope delta 缓冲区的处理,它展示了”省略即错误”这个原则:
if mrope_delta_read_seq_slots is not None: ... static_tensors['mrope_delta_read_seq_slots'][:...].copy_(...)else: logger.debug("replay() got no mrope_delta_read_seq_slots for a use_mrope graph; " "filling the static buffer with the dummy seq slot instead of " "copying real values.") mrope_dummy_seq_slot = get_mrope_dummy_seq_slot(...) static_tensors['mrope_delta_read_seq_slots'][:num_slots].fill_(mrope_dummy_seq_slot)没有收到真实值时,代码不是”什么都不做”,而是主动填上假槽位。因为什么都不做意味着保留上一轮的值,而上一轮的值在本轮的语义下是错的。这与前面 pad 时清零、短输入时抛异常,是同一个原则的三种表现:在图重放的路径上,每一行缓冲区都必须被显式赋予本轮的语义,不能依赖”上一轮大概也是这个值”。
图捕获的初始化:为什么 WARMUP_STEPS = 1 不是省事
捕获函数开头有一句注释,解释了为什么捕获前必须跑一次前向:
# We have to do a warmup run to initialize PyTorch's internal# states according to the docs:# https://pytorch.org/docs/stable/notes/cuda.html#cuda-graph-semantics# This also lets us initialize states in the attn_metadata and# resize the shared attention workspace before any graph is captured.两个理由:一是 PyTorch 自己的要求(CUDA Graph 语义要求捕获前先跑一次,让 cuBLAS/cuDNN 这些库完成自己的惰性初始化);二是 TensorRT-LLM 自己的需要——注意力后端的工作区要按这次的真实形状 resize,resize 意味着重新分配,而重新分配一旦发生在捕获之后就会让图里记录的地址失效。
所以捕获的顺序被严格固定为:warmup 前向 → 状态初始化 → 分配/调整工作区 → torch.cuda.graph(...) 捕获 → 快照 → 后处理。
还有一个细节是捕获用的内存池:
with torch.cuda.graph(graph, pool=self.memory_pool): output = forward_fn(capture_inputs)...self.memory_pool = graph.pool()捕获时用当前池,捕获后把 graph.pool() 存回去作为下一次的池。这让多张图共享同一个内存池——如果每张图各用一个池,按批次大小分桶的那一堆图会各自占用一份显存。共享池的代价是图与图之间的显存复用必须以”同时最多只重放一张图”为前提,而这一点由调度器保证(一步只跑一个批次)。这是一个典型的”用执行模型的约束换显存”的取舍。
捕获还被默认禁止在运行时发生:
# On-the-fly capture is disabled by default to prevent workspace# tensor reallocation from invalidating addresses baked into existing# CUDA graphs. Use allow_capture() context manager during warmup.self._capture_allowed = Falseself.is_warmup_only = False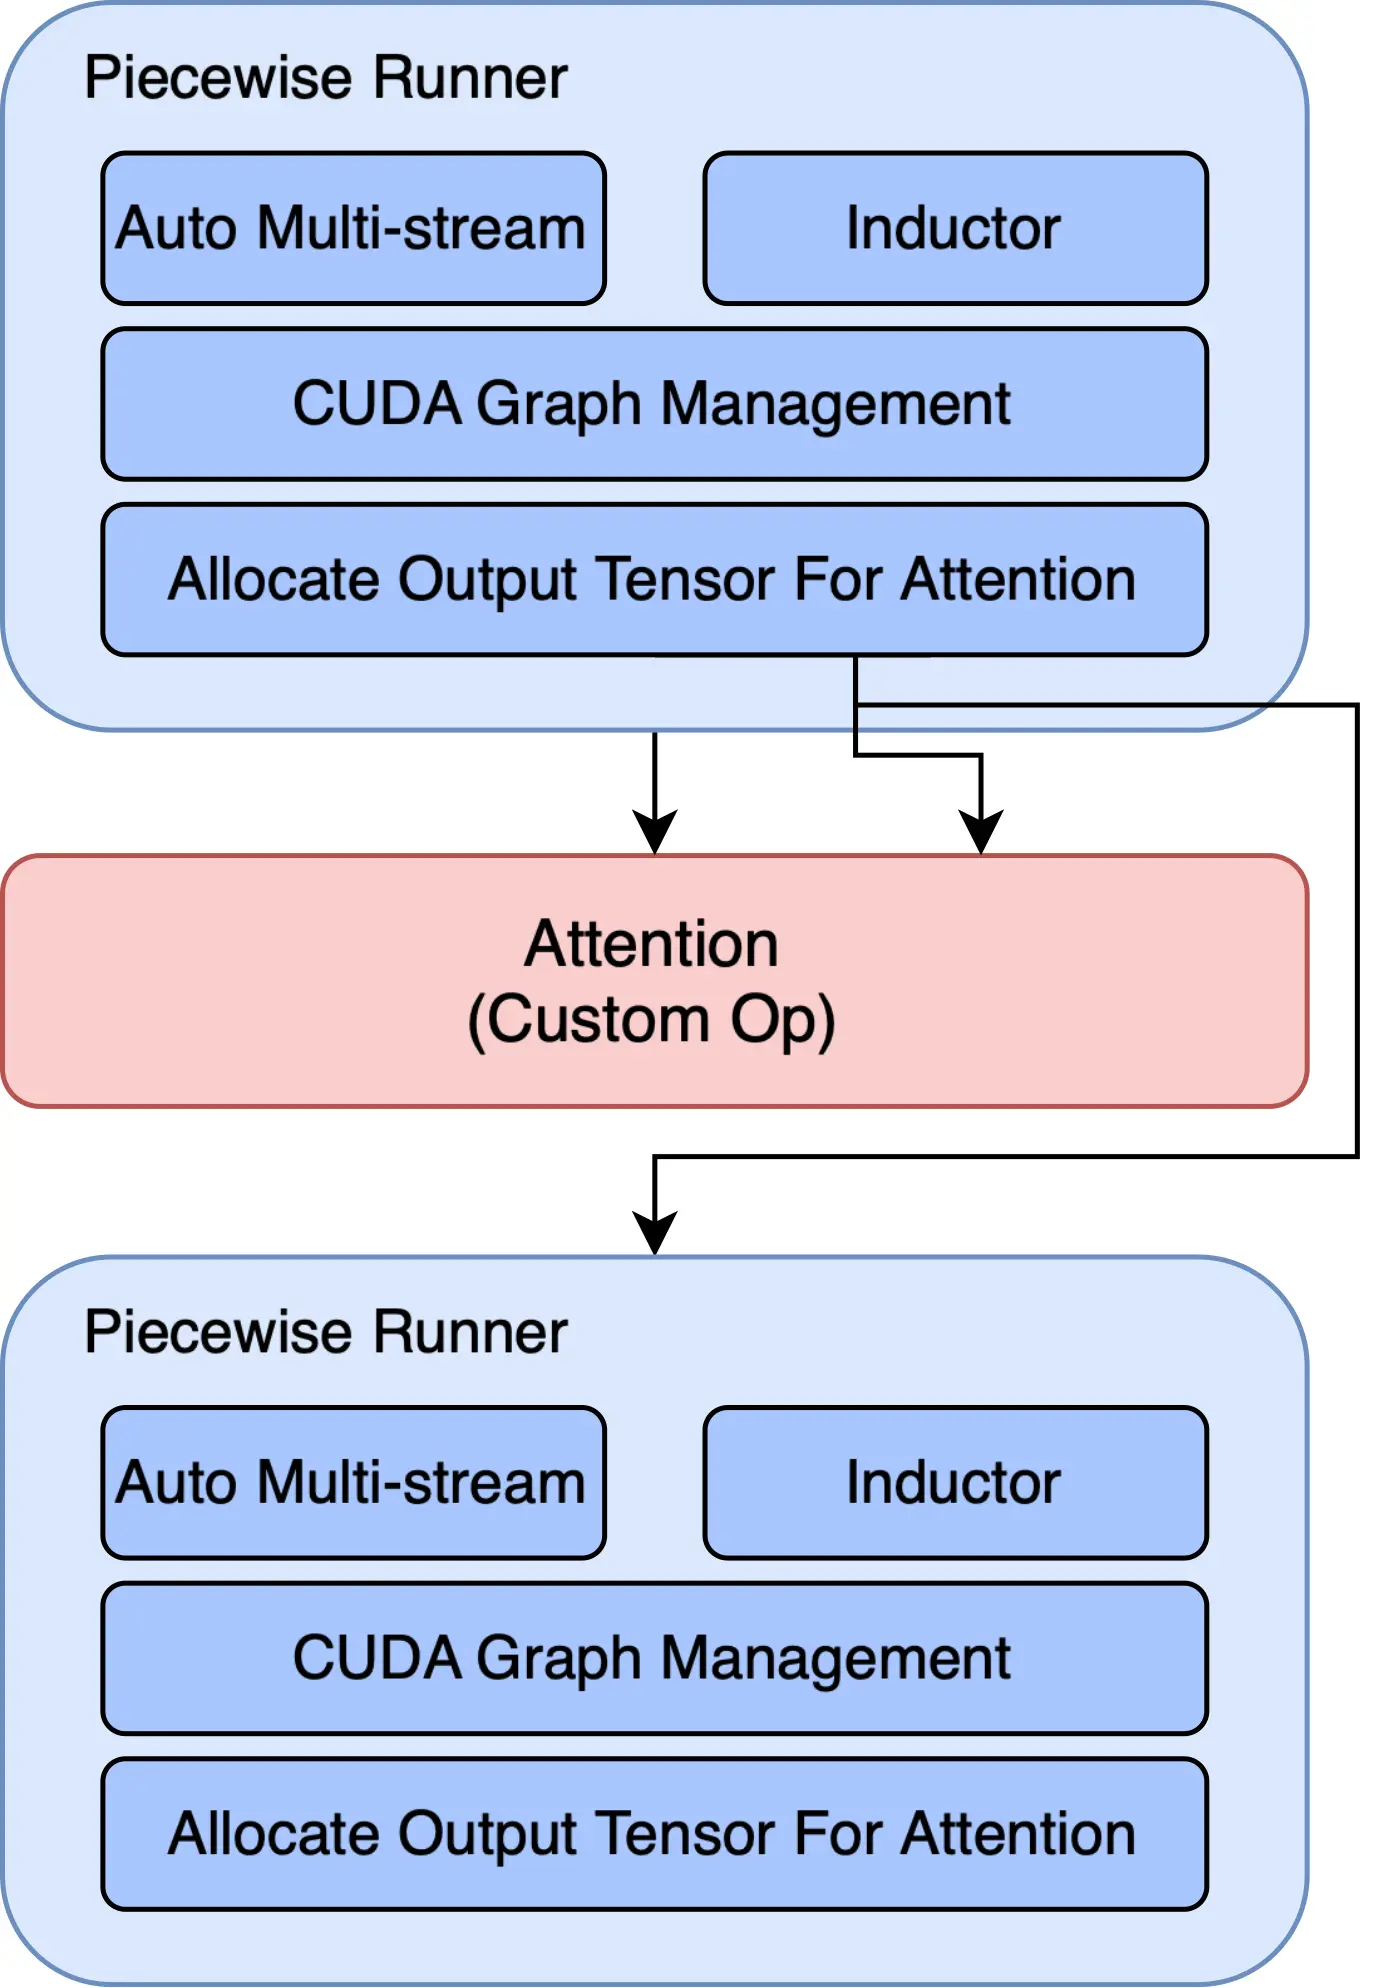
上面这张官方示意图解释了”分段图”(Piecewise CUDA Graph)的思路:预填充阶段并非整段都能进图,注意力这类组件在上下文阶段形状变化大、难以稳定捕获,于是框架把它们留在 eager,只把可捕获的部分(GEMM、归一化等)分段捕成图并重放,从而降低上下文阶段的 kernel launch 开销。这正是 CUDAGraphRunner 里 is_warmup_only 与 breakable/prefill 图分支存在的理由——不是所有执行都适合整图,解码适合,预填充只能分段。图片来源:TensorRT-LLM 官方文档 torch_compile_and_piecewise_cuda_graph.md。
原因写得很直白:运行中捕获需要分配工作区,而分配可能让已有图里烘焙的地址失效。所以所有捕获都集中在 warmup 阶段完成(warmup_and_capture → _capture_generation_cuda_graphs),运行期只允许重放。这解释了一个实际现象:TensorRT-LLM 服务启动时会有一段”预热”时间,跑一批假请求把各种批次的图都捕出来;这段预热不是可选的优化,而是图路线的必要条件。
与前四个框架的横向对照
这一篇讲的是”调度输出 → 设备输入”这一段,把它和其他三个框架对照,差异非常清楚。
| 维度 | TensorRT-LLM | vLLM | SGLang | llama.cpp |
|---|---|---|---|---|
| 批对象 | ScheduledRequests + 持久缓冲区 | InputBatch 每步构造 | ForwardBatch 每步构造 | llama_batch 每步构造 |
| 输入存储 | 按上限预分配,只切片不重建 | InputBatch 内部张量,可重建 | 每步聚合到 batch 对象 | 每次 decode 构造 batch |
| 形状策略 | 分桶 + 补假请求 | 动态形状为主 | 动态形状为主 | 动态形状 |
| 图覆盖 | 解码整图 + 预填充分桶图 | 解码图为主 | decode 整图 + prefill 分段图 | 无(后端自己优化) |
| 跨步复用 | 稳态快路径 + 元数据引用 | 有限 | 有限 | 不适用 |
| 硬约束 | 地址不变、对象同一、形状分桶 | 形状固定即可 | 形状固定即可 | 无 |
理解这张表的关键是最后一行。TensorRT-LLM 的约束比另外三个框架都多:不仅要形状固定(所有走 CUDA Graph 的框架都要),还要求元数据对象身份不变、要求缓冲区地址不变、要求每个维度分桶。
多出来的这些约束换来了什么?换来了重放路径上完全没有 Python 对象重建。SGLang 的 ForwardBatch 每步都要构造一次(站内 SGLang 源码完全拆解(七):ForwardBatch、TpModelWorker 与 ModelRunner 详细讲过这条链路),vLLM 的 InputBatch 同理;而 TensorRT-LLM 在稳态解码下把构造压缩成”几次原地加一”。在解码步频率极高、单步 GPU 时间只有几百微秒的场景里,CPU 侧省下的这几十微秒正是能否让 GPU 吃满的分界线。
代价则体现在灵活性上:批次的形状必须落在预先捕获的桶里,混合 chunk 大小的上下文批会被直接拒图,不同草稿长度的请求会被断言拒绝,运行中也不允许补捕新图。这是一条”用启动成本和形状约束换稳态确定性”的路线,理解这一点,才能理解 TensorRT-LLM 调参(cuda_graph_batch_sizes 怎么设、预热要多久)时那些看起来反直觉的建议从何而来。
小结
这篇补上了调度与执行之间那一段:
ModelEngine按模型类型持有三种 runner,runner 又分为ScheduledModelRunner(批次由调度器定义,需要资源管理器)与PackedModelRunner(批次自带边界)。- 输入存储是按上限预分配的持久缓冲区(
InputBuffers/DecoderInputBuffers),只切片、只原地写、永不重建——因为 CUDA Graph 记录的是设备地址。 prepare_inputs是一条七步流水线:前置钩子 → 解析上一步采样结果 → 三条快路径选择 → 逐请求打包(上下文/扩展/解码三组)→ 搬 token 与位置 → 构造AttentionMetadata→ padding 与_build_inputs。- 稳态解码快路径把”重新打包”换成”原地加一 + 一次
index_select”,是解码阶段 CPU 开销极低的第二个支柱(第一个是整图重放)。 AttentionMetadata.prepare()是账本与内核的接缝:num_cached_tokens_per_seq承载前缀复用收益,num_chunked_ctx_requests决定走哪个内核,kv_cache_manager是引用而非拷贝,padded_num_tokens让后端知道哪些 KV 行无效。- padding 不是浪费:批次形状要落到预先捕获的桶里,attention DP 还要跨 rank 对齐;补进来的假请求是结构完整的
LlmRequest,其输入行必须显式清零。 - 图捕获与重放的边界很硬:元数据必须是同一对象(
is而非==)、token 数必须与图键一致、位置形状会静默广播所以必须校验、省略的值要主动填默认而非留残留。
下一篇进入 注意力后端的 prepare() 内部:AttentionMetadata 的那些字段如何在 TRT-LLM 原生后端、FlashInfer 后端与 Vanilla 后端里分别转成块表、页表与序列长度数组,块表如何与第四篇讲的 KVCacheManager 的块句柄一一对应,以及稀疏注意力后端(含 DSA 这类算法的短/长序列分支)如何在同一套元数据契约下插入自己的索引器选择。输入已经组装好,接下来看它如何被消费。
参考资料
- TensorRT-LLM 官方仓库(NVIDIA/TensorRT-LLM)
- TensorRT-LLM
_torch/pyexecutor/cuda_graph_runner.py - TensorRT-LLM
_torch/pyexecutor/engine/runners/decoder/inputs.py - TensorRT-LLM
_torch/pyexecutor/engine/input_buffers.py - TensorRT-LLM
_torch/attention/backends/interface.py - PyTorch 官方文档:CUDA Graph 语义与捕获前置要求
- NVIDIA TensorRT-LLM 文档:CUDA Graph 与批次大小配置
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



