


TensorRT-LLM 源码完全拆解(八):KV Cache 的写入与读取路径——一次前向里 K/V 如何落进分页池、又如何被内核取回
系列进度与本篇定位
前七篇把 TensorRT-LLM 的推理路径从服务入口一路读到了 KV 池的物理布局。第一篇建立仓库地形与”构建期消失、PyTorch 后端接管”的整体判断;第二篇走完 create_py_executor 装配线与 PyExecutor 的单步闭环;第三篇钻进调度器的准入算术与微批选择;第四篇打开 KV 账本,讲清 KVCacheManager 的两级池、块表构造与前缀复用树;第五篇讲 PyTorchModelEngine 如何把动态请求拼成静态形状的输入缓冲;第六篇进入注意力后端,看 AttentionMetadata.prepare() 如何把块句柄翻成各后端要的块表、页索引与块偏移数组;第七篇补上了”索引 × stride = 地址”这一步乘法,讲清 KV 池的六维形状、NHD/HND 两种维序、FP8/NVFP4 的量化存储与 MLA 的 latent 池。
到这里,账本和地形都讲完了,但有一个位置始终空着:新算出来的 K/V 是怎么被打进池子的,解码时又是怎么被取回来的。第七篇的结尾说”下一篇讲数据怎么进出这个池”,这一篇就是那一篇。
具体要回答五个问题:
- 一次前向里,
qkv_input里那三块张量(Q、K、V)分别在什么时候、被哪个内核处理?为什么 Q 不进池而 K/V 要进池? - 写入之前有多少准备工作——RoPE 在哪一步施加、bias 在哪一步加、量化 scale 在哪一步算?为什么这些事要和写入合并成一个内核?
- 分页写入的索引算术长什么样?FlashInfer 的
append_paged_kv_cache只有十几行循环,它凭什么能同时处理预填充的连续 token 段和解码的单 token? - 一个 token 的 KV 向量跨越两个物理块时会怎样?谁负责把它拆成两段写?
- 解码时读取侧怎么走?为什么读取不是一条”分页 gather”,而是”让注意力内核直接按页表访存”?这两条路线的取舍是什么?
这一篇的重点不是”再讲一遍 PagedAttention”,而是把写入与读取这两条数据通路上每一层的接口、索引与并行划分讲清楚,让读者能拿着这篇的伪代码去读真实的 .cu 文件。
写入通路的全貌:从 QKV 到池
先给出一张粗粒度的流程图,后面每一节都在补这张图上的某个方框。
hidden_states (前一层输出) │ │ QKV GEMM (Linear / 融合权重) ▼ qkv_input: [num_tokens, (q_hidden + 2 * kv_hidden)] │ │ ┌────────────────────────────────────────────┐ ├─▶│ QKV 预处理内核(写入通路的唯一入口) │ │ │ 1. 读取 Q/K/V 三条切片 │ │ │ 2. 加 QKV bias(可选) │ │ │ 3. 对 Q、K 施加 RoPE(逐 token 不同位置) │ │ │ 4. 算量化 scale(FP8 / NVFP4 时) │ │ │ 5. Q 写回输出缓冲,K/V 写进分页池 │ │ │ 6. 清零 V 页尾未使用行(防止 NaN 传播) │ │ └────────────────────────────────────────────┘ │ ├──▶ Q 输出缓冲 ──▶ 注意力内核(Q 只被消费一次,从不入池) │ └──▶ 分页 KV 池 ──▶ 后续所有步的注意力内核都从这里读这张图里有一个容易被忽略但很关键的事实:Q 和 K/V 的命运在预处理内核之后就分岔了。Q 只服务当前这一次前向——当前 token 的 Q 要和它之前的全部 K 做点积,做完这次注意力它就没用了;而 K/V 要留在池里,服务未来所有步。这个不对称是整条写入通路的组织原则:Q 走”一次性缓冲”,K/V 走”持久化分页池”。第七篇讲的池形状、维序、量化格式,全部是为后者服务的。
为什么写入要”合并”
一个自然的疑问是:加 bias、施加 RoPE、量化、写池,这四件事为什么要塞进同一个内核,而不是拆成四个小内核顺序执行?
答案在 kernel launch 与访存的账上:
- 中间张量的显存流量。如果拆成四个内核,每一步都要把整个 QKV 张量读一遍、写一遍。以
num_tokens = 4096、hidden = 8192、BF16 为例,qkv_input是 MB,读 + 写一轮就是 128 MB 的流量。四步串行就多出三倍的显存往返。 - kernel launch 开销。每个内核的启动本身有微秒级开销,解码阶段单步的 GPU 计算时间本身就只有几百微秒,几个额外内核的启动开销占比可观。
- 融合之后中间值留在寄存器里。bias 加完的
q、RoPE 旋转后的k,全程在寄存器中传递,只有最终的 Q(写回)和 K/V(写池)落地。
这三条理由对预填充阶段(token 多、张量大)是显存带宽账,对解码阶段(token 少、单步时间短)是启动开销账。TensorRT-LLM 把两件事用一个内核覆盖,靠的是模板参数区分:同样的 kernel 代码,编译出”预填充变体”和”解码变体”两份二进制。
写入内核一:applyBiasRopeUpdateKVCache 逐段拆解
TensorRT-LLM 的写入入口是 cpp/tensorrt_llm/kernels/unfusedAttentionKernels/unfusedAttentionKernels_2_template.h 里的 applyBiasRopeUpdateKVCache(以及它在 _torch 路径上的继任者 applyBiasRopeUpdateKVCacheV2)。名字已经把四件事连起来了:apply bias → rope → update KV cache。“unfused” 是相对 Hopper 上的融合注意力内核而言——这条路径把 QKV 预处理与注意力本身分开,因为写池这件事在两种路径上都要做。
这个内核的签名值得先看一眼:
template <typename T, typename TCache, int Dh_MAX, bool ADD_BIAS, bool STORE_QKV, bool FP8_OUTPUT, bool GEN_PHASE, typename KVCacheBuffer, RotaryPositionEmbeddingType ROTARY_TYPE>__global__ void applyBiasRopeUpdateKVCache(QKVPreprocessingParams<T, KVCacheBuffer> params)八个模板参数,每一个都在回答一个编译期问题:
| 模板参数 | 含义 | 为什么必须在编译期定 |
|---|---|---|
T | 输入/输出精度(float/half/bf16) | 决定向量化宽度与 RoPE 辅助函数的重载 |
TCache | 池内存储类型(同 T、int8_t、__nv_fp8_e4m3、__nv_fp4_e2m1) | 决定走 ENABLE_8BITS_CACHE 还是 ENABLE_4BITS_CACHE 分支 |
Dh_MAX | head dim 的上界(用于推导向量宽度) | 决定 VEC_SIZE 与寄存器数组大小 |
ADD_BIAS | 是否加 QKV bias | 省掉一整段访存与加法 |
STORE_QKV | Q 写回原缓冲还是写独立的 q_output | 决定地址计算 |
FP8_OUTPUT | Q 是否以 FP8 输出 | 影响是否调用 store_8bits_vec |
GEN_PHASE | 解码阶段还是预填充阶段 | 决定 token 到池位置的映射方式 |
ROTARY_TYPE | GPTJ / GPT_NEOX / LONG_ROPE 等 | 决定旋转系数的配对方式(相邻配对还是半维配对) |
这八个开关组合起来,就是第七篇说的”同一条语句在不同配置下编译出不同内核”。它把运行时的分支判断成本换成了编译期的代码特化,代价是二进制体积膨胀(仓库里那个 unfusedAttentionKernels_2_*.cu 目录,12 个文件,每个文件是一组 <T, TCache> 组合的显式实例化)。
线程组织:一个 block 负责一个头
内核的并行划分是三维的:
int const head_idx = blockIdx.y; // 一个 block 负责一个头int const tidx = threadIdx.x; // x 维:head_dim 方向(固定 32 个线程)int local_token_idx = blockIdx.x * blockDim.y + threadIdx.y; // y 维:token 方向// blockIdx.z 维:batch(以 gridDim.z 为步长循环跨越)核心设计是 x 维固定 32 个线程,每个线程负责 VEC_SIZE = size_per_head / 32 个元素。以 head_dim = 128、BF16 为例:VEC_SIZE = 4,每个线程处理 4 个 BF16 元素,打包成一个 uint16_t(VecType<half> 的 GPTNeoXEltType = uint16_t,VecType<__nv_bfloat16> 的 Type = mmha::bf16_8_t)。这个 32 的来源有实际理由:
- RoPE 的配对语义需要跨线程通信。GPT_NEOX 的旋转是”前半维与后半维配对”,如果 head_dim 维的线程数是 8 或 16,配对的两半可能落在同一个 warp 的不同 lane 上,就得走 shuffle。固定 32 则让配对关系与 warp 边界对齐,两个线程各自持有配对的两半,在寄存器层面完成旋转,必要时才退到 shared memory。
- warp 内的 32 个 lane 恰好铺满 head_dim。对 GQA 场景(
qheads_per_kv_head = 4之类),多个 Q 头共享一个 KV 头,写入时只有”该 KV 头对应的第一个 Q 头”那个 block 才执行写池(见下面的代码),其余 block 白跑一趟——这是 GQA 在写入侧的固有浪费,也是为什么写入侧会做”head_num == kv_head_num 就直接写”的判断来加速。
token 到池位置的映射:三步算术
这是整个写入内核里最值得逐行读的部分,因为它把”逻辑 token 序号”翻译成了”池里的物理位置”:
// The index of the token in the batch.int const global_token_idx = local_token_idx + ((variable_sequence_length && params.remove_padding) ? params.cu_seq_lens[batch_idx] // 变长 + 去 padding:用累积偏移 : batch_idx * params.max_input_seq_len); // 否则:按最大长度整齐排布
int const cache_seq_len = params.cache_lens[batch_idx]; // 写完之后池里应该有多少个 tokenint const actual_seq_len = variable_sequence_length ? params.seq_lens[batch_idx] : params.max_input_seq_len;int const past_seq_len = (cache_seq_len - actual_seq_len); // 这一步之前池里已有的 token 数int const token_idx_in_seq = past_seq_len + local_token_idx;bool const valid_token = token_idx_in_seq < cache_seq_len;三个量必须分清,它们代表了三个不同的”长度”:
actual_seq_len:本次前向新输入的 token 数(预填充时是提示长度,解码时是 1)。past_seq_len:这次之前池里已经有的 token 数。它等于cache_seq_len - actual_seq_len——注意这个式子本身就是”池里有多少”的定义,而不是从别处查来的。cache_seq_len:写完之后池里应该有的 token 数,即past + actual。它是调度器算好、由cache_lens传进来的。
为什么 past_seq_len 要这么算?因为分块预填充(chunked prefill)会把一条长提示切成几段分批送入。第一批处理 token 0…N-1,第二批处理 N…2N-1,此时第二批的 past_seq_len = N,新 token 应该写进池的第 N 个位置往后。没有这行减法,第二批就会从头覆写第一批的 KV——这是分块预填充最经典的实现错误,也是”一个不报错但算错”的典型。
RoPE 的施加位置:为什么不是”每 token 查表”
在拿到 token_idx_in_seq 之后,内核算的是旋转位置,而不是直接用它:
int const rotary_position = (params.helix_position_offsets != nullptr ? params.helix_position_offsets[global_token_idx] : params.spec_decoding_position_offsets != nullptr ? (params.spec_decoding_position_offsets[local_token_idx + batch_idx * params.max_input_seq_len] + past_seq_len) : token_idx_in_seq) + (params.mrope_position_deltas != nullptr ? params.mrope_position_deltas[batch_idx] : 0);三层来源,每一层都对应一种特殊场景:
helix_position_offsets(Helix 并行):当模型按 token 维切分到多个 rank 时,本 rank 看到的”局部 token 序号”不等于全局位置,必须查一张全局位置表。spec_decoding_position_offsets(投机解码):一次前向要验证 个草稿 token,它们的 Q 各自处在不同的未来位置上。这个偏移数组给出每个草稿位置的相对偏移,加上past_seq_len得到绝对位置。- 默认:就是
token_idx_in_seq,即”池里的第几个 token”,对普通自回归解码而言这正是它的绝对位置。
而 mrope_position_deltas 是多模态位置修正(M-RoPE):图像 token 占据的是二维/三维位置网格,文本位置需要一个 delta 来补偿,否则图文混合序列的位置会错位。
关键设计点:旋转系数是”逐位置”而非”逐 token”缓存的。 代码里有一个 float2 rotary_coef_cache[ROTARY_COEF_VEC_SIZE] 的寄存器数组,配合 cached_rotary_position:
if (DYNAMIC_ROTARY_SCALING || rotary_position != cached_rotary_position) { apply_rotary_embedding_gptj<...>(q, k, rotary_coef_cache, ..., rotary_position); cached_rotary_position = rotary_position;} else { apply_rotary_embedding_gptj<..., /*计算系数=*/false>(q, k, rotary_coef_cache, ..., rotary_position);}在解码阶段同一个 token 的所有头共享同一个位置,所以同一线程连续处理不同 head 时,三角函数只需算一次,后续复用寄存器里的 cos/sin。这是一个”以寄存器换三角函数调用”的优化:__sincosf 本身不便宜,而解码阶段每步要调用的次数是 kv_head_num × half_rotary_dim / VEC_SIZE 级别。
三类精度分支:同一个 store 语句的三副面孔
拿到旋转过的 k 与原始 v 之后,写入池的分支长这样:
if (valid_kv_cache_pos && !helix_inactive) { if constexpr (ENABLE_8BITS_CACHE) { inBlockIdx = inBlockIdx * VEC_SIZE; // 元素索引 → 字节索引 mmha::store_8bits_vec(kDst, k_to_cache, inBlockIdx, scaleOrigQuant); mmha::store_8bits_vec(vDst, v, inBlockIdx, scaleOrigQuant); } else if constexpr (ENABLE_4BITS_CACHE) { auto* kBlockScales = reinterpret_cast<uint8_t*>( params.kv_cache_block_scales_buffer.getKBlockPtr(batch_idx, token_idx_in_kv_cache)); auto* vBlockScales = ...; float kSecondLevelSF = params.qkv_scale_orig_quant[1]; // K 的第二级 scale float vSecondLevelSF = params.qkv_scale_orig_quant[2]; // V 的第二级 scale quantizeAndWriteFP4KVCache<T, VECS_PER_HEAD>(kBlockScales, vBlockScales, reinterpret_cast<uint32_t*>(kDst), reinterpret_cast<uint32_t*>(vDst), kSecondLevelSF, vSecondLevelSF, inBlockIdx, kPacked, vPacked); } else { reinterpret_cast<VecType*>(kDst)[inBlockIdx] = k_to_cache; // 直接向量写 reinterpret_cast<VecType*>(vDst)[inBlockIdx] = v; }}三个分支对应第七篇讲的三种存储类型,注意它们在索引单位上的差异:
- FP8/INT8 路径:
inBlockIdx * VEC_SIZE——第七篇提过,量化是逐元素(每元素一字节),而getKVLocalIdx返回的是按sizePerHeadDivX为元素单位算的索引(sizePerHeadDivX = size_per_head / VEC_SIZE)。所以这里要乘回VEC_SIZE才能从”向量槽位号”变成”字节偏移”。 - FP4 路径:走
quantizeAndWriteFP4KVCache辅助函数,同时写主池与 scale 池。注意kSecondLevelSF取自qkv_scale_orig_quant[1]、vSecondLevelSF取自[2]——K 和 V 各有自己的第二级 scale,因为 K 与 V 的数值分布完全不同(K 有 RoPE 旋转、V 是原始投影值),共用一个全局 scale 会让其中一方精度塌陷。这正是第七篇”两级缩放”在写入侧的落地。 - BF16/FP16 路径:直接向量写,
inBlockIdx就是向量下标,不需要换算。
FP8_OUTPUT 分支里还有一处细节:mmha::store_8bits_vec 在 STORE_QKV 场景下也会把 Q 与 K/V 一起量化写回 quantized_qkv_output。这意味着 FP8 路径下 Q 也走 8 位存储,但Q 走的是输出缓冲而不是池——两条通路共用了同一个”量化 + 存储”辅助函数,但目的地不同。
zeroPagedVCacheTail:为什么要主动清零
在写入分支的最后,有一行不起眼但极其重要的调用:
zeroPagedVCacheTail<T, TCache, VecType, GEN_PHASE>(params, batch_idx, token_idx_in_kv_cache, cache_seq_len, kv_head_idx, sizePerHeadDivX, channelIdx, /*isUniqueTokenWriter=*/true);它的实现(节选)与注释直说了动机:
// Context owns the last physical page exclusively. Clear unused V rows because paged FMHA loads full pages and// masked zero probabilities can still propagate NaNs through BMM2.if constexpr (!GEN_PHASE && std::is_same_v<KVCacheBuffer, KVBlockArray> && std::is_same_v<T, TCache>) { ... int const validTokensInLastBlock = params.kv_cache_buffer.getLocalIdx(cacheSeqLen - 1) + 1; if (validTokensInLastBlock >= tokensPerBlock) return; auto* vBlock = ...getVBlockPtr(batchIdx, cacheSeqLen - 1); TVec const zero{}; for (int tokenInBlock = validTokensInLastBlock; tokenInBlock < tokensPerBlock; ++tokenInBlock) { int const vIdx = kvHeadIdx * tokensPerBlock * vecsPerHead + tokenInBlock * vecsPerHead + channelIdx; vBlockVec[vIdx] = zero; }}条件是预填充阶段 + 分页池 + 池与输入同精度(量化路径另有处理)。做的是:把最后一个物理块里超出有效长度的那几行 V 清零。
为什么要清零?注释给的理由是”paged FMHA loads full pages and masked zero probabilities can still propagate NaNs through BMM2”。展开讲:
- 分页注意力内核按整块加载 V(页大小通常 32/64/128),不会只加载有效行——因为按块加载才能连续访存,逐行加载会退化成非合并访问。
- 注意力权重的掩码把无效行对应的 softmax 概率压成 0。数学上 ——如果那些无效行里恰好是上一次请求残留的脏数据或者未初始化的 NaN,乘 0 之后仍然会把整行的输出污染成 NaN。
- 所以必须在写入时主动把这些位置清零,而不是依赖”反正权重是 0”。
第 1 条同时解释了为什么是”清零 V 而不清零 K”:K 参与的是 ,无效行会被掩码加成 ,softmax 后为 0,它自身取什么值不影响结果(只要不是 NaN/Inf 引起溢出);而 V 是加权求和的对象,会直接乘进输出。实现里也确实只处理 V 块。
再看条件 !GEN_PHASE:解码阶段不清理。原因是解码时每个块都已被写入过至少一次(块是按需分配、用完就走的),不会有”新建但没写满”的块;而预填充阶段一条请求的最后一个块通常是半满的,必须清。另外 isUniqueTokenWriter 这个参数提示了一种并行风险:如果多个 block 同时写同一个块的不同行,清理者必须唯一,否则会互相清掉对方刚写的数据。
写入内核二:reshape_and_cache 式的通用分页写入
applyBiasRopeUpdateKVCache 是”和预处理绑定”的写入路径。另有一条更通用的路径:QKV 已经准备好、只差写进池。这条路径在 FlashInfer 里叫 append_paged_kv_cache,也是 TensorRT-LLM 的 FlashInfer 后端实际调用的实现(tensorrt_llm/_torch/attention/backends/flashinfer.py 的 _append_paged_kv_cache)。
一个 kernel 同时覆盖预填充与解码
AppendPagedKVCacheKernel 的全部循环体只有十来行:
__global__ void AppendPagedKVCacheKernel(paged_kv_t<DType, IdType> paged_kv, DType* __restrict__ append_key, DType* __restrict__ append_value, IdType* __restrict__ batch_indices, IdType* __restrict__ positions, uint32_t nnz, size_t append_k_stride_n, size_t append_k_stride_h, size_t append_v_stride_n, size_t append_v_stride_h) { uint32_t tx = threadIdx.x, ty = threadIdx.y; uint32_t num_heads = paged_kv.num_heads; uint32_t head_idx = ty; uint32_t cta_id = blockIdx.x; uint32_t num_ctas = gridDim.x;
#pragma unroll 4 for (uint32_t i = cta_id; i < nnz; i += num_ctas) { uint32_t page_iter, entry_idx; paged_kv.page_size.divmod(paged_kv.indptr[batch_indices[i]] * paged_kv.page_size + positions[i], page_iter, entry_idx); DType* k_ptr = paged_kv.get_k_ptr(page_iter, head_idx, entry_idx, tx * vec_size); DType* v_ptr = paged_kv.get_v_ptr(page_iter, head_idx, entry_idx, tx * vec_size); vec_t<DType, vec_size>::memcpy( k_ptr, append_key + i * append_k_stride_n + head_idx * append_k_stride_h + tx * vec_size); vec_t<DType, vec_size>::memcpy( v_ptr, append_value + i * append_v_stride_n + head_idx * append_v_stride_h + tx * vec_size); }}逐个参数理解:
nnz:要写入的 (token, 序列) 对总数,即”总共有多少行要落盘”。预填充时是所有请求的提示长度之和,解码时是批大小。batch_indices[i]:第i行属于哪条请求。positions[i]:第i行是该请求内的第几个 token(绝对位置,从 0 数)。indptr:这条请求在页表里的起始页表项下标(也就是第六篇讲的kv_indptr)。indptr[b]到indptr[b+1]是请求b在kv_indices里占的区间。
核心算术:divmod 一行拆解
整个分页写入的灵魂是这一行:
paged_kv.page_size.divmod(paged_kv.indptr[batch_indices[i]] * paged_kv.page_size + positions[i], page_iter, entry_idx);拆开看,左边这个量是:请求 b 的第一页之前的全部 token 数(indptr[b] * page_size)加上本 token 在请求内的位置(positions[i])= 该 token 在”逻辑全局 token 坐标系”里的下标。然后对这个下标做除以页大小的 divmod:
page_iter = 逻辑下标 / page_size→ 这是”逻辑页号”,即该 token 落在这条请求的第几个页里。entry_idx = 逻辑下标 % page_size→ 这是页内偏移,即该 token 在这个页里的第几个槽位。
为什么 indptr[b] * page_size 这个写法成立? 因为它隐含了一个约定:每条请求在页表里占用的页数,正好等于它已分配 token 数除以页大小向上取整。于是”前面请求分掉的逻辑页数”乘以页大小,就是前面请求占用的逻辑 token 总数——而本请求的逻辑 token 编号从这里接着往下续。
这个约定有个重要后果:逻辑页号是连续的,物理页号不一定连续。page_iter 是一个纯粹的逻辑量,只用来在页表里定位;真正要访问的物理页要靠 paged_kv.indices[page_iter] 这一跳:
__device__ __forceinline__ DType* get_k_ptr(IdType page_iter, uint32_t head_idx, uint32_t entry_idx, uint32_t feat_idx) const { return k_data + get_elem_offset(__ldg(indices + page_iter), head_idx, entry_idx, feat_idx);}注意 indices + page_iter 传进去的是 page_iter,但取出来的是 indices[page_iter]——一个物理页号,再乘 stride_page。这就是分页的核心一跳:逻辑页号 → 物理页号 → 字节偏移。前两跳靠这张索引表,第三跳靠第七篇讲的 stride。
get_elem_offset 把三跳合成一个式子:
__host__ __device__ __forceinline__ size_t get_elem_offset(size_t page_idx, size_t head_idx, size_t entry_idx, size_t feat_idx) const { return page_idx * stride_page + head_idx * stride_h + entry_idx * stride_n + feat_idx;}四个 stride 全部来自第七篇的池形状:stride_page 是页间步长,stride_h 是头间步长,stride_n 是页内 token 间步长,feat_idx 是 head_dim 内元素偏移(连续,所以没有 stride 变量)。NHD 与 HND 的区别就体现在 stride_h 与 stride_n 的相对大小上:NHD 下 token 维在外、head 维在内,stride_n = head_dim × num_heads、stride_h = head_dim;HND 下正好反过来。内核代码一行没变,换的是三个 stride 的取值——这就是第七篇说”维序是契约字段”在代码层面的样子。
vec_size 与 page_size.divmod
两个实现细节值得单独讲,因为它们都是”看起来是小事、算错了全盘崩”的类型。
第一,vec_size 怎么来的。
constexpr uint32_t vec_size = std::max(16 / sizeof(DType), HEAD_DIM / 32);uint32_t bdx = HEAD_DIM / vec_size; // x 维线程数uint32_t bdy = num_heads; // y 维线程数vec_size 取两个量的较大者:
16 / sizeof(DType):一个 128 位访问能装多少个元素。BF16 是16/2 = 8,FP8 是16/1 = 16。这是”至少要有 16 字节向量化”的下限——不足 16 字节的访问在 GPU 上浪费 cache line。HEAD_DIM / 32:让 x 维恰好 32 个线程。head_dim = 128时是 4,head_dim = 256时是 8。
取 max 的效果是:head_dim 小的时候由 16 字节下限主导(保证向量宽度),head_dim 大的时候由 32 线程主导(保证线程数不超 32,warp 内对齐)。以 head_dim = 128、BF16 为例 vec_size = 8,bdx = 16、bdy = num_heads;以 head_dim = 64、FP8 为例 vec_size = 16,bdx = 4。这个算式是”访存效率”与”线程组织”之间的一个折中,也是为什么 HEAD_DIM 必须走 DISPATCH_HEAD_DIM 宏在编译期确定——vec_size 是 constexpr。
第二,divmod 不是两条指令。
paged_kv.page_size.divmod(linear_index, page_iter, entry_idx);page_size 在 FlashInfer 里被包装成一个带 divmod 方法的类型,当 page_size 是 2 的幂时它退化成移位与掩码,当不是 2 的幂时才走通用整数除法。为什么页大小默认是 2 的幂(16/32/64/128)? 因为除法在 GPU 上代价高(几十个周期,且会占用特殊功能单元),而写入内核是每个 token 都要做一次这个除法。页大小取 2 的幂,这一步就变成一条移位加一条掩码——和 TensorRT-LLM 的 getBlockPtr 里那个 offsets[tokenIdx >> mTokensPerBlockLog2] 完全同源:
inline void* getBlockPtr(DataType const* offsets, int32_t tokenIdx) const { auto const offset = offsets[tokenIdx >> mTokensPerBlockLog2]; return reinterpret_cast<void*>( reinterpret_cast<char*>(getPoolPtr(offset)) + offset.get() * static_cast<uint64_t>(mBytesPerBlock));}注意这里用了两个不同的信息:tokenIdx >> mTokensPerBlockLog2 只取”页号”(这是自带的连续页表,不含物理页跳转),返回的 offset 则是一个带 isPrimary() 标志的封装值(第七篇的两级池),既给出物理页号又给出它在哪个池里。而页内偏移在这个函数里根本没算——它由调用方的 getKVLocalIdx 单独处理:
return headIdx * mTokensPerBlock * dimsPerHead + getLocalIdx(globalTokenIdx) * dimsPerHead + channelIdx;// 其中 getLocalIdx(globalIdx) = globalIdx & ((1 << mTokensPerBlockLog2) - 1)& (page_size - 1) 就是 % page_size 在 2 的幂下的形态。TensorRT-LLM 把”页号”与”页内偏移”拆成两个 helper,FlashInfer 用一个 divmod 一起返回——两种写法等价,差别只在代码组织。
写入侧的并行划分:为什么用 grid-stride loop
回看内核的循环头:
for (uint32_t i = cta_id; i < nnz; i += num_ctas) {这是一个 grid-stride loop:每个 block 处理第 cta_id、cta_id + num_ctas、cta_id + 2*num_ctas… 行,直到超过 nnz。CTAs 的数量由主机端算出:
uint32_t num_threads = bdx * bdy;cudaOccupancyMaxActiveBlocksPerMultiprocessor(&num_blocks_per_sm, kernel, num_threads, smem_size);num_blocks_per_sm = min(num_blocks_per_sm, ceil_div(int(nnz), num_sms));dim3 nblks(num_blocks_per_sm * num_sms);三行代码的逻辑是:
- 问硬件”每个 SM 最多能同时跑几个这样的 block”(
cudaOccupancyMaxActiveBlocksPerMultiprocessor)。 - 取它与
ceil(nnz / num_sms)的较小者——保证每个 SM 平均至少有一行活干,不会出现大量空转的 block。 - 乘上 SM 总数,得到最终 grid 大小。
这套算法的价值在于 nnz 的巨大动态范围:预填充一条 32K 的提示,nnz = 32768;解码一个 batch=1 的请求,nnz = 1。如果 grid 大小写死成 nnz(像 AppendPagedKVCacheDecode 那样 dim3 nblks(batch_size)),解码时只有 1 个 block 在跑,GPU 上其余 SM 全部空闲——解码阶段的写入是典型的小批量问题,需要靠更细的线程组织而不是更多 block 来填满机器。反过来预填充时 nnz 很大,用 grid-stride 保证不会启动几万个 block 把启动开销撑爆(FlashInfer 在 TensorRT-LLM 里还有一层额外的 CTA 上限切分,见下面)。
头数太多怎么办:CTA 上限切分
TensorRT-LLM 的 FlashInfer 后端在调用前做了一次包装(_append_paged_kv_cache):
head_dim = append_key.shape[-1]vec_size = max(16 // append_key.element_size(), head_dim // 32)threads_per_head = head_dim // vec_sizemax_heads_per_launch = _MAX_CUDA_THREADS_PER_BLOCK // threads_per_head
num_kv_heads = append_key.shape[1]if num_kv_heads <= max_heads_per_launch: flashinfer.page.append_paged_kv_cache(...) return
for start in range(0, num_kv_heads, max_heads_per_launch): end = min(start + max_heads_per_launch, num_kv_heads) flashinfer.page.append_paged_kv_cache( append_key=append_key[:, start:end], append_value=append_value[:, start:end], paged_kv_cache=_slice_paged_kv_cache_heads(paged_kv_cache, start, end, kv_layout), ...)这段代码解决一个很具体的约束:内核把 head 放在 threadIdx.y 上,所以线程总数是 bdx × num_heads,而 CUDA 的 block 线程上限是 1024。以 head_dim = 128、BF16、num_kv_heads = 64(DeepSeek 级模型的 KV 头数)为例:vec_size = max(8, 4) = 8,bdx = 16,threads_per_head = 16,max_heads_per_launch = 1024 / 16 = 64——恰好卡在上限。如果 head_dim 更小(比如 64,bdx = 4,即 1024/4 = 256 头才超)或者 KV 头数更多(MLA 的某些配置),就必须切分。
切分时有两个细节:
append_key[:, start:end]是切片而非拷贝。head_idx在内核里从 0 数起,所以切片后的第 0 个 head 对应原张量的第start个 head——这对吗?对的,因为 K/V 的 head 维在池里也按同样的顺序排布,切片只是”这次只处理池里的第start到end个头”。paged_kv_cache也要同步切片(_slice_paged_kv_cache_heads),否则内核算出的head_idx * stride_h会指向错误的头。
这里有一个通用教训:当一个 kernel 用线程维去铺某个”逻辑维”时,那个逻辑维的上界就被 CUDA 的 1024 线程上限卡住了。解决方法不是改内核,而是在调用侧切分——前提是池的布局允许按该维切片(即该维在池里是一段连续或规则步长的区间)。这正是第七篇说”池是六维规则张量”的回报:规则性让切分成为可能。
跨块边界:一个 token 会不会被拆成两段
前面讲了 divmod 拿到 (page_iter, entry_idx),然后一次 vec_t::memcpy 把整个 head_dim 写完。这里藏着一个前提:一个 token 的 KV 向量必须完整落在单个页内。
这个前提成立吗?成立,而且是被两个约束同时保证的:
- 页大小是 token 数的整数倍。
tokensPerBlock是”一个物理页装几个 token”,页内布局是[head, token_in_page, head_dim],一个 token 的所有头在页内占据num_heads × head_dim个连续元素(NHD)或按 head 分段的num_heads段(HND)。无论哪种,单个 token 的单个头是连续的head_dim个元素。 - head_dim ≤ 页内可用空间。一个页装
tokensPerBlock个 token,每个 token 有num_heads个头,每头head_dim元素。单个 token 的一个头显然是页的子集,只要head_dim不超过整页容量(显然成立)。
所以”一个 token 的 KV 向量跨页”这件事在分页 KV 缓存里根本不会发生。会发生的是另一种跨块:一次请求的 token 序列跨页。比如页大小 32,一条请求已有 30 个 token,本次要写 5 个 token,那么 token 30、31 落在第 0 页的最后两个槽位,token 32、33、34 落在第 1 页。跨页的是”序列”,不是”单个 token”。
这个区别决定了实现形态:不需要在 token 内部做拆分逻辑,只需要让每个 token 各自算出自己的页号和页内偏移。AppendPagedKVCacheKernel 的循环正是这样——每次迭代只处理一个 (token, 请求) 对,独立算 (page_iter, entry_idx),独立访问。页边界的跨越对内核完全透明。
但代价是:页号的切换点会造成访存不连续。同一 block 内连续处理 i 和 i+1 两行时,若它们属于同一请求且恰好跨越页边界,两个目标地址就相差很远(物理页不连续)。这是分页缓存固有的访存代价,也是为什么分页注意力内核要用”按页循环 + 页内连续”的组织方式来把损失局部化。
ragged:变长序列怎么分段
上面假设了每行 token 都能独立算位置。但”i 属于哪条请求”这件事本身是需要查表的:
paged_kv.indptr[batch_indices[i]] * paged_kv.page_size + positions[i]batch_indices[i] 把”总行号”映射到”请求号”,positions[i] 把”总行号”映射到”请求内位置”。这两个数组就是 ragged 批处理的全部——它们不需要 indptr 之外的结构,因为 batch_indices 与 positions 已经把每条请求的 token 段”拉平”了。
生成这两个数组的方式,正是第五篇讲的扁平化:cu_seq_lens(累积序列长度)在变长场景下给出每一行属于哪条请求;positions 则由每行的全局位置减去该请求的起点得到。第七篇提过的 kv_indptr 与 kv_last_page_len 则是同一个 ragged 结构在页表维的镜像:
__host__ __device__ __forceinline__ uint32_t get_length(uint32_t batch_idx) const { if (indptr[batch_idx + 1] == indptr[batch_idx]) return 0; return (indptr[batch_idx + 1] - indptr[batch_idx] - 1) * page_size + last_page_len[batch_idx];}get_length 算的是”这条请求已经占用的 token 数”,式子是整页数 × 页大小 + 最后一页的有效长度。这个式子与写入侧的 divmod 是互逆的:写入时从”逻辑 token 下标”正推 (页, 页内偏移),读取时从 (页区间的长度, 最后一页长度) 反推”总 token 数”。两者必须严格一致,否则写入位置和读取范围就会错位——而错位不会报错,只会读出一段看似合理但内容错乱的上下文。
MLA 与 FP4:写入侧的两个额外分支
分页写入在两种模型结构上会走特殊路径。
第一,MLA(Multi-head Latent Attention)。 第七篇讲过 MLA 的 latent 池是 kvFactor=1、numKvHeads=1、sizePerHead=d_latent——一份张量同时当 K 和 V,且每个 token 只有一条 latent 向量加一条 RoPE 分量。写入侧的差别在于:
- 没有”K 和 V 分头写”这回事,只有一条
ckv(compressed KV)加一条kpe(RoPE 部分),FlashInfer 里对应append_paged_mla_kv_cache(append_ckv, append_kpe, ...)。 - 池布局变成
[page, entry, ckv_dim]与[page, entry, kpe_dim]两段(或同一段的不同偏移,见paged_kv_mla_t::get_elem_offset_ckv)。 - 上投影发生在读取侧:写进池的是压缩后的 latent,注意力内核读出来之后才做上投影恢复成 K/V。所以 MLA 的写入更省带宽(写得更少),读取更贵(要算投影)——这是第七篇”收益是缓存压到约三成、代价是读出来之后要做上投影”在通路上的具体体现。
第二,NVFP4 写入。 前面提过 quantizeAndWriteFP4KVCache 同时写主池与 scale 池。FlashInfer 侧的对应实现是 nvfp4_append_quantize_block:
__device__ __forceinline__ void nvfp4_append_quantize_block( const DType* __restrict__ input, const float global_scale, const size_t input_base, const uint32_t dim_base, uint8_t* __restrict__ packed_out, uint8_t* __restrict__ sf_out) { float values[16]; float amax = 0.0f;#pragma unroll for (uint32_t i = 0; i < 16; ++i) { const float value = nvfp4_append_to_float(input[input_base + dim_base + i]); values[i] = value; amax = fmaxf(amax, fabsf(value)); }
float sf_value = 0.0f; if (amax > 0.0f && global_scale > 0.0f) { sf_value = precise_rounding ? amax * __frcp_rn(6.0f * global_scale) : amax / (6.0f * global_scale); } __nv_fp8_e4m3 sf_fp8 = __nv_fp8_e4m3(sf_value); *sf_out = sf_fp8.__x;
const float sf_rounded = static_cast<float>(sf_fp8); const float output_scale = (amax > 0.0f && sf_rounded > 0.0f && global_scale > 0.0f) ? (precise_rounding ? __frcp_rn(sf_rounded * global_scale) : (1.0f / (sf_rounded * global_scale))) : 0.0f;
#pragma unroll for (uint32_t i = 0; i < 8; ++i) { const uint8_t lo = nvfp4_append_quantize_e2m1(values[i * 2] * output_scale); const uint8_t hi = nvfp4_append_quantize_e2m1(values[i * 2 + 1] * output_scale); packed_out[i] = lo | (hi << 4); }}逐段读:
- 16 个一组:NVFP4 的块内 scale 覆盖 16 个元素(第七篇的
head_size / N,N = 16)。所以一次处理 16 个元素、输出 1 个 scale 字节。 amax规约:块内最大绝对值。这就是第七篇说的”写入路径上的一次规约”——逐 token(更准确说是逐 16 元素块)缩放,而不是整池共用 scale。sf_value = amax / (6 * global_scale):这里有个必须解释的常数 6。E2M1 的可表示范围是 ,所以”块内最大值的映射目标”就是 6;除以global_scale是因为第二级 scale 是全局的——第一级 scale 存的应该是在”全局 scale 已生效”的坐标系下的相对缩放因子。sf_fp8 = __nv_fp8_e4m3(sf_value),然后再读回来sf_rounded:这一步”先量化再反量化”是故意的。第一级 scale 本身以 FP8 存储,它也会丢精度;如果反量化时用的output_scale是按未量化的sf_value算的,那么 16 个元素的反量化结果,与读取侧拿 FP8 版本的 scale 去反量化的结果就不一致了。用sf_rounded(FP8 往返后的值)算output_scale,保证写入的码位在读取侧能精确还原。packed_out[i] = lo | (hi << 4):两个 4 位码位挤进一个字节容器。这正是第七篇getNumEltsPerContainer()返回 2 的东西——在写入侧就必须按容器打包,因为读取侧只会按容器粒度取数。
第 4 点是整个函数里最容易出错的地方,也是最值得记住的工程教训:当一个缩放因子本身也要被量化存储时,所有依赖它的计算都必须用”量化后的值”,否则编码与解码两侧的假设不一致。这类不一致不会导致崩溃,只会让数值悄悄变差。
索引器 K 缓存的写入:完全按 stride 走的 scatter
第七篇提过 DSA(DeepSeek 稀疏注意力)的索引器有自己独立的 K 缓存池(containsIndexerKCache)。它的写入路径与主池不同,走的是 invokeIndexerKCacheScatter:
__device__ __forceinline__ int64_t flatIndexToMemoryOffset( int64_t flat_idx, int32_t d0, int32_t d1, int32_t d2, int32_t d3, int64_t s0, int64_t s1, int64_t s2, int64_t s3){ int32_t i3 = flat_idx % d3; flat_idx /= d3; int32_t i2 = flat_idx % d2; flat_idx /= d2; int32_t i1 = flat_idx % d1; flat_idx /= d1; int32_t i0 = flat_idx; return i0 * s0 + i1 * s1 + i2 * s2 + i3 * s3;}这个函数的名字说明了一切:它把”扁平元素下标”翻译成”考虑了 stride 的内存偏移”。注意注释里的一句话:
// Convert flat index to memory offset using strides (k cache pool from cpp kv cache manager is non-contiguous)non-contiguous 是关键——索引器 K 缓存的池可能是不连续的(跨多个分配段),所以不能像主池那样用一条统一公式算地址,而是必须老老实实按四维 shape + stride 逐维展开。四维的语义是 [num_blocks, block_size, 1, per_token_size]:块维、块内 token 维、一个恒为 1 的占位维、token 内字节维。
写入内核本身非常轻:
__global__ void indexerKCacheScatterUnifiedKernel(uint8_t const* __restrict__ k_fp8_bytes, uint8_t const* __restrict__ k_scale_bytes, uint8_t* __restrict__ k_cache, int64_t const* __restrict__ slot_mapping_fp8, int64_t const* __restrict__ slot_mapping_scale, ...){ constexpr int VEC_SIZE = 4; int32_t token_idx = blockIdx.x; // 一个 block 处理一个 token if (token_idx >= num_tokens) return;
int64_t flat_idx_fp8_base = slot_mapping_fp8[token_idx]; // 该 token 在池里的扁平起点 int64_t flat_idx_scale_base = slot_mapping_scale[token_idx]; if (flat_idx_fp8_base < 0 || flat_idx_scale_base < 0) return; // 负值 = 该 token 不写(如 padding)
int32_t head_dim_idx = threadIdx.x * VEC_SIZE; int64_t flat_idx = flat_idx_fp8_base + head_dim_idx; int64_t dst_offset = flatIndexToMemoryOffset(flat_idx, cache_dim_0, cache_dim_1, cache_dim_2, cache_dim_3, cache_stride_0, cache_stride_1, cache_stride_2, cache_stride_3); int64_t src_offset = static_cast<int64_t>(token_idx) * head_dim + head_dim_idx;
*reinterpret_cast<uint32_t*>(&k_cache[dst_offset]) = *reinterpret_cast<uint32_t const*>(&k_fp8_bytes[src_offset]);
if (threadIdx.x == 0) { // 只有 thread 0 写那 4 字节 scale int64_t dst_offset_scale = flatIndexToMemoryOffset(flat_idx_scale_base, ...); int64_t src_offset_scale = static_cast<int64_t>(token_idx) * scale_size; *reinterpret_cast<uint32_t*>(&k_cache[dst_offset_scale]) = *reinterpret_cast<uint32_t const*>(&k_scale_bytes[src_offset_scale]); }}三个设计点:
- 索引由
slot_mapping给出,而不是内核自己算。 注释说得很直白:slot_mapping_fp8是”Flat element index for FP8 data start position”,即该 token 的数据在池里的扁平元素起点。这是谁算的?是管理侧(页表 + 块分配)算好后传进来的。这让内核完全不需要知道页结构、页大小、块编号这些概念——它只做”按 stride 展开地址 + 拷贝”。 - scale 与数据走两条独立的 slot mapping。 因为 scale 池与主池是两块不同的张量,各自有自己的 stride。这也解释了为什么函数签名里有
slot_mapping_fp8和slot_mapping_scale两个数组。 -1作为”不写”的哨兵值。 负的 slot 直接在开头return,这让 padding token 或不该写的位置可以统一用 -1 表示,不需要额外的 mask 分支。
把索引器 K 缓存的写入和主池的写入对比看,是很清楚的两种设计哲学:
| 主池分页写入 | 索引器 K 缓存写入 | |
|---|---|---|
| 索引来源 | 内核自己用 indptr + positions 算 divmod | 主机侧预先算好 slot_mapping 传入 |
| 池假设 | 规则六维张量、步长可由参数推出 | 可能不连续、必须显式传四个 stride |
| 页结构 | 内核知道页大小并做除法 | 内核完全不知道页概念 |
| 并行粒度 | grid-stride over (token,请求) 对 | 一个 block 一个 token |
两条路线的取舍很清楚:主池的结构是框架内部固定契约,可以让内核吃掉复杂度;索引器缓存的结构更灵活(可跨分配段),于是复杂度的成本被前移到主机侧的 slot 计算。这也解释了为什么索引器缓存的写入内核代码这么短——它的短是”复杂度搬家”的结果,不是问题更简单。
读取通路:为什么不是一个”分页 gather”
写入侧讲完了,现在转过来看读取。这里首先要破除一个常见的想象:解码时的读取不是”先把分页的 KV 收集成一段连续张量,再喂给普通注意力内核”。
为什么不能这么做?算一笔账。设 max_seq_len = 128K、batch = 32、num_kv_heads = 8、head_dim = 128、BF16:
单是”把 KV 整理成连续缓冲”这一步,就要搬运 34 GB。而 GPU 的显存带宽在 B200 级别大约 8 TB/s,这一趟最少 4.3 ms——而解码一整个 batch 一步的计算时间本身往往就在这个量级。搬运成本翻倍,收益为零。
所以正确的做法是让注意力内核自己在读的过程中顺着页表跳。也就是说:分页结构不是被”展开”掉,而是被”内联”到注意力内核的访存循环里。这条路线要求内核知道页表怎么读、页边界在哪、页内怎么连续——也就是第七篇讲的那些 stride 与第六篇讲的那些索引数组存在的全部理由。
三条读取路线的取舍
TensorRT-LLM 里读取侧实际有三条并存的路线,各自服务不同的场景:
| 路线 | 代表实现 | 内联页表的方式 | 适用场景 |
|---|---|---|---|
| 通用分页注意力 | FlashInfer 后端 / TrtllmAttention | 内核内按 kv_indptr + kv_indices 逐页循环 | 预填充与解码通用、需要最大兼容性 |
| 专门化解码内核 | MMHA(decoderMaskedMultiheadAttention) | 按 blockIdx.x 映射一个请求,内联块指针 | 小批量解码、低延迟 |
| 张量核解码 | XQA(decoderXQA*) | JIT 生成 + TensorMap | 大批量、占满 Tensor Core |
路线一(通用分页) 的形态最接近大家的直觉:每个请求对应页表里的一段,内核在序列维上按页循环,每页内按 token 连续读。它的代价是对小批量解码不够高效——页循环带来的地址计算、页号查表、边界判断在小批量下摊不开。
路线二(MMHA) 的组织方式完全不同:一个 block 处理一条请求,把整条请求的 KV 序列切成”块对齐的循环”。它的访存形式是先取块指针数组,再在块内连续读。这条路线在第一批 vLLM/TRT-LLM 的对比里是 TRT-LLM 解码延迟优势的主要来源之一,但它的适用面窄——需要 head_dim、head 数等都在编译期确定,因此仓库里靠 decoderMaskedMultiheadAttentionLaunch.h + 大量实例化文件来覆盖组合。
路线三(XQA) 是新一代做法:把解码注意力交给 Tensor Core,用 JIT 编译生成针对具体 head_dim、page_size、精度组合的 kernel,并把 KV 池的地址描述成 TensorMap(TMA 描述符)。TMA 让内核可以用一条指令搬一整块数据,而不用手写地址算术——页表在这里的角色从”内核自己算地址”变成”为 TMA 准备描述符”。
三条路线的共同点是:页表都是被内联的,没有任何一条路线会先把 KV 收集成连续张量。差异只在”谁来承担地址算术”:内核自己算(路线一)、主机侧预先摊平成块指针数组(路线二)、硬件描述符承担(路线三)。
一条更具体的读取形态:get_length 与页表三件套的配合
无论走哪条路线,读取侧起步时都要先回答一个问题:这条请求要读多少 token、从哪些页读。这两个问题的答案就是 FlashInfer 那三件套(第七篇、第六篇都出现过):
# from flashinfer docs/tutorials/kv_layout.rst# For each request, we keep records of its page_indices and last_page_len ...# The KV sequence length of request i is# page_size * (len(page_indices[i]) - 1) + last_page_len[i]这个式子在写入侧有严格的对偶(前面 get_length 那段):
其中 是请求 当前的 KV 长度, 是它占用的页数, 是最后一页里有效 token 数。式子里那个 是关键:前面的 页是满页,最后一页按有效长度计。这三件套(kv_indices / kv_indptr / kv_last_page_len)就是第六篇讲的 AttentionMetadata.prepare() 要构造出来的东西,而它们的语义正是由这条式子定义的。
读取侧拿到这三件套之后的循环形态(伪代码):
for each request r in batch: seq_len = page_size * (indptr[r+1] - indptr[r] - 1) + last_page_len[r] for page_slot in range(indptr[r], indptr[r+1]): phys_page = page_table[page_slot] # 逻辑页 → 物理页 valid_tokens = page_size if not last page else last_page_len[r] for token in range(valid_tokens): load K[phys_page][token][:] and V[phys_page][token][:] accumulate into attention output这段伪代码里有两层循环嵌套在同一个”序列维”上(页循环 + 页内 token 循环)。这正是分页注意力内核在序列维上的标准组织方式,也是它相对连续 KV 的访存代价来源:每跨一个页边界就一次间接跳转。
n_i 越大,跳转次数越多。页大小 32 时,128K 上下文有 4096 个页,即 4096 次页号查表;页大小 128 时只有 1024 次。这是”页大小怎么选”的一个直接影响因素。
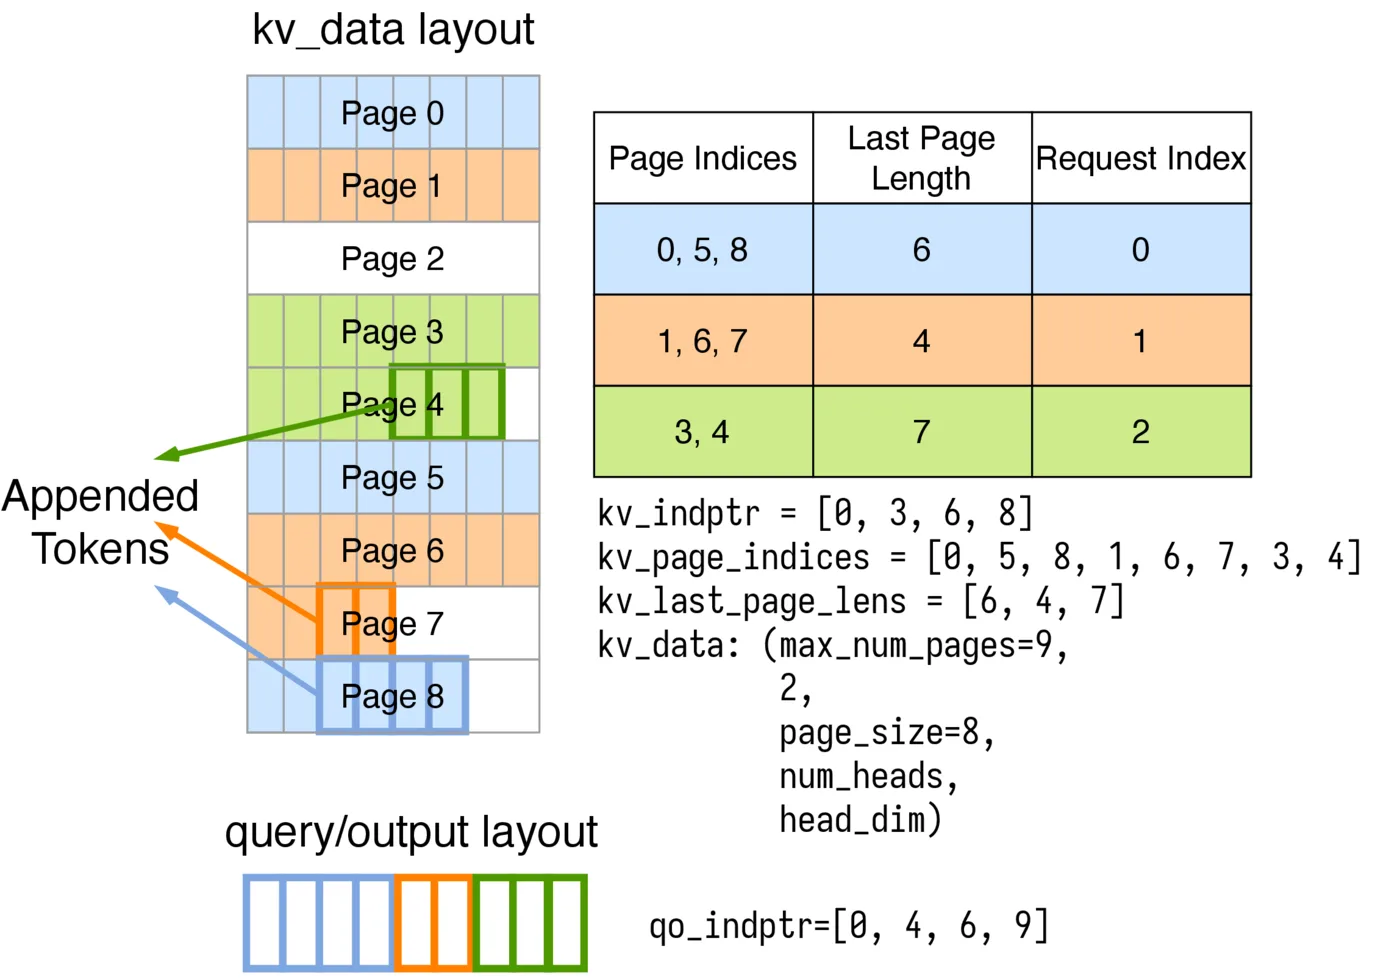
上图是 FlashInfer 官方文档给出的分页布局示意:整池被切成固定大小的页,每条请求持有自己那一串页号。注意图里”页表”的视角——它把请求到页的映射画成一张表,而读写两侧都是拿这张表在做”逻辑槽位 → 物理页”的翻译。图片来源:FlashInfer 官方文档 KV-Cache Layout 教程。
写入与读取的对偶:同一个页表,两个方向的翻译
把写入与读取放在一起看,会发现它们是同一个页表在两个方向上的使用:
| 写入侧 | 读取侧 | |
|---|---|---|
| 输入 | 逻辑 token 下标(该 token 是第几个) | 页表区间(indptr 到 indptr+1) |
| 翻译方向 | 逻辑下标 → 页号 + 页内偏移 → 物理页 | 逻辑页槽位 → 物理页 → 页内全部 token |
| 粒度 | 逐 token,每 token 一次 divmod | 逐页,每页一次页号查表 + 页内连续读 |
| 是否需要页内偏移 | 需要(精确到槽位) | 不需要(整页全读,只对最后一页截断) |
| 并行划分 | token 维 × head 维 | 页维 × head 维 |
这个对偶关系解释了很多设计选择的由来:
- 为什么写入内核要
divmod而读取内核不用?因为写入要精确落在某一个槽位,读取则把整页读进来。读得比需要多一点是免费的(掩码会把多余的部分压成 0 权重),写得偏了则是灾难。这是读写不对称的根本原因。 - 为什么页大小要 2 的幂?写入侧靠
divmod(2 的幂 → 移位 + 掩码),读取侧的页边界判断也是& (page_size - 1)。两侧都受益。 - 为什么写入侧要清零的只有 V 的页尾?因为读取侧会整页读 V,多余的槽位必须保证不污染结果。写入侧那个
zeroPagedVCacheTail的存在理由,正是读取侧”整页读”这个行为。
变量注意力窗口与读取侧的长度裁剪
第七篇讲过 KVBlockArray 里那组与窗口相关的字段。它们在读取侧的作用,可以从官方文档的一句话理解:
Blocks that leave the attention window are freed and placed on the radix search tree so they can be reused.
这句话描述的是有限注意力窗口(VSWA,variable sliding window attention)下的行为:块滑出窗口后就被释放、挂回前缀复用树,等待其他请求复用。而 KVBlockArray::getKVTokenIdx 正是这个机制在内核里的对应物:
__host__ __device__ [[nodiscard]] inline int32_t getKVTokenIdx(int32_t tokenIdx) const{ if (!isSinkToken(tokenIdx)) { // Apply cyclic kv cache if tokenIdx >= max_attention_window_size. return mSinkTokens + mBubbleLen + (tokenIdx - mSinkTokens) % mCyclicCacheLen; } return tokenIdx;}逐段拆:
isSinkToken(tokenIdx):前mSinkTokens个 token 是 attention sink,永远保留,位置不走环形映射。这就是 StreamingLLM 那条”若干 sink + 滑窗”的路线在缓存层的落地。(本站在 JSSA 那篇里对比过”不保 sink”的另一条哲学,两条路线的分歧点就在这里。)mBubbleLen:气泡长度。它是为了让 sink 之后的有效区域在环形缓冲区里对齐而留的余量,构造式是:
auto sinkTokensInLastBlock = mSinkTokens % mTokensPerBlock;mBubbleLen = sinkTokensInLastBlock == 0 ? 0 : mTokensPerBlock - sinkTokensInLastBlock;这个”气泡”的存在理由是块对齐:环形缓冲区的起点如果不是块的起始位置,那么”滑窗的边界”就会落在块的中间,导致每个块都要额外处理”部分有效”的情况。补齐到块边界之后,窗口边界与块边界一致——读取侧就可以整块加载、整块丢弃,不必逐 token 判断有效性。这是一个纯粹为”读写粒度对齐”而存在的字段,它不产生任何数值语义。
(tokenIdx - mSinkTokens) % mCyclicCacheLen:环形映射。超出窗口的历史 token 会覆盖掉最老的槽位,而不是新分配内存。mCyclicCacheLen就是环的长度:
mCyclicCacheLen = (mEnableOneMoreBlock) ? mMaxAttentionWindow + mTokensPerBlock - mSinkTokens : mMaxAttentionWindow - mSinkTokens;注意 mEnableOneMoreBlock 决定环长是”窗口 + 一整块”还是”窗口”。多留一整块的意义在于:当窗口恰好跨块边界时,不会因为环形覆盖而把正在读取的那一块中的有效部分覆盖掉。这也解释了为什么这个开关要由主机侧算好并传进来(canUseOneMoreBlock)——它取决于池里到底有几个块可用,是个容量约束,不是数学约束。
环形映射在写入与读取两侧必须完全一致。写入侧走 getKVTokenIdx 算出实际槽位再写,读取侧走同一个函数算出实际槽位再读。两个方向用同一个函数(都在 kvCacheUtils.h 里,__host__ __device__ 双端可用)是刻意的设计——如果两侧各写一份取模逻辑,任何一处偏差都会让读写指向不同槽位。
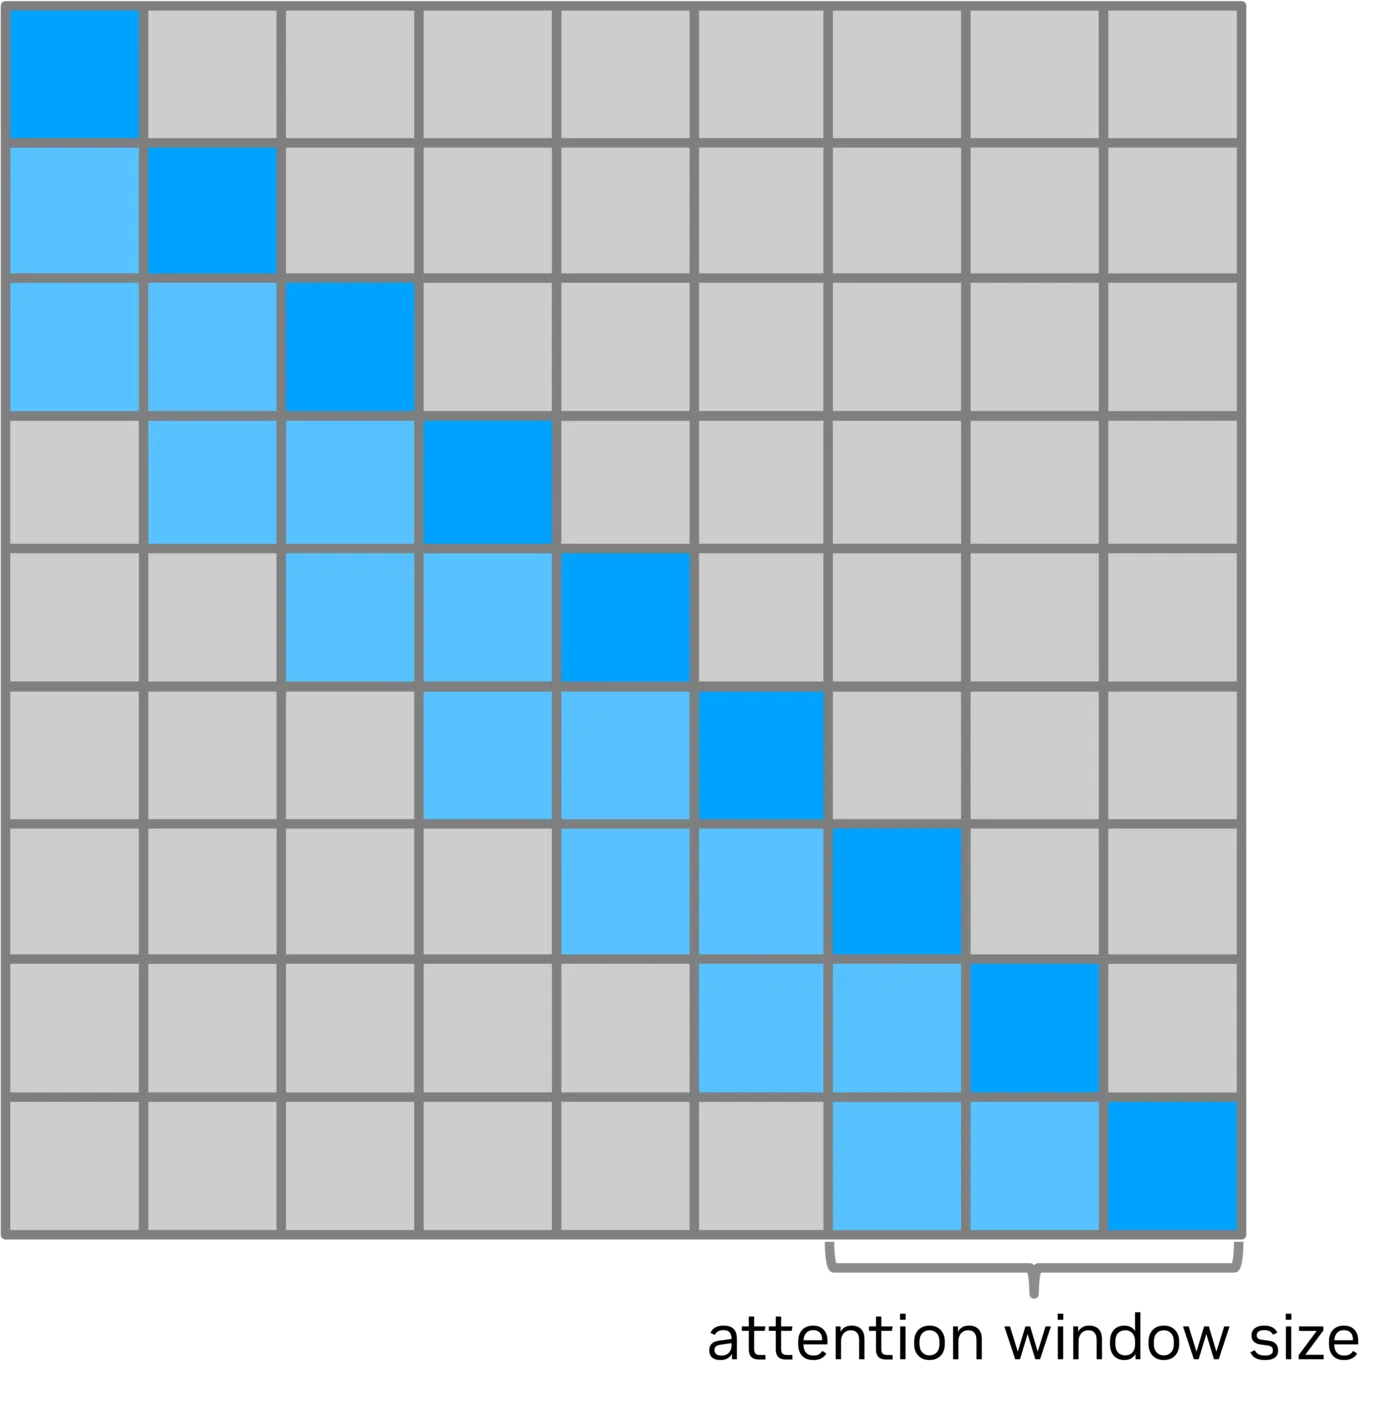
上图是 TensorRT-LLM 官方文档的滑动窗口注意力示意。窗口滑走后,早期块被释放并挂回复用树;写入侧靠 getKVTokenIdx 的环形映射把新 token 落进被腾出的槽位,读取侧靠同一映射找到窗口内的全部槽位。两侧共用同一个位置映射函数,是这套机制唯一的安全保证。图片来源:TensorRT-LLM 官方文档 media/feat_long_seq_sliding_win_attn.png。
三个官方后端的分工:同一件事的三种做法
TensorRT-LLM 的 PyTorch 后端有多个注意力后端(第五、六篇讲过选择机制),它们在”谁负责写池”这件事上分工不同。把三个官方实现放在一起对比,能看到三种截然不同的工程取舍。
TrtllmAttention:写池藏在注意力算子内部
tensorrt_llm/_torch/attention/backends/trtllm.py 里出现的是一个开关而不是一次调用:
forward_args.update_kv_cache = True # 默认:这次前向要更新池...forward_args.update_kv_cache = not has_q_only # Q-only 前向不更新forward_args.update_kv_cache = not metadata.is_cross or k is not None对应的 C++ 契约在预处理参数里有明确注释:
// The input contains Q only and the existing KV cache must not be updated.也就是说:TrtllmAttention 后端把写池合进了它自己的融合算子。update_kv_cache 这个布尔值一路传到设备侧,决定融合 kernel 内部是否执行写分支。三种情况必须关掉写入:
- Q-only 前向:只算 Q 不产生新 KV(例如某些需要重算注意力的场景)。
- 交叉注意力:cross attention 的 K/V 来自编码器,不该进解码器的自回归池。
- 投机解码的验证步:草稿 token 的 KV 需要特殊处理(可能只写被接受的部分),不能走常规路径。
这个设计的收益很明显:一次 kernel launch 完成”预处理 + 写池 + 注意力计算”,中间不需要任何跨 kernel 的中间张量。代价是算子接口变复杂(要传池指针、页表、窗口参数),而且写入逻辑与注意力逻辑耦合在一起,无法单独测试或替换。
FlashInferAttention:显式的 append_paged_kv_cache
FlashInfer 后端走的是另一条路线:写池是一次独立的、显式的调用(前面的 _append_paged_kv_cache)。原因是 FlashInfer 的注意力内核(BatchDecodeWithPagedKVCache / BatchPrefillWithPagedKVCache)只负责读,不负责写——它需要一个已经填好的池。
于是流程变成:先 append_paged_kv_cache 把新 token 写进池,再启动注意力内核从池里读。这多了一次 kernel launch 和一次中间张量的读写(写入侧要先把 K/V 从 qkv_input 布局转成 append 需要的布局),换来的是职责清晰:写池与注意力各自独立、各自可替换、各自可单独测试。
VanillaAttention:教学式的 PyTorch 参考实现
vanilla.py 的 _single_request_update_kv_cache 是三个实现里唯一用 PyTorch 算子写清楚每个步骤的,它的价值在于把索引算术暴露成可读的 Python:
seq_len = past_seen_token + kv_lentokens_per_block = kv_cache_tensor.shape[2]
if k is not None and v is not None: written = 0 while written < kv_len: pos = past_seen_token + written blk = block_ids[pos // tokens_per_block] # 块号:pos 除以页大小 off = pos % tokens_per_block # 页内偏移:pos 取模页大小 n = min(tokens_per_block - off, kv_len - written) # 本块还能装几个 assert blk != BAD_PAGE_INDEX, ( f"Writing new KV into an evicted/invalid page (pos {pos}); " "block_ids/metadata are inconsistent.") dst = torch.arange(off, off + n, device=kv_cache_tensor.device) kv_cache_tensor[blk, 0].view(dtype=access_type).index_copy_( 0, dst, k_selected[0, written:written + n].view(dtype=access_type)) kv_cache_tensor[blk, 1].view(dtype=access_type).index_copy_( 0, dst, v_selected[0, written:written + n].view(dtype=access_type)) written += n这段代码就是写入侧的数学定义,逐行对照着 CUDA 版本读会非常清楚:
pos // tokens_per_block与pos % tokens_per_block:就是 CUDA 里那个divmod,这里用 Python 的整除/取模直接写出来。注意这里直接用了blk = block_ids[...]一步拿到物理块号——因为block_ids是主机侧从KVCacheManager拿到的块号列表,逻辑页到物理页的翻译在外面做完了。CUDA 侧那两步(indptr[b]*page_size + pos再divmod)是为了在没有block_ids数组的场合也能算出来,两者的目标一致。n = min(tokens_per_block - off, kv_len - written):这段while循环就是”跨页”的全部处理。它把一次写入拆成若干”页内连续段”,每段落在单个页内——前面说”跨页的是序列而不是 token”,这里就是它的实现形态。assert blk != BAD_PAGE_INDEX:注释写得很直白——“New tokens must land in a live page; fail loudly rather than writing into the last page via negative indexing.”。这是一个明确的工程决策:宁可让断言炸掉,也不要让负索引悄悄写到错误的位置。第八篇这个系列反复出现的主题——“不报错的错误最难查”——在这里被主动防御了。view(dtype=access_type):按字节容器重解释。access_type由k_selected.dtype.itemsize决定(FP8 时是uint8、FP4 打包时是uint32)。这是第七篇讲的”元素数 vs 容器数”在 PyTorch 侧的写法:用一个更宽的 dtype 视图去一次搬运多个窄元素。
读取侧的同款参考实现
vanilla.py 里还有 _gather_paged_kv,它是”读取侧要不要物化连续张量”这个问题的明确答案:
def _gather_paged_kv(kv_cache_tensor, block_ids, kv_idx, num_tokens, tokens_per_block): """Materialize the first ``num_tokens`` logical K (``kv_idx=0``) or V (``kv_idx=1``) tokens from the paged pool as a contiguous ``[num_tokens, num_kv_heads, head_dim]`` tensor (NHD view).
A single block returns the contiguous view directly (no copy), which keeps a within-one-page request allocation-free. """ if num_tokens <= 0: return kv_cache_tensor[0, kv_idx, :0] chunks = [] read = 0 while read < num_tokens: blk = block_ids[read // tokens_per_block] off = read % tokens_per_block n = min(tokens_per_block - off, num_tokens - read) if blk == BAD_PAGE_INDEX: chunks.append(kv_cache_tensor.new_zeros((n, *kv_cache_tensor.shape[3:]))) else: chunks.append(kv_cache_tensor[blk, kv_idx, off:off + n]) read += n return chunks[0] if len(chunks) == 1 else torch.cat(chunks, dim=0)三个细节值得注意:
- “A single block returns the contiguous view directly (no copy)“:如果一条请求的全部 token 都在一个页内,那就直接返回池里那一段的视图,零拷贝。这个优化针对的正是解码阶段的短请求——第 100 步解码时
num_tokens = 101,页大小 32 的话其实横跨 4 个页,但要到请求很长时页数才多。“能不拷贝就不拷贝”这个判断放在最前面,说明作者知道这条路径命中率高。 BAD_PAGE_INDEX用零填充而不是报错(读取侧与会写入侧的断言形成对比):写入不能容忍错误(会把数据写到别人页上),读取则可以退化成”读出一段 0”——因为注意力权重会在别处把这段 0 的贡献压掉(或者这段本来就不该被读到)。这是读写两侧错误处理策略不对称的又一个例子。- 返回的是”前缀 num_tokens 个 token”而不是整段:调用方用
past_seen_token与seq_len两个值区分”读历史”还是”读全量”。注意_single_request_update_kv_cache里_gather_paged_kv被调用了两次,一次读past_seen_token(历史)、一次读seq_len(含新 token)——这正是滑动窗口与稀疏注意力需要的”过去 vs 现在”两种视图。
vanilla.py 的这套实现慢(每个请求一次 Python 循环、每个页一次 index_copy_),但它把接口语义钉死了:block_ids 是逻辑槽位到物理块的映射,BAD_PAGE_INDEX 是无效块哨兵,页内偏移按 pos % tokens_per_block 算。任何新的后端实现,只要满足这套语义,就能和调度、KV 管理、前缀复用正确对接。这是”参考实现”存在的意义:它不是性能路径,它是契约的文档。
写入侧的两张账:物理页归属与写入顺序
前面讲的所有机制,最终要落到两件事上才算真正”落盘”:写到哪个物理页、什么时候写。
物理页从哪来
写入内核拿到的从来不是”这块数据该写哪个物理页”的直接答案,而是一张间接表(第六篇的 kv_block_ids_per_seq、第七篇的 block_ids、FlashInfer 的 kv_indices)。内核顺着这张表跳到物理页。谁维护这张表?调度器与 KVCacheManager(第三、四篇)——它们决定了每条请求当前持有哪些块,并在请求被抢占、块被驱逐时同步更新表。
于是有一条重要的时序约束:写入必须发生在”页表已经包含本步要用的块”之后。顺序是:
调度器分配/复用块(更新账本与页表) │ ▼prepare() 构造索引数组(第六篇:块句柄 → 块表/页表/偏移) │ ▼写入内核执行(本步新 token 的 KV 落进池) │ ▼注意力内核执行(读取含新 token 在内的整段 KV)这四步的顺序不能乱。特别是最后两步:如果写入与注意力并行执行,注意力就可能读不到刚写的 token(读到的是上一步的内容),或者更糟——读到部分写入的中间状态。TensorRT-LLM 的做法是把”写入 + 注意力”做成同一算子内部的两段(TrtllmAttention 路线),从而在算子内部保证顺序;FlashInfer 路线则靠同一个 CUDA stream 上的顺序执行来保证。
分块预填充的写入节奏
分块预填充(chunked prefill)把一条长提示切成多段依次执行,这让写入侧的节奏变得不规则:
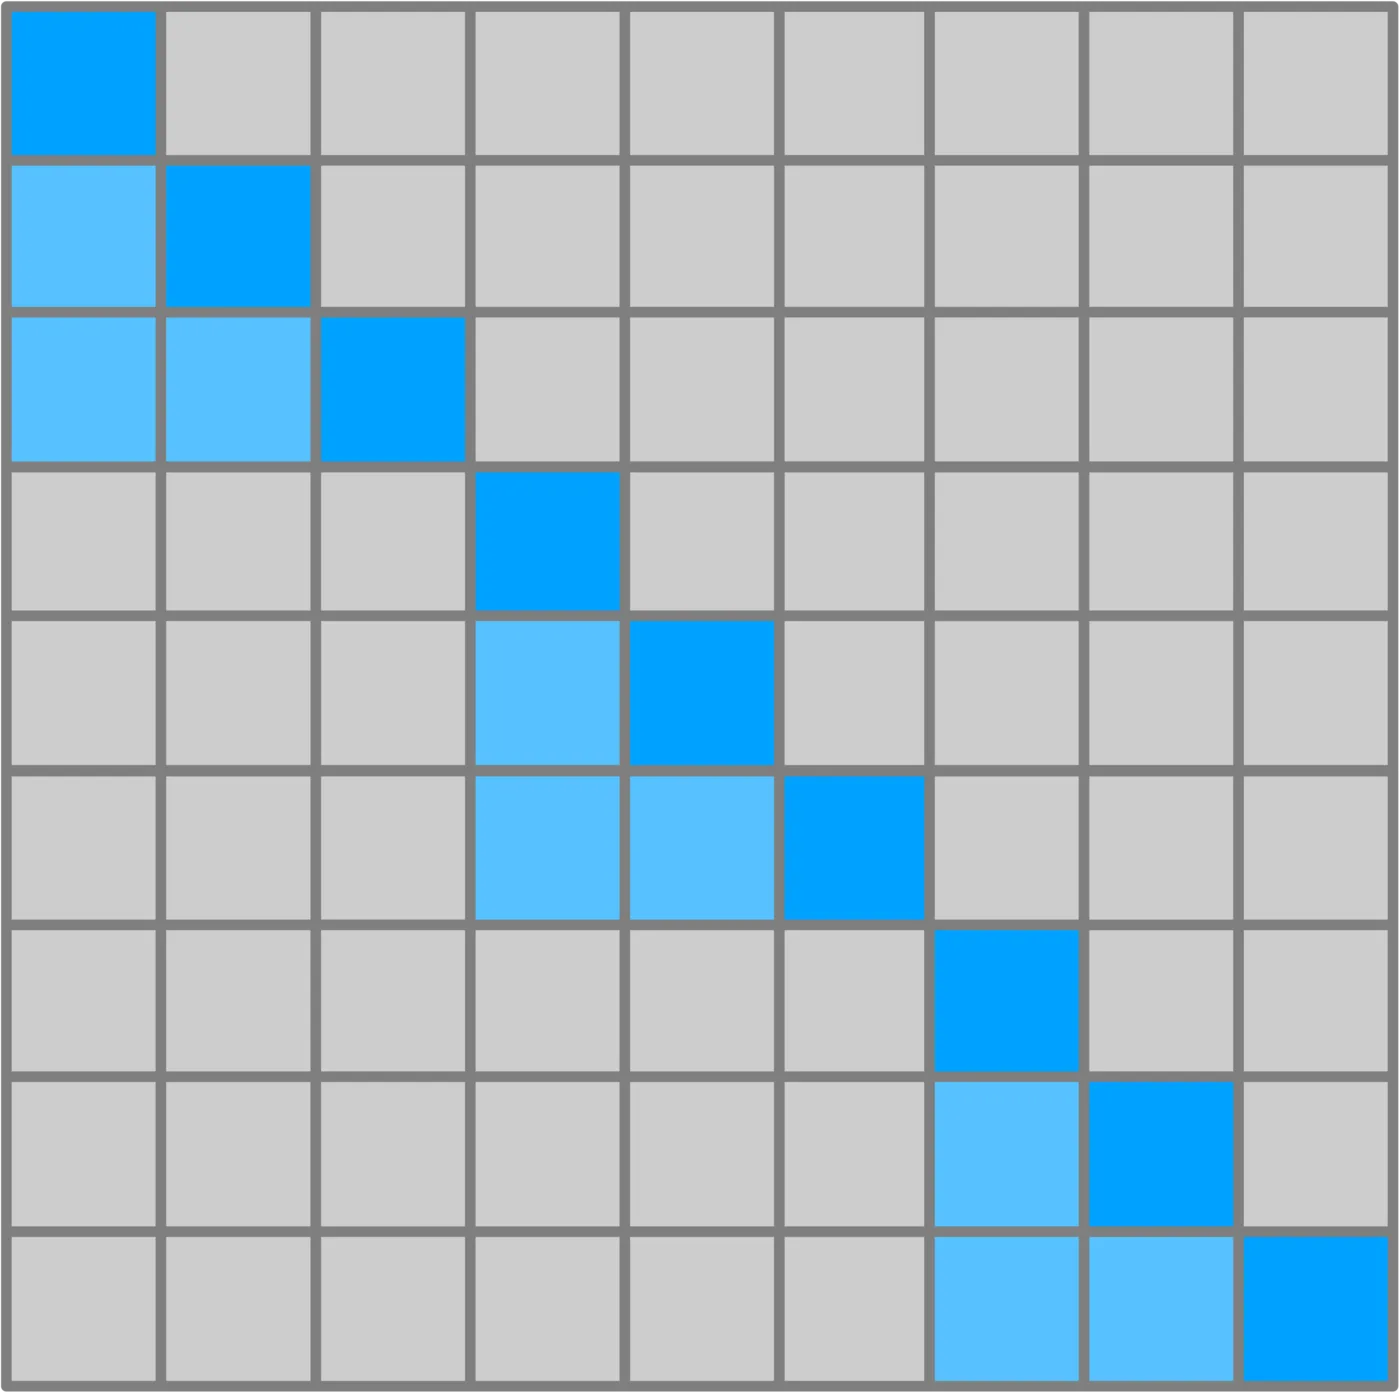
上图是 TensorRT-LLM 官方文档的分块上下文注意力示意:长提示被切成多段,每段依次执行、产生的 KV 依次写进池。写入侧的关键在于 past_seq_len 的逐段递增(前面 cache_seq_len - actual_seq_len 那段):第 段的 token 必须落在池里的第 个位置往后( 是分块大小),而不是从头写。这也是为什么”分块预填充 + 前缀复用”的组合特别容易出错——池里的位置既要与当前请求的实际 token 序号一致,又要与前缀复用命中的那些块的物理内容对得上。图片来源:TensorRT-LLM 官方文档 media/feat_long_seq_chunked_attention.png。
在本站 SGLang 源码完全拆解(四):PrefillAdder 如何预算 KV、切分长提示并组装 Prefill Batch 那篇里,分块预填充的接纳算法是从调度侧讲的;这一节讲的是它的写入侧后果:同一段提示被切成 段之后,只有”这段写在池的哪个位置”这件事必须由写入路径自己算对。
常见错误模式与调试思路
这一篇讲的机制有个共同的坏性质:错了不报错。下面把最容易出问题的地方列出来,并给出对应的排查手段。
| 症状 | 可能的根因 | 怎么查 |
|---|---|---|
| 长上下文回答质量随长度下降,短上下文正常 | past_seq_len 算错,分块预填充分段时覆写了前段 KV | 打印每段的 cache_seq_len / actual_seq_len,核对 sum(actual) == cache 且段间单调递增 |
| 滑动窗口模型(Gemma/GPT-OSS 类)偶发输出异常 | 读写两侧的窗口位置映射不一致(一侧用 getKVTokenIdx 一侧直接用绝对位置) | 把窗口设成远大于序列长度跑一遍——如果症状消失,基本就是窗口映射问题 |
| FP8 KV 缓存下输出质量差于 FP16,且随长度恶化 | scale 用错:用了激活量化的 per-tensor scale 而不是 KV 专用的 per-token/per-block scale | 对照 qkv_scale_orig_quant 的下标语义(K/V 各有自己的第二级 scale) |
| 单请求正确、多请求并发时错乱 | 页表/块表在多请求下越界(BAD_PAGE_INDEX 未被拦住) | 打开 vanilla 后端的断言路径跑小批量复现,或检查 kv_indptr 是否单调 |
| 首 token 输出偶发 NaN | 新分配的页未清零,注意力整页读 V 时读到脏数据 | 检查 zeroPagedVCacheTail 的触发条件(预填充、最后一个非满块)是否被绕过 |
| 前缀复用命中的请求结果与不复用时不同 | 复用块的物理内容与请求的逻辑位置对不上(写入侧算错位置或复用块被提前改写) | 关掉 enable_block_reuse 对比——一致则问题在复用路径 |
最后一行值得特别说:前缀复用让”同一段 token 的 KV”可能被多条请求共享,于是”写入”这件事在某些位置上根本不会发生(命中复用的块不需要重算)。这意味着写入侧的账必须与复用侧的账对齐——如果命中了一个被认为内容正确的块,写入侧就必须从那个块之后的位置继续写,而不是从头开始。这正是分块预填充与前缀复用组合时的核心难点,也是第四篇(vLLM 侧)与 TensorRT-LLM 源码完全拆解(四):KVCacheManager 与块管理 讲的前缀复用树为什么必须精确记录”每个块覆盖哪些 token 范围”的原因。
从块表到拷贝:块间搬运与部分拷贝
前面所有内容都假设”一个 token 的 KV 一旦写进某个物理页,就永远待在那页里”。这只在块从不搬迁的前提下成立。实际上块的物理归属会变——它在两种场合被整体搬走:
- 卸载(offloading):显存吃紧时把整块 KV 搬到宿主内存或第二级池。官方文档把这套机制描述得很清楚:“When a block is evicted from primary memory, its KV state is copied to a block in secondary memory. The secondary memory block remains in the search tree, so the block remains reusable until it is evicted from secondary memory.”注意这里的要点:搬走之后块仍留在前缀树里,所以搬走的是物理位置,不是逻辑归属。这正是第七篇”两级池”设计的来处——
offset.isPrimary()决定读哪块指针,而块编号不变。 - 块内部分拷贝(partial copy):某些场景只需要搬一个块里的前若干个 token(比如块内只有一部分内容被复用、或者窗口滑动后需要保留块内的某一截),不必整块搬运。
第 6 条参考资料里的 cuKVCacheBlockPartialCopy 正是为第二种场合准备的:
template <typename T>__global__ void cuKVCacheBlockPartialCopy(T* dst, T const* src, unsigned int numLayers, unsigned int numHeads, unsigned int tokensPerBlock, unsigned int numHidden, unsigned int numTokensToCopy){ if (numTokensToCopy <= 0) { numTokensToCopy = tokensPerBlock; // 传 0 或负数 = 整块拷贝 }
int threadHead = blockIdx.z * blockDim.z + threadIdx.z; int threadToken = blockIdx.y * blockDim.y + threadIdx.y; int threadHidden = blockIdx.x * blockDim.x + threadIdx.x; if (threadHead < numHeads && threadToken < numTokensToCopy && threadHidden < numHidden) { int64_t strideLayer = static_cast<int64_t>(numHeads) * tokensPerBlock * numHidden; for (int iLayer = 0; iLayer < numLayers; ++iLayer) { int flatIndex = (threadHead * tokensPerBlock + threadToken) * numHidden + threadHidden; int64_t globalIndex = strideLayer * iLayer + flatIndex; dst[globalIndex] = src[globalIndex]; } }}这个内核短得可以一眼看完,但有三处设计值得单独讲:
numTokensToCopy <= 0退化成整块拷贝。一个内核同时服务”整流拷贝”和”部分拷贝”两种需求,靠一个哨兵参数区分。对比前面vanilla.py里BAD_PAGE_INDEX用零填充、slot_mapping用-1表示不写——在这个代码库里,“用哨兵值表示特例”是一个反复出现的惯例,好处是不必为每种情形写一个分支入口。threadToken < numTokensToCopy这个裁剪就是”部分”的全部含义。注意块内布局是[head, token_in_block, hidden]——先头、后页内 token、最后 token 内元素。所以”只拷贝前 个 token”退化成一句if,不需要任何地址重排:被裁掉的是每个头里token >= n的那一段,其余部分按下标对齐照搬。这正是第七篇那张”块内布局”表的直接回报:如果块内布局不是”token 维独立成一维”,部分拷贝就得做地址重映射。for (int iLayer = 0; iLayer < numLayers; ++iLayer)循环跨全部层。第七篇讲过”一个块装下所有同构的层、块的元数据是层间共享的”,所以块编号一次确定,就可以把这个编号在同一位置的全部层一次性搬走。strideLayer = numHeads * tokensPerBlock * numHidden就是层间步长。如果当初的设计是”每层各自分配块”,这里就必须传一个块号数组而不是一个标量——“层共享块”这个设计决策在拷贝侧的收益,就是这一个循环。
这个内核的三维线程划分(blockX 沿隐藏维、blockY 沿 token 维、blockZ 沿 head 维)与写入内核的组织方式不同:写入内核把 head 放在 threadIdx.y、把 head_dim 放在 32 个线程的 threadIdx.x 上;拷贝内核则把三者都摊成 block 的维度,用 blockDim 的组合去覆盖全部元素。差异来自目标不同——写入要配合 RoPE 的配对语义(需要固定 32 线程的 head_dim 维),拷贝只求访存合并,不需要任何跨线程协作。
小结
这一篇把第六、七篇之间的那段通路补齐了:第七篇讲清了”池长什么样”,这一篇讲的是”数据怎么进去、怎么出来”。
- Q 与 K/V 在预处理之后就分岔。Q 走一次性缓冲(服务当前这一步),K/V 走持久化分页池(服务未来所有步)。这个不对称是整条写入通路的组织原则。
- 加 bias、施加 RoPE、量化、写池被合并进同一个内核,理由有三:省掉三倍的中间张量显存往返、省掉若干次 kernel launch、中间值全程留在寄存器里。代价是二进制按模板参数特化膨胀(
unfusedAttentionKernels_2_*.cu12 个文件)。 applyBiasRopeUpdateKVCache的核心算术是三步:global_token_idx定位到张量里的行,past_seq_len = cache_seq_len - actual_seq_len定位到池里的逻辑位置,getKBlockPtr+getKVLocalIdx定位到物理偏移。中间那一步是分块预填充不覆写前段的关键。- RoPE 的旋转位置不等于池位置。
helix_position_offsets(Helix 并行)、spec_decoding_position_offsets(投机解码)、mrope_position_deltas(多模态)三层修正,说明”位置”这件事在不同并行/解码模式下是三个不同的量。旋转系数用寄存器数组按位置缓存,避免重复三角函数调用。 - 三类精度分支在索引单位上不同:FP8/INT8 要
inBlockIdx * VEC_SIZE(元素索引 → 字节索引),FP4 走quantizeAndWriteFP4KVCache且同时写 scale 池,BF16 直接向量写。 zeroPagedVCacheTail必须清零 V 的页尾,因为 paged FMHA 整页读 V,而 ,脏数据会穿透掩码污染输出。- 分页 append 的灵魂是一行
divmod:indptr[b] * page_size + position是逻辑全局下标,除以页大小得到逻辑页号与页内偏移,再靠indices[page_iter]一跳拿到物理页。逻辑页连续、物理页不连续。 - 页大小取 2 的幂是因为写入侧每 token 一次除法、读取侧每页一次边界判断,2 的幂让两者都退化成移位与掩码。
- grid-stride loop + 占用率算出的 CTA 数让同一个内核同时应付
nnz = 32768(预填充)与nnz = 1(解码)两个极端;head 维超 1024 线程上限时在调用侧按头切分。 - 跨页的是序列而不是 token:单 token 的 KV 向量永远落在单个页内,所以不需要 token 内拆分逻辑;
n = min(tokens_per_block - off, kv_len - written)这段循环就是跨页的全部处理。 - MLA 的写入更省(只写一条 latent)、读取更贵(要上投影);NVFP4 的写入要”先量化再反量化”地算第一级 scale,保证编码侧与解码侧的假设一致。
- 索引器 K 缓存的写入走 stride 展开而非页结构,因为它的池可能不连续;复杂度被前移到主机侧的
slot_mapping。对比主池可以看出两种设计哲学:内核吃复杂度 vs 主机吃复杂度。 - 读取侧永远不会先把 KV 收集成连续张量——34 GB 的搬运成本直接否掉了这条路线。三条并存路线(FlashInfer 通用分页、MMHA 专门化解码、XQA 张量核)的共同点是”页表被内联进访存循环”,差异只在谁来承担地址算术。
- 写入与读取是同一个页表在两个方向上的使用:写入逐 token 精确到槽位,读取逐页整块取。读多读一点是免费的(掩码会压掉),写得偏了是灾难——这就是两侧不对称性的根源。
- 环形缓存(
getKVTokenIdx)与气泡(mBubbleLen)是有限窗口模型读写共用的位置映射。气泡的存在完全是为了块对齐,不产生数值语义;两侧共用同一函数是这套机制唯一的安全保证。 - 三个官方后端分工不同:
TrtllmAttention把写池合进融合算子(快但耦合)、FlashInferAttention用显式append_paged_kv_cache(清晰但多一次 launch)、VanillaAttention是 PyTorch 参考实现(慢但把接口语义钉死)。 vanilla.py的assert blk != BAD_PAGE_INDEX与_gather_paged_kv的零填充,是读写两侧错误处理策略不对称的明确体现:写入不能容忍错误,读取可以退化。cuKVCacheBlockPartialCopy用numTokensToCopy一个参数把”块内部分拷贝”表达成线程裁剪,让一条拷贝路径既服务整块搬运又服务部分搬运;因为块内布局是[head, token, hidden]、且块跨全部层共享,部分拷贝与跨层搬运都退化成下标对齐的搬运,不需要地址重映射。- 块表给出的是”往哪个物理页写”,而页表/块表的时序在写入之前:调度分配块 → prepare 构造索引 → 写入 → 读取,四步顺序不能乱。
把这一篇和前七篇合起来看,TensorRT-LLM 的 KV 通路可以被一句话概括:调度器决定”写什么”(哪些块属于谁),prepare 决定”往哪写”(索引数组),写入内核决定”怎么落盘”(stride 与量化),注意力内核决定”怎么取回”(内联页表循环)。四层之间只有两组契约:块编号体系(逻辑账)与 stride 体系(物理账)。任何一层的错误都不会崩溃,只会让数值悄悄偏掉——这也是为什么这一篇要用整整一节去列错误模式。
下一篇进入 KV 缓存压缩(KV Cache Compression):TensorRT-LLM 文档里的 KV Cache Compression 一条明确指向一组把缓存变小的方法——令牌驱逐(token eviction)、量化到更低位宽、以及跨请求的复用与卸载如何与压缩共存。这一篇讲的写入路径是压缩得以生效的前提:压缩必须在写入时决定”要不要写、写多少位”,在读取时决定”读出来怎么还原”。下一分会把这条链路单独展开,并且和本站已有的 KV Cache Offloading 完全拆解 那篇的分层放置思路做横向对照——两者都受同一个带宽预算约束,只是一个往”装得更小”走,一个往”放得更远”走。
参考资料
- TensorRT-LLM 官方仓库(NVIDIA/TensorRT-LLM)
- TensorRT-LLM 官方文档:KV Cache System(池结构、分池规则、保留策略与有限窗口)
- TensorRT-LLM
cpp/tensorrt_llm/kernels/kvCacheUtils.h:KVBlockArray 的块指针、页内索引与环形窗口映射 - TensorRT-LLM
cpp/tensorrt_llm/kernels/unfusedAttentionKernels/unfusedAttentionKernels_2_template.h:applyBiasRopeUpdateKVCache 与写池分支 - TensorRT-LLM
cpp/tensorrt_llm/kernels/unfusedAttentionKernels.cu:transpose4dBatchMajorKVCache 与 shiftKCache - TensorRT-LLM
cpp/tensorrt_llm/kernels/kvCachePartialCopy.cu:cuKVCacheBlockPartialCopy 与线程裁剪 - TensorRT-LLM
cpp/tensorrt_llm/kernels/indexerKCacheScatter.cu:索引器 K 缓存的 stride 展开写入 - TensorRT-LLM
tensorrt_llm/_torch/attention/backends/flashinfer.py:_append_paged_kv_cache 与按头切分 - TensorRT-LLM
tensorrt_llm/_torch/attention/backends/vanilla.py:_gather_paged_kv 与 _single_request_update_kv_cache 参考实现 - TensorRT-LLM
tensorrt_llm/_torch/attention/backends/trtllm.py:update_kv_cache 开关与 Helix 并行说明 - FlashInfer
include/flashinfer/page.cuh:paged_kv_t 的 get_elem_offset、AppendPagedKVCacheKernel 与 NVFP4 量化写入 - FlashInfer 官方文档:KV-Cache Layout(NHD/HND、页表三件套与 last_page_len)
- FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model(MLA 的压缩 KV 出处)
- DeepSeek-V3.2 技术报告(DSA 稀疏注意力与索引器 K 缓存)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



