


TensorRT-LLM 源码完全拆解(三):调度器内部——CapacityScheduler 的准入算术、MicroBatchScheduler 的选择与 paused_requests 生命周期
系列进度与本篇定位
这是「四个推理框架源码系统学习」系列的第四站第三篇。前三站已经走完:vLLM(16 篇)、SGLang(18 篇)、llama.cpp(8 篇),第四站 TensorRT-LLM 的前两篇分别建立了地形图与装配图:
- 第一篇(TensorRT-LLM 源码完全拆解(一):整体架构与模块全景)摸清了地形:TensorRT engine 后端已被彻底移除,PyTorch 是唯一执行后端;调度与 KV Cache Manager 的实现在
cpp/tensorrt_llm/batch_manager/,接口通过 nanobind 暴露到 Python。 - 第二篇(TensorRT-LLM 源码完全拆解(二):PyExecutor 装配线与单步闭环)走完了装配线:
create_py_executor如何按六段流程把模型引擎、KV 容量估算、调度器、资源管理器装成一台推理机器,以及一次step的五个动作与两个循环的差别。
那两篇反复出现一个名字,却始终没有打开:调度器。我们知道了它是两级结构(CapacityScheduler + MicroBatchScheduler),知道了它在 _schedule 里被调用,知道了它输出 context_requests、generation_requests 与 paused_requests 三样东西——但「准入算术到底怎么算」「暂停一个请求时到底发生了什么」「前缀命中如何变成调度决策」这些核心问题都停在门口。
本篇就下潜到最底层,直接读 C++ 侧的 capacityScheduler.cpp(811 行)与 microBatchScheduler.cpp(539 行),把调度器的每一个决策还原成可验证的代码路径。读完之后,你应该能够说清楚:
- 一个请求在哪些状态能被调度、在哪些状态会被无视,以及这套状态机为什么按数值顺序比较就能表达「时间先后」。
GUARANTEED_NO_EVICT、MAX_UTILIZATION、STATIC_BATCH三种容量策略在准入逻辑上的真实差别,特别是MAX_UTILIZATION那套「暂停已运行请求再重试」的循环怎么写才不会死循环。paused_requests被 PyExecutor 接住之后,请求对象被改成了什么样,为什么「暂停」的语义是重算而不是换出。- 微批 scheduler 的 token 预算如何计价、三种分块策略(锁步、先到先服务、强制分块)的差异,以及投机解码的草稿 token 为什么会被丢弃。
- 前缀感知调度如何用一次 radix tree 查询同时服务「跳过判定」与「块预算估算」,以及它为什么在可变窗口注意力下失效。
调度是推理服务里最「反直觉」的一块:它没有 kernel 那样的性能数字,却决定了所有 kernel 的利用率。先从一个问题开始——为什么调度这么难?
为什么调度难:队头阻塞与「重调度」的本质
调度器要回答的问题只有一句话:这一步里,哪些请求的哪些 token 该被送进 GPU? 但它面对的是三个互相冲突的约束:
- 资源约束:KV Cache 的块数是有限的。一条长度为 的序列至少要占 个块( 是每块 token 数),长序列会把显存吃光。
- 延迟约束:每个用户都希望自己的 token 尽快出来。一条长提示词独占一步,所有正在解码的短请求就要等一步——这就是著名的队头阻塞(head-of-line blocking)。
- 吞吐约束:GPU 只有吃下足够大的 batch,矩阵乘的效率才有意义。一步里 token 太少,算力就被浪费。
这三个约束不能同时满足,只能取舍。下面的图来自 Llumnix 论文(SOSP 2024),它把问题画得非常清楚:多个实例各自空闲显存不同,而队头排队请求的需求各异——如果调度器只会「先来先服务」,就会出现「明明某个实例放得下,但请求卡在另一个实例的队头」的局面。
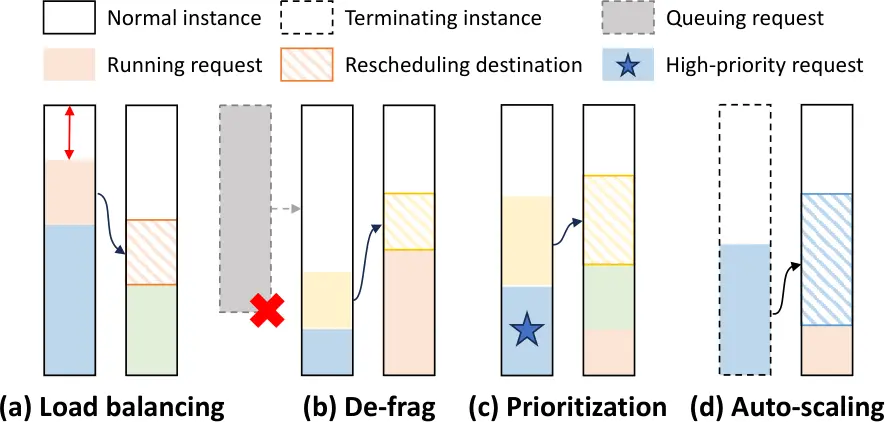
图:Llumnix 论文 Figure 1「Example rescheduling scenarios in Llumnix」。三条水平带代表三个推理实例,格子代表请求占用的显存;可以看出队头请求(大块)会挡住后面的小请求,而其他实例的空闲空间无法被利用。调度器的任务就是把「谁先走、谁等、谁换地方」算清楚。(来源:arXiv:2406.03243,Llumnix: Dynamic Scheduling for Large Language Model Serving)
TensorRT-LLM 给出的答案是把调度拆成两级:容量级回答「资源上谁有资格进入这一步」(KV 块够不够、序列数够不够),微批级回答「在 token 预算内真正跑哪些、各自跑多少」(token 总量上限、分块)。两级之间通过一个中间列表传递,这个列表叫 fitting_requests。
这个两级划分不是 TensorRT-LLM 独创。vLLM 的调度把两者揉在 Scheduler.schedule 一个函数里(可参考 vLLM 源码完全拆解(三):Scheduler.schedule 如何分配 Token 预算与 KV Block),SGLang 则用 PrefillAdder 做容量预算、ScheduleBatch 做组装(可参考 SGLang 源码完全拆解(四):PrefillAdder 如何预算 KV、切分长提示并组装 Prefill Batch)。TensorRT-LLM 的特别之处在于:两级不仅分开成两个类,还被绑定到了 C++,并且容量级可以主动输出「暂停请求」——这是它区别于前三个框架的最大特征。
请求的一生:LlmRequestState 状态机
在看调度代码之前,必须先看懂请求的状态机,因为调度器的每一个判断都建立在状态比较上。真实定义在 cpp/include/tensorrt_llm/batch_manager/llmRequest.h:
enum class LlmRequestState : int32_t{ kUNKNOWN = 0, ///< Unknown state kENCODER_INIT = 1, ///< Encoder phase starts (for encoder-decoder models)
kDISAGG_CONTEXT_WAIT_SCHEDULER = 7, ///< Waiting for scheduler to schedule the context-only request kDISAGG_GENERATION_INIT = 8, ///< New Generation request arrived at generation model kDISAGG_GENERATION_TRANS_IN_PROGRESS = 9, ///< Transmitting the kv cache
// schedulable states starts kCONTEXT_INIT = 10, ///< Context phase starts kDISAGG_CONTEXT_INIT_AND_TRANS = 11, ///< Context phase starts and cache transmission is in progress kDISAGG_GENERATION_TRANS_COMPLETE = 12, ///< Kv cache transmission are finished kGENERATION_IN_PROGRESS = 13, ///< Generation phase is in progress // schedulable states ends
kGENERATION_TO_COMPLETE = 14, ///< Generation phase is to be completed kGENERATION_COMPLETE = 20, ///< Generation phase completed kDISAGG_CONTEXT_TRANS_IN_PROGRESS = 21, ///< Waiting context-only request transmitting the kv cache kDISAGG_CONTEXT_COMPLETE = 22, ///< Context-only request finished kv cache transmission. kDISAGG_GENERATION_WAIT_TOKENS = 23, ///< Generation-only request waiting for ctx/draft tokens
// error states kDISAGG_TRANS_ERROR = -1, ///< Error occurred during kv cache transmission};这份枚举的第一个设计要点写在注释里:枚举顺序必须遵循时间顺序(Enum order must follow chronological order for state dependency check)。于是状态判断可以退化成整数比较:
[[nodiscard]] bool hasReachedState(LlmRequestState state) const noexcept{ return mState >= state;}一个请求是否「已经至少走到某个状态」,就是一次 >=。这也解释了为什么 kENCODER_INIT = 1 而 kCONTEXT_INIT = 10 之间留了空档:编码器阶段(encoder-decoder 模型)必须先于解码器上下文阶段,而 7、8、9 三个 disagg 状态(P/D 分离场景)也必须排在「可调度区间」之前。kGENERATION_COMPLETE = 20 与 kGENERATION_TO_COMPLETE = 14 之间的空档同理,为传输类状态留位。
有了这个语义,调度器的状态边界就非常容易理解了。两个调度器各带一对阈值:
| 调度器 | no_schedule_until_state | no_schedule_after_state | 含义 |
|---|---|---|---|
CapacityScheduler(绑定默认) | kCONTEXT_INIT | kGENERATION_COMPLETE | 准入只发生在「上下文开始」到「生成完成」之间 |
MicroBatchScheduler(绑定默认) | kCONTEXT_INIT | kGENERATION_TO_COMPLETE | 微批选择略早收口,避免把「即将完成」的请求再次塞进 batch |
于是每个调度器循环里的第一句都是同一行逻辑:
// if request cannot be scheduled yet or request should no longer be scheduled, skipif (!req->hasReachedState(getNoScheduleUntilState()) || req->hasReachedState(getNoScheduleAfterState())){ continue;}「还没走到」与「已经走过」的请求都被跳过。比如 kGENERATION_COMPLETE(20)的请求已被收尾流程接管,kENCODER_INIT(1)的请求在纯解码器模型里根本不存在,在 encoder-decoder 模型里则要等编码器专门调度(后文会讲双池准入)。
注意这行判断在 GuaranteedNoEvictScheduler 与 MaxUtilizationScheduler 里都加了一个前置豁免:
!req->isDisaggGenerationInitState() && !req->isDisaggGenerationTransmissionInProgress()&& (!req->hasReachedState(getNoScheduleUntilState()) || req->hasReachedState(getNoScheduleAfterState()))也就是说 kDISAGG_GENERATION_INIT(8)这类数值上「早于可调度区间」的状态被特别放行——注释写得很直白:「Allow disagg_generation_init requests to be scheduled, so that we’ll allocate their KV cache」。P/D 分离下生成端要提前为即将到来的 KV 传输预留显存,所以哪怕请求还没有 prompt 可算,也得让它进入调度视野先记账。
调度器家族:一个策略枚举背后的五个类
CapacityScheduler 并不是一个类,而是一个分发器。它的构造逻辑(capacityScheduler.cpp)用 CapacitySchedulerPolicy 枚举选择具体的实现,存进一个 std::variant:
CapacityScheduler::CapacityScheduler(SizeType32 maxNumRequests, executor::CapacitySchedulerPolicy capacitySchedulerPolicy, bool hasKvCacheManager, bool twoStepsLookAhead, LlmRequestState noScheduleUntilState, LlmRequestState noScheduleAfterState, bool enablePrefixAwareScheduling){ if (!hasKvCacheManager) { mScheduler = MaxRequestsScheduler{maxNumRequests, noScheduleUntilState, noScheduleAfterState}; } else if (capacitySchedulerPolicy == executor::CapacitySchedulerPolicy::kMAX_UTILIZATION) { mScheduler = MaxUtilizationScheduler{ maxNumRequests, twoStepsLookAhead, noScheduleUntilState, noScheduleAfterState, enablePrefixAwareScheduling}; } else if (capacitySchedulerPolicy == executor::CapacitySchedulerPolicy::kGUARANTEED_NO_EVICT) { mScheduler = GuaranteedNoEvictScheduler{ maxNumRequests, noScheduleUntilState, noScheduleAfterState, enablePrefixAwareScheduling}; } else if (capacitySchedulerPolicy == executor::CapacitySchedulerPolicy::kSTATIC_BATCH) { mScheduler = StaticBatchScheduler{ maxNumRequests, noScheduleUntilState, noScheduleAfterState, enablePrefixAwareScheduling}; } else { throw std::runtime_error("Unsupported capacity scheduler policy"); }}四个分支对应四个类,外加没有 KV 管理器时的 MaxRequestsScheduler,一共五个。它们的取舍方向可以先用一句话总结:
MaxRequestsScheduler:只看序列条数(max_num_requests),不看 KV。没有 KV Cache 管理器的场景下唯一能选的。GuaranteedNoEvictScheduler:承诺「一旦接纳,就保证跑完」。为此它在准入时把「这条请求跑到完成还需要多少块」全部预留出来,宁可拒绝新请求也不驱逐老请求。StaticBatchScheduler:继承自GuaranteedNoEvictScheduler,只是通过一个模板参数打开了「静态批」语义——只有当前没有任何在跑请求时才接纳新请求。适合 benchmark 或对批次组成有硬性要求的场景。MaxUtilizationScheduler:把吞吐放在第一位。它为请求只预留「下一步所需」的块(而不是跑完所需的全部块),不够时就暂停已运行请求,把块腾出来给新请求。
这里有个容易误解的点:guaranteed_no_evict 与 max_utilization 的差别不是「驱逐策略开关」,而是预留粒度。前者按「到完成」预留(NoEvictScheduledBlocksManager),后者按「下一步」预留(MaxUtilizationScheduledBlocksManager)。粒度决定了两者的失败模式:粗预留更保守、吞吐低但不重算;细预留更激进、吞吐高但会触发暂停-重算。
除了四个容量实现,CapacityScheduler::operator() 里还藏着一个不显眼但越来越重要的机制——重排策略:
// Apply reorder policy if setRequestList requestsToSchedule = mReorderPolicy ? mReorderPolicy->reorderRequests(activeRequests) : activeRequests;setAgentTreeReorderPolicy 允许在调度前先对请求列表做一次重排,当前仓库里实现的 AgentTreePolicy 会按「agent 请求占比」「agent 类型」「在途序列数」等参数给 agent 流量设定优先级。这是 agentic 推理负载兴起之后新增的调度维度:同一批请求里,工具调用型请求与普通对话请求的时延敏感度完全不同,与其在准入里硬编码,不如先重排再走既有的两级流水线。
在 Python 侧,这些 C++ 类通过 BindCapacityScheduler 暴露:
class BindCapacityScheduler(CapacityScheduler): def schedule_request( self, active_requests: RequestList ) -> tuple[list[LlmRequest], list[LlmRequest], list[LlmRequest]]: return self.impl( active_requests, self.kv_cache_manager, self.peft_cache_manager, self.cross_kv_cache_manager, )注意返回值是三元组:fitting_requests、fitting_disagg_gen_init_requests、paused_requests。第三项就是本篇的另一个主角。而 SimpleScheduler 把容量级与微批级串起来:
def schedule_request(self, active_requests, inflight_request_ids) -> SchedulerOutput: active_requests = drop_decoder_context_requests_waiting_for_encoder_output(active_requests) fitting_requests, fitting_disagg_gen_init_requests, paused_requests = ( self.capacity_scheduler.schedule_request(active_requests) ) encoder_requests, context_requests, generation_requests = ( self.micro_batch_scheduler.schedule(fitting_requests, inflight_request_ids) ) return SchedulerOutput(...)两行调用,职责边界非常清晰:容量级决定「谁有资格」,微批级决定「谁真正跑、跑多少」。
GUARANTEED_NO_EVICT:粗粒度的「到完成」预留
先看最保守的实现。GuaranteedNoEvictScheduler::impl 是一个模板函数,StaticBatchScheduling 作为参数决定要不要走静态批语义。它的前半段做一件很关键的事:把所有已经在跑的请求先钉住。
auto reservedBlocks = kv_cache_manager::NoEvictScheduledBlocksManager(kvCacheManager);...for (auto const& req : activeRequests){ if ( !req->isDisaggGenerationInitState() && !req->isDisaggGenerationTransmissionInProgress() && (!req->hasReachedState(getNoScheduleUntilState()) || req->hasReachedState(getNoScheduleAfterState()))) { continue; }
if (numAdmittedRequests >= static_cast<std::size_t>(mMaxNumRequests)) { break; }
if (req->isDisaggGenerationTransmissionInProgress() || req->isGenerationInProgressState()) { ++numAdmittedRequests; if (req->isGenerationInProgressState()) { scheduledRequests.emplace_back(req); } reservedBlocks.enoughAvailableBlocks(*req); reservedBlocks.commitBlocks(); ... } else if (req->isDisaggGenerationInitState()) { pendingDisGenInitRequests.emplace_back(req); } else { pendingRequests.emplace_back(req); }}这段循环做的事可以概括为「三分类 + 立刻预留」:
- 已经在生成的请求(
isGenerationInProgressState)直接放进scheduledRequests,它们必然要继续跑,不能被拒。 - P/D 分离下正在传输的请求(
isDisaggGenerationTransmissionInProgress)不计入输出列表,但照样提交块预留——它在等待远端 KV 到达,显存必须先占住。 - 尚未开始的请求(
context_init)进入pendingRequests,等待后面统一决定。 - 编码器待处理请求(
encoder_init)按状态归入pendingRequests(它不吃 KV 块,后面单独处理)。
注意 reservedBlocks.enoughAvailableBlocks(*req) 之后紧跟 commitBlocks():check 与 commit 是分开的两步。这个拆分不是风格问题,而是为了支持「先探测、后提交」的语义——后面的 MaxUtilizationScheduler 会利用这一点:探测失败时不留副作用,可以安全地重试。
预留的量由 KV 管理器给出。NoEvictScheduledBlocksManager 走的是 getNeededBlocksOneStep 之外的另一条路:它问的是「这条请求到完成为止还差几块」,而不是「下一步要几块」。语义差别的现实后果是:一条刚接纳的 8K 提示词请求,会一次性把它整个上下文加上后续生成长度所能占用的块都算进预留。这解释了为什么官方文档反复强调 GUARANTEED_NO_EVICT 下 KV 池要开得足够大——它不是按 step 记账,而是按请求生命周期记账。
钉住已有请求之后,剩下的事就是按剩余预算接纳新请求。这里有一段值得单独讲的优化逻辑:
// The optimization of delaying requests won't work for variable window attentionbool skippingIsRelevant = mEnablePrefixAwareScheduling && (!kvCacheManager.getBlockManager().isVariableWindow()) && (!crossKvCacheManager || !crossKvCacheManager->getBlockManager().isVariableWindow());
// Keep track of blocks contributed by requests in context phasestd::unordered_set<BlockKey, BlockKeyHasher> newlyContributedContextBlocks;std::unordered_set<BlockKey, BlockKeyHasher> newlyContributedCrossContextBlocks;if constexpr (!StaticBatchScheduling){ if (skippingIsRelevant) { std::tie(newlyContributedContextBlocks, newlyContributedCrossContextBlocks) = prefillWithChunkedContextsAlreadyExecuting(activeRequests, kvCacheManager, crossKvCacheManager); }}prefillWithChunkedContextsAlreadyExecuting 的作用是:先统计本轮的「在位贡献者」。那些已经在执行、但还没跑完所有分块的长提示词请求(isContextInitState() && !isFirstContextChunk()),它们这一轮算出来的 KV 块是可以被别的请求复用的。于是调度器把这些块记进 newlyContributedContextBlocks,后面遇到具有相同前缀的新请求时,就可以故意跳过它——反正等一轮就能白拿这些块,没必要现在为它分配显存。
这段逻辑的三个判断都值得解释:
mEnablePrefixAwareScheduling是总开关(对应 Python 侧的enable_prefix_aware_scheduling)。!isVariableWindow()是硬性排除条件。可变窗口注意力(VSWA,per-layer 不同的attention_window_size)下每个窗口尺寸有自己的一套池与块表,用单一的BlockKey集合去表达「这些块可以被复用」是不成立的——同一个 key 在不同窗口池里指向不同的块。constexpr (!StaticBatchScheduling)保证静态批路径直接跳过这套逻辑,因为静态批压根不允许「边跑边接纳新请求」。
接着是准入主循环。为了同时处理「前缀复用跳过」与「块预算」,代码先把每条候选请求的复用情况算一次(radix tree 走一遍),再复用这份结果做两个判断:
bool const isFirstChunkContext = req->isContextInitState() && req->isFirstContextChunk() && !req->isDisaggGenerationInitState();...std::optional<kv_cache_manager::PrefixReuseSummary> summary;if (mEnablePrefixAwareScheduling){ if (isFirstChunkContext) { // analyzePrefixReuse asserts on variable-window managers; skip the walk there if (kvCacheManager.isEnableBlockReuse() && !kvCacheManager.getBlockManager().isVariableWindow()) { auto uniqueTokens = req->getUniqueTokens(0); summary = kvCacheManager.analyzePrefixReuse(uniqueTokens, *req); } ... }}注释里那句「This single radix tree walk serves both the beneficial-to-skip check and the block budget estimation … eliminating 2 redundant walks per request」说明了设计意图:一次树查询、两处使用。前缀树查询(analyzePrefixReuse)在长上下文场景下不是免费的——它要按块粒度走树、比对 token 哈希——所以调度热路径上绝不能对同一条请求查三遍。
判断「是否值得跳过」的谓词被单独抽成函数,并配了详细的注释:
/// @brief Check if it is beneficial to skip this request rather than schedule it./// @note Pure: this does NOT register the request's own contributions. Callers must invoke/// registerContributedBlocks once — and only once — the request has actually been admitted./// Registering at check time would defer later duplicates on behalf of a contributor that the/// budget checks below then reject, and in MaxUtilization it would make a request skip itself/// on the retry that follows a pause.bool beneficialToSkip(...){ return oneManagerBeneficialToSkip(summary, newlyContributedContextBlocks) || oneManagerBeneficialToSkip(crossSummary, newlyContributedCrossContextBlocks);}这段注释点出了一个非常容易写错的地方。假设你图省事,在「判定值得跳过」的时候就顺手把这条请求的贡献块登记进集合,会发生两件事:
- 如果这条请求随后因为预算不足没有被真正接纳,那么集合里就多了一批「声称会被贡献、实际上不会出现」的块,后面的同前缀请求会基于这个假前提而白白等待一轮。
- 在
MaxUtilization里更糟:那条「暂停一个已运行请求后重试当前请求」的循环会让这条请求在重试时看到自己刚登记的firstNewBlock,于是把自己跳过了——刚暂停腾出来的容量就这样被浪费掉。
正确的做法是保持判定函数纯(pure),把登记放到「确认接纳」之后:
if (skipTrackingApplies && beneficialToSkip(summary, crossSummary, newlyContributedContextBlocks, newlyContributedCrossContextBlocks)){ continue;}... scheduledRequests.emplace_back(req); ... if (skipTrackingApplies) { registerContributedBlocks(summary, crossSummary, newlyContributedContextBlocks, newlyContributedCrossContextBlocks); }registerContributedBlocks 的注释把不变量写得很清楚:不存在「贡献者未被调度、而依赖它的请求却被延后」的迭代。这是并发/增量算法里典型的「先提交再发布」模式。
最后是预算检查:
else if (req->isContextInitState() || req->isDisaggGenerationInitState()){ // Check block availability using the cached summary when available. // enoughAvailableBlocks is check-only (no decrement) — safe if cross check fails. bool enoughBlocks = reservedBlocks.enoughAvailableBlocks(*req, summary); bool enoughCrossBlocks = true; if (reservedCrossBlocks) { enoughCrossBlocks = reservedCrossBlocks->enoughAvailableBlocks(*req, crossSummary); } ... if (enoughBlocks && enoughCrossBlocks && neededPeftPages <= availablePeftPages) { scheduledRequests.emplace_back(req); ++numAdmittedRequests; // Decrement using the cached values computed by enoughAvailableBlocks. reservedBlocks.commitBlocks(); ... } else if (!enoughBlocks || !enoughCrossBlocks) { // If one requests fails to be scheduled, break break; }}三个细节值得展开:
enoughAvailableBlocks是只读探测,探测通过后再commitBlocks()真正扣减。注释解释了为什么这样设计:「safe if cross check fails」——如果自池够但交叉池不够,探测阶段不能已经扣掉自池的块,否则这条请求被拒之后,自池的账目就永久错了。- 块不够就
break而不是continue。这是从 Python 参考实现GuaranteedNoEvictScheduler继承下来的语义,官方文档里的示例代码写着同样的注释「If one requests fails to be scheduled, break」。背后的理由是队列有序性:如果连队头这条都放不下,放行后面那些(大概率更长的)请求只会让显存更紧张,不如把这一轮让给下一轮。代价是可能出现「小请求被大队头连带阻塞」的公平性问题。 - LoRA 页也要计入预算。
claimPeftPagesForRequest会为新出现的 LoRA task id 计算需要多少 adapter 页,peftCacheManager->determineNumPages(req)给出页数;同一批里重复的 task id 只算一次(uniqTaskIds去重)。这条逻辑在 SGLang 源码完全拆解(十三):多 LoRA 服务 里对应的是LoRAMemoryPool的 adapter 槽位管理,思路一致:适配器是显存资源,必须参与准入。
StaticBatchScheduler 与 GuaranteedNoEvictScheduler 共用这段实现,只差一个模板参数:
// If StaticBatchScheduling == true check if we can add pending requests only when no requests are active.if (!StaticBatchScheduling || numAdmittedRequests == 0)静态批语义就是这一行:只有在「当前没有任何请求在跑」时,才去考虑接纳新请求。它带来的是完全可复现的批次组成,代价是吞吐会明显下降——上一批的尾巴必须等干净。
MAX_UTILIZATION:暂停-重试循环与它的正确性陷阱
如果说 GUARANTEED_NO_EVICT 是「不驱逐、只拒绝」,那么 MAX_UTILIZATION 就是「不够就想办法腾出来」。它的实现是全部调度代码里最需要小心的一段,因为它是唯一会修改其他请求状态的调度器。
它的核心结构是一个带反序迭代器的循环:
auto reqItEnd = std::end(activeRequests);for (auto reqIt = std::begin(activeRequests); reqIt != reqItEnd;){ auto const& req = *reqIt; ... bool const wasScheduled = trySchedulingRequestMaxUtilization(req, mMaxNumRequests, numAdmittedRequests, scheduledRequests, scheduledBlocksManager, scheduledCrossBlocksManager, peftCacheManager, numScheduledPeftPages, seenTaskIds, summary); if (wasScheduled) { ... reqIt++; } else { auto const rbegin = std::reverse_iterator(reqItEnd); auto const rend = std::reverse_iterator(reqIt); auto const lastStartedReqIt = std::find_if(rbegin, rend, startedReqLambda); if (lastStartedReqIt != rend) { // If we can't allocate a started request, we need to start freeing started requests // from the end of the vector and try again // Here we simulate freeing the kvCache blocks associated with that sequence kvCacheManager.schedulingRemoveSequence((*lastStartedReqIt)->mRequestId); ... pausedRequests.emplace_back(*lastStartedReqIt); TLLM_LOG_INFO("MaxUtilizationScheduler: request ID %lu -> pause", (*lastStartedReqIt)->mRequestId); reqItEnd = std::next(lastStartedReqIt).base(); } else { break; } }}分三步拆开看:
第一步,从后往前找「可以牺牲的」请求。 用反向迭代器在 [reqIt, reqItEnd) 范围内从后向前找第一个满足 startedReqLambda 的请求。注意这个 lambda 有明确的排除项:
auto startedReqLambda = [this](std::shared_ptr<LlmRequest> const& req){ return (req->hasReachedState(getNoScheduleUntilState()) && !req->hasReachedState(getNoScheduleAfterState()) && ((req->isContextInitState() && !req->isFirstContextChunk()) || req->isGenerationInProgressState()));};它只挑两类:正在跑分块上下文的请求(已经算了一部分,不是第一块)与正在生成的请求。首块上下文请求不算候选——因为它们还没算任何东西,暂停它们不释放任何有意义的 KV 块。这也解释了代码里那句注释「Encoder-init requests are intentionally excluded here: they hold no started self- or cross-pool blocks, so pausing them would not free any KV budget.」
为什么从后往前找? 因为列表是按优先级排序的(队头优先),从后往前找到的是最不优先的在跑请求。牺牲尾部、保住队头,是「最大化利用率」策略保持公平性的方式。
第二步,模拟释放,然后收缩搜索范围。 schedulingRemoveSequence 是 KV 管理器的接口(声明在 kvCacheManager.h),它把这条序列在本次调度视角下占用的块释放掉;注意这是调度期的模拟释放,不是真正的资源回收——真正的回收发生在 PyExecutor 处理 paused_requests 时。
紧接着 reqItEnd = std::next(lastStartedReqIt).base() 把搜索上界收缩到被暂停请求的位置。这一步保证同一轮里不会反复暂停同一条请求,也让整个循环存在明确的终止条件:每暂停一次,可暂停区间就缩小一格。
第三步,重试当前请求而不推进迭代器。 trySchedulingRequestMaxUtilization 返回 false 时,reqIt 原地不动,下一轮循环会用刚刚释放出来的块重新尝试这条请求。这就是「暂停-重试」的完整闭环。
终止条件由三个「break」共同保证:找不到可暂停的请求(lastStartedReqIt == rend)、达到序列数上限、或者微批预算耗尽。三者任一成立,循环退出,剩余请求自然留到下轮。
现在回到前面那段注释提到的陷阱。在 MaxUtilizationScheduler::operator() 里,登记块的时机被严格限制在「确认调度成功之后」:
if (wasScheduled){ // Register only now. The failure branch below pauses a started request and retries this // same request without advancing reqIt; registering at check time would put this // request's own firstNewBlock in the set and make it skip itself on that retry — // wasting the capacity the pause just freed. if (skipTrackingApplies) { registerContributedBlocks( summary, std::nullopt, newlyContributedContextBlocks, newlyContributedCrossContextBlocks); } reqIt++;}把这段话翻译成场景:请求 X 是第一块上下文请求,它的 firstNewBlock 记作 。X 探测失败 → 调度器暂停了请求 Y,释放出一批块 → 循环重试 X。如果 X 在探测阶段就把 登记进了集合,那么重试时 beneficialToSkip 会发现「 已经在集合里」,判定「有别的请求会贡献这个块,我等一轮更划算」,于是跳过 X。结果:Y 被暂停了,块空出来了,而需要这些块的 X 却主动让路——一次纯粹的容量浪费,并且会表现为吞吐下降这种极难定位的症状。
第二处正确性细节在调度块管理器上。MaxUtilizationScheduledBlocksManager 的接口与 NoEvict 版本不同:
auto const scheduledBlocksIfFitsKvCache = blocksManager.prepareNewNumberOfBlocksIfWeEndUpScheduling(*req, cachedSummary);...if (crossBlocksManager){ crossScheduledIfFits = crossBlocksManager->prepareNewNumberOfBlocksIfWeEndUpScheduling(*req); if (!crossScheduledIfFits) { return false; }}
if (scheduledBlocksIfFitsKvCache && fitsPeft){ blocksManager.updateScheduledBlocks(scheduledBlocksIfFitsKvCache.value()); ... return true;}prepareNewNumberOfBlocksIfWeEndUpScheduling 返回的是一个 std::optional<std::map<SizeType32, SizeType32>>——「如果最终决定调度这条请求,各池的块数会变成多少」。它是只读预测,返回 nullopt 表示放不下;只有确认放得下且 PEFT 也够(fitsPeft),才用 updateScheduledBlocks 提交预测结果。
这套「predict-then-commit」范式与 NoEvict 的「probe-then-commit」是同一个思路的两种实现,目的都是让探测无副作用。为什么在 MaxUtilization 里必须这样?因为它每轮都可能重试同一条请求:如果探测本身会扣账,那么每次失败的探测都会留下错误的扣减,重试几次之后预算就被自己吃光了。
最后一个开关是 twoStepsLookAhead(Python 侧参数 two_step_lookahead),它透传给 MaxUtilizationScheduledBlocksManager。名字直译是「两步预看」:不只算这一步要多少块,还把下一步的增量一起算进去。它存在的理由是 P/D 分离与流水线并行下的跨步资源连续性——上下文分块请求的下一步还要继续吃块,如果只按单步记账,就可能出现「这一步放得下、下一步放不下」的抖动。
这里必须诚实说明一个源码事实:create_py_executor 装配出的默认调度器是 SimpleScheduler(绑定 BindCapacityScheduler + BindMicroBatchScheduler),而 two_step_lookahead 在其中通常不会被打开,官方文档也明确写着「Since PyTorch Flow does not support pipeline parallelism, inflight_request_ids is an empty set」。这个开关在当前路径下更多是给支持流水线的路径预留的能力,读代码时不要假设它一定生效。
paused_requests 的下游:从「暂停」到「重算」
调度器把请求放进 paused_requests 只是第一步。真正改变请求对象的是 PyExecutor。它在单步循环的收尾处分别调用两个处理函数:
self._terminate_requests(scheduled_batch.paused_requests)self._pause_requests(scheduled_batch.paused_requests)两个函数体都很短,但语义差别极大:
def _pause_requests(self, requests_to_pause: Iterable[LlmRequest]) -> None: for req in requests_to_pause: req.pause(self.max_input_len)核心在 LlmRequest::pause(llmRequest.h):
/// @brief Pause a request by moving the generated tokens to the prompt/// @param maxInputLen The maximum prompt len.void pause(SizeType32 maxInputLen){ if (mSamplingConfig.getBeamWidth() > 1) { // TODO: For beamWidth > 1, we would need to support swapping to avoid // recomputing from the start for (std::size_t beam = 0; beam < mTokens.size(); ++beam) { auto& beamTokens = mTokens.at(beam); beamTokens.resize(mPromptLen); beamUniqueTokens.resize(mPromptLen); ... } } else { SizeType32 newPromptLen = std::min(maxInputLen, mPromptLen + getMaxNumGeneratedTokens()); for (std::size_t beam = 0; beam < mTokens.size(); ++beam) { auto& beamTokens = mTokens.at(beam); beamTokens.resize(newPromptLen); ... } mMaxNewTokens -= (newPromptLen - mPromptLen); mPromptLen = newPromptLen; }
mState = mEncoderTokens.has_value() || mEncoderInputFeatures ? LlmRequestState::kENCODER_INIT : LlmRequestState::kCONTEXT_INIT; ... mContextCurrentPositionTarget = 0; mContextCurrentPositionDraft = 0; mPrepopulatedPromptLenTarget = 0; mPrepopulatedPromptLenDraft = 0; mContextChunkSizeTarget = mPromptLen; mContextChunkSizeDraft = mPromptLen; mEstimatedReusableTokens = 0; mSeqSlot.reset();}这段代码把「暂停」的真实语义暴露得很清楚——它不是换出,而是回卷:
- 已生成的 token 被并入 prompt。
newPromptLen = min(maxInputLen, mPromptLen + 生成的 token 数),然后mMaxNewTokens相应减少。也就是说,暂停前已经吐出来的 N 个 token 不会丢,它们变成 prompt 的一部分;等请求被重新调度时,这 N 个 token 与原始 prompt 一起重新走上下文阶段。用户侧看到的是输出继续,但服务端做了一次多余的前向。 max_input_len是一个硬上限。mPromptLen + getMaxNumGeneratedTokens()与maxInputLen取 min 意味着:如果一条请求已经生成了很久(prompt 变得很长),暂停时可能只能保留部分生成 token,超出的部分直接丢弃——因为回卷后的长度不能超过引擎允许的最大输入长度。这是MAX_UTILIZATION策略下可能出现的真实数据损失路径,值得在部署时留意。- 状态被重置回
kCONTEXT_INIT(encoder-decoder 模型则回到kENCODER_INIT)。这一行解释了为什么暂停是「重算」:请求会重新进入上下文阶段,把「原 prompt + 已生成 token」整段重新算一遍 KV。 - 上下文游标、预填充长度、分块大小、复用估计、序列槽位全部清零。
mSeqSlot.reset()释放序列槽位,mEstimatedReusableTokens = 0清掉上一次调度的复用估计。这是一次彻底的「回到起点」,唯一的收获是请求本身还活着,且它的输出没有被用户感知为中断。
代价因此非常具体:一次暂停意味着一次全量重算。对于一条已经生成到 2000 token 的请求,重算的代价接近重新处理一个 2000 token 的 prompt。这就是为什么 MAX_UTILIZATION 只在「吞吐优先、愿意为重算付钱」的场景下才被推荐。
同一份代码里还有一个坦白得可爱的注释,讲 gen-only 服务(P/D 分离的生成端)的困境:
if (mLlmRequestType == LlmRequestType::LLMREQUEST_TYPE_GENERATION_ONLY){ // If gen only server is configured with MAX_UTILIZATION scheduler, the running gen only request may be // paused and rescheduled as context_init state, which will run context phase, degrading performance. // Have no idea how to avoid this. If we modify the max utilization scheduler to avoid pausing // generation-only requests, it could result in no KV cache being available, causing requests to remain // unscheduled indefinitely. We just issue a warning here. TLLM_LOG_WARNING( "Pausing generation-only request, request_id: %lu, changes it to context init state, which may degrade " "performance.", mRequestId);}这段注释的价值在于它给出了一个没有被解决的权衡:生成端请求本不该走上下文阶段(它的上下文在 prefill 端已经算过),但为了腾显存只能暂停;而暂停又强制它回到 kCONTEXT_INIT。两难之处是——如果不允许暂停生成请求,显存腾不出来,请求会无限期等待。作者选择保留行为并打一条 WARNING,把判断留给运维。这类「已知退化但无更好解」的取舍,在真实系统里比教科书上的最优算法常见得多。
MicroBatchScheduler:token 预算如何计价
容量级交出了 fitting_requests,微批级要在这些请求里挑出真正进入这一步前向的集合。它的签名很短,但参数含义需要逐个拆开:
std::tuple<RequestVector, RequestVector> operator()(RequestVector& activeRequests, ReqIdsSet const& inflightReqIds, SizeType32 maxBatchSizeRuntime, std::optional<SizeType32> maxNumTokensRuntime) const;activeRequests:容量级筛过的fitting_requests。inflightReqIds:已经在模型里飞着的请求——流水线并行下别的 microbatch 正在算的那些。它们必须被跳过,否则会被重复调度。官方文档明确写着 PyTorch 流程不支持流水线并行,所以这个集合是空的;但代码保留了这个机制。maxBatchSizeRuntime:本步的序列条数上限。maxNumTokensRuntime:本步的 token 总量上限。注意它是std::optional——为nullopt时表示不限。
两个上限对应两重完全不同的约束。这一点官方文档给出的示意图非常直观:
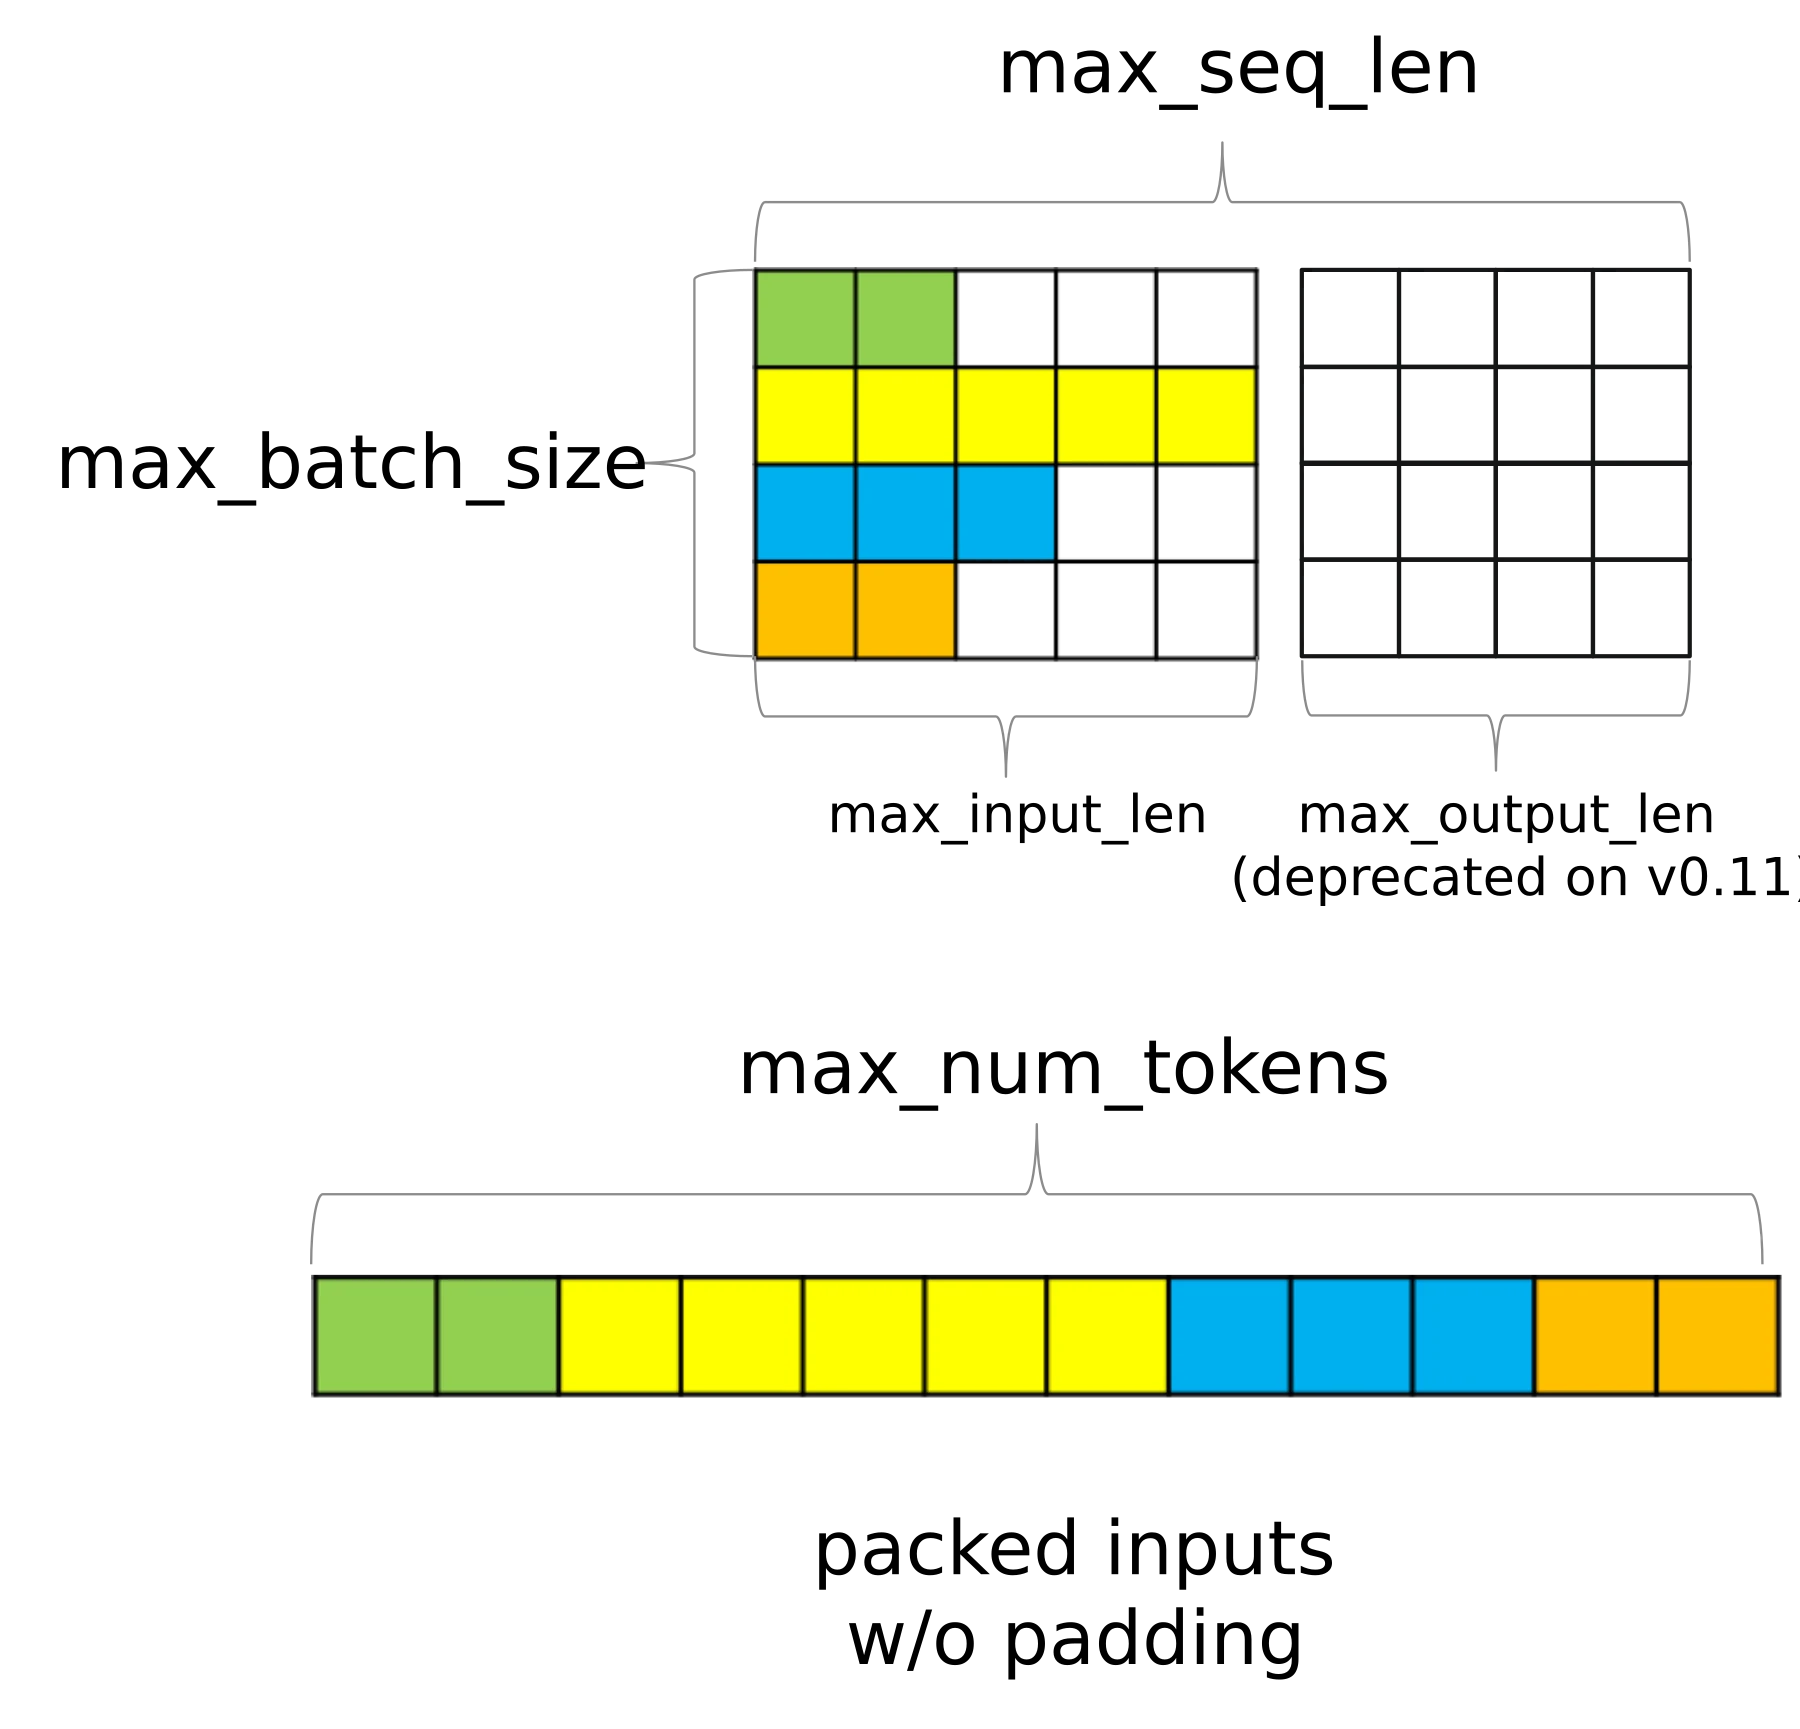
图:TensorRT-LLM 官方文档对各类上限的说明。max_input_len、max_output_len、max_seq_len 是单条序列的长度上限,max_batch_size 是并发序列条数上限,而 max_num_tokens 是一次前向里所有序列 token 数的总和上限——真正约束显存与算力的是「打包后的 token 总量」,而不是「批次里有多少条序列」。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/media/max_bs_toks_len.svg)
有了这两重约束,TensorRT-LLM 源码完全拆解(二) 里讲过的「分块上下文是微批调度的核心预算」就有了代码依据:max_batch_size 与 max_num_tokens 是两条独立的闸门,而 ctx_chunk_config 决定长提示词怎么被切进多轮。
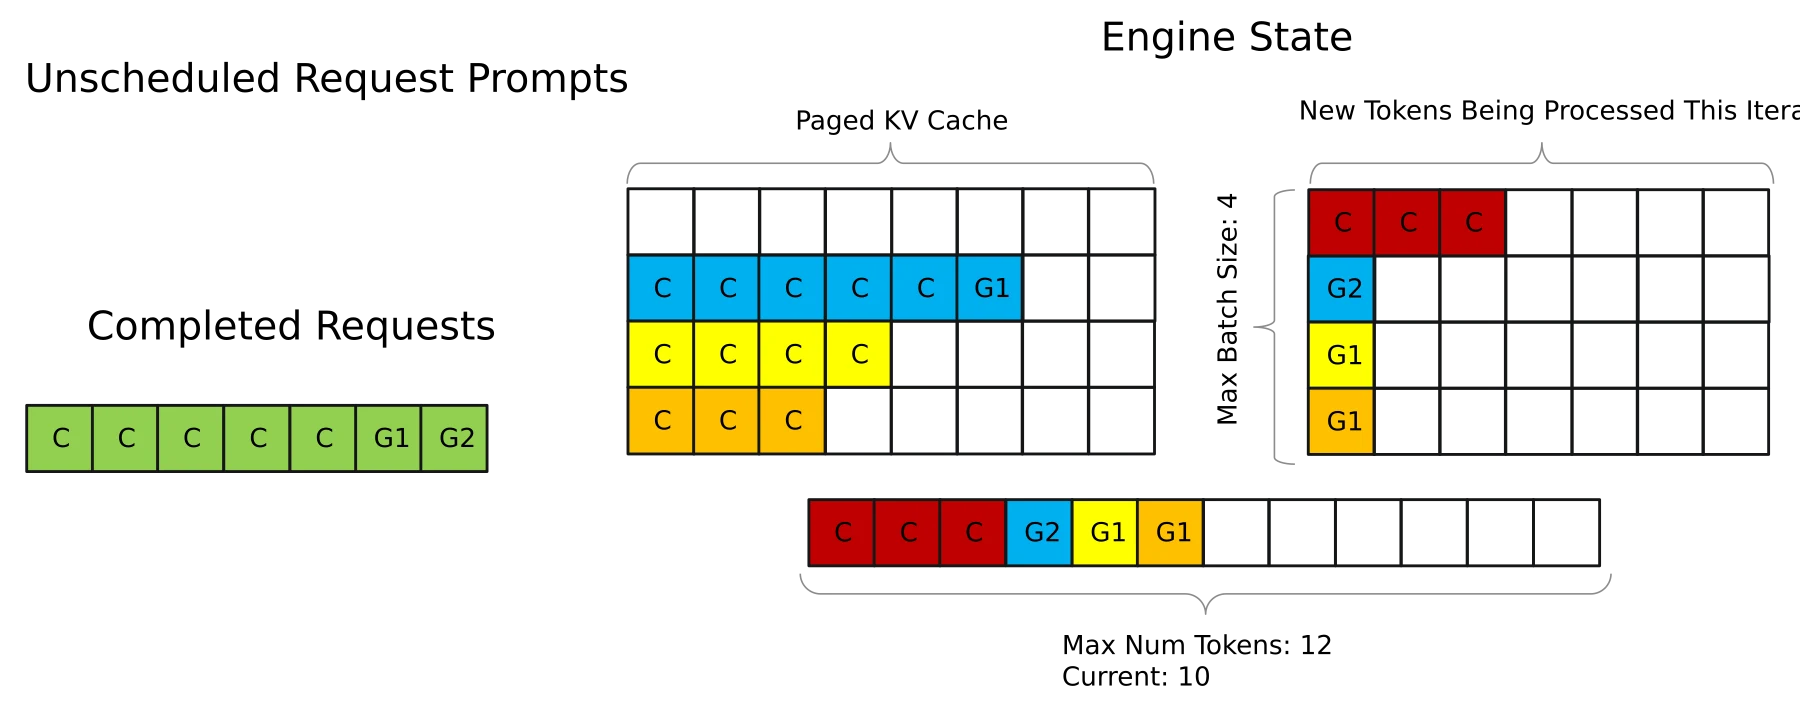
图:TensorRT-LLM 官方调度器示意的进一步形态,出现了 Max Batch Size: 4、Max Num Tokens: 12 与 Completed Requests 三组标记。它把两重约束并置——序列条数上限与 token 总量上限同时生效——并展示了完成的请求如何从引擎状态中移除、其占用的分页 KV 块随之回到可用池。微批 scheduler 的主循环就是在同时维护这两本账。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/media/TRTLLM_Scheduler_Vis_4.svg)
真正精巧的部分是计价函数。微批 scheduler 不把「请求有多少 token」当成成本,而是用一个专门的计算:
/// Return the forward-pass token cost for a context chunk with KV cache reuse.static SizeType32 reuse_adjusted_compute(SizeType32 chunkSize, SizeType32 reusable, SizeType32 contextRemaining){ if (reusable <= 0) { return chunkSize; } if (reusable + chunkSize < contextRemaining) { return chunkSize; } return std::max<SizeType32>(0, contextRemaining - reusable);}这三行浓缩了前缀复用的计价规则,值得逐步推演。设 chunkSize 为本轮的块大小、reusable 为可以从 KV 缓存里直接复用的 token 数、contextRemaining 为这条请求剩余待处理的上下文长度。
reusable <= 0:没有复用,成本就是块大小本身。reusable + chunkSize < contextRemaining:说明本轮这一块不是最后一块。此时成本仍然是chunkSize。原因写在调用点的注释里:
/// setPrepopulatedPromptLen shifts the chunk window right by the prepopulated/// amount rather than shrinking it. For non-last chunks the model still/// processes approximately chunkSize tokens; only for the last chunk is the/// cost contextRemaining - reusable.也就是说,复用带来的效果是窗口整体右移(预填充长度把游标往前推),而不是把这一块变小。非末块依然要算满 chunkSize 个 token。
reusable + chunkSize >= contextRemaining:本轮这一块能走到上下文末尾,那么真正需要计算的只剩contextRemaining - reusable个 token——前缀部分白拿。
这个函数是理解整个微批预算的钥匙:前缀复用只对「最后一块」产生计价折扣。这与直觉不完全一致(直觉上会以为命中前缀能省掉前缀长度那么多计算量),但它是正确的——因为分块是按块边界切的,命中前缀只是让块窗口在绝对位置上右移。只有在最后一块,右移才会把可复用的部分与「剩余不足一块」的部分重叠起来,产生真实的节省。
fitDraftTokens 是另一处容易被忽略的逻辑。当请求带有投机解码的草稿 token 时,草稿 token 也要占预算:
for (auto& llmReq : contextsToBeChunked){ if (llmReq->isLastContextChunk() && llmReq->hasDraftTokens()) { // How many more tokens could fit into this chunkUnit? (Round up to next multiple of chunkUnitSize) // Each chunkUnit requires an additional kvcache block, so we don't want to use an extra one just for draft // tokens. SizeType32 remainder = llmReq->getContextChunkSize() % chunkUnitSize; SizeType32 remainingSpaceForDraftTokens = remainder == 0 ? 0 : chunkUnitSize - remainder; ... SizeType32 const draftTokensToDiscard = llmReq->getNumDraftTokens() - remainingSpaceForDraftTokens; if (draftTokensToDiscard > 0) { TLLM_LOG_DEBUG("Discarding %d draft tokens", draftTokensToDiscard); llmReq->discardDraftTokens(draftTokensToDiscard); } }}推理链条是:草稿 token 想搭上最后一块的顺风车(它们紧跟在上下文之后),但块按 chunkUnitSize 对齐,多用一个块就是多占一份分页缓存;与其为几个草稿 token 再分配一个块,不如把装不下的草稿 token 丢掉。丢弃不影响正确性(草稿本来就是猜测),只是投机解码的收益会略降。这是一个典型的「碎片 vs 收益」权衡,且它把决策放在了调度侧而非执行侧。
最后是排序。微批 scheduler 在返回前会对两个列表排序:
if (chunksPresent){ // Move context requests that reached the last context chunk to the end of the vector. // This order is required to efficiently group requests in the sampler. auto firstFinished = std::partition(contextRequests.begin(), contextRequests.end(), [](auto const& llmReq) { return !llmReq->isLastContextChunk(); });
sortByLoraId(contextRequests.begin(), firstFinished); sortByLoraId(firstFinished, contextRequests.end());}else{ sortByLoraId(contextRequests.begin(), contextRequests.end());}sortByLoraId(generationRequests.begin(), generationRequests.end());两个排序键:是否最后一块与 LoRA task id。前者是为了让采样器能把「这一步就要出 token 的请求」聚在一起做批量采样;后者是为了让同一适配器的请求连续排布,减少 SGMV 类内核的切换开销(对照 SGLang 源码完全拆解(十三):多 LoRA 服务 里的批内多适配器路由)。调度器在这里承担了「为下游内核准备友好布局」的职责——这也是为什么调度代码往往是框架里注释最多的部分。
微批级的选择循环与三重分块策略
微批 scheduler 的主循环分两趟:第一趟挑人并分块,第二趟为分块请求分配块大小。
第一趟遍历所有 fitting_requests,按状态走三条分支:
if (llmReq->isEncoderInitState()){ reqNumTokens = llmReq->getEncoderOutputLen(); ... contextRequests.emplace_back(llmReq); batchNumTokens += reqNumTokens;}else if (llmReq->isContextInitState()){ // Reusable tokens set by capacity scheduler (from radix tree lookup). // Only valid for the first context chunk; subsequent chunks must compute all remaining tokens. SizeType32 const reusable = llmReq->isFirstContextChunk() ? llmReq->getEstimatedReusableTokens() : 0;
if (!mCtxChunkConfig) // skip chunking { SizeType32 const contextTokens = llmReq->getNumTokens(beam); SizeType32 const draftTokens = llmReq->hasDraftTokens() ? llmReq->getNumDraftTokens() : 0; reqNumTokens = contextTokens + draftTokens; SizeType32 const contextCompute = reuse_adjusted_compute(contextTokens, reusable, llmReq->getContextRemainingLength()); SizeType32 const computeTokens = std::max(1, contextCompute + draftTokens); ... batchNumTokens += computeTokens; } else { llmReq->setContextChunkSize(llmReq->getContextRemainingLength()); ... contextsToBeChunked.emplace_back(llmReq); numChunkedComputeTokens += computeTokens; }}else // (llmReq->isGenerationInProgressState()){ auto const reqBeamWidth = llmReq->getBeamWidthByIter(); reqNumTokens = reqBeamWidth + llmReq->getNumDraftTokens(); ... if (scheduledBeamWidth == 0) // set `scheduledBeamWidth` when the first request is scheduled { scheduledBeamWidth = reqBeamWidth; } else if (scheduledBeamWidth != reqBeamWidth) // Skip request with different beam width { ... continue; } generationRequests.emplace_back(llmReq); batchNumTokens += reqNumTokens;}几个要点:
reusable只在第一块有效。注释解释得很清楚:后续块的contextRemainingLength已经反映了预填充带来的推进,重复折扣会重复计算。isFirstContextChunk()的实现也很巧妙——它不查计数器,而是比较「当前位置是否等于预填充长度」:
[[nodiscard]] bool isFirstContextChunk() const noexcept{ // The number of cached token is encountered in mContextCurrentPosition, // so the start position of the context is mPrepopulatedPromptLen. return getContextCurrentPosition() == getPrepopulatedPromptLen();}std::max(1, contextCompute + draftTokens)里的那个 1 是在防「零成本请求」。如果一条请求整段都被前缀覆盖(contextCompute == 0),计价会变成 0——它在预算上「免费」,但实际仍要跑一次前向采样。强制最低成本 1 保证它不会被无限量塞进同一批。- beam width 一致性检查。同一批里混入不同 beam width 的请求会让采样器的张量形状不一致,所以第一个被调度的生成请求定下
scheduledBeamWidth,后续 beam width 不同的请求直接跳过。这是「批次内形状必须统一」的硬约束在调度层的体现。
第二趟只在「并非所有上下文都放得下」时进行:
if (maxNumTokensRuntime && numChunkedComputeTokens > maxNumTokensRuntime.value() - batchNumTokens){ allContextRequestsFit = false;}
// FORCE_CHUNK must always run boundary selection even when all contexts fit.if (mCtxChunkConfig && mCtxChunkConfig.value().chunkingPolicy == ContextChunkingPolicy::kFORCE_CHUNK){ allContextRequestsFit = false;}
if (!allContextRequestsFit){ TLLM_CHECK_WITH_INFO(mCtxChunkConfig, "If chunking is not enabled, context scheduling should be completed."); auto const ctxTokensCapacity = maxNumTokensRuntime ? std::make_optional(maxNumTokensRuntime.value() - batchNumTokens) : std::nullopt; setCtxRequestsChunkSize(contextsToBeChunked, mCtxChunkConfig.value().chunkingPolicy, ctxTokensCapacity, mCtxChunkConfig.value().chunkUnitSize, mMaxContextLength);}ctxTokensCapacity 是「生成请求吃完之后还剩多少 token 预算」,交给分块策略分配。注意 FORCE_CHUNK 被强制置为 allContextRequestsFit = false——它必须每次都跑边界选择,因为它的分块依据是「快照点」而不是「预算是否够」。
三种策略各有一段实现,它们是理解「分块到底在优化什么」的最好材料。
kEQUAL_PROGRESS:锁步推进。 每个请求每轮只前进一个 chunkUnitSize:
while ((!ctxTokensCapacity || numCtxTokens < ctxTokensCapacity.value()) && numTokensSingleLoop){ numTokensSingleLoop = 0; for (auto& llmReq : contextsToBeChunked) { SizeType32 pastChunkSize = llmReq->getContextChunkSize(); SizeType32 suggestedChunkSize = pastChunkSize + chunkUnitSize; llmReq->setContextChunkSize(suggestedChunkSize);
SizeType32 actualChunkSize = llmReq->getContextChunkSize(); SizeType32 actualIncrement = actualChunkSize - pastChunkSize; ... if ((ctxTokensCapacity && numCtxTokens + computeIncrement > ctxTokensCapacity.value()) || (maxContextLength && actualChunkSize > maxContextLength.value())) { llmReq->setContextChunkSize(pastChunkSize); continue; } numCtxTokens += computeIncrement; // Keep raw actualIncrement for loop-termination detection (not compute-aware). numTokensSingleLoop += actualIncrement; }}它的效果是所有上下文请求同步前进,长提示词与短提示词每轮各推进相同的小块。这带来两个好处:批次内的计算量分布均匀(对流水线并行友好),以及每条请求的 TTFT 相对公平(不会出现「后来的短请求先跑完、先来的长请求还在等」)。注释里那句「Loop-termination uses the raw token increment (actualIncrement), not the compute-adjusted one, so a request whose entire new chunk is reusable still counts as progress and does not cause a premature exit」是一个容易写错的地方:如果拿「计价后的增量」做终止判断,那么当一块全被前缀覆盖(计价增量为 0)时循环会误判为「没有进展」而提前退出,丢掉本该分配的分块。
kFIRST_COME_FIRST_SERVED:贪心吃满。 按顺序,每条请求先要「剩余全部」,再被两个约束削减:
SizeType32 const suggestedChunkSize = llmReq->getContextRemainingLength();SizeType32 const reusable = llmReq->isFirstContextChunk() ? std::min(llmReq->getEstimatedReusableTokens(), suggestedChunkSize) : 0;SizeType32 const computeCost = reuse_adjusted_compute(suggestedChunkSize, reusable, suggestedChunkSize);SizeType32 actualChunkSize = suggestedChunkSize;if (ctxTokensCapacity && computeCost > ctxTokensCapacity.value()){ actualChunkSize = ctxTokensCapacity.value();}if (maxContextLength){ SizeType32 const actualCompute = reuse_adjusted_compute(actualChunkSize, reusable, suggestedChunkSize); if (actualCompute > maxContextLength.value()) { actualChunkSize = maxContextLength.value(); actualChunkSize = std::min(actualChunkSize, suggestedChunkSize); }}if (actualChunkSize != suggestedChunkSize){ actualChunkSize = actualChunkSize / chunkUnitSize * chunkUnitSize;}llmReq->setContextChunkSize(actualChunkSize);if (ctxTokensCapacity){ SizeType32 const modelCost = reuse_adjusted_compute(actualChunkSize, reusable, suggestedChunkSize); ctxTokensCapacity = ctxTokensCapacity.value() - modelCost;}两个约束分别是「token 预算」与「单块最大计算量上限」。削减之后一律向下对齐到 chunkUnitSize 边界(actualChunkSize / chunkUnitSize * chunkUnitSize),理由与 chunkUnitSize 的注释一致:「it generally needs to be equal to the size of the kv cache block or its integer multiples (except for the last context chunk) to avoid fragmentation」。这条对齐规则在 TensorRT-LLM 源码完全拆解(二) 提到的「分块越细 TTFT 越差、批内混杂度越高」之外,补上了另一半代价:不对齐就会产生碎片。
kFORCE_CHUNK:按快照点切。 这一种最特殊,它服务于线性注意力等模型的循环状态快照:
auto const& expectedSnapshotPoints = llmReq->getExpectedSnapshotPoints();if (!expectedSnapshotPoints.empty()){ auto const currentPosition = llmReq->getContextCurrentPosition(); std::optional<SizeType32> nextSnapshotPoint; for (auto const point : expectedSnapshotPoints) { if (point > currentPosition && (!nextSnapshotPoint || point < nextSnapshotPoint.value())) { nextSnapshotPoint = point; } } chunkSize = nextSnapshotPoint ? std::max<SizeType32>(0, std::min(nextSnapshotPoint.value(), llmReq->getPromptLen()) - currentPosition) : llmReq->getContextRemainingLength();}它把块边界对齐到「下一个期望快照点」,注释说明了原因:「This policy is designed for linear attention state caching, so reusable KV-cache tokens are NOT calculated because it’s not supported yet.」线性注意力的状态(如 Kimi Delta Attention 里的递推状态)无法像 KV 块那样按需取用,只能在预设快照点保存;因此分块必须落在快照点上,而前缀复用计价在这里也被刻意关闭。
三种策略的对比可以收成一张表:
| 策略 | 分块依据 | 复用计价 | 适合场景 | 主要代价 |
|---|---|---|---|---|
kEQUAL_PROGRESS | 所有请求锁步各进一块 | 是(仅首块) | 公平 TTFT、流水线并行 | 短请求要陪着长请求慢慢走 |
kFIRST_COME_FIRST_SERVED | 队头贪心吃满预算 | 是(仅首块) | 吞吐优先、提示词长度差异大 | 后面的请求可能整轮分不到预算 |
kFORCE_CHUNK | 对齐循环状态快照点 | 否 | 线性注意力 / 混合模型 | 分块粒度受限,失去前缀折扣 |
这里还有个细节:分块后的请求要重新过一遍预算累加,且只有块大小大于 0 才被放进 contextRequests:
for (auto const& llmReq : contextsToBeChunked){ if (llmReq->getContextChunkSize() > 0) { contextRequests.emplace_back(llmReq); SizeType32 const reusable = llmReq->isFirstContextChunk() ? llmReq->getEstimatedReusableTokens() : 0; SizeType32 const computeTokens = reuse_adjusted_compute(llmReq->getContextChunkSize(), reusable, llmReq->getContextRemainingLength()); batchNumTokens += computeTokens; ... }}getContextChunkSize() > 0 这个判断挡住了「本轮预算已经耗尽、某条请求分到 0 个 token」的情况——分到 0 就不该出现在 batch 里,它的状态也不会被推进,下轮重新参与调度。
为什么分块是「对齐计算量」而不是「省计算量」
前面反复出现 chunkUnitSize、max_num_tokens、锁步推进这些概念,它们共同指向一个更基础的问题:分块到底解决了什么? 这一点在 Sarathi-Serve 论文(OSDI 2024)里被讲得最清楚,它的答案常被误解——分块不是为了少算,而是为了让每一步的计算量均匀。
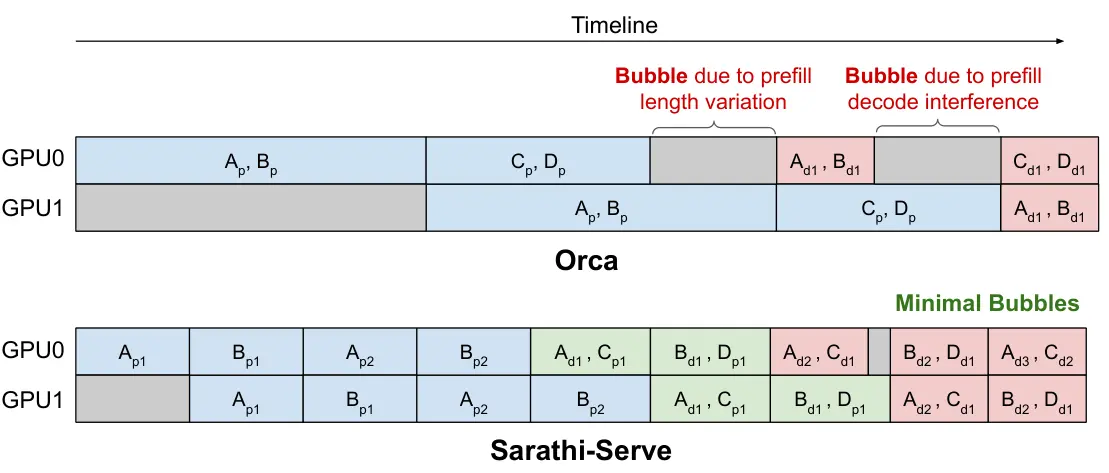
图:Sarathi-Serve 论文 Figure 8「A 2-way pipeline parallel iteration-level schedule in Orca across 4 requests (A,B,C,D) shows the existence of pipeline bubbles due to non-uniform batch execution times. Sarathi-Serve is able to minimize these stalls by creating uniform-compute batches.」图中四个请求在两级流水线上交错执行,可以看到因为各步计算量不同而出现的空白区(气泡)——这些空白就是被浪费的算力。(来源:arXiv:2403.02310,Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve)
原始论文的立论是:prefill 与 decode 的计算特征完全不同。Prefill 是计算密集的(一条 1024 token 的提示词要算 1024 个位置的注意力),decode 是访存密集的(一个 token 却要读完整份 KV Cache)。把两者混在同一步里,就会出现「这一步很重、下一步很轻」的锯齿,锯齿在流水线并行下变成气泡,在单卡上则表现为 GPU 利用率的剧烈波动。
Sarathi-Serve 的解法是把长提示词切成等大的块(chunked prefill),让每一步都吃下大体相当的 token 量:
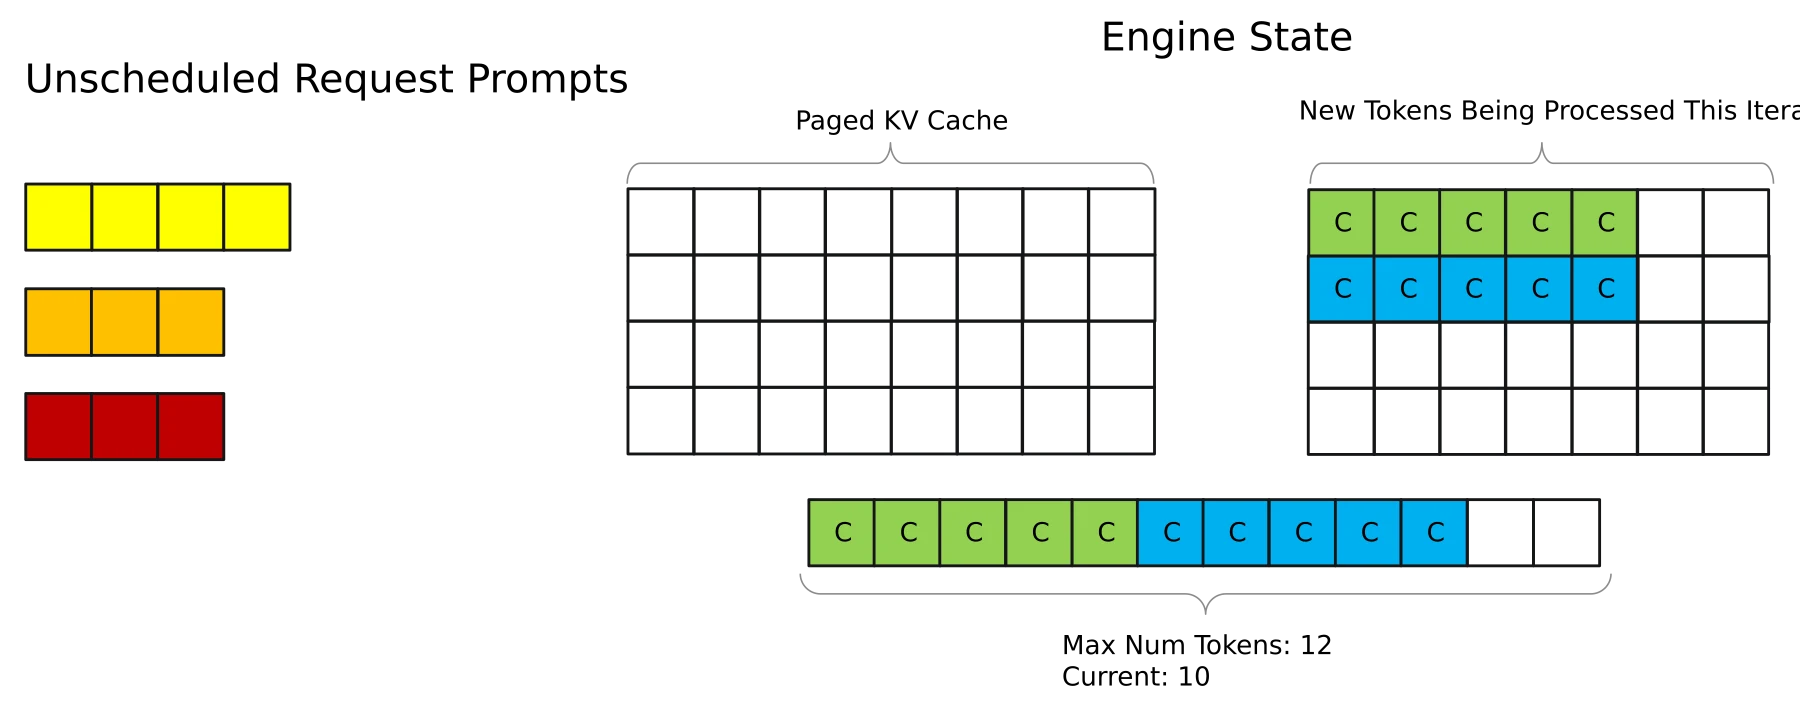
图:TensorRT-LLM 官方调度器示意(带 Max Num Tokens: 12 / Current: 10 的预算计数)。每轮处理的 token 数被显式计入预算,未调度的请求留在队列等待下一轮。这正是分块上下文所需的记账方式:max_num_tokens 是每轮的硬预算,调度器按预算把上下文块与生成请求拼进同一批。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/media/TRTLLM_Scheduler_Vis_2.svg)
对照 TensorRT-LLM 的实现,可以看到这套思想被完整继承了下来,只是被拆得更细:
- 预算显式化:
max_num_tokens就是图中那个Max Num Tokens: 12,batchNumTokens就是Current: 10。 - 计算量而非 token 数计价:
reuse_adjusted_compute让「已经缓存过的前缀」不计入预算——因为前缀复用的部分不产生前向计算。 - 块边界对齐块大小:
chunkUnitSize必须与kvTokensPerBlock对齐或为其整数倍,否则会产生分页碎片。 - 三种分配策略:Sarathi-Serve 论文里的调度是「优先保证 decode 的 TBT,剩下的预算给 prefill」;TensorRT-LLM 把它扩展成三种可选策略,让运维按负载特征选。
真正被解决的问题在这里:分块让每一步的计算量可控且可预测。它不减少总计算量(长提示词还是那些 token),但它把「一整块巨石」变成「一排等重的砖」,于是调度器可以精确地往每一步里塞进尽可能多的砖——这才是「taming throughput-latency tradeoff」的准确含义。
横向对比:四个框架的调度器对照
把 TensorRT-LLM 的两级调度放进四框架的坐标系,差异会更清楚。下表按本篇与前三站源码整理:
| 维度 | vLLM(V1) | SGLang | llama.cpp | TensorRT-LLM |
|---|---|---|---|---|
| 调度粒度 | 单级 Scheduler.schedule | PrefillAdder 预算 + ScheduleBatch 组装 | slot 状态机 + 批组装 | 两级:Capacity + MicroBatch |
| 准入判据 | num_free_blocks / 预算判定 | kv_available 三重容量预算 | slot 是否空闲、上下文预算 | per-request 块探测(predict-then-commit) |
| 抢占语义 | 抢占(preemption),可重算或换出 | 撤回(retract) | 无真正的抢占(slot 复用) | paused_requests → 必然重算 |
| 前缀复用决策 | 前缀命中在分配时体现 | RadixCache 命中 + 缓存感知调度 | 前缀检查点复用 | 写进准入决策(beneficialToSkip) |
| 分块策略 | 统一调度 + 分块预填 | Chunked Prefill 三重预算 | 无(按 slot 批量) | 三种策略(锁步 / FCFS / 强制) |
| 并行场景支持 | TP / DP / P-D 分离 | TP / DP Attention / EP / P-D | 单机为主 | TP / PP / DP / EP / CP / Wide-EP |
几处值得单独解释的差异:
前缀复用是否参与准入。 这是 TensorRT-LLM 最有辨识度的设计。vLLM 与 SGLang 都做前缀缓存,但它们的命中结果影响的是「分配了多少块」;TensorRT-LLM 让命中结果影响「这一轮到底接不接纳这条请求」——如果发现有别的请求马上会贡献同样的块,就主动延后自己。这是一个把「缓存命中率」提升为「调度目标」的决定性设计。
抢占的代价是否显式。 vLLM 的抢占可以走重算或换出两条路(取决于是否启用 swap),SGLang 的 retract 语义更接近「撤回等待」。而 TensorRT-LLM 的 LlmRequest::pause 只有一条路:把已生成 token 并入 prompt,然后全量重算。这个设计更简单、更可预测,代价是单次暂停的开销上限更高(见前文对 max_input_len 截断的分析)。
调度器是否被绑定到 C++。 vLLM 与 SGLang 的调度器是纯 Python,改动调度逻辑只需要改 Python;TensorRT-LLM 的容量级与微批级都在 C++,Python 侧只留了一层薄绑定:
class BindMicroBatchScheduler(MicroBatchScheduler): def __init__(self, max_batch_size, max_num_tokens=None, ctx_chunk_config=None, ...): self.impl = tb_internal.algorithms.MicroBatchScheduler( ctx_chunk_config=ctx_chunk_config_cpp, max_context_length=max_num_tokens, no_schedule_until_state=no_schedule_until_state, no_schedule_after_state=no_schedule_after_state, )选择 C++ 的收益是每步调度开销更低(调度在关键路径上,每步都跑)、能做更激进的原地数据结构操作(比如 reqItEnd 收缩);代价是自定义调度必须重建整个库。官方给出的平衡方案是保留 Python 的 PyMicroBatchScheduler 参考实现(scheduler_pkg.py 里的 PyCapacityScheduler / PyMicroBatchScheduler / SimpleUnifiedScheduler),需要实验性调度逻辑时可以走纯 Python 路径。
顺带说明 Python 侧那条路径的现状:SimpleUnifiedScheduler 会构造 PyCapacityScheduler 与 PyMicroBatchScheduler,前者的注释写着「Now fully aligned with C++ CapacityScheduler」——也就是说这份 Python 实现是 C++ 实现的镜像,既可以用作参考读物,也可以作为自定义调度的起点。仓库里还有一份 GuaranteedNoEvictScheduler 的 Python 版本,官方文档直接把它当成「自定义容量调度器」的示例:
class GuaranteedNoEvictScheduler(CapacityScheduler): # only schedule requests has no_schedule_until_state <= state < no_schedule_after_state no_schedule_until_state = LlmRequestState.CONTEXT_INIT no_schedule_after_state = LlmRequestState.GENERATION_COMPLETE
def schedule_request(self, active_requests: RequestList) -> tuple[list[LlmRequest], list[LlmRequest]]: scheduled_requests = [] pending_requests = [] reserved_blocks = 0 max_blocks = self.kv_cache_manager.get_max_resource_count() for request in active_requests: req_state = request.state if req_state.value < self.no_schedule_until_state.value or req_state.value >= self.no_schedule_after_state.value: continue if len(scheduled_requests) >= self.max_num_requests or reserved_blocks >= max_blocks: break elif req_state == LlmRequestState.GENERATION_IN_PROGRESS or req_state == LlmRequestState.GENERATION_TO_COMPLETE: scheduled_requests.append(request) reserved_blocks += self.kv_cache_manager.get_needed_resource_to_completion(request) else: pending_requests.append(request)
available_blocks = max_blocks - reserved_blocks for request in pending_requests: ...这份实现把 C++ 版本的骨架用 Python 复述了一遍:先钉住在跑请求并累计「到完成」的块需求,再用剩余额度接纳新请求。读 C++ 之前先看这段 Python,理解成本会低很多——这也是官方文档把它留在教程里的原因。
局限与工程取舍
调度器的每一条规则背后都有代价,部署前值得逐条想清楚:
GUARANTEED_NO_EVICT的「到完成」预留会显著降低并发度。一条刚接纳的请求会把它整个生命周期可能占用的块一次性预留,于是同样大小的 KV 池能容纳的请求数远少于按步记账的方案。表现为「池子看起来够大,但并发上不去」。官方对此的补救是提供get_needed_resource_to_completion的估算口径,但估算本身依赖生成长度上限的配置——max_output_len配得越大,预留越保守。MAX_UTILIZATION的重算代价可能吃掉吞吐收益。暂停一条已生成 2000 token 的请求,意味着下一次要重算 2000+ token 的上下文。在高并发短输出场景下这个代价可以忽略;在长输出场景下它可能让「提升利用率」变成净亏损。选择策略前应估算平均输出长度与暂停频率。- 暂停时的
max_input_len截断会造成输出丢失。newPromptLen = min(maxInputLen, mPromptLen + getMaxNumGeneratedTokens())意味着回卷后的长度有硬上限,超出部分被丢弃。长对话 +MAX_UTILIZATION的组合需要特别留意这一点。 - 前缀感知跳过的收益依赖前缀重叠度。
beneficialToSkip只在「同前缀请求成组到达」时才有价值;如果流量里几乎没有重复前缀,那它只带来额外的一次 radix tree 查询开销。这也解释了为什么它有一个独立开关enable_prefix_aware_scheduling。 - 可变窗口注意力下前缀感知整体失效。
isVariableWindow()一为真,跳过逻辑与analyzePrefixReuse都被关闭(后者在可变窗口管理器上会直接 assert)。VSWA 模型(per-layer 不同窗口尺寸)因此在调度侧拿不到前缀复用的收益,收益只能靠分配侧的块复用兜住。 - FCFS 分块策略存在队头阻塞的残余。队头长提示词会先吃满预算,后面的请求整轮拿不到 token。
kEQUAL_PROGRESS缓解了这一点,但代价是短请求也被迫陪着慢慢走。 FORCE_CHUNK关闭了复用计价。线性注意力模型享受不到前缀折扣,因为循环状态只能在快照点保存。这是模型结构带来的硬约束,不是实现缺陷。- 微批 scheduler 的
inflight_request_ids在 PyTorch 路径下恒为空。流水线并行不支持,意味着这套「跳过在途请求」的机制在当前主干上没有实际作用;读代码时不要假设它生效,也不要基于它推断调度行为。
小结
本篇把 TensorRT-LLM 的调度器从接口一路读到了每一行判断,可验证的结论收拢如下:
- 请求状态机靠枚举数值表达时间顺序(
Enum order must follow chronological order),因此状态判断是mState >= state一次比较;kDISAGG_GENERATION_INIT等状态被特别放行,目的是让 P/D 分离的生成端提前预留 KV。 CapacityScheduler是分发器而非实现,按CapacitySchedulerPolicy在MaxRequestsScheduler、GuaranteedNoEvictScheduler、StaticBatchScheduler、MaxUtilizationScheduler四个实现中选择,另有AgentTreePolicy重排策略可在调度前对 agent 流量重排序。- 两种预留粒度决定两种失败模式:
NoEvictScheduledBlocksManager按「到完成」预留(保守、不重算),MaxUtilizationScheduledBlocksManager按「下一步」预留(激进、会暂停)。两者的探测接口都是「先预测、后提交」,保证失败探测无副作用。 - 前缀感知调度把缓存命中变成准入判据:
beneficialToSkip纯函数负责判定、registerContributedBlocks在确认接纳后登记,二者由同一个谓词skipTrackingApplies把门,避免「贡献者未被调度、依赖者却被延后」。登记若提前到判定阶段,会让MAX_UTILIZATION的请求在暂停-重试时把自己跳过,白丢一次腾出来的容量。 paused_requests的语义是重算而非换出:LlmRequest::pause把已生成 token 并入 prompt(受max_input_len截断)、重置上下文游标与复用估计、释放序列槽位,状态回到kCONTEXT_INIT;代价是一次全量重算,官方代码里对此留有明确的 WARNING。- 微批级的预算按「前向计算量」计价:
reuse_adjusted_compute只在「最后一块」对可复用前缀打折,因为非末块的复用以窗口右移体现而非缩小块体;草稿 token 装不进对齐后的块时会被主动丢弃以避免多占一个分页块。 - 三种分块策略各有明确的适用面:锁步推进(公平、均匀)、先到先服务(吞吐、贪心)、强制分块(对齐循环状态快照点)。
下一篇进入 KV Cache Manager 与 ScheduledBlocksManager 的内部:块分配器如何在 startScheduling / schedulingRemoveSequence / commitBlocks 这套接口下维护一致账目、块表如何从逻辑位置映射到物理块、前缀复用的 radix tree 如何与调度器共享同一份 PrefixReuseSummary,以及 KV 容量估算出的块数最终怎样约束调度决策。
参考资料
- TensorRT LLM Scheduler 官方文档
- TensorRT LLM KV Cache Manager 官方文档
- KV Cache Management: Pools, Blocks, and Events
- Capacity Scheduler 源码(cpp/tensorrt_llm/batch_manager/capacityScheduler.cpp)
- Micro Batch Scheduler 源码(cpp/tensorrt_llm/batch_manager/microBatchScheduler.cpp)
- LlmRequest 与状态机定义(cpp/include/tensorrt_llm/batch_manager/llmRequest.h)
- Python 侧调度器包(tensorrt_llm/_torch/pyexecutor/scheduler.py)
- NVIDIA/TensorRT-LLM GitHub 仓库
- Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve(OSDI 2024)
- Llumnix: Dynamic Scheduling for Large Language Model Serving(SOSP 2024)
- Efficient Memory Management for Large Language Model Serving with PagedAttention
- Orca: A Distributed Serving System for Transformer-Based Generative Models(OSDI 2022)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



