


TensorRT-LLM 源码完全拆解(一):整体架构与模块全景——构建期已消失,PyTorch 后端如何接管推理引擎
系列进度与本篇定位
这是「四个推理框架源码系统学习」系列的第四站。前三站已经走完:
- vLLM(16 篇):从整体架构、
EngineCore.step调度闭环,到 Scheduler、KVCacheManager、GPUModelRunner、Attention Backend、PagedAttention Kernel、FusedMoE、Sampler,最后用一篇源码阅读地图把十六篇串成一条路径。可参考 vLLM 源码完全拆解(十六):把十五篇机制拼成一张可执行的源码阅读地图。 - SGLang(18 篇):从进程拓扑、
Req状态机、PrefillAdder 预算、RadixCache 所有权,到 Overlap Scheduler、ForwardBatch、Attention Backend、CUDA Graph、Sampling/Grammar、投机解码、P/D 分离、多 LoRA、多模态、HiCache、DP Attention + EPLB、弹性 EP 与故障恢复。可参考 SGLang 源码完全拆解(一):整体架构、进程拓扑与请求数据流。 - llama.cpp(8 篇):从 ggml 后端抽象、计算图与内存分配器、GGUF 装载与 mmap,到
llama_context与 KV Cache、采样与 GBNF、图构建与注意力、后端 kernel、服务化调度。可参考 llama.cpp 源码完全拆解(一):整体架构与模块全景——ggml 后端抽象、llama_model/llama_context 与图构建。
前三站的读法有一个共同点:它们都是「Python 编排 + 底层 kernel」的两层结构,我们可以顺着 Python 一路读到 CUDA。TensorRT-LLM 不一样——它曾经是最重的那一层,而现在刚刚经历了一次伤筋动骨的重构。
所以本系列第一篇不讲调度细节,先把地形摸清楚:它被砍掉了什么、留下的骨架长什么样、哪些模块是这套框架真正独有的东西。
最重要的事实:TensorRT engine 后端已被移除
如果你手上是 2024 年之前的资料,几乎一定会看到这样一个流程:
HF checkpoint → convert_checkpoint.py → trtllm-build → engine 文件 → runtime 加载这是 TensorRT-LLM 早期的核心形态:先用一个「转换脚本」把 HuggingFace 权重转成中间格式,再调用 NVIDIA TensorRT 编译器离线构建出一个序列化的 .engine 文件,运行时加载这个 engine 直接执行。这个形态有明确的工程收益(编译期做完算子融合、kernel 自动调优、形状特化),代价也很明确:模型改一行就要重新构建一次,构建过程动辄几十分钟到几小时。
现在这套东西没了。仓库里 docs/source/legacy/tensorrt-backend-removal.md 写得非常直接:
Breaking change. The TensorRT engine backend has been removed. PyTorch is now the sole execution backend for TensorRT LLM.
对应的迁移表里,被删掉的东西包括:
| 被移除 | 替代 |
|---|---|
LLM(backend="tensorrt") | 直接报 ValueError,PyTorch 是唯一后端 |
TrtLlmArgs | TorchLlmArgs(默认) |
trtllm-build / trtllm-refit / trtllm-prune | 不存在了,构建步骤取消 |
每个模型一个的 convert_checkpoint.py | 不需要,不做 checkout 转换 |
tensorrt pip 依赖 | 已不再安装 |
这段变化值得单独强调,因为它改变了读源码的方式。你已经不需要理解 TensorRT 的 builder / network / plugin 机制,也不再需要在 cpp/tensorrt_llm/ 里找 engine 反序列化逻辑。今天的 TensorRT-LLM 是一个「以 PyTorch 为核心的推理引擎」:模型用原生 PyTorch 定义(tensorrt_llm/_torch/models/modeling_*.py),kernel 用 CUDA/CUTLASS/CuTe DSL 写(cpp/tensorrt_llm/kernels/、cute_dsl_kernels/),中间由一个 Python 执行器把它们调度起来。
一个自然的疑问是:那「TensorRT-LLM」这个名字里的 TensorRT 去哪了? 答案是它退化成了一个可选的、性能取向的 kernel 提供方,而不是必须经过的编译阶段。真正撑起框架的是下面这套执行器体系。
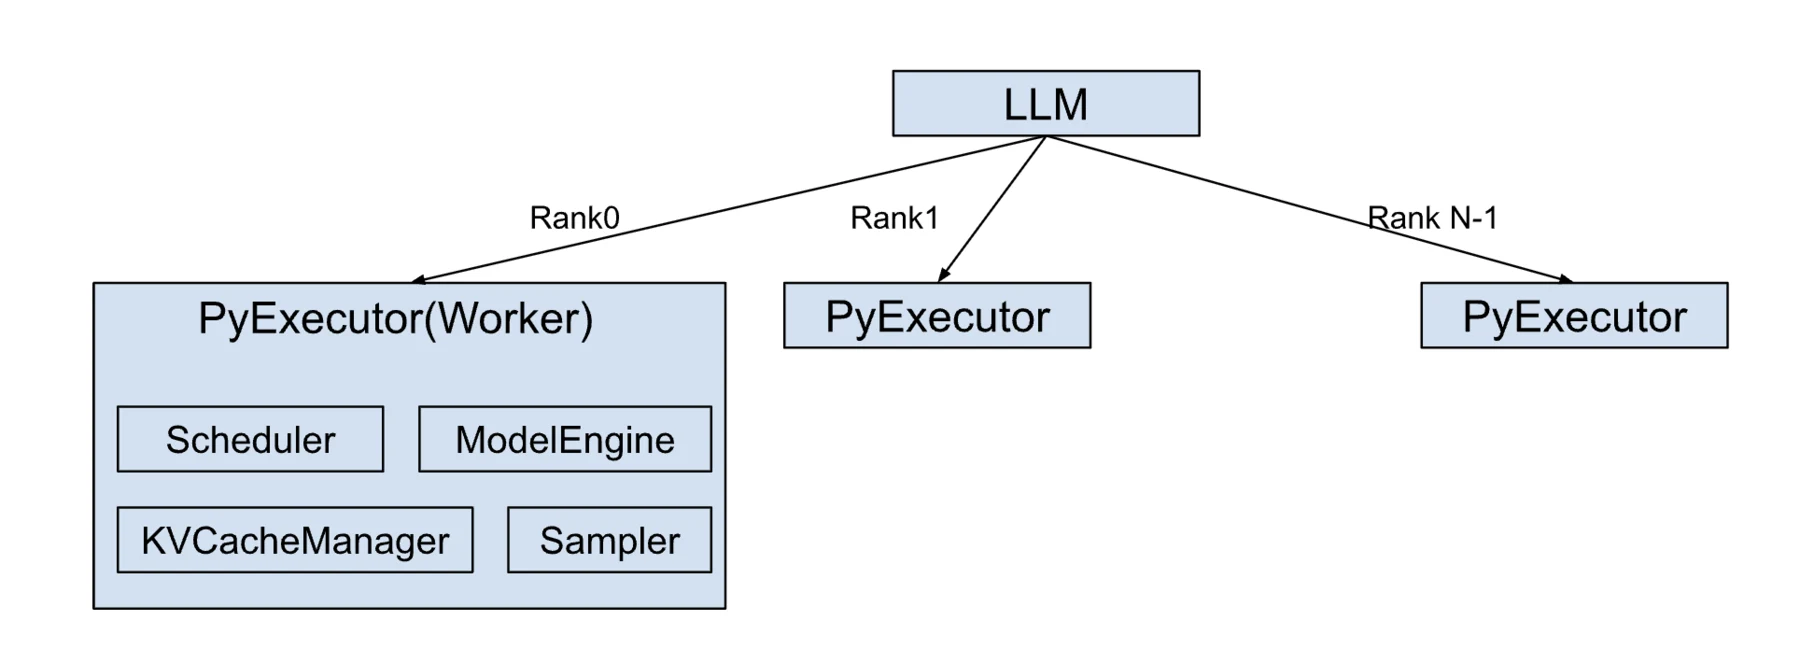
图:TensorRT-LLM 官方文档给出的架构总览。自上而下是 LLM API、PyExecutor(含 Scheduler / KV Cache Manager / Decoder / Model Engine)、以及底层的 TensorRT-LLM C++ Runtime 与各类 kernel。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/media/)
这张图是理解本篇的关键:它直接给出了「请求进来之后,被谁接住、被谁调度、最后被什么执行」的分层。接下来我们逐层拆开。
仓库地形:一个仓库里的六种东西
读一个陌生框架,先看顶层目录比读 README 更快。TensorRT-LLM 主分支的顶层结构是这样的(省略配置文件):
cpp/ C++ 侧全部内容 include/ 对外头文件 kernels/ 独立 kernel 库(xqa、fmha_v2) tensorrt_llm/ C++ 核心:batch_manager / executor / runtime / kernels micro_benchmarks/ 微基准tensorrt_llm/ Python 侧全部内容 _torch/ PyTorch 后端主体(下一篇的主角) llmapi/ LLM API 与 LLM 对象 models/ 模型定义(旧路径,逐步迁往 _torch/models) quantization/ 量化配置与 mode executor/ Executor API 的 Python 封装 commands/ CLI(trtllm-serve / trtllm-bench 等) bench/ evaluate/ serve/ tokenizer/ ...kernels/ (已归并到 cpp/kernels)examples/ 分场景示例(quickstart_advanced 等)triton_backend/ Triton Inference Server 后端适配triton_kernels/ Triton kerneldocs/ 文档scripts/ 构建与环境脚本这里有一个非常值得注意的结构特征:同一个框架里同时存在 Python 与 C++ 两套「核心」,而且它们不是简单的主从关系。
tensorrt_llm/_torch/是 Python 后端的主体,包含模型定义、注意力后端、MoE、投机解码、KV Cache 管理、编译路径、显存管理等几乎所有推理逻辑。cpp/tensorrt_llm/包含batch_manager(批管理、KV Cache Manager、缓存传输)、executor(请求/响应抽象、序列化)、runtime(缓冲区、通信、虚拟内存)、kernels(真正的 CUDA 算子)。
关键问题是:哪些逻辑在 Python,哪些下沉到 C++? 官方文档给的答案很具体——调度器与 KV Cache Manager 当前使用 C++ binding,但接口用 Python 实现,因此可以自定义:
Both CapacityScheduler and MicroBatchScheduler currently use C++ bindings. However, since the interfaces are implemented in Python, customization is possible.
Currently, the KVCacheManager uses C++ binding. However, customization in Python is possible, as its interface is implemented in Python.
翻译成可操作的结论:读调度和 KV 管理时,你会看到 Python 接口调用 C++ binding(例如 BindCapacityScheduler(max_num_requests, kv_cache_manager.impl)),逻辑主体在 cpp/tensorrt_llm/batch_manager/ 里;但 Python 侧留了继承点,你可以用 Python 重写算法而不碰 C++——GuaranteedNoEvictScheduler 就是文档给出的例子,它继承 CapacityScheduler 并自己实现 schedule_request。
这个「接口在 Python、实现在 C++」的设计贯穿整个框架,也是它和 vLLM/SGLang 最大的手感差异:后两者基本是纯 Python + 少量自定义 kernel,而 TensorRT-LLM 是「Python 编排层 + 厚重的 C++ 运行时」,两者通过 nanobind(cpp/tensorrt_llm/nanobind/)绑定。
C++ 侧的三个支柱:executor、runtime 与 batch_manager
既然逻辑主体在 C++,就有必要把 cpp/tensorrt_llm/ 这三个目录的边界说清楚。它们的分工是:executor 定义「请求和响应长什么样」,runtime 提供「跑起来需要的内存与通信」,batch_manager 决定「请求怎么被组织成批次」。
cpp/tensorrt_llm/executor/:请求与响应的契约层
这个目录里几乎没有算法,全是数据结构与配置的序列化:
request.cpp / requestWithId.cpp / response.cpp 请求与响应对象schedulerConfig.cpp 调度器配置kvCacheConfig.cpp / kvCacheRetentionConfig.cpp KV Cache 容量与保留策略配置dynamicBatchConfig.cpp 动态批配置guidedDecodingConfig.cpp / guidedDecodingParams.cpp 结构化输出(引导解码)配置loraConfig.cpp / peftCacheConfig.cpp LoRA 与 PEFT 缓存配置multimodalInput.cpp 多模态输入描述mropeConfig.cpp M-RoPE(多模态 RoPE)配置promptTuningConfig.cpp 提示调优配置cacheTransmissionConfig.cpp 缓存传输配置contextPhaseParams.cpp context 阶段参数tensor.cpp / types.cpp / serialization.cpp 张量与类型、序列化基础设施把它读成一张「能力清单」会很有收获:一个推理引擎对外需要暴露的可配置面,几乎就是这个目录的文件名列表。调度策略、KV 容量与保留、动态批、引导解码、LoRA、多模态输入、M-RoPE、缓存传输——每一项都对应一个独立的配置文件。这也解释了为什么 Python 侧的 llm_args.py 会那么庞大:它要一对一地映射这些 C++ 侧的配置结构。
guidedDecodingConfig 与 guidedDecodingParams 分成两个文件这件事也值得注意:前者是「如何配置」,后者是「本次请求具体用什么语法/约束」。这种「配置与参数分离」的模式在 KV Cache(kvCacheConfig 与 kvCacheRetentionConfig)上也重复了一次,是这套代码库的一致风格。
cpp/tensorrt_llm/runtime/:内存、通信与设备抽象
bufferManager.cpp / iBuffer.cpp / tllmBuffers.cpp 缓冲区管理cudaMemPool.cpp CUDA 内存池virtualMemory.cpp 虚拟内存ncclCommunicator.cpp NCCL 通信封装worldConfig.cpp / workerPool.cpp 世界配置与 worker 池ipcSocket.cpp / ipcNvlsMemory.cu / ipcUtils.cpp IPC 与 NVLS 内存mcastDeviceMemory.cpp / mcastGroupComm.cpp 多播设备内存与组通信bufferManagerNvls.cpp NVLS 缓冲管理loraCache.cpp / loraModule.cpp / loraUtils.cpp LoRA 权重缓存memoryCounters.cpp 显存计数moeLoadBalancer/ MoE 负载均衡locality_domain/ 局部性域(拓扑感知)tllmBuffers.h / torch.h / torchUtils.h / torchView.h 与 PyTorch 张量的桥接这里有三组值得记住的东西:
torch.h/torchView.h/torchUtils.h:这是 C++ 与 PyTorch 张量互操作的桥。既然模型跑在 PyTorch 侧而 runtime 在 C++ 侧,就必须有一层把at::Tensor的存储映射成 C++ 侧可操作视图的机制。读 C++ kernel 时如果看到「这个 tensor 从哪来」,答案通常在这几个文件里。virtualMemory.cpp与cudaMemPool.cpp:前者是 CUDA 虚拟内存(VMM)的使用者,后者是内存池。这两者一起构成显存管理的地基。关于用 CUDA 虚拟内存保住连续 KV Cache 的思路,本站有 vAttention 完全拆解:用 CUDA 虚拟内存保住连续 KV Cache。mcastGroupComm.cpp/mcastDeviceMemory.cpp/bufferManagerNvls.cpp:NVLS(NVLink SHARP)多播通信基础设施。存在这一组文件说明这套框架会在支持的硬件上使用 NVLink 多播来广播数据,而不是逐个 peer 发送——这是集合通信层面的硬件特化。
moeLoadBalancer/ 出现在 runtime 而不是 batch_manager 里,同样是设计选择:负载均衡被当作「资源分配问题」而不是「调度问题」。
cpp/tensorrt_llm/batch_manager/:批次与 KV 的生命周期
这是三个支柱里最贴近推理逻辑的一个,也是本系列后续会反复回到的地方:
kvCacheManager.cpp / kvCacheManagerV2Utils.cu KV Cache 管理器(两代)kv_cache_manager_v2/ 新版分块 KV 管理blockKey.cpp 块键(前缀复用寻址)evictionPolicy.cpp 淘汰策略capacityScheduler.cpp 容量调度microBatchScheduler.cpp 微批调度scheduledBlocksManager.h 已调度块管理cacheTransceiver.cpp / cacheFormatter.cpp KV 传输与格式化mlaCacheFormatter.cpp / rnnCacheFormatter.cpp MLA / 循环层专用格式化contextTransferCoordinator.cpp context 传输协调contextProgress.cpp 上下文进度跟踪dataTransceiver.cpp / cacheTransferLayer.cpp 数据传输层kvCacheTransferManager.cpp / kvCacheEventManager.cpp KV 传输与事件peftCacheManager.cpp PEFT/LoRA 缓存llmRequest.cpp 请求对象agentTree.cpp Agent 树(请求依赖关系)baseTransBuffer.cpp / cacheTransBuffer.cpp 传输缓冲四条观察:
- KV Cache Manager 有两代实现并存(
kvCacheManager.cpp与kv_cache_manager_v2/+kvCacheManagerV2Utils.cu)。迁移期的痕迹本身就是有价值的信息:V2 显然是为了解决某些 V1 的结构性问题(很可能是更细粒度的块管理与更灵活的复用),读源码时应当以 V2 为主要目标,把 V1 当参考。 blockKey.cpp+evictionPolicy.cpp:一个是前缀复用的寻址键,一个是淘汰策略。这两个文件的存在验证了一件事——前缀共享与缓存淘汰是被显式建模的。而「哪种淘汰策略真的有效」本身是个有争议的问题,本站 前缀缓存淘汰完全拆解:为什么 14 种复杂算法赢不了 LRU 用生产轨迹回答了这个问题。- 为不同 KV 布局各写一个格式化器(
mlaCacheFormatter、rnnCacheFormatter)。这说明「KV Cache 传输」不是一个通用的 memcpy:MLA 的 KV 是压缩后的 latent(见 MLA 完全拆解),循环层(Mamba 类)的状态根本不是一个可切分的 KV 序列。每一类架构的传输格式都不同,因此需要各自的 formatter。 agentTree.cpp:请求之间可以存在依赖关系(Agent 场景里一个请求的结果是另一个的输入),所以需要一棵树来管理。这是 Agent 时代推理服务的新需求被下沉到 C++ 层的例子。
把这三个目录连起来看,cpp/tensorrt_llm/ 的定位就清楚了:它是「服务能力」的所在地——契约、资源、生命周期。而真正的数值计算在 kernels/ 与外部集成的 kernel 库里。
顶层入口:LLM 对象做了什么
tensorrt_llm/llmapi/llm.py 里的 LLM 类是对外唯一入口,和 vLLM/SGLang 的 LLM 定位一致:
from tensorrt_llm import LLM
llm = LLM(model=<path_to_llama_from_hf>)官方架构文档对它的职责只给了一句话,但信息量不小:
The interface for PyTorch backend is
tensorrt_llm.LLM. TheLLMalso manages the tokenization and detokenization processes of the input.
也就是说,LLM 至少承担三件事:
- 配置解析:
llmapi/llm_args.py里的TorchLlmArgs是全部参数的载体(取代了旧的TrtLlmArgs)。 - 构建 PyExecutor:把参数、模型、KV Cache Manager、调度器组装成执行器。
- 分词/反分词:
llmapi/tokenizer.py与sanglang式的增量解码逻辑——注意这里只是「管理」,真正的增量解码细节在pyexecutor侧。
读源码时的实际路径是:
LLM.__init__ └─ llm_args.py: TorchLlmArgs # 参数对象 └─ _torch/pyexecutor/py_executor_creator.py: create_py_executor ├─ _util.py: KvCacheCreator._create_kv_cache_manager ├─ BindCapacityScheduler / MicroBatchScheduler └─ PyTorchModelEngine └─ _torch/pyexecutor/py_executor.py: PyExecutorcreate_py_executor 是整个装配线的中心,下一篇会沿着它展开。这里先记住一点:TensorRT-LLM 的 LLM 对象比 vLLM 的重,因为它要在初始化阶段就把 KV Cache 池、调度器、模型引擎、显存缓冲全部建好,而不是留到第一次请求。
模型层:原生 PyTorch 定义改变了什么
tensorrt_llm/_torch/models/ 是这次重构后最重要的目录,因为它回答了一个根本问题:没有编译期,模型是怎么被描述给引擎的?
答案是:用原生 PyTorch 写。目录里是一长串 modeling_*.py,每个文件定义一个(或一族)模型架构:
modeling_auto.py 自动架构分发_arch_index.py 架构索引modeling_llama.py Llama 系列modeling_qwen.py / modeling_qwen3.py / modeling_qwen3_moe.py / modeling_qwen3_next.pymodeling_deepseekv3.py / modeling_deepseekv4.py / modeling_deepseekv41.pymodeling_mistral.py / modeling_mixtral.pymodeling_gemma3.py / modeling_gemma4.py ...modeling_gpt_oss.py / modeling_glm.py / modeling_kimi_k25.py / modeling_kimi_linear.pymodeling_nemotron.py / modeling_nemotron_h.py ...modeling_llava_next.py / modeling_qwen2vl.py / modeling_pixtral.py / modeling_mllama.py ...checkpoints/ 检查点加载相关hf_parameter_utils.py 从 HuggingFace 权重映射到模型参数modeling_multimodal_mixin.py 多模态混入官方 overview 对这一点的措辞很直接:
Several popular models are also pre-defined and can be customized using [native PyTorch code], making it easy to adapt the system to specific needs.
这段变化带来的三个实际后果,是把 TensorRT-LLM 与「编译型」推理栈彻底区分开的标志:
- 新模型的支持成本大幅下降。在旧的 engine 时代,支持一个新架构通常要走「写 plugin → 写转换脚本 → 适配 builder」这条长链路;现在只需要写一个
modeling_xxx.py,把 PyTorch 的nn.Module前向按规范组织起来。这就是官方反复强调 Day 0 支持的工程基础。 - 调试路径变短。engine 文件是序列化的编译产物,出问题只能看日志和 profiler;现在模型就是 Python 代码,可以直接打印中间张量、可以在
forward里打断点、可以逐层对照 HuggingFace 参考实现。 - 代价从「构建期」转移到了「运行期」。编译期做过的形状特化与算子融合,现在要靠:注意力后端在元数据准备阶段做形状处理、CUDA Graph 在 warmup 阶段固定形状、以及手工融合的 kernel。这也是为什么这套框架对 CUDA Graph 与编译路径(
compilation/、breakable_cuda_graph/)的依赖远比其他框架重——它必须把「编译」这件事在运行时补回来。
modeling_multimodal_mixin.py 与 checkpoints/ 里的加载逻辑,则分别解决了两个具体的工程问题:多模态模型的前向需要把视觉编码器的输出插入到文本 token 流中(混入机制),而权重从 HuggingFace 命名到模型内部命名的映射需要一层参数名转换。这两个问题在任何框架里都必须解决,TensorRT-LLM 的做法是把它们放在模型层而不是引擎层。
与 llama.cpp 的对比可以加深理解:llama.cpp 用 ggml 计算图 build_llama 系列函数拼出一次前向,图的形状与算子都由预定义的 C++ 逻辑决定,新架构要手写图构建代码;而 TensorRT-LLM 用 PyTorch 的 nn.Module 表达同一件事,新架构写一个模块即可,灵活度更高但失去了图级别的静态优化机会。可参考 llama.cpp 源码完全拆解(六):图构建与注意力——llama-graph 如何把模型结构翻译成 ggml 图。
PyExecutor:一次 step 的五个动作
PyExecutor 是 Python 后端的执行核心。官方文档把它的关键组件和单步流程都写得很清楚,这部分值得完整抄下来,因为它是本系列的骨架。
三个关键组件:
- Model Engine:持有语言模型,高效支持单步前向。
- Decoder:根据 Model Engine 的输出生成输出 token。
- Scheduler:决定是否为某个请求分配资源(如 KV Cache),以及当前步是否为该请求跑前向。
单步流程(single-step flow):
- 从请求队列取新请求(如果有)。
- 调度部分请求(scheduling some requests)。
- 为被调度的请求跑模型前向(running model forward)。
- 用前向输出为被调度的请求跑 Decoder。
- 给每个请求追加输出 token,并处理已完成的请求。
这五步和 vLLM 的 EngineCore.step、SGLang 的调度循环在语义上几乎是同构的——这正是「连续批处理」这条主线的同一个骨架,如果你想先补齐这块基础,可以看 连续批处理完全拆解:Orca 的迭代级调度与选择性批处理。差异在于 TensorRT-LLM 把「资源分配」这件事显式拆成了一个 ResourceManager 概念。
ResourceManager:把「请求需要的东西」抽象成资源
这是 TensorRT-LLM 比较独特的一层设计。官方文档的定义是:
ResourceManagerhelps allocate and manage these resources that may be needed to run inference for a single request. It is a container of objects inherited fromBaseResourceManager, each managing a specific type of resource.
BaseResourceManager 定义了三个生命周期接口,语义边界很清晰:
| 接口 | 调用时机 | 语义 |
|---|---|---|
prepare_resources | 每步前向前 | 为当前 batch 准备资源 |
update_resources | 每步结束后 | 更新本步消耗的资源 |
free_resources | 请求结束 | 释放该请求占用的资源 |
最关键的一个资源管理器就是 KV Cache Manager。文档对它在 prepare_resources 里的行为描述得很细:
In
KVCacheManager, this involves allocating KV Cache memory. This allocation varies depending on the request type. For requests entering the context phase for the first time, KV Cache needs to be allocated for the entire context. For requests already in the generation phase, KV Cache is allocated for the upcoming step. If KV Cache is organized in blocks and free space is available within a block, actual allocation may not occur.
「首次进入 context 阶段要为整个 context 分配、已在 generation 阶段只为下一步分配」——这正好对应了 prefill 与 decode 两种请求形态下的 KV 增长模式差异。而最后一句「块内有剩余空间时可能根本不发生实际分配」则是分页 KV Cache 的直接后果:分配粒度是块,不是 token。关于这套分页机制本身,本站已有 PagedAttention 完全拆解:操作系统分页思想如何拯救 LLM 推理的内存利用率。
KVCacheManager 的三个对外接口
除了 BaseResourceManager 的通用接口,KV Cache Manager 还给 ModelEngine 和 Scheduler 各留了专用接口。文档列出的是:
get_max_resource_count:查询最大可用资源数——对 KV Cache Manager 来说通常是最大 KV block 数。Scheduler 用它判断容量上限。get_needed_resource_to_completion:计算「某个请求从头跑到结束」需要多少资源。Scheduler 把活跃请求的这个值累加,判断新请求能否被接纳。这就是CapacityScheduler做接纳决策的输入。get_batch_cache_indices:输入LlmRequest列表,返回每个请求占用的 block ID(Dict[List[int]])。这个结果最终会变成注意力 kernel 遍历分页 KV 用的 block table。get_buffers:返回某一层的 KV Cache pool buffer,形状是[num_blocks, 2, num_tokens_per_block, num_kv_heads, head_dim]——注意这里的2正好是 K 和 V 两个张量被堆在同一个维度上。get_num_free_blocks:返回可分配的空闲块数。add_padding_request:给 CUDA Graph warmup 用的padding 请求(上下文长度 1)。
get_buffers 的返回值形状几乎把存储布局的秘密全交代了。[num_blocks, 2, num_tokens_per_block, num_kv_heads, head_dim] 这个五维张量读法是:
- 第 0 维
num_blocks:块编号,由 block table 间接寻址。 - 第 1 维
2:K/V 共用一块物理内存(这也是为什么后面对 KV 做量化时,K 和 V 常常要分别设计策略,本站 KIVI 完全拆解:非对称 2-bit KV Cache 量化,为什么 Key 按通道、Value 按 token 讲的就是这个差异)。 - 第 2 维
num_tokens_per_block:块内 token 数,即 block size。 - 第 3 维
num_kv_heads:KV 头数——对 GQA/MLA 模型来说这个数远小于 Q 头数,参考 GQA 完全拆解:分组查询注意力,用 1/8 的 KV 缓存保住 MHA 的质量。 - 第 4 维
head_dim:单头维度。
自定义 KV Cache Manager 的接入点
文档给出了自定义 Manager 的注入代码,它同时暴露了 Manager 初始化需要的全部参数:
kv_cache_manager = KVCacheManager( executor_config.kv_cache_config, tensorrt_llm.bindings.internal.batch_manager.CacheType.SELF, num_layers=model_engine.model.config.num_hidden_layers, num_kv_heads=model_engine.model.config.num_key_value_heads, head_dim=head_dim, tokens_per_block=tokens_per_block, max_seq_len=max_seq_len, max_batch_size=max_num_requests, mapping=mapping, dtype=kv_cache_dtype,)这段代码能读出三件事:
CacheType.SELF:KV Cache 类型是枚举的,存在 self-attention 之外的类型(比如 cross-attention 的CacheType.CROSS,以及自回归模型里的循环层缓存)。mapping:并行映射信息被直接传进 Manager——这意味着 KV Cache 的分配方式本身是并行策略相关的(TP 时 KV 头被切分,DP attention 时 KV 按 rank 分区)。dtype=kv_cache_dtype:KV Cache 的存储精度是可配的,可以不等于模型权重精度。
注入点在 pyexecutor/_util.py 的 KvCacheCreator._create_kv_cache_manager,这是读源码时定位 KV 管理逻辑的锚点。
Scheduler:两级决策与它的两个阶段
调度器的设计是本篇最容易和 vLLM 混淆的地方,因为名字完全不同但语义高度对应。官方文档的定义:
There are two kinds of schedulers:
CapacityScheduler: This scheduler decides if resources should be allocated for each active request. It considers the KV cache capacity and other resources, if applicable.MicroBatchScheduler: This scheduler selects some requests fromfitting_requestschosen byCapacityScheduler.
两者串起来的方式也写明了:
SimpleSchedulercombines these two schedulers, first usingCapacitySchedulerand thenMicroBatchScheduler, to get the final schedule result.
用一张对照表把三套框架的调度语义对齐,会让你在切换阅读时省很多力气:
| 语义 | TensorRT-LLM | vLLM | SGLang |
|---|---|---|---|
| 容量准入(能否放得下) | CapacityScheduler | Scheduler.schedule 的预算判定 | PrefillAdder 的三重容量预算 |
| 本步选出哪些请求 | MicroBatchScheduler | Scheduler 的 token budget 分配 | ScheduleBatch 组装 |
| 被暂停的请求 | paused_requests | 抢占(preemption) | 撤回(retract) |
| 容量查询接口 | get_needed_resource_to_completion | num_free_blocks / block 预估 | kv_available 预算 |
CapacityScheduler 的两个输出值得单独说:fitting_requests 和 paused_requests。文档特别指出 paused_requests 是为了支持 C++ runtime 里的请求暂停(request pausing)。也就是说 TensorRT-LLM 把「放不下怎么办」显式建模成了一个「暂停」状态,而不是像 vLLM 那样直接抢占释放。这是一个语义选择:暂停意味着请求保留但本步不执行,抢占意味着释放 KV 要重算,两者的代价模型完全不同。
MicroBatchScheduler 的输入里还有一项 inflight_request_ids,文档说它是为了支持流水线并行(PP)或 C++ runtime 里的重叠执行,并且明确指出:PyTorch flow 不支持流水线并行,所以这个集合是空的。
这句话是本次重构留下的一个清晰边界标记:PyTorch 后端目前不做 PP。读源码时如果你在找 PP 相关逻辑,在 _torch 下是找不到的。
自定义调度器的两个层次
官方给出的定制路径分两级,这个「粒度选择」本身也反映了设计的可组合性:
- 两级都要改:分别继承
CapacityScheduler和MicroBatchScheduler,各自实现自己的准入与选择逻辑。 - 不需要两级:继承
RequestScheduler直接实现schedule_request。
文档给的 GuaranteedNoEvictScheduler 例子非常值得读,因为它用最短的代码展示了准入逻辑的核心形态——先保已在跑的,再按剩余容量接纳新的:
available_blocks = max_blocks - reserved_blocksfor request in pending_requests: needed_blocks = self.kv_cache_manager.get_needed_resource_to_completion(request) if needed_blocks <= available_blocks: scheduled_requests.append(request) available_blocks -= needed_blocks elif needed_blocks > available_blocks: # If one requests fails to be scheduled, break break注意这里的两处设计决策:
- 已经在 generation 阶段的请求无条件先入选(
GENERATION_IN_PROGRESS/GENERATION_TO_COMPLETE分支直接 append 并累加预留块)。这体现了「已开始的解码不能饿死」这一延迟保证。 - 遇到第一个放不下的新请求就
break,而不是 continue 去找更小的请求。这是一个 FIFO 公平性选择——避免大请求永远被小请求插队导致饥饿。这和 SGLang 的 PrefillAdder「长提示切分」策略形成对比,可参考 SGLang 源码完全拆解(四):PrefillAdder 如何预算 KV、切分长提示并组装 Prefill Batch。
另外,GuaranteedNoEvictScheduler 的类名和它在文档中的地位说明了一件事:在 C++ binding 出现之前,Python 侧曾有一套完整可用的调度实现,现在它仍然保留着,作为自定义调度的参考范本和回归基准。
模型引擎与 Decoder:执行侧的两个角色
PyExecutor 的核心组件里,ModelEngine 承担真正的 GPU 执行:
The core component of
PyExecutoris theModelEngine, responsible for executing the model’s forward pass efficiently on the GPU. The key method ofModelEngineisforward, which handles the forward pass computation.
PyTorch 后端的派生类是 PyTorchModelEngine,声明在 tensorrt_llm/_torch/pyexecutor/model_engine.py。这个文件是本系列后续的重点对象之一,因为「动态请求如何拼成一次静态形状的 GPU 前向」这件最难的事就在这里。
Decoder 的职责文档写得很克制:
The Decoder generates output tokens based on Model Engine outputs and supports greedy search decoding.
「supports greedy search decoding」是一个必要的限定:采样策略(temperature / top-k / top-p / 惩罚项)不在 Decoder 里,而在采样器模块。TensorRT-LLM 把「贪心解码」放在 Decoder、把完整采样管线放在 pyexecutor/sampler/,这个切分意味着 Decoder 只做「取 argmax + 应用停止条件」这种最轻的工作。贪心与采样的分布差异本身值得单独理解,本站 信息论基础:熵、交叉熵与 KL 散度——LLM 推理中无处不在的数学 里有对采样与温度的推导。
注意力后端:三个实现与它们的取舍
注意力是推理框架里最需要特化的部分。官方文档(docs/source/torch/attention.md)把 TensorRT-LLM 的注意力后端讲成了一篇「如何实现新后端」的教程,这个组织方式本身说明了设计取向:注意力后端是一个可插拔的第三方库集成点。
当前有三个可选后端,通过 PyTorchConfig.attn_backend 指定:
| 后端 | 类名 | 定位 | 关键能力 |
|---|---|---|---|
| vanilla | VanillaAttention | 参考实现(reference) | 支持 inflight batching 与线性 KV Cache;不推荐生产使用 |
| FlashInfer | FlashInferAttention | 性能优化实现 | 支持分页 KV;FP8 量化;RoPE 融合 |
| TRT-LLM | TrtllmAttention | 默认后端 | 包含 FlashInfer 全部能力,另有 Fused QKV 输入与 FP8 输出 |
这个表格里最值得注意的是 vanilla 后端的存在和它的定位。官方明确说它「designed primarily for inflight batching and linear KV cache support」且「not recommended for production use due to its limited optimizations」。一个成熟框架保留一个明确不推荐生产的参考实现,通常有三个目的:给新模型 bring-up 时提供一个一定能跑通的基线;作为其他后端的正确性对照;给实现新后端的开发者一个最小的模仿对象。
而默认后端选择 TrtllmAttention 而非 FlashInfer,理由在文档里给出了两条具体的融合优化:
- Fused QKV Input:可以接受单个 QKV 张量作为输入,比分开传 Q/K/V 三个张量更高效。
- FP8 Output:支持以 FP8 输出注意力结果,把量化融合进注意力计算过程。
这两条都是典型的「减少一次 kernel 边界就是省一次 HBM 往返」的思路:Fused QKV 省掉的是 QKV 投影之后的拼接或多次读写,FP8 Output 省掉的是「注意力输出 → 单独量化 kernel → 后续 GEMM」这一整条链路。FP8 这条路线的整体背景可以看 DeepGEMM 完全拆解:300 行 FP8 GEMM 内核,如何逼近 Hopper 的算力峰值。
后端的三阶段生命周期
文档把注意力后端在 PyTorch 里参与的时机拆成三个阶段,这是本节最有工程价值的部分:
- 模型构建期:在模型的
__init__里调用AttentionBackend.__init__,为每一层创建后端实例。 - 元数据准备:每步前向前:
- 若元数据未初始化,调用
AttentionMetadata.__init__; - 若使用 CUDA Graph,调用
AttentionMetadata.create_cuda_graph_metadata把元数据转换为 CUDA graph 元数据——它预先分配全部张量,用于捕获 CUDA graph;文档特别警告:使用 CUDA Graph 时不要在初始 warmup 之后重新分配AttentionMetadata里的任何张量; - 调用
AttentionMetadata.prepare,从已有元数据与 KV Cache Manager 转换出输入与 KV Cache 的相关参数。
- 若元数据未初始化,调用
- 单步前向:在每层注意力前向时调用
AttentionBackend.forward,AttentionMetadata作为前向参数传入。
第 2.2 条那个警告值得展开:CUDA Graph 的本质是把一段 kernel 序列录制成一张可重放的图,图中所有地址都固定在录制时刻的显存位置上。如果重放之前重新分配了元数据里的张量,录下来的地址就失效了——轻则结果错误,重则非法访存。所以「元数据张量只分配一次」不是性能建议,而是正确性约束。本站 CUDA Graph 完全拆解:从逐次 Kernel Launch 到可重放推理执行图 和 vLLM 源码完全拆解(十二):piecewise compilation 与 CUDA Graph 对这套机制有更完整的交代。
AttentionMetadata 的字段与它的含义
文档给出了 AttentionMetadata 的预定义字段表,这张表几乎就是「一次注意力前向需要知道的一切」的清单:
| 字段 | 类型 | 含义 |
|---|---|---|
max_num_requests | int | 单 batch 最大请求数 |
num_contexts | int | batch 中 context 阶段序列数 |
num_generations | int | batch 中 generation 阶段序列数 |
max_num_tokens | int | 单 batch 全部请求的最大 token 数 |
num_tokens | int | batch 中 token 总数 |
num_ctx_tokens | int | context 阶段序列的 token 数 |
kv_cache_manager | KVCacheManager | KV Cache 管理器 |
is_cuda_graph | bool | 是否启用 CUDA Graph |
seq_lens | Tensor | 每个序列长度,形状 (batch_size),位于 CPU 内存 |
seq_lens_cuda | Tensor | seq_lens 的 GPU 副本 |
context_lens | Tensor | context 阶段序列长度,形状 (num_contexts) |
position_ids | Optional[Tensor] | 每个 token 在序列中的位置;若位置编码由模型外部施加则可为 None |
request_ids | List[int] | batch 中每个序列的请求 ID |
prompt_lens | List[int] | batch 中每个序列的 prompt 长度 |
kv_cache_params | KVCacheParams | KV Cache 参数 |
其中三处细节很说明问题:
seq_lens在 CPU、seq_lens_cuda是 GPU 副本,两个字段并存。这是为了同一份数据服务两类消费者:CUDA Graph 捕获和 kernel 启动参数的准备在 CPU 侧需要它,kernel 内部计算又需要它在 GPU 上。显式维护两份副本,避免在热路径里做 H2D 拷贝。num_contexts与num_generations分开计数。这说明一个 batch 里可以同时存在 context 和 generation 两个阶段的序列,也就是前面说的 inflight batching——一次前向里既有 prefill 又有 decode。这时context_lens只覆盖 context 部分,所以形状是(num_contexts)而不是(batch_size)。position_ids是可选的。文档给出了条件:「May be None if positional embedding is applied outside of the backend」。这直接对应上面AttentionBackend.__init__的pos_embd_params参数——如果后端声明自己接管位置编码(比如 FlashInfer 的 RoPE 融合、TRT-LLM 的 Fused QKV + RoPE),那么模型侧就不用再传position_ids,甚至可以「缓存未施加 RoPE 的 K,之后再施加」。RoPE 本身见 RoPE 完全拆解:旋转位置编码的原理、实现与长度外推。
AttentionBackend.forward 的签名同样是信息密集的:
q: Tensor 形状 (num_tokens, num_heads * head_dim)k: Tensor 形状 (num_tokens, num_kv_heads * head_dim)v: Tensor 形状 (num_tokens, num_kv_heads * head_dim)metadata: AttentionMetadataforward_args: AttentionForwardArgs # 注意力掩码、输出缓冲与 scale、RoPE/MRoPE 输入、MLA 缓冲、稀疏注意力输入**kwargs # 兼容路径;未知字段会报错q 的形状是 (num_tokens, num_heads * head_dim) 而不是 (batch, num_heads, seq, head_dim)——所有序列被压平成一个 token 维度。这是连续批处理对 kernel 接口的直接改造:attention kernel 收到的不是「一批规整矩阵」,而是「一维 token 流 + 若干描述每条序列边界的元数据」。同一个 forward 要同时服务 prefill(序列内因果注意力)和 decode(K/V 长度远大于 Q),所以掩码、qo_indptr 这类结构必须外置成参数。
关于 forward_args 里提到的 MLA 缓冲和稀疏注意力输入:MLA 是 DeepSeek 的低秩 KV 压缩方案(见 MLA 完全拆解:DeepSeek 低秩 KV 压缩注意力的原理与全部实现细节),它在注意力接口上的特殊之处在于要额外传压缩后的 latent 缓冲;稀疏注意力输入则是 DSA 这类方案的接入点(见 DSA 稀疏注意力完全拆解:从 DeepSeek-V3.2 的闪电索引器到 vLLM 的算子实现)。
Kernel 生态:为什么它「这么杂」
cpp/tensorrt_llm/kernels/ 目录的规模需要单独看,因为它直接回答了一个常见困惑:为什么 TensorRT-LLM 的 kernel 这么散、这么多命名风格?
先看几个代表性目录:
cpp/kernels/ fmha_v2/ Fused Multi-Head Attention(独立版本化目录) xqa/ XQA:MultiQuery/GroupQuery Attention kernel(Hopper 优化) contextFusedMultiHeadAttention/ 上下文阶段 FMHA decoderMaskedMultiheadAttention/ 解码阶段 MHA cutlass_kernels/ 基于 CUTLASS 的 GEMM 集合 flashMLA/ MLA 专用 kernel dsv3MinLatencyKernels/ DeepSeek-V3 低延迟 kernel groupRmsNormKernels/ 分组 RMSNorm fusedQKNormRopeKernel.cu 融合 QK Norm + RoPE fusedLayernormKernels/ 融合 LayerNorm fusedActivationQuant.cu 激活 + 量化融合 ...cpp/tensorrt_llm/ deep_ep/ DeepEP(专家并行通信) deep_gemm/ DeepGEMM(FP8 GEMM) flash_mla/ FlashMLA 集成 nccl_extensions/ NCCL 扩展 cutlass_extensions/ CUTLASS 扩展以及 tensorrt_llm/_torch/ 下并列存在的多种 kernel 来源:
cute_dsl_kernels/ CuTe DSL 写的 kernelcuda_tile_kernels/ CUDA Tile 路径custom_ops/ 自定义算子flashinfer_utils.py FlashInfer 集成fused_relu2_triton.py Triton 写的融合算子「杂」的根因有三个,理解了就不会乱:
- kernel 的来源本就是多元的:有的来自 NVIDIA 内部长期迭代的库(FMHA v2、XQA 都带版本号,说明是独立演进的产品线),有的来自开源(DeepEP、DeepGEMM 是 DeepSeek 开源后被集成),有的来自第三方推理 kernel 库(FlashInfer),有的是用新 DSL 写的(CuTe DSL、TileLang 风格)。
- 注意力 kernel 必须按「阶段 × 形态」组合特化:context 阶段(长 Q,因果掩码)和 generation 阶段(Q 长度 1,读长 KV)的计算形态完全不同,MHA/MQA/GQA/MLA 的 KV 组织也不同。所以你会看到
contextFusedMultiHeadAttention、decoderMaskedMultiheadAttention、xqa、flashMLA各自独立——它们不是重复劳动,而是针对不同角落的专门优化。 - 融合算子的收益极高:目录里大量
fused*前缀(fusedQKNormRopeKernel、fusedActivationQuant、fusedLayernormKernels、fusedGatedRMSNormQuant)说明这套框架把「减少 HBM 往返」当作核心优化手段。每一次融合都在省一次「读出、计算、写回」。
关于这批 kernel 中相当重要的一个:cpp/kernels/xqa 这个目录名值得记住——XQA 是 NVIDIA 针对 Hopper 架构、面向 MQA/GQA 的解码注意力 kernel,它是「低算术强度场景下如何喂满 Tensor Core」这个问题的一个专门答案。
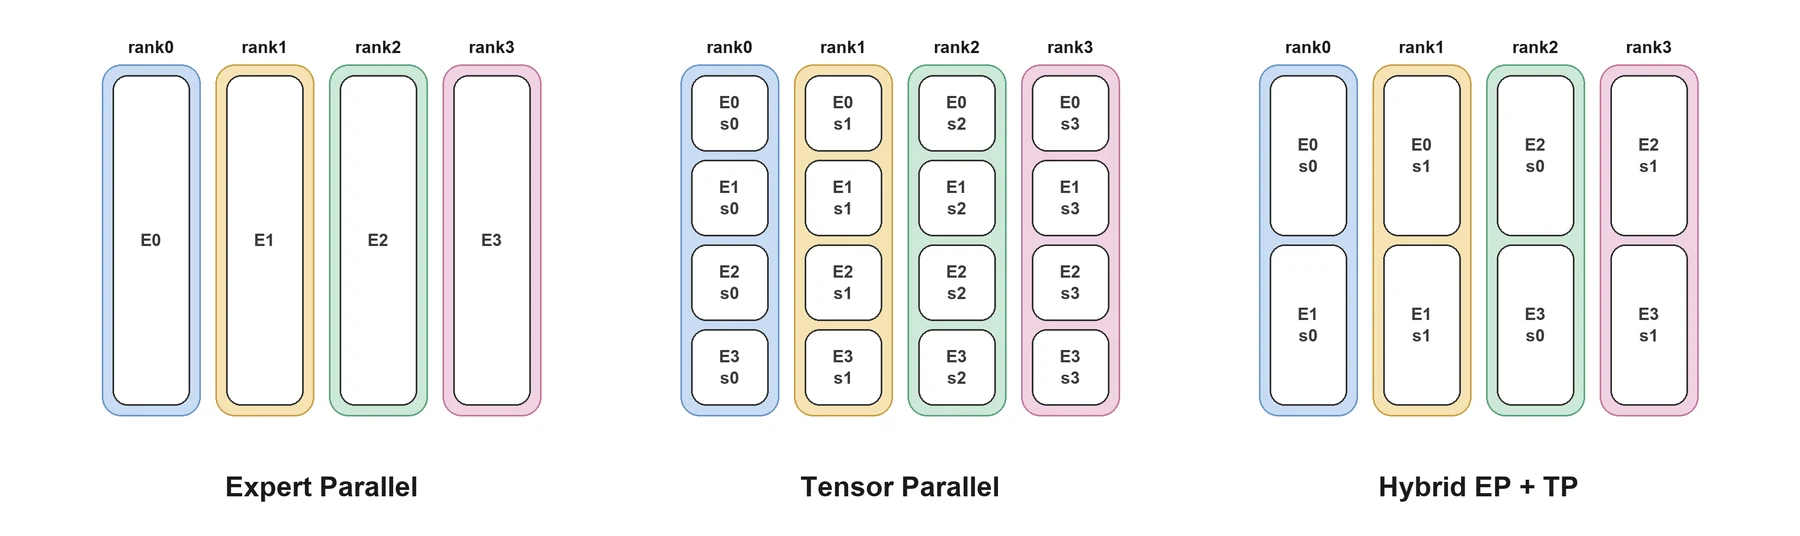
图:TensorRT-LLM 官方文档给出的 MoE 并行策略示意。TP 下每个专家的权重矩阵被切分到所有 GPU、每个 GPU 看到全部 token;EP 下每个专家的完整权重驻留单卡、每个 GPU 只看到路由到本地专家的 token;Hybrid ETP 则在 EP 基础上再做 TP 切分以平衡负载与 kernel 效率。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/media/moe-parallelism.png)
并行策略:六种切法与模块级选择
docs/source/features/parallel-strategy.md 给出的并行策略清单比 vLLM/SGLang 公开的更宽,一共六种:
| 策略 | 含义 | 适用场景 |
|---|---|---|
| Tensor Parallel(TP) | 切分权重 | 小 batch、显存受限 |
| Pipeline Parallel(PP) | 按层分布在多卡 | 单卡放不下的大模型 |
| Data Parallel(DP) | 复制整个模型 | 大 batch、高吞吐 |
| Expert Parallel(EP) | 专家分散到多卡 | MoE 模型 |
| Context Parallel(CP) | 切分长序列处理 | 长上下文 |
| Wide Expert Parallel(Wide-EP) | 带负载均衡的高级 EP | DeepSeek-V3/R1、LLaMA4、Qwen3 等大规模 MoE |
其中 Wide-EP 是这套框架最有辨识度的设计,文档对它的动机交代得很直接:
Large-scale MoE models like DeepSeek-V3/R1, LLaMA4, and Qwen3 use fine-grained expert designs that introduce new challenges:
- High memory demands for expert weights
- Inherent expert-level workload imbalance due to sparse execution patterns
- Communication overhead in distributed expert parallelism
- Hot expert problem where certain experts receive significantly more tokens than others
而 Wide-EP 的解法核心是把「专家」和「槽位」两个概念解耦:
Wide-EP separates the concepts of experts and slots:
- Expert: The concept from the model’s perspective (e.g., Expert 0, Expert 1, etc.)
- Slot: The concept from the model engine’s perspective (e.g., Slot 0, Slot 1, etc.) The system maintains a routing table that maps Expert IDs to Slot IDs, which can be updated by the load balancing policy.
这个解耦是「专家复制」得以实现的前提:模型视角下 Expert 0 只有一个身份,而引擎视角下可以有多个 Slot 同时承载 Expert 0 的副本,分散在不同 GPU 上。路由表把两者接起来,并由负载均衡策略动态更新。
配套的两个机制:
- Offline EPLB:基于历史负载统计预先计算专家放置。
- Online EPLB:根据实时流量动态调整专家放置,且做逐层权重重分配(layer-wise weight redistribution)以最小化推理中断。
「逐层重分配」这个细节值得注意:重排专家意味着要搬权重,如果一次性全搬,服务会有一个明显的停顿窗口;逐层做则把停顿切成小段,每一层搬完即可继续服务。这与 SGLang 的 EPLB 实现思路可以对照阅读,见 SGLang 源码完全拆解(十七):DP Attention 与专家并行——注意力数据并行、DeepEP 通信与 EPLB 负载均衡。关于 MoE 路由本身,本站有 DeepSeekMoE 完全拆解:细粒度专家切分与共享专家隔离。
模块级并行:注意力与 FFN 可以选择不同策略
文档里有一个非常实用的段落,讲「哪个模块该用哪种并行」:
注意力模块支持两种:
- TP:注意力 kernel 前后的 GEMM 权重均匀切分到各 GPU,注意力的
num_heads同样切分。两个例外:DeepSeek-R1 的fused_AGEMM 不做切分;GQA/MQA/MLA 在num_heads < tensor_parallel_size时,KV Cache 在每个 GPU 上复制。 - DP:所有 GEMM 权重在每个 GPU 上复制;KV Cache 是分区的,因为不同用户请求被路由到不同 DP rank。
那两个例外各有原因。fused_A 不切分是因为它是 MLA 路径上的一个小矩阵(把 hidden 投影到压缩的 latent),切分它的通信开销会超过计算收益。而「KV 头数少于 TP 度时复制 KV Cache」是一个必须记住的约束:TP=8 而模型只有 1 个 KV 头时(MQA 极端情况),KV 无法按头切分,只能每个 rank 存一份完整副本——这会让 KV 显存占用放大 8 倍,是选并行策略时必须先算的账。
FFN 模块分两种情形:稠密模型的 FFN 支持 TP;MoE 则支持三种执行模式:
- TP:每个专家的权重矩阵被切分到所有 GPU,每个 GPU 看到全部 token。
- EP:每个专家的完整权重驻留单卡,每个 GPU 只看到路由到本地专家的 token。
- Hybrid ETP:每个 GPU 存一部分专家(EP)再把这些权重进一步切分(TP),平衡负载与 kernel 效率。
文档给的配置约束很硬:moe_tensor_parallel_size × moe_expert_parallel_size == tensor_parallel_size。读配置时要拿这条等式对一下,否则初始化会直接失败。
一个绕不开的取舍:Wide-EP 的通信代价藏在哪
Wide-EP 的收益(吞吐、均衡)是显性的,代价是隐藏的:EP 度越大,all-to-all 的通信量越大。文档提到 Wide-EP 配有「Custom EP Communication Kernels」,针对 NVIDIA GB200 的 Multi-Node NVLink(MNNVL)优化,并明确说「Reduced communication overhead compared to traditional EP」。
这句「比传统 EP 通信开销更低」的实现基础是 NVLink 域内的高带宽:在 GB200 这类系统里,MNNVL 让多个节点形成一个大的 NVLink 域,专家 dispatch/combine 不需要走以太网。一旦部署规模超出 MNNVL 域,EP 的通信代价就会急剧上升——这是 Wide-EP 适用的物理边界,也是为什么文档把 max_num_tokens 调优列为最佳实践之一:token 数直接决定 all-to-all 的数据量。
关于 all-to-all 通信本身,本站有 DeepEP 完全拆解:DeepSeek 开源通信库如何把 MoE 推理的 dispatch/combine 压到硬件极限。
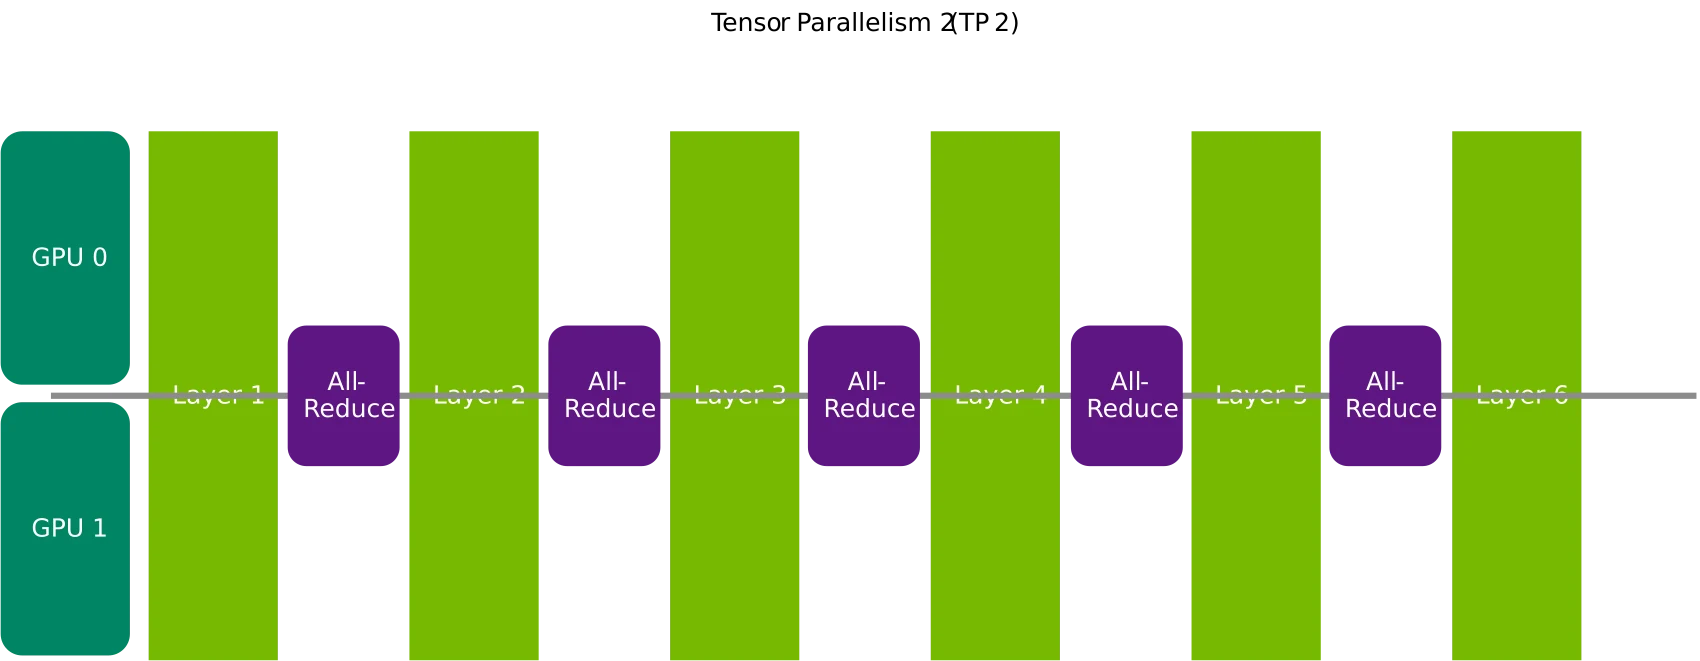
图:张量并行的基本形态。注意它与 MoE 示意图的差别——TP 下每张卡都看到全部 token,只是各自持有部分权重;这也是为什么 TensorRT-LLM 文档把注意力模块的 TP 描述为「注意力 kernel 前后的 GEMM 权重均匀切分,注意力的 num_heads 同样切分」。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/media/Tensor_Parallelism_Vis.svg)
构建期消失之后,这套框架靠什么取得性能
这是读全新架构时最该问的问题:丢掉了编译期的算子融合与自动调优,性能从哪来?
从前面看到的模块清单,答案大致有五条:
- 手工融合 kernel(
fused\*系列):编译期能做的融合,改成人工在设计时就写好融合算子。 - 专门化的注意力 kernel(FMHA v2 / XQA / FlashMLA / context FMHA / decoder MHA):按阶段与 KV 组织形态分别提供最优实现。
- 多种精度路径(FP8 / FP4 / W4A16 / 块量化):DeepGEMM、Marlin、CUTLASS 扩展与各类量化 kernel 提供低精度算力。
- 通信与计算的深度重叠(overlap scheduler、Wide-EP 专用通信 kernel、双批重叠)。
- CUDA Graph + 编译路径(
cuda_graph_runner.py、breakable_cuda_graph/、compilation/):把调度与启动开销压出去。
关于重叠调度,官方文档(features/overlap-scheduler.md)给出了 PyExecutor 里的真实代码形态,这段代码几乎不需要解释:
# Schedule and launch GPU work for the current step (n)scheduled_batch, _, _ = self._schedule()batch_outputs = self._forward_step(scheduled_batch, previous_tensors_device)sample_state = self._sample_async(scheduled_batch, batch_outputs)
# While the GPU is busy, process the CPU-bound results from the previous step (n-1)if self.previous_batch is not None: self._process_previous_batch()文档同时给出了代价的明确表述:
The optimization introduces one extra decoding step but significantly improves throughput.
「多一个解码步」换「吞吐显著提升」——这是一笔典型的延迟换吞吐的交易,也是默认开启的原因。对应 vLLM 的同名机制见 vLLM 源码完全拆解(二):从 add_request 到 EngineCore.step,一次请求如何穿过 V1 引擎;SGLang 的对应实现见 SGLang 源码完全拆解(六):Overlap Scheduler 如何重叠 CPU 调度与 GPU 执行。
还有哪些值得一提的模块
仓库里还有几个目录,虽然本篇不作深入,但值得在脑子里留下索引,因为它们往往是后续章节的主角:
_torch/speculative/:投机解码。TensorRT-LLM 支持的算法家族里包括 EAGLE、MTP、NGram,文档在 overview 里明确列出。可参考 EAGLE 完全拆解:特征级草稿模型如何把投机解码推到 3 倍以上 与 MTP 完全拆解:多 token 预测如何让 DeepSeek 自带草稿模型。_torch/moe/与_torch/distributed/:MoE 执行与分布式通信。_torch/kv_cache_compression/:KV Cache 压缩(对应features/kv-cache-compression.md)。_torch/disaggregation/与cpp/tensorrt_llm/batch_manager/cache_transmission/:P/D 分离与 KV 传输。
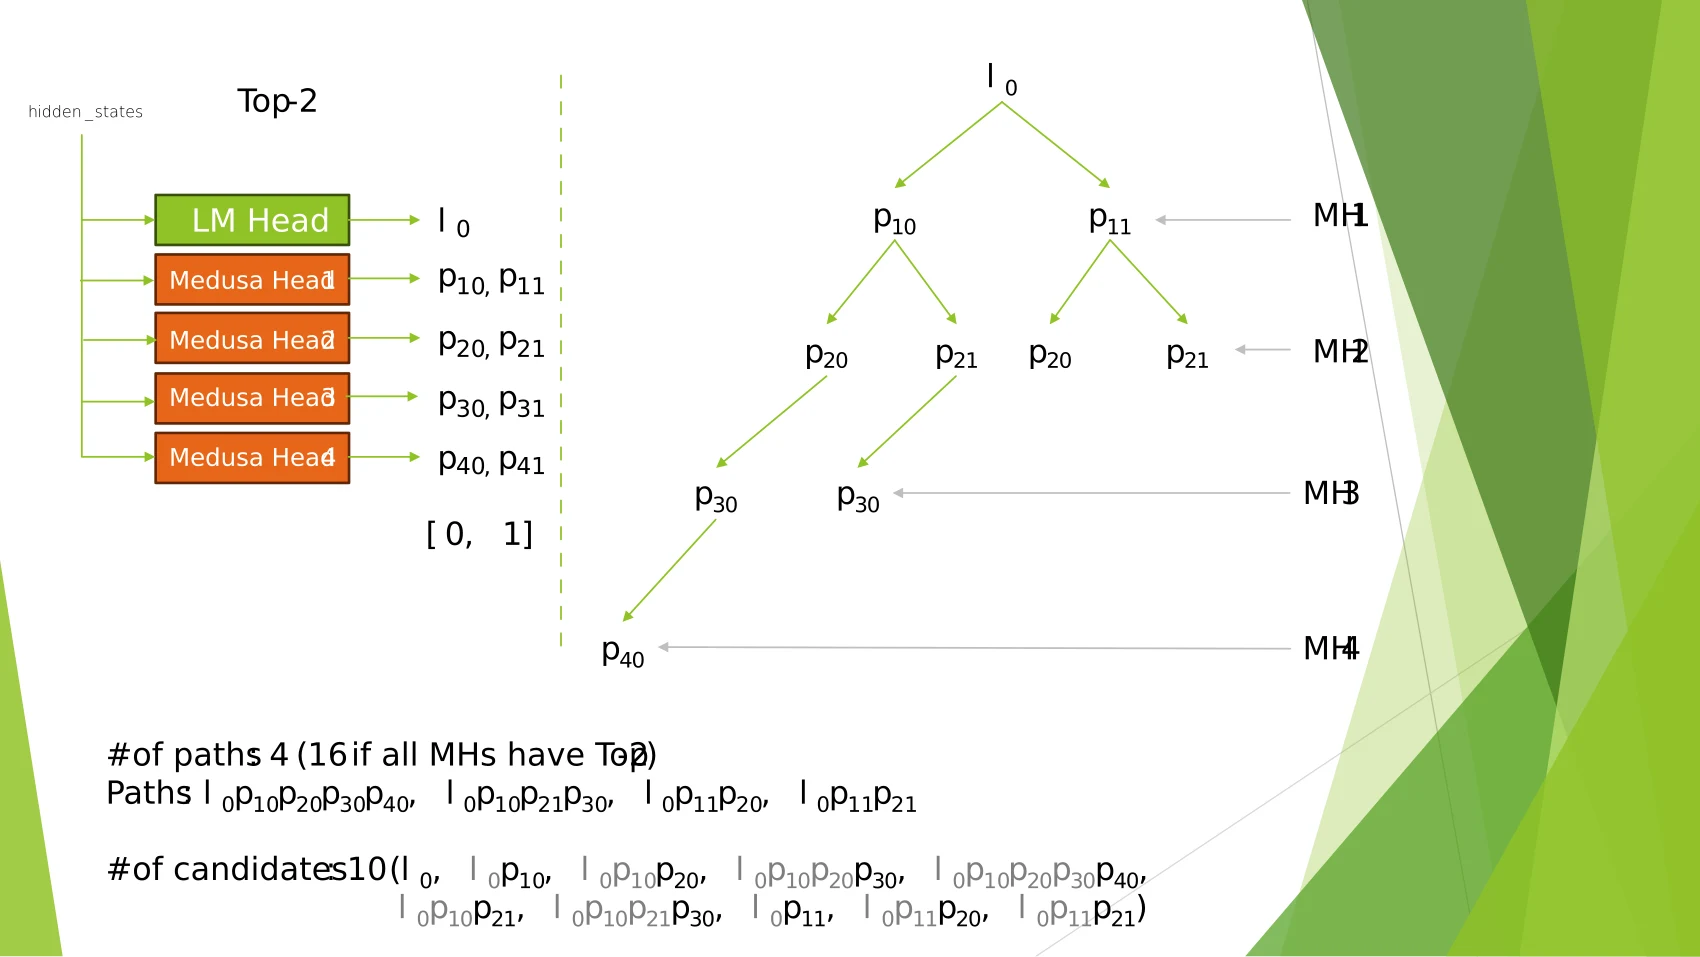
图:Medusa 的树式候选结构,用于说明投机解码在「一次前向验证多个候选」这件事上的数据结构形态。TensorRT-LLM 的投机解码模块同样要在批量验证阶段处理这类树形候选与 KV 索引映射——这是 speculative/ 目录里最需要细读的部分。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/media/medusa_tree.svg)
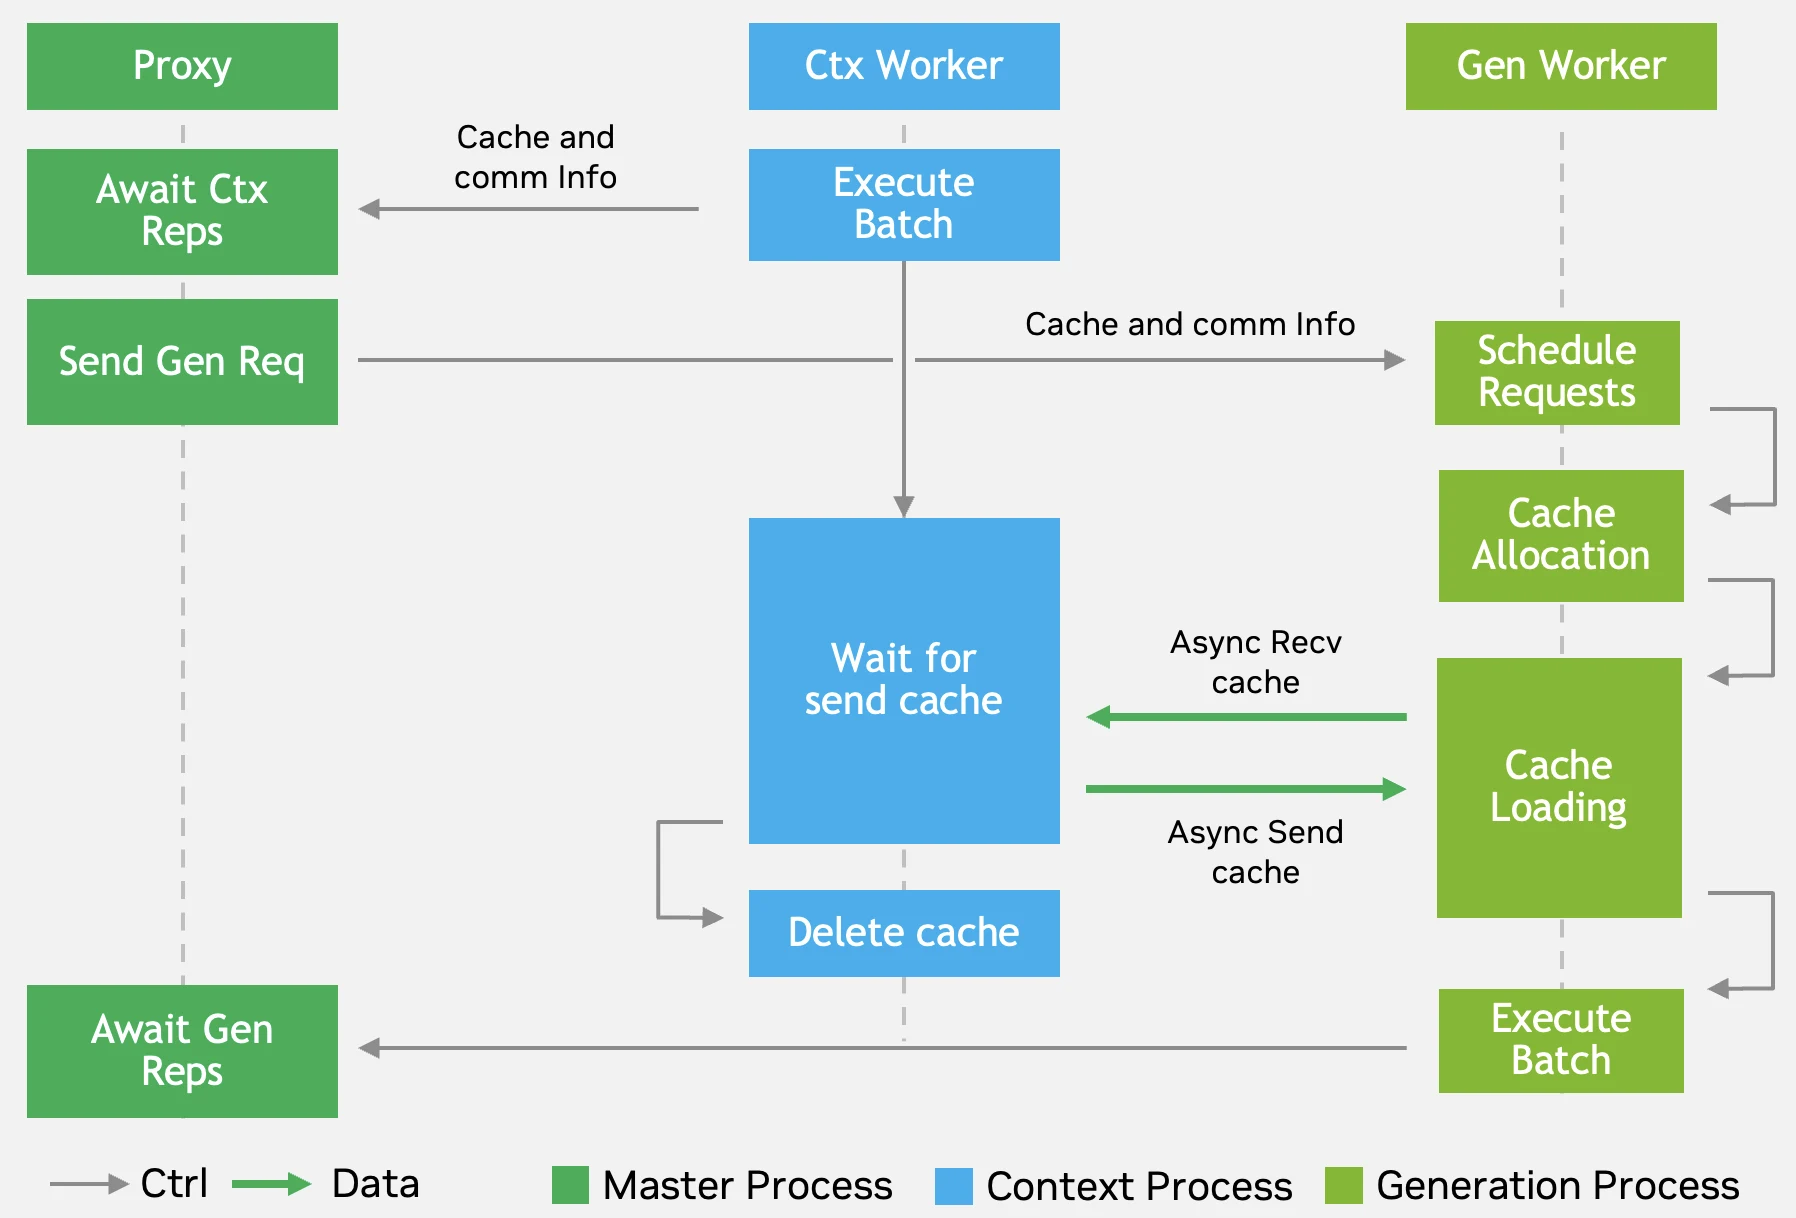
图:P/D 分离场景中 KV Cache 的跨实例传输路径。TensorRT-LLM 在 cpp/tensorrt_llm/batch_manager/ 下为此准备了完整的传输设施:cacheTransceiver、cacheFormatter、mlaCacheFormatter、rnnCacheFormatter 与 contextTransferCoordinator——甚至为 MLA 与循环层单独写了格式化器,因为它们的 KV 布局与标准注意力不同。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/media/kv_transfer.png)
_torch/weight_sharing/、shared_tensor/、tensor_lru_cache.py、pinned_weight_staging.py、host_staging.py:显存与权重的分层管理,包括 host 侧暂存与 LRU 缓存。_torch/adp_iter_stats.py、perf_metrics_manager.py、hang_detector.py、gpu_keepalive.py:性能观测、hang 检测与保活——这类「生产运维」模块的存在,说明这套框架的设计目标包含长时间稳定服务,而不只是吞吐数字。_torch/locality_domain/、_torch/mnnvl_alltoall_workspace.py、_torch/device_mesh.py:拓扑感知与设备网格,是 Wide-EP 与 MNNVL 的基础设施。
还有一件容易被忽略的事:tensorrt_llm/llmapi/ 下有 reasoning_parser.py 和 thinking_budget.py。这说明推理模型(带思维链的模型)的输出解析与思考预算控制已经被当作一等公民写进了 API 层。对于需要区分 reasoning_content 与正式回答的部署场景,这是必须在 API 层处理的问题。
推荐阅读路径(本系列后续篇目)
摸清地形之后,本系列的后续规划按「先结构后细节」推进,大致分为四个阶段:
第一阶段:执行闭环
- PyExecutor 与 py_executor_creator:
create_py_executor如何把参数、KV Cache Manager、调度器、模型引擎装到一起,以及单步五动作的真实代码形态。 - Scheduler:CapacityScheduler 与 MicroBatchScheduler:C++ binding 的准入逻辑、
paused_requests的语义、inflight_request_ids为空的边界。 - KVCacheManager 与 ResourceManager:块分配、块表构造、
prepare/update/free三个钩子的调用点。
第二阶段:模型执行
- PyTorchModelEngine:
forward如何把动态请求拼成静态形状输入。 - Attention Backend 家族:三个后端的实现差异,
AttentionMetadata.prepare的构造细节,CUDA Graph 元数据的约束。 - KV Cache 压缩与量化路径:
kv_cache_compression/的设计。
第三阶段:分布式与通信
- 并行策略落地:TP/DP attention 的 KV 分区、MoE 的 EP/ETP 选择、
mapping如何影响 KV 分配。 - Wide-EP 与 EPLB:expert/slot 解耦、路由表更新、逐层重分配。
- P/D 分离与 KV 传输:
cache_transmission/与disaggregation/。
第四阶段:kernel 与性能
- XQA 与 FMHA v2:解码注意力的专门 kernel。
- DeepGEMM / DeepEP / flash_mla 集成:开源自研 kernel 如何被接进这套框架。
- CUDA Graph 与编译路径:
cuda_graph_runner、breakable_cuda_graph、compilation/。
小结
本篇是 TensorRT-LLM 系列的地形图,把可验证的事实收拢如下:
- TensorRT engine 后端已被彻底移除,PyTorch 是唯一执行后端;
trtllm-build、convert_checkpoint.py、tensorrtpip 依赖都不再需要。读源码时不需要理解 TensorRT builder/plugin 机制。 - 框架是「Python 编排层 + 厚重 C++ 运行时」:调度与 KV Cache Manager 的实现在
cpp/tensorrt_llm/batch_manager/,接口在 Python,通过 nanobind 绑定,因此两者都可以用 Python 自定义。 - PyExecutor 单步五动作:取新请求 → 调度 → 前向 → Decoder → 追加输出并处理完成。
ResourceManager用prepare/update/free三个钩子把「请求需要的资源」抽象出来,KV Cache Manager 是其中最重要的一个。 - 调度是两级:
CapacityScheduler做容量准入、MicroBatchScheduler做本步选择,SimpleScheduler串联;paused_requests显式建模「暂停」,inflight_request_ids在 PyTorch flow 下为空(不支持 PP)。 - KV Cache 布局是
[num_blocks, 2, tokens_per_block, num_kv_heads, head_dim],K/V 共用物理内存、按块寻址、KV 头数决定压缩比。 - 注意力后端三选一:vanilla(参考)、FlashInfer(分页 KV + FP8 + RoPE 融合)、TRT-LLM(默认,另有 Fused QKV 与 FP8 输出);后端生命周期分模型构建、元数据准备、单步前向三个阶段,CUDA Graph 下元数据张量只能分配一次。
- 并行策略六种,注意力可选 TP 或 DP(GQA/MQA/MLA 在
num_heads < tp_size时 KV 复制),MoE 可选 TP / EP / Hybrid ETP,且满足moe_tp × moe_ep == tp。Wide-EP 通过 expert 与 slot 解耦实现专家复制,代价是 all-to-all 通信,收益依赖 MNNVL 高带宽域。 - 性能来自手工融合 kernel、专门化注意力 kernel、多精度路径、通信-计算重叠与 CUDA Graph,而不是编译期自动优化。
下一篇进入第一阶段的核心:create_py_executor 与 PyExecutor 的单步闭环,看这套装配线如何把 LLM 对象的初始化参数变成一台持续运转的推理机器。
参考资料
- TensorRT LLM 官方架构总览(PyTorch 后端)
- Migration Guide: TensorRT Backend Removed
- TensorRT LLM Attention 后端文档
- TensorRT LLM Scheduler 文档
- TensorRT LLM KV Cache Manager 文档
- TensorRT LLM Overview
- Parallelism in TensorRT LLM
- Overlap Scheduler
- NVIDIA/TensorRT-LLM GitHub 仓库
- Scaling Expert Parallelism in TensorRT LLM(技术博客)
- DeepSeek-V3 Technical Report(EPLB 与细粒度 MoE 背景)
- Attention Is All You Need
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



