


SGLang 源码完全拆解(二十三):权重装载管线——文件名如何变成 GPU 上切好的参数
为什么单独讲「权重装载」
上一篇讲量化方法时,有一个问题一直被压在末尾没有正面处理:Fp8Config、AWQConfig、GPTQMarlinConfig 这些配置对象在启动时就已经决定「每一层用哪种量化实现、scale 应该长成什么形状」。可是谁去读 checkpoint 的文件、谁把文件里的张量按 rank 切开、谁在切的过程中顺便把量化 scale 对齐到内核布局?这些动作不在量化代码里,而在 sglang/srt/model_loader/ 这一层。
权重装载在推理引擎里是一个容易被低估的子系统。推理的正文——调度、注意力、kernel——在论文里有清晰的分工描述;权重装载的论文描述通常只有一句「用 tensor parallel 切分权重」。但在真实的 SGLang 代码里,这一层要同时回答下面这些问题:
- 一个 HuggingFace checkpoint 目录里可能有十几到几百个
safetensors分片,也可能混着model.safetensors与model-00001-of-00008.safetensors两套,甚至附带一个索引文件漏报的mtp.safetensors。该读哪些文件、用什么顺序读? - 一个 671B 的 MoE 模型,专家权重按
experts.{id}.gate_proj分布在分片里,而本 rank 的FusedMoE只拥有其中几十个专家。名字怎么映射到参数、被本 rank 丢弃的专家张量要不要解包进内存? - 张量并行要按
shard_axis切,MoE 的专家并行还要按expert_id选槽位;MLA 的kv_b_proj在加载之后还要被拆成w_kc和w_vc两个反向布局的参数。这一步为什么不能放到前向里? - 启动时间的可观部分花在等磁盘上。SGLang 近期的启动重叠机制(capture-safe model、checkpoint prefetch、IPC 权重缓存)是怎么搭在这条管线上的?
这些问题串起来就是一条完整的管线:文件定位 → 分片迭代 → 名字映射 → 分片落位 → 后处理 → 量化方法收尾。本篇按这条链路逐段拆源码,每段讲清楚它解决什么问题、为什么这么实现、写错会暴露成什么现象。
系列前二十几篇已经把调度、KV 内存、注意力后端、MoE 前向拆完了。如果对 RadixCache 的所有权模型或 FusedMoE 的分组 GEMM 还不熟,建议先看 SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环和 SGLang 源码完全拆解(二十一):从对齐表到分组 GEMM。本篇只讲权重怎么从磁盘走到那里。
一张全景图:六段管线,谁调用谁
先把调用关系摆出来。SGLang 这条管线从 ModelRunner 一路接到具体模型的 load_weights,中间每一层的职责都很清楚:
ModelRunner.load_model() └─ load_model_with_memory_saver() ├─ build_load_config() # ServerArgs → LoadConfig ├─ get_model_loader() # load_format → 具体 Loader 类 └─ loader.load_model() ├─ _get_quantization_config() # 量化配置(上一篇) ├─ _initialize_model() # 建「空壳」:结构 + 参数 + scale 槽位 └─ load_weights_and_postprocess() ├─ _get_all_weights() # DefaultModelLoader._get_weights_iterator │ ├─ _prepare_weights() # 找文件、过滤、排序 │ └─ safetensors_weights_iterator() # 按分片产出 (name, tensor) ├─ model.load_weights(...) # 模型自定义映射 │ └─ DeepseekV2WeightLoaderMixin.do_load_weights └─ postprocess_weights() # quant_method 收尾 └─ model.post_load_weights() # MLA 的 w_kc / w_vc 分裂这张图里有两个「由模型自己负责」的环节:model.load_weights 和 model.post_load_weights。这不是设计上的随意,而是由「参数形状在建模时就定了」这个前提推出来的——通用装载器只负责把 (name, tensor) 送过去,真正知道「这个参数该按哪个轴切、切完放第几个槽」的只有建模代码。下面逐段展开。
第一段:From LoadFormat 到具体 Loader
LoadConfig.load_format 是用户在 --load-format 里写的字符串,也可以是程序内部推断出来的。get_model_loader 先处理最特殊的几个分支,再按 load_format 逐个判断:
def get_model_loader(load_config: LoadConfig, model_config=None) -> BaseModelLoader: if load_config.load_format == LoadFormat.DUMMY: return DummyModelLoader(load_config) if isinstance(load_config.load_format, type): return load_config.load_format(load_config) if model_config and model_config.quantization in ["auto-round-int8"]: return IncModelLoader(load_config) ... if load_config.load_format == LoadFormat.SHARDED_STATE: return ShardedStateLoader(load_config) if load_config.load_format == LoadFormat.PRESHARDED: return PreshardedModelLoader(load_config) if load_config.load_format == LoadFormat.GGUF: return GGUFModelLoader(load_config) ... return DefaultModelLoader(load_config)几个分支值得单独说:
load_format是一个类:isinstance(load_config.load_format, type)这一支允许调用方直接传一个 Loader 类而不是枚举值。SGLang 用它给测试和内部工具注入自定义装载器,正式推理路径上不会走到。auto-round-int8抢先返回IncModelLoader:它是 Intel Neural Compressor 量化路径,量化格式与普通 safetensors 不同,必须在枚举匹配之前拦下。- ModelOpt 系列优先:只要
model_config.quantization是modelopt_fp8、modelopt_fp4、modelopt_mixed之一,就交给ModelOptModelLoader。但有一个例外:在线modelopt_fp4(checkpoint 是 BF16,需要运行时量化成 NVFP4)走DefaultModelLoader。在线量化只借用默认的读盘与切分管线,量化动作交给层方法完成,这也是 TensorRT-LLM 源码完全拆解(十四):量化全链路里 ModelOpt 的相同思路。 - 兜底是
DefaultModelLoader:所有没被特殊分支命中的load_format最后都落到这里。
LoadFormat 枚举本身也反映了装载子系统的演化。除了 vLLM 时代的 auto、pt、safetensors、dummy、sharded_state、bitsandbytes,SGLang 后来加入了 presharded(按目标并行拓扑预切好的权重,多 rank 各读自己的分片)、expert_pack(EP 专用打包)、fastsafetensors、instanttensor、ipc_cache(多个进程共享同一份权重)、remote/remote_instance(从其他实例拉权重),以及 layered(逐层装载以压低峰值显存)。每一个格式对应一个不同的「文件怎么变成张量」策略,而它们之后的命名映射、切分、后处理逻辑完全相同——这正是后面几段能通用讲的原因。
DeepSeek 的 MoE 与 MLA 是理解这条管线最好的样本,因为它们的 checkpoint 形态与参数树形态差异最大。下图是 DeepSeek-V3 的整体结构:MLA 注意力与 DeepSeekMoE,前者决定了 kv_b_proj 必须在加载后被拆分,后者决定了专家权重必须按 expert_id 逐一落位:
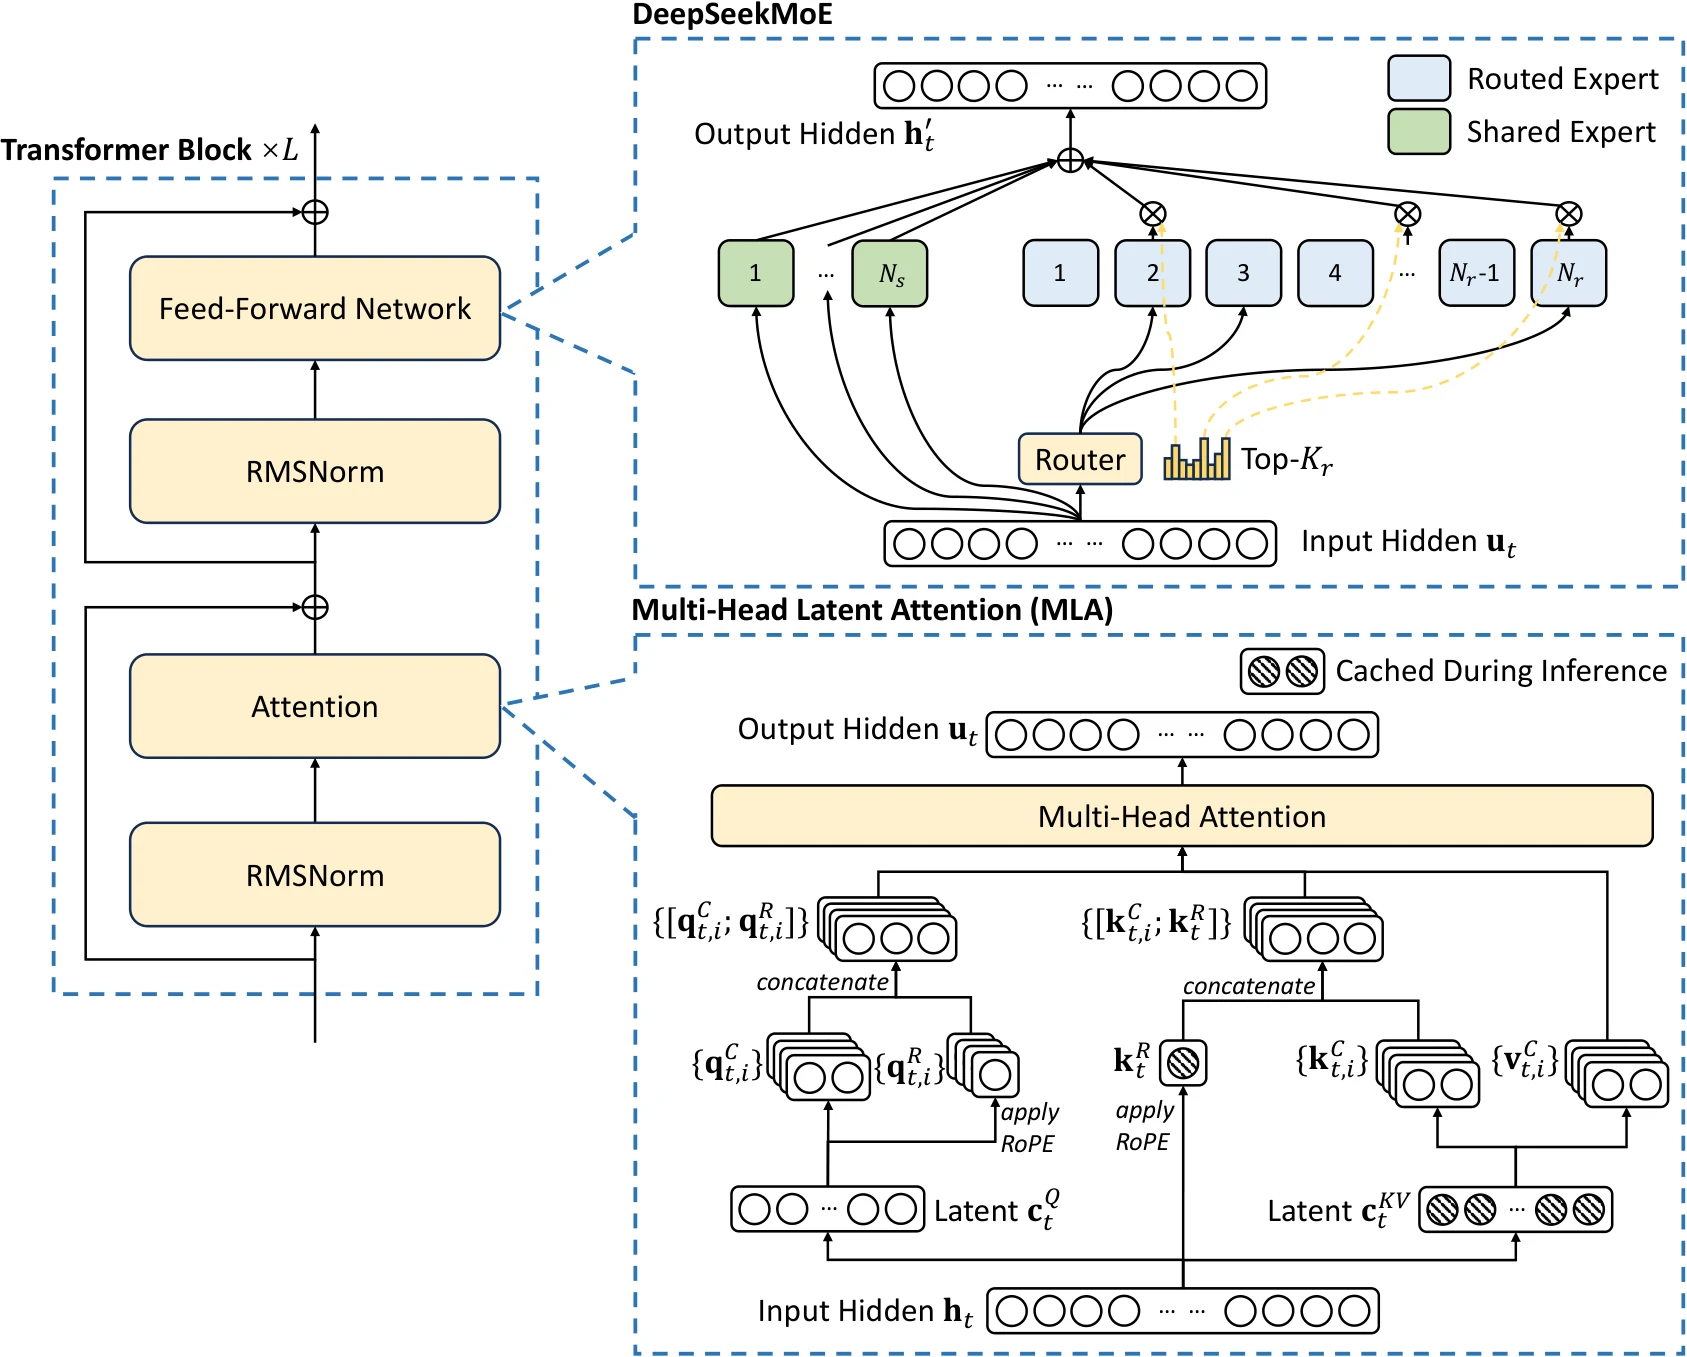
图中左侧的 MLA 块把 K/V 压缩成 latent,右侧的 MoE 块把 256 个路由专家与一个共享专家放在一起。加载器看到的 checkpoint 是「每个专家三个独立投影、MLA 一个完整 kv_b_proj」,而参数树是「两个融合专家参数、两个头部重排后的 w_kc / w_vc」。这条管线的主体工作,就是把前一种形态翻译成后一种。
第二段:_prepare_weights——从目录到一组文件,过滤顺序决定了结果
_prepare_weights 的职责是回答「这个模型目录里,哪些文件是权重」。看起来只是一个 glob,但里面的判断顺序每一步都有理由:
if load_format == LoadFormat.AUTO: allow_patterns = ["*.safetensors", "*.bin"]elif load_format in (LoadFormat.SAFETENSORS, LoadFormat.FASTSAFETENSORS, LoadFormat.INSTANTTENSOR): use_safetensors = True allow_patterns = ["*.safetensors"]elif load_format == LoadFormat.MISTRAL: use_safetensors = True allow_patterns = ["consolidated*.safetensors"] index_file = "consolidated.safetensors.index.json"elif load_format == LoadFormat.PT: allow_patterns = ["*.pt"]...if fall_back_to_pt: allow_patterns += ["*.pt"]
for pattern in allow_patterns: hf_weights_files += glob.glob(os.path.join(hf_folder, pattern)) if len(hf_weights_files) > 0: if pattern.endswith(".safetensors"): use_safetensors = True break第一个要注意的是模式的顺序决定格式。AUTO 把 *.safetensors 放在 *.bin 前面,循环遇到第一个命中非空的模式就 break。结果是:一个目录里同时有 safetensors 和 bin 时,自动选 safetensors;只有 bin 才退回 PyTorch 格式。用户显式指定 safetensors 却找不到文件时不会退回 bin(除非 fall_back_to_pt 打开,这是给某些量化模型留下 *.pt 的兼容口)。
第二个要注意的是 Mistral 的专用分支。Mistral 的原始 checkpoint 既带分片的 consolidated.*.safetensors 又可能带其他 safetensors,装载器把允许模式收窄到 consolidated*,索引文件名也换成 consolidated.safetensors.index.json。这类「只认一套文件」的约束在代码注释里写得很直白:如果一套分片和一份合并文件被同时加载,同一个张量会被写两遍,shape == shape 的断言能过,但数值取决于加载顺序。
第三个关键步骤是 safetensors 的索引去重:
if use_safetensors: if not is_local: download_safetensors_index_file_from_hf(...) hf_weights_files = filter_duplicate_safetensors_files( hf_weights_files, hf_folder, index_file, allow_patterns=allow_patterns if allow_patterns_overrides is not None else None, )else: hf_weights_files = filter_files_not_needed_for_inference(hf_weights_files)filter_duplicate_safetensors_files 读取 model.safetensors.index.json 的 weight_map,只保留索引里出现的分片文件。它还顺手做了一次完整性检查:索引引用的分片如果不在磁盘上(典型是下载中断),直接抛 RuntimeError 并列出缺哪些文件;如果索引不存在,则在「恰好只有 consolidated.safetensors 与 model.safetensors 两个文件」时保留后者——这是处理 Mistral 的旧 trick。索引文件让装载器可以信任 checkpoint 作者声明的分片清单;但 SGLang 又对两类「作者声明不可靠」的情况做了兜底:
maybe_add_mtp_safetensors:某些 GLM4Moe 系列模型打包 FP4 时,mtp.safetensors存在于目录里却没有写进索引。如果模型架构是Glm4MoeForCausalLM且num_nextn_predict_layers > 0,装载器会把这个文件补回来并打警告,同时提示向 checkpoint 提供方报告。这是一个典型的「推理引擎为生态妥协」的例子:严格按索引过滤更正确,但会导致投机解码的草稿层完全加载不到。filter_files_not_needed_for_inference:非 safetensors 路径下,把training_args.bin、optimizer.bin、optimizer.pt、scheduler.pt、scaler.pt这些训练产物过滤掉。推理不需要优化器状态,读到它们既浪费时间又可能触发形状不匹配。
文件列表确定之后还有一个排序与错峰步骤,这是多 rank 启动时常见的性能点:
k = envs.SGLANG_SORT_WEIGHT_FILES.get()if k >= 0: hf_weights_files.sort() if k > 0: tp_size = get_parallel().tp_size if tp_size > 1: tp_rank = get_parallel().tp_rank group_size = tp_size * k staggered = [] for i in range(0, len(hf_weights_files), group_size): group = hf_weights_files[i : i + group_size] n = len(group) staggered.extend(group[(j + tp_rank * k) % n] for j in range(n)) hf_weights_files = staggered为什么需要错峰?默认所有 rank 用同一个顺序读同一组文件。如果模型存放在共享网络文件系统(NFS、Lustre)上,glob 返回的顺序通常就是目录顺序,于是 8 个 rank 在启动的第一秒同时请求第一个分片,网络存储的带宽被一个文件吃满,其余 rank 全部等待。错峰让第 r 个 rank 从组内偏移 r * k 开始读,把同一时刻的请求摊到 tp_size * k 个不同文件上。注意错峰只在「一组 group_size 个文件」内轮转——这保证了每个 rank 的读文件集合不变,只是顺序变了,对结果没有影响。
这一步在本地 NVMe 上往往是净收益为零甚至负收益(顺序读本身就是最优),所以默认由环境变量控制,而不是无条件开启。
第三段:迭代器——一个文件怎么变成张量流
_get_weights_iterator 根据格式和配置选择不同的迭代器。最常用的是 safetensors_weights_iterator,它用 safetensors.safe_open 以 mmap 方式打开文件,逐个 get_tensor:
def safetensors_weights_iterator(hf_weights_files, disable_mmap=False, prefetch=False, prefetch_num_threads=4, drop_cache_after_load=False): ... for st_file in tqdm(hf_weights_files, desc="Loading safetensors checkpoint shards"): if disable_mmap: with open(st_file, "rb") as f: result = safetensors.torch.load(f.read()) for name in sorted(result.keys()): yield name, result[name] else: with safetensors.safe_open(st_file, framework="pt", device="cpu") as f: for name in f.keys(): yield name, f.get_tensor(name) if drop_cache_after_load: _drop_file_cache_after_load(st_file)有三个设计点值得解释:
为什么是生成器,而不是一次性读进 dict? 一个 70B 模型单个分片可能就有 4–8 GB,671B 模型的分片更大。如果每个 rank 把所有分片都读成 dict,CPU 内存峰值等于整个 checkpoint 的体积乘以副本数;而生成器的峰值约等于「当前正在读的文件 + 已产出但未消费的张量」。SGLang 把「读盘 → 迭代 → 消费」做成生产者-消费者,消费速度(H2D 拷贝 + 切分)决定读盘速度,内存自然有界。
mmap 和 load 有什么区别? safe_open 内部是 mmap,get_tensor 返回的是映射到文件的 CPU 张量,真正的页在第一次访问时才从磁盘读入。disable_mmap=True 时直接 f.read() 整个文件再解析,代价是整文件进入进程内存,收益是后续访问没有缺页开销。默认 mmap 的好处是:如果模型被多个 rank 加载(同一台机器、同一份文件),所有 rank 共享页缓存,内存里只存一份;坏处是如果 H2D 拷贝很慢或张量被长期持有,页缓存会被挤掉,后续访问重新触发读盘。SGLang 用 drop_cache_after_load 主动给已经加载完的文件 DONTNEED,注释里也提醒了副作用:后续 mmap 访问可能重新缺页。
多线程版本 buffered_multi_thread_safetensors_weights_iterator 的核心是滑动窗口:
buffer_size = max_workers + 1with concurrent.futures.ThreadPoolExecutor(max_workers=max_workers) as executor: file_iter = iter(hf_weights_files) pending = collections.deque() for st_file in itertools.islice(file_iter, buffer_size): pending.append((st_file, executor.submit(_load_file, st_file))) while pending: st_file, future = pending.popleft() state_dict = future.result() del future next_file = next(file_iter, None) if next_file is not None: pending.append((next_file, executor.submit(_load_file, next_file))) for name in sorted(state_dict.keys()): yield name, state_dict[name] del state_dict窗口大小是 max_workers + 1:max_workers 个文件在并行解析,另 1 个已解析完、等待产出。所以峰值 CPU 内存约为 (max_workers + 2) × 单个分片大小。docstring 里写得很明确。为什么不干脆把所有文件都提交给线程池?因为在 100 个分片的模型上,全提交等于把所有分片同时读进内存,这正是上面说的「一次性 dict」的问题。滑动窗口把「并行度」和「内存上限」解耦:并行度只影响吞吐,内存在构造时就确定了。
sorted(state_dict.keys()) 为什么重要? 多线程模式下文件是并发解析的,但每个文件内部的产出顺序要稳定。更重要的是,SGLang 的其他部分对「同名参数被多次加载」有严格约定:例如共享的 embed_tokens 出现在多个分片里,最终值取决于谁最后写;排序让这个「最后写」在并行与非并行路径上完全一致。类似地,prefetch 与多线程读盘共享 I/O,所以 _get_weights_iterator 在 prefetch 激活且用户没有显式指定多线程时,会降级为单线程读盘,让 prefetch 线程预热的页缓存发挥作用:
if (concurrent_prefetch_active and not weight_loader_disable_mmap and self.load_config.load_format != LoadFormat.FASTSAFETENSORS and use_multithread and not ({"enable_multithread_load", "num_threads"} & extra_config.keys())): logger.debug("Checkpoint prefetching is active; falling back to single-threaded ...") use_multithread = False这段条件里的四个「与」值得逐条读:prefetch 激活、没有禁用 mmap、不是 GDS 直读的 fastsafetensors、用户没显式点名多线程。四条同时成立才降级。用户显式写了 enable_multithread_load 或 num_threads,说明他清楚自己要什么(例如本地 NVMe 上 prefetch 无意义),装载器尊重这个意图。
pt_weights_iterator 相对简单,但有一个安全细节:_load_pt_file 用的是 torch.load(..., weights_only=True)。weights_only 会拒绝反序列化执行任意 Python 代码的 pickle 载荷,这是加载外部 checkpoint 时的基本防护,SGLang 没有把它留成开关。
第四段:名字映射——checkpoint 的名字与参数树的名字不是一回事
迭代器产出的是 (name, tensor),其中 name 是 checkpoint 里的原始名字,例如 model.layers.5.mlp.experts.17.gate_proj.weight。而模型参数树里的名字可能长成 model.layers.5.mlp.experts.w13_weight。两者之间不是简单的字符串替换,而是一套由建模代码声明的映射规则。SGLang 把这一步分成三个层次。
4.1 前缀与模型级映射
_get_weights_iterator 在返回前做了一次前缀拼接:
return ((source.prefix + name, tensor) for (name, tensor) in weights_iterator)Source.prefix 用于组合模型(例如视觉塔、草稿模型作为第二个权重源),通过给不同来源加前缀,避免两个模型的同名参数互相覆盖。_get_all_weights 先产出主模型,再遍历 model.secondary_weights 产出额外的源。
更复杂的是量化层的命名映射。某些模型(例如 DeepSeek 系列的 FP4 checkpoint)在 checkpoint 与 SGLang 的参数名之间有一套固定的改写规则,_get_quantization_config 会把它交给量化配置:
get_hf_to_sglang_mapper = getattr(model_class, "get_hf_to_sglang_mapper", None)if get_hf_to_sglang_mapper is not None: hf_to_sglang_mapper = get_hf_to_sglang_mapper(model_config.hf_config)else: hf_to_sglang_mapper = getattr(model_class, "hf_to_sglang_mapper", None)if hf_to_sglang_mapper is not None and quant_config is not None: quant_config.apply_weight_name_mapper(hf_to_sglang_mapper)为什么是量化配置来持有这个映射,而不是通用装载器?因为这类改名的动因几乎都来自量化格式:checkpoint 把 weight_scale_inv 写在某个位置,量化方法的 create_weights 却把 scale 注册在另一个名字下;映射规则只有量化方法自己最清楚。把它放在 quant_config 上,create_weights 与加载时的名字查找才能用同一张表。
4.2 融合层的「堆叠映射」
SGLang 的 Linear 层会把多个逻辑投影融合成一个参数,以减少 kernel 启动次数。最典型的是 MLP 的 gate_up_proj:checkpoint 里是两个独立的 gate_proj 与 up_proj,模型里是一个 gate_up_proj。DeepSeek 的加载器用一张三列表来表达这件事:
stacked_params_mapping = [ # (param_name, shard_name, shard_id) ("gate_up_proj", "gate_proj", 0), ("gate_up_proj", "up_proj", 1),]加载循环对每个 checkpoint 名字依次尝试这张表。命中后先把名字改写成参数名,再调用参数的 weight_loader,并把 shard_id 传进去:
for param_name, weight_name, shard_id in stacked_params_mapping: if weight_name not in name: continue if ("mlp.experts." in name) and name not in params_dict: continue # 专家由下一张表处理 name = name.replace(weight_name, param_name) if name.endswith(".bias") and name not in params_dict: continue # GPTQ 模型多出来的 bias param = params_dict[name] weight_loader = param.weight_loader maybe_executor_submit(..., func=weight_loader, func_args=(param, loaded_weight, shard_id)) breakelse: ... # 进入 expert_params_mapping这里的 for ... else 结构很关键:只有当堆叠表没有任何一条命中时才进入专家表。如果顺序反过来,mlp.experts.0.gate_proj 会先被堆叠表命中,名字变成 mlp.experts.0.gate_up_proj,而专家表期待的是 experts.w13_weight,于是永远匹配不上。源码注释专门写了这一点,说明这是一个实际踩过的坑。
shard_id 不是「第几个张量」,而是融合参数内部的逻辑槽位。gate_up_proj 的权重沿输出维拼接,shard_id=0 表示写到前半段(gate),shard_id=1 表示写到后半段(up)。写入由参数自己的 weight_loader 完成,它同时处理了张量并行切分——这是一个「一次调用完成两件事」的合并:先按 shard_id 选槽,再按 TP rank 在自己的槽内取出局部切片。
4.3 专家映射:三列变四列
专家权重的映射更复杂,因为多了「哪个专家」这一维。FusedMoE.make_expert_params_mapping 返回的是四元组:
return [ # (param_name, weight_name, expert_id, shard_id) ( ("experts.w13_" if weight_name in [ckpt_gate_proj_name, ckpt_up_proj_name] else "experts.w2_"), f"experts.{expert_id}.{weight_name}.", expert_id, shard_id, ) for expert_id in range(num_experts) for shard_id, weight_name in [("w1", ckpt_gate_proj_name), ("w2", ckpt_down_proj_name), ("w3", ckpt_up_proj_name)]]把这段展开读:对每个专家 e,checkpoint 里的 experts.e.gate_proj 映射到 experts.w13_weight 的 w1 槽,experts.e.up_proj 映射到同一参数的 w3 槽,experts.e.down_proj 映射到 experts.w2_weight 的 w2 槽。也就是说,FusedMoE 用两个大参数装下所有专家:w13_weight 形状是 [num_local_experts, 2 * intermediate, hidden],w2_weight 是 [num_local_experts, hidden, intermediate]。这样一次分组 GEMM 就能处理整个批的专家计算,而不是每个专家一次 GEMM。
代价是加载时要多做三件事:
- 名字匹配变成 O(num_experts) 的表扫描。
num_experts可能是 256,映射表有 768 条,每条都做一次子串匹配。这就是为什么循环里先查stacked_params_mapping(只有两条)再查专家表——把便宜的表放前面。 - 本地专家过滤。checkpoint 包含全局所有专家,本 rank 只拥有其中一部分。
FusedMoE.weight_loader在写之前调用_map_global_expert_id_to_local_expert_id,返回-1就直接丢弃:
if not getattr(param, "_sglang_require_global_experts", False): expert_id = self._map_global_expert_id_to_local_expert_id(expert_id) if expert_id == -1: return这一步决定了一件重要的事:被丢弃的张量仍然会被迭代器读出来。SGLang 没法在 safetensors 迭代器层面跳过「本 rank 不需要的专家」,因为那需要先解析名字再决定是否解包,而迭代器只负责产出。这让 EP 场景下的读盘量偏大:每个 rank 都要把全部专家读一遍,再丢掉大部分。generate_weight_name_filter 这类按 EP 布点生成的名字过滤器,以及 expert_pack 格式,就是为压缩这部分浪费而存在的。
- 专家 id 可能被物理重映射。EPLB 在线重排后,同一个逻辑专家可能在多个物理槽位上有副本。
weight_loader里logical_to_all_physical会返回一组物理 id,循环把同一份权重写进所有副本。这保证了扩容或换点之后,副本与主本的数据一致,而不需要在重排时单独搬运权重。
4.4 加载之前先「剔骨」:哪些张量根本不用进显存
名字映射之前还有一组丢弃规则,它们不改变任何数值,但直接决定启动时的峰值内存:
if "rotary_emb.inv_freq" in name: continueif ".indexer." in name and (name.rsplit(".indexer.", 1)[0] not in indexer_present_prefixes): continuerotary_emb.inv_freq是旧版 HF checkpoint 留下的缓存张量,SGLang 的 RoPE 在构造时按公式算出频率表,不需要从文件读。- 没有索引器的层,checkpoint 里却带着索引器权重(常见于把稀疏注意力的 checkpoint 复用到其他层数的模型),装载时直接丢弃,否则会报「参数找不到」。
还有两条与并行相关:
layer_id = get_layer_id(name)if (layer_id is not None and hasattr(self.model, "start_layer") and (layer_id < self.model.start_layer or layer_id >= self.model.end_layer)): continue流水线并行下,每个 PP stage 只拥有自己那几层。get_layer_id 从名字里正则提取 layers.(\d+).,落在区间外的层直接跳过——注意这是在读盘之后才发生的,因为名字来自迭代器。如果要进一步省读盘,就得像 EP 那样在迭代器层做过滤。
if ".norm." in name and not self.pp_group.is_last_rank: continue最终 norm 只存在于最后一个 PP stage,其他 stage 连读都不该读。这几条规则共同构成一个原则:加载器的过滤越靠前,省下的 I/O 和内存越多;但过滤需要的元信息(层号、专家号、是否量化)也越靠前。SGLang 的现状是「名字级过滤在模型层,文件级过滤在装载器层」,中间那一档(按名字跳过读盘)只在专门的格式里做。
第五段:分片落位——TP、EP 和「切一半再切一半」
名字映射解决「写到哪个参数」,分片落位解决「写到参数的哪一段」。SGLang 把这一步做成参数上的 weight_loader 属性,set_weight_attrs(param, {"weight_loader": loader}) 在建模层调用时把它挂上去。这样模型层的加载循环不需要知道 TP 结构,只负责「找到参数、调用它的 loader」。
5.1 默认 loader 与它的两个前提
先把三种并行落位方式放在一起,后面每种都只在这张形状上做局部调整:
| 并行方式 | 切什么 | 谁决定目标槽位 | 目标参数形状 |
|---|---|---|---|
TP(sharded_weight_loader) | 参数的一个轴,按 tp_rank 取一段 | shard_axis | 本 rank 的局部切片 |
融合层(shard_id) | 先选逻辑槽位,再在槽内做 TP 切片 | shard_id + tp_rank | 槽位的局部切片 |
EP(FusedMoE.weight_loader) | 不切专家,只按 expert_id 选本地槽 | 逻辑 id → 物理 id 映射 | 本地专家若干槽 |
三种方式可以叠加:MoE 的专家权重既是 EP 的(本地专家子集),又是 TP 的(每个专家的中间维按 tp_rank 切)。叠加顺序在源码里是固定的——EP 先选专家,TP 再在选中的专家里切中间维,这也是下面 _load_w13 里同时出现 expert_data 与 moe_tp_rank 的原因。
最基础的 default_weight_loader 只有十几行,但它隐含了两个前提:
def default_weight_loader(param, loaded_weight): if param.numel() == 1 and loaded_weight.numel() == 1: param.data.fill_(loaded_weight.item()) else: assert param.size() == loaded_weight.size(), ( f"Attempted to load weight ({loaded_weight.size()}) " f"into parameter ({param.size()})" ) param.data.copy_(loaded_weight)第一个前提是 形状必须完全一致。当 TP size 大于 1 或 EP 打开时,参数形状是「本 rank 的那一份」,而 checkpoint 是全局形状,默认 loader 必然触发断言。这就是为什么带切分的参数必须换成 sharded_weight_loader。
第二个前提是 单元素标量按广播处理。k_scale、v_scale、某些 per-tensor 的量化 scale 在很多 checkpoint 里被存为零维标量,而参数可能是一维的 [1]。param.size() == loaded_weight.size() 对 () 与 (1,) 不成立,广播分支让这种常见的格式差异不至于报错。
张量并行的切分规则来自 Megatron-LM 的那套定义,下图是它的经典示意:MLP 的第一层按输出维切(列并行),第二层按输入维切(行并行),前向只在行并行层之后做一次 all-reduce:
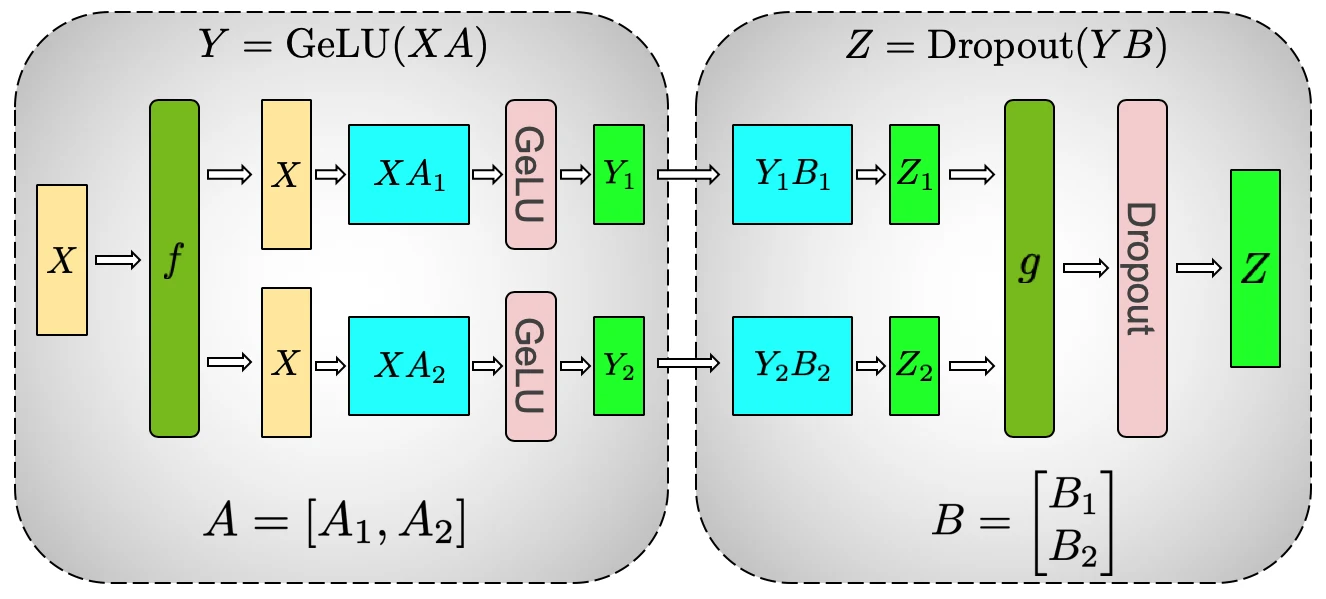
SGLang 的 sharded_weight_loader(shard_axis) 里的 shard_axis 就是这张图里的「切哪一维」:列并行切输出维(权重张量 [out, in] 的第 0 维),行并行切输入维(第 1 维)。checkpoint 里的张量是全局形状,每个 rank 只保留自己那一段,截取起点由 tp_rank * shard_size 决定。
5.2 sharded_weight_loader:在构造时冻结 rank
SGLang 的切分 loader 是闭包工厂,rank 在一次构造中确定:
def sharded_weight_loader(shard_axis, tp_rank_getter=None, *, parallel_group=None): if parallel_group is not None: tp_rank, tp_size = resolve_linear_parallel_group(parallel_group) else: tp_rank = (tp_rank_getter() if tp_rank_getter is not None else get_parallel().attn_tp_rank) tp_size = get_parallel().tp_size
def loader(param, loaded_weight): shard_size = param.data.shape[shard_axis] start_idx = tp_rank * shard_size ... loaded_weight = loaded_weight.narrow(shard_axis, start_idx, shard_size) return default_weight_loader(param, loaded_weight)
return loader三个值得展开的点:
起点与宽度怎么来。 shard_size 取的是参数自己的维度长度而不是「全局长度除以 tp_size」。这在均匀切分下等价,但在不均匀场景下(例如 TP size 与 head 数不整除,或某些维度的输出被 padding)更稳健:参数形状是建模阶段按本 rank 真实容量申请出来的,用它反推切片是最直接的做法。start_idx = tp_rank * shard_size 也因此天然对齐。
为什么 rank 要冻结在闭包里。 注释写的是「a weight loader with placement frozen in its construction scope」。冻结的原因与上下文管理器有关:SGLang 有草稿模型(EAGLE/NextN)构造时临时切换并行拓扑的场景,如果 loader 在调用时再去读 get_parallel(),可能读到草稿模型的拓扑而不是目标模型的。构造时定死,等于把「这个参数的切法属于谁」记在 loader 上。SGLang 源码完全拆解(十七):DP Attention 与专家并行里 DP attention 下 attention 层用的是 attn_tp_rank 而不是全局 tp_rank,默认的 tp_rank_getter 正好对应这一语义。
CPU 上的不均匀 padding。 CPU 路径多了一段分支:
if (is_cpu() and (loaded_weight.size(0) % tp_size != 0 or loaded_weight.size(0) < tp_size * shard_size) and loaded_weight.dim() == 1): param_data = param.data param_data, loaded_weight = narrow_padded_param_and_loaded_weight( param_data, loaded_weight, 0, start_idx, shard_axis, shard_size) return default_weight_loader(param_data, loaded_weight)loaded_weight.size(0) < tp_size * shard_size 对应「参数被 pad 得比 checkpoint 更宽」的情况(CPU 上的 AMX 要求某些维度对齐)。此时用 narrow_padded_param_and_loaded_weight 同时收缩参数视图与权重,再拷贝。
融合层的切分比普通 Linear 更绕一层。下图是 Megatron-LM 原论文里的自注意力张量并行布局:
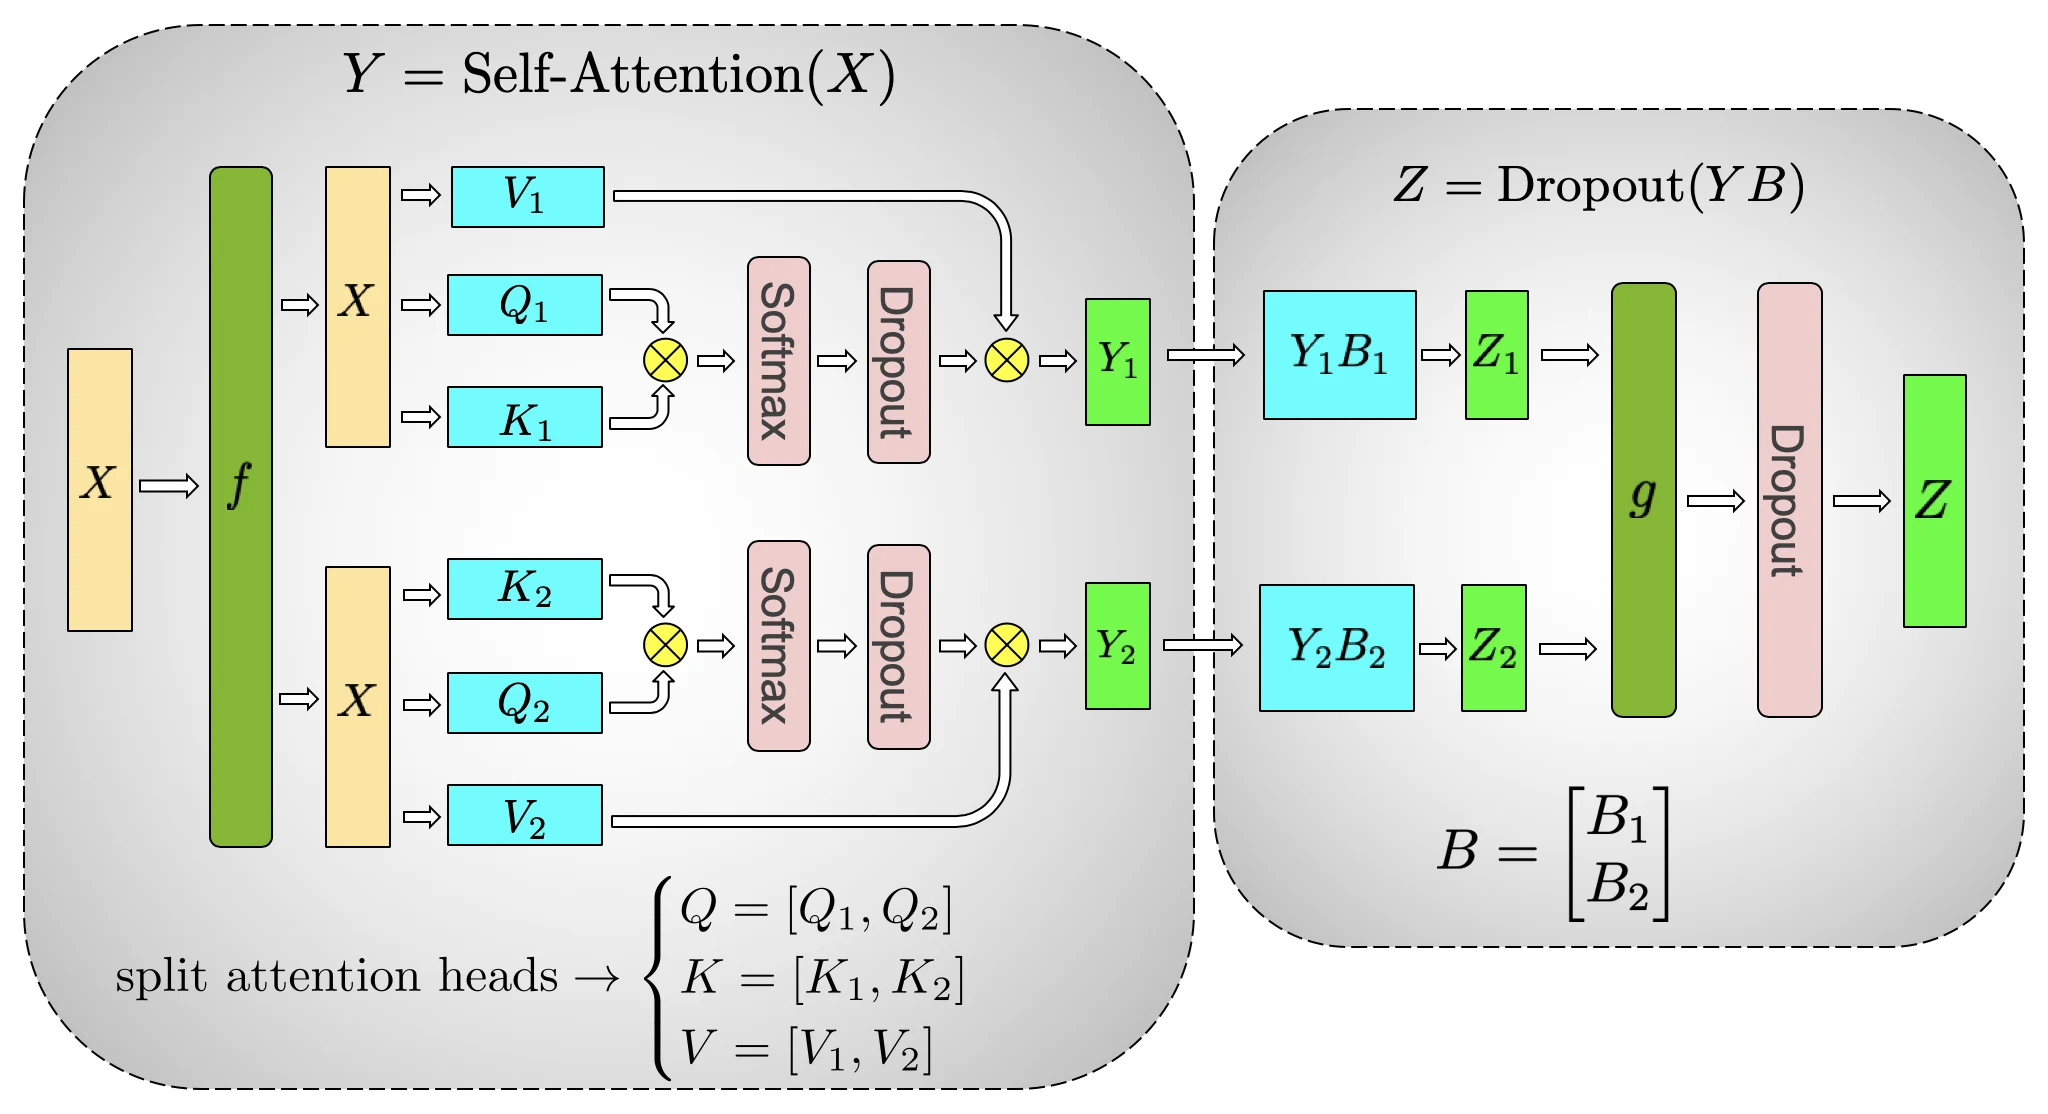
head 维度被切到不同 rank,意味着融合的 qkv_proj 参数在每个 rank 上既承载了「Q/K/V 三个槽位」又承载了「本 rank 的 head 子集」。SGLang 用一个 shard_id 编码前者,用参数形状与 tp_rank 编码后者;加载时两者必须同时满足,否则切出来的切片会跨槽位。
5.3 融合层:一个 shard_id 同时表达「槽位」与「切分」
融合的 gate_up_proj 与 QKV 这类参数,加载器既要区分逻辑槽位,又要按 TP 切。以 DeepSeek 的 MoE 为例,FusedMoE._load_w13 把两件事写在一起:
if shard_id in {"w1", "w3"} and self.moe_runner_config.is_gated: shard_size = expert_data.shape[shard_dim] // 2...switch_w13 = getattr(_weight_layout_method(self), "load_up_proj_weight_first", False)if ((switch_w13 and shard_id == "w1") or (not switch_w13 and shard_id == "w3")): start = shard_sizeelse: start = 0先看 shard_size = expert_data.shape[shard_dim] // 2:参数把 gate 和 up 沿输出维拼在一段长度为 2 × intermediate 的缓冲区里,gate 占前一半、up 占后一半,所以每片宽度是一半。start 决定写到哪一半。
switch_w13 这一段是内核布局差异的直接体现。Triton 组的 MoE 内核与 TensorRT-LLM/FlashInfer 的 cutlass 内核期待 gate/up 的排列顺序不同,源码注释写的就是「trtllm cutlass kernel assumes differently」。同一个 checkpoint、同一份权重,落到不同内核后权重布局不同——如果加载器写死 up 永远在后半段,换内核后算出来的 SwiGLU 会静默错位(形状对、数值错,不会报异常)。
再往下是 TP 与 padding:
if self.use_padded_loading: weight_start = shard_size * self.moe_tp_rank if _is_cpu and self.use_presharded_weights: weight_start = 0 expert_data, loaded_weight = narrow_padded_param_and_loaded_weight( expert_data, loaded_weight, start, weight_start, shard_dim, shard_size, not self.use_presharded_weights)else: if not self.use_presharded_weights: if not is_bias and self.use_triton_kernels: loaded_weight = loaded_weight.transpose(-2, -1) loaded_shard_size = loaded_weight.shape[shard_dim] // self.moe_tp_size loaded_weight = loaded_weight.narrow( shard_dim, loaded_shard_size * self.moe_tp_rank, loaded_shard_size) expert_data = expert_data.narrow(shard_dim, start, shard_size)use_padded_loading 的判定在 FusedMoE 里是:
return _is_cpu or self.use_flashinfer_trtllm_moe or aiter_padded三种情况需要 padding:CPU 路径(AMX 等实现)要求中间维对齐;FlashInfer 的 TRT-LLM MoE 路径要求中间维 padding 到 128(gated NVFP4 是 64);AITER 的权重也带 padding。因此参数缓冲区可能比 checkpoint 的 TP 切片更宽,加载时 expert_data.narrow(...).zero_() 先把多出来的部分清零,再拷数据:
if (loaded_weight.dim() == expert_data.dim() and loaded_weight.shape[shard_dim] < expert_data.shape[shard_dim]): loaded_size = loaded_weight.shape[shard_dim] expert_data.narrow(shard_dim, loaded_size, expert_data.shape[shard_dim] - loaded_size).zero_() expert_data.narrow(shard_dim, 0, loaded_size).copy_(loaded_weight)为什么要清零而不是留着 torch.empty 的垃圾值? padding 区域虽然不参与真实计算,但会参与分组 GEMM:对齐表把每个专家的 token 行 pad 到块边界,GEMM 计算完再丢弃。如果 padding 权重里是 NaN 或随机大值,GEMM 的结果可能溢出到合法区域(某些内核的累加顺序与 padding 有关)或者触发 NaN 传播。清零让 padding 对结果严格无贡献。
transpose(-2, -1) 则是 Triton kernel 的布局要求:权重按 [N, K] 存、输入按 [K, N] 乘,与 checkpoint 的 [out, in] 差一次转置。同样的思路在 llama.cpp 源码完全拆解(十五):量化 GEMM 的矩阵编队里也有对应,只是 llama.cpp 用 ggml_mul_mat 的转置语义表达。
5.4 不整除:TP 与专家数对不上时
TP size 不整除中间维或 head 数是常见的部署选择,例如 8 卡上的 96 个 attention head、或 6 卡上的 MoE。SGLang 用 pad_loaded_weight 解决「全局输出维不能被 tp_size 整除」的情况:
def pad_loaded_weight(loaded_weight, output_dim, output_sizes): total_output_size = sum(output_sizes) raw_output_size = loaded_weight.size(output_dim) if total_output_size > raw_output_size: weight_split_size = [int(o / total_output_size * raw) for o in output_sizes] assert sum(weight_split_size) == raw_output_size, ... split_weight = loaded_weight.split_with_sizes(weight_split_size, dim=output_dim) ... # 每片末尾补零到对应的 output_sizes[i]它是「按比例分配再补零」的策略:全局 96 个 head 分给 6 个 rank 时,有的 rank 拿 16 个、有的拿 17 个;参数按最大值 17 申请,少的一份补零。补零的 head 在注意力里被 mask 掉或参与计算但输出丢弃,所以数值无害;关键在于几何上必须补齐,否则 Q/K/V 的 head 数不同,注意力 kernel 的 stride 计算会出错。
第六段:参数形状先于加载——空壳是怎么建出来的
在讲落位之前,还要先明确一个顺序问题:参数在加载之前就已经存在了。load_model 的第一步不是读权重,而是建模型:
target_device = torch.device(device_config.device)quant_config = _get_quantization_config(model_config, self.load_config)with set_default_torch_dtype(model_config.dtype): with target_device: model = _initialize_model(model_config, self.load_config, quant_config) self.load_weights_and_postprocess( model, self._get_all_weights(model_config, model), target_device)with target_device: 是一个 torch.device 上下文管理器,它让 __init__ 里 torch.empty(...) 的默认 device 变成 cuda:N。也就是说,参数直接在 GPU 显存里开辟,形状在建模时就按本 rank 的容量算好——tp_size、ep_size、draft_model_idx 等都在此时生效。加载器随后把这些已经开好槽的参数当目标,往里写局部切片。
这个顺序有一个直接后果:加载前已经占掉了几乎全部的权重显存。因此「加载时的 OOM」往往发生在建壳阶段,而不是拷贝阶段;排查时要区分是 __init__ 申请失败,还是加载过程申请的临时内存超了预算。_initialize_model 里的 shared_experts 解析、draft_model_idx 传参、check_stage_producers(model) 的装配期校验也都在这一刻完成,与装载器无关。
under torch.device 直接开在 GPU 上的另一个好处是:加载时只需 copy_ 一次,不需要「先 CPU 建壳再 .to(device)」的二次搬运。坏处与上面的显存账相同——壳一建好就没有回头路。
第七段:DeepSeek 加载器的完整名字解析顺序
前几节的规则散落在多个文件里。把它们按 DeepSeek 的 do_load_weights 串成一条顺序,是这一篇最核心的部分。它对每个 (name, tensor) 依次做下面这些判断:
1. expert input_scale 无落点 → 丢弃(计数后继续)2. use_async_loading = should_async_load(loaded_weight)3. layer_id 不在 [start_layer, end_layer) → 丢弃4. 共享专家融合:mlp.shared_experts → mlp.experts.{n_routed_experts}5. NextN 配置:只保留草稿层,并改写前缀为 model.* 或 model.decoder.*6. NextN 关闭:num_hidden_layers 之后的层(草稿层)丢弃7. 融合专家大张量(gate_up_proj / down_proj)→ 按专家切分后逐个写入8. rotary_emb.inv_freq → 丢弃9. 没有索引器的层 → 丢弃 .indexer.*10. 融合索引器 wk / weights_proj → 写入 wk_weights_proj(可能要先等 scale 反量化)11. stacked_params_mapping(gate_proj / up_proj)→ gate_up_proj12. expert_params_mapping(gate/up/down × expert_id)→ w13 / w213. 特殊适配:modelopt 的 k_scale / v_scale 改名、quark 的 block scale 改名14. 名字不在 params_dict → 警告并丢弃15. 取 param.weight_loader,提交到线程池或就地执行这张表里有几处是「推理框架必须处理、但论文不会提」的工程细节。
7.1 共享专家融合:把共享专家伪装成第 N 个路由专家
DeepSeek 的 MoE 每个层有一个共享专家和 256 个路由专家。部分部署选择把共享专家与路由专家放进同一个 FusedMoE 参数,以便一次分组 GEMM 算完:
if self.num_fused_shared_experts > 0 and "mlp.shared_experts" in name: name = name.replace("mlp.shared_experts", f"mlp.experts.{self.config.n_routed_experts}")于是专家映射表的 num_experts 也变成 n_routed_experts + num_fused_shared_experts。共享专家占据索引 n_routed_experts(DeepSeek-V3 上是 256)这个槽位。FusedMoE.weight_loader 里的 _has_fused_shared 分支就是为它准备的:
shared_expert_id = (expert_id - global_expert_location_metadata.num_logical_experts if self._has_fused_shared and expert_id is not None else -1)if 0 <= shared_expert_id < self.num_fused_shared_experts: ... physical_expert_ids = [self._num_global_routed + shared_expert_id]注释说得清楚:「Checkpoint shared experts start after logical routed experts, while local fused MoE weights store them after physical routed experts.」checkpoint 的共享专家排在逻辑专家之后,而本 rank 的参数里共享专家排在物理专家(包含 EPLB 复制出来的冗余专家)之后。两个「之后」不是同一个位置,因为 EP 下物理专家数可能多于逻辑专家数。加载器必须按物理布局重新计算目标槽位。
7.2 NextN:一份 checkpoint 两种角色
DeepSeek-V3 的 MTP(Multi-Token Prediction)层编号紧跟在主干层之后:主干有 61 层(编号 0–60),MTP 层编号 61。同一个 checkpoint 既可以被加载成「主干模型」,也可以被加载成「草稿模型」:
- NextN 关闭(主干模型):所有
layers.{i}且i >= num_hidden_layers的张量都会被丢弃。 - NextN 开启(草稿模型):只保留 MTP 层,并且按张量类别改前缀——spec 权重(
shared_head、enorm、hnorm、eh_proj)改成model.*,其余改成model.decoder.*。
if any(s in name for s in spec_weight_names): name = name.replace(layer_prefix, "model")else: name = name.replace(layer_prefix, "model.decoder")为什么同一层要拆成两个前缀?因为草稿模型的结构是「一个解码器层 + 一套 spec 模块」,model.decoder 对应那个解码器层,model.* 对应挂在模型根上的 spec 头。如果都用同一个前缀,参数树里要么多出找不到的槽位,要么把解码器层的名字挤掉。SGLang 源码完全拆解(十一):投机解码讲了草稿前向如何使用这些参数,这里只负责把它们放进正确的槽。
还有一个细节:"shared_head.head" in name or "embed_tokens" in name: continue。草稿模型复用主干的 lm_head 与 embed_tokens,checkpoint 里这份副本被丢弃以避免重复占显存。
7.3 融合专家大张量:一次读入、多次写入
FP4/NVFP4 的 checkpoint 往往把每个专家的 gate 与 up 预先拼接成 experts.gate_up_proj,形状是 [num_experts, 2 × intermediate, hidden]。名字里已经没有 experts.{id}. 这一层,专家表一条都匹配不上,于是走 _load_fused_expert_tensor:
mappings = ( (".experts.gate_up_proj_scale", ".experts.w13_weight_scale_inv", "w13"), (".experts.down_proj_scale", ".experts.w2_weight_scale_inv", "w2"), (".experts.gate_up_proj", ".experts.w13_weight", "w13"), (".experts.down_proj", ".experts.w2_weight", "w2"),)for source, target, shard_id in mappings: if not name.endswith(source): continue param = params_dict.get(name[: -len(source)] + target) if param is None: return False for expert_id, expert_weight in enumerate(loaded_weight): if shard_id == "w13": gate, up = expert_weight.chunk(2, dim=0) weight_loader(param, gate, param_name, shard_id="w1", expert_id=expert_id) weight_loader(param, up, param_name, shard_id="w3", expert_id=expert_id) else: weight_loader(param, expert_weight, param_name, shard_id="w2", expert_id=expert_id) return True这一段是加载器的「二次分发」:一个大张量在 Python 层枚举出各专家的切片,再分别交给 weight_loader,后者继续做本地专家过滤、TP 切分、padding。优点是不必修改内核或参数布局;代价是 enumerate 会把整个大张量驻留在内存中(迭代器只产出一次),一个 256 专家、2 × 2048 × 7168 的 BF16 张量约 15 GB(256 × 2 × 2048 × 7168 个元素 × 2 字节)。这也是 enable_multithread_load 配合滑动窗口重要的原因——同一时刻只有一个大张量在内存里。
7.4 融合索引器与「等 scale 才能反量化」
DeepSeek-V3.2/V4 的稀疏索引器有一个 wk 与一个 weights_proj。CUDA 路径把两者融合成一个 bf16 参数 wk_weights_proj:
fused_name = name.rsplit(".indexer.", 1)[0] + ".indexer.wk_weights_proj.weight"fused_param = params_dict.get(fused_name)if fused_param is None or fused_param.dtype != torch.bfloat16: return False融合参数是 bf16,但 checkpoint 里可能是块状 FP8:wk 分两片(weight 与 weight_scale_inv),weights_proj 也分两片。于是加载器要跨两个名字攒齐再反量化:
entry = pending.setdefault(fused_name, {})entry["scale" if is_scale else "weight"] = _clone_if_runai_streamed_tensor(loaded_weight)if "weight" in entry and "scale" in entry: pending.pop(fused_name) wk_bf16 = block_quant_dequant(entry["weight"], entry["scale"], block_size, torch.bfloat16) fused_param.data[: wk_bf16.shape[0]].copy_(wk_bf16)pending 字典的生命周期是整个加载循环,攒齐后立刻清除对应的键。这种「按名字配对」的写法在加载器里很常见,常见错误是跨层的同名键互相覆盖——这里用完整前缀 fused_name 作键,按层区分。
_clone_if_runai_streamed_tensor 不是多余的拷贝。RunAI streamer 模式下张量是复用 CPU 缓冲的零拷贝视图,如果你把它存进 pending 而不拷贝,streamer 填下一批时视图内容会被覆盖。源码在 should_async_load 的注释里也强调这一点。
7.5 线程池与 CUDA device 的坑
所有 weight_loader 调用都经过 maybe_executor_submit:
if use_async: current_device = torch.cuda.current_device() if torch.cuda.is_available() else None def device_aware_wrapper(*args, **kwargs): if current_device is not None: torch.cuda.set_device(current_device) return func(*args, **kwargs) futures.append(executor.submit(device_aware_wrapper, *func_args, **func_kwargs))else: func(*func_args, **func_kwargs)use_async 由 should_async_load 决定,判断依据有三条:张量带 RunAI streamer 标记就同步(零拷贝视图必须当场消费),不在任何 device 上就同步,其余只在 CPU 张量上异步。注释解释了原因:CPU 张量的 copy_ 是 H2D 拷贝,把多个专家的拷贝分散到线程池可以重叠 I/O 与拷贝;GPU 张量的拷贝已经在 GPU 侧异步执行,Python 线程只会带来 GIL 争用与全局解释器锁下的上下文切换。
device_aware_wrapper 处理的是一个 PyTorch 的老问题:torch.cuda.current_device() 是线程本地状态,新线程的默认 device 是 0。在多 GPU 机器上,如果 rank i 的加载线程没有 set_device(i),copy_ 会落到 GPU 0 上;运气好是报「device mismatch」,运气差是把数据写进另一个 rank 的显存。源码里链接的 PyTorch issue 就是这个问题的出处。
线程池在 with concurrent.futures.ThreadPoolExecutor() as executor: 里创建,没有传 max_workers,按 Python 默认规则取 min(32, os.cpu_count() + 4)。提交完 futures 之后,循环末尾统一 as_completed 收集,任何一个 future.result() 抛异常都会中止加载;这里没有 try/except,注释写的是「Wait for all tasks to complete and raise any exceptions」——加载出错就应该启动失败,而不是带着残缺权重进入服务。
第八段:MLA 的 kv_b_proj 为什么要在加载后「劈成两半」
postprocess_weights 对每个带 quant_method 的模块调用 process_weights_after_loading,之后 post_load_weights(model) 还会触发模型自己的收尾。DeepSeek 的 post_load_weights 是一个最能说明「加载期 = 布局转换期」的例子:它把 kv_b_proj 拆成 w_kc 与 w_vc。
MLA 与 MHA、GQA、MQA 的根本差别在于 KV Cache 里存什么。DeepSeek-V2 论文的对比图把这一点画得很清楚:
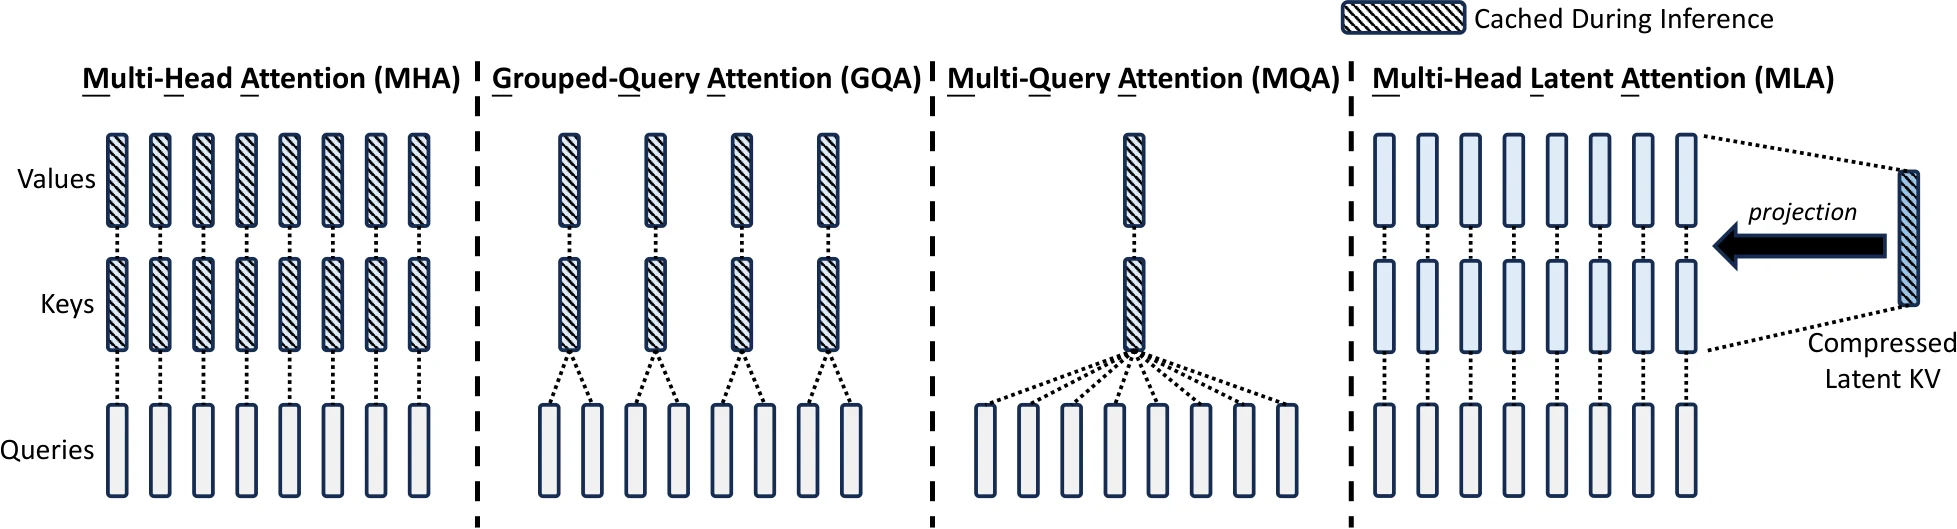
前三者缓存的是按 head 展开的 K 与 V,MLA 缓存的是一个与 head 数无关的 latent 向量。正因为缓存里没有 head 维度,前向才需要用 w_kc、w_vc 在「吸收」形式下与每个 head 的 Q、输出打交道——这两个参数的形状与布局,也就必须在加载时就准备好。
先看背景。MLA 的低秩结构中,KV 的压缩表示是 latent 向量 c^{KV}(kv_lora_rank = 512 维),要还原成各头的 K 与 V,需要一次升维投影:
式中的 W^{UK}、W^{UV} 是升维所用的两个分解矩阵,下标 t 表示第 t 个 token,上标 C 表示这部分是由 c^{KV} 投影出来的分量。kv_b_proj 的权重就是这两个矩阵沿输出维拼接后的结果,形状为 [heads × (d_nope + d_v), r];前 heads × d_nope 行属于 K,后 heads × d_v 行属于 V,每一段内部再按 head 排布。在朴素的实现里,前向是「先展开 K 和 V、再在解耦 RoPE 后拼接、再做完整注意力」。如果真要这么做,KV Cache 就得存展开后的 K/V,MLA 压缩缓存的全部收益就没有了。DeepSeek 的推理实现用的是吸收(absorption)形式:把 W^{UK} 吸收进 Q 的投影、把 W^{UV} 吸收进注意力的输出投影,注意力核只与 latent 打交道。
吸收形式对参数布局有具体要求:头数一多,W^{UK} 要按头切成 w_kc,形状是 [num_heads, kv_lora_rank, qk_nope_head_dim];W^{UV} 切成 w_vc,形状是 [num_heads, kv_lora_rank, v_head_dim]。两者都与 checkpoint 的 [num_heads × (qk_nope + v), kv_lora_rank] 不同,必须重新排列。源码做的是:
w_kc, w_vc = w.unflatten( 0, (-1, self_attn.qk_nope_head_dim + self_attn.v_head_dim)).split([self_attn.qk_nope_head_dim, self_attn.v_head_dim], dim=1)...self_attn.w_kc = bind_or_assign( self_attn.w_kc, w_kc.transpose(1, 2).contiguous().transpose(1, 2))w_vc = w_vc.contiguous().transpose(1, 2)self_attn.w_vc = bind_or_assign(self_attn.w_vc, w_vc)逐句读:unflatten(0, (-1, d_nope + d_v)) 把输出维 num_heads × (d_nope + d_v) 拆成 [num_heads, d_nope + d_v];split([d_nope, d_v], dim=1) 按头拆出 K 段和 V 段;结果 w_kc 是 [heads, d_nope, kv_lora_rank]、w_vc 是 [heads, d_v, kv_lora_rank]。
transpose(1, 2).contiguous().transpose(1, 2) 这个写法初看很怪:两次转置等于回到原状,那为什么还要做?关键在于 contiguous() 夹在中间。第一次转置后内存布局变成 [heads, r, d] 的物理顺序,contiguous() 把这份物理顺序固化成新张量,第二次转置只是把形状标注改回 [heads, d, r],但它对应的 stride 已经指向新的连续内存。这样 w_kc 就是一个形状为 [heads, d, r]、但物理布局是 [heads, r, d] 的张量,bmm 与融合内核可以直接按两种视角读它,不需要另外拷贝一份。w_vc 则只做一次 transpose,物理布局即目标布局。
bind_or_assign 处理的是一个易被忽略的问题:参数可能在加载前已经被 bind 成某个共享 buffer 的视图(内存池或 IPC 共享权重),此时直接赋值 param.data = ... 会让原来的绑定失效。bind_or_assign 在绑定存在时把数据写进原 buffer,否则才替换。共享权重、RL 场景的权重热更新都依赖这条语义。
8.1 量化:先变成一个统一的 dtype 再拆
post_load_weights 之所以长,是因为它要处理 kv_b_proj 的量化输入。它依次判断 AWQ 解包、FP8 块状、FP8 通道、INT8 块状、INT8 通道:
- 块状 FP8 且块大小是 128×128:如果 DeepGEMM 的 BMM 可用(JIT DeepGEMM 启用、非 Blackwell、且
SGLANG_USE_DEEPGEMM_BMM打开),就保留块状 FP8 与块状 scale,直接交给 DeepGEMM;否则先block_quant_dequant反量化成 BF16,再拆。 - 块状 FP8 但块大小不是 128×128:
block_quant_to_tensor_quant把所有块的 scale 压成一个 per-tensor scale,存到self_attn.w_scale。注释写明原因:「bmm_fp8only supports per-tensor scale」。这是精度与通用内核之间的取舍:块状量化会损失一部分精度,但能跑在更广泛的硬件上。 - 通道状 FP8:scale 是一维
[out],先view(-1, 1)让它在[out, in]上正确广播,再channel_quant_to_tensor_quant合并成 per-tensor。
三个分支的共同终点是:拆分之前,w 必须是一份布局为 [heads × (d_nope + d_v), r] 的张量。量化格式不同只决定它怎么从量化形式变回这个布局,拆分本身完全不变。
这段代码还留了 AMD 特有处理:gfx95 上如果架构是 GlmMoeDsaForCausalLM 且权重是 BF16,会量化成 per-tensor 的 float8_e4m3fn(不是 fnuz),以匹配 forward_mla_rocm 的 dtype 门槛;w_scale 在 HIP 上要乘 2.0,因为 fnuz 格式的指数偏置不同。这些是「加载期按平台调整布局」的典型例子——同一个 checkpoint 在不同加速器上需要不同的物理表示,全部集中在加载时做一次,前向路径就不必分叉。
8.2 为什么不在前向里拆
一个自然的问题是:既然 w_kc、w_vc 只是 kv_b_proj 的视图,为什么不保留 kv_b_proj,在前向里按需切?理由有三条:
- 内存。保留原张量再切出两个视图意味着两份参数同时驻留(视图与原张量共享存储时还好,但
transpose后需要新布局的副本)。对 MLA 来说kv_b_proj每层是[128 × (128 + 128), 512],BF16 下约 33.5 MB,61 层合计约 2 GB;拆开之后原张量可以释放,显存峰值更可控。 - 前向路径的干净程度。注意力内核只认
w_kc与w_vc,前者在吸收形式的 Q 投影里当[heads, d, r]用、后者在输出投影里当[heads, r, d]用。让内核每次前向都从一个大张量里narrow、transpose,等于每次都在重复同一个只做一次的转换。 - 量化后处理。FP8 反量化、块状 scale 合并、MUSA 上「bmm 不支持 FP8 就转 BF16 并把 scale 乘进去」这些操作都只与加载时的一次性转换有关,放在前向里会随 batch 重复执行。
TensorRT-LLM 与 vLLM 的思路一致:前者在 Linear 的加载后处理里重排权重,后者在 process_weights_after_loading 里做,区别只在拆分发生在哪个钩子里。可参考 TensorRT-LLM 源码完全拆解(十二):注意力层的张量并行,那一篇从 MLA 的张量并行视角讲了 w_kc/w_vc 的切分方式。
第九段:启动时间与内存——装载管线上的三项工程
读完前八段,管线在功能上是完整的,但启动时它还有两个可测量的成本:时间(读盘与拷贝)和峰值内存(分片 + 空壳 + 临时张量)。SGLang 在这个层面做了三项改造,都属于「不改功能、只改时序与内存」。
9.1 capture-safe model:用占位值先把 CUDA Graph 抓完
GPU 上启动耗时的很大一部分不是加载权重,而是 CUDA Graph 捕获与 warmup。可先读 SGLang 源码完全拆解(九):CUDA Graph 与编译路径,那一篇讲过整图捕获的形状约束;抓图需要模型参数已经存在(形状、stride、device 都对),但不需要参数是真值。于是 SGLang 把「建壳 + 抓图」和「读真权重」拆开并允许重叠:
def prepare_model_for_capture(self, *, model, model_config): with set_default_torch_dtype(model_config.dtype): initialize_capture_safe_weights(model) # 全部浮点参数填 1e-3 post_load_weights(model) for _, module in model.named_modules(): quant_method = getattr(module, "quant_method", None) if quant_method is None or (hasattr(module, "is_weights_quantized") and module.is_weights_quantized()): continue quant_method.process_weights_after_loading(module) return model.eval()initialize_capture_safe_weights 把所有浮点参数填成一个可检测的哨兵值 1e-3(CAPTURE_SAFE_WEIGHT_SENTINEL),持久化 buffer 不动。为什么是 1e-3 而不是 0?两个原因:0 会让所有输出为 0,某些内核在图捕获时对全零输入可能有特化分支;取一个小正值能让前向不出现 NaN,又能被 ModelStorageManifest.unchanged_parameter_names 精确识别出「哪些参数没被真权重覆盖」。
抓完图之后,commit_model_weights 加载真权重,并靠 ModelStorageManifest 校验:
def commit_model_weights(self, *, model, model_config, resolved_sources, target_device, startup_prefetch_active): def weights_iterator(): for resolved_source in resolved_sources: yield from self._get_weights_iterator( resolved_source.source, resolved_source=resolved_source, startup_prefetch_started=True, startup_prefetch_active=startup_prefetch_active) with set_default_torch_dtype(model_config.dtype): self.load_weights_and_postprocess(model, weights_iterator(), target_device)ResolvedSource 这个类型就是为这次拆分准备的:resolve_model_weights 在抓图前把「读哪些文件」一次性定下来(hf_folder、weight_files、use_safetensors),抓图期间后台线程去预热这些文件的页缓存,提交阶段复用同一份结果,不再重复 glob 与过滤。
ModelStorageManifest 记录每个参数与 buffer 的 data_ptr、形状、stride、dtype、device、storage_offset,提交后对比一遍,凡是存储发生变化的名字都会被找出来:
changed_names = manifest.changed_names(self._model)if changed_names: raise RuntimeError(f"Startup weight commit changed graph-visible tensor storage: {preview}")unchanged_names = manifest.unchanged_parameter_names(CAPTURE_SAFE_WEIGHT_SENTINEL)if unchanged_names: raise RuntimeError("Startup weight commit did not replace capture-safe dummy values: ...")两行断言正好覆盖两个方向的错误:前者抓「图里引用的地址被换了」,后者抓「哨兵值没被真权重覆盖」。这个设计解决了一个隐蔽问题:抓图时 process_weights_after_loading 已经把哨兵权重做了量化后处理(例如打包成 4-bit),如果加载真权重时换成了一块新的 Parameter 对象,图里引用的地址就失效了。Manifest 用「同一对象 + 同一指针 + 同一 stride」严格判定,任何替换都会被当作错误。
StartupWeightLoadManager.finalize 里还藏着一条顺序信息:它在提交前自己 capture 一次 manifest,而不是用 prepare 阶段的旧快照。原因是 finalize 之前可能已经插入了 CUDA Graph 捕获,捕获过程本身会分配临时 buffer、可能改动部分 param 的存储;以「提交前的状态」为基线,changed_names 才能只报告提交动作造成的差异。
源码的 docstring 也点出了一个已知代价:prepare_model_for_capture 与 commit_model_weights 会分别调用一次 process_weights_after_loading,比串行路径多一次。对当前支持的矩阵(CUDA 上未量化的 process_weights_after_loading 是空操作)是安全的;但对 在原位修改权重 的量化方法,这个多出来的调用可能把已经打包好的权重再打一次。所以启动重叠路径对支持的架构与量化方法做了准入检查(StartupWeightLoadManager._get_unsupported_reason),不满足就直接走串行加载。
9.2 checkpoint prefetch:先把页缓存喂热
第二个改造是页缓存预热。_prefetch_checkpoint_file 的行为非常简单:
with open(file_path, "rb") as f: while cancel_event is None or not cancel_event.is_set(): if not f.read(_get_prefetch_block_size()): # 默认按 16 MB 块读 break顺序读完整文件,什么都不保留。目的不是拿到数据,而是让内核把文件页缓存在内存里;之后所有 rank 的 mmap 访问都命中缓存,而不是各自去争磁盘带宽。CheckpointFilePrefetchHandle 提供 wait / cancel / stop 生命周期,failed 会把「后台线程报错」与「线程结束但没有成功事件」都算作失败。
为什么 prefetch 在多线程路径上会主动降级为单线程?第四段已经引过那段条件,这里补上原因:多线程读盘同样会填页缓存,但每条线程读的是不同文件,页缓存的竞争让预热线程与加载线程互相挤掉对方的页;单线程 + prefetch 的组合让读盘交给一个线程、预热交给另一个线程,两者不在同一批文件上争抢。注释里给出的判断线索是「用户是否显式指定多线程」——本地 NVMe 上 prefetch 没用,用户显式点名多线程说明场景是本地盘。
9.3 IPC 权重缓存:多个进程共享同一份权重
第三个改造更彻底:权重只加载一次,所有进程共享。maybe_enable_ipc_weight_cache 只改两行:
if load_config.load_format != LoadFormat.IPC_CACHE: load_config.fallback_load_format = load_config.load_format load_config.load_format = LoadFormat.IPC_CACHE原来的 load_format 被保存成 fallback,主格式换成 IPC_CACHE。之后 get_model_loader 会返回 IpcModelLoader,从权重缓存守护进程(Weight Cache Daemon)通过 CUDA IPC 拿到已经建好的权重。IpcModelLoader 的注释说明了两种模式的区别:daemon 模式下引擎与守护进程共享同一份权重,如果守护进程不可用就报错,而不是退回磁盘——因为在同一张 GPU 上再建一份权重会直接吃满显存;client 模式下允许退回磁盘,但只有 Unix socket 文件不存在这一种情况才退回;连接被拒(守护进程绑定后崩溃)、CacheConfig 不匹配、协议或传输错误全部直接抛出,防止「IPC 路径坏了却静默变慢」或者「在同一张卡上按另一份配置的指纹读了权重」。这个「失败即报错、不降级」的契约就写在类的 docstring 里,对应的判定集中在 _fetch_from_cache。多进程场景(例如每个进程一个 TP rank 同机部署,或者 P/D 分离中同一台机器上跑多个实例)下,这样能省掉 tp_size 倍的读盘与 tp_size 倍的 CPU 内存。
这套 IPC 路径对加载管线的其余部分有一个硬约束:init_weights 阶段的参数必须允许被重新绑定到 IPC 内存上,所以像 bind_or_assign、_rebind_parameter_aliases 这类「改写指针而不替换对象」的工具要贯穿整条管线。前面第八段 MLA 分裂时用 bind_or_assign 的原因也在这一层——它同时服务 IPC 共享与 RL 热更新两种场景。
9.4 LayeredModelLoader:逐层加载,压低峰值
LayeredModelLoader 继承 DefaultModelLoader,docstring 一句话说清了取舍:「loads weights layer by layer so that one can quantize a layer before loading another to make the peak memory envelope smaller」。在线量化(BF16 checkpoint → FP8/NVFP4)时,如果先把整体 BF16 读进来再量化,峰值是「全量 BF16 + 全量量化后权重」;逐层加载则每一层读完、量化完、释放原 BF16,峰值只多一层。代价是读盘与量化无法跨层并行,启动会变慢。这也是在线量化部署里常见的选择:显存够就开多线程整体加载,显存紧就切逐层。
装载之后的交接:模型如何交到 ModelRunner
加载函数返回的是 model.eval(),调用方 ModelRunner 在之后做三件事:current_platform.post_load_model(model)(平台相关的后处理钩子)、KV 池与缓存分配、以及首轮 CUDA Graph 的 warmup 与捕获。顺序不能调换——KV 池的大小取决于模型参数与 kv_cache_dtype,抓图需要 KV 池已经就位。所以「权重装载完成」只是启动流水线的一个中间标记,它交付的是一个参数齐备、布局已经是内核形态的模型对象。
从这个角度看,本篇讲的每一段都在为一个前提服务:前向路径上不应再出现任何与「checkpoint 长什么样」有关的判断。switch_w13、padding 区的清零、MLA 的头部转置、块状 scale 的合并,全部在加载期完成一次;前向只按最终布局计算。这个原则也解释了为什么 post_load_weights 要独立成一个钩子,而不是塞进 load_weights——它处理的对象已经不是「从文件读到的张量」,而是「由读到的张量加工出来的参数」。
第十段:故障排查——症状对应到管线上的哪一段
把前面几段的判断点排成一张排查表,加载出错时按表的顺序走,基本能一步定位。
| 症状 | 发生位置 | 常见原因 |
|---|---|---|
Cannot find any model weights with ... | _prepare_weights | 目录里没有匹配模式的文件;--load-format 指定了 safetensors 但目录只有 .bin |
| 同名参数被加载了两次、数值不确定 | _prepare_weights 过滤 | 同时存在合并文件与分片;索引文件漏报分片(Mistral/GLM MTP 类) |
| 某个参数在 checkpoint 里但没被初始化 | _prepare_weights + 名字映射 | 索引没有该分片;maybe_add_mtp_safetensors 未命中;前缀被 source.prefix 改写 |
Attempted to load weight (a) into parameter (b) | default_weight_loader 断言 | 参数应为切分参数但误用了默认 loader;TP size 与形状不整除但没走 pad_loaded_weight |
| 启动后期前向结果全为 NaN 或接近 0 | capture-safe 路径 | 哨兵值 1e-3 没被覆盖;某参数不在 checkpoint 里且 __init__ 自带浮点初值 |
| FP8 启动后数值偏差、loss 对不上 | post_load_weights | kv_b_proj 的块状 scale 被压成 per-tensor;UE8M0 的 uint8 scale 被当成普通 uint8 读 |
| MoE 层输出对不上参考实现 | _load_w13 | switch_w13 与内核不匹配,gate/up 顺序反了;padding 区未清零 |
| EP 下某些专家结果错乱 | FusedMoE.weight_loader | 逻辑 id 到物理 id 映射错误;EPLB 副本槽位没覆盖;共享专家排到了错误位置 |
| 启动时 0 号卡显存暴涨/OOM | maybe_executor_submit | 线程未 set_device,H2D 拷贝落到 GPU 0 |
| 加载很慢且 i/o 打满 | _get_weights_iterator | prefetch 与多线程同时开,争用页缓存;未开错峰(SGLANG_SORT_WEIGHT_FILES) |
| 多份 checkpoint hash 一致但性能不同 | 错峰与 mmap | 排序/错峰只是顺序变化,不影响正确性;mmap 被禁用导致页缓存不可共享 |
这张表的核心逻辑是:每一段只管一类错误。文件级错误不会在 load_weights 里炸出来,而是表现为「参数没被初始化」;名字级错误不会在迭代器里炸出来,而是在 params_dict 查不到时打一条 warning 后丢弃。读源码时先记住每一段的断言和日志,排查效率会高很多。
与 vLLM、TensorRT-LLM 的管线对比
权重装载在五个推理框架里做的事情本质相同,差异集中在对「环境」的假设上:
| 维度 | SGLang | vLLM | TensorRT-LLM |
|---|---|---|---|
| 读盘层 | safetensors_weights_iterator,多线程滑动窗口、页缓存预热、GDS 直读 | 类似,DefaultModelLoader 是两家的共同祖先 | 构建期把权重重排进 engine,运行期直接按引擎布局读 |
| 名字映射 | 模型自定义的 stacked_params_mapping / expert_params_mapping | AutoWeightsLoader + WeightsMapper,更通用 | Linear 模块的列/行并行声明 |
| 切分落位 | 参数上挂 weight_loader 闭包,TP rank 构造时冻结 | 参数上挂 weight_loader,TP rank 调用时读取 | 构建期按 Mapping 生成切分与 GEMM-AllReduce 融合 |
| 后处理 | process_weights_after_loading + 模型 post_load_weights(MLA 分裂) | process_weights_after_loading;MLA 在注意力层后处理 | load_weights 中重排,权重重排后只用于引擎 |
| 启动重叠 | capture-safe model、prefetch、IPC 权重缓存 | 部分提供 page-cache 预热与环境变量开关 | 构建期与运行期分离,启动本身只读已编译产物 |
差异的来源是对部署形态的假设。vLLM 的设计目标是通用、稳定的多模型服务,装载器尽量与模型无关;SGLang 的定位是高吞吐、低延迟的批量服务与结构化生成,因此更愿意在装载期与模型深耦合(例如 DeepSeek 的专家融合、索引器融合),换取前向路径的简洁;TensorRT-LLM 把更多工作推到构建期,运行期的加载更像「读产物」而不是「处理 checkpoint」。
这里没有绝对优劣:SGLang 的深耦合意味着每支持一个新模型,都要在 load_weights 里补一段映射;vLLM 的通用映射意味着某些模型的特殊张量(融合索引器、共享专家)需要额外的模型级钩子。如果继续跟着 SGLang 往下读,下一篇会进入 GPUModelRunner 的初始化阶段,看加载完成后权重如何与 KV 池、注意力元数据、CUDA Graph 的缓冲一起被组织进一次前向。
小结
SGLang 的权重装载管线可以压缩成一句话:装载器负责「把文件变成名字明确的张量流」,模型负责「把张量流变成参数树上的槽位」,量化方法负责「把槽位变成内核能用的布局」。
- 装载器层(
model_loader/):get_model_loader按格式选策略,特殊量化(ModelOpt、InC)在枚举匹配之前拦截;_prepare_weights按固定顺序过滤与错峰,索引文件是信任边界,但又为漏报的分片留了兜底;- 迭代器用生成器 + 滑动窗口保证内存有界,prefetch 预热页缓存,两者同时开启时主动降级为单线程。
- 模型层(
models/):do_load_weights用堆叠表与专家表把 checkpoint 名映射到融合参数,并用一组「丢弃规则」省掉不必要的工作;post_load_weights把 MLA 的kv_b_proj拆成w_kc/w_vc,先统一量化格式再拆分。 - 落位层(
FusedMoE/ 参数上的weight_loader):shard_axis管 TP、shard_id管槽位、expert_id管专家、use_padded_loading管对齐、switch_w13管内核布局。 - 时序层:capture-safe 与 manifest 让抓图与读盘重叠,IPC 权重缓存让多进程共享同一份权重,逐层加载压低在线量化的峰值。
真正容易出错的地方,几乎都不在「读张量」本身,而在名字、形状、布局三者的对齐:名字对不上就静默丢弃,形状对不上就在断言处炸,布局对不上则形状对、数值错。
三类错误里,第三种最难发现,因为它不会让进程崩溃,只会让服务算错。对付它的办法不是更仔细地读代码,而是给每一段写一个契约测试:对同一个 checkpoint,比较「装载后参数的逐头切片」与「checkpoint 按论文公式展开后的结果」是否逐元素相等;对 MoE 用单层专家做一个小矩阵乘法,与 torch 的参考实现在相同输入上对拍。这类测试的共同点是只测一个算子或一段映射,不跑完整前向,正好对应本篇的分段视角:每一段都要能单独给出「输入张量 → 输出张量」的正确答案,管线才谈得上是可验证的。
参考资料
- SGLang GitHub 仓库
- SGLang: Efficient Execution of Structured Language Model Programs(arXiv:2312.07104)
- DeepSeek-V2:A Strong, Economical, and Efficient Mixture-of-Experts Language Model(MLA 结构与 KV 压缩)
- DeepSeek-V3 Technical Report(MLA、DeepSeekMoE 与 FP8 分块量化)
- Megatron-LM:Training Multi-Billion Parameter Language Models Using Model Parallelism(张量并行切分的经典定义)
- safetensors:HuggingFace 的分片权重格式与索引规范
- SGLang 官方文档:Server Arguments(
--load-format、--model-loader-extra-config等参数)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



