


SGLang 源码完全拆解(二十二):Two-batch Overlap——一次前向切成两半,让通信藏进计算背后
多节点专家并行(Expert Parallelism)推理里有一笔绕不开的账:每层 MoE 都要做两次 all-to-all,一次把 token 发到持有目标专家的 rank 上(dispatch),一次把专家算完的结果收回来(combine)。这两次通信必须等对面 rank 的数据就位才能往下走,而这段时间 GPU 的计算单元是空的。SGLang 用 Two-batch Overlap(双批重叠,下文简称 TBO)来填这个空:把一次前向的 batch 沿 token 维切成两半,让 A 半在算的时候 B 半在通信、B 半在算的时候 A 半在通信,通信时间就从”叠加在计算之上”变成了”藏在计算背后”。这套机制最早出现在 DeepSeek 官方的 V3/R1 推理系统设计里,SGLang 团队在 2025 年复刻并开源了完整实现。
可 TBO 写起来远比说上去麻烦。如果照着设计图画”切两个 micro-batch、交错执行”,每个模型层、每个算子都要处理”我现在是 A 还是 B”的分支,同一段代码被复制两遍,变量多两组后缀,将来想改成三批重叠几乎要重写。SGLang 的 python/sglang/srt/batch_overlap/ 目录给出了一个干净得多的答案:把一层的前向写成一张扁平的”操作表”,用显式的”让出点”标出通信可被打断的位置,再让两个执行器按错位的节拍各自推进这张表。
这篇文章沿这一份真实源码,把 TBO 从动机到实现逐层拆开。涉及的站内相关背景可以先看 SGLang 源码完全拆解(十七):DP Attention 与专家并行——那篇讲了 DP Attention、DeepEP 通信与 EPLB 的整体拓扑,并在末尾用一小节带过了 TBO 的切分与执行骨架;本篇则是把那一节里被一笔带过的东西全部展开,并且覆盖此后 SGLang 主线上新增的部分:显式的 residual stream 交接、按层边界声明的操作策略、与 CUDA Graph 回放的配合、以及 DeepSeek-V4 与注意力后端的集成。文章里的源码片段以 SGLang 主线仓库当前版本为准,具体行数与字段名可能随版本变化,但切分规则、让出点语义与执行节拍是稳定的。DeepEP 通信本身的分块语义可参考 DeepEP 完全拆解;DeepSeek 官方系统里双批重叠的调度形态见 DeepSeek-V3/R1 推理系统完全拆解。
通信为什么必须被藏起来
先算一笔账。DeepSeek-V3 是 671B 参数的 MoE 模型,每个 token 只激活约 37B(DeepSeek-V3 技术报告)。MoE 部分有 256 个路由专家、每 token 选 8 个,外加一个共享专家。要让这么多专家同时驻留在显存里,单个 rank 放不下,必须做专家并行:每个 rank 只持有全部专家的一小部分,token 被路由到哪儿,就得把它送到持有那个专家的 rank 上算,再把结果送回原 rank。
于是每一层 MoE 的前向都变成”计算—通信—计算—通信”的链条:
- 门控网络算出每个 token 该去哪些专家,以及各 rank 需要给本 rank 发多少 token(这需要一个跨 rank 的 all-to-all 元数据交换);
- dispatch:按目标 rank 把 token 的隐藏状态发出去;
- 本 rank 用自己的专家算这些 token;
- combine:把结果按来源 rank 发回去,再按 token 求和。
如果按顺序执行,dispatch 和 combine 期间 GPU 的 SM 几乎全闲着——它们的瓶颈是网卡带宽和跨节点延迟,不是算力。单机 8 卡还好,一旦扩到多节点、跨机架,通信时间会在每层前向里占掉相当可观的比例。SGLang 团队在 大规模 EP 部署博客 里给出的 prefill 与 decode 时间分解清楚地展示了这一点:不开 TBO 时,DeepEP 的 combine 与 dispatch 在 GPU 时间线上是一段完整而空白的区间,前后夹着 attention 与 MLP。
一个自然的思路是”把通信和计算放到不同 CUDA stream 上并行发射”。但只靠多流解决不了根本问题:同一批 token 的通信结果就是下一段计算的输入,依赖关系摆在那里,多流只是让你能提前发射,而不能让两个互相依赖的阶段真正并行。真正的并行必须来自”有两份互不依赖的工作”。
核心思想:一份 batch,两份互不依赖的工作
TBO 的出发点就是把一份 batch 拆成 A、B 两个 micro-batch(源码里叫 child 或 sub-batch)。在默认的按序列边界切分下,A 和 B 各自的 attention、各自由本 rank 专家算的 MLP 互不依赖;它们的 dispatch/combine 也互不依赖。(后面会讲到两段切是唯一的例外:被劈开的那条序列会让 B 依赖 A 写下的 KV。)于是只要把两个 child 的同一张操作表错开几步执行,就能保证:任意时刻 GPU 上至少有一份 child 在做计算,另一份 child 的通信在被等待。用源码里的话说,两个执行器”交错前进”:
执行器 A: [stage0][stage1][stage2][stage3][stage4][stage5]执行器 B: [stage0][stage1][stage2][stage3][stage4][stage5]时间轴: ←—— A 的 stage0~1 ——→←—— A 的 stage2 与 B 的 stage0 同处一段 ——→...当 A 推进到”即将进入通信等待”时,B 正好推进到”算 attention”——于是等待期间 SM 有活干。这就是为什么必须切成两份而不是靠多流:只有存在第二份独立工作时,“等待”才可能被另一份计算填满。
切两份还有一个附带好处:单份 micro-batch 的中间激活只有原来的一半,峰值显存下降。这在 prefill 上尤其重要,因为 prefill 的 hidden states 是按 token 计的,batch 越大显存越紧张。SGLang 博客里给出的 prefill 消融显示,不开 TBO 时单卡到 16,384 token 就会 OOM,开 TBO 后同样 16,384 token 能跑起来,反而又带来约 40% 的提升;而在同样 token 数的前提下,TBO 的吞吐比不开时高 27%~35%。
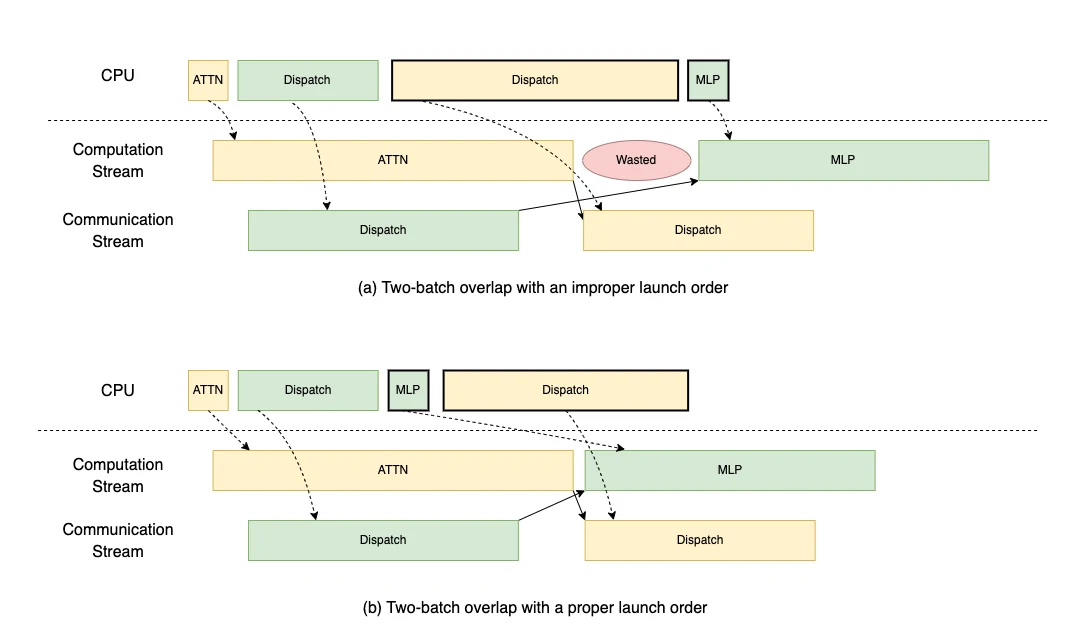
图片来源:SGLang 团队 大规模 EP 部署博客 的 Two-batch Overlap 一节,(a) 是错误顺序、(b) 是正确顺序,图下方的说明文字讲的是为什么发射顺序会决定有没有气泡。这点后面会单独讲。
参考实现:DeepSeek 官方的双批设计
TBO 不是 SGLang 的发明,它来自 DeepSeek 在 V3/R1 推理系统 里提出的双批处理。DeepSeek 官方博客描述的是一个把 batch 切成两份、一份在 dispatch 时另一份在 combine、一份在算 MLP 时另一份在算 attention 的流水形态;在 decode 阶段,因为各算子耗时极不均衡,attention 要读全部 KV、耗时很长,而 MLP 相对较短,官方做了更细的”把 attention 拆成两段”的处理,形成五级流水线。站内那篇 DeepSeek-V3/R1 推理系统完全拆解 已按官方博客的调度形态讲清了这一点,本篇不再重复官方设计,而是聚焦 SGLang 在开源代码里怎么把同一个思想落成可维护的工程。
SGLang 团队在博客里直接点出了两处落地难点,这正好是本篇的主线:
- 代码复杂度:如果直接按设计图写代码,管理多个 micro-batch 的逻辑会在每层、每个算子处复制,随着重叠点和重叠方式增多,代码会迅速失控;
- prefill 阶段的同步问题:DeepEP 的 normal dispatch 会在 CPU 上阻塞(要等对面 rank 的元数据回来才能分配正确大小的输出缓冲),而且即便用异步模式,这个阻塞依然存在。如果实现顺序不当,阻塞期间计算流上没有任何任务被发射,GPU 就空转,重叠反而变成负收益。
SGLang 的回答是两件工具:一张”操作表 + 让出点”的抽象(对付前者),以及一套显式的发射顺序与分层策略(对付后者)。下面依次拆开。
操作表与让出点:把两种执行写成一种
先看抽象本身。batch_overlap/operations.py 里有三个核心类型:
class YieldOperation: pass
@dataclassclass ExecutionOperation: debug_name: str fn: Callable
Operation = Union[YieldOperation, ExecutionOperation, Callable]Stage = List[ExecutionOperation]Operation 是一个联合类型:要么是一个普普通通的函数(会被装饰成 ExecutionOperation,带一个用于 NVTX 打点的名字),要么是一个 YieldOperation——它没有任何行为,只是一个分隔符。_convert_operations_to_stages 把操作表沿 YieldOperation 切开,每一段就是一个 Stage:
def _convert_operations_to_stages(operations: List[Operation]) -> List[Stage]: operations = _decorate_operations(operations) operation_chunks = list( _chunk_by_separator(operations, lambda op: isinstance(op, YieldOperation)) ) assert all(len(chunk) > 0 for chunk in operation_chunks) return operation_chunks所以”让出点”的含义是:上一段 Stage 的全部操作都已执行完,当前 micro-batch 下一步要进入一段通信,而它的结果要等对面 rank——此刻正是另一个 micro-batch 可以插进来推进的时刻。SGLang 博客里给的示意写法与这段代码完全同构:
operations = [ self._forward_attn, YieldOperation(), # Pause execution for other micro-batches self._forward_dispatch, self._forward_mlp, YieldOperation(), self._forward_combine,]这里有个设计要点值得停下来想想:为什么用”扁平列表 + 分隔符”而不是”把每层写成一个生成器,用 yield 交出控制权”?生成器的确更自然,Python 原生就有,但它有两个问题。其一,生成器的控制权流转是隐式的——调用方 next() 一次就跑完整个 stage,你没法在 stage 内部再插入打点或做错误检查;其二,生成器一旦出现异常,栈帧与状态会被打碎,调试困难。SGLang 的选择是:操作表是数据,不是控制流。执行器是一个显式的游标对象,每调用一次 next() 恰好推进一个 Stage,状态存在一个受控的 _StateDict 里。这样”哪份 child 在哪个 stage”是一等公民,可以随时被检查、被记录到 NVTX,也可以被 CUDA Graph 捕获路径复用。
执行器:一个带游标的 Stage 推进器
_StageExecutor 是单个 micro-batch 的执行器,构造时接收一个 inputs 字典和一个(可选的)子上下文,核心循环在 next():
class _StageExecutor: def __init__(self, debug_name, stages, inputs, child_ctx=None): self._debug_name = debug_name self._stages = stages self._index = 0 self._stage_state = _StateDict() self._stage_output = inputs self._child_ctx = child_ctx # handling DP attention forward_batch: ForwardBatch = inputs["forward_batch"] self._child_ctx = replace( child_ctx if child_ctx is not None else get_forward_context(), moe_num_token_non_padded=forward_batch.moe_num_token_non_padded, ) self._global_dp_buffer_len = forward_batch.global_dp_buffer_len self._local_dp_buffer_len = forward_batch.tbo_padded_len ...
def next(self): assert not self.done stage = self._stages[self._index] set_dp_buffer_len( self._global_dp_buffer_len, self._local_dp_buffer_len, self._is_dp_max_padding, self._global_num_tokens, ) ctx_mgr = forward_context(self._child_ctx) if self._child_ctx is not None else nullcontext() stage_range = operations_nvtx_range(debug_name=f"{self._debug_name}{self._index}", color="orange") with ctx_mgr, stage_range: for op in stage: with operations_nvtx_range(debug_name=op.debug_name, color="yellow"): self._stage_output = op.fn( state=self._stage_state, **(self._stage_output if self._stage_output is not None else {}), ) self._index += 1三点值得注意:
第一,每个算子的输入是上一段的输出字典。 ExecutionOperation.fn(state=..., **output) 的签名意味着操作表里的每个函数都是”读 state、读上一段的结果、产出下一段要用的键”。state 是一个 _StateDict,它有个特殊约束:__setattr__ 里断言键不能重复写,如果某个操作想覆盖已有的键就会直接报错,并提示”你是不是没及时释放显存”(clear() 里对未释放的键也有类似的断言)。这把内存生命周期问题变成了显式的错误,而不是埋进一个隐蔽的显存泄漏。
第二,每推进一个 stage 都要重设 DP buffer 长度。 set_dp_buffer_len 传的是”全局 DP 缓冲区长度”与”本 child 的对齐后长度”。原因是两个 child 的 token 数可以不同,DP Attention 在 all-gather / reduce-scatter 时用的是按 rank 对齐过的长度,调度时必须知道当前这一步的本地长度。源码里留了 TODO:等 TBO 的 slice & pad 逻辑重构后,这一步也许可以去掉。它暴露了一个事实——TBO 不是”把 batch 切两半”这么简单,它切完之后每个 child 的 padding、对齐、DP 通信长度都要重新算一遍。
第三,child_ctx 让每个 child 用自己那份注意力后端。 执行每个 stage 时进入 forward_context(self._child_ctx)。这个上下文里换成了该 child 对应的 AttentionBackend,于是模型代码里 get_attn_backend() 拿到的是这个 child 的后端而不是主后端。后面讲注意力后端时会看到,这正是两个 child 在同一个 GPU 上共享池、却各自持有独立分页元数据的关键。
错位执行:两个游标的节拍
有了单个执行器,交错执行就是几行:
def execute_overlapped_operations(inputs_arr, operations_arr, delta_stages): inputs_a, inputs_b = inputs_arr operations_a, operations_b = operations_arr delta_stage_a, delta_stage_b = delta_stages assert delta_stage_a == 0 delta_stage = delta_stage_b
child_ctx_a, child_ctx_b = _resolve_tbo_child_contexts() stages_a = _convert_operations_to_stages(operations_a) stages_b = _convert_operations_to_stages(operations_b) executor_a = _StageExecutor("a", stages_a, inputs=inputs_a, child_ctx=child_ctx_a) executor_b = _StageExecutor("b", stages_b, inputs=inputs_b, child_ctx=child_ctx_b)
for _ in range(delta_stage): executor_a.next() for _ in range(executor_a.num_stages - delta_stage): executor_a.next() executor_b.next() for _ in range(delta_stage): executor_b.next()
assert executor_a.done and executor_b.done return [executor_a.output, executor_b.output]读法很直白:A 先单独跑 delta_stage 个 Stage;然后 A、B 各跑一步、交替前进;A 跑完后 B 独自收尾。delta_stage 就是两个 child 之间的相位差,也就是”错开几步”的那个步数。 如果 delta_stage == 0,两个 child 完全同步地推进同一个 stage——那还不如不切;如果 delta_stage 太大,A 早早跑完、B 却在通信里空等,重叠也不充分。所以 delta_stage 的选择本质上是”把 A 的哪一段通信对齐到 B 的哪一段计算”,这必须由每层的操作策略来决定,而不能写死在执行器里。
源码里 A 的 delta 被断言为 0、只有 B 有相位差,是因为 A 被当作”基准 child”。这不是原理上的限制,而是实现时的简化:两个 child 的相位差只需要一个自由度。
回到前面那张图:(a) 里 A 的 dispatch 之后直接接了自己的 combine、然后才是 B 的 attention——A 在 dispatch 等结果的时候,B 还没开始算,于是有一段 GPU 空转(图里灰色区域标注 “Wasted”);(b) 里 A 的 dispatch 之后先把 B 的 attention 发射出去,A 在等的时候 GPU 已经在跑 B 的计算了。两次交错都”切了两份、都有 yield”,差别只在于 yield 的位置与相位——这就是为什么操作表的形状(策略)和执行的节拍(delta)必须一起看。
重叠不发生在操作表里:CPU 编排与两条流的真实关系
把执行器读到这里,很容易产生一个误解:既然 A、B 交替执行,是不是每个 child 各自有一条 CUDA stream?并不是。execute_overlapped_operations 从头到尾没有创建 stream、没有建 event、也没有调用 wait_stream——它只是在一个 CPU 线程里交替推进两个 Stage 执行器。于是有两件事必须分开看:
- 操作表的交错是 host 侧的发射顺序。它决定”下一步把哪个 child 的哪些 kernel 提交到 GPU 队列”,并不直接决定 GPU 上的并发关系;
- GPU 上通信与计算的并发,由 DeepEP 分派器内部的通信流与事件保证。normal 路径在
async_finish=True时先Buffer.capture()记录当前流,随后buffer.dispatch/buffer.combine以allocate_on_comm_stream=True在通信流上分配并执行,返回一个 event;dispatch_b/combine_b再在当前流上event.current_stream_wait()等它。计算 kernel 留在当前流,通信 kernel 在通信流,二者才可能真正并行。
因此 TBO 在 host 侧真正做的,是两件 DeepEP 自己做不到的事:
- 制造第二份可发射的工作。如果只有一份 batch,A 的通信在通信流上跑着,当前流上没有后续计算可提交,GPU 依然空。切出 A、B 后,A 进入通信阶段时 host 可以把 B 的 attention 或 MLP 提交到当前流;
- 安排提交的先后。prefill 的
dispatch_b会阻塞 host,必须先把足够多的计算提交出去,再进入这个阻塞调用,否则提交队列见底、GPU 无活可干。
这解释了一个源码里的现象:batch_overlap/ 目录里几乎看不到 stream 编排代码,所有流同步都藏在 token_dispatcher/deepep.py 的 A/B 接口里。TBO 的复杂度因此集中在”切分与状态”上,而不是”多流调度”上。 顺带一提,SGLang 另有一套 SBO(single batch overlap),它用显式的 alt_stream 把共享专家等计算挪到备用流、与通信并行;两者解决的问题不同——前者靠”两个 child”,后者靠”一份 batch 内的独立算子”。
切分之前:先决定这一轮要不要切
TBO 不是”开了 flag 就每轮都切”。切与不切是一个整机级决定,入口在调度侧的 TboDPAttentionPreparer,它嵌在 DP Attention 的全局 all-gather 流程里:
def prepare_all_gather(self, local_batch: ScheduleBatch): deepep_mode = get_deepep_mode() enable_a2a_moe = not get_moe_a2a_backend().is_none() enable_two_batch_overlap = is_tbo_enabled() self.enable_two_batch_overlap = enable_two_batch_overlap if not enable_two_batch_overlap: self.local_tbo_split_seq_index = None return False, self._compute_local_forward_mode(local_batch) if local_batch is not None: ... resolved_deepep_mode = deepep_mode.resolve(local_batch.is_extend_in_batch) local_can_run_tbo = (self.local_tbo_split_seq_index is not None) and not ( (local_batch.forward_mode.is_extend() and not local_batch.forward_mode.is_target_verify()) and enable_a2a_moe and (resolved_deepep_mode.is_low_latency())) else: self.local_tbo_split_seq_index = 0 local_can_run_tbo = True return local_can_run_tbo, self._compute_local_forward_mode(local_batch)
def compute_output(self, partial_global_info_cpu): local_can_run_tbo_aggregated = min(partial_global_info_cpu[:, 0].tolist()) forward_modes = partial_global_info_cpu[:, 1].tolist() global_forward_mode, forward_mode_agree = self._compute_global_forward_mode(forward_modes) can_run_tbo = (self.enable_two_batch_overlap and local_can_run_tbo_aggregated and forward_mode_agree) tbo_split_seq_index = self.local_tbo_split_seq_index if can_run_tbo else None global_forward_mode = global_forward_mode if can_run_tbo else None return tbo_split_seq_index, global_forward_mode每个 rank 先算出”本地这一步能不能切”(一个 0/1 标志)与”本地的 forward mode”,再做一次跨 rank 的汇总:所有 rank 都可切(取 min)且去掉 IDLE / PREBUILT 后 forward mode 全部相同,才会启用。空 rank(local_batch is None)必须被当作”可切”,因为 all-to-all 的参与方形状要一致,一个 rank 擅自退出 TBO 会让两边的通信组形状对不上。
三个条件缺一不可:TBO 全局开着(启动参数 --enable-two-batch-overlap)、所有 rank 本地都可切(min 为 1)、全局 forward mode 一致(去掉 IDLE 与 PREBUILT 后全同)。第二条里有个反例值得单独说:extend(且非 target-verify)+ 走 A2A MoE + DeepEP 处于 low-latency 模式时禁止 TBO——low-latency 是 DeepEP 给小 batch 设计的高延迟优化路径,它的 prefill 与 TBO 的切片/对齐方式不兼容。第三条的根源在切分算法本身:compute_split_seq_index 对 EXTEND 用”按序列边界找平衡点”,对 DECODE 用”序列数对半”,两者不通用;如果一个 rank 在 prefill 而另一个在 decode,就不存在一个统一的切法,TBO 只能关闭。
整机决策的结果 tbo_split_seq_index 与 global_forward_mode 被写回 batch;后续 TboForwardBatchPreparer.prepare 只有在 tbo_split_seq_index is not None 时才真正切分。DP Attention 与 TBO 的这种强耦合,前面那篇 SGLang 源码完全拆解(十七) 已经按拓扑讲过;这里从源码补上的关键点是”一致性检查发生在调度期、切分发生在前向期”——调度期决定能不能切,前向期按切点执行。
切分:一份 batch 如何变成两个 child
切分是 TBO 里最容易出隐蔽 bug 的地方,因为 forward mode 不同,切法完全不同:
- decode:每条序列一次只处理 1 个 token(开了投机解码则是
draft_token_num个),整个 batch 是等长的 token 行。切法就是按 token 数对半:(num_tokens // token_num_per_seq) // 2,前一半序列归 child A、后一半归 child B。 - extend / prefill:每条序列长度不同,整个 batch 是一串不等长的 token 行。切点要落在序列边界上,否则一条序列会被劈成两段,而注意力对一条序列的 QK 计算不能把一段当成别人的前缀。
- TARGET_VERIFY(投机解码的验证前向):和 decode 一样按
token_num_per_seq = draft_token_num对半切,但spec_info里的 draft token、custom mask、positions 都要跟着切。 - IDLE(DP 里没有请求的空 rank):token 数为 0,切点固定为 0。
compute_split_seq_index 是切分决策的总入口:
def compute_split_seq_index(forward_mode, num_tokens, extend_lens, token_num_per_seq): if forward_mode == ForwardMode.EXTEND or forward_mode == ForwardMode.MIXED: assert extend_lens is not None return _split_extend_seqs(extend_lens) elif forward_mode.is_target_verify() or forward_mode.is_decode(): assert token_num_per_seq is not None return (num_tokens // token_num_per_seq) // 2 elif forward_mode.is_idle() or forward_mode.is_prebuilt(): assert num_tokens == 0 return 0 else: raise NotImplementedError()按序列边界切:让两边 token 数尽量相等
对 extend,默认切法是 _split_array_by_balanced_sum:从第 1 条序列开始累加左侧长度,一旦左侧和右侧的差额不再变小就停止,取差额最小的那个位置。伪代码如下:
best = 0; min_diff = inf; left = 0; total = sum(extend_lens)for i in 1 .. len(extend_lens)-1: left += extend_lens[i-1] diff = |left - (total - left)| if diff <= min_diff: min_diff = diff; best = i else: breakreturn best注意 else: break——这不是找全局最优,而是在”前缀和单调增”的前提下找第一个局部最优。为什么可以这么做?序列长度序列不一定单调,但前缀和一定单调递增,而 |left - right| 在 left 穿过 total/2 之后会由递减转为递增,所以第一个局部最优就是全局最优的候选。这里有个隐含假设:切点必须落在序列边界上——这是 extend 切分与 decode 切分的本质区别。
“两段切”:把一条长序列横着劈开
还有一种更激进的情况:如果按序列边界切出来的左半部分token 数极少(比如整批只有一条超长序列,或一条 60K 序列加一对 100 token 的短序列),那么 A、B 严重失衡,重叠几乎没意义——A 只有几行 token 要算,很快就跑完,然后干等 B。SGLang 对这种情况做了”两段切”(two-chunk split):允许在一条序列中间下刀,把这条长序列的 token 维切成前后两段。
def _is_two_chunk_split_enabled(extend_lens) -> bool: vanilla_split_seq_index = _split_array_by_balanced_sum(extend_lens) left_sum = sum(extend_lens[:vanilla_split_seq_index]) overall_sum = sum(extend_lens) threshold = get_tbo_token_distribution_threshold() # 默认 0.48 assert threshold <= 0.5 want_two_chunk = left_sum < overall_sum * threshold or left_sum > overall_sum * (1 - threshold) if not want_two_chunk: return False split_seq_index = _split_array_by_cum_less_than_half(extend_lens) child_a_batch_size = split_seq_index + 1 child_a_num_q_tokens = overall_sum // 2 if child_a_batch_size > child_a_num_q_tokens: return False return Truetbo_token_distribution_threshold 默认 0.48:如果按序列边界切出来的左半部分 token 数占比低于 48%,或高于 52%,就判定为失衡、启用两段切(即直接在累计 token 刚过半的位置下刀)。CLI 上这个值的说明写的是”决定走 two-batch-overlap 还是 two-chunk-overlap,设为 0 关闭 two-chunk-overlap”。
那个 child_a_batch_size > child_a_num_q_tokens 的检查是针对一个具体的内核不变量的保护(源码注释里写的是 DSV4 压缩规划器的 batch_size <= num_q_tokens):如果一条序列被切成两段后,前半个 child 的序列数(含那条被切开的序列)超过了它真正要处理的 q token 数,就退回序列边界切法——后者的子 batch 至少每条序列贡献 1 个 token,不会出现”batch 里有序列却没有 token”的退化情形。
两段切一旦启用,切分之后有一堆长度字段需要按前后两段重算,derive_fields_related_to_seq_len_for_two_chunk 做的就是这件事:
extend_seq_lens_cpu = batch.extend_seq_lens_cpuoverall_seq_lens_sum = sum(extend_seq_lens_cpu)half_seq_lens_sum = overall_seq_lens_sum // 2left_last_seq_token_num = half_seq_lens_sum - sum(extend_seq_lens_cpu[:tbo_split_seq_index])right_first_seq_token_num = extend_seq_lens_cpu[tbo_split_seq_index] - left_last_seq_token_num
child_a.extend_seq_lens_cpu[-1] = left_last_seq_token_numchild_b.extend_seq_lens_cpu[0] = right_first_seq_token_num# child_a 的最后一条序列,其完整长度 = 前半段 + 原有前缀child_a.seq_lens_cpu[-1] = child_a.extend_seq_lens_cpu[-1] + child_a.extend_prefix_lens_cpu[-1]# child_b 被切开的那条序列,前缀长度要加上 child_a 已算过的那段child_b.extend_prefix_lens_cpu[0] += left_last_seq_token_num最后一行是整个切分里最有洞察力的一处:child B 里那条被劈开的序列,它的”前缀”包含了 child A 已经处理过的 token——因果注意力下 A 算完的那段就是 B 的上下文,所以 B 的 extend_prefix_lens 要加上它。这与 Sarathi-Serve 完全拆解 里块状预填充(chunked prefill)的思想完全同源:把一条长 prompt 切成多块顺序处理,第 k 块的前缀就是前 k-1 块的全部 token。这里的区别在于两块是并行推进的,B 依赖 A 已经写入 KV 的那一段,这个依赖没有额外的同步原语:A 的 attention(stage 0)与 B 的 attention 都在同一个当前流上按 host 发射顺序执行,A 已经写完的 KV 是 B 读取时的天然前缀。
构造 child:ForwardBatch 的逐字段切分
确定切点之后,一步是把父 ForwardBatch 切出两个独立的 ForwardBatch。TboForwardBatchPreparer.prepare_raw 先算出 token 切点,然后把同一个 filter_batch 调两次:
tbo_split_token_index = cls._compute_split_token_index(batch)[out_num_token_non_padded_a, out_num_token_non_padded_b] = tbo_children_num_token_non_padded
child_a = cls.filter_batch( batch, start_token_index=0, end_token_index=tbo_split_token_index, start_seq_index=0, end_seq_index=(batch.tbo_split_seq_index + 1 if is_enable_two_chunk else batch.tbo_split_seq_index), out_num_token_non_padded=out_num_token_non_padded_a, ...)child_b = cls.filter_batch( batch, start_token_index=tbo_split_token_index, end_token_index=batch.input_ids.shape[0], start_seq_index=batch.tbo_split_seq_index, end_seq_index=batch.batch_size, ...)batch.tbo_children = [child_a, child_b]filter_batch 把字段分成四类来处理:
第一类,按 token 切:input_ids、positions、out_cache_loc(本步要写入的 KV 槽位)、mrope_positions(多模态的位置编码)、iteration_cols(DSA/迭代式注意力的 token 列切片)。这些张量沿 token 维切开,直接用 [start_token_index:end_token_index](mrope_positions 是 [:, start:end])。注意 iteration_ids 本身是一个计划对象,不按 token 切,只按它的 cols_slice 切出 iteration_cols。
第二类,按序列切:req_pool_indices、seq_lens、extend_seq_lens、extend_prefix_lens、extend_start_loc、lora_ids、rids 等。它们第 0 维是序列数,用 [start_seq_index:end_seq_index];其中 extend_start_loc 在 target-verify 模式下会被置 None(验证模式下不靠 start_loc 定位每条序列的起点)。
第三类,整体继承:forward_mode、return_logprob、dp_padding_mode、spec_algorithm、capture_hidden_mode、can_run_decode_cuda_graph 等 forward 级别的标志,两个 child 完全一致。
第四类,需要重算的派生量:
output_dict.update(dict( batch_size=end_seq_index - start_seq_index, seq_lens_sum=output_dict["seq_lens_cpu"].sum() if "seq_lens_cpu" in output_dict else None, extend_num_tokens=extend_num_tokens, num_token_non_padded=out_num_token_non_padded, global_num_token_non_padded=None, ... forward_metadata_ready=False, forward_metadata_planned_bs=None,))这里最值得讲的是 num_token_non_padded 的切分,也就是 _split_num_token_non_padded:
value_a = min(tbo_split_token_index, num_token_non_padded)value_b = max(0, num_token_non_padded - tbo_split_token_index)num_token_non_padded 是什么?在 DP Attention 里,各个 rank 的 batch 大小不一样,为了让所有 rank 的 all-gather 形状一致,会把本地 batch 补到全局最大值——补进去的是”填充 token”。这些填充 token 不应该参与专家计算和注意力输出,所以每个 rank 要告诉内核”前多少个 token 是真的”。input_ids 的长度是补过之后的长度(物理行数),真 token 数与物理行数可能不同。
TBO 一切两半之后,真 token 的切点可能和物理 token 的切点不一致——比如切点在填充区里,第二个 child 就一个真 token 也没有。源码的做法是:A 拿 min(split, non_padded),B 拿剩下的。这看起来朴素,但源码注释里专门提了一句之所以用父 batch 的 CPU 计数而不是 len(input_ids):如果拿物理长度去算,会把 IDLE rank 的 dummy token 一并算成真 token,破坏填充掩码。forward_metadata_ready=False 同理:child 的分页元数据必须由 TBO 感知的初始化流程重新规划,继承父 batch 的 ready 状态会错误地跳过规划。
filter_batch 末尾还有一段”完整性检查”:遍历 ForwardBatch 的所有 dataclass 字段,如果父 batch 上有值、但切分逻辑没有为 child 提供对应键,就抛出错误。这是一个防回归的设计——新增字段的人一旦没有在 TBO 里处理,任何一次请求都会立刻炸,而不是等线上跑到某条冷路径才出事。源码里也因此保留了 # TODO: handle it when we need TBO + DeepSeek V3.2 这样的注释(DSV3.2 的 DSA 索引缓存等字段目前仍走 None)。
操作策略:每层写一张自己的表
操作是不是该一路拆到最细,并不是随意的。 以 DeepSeek 系列层为例,一个 MoE 层的前向要经过 attention 前的通信准备、attention 本身的 prepare/core、MoE 前的通信准备、门控、专家选择、dispatch、专家计算、combine、共享专家、输出后处理。要让让出点精确落在”通信阶段的门槛上”,策略表就必须能单独引用这些子步骤,于是每层都把它们拆成带独立名字的方法(op_comm_prepare_attn、self_attn.op_prepare、self_attn.op_core、mlp.op_gate、mlp.op_select_experts、mlp.op_dispatch_a……),每个方法自己维护一个 state 键的约定。代价是模型层要为 TBO 付出结构改造,收益是策略表变成了可以按模式、按硬件、按后端自由重排的字符串序列。
抽象定好了,接下来要决定”每个模型层、每种 forward mode 下,操作表长什么样”。这份决定被集中放在 batch_overlap/operations_strategy.py,入口是 OperationsStrategy.init_new_tbo:
@staticmethoddef init_new_tbo(layers, forward_mode) -> "OperationsStrategy": layer_name = layers[0].__class__.__name__ if layer_name == "DeepseekV2DecoderLayer": return OperationsStrategy.concat([... for layer in layers]) elif layer_name == "Qwen3MoeDecoderLayer": ... elif layer_name == "MiMoV2DecoderLayer": ... from sglang.srt.models.deepseek_v4 import DeepseekV4DecoderLayerBase if isinstance(layers[0], DeepseekV4DecoderLayerBase): ... raise NotImplementedError它按层的类名分派,而且只认这几种 MoE 解码层:其他模型类会直接落到 raise NotImplementedError。这是一个必须说清的工程取舍——TBO 不透明,它要求模型层为 TBO 改写前向:每一层要把自己的计算拆成具名方法,策略表才能引用它们。换来的好处是策略表是纯数据,可以按 forward mode、按硬件、按后端各自调整,而执行器、切分器、后端壳都不用动。新增一个支持 TBO 的模型,工作量的主体在”把层拆开”,而不在”接进框架”。
DeepSeek 的 prefill 表:在 dispatch 与 combine 之间让出
以 DeepSeek 系列 MoE 层的 prefill 策略为例:
def _compute_moe_deepseek_blog_prefill(layer): total_num_sms = torch.cuda.get_device_properties(device="cuda").multi_processor_count deep_gemm_num_sms = None if not _is_hip: deep_gemm_num_sms = total_num_sms - DeepEPConfig.get_instance().num_sms
return OperationsStrategy( deep_gemm_num_sms=deep_gemm_num_sms, tbo_delta_stages=0, operations=[ layer.op_comm_prepare_attn, layer.self_attn.op_prepare, layer.self_attn.op_core, layer.op_comm_prepare_mlp, layer.mlp.op_gate, layer.mlp.op_select_experts, layer.mlp.op_dispatch_a, operations.YieldOperation(), layer.mlp.op_dispatch_b, layer.mlp.op_experts, layer.mlp.op_combine_a, operations.YieldOperation(), layer.mlp.op_shared_experts, layer.mlp.op_combine_b, layer.mlp.op_output, layer.op_comm_postprocess_layer, ], )让出点精确落在 dispatch_a 之后与 combine_a 之后。这两处都是”本 child 即将进入通信阶段、可以先让另一份 child 推进”的位置。结合 DeepEP 分派器的 A/B 拆法更容易理解(layers/moe/token_dispatcher/deepep.py 的 normal 路径):
def dispatch_a(self, hidden_states, topk_output): ... previous_event = Buffer.capture() if self.async_finish else None return hidden_states, topk_ids, topk_weights, previous_event
def dispatch_b(self, hidden_states, topk_ids, topk_weights, previous_event): (hidden_states, topk_ids, topk_weights, num_recv_tokens_per_expert, event) = \ self._dispatch_core(hidden_states, topk_ids, topk_weights, previous_event) event.current_stream_wait() if self.async_finish else ()dispatch_a 只做本地准备——可选的 FP8 分块量化、记录一个事件——真正的 buffer.dispatch 调用发生在 dispatch_b 里。combine_a/combine_b 同理,combine_b 里才调 buffer.combine,然后等 event。所以”a”与”b”之间的边界是本地准备已完成、跨 rank 调用尚未下发的时刻,而不是”已发出、未完成”。这一点很关键:dispatch_b 是 CPU 会阻塞的调用(即便 async_finish=True,DeepEP 的 normal dispatch 仍要在内部等跨 rank 的元数据交换回来,才能确定接收张量的形状),而 combine_b 的等待主要是 stream 上的 event 等待。因此操作表在 dispatch_a 后让出,意义是先把 CPU 侧能做的准备做完、把这一段留白给另一个 micro-batch 推进;而 dispatch_b 的 CPU 阻塞期间要不空转,就必须靠”提前发射足够多的计算”——这就是后面要讲的 prefill 发射顺序问题。decode 路径的 low-latency dispatch 提供了 return_recv_hook,可以在 dispatch_b 里不等待、改为稍后调用 hook,但那属于另一套模式,与 TBO 的 normal 路径不同。
tbo_delta_stages=0 表示 prefill 里两个 child 不需要额外相位差——因为每个 child 在这个表里的两个 yield 之间,都恰好有一整段”attention + 门控”的工作,B 天然就在 A 等 dispatch 的时候有活可干。
deep_gemm_num_sms = total_num_sms - DeepEPConfig.get_instance().num_sms 这一行是”重叠能不能落地”的物理前提。DeepEP 的通信 kernel 自己会占用一部分 SM;如果 DeepGEMM 的 GEMM 把全部 SM 都占了,通信 kernel 根本拿不到 SM,重叠在硬件上就是假的。所以这里显式地把 GEMM 可用的 SM 数减去通信的 SM 数。博客里也讲得很清楚:要让计算与通信真并行,SM 必须分开。这与 CUDA 上”通信与计算并发”的一般做法一致:资源切分是并行的必要条件,调度只是让切分得以发生的手段。站内 DeepSeek-V3/R1 推理系统完全拆解 里讲的 DeepSeek 官方做法也是同一个思路——把通信限制在少数 SM 上,让 GEMM 用剩下的 SM。
decode 表:把让出点放到 attention 之前
decode 的表形状明显不同:
def _compute_moe_deepseek_blog_decode(layer): return OperationsStrategy( deep_gemm_num_sms=None, tbo_delta_stages=2, operations=[ layer.op_comm_prepare_attn, layer.self_attn.op_prepare, operations.YieldOperation(), # ← 在 attention 之前让出 layer.self_attn.op_core, layer.op_comm_prepare_mlp, layer.mlp.op_gate, layer.mlp.op_select_experts, operations.YieldOperation(), layer.mlp.op_dispatch_a, layer.mlp.op_shared_experts, # ← 共享专家挪到 dispatch_a 之后 operations.YieldOperation(), layer.mlp.op_dispatch_b, layer.mlp.op_experts, layer.mlp.op_combine_a, operations.YieldOperation(), layer.mlp.op_combine_b, operations.YieldOperation(), layer.mlp.op_output, layer.op_comm_postprocess_layer, ], )对比 prefill 表,差异有三个:
其一,在 self_attn.op_core 之前多了个让出点。decode 时每个 child 只有几行 token,attention 要读很长的 KV,是整个 decode 前向里最耗时的一段。把它单独占一个 Stage,就能在 A 的 attention 与 B 的 attention 之间形成交错——A 在算 attention 的时候,B 可以先做自己的 dispatch 相关工作。博客里指出,decode 的收益与”attention 处理时间”强相关,并且用模拟 MTP 场景(每个 decode step 处理 128 请求、生成 256 token)拿到最高 35% 的加速,原因正是 attention 变长后可以对齐的通信也变长。
其二,共享专家(shared expert)被挪到 dispatch_a 之后。共享专家是每个 token 都要走的那一个专家,没有 all-to-all,纯计算。把它放在 dispatch_a(本地准备完毕)与 dispatch_b(即将发起阻塞通信)之间,等于用一个纯计算填一段等待。同一个 GPU 上的独立工作,不只可以来自另一个 micro-batch,也可以来自同一 micro-batch 里没有通信依赖的算子——前者叫 TBO,后者的思想在 single_batch_overlap.py 里被单独实现(SBO,单批重叠)。
其三,tbo_delta_stages=2。decode 的 stage 数更多、单 stage 更短,两个 child 需要错开两个 stage 才能把”一个的通信”和”另一个的 attention”对齐。这个数字是经验值,不是推导出来的——操作表的形状和 delta 一起构成”重叠模式”,调参很大程度上是在调这两个东西。
MiMoV2 与 DeepSeek-V4:同一框架,不同层接口
Qwen3 与 MiMoV2 的策略几乎照抄 DeepSeek(源码注释里直接写着”当前策略与 DeepSeek 几乎一样,为了方便调整策略而保留冗余代码”),只差一个 op_shared_experts(MiMoV2 没有共享专家,相应位置直接接 combine_b)。这反过来说明操作表的抽象是稳定的:只要层把自己拆成具名操作,“哪些操作放进哪个 stage、在哪里让出”就是策略代码里可以随便挪的字符串序列。
DeepSeek-V4 的策略则引入了另一层接口:V4 的层用的是 hc_pre / hc_post 与 op_mhc_* 系列操作,源码注释写得很明白——TBO 下跨层的 mHC 融合被禁用了,所以每层都是自包含的:“attn 侧 mHC pre+norm → attn → ffn 侧 mHC pre+norm → MoE(a2a 的 dispatch/combine 被重叠)→ mHC post”。它又按”有没有走 all-to-all EP”分叉:
if get_moe_a2a_backend().is_none(): # Non-EP DP TP-MoE:DP 的 all_gatherv(gather)与 reduce_scatterv(combine) # 与另一个 ubatch 的 attn+MoE 计算重叠 ops = [layer.op_mhc_prepare_attn, layer.self_attn.op_attn, layer.op_mhc_post_attn_pre_mlp, layer.op_gather_a, operations.YieldOperation(), layer.op_gather_b, layer.op_moe, layer.op_combine_a, operations.YieldOperation(), layer.op_combine_b, layer.op_mhc_postprocess]else: ops = [ ... layer.mlp.op_dispatch_a, YieldOperation(), layer.mlp.op_dispatch_b, layer.mlp.op_experts, layer.mlp.op_combine_a, YieldOperation(), ... ]这说明 TBO 抽象并不绑死在 DeepEP 上——只要某段通信能拆成”发起”与”完成”两半,它就能被包成一对 op_xxx_a / op_xxx_b 插进操作表。DP 的 gather/reduce-scatter 走的是另一套通信原语,但策略结构完全一样。源码里还注明 V4 目前只支持 prefill:注释提到在 ATOM 的测试数据上 decode TBO 出现回退,还需要 CUDA Graph 捕获方面的工作。
一次前向的完整流程:model_forward_stages
策略表有了,谁来跑?模型的前向函数负责构造两张相同的操作表、切好两个 child、交给执行器。以 DeepSeek-V2 系列层的 DeepseekV2Model.forward 为例,它先把”TBO 不参与”的层正常跑完(比如 DeepSeek 前几层的 dense 层),再对剩下的稀疏层调用 model_forward_stages:
if forward_batch.can_run_tbo: if self.first_k_dense_replace > normal_start_layer and self.first_k_dense_replace < normal_end_layer: normal_end_layer = self.first_k_dense_replace elif self.first_k_dense_replace < normal_start_layer: normal_end_layer = normal_start_layer = 0# ... 正常跑 normal_start_layer .. normal_end_layer 的层 ...
if normal_end_layer != self.end_layer: hidden_states = model_forward_stages( layers=self.layers[normal_end_layer : self.end_layer], enable_tbo=True, positions=positions, forward_batch=forward_batch, hidden_states=hidden_states, zero_allocator=zero_allocator, )为什么 dense 层不走 TBO? 源码里 _compute_moe_deepseek_layer_operations_strategy_tbo 的第一行就是 assert layer.is_layer_sparse, "dense layer TBO not yet implemented"。dense 层没有 all-to-all,切两份除了增加切分开销没有任何收益;更现实的原因是 dense 层的 SM 布局与通信 SM 的划分、buffer 分配都还没按 TBO 模式调试过。另外注意 zero_allocator 的尺寸按 total_num_layers * 2 * (2 if forward_batch.can_run_tbo else 1) 预留——开 TBO 后同一时刻有两份 child 在用 bump allocator,缓冲要翻倍。
model_forward_stages 本身做的事情是:构造策略、把整批的 hidden_states 按 token 切成两段并各自做 padding、给每个 child 绑定一个独立的 residual stream,然后交给 execute_overlapped_operations:
def model_forward_stages(layers, enable_tbo, positions, forward_batch, hidden_states, zero_allocator=None): strategy = OperationsStrategy.init_new_tbo(layers, forward_batch.global_forward_mode) inputs = dict(positions=positions, hidden_states=hidden_states, forward_batch=forward_batch, zero_allocator=zero_allocator) if not enable_tbo: return execute_operations(inputs, strategy.operations)["hidden_states"]
stream = residual_batch.stream_of(forward_batch) pending = stream.pending hidden_states, residual = stream.export(hidden_states) inputs["hidden_states"] = hidden_states parts = _model_forward_tbo_split_inputs( **inputs, residual=residual, layer_input_rows=layers[0].attn_boundary.incoming_residual_rows, ) for part in parts: part["hidden_states"], child_stream = ResidualStream.from_handoff( part["hidden_states"], part.pop("residual"), pending.update if pending is not None else None, ) part["forward_batch"].residual_stream = child_stream ... with context: outputs = execute_overlapped_operations( inputs_arr=parts, operations_arr=[strategy.operations] * 2, delta_stages=[0, strategy.tbo_delta_stages], ) ... hidden_states, forward_batch.residual_stream = _model_forward_tbo_merge_outputs(*outputs, original_len) return hidden_states这里有两块本文开篇提到”后来新增”的东西:residual stream 与显式的切分/合并。
关于 residual stream。现代 decoder 层的写法普遍是”残差与 hidden 分开保存”:每层拿到 hidden_states 和 residual 两个张量,norm 前合并、MLP 后拆开,避免中途多做一次加法。两个 child 各有自己的这两条流,于是 model_forward_stages 在进入前把父 batch 的流”导出”(export)并交接(handoff)给两个 child,跑完后各 child 再把流交回、由 _model_forward_tbo_merge_outputs 按 token 区间拼回一条完整的流。源码里合并时有一个细节:两个 child 的 pending.update 必须是同一个对象(assert pending_a.update is pending_b.update),否则报错——因为那个 update 是跨层保留的一段中间量(对某些模型来说是 mHC 或其他跨层状态),两份 child 必须共用同一个状态对象,否则下一层读到的就是各自的一份,结果不一致。
关于切分与合并。_model_forward_filter_inputs 按 tbo_parent_token_range 切出每个 child 的行,并把每段补到 tbo_padded_len(按注意力 TP 大小向上取整),合并时按同样的区间写回父张量。padding 到 TP 对齐是注意力内核的形状要求:每个 rank 拿到的 q token 行数要能被 TP 整除,否则 kernel 的 tile 划分会有尾块。
一个容易忽略的点是同一张操作表被两份 child 共用([strategy.operations] * 2):策略不是每个 child 一份,而是同一串函数的两个不同调用。函数里的 state 是各 child 自己的,输入是各 child 自己的,所以不会串味。
通信器与注意力后端:TBO 渗进去的两块
操作表只描述了”层内”的执行顺序。TBO 还要处理两处”层外”的东西:专家分派器与注意力后端。
MaybeTboDeepEPDispatcher:一个壳,两份实例
DeepEP 的分派器内部维护着跨调用的状态(dispatch_a 之后要能接上 dispatch_b,中间还要维护收到的 token 分布、SM 配置等)。如果两个 child 共用同一个分派器实例,A 的 dispatch_a 与 B 的 dispatch_a 会在实例状态上互相覆盖。SGLang 的解法很直接——开 TBO 时给分派器开两份内部实例:
class MaybeTboDeepEPDispatcher(BaseDispatcher): def __init__(self, runner_backend=None, **kwargs): super().__init__() num_inner_dispatchers = 2 if is_tbo_enabled() else 1 if get_moe_a2a_backend().is_deepep(): self._inners = [DeepEPDispatcher(runner_backend=runner_backend, **kwargs) for _ in range(num_inner_dispatchers)] elif get_moe_a2a_backend().is_mooncake(): ... ... def _execute(self, name, tbo_subbatch_index=None, **kwargs): return getattr(self._inners[tbo_subbatch_index or 0], name)(**kwargs) def dispatch(self, **kwargs): return self._execute("dispatch", **kwargs) def combine(self, **kwargs): return self._execute("combine", **kwargs) def dispatch_a(self, **kwargs): return self._execute("dispatch_a", **kwargs) def dispatch_b(self, **kwargs): return self._execute("dispatch_b", **kwargs) ...tbo_subbatch_index 从哪里来?就是执行器在 _model_forward_filter_inputs 里给每个 child 附上的 tbo_subbatch_index,模型层的 op_dispatch_a 等操作把它透传给分派器。这就是”每层拆成具名操作”的另一个回报:如果不拆,模型前向就是一大块黑箱,分派器这个全局对象没法按 child 分派;拆开之后,每个 op 都是显式函数,函数参数里带上”我在哪个 child 里”,状态就能隔离。这个壳还同时支持 Mooncake、Mori、Nixl、Pplx 等几种 EP 后端,说明”双实例 + 按 child 索引分派”是一种通用的工程手法。
TboAttnBackend:主后端 + 两个 child 后端
注意力后端同理但更微妙。TboAttnBackend 的设计是:
class TboAttnBackend(AttentionBackend): def __init__(self, primary, children): super().__init__() self.primary = primary self.children = children # Dispatcher aliases the primary's pool refs so get_attn_backend() # reads through TboAttnBackend resolve to the underlying pool. self.token_to_kv_pool = primary.token_to_kv_pool self.req_to_token_pool = primary.req_to_token_pool ...
@classmethod def init_new(cls, creator): return cls(primary=creator(), children=[creator() for _ in range(2)])
def init_forward_metadata(self, forward_batch): self.primary.init_forward_metadata(forward_batch=forward_batch) if forward_batch.tbo_children is not None: for child, forward_batch_child in zip(self.children, forward_batch.tbo_children, strict=True): if forward_batch_child.batch_size > 0: child.init_forward_metadata(forward_batch=forward_batch_child)三个后端共享同一个 token_to_kv_pool 与 req_to_token_pool——数据是同一份 KV 池与同一份页表,但每个 child 后端各自持有一份”这一步的分页元数据”(块表、序列长度、CUDA Graph 缓冲等)。这正是执行器里 _resolve_tbo_child_contexts 要替换 attn_backend 的原因:child 的注意力必须用 child 自己的元数据去遍历它自己的分页 KV 槽位。
_children_use_cuda_graph() 这段注释值得一提:DeepSeek-V4 在 eager prefill 下走 TBO,但它的 decode/target-verify 是图捕获模式且不走 TBO。对这些模型,child 后端不应该被驱进 CUDA Graph 路径——因为捕获的图里根本没有 child,每一步重放都去重算 child 的元数据(压缩器/索引器)会在 ROCm 上泄漏 HSA 资源,最终以 HSA_STATUS_ERROR_OUT_OF_RESOURCES 失败。于是后端提供了一个开关 tbo_supports_cuda_graph,只对”TBO 本身跑在图里”的模型打开。这是一个很具体的工程教训:TBO 与 CUDA Graph 是两个正交的机制,组合时必须明确”图里的东西是否真的是 TBO 图”。
prefill 的发射顺序:为什么会有 CPU 阻塞的气泡
回到博客点出的第二个难点。就算操作表和执行器都对,prefill 依然可能不出收益。原因在 DeepEP 的 dispatch:即便用异步模式,normal dispatch 在 CPU 上要阻塞——它要等所有 rank 的元数据交换完成,才知道本 rank 应该接收多少 token、分配多大的张量。阻塞期间,如果 CPU 没有向计算流提交任何任务,GPU 流就会空。
SGLang 的解法是调整发射顺序:把计算任务提前发射到 GPU 上,再发起阻塞式的通信调用。这样 CPU 阻塞的时候,GPU 上已经有排队的计算在跑。这正是第一张图 (a)/(b) 的差别——(a) 里没有足够多的计算被提前发射,(b) 里 A 的 dispatch 之前已经把 B 的 attention 发射出去了。
这个教训放到更抽象的层次看:重叠是否成立,不只取决于 GPU 上”有没有可并行的任务”,还取决于 CPU 发射的时序。CUDA 的 stream 是异步队列,但 CPU 侧的阻塞调用会卡住向队列中投递新任务的手。这跟 GLM-5.3 推理全链路(十八):重叠调度 里讨论的”前向在 GPU 上跑时 CPU 在做什么”是同一类问题,区别在于:那里的 CPU 在做下一轮的调度,这里的 CPU 在给另一个 micro-batch 提交计算;两者共同的前提都是”GPU 上已经有足够多的计算排好队”。
CUDA Graph 下的 TBO:图里的两半怎么切
TBO 的 host 端逻辑(切 ForwardBatch、构造元数据)是纯 CPU 的 Python;CUDA Graph 捕获的恰恰是”跳过 host 端逻辑、直接重放 GPU 侧 launch”。两者如何兼容?
SGLang 的做法是把 TBO 的切分也冻结进图里,重放时只做最小的重算。TboCudaGraphRunnerPlugin 有两个钩子:
class TboCudaGraphRunnerPlugin: def __init__(self): self._tbo_children_num_token_non_padded = torch.zeros((2,), dtype=torch.int32, device=get_device().device)
def capture_one_batch_size(self, batch, num_tokens): if not is_tbo_enabled(): return batch.tbo_split_seq_index = compute_split_seq_index(...) # For simplicity, when two_batch_overlap is enabled, we only capture CUDA Graph for tbo=true assert batch.tbo_split_seq_index is not None self._tbo_children_num_token_non_padded[...] = ( TboForwardBatchPreparer.compute_tbo_children_num_token_non_padded(batch)) TboForwardBatchPreparer.prepare_raw(batch, tbo_children_num_token_non_padded=self._tbo_children_num_token_non_padded)
def replay_prepare(self, forward_mode, bs, num_token_non_padded, spec_info): tbo_split_seq_index, tbo_split_token_index = compute_split_indices_for_cuda_graph_replay( forward_mode=forward_mode, cuda_graph_num_tokens=bs * token_num_per_seq, spec_info=spec_info) self._tbo_children_num_token_non_padded[...] = ( TboForwardBatchPreparer.compute_tbo_children_num_token_non_padded_raw( tbo_split_token_index=tbo_split_token_index, num_token_non_padded=num_token_non_padded))关键点有三:
- 捕获时按
num_tokens冻结切点。CUDA Graph 的每个捕获尺寸(bucket)对应一个固定的 token 数,切点tbo_split_seq_index在捕获时就确定下来并写进 batch。注释也点明了”开 TBO 时只做 TBO=true 的捕获”。这样做的好处是捕获路径与执行路径的 host 逻辑合一:图里的 launch 序列就是两个 child 交错后的序列,重放时不必再区分”这份图是不是切过的”。代价是非 TBO 的 batch(例如小到不值得切)在图模式下无法复用同一份捕获结果,只能回退到 eager,或按另一套捕获逻辑处理。 - 重放时只更新”两个 child 的真 token 数”。这两个数是一个 2 元素 int32 张量
_tbo_children_num_token_non_padded,在每次重放时根据bs和num_token_non_padded反推切点并重新写。为什么要单独处理它?因为它是唯一一个依赖运行时”有多少真 token”的数字——图里其他形状都是捕获时定死的,只有这个计数要按当前请求的填充情况更新。执行器在初始化时把它作为moe_num_token_non_padded写进 child 上下文;MoE 的专家计算通过它判断”本 child 前多少个 token 是真 token”,从而跳过填充行。 - 重放路径的 child 元数据在
TboAttnBackend._dispatch_children_from_replay_view里重建。重放时不再走prepare_raw,没有现成的 child ForwardBatch,所以后端从父fb_view用同样的切点索引切出每个 child 的视图(SimpleNamespace),再逐个调用init_forward_metadata_out_graph建立 child 的分页元数据。
这里有一个值得记住的结论:TBO 与 CUDA Graph 的组合并没有让 host 端逻辑消失,它只是把 host 端逻辑从”每次前向都跑一遍”降级成了”重放时只跑必要的那一小部分”。每个 bucket 的切点是冻结的,只有 token 计数是动态的——这是一种”最大程度静态化、最小程度动态化”的典型工程做法。站内 CUDA Graph 的桶与垫:五个推理框架如何把动态解码批塞进静态图 讨论过各框架如何用 padding 把动态批量塞进静态图,TBO 这里是把”切分点”也当成静态量处理的一种延伸。
与调度器的边界:TBO 管不到的东西
TBO 只覆盖一次 GPU 前向的内部。一次请求从进入引擎到吐出 token 的全过程里,还有若干阶段既不切、也不重叠:
- 请求的准入与排队。这一轮 batch 由谁组成、哪些请求被放进 prefill、哪些被放进 decode,都是调度器决定的;TBO 拿到的是一份已经组好的 batch。站内 SGLang 源码完全拆解(三):Scheduler 请求状态机 讲的正是这一层。
- 分块预填充与 token 预算。prefill 能被切成多大的块、每条请求分到多少 token,由
PrefillAdder的预算逻辑决定;TBO 的”两段切”虽然也在切 patch,但它是在一块已经分好的 prefill 内部再横切一刀,不会改变 token 预算本身。见 SGLang 源码完全拆解(四):PrefillAdder。 - CPU 与 GPU 的重叠。调度器在 GPU 前向还在跑的时候准备下一轮 batch、计算 KV 需求、处理输出——这是另一条”重叠线”,和 TBO 正交。见前面提到的 GLM-5.3 推理全链路(十八)。
把这些边界画出来,是为了避免一个常见误解:看到 TBO 报出 30% 的吞吐提升,就以为整个服务端到端快了 30%。博客里 TBO 的收益数字都是在”给定 batch、给定并行拓扑、给定通信后端”的条件下测的;端到端吞吐还取决于 batch 能不能组得够大(EPLB 的分摊、MTP 带来的解码扩张都在影响这一点)、TTFT 与 ITL 的约束、以及 KV 池的大小。站内 SGLang 源码完全拆解(十七) 里对 EPLB 与 TBO 的联合消融正是从这个角度做的。
效果与消融:哪些场景真能赚到
博客的消融数据把 TBO 的收益边界划得很清楚,对估算”值不值得开”有用。
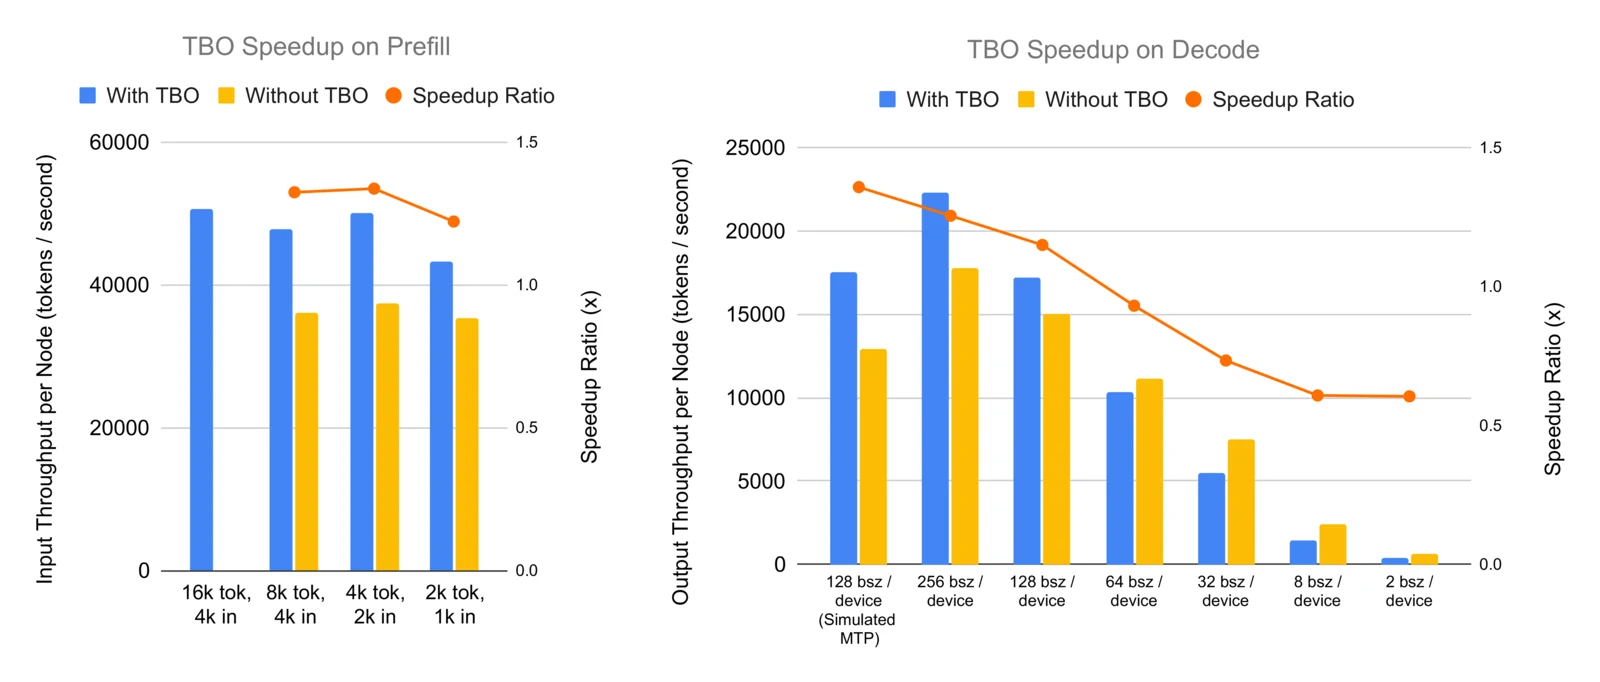
图片来源:SGLang 团队 大规模 EP 部署博客 的 Two-batch Overlap 消融,横轴为每设备的 token 数,包含真实测试与模拟 MTP 两种口径。
prefill 阶段,收益稳定:
- 同样 token 数下,TBO 的吞吐比不开时高 27%~35%,主要来自 attention 与 MLP 计算和 DeepEP dispatch/combine 的重叠;
- 显存方面,不开 TBO 时单卡 8,192 token 就会 OOM、16,384 必然 OOM;开 TBO 后 16,384 可以跑,与”其他配置都最优”的对照组相比再提升 40.5%。
这里要读清楚”40.5%“的口径:它不是”TBO 让同样的 batch 快 40%“,而是”TBO 让 batch 从 8K 扩到 16K,且对照基线本身已经包含了其他优化”。prefill 的 TBO 收益有一部分是通过”能跑更大的 batch”间接得到的,与”同样的 batch 少花 30% 时间”是两笔不同的账。
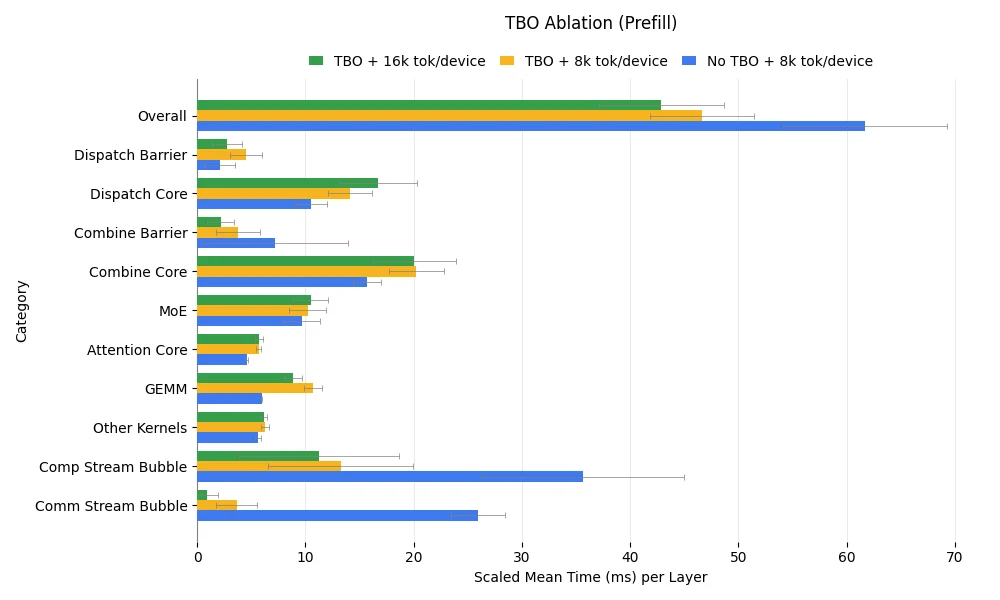
图片来源:同上博客的 prefill 时间分解。比较 TBO 8K 与无 TBO 8K,能看到通信被计算覆盖的程度;比较 TBO 16K 与 TBO 8K,能看到批量翻倍后 attention 与 MLP 的增长比例。
decode 阶段,收益有阈值:
- 真实测试里,每设备 batch 小于约 64~128 token 时 TBO 收益很小甚至为负,32 token/设备时是 -27%——小 batch 下每个 child 只有一两行 token,内核效率本来就低,再切成两份只会让 tile 更空;
- batch 到 256 token/设备时加速约 25.5%,吞吐 22,310 token/s;
- 模拟 MTP 场景(每 decode step 128 请求 × 256 token)下,128 序列/设备达到 35% 加速,吞吐 17,552 token/s 对 12,929 token/s。
这个”阈值”其实是 TBO 最本质的权衡:TBO 用”多切一份带来的效率损失”换”通信被计算覆盖的收益”。前者的代价在所有 batch 大小下都存在(两份 kernel 的 launch 更多、tile 更碎、访存更分散),后者的收益随 batch 增大、attention 变长而变大。两者交叉的那一点就是启用阈值。博客说 decode 的收益”与 attention 处理时间相关”——attention 越长,一段被覆盖的通信越长;MTP 让 decode 一次处理多 token,等价于让 attention 变长,因此成了 TBO 收益最大的场景。
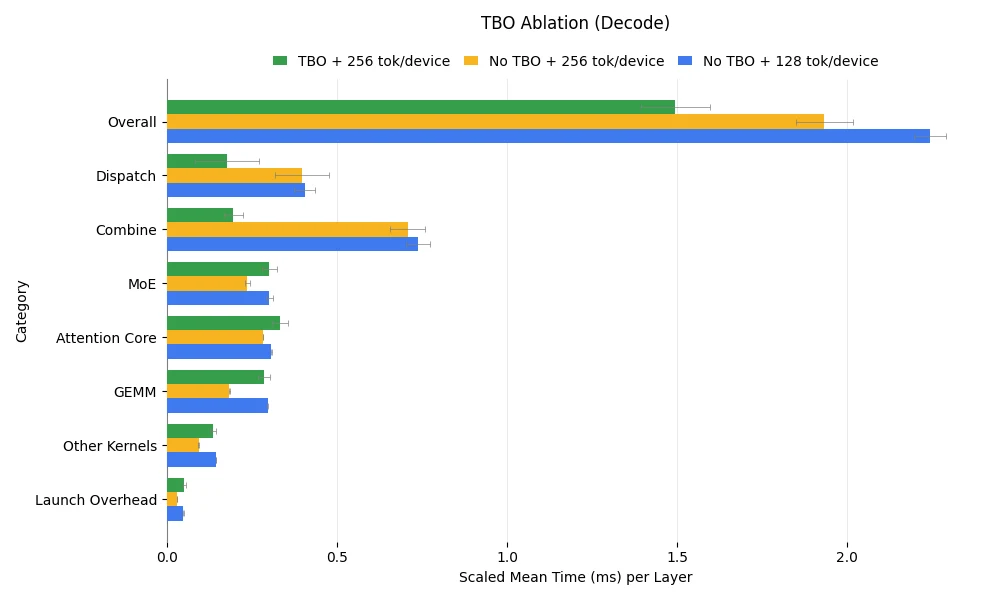
图片来源:同上博客的 decode 时间分解。TBO 256 与无 TBO 256 的对比把通信时长的变化单独拎了出来。
限制与边界:TBO 不能解决什么
综合源码与博客,TBO 至少有以下几条明确的边界:
只覆盖稀疏 MoE 层。 dense 层直接断言不走 TBO,DeepSeek-V3 的前 3 层 dense FFN、LM head 等都在 TBO 之外。MoE 模型里 dense 层占比小,影响有限,但对”每层都有通信”的其他架构就不一定了。
forward mode 必须整机一致。 混批(prefill 与 decode 在同一个 batch 里)天然破坏一致性——只要有一个 rank 在 prefill 而另一个在 decode,TBO 就整机关闭。站内 GLM-5.3 推理全链路(九):混批 里讨论的混合 batch 场景,就属于 TBO 默认不适用的情形。
两段切会把一条序列拆开。 对一条超长序列做两段切,等于把它的 prefill 拆成两个相互依赖的 chunk 并行推进;源码已经处理了前缀长度衔接、位置编码与注意力掩码,但这也意味着一条序列必须在两个 child 上都有 KV 写入,而 KV 池是共享的、槽位是按 token 顺序分配的,切错槽位就是读错 KV。源码里 DSA/迭代式注意力相关的字段(iteration_ids、iteration_cols)也需要一并切片;另外注释里写明 unified memory 配置下拒绝 TBO,说明并非所有 KV 存储形态都能配合这种切分。
DeepSeek-V4 目前只有 prefill。 源码注释提到在 ATOM 的测试数据上 decode TBO 出现回退,原因之一是 CUDA Graph 捕获方面的工作尚未完成。这说明”操作表抽象很好移植”不等于”每个模式的性能收益都成立”——策略表是写出来的,delta 是调出来的。
low-latency 的 DeepEP 模式与 TBO 的 prefill 冲突。 前面那张 DP 判断表里已经体现:走 A2A + low-latency + extend 时 TBO 被禁用,而在 decode 里 low-latency 反而是常用模式。也就是说同一个启动参数下,TBO 能不能用还取决于这一轮请求走的是哪条 DeepEP 路径;源码没有展开解释原因,从设计上看是两者对 prefill 的切分与对齐假设不同。
另外博客提到的另一些限制(TTFT 2~5 秒、ITL 约 100ms 之类)属于整个系统层面的延迟指标,与 TBO 本身关系不大,不再展开。
小结:一种把重叠写成数据的工程方法
把这篇的要点收在一张表里:
| 层 | 关键源码 | 它解决的问题 |
|---|---|---|
| 抽象 | operations.py 的 Operation / YieldOperation / Stage | 把”一层的前向”写成数据,通信等待点变成显式的分隔符 |
| 执行 | execute_overlapped_operations + _StageExecutor | 两个游标错位推进,delta_stage 控制相位差 |
| 切分 | compute_split_seq_index / _split_extend_seqs / filter_batch | 按 forward mode 选切法,逐字段切出两个 ForwardBatch |
| 策略 | operations_strategy.py | 每个模型层、每种模式一张操作表;SM 划分与共享专家位置都在这里 |
| 前向编排 | model_forward_stages | residual stream 交接、token 切分与 padding、合并 |
| 通信/注意力 | MaybeTboDeepEPDispatcher / TboAttnBackend | 双实例分派器与每 child 独立的分页元数据 |
| 图模式 | TboCudaGraphRunnerPlugin | 捕获时冻结切点,重放时只更新真 token 计数 |
| 可用性 | TboDPAttentionPreparer | 全局 mode 一致、所有 rank 本地可跑才启用 |
如果只记一句话:TBO 的价值不在于”切了两份”,而在于把”在哪里等通信、在哪里插计算”这件原本散落在每个算子内部的事,收拢成了一张可以被阅读、被修改、被执行器按节拍推进的数据表。 代码复杂度的问题用”操作表是数据”消解;prefill 的 CPU 阻塞问题用”先发计算、再发阻塞通信”的发射顺序与显式的阶段划分消解。这两件事与”切两半”本身同等重要——切两半只是前提;让出点摆在哪里、发射顺序怎么排,才决定最终看到的是博客里那张 (b) 图还是 (a) 图。
下一篇计划沿 SGLang 源码拆 single batch overlap(SBO):不开 TBO、只有一份 batch 时,如何靠”同一份 batch 内把低效的通信与共享专家计算并行到另一个 stream”来填同样一段等待。SBO 用的 alt_stream / compute_overlap_args 是另一套基础设施;先把它讲清,也能更准确地理解 decode 表里”共享专家被挪到 dispatch_a 之后”这一步的用意。
参考资料
- Deploying DeepSeek with PD Disaggregation and Large-Scale Expert Parallelism on 96 H100 GPUs(LMSYS Org,2025-05-05)
- SGLang GitHub 仓库
- SGLang batch_overlap 源码目录
- DeepSeek-V3 Technical Report(arXiv:2412.19437)
- DeepSeek-V3/R1 推理系统概览(DeepSeek 官方)
- DeepEP:面向 MoE 的高效 EP 通信库
- DeepGEMM:面向 FP8 的高性能 GEMM 库
- DeepSeek 官方公开的双批重叠 profiling 数据
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



