


llama.cpp 源码完全拆解(十五):量化 GEMM 的矩阵编队——MMQ 如何把 MoE 与预填充塞满 GPU
引言:从解码到批量的那一步
上一篇把 mul_mat_vec_q(MMVQ)拆到指令级别:解码时一次只有一个 token,矩阵乘退化成矩阵-向量乘,瓶颈是显存带宽,答案是一条 warp 沿着输出行向下滚动、用 dp4a 把量化块逐块点积掉。
但推理从来不只有解码。一个请求在进入解码之前,要先走预填充——一次喂进几百到几千个 token;多个请求并发时,调度器还会把它们的预填充拼成一个 batch 一起算;MoE 模型更进一步,每个 token 被路由到若干专家,同一个 token 可能出现在多张专家权重前面。
这些场景的共同特征是:激活不再是一列,而是若干列。矩阵-向量乘的那套「每个 warp 负责一组输出行、权重读一遍就丢」的做法,在输出列数变大之后会失效,因为此时算术强度上来了,瓶颈从显存带宽转向了算力,而算力的关键指标是权重被读进寄存器或共享内存之后,能复用多少次。
mul_mat_q(MMQ)就是 llama.cpp 为这个场景准备的量化 GEMM 内核。它的总体思路和任何成熟的 GEMM 实现一样——分块(tiling),但它要额外解决三个量化特有的问题:
- 权重是 Q4_K、Q6_K 这类两级块量化格式,解包本身要花指令;
- 激活被压成
q8_1,内积必须用整数指令(dp4a)或 Tensor Core 的 MMA; - 输出 tile 的个数经常填不满 SM,或者在 MoE 下每个专家分到的 token 数极不均衡,需要一套工作重分配机制。
本文沿着 ggml/src/ggml-cuda/mmq.cu、mmq.cuh、mmq-load-tiles.cuh、mmq-vec-dot.cuh 与 ggml-cuda.cu 里的 ggml_cuda_mul_mat_id,把这三件事逐一拆开。前一篇 llama.cpp 源码完全拆解(十四):mul_mat_vec_q——解码时一条量化权重如何被 dp4a 逐块点积 讲的是「带宽受限时怎么走捷径」,这一篇讲的是「算力受限时怎么排兵布阵」。
为什么单独需要一个批量量化内核
形状判据:什么时候该换内核
ggml-cuda.cu 里的派发判定树决定了一个 mul_mat 走哪条路径。剥掉 FP16 的特殊分支,量化权重相关的判定可以浓缩成三行:
if (ggml_cuda_should_use_mmvq(src0->type, cc, ne11)) { ggml_cuda_mul_mat_vec_q(ctx, src0, src1, nullptr, dst); return;}if (ggml_cuda_should_use_mmq(src0->type, cc, ne11, /*n_experts =*/ 0)) { ggml_cuda_mul_mat_q(ctx, src0, src1, nullptr, dst); return;}ggml_cuda_mul_mat_cublas(ctx, src0, src1, dst);ne11 就是激活的列数,也就是这个 mul_mat 一次要算多少个 token。should_use_mmvq 的含义是「列数足够少」;should_use_mmq 的含义是「列数上来了,但还没大到应该反量化成 FP16 去用 cuBLAS 的 Tensor Core」。
should_use_mmq 的签名里有一个容易被忽略的参数 n_experts:
bool ggml_cuda_should_use_mmq(enum ggml_type type, int cc, int64_t ne11, int64_t n_experts);它能感知「这是一个按专家分组的矩阵乘」,因为 MoE 场景下有效的批量并不是 ne11 本身,而是每个专家平均看到多少 token。同样的 512 个 token,稠密模型是一次 512 列的 GEMM,MoE 模型却是 8 个专家各分到大约 64 列、还要加上重复路由——每个专家的 GEMM 都小得足以退回 MMVQ。这个参数的存在说明 MMQ 的适用范围是按「单次 GEMM 的列数」衡量的,而不是按整批 token 数衡量的。
为什么不能直接反量化
一个自然的疑问是:既然激活列数足够大、算力足够喂饱 Tensor Core,为什么不把权重在 kernel 里就地反量化成 FP16,再走常规的 GEMM?原因有三条,都在 mul_mat_q_process_tile 里能直接对上:
- 反量化要多一份寄存器或共享内存空间:Q4_K 每 256 个权重只有 144 字节,反量化成 FP16 变成 512 字节,共享内存的 tile 容量直接变成三分之一;
- 反量化本身是额外的指令:Q4_K 的 6 位 scale 要在
qs的 nibble 之间拆分,再与 32 元素一组的q8_1对齐,这套「拆包 + 对齐」如果摊不到足够的输出列上,就是纯粹的开销; mul_mat是推理里调用最频繁的算子,为它单独维护一个内核、把量化布局直接编进 kernel 的模板参数,可以让编译器把解包指令与内积指令调度到同一个循环里、共享流水线。
所以 MMQ 的设计选择是:保持量化格式,只把激活压成 Q8_1,用整数内积。这是把「量化带来的带宽收益」与「批量带来的算力收益」同时攥在手里的做法,代价是内核复杂度——它有配置表、有 stream-K、有分专家路径,还有一条面向新硬件的 FP4 路径。
分块的骨架:I、J 与 K 三根轴
SUM 数组:每个线程持有一小片输出
MMQ 的核心循环在 mul_mat_q_process_tile 里,它的第一行就定义了每个线程持有什么:
constexpr int I = ggml_cuda_mmq_get_I(type, J, fallback, prec_src1);...float sum[J*I / (nwarps*warp_size)] = {0.0f};sum 是一个每个线程私有的寄存器数组,总长度是 J*I / (nwarps*warp_size),也就是说一个 block 的线程数 nwarps*warp_size 正好把 J × I 个输出元素平分成对应的份数。这是 GEMM 里最常见的「每线程持有几个输出格子」的布局。
三根轴的定义要对照结构体的注释来读:
struct ggml_cuda_mmq_config { ggml_type type; int nthreads; // Number of threads per CUDA block. int occupancy; // Targeted occupancy for the MMA kernel. int I; // SRAM tile width in src0->ne[1]/dst->ne[0] direction. int J; // SRAM tile width in src1->ne[1]/dst->ne[1] direction. ggml_cuda_mmq_sram_layout sram_layout; // SRAM tile length ... in 32 bit elements. int K_vram; // VRAM tile length in src0->ne[0]/src1->ne[0] direction. bool stream_k; bool fallback;};- I(注释写作 tile 宽度在
src0->ne[1],即输出行方向):一个 block 一次处理I行输出。配置表对I施加了static_assert((I_) % 32 == 0),常见值是 64、128,不一定就是 128;mmq_needs_fallback(nrows_x)判定的也正是「行数不是 tile 的整数倍」这种边界情形; - J(tile 宽度在
src1->ne[1],即输出列方向):一个 block 一次处理 J 个 token 的列,J 从 8 到 128 步进 8,由运行期挑选; - K_vram(tile 长度在 K 方向):一个 block 在 K 方向上一次性把多少元素搬进共享内存,
static_assert((K_vram_) % 256 == 0)要求它是 256 的整数倍。
还有一组和 K 方向相关的常量,在 mmq.cuh 的头部:
#define MMQ_ITER_K 256#define MMQ_TILE_NE_K 32#define MMQ_TILE_Y_K (MMQ_TILE_NE_K + MMQ_TILE_NE_K / QI8_1)MMQ_TILE_NE_K = 32 是共享内存 tile 在 K 方向的基本单位——32 个 32 位元素。MMQ_TILE_Y_K = 32 + 4 = 36:一个 block_q8_1_mmq 的 128 个 int8 折成 32 个 int,再加上 4 个 int 的 scale。所以激活 tile 的一行是 36 个 int,刚好装下 128 个 q8_1 值加其缩放。
K 方向的循环在 kb0 上每步 blocks_per_iter = K_vram / qk 个量化块。每个 K 段里发生的动作是一条五步序列:
for (int kb0 = kb0_start; kb0 < kb0_stop; kb0 += blocks_per_iter) { load_tiles(x, x_gate, tile_x, offset_x + kb0, tile_x_max_i, stride_row_x); // 加载第一块激活:J 列 × 36 int,其中 32 int 是 128 个 q8_1 值、4 int 是 scale for (int l0 = 0; l0 < J * MMQ_TILE_Y_K; l0 += nwarps * warp_size) { int l = l0 + threadIdx.y*warp_size + threadIdx.x; tile_y[l] = by0[l]; } __syncthreads(); vec_dot(tile_x, tile_y, sum, 0); __syncthreads(); // 加载第二块激活(下一个 128 值),复用同一块激活 SRAM __syncthreads(); vec_dot(tile_x, tile_y, sum, MMQ_TILE_NE_K); __syncthreads();}把 vec_dot 连续调用两次、offset 分别是 0 和 MMQ_TILE_NE_K,是这套内核在共享内存布局上的一个精巧之处。K_vram 必须是 256 的整数倍,一个 K 段里正好装两个 block_q8_1_mmq(每个 128 个激活值、36 个 int,其中最后 4 个 int 是 4 组 (d, s))。第一次 vec_dot 用权重 tile 的 K[0,128) 与第一块激活相乘,第二次用 K[128,256)(指针偏移 MMQ_TILE_NE_K = 32 个 int,即 128 个 4-bit 权重)与第二块激活相乘。权重 tile 只加载一次、被两次内积共享;激活 SRAM 只有一份、被复用两次。这就是为什么 tile_y 的尺寸是 J * 36 而不是 J * 72:MMQ 用「加载—内积—覆盖—再内积」把激活 tile 的共享内存砍了一半,代价是两次 __syncthreads() 的同步。
两个 __syncthreads() 之间夹着 vec_dot,说明了这里的线程分工:vec_dot 是 block 内所有线程共同对同一个 tile 计算,每个线程只负责 sum 里属于自己的那几格。所以 vec_dot 本身就是一个「块内合作」的函数,每个线程读的是同一份共享内存,写的是各自的寄存器。
J 的运行期选择:找一个刚好塞满的宽度
J 并不是常量,而是由 ggml_cuda_mmq_get_J_best 在运行期挑出来的(ggml_cuda_mul_mat_q 只是把 ncols_opt 喂进去并顺便回收 nthreads_best)。挑选逻辑在上一篇已经出现过,但值得换一个角度重新读一遍:它的目标函数是 让输出 tile 的数量最少。
int ntiles_J_best = INT_MAX;for (int J = 8; J <= 128 && ntiles_J_best > 1; J += 8) { const ggml_cuda_mmq_config config = ggml_cuda_mmq_get_config(src0->type, J, fallback, cc, prec_src1); if (config.type == GGML_TYPE_COUNT) continue; // 该量化类型 + 该 J 没有配置,跳过 if (mmq_get_nbytes_shared(config, cc) > smpbo) continue; // SRAM 装不下,跳过 const int ntiles_x = (ncols + config.J - 1) / config.J; if (ntiles_x < ntiles_J_best) { J_best = J; if (nthreads_best) { *nthreads_best = config.nthreads; } ntiles_J_best = ntiles_x; }}三个约束的顺序值得细读:
- 配置存在性:每个量化类型 × J 的组合是否在
mmq-config-*.cuh表里有条目。这张表是按 GPU 架构分文件的(mmq-config-ampere.cuh、mmq-config-blackwell.cuh、mmq-config-cdna.cuh、mmq-config-rdna3.cuh等),意味着「哪个 J 值得试」本身就是逐架构调参的结果; - 共享内存容量:
mmq_get_nbytes_shared计算的是 ids 数组、权重 tile 与激活 tile 三者之和。J 增大,激活 tile 线性增大,超过smpbo就不可行; - tile 数最小:
ntiles_x = ceil(ncols/J),取能让输出列方向 tile 数最少的 J。ntiles_J_best > 1是提前退出条件:一旦某个 J 让列方向只剩一个 tile,就没必要再试更大的 J——更大的 J 只会浪费共享内存。
这个循环真正想解决的问题,是让 J 尽量逼近实际的列数。J 太大,最后一个 tile 里大部分列是空的;J 太小,tile 数多、每个 tile 的 K 循环都要重新加载一遍权重 tile。选一个刚好把列数整除的 J,是这两者之间的折中。而这个折中之所以能成立,是因为候选 J 只有 16 个(8 到 128),每个量化类型 × 架构只需要准备十几个配置实例,编译时间和代码体积都可控。如果 J 是运行期任意值,这套「配置表 + 模板实例」的整体设计就崩了。
MoE 情形下这个循环的输入会被提前改写。ggml_cuda_mul_mat_q 里:
int64_t ncols_opt = ne11;if (ids) { const int64_t n_expert_used = ids->ne[0]; ncols_opt = ne12; // Each expert only sees ne12*n_expert_used/ne02 tokens on average. // On RDNA3 and RDNA4 it is faster to pick the tile size against this value instead of ne12. if (GGML_CUDA_CC_IS_RDNA3(cc) || GGML_CUDA_CC_IS_RDNA4(cc)) { ncols_opt = (ne12*n_expert_used + ne02 - 1) / ne02; }}NVIDIA 上 ncols_opt 保持为全部 token 数,RDNA3/RDNA4 上则换成「每个专家平均看到的 token 数」。这是同一份配置表的两种口径:前者按整批的有效列数选 tile,后者按单专家的典型列数选 tile。注释只说 RDNA3/4 上后者更快,没有给出推导——和 90% 效率阈值、64 的批量上限一样,是实测结果,不是可证明的最优解。
读 mmq-config-ampere.cuh 里 Q6_K 的条目还能看到一个细节:fallback=true 只列出 J = 8、16、32、64、128 五档,而 fallback=false 把 J 从 8 到 128 每隔 8 都列了一遍(8, 16, 24, 32, …, 128)。原因是边界情形下每个 warp 要处理越界行、模板实例与寄存器压力更大,能放心展开的 tile 档位更少;主路径则放开 J 的粒度,让 J_best 更贴住实际列数。
配置表里还有一列 stream_k,Q6_K 的全部条目都是 true——意味着 Q6_K 在 Ampere 上默认允许 stream-K 分解,而不像某些条目那样按场景关闭它。
加载端:权重 tile 怎么被摆进共享内存
共享内存里的三段布局
tile_x_sizes 结构体把权重 tile 在共享内存里分成三段:
struct tile_x_sizes { int qs; // 量化数据 int dm; // 块缩放因子 int sc; // 子块 scale / min(仅 K 系格式有)};Q4_0 只有 qs 与 df 两段(对称量化只有 delta);Q4_K/Q5_K 三段齐全(dm 是超块级的 (d, dmin),sc 是 8 个子块的 6 位 scale/min)。这张表在 mmq.cuh 里以宏的形式写死:
#define MMQ_DP4A_TXS_Q4_0 tile_x_sizes{I*MMQ_TILE_NE_K + I, I*MMQ_TILE_NE_K/QI4_0 + I/QI4_0, 0}#define MMQ_DP4A_TXS_Q4_K tile_x_sizes{I*MMQ_TILE_NE_K + I, I*MMQ_TILE_NE_K/QI4_K, I*MMQ_TILE_NE_K/8 + I/8}#define MMQ_DP4A_TXS_Q6_K tile_x_sizes{I*MMQ_TILE_NE_K*2 + I, I*MMQ_TILE_NE_K/QI6_K + I/QI6_K, I*MMQ_TILE_NE_K/8 + I/8}Qs 那一项末尾的 + I 就是 padding:K 方向每行多留一个 int。后面的 vec_dot 里所有对 x_qs 的访问都带着 i*(MMQ_TILE_NE_K + 1) + ...,那个 +1 正是这个 padding 在索引上的体现。padding 保证换行时地址计算不落到别行,也让对齐得以保持——这是上一篇已经讲过的「无条件访存」策略在批量场景的延续。
至于 MMA 路径(Turing 及以上、AMD WMMA/MFMA),布局交给 ggml_cuda_mmq_sram_layout,不同量化类型有不同的 get_sram_stride 返回值,例如 Q6_K 的 stride 是 2*MMQ_TILE_NE_K + MMQ_TILE_NE_K/QI6_K + MMQ_TILE_NE_K/8 + 7。末尾的 +7 是 padding 到 8 的倍数差 1,这样跨行的 K 宽度就是 K % 8 == 4,正好对应注释里写的「让共享内存 bank 冲突最小、K 维最终 tile 大小是 32 的整数倍」。
Q4_0:一个 get_int_b2 搬进 8 个 4-bit
Q4_0 的加载函数 ggml_cuda_mmq_load_tiles_q4_0 是最简单的一版,可以用来看清「nibble 压在一个 int 里」时的基本操作:
constexpr int threads_per_row = MMQ_ITER_K / (4 * QR4_0);// ...每行由 threads_per_row 个线程协作加载const block_q4_0 * bxi = (const block_q4_0 *) x + kbx0 + i*stride + kbx;const int qs0 = get_int_b2(bxi->qs, kqsx);x_qs[i*(MMQ_TILE_NE_K + 1) + txi] = qs0; // dp4a 路径get_int_b2 从 qs 里取出第 kqsx 个 int,也就是 8 个 4-bit 值。一个 int 装 8 个权重,这是共享内存带宽账的起点:整块 q4_0 的 tile 在 K 方向是 32×4=128 个权重,折成 32 个 int 正好一行。dp4a 路径直接把 nibble 原样存进去,解包留给 vec_dot——因为 vec_dot 内部本来就要把 nibble 拆成 int8 数组喂 dp4a,在加载时再拆一遍是重复劳动。
MMA 路径则必须在加载时拆开:
x_qs[i*sram_stride + kbx*(2*QI4_0) + kqsx + 0] = __vsub4((qs0 >> 0) & 0x0F0F0F0F, 0x08080808);x_qs[i*sram_stride + kbx*(2*QI4_0) + kqsx + QI4_0] = __vsub4((qs0 >> 4) & 0x0F0F0F0F, 0x08080808);两个细节:
(qs0 >> 0) & 0x0F0F0F0F与(qs0 >> 4) & 0x0F0F0F0F拆出前后两半 nibble,分别写到 stride 内的两个区域;__vsub4一次性从四个字节里各减去 8。Q4_0 是对称量化,存储的值是[-8, 7]的偏移表示,真值是scale × (q − 8)。MMA 的 4-bit 输入通常要无符号 0..15,如果保留偏移表示,就要在内积里额外处理零点;直接把q − 8在加载时做掉,内积就可以走无符号路径。这一条在下一篇讲 MMVQ 的 MMA 路径时也会出现,是同一类「把常数部分提前到加载阶段」的优化。
Q4_K:在加载期就把两层 scale 合并成 half2
K 系格式(Q2_K 到 Q6_K)用 256 元素一个超块,块内 8 个子块各 32 个元素,子块的 scale 与 min 用 6 位打包,再乘上超块级的 d/dmin。如果每做一次内积都重新拆一遍 6 位 scale,这条路径的性能会被拆包指令吃掉。ggml_cuda_mmq_load_tiles_q4_K 的做法是:在加载期把 d、dmin、子块 scale、子块 min 两两乘好,以 half2 存进共享内存。
const int sc32 = unpack_scales_q45_K(scales, ksc + 0);const int m32 = unpack_scales_q45_K(scales, ksc + 2);const half2 dm = bxi->dm * make_half2(1.0f, -1.0f);for (int l = 0; l < int(sizeof(int)); ++l) { x_dm[i*sram_stride + sizeof(int)*ksc + l] = dm*make_half2(sc8[l], m8[l]);}逐项解释:
unpack_scales_q45_K从scales[]的 12 字节里抽出第ksc个子块的 6 位 scale 与 6 位 min。注释给出的映射是:第 0、1 个占低 4 位,第 4~7 个占高 2 位,第 2、3 个从另一处取——这是 GGUF 的 Q4_K/Q5_K 块布局本身的规则;dm = (d, dmin) × (1, −1)构造出half2(d, −dmin),x_dm里每个元素是(d·sc, −dmin·m)。注意那个负号:Q4_K 是非对称量化,真值是d·sc·q − dmin·m,把(−dmin·m)预存好,内积时只需要在最后的return里做一次dm4f.x*sumf_d + dm4f.y*sumf_m;for (l = 0; l < sizeof(int); ++l)把一个 int 的 4 个子块展开,每个子块写入一个half2,刚好 4 个half2覆盖一个sc32的四个字节。
dp4a 路径的 x_sc 则只做 6 位解包、不乘:
const int scales8 = unpack_scales_q45_K(scales, ksc);x_sc[i*(MMQ_TILE_NE_K/8) + i/8 + ksc] = scales8;因为 dp4a 路径的 vec_dot 会在内积结束后用 sc[i] 与 m[i] 与 d/dmin 相乘。这是两条路径在「哪一步做乘法」上的根本分歧:MMA 要的是已经乘好的半精度 scale,dp4a 要的是原始整型 scale。把这件事放在加载期而不是内积期,是为了让内积循环里的指令数降到最低。
Q6_K:6 位数据要多占一半的共享内存
Q6_K 的 qs 项是 I*MMQ_TILE_NE_K*2 + I——比 Q4_K 大一倍。原因是 6 位值被拆成两半存:ql 里存每元素 4 位,qh 里再补 2 位,加载函数 ggml_cuda_mmq_load_tiles_q6_K 要把两半按位对齐拼回一个字节:
const int ql = get_int_b2(bxi->ql, txi);const int ql0 = (ql >> 0) & 0x0F0F0F0F;const int ql1 = (ql >> 4) & 0x0F0F0F0F;
const int qh = get_int_b2(bxi->qh, (QI6_K/4) * (txi / (QI6_K/2)) + txi % (QI6_K/4));const int qh0 = ((qh >> ((txi & 0x08) >> 2)) << 4) & 0x30303030;const int qh1 = (qh >> ((txi & 0x08) >> 2)) & 0x30303030;
x_qs[i*(2*MMQ_TILE_NE_K + 1) + kq0] = __vsub4(ql0 | qh0, 0x20202020);x_qs[i*(2*MMQ_TILE_NE_K + 1) + kq1] = __vsub4(ql1 | qh1, 0x20202020);读法:ql 与 qh 各取 8 个元素的位段,拼出来的 6 位值仍然以 32 为中心,所以 dp4a 路径在写共享内存时就用 __vsub4(..., 0x20202020) 把 32 减掉了——四个字节各减 32 是一条指令。这条减法是在加载期一次性完成的,内积循环里就不用再管偏移。同理,MMA 路径也在这里做同样的 __vsub4,只是写到 sram_stride 编址的条带上。
这也解释了为什么 Q6_K 通常只用在少数敏感层(例如 output.weight):它的 tile 共享内存占用是 Q4_K 的两倍,解包要多读一个 qh 数组、多两条位运算。MMQ 并不为这种差异做特殊适配,而是用同一套骨架、换一个加载函数和一个内积函数——模板参数 type 决定了 load_tiles、vec_dot、write_back 三个在编译期被替换成对应实现。
内积端:dp4a 与 MMA 两条路线
dp4a 路径的 Q4_K:把子块 scale 循环展开掉
K 系格式的 vec_dot 在 mmq-vec-dot.cuh,Q4_K 这一版结构如下:
for (int k01 = 0; k01 < MMQ_TILE_NE_K; k01 += QR4_K*VDR_Q4_K_Q8_1_MMQ) { const int k0 = k00 + k01; for (int j0 = 0; j0 < J; j0 += nwarps) { const int j = j0 + threadIdx.y; for (int i0 = 0; i0 < I; i0 += warp_size) { const int i = i0 + threadIdx.x; const uint8_t * sc = (const uint8_t *) &x_sc[i * (MMQ_TILE_NE_K/8) + i/8 + k0/32] + 2*(k01/16); sum[j0/nwarps*I/warp_size + i0/warp_size] += vec_dot_q4_K_q8_1_impl_mmq( &x_qs[i*(MMQ_TILE_NE_K + 1) + k0/2], &y_qs[j*MMQ_TILE_Y_K + k01], sc, sc+8, x_dm[i], &y_ds[j*MMQ_TILE_Y_K + k01/QI8_1]); } }}几个常量的取值:QR4_K = 2(ggml-common.h 里定义为 QK_K / (4*QI4_K) 的形式,表示一次 dp4a 覆盖的 K 步幅;它不是「一个 int 装几个子块」,而是量化块的 K 步长参数),VDR_Q4_K_Q8_1_MMQ = 8,所以 sum 的分下标 j0/nwarps*I/warp_size + i0/warp_size 是一个按 (列组, 行组) 编址的二维数组,长度为 J*I/(nwarps*warp_size)。
函数体是:
float sumf_d = 0.0f;float sumf_m = 0.0f;for (int i = 0; i < QR4_K*VDR_Q4_K_Q8_1_MMQ/QI8_1; ++i) { int sumi_d = 0; for (int j = 0; j < QI8_1; ++j) { sumi_d = ggml_cuda_dp4a((v[j] >> (4*i)) & 0x0F0F0F0F, u[i*QI8_1 + j], sumi_d); } const float2 ds8f = __half22float2(ds8[i]); sumf_d += ds8f.x * (sc[i] * sumi_d); sumf_m += ds8f.y * m[i];}return dm4f.x*sumf_d - dm4f.y*sumf_m;内层是两个循环的乘积结构:
- 外层
i遍历子块(QR4_K*VDR/QI8_1个子块),每个子块对应一个q8_1块(32 个 int8); - 内层
j遍历 q8_1 块内的 8 个 int,每次dp4a把 4 个”4 位权重 × 4 个 int8 激活”乘加一次; (v[j] >> (4*i)) & 0x0F0F0F0F把第i个子块的 nibble 从 v 里抽出来。v 里一个 int 装 8 个 4-bit 值,第i个子块占的是第i个 nibble,因此右移4*i;sumi_d只累积整数点积,最后才乘ds8f.x(激活块 scaled8)与sc[i](子块 scale)。sumf_m则不依赖权重值,只用ds8f.y(激活块的和s = d·Σq)与子块 minm[i]。这是上一篇已经讲过的「预计算 sum、让零点修正只剩一次乘减」在 K 系格式上的推广:每个子块的偏移项变成了一个「激活和 × 子块 min」的纯标量累加。
Q6_K:子块尺度与 q8_1 块长错位,用 int2 同时累积
Q6_K 的 vec_dot 与 Q4_K 结构相同,但有两处细节不同:
const int8_t * sc = ((const int8_t *) &x_sc[i * (MMQ_TILE_NE_K/8) + i/8 + k0/16]);
sum[...] += vec_dot_q6_K_q8_1_impl_mmq( &x_qs[i*(QR6_K*MMQ_TILE_NE_K + 1) + k0], &y_qs[j*MMQ_TILE_Y_K + k01], sc, x_df[i*(MMQ_TILE_NE_K/QI6_K) + i/QI6_K], &y_df[j*MMQ_TILE_Y_K + k01/QI8_1]);sc是int8_t:Q6_K 的子块 scale 是带符号的 8 位值(d·sc可能为负),不是 Q4_K 那种 6 位打包;- 一个子块 16 个元素,一个
q8_1块 32 个元素:QK_K/QK6_K = 16与QK8_1 = 32相差两倍,所以两个 Q6_K 子块共享同一个激活块 scale。vec_dot_q6_K_q8_1_impl_mmq里用int2同时累积两组:
int2 sumi_d = {0, 0}; // 2 q6_K scales per q8_1 scalefor (int i = i0; i < i0 + 2; ++i) { sumi_d.x = ggml_cuda_dp4a(v[2*i+0], u[2*i+0], sumi_d.x); sumi_d.x = ggml_cuda_dp4a(v[2*i+1], u[2*i+1], sumi_d.x); sumi_d.y = ggml_cuda_dp4a(v[2*i+4], u[2*i+4], sumi_d.y); sumi_d.y = ggml_cuda_dp4a(v[2*i+5], u[2*i+5], sumi_d.y);}sumf_d += d8[i0/4] * (sc_reg[i0/2+0]*sumi_d.x + sc_reg[i0/2+1]*sumi_d.y);return d6 * sumf_d;一次循环里四个 dp4a 把两个子块的点积分别累积在 .x 与 .y,最后乘上各自的 int8 scale。把「两个子块共享一次激活缩放」这一步放进实现内部,是为了让外层循环的步长与 q8_1 块对齐,避免在内层再按子块做除法。
MMA 路径:同一份共享内存、不同的数据布局
从 Turing 架构起,MMQ 可以走一条用 Tensor Core 的内积路径。ggml_cuda_mmq_get_vec_dot 根据 use_mma_data_layout() 返回不同的函数;对于某些量化类型(例如 Q6_K),dp4a 与 MMA 两版 vec_dot 并存:
template <ggml_type type, int J, bool fallback>static __device__ __forceinline__ void ggml_cuda_mmq_vec_dot_q6_K_q8_1_dp4a(...);template <ggml_type type, int J, bool fallback>static __device__ __forceinline__ void ggml_cuda_mmq_vec_dot_q6_K_q8_1_mma(...);MMA 路径里 K 方向的数据布局改成 tile<16, 4, int, layout> 的碎片,加载函数按 sram_stride 的步长写入,vec_dot 再用 mma 指令一次算一小块。关键点是两条路径共用同一套 I/J/K 分块骨架和同一张配置表:配置表里的 nthreads、I、J、K_vram 不区分 dp4a/MMA,只是内积函数不同。这正是上一章末尾说的「配置表是一张逐架构、逐类型调出来的经验表」——表里的 sram_layout 字段就是在告诉内核「这个量化类型在当前架构上走哪条布局」。
工作重分配:当 tile 填不满 SM
朴素切法的负载缺口
标准的 GEMM 分块是「一个 block 算一个输出 tile、这个 block 把整个 K 方向从头扫到尾」。当输出 tile 的总数 ntiles_dst 恰好是 SM 数的整数倍时,这种切法很完美——每一轮 SM 都被占满、没有尾巴。但 llama.cpp 的实际形状经常不巧:7B 模型的一个线性层可能有几百个 tile,而 GPU 只有 108 个 SM(A100)或 132 个(H100),最后一轮只有部分 SM 在工作。
launch_mul_mat_q 里用一个百分数把这个浪费量化出来:
const int64_t tiles_nwaves = (ntiles + nsm - 1) / nsm;const int64_t tiles_efficiency_percent = 100 * ntiles / (nsm*tiles_nwaves);should_use_mmq 的完整判据本身就是一张小型的「硬件 × 类型 × 形状」决策表,值得把它从头读一遍,因为它决定了后文所有分块设计什么时候才会被启用:
- 类型支持:只有
mmq.cu里DECL_MMQ_CASE列出的类型(Q1_0 到 Q8_K、IQ 系、MXFP4/NVFP4)才有内核实例,其余类型直接返回 false; - 48 KiB 共享内存门槛:
if (smpbo < 48 * 1024) return false;——MMQ 的 tile 至少要 48 KiB 动态共享内存,老卡不够就直接退回 BLAS; - Turing 及以上:
if (turing_mma_available(cc)) return true;——有 Tensor Core 的卡无条件走 MMQ(走 MMA 布局); - 无 dp4a 的老卡:只有 Pascal 及以上、且
n_experts > 0(MoE)时才走 MMQ,注释写明「for MoE, mmq is faster even without native dp4a」; - NVIDIA:
return !fp16_mma_hardware_available(cc) || ne11 < MMQ_DP4A_MAX_BATCH_SIZE;——没有 FP16 Tensor Core 的老卡无条件可用;有则只在批量 < 64 时走 dp4a 版 MMQ; - AMD CDNA(MFMA):CDNA3 因 hipBLASLt 崩溃一律走 MMQ;
n_experts > 64 || ne11 <= 128也走 MMQ;再按量化类型与ne11分档(如ne11 <= 256的 Q4_K/Q5_K); - AMD WMMA:RDNA3 上
n_experts >= 64一律走 MMQ(注释说明高频专家数下 cuBLAS/hipBLAS 路径的同步开销太大),否则按类型分档(Q6_K 在 RDNA3.0 上ne11 <= 128、RDNA3.5 上<= 256);RDNA4 无条件为真。
每一行阈值都能在注释里找到一条 PR 链接或实测说明。这张判据表和 mmq-config-*.cuh 里的 tile 配置表合在一起,才是 MMQ 真正的「参数」——内核代码本身反而是最稳定的部分。
tiles_nwaves 是「至少需要几轮才能扫完」,tiles_efficiency_percent 是「理想工作量 / 实际安排的工作量」,上限 100。例如 ntiles = 100、nsm = 108 时 tiles_nwaves = 1、效率 92%;ntiles = 120、nsm = 108 时 tiles_nwaves = 2、效率 55%——第二轮只有 12 个 SM 在干活。这个 55% 就是应该改用 stream-K 的信号。
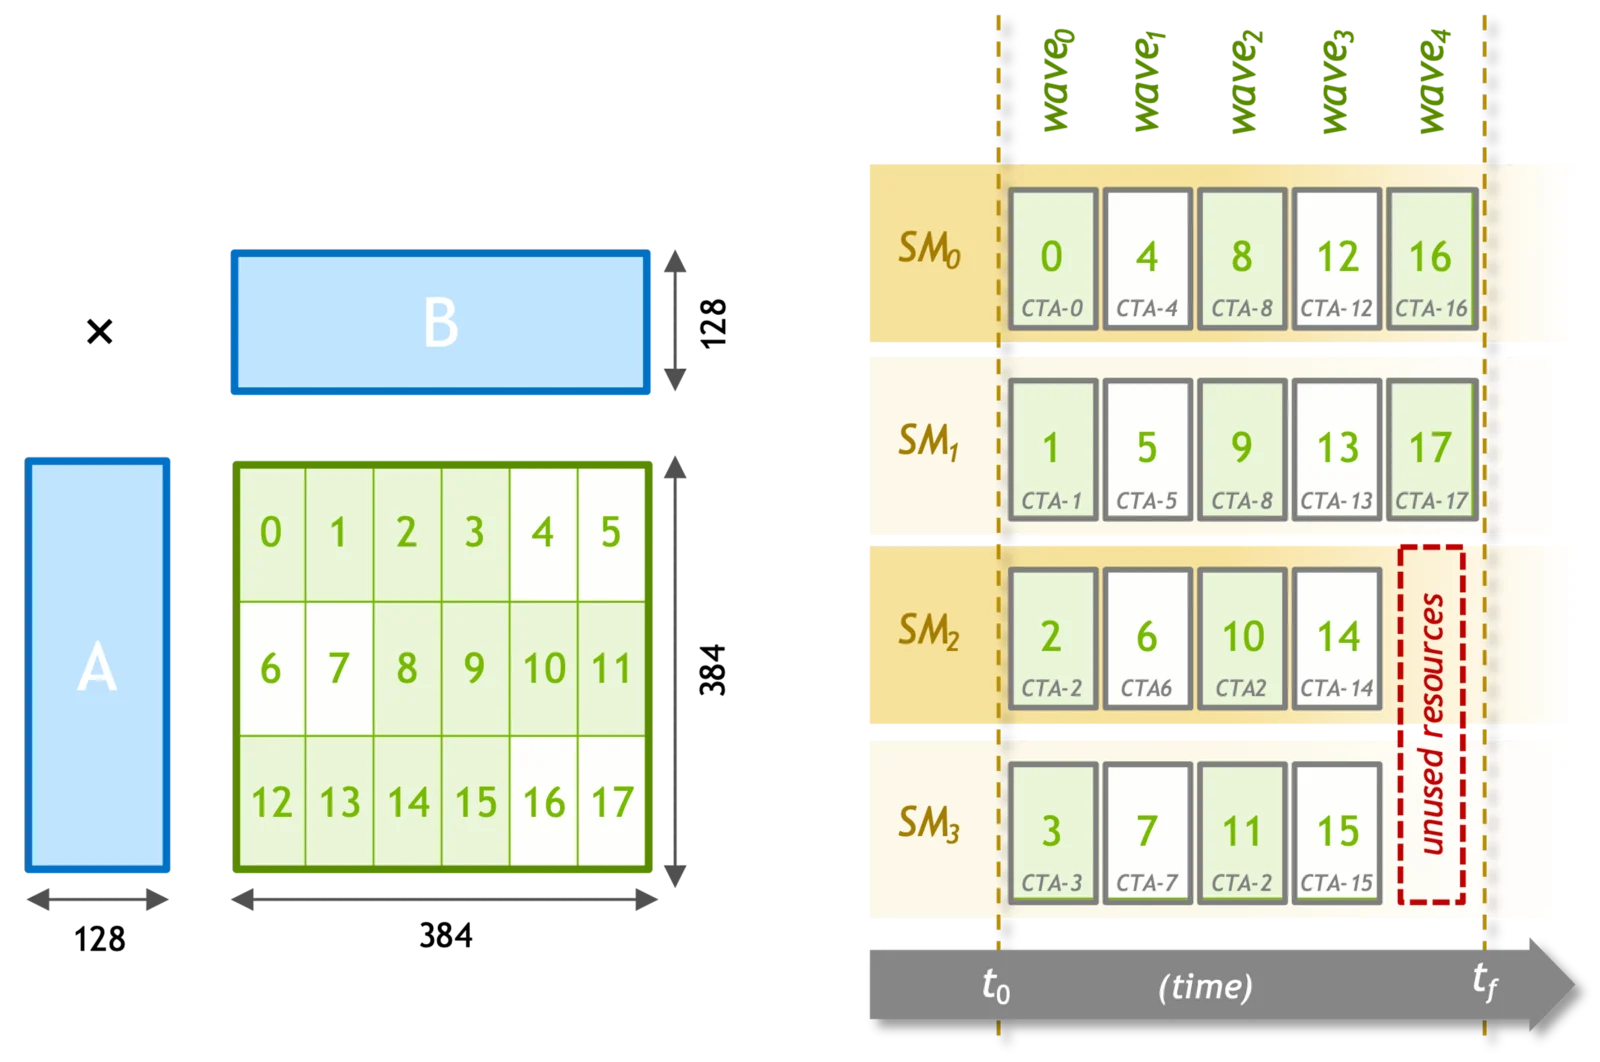
图 1:Stream-K 论文中「数据并行分解」的执行示意:18 个 CTA、每个 CTA 负责 128×64×128 的工作量、利用率上限 90%。可以看到每一轮都受最慢 CTA 约束,尾部出现明显的空转。MMQ 里 tiles_efficiency_percent 量的就是这种空转比例。
stream-K 的切法:把 K 切给多个 block
stream-K 的思路来自 CUTLASS,论文是 Stream-K: Work-Centric Parallel Decomposition for Dense Matrix-Matrix Multiplication(2023 年)。mmq.cuh 在 mul_mat_q 的内积循环前面有一行注释直接引用了这篇论文。
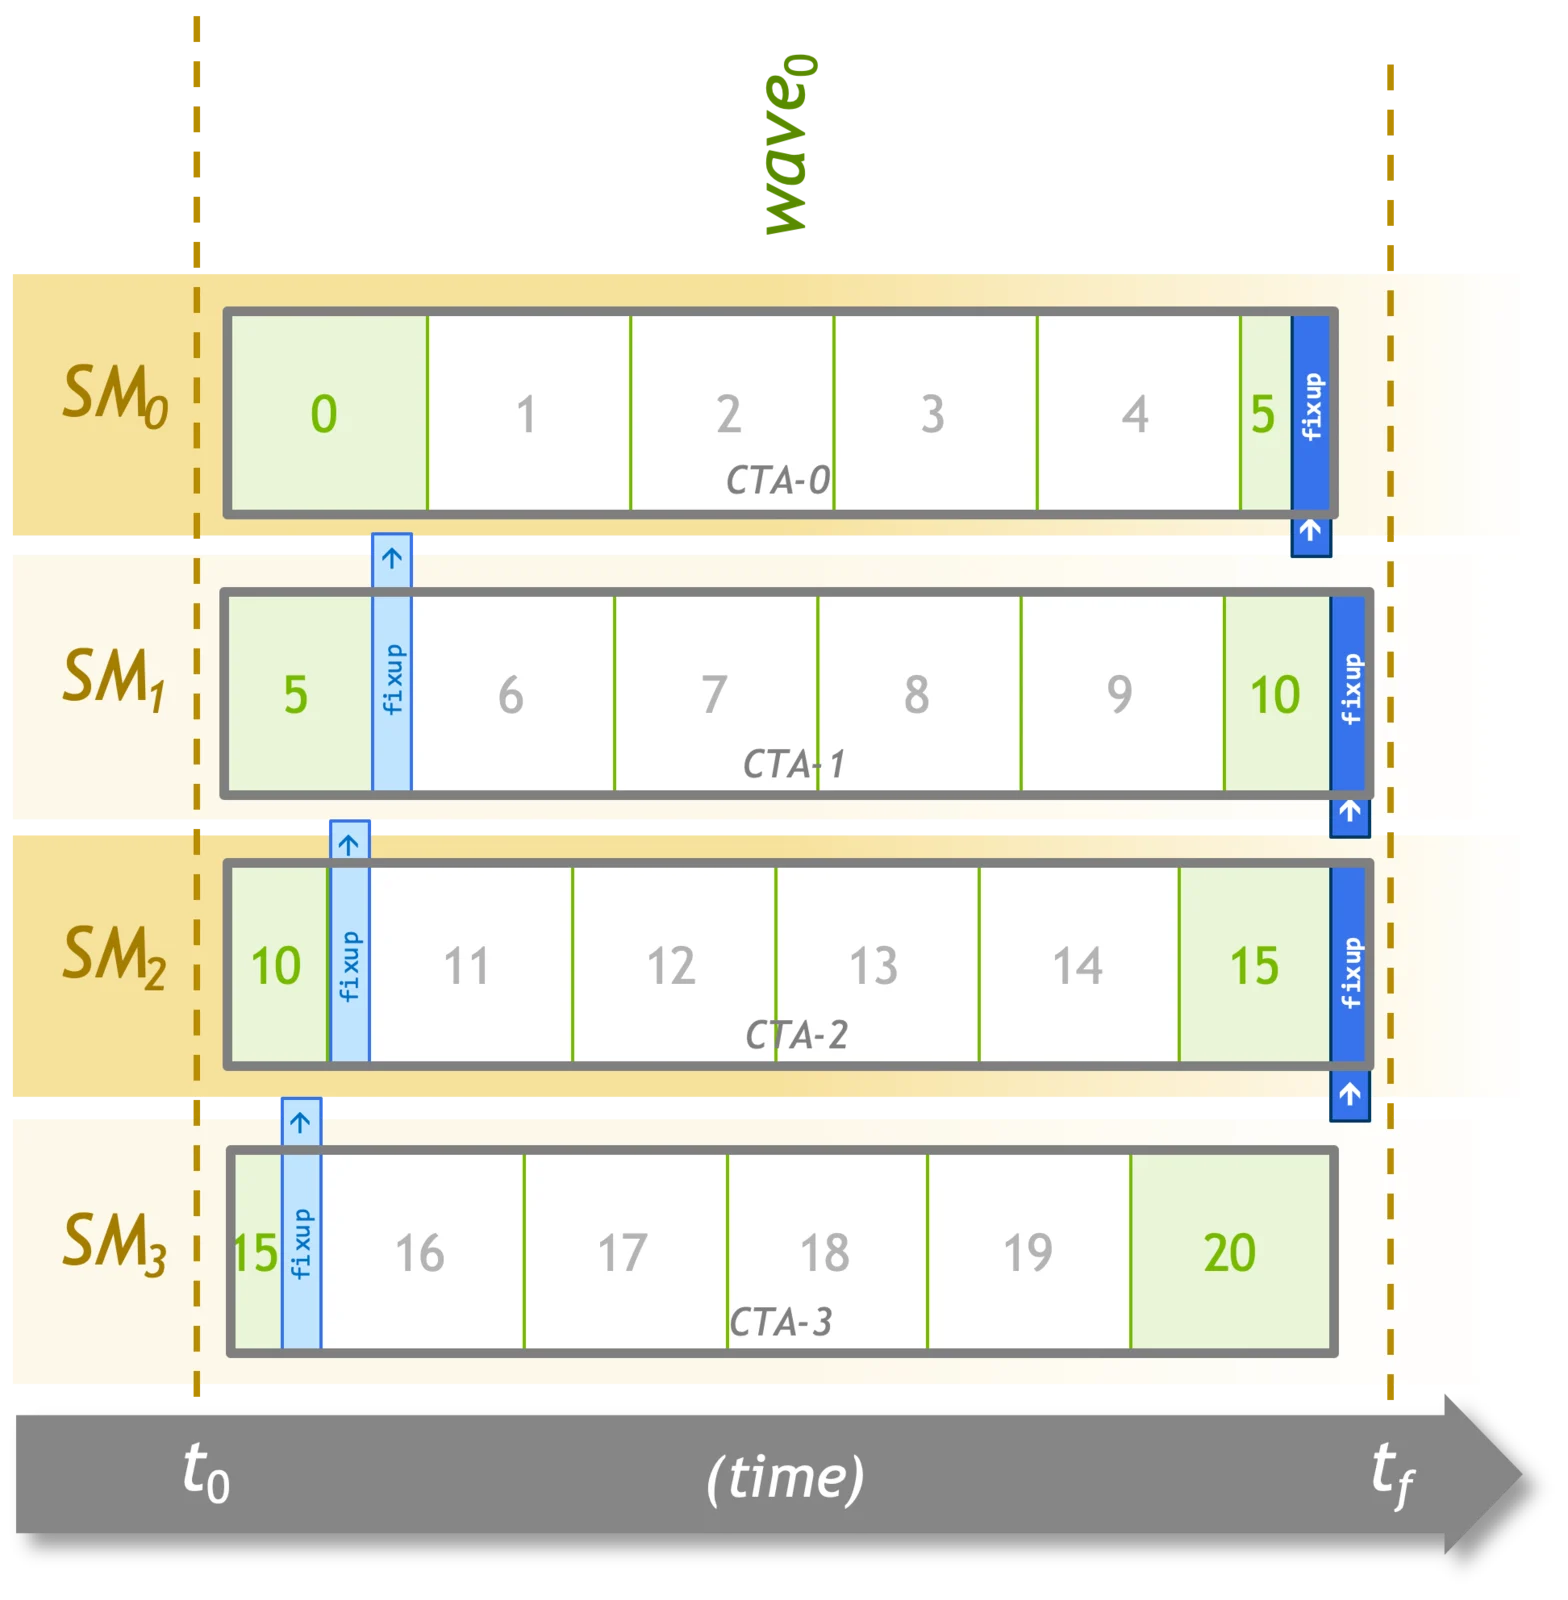
图 2:来自 Stream-K 论文(arXiv:2301.03598)的分解示意。(a) 是 Basic Stream-K,(b) 是「数据并行 + 一个 tile 的 stream-K」——把绝大多数输出 tile 分配给一个 CTA,只让最后一个 tile 由多个 CTA 按 K 协作,以同时拿到数据并行的低通信与 stream-K 的负载均衡。MMQ 的 kbc/gridDim.x 均分属于更一般的「工作中心」形态。
朴素切法的问题在于「K 是 block 私有的」。stream-K 把 K 方向的所有迭代视为一条连续的「工作流」kbc,再按 block 数把它均分:
constexpr int ITER_K = ggml_cuda_mmq_get_K_vram(type, J, fallback, prec_src1);constexpr int blocks_per_iter = ITER_K / qk;
int kbc = int64_t(blockIdx.x) *(nsamples_y.z*nchannels_y.z*ntx.z*nty*blocks_per_ne00.z) / gridDim.x;int kbc_stop = int64_t(blockIdx.x + 1)*(nsamples_y.z*nchannels_y.z*ntx.z*nty*blocks_per_ne00.z) / gridDim.x;
kbc -= fastmodulo(kbc, blocks_per_ne00) % blocks_per_iter;kbc_stop -= fastmodulo(kbc_stop, blocks_per_ne00) % blocks_per_iter;逐行解释:
kbc是「连续的 ijk 空间」里的索引,把 (i tile, j tile, k tile) 压扁成一维。第blockIdx.x个 block 负责[kbc, kbc_stop)这一段;kbc -= fastmodulo(kbc, blocks_per_ne00) % blocks_per_iter把起点对齐到blocks_per_iter的整数倍。blocks_per_ne00.z是 K 方向的总块数,对齐之后 block 不会从某个 tile 的 K 中途开始算——一个 block 可以跨 tile,但不能从 tile 中间开始;kb0_start、kb0_stop在循环体里重新算出来,表示当前输出 tile 内要负责的 K 段;循环条件是while (kbc < kbc_stop && kb0_stop == blocks_per_ne00.z),只有当当前 tile 的 K 段完整时才继续,否则留给下一个 block。
循环体每轮开头有一个「解压」:把连续的 kbc 还原成 (it, wt, zt, jt) 四元组,再用它算出 offset_y、offset_dst、offset_x。所以 stream-K 下,同一个输出 tile 可能被多个 block 分别累加一部分 K,这些 block 各自持有 sum[] 的一段部分和。
fixup:部分和的归约
比 stream-K 更朴素的折中是「固定切分」(fixed-split):把一个输出 tile 沿 K 切成 s 段,由 s 个 CTA 各算一段、再归约。Stream-K 论文用 s=2 的版本说明了它的代价:部分和归约本身要额外的读写与同步。
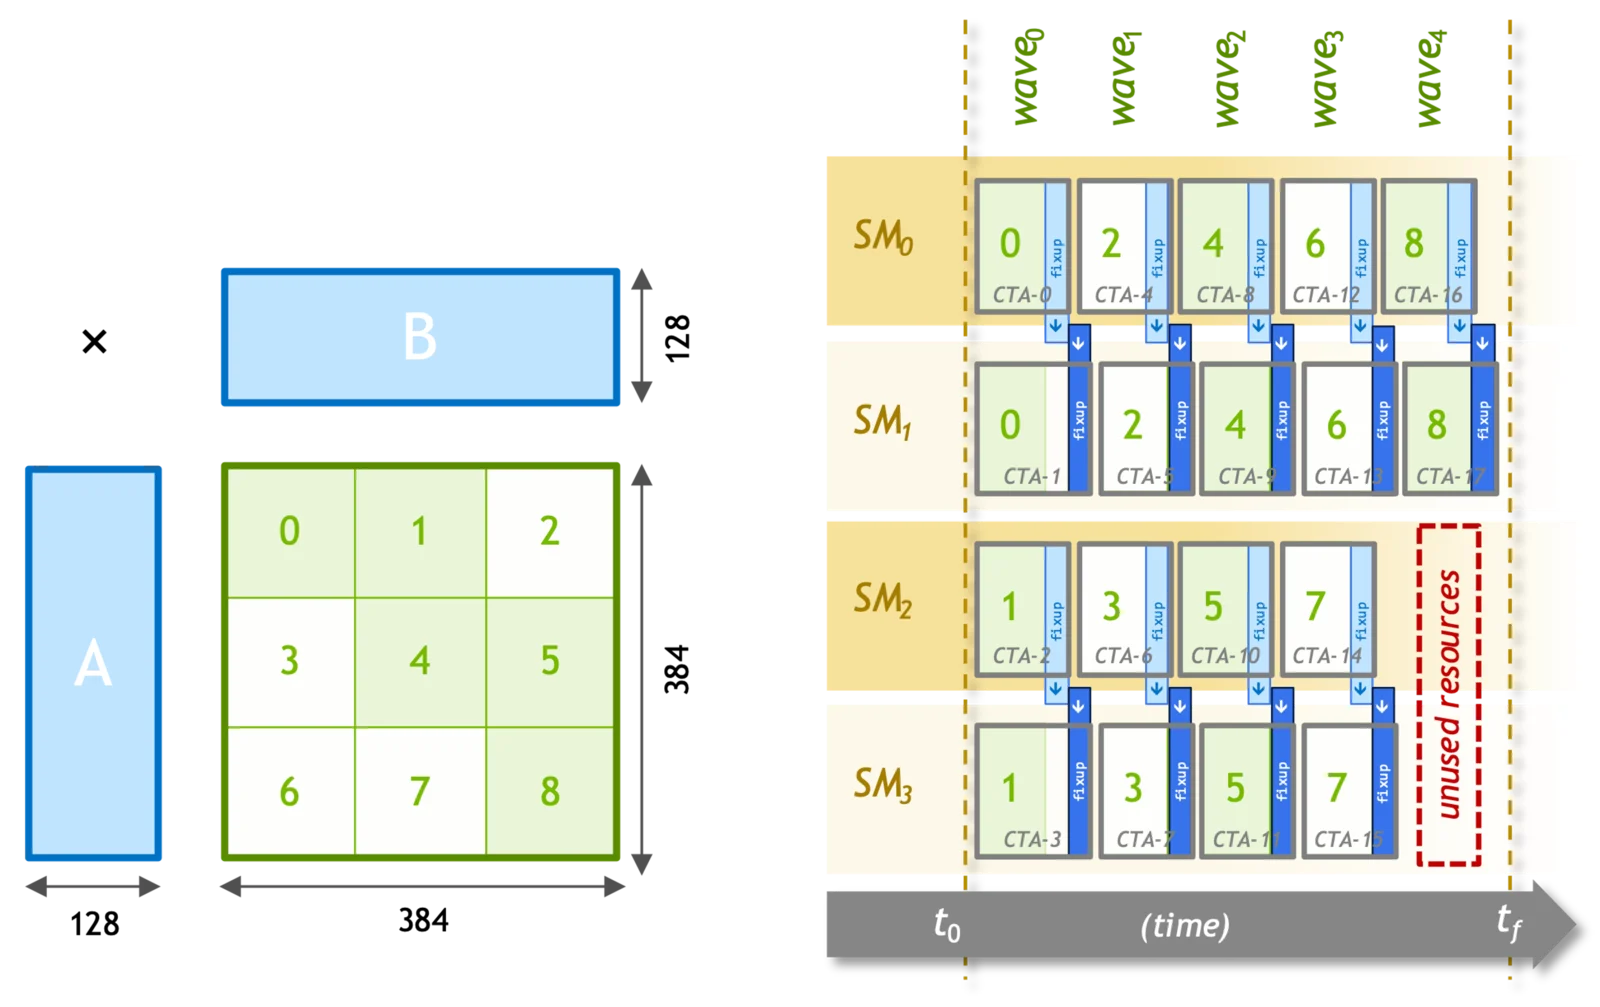
图 3:固定切分(splitting factor s=2)的示意:18 个 CTA、每个 CTA 的工作量为 128×128×64。相比 stream-K,固定切分的切点是静态的,归约路径也更简单,但当 K 本身不长时,每个 CTA 分到的工作量不足以摊薄归约成本。
部分和需要归约。kernel 末尾:
constexpr bool fixup = true; // 最后一个 K 段的块写入 fixup 缓冲,避免与其他 block 的数据竞争mul_mat_q_process_tile<type, J, fallback, fixup, prec_src1, false> (x, x_gate, offset_x, y + offset_y, ids_dst_shared, dst + offset_dst, tmp_fixup, ...);fixup = true 时,write_back 把结果写到 tmp_fixup + blockIdx.x*(J*I) 而不是 dst——按 block 独立的缓冲区,每个 block 一个 J*I 的槽位。然后 mul_mat_q_stream_k_fixup 这个归约 kernel 把所有部分和加回去:
bool any_fixup = false;// 遍历之前的 block,把它们的部分和加到 dst 上fixup 的 grid 是 (block_nums_stream_k.x, config.I/warp_size, 1),block 尺寸的 y 维度减半(block_dims.y/2)。它和主 kernel 一一对应:主 kernel 每个 block 的部分和都写到自己槽位,fixup kernel 用自己的 block 索引去找那几个槽位。
stream-K 的代码里还有一层细节值得指出:中间段的 block 在 fixup = false 时写的是 dst 而不是 fixup 缓冲。所以一个 tile 被多个 block 计算时,除了最后一小段,其他 block 都直接累加进 dst,而累加需要保证不冲突——mul_mat_q_process_tile 的 fixup = false 分支在 K 循环里不写、写完整个 sum 才写一次。这就是为什么要「起点对齐到 blocks_per_iter」:不同 block 写的区域不重叠,因此中间段之间无需同步。
什么时候不用 stream-K
launch_mul_mat_q 末尾的决策只有一行:
const int nwork = ntiles_dst * ((args.ncols_x + config.K_vram - 1) / config.K_vram);const dim3 block_nums_stream_k(GGML_CUDA_CC_IS_NVIDIA(cc) && tiles_efficiency_percent >= 90 ? ntiles_dst : std::min(nsm, nwork), 1, 1);const bool fixup_needed = ntiles_dst % block_nums_stream_k.x != 0;nwork是「最多有多少个 block 有事可做」:每个输出 tile 的 K 方向至少被切成ceil(ncols_x/K_vram)段,每段要一个 block 才能分摊;- NVIDIA 架构且 tile 效率 ≥ 90%:直接用「每 tile 一个 block」的朴素切法(
block_nums = ntiles_dst),跳过 fixup kernel; - 否则:用
min(nsm, nwork)个 block 走 stream-K。上限取nsm是因为 block 数超过 SM 数没有意义(同一时刻只能有nsm个 block 在位,多出来的会被排队);下限取nwork是因为每个 block 至少要有一段可以完整算的 K(起点对齐要求); fixup_needed:ntiles_dst % block_nums != 0时说明至少有一个 tile 被多个 block 分摊,就需要 fixup kernel。
这里的关键判据是 90% 效率。90% 意味着损失的工作量在 10% 以内;只要换到 stream-K 就能救回来,代价是一个 fixup kernel 的启动和一次跨 block 的读写。launch_mul_mat_q 的注释直接写明这个取舍:只有当 tile 效率高、fixup 的开销比重分配带来的收益更大时,才跳过 fixup。这是一个以「省一次 kernel 启动」换来的经验阈值,和 MMQ_DP4A_MAX_BATCH_SIZE = 64 一样,是实测出来的。
分专家矩阵乘:MoE 下的 MMQ
派发路径
MoE 层的矩阵乘在 ggml 里是 GGML_OP_MUL_MAT_ID,权重是三维张量 [n_embd, n_ff, n_expert],第二个输入是路由结果 ids(形状 [n_expert_used, n_tokens])。ggml_cuda_mul_mat_id 的派发逻辑比稠密版本多一层「按批大小分档」:
if (ne2 <= MMVQ_MAX_BATCH_SIZE) { if (ggml_is_quantized(src0->type)) { const int mmvq_mmid_max = get_mmvq_mmid_max_batch(src0->type, cc); if (ne2 <= mmvq_mmid_max) { ggml_cuda_mul_mat_vec_q(ctx, src0, src1, ids, dst); return; } } else if (GGML_CUDA_CC_IS_AMD(cc)) { ggml_cuda_mul_mat_vec_f(ctx, src0, src1, ids, dst); return; }}
if (ggml_cuda_should_use_mmq(src0->type, cc, ne12, /*n_experts=*/ne02)) { ggml_cuda_mul_mat_q(ctx, src0, src1, ids, dst); return;}ne2 是 token 数(dst->ne[2]),ne12 是 src1->ne[2](token 数),ne02 是专家数。注意这里传给 should_use_mmq 的 n_experts = ne02——同一次调用,稠密路径传 0,ID 路径传真正的专家数。这正是开头提到的「按单次 GEMM 的列数」判据在 MoE 上的落实:512 个 token 分给 64 个专家,每个专家平均 8 列,should_use_mmq 会据此判定「不该走 MMQ」,回到 MMVQ 路径。
但 mul_mat_vec_q 的签名里有 ids 参数,说明 MMVQ 本身也支持 mul_mat_id。mmvq.cu 里专门有一条 MoE 多 token 内核,注释是「Block: (warp_size, ncols_dst) - each warp handles one token independently」:一个 block 的每个 y 维 warp 处理一个 token,按 ids[channel_dst + token_idx * ids_stride] 取出它要用的专家权重,没有任何跨 token 的权重复用;MMQ 的 ID 模式则把同一个专家处理的所有 token 拼在一起做成 tile,权重 tile 被这些列共用。
专家边界:在 GPU 上做分段,而不是在 host 上
MMQ 的 ID 模式不需要 host 读回任何东西。mul_mat_q 的 kernel 参数里有:
const int32_t * __restrict__ ids_dst, const int32_t * __restrict__ expert_boundsexpert_bounds 是每个专家的 token 在排序后数组里的起止下标。当 ids_dst 非空时,每个 block 在开始计算前先算出自己所属专家的 token 范围:
if (ids_dst) { col_low = expert_bounds[zt + 0]; col_high = expert_bounds[zt + 1]; col_diff = col_high - col_low; if (jt*J >= col_diff) return; // 该 tile 的列全部在本专家范围之外 for (int j0 = 0; j0 < J; j0 += nwarps*warp_size) { int j = j0 + threadIdx.y*warp_size + threadIdx.x; if (j0 + nwarps*warp_size > J && j >= J) break; ids_dst_shared[j] = ids_dst[col_low + jt*J + j]; } __syncthreads();}这条分支做了几件事:
zt是 blockIdx.z,对应一个专家(nchannels_y的第 z 维等于专家数),所以每个 block 天然只关心一个专家的权重切片;col_low、col_high是排序后token数组里这个专家的范围。jt*J >= col_diff时整个 tile 落在范围外,直接return——这是 MMQ ID 模式下最便宜的「空 tile 跳过」;ids_dst_shared被写成「本 tile 每一列对应原始 token 的下标」,写回时dst[ids_dst_shared[j]*stride + i]就能把排序后的列还原到原始 token 位置。kernel 开头默认填的是ids_dst_shared[j] = j(恒等映射),ID 模式下才覆盖成真实映射;offset_y被重置为 0,因为expert_bounds已经把偏移加进了ids数组本身——激活 tile 在这个专家的 token 段里从头开始读。
这也是为什么 ggml_cuda_mul_mat_id 里 src1_slice 的 ne[1] 是 tokens_per_expert[i02]:每个专家的 GEMM 是单独切出来算的,而不是让 kernel 在一个大数组里跳着读。这个设计有个直接的性能后果:每个专家都是一个独立的小 GEMM,列数可能远小于 J,于是绝大多数 tile 会在 jt*J >= col_diff 处返回。
「分专家」与「整批」之间:host 侧的代价
ggml_cuda_mul_mat_id 里还有一条兜底分支——当 MMVQ、MMQ、MMF 三条路径都接不下来时,host 需要把每个专家的 token 段原地切开再分别调用:
ggml_cuda_mul_mat(ctx, &src0_slice, &src1_slice, &dst_slice);...src1_data_cur += src1_slice.nb[2];这条路径在 ggml_cuda_mul_mat_id_needs_sync 返回 true 时才会走:函数先把 src1/dst 不是 F32、或者批量大到 MMVQ 接不下、MMQ 与 MMF 也都不适用的情形逐一排除,剩下的才落到这里。更麻烦的是它需要 host 侧的同步——ids 要读回 CPU、按专家切开激活、再逐个发起 kernel,所以注释特意标注「记录 CUDA Graph 时不应走到这条路径」。对量化权重、常见批量,ggml_cuda_mul_mat_q 的 ID 模式接管一切,host 不参与。
所以 llama.cpp 的 MoE 高效路径的完整链条是:
- 图里:
build_moe_ffn→ 路由 → Top-K →mul_mat_id(三个GGML_OP_MUL_MAT_ID,对应 gate/up/down); - 派发层:
ggml_cuda_mul_mat_id按ne2与should_use_mmq选定 MMVQ / MMQ / MMF; - MMQ 内部:blockIdx.z 对应专家,
expert_bounds切出每个专家的 token 段,ids_dst_shared记录还原映射; - 写回:
dst[ids_dst[j]*stride + i],把每个专家的输出写回排序前的位置。
四步里没有一步需要 host 读回 ids,这就是上一篇文章里说的 MoE 拷贝回调可以「只看 split 的第一个节点是不是 MUL_MAT_ID」的前提——ids 完全在 GPU 上消费。
MoE 的二次账:为什么小专家会拖慢整个 batch
上面那条流程里有一个不容易看出来的性能问题:每个专家都是一个独立的 GEMM,而独立 GEMM 的 tile 数会随专家数增多而变碎。一个 64 专家、每专家 8 个 token 的 MoE 层,每个专家的激活列数是 8,J 会被选成 8 或更小,tile 数在列方向是 1,行方向是 nrows_x/I 个 tile。每个专家可能只有十几个 tile——对于 132 个 SM 来说,每个专家自己的 tile 数都填不满 GPU。
这正是 stream-K 存在的另一个理由:nwork = ntiles_dst * ceil(K/K_vram),在 ID 模式下 ntiles_dst 是所有专家的 tile 之和,而实际调度是 blockIdx.z 维度让所有专家并行——不同专家之间本来就天然并行,所以专家数越多,总 tile 数越大,越容易填满 SM。真正的风险是专家负载不均衡:路由结果里热门专家可能拿到几百个 token、冷门专家只有一两个。热门专家自己的 GEMM 需要多轮扫描,而冷门专家的 tile 早已返回,SM 只能等最慢的那个专家。
llama.cpp 应对这件事的手段在两端:
- 专家排序(
ids按专家排序)让每个专家的 token 段连续,便于「连续段合并」; - MMQ 的 ID 模式下,每个专家依然走完整的 J 选择与 stream-K 判定,只是
ncols变成该专家的 token 数。这意味着若某个专家特别热,它自己的 GEMM 可能已经大到需要 stream-K,而冷专家走朴素 tile 切法。
还有一种 llama.cpp 特有的优化,把 MoE 的两层矩阵乘压成同一个 kernel:ggml_cuda_mul_mat_q_fusion。它识别出 mul_mat_id(gate, x) → mul_mat_id(up, x) → GLU 这个子图,把 gate 与 up 的权重 tile 一起加载、一起内积、在内积结束后立即做 GLU 激活。mul_mat_q_process_tile 的 has_fusion 模板参数与 x_gate 参数就是为它准备的:I_dst = has_fusion ? I/2 : I,一个 block 同时算 I/2 行 up 与 I/2 行 gate,然后在 write_back 里调用 ggml_cuda_op_glu_single(glu_op, sum[...+ne/2], sum[...], glu_limit)。
Fusion 的判据里有一条注释值得单独摘出来:
// The fused kernel needs the whole K range of a tile in one block, so it always uses tiling.也就是说 fusion 与 stream-K 互斥:fused kernel 不能用 stream-K 分解,因为它要在同一个 block 里同时持有 up 与 gate 的完整结果才能做 GLU。于是 ggml_cuda_mul_mat_q_fusion_is_efficient 必须在启用 fusion 前先确认「朴素切法的 tile 效率足够高」。这是一个连锁的设计取舍:越激进的重排越依赖形状规整。
输出端:写回与 scale 修正
MMA 路径的写回比 dp4a 多一层布局换算。dp4a 路径的 sum 是「每线程几个格」的平铺数组,写回时直接 dst[ids_dst[j]*stride + i] = sum[...];而 MMA 路径的 sum 是按 tile<16, 8, int> 的 C 碎片(fragment)存放的,ggml_cuda_mmq_write_back_mma 要先用 tile_C 的布局约定把碎片还原成 (i, j) 坐标,再按 rows_per_warp 与 ntx 算出每个 warp 该写哪一段行。这也是为什么配置表里要为 MMA 单独记录 occupancy——寄存器压力不同、warp 数不同,碎片到行段的映射也就不同。
还有一个容易忽略的点:ggml_cuda_mmq_fusion_supported 只覆盖 Q4_K、Q5_K、Q6_K、Q8_0、IQ4_XS 五种类型,且 fusion 的 tile 是「up 行与 gate 行按 GGML_CUDA_MMQ_FUSION_ROWS = 8 交错」存放的——ggml_cuda_mmq_x_row 在 has_fusion 时按 (i / 8) % 2 在 x 与 x_gate 之间切换,并按 (i/(2*8))*8 + i%8 重算行号。交错的原因在 write_back_mma 的注释里:一个 MMA tile 里行 r 与 r+8 由同一个线程持有,把 up 与 gate 按 8 行交错,就能让同一个线程同时拿到一个输出元素的 up 值与 gate 值,直接算 GLU。
write_back 是 ggml_cuda_mmq_write_back_* 函数族,做的事是把 sum[] 里的累加结果转换成 dst 的值。对 dp4a 路径,通常只需要 dst[...] = sum[...];对 MMA 路径,要考虑布局转换(register fragment 到行主序);对 FP4 路径,要考虑 y_scale(per-token 缩放)的乘法:
if constexpr (type == GGML_TYPE_NVFP4) { if (y_scale_used) { dst[ids_dst[j]*stride + i] = y_scale[j] * sum[...]; } else { dst[ids_dst[j]*stride + i] = sum[...]; }}y_scale[j] 是每个 token 的缩放,在 ggml_cuda_mul_mat_q 里通过 src1_scale.alloc(ne13*ne12*ne11) 单独开一块显存。这是 FP4 路径的特殊之处:FP4 的动态范围太窄,必须靠 per-token scale 兜底,不能像 Q8_1 那样把缩放都折进块结构。write_back 里那个 if constexpr (type == ...) 意味着每个量化类型有自己的一份写回实现,但共享同一个「先算 IDs 再写」的外层逻辑。
还有一点容易被忽略:sum[] 的累加是浮点累加。尽管内积是整数 dp4a,但 sumi_d 在 sumf_d += ds8f.x*(sc[i]*sumi_d) 之后变成一个 float。所以 MMQ 的数值误差来源分两类:一类是整型内积的精确累积(无误差),另一类是 scale 乘法与最后的 dm4f.x*sumf_d − dm4f.y*sumf_m 的浮点误差。前者的精度由 q8_1 的 8 位决定,后者的精度由 float 决定。这也解释了为什么 llama.cpp 敢在批量场景直接用 FP32 累加:K 方向的块数是几十到几百,float 累加在这种量级下误差可以接受,而真正的精度问题集中在激活被压成 8 位这一步。
与 MMVQ 的边界:分水岭在哪、为什么在这里
现在可以把 MMVQ 与 MMQ 的关系收拢成一张表:
| 维度 | MMVQ(mul_mat_vec_q) | MMQ(mul_mat_q) |
|---|---|---|
| 激活形状 | 1 列到 MMVQ_MAX_BATCH_SIZE 列 | 多列,通常 J 覆盖到 128 |
| 权重复用 | 每个 warp 读一遍即丢 | 权重 tile 载入共享内存,被 J 列复用 |
| 主要瓶颈 | 显存带宽 | 算力与共享内存带宽 |
| 内积分派 | 以 dp4a 为主,少数走 MMA | dp4a 与 MMA 两条完整路径 |
| 工作划分 | 每 warp 扫描输出行 | (I, J, K) 三维 tile + stream-K |
| MoE 处理 | 每个 (token, 专家) 对独立计算 | 每个专家一个 GEMM,专家并行 |
| 典型场景 | decode | prefill、混批、MoE 的 gate/up |
MMQ_DP4A_MAX_BATCH_SIZE = 64 与 MMVQ_MAX_BATCH_SIZE 这两个常数,是这张表的「切换开关」。它们不是理论推导出来的,而是从这两条路径的实测交点附近选出来的:batch 很小时,MMQ 的 tile 里大部分列是空的,共享内存与同步开销反而拖慢;batch 大到数十列,tile 被填满,MMQ 的复用优势开始显现。注意判据里还有架构条件——只有支持 FP16 Tensor Core 的卡才把 MMQ 的可用批上限压到 64,老卡上 MMQ 无条件可用。这又回到了那张 mmq-config-*.cuh 表:每块 GPU 上「什么时候该切」的答案是不一样的。
局限与工程含义
MMQ 是一个成熟到「看起来非常常规」的 GEMM 内核,它的复杂度体现在三处:
- 配置表是手工的。
mmq-config-*.cuh里有几十到上百个条目,每个都是一次实测。更换一个量化类型或一块新 GPU,就意味着要重新做一次参数扫描。这正是「性能分界点来自 benchmark,不来自理论」的另一个例证。 - stream-K 与融合的冲突。fusion 需要完整的 K 段,stream-K 需要把 K 段切碎,两者不可兼得。于是
mul_mat_q_process_tile里有static_assert(!(fallback && has_fusion)),启动注释写着「The fused kernel needs the whole K range of a tile in one block, so it always uses tiling」。判据函数ggml_cuda_mul_mat_q_fusion_is_efficient必须在启用 fusion 前先确认朴素切法的 tile 效率足够高,否则融合带来的收益会被尾部空转吃掉。 - MoE 的专家粒度决定了它无法真正「编队」。MMQ 在稠密场景可以一次把整批 token 压成满 tile;MoE 下每个专家的 tile 都小,整个 layer 的吞吐是「很多个小 GEMM + 一次跨专家汇聚」的组合。这也是当今多数 MoE 服务框架倾向用
grouped GEMM或masked GEMM的原因——把各个专家的小 GEMM 合并成一次调度,是 llama.cpp 的mul_mat_id路径没走的那一步。
从工程角度看,llama.cpp 对 MoE 的取舍其实是清晰的:它优先保证「单机、单卡上多小模型都能跑」,而不是在数据中心规模上追求极限。mul_mat_id 的 ID 模式把 host 完全摘出去,保证了 -ngl 部分卸载与专家按需上传的组合可以工作;把 MMQ 的批量路径做成配置表驱动,保证了新量化类型与新 GPU 能低成本地接入。这两点对于边缘部署和本地推理来说比「峰值性能」更重要。
下一篇将回到 CPU 侧与打包格式的边界:从 GGUF 的块布局反推 Q4_K 为什么是 144 字节、6 位 scale 为什么这么排,以及这些布局是如何被 MMQ、MMVQ 与 get_rows 三个内核同时消费的——这是一条从文件格式一路走到指令集的长链路。
mul_mat_id 的第三条路:批量落在 MMVQ 与 MMQ 之间时
前面把 MoE 派发简化成了「MMVQ 或 MMQ」,但 ggml_cuda_mul_mat_id 的判定是一条三级阶梯:
if (ne2 <= MMVQ_MAX_BATCH_SIZE) { if (ggml_is_quantized(src0->type)) { const int mmvq_mmid_max = get_mmvq_mmid_max_batch(src0->type, cc); if (ne2 <= mmvq_mmid_max) { ggml_cuda_mul_mat_vec_q(ctx, src0, src1, ids, dst); return; } } else if (GGML_CUDA_CC_IS_AMD(cc)) { ggml_cuda_mul_mat_vec_f(ctx, src0, src1, ids, dst); return; }}
if (ggml_cuda_should_use_mmq(src0->type, cc, ne12, /*n_experts=*/ne02)) { ggml_cuda_mul_mat_q(ctx, src0, src1, ids, dst); return;}
if (ggml_cuda_should_use_mmf(...)) { ggml_cuda_mul_mat_f(ctx, src0, src1, ids, dst); return; }// 最后才落到 host 切段 + 同步的兜底路径第一段里的 get_mmvq_mmid_max_batch(type, cc) 是一个按量化类型与架构区分的 MoE 批量上限,而不是 should_use_mmvq 用的统一阈值。它把 MMVQ 的适用范围收窄到「这个类型在这张卡上实测跑得动的批量」,因此同一个 MoE 层在不同量化格式下会在不同批量点切换内核。
第二段 should_use_mmq(..., ne12, ne02) 的 ne11 参数传的是 src1->ne[2](全部 token 数),而不是 ne12/n_experts 的平均值。这与 J 的选择口径不同:派发阶段关心的是「整批工作有多少」,而 tile 选择关心的是「单专家列的宽度」。两个函数都对专家数敏感,但敏感的方式不同——一个用于判断「值得不值得换内核」,一个用于判断「tile 该多宽」。
还有一条常被忽略的隐式约束:ggml_cuda_mul_mat_id 一进入函数就断言了 src1->type == F32 && dst->type == F32,ggml_cuda_mul_mat_id_needs_sync 也把这两项 dtype 检查放在第一位。换句话说,只要某一层的激活被安排成非 F32,这条链就会跳过 MMVQ/MMQ、落到需要 host 同步的兜底路径;而兜底路径又明确不被 CUDA Graph 接受。llama.cpp 默认的量化推理路径让激活保持在 F32、只在 kernel 内部压到 q8_1,正是为了避免踩到这个分支。
一个具体形状走一遍:8K 预填的 gate/up
把前文所有环节串起来,看 Llama-2 7B 这类稠密模型(n_embd = 4096、n_ff = 11008、32 层)的 gate/up 层,一次 8K 预填充:
- 权重 Q4_K,每层 gate 与 up 各
4096 × 11008;mul_mat的ne11 = 8192; - 派发:
should_use_mmq在 Turing+ 上返回 true,ne11远超 MMVQ 的批量上限,走 MMQ; - J 选择:
ncols_opt = 8192,列方向需要 64 个 J=128 的 tile——J_best取 128,行方向11008 / 128 = 86个 tile,合计 5504 个 tile,远超 108 个 SM; - 块数:每 tile 一个 block,
ntiles_dst远大于nsm,tiles_efficiency_percent接近 100%,大概率不用 stream-K(只有最后一轮略有余数); - 每 block 的 K 循环:
K_vram取 256 的整数倍,ncols_x = 4096,blocks_per_iter = K_vram / 256,K 段数很少; - 若开启了 fusion,gate 与 up 会被压成一次
MUL_MAT加 GLU,block 的I行 tile 里一半读 up、一半读 gate,写回时直接做 SwiGLU。
再看 MoE 的另一端:64 专家的 8K 混合批,每 token top-2,ne12 = 8192。should_use_mmq 传来的 n_experts = 64,should_use_mmq 从 n_experts = 64 得知「每个专家平均只看到 8192 × 2 / 64 = 256 个 token」,于是 J 的选择在 NVIDIA 上仍按整批 ncols_opt = 8192 进行、在 RDNA3/4 上则按每专家的 256 进行;但每个专家的 GEMM 实际只有约 256 列,J=128 时每个专家只有两个列 tile。expert_bounds 在 GPU 上切出各专家的连续段,每个专家的 GEMM 是独立的 256 列形状,tile 数凑得够、负载却取决于路由分布——热门专家可能拿到 1000 个 token、冷门可能不到 10 个,后者几乎整块 tile 直接 return。
这一对形状说明了两件事:tile 切法在稠密预填里是「把大问题切得刚好」,在 MoE 里是「把许多小问题拼得刚好」;同一套内核,同一个 J 选择循环,因为输入不同,落在 GPU 上的效率曲线完全不同。
参考资料
- Stream-K: Work-centric Parallel Decomposition for Dense Matrix-Matrix Multiplication on the GPU — 2023,MMQ 的 stream-K 分解来源
- ggml-org/llama.cpp —
ggml/src/ggml-cuda/mmq.cu、mmq.cuh、mmq-load-tiles.cuh、mmq-vec-dot.cuh、vecdotq.cuh、ggml-cuda.cu - llama.cpp 源码完全拆解(七):后端与 Kernel——mmq、flash-attn 与 CPU 指令集特化如何把图跑成算力 — 派发判定树、
block_q8_1_mmq与 tile 配置表的入门讲解 - llama.cpp 源码完全拆解(十四):mul_mat_vec_q——解码时一条量化权重如何被 dp4a 逐块点积 — 解码路径上 MMVQ 的逐行实现,与本篇的 MMQ 形成对照
- llama.cpp 源码完全拆解(六):图构建与注意力——llama-graph 如何把模型结构翻译成 ggml 图 —
build_moe_ffn与MUL_MAT_ID在图里的生成方式
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



