


SGLang 源码完全拆解(十一):投机解码——草稿生成、批量验证与 token 接受如何接进同一条前向
接上一篇:采样之后,还有一条被跳过的路
系列第十篇把采样侧讲完了:SamplingBatchInfo 把每请求参数压成设备缓冲、Sampler 把 logits 变成 token、GrammarManager 与 xgrammar 位掩码把非法 token 打成 -inf。那一篇的视角建立在一条隐含前提上——每轮前向只产生一个 token。logits_output.next_token_logits 的形状是 [batch, vocab_size],每一行对应一个请求,采样器从每一行里挑出恰好一个 token,接着调度器把这个 token 追加到序列末尾,推进 seq_lens,进入下一轮。
这条路径从(三)到(十)贯穿整个系列,但它只是 SGLang 解码主循环的一半。另一半是:一轮前向能不能产生多个 token。这正是投机解码(speculative decoding)要回答的问题,也是本篇的主题。
回顾一下为什么单 token 解码是瓶颈。解码阶段每步前向的计算量是 量级的矩阵-向量乘法,算术强度极低——每读一个权重元素只做几次浮点运算,GPU 的算力单元大部分时间在等显存。这个瓶颈的定量分析在 GPU GEMM 优化完全拆解(一) 与 FlashAttention 完全拆解(一) 里都从不同角度拆过:解码的速度上限由显存带宽决定,而不是由 TFLOPS 决定。既然一轮前向的开销主要花在”把所有参数从显存搬进 SM”上,那么让这一轮多算几个 token 的边际成本远小于线性增长——多验证 4 个候选 token 的额外计算,摊在已经付过的权重装载成本上,几乎可以忽略。这就是投机解码的全部经济学。
站内已经拆过多篇投机解码工作:草稿模型的鼻祖路线有 EAGLE 完全拆解、EAGLE-2 与 EAGLE-3 三篇;不走草稿模型的有 Lookahead Decoding 完全拆解(Jacobi 迭代 + N-gram 池);扩散路线有 DFlash 与 DSpark;多头候选路线有 Medusa 完全拆解;vLLM 侧的工程落地有 vLLM 源码完全拆解(十):投机解码。这些文章讲的是算法与机制。本篇要讲的是第三层:这些机制在 SGLang 里怎么被组织成代码——草稿阶段的输入怎么构造、验证阶段的行怎么扩展、接受判定如何在设备上完成、接受之后 KV Cache 怎么写回、以及这一切如何与调度器、Attention Backend、CUDA Graph 三条已有主线咬合。
本篇仍以系列统一的源码坐标——提交 d88d5c3 为基准,路径以 python/sglang/srt/speculative/ 目录为中心。要回答的问题有五个:
SpeculativeAlgorithm这个枚举背后有多少种算法,它们共享什么接口、差异在哪里?- EAGLE 草稿阶段的那棵”树”是怎么从
score_list、token_list、parents_list这三张逐步累积的表里长出来的? - 树形 mask 如何被编译成 attention kernel 能吃的形状?
retrieve_index、retrieve_next_token、retrieve_next_sibling这三个张量为什么长得像 DFS 的邻接表? - 验证之后的接受判定:贪心请求与采样请求为什么走两条完全不同的路径?
accept_index和num_correct_drafts各自的语义边界在哪里? - 被接受的 token 如何把 KV 搬回 target 模型的缓存?被拒绝的部分如何清理?这条”回写”路径与(五)讲的 RadixCache 所有权、(六)讲的 overlap 在途批次如何共存?
spec_algorithm:一个枚举背后的算法家族
任何投机解码实现的第一层抽象都是”算法选择”。SGLang 的入口是 server_args.speculative_algorithm 字符串,它在启动时被翻译成 SpeculativeAlgorithm 枚举:
class SpeculativeAlgorithm(Enum): DFLASH = auto() UNO = auto() DSPARK = auto() EAGLE = auto() EAGLE3 = auto() FROZEN_KV_MTP = auto() STANDALONE = auto() NGRAM = auto() NONE = auto()这个枚举本身就是一张路线图。EAGLE 与 EAGLE3 分别对应 EAGLE 系草稿头的第一代与第三代实现(第二代的动态草稿树是运行策略,不是独立的 draft 网络结构,因此没有独立枚举);FROZEN_KV_MTP 对应”冻结的 KV + 多 token 预测”路线,典型场景是 DeepSeek 系模型的 MTP 层复用(站内 MTP 完全拆解 讲过 MTP 的机制,SGLang 把它接成了独立算法);NGRAM 是不训练草稿模型、直接用外部语料做 N-gram 匹配的路线(对应站的 Lookahead Decoding 是同类思想的不同实现);DFLASH、DSPARK、UNO 是较新的扩散系与统一系草稿算法;STANDALONE 表示”只有草稿模型、单独当小模型跑”的特殊模式;NONE 是关闭。
from_string 的解析逻辑值得看一眼,因为它暴露了插件机制:
@classmethoddef from_string(cls, name): if name is None: return cls.NONE upper = name.upper() try: return cls[upper] # 内置枚举优先 except KeyError: pass if upper in _RESERVED_ALIASES: return cls.EAGLE # 别名重定向 spec = _get_registered_spec(upper) # 插件注册表 if spec is not None: return spec raise ValueError(f"Unknown speculative algorithm name: {name}")三层查找:内置枚举、保留别名、外部注册。register 装饰器允许外部代码把自己的 worker 类挂进枚举体系,注册时需要声明两件事——supports_overlap(该算法能否在 overlap 调度下工作)与 validate_server_args(启动参数校验钩子)。这个设计回应了系列(六)留下的问题:overlap 调度要求前一轮的结果在下一轮调度前不需要立即读取,而投机解码的”验证结果决定下一轮草稿输入”,天然与 overlap 冲突,因此每个算法必须显式声明自己是否支持。
枚举的方法族把”算法能力”表达成布尔谓词,调用方靠这些谓词分支,而不是靠 isinstance 判断具体类:
| 谓词 | 语义 | 谁在用它 |
|---|---|---|
is_eagle() | EAGLE 系(含 EAGLE3、FROZEN_KV_MTP) | draft 阶段的通用准备路径 eagle_prepare_for_decode |
is_dflash_family() | DFLASH 或 DSPARK | 共享 dflash 前缀的分支 |
has_draft_kv() | 草稿模型是否持有自己的 KV | 显存池与 draft_runners 枚举 |
supports_grammar_overlap() | 与语法状态机能否在 overlap 下共存 | ScheduleBatch.grammar_needs_sync() |
need_topk() | 判定草稿是否需要 top-k 采样 | 草稿前向的采样器选择 |
其中 supports_grammar_overlap 值得多说一句。第十篇讲到 grammar_needs_sync():语法状态机推进需要上一轮已验证的 token 序列,如果批次里有语法请求且算法不支持语法 overlap,整个批次会被强制拉回同步路径——这是(六)里 overlap 调度的例外清单之一。投机解码的验证行是”一批候选”,语法掩码的推进必须沿树逐路径 DFS(后文会拆 traverse_tree),这与 overlap 的”结果先不读、下一轮先排”天然冲突;支持与不支持的分界就在这里。
三段式流水:draft、verify、accept
不论哪种算法,投机解码的一轮迭代都可以拆成三段:
- Draft(草稿):用小模型(EAGLE 头、MTP 层、N-gram 表)一次前向生成 个候选 token 及其树状结构。
- Verify(验证):把 个候选拼进 target 模型的一次前向,得到这 个位置上 target 模型的分布(或 argmax)。
- Accept(接受):按接受规则决定每个请求实际接受多少候选;被接受的 token 写回 target KV Cache,序列前进 步;顺便从未被拒绝的验证分布里再拿一个 bonus token。
三段之间传递的状态被统一抽象为 SpecInput:
class SpecInput(ABC): cuda_graph_compatible: bool = True ragged_verify_layout: Optional[RaggedVerifyLayout] = None num_tokens_per_req: int = -1 num_tokens_for_logprob_per_req: int = -1 custom_mask: Optional[torch.Tensor] = None # DSA MTP IndexShare 种子中继(EAGLE 系输入会覆写) dsa_topk_indices: Optional[torch.Tensor] = None future_dsa_topk_indices_available: bool = False dsa_seed_topk_capture: Optional[torch.Tensor] = NoneSpecInputType 枚举标出每个 SpecInput 属于哪种阶段与算法:
class SpecInputType(IntEnum): EAGLE_DRAFT = auto() EAGLE_DRAFT_EXTEND = auto() EAGLE_VERIFY = auto() FROZEN_KV_MTP_DRAFT = auto() FROZEN_KV_MTP_VERIFY = auto() DFLASH_DRAFT = auto() DFLASH_VERIFY = auto() NGRAM_VERIFY = auto() UNO_STATE = auto() UNO_DRAFT = auto() UNO_VERIFY = auto() PP_SPEC_RELAY = auto()这个枚举回答”当前这次前向是什么性质”,attention backend 与 ForwardBatch 的 padding 逻辑靠 is_draft_input() / is_verify_input() 分派,而不需要知道具体算法类。两个字段特别值得注意:
num_tokens_per_req:本次前向每个请求的统一 token 宽度。draft-decode 阶段宽度是 top-k(每个请求一次前向摊 top-k 个草稿分支);draft-extend 阶段宽度等于草稿 token 总数;verify 阶段宽度是num_draft_tokens。DP attention 场景下它同时充当global_num_tokens的乘数——把”请求数”换算成”token 数”送给跨 DP rank 的同步逻辑。cuda_graph_compatible:本输入携带的状态是否足以支撑 CUDA Graph 重放。(九)讲过图捕获要求张量地址与形状稳定;验证阶段的行数与树结构随批变化,因此每种算法的SpecInput必须显式声明自己能不能进图,以及用哪套ragged_verify布局来参数化形状。
PP_SPEC_RELAY 是流水线并行(pipeline parallelism)下的特殊类型:最后一 stage 草稿出的树,被所有 stage 共享用于重建各自的 verify 输入——它既不是 draft 也不是 verify,不会有任何前向跑在它上面,只作为跨 stage 的状态载体存在。
SpecInput 上还有一对钩子函数 is_draft_input()、is_verify_input(),以及 pad_batch():把本输入的设备张量 padding 到指定 batch 尺寸——这是给 CUDA Graph 的静态形状约束用的(图捕获时 batch 必须填充到桶尺寸)。create_dummy_verify_input() 则负责在捕获阶段造一棵形状匹配的假树,让图能被捕获下来。这两个函数与(九)的 breakable CUDA Graph 是配套设计:投机解码的一切动态性必须在图外消化干净,图内只允许静态形状的重复执行。
落到调度器:spec_info 与 prepare_for_decode 的分叉
三段流水在调度器侧的载体是 ScheduleBatch.spec_info:
# Speculative decoding # spec_info: Optional[SpecInput] = None spec_info: Optional[SpecInput] = None(注释保留了一行历史写法,说明这个字段经历过重构,从可选直接引用变为带类型声明的字段。)每一轮迭代,调度器决定本轮跑什么(比如 draft-decode、target-verify),把对应的 SpecInput 挂到批次上,ForwardBatch 再把它带给模型前向。
解码准备阶段有一个显式分叉。普通路径(无投机)在 prepare_for_decode 里做三件事:给每个请求分配 1 个 token 的 KV 槽(alloc_for_decode)、推进 seq_lens、更新采样计罚计数器。而投机路径直接让位给专门的准备函数:
if not self.spec_algorithm.is_none(): # Spec decoding owns decode preparation (allocation, seq-lens bookkeeping). from sglang.srt.speculative.spec_utils import spec_prepare_for_decode
self.mamba_track_mask_cpu = None self.mamba_track_mask_next_cpu = None self.mamba_decode_batch_idx_cpu = None spec_prepare_for_decode(self) returnspec_prepare_for_decode 是一个小小的分派器:
def spec_prepare_for_decode(batch: ScheduleBatch) -> None: if get_exec().mamba.enable_mamba_extra_buffer_lazy: batch.mamba_lazy_spec_prepare(...) if batch.spec_algorithm.is_dflash_family(): batch.spec_info.prepare_for_decode(batch) elif batch.spec_algorithm.is_uno(): batch.spec_info.prepare_for_decode(batch) else: # eagle/ngram 共享无状态自由函数 from sglang.srt.speculative.eagle_utils import eagle_prepare_for_decode eagle_prepare_for_decode(batch)注释写得很清楚:dflash 系与 UNO 把 decode 准备做成 SpecInput 的有状态方法(准备逻辑依赖输入自身携带的张量),而 EAGLE 与 NGRAM 共享一个无状态自由函数。这是两类设计哲学的对照:有状态方法适合”输入自己就是全部上下文”的算法,自由函数适合”算法状态其实活在批次与 worker 里”的算法。后文拆 eagle_prepare_for_decode 时会看到,EAGLE 的 decode 准备确实几乎只依赖 ScheduleBatch 与全局配置。
为什么 decode 准备必须整体让位?因为普通路径假设”每请求每轮一个 token”:分配一个槽、seq_lens + 1。投机解码每一轮的节奏不同——draft-decode 轮每个请求要写入 top-k 个草稿分支的 KV;verify 轮要把 num_draft_tokens 个位置全排开;而真正提交给序列的步数由验证结果决定(接受 n 个就是 n 步,加 bonus)。这三套节奏 KV 槽位的分配算法、页对齐规则、写指针推进方式都不一样,硬塞进普通路径会到处是条件分支,因此 SGLang 选择在 prepare_for_decode 最早处整体换轨。
草稿阶段:一棵树如何从三张表里长出来
EAGLE 系的草稿阶段本质上是一台逐步长树的机器。它每次前向只推进一层:用当前层的候选及其打分,选出下一层要扩展的 top-k 路径,把 token 与父节点关系记录下来;重复 speculative_num_steps 次,就得到一棵深度为步数的候选树。全部 draft 前向结束后,organize_draft_results 把逐层的记录压成”选前 num_draft_tokens - 1 个节点”的最终树。
草稿阶段涉及四个配置参数,先把语义对齐:
speculative_num_steps:草稿前向的步数,即树的深度(不含根)。speculative_eagle_topk:每步从候选中扩展的路径数(top-k 分支因子)。speculative_num_draft_tokens:最终送进验证的候选 token 总数(树的节点预算)。- bonus token:不来自草稿、由上一轮验证分布直接给出的那个”白捡”token,它充当树的根。
resolve_num_tokens_per_req 是这三个数字的单一推导点:
def resolve_num_tokens_per_req(*, phase, spec_algorithm=None, is_draft_worker=False, num_draft_tokens=None): spec = get_spec() if phase == "draft_decode": return spec.speculative_eagle_topk if phase == "draft_extend": return spec.speculative_num_draft_tokens if phase == "target_verify": if num_draft_tokens is None: num_draft_tokens = spec.speculative_num_draft_tokens return spec_algorithm.get_num_tokens_per_req_for_target_verify(...)注意 draft_decode 阶段的宽度是 top-k 而不是 1:一次草稿前向,每个请求摊开 top-k 行——每一行是对应分支的当前位置,模型对 top-k 行同时打分,选出每行各自的下层扩展。这是 EAGLE 树式草稿与”链式草稿”的本质区别:链式草稿每步只需 1 行(沿着唯一路径走),树式草稿用 top-k 行把分支因子塞进同一次前向,代价是每步多算的 KV 与注意力,收益是候选覆盖率高得多。EAGLE-2 完全拆解 讲的动态树就是这个分支结构的自适应版本。
draft 前向的输入准备:prepare_for_draft
prepare_for_draft 负责把”这一轮 draft-decode 要跑哪些行、写到哪些 KV 槽”确定下来。它由两个 worker 变体(EAGLE 单层与多层)共享,签名里有几个关键参数:topk、num_steps、可选的 target_translator(多层草稿的 KV 索引翻译器)与 num_draft_tokens。
函数做三件事。
第一件,给草稿写入分配 KV 缓存位置。 页大小(page_size)与 top-k 的组合决定分配策略。最干净的情况是 page_size == 1 或 topk == 1:草稿树的每一行写入连续槽位,直接调 assign_draft_cache_locs_contiguous 一次算出整批 out_cache_loc。为了省一次 kernel 启动,函数甚至预分配 positions 张量并在同一个 kernel 里算出位置:
if batch.seq_lens.is_cuda and topk == 1: prepared_positions = torch.empty_like(batch.seq_lens) ... assign_draft_cache_locs_contiguous[(bs,)]( batch.req_pool_indices, req_to_token_pool.req_to_token, batch.seq_lens, batch.out_cache_loc, req_to_token_pool.req_to_token.shape[1], topk, window_cols, positions=prepared_positions, ... WRITE_POSITIONS=prepared_positions is not None, ... )代码注释里 FIXME(lsyin): align with the default code path 坦诚地标注了这条快路径与默认路径尚未统一——生产代码里这种”为 top-k=1 特化的捷径”很常见,读源码时要意识到两条路径的语义必须等价。
麻烦的情况是 page_size > 1 且 topk > 1:多分支的草稿写入必须按页对齐,每个分支的页区域内还要复制前缀尾页的真实 KV,因为整页读取的 kernel 会把页内所有槽位读进来,而分支页的前几个槽位是”洞”(逻辑上属于前缀尾页)。这正是下面这段注释在解释的事:
# Each branch's page-aligned region starts with `last_page` hole slots # overlapping the prefix tail page; duplicate the real prefix-tail KV # into them so whole-page reads stay coherent (see helper docstring). duplicate_prefix_tail_to_draft_branches( draft_model_runner.token_to_kv_pool, rows, prefix_base, last_page, num_new_pages, topk, page_size, )这段代码把(五)的页式 KV 与投机解码的耦合点暴露得很完整:分页机制本来是给 target 模型的线性序列设计的,草稿树的分叉结构借道分页时,必须付出”前缀尾页复制”的代价来保持页读取一致性。工程含义是:page_size > 1 的树式草稿在显存上不是零成本的,分支数越深、复制越多。
第二件,构造 ForwardBatch。 注意这里捕获模式的选择:
capture_mode = ( CaptureHiddenMode.NULL if draft_model_runner.spec_algorithm.is_standalone() else CaptureHiddenMode.LAST )草稿前向默认需要捕获最后一层的 hidden states(LAST),供下一步草稿前向直接消费——这正是 EAGLE 论文的核心洞见:草稿模型不复用 token,而是复用 target 模型的特征。STANDALONE 模式(把草稿头当小模型独立跑)不需要这个捕获。
第三件,返回能否走 CUDA Graph。 函数返回三元组 (forward_batch, can_run_decode_cuda_graph, kv_loc_plan)。第三个元素是 chain 草稿(topk=1)的优化:当草稿退化成链时,一次迭代的整个写入窗口(跨 draft-decode、verify、draft-extend 三个子阶段的总槽位)可以被统一规划,target_translator.plan() 算出这份”KV 位置计划”,后续子阶段复用,不必各自重算。
organize_draft_results:三张表的归约
草稿逐层推进时,每一层都留下三样东西:score_list(每个候选的打分)、token_list(每个候选的 token id)、parents_list(候选与父节点的索引关系)。全部步数走完后,归约函数把它们压成最终树:
def organize_draft_results(score_list, token_list, parents_list, num_draft_token): # b, n, topk; n = 1 + (num_steps-1) * topk score_list = torch.cat(score_list, dim=1).flatten(1) # b, (topk + (num_steps-1) * topk) ss_token_list = torch.cat(token_list, dim=1) top_scores = torch.topk(score_list, num_draft_token - 1, dim=-1) top_scores_index = top_scores.indices top_scores_index = torch.sort(top_scores_index).values draft_tokens = torch.gather(ss_token_list, index=top_scores_index, dim=1)
if len(parents_list) > 1: parent_list = torch.cat(parents_list[:-1], dim=1) else: parent_list = torch.empty(batch_size, 0, ...) return parent_list, top_scores_index, draft_tokens逐句解释:
- 打分表按候选维度拼接后
flatten,得到每个请求”所有曾出现过的候选”的打分长表。 torch.topk(score_list, num_draft_token - 1)不是取前 k 个候选那么简单——注意- 1:最终树的节点预算里有一个位置留给 bonus token(根),因此从候选里选num_draft_token - 1个。- 选出来的索引重新排序(
torch.sort):这是为了让保留下来的节点按”出现顺序”排列,从而父节点的索引必然小于子节点索引——树结构在后续 attention kernel 里要按这个单调序处理,排序是把树”线性化”的必要步骤。 torch.gather取出对应的 token id。parent_list的构建注意parents_list[:-1]:丢弃最后一步的父亲记录。因为最后一步的候选没有被扩展出子节点(那需要再前向一次),对最终树没有贡献;最后一步的score_list之所以还参与打分选择,是因为它们作为叶子候选本身仍有被选中的价值。
三张表的形状注释(b, n, topk; n = 1 + (num_steps-1) * topk)值得咀嚼:草稿每步产生 top-k 个候选,但第一步的候选数与后续不同(第一步从根出发只有一次打分),因此候选总数是 。以 num_steps=5、topk=4 为例,候选总数是 17。
要理解三张表怎么对齐,必须回到它们的产生端——spec_utils.py 里的 select_top_k_tokens。这个函数每步被调用一次,返回的 tree_info 就是三张表的一行记录。第一步(i == 0)与后续步的实现完全不同:
def _select_top_k_tokens_first(topk_p, topk_index, hidden_states, topk): input_ids = topk_index.flatten() if hidden_states is not None: hidden_states = hidden_states.repeat_interleave(topk, dim=0) tree_info = ( topk_p.unsqueeze(1), # (b, 1, topk) —— 打分 topk_index, # (b, topk) —— token torch.arange(-1, topk, ...).expand(topk_p.shape[0], -1), # (b, topk + 1) ) return input_ids, hidden_states, topk_p, tree_info第一步的候选来自根位置的分布:topk_p 是根分布上的 top-k 概率,topk_index 是对应的 top-k token。hidden_states.repeat_interleave(topk) 把根的一个 hidden state 复制成 top-k 份——树式草稿的第一步就是”从一个位置摊开 top-k 个分支”,因此后续前向的行数是 top-k。
后续步(_select_top_k_tokens_later)是树生长的主力。每一步拿到上一轮选出的 top-k 个当前分支(scores 是它们各自的”累积概率”),以及每个分支分布上的 top-k 采样结果(topk_index,形状 [b, topk*topk]——每个分支摊 top-k 个候选),然后把两者的概率相乘得到联合打分,再做一次跨分支的 top-k 选择:
topk_sq = topk * topk expand_scores = scores.unsqueeze(2) * topk_p.view(-1, topk, topk) # (b, topk, 1) * (b, topk, topk) -> (b, topk, topk) topk_cs_p, topk_cs_index = fast_topk( expand_scores.flatten(start_dim=1), topk, dim=-1 ) # (b, topk) topk_index = topk_index.view(-1, topk_sq) input_ids = torch.gather(topk_index, 1, topk_cs_index).flatten() tree_info = ( expand_scores, # (b, topk, topk) topk_index, # (b, topk * topk) topk_cs_index + (topk_sq * (i - 1) + topk), # (b, topk) )这段代码信息量很大,逐点拆开:
scores.unsqueeze(2) * topk_p.view(-1, topk, topk):把”父链累积概率”与”子候选局部概率”相乘,得到树上的路径联合概率。EAGLE 的草稿选择按路径联合概率排序,而不是只看单步概率——这是树搜索与贪心链式采样的重要区别,保证选出的叶子在整条路径上都足够可信。fast_topk(..., topk)在[b, topk²]的扁平空间里选 top-k 个 (分支, 子候选) 组合。这一步把树宽从 剪回 top-k——树宽恒定、深度递增,这就是 EAGLE 树的增长规则:每层候选空间是 top-k 平方量级,但只有路径联合概率最高的 top-k 条能进入下一层。input_ids = gather(topk_index.flatten(), topk_cs_index):把选中的候选 token 排开,它们将成为下一次草稿前向的输入行。tree_info第三项topk_cs_index + (topk_sq * (i - 1) + topk):这是父指针的全局化的核心公式。topk_cs_index是选中的候选在本步局部展开空间[b, topk²]里的扁平位置;偏移量topk_sq*(i-1) + topk把这个局部位置换算进全局候选空间——第一块是第一步贡献的topk个位置,之后每步贡献topk²个位置。
于是三张表的长表可以对齐了:打分表每步贡献 1(第一步)或 topk(后续步)行、每行 topk 列,拼接后 [b, 1 + (num_steps-1)*topk, topk],flatten(1) 后长度是 ;token 表第一步贡献 topk 个、后续步各贡献 topk² 个,拼接后长度是 。两式恒等——打分空间与 token 空间是同构的:扁平位置 在打分表里是该候选的子候选打分,在 token 表里是该候选自己的 token id。代码里 maybe_detect_oob(top_scores_index, 0, ss_token_list.shape[1], ...) 这行越界检测守的就是这份同构关系:top_scores_index 是打分空间里选出的位置,必须同时是 token 空间的合法下标,否则 gather 会读到非法内存。注意 token 表那行注释把第二项简写成 (num_steps-1) * topk,实际量级是 (num_steps-1) * topk²——注释是重构期的简写,以同构关系与越界检测为准。
parents_list[:-1] 丢弃最后一步的理由至此也有了更精确的解释:全局候选数组 parent_list 的长度是 (等于每请求的全局候选数 n),而各步父指针块的长度是”第一步 、后续步各 “——第一步多出的那个元素就是根哨兵 -1(见 arange(-1, topk))。拼接时必须丢掉最后一步:最后一步的候选没有被展开,它们在父指针数组里没有对应的”被引用”位置,保留会破坏长度关系。
一句话总结这段归约:EAGLE 树的本质是一张按”出现顺序线性化”的节点表(token + 打分),加上一张长度相同的父指针表(parent_list + 全局偏移);organize_draft_results 的职责就是在节点表上选出 top-num_draft_tokens-1 个叶子,并按父先子后的顺序重排索引,让下游的树构建 kernel 能一次性还原整棵树的结构。(后面拆 build_tree_kernel_efficient 时会看到,父指针表正是 tree mask 与位置编码的输入。)
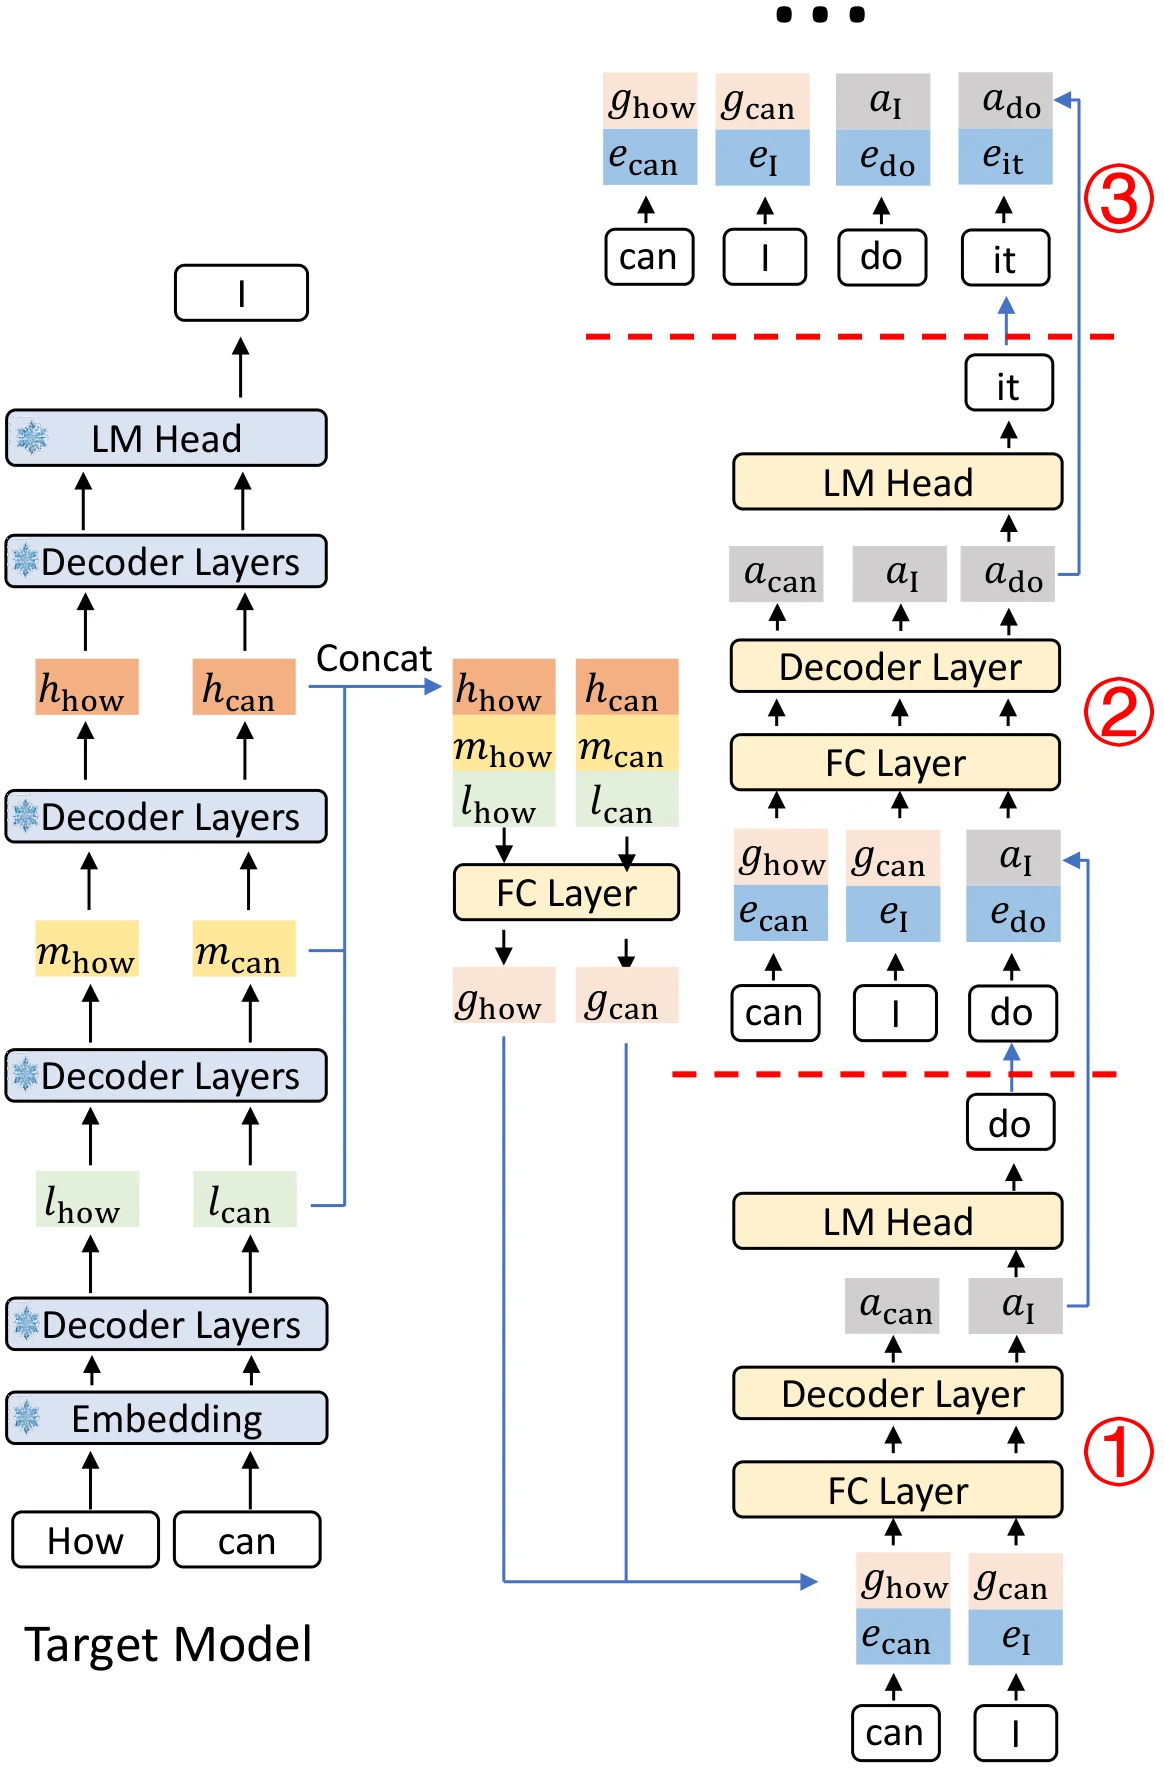
图源:EAGLE-3 论文 EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test(arXiv:2503.01840)。这张总览图把 EAGLE-3 的三个核心部件画在一起:草稿头的多层特征融合、逐层生长的候选树、以及 target 模型上的并行验证——本节的 draft() 主循环、下一节的 build_tree_kernel_efficient、以及”验证与接受”一节的 eagle_sample 分别对应图中的三个阶段。
草稿主循环:draft() 的步进结构
把三张表的产生逻辑放回主循环,EAGLE 草稿的全貌就清楚了。eagle_worker_v2.py 里的 draft() 结构是:
score_list: List[torch.Tensor] = [] token_list: List[torch.Tensor] = [] parents_list: List[torch.Tensor] = [] needs_draft_probs = ( get_spec().speculative_use_rejection_sampling and not forward_batch.sampling_info.is_all_greedy ) ... with IndexTopKShareState.mtp_iteration(...): for i in range(self.speculative_num_steps): if draft_tokens_topk1 is not None: input_ids = topk_index.flatten() else: input_ids, hidden_states, scores, tree_info = select_top_k_tokens( i, topk_p, topk_index, hidden_states, scores, self.topk ) score_list.append(tree_info[0]) token_list.append(tree_info[1]) parents_list.append(tree_info[2])
if i == self.speculative_num_steps - 1: break
forward_batch.input_ids = input_ids forward_batch.out_cache_loc = out_cache_loc[i] spec_info.hidden_states = hidden_states ...循环体里几个设计点值得展开:
-
needs_draft_probs的条件:只有”开启拒绝采样 且 批次不是全贪心”时才需要草稿分布。注释解释了另一半:Verify commits argmax for an all-greedy batch and never reads the draft distribution, so skip building it.——全贪心批次的验证只用 argmax,草稿分布白算了也是浪费。 -
select_top_k_tokens是循环的核心:它接收当前步的子候选概率topk_p、索引topk_index、hidden states 与累积分数scores,输出本次前向的输入行input_ids、更新后的 hidden states、新的累积分数与tree_info(三张表的本步行)。注意i被传入,因为第一步与后续步的实现分支不同(前面拆过_select_top_k_tokens_first与_select_top_k_tokens_later)。 -
hidden states 的传递:
spec_info.hidden_states = hidden_states把上一步捕获的隐状态挂回输入,下一步前向直接消费。这就是 EAGLE”复用特征而非 token”在代码里的落点,也是CaptureHiddenMode.LAST存在的原因。 -
out_cache_loc[i]的分步写入:草稿每步写一段 KV 槽,out_cache_loc是二维的(步数 × 每步槽数),循环里按步取切片。这对应prepare_for_draft里算出的整批写入位置。 -
IndexTopKShareState.mtp_iteration上下文:这是 MTP 迭代的 top-k 索引共享状态管理器,keep_carry_seed参数控制是否把种子 top-k 索引跨迭代保留。这套机制服务于 DeepSeek 系 MTP 草稿头(MTP 完全拆解 讲过 MTP 层的顺序模块结构),让多次草稿迭代共享同一份索引状态,避免重复计算。 -
topk=1 的快路径:
draft_tokens_topk1 = torch.empty((bs, num_steps))直接预分配整条链的 token 张量,第一步copy_写入,后续步直接input_ids = topk_index.flatten()——链式草稿连select_top_k_tokens都省了,因为链没有分支选择。这就是前文_rebuild_topk1_chain_buffers与_topk1_parents_prealloc存在的场景:topk=1 时父指针与打分索引是运行时不变的(恒为线性递增),因此可以预分配并复用,代码里那段assert self.speculative_num_draft_tokens == self.speculative_num_steps + 1就是这条快路径的合法性前提。
验证前向的组装:一次 forward 摊平整棵树
草稿与验证之间的连接点是 ForwardBatch 的构造。验证阶段每请求要跑 num_draft_tokens 行(整棵树的节点),因此:
- 行数放大:验证批次的 token 数 =
bs * num_draft_tokens,而非普通解码的bs * 1。这是num_tokens_per_req在 verify 阶段取值num_draft_tokens的含义(resolve_num_tokens_per_req的第三个分支)。 custom_mask进入注意力:EagleVerifyInput.custom_mask就是上一节产出的tree_mask,它被传给 attention backend 作为注意力掩码——验证前向的注意力不是因果掩码,而是树掩码。这是验证阶段与普通解码在 kernel 层最根本的差别。positions驱动 RoPE:EagleVerifyInput.positions是build_tree_kernel_efficient算出的树位置,模型前向用它算旋转角。同一层不同分支拿到同一位置——前文已强调这一点。prepared_out_cache_loc:build_eagle_verify_input在 chain 特化路径下会连 KV 写位置一起算好(build_chain_tree的返回项),避免验证阶段再算一遍。这是链式草稿的又一处”常数结构写死”优化。
验证前向结束、eagle_sample 判定完成之后,回到调度器做提交:推进 seq_lens、搬 KV、更新 Req.output_ids。(三)讲的”只有结果处理器完成 commit,Req.output_ids 与 finished_reason 才代表已发生事实”这条不变量在这里同样成立——投机解码只是把”一轮一个 token”变成”一轮 n 个 token”,提交语义本身没有变。
从树到 mask:build_tree_kernel_efficient
草稿树长出来之后,必须翻译成 attention kernel 能理解的三种东西:每个节点能看见哪些 token(mask)、每个节点在序列里的绝对位置(positions)、树结构本身(供接受判定 DFS 用的邻接表)。这三件事由 build_tree_kernel_efficient 一次算完,它是草稿与验证之间的桥。
先看它的输入输出契约:
def build_tree_kernel_efficient( bonus_tokens, parent_list, top_scores_index, draft_tokens, seq_lens, seq_lens_sum, topk, spec_steps, num_verify_tokens, tree_mask_mode=TreeMaskMode.FULL_MASK, tree_mask_buf=None, fill_prefix_mask=True,): draft_tokens = torch.cat((bonus_tokens.unsqueeze(1), draft_tokens), dim=1).flatten() bs = seq_lens.numel() ... return (tree_mask, positions, retrieve_index, retrieve_next_token, retrieve_next_sibling, draft_tokens)第一行就把 bonus token 塞进树的第 0 位:cat((bonus_tokens.unsqueeze(1), draft_tokens), dim=1).flatten()。这解释了为什么树的节点总数是 num_verify_tokens = num_draft_tokens,而草稿只产出了 num_draft_tokens - 1 个节点——根节点是 bonus token,它来自上一轮验证得到的那颗”白捡”的 Token。
三种 mask 形态
TreeMaskMode 决定了 mask 的物理形态:
class TreeMaskMode(IntEnum): FULL_MASK = 0 QLEN_ONLY = 1 QLEN_ONLY_BITPACKING = 2
def default_tree_mask_mode(): # CPU verify attention kernel (intel_amx) 直接消费 qlen x qlen 的 QLEN_ONLY mask; # FULL_MASK 是给 GPU kernel 的。 return TreeMaskMode.QLEN_ONLY if _is_cpu else TreeMaskMode.FULL_MASK- FULL_MASK:完整的
[bs * num_verify_tokens, seq_lens_sum + num_verify_tokens * bs]布尔掩码。每一行对应一个验证 token,列覆盖”全部前缀 + 全部树内 token”。这是最直白也最占内存的形态:前缀部分全为 True(每个验证 token 都能看见全部已提交上下文),树内部分按树结构填。 - QLEN_ONLY:只保留
num_verify_tokens × num_verify_tokens的树内掩码,前缀列由 kernel 隐式当作全可见。因为前缀对每个验证行都是”全 True”,把它真的物化出来纯属浪费——seq_lens_sum可能上万,而树只有几十个节点。 - QLEN_ONLY_BITPACKING:把 QLEN_ONLY 按位打包成 uint8/uint16/uint32。
packed_dtype_idx = ceil(log2((num_verify_tokens + 7) // 8))根据树宽选择打包粒度,树宽 ≤ 8 用 uint8、≤ 64 用 uint16 等。
代码里有一段对性能很关键的判断:
elif tree_mask_mode == TreeMaskMode.FULL_MASK: # Only the [0, seq_len) prefix columns depend on this fill; the # kernel below writes every tree cell itself. Skip the (up to # 100s of MB) per-step memset when nothing reads the mask. if fill_prefix_mask: tree_mask.fill_(True)注释直白地说明了 FULL_MASK 的代价量级——前缀列可能上百 MB,每步一次 memset 是实打实的开销。因此引入了 fill_prefix_mask 开关:当后端自有的 mask buffer 被复用且本步不读前缀列时,跳过整片填充。这是与(八)Attention Backend 的直接咬合点:验证 mask 的缓冲区由后端持有(target_attn_backend.verify_mask),后端告诉调用方 mode 与 is_read,调用方据此决定填不填。
邻接表:retrieve_* 三兄弟
返回值里最容易看懵的是 retrieve_index、retrieve_next_token、retrieve_next_sibling。它们来自同一个缓冲区:
retrieve_buf = torch.full((3, bs, num_verify_tokens), -1, device=device, dtype=torch.long) retrieve_index, retrieve_next_token, retrieve_next_sibling = retrieve_buf三张 [bs, num_verify_tokens] 的 int64 表,初始值全 -1(表示”无”),由 kernel 填充:
retrieve_index:节点在扁平化验证张量中的物理位置(节点 → 行号)。retrieve_next_token:节点的第一个子节点编号(树的孩子链头)。retrieve_next_sibling:节点的下一个兄弟编号。
这三张表合起来就是一份孩子-兄弟表示法(child-sibling representation)的树:一个节点想遍历全部子节点,沿 retrieve_next_token 找到长子,再沿 retrieve_next_sibling 顺次走完兄弟链——标准的多叉树紧凑表示,不需要给每个节点分配变长子列表。后文拆接受判定时会看到 verify_tree_greedy_func 与 traverse_tree 正是靠这两张表做 DFS。
positions 的语义也在注释里给了例子:
# position: where each token belongs to # e.g. if depth of each draft token is [0, 1, 1, 2] and the prompt length is 7 # then, positions = [7, 8, 8, 9]同一层的节点共享同一个绝对位置——深度为 1 的两个节点都是位置 8,因为它们是同一父节点的两个平行猜测,都接在位置 7 之后。这是树形验证与线性解码最本质的区别:position 不再是”序列下标”,而是”树深度 + 前缀长度”。RoPE 旋转角度必须按这个位置算,否则同一层不同分支会拿到不同的位置编码,注意力分布就错了(RoPE 完全拆解 里讲过位置编码如何进入注意力计算)。
平台分派与 chain 特化
kernel 调用按平台分四种:NPU 走 torch.ops.npu.build_tree_kernel_efficient,XPU 与 CPU 走 Triton 与自有实现,GPU 默认走 sgl_build_tree_kernel_efficient。这种”一份语义、多套 kernel”的组织方式是 SGLang 多硬件支持的标准姿势——语义层与 kernel 层分离,前端逻辑不必关心后端。
build_eagle_verify_input 是调用这个 kernel 并组装 EagleVerifyInput 的地方。它有一个值得注意的链式特化:
if (batch.seq_lens.is_cuda and topk == 1 and num_draft_tokens == num_steps + 1 and draft_tokens.shape == (bs, num_steps) and mask_mode == TreeMaskMode.QLEN_ONLY): tree_outputs = build_chain_tree( draft_input.bonus_tokens, draft_tokens, batch.seq_lens, tree_mask_buf, req_pool_indices=batch.req_pool_indices, req_to_token=batch.req_to_token_pool.req_to_token, with_mrope=..., )条件里 num_draft_tokens == num_steps + 1 就是”链而非树”的判据——链的节点数恰好是深度加一(每一步一个节点,加上根)。此时树退化成链,掩码是下三角、父指针是线性递增,build_chain_tree 能把这些常数结构直接写死,省掉通用 kernel 的树构建开销。这个特化对应(十)里提到的 speculative_eagle_topk=1 场景,也是 prepare_for_draft 里 plans_window 优化的同一前提。
组装完成的 EagleVerifyInput 就是系列的第三个 SpecInput 子类实例:
return EagleVerifyInput( draft_token=draft_tokens, custom_mask=tree_mask, positions=position, retrieve_index=retrieve_index, retrieve_next_token=retrieve_next_token, retrieve_next_sibling=retrieve_next_sibling, retrieve_cum_len=None, spec_steps=num_steps, topk=topk, draft_token_num=num_draft_tokens, capture_hidden_mode=None, seq_lens_sum=None, seq_lens_cpu=None, draft_probs=draft_probs, prepared_out_cache_loc=prepared_out_cache_loc, prepared_mrope_positions=prepared_mrope_positions, )它携带的内容正好是验证前向所需的一切:候选 token、树掩码、位置、邻接表、以及(可选的)草稿分布 draft_probs——最后这一项只在拒绝采样路径下需要,后文会讲。
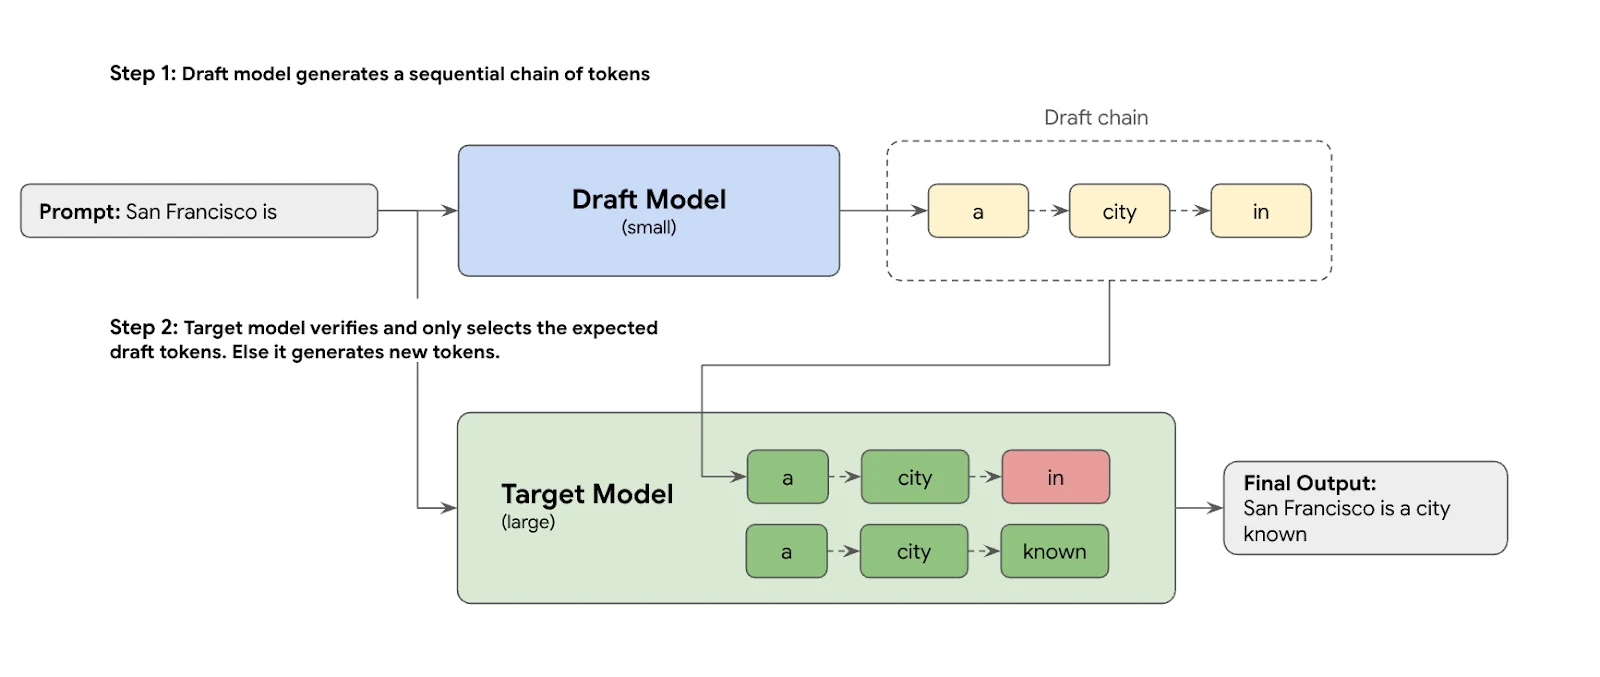
图源:LMSYS 官方博客 From research to production: Accelerate OSS LLM with EAGLE-3 on Vertex。这张图画出了 EAGLE-3 草稿头与 target 模型的分工:中间层特征(图中 TTT 融合的多层 hidden states)被喂进草稿头,草稿头一次前向输出多个候选位置。SGLang 里 prepare_for_draft 的 CaptureHiddenMode.LAST 与 spec_info.hidden_states 传递链,实现的就是这张图的数据流。
验证与接受:一次前向判定整棵树
验证阶段的目标只有一句话:用 target 模型对整棵候选树做一次前向,然后决定每个请求接受几条路径上的 token。 但”决定”这一步的分支比想象中多——贪心请求、采样请求、拒绝采样、确定性模式,四条路径的实现完全不同。
eagle_sample 的骨架
eagle_sample 是 EAGLE 系的接受判定总入口。它接收 verify_input(上一节组装的树)、batch、logits_output(验证前向的输出),返回三个张量:predict(每个验证位置选出的 token)、num_correct_drafts(每请求正确草稿数)、accept_index(接受路径的索引)。开头有一段幂等处理:
if batch.forward_mode.is_idle(): predict = torch.empty(0, dtype=torch.int32, device=device) num_correct_drafts = torch.empty(0, dtype=torch.int32, device=device) accept_index = torch.empty(0, dtype=torch.int32, device=device) return predict, num_correct_drafts, accept_indexidle 批次(图重放时为了填满静态形状而塞的假批次)直接返回空张量,不做任何判定——这是(九)里”空批次必须能被安全跳过”这条不变量的具体体现。
接着是惩罚与偏置的对齐,这段代码揭示了投机解码里一个容易错的地方:
if sampling_info.acc_additive_penalties is not None: next_token_logits.add_( torch.repeat_interleave( sampling_info.acc_additive_penalties, verify_input.draft_token_num, dim=0, ) )next_token_logits 有 bs * draft_token_num 行(每个请求的每个验证位置一行),而惩罚表是每请求一项。repeat_interleave(..., draft_token_num) 把每请求的惩罚复制成 draft_token_num 份——同一请求的所有验证位置共享同一份惩罚。注意这里的”惩罚”是 relaxed 版本(注释原话:This is a relaxed version of penalties for speculative decoding):真实的重复惩罚需要知道”这个位置之前生成过哪些 token”,而树上的每个位置都处于不同的猜测路径,精确计算代价极高;SGLang 选择用统一的累积惩罚近似。这是投机解码与普通解码在采样语义上的一处已知偏差。
然后是三个输出张量的初始化:
candidates = verify_input.draft_token.reshape(bs, verify_input.draft_token_num) predict_shape = list(next_token_logits.shape)[:-1] predict = torch.zeros(predict_shape, dtype=torch.int32, device=device).flatten() accept_index = torch.full((bs, verify_input.max_tree_depth), -1, dtype=torch.int32, device=device) num_correct_drafts = torch.empty((bs,), dtype=torch.int32, device=device)candidates把扁平候选张量 reshape 回[bs, draft_token_num]。accept_index形状是[bs, max_tree_depth],初值-1——一个请求最多接受max_tree_depth个 token(树深度为 d 意味着最长的接受链长度不超过 d),-1表示”这个位置没有 token”。num_correct_drafts每请求一个计数。
三条判定路径
判定逻辑的核心分叉:
use_rejection_sampling = get_spec().speculative_use_rejection_sampling if _verify_uses_greedy(is_all_greedy=..., is_cpu=..., is_hip=..., is_xpu=..., use_rejection_sampling=...): target_predict = torch.argmax(next_token_logits, dim=-1) target_predict = target_predict.reshape(bs, verify_input.draft_token_num) predict, accept_index, num_correct_drafts = verify_tree_greedy_func( predicts=predict, accept_index=accept_index, accept_token_num=num_correct_drafts, candidates=candidates, retrieve_index=verify_input.retrieve_index, retrieve_next_token=verify_input.retrieve_next_token, retrieve_next_sibling=verify_input.retrieve_next_sibling, target_predict=target_predict, topk=verify_input.tree_topk, ) ... if tp_group.world_size > 1: tp_group.broadcast(predict, src=0) tp_group.broadcast(accept_index, src=0) tp_group.broadcast(num_correct_drafts, src=0)路径一:贪心验证。 所有请求都是贪心采样时,target 模型的判定就是 argmax。verify_tree_greedy_func 沿树自顶向下逐层比对:某节点的 target argmax 恰好等于草稿在该位置的 token,就接受并往子节点走;不相等就停止这条路径。注意后面那段 TP broadcast——注释解释了原因:
# On ROCm, the per-rank draft tokens can differ, so ranks accept a # different number of drafts, desynchronize the committed seq_lens, and # deadlock the next TP collective.各 rank 的接受数可能不同(草稿阶段浮点非确定性导致),而”接受数”直接决定 seq_lens 推进多少——seq_lens 不一致会让下一轮的 TP 集合通信死锁。解决办法是从 rank 0 广播判定结果,强制所有 rank 接受同一个数量。这是一条正确性优先于效率的工程决策:多一次广播,换来集合通信不死锁。
路径二:UNO 稀疏树目标采样。 _can_use_sparse_uno_tree_target_sampling 成立时走这条分支,它用 sample_uno_tree_target_tokens 从 target 分布里为 UNO 的稀疏树采样目标 token,仍交给 verify_tree_greedy_func 做结构遍历,末尾同样广播。这条路径是 UNO 算法特有的优化,骨架与贪心一致。
路径三:拒绝采样(rejection sampling)。 采样请求且开启拒绝采样时走这里。先对分布做 top-k/top-p 重归一化,然后:
target_probs = target_probs.reshape(bs, verify_input.draft_token_num, -1) draft_probs = ( verify_input.draft_probs if use_rejection_sampling else torch.zeros_like(target_probs) ) if use_rejection_sampling and ( draft_probs is None or draft_probs.shape[-1] != target_probs.shape[-1] ): raise ValueError( "Rejection sampling requires a target-vocab draft proposal " "distribution; ..." )这段断言很有信息量:拒绝采样需要草稿模型给出与 target 同词表大小的完整分布。多数草稿头为了省显存只输出 top-k 候选的 logits(词表维度被截断),此时无法做标准拒绝采样,只能退化为”贪心式接受 + 修正”(draft_probs = zeros_like(target_probs),即把草稿分布当全零处理)。这解释了为什么 EagleDraftInput 需要携带 draft_probs、以及 draft() 里那个 needs_draft_probs 判断(避免为不需要的路径白算分布)。
拒绝采样的核心是 sampling_fn(CUDA 上是 chain_speculative_sampling_triton,NPU 上有对应实现):
sampling_fn( predicts=predict, accept_index=accept_index, accept_token_num=num_correct_drafts, candidates=candidates, retrive_index=verify_input.retrieve_index, retrive_next_token=verify_input.retrieve_next_token, retrive_next_sibling=verify_input.retrieve_next_sibling, uniform_samples=coins, uniform_samples_for_final_sampling=coins_for_final_sampling, target_probs=target_probs, draft_probs=draft_probs, threshold_single=get_spec().speculative_accept_threshold_single, threshold_acc=get_spec().speculative_accept_threshold_acc, deterministic=True, )注意参数名的拼写:kwarg 左侧保留成 retrive_*(少一个 e)是为了匹配 sgl_kernel 的算子 schema,注释里写得很直白。读源码时看到这种”故意拼错”的地方,通常意味着跨模块的 ABI 约束,不要”顺手修正”。
两个阈值 threshold_single 与 threshold_acc 是拒绝采样的接受门限:单 token 的接受阈值与累积接受阈值,它们让接受判定可以在”更激进加速”与”更接近 target 分布”之间调节。deterministic=True 表示采样使用固定随机数序列(为了跨 rank 一致与可复现)。
随机数硬币:coins
拒绝采样需要随机性,但不能让每个 rank 各自摇随机数(否则 rank 间判定不同)。SGLang 的做法是确定性生成”硬币”:
coins, coins_for_final_sampling = _verify_coins( sampling_info=sampling_info, seq_lens=batch.seq_lens, draft_token_num=verify_input.draft_token_num, candidates=candidates, device=device, )_verify_coins 与 _seeded_verify_coins 两个 helper 的存在说明这件事有”有种子”与”无种子”两条路:开启种子时,随机数由 (请求身份, 位置) 确定性地导出,从而保证同一请求在任意 rank 上拿到同一串硬币,判定结果自然一致。这套机制是投机解码里”采样语义 + 分布式一致性”两者冲突时的标准解法。
返回值语义:num_correct_drafts + 1
函数最后一行值得单独拎出来:
# `num_correct_drafts` stays drafts-only inside this function; the returned # tensor includes the trailing/bonus token via out-of-place +1 so the # name no longer flips semantics mid-function (naming doc C2). return predict, num_correct_drafts + 1, accept_index函数内部的 num_correct_drafts 只数”草稿被接受的个数”,返回值把它 +1 表示”含 bonus token 的总推进步数”。 注释特意解释了这样做的理由:避免同一个名字在函数中途语义翻转。这是个命名规范问题(注释里引用了 naming doc C2),但对读代码的人非常关键——看到 num_correct_drafts 时必须先确认它在哪个语义区间:
- 在
eagle_sample内部:草稿接受数,accept_index里-1之外的位置数。 - 返回值与下游
move_accept_tokens_to_target_kvcache:草稿接受数 + 1,即seq_lens的推进量。
后文拆 KV 回写时会看到调用点用 batch.seq_lens + num_correct_drafts + 1 计算目标位置——那里的 num_correct_drafts 已经是”返回值语义”,再加 1 是给 bonus 之后的下一轮留位。这类”名字相同、语义区间不同”的坑,是读投机解码源码时最容易踩的。
模拟接受长度:为压测而生的开关
eagle_sample 末尾有一段看起来与生产逻辑无关的代码:
if SIMULATE_ACC_LEN > 0: if SIMULATE_ACC_TOKEN_MODE not in ("fixed", "real-draft-token"): raise ValueError(...) if SIMULATE_ACC_TOKEN_MODE == "real-draft-token": if verify_input.tree_topk != 1: raise ValueError( "SGLANG_SIMULATE_ACC_LEN with real draft tokens currently " "requires speculative_eagle_topk=1." ) if target_predict is None: target_predict = torch.argmax(next_token_logits, dim=-1).reshape( bs, verify_input.draft_token_num) accept_index = generate_simulated_accept_index( accept_index=accept_index, predict=predict, num_correct_drafts=num_correct_drafts, candidates=candidates, target_predict=target_predict, simulate_acc_len=SIMULATE_ACC_LEN, simulate_acc_token_mode=SIMULATE_ACC_TOKEN_MODE, bs=bs, spec_steps=verify_input.max_tree_depth - 1, )SGLANG_SIMULATE_ACC_LEN 是调试/压测环境变量:它把真实的接受判定替换成”假装接受了 N 个 token”。这样可以在不依赖草稿质量的前提下,测出”如果接受率是 100%,系统吞吐能到多少”,从而分离”算法质量”与”系统上限”两个变量。generate_simulated_accept_index 的注释说明它返回宽度 spec_steps + 1 的替换 accept_index,所以调用方传 max_tree_depth - 1 保持宽度一致。生产路径上这个开关必须是 0;但它的存在对理解”接受数如何驱动后续所有账本”很有帮助——整个投机解码的后续流程只依赖 accept_index 与 num_correct_drafts 两个输出,与它们是怎么算出来的无关。
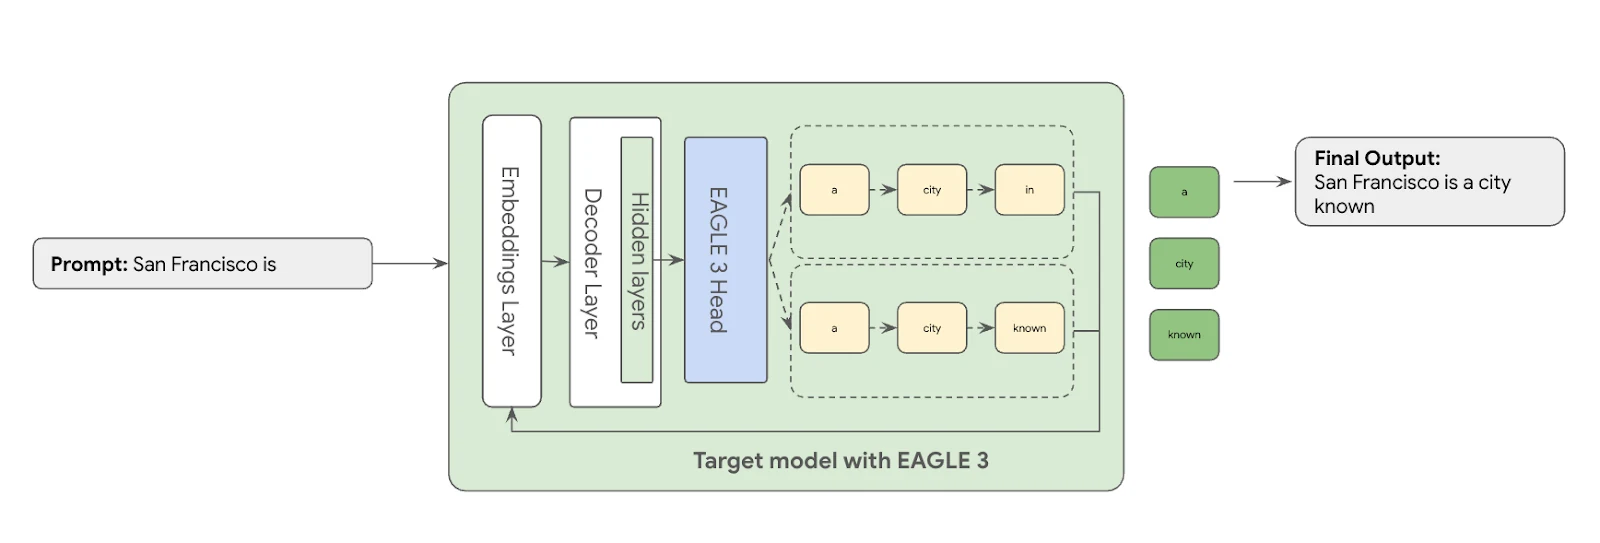
图源:LMSYS 官方博客 From research to production: Accelerate OSS LLM with EAGLE-3 on Vertex。图中左侧是 target 模型的单次前向,右侧是被接受的 token 序列——一次前向验证整棵树,接受链的长度由验证结果决定,这正是 eagle_sample 与 verify_tree_greedy_func 实现的语义。
语法与树:traverse_tree 的借用-回滚遍历
(十)讲到结构化输出时留下过一个悬念:语法状态机如何与投机解码的树共存。答案在 spec_utils.py 的 traverse_tree 里。函数签名很直接:
def traverse_tree(retrieve_next_token, retrieve_next_sibling, draft_tokens, grammar, allocate_token_bitmask, vocab_size=None): """Traverse the tree constructed by the draft model to generate the logits mask."""
def dfs(curr, retrieve_next_token, retrieve_next_sibling, parent_pos): if curr == 0: # the first token generated by the target model, and thus it is always # accepted from the previous iteration is_accepted = True else: parent_bitmask = allocate_token_bitmask[parent_pos] current_token = draft_tokens[curr] if vocab_size and current_token >= vocab_size: is_accepted = False else: # 32 boolean bitmask values are packed into 32-bit integers is_accepted = ( parent_bitmask[current_token // 32] & (1 << (current_token % 32)) ) != 0
if is_accepted: if curr != 0: grammar.accept_token(int(draft_tokens[curr])) if not grammar.is_terminated(): grammar.fill_vocab_mask(allocate_token_bitmask, curr) if retrieve_next_token[curr] != -1: dfs(int(retrieve_next_token[curr]), ..., curr)
if curr != 0: grammar.rollback(1)
if retrieve_next_sibling[curr] != -1: dfs(int(retrieve_next_sibling[curr]), ..., parent_pos)
dfs(0, retrieve_next_token, retrieve_next_sibling, -1)这段 40 行的 DFS 把三件事一次性做完:
第一,树上的语法合法性判定。 一个候选 token 是否被接受,取决于它的父节点的语法状态是否允许这个 token。掩码以位图形式存在 allocate_token_bitmask 里(每 token 一位,32 位打包成一个 int32),判定就是一行位运算:parent_bitmask[current_token // 32] & (1 << (current_token % 32))。根节点(curr == 0)无条件接受——注释原话是”target 模型生成的第一个 token,上一轮已经验证过”。
第二,子树掩码的生成。 接受一个节点后,grammar.fill_vocab_mask(allocate_token_bitmask, curr) 为该节点写出”它的所有子候选必须满足的允许集”。这样即使后面的节点因为父节点被拒绝而不会走到,只要父节点被接受,子节点的掩码就已经就位,采样时直接可用。
第三,“借用-回滚”式的状态机遍历。 这是整段代码最精巧的地方:grammar 是一个单一的线性状态机,而树有多条路径。DFS 的解法是——进入一个节点时 accept_token 推进状态,遍历完它的子树后 rollback(1) 回退一步,再走兄弟节点。任何时刻状态机只保留”当前根到当前节点”这一条路径的状态,空间开销与树宽无关,只与树深度有关。rollback(1) 这个动词与(十)里语法管理器的 rollback 语义完全一致,两篇在这里合上了。
代价同样明确:整个 DFS 是串行的、宿主侧(或按算法实现)单线程的,遍历成本与树节点数成正比。这正是 supports_grammar_overlap() 存在的理由:语法遍历不能在 GPU 前向的异步流水里被”提前做”,因此带语法的批次必须走同步路径。从(十)的 grammar_needs_sync() 到本节的 traverse_tree,语法与投机解码的每一个耦合点都指向同一结论——语法约束把投机解码的并行性按下去一档,这是结构化输出的固有代价。
KV 回写:被接受的 token 如何搬回 target 缓存
接受判定给出 accept_index 之后,还有一件必须做的事:把被接受草稿的 KV 从”草稿写入的位置”搬到”target 序列的位置”。这一点初看反直觉——草稿阶段的 KV 是草稿模型算的,target 模型的 KV 需要按 target 权重算,两者不是一回事。SGLang 的做法是:验证前向在 target 模型上跑,它的 KV 写在 batch.out_cache_loc 指定的槽位里;接受判定之后,通过 move_accept_tokens_to_target_kvcache 把被接受位置的 KV 在 target 缓冲内搬移/固化成正式序列的 KV。
def move_accept_tokens_to_target_kvcache(batch, accept_index, num_correct_drafts, token_to_kv_pool_allocator): bs = len(batch.seq_lens) device = batch.seq_lens.device # accept_index element count, NOT bs * num_draft_tokens: for topk > 1 the # tree exceeds the accepted chain, over-reading accept_index (illegal memory). size = bs * accept_index.shape[1]
maybe_detect_oob(accept_index, -1, batch.out_cache_loc.size(0), "spec v2 move_accept_tokens accept_index")
tgt_cache_loc = torch.zeros(size, dtype=torch.int64, device=device) accept_out_cache_loc = torch.zeros(size, dtype=torch.int64, device=device) if _is_cpu: assign_extend_cache_locs_cpu(...) else: assign_extend_cache_locs[(bs,)]( batch.req_pool_indices, batch.req_to_token_pool.req_to_token, batch.seq_lens, batch.seq_lens + num_correct_drafts + 1, tgt_cache_loc, batch.req_to_token_pool.req_to_token.shape[1], next_power_of_2(bs), ) fill_accept_out_cache_loc_func( accept_index, batch.out_cache_loc, accept_out_cache_loc, size ) token_to_kv_pool_allocator.get_kvcache().move_kv_cache( tgt_cache_loc, accept_out_cache_loc )逐点拆开这段代码里的三个关键决策。
第一,size 的取法。 注释写得很清楚:size = bs * accept_index.shape[1],不能用 bs * num_draft_tokens。原因:当 topk > 1 时,树的节点数多于”最长可接受链”的长度,accept_index 的宽度是 max_tree_depth 而不是 num_draft_tokens;按后者算尺寸会越界读 accept_index(非法内存访问)。这是一条”用错尺寸就崩”的硬约束,也是树式草稿与链式草稿在内存布局上的差异。
第二,目标槽位的计算。 assign_extend_cache_locs 用 batch.seq_lens 作为起点、batch.seq_lens + num_correct_drafts + 1 作为终点,把这一段位置映射成 target-side 的物理槽位(tgt_cache_loc)。注意这里两个端点都用了:
- 起点
seq_lens:已经被接受并提交的历史长度。 - 终点
seq_lens + num_correct_drafts + 1:加上这次接受的 token 数(含 bonus)。
也就是说,KV 回写覆盖的是”接受之后新增的这段序列”,它把验证前向写在临时槽位的 KV 重新落到正式序列对应的位置。这是(五)讲的 req_to_token 页表在投机解码下的具体用法:正式序列位置 → 物理 KV 槽的映射由 req_to_token_pool 维护,回写要把”临时验证槽”的 KV 搬进”正式槽”。
第三,搬移本身。 fill_accept_out_cache_loc_func(accept_index, batch.out_cache_loc, accept_out_cache_loc, size) 把 accept_index 指向的验证槽位收集成 accept_out_cache_loc(源地址),然后 move_kv_cache(tgt_cache_loc, accept_out_cache_loc) 一次性把 KV 从源搬到目标。accept_index 里的 -1 哨兵是合法的(对应”没有 token”的位置),maybe_detect_oob 检查的就是这些索引都在 out_cache_loc 范围内。
这段流程在概念上对应(五)里的 alloc_for_decode + req_to_token 更新,但它比普通解码复杂得多:
- 普通解码只搬 1 个 token 的 KV,位置是
seq_lens(单调推进 1)。 - 投机解码搬
num_correct_drafts + 1个 token,位置是[seq_lens, seq_lens + n)——一段区间。 - 普通解码的源槽就是目标槽(写完直接用);投机解码的源槽(验证位置)与目标槽(正式序列位置)不同,必须搬移。
- 树上可能有大量被拒绝的节点,它们的 KV 写在临时槽里但没有进入正式序列——这些槽在后续按(五)的回收路径释放。
被拒绝的 token 怎么办? 树上的每个节点在验证前向里都占了一个 KV 槽(out_cache_loc 的一段)。接受判定之后,只有 accept_index 指向的那些槽的 KV 被搬进正式序列;其余槽位对应的 KV 应当在批次结束时随 out_cache_loc 一起被 allocator 回收。这就是 accept_index 初值设为 -1 的第二个用意:-1 既是”没有 token”的标记,也让搬移 kernel 能跳过未使用的位置。
另一条路线:N-gram 草稿
EAGLE 系需要草稿模型,NGRAM 不需要——它直接用外部语料构建的 N-gram 表做草稿。这条路线值得独立讲一小节,因为它展示了同一个三段式抽象如何容纳一个完全不同的”草稿生成”机制。
ngram_worker.py 里的 NGRAMWorker 是这条路径的实现。它的草稿来源不是神经网络,而是:
from sglang.srt.speculative.ngram_info import NgramVerifyInput ... spec_info = NgramVerifyInput( draft_token=None, custom_mask=custom_mask, positions=None, retrieve_index=None, retrieve_next_token=None, retrieve_next_sibling=None, draft_token_num=num_tokens_per_req, ) spec_info.capture_hidden_mode = CaptureHiddenMode.NULL两个细节值得注意:
capture_hidden_mode = NULL:N-gram 草稿不依赖 hidden states,因此验证前向不必捕获隐层输出。这与 EAGLE 的CaptureHiddenMode.LAST形成对照,说明捕获模式的声明是每种算法必须回答的问题——(七)里ForwardBatch的 hidden states 捕获、以及(九)里图重放对张量地址的要求,都由这个声明决定要不要付代价。external_corpus_manager.py的存在说明 N-gram 表可以来自外部语料(不只是当前请求自身的历史),这是NGRAM与”自己上下文里找重复”的朴素 N-gram 加速的区别。
N-gram 路线在规格上仍要产出与 EAGLE 同样的 retrieve_* 邻接表与 tree_mask——因为接受判定、KV 回写、调度记账这些下游环节全部复用同一套逻辑。这印证了 SpecInput 抽象的价值:算法可以完全不同,但只要产出”候选 token + 树结构 + 掩码”三件套,后面的整条流水线都不必改。
站内 Lookahead Decoding 完全拆解 讲的是 Jacobi 迭代 + N-gram 池的并行解码路线,与 SGLang 的 NGRAM worker 是同一思想家族的不同工程形态:都不用草稿模型,都靠”序列里已出现过的模式”来猜下一段。不同的是 Lookahead 用 Jacobi 不动点迭代同时推进多条轨迹,而 SGLang 的 NGRAM worker 直接查表生成候选树。
与三条主线的咬合
投机解码不是孤立模块,它必须与系列前面拆过的三条主线共存。这一节把咬合点集中列出来。
与调度器(三、四、六)
prepare_for_decode的整体让位:前文已经拆过,投机批次跳过普通解码准备,改走spec_prepare_for_decode。- overlap 的例外:
supports_overlap与supports_grammar_overlap是算法声明,调度器据此决定一个批次能否在 overlap 路径上跑。EAGLE 的验证结果决定下一轮草稿输入,天然打断 overlap 的流水线,因此多数算法在 overlap 下需要同步或特殊处理。(六)讲的last_batch、future token、延迟提交这些机制,在投机模式下都要重新审视”什么时候可以安全地推进seq_lens”。 - KV 预算:
PrefillAdder(四)在做接纳预算时,必须为投机解码预留比一个 token 更多的未来 KV。get_alloc_reserve_per_decode()就是这份预留量——eagle_prepare_for_decode里page_aligned_decode_alloc_lens(..., reserve=double_alloc, ...)直接用它算下一轮需要多少槽位。预留不足会导致页 >1 + topk >1 的草稿写入越界,代码里那段断言就是在防这个:
if page_size > 1 and (get_spec().speculative_eagle_topk or 1) > 1: max_alloc_len = int(nxt_kv_lens_cpu.max()) row_width = batch.req_to_token_pool.req_to_token.shape[1] assert max_alloc_len <= row_width, ( f"spec v2 page>1 topk>1 draft over-allocation ({max_alloc_len}) exceeds " f"req_to_token row width ({row_width}); page_size={page_size}. ..." )这条断言把”页式 KV + 树式草稿 + 预分配不足”三者叠加的失败模式显式化了——req_to_token 的每行宽度必须能容纳”已提交 + 预留量”,否则写入越界,后续释放还会泄漏 KV。这是(五)讲的所有权闭环在投机解码下新增的一条边界条件。
与 attention backend(八)
- 验证掩码由后端持有:
target_attn_backend.verify_mask提供mode、is_read、buffer与fits(bs)。build_eagle_verify_input依据它决定是”写进后端预分配的 buffer”还是”临时分配”:
verify_mask = target_attn_backend.verify_mask if verify_mask is None: tree_mask_buf, mask_mode, fill_mask = None, tree_mask_mode, True else: mask_mode, fill_mask = verify_mask.mode, verify_mask.is_read tree_mask_buf = verify_mask.buffer if verify_mask.fits(bs) else Nonefill_mask = verify_mask.is_read 这一行的含义是:当后端本步不读前缀列时,跳过填充(对应前文讲的上百 MB memset 优化)。eager 批次超过捕获的 max_bs 时回退到临时分配——这是”图捕获尺寸之外”的降级路径。
SpecInputType用于后端分派:attention backend 靠spec_info.is_draft_input()/is_verify_input()选择对应的注意力路径,不需要知道具体算法类。这就是SpecInputType枚举存在的理由(源码注释原话:introduce this to distinguish the SpecInput types of multiple algorithms when asserting in attention backends)。num_tokens_per_req同时是 DP attention 的乘数:spec_scale_global_num_tokens把”每 rank 的请求数”换算成”本次前向的 token 数”,DP attention 的global_num_tokens同步依赖它。草稿阶段每请求宽度是 top-k、验证阶段是num_draft_tokens,这个宽度必须准确上报,否则 DP rank 间的 token 数对不上。
与 CUDA Graph(九)
投机解码与 CUDA Graph 的冲突最尖锐:图捕获要求形状与地址稳定,而验证阶段的树形状随批、随树动态变化。SGLang 的应对有三层:
SpecInput.cuda_graph_compatible:算法/输入级声明自己能否进图。ragged_verify_layout:用一套”参差不齐”的布局参数化形状——形状不再由”每请求固定宽度”决定,而是由这份布局描述,图按布局参数捕获。create_dummy_verify_input():捕获阶段造形状匹配的假树(见前文引用的代码,EagleVerifyInput/DFlashVerifyInput/NgramVerifyInput各有分支),让图能被捕获;draft_token=None表示捕获期不需要真实候选。
草稿阶段反而容易进图:prepare_for_draft 的 topk 宽度是固定的(每请求恰好 top-k 行),因此 EAGLE_DRAFT 是形状稳定的阶段——这也解释了为什么 eagle_draft_cuda_graph_runner.py 与 eagle_draft_extend_cuda_graph_runner.py 是两个独立文件:draft-decode 与 draft-extend 的宽度不同(topk vs num_draft_tokens),必须分别捕获。
can_run_decode_cuda_graph = cuda_graph_runner and cuda_graph_runner.can_run_graph(forward_batch) 是 prepare_for_draft 的返回项之一:草稿前向能否走图,由 runner 按当前批的形状判断。这个返回值一路传到 worker,决定本次前向走 eager 还是重放。
小结
这一篇把 SGLang 投机解码的组织方式拆完了。可操作的结论有五条:
-
一个枚举、一套三段式、五种算法实现。
SpeculativeAlgorithm把 EAGLE/EAGLE3/FROZEN_KV_MTP/NGRAM/DFLASH/DSPARK/UNO 收进同一接口,SpecInput与SpecInputType提供”阶段 + 算法”的统一分派,attention backend 与调度器只依赖这些抽象谓词。新增算法的门槛因此被压到”实现 draft + verify + 三件套输出”。 -
草稿树的归约是索引空间的代数。
organize_draft_results从三张表里选出叶子集合、按父先子后重排;select_top_k_tokens的topk_cs_index + (topk_sq*(i-1) + topk)是父指针的全局化公式;打分表与 token 表同构是整段代码的正确性根基,也是maybe_detect_oob守着的东西。理解这一点比记住参数默认值重要得多。 -
树必须翻译成 mask、位置与邻接表。
build_tree_kernel_efficient一次产出三样:tree_mask(三种形态,FULL_MASK 最贵、QLEN_ONLY 最常用、位打包最省)、positions(同层共享位置,这是树形验证与线性解码的根本差别)、retrieve_*三兄弟(孩子-兄弟表示的树,供接受判定 DFS)。bonus token 在第 0 行,这个细节决定了节点预算num_draft_tokens与草稿产出-1的关系。 -
接受判定有多条路径,但下游只依赖两个输出。 贪心走
verify_tree_greedy_func、拒绝采样走sampling_fn+ 确定性硬币、UNO 走稀疏树采样;无论哪条,产出都是accept_index与num_correct_drafts + 1。TP 广播是为了让各 rank 的seq_lens推进一致、避免集合通信死锁——正确性优先于效率的典型取舍。num_correct_drafts在函数内外语义不同(草稿数 vs 含 bonus 的步数),是读代码最主要的坑。 -
KV 回写是页表 + 搬移的组合拳。
move_accept_tokens_to_target_kvcache用seq_lens与seq_lens + n + 1定位目标区间,把验证槽的 KV 搬进正式序列;size必须按accept_index.shape[1]而非num_draft_tokens算,否则树式草稿会越界读非法内存。页 >1 + topk >1 时还需要req_to_token行宽足够容纳预留量,否则写入越界且释放泄漏——这条断言把(五)的所有权闭环在投机模式下的新边界显式化了。
从系列的整体视角看,这一篇把”前向之后”的下半条流水线补齐了:第十篇解决了”一轮前向出一个 token 之后怎么采样”,本篇解决了”一轮前向出多个 token 怎么组织、验证与提交”。剩下的 SGLang 待讲模块里,与投机解码关系最近的是 Disaggregation(P/D 分离调度)——投机解码在 prefill/decode 分离架构下需要额外的 KV 传输与草稿 KV 管理(eagle_disaggregation.py、dflash_disaggregation.py 就是为这个准备的),以及 LoRA 与多 LoRA 批处理(草稿头与 target 各自挂 LoRA 时的批处理语义)。
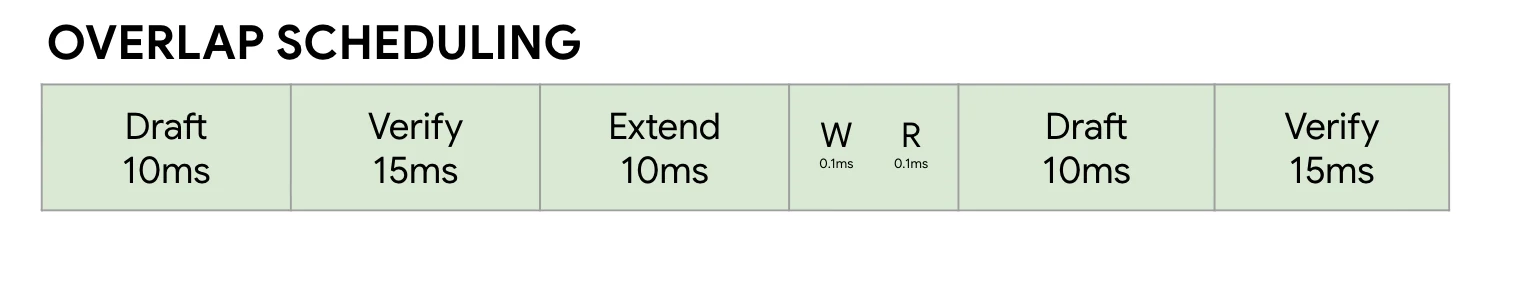
图源:LMSYS 官方博客 From research to production: Accelerate OSS LLM with EAGLE-3 on Vertex。图中展示草稿与验证阶段的重叠调度安排——这正是(六)Overlap Scheduler 与投机解码需要共同处理的场景,也是 supports_overlap 声明存在的理由。
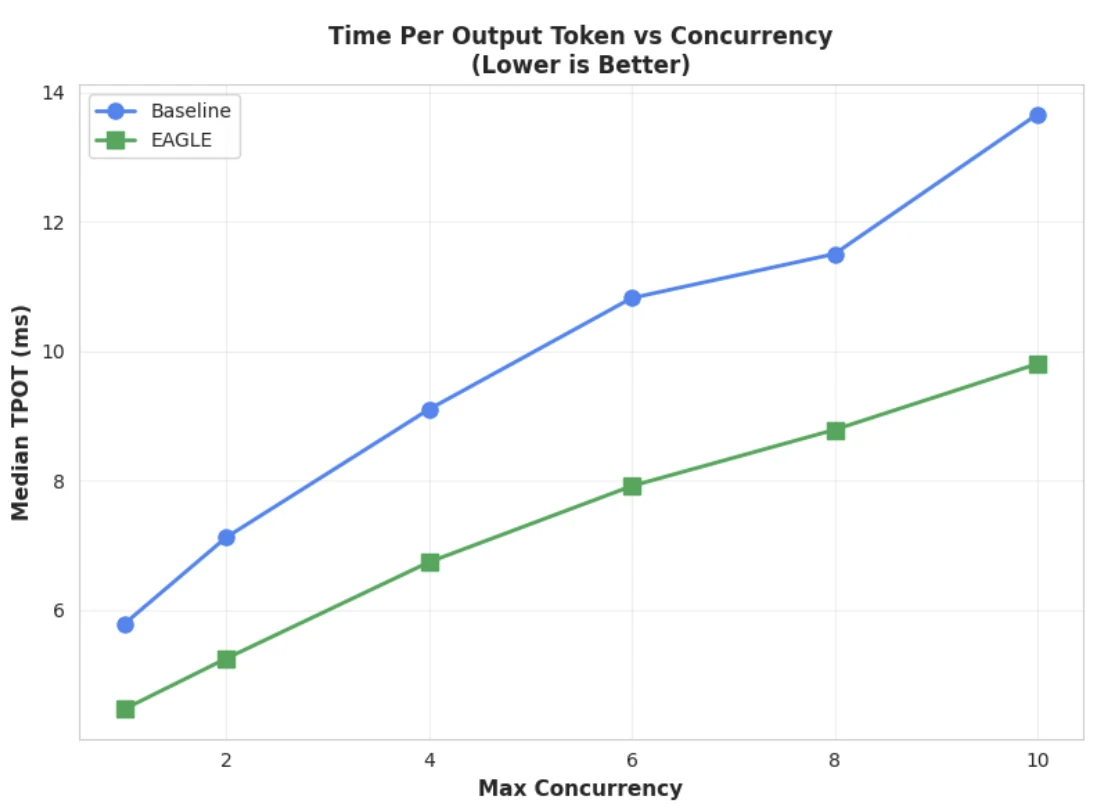
图源:LMSYS 官方博客 From research to production: Accelerate OSS LLM with EAGLE-3 on Vertex。这张图把”平均接受长度”与”吞吐”的关系画了出来:接受长度是投机解码唯一的收益变量,而它由草稿质量(算法)与验证开销(系统)共同决定。前文讲的 SGLANG_SIMULATE_ACC_LEN 就是用来分离这两个变量的调试开关。
本系列进度与路线图
已发布(vLLM 部分,共 16 篇):(一)整体架构与模块全景 → (二)请求生命周期 → (三)Scheduler 调度 → (四)KVCacheManager → (五)GPUModelRunner 输入批 → (六)Attention Backend → (七)PagedAttention Kernel → (八)MoE 层 → (九)Sampler 与采样 → (十)投机解码 → (十一)张量并行 → (十二)torch.compile 与 CUDA Graph → (十三)多模态输入 → (十四)结构化输出 → (十五)停止条件与增量解码 → (十六)源码阅读地图。
已发布(SGLang 部分,含本篇共 11 篇):
| 篇号 | 主题 | 状态 |
|---|---|---|
| (一) | 整体架构、进程拓扑与请求数据流 | 已发布 |
| (二) | 入口、分词与流式输出如何闭环 | 已发布 |
| (三) | Scheduler 请求状态机 | 已发布 |
| (四) | PrefillAdder 与 KV 预算 | 已发布 |
| (五) | KV 内存池与 RadixCache | 已发布 |
| (六) | Overlap Scheduler | 已发布 |
| (七) | ForwardBatch、TpModelWorker 与 ModelRunner | 已发布 |
| (八) | Attention Backend 与注意力 Kernel 落点 | 已发布 |
| (九) | CUDA Graph 与编译路径 | 已发布 |
| (十) | Sampling、Grammar 与结构化输出 | 已发布 |
| (十一) | 投机解码:草稿、验证与接受(本篇) | 已发布 |
SGLang 待讲模块清单:Disaggregation(P/D 分离调度与 KV 传输)、LoRA 与多 LoRA 批处理、多模态与 VLM 输入链路、权重加载与量化后端(--quantization 家族)、DP Attention 与负载均衡、Metrics 与可观测性、约束后端横向对比,以及迁移到其他框架(llama.cpp、TensorRT-LLM)后的收尾对比篇。
下一篇将进入「Disaggregation」这条线:SGLang 如何把 prefill 与 decode 拆到不同实例上执行、KV 如何通过 disaggregation 通道传输、eagle_disaggregation.py 与 dflash_disaggregation.py 为投机解码准备了哪些额外状态,以及 P/D 分离下调度器与内存池的所有权如何重新划分。本篇只在与调度记账相关处提到了 P/D 分离,下一篇会把它作为主题展开。
参考资料
- SGLang 官方 GitHub 仓库
- SGLang 投机输入与算法枚举源码(spec_info.py,固定提交)
- SGLang 投机算法注册表源码(spec_registry.py,固定提交)
- SGLang 投机工具函数源码(spec_utils.py,固定提交)
- SGLang EAGLE 工具与接受判定源码(eagle_utils.py,固定提交)
- SGLang EAGLE worker 公共逻辑源码(eagle_worker_common.py,固定提交)
- SGLang EAGLE worker V2 源码(eagle_worker_v2.py,固定提交)
- SGLang 草稿 worker 基类源码(base_spec_worker.py,固定提交)
- SGLang N-gram worker 源码(ngram_worker.py,固定提交)
- SGLang 批次对象源码(schedule_batch.py,固定提交)
- EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty(arXiv:2401.15077)
- EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test(arXiv:2503.01840)
- LMSYS 博客:From research to production: Accelerate OSS LLM with EAGLE-3 on Vertex
- EAGLE 完全拆解:特征级草稿模型如何把投机解码推到 3 倍以上
- EAGLE-3 完全拆解:Training-Time Test 如何解除特征预测的天花板
- Lookahead Decoding 完全拆解:Jacobi 迭代与 N-gram 池,不靠草稿模型的投机解码
- vLLM 源码完全拆解(十):投机解码——草稿模型、批量验证与 token 接受流水线
- SGLang 源码完全拆解(六):Overlap Scheduler 如何重叠 CPU 调度与 GPU 执行
- SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环
- SGLang 源码完全拆解(九):CUDA Graph 与编译路径——解码整图捕获、Prefill 分段图与静态形状约束
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



