


SGLang 源码完全拆解(十七):DP Attention 与专家并行——注意力数据并行、DeepEP 通信与 EPLB 负载均衡
这一篇要回答的问题
到第十六篇为止,我们对 SGLang 的阅读一直绕着一个隐含前提转:一次前向里的所有 token,都住在同一批 rank 上。调度器把一个 batch 交给 ModelRunner,ModelRunner 把它铺成 ForwardBatch,各层的 attention 和 MoE 在这批 token 上依次算完。TP(张量并行)在这里干的事是”切权重、算子算完再 all-reduce 回来”,无论怎么切,每个 rank 最终都要持有这一批所有 token 的激活值——因为 all-reduce 是求和,求和的每一份都必须覆盖全部行。
这个前提在中小规模部署下没出问题。但当模型变成 671B 的 MoE、集群变成几十个节点时,它会撞上两堵墙:
- 墙一:显存装不下。MoE 的专家权重按 TP 切分是切不均匀的——单个专家的中间维很小(DeepSeek-V3 是 2048),把它再按 TP 切到 16 份,每份只剩 128 行,GEMM 会小到没有效率甚至报错。所以专家层必须换一种切法:按专家切(Expert Parallelism,EP),每个 rank 只放一部分专家,token 按 top-k 路由结果跨节点搬运。
- 墙二:KV Cache 装不下。TP 下每张卡都要存全部 KV(因为 all-reduce 要求每 rank 都持有完整激活)。对长上下文请求来说,这等于把最贵的资源复制了 TP 份。
SGLang 的解法是把 attention 和 MoE 的并行方式故意错开:
- attention 走 DP Attention(数据并行注意力)。TP 组内部再切成若干个 attention-DP 副本,每个副本有独立的调度器、独立的 batch、独立的 KV Cache。KV Cache 的容量因此随 DP 副本数线性增长,而不是被复制。
- MoE 走 EP。专家分散在各 rank 上,token 用 all-to-all(A2A)搬运。
错开之后,一段 hidden state 在同一个 Transformer 层内部的旅程变成了这样:它先以”DP 本地”的姿态进入 attention(本副本只算自己的 KV),出来后必须汇合成全局 batch 才能交给 EP 的 MoE(因为专家分布在所有 rank 上,路由需要看到所有 token),MoE 算完再散回本 DP 副本,去做残差、norm、下一层。
这一进一出,就是本篇的主题。我们要拆开的东西包括:
layers/dp_attention.py里的全局缓冲区、gather/scatter 的两类实现,以及DpPaddingMode如何在”补齐到最长”和”补齐到总和”之间选;managers/scheduler_components/dp_attn.py里调度器侧的MLPSyncBatchInfo——各 DP 副本怎么对齐 token 数、CUDA Graph 资格、forward mode,以及为什么”某个副本闲着”也必须参与通信;layers/layer_boundary/这套 token 轴的抽象:SGLang 如何把”哪几维被切了”这件事从每个模型文件里抽出来,统一决定通信点;layers/moe/token_dispatcher/deepep.py:DeepEP 的 normal 与 low-latency 两种 dispatch 模式,为什么一个支持 CUDA Graph 一个不支持,以及 SGLang 怎么按 prefill/decode 自动切换;batch_overlap/two_batch_overlap.py:two-batch overlap 如何把一次 batch 切成两个 micro-batch 让通信和计算重叠,以及它与 DP Attention 的耦合点;eplb/整个目录:专家分布统计、负载均衡算法(分组、复制、再打包三步)、位置更新(P2P 换权重)与动态重排。
前置的并行基础在站内已经有铺垫:连续批处理与调度见 连续批处理完全拆解,KV 分页与块表见 PagedAttention 完全拆解,TP 如何切权重见 vLLM 源码完全拆解(十一):模型并行与 Worker 层,DeepSeek 侧的大规模 EP 服务设计见 DeepSeek-V3/R1 推理系统完全拆解,DeepEP 库本身的机制见 DeepEP 完全拆解。SGLang 系列前十六篇的阅读路径见 SGLang 源码完全拆解(一):整体架构、进程拓扑与请求数据流。
为什么 attention 与 MoE 不能用同一种并行
先把”错开”这个设计决策讲清楚,否则后面所有的 gather/scatter 都像是凭空造出来的麻烦。
TP 下 KV Cache 的复制问题
设 TP 大小为 8。注意力层的权重是切分的:Q/K/V 的投影矩阵按输出维切成 8 份,每张卡算自己那一份 head 的输出。算完之后要做一次 all-reduce,因为输出投影 W_O 需要看到全部 head 的结果。
问题的关键在于:每张卡要自己算自己的那些 head,就必须自己读自己那些 head 的 K 和 V。而 K 和 V 是历史所有 token 的,来自上一层。于是每张卡都必须把完整的 KV Cache 存在本地——否则它算不出自己那份 head 的注意力。
一台 8 卡机器跑一个 70B 模型、128K 上下文:按 GQA 8 个 KV 头、头维 128、80 层、FP16 算,单个请求的 KV 是
如果每张卡都存一份,8 卡一共吃掉 344 GB 显存——而真正需要的数据只有 43 GB。换句话说,TP 把 KV Cache 放大了 TP 倍。这在短上下文、小模型时不明显,在长上下文场景下是致命的:它直接把可并发的请求数除以 8。
EP 下专家权重切不均匀的问题
MoE 层反过来:如果按 TP 切专家权重,每个专家都要被切开。DeepSeek-V3 每个专家的 gate_proj 是 [2048, 7168],up_proj 同尺寸,down_proj 是 [7168, 2048]。按 TP=16 切,中间维 2048 被切成 128 行——GEMM 的 N 维只有 128,在 Hopper Tensor Core 上远低于最小有效 tile,kernel 要么退化要么直接不支持。
更合理的做法是不切专家,而是把 256 个专家分给各个 rank:EP=16 时每 rank 拿 16 个专家,专家内部的 GEMM 保持完整尺寸。代价是:token 必须被送到”持有它要用的专家”的那个 rank 上去。这就是 all-to-all。
所以一个自然的结论:attention 适合 DP(避免 KV 复制),MoE 适合 EP(避免专家切碎)。而这两者在同一层里必须拼接,就产生了一个”进出各一次全局通信”的结构。
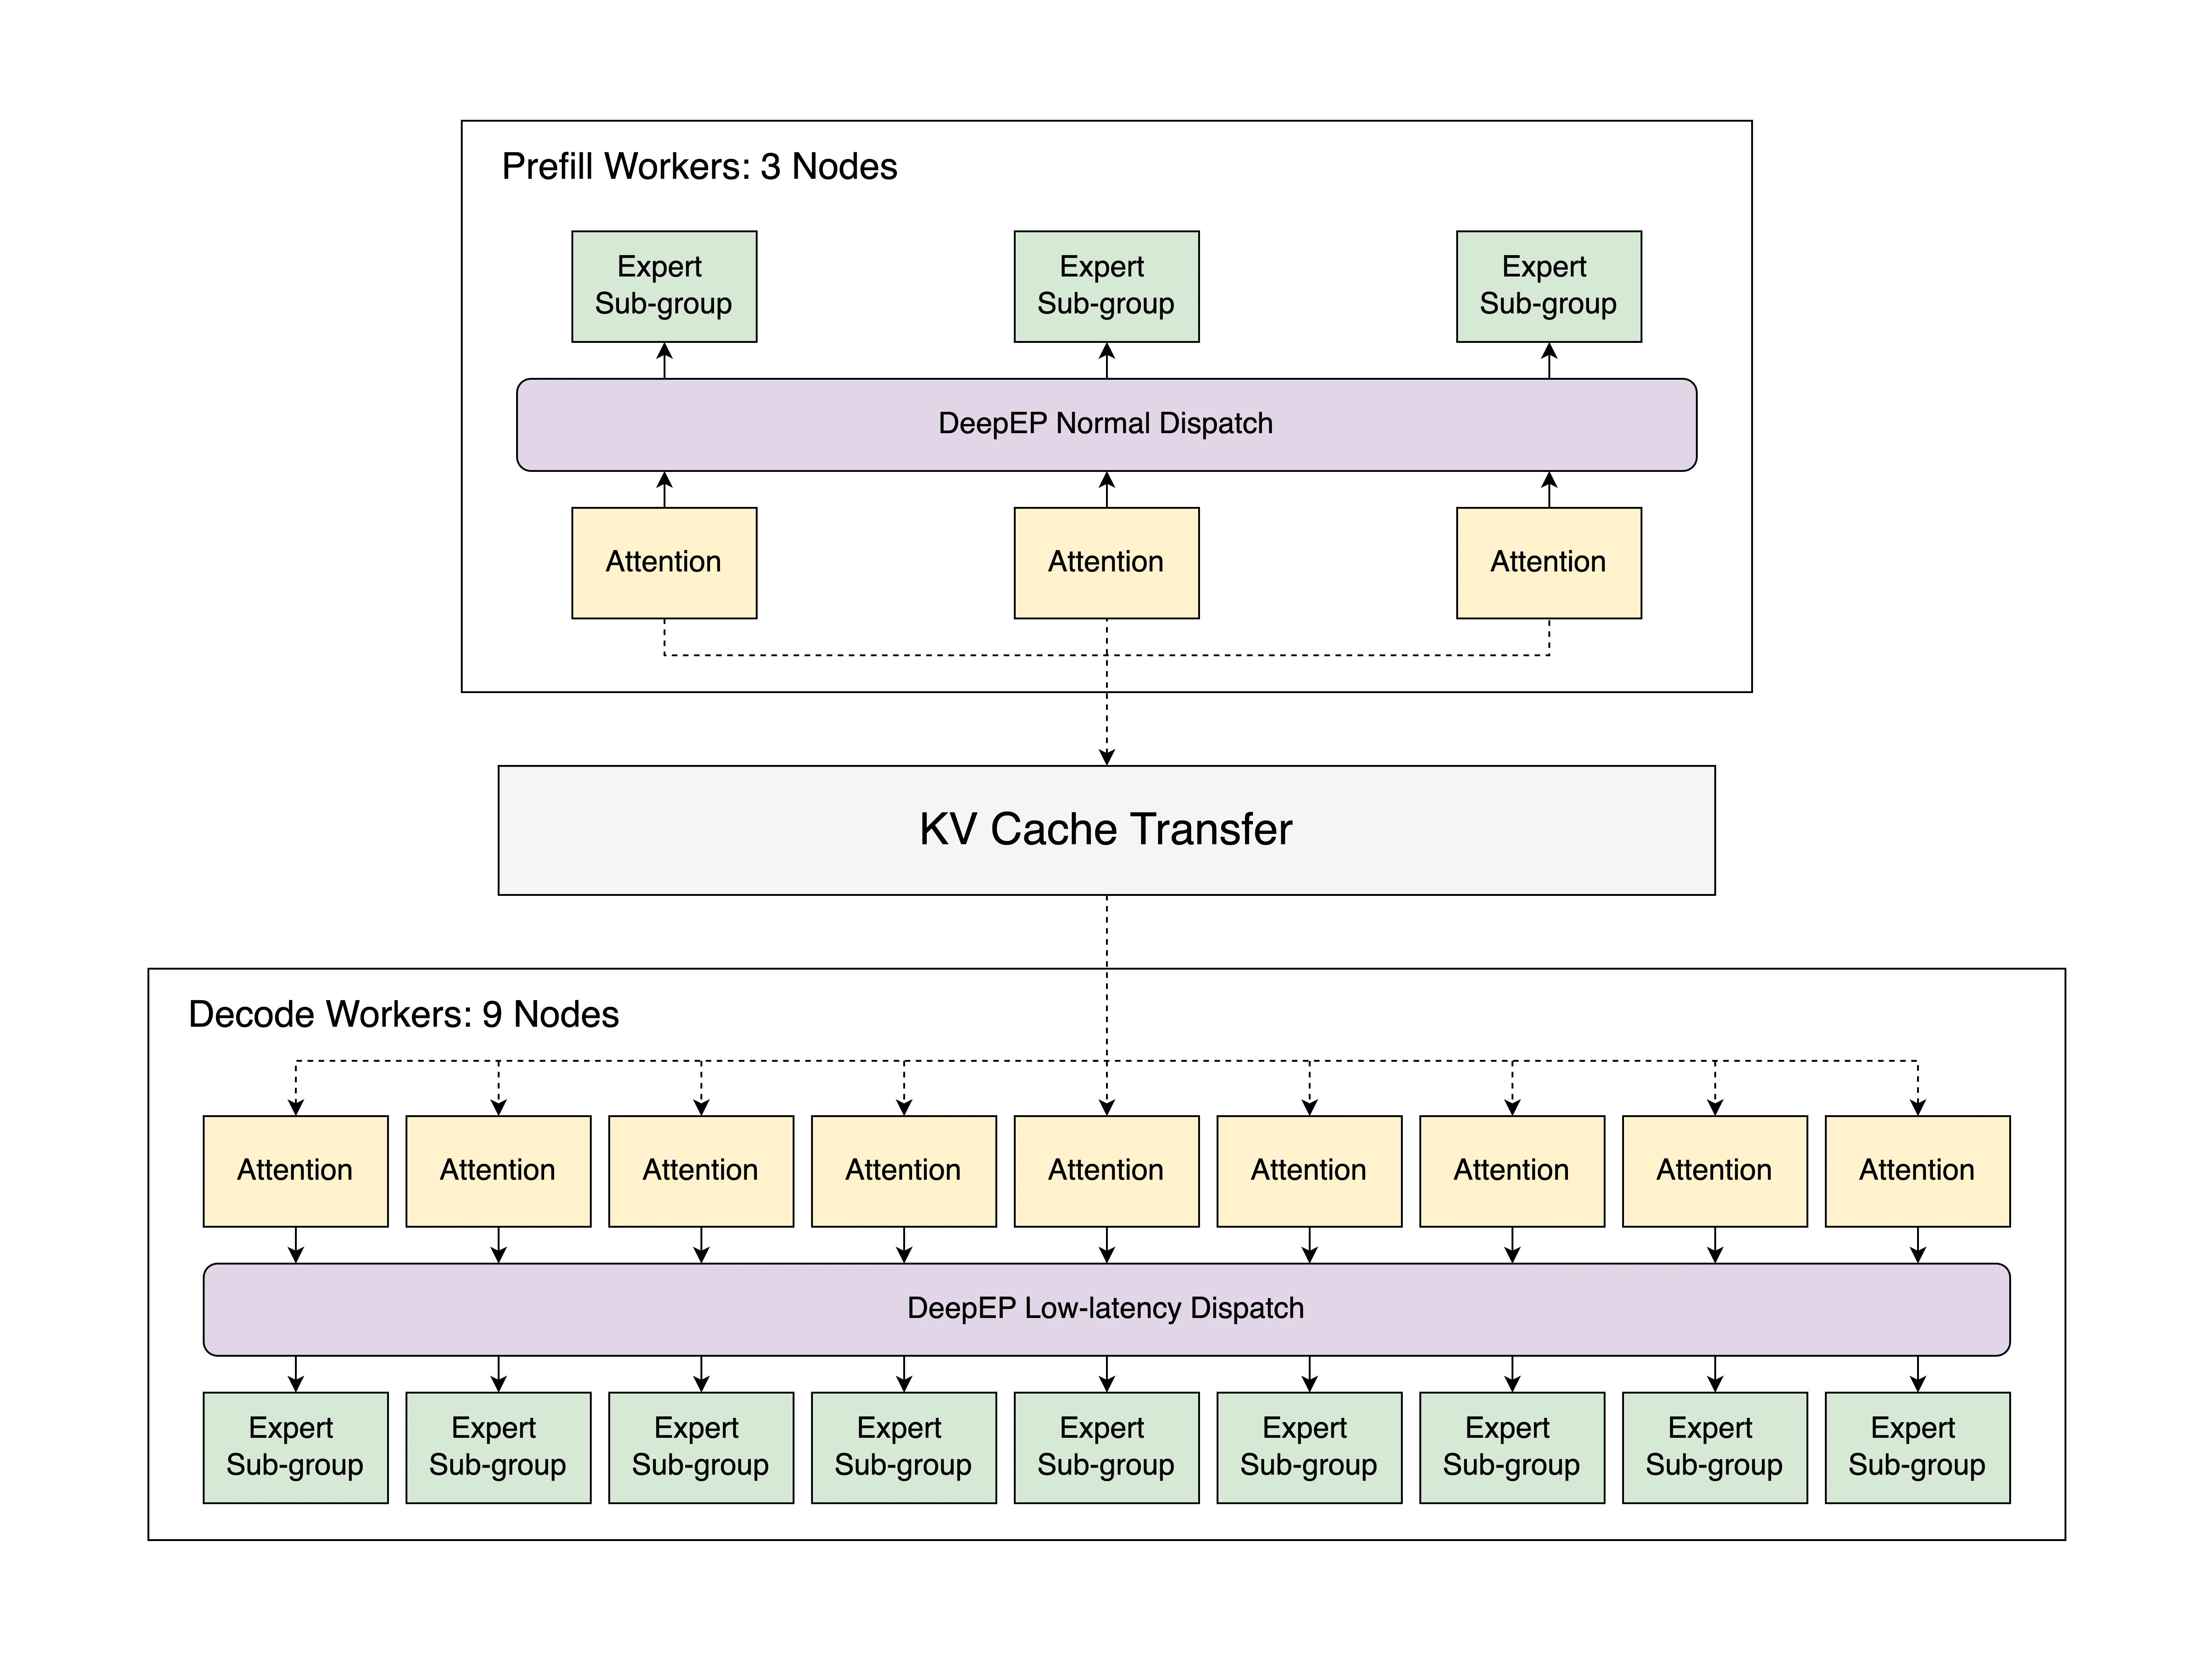
图片来源:SGLang 大规模 EP 设计博客 的整体架构图
图里值得注意的是两件事:一是 attention 部分被画成了若干个并排的副本(DP),二是 MoE 部分被画成一个横跨所有 GPU 的专家池(EP)。中间的箭头就是本篇要拆的 gather/scatter 与 A2A。
名称上的一个坑:dp_size 与 attn_dp_size
SGLang 的并行度参数在过去一年里被重命名过一次,读源码时必须分清:
--dp-size是真正的数据并行副本数,每个副本有独立的模型权重副本、独立调度器。这是”多副本服务”的语义。--attn-dp-size是TP 组内的注意力数据并行宽度:在同一个 TP 组内部,把 token 分给若干个 attention-DP 副本,attention 是数据并行的,FFN 仍然是张量并行的。这是”混合”的语义。--enable-dp-attention是已废弃的写法。在固定提交d88d5c3上,它已经被解析成attn_dp_size:server_args.py里明确写着解析逻辑是resolved["enable_dp_attention"] = resolving_view(self).attn_dp_size > 1,并且注释标注TODO: remove after 2026-12-31。CLI 上仍保留这个 flag,但它实际报的是”是否配置了 attention-DP 宽度”。
参数文档里对 attn_dp_size 的定义是:attention 数据并行尺寸,即 TP 组内部的数据并行注意力组数,每组一个调度器,而 FFN 保持张量并行。这句话是整个设计的浓缩版,后面所有机制都在兑现它。
于是 tp_size 被拆成两个正交的乘积:
其中 attn_cp_size 是注意力的上下文并行(把序列维切开做长上下文 prefill)。attn_tp_size 由 derive_attn_tp_size 导出:
def derive_attn_tp_size(*, tp_size: int, attn_cp_size: int, attn_dp_size: int) -> int: return tp_size // attn_dp_size // attn_cp_sizeMoE 侧是另一套乘积:
两套分解同时成立、共用同一批物理 rank,只是分组方式不同。initialize_model_parallel 的文档注释给了一个具体例子:8 张卡,attn_cp_size=2、attn_tp_size=4,同时 moe_dp_size=2、moe_ep_size=4,那么:
- attention context-parallel 组:
[g0,g4] [g1,g5] [g2,g6] [g3,g7] - attention tensor-parallel 组:
[g0,g1,g2,g3] [g4,g5,g6,g7] - MoE expert-parallel 组:
[g0,g1,g2,g3] [g4,g5,g6,g7] - MoE data-parallel 组:
[g0,g4] [g1,g5] [g2,g6] [g3,g7]
同一个 rank 同时属于四个不同名字的组。这是理解后面所有 gather/scatter 的坐标系——通信到底在哪个组上做,取决于这一维是谁切的。
DP 本地与全局:一段 hidden state 的两种身份
现在进入代码。layers/dp_attention.py 是这个机制的核心文件,它维护了一个”全局缓冲区”的概念。
全局缓冲区的尺寸与语义
_DpGatheredBufferWrapper 是一个状态门面,把”全局 gather 缓冲区”的元数据(hidden size、dtype、device)挂在 flags.dp 上,把每次前向的尺寸四元组保留为类属性:
_global_dp_buffer_len: int = 0_local_dp_buffer_len: int = 0_dp_max_padding: bool = False_global_num_tokens: Optional[List[int]] = None_global_num_tokens_gpu: Optional[torch.Tensor] = None源码注释解释了为什么尺寸要放类属性而不是 contextvar:这些值会在被 torch.compile 追踪的模型代码里读到,而属性来源的 int 会被 dynamo 当作自动动态(automatic dynamic),contextvar 则无法追踪,dict 槽位还会触发 recompile 上限——每个不同的 size 都重编译一次。这是一个典型的性能工程细节:为了不让编译器为每种 token 数重新编译一遍图,把这些标量放在”编译器看得懂”的位置上。
global_num_tokens 是一个长度为 DP 副本数的列表:第 i 个元素是第 i 个 DP 副本这一轮有多少 token。global_num_tokens_gpu 是它在 GPU 上的张量版本,用来在 kernel 里算偏移。
本 rank 的切片位置怎么算
get_dp_local_info 回答一个问题:在拼接后的全局 buffer 里,我这一段从哪一行开始、有多长?
def get_dp_local_info(forward_batch: ForwardBatch) -> Tuple[torch.Tensor, torch.Tensor]: if forward_batch.dp_local_start_pos is None: dp_rank = dp_slot_in(forward_batch.global_num_tokens_gpu) cumtokens = torch.cumsum(forward_batch.global_num_tokens_gpu, dim=0) if dp_rank == 0: local_start_pos = torch.zeros_like(cumtokens[0]) else: local_start_pos = cumtokens[dp_rank - 1] local_num_tokens = forward_batch.global_num_tokens_gpu[dp_rank] forward_batch.dp_local_start_pos = local_start_pos forward_batch.dp_local_num_tokens = local_num_tokens return forward_batch.dp_local_start_pos, forward_batch.dp_local_num_tokens先 cumsum 得到前缀和,rank 0 从 0 开始,rank i 从”前面所有 rank 的 token 数之和”开始。这就是把各副本的 token 顺序拼成一个全局序列的下标计算。注意这是在 GPU 上算的(张量运算),结果缓存在 ForwardBatch 上避免重复计算。
两种 gather:all_reduce 与 all_gather
SGLang 为 gather 写了两条完全不同的实现路径,选哪条取决于拓扑。
路径一:_dp_gather_via_all_reduce。 思路是”反向 all-reduce”:每个 rank 先把全局 buffer 清零,然后把自己那一段写进对应位置,再做一次 all-reduce,各段的贡献加起来正好拼出完整 buffer。
global_tokens.fill_(0) ... writes = (is_partial or get_parallel().attn_tp_rank == 0) and ( cp_shard_counts is not None or get_parallel().attn_cp_rank == 0 ) if local_tokens.shape[0] > 0 and writes: ... memcpy(global_tokens, local_tokens, 0, local_start_pos, local_num_tokens, False)这里有个关键设计:只有 attn_tp_rank == 0 才写。因为 attention-TP 组内的各 rank 持有的是同一批 token 的切片(sequence parallel 或 head 切分),只有一个 rank 该负责写入自己的 DP 段,否则同一份数据会被写多次、all-reduce 之后数值翻倍。all-reduce 完成后,所有 rank 都拿到了完整的全局 buffer——这正是 EP 需要的(每个 rank 都要看到全部 token 才能做正确的路由)。
注释还提到一个细节:输入 ID 是 int32 类型,所以本地情形下要用 inplace_all_reduce(custom all-reduce 的路径),
NUM_GPUS_PER_NODE = 8 if ( not local_tokens.dtype.is_floating_point and get_parallel().tp_size <= NUM_GPUS_PER_NODE ): from sglang.srt.distributed.parallel_state import inplace_all_reduce
inplace_all_reduce( global_tokens, group_name=get_parallel().tp_group.unique_name )整数类型的 all-reduce 走 NCCL 的原地路径更快,且只在单机 8 卡以内有效——跨机时自定义 all-reduce(通常基于 NVLink + P2P 实现)不再适用。
路径二:_dp_gather_via_all_gather。 如果 attn_tp_size == 1,说明每个 DP 副本就是一个 rank,直接 all-gather 即可:
if get_parallel().attn_tp_size == 1: if use_world: all_gather_single(global_tokens, local_tokens, group=torch.distributed.group.WORLD) else: get_parallel().tp_group.all_gather_into_tensor(global_tokens, local_tokens) return如果 attn_tp_size > 1,则要先在 attention-TP 组内把切片拼回本 DP 副本的完整 token,再跨 DP 做 gather,代码用 reduce_scatter_tensor 与前缀拼接处理:
if not is_partial: if get_parallel().attn_tp_rank != 0: local_tokens.fill_(0) scattered_local_tokens = local_tokens.tensor_split(get_parallel().attn_tp_size)[ get_parallel().attn_tp_rank ] get_parallel().attn_tp_group.reduce_scatter_tensor( scattered_local_tokens, local_tokens )这里出现了一个重要概念:is_partial。它表示”这批 hidden state 本身还是 attention-TP 意义上的部分和”,即各 attn_tp rank 各持一部分贡献,需要先 reduce 才能用。这对应着一层里 attention 输出还没做 all-reduce 的情形(融合了 reduce 的路径,后面会讲)。
DpPaddingMode:补齐到最长还是补齐到总和
既然要拼成一个全局 buffer,就有一个不可避免的问题:各 DP 副本本轮 token 数不一样。副本 A 有 3000 个 token,副本 B 只有 200 个,拼起来没问题(用 cumsum 定位即可),但集合通信往往要求各 rank 的输入形状一致。SGLang 因此定义了两个 padding 模式:
class DpPaddingMode(IntEnum): # Padding tokens to max length and then gather tokens using `all_gather_into_tensor` MAX_LEN = auto() # Padding tokens to sum length and then gather tokens using `all_reduce` SUM_LEN = auto()- MAX_LEN:每个副本都补齐到
max(global_num_tokens),然后用all_gather_into_tensor(要求等长)。 - SUM_LEN:每个副本补齐到”全体之和”,然后用
all_reduce(all-reduce 对不等长的分段求和)。
选择逻辑在 get_dp_padding_mode,这是一段非常值得读的启发式:
if moe_a2a_backend.is_pplx(): return DpPaddingMode.MAX_LEN
if moe_a2a_backend.is_deepep_v2() and envs.SGLANG_DEEPEP_V2_FORCE_MAX_LEN.get(): return DpPaddingMode.MAX_LEN
if is_extend_in_batch and gather_width > 1: if get_flags().dp.max_len_with_idle and min(global_num_tokens) == 0: return DpPaddingMode.MAX_LEN return DpPaddingMode.SUM_LEN
# we choose the mode that minimizes the communication cost max_len = max(global_num_tokens) sum_len = sum(global_num_tokens) if sum_len * 2 >= max_len * gather_width: return cls.MAX_LEN else: return cls.SUM_LEN逐条解释这四个分支:
- pplx 后端强制 MAX_LEN。源码注释给了原因:pplx-kernels 的 a2a 是一个对称集合通信,每个 EP rank 必须 dispatch 相同数量的 token,否则设备侧握手死锁——空闲的 DP rank(0 token)永远不发信号,对端就永远等。这是一个真实的死锁,不是性能问题。
- DeepEP v2 强制 MAX_LEN(可通过环境变量开关)。同样是按阶段选择的通信拓扑对形状对称性的要求。
- prefill 阶段(
is_extend_in_batch)且 gather 跨多个 DP rank 时用 SUM_LEN。注释说得很直接:避免 token 分布不均带来的 padding 开销。prefill 阶段各副本的 token 数差异可以极大(有人在做 4K 的 prompt,有人在解码),补到最长意味着大量无效行白算。例外是”混合 SSM 模型”(max_len_with_idle)且某个副本恰好为空时需要 MAX_LEN,源码注释说这是因为这类模型要用”fabricated-row conversion”来实体化空闲 rank。 - 默认走代价最小化:
sum_len * 2 >= max_len * gather_width时选 MAX_LEN。这个不等式的含义是——如果按 MAX_LEN 补,通信总量是max_len × width;如果按 SUM_LEN,通信总量是sum_len。当sum_len超过max_len × width的一半时,两者相近,而 MAX_LEN 还能顺带启用对称内存优化(use_symmetric_memory,后面提),因此倾向 MAX_LEN。
在 CUDA Graph 场景下还有默认模式:
@classmethod def get_default_mode_in_cuda_graph(cls) -> DpPaddingMode: if _USE_ROCM700A_WA: return cls.SUM_LEN else: return cls.MAX_LENCUDA Graph 要求形状固定,所以必须选一个确定的 padding 模式;MAX_LEN 在等长情形下更容易做出稳定的图。
scatter:把 MoE 的输出还回本副本
相反方向的操作在 layers/layer_boundary/ops.py。_dp_scatter_step 是 dispatch 表里的一项,真正的实现在 dp_scatter:
def dp_reduce_scatterv( local_hidden_states: torch.Tensor, hidden_states: torch.Tensor, forward_batch: ForwardBatch,) -> None: get_parallel().tp_group.reduce_scatterv( hidden_states, output=local_hidden_states, sizes=get_dp_global_num_tokens(), )reduce_scatterv 是”不等长版本的 reduce-scatter”:按 sizes 指定的切分点,把输入切给各 rank,同时做求和。这正好是 gather 的逆操作——gather 时用 all-reduce 拼,scatter 时就用 reduce-scatterv 拆,且 sizes 就是 global_num_tokens。一致性由此保证:同一份 global_num_tokens 既决定拼的偏移,也决定拆的长度。
还有一个值得看的群体选择函数:
def _dp_scatter_group() -> GroupCoordinator: parallel = get_parallel() if parallel.tp_size == parallel.attn_dp_size: return parallel.tp_group return parallel.attn_tp_group当 tp_size == attn_dp_size 时,attn_tp_size 必然为 1,每一个 DP 副本就是一个 rank(没有 attention-TP 切片),这时用整个 TP 组做 scatter;否则用 attention-TP 组(因为切片要先在组内合并)。通信组的选取完全由”这一维是否真的被切过”决定——这是 layer_boundary 那套抽象的核心思想。
调度器侧的 DP 同步:MLPSyncBatchInfo
模型侧的 gather/scatter 需要一个前提:各 DP 副本对”这一轮全局有多少 token”达成一致。这个信息由调度器侧收集,代码在 managers/scheduler_components/dp_attn.py。
每个副本为什么必须有调度器
DP Attention 的一个硬性后果是:每个 attention-DP 副本都需要自己的调度器进程。因为每个副本的 batch 是独立的——副本 A 的请求队列和副本 B 完全不同,KV Cache 也是各自独立的池。所以 SGLang 在 attn_dp_size > 1 时的进程拓扑是:
这个数字在参数文档里被明确写出:num_dp_ranks 的定义就是”这个部署用多少个数据并行 rank 来服务,每个一个调度器:dp_size * attn_dp_size”。
多个调度器之间需要同步,是因为 MoE 的 EP 通信跨越所有 rank:如果各调度器各自决定”我这轮跑多少 token”,A2A 的 buffer 对不上,通信就会挂住。所以每轮前向之前,各调度器要交换一轮元数据。
11 个字段的元数据
MLPSyncBatchInfo 把要同步的东西打包成一个固定长度的张量:
def _get_local_tensor(self, device, dtype=torch.int64) -> torch.Tensor: return torch.tensor( [ self.num_tokens, self.num_tokens_for_logprob, int(self.can_run_decode_cuda_graph), int(self.is_extend_in_batch), int(self.local_can_run_tbo), self.local_forward_mode, int(self.can_run_prefill_cuda_graph), self.prefill_cuda_graph_max_prefix_len, int(self.can_run_draft_cuda_graph), int(self.is_health_check), self.attention_pairs, ], device=device, dtype=dtype, )这 11 个字段不是随便选的,它们覆盖了”跨副本必须一致”的每一件事:
num_tokens/num_tokens_for_logprob:本副本的 token 数,用来算全局偏移与 padding 目标。is_extend_in_batch:这一轮全局是不是 prefill 批次。这个信息决定 DeepEP 用 normal 还是 low-latency(后面讲),也决定 padding 模式。can_run_decode_cuda_graph/can_run_prefill_cuda_graph/can_run_draft_cuda_graph:本副本是否能用 CUDA Graph。这是一个必须全局一致的决策——如果用图的 rank 和不用图的 rank 混在一起,通信形状就可能对不上。local_can_run_tbo:本副本能否参与 two-batch overlap。local_forward_mode:本副本的 forward mode(decode / extend / idle / …),用来推导”全局 forward mode”。prefill_cuda_graph_max_prefix_len:prefill 图的形状分桶依据。is_health_check:这一批是否全是一次健康检查探针。健康检查要特别对待,因为它出现在系统本就空闲的时刻,把它算进负载不均衡统计会得到假象。attention_pairs:这一轮本副本处理的因果 (query, key) 对数量。这是个比 token 数更能反映真实计算量的量——decode 时每个请求 1 个 query 但要看全部历史 KV,token 数完全反映不出负载。
一个 D2H 而不是十一个
同步的实现是 all-gather 全部副本的这 11 个 int64:
global_info_tensor = fallback_tensor.repeat( self.num_dp_ranks, self.tp_size * self.cp_size, 1 )形状是 [num_dp_ranks, tp_size * cp_size, 11]。tp_size * cp_size 这一维存在是因为 attention-TP 组内的各 rank 也需要参与(它们构成 DP 副本的切片)。每个槽位先填 fallback 值,再把活跃 rank 的真实值写进去:
if device == "cpu": tp_active_ranks = get_parallel().tp_group.active_ranks_cpu else: tp_active_ranks = get_parallel().tp_group.active_ranks if tp_active_ranks.shape[0] < num_ranks_in_tp_info: tp_active_ranks = torch.ones( num_ranks_in_tp_info, dtype=tp_active_ranks.dtype, device=tp_active_ranks.device, ) tp_info[tp_active_ranks[:num_ranks_in_tp_info] == 0] = fallback_tensoractive_ranks 是弹性 EP 场景下的”当前有哪些 rank 活着”。不活跃的槽位会被强制回填成 fallback,避免读到垃圾数据。
最后一步是把结果搬到 CPU。这里有一个被显式注释的性能点:
# One D2H for every field: each `.item()` / `.tolist()` on a device # tensor is its own stream sync. Copy the whole tensor, not the # `[:, 0, :]` slice -- that slice is non-contiguous once # attn_tp * attn_cp > 1, adding a gather kernel inside the wait. tp0_info_cpu = global_info_tensor.cpu()[:, 0, :]注释说了两件事:第一,每个 .item() 都是一次独立的流同步,所以要把整块搬回来一次性 .tolist();第二,不能直接拷 [:, 0, :] 这个切片,因为当 attn_tp * attn_cp > 1 时它在内存上不连续,.cpu() 会额外插一个 gather kernel 到等待路径里——直接把整块拷回来再索引反而更快。这类”看着多做了、实际更快”的取舍,是推理系统代码里很常见的东西。
只取 [:, 0, :](tp rank 0 那一列)是因为同一 DP 副本的各 attn_tp rank 持有相同元数据,取一个代表即可。
从”本副本的 vote”到”全局的决策”
元数据回来之后,各个字段用不同的归约:
self.global_num_tokens = tp0_info_cpu[:, 0].tolist() self.global_num_tokens_for_logprob = tp0_info_cpu[:, 1].tolist() self.can_run_decode_cuda_graph = bool(tp0_info_cpu[:, 2].min()) self.is_extend_in_batch = bool(tp0_info_cpu[:, 3].max()) self.can_run_prefill_cuda_graph = bool(tp0_info_cpu[:, 6].min()) self.prefill_cuda_graph_max_prefix_len = int(tp0_info_cpu[:, 7].max()) self.can_run_draft_cuda_graph = bool(tp0_info_cpu[:, 8].min()) self.any_health_check = bool(tp0_info_cpu[:, 9].max()) self.global_attention_pairs = tp0_info_cpu[:, 10].tolist()- token 数和 attention_pairs 要”全部保留”(list),因为后面要用 cumsum 定位每个人的段。
- CUDA Graph 资格用
min():只要有一个副本不能用图,全体都不能用。这叫”一票否决”,理由是形状必须全局对齐。 is_extend_in_batch用max():只要有任何一个副本有 prefill,就算这一轮是 prefill 轮。这是为了让 DeepEP 选择 normal dispatch——所有副本必须用同一种 dispatch 模式。prefill_cuda_graph_max_prefix_len用max():取最长的前缀长度,图的分桶要覆盖最坏情况。- 健康检查用
max():任何一个副本在跑探针,全轮都要特殊标记。
注意投票函数的单侧语义——_local_decode_cuda_graph_vote 里空闲和 prebuilt 批次都被认为是”可以用图”(返回 True):
def _local_decode_cuda_graph_vote( *, local_batch: Optional[ScheduleBatch], disable_cuda_graph: bool,) -> bool: """This rank's vote for the decode graph (min-reduced across dp ranks).""" if disable_cuda_graph: return False return ( local_batch is None or local_batch.forward_mode.is_decode_or_idle() or local_batch.forward_mode.is_prebuilt() )这很重要:空闲的副本不应该否决别人的图,它自己没有形状要求。
空闲副本也必须参与
一个容易被忽略的事实是:即使某个 DP 副本本轮一个请求都没有,它也必须参加这次 gather。原因就是前面 pplx 那段注释说的对称性——集合通信要求所有 rank 到场。为此 SGLang 会为它构造一个 IDLE 批次:
if skip_all_gather: # Skip idle batch when attn-dp=1 (and always under DWDP: ranks run independently) need_idle_batch = not dwdp and num_dp_ranks > 1 else: need_idle_batch = max(mlp_sync_info.global_num_tokens) > 0如果一轮里所有副本都是 0 token(整个集群完全空闲),那就没必要造 idle 批次了——max(...) > 0 这个条件就是在剪掉这种情形。反过来只要有任何一个副本有活,其他空的副本都要造一个 idle 批次陪着走完这轮通信。
fallback 张量里的 forward mode 就是 IDLE:
def _get_fallback_tensor(self, device, dtype=torch.int64) -> torch.Tensor: return torch.tensor( [ 0, # num_tokens 0, # num_tokens_for_logprob 1, # can_run_decode_cuda_graph 0, # is_extend_in_batch 1, # local_can_run_tbo ForwardMode.IDLE.value, # local_forward_mode 0, # can_run_prefill_cuda_graph 0, # prefill_cuda_graph_max_prefix_len 1, # can_run_draft_cuda_graph 0, # is_health_check 0, # attention_pairs ], device=device, dtype=dtype, )注意空闲 rank 的 can_run_decode_cuda_graph 和 can_run_draft_cuda_graph 都是 1——同样的道理,它没有形状要求,不应该拖累别人。
should_skip_scheduler_all_gather:什么时候可以省掉这次通信
def should_skip_scheduler_all_gather(num_dp_ranks: int) -> bool: """Return whether scheduler metadata is already local and rank-invariant.
With one attention-DP rank there is no cross-DP state to reconcile. The TP schedulers consume the same broadcast request stream, so gathering the identical batch mode, graph eligibility, and token counts only adds a device collective plus host synchronization. Preserve the environment override for deployments that explicitly guarantee this invariant beyond DP1. """
return num_dp_ranks == 1 or envs.SGLANG_SCHEDULER_SKIP_ALL_GATHER.get()当 num_dp_ranks == 1 时,没有跨 DP 的状态要协调,这次 all-gather 纯属浪费(一次设备集合通信加一次主机同步)。环境变量 SGLANG_SCHEDULER_SKIP_ALL_GATHER 是给那些”明确保证不变量”的部署的逃生门。
还有一个细节:sync_wait_seconds 被单独记账并用 DPSyncWaitCarry 跨轮传递:
sync_wait_seconds = mlp_sync_info.sync_wait_seconds if sync_wait_carry is not None: sync_wait_seconds += sync_wait_carry.seconds sync_wait_carry.seconds = 0.0如果某轮没产出 batch(drop_sync_wait_carry),这次等待的时间会被记到下一轮,避免统计上丢掉。因为”等待最慢的副本”正是 DP Attention 最典型的开销,把它单独测量出来才能判断批处理是否失衡。
全局 forward mode 与 TBO 的耦合
MLPSyncBatchInfo 里还有一个 global_forward_mode,它由 TboDPAttentionPreparer.compute_output 产出:
@staticmethod def _compute_global_forward_mode(forward_modes): forward_modes_excluding_idle_and_prebuilt = [ x for x in forward_modes if x != ForwardMode.IDLE.value and x != ForwardMode.PREBUILT.value ]
if not forward_modes_excluding_idle_and_prebuilt: return ForwardMode.IDLE, False
forward_mode_agree = TboDPAttentionPreparer._is_all_same( forward_modes_excluding_idle_and_prebuilt )
global_forward_mode = ( ForwardMode(forward_modes_excluding_idle_and_prebuilt[0]) if forward_mode_agree else None ) return global_forward_mode, forward_mode_agree逻辑是先剔掉 IDLE 与 PREBUILT,再看剩下的是不是全部相同。全部相同才给出全局 mode,否则给 None。为什么这么严格?因为 two-batch overlap 需要把 batch 按 token 维切成两个 micro-batch,切分点的计算依赖 forward mode:
def compute_split_seq_index( forward_mode: ForwardMode, num_tokens: int, extend_lens: Optional[Sequence[int]], token_num_per_seq: Optional[int],) -> Optional[int]: if forward_mode == ForwardMode.EXTEND or forward_mode == ForwardMode.MIXED: assert extend_lens is not None return _split_extend_seqs(extend_lens) elif forward_mode.is_target_verify() or forward_mode.is_decode(): assert token_num_per_seq is not None return (num_tokens // token_num_per_seq) // 2 elif forward_mode.is_idle() or forward_mode.is_prebuilt(): assert num_tokens == 0 return 0 else: raise NotImplementedError()EXTEND 按序列边界切(_split_extend_seqs),decode 按 token 数对半切((num_tokens // token_num_per_seq) // 2)。如果各副本的 forward mode 不一致(有人在 prefill 有人在 decode),就没有一个统一的切法,TBO 只能关掉。这就是 DP Attention 与 TBO 的耦合点:TBO 的可用性由 DP 副本的 mode 一致性决定。
两层通信怎么省:layer_boundary 与融合读取
如果每个 Transformer 层都要”attention 本地算 → gather → MoE → scatter”两次通信,深模型上通信量会非常可观。SGLang 在 layers/layer_boundary/ 引入了一套抽象来压缩这件事。
Token 轴:把”谁切了什么”显式化
layout.py 定义了三个 token 轴:
class TokenAxis(Enum): """A parallel dimension across which ranks hold different tokens."""
ATTN_DP = auto() ATTN_CP = auto() # Each attention-TP rank holds a slice of its group's tokens. ATTN_TP = auto()配套的 Layout 只记录一件事:哪些轴被真正切过(size 为 1 的轴被 sharded_over() 过滤掉):
@classmethod def sharded_over( cls, *axes: TokenAxis, axis_sizes: Mapping[TokenAxis, int] ) -> "Layout": return cls(frozenset(axis for axis in axes if axis_sizes[axis] > 1))这个设计解决了一个很实际的问题:模型文件不该知道部署拓扑。一个 DeepSeek 层的代码不需要写”如果 attn_dp_size > 1 就 gather”这种分支,它只要声明”我这个阶段的输入/输出在哪些轴上是切分的”,边界层根据 Layout 的差集自动决定要不要通信、在哪个组上通信。move_rows 就是这个决策的执行者:
def move_rows( hidden_states: torch.Tensor, rows: Layout, to: Layout, forward_batch: ForwardBatch,) -> torch.Tensor: """A complete value from the rows it is on to ``to``: gathered over the token axes ``to`` does not shard (attention TP, then attention DP), or cut to this rank's share of those it does (attention DP, then attention TP).""" gathered, cut = rows.sharded - to.sharded, to.sharded - rows.sharded if (gathered and cut) or TokenAxis.ATTN_CP in gathered | cut: raise NotImplementedError(f"{rows=} {to=}") if TokenAxis.ATTN_TP in gathered: hidden_states = attn_tp_gather(hidden_states) if TokenAxis.ATTN_DP in gathered: hidden_states = dp_gather(hidden_states, forward_batch) if TokenAxis.ATTN_DP in cut: hidden_states = to_dp_local(_dp_scatter_step, forward_batch, hidden_states) if TokenAxis.ATTN_TP in cut: parallel = get_parallel() hidden_states = hidden_states.tensor_split(parallel.attn_tp_size)[ parallel.attn_tp_rank ] return hidden_states它的输入是”当前在哪些轴上被切了”和”目标要求哪些轴被切”,输出是执行必要通信后的张量。注意几个约束:不允许同时既有 gather 又有 cut(那说明布局设计有问题,直接 NotImplementedError 而不是默默算错),ATTN_CP 不允许在这里移动(上下文并行的重排有自己的路径)。
边界判定的融合
boundary.py 里有一段逻辑决定”这次 gather 要不要顺手把该做的 reduce 和 norm 一起做掉”。核心判定是:
places_cp_shards = TokenAxis.ATTN_CP in gathered if ( owes_attention_tp and not read.reads_before_dp_gather and is_plain_add and read.is_plain_norm ): return EntryStep( partial( _dp_gather_sum_read, gathers_residual=gathers_residual, places_cp_shards=places_cp_shards, read=read, ) ) return EntryStep( partial( _reduce_update_read_dp_gather, gathers_residual=gathers_residual, reduces_attention_tp=owes is not None, group=owes, places_cp_shards=places_cp_shards, read=read, ) )三个条件同时满足才有”最强融合”:
owes_attention_tp:attention-TP 组欠一次 all-reduce(输出投影还没做完);not read.reads_before_dp_gather:这次读取在 gather 之后做,而不是之前;is_plain_add且read.is_plain_norm:残差只是普通加法、norm 只是普通 RMSNorm。
reads_before_dp_gather 是一个很有意思的标记。源码里的解释是:某些残差读取(比如 attention-residual bank 的聚合读取)必须在 DP gather 之前完成,因为它读的是本 rank 自己持有的那些行(bank 就存在本 rank 上),gather 之后行序变了就找不到了。同理,“gated” 类残差(门控残差)也不能被普通 add+norm 的融合 kernel 接管,所以它们的 is_plain_add 是 False。
于是 _reduce_update_read_dp_gather 的实现就是顺理成章的”一次做完三件事”:
def _reduce_update_read_dp_gather( hidden_states: torch.Tensor, residual: torch.Tensor, forward_batch: ForwardBatch, norm: torch.nn.Module, *, cache=None, gathers_residual: bool, reduces_attention_tp: bool, places_cp_shards: bool = False, group: SumGroup = SumGroup.ATTN_TP, read: ResidualReadout = NORM_READOUT, update: ResidualUpdate = PLAIN_ADD,): """Attention DP: complete the attention-TP sum if it is owed, write the output into the residual and read the FFN input locally, then gather.""" if gathers_residual: residual = update.gather_residual_attn_tp(residual) if hidden_states.shape[0] != 0: if reduces_attention_tp: hidden_states = ( attention_tensor_model_parallel_all_reduce(hidden_states) if group is SumGroup.ATTN_TP else _sum_group(group).all_reduce(hidden_states) ) with use_symmetric_memory( get_parallel().tp_group, disabled=not is_allocation_symmetric(), ): hidden_states, residual = read.update_and_read( update, hidden_states, residual, norm ) else: hidden_states, residual = read.update_and_read( update, hidden_states, residual, norm ) cp_shard_counts = _cp_shard_token_rows(forward_batch) if places_cp_shards else None return ( dp_gather(hidden_states, forward_batch, cp_shard_counts), residual, )顺序是:先 all-reduce 完成 attention-TP 的求和 → 再 update_and_read(把结果写进残差、读出 norm 后的 FFN 输入)→ 最后 DP gather。这三步原本是三次独立的算子(一次集合通信、一次残差加法、一次 RMSNorm,再加一次集合通信),现在合成一趟。
use_symmetric_memory 这个上下文管理器也值得注意:它是对称显存分配,让参与通信的 rank 在相同的地址上拥有相同大小的 buffer,从而让通信库可以做更高效的 zero-copy 传输。is_allocation_symmetric() 决定能不能启用——如果某个 rank 的分配不对称(通常是动态形状),就退回普通分配。
hidden_states.shape[0] != 0 这个分支是给空闲 rank 准备的:0 token 的 rank 不做 all-reduce(没意义),但仍要完成 update/read 与 gather(保持对称)。
DeepEP:token 怎么跨节点搬
gather 之后,所有 rank 都持有完整的全局 token。接下来要把 token 送到持有对应专家的 rank 上——这是 all-to-all,由 token dispatcher 完成。
后端注册表
layers/moe/token_dispatcher/__init__.py 导出了十来个 dispatcher:DeepEPDispatcher、DeepEPv2Dispatcher、MooncakeEPDispatcher、NixlEPDispatcher、MoriEPDispatcher、PplxDispatcher、FlashinferDispatcher、AscendTPDispatcher、StandardDispatcher。对应的 moe_a2a_backend 取值在参数文档里有完整枚举:none / deepep / mooncake / nixl / mori / ascend_fuseep / flashinfer / megamoe / deepep_v2 / ascend_tp / pplx / flashinfer_megamoe。
StandardDispatcher 是”没有 A2A 后端”时的路径,它不搬 token,而是用 all-gatherv 把各 DP 副本的 hidden state 拼起来、用 reduce_scatterv 把结果拆回去——换汤不换药,本质上还是 DP gather/scatter 那一套。所以 DP Attention 在没有 EP 的情况下也能工作,只是专家分片和 token 搬运都由 TP 组承担。
normal 与 low-latency:一对互补的模式
DeepEP 提供两种 dispatch 模式,它们的取舍是整个 EP 设计的枢纽。先看模式枚举:
class DeepEPMode(Enum): NORMAL = "normal" LOW_LATENCY = "low_latency" AUTO = "auto"
def enable_normal(self) -> bool: return self in [DeepEPMode.NORMAL, DeepEPMode.AUTO]
def enable_low_latency(self) -> bool: return self in [DeepEPMode.LOW_LATENCY, DeepEPMode.AUTO]
def resolve(self, is_extend_in_batch: bool) -> DeepEPMode: if self != DeepEPMode.AUTO: return self if is_extend_in_batch: return DeepEPMode.NORMAL else: return DeepEPMode.LOW_LATENCYAUTO 的规则一句话:prefill 用 normal,decode 用 low-latency。这不是偏好,而是两种模式的物理特性决定的:
- normal dispatch 为长输入优化。prefill 时一个 batch 可能有几万个 token,通信量巨大,追求的是吞吐。它的输出形状是符号化的(symbolic shape)——每个专家收到多少 token 取决于路由结果,事先不知道。
- low-latency dispatch 为逐 token 生成优化。decode 时每个请求只有 1 个 token,通信量极小但延迟极其关键。它要求预分配固定内存:每个专家最多能收多少 token 是启动时定死的,超出就报运行时错误。
这两条特性各自带来一个后果,而后果决定了能不能配 DP Attention 和 CUDA Graph:
| 模式 | 长输入 | 长输出 | DP Attention | CUDA Graph |
|---|---|---|---|---|
| Normal | ✅ | ❌ | ✅ | ❌ |
| Low-Latency | ❌ | ✅ | ✅ | ✅ |
| Auto | ✅ | ✅ | ❌ | ✅ |
这张表来自 LMSYS 的大规模 EP 博客。读法:
- Normal 支持 DP Attention 但不支持 CUDA Graph。因为符号化形状没法捕获成静态图。
- Low-Latency 支持 CUDA Graph 但只擅长长输出(decode)。
- Auto 两者都好,但不支持 DP Attention——在非 PD 分离的部署下。博客的解释是:auto 模式无法在同一个通信组里同时支持 normal(给 prefill)和 low-latency(给 decode),而这个限制恰好与 DP Attention 冲突。
这解释了一个看起来奇怪的组合最优解:PD 分离 + Auto。把 prefill 和 decode 拆到不同实例之后,prefill 实例(跑 EP + normal dispatch)和 decode 实例(跑 EP + low-latency dispatch)可以各自选适合的模式,两者都在 DP Attention 下工作,资源利用率和性能都更好。这也是为什么站内讲 P/D 分离时总把它和 EP 放在一起——见 SGLang 源码完全拆解(十二):Disaggregation。
这里的结论对工程很重要:“能不能同时用 DP Attention + CUDA Graph + 混合负载”是一个三角约束,PD 分离是把它解开的那把钥匙。
normal dispatch 的调用链
_DeepEPDispatcherImplNormal._dispatch_core 是真实通信发生的地方:
buffer = self._get_buffer() ( num_tokens_per_rank, num_tokens_per_rdma_rank, num_tokens_per_expert, is_token_in_rank, previous_event, ) = buffer.get_dispatch_layout( topk_ids, self.num_experts, previous_event=previous_event, async_finish=self.async_finish, allocate_on_comm_stream=previous_event is not None, ) ... ( recv_x, recv_topk_ids, recv_topk_weights, num_recv_tokens_per_expert, self.handle, event, ) = buffer.dispatch( x, topk_idx=topk_ids, topk_weights=topk_weights, num_tokens_per_rank=num_tokens_per_rank, num_tokens_per_rdma_rank=num_tokens_per_rdma_rank, is_token_in_rank=is_token_in_rank, num_tokens_per_expert=num_tokens_per_expert, previous_event=previous_event, async_finish=self.async_finish, allocate_on_comm_stream=(previous_event is not None) and self.async_finish, expert_alignment=128 if deep_gemm_wrapper.ENABLE_JIT_DEEPGEMM else 1, config=DeepEPConfig.get_instance().normal_dispatch_config, **npu_quantization_opts, )几个关键点:
get_dispatch_layout先算出四个统计量:每 rank 收多少 token、每 RDMA rank 收多少(RDMA rank 是”节点”层面的计数,因为跨节点要先到对端节点再分发)、每专家收多少、以及每个 token 属于哪些 rank(is_token_in_rank是布尔矩阵)。这套 layout 是后续通信的”地址簿”。expert_alignment=128(当启用 JIT DeepGEMM 时):把每个专家的 token 数对齐到 128 的倍数,让后续的 grouped GEMM 能用整齐的 tile,并且能配合masked布局。self.handle被存成成员变量,源码注释坦白说这是个妥协:
# FIXME: `handle` should be transmitted with tokens from dispatch to combine. # However, doing this would incur an unknown synchronization error, but keeping # `handle` as a member variable works.handle 里记录的是”combine 阶段要把结果送回哪里”的信息。理论上它应该跟着 token 一起传(因为它是每批数据的一部分),但因为一个尚未定位的同步错误,SGLang 选择把它挂在 dispatcher 对象上。这类”注释里留着 FIXME 但实际必须这么写”的地方,是读源码时最值得记下来的——它说明这个约束来自底层通信库的实现细节,不是设计者的偏好。
低延迟路径对应的 dispatch_a 则先算一个 expected_m:
def dispatch_a( self, hidden_states: torch.Tensor, topk_output: TopKOutput, ): buffer = self._get_buffer() topk_weights, topk_ids = topk_output.topk_weights, topk_output.topk_ids topk_ids = topk_ids.to(torch.int64) expected_m = ( hidden_states.shape[0] * buffer.group_size * topk_ids.shape[1] + self.num_experts ) // self.num_experts ...expected_m 是”每个专家平均会收到多少 token”的估计值:(本 rank token 数 × 组大小 × top-k) / 专家数,上取整。为什么要这个估计?因为 low-latency 模式要预分配固定内存,分配多少必须事先知道。这个公式就是”最坏情况下的期望值”,用它作为分配依据。
为什么要拆成 dispatch_a / dispatch_b
两种模式的实现都把 dispatch 拆成两段:dispatch_a 做准备工作(量化、记录事件、算期望值),dispatch_b 真正等待通信完成并组装输出。看 DeepEPDispatcher 的门面:
def dispatch_a( self, hidden_states: torch.Tensor, topk_output: TopKOutput, ): self._update_stage(_Stage.INITIAL, _Stage.AFTER_DISPATCH_A) inner_state = self._get_impl().dispatch_a( hidden_states=hidden_states, topk_output=topk_output, ) self._dispatch_intermediate_state = inner_state
def dispatch_b(self): self._update_stage(_Stage.AFTER_DISPATCH_A, _Stage.AFTER_DISPATCH_B) inner_state = self._dispatch_intermediate_state del self._dispatch_intermediate_state return self._get_impl().dispatch_b(*inner_state)拆分的目的是插入重叠点。两次调用之间,调度层可以插入别的计算(比如另一个 micro-batch 的 attention),这就是 two-batch overlap 的实现基础。_update_stage 里那些断言(assert self._stage == old_stage)是状态机的守卫:如果一个 dispatcher 被 dispatch_a 之后没有 dispatch_b 又被复用,就会立刻报错而不是产生错误结果。
同时注意 self.handle 那个设计为什么必须如此:因为 dispatch_a 与 dispatch_b 之间状态被暂存在对象上,handle 作为成员变量恰好与这个生命周期吻合。
_dispatch_core 还在 NPU 路径上加了量化选项:
def _get_quantization_kwargs(self, buffer: Buffer) -> dict: if not _is_npu: return {} dispatch_params = inspect.signature(buffer.dispatch).parameters flag_kwargs = {"use_fp8": self.use_fp8, "use_mxfp4": self.use_mxfp4, "use_mxfp8": self.use_mxfp8} if all(name in dispatch_params for name in flag_kwargs): return flag_kwargs if "quant_mode" in dispatch_params: if self.use_mxfp4: quant_mode = "mx_fp4_e2m1" elif self.use_mxfp8: quant_mode = "mx_fp8_e4m3" elif self.use_fp8: quant_mode = "int8" else: quant_mode = "bf16" return {"quant_mode": quant_mode}它用 inspect.signature 探测底层 buffer 支持哪套参数名,然后在新旧 API 之间做适配。deepep_dispatcher_output_dtype 这个参数在文档里的取值是 auto / bf16 / fp8 / int8 / nvfp4——通信也可以量化。把 token 用 FP8 或 FP4 发出去,通信量减半甚至降到四分之一,代价是精度损失;在带宽受限的多节点场景下这笔账通常是划算的。
prefll 侧的一个必要步骤:per-token-group 量化
dispatch_a 里还有一段:
topk_ids = topk_ids.to(torch.int64) if deep_gemm_wrapper.ENABLE_JIT_DEEPGEMM and self.use_fp8: # TODO hard code 128 block quant,use fp8 communication hidden_states = sglang_per_token_group_quant_fp8( hidden_states, 128, column_major_scales=deep_gemm_wrapper.DEEPGEMM_SCALE_UE8M0, scale_tma_aligned=deep_gemm_wrapper.DEEPGEMM_SCALE_UE8M0, scale_ue8m0=deep_gemm_wrapper.DEEPGEMM_SCALE_UE8M0, )注释里那句 TODO hard code 128 block quant 很直白:量化块大小固定写死成 128,与 expert_alignment=128 是同一个数字,两者是配合关系。如果启用了 DeepGEMM,缩放因子还要按 UE8M0 格式排布并且 TMA 对齐——因为这些缩放因子最终要喂给 DeepGEMM 的 kernel,格式必须匹配。DeepGEMM 的 1×128 细粒度缩放机制见 DeepGEMM 完全拆解。
Two-batch Overlap:把通信藏进另一个 micro-batch 的计算里
即使有了 high-throughput 的 normal dispatch,跨节点通信的绝对时间仍然是瓶颈——尤其在带宽受限的多节点环境。DeepSeek 的系统设计给了一个答案:把一次 batch 拆成两个 micro-batch,让一个的通信和另一个的计算重叠。
切分点怎么定
compute_split_seq_index 已经在前面看过:EXTEND 按序列边界切,decode 按 token 数对半切。但还有一个更细的问题——能不能把单条序列切开?_is_two_chunk_split_enabled 处理这个:
def _is_two_chunk_split_enabled(extend_lens: Sequence[int]) -> bool: if extend_lens is None: return False
vanilla_split_seq_index = _split_array_by_balanced_sum(extend_lens) left_sum = sum(extend_lens[:vanilla_split_seq_index]) overall_sum = sum(extend_lens) threshold = get_tbo_token_distribution_threshold() assert threshold <= 0.5, f"{threshold=}" want_two_chunk = left_sum < overall_sum * threshold or left_sum > overall_sum * ( 1 - threshold ) if not want_two_chunk: return False ...默认策略是按”累积和接近一半”找序列边界切(_split_array_by_balanced_sum)。但如果这样切出来极不平衡——左边占不到 48% 或者超过 52%(tbo_token_distribution_threshold 默认 0.48)——说明某个长序列霸占了大部分 token,按序列边界切会让两个 micro-batch 的负载严重不均。这时改用”把单条序列切成两半”的两块模式。但源码紧接着留了一个保护:
split_seq_index = _split_array_by_cum_less_than_half(extend_lens) child_a_batch_size = split_seq_index + 1 child_a_num_q_tokens = overall_sum // 2 if child_a_batch_size > child_a_num_q_tokens: return False
return True注释详细解释了原因:two-chunk 切法让 child_a 跨越 split_seq_index + 1 条序列,但只分到 overall_sum // 2 个 query token。对一个退化 batch(只有一条序列,或者接近空的 DP-sync batch),这个”半个总数”可能只有 0 或极小,于是 child_a 的 batch_size 大于它的 query token 数——这违反了 DSV4 压缩规划器的不变量 batch_size <= num_q_tokens,kernel 会崩溃。所以检测到这种情况就退回按序列边界切,那种切法保证 child_a 每条序列至少贡献 1 个 token,不会出现”有行无 token”。
这就是推理框架里最典型的一类 bug:切分逻辑在正常情况下完全正确,但在极端小的 batch 上产生一个退化输入,然后在某个深层 kernel 的断言上炸掉。
切完之后要重建哪些字段
切成两个 child 之后,很多与序列长度相关的字段需要重新推导。_two_chunk 路径下,derive_fields_related_to_seq_len_for_two_chunk 做的事是:
extend_seq_lens_cpu = batch.extend_seq_lens_cpu overall_seq_lens_sum = sum(extend_seq_lens_cpu) half_seq_lens_sum = overall_seq_lens_sum // 2 left_last_seq_token_num = half_seq_lens_sum - sum( extend_seq_lens_cpu[:tbo_split_seq_index] ) right_first_seq_token_num = ( extend_seq_lens_cpu[tbo_split_seq_index] - left_last_seq_token_num )
child_a.extend_seq_lens_cpu = copy.deepcopy(child_a.extend_seq_lens_cpu) child_a.extend_seq_lens_cpu[-1] = left_last_seq_token_num child_b.extend_seq_lens_cpu = copy.deepcopy(child_b.extend_seq_lens_cpu) child_b.extend_seq_lens_cpu[0] = right_first_seq_token_num被切开的那条序列(第 tbo_split_seq_index 条)在两个 child 里各占一段:child_a 拿它的前 left_last_seq_token_num 个 token,child_b 拿剩下的。对应的 seq_lens(含前缀)、extend_prefix_lens 也都要跟着改:
child_a.seq_lens_cpu = copy.deepcopy(child_a.seq_lens_cpu) child_a.seq_lens_cpu[-1] = ( child_a.extend_seq_lens_cpu[-1] + child_a.extend_prefix_lens_cpu[-1] ) ... child_b.extend_prefix_lens_cpu = copy.deepcopy(child_b.extend_prefix_lens_cpu) child_b.extend_prefix_lens_cpu[0] += left_last_seq_token_numchild_b 的那条被切序列,它的前缀长度要加上 child_a 已经算过的那一段——因为从 child_b 的视角看,child_a 处理过的 token 在因果意义上就是它的前缀。这是块状 prefill 的同一个思想(见 Sarathi-Serve 完全拆解),只是这里切的是 micro-batch 而不是 chunk。
operations 与 yield:TBO 的表达方式
LMSYS 博客里点出了 TBO 实现的两个难点:代码复杂度(直接写会把 micro-batch 管理逻辑复制到各处)和 prefill 阶段的同步问题(normal dispatch 会阻塞 CPU,pipeline 被卡住)。
SGLang 的解法是引入”操作 + 让出点”的抽象。batch_overlap/operations.py 里 Operation 是三种东西的联合:
class YieldOperation: pass
@dataclassclass ExecutionOperation: debug_name: str fn: Callable
Operation = Union[YieldOperation, ExecutionOperation, Callable]Stage = List[ExecutionOperation]一个 micro-batch 的整层计算被写成一个扁平的 operation 列表,其中 YieldOperation() 标记”这里可以让另一个 micro-batch 插进来”。以 DeepSeek 的 prefill 策略为例:
def _compute_moe_deepseek_blog_prefill(layer): device_properties = torch.cuda.get_device_properties(device="cuda") total_num_sms = device_properties.multi_processor_count deep_gemm_num_sms = None if not _is_hip: deep_gemm_num_sms = total_num_sms - DeepEPConfig.get_instance().num_sms
return OperationsStrategy( deep_gemm_num_sms=deep_gemm_num_sms, tbo_delta_stages=0, operations=[ layer.op_comm_prepare_attn, layer.self_attn.op_prepare, layer.self_attn.op_core, layer.op_comm_prepare_mlp, layer.mlp.op_gate, layer.mlp.op_select_experts, layer.mlp.op_dispatch_a, operations.YieldOperation(), layer.mlp.op_dispatch_b, layer.mlp.op_experts, layer.mlp.op_combine_a, operations.YieldOperation(), layer.mlp.op_shared_experts, layer.mlp.op_combine_b, layer.mlp.op_output, layer.op_comm_postprocess_layer, ], )这份列表就是”顺序执行时的完整流程”,YieldOperation 精确地插在两个地方:dispatch_a 之后(通信已经发起、还没等结果)和 combine_a 之后。这些正是通信可以被打断、让位于另一个 micro-batch 计算的时刻。
deep_gemm_num_sms = total_num_sms - DeepEPConfig.get_instance().num_sms 这一行也很关键:通信和计算要真正并行,SM 必须分开。如果 GEMM 把 132 个 SM 全占了,通信 kernel 就没有 SM 可用,重叠是假的。所以 GEMM 只准用”总 SM 数减去通信核占用”的那些。这是 overlap 能不能落地的物理前提,而不是调度技巧。
decode 的策略 tbo_delta_stages=2,意思是 child_b 相对 child_a 延迟 2 个 stage 开始,错开得更精细。
execute_overlapped_operations 是执行器:
def execute_overlapped_operations( inputs_arr: Sequence, operations_arr: Sequence, delta_stages: Sequence[int],) -> Sequence: inputs_a, inputs_b = inputs_arr operations_a, operations_b = operations_arr delta_stage_a, delta_stage_b = delta_stages assert delta_stage_a == 0 delta_stage = delta_stage_b ... stages_a = _convert_operations_to_stages(operations_a) stages_b = _convert_operations_to_stages(operations_b) executor_a = _StageExecutor("a", stages_a, inputs=inputs_a, child_ctx=child_ctx_a) executor_b = _StageExecutor("b", stages_b, inputs=inputs_b, child_ctx=child_ctx_b)
for _ in range(delta_stage): executor_a.next()
for _ in range(executor_a.num_stages - delta_stage): executor_a.next() executor_b.next()
for _ in range(delta_stage): executor_b.next()模型是”两个游标交错前进”:a 先单独跑 delta_stage 个 stage,然后两者一步步交替,最后 b 独自收尾。stage 划分规则没显式写出来,但从 YieldOperation 作为分界来看,每个 stage 就是”从上一次让出到下一次让出之间的所有操作”——即”发起到等待”为一段。这样交替执行时,a 在等通信的那一段正好 b 在算,反之亦然。
_resolve_tbo_child_contexts 是个容易被忽略的细节:
def _resolve_tbo_child_contexts(): """Return (child_ctx_a, child_ctx_b) derived from the active TboAttnBackend, or (None, None) if the active backend is not a TBO dispatcher.""" from sglang.srt.layers.attention.tbo_backend import TboAttnBackend
ctx = get_forward_context() backend = ctx.attn_backend if not isinstance(backend, TboAttnBackend): return None, None child_a, child_b = backend.children return ( replace(ctx, attn_backend=child_a), replace(ctx, attn_backend=child_b), )每个 child 需要自己的注意力后端实例——因为两个 child 的 batch 形状和 KV 访问模式不同,注意力后端里缓存的元数据(页表、序列长度等)也不同。TboAttnBackend 就是为此把两个后端包起来、按当前执行的是哪个 child 分派。所以 TBO 不只是切 batch,还要把整条执行上下文复制两份。
TBO 与 DP Attention 的耦合,以及 forward mode 一致性的来源
前面已经看到 TBO 的启用条件包含”全局 forward mode 一致”。把两段代码连起来:
self.global_forward_mode = mlp_sync_info.global_forward_mode ... # Decide whether to emit idle batchglobal_forward_mode 在 compute_output 里算出,写进 ScheduleBatch,最终影响到是否切分。于是一个 DP 副本在 prefill、另一个在 decode 时,TBO 会自动关闭——因为没有任何一致的切分策略同时适用于两边。
这也是为什么 TBO 只在 decode 或只在 prefill 时最有效:这两种场景下各副本的 mode 天然一致,TBO 可以稳定开启。
EPLB:专家分布不均怎么办
到这里,token 已经能跨节点正确搬运了。但还有一个问题没解决:搬过去的 token 在专家之间分布极不均匀。
DeepSeek-V3 有 256 个路由专家,每 token 选 8 个。理想情况下每个专家收到 1/256 的流量,但现实中某些专家会被大量选中,某些几乎没人用。EP 的瓶颈是”最慢的那个 rank”——如果某个 rank 上的专家被打爆,整个 A2A 就要等它。
不均衡的代价与冗余专家的思路
SGLang 用的度量是 balancedness:
def compute_utilization_rate( gpu_physical_count_of_batch: torch.Tensor, # (..., num_layer, num_gpu)): """output: utilization_rate (..., num_layer)""" gpu_physical_count_of_batch = gpu_physical_count_of_batch.float() max_gpu_physical_count = einops.reduce( gpu_physical_count_of_batch, "... num_layer num_gpu -> ... num_layer", "max", ) avg_gpu_physical_count = einops.reduce( gpu_physical_count_of_batch, "... num_layer num_gpu -> ... num_layer", "mean", ) return (avg_gpu_physical_count + 1e-5) / (max_gpu_physical_count + 1e-5)先按 GPU 把物理专家的 token 数求和,再取所有 GPU 里的最大值与平均值之比。等于 1 表示完美均衡,越小越不均衡。分母加 1e-5 是防除零。
LMSYS 博客给出的量化:随着节点数(EP 规模)增加,利用率会持续下降,打开 EPLB 后显著回升。这就是这张图要表达的东西:
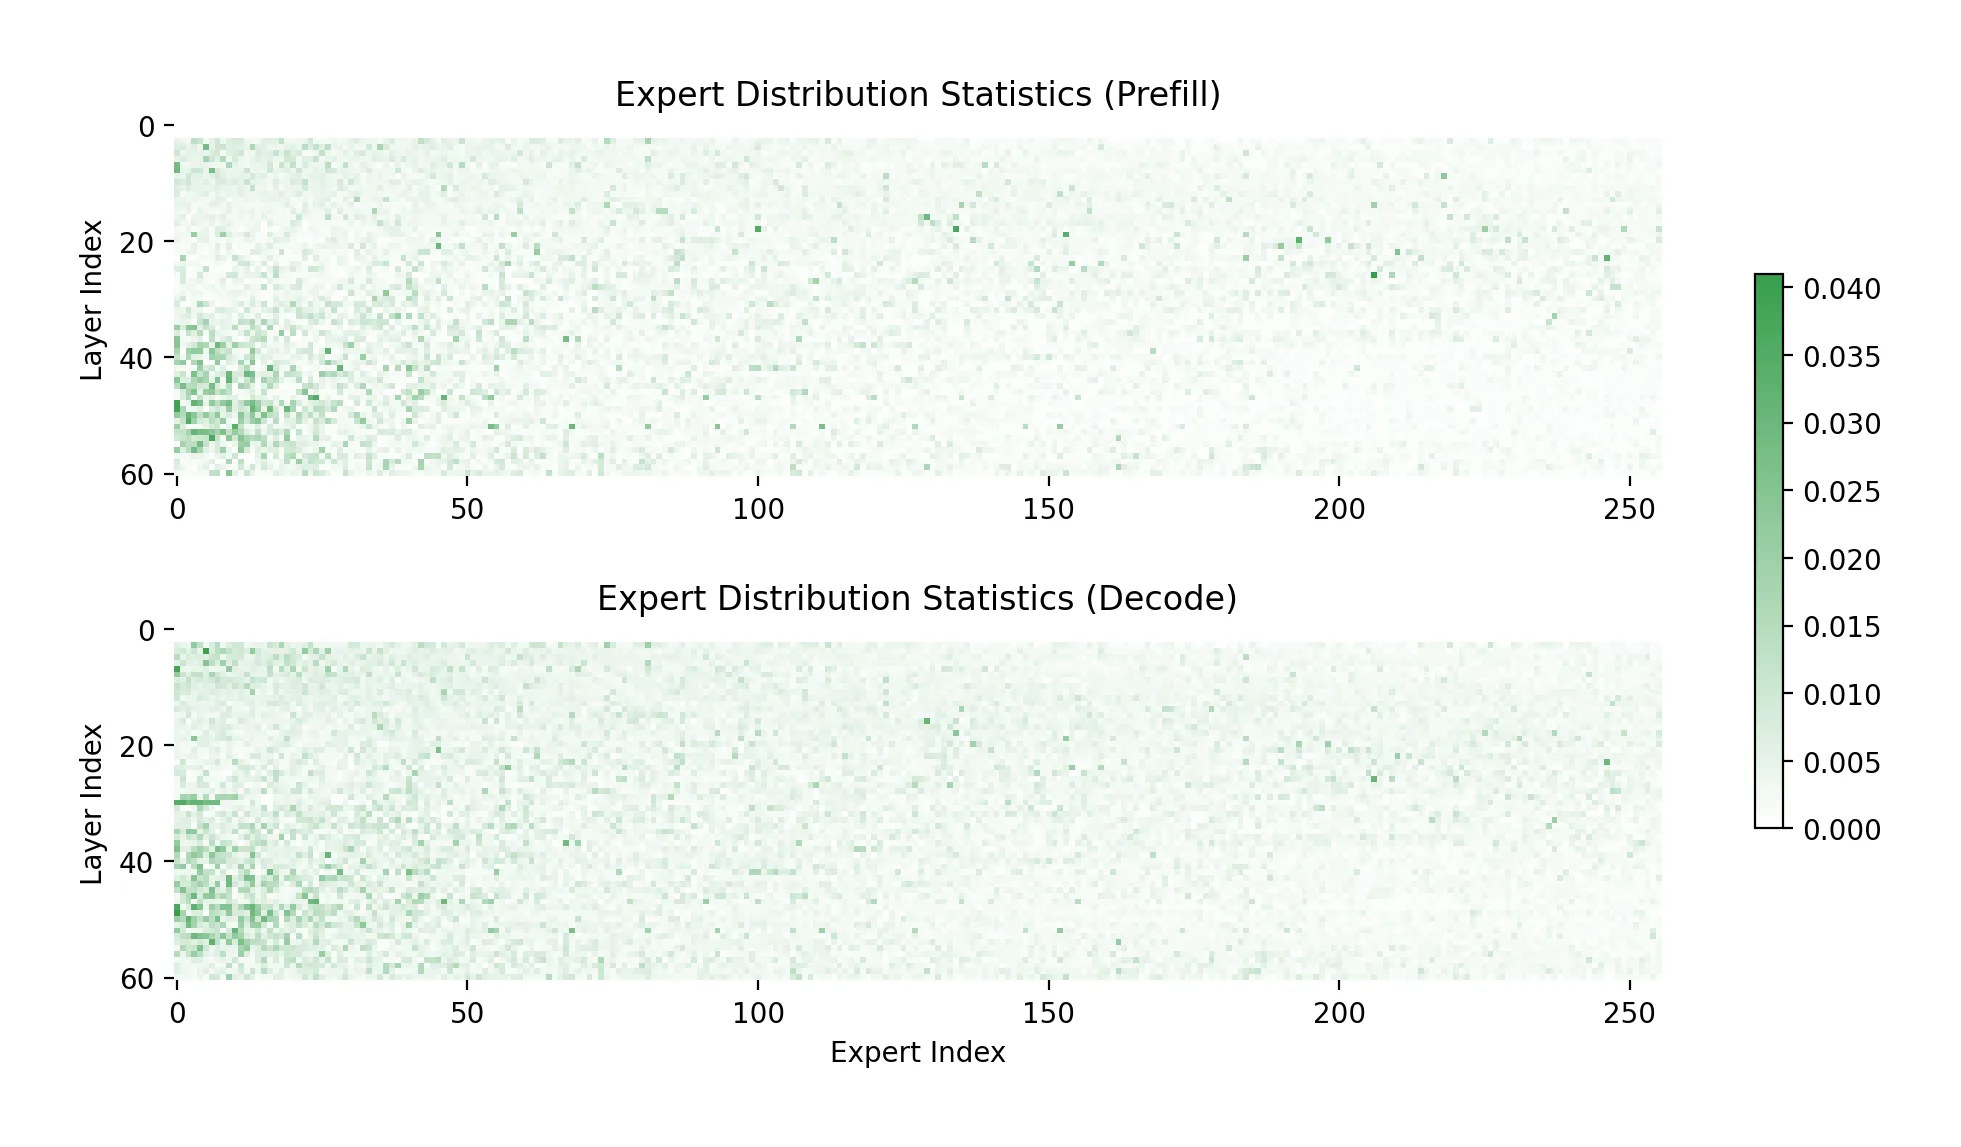
图片来源:SGLang 大规模 EP 设计博客 的 EPLB 仿真图
解决思路来自 DeepSeek 的 EPLB:允许冗余专家。原本 256 个专家、EP=16 时每 rank 16 个;现在多分配 32 个冗余槽位,组成 288 个物理专家的池子,让高频专家被复制多份摆在不同 GPU 上,中低频专家被打包合并到同一个 GPU 上。
参数上对应的就是:
ep_num_redundant_experts: "Allocate this number of redundant experts in expert parallel." # 默认 0enable_eplb: "Enable EPLB algorithm" # 默认 Falseeplb_algorithm: "Chosen EPLB algorithm" # 默认 "auto"init_expert_location: "Initial location of EP experts." # 默认 "trivial"ep_dispatch_algorithm: "The algorithm to choose ranks for redundant experts in expert parallel." # 取值 static / dynamic / fake / lp,默认 Noneinit_expert_location = "trivial" 就是”逻辑专家 i 对应物理专家 i、没有冗余”的平凡布局;ep_num_redundant_experts = 0 时就是这个状态。
博客还指出冗余专家的一个附带好处:并行度不再被限制为 2 的幂。256 个专家时,能整除它的 GPU 数只有 2 的幂次(必须让专家数能被 GPU 数整除);换成 288(= 256 + 32)之后,12、72 这类规模也变得可行。这直接解释了后面评测里为什么用 EP72。
三步算法:分组、复制、再打包
eplb/eplb_algorithms/deepseek.py 里的 rebalance_experts_hierarchical 是整个算法的入口,它的签名很能说明问题:
def rebalance_experts_hierarchical( weight: torch.Tensor, num_physical_experts: int, num_groups: int, num_nodes: int, num_gpus: int,): """ Parameters: weight: [num_moe_layers, num_logical_experts] num_physical_experts: number of physical experts after replication num_groups: number of expert groups num_nodes: number of server nodes, where the intra-node network (e.g, NVLink) is faster num_gpus: number of GPUs, must be a multiple of `num_nodes` """输入是每个逻辑专家的负载权重,输出是物理专家的排布方案。num_nodes 这个参数是算法的核心约束来源:NVLink 比跨节点网络快得多,所以同一个专家组内的通信应当尽量留在节点内。
算法分三步:
第一步:把专家组打包到节点上。
# Step 1: pack groups to nodes tokens_per_group = weight.unflatten(-1, (num_groups, group_size)).sum(-1) group_pack_index, group_rank_in_pack = balanced_packing(tokens_per_group, num_nodes) log2mlog = ( ( (group_pack_index * groups_per_node + group_rank_in_pack) * group_size ).unsqueeze(-1) + torch.arange(group_size, dtype=torch.int64, device=group_pack_index.device) ).flatten(-2) mlog2log = inverse(log2mlog)先把专家按组聚合负载(tokens_per_group),然后用 balanced_packing 把组均匀分配到各节点上。这一步的目标是让各节点的总负载接近——因为跨节点通信最贵,节点间的失衡代价最大。得到 log2mlog(逻辑→节点内逻辑的映射)和它的逆 mlog2log。
第二步:在节点内构造冗余专家。
# Step 2: construct redundant experts within nodes # [num_layers * num_nodes, num_logical_experts // num_nodes] tokens_per_mlog = weight.gather(-1, mlog2log).view( -1, num_logical_experts // num_nodes ) phy2mlog, phyrank, mlogcnt = replicate_experts( tokens_per_mlog, num_physical_experts // num_nodes )replicate_experts 就是在每个节点内部做复制:负载高的专家多给几个物理槽位,负载低的合并。它返回三样东西:phy2mlog(物理→节点内逻辑的映射)、phyrank(该物理专家是第几份副本)、mlogcnt(每个节点内逻辑专家被复制了几份)。冗余只发生在节点内——这是刻意的:跨节点复制高频专家会把跨节点通信量翻倍,得不偿失。
第三步:把物理专家打包到 GPU 上。
# Step 3: pack physical_experts to GPUs # [num_layers * num_nodes, num_physical_experts // num_nodes] tokens_per_phy = (tokens_per_mlog / mlogcnt).gather(-1, phy2mlog) pack_index, rank_in_pack = balanced_packing(tokens_per_phy, num_gpus // num_nodes) phy2pphy = pack_index * phy_experts_per_gpu + rank_in_pack pphy2phy = inverse(phy2pphy)注意 tokens_per_phy = (tokens_per_mlog / mlogcnt).gather(-1, phy2mlog) 这一行:复制出来的副本平摊负载。如果一个专家被复制了 3 份,那每一份名义上承担 1/3 的流量,打包时按平摊后的值算。这不是精确建模(实际路由是”选最不忙的副本”,不是均分),但它是一个合理的近似,让打包结果能把副本分散到不同 GPU。
然后 balanced_packing(tokens_per_phy, num_gpus // num_nodes) 把物理专家均匀分配到节点内的各 GPU 上。
算法骨架的意义:三层嵌套均衡(组→节点、专家→节点内槽位、槽位→GPU)不是随意的,它精确对应了三种通信代价的量级——跨节点最贵、节点内 NVLink 次之、GPU 内最便宜。每一层的均衡目标都是”把最贵的通信路径上的不平衡压掉”。
逻辑与物理的两套映射
结果用 ExpertLocationMetadata 装上:
class ExpertLocationMetadata: physical_to_logical_map: torch.Tensor # (layers, num_physical_experts) physical_to_logical_map_cpu: torch.Tensor logical_to_all_physical_map: torch.Tensor # (layers, num_logical_experts, X) logical_to_all_physical_map_cpu: torch.Tensor # CPU copy for performance logical_to_all_physical_map_num_valid: torch.Tensor # (layers, num_logical_experts) ep_size: int # (layers, num_logical_experts) logical_to_rank_dispatch_physical_map: Optional[torch.Tensor]两套映射是理解 EPLB 的关键:
physical_to_logical_map:每个物理槽位上放的是哪个逻辑专家。用来更新权重(把专家的参数搬到位)和统计负载(把物理计数还原成逻辑计数)。logical_to_all_physical_map:每个逻辑专家被复制到了哪些物理槽位。用来在推理时分派(token 路由到某逻辑专家后,要选一个物理副本)。
logical_to_all_physical_map_num_valid 记录每个逻辑专家实际有几个有效副本(因为 X 是最大副本数的上界,某些专家副本少)。logical_to_rank_dispatch_physical_map 是”某逻辑专家在某 rank 上应该派到哪个物理槽位”的预计算表。
__post_init__ 里的断言检查三者形状一致:
def __post_init__(self): num_layers_0, num_physical_experts_0 = self.physical_to_logical_map.shape num_layers_1, num_logical_experts_0, num_physical_experts_1 = ( self.logical_to_all_physical_map.shape ) num_layers_2, num_logical_experts_1 = ( self.logical_to_all_physical_map_num_valid.shape ) assert num_layers_0 == num_layers_1 == num_layers_2 assert num_logical_experts_0 == num_logical_experts_1 assert num_physical_experts_0 == num_physical_experts_1init_trivial 给出无冗余时的布局:
@staticmethod def init_trivial(model_config: ModelConfig, moe_ep_rank: int): """Trivial location - logical expert i corresponds to physical expert i""" ... physical_to_logical_map = ( torch.arange(0, base_num_physical_experts).repeat(num_layers, 1) % num_logical_experts ) physical_to_logical_map = append_trivial_expert_slots( physical_to_logical_map, num_physical_experts - base_num_physical_experts, num_logical_experts, )arange(...) % num_logical_experts:物理槽位 i 对应逻辑专家 i % 256。也就是说,当物理专家数超过逻辑专家数时,多出来的槽位是前几个逻辑专家的副本——这是”平凡冗余”的朴素起点,EPLB 会把它算成一个更优的排布。
推理时怎么”选副本”
这是整个 EPLB 里最容易被忽略的一环:冗余专家存在之后,token 路由到逻辑专家 k,应该实际去哪个物理槽位?
expert_location_dispatch.py 里的 ExpertLocationDispatchInfo 有个很关键的注释:
# Whether every rank must pick the same physical expert for a token. True # without an a2a backend: all EP ranks then run the MoE over the same tokens # and sum their partial outputs, so a rank-dependent pick counts a replicated # logical expert several times. With one, each rank dispatches only its own # tokens and is free to disagree. rank_invariant: bool = False以及初始化:
return cls( ep_dispatch_algorithm=ep_dispatch_algorithm, rank_invariant=get_exec().moe.moe_a2a_backend == "none", ... )这段话讲的是一个很容易踩的坑:在没有 A2A 后端时,EP 各 rank 是在同一批 token 上各自算自己的专家、然后把部分和加起来。如果允许各 rank 独立决定”逻辑专家 k 去哪个物理副本”,那么一个被复制了 3 份的逻辑专家会被算了 3 次并加总——结果直接错 3 倍。所以这种拓扑下必须 rank_invariant = True:所有 rank 选同一个副本。反过来有 A2A 后端时,每个 rank 只处理自己收到的 token,不存在重复计数,就可以各自为政。
ep_dispatch_algorithm 的四个取值(static / dynamic / fake / lp)决定用什么策略选副本。fake 是个调试用的:把 router logits 强行 uniform 化来制造”完美均衡”的对照实验:
def transform_select_experts_inputs( router_logits: torch.Tensor, correction_bias: Optional[torch.Tensor], info: Optional[ExpertLocationDispatchInfo],): if (info is not None) and (info.ep_dispatch_algorithm == "fake"): router_logits.uniform_(5, 10) correction_bias = torch.zeros_like(correction_bias) return router_logits, correction_bias把 logits 均匀化到 [5,10],再把 DeepSeek 用来做无辅助损失负载均衡的 correction_bias 清零——这样专家选择就接近均匀分布,可以单独测出”路由不均衡”贡献了多少开销。
统计:把物理计数还原成逻辑计数
EPLB 的输入是”每个逻辑专家的负载”,但分布式运行时观察到的是物理专家的计数。所以需要一个还原步骤:
def _convert_global_physical_count_to_logical_count( # (whatever, num_layers, num_physical_experts) global_physical_count: torch.Tensor, num_layers: int, num_logical_experts: int, physical_to_logical_map: torch.Tensor,): dim_extra, _, _ = global_physical_count.shape dtype = global_physical_count.dtype device = global_physical_count.device logical_count = torch.zeros( (dim_extra, num_layers, num_logical_experts), dtype=dtype, device=device ) logical_count.scatter_add_( dim=2, index=physical_to_logical_map.unsqueeze(0) .expand(dim_extra, -1, -1) .to(torch.int64), src=global_physical_count, ) return logical_countscatter_add_:把每个物理槽位的计数加到它对应的逻辑专家上。一个逻辑专家如果被复制了 3 份,三个槽位的计数会在这里加起来——这正是我们想要的,因为 EPLB 要重新分配的是”这个逻辑专家总共多大负载”。
反过来的转换是 _convert_local_to_global_physical_count,因为每个 rank 只知道本地物理专家收到了多少 token,需要拼成全局视图才能做均衡决策。
在 DeepEP 路径上,统计的来源是 dispatcher 自己的报告:
get_global_expert_distribution_recorder().on_deepep_dispatch_normal( num_recv_tokens_per_expert, num_tokens_per_rank=num_tokens_per_rank, num_tokens_per_rdma_rank=num_tokens_per_rdma_rank, num_tokens_per_expert=num_tokens_per_expert, )num_recv_tokens_per_expert 是 dispatch 后每个专家实际收到的 token 数——这是最真实的负载数据,不需要从路由结果估算。
还有一个”近似模式”的选择在 recorder 的构造里:
class _SinglePassGatherer(ABC): @staticmethod def init_new( expert_location_metadata: ExpertLocationMetadata, rank: int, ) -> _SinglePassGatherer: if get_exec().moe.expert_distribution_recorder_mode == "per_token": return _DetailSinglePassGatherer(expert_location_metadata, rank)对应的参数文档把四种模式列全了:stat / stat_approx / per_pass / per_token。粒度从粗到细,代价从低到高:
stat/stat_approx:只做聚合计数。per_pass:每轮前向统计一次。per_token:逐 token 记录。精度最高、开销最大,只在调试时用。
生产环境用粗粒度、调试用细粒度,这是标准做法。expert_balancedness_report_mode(off / server_log / prometheus / both)决定把 balancedness 报到哪里,默认 off——因为算这个指标本身要花通信。
缓存的滚动窗口也有明确设计:
EPLB_BALANCEDNESS_WINDOW_SIZES = (10, 100, 1000)三个窗口同时在维护:10 轮看瞬时、100 轮看近期、1000 轮看长期。取哪个由 _get_global_average_utilization_rate 用最后一个窗口决定。为什么要多窗口?因为”要不要重排”是个需要跨时间尺度判断的决策——瞬时波动不该触发重排(重排很贵),但持续 1000 轮的偏移应该触发。
重排的触发条件与三段式加载
EPLBManager 的骨架是一个生成器,每 eplb_rebalance_num_iterations 轮(默认 1000)触发一次:
def _entrypoint(self): while True: for _ in range(self._rebalance_num_iterations): yield yield from self.rebalance()它在每次前向结束时被推进一步(on_forward_pass_end)。用生成器而不是定时线程的原因很直白:重排必须在 GPU 空闲的间隙做,线程没法保证这一点。
触发判断就是前面那个利用率阈值:
if ( average_utilization_rate_over_window > get_exec().moe.eplb_min_rebalancing_utilization_threshold ): logger.info( f"[EPLBManager] Skipped ep rebalancing: current GPU utilization {average_utilization_rate_over_window:.2f} > minimum rebalance threshold {get_exec().moe.eplb_min_rebalancing_utilization_threshold:.2f}" ) return False return Trueeplb_min_rebalancing_utilization_threshold 默认是 1.0——默认永不重排。这是个保守的选择:重排要搬专家权重(几百 GB 量级),代价很高,只有利用率明显偏低时才值得做。
构造函数里还有一条断言:
assert ( get_exec().moe.eplb_rebalance_num_iterations >= get_exec().moe.expert_distribution_recorder_buffer_size ), ( "eplb_rebalance_num_iterations must be greater than expert_distribution_recorder_buffer_size" )原理是:recorder 用一个环形缓冲区存统计,重排间隔必须不小于缓冲区容量,否则缓冲区里的数据会在被读取之前被覆盖,得到残缺的统计。
LMSYS 博客把重排的实现拆成三段,并解释了每一段为什么这么设计:
- 系统加载阶段:权重可选地从磁盘预载到主存(为了重排更快),或者留在磁盘上用 mmap(为了省内存)。这两种选择的取舍是”重排延迟 vs 常驻内存”。
- 重排准备阶段:需要的权重在后台异步传到设备显存,利用空闲的 DMA 引擎,不打断正在进行的 GPU 操作。
- 重排执行阶段:设备到设备的拷贝更新权重,可进一步用物理内存重绑定优化。
这三段式的核心思想是 “把搬数据的重活拆成可以提前做的和必须同步做的两部分”,让重排对在线服务的影响降到最低。第三段提到的”物理内存重绑定”就是 CUDA 虚拟内存那一类技巧——见 vAttention 完全拆解。
真到搬权重的时候,用的是 P2P:
def update_expert_weights_single_layer( routed_experts_weights: List[torch.Tensor], temp_buffers: List[torch.Tensor], old_physical_to_logical_map: List[int], # (num_physical_Experts,) new_physical_to_logical_map: List[int], # (num_physical_Experts,) num_local_physical_experts: int, num_gpu_per_node: int, rank: int, world_size: Optional[int] = None, missing_logical_experts_info: Optional[List[int]] = None, debug: bool = False, log_metrics: bool = False,):参数里有 temp_buffers(中转缓冲区)和 num_gpu_per_node(用来识别同节点/跨节点,走 NVLink 还是 RDMA)。返回值里有 missing_logical_experts_info——这是给弹性 EP 场景用的:如果有 rank 在重排期间挂掉了,某些逻辑专家的副本可能全部丢失,要把这个信息报上去(_update_expert_weights 的文档注释明确写了”Returns a map of layer_id to expert_ids that are missing due to rank failures during fault conditions when elastic EP is enabled”)。
评测:这些机制加起来值多少
LMSYS 博客给了一组端到端数据,值得放在机制之后看,因为它们验证了上面每条设计的实际收益。
实验设置
12 个节点、每节点 8 张 H100、InfiniBand 互联,跑 DeepSeek-V3。对比四组配置:
- SGLang with TP16 × 6:每两个节点一组独立运行,TP=16 + DP Attention 的基线。
- SGLang with PD Disaggregation:加上 P/D 分离与完整 EP 优化;EPLB 用的是与输入输出数据匹配的分布(因为拿不到实时服务统计,只能离线估)。
- SGLang with PD Disaggregation and simulated MTP:模拟 MTP 的效果——batch 翻倍、KV 长度减半以保持 GroupedGEMM 的工作量不变;在真实注意力计算后插入 dummy kernel 让注意力阶段耗时与 DeepSeek 的 profile 一致(因为 MTP 会影响注意力开销);保守假设 70% 的接受率。
- DeepSeek Profile Results:以 DeepSeek 官方 profiling 数据推算的吞吐作为参照。
注意这里评测分 P、D 两个阶段独立进行,非测试阶段假设资源无限——这与 DeepSeek 自己的口径一致,目的是把被测侧的压力压满。
prefill 结果
4 个节点(4×8×H100,EP32):
- prompt 长度 1K / 2K / 4K 时,每节点吞吐分别是 57,674 / 54,543 / 50,302 tokens/sec。
- 相对 TP16 基线最高提升 3.3 倍,主要贡献来自优化的 GroupedGEMM kernel(DeepGEMM)与 two-batch overlap。
- 假设工作负载完美均衡时,系统吞吐与 DeepSeek 官方 profile 的差距在 5.6% 以内。
这里三个数字随 prompt 长度递减是符合预期的:prompt 越长,注意力部分的相对比重越大,而 prefill 的瓶颈恰恰在注意力而非 GEMM。3.3 倍提升的归因也很明确:DeepGEMM(Grouped GEMM)解决 MoE 矩阵乘的效率,TBO 解决通信被算力掩盖。
decode 结果
9 个节点(9×8×H100,EP72;只有 DeepSeek 规模的一半):
- 2K 输入时每节点 22,282 tokens/sec。
- 相对 TP16 基线提升 5.2 倍。
decode 的提升倍数比 prefill 更大,原因是 decode 的基线更差:TP16 下 decode 每步只有很少的 token,算力利用率极低但 KV Cache 复制了 16 份导致可并发请求数被压死。DP Attention + EP 同时解决了容量和效率问题。
EP72 这个数字也值得注意——它正是 EPLB 冗余专家(288 个物理专家)带来的非 2 的幂并行度。没有 EPLB 的 256 专家约束,9 节点 72 卡的配置根本跑不起来。
TBO 与 EPLB 的消融
博客还单独做了两个消融:
- TBO 消融:对比开启/关闭 two-batch overlap 时各层的时间分解,能看到通信时间被计算遮盖的程度。
- EPLB 消融:对比开启/关闭 EPLB 时的吞吐与不均衡度。
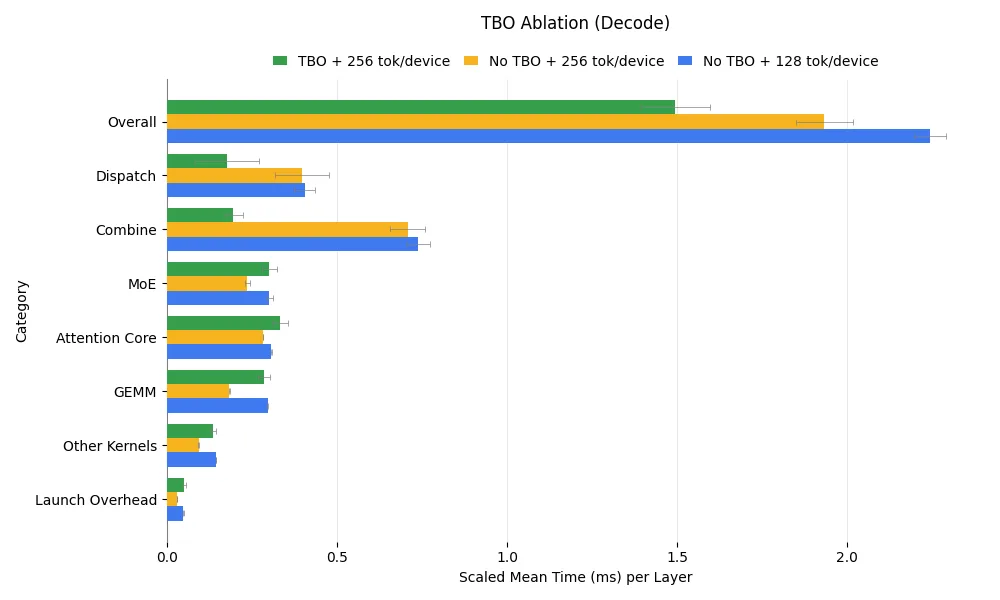
图片来源:SGLang 大规模 EP 设计博客 的 TBO 消融图
这两组消融的价值在于把”哪个机制贡献了多少”分离出来。只看端到端倍数,你无法判断收益是来自 DeepGEMM、TBO 还是 EPLB;只有消融才能给出归因。
并行设计的一览
博客里那张并行设计图把整套拓扑画成了一张图,包括 attention 侧的 DP 分片与 MoE 侧的 EP 专家池如何对应:
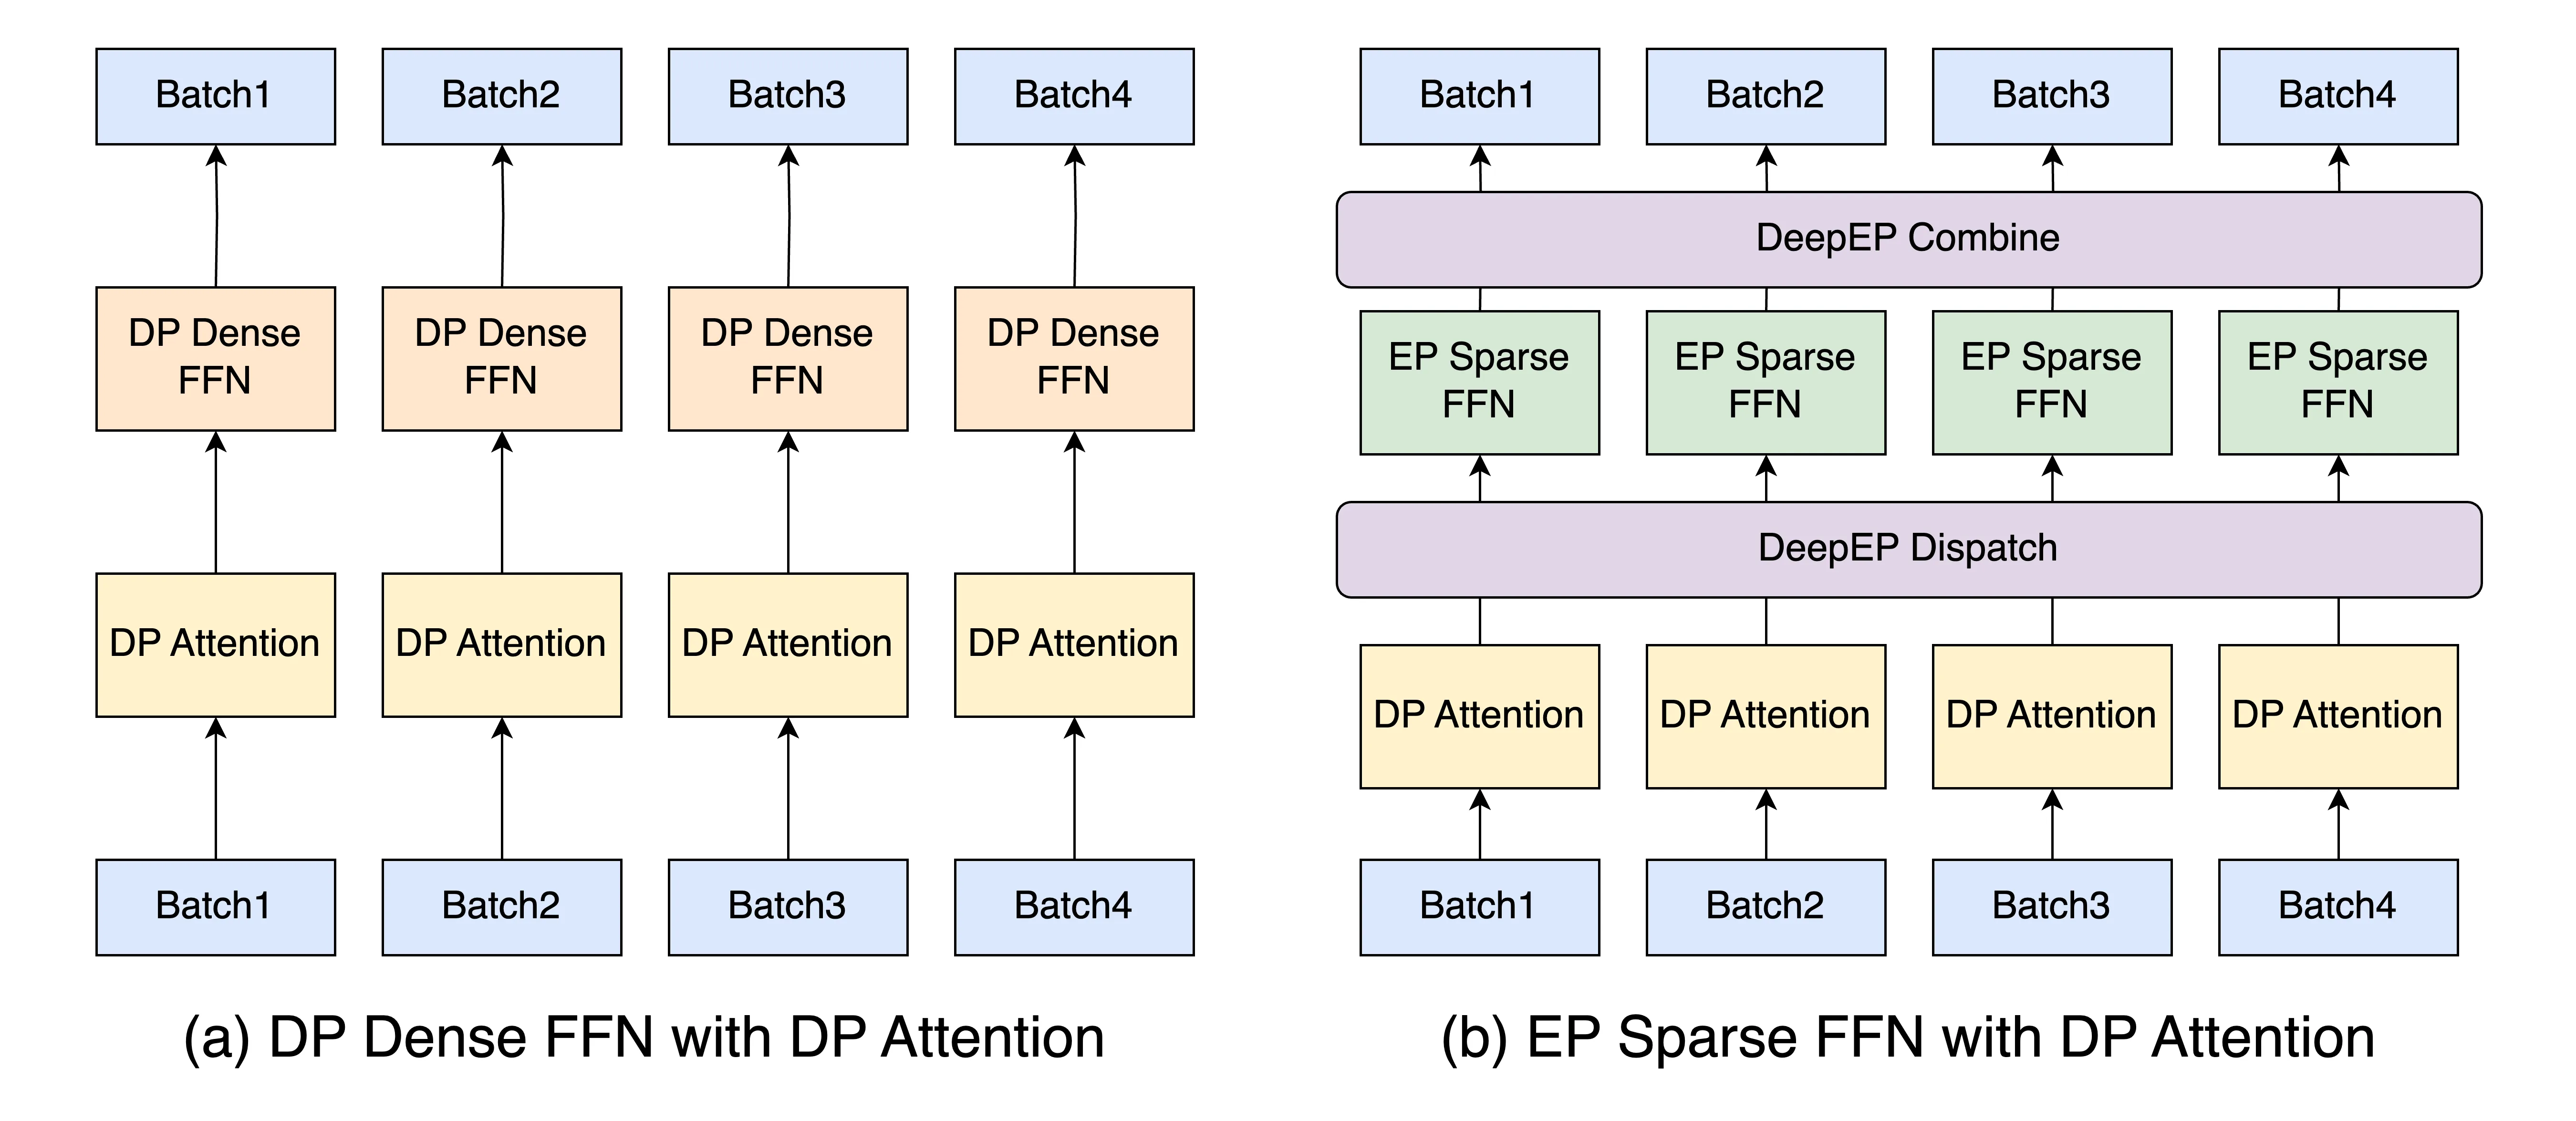
图片来源:SGLang 大规模 EP 设计博客 的并行设计图
这套设计留下的边界
机制讲完了,该说说它没解决什么。
第一,通信是硬约束。 DP Attention 每层两次全局通信(gather + scatter),EP 每层两次 A2A(dispatch + combine)。层数一乘就是几百次集合通信。TBO 和 fused read 能把这些藏起来一部分,但通信的绝对时间不会消失——节点越多、带宽越紧张,可藏的比例越少。博主自己也点到:“即使在多节点环境下,有限的通信带宽仍会显著增加总延迟”。
第二,EPLB 只能改善不能消除不均衡。 博客明确写着”即使有 EPLB,某些不均衡仍然不可避免,进一步的优化是有价值的未来方向”。根本原因是冗余专家的数量有限(默认 0,实践中几十个),而负载分布是动态变化的,重排的周期又受限于搬运成本。在两次重排之间,负载分布可能已经变了。
第三,冗余专家的选副本策略是启发式的。 static / dynamic / lp 这些算法各有假设,rank_invariant 这条约束在无 A2A 拓扑下又进一步收窄了选择空间。前面那句注释已经说明:在没有 A2A 后端时,选副本的自由度几乎为零,否则结果会重复计数。这是一个结构性的限制,不是调参能解决的。
第四,TBO 的可用性依赖 forward mode 一致。 各 DP 副本一旦 mode 不同(部分在 prefill、部分在 decode),TBO 立刻关闭。这在真实负载下意味着混合批次的时段恰好享受不到 TBO 的收益——而混合批次恰恰是通信最紧张的时候。这是一个还没有被完全解决的问题。
第五,物理拓扑的假设很强。 EPLB 的三步算法以”NVLink 快于跨节点”为前提,并且要求 num_groups % num_nodes == 0、num_gpus % num_nodes == 0、num_physical_experts % num_gpus == 0。这些都是整除约束,意味着某些集群规模下算法根本用不了,或者要退化到 use_flat_topology = True(把整个集群当成一个节点,放弃节点内优先的优化)。
小结
把这一篇的机制串起来,DP Attention 与专家并行的完整逻辑是:
为什么错开。 TP 会让 KV Cache 复制 TP 份,EP 会把专家切碎。attention 走 DP 保住 KV 容量,MoE 走 EP 保住专家 GEMM 尺寸,两者在同一层内拼接,代价是每层两次全局通信。
怎么拼。 每轮前向之前,各 DP 副本的调度器用一次形状固定的 all-gather 交换 11 个字段(token 数、forward mode、CUDA Graph 资格、attention_pairs……),用 min 做”一票否决”(图资格)、max 做”任一即真”(是否 prefill)、完整列表做偏移计算。空闲副本也必须到场,否则集合通信挂死。
拼接的性能考量。 DpPaddingMode 在 MAX_LEN 与 SUM_LEN 之间按通信代价权衡;layer_boundary 用 TokenAxis 抽象把”哪一维被切了”从模型文件里抽出去,并在条件允许时把 all-reduce + 残差加法 + RMSNorm + DP gather 融成一趟。
通信怎么做。 DeepEP 的 normal 模式为长输入优化但输出是符号形状(不支持 CUDA Graph);low-latency 模式为 decode 优化且支持 CUDA Graph 但要预分配固定内存。AUTO 按 prefill/decode 自动切换,而”同时要 DP Attention + CUDA Graph + 混合负载”这个三角约束要靠 P/D 分离解开。通信本身还可以量化(FP8/INT8/NVFP4),因为带宽是瓶颈。
通信怎么藏。 Two-batch overlap 把 batch 切成两个 micro-batch,用 operations + yield 的扁平列表表达”在哪里可以让出”,让一个的 dispatch/combine 与另一个的计算重叠;GEMM 必须刻意少占 SM,把 SM 留给通信 kernel。
不均衡怎么办。 EPLB 用冗余专家(默认 32 个,物理专家从 256 变 288)把高频专家复制多份、低频专家打包合并,算法本身是三层嵌套均衡(组→节点、专家→节点内槽位、槽位→GPU),每一层对应一种通信代价量级。运行时统计物理计数、用 scatter_add_ 还原成逻辑计数,超过阈值才触发重排,重排用三段式加载把代价摊开。冗余专家还顺带把并行度从 2 的幂解锁成 12、72 这类配置。
评测说了什么。 prefill 在 EP32 上相对 TP16 最高 3.3 倍、decode 在 EP72 上 5.2 倍;prefill 与 DeepSeek 官方 profile 的差距在 5.6% 以内。收益来自 DeepGEMM、TBO 与 EPLB 三者叠加,必须靠消融才能拆开归因。
这套机制回答了大规模 MoE 服务最核心的一个问题:当模型大到单卡装不下、集群大到通信成为瓶颈时,并行方式的选择不是”选一个最好的”,而是”让不同部分各自用最合适的”,然后用精细的同步与重叠把接缝处缝起来。 SGLang 的代码里那些看起来繁琐的 gather/scatter 分支、padding 模式启发式、idle 批次、yield 点,全部是这道缝合工序的具体实现。
下一篇会进入 SGLang 的弹性 EP 与故障恢复:当集群规模可以在运行时扩展、或者某些节点挂掉时,专家布局、世界大小与通信组如何重建——这会把本篇讲的所有映射表(physical_to_logical_map、max_ep_size、ep_join_rank_offset、elastic_ep_backend)真正用上。
参考资料
- SGLang: Efficient Execution of Structured Language Model Programs
- SGLang v0.4: Cache-Aware Load Balancing and Faster Structured Output
- SGLang: Large-Scale Expert Parallelism for DeepSeek
- SGLang 源码:layers/dp_attention.py(固定提交 d88d5c3)
- SGLang 源码:managers/scheduler_components/dp_attn.py(固定提交 d88d5c3)
- SGLang 源码:layers/layer_boundary/ops.py(固定提交 d88d5c3)
- SGLang 源码:layers/moe/token_dispatcher/deepep.py(固定提交 d88d5c3)
- SGLang 源码:batch_overlap/two_batch_overlap.py(固定提交 d88d5c3)
- SGLang 源码:batch_overlap/operations_strategy.py(固定提交 d88d5c3)
- SGLang 源码:eplb/eplb_manager.py(固定提交 d88d5c3)
- SGLang 源码:eplb/expert_location.py(固定提交 d88d5c3)
- SGLang 源码:eplb/eplb_algorithms/deepseek.py(固定提交 d88d5c3)
- DeepEP: an efficient expert-parallel communication library
- DeepGEMM: clean and efficient FP8 GEMM kernels with fine-grained scaling
- DeepSeek-V3 Technical Report
- DeepSeek-V3/R1 Inference System Overview
- SGLang Server Arguments Reference
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



