


SGLang 源码完全拆解(二十一):从对齐表到分组 GEMM——FusedMoE 如何把每个专家的几行 token 塞满 Tensor Core
上一篇《SGLang 源码完全拆解(二十):门控 Router 与按专家对齐——三份路由账本、五种输出格式与 moe_align_block_size 的排序账》走到了这样一个中间态:每个 token 挑出了 k 个专家,路由内核吐出 topk_weights [T, k] 与 topk_ids [T, k],随后 moe_align_block_size 把「token-expert 配对」按专家号排序,补齐到块的整数倍,产出三件东西——sorted_token_ids、expert_ids、num_tokens_post_padded。
那篇停在了对齐表的出口。接下来的问题全部落在同一层:这张对齐表交出去之后,到底由谁、以什么内核、在一次前向里把它变成每个专家的输出,再把 k 份结果加权求和回一条 hidden state?
本篇就沿着 SGLang 单机路径把这最后一环拆完。它覆盖的代码集中在 python/sglang/srt/layers/moe/ 目录下:
fused_moe_triton/layer.py里的FusedMoE模块——MoE 层在模型前向中的入口;moe_runner/runner.py、moe_runner/base.py、moe_runner/triton.py——执行后端的选择与格式转换;moe_runner/triton_utils/fused_moe.py——三次 launch 的编排;sglang/kernels/ops/moe/fused_moe_triton_kernels.py——真正的 Triton 内核;token_dispatcher/standard.py——单机「分发器」到底做了什么。
EP 通信(DeepEP、MegaMOE、EPLB)已经在第十七篇讲过,这里只在必要时指出来,不作为主线。
一、把 MoE 的一次前向摊平:五个阶段与三次 launch
先给结论,再看代码。SGLang 单机路径上的 FusedMoE.forward,完整链路是五个阶段:
hidden_states [T, H] + topk_weights/topk_ids [T, k] │ ├─ ① dispatch (StandardDispatcher) 单机:只做逻辑→本地专家号映射与 dp 补齐行 ├─ ② align (moe_align_block_size) 每专家 token 排序、按 BLOCK_SIZE_M 补齐 ├─ ③ GEMM1 + act (fused_moe_kernel) [M_pad, N] W13 收缩 + SiLU*up ├─ ④ GEMM2 (fused_moe_kernel) [M_pad, H] W2 收缩 + 乘路由权重 └─ ⑤ combine (moe_sum_reduce) k 份加权结果求和 + routed_scaling_factor其中真正落到 GPU 的是 ③④⑤。① 与 ② 的产物——映射表和对齐表——是 GPU 侧三个内核的公共输入。注意这和 vLLM 经典的「三次 launch」并不矛盾:vLLM 的 fused_experts 通常是 sorted_token_ids 排序内核、两个 GEMM 内核、再加一个 moe_sum,SGLang 的结构一致,差别在于每个阶段被做成了可替换的部件。
下图可以帮助建立手感。DeepSeek-V3 的技术报告给出的 MoE 结构里,每个 token 进入门控后选 8 个专家,另有 1 个共享专家:
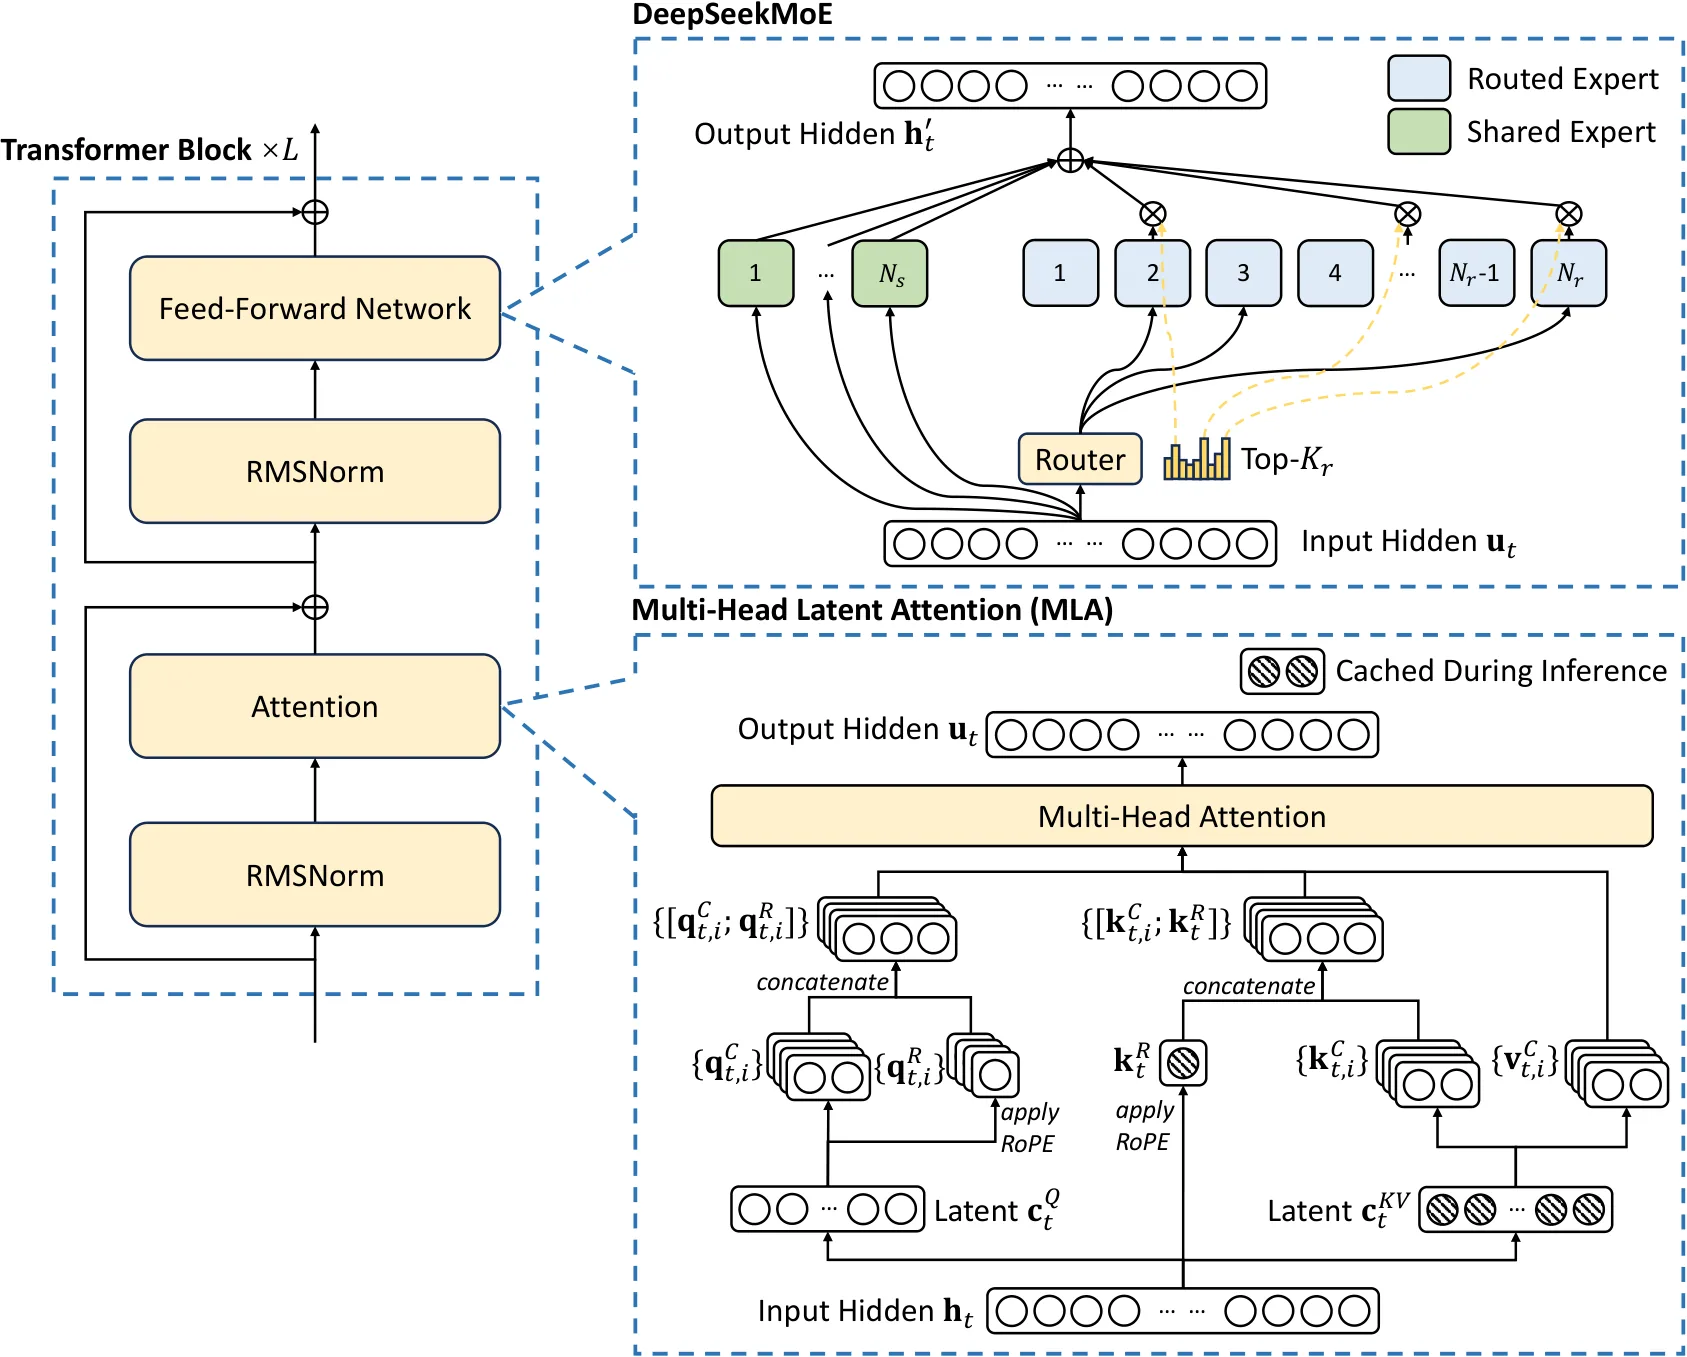
(这里用官方架构图,帮助理解「共享专家是一条独立的稠密 MLP、路由专家才是分组 GEMM 的对象」这一点,后面的 num_fused_shared_experts 就是把共享专家塞回同一批专家的账本。)
再看一个更直观的路由示意图。Mixtral 的论文里有一张「8 个 token 各自路由到前两个专家」的示例图,它把「同一条 token 会被复制到 k 个不同的专家桶里」这件事画得非常清楚:
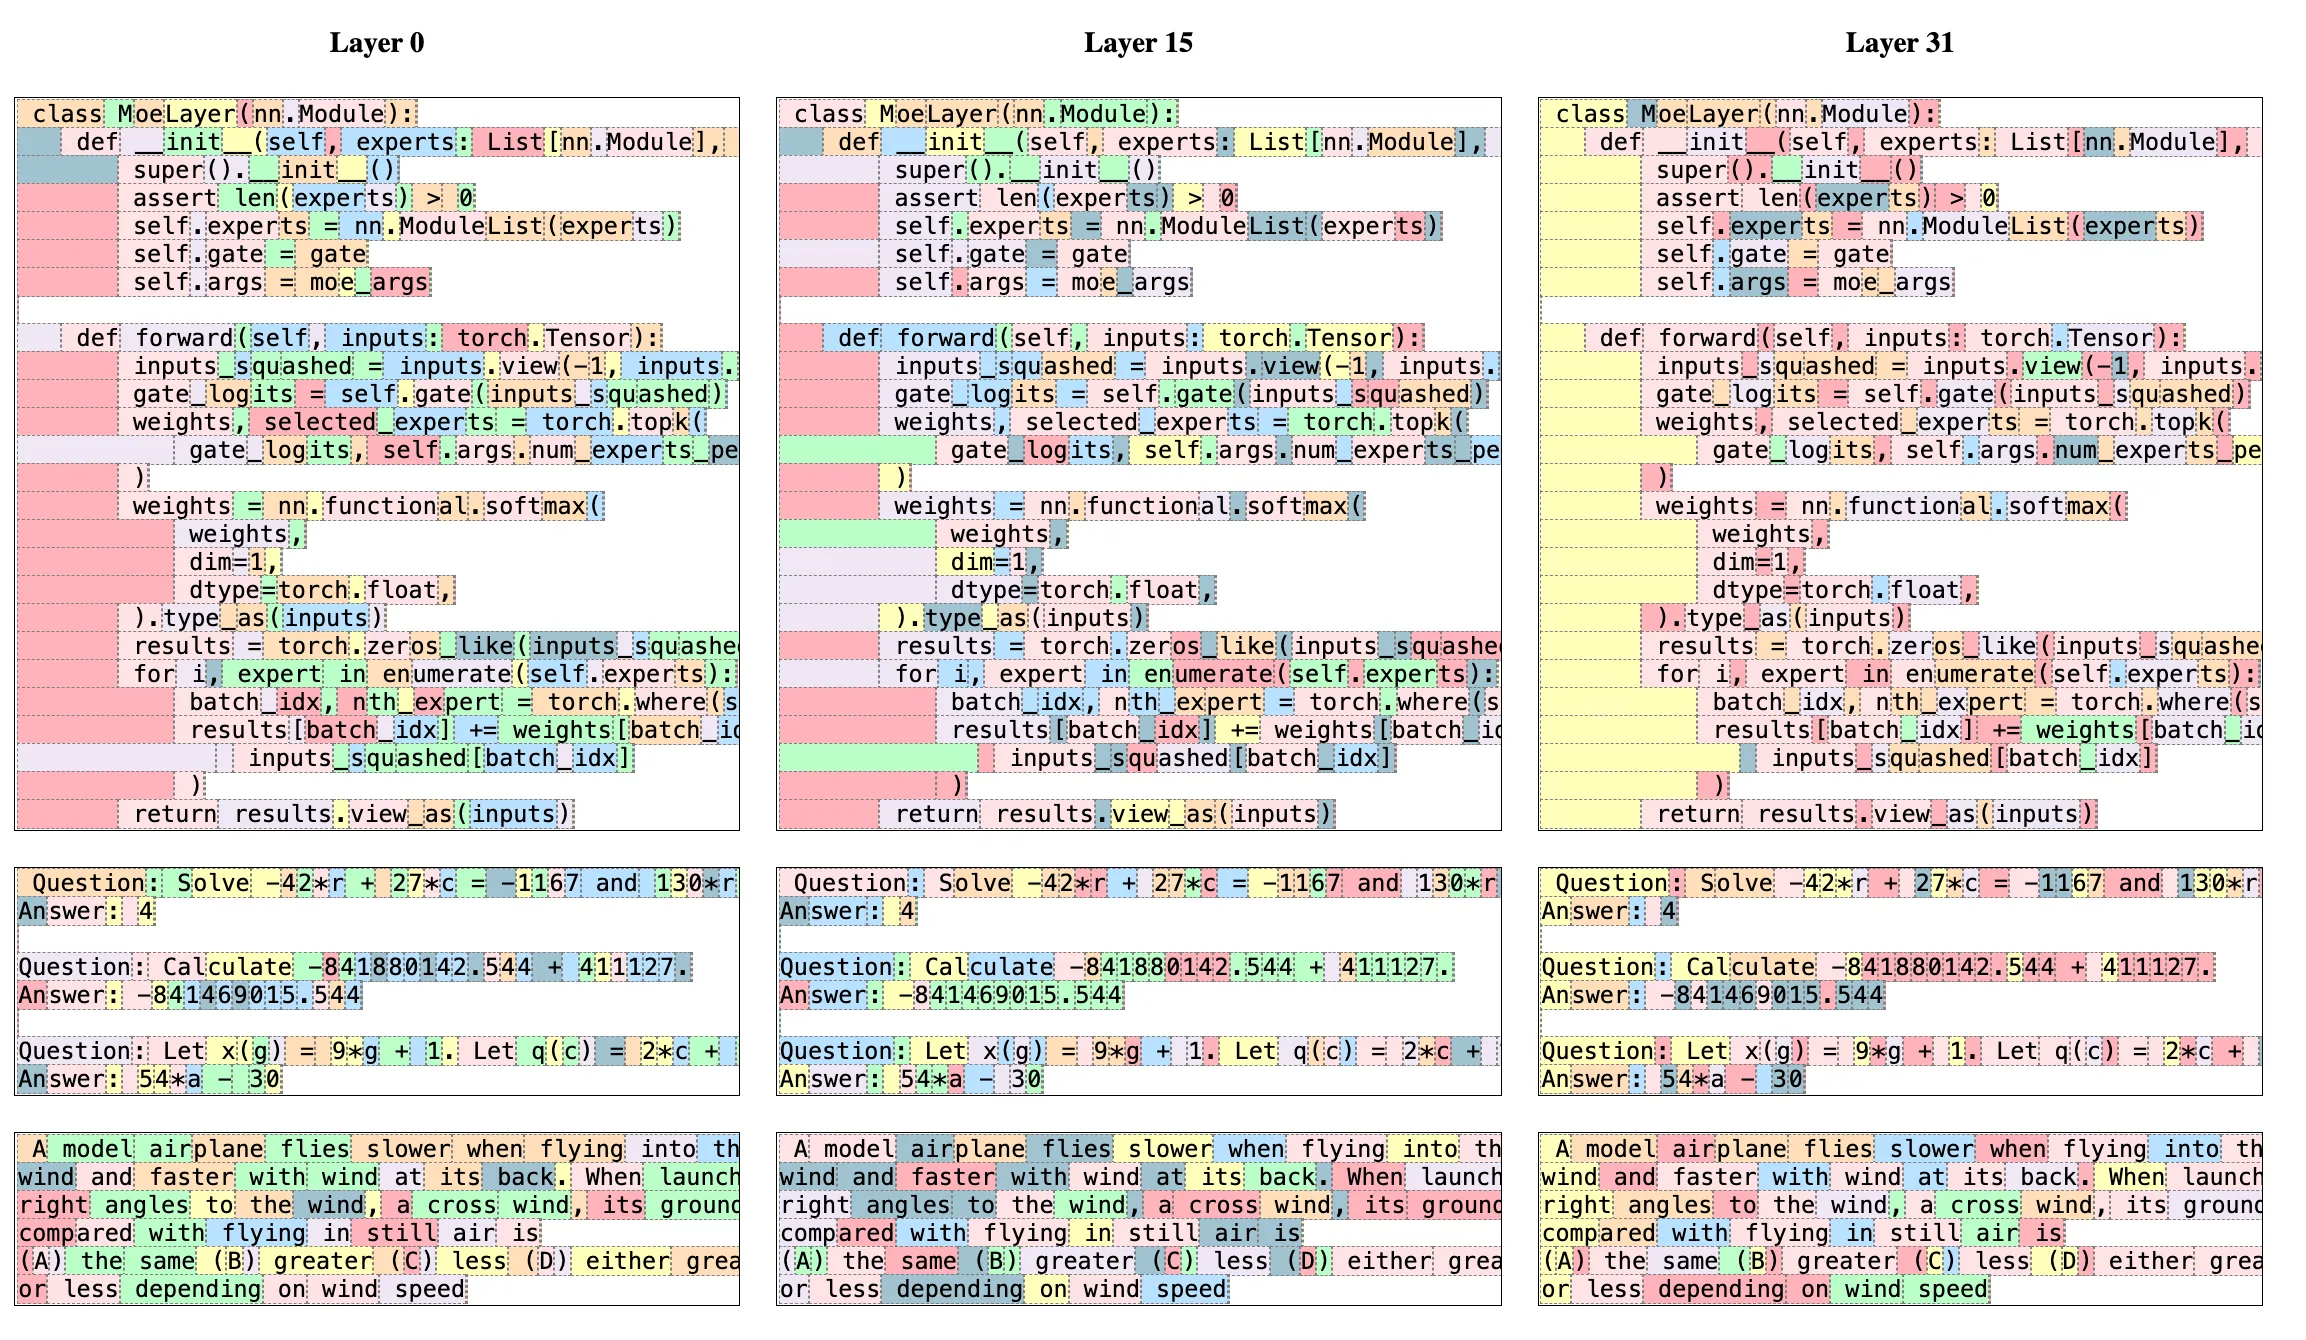
这张图对应到代码里,就是 sorted_token_ids 里同一个 token 号出现 k 次(甚至更多,见后面 token*k+slot 的编码)。
1.1 三次 launch 到底省了什么
如果不做融合,朴素实现是:
for e in range(E): idx = (topk_ids == e).nonzero() # 一遍扫描 + 主机同步 if idx.numel() == 0: continue x_e = hidden_states[idx] * weights[idx] # 高级索引:一次 gather h = act(x_e @ w13[e]) @ w2[e] # 两次 GEMM,e 个问题有三层:
- launch 次数:
E次循环意味着最多2E + 1次内核启动,DeepSeek-V3 有 256 个路由专家,一步 decode 就要发几百次 launch,每次 launch 在 Hopper 上约 3–5 µs 的调度开销,几乎等于一次小 GEMM 的计算时长; - 形状太碎:decode 时每个专家往往只分到几行甚至零行 token,cuBLAS 对
M < 16的矩阵效率极差,Tensor Core 的m16n8k16/m64n*k16指令需要至少 16/64 行才有意义; - 主机同步:
nonzero()要读回设备上的结果才能在 Python 层决定形状,这在 CUDA Graph 捕获时是致命的——图里不允许主机依赖。
融合方案把这三点一起解决:先排序再补零,让所有专家的 token 连续排列在同一个「虚拟矩阵」里,用一个大 kernel 按块处理,块内 expert_ids[block] 指出这块该用哪个专家的权重;k 份结果写进 intermediate_cache3,最后一次 moe_sum_reduce 求和。
1.2 为什么不是「让每个专家各发一个 grid」
分组 GEMM 的另一种写法是「每个专家一个 grid」,即 grid 的第一维是专家号,每个专家自己决定要处理多少行。这在 EP(专家并行)场景下更自然,DeepGEMM 的 grouped_gemm_nt_f8f8bf16_contig 就是这样:传入 m_indices 标出每行属于哪个专家,内核内部按专家分块。我们后面会看到,SGLang 在 deep_gemm 后端上正是这么做的。
但 Triton 单机路径选择「单一 grid + 对齐表」,因为:
- 对齐表让 grid 的 shape 是静态可推导的(
M_pad / BLOCK_SIZE_M × N / BLOCK_SIZE_N),可以挂在 CUDA Graph 里; - 每个 program 只看自己那几行,天然适合 Triton 的 program-level 并行模型,不需要额外处理「专家之间行数不均」的动态负载;
- 零行专家不需要单独跳过——对齐表根本不给它块,
expert_ids中出现的专家号已经过滤掉了空桶。
代价在下一篇会展开:补齐的零行会被白算。这个代价的大小直接由 BLOCK_SIZE_M 决定,所以 BLOCK_SIZE_M 的选择是这一层最关键的调参旋钮。
二、入口:FusedMoE 里到底存了什么
打开 fused_moe_triton/layer.py,FusedMoE 是一个 torch.nn.Module。它的构造函数里的几组参数值得单独留意:
| 参数组 | 含义 |
|---|---|
num_experts、top_k | 逻辑全局专家数与每 token 选择数(可能含共享专家、冗余专家) |
num_local_experts | 本 rank 实际持有的专家数,= 本地路由专家 + 融合共享专家 |
num_fused_shared_experts | 被「塞进同一批专家」的共享专家个数 |
intermediate_size_per_partition | 每个专家的中间维在 TP 切分后的长度 |
routed_scaling_factor | DeepSeek 风格的 2.5,作用在路由输出上 |
is_gated、gate_up_interleaved | 是否门控、gate/up 是否在加载时交错 |
构造函数里有一段很能说明设计意图的算术:
# fused_moe_triton/layer.py(节选)self._num_global_routed = num_experts - num_shared_slotsassert self._num_global_routed % storage_ep_size == 0self._num_local_routed = self._num_global_routed // storage_ep_sizeself.num_local_experts = self._num_local_routed + num_fused_shared_expertsself._has_fused_shared = num_fused_shared_experts > 0num_local_experts 决定了 w13_weight、w2_weight 的第一维。也就是说,共享专家并没有单独的权重数组——它被拼在本地路由专家之后的几个槽位上。门控那边输出的 k 包含这一份共享专家(top_k_for_moe = num_experts_per_tok + 1),对齐表和 GEMM 都不知道「谁是共享专家」,所有专家一视同仁。
这解释了为什么 DeepSeek-V2/V3 的共享专家在这个内核里不需要额外开销:它本来就只是第 257 号专家。
构造函数里还有一种「ep_join_mode == "scale"」的分支。它处理的是一种弹性 EP 部署——不同节点上实际参与的 rank 数不同,冗余专家的位置需要做偏移。这属于 seventeenth 篇(弹性 EP)的范围,这里只需要知道 storage_ep_size 与 moe_ep_size 的区别:存储侧把权重切到几个 rank,计算侧可能只有更少的 rank 在工作。
2.1 三个 dispatch 相关的字段
FusedMoE 还存了三个与单机无关、但会影响 forward 分支的字段:
self.dispatcher:由create_moe_dispatcher(moe_runner_config, quant_method)构造。单机时是StandardDispatcher,EP 时是DeepEPDispatcher等。self.runner:由quant_method.runner直接取出来,也是MoeRunner。self.moe_runner_config:一个 dataclass,把上面那堆参数打包成一份「执行合同」。
其中 moe_runner_config 是贯穿三层抽象的物件。它定义在 moe_runner/base.py:
@dataclassclass MoeRunnerConfig: num_experts: Optional[int] = None num_local_experts: Optional[int] = None hidden_size: Optional[int] = None intermediate_size_per_partition: Optional[int] = None layer_id: Optional[int] = None top_k: Optional[int] = None ... runner_backend: Optional[MoeRunnerBackendLike] = None activation: str = "silu" is_gated: bool = True apply_router_weight_on_input: bool = False inplace: bool = True no_combine: bool = False routed_scaling_factor: Optional[float] = None gate_up_interleaved: bool = True layer: Optional[torch.nn.Module] = None silu_mul_keep_fp32: bool = False它有四个属性其实是从 layer 上读的:
@propertydef moe_tp_size(self) -> int: return self._layer_placement("moe_tp_size")为什么不在构造时直接拷一份?源码注释里写得很直白——DWDP 的 bind_full_expert_weights 会在权重加载完之后「塌缩」层的 EP 视图,也就是把「本地专家」改回「全部专家」,而 MoeRunnerConfig 可能在那之前就构造了。保持一个地址、每次读层,才不会出现两份不一致的账。
三、Runner 与 FusedOp:两层「可替换」
3.1 MoeRunner 的选择逻辑
MoeRunner.__init__ 是一棵很长的分支树。按优先级大致是:
自定义注册工厂 > triton > ascend (NPU) > triton_kernels > deep_gemm > humming > aiter (ROCm) > marlin / flashinfer_* / cutlass / hpc_ops ← 这些 runner_core 为 None,只走 fused 路径每个分支背后是一个 MoeRunnerCore 子类,实现 run(runner_input, quant_info, running_state)。但更关键的是构造函数的末尾这段:
if not lora_enabled: a2a_backend_name = get_moe_a2a_backend().value runner_backend_name = runner_backend.value self.fused_func = FusedOpPool.get_fused_func(a2a_backend_name, runner_backend_name)
if self.runner_core is None and self.fused_func is None: raise NotImplementedError(...)也就是说,存在两套并行的执行模式:
- fused 模式:
(a2a_backend, runner_backend)这一对在FusedOpPool里注册过,就直接调用它,跳过所有格式转换; - core 模式:没有 fused 函数时,走
pre_permute → runner_core.run → post_permute三段式。
FusedOpPool 的 key 为什么是两维而不是一维?因为融合函数通常把「分发格式」和「计算布局」焊死在一起。例如 Triton 后端的 fused_experts_none_to_triton,它要求 dispatch 输出是 StandardDispatchOutput 且数据从未被重排过——它直接在原始 hidden_states 上开始算。如果换成 DeepEP 的 dispatch,输出已经是按目标 rank 分好的 buffer,这时就必须走 deep_gemm 的 grouped GEMM,而不能复用 Triton 的实现。
3.2 PermuteMethodPool 与三段式
三段式中的 pre/post permute 用 (输出格式, runner backend) 作为 key:
@register_pre_permute("standard", "triton")def pre_permute_standard_to_triton(dispatch_output, quant_info, runner_config, running_state): config, down_config, down_moe_use_tma, up_moe_use_tma, \ sorted_token_ids, expert_ids, num_tokens_post_padded = _prepare_fused_moe_run(...)
running_state["config"] = config running_state["down_config"] = down_config running_state["down_moe_use_tma"] = down_moe_use_tma running_state["up_moe_use_tma"] = up_moe_use_tma
return TritonRunnerInput(hidden_states=..., topk_weights=..., topk_ids=..., sorted_token_ids=..., expert_ids=..., num_tokens_post_padded=...)注意 pre_permute 并不只做「排列」,它同时做了配置解析与对齐表构造。running_state 是一个在三个阶段之间传递可变字典——它承载了 config、TMA 开关,以及 CUDA Graph 场景下的 down_gemm_overlap_args。这是一种轻量的「side channel」:避免把这些字段塞进 RunnerInput 从而污染 dataclass 的语义。
TritonRunnerInput 本身很朴素,六个字段:
@dataclassclass TritonRunnerInput(RunnerInput): hidden_states: torch.Tensor topk_weights: torch.Tensor topk_ids: torch.Tensor sorted_token_ids: torch.Tensor expert_ids: torch.Tensor num_tokens_post_padded: torch.TensorTritonMoeQuantInfo 则是量化态的载体:w13_weight、w2_weight、各种 use_fp8_w8a8/use_int4_w4a16 开关、w13_scale、block_shape、fuse_swiglu_interleaved。它从 quant_method.get_moe_quant_info(layer, runner_backend) 里来——因此更换量化方案时,只需要换一个 TritonMoeQuantInfo 构造器。
3.3 一段「兜底断言」的工程含义
MoeRunner.__init__ 里还有三条启动期校验,很值得单独读,因为它们是跨模块耦合的显式契约:
if get_moe_runner_backend().is_hpc_ops() and not runner_backend.is_hpc_ops(): raise ValueError( "--moe-runner-backend hpc_ops ... would consume global ids as local ones and misroute " "tokens under EP>1, so fail loudly at startup instead." )
if get_moe_a2a_backend().is_deepep_v2() and not runner_backend.is_deep_gemm(): raise ValueError("--moe-a2a-backend deepep_v2 requires the deep_gemm MoE runner ...")第一条说明了一个很容易踩的坑:hpc_ops 的 dispatcher 会让 StandardDispatcher 保留全局专家号(skip_local_expert_mapping),因为它自己会做 EP 映射。如果某一层因为量化方法退化到 Triton runner,Triton 会把全局号当成本地号用,在 EP>1 下静默错路由。源码选择「启动即报错」而不是「运行期出错」,这类 fail-fast 在大规模部署里比任何日志都可靠。
第二条是 deepep_v2 与 deep_gemm 之间的耦合:deepep_v2 的输出直接是 DeepGEMM 要求的 m_indices 布局(FP8 激活 + scale,或未量化专家的 BF16 激活),换成 Triton runner 就没法消费。
3.4 FusedOpPool 的实际成员
了解哪些组合有 fused 函数,就能知道「常规部署走的是哪条路」:
("none", "triton")→fused_experts_none_to_triton- 还有
("deepep", "deep_gemm")、("flashinfer", "flashinfer_trtllm")、("mooncake", ...)、("nixl", ...)、("pplx", ...)等组合。 marlin/cutlass/hpc_ops/flashinfer_*的runner_core是None,要求它们必须能找到 fused 函数。
所以「单机 Triton」这条路的名字有点误导:它并不是没有分发器,而是分发器什么都不做,然后直接调一个融合函数。
四、StandardDispatcher:单机分发器只做了两件小事
打开 token_dispatcher/standard.py,StandardDispatcher.dispatch 的骨架是这样的:
def dispatch(self, hidden_states, topk_output) -> StandardDispatchOutput: needs_dp_allgather = should_use_flashinfer_cutlass_moe_fp4_allgather() if needs_dp_allgather and not use_fp4_payload: # all_gatherv topk_weights, topk_ids, hidden_states elif needs_dp_allgather: # fp4 先量化、再 all_gatherv、再 swizzle
if self.moe_ep_size > 1 and not self.skip_local_expert_mapping ...: self.local_expert_mapping = ... topk_ids_local = _map_topk_ids_to_local_experts(topk_output.topk_ids, self.local_expert_mapping) if _MASK_DP_PAD_MOE and is_dp_max_padding(): mask_dp_pad_moe_topk_ids(topk_ids_local) topk_output = topk_output._replace(topk_ids=topk_ids_local)
return StandardDispatchOutput(hidden_states=hidden_states, ..., topk_output=topk_output)大部分情况下,这就是一个「原样传下去」的函数。但它隐含了三件事:
- 逻辑 → 物理的映射。EP 时
topk_ids是全局专家号,本 rank 只持有其中一段;local_expert_mapping把全局号重写成[0, num_local_experts)或-1(不属于本 rank)。-1是关键哨兵,后面moe_align_block_size会把-1分到一个专门的桶,并在 GEMM 时整块跳过。这一件事在第二十篇里已经讲过。 - DP Attention 的补齐行屏蔽。数据并行注意力(第十七篇)要求各 rank 的 batch 对齐到同一个长度,补出来的行带着陈旧 hidden 进入路由,会产生一堆无意义路由结果,还会在分组 GEMM 的 workspace 里「撞桶」。
mask_dp_pad_moe_topk_ids把这些行的topk_ids全部改为-1,让它们在后续被整块丢弃。 - FP4 的量化前移。当
flashinfer_cutlass在 DP 场景下需要 all-gather 时,先量化再通信、通信后再 swizzle。这是带宽账:FP4 每行只占 1/4 字节数(相对于 BF16),all-gather 传输量小 4 倍;swizzle 是 NVFP4 的块布局,放在通信之后就不用搬已经重排过的字节。
combine 更简单:如果走了 FP4 allgather,就做一个 reduce_scatterv 把全局输出切回本 rank;否则直接返回。
五、对齐表的产出:BLOCK_SIZE_M 的两难
上一篇已经把 moe_align_block_size 的 CUDA 内核(一次扫描 + 二次扫描 + 二分定块)拆过了。这里补充它在单机路径里被使用的方式——_prepare_fused_moe_run:
config, (down_config, _) = try_get_optimal_moe_config( w1.shape, (w2.shape[0], w2.shape[1], w2.shape[2] - padded_size), topk_ids.shape[1], config_dtype, num_tokens, block_shape=block_shape, per_channel_quant=per_channel_quant, return_down_config=True,)config = dict(config)up_tma_requested = config.pop("USE_TMA", False)up_moe_use_tma = _moe_support_tma() and up_tma_requesteddown_moe_use_tma = _moe_support_tma() and down_config.pop("USE_TMA", False)
sorted_token_ids, expert_ids, num_tokens_post_padded = moe_align_block_size( topk_ids, config["BLOCK_SIZE_M"], E)有三点要读懂:
第一,try_get_optimal_moe_config 用「运行时 M」去一个下载好的配置文件里找最近的 key:
config = configs[min(configs.keys(), key=lambda x: abs(x - M))]如果找不到配置文件,就用 get_default_config:
if M <= E or (is_marlin and M <= 32): config = {"BLOCK_SIZE_M": 16, "BLOCK_SIZE_N": 32, "BLOCK_SIZE_K": 64, "GROUP_SIZE_M": 1}else: config = {"BLOCK_SIZE_M": 64, "BLOCK_SIZE_N": 64, "BLOCK_SIZE_K": 32, "GROUP_SIZE_M": 8}decode 时 M = T(batch 大小)远小于 E = 256,于是走 BLOCK_SIZE_M=16 分支——每个 block 只处理 16 个 token-expert 配对,平均每个专家恰好 1 块,几乎不浪费。prefill 时 M 很大,走 64 或 128 分支,减少 launch 网格冗余。
第二,上下两次 GEMM 必须共享同一个 BLOCK_SIZE_M,因为它们只做了一次对齐。源码里有一个显式修正:
if return_down_config and config["BLOCK_SIZE_M"] != down_config["BLOCK_SIZE_M"]: logger.warning_once("down_moe config BLOCK_SIZE_M=%d does not match up config ...") down_config["BLOCK_SIZE_M"] = config["BLOCK_SIZE_M"]这是整个系统里很典型的「多一个约束」:调优时如果你用了两个独立的最优配置,运行时必须削掉不一致项,否则对齐表用一套块,第二次 GEMM 用另一套,就会错位。
第三,USE_TMA 被 pop 掉:配置文件里它是标记,不是内核参数,不能在 launch 时传给 Triton。
5.1 补齐行到底长什么样
moe_align_block_size 的文档字符串里有一个完整例子:
topk_ids = [[2,3,4],[1,2,4],[1,3,4],[1,2,3]], block_size = 4, num_experts = 4flatten → [2,3,4, 1,2,4, 1,3,4, 1,2,3]每专家 3 行,补到 4 → 各补 1 个占位 token(编号 = numel = 12)排序后 token_ids = [3,6,9,12, 0,4,10,12, 1,7,11,12, 2,5,8,12]其中 12 是「不存在的 token」,它在 sorted_token_ids 里的值超过了 num_valid_tokens。Triton 内核就是靠这个阈值判断「这块的这一行是补齐行,跳过」:
offs_token = tl.load(sorted_token_ids_ptr + offs_token_id)token_mask = offs_token < num_valid_tokens这个阈值 num_valid_tokens = topk_ids.numel(),是内核从 Python 侧作为标量拿到的,不需要每行单独判断。所以补齐行的开销只是「块内多算了几个无效元素」,而不是「额外的分支」。
5.2 什么时候 ALIGN 会变成大头
考虑 DeepSeek-V3 的 decode:T = 128,k = 8,E = 256(不含共享专家)。numel = 1024。
- 随机路由下,每个专家的平均 token 数为 4,
BLOCK_SIZE_M = 16,每专家补到 16,M_pad ≈ 256 × 16 = 4096。 - 也就是说,真实要算的 1024 行,被扩成了 4096 行——4 倍放大。
这个 4 倍放大就是 decode 阶段 MoE 的主要冗余来源。它换来的是:每个 program 都能吃满 m16n8k16 的指令,而且不需要动态 shape。prefill 时 numel 远大于 E × BLOCK_SIZE_M,对齐表几乎无冗余,收益就非常明显。
这里有一个容易忽略的细节:每个专家的补齐块数是 ceil(count / BLOCK_SIZE_M),如果某专家 count = 0,它就没有块。expert_ids 的长度因此是 sum(ceil(count_e / BM)),而不是 E * ceil(...)。空专家完全被跳过,这与「朴素实现里要 continue」是对偶的,只是发生在 GPU 侧、不需要主机同步。
六、fused_moe_kernel:一行 token 究竟被哪些块读过
这一节是全篇的核心。内核在 sglang/kernels/ops/moe/fused_moe_triton_kernels.py,签名超过 50 个参数,先把关键维度对齐:
| 名字 | 含义 | 在 decode 时的典型值 |
|---|---|---|
A | 输入 hidden 或上一层中间结果 | [T, H],H = 7168 |
B | 堆叠的专家权重 | GEMM1:[E, 2·I_pp, H];GEMM2:[E, H, I_pp] |
C | 中间缓存 | [M_pad, topk, N] 或 sorted 布局 |
EM | sorted_token_ids.shape[0] | M_pad |
num_valid_tokens | topk_ids.numel() | T × k |
top_k | 每个 token 复制数 | k(含共享专家时 +1) |
group_n、group_k | 块量化粒度 | FP8 块量化时为 128, 128 |
6.1 第一步:program 映射到哪个块
pid = tl.program_id(axis=0)num_pid_m = tl.cdiv(EM, BLOCK_SIZE_M)num_pid_n = tl.cdiv(N, BLOCK_SIZE_N)num_pid_in_group = GROUP_SIZE_M * num_pid_ngroup_id = pid // num_pid_in_groupfirst_pid_m = group_id * GROUP_SIZE_Mgroup_size_m = min(num_pid_m - first_pid_m, GROUP_SIZE_M)pid_m = first_pid_m + ((pid % num_pid_in_group) % group_size_m)pid_n = (pid % num_pid_in_group) // group_size_m这是 GROUP_SIZE_M 排序技巧(也见于 cuBLAS 的「swizzle」概念):把 grid 切成一段一段的列,每段里面先沿 m 方向走,让相邻 program 覆盖同一个专家块的连续行,从而提高 L2 里 B[expert] 的复用。在 MoE 里它还有另一层含义——同一个 pid_m 段内的块可能对应同一个专家(对齐表按专家排),所以段内更有可能命中同一份 B。
6.2 第二步:这块属于谁、要处理谁
num_tokens_post_padded = tl.load(num_tokens_post_padded_ptr)if pid_m * BLOCK_SIZE_M >= num_tokens_post_padded: returnoffs_token_id = pid_m * BLOCK_SIZE_M + tl.arange(0, BLOCK_SIZE_M).to(tl.int64)offs_token = tl.load(sorted_token_ids_ptr + offs_token_id).to(tl.int64)token_mask = offs_token < num_valid_tokens
off_experts_i32 = tl.load(expert_ids_ptr + pid_m)off_experts = off_experts_i32.to(tl.int64)offs_token_id 是排序后的位置,offs_token 是原始的 token*k+slot 编码,off_experts 是这块负责的专家号。三者合在一起就能回答:「我要从原始 A 里取哪几行、用 B 的哪一页、写到 C 的哪些位置」。
这里的 token*k+slot 编码是为了解决一个细节:同一个 token 被复制 k 次,每次对应一个专家,但路由权重不同。用 token*k+slot 编码可以同时知道原始 token 和它在本行中的位置,从而从 topk_weights 里取出正确的权重:
moe_weight = tl.load(topk_weights_ptr + offs_token, mask=token_mask, other=0)topk_weights 是 [T, k] 展平后的一维数组,索引恰好是 token*k+slot。
6.3 第三步:构造 A、B 的指针
# A 的指针:跳过补齐行、跳过 slot,取原始 hidden 的那一行a_ptrs = a_ptr + ( offs_token[:, None] // top_k * stride_am + offs_k[None, :] * stride_ak)
# B 的指针:按专家号取权重页b_ptrs = ( b_ptr + off_experts * stride_be + (offs_k[:, None] * stride_bk + offs_bn[None, :] * stride_bn))注意 offs_token[:, None] // top_k:这一步把 token*k+slot 还原成原始 token 号。所以同一个 token 的不同 slot,读的是同一行 A,但 B 不同、写入位置不同。
这一段还体现了 TMA 与非 TMA 的分叉:
if a_desc is not None: start_offs_m = pid_m * BLOCK_SIZE_Melse: ...if b_desc is not None: start_offs_n = pid_n * BLOCK_SIZE_Nelse: ...TMA 模式不通过指针算术访问,而是把整块描述成 TensorDescriptor,由硬件 DMA 引擎按描述符搬运。描述符的坐标 [start_offs_m, k_start] 必须是块的起点,所以 sorted_token_ids 的取值不能被直接用在描述符上——c_sorted 这个开关就是干这个的。
6.4 第四步:K 方向累加与量化还原
for k_start in range(0, K, BLOCK_SIZE_K): if even_Ks: a = tl.load(a_ptrs, mask=token_mask[:, None], other=0.0) b = tl.load(b_ptrs) else: a = tl.load(a_ptrs, mask=token_mask[:, None] & (offs_k[None, :] < K - k_start), other=0.0) b = tl.load(b_ptrs, mask=offs_k[:, None] < K - k_start, other=0.0)
if use_int8_w8a16: accumulator = tl.dot(a, b.to(compute_type), acc=accumulator) elif use_fp8_w8a8 or use_int8_w8a8: if group_k > 0 and group_n > 0: # 块量化:每个 BLOCK_SIZE_K 块各自乘一组 scale offs_ks = k_start // group_k a_scale = tl.load(a_scale_ptrs + offs_ks * stride_ask, mask=token_mask, other=0.0) b_scale = tl.load(b_scale_ptrs + offs_ks * stride_bsk) accumulator += tl.dot(a, b) * a_scale[:, None] * b_scale[None, :] else: accumulator = tl.dot(a, b, acc=accumulator) else: accumulator += tl.dot(a, b)这里最值得读的是 FP8 块量化的三处细节:
even_Ks:如果K % BLOCK_SIZE_K == 0,A、B 都不需要在 K 方向做 mask,这样可以省掉两次逐元素比较指令。这就是为什么padded_size允许在权重末尾补几列——补到能被BLOCK_SIZE_K整除,换取内层循环里更轻的加法。- 块 scale 的读取位置:
offs_bsn = pid_n * BLOCK_SIZE_N // group_n(当BLOCK_SIZE_N <= group_n)或offs_bsn = offs_bn // group_n(当BLOCK_SIZE_N > group_n)。这是 DeepSeek-V3 的「128×128 块」,group_k = 128、group_n = 128。在内层 K 循环中,offs_ks = k_start // 128标出当前 K 块属于哪一组。 - 累加方式的分叉:当
BLOCK_SIZE_N <= group_n时,一个 B 块只属于一列组,b_scale是标量,于是写法是a_scale[:, None] * b_scale;当BLOCK_SIZE_N > group_n时,一个 B 块横跨多列组,b_scale是向量,于是a_scale[:, None] * b_scale[None, :]。这两条路径本质是同一件事,区别只在广播维度。
还有一个 swap_ab 分支,只在 FP8 且配置里指定时启用:
if swap_ab: a, b = tl.trans(b, (1, 0)), tl.trans(a, (1, 0)) a_scale, b_scale = b_scale, a_scale它把 [BM, BK] × [BK, BN] 换成 [BN, BK] × [BK, BM],主要是为了在 BLOCK_SIZE_M 很小时让 tl.dot 的形状更符合 Tensor Core 的偏好。对 decode(M 只有 16)特别有用:M 维太短,把 B 放到「A 位置」会让 W 矩阵的 N 维(intermediate size,通常 2048)占据 M 槽位,指令利用率更高。
6.5 第五步:epilogue——乘路由权重、写回
if bias_ptr is not None: accumulator += bias
if MUL_ROUTED_WEIGHT: moe_weight = tl.load(topk_weights_ptr + offs_token, mask=token_mask, other=0) accumulator *= moe_weight[:, None]
accumulator = accumulator.to(compute_type)MUL_ROUTED_WEIGHT 在 GEMM1 里通常为 False、在 GEMM2 里为 True(除了 apply_router_weight_on_input 的情况)。为什么不统一乘在 GEMM2?因为 GEMM1 的输出要经过 SiLU(gate) * up,这个非线性操作与路由权重相乘的顺序不同——w·SiLU(g) * up ≠ SiLU(w·g) * (w·up)。所以必须把路由权重放在 GEMM2 的最后,而 apply_router_weight_on_input 是另一种模式:先把权重乘到输入上,这样 GEMM1 与 GEMM2 都不用再乘。
写回有三个变体,其中 FUSE_SWIGLU 那一段最长,值得单独拆:
if FUSE_SWIGLU: acc_pairs = tl.reshape(accumulator, (BLOCK_SIZE_M, BLOCK_SIZE_N // 2, 2)) gate_b, up_b = tl.split(acc_pairs) gate_f = gate_b.to(tl.float32) exp_neg = tl.inline_asm_elementwise( "{ mul.ftz.f32 $0, $1, 0fBFB8AA3B; ex2.approx.ftz.f32 $0, $0; }", "=f,f", [gate_f], dtype=tl.float32, is_pure=True, pack=1, ) silu_f = tl.inline_asm_elementwise( "div.approx.ftz.f32 $0, $1, $2;", "=f,f,f", [gate_f, 1.0 + exp_neg], dtype=tl.float32, is_pure=True, pack=1, ) out_act = (silu_f * up_b.to(tl.float32)).to(compute_type)这里有一个重要的工程细节,源码注释写得很清楚:
The asm below is the bit-parity contract with the
silu_and_multhis replaces, not an optimization: that kernel uses the fast-math intrinsics__fdividef(x, 1 + __expf(-x)), while Triton’s operators lower to accurate expf and IEEEdiv.rn. The 1-2 ULP gap is enough to flip the stored bf16 (8 mantissa bits) on many inputs.
也就是说,这段内联 PTX 不是「更快」,而是「算得和原来那个独立 silu_and_mul 完全一样」。因为 bf16 只有 8 个尾数位,1–2 ULP 的差异会让很多值在舍入时翻转。对于「batch-invariant」(结果不随 batch 组成变化)这类严格要求,这种位级对齐是必须的。
0fBFB8AA3B 是 -log2(e) 的 float 位模式,前面把负号折叠进常量,这样 ex2.approx(x * -log2 e) 就等于 exp(-x) 的近似,少一条指令,且符号翻转精确。
6.6 第四阶段的 combine 去哪了
回到 _fused_moe_kernel_sequence。GEMM2 写完 intermediate_cache3 [T, k, H] 之后,调用 moe_combine_topk:
elif _is_cuda or _is_musa: if topk == 1 and routed_scaling_factor == 1.0 and not _use_intermediate: pass # 直接写进 out_hidden_states elif topk == 2 and routed_scaling_factor == 1.0: torch.add(intermediate_cache3[:, 0], intermediate_cache3[:, 1], out=out_hidden_states).squeeze(dim=1) else: if _use_moe_sum_reduce_torch_compile(num_tokens): ... moe_sum_reduce_torch_compile / moe_sum_reduce_triton ... else: moe_sum_reduce(...)这里有三个可以省的分支:
topk == 1:不需要求和,GEMM2 直接写入输出。topk == 2:用torch.add而不是专用内核,因为两路求和用add就是最优路径。topk > 2:分两档,小 token 数用torch.compile的版本(编译器会展开为向量化加法),大 token 数用预编译的moe_sum_reduce(减少编译开销与寄存器压力)。_use_moe_sum_reduce_torch_compile的阈值就是这两档的分界线。
topk == 2 这条路径对 Mixtral 很关键:num_experts_per_tok = 2 是经典配置。
6.7 defer_sum 与「最后一次求和」外移
_fused_moe_kernel_sequence 有一个 defer_sum 参数:
if defer_sum: # Keep routing multiplication inside GEMM2, including its BF16 output # rounding. The consumer owns the FP32 sum and routed scaling. return intermediate_cache3它允许 GEMM2 只产出加权后的 [T, k, H],把求和挪到调用方。谁会用?在 DeepseekV2MoE 的分层边界(stage boundary)场景——当流水/PP 在层边界需要做 reduce_scatter 或与共享专家输出合并时,可以在求和之前先把共享专家那一路加进来,再一次性做 FP32 求和与 routed_scaling_factor。这比「先求和、再加共享专家」少一次读改写。
七、三次 launch 的时序:把内核流串起来
把 _fused_moe_kernel_sequence 的启动顺序画出来,就是下面这张图。注意第二步的 gemm1_out = intermediate_cache1 有两种形态:
if fuse_swiglu_interleaved: intermediate_cache1 = None gemm1_out = intermediate_cache2 = torch.empty((total_tokens, N // 2), ...)else: gemm1_out = intermediate_cache1 = torch.empty((total_tokens, N), ...)N // 2 是「gate」与「up」拼在一起后的半宽——因为 W13 的行在加载时被交错成 (gate0, up0), (gate1, up1), ...,GEMM1 一算出来就在 epilogue 里取相邻两列做 SiLU(g0)*u0,于是结果宽度只要原宽的一半。这就是前面 _maybe_interleave_w13_for_fused_swiglu 的作用——加载期多一次全量重排,换取每层 MoE 少一个中间缓冲区 + 少一次独立激活 launch。
激活之后是 row_filter:
row_filter = _activation_row_filter( down_moe_use_tma=down_moe_use_tma, filter_expert=filter_expert, topk_ids=topk_ids, expert_ids=expert_ids, sorted_token_ids=sorted_token_ids, num_tokens_post_padded=num_tokens_post_padded, block_size_m=config["BLOCK_SIZE_M"],)这段函数根据后面的 GEMM2 是否需要 TMA 来决定激活时要不要按块过滤无效行。原因是:
- 非 TMA 模式:激活就是一个普通 elementwise,多余行的结果会被 GEMM2 的
token_mask丢掉,白算几十行不影响正确性; - TMA 模式:
c_sorted = True,GEMM2 直接读连续排布的中间结果,且每块内部假定该块的行都属于同一个专家,所以激活必须按expert_ids把不匹配的行写成 0(或 skip),否则把别专家的结果混进来了。
这就解释了代码里的注释:
LoRA hooks consume and update route-major intermediate buffers. The TMA down path keeps those buffers in expert-sorted, block-padded order, which is incompatible with the hook contract.
当 hooks 存在时,代码强制 down_moe_use_tma = False,因为 LoRA 增量的内存布局是按 [T, k, N] 的,而 TMA 中间结果是按 [M_pad, N//2] 的。
7.1 total_tokens 的两套口径
padded_tokens = ( min(num_tokens * topk, E + 1) * (config["BLOCK_SIZE_M"] - 1) if down_moe_use_tma else 0)total_tokens = num_tokens * topk + padded_tokens非 TMA 模式:中间缓冲区大小恰好是 T × k,因为对齐表里的「虚拟补零」写进 C 时靠 mask 处理,不会多分配。
TMA 模式:每行还可能因为 BLOCK_SIZE_M 补齐而多出现一次(同一行可能被拆到相邻两块的不同位置),所以额外多分配 min(T·k, E+1) × (BM-1)。这个上界来自「每块至多浪费 BM-1 行 × 最多 E+1 个块」。
7.2 use_fused_moe_sum_all_reduce
在 TP 模式下,MoE 的输出需要 all_reduce。普通做法是「求 k 路和 → 一次 all_reduce」,但在某些配置下还有一个更激进的选择:
use_fused_moe_sum_all_reduce = ( get_exec().moe.enable_fused_moe_sum_all_reduce and (not no_combine) and (not defer_sum) and (topk > 2) and (not use_int8_w8a16) and (not use_int4_w4a16) and (not (hooks and hooks.after_down is not None)))启用时,GEMM2 不用 intermediate_cache3,而是直接用 tl.atomic_add 把每个专家的输出累加到输出缓冲区,再借 NCCL 的对称内存做一次「求和 + all_reduce」融合。topk > 2 是必要条件:两路用 add 更快;小于等于 2 时融合的收益被融合开销吃掉。
tl.atomic_add 为什么安全?因为每个 token 的 k 个 slot 由同一 pid_m 内的不同行处理,目标地址不重叠(不同 token 的目标不同),但 pid_n 方向上会有多个 program 争抢同一列。atomic_add 保证了同位置累加不丢;out_slice.zero_() 提前清零提供初始值。
八、CUDA Graph 与 TMA:为什么需要「整层是一个 op」
8.1 三个内核怎么塞进一张图
CUDA Graph 捕获要求所有内核的 grid 与参数在捕获时可以静态决定。SGLang 的 FusedMoE.forward 做了这样的判断:
if is_in_tc_piecewise_cuda_graph(): if TopKOutputChecker.format_is_bypassed(topk_output) and (...): return self.forward_impl(...) if TopKOutputChecker.format_is_standard(topk_output): return moe_forward_piecewise_cuda_graph_impl(...) elif TopKOutputChecker.format_is_bypassed(topk_output): return fused_moe_bypassed_piecewise_cuda_graph_impl(...) else: return self.forward_impl(...)(tc 指 Tensor Core 分段图,在 SGLang 第九篇、vLLM 第十二篇里有更完整的铺垫。)
这里的分支逻辑在说:
- standard TopK:
topk_weights/topk_ids已物化,图的形状由「当前 batch 的 padding 桶」决定;此时三个内核都可以作为「固定 shape」的 op 被捕获。 - bypassed TopK:路由与专家执行需要同一个 op 捕获——因为中间结果
router_logits与topk_ids的 shape 是动态的,不能跨 op 边界留在图里。fused_moe_bypassed_piecewise_cuda_graph_impl就是把「路由 + 对齐 + GEMM + 求和」整段注册为一个 custom op。 - 带 padding 或 expert_location 元数据的:只能走非图路径。
8.2 TMA descriptor 的缓存
TMA 模式需要为 A 与 B 各构造 TensorDescriptor。A 的 descriptor 每次都要新建(shape 是当前 batch 的),B 的 descriptor 可以被缓存,因为 B 是静态权重:
if b_use_tma: b_desc = _get_b_tma_desc_cached(B, config["BLOCK_SIZE_N"], config["BLOCK_SIZE_K"])_get_b_tma_desc_cached 用 (data_ptr, BN, BK) 做 key。这是一个细小的工程点:TMA descriptor 构造约几十微秒,若每层每步都新建,decode 的 CPU 开销会明显增长。权重是常驻的,所以缓存是安全的——除非 EP 重排(EPLB)会改变专家顺序,那时需要清缓存,源码里对应 clear_b_tma_desc_cache()。
8.3 PDL:核间流水
最后有一行很容易被忽略的 launch 参数:
pdl_kwargs = ( {"USE_GDC": True, "launch_pdl": True, "GDC_EARLY": A.shape[0] <= 512} if is_arch_support_pdl() else {})PDL(Programmatic Dependent Launch)是 Hopper 引入的机制:下个 kernel 可以在上个 kernel 还没完全退出时就开始启动,通过 gdc_wait/gdc_launch_dependents 同步。内核开头与结尾的:
if USE_GDC: tl.extra.cuda.gdc_wait() if GDC_EARLY: tl.extra.cuda.gdc_launch_dependents()...if USE_GDC and not GDC_EARLY: tl.extra.cuda.gdc_launch_dependents()就是手写的握手。在 GEMM1 → 激活 → GEMM2 这条链上,PDL 能把三次 launch 的尾部气泡从约 2×3 µs 压到 1 µs 量级。
GDC_EARLY 由 A.shape[0] <= 512 决定:小 batch 时,前一个 kernel 的尾巴很长(每块浪费的补齐行比例高),提前放行后续 kernel 反而可能读到还没写的数据——这个开关的选择依据是「GEMM1 的 epilogue 是否已经能把数据安全地交给下一个阶段」。
九、把三张图放回文章里
前面留了两张待放图。下面配合代码把它们讲清楚。
第一张是 Mixtral 论文里的 SMoE 结构图(Figure 1),画的是「Transformer 层里把 FFN 换成 k 个专家,由一个门控决定读哪几个」:
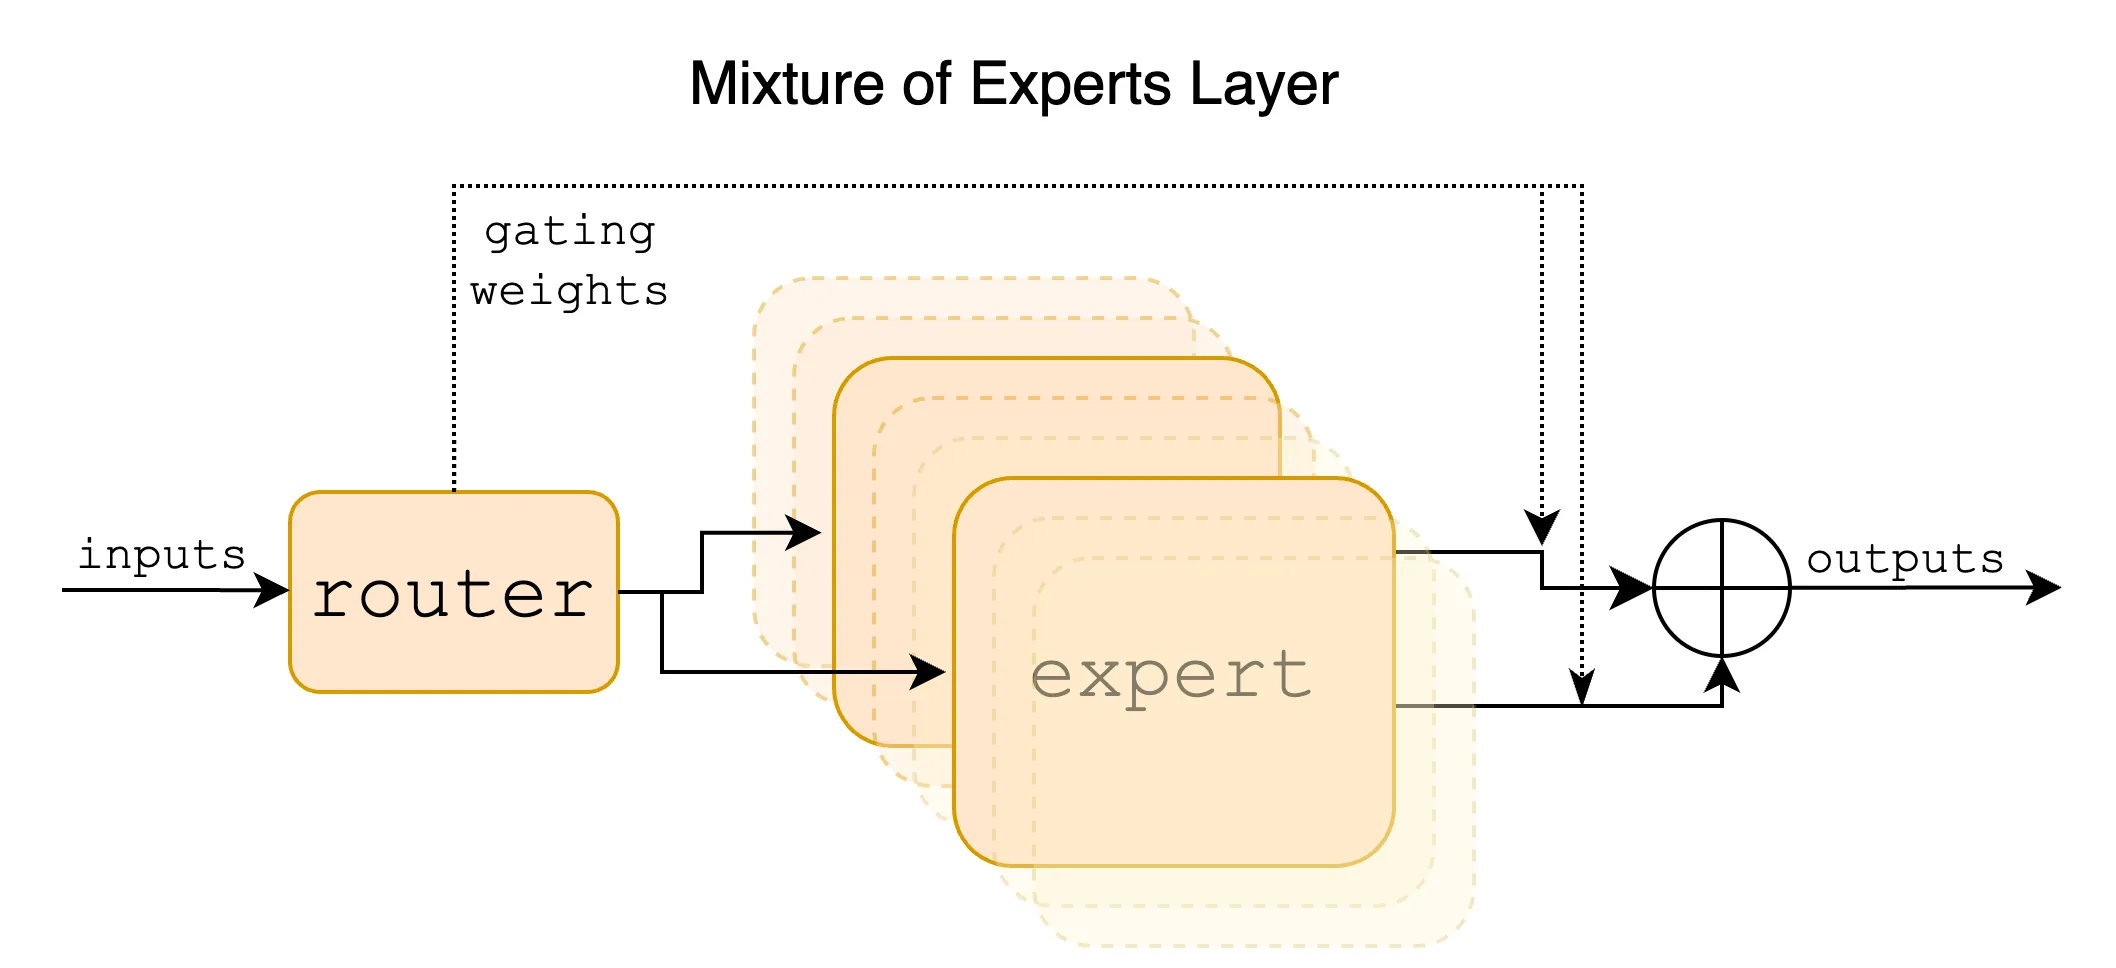
对照代码看:图中「Router」就是 MoEGate + TopK(第二十篇);图中每个 expert 是一个 FFN,即本层的 w13_weight[e] 与 w2_weight[e]——两个矩阵被拼在同一个 tensor 的专家维里。SGLang 的 FusedMoE 把 w1、w3 合成 w13_weight,w2 单独,正好对应「gate/up 合并成一个 GEMM,down 是独立一个 GEMM」。图里「选 top-2」对应的是 topk_ids 的第二维长度 k = 2,此时会走 moe_combine_topk 的 topk == 2 分支。
第二张是 token 路由示例图(Figure 2),画的是「两条 token 选了同一个专家」的场景:
这张图是本篇的主角。它画出来的「Expert 1 → tokens [0,1], Expert 2 → tokens [1,2], …」如果直接排序、每组补齐到 BLOCK_SIZE_M = 16,每个专家的那组就都会扩到 16 行——图中只有 3 行有效,其余 13 行是补齐。对齐表把这些配对摊平成一个 [M_pad, H] 的「虚拟矩阵」,三块依次交给同一个内核,用 expert_ids 告诉内核每块用哪个专家。
第三张是 SGLang v0.4 博客里的 DP Attention 示意图:
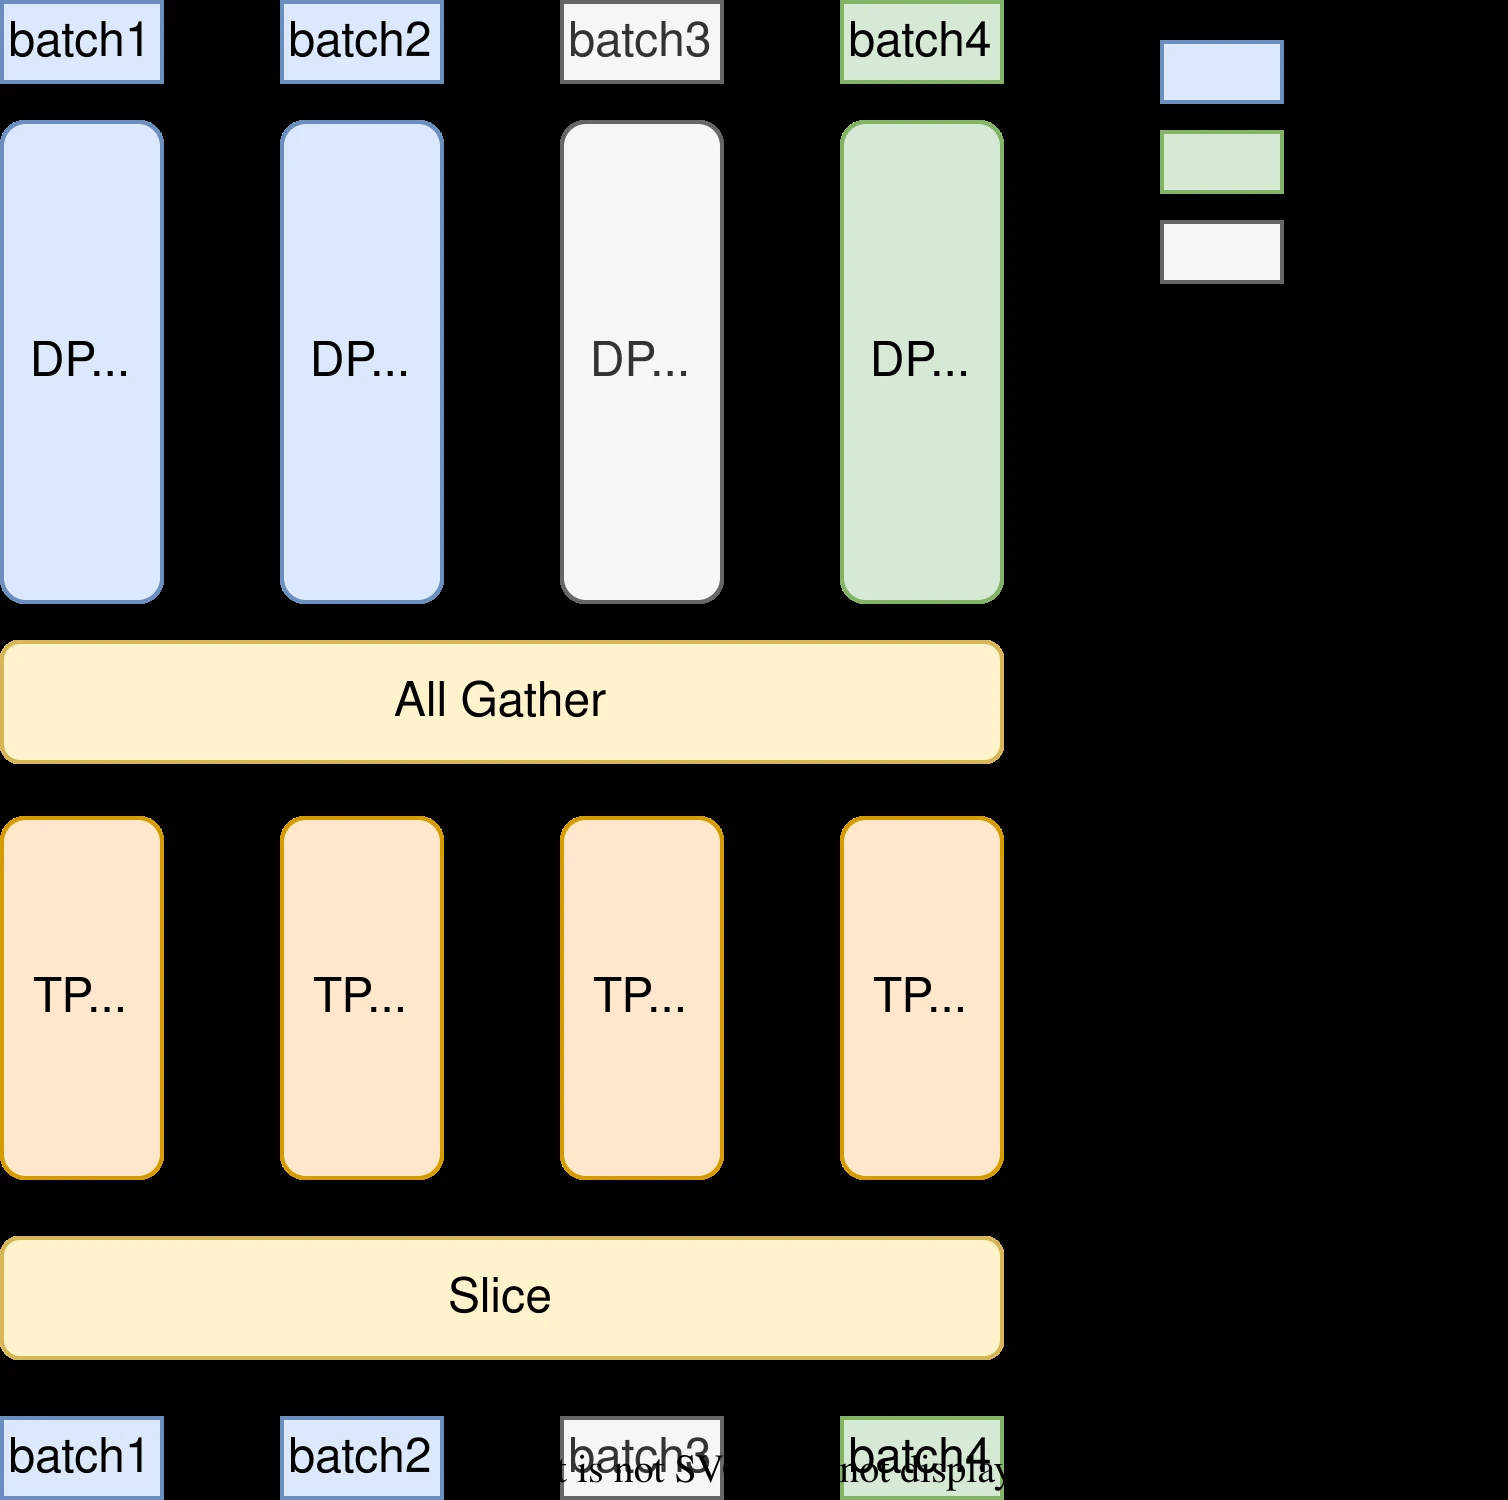
它解释了 StandardDispatcher 里那段 needs_dp_allgather 的背景:在 DP Attention 模式下,注意力是数据并行的(每个 rank 处理不同请求),但 MoE 是张量并行的(每个 rank 持有专家的一部分)。请求进入 MoE 之前要 all-gather 到所有 rank,这样每个 rank 才能看到完整的 batch;出去之后要 reduce_scatter 回每个 rank。图中「Idle / Slice」那段就是本篇第八节提到的「按 batch 长度补齐并屏蔽」的效果——空闲的 rank 收到的是补出来的行。
十、实现细节里的四个坑
10.1 inplace 与 no_combine 不能同时开
fused_experts 里:
if moe_runner_config.inplace: assert not moe_runner_config.no_combine, "no combine + inplace makes no sense" inplace_fused_experts(...) return hidden_statesinplace=True 时 GEMM2 直接写到 hidden_states,省掉再分配输出。但如果 no_combine=True(要求返回 [T, k, H] 中间结果),输出跟输入形状不同,原地写就不成立。
10.2 out_hidden_states.unsqueeze(0)
当 topk == 1 且 routed_scaling_factor 是 1.0、又没有 LoRA 钩子时,GEMM2 的目标指针写的是:
out_hidden_states if use_fused_moe_sum_all_reduceelse (intermediate_cache3 if _use_intermediate else out_hidden_states.unsqueeze(0))unsqueeze(0) 是把 [T, H] 变成 [1, T, H],从而把 topk 维看作长度 1。这样一个写入路径可以同时覆盖 [T, k, H] 与 [T, H],且在内核里不需要多一个分支。
10.3 共享专家缩放因子的两个来源
DeepseekV2MoE 的构造函数里有一个计算:
fused_shared_experts_scaling_factor = Noneif self.moe_ep_size > 1 and self.num_fused_shared_experts > 0 and not _uses_per_rank_shared_slots: fused_shared_experts_scaling_factor = 1.0 / float(self.moe_ep_size)在 TP 模式下,每个 rank 都持有全部共享专家、都会算出同一份输出,最终 all_reduce 会把这份输出加 TP 次。于是在 EP 模式下需要乘 1/ep_size 来抵消这种重复相加。而 DeepEP/MegaMOE 用的是每 rank 物理槽位,共享专家只在「家 rank」算一次,就无需缩放。这个细节和第二十篇里的「共享专家列如何拼进 topk」是一致的:拓扑决定了账本。
10.4 MoE 的「最小形状」在推理框架里被两种方式处理
intermediate_size_per_partition 在 flashinfer_trtllm 分支下会被 round-up:
if (self.use_flashinfer_trtllm_moe and not isinstance(self.quant_method, ModelOptNvFp4FusedMoEMethod) and self.intermediate_size_per_partition % 128 != 0): self.intermediate_size_per_partition = round_up(self.intermediate_size_per_partition, 128)TRT-LLM 的后端对 I_pp 有 128 对齐要求,缺的列在权重加载时补零。这与 padded_size(K 补零)是同一个思路:用权重末端的空白换取内核里无分支。Triton 路径则不做这个补齐,而是在 even_Ks 分支里用 mask 处理。
十一、这套设计的边界
从 FusedMoE 的实现反推,可以列出它在哪些场景会「不够用」:
对齐表带来的固定放大。前面算过,decode 时 4 倍放大是常态。要消掉它,有两条路:一是动态 BLOCK_SIZE_M(按专家实际行数选块大小),二是 DeepGEMM 式的「按专家分块、m_indices 标记」(下一篇)。前者会让 grid 形状依赖数据,破坏 CUDA Graph 的静态形状;后者只适合 DeepGEMM / CUTLASS 这类原生支持分组 GEMM 的编译器,Triton 的 program 模型没有这么灵活的 metadata 消费能力。
同一层只能有一个后端。runner_backend 由 quant_method.get_moe_runner_backend 统一决定,不能「prefill 用 CUTLASS、decode 用 Triton」。这一点在 prefill 与 decode 共用一条路径时尤为突出:大 batch prefill 与 decode 的最优块参数完全不同,只能靠「同一套配置 + 对 M 的启发式切换」折中。这是 try_get_optimal_moe_config 同时服务两种阶段的根本原因。
位级一致性是逐内核保证的。FUSE_SWIGLU 那段内联 PTX 证明了:只要有一条路径(例如 silu_and_mul)用了 fast-math,另一条就要照抄。这对 Triton 与专用 CUDA 内核之间的迁移是一个隐藏成本——迁移时不仅要保证数值精度,还要保证「与旧路径逐位相同」。
没有专门的稀疏/未排序路径。SGLang 单机 Triton 的每个 program 都会走块级的 token_mask,哪怕这 16 行里只有 1 行有效。对极稀疏的 batch(例如 T = 1、k = 8、E = 256),M_pad = 8 × 16 = 128,其中 120 行是补齐。此时更高效的可能是「每行一个 program」的点积形式,而 SGLang 是通过 BLOCK_SIZE_M = 1 或 16 的配置来近似这件事——M <= E 时默认 16,已经是最小 Tensor Core 块。
十二、小结
这一层可以总结成一句话:对齐表把「每个专家几行」这种不规则问题,规整成一个按块处理的大矩阵,再用一个程序统一处理所有专家,代价是补齐行的浪费与块参数的选择。
三条贯穿性的设计选择,值得单独记住:
- 三层抽象——
dispatcher决定数据在哪、格式是什么;MoeRunner决定交给哪个后端、要不要格式转换;MoeRunnerCore实现真正的计算。三者由 dataclassMoeRunnerConfig与FusedOpPool连接。这个结构让 SGLang 能同时支持 Triton、DeepGEMM、FlashInfer、CUTLASS 等后端,而不用在每个后端里重复实现「分发 + 对齐 + 求和」。 - 一次对齐、两次共享——
BLOCK_SIZE_M决定对齐粒度,上下两次 GEMM 必须一致;down_config如果不一致,运行时自动纠正。 - 图内要能固定形状——
bypassed格式用整段 custom op 捕获,standard格式用分桶 grid 捕获,TMA 的 descriptor 用缓存。任何一个环节引入动态 shape,就会掉出图路径,decode 延迟直接受影响。
下一篇会离开「单机 + Triton」,去看 DeepGEMM 与 FlashInfer 路径上的分组 GEMM:DeepGEMM 的 m_indices 布局、按专家分块的调度器、TMA multicast 在多卡 DP Attention 下怎么复用广播路径,以及 flashinfer_trtllm 把路由、对齐、GEMM 收成一个 fused op 之后,「省掉对齐表」究竟省掉了哪几步。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



