


vLLM 源码完全拆解(二十六):Metrics 与统计管线——一条请求的每一段时间,是在哪个进程里被打上时间戳的
背景:监控一个推理服务,究竟要回答哪些问题
一个线上 LLM 服务出问题时,值班的人通常不会先问「模型的算术强度是多少」,而是问几个很具体的问题:
- 首 token 为什么慢了三倍?是请求在队列里等,是 prefill 太长,还是前端分词和网络传输占了大头?
- 解码阶段的 token 间隔是否稳定?P99 的卡顿来自调度、KV 读取,还是某一次抢占?
- KV 缓存是否已经逼近上限?抢占是否频繁发生?前缀缓存到底命中了多少?
- 投机解码的接受率是多少?草稿深度调大以后,究竟是多产出了 token,还是把验证算力浪费掉了?
- 数据并行部署下,每个 DP rank 的负载是否均衡?是谁在拖慢整个同步步?
这些问题分别对应不同的数据源:调度器的队列长度、KV 块池的使用率、请求级的时间区间、投机解码的逐位置接受计数。把它们塞进同一套「打印几行日志」的实现里,很快就会变成口径混乱的数字堆。vLLM V1 的指标子系统解决的正是这个问题:先定义清楚对象和时钟,再决定谁生产、谁计算、谁导出。
在 vLLM 的官方设计文档里,指标被分成两类:
- 服务器级指标(server-level):描述整个引擎当前的状态与吞吐,例如运行中的请求数、等待请求数、KV 缓存使用率、每秒处理的 token 数。它们通常以 Gauge 或 Counter 的形式暴露。
- 请求级指标(request-level):描述单个请求的特征与时延,例如输入长度、输出长度、TTFT、ITL、端到端时延。它们通常是 Histogram,也是 SRE 真正拿来对照 SLO 的对象。
文档里给了一个很关键的思维模型:服务器级指标用来解释请求级指标的取值。看到 TTFT 的 P99 突然抬高,单看 TTFT 直方图只能知道「变慢了」;再看同一时间段的等待请求数、KV 使用率、前缀命中率,才能判断是容量不足、缓存抖动,还是长 prefill 把解码请求挤住了。指标系统真正的价值不在于把数字画出来,而在于让不同层级的数字能够互相对账。
这套指标在 V1 里经历了一次架构迁移。早期的实现把统计放在 EngineCore 进程里,再用多进程模式让 API server 读到这些指标。V1 的设计目标相反:EngineCore 是最内层循环,每一微秒都要让给前向计算;所有能搬走的开销都搬到 AsyncLLM 这一层,也就是与 GPU 执行重叠的外循环。于是指标改为在 API server 进程里收集,数据来源是 EngineCore 回传的 EngineCoreOutputs。只有当 --api-server-count > 1 时,才重新启用 prometheus_client 的多进程模式。
这条迁移路线解释了一个容易误解的现象:/metrics 端点返回的数字并不是引擎进程内部实时读出来的,而是前端进程根据引擎回传的快照计算出来的。理解这一点,后面所有的时间戳与聚合规则才讲得通。
总体数据流:四个对象和三层职责
vLLM 的指标管线可以压缩成一句话:引擎核心只负责记录「发生了什么」和「当时几点」,前端负责把「几点」算成「多久」,发布层负责把「多久」变成日志与时间序列。
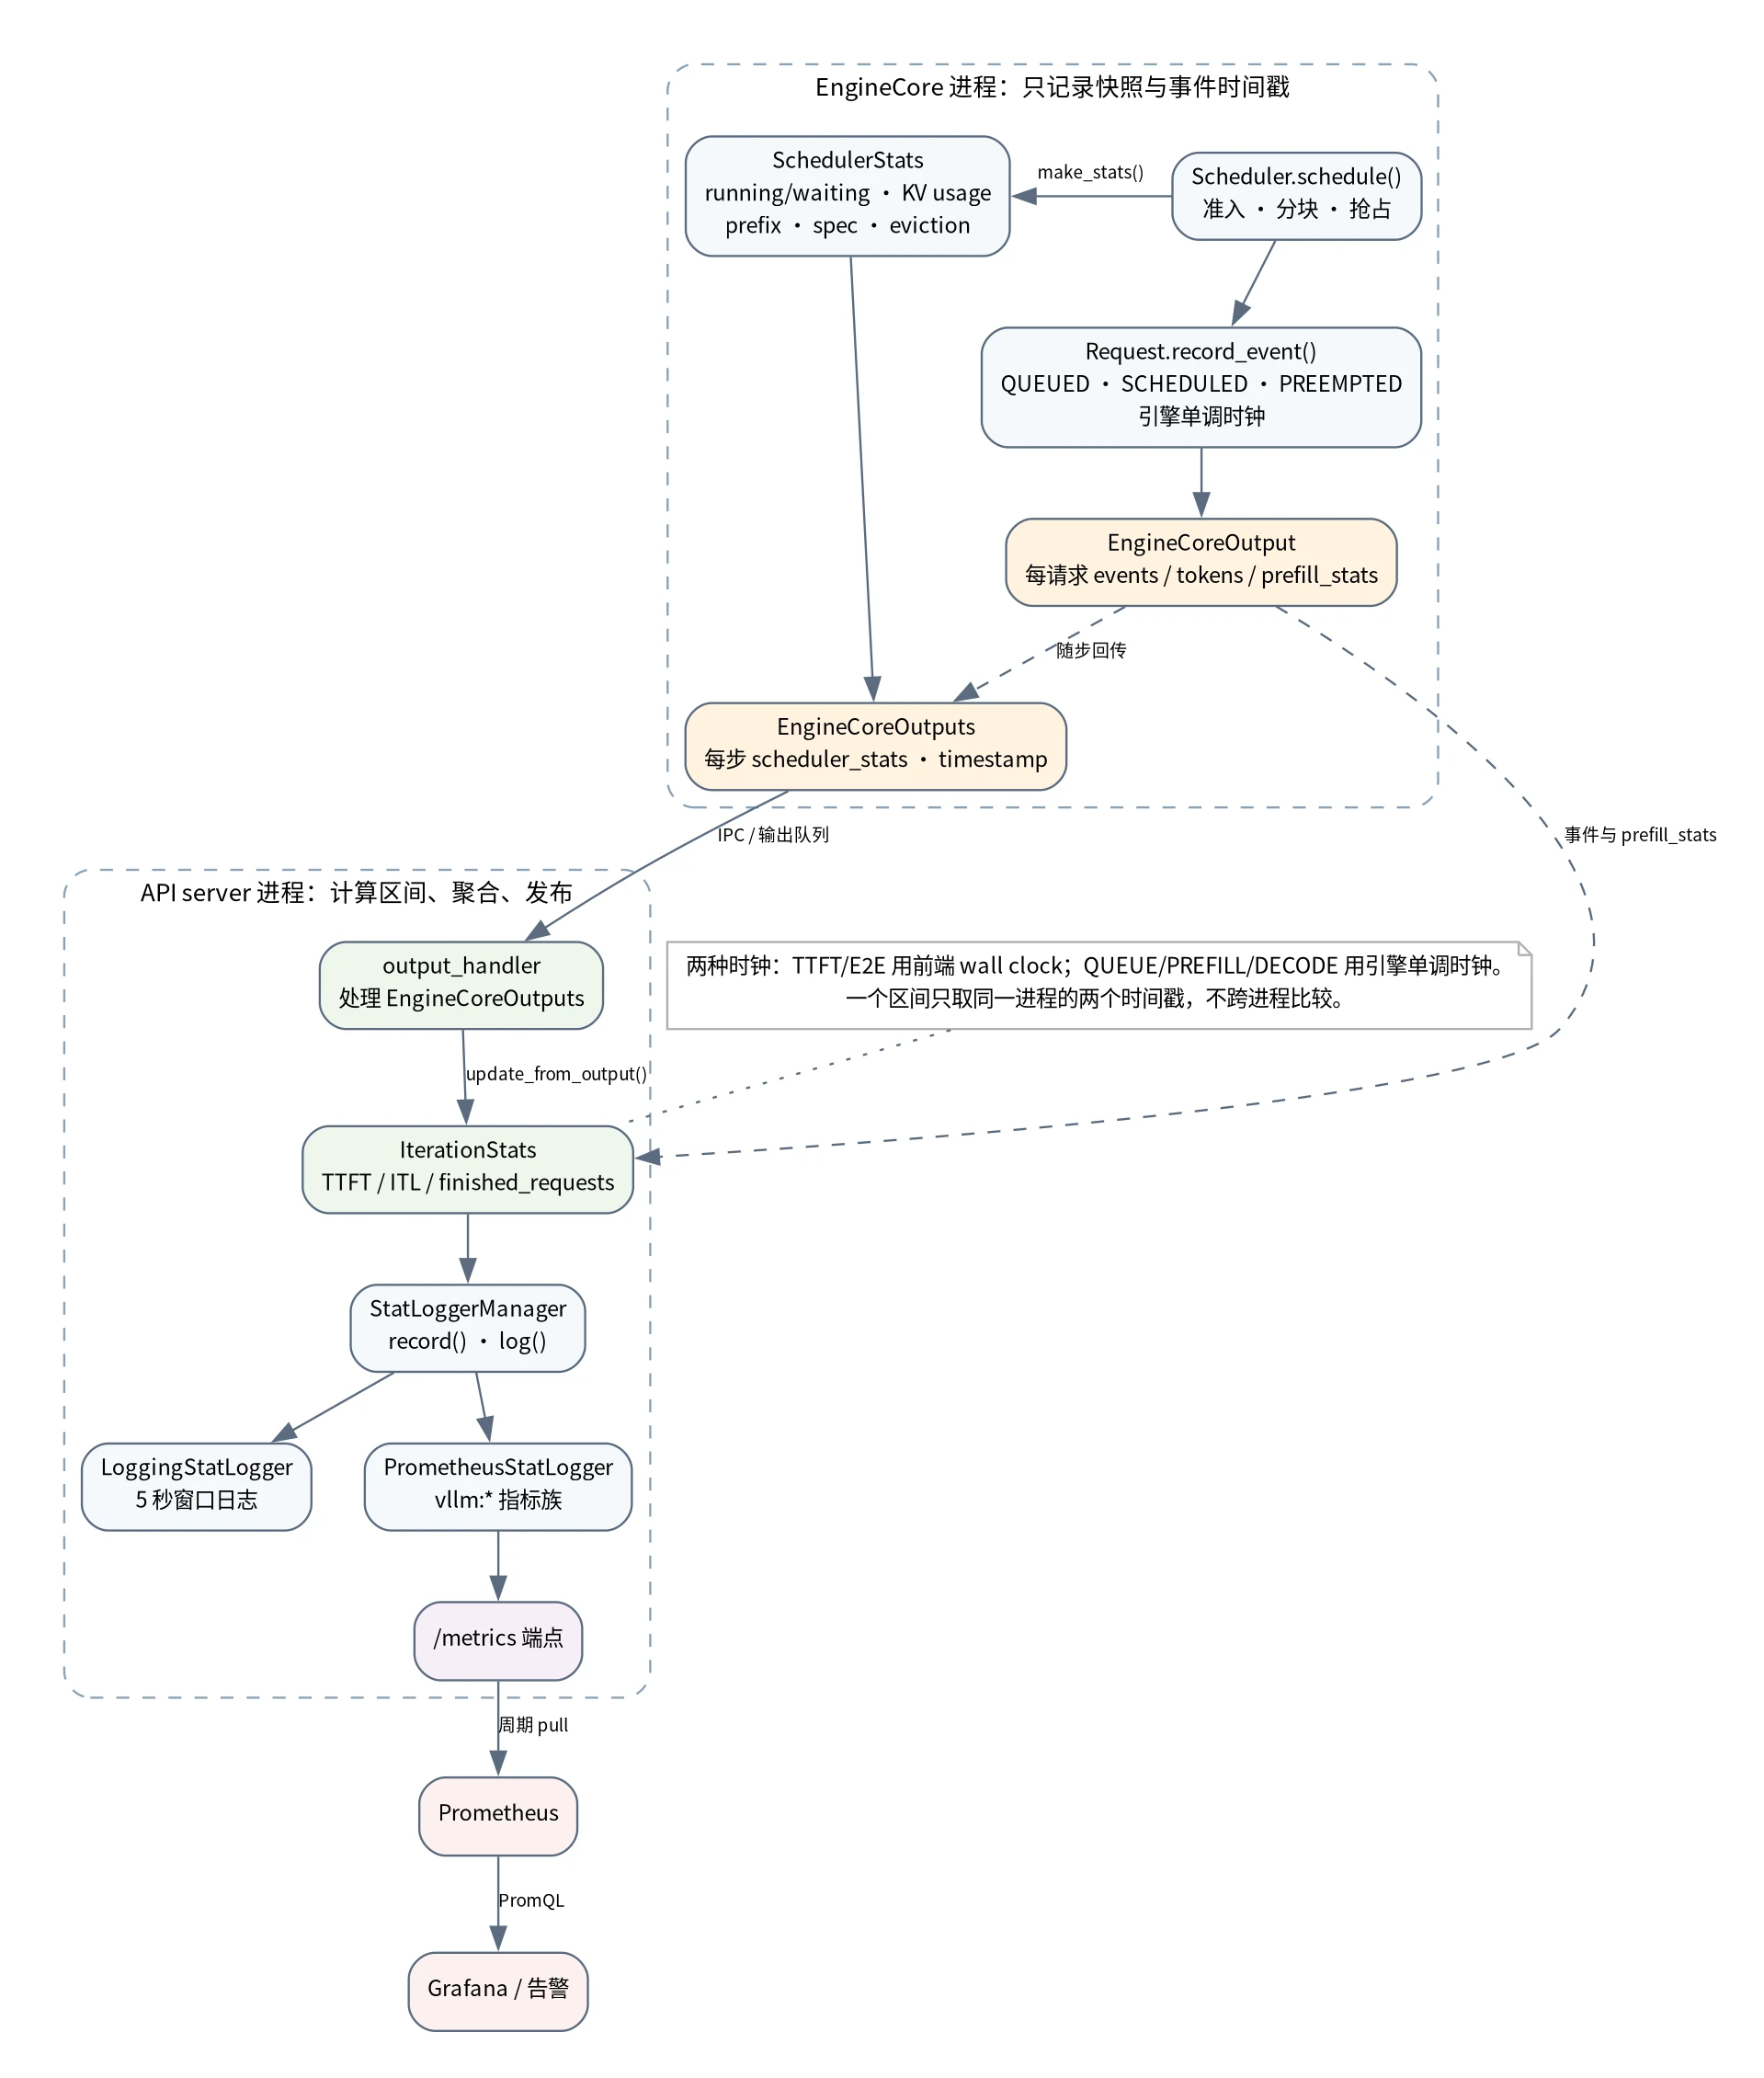
图里有两个进程边界。左侧的 EngineCore 进程每一轮调度产生两类数据:
SchedulerStats:这一轮调度结束后的状态快照,包括运行/等待请求数、KV 使用率、前缀缓存统计、投机解码统计、KV 驱逐采样事件等。EngineCoreOutput:每个请求这一轮新生成的 token,以及挂在该请求上的EngineCoreEvent时间戳和PrefillStats。
这两类数据被装进 EngineCoreOutputs,通过进程间通道送到 API server。右侧的 output_handler 每收到一批输出,就构造一个 IterationStats,把本轮的 token 数、TTFT、ITL、完成请求逐个累加进去。随后 StatLoggerManager.record() 把同一份数据分发给所有注册的 logger:日志 logger 负责按时间窗口汇总成人能读的 INFO 行,Prometheus logger 负责把这些数字写进对应的 Counter/Gauge/Histogram。
几个关键对象的分工如下:
| 对象 | 产生位置 | 生命周期 | 主要内容 |
|---|---|---|---|
SchedulerStats | 引擎核心的调度器 | 每个 engine step 一份 | 队列长度、KV 使用率、前缀缓存、投机解码、驱逐事件 |
EngineCoreOutput | 引擎核心 | 每个请求每个 step 一份 | 新 token、请求事件时间戳、prefill 统计、投机指标 |
IterationStats | 前端 output_handler | 每个 engine step 一份 | 本步 token 总数、TTFT/ITL 样本、完成请求列表、LoRA 状态 |
FinishedRequestStats | 前端 | 每个完成请求一份 | 队列/预填/解码/推理区间、TPOT、缓存 token 数 |
PrefixCacheStats | 调度器 / KV 缓存管理器 | 每个 step 累积、取走后重置 | 查询 token 数、命中 token 数、被抢占请求的单独计数 |
CachingMetrics | 日志层 | 跨 step 的滑动窗口 | 最近 N 个请求的前缀命中率 |
这里有一个容易被忽略的设计:SchedulerStats 是快照,而 IterationStats 是增量。前者描述「此刻引擎长什么样」,所以 Prometheus 用 Gauge 直接 set;后者描述「这一步发生了什么」,所以 Prometheus 用 Counter 累加、用 Histogram 记录分布。把快照当成增量累加,或者把增量当成快照覆盖,是读源码时最常见的两类错误。
另一个分界线是 log_stats 开关。--disable-log-stats 打开时,调度器不会构建 SchedulerStats,请求也不会创建 RequestStateStats,更不会记录 EngineCoreEvent。这不是「少打几行日志」那么简单:关闭之后,请求级时间戳根本不产生,FinishedRequestStats 里的区间会全部退化为零。自定义 logger 插件也会强制打开统计,因为插件本身需要这些数据。
三层职责对应到源码:
- 记录层:
vllm/v1/engine/__init__.py里的EngineCoreEventType与EngineCoreEvent,以及调度器里的record_event()调用。 - 计算层:
vllm/v1/metrics/stats.py里的IterationStats.update_from_output()、update_from_finished_request(),以及vllm/v1/engine/output_processor.py里的完成请求收尾。 - 发布层:
vllm/v1/metrics/loggers.py里的StatLoggerManager、LoggingStatLogger、PrometheusStatLogger,以及vllm/entrypoints/serve/instrumentator/metrics.py暴露的/metrics路由。后者的attach_router()用prometheus_fastapi_instrumentator自动给 HTTP 请求打上http_requests_total、http_request_duration_seconds一类指标,再把 prometheus_client 的 ASGI 应用挂到/metrics上;/health、/ping、/version这类探针端点被排除在 HTTP 统计之外,避免健康检查把流量指标撑大。
指标的分类:服务器级与请求级
把 vLLM 的指标族按「回答什么问题」重新归一次类,会比按字母顺序背指标名有用得多。
队列与容量回答「系统还装得下吗」:vllm:num_requests_running、vllm:num_requests_waiting、vllm:num_requests_waiting_by_reason、vllm:kv_cache_usage_perc、vllm:num_preemptions。这一组几乎都是 Gauge 或只增不减的 Counter,采样频率高一点也没关系。
吞吐回答「每秒到底产出了多少」:vllm:prompt_tokens、vllm:generation_tokens。日志层会把这两个 Counter 的窗口增量除以上一个窗口的秒数,变成 tokens/s。vllm:iteration_tokens_total 名字里带 total,但它其实是「每步 token 数」的 Histogram,用来观察批次形状,不是吞吐计数器。
请求级时延回答「用户等了多久」:vllm:time_to_first_token_seconds、vllm:inter_token_latency_seconds、vllm:request_time_per_output_token_seconds、vllm:e2e_request_latency_seconds,以及 queue/prefill/decode/inference 四个阶段直方图。
缓存效率回答「复用是否真的发生」:vllm:prefix_cache_queries、vllm:prefix_cache_hits、vllm:external_prefix_cache_queries、vllm:external_prefix_cache_hits,以及按 source 标签拆开的 vllm:prompt_tokens_by_source。
投机解码回答「草稿是否值得」:vllm:spec_decode_num_drafts、vllm:spec_decode_num_draft_tokens、vllm:spec_decode_num_accepted_tokens,以及逐位置的 vllm:spec_decode_num_accepted_tokens_per_pos。
KV 驻留回答「缓存块活多久、闲置多久」:vllm:kv_block_lifetime_seconds、vllm:kv_block_idle_before_evict_seconds、vllm:kv_block_reuse_gap_seconds。
资源估算回答「算力和带宽用到了什么程度」:vllm:estimated_flops_per_gpu_total、vllm:estimated_read_bytes_per_gpu_total、vllm:estimated_write_bytes_per_gpu_total。
这七组里,前三组是 SRE 日常盯的,后四组是容量规划、缓存策略和特性开关的依据。它们共享同一套管线,但更新频率和聚合方式不同:容量类指标每步覆盖,吞吐类指标累加后按窗口求速率,时延类指标按请求完成或首 token 事件打点,缓存与投机类指标按 step 增量累加。
时间戳从哪里来:EngineCoreEvent 与单调时钟
时延指标的全部难点都在「时间戳是谁打的」。vLLM 的源码里有一个非常明确的约定:
计算区间要用单调时钟(
time.monotonic()),不要用墙钟(time.time()),因为墙钟会被 NTP 校时或手动改时间影响。单调时钟的参考点在每个进程里各不相同,所以跨进程比较单调时间戳没有意义,一个区间必须由同一进程里的两个时间戳相减得到。
这条约定直接决定了指标的采集位置。请求在引擎核心里有三个可记录的事件:
class EngineCoreEventType(enum.IntEnum): QUEUED = 1 SCHEDULED = 2 PREEMPTED = 3
class EngineCoreEvent(msgspec.Struct): type: EngineCoreEventType timestamp: float
@classmethod def new_event(cls, event_type, timestamp=None): timestamp = time.monotonic() if timestamp is None else timestamp return cls(event_type, timestamp)事件只有三种,第四种「NEW_TOKENS」并不是逐请求记录的 EngineCoreEvent,而是 EngineCoreOutputs 上带的一个批次级时间戳:同一轮里所有请求的新 token 都算在这个时间点上产生。这样做的原因很实际:一轮 decode 里可能有几十个请求同时产出 token,给每个请求单独取一次时间戳既没有额外信息量,又增加开销。
请求级的 RequestStateStats 保存四个由引擎核心事件写入的时间戳:
| 字段 | 写入时机 | 含义 |
|---|---|---|
queued_ts | 收到 QUEUED 事件 | 请求进入调度器队列 |
scheduled_ts | 第一次收到 SCHEDULED 事件 | 第一次真正被调度执行 |
first_token_ts | prefill 阶段第一次收到批次时间戳 | 首 token 产出 |
last_token_ts | 每次产出新 token 后更新 | 最近一次 token 产出 |
arrival_time 不在这个表里,因为它来自前端:请求进入 InputProcessor 时用 time.time() 打点,官方文档明确说这个时间从分词开始时算起。TTFT 之所以用 arrival_time 而不是引擎侧的首个事件,就是为了把前端渲染、分词和排队进引擎的时间一起算进去,贴近用户真实感受到的等待。
update_from_events() 里还有两个容易看漏的细节:
elif event.type == EngineCoreEventType.SCHEDULED: if req_stats.scheduled_ts == 0.0: # ignore preemptions req_stats.scheduled_ts = event.timestampelif event.type == EngineCoreEventType.PREEMPTED: self.num_preempted_reqs += 1 req_stats.num_preemptions += 1第一,scheduled_ts 只记第一次调度。请求被抢占后重新排队、再次被调度时,SCHEDULED 事件会再次出现,但代码故意忽略它,保证「排队时间」始终是「第一次排队到第一次开跑」,不会因为抢占而反复重置。第二,PREEMPTED 只增加计数,不直接修改时间戳;预填和解码区间如何把抢占包含进去,是在计算区间时统一处理的。
官方设计文档给出的区间定义,可以直接写成一组减法:
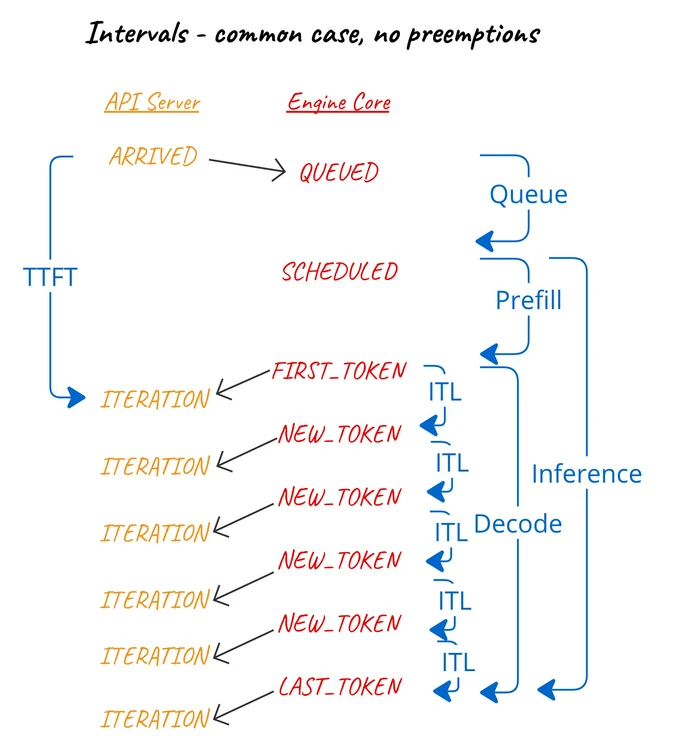
图里最值得对照源码看的是「prefill 区间的右端点是首个 NEW_TOKENS」。prefill 阶段本身会把 prompt 的所有 token 算完,但统计上的 prefill 时间只到首 token 产出为止;这正好对应 TTFT 中「等待第一个可见输出」的部分。decode 则从首 token 到最后一个 token,中间每次 NEW_TOKENS 的间隔就是 ITL 的样本。
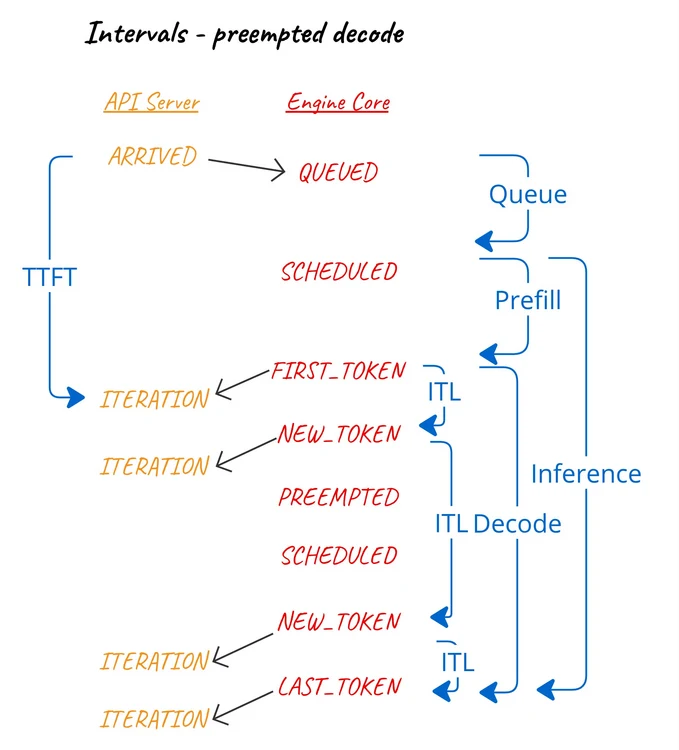
抢占会把这张图改写成两段。解码阶段被抢占时,请求已经生成的 token 仍然保留,重新调度后继续解码,因此抢占的停顿被算进 ITL、decode 和 inference 区间:
预填阶段被抢占时,请求的 KV 被释放,重新调度后要从头重算 prefill,因此停顿被算进 TTFT 和 prefill 区间:
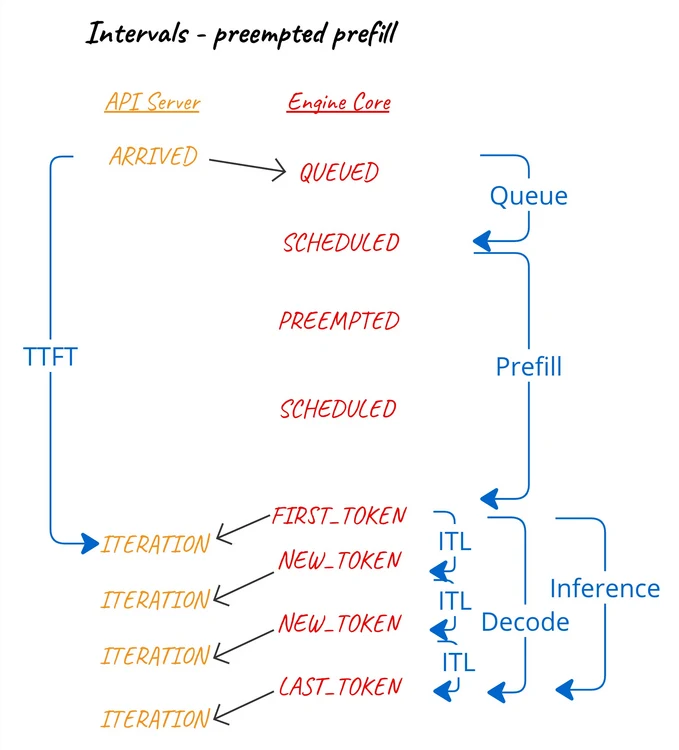
这两张图解释了一个常被问到的现象:同样一次抢占,落在 prefill 还是 decode,对指标的影响完全不同。落在 prefill,TTFT 直方图会明显变长;落在 decode,TTFT 不受影响,但 ITL 的尾部会变厚。只看一个指标,很容易把原因判断错。
还需要强调一个时钟边界:arrival_time 和 IterationStats.iteration_timestamp 都是前端的 time.time(),所以 TTFT 与 e2e 是「前端墙钟减前端墙钟」;queue、prefill、decode、inference 是「引擎单调钟减引擎单调钟」。两组时间戳绝不混用。前端不能用自己看到的输出到达时间去减引擎的 first_token_ts,因为两个进程的单调钟参考点不同;引擎也不能用前端的 arrival_time 去算排队区间,因为那是另一个时钟域。源码把这一点落实到了字段来源上,而不是靠注释提醒。
事件产生的位置也值得顺着源码走一遍,因为只有 log_stats 打开时它们才存在:
Scheduler.add_request()在请求第一次进入等待队列时(由_enqueue_waiting_request()完成)会request.record_event(EngineCoreEventType.QUEUED)。数据并行部署下这一步发生在本地 rank 上,所以排队区间只反映该 rank 看到的排队,而不是全局排队。Scheduler.schedule()把请求从等待队列放进运行队列时,会以scheduled_timestamp记录SCHEDULED。同一轮里多个请求共享这个时间戳,它实际上是这一轮开始调度的时刻。Scheduler._preempt_request()(抢占路径)会把请求状态改为PREEMPTED、清空已计算 token 数、把它放回等待队列队首,并在log_stats打开时记录PREEMPTED事件。因为schedule()会在下一个 step 再次记录SCHEDULED,没有scheduled_ts == 0.0这个守卫,排队时间就会被截成「最后一次入队到重新开跑」这一段很短的区间。
关于 NEW_TOKENS 的时间戳,需要补充一个工程背景。EngineCoreOutputs 上的 timestamp 是引擎核心在构造这一批输出时用 time.monotonic() 写的,逐请求的 EngineCoreOutput 不再各自带时间。V1 后来引入了异步调度,GPU 执行和 CPU 调度重叠,因此这个时间点更接近「引擎核心确认本轮输出」的时刻,而不是某个核函数写完 token 的精确瞬间。这意味着 ITL 的样本里同时包含了 GPU 计算与调度/通信的间隔;读高负载下的 ITL 尾部时,要记得它天然带着一些前向之外的开销。这恰恰是指标想要的,因为用户看到的 token 间隔本来就不只包含计算。
一次迭代的记账:IterationStats
IterationStats 是前端对「一轮引擎 step」的记账本。它的生命周期很短:output_handler 每收到一批 EngineCoreOutputs 且带输出时创建一个,处理完这一批就交给 StatLoggerManager.record(),然后丢弃。它不跨 step 保存任何东西,跨 step 的聚合全部交给日志层的窗口状态(例如 LoggingStatLogger 的累计计数器)或 prometheus_client 的 Counter。
先看它的字段:
class IterationStats: def __init__(self): self.iteration_timestamp = time.time() self.compute_nans_in_logits = envs.VLLM_COMPUTE_NANS_IN_LOGITS self.num_generation_tokens = 0 self.prompt_token_stats = PromptTokenStats() self.num_preempted_reqs = 0 self.finished_requests: list[FinishedRequestStats] = [] self.max_num_generation_tokens_iter: list[int] = [] self.n_params_iter: list[int] = [] self.time_to_first_tokens_iter: list[float] = [] self.inter_token_latencies_iter: list[float] = [] ...这些字段可以分成四类:
- 本轮 token 数:
num_generation_tokens与prompt_token_stats。后者按来源拆成computed、local_cache_hit、external_kv_transfer三类,并维持computed + local_cache_hit + external_kv_transfer == total的不变量。 - 本轮分布的样本:
time_to_first_tokens_iter与inter_token_latencies_iter,每个首 token 事件、每个 token 间隔各追加一个样本。它们不进finished_requests,而是在record()时逐条喂给 Prometheus 直方图。 - 本轮结束时才确定的值:
finished_requests列表、max_num_generation_tokens_iter、n_params_iter(n采样参数的取值)。这些在请求完成时才写入,所以同一个请求的完成样本总是落在「它产出最后一个 token 的那一轮」的IterationStats里。 - 异常与业务标记:
num_corrupted_reqs、水位标记相关的计数,以及 LoRA 的等待/运行状态。
update_from_output() 是每个请求每轮都会调用的函数。它的分支顺序值得逐行看:
def update_from_output(self, output, engine_core_timestamp, is_prefilling, req_stats, lora_states, lora_name): num_new_generation_tokens = len(output.new_token_ids) self.num_generation_tokens += num_new_generation_tokens
if is_prefilling: if output.prefill_stats is not None: self.prompt_token_stats.update_from_output(output.prefill_stats) first_token_latency = self._time_since(req_stats.arrival_time) self.time_to_first_tokens_iter.append(first_token_latency) req_stats.first_token_latency = first_token_latency
req_stats.num_generation_tokens += num_new_generation_tokens ... if is_prefilling: req_stats.first_token_ts = engine_core_timestamp else: itl = engine_core_timestamp - req_stats.last_token_ts self.inter_token_latencies_iter.append(itl) req_stats.last_token_ts = engine_core_timestamp这里有三笔账:
- TTFT 用前端时间算,但需要引擎标记「这一轮是不是 prefill 收尾」。
is_prefilling由输出处理器在请求状态里维护:只要这一轮输出意味着 prefill 结束(包括分块预填的最后一块),就写一条 TTFT 样本,并记下first_token_ts。分块预填下,一个请求的 prompt 可能跨好几轮算完,但 TTFT 只在最后一次产出首 token 时记一次。 - ITL 只在非 prefill 轮计算。prefill 那一轮不追加 ITL 样本,因为「首 token 之前的等待」属于 TTFT,不属于 token 间隔。这也是为什么 TTFT 和 ITL 是两个不同的直方图,而不是一个指标的两个分位数。
- 抢占轮也会产生 ITL 样本。被抢占的请求如果这一轮仍带回了在途输出,时间戳和
last_token_ts的差值会被记成 ITL,因此 ITL 尾部天然包含抢占停顿。对 SLO 来说这是正确的口径:用户确实多等了这么久。
PromptTokenStats 的设计解决了一个很实际的对账问题:vllm:prompt_tokens 这个 Counter 到底该不该包含缓存命中的 token?答案是不该——它衡量的是实际做的 prefill 计算。日志层明确用 prompt_token_stats.computed 来算 prompt 吞吐:
def _track_iteration_stats(self, iteration_stats): self.num_prompt_tokens += iteration_stats.prompt_token_stats.computed self.num_generation_tokens += iteration_stats.num_generation_tokens而 Prometheus 那边的 vllm:prompt_tokens 用的是 iteration_stats.num_prompt_tokens,即 prompt_token_stats.total,同时用 vllm:prompt_tokens_by_source 按 local_compute、local_cache_hit、external_kv_transfer 三个标签分别计数。两者放在一起看,就能区分「输入总共有多少 token」和「其中多少真的算了」。做容量模型时,例如估算 prefill 的 FLOPs 预算,应该基于 local_compute 的增量,而不是 prompt_tokens 的增量;只拿后者乘上「每 token 的 prefill 成本」,会把前缀缓存命中的请求也算成满负载计算,从而高估所需算力。
PrefillStats 的字段进一步细化了「缓存」的来源:
def set(self, num_prompt_tokens, num_local_cached_tokens, num_external_cached_tokens): num_cached_tokens = num_local_cached_tokens + num_external_cached_tokens self.num_prompt_tokens = num_prompt_tokens self.num_computed_tokens = num_prompt_tokens - num_cached_tokens self.num_cache_creation_tokens = ... # finalize() 里确定num_computed_tokens 是真正落到 GPU 上的 token 数;num_local_cached_tokens 来自本实例的前缀缓存;num_external_cached_tokens 来自 KV 连接器(P/D 分离、外部缓存池等)。finalize() 再把「本次 prefill 额外写入前缀缓存的 token 数」算出来,于是可以回答「命中率背后,引擎是在造缓存还是在花缓存」。
finished_requests 则在请求收尾时追加。update_from_finished_request() 会把四个区间、TPOT、抢占次数和缓存 token 数打包成一个 FinishedRequestStats:
e2e_latency = self._time_since(req_stats.arrival_time)queued_time = req_stats.scheduled_ts - req_stats.queued_tsprefill_time = req_stats.first_token_ts - req_stats.scheduled_tsdecode_time = req_stats.last_token_ts - req_stats.first_token_tsinference_time = req_stats.last_token_ts - req_stats.scheduled_ts
mean_time_per_output_token = ( decode_time / (req_stats.num_generation_tokens - 1) if req_stats.num_generation_tokens - 1 > 0 else 0)注意 TPOT 的分母是「输出 token 数减一」。原因在于首个输出 token 是 prefill 收尾时产出的,它的等待时间已经计入 TTFT,如果再算进 TPOT,同一个请求的延迟就会被重复计时。只产出一个 token 的请求,分母为零,TPOT 直接记 0;官方文档也提醒,带投机解码时一次输出可能带多个 token,所以请求级 TPOT 与逐 token 的 ITL 聚合结果会不同,必须分开看。
迭代统计里还有一个和异常检测相关的开关:VLLM_COMPUTE_NANS_IN_LOGITS。打开后,采样侧会统计 logits 中的 NaN 个数,IterationStats 会在请求上打标记,vllm:corrupted_requests 与 vllm:request_success 的 finished_reason 一起用于定位数值崩溃。它不是延迟指标,但属于同一套记账体系里的「健康检查」。
调度器的快照:SchedulerStats
SchedulerStats 是每轮调度结束后的状态快照,由 Scheduler.make_stats() 组装。它不是「这一轮新增了多少」,而是「这一轮结束时引擎是什么样」。这一点从字段名就能看出来:num_running_reqs、num_waiting_reqs、kv_cache_usage 都是当前值,Prometheus 收到后直接 set() 到 Gauge 上。
make_stats() 的代码不复杂,但它决定了哪些指标会在这一轮出现:
def make_stats(self, spec_decoding_stats=None, kv_connector_stats=None, cudagraph_stats=None, perf_stats=None, ec_connector_stats=None): if not self.log_stats: return None prefix_cache_stats = self.kv_cache_manager.make_prefix_cache_stats() connector_prefix_cache_stats = self.connector_prefix_cache_stats self.connector_prefix_cache_stats = PrefixCacheStats() eviction_events = (self.kv_metrics_collector.drain_events() if self.kv_metrics_collector is not None else []) num_running, num_waiting = self.get_request_counts() num_deferred = len(self.deferred_waiting) return SchedulerStats( num_running_reqs=num_running, num_waiting_reqs=num_waiting - num_deferred, num_skipped_waiting_reqs=num_deferred, num_kv_fetch_reqs_by_stage=self._kv_fetch_counts.copy(), kv_cache_usage=self.kv_cache_manager.usage, prefix_cache_stats=prefix_cache_stats, connector_prefix_cache_stats=connector_prefix_cache_stats, kv_cache_eviction_events=eviction_events, spec_decoding_stats=spec_decoding_stats, ... )这里的「取走即重置」是理解缓存统计的关键:make_prefix_cache_stats() 返回上一轮累积的 PrefixCacheStats,并立刻换上一个新的空对象。connector_prefix_cache_stats 同理,取走后重置。这样每个 step 的 SchedulerStats 里装的是「这一轮新发生的查询与命中」,前端可以逐轮累加到 Prometheus Counter 上,也可以逐轮丢进滑动窗口。如果把这一步漏掉,第二轮就会把第一轮的统计再算一遍,命中数会翻倍增长。
字段可以按用途分成六组:
| 分组 | 字段 | 读法 |
|---|---|---|
| 队列 | num_running_reqs、num_waiting_reqs、num_skipped_waiting_reqs | 前者是正在跑的请求;后两者相加才是总等待数,其中 deferred 是被短暂约束挡住的请求 |
| 容量 | kv_cache_usage、num_kv_fetch_reqs_by_stage | 块池使用率(0 到 1);P/D 场景下按「等待开始、传输中、完成等待」分阶段的 KV 拉取请求数 |
| 前缀缓存 | prefix_cache_stats、connector_prefix_cache_stats | 本地前缀缓存与外部 KV 连接器的查询/命中增量 |
| 投机解码 | spec_decoding_stats | 本轮草稿数、草稿 token 数、接受 token 数、逐位置接受计数 |
| KV 驱逐 | kv_cache_eviction_events | 采样到的块生命周期、空闲时长与复用间隔 |
| 扩展子系统 | kv_connector_stats、ec_connector_stats、cudagraph_stats、perf_stats、LoRA 适配器计数 | 只有对应特性启用时才出现 |
num_waiting_reqs 与 num_skipped_waiting_reqs 的拆分值得单独讲。调度器有一个 deferred_waiting 集合,用来放那些不是「没容量」而是被临时条件挡住的请求:LoRA 预算用尽、KV 传输尚未完成、请求处于阻塞状态等。get_request_counts() 返回的等待数是 len(waiting) + len(kv_holding_waiting),其中流式输入的请求还会在 get_num_unfinished_requests() 里被扣掉。make_stats() 再减去 deferred,于是:
num_waiting_reqs对应 Prometheus 的reason="capacity",语义是「等待调度容量」:既包括常规的容量等待,也包括持有 KV、等待传输就绪而暂时不能调度的请求;num_skipped_waiting_reqs统计被临时约束挡住的请求,对应reason="deferred"(LoRA 预算、阻断状态等);- 两者的和等于 Prometheus
vllm:num_requests_waiting的值。P/D 场景下,若想知道其中多少在等 KV 拉取,还要结合vllm:num_requests_kv_fetch_by_stage这个分阶段 Gauge。
这个拆分对排障很有用。等待数高但 deferred 为零,说明是容量问题,应该看 KV 使用率、运行批大小和抢占;deferred 高而 capacity 低,说明是 LoRA 配额、KV 传输或阻塞状态在卡请求,扩容 GPU 并不能解决。如果只看一个总数,这两种情况会被混成同一个告警。
kv_cache_usage 来自 kv_cache_manager.usage,最终落到 block_pool.get_usage()。它的分母是块池里可用于 KV 的块总数,分子是已分配(包括被前缀缓存 pin 住)的块数。因此它和「显存占用率」不是一回事:权重、激活、workspace 不在这本账里;前缀缓存保留的空闲块也算「已用」。读这个指标时要知道它回答的是「KV 块池还剩多少可分配」,而不是「GPU 显存还剩多少」。块池的回收与 pin 语义在 vLLM 源码完全拆解(二十二):BlockPool 里有完整拆解。
iteration_details 是一个默认关闭的细粒度补充。调度器配置里打开 enable_logging_iteration_details 后,引擎核心会用 compute_iteration_details(scheduler_output) 统计这一轮里「上下文阶段请求数/ token 数」与「生成阶段请求数/ token 数」,并记录这一轮的耗时。这里判断上下文阶段的标准是「该请求的输出 token 仍为 0,或者它属于分块预填的后续块」,所以一个已经产出过 token 的请求即使这一轮被分块预填,也会被算进生成阶段。这个字段只用于日志里的 Iteration(...) 明细行,不进 Prometheus,因为每轮都算一遍的字符串与统计开销不值得放进默认路径。
数据并行场景下还有一组不属于 SchedulerStats、但和它一起回传的字段:EngineCoreOutputs.step_counter 与 current_wave。引擎核心每个 step 递增 step_counter,按 dp_sync_interval 与其它 rank 做同步;当全局都没有未完成请求时,它把 wave_complete 发给前端并递增 current_wave。这套机制用于协调多个 DP rank 的暂停与唤醒,不是给 Prometheus 用的业务指标。把它误当成「当前批次的序号」去画图,会得到一条在暂停时突然归零的曲线,没有诊断意义。
前缀缓存与 CachingMetrics:命中率为什么必须用滑动窗口
前缀缓存的原始统计由 PrefixCacheStats 累积。它的字段不多,但每个都有明确口径:
@dataclassclass PrefixCacheStats(BaseCacheStats): reset: bool = False preempted_requests: int = 0 preempted_queries: int = 0 preempted_hits: int = 0 hits_by_source: dict[CacheHitSource, int] = field(default_factory=dict)record() 的逻辑是:
- 如果请求此前被抢占过(
preempted=True),把请求数、查询 token 数、命中 token 数记到preempted_*三个字段,不计入正常的requests/queries/hits; - 否则累加正常字段,并在连接器给出
hits_by_source时按来源拆分命中; - 如果
hits_by_source各项之和与num_hits对不上,记一条warning_once,并把全部命中归到EXTERNAL_UNSPECIFIED,避免标签统计出现负数或漏账。
把被抢占请求单独记账,是为了不让「命中率」被重复 prefill 污染。一个请求被抢占后重新调度,会再次查询前缀缓存;如果把它算进正常查询,命中率会因为同一段 prompt 被查了两次而失真。单独计数后,正常命中率只反映「新请求第一次查缓存」的效率,被抢占的部分可以另行分析。
hits_by_source 的来源枚举是 CacheHitSource:
class CacheHitSource(str, Enum): DEVICE = "device" HOST = "host" P2P = "p2p" DISK = "disk" EXTERNAL_UNSPECIFIED = "external_unspecified"顺序本身有含义:outermost() 取的是「离加速器最远」的那一层。也就是说,当一次命中同时涉及 GPU 块池和主机内存时,分来源统计要按最外层归类,避免把跨层搬运的命中记到设备层。这个细节在三级缓存(GPU / CPU / 磁盘)同时开启时尤其重要,官方在 HiCache 一类实现里就是按这个层次记账的。站内 SGLang HiCache 拆解 讲过分层前缀树的命中路径,可以对照阅读。
原始统计是逐 step 的增量,日志层却要回答「最近一段时间命中率多少」。如果直接用进程启动以来的累计值,冷启动阶段的大量 miss 会长期压低命中率,缓存重置(reset_prefix_cache)也不会反映出来。CachingMetrics 因此采用「最近 N 个请求的滑动窗口」:
def observe(self, stats: BaseCacheStats): if stats.reset: self.reset() if stats.requests == 0: return self.query_queue.append((stats.requests, stats.queries, stats.hits)) self.aggregated_requests += stats.requests self.aggregated_query_total += stats.queries self.aggregated_query_hit += stats.hits while (len(self.query_queue) > 1 and self.aggregated_requests > self.max_recent_requests): old_requests, old_queries, old_hits = self.query_queue.popleft() self.aggregated_requests -= old_requests self.aggregated_query_total -= old_queries self.aggregated_query_hit -= old_hitsCachingMetrics 的 max_recent_requests 默认是 1000,窗口的单位是「请求数」而不是时间,这样在高负载和低负载下窗口覆盖的样本量一致。三个保护条件各有原因:
reset清空窗口。调用reset_prefix_cache后,旧窗口里的命中不再代表当前缓存状态,必须从零开始。- 空统计不入队。某些 step 没有任何请求查询前缀缓存,如果把
(0,0,0)塞进队列,滑动窗口的位置会被无效样本占掉,真正有用的历史反而被提前挤出。 - 至少保留最新一条。
while条件里的len(self.query_queue) > 1保证即使单个请求的查询数就超过max_recent_requests,窗口也不会把它删空,命中率仍然有定义。
举个具体例子。假设最近三次调度分别记录了 (2 个请求, 200 次查询, 50 次命中)、(1, 100, 10)、(3, 300, 120),窗口上限是 4 个请求。前两条入队后总请求数为 3,未超限;第三条入队后总请求数为 6,需要从队首弹出第一条,剩下 (1,100,10) 与 (3,300,120),总请求数 4,命中率为 130/400 = 32.5%。注意这里减的是请求数、查询数和命中数三个累加器,而不是重新遍历队列求和;这是滑动窗口能够做到 O(1) 摊销的原因。
日志层的 Prefix cache hit rate 用的是这个窗口值;Prometheus 的 vllm:prefix_cache_queries 与 vllm:prefix_cache_hits 则是从进程启动以来一直累加的 Counter。两者的口径不同,不能拿日志里的百分比去对 Prometheus 的 hits/queries 做等式校验。做面板时应该用 increase(vllm:prefix_cache_hits[...]) / increase(vllm:prefix_cache_queries[...]) 得到区间命中率,或者用 rate() 做同样的除法;直接 hits/queries 得到的是生命周期命中率。
外部前缀缓存走另一套字段。connector_prefix_cache_stats 只统计 KV 连接器带来的跨实例命中,Prometheus 指标名带 external_ 前缀;hits_by_source 会进一步拆成 host、p2p、disk 等来源,写进 vllm:prompt_tokens_by_source。这条链路把「命中是本地块池、主机内存、P2P 传输还是磁盘」区分开来,是做缓存分层容量规划的依据。前缀缓存的淘汰策略与命中率之间的关系,在 前缀缓存淘汰完全拆解 里有更完整的讨论。
前端的装配线:StatLoggerManager 与日志器分层
StatLoggerManager 的职责不是「打印指标」,而是把「一份数据、多种引擎拓扑」翻译成「一组 logger 调用」。它的 docstring 写得很直白:
日志发生在 EngineCore(每个调度器)的粒度上。数据并行时,一个
AsyncLLM可能对应多个 EngineCore:本地日志需要为每个 EngineCore 各生成一份;Prometheus 则只需要一个 logger,用 N 组标签区分。
这句话解释了构造函数的三个分支:
self.engine_indexes = engine_idxs if engine_idxs else [0]...if enable_default_loggers and logger.isEnabledFor(logging.INFO): if client_count > 1: logger.warning("api_server_count more than 1; disabling stats logging ...") else: default_logger_factory = ( AggregatedLoggingStatLogger if aggregate_engine_logging else LoggingStatLogger ) stat_logger_factories.append(default_logger_factory)...if not custom_prometheus_logger: self.stat_loggers.append(PrometheusStatLogger(vllm_config, self.engine_indexes))第一,engine_idxs 来自 engine_core.engine_ranks_managed,不是进程号。数据并行时一个前端可能管理多个引擎 rank,每个 rank 的 SchedulerStats 都有独立的 engine_index,logger 必须按这个索引而不是按 PID 区分。
第二,默认的文本日志在 client_count > 1 时被关闭。原因不是省磁盘,而是多 API server 进程各自只看到一部分 EngineCoreOutputs,每个进程打印的吞吐与队列数都是残缺的,拼起来也不完整。Prometheus 反而可以多进程共享注册表,所以 Prometheus logger 仍然保留。
第三,如果用户通过插件注册了自定义 logger,manager 会把它包装成 PerEngineStatLoggerAdapter,让「每引擎工厂」也能以统一接口接收 engine_idx。如果自定义 logger 本身继承自 AggregateStatLoggerBase,则直接作为单实例使用。只有一种情况会跳过默认 Prometheus logger:自定义 logger 自己就是 PrometheusStatLogger 的子类,避免同一份指标注册两次。
三类文本 logger 的差别值得单独说明:
LoggingStatLogger:每个引擎一个实例,record()把本轮数据累加到本地窗口计数器,log()用time.monotonic()算窗口长度,输出一行 INFO。它维护last_scheduler_stats,所以日志里的 running/waiting/KV usage 是「最近一次快照」,而不是窗口平均值。AggregatedLoggingStatLogger:继承前者,但aggregate_scheduler_stats()会把所有引擎的 running/waiting/deferred/KV fetch 相加,并把kv_cache_usage取平均。它明确禁用 MFU 统计,注释写的是「把每 GPU 的 perf 数据跨引擎相加会得到误导性的数字」。这句话也适用于运维:跨 DP rank 平均 KV 使用率会掩盖不均衡,真正的容量判断应该看每个 engine 的 Prometheus Gauge。PerEngineStatLoggerAdapter:把自定义的「每引擎 logger 工厂」包装成聚合接口,按engine_idx找到对应实例再转发。
record() 每收到一批 EngineCoreOutputs 调用一次,log() 则由外部周期性调用。官方设计文档描述文本日志默认每 5 秒输出一行;代码本身不硬编码这个周期,而是把窗口起点保存在 last_log_time,由调用方决定节奏。--disable-log-stats 同时关掉 record 和 log 的数据来源,因此不是「把日志级别调高」能替代的。
一行日志里的字段顺序可以当作「排障阅读顺序」:
Engine 000: Avg prompt throughput: 1234.5 tokens/s, Avg generation throughput: 2345.6 tokens/s,Running: 64 reqs, Waiting: 12 reqs, Deferred: 3 reqs, Preemptions: 0,GPU KV cache usage: 78.3%, Prefix cache hit rate: 41.2%(数值是示意,格式取自 LoggingStatLogger.log()。)
Avg prompt throughput只算computedtoken,不含缓存命中;Avg generation throughput是窗口内新生成 token 数除以单调时钟窗口;Running是最近一次快照的运行请求数;Waiting是 capacity 等待数,Deferred单独列出,只有非零时才出现;Preemptions是窗口内抢占总数,只有非零时才出现;KV cache usage是最近快照,标签会按设备显示 GPU 或其它设备名;Prefix cache hit rate是CachingMetrics的最近 1000 请求窗口值,不是生命周期值。
如果启用了外部前缀缓存、多模态缓存、投机解码、KV 连接器或 CUDA Graph 统计,日志会在主行之后追加对应子系统的行。例如投机解码会单独打印:
SpecDecoding metrics: Mean acceptance length: 2.71, Accepted throughput: 812.4 tokens/s,Drafted throughput: 1203.7 tokens/s, Accepted: 15234 tokens, Drafted: 20480 tokens,Per-position acceptance rate: 0.812, 0.634, 0.421, 0.207, Avg Draft acceptance rate: 74.4%Mean acceptance length 的约定包含 bonus token,所以是 1 + accepted/drafts;逐位置接受率是「第 i 个草稿位置被接受次数除以草稿次数」,长度等于 num_speculative_tokens。这组数字比单一的「接受率」更能说明草稿深度是否合理:如果第一个位置接受率很高、后面骤降,说明草稿模型的短期预测不错,但长程一致性差,继续加深草稿树只会增加验证开销。
Prometheus 出口:标签、直方图与服务端配置
PrometheusStatLogger 是唯一默认总会安装的 logger。它在构造时做了几件固定动作:
- 调用
unregister_vllm_metrics()清掉同一进程里上一次注册的 vLLM 指标,避免测试或重复初始化时出现 duplicate timeseries; - 固定标签名
["model_name", "engine"],每个 engine index 生成一组子指标; - 对 Gauge 使用
multiprocess_mode="mostrecent",让多进程模式下读到最近一次写入的值,而不是各进程相加; - 按配置决定是否注册 KV 驻留、MFU、水位、sleep state 等可选指标族。
这里的 create_metric_per_engine() 只是对 metric.labels(*labelvalues) 做了一层字典封装:
def create_metric_per_engine(metric, per_engine_labelvalues): return {idx: metric.labels(*labelvalues) for idx, labelvalues in per_engine_labelvalues.items()}它的意义在于把「一个指标对象」变成「每个引擎一个带标签的子对象」,后续 record() 里所有 self.gauge_xxx[engine_idx].set(...)、self.counter_xxx[engine_idx].inc(...) 都直接命中对应的子指标。数据并行下,engine 标签把每个 rank 分开,Prometheus 里可以用 sum by (engine) 或 max by (engine) 做聚合;如果不带这个标签,所有 rank 会写同一个时间序列,最后写入者覆盖前面的值。
指标类型的选择遵循 Prometheus 的语义:
| 类型 | vLLM 中的典型指标 | 语义 |
|---|---|---|
| Gauge | vllm:num_requests_running、vllm:num_requests_waiting、vllm:kv_cache_usage_perc、vllm:cache_config_info、vllm:engine_sleep_state | 当前值,可升可降,每步覆盖 |
| Counter | vllm:prompt_tokens、vllm:generation_tokens、vllm:prefix_cache_queries、vllm:num_preemptions、vllm:request_success、vllm:admission_rejections | 只增不减,进程重启归零,导出时按 prometheus_client 约定加 _total 后缀 |
| Histogram | TTFT、ITL、TPOT、e2e、queue/prefill/decode/inference、请求 token 数、KV 驻留 | 按桶累计计数,可算分位数与均值 |
vllm:cache_config_info 是一个特别的 Gauge:它的值永远是 1,信息全部放在标签里(block_size、cache_dtype、enable_prefix_caching、gpu_memory_utilization 等)。Prometheus 的 Info 类型在多进程模式下不受支持,vLLM 用「值为 1 的 Gauge + mostrecent」模拟,这样不同实例的配置可以并排比较。vllm:engine_sleep_state 同理,用 sleep_state="awake|weights_offloaded|discard_all" 三个标签值表示引擎是否处于休眠、权重是否卸载。
直方图的桶边界是读指标时最容易踩坑的地方。vLLM 把默认边界按族集中在 vllm/v1/metrics/buckets.py:
| 族 | 用途 | 默认边界的形状 |
|---|---|---|
request_latency | e2e、queue、prefill、decode、inference | 0.3 秒起步,覆盖到 7680 秒 |
time_to_first_token | TTFT | 1 毫秒起步,在 0.1 秒以内最密,覆盖到 2560 秒 |
inter_token_latency | ITL 与请求级 TPOT | 10 毫秒起步,覆盖到 80 秒 |
iteration_tokens | 每步 token 数(vllm:iteration_tokens_total,命名带 total 但类型是 Histogram) | 1 到 16384 的 2 的幂 |
request_tokens | prompt/generation token 数 | 按 max_model_len 伸缩 |
kv_cache_residency | 块生命周期、空闲、复用间隔 | 1 毫秒到 1800 秒 |
这些边界的取值不是随手写的。TTFT 在交互式场景通常落在几十到几百毫秒,所以 0.02、0.04、0.06、0.08、0.1 附近的桶很密;请求级 e2e 可能是批处理任务,几十分钟也正常,所以一直排到 7680 秒。如果业务 SLO 是 300 毫秒以内,而默认 request_latency 最小的桶是 0.3 秒,那么所有请求都会落进 le="0.3" 甚至更大的桶,P99 只能内插出一个很粗的值。vLLM 为此提供了 --custom-histogram-buckets,按族替换边界:
vllm serve Qwen/Qwen3-0.6B \ --custom-histogram-buckets '{"request_latency": [0.01, 0.05, 0.1, 0.25, 0.5, 1.0, 5.0, 30.0]}'覆盖只影响列出的族,其它族保留默认值;未知的族名在启动时直接拒绝。官方文档特别提醒桶的基数问题:每个桶边界都会为每个指标、每组标签组合生成一条额外的时间序列,数据并行下还要乘以 engine 数。把 request_latency 切成一百个桶,Prometheus 的存储和查询成本会线性上升,而分位数的精度收益远没有想象中大。
/metrics 的抓取路径由 attach_router() 完成:它用 prometheus_fastapi_instrumentator 给 FastAPI 应用装 HTTP 指标中间件,再把 prometheus_client 的 ASGI app 挂到 /metrics。所以一次 curl /metrics 看到的不仅有 vllm:*,还有 http_requests_total、http_request_duration_seconds 这类 HTTP 层指标;后者能回答「慢在推理还是在网关」。
Prometheus 的抓取模型是 pull:Prometheus 按 scrape_interval 周期访问 /metrics,把样本写进时序数据库,Grafana 再通过 PromQL 查询。官方架构图把这条链路画得很清楚:
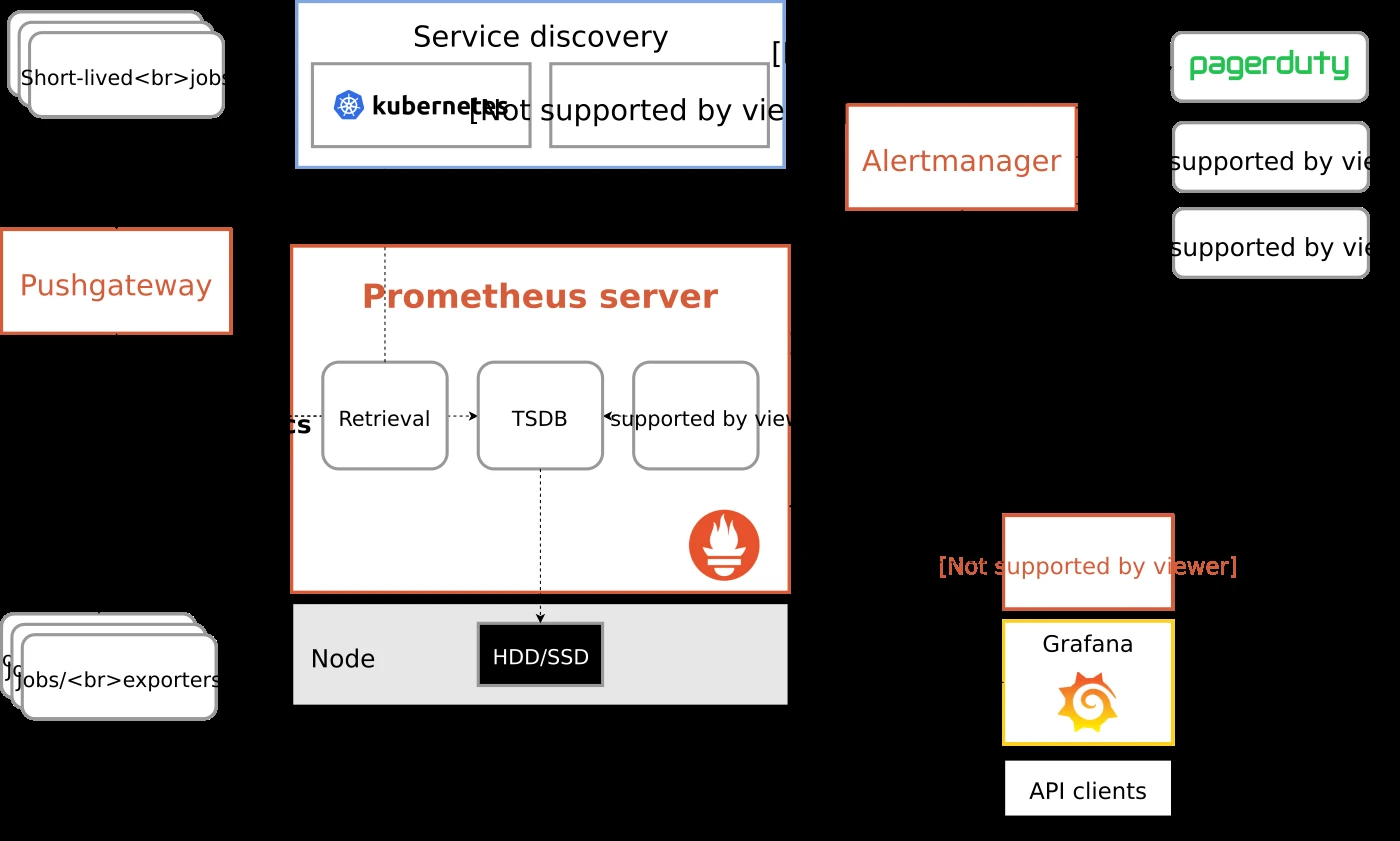
这解释了为什么 vLLM 不需要自己保存历史:它只负责在 /metrics 上暴露当前值,历史由 Prometheus 保存。也解释了为什么 Counter 的 rate() 需要至少两个抓取点:单个抓取样本只有累计值,没有速率信息。
几条常用的 PromQL 可以直接从源码口径推出来:
# 每个 engine 的 TTFT P99(秒)histogram_quantile(0.99, sum by (le, engine) (rate(vllm:time_to_first_token_seconds_bucket[5m])))
# 区间前缀缓存命中率(注意 Counter 的 _total 后缀)sum(rate(vllm:prefix_cache_hits_total[5m])) / sum(rate(vllm:prefix_cache_queries_total[5m]))
# 投机解码接受率与平均接受长度sum(rate(vllm:spec_decode_num_accepted_tokens_total[5m])) / sum(rate(vllm:spec_decode_num_draft_tokens_total[5m]))1 + sum(rate(vllm:spec_decode_num_accepted_tokens_total[5m])) / sum(rate(vllm:spec_decode_num_drafts_total[5m]))
# 每个 engine 的 KV 使用率,别直接跨 engine 求平均max by (engine) (vllm:kv_cache_usage_perc)官方 Grafana 示例仪表盘的面板也基本围着这几组转:E2E latency 的 Avg/P50/P90/P99、TTFT 的 Avg/P50/P90/P99、ITL 的 Avg/P50/P90/P99,以及 TPS 曲线。面板名称本身透露了一个经验:延迟看分位数,吞吐看速率。把 P99 和均值画在同一张图上,均值会把长尾抹平;把 TPS 画成 Counter 原值,曲线只会单调上升,没有诊断意义。
多进程模式需要单独说明。默认情况下指标在 API server 进程里注册;--api-server-count > 1 时,多个 API server 进程各自有一份注册表,prometheus_client 的 multiprocess 模式会把它们汇总到同一个 /metrics。这条路径有两个限制:一是 Python/进程级指标(process_cpu_seconds_total、process_resident_memory_bytes 等)在多进程模式下不暴露;二是默认文本日志会被关闭,因为每个进程只看到部分引擎数据。生产环境如果同时开了多 API server 和自定义 stat logger,需要确认自定义 logger 是否支持多进程聚合,否则会得到一份「看起来有数据、实际只覆盖一个进程」的指标。
缓存与投机解码的专项指标
投机解码:为什么要记到「第几个草稿位置」
SpecDecodingStats 是调度器每轮累积的专项账本:
@dataclassclass SpecDecodingStats: num_spec_tokens: int num_drafts: int = 0 num_draft_tokens: int = 0 num_accepted_tokens: int = 0 num_accepted_tokens_per_pos: list[int] = field(default_factory=list) num_draft_tokens_per_pos: list[int] = field(default_factory=list)
@classmethod def new(cls, num_spec_tokens: int): return cls(num_spec_tokens=num_spec_tokens, num_accepted_tokens_per_pos=[0] * num_spec_tokens, num_draft_tokens_per_pos=[0] * num_spec_tokens)
def observe_draft(self, num_draft_tokens, num_accepted_tokens): self.num_drafts += 1 self.num_draft_tokens += num_draft_tokens self.num_accepted_tokens += num_accepted_tokens for i in range(num_accepted_tokens): self.num_accepted_tokens_per_pos[i] += 1 for i in range(num_draft_tokens): self.num_draft_tokens_per_pos[i] += 1逐位置数组的长度固定为 num_speculative_tokens,每个草稿步只更新前 num_draft_tokens 个位置。这个设计回答了一个单一接受率回答不了的问题:草稿模型在哪一个深度开始失效。如果第 1、2 个位置接受率是 0.8、0.6,第 4 个位置掉到 0.1,继续把草稿深度加到 8 只会让验证阶段的 batch 变大、有效 token 变少;反过来,如果各位置衰减很慢,加深草稿仍然划算。
调度器在 make_spec_decoding_stats() 里还会先扣掉「语法非法、被结构化输出直接判死」的草稿 token:
if num_invalid_spec_tokens: num_draft_tokens -= num_invalid_spec_tokens.get(request_id, 0)spec_decoding_stats.observe_draft( num_draft_tokens=num_draft_tokens, num_accepted_tokens=num_accepted_tokens,)这样接受率反映的是「模型与验证器之间」的效率,而不是被语法约束强行拒绝的比例。语法拒绝另有一套结构化输出指标,混在一起会低估草稿模型的能力。
Prometheus 侧使用三个 Counter 加一个逐位置 Counter:
vllm:spec_decode_num_drafts_totalvllm:spec_decode_num_draft_tokens_totalvllm:spec_decode_num_accepted_tokens_totalvllm:spec_decode_num_accepted_tokens_per_pos_total{position="0"}等
文档里给出的 PromQL 口径是:
逐位置接受率则是「某个位置的接受计数增量除以 drafts 增量」,可以直接画成一条随 position 变化的曲线。注意这里的 1 +:验证阶段总会额外接受一个 bonus token,所以「平均每次草稿产出多少 token」要比草稿接受率多 1。如果不加这个 1,会低估投机解码的实际收益,进而做出「不值得开」的错误判断。
当模型是扩散语言模型(dLLM)时,vLLM 复用了同一套数据路径,但把语义映射成 denoising steps、canvas positions、committed tokens,并去掉逐位置数组,因为扩散解码没有「第 i 个草稿位置」的概念。SpecDecodingLogging 里有一个 is_diffusion 分支专门处理这件事,日志会打印 DiffusionDecoding metrics 而不是 SpecDecoding metrics。站内 vLLM 源码完全拆解(十):投机解码 讲了草稿、验证与接受的完整流水线,EAGLE 完全拆解 则解释了特征级草稿模型为什么能把接受率做上去。
MFU:从每步 FLOPs 估算到 Prometheus Counter
--enable-mfu-metrics 打开后,调度器会在每个 step 调用 PerfMetrics.get_step_perf_stats_per_gpu(scheduler_output),按本轮实际调度的 token 与上下文长度估算每个 GPU 的 FLOPs 和读写字节数,再打包进 SchedulerStats.perf_stats。它不是在 GPU 上实测 FLOPs,而是按模型结构和批次形状做解析估算;好处是开销极低,坏处是必须理解它的假设。
以标准注意力为例,估算把 FLOPs 拆成四块:
其中 是本轮 token 总数, 是 hidden size, 是注意力头数, 是 KV 头数, 是 head dim, 是层数,。张量并行下 与 按 TP size 除,流水并行下 按 PP size 除。MLA 的公式不同:它把 Q 路径拆成 q_a_proj/q_b_proj,KV 路径拆成 kv_a_proj(压缩到 kv_lora_rank + qk_rope_head_dim)与 kv_b_proj(再展开到每头维度),注意力核心则用 qk_head_dim 与 v_head_dim 分别计 QK 和 AV。
FFN 的估算同样按结构展开:稠密层按 SwiGLU 的三个线性层算 2 * D * 3 * DI * T * Ld;MoE 路由专家按「每 token 激活 E 个专家」算,并把 num_activated_tokens 按 EP size 除;共享专家按每 token 都激活 S 个算。这一套公式和 DeepInfer 的 MFU 估算 在结构上很接近,只是 DeepInfer 把它做成了调度期的独立估算器。
有一个估算口径必须说清楚:total_token_context_product() 把每个 query token 与完整 context_len 相乘,没有额外乘 0.5 去近似因果掩码的三角结构。因此 prefill 阶段的 attn_qk/attn_av 是一个偏高的估计;对 decode(每请求 1 个 token,上下文完整参与)则接近真实值。滑窗注意力会用 min(context_len, sliding_window) 截断,避免把不参与计算的远距离上下文算进去。读 MFU 时如果发现 prefill 密集的场景数值偏高,先检查这个保守估计,再怀疑硬件。
PerfMetricsProm 把每步估算值累加到三个 Counter:
vllm:estimated_flops_per_gpu_totalvllm:estimated_read_bytes_per_gpu_totalvllm:estimated_write_bytes_per_gpu_total
MFU 本身不是 vLLM 直接暴露的 Gauge,而是用 PromQL 结合硬件峰值算出来的:
# 以每 GPU 峰值 989 TFLOPS 为例,按实际卡型替换分母sum(rate(vllm:estimated_flops_per_gpu_total[1m])) / 1e12 / 989这带来两个工程含义。第一,峰值算力必须由部署者提供,vLLM 不知道你用的是哪张卡、跑的是什么精度;用 FP8 峰值去除 BF16 的实际 FLOPs,会得到超过 100% 的 MFU。第二,Counter 的 rate() 对抓取间隔敏感,短窗口的 MFU 曲线会剧烈抖动,容量评估应该用 5 分钟以上的窗口。
KV 驻留:采样 1% 的块,回答「缓存到底有没有被复用」
KV 块的生命周期指标默认关闭,打开 --kv-cache-metrics 后才注册三个直方图:
vllm:kv_block_lifetime_seconds:块从分配到被驱逐的时间;vllm:kv_block_idle_before_evict_seconds:最后一次访问到被驱逐的空闲时间;vllm:kv_block_reuse_gap_seconds:块被复用时,两次访问之间的间隔。
采集器 KVCacheMetricsCollector 用随机采样控制开销,默认采样率为 1%(对应 --kv-cache-metrics-sample,可在 0 到 1 之间调整,越大统计越准确、开销越高):
def __init__(self, sample_rate: float = 0.01): self.sample_rate = sample_rate self.block_metrics = {} self._eviction_events = []
def should_sample_block(self): return random.random() < self.sample_rate
def on_block_allocated(self, block): if self.should_sample_block(): self.block_metrics[block.block_id] = BlockMetricsState()
def on_block_evicted(self, block): metrics = self.block_metrics.pop(block.block_id, None) if not metrics: return self._eviction_events.append(KVCacheEvictionEvent( lifetime_seconds=metrics.get_lifetime_seconds(), idle_seconds=metrics.get_idle_time_seconds(), reuse_gaps_seconds=tuple(metrics.get_reuse_gaps_seconds()), ))默认采样率是 1%,所以这些直方图的样本量远小于请求级指标,但足以看出分布形状。三个指标要一起读:
- lifetime 很长、idle 很短:块一直被访问,属于热缓存,扩容 KV 池可能直接转化为更高并发;
- lifetime 很长、idle 也很长:块被前缀缓存 pin 住但长期没人复用,属于「搁浅缓存」,应该调整前缀缓存的淘汰策略或容量;
- reuse gap 很短:同一段前缀在短时间内被反复使用,前缀缓存收益高;
- reuse gap 很长:复用稀疏,前缀缓存可能只是占着块不释放。
SchedulerStats.kv_cache_eviction_events 只携带原始事件,Prometheus logger 在前端把事件展开成三次 observe();日志层不打印这些事件,因为它们更适合画分布而不是打一行文本。把 lifetime 和 idle 画在同一张图上,很容易看出「块活了很久但没被用」的搁浅模式,这是单看 kv_cache_usage 看不出来的。
CUDA Graph、准入拒绝与休眠状态
CUDAGraphStat 记录的是图捕获/回放带来的 padding 开销:
class CUDAGraphStat: num_unpadded_tokens: int num_padded_tokens: int num_paddings: int runtime_mode: str它只在 observability_config.cudagraph_metrics 打开时收集,日志会以表格形式打印每个 capture size 的未填充 token、填充后 token、padding 次数与运行时模式。对推理优化来说,这组数字直接量化了「为了套进静态图,浪费了多少 token 槽位」;padding 比例高说明桶划分或批形状与真实流量不匹配。站内 CUDA Graph 完全拆解 讲了捕获与重放的基本机制。
准入拒绝是另一类容易被忽略的指标。前端在队列门限处拒绝请求时,会调用 _record_admission_rejection("max_num_queued_reqs") 或 _record_admission_rejection("max_num_queued_tokens"),最终落到 vllm:admission_rejections_total{reason=...}。它统计的不是引擎内部的等待,而是请求在进入引擎之前就被挡回去的次数。队列长度看起来不高但拒绝数飙升,说明前端门限设得太紧,或者上游流量突增而调度器还没来得及反映。相关的准入链路在 vLLM 源码完全拆解(二十五):请求准入的五层关卡 里有完整拆解。
休眠状态用三个互斥的 Gauge 表示:sleep_state="awake"、"weights_offloaded"、"discard_all"。它们适合在弹性伸缩或权重换入换出的场景里判断实例是否真的可服务;只看 num_requests_running 为零,可能是空闲,也可能是权重已经卸载、根本接不了请求。
读指标:几条从数到结论的路径
指标系统最容易犯的错误不是「没采集」,而是「把两个口径不同的数字放在一起比较」。下面几条是读这套指标时最常见的误读,以及对应的正确做法。
第一,ITL 不等于 TPOT。 vllm:inter_token_latency_seconds 记录的是相邻两次流式输出之间的墙钟间隔,每次输出一条样本;vllm:request_time_per_output_token_seconds 记录的是请求完成时 decode_time / (输出 token 数 - 1),每个请求一条样本。开启投机解码后,一次输出可能带多个 token,ITL 的样本数会少于 token 数;按请求聚合的 TPOT 与按输出事件聚合的 ITL 均值也会因为权重不同而不相等。官方文档明确说两者在「一次输出包含多个 token」或「聚合权重不同」时会分叉。选哪个取决于问题:想知道用户看到的流式节奏,用 ITL;想知道单请求的稳态解码速度,用 TPOT。
第二,TTFT 高不一定是 prefill 慢。 TTFT 从 arrival_time(分词开始)算起,包含前端渲染、分词、排队进引擎、等待调度、prefill 计算和首 token 回传。正确的拆法是同时看 vllm:request_queue_time_seconds 与 vllm:request_prefill_time_seconds:队列时间高说明容量或调度问题,prefill 时间高说明输入太长或分块预填被抢占,两者都不高但 TTFT 高,则要把注意力放到前端与网络。只盯 TTFT 分位数,很容易在扩容 GPU 之后发现数字没变。
第三,前缀命中率有窗口值与生命周期值两套口径。 日志里的 Prefix cache hit rate 是最近 1000 个请求的滑动窗口;Prometheus 的 vllm:prefix_cache_queries 与 vllm:prefix_cache_hits 是进程生命周期累计的 Counter。用日志值去对 hits/queries 做等式校验会得到不一致的结果,这不是 bug。面板里要用 increase() 或 rate() 做区间比值,并且把 reset_prefix_cache 的时间点标出来,否则重置前后的数字会被混在同一个窗口里。
第四,kv_cache_usage_perc 是块池使用率,不是显存使用率,也不是全局值。 它的分母是可用于 KV 的块数,分子包含被前缀缓存 pin 住的块;权重、激活、workspace 不在这本账里。数据并行下每个 engine 有独立的 Gauge,跨 engine 求平均会掩盖「一个 rank 已满、另一个 rank 空闲」的不均衡。正确的聚合是 max by (engine) 看最紧的 rank,或者同时看 vllm:num_requests_waiting_by_reason{reason="capacity"} 判断是否真的缺容量。使用率接近 1 也不等于马上 OOM,它意味着新请求无法再分配块,接下来会发生排队或抢占;真正的风险信号是「使用率高 + 等待数上升 + 抢占计数上升」三者同时出现。
第五,Counter 可以相加,Gauge 不能随便相加,直方图不能把分位数再平均。 多个 engine 的 generation_tokens 相加得到全局吞吐,这是合理的;多个 engine 的 kv_cache_usage_perc 相加没有物理意义,只能取最大或按容量加权。直方图更不能「先算每个 engine 的 P99,再取平均」:分位数不是线性可加的,正确做法是把各 engine 的 bucket 按 le 求和后用 histogram_quantile() 重新计算,或者直接 sum by (le)。这也解释了为什么 vLLM 的 Prometheus 指标统一带 engine 标签:先保留每个 engine 的原始桶,聚合方式留给查询侧决定。
第六,完成请求的时延样本只在请求结束时出现。 vllm:e2e_request_latency_seconds 与 queue/prefill/decode 直方图都是在 finished_requests 里 observe 的;一个跑了十分钟还没结束的请求,不会给 e2e 直方图贡献任何样本。因此「e2e P99 很漂亮」不能证明没有长尾卡死,必须同时看 vllm:num_requests_running 的持续时间和 ITL 的尾部。TTFT 稍微好一点,它在首 token 产出时就写入 time_to_first_tokens_iter,不需要等请求结束,所以卡在 prefill 的请求至少会在 TTFT 上留下痕迹。
第七,Counter 会因进程重启归零。 容器滚动更新、OOM 重启、弹性扩缩容都会让 Counter 从零开始。Prometheus 的 rate() 能处理单次重置,但跨重置的窗口会给出偏低的速率;increase() 在重置点附近也可能失真。做容量报表时,应该用长时间窗口并结合 process_start_time_seconds 或实例的 up 状态判断重启点,不要把一个跨重启的 rate() 当成真实吞吐。
第八,多 API server 与多进程模式有覆盖边界。 --api-server-count > 1 时,默认文本日志被关闭,Python/进程级指标不暴露,某些自定义 logger 可能只覆盖部分进程。排查「指标突然少了一半」时,先确认部署拓扑,再看指标注册路径;不要先怀疑模型。
把这些误读反过来,就是一套可操作的排障顺序:
- 先看
num_requests_waiting_by_reason与kv_cache_usage_perc,判断是容量问题还是临时约束; - 若等待集中在 capacity,再看
num_preemptions_total与request_num_preemptions直方图,确认是否发生抢占; - 若 TTFT 高而队列不高,看
request_prefill_time与输入 token 直方图,判断是否是长 prompt; - 若 ITL 尾部厚,先看抢占计数与
kv_cache_usage,再看投机解码接受率与 CUDA Graph padding; - 若吞吐下降但延迟正常,看
prompt_tokens_by_source与prefix_cache_hits,确认是不是缓存命中减少导致实际计算量上升; - 若 MFU 低而队列高,回到 GPU 侧用 profiler 定位 kernel 利用率,而不是继续加批次。
指标能告诉你「哪里不对」,不能告诉你「为什么不对」;后者仍然要回到调度器、KV 块池、注意力 kernel 的源码里去找。这套指标的价值,是让排查从「凭感觉猜」变成「按层缩小范围」。
小结
vLLM V1 的指标管线有三个值得记住的设计决定。
第一,把开销搬出内循环。EngineCore 只记录调度快照和事件时间戳,所有区间计算、窗口聚合、Prometheus 编码都在前端完成。这样引擎核心的每一步都只做最少的工作,指标开销与 GPU 执行重叠在外循环里。
第二,用两种时钟划清边界。TTFT 与 e2e 用前端墙钟,queue/prefill/decode/inference 用引擎单调钟;一个区间只由同一进程的两个时间戳相减。这个约定不是实现细节,而是指标可信度的前提。跨进程减时间戳得到的数字看起来合理,实际上会随进程启动顺序漂移。
第三,快照与增量分开处理,窗口与累计分开导出。SchedulerStats 每步覆盖成 Gauge,IterationStats 每步累加成 Counter/Histogram;日志层用滑动窗口回答「最近怎么样」,Prometheus 用累计 Counter 回答「从启动到现在怎么样」。同一份数据在不同出口有不同的时间语义,读的时候必须知道自己在看哪一种。
从源码地图上看,这套系统可以按四层记忆:
- 事件层:
vllm/v1/engine/__init__.py的EngineCoreEventType,以及调度器里的record_event(); - 统计对象层:
vllm/v1/metrics/stats.py的SchedulerStats、IterationStats、FinishedRequestStats、PrefixCacheStats; - 出口层:
vllm/v1/metrics/loggers.py的StatLoggerManager、LoggingStatLogger、PrometheusStatLogger; - 辅助层:
vllm/v1/metrics/perf.py的 MFU 估算、vllm/v1/metrics/buckets.py的桶边界、vllm/v1/core/kv_cache_metrics.py的驻留采样、vllm/entrypoints/serve/instrumentator/metrics.py的/metrics路由。
把这四层串起来,一条请求从进入引擎到变成 /metrics 上的一行时间序列,中间经过了哪些进程、哪些时钟、哪些重置与聚合,就都能讲清楚了。这也是读推理框架指标代码的通用方法:先找「谁打时间戳」,再找「谁算区间」,最后找「谁负责导出与重置」。三个问题答对,指标的口径就不会错。
参考资料
- vLLM Metrics Design
- vLLM Production Metrics
- vLLM
vllm/v1/metrics/stats.py - vLLM
vllm/v1/metrics/loggers.py - vLLM
vllm/v1/metrics/perf.py - vLLM
vllm/v1/metrics/buckets.py - vLLM
vllm/v1/spec_decode/metrics.py - vLLM
vllm/v1/engine/__init__.py:EngineCoreEvent - vLLM
vllm/v1/engine/output_processor.py - vLLM
vllm/v1/core/kv_cache_metrics.py - vLLM Observability Roadmap(Issue #3616)
- Prometheus Overview
- Prometheus Histograms and Summaries
- vLLM Grafana Dashboard Examples
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



