


llama.cpp 源码完全拆解(二十四):HTTP 路由与参数解析——一条请求如何穿过路由表、JSON 体与 URL 参数,才变成 server_task
引言:前几篇停在「任务已经进队」的那一刻,这一篇往回走
vLLM、SGLang 这些框架的源码拆解里,入口层往往被一带而过:反正就是一个 FastAPI 或 ZMQ 网关,把 JSON 翻译一下丢进调度队列。但在 llama.cpp 的 tools/server 里,这一段恰恰是近几年重写得最频繁、结构最特殊的一层。它没有 Python 生态的 pydantic 校验器,也没有 Web 框架自动生成的 OpenAPI 文档,从 socket 读到字节,到 handler 里拿到一个 server_http_req,中间经过的是手写路由、手写中间件、手写参数合并,以及一个非常关键的「按角色分发」:同一个 HTTP 端口,可能是单模型实例,也可能是多模型管理器(router),两者共享同一张路由表,但 handler 背后连的东西完全不一样。
本文的定位是给前面几篇补上这块缺口。llama.cpp 源码完全拆解(八) 讲的是 server-context.cpp 的任务队列、slot 状态机与批组装,它的入口是 server_task;llama.cpp 源码完全拆解(十八) 讲的是 prompt cache 在 slot 层面的复用账本。这两篇都假设「请求已经被翻译成 task 了」。本篇回答的正是被跳过的部分:
- 一条 TCP 连接进来,在哪个线程上被解析,第一个真正由 llama.cpp 写的代码是什么;
GET /slots?fail_on_no_slot=1里的fail_on_no_slot和POST /slots/:id_slot里的id_slot是从两个不同来源取到的,为什么需要解码;POST /v1/chat/completions的 handler 里为什么看不到json::parse之外的任何参数提取,stream、id_slot、n_cmpl又分别在哪一步被读出来;/models、/v1/health、/v1/realtime、/v1/stream这些端点为什么会出现在一个「推理端点」的清单里;- 为什么
ex_wrapper是 handler 注册时唯一必需的包装,它兜住的异常分类直接决定了客户端拿到 400 还是 500。
本篇的线索是一张分层图:从 httplib 的连接处理,到 set_pre_routing_handler 的前置检查,再到按路径查找的 handler。读完之后,读者应该能对着任意一个 llama.cpp 端点说出三件事:它的 URL 在路由表里的 key 是什么、它的参数从 body 还是 query/path 里取、它最终向 queue_tasks 投递了几条 task。
先建立一张分层地图
下图把 tools/server 中请求从 socket 到 server_task 的全部层次画出来,每一层都标注了它所在的源文件与关键函数。
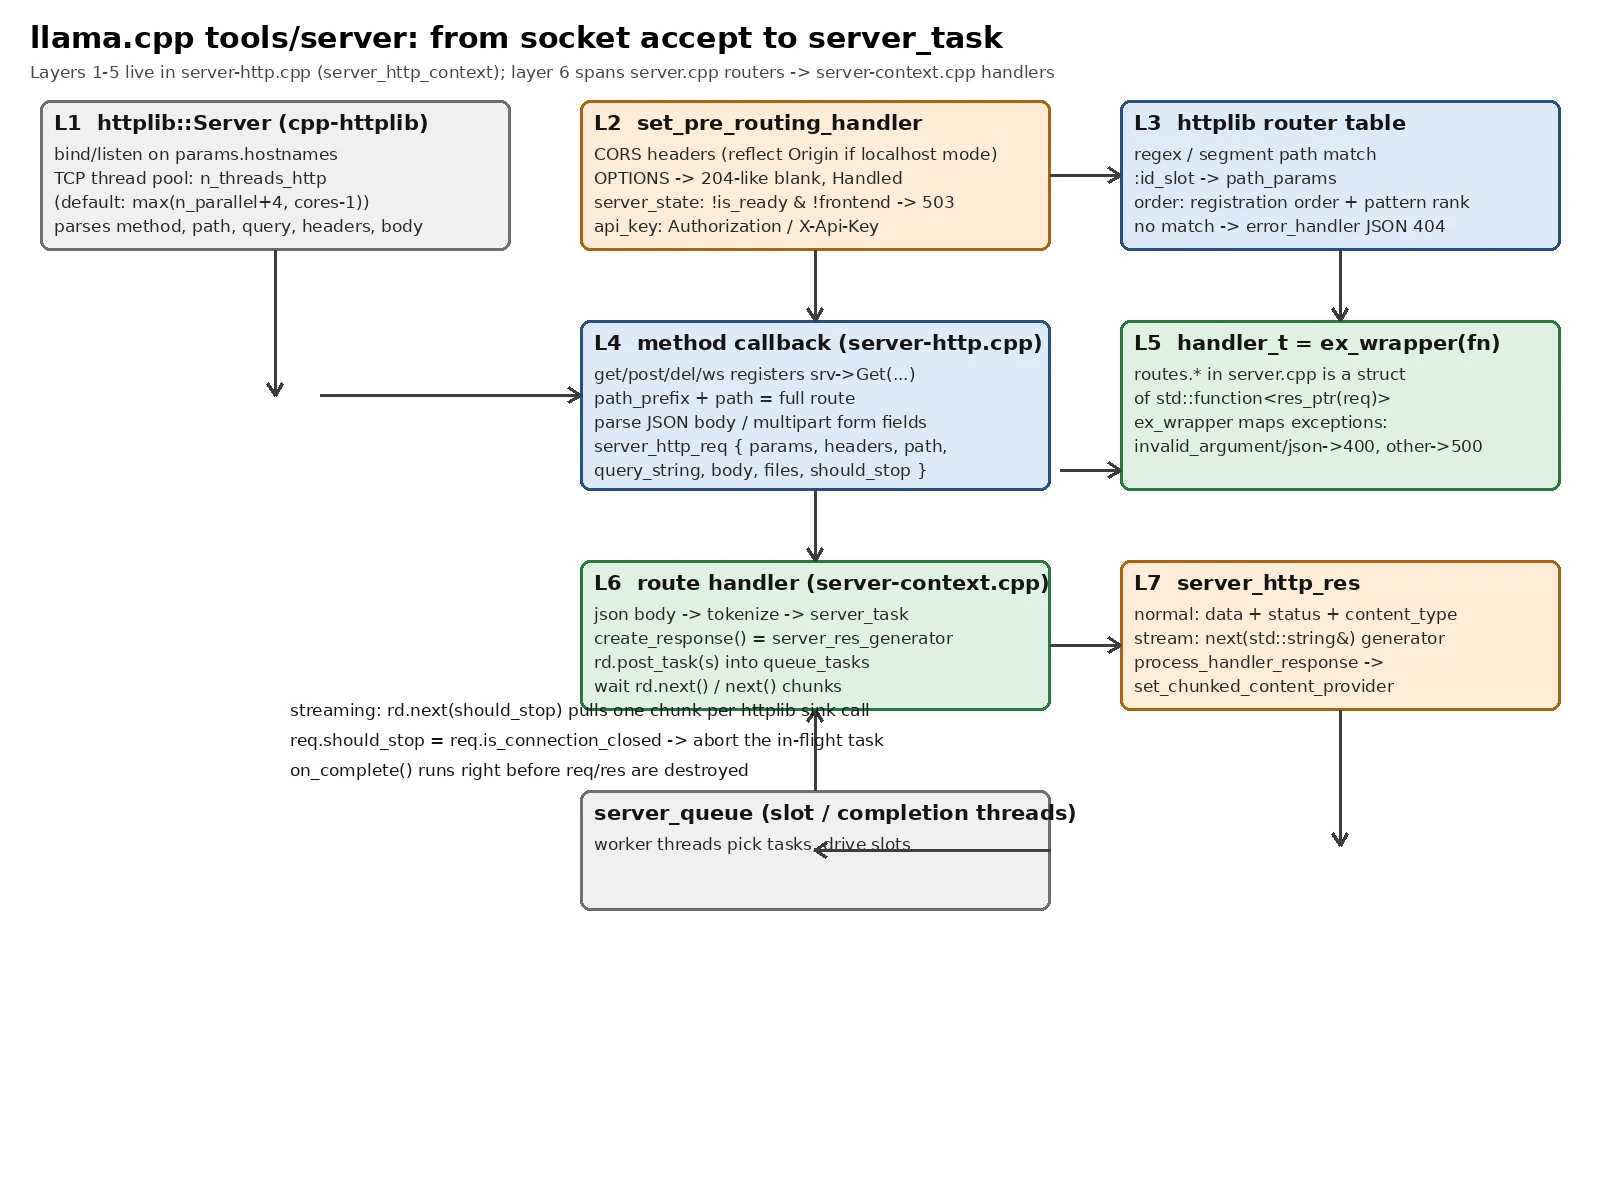
图中自上而下的箭头描述的是控制流,自右向左回到 server_queue 的那条箭头描述的是数据流:handler 生成 task 投递进队列,worker 线程从槽位里取出执行,结果再从 queue_results 回到 handler 的 reader。需要强调的是,这个框架里 HTTP 线程与推理线程是完全解耦的两组线程:前者负责解析与等待,后者负责跑槽位。这个设计决定了后面很多细节,比如为什么 should_stop 必须由 HTTP 侧提供、为什么长连接必须靠 chunked provider 而不能在 handler 里阻塞写。
这套 HTTP 层最终服务的是 llama-server,它最直观的消费者是官方自带的 Web UI。下图是该 UI 直连 llama-server 的界面,可以看到对话、参数面板与采样设置都通过本文要拆解的同一个端口访问:
第一层:哪个进程、哪个端口、多少线程
执行器分发:instance 与 router
很多读者会以为 llama-server 就是一个「装一个模型、开一个端口」的程序。从 server.cpp 的入口看,它至少有三种形态:
- 单模型实例(instance):加载一个模型,在
/slots里能看到几个槽位; - 多模型管理器(router):自身不常驻 GPU,把
/models、/models/load、/models/unload等端点暴露出来,其他推理端点全部代理到具体模型实例; - 工具模式:只提供 tokenize、detokenize、模板渲染之类 CPU 侧能力,供其他进程调用。
第三种形态值得与 llama-cli 对照着看。下图是同一个二进制家族的 CLI 会话界面——它对多模态输入的处理、对话模板与采样参数的设置都在进程内完成,不经过任何 HTTP:
把这两张界面放在一起,就能看出 tools/server 的定位:它把 CLI 里「模板渲染、分词、采样、上下文管理」这些能力重新组织成一组 HTTP 端点,再让所有外部客户端(Web UI、SDK、router)共用。这也是为什么本文后面讨论的 /apply-template、/tokenize 这类工具端点,在 CLI 里根本没有对应的 URL——它们只是把 CLI 内部的步骤拆出来给外部复用。
server.cpp 中的 server_run_router(...) 与 server_run_instance(...) 分别对应前两种。二者最重要的差别在于 server_routes 这个结构体的填充方式。server_routes 是一个普通的函数表,里面的 get_health、post_completions、post_chat_completions 等字段都是 handler_t。在 instance 模式中,它们指向 server-context.cpp 里的真实实现,也就是 server_routes 对象的成员 lambda;在 router 模式中,同一个字段被重新赋值为 models_routes->proxy_post 或 proxy_get:
// 摘自 server.cpp,router 分支:把真实 handler 替换为代理routes.post_completions = models_routes->proxy_post;routes.post_chat_completions = models_routes->proxy_post;routes.ws_realtime = models_routes->proxy_ws;// ...// 然后调用与 instance 完全相同的注册表server_register_routes(ctx_http, routes);这个「先改函数表、再注册路由」的顺序非常关键。它意味着 server_register_routes(...) 里的路由路径、方法、路径参数格式不会因为角色而改变——从客户端的视角,router 与 instance 暴露的是完全同一套 API。差异只发生在 handler 被调用之后:instance 去查本地槽位,router 去查已加载的模型列表、选一个,再把请求转发过去。这个做法后来在很多推理服务框架里被叫「透明代理」,在 llama.cpp 里实现得相当简洁,代价是 router 必须对已注册的所有路由做一份镜像。
端口绑定与多个监听地址
server_http_context::init 里,params.hostnames 是一个列表,列表里每一个元素对应一个 httplib::Server。如果列表里既有 Unix socket 路径(以 .sock 结尾)又有 TCP 地址,会为每个地址各建一个 server 对象。有一个细节值得注意:
if (port == 0 && n_tcp_hosts > 1) { SRV_ERR("--port 0 is not supported with multiple TCP addresses\n"); return false;}if (n_tcp_hosts > 1) { pimpl->servers.back()->set_ipv6_v6only(true);}当用户同时监听 [::] 和 0.0.0.0 时,若 IPv6 的 socket 不设置 V6ONLY,Linux 会默认让它也接受 IPv4 映射地址,于是 v4 监听器 bind 时就会因为端口被占用而失败。把 set_ipv6_v6only(true) 放在「多于一个 TCP 地址」的分支里,是一个很典型的实战修补。port == 0 被排除在双地址之外,是因为 0 端口表示「让内核分配」,两个监听器会分到不同端口,用户无法预测访问地址。
另外,服务端还可能因为 Google Cloud(Vertex AI)兼容模式而改写端口:一旦 AIP_MODE=PREDICTION,gcp_params 会把端口无条件改成 AIP_HTTP_PORT(未设置时是默认的 8080),与 params.port 不同则在日志里给出告警。这就是为什么在某些托管平台上部署时 --port 不生效。
HTTP 线程数:为什么默认是 n_parallel + 4
下一个问题:httplib 的连接线程池开多大?server_http_context::init 中:
pimpl->n_threads_http = params.n_threads_http;if (pimpl->n_threads_http < 1) { // +4 threads for monitoring, health and MCP. pimpl->n_threads_http = std::max(params.n_parallel + 4, static_cast<int32_t>(std::thread::hardware_concurrency() - 1));}注释写得很直白:默认值是「槽位数 + 4」与「CPU 核数 − 1」两者取大。这里要解释两个数背后的推理。
第一个是 n_parallel + 4。在 llama.cpp 的服务模型里,每个在推理的请求通常占用一个槽位。HTTP 线程在 rd.next() 等待结果时会被阻塞(对非流式请求),因此如果线程数少于正在等待结果的请求数,后续请求就无法进入解析阶段,即便它在队列里根本不会抢占资源。+4 是留给健康检查、监控与 MCP(模型上下文协议)代理这类短请求的余量。换句话说,HTTP 线程数的下限不是按「并发请求数」设置的,而是按「同时阻塞在结果等待上的请求数」设置的。
第二个是 cores − 1。它主要针对工具型端点,比如 /tokenize 这类不经过调度队列、直接在 HTTP 线程里做 CPU 计算的请求;也可能是多路 GET /props 之类的读操作。留 1 个核给主线程与推理线程,避免 CPU 侧被 HTTP 打满。
用户可以通过 --threads-http 手动覆盖。当手动设置的数值过小时,会立刻暴露为「客户端超时、服务器里请求排队」这种症状。理解默认值来源,有助于在调优时找到正确的方向:是增加槽位,还是增加 HTTP 线程,二者不是一回事。
任务队列的执行器抽象
httplib 默认在自己的线程池里执行 handler。llama.cpp 替换成了自定义的 server_http_task_queue:
srv->new_task_queue = [this] { return new server_http_task_queue(*pimpl->pool); };pimpl->pool 是一个固定大小的线程池(大小等于 n_threads_http),server_http_task_queue::enqueue 把 httplib 的任务投递给它。之所以要多包一层,而不是直接用 httplib::ThreadPool:一是需要统一控制线程生命周期(stop() 之后要能被 join()),二是某些构建下 WebSocket 长连接需要独占线程。这个区别对行为的影响不大,但它是理解「handler 运行在哪个线程」的关键:handler 运行在 llama.cpp 自己创建的线程里,而不是 httplib 的默认线程。
第二层:前置中间件,在被路由之前就决定去留
init_listener 中注册了三个东西:set_pre_routing_handler、set_exception_handler、set_error_handler。其中 set_pre_routing_handler 是「在任何路由匹配之前」运行的函数,它返回三种状态之一:Handled(已处理,不再走路由)、Unhandled(继续走路由),或者通过设置响应体与状态码来终止。
OPTIONS、CORS 与「浏览器没有 Authorization」
前置处理器里第一段是 CORS 处理。--cors-origins 支持三个取值:具体来源、localhost、*。当设为 * 且开启了 --cors-credentials 时,回显 Origin 并带上凭据头不能与通配符同时存在,处理器会改为把请求的 Origin 原样写回响应头:
if (params.cors_credentials && params.cors_origins == "*") { res.set_header("Access-Control-Allow-Origin", req.get_header_value("Origin"));} else if (params.cors_origins == "localhost") { // ... 只有 localhost 来源才回显}紧接着,对 OPTIONS 做短路:补上 Access-Control-Allow-Methods 与 Access-Control-Allow-Headers,返回一个空 body,直接 Handled。原因在注释里——浏览器的预检请求不带 Authorization 头,如果不短路,预检会因为 API key 校验失败而返回 401,前端就会看到「预检失败」而不是真正的业务错误。
模型是否加载完成:503 的加载态
middleware_server_state 读的是 is_ready 原子布尔量。它的逻辑是:只要 is_ready == false,除前端静态资源外的一切请求都返回 503。前端资源放行是为了让浏览器至少能打开页面并显示「loading」。
这条规则在 instance 模式下非常重要:server_run_instance 会先 ctx_http.start() 打开端口,然后再加载模型、初始化 llama_context、采样器、图捕获。用户在此期间发来的 /health 会得到 503,而不是 200。换句话说,/health 的语义在 llama.cpp 里是「服务可用」,而不是「进程存活」。容器编排的 readiness 探针据此判断何时把流量切过来。
router 模式也适用同一条规则:router 自身的 is_ready 在 ctx_http.start() 后立即置 true,之后才是 models.load_startup_models()。启动时预加载失败时,is_ready 已经为 true,但此时 /models 会显示模型列表为空,/health 仍然返回 200。这是 router 与 instance 在健康语义上的区别,部署时需要注意。
API key:两个头、一个前缀
middleware_validate_api_key 的实现值得一提:
std::string req_api_key = req.get_header_value("Authorization");if (req_api_key.empty()) { req_api_key = req.get_header_value("X-Api-Key");}static std::string prefix = "Bearer ";if (req_api_key.substr(0, prefix.size()) == prefix) { req_api_key = req_api_key.substr(prefix.size());}两个兼容逻辑:一是同时接受 OpenAI 风格的 Authorization: Bearer xxx 与 Anthropic 风格的 X-Api-Key: xxx;二是 Bearer 前缀被剥离后再比较。get_header_value 对 HTTP 头的大小写不敏感,所以实际来源可以是小写的 authorization,也可以是任意大小写。
放行名单 get_public_endpoints 由两部分组成:固定的 /health、/v1/health,加上前端静态资源集合。这个集合在 init_listener 里通过 llama_ui_get_assets() 一次性构造为 unordered_set,静态集合初始化之后不会再变。只要 --api-key 未设置,整个中间件直接返回 true。
一个常见的坑是客户端把 key 放进 query 字符串里,而处理器只读两个头。遇到 401 时第一件事应该是检查头而不是 URL。
is_ready 之外:一个被注释掉的 logger
在同一次 init_listener 里还有一行被注释掉的 srv->set_logger(log_server_request),注释写的是「太吵了,意义不大,以后改进」。它反映了一个取舍:llama.cpp 默认不打印每条请求的访问日志。当需要定位「请求到底有没有进到这个端点」时,只能依靠 SRV_DBG/SRV_TRC 级别的日志,而这两级默认不输出。排查 404 与 401 时,--verbose 往往是第一件要做的事。
静态资源的两套路径
如果用户传了 --path(params.public_path),前端资产从磁盘目录挂载(set_mount_point);否则从编译期嵌入的 llama_ui_get_assets() 表里按名字取。嵌入式资产的 ETag 与 Content-Encoding: gzip 由 serve_asset_cached 处理:index.html 用 no-cache 以便更新后立即生效,带哈希的其余资源用 immutable。这段逻辑虽然只服务前端,但它决定了「升级 llama-server 后浏览器是否还显示旧 UI」,是部署时实际会踩到的问题。
第三层:路由表长什么样
一张表、一个前缀、多个角色
server_register_routes 是整张路由表的唯一来源。它按方法注册,例如:
ctx_http.get ("/health", ex_wrapper(routes.get_health));ctx_http.get ("/metrics", ex_wrapper(routes.get_metrics));ctx_http.post("/v1/chat/completions", ex_wrapper(routes.post_chat_completions));ctx_http.post("/v1/messages", ex_wrapper(routes.post_anthropic_messages));ctx_http.post("/slots/:id_slot", ex_wrapper(routes.post_slots));ctx_http.ws ("/v1/realtime", routes.ws_realtime);所有路径都会被加上 params.api_prefix 之后传给 httplib,所以 --api-prefix 会让整个服务搬到某个前缀之下。前缀是在注册阶段拼接的,因此路由表本身并不感知前缀。
端点可以归为五组,每组的存在理由都不同:
| 组别 | 例子 | 为什么要在这个进程里 |
|---|---|---|
| 推理主路径 | /v1/chat/completions、/v1/completions、/v1/responses、/completion | 直接构造 server_task 放进调度队列 |
| 会话控制 | /v1/chat/completions/control、/v1/stream | 中途让一个正在生成的请求结束思考,或者删除一个流 |
| 模型与推理元信息 | /props、/models、/lora-adapters | 返回模型架构、上下文长度、LoRA 适配器状态 |
| CPU 侧工具 | /tokenize、/detokenize、/apply-template、/infill | 不需要 GPU,只依赖词表与模板 |
| 运维与兼容 | /health、/metrics、/v1/realtime、GCP 兼容端点 | 探针、监控、语音、云平台托管 |
其中 endpoint_slots、endpoint_props、endpoint_metrics 三个开关的默认值并不相同:common_params 里写作
// "advanced" endpoints are disabled by default for better securitybool endpoint_slots = true;bool endpoint_props = false; // only control POST requests, not GETbool endpoint_metrics = false;即 /slots 默认开放,因为它是排查槽位占用最常用的工具;POST /props(修改全局属性)与 /metrics 默认关闭。endpoint_props 注释特意说明只控制 POST——GET /props 始终可用,因为客户端需要靠它读到那些开关本身。所以客户端先读 /props,看到 endpoint_metrics: false 后就不必再反复轮询一个必然返回 501 的地址。这也解释了为什么开关检查写在 handler 里,而不是在 server_register_routes 里条件注册:如果没注册,/props 就无法向客户端报告「这个能力是关闭的」,客户端只会收到一个无从解释的 404。
/v1/stream 与 /v1/streams/lookup 由 server_register_stream_routes 注册,注释写明是「可恢复的流式」:客户端断开后,仍可以通过 stream ID 恢复读取后续 token。这是 llama.cpp 独有的一个小能力,普通 /v1/chat/completions 的流断开后无法续读。
httplib 的匹配规则与路径参数
路由表的匹配完全由 httplib 的路由器完成。一个常见的误解是「精确匹配优先于带参数匹配」。httplib 实际采用两类正则:不含 :param 的路径被编译为精确匹配的正则;含 :param 的路径则把 :param 替换为 ([^/]+) 形式的捕获组,并按正则的优先级评分选择。对于 llama.cpp 当前的路由表,带参数的只有 /slots/:id_slot 一条,并不存在与其他精确路径的冲突。一旦后续增加 /models/:name 之类的通配路径,就要留意与 /models/load 这类精确路径的歧义——httplib 会让精确路径优先,但别名与镜像表的生成(见后文 GCP 兼容)不会自动意识到这一点。
httplib 会把路径参数放入 req.path_params,query 参数放入 req.params。注意 req.params 已经被 httplib 完成百分号解码,而 req.path_params 没有。这个不对称是 decode_path_component 存在的直接原因。
:id_slot 与百分号解码
在 POST /slots/:id_slot?action=save&filename=foo.bin 这个请求里,id_slot 来自路径,action 来自 query。如果请求的路径参数里含特殊字符,httplib 交给 path_params 的值是原始形式,而 get_params 统一对路径参数做一次解码:
static std::map<std::string, std::string> get_params(const httplib::Request &req) { std::map<std::string, std::string> params; for (const auto &[key, value] : req.params) { params[key] = value; } for (const auto &[key, value] : req.path_params) { params[key] = decode_path_component(value); } return params;}decode_path_component 本身是一个很小的 %XX 解码器,对不合法的十六进制序列原样保留。它的注释给出了直接的理由:会话 ID 可能包含 ::,客户端把它编码成 conv%3A%3Amodel,如果不解码,handler 里比较 X-Conversation-Id 头时会匹配失败。
这里还有一层覆盖顺序:先把 query 参数全部拷进去,再用路径参数覆盖。这意味着如果同名的参数同时出现在 query 与 path 中,路径参数胜出。这种覆盖顺序没有文档说明,但对 id_slot 这类字段有实际影响。
build_query_string 与 MCP 代理
server_http_req 里除了 params 还有 query_string,由 build_query_string 重新构造。它把 req.params 按 k=v 用 & 拼接,并对每一边做 encode_query_component。为什么不直接保存 req.target 的 query 部分?因为 httplib 已经对 query 做过一次解码,而代理给 MCP 服务端时需要保证被代理端读到的是同一组键值对;重新编码比依赖原始字符串更稳。
这个字段与 /tools(MCP 工具代理,见 tools/server/server-tools.*)和 /cors-proxy 的转发直接相关。MCP 代理会把请求的 header 也打包进去,所以 server_http_req 里专门留了 headers 字段,注释写明「used by MCP proxy」。
第四层:server_http_req——一个扁平化的请求视图
字段与用途
server_http_req 的字段列表很短,但每一个都有明确的消费者:
struct server_http_req { std::map<std::string, std::string> params; // path_params + query_params std::map<std::string, std::string> headers; // used by MCP proxy std::string path; std::string query_string; std::string body; std::map<std::string, uploaded_file> files; // 上传文件 const std::function<bool()> &should_stop;};should_stop 是一个引用,指向 httplib 的 req.is_connection_closed。这是整个框架里「客户端断开」的唯一信号来源。server-context.cpp 里几乎每一个 rd.next(...)、rd.wait_for_all(...) 都会把它传进去;一旦该函数返回 true,handler 就会提前返回。调度器层则会在下一次调度时丢弃已经失去客户的请求,那部分内容可以参照本站的 请求的取消与抢占:五个推理框架的回收路径。
files 只对 multipart 请求有意义。post 里对 multipart 做了两件事:把表单字段折叠成一个 JSON 对象当作 body 用,把文件字段读入 uploaded_file。折叠时如果同名键出现多次,会把值转成数组。这样做的原因是多模态请求(图像、音频)经常以表单方式发送,而 handler 只认 JSON body,于是在 HTTP 层先把表单「翻译」成 JSON。
uploaded_file 与内存
uploaded_file 把文件内容读成 raw_buffer,也就是 std::vector<uint8_t>。没有临时文件落盘,没有单独的大小限制(httplib 的 payload 上限另行设置)。对于图像,这个设计足够;对于音频,也足够;对于很大的文件,内存占用需要留意。/audio/transcriptions 与 MCP 是主要用户。
为什么没有 body 解析
server_http_req 里的 body 是原始字符串,没有在 HTTP 层做 json::parse。这与很多框架不同:Flask 会用 JSON 中间件自动解析,FastAPI 用 pydantic 做校验。llama.cpp 把解析放到每个 handler 里,例如:
this->post_chat_completions = [this](const server_http_req &req) { auto res = create_response(); std::vector<raw_buffer> files; json body = json::parse(req.body); // ...};原因有三:一是 handler 需要看到 req.should_stop 与其他字段,原始字符串更灵活;二是不同端点对 body 的期望不同(/tokenize 的 content 字段既可以是字符串也可以是逐段数组,/completions 的 prompt 同理),统一解析反而多一层;三是 json::parse 抛出的异常需要被统一映射成 400,而这件事由 ex_wrapper 负责,放在 handler 里抛最自然。
/tokenize 的实现可以说明第二点。它用 body.count("content") != 0 判断字段是否存在,而不是 json_value 给默认值;因为「content 缺失」在语义上和「content 是空字符串」不同——前者应当返回空的 token 列表,后者返回 [](一个空字符串仍然是一个合法输入)。with_pieces 打开时,每个 token 会被还原成文本片段;如果片段不是合法 UTF-8(例如字节级 BPE 切开的半个汉字),就退化成字节值数组。这个细节关系到客户端能不能把 token 拼回原始文本,在流式输出与错误定位里经常被用到。
第五层:ex_wrapper——把异常翻译成状态码
server.cpp 里的 ex_wrapper 是注册时唯一的包装:
static server_http_context::handler_t ex_wrapper(server_http_context::handler_t func) { return [func = std::move(func)](const server_http_req &req) -> server_http_res_ptr { try { return func(req); } catch (const std::invalid_argument &e) { // treat invalid_argument as invalid request (400) } catch (const common_json_error &e) { // JSON parse and type errors are invalid requests (400) } catch (const std::exception &e) { // treat other exceptions as server error (500) } catch (...) { // 未知异常,同样映射为 500 } // 把 message 与 error_type 组装成错误响应 };}它建立了一条约定:handler 里抛出的 std::invalid_argument 与 JSON 错误一律视为客户端错误 400;其他异常视为 500。这个约定让 handler 的写法可以非常直接——参数不对就 throw std::invalid_argument("..."),不需要在每个函数里手工构造错误响应。
约定能成立,是因为 ex_wrapper 最终把异常交给 format_error_response(message, type) 统一序列化。这个函数是「错误类型 → 状态码 + type 字符串」的唯一定义点:
error_type | HTTP 状态码 | type 字段 |
|---|---|---|
ERROR_TYPE_INVALID_REQUEST | 400 | invalid_request_error |
ERROR_TYPE_AUTHENTICATION | 401 | authentication_error |
ERROR_TYPE_PERMISSION | 403 | permission_error |
ERROR_TYPE_NOT_FOUND | 404 | not_found_error |
ERROR_TYPE_SERVER | 500 | server_error |
ERROR_TYPE_NOT_SUPPORTED | 501 | not_supported_error |
ERROR_TYPE_UNAVAILABLE | 503 | unavailable_error |
ERROR_TYPE_EXCEED_CONTEXT_SIZE | 400 | exceed_context_size_error |
其中 NOT_SUPPORTED(模型不支持某个能力,比如无 FIM token 时调用 /infill)、UNAVAILABLE(fail_on_no_slot 且所有槽位都被占用)、EXCEED_CONTEXT_SIZE(输入超过上下文长度)是 llama.cpp 自定义的三类,OpenAI 官方 API 没有对应项。客户端如果只按 OpenAI 的 400/401/404/500 四类写错误处理,501 与 503 就会被归入「未知错误」,这是自建服务时需要留意的一处兼容性缺口。
与它配套的是 set_exception_handler(httplib 级兜底),注释写明「应该是 fail-safe,异常应该已经被 ex_wrapper 处理」。这是双层保险:httplib 在调用 handler 的路径上如果出现别的异常,比如在构造 server_http_req 的过程里出现内存分配失败,就会落到这里,返回一个 text/plain 的 500。
另外,set_error_handler 只对 404 做处理:当路由不匹配时,返回一个 JSON 结构的 404(not_found_error),而不是 httplib 默认的 HTML。其他状态码不动,因为它们已经由 res->error() 写过 body。这个细节让客户端的错误处理可以统一走 OpenAI 风格的 JSON。
第六层:参数从哪里来——三层读取的优先级
llama.cpp 的 handler 读参数有三条渠道,它们的来源、类型与错误处理方式都不同。下图把这三条渠道与它们的汇聚点、以及参数如何变成一个或多个 server_task 画在一起:
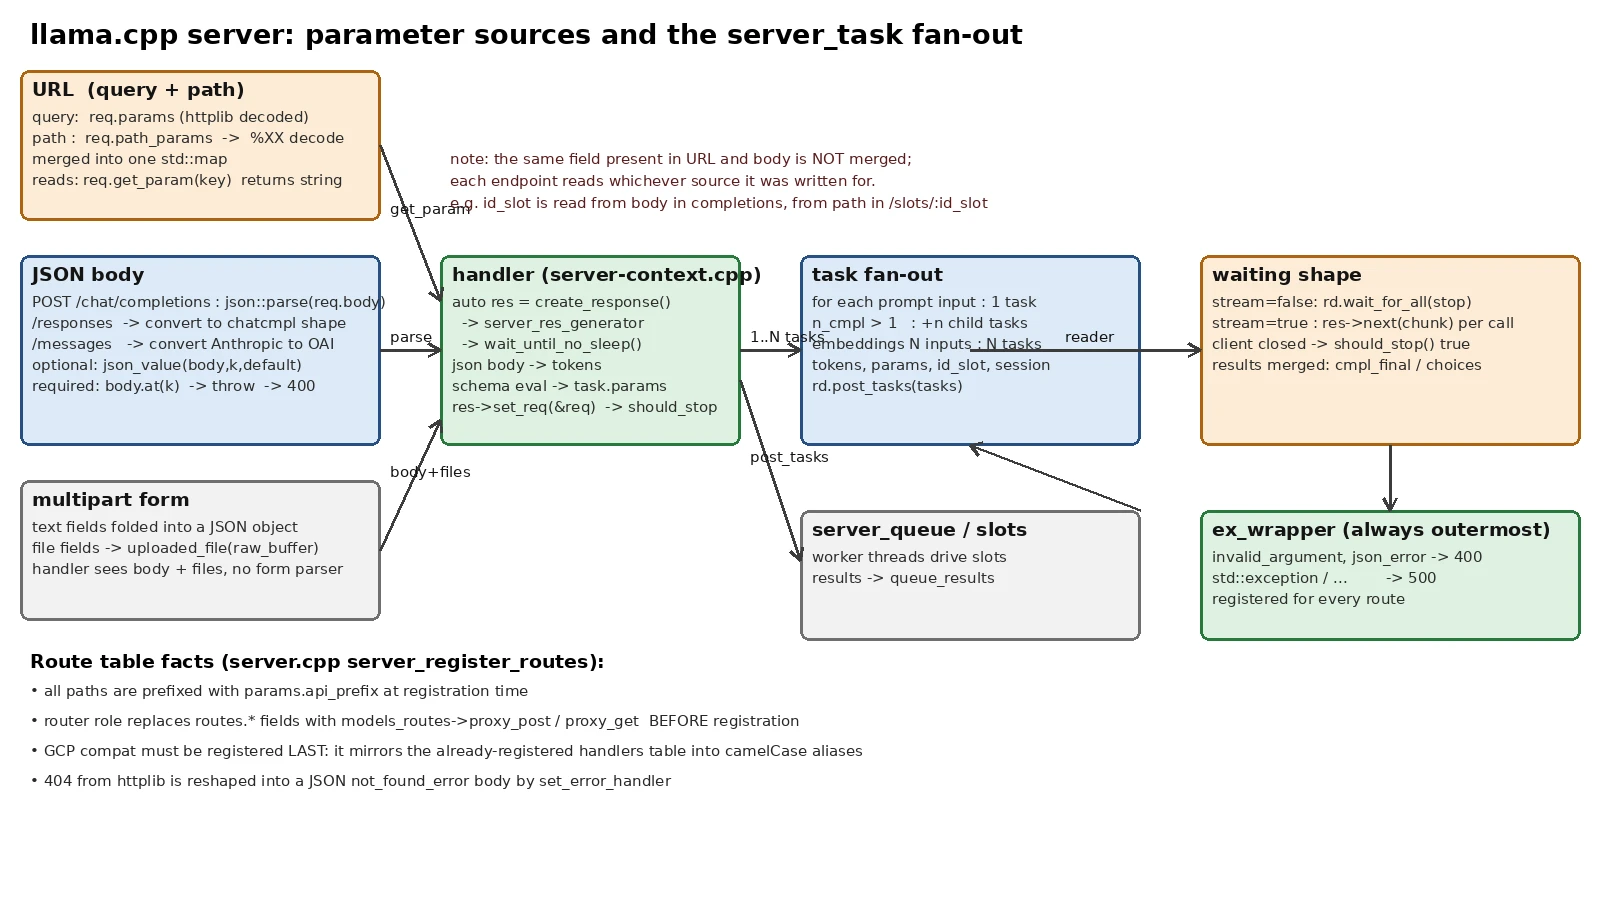
图左侧是三条参数来源:URL(query 已解码、path 需解码后合并)、JSON 体、multipart 表单;中间是 handler 与 server_res_generator;右侧是等待形态;底部是 ex_wrapper 对整条调用链的异常兜底。图中强调的一点是:URL 与 body 里的同名字段并不会自动合并,每个端点读的是它被写死的那一个来源。
渠道一:URL 参数(query + path),无类型
req.get_param 返回字符串,支持默认值:
std::string get_param(const std::string &key, const std::string &def = "") const { auto it = params.find(key); if (it != params.end()) return it->second; return def;}它在整个 server-context.cpp 里被调用的位置非常集中,几乎全是「存在性」或「枚举值」判断。例如 get_slots 里:
if (!req.get_param("fail_on_no_slot").empty()) { if (res_task->n_idle_slots == 0) { res->error(format_error_response("no slot available", ERROR_TYPE_UNAVAILABLE)); }}注意判断方式:fail_on_no_slot=0 也会让 .empty() 为 false,从而触发该逻辑。严格来说客户端应该只发送 fail_on_no_slot=1,服务端并不解析该值。这是 query 参数在 llama.cpp 里「只表示存在」的典型用法。
post_slots 里则同时读两个参数:
std::string id_slot_str = req.get_param("id_slot");int id_slot;try { id_slot = std::stoi(id_slot_str);} catch (const std::exception &) { res->error(format_error_response("Invalid slot ID", ERROR_TYPE_INVALID_REQUEST)); return res;}std::string action = req.get_param("action");if (action == "save") return handle_slots_save(req, id_slot);if (action == "restore") return handle_slots_restore(req, id_slot);if (action == "erase") return handle_slots_erase(req, id_slot);id_slot 来自路径,action 来自 query,两者最终都被合进同一个 params,所以 get_param 不需要区分来源。如果参数缺失,std::stoi("") 会抛出异常,捕获后返回 400;如果路径整体不匹配,httplib 直接返回 404。两者在客户端看来很接近,但含义不同:404 表示这条 URL 不存在,400 表示 URL 存在、参数不对。
渠道二:JSON 体,有类型与默认值
server-common.h 里的 json_value 是一个模板,它对类型不匹配与缺失都做了容忍:
template <typename T>static T json_value(const json &body, const std::string &key, const T &default_value) { if (body.contains(key) && !body.at(key).is_null()) { try { return body.at(key).get<T>(); } catch (const common_json_error &err) { LOG_WRN("Wrong type supplied for parameter '%s', using default value: %s\n", ...); return default_value; } } return default_value;}三个行为直接定义了 llama.cpp 对客户端错误的宽容度:缺字段用默认值、值为 null 用默认值、类型错误也用默认值并打一条警告。它没有把「客户端提供了错误类型」当成 400,这与其他推理框架的严格校验不同。好处是兼容性极强,很多客户端库「顺手多塞一个字段、多给一种类型」的请求不会失败;代价是错误被静默吞掉,用户发现「我传了 temperature 却没生效」时需要去翻日志。
对比 data.at("prompt") 这种写法:.at() 在键不存在时直接抛出 JSON 错误,被 ex_wrapper 兜住后变成 400。所以同一个文件里存在两种风格——必填字段用 .at(),可选字段用 json_value。这两种风格的边界正好就是「哪些字段缺失可以接受」的边界。
渠道三:从原始体转换再走渠道二
/v1/responses 与 /v1/messages 两个端点多一步协议转换:
json body = server_chat_convert_responses_to_chatcmpl(json::parse(req.body));// 或者json body = server_chat_convert_anthropic_to_oai(json::parse(req.body));也就是说,HTTP 层不做协议归一化,而是端点自己把握「OpenAI Responses 与 Anthropic Messages 在语义上等价的部分」转换到统一结构,然后再交给同一个 oaicompat_chat_params_parse。这一点与 vLLM、DeepInfer 的设计思路不同:后两者在入口层就把 Anthropic 协议转成 OpenAI 协议,llama.cpp 则是每个端点一层浅转换,尽量减少语义损耗。
优先级与覆盖规则
当同一个字段在 URL 与 body 里都出现时,以哪个为准?llama.cpp 并没有全局规则。handle_completions_impl 中 params 结构体由 server_schema::eval_llama_cmpl_schema(...) 从 data 解析出来,而 data 是 JSON body;URL 参数不会进入 data。唯一的例外是某些端点会把 URL 里的开关直接当作独立变量使用,例如 ws_realtime 在判断是否走实时转写时:
const bool live_asr = !ctx_server.asr_prompt.empty() && req.get_param("intent") == "transcription";这里 intent 只出现在 query 里。综上,参数源的约定是「哪个端点用哪个源」,而不是「URL 覆盖 body 或反之」。
第七层:从参数到 server_task
handle_completions_impl 的六段结构
无论是 /completion、/v1/completions、/v1/chat/completions,还是 /v1/responses 与音频转写,大多数「会进 GPU」的端点最终都走到同一个实现:
std::unique_ptr<server_res_generator> server_routes::handle_completions_impl( const server_http_req &req, server_task_type type, const json &data, const std::vector<raw_buffer> &files, task_response_type res_type, const common_chat_session &chat_session);它的结构可以拆成六段:
- 建响应对象:
auto res = create_response();创建server_res_generator,它内部包含一个server_response_reader,后者在构造时可能调用queue_tasks.wait_until_no_sleep()。 - 前置能力检查:
ctx_server.has_cap_chat(),不支持就返回 400。 - prompt 归一化:
prompt允许字符串或数组,tokenize_input_prompts或process_mtmd_prompt处理多模态。 - 逐输入构造 task:对每个 prompt 输入创建一条
server_task(type),task.id从 reader 里取新 ID,task.tokens存 token 序列,task.params用eval_llama_cmpl_schema解析采样参数,task.id_slot从 body 里的id_slot读取,task.apply_chat_session(chat_session)记录会话。 - 子任务分叉:如果
n_cmpl > 1,为每个额外结果再加一条 child task,共享父任务的 ID。 - 投递与等待:
rd.post_tasks(std::move(tasks), chat_session);如果是流式,则设置res->next让 httplib 按 chunk 拉取;如果是非流式,则rd.wait_for_all(req.should_stop)一次性等齐。
第 4 和第 5 段最容易误解。一个请求里 prompt 是数组、n_cmpl 是 3,最终会投递「输入数 × n_cmpl」条 task,而不是一条。task 之间通过 id 与父子关系关联,结果是等所有任务完成后合并。这正是「一个端点可以变成多条 task」的机制。子任务并不会在入口层独立执行:父子关系被编进 child_tasks,调度器在 launch_slots_with_parent_task 里一次性为父任务与每个子任务各分一个槽位,子槽位会先进入 SLOT_STATE_WAIT_OTHER 等待父槽位处理完 prompt,然后才共享父任务算出的前缀继续生成。这套槽位分配、等待状态与结果合并的细节在 llama.cpp 源码完全拆解(八):服务化与调度 里有完整展开。入口层需要负责的只是把父子关系与 task id 事先编好,并保证所有 id 都来自同一个 response reader——否则 reader 会等待一个永远不会回来的 id。
stream 决定响应形态,但不决定调度
bool stream = json_value(data, "stream", false);这个值在投递之后才被读取。它只决定响应对象的 next 是否被设置,不影响 task 入队与调度。调度层对「是否流式」没有概念——所有任务都在同一个槽位上逐 token 推进,流式只是把结果从槽位回到 HTTP 线程的时机不同:非流式等全部生成结束再返回,流式每个增量结果立即写进 chunk。
反过来,客户端断开(should_stop)在两种模式下都有效。非流式请求在 wait_for_all 里检测到连接关闭就会放弃结果;流式请求在每次 next() 拉数据时检查。这里的「放弃」只在 HTTP 层;调度层的取消由 reader 关闭后队列感知。
create_response 与睡眠
server_res_generator 的构造函数里有一个容易被忽略的细节:
bypass_sleep |= sleep_idle_seconds < 0;if (!bypass_sleep) { queue_tasks.wait_until_no_sleep();}当 --sleep-idle-seconds 生效时,服务可能在空闲后卸载模型,再次收到请求时需要先从睡眠状态唤醒。wait_until_no_sleep 在这里把唤醒的等待放在「创建响应对象」这一步,因此 handler 的第一行就承担了唤醒职责。之后所有「拿到结果」的等待都在 rd.next() 与 rd.wait_for_all() 里。
某些端点需要绕过睡眠等待,比如 get_props,它被明确要求「在睡眠期间也能访问」。这解释了它在实现里特意不使用 ctx_server,而是读缓存:
if (queue_tasks.is_sleeping()) { std::unique_lock<std::mutex> lock(mutex_cache); res->ok(cached_props);}缓存 cached_props 是在进入睡眠前写好的快照,睡眠期间的 /props 读它而不是去查 llama_context——因为后者已经卸掉了。这是入口层与生命周期管理层之间少数显式的契约之一。
一份 body 的两道解析:server_schema
上面提到 task.params 由 server_schema::eval_llama_cmpl_schema 从 data 解析。这里是入口层与调度层之间最值得单独看的一处「第二次解析」。
入口层已经 json::parse(req.body) 一次,拿到了 data;但 data 里的字段要变成 server_task_params 这种强类型结构体,还需要一次字段级的映射。server_schema 正是这个映射器,它按端点类型(LLaMA 原生 completions、OAI completions、OAI chat、TTS 等)分别把 temperature、top_k、min_p、repeat_penalty、n_predict、stop、logit_bias 等字段搬到结构体里,同时把「服务器默认值」与「客户端显式传入值」区分开。
为什么要在入口层做这件事,而不是在调度层?因为服务器默认值来自 meta- 与 params(例如模型自带的采样默认值、--temp 这类启动参数),只有入口层同时持有 HTTP 请求与服务配置。如果放到调度层,每个 task 都得再带一份服务配置的副本,反而更复杂。
这也解释了为什么 task.params 里有一个 sse_ping_interval 字段会被入口层从 schema 结果里反读出来:sse_ping_interval = task.params.sse_ping_interval;。心跳间隔虽然是采样参数的一部分,但它的消费者是 HTTP 侧的流式写入器,所以必须回到入口层使用。
多任务端点的几个典型
除了 handle_completions_impl,还有几类端点也是「一条请求 → 多条 task」或多路:
/embeddings与/rerank:输入是一个数组时,handle_embeddings_impl会为每个输入构造 task,并行投递。由于这些任务在槽位上只做一次前向,结果合并很快。实现里用res_type区分格式(OpenAI 与 llama 自有),对应不同响应包装方式。/infill:FIM(fill-in-the-middle)请求把前缀、后缀、中间拼成一个特殊 prompt,最终仍是一条 task,但 tokenization 不同。它的前置检查是词表是否含 FIM 专用 token,缺失就返回「模型不支持」。/models的 router 版本:post_router_models_load会启动一个子进程加载指定模型,然后返回;这不是「投递到 queue_tasks」,而是另一个维度的并发。/v1/chat/completions/control:这是一个「发出即返回」的端点,构造一条SERVER_TASK_TYPE_CONTROL任务,让正在生成的请求结束思考段,然后同步等待结果并返回。它不产生新 token,只改变已有请求的状态。
把一条 chat 请求完整走一遍
前面分层讲完,这里把一条具体的请求拼起来,验证每一层各自做了什么。请求如下:
POST /v1/chat/completions HTTP/1.1Authorization: Bearer sk-localContent-Type: application/json
{"model":"local","messages":[{"role":"user","content":"你好"}], "temperature":0.7,"stream":true,"n_cmpl":2}假设服务以 --parallel 4 启动,当前没有其它请求。
- 连接与线程:httplib 接受连接,从
server_http_task_queue的线程池里取一个线程执行 handler。--parallel 4意味着默认 HTTP 线程数是max(4+4, cores-1),这条请求占其中之一。 - 前置检查:
set_pre_routing_handler先写 CORS 头;请求不是OPTIONS,继续;is_ready为 true;Authorization头去掉Bearer后与--api-key比较。全部通过,返回Unhandled。 - 路由匹配:路径
/v1/chat/completions与注册表中的POST精确匹配,httplib 找到ex_wrapper(routes.post_chat_completions)。该路由没有路径参数,req.path_params为空。 - 构造请求视图:
post的 callback 调get_params(此时只有 query 参数,为空)、get_headers、build_query_string,body 原样保留,should_stop绑定到req.is_connection_closed。 - handler 入口:
post_chat_completions里json::parse(req.body),然后oaicompat_chat_params_parse(...)把 OpenAI 的messages渲染成 chat 模板、处理多模态、返回统一结构的body_parsed与一个common_chat_session。 - 能力与预算:
handle_completions_impl检查has_cap_chat();prompt字段是字符串;tokenize_input_prompts切成 token 序列;eval_llama_cmpl_schema把temperature=0.7、n_cmpl=2搬进server_task_params。stream不在这里使用——它留到投递之后才被读,因为它是响应形态而不是调度参数。 - 构 task:循环产生一条主 task,
task.id来自 reader 的新 id,task.id_slot是-1(body 未指定),且n_cmpl=2触发一条 child task,经task.add_child(task.id, rd.get_new_id())挂到主 task 上。 - 投递:
rd.post_tasks(tasks, chat_session)把主 task 与子 task 一起放进queue_tasks,并把 chat session 注册进会话表。 - 等待形态:
stream=true,因此res->next被设置为读者拉取一个 chunk 的函数,process_handler_response走 chunked 路径,加上X-Accel-Buffering: no。 - 槽位执行:调度线程从队列取主 task,经
launch_slots_with_parent_task同时分配父槽位与一个子槽位;父槽位处理 prompt,子槽位处于SLOT_STATE_WAIT_OTHER,等到父槽位算完前缀后才开始采样。生成过程中每个增量结果通过queue_results回到 reader,reader 的next再把它写进 HTTP sink。 - 收尾:主/子 task 都结束,结果合并成一条 OAI 响应;
on_complete在 httplib 销毁请求与响应对象之前触发,reader 关闭,槽位释放;若客户端中途断开,should_stop为 true,reader 返回空,handler 提前退出。
这条路径里有两个容易在阅读时漏掉的点:model 字段实际上不参与调度(单模型实例只有一个模型),真正的模型选择发生在 router 侧;n_cmpl 的子任务并不额外计费式地复制 KV,它共享父任务的 prompt 前缀,只是在采样阶段分叉。这两点都说明入口层「只是翻译」,并不改变调度语义。
流式响应的三条边界
process_handler_response 是 HTTP 层把 server_http_res 交给 httplib 的唯一出口:
if (response->is_stream()) { res.status = response->status; response->headers["X-Accel-Buffering"] = "no"; set_headers(res, response->headers); // ... res.set_chunked_content_provider(content_type, chunked_content_provider, on_complete);} else { res.status = response->status; set_headers(res, response->headers); res.set_content(response->data, response->content_type); response->on_complete();}三个边界值得记住:
第一,X-Accel-Buffering: no 是给 Nginx 看的。没有它,反向代理会把 chunk 攒成一个完整响应再发送,流式就退化成非流式。
第二,chunked provider 的每次调用只拉一个 chunk,空 chunk 不会写数据但也不终止流。这允许「心跳」与「真实 token」共用同一条通道,sse_ping_interval 就是用来决定多久发一个空事件。
第三,on_complete 在流结束与响应销毁之间执行,因此它是清理 reader、归还会话的唯一安全点。非流式路径在 set_content 之后立刻调用它;流式路径把它交给 httplib,等 sink 关闭时回调。
端点与任务的对应关系
把入口层的 handler 与 server_task_type 对齐,可以得到一张很适合贴在源码旁边的表:
| 端点 | 主要 task 类型 | 是否经过 GPU |
|---|---|---|
/completion、/v1/completions、/v1/chat/completions | COMPLETION | 是 |
/v1/responses、/v1/messages | COMPLETION(先转协议) | 是 |
/infill | INFILL | 是 |
/embeddings、/v1/embeddings | EMBEDDING | 是(一次前向) |
/rerank、/v1/rerank | RERANK | 是(一次前向) |
/tts | TTS | 是 |
/v1/audio/transcriptions | COMPLETION(先转成 chat completions) | 是 |
/v1/realtime | REALTIME over WebSocket | 是 |
/v1/systemone | DECISION | 是(单步读出) |
/v1/chat/completions/control | CONTROL | 否(改变已有请求) |
/slots、/slots/:id_slot | SLOT_GET/SAVE/RESTORE/ERASE | 否(可能触发状态拷贝) |
/metrics | METRICS | 否 |
/lora-adapters | GET_LORA/SET_LORA | 否(改权重指针) |
/tokenize、/detokenize、/apply-template | 无 task,直接 CPU | 否 |
/props、/health、/models | 无 task,直接读状态 | 否 |
这张表也解释了为什么 /metrics 需要走任务队列:它要读到每个槽位的实时计数(已生成 token、缓存命中、prompt 处理时间),这些数据由调度线程更新,直接读会有数据竞争。SLOT_GET 同理。反过来说,/tokenize 之所以不排队,是因为它只依赖词表,而词表在加载后是只读的。
还有四个端点的阅读方式值得单独点出,因为它们都展示了同一种做法——「把一小段状态读取也包装成 task,交给调度线程去执行」。
/metrics 是需要显式开启的端点(params.endpoint_metrics),未开启时直接返回 NOT_SUPPORTED。即便开启,它也有两条路径。get_metrics 是最完整的例子。正常路径下它投递一个高优先级 METRICS 任务,然后 rd.next 的停止条件不只是 req.should_stop,还多了一个 queue_tasks.is_sleeping():
auto result = res->rd.next([&]{ return req.should_stop() || queue_tasks.is_sleeping(); });if (!result) { if (!req.should_stop()) { use_cached_metrics(); } return res;}理由是:如果任务刚投递、服务就进入睡眠,这条任务永远不会被处理,等下去就会挂住。于是这里改用睡眠前缓存下来的 cached_metrics。缓存路径还会 reset_bucket(),让下一次真正采集时重新开始统计窗口。这个「投递—等待—回退到缓存」的模式,是入口层与生命周期管理配合的标准写法。
get_lora_adapters 与 post_lora_adapters 同理:它们分别投递 GET_LORA 与 SET_LORA,因为适配器列表可以在运行时被 --lora-init-without-apply 之类的配置改变,也可能被别的请求并发修改,直接读会与环境状态脱节。post_lora_adapters 还额外要求 body 是一个数组(每项含 id 与 scale),非数组直接 400,而不是交给 json_value 宽容处理。
/health 的实现是另一个极端。它甚至写了一行看似无用的代码:
bool ctx_server; // do NOT delete this lineGGML_UNUSED(ctx_server);意图是「让后面加代码的人不要误用 ctx_server」——因为在睡眠状态下 ctx_server 里的上下文已经释放,任何访问都是悬空指针。注释与这行空声明一起构成了编译器与审查者都能看到的「警戒线」。这是入口层里少见但很有效的防御性写法。
/v1/audio/transcriptions 这一行尤其能说明「入口层只是翻译」:它是 OpenAI 的语音转写 API,但 llama.cpp 的实现并不是直接起一个 ASR 任务,而是先把请求转换成 chat completions 的形状(convert_transcriptions_to_chatcmpl),再交给同一个 handle_completions_impl,只是响应类型标为 TASK_RESPONSE_TYPE_OAI_ASR。这样做的好处是,音频输入、多模态预处理、采样与停止条件全部复用现成的管线;代价是转录的返回结构需要在响应侧再做一次转换。task_response_type 正是承载这类差异的字段:NONE 是 llama 原生格式,OAI_CHAT/OAI_CMPL/OAI_RESP/OAI_ASR/OAI_EMBD 分别对应不同 OAI 端点,ANTHROPIC 对应 /v1/messages。同一条 COMPLETION 任务,可以通过不同的 res_type 渲染成原生、OAI chat/completions/responses、ASR 与 Anthropic 多种协议格式——这也是 llama.cpp 用一份管线同时兼容多种协议的核心手法。
GCP 兼容层:把 handler 表镜像成一组别名
register_gcp_compat 是一个比较特殊的注册函数。它是否启用由 gcp_params 的构造函数决定,而那里读的是 AIP_MODE:
enabled = getenv("AIP_MODE", "") == "PREDICTION";path_predict = getenv("AIP_PREDICT_ROUTE", "/predict", true); // 自动补前导斜杠port = std::stoi(getenv("AIP_HTTP_PORT", "8080"));也就是说,只有在 Vertex AI 的预测容器环境(AIP_MODE=PREDICTION)里,/predict 端点才会被注册,默认路径 /predict、默认端口 8080;AIP_HEALTH_ROUTE 为空时沿用 llama.cpp 自己的 /health。启用后,它把每个已注册路径映射到一个 camelCase 别名,然后按请求体里的 instances 数组逐条调用内部 handler。这个设计让 llama.cpp 能被 Vertex AI 的托管容器规范直接接住。
// "/v1/chat/completions" -> "chatCompletions", "/apply-template" -> "applyTemplate"static std::string path_to_gcp_format(const std::string &path) { /* ... */ }处理流程:解析 instances 数组(上限 128),对每一项校验 @requestFormat 是字符串,把它从 payload 里删掉,改写 stream=false(GCP 不支持逐实例流式),然后找对应 handler 构造一个 server_http_req 并调用,把返回体解析成 JSON 收集进 predictions。这一层用 std::async 并发执行多个实例。
为什么这个函数必须在「所有其他路由注册之后」调用?因为它要遍历 handlers 表,为每个已存在的路径生成别名。如果提前调用,handlers 里只有自己添加的几个,别名会缺失。源码注释明确写了「Must be called AFTER all other API routes are registered」。这是「注册顺序即语义」的又一例,也提醒读者:路由表不仅是查找表,还承担了「已知有哪些端点」的元数据职责。
有一个细节容易被忽略:它调用的是 handlers.at(dispatch_path)(internal_req),也就是直接调用 server_http_context::handler_t,绕过了 ex_wrapper 的异常映射。因此它自己在 try/catch 里把异常转成 ERROR_TYPE_INVALID_REQUEST 或 ERROR_TYPE_SERVER,并保证不抛出。这是「间接调用层需要自己兜底」的教科书例子。同样的道理适用于 router 的代理:代理调用的是原始 handler,而不是包过 ex_wrapper 的版本。
实例与路由器的差异:同一个 URL,不同的后端
前面提到 router 与 instance 共享路由表。具体到 handler,差异体现在几处:
/models:router 的get_models返回已加载与可加载的模型列表;instance 的get_models返回当前这一个模型。instance 的get_models走create_response(true),并在睡眠状态下回退到cached_models,因此即使模型已卸载,/models仍然能反映卸载前的快照。/models/load、/models/unload:只有 router 注册这三个端点(POST /models、POST /models/load、POST /models/unload、GET /models/sse、DELETE /models),instance 不注册。- 推理路径:router 会把请求代理到某个子实例。代理时的认证与参数保真属于「管理器」的范畴,具体由
server-models.*决定,入口层只负责调用proxy_post。 /props:router 的get_props返回 router 自己的属性,而不是任何子模型;子模型的属性要通过/models读到。/health:如前所述,router 的is_ready在启动模型加载前就已为 true,因此健康语义与 instance 不同。- WebSocket:
/v1/realtime在 router 模式下映射到proxy_ws,代理方式与普通 HTTP 不同,因为 WebSocket 需要双向、长连接。server_http_context::ws的实现给每个连接分配一个独立的 HTTP 线程,read阻塞在那里,send可以从别的线程调用。这也解释了ws_conn的接口为什么将send注释为「thread-safe,可与其他线程的 read 并发调用」。
理解了这些差异,才能解释一个常见现象:用 router 加载模型后,客户端打到 router 的 /v1/chat/completions 能正常工作,但 /props 返回的上下文长度不是子模型的上下文长度。客户端如果依赖 /props 做容量预算,在 router 部署下需要改用 /models 加型号查询。
入口层的工程权衡:为什么不用框架
把视角拉远,llama.cpp 的入口层全部手写,没有使用 Python Web 框架或 C++ 的 Web 框架抽象,背后有三层考虑:
第一,部署形态要求「零运行时依赖」。llama.cpp 的二进制经常被放进 Docker 镜像、边缘设备、桌面应用包,多一个运行时或依赖就多一份体积和版本风险。httplib 是 header-only,JSON 库是内置的,几乎不引入外部依赖。
第二,性能目标放在推理而不是 HTTP 上。入口层不是瓶颈,简单胜于精致。用一个 std::map 存参数、一个字符串当 body、一个 unordered_map 当路由表就足够,省掉框架开销与抽象层。
第三,跨语言移植的代价。Python 框架不能直接复用,但 C++ 手写代码可以在 iOS、Android、Windows、Linux 各处复用。这也解释了为什么后来的 llama-server 能同时作为路由器、单实例、Embedding 服务、语音服务存在——同一份源码,只有角色配置不同。
代价是显而易见的:缺少自动生成的 OpenAPI,缺少统一的 schema 校验,缺少框架级的中间件扩展点。于是每新增一个端点,都要同时维护「注册表、别名表、GCP 兼容映射、文档」四份列表。这是代码量增长时最需要警惕的地方——路由表一旦成为事实上的协议定义,新增路径必须同时考虑是否要给 GCP 别名,是否要给 MCP 暴露,是否要被 router 代理。
小结
这篇的重点可以压成五句话:
server.cpp先决定角色(instance 还是 router),再填server_routes函数表,最后用同一张路由表注册;角色差异发生在 handler 内部,而不是 URL。set_pre_routing_handler在路由之前处理 CORS、加载态与 API key;加载态决定了/health的语义是「可用」而非「存活」。get_params把 query(已解码)与 path(需解码)合并成一份 map,decode_path_component补上 httplib 对路径参数不做解码的空白。server_http_req是一个扁平化的视图,body 不在 HTTP 层解析,should_stop是客户端断开的唯一信号。ex_wrapper把invalid_argument与 JSON 错误映射为 400,其他为 500;handler 内部再通过json_value把类型错误的可选参数宽容成默认值,必填字段则用.at()抛出 400。
对后续源码阅读来说,这几条足以避免最常见的两类误读:把 URL 参数当万能覆盖层(实际是「哪个端点用哪个源」),以及把 /models 当成本地推理端点(router 下它是管理器接口)。
还有一个更结构化的认识:入口层并不只是「把 JSON 转成 task」,它在 server-task.h 的 server_task_type 上做了一次分派。这个枚举覆盖了 18 种任务,从推理本身(COMPLETION、EMBEDDING、RERANK、INFILL、TTS、TRANSCRIBE_RT、REALTIME),到状态操作(CANCEL、CONTROL、METRICS、SLOT_GET/SAVE/RESTORE/ERASE、GET_LORA、SET_LORA),再到框架自己的推进(NEXT_RESPONSE)。入口层的每个 handler 本质上只是从「HTTP 方法 + 路径 + body」里挑出正确的任务类型,并把字段填进对应的参数结构体。理解了这条对应关系,读后面任何一篇关于调度或槽位状态机的文章时,都能立刻定位到「这是哪一类任务在跑」。
下一篇将转入请求生命周期的下一段:server_http_req 进入 handler 后,如何经 server_res_generator 与 server_task 的父子关系成为调度器可见的实体,以及在 router 场景下代理请求的进程边界与身份保持。
参考资料
- llama.cpp tools/server/server-http.cpp
- llama.cpp tools/server/server.cpp
- llama.cpp tools/server/server-http.h
- llama.cpp tools/server/server-context.cpp
- llama.cpp tools/server/server-common.h
- cpp-httplib 官方仓库
- Vertex AI 自定义容器预测规范(AIP_PREDICT_ROUTE)
- llama.cpp 官方文档:llama-server
- llama.cpp tools/server/server-task.h
- llama.cpp tools/server/server-common.cpp
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



