


SGLang 源码完全拆解(九):CUDA Graph 与编译路径——解码整图捕获、Prefill 分段图与静态形状约束
接上一篇:后端就位之后,图机制还缺什么
系列第八篇把注意力后端的契约讲完了:AttentionBackend 用 init_forward_metadata_out_graph / init_forward_metadata_in_graph 两个方法族,把「每轮重算的元数据」拆成「主机侧准备」和「可以录进图的设备侧算子」;用 init_cuda_graph_state 预分配地址固定的缓冲;用 get_cuda_graph_seq_len_fill_value 决定捕获时 seq_lens 填什么值;再用 SharedReadEnds 声明自己什么时候读完调度器共享的数据。那一篇反复出现一个词——Breakable CUDA Graph(BCG)——但只讲了后端在其中的配合义务,没有讲图机制本身。
这一篇补齐它。要回答的问题有三个:
- 一次 decode 前向只有几十个 kernel,为什么值得用 CUDA Graph 捕获?
- 图一旦捕获,张量地址与形状全被冻结;而推理的 batch size、序列长度每轮都在变。SGLang 怎么让动态请求落进静态图?
- prefill 的序列长度可以从 1 变到几万,整图捕获显然不可行。SGLang 的
PrefillCudaGraphRunner与 BCG 到底把图切在哪里、为什么必须切在那里?
先给出结论式的路线:SGLang 把「图」拆成三层——捕获后端(backend)负责录与放,runner 负责选桶、填缓冲、建元数据、切片输出,配置与调度 负责决定录哪些形状、以及哪些批次根本不允许走图。三层加起来只有一句话作为不变量:图内引用的每一个张量地址,在重放时必须仍然属于同一块缓冲。
为什么 decode 需要 CUDA Graph:一笔可以算清楚的账
CPU 提交一次 kernel 要花多久
GPU 计算 kernel 的耗时由硬件决定,但提交 kernel 的耗时由 CPU 与驱动决定。一次普通的 kernel launch 需要走:Python 层调用 → framework dispatch → CUDA runtime API → 驱动命令入队 → GPU 前端取出执行。这条路径在没有任何优化时的量级是每次 5–10 微秒,其中相当一部分是 CPU 侧固定开销。
这个数字对 prefill 无关紧要:一次 prefill 前向要算几千上万个 token,矩阵乘本身耗时是毫秒级,几微秒的提交开销被完全淹没。
但对 decode 就是致命的。decode 每轮每个请求只产出 1 个 token,一次前向里的矩阵乘退化成「向量 × 矩阵」,单个 kernel 只有几微秒到十几微秒的真计算量。而一轮完整前向要走遍所有层,每层包含 RMSNorm、QKV 投影、RoPE、注意力、输出投影、MLP、残差等多个算子;一个 32 层左右的模型,一轮 decode 的 kernel 数量在数百量级。于是 CPU 侧提交开销累加起来是毫秒级,与 GPU 真计算量同阶甚至更大。
这还没算 Python 的开销。SGLang 的模型前向是纯 Python 组装的:每个 nn.Module.__call__、每次 torch.empty、每个 if forward_mode.is_decode() 分支都要走 Python 解释器。对于小 batch 的 decode,Python 解释与 framework dispatch 的时间占比可以超过 50%,GPU 在两次 kernel 之间反复空转。
CUDA Graph 解决的是什么
CUDA Graph 的思路非常直接:把一串 kernel launch 录下来,之后用一个 API 调用把整串重放出去。
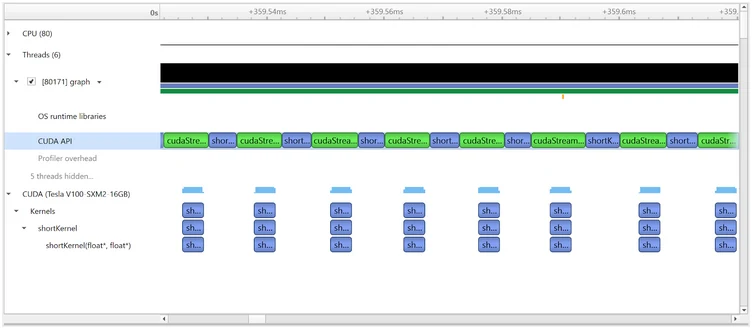
上图(来源:NVIDIA CUDA Graphs 技术博客)画的就是这次替换。左侧每个 kernel 之间都有一段 CPU 提交的空隙,GPU 在空隙里闲着;右侧整个串行流被录成一张图,重放时只需一次「graph launch」,CPU 的空隙全部消失。
NVIDIA 在那篇博客里给出了一个量化的观察:在单 kernel 尺度、batch 很小时,launch 开销可以吞掉接近一半的时间。这正是 decode 的处境。
下图是捕获与重放两种状态下的时间线对照(同源):捕获阶段要真实执行一遍并把 kernel 与依赖关系记下来;重放阶段只需发布图,所有 kernel 由 GPU 前端按记录的依赖自主调度。
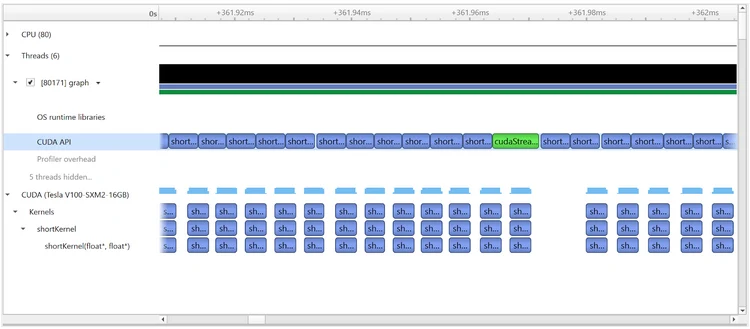
PyTorch 侧的使用方式也很简洁,官方博客给出的形态大致是:
g = torch.cuda.CUDAGraph()# 静态输入:地址固定,内容可变static_input = torch.empty(batch, device="cuda")
# warmup:多次执行,让所有 kernel / 内存池进入稳定状态for _ in range(3): s = model(static_input)
torch.cuda.synchronize()with torch.cuda.graph(g): static_output = model(static_input)
# 之后每轮:只改内容,不改地址static_input.copy_(new_input)g.replay()result = static_output
图源:Accelerating PyTorch with CUDA Graphs。这张图里有一个关键约定值得强调:static_input 是同一个张量对象。g.replay() 读的是捕获时刻记录下来的指针,所以「换输入」只能靠 copy_ 改内容,不能靠重新赋值。这个约定正是 SGLang 整个 InputBuffers 体系存在的理由。
三条硬约束,决定了后面所有设计
把上面的机制压成规则,只有三条:
| 约束 | 含义 | SGLang 的对策 |
|---|---|---|
| 地址冻结 | 图内所有张量指针在捕获时确定 | 预分配最大值缓冲,每轮只 copy_ 内容 |
| 形状冻结 | 控制流与张量形状在捕获时确定 | 按形状分桶捕获,重放时向上取整对齐 |
| 无同步 | 捕获区间内不允许出现阻塞同步、不能新建内存池 | warmup 前置、freeze_gc、禁用 memory-saver 的某些路径 |
后面讲到 capture_prepare、load_batch、PaddingPolicy、can_run_graph 时,全部可以回溯到这三条。
SGLang 图机制的三层结构
SGLang 当前把图相关的代码放在三个目录里,职责划分得很清楚:
python/sglang/srt/├── model_executor/│ ├── cuda_graph_config.py # 相位 / 后端标识 + 配置解析│ ├── cuda_graph_buffer_registry.py # FB→缓冲 的槽位注册表 + 填充分策略│ ├── input_buffers.py # 静态输入缓冲的分配与共享│ ├── graph_memory_usage.py # 捕获显存与时间的记账│ ├── runner/│ │ ├── base_runner.py # eager / graph runner 的共同基类 + warmup│ │ ├── base_cuda_graph_runner.py # 捕获编排的骨架(选桶、capture_prepare)│ │ ├── decode_cuda_graph_runner.py # 解码相位│ │ ├── prefill_cuda_graph_runner.py # 预填充相位│ │ └── shape_key.py # 图键│ ├── runner_backend/│ │ ├── base_cuda_graph_backend.py # 捕获后端的纯 ABC│ │ ├── full_cuda_graph_backend.py # 整图捕获│ │ └── breakable_cuda_graph_backend.py # 分段捕获│ └── runner_backend_utils/│ └── breakable_cuda_graph/ # BCG 的分段机制本体└── compilation/ └── torch_compile_decoration.py # 解码路径上的 torch.compile 包装要理解的是为什么要把 runner 和 backend 拆开。
runner 管的是相位语义:decode 是按请求数选的桶(capture_bs),prefill 是按 token 数选的桶(capture_num_tokens);decode 需要填 seq_lens、out_cache_loc、positions,prefill 还需要填 extend_seq_lens、extend_start_loc;decode 的输出是每个请求一行 logits,prefill 的输出是每个 token 一行 hidden states。
backend 管的是录制语义:是一整段录成一个 torch.cuda.CUDAGraph(Full),还是按注意力层切成若干段、中间插入 eager 段(Breakable)。
两者正交,所以拆成了两层。BaseCudaGraphRunner 的类注释把这件事说得很明白:subclass(decode / prefill runner)拥有一个相位,并插入一个 BaseCudaGraphBackend 来处理捕获/重放的机械动作;runner 自己负责选桶、填静态缓冲、初始化注意力元数据、分派重放、切片输出。
BaseCudaGraphBackend 则是一个纯 ABC,没有状态、没有默认实现,只声明六个方法:capture_session、capture_one、can_run、replay_session、replay、cleanup。注释里特意说明:每个实现自己持有状态、自己从构造参数里的 cuda_graph_runner 绑定需要的句柄;外层捕获循环属于 runner,不属于 backend。这条边界让「同一个 runner 换 backend」变成一行构造参数,而不是重写整套捕获流程。
图键 ShapeKey:一张图唯一标识什么
图的查找靠一个不可变数据类 ShapeKey:
@dataclass(frozen=True)class ShapeKey: # Tokens for prefill/ragged verify; requests for ordinary decode. size: int # PDMux stream, or None for a single stream. stream_idx: Optional[int] = None # LoRA or prefill-prefix variant; None selects the default. variant_label: Optional[str] = None # Independent attention variant (DSA dense/sparse, candidate_*); None is default. attention_variant: Optional[str] = None四个字段的语义是:
size:主管形状。decode 相位它是以请求数计的桶,prefill 相位它是以 token 数计的桶,ragged 投机验证时它又是某种 token 网格。同一个字段在不同相位含义不同,这是刻意的——因为录制出来的图确实由这一个维度索引。stream_idx:PDMux(prefill-decode multiplexing)下同一相位有多条 CUDA stream,每条 stream 有自己的注意力后端实例,所以要分别录。variant_label:LoRA 与 prefill 分块前缀(chunked prefix)会改变图内的 kernel 分支,必须分别录。prefill 侧的具体取值形如_chunked_prefix_variant(n)。attention_variant:DeepSeek-V4 这类模型在 dense / sparse 注意力、candidate 候选集上有不同的 kernel 路径,各自录一张。
四个维度合起来意味着图的张数会成倍增长。这解释了为什么后面 capture_bs 列表要设计得那么抠:它不是「越多越好」,而是在覆盖度和捕获显存之间取平衡。
解码整图捕获:从 warmup 到 replay 的完整链条
decode 相位是 SGLang 图机制的主战场,因为它收益最大、形状最规整。
桶列表怎么来
get_batch_sizes_to_capture 负责把配置里的桶列表过滤成实际可用的列表,返回 (capture_bs, compile_bs):
capture_bs = list(get_exec().graph.cuda_graph_config.decode.bs)num_max_requests = model_runner.req_to_token_pool.size...mul_base = get_cuda_graph_batch_size_alignment( gathered_buffer_required=gathered_buffer_required)alignment_width = captured_req_widthif get_exec().overlap.enable_two_batch_overlap: alignment_width = 1
num_max_requests = ceil_align(num_max_requests, mul_base)if max(capture_bs) > num_max_requests: capture_bs += [num_max_requests]
# Model input token count = bs * alignment_width; must be a multiple of attn_tp_size.capture_bs = [bs for bs in capture_bs if bs * alignment_width % mul_base == 0]capture_bs = [bs for bs in capture_bs if bs <= num_max_requests]capture_bs = list(sorted(set(capture_bs)))三处过滤都是有理由的:
- 对齐约束。当开启 gather 缓冲(MLP-TP gather 或 attention-TP gather)时,图内会做一次跨 rank 的 token 收集,收集后的 token 总量必须是某个对齐宽度的整数倍,否则集合通信的切分会不均匀。
captured_req_width是每个请求在图内占据的 token 宽度(普通 decode 是 1,投机解码是草稿 token 数),所以约束写成bs * alignment_width % mul_base == 0。TBO(two-batch overlap)是例外:它把每个请求的行拆到两个 micro-batch 里,对齐约束变成按请求而非按 token 行计,所以alignment_width被强制回 1。 - 请求池上限。图内的
req_pool_indices要指向 KV 池里的真实行号,行号不能超过req_to_token_pool.size。如果配置里的最大桶超过了池容量(小 GPU 或手动限制了max-running-requests时会发生),代码不是报错,而是追加一个等于池容量的桶,保证「能跑满池」这种极端情形也有图可用。 - 去重与排序。同一张图录两次没有意义,且捕获顺序影响内存池复用效果,所以去重后升序排列。
compile_bs 是从 capture_bs 里再筛一遍,只保留不超过 torch_compile_max_bs 的那些:
compile_bs = ( [bs for bs in capture_bs if bs <= get_exec().graph.torch_compile_max_bs] if get_flags().capture.enable_torch_compile else [])也就是说,同一份桶列表被两条路径共用:大桶走「纯图 + eager 前向」的捕获,小桶走「torch.compile 编译 + 捕获」的路径。为什么阈值默认是 32,后面讲 torch.compile 时会解释。
默认桶列表长什么样
桶列表的默认生成在 arg_groups/cuda_graph_hook.py 的 generate_decode_cuda_graph_batch_sizes 里:
if cfg.disable_cuda_graph_padding: capture_bs = list(range(1, max_bs + 1))elif cfg.speculative_algorithm is None: capture_bs = ( [1, 2, 4, 8, 12] + list(range(16, 257, 8)) + list(range(272, 512, 16)) + list(range(512, max_bs + 1, 32)) )else: capture_bs = ( list(range(1, 9, 1)) + list(range(10, 33, 2)) + list(range(40, 65, 4)) + list(range(72, 257, 8)) + list(range(272, max_bs + 1, 16)) )这张表本身就是一段工程结论,值得逐段读:
- 小 batch 段最密(1, 2, 4, 8, 12)。低并发场景下 batch 的绝对值小,桶间空隙的相对浪费大:实际 batch=9 对上桶 12,浪费 33%;而 batch=200 对上桶 208 只浪费 4%。所以小端必须密。
- 投机解码时更密。投机解码每轮的真实 token 数是
bs × 草稿宽度,小 batch 下真实 token 数的变化步长更大,粗桶会放大浪费,所以 1–8 逐个录、10–32 每 2 录、40–64 每 4 录。 - 大端逐步放松。512 以上按 32 间隔,是因为大 batch 下相对浪费已经很小,而每多一张图就要多占一份捕获显存(记忆池 + 静态缓冲)。
--disable-cuda-graph-padding会把桶铺满(1..max_bs 全录)。这个选项的语义是「只有形状完全一致才用图」,等价于不允许任何 padding。它的代价是图数量爆炸、捕获时间与显存随之爆炸,收益是彻底消灭了 padding 带来的无效计算。这明显是一个给特定场景(例如对延迟极度敏感、batch 分布高度集中)用的开关。
prefill 侧的默认表完全不同:
capture_sizes = ( list(range(4, 33, 4)) + list(range(48, 257, 16)) + list(range(288, 513, 32)) + list(range(576, 1024 + 1, 64)) + list(range(1280, 4096 + 1, 256)) + list(range(4608, max_bs + 1, 512)))粒度随 token 数迅速放宽,最小桶是 4 个 token、最大间隔到 512。道理相同:prefill 的 token 数是几百到几万量级,几十个 token 的 padding 在总量里占比可以忽略。
桶选择:向上取整
实际批次进来后,选桶就是一次二分:
@staticmethoddef _pad_to_bucket(raw_size: int, buckets: Sequence[int]) -> int: assert raw_size <= buckets[-1], ( f"size {raw_size} exceeds max captured bucket {buckets[-1]}; " f"can_run_graph should have rejected this batch" ) index = bisect.bisect_left(buckets, raw_size) return buckets[index]注意这里的断言顺序:先由 can_run_graph 把超限批次挡掉,再进 load_batch 选桶。如果不先挡,bisect_left 在超出所有桶时会返回 len(buckets),随后 buckets[index] 直接 IndexError,而且报错信息毫无线索。把契约写成断言,是让这条边界显式化。
捕获编排
decode_cuda_graph_runner.capture() 的整体骨架:
self.warmup()...self.buffers.seq_lens.fill_(self.seq_len_fill_value)self.buffers.seq_lens_cpu.fill_(self.seq_len_fill_value)self.buffers.reset_index_buffers()
with freeze_gc(get_exec().graph.enable_cudagraph_gc): if not self.enable_pdmux: with ( graph_capture(stream=get_or_create_global_graph_capture_stream()) as graph_capture_context, profile_context as prof, ): self.stream = graph_capture_context.stream with self.backend.capture_session(self.stream): self._capture_one_stream() else: for i, sg in enumerate(self.stream_groups): ...这段代码里有四个容易忽略但很关键的动作:
第一,seq_lens 先填成 seq_len_fill_value。 这个值来自后端的 get_cuda_graph_seq_len_fill_value(),FlashInfer 与 Triton 都返回 1。为什么不是 0:捕获阶段会真实执行一遍前向,kernel 会真的去读 seq_lens。填 0 会让某些注意力 kernel 进入零长度退化路径,甚至触发除零;填一个小的合法值(1)能让捕获走完正常的完整流程,而真正的内容在每轮重放前由 init_forward_metadata_out_graph 刷新。
第二,reset_index_buffers()。 捕获会真的跑前向,因此会真的写 KV。如果捕获发生在服务中途(例如弹性 EP 扩缩容后重捕),缓冲里可能残留上一个真实批次的索引值,捕获就会按那批索引去写 KV——写错位置。所以捕获前必须把索引类缓冲复位。
第三,freeze_gc。 捕获期间禁用 GC 并 gc.freeze() 现有对象,捕获结束再 unfreeze。原因是 GC 可能在捕获中途触发一次回收,而 GC 会触碰 Python 对象、可能间接释放 CUDA 内存;这既拖慢捕获,也可能改变内存池状态。--enable-cudagraph-gc 可以打开 GC,默认关掉。
第四,捕获顺序倒序。 _capture_one_stream 里写着:
# Reverse so cuda graphs share memory better.capture_range = ( tqdm.tqdm(list(reversed(self.capture_bs))) if get_parallel().tp_rank == 0 else reversed(self.capture_bs))PyTorch 的 CUDA Graph 从共享的私有内存池(graph pool)里分配图内中间张量。先捕获大形状,就先把大块内存从池里切走;之后捕获小形状时,池里已有的空闲块可以直接复用,不必再向全局 allocator 申请。反过来先捕获小形状,大形状仍然要新申请,池就被撑得更大。所以「从大到小」是显存最优的顺序。这一点在 prefill runner 里同样出现(capture_shapes = list(reversed(self.capture_num_tokens)))。
每个形状的捕获
capture_one_shape 的骨架是「建 dummy 批次 → 进 ForwardContext → 建元数据 → 录制」:
forward_batch, attn_backend, pp_proxy_tensors = self.capture_prepare( bs, stream_idx=stream_idx, num_tokens=num_tokens)
with forward_context(ForwardContext(attn_backend=attn_backend)): self.tbo_plugin.capture_one_batch_size(forward_batch, num_tokens=num_tokens) if forward_batch.lora_ids is not None: self.model_runner.lora_manager.prepare_lora_batch(forward_batch) attn_backend.init_forward_metadata_out_graph(forward_batch, in_capture=True)
def run_once(): attn_backend.init_forward_metadata_in_graph(forward_batch) self._record_in_graph_metadata_prep_done() ... out = forward( forward_batch.input_ids, forward_batch.positions, forward_batch, **kwargs, ) for capture_hook in self.model_runner.capture_tail_hooks: capture_hook(self, out, forward_batch, num_tokens) return out ... self.backend.capture_one( shape_key, run_once, capture_inputs=None, post_warmup_hook=post_warmup_hook, )注意 init_forward_metadata_out_graph 在 run_once 外面调用,而 init_forward_metadata_in_graph 在里面。这正是第八篇讲的「元数据两段式」:主机侧准备(涉及 Python 分支、host 端计算、可能的 .item() 同步)必须在捕获区间之外做完;只有纯设备算子才放进 run_once,才会被录进图。
如果反过来,把一个含 host 读取的元数据准备录进图,捕获会直接失败(CUDA 不允许在捕获中做同步)。第八篇里 MetadataGlueGraph 的注释把更隐蔽的失败讲了出来:某些后端的元数据准备每个重放步都要在 host 上重算值,这种后端绝不能录进图——录了不会报错,捕获成功、输出「正确」,但 host 写入的计划输入被冻结在捕获时刻的值,只有接受长度会悄悄塌掉。 这类「静默错误」是图机制里最难查的一类。
重放
每轮 decode 的入口是 execute:
with timer_ctx, self.backend.replay_session(): self.load_batch(forward_batch, pp_proxy_tensors) ... if shared_read_ends is SharedReadEnds.PRE_REPLAY: self._publish_read_done(in_graph=False)
output = self.backend.replay(self._replay_graph_key, forward_batch)
if shared_read_ends is SharedReadEnds.IN_REPLAY: self._publish_read_done(in_graph=True)
if shared_read_ends is SharedReadEnds.POST_REPLAY: self._publish_read_done(in_graph=False)
output = self._process_output_after_replay(output, forward_batch)load_batch 负责把真实批次拷进静态缓冲并算出图键,backend.replay 负责执行图,_process_output_after_replay 负责切出真实的 token 行数。SharedReadEnds 的三个时机(预重放前 / 重放中 / 重放后)就是第八篇讲的「后端自证什么时候读完调度器共享数据」,它决定了重叠调度器能提前多久准备下一轮。
输出切片是必要的:load_batch 把 batch 向上取整到桶,图算出来的是桶大小行数的结果,而真实 batch 只有 raw_num_token 行:
next_token_logits = ( output.next_token_logits[: self.raw_num_token] if output.next_token_logits is not None else None)静态缓冲体系:PaddingPolicy 为什么有五种
load_batch 一开头就选桶、然后调 buffer_registry.fill_from(...)。这个注册表是理解 SGLang 图机制的核心,因为它把「哪些槽位的 padding 区需要处理、怎么处理」变成了显式声明。
注册表的设计
CudaGraphBufferRegistry 的模块注释说得很清楚:它是 ForwardBatch 到图内缓冲的镜像,取代了原先手写的逐 runner 缓冲填充逻辑;采用 DecodeInputBuffers / PrefillInputBuffers 已经分配好的存储(同一个物理张量、data_ptr 在捕获与重放间稳定),只负责填充。后端私有的缓冲(kernel workspace、派生页表)留在 AttentionBackend.cuda_graph_* 上,注册表只管 FB 共享槽位——槽位名与 FB 属性名一一对应。
每个槽位是一个 GraphSlot:
@dataclassclass GraphSlot: name: str shape_fn: Callable[[int, int], Tuple[int, ...]] dtype: torch.dtype axis: str = "tokens" # "bs" | "tokens" | "none" device: Optional[torch.device] = None padding_policy: PaddingPolicy = PaddingPolicy.FOREACH_COPY pad_value: Optional[Any] = None enabled: bool = True copy_from_fb: bool = True post_fill: Optional[Callable[[torch.Tensor, ForwardBatch, FillContext], None]] = None slice_fn: Optional[Callable[[torch.Tensor, int], Tensor]] = None source_fn: Optional[Callable[[ForwardBatch, FillContext], Optional[torch.Tensor]]] = None几个字段值得展开:
axis:槽位在 batch 轴([:bs])还是 token 轴([:num_tokens])切片,或者不切片(全局计数类)。批量填充时按轴分组,才能一次性foreach_copy_。slice_fn:非平凡布局的切片覆盖,例如mrope_positions形状是[3, T],要沿 1 轴切而不是 0 轴。copy_from_fb:默认True表示「把 FB 上同名张量拷进缓冲头部」。设成False用于算出来的槽位(如global_num_tokens_*),它们的值不来自 FB 拷贝,由post_fill算出。source_fn:拷贝源不是同名 FB 属性时的覆盖。例如流水线并行的 proxy 张量根本不在 FB 上,而是作为load_batch的独立参数传入、挂在FillContext上;再如 ngram embedding 的信息嵌在 FB 的嵌套 dataclass 里。这类槽位用点号命名,并被extract_buffer跳过。
五种 PaddingPolicy
这是全篇最值得记住的一张表。当真实长度 raw_n 小于桶长度 padded_n 时,多出来的尾巴怎么处理:
| 策略 | 语义 | 典型槽位 |
|---|---|---|
KEEP_PAD | 保持原样,调用者证明尾巴不会被读 | 已证明安全的槽位 |
FILL_SENTINEL | 拷前先用 pad_value 重置尾巴 | seq_lens(填 seq_len_fill_value) |
ZERO | 尾巴清零 | out_cache_loc、req_pool_indices |
FOREACH_COPY | 只拷 raw_n,尾巴保持上一轮或初始化的内容 | 默认 |
FILL_ONCE | 分配时整体填一次 pad_value,之后每轮不再重置 | encoder_lens |
逐个解释「为什么」:
为什么 seq_lens 要 FILL_SENTINEL。 补齐出来的假请求,其真实 KV 长度是 0,但图内 kernel 不能读 0(第八篇讲过:零长度会让某些 kernel 退化、甚至除零)。填 1 让 kernel 走完整的合法路径,算出来的结果落在被丢弃的尾部。这个值是后端声明的,不是 runner 硬编码——因为不同后端对「最小合法长度」的要求不同。
为什么 out_cache_loc 和 req_pool_indices 要 ZERO。 这是最关键的一条。out_cache_loc 是写 KV 的目标槽位:图内注意力 kernel 会按它把当前 token 的 K/V 写进 KV 池。补齐出来的假行如果不处理,其值就是上一轮真实批次留下的槽位号——图会照着写一遍,把别人已经算好的 KV 覆盖掉。清零的语义是「指向槽位 0」,一个安全、无害的目标。注释原话是:padded rows must point at slot 0 so dummy attention reads land harmlessly。
req_pool_indices 同理:它指向 req_to_token_pool 里的请求行,kernel 用它查页表。假行指向第 0 行,读到一份合法但无意义的映射,不会越界。
为什么有 KEEP_PAD 和 FOREACH_COPY 的分工。 FOREACH_COPY 是默认:只拷真实部分,尾巴不管。这依赖调用者证明「尾巴不会被读」或「被读也无害」。KEEP_PAD 更显式地把这个责任写在策略名上,用于那些已经被证明尾部安全的槽位——写成 KEEP_PAD 而不是默认值,是为了让审阅者一眼看到「这里有人做过论证」。
为什么 encoder_lens 要 FILL_ONCE。 encoder-decoder 模型的 cross-attention 需要每个请求的 encoder 长度,图内用 encoder_len_fill_value(来自 max_source_positions)非零填充,保证 cross-attention kernel 被真实录进图。这个值在整个生命周期里不需要变,所以只在分配时填一次。
fill_from 的执行分两阶段,注释里写明:阶段一按每个槽位的策略重置 padding 尾巴;阶段二按 (dst_dtype, src_dtype) 分组做 torch._foreach_copy_——一次 foreach 调用要求 dtype 对一致,所以先分组。分批的原因是:一轮重放要填几十个槽位,逐个 copy_ 就是几十次 kernel launch,正好抵消了图带来的收益;分成几组 foreach 可以把内核数压到一个很小的常数。
元数据 glue graph:把「op 汤」也录进去
即使模型前向已经录进图,每轮重放前仍然要在 host 上跑一遍 init_forward_metadata_out_graph。在 bs=1 的投机解码场景下,这段元数据准备是几十个极小张量算子,host 侧 dispatch 开销主导了 prefill-decode 之间的接缝。
MetadataGlueGraph 就把这段也录下来:
def run(self, attn_backend, fb_view, key) -> None: st = self._states.get(key) ... if st["graph"] is not None: for backend, metadata in st["meta"]: backend.forward_metadata = metadata st["graph"].replay() return
if st["warmups"] < self.NUM_WARMUP: st["warmups"] += 1 attn_backend.init_forward_metadata_out_graph(fb_view) return
graph = torch.cuda.CUDAGraph() try: with torch.cuda.graph(graph, stream=self._capture_stream): attn_backend.init_forward_metadata_out_graph(fb_view) except Exception: logger.warning(...) self.disabled = True attn_backend.init_forward_metadata_out_graph(fb_view) return
st["meta"] = [(b, b.forward_metadata) for b in self._leaves(attn_backend)] st["graph"] = graph graph.replay()三个设计点:
- Python 副作用用快照 + 重装解决。元数据准备会写各后端的
forward_metadata对象(这是 Python 属性),而图只录设备算子。所以捕获时把forward_metadata快照下来,每次重放前重新装回后端,再graph.replay()刷新它指向的张量内容。 NUM_WARMUP = 2次 eager 前置,让 Triton 的 JIT 编译与 autotune 在捕获之外完成。捕获区间内不允许编译(编译会做同步与内存分配)。- 捕获失败就永久禁用并回退 eager。注释里点名了必须被排除的一类:DFlash 家族的 host-fed fast verify plan——它的计划输入是 host 每轮写的,录进图会被冻结。而且失败是静默的:捕获成功、输出正确、只有接受长度塌掉。所以调用方必须在路由前就把这种配置排除(
decode_cuda_graph_runner对 DFlash 家族强制禁用 glue)。
MetadataGlueGraph 只在严格条件下才被路由到:raw_bs == bs(无 padding)、TBO / pdmux / LoRA 全关、且图键里带上 actual_forward_mode——因为 DSV4 的重放准备在运行时模式为 IDLE 时会替换 seq_lens / req_pool_indices / out_cache_loc,IDLE 与活跃 DECODE 是不同的 Python 分支,不能共用一张录好的 glue 图。
can_run_graph:一张准入清单
DecodeCudaGraphRunner.can_run_graph 是一串守卫,任何一条不满足就退回 eager:
def can_run_graph(self, forward_batch: ForwardBatch): if forward_batch.replace_embeds is not None: return False ... spec_info = forward_batch.spec_info if ( spec_info is not None and spec_info.num_tokens_per_req > 0 and spec_info.num_tokens_per_req != self.captured_req_width ): return False
if self.require_mlp_tp_gather: cuda_graph_bs = self._max_dp_batch_size(forward_batch) else: cuda_graph_bs = forward_batch.batch_size ... is_bs_supported = ( self.backend.can_run(forward_batch, graph_key) if self.disable_padding else cuda_graph_bs <= self.max_bs ) ... return ( is_bs_supported and is_encoder_lens_supported and is_tbo_supported and is_ngram_supported )逐条解释:
replace_embeds直接禁:这是逐请求动态覆盖 token embedding 的功能,图内没有对应形状的输入槽位。- 每请求宽度必须一致:投机解码里每个请求携带的 token 数(草稿宽度)必须等于捕获时用的
captured_req_width。图是按固定宽度录的,宽度不匹配整张图就作废。 - DP 场景下用全局最大 batch:开 MLP-TP gather 时各 DP rank 要一起跑图,选取的桶必须覆盖所有 rank 里最大的那个 batch,否则某些 rank 的图会装不下。
- padding 关闭时改问 backend:
--disable-cuda-graph-padding语义是不允许 padding,此时判断条件从「不超过最大桶」变成「这个精确形状有图」(backend.can_run就是shape_key in self._graphs)。 - encoder_lens 必须全为正:encoder-decoder 不支持混合 batch(
encoder_len = 0),因为图内 cross-attention 的掩码张量在混合情形下没有正确形状。 - TBO / ngram 各自的附加条件:TBO 有自己的子批次约束;ngram embedding 投机要求
batch_size * captured_req_width == input_ids.numel(),即输入确实是规整的定宽排布。
这串守卫的存在说明一件事:图是一条快速路径,而不是唯一路径。任何一条约束不满足,批次就落回 EagerRunner,功能永远正确,只是慢一点。这是工程上的正确取舍——图机制引入了大量「必须成立的隐含前提」,与其在每条前提上做特判,不如承认图是「形状规整、无特殊功能」子集的专用通道。
Prefill 分段图:为什么整图捕获不可行
prefill 相位的处境与 decode 完全不同,这才是 BCG 存在的根本原因。
两个绕不开的特征
特征一:形状连续变化且范围极大。 prefill 的 token 数从 1 到几万,不可能像 decode 那样「用几十个桶覆盖」。SGLang 的做法是分桶 + 向上取整,并给 padding 浪费设一个上限:
# No exact-shape check: load_batch bucket-pads; only reject disproportionate padding waste.padded_num_tokens = self._pad_to_bucket(num_tokens, self.capture_num_tokens)if padded_num_tokens > num_tokens * _MAX_PREFILL_CUDA_GRAPH_PADDING_FACTOR: return False特征二,也是决定性的特征:prefill 的注意力是「变长」的。 decode 时每个请求的 query 长度固定为 1(或投机时的固定宽度),不同请求只在 KV 长度上不同,而 KV 长度的差异可以被分页注意力 + kv_indptr 自然吸收,图内的 kernel 形状依然统一。prefill 则不同:每个请求的 query 长度各不相同(从几十到几万),且因果掩码的形状随之变化。FlashAttention 这类 kernel 是按 query 分块在 grid 上展开的,query 长度直接决定 grid 与执行路径。
结论:把 prefill 的注意力层录进 CUDA Graph,要求所有请求的 query 长度完全一致。 但真实服务里的请求长度是连续分布,这就意味着捕获只能覆盖「所有人长度恰好相同」这个测度为零的情形。于是要么放弃图,要么不录注意力层。
分段捕获 BCG 把图切在哪里
BreakableCudaGraphBackend 的类注释直接给出了答案:
Segmented capture: graphs break at attention / mamba boundaries; attention metadata is recomputed at replay outside captured segments.
机制本体在 runner_backend_utils/breakable_cuda_graph/breakable_cuda_graph.py。核心是 @eager_on_graph 装饰器:
def eager_on_graph(fn=None, capture_stub=None, *, enable=None): def decorator(inner: Callable): @functools.wraps(inner) def wrapper(*args, **kwargs): capture = _current_capture_var.get() if capture is None: return inner(*args, **kwargs)
# End the segment that captured up to this break point. capture._end_current_segment()
# Re-sync ranks after segment teardown before break fns with # rank-coupled collectives and hard timeouts。 if capture._barrier_fn is not None: capture._barrier_fn()
if capture_stub is not None: output = capture_stub(*args, **kwargs) else: output = inner(*args, **kwargs)
captured_inner = inner captured_args = tuple(_weak_ref_if_tensor(a) for a in args) captured_kwargs = {k: _weak_ref_if_tensor(v) for k, v in kwargs.items()} captured_output = output
def replay_fn(): new_out = captured_inner(*captured_args, **captured_kwargs) return _copy_output(captured_output, new_out)
capture.cuda_graph._break_fns.append(replay_fn)
# Start a fresh CUDAGraph segment for the remainder of the forward. capture._begin_new_segment() return output
return functools.update_wrapper(_EagerOnGraphCallable(wrapper, inner), inner)
return decorator(fn) if fn is not None else decorator逐步拆开这段逻辑:
第一步,结束当前段。 _end_current_segment() 对当前 torch.cuda.CUDAGraph 调 capture_end(),把它追加进 BreakableCUDAGraph._segments。注意注释里那句:A segment that enqueued no kernels captures an empty graph, which replays as a no-op——两个断点紧挨着会录出一张空图,重放是空操作,无害;torch 每次都会对空图发警告,所以这里显式过滤掉了那个警告。
第二步,跨 rank 屏障。 断点处各 rank 要分开录制,段拆除是个「慢且耗时可变」的步骤。如果断点函数里有与 rank 耦合的集合通信且带硬超时(注释点名 DeepEP NORMAL 的 100 秒超时),一段录得快、另一段录得慢就会把对端拖到超时。所以在段拆除后插一次 tp_group.barrier()。这个屏障只在捕获期需要,重放期不走这个 wrapper。
第三步,执行断点函数(真身)。 断点函数在这里被真实执行一次,目的是让它的输出被分配出来、地址被记录下来。同时,被捕获段产出的中间张量用弱引用记录(_weak_ref_if_tensor)——因为它们的存储被段的 CUDAGraph mempool 的 use-count 钉住了,Python 侧不必强引用。但断点函数的输出必须强引用(captured_output = output),因为它是「下一个被捕获段的静态输入地址」,需要跨重放存活。
第四步,登记重放函数。
def replay_fn(): new_out = captured_inner(*captured_args, **captured_kwargs) return _copy_output(captured_output, new_out)重放时真实调用断点函数(用弱引用拿回的捕获期参数),把结果 _copy_output 拷进当初记录的那块桥接缓冲。也就是说:断点在捕获期与重放期都会真跑,且都写到同一块地址。
第五步,开新段。 _begin_new_segment() 新建一个 torch.cuda.CUDAGraph,capture_begin(pool=..., capture_error_mode="global")。新段与旧段共用同一个 memory pool(构造函数里的 self._pool),所以段间分配的中间张量可以复用池里的空闲块——注释说明:任何段存活时,它的 beginAllocateToPool 都让 mempool 的 use_count 保持大于 0,因此对段内分配张量做 weak_ref_tensor 在后续重放中是安全的。
BreakableCUDAGraph.replay() 就是把二者交替跑一遍:
def replay(self) -> None: stream = get_device_module().current_stream() token = _current_stream_var.set(stream) try: for i, seg in enumerate(self._segments): seg.replay() if i < len(self._break_fns): self._break_fns[i]() finally: _current_stream_var.reset(token)断点插在哪里:注意力层
断点函数由 @eager_on_graph 标注在注意力层与 mamba 层上(backend 注释原话:eager break markers (eager_on_graph decorators on attention / mamba layers))。于是 prefill 的一次前向被切成:
[段1: embedding + layer0 的 norm/qkv/rope] → eager: layer0 注意力(读真实元数据)[段2: layer0 o_proj + MLP + layer1 前半] → eager: layer1 注意力...[eager tail: lm_head + logits 处理]每个被捕获段内的张量形状是静态的:hidden states 的 token 数就是捕获桶大小,权重形状不变。唯一随请求变化的注意力计算被赶到 eager 段里,它可以自由读真实的 extend_seq_lens / extend_start_loc / block table。
这个结构的收益是:Transformer 主体的所有线性层、norm、激活,占了一次前向上绝大部分的 kernel 数量与计算量,全部进了图;只有注意力层(数量上只有每层一个)留在图外。
为什么这仍然值得
有人会问:既然注意力层还是 eager,收益是不是就打折了?
打折,但仍然显著。理由有三:
- 注意力层是变长的,且通常被高度优化过。 FlashAttention / FlashInfer 的 prefill kernel 一次 launch 就覆盖整个变长 batch,kernel 数量本来就少(每个注意力层 1–2 个 launch)。其余部分——每一层的多个线性投影、RMSNorm、激活、残差——才是「碎 kernel」的大头,数十倍于注意力层数。
- prefill 的 chunked prefill 让形状集中在少数几个值。 SGLang 默认按
chunked_prefill_size切分长提示,真实 prefill 桶常常是「一整块」或「一小块」,命中率不低。 - BCG 与 prefill 是默认开启的(在 CUDA 上):
def default_prefill_backend() -> str: """Enable BCG by default on CUDA; other platforms remain opt-in.""" from sglang.srt.utils import is_cuda
return Backend.BREAKABLE if is_cuda() else Backend.DISABLED而 decode 默认是 Backend.FULL(整图)。这个默认值的分工本身就是结论:decode 用整图(形状规整、收益最大),prefill 用分段图(必须绕开变长注意力)。
BCG 的额外约束与配套机制
分段捕获带来了几个整图没有的约束:
一、与 memory saver 不兼容。 BreakableCudaGraphBackend.__init__ 直接抛 NotImplementedError:
if ( self._memory_saver_adapter is not None and self._memory_saver_adapter.enabled): raise NotImplementedError( "Breakable CUDA graph is not compatible with memory saver mode" )原因是 memory saver 的暂停/恢复会对图池做 CPU 备份,而分段捕获的跨段引用语义(弱引用 + 桥接缓冲)让「恢复后地址仍有效」这个隐含前提不再可靠。
二、需要 post-warmup hook。 BCG 的 capture_one 会跑两次 warmup,并在每次之后调用 post_warmup_hook:
warmup_out = Nonefor _ in range(2): self._device_module.synchronize() self._tp_group.barrier() with self._precarve.measure(): warmup_out = forward_fn() if post_warmup_hook is not None: post_warmup_hook()这个 hook 的作用是「重置被 warmup 改动的后端状态」。prefill runner 里有一段具体的例子:mamba 池在 warmup 中被写入,如果不清理,第二次 warmup 和真正的捕获就会读到脏状态:
if isinstance(self.backend, BreakableCudaGraphBackend): post_warmup_hook = None req_pool = self.model_runner.req_to_token_pool mamba_pool = getattr(req_pool, "mamba_pool", None) if mamba_pool is not None and not prefix_num_chunks: capture_state_indices = req_pool.translate_mamba_indices( req_pool.get_mamba_indices(forward_batch.req_pool_indices) ).unique()
def post_warmup_hook(): mamba_pool.clear_slots(capture_state_indices)
post_warmup_hook()注意这里的写法:hook 先被手动调用一次,再作为参数传给 capture_one(后者在两次 warmup 后各调一次)。因为 capture_one 的第一段 warmup 前没有 hook 机会,脏状态必须在进入前先清一遍。
三、BCG 只捕获 Transformer 主体,不捕获 lm_head。 prefill runner 的 _run_forward 注释:
BCG path: captures only the inner layer_model.forward (transformer stack), excluding the outer model.forward tail (logits_processor / pooler). The captured output is bs=1 hidden states; replay then runs the outer tail eagerly with live multi-req metadata.
原因是显存:如果把 lm_head 与 logits 处理也录进图,图内就要绑定一块形状为 (req_slots, vocab_size) 的输出缓冲,几十万词表乘以请求槽位数是几百 MB 到 GB 级,而且必须按最大请求槽位分配。把尾巴留在图外 eager 跑,图的输出就只是 hidden states,形状只跟 token 数有关,req_slots 不再约束缓冲大小。
这段注释还提到同一函数里 @torch.no_grad 是刻意补上的:外层 *ForCausalLM.forward 本身带这个装饰器,但 BCG 直接调 layer_model.forward 就绕过了它,导致某些 MoE 的 @torch.compile kernel(torch.sum(out=...))在 dynamo 里报「out= doesn’t support autograd」,mamba 状态算子也会莫名开始追踪梯度。
Prefill 的重放准入
prefill 的重放判定被集中到一个函数 can_replay_locally,它的 docstring 讲清了为什么要集中:
Rank-local replay eligibility: the single source of truth for
can_run_graph(ForwardBatch, forward time) and the dp mlp-sync vote (ScheduleBatch, schedule time) — all dp ranks must reach the same replay-vs-eager decision or their collectives mismatch.
这是 prefill 图与 decode 图最大的结构差异:prefill 的判定必须提前到调度时刻。 DP attention 下所有 rank 要一起进入集合通信,如果 rank A 重放图、rank B 走 eager,通信就分叉了。而重放与否取决于 num_tokens、prefix_lens、return_logprob 等必须等批次组好才知道的信息,所以判定函数被抽出来,让调度期的投票与执行期的判断用同一个逻辑(注释里叫 “dp mlp-sync vote”,以 ScheduleBatch 为输入)。
判定条件里几个值得注意的:
if self._is_full_backend and self._fa4_prefill and contains_mm_inputs: return False...if lora_ineligible: return Falseif is_mixed and getattr(self, "prefer_eager_mixed_prefill", False): return Falseif input_embeds is not None: return Falseif replace_embeds is not None: return False...if is_target_verify: return Falseif ( capture_hidden_mode is not None and self.capture_hidden_mode < capture_hidden_mode): return Falseif return_logprob and not self._uses_eager_prefill_tail(): return Falsefor context_limit in (self.max_context_size, self.max_seq_len): if context_limit is not None and ( batch_max_context_len is None or batch_max_context_len > context_limit ): return False- 多模态输入在某些后端下禁:Full 图重放会绕过
forward_extend里的 Python 图像掩码守卫,FA4 的完整图路径尚未支持,所以保持 eager。 - LoRA 不合格则禁:LoRA 重放需要
prepare_lora_batch建好的静态元数据;在 DP attention 下 LoRA prefill 在所有 rank 上都保持 eager,保证投票一致。 - mixed batch 在特定组合下禁:BCG + DP attention 时倾向 eager mixed prefill。
return_logprob有讲究:它只在图外有 eager 尾巴时才能重放——因为 logprob 要在图外对完整 logits 做处理。- 上下文长度双上限:
max_context_size与max_seq_len两个都要判,注释原话是 “Vote on both bounds so DP ranks agree on graph versus eager”。原因是 DeepSeek-V4 的上下文形状元数据与 indexer logits 是按固定max_context_size分配的,而max_seq_len是另一维约束;两个上限不同时满足会导致 rank 间决策不一致。
分块前缀的额外拓扑
当启用 full_prefill_prefix_chunk_tokens(注释里叫 chunked-prefix),Full prefill 图会额外捕获不同 Cached Prefix 拓扑的变体:
Only meaningful for Full prefill CUDA graphs that capture a distinct cached-prefix topology: aggregate cached-prefix tokens represented by one fixed-capacity chunk across all request slots. FullCG captures 1/2/4/8/16 chunk variants and chooses the smallest one covering a batch.
也就是说,请求命中 RadixCache 的前缀长度也会影响图内 kernel 的形状,所以按「一个固定容量的 chunk」为单位录 1/2/4/8/16 五种变体,重放时选最小的能覆盖的那一个。这解释了 ShapeKey.variant_label 为什么要存在。
配置层:相位、后端与自动降级
图机制的配置被抽象成一棵显式的数据结构,而不是一堆散落的布尔开关。
cuda_graph_config.py 定义了两个枚举:Phase(decode / prefill)与 Backend(tc_piecewise / full / breakable / disabled),以及每相位允许的后端集合与键集合:
ALLOWED_KEYS_PER_PHASE = { Phase.DECODE: ("backend", "max_bs", "bs"), Phase.PREFILL: ( "backend", "max_bs", "bs", "max_context_size", "full_prefill_max_req", "full_prefill_prefix_chunk_tokens", "max_seq_len", ),}这是一个很有信息量的对照:decode 相位的配置面只有三个键,prefill 相位有七个。 prefill 图天生更复杂——它需要单独控制「请求槽位数」(full_prefill_max_req)、「缓存前缀拓扑」(full_prefill_prefix_chunk_tokens)、「上下文上限」(max_context_size / max_seq_len);decode 只需要「多大桶」。这与前面「decode 形状规整、prefill 形状多变」的判断完全一致。
PhaseConfig 里几个字段的注释值得抄下来:
# Only meaningful for the prefill phase with backend == full: max number of# request slots baked into each captured graph. Real bs <= full_prefill_max_req# reuses the graph (unused slots become zero-length sentinels); larger# batches fall back to eager. Ignored by BCG. None# auto-derives chunked_prefill_size // 512.full_prefill_max_req: Optional[int] = None「未使用的请求槽变成零长度哨兵」这句话解释了 Full prefill 图的一个设计:请求轴被固定为 full_prefill_max_req,真实 batch 小于它时,多余的行用零长度请求填充,load_batch 里对每条请求的 extend_seq_lens 补 0——kernel 读到零长度就自然跳过。
外部接口是 --cuda-graph-config 这个 JSON 参数:
--cuda-graph-config '{ "decode": {"backend": "full", "max_bs": 256}, "prefill": {"backend": "breakable"}}'以及一组便捷单相位参数(--cuda-graph-backend-decode、--cuda-graph-max-bs-prefill、--cuda-graph-bs-decode……)。解析器有两条设计原则写在代码注释里:
- JSON 优先于便捷参数,便捷参数优先于历史开关。
to_dict()只输出与默认值不同的字段(diff-only,不是asdict),因为解析器会「锁定它看到的每一个 (phase, key)」,输出默认值会锁住调用者从未设置的字段,破坏后续自动降级。
这个「锁定」机制是配置层最巧妙的一处。explicit_keys_in 收集用户显式给过的 (相位, 键) 元组,自动降级级联会跳过被锁定的键:
# 自动降级时:if (Phase.PREFILL, "backend") not in server_args._cuda_graph_config_locked: declare_resolution(..., cuda_graph_config=with_phase(cfg, Phase.PREFILL, backend=Backend.DISABLED))也就是说:如果用户显式说了 prefill 用什么后端,系统就不再替他做「这个配置不兼容,帮你关掉」的决定;反之,如果用户没表态,系统可以自由降级并打日志。这条规则解决了「自动降级覆盖用户意图」这个经典冲突。
自动降级:什么时候必须关掉图
arg_groups/cuda_graph_hook.py 里有一族 apply_* / disable_* 函数,代表性的是:
disable_breakable_cudagraph_if_incompatible:BCG 有一张不兼容规则表,命中就降级。从源码里的分支看,涉及 prefill context parallelism + pipeline parallelism 的组合、非标准 GQA 层、LoRA 后端能力不足等。disable_full_prefill_cudagraph_if_incompatible:注释写得很直白——Full prefill CG: empty rule list today,目前是空规则表,即 Full prefill 还处在「实验性、无自动降级规则」的阶段。disable_prefill_cuda_graph_for_deepseek_trtllm_mla:在使用trtllm_mla后端时默认关掉 prefill 图。apply_deepep_adjustments:DeepEP 需要对齐的桶,会把max_bs or 2048转成generate_prefill_cuda_graph_batch_sizes(max_bs)。apply_cuda_graph_disaggregation_roles:PD 分离下按角色关掉对应相位——prefill 实例关 decode 图,decode 实例关 prefill 图:
if cfg.disaggregation_mode == "prefill": if (Phase.DECODE, "backend") not in server_args._cuda_graph_config_locked: declare_resolution(..., cuda_graph_config=with_phase(cfg, Phase.DECODE, backend=Backend.DISABLED))理由直接:PD 分离后,prefill 实例永远只跑 prefill,decode 实例永远只跑 decode。给 prefill 实例录 decode 图纯粹是浪费显存、浪费启动时间。
在 runner 构造层面还有一层兜底。capture_prefill_graph 里有一长串 return-to-eager 的分支:
if check_cuda_graph_backend(Phase.PREFILL, Backend.DISABLED): ... return result(eager_runner)try: language_model = resolve_language_model(model_runner.model)except AttributeError: logger.warning("Disable prefill CUDA graph because the model is not a language model") return result(None)if not get_exec().graph.cuda_graph_config.prefill.bs: logger.warning("Disable prefill CUDA graph because the capture size is not set") return result(None)...if not has_standard_gqa_for_all_local_layers(...): log_info_on_rank0(logger, "Disable prefill CUDA graph because some layers do not apply Standard GQA") return result(None)其中「非标准 GQA」这条尤其能说明图的边界:注意力层如果用了非标准的 query/key/value 头排布,图内 kernel 的 reshape 布局就不通用,图机制直接放弃这个模型。
与 torch.compile 的协同
SGLang 的图机制并不孤立,它与 torch.compile 有一层配合关系。
decode 路径:小桶直接编译
_capture_one_stream 里对每个桶包了一层 patch_model:
with torch_compile_decoration.patch_model( self.model_runner.model, bs in self.compile_bs, num_tokens=bs * self.captured_req_width, tp_group=get_parallel().tp_group,) as forward: self.capture_one_shape(bs, forward, stream_idx, variant_label, attention_variant)patch_model 的行为是「落在编译桶里就返回一个被 torch.compile 包过的 forward,否则返回原始 forward」:
@contextmanagerdef patch_model(model, enable_compile, num_tokens, tp_group): backup_ca_comm = None try: if enable_compile: _to_torch(model, reverse=False, num_tokens=num_tokens) backup_ca_comm = tp_group.ca_comm yield torch.compile( torch.no_grad()(model.forward), mode=os.environ.get( "SGLANG_TORCH_COMPILE_MODE", "max-autotune-no-cudagraphs" ), dynamic=_is_hip and get_bool_env_var("SGLANG_TORCH_DYNAMIC_SHAPE"), ) else: yield model.forward finally: if enable_compile: _to_torch(model, reverse=True, num_tokens=num_tokens) tp_group.ca_comm = backup_ca_comm三处细节:
max-autotune-no-cudagraphs这个 mode 名字很关键。max-autotune会做自动调优(对候选 kernel 配置做 benchmark),而-no-cudagraphs后缀明确禁止 Inductor 自己再做一层 CUDA Graph 包装——因为外层 SGLang 已经在录图了,两层图嵌套是无效也是危险的。- 编译前后切换融合算子:
_to_torch递归遍历模型,把BaseFusedOp子模块在「编译态」与「普通态」之间切换(enter_torch_compile(num_tokens=...)/leave_torch_compile())。原因是某些融合算子在编译态下需要暴露可被 Dynamo 追踪的实现,而运行时用高度手写 kernel。 tp_group.ca_comm被备份并临时置空:编译期间的追踪不应触发自定义 all-reduce 的图缓冲注册(那个注册必须在捕获上下文之外完成,否则与custom_all_reduce.register_graph_buffers死锁——BaseRunner.warmup的注释也专门警告过这一点)。
torch_compile_max_bs 默认 32 的理由由此清楚:Inductor 对每个新的形状都要重新编译一份 kernel,编译桶里每多一个 batch size,就多一份编译产物与编译时间(启动耗时)。小 batch 的收益最大而形状种类最少,所以只在 32 以下编译;大 batch 靠 CUDA Graph 本身的收益就够了。
prefill 路径:编译是另一条腿
prefill 侧的结构更微妙。_run_forward 的注释把两条路径摆在一起:
BCG path: captures only the inner layer_model.forward (transformer stack),excluding the outer model.forward tail ...TC_PIECEWISE path: captures the outer model.forward; torch.compileFX-traces produce bs-invariant kernels.tc_piecewise 是第三种捕获后端,它的思路是「用编译把形状敏感性消除掉」:让 torch.compile 把模型追踪成 FX 图,Inductor 生成的主 kernel 用 bs-invariant 的循环结构(用 tl.range 之类表达动态行程),于是同一份编译产物能服务多个 batch size,图内形状不再随桶变化。这就是 “piecewise” 与 “bs-invariant” 的含义。
不过当前代码里 tc_piecewise 已经退役。cuda_graph_config.py 的解析器会直接拒绝:
if phase_settings.get("backend") == "tc_piecewise": raise ValueError( "tc_piecewise was removed; select breakable, full, or disabled" )if "tc_compiler" in phase_settings: raise ValueError("tc_compiler was removed with tc_piecewise")Backend.TC_PIECEWISE 字段本身还留着,注释是 Temporary internal name while unreachable legacy branches are removed。prefill 的默认现在是 BCG,Full 是可选的实验路径。
这个演变的信号值得注意:「编译 + 整图」这条路线在 prefill 上被「分段 + 绕开变长算子」取代了。原因不难推断——编译路线要求把变长注意力也表达成图内可重放的 kernel,这需要后端 kernel 本身支持「形状由张量内容决定」;而分段路线只需要在 Python 层面把注意力层摘出去,工程复杂度低得多,对后端的改动也小。
编译与捕获的顺序:warmup 先行
BaseRunner.warmup 是所有 runner 共用的前置动作:
def warmup(self) -> None: """Run kernel warmup + autotune once, gated by mr._kernel_warmed_up.""" mr = self.model_runner if getattr(mr, "_kernel_warmed_up", False): return mr._kernel_warmed_up = True if mr.device != "cuda": return self._pre_initialize_flashinfer_allreduce_workspace() self._pre_initialize_fi_a2a_workspace() self._pre_initialize_pcie_ipc_workspace() prepare_model_resources = getattr( mr.model, "prepare_before_cuda_graph_capture", None ) if prepare_model_resources is not None: prepare_model_resources(mr) ..._kernel_warmed_up 这个标志意味着 warmup 在整个进程里只跑一次(decode runner 与 prefill runner 共享),因为两件事都必须在任何捕获之前完成:
- 所有一次性初始化必须在捕获之外。FlashInfer 的 allreduce workspace、FI all2all workspace、PCIe IPC workspace 的分配都会做同步与集合通信;注释原话是 “must run before CG capture to keep broadcasts/barriers outside the capture context (else deadlock with custom_all_reduce.register_graph_buffers)”。
- JIT 编译与 autotune 必须在捕获之外。Triton kernel 第一次执行要编译,FlashInfer 的 plan 要做 autotune,两者都会打断捕获。
_dummy_run 则是 warmup 的执行体:构造一个形状合适的 dummy 批次,跑一遍前向。它有一个约束写在断言里:
assert ( buffers is not None and num_tokens <= buffers.input_ids.shape[0] and batch_size <= buffers.seq_lens.shape[0]), (...)_dummy_run 从不分配、从不重新 padding——调用者拥有形状,必须传入一份不小于 dummy 形状的静态缓冲。注释解释了原因:autotune 必须在「最终会用的形状」上跑,否则调优结果不适用;而且复用已有缓冲能让 dummy 前向分配出的临时张量与后续捕获共用池,避免池被撑大。
显存账本:图捕获吃掉多少,谁来还
图机制不是免费的,它要占显存。SGLang 把这件事做成了显式记账。
捕获成本的测量
capture_prefill_graph 与 capture_decode_graph 都用同一个模式测成本:
tic = time.perf_counter()before_mem = get_available_gpu_memory(model_runner.device, model_runner.gpu_id)...prefill_runner = PrefillCudaGraphRunner(model_runner)after_mem = get_available_gpu_memory(model_runner.device, model_runner.gpu_id)mem_usage = before_mem - after_memcapture_time = time.perf_counter() - ticlogger.info( f"Capture {capture_name} CUDA graph end. " f"elapsed={capture_time:.2f} s, " f"mem usage={mem_usage:.2f} GB, avail mem={after_mem:.2f} GB.")测量结果按相位归到 graph_memory_usage 字典(decode / prefill / target_verify / draft_decode / draft_prefill),GraphCapture.memory_usage 与 time_usage 是它的读写接口,最终由调度器上报:
graph_memory_usage_gb=combine_graph_memory_usage( self.tp_worker.graph_memory_usage, (None if self.draft_worker is None else self.draft_worker.graph_memory_usage),),启动日志里的 elapsed=... mem usage=... GB 与 /get_server_info 暴露出来的 graph 内存用量,都是从这里来的。
谁来为图留出显存
关键的一步在 KV 池的容量计算。KV cache configurator 的 _profile_available_bytes 决定了 KV 池能拿多少:
gc.collect()available_gpu_memory = get_available_gpu_memory(...)slack_gb = pre_model_load_memory * (1 - get_schedule().mem_fraction_static)...if ( self.mambaish_config is not None and self.post_capture_kv_active and not capped_full_prefill_role): slack_gb = max( slack_gb, pre_capture_activation_reserve_mb( get_device_memory_capacity(self.device) ) / 1024, )...rest_memory = available_gpu_memory - slack_gb - mm_reservation_gb这里有两个概念:
mem_fraction_static:静态内存(权重 + KV 池 + 图)占 GPU 总显存的比例。pre_model_load_memory * (1 - mem_fraction_static)就是留给「非静态运行时」的余量slack_gb。pre_capture_activation_reserve_mb:捕获之前必须预留的激活内存估算:
def pre_capture_activation_reserve_mb(gpu_mem: float | None) -> float: """Return the activation reserve in MB before CUDA graph capture, using current config.""" schedule = get_schedule() if get_disagg().disaggregation_mode == "decode": running_requests = ( schedule.max_running_requests or get_exec().graph.cuda_graph_config.decode.max_bs or 1 ) activation_tokens = max( running_requests * (get_spec().speculative_num_draft_tokens or 1), 2048 ) elif schedule.chunked_prefill_size > 0: activation_tokens = max(schedule.chunked_prefill_size, 2048) else: activation_tokens = max(schedule.max_prefill_tokens, 2048) parallel = get_parallel() reserved_mem = ( 512 + activation_tokens * 1.5 + parallel.tp_size * parallel.pp_size / 8 * 1024 ) if gpu_mem is not None and gpu_mem > 60 * 1024: reserved_mem = max(reserved_mem, 10 * 1024) return reserved_mem公式把三块加起来:512 MB 固定开销、activation_tokens × 1.5(激活的经验系数)、以及并行度相关的通信缓冲(tp_size × pp_size / 8 × 1024 MB,即每 8 个 rank 预留 1 GB)。大显存卡(> 60 GB)再兜一个 10 GB 的下限。
为什么这块余量必须留。 因为 CUDA Graph 捕获时真实跑前向,图外还有 eager 路径(大 batch 回退、prefill 尾巴、logits 处理)要跑,Mamba 状态是固定预捕获分配。如果按「理论上需要」精确抠出来,KV 池会把显存占满,运行时的激活分配立刻 OOM。_profile_available_bytes 的注释专门留了一句实战教训:如果不先 gc.collect(),权重加载的临时张量仍被引用,empty_cache() 收不回,KV 池会被算成小几个数量级,而 GPU 显存还在闲置。
与调度器的闭环
调度器那边能看到两组数字:一是 max_total_num_tokens 与 max_running_requests(KV 池容量,已被图预留扣减过),二是 decode_cuda_graph_capture_bs(实际捕获的桶列表,通过 /get_server_info 暴露)。批次尺寸超过 max_bs 的请求会走 eager,这在功能上正确,在性能上退化成「无图 decode」。
这个闭环的形态是:配置桶列表 → 捕获占用显存 → KV 池容量按剩余显存计算 → max_running_requests 受池容量约束 → 实际 batch 上限受资源约束。任何一个环节设得太满都会互相挤压,这就是为什么桶列表默认值那么克制。
与 vLLM 源码完全拆解系列的对照
系列前面用十六篇拆过 vLLM。两边在图机制上有一组值得对照的设计差异。
| 维度 | vLLM 源码完全拆解(十二) | SGLang 本篇 |
|---|---|---|
| 图的粒度 | 解码整图 + 按编译断点分段的 piecewise | 解码整图 + 按注意力层分段(BCG) |
| 分段依据 | torch.compile 切出的图断点(编译期决定) | @eager_on_graph 显式标注在注意力层(源码期决定) |
| 元数据 | AttentionMetadataBuilder 独立类,与 backend 分离 | backend 的两方法族,元数据是 backend 的 forward_metadata 属性 |
| 批次选择 | cudagraph_capture_sizes 列表 + 向上取整 | capture_bs / capture_num_tokens + 向上取整 |
| 缓冲管理 | 各 runner 手写填充 | CudaGraphBufferRegistry + PaddingPolicy 显式声明 |
| prefill 图 | 分段编译路径为主 | BCG(默认)/ Full(实验) |
第二行是最本质的差异。vLLM 的 twelve 篇讲过:vLLM 用 torch.compile 的 splitting_ops 决定在哪里把图切开,eager 断点位置由编译器决定;SGLang 的 BCG 则是用装饰器在源码层面显式标注「这个函数要 eager 执行」。前者对模型代码透明但依赖编译器的切图能力,后者需要在注意力层源码上打标记但断点位置完全可控、且不依赖 torch.compile(BCG 的注释原话就是 No torch.compile)。
第五行则是 SGLang 当前版本最独特的一处工程抽象。PaddingPolicy 把「图内静态缓冲的 padding 区怎么处理」从各 runner 的散落代码提升为一等公民声明,配合 reset_padding 与分组 foreach_copy_,既统一了填充逻辑,也让「这里为什么安全」变成可审阅的代码而不是注释。vLLM 源码完全拆解(十二)里讲过的那些逐 runner 填充细节,在 SGLang 侧被收敛成了一组策略。
顺带把前置阅读串一下:图机制要能读懂,SGLang 源码完全拆解(八):Attention Backend 讲的后端契约是必备前提(out_graph / in_graph 拆分、init_cuda_graph_state、get_cuda_graph_seq_len_fill_value、SharedReadEnds);调度侧为什么要把批次切成这些形状,见 SGLang 源码完全拆解(四):PrefillAdder 如何预算 KV、切分长提示并组装 Prefill Batch 与 SGLang 源码完全拆解(六):Overlap Scheduler;KV 池容量如何反向约束批次尺寸,见 SGLang 源码完全拆解(五):KV 内存池与 RadixCache。CUDA Graph 本身的机制在 vLLM 系列里已从 torch.compile 与 piecewise 角度讲过,可参考 vLLM 源码完全拆解(十二):piecewise compilation 与 CUDA Graph。
小结
SGLang 的图机制可以压成一张三层表和一个不变量。
三层:
| 层 | 载体 | 职责 |
|---|---|---|
| 捕获后端 | BaseCudaGraphBackend 及其 Full / Breakable 实现 | 录与放的机械动作:起段、断点、重放、输出桥接 |
| 相位 runner | Decode / PrefillCudaGraphRunner | 选桶、填缓冲、建元数据、分派重放、切片输出 |
| 配置与调度 | CudaGraphConfig / arg_groups/cuda_graph_hook.py / can_run_graph | 决定录哪些形状、哪些批次允许走图、不兼容时如何降级 |
不变量: 图内引用的每一个张量地址,在重放时必须仍然属于同一块缓冲。所有机制都是它的推论——静态缓冲预分配(地址固定)、PaddingPolicy(补齐行内容的正确处理)、freeze_gc 与 warmup 前置(捕获期间禁止分配与同步)、can_run_graph(形状与功能前提的准入)、BCG 在注意力层断点(必须离开图的那部分计算)。
四条可操作的结论:
- decode 用整图,prefill 用分段图,这个分工写死在默认配置里(
decode.backend = full、prefill.backend = breakable on CUDA)。原因是 prefill 的注意力 query 长度变长且直接决定 kernel grid,整图捕获无法覆盖。 - 桶列表是收益与显存的平衡器。小端密、大端疏、投机更密、
disable_cuda_graph_padding全铺;捕获从大到小以复用图内存池。 - padding 的内容必须按语义分类处理。写 KV 的槽位清零、读长度的槽位填哨兵、只读安全的槽位保持原样——
PaddingPolicy把这件事变成了声明。 - 图永远是一条可回退的快速路径。任何前提不成立就落回
EagerRunner,功能正确性从不依赖图。
下一篇沿路线图向下进入「Sampling、Grammar 与结构化输出」:采样参数如何编译成每轮的 logits 变换、LogitsProcessor 如何与图重放后的输出衔接、语法约束的 FSM 如何在每步生成 bitmask,以及流式输出与概率返回在调度器侧如何组装。本章只讲了图与编译路径如何把前向压成一个可重放的静态程序,下一篇会补齐「前向之后」的那一段。
参考资料
- SGLang 官方 GitHub 仓库
- SGLang 解码 CUDA Graph Runner 源码
- SGLang 预填充 CUDA Graph Runner 源码
- SGLang 捕获后端基类源码
- SGLang Breakable CUDA Graph 后端源码
- SGLang Breakable CUDA Graph 分段机制源码
- SGLang CUDA Graph 缓冲注册表源码
- SGLang CUDA Graph 配置与相位定义
- SGLang CUDA Graph 参数解析与自动降级
- SGLang 元数据 Glue Graph 源码
- SGLang torch.compile 装饰器源码
- NVIDIA: CUDA Graphs 技术博客
- PyTorch: Accelerating PyTorch with CUDA Graphs
- vLLM 源码完全拆解(十二):piecewise compilation 与 CUDA Graph
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



