


SGLang 源码完全拆解(二十五):模型层——一个 LLaMA 层如何被组装成可服务的模型
从调度器再往里一层:模型层是什么
前面二十多篇一路走过 SGLang 的入口、调度、KV 池、注意力后端、CUDA Graph 和采样,讨论的对象几乎都是「引擎怎么组织一次前向」。这一次换一个视角:前向本身长什么样。调度器决定这一批里有哪些请求、每条请求要算多少 token;ModelRunner 把这些决定拼成 ForwardBatch;而真正消费 ForwardBatch、把它变成一串张量算子的,是 sglang/srt/models/ 下的模型类。
模型层在推理框架里承担的工作,和训练框架里的同名文件并不一样。训练时需要完整的反向图、参数初始化和优化器状态;推理时模型类只需要回答五个问题:
- 这个 Hugging Face 的
config对应哪个模型类? - 张量并行(TP)这么大时,每个权重矩阵该切哪一维、切完以后每张卡上的形状是多少?
- Q、K、V 算出来之后,KV 写进哪块显存、注意力用哪个后端?
- 外部权重文件的命名和框架内部的参数命名怎么对齐?
- 最后一层隐状态怎么变成 logits,又怎么在分布式词表上收集?
这五个问题分别落在「注册表」「并行线性层」「RadixAttention」「load_weights」「LogitsProcessor」五块代码上。本文以 LlamaForCausalLM 为主线,把这条装配线从头到尾走一遍,再用 Qwen3 的差异说明模型层如何扩展。调度与 KV 池的细节不再重复,需要的读者可以先看 SGLang 源码完全拆解(三):Scheduler 请求状态机如何闭环 和 SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环。
模型层的五层结构
把 sglang/srt/models/ 下任何一个稠密模型按继承关系展开,都能看到一个自底向上的五层结构。以 LLaMA 为例:
| 层级 | 类 | 职责 | 出现在哪里 |
|---|---|---|---|
| 1 | LlamaForCausalLM | 对外接口:forward 返回 LogitsProcessorOutput,load_weights 入口 | ModelRunner 拿到的就是这一层 |
| 2 | LlamaModel | 嵌入、层堆叠、最终 RMSNorm、流水线切分 | 被 LlamaForCausalLM.model 持有 |
| 3 | LlamaDecoderLayer | 一层 Transformer:输入 norm、注意力、残差、FFN norm、MLP、残差 | ModuleList 的每个元素 |
| 4 | LlamaAttention / LlamaMLP | 单个子模块:QKV 投影、RoPE、注意力调用、输出投影;gate/up/down 三段 FFN | 被第 3 层持有 |
| 5 | QKVParallelLinear / RowParallelLinear / RadixAttention / RMSNorm / SiluAndMul | 可复用的算子积木,负责并行切分、量化方法和内核分派 | 被第 4 层持有 |
这张表本身就是读模型层代码的地图。自顶向下读,每一层新增的职责很少:第 1 层只是「把第 2 层输出接上词表投影和 logits 处理」;第 2 层只是「循环调用第 3 层」加上嵌入和最终 norm;第 3 层是最典型的 Transformer 骨架;真正有信息量的是第 4、5 层——并行怎么切、KV 写在哪、量化方法怎么挂都发生在那里。
需要先说清楚一个术语。本文中的「并行组」指一组参与同一次权重切分的 rank,每一个线性层都显式声明自己属于哪个组。QKVParallelLinear 与 RowParallelLinear 的构造函数都带一个 parallel_group 参数,按名字从运行期上下文解析出组对象。LLaMA 默认传 tp,Qwen3 的注意力则固定传 attn_tp,并且把 o_proj 的 reduce_results 设成 False。为什么注意力要单独成组?因为 SGLang 支持数据并行注意力:注意力层的 TP 规模可以小于整体 TP 规模,FFN 可能跑在更宽的组上,两组之间的行搬运由层边界负责。若模型层仍在全局读 tp_size,这种拓扑就无法表达。把组作为构造参数传入,同一个 LlamaAttention 才能既跑在纯 TP 上,也跑在 DP Attention 上。
注册表:architectures 字符串如何找到模型类
sglang/srt/models/registry.py 里只有一个 _ModelRegistry 实例和一段导入逻辑。注册表的键是 Hugging Face config.json 里的 architectures[0],值是模型类。注意这里不是 @register_model 装饰器,而是模块级约定:
# python/sglang/srt/models/llama.py 末尾EntryClass = [ LlamaForCausalLM, Phi3ForCausalLM, InternLM3ForCausalLM, IQuestCoderForCausalLM,]每个模型文件暴露一个 EntryClass(单个类或列表),import_model_classes 用 pkgutil.iter_modules 遍历包,逐个导入模块,读 EntryClass,再把类名作为键写进字典。类名通常与 architectures 字符串一致,因此 "LlamaForCausalLM" 能直接命中。一个文件登记多个类,是为了让结构完全相同的变体复用同一份实现——Phi-3、InternLM3 和 LLaMA 的 decoder 结构几乎一致,没有必要复制三遍。
这个设计有一个直接后果:导入模型包等于导入所有模型文件。SGLang 用 @lru_cache() 缓存整个导入结果,并且允许通过 SGLANG_DISABLED_MODEL_ARCHS 环境变量在遍历时跳过某些模块,避免可选依赖(例如某个只对特定硬件可用的注意力实现)导致整体导入失败。strict=False 时,单个模块导入异常只记一条警告,不阻止其他模型可用——这是推理框架必须接受的取舍:宁可少支持一个架构,也不能因为一个冷门模型的依赖缺失而让服务起不来。
注册表还留了一条快速路径:如果 architectures 的第一个名字已经直接出现在 self.models 里,就不触发默认模型的懒加载。对于大规模部署,这条路径能省掉扫描整个 models/ 目录的开销。外部模型包则通过 SGLANG_EXTERNAL_MODEL_PACKAGE 注入,先注册外部类,再把 _default_models_loaded 置为 False,把内置模型的导入推迟到真正需要时。
ModelConfig(模型配置层)随后调用 ModelRegistry.resolve_model_cls(architectures) 拿到类,并实例化。注意实例化时传入的是 quant_config、prefix 和并行上下文,而不是权重;权重是第二阶段的 load_weights 才进来。构造只负责建出形状正确的空壳,这一点对后面理解显存 profile 和权重装载时序很重要。
顶层:LlamaForCausalLM 的装配线
顶层的构造函数短得惊人,它不定义任何计算,只负责把「模型主体 + 输出侧组件 + 权重映射表」装到一起:
class LlamaForCausalLM(nn.Module): def __init__(self, config, quant_config=None, prefix=""): super().__init__() self.pp_group = get_parallel().pp_group self.config = config self.quant_config = quant_config self.model = self._init_model(config, quant_config, add_prefix("model", prefix)) if self.config.tie_word_embeddings: self.lm_head = self.model.embed_tokens else: self.lm_head = ParallelLMHead( config.vocab_size, config.hidden_size, quant_config=quant_config, prefix=add_prefix("lm_head", prefix), use_attn_tp_group=get_parallel().enable_dp_lm_head, ) self.logits_processor = LogitsProcessor(config) self.pooler = Pooler(pooling_type=PoolingType.LAST, normalize=True) self.stacked_params_mapping = [ (".qkv_proj", ".q_proj", "q"), (".qkv_proj", ".k_proj", "k"), (".qkv_proj", ".v_proj", "v"), (".gate_up_proj", ".gate_proj", 0), (".gate_up_proj", ".up_proj", 1), ] self.capture_aux_hidden_states = False这段代码有四处值得停下来看。
第一处是 tie_word_embeddings。 LLaMA 3.2 1B 这类小模型把输入嵌入和输出投影共享成同一张矩阵,LLaMA 3.1 8B 则分开。框架必须两种都支持,而且不能简单地「复制一份」——如果 lm_head 和 embed_tokens 是两个独立参数,权重装载时同一份张量会被加载两次,显存多占一份;正确做法是直接让 lm_head 指向同一个模块。代价是:如果之后要单独替换 lm_head(例如做词表裁剪),必须先把两者拆开。
第二处是 ParallelLMHead。 词表可能到十万级(多语言模型更大),一个 hidden × vocab 的矩阵在 TP 下必须按词表维切分:每个 rank 只持有自己那一段词表对应的行,算完 logits 后由 LogitsProcessor 做 all-gather 把它拼完整。这里传入的 use_attn_tp_group 表示「logits 的收集用注意力 TP 组还是全局 TP 组」,在 DP Attention 部署里两者不同,因为每条请求只在注意力组内冗余或切分。
第三处是 stacked_params_mapping。 这张五行的表记录了「外部权重的分名」到「框架内合并参数」的映射。Hugging Face 的 LLaMA 权重是 q_proj、k_proj、v_proj 三个独立张量,SGLang 内部把它们合并成一个 qkv_proj 的连续矩阵;FFN 的 gate_proj 和 up_proj 同理合并成 gate_up_proj。合并的好处是前向只发一次 GEMM、一次量化反量化,坏处是装载时要按 shard 切开再拼。这张表就是 load_weights 的字典。
第四处是 capture_aux_hidden_states。 默认 False,只有开启 EAGLE-3 或 DFlash 投机解码时才会被 set_eagle3_layers_to_capture / set_dflash_layers_to_capture 打开,让第 2 层在指定层额外收集隐状态,作为草稿头的输入。投机解码的草稿端和执行端如何共用一次前向,可以看 SGLang 源码完全拆解(十一):投机解码;这里只需记住,模型层为此预留了「收集若干中间层输出」的钩子,而不是让草稿模型单独跑一遍。
顶层的 forward 则把三件事串起来:
@torch.no_grad()def forward(self, input_ids, positions, forward_batch, input_embeds=None, get_embedding=False, pp_proxy_tensors=None): hidden_states = self.model(input_ids, positions, forward_batch, input_embeds, pp_proxy_tensors=pp_proxy_tensors) aux_hidden_states = None if self.capture_aux_hidden_states: hidden_states, aux_hidden_states = hidden_states if self.pp_group.is_last_rank: if not get_embedding: return self.logits_processor(input_ids, hidden_states, self.lm_head, forward_batch, aux_hidden_states) return self.pooler(hidden_states, forward_batch) return hidden_statesget_embedding 是一个布尔开关:同一个类既服务生成,也服务嵌入/重排。嵌入任务不需要 logits,只需要对隐状态做池化;池化类型是 LAST,即取最后一行有效 token,再归一化。把这个分支放在模型类里而不是另写一个模型,是为了让权重装载、并行切分、KV 池这些基础设施完全复用。vLLM 把这类模型单独做成 pooling runner,SGLang 选择了同一个类内分支,两种做法各有理由:前者把类型系统分得更干净,后者减少了模型文件的重复。
pp_proxy_tensors 是流水并行的接力棒。非最后一个流水段的 rank 不计算 logits,它把本段的隐状态打包成 proxy tensors 交给下一段;最后一个 rank 拿到后继续跑剩下的层,最后才进 LogitsProcessor。因此 forward 的返回类型在前几段和最后一段是不同的,这一点在调用方(ModelRunner)里必须按 is_last_rank 分支处理。
LlamaModel:嵌入、层堆叠与流水线切片
第二层是 LlamaModel。它的构造函数解决三个问题:嵌入放在哪、层怎么切给流水段、最终 norm 放在哪。
if self.pp_group.is_first_rank: self.embed_tokens = VocabParallelEmbedding(config.vocab_size, config.hidden_size, ...)else: self.embed_tokens = PPMissingLayer()
pp_start_layer, _ = get_pp_indices( config.num_hidden_layers, self.pp_group.rank_in_group, self.pp_group.world_size)self.layers, self.start_layer, self.end_layer = make_pp_layers( config.num_hidden_layers, lambda idx, prefix: LlamaDecoderLayer(config=config, quant_config=quant_config, layer_id=idx, start_layer=pp_start_layer, prefix=prefix), prefix="model.layers", stage_facts=lambda idx: LlamaDecoderLayer.stage_facts(config, idx),)
if self.pp_group.is_last_rank: self.norm = RMSNorm(config.hidden_size, eps=config.rms_norm_eps)else: self.norm = PPMissingLayer(return_tuple=True)PPMissingLayer 是理解流水并行的关键小物件。假设 32 层切成 4 段,第 1 段负责第 0–7 层,但模型对象仍然需要「看起来有 32 层」,否则权重装载时按层号定位会错位,layer_id 传到注意力里也会错。因此不在本段的层用一个占位模块填住,ModuleList 的长度始终是 num_hidden_layers,start_layer/end_layer 才告诉你真实的计算区间。PPMissingLayer(return_tuple=True) 用在最终 norm 上,是因为最后一层的输出可能带 aux hidden states,占位符要保证返回结构一致。
make_pp_layers 还承担了「层边界连接」的工作。注意 stage_facts 参数:它接受一个「只根据层号返回该层声明的阶段类型」的函数,而不需要真的构造这一层。为什么需要这样?因为流水并行时,第 0 段要判断「本段最后一层的输出该以什么布局交给下一段」,而下一段的第一层在另一个进程里,本进程没有它的对象。通过一个纯函数声明「第 8 层会先做 norm 再走注意力」,两段就能在不共享对象的情况下对齐边界布局。这是把「层内结构」和「跨进程的层间契约」分开的典型手法。
LlamaModel.forward 的主循环因此非常薄:
for i in range(self.start_layer, self.end_layer): hidden_states = self.layers[i](positions, hidden_states, forward_batch, capture_output=aux_hidden_states.capture if i in self.layers_to_capture else None)if not self.pp_group.is_last_rank: return residual_batch.to_pp(hidden_states, forward_batch)hidden_states = residual_batch.final_norm(hidden_states, forward_batch, self.norm)第一段还会调用 residual_batch.start(forward_batch),最后一段调用 residual_batch.final_norm。这两个调用说明残差流不再由每层自己「加回输入」,而是被抽到一个跨层的共享对象里统一管理——这正是下一节要讲的层边界。
LlamaDecoderLayer:层边界把残差和通信收走
第三层看起来是三段式:
def forward(self, positions, hidden_states, forward_batch, capture_output=None): hidden_states = self.attn_boundary.prepare( hidden_states, forward_batch, capture=capture_output) hidden_states = self.self_attn(positions=positions, hidden_states=hidden_states, forward_batch=forward_batch) hidden_states = self.attn_boundary.finish(hidden_states, forward_batch) hidden_states = self.ffn_boundary.prepare(hidden_states, forward_batch) hidden_states = self.mlp(hidden_states, forward_batch=forward_batch) return self.ffn_boundary.finish(hidden_states, forward_batch)注意力本身和 MLP 本身都「不知道」残差、norm、跨卡归约;它们只负责纯计算。prepare 负责「读」:从残差流里取出本阶段的输入,做归一化,必要时量化,使输入直接匹配下游 GEMM 的期望格式;finish 负责「写」:把本阶段算出来的部分和补齐(可能是一次 reduce-scatter 或 all-reduce),加到残差上,再把新残差存回流里。
为什么要拆成这样?把标准的后置 norm 写法展开看:
x = x + Attn(Norm(x)),然后 x = x + MLP(Norm(x))。
如果每层都独立实现这句话,会出现两个问题。其一,Norm 和残差加法都可以和下一个 GEMM 融合,但融合点横跨「层的边界」——Norm(x) 的输出要喂给 attn.qkv_proj,量化参数需要由那个 GEMM 决定;把一个融合写死在层里,就丢失了整个框架层面「按前向模式、按量化格式、按并行拓扑重新选择融合方案」的自由度。其二,TP 下 o_proj 和 down_proj 是行并行,输出是部分和,需要跨卡归约后才能加进残差。归约可以和下一个 Norm 融合、可以变成 reduce-scatter(输出直接散开给 token 并行的下一段)、在有双向重叠(TBO)时还能推迟到另一个 micro-batch 的窗口里做。把归约写到层里,这些选择就全没了。
于是 SGLang 把「一个计算阶段」(attention 阶段、FFN 阶段)抽象成一个声明,再由层边界根据「前后邻居是谁、当前拓扑是什么、当前前向模式是什么」把它构造为一份执行计划。构造时声明的函数就是 declare_attn、declare_ffn:
@classmethoddef stage_facts(cls, config, layer_id): return ( declare_attn(read=cls._attn_readout(layer_id)), declare_ffn(sparse=False, next_layer_sparse=False), )declare_attn 的默认参数本身就说明了注意力阶段的语义:read=NORM_QUANT_READOUT(输入先 norm、再按下游量化格式处理)、reduction=ALWAYS_PARTIAL(注意力输出的和永远是「部分和」,由下一阶段的输入完成汇总)、tp_group=SumGroup.ATTN_TP(求和发生在注意力 TP 组内)。declare_ffn 则声明它是不是稀疏 FFN(sparse=True 表示 MoE)、下一层的 FFN 是否稀疏——后一个参数只用于在 TBO 场景推导「这一阶段应该在哪些行上退出」,因为两个相邻阶段的 token 行布局可能不同,退出行的选择要两两对齐。
append_stages 把这对声明挂到当前「层栈」上,并直接返回两个 StageBoundary 对象供该层调用。它们此刻还没有执行计划,只有声明;等到 make_pp_layers 打开的那个 layer_stack 上下文关闭时,栈里的阶段才知道自己的前驱和后驱,才被统一绑定(_bind_stack)。流水并行时,前驱可能根本不在本进程里——这就是 make_layers 要传 stage_facts 的原因:栈只需要知道「第 7 层声明了哪些阶段」,而不需要它的对象。
这里还有一个容易忽略的细节:LlamaDecoderLayer.__init__ 在挂阶段之前做了两件事:
self.input_layernorm.fuse_input_quant(self.self_attn.qkv_proj)self.post_attention_layernorm.fuse_input_quant(self.mlp.gate_up_proj)RMSNorm.fuse_input_quant 的文档字符串写得很具体:它登记的是下游投影的「静态 per-tensor FP8 输入量化」,使 norm 在 CUDA 路径上能把「归一化 + 量化」融进一个内核,直接产出 FP8 激活,省掉一次单独的量化 kernel 和一趟 HBM 往返。这是一种跨模块的静态依赖登记:构造期登记,执行期由 norm 自己读取。注意顺序——norm 被构造在 append_stages 之前,而 qkv_proj 也在注意力构造之后才存在,所以登记必须放在两者都已构造之后,这决定了 __init__ 里语句的先后顺序。
stage_boundaries=False 这个开关是为子类准备的:它的文档字符串写得很明白,子类若在自己的 forward 里驱动残差,就关闭边界,此时注意力和 MLP 各自完成自己的求和、不再构建边界。默认 True 是绝大多数稠密模型的路径。Qwen3 的 Qwen3DecoderLayer 同样调用 append_stages,而 Qwen3Attention 的 o_proj 写的是 reduce_results=False——两者合起来说明:一旦边界负责归约,行并行层就不再重复做一次全量 all-reduce。
边界最终如何执行——prepare/finish 中「读残差流、写残差流」的具体计划、各种布局变体如何选择——属于下一篇文章的主题。这一篇只需要记住结论:层的 forward 里看不到残差 +、看不到 all_reduce,是因为它们都被移到了边界里,而边界的形状是由「谁在它前后」决定的。
并行线性层:QKV 怎么按头切、Row 怎么按列切
第五层是真正的重复劳动所在地,也是 TP 正确性和性能的主要来源。SGLang 在这层沿用了 vLLM 的四个线性类(文件头里明确写着 adapted 自 vLLM),并在其上增加了「并行组」和「层边界」两处改造。layers/linear.py 里四个核心类的关系是:
| 类 | 权重切法 | 输入 | 输出 | 典型位置 |
|---|---|---|---|---|
ReplicatedLinear | 不切,每卡全量 | 完整 | 完整 | 小投影、门控打分等 |
ColumnParallelLinear | 按输出维切 | 完整 | 部分列 | 单段投影 |
MergedColumnParallelLinear | 按输出维切,内部按段合并 | 完整 | 部分列 | gate_up_proj |
QKVParallelLinear | 按头切 Q、按头切或复制 K/V | 完整 | 部分 Q/K/V | qkv_proj |
RowParallelLinear | 按输入维切 | 部分列(必须已切) | 部分和,需归约 | o_proj、down_proj |
LinearBase 本身只做三件事:保存尺寸、根据 quant_config 选出量化方法(没有量化配置时落到 UnquantizedLinearMethod)、把权重创建交给 quant_method.create_weights。注意最后一点:线性层的权重不是自己 torch.empty 出来的,而是由量化方法创建并返回,因此不同量化方案可以产出不同的参数集合——GPTQ 有 qweight、qzeros、scales、g_idx,FP8 有 weight 与 weight_scale,MXFP8 还有带 block scale 的打包格式。这也是 (output, bias) 元组返回值的来源:skip_bias_add 为真时,bias 不在这里加,而是返回出去由调用者融合。
ColumnParallelLinear 为什么在 forward 里不通信
列并行层把 output_size 按 tp_size 切开,每个 rank 持有 Y[:, r*W/P : (r+1)*W/P],输入 X 是完整副本。前向是纯本地 GEMM,不需要任何通信;代价是后续层要消费这个「列切片」,所以下一层必须是行并行,才能在输入侧接受切片。这就是 Megatron 式 TP 的交替结构——列并行切输出、行并行切输入、行并行末尾做一次归约,一「块」由一对列/行并行组成,一次通信。
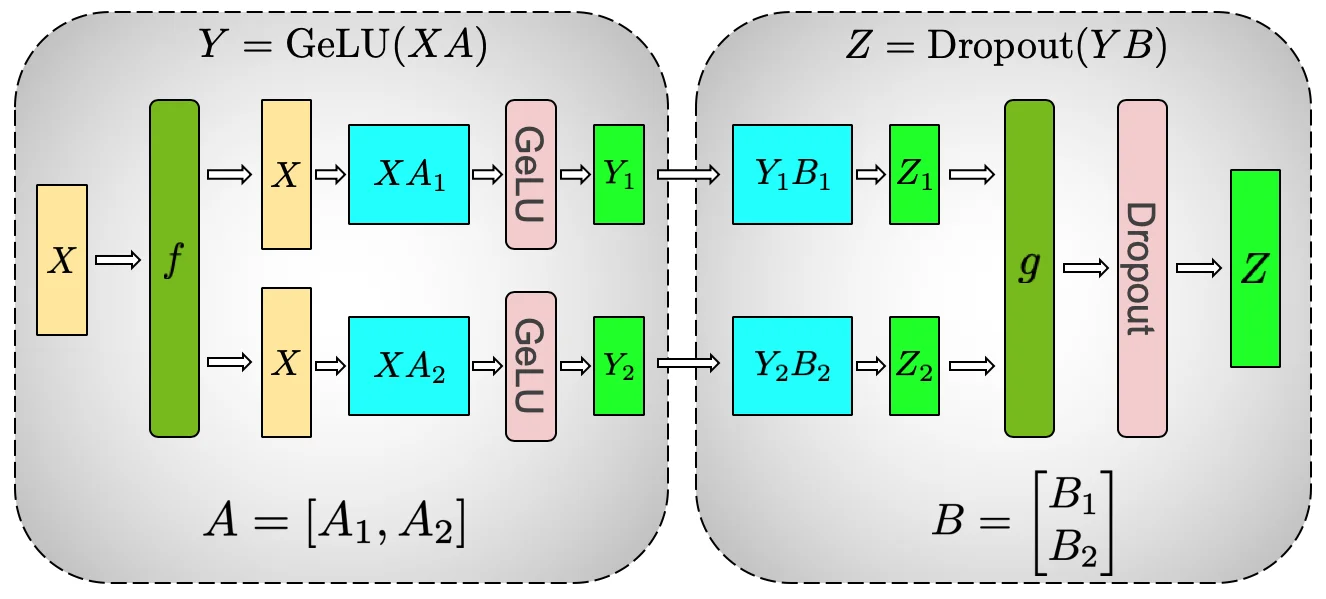
图:Megatron-LM 论文(Shoeybi 等,2019)的 FFN 张量并行布局。左侧第一个线性层按输出维切成 A1、A2(列并行),中间 GeLU 逐元素,右侧第二个线性层按输入维切成 B1、B2(行并行),两卡的输出再相加。SGLang 的 `gate_up_proj` + `down_proj` 完全对应这张图。
对照 SGLang 的 LlamaMLP:gate_up_proj 是 MergedColumnParallelLinear,down_proj 是 RowParallelLinear,中间夹一个 SiluAndMul。MergedColumnParallelLinear 的特别之处在于它一次创建 两段 输出:[intermediate_size] * 2 表示这段权重由 gate 段和 up 段拼成,切分时两段各自切成 P 份,各 rank 拿到本 rank 的 gate 片和 up 片,前向一次 GEMM 出全部结果,再由 SiluAndMul 在片内计算 silu(gate) * up。为什么合并?因为 gate 和 up 都是对同一个输入的列并行投影,合并后是一次 GEMM 读一次 X、发一次 kernel,而不是两次;在 decode 这种 X 只有几行的场景里,kernel 启动和读 X 的开销占比很大,合并收益明显。
LlamaMLP 里另有两处有意思的分支:
if self.dual_gemm.can_run(x, self.gate_up_proj): x = self.dual_gemm(x, self.gate_up_proj)else: gate_up, _ = self.gate_up_proj(x) if forward_batch is not None and forward_batch.forward_mode.is_decode(): x = self.activation_quant.forward_decode(gate_up, self.act_fn, self.down_proj) else: x = self.act_fn(gate_up)DualGemm 让上游与 gate_up_proj 并行发起,从而把「上一层 kernel 的尾部」和「本层 GEMM 的头部」叠起来;DenseSiluAndMulQuant 则在 decode 模式下把激活和下游 down_proj 的输入量化合并。两者都是「按前向模式选融合」的例子:prefill 时 X 的行数多,GEMM 本身已经足够饱和,再做激进融合的收益小;decode 时 X 只有 batch 行,激活 kernel 近乎纯粹的带宽开销,值得融合。
QKVParallelLinear:GQA 下 K/V 头可能被复制
这是 TP 里最容易写错的一块,因为它切的不只是「列」,而是「头」。构造参数除了 hidden_size、head_size、total_num_heads、total_num_kv_heads 之外,还接受一个独立的 kv_parallel_group——也就是说 Q 的切分组和 K/V 的切分组可以不同。
先回忆 GQA 的结构:总共有 H 个 query 头、K 个 KV 头,每组 H/K 个 query 头共享同一对 K/V。
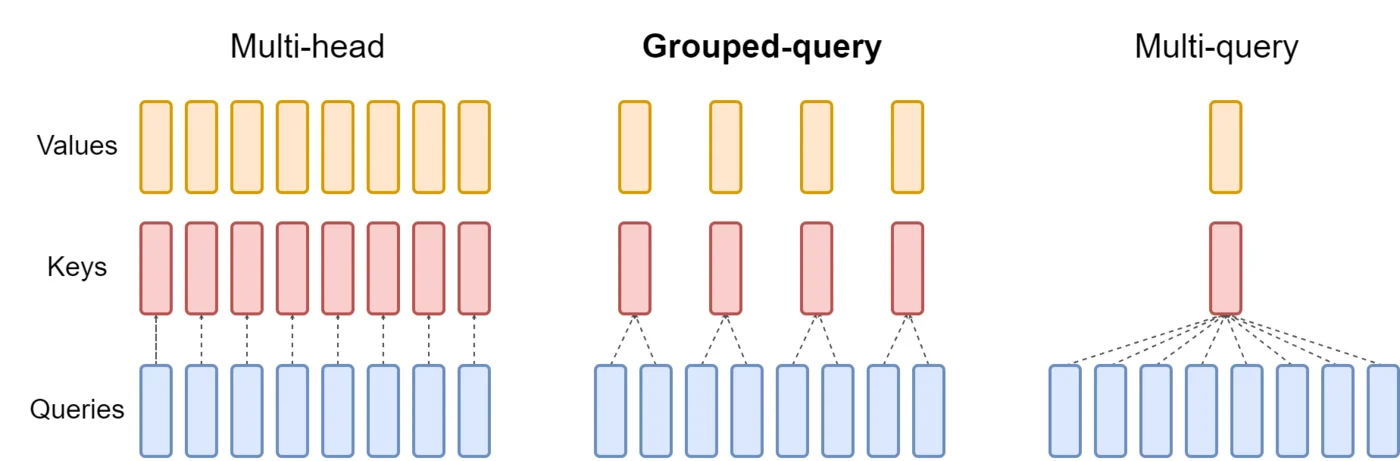
图:GQA 论文(Ainslie 等,2023)展示的 MHA、GQA、MQA 在 query/K-V 头维度和单元尺寸上的差异。GQA 让每个 K-V 头服务一组 query 头,这正是模型层必须在「KV 头数可能小于 TP 规模」时决定复制还是切分的原因。
现在把 H、K 和 P(TP 规模)放在一起看,核心矛盾是:query 头数 H 通常能被 P 整除,但 KV 头数 K 未必。以 H=32, K=4, P=8 为例,每个 rank 应该拿 4 个 query 头,但只有 4 个 KV 头,8 > 4,不可能让 8 个 rank 各拿「半个 KV 头」——KV 头是整块存储的,不能切。代码给出的答案是复制:每个 rank 持有全部的 K/P = 1 个 KV 头中它被分到的那个,但 8 个 rank 里只有 4 种不同的 KV 头,所以每个 KV 头在两个 rank 上各存一份相同的拷贝。
QKVParallelLinear.__init__ 的算术正好表达这一点:
self.num_heads = divide(self.total_num_heads, tp_size)if kv_tp_size >= self.total_num_kv_heads: self.num_kv_heads = 1 self.num_kv_head_replicas = divide(kv_tp_size, self.total_num_kv_heads)else: self.num_kv_heads = divide(self.total_num_kv_heads, kv_tp_size) self.num_kv_head_replicas = 1self.q_proj_shard_size = self.num_heads * self.head_sizeself.kv_proj_shard_size = self.num_kv_heads * self.head_sizeself.v_proj_shard_size = self.num_kv_heads * self.v_head_sizenum_kv_head_replicas 表示每个 KV 头在几张卡上重复存储。以 K=4, P=8 计:kv_tp_size(8) >= K(4),所以 num_kv_heads = 1,num_kv_head_replicas = 2——每个 rank 1 个 KV 头,每个头被复制 2 份。以 K=8, P=4 计:num_kv_heads = 2、复制数为 1——每个 rank 切到 2 个真实 KV 头,不复制。
这个设计引入了一个推理框架特有的开销:KV Cache 也可能被重复存储。如果每个 rank 都按自己那份 KV 头写缓存,复制的头就会在显存里存多份、带宽也耗多次。SGLang 的 LlamaModel 构造时会解析一份 _kv_cache_parallel_layout(来自 resolve_linear_parallel_group("tp")),它就是 KV Cache 池的物理切分布局;load_kv_cache_scales 也按这份布局的 (tp_rank, tp_size) 去匹配每层的 scale。KV 池本身、以及复制的 K/V 头如何在读写时处理,属于 KV 池与注意力后端的主题,这里只强调:模型层里「KV 头是否复制」的判定,会一路传导到显存规划,所以每次阅读 KV 显存相关代码遇到奇怪的倍数关系,都应回头检查这里。
QKVParallelLinear 的输出是「Q 片 + K 片 + V 片」在最后一维拼起来的单张量。LlamaAttention.forward_prepare_native 因此可以用一次 split 把它拆开:
qkv, _ = self.qkv_proj(hidden_states)q, k, v = qkv.split([self.q_size, self.kv_size, self.kv_size], dim=-1)q, k = self.rotary_emb(positions, q, k)q_size = num_heads * head_dim、kv_size = num_kv_heads * head_dim 都是本 rank 上的尺寸,而不是全局尺寸。scaling = head_dim ** -0.5 是 GQA 的标准缩放因子;注意它用的是 head_dim 而不是 kv_size,这符合注意力的定义——每个 query 头的分数只和单个 K 头内的 head_dim 个分量做内积。
RowParallelLinear:输入按列切、输出部分和
行并行层切的是输入维:每个 rank 持有 W[r*I/P : (r+1)*I/P, :],它的输入应该是上一个列并行层的输出切片。forward 里的关键分支有三处:
if self.input_is_parallel: input_parallel = input_else: input_parallel = split_tensor_along_last_dim(input_, tp_size)[tp_rank]
bias_ = None if (tp_rank > 0 or self.skip_bias_add) else self.biasinput_is_parallel=True是默认,意味着上游自己保证输入已经是本 rank 那一列;如果上游是完整张量(例如某个非并行层的输出),则必须在这里切。- bias 只在 rank 0 上融合进 GEMM。 这样做的道理很简单:行并行各 rank 的输出后面要加在一起,如果每个 rank 都加一次 bias,结果就是
P × bias。只让 rank 0 加,求和后恰好加一次。这是 TP 代码里极典型的「利用后续归约抵消乘法」的技巧,和all_reduce前只汇总部分和是一个道理。 - 归约本身,在
reduce_results=True且未被调用方接管时执行;SGLang 在此基础上还增加了三条路径:skip_all_reduce(调用点显式跳过)、use_dp_attention_reduce(归约发生在注意力组内,而非全局 TP 组)、以及 LayerNorm 序列并行下的row_parallel_gbar_matmul(用 reduce-scatter 代替 all-reduce,输出保持按 token 散开,供下一段 token 并行的 LayerNorm 直接使用)。
这些路径的细节分别在序列并行与 DP Attention 相关文章里,这里需要的是记住一个结论:reduce_results=False 不是「不做归约」,而是「归约由别处做」。在 LLaMA 里,因为层边界接管了归约,注意力的 o_proj 和 MLP 的 down_proj 构造时都拿到 reduce_results=not stage_boundaries,也就是默认 False。
还有一个细节容易被忽略:QKVParallelLinear 的 output_sizes 乘上了 tp_size:
self.output_sizes = [ self.num_heads * self.head_size * tp_size, self.num_kv_heads * self.head_size * tp_size, self.num_kv_heads * self.v_head_size * tp_size,]这些是全局尺寸,用于权重装载时判断外部张量应该切成几段。参数本身的形状用的是本 rank 尺寸(ColumnParallelLinear._initialize_partition 里再除一次)。同一个层里同时存在全局尺寸和每 rank 尺寸,是读这段代码时最容易混淆的点,建议在脑子里把两套数字分开放。
LlamaAttention:从配置到一次注意力调用
LlamaAttention.__init__ 的第一段是纯算术,把「模型的配置」翻译成「本 rank 的形状」。它和 QKVParallelLinear 内部的算术是同一套,但这里多做了三件事:把 head_dim 从配置里解出来、算出 RoPE 的维度、把 scaling 定下来。
self.total_num_heads = num_headsassert self.total_num_heads % tp_size == 0self.num_heads = self.total_num_heads // tp_size
self.total_num_kv_heads = num_kv_headsif self.total_num_kv_heads >= tp_size: assert self.total_num_kv_heads % tp_size == 0else: assert tp_size % self.total_num_kv_heads == 0self.num_kv_heads = max(1, self.total_num_kv_heads // tp_size)
self.head_dim = getattr(config, "head_dim", self.hidden_size // self.total_num_heads)partial_rotary_factor = getattr(config, "partial_rotary_factor", 1)self.rotary_dim = int(partial_rotary_factor * self.head_dim)self.q_size = self.num_heads * self.head_dimself.kv_size = self.num_kv_heads * self.head_dimself.scaling = self.head_dim ** -0.5为什么 head_dim 要 getattr? 标准 LLaMA 的 head_dim = hidden_size / num_heads(例如 4096/32=128),但 Mistral-Nemo 这类模型显式给了 head_dim,且它不等于 hidden/heads。如果不读配置,q_size 会和 qkv_proj 的输出宽度对不上,split 立刻报错。partial_rotary_factor 更少见——有些模型只对一部分维度施加 RoPE(例如部分维度留给内容、部分维度留给位置),此时 rotary_dim < head_dim。这两个 getattr 是模型层「兼容异构配置」的典型写法:默认值走主流路径,特殊模型通过配置覆盖。
为什么两个断言方向相反? 这是 KV 头复制规则的另一半。K >= P 时要求 K % P == 0(每个 rank 分到整数个真实 KV 头);K < P 时要求 P % K == 0(每个 KV 头被整数张卡复制)。如果配置不满足,构造期就失败,而不是等到运行时 shape 对不上——这是推理框架里常见的「fail fast」:模型配置和并行度不匹配属于部署错误,越早报错越好。
接下来是三个子模块:qkv_proj、o_proj、rotary_emb、attn。
self.qkv_proj = QKVParallelLinear(hidden_size, self.head_dim, self.total_num_heads, self.total_num_kv_heads, bias=bias, quant_config=quant_config, prefix=add_prefix("qkv_proj", prefix))self.o_proj = RowParallelLinear(self.total_num_heads * self.head_dim, hidden_size, bias=bias, quant_config=quant_config, reduce_results=reduce_results, prefix=add_prefix("o_proj", prefix))self.rotary_emb = get_rope(self.head_dim, rotary_dim=self.rotary_dim, max_position=max_position_embeddings, base=rope_theta, rope_scaling=rope_scaling, is_neox_style=rope_is_neox_style)self.attn = RadixAttention(self.num_heads, self.head_dim, self.scaling, num_kv_heads=self.num_kv_heads, layer_id=layer_id, quant_config=quant_config, prefix=add_prefix("attn", prefix))o_proj 的 input_size 是 total_num_heads * head_dim(全局),output_size 是 hidden_size,它按输入维切,所以构造时传全局输入尺寸、内部再除 tp_size。这一点和 QKVParallelLinear 的「同时存在全局与局部尺寸」是同一模式。
get_rope 把 head_dim、rotary_dim、rope_theta、rope_scaling、is_neox_style 收进去,返回一个 RotaryEmbedding 对象。它内部会预计算 cos/sin 表,并按 rope_scaling 选择 PI、NTK 或 YaRN 的变体。RoPE 的完整数学与实现可以看 RoPE 完全拆解:旋转位置编码的原理、实现与长度外推,本文只关心模型层如何把它接进来:RoPE 是每层一个对象,但 cos/sin 表通常跨层共享同一份缓存,所以构造 32 个层并不会生成 32 份表——具体共享策略由 get_rope 与运行期上下文决定。
RadixAttention 拿到的 num_heads、num_kv_heads 都是本 rank 的数字,它不再做并行算术,只负责「调用注意力」。这一点和 vLLM 的 Attention 模块不同:vLLM 的 Attention 同时承担层内并行与后端调用,SGLang 把并行算术留在模型层,RadixAttention 只保留调用契约。
一次前向因此分成三段:
q, k, v = self.forward_prepare_native(positions, hidden_states)attn_output = self.attn(q, k, v, forward_batch)output, _ = self.o_proj(attn_output)forward_prepare_native 就是 QKV 投影 + split + RoPE。forward_prepare_npu 是 NPU 专用路径:它把 QKV 的 split 与 RMSNorm + RoPE 融进一个设备内核(split_qkv_rmsnorm_rope),并且只在每段的第一层生成 cos/sin。这个分支说明模型层不只是「写死 CUDA」,而是把设备差异收在少数几个预处理函数里,主流程保持一致。
o_proj 的输出再回到层边界做汇总。注意 attn_output 的形状是 [tokens, num_heads * head_dim]——每 rank 自己的头,而 o_proj 的输入维正好就是这份局部宽度(它按输入维切,input_size=total_num_heads*head_dim,每 rank 拿 total/P,但局部头数恰好是 total/P,所以维度对得上)。这个「列并行输出宽度 = 行并行输入切片宽度」的等式,是 TP 能成立的根本原因。
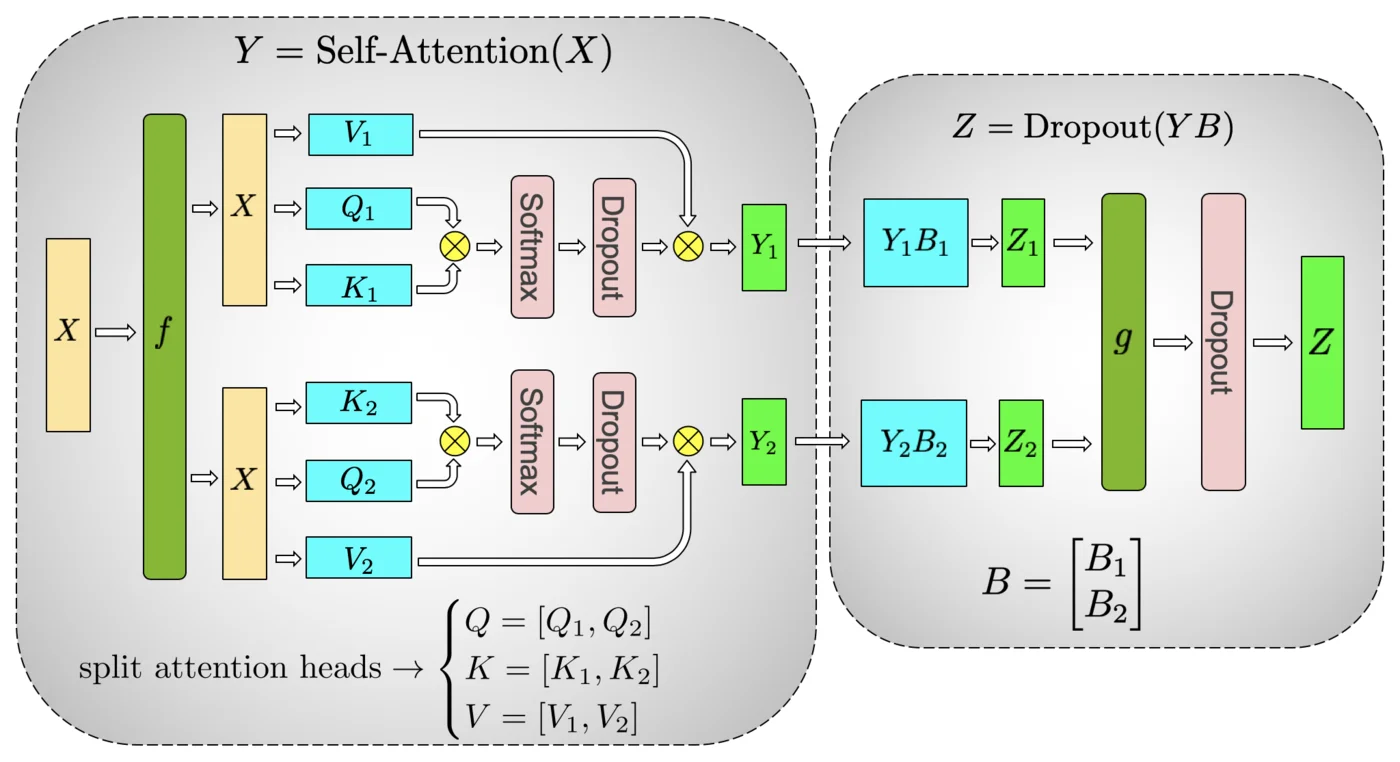
图:Megatron-LM 论文的多头注意力 TP 布局。每个 rank 持有若干个完整的头(Q、K、V 各自列并行),在头内完成 softmax 与加权,随后输出投影按输入维切(行并行),最后跨卡相加。SGLang 的 `QKVParallelLinear` + `RadixAttention` + `RowParallelLinear` 正是这套布局,只是 K/V 头数可以小于 query 头数(GQA)。
RadixAttention:名字里有 radix,但它不是前缀树
第一次读 layers/radix_attention.py 很容易误解:以为前缀树、KV 复用都发生在这个类里。实际上这个类只有两百多行,且没有任何树结构——它的 forward 做的是「形态检查 → 选择执行路径 → 交给注意力后端」。
名字的来源是历史:SGLang 最早把「用 RadixAttention 做前缀复用」作为核心卖点,注意力模块因此得名;后来前缀树搬进了调度器与 RadixCache,模块名保留了下来。今天它更准确的定位是:模型层与注意力后端之间的适配器。
构造时它保存本 rank 的头数、头维、缩放因子、层号、滑动窗口大小、attn_type(decoder / 双向 decoder / encoder-only)、位置编码模式和 logit_cap。这些字段不是给模型层用的,而是给后端用的——后端需要知道「这一层是不是滑窗」「是不是交叉注意力」「要不要对 logits 做 cap」。如果传了 quant_config,它还会向量化配置要一个量化方法并创建权重:
if quant_config is not None: self.quant_method = quant_config.get_quant_method(self, prefix=prefix)if self.quant_method is not None: self.quant_method.create_weights(self)这意味着 KV Cache 的量化 scale(k_scale、v_scale)是挂在 RadixAttention 上的参数,之后由 LlamaModel.load_kv_cache_scales 从外部文件读入并写到 layer.self_attn.attn.k_scale。这也解释了为什么模型层需要 load_kv_cache_scales 这个看起来「不该在模型里」的函数:scale 是逐层的、和注意力模块绑定的状态,模型层是唯一知道「第 i 层是哪个注意力对象」的地方。
forward 的前半段是形态整理:
if k is not None: k = k.view(-1, self.tp_k_head_num, self.v_head_dim if "k_rope" in kwargs else self.qk_head_dim) if "k_rope" not in kwargs: v = v.view(-1, self.tp_v_head_num, self.v_head_dim)q、k、v 进来时是二维 [tokens, width],这里 reshape 成三维 [tokens, heads, head_dim],因为后端内核需要头维。v_head_dim 与 qk_head_dim 分开,是为 MLA 这类 Q/K 与 V 维度不同的模型准备的(DeepSeek 的 MLA 中 V 的维度可以小于 Q/K);k_rope 则在 MLA 的「K 由 latent 与 rope 两部分拼成」时出现,此时 K 的宽度不是 qk_head_dim,不能按普通规则 reshape。这两个分支说明:同一个注意力入口要同时服务标准 GQA 和 MLA,模型层的差异被压缩成参数。
后半段是四条执行路径,按优先级依次判断:
- eager 路径:当前处于可断开的 CUDA Graph(breakable CUDA Graph)或整段 prefill 图的作用域内,且是 extend 模式,就走
_eager_attention。它只对「真实 token」执行注意力,把 padding 出来的行留到下一个图段;若本段真实 token 数为 0,直接把输出清零。 - 真实行重排路径:
padded_extend_real_tokens返回非空时,走_attention_on_real_rows,先把真实行挑出来算,再散回原位置。 - 常规后端路径:
get_attn_backend().forward(q, k, v, self, forward_batch, save_kv_cache, **kwargs)。 - 特殊稀疏路径:如果传入了
idx_q(索引器的 query),则同时返回索引器输出与主注意力输出,供 DSA 这类稀疏注意力使用。
为什么需要前两条?因为 CUDA Graph 要求静态形状,框架会把 batch padding 到固定大小。padding 出来的行如果也参与注意力,会写脏 KV、浪费算力,甚至因为 seq_len 不对而算错。_eager_attention 里那段 n = forward_batch.global_num_token_non_padded_cpu 就是在拿「真实 token 数」,只对前 n 行调用后端,其余行清零。这是「图必须静态、语义必须动态」之间的妥协,细节在 SGLang 源码完全拆解(九):CUDA Graph 与编译路径 里有完整讨论。
还有一个参数值得单独说:save_kv_cache。它默认 True,作为形参一路传到后端,最终决定内核是否执行 KV 写入指令;key_value_num_tokens 则允许「写入的 token 数」与「参与注意力的 token 数」不同。为什么需要这两个开关?最典型的是投机解码的验证前向:一次前向要同时处理目标模型已确认的 token 和若干草稿 token,草稿 token 的 K/V 即使写了,在被拒绝后也要回滚;而 draft_extend 之类的阶段,写入的 K/V 数与注意力查询数并不一致。模型层不关心「写到哪」、也不承担回滚,它只把「本次要不要写、写多少」告诉后端。
前缀树不在模型层,但模型层依赖它的两个约定
虽然 RadixAttention 不做前缀匹配,模型层仍然依赖 RadixCache 的两个约定,读代码时值得留意。
第一个约定是「KV 的物理位置由 ForwardBatch 携带」。 模型层从不计算「这条请求的 KV 在哪个页」。RadixAttention.forward 把 forward_batch 原样交给后端,后端从 forward_batch 里取 out_cache_loc、req_pool_indices、seq_lens 等元数据,再翻译成内核的索引。因此模型层的 layer_id 是它唯一需要知道的「位置信息」——后端用 layer_id 去 KV 池里取这一层的缓存。
第二个约定是「层号必须全局一致」。 RadixAttention(layer_id=layer_id) 里的 layer_id 是全局层号,不是本流水段内的局部下标。流水并行时,第 2 段的第 0 层实际是全局第 8 层,make_pp_layers 通过 layer_id=idx 保证传进去的是全局值。如果传成局部下标,KV 池会取错层,而且这种错误不会在形状上暴露——它只会让输出悄悄变差。这是读模型层时最值得警惕的一类 bug:形状对、语义错。
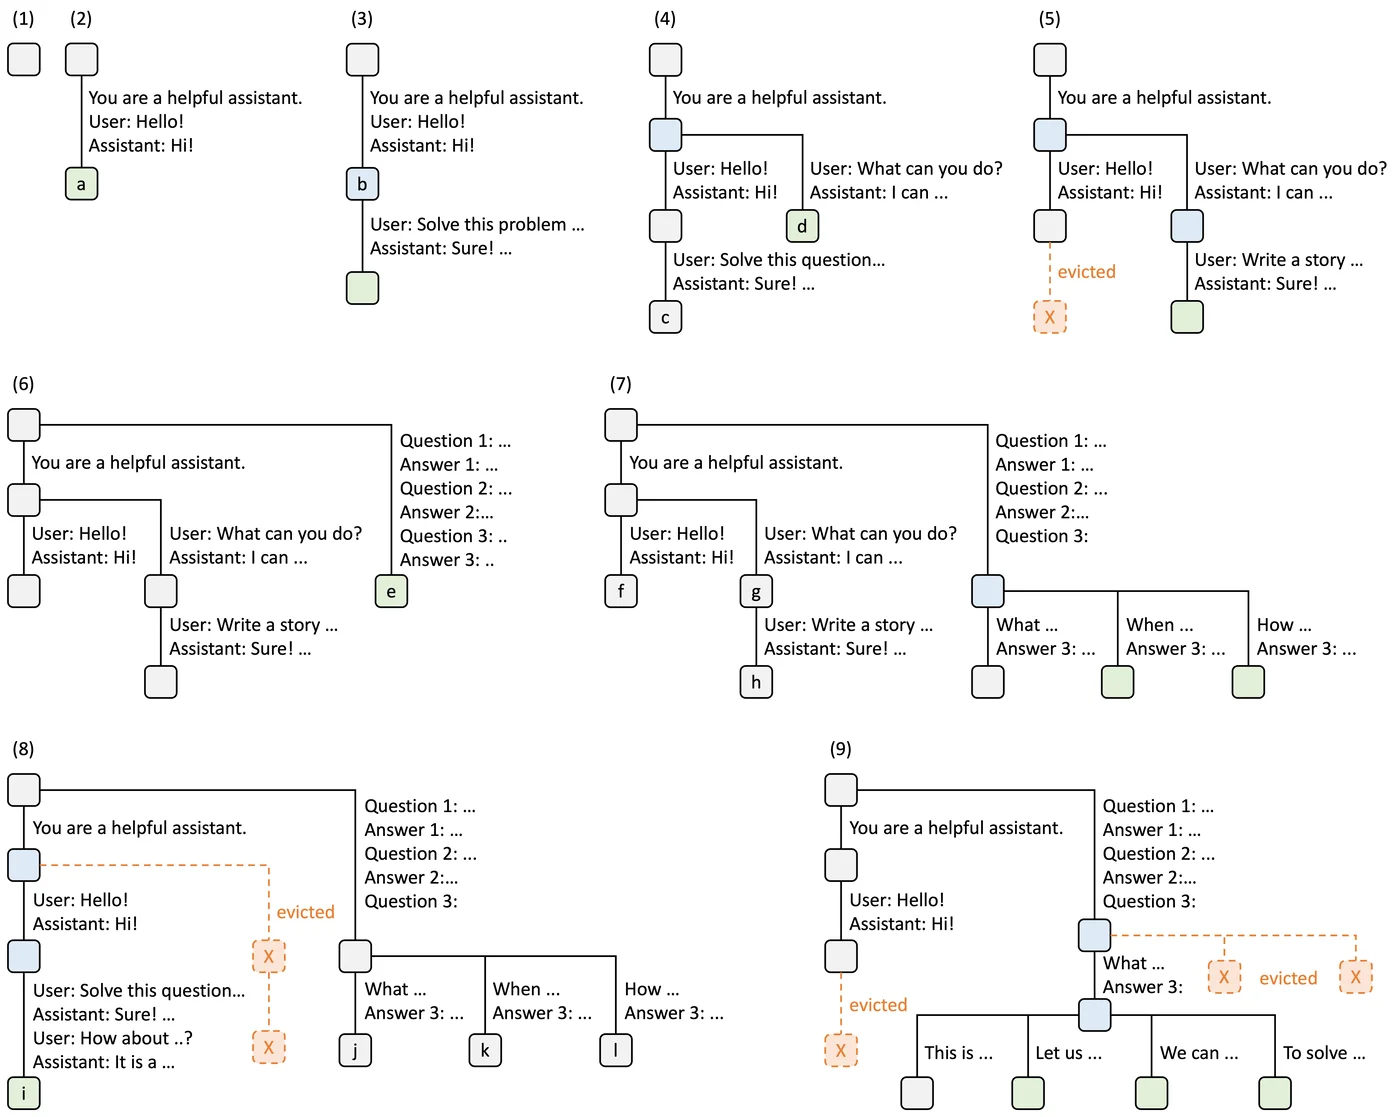
图:SGLang 官方博客中的 RadixAttention 前缀树示意。树节点保存一段 token 序列对应的 KV,多个请求共享同一前缀的节点,分叉后才各自占用新节点。模型层只负责按 `layer_id` 读写 KV;树结构、引用计数与淘汰发生在调度器和 `RadixCache` 里。
权重装载:同一个参数名,三种写法
模型层的 load_weights 是把「外部权重流的名字」映射到「已构造的空壳参数」。LLaMA 的权重来自 Hugging Face checkpoint,命名是 model.layers.0.self_attn.q_proj.weight;而框架内部是 model.layers.0.self_attn.qkv_proj.weight,且这张矩阵是三个张量拼起来的。stacked_params_mapping 就是这份映射:
| 外部张量名后缀 | 框架参数名 | shard 标识 |
|---|---|---|
.q_proj | .qkv_proj | "q" |
.k_proj | .qkv_proj | "k" |
.v_proj | .qkv_proj | "v" |
.gate_proj | .gate_up_proj | 0 |
.up_proj | .gate_up_proj | 1 |
装载的循环逻辑可以抽象成:
params_dict = dict(self.named_parameters())for name, loaded_weight in weights: # 1. 流水段过滤:不属于本段的层直接跳过 layer_id = get_layer_id(name) if layer_id is not None and not (start_layer <= layer_id < end_layer): continue # 2. 无关张量跳过 if "rotary_emb.inv_freq" in name or "rotary_emb.cos_cached" in name: continue # 3. 合并参数:拼接后交给该参数的 weight_loader for param_name, weight_name, shard_id in stacked_params_mapping: if weight_name not in name: continue name = name.replace(weight_name, param_name) param = params_dict[name] param.weight_loader(param, loaded_weight, shard_id) break这个循环有四个容易踩的坑,分别对应四行逻辑:
第一,流水段过滤要看全局层号。 每个流水段只装载自己负责的层,但外层循环遍历的是整个 checkpoint 的权重流,所以必须在按层号跳过非本段权重。这一步和前面「layer_id 必须是全局号」是同一约定的两个面。
第二,有些张量必须主动跳过。 rotary_emb.inv_freq 是 HF 推理时预计算的频率倒数,SGLang 自己在 get_rope 里按 rope_scaling 重新生成,不能直接加载;rotary_emb.cos_cached/sin_cached 则来自某些训练框架(如 ColossalAI)额外保存的缓存。这些张量如果被装进去,不仅占显存,还可能与框架自己的 RoPE 实现冲突。
第三,合并参数的 shard 切法由 weight_loader 决定,而不是模型层。 模型层只负责「把 .q_proj 改写为 .qkv_proj 并告诉它是 "q"」;真正「按头切、按 TP rank 取片、按量化格式打包」发生在 QKVParallelLinear.weight_loader 里。QKVParallelLinear._get_shard_offset_mapping 定义了各 shard 在合并矩阵里的偏移:
{"q": 0, "k": num_heads * head_size, "v": (num_heads + num_kv_heads) * head_size}注意这些偏移是本 rank 视图:num_heads、num_kv_heads 都是每卡的值,所以每个 rank 认为 Q 段是 [0, q_shard)、K 段紧随其后、V 段最后。外部张量先被按头切、再按偏移写进对应位置,切与拼在同一个 loader 里一次完成。
第四,FP8 权重的后缀要先归一化。 _legacy_load_weights 里有一段:「如果名字以 .activation_scale 结尾,就改名为 .input_scale;以 .weight_scale_inv 结尾,改名为 .weight_scale」;_load_weights_v2 则把它交给 get_weight_remap(self) 返回的 RemapRegistry。原因是不同来源的 FP8 checkpoint 有不同的 scale 命名习惯(有的用 activation、有的用 input;有的用 weight_scale_inv 表示逆缩放),而框架内部只认一套名字。把「命名归一」放在装载入口,而不是散落到每个量化层,是一种简化维护的策略。
两条装载路径:legacy 与 AutoWeightsLoader
SGLang 当前为 load_weights 保留了两条路径,由环境变量 SGLANG_ENABLE_WEIGHT_LOADER_V2 切换:
def load_weights(self, weights): from sglang.srt.environ import envs if envs.SGLANG_ENABLE_WEIGHT_LOADER_V2.get(): return self._load_weights_v2(weights) return self._legacy_load_weights(weights)_legacy_load_weights 是模型层自己写的循环,逻辑如上;_load_weights_v2 则完全交给通用的 AutoWeightsLoader:
loader = AutoWeightsLoader( self, skip_prefixes=skip_prefixes, # tie 时跳过 lm_head. skip_substrs=["projector", "model.vision_tower"], ignore_unexpected_suffixes=[".bias", ".kv_scale"],)mapper = get_weight_remap(self)loaded = loader.load_weights(weights, mapper=mapper)两者的分工很值得注意。legacy 路径里,每个模型文件都要自己写一遍「堆叠映射 + 流水过滤 + skip 规则」,LLaMA、Qwen、Mistral…几十个文件各一份。AutoWeightsLoader 把这些通用规则抽出来,模型层只需要提供「命名重映射」和「哪些不是我的参数」,其余交给通用装载器。这也解释了新版本里 LlamaMLP.load_weights、LlamaAttention.load_weights 为什么只剩十几行:它们把工作委托给 STANDARD_GATE_UP_MAPPING.try_load 和 STANDARD_QKV_MAPPING.try_load,这两个共享映射实现了「参数已经存在就直接装、需要拼接就按段拼」的统一逻辑,模型文件不再关心细节。
两条路径都返回一个已装载参数名的集合。这个返回值的用途是核对:上层可以比较「集合大小」与「模型参数总数」,发现漏装。漏装在推理里是灾难性的——未装载的参数保持 torch.empty 或零值,模型不会报错,只会输出无意义的结果。
tie_word_embeddings 在 v2 路径里还有一段补丁:checkpoint 里可能没有 lm_head.weight,因此跳过 lm_head. 前缀;装载完后再用 embed_tokens.weight 的数据通过 weight_loader 写进 lm_head 参数。为什么 tied 模型里 lm_head 仍然是一个独立参数?因为 LlamaForCausalLM.forward 里 self.lm_head 可能直接指向 self.model.embed_tokens(此时没有独立参数),但对某些量化方案,lm_head 需要独立的量化参数(scale 等),此时两者不能共用一个对象。_load_weights_v2 里这段补丁处理的是后一种情况:参数存在,但 checkpoint 不提供,就从嵌入复制过去。
输出侧:LogitsProcessor 与分布式词表
最后一层隐状态是 [tokens, hidden],要变成 [tokens, vocab] 的 logits。这一步看似只是一次矩阵乘,实际藏着三个推理特有的问题:分布式词表怎么收集、只选需要的行怎么省算力、logprobs 怎么算。
LogitsProcessor 的入口是:
self.logits_processor(input_ids, hidden_states, self.lm_head, forward_batch, aux_hidden_states)它拿到的 lm_head 是 ParallelLMHead,按词表维切分:每个 rank 持有 vocab/P 行的 [vocab/P, hidden],做一次 GEMM 得到本 rank 的 logits 片(形状 [tokens, vocab/P]),然后沿词表维 gather 拼成完整 logits,或者只在采样需要时才收集。
第一个问题:为什么按词表维切,而不是按隐藏维切? 按隐藏维切的话,每个 rank 也会输出一个「部分 logits」,但需要跨卡相加才能得到完整值,而 softmax 采样需要完整值——这意味着一次 all-reduce,数据和输出一样大。按词表维切,一次 all-gather 就够了,且 logits 只是切片,不涉及浮点求和,确定性更好。这正是词表维上的并行账:嵌入查表、LM Head 切分与 logits 收集的跨框架拆解 里横向比较的结论,这里不再展开。
第二个问题:prefill 时只有最后一行的 logits 有用。 一条 prefill 请求计算出成千上万个位置,但只有最后一个位置需要采样下一个 token。如果把每个位置的 logits 都算出来再 gather,会浪费大量带宽(vocab × prompts_len 的 logits 传输)。LogitsProcessor 会按 forward_batch 里的「需要采样的行」选择行——通常是 prefill 的最后一行、decode 的唯一一行、投机验证的每个候选行。选行发生在计算 lm_head 之前还是之后,取决于具体的 gather 策略;选行越早,省掉的 GEMM 越多。
第三个问题:aux_hidden_states 的去向。 投机解码时,被选中层捕获的中间隐状态要和主 logits 一起返回,供草稿头使用。它走的是同一个 LogitsProcessorOutput 结构,而不是另开一条返回路径——这一点让「同一次前向同时服务执行端和草稿端」在接口层成为可能。
pooler 则用在嵌入场景:不复用 lm_head,直接对 hidden_states 按 LAST 池化再 L2 归一化,输出 [tokens, hidden] 的向量。注意池化也要处理「哪些行是有效 token」——和注意力里的 padding 问题同源:CUDA Graph 下 batch 被 padding,池化必须按 forward_batch 里的真实长度取最后一行,而不是简单取张量的最后一行。
Qwen3:同一套骨架,几处扩展
把 Qwen2/3 对照 LLaMA 看,能清楚看出这套五层骨架的扩展点。models/llama.py 的文件头就写着 adapted 自 vLLM 的 LLaMA 实现,而 Qwen3 文件里的结构几乎照搬,差异集中在四处:
Qwen3Attention多了 QK-Norm。 它在head_dim维度上各放一个RMSNorm(q_norm、k_norm),对 Q 和 K 在进入 RoPE 之前做归一化。这直接影响模型层:预处理要多两步 norm,而这两步可以和 RoPE 融合。当前源码里为此准备了多条融合路径——CUDA 上的table_qk_norm_rope、AMD 上的aiter融合内核(fused_qk_norm_rope_cache_pts_quant_shuffle),以及普通路径。融合是否启用由get_exec().kernel.enable_fused_qk_norm_rope和具体设备决定,模型层只负责探测并选择。- 并行组写死为
attn_tp。Qwen3Attention的qkv_proj、o_proj都传parallel_group="attn_tp",o_proj的reduce_results=False。这意味着 Qwen3 的注意力层已经假定「注意力与 FFN 可能在不同宽度的组上」,归约交给边界。 - RoPE 的默认参数不同。
rope_theta = 1000000、max_position_embeddings = 32768,说明它是长上下文模型,cos/sin 表的构造参数和 LLaMA 不同,但接口完全一致。 Qwen3Model继承Qwen2Model,并通过构造参数decoder_layer_type=Qwen3DecoderLayer把层类换掉。 嵌入、层堆叠循环、最终 norm 全部复用,只有层类不同。Qwen3ForCausalLM则是一个独立的nn.Module(不是继承Qwen2ForCausalLM),但它的装配线与 LLaMA 顶层几乎逐行对应:model、lm_head、logits_processor、pooler、stacked_params_mapping。这说明「顶层装配线」是约定俗成的模板,而「层类」才是模型之间真正的差异点。把层类做成Qwen2Model的构造参数,是比继承整条模型更轻的扩展方式:复用骨架,只替换一层。
同时,Qwen3DecoderLayer 依然调用 append_stages 建立边界,并声明 declare_attn()、declare_ffn(sparse=False, next_layer_sparse=False)——说明层边界不是 LLaMA 专属,它是模型层的通用基础设施,任何稠密模型都可以用。这也解释了为什么 make_layers 要接受 stage_facts:只要一个模型声明了阶段,就必须能回答「第 i 层声明了什么」,否则流水并行时跨段绑定无从谈起。
一个反面例子可以说明「是否要新写一个模型文件」的判据:模型如果只在子模块内部(注意力、FFN、norm)不同,通常复用骨架、替换子模块;如果层与层之间的连接不同(残差形式、跨层共享、门控),就需要自己的 DecoderLayer,并且很可能要自定义 stage_facts 甚至关闭 stage_boundaries。前者对应 Phi3、InternLM3 直接继承 LlamaForCausalLM;后者对应 DeepSeek 系列、GLM 这类带非线性层间结构的模型,它们需要自己的层类和连接声明——这正是 layer_boundary 之所以做成可声明、可扩展的原因:它必须同时容纳「标准残差」和「非标准连接」。
和另外三个框架的模型层对照
同样一层「模型定义」,四个框架的写法差异很大,这些差异不是风格问题,而是各自对「谁来承担并行与后端适配」的不同回答。
| 维度 | SGLang | vLLM | TensorRT-LLM | llama.cpp |
|---|---|---|---|---|
| 模型组织 | nn.Module,五层结构 | nn.Module,结构类似 | nn.Module(PyTorch 后端) | C++ 函数建图,无模块树 |
| 找到模型类 | 模块级 EntryClass + pkgutil 扫描 | 静态映射表 + 脚本生成校验 | 懒加载注册表 + 装饰器 | llm_arch 枚举 + 分支 |
| 并行切分 | 线性层自带 parallel_group,注意力可独立成组 | 线性层读全局 TP 组 | Linear 模块封装列/行并行与量化 | 张量切分在加载与图构建里完成 |
| 注意力入口 | RadixAttention 适配器 + 后端 | Attention 层 + 后端 | Attention 模块 + AttentionMetadata | 图里直接构造 flash_attn_ext 节点 |
| 残差与归约 | 层边界统一接管 | 层内实现 + 自定义 op | 层内实现 + 融合 | 图节点显式相加 |
| 权重命名映射 | stacked_params_mapping + AutoWeightsLoader | AutoWeightsLoader + WeightsMapper | 每模型 load_weights + 显式映射 | 张量名表 + 架构专属加载器 |
vLLM 的模型层更像「标准答案」。 它的 LlamaForCausalLM、LlamaModel、LlamaDecoderLayer 结构与 SGLang 几乎一致(SGLang 的文件头也承认 adapted 自 vLLM),差异主要在注意力模块:vLLM 的 Attention 类内部直接持有 num_heads、num_kv_heads、head_size,并在 forward 里构造后端需要的 metadata;SGLang 把这些算术留在 LlamaAttention,RadixAttention 只做适配。两种切法各有代价:vLLM 的封装更紧,模型文件更短;SGLang 的注意力模块与模型解耦,MLA、稀疏注意力等特殊形态更容易插进来。
TensorRT-LLM 的模型层承担了最多的显式工作。 它没有 SGLang 那样的层边界抽象,残差、norm、归约都写在层里;换来的是每一处都可以针对具体模型手写融合,因为它的目标不是「支持所有架构」,而是「把重点架构压到极限」。它用 AttentionMetadata.prepare 把调度信息编译成各后端需要的索引数组,这一点和 SGLang 的「后端从 ForwardBatch 自取」形成对照:前者把准备工作集中到一处,后者把契约分散到后端。
llama.cpp 根本没有 nn.Module 这一层。 它的模型定义表现为「架构枚举 + 张量名表 + 建图函数」:llama_model 持有张量,llama-graph.cpp 按架构把计算图搭出来,残差就是图里的 ggml_add 节点。因此它没有「并行线性层」这种对象,TP 通过 meta device 与张量切分策略在加载期完成(参见 llama.cpp 源码完全拆解(二十九):Meta device 与张量并行)。这种写法的好处是图完全可控、没有 Python 开销;代价是每加一个模型都要写一份建图代码,且很难像 Python 框架那样用继承复用。
一个值得注意的趋同:四个框架都在把「模型定义」和「执行策略」分开。 SGLang 用层边界声明、vLLM 用自定义 op 与后端抽象、TensorRT-LLM 用 attention backend 与 metadata、llama.cpp 用图构建与后端调度器。模型层越来越像「声明结构」,性能优化越来越像「在结构之上选计划」。读模型层代码时,抓住这条分界线,就不会把「结构」和「策略」混在一起看。
读模型层代码的一条实用路径
如果要在半天内读懂一个新模型在 SGLang 里的实现,可以按下面的顺序:
- 先看文件末尾的
EntryClass:确认这个文件登记了哪些架构,以及它们之间是继承还是并列。 - 看
XxxForCausalLM.__init__:确认lm_head是否 tied、stacked_params_mapping有哪些行、有没有capture_aux_hidden_states之类的特殊钩子。这三项决定了权重装载和输出侧行为。 - 看
XxxModel.__init__:确认嵌入是否 vocab 并行、层是怎么被make_pp_layers造出来的、最终 norm 放在哪。流水并行的所有特殊性都在这里。 - 看
XxxDecoderLayer.__init__与forward:确认它是标准两段式(attn + ffn),还是有额外的跨层连接;确认stage_boundaries是真是假、stage_facts声明了什么。这一步决定你是否需要读层边界。 - 看
XxxAttention.__init__:把num_heads、num_kv_heads、head_dim三个数字和tp_size放在一起算一遍,确认 K/V 是切分还是复制;确认 RoPE 的rotary_dim与is_neox_style。 - 最后看
load_weights:确认命名映射与特殊跳过规则。到这一步,你已经能解释「权重文件里的每个张量去了哪」。
反过来,如果只是想定位一个 bug,顺序可以倒过来:先看 load_weights 有没有漏装,再看注意力的头数算术,最后才怀疑后端。模型层的 bug 有一个共同特征:不报错、只掉点。头数算错、层号传错、tied 权重装重,都会让模型「能跑但不对」,而形状检查往往拦不住。
小结
模型层的工作可以压缩成一句话:把一份 Hugging Face 配置翻译成一组形状正确、并行正确、命名正确的模块,再把执行策略留给边界与后端。
- 注册表用
EntryClass约定把架构名映射到类,模块级扫描 + 懒加载是它的工程取舍。 - 顶层
LlamaForCausalLM只做装配:tied 词表、并行 LM Head、logits 处理、权重映射表、投机解码的隐状态钩子。 LlamaModel负责嵌入、流水线切片与层堆叠,PPMissingLayer让每个流水段都「看起来有全部层」。LlamaDecoderLayer把残差、norm 与跨卡归约交给层边界,自己只剩两段纯计算。QKVParallelLinear的 KV 头复制规则会一路传导到 KV Cache 的物理布局;RowParallelLinear的 bias 只在 rank 0 加,是利用归约抵消的经典技巧。RadixAttention不是前缀树,而是模型层与注意力后端之间的适配器;KV 的物理位置由ForwardBatch携带,layer_id必须是全局号。- 权重装载的关键在「先改名、再按 shard 拼」,legacy 与
AutoWeightsLoader两条路径共存。 - 输出侧的三个问题是分布式词表收集、只选需要的行、以及 aux hidden states 的随行返回。
下一篇将接着拆层边界的执行侧:prepare / finish 如何从残差流里读、如何把部分和补齐,StagePath 的布局变体在 prefill、decode、TBO、上下文并行下分别选哪一条,以及 reduce-scatter 替代 all-reduce 的边界条件。
参考资料
- SGLang 仓库(
sglang/srt/models/llama.py) - SGLang 仓库(
sglang/srt/layers/radix_attention.py) - SGLang 仓库(
sglang/srt/layers/linear.py) - SGLang 仓库(
sglang/srt/layers/layer_boundary/factories.py) - SGLang: Efficient Execution of Structured Language Model Programs
- Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
- vLLM 仓库(模型层的对照实现)
- TensorRT-LLM 仓库
- llama.cpp 仓库
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



