


SGLang 源码完全拆解(二十八):线性层的并行契约——一个 Linear 同时管着怎么切、怎么装、怎么算、怎么归约
这一篇要回答的问题
第二十五篇站在模型层的视角,看过一个 LLaMA 层如何被装配起来;第二十六篇从 MoE 的 MLP 出发,看一个算子在模型层、算子层与后端之间如何被分派。两篇都碰到同一个对象,但都只是擦肩而过:layers/linear.py 里的那几个 xxxParallelLinear。
它们是整个框架里最不起眼、也最容易被误解的一类代码。表面上,它们只是「带切分的 nn.Linear」:拿一个浮点张量进来,做一次矩阵乘,吐一个浮点张量出去。但一个推理框架里的 Linear 远不止做这一次乘法。它同时承担四份互相独立的契约:
- 并行契约:这条权重在一组 rank 上怎么切——切输出维还是切输入维,切到「头」的粒度还是「列」的粒度,K/V 头数少于切分份数时又该怎么办。
- 装载契约:磁盘上的一个张量(或者三个分开的张量)如何被切成本 rank 的那一片,scale 和打包格式在这条路径上被如何换算。
- 计算契约:真正发出 GEMM 的不是 Linear 自己,而是挂在上面的量化方法;Linear 只负责「把形状和参数交给它」。
- 归约契约:行并行的输出是部分和,谁来做那次 all-reduce——是这一段自己,还是上层的层边界,还是更外层的 DP Attention 组。
这四份契约在代码里是分开定义、分开演化的。一个刚读代码的人最容易犯的错,是把它们当成同一件事:看到 tp_size 就以为切分、装载、归约用的是同一个组;看到 reduce_results=False 就以为「这里不做归约」;看到 weight_loader 就以为只是「切片再 copy」。
这一篇要做的,就是沿着 sglang/srt/layers/linear.py(约两千行)和 sglang/srt/layers/parameter.py,把这四份契约逐份拆开,说明每一份在哪些类里、以什么参数形式出现、为什么必须这样设计。读完应当能做到:给任意一条模型层的 Linear...(...) 构造语句,都能在脑海里复原出「每个 rank 上这块权重是什么形状、它从磁盘的哪个位置来、前向发出去的是哪个 kernel、结果要不要跨卡求和」。
和前三篇的关系是这样的:第二十五篇讲的是模型层怎么摆这些 Linear,第二十六篇讲的是MoE 算子怎么分派后端,本篇讲的是Linear 自己——它是两者共用的最底层积木。KV 池、注意力后端、层边界这些相邻话题在前文都已拆过,本篇只在必需时引用结论。
先说清楚本文的语境。SGLang 的 linear.py 文件头第一行就写着「Adapted from vLLM」,核心的四个类——不切、列并行、行并行、QKV 并行——沿用的是 vLLM 的设计。SGLang 在其上做了两类改造:一是把并行组显式化(parallel_group 参数),二是在前向里接入了层边界与 DP Attention 的归约归属。这两类改造正是本篇与「只想了解 TP 基本原理」的文章之间的差别。
张量并行的基本形态:列并行与行并行
在拆 SGLang 的代码之前,先把张量并行(Tensor Parallelism,TP)的基本算术摆清楚。Megatron-LM 在 2019 年的论文《Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism》(Shoeybi 等,arXiv:1909.08053)给出了 Transformer 的两种切法,这套切法至今在所有推理框架里都能看到影子。
一个全连接层写成 ,其中 ( 是 token 数、 是输入维),,。要在 个 rank 上分摊,只有两种不引发中间通信的切法:
列并行(Column Parallel):把 按输出维切成 段,,每段 。每个 rank 拿完整的 ,算 ,尺寸 。切分沿「列」方向进行,输入不需要任何重排,前向无通信;代价是输出被切开了,如果下游需要完整的 ,就得一次 all-gather。
行并行(Row Parallel):把 按输入维切成 段,叠起来 ,每段 。此时每个 rank 只能算一部分内积:
其中 是 沿输入维的第 段。每段的乘积 是一张完整的 矩阵,把 份加起来才得到真正的 。所以行并行的输出是部分和,必须做一次跨 rank 的 all-reduce(或 reduce-scatter)。
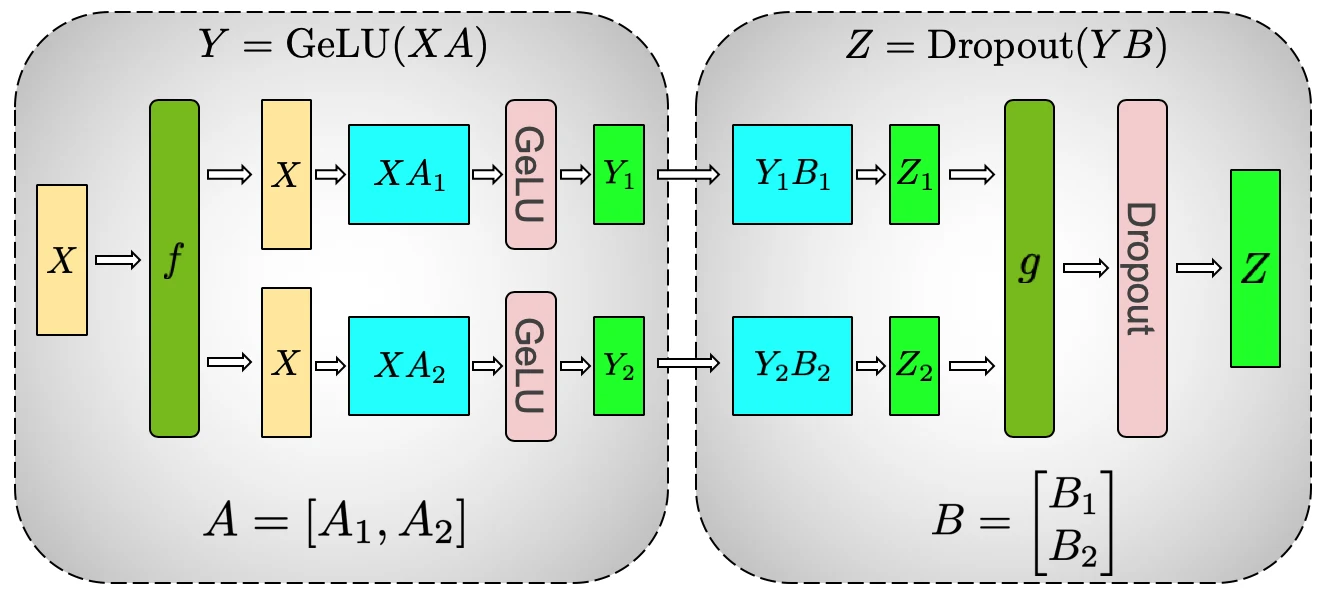
图:Megatron-LM(Shoeybi 等,2019)给出的 MLP 并行切分。第一段 `f` 是列并行,各 rank 只持有本 rank 的中间激活;第二段 `g` 是行并行,各 rank 的结果先求和(`f` 箭头处的 $\oplus$)再进入 dropout。这正是 SGLang 的 `gate_up_proj` + `down_proj` 这一对的结构。来源:arXiv:1909.08053。
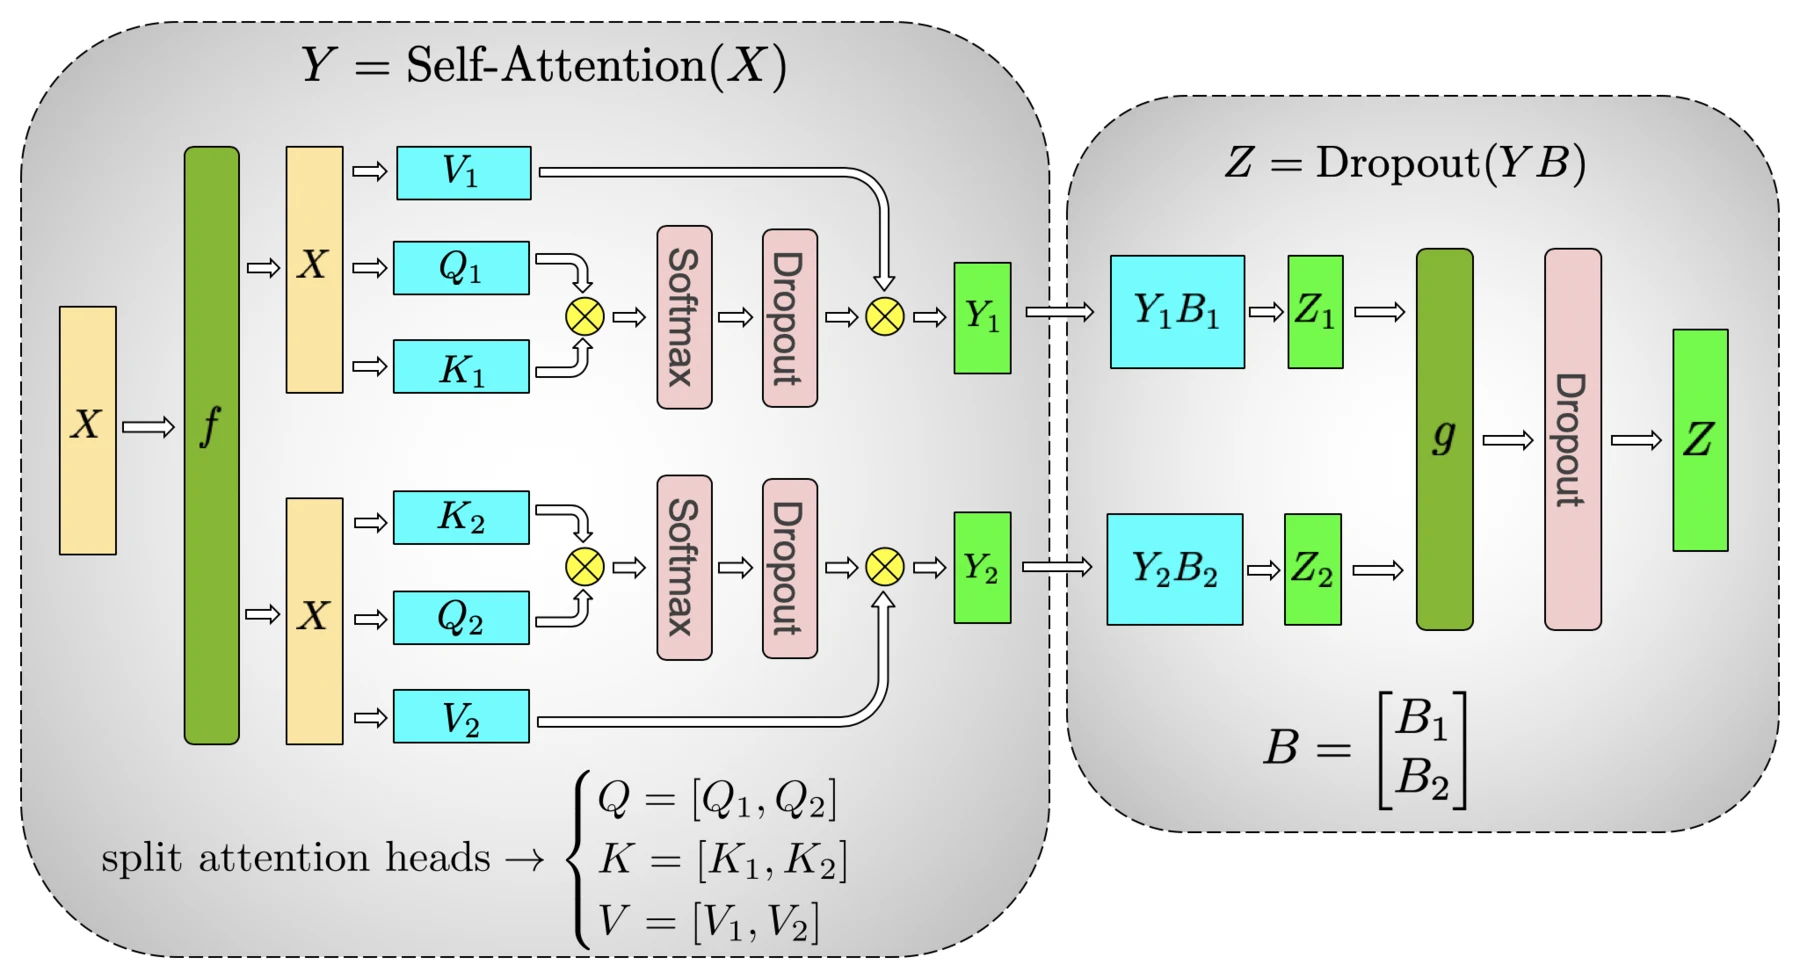
图:Megatron-LM 的多头注意力切分。Q、K、V 三个投影都按「头」切分,每个 rank 只算自己那几个头的注意力;输出投影按输入维(也就是头维的拼接维)切成行并行,最后在 $Z$ 处求和。SGLang 的 `QKVParallelLinear` + `RowParallelLinear`(`o_proj`)与此一一对应,区别只在「头数不能被整除时怎么办」。来源:arXiv:1909.08053。
把两张图放在一起看,Transformer 层的 TP 形态就出来了:注意力的 QKV 投影是列并行、输出投影是行并行;MLP 的 gate/up 投影是列并行、down 投影是行并行。也就是说,一次前向里每段行并行之后恰好跟着一段可以吸收归约的逐元素操作(dropout、残差加法、下一层的 norm),Megatron 的原始设计就是把归约夹在两段列并行之间,让通信次数等于「层数 × 2」而不是「层数 × 每层 4 个线性层」。
SGLang 的四个类——ReplicatedLinear、ColumnParallelLinear、RowParallelLinear、QKVParallelLinear——与这套形态一一对应。其中 QKVParallelLinear 是列并行的一个特化,专门处理「按头切、且 GQA 下 K/V 头可能不够切」的情形。MergedColumnParallelLinear 则是把若干段列并行在输出维上拼接成一个参数,目的是把 gate 与 up 两次投影合并成一次 GEMM。
四份契约的对照表
在展开细节前,先把四份契约在代码里的落点列出来。这张表是本文的纲,后面的每一节都是在它的一行里往下挖。
| 契约 | 回答的问题 | 落点 | 受什么影响 |
|---|---|---|---|
| 并行契约 | 权重在哪些 rank 上切、切哪个维 | 构造期 parallel_group → _resolve_linear_group → tp_group | TP 规模、atten-TP 规模、CP、独立 K/V 组 |
| 装载契约 | 磁盘上哪一段进到本 rank 的哪个位置 | weight_loader / weight_loader_v2 + parameter.py 的 ModelWeightParameter 等 | 量化打包格式、scale 形状、GQA 复制、preshard |
| 计算契约 | 谁来发 GEMM | quant_method.create_weights + quant_method.apply | 量化配置、内核后端 |
| 归约契约 | 部分和谁求和、在哪个组上求和 | forward 里的 reduce_results、skip_all_reduce、use_dp_attention_reduce | 层边界、DP Attention、序列并行 |
最容易出 bug 的地方恰恰在这四份契约的交叉点上:并行契约选了 attn_tp 组,装载契约却按 tp 组去切;归约契约把 reduce_results 交给上层,上层却没接住;量化方法换了一套参数名,装载器却没换 v2 版本。这些错的共同形态是「每一份契约单独看都自洽,拼在一起就错位」。
并行契约(一):并行组是显式传入的
打开 ColumnParallelLinear.__init__,第一个不寻常的地方是它不读全局的 tp_size,而是先解析一个 parallel_group:
class ColumnParallelLinear(LinearBase): def __init__(self, input_size, output_size, ..., parallel_group=None, ...): self._initialize_partition(..., parallel_group=parallel_group, tp_group=_resolve_linear_group(parallel_group))
def _initialize_partition(self, ..., tp_group, parallel_group=None, ...): self.tp_group = tp_group self.parallel_group = parallel_group _, tp_size = get_group_rank_size(tp_group) super().__init__(input_size, output_size, skip_bias_add, params_dtype, quant_config, prefix) ... self.output_size_per_partition = divide(self.output_size, tp_size)parallel_group 的取值是一个联合类型:
LinearParallelGroup = ( Literal["tp", "attn_tp", "replicated", "shared_experts_tp"] | ReplicatedParallelGroup)四个字符串,加上一个结构体。它们分别对应「普通 TP」「注意力 TP」「完全不切」「共享专家 TP」,以及「在某个组内再按相邻 rank 复制份数合并权重」。_resolve_linear_group 负责把名字翻译成一个组对象,翻译过程分三档:
def _resolve_linear_group(parallel_group): if isinstance(parallel_group, ReplicatedParallelGroup): group = _resolve_linear_group(parallel_group.group) if group is None: if parallel_group.replica_size != 1: raise ValueError("Cannot replicate a size-one group") return None return _ReplicatedGroup(group, parallel_group.replica_size) if parallel_group == "replicated": return None name = "tp" if parallel_group is None else parallel_group if name not in ("tp", "attn_tp", "shared_experts_tp"): raise ValueError(f"Unknown linear parallel_group: {parallel_group!r}") parallel = get_parallel() try: group = getattr(parallel, f"{name}_group") except RuntimeError: group = None if group is None: if name == "shared_experts_tp": raise ValueError(f"The {name} group must exist before construction") size = getattr(parallel, f"{name}_size") if size > 1: return _LogicalGroup(getattr(parallel, f"{name}_rank"), size) return group这里有几个设计点值得停一下。
第一,None 表示「不切」,而不是「默认 TP」。 parallel_group == "replicated" 返回 None;而默认值 None(没传参数)反而被翻译成 "tp"。这个反直觉的约定必须记住,因为 get_group_rank_size(None) 返回 (0, 1)——不切时 rank 是 0、规模是 1,divide(output_size, 1) 就是原尺寸。所以「传 None」和「不传」是两件完全不同的事,读代码时看到 parallel_group=parallel_group 这种透传,要回溯到调用方才知道真正的值。
第二,构造期可能拿不到真正的通信组。 模型层在构造 Linear 时会建一堆 M 维大小为 0 的空参数,这时 NCCL 通信组可能还没建好。代码的处理是退回 _LogicalGroup——一个只记了 rank_in_group 和 world_size 的冻结结构体:
class _LogicalGroup(msgspec.Struct, frozen=True): """Own a weight partition before distributed communication is initialized.""" rank_in_group: int world_size: int也就是说,切分算术只需要「我是第几个、一共有几个」两条信息,根本不需要通信对象。这个抽象让「构造期定形状」与「运行期做集合通信」彻底解耦:形状可以早早定下来,通信等到前向时才发生。shared_experts_tp 是唯一的例外,它要求组必须已经存在——因为共享专家的切分份额要与其他组对齐,不能等到运行期再补。
第三,组的选择不是越多越好,而是有严格语义的。 attn_tp 是 DP Attention 拓扑下「注意力线性层实际使用的 TP 组」。SGLang 的 derive_attn_tp_size 写得极简:
def derive_attn_tp_size(*, tp_size: int, attn_cp_size: int, attn_dp_size: int) -> int: return tp_size // attn_dp_size // attn_cp_sizeTP 组被切成 attention-DP 与 attention-CP 两个维度之后,剩下的才是 attention-TP。rank 的排列顺序是 (dp, cp, tp)、tp 变化最快:
代码里对应的两行是 tp_rank % attn_tp_size 与 tp_rank // (attn_tp_size * attn_cp_size)。想通这个公式的办法是:最低若干位是 tp、其上是 cp、再上是 dp——一个标准的「多维坐标按行主序展平」问题。DP Attention 的动机(注意力走数据并行以扩 KV 容量、MoE 走专家并行)在 SGLang 源码完全拆解(十七):DP Attention 与专家并行 里已详细拆过,这里只取它的结论:注意力线性层必须用 attn_tp 组,不能用全局 tp 组,否则在 DP 副本之间存在多余的切分,前向会算错形状。
模型层的调用点印证了这一点:Qwen3Attention 的 qkv 与 o_proj 都写死 parallel_group="attn_tp"(models/qwen3.py),而 LlamaMLP 的默认值是 "tp"。同一个注意力里,o_proj 还额外把 reduce_results 设成 False——归约交给层边界。这就把「用哪个组」与「在哪个组上归约」分成了两件事,后面的第四节专门讲。
为什么必须是「组」而不是「规模」
如果只需要一个 tp_size 整数,几乎所有场景也能算对形状;那为什么要把整个组对象传进来?关键在于rank 的排列方式。parallel_state.py 里构造注意力 TP 组时的注释给出了一个 8 卡的具体排布:attn_cp_size=2、attn_tp_size=4、attn_dp_size=2(由 tp_size // attn_cp_size // attn_dp_size 反推得 tp_size=8)时,注意力 TP 组是 [g0,g1,g2,g3] 与 [g4,g5,g6,g7],上下文并行组是 [g0,g4] …。组内 rank 的编号是连续的,但成员在全局的编号并不连续——attn_tp_rank 是 tp_rank % attn_tp_size,而 attn_dp_rank 是 tp_rank // (attn_tp_size * attn_cp_size)。
一个只有规模的整数无法同时回答「我在组里是第几」与「我的组是哪一个」。装载器需要前者(tp_rank * shard_size 的偏移),归约时集合通信需要后者(在哪个通信器的成员列表里)。GroupCoordinator 同时提供这两个量(rank_in_group 与 world_size),因此 Linear 的每个需要切分的属性都存的是组对象,而不是规模数字。_LogicalGroup 是这个需求在「通信尚未初始化」时的最小实现——只提供这两个量的冻结结构体。
构造顺序:tp_group 为什么必须早于 super().__init__
ColumnParallelLinear._initialize_partition 里有一个很容易被略过的顺序:
# Bind the selected group before quantization creates weight loaders.self.tp_group = tp_groupself.parallel_group = parallel_group_, tp_size = get_group_rank_size(tp_group)super().__init__(input_size, output_size, skip_bias_add, params_dtype, quant_config, prefix)self.tp_group 在 super().__init__ 之前就赋值,而 super().__init__ 内部会调用 quant_config.get_quant_method(self, prefix)。这个顺序是依赖链:量化方法在构造期可能要读 layer.tp_group 来决定本层参数的形状或选择哪个参数类;如果组还没绑定,读到的就是 LinearBase 的类属性默认值 None,get_group_rank_size 返回 (0, 1),于是整层按「不切分」造出错误形状,而且不会立刻报错——要么装载时某个 assert 才炸,要么等到前向形状不匹配才暴露。
LinearBase 把 tp_group 声明成类属性默认 None,既让未绑定的层能安全调用 get_group_rank_size,也给了 replicated 层一个合法状态:不切分就是 None。同一行默认值同时服务两种语义,读的时候要清楚当前是哪一种。
复制并行组:权重复制,通信不复制
parallel_group 的最后一个取值是结构体 ReplicatedParallelGroup,它的文档字符串只有一句话,但信息量很大:
class ReplicatedParallelGroup(msgspec.Struct, frozen=True): """Share weight partitions across consecutive ranks; collectives stay separate.""" group: Literal["tp", "attn_tp"] replica_size: int两个字段:底层组(只能是 tp 或 attn_tp)与复制份数。解析时它被包成 _ReplicatedGroup:
class _ReplicatedGroup(msgspec.Struct, frozen=True): group: GroupCoordinator | _LogicalGroup replica_size: int
def __post_init__(self): divide(self.group.world_size, self.replica_size)
@property def rank_in_group(self): return self.group.rank_in_group // self.replica_size
@property def world_size(self): return self.group.world_size // self.replica_sizerank_in_group 与 world_size 都做了整数除法,所以从 Linear 的角度看,原来 8 个 rank 的 TP 组变成了 4 个「逻辑 rank」;每 replica_size=2 个相邻物理 rank 共享同一份权重分区。但注意它的名字:collectives stay separate——前向做集合通信时用的仍是那个完整的 8 rank 组,复制只发生在权重分区这一层。
它与 replicated 的区别要分清:
| 取值 | 权重分区数 | 每 rank 是否持有完整权重 | 集合通信域 |
|---|---|---|---|
"replicated" | 1 | 是 | 无(tp_group=None) |
ReplicatedParallelGroup(..., replica_size=2) | P/2 | 否,只持有 1/(P/2) | 仍是完整 P |
"tp" | P | 否,只持有 1/P | 完整 P |
__post_init__ 里那句 divide(group.world_size, replica_size) 是构造期的硬检查:复制份数必须整除组规模,否则逻辑分区会残缺,直接报错比运行期算错好。
这套机制解决的是一个具体矛盾:有些层的权重需要在一小组 rank 上重复(这样这一小组可以独立算各自的数据),但它们仍要参与全组的集合通信。GQA 里 K/V 头的复制(num_kv_head_replicas)是同一个思想在「头」粒度上的特化;ReplicatedParallelGroup 把它提升到「任意 Linear」的组粒度。两者的区别在于:前者由 QKVParallelLinear 内部按头数自动推导,后者由模型层显式声明,适用于任何列并行或行并行层。
前向里的分支也印证了「通信不复制」:ColumnParallelLinear.forward 用 if self.parallel_group == "replicated" / elif == "attn_tp" / elif == "tp" 三个字符串比较来选通信域;ReplicatedParallelGroup 是结构体,不匹配任何一个,于是落到 else 分支的全局 all-gather。这不是遗漏,而是语义一致:复制组的集合通信就该走完整组。
第四,K/V 可以有独立的并行组。 QKVParallelLinear 除了 parallel_group,还有一个 kv_parallel_group:
kv_tp_group = (_resolve_linear_group(kv_parallel_group) if kv_parallel_group is not None else tp_group)_, kv_tp_size = get_group_rank_size(kv_tp_group)self.num_heads = divide(self.total_num_heads, tp_size)if kv_tp_size >= self.total_num_kv_heads: self.num_kv_heads = 1 self.num_kv_head_replicas = divide(kv_tp_size, self.total_num_kv_heads)else: self.num_kv_heads = divide(self.total_num_kv_heads, kv_tp_size) self.num_kv_head_replicas = 1为什么 K/V 单独成组?在 DP Attention 下,不同 DP 副本算的是不同的 batch,但 GQA 里 KV 头数可能大于 attn-TP 规模、也可能小于。如果 Q 和 KV 用同一个组,副本之间的 KV 布局就绑死了;拆开之后,可以选择「KV 头在 attn-TP 组内不切、每副本复制」或「KV 头按更宽的组切、副本间共享物理存储」。第二十五篇描述过 H=32, K=4, P=8 下 num_kv_heads=1, num_kv_head_replicas=2 的算术,这里补上它的意义:复制数不是浪费,而是把 K/V 头「降到能整除的最小单位」的代价。复制数会一路传导到 KV Cache 池的布局与 _kv_cache_parallel_layout,这也是为什么读 KV 显存代码时经常看到奇怪的倍数。
计算契约:权重不是 Linear 自己造的
LinearBase 的构造函数里有一行是整个设计的关键:
if quant_config is None: from sglang.srt.layers.quantization.unquant import UnquantizedLinearMethod self.quant_method = UnquantizedLinearMethod()else: self.quant_method = quant_config.get_quant_method(self, prefix=prefix)Linear 从来不 torch.empty 自己的权重。它把「创建权重」这件事托付给 quant_method.create_weights(...)。对应的抽象在 layers/quantization/base_config.py:
class LinearMethodBase(QuantizeMethodBase): def create_weights(self, layer, input_size_per_partition, output_partition_sizes, input_size, output_size, params_dtype, **extra_weight_attrs): ... def apply(self, layer, x, bias=None): ... def process_weights_after_loading(self, layer) -> None: return这个接口只有三件事:造参数、发计算、装载后整理。不同量化方法给出完全不同的参数集合:无量化时是一张 weight(加可选 bias);GPTQ 是 qweight、qzeros、scales、g_idx;FP8 有 per-tensor 与 block 两套布局;MXFP8 还有按块打包的块 scale。Linear 的构造代码对这些名字一无所知——它只知道「参数创建好了,apply 能消费当前输入」。
第三个方法 process_weights_after_loading 常常被低估。它发生在「权重全部装载完、可以开始服务」之前,是唯一允许改形状、换布局、换数据类型的时机。以 SGLang 的 Fp8LinearMethod 为例(layers/quantization/fp8.py),它在 block 量化路径下会做三件不同的事:
- checkpoint 本来就是 MXFP8 时,
convert_mxfp8_weight_to_block_fp8把它就地转换成 128×128 的块 FP8 布局,并重新赋给layer.weight——参数的形状与语义在装载后被整体替换。 - 某些加速器的小 batch 路径需要一份 row-wise FP8 的副本(由
dequant_mxfp8_2d_to_bf16先反量化到 BF16、再逐行重新量化),这一份只服务 decode 时的小 M 场景。 - 如果模型声明了
deepgemm_mxfp8_input,它还会准备 DeepGEMM 需要的 MXFP8 输入路径,并把 Linear 上的对应标志置为可用。
这三件事有一个共同点:它们都依赖实际加载到的权重与目标硬件,只有装载后才可能知道。这就是为什么接口里要单独留出这一阶段,而不是塞进 create_weights。对应的 restore_weights_before_loading 则处理「需要重新装载」的场景(例如权重热更新或 QuantizedRL 重载):撤销那些改变了参数形状的就地重排,让 checkpoint 格式的权重能再装一次。两个方法合起来,构成了「装载—整理—(可能)回滚」的闭环。
create_weights 接收的尺寸参数是每 rank 尺寸与全局尺寸同时传入:
self.quant_method.create_weights( layer=self, input_size_per_partition=self.input_size, # 列并行:输入不切 output_partition_sizes=self.output_partition_sizes, # 本 rank 每段输出宽 input_size=self.input_size, # 全局输入维 output_size=self.output_size, # 全局输出维 params_dtype=self.params_dtype, weight_loader=(self.weight_loader_v2 if ... else self.weight_loader),)两套尺寸同时在场的理由,是要 create_weights 能同时服务造形状与造装载器:参数本身的形状取每 rank 尺寸;而装载器要知道全局尺寸才能把磁盘张量切成 P 份。这也就是第二十五篇提醒过的「同一个层里同时存在全局尺寸和每 rank 尺寸,脑子要分开放」。
前向一侧就更简单了:
def forward(self, input_): bias = self.bias if not self.skip_bias_add else None output_parallel = self.quant_method.apply(self, input_, bias) ...注意 apply(self, ...) 传的是整个 layer 对象,而不是单独的权重张量。这让量化方法可以访问 layer.weight、layer.weight_scale、layer.input_size_per_partition 等一切它需要的东西,也可以在 apply 里按输入形状临时选择不同的内核(比如 decode 时用 GEMV、prefill 时用 GEMM)。核函数的选择权在量化方法手里,不在 Linear 手里——SGLang 里一个 Fp8LinearMethod 在不同 SM 架构、不同量化方案下可以落到不同的 GEMM 实现,Linear 不需要知道任何细节。
skip_bias_add 把 bias 从 GEMM 里剥出来返回给调用者,也是为融合服务的:调用者可以把「加 bias」和后续的激活、量化写回融进一个 kernel。这个参数在 vLLM 与 SGLang 里一直存在,是 epilogue 融合的入口——GEMM Epilogue 完全拆解 一文里讨论的「主循环只算乘积,真正决定性能的是尾声」,在 Linear 这一层就体现为「bias 不进主循环」。
scheme:逐层量化的一个裸对象
LinearBase 的类属性里还有一个不起眼但很关键的定义:
scheme = None类上方的注释解释了它的来历:有些量化方法会给每一层单独挂一个 scheme(方案对象),可能在 get_quant_method() 里提前设置,也可能在 create_weights() 里延迟设置(GPTQ 属于后者);默认值 None 让调用方可以用 is None 判断「还没设置」,而 hasattr 判断会永远为真。
为什么需要逐层方案?现代量化 checkpoint(尤其是 compressed-tensors 格式)允许同一模型的不同层使用不同的量化方案:有的层 4-bit、有的层 8-bit、有的层干脆不量化。quant_config.get_quant_method(self, prefix) 是按层调用的,prefix 就是这一层在 state dict 里的名字,量化配置据此查表,返回该层专属的方法对象。scheme 则是这个方法对象携带的「本层方案描述」,装载器选 v1 还是 v2 时会读它:
weight_loader=( self.weight_loader_v2 if (self.quant_method.__class__.__name__ in WEIGHT_LOADER_V2_SUPPORTED or (self.scheme is not None and self.scheme.requires_weight_loader_v2)) else self.weight_loader)注意第二个条件:即使量化方法的类名不在白名单里,只要本层方案声明需要 v2,也走 v2。这让混合精度 checkpoint 的个别层可以独立选择装载路径。
注释里还有一条容易踩的 Python 陷阱:scheme 必须是普通对象,不能是 nn.Module。nn.Module.__setattr__ 会把 Module 类型的值放进 self._modules,而 LinearBase.scheme = None 这个类属性会在属性查找时先命中,结果读到的仍是 None——对象被「藏」进 _modules 里了。这类问题不会报错,只会让判断条件永远为假,是典型的「看起来设置了、实际没生效」。把 scheme 约束成 msgspec.Struct 或普通 dataclass,就是为了绕开 nn.Module 的属性语义。
装载契约:一个张量要同时满足四个约束
装载是四份契约里最琐碎、也最容易出错的一份。它要回答的问题看起来只有一句「把磁盘上的张量搬进本 rank 的参数」,但实际上要同时处理四类约束:
- 并行约束:本 rank 该拿哪一段(列并行按输出维、行并行按输入维)。
- 合并约束:磁盘上的三个张量(q、k、v)要拼进一个连续参数,或者反过来,一个合并张量要按 shard 切开。
- 量化约束:打包格式(每
pack_factor个值压进一个元素)、scale 的形状(标量、按通道、按块)。 - 复制约束:GQA 下 K/V 头被复制时,每个 rank 拿的是哪一份。
除了这四条「从哪里来」的约束,还有一条方向相反的约束:磁盘上可能已经切好了。QKV 层的构造参数 load_presharded_attn=True 会把 use_presharded_weights 设成真,表示磁盘里的张量本身就是「每 rank 一份」的预切分格式。此时装载器不能再切一次:
if not use_presharded_weights: loaded_weight = loaded_weight.narrow(self.output_dim, tp_rank * shard_size, shard_size)copy_with_check(self.data, loaded_weight)同时,MergedColumnParallelLinear.weight_loader 里计算各段偏移时也要把 use_presharded_weights 算进去:
effective_size = (output_size // tp_size if self.use_presharded_weights else output_size)否则「磁盘已是每 rank 尺寸」和「按全局尺寸切 P 份」会被重复应用一次,切出来的片只有期望的 1/P 那么大。预切分是一个全路径都要感知的开关,它出现在切片、偏移、断言三处;漏掉任何一处,结果都会是形状对不上或者静默读错段。
两代装载器:为什么会有 v2
linear.py 里每个列并行、行并行类都有两个装载方法:weight_loader 与 weight_loader_v2。选哪个是在 create_weights 时决定的:
weight_loader=( self.weight_loader_v2 if (self.quant_method.__class__.__name__ in WEIGHT_LOADER_V2_SUPPORTED or (self.scheme is not None and self.scheme.requires_weight_loader_v2)) else self.weight_loader)WEIGHT_LOADER_V2_SUPPORTED 是一张二十个类名的清单(CompressedTensors、AWQ、GPTQMarlin、Fp8、ModelOptFp8、ModelOptFp4 等)。为什么需要两代?
- v1 装载器是「在 Linear 里切好片,再
copy_进参数」。 它假设参数就是一张朴素张量,切片规则全部写在 Linear 的方法体里。这对「只有 weight 一张参数」的经典路径足够。 - v2 装载器把切片逻辑下沉到参数对象自身。
parameter.py里有ModelWeightParameter、GroupQuantScaleParameter、BlockQuantScaleParameter、PackedColumnParameter等一批类,每个都继承「列并行装载」与「行并行装载」两个 mixin,并且知道自己的打包因子、block 尺寸与 scale 布局。weight_loader_v2只负责算出tp_rank,然后调用param.load_column_parallel_weight(...),剩下交给参数自己。
这个重构的动机在 vLLM 的同一个文件里有明确注释:量化方案的参数种类越来越多,如果每个都往 linear.py 里塞一套切片逻辑,linear.py 会失控。下沉之后,新增一个量化格式只需要写一个新的参数类,Linear 不动。代价是读代码的人要同时读两个文件:切分算术的入口在 linear.py,真正的切片细节在 parameter.py。
列并行装载:先按段选,再按 rank 切
_ColumnvLLMParameter.load_column_parallel_weight 的核心只有几行:
def load_column_parallel_weight(self, loaded_weight, tp_rank, use_presharded_weights=False): if not use_presharded_weights: shard_size = self.data.shape[self.output_dim] loaded_weight = loaded_weight.narrow( self.output_dim, tp_rank * shard_size, shard_size) copy_with_check(self.data, loaded_weight)shard_size 取的是参数自己的输出维,不是磁盘张量的输出维——这是「参数形状已按本 rank 尺寸造好」的结果。tp_rank * shard_size 是本 rank 在全局输出维里的起点。注意 narrow 的结果形状必须和 self.data 完全一致,copy_with_check 会断言这一点。
load_merged_column_weight 在此基础上多一层:先按 shard_offset/shard_size 在参数内定位到某一段(gate、up、或者 q/k/v),再在这段内按 rank 切:
param_data = param_data.narrow(self.output_dim, shard_offset, shard_size)start_idx = tp_rank * shard_sizeend_idx = start_idx + shard_sizeif end_idx > loaded_weight.shape[self.output_dim]: loaded_weight = pad_or_narrow_weight(loaded_weight, self.output_dim, start_idx, shard_size)else: loaded_weight = loaded_weight.narrow(self.output_dim, start_idx, shard_size)末尾那段分支处理的是「输入维不能被 TP 整除」的模型(注释里点名 qwen2_5-VL 的 MLP 不是 8 的倍数):参数已经按 divide 后的尺寸造好(向上取整的部分用 pad 填),磁盘张量却可能比需要的短,于是 pad_or_narrow_weight 统一成「窄取或补零」两种情况的单一出口。这类分支正是「读 Linear 代码会觉得碎」的来源,但它们都是真实模型的真问题:只要有一个主流模型的结构不满足整除假设,装载路径就得处理它,否则这个模型切了就装不上。
打包与 scale:装载时看不见的换算
量化参数里最容易错的是打包因子。packed_dim == output_dim 时,切片的宽度与偏移都要除 pack_factor:
if packed_dim == output_dim: shard_size = round(shard_size // param.pack_factor) shard_offset = round(shard_offset // param.pack_factor) shard_size, shard_offset = adjust_marlin_shard(param, shard_size, shard_offset)Marlin 还有额外的一层:它的权重在内存里是交错布局,marlin_tile_size 把「逻辑上的连续一段」映射成存储上的跳跃段,所以 adjust_marlin_shard 把宽度和偏移再乘一次 tile 大小。这类「逻辑下标与物理下标不是线性对应」的格式,在 Marlin 完全拆解 里详细讲过;在装载路径上,它就是「切之前要先换算坐标」的那一步。
scale 参数更麻烦。BlockQuantScaleParameter 同时继承列并行与行并行两个 mixin,因为 block 量化的 scale 既可能在输出维上按块排、也可能在输入维上按块排。QKVParallelLinear.weight_loader_v2 里专门为它写了一段:
if isinstance(param, BlockQuantScaleParameter): weight_block_size = self.quant_method.quant_config.weight_block_size raw_block_n, _ = weight_block_size[0], weight_block_size[1] block_n = 1 if getattr(param, "format_ue8m0", False) else raw_block_n shard_offset = (shard_offset + block_n - 1) // block_n shard_size = (shard_size + block_n - 1) // block_n这一段的意思是:scale 张量的每个元素管辖 block_n 个权重,所以权重切到 [offset, offset+size) 之后,对应的 scale 索引必须做一次除以 block_n 的坐标变换,且用向上取整保证边界块不被漏掉。format_ue8m0 是 MXFP8/NVFP4 一类「每块共享一个指数」的格式,此时 scale 的块粒度是 1——因此 block_n 取 1。FP8 块量化(例如 DeepSeek-V3 的 128×128 块)则是 block_n = 128。同一个类里,因格式不同而走两条不同的坐标变换,这就是「量化约束」在装载路径上的真实形态。
特殊的三种层
linear.py 里除了四个主类,还有三种值得单独讲的形态:QKVParallelLinear 的按头装载、RowParallelLinear 的「bias 只落一次」、以及 MergedColumnParallelRepeatedLinear 与 ColumnParallelBatchedLinear 这两类为特殊模型准备的变体。
QKVParallelLinear:按头切与按头装
QKV 的切分粒度是「头」,不是「列」。这带来一个直接后果:当 KV 头被复制时,Q 与 K/V 的 tp_rank 不是同一个。装载器里对应的判断是:
kv_tp_rank, _ = get_group_rank_size(self.kv_tp_group)tp_rank, _ = get_group_rank_size(self.tp_group)param.load_qkv_weight( loaded_weight=loaded_weight, num_heads=self.num_kv_head_replicas, shard_id=loaded_shard_id, shard_offset=shard_offset, shard_size=shard_size, tp_rank=(tp_rank if loaded_shard_id == "q" else kv_tp_rank), use_presharded_weights=self.use_presharded_weights,)参数对象里再做一次换算:
shard_id = tp_rank if shard_id == "q" else tp_rank // num_headsparam_data = param_data.narrow(self.output_dim, shard_offset, shard_size)...loaded_weight = loaded_weight.narrow(self.output_dim, shard_id * shard_size, shard_size)把 num_heads 在这里理解成 num_kv_head_replicas 是关键:K/V 的「第几段偏移」是 kv_tp_rank // replica_size,也就是说,多个 rank 会拿到同一段。用 H=32, K=4, P=8 的数字走一遍:Q 每 rank 拿 4 个头,偏移为 tp_rank * 4 * head_size;KV 每 rank 拿 1 个头、复制数是 2,偏移为 (tp_rank // 2) * head_size,于是 rank 0 和 1 拿到同一个 K 头、rank 2 和 3 拿到下一个。这解释了「复制」在装载层究竟发生了什么:不是每个 rank 都去读整个张量,而是每两份读同一段。
_get_shard_offset_mapping 与 _get_shard_size_mapping 这一对方法则定义了「合并参数里的 Q/K/V 三段分别在哪个位置」:
shard_offset_mapping = { "q": 0, "k": self.num_heads * self.head_size, "v": (self.num_heads + self.num_kv_heads) * self.head_size, ...}注意全是本 rank 尺寸(self.num_heads 是每 rank 的 Q 头数),而不是全局尺寸;这与 output_sizes 乘 tp_size 的记账正好互补:一个记「本 rank 参数内各段位置」,一个记「磁盘张量里各段全局宽度、用于判断切几份」。同一层里两套账,读的时候一定要区分。
一个具体例子能把这套账彻底钉住。设 H=32, K=8, P=8,每组 4 个 Q 头共享 1 个 KV 头,head_size=128:
num_heads = 4、num_kv_heads = 1、num_kv_head_replicas = 1;output_sizes = [32×128, 8×128, 8×128] = [4096, 1024, 1024](全局,合计 6144);- 参数形状
[512 + 128 + 128, hidden] = [768, hidden](本 rank); - 偏移映射(本 rank):
q起点 0、宽 512;k起点 512、宽 128;v起点 640、宽 128。
装载 K 时,shard_offset 取 512、shard_size 取 128,kv_tp_rank 若为 3,则在磁盘的 K 张量里读 [3 × 128, 4 × 128) 这一段,拷进参数的第 512–640 列。如果 kv_parallel_group 指向一个 4 rank 的组而 H/K 组是 8 rank,那么 num_kv_head_replicas = 4 // 8 不成立——这正是代码用 if kv_tp_size >= total_num_kv_heads 分支保护的情形:复制数只会在「切分份数不少于头数」时出现。读这段算术时,先把 Q、K、V 三段的「全局宽」与「本 rank 宽」各写一行,再对偏移映射,错位会非常明显。
RowParallelLinear:bias 只在一处落
行并行的 forward 里有一行:
# Only fuse bias add into GEMM for rank 0 (this ensures that bias will not# get added more than once in TP>1 case)bias_ = None if (tp_rank > 0 or self.skip_bias_add) else self.bias为什么只让 rank 0 加?因为各 rank 的输出随后要被求和。若每个 rank 都加一次 bias,求和后就是 。让 rank 0 加一次,求和恰好得到 。这利用了「归约运算的分线性」: 在 1/P 的份额上,乘 P 就是原值。这个技巧依赖归约一定是加法——所以当归约变成 reduce-scatter 或由层边界接管时,bias_ 的取舍仍然成立(reduce-scatter 也是加法,只是输出被散开),但必须在做加法的那一侧加上:层边界做加法时,如果 bias 已经被 rank 0 融合进 GEMM,边界就不能再加一次。第二十五篇提到 LLaMA 里 o_proj 与 down_proj 的 reduce_results=False 时,没展开的是:边界接管归约后,bias 的处理也要一起接管或保证不重复。SGLang 的 LLaMA 没有 bias(qkv/MLP 都是 bias=False),所以这条路径上没有冲突;但读带 bias 的模型(例如部分 Qwen 早期版本、Gemma 家族的某些层)时要特别留意。
行并行的 weight_loader 对称地按输入维切:
if (input_dim is not None and not use_bitsandbytes_4bit and not self.use_presharded_weights): shard_size = param_data.shape[input_dim] start_idx = tp_rank * shard_size end_idx = start_idx + shard_size if end_idx > loaded_weight.shape[input_dim]: loaded_weight = pad_or_narrow_weight(loaded_weight, input_dim, start_idx, shard_size) else: loaded_weight = loaded_weight.narrow(input_dim, start_idx, shard_size)shard_size 取「参数自己的输入维」,参数已经按 divide(input_size, tp_size) 造好——又一处「本 rank 尺寸定义切片宽度」。
两个为特殊模型准备的变体
MergedColumnParallelRepeatedLinear 把列并行与重复不切(repeated)两类输出拼进同一个参数:column_output_sizes 的段按 rank 切,repeated_output_sizes 的段每卡全量。文档字符串写得很直接:「TODO: quantization is not supported yet」。为什么会有这种层?某些模型把「需要切分的投影」与「必须每卡都用的投影」在磁盘上存成一个合并张量,框架为了让前向只发一次 GEMM,把两者拼在参数里。
def weight_loader(self, param, loaded_weight, loaded_shard_id): output_dim = param.output_dim shard_offset = sum(self.output_partition_sizes[:loaded_shard_id]) shard_size = self.output_partition_sizes[loaded_shard_id] param_data = param.data.narrow(output_dim, shard_offset, shard_size) tp_rank, _ = get_group_rank_size(self.tp_group) if loaded_shard_id < self.num_column_parallel: start_idx = tp_rank * shard_size loaded_weight = loaded_weight.narrow(output_dim, start_idx, shard_size) param_data.copy_(loaded_weight)if loaded_shard_id < self.num_column_parallel 这一行就是全部语义:前若干段按 rank 切,后若干段整段拷贝。
ColumnParallelBatchedLinear 是另一个方向:它有一个额外的批量维,权重形状是 [batch, output_size // tp_size, input_size],前向是 torch.bmm。装载时按 narrow(0, ...) 在第 0 维(批量维)上切片——这与普通列并行按输出维切片完全不同。它同样标着不支持量化。这类「非标准层」的存在,说明模型层不能只靠通用的四个类覆盖所有模型;框架的选择是为不标准的部分造专用的最小类,而不是把通用类改成能容纳一切。
归约契约:部分和由谁求和
归约契约是 SGLang 相对 vLLM 改动最大的一份。RowParallelLinear.forward 的签名本身就透露出这不是一个简单的 Linear:
def forward(self, input_, skip_all_reduce=False, forward_batch=None, output_tensor=None):四个参数,其中三个与归约和内存有关。拆开看:
组:在哪个集合上求和
if self.use_dp_attention_reduce: output = get_parallel().attn_tp_group.all_reduce(output_parallel)else: if quantize_communications: output = tensor_model_parallel_quant_all_reduce(output_parallel) elif self.parallel_group == "tp": output = get_parallel().tp_group.all_reduce(output_parallel) else: output = tensor_model_parallel_all_reduce(output_parallel)这里有三条独立的选择:
use_dp_attention_reduce时走attn_tp组。 这对应 DP Attention 下注意力输出的归约:部分和只在同一个 DP 副本内的 attention-TP 组里求和,不跨副本。因为不同副本处理的是不同请求,跨副本求和没有意义,反而会把两个 batch 的激活混在一起。quantize_communications时走量化版本。 判定条件是「不是 decode 或 idle 模式」且执行器开了通信量化。为什么 decode 不用?decode 时 batch 小、每次 all-reduce 的数据量小,量化带来的 kernel 与反量化开销可能超过省下的带宽;prefill 时数据量大,量化收益明显。这是「按前向模式切换通信策略」的典型例子。- 其余情况按
parallel_group选择组,兜底走tensor_model_parallel_all_reduce。
跳过:哪条路径把归约交给了上层
if (((self.reduce_results and tp_size > 1) or self.use_decode_attn_tp) and not skip_all_reduce and not should_skip_mlp_all_reduce()): ...do all_reduce...else: output = output_parallel三个与「做不做」有关的开关:
reduce_results:构造函数参数,语义是「这条 Linear 是否自己负责求和」。o_proj与down_proj在 LLaMA 里是False,意味着归约由层边界做。skip_all_reduce:调用点的显式覆盖。「这一层之外没有别处会求」的调用方传True。should_skip_mlp_all_reduce():一个由解码器发布的前向标志(mlp_reduce_scatter)。它的存在说明:调用方不应该逐个把标志穿进模块,而是让模块在执行期读一个「当前前向上下文」里的标志。这和_LogicalGroup的思路一样——把构造期的选择与执行期的选择分开。
还有一个容易混淆的变量 use_decode_attn_tp,由 CpDecodeAttnTpContext 在 decode 期间设为 True,作用是把「即便 reduce_results=False,decode 时仍要在 attn-TP 上求和」这条特例写进条件里。它的场景是上下文并行(CP)下 decode 时的注意力输出切分——o_proj 构造时 reduce_results=False 是为了 prefill 阶段层边界接管,但 decode 阶段路径不同,需要在这里补一次归约。
reduce_results=False 不等于「不归约」,而是「归约的时机与归属在别处」。把这句话落实:如果读到 o_proj 的 reduce_results=False,必须在同一路径上确认层边界(append_stages 的边界逻辑、stage_boundaries 开关)确实做了加法;否则这个模型的输出就是错的——一个在 TP=1 下测试通过、TP=4 下静默出错的分歧就藏在这里。
输出位置:output_tensor 与融合累加
output_tensor 是第四个参数,含义是「把结果写进调用方拥有的张量」。对应代码路径:
if output_tensor is None: output_parallel = self.quant_method.apply(self, input_parallel, bias=bias_)else: apply_into = getattr(self.quant_method, "apply_into", None) if apply_into is None: raise RuntimeError(f"{type(self.quant_method).__name__} cannot write into " f"caller-owned linear output") output_parallel = apply_into(self, input_parallel, output_tensor, bias=bias_)这是 CUDA Graph 的一类需求:图里的输出缓冲区是静态预分配的,算子必须写进那块固定内存,而不是每次新分配。apply_into 是可选的,没实现的量化方法直接报错——这是「宁可显式失败,也不静默多分配」的写法,对排查图捕获问题很有帮助。
对称内存:归约缓冲区从哪来
forward 里还有一处与显存分配有关:
if self.use_dp_attention_reduce: symm_ctx = use_symmetric_memory(get_parallel().attn_tp_group)else: symm_ctx = use_symmetric_memory( get_parallel().tp_group, disabled=self.tp_group is None or not is_allocation_symmetric(), )with symm_ctx: output_parallel = self.quant_method.apply(self, input_parallel, bias=bias_)use_symmetric_memory 让这一区段内的输出分配走对称内存(每个 rank 在虚拟地址空间的同一偏移处持有同样大小的缓冲区),这样后续的自定义 all-reduce 可以直接按偏移访问远端显存、省掉一次注册。不切分(tp_group is None)的层不需要这个窗口——它没有集合通信,输出就是完整结果。对称内存本身的机制在 DeepInfer userbuffer 与对称通信 一文里有完整拆解;在这里只需要记住:Linear 的 forward 已经不只是计算,它还负责为归约准备内存窗口。
序列并行的两条别名路径
forward 开头还有两个分支,与归约方向有关:
if (get_forward().sp_active and tp_size > 1 and not skip_all_reduce and output_tensor is None): output = layernorm_sp.row_parallel_gbar_matmul(self, input_parallel, bias_) ...以及列并行里的:
if get_forward().sp_active and tp_size > 1: output = layernorm_sp.column_parallel_g_matmul(self, input_, bias)它们对应 Megatron 序列并行里 f 与 g 的变体:列并行时输入本身是 token 维切分后的分片,需要先 all-gather 到完整序列再做 GEMM(g);行并行时用 reduce-scatter 代替 all-reduce,输出保持按 token 散开,直接喂给下一段 token 并行的 LayerNorm(ḡ)。这属于序列并行的主题,本篇不展开,只要知道:当序列并行打开时,Linear 的通信形态从「all-reduce」变成「all-gather / reduce-scatter」,仍走同一个 forward 入口。
一次前向走查:以 LLaMA 的一个解码 batch 为例
把四份契约串起来,用 LLaMA 的注意力 + MLP 走一次解码的前向,看每一段 Linear 在每一步发生了什么。设 TP=8,Q 头 32、KV 头 8(不复制),hidden=4096,head_size=128,decode 时 batch 有 64 条请求、每请求 1 个 token,共 64 行输入。
| 段 | 类与组 | 本 rank 形状 | 装载方式 | 前向 | 归约 |
|---|---|---|---|---|---|
qkv_proj | QKVParallelLinear,tp | 输出 768 = Q 512 + K 128 + V 128 | 按头切;q/k/v 分别按 rank 取 4/1/1 个头 | 一次列并行 GEMM | 无 |
| 注意力 | RadixAttention | 每 rank 4 个 Q 头写分页 KV | 不涉及 | 注意力 kernel | 无 |
o_proj | RowParallelLinear,tp,reduce_results=False | 输入 512、输出 4096 | 按输入维切 64 | 行并行 GEMM | 交给层边界 |
gate_up_proj | MergedColumnParallelLinear,tp | 输出 2 * intermediate/8 | 两段各自切 | 一次列并行 GEMM | 无 |
SiluAndMul | 逐元素 | 同上一段 | 不涉及 | 激活核 | 无 |
down_proj | RowParallelLinear,tp,reduce_results=False | 输入 intermediate/8、输出 4096 | 按输入维切 | 行并行 GEMM | 交给层边界 |
| 层边界 | — | 4096 | — | 残差求和 + 归约 | all-reduce(或 reduce-scatter) |
对照表看两件事:
第一,每一段的「本 rank 形状」都可以从构造参数直接算出来,不需要看磁盘。 qkv_proj 的 Q 段是 num_heads = divide(32, 8) = 4,宽度 4 × 128 = 512;K/V 段是 num_kv_heads = divide(8, 8) = 1,宽度 1 × 128 = 128,合计 768。这里有一个很容易犯的错:读代码时把全局头数当成每 rank 头数,把 K 宽算成 8 × 128 = 1024——一旦这么算,qkv.split([q_size, kv_size, kv_size]) 就会对不上。q_size 与 kv_size 都是 LlamaAttention 里按「每 rank」算出来的,与 QKVParallelLinear 内部的算术是同一套。任何形状都从 divide(total, tp) 开始推,这是读 Linear 代码必须养成的习惯。
第二,归约的次数与位置由层边界决定,与 Linear 自己无关。 注意力里有一段行并行、MLP 里有一段行并行,但归约发生了两次而不是四次,而且都不在 Linear 的 forward 里。这就是第二十五篇讲的「层边界把残差和通信收走」在更深一层的表现:Linear 只是「可能」做归约,「一定」做归约的是边界。
同一段前向,换成 DP Attention 拓扑
上面的例子是纯 TP。把注意力切成两个 DP 副本、让 FFN 继续留在完整的 TP 组上,就能看到「线性层同时使用两个不同的组」到底意味着什么。设 TP=8、attn_dp_size=2、attn_cp_size=1,于是 attn_tp_size = 8 // 2 // 1 = 4,注意力 TP 组是 [0,1,2,3] 与 [4,5,6,7] 两个副本,FFN 仍用 [0..7]。
| 段 | 使用的组 | 本 rank 形状(hidden 4096、32 Q 头、8 KV 头、head 128、intermediate 14336) | 归约域 |
|---|---|---|---|
qkv_proj | attn_tp(4) | Q 8 头 = 1024;K/V 各 2 头 = 256;合计 1536 | 无 |
| 注意力 / KV 写入 | attn_tp 副本 | 每副本持有全部 8 个 KV 头(本 rank 2 个) | 无 |
o_proj | attn_tp(4) | 输入 8×128 = 1024,输出 4096 | attn_tp 组内(4 rank) |
gate_up_proj | tp(8) | 2 × 14336 / 8 = 3584 | 无 |
down_proj | tp(8) | 输入 14336 / 8 = 1792,输出 4096 | tp 组内(8 rank) |
这张表和上一张表只差了几个数字,却对应两个完全不同的服务形态:
注意力侧,两个副本各自持有一份完整的 8 个 KV 头,各自服务自己的请求 batch。 每副本 4 个 rank、每 rank 2 个头,合起来 8 个头;另一个副本也同样有 8 个头。物理上 KV 头被存了两份,但两份服务的是不同的 token,所以聚合的 KV 容量翻倍、显存也翻倍——这不是浪费,而是用更多卡换取更多并发上下文。如果只看「每 rank 2 个头」就以为容量和纯 TP 一样,就漏掉了副本数这个乘数。
FFN 侧,权重仍按完整的 TP 组切分,没有复制。 注意力输出的 token 需要先跨两个副本收集成全局 batch,FFN 才能一次算完;算完后再散回各自的副本。注意力权重(qkv/o)虽然被复制了两份,但它们在总权重里占比很小;FFN 与 MoE 才是参数大头,必须共享。「注意力 DP、FFN TP/EP」这个组合的本质,是把复制代价留给小的那部分权重,把容量收益留给大的那部分 KV。
再看归约的通信量。o_proj 的 all-reduce 从 8 个 rank 缩到 4 个 rank:ring 算法的每 rank 搬运量约为 ( 是张量字节数), 时是 , 时是 。单看一条请求,归约字节数下降约 14%;更重要的是归约不再跨副本,两个副本的集合通信互不等待,慢 rank 的抖动只影响自己那一半请求。这与 AllReduce 完全拆解 里讨论的「通信域越小、同步面越窄」是同一件事。
use_dp_attention_reduce=True 的 RowParallelLinear 就是为这张表服务的:它让 o_proj 的归约发生在 attn_tp 组内,而不是全局 tp 组。对照上一张表,同样的 LLaMA 结构、同样 8 张卡,仅仅因为组的选择不同,o_proj 的归约域就从 8 变成 4。「Linear 用哪个组」并不是一个可以随便默认的细节,它直接决定了通信拓扑。
与 vLLM、TensorRT-LLM 的对照
SGLang 这套设计与另外两个框架对照着看,能更清楚它的取舍。
vLLM:vllm/model_executor/layers/linear.py 的四个主类与 SGLang 几乎同构(SGLang 文件头明确引用 vLLM v0.6.4)。vLLM 的 parallel_group 是一个后加的雏形,主要服务于 DP Attention 场景;SGLang 把它扩展成完整的类型系统(四个名字加复制结构体),并把 _LogicalGroup 引入构造期。vLLM 有 weight_loader_v2 与 parameter.py 的参数类体系,两边的设计基本一致。
TensorRT-LLM:新一代 PyTorch 后端里,线性层由 Linear 模块配合 QuantizeMethodBase,同时承担 TP 切分与 GEMM-AllReduce 融合。它的特殊之处是把「列并行 GEMM 后立刻 all-reduce」作为可选融合路径,归约的归属由模块自己决定;这比 SGLang 的「层边界接管」更集中,但灵活性低一些。TensorRT-LLM 源码完全拆解(二十三):Linear 与层内张量并行 有完整拆解。
llama.cpp:走的是另一条路——ggml-backend-meta.cpp 用虚拟设备表达张量并行,线性层在计算图里是普通的 MUL_MAT,只不过权重被切分到多个后端上,最后用 all-reduce 节点合并。它没有「Linear 类」,切分与归约都是图节点。可参考 llama.cpp 源码完全拆解(二十九):Meta device 与张量并行。
这三条路线放在一起,可以看到「四份契约」的另一种组织方式。vLLM 与 SGLang 把四份契约塞进一个类对象,用构造参数与挂载的量化方法表达;TensorRT-LLM 把归约契约部分上提到模块自身的融合选项;llama.cpp 则干脆把并行契约与归约契约外化成图,Linear 只剩计算契约。
| 维度 | vLLM / SGLang | TensorRT-LLM | llama.cpp |
|---|---|---|---|
| 并行契约表达方式 | 构造期 parallel_group + 组对象 | 模块构造期的 TP 模式 | 后端 split 模式(SPLIT_MODE_*) |
| 装载契约载体 | weight_loader v1/v2 + 参数类 | 可消费权重字典 + 模块 load_weights | 张量字节流 + loader 回调 |
| 计算契约载体 | quant_method.apply | QuantizeMethodBase + 融合选项 | 图里的 MUL_MAT 等节点 |
| 归约契约载体 | forward 分支 + 上层边界 | 模块内可选 GEMM-AllReduce 融合 | 独立的 all-reduce 图节点 |
前两列的共同点是「契约在对象上」,第三列是「契约在图上」。对象化写法的优点是能在一个类里读到全部规则,缺点是规则分散在构造参数、类属性、前向分支三处;图化写法的优点是规则一目了然,缺点是每种拓扑组合都要在图里表达一次,代码复用困难。SGLang 选择对象化,并用 parallel_group 把最易错的部分显式化,本质上是在「规则分散」与「形态单一」之间做了一个偏向可读性的取舍。
三个框架的共同点是:「怎么切」与「谁归约」必须分开表达,否则同一份切分逻辑无法同时服务纯 TP、DP Attention、序列并行、上下文并行这四种拓扑。
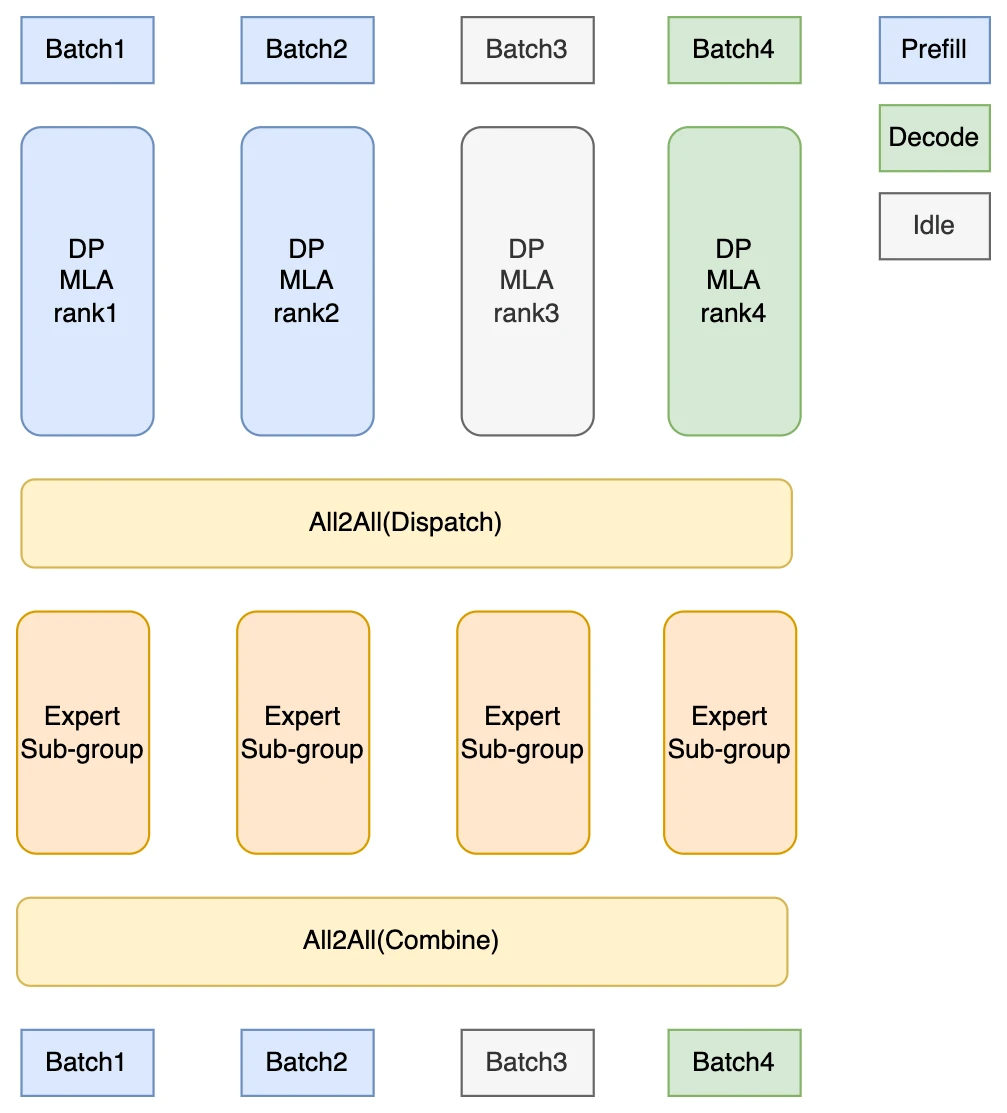
图:SGLang 官方文档给出的 DP Attention + EP 架构示意。左侧是各 DP 副本各自持有注意力与 KV、右侧是专家分片;中间的搬运与归约正是本文「归约契约」里 `use_dp_attention_reduce` 与 `attn_tp` 组所服务的路径。来源:SGLang 文档《DP Attention / DPA + SMG 使用指南》。
读这段代码的实用路径
最后给出一条可执行的阅读顺序,适合需要在自己的框架或模型里复用这套设计时对照。
- 先看模型层的构造语句(
models/llama.py的LlamaMLP、models/qwen3.py的Qwen3Attention),记下每条 Linear 用了哪个parallel_group、reduce_results是什么值。这一步回答「契约的输入是什么」。 - 进
linear.py看_resolve_linear_group与_initialize_partition,确认本 rank 形状是怎么从名组、total_num_heads、head_size算出来的。这一步建立「形状算术」。 - 判断走 v1 还是 v2 装载器(查
WEIGHT_LOADER_V2_SUPPORTED与scheme.requires_weight_loader_v2),然后只在对应的那份代码里读切片。这一步避免在两代装载器之间来回跳。 - 对量化参数,去
parameter.py找对应的参数类(ModelWeightParameter、BlockQuantScaleParameter……),读它的load_column_parallel_weight与load_row_parallel_weight。这一步补上打包与 scale 的坐标变换。 - 回到
forward,只读归约分支:use_dp_attention_reduce、quantize_communications、reduce_results/skip_all_reduce/should_skip_mlp_all_reduce。这一步确认归约的实际归属。 - 最后核对:构造期选的组、装载期用的 rank、归约时用的组,三者是否一致。不一致必然有一个是 bug 或特例,顺着它就能找到原因。
第 6 步是本篇最想留下的一点。读 Linear 代码时的多数困惑,不是因为某处代码写得晦涩,而是因为你在三份契约之间串错了线。把「组、装载 rank、归约组」三个名字并排写在纸上,逐一对照,大多数问题会立刻浮现。
五个对齐检查
把常见错位整理成一张表,遇到形状或数值不对时按顺序核。每一项的左右两边应当一致,不一致就顺着对应的代码往回找。
| 检查 | 左边的量 | 右边的量 | 错位时的表现 |
|---|---|---|---|
| 组对齐 | 构造期 parallel_group 解析出的 self.tp_group | weight_loader 里实际用的 get_group_rank_size(self.tp_group) | 切出来的片宽与参数宽不一致,copy_with_check 断言失败 |
| 全局/本 rank 对齐 | output_sizes[i](乘过 tp_size) | output_partition_sizes[i](除以 tp_size) | 装载偏移多切/少切一个 rank 的宽度 |
| 逻辑/物理对齐 | shard_offset、shard_size(逻辑列) | 除以 pack_factor、再乘 marlin_tile_size 后(物理列) | 量化权重读进来是乱序,前向精度暴跌但形状正确 |
| 复制对齐 | num_kv_head_replicas | kv_tp_size // total_num_kv_heads(当 kv_tp_size >= total_num_kv_heads) | K/V 头装错段,GQA 输出偏差但每 rank 形状正确 |
| 归约对齐 | use_dp_attention_reduce / parallel_group | 实际执行 all_reduce 的组 | 跨副本求和或漏求和,TP=1 正常、TP>1 出错 |
第 4 项最隐蔽:形状断言全部通过,只有数值不对。判断方法是对比「同一个 K 头在相邻 rank 上的权重是否相同」——如果复制数大于 1,相邻两个 rank 的对应 K 头应当逐元素相等;如果不等,说明偏移换算错了。
第 5 项则要看「前向模式」:use_decode_attn_tp 只影响 decode,prefill 走另一条路径。如果只在 decode 时结果不对,优先查这个标志与 CpDecodeAttnTpContext,而不是查权重。
小结
- 一个推理框架里的 Linear 同时承担并行、装载、计算、归约四份互相独立、分别演化的契约;它们共享同一个类,但不共享同一个参数。
- 并行契约的关键是并行组显式传入:
tp、attn_tp、shared_experts_tp、replicated,外加一个可按相邻 rank 复制的结构体;构造期可以用_LogicalGroup在没有通信组时先定形状。 - Q/K/V 可有独立的
kv_parallel_group;GQA 下num_kv_head_replicas把「KV 头不够切」变成「相邻 rank 读同一段」。 - 计算契约把「造参数、发 GEMM」全部托付给
quant_method;Linear 只管形状与装载器的选择,核函数的选择权在量化方法手里。 - 装载契约有两代:v1 在 Linear 里切片,v2 下沉到参数类;打包因子、Marlin tile、块 scale 的坐标变换都在装载路径上发生。
- 归约契约的三个开关(
reduce_results、skip_all_reduce、前向标志)和三条组选择(attn_tp、量化通信、按组兜底)决定了一次前向里部分和在哪求和;reduce_results=False不等于不归约。 - 对照 vLLM、TensorRT-LLM、llama.cpp,三者的共同结论是:「怎么切」与「谁归约」必须分开表达,才能同时适配纯 TP、DP Attention、序列并行、上下文并行四种拓扑。
下一篇会接着往「层边界」走:残差、norm 与归约如何在 layers/layer_boundary/ 里被组织成一段可替换的执行段,以及它如何与 Linear 的归约契约对接、与 CUDA Graph 的形状约束对齐。
参考资料
- SGLang 源码:layers/linear.py
- SGLang 源码:layers/parameter.py
- SGLang 文档:DP Attention 与 DPA + SMG 使用指南
- Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism(Shoeybi 等,2019)
- NVIDIA Megatron-LM 仓库
- vLLM 源码:model_executor/layers/linear.py
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints(Ainslie 等,2023)
- Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM(Narayanan 等,2021)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



