


vLLM 源码完全拆解(二十):权重装载——safetensors 分片、TP 切分与量化层的参数清单
一个 671B 参数的 MoE 模型,以 BF16 存下来是 1.3TB 左右;以 FP8 存下来约 670GB;即便做了 4-bit 量化,也有 300GB 以上。把这些字节从存储搬进 GPU 显存,再变成推理引擎可以执行的一组张量,是每次服务启动都绕不开的第一道工序。推理框架的调度、KV 缓存、注意力 kernel 都很显眼,权重装载却常被当成一句 from_pretrained 带过。真正读 vLLM 的 model_loader 会发现,它既不是简单的 torch.load,也不是按 checkpoint 原名逐张量拷贝:模型结构要先按张量并行切好形状,量化方法要先决定这一层到底有哪些参数,checkpoint 里的名字要先映射成 vLLM 的模块名,融合层的多个逻辑矩阵要按 shard_id 拆开再各归各位,最后还要做转置、重排、重新量化,才能交给 kernel。
这篇沿着 vLLM 当前的 model_executor/model_loader、model_executor/layers/linear.py、model_executor/layers/quantization/ 三条源码线,把一次权重装载拆成六个关卡。重点不是罗列函数,而是回答三个问题:为什么必须在装载权重之前就把模型壳建出来;一个 checkpoint 张量如何被切成当前 rank 需要的那一片;量化层的参数清单由谁决定、又为什么必须在加载后重做一遍。
为什么权重装载值得单独讲
先把代价摆出来。权重装载处在服务冷启动的关键路径上,它的耗时和峰值显存直接决定扩容速度、单机可部署的模型规模,以及量化模型能不能在给定卡数下装得下。
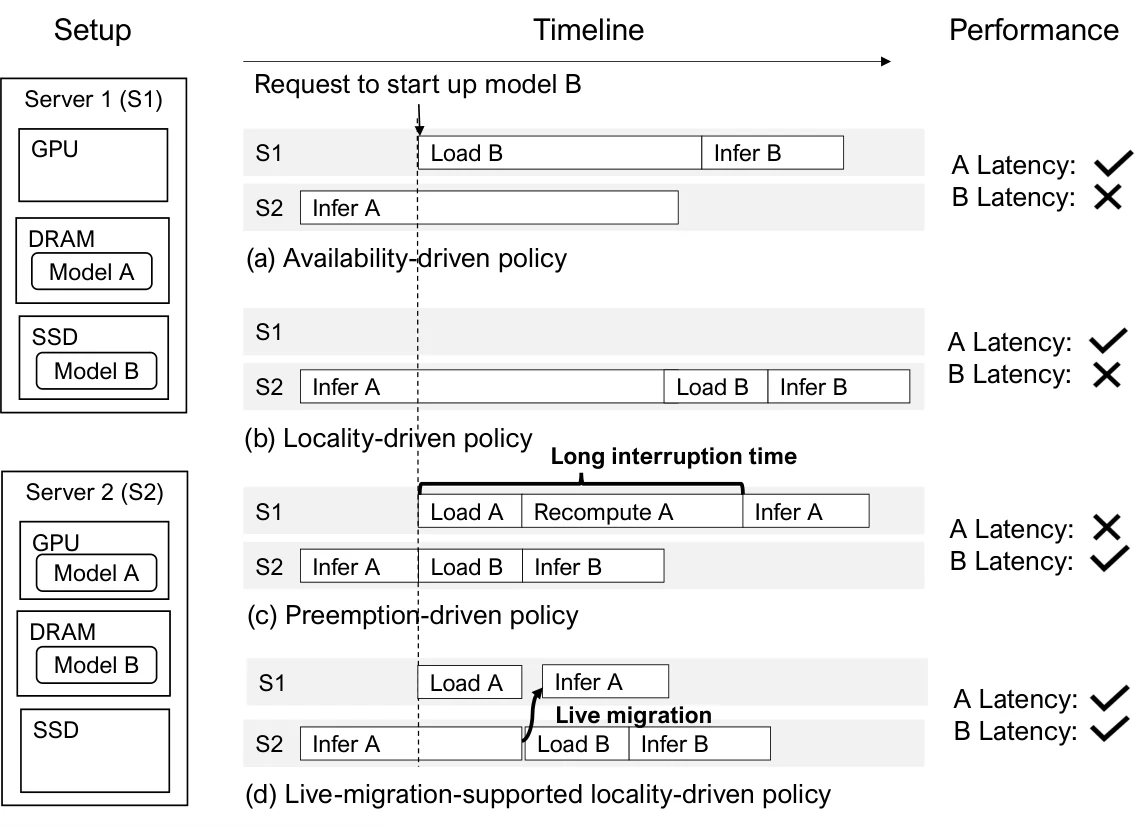
ServerlessLLM 在 2024 年给出的测量很直观:在一个需要频繁换入换出模型的 serverless 场景里,从存储读取 checkpoint 并装载到 GPU 的时间,已经可以和一次推理请求的端到端延迟相比;他们统计的模型切换开销中,checkpoint 读取占据了主要部分。这篇论文的核心工作之一,就是把 checkpoint 加载从「每次冷启动重新读盘」改成「利用本地/分层缓存与并行读取」,让模型换入的延迟降下来。这说明一个事实:装载不是免费的预处理,而是服务系统的一等公民。
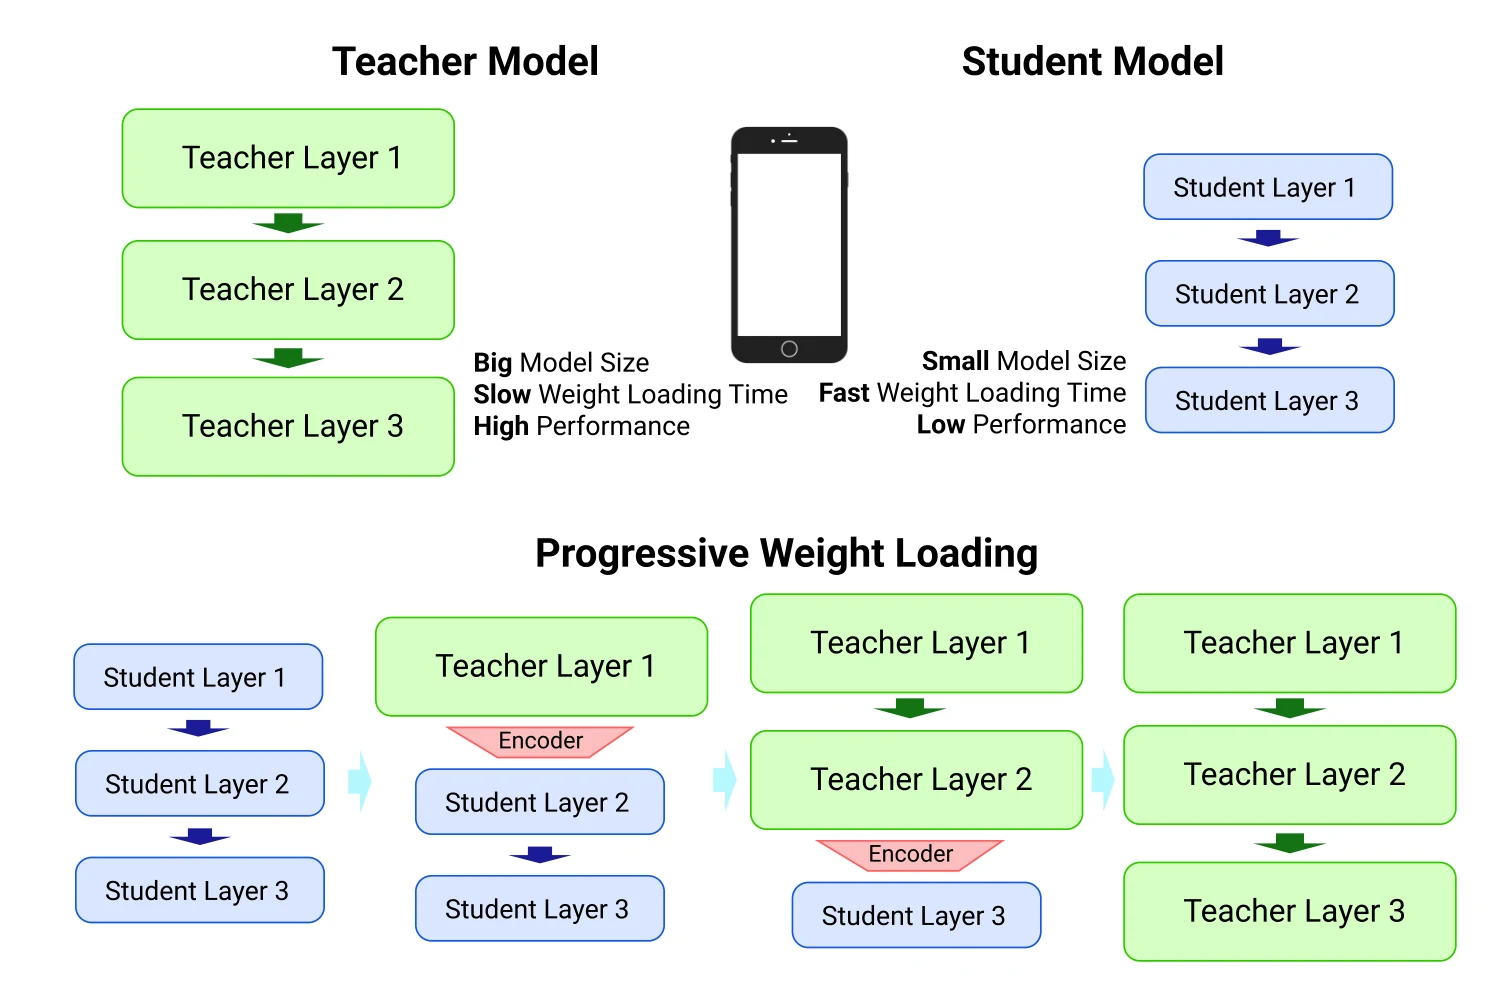
更近一些的工作把问题推到「边装边算」。Progressive Weight Loading(2025)观察到:在资源受限的环境里,模型全部装完才能开始第一次推理,首 token 延迟被装载时间拖住;而 transformer 是逐层执行的,完全可以在前面的层装好之后就先用低精度/部分权重提供服务,再随着后续层加载逐步恢复质量。它给出的概念图把「装载」和「推理」画成两条可以重叠的时间线。
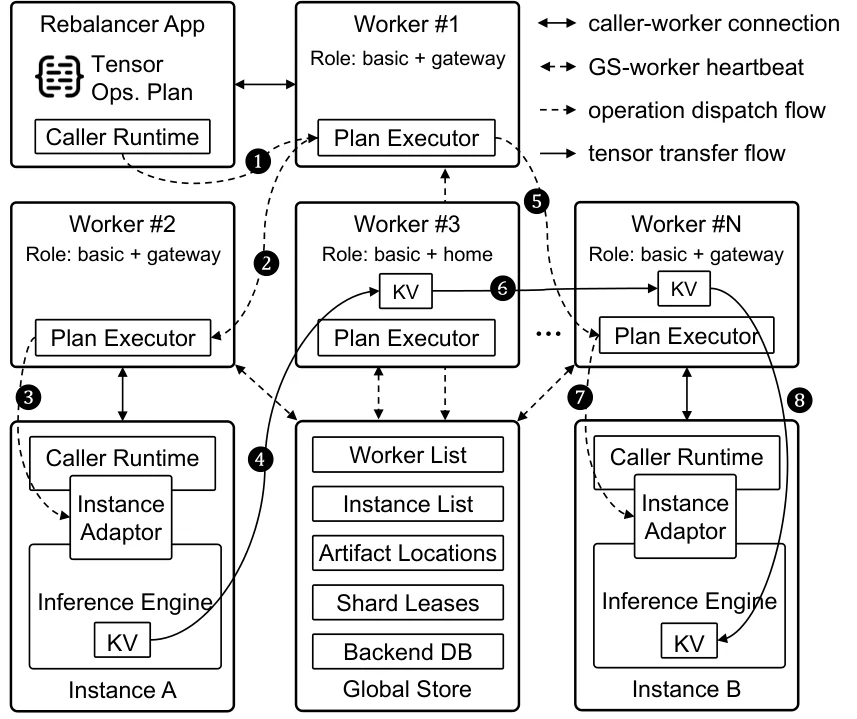
TensorCast(2026)则从更抽象的层面指出,LLM 基础设施里权重的物化、复制、同步、卸载,和 KV 缓存的重平衡一样,都是「张量生命周期管理」问题;它把这些操作抽成一个统一的张量管理层,并明确把 model weight materialization 列为第一类场景。
本文拆解的六个关卡,以及同一逻辑权重在 BF16、per-tensor FP8、block FP8 与 4-bit 打包下的布局差异,汇总在下图中:
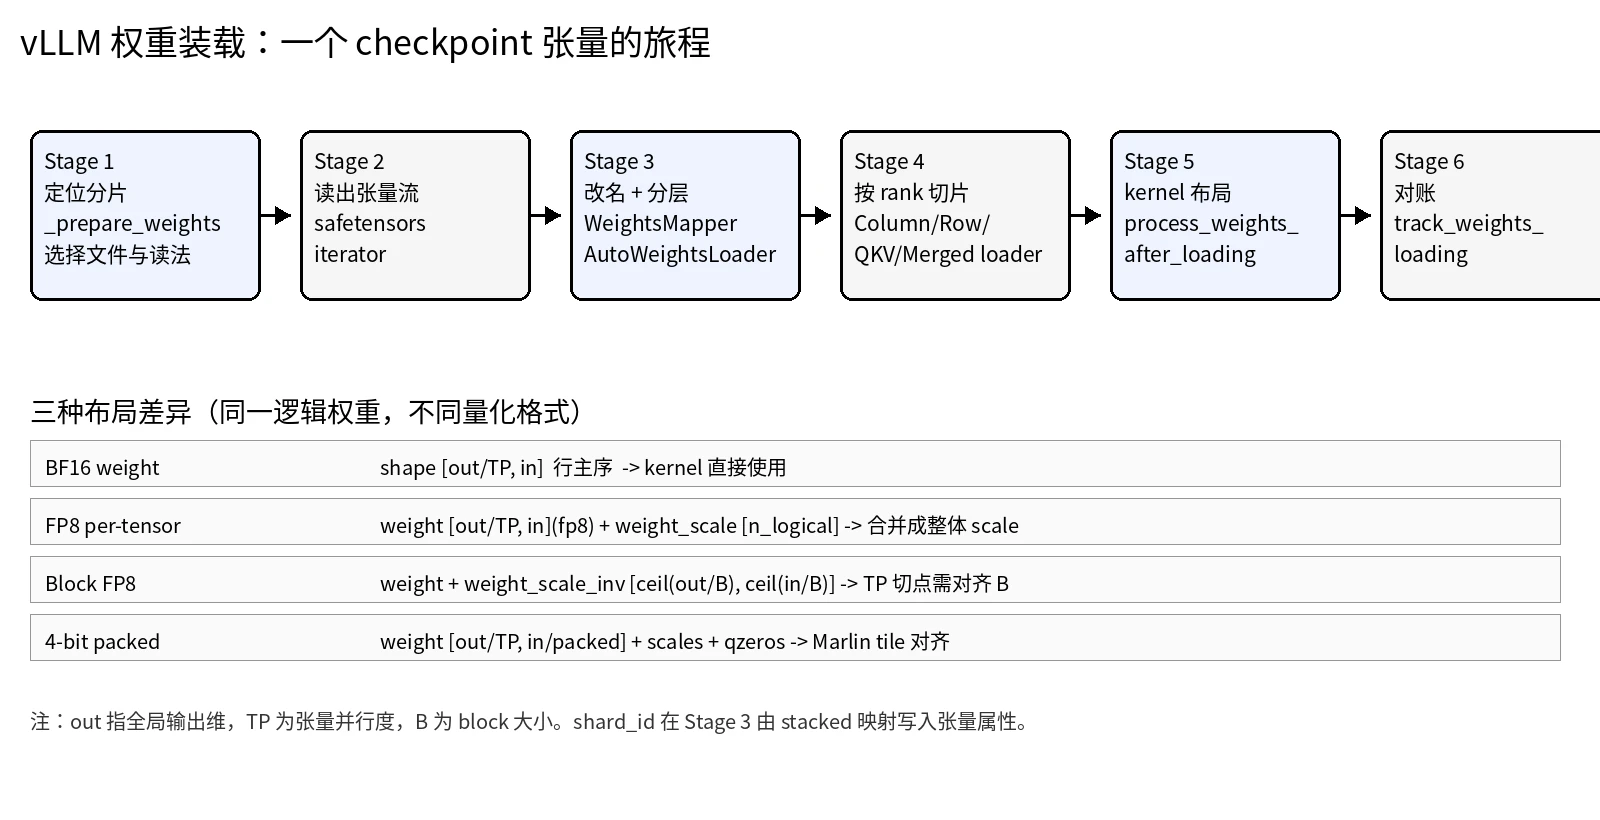
本文把这条链路拆成六个关卡:定位分片、读出张量流、改名与分层、按 rank 切片、kernel 布局整理、装载对账。后面的每一节对应其中一到两个关卡。
这些工作说明,装载阶段的设计空间很大:读盘策略、并行度、装载与计算的重叠、峰值内存、量化发生的时机。vLLM 作为通用推理引擎,不能假设所有模型都适合逐层流式加载,但它必须在通用性、显存峰值和启动时间之间做出明确的工程取舍。理解这些取舍,比记住某个函数名更有价值。
自上而下:一次装载要经过哪五层
在进入代码之前,先画一张自上而下的地图。vLLM 的权重装载从外到内大致是这样分层的:
| 层次 | 代表模块 | 职责 |
|---|---|---|
| 入口 | get_model(...),get_model_loader(load_config) | 根据 load_format 选择装载器实现 |
| 装载器 | BaseModelLoader、DefaultModelLoader 等 | 定义「建壳 → 装权重 → 后处理」的骨架;不同格式的差异在于读盘方式 |
| 文件与迭代器 | _prepare_weights、各类 *_weights_iterator | 定位分片、过滤无关文件、按 (name, tensor) 流式产出 |
| 参数与切分 | LinearBase 子类的 create_weights、weight_loader,BasevLLMParameter | 每层决定自己有哪些参数、每个张量如何按 TP rank 切片后写入 |
| 分发与后处理 | AutoWeightsLoader、process_weights_after_loading | 把名字路由到对应模块/参数;把权重整理成 kernel 期望的布局 |
这张表里有一条容易被忽略的主线:参数清单的决定权在层和量化方法手里,而不是在装载器手里。装载器只负责把 checkpoint 的 (name, tensor) 流交给模型;模型里的每一层在构造时就已经通过 quant_method.create_weights() 声明了自己的参数(名字、形状、weight_loader 等属性);装载时 checkpoint 名字经过映射和融合拆分,最终落到某个参数对象的 weight_loader 上。这就是为什么必须先建壳、后装权重。
BaseModelLoader 的抽象接口很短,只有两个必须实现的方法:
class BaseModelLoader(ABC): @abstractmethod def download_model(self, model_config): ... @abstractmethod def load_weights(self, model: nn.Module, model_config): ...而真正固定流程的是基类里的 load_model:
@instrument(span_name="Load model")def load_model(self, vllm_config, model_config, prefix=""): device_config = vllm_config.device_config load_config = vllm_config.load_config load_device = device_config.device if load_config.device is None else load_config.device target_device = torch.device(load_device) with set_default_torch_dtype(model_config.dtype): with target_device: model = self.create_model(vllm_config=vllm_config, model_config=model_config, prefix=prefix) self.load_weights(model, model_config)
gc.collect() torch.accelerator.empty_cache()
if _has_online_quant(model): finalize_layerwise_processing(model, model_config)
process_weights_after_loading(model, model_config, target_device) gc.collect() torch.accelerator.empty_cache() return model.eval()这三十多行浓缩了四个关键决定:
- 建壳发生在设备上下文里。
with target_device:意味着模型的空参数直接用目标设备创建(CUDA 上就是显存),而不是先在 CPU 分配、再搬过去。代价是显存必须先够放一份完整权重;收益是省掉一次大拷贝,以及 CPU 端一份内存峰值。 set_default_torch_dtype(model_config.dtype)。如果ModelConfig的 dtype 是 BF16,那么create_weights里torch.empty(..., dtype=params_dtype)用默认 dtype 创建的空参数自然就是 BF16。用户指定了--dtype half也不会出现「壳是 BF16、权重是 FP16」的错位。load_weights只负责写数据,不做最终布局。读盘迭代、名字路由、TP 切分全在这一步里完成,但 FP8 转置、Marlin 重排、scale 合并这类「为 kernel 重塑」的工作被推迟到后面。- 两级
empty_cache。第一次是为了把装载过程中的临时张量还给 caching allocator 和驱动,再去做可能申请原始显存的后处理;第二次是清理后处理产生的中间张量。
create_model 本身很薄,真正的「建壳」在 model_loader/utils.py 的 initialize_model 里:先根据 architectures 解析出模型类,再判断构造函数签名是不是新式的 (vllm_config, prefix),如果是就在 set_current_vllm_config(...) 上下文里调用它;老式模型类会给出弃用警告,并尝试按 config/cache_config/quant_config/lora_config/scheduler_config 等关键字逐个猜测参数。新式签名之所以重要,是因为模型的每一层在建壳时都要读取当前 vllm_config 里的并行配置(TP 大小、EP 是否开启)、量化配置、前缀名,来判断自己要建几个分片、用哪种量化方法。这些信息只能在构造期获得,到了装载期就已经写死在参数对象里了。
还有一个细节:initialize_model 会调用 configure_quant_config(quant_config, model_class),把模型类的 hf_to_vllm_mapper(HF 名字到 vLLM 名字的映射)、packed_modules_mapping(融合模块到逻辑子模块的映射)按引用塞进量化配置。原因后面会讲:量化配置里的 quantized_layers 这类字段,写的是 HF 侧的名字,而 get_quant_method(layer, prefix) 里收到的是 vLLM 侧的前缀名。如果模型名和 HF 名不一致,映射表必须先就位,否则模型 Opt 的按层量化会「按名字找不到这一层」。
选装载器:load_format 背后是读盘策略
model_loader/__init__.py 里维护了一张 load_format → 装载器类 的注册表:
_LOAD_FORMAT_TO_MODEL_LOADER = { "auto": DefaultModelLoader, "hf": DefaultModelLoader, "dummy": DummyModelLoader, "fastsafetensors": DefaultModelLoader, "instanttensor": DefaultModelLoader, "npcache": DefaultModelLoader, "pt": DefaultModelLoader, "runai_streamer": RunaiModelStreamerLoader, "runai_streamer_sharded": ShardedStateLoader, "sharded_state": ShardedStateLoader, "tensorizer": TensorizerLoader, "mistral": DefaultModelLoader, ...}这里有个很容易误读的地方:fastsafetensors、instanttensor 并没有独立的装载器类,它们共用 DefaultModelLoader。区别全部落在 DefaultModelLoader._get_weights_iterator 里选哪个迭代器上。换句话说,「装载器的抽象边界」切在「把文件变成 (name, tensor) 流」这一层,而不是切在「把张量放到参数里」这一层。只要你的格式最终能产出一个 (name, tensor) 生成器,并且模型侧路由逻辑不变,它就能复用整个装载骨架。
DummyModelLoader 是一个特例。它不读盘,只在参数形状确定之后用随机数(或零)填充,主要用于启动期显存 profiling——vLLM 的 profile_run 需要一个形状正确、但不关心数值的模型,来测量激活和 KV 缓存的峰值。这也反过来说明:参数形状的定义完全发生在建壳阶段,不依赖真实权重。
ShardedStateLoader 对应的是 vLLM 自己保存的「预分片权重」:如果你事先知道 TP/PP 拓扑,可以把一份 checkpoint 按 rank 预先存好,每个进程只读自己那一片。SaveModel 工具就是干这个的。它在启动阶段的收益是确定性的:不需要每个 rank 都读全量、再各自丢弃不属于自己的部分。代价是模型仓库不再通用,换一个 TP 配置就得重新分片。
定位分片:_prepare_weights 的过滤顺序
DefaultModelLoader._prepare_weights 回答的是「我该读哪些文件」。看似琐碎,但它决定了一个模型能否在混合文件结构的仓库里正确启动。逻辑可以拆成五步。
第一步,本地路径还是仓库。os.path.isdir(model_name_or_path) 判断是否为本地目录;不是的话,先尝试 ModelScope 镜像(maybe_download_from_modelscope),再走 Hugging Face 的 download_weights_from_hf,只按允许的模式下载,ignore_patterns 默认是 original/**/*,避免把 llama 系列仓库里用于训练的原始 checkpoint 也拖下来。
第二步,auto 如何选择格式。auto 先检查仓库里有没有 consolidated*.safetensors(Mistral 系列官方格式),有就走 mistral,否则走 hf:
if load_format == "auto": load_format = ( "mistral" if len(list_filtered_repo_files(model_name_or_path, allow_patterns=["consolidated*.safetensors"], ...)) > 0 else "hf" )第三步,允许模式确定。hf 同时接受 *.safetensors 和 *.bin;显式 safetensors/fastsafetensors/instanttensor 只接受 *.safetensors,并且设置了 use_safetensors=True;pt 只接受 *.pt;npcache 只接受 *.bin。这里的 use_safetensors 标志非常关键:只有在 fall_back_to_pt 为真且不是显式 safetensors 时,才会把 *.pt 追加进模式。代码注释解释了原因——否则一个 .pt 文件会被匹配到,后面却用 safetensors 解析器打开,直接报错。
第四步,按模式优先级 glob,第一个命中的模式胜出:
for pattern in allow_patterns: hf_weights_files += glob.glob(os.path.join(hf_folder, pattern)) if len(hf_weights_files) > 0: if pattern.endswith(".safetensors"): use_safetensors = True break也就是说,同一个目录里同时有 model.safetensors 和 pytorch_model.bin 时,只会读前者。这是一个「优先用更安全、更快的格式」的隐含约定。
第五步,去重与剔除。如果走 safetensors 且文件多于一个,下载并读取 model.safetensors.index.json,用 filter_duplicate_safetensors_files 把索引里没有的分片剔掉。这条逻辑来自一个真实问题:Mistral-7B-Instruct-v0.3 一类仓库里同时存在分片 safetensors 和 consolidated safetensors,两份都读会导致同名张量重复加载、甚至形状冲突。filter_files_not_needed_for_inference 则处理 .bin 路径下与推理无关的优化器状态/训练状态文件。
_prepare_weights 的返回值是 (hf_folder, hf_weights_files, use_safetensors, index_file)。一个「没有任何候选文件」的结果会直接抛 RuntimeError,而不是等到迭代器空转后才报错——尽早失败,对自动部署脚本更友好。
需要留意的是,_prepare_weights 在 download_model 和 _get_weights_iterator 里都可能被调用。download_model 是单独的预下载接口,可以在真正启动引擎前把文件拉好,便于在多机部署里把网络等待从 load_model 的计时里剥离出来。
把文件变成张量流:四种 safetensors 读取策略
确定了文件列表之后,_get_weights_iterator 要把它变成 (name, tensor) 生成器。同一批 safetensors 文件,vLLM 提供了几种读法,由 load_format 和 safetensors_load_strategy 共同决定。
最基础的是 safetensors_weights_iterator,对每个分片 safe_open(st_file, framework="pt"),然后按 f.keys() 逐张量 get_tensor(name)。safe_open 走的是内存映射(mmap):打开文件时并不读入整个文件,读取某个张量时只把对应字节段映射进来。这种「按需读」对本地 NVMe 非常高效,但对 NFS、Lustre 这类网络文件系统就不友好——随机小读会被放大成大量网络往返。
因此代码在迭代开始前做了一次「文件系统体检」:
fs_type = _get_fs_type(sorted_files)is_net_fs = fs_type in ("nfs", "nfs4", "lustre")total_bytes = _get_checkpoints_size_bytes(sorted_files)avail_bytes = _get_available_ram_bytes()fits_in_ram = total_bytes <= (90 / 100.0) * avail_bytes如果 safetensors_load_strategy 是 None(默认),并且检测到网络文件系统、且 checkpoint 总量不超过可用内存的 90%,就自动开启 prefetch;否则打日志说明原因——比如「是网络文件系统但装不进内存,跳过自动 prefetch」,或者「不是网络文件系统,自动 prefetch 关闭,如需可显式指定 --safetensors-load-strategy=prefetch」。这种「自动但可解释」的默认行为,对一个要在客户各种存储环境下运行的框架很重要。
几种策略的差异可以归纳如下:
| 策略 | 读取方式 | 适用场景 | 代价 |
|---|---|---|---|
lazy(默认的底层行为) | safe_open + 逐张量 mmap | 本地 SSD/NVMe | 网络 FS 上随机读放大 |
eager | f.read() 整个文件读入内存再解析 | 网络 FS,避免随机读 | CPU 内存峰值等于单个分片大小 |
prefetch | 后台线程按块大小把文件读进 OS page cache | 高延迟存储、NFS/Lustre | 占用 page cache,文件总量需装得下内存 |
torchao | 读出后再 unflatten_tensor_state_dict 还原子类 | torchao 量化的 checkpoint | 需要 torchao >= 0.15,跨分片的张量要暂存 leftover |
prefetch 由 _prefetch_all_checkpoints 完成,线程数和分块大小来自 LoadConfig.safetensors_prefetch_num_threads(默认 8)和 safetensors_prefetch_block_size(默认 16 MiB)。分块读的意义是把一个文件的顺序读拆成多个可并行的块,让网络往返重叠起来;块大小的选择取决于链路的延迟与带宽比。
torchao 这一支值得单说。torchao 的量化权重在 safetensors 里不是普通张量,而是被展平成若干带元数据的子张量,保存时按分片切开;一个逻辑上的 tensor subclass 可能跨两个分片。因此迭代器维护了一个 leftover_state_dict,把当前分片里还不完整的子张量数据留到下一次迭代,等后续分片补齐后再一起还原。注释写得很清楚:「由于分片 checkpoint,我们不能保证一个文件里包含某个 tensor subclass 的全部数据」。这是格式特性逼出来的状态机,不是装载器想复杂。
线程化装载与算子预取
除「文件级」的读法差异之外,vLLM 还有一个「线程化」选项:model_loader_extra_config={"enable_multithread_load": True, "num_threads": N}。此时 multi_thread_safetensors_weights_iterator / multi_thread_pt_weights_iterator 用线程池并发读多个分片,按文件顺序产出,保证同一文件内的名字顺序不变。它和 prefetch 的区别在于:prefetch 只把数据推进 page cache,真正的解析仍然由主线程按需触发;多线程则是把解析(包括 safetensors 解析和 .pt 反序列化)也放到工作线程,主线程只负责消费。
但线程化装载与 safetensors_load_strategy 有互斥条件:
if extra_config.get("enable_multithread_load") and (load_config.safetensors_load_strategy not in (None, "lazy")): raise ValueError( "enable_multithread_load does not support " f"safetensors_load_strategy={load_config.safetensors_load_strategy!r}; the multi-thread " "loader only implements the default lazy strategy." )原因很实在:多线程迭代器只实现了默认的 lazy 读法,如果用户同时要求 eager,静默忽略会比报错更危险——用户以为得到了 eager 的性能特征,实际上得到的是另一个。vLLM 选择显式拒绝。
safetensors_weights_iterator 的签名里还有一个 local_expert_ids 参数,这属于 MoE 专家并行场景的读盘优化:在 _init_ep_weight_filter 里,当模型是 MoE、开启了 EP、且开启了 enable_ep_weight_filter,装载器会提前计算当前 rank 应该持有哪些逻辑专家,然后迭代器在读出张量之前就按名字跳过非本地专家。MoE 模型的权重里专家部分往往占大头,在 EP=64 时每个 rank 只有其中几十分之一需要,如果不跳过,读盘 I/O 会放大一个数量级。
这里有一个必须跳过的情形:开启了 EPLB(专家负载均衡)时,冗余专家槽位可能映射到默认分区里属于其它 rank 的逻辑专家,装载器需要看到所有逻辑专家才能填充冗余槽,所以 enable_eplb 为真时直接放弃权重过滤。
另外,safetensors_weights_iterator 返回之前还有两处过滤逻辑挂在 Source 上:
is_unused_weight:模型自己声明的「这个 checkpoint 名字用不上」的谓词,用于跳过只包含未使用权重的分片。典型情形是某些 HF checkpoint 里保留的旋转位置编码缓存、旧训练框架写入的多余张量。mm_encoder_only_lm_prefixes:多模态模型在--mm-encoder-only模式下只需要编码器,纯语言模型部分的分片可以整片跳过。前缀从模型的_language_model_names推导,经过 mapper 映射,避免对 Molmo/Phi-4-MM 这类「编码器和语言模型共享 HF 根」的模型误删。
这两个过滤都在读盘之前完成,针对的都是「读了也用不上」的字节。
名字先于张量:AutoWeightsLoader 如何路由
checkpoint 里的名字是 HF 的命名习惯:model.layers.0.self_attn.q_proj.weight、model.layers.0.mlp.gate_proj.weight。vLLM 的模型结构却可能把它们融合成 qkv_proj、gate_up_proj,还可能因为 PP 把某些层替换成 PPMissingLayer,因为 tied embedding 让 lm_head.weight 与 embed_tokens.weight 共享同一块存储。如果直接按名字 getattr(model, name),绝大多数模型都装不进去。AutoWeightsLoader 就是解决这件事的。
它的入口做三件事:
def load_weights(self, weights, *, mapper=None): self.ignore_unexpected_suffixes.append(".bias") mapper = mapper or WeightsMapper() ... if quant_config := next(iterator, None): mapper |= quant_config.get_cache_scale_mapper() mapper |= quant_config.get_checkpoint_weight_mapper() self.ignore_unexpected_suffixes.extend(quant_config._ignore_unexpected_suffixes) mapper |= self.REMOVE_UNUSED_ROTARY_EMBEDS_MAPPER weights = mapper.apply(weights) weights = self._filter_skipped(weights) autoloaded_weights = set(self._load_module("", self.module, weights)) self._check_skipped_aliases(autoloaded_weights) return autoloaded_weights第一,默认忽略 .bias 后缀。不少 GPTQ checkpoint 会带 bias 张量,而对应模型层没有 bias 参数;与其为每个模型写例外,不如统一忽略。
第二,叠加量化配置的映射器。get_cache_scale_mapper() 处理 KV cache scale 的名字差异:旧格式的 .kv_scale 要拆成 .attn.k_scale 与 .attn.v_scale,ModelOpt 的 .self_attn.k_proj.k_scale 要映射到 .self_attn.attn.k_scale。get_checkpoint_weight_mapper() 则丢弃 .g_idx——GPTQ 的激活顺序元数据,vLLM 支持的 kernel 不需要它。_ignore_unexpected_suffixes 列出的是「checkpoint 可能有、模型参数里没有」的量化后缀,比如 .q_scale、.k_zero_point;这些张量被映射后如果找不到宿主参数,不应该让整个加载失败。
第三,丢弃无用的旋转位置编码缓存。rotary_pos_emb.inv_freq、rotary_emb.cos_cached 一类张量在老 checkpoint 里很常见,vLLM 在运行时自己算 RoPE,读到它们只会制造「unexpected weight」错误。
真正做路由的是 _load_module。它按名字的第一段做 itertools.groupby 分组,然后分三种情况处理:
- 如果这个前缀对应一个子模块,就递归进去。递归前有一个重要判断:如果子模块自己实现了
load_weights,先调用它,把这个前缀下的所有权重交给子模块;子模块返回它实际加载了哪些名字。这就是模型自定义装载逻辑的挂载点。 - 如果前缀对应一个直接参数(
named_parameters(recurse=False)),就取这个参数对象上的weight_loader,没有的话用default_weight_loader。 - 如果两者都不匹配,检查是不是在忽略列表里;不是就抛
ValueError,并把当前模块下所有可用参数名列出来。这个错误信息在排查名字映射问题时非常有用。
_load_param 里还有一条容易忽略的 dtype 规则:如果参数 dtype 和 checkpoint dtype 不一致,会打日志。精确加宽(FP16/BF16/FP32 → FP32/FP64)只记 debug,因为不丢信息;其它组合记 warning。比如把 FP32 checkpoint 装进 BF16 参数,会warning 但继续;把 BF16 装进 FP8 参数则属于另一条路径(量化方法在 create_weights 里就把参数建成了 FP8,checkpoint 的 BF16 张量通常不会直接走这里,而是在后处理阶段量化)。
WeightsMapper:五类映射
WeightsMapper 支持五类规则,按固定顺序应用:
| 规则 | 作用 | 典型用途 |
|---|---|---|
orig_to_new_renaming | 结构化重命名对象 | 复杂模型的整段前缀替换 |
orig_to_new_regex | 正则替换,值为 None 表示丢弃 | KV scale 的多种历史命名 |
orig_to_new_substr | 第一次出现的子串替换 | 把 transformer.h 改成 model.layers |
orig_to_new_stacked | 子串替换 + 附加 shard_id | q_proj/k_proj/v_proj → qkv_proj |
orig_to_new_prefix / orig_to_new_suffix | 前缀/后缀替换,None 丢弃 | 去掉 language_model. 前缀、丢弃 .g_idx |
Qwen2 的 hf_to_vllm_mapper 是 stacked 规则最清楚的例子:
hf_to_vllm_mapper = WeightsMapper( orig_to_new_stacked={ ".q_proj": (".qkv_proj", "q"), ".k_proj": (".qkv_proj", "k"), ".v_proj": (".qkv_proj", "v"), ".gate_proj": (".gate_up_proj", 0), ".up_proj": (".gate_up_proj", 1), })apply() 把 q_proj 改名为 qkv_proj,并在产出的张量对象上挂一个 shard_id="q" 属性。后面 QKVParallelLinear.weight_loader 会读这个属性,决定这个张量应该写进融合参数的 q/k/v 哪一段。gate_proj 和 up_proj 则用整数 0/1 标识 gate_up_proj 的两个逻辑分片。这个设计把「名字映射」和「融合层切片」解耦了:映射器只负责告诉下游「这是第几个逻辑分片」,怎么切由线性层自己决定。
get_rename_mapper() 是同一套映射的「只保留改名」变体:去掉 stacked 规则和映射到 None 的规则。它服务于那些只需要按名字找模块、不需要装权重的消费者,比如 LoRA 名字解析和量化配置里的 quantized_layers 列表。这个细节很关键:量化配置里写的是 HF 名字,get_quant_method(layer, prefix) 收到的是 vLLM 名字,必须用「只改名、不融合」的映射把前者翻译成后者;如果用完整映射,q_proj 会被改写为 qkv_proj,量化配置就找不到原来的层了。
绑定词嵌入与别名参数
tied word embedding 让 lm_head.weight 和 model.embed_tokens.weight 指向同一个 nn.Parameter。如果 checkpoint 里两个名字都存在,按名字逐个加载会把同一块存储写两遍;如果只存在一个,另一个名字会找不到宿主。
AutoWeightsLoader 的做法是:初始化时用 _get_tied_embedding_params(module) 找出所有别名关系,得到 aliased_params: alias → canonical。加载时 _filter_skipped 把别名张量直接丢掉,只保留 canonical 名字;加载结束后 _check_skipped_aliases 检查 canonical 名字是否真的 loaded 过,如果没有,说明这个共享权重根本没被初始化,直接报错。这比「静默地留下一个未初始化张量」安全得多。
maybe_retie_word_embeddings 则在装载后的 process_weights_after_loading 里再处理一次:有些 checkpoint 同时存了 lm_head.weight 和 embed_tokens.weight,两者数值相同但占了两份显存;函数会把它们重新绑定,释放重复的那一份。对 7B 级模型,词表 15 万、hidden 4096,一份 BF16 词嵌入就是 1.2GB 左右,能省则省。
模块级 load_weights 与融合层
MergedColumnParallelLinear.load_weights 是一个模块级实现的典型:
def load_weights(self, weights): for name, loaded_weight in weights: shard_id = getattr(loaded_weight, "shard_id", None) self.validate_shard_id(shard_id) ... param.weight_loader(param, loaded_weight, shard_id) yield name它先把 shard_id 从张量属性上取下来并校验合法性(整数必须在 [0, len(output_sizes)),元组必须连续),再把张量和 shard_id 一起交给参数的 weight_loader。QKVParallelLinear 的版本类似,只是 shard_id 是 "q"/"k"/"v"。
这里有一个设计上的取舍:为什么不让 AutoWeightsLoader 直接调用 param.weight_loader(param, tensor),而要让线性层再包一层?因为融合层的 weight_loader 需要知道「这个张量是第几个逻辑分片」和「这个融合参数在磁盘上是否已经融合」。后者对应 loaded_shard_id is None 的分支:Phi-3 一类模型的 gate_up_proj 在 checkpoint 里已经是融合的,此时不需要拆 shard,直接按整体形状拷贝即可。这个信息只有线性层自己知道,通用的参数加载器无法判断。
按 rank 切片:四种线性层与三种参数
名字路由解决「张量该去哪一层」,接下来解决「这一层的哪个位置」。vLLM 的线性层按并行方式分成四类,每类的 weight_loader 切法不同。
列并行:切输出维
ColumnParallelLinear 计算 ,其中 的形状是 [output_size, input_size](PyTorch 的 Linear 习惯)。列并行把输出维切开:
rank 只持有 ,形状 [output_size / p, input_size]。因此加载时沿 output_dim=0 取第 段:
shard_size = param_data.shape[output_dim]start_idx = self.tp_rank * shard_sizeloaded_weight = loaded_weight.narrow(output_dim, start_idx, shard_size)param_data.copy_(loaded_weight)注意 shard_size 是从参数的形状推出来的,而不是从 checkpoint 张量推出来的。这是一个防御性设计:如果 checkpoint 的实际输出维和模型配置不一致,narrow 会先因为越界报错,而不是悄悄装进错误的位置。
行并行:切输入维
RowParallelLinear 的输入来自上一层的输出,已经按最后一维切分。它沿输入维切权重:
rank 持有 [output_size, input_size / p],加载时沿 input_dim=1 取第 段。前向结束后需要一次 all-reduce 把各 rank 的部分和加起来;bias 只在 rank 0 加,避免重复。这个「bias 只加一次」的细节在 RowParallelLinear.forward 里写得很直白:
bias_ = None if (self.tp_rank > 0 or self.skip_bias_add) else self.biasoutput_parallel = self.quant_method.apply(self, input_parallel, bias_)if self.reduce_results and self.tp_size > 1: output = tensor_model_parallel_all_reduce(output_parallel)融合列并行:按 shard_id 定位逻辑分片
MergedColumnParallelLinear 把多个逻辑矩阵沿输出维拼成一个参数。比如 MLP 的 gate_up_proj 由 gate_proj 和 up_proj 拼接,output_sizes=[intermediate, intermediate],融合后的参数形状是 [2 * intermediate / p, hidden]。
加载单个逻辑分片时,先算它在未切分融合矩阵里的偏移,再除以 TP:
shard_offset = sum(self.output_sizes[:shard_id])shard_size = self.output_sizes[shard_id]shard_offset //= self.tp_sizeshard_size //= self.tp_sizeparam.load_merged_column_weight( loaded_weight=loaded_weight, shard_id=shard_id, shard_offset=shard_offset, shard_size=shard_size,)参数侧的 load_merged_column_weight 在 param.data 上按 shard_offset/shard_size 取出目标段,再把 checkpoint 张量按 tp_rank * shard_size 取对应段,两者形状一致后 copy_。这里的两次 narrow 分别对应「融合矩阵里的逻辑分片位置」和「该逻辑分片在 TP 下的 rank 位置」,是最容易写错的地方之一。
QKV 并行:按 head 切,K/V 可能复制
QKVParallelLinear 是融合列并行的特例,但它的切分单位不是任意行,而是 head。设总 query head 数为 ,KV head 数为 ,head_dim 为 ,则融合权重的输出维依次是:
- Q:
- K:
- V:(多数模型 )
rank 的偏移分别是:
其中 是 KV head 的复制倍数。当 时,KV head 可以按 rank 整除,;当 时,一个 KV head 要服务多个 query head 所在的 rank,必须复制,。代码里对应:
if loaded_shard_id == "q": shard_rank = self.tp_rankelse: shard_rank = self.tp_rank // self.num_kv_head_replicasstart_idx = shard_rank * shard_size举个具体例子:Qwen2-7B 有 28 个 query head、4 个 KV head,head_dim 128。TP=4 时,每个 rank 分到 7 个 query head;KV head 只有 4 个,正好每个 rank 1 个,。TP=8 时,query head 每个 rank 3.5 个——不整除,模型根本不允许这种 TP 配置;如果强行配置,构造期的 assert self.total_num_heads % tp_size == 0 会先失败。KV head 4 个、TP=8 时,,rank 0 和 1 都拿第 0 个 KV head,rank 2 和 3 拿第 1 个,以此类推。这个复制是有意的:每个 rank 上的 query head 需要看到对应的 K/V,复制一份比跨 rank 通信更便宜。
MLA 是另一条路。DeepSeek 的 MLA 把 K/V 压成一个 latent 向量,KV cache 里每个 token 只存一份 latent,不再有「KV head 数」的概念;kv_b_proj 这类上投影仍然按线性层规则切,但 cache 的切分逻辑由注意力后端单独处理。MLA 的低秩压缩和矩阵吸收可参考站内 MLA 完全拆解;TensorRT-LLM 里 MLA 为什么不能照搬普通 TP 切法,可参考 注意力层的张量并行。
参数对象如何记住切法
切分规则不是写在 weight_loader 里的硬编码,而是参数对象上的元数据。BasevLLMParameter 在构造时接收一个 weight_loader 回调,并记录自己的 tp_rank/tp_size。ModelWeightParameter 同时继承 _ColumnvLLMParameter 和 RowvLLMParameter,因此既有 output_dim 又有 input_dim;具体走哪个 loader,由线性层在 create_weights 时传进来的回调决定。
PerTensorScaleParameter 是另一类:它存的是「每个逻辑矩阵一个 scale」,形状是 [num_logical_matrices]。对 QKV 融合层,一个 per-tensor FP8 checkpoint 会给出 q/k/v 三个标量 scale;模型的参数却是一个长度 3 的数组。load_qkv_weight 会把标量写进 shard_id 对应的槽位;如果 checkpoint 已经把 qkv 融合、只给一个 scale,则把同一个值填满三个槽位,保证后续 .max() 之类的归约仍然有正确的形状。
PackedvLLMParameter 处理 4-bit 打包权重。Marlin/AWQ 一类格式把两个 4-bit 值塞进一个字节,参数的实际形状是 [output, input / packed_factor]。切分时偏移和大小都要先除以 packed_factor,还要按 Marlin 的 tile size 对齐:
def adjust_shard_indexes_for_packing(self, shard_size, shard_offset): return ( shard_size // self.packed_factor + self.marlin_tile_size - 1, shard_offset // self.packed_factor, )向上取整是为了覆盖边界 tile:一个 tile 可能横跨两个逻辑分片,不能简单截断。
BlockQuantScaleParameter 则处理块量化(如 FP8 的 128×128 block)。weight 按块切,scale 的张量形状是 [ceil(out/128), ceil(in/128)];如果输出维切分点不在 128 的边界上,scale 的切片也要包含被切开的那个块。adjust_block_scale_shard(weight_block_size, shard_size, shard_offset) 就是做这件事。FP8 block 量化模型在 TP 下出现 shape mismatch,十有八九是这里没有对齐 block 边界。
v1 与 v2 两套 loader
vLLM 同时保留了两套参数加载路径。老的 weight_loader 直接操作 param.data,用 narrow + copy_;新的 weight_loader_v2 把切分逻辑下沉到 BasevLLMParameter.load_column_parallel_weight / load_row_parallel_weight / load_qkv_weight 等方法里,线性层只负责算偏移和 shard_id。
是否走 v2 由 WEIGHT_LOADER_V2_SUPPORTED 名单决定:
weight_loader = ( self.weight_loader_v2 if quant_method.__class__.__name__ in WEIGHT_LOADER_V2_SUPPORTED else self.weight_loader)名单里是 UnquantizedLinearMethod、Fp8LinearMethod、AutoAWQLinearMethod、AutoGPTQLinearMethod、CompressedTensorsLinearMethod 等常用方法。v2 的好处是把「怎么切」和「切到哪」分开:线性层只算逻辑分片的偏移,参数类自己知道 packing、block scale、Marlin tile 等细节;代价是两套路径并存,阅读源码时要先确认当前方法走的是哪一套。自定义量化插件如果没注册进名单,会退回 v1,这时参数类上的 packed/block 元数据可能不会被正确处理——这是写第三方量化后端时的一个常见坑。
替换参数后的 TP 状态
process_weights_after_loading 可能用 replace_parameter 换掉一个 Parameter。新参数由 BasevLLMParameter.__init__ 创建时,tp_rank 被盖成全局 rank;但线性层可能设置了 disable_tp=True,此时层内的 tp_rank 是 0、tp_size 是 1。如果之后还要 reload 权重(RL weight refit 或权重热更新),用全局 rank 去切一个复制权重就会越界。
vLLM 的修法是 update_param_tp_status():在构造末尾和后处理之后各调用一次,把每个 BasevLLMParameter 的 tp_rank/tp_size 重新对齐到层自己的值。这个函数看起来只是两行赋值,但它解决的是「参数被替换后元数据失配」这一整类问题。
量化层:参数清单由谁决定
到这里,一个 BF16 模型已经能装进去了:名字映射、TP 切分、copy_ 三步。量化模型多出来的复杂度在于:这一层的参数清单本身就不一样。Unquantized 的 LinearBase 只有一个 weight,外加可选 bias;FP8 的线性层除 weight 外还有 weight_scale,可能是 block scale 或 per-tensor scale;GPTQ/AWQ 还有 qzeros、scales、bias;KV cache 量化层再挂一两个 k_scale/v_scale。装载器如果自己维护一份「量化层有哪些参数」的表,每加一种量化方法就要改装载器,这显然不可持续。
vLLM 的解法是把这件事交给量化方法:create_weights 由量化方法实现,线性层在第 2 节说的「建壳」阶段调用它。LinearBase.__init__ 里的这行是整条链路的起点:
if quant_config is None: self.quant_method = UnquantizedLinearMethod()elif quant_method := resolve_quant_method(quant_config, self, prefix=prefix): self.quant_method = quant_methodresolve_quant_method 先按前缀问量化配置「这一层用什么方法」,再叠加在线量化配置。这一步发生在构造期,因此后面 ColumnParallelLinear.__init__ 可以按方法类型选 loader:
self.quant_method.create_weights( layer=self, input_size_per_partition=self.input_size_per_partition, output_partition_sizes=self.output_partition_sizes, input_size=self.input_size, output_size=self.output_size, params_dtype=self.params_dtype, weight_loader=weight_loader,)传给 create_weights 的四个尺寸参数,分别回答「本 rank 的输入维」、「本 rank 每个逻辑分片的输出维」、「全局输入维」、「全局输出维」。前两个决定参数实际形状,后两个用于校验和推导 scale 的逻辑形状。以 FP8 为例:
output_size_per_partition = sum(output_partition_sizes)layer.logical_widths = output_partition_sizes...weight = create_fp8_weight_parameter( output_size_per_partition, input_size_per_partition, weight_loader)layer.register_parameter("weight", weight)if not self.block_quant: scale = create_fp8_scale_parameter( PerTensorScaleParameter, output_partition_sizes, input_size_per_partition, None, weight_loader ) layer.register_parameter("weight_scale", scale)else: scale = create_fp8_scale_parameter( BlockQuantScaleParameter, output_partition_sizes, input_size_per_partition, self.weight_block_size, weight_loader, scale_dtype=(torch.float8_e8m0fnu if self.is_scale_e8m0 else None), ) layer.register_parameter("weight_scale_inv", scale)几个关键信息:
layer.logical_widths = output_partition_sizes记下「本 rank 上这个融合参数由几个逻辑矩阵组成、各宽多少」。后处理阶段要把「每个逻辑分片一个 scale」合成「整个参数一个 scale」,就必须知道这个划分。- per-tensor FP8 的 scale 参数是
PerTensorScaleParameter,长度等于逻辑分片个数。QKV 融合层就是 3 个槽位;MLP 的 gate_up 是 2 个。 - block FP8 的 scale 参数名是
weight_scale_inv,形状是[ceil(out/block), ceil(in/block)]。名字刻意保留scale_inv,是为了兼容 DeepSeek 系 checkpoint 的原始命名——这些 checkpoint 里 scale 值存的是「除以权重」的逆 scale,而不同 kernel 期待的约定不同,后处理阶段要做一次统一。 scale_dtype=float8_e8m0fnu是 MXFP8 的 E8M0 scale 格式:scale 本身不存浮点尾数,只有一个 8-bit 指数。这种格式的 scale 只占 1 字节,对 block 很细的量化(比如 32×32)能显著减少 scale 开销。
weight_loader 被同一个回调传给 weight 和 scale 两个参数。回调和参数类一起决定了「这个 scale 张量该切哪一段」。PerTensorScaleParameter 对列并行层不切(一个逻辑分片对应一个标量),对融合层按 shard_id 写进对应槽位;BlockQuantScaleParameter 则按 block 对齐后切。
RoutedExperts(MoE 层)走的是另一套 create_weights 签名:num_experts、hidden_size、intermediate_size_per_partition。注意这里没有 output_partition_sizes 列表,因为专家并行的切分单位是专家,不是列分片。每个 rank 持有 num_local_experts 个专家时,w13_weight 形状是 [num_local, 2*intermediate, hidden],w2_weight 是 [num_local, hidden, intermediate]。EP 开关不同、专家放置策略不同,本地专家的编号也不同,所以专家加载器的逻辑和普通线性层完全不同,一般由 MoE 层自己的 load_weights 处理。
为什么量化方法必须参与「建壳」
可以换一个角度理解这条设计。假设装载器先建一个普通的 BF16 模型,装完再量化,会有什么问题?
- 显存峰值翻倍。671B 的 BF16 权重 1.3TB,量化前必须先放下一份 BF16 再转换成 FP8;多卡也一样,每个 rank 都要额外扛一份。
- 很多量化格式的参数字形状和 BF16 不同。4-bit 打包后 shape 减半,Marlin 还有额外的 tile 排布;不可能先按 BF16 形状建好再「改形状」。
- 部分量化方法必须知道「这是第几个逻辑分片」才能决定 scale 的形状。QKV 融合层如果先建了一个大 weight,再拆成三个 scale 槽位,信息已经丢了。
所以量化方法参与 create_weights 是必然的。它让参数清单、参数形状、参数上的 loader 元数据一次性在构造期确定下来;装载期只是把 checkpoint 张量按这些元数据切进去。这个分界点很清晰:构造期决定「我是谁」,装载期决定「我填哪一块」。
在线量化:uses_meta_device
vLLM 还支持「在线量化」:checkpoint 是 BF16(或 FP16),启动时即时量化成 FP8/INT8。这和「离线量化」共享同一套壳和 loader,但有一个特殊标志:
class QuantizeMethodBase(ABC): uses_meta_device: bool = False """ Whether this method creates weights on meta device for online quantization. When True, weights are created on meta device and quantized layer-wise in process_weights_after_loading, reducing peak memory during loading. """如果在线量化方法把参数建在 meta 设备上(只有形状元数据、没有真实存储),那么装载阶段就不会真的把 BF16 权重写进显存;量化的实际发生被推迟到后处理阶段,按层进行,峰值显存只有「当前层 BF16 + 当前层 FP8」,而不是「全模型 BF16 + 全模型 FP8」。
BaseModelLoader.load_model 里的这个分支就是为它准备的:
if _has_online_quant(model): finalize_layerwise_processing(model, model_config)_has_online_quant 遍历所有模块,只要有一个 quant_method.uses_meta_device 为真就走逐层后处理。log_online_quantization_time 会打印在线量化总耗时,log_online_quantization 会打印被量化的层数和类型。
这个设计在 process_weights_after_loading 里还有配套:device_loading_context(module, target_device) 把 CPU 上的参数临时搬到设备上处理、处理完再搬回并以 pinned memory 保留,用于 CPU offload 场景;而 requires_device_loading=False 的方法(比如只在 CPU 上做 scale 校验的 PLE 量化)跳过这次搬运。
权重装载的严格性检查
DefaultModelLoader.load_weights 末尾有一个可选的 track_weights_loading,用来检查「模型声明了哪些参数、checkpoint 实际给了哪些」,差集不为空就抛异常:
weights_not_loaded = weights_to_load - loaded_weightsif weights_not_loaded: raise ValueError("Following weights were not initialized from checkpoint: ...")默认只在非量化模型上开启:model_config.quantization is None and loaded_weights is not None。原因是量化模型的参数清单里有很多 checkpoint 本来就不带的东西——在线量化 scale、KV cache scale(BaseKVCacheMethod 在后处理阶段给默认值)、对称 GPTQ 的空占位 qzeros、量化配置自己构造的 input_scale_ub。如果对这些参数逐一要求「必须从 checkpoint 加载」,几乎所有量化模型都会失败。
但即使是量化模型,真正的权重参数也不应该被放过。代码的豁免逻辑很细:
if (quantized and not has_online_quant and not isinstance(quant_method, BaseKVCacheMethod) and param.numel() > 0 and param_name.rsplit(".", 1)[-1] not in _CONFIG_BUILT_PARAMS): continue只有「在线量化参数」「KV cache scale」「空占位」「配置构造参数」这四类可以豁免;其它量化参数,包括 weight、weight_scale、qzeros、scales,全部要求被加载过。这是一个务实的严格性:检查能真正抓到「某个 adapter 的 scale 漏了」「某个 expert 的 weight 没读到」这类致命错误,又不至于被格式自带的非权重张量误伤。
可以用 model_loader_extra_config={"enable_weights_track": False} 关掉这项检查,通常用于自定义模型或实验性 checkpoint 调试。
装载之后:为什么还要再「加工」一遍
权重已经按名字切进参数,为什么不能直接前向?因为 checkpoint 的布局是给存储/训练用的,kernel 的布局是给计算用的,两者经常不一致。几个典型差异:
- FP8 的
torch._scaled_mm期望权重是(K, N)列主序,而 checkpoint 存的是(N, K)行主序;需要转置。 - 融合层的 per-tensor scale 在 checkpoint 里是「每个逻辑分片一个」,而 per-tensor kernel 要求「整个融合权重一个」;需要取最大值合并。
- 4-bit 权重需要按 Marlin 的 tile 布局重排,否则 kernel 读出来的顺序是乱的。
- AMD 的 FP8 格式是
e4m3fnuz(FNUZ),NVIDIA 是e4m3fn;同一份 checkpoint 在 MI300 上需要转换。 - 在线量化的权重在装载时还是 BF16,必须在这里逐层量化。
process_weights_after_loading 就是统一处理这些差异的入口。驱动逻辑在 model_loader/utils.py:
for name, module in model.named_modules(): quant_method = getattr(module, "quant_method", None) if isinstance(quant_method, QuantizeMethodBase): loading_context = ( device_loading_context(module, target_device) if quant_method.requires_device_loading else nullcontext() ) with loading_context: quant_method.process_weights_after_loading(module) if hasattr(module, "update_param_tp_status"): module.update_param_tp_status() release_device_memory_under_pressure(target_device)几个设计点值得展开:
只处理有 quant_method 且是 QuantizeMethodBase 的模块。 不是所有模块都需要后处理;LoRA 的 adapter、embedding、norm 都不在这个循环里。它们要么在装载时已经就位,要么由模型级的 process_weights_after_loading 钩子处理。
device_loading_context 是为 CPU offload 准备的。 如果参数在 CPU 上(用户开了 --cpu-offload-gb),后处理通常需要 GPU 上的 kernel(比如 FP8 转置、Marlin 重排)。这个上下文把模块的 CPU 参数临时搬到 target_device,处理完再搬回 CPU,并用 pinned memory 保留,方便下一次快速上传。注意它只搬 named_parameters 里当前在 CPU 上的参数;已经在 GPU 上的不动。
release_device_memory_under_pressure 在每个模块处理完后调用。 后处理会产生临时张量(转置副本、重排缓冲),PyTorch 的 caching allocator 不一定立刻归还。这个函数在显存压力大时主动释放缓存,避免「一层处理完,下一层却 OOM」。
update_param_tp_status 在参数可能被替换后重新对齐 TP 元数据,前面已经讲过。
循环结束后还有两段:
for _, module in model.named_modules(): if is_deferred_attention_layer(module): with device_loading_context(module, target_device): module.process_weights_after_loading(model_config.dtype)
if hasattr(model, "process_weights_after_loading"): model.process_weights_after_loading()第一段处理「延迟初始化的注意力层」:有些注意力后端(比如 MLA 的某些实现)需要等所有层的量化权重都就位后,才能根据实际的 KV cache 布局初始化自己的权重。放在主循环之后,是为了保证前面的解压/重排已经完成。第二段是模型级钩子,给需要跨层协调的模型用。
FP8 的后处理:转置、合并、替换
以 Fp8LinearMethod.process_weights_after_loading 为例,它有三条路径。
Marlin 路径。当 GPU 不支持原生 FP8、但支持 Marlin 时,use_marlin=True。非 block 量化的情况下,权重先转置成 (K, N):
if not self.block_quant: replace_parameter(layer, "weight", layer.weight.t())然后调用 self.fp8_linear.process_weights_after_loading(layer),由 Marlin kernel 自己做重排。
非 Marlin、非 block 路径。checkpoint 是 per-tensor FP8 时,融合层有 N 个 scale(N = logical_widths 的长度)。process_fp8_weight_tensor_strategy 会把逻辑分片重新量化成「整个权重一个 scale」:
weight, weight_scale, input_scale = process_fp8_weight_tensor_strategy( weight, weight_scale, layer.logical_widths, getattr(layer, "input_scale", None),)if self.act_q_static: input_scale = input_scale.max()replace_parameter(layer, "weight", weight.data)layer.processed_weight_dims = (0, 1)replace_parameter(layer, "weight_scale", weight_scale.data)这里为什么需要「重新量化」而不是简单取 max?因为不同逻辑分片的 scale 不同,直接拼在一起会让某些分片的数值范围溢出或精度损失。正确做法是把每个分片先反量化成 FP32/BF16,再用一个统一的 scale 重新量化。process_fp8_weight_tensor_strategy 做的就是这件事。代价是启动时多一遍读写,收益是 kernel 只需要一个 scale,访存和指令都更简单。
block FP8 路径。权重和 weight_scale_inv 保持 block 布局,不需要合并 scale;但要做 block 形状校验和可能的 FNUZ 转换。layer.weight_block_size 在 create_weights 时已经设好,后处理只需确认 kernel 能接受这个 block 形状。
replace_parameter 这个动作看起来只是「把 layer.weight 指向新张量」,实际上做了三件事:保留原参数的 weight_loader 和 TP 元数据、用新张量替换 Parameter 对象、把旧张量从模块的 _parameters 里摘掉。如果直接用 layer.weight.data = new_tensor,shape 可能变,Parameter 的元数据会失配;replace_parameter 是更安全的写法。
MoE 的 FP8 后处理
Fp8MoEMethod.process_weights_after_loading 走的是另一套逻辑,因为 MoE 的参数是「按专家堆叠」的:
w13 = layer.w13_weightw2 = layer.w2_weightw13_scale = getattr(layer, f"w13_{self.weight_scale_name}")w2_scale = getattr(layer, f"w2_{self.weight_scale_name}")...if current_platform.is_fp8_fnuz(): w13, w13_scale, w13_input_scale = normalize_e4m3fn_to_e4m3fnuz(...)w13是 gate+up 的融合权重,形状[num_local_experts, 2*intermediate, hidden];w2是 down 投影,[num_local_experts, hidden, intermediate]。- per-tensor kernel 要求每个专家一个 scale,或者整体一个 scale;代码会按 kernel 的要求做
.max()合并。 - FNUZ 转换只对 AMD 平台生效,把 NVIDIA 的
e4m3fn数值映射到 AMD 的e4m3fnuz。这不是简单的 dtype cast:两种格式的指数偏置和 NaN 表示不同,normalize_e4m3fn_to_e4m3fnuz会同时调整 scale,保证反量化后的数值不变。 - block 量化时,
w13_scale/w2_scale的形状是[num_local_experts, ceil(...), ceil(...)],后处理要检查每个专家的 block 形状一致,并可能把 scale 重排成 kernel 期望的[num_local_experts, ...]连续布局。
MoE 的后处理还有一个额外约束:专家并行下每个 rank 只有一部分专家,所以后处理只能看到本地专家。scale 的合并、转换都必须按本地专家做,不能假设全局专家数量。这也是为什么 MoE 的 create_weights 接收的是 num_experts(全局)和 intermediate_size_per_partition(本地),而不是一个统一的 output_partition_sizes。
在线量化的逐层处理
在线量化的后处理是另一个量级的工作:它不是「整理已有权重」,而是「把 BF16 权重变成量化权重」。uses_meta_device=True 的方法在 create_weights 时只建形状、不分配真实存储;load_weights 阶段把 BF16 权重写进一个临时的 meta 参数(实际是延迟物化),到 process_weights_after_loading 才逐层量化。
finalize_layerwise_processing(model, model_config) 是这条路径的收尾。它按层遍历,对每一层:
- 把 BF16 权重物化到 GPU(如果之前在 meta/CPU 上)。
- 计算 scale(per-tensor 用最大值,per-block 用 block 最大值)。
- 量化成 FP8/INT8,写入正式的量化参数。
- 释放 BF16 临时权重。
这样峰值显存大约是「一层 BF16 + 一层量化权重 + 少量临时」,而不是「全模型 BF16 + 全模型量化权重」。对 671B 模型,这个差别是几百 GB 级别的。代价是启动时间变长:每层都要做一遍 reduce/quantize,而且不能像离线量化那样用更复杂的校准算法(在线量化通常只做 min-max 或 percentile,不做 GPTQ/AWQ 那种重构)。
supports_pre_processed_weights 则服务于另一条路径:权重缓存守护进程(vllm preload + --load-format ipc_cache)已经把后处理做完,权重以 CUDA IPC 共享内存的形式交给引擎。此时 is_weights_pre_processed() 为真,量化方法的 process_weights_after_loading 必须跳过所有张量变换,只做 kernel 初始化;如果某个方法没声明支持,驱动会直接报错,而不是让它重复处理一遍。
装载期的显存账:峰值到底花在哪
讲完机制,回到工程最关心的两个数:要装多久、峰值要多少显存。
权重本身占多少
每个参数的字节数由 dtype 决定:
| dtype | 每参数字节 | 备注 |
|---|---|---|
| BF16 / FP16 | 2 | 最常见的推理精度 |
| FP8(E4M3) | 1 | 需要 Hopper/Ada 或支持 FP8 的加速器 |
| INT8 | 1 | 通常配 per-channel scale |
| INT4 / NVFP4 | 0.5 | 打包存储;还要加 scale/zero point |
| 2-bit | 0.25 | 实验性,精度风险大 |
以 DeepSeek-V3/R1 级别的 671B 总参数为例(MoE 激活参数远小于总参数,但装载要装全部专家):
- BF16: TB
- FP8:约 671 GB
- INT4:约 336 GB,加上 scale/zero point 通常再多 3%–6%
单卡 H100 80GB 显然放不下 FP8 的 671B;TP=8 的 8 卡节点总显存 640GB,仍然小于 671GB,连权重都装不下,更不用说 KV cache 和激活。现实部署要么用 16 卡以上、要么用更激进的量化(FP4/INT4)、要么把专家卸载到 CPU/SSD。这个算术不复杂,但它决定了很多「为什么这个模型必须这么部署」的问题。
每卡的权重字节是总量除以并行度,但不是所有参数都按 TP 切:embedding 和 LM head 可能按词表切,norm 是复制的,MoE 专家按 EP 切。所以「671GB / 16 = 42GB」只是粗略下界,实际每卡还要加复制参数和对齐开销。
装载时间
理论下界是「总字节 / 有效带宽」:
其中 是有效带宽利用率。几个参考值:
- 本地 NVMe:顺序读 7 GB/s 左右,671GB 需要约 96 秒;如果走 mmap 随机读,实际可能更慢。
- 25GbE/100GbE 网络存储:25 GB/s 对应约 27 秒;但网络文件系统的元数据操作和随机读会显著拉低 。
- PCIe Gen5 x16:理论 64 GB/s,实际 H2D 拷贝常见 20–40 GB/s;671GB 约 17–34 秒。
这些数字只算「搬字节」,没算反序列化、名字映射、TP 切片、后处理。真实启动时间通常是理论值的 1.5–3 倍。这也是为什么 ServerlessLLM 一类工作要专门优化 checkpoint 读取,为什么 prefetch/eager/多线程装载值得做成可配置项。
峰值显存的四个来源
- 模型壳的空参数。
with target_device:让torch.empty直接在 GPU 上分配。对 BF16 模型,这一步就占了全部权重的显存;如果显存不够,会在建壳阶段直接 OOM,而不是等到装载。 - 单个 checkpoint 张量的临时副本。
f.get_tensor(name)返回一个 CPU 张量(mmap 或拷贝),然后copy_到 GPU 参数。生成器一次只持有一个张量,所以临时峰值大致是「最大的单个张量」,不是整个分片。但注意:如果某个张量特别大(比如 15 万词表的 embedding,BF16 约 1.2GB),它会短暂地同时存在于 CPU 和 GPU。 - 后处理的临时张量。FP8 转置会创建一个同形状的新张量;
process_fp8_weight_tensor_strategy会先反量化再量化,临时量可能是权重的 2–4 倍(FP32 中间态)。replace_parameter之后旧张量才会被释放。逐层处理把这份峰值限制在「一层」,但 MoE 的一层可能包含几十个专家,仍然不小。 - 量化 scale 和 zero point。per-tensor 可以忽略;block 量化在 block 很细时(如 32×32)scale 可能占到权重的 1/32;4-bit 的 group scale 通常每 32/64 个权重一个 FP16 scale,额外 3%–6%。
gc.collect() + torch.accelerator.empty_cache() 在 load_weights 之后和后处理之后各调用一次,目的就是把这四类临时量尽量还给驱动。Python 的引用计数对循环引用无效,gc.collect() 处理的是后者;empty_cache 处理的是 caching allocator 的空闲块。两者都不能解决「真实峰值超过显存」的问题,只能减少「峰值过后仍然占着」的浪费。
在线量化把峰值压到一层
离线量化的峰值是「BF16 全模型 + 量化全模型」;在线量化用 meta device 把 BF16 权重延迟到逐层处理,峰值变成「一层 BF16 + 一层量化 + 临时」。对 671B:
- 离线:1.34TB(BF16)+ 671GB(FP8)= 约 2TB 的瞬时占用,必须分布在足够多的卡上。
- 在线:每层 BF16 权重可能是几十 GB(MoE 层),加上量化副本,单卡峰值可能只有 100GB 量级;16 卡就能跑起来。
代价是启动时间增加,以及量化算法更简单。vLLM 的在线 FP8 通常用 per-tensor 动态/静态 scale,不做 GPTQ 的 Hessian 重构;精度和离线 GPTQ/AWQ 有差距,但胜在「拿到任何 BF16 checkpoint 都能直接跑」。
与逐层流式装载的关系
Progressive Weight Loading 的思路是把「装载」和「推理」重叠:第 0 层装好就能开始处理请求,后续层在后台继续装。vLLM 当前的默认路径是「全部装完再服务」,原因有三:
- 调度器需要知道完整的显存预算才能分配 KV cache;逐层装载会让可用显存动态变化,调度逻辑复杂。
- 量化后处理需要跨层一致性(比如 MLA 的延迟注意力层),逐层加载会打乱顺序。
- 多卡场景下,各 rank 的装载进度必须同步,否则集合通信会死锁。
但 vLLM 已经有一些「部分重叠」的机制:DummyModelLoader 用于 profiling 阶段快速建壳;prefetch 在后台把文件推进 page cache;在线量化把 BF16 权重的生命周期压到一层。这些都是在不改变「服务前必须装完」的前提下,尽量把等待时间藏起来。
常见装载故障与排查路径
装载阶段的错误有一个特点:错误信息往往指向「名字」或「形状」,但根因可能在量化方法、并行配置、checkpoint 格式三者中的任意一个。下面几类是最常见的。
「Following weights were not initialized from checkpoint」
这是 track_weights_loading 抛出的差集错误。排查顺序:
- 看列出来的名字。如果全是量化张量(
weight_scale、qzeros、input_scale),说明这个 checkpoint 不是该量化方法期望的格式,或者该方法的豁免表没写全。这是 vLLM 侧的问题,通常需要在track_weights_loading里补豁免,而不是改 checkpoint。 - 如果列出来的是
model.layers.N.xxx形式的权重,说明某层的load_weights没有消费这个张量。多半是名字映射漏了一类(比如某个 adapter 用了不同的前缀),或者模型的load_weights提前return了。 - 如果是
lm_head.weight或embed_tokens.weight,检查 tied embedding 的别名逻辑:canonical 名字是否在 checkpoint 里存在?如果 checkpoint 只有lm_head.weight,而模型把它当别名丢掉了,就会漏装。
「There is no module or parameter named …」
AutoWeightsLoader._load_module 抛出的路由错误。错误信息会列出当前模块下所有可用的参数名,这是最直接的线索。常见原因:
- checkpoint 是旧版 HF 格式,模块名用了
transformer.h.0而不是model.layers.0;需要orig_to_new_prefix或orig_to_new_substr映射。 - 模型融合了模块(
qkv_proj),但 checkpoint 名字没有被 stacked 映射覆盖,导致试图把q_proj路由到不存在的子模块。 - 量化配置里声明了某个层要量化,但模型按前缀找不到这个层,于是量化方法返回
None,层被建成了 unquantized,checkpoint 里的量化张量无处可放。这个错误信息有时会误导人,因为真正的根因在前面的get_quant_method(prefix)。
形状不匹配
assert param_data.shape == loaded_weight.shape 失败。按并行类型分:
- 列并行 / 行并行:多半是 checkpoint 的维度顺序和模型预期相反。HF 的
Linear权重是(out, in),但某些转换脚本会存成(in, out)。检查output_dim/input_dim是否设置正确。 - QKV 并行:KV head 数小于 TP 时,
num_kv_head_replicas的计算和 checkpoint 的 KV head 数要一致;如果模型配置写错了num_key_value_heads,切片会越界。 - block 量化:TP 切点没有对齐 block 边界。
adjust_block_scale_shard只在BlockQuantScaleParameter上生效;如果用的是旧的weight_loader(v1),block scale 的切片可能没有对齐。确认该方法是否在WEIGHT_LOADER_V2_SUPPORTED名单里。 - 4-bit packed:
packed_factor和 checkpoint 的打包方式不一致(有的格式把 8 个 4-bit 打包,有的把 2 个打包)。Marlin 的 tile 对齐也会导致形状看起来差几个元素。
FP8 启动后前向结果不对
装载成功了,但推理输出乱码或精度暴跌。常见原因:
weight_scale_inv的语义搞反:有些 checkpoint 存的是scale(乘以权重),有些存的是scale_inv(除以权重)。vLLM 在process_weights_after_loading里统一成 kernel 期望的约定,但如果自定义 kernel 直接读原始参数,就会差一个倒数。- 融合层 scale 合并错误:per-tensor FP8 的多分片 scale 如果只取了第一个分片的 scale,其它分片的数值会溢出。
- FNUZ 未转换:在 MI300 上加载 NVIDIA 生成的 FP8 checkpoint,没有走
normalize_e4m3fn_to_e4m3fnuz,数值范围不同会导致大量饱和。
OOM 发生在装载而非推理
如果模型「推理时能跑,启动时 OOM」,说明峰值出现在装载或后处理阶段。对策:
- 用
--load-format dummy先测「仅建壳 + 推理」的显存需求,确认是装载侧的问题。 - 开在线量化,把 BF16 权重生命周期压到一层。
- 逐层后处理时压力太大,检查
release_device_memory_under_pressure是否生效;某些平台(UMA,如 Grace Hopper)需要更激进地归还内存。 - 临时关掉
enable_weights_track排除差集检查本身带来的额外集合开销(很小,但能缩小范围)。
排查工具
VLLM_LOGGING_LEVEL=DEBUG会打印每个权重加载的 debug 日志,能看到名字、形状、目标参数。VLLM_LOG_MODEL_INSPECTION=1会在建壳后打印完整模型结构,适合确认模块名和参数名。load_weights里的logger.info_once("Loading weights took %.2f seconds")和建壳的Initializing model took %.6f seconds把装载分成两段计时;后处理的耗时会出现在在线量化的日志里。- 对单个层,可以写一个小脚本
model.load_weights([(name, tensor)]),单独复现路由问题,不必启动整个引擎。
把六道关卡串起来:一个 Qwen2 层的完整路径
抽象讲了太多,最后用一个具体例子走完整条链路。假设用 TP=8 加载 Qwen2-7B 的 FP8 per-tensor checkpoint,关注第 0 层。
建壳。initialize_model 解析出 Qwen2ForCausalLM,构造 Qwen2DecoderLayer(vllm_config, prefix="model.layers.0")。层的 __init__ 依次构造:
Qwen2Attention:读取tp_size=8,28 个 query head 每个 rank 分到 3 个(28 不能被 8 整除,实际模型不会允许 TP=8;这里换成 Qwen2-7B 的 28 head 配 TP=4,或者用 head 数能被 8 整除的模型更合理)。为了说明复制逻辑,假设 32 个 query head、8 个 KV head、TP=8:每个 rank 4 个 query head、1 个 KV head,num_kv_head_replicas=1。QKVParallelLinear:create_weights建出weight(FP8)形状[(32+8+8)*128/8, 3584] = [768, 3584],weight_scale形状[3](q/k/v 各一个)。RowParallelLinear(o_proj):create_weights建出weight形状[3584, 32*128/8] = [3584, 512],weight_scale形状[1]。MergedColumnParallelLinear(gate_up):output_sizes=[18944, 18944],weight形状[2*18944/8, 3584] = [4736, 3584],weight_scale形状[2]。RowParallelLinear(down):weight形状[3584, 18944/8] = [3584, 2368]。
此时显存里已经有了这一层全部参数的空壳(FP8),但数值是未初始化的垃圾。
读盘。safetensors_weights_iterator 按自然排序遍历分片。第一个分片包含 model.layers.0.self_attn.q_proj.weight、...q_proj.weight_scale 等。
路由。AutoWeightsLoader 用 Qwen2 的 hf_to_vllm_mapper 把 q_proj 映射成 qkv_proj,并给张量挂 shard_id="q"。weight_scale 名字同样被映射成 qkv_proj.weight_scale,挂 shard_id="q"。名字路由找到 model.layers.0.self_attn.qkv_proj 模块,模块有自己的 load_weights,它读 shard_id 属性并调用 param.weight_loader(param, tensor, "q")。
切片。
qkv_proj.weight:weight_loader走 v2(Fp8LinearMethod在名单里),shard_offset=0、shard_size=num_heads*head_size=512,按tp_rank*512从 checkpoint 的q_proj.weight里取 512 行,写进融合参数的前 512 行。qkv_proj.weight_scale:PerTensorScaleParameter.load_qkv_weight把标量写进槽位 0(q)。k 的 scale 写槽位 1,v 写槽位 2。o_proj.weight:RowParallelLinear,沿输入维取tp_rank*512起的 512 列。gate_up_proj.weight:MergedColumnParallelLinear,gate_proj的shard_id=0,偏移 0、大小18944/8=2368,取 checkpointgate_proj的第tp_rank*2368行;up_proj的shard_id=1,在融合参数里的偏移是 2368,同样是 checkpoint 的第tp_rank*2368行。down_proj.weight:行并行,沿输入维切 1/8。
后处理。Fp8LinearMethod.process_weights_after_loading 对每个线性层:
qkv_proj:checkpoint 是 per-tensor,三个 scale 现在在[3]数组里。process_fp8_weight_tensor_strategy把 q/k/v 三段反量化成 FP32,算一个全局 max scale,再量化成 FP8,权重变成「一个 scale」的形态。replace_parameter换上新权重和新 scale。processed_weight_dims=(0,1)告诉后续代码新权重的维度语义。o_proj、gate_up_proj同理。gate_up的两个 scale 也合并成一个。- 如果实际选中了 Marlin kernel,则先转置成
(K, N),由 Marlin 自己做重排。
对账。非量化模型会检查差集;FP8 模型的默认检查关闭,但 weight_scale 属于必须加载的参数,如果某个分片的 scale 没读到,前向会报错而不是静默算错。
整个链路里,名字、形状、scale 数量三者的对齐是最容易出错的地方:
- 名字对齐:
q_proj.weight_scale必须和q_proj.weight一起被映射,不能只映射 weight。 - 形状对齐:KV head 的复制倍数决定了 k/v 的切片大小,配置错了就会越界。
- scale 数量对齐:融合层有 N 个逻辑分片就有 N 个 scale 槽位,checkpoint 融合与否决定是逐个填充还是整体填满。
这三者任意一处不对,错误往往不会在装载时立刻暴露,而是在第一次前向时以 NaN 或乱码的形式出现。所以调试量化模型的装载问题时,先打印每一层的参数形状和 scale 形状,比盯着错误堆栈更有效。
小结
vLLM 的权重装载可以概括成一句:建壳时量化方法决定参数清单,装载时名字映射与线性层共同决定张量落在哪个 rank 的哪一段,后处理再把这段数据整理成 kernel 期望的布局。
六个关卡的职责边界:
_prepare_weights决定读哪些文件,以及「本地 mmap / 整片 eager / 后台 prefetch」三种读法的选择。- 迭代器把文件变成
(name, tensor)流,并在读盘前过滤掉本地专家之外的 MoE 权重、只包含无用张量的分片。 WeightsMapper+AutoWeightsLoader负责把 HF 名字翻译成 vLLM 模块名、把融合模块拆成带shard_id的张量、处理 tied embedding 的别名。- 四类线性层(Column / Row / MergedColumn / QKV)按各自的并行规则切分;参数对象上的元数据(
output_dim/input_dim/packed_factor/block_size)决定了切分时的对齐方式。 process_weights_after_loading按量化方法转置、合并 scale、重排 tile、转换 FNUZ、逐层在线量化。track_weights_loading对账,把「声明了但没装」的参数报出来。
其中第 3、4 步的收益来自同一件事:把「这一层有哪些参数、每个参数的 layout 是什么」在构造期就确定下来。装载器不需要知道 FP8 还是 AWQ,它只负责把张量交给参数对象上挂着的 weight_loader;量化方法也不需要知道文件怎么排布,它只负责在 create_weights 里把参数清单写清楚。这种「构造期决定身份、装载期只填数据」的分工,是 vLLM 能同时支持十几种量化格式和一二十种并行配置而不爆炸的关键。
如果要继续往下读,建议沿着两条线:一是 model_executor/models/<arch>.py 里模型的 load_weights,看具体的名字映射与融合拆分;二是 model_executor/layers/quantization/ 下各方法的 create_weights 与 process_weights_after_loading,看不同量化格式在两端分别做了什么。把这两条线和本文的六道关卡对照起来,整个装载链路就不再神秘。
参考资料
- vLLM 官方文档:Model Loader
- vLLM 官方文档:Quantization
- vLLM 官方文档:Torch.compile 与 CUDA Graph
- vLLM GitHub 仓库
- ServerlessLLM: Low-Latency Serverless Inference for Large Language Models(SOSP 2024)
- Progressive Weight Loading: Accelerating Initial Inference and Gradually Boosting Performance on Resource-Constrained Environments(2025)
- TensorCast: The Missing Tensor Management Layer in Large Language Model Infrastructure(2026)
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration
- QServe: W4A8KV4 Quantization and System Co-design for Efficient LLM Serving
- FP8 Formats for Deep Learning
- Marlin(IST-DASLab/gptqmodel 与 vLLM 的 FP8/INT4 加速 kernel)
本文图片来源:ServerlessLLM 论文(arXiv:2401.14351)动机分析图、Progressive Weight Loading 论文(arXiv:2509.22319)概念图、TensorCast 论文(arXiv:2608.06007)系统架构图;阶段与布局对照图为按其源码结构自绘。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



