


SGLang 源码完全拆解(十九):量化方法的注册与层分派——从 `--quantization fp8` 到线性层的 FP8 内核
从一个命令行参数说起
部署一个已经量化好的模型时,启动命令里通常只多了一个参数:
python3 -m sglang.launch_server \ --model-path /models/DeepSeek-V3-FP8 \ --quantization fp8 \ --tp 8但在这一个参数背后,SGLang 要完成六件事:找到量化方法的配置类、从 checkpoint 的 JSON 里读出量化粒度、给每一层选出对应的量化方法、按量化格式申请权重和 scale 的存储、在权重装载完成后做重排或重新量化、最后在每次前向时把激活量化后送进正确的 GEMM 内核。任何一步选错,表现都不是“精度差一点”,而是启动时报维度不匹配、加载时报找不到 scale、或者前向时算出 NaN。
SGLang 的量化层不是为某一种格式写死的。它维护着一个包含二十多种方法的注册表,覆盖 FP8、INT8、AWQ、GPTQ、MXFP4、NVFP4、GGUF、ModelOpt、Quark 等格式,还要在 NVIDIA、AMD、Intel、Ascend 等平台上走不同分支。理解这层代码的价值在于:当一个新的量化 checkpoint 加载失败时,可以沿着配置解析、层分派、权重形状、GEMM 后端这条链迅速定位问题,而不是把整个模型重新转一遍格式。
本文以 FP8 为主线,因为它同时包含三种权重粒度(per-tensor、per-channel、block-wise)和两种激活粒度(静态、动态),足以把整条路径讲完整;其他格式只是在同样的骨架上换一套 create_weights 与 apply。文中的源码对照 SGLang 主分支在 2026 年 10 月的快照,关键类名和函数名可以直接在仓库里检索。
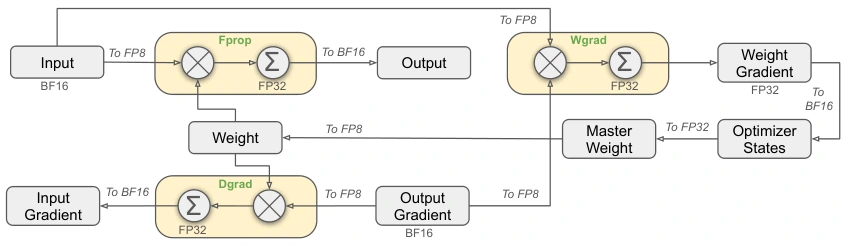
图中只画了 Linear 算子,因为矩阵乘是低精度收益最大、也最需要精细 scale 的地方。这张图出自 FP8 训练框架,但 Linear 的权重分块与 scale 粒度在推理端沿用同一套格式。SGLang 的量化层同样是围绕 LinearBase 与 FusedMoE 这两类层展开的。图片来源:DeepSeek-V3 技术报告(arXiv:2412.19437)Figure 6。
三层抽象:配置、方法、scheme
先建立骨架。SGLang 的量化代码集中在 python/sglang/srt/layers/quantization/ 下,最核心的是三个概念。
第一层是 QuantizationConfig,描述“这个 checkpoint 用的是哪种量化”。它是一个抽象类,要求子类回答几个问题:方法名是什么、支持哪些激活 dtype、最低需要哪代 GPU、checkpoint 里的配置文件叫什么、如何从 JSON 构造自己,以及最重要的 get_quant_method(layer, prefix)——给定一个层实例和它的模块路径,返回这个层应该使用的量化方法。
第二层是 QuantizeMethodBase,描述“这一层怎么创建权重、怎么做前向”。它有三个关键钩子:
class QuantizeMethodBase(ABC): def create_weights(self, layer, *weight_args, **extra_weight_attrs): ... def apply(self, layer, *args, **kwargs): ... def process_weights_after_loading(self, layer): ...create_weights 在模型构造阶段被调用,负责把权重和 scale 注册成 Parameter;process_weights_after_loading 在所有 checkpoint 张量都拷进参数之后调用,负责转置、重排、重新量化;apply 则是每次前向真正执行的路径。
第三层是 LinearMethodBase 与 FusedMoEMethodBase,它们把 QuantizeMethodBase 按层类型拆开:前者接收输入张量、bias,返回输出;后者接收 MoE 的 dispatch 结果,返回 combine 结果。再往下还有一些方法使用 BaseLinearScheme 与 BaseMoEScheme 把“建权重、后处理、前向”三步进一步封装成可替换的 scheme,这是较新的代码路径,AWQ 在 NPU 上就走这条线。对理解主干来说,记住“Config 选方法,方法管一层”即可。
这种分层带来一个直接好处:模型代码完全不需要知道量化格式。LinearBase.__init__ 只做一件事:
if quant_config is None: self.quant_method = UnquantizedLinearMethod()else: self.quant_method = quant_config.get_quant_method(self, prefix=prefix)之后模型里所有 qkv_proj、o_proj、gate_up_proj 都统一调用 quant_method.apply。同一份模型定义可以加载 BF16、FP8、AWQ、GPTQ 等任意 checkpoint,差异被压在量化层内部。
配置从哪来:从命令行到 JSON
命令行只是第一优先级
--quantization 的取值来自 QUANTIZATION_CHOICES,这是一张显式列表,fp8、mxfp8、w8a8_fp8、awq、gptq_marlin、modelopt_fp4、gguf 等都在其中。启动时这个字符串先进入 ModelConfig.quantization,再由 model_loader/loader.py 的 _get_quantization_config 转成配置对象。
这里有一个容易误解的点:命令行给的是“方法名”,不是“精度等级”。比如 --quantization fp8 可以加载 per-tensor 的 FP8 checkpoint,也可以加载 128×128 分块的 FP8 checkpoint;究竟走哪条路,由 checkpoint 自带的 quantization_config 决定。Fp8Config.from_config 会读取 weight_block_size,只有它非空时才启用 block-wise 分支。
如果用户显式指定了方法,SGLang 会优先使用该方法对应的配置类,而不是 Hugging Face 配置里声明的方法。官方文档给过一个典型例子:neuralmagic/Meta-Llama-3.1-8B-Instruct-FP8-dynamic 的配置声明为 compressed-tensors,但加上 --quantization w8a8_fp8 后,SGLang 会用 W8A8Fp8Config 和自家的 sgl-kernel,而不是 compressed-tensors 的实现。这相当于用同一份权重换一套运行时语义,前提是两种方法对权重布局的理解一致。
checkpoint 里的量化元数据
配置文件查找顺序在 model_loader/checkpoint_quantization.py 里写得很清楚:先看顶层 quantization_config,再看多模态模型常用的 text_config.quantization_config,最后看 compression_config。找到之后深拷贝一份,附加运行时字段,再交给对应配置类的 from_config。
以 FP8 为例,Fp8Config.__init__ 关心的字段有:
| 字段 | 作用 | 典型值 |
|---|---|---|
quant_method | 区分 fp8、mxfp8、modelopt_fp8 | "fp8" |
activation_scheme | 激活 scale 是静态还是动态 | "dynamic" |
weight_block_size | 权重分块大小,非空即 block-wise | [128, 128] |
ignored_layers / modules_to_not_convert | 保持高精度的层 | ["lm_head"] |
kv_cache_quant_algo | KV Cache 的量化算法 | "fp8" |
scale_fmt | scale 的数值格式,如 "ue8m0" | None 或 "ue8m0" |
from_config 不只是读字段,还做了几项约束检查。比如 weight_block_size 非空时,要求 is_checkpoint_fp8_serialized 为真,也就是权重必须已经以 FP8 序列化;同时要求 activation_scheme 必须是 dynamic。代码里的理由是 block-wise 的激活 scale 需要按块在运行时计算,静态的单个输入 scale 无法表达这种粒度。再比如 use_mxfp8 为真时,块大小被强制为 [1, 32],因为 OCP 的 MXFP8 规范就是每 32 个元素一个 E8M0 scale,checkpoint 里写了别的值只会得到一条警告然后被覆盖。
还有一处细节值得注意:ignored_layers 会被规范化成带 model. 前缀和不带前缀两份。原因是不同模型的模块路径有的从 model.layers 开始,有的从 layers 开始,只保留一种写法会让前缀匹配漏掉一部分层。这个处理看起来很小,但它决定了 lm_head、视觉编码器之类不该量化的层是否真的被跳过。
配置对象还要过三道硬件检查
配置构造完成后,_get_quantization_config 还会做三件事。
第一,检查 GPU 计算能力:
capability = major * 10 + minorif capability < quant_config.get_min_capability(): raise ValueError(...)FP8 的 get_min_capability 返回 80,也就是 Ampere 起;MXFP8 在 NVIDIA 上返回 100,因为需要 Blackwell 的 FP8/FP4 张量核心与相应的 scale 指令。W8A8 FP8 更严格,返回 89,因为它的 per-channel GEMM 依赖 CUTLASS 在 Ada 及更新架构上的实现。
第二,检查激活 dtype。FP8 只支持 bfloat16 与 float16;如果用户传了 --dtype float32,会在启动阶段直接报错,而不是等到 kernel 里出现类型不匹配。
第三,把模型类的 packed_modules_mapping 交给配置对象,并调用 apply_weight_name_mapper。这一步解决的是“融合层”问题:checkpoint 里可能存的是分开的 q_proj、k_proj、v_proj,而 SGLang 模型里是一个 qkv_proj;量化配置里的 ignored_layers 写的是 checkpoint 的名字,必须映射到运行时模块名才能正确跳过。同理,gate_up_proj 对应 gate_proj 与 up_proj 两个 shard,跳过时必须两个 shard 一起跳过,否则会得到一个“半量化”的融合层。
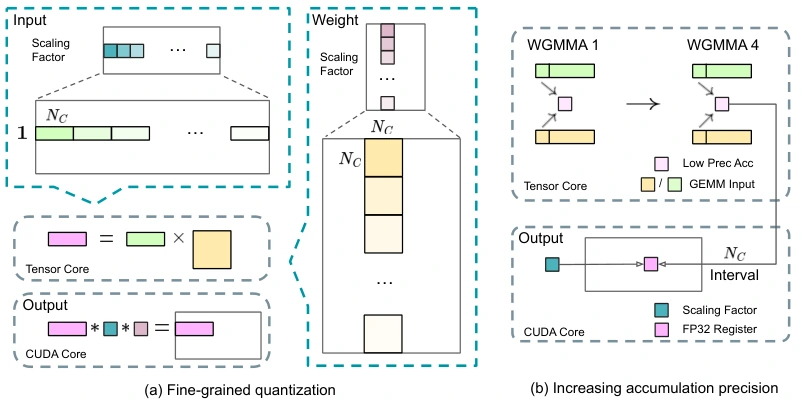
这张图解释了为什么 block-wise FP8 不能简单套用 per-tensor 的 GEMM:每个块有自己的 scale,乘加过程中还要控制累加精度。图片来源:DeepSeek-V3 技术报告(arXiv:2412.19437)Figure 7。
注册表:一个字典如何承载多平台
quantization/__init__.py 的核心是一张 BASE_QUANTIZATION_METHODS 字典,键是方法名,值是配置类。它看起来只是注册表,实际做了四件设计权衡。
第一,默认只注册通用实现,平台特有实现按需叠加。MXFP4 在 CPU、CUDA、gfx95 的 AMD GPU 和 Intel XPU 上都注册为 Mxfp4Config;但在 NPU 上,mxfp4 这个名字被重新绑定到 Mxfp4W4A4Config,因为昇腾上的定义是单级 W4A4,而 CUDA 上的定义是 OCP MoE 路径。同一个 CLI 字符串在不同平台上指向不同的语义,代码里用注释明确说明了这一点,避免后来的人误以为 mxfp4 是全局统一格式。
第二,纯 GPTQ 在 CUDA 上已经被移除,只保留在 CPU 与 XPU 上。
if is_cpu(): BASE_QUANTIZATION_METHODS.update({ "gptq": CPUGPTQConfig, })if is_xpu(): BASE_QUANTIZATION_METHODS.update({ "gptq": GPTQXPUConfig, "awq": AWQXPUConfig, })原因在官方量化文档里写得很直接:NVIDIA 与 AMD GPU 上原始的 GPTQ 内核已经没有维护,推荐使用 gptq_marlin,后者把 GPTQ 权重重排成 Marlin 布局,再用 Marlin 内核做反量化矩阵乘。GPTQMarlinConfig.override_quantization_method 会在用户没有显式指定方法、而 checkpoint 的 quant_method 是 gptq 且位宽与 group size 可以转换时,自动把方法切到 gptq_marlin;但如果用户显式写了 --quantization gptq,代码反而会打印一条“强制走 gptq,建议改用 gptq_marlin”的日志并返回 None。也就是说,自动升级发生在“未指定”的场景,而不是把 gptq 这个名字在所有平台上无条件映射到 Marlin。
第三,CPU 没有单独的方法表,而是一个子集检查。
if is_cpu() and cpu_has_amx_support(): if quantization not in CPU_QUANTIZATION_METHODS: raise ValueError(...) return CPU_QUANTIZATION_METHODS[quantization]CPU 上只开放 fp8、w8a8_int8、compressed-tensors、awq、gptq、mxfp4、auto-round 七个方法,而且前提是 CPU 支持 AMX。FP8 在 CPU 上走的是 AMX 的 VNNI 布局矩阵乘;AWQ 走 AVX512 的手写内核;不在子集里的方法并不是“精度不支持”,而是根本没有可用的 CPU 内核。把检查做成“先查全集、再查子集”而不是维护两张独立表,是为了让 --quantization xxx 的报错信息同时列出通用可用方法和 CPU 可用方法,降低排查成本。
第四,平台插件可以覆盖注册表。get_quantization_config 在返回通用实现之前,会先询问 current_platform.is_out_of_tree();如果是外部平台,就调用它的 get_quantization_config(quantization),拿到非空结果就用平台的实现。昇腾、Intel GPU 这类平台正是通过这个入口把同一方法名替换成自己的配置类。
def get_quantization_config(quantization: str) -> Type[QuantizationConfig]: if quantization not in QUANTIZATION_METHODS: raise ValueError(...) if is_cpu() and cpu_has_amx_support(): ... if current_platform.is_out_of_tree(): config = current_platform.get_quantization_config(quantization) if config is not None: return config return QUANTIZATION_METHODS[quantization]这段代码不到二十行,但它决定了“同一个模型、同一条命令、换一张卡跑”时到底走哪套内核。
层分派:同一个配置,五种层类型
拿到了配置对象,下一步是给模型里的每一层选方法。入口统一是 get_quant_method(layer, prefix)。FP8 的实现把层分成三类,另外给未知层留下一个 None 兜底。
def get_quant_method(self, layer, prefix): from sglang.srt.layers.linear import LinearBase from sglang.srt.layers.moe.fused_moe_triton import FusedMoE from sglang.srt.layers.radix_attention import RadixAttention
if isinstance(layer, LinearBase): if is_layer_skipped(prefix, self.ignored_layers, fused_mapping=self.packed_modules_mapping): return UnquantizedLinearMethod() ... return Fp8LinearMethod(self) elif isinstance(layer, FusedMoE): ... return Fp8MoEMethod(self) elif isinstance(layer, RadixAttention): return Fp8KVCacheMethod(self) return None顺序是有讲究的。LinearBase 是普通线性层,包括 ColumnParallelLinear、RowParallelLinear、QKVParallelLinear、MergedColumnParallelLinear 这些子类;FusedMoE 是专家层;RadixAttention 是注意力层。三个分支分别对应“权重矩阵”“专家权重”“KV Cache scale”三种完全不同的存储对象。返回 None 的语义要看层类型:FusedMoE 会在构造时显式退回未量化方法,而 LinearBase 不会自动兜底,拿到 None 后前向时才暴露错误。
为什么每层都要传 prefix
prefix 是模块在模型里的完整路径,比如 model.layers.12.self_attn.qkv_proj。它有两个用途:一是匹配 ignored_layers,二是让量化方法在日志里能指出具体是哪一层出了问题。is_layer_skipped 的实现比字符串包含复杂得多,原因是融合层。
假设 checkpoint 里 q_proj、k_proj、v_proj 三个投影都被标记为不量化,而运行时它们被合并成 qkv_proj。如果只看 qkv_proj 是否出现在 ignored_layers 里,会漏掉这三个名字;如果只看其中一个 shard,又可能把整个融合层跳过,导致另外两个本该量化的 shard 也变成高精度。代码的处理是先把融合名展开成 shard 名,逐个判断,然后要求所有 shard 的结论一致:
if proj_name in effective_fused: shard_prefixes = [prefix.replace(proj_name, shard_name) for shard_name in effective_fused[proj_name]] is_skipped = None for shard_prefix in shard_prefixes: is_shard_skipped = any(...) if is_skipped is None: is_skipped = is_shard_skipped elif is_shard_skipped != is_skipped: raise ValueError("Detected some but not all shards ...")这条检查拦下的是真实事故:checkpoint 的配置文件只写了 q_proj 不量化,另外两个没写,加载后融合层的权重一部分是 FP8、一部分是 BF16,create_weights 按 FP8 申请了整块存储,拷贝时就会出现 dtype 或形状错误。与其在前向时得到难以定位的数值问题,不如在构造阶段明确报错。
gate_up_proj 还有一条额外规则:如果 gate_proj 与 up_proj 都被跳过,融合层才跳过;只跳过其中一个时不会整体跳过。MoE 的 experts 路径则允许粗粒度的层前缀匹配,因为专家名可能带完整的模块路径,精确匹配反而容易漏。
MoE 分支为什么更长
Fp8MoEMethod 本身只有一套 FP8 专家权重逻辑,但 get_quant_method 里有一长串条件分支。它们处理的不是“FP8 还是 BF16”,而是“这份 checkpoint 的专家权重实际上是 FP4,只是被当作 FP8 配置加载”。is_fp4_experts 由模型加载器根据模型配置注入,命中后可能走四条路:
- 反量化成 FP8(
dequant_fp4_to_fp8); - 昇腾上的 W4A8 MXFP4 专用方法;
- Marlin 的 MXFP4 包装方法;
- FlashInfer 的 MXFP4 方法,且在 SM90/SM120 与 SM100 上实现不同。
这些分支之所以放在 get_quant_method 而不是 Fp8Config.from_config,是因为选择依赖运行时后端(get_moe_runner_backend()),而配置解析阶段还不知道用户最终选了哪个 MoE runner。把“格式解析”和“执行路径选择”分开,是这一层代码最值得借鉴的结构。
注意力层只拿到 KV scale
RadixAttention 分支返回 Fp8KVCacheMethod,它不碰权重,只注册 k_scale 与 v_scale 两个标量。原因很直接:权重量化改变的是矩阵乘的输入,KV Cache 量化改变的是缓存里 K/V 的存储格式,两者在计算图上位于不同位置。把 KV 量化挂在注意力层上,而不是挂在 Linear 上,才能保证每个注意力层拿到自己的 scale,并且在 prefix cache 命中、跨实例传输时把 scale 一起带过去。KV Cache 量化的细节可以对照 SGLang 源码完全拆解(十五):内存池与显存管理 里的 KVPool 结构来读。
建权重:先决定 scale 的形状
Fp8LinearMethod.create_weights 是所有后续行为的起点。它不拷贝任何真实权重,只按量化格式申请参数,并把 weight_loader 挂上去。真正的数据在 model.load_weights 阶段才流进来。
权重本身的 dtype
weight_dtype = ( torch.float8_e4m3fn if is_checkpoint_fp8_serialized else params_dtype)weight = ModelWeightParameter( data=torch.empty(output_size_per_partition, input_size_per_partition, dtype=weight_dtype), input_dim=1, output_dim=0, weight_loader=weight_loader,)layer.register_parameter("weight", weight)这段代码回答了一个常见疑问:如果 checkpoint 是 BF16,为什么 --quantization fp8 还能工作?因为 is_checkpoint_fp8_serialized 为假时,权重先以 BF16 申请,装载完成后在 process_weights_after_loading 里现场量化。反过来,如果 checkpoint 已经是 FP8,权重直接以 float8_e4m3fn 申请,装载时就不需要再做一次转换。
注意这里只用了 e4m3fn,没有 e5m2。E4M3 有 3 位尾数、4 位指数,最大可表示 448;E5M2 有 2 位尾数、5 位指数,最大可表示 57344。权重的动态范围通常不大,但需要精度,所以 E4M3 是默认;E5M2 只在需要表示极大激活或梯度时才有意义。SGLang 的推理路径统一使用 E4M3,checkpoint 若以 E5M2 保存,需要在转换阶段处理,而不是在运行时混用两种格式。
三种 scale 的存储形状
scale 不是附属信息,它是参与模型并行的参数。SGLang 为它准备了三种参数类:
| 参数类 | 形状 | 对应粒度 |
|---|---|---|
PerTensorScaleParameter | 每个逻辑矩阵一个标量 | per-tensor |
ChannelQuantScaleParameter | [output_channels, 1] | per-channel |
BlockQuantScaleParameter | [ceil(N/b_n), ceil(K/b_k)] | block-wise |
block-wise 的 scale 形状是一个二维网格:
其中 是输出通道数, 是输入通道数, 与 是块的高和宽。以 DeepSeek-V3 的 128×128 分块为例,一个 的权重矩阵会产生 个 scale,而不是 1 个。每个 scale 只负责自己那块 128×128 元素的反量化。
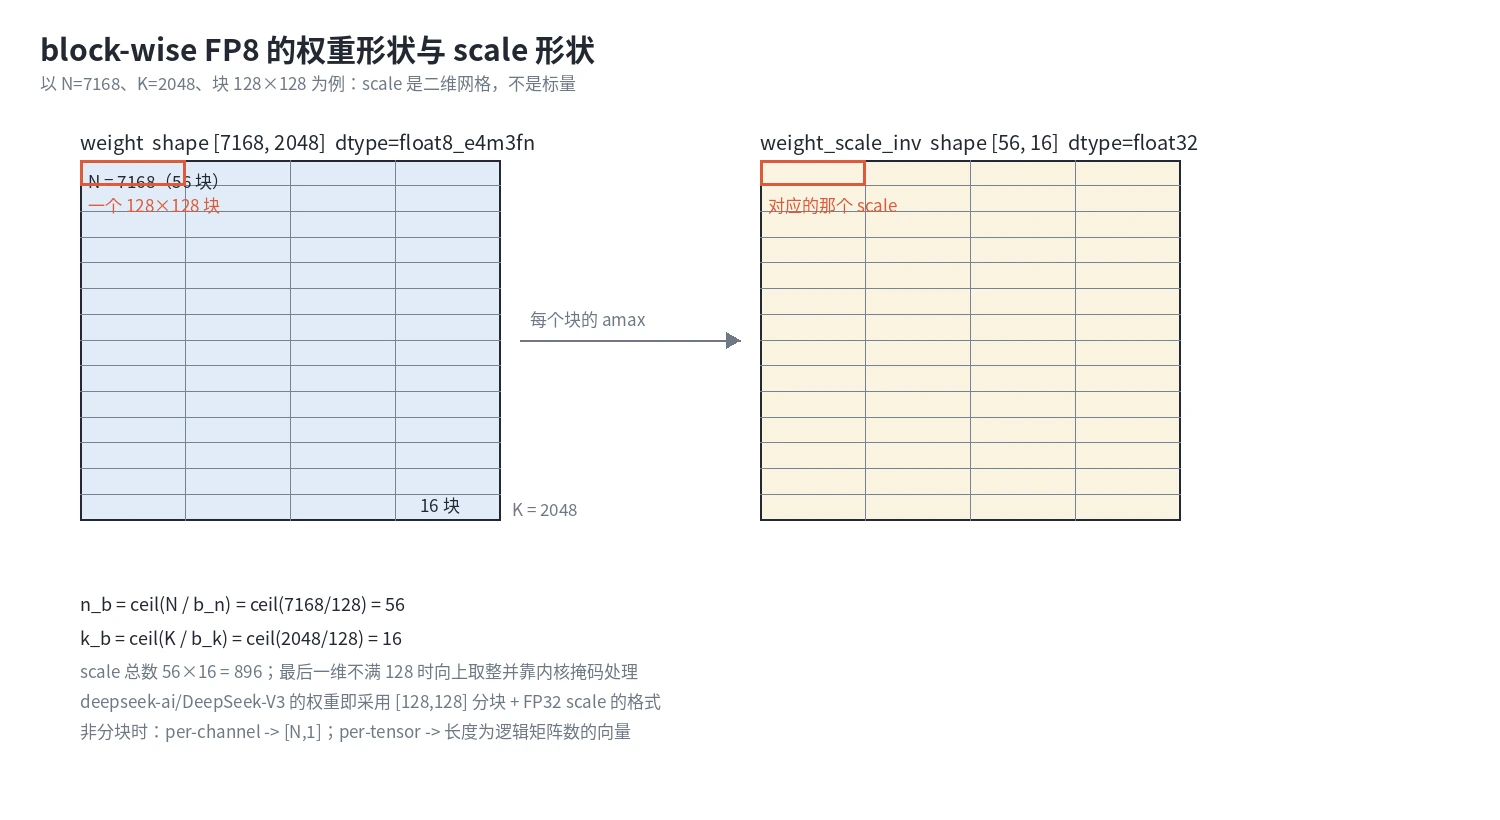
weight 与 weight_scale_inv 是两张形状完全不同的参数:前者按元素存 FP8,后者按块存 FP32。图中标红的权重块与 scale 网格中同位置的红色格子一一对应。本站自制示意图。
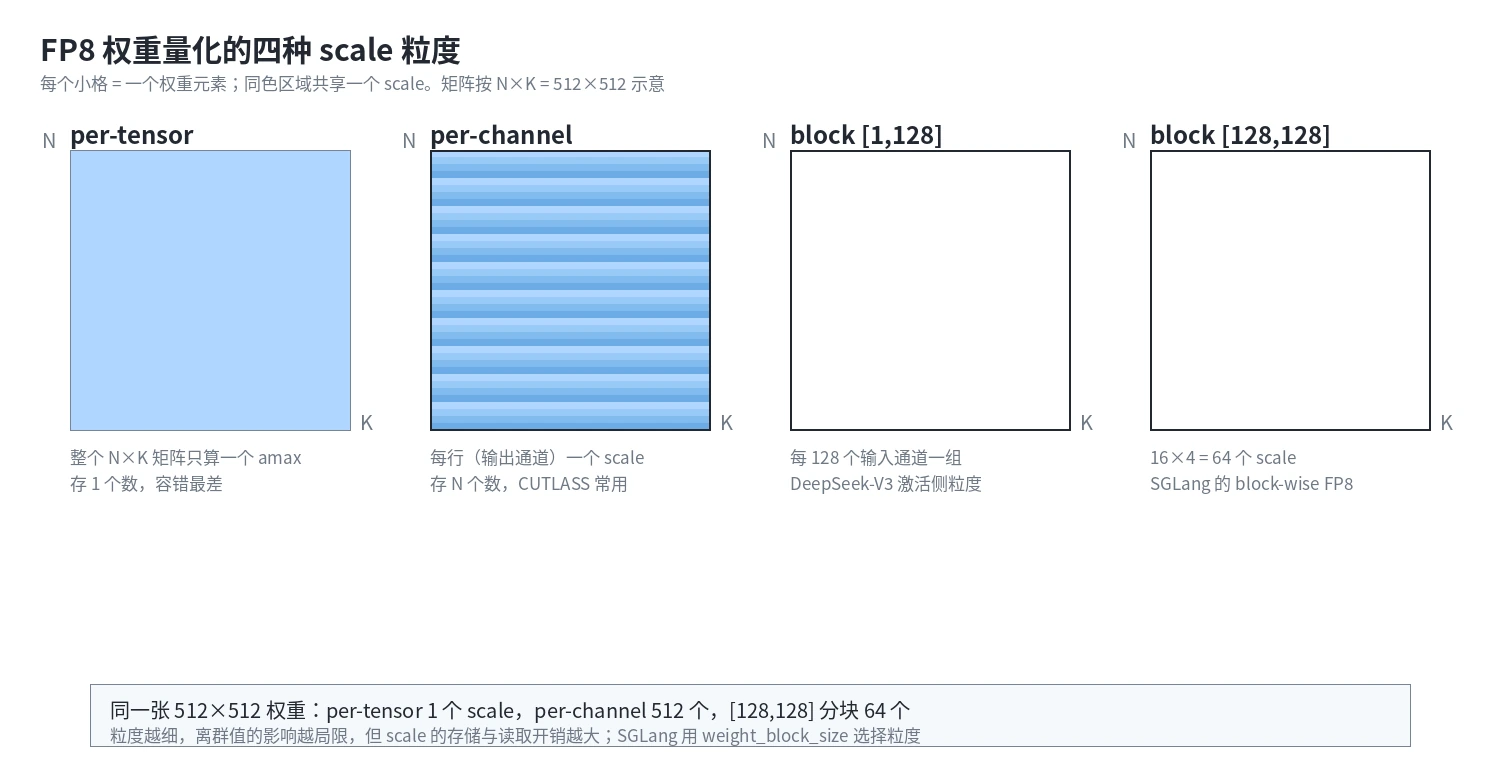
图中每个小格代表一个权重元素,颜色代表共享同一个 scale 的范围。粒度越细,离群值的影响越局限,但 scale 的存储与读取开销也越大。本站自制示意图。
为什么 block 的边界要向上取整?因为最后一个块可能不满。这里的 与 恰好都能被 128 整除,但一旦遇到 这类不是 128 倍数的中间维度,最后一块只有部分有效元素,scale 仍然要占一个位置。内核在读取时会用掩码处理越界元素,而不是要求权重矩阵必须被 padding 到整数块。这个设计避免了为了对齐而复制权重,代价是内核里多一层边界判断。
并行切分对块的约束
validate_block_quant_shapes 检查的是张量并行后的局部形状:
if tp_size > 1 and input_size // input_size_per_partition == tp_size: if input_size_per_partition % block_k != 0: raise ValueError(...)if tp_size > 1 and output_size // output_size_per_partition == tp_size: for output_partition_size in output_partition_sizes: if output_partition_size % block_n != 0: raise ValueError(...)这两条检查对应两种切法。行并行把输入维切开,每个 rank 拿到 列;列并行把输出维切开,每个 rank 拿到 行。分块量化要求每个 rank 的局部矩阵仍然能被块大小整除,否则块的边界会落在 rank 之间,scale 无法独立计算。举例来说,、TP=8 时每个 rank 拿到 512 列,512 可以被 128 整除,合法;如果 、TP=6,每个 rank 拿到约 682.67 列,除了切不匀,块也对不齐,代码会直接拒绝。
这也是为什么 block-wise FP8 对 TP 大小比 per-tensor 更敏感。per-tensor 只需要每个 rank 自己算一个 max,切法任意;block-wise 要求切分线与 128 对齐,否则就得在 rank 之间交换边界数据,通信成本会把收益吃掉。
scale 的初始值不是零
注册 scale 时,代码把初值设成 torch.finfo(torch.float32).min:
scale[:] = torch.finfo(torch.float32).min这是一个哨兵值。权重装载器只会在 checkpoint 里存在对应 scale 时覆盖它;如果某个 scale 没有被覆盖,它会保持极小值。per-tensor 路径的 requantize_with_max_scale 正是利用这一点判断融合层是否真的只带了一个 scale;分块路径没有同样显式的哨兵检查,缺字段往往要等到前向出现异常数值才暴露。相比用 0 或 1 初始化,极小值不会被误认为合法 scale,也不会在反量化时把权重全部压成 0 而不报错。这种“用非法值占位”的做法在量化代码里很常见,读源码时看到别跳过。
装载后的账:重新量化与 scale 重排
create_weights 只是把空壳参数注册好,真正的数值在 model.load_weights 阶段被逐个拷进这些参数。拷贝完成后,加载器会遍历所有模块,对每个带 quant_method 的层调用一次 process_weights_after_loading。这段代码看起来零散,实际上在回答三个问题:checkpoint 里的权重是不是已经量化?GEMM 内核需要什么布局?多个逻辑矩阵的 scale 要不要合并?
从浮点到 FP8 的基本公式
先把量化本身写清楚。给定一个浮点张量 和一个 scale ,FP8 的量化与反量化是:
其中 448 是 E4M3FN 能表示的最大有限值;clamp 防止离群值溢出成 NaN;round 在实际内核里是 round-to-nearest-even,而不是简单的四舍五入。scale 的选择决定了量化误差:
per-tensor 用整个矩阵的绝对值最大值,per-channel 用每一行的最大值。前者只需要一次全局归约,后者要做 次行归约,但能把不同输出通道的动态范围分开。block-wise 则把这两个公式限制在 的子矩阵里,每个块独立算自己的最大值。
装载后的三个分支
Fp8LinearMethod.process_weights_after_loading 先判断 block_quant。如果是分块路径,进入 process_weights_after_loading_block_quant;否则处理 per-tensor 或 per-channel。
非分块路径中,如果 is_checkpoint_fp8_serialized 为假,说明权重还是 BF16/FP16,需要现场量化:
if self.cutlass_fp8_supported or _is_xpu or self.use_marlin: qweight, weight_scale = per_token_group_quant_fp8( layer.weight, layer.weight.shape[-1] ) weight_scale = weight_scale.t().contiguous()else: qweight, weight_scale = input_to_float8(layer.weight)这里调用 per_token_group_quant_fp8(weight, group_size=K),group_size 等于整行长度,等价于“每行一个 group”,也就是 per-channel。选择 per-channel 还是 per-tensor,取决于后端能力:CUTLASS 的 FP8 GEMM 与 Marlin 只接受 per-channel scale;没有这些内核时退回到 input_to_float8 的 per-tensor 量化。代码没有把“per-channel 更准”作为唯一标准,而是先保证内核能读。
如果 checkpoint 已经序列化,逻辑反过来:权重与 scale 都已经在文件里,代码要做的是把布局改成内核期望的样子。convert_to_channelwise 负责把“每个逻辑矩阵一个 scale”展开成“每个输出通道一个 scale”:
weight_scale_channel = torch.empty((sum(logical_widths), 1), ...)start = 0for idx, logical_width in enumerate(logical_widths): end = start + logical_width weight_scale_channel[start:end, :] = weight_scale[idx] start = endlogical_widths 是融合层里每个逻辑矩阵的输出宽度。以 QKV 为例,checkpoint 可能给 q_proj、k_proj、v_proj 各存一个 scale,而运行时是一个 qkv_proj,输出维被拼在一起。展开后,前 行用 Q 的 scale,中间 行用 K 的 scale,最后 行用 V 的 scale,这样 per-channel GEMM 才能逐行取到正确的缩放因子。
另一个函数 requantize_with_max_scale 处理的是相反的情况:checkpoint 把 QKV 当成一个融合矩阵存,只给了一个 scale,但运行时的 logical_widths 告诉代码这里有三个逻辑矩阵。代码初始化了三个 scale 槽位,加载时只有一个被覆盖,其余仍然是哨兵值。它会检查最后一个槽位是否还是 finfo.min,如果是,就跳过重量化;否则把每个分片反量化后,统一用三者中的最大 scale 重新量化:
max_w_scale = weight_scale.max()if unfused_module_in_checkpoint: for idx, logical_width in enumerate(logical_widths): weight_dq = per_tensor_dequantize(weight[start:end, :], weight_scale[idx]) weight[start:end, :], _ = scaled_fp8_quant(weight_dq, max_w_scale)为什么要用最大 scale?因为三个分片要共享一个 scale 才能拼成一次 GEMM。如果取最小 scale,原本动态范围较大的分片会溢出;取最大 scale 虽然会让小分片的有效位数变少,但不会产生 inf/NaN。这是一次用少量精度换正确性的取舍。
在线量化:BF16 checkpoint 的代价
如果 checkpoint 没有量化,is_checkpoint_fp8_serialized 为假,SGLang 会在加载时把 BF16 权重量化成 FP8。这条路径经常被当作“免校准量化”来用,但它与离线 AWQ/GPTQ 的差别需要说清楚。
第一,它没有校准数据。per-channel 的 scale 直接取每行绝对值的最大值,只保证不溢出,不考虑激活分布;而 AWQ 会根据激活的显著性挑保护通道,GPTQ 会用二阶信息补偿舍入误差。前者的误差通常更大,尤其在激活离群值明显的模型上。
第二,它发生在加载阶段,会增加启动时间。以 70B 模型为例,逐个 Linear 求 amax、量化、转置,单卡可能要几十秒到几分钟;如果每次重启都做一遍,冷启动成本不可忽略。离线量化的 checkpoint 把这一步固化在文件里,加载时只做反量化或重排。
第三,它只支持 FP8 的三种粒度,不支持 group-wise 的 4-bit。weight_block_size 非空时还要求 checkpoint 已经序列化,所以“BF16 + block-wise”组合会在 Fp8Config.from_config 直接被拒绝。想用分块 FP8,必须先离线转换。
因此“--quantization fp8 + BF16 checkpoint”适合快速验证和显存紧张但精度要求不高的场景;生产环境如果对精度敏感,应该用离线工具生成带 per-channel 或 block scale 的 checkpoint,再让 SGLang 走序列化路径。
静态激活 scale 为什么要取 max
如果 activation_scheme 是 static,checkpoint 里每个逻辑矩阵还带一个 input_scale。融合之后同样只能保留一个:
layer.input_scale = Parameter(layer.input_scale.max(), requires_grad=False)取 max 的理由与权重相同:静态 scale 在运行时不再重新计算,必须保证所有输入都不会溢出。代价是较小的分片在量化时有效位数下降。动态 per-token 量化没有这个问题,因为每个 token 自己算 scale,所以 SGLang 的默认配置是 dynamic,静态路径主要用于兼容旧 checkpoint。
A100 上的 Marlin 兜底
FP8 的 get_min_capability 返回 80,但 Ampere 的 A100 并没有原生 FP8 张量核心。SGLang 的处理是自动启用 Marlin:
def can_auto_enable_marlin_fp8(): major, minor = get_device_capability() sm = major * 10 + minor return 80 <= sm < 89Fp8LinearMethod.__init__ 在 CUDA 上把 use_marlin 设为 force_marlin or auto_enable。命中后,process_weights_after_loading 调用 prepare_fp8_layer_for_marlin,把 FP8 权重打包成 int32 后按 num_bits=8 做 Marlin repack,apply 走 torch.ops.sglang.apply_fp8_marlin_linear。这条路径不做激活量化,input_scale 会被删掉;它本质上是“权重保持 FP8 存储、计算时反量化到 FP16/BF16 再乘”的 weight-only 方案。也就是说,--quantization fp8 在 A100 上能跑,但走的是 Marlin,而不是 CUTLASS 的 FP8 GEMM;两者的吞吐与精度特性不同,排查性能问题时不要假设一定用了原生 FP8 内核。
SM120 的 per-tensor 特例
代码里有一段不太直观的分支:在 SM120(Blackwell RTX 50 系列)上,如果走的是 CUTLASS per-channel 路径,反而要把 per-channel scale 合并成 per-tensor:
use_sm120_fp8_pertensor = ( self.cutlass_fp8_supported and not self.use_marlin and get_device_capability()[0] == 12)注释给出的理由是:SM120 上 per-tensor FP8 会分派到更快的 cudnn/nvjet 内核,在 decode 与 prefill 的 M 范围内比 channelwise 的 CUTLASS GemmUniversal 快约 1.2 到 2.7 倍,这一选择与 vLLM 在 SM120 上的做法一致。为了用上这个内核,权重需要从 per-channel 重新量化成 per-tensor,requantize_with_max_scale 正好完成这件事。
这条分支说明了一个常见误区:量化粒度不是越细越好,最终取决于“哪条内核在这个形状、这张卡上更快”。per-channel 的数值优势只有在对应内核支持且性能更好时才有意义。
分块路径的后处理
分块路径的 process_weights_after_loading_block_quant 更长,因为要处理多种 scale 格式:
- ROCm 的 E4M3FNUZ 需要把权重与 scale 归一化,FNUZ 的位模式与 FN 不同,scale 还要乘 2;
- DeepGEMM 作为当前 runner 时,FP32 block scale 可能被重新量化成 UE8M0 的二次幂 scale,只有二次幂才能被内核精确转换;
- MXFP8 checkpoint 可能被转换成 [128,128] 的 block FP8,或者反过来把 block FP8 当作 MXFP8 视图使用;
- AMD 的 AITER 路径会把权重做 16×16 的 preshuffle,重排后的布局只有 AITER 内核能读,因此代码用
keep_plain_weight_layout保护那些自己直接读.weight的层; - Hopper 上还可能缓存一份 BF16 反量化权重,供较大的 GEMM 复用,decode 仍用 FP8 原权重。
这些分支的共同点是:create_weights 阶段申请的 weight_scale_inv 形状不变,变的只是 scale 的数值格式与内存布局。读这段代码时,建议先画一张表,列出“checkpoint 格式 × 当前 runner × 平台”对应的后处理动作,再逐条对照源码,否则很容易被十几个 if 绕晕。
后处理在什么设备上执行
加载器调用 process_weights_after_loading 时,会把模块的参数临时放到目标设备上:
with device_loading_context(module, target_device): quant_method.process_weights_after_loading(module)原因是一些后处理需要 GPU 归约,比如求每行的 amax、把 BF16 权重量化成 FP8、做 16×16 shuffle;而 CPU offload 场景下参数平时在 host 内存。这个上下文保证后处理在 GPU 上完成,结束后再把参数放回原来的设备。自己写量化方法时如果漏掉这一点,在纯 GPU 加载时看不出问题,一旦开启 offload 就会得到“expected CUDA tensor”之类的错误。
前向:激活怎么量化,GEMM 走哪条内核
所有准备都完成后,quant_method.apply 才是每次前向真正执行的代码。以 Fp8LinearMethod.apply 为例,它先处理几条特殊路径:Marlin、AMD 的 block-as-MXFP8、预量化的 Mxfp8SwizzledInput、分块 GEMM、Intel AMX;最后才落到普通的 apply_fp8_linear。
一条 GEMM 的三种缩放组合
FP8 矩阵乘的数学形式可以写成:
其中 是量化后的激活, 是量化后的权重, 与 是它们各自的 scale。FP8 张量核心负责计算 ,累加在 FP32 里;两个 scale 的乘积在 epilogue 里逐元素乘回去。对 per-tensor 量化, 与 都是标量,上式退化成一次标量乘法;对 per-token + per-channel, 是 , 是 ,输出 scale 是一个 的外积,内核要为每一行、每一列取不同的值。
block-wise 更复杂。激活按 分组,权重按 分块,输出元素 是:
scale 依赖 ,不能像 per-tensor 那样提到求和号外面。所以内核必须在每个 K 块结束时把部分和乘上对应的 scale,再累加到输出;或者先把每个块的 scale 折进 FP8 权重再做一次大 GEMM——后者会破坏 FP8 的数值范围。这正是 block FP8 需要专门内核、不能直接用 torch._scaled_mm 的原因。
激活量化的三种选择
apply_fp8_linear 先看 input_scale:
- 如果
input_scale非空,说明是静态量化,调用static_quant_fp8,直接用 checkpoint 里的标量; - 如果为空且是 CUDA,调用
sglang_per_token_quant_fp8,每个 token 算一个 scale; - 如果为空且在 ROCm,先尝试
scaled_fp8_quant的 per-token 分支,否则退回per_token_group_quant_fp8,按 分组算 scale。
per-token 动态量化是默认路径。它的好处是激活的离群值只影响当前 token 的量化精度,不会像静态 per-tensor 那样把整个 batch 的动态范围绑在一起;代价是每次前向都要多一次归约内核。代码把这次归约和量化融进一个 kernel,避免先算 max 再写回的两次访存。
输出 padding 的 17 行
pad_output = not cutlass_fp8_supported and not get_bool_env_var( "SGLANG_ENABLE_TORCH_COMPILE")output_padding = 17 if pad_output else None这段代码在 compressed_tensor_quant 路径上把量化输入的 token 维补齐到 17 的倍数,注释给出的理由是 torch._scaled_mm 在 batch 维度大于 16 时性能更好。没有 CUTLASS 的机器上,SGLang 用 PyTorch 自带的 scaled_mm,padding 能让它走更快的分支;开启 torch.compile 时不做 padding,因为动态形状会打断编译。17 这个数本身不是对齐要求,只是“刚好超过 16”的最小奇数;补出来的行是空的,不会被写回输出,因此不影响结果。
channelwise 与 per-tensor 的分派
apply_fp8_linear 用一个条件判断权重是不是 per-channel:
channelwise_cutlass = ( cutlass_fp8_supported and weight_scale.numel() == weight.shape[1])weight_scale.numel() == N 说明每个输出通道一个 scale,这正是 convert_to_channelwise 展开后的形状。满足条件时走 cutlass 的 channelwise GEMM;否则检查权重是否 per-tensor,再走 torch._scaled_mm 或朴素的 dequant + matmul。还有一层优化:在 CUTLASS 路径上,如果离线调优过某个形状的 Triton tile,会用 triton_scaled_mm 的固定配置,而不是 CUTLASS 的默认启发式。代码通过 get_w8a8_channelwise_fp8_config(N, K, M) 查表,查不到才回退。
分块 GEMM 的后端分派
dispatch_w8a8_block_fp8_linear 是整条路径里最关键的分派函数。它接收 weight_block_size 与 act_scale_ue8m0,返回一个可调用的 GEMM 实现。优先级大致是:
- 如果块大小是
[32, 32],且 DeepGEMM 已启用,在 SM90 上(auto 或显式 deep_gemm)直接走 DeepGEMM;SM100 上要求显式 deep_gemm 且激活 scale 是 UE8M0。 - 如果 block 的 K 维不是 128,直接走 Triton;DeepGEMM 只接受它支持的块形状,强行使用只会在 kernel 里报错。
- 如果用户显式指定了
--fp8-gemm-backend,按指定后端分派;否则按硬件自动选择:DeepGEMM → Blackwell 上的 FlashInfer → SM120 的 CUTLASS → AMD 的 AITER → 昇腾 → Intel XPU → Triton 兜底。
if deep_gemm_wrapper.ENABLE_JIT_DEEPGEMM: return deepgemm_w8a8_block_fp8_linear_with_fallbackelif get_platform().is_blackwell and is_flashinfer_available(): return flashinfer_gemm_w8a8_block_fp8_linear_with_fallbackelif get_platform().is_sm120: return cutlass_w8a8_block_fp8_linear_with_fallbackelif _use_aiter: return aiter_w8a8_block_fp8_linear...else: return triton_w8a8_block_fp8_linear这张优先级表不是按“理论峰值”排的,而是按“在当前形状范围内稳定可用”排的。DeepGEMM 放在最前,是因为它在 Hopper 的 [128,128] 块上有成熟实现;FlashInfer 次之,因为它的 TRT-LLM 后端在 Blackwell 上对 groupwise scale 有专门支持;SM120 单独走 CUTLASS,是因为自动分派在该架构上把 CUTLASS 作为首选;AITER 与昇腾则各自有平台专用的 GEMM。Triton 是兜底,几乎能在所有 CUDA/ROCm 设备上跑,但性能不如专用内核。
Triton 分块内核在做什么
triton_w8a8_block_fp8_linear 的逻辑可以概括为三步:
q_input, x_scale = per_token_group_quant_fp8( input_2d, block_size[1], column_major_scales=False)output = w8a8_block_fp8_matmul_triton( q_input, weight, x_scale, weight_scale, block_size, output_dtype)第一步按 把激活量化,得到 的 scale;第二步调用 Triton 矩阵乘,内核在 K 方向按块循环,每个块取出对应的 weight_scale_inv 与 x_scale,把 FP8 乘积累加到 FP32,再乘 scale;第三步处理 bias 与输出 dtype。column_major_scales=False 表示 scale 按行主序存放,这对内核的合并访存更友好。
内核的 tile 配置也围绕块大小来定。没有离线调优表时,默认 BLOCK_SIZE_M=64、BLOCK_SIZE_N=block_n、BLOCK_SIZE_K=block_k,也就是默认配置下每个 tile 在 N 方向正好覆盖一个完整的量化块。这样每个 tile 在 K 方向只需要读一个 weight_scale_inv,scale 的读取次数与 K 块数成正比,而不是与元素数成正比。如果 K 不能被 BLOCK_SIZE_K 整除,内核会用 needs_masking=True 在最后一次循环里做边界掩码;如果离线调优表给出 SPLIT_K > 1,则先把 K 切成若干段,各自累加到 FP32 的部分和,最后再用一个归约内核相加。Split-K 会改变浮点累加顺序,因此结果与单累加器版本不是逐位一致的,SGLang 只在 Hopper 的调优配置里启用它。
如果 act_scale_ue8m0 为真,激活量化会改用 sglang_per_token_group_quant_fp8(..., scale_ue8m0=True),把 scale 限制为 2 的整数次幂。UE8M0 格式只有 8 位指数、没有尾数,能精确表示 到 的范围;好处是内核做 scale 乘法时可以用指数加法,不必做浮点乘。代价是 scale 只能取二次幂,量化误差比 FP32 scale 略大。DeepSeek-V4.1 的 FP8 dense 权重就使用 32-wide 的 UE8M0 block scale,SGLang 用 scale_fmt == "ue8m0" 来识别这类 checkpoint。
为什么显式指定后端仍然可能被改写
dispatch_w8a8_block_fp8_linear 里有一条:块大小非 [128,128] 且用户选了 deep_gemm 时,代码打印警告并改用 Triton。这不是“不尊重用户选择”,而是因为 DeepGEMM 的 block FP8 内核只接受特定块形状,硬跑会得到错误结果或直接崩溃。类似地,SM100 的 DeepGEMM 需要 UE8M0 scale,如果 checkpoint 是 FP32 block scale,就会回退。读这段代码时要记住:后端选择是“用户偏好 + 格式约束 + 硬件能力”三者的交集,而不是单一优先级。
一次前向的完整时序
把上面的步骤串起来,一次 FP8 线性层前向是:
- 输入张量进入
Fp8LinearMethod.apply; - 如果是分块路径,调用
w8a8_block_fp8_linear;否则调用apply_fp8_linear; - 激活按静态、per-token 或 per-group 量化,得到 FP8 输入与 scale;
- 选择 CUTLASS、Triton、DeepGEMM、FlashInfer、AITER 或
torch._scaled_mm执行 GEMM; - epilogue 乘 scale、加 bias、转回 BF16/FP16;
- 输出写回模型层。
这条链上没有“反量化整个权重”的步骤。权重始终以 FP8 存在显存里,只有 GEMM 的乘加在张量核心内部完成。这也是 FP8 推理能同时省显存和提吞吐的原因:反量化被折进了矩阵乘的 epilogue,而不是单独跑一个 kernel。
MoE 与注意力:同一套骨架,不同的两本账
线性层是量化路径的主干,但 SGLang 在 MoE 与注意力层上还有两条分支。它们与线性层的区别,恰好能说明“配置—方法—权重”这层抽象的可扩展性。
MoE:专家权重多一个维度
Fp8MoEMethod.create_weights 复用的是 create_fp8_moe_weight_,它注册的参数是 w13_weight、w2_weight 以及对应的 scale(分块时是 *_weight_scale_inv,非分块时是 *_weight_scale)。形状上比线性层多一个专家维,下面以分块格式为例:
w13_weight [E, 2 * I_p, H] gate 与 up 拼在一起w13_weight_scale_inv [E, 2 * ceil(I_p/b_n), ceil(H/b_k)]w2_weight [E, H, I_p]w2_weight_scale_inv [E, ceil(H/b_n), ceil(I_p/b_k)]其中 是本地专家数(经过专家并行切分后), 是 hidden size, 是每个 rank 上中间维的大小, 与 是块的二维大小。注意 w13 的 scale 第二维是“每个 shard 的块数之和”,而不是先算 再除 :当 不能被 128 整除时,两个 shard 各自向上取整,直接合并会少算一块。
分块 scale 在专家维上再复制一份,因此内存开销是“块数 × 专家数”,而不是块数。以 256 个专家、、、128×128 块为例,w13 每个专家有 个 scale,w2 有 个,合计 2688 个;256 个专家就是 688128 个 FP32 scale,约 2.75 MB。相对于权重本身可以忽略,但内核读取 scale 的模式会随专家并行方式变化。
MoE 的 create_moe_runner 负责选择执行路径。auto 模式下,如果启用了 DeepEP、Mooncake 或 NIXL 这类 all-to-all 通信后端且 DeepGEMM 可用,就走 DeepGEMM 的 grouped GEMM;否则走 Triton 的 fused_moe。AMD 上如果启用了 AITER 且 A2A 后端支持,就走 AITER。这里的选择依赖的不仅是硬件,还包括通信后端:grouped GEMM 要求输入是按专家排序后的连续布局,而排序由 dispatch 阶段完成,所以 GEMM 后端必须与 dispatch 后端匹配。量化层自己不知道该选哪个,只能通过 get_moe_runner_backend() 读取全局配置。
还有一个细节值得注意:get_triton_quant_info 把 w13_weight、w2_weight、w13_weight_scale_inv、w2_weight_scale_inv 以及块大小打包成 TritonMoeQuantInfo,交给 LoRA 的 MoE runner。原因是 LoRA 路径需要在不改变基座权重的前提下叠加低秩增量,它复用同一套 Triton 内核,但必须知道基座权重的量化格式才能正确计算增量。量化方法在这里扮演的是“格式描述者”,而不是“执行者”。
注意力:scale 是逐层标量
Fp8Config.get_quant_method 对 RadixAttention 返回 Fp8KVCacheMethod,后者继承自 BaseKVCacheMethod。它的 create_weights 只做一件事:把 k_scale 与 v_scale 注册成值为 的标量参数,并打上 _skip_weight_check 标记,让加载器允许 checkpoint 里没有这两个键。
layer.k_scale = torch.nn.Parameter(torch.tensor(-1.0, dtype=torch.float32))layer.v_scale = torch.nn.Parameter(torch.tensor(-1.0, dtype=torch.float32))layer.k_scale._skip_weight_check = Truelayer.v_scale._skip_weight_check = Trueprocess_weights_after_loading 再根据加载结果决定最终值:两个都为正,就用各自的 scale;两个都还是负数,说明 checkpoint 没带 KV scale,用默认值 1.0;只有一个为正,说明 checkpoint 里只有一个 kv_scale,把它复制给两者。最后把值转成 Python float,存进 k_scale_float 与 v_scale_float,供注意力后端直接使用。
为什么要区分“权重的方法”和“KV 的方法”?因为两者作用的时机不同。权重 scale 只在 GEMM 的 epilogue 里用一次,可以留在参数里;KV scale 在每次写缓存和读缓存时都要用,而且 FlashAttention、FlashInfer、Triton 后端各自有不同接口,有的要求传 float,有的要求传 tensor。把 scale 做成注意力层上的标量参数,再在 process_weights_after_loading 里统一成 float,能让不同后端以相同方式读取。这也解释了为什么 KV 量化不需要 create_weights 里的复杂形状计算:KV Cache 是按 token 与 head 分配的,scale 是逐层的,不随 token 数变化。
Fp8KVCacheMethod 没有实现 apply,一旦被调用就抛异常。这是刻意的:KV scale 不是通过 apply 参与前向,而是被注意力后端在构造 metadata 时读取。如果某个模型层误把 KV 方法当作 Linear 方法使用,抛异常比静默返回错误结果更容易定位。
get_quant_method 的返回 None 意味着什么
在 MoE 层里,quant_config.get_quant_method 可能返回 None。FusedMoE.__init__ 的处理是:
if self.quant_method is None and quant_config is not None: self.quant_method = quant_config.get_quant_method(self, prefix)if self.quant_method is None: self.quant_method = UnquantizedFusedMoEMethod(...)也就是说,配置对象说“这层我不认识”时,层会退回未量化实现,而不是报错。这与 Linear 层不同:Linear 层在 quant_config is None 时用未量化方法,但 get_quant_method 返回 None 时,wrap_method_with_debug_kernel_once 会跳过,forward 里再调用 quant_method.apply 就会得到 AttributeError。两种行为不一致,是因为 MoE 层有更多可替换的执行路径(Triton、DeepGEMM、FlashInfer),而 Linear 层的未量化路径由模型代码直接选择。读源码时要留意这种“同一接口、不同容错语义”的地方。
其他格式只是换了一套权重与内核
FP8 之外的格式,骨架完全相同,差异集中在 create_weights 与 apply。看几个有代表性的例子就有助于建立直觉。
AWQ:4-bit 权重的打包与多平台方案
AWQConfig 把 weight_bits 固定为 4,pack_factor = 32 // 4 = 8,即一个 int32 里打包 8 个 4-bit 权重。get_quant_method 在 NPU 上会把 AWQAscendLinearScheme 挂到 layer.scheme 上,再返回 AWQLinearMethod;在 NVIDIA 上则用 AWQLinearScheme。scheme 是较新的抽象,把“创建权重、后处理、前向”三步打包成可替换对象,而 method 只负责调度。
AWQ 的 scale 是 group-wise 的:每 group_size 个输入通道共享一个 scale 与 zero point。因此 create_weights 注册的 qweight 形状是 [K, N/8](K 方向不打包、N 方向每 8 个 4-bit 值塞进一个 int32),scales 是 [K/group_size, N],qzeros 是 [K/group_size, N/8]。apply 在 NVIDIA 上走 AWQ 的 packed GEMM 内核,在 AMD 上用 Triton 反量化后再乘,NPU 上交给 CANN 的内核。同一个 checkpoint 在三种硬件上的执行路径完全不同,但配置层与层分派层不变。
W8A8 FP8:per-channel 权重 + per-token 激活
W8A8Fp8Config 与 Fp8Config 的区别在于,它明确限定为“静态 per-channel 权重 + 动态 per-token 激活”,get_min_capability 返回 89,要求 Ada 或更新架构。它的 create_weights 直接注册 ChannelQuantScaleParameter,形状是 [sum(output_partition_sizes), 1],而不是像 Fp8Config 那样先注册 per-tensor 再在加载后展开。apply 直接调用 apply_fp8_linear,没有分块与 Marlin 分支。
W8A8 FP8 存在的意义是兼容那些用 compressed-tensors 导出的 checkpoint:它们的配置文件声明 quant_method 为 compressed-tensors,但权重布局恰好是 per-channel FP8。用户可以用 --quantization w8a8_fp8 强制 SGLang 使用自己的内核,而不是 compressed-tensors 的实现。这也说明命令行参数的作用是“选择运行时语义”,不只用来“声明精度”。
MXFP4:只有专家层量化
Mxfp4Config.get_quant_method 对 LinearBase 只在命中忽略列表或 AMD 上返回未量化方法,其余情况返回 None;真正的量化方法只给 FusedMoE,按 checkpoint 是否已序列化返回 Mxfp4MoEMethod 或 Mxfp4DynamicQuantMoEMethod。类注释与注册表里的 "mxfp4": # MOE-only 相互印证。原因在于 OCP 的 MXFP4 格式每 32 个元素一个 E8M0 scale,粒度极细,scale 的开销相对权重已经不可忽略;而 MoE 的专家权重占模型显存的大头,收益最明显。dense 层保留高精度,是一种“把量化预算花在收益最大处”的取舍。
GPTQ 与 Marlin:同一份权重,两套内核
GPTQMarlinConfig.is_gptq_marlin_compatible 检查 quant_method、bits、group_size、sym、desc_act 五个字段,只有类型在 TYPE_MAP 里且 group size 受支持时,才认为可以转换。转换本身在 GPTQMarlinLinearKernel.process_weights_after_loading 里完成:用 gptq_marlin_repack 把 qweight 重排成 Marlin 的 packed 布局,用 marlin_permute_scales 重排 scale,准备好 kernel 需要的 workspace,并给 g_idx、qzeros 补上空参数或重排后的值;apply 再调用 apply_gptq_marlin_linear。
Marlin 布局的核心是把反量化与矩阵乘融合:权重以 packed 4-bit 存在寄存器里,加载后立即与 scale 相乘并转成 FP16,再送进 Tensor Core。这样不需要在显存里物化一个 FP16 权重。MarlinLinearLayerConfig 记录的是完整权重与分片权重的形状、weight_type、act_type、group_size、是否有 zero point 与 g_idx;这些字段决定 repack 的排列方式和内核模板参数,任何一个填错都会让结果错位。GPTQ 与 AWQ 都能走 Marlin,区别只在打包方式与 zero point 的处理;这正是 Marlin 被注册 gptq_marlin、awq_marlin 多个方法名的原因。
调试量化问题的顺序
读完整条路径之后,排查量化相关的问题可以按下面的顺序走,每一步都对应源码里的一个判断点。
- 先确认方法名解析成功。
get_quantization_config抛Invalid quantization method说明字符串不在注册表里,或者当前平台没有注册。CPU 上还要额外检查 AMX 支持。 - 再确认 checkpoint 元数据被读到。
Fp8Config.from_config抛Cannot find any of [...]说明 JSON 里缺字段;如果报“block-wise 只支持 fp8 序列化 checkpoint”,说明配置写了weight_block_size但权重实际是 BF16。 - 检查硬件能力与 dtype。
The quantization method ... is not supported for the current GPU来自capability < get_min_capability();dtype 错误来自get_supported_act_dtypes。 - 检查层分派。某个本该量化的层走了未量化路径,通常是
ignored_layers的前缀匹配问题,尤其是融合层只写了一个 shard 名的情况。 - 检查权重形状约束。
validate_block_quant_shapes抛出“not divisible by block_k”,说明张量并行切分后局部维度不能被块整除,需要换 TP 大小或改块形状。 - 检查 scale 是否被加载。如果某层的
weight_scale_inv仍是finfo.min,说明 checkpoint 缺字段或名字映射不对;加载器对 scale 的命名通常比权重多一个后缀,名字映射错了会静默留下哨兵值。 - 检查后端选择。启动后看日志里的
--fp8-gemm-backend最终值,或直接用get_fp8_gemm_runner_backend()打印;如果出现“cannot serve … using Triton”,说明指定的后端不支持当前块形状。 - 最后再怀疑数值本身。真到这一步,通常是 scale 的布局或格式不对(比如把 UE8M0 的 uint8 当了 FP32 读),可以通过比较同一层的 FP8 结果与 BF16 反量化结果来定位。
这个顺序的原则是:越早发生的判断越优先;配置、硬件、层分派都在加载前完成,权重与 scale 在加载中,后端选择在首层构造时,数值问题只在前向时暴露。
小结
SGLang 的量化层用三层抽象把“格式”与“执行”拆开:QuantizationConfig 描述 checkpoint 的格式并决定每层用什么方法;QuantizeMethodBase 负责一层的权重创建、后处理与前向;具体的 GEMM 后端再按形状与硬件分派。FP8 路径最能说明这套结构:配置阶段区分 per-tensor、per-channel、block-wise 与 MXFP8,权重阶段把 scale 按粒度申请成标量、向量或二维网格,加载后根据内核能力做 channelwise 展开、max-scale 重量化、UE8M0 转换或 preshuffle,前向阶段再根据 block 大小与硬件选 CUTLASS、Triton、DeepGEMM、FlashInfer 或 AITER。
对读源码的人来说,最值得记住的不是某个 if 分支,而是两个原则:第一,scale 的形状必须与量化粒度、并行切分、内核布局三者同时对齐,任何一个对不上都会在前向时暴露;第二,后端选择是“用户偏好、格式约束、硬件能力”的交集,显式指定不代表一定执行。把这两条记住,再看其他格式(AWQ、GPTQ、MXFP4、W8A8)的源码,就只是在同一张骨架上替换参数与内核。
下一篇将沿着 model.load_weights 的调用链,讨论 SGLang 的权重装载管线:safetensors 分片索引、张量级并行切分、post_load_weights 的收尾,以及量化参数如何在这条管线里被正确落到每个 rank。
参考资料
- SGLang GitHub 仓库
- SGLang 官方文档:Quantization
- SGLang 官方文档:Server Arguments
- DeepSeek-V3 Technical Report(FP8 混合精度与分块量化)
- FP8 Formats for Deep Learning
- vLLM GitHub 仓库(SGLang 量化层最初从 vLLM 0.5.5 的接口改写而来)
- DeepGEMM:FP8 GEMM 与 grouped GEMM 实现
- FlashInfer:GPU 内核库,含 TRT-LLM 与 CUTLASS groupwise GEMM
- Marlin:4-bit 权重与 Tensor Core 的高效矩阵乘
- AWQ: Activation-aware Weight Quantization
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



