


TensorRT-LLM 源码完全拆解(二十四):DWDP 的复合虚拟地址——局部专家零拷贝映射、页池远程槽位与预取调度器如何让每个 rank 独立跑
从上一篇的 Linear 说起
TensorRT-LLM 源码完全拆解系列已经走到了第二十三章,前二十二章把 PyExecutor 的装配线、调度器、KV Cache 的块管理、注意力后端、量化、投机解码、并行拓扑、MoE 前向、P/D 分离等主干都过了一遍。第二十三篇拆的是 Linear 模块如何在一个 Linear 里同时管住列并行、行并行、量化对齐与 GEMM-AllReduce 融合。那一篇的结论可以压缩成一句话:张量并行是把一张权重沿某个维度切开,每一次前向都把切开的碎片通过 AllReduce 重新拼合。
这一篇讲的是另一条完全不同的路径。它同样面对「一张权重放不进单卡、一次前向需要多卡协作」的问题,但它给出的答案不是「切开、计算、拼合、再同步」,而是「每张卡只长期存一小块,缺的部分在计算之前从邻居那里拉过来,而且全程不做集合通信」。
在 TensorRT-LLM 的源码里,这套机制叫做 DWDP(Distributed Weight Data Parallelism,分布式权重数据并行)。它的论文是 NVIDIA 团队 2026 年 4 月发布在 arXiv 上的 DWDP: Distributed Weight Data Parallelism for High-Performance LLM Inference on NVL72,工程实现通过 PR #12136 合入主线。论文和官方博客从系统层面讲了它的动机、roofline 模型与评估结果,而这一篇要往下钻一层:在 Python 控制器里,一次前向到底是怎么把「缺失的专家权重」变成可被 GEMM kernel 直接读取的内存。
沿着这样一条链讲下去:
- 为什么在 NVLink 域里,专家并行的集合通信会成为瓶颈;
- DWDP 的总体设计:完整模型副本 + 专家分片 + 复制引擎拉取;
- 启动期:MNNVL fabric handle 分配、句柄交换、复合虚拟地址布局、边界字节填充、MoE 后端改写;
- 运行期:预取调度器决定发哪些拷贝、拷贝引擎把数据搬进页池槽位、计算流在绑定前等待事件;
- 两条工程优化:消除 split-weight 合并拷贝,以及对抗源端多对一竞争;
- 当前代码级约束与适用边界。
代码来自 TensorRT-LLM 主线的 tensorrt_llm/_torch/modules/dwdp/ 与 tensorrt_llm/_torch/pyexecutor/dwdp.py。读的时候可以对照 tensorrt_llm/_torch/pyexecutor/ 下的其他模块,因为 DWDP 在运行期并不接管调度器,它只是在 PyExecutor 的固定位置被敲一下。
为什么需要 DWDP:同步的代价
现代大模型推理的多卡并行大致有三条路线:张量并行(TP)沿隐藏维切,流水并行(PP)沿层切,专家并行(EP)沿专家切。三条路线在实现上各不相同,但它们共享同一个结构性事实:一层计算完成之后,参与计算的各个 rank 必须交换信息,才能进入下一层。
TP 的一层结束时要做 AllReduce;EP 的一层结束时要做两次 all-to-all(先把 token 分发给各专家所在的 rank,再把专家输出合并回原 rank);PP 是流水线,层与层之间靠点对点握手推进,但整条流水线的节拍仍然被最慢的级拖住。这些交换都是集合通信,集合通信的语义是「所有参与者都到齐了才继续」。于是只要有一个 rank 稍慢,全组都要等。TP 与 EP 的层内通信细节可以参考 TensorRT-LLM 源码完全拆解(十二):注意力层的张量并行 与 TensorRT-LLM 源码完全拆解(十三):MoE 层前向执行。
在真实的推理服务中,「某个 rank 稍慢」几乎是常态。原因有两层:
- 请求层的不均衡。一个 batch 里各条请求的输入长度不同、KV cache 命中率不同。在数据并行加专家并行的组合下(论文把这种组合称为 DEP,data parallelism with expert parallelism),每张卡拿到的请求切片的 token 数可能相差很多。计算量不同,到达 all-to-all 的时间就不同。
- 权重层的不均衡。MoE 模型的路由是稀疏且倾斜的:热门专家会被大量 token 选中,一些 rank 会因此承担明显更多的分组 GEMM 工作。
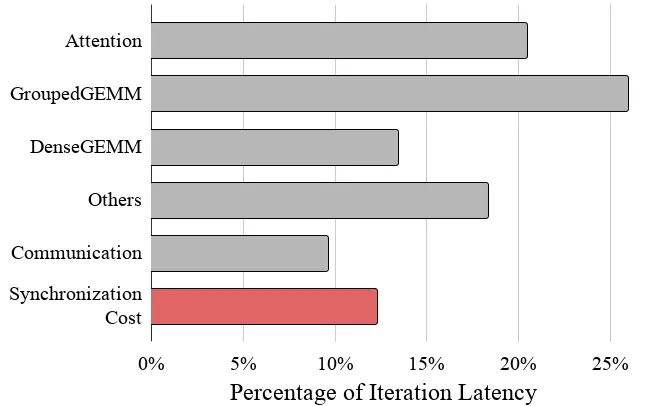
论文在 GB200 上用 DeepSeek-R1 做了一个量化实验:输入 8K、输出 1 token、输入长度在 0.8×8K 到 8K 之间波动,当各 rank 序列长度的变异系数(标准差/均值)只有 20% 时,同步开销就已经占到总延迟的约 12%。20% 的变异在真实生产流量里并不极端,这个数字说明同步开销不是边角情况,而是系统级的固定损耗。
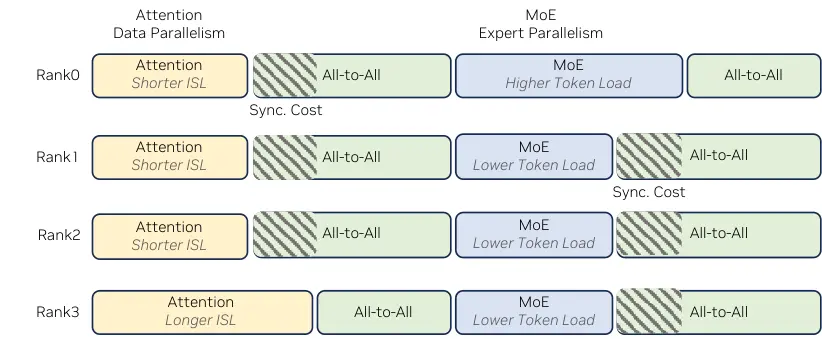
这张图有两个子图。左图把一次前向的时序按 rank 画成长条:经过注意力之后,各 rank 的进度已经出现错位,第一个 all-to-all 把这些错位变成等待;进入 MoE 之后,路由倾斜让错位再次放大,第二个 all-to-all 又把放大后的错位变成等待。右图是同一配置下的 kernel 时间片分解,可以看出「等待」在总时间里的占比。这个等待是结构性的:即使把调度做得很精细、把负载均衡做得很充分,只要一层结束必须集合通信,最慢的 rank 依然决定全组的节拍。
已有的缓解手段大致有三类:缓存感知调度(按 KV 命中率把相似请求分给同一 rank)、负载感知调度(把 token 数相近的请求分到一起)、专家负载均衡(EPLB,把热门专家复制到多个 slot)。这些工作都很有效,但它们做的是「让各 rank 尽量一样快」,而不是「让各 rank 不必等」。前者是概率性的优化,后者是架构性的改变。DWDP 走的是后一条路。
DWDP 的总体设计:没有集合通信的权重分片
DWDP 的核心设定可以一句话概括:每个 rank 都是一个完整模型副本,专家权重按 rank 分片存放,缺的专家通过复制引擎从邻居拉取,不做任何集合通信。
这里的「完整模型副本」不是指整模型都在本卡显存里,而是指从推理逻辑看,每个 rank 都能独立处理自己的请求、独立采样、独立返回。注意力权重(以及除专家之外的绝大多数参数)在每组内每张卡都完整复制;MoE 的专家权重则在组内各 rank 之间分片,每张卡长期只存 num_experts_per_worker 个专家。
一次前向里,对于某个 MoE 层的计算,本 rank 需要的其实是全部专家中被当前 token 路由到的那些。假设路由到专家 37,而专家 37 住在邻居 rank 1 的显存里,那么本 rank 必须在 MoE 计算开始之前把专家 37 的权重搬到自己的一块「预取缓冲区」里。
关键在于,这个搬运是怎么完成的:
- 不是 NCCL 的 all-gather。all-gather 是集合通信,所有 rank 必须同时参与,同步语义不可避免。
- 用 CUDA 复制引擎的
cudaMemcpyAsync点对点拉取。复制引擎(copy engine,也叫 DMA engine)是 GPU 上一个独立于 SM 的硬件单元,它只做显存搬运,不占 SM。一个 rank 发起拉取,自己指定源和目标,不需要其他 rank 配合。拉取的完成状态由 CUDA 事件来同步,而不是由组内屏障来同步。 - 拉取是串行发起的。每次前向时,本 rank 会依次向各个邻居发起若干次拷贝。这些拷贝之间只有「我发完了才发下一个」的本地顺序,不涉及跨 rank 的约定。
从系统视角看,DEP 的一层是「计算 + 通信」串联,而 DWDP 的一层是「计算」与「预取」并行,谁长谁短取 max。论文给出的 roofline 模型就是这么写的:
其中 是这一层的计算时间, 是从邻居拉齐缺失专家权重所需的时间, 是 DEP 中专家并行 all-to-all 的延迟。两个式子放在一起可以看出,DWDP 的收益取决于两个比值:(能否把拉取藏进计算)和 (相对 DEP 快多少)。
论文用逐算子的 roofline 估计来算 :对一个 FLOPs 为 、访存字节数为 的算子,有
把所有算子时间加起来就是 。在 batch size 为 1 的上下文阶段预算下,DWDP 在 16K 输入 token附近开始超过 DEP。输入越长,每个 MoE 层的注意力与专家组 GEMM 计算越重,拉取开销被摊薄得越充分, 从 1 以下涨到 1 以上。而当输入继续变长(例如 32K),两边计算都占据主导,all-to-all 在 DEP 里的占比反而变小,DWDP 的边际优势回落。这是一个有「最优区间」的机制,不是输入越长越好的线性加速。
这张图里有两张子图合成一组,横轴都是输入序列长度,虚线 是分界线。左图表示「计算能不能盖住拉取」,右图表示「DWDP 是否比 DEP 快」。两条曲线都在 16K 附近跨过 1,这是 batch size 为 1 时的交叉点;batch 越大,每个层一次前向要处理的 token 越多,计算窗口越大,交叉点就会提前到更短的输入。
这个分析也解释了为什么 DWDP 在官方实现里只用于分离式服务中的上下文服务器(context server)。上下文阶段一次前向要吃下整段 prompt,token 数动辄数千上万,计算窗口足够大;解码阶段一次前向只有一个 token,计算窗口极小,拉取权重根本藏不住,用 DWDP 只会更慢。分离式服务本身的结构可以参考 TensorRT-LLM 源码完全拆解(十六):P/D 分离与 KV 传输。
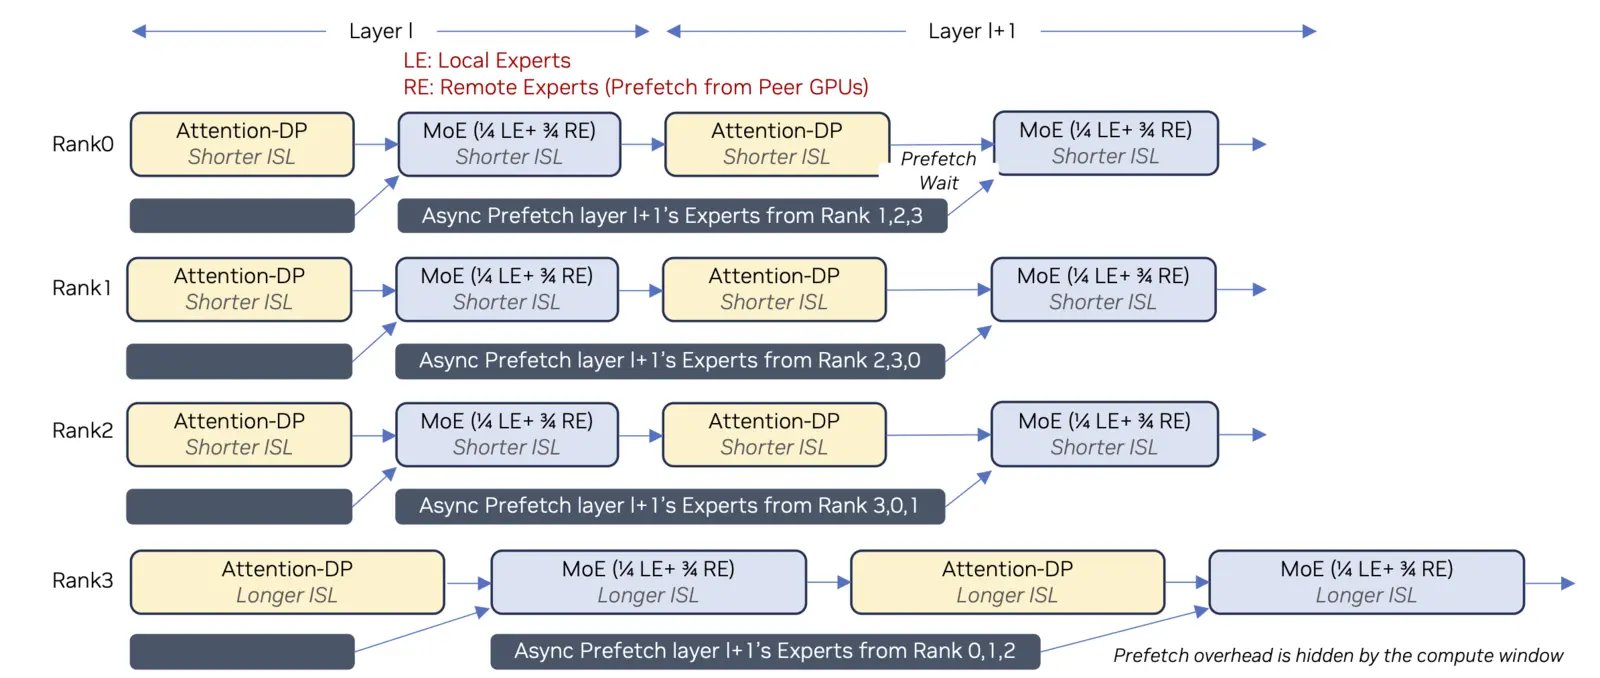
图中左上角的 rank 0 只长期持有专家 0-3 等少数几个(组大小为 4),其余专家的物理位置在 rank 1、2、3 的显存里;右侧的时间轴把一次前向拆成「注意力 + MoE」交替的块,斜线阴影的块表示预取远程专家,它们与相邻块的注意力、MoE 计算重叠。预取 l+1 层远程专家的窗口并不只是 l+1 层的注意力——还包括 l 层自身的 MoE 块,这是论文里「计算窗口 = 两个块」的具体含义。也正因为窗口需要跨层重叠,DWDP 在实现上与 overlap scheduler 不兼容(后文会讲)。
运行期流水
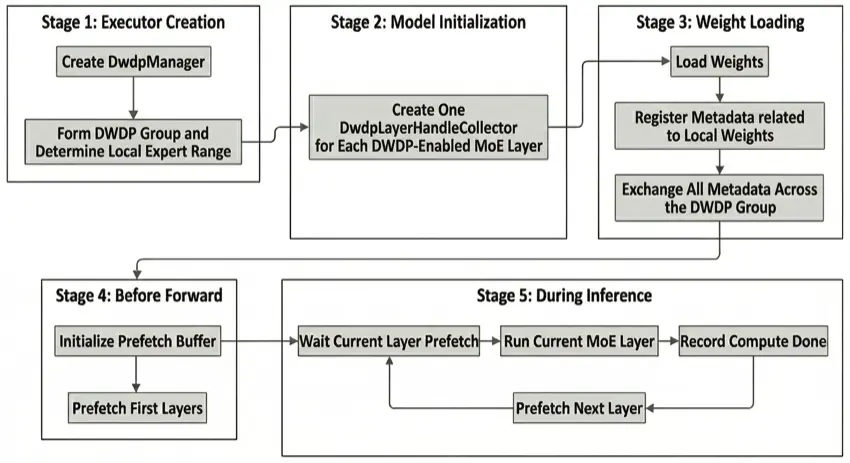
这张图把 DWDP 的生命周期分成上下两段:上段是启动期(配置 → 注册层 → 交换句柄 → 初始化预取缓冲),下段是运行期(每步预热 → 逐层预取)。官方博客里的早期版本用 DwdpLayerHandleCollector 这种对象来描述句柄收集,现在主线的实现路径已经演进为 Transport → WeightBuffer → WeightManager,功能对得上,但组织方式不同:旧的层句柄收集器承担的责任被拆到了三种角色里——Transport 负责句柄分配与交换,WeightBuffer 负责复合 VA 与页池,WeightManager 负责预取与绑定。
双层分片:DWDP 尺寸与本地专家数
从配置层面看,DWDP 暴露四个字段(定义在 tensorrt_llm/llmapi/llm_args.py 的 DwdpConfig 里):
| 字段 | 含义 |
|---|---|
dwdp_size | 每个 DWDP 组内的 GPU 数 |
num_groups | DWDP 组数,上下文 workers 总数 = num_groups × dwdp_size |
num_experts_per_worker | 每个 worker 本地长期持有的专家数(各 rank 相同) |
num_prefetch_experts | 相邻 rank 起始专家号之间的步长(rank-to-rank stride) |
num_prefetch_slots | 远程专家预取槽位数,默认 2,最小 2 |
contention_opt | 是否启用批量 memcpy 与跨邻居 2MB 轮转,降低 NVLink 竞争 |
前两个字段定义组结构,后两个定义专家怎么摊在组里。num_prefetch_experts 是整个 DWDP 分区逻辑里最容易被忽略、但设计上非常关键的一个数:它决定了重叠。
设 rank 的本地存储区间为 ,其中 num_experts_per_worker、 num_prefetch_experts。如果 ,各 rank 的区间首尾相接,完全不相交,等价于均匀切分专家表。如果 ,相邻区间就发生重叠,同一个专家会同时住在多个 rank 上;反过来,如果 ,就会留下空洞,某些专家谁也没存——后者是不允许的,覆盖条件为
否则有些专家会被路由到却无处可取。这里 是组大小, 是专家总数。
为什么允许重叠?因为「专家数必须被 DWDP 组大小整除」和「必须完全不相交」这两个约束都很强。DeepSeek-R1 有 256 个专家,DWDP3 的均分结果是每卡约 85.3 个,没法整数划分;如果强行规定必须整除,那么可选的组大小就只剩 2、4、8、16……这在按单卡粒度扩容的分离式服务里很不灵活。允许每卡存相同数量的专家、允许区间重叠,就把资源规划的自由度从「组大小受限」放宽到了「单卡粒度」,DWDP3 在论文实验里也因此成为一个可用的配置。
重叠还有一个附带收益:本 rank 的本地专家越多,需要拉的远程专家越少,预取时间越短。如果显存富裕,可以把 num_experts_per_worker 设大一点,用显存换带宽。
还有一个细节:所有 rank 的存储槽位大小都是 num_experts_per_worker,各 rank 的 MNNVL 句柄尺寸因此一致。但每个 rank 的有效专家区间会被截断在 以内——尾部的 rank 可能有若干个存储槽其实超出专家总数,那些槽里的数据无效。这个有效区间的计算在 modules/dwdp/specs.py 的 compute_peer_ranges 里,几行代码就够了:
def compute_peer_ranges(*, dwdp_size, num_experts_per_worker, num_prefetch_experts, num_experts_total): ranges = [] for peer_rank in range(dwdp_size): start = peer_rank * num_prefetch_experts end_capped = min(start + num_experts_per_worker, num_experts_total) ranges.append((start, end_capped)) return ranges每个 rank 都能从共享的 DwdpConfig 确定性地算出同一份 PeerRanges,不需要任何通信。这一点很重要:如果每个 rank 都要去通信才能知道邻居有哪些专家,那么即便专家数据是异步拉的,组内仍然存在一次集中同步。DWDP 把「谁拥有什么」做成纯计算,从设计上就避开了这个同步点。
配合 PeerRanges 的是 lookup_owner:给定一个专家号,返回第一个有效区间包含它的 rank 号。
def lookup_owner(expert_id, peer_ranges): for peer_rank, (start, end) in enumerate(peer_ranges): if start <= expert_id < end: return peer_rank raise ValueError(f"expert_id={expert_id} not owned by any peer")「第一个匹配」的规则在区间重叠时指向最低 rank。这条规则本身很随意,但重要的是所有 rank 用的都是同一条规则,所以对同一个专家号,所有 rank 都会去同一个源拉取,结果确定。这也是句柄交换能够一对一建立视图的前提。
启动期:改写内存形态
DWDP 的启动期工作全部发生在权重装载完成之后、第一次前向之前。它要完成的事情是把一个常规 MoE 模型的内存形态改写为 DWDP 形态,让运行期只需要做拷贝和绑定。
第一步:分配 MNNVL fabric handle,把本地专家搬进去
要理解这一步,先要说清楚 NVL72 的物理结构。GB200 NVL72 是一个机架级系统,72 张 GPU 通过 NVLink 交换机连成一个大 NVLink 域,同一域内的任意两张 GPU 之间都有高带宽链路。这个跨节点的 NVLink 域在 CUDA 层面通过 MNNVL(multi-node NVLink)暴露出来:一张卡可以把自己的显存以 fabric handle 的形式导出,其他卡可以导入这个 handle,得到一块远端可访问的内存。
于是 DWDP 的第一步就是:在每张卡上,把本地专家的权重分配成 MNNVL fabric handle,而不是普通的 cudaMalloc 内存。这一步之后,本地专家的物理位置对全组可见。
modules/dwdp/transport.py 里的 DWDPTransport.create 负责这件事。它的注释里明确写了设计意图:
- 交错分配:逐 (层, 权重) 分配 fabric handle,每次分配一份就把对应的原始参数张量释放掉,以免在显存紧张的卡上同时存在两份大权重。
- GB200 约束:所有句柄都用
CU_MEM_HANDLE_TYPE_FABRIC。GB200 上非 fabric 句柄没法被远端卡映射。 - 远端视图不可变:句柄在 setup 之后不再被写,所以 P2P 读不需要同步。
分配完之后还有「导出 → 交换 → 导入」的流程,这就是下一步。
第二步:句柄交换
每张卡把自己刚分配的 fabric handle 导出成字节串,然后通过一个只覆盖本 DWDP 组的 MPI 子通信器,和组内其他 rank 交换句柄字节。每个 rank 拿到邻居的句柄字节后导入,并建立只读张量视图——这个视图指向邻居显存里的本地专家数据。
DWDPTransport.create 的文档注释分了三个阶段:
- Phase 1:逐 (层, 权重) 分配 fabric handle、把本地数据拷进去、释放原始参数、导出句柄、用
comm.allgather把句柄字节广播给所有邻居。 - Phase 2:对每个非自身的邻居、每个 (层, 权重),从缓存的句柄字节导入 fabric handle、映射到临时 VA、建立张量视图。
- Phase 3:所有导入完成之后
comm.Barrier(),确保没有 rank 在别的 rank 完成导入之前就开始读。
这里的 allgather 和 Barrier 都发生在启动期,只做一次。运行期是一点集合通信都没有的。这是 DWDP 一次性付出、永久不付的典型结构。
句柄交换完成后,每个 rank 同时拥有两份视图:
MnnvlHandleSet:本 rank 的本地句柄,后面要被映射进复合 VA;peer_views:(peer_rank, layer_idx, weight_name)到邻居显存只读张量视图的映射,后面预取拷贝的源就是这里。
第三步:复合虚拟地址布局
这是 DWDP 内存管理里最精妙的一步。目标很明确:让 GEMM kernel 看到一个形状为 [num_experts, ...] 的完整权重张量,无论专家的物理数据分散在几块内存上。如果每层每次前向之前都要先把本地和远程专家拼成一个连续 buffer,那把同步问题换成了拷贝问题,不划算。DWDP 的做法是:用 CUDA 虚拟内存管理(VMM,virtual memory management)把不同的物理内存片段映射到同一段连续虚拟地址,让 GEMM 直接读到拼好的权重,而背后每个专家其实指向各自原本的物理位置。
对每个 (层, 权重),布局是这样的:
[ pre_region | mnnvl_region | post_region ] (页池) (MNNVL 句柄) (页池) 远程专家 本地专家 远程专家 [0, local_start) [local_start, local_end) [local_end, N)mnnvl_region 是本 rank 本地专家的 MNNVL 句柄,映射进来时不做任何拷贝,这就是零拷贝本地映射。pre_region 和 post_region 是页池里的物理页,它们是复制引擎的目标,预取时邻居的专家数据会被拷到这里。
modules/dwdp/weight_buffer.py 的模块注释里把这件事写得很直白:本地区域永远不是 memcpy 的目标,它总是 MNNVL 物理句柄的直接 cuMemMap。这条不变量很关键:本地专家本来就住在这张卡上,拉取远程专家时不需要把本地部分也挪一遍。如果一开始就做全量拷贝,那每次前向搬的字节数会翻好几倍。
_setup_layer 是这段布局的具体实现,可以逐段看:
# 为这个权重预留一整段复合 VAva_base = reserve_va(layout.total_size, self._granularity)
# pre 区:页池页,供远程专家 [0, local_start)if layout.pre_size > 0: pre_mappings = self._page_pool.map_pages( slot=buf_slot, va_start=va_base, size=layout.pre_size, page_offset=page_pool_offset) page_pool_offset += layout.pre_pages
# MNNVL 区:本地专家,零拷贝映射mnnvl_va = va_base + layout.pre_sizemap_handle(mnnvl_va, layout.mnnvl_size, handle, offset=0)
# post 区:页池页,供远程专家 [local_end, N)if layout.post_size > 0: post_va = mnnvl_va + layout.mnnvl_size post_mappings = self._page_pool.map_pages( slot=buf_slot, va_start=post_va, size=layout.post_size, page_offset=page_pool_offset) page_pool_offset += layout.post_pages
# 整个复合 VA 一次性 set_accessset_access(va_base, layout.total_size, self._device_id)
# 张量视图从 pre_padding 开始,使 expert[0] 对准正确物理地址tensor_start = va_base + layout.pre_paddingfull_tensor = tensor_from_ptr( ptr=tensor_start, shape=spec.full_shape, dtype=spec.dtype, device_id=self._device_id)这段代码里有三个容易被忽略的工程细节。
细节一:为什么要 pre_padding。 虚拟地址的粒度是 2MB(GB200 上的 allocation granularity),页池页的尺寸更大(默认 16MB,下文会说)。本地专家区域的起点 local_start × expert_bytes 一般不是页池页尺寸的整数倍,所以 pre 区映射的物理页数会被向上取整到页池页边界。于是 pre 区末尾会多出一块没用上的页池空间,这块空间就是 pre_padding。张量视图如果从 va_base 开始,expert[0] 会落到多出来的那截空间里;从 va_base + pre_padding 开始,expert[0] 落在 pre 区的实际数据起点,expert[local_start] 落在 mnnvl_va + data_offset。代码注释里给了这一段推导:
expert[0] @ va_base + pre_paddingexpert[local_start] @ va_base + pre_size + data_offset = va_base + pre_padding + page_start + data_offset = va_base + pre_padding + local_start_bytes细节二:为什么整个 VA 只 set_access 一次。 注释里提到 GB200 的 routing table 预算:整个系统大约 928 个条目,Transport 在启动期消耗了 696 条(3 个邻居 × 4 个权重 × 58 层),留给 WeightBuffer 的只剩 232 条,而 DeepSeek-R1 有 58 个 MoE 层、每层 4 个专家权重(w3_w1_weight、w2_weight、w3_w1_weight_scale、w2_weight_scale),正好 232 条——一条都不能浪费。如果按 pre / mnnvl / post 三个子区分别 set_access,每层每权重会消耗 3 条,总共 696 条,路由表直接打满。所以代码把三次映射合并成一次对整段 VA 的 set_access 调用,只消耗 1 条。
这类硬件表大小约束在源码注释里通常只出现一次,但它决定了整个设计形态:如果路由表足够大,复合 VA 的设计可以更自由;如果不够,就只能用一次 set_access 覆盖整段这种很克制的写法。
细节三:页池的页尺寸为什么不是 2MB。 页池负责给 2 个以上的预取槽位(num_prefetch_slots)提供物理页。每次预取需要在页池里映射若干页。如果页池的每个句柄只有 2MB,那么 DeepSeek-R1 这种每层远程专家几十 GB 的模型,映射次数会非常多,而 CUDA 驱动内部对每个进程的映射数量有上限(大约 13 万个),4 个进程共享一个 GB200 节点、2MB 页的情况下会很快触顶,触发 OOM。PagePool 把每个池句柄做成 8 × granularity(GB200 上为 16MB),映射调用次数因此减少 8 倍。
# Default pool page multiplier: each pool handle = 8 * granularity.# On GB200 with 2MB granularity this gives 16MB pool pages, reducing# cuMemMap calls by 8x compared to 1 * granularity.DEFAULT_PAGE_SIZE_MULTIPLIER = 8这是典型的「为驱动限制做妥协」的设计。代价是页内碎片会增加,但由于页池的尺寸是按该槽位所有层里最大远程字节数来分配的(compute_slot_sizes),而层间差异不大,所以碎片损耗可以接受。
第四步:边界字节填充
复合 VA 虽然让 kernel 看到 [num_experts, ...] 的连续张量,但有一个边角情况必须处理:MNNVL 区域按页边界起止,而专家数据不一定按页边界对齐。
具体来说,如果 local_start × expert_bytes 不是页的整数倍,那么 MNNVL 区映射的第一页里,[page_start, local_start_bytes) 这一段其实还装着上一个专家(即 local_start - 1)的数据,但物理上它属于本 rank 的 MNNVL 句柄,句柄里这块位置的内容是无效的。同理,post 区映射的第一页里,[local_end_bytes, page_end) 一段装着 local_end 专家的数据头,也是无效的。
如果 kernel 真的去读这些专家(它们通常会被路由到),就会读到垃圾。所以 setup.py 的 fill_edge_bytes 在启动期做一次修补:找出前导边界(prev_expert = local_start - 1)和后继边界(next_expert = local_end),用 lookup_owner 找到拥有它们的邻居,从邻居的只读视图里把整条专家拷贝到本地复合 VA 对应位置。
if edge_info.leading_edge > 0 and local_start > 0: prev_expert = local_start - 1 peer_rank = lookup_owner(prev_expert, peer_ranges) peer_chunk_start, _ = peer_ranges[peer_rank] peer_local_offset = prev_expert - peer_chunk_start src = peer_views[(peer_rank, layer_idx, name)] full_tensor[prev_expert].copy_(src[peer_local_offset])
if edge_info.trailing_edge > 0 and local_end < full_tensor.shape[0]: next_expert = local_end peer_rank = lookup_owner(next_expert, peer_ranges) peer_chunk_start, _ = peer_ranges[peer_rank] peer_local_offset = next_expert - peer_chunk_start src = peer_views[(peer_rank, layer_idx, name)] full_tensor[next_expert].copy_(src[peer_local_offset])这里写的是「整条专家」而不是「只拷贝边界字节」。原因是复合 VA 的 expert 维度在张量视图上是对齐的(每个专家槽 expert_bytes 大小),所以 full_tensor[prev_expert] 落到的是 MNNVL 区第一页里某个专家槽的起点位置——这个槽在 MNNVL 句柄里只有一部分有效,其余部分是 page padding。整条拷贝能把有效部分写进去,并保证后面读这个专家时读到完整数据。
注意这里往本地 MNNVL 区域写,但只在启动期一次写完;运行期本地区域永远不被写。这是一次性的正确性修复,不是运行期行为。
第五步:MoE 后端改写与小子参数补齐
启动期的最后一步是把 MoE 后端从专家并行视角改写为全专家视角。setup_dwdp 的最后会调用 fixup_moe_backends,它把每层 MoE 的 ep_size 设为 1、ep_rank 设为 0、expert_size_per_partition 设为专家总数、slot_start 与 slot_end 设为 [0, num_experts)、initial_local_expert_ids 与 initial_global_assignments 设为 range(num_experts)。
为什么要这么改?因为在 DWDP 下,从 MoE 后端角度看,所有专家都在。它看到的是一整张 [num_experts, ...] 的权重(复合 VA 提供),路由计算、专家编号、分组 GEMM 的输入输出都是全专家的。DWDP 的分片信息完全封装在 WeightBuffer 里,MoE 后端不需要知道。SGLang 里同样的单机分组 GEMM 视角可以参考 SGLang 源码完全拆解(二十一):从对齐表到分组 GEMM。
mapping.py 里有一段注释解释了这一点:DWDP 把 fused-MoE 的 EP 布局从 DWDP 布局里解耦——设 moe_ep_size = 1 让后端看到单个完整专家表,DWDP 专用的布局由 _init_dwdp_expert_layout 用 DwdpManager.start_expert_id 和 num_experts_per_worker 安装。注释里还提到,这正是 dwdp_size 可以取 3、5 这种不整除专家数的值的根本原因。
改写之后还有一类参数需要特殊处理:小的 EP 分片参数。例如 e_score_correction_bias(门控分数的偏置修正)、fc31_alpha 和 fc2_alpha(NVFP4 量化里的 scale 参数)这类参数,在原来的 EP 下是按 rank 切的。DWDP 的复合 VA 只服务于专家权重,这些「每专家一个小标量」的参数不走 MNNVL,而是通过 MPI 做一次 all-gather 补全。因为它们在启动期补全一次就够了,量小且每个 rank 需要完整副本。_allgather_e_score_correction_bias 和 _allgather_expert_scales 做这件事,之后 _rebuild_quant_scales 把补全后的量化 scale 重新组装。
# Transport (MNNVL handles) → WeightBuffer (composite VA) → WeightManager (P2P prefetch)# Includes the main expert weights AND their large EP-sharded scale params._EXPERT_WEIGHT_NAMES = ( "w3_w1_weight", "w2_weight", "w3_w1_weight_scale", "w2_weight_scale",)w3_w1_weight_scale 和 w2_weight_scale 这类「每个专家一块 scale」的参数很大(和专家权重同量级),所以走 MNNVL 预取路径;fc31_alpha / fc2_alpha 这类「每专家一个标量」的参数很小,all-gather 一次更划算。NVFP4 与 blockscaled 量化在这套管线里的角色,可以参考 TensorRT-LLM 源码完全拆解(十四):量化全链路。
最后,setup_dwdp 把这个 DWDPWeightManager 同时挂到顶层模型上(键为 dwdp_weight_manager,用于幂等检索)和内部 decoder 模型上(decoder_model.dwdp_weight_manager)。DeepSeek 模型的 forward 正是从内部 decoder 上读取这个属性,从而在 MoE 层前后调用 wait_and_bind 与 finish_layer——DWDP 的逐层钩子由此进入模型前向,而不需要改造 PyExecutor 的调度循环。transport 也在这一步把所有权转交给 weight manager,后续任何失败都通过同一个幂等的 release() 回滚(_release_during_rollback 会吞掉清理异常,避免掩盖原始错误)。
到这一步,DWDP 的启动期结束。总结一下:把所有 MoE 专家权重拆成「本地 MNNVL」和「远程页池」两块,再用复合 VA 拼成 kernel 可以直接读的完整张量,用 MoE 后端改写让后端不感知分片,用一次 MPI all-gather 补齐不能用复合 VA 表达的小参数。运行期要做的只剩把远程部分搬进页池。
运行期:三段流水
运行期的实现在 modules/dwdp/prefetch_schedule.py、weight_manager.py 和 pyexecutor/dwdp.py 里。pyexecutor/dwdp.py 的 DwdpManager 是一个门面(facade),管生命周期、组结构和层注册,真正的预取逻辑都在 DWDPWeightManager 里。
双流与双事件:RAW 与 WAR
DWDP 的并发模型是两条 CUDA 流加两对事件,理解这一点是理解整个运行期的前提。
- 计算流(compute stream):模型前向的默认流,GEMM kernel 在这里执行;
- 拷贝流(copy stream):一个专用的流,所有 P2P 拷贝都在这里入队;
prefetch_events[i]:拷贝流完成第 个槽位写入时记录,计算流读这个槽位之前等待;consume_events[i]:计算流完成对第 个槽位的读取后记录,拷贝流复用这个槽位之前等待。
这两对事件分别解决两种 hazard:
- RAW(read after write):拷贝流写入槽位,计算流读槽位。计算流必须等拷贝流完成,用
prefetch_events。 - WAR(write after read):计算流读过槽位,拷贝流要覆盖它。拷贝流必须等计算流的 kernel 真正读完这个槽位,用
consume_events。
WAR 的时序特别微妙,值得用 weight_manager.py 模块注释里那张图来讲:
compute_stream: --wait(prefetch[0])--> [MoE L3] rec(consume[0]) [attention] --wait(prefetch[1])--> [MoE L4] rec(consume[1]) [attention] ...copy_stream: --wait(consume[0])--> [P2P L5] --wait(consume[1])--> [P2P L6]假设有两个槽位、MoE 层依次是 L3、L4、L5、L6。
- 计算流:等
prefetch[0]→ 执行 L3 的 MoE → 在计算流上记录consume[0]→ 执行注意力; - 拷贝流:等
consume[0]→ 把 L5 的远程专家拷进槽位 0; - 计算流:等
prefetch[1]→ 执行 L4 的 MoE → 记录consume[1]→ 执行注意力; - 拷贝流:等
consume[1]→ 把 L6 的远程专家拷进槽位 1。
最关键的一条是 consume 事件必须在 MoE kernel 入队之后才记录。如果直觉上在绑定(bind)时记录,事件会排在 MoE kernel 之前,拷贝流看到事件完成就以为可以覆盖,但 MoE kernel 可能还在读这个槽位——这是典型的 WAR 冲突,表现为偶发的权重错乱或数值异常。wait_and_bind 的注释里专门说了这一点:WAR 信号刻意由 finish_layer 在 MoE kernel 已入队之后记录,在 bind 处记录会把事件放到 kernel 之前,可能让拷贝流覆盖 kernel 仍在读取的槽位。
另外,构造函数里对 consume_events 做了一个初始化:
# Initialize consume_events as "already signaled" so the first prefetch# does not stall.current_stream = torch.cuda.current_stream(device)for event in self._consume_events: event.record(current_stream)首次预取时没有「之前的计算读过这个槽位」这件事,如果 consume_events 从未记录,拷贝流会等一个永远不完成的事件,整条流水卡住。在默认流上预先记录一次,把它们标记为已完成,是最简单的解法。
整个运行期还有一个「稳态不阻塞 CPU」的约束。weight_manager.py 的模块注释写了三条设计不变量:
- 稳态里永远不调用
torch.cuda.synchronize(),同步全部走stream.wait_event(),只有「一次前向在某个 MoE 层内部被放弃」时才用设备同步恢复; - 推理过程中永不分配或释放内存,所有 buffer 预分配;
- 只拷贝远程专家,本地专家是零拷贝 MNNVL。
这三条在别的推理框架里也很常见,但在这里格外重要,因为 DWDP 的「不阻塞」直接关系到它「不引入同步」的设计目标。如果任何地方冒出一个设备同步,DWDP 相对 DEP 的同步优势就会被局部抵消。
预取调度器:谁决定发哪些拷贝
prefetch_schedule.py 是整个运行期里最抽象、也最有意思的模块。它解决的问题是:在多槽位、多 MoE 层的场景下,什么时候该向哪个槽位发起哪一层的拷贝。
它只做主机侧记账,不碰任何 CUDA API。每次状态变化返回一个 ScheduleStep,调用方按字段顺序入队:
class ScheduleStep(NamedTuple): synchronize: bool # 是否先做一次设备同步 release: Optional[int] # 现在应记录 consume 事件的槽位 prefetch: List[int] # 现在应发起拷贝的 MoE 顺序号调度器的核心状态:
self._slots = list(slots) # 每个 MoE 顺序号对应的槽位self._num_layers = len(self._slots)self._repeated = frozenset(repeated_orders)self._next_bind = 0 # 下一个应被绑定的位置self._issued = 0 # 已发起拷贝的位置数self._slot_owner = [None] * n_slots # 槽位当前被哪个位置占用self._bound = None # 当前已绑定、未完成的位置self._held = None # 重复层完成后仍被占用的位置位置的编号是「跨多次前向的连续计数」,第 个位置对应 MoE 顺序 ,其中 是 MoE 层数。所以,一次前向的最后几层会在下一次前向开始之前,就去预取下一次前向的前几层——这是通过槽位复用实现的,不是通过跨前向协调实现的。
_issue 是推进逻辑:
def _issue(self) -> List[int]: orders = [] while True: order = self._issued % self._num_layers slot = self.slot(order) if self._slot_owner[slot] is not None: return orders # 槽位被占用,停下 self._slot_owner[slot] = self._issued self._issued += 1 orders.append(order)它会不断向所有空闲槽位铺满拷贝,直到遇到第一个被占用的槽位。这一步是 DWDP 能提前几层预取的根源:槽位数为 2 时,一次前向可以预取当前层之后的两层;槽位数为 4 时,可以预取四层,代价是显存——num_prefetch_slots 的默认值是 2,注释里写明「更多槽位让预取跑得更靠前,代价是占用的设备内存不能再给 KV cache」。
start_forward 处理两种情况:
def start_forward(self) -> ScheduleStep: release = self._release_held() if self._bound is None and self._next_bind % self._num_layers == 0: # 上一次前向正好在层边界结束;它已经预取了本次前向的前几层 return ScheduleStep(False, release, self._issue()) self._num_restarts += 1 synchronize = self._restart(0) return ScheduleStep(synchronize, release, self._issue())第一种是稳态:上一次前向的最后几层已经预取了本次前向的第一层,无需任何额外动作。第二种是重启:上一次前向在 MoE 序列中间中断(比如被抢占或异常回滚),或者某个层被跳过,序列不再匹配。此时需要 _restart(0):清空所有槽位占用、重置计数、标记 synchronize = True,因为可能存在「上一个前向绑定的槽位还在被读」的情况,必须让设备同步一次才能安全覆盖。
bind 和 finish 是每层的两个钩子:
bind(order):在 MoE kernel 入队之前调用。如果顺序匹配,返回空步骤;如果顺序不匹配(例如某个层被走了两次),会重启序列。返回后_issued > _next_bind,保证「拷贝已发起」。finish(order):在 MoE kernel 入队之后调用。推进_next_bind、释放槽位、发起后面层的拷贝。
bind 里还有一个针对「重复层」的分支:
if (self._bound is None and self._held is not None and order == self._held % self._num_layers): self._bound = self._held return ScheduleStep(False, None, [])这是为 MTP(multi-token prediction)这类投机解码的草稿层准备的:一个 MoE 层在一次前向里会被连续调用多次(每个草稿步一次),它的远程专家数据被拉一次之后应该保留在槽位里复用,而不是重复拉取。_held 记录了这个「完成但仍持有」的位置,下一次对同一层的 bind 直接复用。EAGLE-3 草稿端如何把一个层跑多次,可以参考 TensorRT-LLM 源码完全拆解(二十二):EAGLE-3 一体式草稿。
调度器里还有一些防御性检查:
finish必须对应一个bind,否则直接RuntimeError;- 一次
bind之后若_issued <= _next_bind,直接RuntimeError,因为这表示「拷贝还没发起就被绑定了」,数据必然错误; - 重启计数只在 2 的幂次时打日志,避免日志洪水。
这些检查都是运行期正确性的重要保险。DWDP 是一个「数据由后台异步搬运」的机制,出错时表现为数值异常而非崩溃,所以尽早在主机侧用断言拦截,比在 GPU 上排查划算得多。
门面:DwdpManager
pyexecutor/dwdp.py 的 DwdpManager 管三件事:
- 生命周期与全局单例:
__enter__/__exit__配合set_global_dwdp_manager/get_global_dwdp_manager; - 组创建:
_create_dwdp_comm创建一个只覆盖本 DWDP 组的 MPI 子通信器,或者一个 TCPStore 会合(StoreDwdpGroup)——后者用于上下文 workers 独立启动的场景; - 层索引注册与运行期转发:
add_layer是 MoE 层索引的单一事实来源(single source of truth),configurable_moe.__init__在构造模型时逐层注册。运行期的start_forward、wait_and_bind、finish_layer直接转发给DWDPWeightManager。
组的划分规则在 _create_dwdp_comm 里:
group_id = self.rank // self.dwdp_sizegroup_start = group_id * self.dwdp_sizeranks = list(range(group_start, group_start + self.dwdp_size))return COMM_WORLD.Create_group(COMM_WORLD.group.Incl(ranks))num_groups = 2、dwdp_size = 4 时,rank 0-3 是组 0,rank 4-7 是组 1。DwdpManager.__init__ 里还有对 num_groups × dwdp_size = 上下文 workers 数的校验,确保启动的 worker 数量与声明的拓扑一致。
__init__ 里还有一个细节:self.resident_sms = fabric_gather.resident_sms()。这是为下文会讲的 SM gather 传输方式准备的——使用 SM 加载的 gather kernel 会长期占用一部分 SM,所以进入 __enter__ 时就通过 set_sm_reserve 把 SM 数告诉后续的 persistent grid 计算内核,让它们主动避开这些 SM。
预取内核:三种传输方式
DWDPWeightManager.prefetch_layer 是整个运行期的核心函数,负责把某一层的远程专家从邻居搬到页池。它先把拷贝流切到 self._copy_stream,等目标槽位的 consume_event(WAR),然后按传输方式入队,最后在拷贝流上记录 prefetch_event(RAW)。
方式一:逐片拷贝(默认)。对每个权重、每块远程切片,用 torch.Tensor.copy_ 一次拷一块。
for name in self._weight_names: remote_slices = self._weight_buffer.get_remote_slices(layer_idx, name) for dst_slice, expert_start, expert_end in remote_slices: cursor = expert_start dst_offset = 0 while cursor < expert_end: peer_rank = lookup_owner(cursor, self._peer_ranges) peer_local_start, peer_local_end = self._peer_ranges[peer_rank] local_offset = cursor - peer_local_start chunk_end = min(expert_end, peer_local_end) n = chunk_end - cursor src = self._peer_views[(peer_rank, layer_idx, name)] dst_slice[dst_offset : dst_offset + n].copy_( src[local_offset : local_offset + n]) dst_offset += n cursor = chunk_end这段代码在「一块远程切片跨越多个邻居」时会逐个邻居切分:lookup_owner 找到该专家所属的邻居(重叠区间下是最低 rank),peer_local_end 截断到该邻居有效区间的末尾,然后发起一次拷贝。这是非均匀或重叠分区下能正确工作的关键。
方式二:批量拷贝(contention_opt=True)。把一层里所有按邻居分组的拷贝描述符 (dst_ptr, src_ptr, size) 先按邻居分到若干个组,每组内部把相邻的地址合并,然后把每组再切成 2MB 的小块,在邻居之间轮转交错排列,用一次 cudaMemcpyBatchAsync 提交。
MEMCPY_BATCH_SLICE_BYTES = 1 << 21 # 2 MiB
# 同一层里,各邻居的 2MB 子片按轮转顺序交错提交while cursors: for peer in list(cursors): idx = cursors[peer] if idx < len(peer_subslices[peer]): d, s, sz = peer_subslices[peer][idx] dst_ptrs.append(d) src_ptrs.append(s) sizes.append(sz) cursors[peer] = idx + 1 else: del cursors[peer]交错是为了对抗单条链路饱和:如果在途拷贝全来自同一个邻居,就只有一条 NVLink 被压满,其余链路闲着;轮转交错以后,任一时刻的拷贝分布在多条链路上,整体带宽更高。源码注释还提到,计划在初始化后缓存,因为邻居的 data_ptr() 和目的 data_ptr() 都是稳定的,不必每次预取都重新构建描述符。
方式三:SM gather(TRTLLM_DWDP_PREFETCH_GATHER=1)。用一个 SM kernel 替代复制引擎:kernel 的每个 block 按描述符发起 16 字节对齐的 load,把数据从源地址拉到目的地址。这是「用 SM 换时长」的取舍——注释里写得很清楚:发放 16 字节 load 的 SM kernel 比复制引擎快,但会占用 SM 一整个 step,只有当计算能完全盖住拷贝时长时才划算。
fabric_gather.py 里有几个实现细节:
- 16 字节对齐:
LINE_BYTES = 16,所有描述符指针和字节数必须是 16 的倍数;不满足时回退到复制引擎,并记录一条警告,不报错; - 网格布局:
TARGET_BLOCKS = 30是「足以饱和 fabric 的最小网格」,每个邻居的块作为一行,各行作为一个 cluster 启动,这样一个邻居的块占满整块 TPC; - SM 预占:
resident_sms()返回 gather 占用的 SM 数,DwdpManager.__enter__把它设为set_sm_reserve,让计算端的 persistent grid 避开。用户手动设了TRTLLM_CUTEDSL_SM_RESERVE时以用户为准; - 计算端默认值:
apply_compute_side_defaults()在 gather 开启时自动把 dense GEMM 调度器设为clc_dynamic,否则 persistent grid 会在 gather 占用的 SM 上多跑一波;同时关闭 grid-cooperative 的 MoE routing kernel,因为它需要所有 SM 同时驻留,会等在 gather 后面。
第三种传输方式在默认路径里是关闭的,属于可选的工程路径,但源码保留得比较完整。
运行期的钩子位置
DwdpManager 的运行期入口有四个:start_forward(前向开始,预取前几层)、wait_and_bind(某层 MoE 前,等拷贝并绑定)、finish_layer(MoE 入队后,释放槽位并预取后续层)、invalidate_prefetch(权重被修改后,丢弃已发起的预取)。
pyexecutor/py_executor.py 里,PyExecutor 只是在固定位置调用它们。py_executor_creator.py 在 PyExecutor 创建时构造 DwdpManager 并用 __enter__ 激活它,同时校验了一组前置条件:
dwdp_size > 1;- 每个 rank 必须是完整模型副本,不能是已经被切开的模型;
- DWDP 不支持 CUDA Graph,要求
cuda_graph_config=None; PyExecutor校验 DWDP 不支持 overlap scheduler:当dwdp_manager is not None and not disable_overlap_scheduler时直接报错。
这些限制不是实现细节,而是机制边界:DWDP 的槽位复用必须由 PrefetchSchedule 精确控制,而 CUDA Graph 和 overlap scheduler 都会把「层何时执行」变得不可预测,破坏调度器的假设。CUDA Graph 路径可以参考 TensorRT-LLM 源码完全拆解(二十):CUDA Graph 与编译路径。
wait_and_bind 本身也值得看一遍:
def wait_and_bind(self, backend_module, layer_idx): order = self._order_of(layer_idx) self._apply(self._schedule.bind(order)) buf_idx = self._schedule.slot(order)
# RAW:等拷贝完成 compute_stream.wait_event(self._prefetch_events[buf_idx])
# 把完整的 [num_experts, ...] 张量绑定到后端模块的参数上 for name in self._weight_names: full_tensor = self._weight_buffer.get_full_tensor(layer_idx, name) param = getattr(backend_module, name) param.data = full_tensor绑定就是 param.data = full_tensor。这里没有拷贝,只是把后端模块的参数对象指向复合 VA 上的张量。每次前向后端模块的参数都指向同一个 full_tensor(复合 VA 是稳定的),所以绑定其实可以不重复;但代码每次绑定一次,成本极低(一次 Python 赋值),语义上也更清晰。
_apply 是调度器步骤的执行层:
def _apply(self, step): if step.synchronize: torch.cuda.synchronize(self._weight_buffer.device_id) if step.release is not None: compute_stream = torch.cuda.current_stream(...) self._consume_events[step.release].record(compute_stream) for order in step.prefetch: self.prefetch_layer(self._moe_layer_indices[order])它把同步、记录 consume、发起预取三件事按固定顺序执行,与 ScheduleStep 的字段顺序一一对应。调度器负责决定做什么,执行器负责在正确的流上做,这是整个运行期里逻辑与执行分离的体现。
两项工程优化
前面把 DWDP 的机制讲完了,但实际部署里有两类问题会显著吃掉理论收益。论文里专门用两节讲它们,源码里也都有对应实现。
消除 split-weight 合并拷贝
DWDP 天然会产生分裂权重:本地专家在 mnnvl 区域,远程专家在 pre 与 post 区域。常规的 grouped GEMM 内核假设所有专家权重在一个连续 buffer 里,所以朴素的 DWDP 实现会在每层 MoE 之前做一次 D2D 拷贝,把本地和远程拼成一个连续 buffer。
论文的 kernel 分解里,这项合并拷贝占 34 μs 左右,约为一次迭代延迟的 3%。它直接落在关键路径上,是纯粹的额外带宽消耗。
解决方案是让 grouped GEMM 内核直接支持多 buffer 输入。论文提到这个内核是用 CuTeDSL 实现的,可扩展接口让改动比较自然:加 TensorList 形式的输入,让内核在内部选择本地 buffer 或预取 buffer,而不是依赖外部合并。具体改动分布在:
tensorrt_llm/_torch/modules/fused_moe/fused_moe_cute_dsl.pytensorrt_llm/_torch/custom_ops/cute_dsl_custom_ops.pytensorrt_llm/_torch/cute_dsl_kernels/blackwell/blockscaled_contiguous_gather_grouped_gemm_swiglu_fusion.pytensorrt_llm/_torch/cute_dsl_kernels/blackwell/blockscaled_contiguous_grouped_gemm_finalize_fusion.py
从文件名可以看出,这是 Blackwell 架构上的 blockscaled contiguous grouped GEMM,带 SwiGLU 融合和 finalize 融合。gather 这个词说明内核本来就有某种 gather 语义,加 TensorList 是在这个语义上扩展。
代价是内核多了一些指令开销——额外的地址计算、描述符加载。论文说 profiling 和端到端评估都显示没有明显回退,因为主流瓶颈仍然是主计算和访存。这和复合 VA 的设计是互补的:复合 VA 在「同一个权重张量」的粒度上把多块物理内存拼起来,TensorList 在「不同权重张量」的粒度上让内核不依赖合并。两者合力,把拼合这件事完全消除了。
对抗源端多对一竞争
DWDP 的异步拉取有一个副作用:源端的复制引擎会被多个目的端同时抢占。一层 MoE 里,rank A 可能需要从 rank D 拉专家 100,rank B 也需要从 rank D 拉专家 120,rank C 需要从 rank D 拉专家 140。rank D 上的复制引擎一次只能处理一个请求,所有请求排队,形成多对一竞争。
论文的 Nsight Systems trace 展示了这种情况。在「计算窗口与预取时长相当」的边界配置下,源端串行会让通信窗口拉长,暴露出明显的计算气泡。
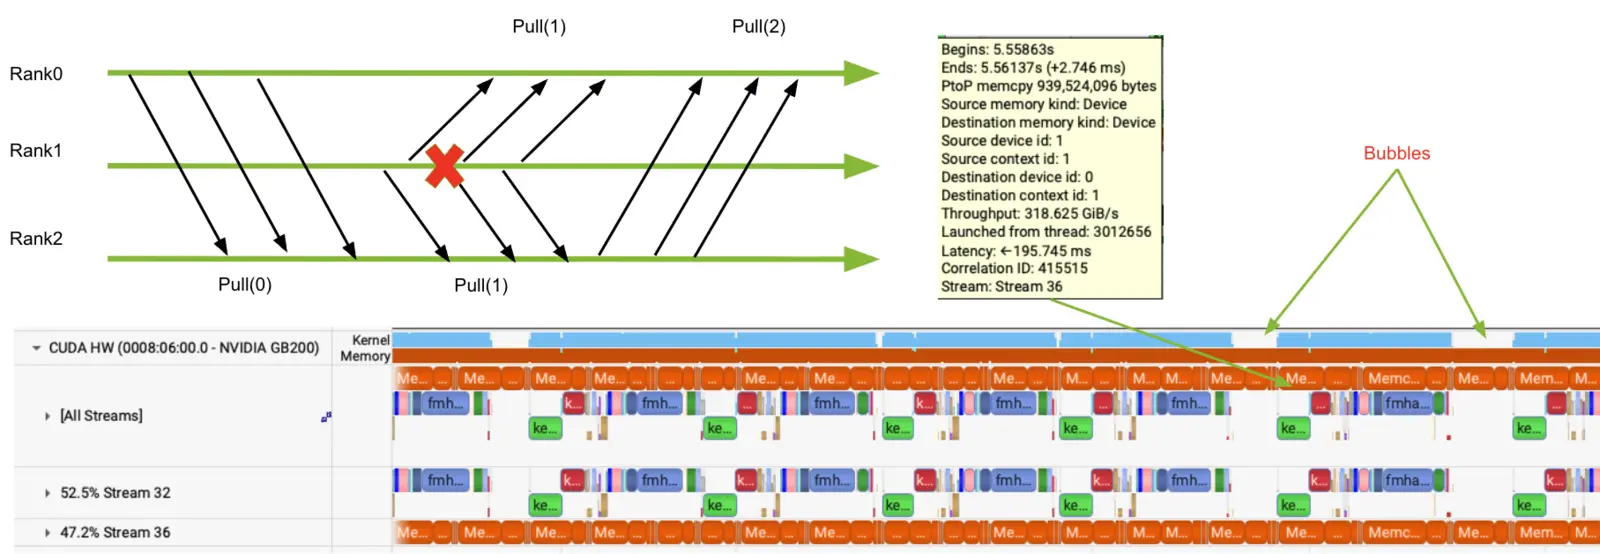
这张 trace 的横轴是时间,纵轴是流。可以看到源端(同一行里的若干拷贝操作)被多段来自不同目的端的请求交替插入,没有一组完整的连续拷贝。这就是竞争的视觉表现:本该能隐藏的通信,因为源端排队而拉长。
论文提出了一个概率模型来量化这件事。设组内有 个 rank,一轮通信里每个 rank 要从其他 个 rank 拉取。理想总通信时间为 ,因为每个 rank 串行发起 次,单次理想服务时长为:
任意时刻,一个 rank 准备发下一次拉取时,源端在剩余对等端里均匀分布。对某个被标记的 rank 来说,它选了一个源端之后,其他 个 rank 以 的概率也选同一个源端,所以竞争请求数是二项分布:
竞争程度(包括自己)为 。论文给出了 时 的概率是 50%,即一半的情况下没有竞争,另一半的情况下至少有一方在等。这个模型只算概率不算精确时长,目的是证明低阶多对一竞争在异步模型下自然会出现,应该显式处理。
缓解思路是把每个远程权重传输切成固定大小的片,再在活跃的目的端之间轮转调度。这就是 contention_opt 里 2MB 轮转交错的直接动机(论文实验用的是 1MB 分片)。论文明确说这个优化当时不在产品化的 DWDP 路径里,但主线的 weight_manager.py 现在已经有 contention_opt 路径,只是默认关闭。这反映了一个开源项目的常态:学术论文的前瞻优化和主线代码的可用功能之间有滞后,代码里的 docstring 往往比博客更准确地反映当前状态。
通信与计算干涉:功率引起的降频
还有一类问题比竞争更微妙:拷贝引擎与计算内核在时间和功率上的干涉。论文的表里,DWDP 的 Attention(269.67 μs → 320.56 μs)、DenseGEMM(177.50 μs → 189.28 μs)、Others(241.69 μs → 284.32 μs)都比 DEP 慢。这不是因为 DWDP 让单个 kernel 变慢了,而是因为拷贝引擎和计算内核同时运行时,GPU 的功率预算被挤压,时钟频率下降,进而所有计算 kernel 都变慢。
论文附录专门分析了这一点,并给出两个结论:
- 与访存密集内核的干涉:带宽瓶颈。P2P 拷贝占用 HBM 与 NVLink 带宽,访存密集的内核(注意力、RMSNorm)本来就受带宽限制,再被拷贝挤占带宽就进一步变慢;
- 与计算密集内核的干涉:功率引起的降频。NVFP4 的 grouped GEMM 是计算密集的,拷贝引擎的功耗叠加进来后,GPU 的总功率触及上限,时钟频率被压低;这个影响在 Blackwell 上占主导。
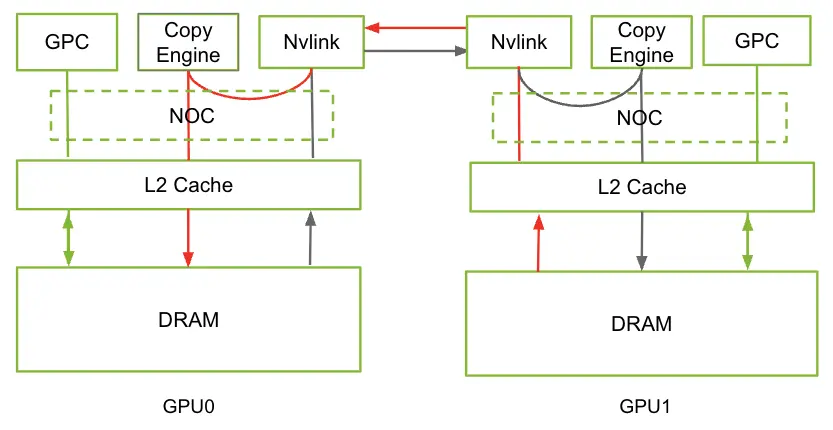
这张图把「为什么 DWDP 的计算 kernel 变慢了」拆成两个机制。粗看会觉得「拷贝不占 SM、不影响计算」是个常识,但功率维度上这个常识不成立:GPU 的总功率预算是一个硬约束,任何额外的硬件单元活动都会分走一部分,计算频率随之下降。这解释了为什么 DWDP 的净收益(14.26% 迭代延迟改进)低于「同步 + 通信」的毛收益(21.86%):多出来的计算时间把一部分收益还了回去。
这一点在别的推理优化里也经常被低估:任何隐藏都不是免费的,被隐藏的东西依然在消耗资源。DWDP 把它写成显式的分析,是它比「只要 overlap 就快」这种直觉更扎实的地方。
当前代码级约束与适用边界
DWDP 在官方博客里列了一组约束,主线源码和博客略有出入,这里把它们汇总成一张表:
| 约束 | 含义 | 原因 |
|---|---|---|
| 仅支持 CuteDSL MoE 后端 + NVFP4 | fused_moe_cute_dsl 与 blockscaled grouped GEMM | TensorList 输入只在这些内核里实现;其他后端需要回退到朴素合并 |
组内 TP = 1 | 不叠加张量并行 | TP 需要层内 AllReduce,与无集合通信目标冲突 |
| 仅支持 MPI worker 启动流程 | trtllm-serve disaggregated_mpi_worker | 句柄交换依赖 MPI;独立启动时需要用 TCPStore 会合 |
| 不支持 overlap scheduler | disable_overlap_scheduler = True | 调度器要精确控制拷贝何时发起 |
| 不支持 CUDA Graph | cuda_graph_config = None | 层执行顺序与槽位分配必须动态 |
| 不支持 EPLB(同一条 MoE 路径) | 动态专家复制会改动权重位置 | 复合 VA 的物理布局是启动期固定的 |
| 需要 fused-finalize 的 FC2 | grouped GEMM 的 finalize 与 DWDP 一起使用 | split-weight 路径依赖这个内核 |
| 仅限上下文服务器 | 分离式服务中应用于 context server | 解码阶段计算窗口太小 |
这些约束不是「实现不完整」的借口,而是设计的边界。例如不支持 CUDA Graph,是因为 DWDP 的槽位复用完全由 PrefetchSchedule 在主机侧决定,而 CUDA Graph 会把层何时执行固化进图里,调度器无法感知;不支持 EPLB,是因为复合 VA 的物理布局启动期就固定了,而 EPLB 要在运行期把热门专家换到不同的物理位置。Wide-EP 与 EPLB 的设计意图可以参考 TensorRT-LLM 并行策略文档。
论文的实验设置本身也值得注意:GB200 NVL72 + DeepSeek-R1 NVFP4 + 分离式服务(DWDP 只用在 context server)+ SemiAnalysis 数据集 8K/1K/输入比例 0.8。按上下文阶段隔离测试,DWDP4 相对 DEP4 的迭代延迟从 1319.85 μs 降到 1131.58 μs,改进 14.26%;端到端则在 20-100 TPS/user 区间、对等 TPS/user 下让输出 TPS/GPU 提升约 8.8%。
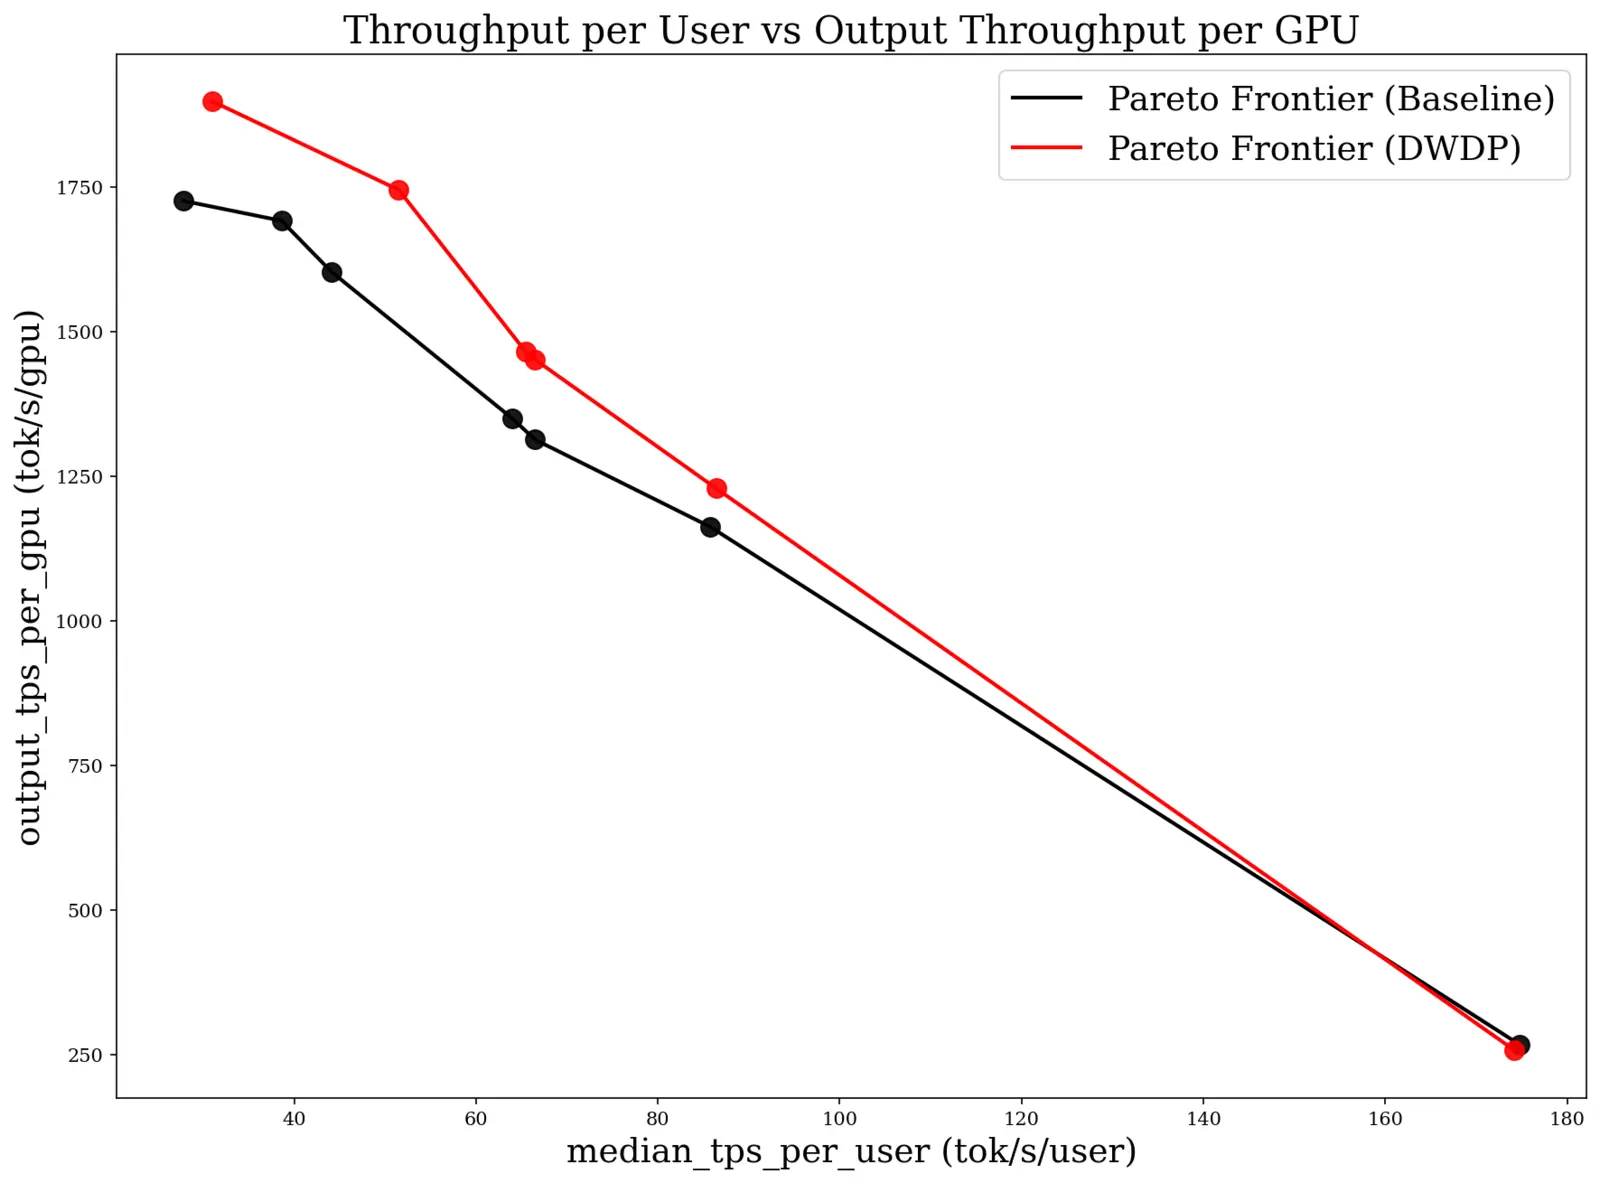
这张 Pareto 图有一个必须同时看的事实:DWDP 推高了 TPS/GPU,但 TTFT 也升高了。博客的表格里,低 TPS/user 区间的 TTFT 从约 2.5 s 涨到约 8.3 s。原因很直接:DWDP 的收益来自减少了上下文 GPU 数量,GPU 少了,总体服务率下降,队列时间变长。所以 DWDP 不能简单地被当成「更快的推理」,它是「以更少的 GPU 实现同等吞吐、以更高的 TTFT 为代价」的工程权衡。在 TTFT 敏感的场景里,这个代价可能需要重新评估。请求在入口层与会话之间如何排队,可以参考 推理服务的入口层完全拆解。
小结
- DWDP 把每层的集合通信换成点对点异步拉取加复制引擎,用「不等待任何 rank」的代价换掉「被最慢 rank 拖住」的损失。它最有效的地方是上下文阶段,因为那里每层计算窗口足够大,能把预取藏进去。
- 启动期做五件事:MNNVL fabric handle 分配与句柄交换、复合 VA 布局(本地零拷贝 + 页池远程槽位)、边界字节填充、MoE 后端改写、小子参数 all-gather。
- 运行期由三部分组成:
PrefetchSchedule在主机侧决定发哪些拷贝,DWDPWeightManager在拷贝流上入队并维护 RAW/WAR 事件链,计算流在wait_and_bind时等待事件并绑定复合 VA 视图。 - 复合 VA 的
pre_padding、单次set_access、16MB 页池页、整条专家边界填充,都是被硬件路由表大小、驱动映射上限等具体约束倒逼出来的工程细节。 - split-weight 合并消除(TensorList 输入)和源端竞争缓解(2MB 轮转交错)是两条实际优化;通信与计算干涉(带宽和功率)是 DWDP 收益打折扣的主要来源。
- 当前实现有 8 条明确约束,核心都指向一个事实:DWDP 需要可预测的层执行顺序、启动期固定的物理布局、足够大的计算窗口。
下一篇沿着输出侧继续:在 TensorRT-LLM 的采样与回传链路里,从 logits 到 token 再到流式返回的完整路径。
参考资料
- DWDP: Distributed Weight Data Parallelism for High-Performance LLM Inference on NVL72(NVIDIA,arXiv:2604.01621,2026 年 4 月)
- TensorRT-LLM 技术博客 blog19:DWDP(Distributed Weight Data Parallelism)
- PR #12136:DWDP 实现合入 TensorRT-LLM
- TensorRT-LLM
modules/dwdp/源码目录 - TensorRT-LLM
pyexecutor/dwdp.py - TensorRT-LLM 并行策略文档:Wide Expert Parallelism(MNNVL 相关)
- DeepSeek-V3 Technical Report(MoE 架构与前向背景)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



