


vLLM 源码完全拆解(二十五):请求准入的五层关卡——max_num_seqs、max_num_active_seqs 与 max_num_queued_tokens 怎样决定一条请求的命运
从「排不上队」这件事说起
推理服务里有一种失败,比模型答错更常见,也比显存溢出更难排查:请求排进了队,但永远轮不到它。客户端等到超时,以为服务挂了;服务端一切正常,GPU 始终满载,日志里没有任何报错。另一种失败看起来温和得多,却更伤业务:几十条超长预填请求同时涌入,把本应毫秒级返回的第一批 token 拖成了十几秒,短对话全部卡死在这批长文之后。
这两种现象背后是同一个问题——准入(admission)。一条请求从 HTTP 连接到模型拿到第一个 token 之前,要穿过不止一道门。第一道门在前面站着一个 Python API 服务进程,它只看全局计数器;后面的门在 GPU 旁边的引擎主循环里,每一轮调度都要重新裁决一次这条请求还配不配继续占用批次。
vLLM 的 V1 引擎把这件事拆得相当清楚。沿着源码从 AsyncLLM 的 add_request 一直追到 Scheduler.schedule() 的第二段扫描,能数出来至少五层关卡,每层管的约束完全不同:
- 前端队列阀门:在途请求数与预填积压的 prompt token 数;
- 调度器准入上限:
max_num_active_reqs控制真正进入running列表的条数; - 批内槽位:model runner 的请求槽、LoRA 槽位、投机草稿槽位;
- token 预算:
max_num_batched_tokens与本轮token_budget的切分; - KV 块预算:物理块不够时,本轮直接不再接纳,甚至反过来抢占已在跑的请求。
这几层之所以容易混在一起,是因为它们的名字长得很像,默认值又大多是同一个数。把每层到底约束什么拆开来看,很多线上配置问题——「为什么设了 max_num_seqs=256 却只跑出 120 的并发」「为什么开了限流还是 503」——会自己浮现出答案。
本篇沿着代码顺序逐层拆。前几层偏 Python 控制面,代码量小、逻辑直白;后两层落到调度循环的循环体里,需要把 SchedulerOutput 的结构带在一起看。读完之后,应该能在心里画出一条请求从 HTTP 到 RUNNING 的完整关卡图,并且知道每一道关卡失败时,用户会看到什么。
把这条链路先写成一句能记住的话:前端数「有多少人在门口」,调度器数「屋里还能塞下几个、每人还能分多少算力、块池还够不够」。注意它并不严格是「线性」的:前端的两个阀门是一次性的,请求通过后就再也不检查;调度器的准入上限与 token/KV 预算每轮都要重新裁决,甚至会让已经跑的请求退回去。这种「前松后紧」的结构,是下面所有结论的来源。
先分清两个进程:谁看得见什么
要把准入讲清楚,第一步必须分清进程边界。vLLM V1 默认的部署形态是 frontend(API Server)+ EngineCore 后端进程两个进程(张量并行时后端还会再拉起每个 rank 的 worker)。两者靠 ZMQ 传消息,共享的状态只有通过返回的 EngineCoreOutputs 才能同步。
这个边界决定了每层关卡「能看见什么」:
| 关卡所在位置 | 能看到的状态 | 更新频率 | 典型失败形态 |
|---|---|---|---|
API Server(AsyncLLM) | 全局在途请求数、预填中的 prompt token 总数 | 每来一条请求检查一次 | HTTP 503 |
EngineCore → Scheduler | 每条请求的 num_computed_tokens、块表、块池水位 | 每一轮 step() | 请求留在 waiting 队列(无报错) |
GPUModelRunner | 已被调度器分配的批次 | 每一轮 | 断言失败(属于程序错误) |
前端之所以只能做「粗阀门」,是因为它的计数器要靠后端的输出回执来维护。我们后面会看到,预填阶段的进度根本不会回传到前端,所以 max_num_queued_tokens 的计数在预填完成前会高估积压——这是 vLLM 在源码注释里明确承认的保守设计。
先建一个最小的心智模型:AsyncLLM 是一个守着门口的门卫,手里只有两张仪表盘读数;真正的房间容量由 Scheduler 每轮重新计算。门卫放进来的人多了,房间这边就只能让他们站在走廊里等(waiting 队列),或者干脆把已经坐下的人请出去(抢占)。
下图是 vLLM 官方文档里的 V1 进程架构图(TP=4 版本),可以把前端的 AsyncLLM(API Server)与左侧那一串 EngineCore 后端进程的位置关系看清楚。准入的第一层就落在图中 API Server 这一侧的进程里,而第二层到第五层全部落在 EngineCore 进程的 Scheduler 里。两侧之间只有 ZMQ 上的 AddRequest 消息与 EngineCoreOutputs 回执,这正是「前端只能做粗阀门」的物理原因。
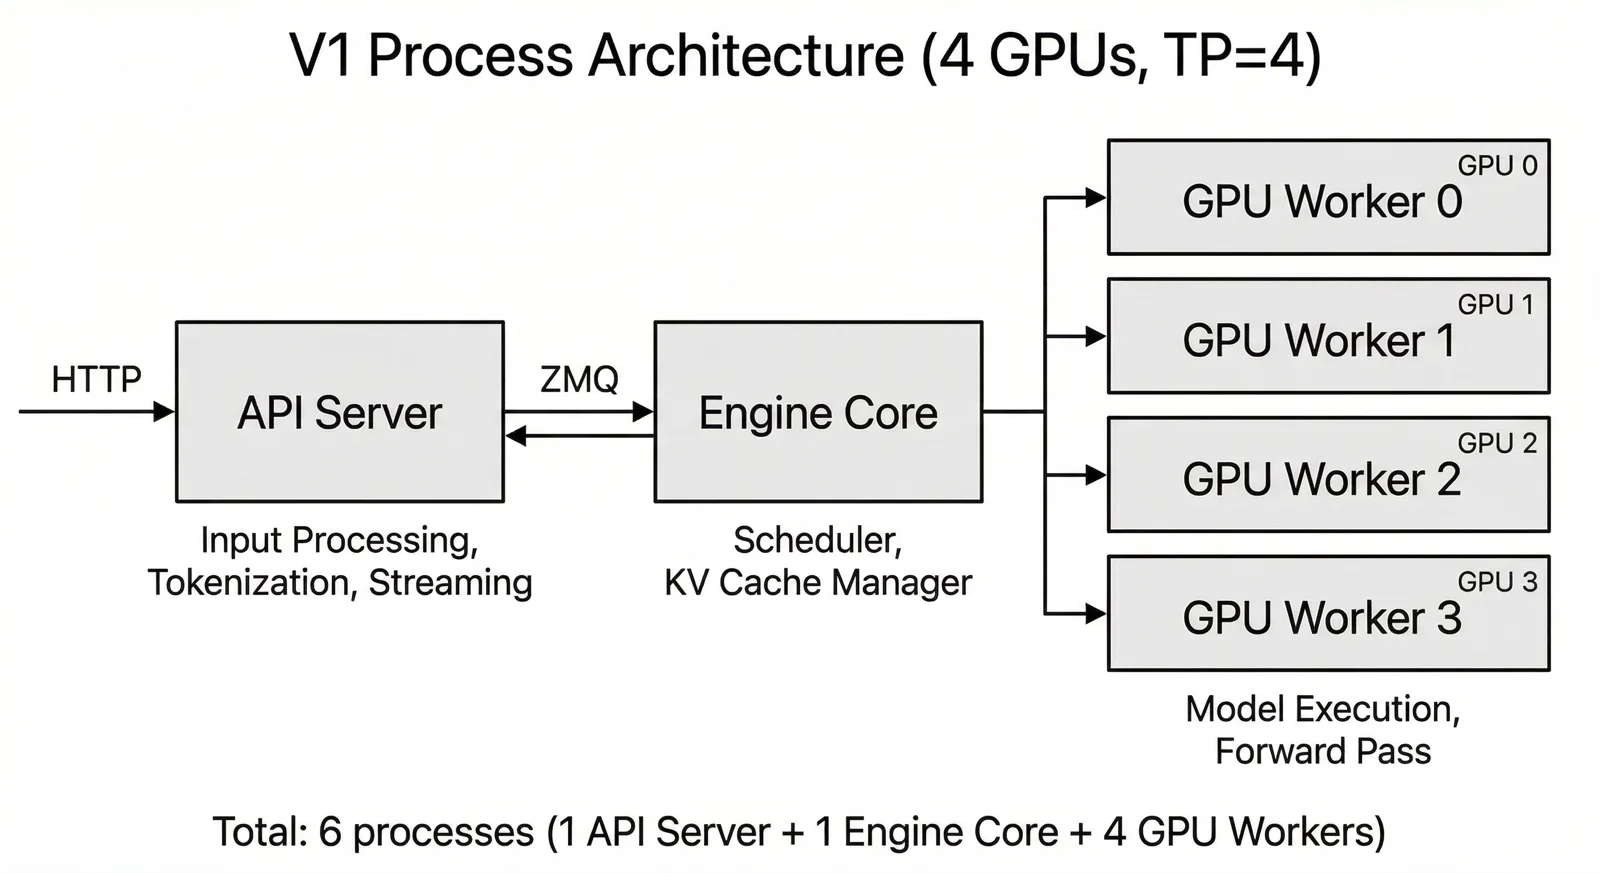
图源:vLLM 官方文档
docs/assets/design/arch_overview/v1_process_architecture_tp4.png。
为什么要分成五层
如果只是「一个进程数一数队列长度」就够了,为什么 vLLM 要把准入拆成五层、近十道检查?答案是三类约束的性质完全不同。
第一类是全局性约束,比如「整个 API Server 前面已经排了 2048 条请求」。这类约束只需要一个计数器,在任何进程里都能判断,而且越早判断越便宜——在反序列化 prompt 之前就返回 503,比让请求一路走到调度器再说要省得多。
第二类是资源性约束,比如「model runner 只有 256 个请求槽位」「今天最多激活 4 个 LoRA 适配器」。这类约束只有在真正组装 GPU 前向的地方才准确,前端并不知道当前批次里还留了几个 LoRA 槽。
第三类是演化性约束,比如「这条请求前缀缓存命中 60%,它本轮只需要算 1000 个 token」「上一条请求刚被抢占、又插回等待队列头部,它原来占的块已经还给了块池」。这类信息随每一轮调度变化,前端完全看不到,只能由 Scheduler 在 schedule() 的循环体里即时裁决。
把三类约束放在同一处,要么让前端背上整个块表的副本,要么让调度器承担阻塞式 HTTP 处理的复杂度。vLLM 选择了「各放各的」,代价就是名字相近的参数很多、行为解释起来要跨进程——这也是后面几节逐一拆开的原因。
先算一笔排队账:为什么不能按条数限流
在拆代码之前,值得先用最基本的排队论把「阀门该数什么」算清楚。推理服务可以粗略看成一条流水线:请求到达(速率 ),排队等待(时间 ),被预填和解码(服务时间 ),然后离开。稳态下,系统中的平均请求数 满足 Little 定律:
其中 是请求在系统中的总停留时间。这个式子不需要任何分布假设,只要系统处于稳态就成立,因此它是一个非常好的「配置 sanity check」。
把服务时间拆开:预填耗时 ( 是该请求独占时的预填吞吐),解码耗时 ( 是单步解码时间)。一条请求的总停留时间就是:
假设一个中等负载的例子:到达率 条/秒,平均输出 512 token,解码单步 ms,平均 prompt 2000 token、预填吞吐 token/s。那么单条请求的服务时间是
按 Little 定律,稳态下系统中平均需要有 条请求同时存在,才能吃下这个到达率。而 SchedulerConfig 里的 max_num_seqs 默认值是 128(实际部署通常会被 EngineArgs 覆写)。这意味着:要么请求在 waiting 队列里排队(TTFT 上升),要么引擎的实际吞吐达不到 20 条/秒。这不是 bug,而是默认值没有针对这个负载配置。
这个例子直接说明了两件事:
- 并发上限必须从「到达率 × 停留时间」反推,而不是拍一个「看起来很大」的数。
- 按请求条数做阀门会把长度差异抹平。一条 32K prompt 的请求和一条 200 token 的请求在
max_num_queued_reqs眼里都只占 1 个槽位,但它们对后续请求 TTFT 的影响相差上百倍——前者要占用几万 token 的预填预算,后者几乎瞬间完成。这就是max_num_queued_tokens存在的根本理由。
反过来说,为什么不能简单地「队列一长就全部拒绝」?因为 GPU 的批处理需要一个最小批深才有经济性。批太小,每步解码的 kernel 启动和权重读取摊不薄;批太大,KV 读取又撑爆带宽。队列深度本质上是为批处理留的缓冲。准入控制要做的不是消灭排队,而是把排队控制在「批处理刚好吃饱、TTFT 还没爆」的窗口里。
第一层:前端的两道容量阀门
1.1 check_admission 的完整逻辑
请求进入引擎的第一站是 AsyncLLM.add_request,它在 _add_request 真正把请求交给 OutputProcessor 之前,先调用 check_admission:
# vllm/v1/engine/async_llm.py(摘自 check_admission)def check_admission(self, n: int = 1, request_id: str | None = None) -> None: """Reject the request if it would exceed queue limits.
Both limits return HTTP 503 (Service Unavailable) so that load balancers and client SDKs retry on a different instance. ... """ if ( self.vllm_config.parallel_config.enable_fault_tolerance and self.engine_core.engine_status.get("status") != "healthy" ): raise EngineFaultedError()
max_num_reqs = self.scheduler_config.max_num_queued_reqs if max_num_reqs is not None: current_requests = ( self.admission_stats.get_num_requests() if self.admission_stats is not None else self.get_num_unfinished_requests() ) if current_requests + n > max_num_reqs: self._record_admission_rejection("max_num_queued_reqs") raise QueueOverflowError()
max_queued_tokens = self.scheduler_config.max_num_queued_tokens if max_queued_tokens is not None: current_tokens = self.get_num_queued_tokens() if current_tokens >= max_queued_tokens: self._record_admission_rejection("max_num_queued_tokens") raise MaxQueuedTokensError()代码很短,但有三处细节值得展开。
第一,n 参数。 n 不是请求总数,而是这条请求要占用的 序列槽位数。OpenAI 兼容接口里的 n 参数(一次生成 n 条候选)会让一条 HTTP 请求在引擎里裂成 n 个子请求,所以准入检查必须按 n 计费,否则一条 n=64 的请求就能把计数器一次性冲破。代码里的调用点也印证了这一点:父请求在 fan-out 之前调用一次 check_admission(parent_params.n, parent_request.request_id),子请求走 _add_request 时不再各自检查,避免同一份积压被重复计费。
第二,503 而不是 429。 注释写得很直白:返回 503 是为了让负载均衡器和客户端 SDK 把它当作「这台实例暂时不可用」而重试到另一台实例上。这和限流场景常见的 429 是两种语义——429 的意思是「你请求太快了,退避一下」,503 的意思是「这台机器满了,换一台」。在多副本部署里,后者几乎不需要客户端做任何事,LB 的下一次重试就会命中另一台。
第三,故障容错分支。 开启了 enable_fault_tolerance 且引擎状态不是 healthy 时,直接抛 EngineFaultedError。这层检查不涉及容量,只是防止把新请求送进一个正在等待恢复的引擎。
1.2 max_num_queued_reqs:全局在途计数
max_num_queued_reqs 的语义是「同时在途(waiting + running)的请求数上限」。配置文档里特别强调它与 max_num_seqs 的区别:
Unlike
max_num_seqs, which applies per data-parallel rank, this limit is enforced in the API server process and counts in-flight requests across all DP ranks it routes to. This bounds vLLM’s otherwise unbounded request queue and is primarily a coarse capacity valve.
这是两者最容易混淆的地方。max_num_seqs 是每个数据并行副本各自的批大小上限;max_num_queued_reqs 是这个 API Server 进程看见的全局在途总数。如果一个 API Server 路由到 8 个 DP rank,每个 rank 的 max_num_seqs=256,那么不设 max_num_queued_reqs 时,队列里可能积压到几千条请求;把 max_num_queued_reqs 设成 2048 以上(再留一点队列深度),就能在积压达到「8×256 再多一点」时停止接收,而不是让请求在队列里无限等待。
建议取值:max_num_queued_reqs ≈ data_parallel_size × max_num_seqs + 期望的队列深度设得低于这个值时,阀门会比每个 rank 的批准入更早生效,表现为「明明还有余量却 503」;设得远高于它时,阀门形同虚设,长队列仍然存在。
1.3 max_num_queued_tokens:为 TTFT 设的闸
第二个阀门是这一篇里最有意思的设计。它数的是正处于预填阶段的请求的 prompt token 总数。AsyncLLM 这一侧只是转发:
def get_num_queued_tokens(self) -> int: return self.output_processor.get_num_queued_tokens()真正的求和发生在 OutputProcessor 里,而且实现只有一行:
def get_num_queued_tokens(self) -> int: """Total prompt tokens of requests currently in the prefill phase.
Uses ``prompt_len`` rather than remaining prefill work because the scheduler's ``num_computed_tokens`` is not propagated to the API server until prefill completes. See ``SchedulerConfig`` docs. """ return sum( req.prompt_len for req in self.request_states.values() if req.is_prefilling )这一行里有两个判断值得细看。一是过滤条件 is_prefilling:一条请求只有在预填阶段才被计入,一旦它开始逐 token 解码,就从积压里消失。这正符合「积压伤害的是首 token 延迟,而不是后续解码」的直觉——解码已经开始了,它的 TTFT 已经发生过了。二是求和使用的是 prompt_len 而不是剩余工作量:这也是下面要解释的保守性来源。
配置文档直接给出了它的定位:
This is a TTFT QoS mechanism: by setting it to
target_TTFT * prefill_throughputyou reject requests when the prefill backlog would exceed the latency target.
推导一下这个式子。假设集群的聚合预填吞吐是 (token/s),当前预填积压总量是 (token)。一条新请求排到队尾后,它要等前面的积压算完才开始出第一个 token,所以它的首 token 时间近似为:
其中 是本请求的 prompt 长度, 是一轮前向的固定开销(kernel 启动、通信等,跟 token 数关系不大)。反过来解:若希望 ,就需要
忽略后两项的保守估计就是 。工程上更简单的近似是只看主项 ,把本请求自身长度当作预留余量。这就是 max_num_queued_tokens 取值的来历。它把「延迟目标」翻译成「积压 token 预算」,比按请求数限流更贴近真实负载——一条 32K prompt 的请求和一条 200 token 的请求,对后续请求 TTFT 的伤害差了上百倍,按条数计数完全看不出来。
1.4 为什么这个计数是「保守」的
源码注释里有一句很关键的说明:这个计数会高估积压,因此拒绝得更早:
Chunked prefill progress and prefix-cache hits are not subtracted because the scheduler’s
num_computed_tokensandnum_cached_tokensare only propagated to the API server after prefill completes.
原因在进程边界上。EngineCoreOutput 只有在请求开始产生输出 token 之后才会发出;预填期间,哪怕一条请求的一半 token 已经算完,这份进度也只存在于 EngineCore 进程的 Request 对象里,前端根本不知道。所以前端看到的 prompt_len 一直等于完整 prompt 长度,直到这条请求预填结束。
同理,前缀缓存命中(num_cached_tokens)也只有预填结束后才会出现在 OutputProcessor 里,预填期间同样被全量计入。
这个偏差的方向是安全的:偏高的积压计数让阀门更早关,TTFT 目标只会更稳,不会更坏。但它的代价也要知道:在 chunked prefill 把长 prompt 拆成几十轮时,实际积压可能只有计数值的一半,于是阀门会比严格需要的更早关闭。短 prompt(一轮前填完)不受影响,这也是注释里写明的「影响仅限分块预填下的长 prompt」。
顺带一个工程细节:admission_stats 如果存在,max_num_queued_reqs 会优先用它计数。这个对象来自 vllm/v1/engine/admission_control.py 里的 SharedAdmissionStats,只在 client_addresses 里带有 mp_admission_counters 时才创建——也就是多个 API Server 进程共享同一块共享内存计数器时才存在。它的实现值得单独看一眼,因为里面藏着一个很底层但很典型的性能取舍:
class SharedAdmissionStats: """Lock-free admission stats shared by API server processes.
Each process writes exclusively to its own cache-line-sized slot. Readers aggregate the slots, avoiding both inter-process locks and cache-line contention on the request path. """
# Space per-process counters 64 bytes apart to avoid false sharing on CPUs # with 64-byte cache lines: one process's writes would otherwise invalidate # the cache line containing another process's counter. CACHE_LINE_BYTES = 64 COUNTER_BYTES = 8 COUNTERS_PER_SLOT = CACHE_LINE_BYTES // COUNTER_BYTES
def get_num_requests(self) -> int: return sum( self._counters[client_index * self.COUNTERS_PER_SLOT] for client_index in range(self._client_count) )每个进程只写自己的槽位(set_num_requests 写 self._slot_offset),而读取时把所有进程的槽位求和。这样既不需要跨进程锁,也避开了伪共享(false sharing):如果多个进程的计数器挤在同一条 64 字节缓存行里,任何一个进程写入都会让其他 CPU 核上的那条缓存行失效,请求路径上的读操作就会被拖慢。每个进程占满一整条缓存行、只用其中第一个 8 字节计数器,是这个模式的标准做法。
明白了这一点,就能解释 max_num_queued_reqs 的语义:它是在共享了 MP 计数器的多客户端部署里,对所有客户端求和后的全局在途数。没有共享计数器时,它退化成「本 AsyncLLM 已知的未完成请求数」,在多副本各自独立部署时这恰好就是本副本的视角。
1.5 多副本部署里,这个阀门到底长在哪
前面反复强调 max_num_queued_reqs 是「API Server 进程视角的全局计数」。数据并行(DP)部署下,这个视角需要落在一张具体的图上才不抽象。下面是 vLLM 文档给出的外部负载均衡 DP 部署示意:
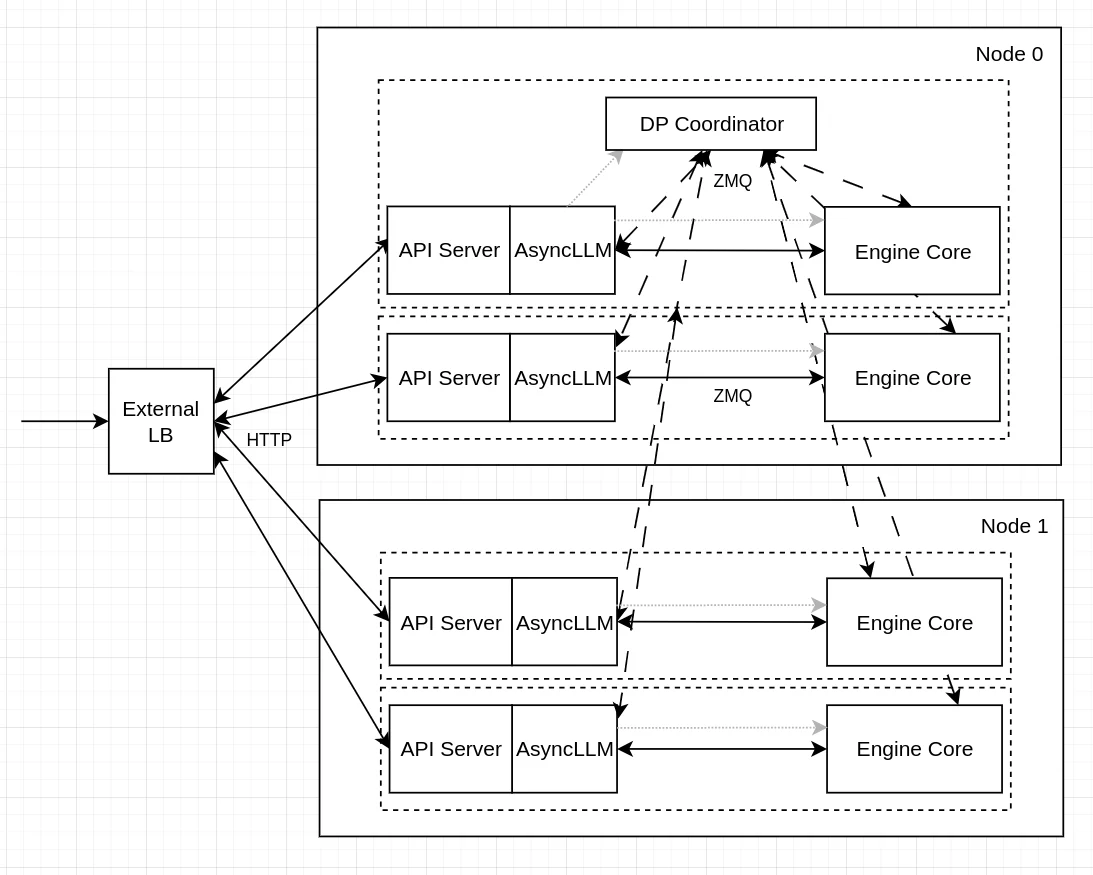
图源:vLLM 官方文档
docs/assets/deployment/dp_external_lb.png。
读这张图要注意两点。第一,负载均衡器在前,而不是在引擎内部:当外部 LB 指向彼此独立的 vLLM 副本时,每台 API Server 只看到自己那份流量,别的副本积压多少它并不知道。所以每个副本的 max_num_queued_reqs 都应该按「本副本覆盖的 DP rank 数 × max_num_seqs + 本副本期望的队列深度」来定,而不是按整个集群来数。如果部署的是「多个 API Server 进程共享同一个引擎」的形态(对应上一节说的 SharedAdmissionStats),那么所有进程相加的计数就是全局在途数,公式里的 data_parallel_size 应取整个共享组的规模。第二,503 的价值在这里显现:当一个副本的阀门关闭时,客户端拿到 503,LB 的下一次重试自然就落到另一个还没满的副本上,这比等待超时快一个数量级。
反过来说,如果每个副本都把 max_num_queued_reqs 设得远大于自身承受能力,那么 LB 看到的每个副本「都有余量」,会继续均衡分发,结果所有副本同时排队,每个请求的 TTFT 一起劣化——这种现象在压测里非常常见,表现为「QPS 再提高一点,P99 陡然抬升」,而不是平缓增长。
第二层:调度器里的「真正准入」
绕过前端阀门,请求到达 Scheduler.add_request,进入 waiting 队列。注意,此时它还没有被「接纳」。vLLM 意义上的接纳,是请求从 waiting 队列被挪进 running 列表,也就是第二段扫描 while token_budget > 0 里循环体走到最后那几行:
# vllm/v1/core/sched/scheduler.py(摘自 schedule() 第二段扫描)while token_budget > 0: request_queue = self.kv_holding_waiting if not request_queue and self._pause_state == PauseState.UNPAUSED: request_queue = self.waiting if not request_queue or input_budget <= draft_slots: break # Paused streaming sessions are not in `running` but still hold a # model-runner request slot. num_running = len(self.running) + self.num_waiting_for_streaming_input if num_running >= self.max_num_active_reqs: break ... self.running.append(request)这里的 break 是整篇最容易看错的一处:它不是「本轮跳过这条、看看下一条」,而是直接结束整个第二段扫描。一旦在途数到达 max_num_active_reqs,本轮就再也不接纳任何新请求,哪怕后面还有便宜的、带前缀命中的请求。
为什么不做成「跳过这条试试下一条」?因为 waiting 队列按到达顺序(或优先级)排列,如果允许跳过,理论上可以继续榨取预算,但接纳顺序就不再是队列顺序,公平性和饥饿边界都会被打乱。V1 的选择是保持顺序,把「跳过多条」留给下面会讲的 skip_request——那里跳过的都是结构上不能进这一轮批的请求(LoRA 槽位不够、KV 外载未就绪等),它们和「容量已满」是两类原因。若想把这段扫描与 running 段、前缀命中和抢占放进同一条时间线,可以对照 vLLM 源码完全拆解(三):Scheduler.schedule 如何分配 Token 预算与 KV Block。
break 与 continue 的分工还有一层含义:break 表示「这一轮到此为止」,continue 表示「这条不合适,换下一条」。前者由全局容量触发,后者由单条请求的局部状态触发。读 schedule() 时把这两个关键字当作两种不同的信号,能少走很多弯路。
2.1 max_num_seqs 与 max_num_active_seqs:一个数管两件事
很久以来 vLLM 只有一个 max_num_seqs,它同时承担两个职责:
- 尺寸:给 model runner 按最大并发预分配每请求缓冲、确定 CUDA Graph 捕获的 batch size 档位;这些资源在启动时一次性划好。
- 准入:限制
running列表里能同时存在多少条请求。
这两个职责绑在一起带来一个很现实的矛盾:想让 CUDA Graph 覆盖到更大的 batch 以获得极致解码性能,就得把 max_num_seqs 设大;但设大之后,实际运行时会真的把那么多请求塞进同一批,解码批次变宽,每步的 KV 读取和 kernel 开销随之上升。
max_num_active_seqs 就是为了把这二者解耦:
# Scheduling constraints.self.max_num_running_reqs = self.scheduler_config.max_num_seqs# Admission into RUNNING. Separate from max_num_running_reqs, which# is the model-runner slot count.self.max_num_active_reqs = ( self.scheduler_config.max_num_active_seqs if self.scheduler_config.max_num_active_seqs is not None else self.max_num_running_reqs)配置文档的话说得更清楚:设置它只会降低占据 RUNNING 状态的请求数,而不会缩小 runner 缓冲与 CUDA Graph 的容量。
这就给配置留下了一个组合:max_num_seqs=512(容纳大 batch 的 runner 与 graph,供突发流量或单轮流式输入使用)+ max_num_active_seqs=128(常态解码批控制在一百多条),既能吃到 graph 捕获的全部档位,又不会让日常批变宽。
2.2 为什么在途数里还加了流式输入
num_running = len(self.running) + self.num_waiting_for_streaming_input。流式输入(一边接收用户新输入的 token,一边推理)的会话并不在 running 里——它们当前没有可调度的 token,处于等待新输入的状态——但它们已经占据了 model runner 的请求槽。如果不计入,准入就会超发,导致 runner 的槽位被超过上限的请求占用。
这个计数器的生命周期也值得跟一遍。会话输出完一段之后,如果没有新的输入到达,调度器的输出处理路径会把它转成 WAITING_FOR_STREAMING_REQ 并给计数器加一:
else: request.status = RequestStatus.WAITING_FOR_STREAMING_REQ self.num_waiting_for_streaming_input += 1新输入到达时,_update_request_as_session 先把计数器减一,再把状态改回 WAITING,让它在下一轮以普通 waiting 请求的身份重新竞争准入:
if session.status == RequestStatus.WAITING_FOR_STREAMING_REQ: self.num_waiting_for_streaming_input -= 1session.status = RequestStatus.WAITING所以同一个会话在「等输入」和「有输入待调度」之间来回切换时,计数器的加一减一是配对的。读代码时如果只看到 += 1 而没看到 -= 1,多半会把这条路径误判成泄漏。
这是一个典型的「状态列表不等于占用资源」的例子:running 是本轮要算的集合,runner 槽位是已被分配的资源,两者只在稳态下重合。
第三层:批内槽位——不止 token 预算一种货币
while token_budget > 0 的循环里,容量不是只有一种货币。每次循环都要通过若干个独立的检查,任何一项不通过,就用 skip_request 把这条请求挪进 deferred_waiting,然后继续看下一条:
def skip_request(from_queue: RequestQueue) -> None: request_to_skip = from_queue.pop_request() self.deferred_waiting.add(request_to_skip) if self._holds_kv_blocks(request_to_skip): step_skipped_kv_holding.appendleft(request_to_skip) else: step_skipped_waiting.appendleft(request_to_skip)deferred_waiting 是个细节:被跳过的请求不会立刻回到 waiting 队列尾,而是先进入一个 deferred_waiting 列表,在 schedule() 结束时再按原来顺序插回 waiting 队列头部。否则一轮扫描下来,排队顺序会被彻底打乱,FCFS 语义就丢了。
具体有哪些槽位类型的检查:
- LoRA 槽位:
max_loras限定了单批能同时激活多少个 adapter。如果新请求的 adapter 不在已激活集合中、且集合已满,本轮跳过。这是一张「稀有资源」的票。 - 投机草稿槽位:
input_budget <= draft_slots时直接结束扫描,因为剩下这点 budget 连草稿都不够。draft_slots来自speculative_config.max_num_new_slots_for_drafting。 - KV 外载未就绪:异步 KV 加载(PD 分离或远程前缀缓存)还没完成的请求,
_handle_blocked_waiting_request返回 False,本轮跳过。 - 陈旧输出未发完:
num_stale_output_tokens且drop_stale_output=False时跳过,因为立刻恢复会与还在传输的旧输出发生重采样冲突。
这些检查在循环体里是连续排列的,每条都可以单独写成一个小节。它们的共同点是:都表现为「这条请求本轮不合适」,而不是「引擎满员」。读代码时看到 continue 与看到 break,含义完全不同。
第四层:token 预算与长预填节流
4.1 token 预算怎么被切分
接纳一条请求时,调度器要给它算本轮能算多少 token。这里有两套预算:
token_budget = max_num_scheduled_tokens,它是计算预算,每调度一条请求就被扣减;input_budget = max_num_batched_tokens,它是输入长度上限,只有新接纳的请求会消耗它(因为它数的是本轮新加入的 prompt token)。
平时两者相等(max_num_scheduled_tokens 缺省为 max_num_batched_tokens),但在投机解码场景下会分开——解码时一条请求可能一次推进多个 token(草稿+验证),这时 token_budget 不能按「每请求 1 个」算。
4.2 long_prefill_token_threshold:长预填不许饿死别人
第二段扫描接纳一条等待中的请求时,如果它是长 prompt,调度器会把它本轮分配的 token 数压到一个阈值以下:
# `long_prefill_token_threshold` exists to stop a long prefill from# starving other requests of the token budget. When it is the only# request there is nobody to starve, so let it use the whole budget.num_running, num_waiting = self.get_request_counts()num_eligible_reqs = num_running + num_waitinglong_prefill_token_threshold = ( self.scheduler_config.long_prefill_token_threshold if num_eligible_reqs > 1 else 0)if long_prefill_token_threshold > 0 and self.adaptive_long_prefill_threshold: long_prefill_token_threshold = max( long_prefill_token_threshold, input_budget // num_eligible_reqs )这段逻辑的精妙之处有三点。
第一,只有一个请求时不节流。 注释写得很直白:没有别人可以被饿死,那就让它吃满全部预算。这避免了「服务只有一个用户时反而慢」的荒唐结果。
第二,「长请求」按固定 token 数定义,而不是按队列长度或比例定义。 阈值以下的中短预填自由竞争 token 预算;只有超过阈值的才会被封顶。所以这个阈值描述的是「一次前向里愿意给单条长预填多少 token」,应该设在几千 token 的量级,并且不超过 max_num_batched_tokens。
第三,自适应下限。 如果你设了一个很小的阈值(比如 512),但当前只有 3 条请求共享一个 8192 的预算,那么把每条都限制在 512 就浪费了 6656 个预算。adaptive_long_prefill_token_threshold 打开后,阈值被抬到 input_budget // num_eligible_reqs,即「公平份额」,保证长请求至少能拿到自己应得的那一份。
这里还有一段关于 本地预填节奏(local prefill interval) 的逻辑:通过周期性推迟预填,让解码能够连续跑几轮不被打断。它和 DP 场景下的 throttle_prefills 是同一思路的镜像,核心都是「不要让预填把解码切得太碎」。但节流必须留一个逃生口:
# ...including its capacity escape: once a release step cannot drain the# waiting queue, throttling stops (#44558, test_throttle_capacity_bound_guard_admits).也就是说,当一轮未节流的预填步骤都无法把等待队列排空时,节流自动停止。否则在引擎已经过载时继续节流,预填吞吐会被压到「每 N 轮一个预算」,等待队列会无界增长,最终演变成前文说的「永远轮不到」。
第五层与反向关卡:KV 块不够时的抢占
容量检查的最后一道是 KV 块,而且它在两段扫描里的行为完全不同——这是读懂第五层的关键。
第一段(running 扫描):已在跑的请求要为本轮新 token 申请块,申请不到时去 running 里找 victim 抢占:
# vllm/v1/core/sched/scheduler.py(摘自 running 扫描中的回收逻辑)victim_index = self.running.index(preempted_req)del self.running[victim_index]...preempted_req = self.running.pop()而在第二段(waiting 扫描)里,情况正相反:新请求申请不到块时,代码并不去抢占别人,而是直接结束整段扫描:
new_blocks = self.kv_cache_manager.allocate_slots(...)if new_blocks is None: # The request cannot be scheduled. ... break这个不对称选择非常合理:如果接纳新请求要靠抢占老请求,那等于「用一条刚开始的请求挤掉一条跑了很久的请求」,得不偿失。第一段里的抢占,逻辑是「老请求自己都续不上步」时才不得已为之;第二段里的 break,逻辑是「块池真的满了,这一轮别再往里塞」。
_preempt_request 的注释有一个关键提醒:
NOTE: The request should be popped from the running queue outside of this function.
也就是说,抢占函数本身只做善后(改状态、还块、记日志),把它从 running 里移除是调用方的事。这种「状态修改分散在两处」的写法在复杂调度器里很常见,读代码时必须把那几行连起来看。
_preempt_request 内部做的善后可以归成五步,按顺序是:
assert request.status == RequestStatus.RUNNING, ( "Only running requests can be preempted")...self._free_request_blocks(request)self.encoder_cache_manager.free(request)...request.status = RequestStatus.PREEMPTEDrequest.num_computed_tokens = 0if request.spec_token_ids: request.spec_token_ids = []...request.num_stale_output_tokens = request.num_in_flight_tokensrequest.num_output_placeholders = 0request.num_preemptions += 1...# Put the request back to the waiting queue.self.waiting.prepend_request(request)self.reset_preempted_req_ids.add(request.request_id)第一行断言值得注意:它要求被抢占的请求此刻状态是 RUNNING。这个断言把「谁能当 victim」写死了——只有正在跑的请求,waiting 队列里的请求谈不上被抢占。第四步把 num_computed_tokens 清零,这是 recompute 策略的核心:恢复时从第一个 token 重新计算 KV;已经生成的输出 token 本身仍然保留(它们记录在请求的 token 序列里),被丢弃的只是这些 token 对应的注意力结果。
第五步的 num_stale_output_tokens = request.num_in_flight_tokens 则和异步调度有关。在异步调度模式下,一条请求被抢占时,它的输出可能还没被前端取走;这些「在途输出」如果直接丢弃,会打乱投机解码的接受率统计,所以调度器选择标记为陈旧但照常投递,只是不允许它们再去推进计数器。另一个参数 drop_stale_output 是为两类特殊场景准备的:前缀缓存重置(同一轮内恢复会导致 token 乱序投递),以及有未完成 KV 交接的 connector(抢占释放块会让交接失去有效 KV)。
最后一步 self.waiting.prepend_request(request) 是抢占最直观的后果:它插回 waiting 队列的头部,而不是尾部。下一次有空闲块时它会被优先恢复,这在一定程度上缓和了「被抢占的请求永远排不上」的问题;但它也意味着,如果引擎持续高负载,一条请求可能经历「跑几步 → 被抢占 → 回到队头 → 再跑几步 → 又被抢占」的循环,num_preemptions 会不断增长。看到这个计数器很大,说明 KV 块池的容量与并发设定严重不匹配,而不是调度器有 bug。
被抢占的请求的代价是已经算好的 KV 要么保留、要么重算——V1 调度器默认走 recompute,即释放全部块、恢复时重算 KV;把 KV 换出到主机内存再换回的路径通常由 KV connector 承担,而不是核心调度器内建。块池侧的分配、复用与回收细节,可以对照 vLLM 源码完全拆解(四):KVCacheManager 如何分配、复用与回收物理 Block。
抢占的受害者选择也和调度策略绑定,代码写得很紧凑:
# 抢占 victim 的选择if self.policy == SchedulingPolicy.PRIORITY: preempted_req = max( self.running, key=lambda r: (r.priority, r.arrival_time), )else: preempted_req = self.running[-1]FCFS 策略下受害者是 running[-1],也就是排在本轮扫描最靠后、尚未被调度到的那条——通常是最近才被接纳的请求,正好还没在这一轮里占用 token 预算,撤掉它的代价最小。这是一种「后来者先走」的倾向,保住已经跑了很久、快要出结果的请求。优先级策略下受害者是 (priority, arrival_time) 最大的那条:Request.__lt__ 规定 priority 数值越小越优先,所以 max 取到的就是优先级最低、且同优先级中到达最晚的请求。
这里有一个很容易忽略的边界:如果此刻正在申请块的这条 running 请求本身就是最低优先级,抢占会选中它自己。代码没有停在「抢自己没意义」,而是:
if preempted_req == request: # No more request to preempt. Cannot schedule this request. break在优先级策略下,它还会额外处理「自抢占后,后面排队的高优先级请求也许能塞进来」的情况:把自己移出 running 后 req_index 已经指向下一条,于是 continue 而不是 break。这段逻辑是优先级策略与抢占交互里最容易读错的地方——它看起来像「失败」,实际是「先把自己让出去,看看别人能不能上」。
还有一处资源归还的细节:如果受害者在本轮已经被调度过(preempted_req in scheduled_running_reqs),抢占会把它本轮占用的 token_budget、input_budget、编码器预算和已记录的块一并撤回。否则会出现「受害者走了,但它的预算已经被扣除」,导致同一轮明明有空闲预算却再也接纳不了别人。
关键是理解它在准入链条里的位置:在 waiting 段,KV 块不足只让本轮停止接纳;在 running 段,它才会反向作用于已经在跑的请求。这是五层关卡中唯一一个「老请求会因为块不够而被中断」的环节。线上表现为:并发刚提高时吞吐上不去、同一请求的首 token 时间呈阶梯状、日志里出现大量 preempt 记录。
5.1 暂停状态:比“拒绝”更软的第三态
除了「接纳」和「拒绝」,调度器还有第三种全局状态:暂停。PauseState 在 sched/interface.py 里定义了三档:
class PauseState(enum.IntEnum): """ - UNPAUSED: Normal operation - PAUSE_NEW: No new requests are scheduled, requests already in running state or holding KV blocks are scheduled. - PAUSE_ALL: No requests are scheduled """ UNPAUSED = 0 PAUSED_NEW = 1 PAUSED_ALL = 2这三档在准入逻辑里各有一处对应的分支:
PAUSED_ALL时,token_budget被直接置零,第一段扫描和第二段扫描都不再接纳任何请求;已经在 running 的请求本轮也不算。PAUSED_NEW时,第二段扫描的队列来源被限制为kv_holding_waiting——也就是只有已经持有 KV 块的请求(比如异步 KV 外载完成、只差恢复计算的请求)能被放行,普通 waiting 请求一律不进。UNPAUSED时才是正常的「先清 kv_holding,再清 waiting」。
这个第三态的意义在于:有些场景需要「停止接新活,但让已经在途的活跑完」,比如引擎准备做一次前缀缓存重置、或者执行一次拓扑级的重配置。用 503 拒绝新请求是前端的事;用 PAUSED_NEW 是后端的事,它连「已经排队但还没开始的请求」都不会推进。读源码时看到 _pause_state 判断,先分清是哪一档,再判断它影响的是「新接纳」还是「全部调度」。
5.2 排队顺序:FCFS 与优先级是两套完全不同的队列
准入的「顺序」由 RequestQueue 决定,代码在 sched/request_queue.py。FCFS 版本就是一个 deque,pop_request 是 popleft,prepend_requests 用 extendleft;优先级版本则是一个堆:
class PriorityRequestQueue(RequestQueue): """A priority queue that supports heap operations.
Respects the ordering defined in the Request class, where requests with a smaller value of `priority` are processed first. If multiple requests have the same priority, the one with the earlier `arrival_time` is processed first. """ def add_request(self, request: Request) -> None: heapq.heappush(self._heap, request)
def prepend_request(self, request: Request) -> None: """Note: In a priority queue, there is no concept of prepending to the front. Requests are ordered by (priority, arrival_time).""" self.add_request(request)优先级实现里有两个反直觉点值得记住。
第一,prepend_request 在优先级队列里退化成普通插入。 前面讲 skip_request 时说过,被跳过的请求会在本轮结束时按原顺序插回 waiting 队列头部;这在 FCFS 下是必要的(否则一轮扫描会打乱到达顺序),但在优先级队列里没有「头部」概念——插回去之后仍按 (priority, arrival_time) 排序。所以同一段 prepend_requests 调用在两种策略下的语义完全不同。
第二,Request.__lt__ 的兜底比较键是 request_id 和 id(self)。 当优先级和到达时间都相同时,堆需要一个确定的顺序,否则两条完全相同的请求在堆里的相对位置不确定,remove_request 之后的重排也可能变化。用 request_id 做 tie-break 是为了确定性——这一点和 vLLM 近年强调的 batch-invariant 思路一致:同一组请求无论以什么顺序进入堆,最终被调度的顺序都应该可复现。
5.3 准入与确定性:为什么顺序也是正确性的一部分
准入顺序不只影响公平性,还影响结果的可复现性。同一批请求,如果因为到达时间戳的微小差异而进入了不同的批次组合,浮点累加顺序就会变,最终生成的 token 可能不同。vLLM 的 batch_invariant 模式就是为此存在的:它要求算子在不同批组成下给出逐位一致的结果。
对准入而言,这意味着两件事:
- 优先级不能替代分层部署。前面说过高优先级请求不会突破
max_num_active_reqs;同样,它也不会改变「谁和谁被拼在同一批」的规则。如果业务要求严格隔离,正确做法是独立副本,而不是在同一引擎里压优先级。 request_id的 tie-break 是对确定性的补丁,不是全部。即使调度顺序确定,GPU 上的 reduction 顺序仍可能随批大小变化;真正的逐位确定性需要算子层的配合,这正是 batch-invariant 系列文章讨论的内容。准入层能做的是「不额外引入不可复现的随机性」,把确定性的边界尽量收窄。
把一轮 schedule() 的决策用一张表讲清楚
把上面所有关卡收进一张表,可以作为读源码时的对照清单:
| 检查点 | 源码位置 | 触发条件 | 失败后果 | 配置项 |
|---|---|---|---|---|
| 故障容错 | AsyncLLM.check_admission | 引擎非 healthy | EngineFaultedError | enable_fault_tolerance |
| 在途请求数 | 同上 | current + n > max | HTTP 503 | max_num_queued_reqs |
| 预填积压 token | 同上 | current >= max | HTTP 503 | max_num_queued_tokens |
| RUNNING 条数 | schedule() 第二段 | num_running >= max_num_active_reqs | 本轮不再接纳(break) | max_num_active_seqs |
| LoRA 槽位 | schedule() 第二段 | adapter 集合已满 | 跳过本条 | max_loras |
| 草稿槽位 | schedule() 第二段 | input_budget <= draft_slots | 结束扫描 | max_num_new_slots_for_drafting |
| token 预算 | schedule() 两段 | token_budget <= 0 | 循环退出 | max_num_batched_tokens |
| 长预填节流 | schedule() 两段 | prompt 超过阈值 | 本轮份额被封顶 | long_prefill_token_threshold |
| KV 外载未就绪 | schedule() 第二段 | 异步 KV 未完成 | 转 WAITING_FOR_REMOTE_KVS 并跳过 | 由 KV connector 决定 |
| 暂停状态 | schedule() 第二段 | PAUSED_NEW / PAUSED_ALL | 只放行持块请求 / 全部不调度 | 由引擎控制面设置 |
| KV 块(running 段) | schedule() 第一段 | allocate_slots 失败 | 抢占 victim → 重试 | 由 gpu_memory_utilization 反推 |
| KV 块(waiting 段) | schedule() 第二段 | allocate_slots 失败 | 本轮停止接纳 | 同上 |
从表中能看出一个设计上的对称:前两个检查在 API Server,其余全部在 Scheduler;前两个是「拒绝请求」,其余是「延迟请求」;最后一个(KV 块)是唯一会「拒绝别人」的。
这种不对称有清晰的理由。API Server 那一侧不做任何块分配或 token 进度跟踪,它只适合维护一个全局计数器;Scheduler 那一侧掌握全部细节,能做「下一轮再看」的精细决策。把硬性拒绝放在最便宜的地方,把软性延迟放在知道一切的地方——这就是 vLLM 准入设计的骨架。
观测:三层关卡各自会留下什么指纹
排障时最忌讳「看到 503 就去调大 max_num_queued_reqs」——那只是把阀门拧松,问题会以另一种形态回来。正确做法是先判断是哪一层在亮红灯。vLLM 暴露的指标足以区分大部分情况,下面这些名字来自官方 docs/design/metrics.md:
| 指标 | 含义 | 指向哪一层 |
|---|---|---|
vllm:admission_rejections_total{reason} | 前端准入拒绝计数,reason 区分是请求数还是 token 数触发 | 第一层 |
vllm:num_requests_waiting | 当前 waiting 队列长度(含持有 KV 的等待) | 第二/三层 |
vllm:num_requests_running | 当前 running 条数,可与 max_num_active_seqs 对照 | 第二层 |
vllm:request_queue_time_seconds | 请求在队列中等待的时长 | 第二/三层 |
vllm:time_to_first_token_seconds | 首 token 延迟分布 | 全局结果 |
vllm:kv_cache_usage_perc | KV 块池使用率 | 第五层 |
vllm:avg_prompt_throughput_toks_per_s | 平均预填吞吐,用来校准 max_num_queued_tokens | 第一层参数校准 |
vllm:num_requests_swapped | 被换出/等待恢复的请求数 | 第五层后果 |
把这些指标组合起来,可以得到一张相当可靠的「指纹表」:
admission_rejections_total在涨,num_requests_waiting很低,TTFT 正常:阀门起作用了,前端在保护引擎。此时该看的是被拒的 reason——如果是max_num_queued_tokens,说明预填积压是瓶颈;如果是max_num_queued_reqs,说明整体并发容量不足。正确动作通常是扩容或提高单副本容量,而不是简单调大阀门。num_requests_waiting持续增长,但没有 503,TTFT 缓升:前端根本没设阀门(或设得太大),请求在引擎里无声排队。这是最危险的状态,因为客户端看到的是「越来越慢」而不是「快速失败」。num_requests_running长期顶在max_num_active_seqs,kv_cache_usage_perc很高,num_requests_swapped频繁抖动:KV 块池是瓶颈,第五层在反复抢占。此时提高max_num_seqs只会让情况更糟,应该降低max_num_active_seqs或降低上下文长度。request_queue_time_seconds的 P99 远大于time_to_first_token_seconds的中位数:说明排队时间占了 TTFT 的大头,问题在准入而非计算本身。对照avg_prompt_throughput_toks_per_s可以判断预填吞吐是否低于预期。
一个容易忽略的细节:vllm:request_queue_time_seconds 统计的是请求第一次被调度之前的等待,而不是被抢占后重新排队的累计时间。也就是说,一个被抢占过三次的请求,它的 queue time 可能很小,但用户体验到的首 token 延迟很大。要捕捉这种「隐形等待」,需要同时看 preempt 日志和 num_requests_swapped,或者比较端到端延迟与 TTFT+解码时间的差值。
从 SLA 反推四层预算
有了前面这些机制,配置就不再是玄学,而是一组可以写下来的不等式。下面这套推导可以直接抄进部署文档,只需要把示例数字替换成实测值。
8.1 先算并发:Little 定律给下界
设目标到达率 (条/秒),平均输出长度 ,单步解码时间 。解码阶段需要的并发是:
预填阶段同时在处理的请求数约为:
因此 max_num_seqs 至少要能容纳 ,否则吞吐必然达不到目标到达率。注意这是下界,不是建议值——实际还要留出突发和批处理的余量。
8.2 再算 KV:显存给上界
每条请求的 KV 占用可以按下面的式子估:
其中因子 2 是 K 和 V 两份, 是每元素字节数(FP16 为 2), 是上下文长度。以 32 层、8 个 KV 头、head_dim 128、FP16 KV 的模型为例,每 token 的 KV 为:
一条 4K 上下文的请求就是 512 MiB。80 GB 的卡扣除权重和激活后假设还剩 60 GB 给 KV,最多只能同时容纳约 120 条 4K 请求。这个数字往往比「拍脑袋的 512」小得多,也解释了为什么 max_num_seqs 设得再大,实际并发也会被 KV 卡住。
8.3 把三个阀门写成不等式
把上面的量组合起来,可以得到一组互相制约的配置:
第一条不等式最容易被忽略:如果吞吐下界已经超过显存上界,那么这台机器无论怎么调参都吃不下这个负载,唯一正确的动作是加副本或降上下文,而不是继续调 max_num_seqs。第二条不等式里的 必须用实测值(vllm:avg_prompt_throughput_toks_per_s),因为分块预填与解码混批会显著拉低有效预填吞吐。第三条里的 是给批处理留的队列深度,通常取 max_num_seqs 的 0.25 到 1 倍。
8.4 一个完整的数值推演
假设单副本 8 卡、DP=8,每 rank max_num_seqs=128,目标 条/秒、输出 512 token、 ms。按 8.1:
而 8 个 rank 合计能提供的 running 槽位是 ,看起来绰绰有余。但按 8.2,如果每 rank 的 KV 容量只够 120 条 4K 请求,那么实际可用的解码并发是 ,仍然够。真正的问题在预填:假设每条 prompt 2000 token,聚合预填吞吐 160K token/s,则预填并发需求只有 条——预填不是瓶颈。
这个例子说明「容量够」不等于「延迟达标」。如果此时把 max_num_active_seqs 设成 128(每 rank),running 条数会长期贴着上限,KV 池接近满,任何一次上下文变长都会触发抢占。更稳的配置是让 running 留出 20% 余量,同时用 max_num_queued_tokens 把预填积压压在 2 秒以内。数字本身不重要,重要的是每一步都能在源码里找到对应的变量。
线上配置:怎样让五层关卡各司其职
把源码读透之后,配置就不再是「调参」,而是「决定哪一层先亮红灯」。一个常用的分场景配置思路:
场景 A:单副本、交互延迟敏感。 主要矛盾是 TTFT 被长 prompt 拖垮。
max_num_queued_tokens = target_TTFT × 实测 prefill_throughputlong_prefill_token_threshold = 4096long_prefill_token_threshold_adaptive = true第一行让前端在积压超过延迟预算时直接 503,把请求甩给别的副本;后两行让长 prompt 不要吃满预算,让短请求有机会插进来。注意 max_num_queued_tokens 要用实测的 prefill 吞吐,而不是理论值——分块预填混批解码之后,有效预填吞吐往往比纯预填低不少。
场景 B:多副本 DP、追求高吞吐。 主要矛盾是队列无界增长。
max_num_queued_reqs ≈ DP_size × max_num_seqs + 队列深度max_num_seqs = 大(覆盖 CUDA Graph)max_num_active_seqs = 中(控制在 decode 批不膨胀)max_num_seqs 与 max_num_active_seqs 分开调,这是近期 vLLM 才出现的能力;在旧版本里两者只有 max_num_seqs,必须二选一,要么 graph 档位不够,要么 decode 批太宽。
场景 C:PD 分离的 Prefill 池。 max_num_queued_tokens 直接对应预填池容量:
max_num_queued_tokens ≈ prefill_pool_aggregate_throughput × target_TTFT因为 P 池只做预填,吞吐容易测准,这个阀门会比混合部署下更「准」。
几个常见误配:
max_num_queued_reqs设得比max_num_seqs还小:单副本下就是「在途计数先满、批次空着」,表现为 503 比排队来得早。应至少为max_num_seqs + 队列深度。max_num_active_seqs设得比max_num_seqs还大:配置校验会直接报错(max_num_active_seqs cannot be greater than max_num_seqs),因为 runner 槽位不够。- 只看 503 不看 waiting 队列长度:前端阀门没设时,请求会在 waiting 队列里无限等待,客户端看到的不是 503 而是超时。监控应该同时盯「在途请求数」「waiting 队列平均等待时间」「preempt 次数」这三个指标。
连续批处理下的准入:为什么静态批不需要这件事
准入之所以在 vLLM 里显得复杂,还有一个历史维度:静态批处理根本不需要准入。在静态批时代,调度单位是「一次 batch」,一次 batch 里的所有请求必须同时开始、同时结束——最长的那条决定整批时长,其余请求算完也只能占着槽位等。下图是 Anyscale 那篇经典博文(2023)里两种批处理方式的对比示意:
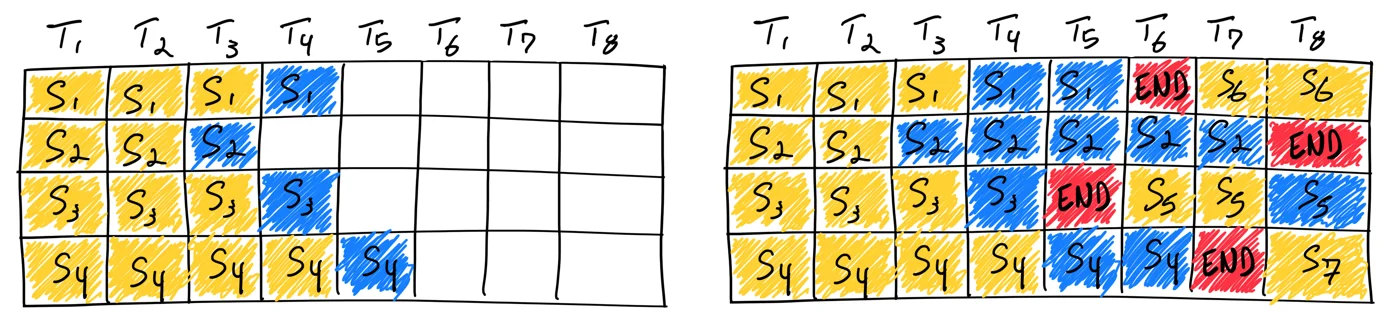
图源:Anyscale 博客(2023)《How continuous batching enables 23x throughput in LLM inference while reducing p50 latency》,
cb_03_diagram-continuous-batching.png。
连续批处理把「批」从「一次固定组合」变成了「每轮重新组合的集合」:一条请求算完立刻离开,空出来的槽位立刻由等待队列里的请求补上。这个变化带来了两个直接后果:
第一,吞吐对排队深度的敏感性急剧上升。静态批下,反正整批要等最长的,队列长一点没什么损失;连续批下,队列太浅会导致批深度不足、GPU 空转,队列太深又会让 TTFT 线性增长。准入就是在调这个深度。
第二,准入从「一次性的容量检查」变成了「每轮都要做的裁决」。因为每轮批组成都在变,上一轮能接纳的请求这一轮未必能;反过来,上一轮被跳过的请求下一轮可能正好合适(比如 LoRA 槽位空出来了)。这就是 schedule() 里那些 continue 和 break 存在的原因。
同一篇博文还给出了连续批处理下延迟分布随负载变化的实测(Llama-70B,4 卡 A100,QPS 从 1 到 4):
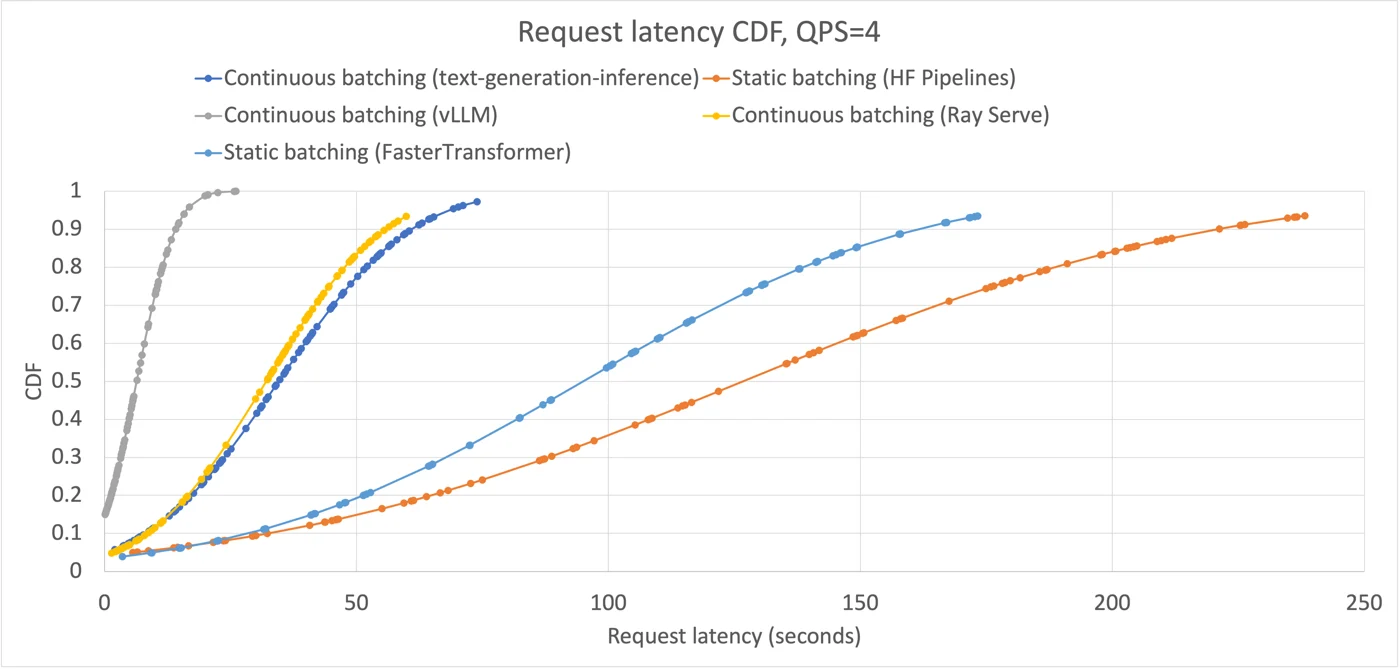
图源:Anyscale 博客同篇,“Latency CDF at different QPS” 图(
cb_11_latency_cdf_qps_4.png,原文中对应 QPS=4 的那张)。
这张 CDF 图值得仔细读:低 QPS 时延迟几乎贴着重心,是「批不够深但有富余」的状态;QPS 升高后曲线明显右移、尾部拉长——这正是准入缺位时的典型形状:请求不是被拒绝,而是被延迟,尾部越来越长。连续批处理能提升吞吐,但它并不能自动保证延迟,延迟的形状最终由准入策略决定。
横向对比:其余推理框架把「接纳」放在哪
vLLM 这套「前端粗阀门 + 调度器精细裁决」不是唯一解。把其他框架的准入位置并排放在一起看,能更清楚地理解每个选择背后的代价。
TensorRT-LLM 走的是「引擎内部两层调度」:调度器内部的 CapacityScheduler 与 MicroBatchScheduler 一个负责按 KV 容量和 token 预算做准入算术,一个决定这一轮哪些请求进入 micro-batch,另有 paused_requests 来承接暂停与恢复的请求。它没有独立的「全局在途计数」阀门,准入算术和 KV 容量从一开始就绑在一起——这是 C++ executor 与 Python frontend 之间接口更窄的必然结果。
SGLang 在 V1 之后把准入融进了 PrefillAdder 的预算与组装流程:它先按 KV 池余量算「还能加多少 token」,再按 token 预算决定每条请求的本轮切片。准入与预填预算的计算在同一步完成,因此它对「长 prompt 能否塞进本轮」的判断比 vLLM 的两段扫描更早、更集中。
llama.cpp 的 server-context 服务化与调度 则用「slot」作为最直白的准入单位:槽位数量就是并发上限,每个 slot 在 prompt cache 命中之后才决定要不要清空 KV。它没有显式的 token 积压计数,也没有 503 阀门——并发控制完全交给上层调用方与 slot 数量。
DeepInfer 把准入与抢占、DP 投票都放在 C++ 调度器 里,前端只做协议解析和分词。这种设计的动机是「控制面尽量贴近计算面」,代价是前端无法快速失败,过载时只能在调度器里排队。
这四种做法没有优劣,只是把「谁看得见什么」的边界划在了不同位置。vLLM 划得最靠前,所以它需要两个专门的前端阀门;TensorRT-LLM 和 DeepInfer 划得最靠后,所以它们在前端几乎不做任何容量判断。
准入与相邻设计的边界
理解准入之后,附近还有几处容易混淆的机制值得划清界线。
准入 vs 调度策略。 准入决定「谁进 running」,调度决定「running 里的谁先算」。V1 默认 policy="fcfs",另有优先级策略。但优先级只在 waiting 队列的选择上起作用,准入上限对所有人都一视同仁——高优先级请求并不会因为优先级高而突破 max_num_active_reqs。如果业务需要硬性优先级,真正有效的手段是分层部署(高优先级请求走独立副本),而不是把优先级压在同一个引擎里。
准入 vs 前端限流。 max_num_queued_reqs 是引擎内部的容量阀门,它保护的是引擎自身;业务层面的限流(按用户、按租户、按 QPS)应该在更前面的网关做。两者不重叠:网关限流管「谁该被服务」,引擎阀门管「引擎还剩多少容量」。
准入 vs 分块预填。 分块预填改变的是「一条请求一轮能算多少」,不改变「一轮能接纳几条」。但当 long_prefill_token_threshold 生效时,长预填请求会持续占据一个 running 槽位很多轮,间接压缩了新请求的接纳空间。这也是为什么 max_num_active_seqs 与长预填节流要一起调。
准入与抢占的关系。 抢占是准入的逆操作:准入要求 KV 块,拿不到就抢占已经在跑的请求来腾出块。它把「拒绝新请求」转成了「中断老请求」,两者的取舍取决于业务——对长对话,中断比拒绝更伤;对短问答,拒绝更经济。V1 的选择是优先接纳新请求、把代价转移到抢占上,这与它「尽量保持批次混合、避免队头阻塞」的整体取舍一致。
小结
这条准入链路最值得带走的,是「同一件事在不同的进程、不同的时间粒度上检查了多次」这一结构:
- 时间粒度:前端只在请求到达时检查一次,调度器每轮检查一次。前端负责快速失败,调度器负责持续调优。
- 信息粒度:前端只有计数器,调度器有块表、token 进度和完整请求状态。信息越全,决策越细,代价也越高。
- 失败语义:前端失败是 HTTP 503(可重试、可换机),调度器失败是挂起(安静等待)与抢占(影响老请求)。线上排障时先分清是哪种失败,再去对应层找原因。
回到开头的两个现象。「永远轮不到」通常出在第二层 break 和第五层 KV 抢占上,根源是前端没有阀门或阀门太大,导致 waiting 队列无界增长;「短对话被长文拖死」通常是第四层长预填节流没开,或者 max_num_queued_tokens 没设,导致长 prompt 持续侵占预算。源码里的每一个变量,都对应着一个具体的线上症状——这也是读 schedule() 最划算的回报。
参考资料
- vLLM 源码:
vllm/v1/core/sched/scheduler.py - vLLM 源码:
vllm/v1/engine/async_llm.py - vLLM 源码:
vllm/config/scheduler.py - vLLM 源码:
vllm/v1/core/sched/request_queue.py - vLLM 源码:
vllm/v1/core/sched/interface.py - vLLM 源码:
vllm/v1/engine/output_processor.py - vLLM 源码:
vllm/v1/request.py - vLLM 文档:Metrics design
- vLLM 文档:Optimization and Tuning
- vLLM API 文档:
vllm.config.scheduler - Anyscale:How continuous batching enables 23x throughput in LLM inference while reducing p50 latency
- Little’s law(排队论基本定律)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



