


TensorRT-LLM 源码完全拆解(二十九):XQA 解码注意力内核——分页 KV、GQA 与 FP8 如何被 Warp 特化流水吃下
为什么单独拿 XQA 出来讲
前面几篇把 TensorRT-LLM 的注意力后端从「选谁」讲到「元数据怎么准备」:AttentionMetadata.prepare() 把块句柄翻译成各后端需要的索引数组,FlashInfer 负责分页 KV 的通用路径,TRTLLM-Gen 的 FMHA 接管 Blackwell 上的新一代内核。可真正撑起 Hopper 及以前各代 GPU 上 decode 注意力的,是一个长期藏在 cpp/kernels/xqa/ 目录里的独立内核族——XQA(官方 README 的定位是 “a set of optimized kernels for generation-phase MQA/GQA”)。
XQA 值得单独拆,原因有三点:
- 它把 decode 注意力的三个约束——每次只算一个 query token、KV 在分页池里不连续、GQA 的多个 Q 头共享一份 KV——同时压进一个内核,而不是像训练侧那样假设 Q 是一个长矩阵。
- 它没有走「一个模板打天下」的路,而是把
head_size、GQA 组大小、页大小、KV 精度、beam width、投机解码开关全部变成编译期宏,用 NVRTC 在运行时编译出只服务当前模型形状的 cubin。 - 它把 Ampere 与 Hopper 分成两套完全不同的实现:Ampere 路径用
mma.sync加软件流水,Hopper 路径用 TMA 加 warpgroup MMA,两者共享同一套 host 侧调度接口。
这一篇按「host 怎么决定用 XQA → 内核参数怎么变成宏 → Ampere 内核的 warp 分工 → Hopper 内核的三角色流水 → 分页 KV 与 FP8 的细节 → 多块模式与工程取舍」的顺序走。读完后应该能回答一个具体问题:一条 decode 请求进来,XQA 凭什么比通用 MMHA 快,又凭什么在某些形状下反而不如它。
先把 decode 注意力的约束写清楚
一个 decode step 里,每条请求只有 1 个新 query token(开启投机解码时是一小段草稿 token;HMMA 路径把「草稿长度 × GQA 组大小」压到 16 或 32 行,QGMMA 路径固定为 64 行)。设 batch 为 、每个 KV 头的 query 头数为 (GQA 的组大小)、KV 头数为 、每头维度为 、上下文长度为 。这一步要算的是:
其中 的形状是 。三个数字决定了内核该怎么写:
- 算术强度:一次 decode 注意力对每个 KV 头要读 个元素,做 次乘加。当 时,每读一个 KV 元素就能复用 8 次,算术强度是「读一次算 8 次」量级——比单头 MHA()好一个数量级,但离 GEMM 主循环那种「读一次算几十次」还差得远。所以 decode 注意力天然是访存受限的,内核设计的核心是「把 KV 流式搬进 SMEM 的同时,让 MMA 单元不闲着」。
- 并行度:一个 CTA 处理一个 KV 头时, 方向只有 行(普通解码、、beam=1 时就是 8 行)。以 Llama-70B 这类 64 Q 头 / 8 KV 头的模型为例,TP8 部署后每张卡只剩 1 个 KV 头和 8 个 Q 头;batch 开到 32,每卡也只有 32 个 CTA,在 132 个 SM 的 H100 上连一个 wave 的零头都填不满,而每个 CTA 内部又只有 8 行——两个方向都没有足够的并行度。
- KV 不连续:分页 KV 缓存里,一条序列的 个 token 分散在 个页里,每页 个 token( 取 8/16/32/64/128)。内核不能假设 是一块连续内存。
这三点共同决定了 XQA 的形态:窄的 方向要靠 GQA 组内共享 KV 换取复用;并行度不足要靠「沿序列维再切一刀」(多块模式)补上;分页 KV 要靠「先算页号、再过 TMA 或手写 gather」绕开不连续性。
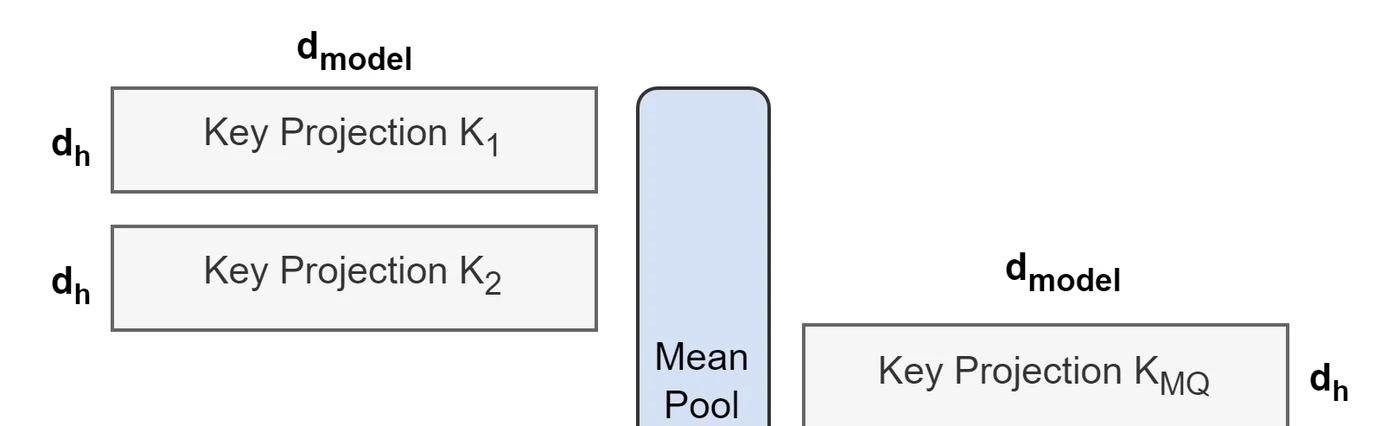
图里是 MHA、MQA 与 GQA 三种头共享方式:MHA 每个 Q 头配一份 KV,MQA 所有 Q 头共用一份 KV,GQA 把 Q 头分组、每组共用一份 KV。XQA 的 HEAD_GRP_SIZE 就是图中 GQA 的组大小 ;它决定了每个 KV 头要被多少个 Q 头复用,也决定了内核 方向的行数。来源:GQA 论文(arXiv:2305.13245)。
通用 MMHA(masked multi-head attention)内核同样要处理这些约束,但它的做法更保守:K 与 V 被逐 token 搬进共享内存,线程按「每个线程负责 K 向量的一段、再跨 warp 归约」的方式算点积,Q 与 K 的相乘是 dot 而不是 tensor core 的 mma。它对任意头数都成立,但每个 token 的 KV 只被用「一次点积」的力度消费,没有为 GQA 组织起「一份 KV 喂 个 Q 头」的 tensor core 瓦片,也没有为 decode 特有的窄 设计过布局。XQA 则是从「GQA 解码」这个特定形状出发重新设计的。
GQA 的组内复用:XQA 的数据布局前提
GQA 在数学上是「多个 Q 头共享一份 K/V」,但在内核里它首先是一个 内存布局约定:同一个 KV 头对应的 个 Q 头必须在内存里连续排列,且顺序与 KV 头一一对应。否则一次 TMA 或 cp.async 搬进来的 K 瓦片,就无法在同一个 MMA 里同时服务这 个 Q 头。
XQA 把这件事写成了两个常量:HEAD_GRP_SIZE(即 )和 HEAD_ELEMS(即 )。内核里的行号直接就是「Q 头在组内的偏移」:
constexpr uint32_t nbValidRows = headGrpSize * beamWidth;constexpr uint2 warpTile = {64, roundUp(nbValidRows, 16U)};nbValidRows 是 。普通解码、、beam=1 时是 8 行,roundUp(8, 16) 得到 16 行的瓦片,其中后 8 行是填充位。填充位不是浪费——mma.sync 的 粒度是 16,8 行本来就必须补到 16 才能发射指令。真正的浪费只发生在「补出来的 8 行」上,而 K/V 的读取量完全由 与 token 数决定,不受 填充影响。
组内复用的收益可以精确算出来。一个 K 瓦片是 ,搬进 SMEM 要做 次加载;同一个瓦片被 个 Q 头共用,做 次乘加。于是每个 KV 元素的复用次数是 ,GQA 把每个 KV 元素的复用次数从 MHA 的 1 提到了 8( 时),这是 decode 访存效率提升的直接来源。这就是为什么 XQA 的准入条件里专门把「原版 MHA 且 beam=1」排除掉—— 时这份复用不存在,XQA 为组内布局付出的间接寻址反而成了纯开销。
输出侧也遵循同一约定。更完整的 GQA 机制与推理收益可参考 GQA 完全拆解:分组查询注意力,用 1/8 的 KV 缓存保住 MHA 的质量。写回时的偏移按「头组」而不是「头」计算:
uint32_t const outOffset = headGrpSize * (nbKHeads * (beamWidth * ctaInputTokBeg) + idxHeadGrp);idxHeadGrp 是 KV 头编号,乘上 headGrpSize 就得到该组第一个 Q 头的全局位置;组内第 个头再偏移 。这也解释了为什么 XQA 要求 num_q_heads % num_kv_heads == 0——只有整除时,每个 KV 头才能对齐到一组固定大小的 Q 头,页表与头号才能用同一套乘法寻址。
XQA 在 TensorRT-LLM 里的位置:谁决定用它
XQA 并不是一个用户直接调用的 API。它挂在 TensorRT-LLM 的 decoder 注意力路径里,由 DecoderXQARunner 决定「这次前向到底用不用 XQA」,再用 CompileEngine 产出 cubin、用 run() 组装参数并发射。官方文档里对这一层的描述很直接:这是一个面向 MQA/GQA 生成阶段的优化,默认开启,但有一个启发式来决定用 XQA 还是 masked MHA,想强制使用可以设置 TRTLLM_FORCE_XQA=1。
决定流程的第一道关是 DecoderXQARunner::supportConfig(),它把三类内核的准入条件并起来:
bool DecoderXQARunner::supportConfig(XQAParams const& xqaParams, bool forConfigurePlugin) const{ return jit::supportConfigQGMMA(xqaParams, mSM, forConfigurePlugin) || jit::supportConfigHMMA(xqaParams, mSM, forConfigurePlugin) || jit::supportConfigMLA(xqaParams, mSM, forConfigurePlugin);}三类内核对应三种硬件画像:HMMA 是 mma.sync 版本,SM80 及以上都能跑;QGMMA 是 Hopper 专属的 TMA + warpgroup MMA 版本,只在 SM90 上;MLA 是 SM120 家族上专为 DeepSeek 式低秩 KV 写的版本。三者都要先过 supportConfigCommon(),这一层过滤掉的是「解码注意力语义不对」的情况:
| 条件 | 被排除的情况 | 原因 |
|---|---|---|
unidirectional == 1 且 mask 为 CAUSAL | 非因果、双向注意力 | XQA 只实现 decode 的因果掩码 |
非 cross_attention | 编码器-解码器交叉注意力 | KV 不是由同一条序列累积而来 |
position_shift_enabled == 0、sink_token_length == 0 | 位置平移、sink token | 索引算术依赖连续的 past 位置 |
num_q_heads % num_kv_heads == 0 | 不规范的头切分 | GQA 组大小必须是整数 |
| 不是「原版 MHA 且 beam=1」 | 纯 MHA 普通解码 | 没有 KV 复用,XQA 的布局优势不成立 |
| 位置编码属于 RoPE 系、learned absolute 或 YaRN | ALiBi 等相对位置编码 | 内核的 RoPE 路径按旋转式实现 |
chunked_attention_size == INT_MAX | 分块注意力 | 未接入 |
其中「纯 MHA 不用 XQA」这一条容易被忽略。MHA 每条请求的 ,XQA 为 GQA 组织的「同一份 KV 喂给 个 Q 头」的布局在这里没有收益,反而多了一层间接寻址。这一类请求交给 masked MHA 更合适。
过了准入之后还有第二道关 mayHavePerfGain():即使配置支持,也要估计这颗 kernel 在当前 batch 下能不能填满 GPU。
int multiBlockCount = 1;if (xqaParams.multi_block_mode){ int historyLength = xqaParams.max_past_kv_length; multiBlockCount = std::max(1, historyLength / kMinHistoryTokensPerBlock);}int blockCount = numKVHeads * batchSize * multiBlockCount;return static_cast<float>(blockCount) * kEnableMinBlockFactor >= static_cast<float>(mMultiProcessorCount);kMinHistoryTokensPerBlock = 128、kEnableMinBlockFactor = 4.0。含义是:把每条序列按每 128 个历史 token 粗估出工作块数量;只有当这个数量的 4 倍还不少于 SM 数量时,才认为 XQA 值得上。换句话说,当上下文很短、batch 很小时,XQA 可能连一个 SM 的零头都填不满,这时切到别的后端或让多块模式兜底更划算。multi_query_tokens(投机解码)和 MLA 则有直接豁免:前者只有 XQA 支持,后者当前一律优先 XQA-MLA。
编译期特化:三个内核,一张宏表
XQA 的源码目录 cpp/kernels/xqa/ 里只有三份设备端实现:
| 文件 | 目标架构 | 计算单元 | 关键宏 | 适用场景 |
|---|---|---|---|---|
mha.cu | SM80 及以上的通用路径 | mma.sync + 手动软件流水 | SPEC_DEC=0/1、M_TILESIZE | 常规 GQA 解码;线性投机验证 |
mha_sm90.cu | 仅 SM90 | TMA + warpgroup MMA(wgmma) | SWAP_AB、SKIP_SOFTMAX_ATTN | Hopper 上的常规解码与树形投机验证 |
mla_sm120.cu | SM120 家族 | 面向 DeepSeek 式 MLA 的 576 维 KV | IS_MLA | FP8 KV 的 MLA 解码 |
三份文件共享同一套头文件(defines.h、mha.h、utils.cuh、barriers.cuh、tma.h 等),差别全在编译期宏。以 defines.h 为例,一个内核实例的形状由下面这些宏决定:
// allowed values are multiples of 16 in range [16, 256](MLA 例外为 576)#define HEAD_ELEMS 128 // 每头维度 D_h#define HEAD_GRP_SIZE 8 // GQA 组大小 G#define IS_MLA (HEAD_GRP_SIZE == 128 && HEAD_ELEMS == 576)#define BEAM_WIDTH 1 // beam search 宽度,允许 1 或 4#define SPEC_DEC 0 // 是否走投机解码验证路径#define M_TILESIZE 32 // 投机路径下 HMMA 的 Q 行块(QGMMA 为 64)#define CACHE_ELEM_ENUM 2 // 0: half/bf16 1: int8 2: fp8_e4m3#define TOKENS_PER_PAGE 32 // 0 表示非分页(连续)KV#define SHORT_SEQ_OPT 1 // 仅 mha.cu:短序列优化#define SLIDING_WINDOW 0#define ENABLE_PDL 2 // programmatic dependent launch模板参数化的传统做法是「对每种组合都实例化一份」,结果是 cubin 数量爆炸—— 有十余种取值、 有数种、KV 精度三种、页大小五种、beam 两种、投机两种。XQA 的选择是 运行时 JIT:源码以字符串形式打进 TensorRT-LLM 的共享库,第一次遇到某个形状组合时调用 NVRTC 现场编译,之后把 cubin 缓存下来复用。
compileEngine.cpp 负责把 XQAParams 翻译成 tllmXqaJitContext,再由 nvrtcWrapper.cpp 翻译成 -D 宏和编译选项。关键逻辑有三个:
bool const isLinearSpecDec = mXqaParams.multi_query_tokens && !mXqaParams.is_spec_dec_tree;bool const useQGMMAKernel = supportConfigQGMMA(mXqaParams, mSM, true) && !isLinearSpecDec;.../*kernel_type=*/mXqaParams.isMLA() ? TLLM_XQA_JIT_MLA : (useQGMMAKernel ? TLLM_XQA_JIT_QGMMA : TLLM_XQA_JIT_HMMA),第一处:线性投机解码(链式草稿 token,不是树状)不走 Hopper 的 QGMMA 内核。注释里写明了原因——QGMMA 路径的注意力在全原生 FP8 下计算,包括 的输出;在链式投机验证这种「每个草稿位置都要被精确复核」的场景里,FP8 的 误差会让本来合法的 token 被拒绝,等于白白损失了接受率。所以这里退回到 HMMA,并用更保守的数值路径。
第二处:Hopper 内核默认把 RoPE 也吞进注意力 kernel 里。appliesRoPEInXqaKernel() 要求 RoPE 维度是 16 的倍数、且属于 kLONG_ROPE、kROPE_GPT_NEOX 或 kROPE_GPTJ 之一,满足时才打开 USE_INPUT_KV=1 与 ROPE_STYLE,否则仍走独立的 invokeQKVPreprocessing 对 Q 做 RoPE。这样做省掉一次单独的 kernel 发射和一遍 Q 的读写,代价是内核里多一段旋转逻辑——这正是 decode 这类「launch 开销占比高」的场景最在意的。
第三处:nvrtcWrapper.cpp 推导 M_TILESIZE 的规则分三种:非投机时直接等于 GQA 组大小;投机且走 QGMMA 时固定为 64;投机且走 HMMA 时取 q_seq_len × G,不足 16 按 16、否则 32。把 TOKENS_PER_PAGE 直接映射成宏,SLIDING_WINDOW 在「树形投机」时强制为 0。编译选项固定为 -dw(忽略告警)、--use_fast_math、-default-device,Hopper 用 -arch=sm_90a(需要 wgmma 与 TMA 的 a 后缀特性),SM120 与 SM121 共用 -arch=sm_120f。
这套 JIT 的设计动机值得展开。decode 注意力对形状极其敏感:D_h=128 与 D_h=256 的 SMEM 布局、K 头的切分数、每瓦片的元素数全都不一样;G=8 与 G=32 直接决定 方向的行数和 warp 分工;KV 是 FP8 还是 BF16 决定了是否需要转换与寄存器预算。如果预编译全部组合,一个 libtensorrt_llm.so 里要塞进几百份 cubin,加载时间和镜像体积都吃不消。反过来,纯运行时编译如果不缓存,每个新形状首次出现都要现场编译一遍(源码规模在数万行量级),对需要快速拉起新模型的服务来说是很明显的冷启动代价。XQA 的做法是 按 hash key 缓存:XQAKernelRuntimeHashKey 把 KV 数据类型、头维度、GQA 组大小、beam、M 瓦片、页大小、是否分页、是否投机、是否 FP8 输出、位置编码类型与 RoPE 维度打包成一个整数,CubinObjRegistry 按此查表,命中就直接发射。
Ampere 路径:一个 CTA 里的两类 warp
mha.cu 的 CTA 形状在编译期就固定下来:
// x: horizontal stacking for cta horizontal tile size// y: vertical stacking for cta vertical tile size// z: must be 2 for warp specialization.constexpr uint3 ctaShapeInWarps = {4, 1, 2};8 个 warp、256 个线程。z 方向上的两个平面承担两种角色:
warpIdx.z == 0(4 个 warp):负责搬数据并执行 GEMM0,即 。它们从全局内存(或分页池)把 K 瓦片搬进 SMEM,调用mma.sync得到 logits,再在 warp 内做行最大值、在线 softmax 的缩放。warpIdx.z == 1(4 个 warp):执行 GEMM1,即 。它们把 softmax 后的概率矩阵 与 V 瓦片相乘,并把结果写回输出。
这就是 FlashAttention 系的「两段 GEMM 切在两组 warp 上」在 decode 场景的落地。中间的 矩阵从 GEMM0 到 GEMM1 的传递走 SMEM:GEMM0 warp 把结果写进 smem.x 的某个缓冲槽,用一个屏障通知 GEMM1;GEMM1 读完后,同一个缓冲要被 GEMM0 的下一瓦片复用,于是还要一个反向屏障。代码里把这一对循环屏障定义成:
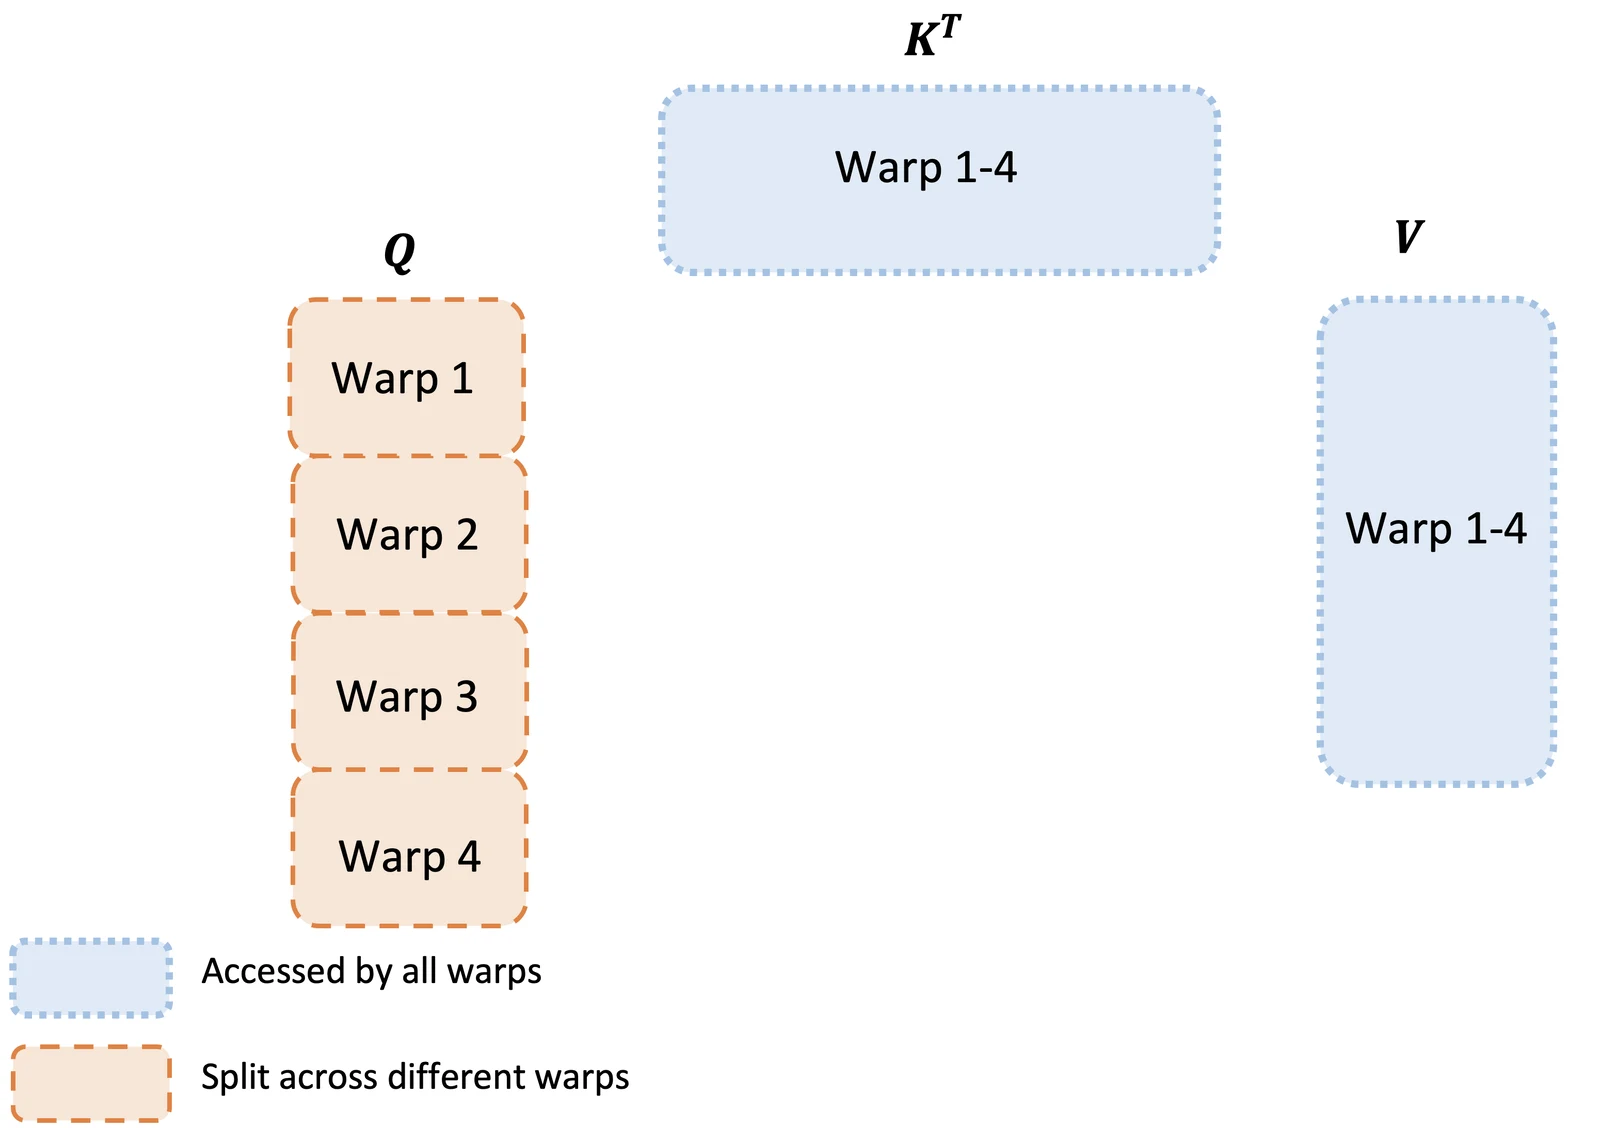
FlashAttention-2 前向的 warp 工作划分可以作为参照:不同 warp 分别负责注意力矩阵的不同条带,靠共享内存交换中间结果。XQA 把这个原则换成了更粗的切法——不按矩阵条带切,而按 GEMM 阶段 切:4 个 warp 只做 与 softmax,另外 4 个只做 与输出。来源:FlashAttention-2 论文(arXiv:2307.08691)Figure 3。
CtaBarrierPair xBarriers[ctaShapeInWarps.y][ctaShapeInWarps.x];CtaBarrierPair 的语义是「一个表示生产者已就绪,一个表示消费者已清空」。用双向屏障而不是简单的 __syncthreads(),是因为两个角色执行完全异步:GEMM0 可能已经在做第 块的 ,而 GEMM1 还在算第 块的 。要让流水不互相等待,必须让「槽位 可写」和「槽位 可读」各自独立同步。
行最大值怎么从 GEMM1 回到 GEMM0
在线 softmax 在 decode 里有一个容易踩坑的地方。FlashAttention 的在线 softmax 需要 整块行的最大值,而 的一行横跨 CTA 的水平瓦片(ctaTile.x 个 token),分摊在 ctaShapeInWarps.x = 4 个 warp 上。所以每块算完之后要跨 warp 归约一次行最大值。
GEMM0 warp 算出的行最大值(ctaRowMax)需要被 下一块 的 GEMM0 与所有 GEMM1 warp 使用。GEMM1 在读 时也要知道当前的缩放因子,以便把上一轮的 累加器按 正确重缩放。mha.cu 文件头有一段很长的注释,专门讨论这个「ctaRowMax 如何从 GEMM1 warp 传回 GEMM0 warp」的问题,列出了四种方案:
- 用
xFwdBarriers + xBwdBarriers保护,把ctaRowMax和其他 X 瓦片一起传递。问题是:GEMM0 warp 必须等到 GEMM1 消费完 X 才能拿到新最大值,而 GEMM1 可能还没开始。 - 在 GEMM0 warp 里再加一份寄存器副本,从 SMEM 读出后留到下一轮;缺点是更新被延后一轮,要多一两个寄存器。
- 用专门的
ctaRowMaxBwdBarriers保护。缺点是多一组 SMEM 屏障与arrive/wait指令。 - 完全不加保护,只用 volatile 读写。最快,但结果在极小数值范围内非确定。
最终选择的是方案 1,注释里给出量化对比:「1 比 4 慢 8%,2/3 比 4 慢 10%」。选 1 而不选 4 的核心原因是确定性:同一个输入、同一个 batch 结构,不同次运行结果必须逐位一致,否则投机解码的验证会让「同一个 token 有时接受有时拒绝」,服务端就无法复现问题。这是一类典型的推理工程取舍——用 8% 的额外流水开销,换取可复现的输出。
每一块的 K 是怎么搬进来的
mha.cu 不用 TMA,用的是 cp.async(ldgsts)做异步拷贝。每次搬 K 时,它把 K 头再切成 kHeadPartBytes 一段:
constexpr uint32_t preferedKHeadPartBytes = 64; // SM86/89/120: 64 字节constexpr uint32_t preferedKHeadPartBytes = 128; // SM80/87/90: 128 字节constexpr uint32_t cacheVTileSeqLen = 32; // 同上两组D_h=128、BF16 的 KV 头是 256 字节,所以切成 2 段、每段 128 字节;FP8 的 KV 头是 128 字节,在偏好 128 字节的架构上一次就能搬完,在偏好 64 字节的架构上仍分两段。这么做有两个考虑:一是 cp.async 单次搬运的粒度和 SMEM 的 bank 排布相匹配(64 或 128 字节对应 swizzle 模式);二是切得越细,流水里可以更早开始计算,而不必等整个头搬完。
K 的分页寻址里,页号向量的长度在编译期就已经算好:
constexpr uint32_t nbPagesPerWarpTile = (warpTile.x <= tokensPerPage ? 1U : exactDiv(warpTile.x, tokensPerPage));当 warpTile.x = 64、tokensPerPage = 32 时,每个 K 瓦片横跨 2 个页;每次搬瓦片前,GEMM0 warp 先把这 2 个页号加载进一个寄存器向量 Vec<KVCachePageIndex, 2>,再按页号把 token 拼成连续的 64 个位置。当页比较大(如 128)时,一个瓦片只落在一个页里,寻址就退化成一次乘法。
Q 为什么能常驻共享内存
decode 的 方向只有 headGrpSize 行(如 8 行)。 的有效数据是 8 × D_h,对 BF16 D_h=128 而言是 2KB;按 warpTile.y = 16 填充后是 4KB,仍然完全放得下一块常驻的 SMEM 缓冲。于是内核让 GEMM0 warp 把 Q 一次搬进 SMEM,并在所有 KV 瓦片之间复用:
constexpr bool persistentQ = paddedInputHeadBytes * ctaTile.y <= (16u << 10);static_assert(persistentQ);只有 Q 能装得下时这个假设才成立,所以代码用 static_assert 把不满足的组合直接排除在编译期。好处是每一块 K 进来时都不必再从全局内存重读 Q,decode 的迭代次数等于 ,几百上千次,这个省下的量很可观。
V 的加载和输出
GEMM1 的瓦片结构与 K 不同。P 的形状是 headGrpSize × warpTile.x,乘以 (warpTile.x × D_h)得到 headGrpSize × D_h。V 的搬入按 cacheVTileSeqLen = 32 分块,而且当 KV 被量化时(CACHE_ELEM_ENUM != 0),V 由「整组 warp」协作加载:
#define GRP_LOAD_V (CACHE_ELEM_ENUM != 0) || (HEAD_ELEMS == 256 && USE_PAGED_KV_CACHE && BEAM_WIDTH > 1)这个条件在 defines.h 的注释里写得很清楚:warpTile.x * cacheElemSize < 128 时组内协作更好。量化 KV 的元素更小,一个 warp 独占一个 V 瓦片时单次搬运的字节数偏少,事务粒度不够;让同一 warp group 的多个 warp 一起搬,才能把每次拷贝做大。反量化后 V 在寄存器里是 BF16/FP16,再送入 mma。
输出的写回是整个 CTA 的最后一步。代码里有一个专门的 gemm0ToPostProcBarrier,注释写得很直白:GEMM1 在等待此屏障后复用同一块 SMEM 做输出归约——也就是说,GEMM0 把 交出去、X 缓冲被释放之后,GEMM1 才会把尾部的归约与写回塞进那块刚空出来的 SMEM。对于多块模式,归约发生在跨 CTA 之间,细节留到后文。
Hopper 路径:从两段 GEMM 到三角色流水
Hopper 上换了计算单元,一切都要重新组织。mha_sm90.cu 的 warp 数量、角色和缓冲结构都与 Ampere 不同:
constexpr uint32_t gmmaWarpsPerGrp = 4;constexpr uint32_t gemm0NbGmmaGrps = 1;constexpr uint32_t gemm0NbWarps = gmmaWarpsPerGrp * gemm0NbGmmaGrps; // 4constexpr uint32_t gemm1NbGmmaGrps = 1;constexpr uint32_t gemm1NbWarps = gmmaWarpsPerGrp * gemm1NbGmmaGrps; // 4constexpr uint32_t nbIOWarps = 4;constexpr uint32_t nbWarps = gemm0NbWarps + gemm1NbWarps + nbIOWarps; // 12CTA 是 blockDim = (128, 1, 3),共 12 个 warp。三类角色:
| 角色 | warp 数 | 职责 |
|---|---|---|
| GEMM0 warpgroup | 4 | 消费 IO warp 搬来的 K 瓦片,执行 (wgmma),做列向在线 softmax |
| GEMM1 warpgroup | 4 | 读 ,执行 (wgmma),写输出 |
| IO warp | 4 | 用 TMA 从分页池搬 K/V 进 SMEM,负责 arrive/wait 的 tx-count 记账 |
这套 Hopper 内核的适用范围比 Ampere 路径窄得多。supportConfigQGMMA() 额外要求:SM == kSM_90、输入是 FP16/BF16、KV 是 FP16/BF16/FP8,并且 非 skip-softmax 时 KV 必须是 FP8——也就是说,BF16 KV 的普通解码默认不会走 Hopper 内核,除非打开 SKIP_SOFTMAX_ATTN;它还不接受 beam search(beam_width != 1 直接拒绝)。设备端 mha_sm90.cu 的实现也被 #if __CUDA_ARCH__ >= 900 && BEAM_WIDTH == 1 包住,其他组合在编译期落到 trap。这看起来苛刻,实际是因为 Hopper 路径的设计目标就是「FP8 KV + 单序列 GQA 解码」:KV 压到 FP8 后,每字节带宽的产出翻倍,才值得为 TMA + wgmma 重写一整套数据流。BF16 KV 的收益不足以覆盖重写成本,所以留给 Ampere 内核。
与 Ampere 最大的不同在于 IO 从计算里拆出来了。Ampere 的 GEMM0 warp 亲自 cp.async 搬 K,搬的时候靠 ldgsts 的异步属性与 MMA 重叠;Hopper 的 TMA 本身就是一次异步事务(transaction),需要一个线程发起并提交 barrier 的预期字节数,而 wgmma 又是 warpgroup 级别的指令,要求同一个 warpgroup 的 128 个线程保持一致的执行节拍。把搬运交给独立的 IO warp,计算侧就能专注于「等 barrier、发 wgmma、做 softmax」,搬运侧可以同时处理多个缓冲区。
SharedMem 的布局也体现了双缓冲的规模:
static constexpr uint32_t nbKBuf = 2;static constexpr uint32_t nbVBuf = 2; // SKIP_SOFTMAX_ATTN 时为 3static constexpr uint32_t nbXBuf = 2 * (gemm0CtaTileNbTokens >= gemm1CtaTileNbTokens ? 1 : exactDiv(gemm1CtaTileNbTokens, gemm0CtaTileNbTokens));K 与 V 各双缓冲;X(softmax 后的 )按「每 X 缓冲对应几个 V 缓冲」的比例扩展。一个很实用的技巧是 X、V 缓冲与输出暂存共用同一块 SMEM:
union ReusedXVOutSwizzleBuf{ struct XV { XBuffer x; VBuffer v; /* ... */ } xv; OutSwizzleBuf outSwizzle;} reusedXVOutSwizzleBuf[nbXBuf]; 与 只在 GEMM1 结束前有用,而输出重排(把累加器寄存器按目标布局写进 SMEM 再 TMA 出去)只发生在 GEMM1 之后。两者生命周期不重叠,所以可以叠在同一地址上,用 union 复用。文件里还有一个断言 static_assert(sizeof(OutSwizzleBuf) <= sizeof(XV)),保证复用不会溢出。这类「显存之外的显存」抠法在 Hopper 内核里很常见——SMEM 是 decode 注意力最紧的资源之一,每省一份缓冲就多一份流水深度。
SWAP_AB:把 K 放在 A 位
mha_sm90.cu 的 gmma 调用处有一个编译期开关:
#define SWAP_AB (!SPEC_DEC) // 默认投机解码时不开,其余解码全部开启在 GEMM0 里,开启 SWAP_AB 时矩阵描述符的传参顺序是 (matDescK, matDescQ),不开时是 (matDescQ, matDescK)。计算的是 ,即把几何上更像「权重矩阵」的 K(64 × D_h 的连续瓦片)当作 A,把 G × D_h 的 Q 当作 B。
这么做的原因要回到 和 的方向。wgmma 的 方向来自 A 的行, 方向来自 B 的列,累加器的行列数、TMA 的 box 形状、softmax 的归约方向都跟这两个维度绑定。decode 时 Q 只有 G × beam 行(swapAB 时向上取整到 8 的倍数),把这么窄的维度放在 wgmma 的 方向上会浪费瓦片,而且 softmax 的归约只能在极少量的行上做,warpgroup 里大部分通道用不上。把 K 放 A 位后, 方向是 64 个 token 的瓦片,直接与指令粒度对齐,真正的「窄」维度变成了 (ctaNbQHeads)。累加器从 (G × 64)变成 (64 × G),softmax 也从「按行」变成「按列」,所以 mha_sm90.cu 里有 RegColWiseVec、xColMax、xColSum 这一整套列向归约设施,而非 SWAP_AB 路径用的是 xRowMax、xRowSum。
这个改动看起来只是转置了一下,实际上重塑了整个内核:V 的加载布局变了(VBuffer 的 rows 从 gemm1CtaTileNbTokens 看过去仍然是 64,但要额外一个 VTBuffer 来做布局转换——#if !SWAP_AB 时才存在),输出的重排方法变了,连跨 CTA 的归约都换了一组实现。在 decode 内核里,「矩阵转置」不是一句语法糖,而是一次数据流重构。
Softmax 与 sink:跳过近零贡献的瓦片
Hopper 路径在 softmax 上多加了一层优化:SKIP_SOFTMAX_ATTN。它在「当前瓦片贡献极小」时,直接跳过这个瓦片的 softmax 与 。
细节在 computeWarpGrpColMax_sync 附近。每个瓦片做完 GEMM0 后,先算本轮的最大值,与当前累积的最大值比较,得到阈值:
bool const disableSkipForShortSeq = (cacheSeqLen < skipSoftmaxThresholdScaleFactor);float const skipSoftmaxThreshold = disableSkipForShortSeq ? 0.0f : skipSoftmaxThresholdScaleFactor / cacheSeqLen;阈值按上下文长度反比设置:当 很大时,单个瓦片在整体 softmax 分母里的占比上限就是 量级,所以「这个瓦片的贡献上限」可以按 factor / L 估计。若本轮瓦片的最大值比累积最大值低出一个大阈值,整个瓦片就记为可跳过,投票结果写进 skipSoftmaxVotesGemm0ToV 与 skipSoftmaxVotesGemm0ToGemm1,V 侧和 侧都不做。
这一改动对 SKIP 模式有两项额外开销:V 缓冲要多一格(nbVBuf = 3),X 缓冲的倍数从 2 改成 3(nbXBuf 公式里的 3 * 而不是 2 *),因为要留出投票结果与延迟到达的 V 的落点。换来的是长上下文后期大量「已无贡献」瓦片被整块跳过,减少 的量。它的有效性与数据分布强相关——注意力在长上下文后期普遍呈现幂律集中,这一点与 H2O 完全拆解:抓住 KV Cache 里的「重击者」,20% 预算无损生成(NeurIPS 2023) 里讨论的重击者现象同源,只是 XQA 是在「瓦片」粒度上做一次保守的 skip,不需要任何重击者统计。
一个容易漏掉的细节:attention sink
XQA 的内核在开始时把 attention sink 的 logit 注入行/列最大值:
auto initialRowMax = ThrdRegRowMax::filled(safeInitRowMax);if (attentionSinks != nullptr){ for (uint32_t i = 0; i < initialRowMax.size; i++) { uint32_t const rowOffset = warp_size * i + laneId(); if (rowOffset < (SPEC_DEC ? warpTile.y : headGrpSize)) { uint32_t const srcOffset = SPEC_DEC ? rowOffset % headGrpSize : rowOffset; initialRowMax[i] = fmaxf(initialRowMax[i], attentionSinks[headGrpSize * idxHeadGrp + srcOffset]); } }}多块模式下的最终归约再把 sink 计入分母。如果没有这一步,启用 sink 的模型(StreamingLLM 一类结构)在 XQA 路径上就会算出错误的注意力权重——所有 token 的概率之和会变成 1 而不是 1 减去 sink 的份额。这一点在 StreamingLLM 完全拆解:attention sink 与大模型的无限流式生成 里讨论过机制,而在内核层面,它就是一个必须被写进初始化值的常数。
分页 KV:页号怎么变成 TMA 坐标
XQA 对分页 KV 最底下一层的抽象是 KVCacheList:它把「全局页池 + 每条序列的页表」包在一起,向内核提供两样东西——给 TMA 用的 tensor map,以及给普通 gather 用的 getHead()。两条路径并存,是因为 Ampere 没有 TMA、必须手工拼地址,而 Hopper 可以把寻址交给 TMA 硬件。
Hopper:一次 TMA 只搬一个页
TMA 的 tensor map 描述的是一个多维张量及其步长,外加每次拷贝的 box 形状。XQA 为分页池建 map 的方式如下(tensorMap.cpp):
// VLLM Layoutuint64_t const globalDims[] = {headElems, nbKHeads, tokensPerPage, 1U << 31};uint32_t const headBytes = elemBytes * headElems;uint64_t const globalStrides[] = {headBytes, headBytes * nbKHeads, headBytes * nbKHeads * tokensPerPage};uint32_t partBytes = partElems * elemBytes;uint32_t const boxDims[] = {partElems, 1, mha::min(tokensPerPage, nbTokensPerTile), 1};四维分别是「头内元素、KV 头、页内 token、页号」。最关键的第四维 1U << 31 是一个相当大的 虚拟上界——张量 map 只描述布局与步长,实际的页号在每次 tma::loadAsync 时作为坐标传入。于是同一张 map 可以服务所有页,只要把「页号」当作最后一个坐标:
tma::loadAsync(&dst(tokensPerPage * i, 0), tensorMap, DimsLE<4>{partElems * idxPart, idxHeadGrp, 0, (uint32_t) pages[i]}, bar);一张 map 同时编码了「页内怎么排」与「页与页之间隔多远」(第三个 stride 是 headBytes * nbKHeads * tokensPerPage,表示页在全局池中按整页连续存放),唯独不含「这一页住在池里的哪一段」——那是页表的职责,由坐标在发射时填写。这正是 PagedAttention 完全拆解:操作系统分页思想如何拯救 LLM 推理的内存利用率 里讨论的「逻辑块号 → 物理块号」翻译在硬件层面的延续。
一个 K 瓦片(gemm0CtaTileNbTokens = 64 个 token)在页大小 32 的情况下横跨两个页,所以循环两次,分别以 pages[0]、pages[1] 作为页坐标,目标地址分别偏移 tokensPerPage * i。TMA 的 box 是 (partElems, 1, min(tokensPerPage, nbTokensPerTile), 1),即每次搬「一个头 × 一页里的若干 token × 一部分头内元素」。
这里有三层设计:
- 张量 map 一次创建、反复重用:
makeTensorMapForPagedKVCache只在 host 端调用,map 以CUtensorMap作为 kernel 参数传进设备端。若每个页建一张 map,host 端开销会失控。 - 页号通过坐标传入:TMA 不关心页是否连续,只要给出坐标,它就按 box 形状从张量里取数据。这正好匹配分页 KV 的精髓——逻辑序连续、物理序离散。
- swizzle 与头内切分对齐:
partBytes取 128 或 64 字节,分别对应CU_TENSOR_MAP_SWIZZLE_128B与64B。SMEM 里 K 缓冲的 bank 排布、wgmma的matDesc都从同一个 swizzle 模式推出来,三者必须一致,否则要么出现 bank 冲突,要么wgmma读到错误数据。
KVTilePartLoader::loadPages() 负责在搬瓦片前把页号读出来:
uint32_t const idxPageBeg = gemm0CtaTileNbTokens >= tokensPerPage ? nbPagesPerTile * idxTile : idxTile / exactDiv(tokensPerPage, gemm0CtaTileNbTokens);for (uint32_t i = 0; i < nbPagesPerTile; i++){ uint32_t const idxPage = idxPageBeg + i; auto const page = (idxPage >= nbSkipLeadingPages && idxPage < nbPages) ? cacheList.kvCachePageList[baseOffset + idxPage] : kBAD_PAGE_INDEX; if (warpElectSync()) pages[i] = page;}要点有三:页号只由 warpElectSync() 选出的一个线程读取,再 __syncwarp() 广播,避免 128 个线程重复读同一地址;越界页被替换成 kBAD_PAGE_INDEX,配合 TMA 的 CU_TENSOR_MAP_FLOAT_OOB_FILL_NONE 与 kernel 里的掩码,保证越界读不会污染结果;nbSkipLeadingPages 是滑窗模式下要跳过的前导页数——滑窗只看最近 个 token,前面的页根本不用搬。baseOffset 的算法随布局而变:VLLM 式布局(K/V 两个独立池,各自按序列优先排列)是 idxReq * maxNbPagesPerSeq,XQA 原生布局则是 ((idxReq * beamWidth) * 2 + (isK ? 0 : 1)) * maxNbPagesPerSeq——后者需要区分 K 池与 V 池,并且把 beam 当作独立序列。
Ampere:页号进寄存器
mha.cu 没有 TMA,K 的搬运靠 cp.async,页号被提前装进寄存器向量:
constexpr uint32_t nbPagesPerWarpTile = (warpTile.x <= tokensPerPage ? 1U : exactDiv(warpTile.x, tokensPerPage));using KCachePageIndices = Vec<KVCachePageIndex, nbPagesPerWarpTile>;随后构造一个带页表的「头指针」HeadPtr / IndexedHeadPtr,把「全局池、页号数组、头号、偏移」四件事打包,交给 copyHeadsAsync 完成实际的异步拷贝:
// XQA 原生布局(K/V 共池)HeadPtr<GMemCacheHead const, tokensPerPage, nbPagesPerWarpTile> const src{ cacheList.pool, pageIdx, nbKHeads, idxHeadBeg};HeadPtr 内部会按 token 序号拆成「页号 + 页内偏移」,再按 pool[tokensPerPage * (nbKHeads * page + head) + offset] 拼出地址。IndexedHeadPtr 在此基础上多一个索引数组,用于 beam search 把每个 query token 映射到它所属 beam 的 KV 序列。页大小在这里必须能被 warpTile.x 整除,这也是 defines.h 把 TOKENS_PER_PAGE 限制在 {0, 16, 32, 64, 128} 的原因之一。
FP8 / INT8 的 KV:转换到底放在哪儿
XQA 支持 FP16、BF16、FP8(E4M3)、INT8 四种 KV 缓存类型,计算精度则取决于路径:Ampere 先转成 FP16/BF16 再做 mma,Hopper 的 FP8 路径直接在 FP8 上做 wgmma。差异体现在 CACHE_ELEM_ENUM 宏:
| 枚举值 | KV 元素类型 | 处理方式 |
|---|---|---|
| 0 | half / bf16 | 直接进 MMA |
| 1 | int8 | 搬入时或进 MMA 前反量化到 FP16 |
| 2 | fp8_e4m3 | Ampere 路径转 FP16;Hopper 的部分路径以 FP8 直接喂 wgmma |
Hopper 路径上 V 不做显式反量化
很多关于 KV 量化的讨论都会强调「K 与 V 都要反量化」,但在 XQA 的 Hopper 路径里,V 走了一条不同的路。GEMM1 的累加器直接以 FP8 的 V 作为 B 操作数,缩放被合并进一个常数:
float const warpRank = warpIdx.x;constexpr float xScale = 1.f / kE4M3_MAX;#if LOW_PREC_OUTPUTfloat const oScale = rcpOutScale[0];#elseconstexpr float oScale = 1.F;#endiffloat const xvoScale = xScale * (isKVCacheQuantized ? kvCacheScale[0] : 1.f) * oScale;xScale = 1 / kE4M3_MAX:softmax 后的概率 落在 ,而 E4M3 能表示的最大正规值是 448,于是把 乘以 写进 FP8,让 恰好对应最大可表示值,其余值按比例缩小;输出端再把 448 乘回来(合并进 xvoScale)。xv 中的 x 指 softmax 后的 ,v 指 V,o 指输出——三个因子被乘成一个常数,在整个 GEMM1 累加过程中只做一次乘法。
对 K 则必须反量化或补偿: 的结果需要回到正确的数值域才能送进 softmax,所以 mha_sm90.cu 在设 qkScale 时把 K 的反量化比例 kvCacheScale[0] 一并乘进去:
float const qkScale = qScale * (isKVCacheQuantized ? kvCacheScale[0] : 1.f) * rsqrtf(validElemsPerHead);如果 KV 是 BF16,qkScale 退化成标准的 缩放。
Ampere:转换在寄存器,按机器字
在 mha.cu 的 GEMM0 内层,如果 InputElem 与 KElemType 不同,K 切片会先被转换成输入类型再进 mma:
auto const kSlice = [&](){ if constexpr (mha::is_same_v<InputElem, KElemType>) return kSliceOrig; else if constexpr (mha::is_same_v<KElemType, int8_t> || mha::is_same_v<KElemType, __nv_fp8_e4m3>) { Array2D<...> ret; for (m, n, i, j) { auto const data = convertKCacheWordToF16<InputElem, KElemType>(kSliceOrig(m, n).data[i][j]); ret(m, n).data[i][j * cvtExp] = data[0]; ret(m, n).data[i][j * cvtExp + 1] = data[1]; } }}();cvtExp = inputElemSize / cacheElemSize:8 位变 16 位时,同样的字节数里目标能装的元素减半,所以每个源位置写到目标位置的 j * cvtExp 处。
真正的转换在 utils.cuh 的 convertKCacheWordToF16 里:输入是 一个 32 位机器字(装 4 个 FP8 元素),输出是两个 32 位字(共 8 字节,装 4 个 BF16 元素):
__device__ inline Vec<uint32_t, 2> convertKCacheWordToF16(uint32_t i8data){#if (defined __CUDA_ARCH__) && (__CUDA_ARCH__ >= 890) if constexpr (mha::is_same_v<InputElem, half> && mha::is_same_v<CacheElem, __nv_fp8_e4m3>) { uint16_t(&src)[2] = reinterpret_cast<uint16_t(&)[2]>(i8data); uint32_t(&dst)[2] = reinterpret_cast<uint32_t(&)[2]>(ret); asm("{\n" "cvt.rn.f16x2.e4m3x2 %0, %2;\n" "cvt.rn.f16x2.e4m3x2 %1, %3;\n" "}\n" : "=r"(dst[0]), "=r"(dst[1]) : "h"(src[0]), "h"(src[1])); return ret; }#endif // 其他组合:逐元素标量转换 for (uint32_t i = 0; i < 4; i++) dst[i] = InputElem(src[i]); return ret;}在 SM89 及以上、且是 FP16 输入 + FP8 缓存时,走 PTX 的 cvt.rn.f16x2.e4m3x2:把 16 位里的两个 E4M3 一次转成 32 位里的两个 FP16,循环两次处理四个元素,四条元素只需两条指令,rn 表示就近舍入。其他组合(BF16 输入、INT8 缓存)退回标量循环,由编译器决定是否向量化。这个细节说明了一件容易被忽略的事:量化 KV 的解码热点并不在「怎么算反量化因子」,而在「转换指令能不能填进 mma 的等待窗口」。PTX 的内置转换指令可以被调度器插进 MMA 的流水空档,而标量循环往往要占用独立的 ALU 周期,在 decode 这种每轮只处理一小段新 K 的负载里,后者的代价会被放大。
为什么不在搬入 SMEM 时就转换
一个自然的疑问是:既然 FP8 到 BF16 最终都要转,为什么不趁 TMA 或 cp.async 搬入时顺手转掉,SMEM 里直接放 BF16?
Hopper 路径做不到——TMA 是由硬件 DMA 引擎执行的、不经过 SM 的计算单元,它只负责搬运字节,无法在途中做类型转换。Ampere 的 cp.async 同样绕开寄存器,转换只能在数据落进 SMEM 之后、或已经进寄存器之后做。
那么剩下的选择就是「SMEM 里存 FP8、进 MMA 前转换」和「SMEM 里存转换后的 BF16」。XQA 选前者,原因是 SMEM 预算:FP8 的 K 头只有 BF16 的一半,同样的 SMEM 能多放一个缓冲,流水深度直接翻倍;而 decode 注意力恰恰是最吃流水深度的负载——每次迭代的数据量小,只有靠更深的双缓冲/三缓冲才能把 HBM 延迟藏住。代价是每次迭代都要重新做转换,但转换量与搬入量严格成正比,在访存受限的 decode 里,这点算术完全可以被内存延迟遮住。
KV 量化在 decode 里的收益比 prefill 更直接:prefill 的算术强度高,多读一点 KV 还能被 GEMM 的计算遮住;decode 每步只算一个 token,时间几乎全花在把 KV 从 HBM 搬进 SM 的路上,KV 每压缩一半,理论上的解码上限就抬高近一倍。也正因为如此,KV 量化的轴选择、按通道还是按 token、离群值怎么处理,都会直接影响注意力的误差形态——可参考 KIVI 完全拆解:非对称 2-bit KV Cache 量化,为什么 Key 按通道、Value 按 token 与 KVQuant 完全拆解:预旋转逐通道量化、敏感度加权非均匀码本与稀疏离群值,3-bit KV Cache 如何近无损(NeurIPS 2024)。XQA 的 FP8 路径选择了最保守的一档:对称 E4M3、K/V 共用一个 per-tensor scale,换来的是内核里只需一次乘法就能把缩放补偿掉。FP8 注意力的误差来源与块量化细节,可参考 FlashAttention 完全拆解(三):Warp 特化异步流水线与 FP8 低精度。
多块模式:把一条序列沿 KV 切成几段
前面反复提到「并行度不足」。TP8 部署的 70B GQA 模型每卡只有 1 个 KV 头,batch 32 时也只有 32 个 CTA,在 132 个 SM 的 H100 上不到 1/4 个 wave。更极端的是单条长上下文请求:每卡只有 1 个 CTA,132 个 SM 里 131 个在看戏——多块模式就是为这种「CTA 数量远小于 SM 数量」的场景准备的。
XQA 的应对方式是 multi-block:沿着 KV 的序列维把一条序列切成 个子序列,每个子序列由一个 CTA 负责,各自独立算出「局部 softmax 结果」,最后由一个 CTA 做合并。这本质上是 FlashDecoding 的思路——解码的 方向太小,就把 方向拆开。可参考 FlashAttention 完全拆解(二):序列维并行、Warp 工作划分与 FlashDecoding 对 split-KV 归约的讲解。
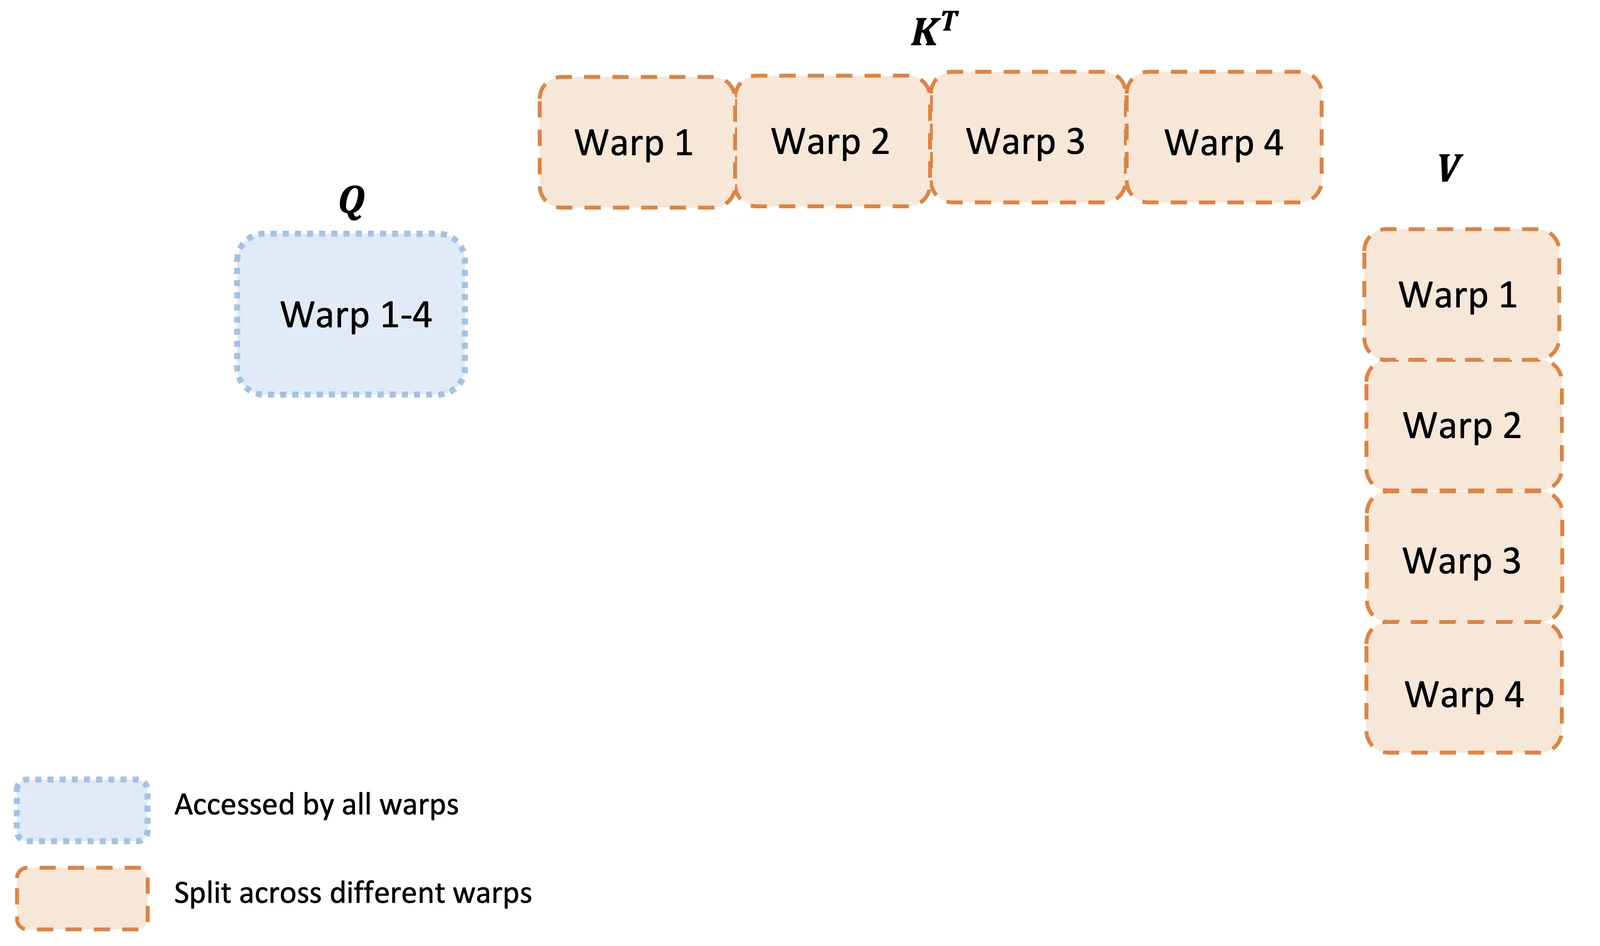
FlashAttention-2 的并行划分示意:前向时每个 worker 负责注意力矩阵的一段行(一段 query),反向后每个 worker 负责一段列。XQA 的多块模式采用同一类思路,但方向相反——decode 只有一行 query,于是沿 KV 的列方向切,把一条序列分给多个 CTA,最后做 split-KV 归约。来源:FlashAttention-2 论文(arXiv:2307.08691)Figure 2。
切多少块:两条不同的启发式
Hopper 与 Ampere 的启发式不同,分别写在 computeNbSubSeqPerSeqHopperF8MHA 和 computeNbSubSeqPerSeqMHA:
float const factor = 0.25f;return mha::min<uint32_t>( mha::max<uint32_t>(1U, (uint32_t) round(prop.multiProcessorCount * 3 / (batchSize * nbKHeads) * factor)), divUp(maxSeqLen, gemm0CtaTileNbTokens));
// mha.cureturn std::min<uint32_t>( std::max<uint32_t>(1U, prop.multiProcessorCount / (batchSize * nbKHeads)), divUp(maxSeqLen, ctaTile.x));两者都遵循「不超过 KV 瓦片数」这个上限(否则会有空块),但 Hopper 多乘了 3 × 0.25 = 0.75,等于「每 4 个 SM 用 3 个 CTA」;Ampere 则朴素地「每个 SM 至少一个 CTA」。这个差异与 tile 大小有关:Hopper 的 gemm0CtaTileNbTokens 是 64,同样上下文切出的子序列数比 Ampere 的 ctaTile.x = 256 多 4 倍,所以 Hopper 需要额外压低块数,避免子序列把 GPU 塞成多个 wave。
还有两层限制在 host 端的 runner 里。decoderXQARunnerUtils.h 的 computeMultiBlockCount() 才是实际发射时用的值:
multiBlockCount = historyLength / kMinHistoryTokensPerBlock; // 128multiBlockCount = std::min(multiBlockCount, (int) std::round(std::sqrt(multiBlockCount * 8.F))); // 防止归约项主导multiBlockCount = std::max(multiBlockCount, 1);double waveCount = (double) batchSize * numKVHeads * multiBlockCount / (double) multiprocessorCount;double adjFactor = waveCount / (double) kTargetWaveFactor; // 8if (adjFactor > 1.0) multiBlockCount = floor(multiBlockCount / adjFactor);multiBlockCount = std::max(multiBlockCount, 1);multiBlockCount = std::max(std::min(multiBlockCount, maxNbSubSeq / batchSize), 1);逐行解释:
- 每 128 个历史 token 一个块。上下文不足 128 的时候,多块只会增加归约开销,直接返回 1。
- 开方压缩:
min(k, sqrt(8k))。这一行的动机是「归约项不能主导」——块数越多,最后合并时要读写的 scratch 越多,合并的并行度反而下降。开方增长是对「块数收益递减」的一个经验拟合。例如 时压到 。 - wave 约束:算一下这批 CTA 会占多少个 wave(
batchSize × kvHeads × multiBlockCount / SM数),若超过目标 8 个 wave,就把块数按比例下调。目标 8 个 wave 意味着最多排 8 批 CTA,既不让单批把 GPU 撑得太满,也避免最后一批只剩零星几个 CTA、把尾延迟拖长。 - workspace 上限:
maxNbSubSeq = 6000(非 MLA)/500(MLA),每通道 scratch 预分配这么多子序列。batchSize × multiBlockCount不能超过它,否则工作区不够。
在 MHA 路径里还有一道前置判断 mayHavePerfGain() 用 kEnableMinBlockFactor = 4 来「开多块是否值得」——如果连每 128 个 token 的切法都填不满 SM 的 1/4,那么启用多块也没多大用,XQA 直接让位给 MMHA。
归约怎么记:每个子序列一个「和-最大值」对
每个 CTA 完成自己的子序列后,把局部结果写进 全局 scratch。scratch 的布局由 ScratchMem 描述,两部分顺序排列:
mRowSumMax = segmenter.newSeg<ColWiseVec>(nbChunks, alignment); // ColWiseVec = Vec<SumMax, ctaNbValidQHeads>mTokens = segmenter.newSeg<Vec<IOHead, ctaNbValidQHeads>>(nbChunks, alignment);SumMax 是 float sum; float max; 的一对。每个子序列贡献一个「局部最大值 、局部分母 、局部未归一化输出 」。合并公式是标准的 FlashAttention 归约:
Hopper 路径的实现按 warp 均分头,每个 warp 负责 headsPerWarp 个 Q 头,每读到一个子序列,就与当前累加状态做一次在线更新:
if (sumMax.max > state.max){ float const scale = expf(state.max - sumMax.max); state.max = sumMax.max; state.sum = state.sum * scale + sumMax.sum; state.acc = state.acc * scale + data * sumMax.sum;}else{ float const scale = expf(sumMax.max - state.max); state.sum = state.sum + sumMax.sum * scale; state.acc = state.acc + data * (sumMax.sum * scale);}这与单块内部逐步累加的公式完全一致,只是「块」的粒度从 KV 瓦片换成了「子序列」。最后的 attention sink 也在这个阶段加回分母。
谁来合并:信号量选出最后一个 CTA
让所有 CTA 都去做合并,等于把同样的数据算 遍;让第一个完成的 CTA 去做,它并不知道别人有没有写完。XQA 用的办法是 原子计数器:每个子序列完成时对信号量做一次 atom.acq_rel.gpu.global.inc.u32,返回的旧值等于 nbSubSeq - 1(即它是第 个、最后一个到达的)的 CTA 承担合并:
uint32_t const lastOld = nbSubSeq - 1;uint32_t const idxSemaphore = idxSeq * nbInputSeqSplit + idxInputSubSeq;auto const pSemaphore = &semaphores[idxSemaphore];asm volatile("atom.acq_rel.gpu.global.inc.u32 %0, [%1], %2;\n" : "=r"(old) : "l"(pSemaphore), "r"(lastOld));smemIsLastCta = (old == lastOld);acq_rel 内存序是关键:确保最后一个 CTA 看到的所有 scratch 写入都是可见的(acq),且之前所有 CTA 的写入都已经落到全局内存(rel)。这个模式在 GPU 编程里叫「atomic counter as completion signal」,与 grid.sync() 相比,它不需要 cooperative launch,可以放在任意 stream 上发射,代价是只有最后一个 CTA 承担合并、其余 CTA 全部退出。
合并阶段,最后一个 CTA 把数学 warp 与 IO warp 重新分工:
- 8 个数学 warp(GEMM0 与 GEMM1 各 4 个)负责在线归约,每个 warp 均分
ctaNbValidQHeads个头; - 4 个 IO warp 负责把 scratch 里的子序列结果用 TMA linear load(线性、非分块)成批搬回 SMEM,用
MultiBlockSMem的 4 个缓冲做乒乓。
MultiBlockSMem 的 nbBuf = useSpecDec ? 2 : 4,IO warp 数等于缓冲数,每个 warp 负责一个缓冲。归约侧通过 bar.produced.wait_parity(...) 等待缓冲填满,读完 bar.consumed.arrive() 交还。wait_parity 的参数按「每轮翻转一次奇偶」计算,使得同一组屏障可以重复使用而不需重置。
Ampere 路径的合并更朴素:所有 CTA 先把各自的输出写进 scratch(copyGrains 把寄存器里的输出 tile 按 grain 复制),再用 __syncthreads() 后由一个 warpgroup 读取所有子序列做最后归约。它的 scratch 中还额外存了 gemm1WarpsPerGrp 份 tile 级别的局部和,以适配 Ampere 上 GEMM1 的 warp 分工。
投机解码:XQA 的第二个工作负载
启用投机解码后,decode step 不再只算一个 query token,而是一次性验证一段草稿 token(树形或链式)。defines.h 把 SPEC_DEC=1 打开时,内核形态变化很大:
#if SPEC_DECusing MaskType = uint32_t;#ifndef M_TILESIZE#define M_TILESIZE 32#endif#endif关键变化有四处:
inputSeqLen不再是 1:mha.h里的constexpr uint32_t inputSeqLen = 1;只在非投机时成立,投机时等于generation_input_length,即每条请求的草稿长度。- 网格的 y 维变成「头 × 草稿 token 块」:
nbTokenBlocksPerGrp = divUp(qSeqLen * headGrpSize, m_tilesize),把「草稿 token × GQA 头」压成一维,再由warpTile.y = roundUp(rowsPerBlock, 16)分块。这样 方向可以填到 16 或 32 行,而不是 8 行。 - 需要树形掩码:
IS_SPEC_DEC_TREE=1(默认)时,草稿 token 之间不是链式关系,而是一棵树,每个 token 只能看到它在树上的祖先。内核在warpGrpApplyMask里逐行读 mask(mask是一个uint32_t*,每个草稿 token 一行 bitmask),把非祖先位置的 logit 置为safeInitRowMax(一个大负数),从而被 softmax 忽略。 SWAP_AB默认关闭:mha_sm90.cu里默认定义#define SWAP_AB (!SPEC_DEC),树形验证时回到 K 在 B 位、Q 在 A 位的标准布局(固定草稿长度的SPEC_Q_SEQ_LEN变体是例外,它强制开启SWAP_AB)。树形掩码要按 query token 逐行处理,而SWAP_AB下 的每一列才对应一个 query token,二者方向不一致。
CompileEngine 里的第一处判断正是关于这里的:
bool const isLinearSpecDec = mXqaParams.multi_query_tokens && !mXqaParams.is_spec_dec_tree;bool const useQGMMAKernel = supportConfigQGMMA(mXqaParams, mSM, true) && !isLinearSpecDec;链式(linear)草稿在 Hopper 上不走 QGMMA,而树形草稿走。前者的原因已经说过:全原生 FP8 的 会损失验证精度;后者的原因要从数据流上理解:树形验证的 方向被多个草稿 token 填满,wgmma 的 粒度不再浪费,FP8 带来的带宽节省变得更值;而且 QGMMA 的 K 瓦片是 64 个 token 一块,树形草稿共享的 KV 前缀能在一次 TMA 里被多个分支复用。
mha.cu 的网格选择也按投机与非投机分叉:
#if SPEC_DEC const uint32_t nbTokenBlocksPerGrp = divUp(qSeqLen * headGrpSize, rowsPerBlock); dim3 const dimGrid{nbSubSeqPerSeq, nbKHeads * nbTokenBlocksPerGrp, batchSize};#else dim3 const dimGrid{nbSubSeqPerSeq, nbKHeads, batchSize};#endif非投机的 dimGrid.y 是 nbKHeads;投机的 dimGrid.y 是 nbKHeads × nbTokenBlocksPerGrp,让每个草稿 token 块与每类头各自独立,互不依赖。投机路径同样可以开多块,但启发式换了:computeMultiBlockCountSpecDec() 只在 batch 不超过 32、历史长度不小于 2048 时才调优;它先按「单块 CTA 数不足一个 wave」的条件算出可填充的块数,取不超过一波 SM 的 2 的幂并限制在 64 以内,再按历史长度右移收缩,最后断言「块数 × 单块网格」不超过 SM 数——避免多开一个 wave 导致尾延迟。
和其他路径怎么配合:为什么 XQA 不是唯一答案
把 XQA 放回 TensorRT-LLM 的注意力后端体系,就能看到一条完整的分工链:
XqaDispatcher构造函数先看是不是 Blackwell(isSM100Family()),是的话直接创建TllmGenFmhaRunner,把整个注意力路径交给 TRTLLM-Gen FMHA;只有非 SM100 才构造DecoderXQARunner。- 不是 Blackwell,就用
DecoderXQARunner判断「这个形状该不该走 XQA」,不行就退回 masked MHA。 - 是 MLA 模型时,
computeMultiBlockCountForMLA()直接返回 1;注释只写了「disable multi-block for MLA kernel for now」,没有给出原因。MLA 的 KV 布局、归约与页表都另写了一套,当前版本尚未把多块接进去。 - FlashInfer 后端完全走自己的路径,与 XQA 无关——它有自己的分页 KV 表示与 JIT 模板,可参考 FlashInfer 完全拆解:把分页 KV、动态批处理与定制注意力编译成服务级 Kernel。
这个分工背后有一个很强的实用主义立场:解码注意力没有一劳永逸的最佳内核。XQA 在「GQA + FP8 KV + 中长上下文」的 Hopper 解码上是首选;但 BF16 KV 的 Hopper 解码可能仍走 HMMA;在 Ampere 上是否优于 MMHA 取决于 batch 与上下文能否填满 SM;在 SM120 且 FP8 条件满足时,MLA 会优先走 XQA-MLA;在 SM100 上它彻底退场。理解这条边界,比记住「XQA 很快」更重要。
一次 decode step 的完整时序
把前面几节串起来,XQA 在一次 decode 前向里的执行顺序是这样的:
- 准入与编译。
XqaDispatcher::prepare()在第一次遇到某种形状时调用DecoderXQARunner::prepare():shouldUse()先过supportConfig()与mayHavePerfGain()两道关,再按CubinObjKey查CubinObjRegistry;未命中则以CompileEngine调 NVRTC 现场生成 cubin 并注册。 - QKV 预处理。
run()里若内核不接管 RoPE(Ampere 一律、Hopper 仅在 RoPE 维度不满足对齐时),先调invokeQKVPreprocessing:应用 QKV bias 与 RoPE,把处理后的 Q 写进 scratch 的xqa_q_input_ptr,并把 这类缩放比例作为标量参数交给注意力(preprocessingParms.fmha_host_bmm1_scale = 1.0f / (sqrtf(head_size) * q_scaling))。XQA 的内核读的是 已经追加过新 token 的 KV 缓存,这一步的前提是上游已经把本步的 K/V 写进分页池。 - 构造网格与参数。
run()按isMLA/isSpecDec && isHMMAKernel/ 常规三条分支组装 kernel 参数数组:TensorMap(Hopper)、页表指针、attentionSinks、kvCacheScale、semaphores、scratch、beamSearchParams。网格尺寸按第 2 节和第 10 节里讨论的规则决定。 - 内核执行。Ampere:8 warp、两平面分工,
cp.async搬 K/V,在线 softmax。Hopper:12 warp、三角色分工,IO warp 用 TMA 搬 K/V,GEMM0/1 用wgmma。多块模式下每个 CTA 只算一段 KV,写完 scratch 后对信号量做一次原子自增。 - 归约与输出。单块模式直接写输出;多块模式由最后一个 CTA 读全部 scratch 做在线归约,加回 attention sink,最后除以分母写回。若
LOW_PREC_OUTPUT,输出是 FP8,需要用rcpOutScale还原。
这个时序里有两个值得记的点:
- preprocessing 与注意力是两个 kernel。在 Ampere 上,Q 的 bias、RoPE 与缩放准备都发生在 preprocessing 里,注意力只拿到「已经转好」的 Q 与一个标量缩放因子;Hopper 在满足条件时把 RoPE 合进注意力,preprocessing 这一步就省掉了。这也意味着在 Ampere 路径上,XQA 并不省掉那次预处理的开销,它省下的是注意力本身在 SM 上的时间。
- KV 的追加不在 XQA 里。新 token 的 K/V 由上游(preprocessing 或框架的 KV 写入路径)落进分页池,XQA 只从页表开始读。这条边界让 XQA 与任何 KV 管理策略解耦:无论页大小、是否前缀共享、是否 P/D 分离中从别的实例收到 KV,只要页表被正确填好,XQA 就能直接读。
工程取舍与局限
读完源码,几个值得记录的取舍:
JIT 换体积和延迟。按形状编译的好处是每个 cubin 都只服务它自己的 、、页大小和精度,寄存器分配、SMEM 布局全是最好情况。代价是首次形状出现时的编译延迟与 cubin 缓存的管理成本。TensorRT-LLM 用 CubinObjRegistry 做进程级缓存,并在编译时按 hash 复用,但多进程部署时每个进程都会各自 JIT。仓库里还保留了 gen_cubins.py,用于把测试常用组合预先生成 cubin 再嵌入库,算是一种「预编译 + JIT」的折中。
确定性与性能的二选一。CTA_ROW_MAX_BACKWARD_METHOD 选 1 而非 4,损失约 8%;但换来的是逐位可复现,这在 SLO 严格、需要结果可比的服务里是硬需求。
多块的归约项。多块的收益在长上下文、小 batch 时最大;但块数过多会让归约项(读 scratch、合并 softmax)变成新的瓶颈。sqrt(8k) 的砍法是经验值,论文或文档里没有给出推导,实际部署时按硬件与负载调整 XQA_NB_SUB_SEQ 环境变量更可靠。
FP8 精度与接受率。QGMMA 路径上链式投机被禁用,说明全 FP8 的注意力在验证环节的误差不可忽视。如果模型输入 FP16/BF16、KV FP8,同时启用链式草稿,就会落到 HMMA:FP8 的带宽收益仍在( 在 FP16 中完成),但 Hopper 的 TMA 与 wgmma 优势用不上,性能曲线与纯 FP8 的 QGMMA 路径并不相同。
sink 与滑窗的组合。SLIDING_WINDOW 与 sink 都支持,但 supportConfigCommon() 要求 sink_token_length == 0,这意味着 XQA 目前不支持带 sink token 的流式生成——内核里有 attentionSinks 参数,但那是另一个含义(attention sink 权重,不是注入的 sink token)。这两者容易混淆,读源码时必须区分。
小结
XQA 是 TensorRT-LLM 在 Ampere/Hopper 上把 decode 注意力「做到极致」的一条路径,也是 SM120 上 MLA 解码的当前实现。它的核心并不在某个非常巧妙的数学技巧,而在三件事的工程组织:
- 形状特化到编译期:用 NVRTC 按 、、页大小、KV 精度、投机模式现场编译 cubin,每个实例都是最优寄存器与 SMEM 布局。
- 角色分工:Ampere 把 GEMM0 与 GEMM1 分到两个 warp 平面,靠双向屏障做流水;Hopper 把搬运拆成独立 IO warp,用 TMA +
wgmma做三角色异步。 - 补足并行度:多块模式沿 KV 切序列,用 scratch 存局部和-最大值,信号量选最后一个 CTA 归约;投机路径则把草稿树压进 方向,让
wgmma的粒度对齐。
最后回到开头的问题:XQA 凭什么比 MMHA 快?对 GQA 解码,它把「每读一份 KV 喂 个 Q 头」这个复用关系做到了数据布局层、SMEM 层与指令层;凭什么在某些形状下不如 MMHA?当每卡的「batch × 本地 KV 头数」太小、KV 太短、或者模型是 MHA 时,它的特化布局没有复用可言,额外的 JIT 与参数组装反而成了负担——这正是 mayHavePerfGain() 与 supportConfigCommon() 两道关卡存在的理由。
参考资料
- TensorRT-LLM XQA kernel source (cpp/kernels/xqa)
- TensorRT-LLM Attention docs: XQA optimization support matrix
- decoderXQARunner.cpp: shouldUse / grid assembly
- decoderXQAImplJIT/compileEngine.cpp: JIT macro translation
- TensorRT-LLM kernels: xqaDispatcher.cpp
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
- CUDA Tensor Memory Accelerator (TMA) programming documentation
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



