


TensorRT-LLM 源码完全拆解(二十):CUDA Graph 与编译路径——动态批如何被冻成静态图,又在哪里被放开
1. 解码阶段的瓶颈不在算力,而在 CPU 与 GPU 之间的那几千次发射
大模型推理有两个阶段:预填充(prefill)一次性把整段提示词吃进去,解码(decode)每次只生成一个 token。这两阶段的计算特征完全不同——预填充是算力密集的大矩阵乘,解码是访存密集的 GEMV:矩阵只有一列,权重读一遍、算一次、丢掉。所以在显存带宽已经打满的情况下,解码每一步能压缩的时间本来就有限。
真正的浪费发生在另外的地方。一个 Transformer 层在解码时要做的事,拆开看是这样的:
q_proj、k_proj、v_proj、o_proj四个 Lineargate_proj、up_proj、down_proj三个 MLP Linear- 两次 RMSNorm
- 一次注意力(读取分页 KV、算 softmax、加权求和)
- 一次残差相加
按 80 层算,一次前向是 500 到 900 个 CUDA kernel。每一个 kernel 的启动都要经过 Python → PyTorch dispatcher → CUDA runtime → 驱动这条链路,单次开销在微秒量级。GPU 上跑一个解码 kernel 可能只需要 5 微秒,但把它「叫起来」要花 3 到 10 微秒。于是 GPU 大部分时间在等 CPU 发号施令,利用率掉到 30% 以下是常态。
这就是 kernel launch bound。它不是显存带宽问题,不是算力问题,是发射问题。解决办法有三个层次:
- 减少 kernel 数量:算子融合(fuse),把 RMSNorm + 残差 + 量化拼成一个 kernel;
- 让 CPU 提前准备:把整个前向的 GPU 工作录成一个「脚本」,之后一次提交;
- 两条腿一起走:图层捕获(CUDA Graph)+ 图编译(torch.compile)。
TensorRT-LLM 的 _torch 后端把这三件事都做了,而且做得很彻底:它用 torch.compile 把 Python 前向编译成 FX 图并做算子融合,再用 CUDA Graph 把编译结果录成一次提交。本系列前十九篇已经把执行链路上的每一段都拆开看过——调度器、KV 块管理、注意力内核、MoE、采样。这一篇要回答的是:这条链路是怎么被「冻」成一张静态图,又在哪里必须被「放开」。
2. CUDA Graph 的原理:录一次,放很多次
CUDA Graph 是 CUDA 10 引入的能力。它的模型很简单:把一段 GPU 工作(一系列 kernel 启动、内存拷贝、事件)录制成一张 DAG(有向无环图),录的时候所有参数——kernel 的指针、grid/block 维度、每个参数缓冲区的设备地址、流依赖——都被固化进图里。之后每次执行只是 cudaGraphLaunch 一次,把整张图交给驱动,由驱动一次性把几百个 kernel 按依赖关系推给硬件。
关键点有两个,它们决定了后面所有的工程复杂度:
第一,图里的指针是死的。 录制的时候 input_ids 张量在显存地址 0x7f...a000,那么图里永远是 0x7f...a000。这不是「参数」,这是编译进图的常量。下次执行如果你把新的输入写到了别的地址,图会照着老地址去读——读到的还是上一次的数据。
第二,图里没有 Python。 录制完成之后,重放(replay)走的是纯 CUDA 路径,中间不会再跑任何一行 Python。任何在 forward 内部靠 Python 逻辑更新的状态——比如注意力元数据里的序列长度、投机解码的草稿 token、MRoPE 的位置增量——都不会被刷新,除非你在重放前手动把新值写进那块固定的缓冲区。
这两条合起来,就是 TensorRT-LLM 里所有 CUDA Graph 相关代码的设计动机:图要能录,就得先把所有输入变成「固定地址的静态缓冲区」;图要能重放,就得在重放前把「随批次变化的那一小撮状态」重新填进去。
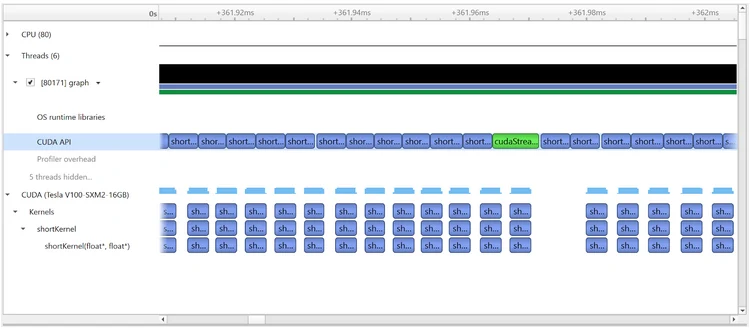
上图是 NVIDIA 官方对 CUDA Graph 建立方式的示意。左侧是显式提交:写代码逐个定义依赖关系,把每个 kernel 及其参数、地址、前后序关系填进图描述;右侧是流捕获(stream capture):让程序在一条专用流上正常执行一遍,运行时把这一遍里发生的所有 kernel 启动、拷贝与事件自动记录成图。TensorRT-LLM 走的是后一条路——torch.cuda.graph(graph, pool=...) 就是 PyTorch 对 cudaStreamBeginCapture / cudaStreamEndCapture 的封装。捕获完成后,那次「正常执行」留下的所有地址都成了图的一部分,这也正是下一节要讲的约束来源。
3. 为什么解码能录、预填充不能(在朴素方案下)
既然图这么好,为什么不把所有前向都录下来?
因为图只对形状固定的计算有效。解码的形状是固定的:
input_ids: (batch_size, 1) 每请求一个 tokenposition_ids: (batch_size, 1)attn_metadata: 序列长度随请求变化,但张量形状固定在同一个 batch_size 下,无论请求内容是长是短,上面这些张量的形状都不变。变的只是内容——也就是写进那几块静态缓冲区的数值。所以只要给每个 batch_size 录一张图,解码就能重放。
预填充做不到这一点。批次里有 1 个请求时 num_tokens 可能是 4096,有 32 个请求时可能是 30000 到 80000,取决于调度器这一轮挤了多少 token 进来。num_tokens 是前向所有中间张量的第一维,形状一旦变化,图里固化的 grid 维度和缓冲区地址全部失效,只能重录。而重录要跑一次 warmup 加一次 capture,代价远超收益。
所以在很长一段时间里,工业界的做法是:解码录图,预填充保持 eager,或者给预填充准备一组有限的「token 桶」(预填充的两条升级路线见第 15、16 节)。
4. 动态批的难题:图是静态的,批次是动态的
即使只录解码,还有一个绕不开的矛盾:批次大小是运行时才知道的。
客户端什么时候发请求、发多少、什么时候结束,都不可预测。某一轮调度器可能凑出 batch=3,下一轮 batch=17。如果每个 batch_size 都单独录一张图,那么 batch=1 到 256 就要录 256 张,warmup 时间和显存都不划算;如果不录,那么多出来的批次就只能回退到 eager,CUDA Graph 的收益忽高忽低。
TensorRT-LLM 的解法是 padding(填充)+ 桶(bucket):
- 启动时,用户给定一组
cuda_graph_batch_sizes,比如[1, 2, 4, 8, 16, 32, 64],只给这些尺寸录图; - 运行时,把实际批次的
batch_size向上取整到最近的桶; - 多出来的槽位用 dummy request(假请求)填满——这些假请求有自己的 KV 块、位置、输入 token,计算出的结果被丢弃。
代价是算力浪费:batch=17 会被 pad 到 32,等于多算了 47% 的 token。这是一个显式的权衡——用确定性的浪费换掉不确定的 launch 开销。在解码这种访存密集、算力富余的场景里,这笔交易通常划算。
但 padding 不是白来的,它会连锁触发三个问题,这正是 TensorRT-LLM 里最复杂的一块代码:
- dummy 请求也有 KV 生命周期:它要分配块、要写 KV、要在批次结束后释放。如果释放不好,就会把物理块泄漏在池子里。
- dummy 的注意力元数据必须是合法的:序列长度、块表、块偏移都要指向真实分配的 KV 块,否则会读到别的请求的数据。TensorRT-LLM 用
_get_or_create_padding_dummy/release_padding_dummy一对函数管理这套生命周期,并在 KV 池重平衡(rebalance)时暂停 dummy 的分配——因为重平衡会搬动物理块,dummy 持有的句柄会失效。 - 投机解码下 draft_len 也要对齐:不同请求的草稿 token 数可能不同,图里却只能有一个形状。
KeyType里断言assert len(set(draft_len_list)) == 1, "All draft lengths must be the same",运行时草稿数不一致的批次直接放弃走图。
5. 图的坐标:KeyType 凭什么长这样
TensorRT-LLM 的 CUDAGraphRunner 用一个 NamedTuple 当图的键,代码在 tensorrt_llm/_torch/pyexecutor/cuda_graph_runner.py:
class KeyType(NamedTuple): batch_size: int draft_len: int short_seq_len_mode: bool = False is_all_greedy_sample: bool = True sample_type: SampleType = SampleType.FULL num_contexts: int = 0 context_query_len: int = 0 num_encoder_tokens: int = 0 peft_cache_data_type: Optional[torch.dtype] = None use_lora_graph: bool = False这个元组就是「一张图的坐标」。理解它的每一个字段,就理解了动态推理里哪些东西会改变图的形状。逐个说明:
batch_size:最直观的一维。前面说过,用户只给一组桶,实际批次向上取整。draft_len:投机解码一轮塞进目标模型的草稿 token 数,等于「每请求 token 数」减一。它决定input_ids的静态缓冲区长度,因为草稿是变长的——动态投机解码(dynamic draft length)会按置信度调整草稿深度,所以同一个 batch_size 下可能有draft_len为 2、4、6 的多张图。dynamic_draft_len_mapping就是 batch size 到草稿长度的映射。short_seq_len_mode:给序列长度感知的稀疏注意力用。有些稀疏注意力方案(比如 PARD、DSA 这类)在序列短时走稠密路径、序列长时走稀疏路径,两条路径的 kernel 集合不同,必须是两张图。这个布尔值标记「这张图是短序列版还是长序列版」。is_all_greedy_sample:投机解码的 one-engine 模式下,采样器有两条代码路径——全 greedy 时可以走 argmax 快路径,只要有一个请求是 top-k/top-p,就得走完整的采样 kernel。kernel 序列不同,图不能共用。sample_type:FULL表示图里根本不含采样,前向结束后采样器 eager 执行;FAST表示采样 kernel 也被录进了图。这是 TensorRT-LLM 显式的「采样是否入图」开关,enable_in_graph_sampling打开才录FAST图。num_contexts/context_query_len:给编码器-解码器(encoder-decoder)模型的混合批次用。这类模型同一轮里既有上下文 token 又有生成 token。num_encoder_tokens:同上,交叉注意力要读的编码器输出长度。peft_cache_data_type/use_lora_graph:LoRA 是否入图,以及 adapter 权重的数据类型。多 LoRA 服务下,带 LoRA 和不带的图必须分开。
这张表是整篇的地图:凡是能让前向跑出不同 kernel 序列的东西,都会进 KeyType。
6. maybe_get_cuda_graph:一次批次能不能走图,要过几道闸
图键有了,接下来的问题是「这一批能不能用」。入口是 maybe_get_cuda_graph,函数会依次检查一串条件,任何一条不过就返回 (None, None, None),引擎回退到 eager:
if ExpertStatistic.should_record(): return None, None, None第一条:统计模式关图。当引擎在做专家统计(为 EPLB 收集每个专家的负载分布)时,forward 里会插入额外的记录代码,形状和语义都和图不符,直接关掉。
第二条:注意力 DP 下的跨 rank 一致性。Attention DP(数据并行)把不同请求分给不同的 rank,每个 rank 看到的批次不一样。如果 rank 0 的 batch=5 能走图、rank 1 的 batch=7 不能,两者就会执行不同的代码路径,而 TP/EP 的集合通信是需要全组对齐的——一旦有 rank 回退 eager、有 rank 走图,通信就会挂死。所以代码在 DP 开启时做一次 all-gather:
graph_batch_info = self._gather_adp_graph_batch_info( batch, can_run_cuda_graph, local_sample_type)all_can_run_cuda_graph = all(r[0] for r in graph_batch_info)all_batch_sizes_equal = all(r[1] == graph_batch_info[0][1] for r in graph_batch_info)if not all_can_run_cuda_graph or not all_batch_sizes_equal: return None, None, None注意 all_batch_sizes_equal:不仅「能不能走图」要对齐,连 batch_size 本身都要对齐。因为 padding 后的实际图尺寸是从 batch_size 算出来的,如果各 rank 的 padding 目标不同,它们重放的图就不是同一张,形状不一致会让通信崩掉。这里还顺带对齐了 sample_type:某个 rank 空闲时批次为空,会解析成 FULL,此时整组退回 FULL。
第三条:MRoPE 的位置增量缓存。多模态模型(Qwen2-VL 一类)使用 MRoPE,位置编码分三个维度。有些路径每个请求有自己的位置增量,需要在重放前写进模型侧缓存;如果某个请求的增量还没准备好,这一轮就不能走图。
第四条:键必须已存在。if key in self.graph_metadata 命中就直接复用;否则要看是否处在「允许捕获」的窗口内——也就是下面这个设计。
7. 一个不显眼但很关键的约束:捕获只在启动期允许
CUDAGraphRunner 里有一个看起来多余的字段:
# On-the-fly capture is disabled by default to prevent workspace# tensor reallocation from invalidating addresses baked into existing# CUDA graphs. Use allow_capture() context manager during warmup.self._capture_allowed = False意思是:运行期遇到没录过的形状,不会顺手录一张,而是直接回退 eager。只有启动 warmup 阶段通过 allow_capture() 显式打开捕获窗口。
为什么要这么保守?因为共享的注意力 workspace 是一块可增长的缓冲区。如果运行到第 1000 步突然来了一个没见过的形状,捕获它会走一次 warmup 前向,这次前向可能要求更大的 workspace,于是 workspace 张量被重新分配——地址变了。而前面录好的所有图里,那个地址是写死的常量。结果就是老图全部读到错误的内存,而且不报错,只是结果悄悄变错。
这个坑在 PyTorch 官方文档里也提到过:CUDA Graph 捕获的语义要求所有张量地址在重放时保持一致,任何在捕获后被重分配或释放的张量都会让图失效。TensorRT-LLM 的处理方式是把「捕获」变成一个只在受控窗口内发生的动作,并在 capture() 里用 piecewise_cuda_graph(False)、with_multi_stream(True) 这样的上下文把编译期开关约束住。
顺带一提,同一个文件里还有个 _strict_buffer_check_enabled() 的调试开关:捕获后把关键张量的地址快照下来,每次重放前比对,地址漂移就直接报错。这是给「图悄悄读错内存」这类最难查的 bug 准备的护栏。
8. capture() 与 replay():两侧对称的静态缓冲区
这两个函数是整篇的核心。捕获和重放必须写同一块内存、写同样的位置、写同样的形状,否则图就会读到脏数据。
先看捕获侧。capture() 拿到 initial_inputs,把其中会随批次变化的张量换成静态缓冲区的切片:
sliced_static_tensors = { "input_ids": self.shared_static_tensors["input_ids"][:num_tokens_for_capture], "position_ids": self.shared_static_tensors["position_ids"][:, :num_tokens_for_capture],}capture_inputs = initial_inputs.copy()capture_inputs.update(sliced_static_tensors)num_tokens_for_capture 由键算出来:
def _get_num_tokens_for_key(self, key: KeyType) -> int: token_per_generation = key.draft_len + 1 return (key.num_contexts * key.context_query_len + (key.batch_size * self.max_beam_width - key.num_contexts) * token_per_generation)也就是「上下文请求各占 context_query_len 个 token,生成请求各占 draft_len + 1 个 token」。这个数就是静态缓冲区的切片长度,也是重放时校验输入长度的基准。
捕获流程本身分两步,这是 PyTorch 要求的:
with with_multi_stream(True), piecewise_cuda_graph(False): # warmup:初始化 PyTorch 内部状态、attn_metadata 状态,并在录图前 # 把共享注意力 workspace 扩到最终大小 for _ in range(self.WARMUP_STEPS): output = forward_fn(capture_inputs) if postprocess_fn is not None: postprocess_fn(capture_inputs) _restore_spec_decode_capture_state(attn_metadata, saved_kv_lens_cuda)
if self.is_warmup_only: return output
graph = torch.cuda.CUDAGraph() output = None with torch.cuda.graph(graph, pool=self.memory_pool): output = forward_fn(capture_inputs)warmup 那几次 eager 前向不是为了「让 cache 热起来」,而是有明确目的:让 workspace 扩到最大,之后录制就不会再触发重分配。注释里写得很直白——“This also lets us initialize states in the attn_metadata and resize the shared attention workspace before any graph is captured.”
再看重放侧。replay() 的第一件事是把当前批次的数据拷进那些静态缓冲区,并在拷之前校验形状:
input_ids = current_inputs["input_ids"]seqlen = input_ids.shape[0]expected_num_tokens = self._get_num_tokens_for_key(key)if seqlen != expected_num_tokens: raise ValueError( f"replay() got {seqlen} tokens for key {key}, but the graph " f"was captured for {expected_num_tokens} tokens. A shorter " "input_ids leaves the tail of the static input buffer stale.")static_tensors["input_ids"][:seqlen].copy_(input_ids)这个 ValueError 的信息量很大:如果传进来的 token 数比图捕获时少,缓冲区尾部会留着上一轮的数据。图会照着老长度去算,把上一批请求的残留 token 当成有效输入。所以这里宁可抛异常也不宽容。
position_ids 的校验更谨慎,因为 copy_() 会静默广播:
expected_position_ids_shape = (1, seqlen)if tuple(position_ids.shape) != expected_position_ids_shape: raise ValueError( f"replay() got position_ids of shape {tuple(position_ids.shape)} " f"for key {key}, but expected {expected_position_ids_shape}. " "torch.Tensor.copy_() silently broadcasts mismatched shapes, " "which would corrupt the static input buffer.")如果形状是 (1, 1) 而目标是 (1, seqlen),copy_() 不报错,而是把同一个值广播满整个缓冲区——所有 token 的位置都变成同一个数,RoPE 全错,输出全是垃圾。这类 bug 不会崩,只会让模型「说得不对」,所以必须显式挡住。
注意 MRoPE 分支里还有第三种情况:mrope_delta_read_seq_slots 缺失时不是「保持不变」,而是显式填成 dummy 槽位:
# Omission means every slot reads the dummy seq slot's permanently-zero# delta. Fill explicitly instead of leaving stale values.static_tensors['mrope_delta_read_seq_slots'][:num_slots].fill_(mrope_dummy_seq_slot)这体现了静态缓冲区的一条铁律:任何一块可能在重放时被读到的缓冲区,都必须在每次重放前被显式写满,不能依赖「上次的值」。忘了写,图就会读脏数据。
重放的最后是 pre_replay_hooks——一个挂着少数几个回调的列表。注释解释了它的存在:
# Called just before each replay, after the static input buffers are# filled. For state a model computes inside its own forward and a graph# therefore captures the address of: a replay runs no Python, so nothing# else refreshes it. Registered by the engine on the model's behalf.典型例子是投机解码的位置偏移:草稿 token 的位置需要在图内被就地更新,而更新发生在捕获进去的预处理逻辑里。但重放时模型的 mrope/position 逻辑可能还需要看到「修正前」的位置,于是引擎注册一个 hook,在图重放前用一份临时张量算出 position_id_offsets 的叠加结果,再交给 hook 使用。这是「图里没有 Python,所以把 Python 换成一个在图外执行、但结果等价的小函数」的典型做法。
9. replay() 之后:输出去哪了
重放结束,output_ref 是一个弱引用,指向图捕获时那一次前向的输出张量:
self.graphs[key] = graphgraph_output = make_weak_ref(output)self.graph_outputs[key] = graph_output为什么用弱引用?因为重放不会产生新的输出张量——输出就写在那块固定的显存里。如果这里持有强引用,那批 activation 就永远释放不掉;用弱引用既保证对象在重放时还活着,又让中间激活能正常被分配器回收。
这也解释了为什么调用方必须在重放后立刻消费输出(或者在下一轮重放前消费):下一次重放会覆盖同一块内存。
10. 桶不是随便给的:capture 候选如何被裁剪
cuda_graph_batch_sizes 给多了没意义,给少了会频繁回退 eager。TensorRT-LLM 在两边都做了裁剪。
第一层在引擎侧,engine/cuda_graph.py 里的 filter_cuda_graph_batch_sizes:桶不能超过引擎的批容量,也不能超过「token 预算除以每请求 token 数」:
max_cuda_graph_batch_size = min(max_batch_size, max_num_tokens // tokens_per_request)如果用户给了超限的桶且开了 padding,函数会把它夹到上限并打日志,而不是静默丢弃。
第二层在预填充图侧,model_engine.py 里的 _filter_piecewise_capture_num_tokens 更微妙。它的上界不是 max_num_tokens,而是
为什么要减一?因为每个在飞请求必须至少留一个 token 的生成空间,所以 warmup 构造出的前向的最大 num_tokens 就是这个乘积。超过它的候选「录不出来」,函数把它们夹到该上界并单独返回 unrecordable 列表让调用方告警。
函数注释还解释了一条不那么直觉的规则:不要把上界追加进桶列表。原因是运行时的 padding 会把实际迭代向上取整到最近的已录桶,如果列表本来只到 13914,却在末尾追加一个 65536 的桶,那么 13915 到 65536 之间的每一次迭代都会跳到 65536 这个形状上执行——不是偶尔浪费,是这一段区间内每一次都浪费满额。
11. 启动期的两趟 warmup:为什么是两趟
TensorRT-LLM 的引擎启动会做两趟捕获,这不是设计洁癖,而是由上一节说的那条约束推出的:图必须录成一个不变的地址布局。
第一趟(warmup-only)做三件事:
- 跑一遍所有批大小的 dummy 前向,让显存分配器把峰值尺寸摸清、让 workspace 扩到最大;
- 如果开了 LoRA,做一次 LoRA 的 autotune,并让 PP 缓存交接/清理也计入 warmup 计时;
- 对于 MXFP8 量化,跑一次 FlashInfer 的 autotune。
这一趟只跑 eager,不录图,is_warmup_only 为真时 capture() 会在 warmup 后提前返回。第二趟才真正录制:这时候所有缓冲区的大小都已经稳定,录下来的图不会因为后续重分配而失效。
run_cuda_graph_warmup 的结构把这两趟写得很清楚:
is_warmup_only = self.cuda_graph_runner.is_warmup_only...with lora_context: if not (self.cuda_graph_runner.enabled or self._config.prefill_cuda_graph_backend != PrefillCudaGraphBackend.DISABLED): return ... with flashinfer_autotune_context, flashinfer_mxfp8_decode_graph_capture(): self._capture_generation_cuda_graphs(resource_manager) self._capture_additional_cuda_graphs(resource_manager)# Piecewise graphs have separate capture machinery and do not use the# whole-model attention workspace. Capture them only on the second pass.if not is_warmup_only: self._capture_prefill_cuda_graphs(resource_manager)最后那几句注释很关键:分段图(piecewise graph)与整模型注意力 workspace 无关,所以放在第二趟单独捕获。两类图的显存来源不同,混在一起会让第二趟的地址布局不稳定。
12. 一个 batch size 要录几张图:变体爆炸与它的收敛
第一趟第二趟只是时间上的划分,真正让 warmup 变长的是变体组合。看 _capture_generation_cuda_graphs 里的变体枚举:
if self._lora.cuda_graph_manager is None: lora_graph_cases = [False]elif self._config.cuda_graph_specialize_lora: lora_graph_cases = [True, False] # 先录大的 LoRA 图,让 base-only 图复用它的内存池else: lora_graph_cases = [True]LoRA 有两档,而且顺序有讲究:先录 LoRA 图,因为 LoRA 图更大,它的内存池分配可以被后面的 base-only 图复用。
采样侧同样分档:
if uses_own_spec_decoder: _capture_variant("greedy") _capture_variant("advanced sampling", force_non_greedy=True)else: _capture_variant("full", sample_type=SampleType.FULL) if self._config.enable_in_graph_sampling: _capture_variant("fast", force_non_greedy=True, sample_type=SampleType.FAST)注释里有一句判断值得记下来:use_one_engine() 而不是 has_spec_decoder()——因为两模型的 eagle3/mtp_eagle 模式「也有 spec decoder」,但它们拿到的是普通 TorchSampler,属于 FULL 分支。判断依据必须是「谁在采样」,而不是「有没有投机解码」。
而 _capture_variant 存在的原因是硬约束:运行期不允许现场捕获。所以任何「某些批次会出现、但没在启动时录过」的图,都只能回退 eager。为了让「批次里有一个非 greedy 请求」这种情况也能走图,就必须在启动时把 advanced sampling 版本也录下来——哪怕绝大多数请求都是 greedy。
变体数随维度相乘:batch_sizes × draft_lens × lora_cases × sample_types × sparse_seq_len_modes。这是 warmup 时间的主要来源,也是 cuda_graph_specialize_lora 这类开关存在的意义——它让用户可以在 warmup 时间和运行时覆盖率之间选。
13. 稀疏注意力:同一个 batch size 为什么需要两张图
_capture_generation_cuda_graphs 里有一段专门处理序列长度感知的稀疏注意力:
if (isinstance(sparse_config, SeqLenAwareSparseAttentionConfig) and sparse_config.needs_separate_short_long_cuda_graphs()): max_runtime_tokens_per_gen_step = self.get_runtime_tokens_per_gen_step( self._config.max_draft_len) max_seq_len = sparse_config.seq_len_threshold - max_runtime_tokens_per_gen_step if max_seq_len < effective_max_seq_len: max_seq_len_list = [effective_max_seq_len, max_seq_len] else: max_seq_len_list = [effective_max_seq_len]道理是:这类方案按序列长度阈值 seq_len_threshold 在稠密路径和稀疏路径之间切换,两条路径的 kernel 不同,因此同一个 batch_size 下需要两张图——一张代表「长序列」形状,一张代表「短序列」形状。重放时由 short_seq_len_mode 字段(第 5 节讲过的 _get_seq_len_mode)决定选哪张。
短序列那张图的最大序列长度要再减掉一个生成步会吃掉的 token 数,注释解释得很清楚:PARD 这类方案在这个减量上用的是 2K 而不是 K+1,因为一个生成步可能消耗的不止一个 token(投机解码)。如果不减,warmup 请求的 position_ids 可能越过 RoPE 表的 max_position_embeddings,warmup 直接崩。
同一段代码里还有一句 CP 相关的话:Helix 上下文并行(CP)下,每个 rank 只持有 max_seq_len / cp_size 个 token,所以 effective_max_seq_len 要按 cp_size 缩小——否则同样会撞到 RoPE 表边界。
14. torch.compile:先解决「kernel 太多」,再解决「发射太慢」
CUDA Graph 减少的是发射次数,但它不减少 kernel 数量:图里依然排着 500 到 900 个节点。要从根上减少发射,得让 kernel 本身变少——也就是算子融合。
TensorRT-LLM 的 _torch 后端用 torch.compile 来做这件事,自定义编译后端在 tensorrt_llm/_torch/compilation/backend.py:
class Backend: def __init__(self, enable_inductor=True, enable_userbuffers=False, enable_piecewise_cuda_graph=False, capture_num_tokens=None, max_num_streams=1, mapping=None): ... self.custom_passes = Backend.build_custom_passes(enable_userbuffers, mapping) self.enable_inductor = enable_inductor self.capture_num_tokens = sorted(capture_num_tokens or []) self.piecewise_cuda_graph = enable_piecewise_cuda_graphbuild_custom_passes 按并行度分两条路:单卡(world_size == 1)注册 add_norm_quant 融合——把「残差相加 + RMSNorm + FP8 量化」拼成一个 kernel;多卡则注册 ar_residual_norm,把 AllReduce + 残差 + RMSNorm 三者融合(如果启用了 userbuffers),并准备一个 add_norm_fallback 兜住「前面没有 AllReduce」的残余模式。多卡时还会强制设置 DISABLE_LAMPORT_REDUCE_NORM_FUSION=1,因为 lamport 融合 kernel 与 torch.compile 目前不兼容。
optimize() 是真正的 FX 图改写入口:
def optimize(self, gm, example_inputs): graph = gm.graph for custom_pass in self.custom_passes: match_count = custom_pass.apply(graph) while match_count: # 反复应用直到不再匹配 match_count = custom_pass.apply(graph) graph.eliminate_dead_code() remove_copy_for_mutates_args(graph) ... if self.piecewise_cuda_graph: gm, num_events, runners = piecewise_optimizer(...) return gm elif self.enable_inductor: return compile_fx_inner(gm, example_inputs) else: return gm三处细节值得停一下:
while match_count循环:pass 应用一次可能暴露新的可融合模式(融合后相邻的算子变了),所以反复应用直到收敛,并逐 pass 记录match_count_by_pass供调试。remove_copy_for_mutates_args之后的注释 “After this pass, cannot run any dce!!!”:这一步移除了「写回原张量」所需的拷贝,死代码消除会把看似无用的边删掉,导致语义变化。这类「顺序敏感」的注释在编译器代码里很常见,也提醒读源码的人不要重排 pass。- 多流调度有条件:
if self.num_streams > 1 and not self.piecewise_cuda_graph and not self.enable_inductor—— 分段图的多流优化在piecewise_optimizer里做,inductor 内部的多流 TensorRT-LLM 控制不了,所以这里只管「既不分段、也不用 inductor」这一种情况。
__call__ 里还有个「探测输入 token 数」的动作,因为分段图必须知道哪一维是 num_tokens:
for node in gm.graph.nodes: if node.op == "placeholder": if node.name in ["l_input_ids_", "l_kwargs_input_ids_", "l_inputs_embeds_", "l_kwargs_inputs_embeds_"]: example_value = node.meta["example_value"] self.input_num_tokens = example_value.shape[0] break多模态模型的前向是 input_ids=None, inputs_embeds=<tensor>,dynamo 会消掉 input_ids 占位符,所以四个候选名字都要查。找不到就直接抛断言错误——分段图无法在不知道 token 维的情况下工作。
最后用 aot_module_simplified 接进 AOTAutograd,fw_compiler=self.optimize——也就是说 optimize 是在 AOT 前向图已生成、但还没交给 inductor 的时候介入的,这个插入点让它既能改写 FX 图,又能把结果丢给 inductor 编译。
15. 分段图:把预填充切成「图段 + eager 断点」
预填充不能整段录图,但可以录成若干段。这就是 piecewise CUDA graph,核心在 compilation/piecewise_optimizer.py。
切分的依据是注意力算子——它们是天然的边界:
def _piecewise_boundary_ops(): op_names = [ "attn_custom_op_inplace", "mla_custom_op_inplace", "mla_dsa_attn_inplace", "gdn_custom_op_inplace", "mamba2_custom_op_inplace", "minimax_m3_attn_custom_op_inplace", ]这些算子都带 inplace 后缀:它们在原地更新 KV Cache。这正是它们必须当边界的理由——KV Cache 的状态必须在图外可见。如果注意力也被录进图里,KV 的写入就和图绑死了,下一轮的元数据变化没法反映进去。
切分器 piecewise_optimizer 遍历 FX 节点,遇到边界算子就翻一个 graph id,并且顺手把边界算子所在的子模块从「可编译模块」里排除(exclude_modules_id)。还有一个「停止切分」的标志:
stop_target = is_call_function(node, [ torch.ops.aten.index.Tensor, torch.ops.aten.cumsum.default,])...if not is_boundary: # We only know it is safe to continue splitting after attention stop_partition = Trueindex 和 cumsum 常见于「按块偏移 gather KV」这类逻辑。注释说得很克制:只有经过一次注意力之后,才知道继续切分是否安全。这是一种保守的正确性策略——宁可少切几段,也不要切出一段语义不完整的子图。
切完交给 split_module,然后 PiecewiseInterpreter 逐个子模块走一遍 fake 输入,给每个子模块创建一个 PiecewiseRunner。PiecewiseInterpreter.call_module 里有个细节:它要在子模块的 placeholder 里找到 num_tokens 所在的那一维:
if (isinstance(i, torch.SymInt) and i == self.compile_time_num_tokens): runtime_num_tokens_idx = (input_idx, dim_idx)找不到就抛 "Cannot identify dynamic shape, please disable enable_piecewise_cuda_graph in TorchCompileConfig"。这段代码的意义是:编译期看到的是 SymInt(符号形状),而分段图的每一步都需要在运行期从真实张量里读出这个数,才能决定「走图还是走 eager」。
PiecewiseRunner.__call__ 就是运行期的分派逻辑,非常短:
if (runtime_num_of_token is None or runtime_num_of_token not in self.entries or not get_piecewise_cuda_graph_flag() or not get_per_request_prefill_cuda_graph_flag()): return self.default_callable(*args)...entry = self.entries[runtime_num_of_token]if entry.cuda_graph is None: if not get_capture_piecewise_cuda_graph_flag(): return entry.callable(*args) if entry.warmup_count < self.WARMUP_STEPS: entry.warmup_count += 1 return entry.callable(*args) ... # 捕获entry.cuda_graph.replay()return entry.output逐条读:
- token 数不在桶里 → 走 eager。桶就是
capture_num_tokens,和第 10 节的裁剪规则接上。 - 两个全局开关:
get_piecewise_cuda_graph_flag()让整段分段逻辑可以被临时关闭(比如跑 profile 时),get_per_request_prefill_cuda_graph_flag()是请求级的开关——某些请求(比如带gather_context_logits的、或者开了某些调试路径的)不适合走图,就单独关掉。 WARMUP_STEPS = 3:一个桶要跑三次 eager 才允许录图。这和整模型图的两趟 warmup 是同一个道理——让 inductor 的编译缓存、workspace 尺寸都稳定下来。- 首尾 runner 维护
set_piecewise_running:第一段和最后一段负责把「正在跑分段图」的全局状态摆正,中间段不管;如果第一段就是最后一段(只有一段),直接置为False。
捕获那一段有两个工程细节:
# Torch's cuda graph will call gc.collect() internally. This will slow down the performance.# We patched it to do nothing.with patch("gc.collect", lambda: None): extra_attrs = get_model_extra_attrs() with torch.cuda.graph(graph, pool=self.graph_pool_handle): extra_attrs["global_stream"] = torch.cuda.current_stream() output = entry.callable(*args)一是把 gc.collect 打成空函数——PyTorch 录图时会触发垃圾回收,在一次 warmup 里做全量 GC 会显著拖慢启动。二是显式设置 global_stream,因为捕获会覆盖当前流,模型内部如果用到了「当前流」这个概念(比如多流调度、跨流事件),必须让它看到正确的那个。
最后,entry.output = make_weak_ref(output) 和第 9 节整模型图的处理一样:输出就在固定显存里,弱引用保证它活到重放,又不阻止后续复用。
还有一个 piecewise_optimizer 之外的协调点:clear_piecewise_cuda_graphs。它要处理 CUDA 分配器的一条限制——私有内存池句柄在最后一张图被 reset 之后不能再复用,所以清理时不是简单地把旧池丢掉,而是给同一编译图下的多个 runner 轮换一个新的共享句柄:
replacement_pools: dict[tuple[int, int], tuple[int, int]] = {}for runner in runners: old_pool = runner.graph_pool_handle if old_pool not in replacement_pools: replacement_pools[old_pool] = torch.cuda.graph_pool_handle() runner.graph_pool_handle = replacement_pools[old_pool]注意「同一个旧池映射到同一个新池」——多个 runner 共享一个池是刻意的,共享才能让它们的分配互相复用地址。
16. Breakable CUDA Graph:在段与段之间插回真正的 eager 代码
分段图解决了「预填充能不能录」的问题,但它有一个前提:切分点必须在编译期确定,而且切出来的每一段都必须是纯 GPU 工作。
实际模型里有不少「运行时才决定、而且必须立刻看到结果」的逻辑。最典型的是注意力元数据的 host 侧处理:块表要重新算、序列长度要重排、投机解码的草稿要重新分配。这些工作里有一部分是 CPU 代码,甚至要和 GPU 同步。
TensorRT-LLM 为此实现了 Breakable CUDA Graph(BCG),文件头写明了来源:
# Adapted from SGLang's breakable CUDA graph implementation.核心抽象是「一张图被切成若干段,段之间可以插 eager 函数」:
class BreakableCUDAGraph: """A sequence of CUDA graph segments separated by eager functions."""
def __init__(self) -> None: self._segments: list[torch.cuda.CUDAGraph] = [] self._break_functions: list[Callable[[], Any]] = []
def replay(self) -> None: stream_token = _current_stream.set(torch.cuda.current_stream()) replay_token = _current_replay_token.set(next(_replay_token_counter)) try: for index, segment in enumerate(self._segments): segment.replay() if index < len(self._break_functions): self._break_functions[index]() finally: _current_stream.reset(stream_token) _current_replay_token.reset(replay_token)重放就是「放一段、跑一个断点函数、再放一段」。这个模型比静态分段图灵活得多:断点的位置由运行时代码自己声明,而不是由编译器在 FX 图上猜。
声明断点的方式是一个装饰器:
def eager_on_graph(inner: Callable) -> Callable: """Run a callable eagerly between captured CUDA graph segments."""
@functools.wraps(inner) def wrapper(*args, **kwargs): if torch.compiler.is_compiling(): return inner(*args, **kwargs) capture = _current_capture.get() if capture is None: return inner(*args, **kwargs)
capture._end_current_segment() output = inner(*args, **kwargs)
captured_args = tuple(make_weak_ref(arg) for arg in args) captured_kwargs = {k: make_weak_ref(v) for k, v in kwargs.items()} captured_output = output
def replay_fn() -> Any: new_output = inner(*captured_args, **captured_kwargs) return _copy_output(captured_output, new_output)
capture.cuda_graph._break_functions.append(replay_fn) capture._begin_new_segment() return output return wrapper逐行看它做了什么:
- 编译期(
torch.compiler.is_compiling())直接放行:不让 dynamo 看到断点逻辑,图里就是一个普通调用。 - 不在捕获上下文(
_current_capture为空)直接放行:正常 eager 路径无影响。 - 捕获期:先把当前段收尾(
_end_current_segment),然后真的 eager 跑一次这个函数——这次执行既是 warmup 也是「获取输出张量」的方式;接着把参数和输出都弱引用存下来,注册一个replay_fn到断点列表里;最后开一个新段(_begin_new_segment)。 - 重放期:
replay_fn用同样的参数再跑一次inner,把结果_copy_output进捕获时那块输出内存。
_copy_output 递归处理 tensor、tuple、list、有 __dict__ 的对象和 dict,就是为了「把新结果写回固定地址」这件事在各种返回结构下都能成立。它和整模型图里「重放前把新数据拷进静态缓冲区」是同一件事的两个方向:一个是把输入灌进去,一个是把输出捞出来。
BCG 还要处理一个 CUDA 语义问题:捕获期插入的 eager 代码可能在别的流上。PyTorch 的 Stream.wait_stream 在捕获期有特殊语义,代码直接把它打了个 hook:
def _hooked_wait_stream(self: torch.cuda.Stream, other: torch.cuda.Stream) -> None: ... if self_is_capture and not other_is_capture: if not _is_stream_capturing(other): logger.warning( "Dropping a wait from the breakable CUDA graph capture stream " "to a non-capturing stream; this dependency will not be " "preserved during replay.", stacklevel=2) return _original_wait_stream(self, other) forked.discard(other)如果捕获流要去等一个没有在捕获的流,这个依赖无法在图里表达——重放时它不会自动恢复。代码选择丢掉这个 wait 并警告,而不是静默保留一个假的依赖。同时它记录了「从捕获流 fork 出去的侧流」集合,在 _end_current_segment 里把这些侧流重新 join 回主流,保证段边界处依赖完整。
另一处约束在 runner 侧:BCG 在 PrefillCudaGraphBackend.BREAKABLE 下才启用,并且 _validate_breakable_cuda_graph_compatibility 会挡住不兼容的配置组合。
17. 三条路线的分工:什么时候用哪一种
到这里可以把 TensorRT-LLM 的三套机制放在一张表里:
| 机制 | 录什么 | 解决什么 | 边界在哪 |
|---|---|---|---|
整模型 decode 图(CUDAGraphRunner) | 一次解码前向的全部 kernel | 消除解码每步几百次 launch | 形状必须命中 KeyType;捕获只在启动期 |
| 分段图(piecewise PCG) | 预填充前向切出的若干「非注意力子图」 | 让预填充也能省 launch | 切点在编译期由注意力算子确定;token 数要命中桶 |
| 可断开图(breakable BCG) | 预填充模型体,段间可插 eager | 让预填充既能走图、又能保留运行时逻辑 | 断点需显式声明;跨流依赖可能丢失 |
选择逻辑大致是:
- 解码侧:只要
cuda_graph_config非空就录整模型图,这是收益最明确的一档。桶的选择(batch_sizes)和 padding 开关是用户最需要调的参数。 - 预填充侧:
prefill_cuda_graph_backend三选一——DISABLED、PIECEWISE、BREAKABLE。分段图依赖 torch.compile(torch_compile_enabled为假时_capture_prefill_cuda_graphs直接返回),可断开图不依赖编译但更依赖模型代码对断点的声明。 - 采样:默认
FULL(不采样入图),enable_in_graph_sampling才录FAST变体——它省掉的是一步解码的尾部几个 kernel,收益小、warmup 成本高,所以默认关。
还有一层容易忽略的配置耦合:开 torch.compile 会改变图的地址布局。编译后的模型把多个算子融成一个 kernel,中间张量少了,workspace 需求也变了。所以编译必须发生在任何捕获之前——这也是「两趟 warmup」里第一趟要先跑 eager 的原因,以及 _capture_prefill_cuda_graphs 为什么只在第二趟执行。
18. 工程上最容易踩的几个坑
把散落在上面各节的坑集中列一遍:
坑一:运行期现场捕获。 最常见的心智错误是「没见过就录一张」。在 TensorRT-LLM 里这条路是主动封死的(_capture_allowed),因为捕获会触发 workspace 重分配,让所有已录图的地址失效。如果你自己写类似的系统,一定要把捕获窗口限制在启动期。
坑二:忘记刷新静态缓冲区。 任何在图外计算、但图内要读的值(位置增量、投机草稿、LoRA 权重指针)都必须在重放前写进去。MRoPE 那段 fill_(mrope_dummy_seq_slot) 就是这条规则的反面教材——「不写」必须显式表达为「写一个确定的默认值」,不能靠残留。
坑三:copy_() 的静默广播。 position_ids 的形状校验不是防御性编程的洁癖,是因为 copy_() 在形状不匹配时会广播而不报错,最后表现为「模型回答变得不合理」而不是崩溃。做类似系统时要对每一个进图的张量都做形状断言。
坑四:DP/TP 下的路径分歧。 只要有集合通信,就必须保证所有 rank 走同一条路径。所有 rank 的「能不能走图」和「padding 到多大」都要对齐,TensorRT-LLM 用一次 all-gather 解决。
坑五:padding dummy 的 KV 生命周期。 假请求也占物理块。KV 池重平衡(搬块)期间必须暂停 dummy 分配,否则句柄失效;批次结束必须释放,否则池子慢慢泄漏。
坑六:变体爆炸。 batch_sizes × draft_lens × lora × sampling × sparse_mode 相乘,warmup 时间会指数级膨胀。控制方法是收紧桶列表、关掉用不到的变体(enable_in_graph_sampling、cuda_graph_specialize_lora)。
坑七:CP 与 RoPE 表的边界。 上下文并行下每个 rank 只持有 max_seq_len / cp_size 个 token,warmup 请求的位置不能越过 max_position_embeddings;短序列稀疏图的长度还要再减掉一个生成步的 token 数。
19. 小结
这一篇拆的是 TensorRT-LLM 让「动态批」跑上「静态图」的整套机制,把可验证的结论收拢如下:
- CUDA Graph 固化的不是参数而是地址与依赖,且重放路径上没有 Python。因此所有输入必须先变成固定地址的静态缓冲区,所有随批次变化的状态必须在重放前显式写回。
KeyType是图的坐标系:batch_size、draft_len、short_seq_len_mode、is_all_greedy_sample、sample_type、num_contexts、context_query_len、num_encoder_tokens、LoRA 相关字段——凡是能改变 kernel 序列的东西都在里面。- 捕获只在启动期的受控窗口内发生(
allow_capture()),因为捕获可能重分配共享 workspace,让已录图的地址失效;运行期遇到未录形状一律回退 eager。 capture()与replay()是对称的:前者把输入切成静态缓冲区并 warmup 到 workspace 稳定,后者把新数据拷回同一块内存并在拷之前做形状断言。输出用弱引用指向固定显存。- 桶要裁剪:引擎侧按
min(max_batch_size, max_num_tokens // tokens_per_request)截断,预填充侧按max_batch_size * (max_seq_len - 1)截断且不得追加超出候选的上界桶。 torch.compile解决的是「kernel 太多」:自定义Backend在 AOTAutograd 前向图上跑add_norm/ar_residual_norm融合 pass,再交给 inductor;多卡下 AllReduce + 残差 + RMSNorm 融合是最大的一块收益。- 预填充有两条图路线:分段图把 FX 图按注意力算子(原位更新 KV 的算子)切成若干子图,每个子图按
num_tokens桶各自录图;可断开图在段间插入声明式的 eager 断点,代价是跨流依赖可能无法在重放时保留。 - 启动做两趟:第一趟只 warmup(摸显存峰值、LoRA autotune、MXFP8 autotune),第二趟才录图,分段图放在第二趟。
到这里,TensorRT-LLM 系列的第四阶段(kernel 与性能)已经开了个头。XQA/FMHA v2 这些解码专用 kernel、DeepGEMM/DeepEP/flash_mla 的接入方式,以及 hostfunc 与 breakable_cuda_graph 在多 GPU 场景下的更细的语义,仍然可以各自展开。
20. 桶列表该多密:官方自己的调参结论
前面第 4 节和第 10 节讲了 padding 的代价与候选裁剪的规则,但「桶列表到底取多密」是一个必须用真实服务数据才能回答的问题。TensorRT-LLM 官方技术博客第 20 篇(blog20)就专门做了这件事,结论也直接改掉了框架的默认配置,很值得单独看一遍。
先看它描述的默认配置。TensorRT-LLM 默认的粗粒度倍增序列是 23 个桶:
1, 2, 4, 8, 16, 24, 32, 40, 48, 56, 64,72, 80, 88, 96, 104, 112, 120, 128, 256, 512, 1024, 2048128 以下很密(每 8 个一批),但 128 以上只剩 256、512、1024、2048 四档。这意味着当并发请求数落在 129 到 256 之间时,批次会被 pad 到 256——单步最多有一半的槽位在算无用功。在解码服务器同时服务几百到几千个请求的场景里,这个浪费是持续发生的。
博客比较了三档密度:
| 配置 | 128 以上的桶序列 | 图总数 |
|---|---|---|
| x2(默认) | 256, 512, 1024, 2048 | 23 |
| +64 | 192, 256, 320, …, 1984, 2048(步长 64) | 49 |
| +8 | 136, 144, 152, …, 2040, 2048(步长 8) | 259 |
+64 把这一区间的单步最大浪费从 1024 降到 63 个 token,+8 进一步降到 7 个。实验在 GB200 上做,模型是 NVFP4 量化后的四个前沿模型,场景分聚合式(单机 4 卡 TP,prefill 与 decode 同机)和分离式(4 或 8 卡做 prefill、4 卡做 decode,EP),固定 ISL=500、OSL=2000,横轴扫并发、纵轴看输出吞吐(TPS)相对 x2 基线的提升。
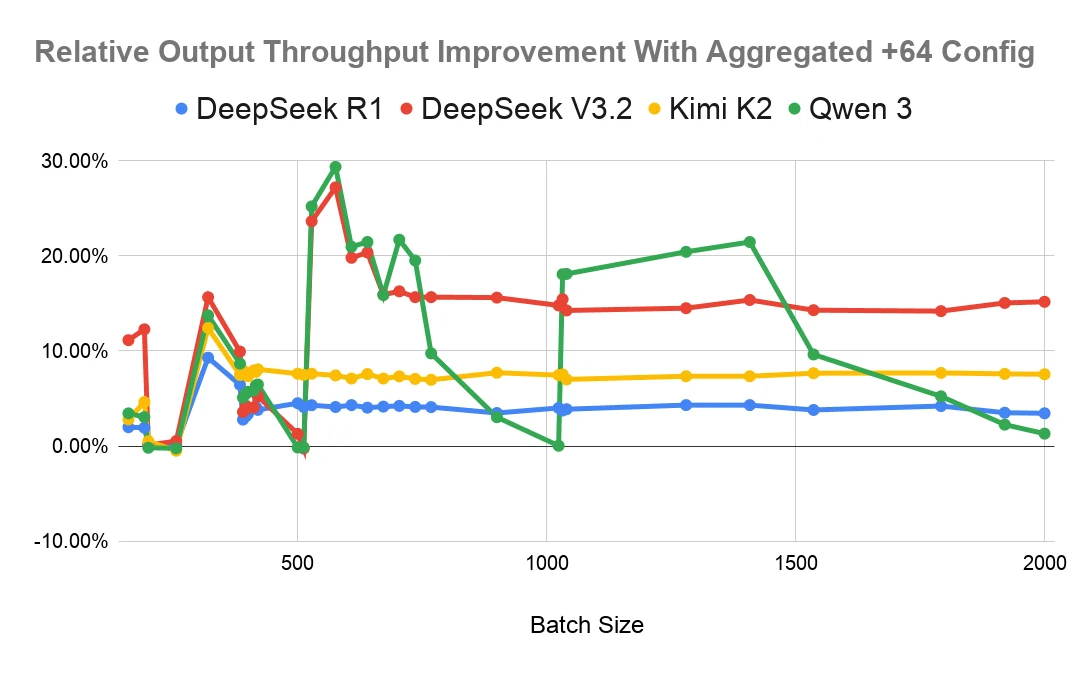
上图是聚合式部署的结果。曲线的形状本身就是结论:低并发区几乎贴着 1.0,因为批次小、本来就命中 128 以下的密桶;曲线抬头的拐点出现在并发越过 128 之后,与「新增桶全部在 128 以上」完全对应。这是 padding 浪费模型最直接的一次验证——你只在有浪费的地方补桶,增益也只在那里出现。
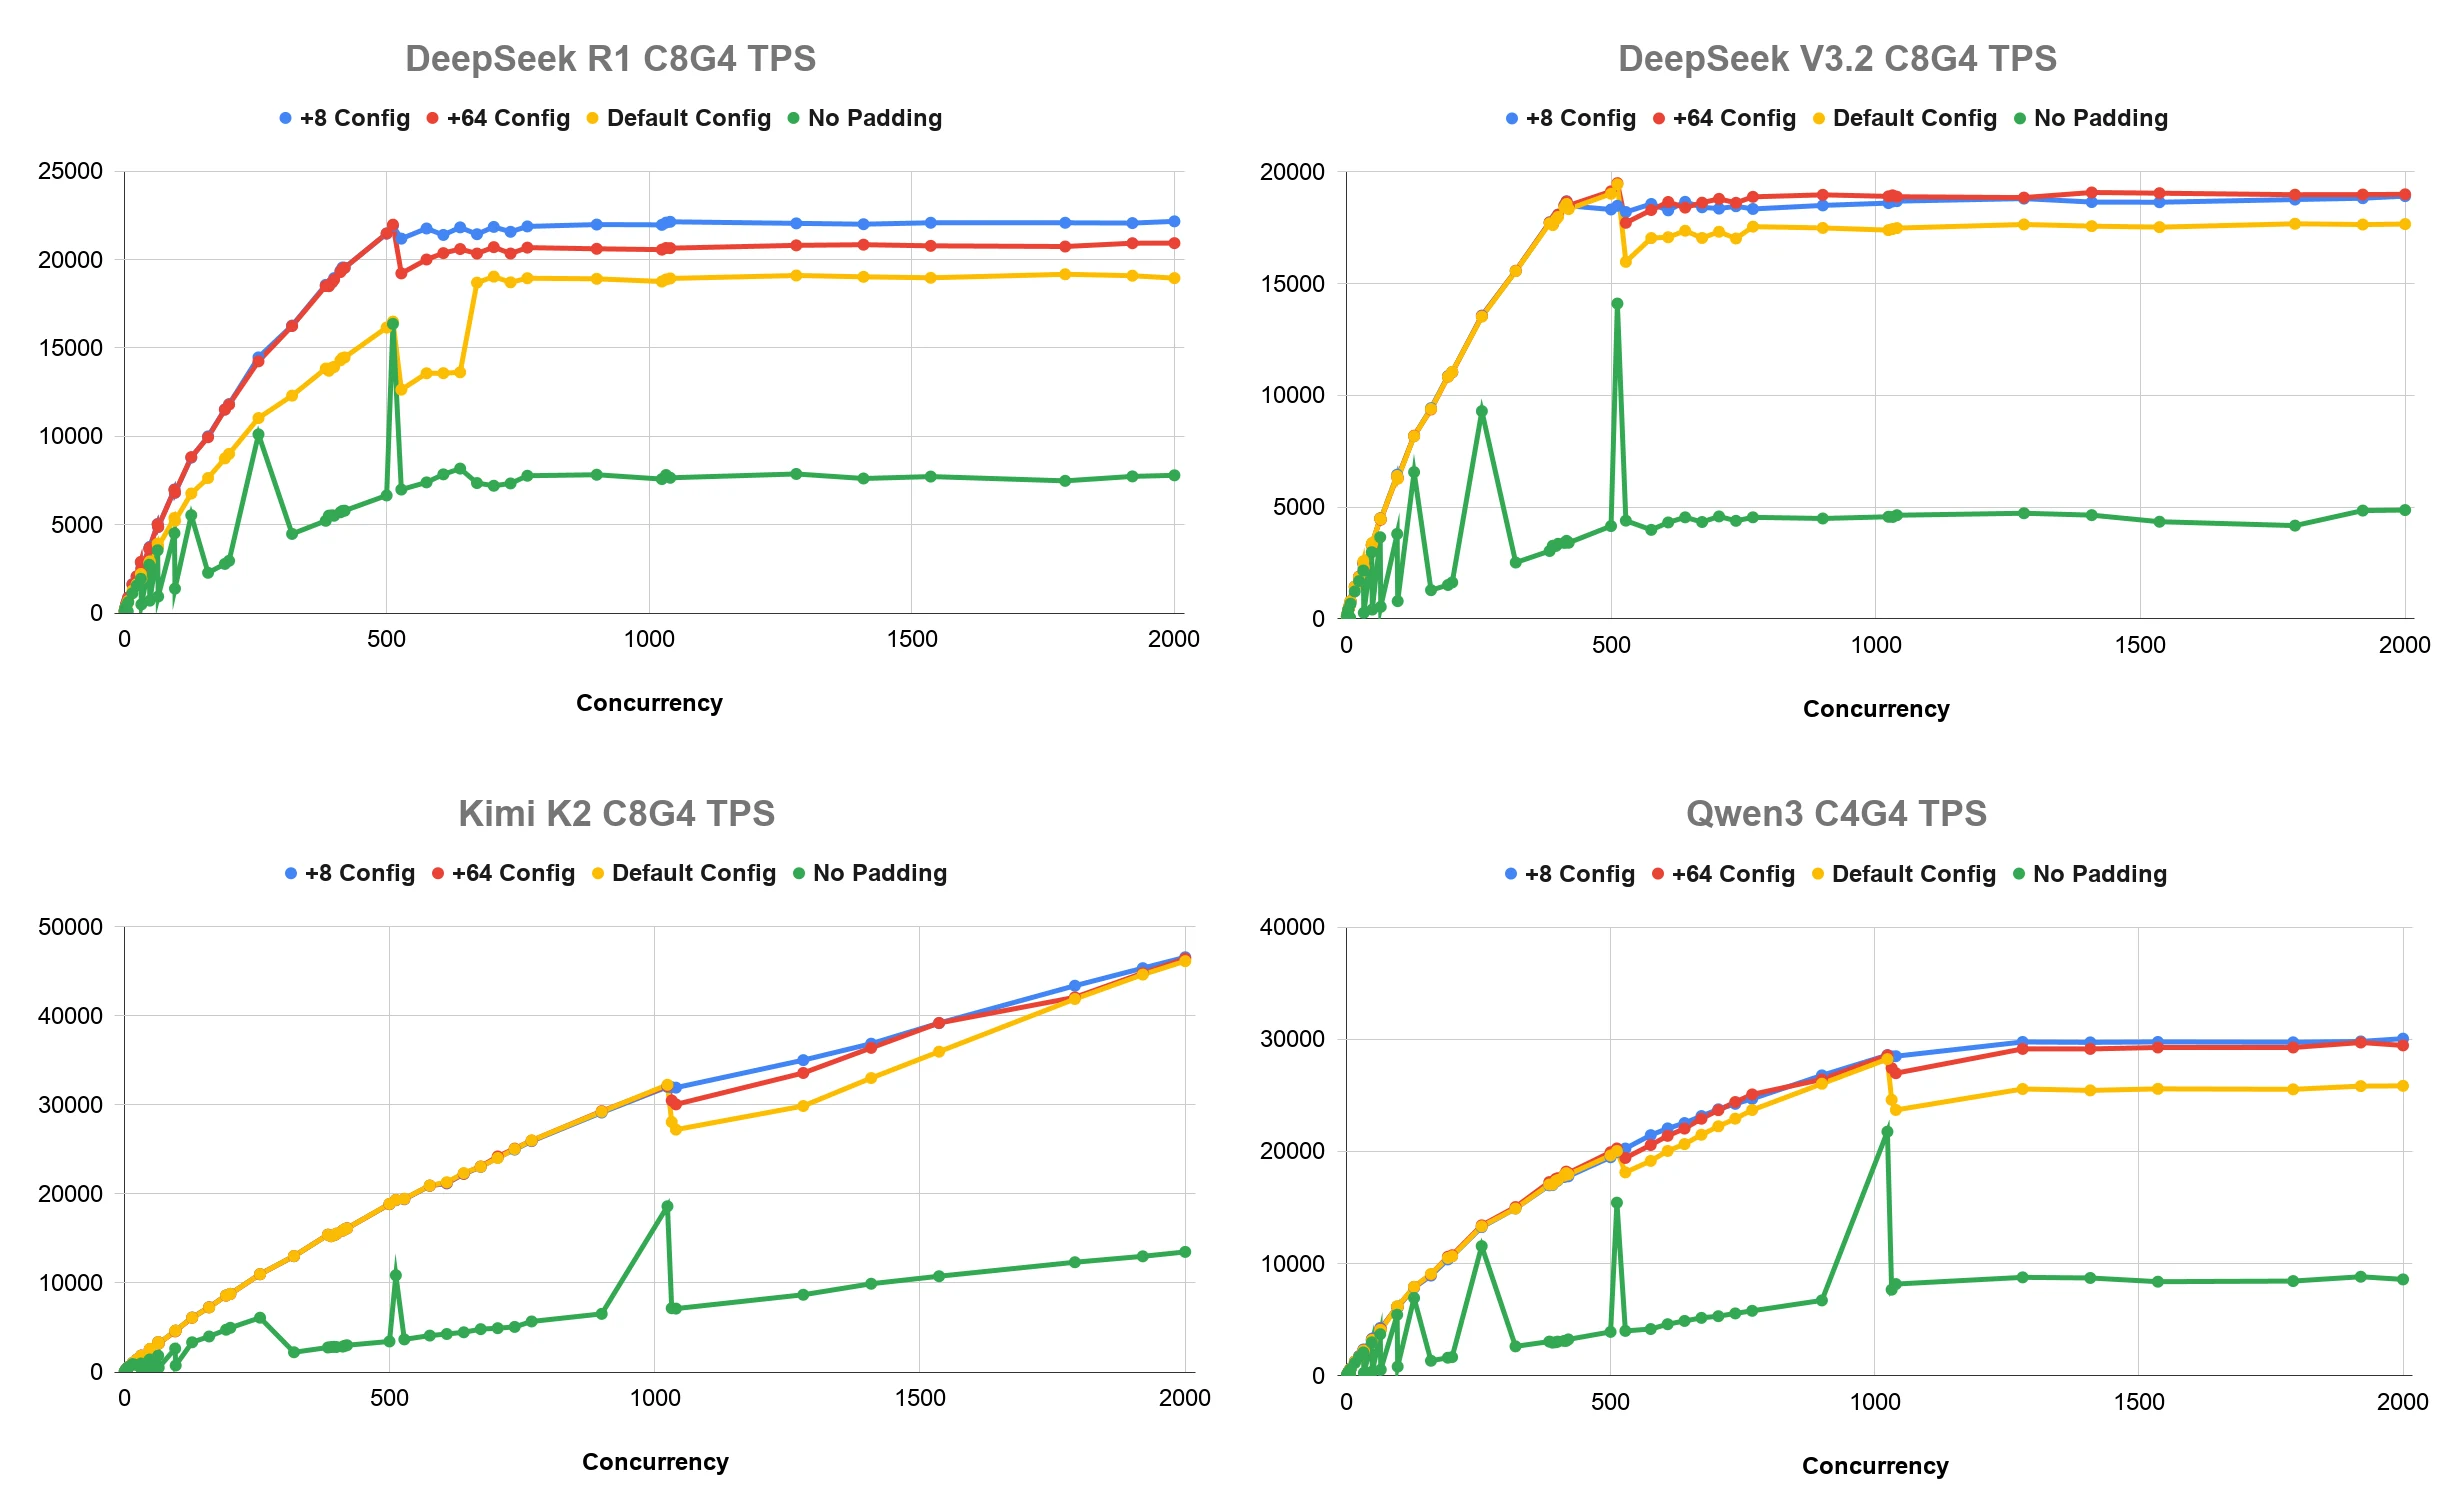
上面这张图把四档配置放在一起,横轴是并发数,纵轴是 TPS。四条曲线的相对位置告诉你两件事:
- 绿线(完全不放 padding,即批次不向上取整、形状不匹配就回退 eager)明显最低,说明「宁可 eager 也不 pad」是最差的选择——这反过来印证了第 4 节的判断:在访存密集的解码场景里,多算那部分 token 比丢掉图重放便宜得多。
- 蓝线(+8)比红线(+64)更平滑、整体更高,但两者的差距远小于「+64 相对默认」的差距,也就是收益随密度提升而快速递减。
真正的代价在显存和启动时间上,博客给了具体数字:
| 指标 | 含义 |
|---|---|
| +64 相对默认 | 图数 23 → 49,额外约 260 MB 显存,服务启动时间增至 1.17 倍(DeepSeek-R1) |
| +8 相对 +64 | 多出 210 张图,DeepSeek-R1 上额外 2.6 GB 显存 |
| KV 容量影响 | +8 下 DeepSeek-R1 的 KV 可容纳 token 数下降 8.6%,DeepSeek-V3.2 下降 17.2% |
这里有个反直觉但很关键的因果链:图的显存与 KV 池的显存来自同一份预算(这正是 TensorRT-LLM 源码完全拆解(十五):显存与缓冲管理 里讲的那份预算)。多录 210 张图,就要从 KV 池里挖走几个 GB;KV 池变小,能同时驻留的请求数就变少,而请求数变少又直接压低吞吐。所以 V3.2 出现了负收益:它的 CUDA Graph 单张占用比 R1 高约 2.4 倍,原因博客推测是其复杂的 DeepSeek Sparse Attention(DSA)机制让每张图更大;同样多录 210 张图,V3.2 要付出 4.86 GB,而 R1 只要 1.99 GB。于是 V3.2 在并发 500 附近反而比 +64 低约 5%。
博客最终的态度很明确:默认配置改为 +64,+8 不推荐。理由是 +64 用约 260 MB 和 17% 的启动时间换到 1.3 倍(聚合式)到 1.5 倍(分离式)的输出吞吐;而 +8 的额外收益小,却在图较大的模型上吃掉可观的 KV 容量,把收益又还了回去。
这段调参史和第 10 节的裁剪规则合起来,构成了一个完整的「桶该怎么选」的判断框架:先按第 10 节的公式确定可录范围,再在真正产生浪费的区间补桶,补桶密度以「单步最大浪费」和「每张图的显存开销」两条线共同决定。当每张图很贵(比如带 DSA 的稀疏注意力模型)时,宁可用粗桶加更大的 KV 池;当每张图很便宜而并发很高时,细桶才划算。
参考资料
- TensorRT-LLM GitHub 仓库
- CUDAGraphRunner 源码(tensorrt_llm/_torch/pyexecutor/cuda_graph_runner.py)
- CUDA Graph 辅助函数与桶裁剪(tensorrt_llm/_torch/pyexecutor/engine/cuda_graph.py)
- torch.compile 自定义后端(tensorrt_llm/_torch/compilation/backend.py)
- 分段图优化器(tensorrt_llm/_torch/compilation/piecewise_optimizer.py)
- 可断开 CUDA Graph 实现(tensorrt_llm/_torch/pyexecutor/breakable_cuda_graph/breakable_cuda_graph.py)
- 解码侧图捕获与 warmup(tensorrt_llm/_torch/pyexecutor/engine/runners/decoder/graphs.py)
- TensorRT-LLM 官方技术博客 blog20:Tuning CUDA Graph Batch Sizes for Higher Output Throughput
- PyTorch CUDA Graph 语义说明
- PyTorch torch.compile 与自定义后端(torch._dynamo / AOTAutograd)
- SGLang breakable CUDA graph 实现
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



