


推理服务的入口层完全拆解:从 HTTP 请求到引擎请求,协议适配、请求准备与流式回传怎么做
在推理框架的源码里,工程师往往一头扎进调度器、KV 池和 kernel,却很少认真看「请求是怎么进来的」。可对线上服务而言,入口层是最早能决定延迟的地方:HTTP 解析、协议转换、prompt 渲染、tokenize、图片下载,任何一环串行化,上游看到的首 token 时间(TTFT, Time To First Token)都会变长。这篇文章不讨论单个框架,而是把入口层当作一个跨框架的子系统来拆:以 deepseek-recipe 的两个示例服务(Rust 的 Axum 版与 Python 的 FastAPI 版)和 DeepInfer 的离线入口 LLM 为标本,逐层讲清请求如何被接住、被转换成引擎能消费的形状、以及流式结果如何被回传。
选这两个标本有原因。deepseek-recipe 是一个专门做「协议 → 会话 → token → 响应」转换的 Rust 库,它把入口层里最脏的部分(多协议 JSON、特殊 token、跨 chunk 状态机)做成了可读的组件,并且给出了完整的、能跑的 FastAPI 示例;生产系统中 DeepInfer 是消费它的推理引擎,其 entrypoints/llm.py 展示了引擎侧真正需要的请求形状。两边合起来正好覆盖从网络到 add_request 的全部环节。
可参考站内 DeepInfer 源码完全拆解(一):整体架构与模块全景 先建立引擎地形;关于协议到 token 的字符串处理,已有 deepseek-recipe 源码拆解(一):三种 API 协议如何统一成会话 从协议转换的角度讲过一遍,本篇侧重服务层的线程、并发与生命周期。
背景:入口层到底要做哪些事
一次请求要过的五道关
无论哪个框架,一次在线补全请求都要经过下面几步:
- 网络层:接受连接,把字节流解析成方法、路径、请求头与请求体。
- 协议层:请求体是一个 JSON,遵循某种对外契约(OpenAI 的 Chat Completions、Responses,Anthropic 的 Messages,或私有格式)。
- 会话层:协议内容被归一化为「消息列表」(system / user / assistant / tool),与具体协议解耦。
- 渲染与编码层:会话按目标模型版本的模板拼成 prompt,prompt 再编码成 token id 序列。
- 引擎层:token id、采样参数、优先级被包装成引擎请求,进入等待队列。
五步之中,第 3、4 步是纯计算,第 1、2 步是 I/O 与解析,第 5 步才触达 GPU。入口层设计的所有取舍,本质上都是在问:哪些步骤必须放在请求的关键路径上,哪些可以推到后台、推到别的进程、或者推到 GPU 上做。
为什么入口层容易被低估
一个常见的误判是把入口层当成「只是读一下 JSON」。实际上一份生产请求里,入口层要处理的东西远比 JSON 多:
- 用户消息里手写的
<|image|>不能被当成图像输入; - 工具调用的参数流可能被拆在多个 chunk 里,解析器要保留状态;
- 图片要以 base64 或外链形式给出,外链可能要下载并按模型要求预处理;
max_tokens可能没填,需要按思考模式与推理强度给默认值,并且要和上下文长度对账;- 客户端断开时,正在进行的推理要能取消,否则 GPU 会继续算一个没人要的请求。
每一条都对应入口层里的一段真实代码。下面按顺序拆。
核心思想:让引擎只看见一种请求
一条总原则
推理引擎的内部是高度特化的:它只认 token id、只认一组有限的采样参数、只认一种 prompt 格式。入口层存在的意义,就是在「对外接口无限多样」和「对内接口极其狭窄」之间架一座桥。
这座桥有两端:
- 对外端:尽量宽。三种协议、流式与非流式、图片、工具、结构化输出,都在这端消化。
- 对内端:尽量窄。进入引擎的请求对象只有 token id 与一组引擎能直接执行的参数。
一个健康的入口层,其逻辑量几乎全在对外端。一旦引擎开始感知「这次请求来自 Chat Completions 还是 Messages」,就说明分层错了。
三个对象的边界
以 deepseek-recipe 为例,请求在入口层会依次变成三个类型:
| 类型 | 含义 | 谁产生 |
|---|---|---|
ChatCompletionRequest / ResponsesRequest / MessagesRequest | 某一种协议的原始请求 | 由 JSON 反序列化 |
ConversationRequest | 归一化后的会话 + 推理选项 + 解析选项 | .convert(ConversionOptions) |
RenderedPrompt | prompt 字符串 + 特殊 token 的字节区间 + 图片源 | render_conversation |
之后,RenderedPrompt 加上 tokenizer 才会得到 token id。这个过程可以用下面这张骨架表示:
from deepseek_recipe import ( ChatCompletionRequest, ConversionOptions, DeepseekV41Encoding, ModelVersion,)
request = ChatCompletionRequest({ "model": "DeepSeek-V4.1-Flash", "messages": [{"role": "user", "content": "Hello"}],})converted = request.convert(ConversionOptions().with_model_alias( "deepseek-flash", ModelVersion.DeepseekV41Flash))rendered = DeepseekV41Encoding().render_conversation(converted.conversation)print(rendered.prompt, rendered.special_ranges)三个对象的分工很清楚:协议对象管对外契约,会话对象管协议无关的语义,渲染对象管模型格式。每一层只依赖前一层,不反向依赖。
原理详解一:示例服务的请求准备管线
prepare_request:一个函数把五道关做完
deepseek-recipe 的 FastAPI 示例服务 server-py/main.py 里,最值得读的是 prepare_request。它是同步函数,由 HTTP handler 用 run_in_threadpool 丢到线程池里执行:
def prepare_request(protocol, body, *, options=None) -> PreparedRequest: request_type, _ = PROTOCOL_TYPES[protocol] try: request = request_type(body) except ValueError as error: raise RequestError(str(error)) from error
if options is None: options = conversion_options() converted = request.convert(options) encoding_type = PROMPT_ENCODINGS[converted.model_version] rendered = encoding_type().render_conversation(converted.conversation)
images = [] image_token_adjustment = 0 if rendered.image_sources: resolver = ImageResolver(ReqwestImageFetcher(), OpenCvImagePreprocessor()) multimodal = resolver.resolve(rendered.image_sources, ImageQuota()) images = multimodal.images image_token_adjustment = multimodal.image_token_adjustment()
return PreparedRequest(protocol, converted, rendered.prompt, images, image_token_adjustment, model)PROTOCOL_TYPES 是一张路由表,把 URL 路径映射到「请求类型 + 响应类型」的二元组:
PROTOCOL_TYPES = { "chat_completions": (ChatCompletionRequest, ChatCompletionResponse), "responses": (ResponsesRequest, ResponsesResponse), "messages": (MessagesRequest, MessagesResponse),}这张表把协议差异收敛到一处:新增一种协议只需要在这里加一行、在路由注册处加一条 add_api_route,其余逻辑全部复用。
每个阶段为什么在这个位置
prepare_request 的执行顺序不是随意排的,每一步都依赖前一步的结果:
- 反序列化必须先做,因为
model字段要从请求体里读出来; convert依据model字段解析模型版本,再据此选择模板风格(V4 与 V4.1 不同);render_conversation依据会话内容产出 prompt 和特殊 token 区间;- 图片解析只在渲染结果里确实有图片源时才做,避免为纯文本请求付出网络开销。
注意第 4 步的顺序:渲染在前、下载在后。渲染只是拼字符串,很快;下载和解码图片慢,并且可能失败。把慢的放在后面,失败时前面的工作也就白做了,但这没关系,因为失败会直接返回 4xx/5xx,不会进入引擎。
图片解析的失败码
示例服务对图片错误的处理值得留意:
try: multimodal = resolver.resolve(rendered.image_sources, ImageQuota())except ImageError as error: status_code = 500 if error.kind in {"Client", "TokenBudget"} else 400 raise RequestError(str(error), status_code) from error这里把「图片获取侧的错误(例如外链返回客户端错误)或图片 token 预算超限」归为 500,把「图片本身不合法」归为 400。这个划分对客户端很重要:400 表示「你给的图片有问题,换一张」,500 表示「我们这边取不到图或预算满了,稍后重试」。如果两类都返回 400,客户端会误以为自己的图片坏了;如果都返回 500,客户端会无意义地重试一张有问题的图。
ImageQuota 记录图像数量与总字节数,用来限制一次请求能带多少图片、总共多大。它和 image_token_adjustment 配合:一张图片在 prompt 里可能只占一个占位符,但实际要展开成若干视觉 token,后者就是渲染时与实际 token 数之间的差值。
PreparedRequest:进入推理前的最后一份快照
PreparedRequest 是一个冻结的 dataclass,字段包括协议名、会话请求、prompt、图片、token 调整量与模型名。它有两个派生属性:
@propertydef stream(self): return self.conversation_request.stream
@propertydef inference_options(self): return self.conversation_request.inference_options把 stream 与推理选项挂在派生属性上,而不是复制一份字段,意味着后续所有逻辑读取的都是「会话请求里的原值」,不会出现快照与原对象不一致的问题。对不可变请求而言,这种写法最安全。
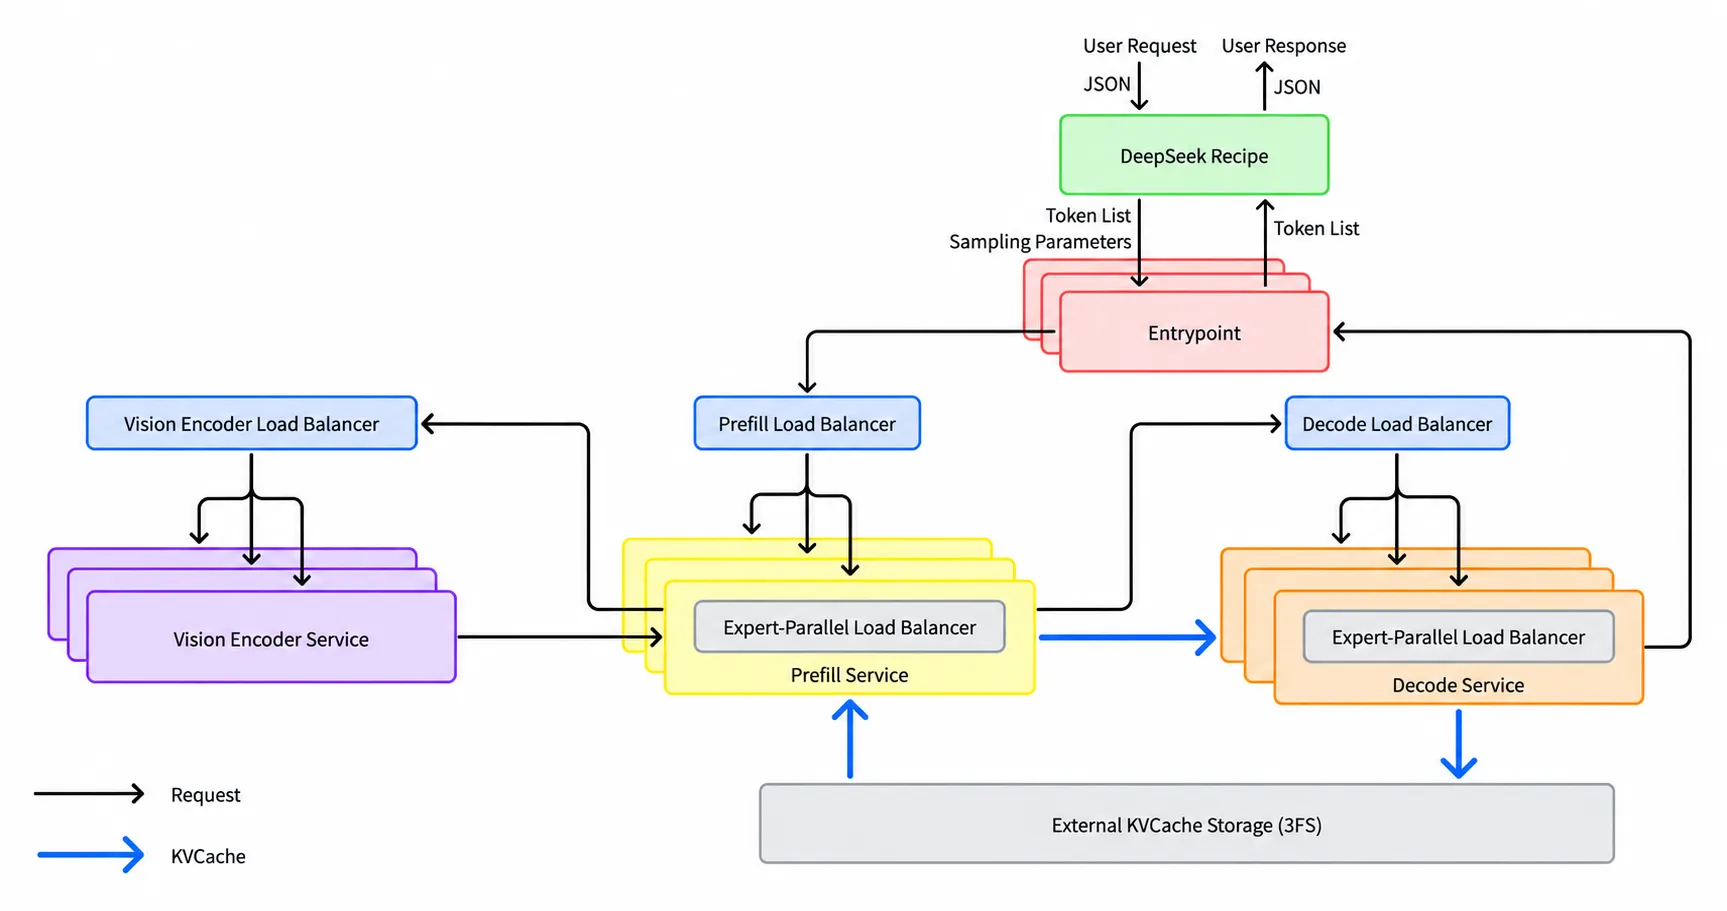
图 1:DeepSeek V4.1 Flash 推理系统参考架构,来自 DeepInfer 部署 Q&A。入口层把请求分给不同角色的实例;图中的 KVCache Storage 正是入口层做前缀命中判断时查询的地方。
原理详解二:线程模型与事件循环
为什么准备逻辑要进线程池
FastAPI 的 handler 跑在 asyncio 事件循环里。如果 handler 里直接调用同步的 CPU 密集函数,整个事件循环会被占住,其他请求的 HTTP 解析、SSE 写回都会停下来。prepare_request 里有 JSON 反序列化、模板渲染、tokenize 与图片解码,每一项都可能耗时几十毫秒,所以示例服务把它包进线程池:
async def handler(request: Request) -> Response: body = await request.body() prepared = await run_in_threadpool(prepare_request, protocol, body, options=options) output = response_body(prepared, infer) ...run_in_threadpool 是 Starlette 提供的工具,底层用 anyio 的线程池。它释放事件循环,让别的协程继续跑;由于 GIL,多个线程不会真正并行执行 Python 字节码,但 Rust 侧的转换可以释放 GIL,外部的网络 I/O 也会释放 GIL,所以整体仍然能获得并行度。
这里有一个容易被忽略的点:prepare_request 是同步函数,它内部调用的是 Rust 绑定的同步 API(request.convert(...)、render_conversation(...))。如果把它写成 async def 再直接 await,反而会因同步阻塞而失去线程池的收益。
流式与非流式在同一处分叉
准备完成后,response_body 是一个异步生成器,流式与非流式共享它:
if prepared.stream: return InferenceStreamingResponse(output, media_type="text/event-stream")content = "".join([part async for part in output])return Response(content, media_type="application/json")非流式走法是把这个生成器整体消费掉,拼成一个完整 JSON;流式走法直接把生成器交给 StreamingResponse。两种模式在后端完全相同,差别只在「什么时候把结果写给客户端」,这样可以保证两种模式的语义(finish reason、usage、错误结构)一致。
断开连接时的清理
流式响应的生命周期比普通响应复杂得多,最典型的问题是客户端中途断开。示例服务专门覆盖了 __call__:
class InferenceStreamingResponse(StreamingResponse): """Close the response iterator after a disconnect or a failed send."""
async def __call__(self, scope, receive, send): try: await super().__call__(scope, receive, send) finally: with CancelScope(shield=True): await self.body_iterator.aclose()CancelScope(shield=True) 的作用是:即使当前任务正被取消,也要把 aclose() 执行完。如果不 shield,取消信号会让清理代码本身也被打断,后端推理流就得不到关闭通知,只能等推理跑完才发现客户端早就走了。
response_body 里对应的 finally 也做了同样的处理:先 aclose 推理流,再 processor.close()。顺序不能颠倒,因为 StreamProcessor 可能还持有推理流中未消费的文本。
客户端断开 ──► 取消当前请求任务 └─► StreamingResponse.__call__ 的 finally └─► shield: inference.aclose() ← 通知后端停止 └─► shield: processor.close() ← 释放解析器状态取消的语义边界
README 里有一句明确的界定:「The backend owns cancellation protection for asynchronous cleanup inside its own iterator. The server protects the explicit aclose() call.」也就是说,示例服务只保证「显式关闭推理流」这一件事不被取消打断;推理流内部的清理(比如关闭到引擎的连接)由后端自己负责,后端在自己的迭代器里同样要用 shield。
这种分工在工程上是对的:入口层不知道后端用的是 HTTP、gRPC 还是共享内存,唯一能做的可靠动作就是 aclose();后端才知道自己有哪些连接与缓冲要回收。
原理详解三:双协议的工程取舍——Rust 与 Python 示例
同一套组件,两种宿主
deepseek-recipe 同时提供了 server-rs(Axum)和 server-py(FastAPI)两个示例,它们调用的是同一个 Rust 核心库(Python 版通过 PyO3 绑定)。选择哪一种,取决于团队的技术栈,而不取决于功能:
| 维度 | server-rs(Axum) | server-py(FastAPI) |
|---|---|---|
| 转换与渲染 | 原生调用,无跨语言开销 | FFI 调用,每次有微小的封送成本 |
| 请求准备的位置 | 直接在 async fn 中(渲染同步完成,图片解析 await 异步) | run_in_threadpool |
| 扩展后端 | 需要写 Rust 代码 | 可以直接写 Python 推理客户端 |
| 流式回传 | impl Stream 直接交给 Axum | 异步生成器交给 StreamingResponse |
Python 示例的价值在于「可读」与「可扩展」:算法团队通常用 Python 写推理客户端,用 PyO3 绑定意味着他们不必学 Rust。Rust 示例的价值在于「高并发下的稳定延迟」:没有 GIL,也没有跨语言边界,所有请求准备都在一个运行时里完成。
语言切换不影响契约
两个示例对外的路线相同:/v1/chat/completions、/v1/responses、/v1/messages,三条路径都支持 stream=false 的 JSON 与 stream=true 的 SSE。这意味着入口层的契约(路径、字段、SSE 事件名)是协议的一部分,实现语言可以换,契约不能换。
curl http://127.0.0.1:7777/v1/chat/completions \ -H 'Content-Type: application/json' \ -d '{"model":"deepseek-flash","messages":[{"role":"user","content":"Hello"}],"stream":false}'这条命令在两个示例上返回相同的结构。示例默认模型名通过 ConversionOptions.with_model_alias 注册,deepseek-flash 被映射到 V4.1,deepseek-v4-pro 映射到 V4。模型名与模型版本的映射表是入口层的配置,而不是硬编码。
模型名表的错误语义
ConversionOptions.resolve_model_version 在遇到未知模型名时会返回一个 400 错误,错误消息里列出所有支持的模型名:
The supported API model names are DeepSeek-V4-Pro, DeepSeek-V4.1-Flash, deepseek-flash, deepseek-v4-pro, but you passed xxx.这是入口层「可操作的错误」的写法:客户端拿到错误后知道该改成什么。相比之下,只回一句「model not found」需要客户端去看文档才能修正。
原理详解四:max_tokens 的解析——入口层里最容易错的一处
为什么不能在转换时定
max_tokens 看起来只是把请求字段抄到引擎,实际上有三层逻辑:
- 没有填时要用默认值,且默认值随思考模式与推理强度变化;
- 要和上下文长度对账,prompt 占了多少,就只剩多少;
- prompt 长度只有 tokenize 之后才知道,转换阶段并不知道。
所以 deepseek-recipe 把这件事拆成两步:转换阶段只记录 requested(可能为 None),编码之后由 resolve_max_tokens 计算最终值。
pub fn resolve_max_tokens(&self, prompt_tokens: u32, context_limit: u32) -> Result<u32, ConversionError>{ let requested = self.inference_options.max_tokens.unwrap_or(0); let total = prompt_tokens.saturating_add(requested); if total > context_limit { return Err(ConversionError::bad_request(format!( "This model's maximum context length is {context_limit} tokens. \ However, you requested {total} tokens ({prompt_tokens} in the messages, \ {requested} in the completion). ..."))); } let default = if !self.conversation.thinking_mode { DEFAULT_NON_THINKING_MAX_TOKENS } else if self.conversation.reasoning_effort == Some(ReasoningEffort::Max) { DEFAULT_MAX_EFFORT_MAX_TOKENS } else { DEFAULT_THINKING_MAX_TOKENS }; let remaining = context_limit - prompt_tokens; Ok(self.inference_options.max_tokens.unwrap_or(default) .min(remaining) .max(1))}三个默认值背后的理由
常量定义在 request/mod.rs:
pub const DEFAULT_NON_THINKING_MAX_TOKENS: u32 = ...; // 非思考模式 8192pub const DEFAULT_THINKING_MAX_TOKENS: u32 = 64 * 1024; // 思考模式 65536pub const DEFAULT_MAX_EFFORT_MAX_TOKENS: u32 = 128 * 1024; // max 推理强度 131072三个默认值随「是否思考」与「推理强度」分层:
- 非思考模式 8192:直接回答通常很短,给太多反而浪费 KV 与解码时间;
- 思考模式 65536:推理链的长度波动很大,默认要足够宽,否则长题还没想完就被截断;
- max 强度 131072:最强的推理配置配最长的预算。
这条分层规则把「用户的显式意图」与「模式的隐含预算」对齐了。用户只写 thinking: {"type": "enabled"} 时,默认预算立刻从 8K 跳到 64K,因为思考模式下 8K 几乎必然不够。
对账的顺序:先拒绝,后裁剪
resolve_max_tokens 的顺序是:先检查 prompt + 请求值 是否超出上下文,再裁剪。这意味着:
- 如果用户显式请求了过大的
max_tokens,直接 400 拒绝,不偷偷裁剪; - 如果用户没请求(
requested = 0),但 prompt 本身就超了,也拒绝,因为连输入都放不下; - 通过检查后,实际值再被
min(remaining)压到剩余空间,并至少为 1。
这里有一个细节:min(remaining) 作用于 unwrap_or(default) 的结果。所以当用户显式请求一个比剩余空间小的值时,保持用户的请求;当用户没请求时,默认值会被裁到剩余空间。这两件事合并在一行里,语义很紧凑。
和 image_token_adjustment 的配合
对有图片的请求,prompt_tokens 不能只算 tokenizer 的输出,因为图片在 tokenizer 里只占一个占位符,但实际在模型里要展开成若干视觉 token(示例服务 README 写明:prompt_tokens adds image_token_adjustment to the encoded token count)。如果忘了这一步,max_tokens 会被算得偏大,导致超过上下文、引擎侧报错或被调度器截断。
这一步在示例里的位置是后端侧(infer 回调),符合职责划分:入口层提供 image_token_adjustment,后端在编码后自行加上。因为「编码」这件事本身由后端执行,只有后端知道确切的 token 数。
原理详解五:输出侧的流式处理
StreamProcessor 的状态机
推理后端产出的 chunk 是粗粒度的,InferenceChunk 只有四种变体:Ready(携带 prompt 用量与 system fingerprint)、Text(携带文本与 token 数)、Tokens(携带 token id 与可选 logprobs)、Finish(携带结束原因)。入口层的任务是把这些 chunk 翻译成协议事件:Chat Completions 的 choices[].delta.content,Responses 的 response.output_text.delta,Messages 的 content_block_delta。
StreamProcessor 就是这个翻译器,它的输入是后端 chunk,输出是协议 chunk 列表:
processors = StreamProcessor(generator, request.conversation_request.parsing_options)for chunk in [ InferenceChunk.ready(system_fingerprint="fp-1", prompt_usage=PromptUsage(prompt_tokens=4)), InferenceChunk.text("Hello!", token_count=2), InferenceChunk.finish(InferenceFinishReason.Stop),]: chunks.extend(processors.push(chunk))chunks.extend(processors.finish())三个方法对应三个时刻:push 处理一个后端 chunk,finish 在流结束时收尾,close 在中断时释放资源。这种「push / finish / close」的接口比单个 process(chunk) 更清晰,因为收尾与中断是两种不同的语义。
为什么必须跨 chunk 保留状态
一个后端 chunk 的文本边界与协议语义边界不一致,可能出现:
- 推理内容(reasoning)刚结束,正文开始;同一 chunk 里既有
<think>的关闭,又有正文; - 一个工具调用名前缀后还有参数,参数需要被 JSON 转义后逐段输出;
- 一个特殊 token 的拼写被拆在两个 chunk 之间。
如果入口层「每个 chunk 独立解析」,上面三种情况都会出错。所以 StreamProcessor 内部保留了从推理阶段到正文阶段、再到工具阶段的状态,以及未完成分隔符的匹配进度。示例 README 强调「determined content is emitted as parsing progresses, with no need to repeatedly rescan earlier text」,核心是增量匹配(类似 KMP)而不是反复扫描。
一个 chunk 可能产出多个协议事件
processor.push(chunk) 返回的是列表而不是单个值,这个细节很关键。一个 Text chunk 可能同时携带「推理结束」与「正文开始」,对应协议里就是两条事件:
Text("<|/think|>Hello") ──► [ delta{reasoning_content: ""}, ← 关闭推理块 delta{content: "Hello"} ← 开始正文]入口层必须在同一个循环里把这批事件依次写出,才能保证客户端看到的事件顺序与模型输出的顺序一致。response_body 里的内层循环就是做这件事:
for output in chunks: if request.stream: yield sse_frame(response_type.sse_event_name(output), output.to_json()) else: response.accumulate(output)非流式走 accumulate,把这些事件累积成一个完整响应;流式走 sse_frame,逐条构造成 SSE 帧。
sse_frame 的格式
def sse_frame(event: str | None, data: str) -> str: prefix = f"event: {event}\n" if event is not None else "" return f"{prefix}data: {data}\n\n"SSE 的结束标记是 data: [DONE],不同协议的写法不同:Chat Completions 用 [DONE],Responses 与 Messages 的结束写法由 sse_done_data() 返回,有的协议返回 None(不需要额外结束帧)。这些差异都被 response_type 封装,response_body 只负责发。
没有 tokenizer 时的限制
示例服务的 README 写得很清楚:示例不挂 tokenizer,所以后端必须产出 Text chunk;产出 Tokens chunk 会让整个响应失败。原因是 StreamProcessor 需要 tokenizer 才能把 token id 解码成文本并统计 reasoning_tokens。
这条限制提示了一个设计选择:把 tokenizer 放在入口层还是后端。放在入口层,解码与统计可以集中做;放在后端,token 与文本可以在一处产出,减少一次跨进程传递。示例选后者;引擎侧通常也选后者,因为 detokenizer 要与采样输出的 token 流紧耦合,跨进程拆开反而增加一次拷贝。
原理详解六:用量口径——入口层的缓存命中与 token 记账
prompt_cache_hit_tokens 从哪来
DeepSeek 的 API 响应里有 prompt_cache_hit_tokens 与 prompt_cache_miss_tokens 两个字段,客户端据此判断本次请求有多少 prompt token 走了缓存、有多少需要重新计算。这两个数字不是入口层能自己算出来的,因为命中判定发生在引擎/存储侧。
在 deepseek-recipe 里,这一点通过 InferenceChunk::Ready 的 PromptUsage 传达:
InferenceChunk::Ready { system_fingerprint: Some("fp-1".into()), prompt_usage: PromptUsage { prompt_tokens: 4, prompt_cache_hit_tokens: 0, // 其余为 cache miss },}后端在开始产出文本之前,先发一个 Ready chunk,告诉入口层这次请求的 prompt 用量。入口层据此在响应里填充 usage 字段。这个协议的细节值得展开:
- 为什么要在第一个 chunk 就报用量:流式场景下,客户端可能很早就想知道「这次输入花了多少」,如果等到结束才报,用户要等到整个响应跑完才拿到。把用量前置,可以尽早展示计费信息。
- 为什么是后端报而不是入口层算:入口层只知道自己编码了多少 token(
prompt_tokens的原始值),不知道其中多少在 GPU 上命中了缓存。命中是 KV 存储层的事,入口层无权判断。 - 为什么分成 hit 与 miss:这是计费口径:DeepSeek 的定价对缓存命中的输入 token 给出更低的价格。如果只报总数,客户端无法核对账单,也无法据此判断自己的前缀设计是否有效。
入口层的 token 数与引擎的 token 数不是一回事
这里有一个容易混淆的点:PromptUsage.prompt_tokens 是引擎实际处理的 token 数,而入口层的 tokenizer 编码结果还包含图片的占位符。两者在纯文本请求时相等,在有图片时不相等:
编码结果: [BOS, "看这张图", <|image|>, "是什么", ...] ← 图片一个占位符引擎处理: [BOS, "看这张图", <img_tok0>, ..., <img_tok255>, "是什么", ...] ← 展开成若干视觉 tokenimage_token_adjustment 就是这个差值。入口层拿到 PreparedRequest 后,由后端在编码时计算 prompt_tokens = encoded_count + image_token_adjustment,再用它去 resolve_max_tokens。如果入口层直接拿编码结果去算,max_tokens 会偏大。
流式下的 usage 累积
非流式请求的 usage 是一次性给出的。流式请求里,后端在 Ready 时已经给出 prompt 用量,生成部分的 token 数则要等 Finish 才能确定。StreamProcessor 在 finish() 时把两部分合并,写入最后一个 chunk。
Ready → prompt_usage = {prompt_tokens: P, cache_hit: H}Text ×N → 累积 completion_tokensFinish → usage = {prompt_tokens: P, cache_hit: H, completion_tokens: N, total_tokens: P + N}这条时序对客户端的含义是:usage 可能分散在两三个 chunk 里,而不是只出现在最后。如果客户端只在最后一条 chunk 里找 usage,有可能会漏掉 prompt 部分(取决于协议是否在中间 chunk 里也携带 usage 字段)。
system_fingerprint 的用途
Ready 还携带 system_fingerprint,这是一个用来标识「后端配置版本」的字符串。当后端换了量化方式、kernel 版本或 KV 布局时,同样的 prompt 可能得到略有差异的 logprobs;把这个标识暴露给客户端,可以让客户端在复现问题时找到对应的配置。
入口层对它的处理很简单:原样透传。但是它的存在说明入口层与后端之间需要传递「版本信息」,而不只是数据。这类字段在协议里往往被忽略,但在排查「为什么昨天和今天的输出不一样」时是唯一的线索。
原理详解七:准入控制与资源边界
入口层是限流的第一把手
引擎的排队是「内部的」,入口层的准入是「外部的」。两者的区别在于:引擎排队时请求已经占用了显存与调度条目,而入口层拒绝时什么都不会被分配。因此,大多数生产系统会把限流、鉴权、请求体大小限制、超时都放在入口层。
deepseek-recipe 的示例服务没有实现这些,README 明确说明「This example has no authentication」,它只适合本地使用。但示例的代码结构预留了位置:create_app(infer=..., options=...) 可以接受自定义后端,鉴权与限流可以做成 FastAPI 的 middleware 或依赖。
请求体大小与超时
长上下文请求的请求体可能达到几十 MB(尤其是带 base64 图片时)。入口层需要设置:
- 请求体上限:防止一次性读入过大请求导致内存峰值;
- 准备阶段超时:
prepare_request里包含图片下载,外部服务慢时会拖住线程池; - 首 token 超时:从投递到引擎算起,超过阈值就取消请求。
这三条超时分别对应不同的失败模式,不应合并成一个。示例里对 profiling 端口就做了类似拆分(_PICKUP_TIMEOUT_S = 30 与 _COMPLETION_TIMEOUT_S = 600),思路相同:不同阶段的超时要分开设,因为它们的正常耗时差了一个数量级。
线程池饱和的背压
run_in_threadpool 背后是一个有容量上限的线程池(anyio 默认允许 40 个并发线程,可通过 CapacityLimiter 调整)。当并发请求量远高于线程数时,准备阶段会排队:
HTTP handler ×1000 ──► run_in_threadpool ──► 线程池(如 32 个)──► prepare_request └─ 其余请求在队列里等 → 客户端看到的首字节延迟上升如果入口层只暴露一个「成功/失败」,这种排队会表现为「请求都成功,但很慢」。好的入口层应当在队列积压时尽早返回 503 或 429,让客户端退避,而不是让所有请求都变慢。这也是把限流放在入口层而不是引擎层的理由:入口层能看到排队,引擎层只能看到已经进来的请求。
原理详解八:入口层与调度语义的衔接
请求元数据里必须带上什么
入口层向引擎投递请求时,除了 token id 与采样参数,还需要一些「非内容」的元数据:
| 元数据 | 用途 | 谁产生 |
|---|---|---|
| 优先级 | 排队顺序与抢占决策 | 入口层(按用户等级、API key、任务类型) |
| 请求 ID | 日志关联、取消定位 | 入口层生成 |
| 是否流式 | 决定是否在首 token 后就返回 | 协议对象 |
| 超时 | 引擎侧的截止时间 | 入口层 |
| 结构化输出引用 | 引擎据此选取 bitmask | 入口层(编译结果的句柄) |
其中优先级与超时是入口层「懂业务」的部分:它知道这个请求来自哪个客户、属于哪种任务,引擎不应该知道。这也是为什么大多数框架的 SamplingParams 之外还有一层 RequestMetadata。
结构化输出的句柄化
受约束解码(结构化输出)需要把 JSON Schema、正则或 EBNF 编译成自动机。编译开销不可忽略,所以生产系统会把编译前置:入口层(或专用的编译服务)在请求进入引擎前完成编译,投递时只带一个句柄。
请求 JSON: response_format = {type: "json_schema", schema: {...}} │ ▼ 编译(可在专用机器上异步进行)自动机 → 句柄(如 grammar_id / bitmask 缓存路径) │ ▼ 投递引擎请求:token_ids + sampling_params + grammar_id入口层对结构化输出的作用因此是「路由」而非「计算」:它决定这个请求去哪编译、取回句柄、放进请求对象。这跟 DeepInfer 源码完全拆解(六):结构化输出与确定性 里讲到的不阻塞推理路径的做法是同一套思路。
原理详解九:协议转换中的几个易错细节
Chat Completions 的 prefix 续写
Chat Completions 支持 prefix 续写:客户端给出一个开头,模型从这个开头之后继续写。这个字段在转换时要被拼进 prompt 的末尾,并且不能被当成普通消息。如果把它当作 assistant 消息插入,模板会加上「assistant 开始」的控制 token,模型会以为上一轮已经说完了前缀,从而重新开始。
一种稳妥的处理方式是在渲染阶段把 prefix 作为「没有结束标记的 assistant 内容」处理,使得模板不会在它后面插入结束 token。这类「看起来是内容、实际是格式控制」的字段,是协议转换里最容易出错的类型。
logprobs 的归属
logprobs 与 top_logprobs 在入口层可以被转换成一个「需要后端返回概率」的选项,但库本身不计算概率(README 写明「The library does not compute probabilities」)。示例里 StreamProcessor 只是把后端给出的值放进 chunk。
这意味着:
- 如果后端不支持
logprobs,入口层不应假装支持(比如返回 0),而应拒绝或忽略; - 概率的计算口径(是否在采样前、是否在 top-k 过滤后)由后端决定,入口层不解释。
工具的 tool_choice 与输出约束
当请求里有工具定义且 tool_choice 不是 none 时,转换会为推理选项选一个 OutputConstraint:把输出约束成工具调用块。反之,response_format 是 json_schema 或 regex 时,约束成 JSON 或正则。
有 tools 且 tool_choice != none → OutputConstraint = ToolCallBlockresponse_format = json_schema → OutputConstraint = JsonSchemaresponse_format = regex → OutputConstraint = Regex否则 response_format = json_object → Json否则 → 不约束这段逻辑写在转换层而不是服务层,好处是三种协议共享同一套决策,服务层不需要知道「什么时候该强制工具调用」。入口层只负责把 OutputConstraint 与编译出的句柄对应起来。
图片在 V4 上的降级
README 有一条容易被忽略的规则:DeepSeek V4 不支持图片,转换时会把每个图片替换成文本 [Unsupported Image]。这是一个「容忍降级」的选择:不直接报错,而是让请求仍然能跑,只是模型看到的是一句话。
对比 V4.1:图片被正常解析、预处理、展开成视觉 token。同一个入口层,对两个模型版本的行为不同——这正是「模型版本从 model 字段解析」的意义:所有后续决策(模板、图片支持、默认 max_tokens)都依赖它。
原理详解十:离线入口 LLM 与在线路径的公共装配线
LLM 的装配线
DeepInfer 的离线入口 LLM 与在线服务背后的引擎共用同一套装配:LLM.__init__ 把参数整理成 EngineArgs,再把 offline_inference=True 打进去,最后构造 LLMEngine。
class LLM: def __init__(self, model, tokenizer=None, trust_remote_code=False, expert_parallel_size=1, revision=None, tokenizer_revision=None, seed=0, gpu_memory_utilization=0.9, decode_sequence=True, **kwargs): kwargs.setdefault("disable_log_stats", True) kwargs.setdefault("stop_preempted_request", False) os.environ.setdefault("TOKENIZERS_PARALLELISM", "false") engine_args = EngineArgs(model=model, tokenizer=tokenizer, ..., offline_inference=True, **kwargs)三处默认值都在入口层设置,而不是引擎层:
disable_log_stats=True:离线不跑滑动窗口统计;stop_preempted_request=False:离线请求被抢占后等待而不是终止;TOKENIZERS_PARALLELISM=false:避免 HuggingFace tokenizer 的 fork 死锁。
这三条正好对应「入口层知道自己的运行上下文」:只有它知道这次是离线批跑还是在线服务,所以由它决定统计、抢占与并行策略。引擎本身保持中立。
请求形状:离线走 token id,在线走会话
离线 LLM.generate 接受 list[str] 或 list[list[int]]。如果调用方给的是字符串,入口层会做 tokenize;如果给的是 token id,可以直接透传,跳过 tokenizer。对于已经在别处编码过的场景(比如从训练数据里取出的 token 序列),这条通道很有用。
在线入口则必须先走 prepare_request,把协议 JSON 变成 prompt 与 token id。两条路径最终汇合在 EngineArgs → LLMEngine,这是「入口层变化,引擎不变」的最好例子。
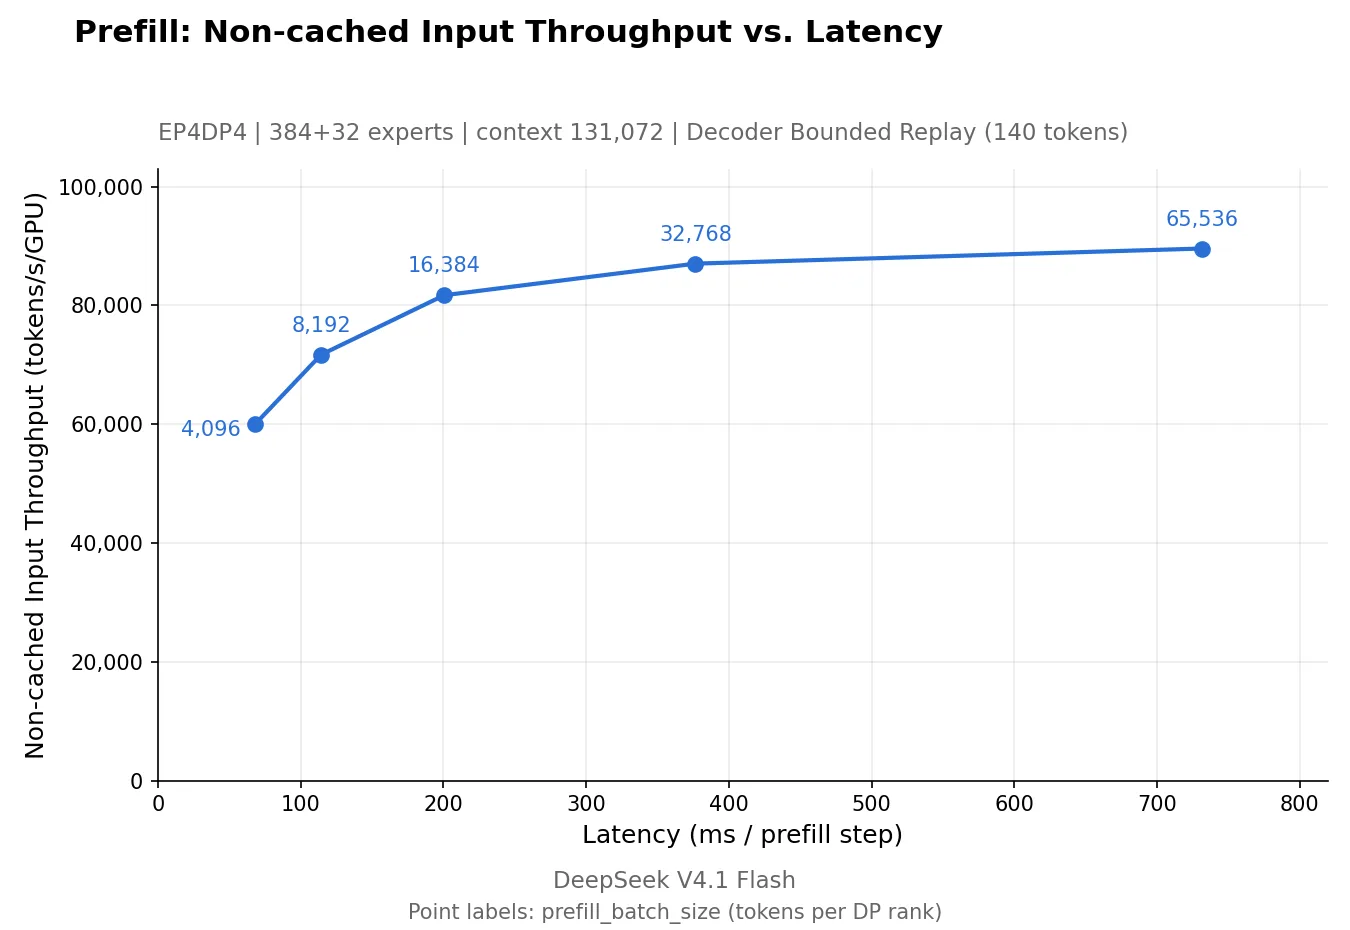
图 2:DeepInfer 官方 README 中的预填充基准(非缓存输入吞吐 vs. 延迟,4 张 SM100 GPU),来自 DeepInfer 仓库。入口层算出的「非缓存 token 数」就是这张图的横轴工作量。
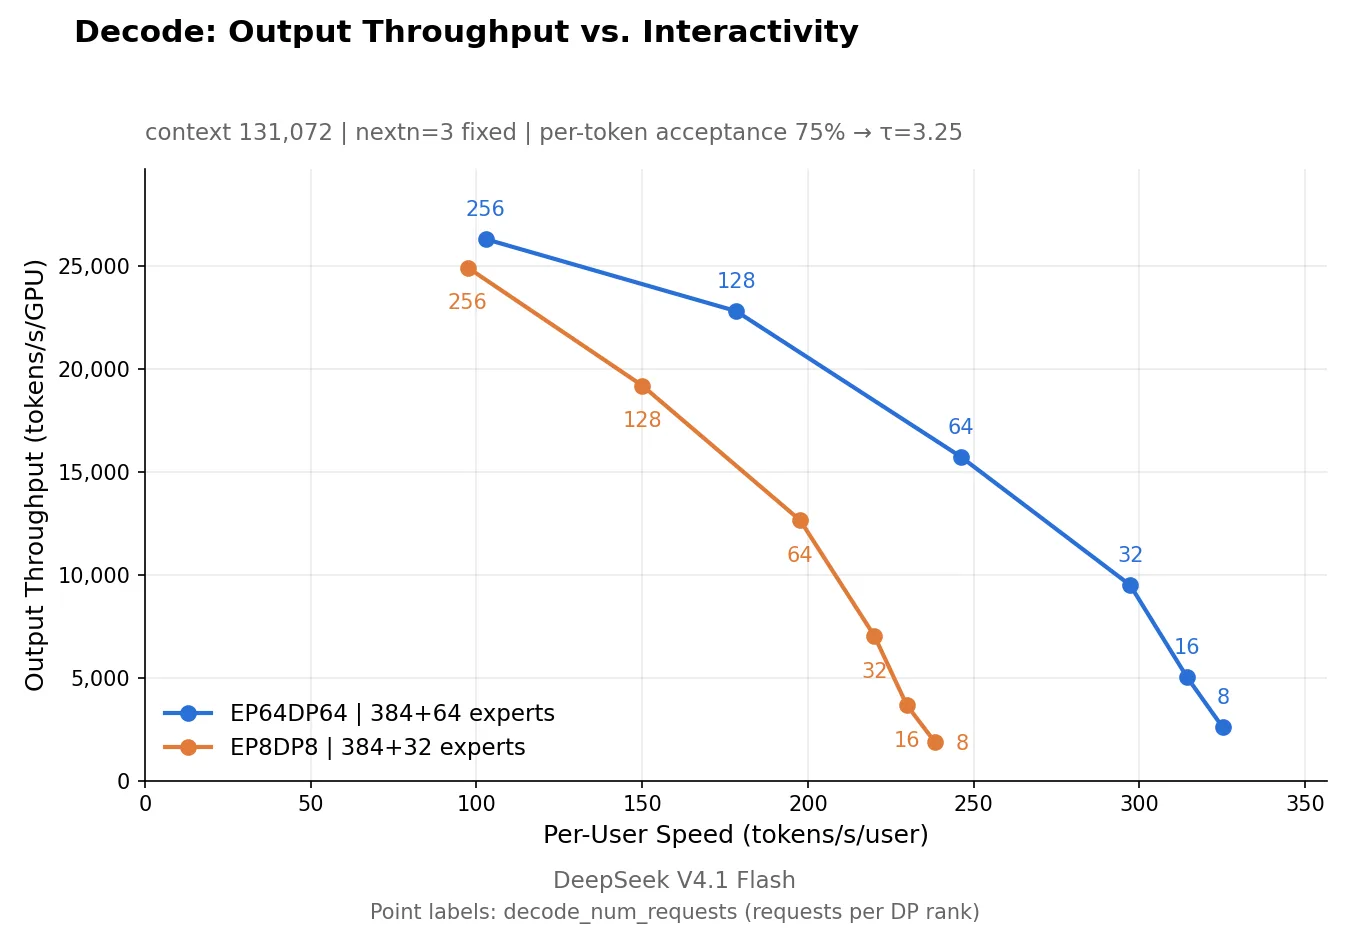
图 3:EP8 与 EP64 的解码吞吐对比,来自 DeepInfer 部署 Q&A。入口层把请求路由到哪个规模的解码实例,最终会体现在这条曲线上;而负载均衡只能依赖入口层已知的「请求数」与「总 KV 长度」两个维度。
原理详解十一:特殊 token 的字节区间与并行编码
special_ranges 是渲染层的输出
render_conversation 不只是返回一个字符串,它同时返回三样东西:
pub struct RenderedPrompt { /// Model input string. pub prompt: String, /// Ascending, disjoint byte ranges of `prompt` that hold explicit special /// tokens. Pass them to `TokenizerEncoder::encode_ids` when encoding `prompt`. pub special_ranges: Vec<Range<usize>>, /// Image sources in the order their placeholders appear in the prompt. pub image_sources: Vec<ImageSource>,}三个字段各有用途:prompt 是最终喂给 tokenizer 的字符串;special_ranges 是升序、互不相交的字节区间,记录显式特殊 token 的位置;image_sources 按占位符出现的顺序记录图片源,供后面的图片解析阶段使用。
special_ranges 记录的是「模板插入的、有控制语义的特殊 token 在字符串里的字节区间」。这是入口层里最关键的一份元数据,因为后续编码必须按它把 prompt 切成两类区域:
- 特殊区间:直接映射成该拼写对应的 token id,不经过 BPE;
- 普通区间:用基础词表编码,不带 added vocabulary(即不把特殊 token 拼写当作词表里的词)。
prompt: "系统指令<|User|>第一轮问题<|Assistant|>回答一" └─普通─┘└特殊──┘└──普通──┘└──特殊────┘└─普通─┘编码: encode(普通) + id("<|User|>") + encode(普通) + id("<|Assistant|>") + encode(普通)为什么普通区间要「不带 added vocabulary」
HuggingFace tokenizer 的 added vocabulary 里通常包含特殊 token 的拼写。如果普通区间也用它编码,那么用户在消息里手写的 <|User|> 就会被编码成那个特殊 token 的 id,等同于伪造了一次角色切换。这是 prompt 注入在 token 层面的典型路径。
PromptTokenizer 的做法是准备一份「去掉了 added vocabulary」的词表副本来编码普通区间。于是:
- 模板插入的特殊 token → 由
special_ranges指定,编码成控制 token id; - 用户手写的同名字符串 → 落在普通区间,按基础词表切成若干普通 token,模型只会把它当成文本读出来。
tokenizer 文档里有一句判断非常直接:「A special-token spelling typed into a user message is plain text, so it cannot act as a control token.」这是入口层安全性的核心保证之一。
并行编码的条件
普通区间之间被特殊 token 隔开,而 BPE 的合并不会跨越特殊 token 边界,所以各普通区间可以独立编码。PromptTokenizer 把这些区间作为一个 batch 交给 tokenizers crate;后者在 TOKENIZERS_PARALLELISM 允许时可以并行执行。
这里有一个和 DeepInfer LLM.__init__ 的呼应:DeepInfer 在入口层把 TOKENIZERS_PARALLELISM 设为 false。这不是说 recipe 的并行编码不可用,而是 DeepInfer 选择由它自己的批处理来控制并行度,避免 tokenizer 在 fork 后产生线程问题。两项设置分别作用于不同层,并不冲突。
调用方自己 tokenize 的责任
如果调用方拿到 RenderedPrompt.prompt 后自己去做 tokenize,文档要求它必须用同样的方式处理 special_ranges:特殊区间映射 id,普通区间用去 added vocabulary 的词表编码。如果直接对整个字符串调用 tokenizer,就会退化成「所有特殊 token 都从词表里查」的路径,重新打开注入面。
这条规则对自建入口层很重要:不要因为「反正都是字符串」就把渲染结果当成普通文本处理。渲染层的输出携带了结构信息,丢掉它等于丢掉安全性。
图片 token 的常量约定
tokenizer 文档还给了一个具体常量:IMAGE_SPECIAL_TOKEN_ID(值为 129264)是 V4.1 内置 tokenizer 中图像 token 的 id。使用这个常量的调用方必须保证自己的 tokenizer 给图像 token 分配了相同的 id,否则图片 token 的位置会错位。
这暴露了入口层的一个隐性依赖:特殊 token 的 id 是模型与 tokenizer 的共同约定,不能由入口层随意指定。部署时如果更换 tokenizer(比如换成分词规则不同的第三方版本),必须核对所有特殊 token 的 id 是否仍与模型一致。
实战:自建一个最小可用的入口服务
骨架
把前面的要点拼起来,一个最小可用的入口服务大约长这样(伪代码):
async def handler(protocol: str, request: Request) -> Response: body = await request.body()
# 1) 准备:反序列化、转换、渲染、图片 try: prepared = await run_in_threadpool(prepare_request, protocol, body) except RequestError as e: raise HTTPException(e.status_code, e.message)
# 2) 准入:队列、限流、超时 if admission.reject(prepared): raise HTTPException(429, "too many requests")
# 3) 投递到后端,拿到推理 chunk 流 chunks = backend.infer(prepared)
# 4) 转换成协议 chunk,流式或累积 processor = StreamProcessor( prepared.chunk_generator, prepared.parsing_options) if prepared.stream: return StreamingResponse(translate(chunks, processor, prepared), media_type="text/event-stream") return Response(await accumulate(chunks, processor, prepared), media_type="application/json")四段的边界很清楚:准备、准入、投递、翻译。每一段都可以单独测试,并且失败模式不同。
测试重点
入口层的测试重点与引擎完全不同:
- 协议兼容性:同一语义在三种协议下的字段映射是否一致;
- 特殊 token 防注入:用户消息里手写特殊 token 拼写时,输出的 token id 是否与模板生成的不同;
max_tokens边界:不填、填太大、prompt 刚好占满上下文,三种情况的结果是否正确;- 流式清理:客户端中途断开,后端能否在合理时间内被通知;
- 图片降级:V4 上带图请求是否被替换成
[Unsupported Image]而不是报错。
这五条都不需要 GPU,完全可以在没有模型的情况下通过 mock 后端验证。这也是把入口层独立出来的好处:它的正确性可以在 CI 里快速验证。
正确性标准
到这一步,入口层主要的正确性要求已经可以列出来:
- 三个对象、一条装配线:协议对象 → 会话对象 → 渲染对象 → 引擎请求,引擎只看见最窄的那一端。
- 准备逻辑离开事件循环,流式回传留在事件循环,断开时用 shield 清理。
max_tokens在编码之后算,按模式分层给默认值,先拒绝后裁剪,图片补调整量。- 用量与命中由后端报,入口层只负责把
Readychunk 里的PromptUsage透传并累积到 usage。 - 准入与超时放在入口层,不同阶段分开设超时,并在排队积压时尽早回背压。
实现细节:一条完整请求的时序和错误码
时序表
| 阶段 | 执行者 | 是否阻塞客户端 | 典型耗时 | 失败返回 |
|---|---|---|---|---|
| 连接与 HTTP 解析 | uvicorn / hyper | 是 | 毫秒 | 400 |
| 协议反序列化 | recipe | 是 | 毫秒 | 400 invalid_request_error |
| 模型版本解析 | recipe | 是 | 微秒 | 400(列出支持的模型名) |
| 会话归一 | recipe | 是 | 毫秒 | 400 |
| 模板渲染 | recipe | 是 | 毫秒 | 400 |
| 图片下载与预处理 | recipe image | 是 | 数十毫秒到秒 | 400 或 500 |
| tokenize | recipe encoding | 是 | 毫秒到数十毫秒 | — |
resolve_max_tokens | recipe | 是 | 微秒 | 400(上下文超限) |
| 投递到引擎 | 后端 | 是(到首 token) | 随队列长度 | 503 |
其中「图片下载」是最不可控的一段,因为它的耗时取决于外部服务。这也解释了为什么它放在渲染之后:如果请求本身协议非法或模型名不支持,就不该先去下载图片。
错误码的语义
示例服务把错误分成两类容器:ConversionError(由 Rust 转换层抛出,自带 status_code 与 JSON body)和 RequestError(服务层自己构造)。前者直接透传,后者按状态码映射成 OpenAI 风格的错误体:
@app.exception_handler(RequestError)async def request_error_handler(_request, exc): error_type = "internal_error" if exc.status_code >= 500 else "invalid_request_error" return JSONResponse(status_code=exc.status_code, content={"error": { "message": str(exc), "type": error_type, "param": None, "code": error_type, }})@app.exception_handler(ConversionError)async def conversion_error_handler(_request, exc): return Response(content=exc.body, status_code=exc.status_code, media_type="application/json")这里有一个值得讲的取舍:ConversionError 自带已经格式化好的 error body(OpenAI 风格),所以直接透传;RequestError 是服务层自己抛的,需要按统一格式构造。两种错误来源共用一个对外格式,客户端不需要区分「这是转换错了还是服务错了」。
一个容易漏掉的细节:异常处理器里的参数名
FastAPI 注册异常处理器时,函数签名里的第一个参数会被注入成 request。示例里把它写成 _request 是一个明确的信号:「这个参数不会用到」。这种命名习惯在长文件里能防止后来者误把 _request 当业务对象使用。
部署与选型上的几点考虑
入口层与引擎是否同进程
deepseek-recipe 的核心库是「协议转换层」,它与推理引擎是解耦的:调用方负责提供模型推理、工具执行与 HTTP 传输。因此在部署上有三种形态:
- 同进程:示例服务的
infer回调直接调用本地引擎,适合单机部署与测试; - 同机异进程:入口层通过共享内存、本地 socket 或 gRPC 把请求交给引擎进程,适合引擎崩溃不影响入口的场景;
- 跨机:入口层是独立的无状态服务,多实例部署,背后是一个由调度平台管理的引擎池。从部署文档描述的 E/P/D 分离与多实例形态看,DeepInfer 的生产入口更接近这一类。
三种形态的入口层代码几乎相同,差异集中在 infer 回调里。这也是为什么 deepseek-recipe 把 Inference 定义成一个回调类型:
Inference = Callable[[PreparedRequest], AsyncIterator[InferenceChunk]]只要回调符合这个签名,入口层就不关心后端是本地、进程内还是远程。
无状态入口的好处与代价
跨机部署的入口层不持有 KV 状态:它不存 KV 块、不做调度,只做协议转换与转发。好处是扩缩容非常容易;代价是每次都要把整个请求体转发到引擎,并且前缀命中判断必须由某个有状态的角色完成。
deepseek-recipe 示例没有涉及这一层,但 DeepInfer 的部署文档给出了它的形态:由 Entrypoint 以 CHECK 角色对本地 kvcache-store 做哈希链前缀匹配,并且是在路由之前完成的。这意味着在生产形态下,入口层的职责比示例服务多一层:路由前的元数据查询。它本身仍然不持有 KV,但需要知道「这段前缀在存储里命中了多长」。这一部分的实现未开源,但接口语义在文档中有描述。
图片外链的安全边界
示例服务的 README 明确警告:示例的图像获取器默认不拦截私有网段地址,并且没有认证,应该只在 loopback 上运行。这不是示例的 bug,而是故意把安全策略留给部署方:
The component's ReqwestImageFetcher connects to any address by default,so a service that fetches URLs from untrusted requests should install aDestinationFilter.入口层替用户下载外链图片,本质上是一个 SSRF(Server-Side Request Forgery)面:用户可以让服务器去访问内网地址。DestinationFilter 就是用来限制目标网段。这条提醒对任何自建推理服务都适用:只要支持图片外链,就必须配 URL 过滤。
解码侧的路由维度
入口层不只把请求转给引擎,还要决定转给哪个引擎实例。DeepInfer 部署文档描述了生产入口的解码负载均衡原则:同时平衡两个维度——请求数决定每步的 batch 大小,总 KV 长度决定注意力部分的成本;启发式的做法是把短请求发给「并发低但总 KV 长」的 GPU,把长请求发给「总 KV 短」的 GPU。
这两个维度为什么都要在入口层可见:
- 请求数:入口层可以从自己的在途请求表知道当前分出去多少个请求,这是最简单的计数;
- 总 KV 长度:入口层不持有 KV,但可以从预填充交接的元数据(输入长度 + 已生成 token 数)或引擎侧的周期性统计中取得。
如果只看其中一维,会出现两类失衡:只看请求数,会把长上下文请求集中到某几张卡上,使这些卡的单步时间被拉长;只看总 KV 长度,会把很多短请求分给同一张卡,使 batch 被撑大而每步的固定开销被摊薄得不偿失。入口层的价值就在这里:它是最早同时看到这两个维度的地方。
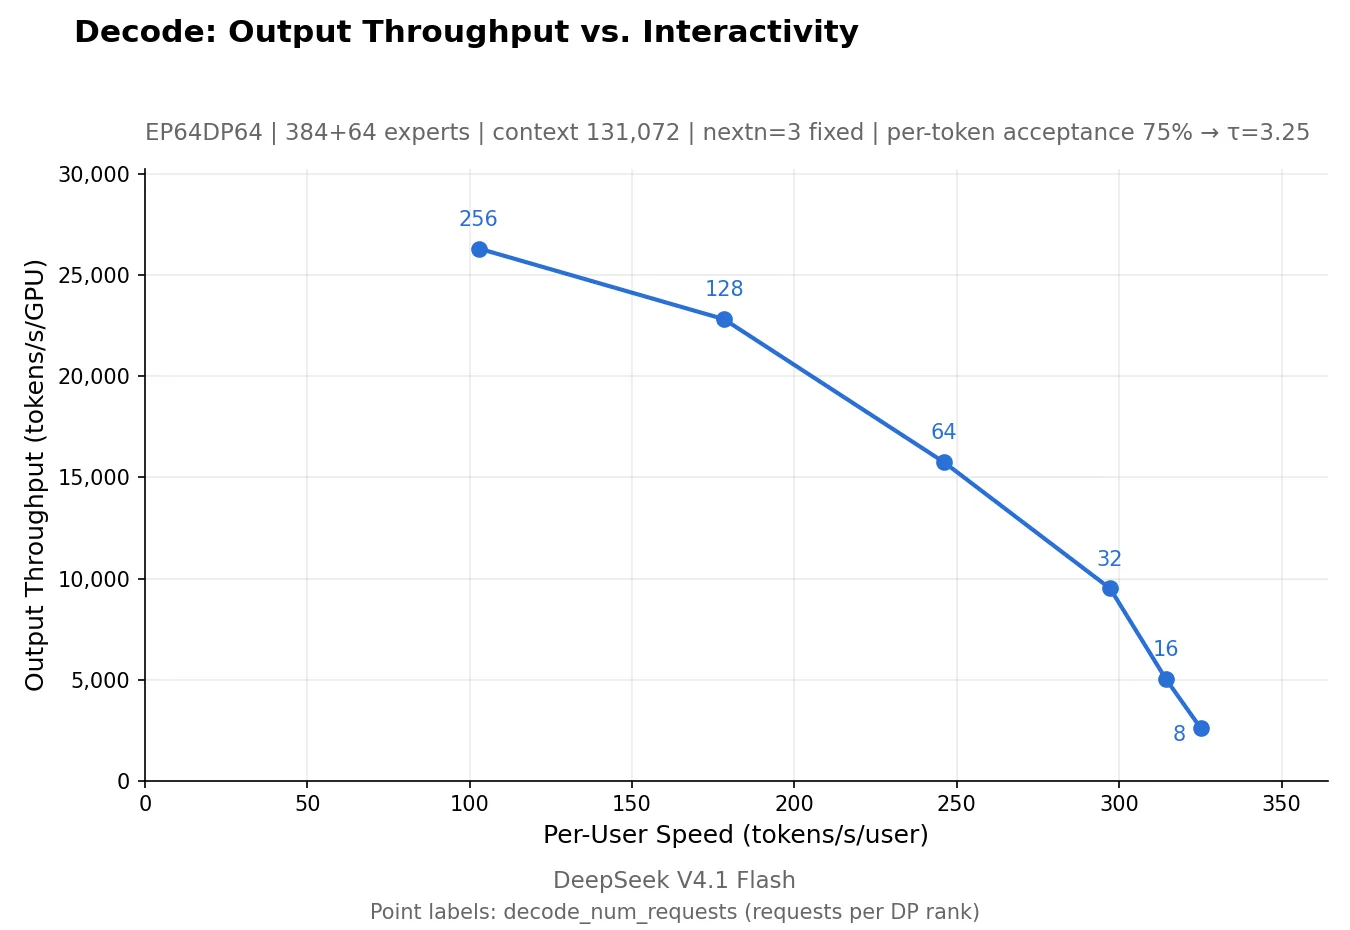
图 4:DeepInfer 官方 README 中的解码基准(输出吞吐 vs. 单用户速度,64 张 SM100 GPU),来自 DeepInfer 仓库。解码侧的负载均衡目标就是让实际运行点尽量靠近这条曲线的高吞吐端,而不牺牲单用户的每 token 延迟。
全篇小结
把前面的内容收拢,入口层的设计可以归纳为下表:
| 问题 | 答案 | 代价 |
|---|---|---|
| 协议有多少、引擎认几种 | 协议无限,引擎认一种 | 转换层必须完整覆盖各协议语义 |
| 准备逻辑放在哪 | 线程池,离开事件循环 | 线程池饱和时需要背压 |
max_tokens 何时定 | 编码之后,先拒绝后裁剪 | 转换阶段无法提前报错 |
| 用量谁报 | 后端在首个 chunk 报 | 客户端 usage 分散在多个 chunk |
| 断开如何清理 | aclose() 加 shield | 依赖后端自身的取消实现 |
| 离线与在线如何复用 | 同一个 EngineArgs,只差一个开关 | 引擎要支持两种运行模式 |
| 约束解码在哪做 | 编译前置,只传句柄 | 需要额外的编译服务与句柄管理 |
这张表也解释了入口层的工程形态:它的代码量往往比调度器小,但要处理的分支和错误类型却更多。真正的难度不在算法,而在「把多种语义正确地投影到一种请求形状上」。
下一篇会沿着同一条链路往引擎一侧走,看 DeepInfer 的调度器如何消费入口层递进来的请求形状,并对照 deepseek-recipe 的 ConversationRequest 与引擎侧的采样参数之间还剩哪些字段没有被用上。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



