


TensorRT-LLM 源码完全拆解(十八):Guided Decoding——语法编译、bitmask 掩码与投机回滚的完整闭环
一个用 Llama-3.1-8B 做工具调用的服务,绝大多数时候输出的 JSON 都能被 json.loads 解析;但只要某次模型多吐了一个逗号,下游的解析器就抛异常、整个 Agent 链条断掉。这不是模型「不够聪明」,而是自回归生成的性质决定的:模型每个 step 从整个词表里挑一个概率最高的 token,而「合法的下一个 token」和「概率最高的 token」本来就是两回事。受约束解码(Guided Decoding,也常被叫做 Constrained Decoding 或 Structured Generation)要做的就是把这个「两回事」变成一个约束:在采样之前,先把所有语法上不可能接下去的 token 从候选集里删掉。
本文是 TensorRT-LLM 源码系列的第(十八)篇。前十七篇从仓库地形、PyExecutor 装配线、调度器、KV Cache 管理一路讲到注意力后端、量化、显存预算、P/D 分离和采样管线,这一篇要补上的是最后一块与「输出正确性」直接相关的拼图:语法约束是怎么在每一个 step 落到 logits 上的。会讲到的东西包括:
- 语法编译器(XGrammar 与 LLGuidance 两个后端)如何把 JSON Schema、正则、EBNF 编译成可增量执行的自动机;
GrammarMatcher的四个方法如何定义一个「可以回退的语法状态机」契约;bitmask的位布局为什么是ceil(vocab_size / 32)个 int32,行数为什么是max_num_draft_tokens + 1;GuidedDecoder在一次迭代里add_batch → build → copy_bitmask → apply_bitmask的完整时序,以及两条 CUDA 流之间的 event 同步;- 投机解码下三个计数器如何记账、被拒绝的草稿 token 如何把语法状态回退;
CapturableGuidedDecoder为了兼容 CUDA Graph 而引入的 hostfunc 机制,以及它踩到的 GIL 死锁坑;- 最终落到 GPU 上的
logits_bitmask内核,逐行读它的分支与访存模式; - 张量并行下 bitmask 的切分为什么必须按 32 位对齐。
一、受约束解码要跨过的三道坎
「把不合法的 token 屏蔽掉」听起来是一句话的事,但真正要在生产级推理引擎里做对,得同时跨过三道坎。
1.1 第一道坎:语法怎么表示
最直观的想法是拿正则表达式匹配输出字符串。但 JSON 是递归嵌套的结构:一个对象里可以再放对象,一个数组里可以再放数组,嵌套深度没有上界。正则表达式对应的是有限自动机(Finite State Machine),有限状态机没有栈,记不住「我现在还欠几个右括号没闭合」,因此它根本无法描述任意深度的嵌套。
这里必须换成上下文无关文法(Context-Free Grammar)那一档的表达能力,对应的执行模型是下推自动机(Pushdown Automaton,PDA)——一个有限状态机加上一个栈。栈里压着「当前还欠哪些闭合符号」,读到一个 { 就压一个 } 进去,读到一个 } 就弹一个出来核对。JSON Schema、EBNF 这类约束最终都会被编译成某种 PDA 形态。
这个区别不是学术洁癖,它直接决定了约束系统的能力边界:只做正则匹配的方案写不出 JSON Schema 支持,而支持 JSON Schema 就意味着必须有栈。
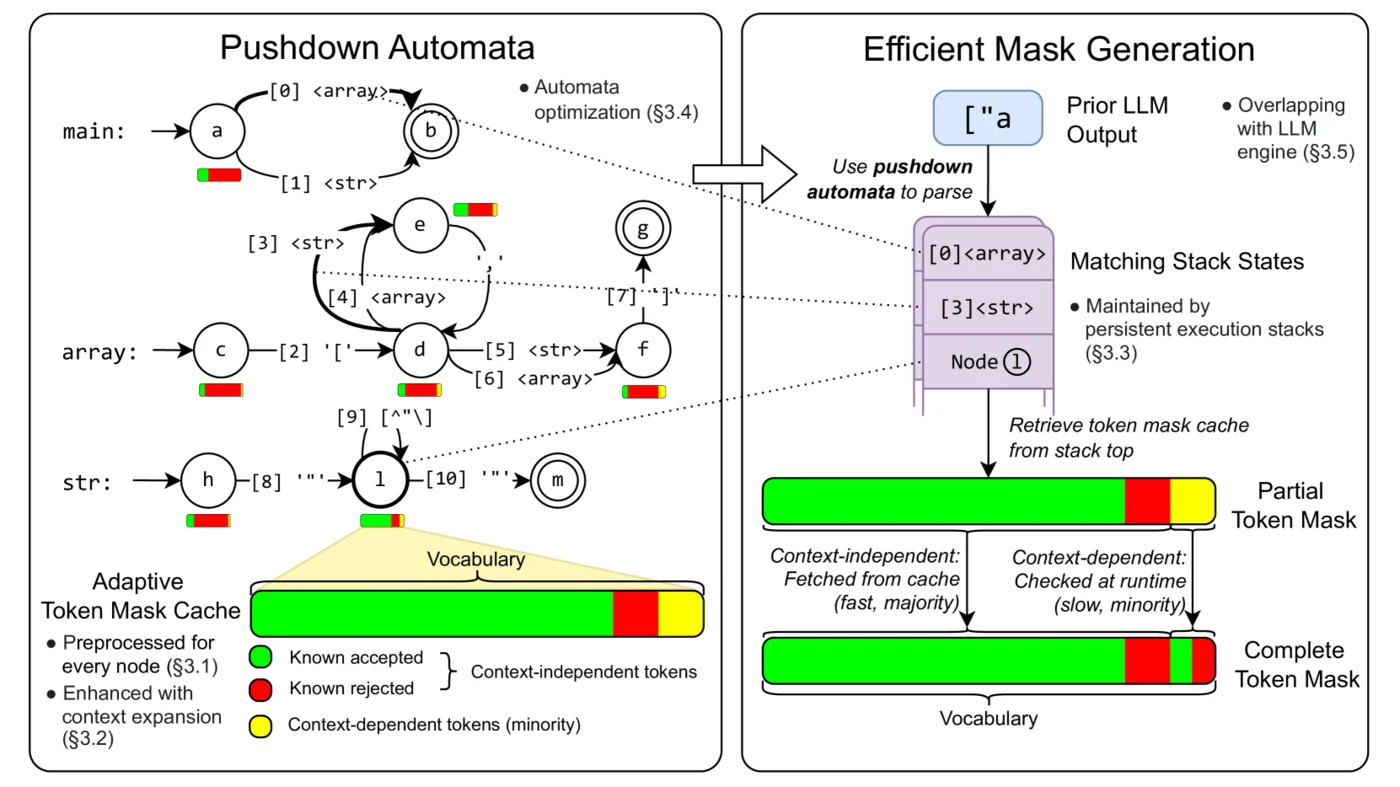
上图是 XGrammar 论文给出的整体流程。左侧是约束(JSON Schema / 正则 / EBNF),中间是编译出的自动机,右侧是它在每一步生成的 per-token 掩码。整篇文章要讲的就是这条链路上每一环在 TensorRT-LLM 源码里的对应实现。
1.2 第二道坎:词表和字符级自动机的错位
语法是按字符定义的:{"name": " 这样一串字符是合法的前缀。但模型吐出来的是 token,而 token 是子词(subword)——一个 token 可能对应一个字符、半个单词、甚至五六个字符。于是每一步要回答的问题其实是:
当前自动机处在状态 ,词表里哪些 token 对应的字节串能让自动机继续走下去而不进入死状态?
这个问题的暴力解法是:对词表里每一个 token,都在自动机上试走一遍,走通了就允许。对 12.8 万词表的 Llama 3 来说,这意味着每一步做 12.8 万次自动机转移。代价不可接受,于是有了各种加速手段——预计算哪些 token 是「上下文无关」的(比如 {、" 这类在任何状态下的行为都固定的 token),把它们的结果缓存起来;只对真正与状态相关的 token 做实时判定。XGrammar 论文里的 token 分类缓存正是这个思路。
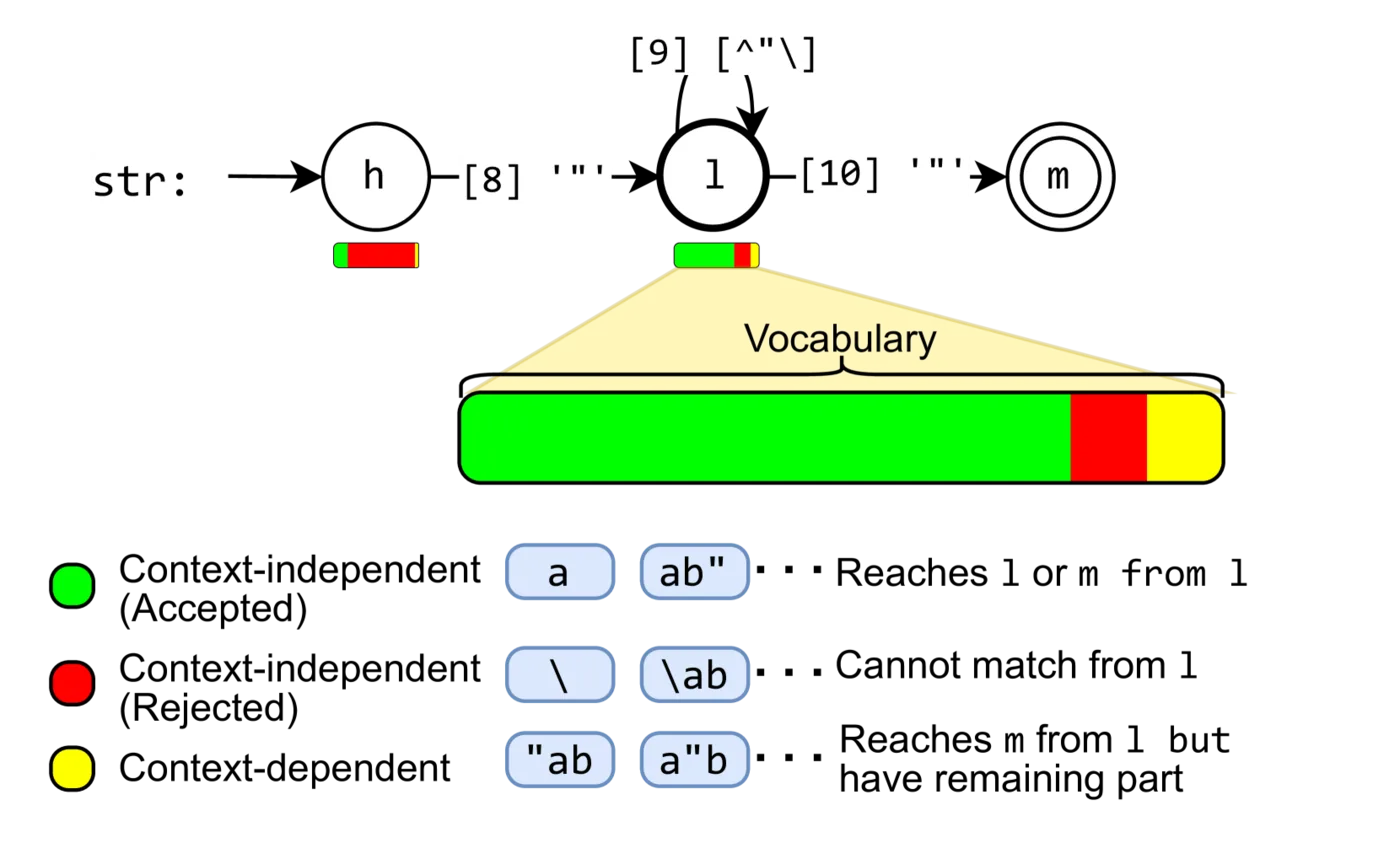
上图来自 XGrammar 论文的 token mask cache 一节,把词表切成了三类:绿色是「在任何语法状态下都合法」的 token,红色是「在任何状态下都非法」的 token,剩下黄色才是必须拿到当前自动机状态才能判定的「上下文相关」token。前两类可以在编译期一次算完、反复复用,于是每一步真正需要实时判定的规模从 12.8 万骤降到几千量级;这也解释了为什么掩码的构建能被塞进 CPU 侧的 build() 而不至于拖垮整个 step。
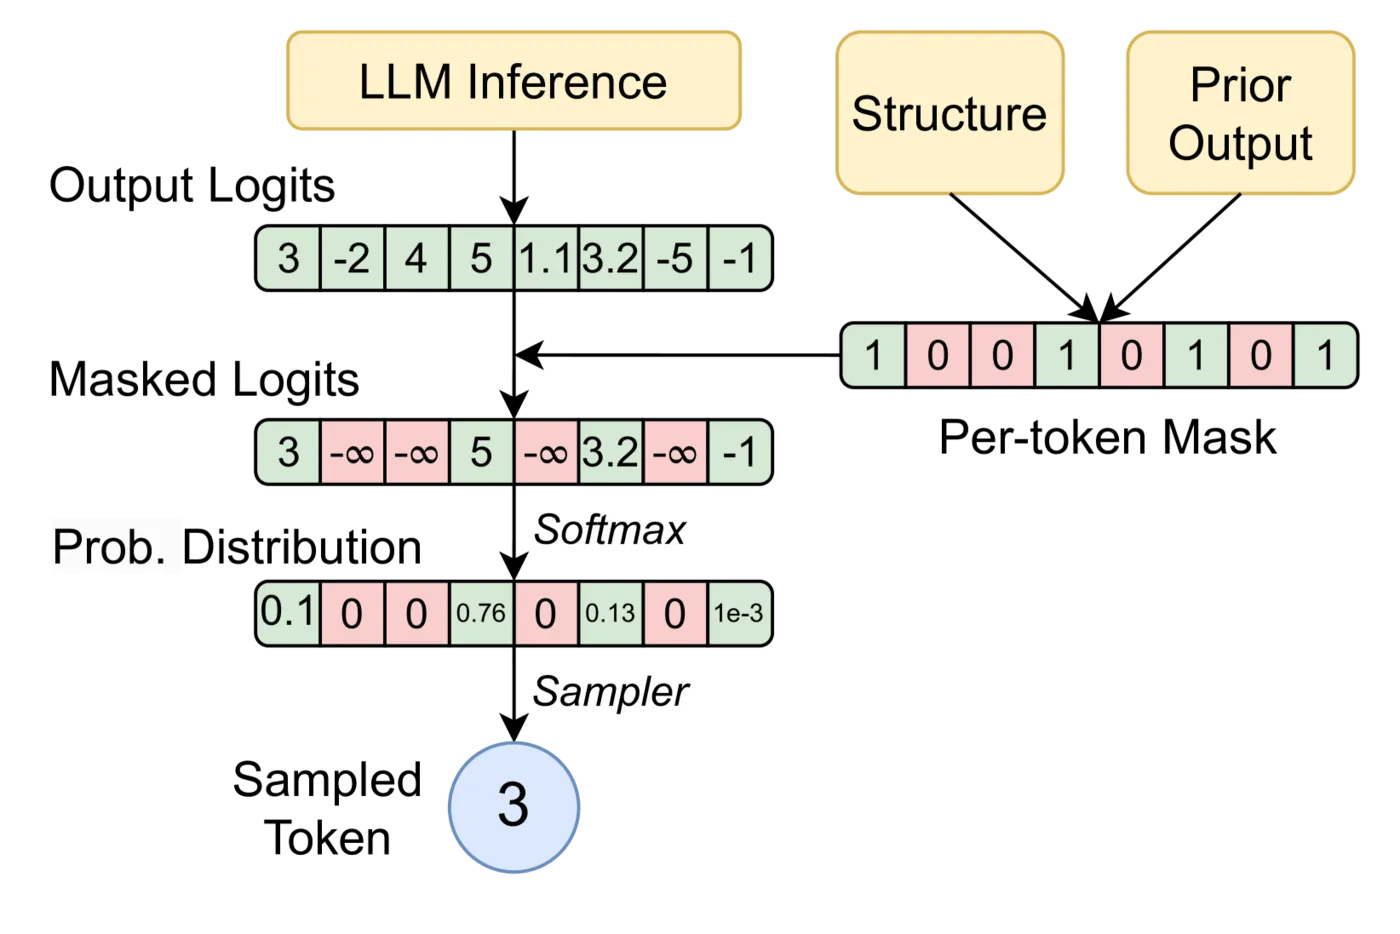
上图把这个机制画得很直白:模型给出 logits(图中一排候选),掩码把非法 token 的位置置零,只有合法子集参与最终的采样。
1.3 第三道坎:不能把 CPU 拖进关键路径
掩码这件事本身是 CPU 侧的工作——自动机跑在 CPU 上,词表也在 CPU 内存或显存里。可推理引擎的关键路径是 GPU 上的前向 + 采样,一个 step 只有几毫秒。如果每个 step 都要「CPU 停下来算掩码 → 传到 GPU → GPU 采样」,那 GPU 就会周期性空转,吞吐直接掉下去。
TensorRT-LLM 的解法是把掩码当作 GPU 侧采样管线的一个前置算子:掩码在 CPU 上算,通过 pinned memory 异步拷到显存,然后由一个定制的 CUDA 内核把掩码施加到 logits 上。更激进的一步是让整个「构建掩码 → 拷贝 → 施加」的流程也能被 CUDA Graph 捕获,这样它就跟前向、采样一样,成为一条被重放的静态执行路径——这也是 CapturableGuidedDecoder 存在的理由,第七节会详细拆。
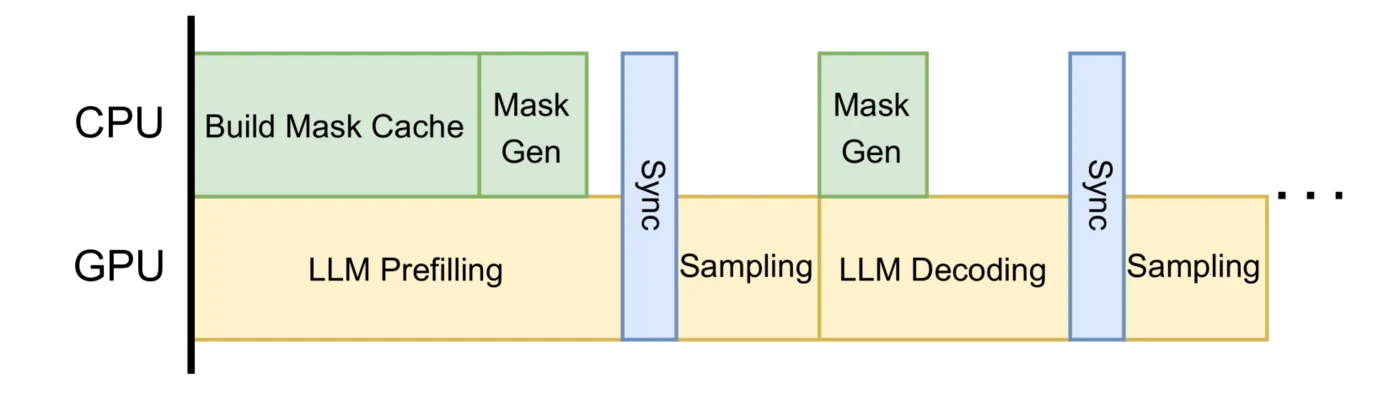
上面这张 XGrammar 论文的示意图给的是另一个层面的答案:既然掩码工作和模型前向是两类不同的资源(CPU 与 GPU),那就不该串行排队——掩码缓存的构建可以叠在 prefill 的窗口里做完,每一步的掩码生成也可以和上一步的 decode 重叠。TensorRT-LLM 这条路径上的 side stream + event 同步 + CUDA Graph 捕获 是同一思路在引擎内部的落地方式,区别在于它必须服从调度器与图重放的约束,第四、六节会看到这些约束具体长什么样。
三道坎对应三个设计层面:表达能力(PDA)、词表对齐(缓存 + 位图)、执行开销(异步拷贝 + GPU 内核 + 图捕获)。后面的源码拆解基本就是按这个顺序展开的。
二、抽象层:GrammarMatcher 只要四个方法
TensorRT-LLM 把「语法引擎」这件事做成了一个可插拔的后端抽象。抽象只有两个接口:一个工厂、一个匹配器。完整定义在 tensorrt_llm/_torch/pyexecutor/grammar_matcher.py 里,去掉实现之后的骨架如下:
class GrammarMatcher(ABC):
@abstractmethod def accept_token(self, token_id: int) -> bool: pass
@abstractmethod def rollback(self, num_tokens: int) -> None: pass
@abstractmethod def fill_next_token_bitmask(self, next_token_bitmask: torch.Tensor, index: int) -> None: pass
@abstractmethod def is_terminated(self) -> bool: pass
class GrammarMatcherFactory(ABC):
@abstractmethod def create(self, guided_decoding_params: GuidedDecodingParams) -> GrammarMatcher: pass四个方法,正好覆盖一个「可回退、可查询的语法状态机」需要的全部能力:
accept_token(token_id):把模型刚生成的 token 喂给自动机,推进状态。返回值是布尔——这个 token 是否被接受。返回False意味着自动机拒收(token 不该出现在这里)。rollback(num_tokens):把自动机状态倒退num_tokens步。这个方法存在的唯一理由是投机解码:草稿 token 先被乐观地喂进自动机,如果目标模型验证后拒绝了其中几个,就必须把自动机退回上一个被接受的位置。fill_next_token_bitmask(bitmask, index):把「当前状态下哪些 token 合法」写进bitmask张量的第index行。这是整个子系统里唯一一个把信息从自动机传递到 GPU 的接口。is_terminated():自动机是否已经走到接受状态(语法已经完整)。一旦 terminated,就不再需要继续填掩码——剩下的生成不受约束。
这四个方法的组合有一个很关键的性质:状态机只前进不重算。每一步只是 accept_token 一个 token,而不是拿整个已生成序列从头重新解析。这就是「增量执行」的含义,也是为什么 rollback 能用 O(退回步数) 而不是 O(整个序列) 完成回退。
2.1 XGrammar 后端:编译期缓存 + 预编译内置语法
XGrammarMatcherFactory 的构造过程里有两个值得注意的决策。
第一个是 TokenizerInfo 的元数据探测。掩码的合法性判断依赖「token 的字节串」,所以必须知道分词器的确切行为——特别是 add_prefix_space 这种细节:有些分词器在编码一个新词时会自动在前面补一个空格,如果语法引擎不知道这件事,它算出来的合法 token 集合就会和模型实际吐出来的对不上。代码里通过 xgrammar.TokenizerInfo._detect_metadata_from_hf 从 HuggingFace tokenizer 配置里读出 vocab_type 和 add_prefix_space:
vocab_type = xgrammar.VocabType.RAWadd_prefix_space = Falseif guided_decoding_config.tokenizer_str is not None: metadata = xgrammar.TokenizerInfo._detect_metadata_from_hf( guided_decoding_config.tokenizer_str) vocab_type = metadata["vocab_type"] add_prefix_space = metadata["add_prefix_space"]
tokenizer_info = xgrammar.TokenizerInfo( guided_decoding_config.encoded_vocab, vocab_type=vocab_type, vocab_size=vocab_size_padded, stop_token_ids=guided_decoding_config.stop_token_ids, add_prefix_space=add_prefix_space)第二个是 GrammarCompiler 的缓存预算。编译一个 JSON Schema 到自动机是有成本的(要做上下文扩展、构建扩展后缀自动机等工作),而线上服务里同一套 schema 会被成千上万个请求反复使用。所以编译器带缓存,缓存上限由环境变量 XGRAMMAR_CACHE_LIMIT_GB 控制,默认 1 GB:
cache_limit_gb = float(os.getenv("XGRAMMAR_CACHE_LIMIT_GB", "1"))cache_limit_bytes = int(cache_limit_gb * 1024 * 1024 * 1024)self._xgrammar_compiler = xgrammar.GrammarCompiler( tokenizer_info, cache_enabled=True, cache_limit_bytes=cache_limit_bytes,)这里有一个工程上的取舍值得说清楚:1 GB 的缓存上限不是随便定的。compile 出来的自动机对象大小与 schema 复杂度正相关,一个中等复杂度的 tool-calling schema 编译结果大约在几十到几百 KB。1 GB 大致能装下几千套不同的 schema。如果服务只暴露固定的几个 schema,这个缓存一次都撑不满;如果 schema 是用户动态传入的(比如用户自己定义输出格式),缓存会因为不断换入换出而失效,这时把上限调大意义也不大,反而应该考虑对 schema 做去重或限制种类。
create() 方法按 guide_type 分派到不同的编译入口,覆盖五种约束类型:
def create(self, guided_decoding_params) -> XGrammarMatcher: guide_type = guided_decoding_params.guide_type guide = guided_decoding_params.guide match guide_type: case GuidedDecodingParams.GuideType.JSON: compiled_grammar = self._xgrammar_compiler.compile_builtin_json_grammar() case GuidedDecodingParams.GuideType.JSON_SCHEMA: compiled_grammar = self._xgrammar_compiler.compile_json_schema(guide) case GuidedDecodingParams.GuideType.REGEX: compiled_grammar = self._xgrammar_compiler.compile_regex(guide) case GuidedDecodingParams.GuideType.EBNF_GRAMMAR: compiled_grammar = self._xgrammar_compiler.compile_grammar(guide) case GuidedDecodingParams.GuideType.STRUCTURAL_TAG: compiled_grammar = self._xgrammar_compiler.compile_structural_tag(guide) case _: raise ValueError(f"Unsupported guide type: {guide_type}.")
matcher = xgrammar.GrammarMatcher( compiled_grammar, max_rollback_tokens=self.max_num_draft_tokens) return XGrammarMatcher(matcher)注意 JSON 和 JSON_SCHEMA 是两个不同的类型。JSON 走 compile_builtin_json_grammar(),意思是「只要是合法 JSON 就行」,不限定结构——这是最便宜的一条路,因为它对应的是一个固定的、可以全局预编译的内置语法。JSON_SCHEMA 才需要传 guide 去做按 schema 的编译。
max_rollback_tokens=self.max_num_draft_tokens 这个参数是把投机解码的配置直接透传给了自动机实现。它的含义是:这个 matcher 需要支持最多回退 max_num_draft_tokens 步。XGrammar 内部为此要预留一份可回退状态的记录(论文里的 persistent stack 机制),传入这个上界让它知道要预留多大。如果不做投机解码,max_num_draft_tokens 就是 0,回退记录的开销可以直接省掉。
2.2 LLGuidance 后端:用 tokenizer 字符串而不是词表数组
第二个后端 LLGuidanceMatcherFactory 走了一条不同的路:它不是把 encoded_vocab(一个字符串数组)拷进来,而是直接拿 tokenizer_str(HuggingFace tokenizer 的路径或标识)交给 LLGuidance 自己加载:
if tokenizer_str is None: raise ValueError("tokenizer_str is required")
eos_token = Noneif stop_token_ids is not None: if len(stop_token_ids) != 1: raise ValueError("expected stop_token_ids size to be 1") eos_token = stop_token_ids[0]
self._tokenizer = llguidance.LLTokenizer(tokenizer_str, n_vocab=vocab_size_padded, eos_token=eos_token)这里有个硬约束:LLGuidance 后端只接受恰好一个 stop token,多于一个直接抛错。原因是它需要明确区分「EOS」和「其它停止符」,而它的 matcher 在 stopped 状态下只认一个 EOS token。XGrammar 后端没有这个限制,它的 stop_token_ids 是一个列表。
这个差异在真实使用中会造成迁移成本:如果你的服务配置了多个停止 token(比如同时配了 <|eot_id|> 和 <|end_of_text|>),从 xgrammar 切到 llguidance 会直接启动失败。这不是 bug,而是两个后端对「终止」这件事的建模粒度不同。
LLGuidanceMatcher.accept_token 的实现还揭示了另一个设计差异:
def accept_token(self, token_id: int) -> bool: if self._matcher.is_stopped(): # Accept EOS token only if the matcher is stopped. if token_id == self._eos_token: self._is_terminated = True return True else: return False
num_accepted = self._matcher.try_consume_tokens([token_id]) self._check_err() return num_accepted > 0try_consume_tokens 返回的是接受的数量而不是布尔。对单 token 输入来说,num_accepted > 0 就等价于「接受了」。这个 API 形状暗示 LLGuidance 支持一次喂多个 token——它的设计里 consume_tokens 是可以批量推进的,比逐个 accept_token 更高效。
另外注意 rollback 里那段特殊的账:
def rollback(self, num_tokens: int) -> None: if num_tokens == 0: return if self._is_terminated: self._is_terminated = False num_tokens -= 1 self._matcher.rollback(num_tokens) self._check_err()如果当前状态是「已终止」,回退时要先把终止状态本身算作一步回退掉(num_tokens -= 1),再把剩下的步数交给底层 matcher。原因很直白:终止标记在 LLGuidance 内部不是一个真正的自动机状态转移,而是在遇到 EOS token 时被这个 wrapper 自己记下来的布尔标志。回退时如果不把这个「虚拟的一步」一并算进去,底层 matcher 就会多退一步,状态对不上。
_check_err() 在几乎每个方法末尾都被调用:
def _check_err(self) -> None: if self._matcher.is_error(): raise ValueError(f"LLGuidance matcher error: {self._matcher.get_error()}")这是一个刻意的失败策略选择。LLGuidance 的底层实现是 Rust,通过 FFI 暴露给 Python。它内部遇到问题不会抛 Python 异常,而是把错误记在自己的状态里,之后所有调用都进入 error 状态。这个 wrapper 每次调用后主动检查并抛出,把「静默进入错误状态、之后行为变得诡异」转成「在出错的那一步就明确抛异常」。这种设计对调试非常友好——错误发生在哪一步一清二楚,而不是等到几百步之后输出完全不合法才发现。
2.3 两个后端的取舍
把两个后端放到一起对比,能看出它们各自的设计重心:
| 维度 | XGrammar | LLGuidance |
|---|---|---|
| 约束类型 | JSON、JSON Schema、正则、EBNF、Structural Tag | JSON Schema、正则、EBNF |
| EBNF 语法风格 | 标准 EBNF | Lark 格式(代码注释里明确指出了这点) |
| 停止 token | 接受多个 | 只接受恰好一个 |
| 初始化输入 | 需要 encoded_vocab 数组 | 只需 tokenizer_str |
| 回退预留 | 构造时传 max_rollback_tokens | 无需显式配置 |
Structural Tag 只在 XGrammar 后端可用——这是一种「在一段自由文本里嵌入结构化片段」的约束,典型场景是「先让模型自由思考,然后在某个标签之后强制输出 JSON」。LLGuidance 不支持这个,如果你的场景需要它,后端就没得选。
反过来,LLGuidance 的 EBNF 入口要求 Lark 语法格式。源码注释把这件事说得很明确:
case GuidedDecodingParams.GuideType.EBNF_GRAMMAR: # Note: LLGuidance expects Lark grammar format, not standard EBNF. # When using LLGuidance backend with EBNF_GRAMMAR type, users must # provide Lark-formatted grammar instead of standard EBNF. grammar = llguidance.LLMatcher.grammar_from_lark(guide)也就是说,同一个 GuideType.EBNF_GRAMMAR,在两个后端下的语义是不一样的:xgrammar 走 compile_grammar 吃标准 EBNF,llguidance 走 grammar_from_lark 吃 Lark。这意味着切换后端可能要求重写用户传入的语法文本——这是一个 API 层面上的隐性耦合,值得在选型时提前确认。
TensorRT-LLM 默认用 XGrammar(backend: GuidedDecodingBackend = Field(default=GuidedDecodingBackend.XGRAMMAR, ...)),想换后端是在 GuidedDecodingConfig 里指定:
class GuidedDecodingConfig(StrictBaseModel):
class GuidedDecodingBackend(Enum): XGRAMMAR = 0 LLGUIDANCE = 1
backend: GuidedDecodingBackend = Field( default=GuidedDecodingBackend.XGRAMMAR, description="The backend for guided decoding config.") encoded_vocab: Optional[List[str]] = Field(default=None, ...) tokenizer_str: Optional[str] = Field(default=None, ...) stop_token_ids: Optional[List[int]] = Field(default=None, ...)这个配置对象同时携带两个后端各自需要的字段,由工厂按 backend 决定读哪些。代价是配置里会存在「对当前后端无意义的字段」,好处是切换后端不用改配置结构。
三、bitmask:一比特代表一个 token
自动机的输出要送到 GPU 上,中间必须有一份紧凑的数据表示,这就是 bitmask。
3.1 为什么是位图而不是索引表
最省事的做法是列一个「合法 token id 的列表」传给 GPU。但问题是长度不固定:某些状态下合法 token 可能有两万个(比如刚要开始一个字符串字段,几乎所有不带引号的 token 都合法),某些状态下可能只有三个。变长数据在 GPU 上处理起来很难受——要么做动态形状,要么按最大长度填 padding,都会破坏 CUDA Graph 要求的静态形状。
位图(bitmask)解决了这个问题:它的长度固定是 ceil(vocab_size / 32) 个 int32,与当前状态下合法 token 的多少无关。每个 bit 对应一个 token id,1 表示允许、0 表示禁止。GPU 内核因此可以按固定 stride 遍历,完美契合静态形状。
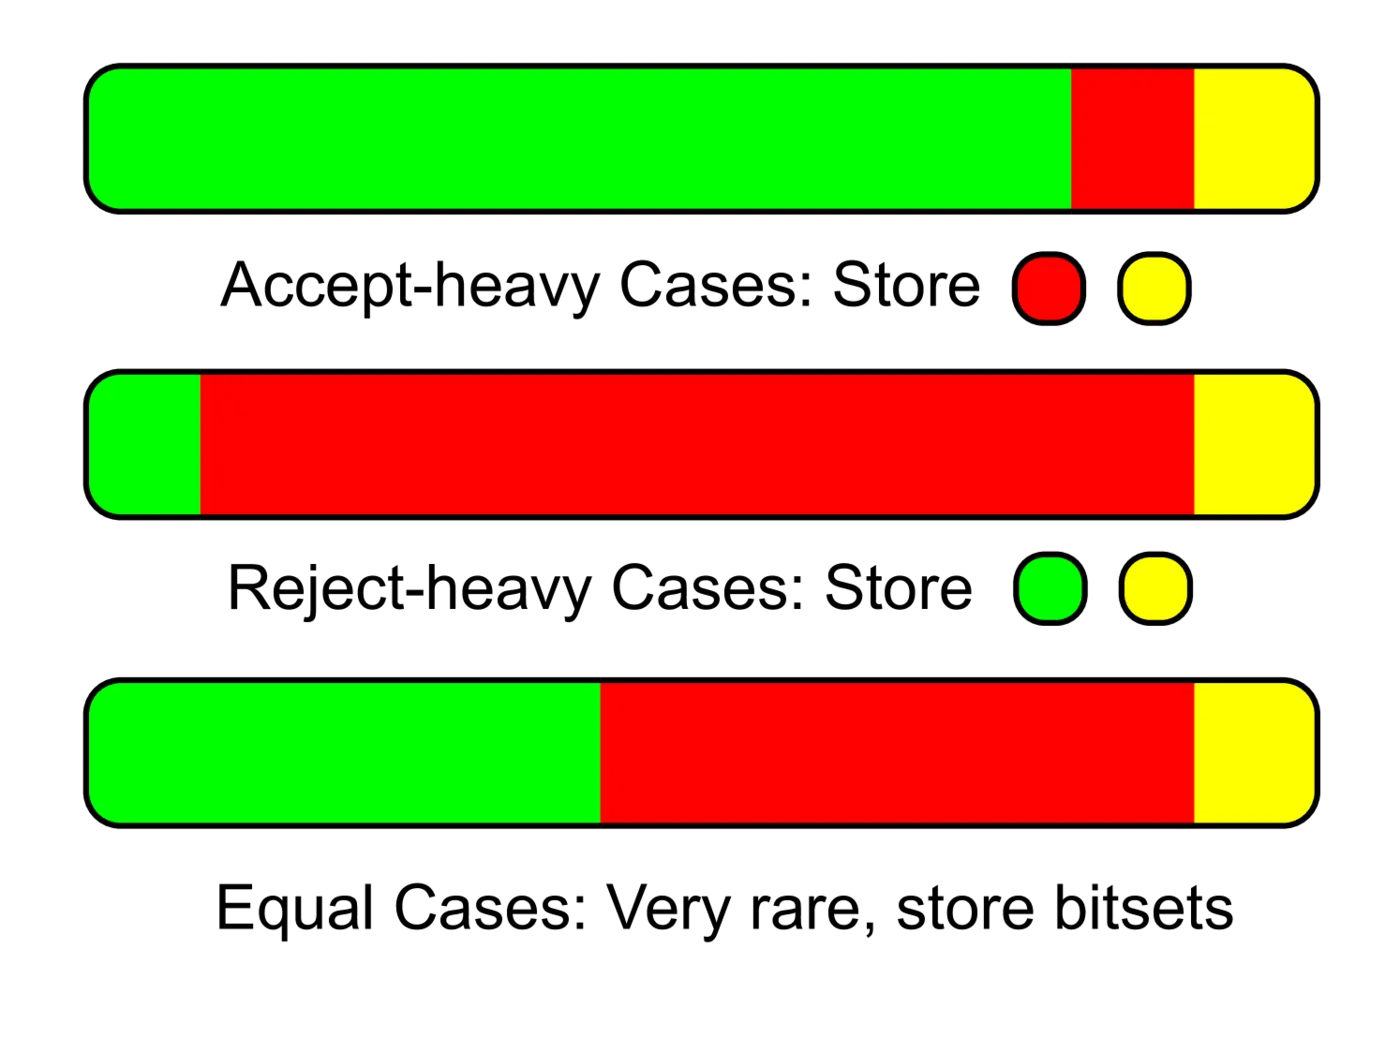
这里值得对照一下 XGrammar 论文里的自适应存储方案:它恰恰是「用列表而不是位图」——但那个列表是引擎内部、CPU 侧的缓存,不是送到 GPU 上的产物。既然大多数语法状态下要么几乎所有 token 都合法、要么几乎都非法,那么只存少数派一侧的 id 列表最省内存,这就是「接受为主」与「拒绝为主」两种格式存在的理由。而一旦数据要过 PCIe 到 GPU,变长列表就必须被压成定长位图——两者的取舍方向正好相反,因为一个受限于内存、一个受限于静态形状。上图的两种布局也顺带说明了为什么「缓存命中」这件事对性能这么关键:命中的 token 根本不需要重新跑自动机,只是从这两类列表里查一次。
class GuidedDecoder: bitmask_dtype = torch.int32 token_mask_dtype = torch.int32 ... @property def bitmask_size(self) -> int: return math.ceil(self.vocab_size_padded / 32)用 int32 而不是 int8/uint8 是因为后续内核要用按位取反和打包访存(下一节会看到 ~bitmaskVal 和 float4 打包),32 位整型正好对齐常见的向量化访存宽度,uint4(128 位)一次能读 4 个 int32 = 128 个 token 的掩码位。
3.2 行数:为什么是 max_num_draft_tokens + 1
bitmask 的分配是这样的:
self.bitmask = torch.empty(self.max_num_sequences * (self.max_num_draft_tokens + 1), self.bitmask_size, dtype=self.bitmask_dtype, device='cuda')self.bitmask_host = torch.empty_like(self.bitmask, device='cpu', pin_memory=prefer_pinned())self.token_mask = torch.empty(self.max_num_sequences * (self.max_num_draft_tokens + 1), dtype=self.token_mask_dtype, device='cuda')self.token_mask_host = torch.empty_like(self.token_mask, device='cpu', pin_memory=prefer_pinned())形状是 [max_num_sequences * (max_num_draft_tokens + 1), bitmask_size]。这个 + 1 就是关键:每个序列要预留 草稿长度 + 1 行掩码。
为什么?因为在投机解码的每个验证 step 里,目标模型一次要吃进「上一轮接受的 bonus token」加上「这一步的 max_num_draft_tokens 个草稿 token」,一共 max_num_draft_tokens + 1 个位置,每个位置都要有自己独立的掩码行。更准确地说,语法状态在第 个位置上是不同的(因为它已经消化了前 个草稿 token),所以不能共用一行掩码。
token_mask 是与之配套的「这一行是否有效」标记。它的作用在 apply_bitmask 里体现:内核会对 token_mask[batchIdx] 为 0 的行直接 return,跳过整行计算。
3.3 双缓冲与 pinned memory
三份张量成对出现:device 侧一份、host 侧一份,host 侧带 pin_memory=prefer_pinned()。
pinned memory(页锁定内存)的意义在于允许真正的异步拷贝。普通可分页内存做 H2D 拷贝时,CUDA 驱动必须先把它拷到一块内部的锁页缓冲区再传给 GPU,这个中转过程会让 copy_ 变成同步阻塞。锁页之后,cudaMemcpyAsync 可以直接用 DMA 引擎从主机内存读数据,CPU 立刻返回继续做别的事:
self.bitmask[:num_bitmask_tokens].copy_( self.bitmask_host[:num_bitmask_tokens], non_blocking=True)self.token_mask[:num_bitmask_tokens].copy_( self.token_mask_host[:num_bitmask_tokens], non_blocking=True)non_blocking=True 只有配上 pinned memory 才有效果,否则 PyTorch 会退化成隐式同步。代价是锁页内存不能被操作系统换出,占用的是「真实的物理内存」,不能像普通内存那样被 swap 掉——所以 prefer_pinned() 留了一个开关,在内存紧张的部署里可以退回普通内存换取容量。
3.4 row_has_valid_token:全零行会让 softmax 产出 NaN
这是整个子系统里最容易踩、后果最严重的一个细节。先看这段代码:
def row_has_valid_token(row: torch.Tensor, vocab_size_padded: int) -> bool: """Whether a filled next-token bitmask row allows at least one token.
A grammar state with no valid continuation produces an all-zero row, which would mask the whole logits row to -inf and make softmax return NaN for it.
Only the bits below `vocab_size_padded` are counted: the trailing bits of a partial last word are never read by the apply kernel and are not guaranteed to be cleared by the backends, so counting them could report a dead-end row as valid. """ num_words, num_tail_bits = divmod(vocab_size_padded, 32) if torch.any(row[:num_words]): return True if num_tail_bits == 0: return False return bool(row[num_words].item() & ((1 << num_tail_bits) - 1))先说清楚「全零行会导致 NaN」这条因果链:
- 掩码全零意味着没有任何 token 合法;
- 施加掩码的内核对这一行里所有位置写
-inf; - 采样前的 softmax 拿到一整行
-inf,分母 里每一项都是 ,分母为 0; - 分子同样是 0,得到 ,结果是 NaN。
NaN 一旦进入采样,无论贪心取 argmax 还是按累积分布采样,输出都是不确定的垃圾 token;更麻烦的是 NaN 会顺着后续的张量运算传播,污染整个 batch。所以「掩码行必须至少有一个 1」不是一个优化,而是一条正确性不变量,必须在 CPU 侧填完掩码之后立刻检查。
再看那个看起来有点绕的第二段:为什么要单独处理 num_tail_bits?
假设 vocab_size_padded = 128001(Llama 3 的填充词表大小),那么 num_words = 4000、num_tail_bits = 1。最后一个 int32 里只有第 0 位是真实 token,剩下 31 位是 padding。
代码对前 4000 个完整字先做 torch.any,如果全零,再单独检查最后一个字的低 num_tail_bits 位。为什么要这么麻烦,不直接检查整个最后一个字?
因为语言后端的实现不保证会把 padding 位置的 bit 清零。fill_next_token_bitmask 是第三方库(xgrammar / llguidance)实现的,它可能只写有效 bit,尾部的 padding bit 保持未初始化状态——也可能是上一轮的残留值。如果直接检查整个最后一个字,就可能把「只有一个残留 1、实际没有任何合法 token」的死路行误判为有效,于是不抛错、继续往下走,最后在 GPU 上炸出 NaN。
这条注释把设计意图写得很清楚:判定必须以「内核实际会读到的 bit」为准。内核只读 vocab_size_padded 范围内的 bit,所以有效性检查也必须只数这个范围内的 bit。两边的口径必须一致,否则检查就是无效的。
顺带说一句:torch.any(row[:num_words]) 这个操作是在 host tensor 上做的,会触发一次 GPU→CPU 的同步吗?不会——self.bitmask_host[index] 本身就在主机内存里,这是一个纯 CPU 的检查,代价是遍历 4000 个 int32(约 16 KB),对每个序列每步都做一次是可以接受的。而这一步之所以放在 build() 里(而不是延后到 GPU 上),正是为了「在错误发生的地方立刻发现它」,而不是让一个 NaN 静默传播几十个 step。
四、一次迭代的完整生命周期
现在进入核心:GuidedDecoder 在一次 PyExecutor 迭代里到底做了什么。
4.1 GuidedRequest:为什么要做快照
@dataclass(slots=True)class GuidedRequest: """A snapshot of an LlmRequest that contains relevant fields for guided decoding.
The instances of this class should be produced on the host and consumed on the device (by hostfunc). """ guided_decoding_params: Optional[GuidedDecodingParams] = None request_id: Optional[int] = None seq_slot: Optional[int] = None prev_seq_slot: Optional[int] = None is_context_init_state: bool = False is_last_context_chunk: bool = False is_generation_in_progress_state: bool = False is_generation_only_first_iteration: bool = False new_token: Optional[int] = None is_draft: bool = False draft_tokens: Optional[List[int]] = None num_accepted_draft_tokens: Optional[int] = NoneLlmRequest 是调度器视角的请求对象,字段很多、生命周期很长。GuidedRequest 是从它身上抽出来的与语法约束相关的字段子集,而且是一个「快照」——在 add_batch 那一刻把值拷出来,之后不再跟随 LlmRequest 变化。
为什么要做这个拷贝?注释里那句「produced on the host and consumed on the device (by hostfunc)」给出了答案:在 CapturableGuidedDecoder 的路径里,这些字段会在 CUDA Graph 重放时被 hostfunc 读取,而那时 LlmRequest 对象的状态可能已经被调度器推进到下一步了。快照保证了「图重放时读到的是本步的数据」。
seq_slot 和 prev_seq_slot 这两个字段的关系值得单独说一下:
seq_slot=(request.py_target_seq_slot if request.py_is_draft else request.py_seq_slot),prev_seq_slot=request.py_batch_idx,seq_slot 是语法状态所在的槽位。对草稿请求,它取 py_target_seq_slot——草稿端的 matcher 在语法状态上依附于目标模型请求的槽位,因为草稿 token 最终要由目标模型验证,两者必须共享同一个语法状态。prev_seq_slot 取 py_batch_idx,记录的是「上一轮这个请求位于 batch 中的哪个位置」,它的用途是让 hostfunc 能根据上一轮的布局找到对应的 new_tokens 张量切片。
4.2 两种触发条件:init 与 advance
GuidedRequest 上挂的两个方法定义了「什么时候该动语法状态机」:
def require_matcher_init(self) -> bool: if self.guided_decoding_params is None: return False if self.is_draft: return False # The request is in the last chunk of a context forward step. return self.is_context_init_state and self.is_last_context_chunk
def require_matcher_advance(self) -> bool: if self.guided_decoding_params is None: return False if self.is_draft: if self.is_context_init_state and self.is_last_context_chunk: return True if self.is_generation_in_progress_state: return True return False # The request is in a generation forward step. return self.is_generation_in_progress_state把它翻译成一张状态表:
| 请求状态 | 非草稿请求 | 草稿请求 |
|---|---|---|
| 未开启 guided decoding | 什么都不做 | 什么都不做 |
| context 阶段,且不是最后一个 chunk | 什么都不做 | 什么都不做 |
| context 阶段,是最后一个 chunk | init(建 matcher,此时还不推进状态) | advance |
| generation 阶段 | advance | advance |
三个设计点:
第一,init 只发生在 context 的最后一个 chunk。 如果 prompt 很长、被切成了多个 chunk(chunked prefill),前面的 chunk 都不初始化 matcher。原因很实在:初始化 matcher 意味着把它建起来,而「建起来」之后紧接着要推进的就是 prompt 本身——但 prompt 前缀根本不归语法管。只有在最后一个 chunk 结束时,我们才确切知道「接下来模型要生成的第一个 token 应该受什么约束」。
第二,init 和 advance 可以在同一个 step 里同时为真。 看 _build() 里的处理:
matcher_init: bool = req.require_matcher_init()matcher_advance: bool = req.require_matcher_advance()if not (matcher_init or matcher_advance): continue
if matcher_init: matcher = self.grammar_matcher_factory.create(req.guided_decoding_params) self.grammar_matchers[slot] = matcher
if matcher_advance: matcher = self.grammar_matchers[slot] ... accepted = matcher.accept_token(req.new_token)两者互不冲突:先 init 建好 matcher,再 advance 把最后一个 context token 喂进去。这正好对应「prompt 已经全部进 KV Cache,但它的最后一个 token 还没被语法引擎消化」的那个时刻。
第三,草稿请求不做 init。 require_matcher_init 对 is_draft 直接返回 False。草稿端没有自己的 matcher——它复用目标端槽位上已经建好的那个 matcher,通过推进和回退来「借用」语法状态。这样设计的好处是草稿和目标两侧不会出现两份可能不一致的语法状态。
4.3 build():一次迭代的全部 CPU 工作
_build() 是整个子系统里最长的一段,值得逐段拆。它的职责可以概括成三件事:
- 推进所有相关请求的语法状态机;
- 让状态机把掩码写进
bitmask_host; - 检查每一行掩码是否死路,并记录失败请求。
def _build(self, requests: GuidedRequests) -> List[Tuple[int, str]]: failed_requests = [] self.token_mask_host[:requests.num_bitmask_tokens].fill_(0)
for req, offset in requests.valid_requests_with_offsets(): slot = req.seq_slot try: self.num_advanced_tokens[slot] = 0 self.num_guided_tokens[slot] = 0
matcher_init: bool = req.require_matcher_init() matcher_advance: bool = req.require_matcher_advance() if not (matcher_init or matcher_advance): continue ...开头两行是两个重要的初始化动作:
token_mask_host[:n].fill_(0):把本轮要用的token_mask全部清零。因为apply_bitmask的内核会用token_mask判断「这一行是否需要施加掩码」,所以每轮必须重新标记,防止上一轮的残留值让内核去处理一行本该跳过的数据。num_advanced_tokens[slot] = 0和num_guided_tokens[slot] = 0:把该槽位本次迭代的计数器清零。注意这里把 slot 当作索引——计数器的粒度是「序列槽位」而不是「请求」。这跟语法的语义一致:语法状态是绑定在序列上的(同一个请求在不同阶段复用同一个槽位),计数器自然也应该按槽位记。
接下来是掩码填充的核心:
self.num_advanced_tokens[slot] += 1 if not matcher.is_terminated(): matcher.fill_next_token_bitmask(self.bitmask_host, offset) if not self._has_valid_token(offset): if req.is_draft: self.is_draft_terminated[slot] = True logger.debug(...) self.num_advanced_draft_tokens[ slot] += self.num_advanced_tokens[slot] continue self.num_advanced_tokens[slot] = 0 raise ValueError( f"Request {req.request_id} at slot {slot} reached a " f"grammar state with no valid token." ) self.token_mask_host[offset] = 1 self.num_guided_tokens[slot] += 1这段逻辑里有几个必须说清楚的细节:
is_terminated() 检查:语法已经完整的话就不再填掩码。此时 token_mask_host[offset] 保持 0,内核会跳过这一行——终止之后模型可以自由生成(通常是 EOS,但也可以是继续输出)。这是合理的:如果语法是 {"a": 1} 这样一个完整对象,生成完之后模型应该可以输出 EOS 结束,而不该被强制继续。
失败路径的分叉:死路行对草稿请求和主请求的处理完全不同。
- 草稿请求:记
is_draft_terminated[slot] = True,然后继续(continue)。理由是草稿只是「猜」,猜到一个语法死路上并不意味着请求有问题,只要让这一轮草稿提前结束就行,剩下的草稿位置不加约束、交给目标模型正常验证。 - 主请求:
self.num_advanced_tokens[slot] = 0然后raise ValueError。注释解释了为什么要把计数器清零:
# The request is about to be terminated, so exclude it# from the rollback pass: the matcher advance made# above is never verified against accepted tokens.也就是说,主请求走到死路是一个真正的不可能状态——如果掩码逻辑正确,主请求的每一次推进都应该至少留下一个合法 token。走到死路说明要么语法本身有问题(比如 schema 自相矛盾),要么是实现出了 bug。这时请求会被标记为失败并返回给上层,而计数器清零是为了让它不被后续的回退逻辑处理(既然请求要失败了,回退它没有意义,而且回退一个已经推进过的 matcher 可能触发二次异常)。
草稿 token 的批量推进:
for i, tid in enumerate( req.draft_tokens[:requests.max_num_draft_tokens], 1): accepted = matcher.accept_token(tid) if not accepted: break self.num_advanced_tokens[slot] += 1 if matcher.is_terminated(): break matcher.fill_next_token_bitmask(self.bitmask_host, offset + i) if not self._has_valid_token(offset + i): # Stop guiding here rather than failing the # request: the remaining draft positions are left # unconstrained and get verified as usual. break self.token_mask_host[offset + i] = 1 self.num_guided_tokens[slot] += 1对草稿 token 逐个推进,每推进一个就为下一个位置(offset + i)填掩码。三个 break 条件分别是「token 被拒收」「语法已终止」「下一状态是死路」。
这里有个细节很有意思:草稿 token 被拒收时 break,但不设置 is_draft_terminated。这跟前面的 token 推进路径不同——前面 accept_token(req.new_token) 失败时会设 is_draft_terminated[slot] = True。区别在于:new_token 是「已经确定要生成的下一个 token」,它被拒收是严重问题;而 draft_tokens 里的后续 token 是纯粹的猜测,猜到一半猜歪了很正常,直接停止推进、让剩下的位置不受约束就行。
注意 req.draft_tokens[:requests.max_num_draft_tokens] 这个切片。注释写得很清楚:
# Process draft tokens. Bound by the layout's draft length:# the new_tokens buffer always holds the static max, but only# `max_num_draft_tokens` slots are reserved this iteration.new_tokens 缓冲区是按静态最大值分配的(为了 CUDA Graph 兼容),但本次迭代实际只预留了 max_num_draft_tokens 个槽位的掩码空间。如果不做这个切片,就会写到本次布局之外的位置去。
4.4 三条终止路径的对比
把上面散落的 is_draft_terminated 逻辑汇总一下,草稿引导终止一共有三条路径:
| 触发条件 | 处理 | num_advanced_draft_tokens 是否累加 |
|---|---|---|
new_token 被 matcher 拒收 | 设 terminated,continue | 不累加 |
| 掩码行是死路(当前状态无合法 token) | 设 terminated,continue | 累加 |
draft_tokens 中某个 token 被拒收 | break(不设 terminated) | 累加(实际推进数) |
第二条路径的特殊之处值得说明。代码注释是这么写的:
# Unlike the unacceptable-token path above, the# matcher did advance past new_token here, so the# drafting loop must still roll that advance back.self.num_advanced_draft_tokens[slot] += self.num_advanced_tokens[slot]在第一条路径里,accept_token 返回 False 意味着 matcher 没有推进——它拒收了这个 token,状态不动。所以不需要回退。
在第二条路径里,accept_token 是成功的(状态已经推进了),只是在推进之后发现新状态没有合法后继。这个推进必须被记账,因为草稿循环结束时要把草稿端的推进全部回退掉——如果漏记这一笔,回退后 matcher 的状态就会比实际正确状态多走一步,后面所有掩码都算错。这是一个非常隐蔽的一步差 bug 的来源,注释里专门点出来说明它是被认真处理过的。
4.5 execute():双流 + event 的同步协议
build() 之后,掩码要从 CPU 内存到 GPU 显存、再施加到 logits 上。整个流程在 execute() 里:
def execute(self, logits: torch.Tensor, d2t: Optional[torch.Tensor] = None) -> List[Tuple[int, str]]: failed_requests = self.build()
with torch.cuda.stream(self.stream): torch.cuda.current_stream().wait_event(self.token_event) self.copy_bitmask() self.bitmask_event.record()
torch.cuda.current_stream().wait_event(self.bitmask_event) self.apply_bitmask(logits, d2t=d2t) self.token_event.record()
return failed_requests这里有两个 CUDA stream(self.stream 是 side stream,torch.cuda.current_stream() 是主执行流)和两个 event(token_event、bitmask_event),构成一个经典的生产者-消费者同步:
build()在 CPU 上同步执行完(填好bitmask_host);- 切到 side stream,先等
token_event——这保证 side stream 不会抢在主执行流完成「上一轮产生 new_tokens」之前就开始拷贝; copy_bitmask()发起 H2D 异步拷贝;- 在 side stream 上记录
bitmask_event,意味着「拷贝已完成」这个时间点被标记了; - 切回主执行流,等
bitmask_event,保证apply_bitmask读到的是完整的新掩码; - 执行
apply_bitmask,然后记录token_event。
为什么要用 side stream 而不是直接在主流程里拷贝?因为这样拷贝可以和其他 GPU 工作重叠。主执行流在这个时刻可能还有前向没算完的尾活(比如最后的归一化、logits 投影),把拷贝放到 side stream 上就能让 DMA 引擎和 SM 同时工作。这是整个设计里唯一真正意义上的「性能优化」,其余都是正确性必需。
token_event 在两处被记录、一处被等待,语义是反过来的:它标记「主执行流已经推进到某个点」。在 execute() 末尾记录它,是为了下一轮进入 side stream 时能等到;在 CapturableGuidedDecoder.add_draft_batch 里也会记录:
def add_draft_batch(self, new_tokens, num_accepted_tokens, draft_step=0): ... self.token_event.record()因为草稿循环会在主执行流上产生新的草稿 token,side stream 必须等这些 token 就绪才能去 fetch_draft_batch 读它们。
一个容易看漏的细节:execute() 返回的是 failed_requests——build() 里捕获的所有异常都被收集成一个 List[Tuple[int, str]](请求 id + 错误信息),而不是让异常直接冒泡。这个设计让一个请求的语法失败不会拖垮整个 batch:其他请求照常完成这一步,失败的请求由上层 _handle_guided_decoder_errors 逐个终止。
4.6 与采样管线的衔接点
GuidedDecoder.execute() 在 py_executor.py 里被调用的位置非常关键:
batch_outputs = self._forward_step(scheduled_batch)
guided_decoder_failed_requests = Noneif self.guided_decoder is not None: guided_decoder_failed_requests = self.guided_decoder.execute( batch_outputs['logits'])
with self.perf_manager.record_perf_events(None, gpu_sample_end) as sample_timing: sample_state = self._sample_async(scheduled_batch, batch_outputs)顺序是:前向 → 施加掩码 → 采样。掩码必须夹在中间,因为采样器读的就是 batch_outputs['logits'],而 apply_bitmask 是原地修改(in-place)这个张量。
更值得看的是 _handle_guided_decoder_errors 被放在 _sample_async 之后这个安排,以及它的注释:
# Handle guided decoder errors after _sample_async to avoid state conflicts.# If called before, failed requests would be marked as GENERATION_COMPLETE,# causing _sample_async to fail when accessing context_chunk_size property.self._handle_guided_decoder_errors( scheduled_batch, guided_decoder_failed_requests)这里描述的是一个具体的时序依赖:处理失败请求会把它们标记为 GENERATION_COMPLETE,而这个状态会影响 context_chunk_size 这类属性的取值。如果提前标记,采样器去读这些请求的属性时就会拿到一个不符合预期的值而报错。所以正确顺序只能是「先采样、后处理失败」。
这种「副作用必须在某个阶段之后才能施加」的约束,在多线程/异步系统里很常见,但往往不会写在 API 文档里——它是在调试中发现的,最后以注释的形式固化在代码里。读这类代码时,注释里那句「为什么放在这里」往往比代码本身更有信息量。
五、投机解码下的计数与回退
投机解码给受约束解码带来的复杂度是数量级上的:一个验证 step 里要处理的 token 数从 1 变成了 max_num_draft_tokens + 1,而且这些 token 的命运还不确定——草稿可能被拒,拒了就要回退语法状态。这一节把三本账和三条回退路径讲清楚。
5.1 四个计数器各管什么
# The number of tokens accepted by the grammar matcher in a build step.self.num_advanced_tokens: List[int] = [0] * self.max_num_sequences# The number of tokens with filled bitmask in a build step.self.num_guided_tokens: List[int] = [0] * self.max_num_sequences# The accumulated number of tokens accepted by the grammar matcher in a# drafting loop.self.num_advanced_draft_tokens: List[int] = [0] * self.max_num_sequences# Whether is guided drafting is terminated because of unacceptable drafted tokens.self.is_draft_terminated: List[bool] = [False] * self.max_num_sequences前三个是计数器,第四个是标志位。按「本次迭代内」和「跨草稿循环累计」两个维度来理解它们:
| 计数器 | 时间跨度 | 含义 | 谁在用 |
|---|---|---|---|
num_advanced_tokens | 本次 build | matcher 本步接受了几个 token | 回退计算、草稿记账 |
num_guided_tokens | 本次 build | 填了几行有效掩码 | 诊断/调试 |
num_advanced_draft_tokens | 整个草稿循环 | 草稿端累计推进了几步 | 草稿循环结束后的整体回退 |
is_draft_terminated | 整个草稿循环 | 草稿引导是否已经终止 | 跳过后续推进 |
num_advanced_tokens 和 num_guided_tokens 的区别很微妙,值得掰开说。「推进了」和「填了掩码」并不是同一件事:
- matcher 推进了最后一个 token 之后如果
is_terminated()为真,就不再填掩码 → 推进了但没填; - 填掩码时若发现死路行,前面的推进仍然算数 → 填了但推进记账要单独处理。
把这两个量分开记,让每条回退路径都能取到自己需要的那个数,而不用在一处「混着算」。
5.2 _rollback_rejected_tokens:按验证结果回退
这是投机解码里最关键的一个函数,代码不长但每一行都有讲究:
def _rollback_rejected_tokens(self, requests: GuidedRequests) -> None: """Rollback the grammar matcher for rejected tokens.
This method should be called: - after the verification (so that the accepted tokens are ready) and - before the first guided decoding build of the next drafting loop. """ if self.max_num_draft_tokens <= 0: return
for req in requests.valid_requests(): slot = req.seq_slot if self.num_advanced_tokens[slot] <= 0: continue num_accepted_tokens = 1 + req.num_accepted_draft_tokens # Rollback the grammar matcher to the last accepted token. num_rollback_tokens = self.num_advanced_tokens[slot] - num_accepted_tokens # TODO: Make this an error response. if num_rollback_tokens < 0: raise ValueError( f"Failed to rollback: num_advanced_tokens={...}, " f"num_accepted_tokens={num_accepted_tokens}, " f"num_rollback_tokens={num_rollback_tokens}" ) self.grammar_matchers[slot].rollback(num_rollback_tokens)核心是这一个减法:
逐项解释:
num_advanced_tokens[slot]:本步 matcher 一共推进了几个 token。在验证 step 里,这包括 1 个 golden token(上一个被接受的、作为下一步输入的那个 token)加上实际推进的草稿 token 数。num_accepted_draft_tokens:目标模型实际接受了几草稿个 token。1 + ...:那个1就是 golden token,它总是被接受的,所以回退计算里必须把它加回来。- 差值:被乐观推进但最终被拒绝的那部分,正是需要回退的步数。
举例说明:假设 max_num_draft_tokens = 5,本步 matcher 推进了 6 个 token(1 个 golden + 5 个草稿),目标模型验证后接受了 2 个草稿 token。那么 num_accepted_tokens = 1 + 2 = 3,num_rollback_tokens = 6 - 3 = 3——把最后 3 个被拒的草稿 token 从前 3 步推进里退回来。
num_rollback_tokens < 0 的判断被显式写出来并抛错,注释是 # TODO: Make this an error response.。负值意味着「接受的 token 数比推进的还多」,这在逻辑上不可能,说明记账出现了不一致。目前的处理是抛异常——注意在一个 batch 里抛异常会比返回错误响应更激烈(整步失败),所以注释里留了 TODO 表示这是待改进项。
调用的时机由 docstring 明确规定:验证之后、下一轮草稿循环的第一次 build 之前。位置错了回退的就不是正确的状态。
5.3 _rollback_draft_tokens:草稿循环的整体回退
def _rollback_draft_tokens(self, requests: GuidedRequests) -> None: """Rollback the grammar matcher for draft tokens.
This method should be called: - after the the drafting loop and - before the guided decoding build of the target model. """ if self.max_num_draft_tokens <= 0: return
for req in requests.valid_requests(): slot = req.seq_slot if self.num_advanced_draft_tokens[slot] > 0: self.grammar_matchers[slot].rollback( self.num_advanced_draft_tokens[slot]) # Reset the drafting states. self.num_advanced_draft_tokens[slot] = 0 self.is_draft_terminated[slot] = False这个函数把草稿端造成的所有推进一次性退干净,让 matcher 回到「草稿循环开始之前」的状态。注意它无条件地把累计值全额回退,而不是像前面那样减去接受数——因为草稿端的推进是纯粹的「试探」,目标模型还没验证过它们,一个都不算数。
循环末尾把 num_advanced_draft_tokens 和 is_draft_terminated 都复位,保证下一轮草稿循环从干净状态开始。
两个回退函数的调用位置在 execute_draft_batch 里体现得最清楚:
def execute_draft_batch(self, logits, d2t=None, draft_step=0): with torch.cuda.stream(self.stream): torch.cuda.current_stream().wait_event(self.token_event) self.fetch_draft_batch(draft_step=draft_step) if draft_step == 0: self.rollback_rejected_tokens() failed_requests = self.build() if draft_step == self.max_num_draft_tokens - 1: self.rollback_draft_tokens() # Overwrite num_bitmask_tokens since the request might not be updated # on CUDA stream yet. self.copy_bitmask(num_bitmask_tokens=len(self.requests)) self.bitmask_event.record() ...draft_step == 0 时回退被拒 token(处理上一轮验证的结果),draft_step == max - 1 时回退整轮草稿(草稿循环收尾)。这两个位置对应的是「草稿循环的入口」和「出口」。
5.4 一个反直觉的细节:接受数取 min
在 fetch_draft_batch 和 fetch_accepted_batch 里,接受数都做了一个 min:
# When overlap scheduler is enabled, it is possible that# - The EOS token is in the draft tokens, and# - Some draft tokens after the EOS token are accepted by the target model.# These requests should be terminated at this executor iteration.req.num_accepted_draft_tokens = min( num_accepted_tokens_list[i], self.num_advanced_tokens[slot]) - 1以及:
# Verification can accept tokens beyond a terminal draft token,# where the matcher stopped advancing (see fetch_draft_batch).req.num_accepted_draft_tokens = min( num_accepted_tokens_list[i], self.num_advanced_tokens[slot]) - 1这个 min 修的是「语法引擎停早了」和「目标模型验证还在继续」之间的不一致。
场景是这样:草稿 token 序列里包含 EOS。语法 matcher 遇到 EOS 就终止了(is_terminated),于是停止推进,后面的草稿 token 它根本没看。但目标模型的验证是独立进行的——它不关心语法,只看概率,于是可能接受了 EOS 之后的若干个 token。
这时候如果直接拿目标模型报的接受数去算回退,就会得到一个大于「matcher 实际推进数」的值,减完变成负数,触发前面那个 raise ValueError。用 min 把接受数夹到实际推进数以内,就避免了这个问题。
语义上这个 min 也是对的:matcher 没推进的 token,对语法状态没有任何影响,不需要回退。而注释里那句「These requests should be terminated at this executor iteration」告诉我们,这种请求会在本步被终止——因为 EOS 已经出现,生成本来就该结束了。
六、CUDA Graph 兼容:CapturableGuidedDecoder
到目前为止讲的 GuidedDecoder 有一个隐含前提:每一步的 build() 都在主执行流上同步跑 Python 代码。这在 eager 模式下没问题,但 TensorRT-LLM 默认会开 CUDA Graph——把「解码 step」的整个执行序列捕获成一张图,之后每步只做一次 graph.replay(),用一次内核启动代替几十次。
问题来了:CUDA Graph 捕获的是设备侧操作序列,Python 代码不可能被捕获进图里。build() 里那些 matcher.accept_token()、fill_next_token_bitmask() 调用都是 CPU 侧的 Python/Rust 代码,它们在图重放时不会被执行。
于是就有了 CapturableGuidedDecoder 这个子类,它要解决的问题是:让 CPU 侧的语法工作能挂在被捕获的图上,跟着图一起「重放」。
6.1 hostfunc:把 Python 回调塞进 CUDA 图
解法是 CUDA 的 host callback 机制(cudaLaunchHostFunc / cudaGraphAddHostNode):图里可以插入一种特殊节点,重放到它时会在主机侧执行一个回调函数。TensorRT-LLM 把它封装成了 @hostfunc 装饰器,guided_decoder.py 里从 ..hostfunc 导入:
from ..hostfunc import hostfunc把 build、fetch_batch、rollback_rejected_tokens 等本来在 Python 里直接调用的方法都加上这个装饰器,它们就成了可以被图节点引用的回调:
@hostfuncdef build(self) -> List[Tuple[int, str]]: return self._build(self.requests_hostfunc)
@hostfuncdef rollback_rejected_tokens(self) -> None: self._rollback_rejected_tokens(self.requests_hostfunc)
@hostfuncdef rollback_draft_tokens(self) -> None: self._rollback_draft_tokens(self.requests_hostfunc)
@hostfuncdef init_disagg_gen_requests(self) -> None: self._init_disagg_gen_requests(self.requests_hostfunc)这样一来,图重放时这些回调会在正确的时序点被 CUDA 运行时调用,语法状态机也就跟着重放推进了。
6.2 队列与双份状态
捕获与重放带来了一个新的状态管理问题:回调要在主机上读请求数据,但请求数据是在捕获之前、由主线程准备好的。于是有了一个队列加一份「双份状态」:
def __init__(self, ...): super().__init__(...) # self.requests should be accessed by normal host code; # self.requests_hostfunc should be accessed by hostfunc (CUDA callback). self.requests_hostfunc: Optional[GuidedRequests] = None self.queue = Queue()
self.new_tokens = torch.empty(self.max_num_draft_tokens + 1, self.max_num_sequences, dtype=torch.int32, pin_memory=prefer_pinned()) self.num_accepted_tokens = torch.empty(self.max_num_sequences, dtype=torch.int32, pin_memory=prefer_pinned())注释把两份状态的职责划得很清楚:self.requests 给普通主机代码用,self.requests_hostfunc 给 hostfunc 回调用。两者是同一份数据的两个视图,同步通过队列完成:
@nvtx_range("GuidedDecoder.add_batch")def add_batch(self, scheduled_requests, new_tokens=None, runtime_draft_len=None): num_draft_tokens = (self.max_num_draft_tokens if runtime_draft_len is None else runtime_draft_len) self.requests = GuidedRequests.from_scheduled_requests( scheduled_requests, num_draft_tokens) if new_tokens is not None: self.new_tokens.copy_(new_tokens.squeeze(-1), non_blocking=True) self.queue.put((self.requests, new_tokens is not None)) # self.token_event.record() should be called inside CUDA graph capturing; # currently, it is in DecoderInputPreparer.preprocess_inputs.add_batch 在主线程跑(捕获前),把请求快照和「是否有 new_tokens」的标记放进队列。重放时回调从队列里取:
@hostfuncdef fetch_batch(self) -> None: # CUDA graph warmup calls model forward for multiple times for one prepared inputs if self.queue.empty(): return self.requests_hostfunc, has_new_tokens = self.queue.get() if not has_new_tokens: return
for req in self.requests_hostfunc.valid_requests(): if req.prev_seq_slot is None: continue req.new_token, *req.draft_tokens = self.new_tokens[:, req.seq_slot].tolist()两处细节值得注意:
if self.queue.empty(): return,以及注释「CUDA graph warmup calls model forward for multiple times for one prepared inputs」。图捕获前需要 warmup(跑几遍让内核预热、分配工作区),warmup 会多次触发前向,但对应的 add_batch 只调了一次。队列为空时直接返回,避免 warmup 的多余调用把队列取空导致后续回调拿不到数据。
self.new_tokens[:, req.seq_slot] 这次索引揭示了那张 new_tokens 张量的布局:形状是 [max_num_draft_tokens + 1, max_num_sequences]——第一个维度是 token 位置,第二个维度是序列槽位。所以 new_tokens[:, seq_slot] 取出的就是「某个序列在当前验证步里所有 token 位置的值」,赋给 req.new_token 和 req.draft_tokens:
req.new_token, *req.draft_tokens = self.new_tokens[:, req.seq_slot].tolist()这一行 Python 解构非常紧凑:等号左边第一个元素接列表第一个值(golden token),剩余的全部塞进 draft_tokens。用 .tolist() 是因为接下来要把这些值喂给 CPU 侧的语法 matcher,必须是 Python int。
6.3 _drain_host_functions:GIL 死锁与它的绕法
这是整个文件里最有意思的一段,代码不长但注释写了整整两大段:
def _drain_host_functions(self) -> None: """Wait until every host function enqueued by the caller has run.
Each host function is a Python callback that must take the GIL. If one is still pending when the caller enters a native call that holds the GIL while waiting on device progress (e.g. a drafter's flash-attn forward, or the context-synchronizing lazy kernel-module load inside it), the rank deadlocks: the callback waits for the GIL, the native call waits for work only the callback can advance. The ``set_stance("force_eager")`` mitigation above covers only torch.compile kernels, not plain extension calls (pytorch#163061).
``bitmask_event`` is recorded on the side stream after every host function the callers enqueue, so synchronizing on it (which releases the GIL) guarantees they have all run. Host-side ordering only — the callers already order the bitmask consumer against the same event on the device. Skipped while capturing: a host wait is illegal there, and captured host nodes do not run until replay. """ if not torch.cuda.is_current_stream_capturing(): self.bitmask_event.synchronize()把死锁的成因完整写出来:
- hostfunc 回调是 Python 函数,执行时必须持有 GIL(全局解释器锁);
- 如果调用方紧接着进入一个「持着 GIL 等待设备进展」的本地调用(比如草稿端的 flash-attention 前向,或它内部的惰性内核模块加载——后者需要同步流),就形成死锁;
- 死锁环:回调在等 GIL,而持着 GIL 的本地调用在等设备进展,而设备进展只能由这个回调推进。互相等待,永久挂住。
更糟的是,PyTorch 自己也知道这类问题——pytorch#163061 就是对应的 issue。仓库里给出的缓解是:
# torch.compile kernels are called with GIL being held;# this could cause deadlock with CUDA callback to Python code.# See: https://github.com/pytorch/pytorch/issues/163061torch.compiler.set_stance("force_eager")set_stance("force_eager") 让 torch.compile 编译出来的内核退化成 eager 执行,避免「编译内核持 GIL 等设备」这种模式。但注释明确说了:这只覆盖 torch.compile 的内核,不覆盖普通的扩展调用。所以还需要一个更通用的兜底。
兜底方案的设计非常巧妙,值得学一下:
- 每次调用方入队 hostfunc 时,都会在 side stream 上记录
bitmask_event; bitmask_event.synchronize()会释放 GIL 去等设备——释放 GIL 正是关键:等待期间别的线程(包括回调所在的线程)就能拿到 GIL 把回调跑完;- 回调跑完 → 设备继续推进 → event 被满足 →
synchronize返回。
也就是说,synchronize() 不只是一个「等一下」的调用,它同时承担了「主动让出 GIL 以打破死锁」的角色。注释里那句「Host-side ordering only — the callers already order the bitmask consumer against the same event on the device」说明这个同步不引入额外的设备侧排序约束——设备侧的排序已经由调用方用同一个 event 保证了,这里只是补一个主机侧的顺序保证。
最后一句也很重要:Skipped while capturing: a host wait is illegal there, and captured host nodes do not run until replay. 在捕获期间不能做主机等待(CUDA 不允许),而且捕获下来的 host 节点在重放前根本不会执行,等待它只会永久挂起。所以捕获时直接跳过这个 drain。
这段代码是「跨语言、跨线程、跨设备的资源竞争」的一个典型样本:死锁的三方分别是 Python GIL、CUDA 设备执行、以及主机的同步调用。解决的思路不是加锁或改时序,而是找到一个本来就要做的等待,把它改造成「顺便释放 GIL」的形式。
6.4 没有 logits 环的 drafter:rollback_rejected_batch
有些草稿方案(源码注释点名了 SA、DFlash、PARD)不调用 execute_draft_batch,也就是说它们不走「草稿端自己生成 logits 并施加掩码」这条路。对于这些方案,被拒 token 的回退不会在草稿循环里被处理,需要另一个入口:
def rollback_rejected_batch(self, num_accepted_tokens: torch.Tensor) -> None: """Restore the accepted grammar prefix for drafters without a logits loop.
Target masking advances matchers through the golden token and draft tokens. SA, DFlash and PARD do not call execute_draft_batch, which normally rolls back the rejected suffix before the next draft loop.
Call after drafting kernels have been enqueued: these host callbacks need the GIL and must not precede native calls that synchronize the stream while holding it.
Args: num_accepted_tokens: Int32 tensor of shape [batch_size], including the bonus token in each verification count. """ self.add_accepted_batch(num_accepted_tokens) with torch.cuda.stream(self.stream): torch.cuda.current_stream().wait_event(self.token_event) self.fetch_accepted_batch() self.rollback_rejected_tokens() # CUDA graph capture requires every forked stream to be joined. self.bitmask_event.record() torch.cuda.current_stream().wait_event(self.bitmask_event) self._drain_host_functions()这个函数把「取接受数 → 回退」两步打包起来,仍然走 side stream + event 的同步协议。「Call after drafting kernels have been enqueued」这条使用约束就是前面 GIL 死锁的同一类问题的防御:回调必须排在「会持 GIL 同步流的本地调用」之后。
另一句注释也值得注意:# CUDA graph capture requires every forked stream to be joined. CUDA Graph 捕获有一条硬性要求——所有 fork 出去的 stream 最终必须 join 回主捕获流,否则捕获会失败或产生不完整的图。所以在 side stream 上做完工作后必须 record 事件、再在主执行流上 wait,把两条流重新合到一起。这不是性能优化,而是捕获正确性的要求。
rollback_rejected_batch 里的 add_accepted_batch 也有一段注释说明了「为什么要 min」:
# Verification can accept tokens beyond a terminal draft token,# where the matcher stopped advancing (see fetch_draft_batch).req.num_accepted_draft_tokens = min( num_accepted_tokens_list[i], self.num_advanced_tokens[slot]) - 1跟前面 fetch_draft_batch 里同样的处理,理由一致。
七、落到 GPU:logits_bitmask 内核
掩码在 CPU 侧准备好之后,最后一步是把「禁止」变成「logits 里的 」。这一步由一个自定义 CUDA 内核完成。
7.1 op 注册与签名
Python 侧通过 torch.ops.trtllm.logits_bitmask 调用:
torch.ops.trtllm.logits_bitmask( logits[:num_bitmask_tokens], self.bitmask[:num_bitmask_tokens, bitmask_start:bitmask_end], token_mask=self.token_mask[:num_bitmask_tokens], d2t=d2t)注册在 cpp/tensorrt_llm/thop/logitsBitmaskOp.cpp 里:
m.def("logits_bitmask(Tensor(a!) logits, Tensor bitmask, Tensor? token_mask=None, Tensor? d2t=None) -> ()");m.impl("logits_bitmask", &tensorrt_llm::torch_ext::logitsBitmask);Tensor(a!) 这个注解表示 logits 是原地修改的(in-place)。这一点很重要:batch_outputs['logits'] 是刚才前向算出来的张量,掩码直接改写它,不做拷贝。省一次显存带宽往返,代价是调用者必须清楚这个张量已经被改过——所以前面 _handle_guided_decoder_errors 的时序安排才有讲究。
参数校验部分也值得看一眼,它揭示了各个张量的形状契约:
if (!d2t.has_value()) { ... }int32_t const* d2tPtr = nullptr;if (d2t.has_value()){ TORCH_CHECK(d2t->is_cuda(), "d2t must be a CUDA tensor."); TORCH_CHECK(d2t->is_contiguous(), "d2t must be contiguous."); TORCH_CHECK(d2t->dim() == 1, "d2t must be a 1D tensor."); TORCH_CHECK(d2t->size(0) == vocabSizePadded, "d2t must have the same vocab size as logits."); TORCH_CHECK(d2t->scalar_type() == torch::kInt32, "d2t must have element type int32."); d2tPtr = static_cast<int32_t const*>(d2t->data_ptr());}d2t 强制要求是连续的一维 int32、长度等于 padded 词表大小。这个约束会在下一节的 d2t 分支里被用到。
7.2 contiguousLogitsBitmaskKernel 逐段读
内核本体(cpp/tensorrt_llm/kernels/logitsBitmask.cu):
template <typename T, typename PackedT, int32_t kBitsPerThread>__global__ void __launch_bounds__(kThreadsPerBlock) contiguousLogitsBitmaskKernel( T* __restrict__ logits, uint32_t const* __restrict__ bitmask, int32_t const* __restrict__ tokenMask, int32_t const* __restrict__ d2t, int32_t vocabSizePadded, int32_t bitmaskStride){ int constexpr kAlignment = sizeof(PackedT) / sizeof(T); uint32_t constexpr kPackedMask = (1 << kAlignment) - 1;
int const batchIdx = blockIdx.y; if (tokenMask != nullptr && !tokenMask[batchIdx]) { return; }
int const blockOffset = blockIdx.x * kThreadsPerBlock * kBitsPerThread; T* logitsGmemPtr = logits + batchIdx * vocabSizePadded + blockOffset;
uint32_t const* bitmaskGmemPtr = bitmask + batchIdx * bitmaskStride + blockOffset / kBitsPerMaskElement; int const bitmaskInnerIdx = threadIdx.x % (kBitsPerMaskElement / kAlignment); T logitsReg[kAlignment]; ...网格布局:blockIdx.y 是 batch 维度(这里的「batch」是一行掩码 = 一个 token 位置),blockIdx.x 是词表分块维度。blockIdx.y 上的早退是整个内核最省时间的一行——如果这一行的 token_mask 是 0(说明该请求这一步不需要掩码:语法已终止,或本来就是草稿位置且没被引导),整个 block 直接 return,一个字节的 logits 都不用读。
打包类型 PackedT:模板参数里 PackedT 是 float4 / float2 / float 之一,T 是 logits 的数据类型(float / half / __nv_bfloat16)。kAlignment = sizeof(PackedT) / sizeof(T),也就是一个打包里装几个元素:float4 打包 half 时 kAlignment = 8。
为什么按元素类型反推对齐宽度?因为不同精度下「128 位打包」能装下的元素数不同。这套模板让同一份内核代码在 fp32/fp16/bf16 三种精度下都能拿到向量化访存,且对齐宽度自动匹配。
位偏移的计算:
int const bitmaskInnerIdx = threadIdx.x % (kBitsPerMaskElement / kAlignment);kBitsPerMaskElement = 32(一个 uint32 掩码字),除以 kAlignment 得到「一个掩码字覆盖几个线程」。bitmaskInnerIdx 就是当前线程在掩码字内部的序号,它的作用是把掩码字右移 bitmaskInnerIdx * kAlignment 位,从而把「本线程负责的那 kAlignment 个 bit」移到低位。
主循环:
#pragma unrollfor (int offset = threadIdx.x * kAlignment; offset < kThreadsPerBlock * kBitsPerThread; offset += kThreadsPerBlock * kAlignment){ if (blockOffset + offset >= vocabSizePadded) { break; }
uint32_t bitmaskVal = 0; if (d2t == nullptr) { bitmaskVal = (~bitmaskGmemPtr[offset / kBitsPerMaskElement] >> (bitmaskInnerIdx * kAlignment)) & kPackedMask; } else { #pragma unroll for (int i = 0; i < kAlignment; i++) { int const d2tOffset = blockOffset + offset + i + d2t[blockOffset + offset + i]; bitmaskVal |= ((~bitmask[batchIdx * bitmaskStride + d2tOffset / kBitsPerMaskElement] >> (d2tOffset % kBitsPerMaskElement)) & 1) << i; } }
if (bitmaskVal == 0) { continue; }
if (bitmaskVal == kPackedMask) { *reinterpret_cast<PackedT*>(logitsGmemPtr + offset) = packedNegativeInfinity<T, PackedT>(); continue; }
*reinterpret_cast<PackedT*>(logitsReg) = *reinterpret_cast<PackedT*>(logitsGmemPtr + offset); #pragma unroll for (int i = 0; i < kAlignment; i++) { if (((bitmaskVal >> i) & 1)) { logitsReg[i] = negativeInfinity<T>(); } } *reinterpret_cast<PackedT*>(logitsGmemPtr + offset) = *reinterpret_cast<PackedT*>(logitsReg);}这个循环里有三个值得讲的点。
一、位语义的反转。 注意 ~bitmaskGmemPtr[...]——取反了。这意味着内核的语义约定是:bitmask 里 1 表示允许,取反后变成「需要屏蔽」。所以 bitmaskVal 里为 1 的 bit 对应「要写成 的位置」。
这个约定需要在两侧保持一致:CPU 侧 fill_next_token_bitmask 填的是「合法 token 的位置为 1」,内核取反得到「非法位置为 1」。如果误以为内核直接用掩码,会把整个逻辑反过来,输出全是不合法的 token——这种 bug 很难从「输出看起来有点怪」上察觉。
二、三档处理的分支。 bitmaskVal 有三个取值区间,分别走不同的路径:
bitmaskVal == 0:这一组kAlignment个 token 全部合法 →continue,一个字节都不读写。对 JSON 约束下的自由文本字段,这种情况出现得很频繁(比如在字符串里,几乎全部 token 都合法),所以这条早退路径贡献了相当一部分的实际收益。bitmaskVal == kPackedMask:这一组全部非法 → 直接写一个打包好的 向量(packedNegativeInfinity),不读 logits。这里连读都省了,因为不管原值是什么都要覆盖成负无穷。- 其它:部分非法 → 读出打包值到寄存器、逐个元素判断、改完写回。这是唯一需要「读-改-写」的路径。
这个三分支结构是一个很典型的 GPU 优化模式:把「全合法」「全非法」「混合」三类分开,让前两类走无内存访问或只写的快路径。判断三档的代价只是一次整数比较,而省下的带宽是实实在在的。
三、packedNegativeInfinity 的实现。
template <typename T, typename PackedT>__device__ PackedT packedNegativeInfinity(){ int constexpr kAlignment = sizeof(PackedT) / sizeof(T); T packed[kAlignment];#pragma unroll for (int i = 0; i < kAlignment; i++) { packed[i] = negativeInfinity<T>(); } return *reinterpret_cast<PackedT*>(packed);}在寄存器里构造一个数组、填满 -INFINITY、再用 reinterpret_cast 当成向量类型返回。而 negativeInfinity<T>() 对三种精度分别特化:
template <typename T>__device__ T negativeInfinity() { return -INFINITY; }
template <>__device__ half negativeInfinity<half>() { return -CUDART_INF_FP16; }
template <>__device__ __nv_bfloat16 negativeInfinity<__nv_bfloat16>() { return -CUDART_INF_BF16; }为什么 fp16/bf16 要用专门的宏而不是直接 -INFINITY?因为在半精度下,-INFINITY 这个 double 常量转换到 half 可能产生溢出或舍入行为,CUDART_INF_FP16 是 CUDA runtime 提供的、保证在 fp16 中表示负无穷的常量。用错会导致写进去的不是真正的 而是一个很大的有限负数——在 softmax 之后表现为「几乎不可能但非零」,输出会变成低概率的非法 token,而不是干净的屏蔽。
7.3 为什么是 而不是「一个很小的数」
常见的替代做法是写 -1e9 或 -65504(fp16 的最小值)。TensorRT-LLM 选择写真正的 ,理由在 softmax 上:
如果非法位置写的是 -1e9,而合法位置的 logits 也可能很小(比如 -20),那么差值 对非法位置大约是 量级, 在 fp32 下直接下溢成 0——行为上和 一样。
但如果用的是 fp16/bf16,精度更差。写 -65504(fp16 的最小正规数)时,如果某个合法位置的 logits 恰好也是 -65504 这个量级(不太可能但理论上存在),两者相等,屏蔽就失效了。而 在任何精度下都严格小于任何有限值,不会出现这种退化。
还有一层考虑: 让「非法」这个语义在数值上是绝对的,不依赖于对 logits 取值范围的假设。模型输出 logits 的量级在不同模型、不同精度下差别很大(fp8 量化下的 logits 甚至可能出现异常值),用一个固定的「很大负数」去屏蔽就变成了一个需要调的超参数。 不需要调。
7.4 d2t 分支:词表被剪枝时怎么办
d2t(draft-to-target)是投机解码里一个特殊的映射表。有些草稿方案(注释里点了 EAGLE3)输出的 logits 不是完整词表的,而是一个剪枝后的子集——只保留了一部分候选 token 的 logits 以省显存和带宽。
这时候 GPU 上的 logits 有 个位置,而语法掩码是按完整词表 位编的(),两边对不上。d2t 就是用来把「剪枝后的位置」映射回「完整词表里的位置」:
int const d2tOffset = blockOffset + offset + i + d2t[blockOffset + offset + i];bitmaskVal |= ((~bitmask[batchIdx * bitmaskStride + d2tOffset / kBitsPerMaskElement] >> (d2tOffset % kBitsPerMaskElement)) & 1) << i;注意这里的顺序:先算完整词表位置 d2tOffset,再用它去查 bitmask,方向是「剪枝位置 → 完整词表位置」。这跟直觉可能相反(可能会以为要按完整词表遍历、判断每个位置是否在剪枝子集里),但反过来做更高效:只需要遍历剪枝后的 个位置,而不是完整的 个。
代价是这里不能再用打包访存:因为 d2t[blockOffset + offset + i] 是任意随机偏移,每个元素要单独算位置、单独取一位,所以整段退化成了 for (int i = 0; i < kAlignment; i++) 的逐元素循环,每个元素一次 bitmask[...] 全局读。这是 d2t 模式比非 d2t 模式慢的根本原因,但只对剪枝词表的草稿路径生效,绝对值上仍然是 量级的访问。
还有个容易忽略的细节:invokeContiguousLogitsBitmask 的注释解释了为什么这里需要显式的 bitmaskStride 参数:
// bitmaskStride may not equal to ceilDiv(vocabSizePadded, kBitsPerMaskElement) when:// (1) d2t is present, then logits are "pruned" (e.g., EAGLE3), while bitmask// is complete and should be accessed according to d2t.// (2) logits are sharded along the vocabulary dimension, while the bitmask is// complete and should be accessed according to the sharding.bitmask 张量本身的行 stride 是由外层 torch.empty(..., self.bitmask_size) 决定的,也就是完整的 ceil(vocab/32)。但 logits 可能被剪枝、也可能被张量并行切分,两者的「每行宽度」不一致。所以内核不能假设 stride 等于 ceil(vocab/32),必须显式传进来。第二种情况(张量并行切分词表)就是下一节的内容。
7.5 启动配置:按 SM 数量反推分块
template <typename T, typename PackedT>void contiguousLogitsBitmaskDispatchToBitsPerThread(T* logits, uint32_t const* bitmask, int32_t const* tokenMask, int32_t const* d2t, int32_t batchSize, int32_t vocabSizePadded, int32_t bitmaskStride, cudaStream_t stream){ int constexpr kAlignment = sizeof(PackedT) / sizeof(T); static int const smCount = tensorrt_llm::common::getMultiProcessorCount(); int32_t const numBlocksPerRow = ceilDiv(2048 / kThreadsPerBlock * smCount, batchSize); int32_t const numBitsPerThread = ceilDiv(vocabSizePadded, kThreadsPerBlock * numBlocksPerRow);
dim3 const block(kThreadsPerBlock);
if (numBitsPerThread <= 4 && kAlignment <= 4) { dim3 const grid(ceilDiv(vocabSizePadded, kThreadsPerBlock * 4), batchSize); contiguousLogitsBitmaskKernel<T, PackedT, 4> <<<grid, block, 0, stream>>>(...); } else if (numBitsPerThread <= 8 && kAlignment <= 8) { ... <<<...>>>; } else if (numBitsPerThread <= 16 && kAlignment <= 16) { ... } else { ... }}numBlocksPerRow 的算法是一个「目标占用率」反推:
int32_t const numBlocksPerRow = ceilDiv(2048 / kThreadsPerBlock * smCount, batchSize);kThreadsPerBlock = 256,所以2048 / 256 = 8——这是「每个 SM 想放 8 个 block」的目标;- 乘以
smCount得到「全卡想放多少个 block」; - 除以
batchSize(这里 batch 是掩码行数,即 token 位置数)得到「每一行分几个 block」。
这个公式的含义是:内核希望把整张卡铺满(每个 SM 8 个 block 并发),然后再把这份预算按行数摊开。batch 越大,每行分到的 block 越少;batch 很小的时候,每行能分到大量 block 来吃满整卡。
kBitsPerThread 的四档分发则是「每线程处理多少 bit」的模板特化:
| 档位 | 条件 | 含义 |
|---|---|---|
4 | numBitsPerThread <= 4 && kAlignment <= 4 | 每线程 4 bit,打包宽度不超过 4 元素 |
8 | <= 8 && kAlignment <= 8 | 每线程 8 bit |
16 | <= 16 && kAlignment <= 16 | 每线程 16 bit |
32 | 兜底 | 每线程 32 bit(整整一个掩码字) |
用模板参数而不是运行时变量,是为了让编译器在编译期为每一档生成完全展开的循环(配合 #pragma unroll),并且寄存器使用量可静态确定。kBitsPerThread 就是内核里那个「每个 block 覆盖 kThreadsPerBlock * kBitsPerThread 个 bit」的乘数。
kAlignment 参与判断的原因:打包越宽(float4 装 bf16 时对齐是 8),一个线程用一条向量访存就能覆盖更多元素,对 kBitsPerThread 的需求就小。所以这两个条件必须同时满足才选低档位,否则要往高档位退,保证每个线程的工作量装得下。
invokeContiguousLogitsBitmask 里的打包类型选择是另一层分发:
if (vocabSizePadded % (sizeof(float4) / sizeof(T)) == 0){ contiguousLogitsBitmaskDispatchToBitsPerThread<T, float4>(...);}else if (vocabSizePadded % (sizeof(float2) / sizeof(T)) == 0){ contiguousLogitsBitmaskDispatchToBitsPerThread<T, float2>(...);}else if (vocabSizePadded % (sizeof(float) / sizeof(T)) == 0){ contiguousLogitsBitmaskDispatchToBitsPerThread<T, float>(...);}else{ contiguousLogitsBitmaskDispatchToBitsPerThread<T, T>(...);}按「词表大小能否被 4/2/1 个元素整除」逐级判断,选最宽的合法打包。之所以要判断整除而不是直接上最宽的,是因为内核里的循环逻辑依赖「每个打包对齐在掩码字内部不跨界」——如果词表大小不是 kAlignment 的整数倍,最后一个打包就会跨过边界,读写越界。这跟前面 bitmask_size = ceil(vocab/32) 那个向上取整是配套的:分配时向上取整留出余量,访存时按整除性选宽度,两个约束合在一起保证既不会越界、也用得上向量化。
7.6 一个真实的性能参照
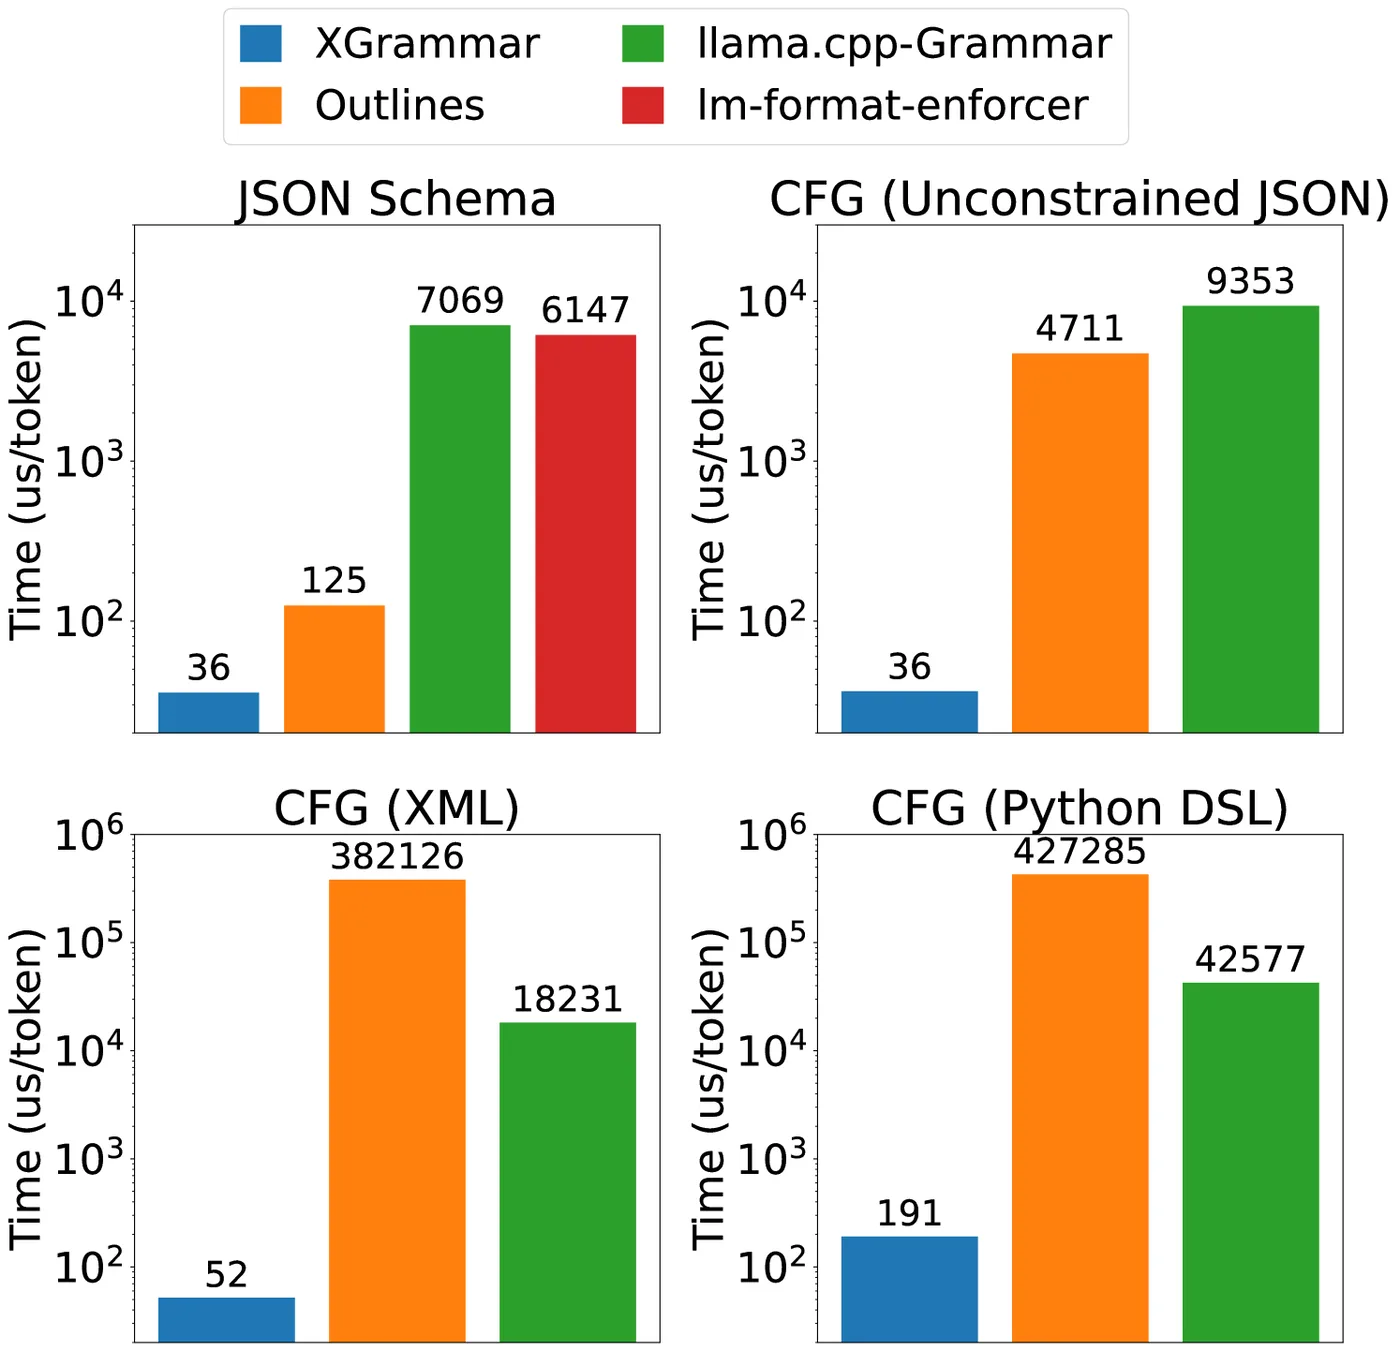
上图是 XGrammar 论文给出的每 token 掩码生成延迟对比。要注意这张图测的是CPU 侧掩码生成这一段(自动机推进 + 填位图),不含 GPU 侧的施加内核。也就是说,整个受约束解码的开销被拆成了两部分:这张图覆盖了「构建」部分,而上面分析的 logits_bitmask 内核覆盖了「施加」部分。两部分都在一个 step 的关键路径上,所以两边都要优化——CPU 侧靠缓存和分类,GPU 侧靠位图 + 三档分支 + 打包访存。
理解这个拆分对排查线上问题很有用:如果开了约束之后吞吐掉得很多,先区分是「构建慢」(CPU 打满、GPU 有空隙)还是「施加慢」(内核时间长、显存带宽瓶颈),再决定往哪边优化。前者对应调 schema 复杂度和编译器缓存,后者对应调整 batch/词表分块配置。
八、张量并行下的位宽对齐
前面提到 _apply_bitmask 需要考虑张量并行,这段代码是理解「为什么 bitmask 必须按 32 位对齐切」的最好样本:
@torch.inference_mode()def _apply_bitmask(self, requests, logits, d2t=None, num_bitmask_tokens=None) -> None: if num_bitmask_tokens is None: num_bitmask_tokens = requests.num_bitmask_tokens
# In general, the logits passed to GuidedDecoder are complete in the vocabulary dimension. # In some special cases (e.g., MTP), the logits are sharded in the vocabulary dimension. vocab_size_padded = self.vocab_size_padded if d2t is None else d2t.size(0) assert vocab_size_padded % logits.size(1) == 0 tp_size = vocab_size_padded // logits.size(1) assert self.bitmask_size % tp_size == 0 tp_rank = self.rank % tp_size bitmask_start = tp_rank * self.bitmask_size // tp_size bitmask_end = bitmask_start + self.bitmask_size // tp_size
if d2t is not None: d2t_start = tp_rank * vocab_size_padded // tp_size d2t_end = d2t_start + vocab_size_padded // tp_size d2t = d2t[d2t_start:d2t_end]
torch.ops.trtllm.logits_bitmask( logits[:num_bitmask_tokens], self.bitmask[:num_bitmask_tokens, bitmask_start:bitmask_end], token_mask=self.token_mask[:num_bitmask_tokens], d2t=d2t)逐步拆这段算术:
第 1 步,反推 tp_size。 logits.size(1) 是本 rank 上 logits 的词表宽度。用完整(padded)词表大小除以它,得到的就是张量并行的切分度:
这里用「宽度」反推而不是从配置里读,是一个有意思的选择。好处是这段代码对「传进来的 logits 到底切没切」是自适应的——如果 logits 是完整的(logits.size(1) == vocab_size_padded),推出来的 tp_size 就是 1,后面的切分逻辑自然退化成不切。一种代码路径覆盖两种情形。
assert vocab_size_padded % logits.size(1) == 0 保证这个除法是整除的,否则说明传进来的宽度不是词表的因子,配置有误。
第 2 步,断言 bitmask 大小能被 tp_size 整除。
assert self.bitmask_size % tp_size == 0这个断言是整个设计的关键约束。bitmask_size = ceil(vocab_size_padded / 32),它必须能被 tp_size 整除,也就是:
为什么?因为每个 rank 只处理自己那一段词表,需要的是 bitmask 里对应的那一段。如果 bitmask_size 不能被 tp_size 整除,就没法把它均匀切成 tp_size 段——有的 rank 会多一个 int32(32 个 bit),切分就出现了不对称。
为什么不许不对称?因为词表的切分本身是按 token 均分的(每个 rank 拿 vocab_size_padded / tp_size 个 token),所以 rank 需要的 bit 区间是 ,长度 个 bit。这个数不一定是 32 的倍数,所以它可能落在某个 int32 的中间——而 mask 是按 int32 为最小单元切分的,无法只给一个 rank 半个 int32。
解决办法是让每段的 int32 数 = bitmask_size / tp_size。这样 rank 拿到的 int32 段是 ,其中 。这段覆盖的 bit 范围是 ,而它需要的 bit 范围是 。
两者是否一致?只有当 时严格一致。由于 padding 的存在( 已经是 padded 过的词表大小), 通常能被较大的 整除,而 向上取整后可能多出最多 31 位。所以实际上每个 rank 拿到的 bit 段可能比它需要的略宽一点——多出来的那部分是 padding bit,本来就不对应任何真实 token,内核也不会去读(回忆 row_has_valid_token 里对 trailing bits 的处理)。
代价是:tp_size 不能任意取。bitmask_size % tp_size == 0 这个断言在启动时就会检查,如果配置的 TP 度数与词表大小凑不出整除关系,就会断言失败。实践中词表大小都做了比较充分的 padding(常见值 128256、151936、129280 都能被 2/4/8/16 整除),所以这条约束在常规配置下不难满足。但它解释了为什么「padded 词表大小」这个概念在这个子系统里处处出现——padding 不只是为了让 GEMM 的维度好看,也是为了让掩码切分能整除。
第 3 步,算本 rank 的 bit 区间。
tp_rank = self.rank % tp_sizebitmask_start = tp_rank * self.bitmask_size // tp_sizebitmask_end = bitmask_start + self.bitmask_size // tp_size注意 self.rank % tp_size 而不是直接用 self.rank。原因是这套代码要同时支持 TP 和 EP/DP——全局 rank 可能包含多个并行维度,而 bitmask 的切分只跟 TP 维度有关,所以取模拿到「TP 维度内的序号」。这与 TensorRT-LLM 源码完全拆解(十二):注意力层的张量并行 里讲的 head 切分是同一套坐标系的处理逻辑。
第 4 步,d2t 也要切。
if d2t is not None: d2t_start = tp_rank * vocab_size_padded // tp_size d2t_end = d2t_start + vocab_size_padded // tp_size d2t = d2t[d2t_start:d2t_end]d2t 是「剪枝位置 → 完整词表位置」的映射表,长度是完整 padded 词表大小。但本 rank 上的 logits 只是词表的一个切片,所以它只需要 d2t 里对应的那一段。注意这里是按 token 数切(vocab_size_padded // tp_size),不是按 int32 数——因为 d2t 的元素就是一个 int32 对应一个完整词表位置,切分口径跟词表一致。
这样切出来之后,内核里的 d2t[blockOffset + offset + i] 索引出来的是完整词表坐标系下的位置,可以直接拿去查完整的 bitmask(注意内核里用的是 bitmask[batchIdx * bitmaskStride + ...],也就是完整的 bitmask 张量、不是切片)。等一下——那第 3 步切出来的 bitmask_start:bitmask_end 段是干嘛的?
这里有个容易看漏的地方:d2t 模式和非 d2t 模式用的是两套不同的 bitmask 访问方式。
- 非 d2t 模式:传进去的是切过的 bitmask 段
[bitmask_start:bitmask_end],内核按offset / 32直接索引(因为 logits 和 bitmask 在同一个坐标系下按同样比例切了)。 - d2t 模式:
d2t索引出的是完整词表位置,所以内核要按完整坐标系去查——但传进去的 bitmask 已经是切过的段了,坐标系不一致。
再看一遍内核的 d2t 分支:
bitmaskVal |= ((~bitmask[batchIdx * bitmaskStride + d2tOffset / kBitsPerMaskElement] >> (d2tOffset % kBitsPerMaskElement)) & 1) << i;它用的是 bitmask[...] 这个基指针,不是 bitmaskGmemPtr(后者是加了 blockOffset / kBitsPerMaskElement 偏移的)。基指针的偏移是由 batchIdx * bitmaskStride 决定的,而 bitmaskStride 是外层传进来的 bitmask.stride(0)。
那这里就有两种可能的读法:要么 d2t 模式下传进去的 bitmask 参数应该是完整的(stride 也是完整的),要么 d2t 里存的偏移其实是相对于本 rank 段的。
从 Python 侧看,d2t 被切成 [d2t_start:d2t_end] 之后传进去,而 bitmask 传的是 [bitmask_start:bitmask_end]。要让内核的 d2tOffset 能正确索引到切片内的位置,d2tOffset 必须落在切片坐标系下。而 d2t 切片的值并没有被平移——切的是表项,表项里存的仍是完整坐标系的位置。
结论是:在 TP + d2t 同时存在的场景下,这段逻辑存在坐标系不一致的风险,需要依赖具体配置(比如 d2t 的张量只在这个 rank 上有效、或 MTP 场景下 tp_size 恰好为 1 的退化情形)才能保证正确。这是一个值得在改动这块代码前仔细确认的点,而不是可以照抄理解的地方。把它标出来是因为读源码时遇到这种「两侧偏移口径对不上但代码能跑」的地方,往往意味着它只在特定配置组合下被验证过。
assert self.bitmask_size % tp_size == 0 之外,这段代码给的另一个启示是:「切分」在这类系统里从来不是简单的张量切片。切什么、按什么单位切、切完之后下游代码用什么坐标系索引——三者必须一致,任何一处错位都会变成「输出偶尔不对」这种最难查的 bug。
九、与调度器和 P/D 分离的接缝
受约束解码不是一个独立模块,它嵌在 PyExecutor 的调度循环里,跟调度器、投机解码、P/D 分离都有耦合点。把 py_executor.py 里的调用点过一遍,能看出这套接缝的形状。
9.1 三个调用位置
第一处,PP 最后一层的前向之后:
if self.guided_decoder is not None and self.kv_cache_transceiver: self.guided_decoder.add_batch(scheduled_batch) self.guided_decoder.init_disagg_gen_requests()
with self.perf_manager.record_perf_events(gpu_forward_start, gpu_forward_end): batch_outputs = self._forward_step(scheduled_batch)
guided_decoder_failed_requests = Noneif self.guided_decoder is not None: self.guided_decoder.add_batch(scheduled_batch) guided_decoder_failed_requests = self.guided_decoder.execute( batch_outputs['logits'])第二处,主路径(非 PP 或 PP 首层),流程更长,包含草稿与回退的完整编排:
if can_queue: # init_disagg_gen_requests must be before drafter loop, otherwise draft # requests do not have initialized matchers. # init_disagg_gen_requests must be before engine forward, where the # prev_seq_slot is updated. if self.guided_decoder is not None: self.guided_decoder.add_batch(scheduled_batch) if self.kv_cache_transceiver: self.guided_decoder.init_disagg_gen_requests()
if self.drafter is not None and self.use_spec_decode: if self.guided_decoder is not None: self.guided_decoder.rollback_rejected_tokens() with request_context(...): ... self.drafter.prepare_draft_tokens(scheduled_batch, self.resource_manager) self.drafter.pad_draft_tokens_for_cuda_graph(..., ...) # add_batch must be called again to restore to target requests with # updated draft tokens. if self.guided_decoder is not None: self.guided_decoder.add_batch(scheduled_batch) if hasattr(self.drafter, "guided_decoder"): self.guided_decoder.rollback_draft_tokens() ... guided_decoder_failed_requests = None if self.guided_decoder is not None: guided_decoder_failed_requests = self.guided_decoder.execute( batch_outputs['logits'])9.2 时序依赖为什么长这样
把上面两个调用点的形状差异说清楚,就能看出这套接缝的核心约束。
约束一:init_disagg_gen_requests 必须在两个东西之前。
注释写得很直白:
# init_disagg_gen_requests must be before drafter loop, otherwise draft# requests do not have initialized matchers.# init_disagg_gen_requests must be before engine forward, where the# prev_seq_slot is updated.两个「必须之前」:草稿循环之前(否则草稿请求拿到的是 None matcher),以及 engine forward 之前(因为 forward 过程会更新 prev_seq_slot,而 init_disagg_gen_requests 依赖这个字段来定位)。这是一个典型的「字段被下游改写、上游读取必须抢在前面」的时序约束。
看它的实现:
def _init_disagg_gen_requests(self, requests: GuidedRequests) -> None: """Initialize the grammar matchers for disagg gen requests.""" for req in requests.valid_requests(): if req.is_generation_only_first_iteration: self.grammar_matchers[req.seq_slot] = self.grammar_matcher_factory.create( req.guided_decoding_params)判定条件 is_generation_only_first_iteration 就是前面 GuidedRequest 里那个字段:
is_generation_only_first_iteration=( request.llm_request_type == LlmRequestType.LLMREQUEST_TYPE_GENERATION_ONLY and request.py_decoding_iter == 1 and request.py_batch_idx is None),三个条件同时成立:请求类型是「纯 generation」(说明它的 prefill 是在另一台机器上做的,这正是 P/D 分离的特征)、这是它的第一次解码迭代、而且它还没有 py_batch_idx(还没进过 batch)。
这正是 P/D 分离场景下的特殊情况:decode 侧的请求从来没有经历过 context 阶段——它的 prefill 在 prefill 实例上完成了,KV Cache 通过传输通道搬过来。既然没有 context 阶段,那么「在 context 最后一个 chunk 初始化 matcher」这条正常路径就永远不会被触发。所以必须有一个专门的入口,在请求第一次进入 decode 循环时把 matcher 建起来。
这就是 init_disagg_gen_requests 存在的全部理由。它是 P/D 分离给受约束解码带来的额外分支——可参考 TensorRT-LLM 源码完全拆解(十六):P/D 分离与 KV 传输 里对这套架构的完整拆解。
约束二:rollback_rejected_tokens 在草稿循环之前。
if self.drafter is not None and self.use_spec_decode: if self.guided_decoder is not None: self.guided_decoder.rollback_rejected_tokens()顺序是:先回退上一轮被拒的 token,再跑这一轮的草稿生成。回退依据的是上一轮验证的结果(num_accepted_draft_tokens),而验证结果是在上一轮 execute 里、由草稿端的 fetch_accepted_batch 取回的。
如果把这个回退放到草稿生成之后,草稿就会基于一个「多走了几步」的语法状态去猜——猜出来的 token 可能在语法上不合法,然后在验证阶段被大量拒绝,投机解码的接受率直接崩掉。这类错误不会让程序崩溃,只会让加速比不如预期,是典型的「性能 bug 而不是正确性 bug」。
约束三:add_batch 要调用两次。
# add_batch must be called again to restore to target requests with# updated draft tokens.if self.guided_decoder is not None: self.guided_decoder.add_batch(scheduled_batch) if hasattr(self.drafter, "guided_decoder"): self.guided_decoder.rollback_draft_tokens()第一次 add_batch 在草稿循环之前(此时 scheduled_batch 还是目标请求的形态),第二次在草稿循环之后(此时草稿 token 已经被 prepare_draft_tokens / pad_draft_tokens_for_cuda_graph 写进了 scheduled_batch,请求形态已经变了)。
为什么要重建快照?因为 GuidedRequest 是快照,草稿 token 是草稿循环里才产生的,第一次快照里没有它们。第二次 add_batch 把更新后的草稿 token 重新快照进来,后面 execute() 才知道要为哪些位置填掩码。
那个 if hasattr(self.drafter, "guided_decoder") 的分支也很有意思:只有一部分草稿方案自带 guided decoder(走 execute_draft_batch 那条路),另一部分(前面提过的 SA、DFlash、PARD)没有,它们的回退走 rollback_rejected_batch。用 hasattr 做能力探测而不是定义在基类里,说明这两个分支是后来陆续加上的,接口没有统一——这是长期演进的系统里很常见的形态。
9.3 overlap scheduler 带来的额外时序
前面 fetch_draft_batch 的注释里提到了 overlap scheduler:
# When overlap scheduler is enabled, it is possible that# - The EOS token is in the draft tokens, and# - Some draft tokens after the EOS token are accepted by the target model.# These requests should be terminated at this executor iteration.以及 _build() 里那段:
# The last new token must be acceptable unless the matcher is terminated or None:# 1. For the main model loop, when overlap scheduler is enabled, the matcher# may have accepted the EOS token in the draft tokens at the previous iteration.# 2. For the draft model loop, the matcher may have accepted the EOS token at# the previous drafting iteration.# 3. The matcher can be None if there was an error during its creation.if matcher is None or matcher.is_terminated() or self.is_draft_terminated[slot]: continueaccepted = matcher.accept_token(req.new_token)overlap scheduler 的作用是「在这一步 GPU 还在执行时,就把下一步的调度算好」。这带来一个后果:语法 matcher 可能提前消化了包含 EOS 的 token 序列,于是当下一步真的开始时,matcher 已经处于 terminated 状态。此时如果还去 accept_token,要么被拒(引发不该有的大错误),要么把状态搞乱。
所以推进前必须先检查三个条件:matcher 是 None(创建时出过错)、已经 terminated、或者草稿引导已经终止。三个条件里只要有一个成立就跳过推进——这个「防御性检查」正是因为 overlap scheduler 让「matcher 状态」和「当前 token」之间不再有严格的同步关系。
这段代码是「异步调度 × 有状态组件」组合起来的典型代价:一个本来简单的时序(推进一步)因为引入了「提前一步」的优化,变成了一个需要三重防御的判断。而这类改动往往是在生产环境里被具体故障逼出来的——注释里逐条列出三个场景,读起来就像是三份故障报告的浓缩。
十、代价、限制与工程判断
最后把整套机制的代价和边界收拢一下。
10.1 三种成本
CPU 成本:构建掩码。 每个 step、每个序列都要跑一次自动机推进 + 填位图。成本与「上下文相关 token 的数量」正相关——约束越松(比如自由文本字段),上下文相关的 token 越多,成本越高。XGrammar 的缓存机制正是为压这个成本而设计的,但缓存对「每次请求都换 schema」的场景无效。
传输成本:掩码的 H2D 拷贝。 每个 token 位置一行 ceil(vocab/32) 个 int32。以 128256 词的词表为例,一行是 4008 个 int32 = 约 16 KB。如果 batch 里有 256 个 token 位置,一轮就是 4 MB 的 H2D 拷贝。这个量级在 PCIe 上需要几百微秒——放在主路径上是能感觉到的。这就是为什么要用 pinned memory + side stream,把拷贝和别的 GPU 工作重叠掉。
GPU 成本:施加内核。 理论上是「读一遍 logits 的掩码位 + 写回被屏蔽的位置」。实际上因为三档分支,全合法和全非法的组可以完全跳过访存,平均代价低于「全量读写一遍」。
10.2 语义上的限制
约束只保证「格式合法」,不保证「内容正确」。 这是最容易被误解的一点。schema 约束能保证输出是合法 JSON、字段都在、类型都对,但不能保证 {"city": "北京"} 里的城市名是对的,也不能保证 {"count": 3} 里的 3 是用户想要的那个数。约束解决的是「可解析性」,不是「准确性」。如果你的场景需要内容准确,需要在 schema 设计上花功夫(限制枚举、加格式约束),而不是指望约束解码本身。
EOS 与终止的关系容易踩坑。 is_terminated() 一为真,掩码就不再填,剩下的生成完全自由。这意味着如果语法在语法上仍然可以继续的位置上被判定为 terminated(比如某个后端的 terminated 判定偏早),后续输出就不受约束了。前面 LLGuidance 那个「只在 stopped 状态接受 EOS」的处理就是在收紧这个边界——不同后端对「什么时候算终止」的判定并不完全一致,迁移后端时值得专门验证。
死路即错误。 主请求一旦走到「当前状态没有任何合法 token」,TensorRT-LLM 的处理是把请求标记为失败。这在语义上是合理的(语法本身有问题,或者实现有 bug),但意味着一个设计不良的 schema 会直接造成请求失败,而不是降级到无约束生成。上线前用真实流量验证 schema 的可满足性是有必要的。
后端能力不齐。 Structural Tag 只有 XGrammar 有;LLGuidance 只接受单个 stop token、EBNF 走 Lark 格式。选型时这些差异都要提前确认,否则会在切换后端时遇到「配置能启动但行为不对」的问题。
10.3 什么场景值得开
给出一个粗略的判断框架:
| 场景 | 是否建议开 | 理由 |
|---|---|---|
| 工具调用 / function calling | 强烈建议 | 输出必然可解析,省掉重试与兜底逻辑 |
| Agent 中间步骤的结构化输出 | 建议 | 与下游解析器形成硬契约 |
| 面向人的自由文本生成 | 不建议 | 约束会限制表达,且没有解析需求 |
| 长文本 + 严格 JSON 的混合输出 | 看后端能力 | 需要 Structural Tag 这类「部分约束」能力 |
| 小 batch、低 QPS 的离线任务 | 可选 | 省下的是重试成本,性能收益不大 |
一个具体的建议:优先用固定的少数几套 schema。因为编译器缓存是按 schema 内容索引的,schema 种类少意味着缓存命中率高、编译开销摊薄;schema 种类多(尤其是请求动态传入)会让缓存不断失效,CPU 成本直接抬起来。如果业务上确实需要动态 schema,考虑先做一层「schema 规范化 + 去重」再传给引擎。
10.4 这套设计里可以带走的几个模式
抛开 TensorRT-LLM 的具体实现,这套代码里有几个可复用的设计模式值得记下来:
模式一:把变长语义压成定长表示。 位图把「当前合法 token 集合」这个变长信息压成定长的 ceil(vocab/32) 个 int32,从而保住了 CUDA Graph 需要的静态形状。当你在设计一个要进图的 GPU 组件时,这个转换是最常用的手法。
模式二:主机侧计算 + 设备侧施加。 语法自动机很难在 GPU 上高效实现(分支多、状态机不规整),但「把 -inf 写进 logits」是完美的 GPU 工作。把任务拆成「CPU 做不擅长的部分 + GPU 做擅长的部分」,中间用位图传递,比强行把整个自动机搬到 GPU 上更现实。
模式三:状态快照 + 主机回调支撑图捕获。 要让有状态的 Python 逻辑进入 CUDA Graph,CapturableGuidedDecoder 的三件套是:请求快照(GuidedRequest)、队列传递(self.queue)、hostfunc 回调。这三样缺一不可。
模式四:用一个已有的等待去破死锁。 _drain_host_functions 不是「加一层锁」或者「改调用顺序」,而是找到一个本来就要做的同步点,让它顺便释放 GIL。跨语言(Python + Rust + CUDA)、跨线程的资源竞争,很多时候最佳解法不是引入新机制,而是重新利用已有的同步点。
小结
这一篇把 TensorRT-LLM 的受约束解码从语法编译一路追到了 GPU 内核:
- 语法表示:JSON 的递归嵌套要求上下文无关文法那一档的表达能力,所以约束最终都编译成下推自动机;
GrammarMatcher用accept_token/rollback/fill_next_token_bitmask/is_terminated四个方法把「可增量执行、可回退的语法状态机」抽象出来,XGrammar 与 LLGuidance 是两个可插拔的后端。 - 词表对齐:变长的「合法 token 集合」被压成定长的位图,一个 bit 一个 token,长度
ceil(vocab/32)个 int32;行数是max_num_sequences × (max_num_draft_tokens + 1),那个+ 1是投机解码验证步里 golden token 的位置。 - 正确性不变量:位图行必须至少有一个 1,否则整行被写成 、softmax 分母为 0、采样出 NaN。
row_has_valid_token是这条不变量的守卫,而且它只数内核实际会读到的 bit,不数 padding。 - 一次迭代的时序:
add_batch → build → copy_bitmask → apply_bitmask,build在 CPU 侧同步跑完,拷贝走 side stream 与主执行流用 event 同步,掩码施加是原地修改 logits,夹在前向和采样之间。 - 投机解码的记账:
num_advanced_tokens/num_guided_tokens/num_advanced_draft_tokens三本账,回退公式num_rollback = num_advanced − (1 + num_accepted),以及用min夹住的「语法引擎停早了但验证还在继续」这个不一致。 - CUDA Graph 兼容:
CapturableGuidedDecoder用 hostfunc 回调把主机侧语法工作挂进图,用队列 + 快照传递状态,用bitmask_event.synchronize()这种「顺便释放 GIL」的方式破掉回调与本地调用之间的死锁。 - GPU 内核:
contiguousLogitsBitmaskKernel按 batch(掩码行)与词表分块铺网格,用token_mask做整块早退,按「全合法 / 全非法 / 混合」三档分支选择跳读、只写或读改写,打包宽度按词表整除性逐级选择,d2t 分支处理剪枝词表下的反向查表。 - 张量并行:位图按 int32 单位切分给各 rank,因此
bitmask_size必须能被tp_size整除——这也是「padded 词表大小」这个概念在系统里处处出现的原因之一。 - 接缝:
init_disagg_gen_requests是 P/D 分离带来的额外分支(decode 侧请求没有 context 阶段),草稿循环前后的两次add_batch、回退的时机、以及 overlap scheduler 造成 matcher 状态与当前 token 不同步而必须加的三重防御,都是在异步调度与有状态组件组合时才出现的复杂度。 - 代价:CPU 构建、掩码 H2D 拷贝、施加内核三段成本都要摊在关键路径上;语义上约束只保证格式合法不保证内容正确;死路会直接让请求失败,schema 的可满足性值得上线前验证。
到这里,TensorRT-LLM 系列里与「输出端」相关的模块就基本讲完了:采样管线在 (十七)Sampler 里拆过,语法约束是这一篇,两者合起来覆盖了「logits 到最终 token」的完整链路。同类主题在站内还有几个不同框架的实现可以对照着看:SGLang 源码完全拆解(十):Sampling、Grammar 与结构化输出 讲的是 SGLang 的 GrammarManager 与 xgrammar bitmask 如何闭合,llama.cpp 源码完全拆解(五):采样管线与语法约束 讲的是 GBNF 语法状态机如何接进采样器链,vLLM 结构化输出 与 DeepInfer 源码完全拆解(六):结构化输出与确定性 分别是另两个框架的实现路径。同一个问题在四个框架下的不同取舍,对比起来看会很有意思。
下一篇将回到 TensorRT-LLM 剩下没有覆盖的部分,讨论多模态输入链路——图像如何被编码、如何在文本流里占位、以及视觉编码器与前向执行如何编排。
参考资料
- XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models
- TensorRT-LLM 官方文档:Guided Decoding
- TensorRT-LLM 仓库(guided_decoder.py / grammar_matcher.py / logitsBitmask.cu)
- XGrammar 项目主页与文档
- LLGuidance 仓库(guidance-ai/llguidance)
- TensorRT-LLM 示例:llm_guided_decoding.py
- PyTorch issue #163061:CUDA callback 与 GIL 的交互
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



