


llama.cpp 源码完全拆解(二十五):从 llama_batch 到 ubatch——一份 token 清单如何被切成能被 KV 同时装下的微批
调用方递给 llama.cpp 的永远是一份扁平的 token 清单:llama_batch 里一个 token 数组、一个 pos 数组、一个 seq_id 指针数组、一个 logits 标志数组。这份清单可能只有 1 个 token(单流解码),也可能是 4096 个 token 的一条长 prompt,还可能是 32 个用户各自的 1 个 token 拼在一起。但 GPU 那边接收的从来不是这份清单:计算图只认一个形状固定、每个序列 token 数相等的矩形块——llama_ubatch。
这中间发生了一次结构性的重新组织。它既要满足硬约束(一个 ubatch 的序列数 × 每序列 token 数不超过 n_ubatch、序列需要能被 KV 缓存同一时刻装下),又要在软目标上尽量不吃亏(别把一个序列切成太多段、别因为一个长序列把其他人挤出去、别让每轮图计算的形状换来换去)。这件事全部发生在 src/llama-batch.cpp 里,主体是三个切分函数 split_simple、split_equal、split_seq 和一个装配函数 ubatch_add。
站内前几篇已经分别讲过这条链路的几个断面:llama.cpp 源码完全拆解(四):llama_context 与记忆系统 讲了 n_batch 与 n_ubatch 的定义和 init_batch 的骨架,llama.cpp 源码完全拆解(二):ggml 计算图与内存分配器 讲了图的计算缓冲区按 n_ubatch 预留,llama.cpp 源码完全拆解(一):整体架构与模块全景 俯瞰了 decode 的六个阶段。这一篇专门补中间那一块:一份扁平 batch 到一串 ubatch 的每一步是怎么走的,包括新的 llama_batch_ext 容器、allocr 的位置推断与校验、三套切分策略各自的取舍、ubatch_add 的重排与指针修复,以及全部切完之后 KV 缓存的「预演式占位」为什么要回滚。
先看全景:一次 llama_decode 里切分处在什么位置
llama_decode 的入口其实有两条。新接口 llama_process(ctx, LLAMA_PROCESS_TYPE_DECODE, &batch_ext) 直接吃 llama_batch_ext;老接口 llama_decode(ctx, batch) 吃老的 llama_batch,由 llama_context::decode(const llama_batch &) 先把它经 llama_batch_compat 翻译成 llama_batch_ext,再走同一条路:
int llama_context::decode(const llama_batch & batch_inp) { llama_batch_compat compat(this, batch_inp); return decode(*compat.batch_ext);}也就是说,切分前的「原始批次」统一是 llama_batch_ext,切分后的「计算单元」统一是 llama_ubatch,中间夹着一个 llama_batch_allocr 做记账。整个流程放在 llama_context::decode(const llama_batch_ext &) 里,可以压缩成下面几步:
- allocr 初始化:
balloc->init(batch_inp, vocab, output_all)。这一步做的是校验与规范化——把seq_ids集合展开、把位置数组按 M-RoPE 的要求展开成段优先布局、统计输出行数、检查位置是否单调。它不做任何切分。 - 记忆模块切分:
memory->init_batch(*balloc, cparams.n_ubatch, embd_all)。切分策略的选择权交给了记忆模块,因为只有记忆模块知道自己的容量与结构:统一 KV(单流)只需要「沿扁平顺序截断」,非统一 KV(每序列一个流)则需要「每个序列在每个 ubatch 里出一样多的 token」。 - KV 预演:
prepare(ubatches)对每个 ubatch 跑一遍find_slot,但只找位置不写单元。任何一个 ubatch 找不到位置,整批失败。 - 逐 ubatch 执行:
mctx->next()循环里,每个 ubatch 经过apply()真正占用 KV 单元、复用或重建图、写输入、计算、取回 logits。 - 输出行序还原:因为重排会让 ubatch 内 token 的顺序与调用方给的顺序不同,最后用
balloc->get_out_ids()建一张output_ids反查表,并记录output_swaps供llama_get_logits_ith按需重排。
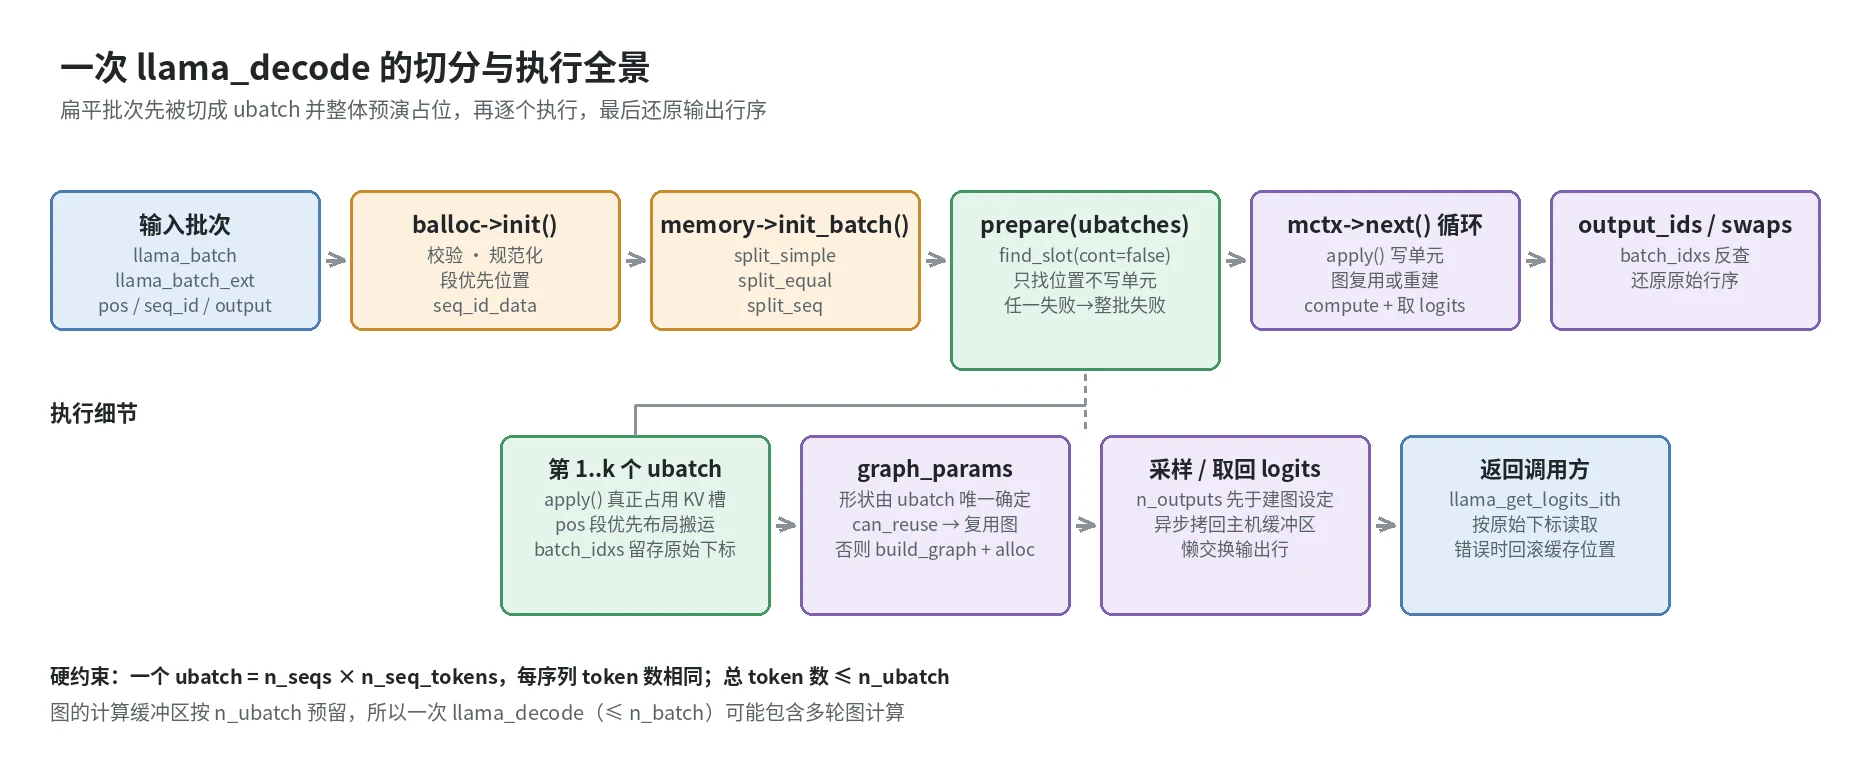
上图把五步画成了一条从左到右的流水。注意第三步的位置:切分是「先全部切完,再统一找位置」,而不是「切一个、放一个、算一个」。这个顺序上的选择后面会专门讲,它是 llama.cpp 在「一次 decode 失败时不留半截状态」这条不变式上的实现方式。图中右侧的分叉表示 split_equal 会把 token 重排成「先序列 0 的所有 token,再序列 1 的所有 token」,而执行完之后要通过 out_ids 把行序还原回调用方的顺序。
两份数据结构:输入侧的 llama_batch_ext 与输出侧的 llama_ubatch
理解切分,首先要理解它一边吃进去的是什么、另一边吐出来的是什么。这两个结构的设计意图截然不同。
llama_batch_ext:给「任意形状的输入」留出空间
llama_batch_ext 是近期的重写产物。老的 llama_batch 是一组裸指针 + 长度,调用方要自己 malloc、自己填 seq_id 二维数组、自己保证 n_seq_id[i] 与 seq_id[i] 一致。llama_batch_ext 换成了「每个 token 一个对象」的容器:
struct llama_batch_ext { const size_t n_tokens_max; // 上限,超过后 add_token 返回 -1 const size_t n_embd_inp; // 输入嵌入宽度(token 嵌入) const size_t n_embd_inp_enc; // 编码器输入宽度(如 EAGLE-3 / DFlash 提取出的特征) const size_t n_embd_state; // MTP 等上下文携带的隐状态宽度,0 表示不带 const llama_seq_id n_seq_max; llama_memory_i * mem; // 用于位置推断 const llama_token n_vocab; const size_t n_pos_per_embd; // M-RoPE 时为 3 或 4,文本模型为 1
size_t n_embd = 0; // 本批实际的嵌入行宽,由第一次 set_token_embd() 确定
struct token { llama_token id = LLAMA_TOKEN_NULL; bool has_embd = false; size_t embd_off = 0; bool has_state = false; size_t state_off = 0; bool output = false; int32_t decision_order = 0; std::unordered_set<llama_seq_id> seq_ids; // 一个 token 可以同时属于多条序列 std::array<llama_pos, GGML_MROPE_SECTIONS> pos = {0, 0, 0, 0}; }; std::vector<token> tokens; std::vector<float> embd; std::vector<float> state;};这里有三个细节对切分影响很大。
第一,seq_ids 是集合而不是数组。 老 llama_batch 里一个 token 的序列归属是 seq_id[i][0..n_seq_id[i]-1],必须紧凑且无重复。新结构用 std::unordered_set,从接口上就允许重复添加而不出错。切分时「一个 token 属于哪些序列」「哪些序列之间有重叠」这些判断都基于集合运算,而不是线性扫描。
第二,pos 是 std::array,长度是 GGML_MROPE_SECTIONS(4)。 对文本模型,n_pos_per_embd = 1,只用 pos[0];对多模态(Qwen2-VL 一类),M-RoPE 需要三维位置——序列维、图像高度维、图像宽度维——对应 pos[0..2];pos[3] 预留给其他用途。init() 里会把每个 token 的位置展开成「段优先」的扁平数组,布局是 pos[j*n_tok + i],即所有 token 的第 0 段连在一起、再是所有 token 的第 1 段,以此类推。这个布局后面会原样传到 llama_ubatch,因为 ggml 的 RoPE 算子要按段取位置。
第三,token 与嵌入可以混合。 MTP 草稿批次里,一部分行是 token id,另一部分是上一阶段的隐状态向量。init() 会统计 n_tok_only、n_embd_only、n_both 三类行数,并拒掉「有的行同时带 token 与嵌入、有的行只带其一」这种不稳定混合。混合批次在 llama_ubatch 里由 type[] 逐行标记,这是 split_* 之后仍需保留行类型的原因之一。
llama_ubatch:给「固定形状的计算」定死约束
llama_ubatch 的头文件第一句话就是 // keep this struct lightweight。它在每个 decode 轮次里都可能被复制一份(llm_graph_params 里按值持有),所以字段必须精简:
struct llama_ubatch { uint32_t b_equal_seqs; // 布尔值,用 32 位存是为了对齐(否则 ASan 会报错) uint32_t n_tokens; // 总 token 数 = n_seq_tokens * n_seqs uint32_t n_seq_tokens; // 每个序列集的 token 数(所有序列集相同) uint32_t n_seqs; // 序列集个数 uint32_t n_seqs_unq; // 不同序列 id 的个数 uint32_t n_pos; // 每个 token 的位置段数
llama_token * token; // [n_tokens] float * embd; // [n_embd, n_tokens] float * embd_state; // [n_embd_state, n_tokens] llama_pos * pos; // [n_tokens*n_pos],段优先 int32_t * n_seq_id; // [n_tokens] llama_seq_id ** seq_id; // [n_tokens],每行指向 seq_id_data 的一段 llama_seq_id * seq_id_unq; // [n_seqs_unq] int32_t * seq_idx; // [LLAMA_MAX_SEQ],序列 id → 在 ubatch 内的下标 int8_t * output; // [n_tokens] int8_t * type; // [n_tokens],混合批次才有
std::shared_ptr<data_t> data; // 所有指针指向这块内存,data_t 里有 batch_idxs};有两个字段需要展开说明,因为它们是切分与后续工序的连接点。
n_seq_tokens 对全部序列集一致,这是 ubatch 能被当作一个矩形块送进计算图的根本原因。ggml 图里每一层的张量形状由 n_seq_tokens 和 n_seqs 决定,比如注意力的查询张量是 [head_dim, n_heads, n_seq_tokens, n_seqs]。如果没有这个约束,「32 个用户各 1 个 token」和「1 个用户 32 个 token」这两种形状完全不同的输入就无法共用同一张图,每轮都要重建——而图的构建与缓冲区分配是微秒级、几十微秒级的开销,在解码(每个 token 都要跑一次)时绝对不能容忍。
data_t::batch_idxs 记录了 ubatch 第 i 行在原始批次里的下标。split_equal 会把 token 按序列集分组后重新拼接,于是 ubatch 内顺序 ≠ 原始顺序;但调用方通过 llama_get_logits_ith(ctx, i) 拿 logits 时,参数 i 指的是原始批次里的位置。batch_idxs 与 out_ids 一起完成这个翻译(最后一节细讲)。
序列集(sequence set):切分算法的基本单位
第三个概念介于两者之间:seq_set_t。
typedef std::bitset<LLAMA_MAX_SEQ> seq_set_t;它是一个位集,第 位为 1 表示「这个 token 属于序列 」。一个 token 可以属于多条序列(例如多条序列共享同一段 prompt 时,这段 prompt 的每个 token 的 seq_ids 里同时包含这几条序列的 id),于是每个 token 对应一个位集。
切分算法把「序列集互不相交」当作可分进同一个 ubatch 的条件。原因很直接:在非统一 KV 模式下,每条序列有自己的连续流,每个 ubatch 里每条序列要放同样多的 token,并且要能找到连续的空单元。如果 ubatch A 里 token 属于序列 {0,1},ubatch B 里 token 属于序列 {1},而 、 又来自同一个序列片段,那么序列 1 的 KV 会在两个 ubatch 里被各写一次,位置记不清。把「共享 token 的序列」绑成一个不可拆分的组(即一个「序列集」),问题就消失了。
init() 里会构造 seq_set(每个 token 的位集)和 seq_set_map(每个位集 → 该位集下所有 token 的原始下标列表),后者是 split_equal 遍历的骨架。
allocr 的 init:切分之前的校验与规范化
split_* 函数看似只是「挑 token」,但很多边界条件在 init() 里就已经被筛掉了。init() 做的事可以归纳为六件,按代码顺序:
1. 内容类型判定。 统计每行的「只带 token」「只带嵌入」「两者都带」的分布。规则是:如果存在「两者都带」的行,则必须全部行都是「两者都带」,不能混用;「只带 token」与「只带嵌入」可以混合,但要求模型 / 上下文支持 allow_mixed(llama_context 构造时传入 llm_arch_supports_mixed_batch(arch) && ctx_type == LLAMA_CONTEXT_TYPE_DEFAULT)。不支持时直接返回 false,decode 返回 -1。
2. 隐状态一致性。 has_state 取自第 0 行,然后逐行比对。MTP 等场景中隐状态要么全带要么全不带,不存在部分行携带的情况。
3. 扁平化 token / 嵌入。 只带 token 的行写进 token_vec;混合批次中嵌入行的 token id 填 0 占位(这一行的实际语义由 type[] 标记)。嵌入行按 embd_off 拷贝到 embd_vec 的对应位置。全部带嵌入时直接 embd_vec = batch_inp.embd 复用,避免大数组拷贝。
4. 位置展开成段优先。 这是读者最容易看错的一步:
pos.resize((size_t) n_tok*n_pos_per_embd);for (int32_t i = 0; i < n_tok; ++i) { const auto & tok = batch_inp.tokens[i]; const bool expand = tok.id != LLAMA_TOKEN_NULL; for (uint32_t j = 0; j < n_pos_per_embd; ++j) { llama_pos p = tok.pos[j]; if (expand) { // 把 [p] 扩展成 [p, p, p, 0],对应 M-RoPE 的文本位置 p = j < 3 ? tok.pos[0] : 0; } pos[(size_t) j*n_tok + i] = p; }}对于 token 行(expand == true),M-RoPE 的三个文本位置段全部写成同一个值——文本没有图像上的二维位置,用同一个位置填满所有段就等价于标准 RoPE 的一维位置。嵌入行(expand == false)则按调用方给的三维位置原样保留,这正是图像 patch 所在行的语义:它们的二维位置要参与编码,从而让图像内部的注意力具有二维局部性。
5. 序列归属展开。 seq_id_data 把所有 token 的序列 id 顺序拼成一块数组,seq_id[i] 指向各自片段,n_seq_id[i] 记录长度。这一步必须做,因为原始输入里 seq_ids 是 unordered_set,没有稳定顺序,切分与后续的 seq_idx 构建都依赖「每行序列 id 连续存放」这个布局。
同时校验每个 seq_id 落在 [0, n_seq_max) 内。
6. 输出标志与位置单调性。 output 数组直接从输入的 output(老接口里是 logits)拷贝;若 output_all(嵌入计算或 embeddings 模式)为真而并非所有行都标了输出,会强制全部置 1 并打一条警告——池化嵌入必须看全部 token。随后逐序列检查 pos 非递减(seq_pos[seq_id] 记录该序列已见的最大位置),递减直接报错,因为 KV 缓存的单元是按位置排序的,乱序写入会让 find_slot 与 seq_rm 的区间假设失效。
init() 结束时调用 split_reset(),清空 used[](一个与 token 数等长的布尔数组),并把 n_used 归零。此后每次切出一块 ubatch,used[] 里对应位置就置 1,n_used 累加;所有 token 都被用过后切分结束。
最后 init() 组装出一份内部的 llama_batch(仍然是扁平指针),字段全部指向自己的 vector:
batch.n_tokens = n_tok;batch.token = token_vec.data(); // 只在需要时有值batch.pos = pos.data(); // 段优先batch.n_seq_id = n_seq_id.data();batch.seq_id = seq_id.data();batch.logits = output.data();注意这里的 pos 已经是段优先布局,而老 llama_batch 通过 llama_batch_compat 翻译进来时也是按 M-RoPE 布局读的——两种输入在 init() 出口处统一成了同一种布局。
三套切分策略:由记忆模块按自己的结构挑选
切分的调用点在 llama_kv_cache::init_batch 里,一行三元表达式决定用哪个策略:
llama_memory_context_ptr llama_kv_cache::init_batch( llama_batch_allocr & balloc, uint32_t n_ubatch, bool embd_all) { do { balloc.split_reset();
std::vector<llama_ubatch> ubatches; while (true) { auto ubatch = n_stream == 1 ? balloc.split_simple(n_ubatch) : embd_all ? balloc.split_seq(n_ubatch) : balloc.split_equal(n_ubatch, true, 0);
if (ubatch.n_tokens == 0) { break; }
ubatches.push_back(std::move(ubatch)); }
if (balloc.get_n_used() < balloc.get_n_tokens()) { // 有 token 没被任何 ubatch 收走 = 切分失败 break; }
auto sinfos = prepare(ubatches); if (sinfos.empty()) { break; }
return std::make_unique<llama_kv_cache_context>( this, std::move(sinfos), std::move(ubatches)); } while (false);
return std::make_unique<llama_kv_cache_context>(LLAMA_MEMORY_STATUS_FAILED_PREPARE);}三个条件分别对应三种 KV 缓存结构:
| 条件 | 选定策略 | KV 结构 | 切分约束 |
|---|---|---|---|
n_stream == 1 | split_simple | 统一 KV(kv_unified),所有序列共用一个连续空间 | 只看扁平顺序,凑满 n_ubatch 就断 |
embd_all | split_seq | 非统一 KV,且所有 token 都要输出(嵌入计算)或非因果注意力 | 整个序列必须落在同一个 ubatch |
| 其余 | split_equal | 非统一 KV,常规解码 / 预填充 | 序列集互不相交,每个序列在每个 ubatch 里出等量 token |
n_stream 在构造函数里定死:n_stream(unified ? 1 : n_seq_max)。kv_unified 是从 llama_context_params 透传下来的开关(-kvu 命令行选项),打开时全部序列共享一个连续 KV 空间,因此不存在「每个序列各有一个流、各放等量 token」的约束,split_simple 是自然选择。
循环的终止条件也值得注意:只要某个策略返回空 ubatch(n_tokens == 0),循环就结束。如果此时 n_used < n_tokens(还有 token 没被收走),说明剩下的 token 无法构成任何一个合法 ubatch——这不是错误返回值,而是「切分失败」,init_batch 会走到最后的 LLAMA_MEMORY_STATUS_FAILED_PREPARE。什么时候会这样?典型场景是 n_ubatch 太小,装不下某条序列的最小可分单位,或者某个序列集的 token 数与 n_ubatch 不成比例。这时 decode 会尝试一次 memory_update(true)(允许做代价高的缓存整理,比如平移、丢弃空闲 slot 的缓存),再重试;仍不行才返回 1(「找不到 KV 槽位」)——用户侧看到的「batch too large / context exceeded」报错大多来自这条路径。
split_simple:统一 KV 下的顺序截断
最简单的策略,代码几乎不需要解释:
llama_ubatch llama_batch_allocr::split_simple(uint32_t n_ubatch) { // 找到第一个还没被用掉的 token uint32_t cur_idx = 0; while (cur_idx < used.size() && used[cur_idx]) { ++cur_idx; } if (cur_idx >= used.size()) { return {}; // 全部用完 }
std::vector<int32_t> idxs; while (true) { idxs.push_back(cur_idx); used[cur_idx] = true; ++n_used; ++cur_idx;
if (cur_idx >= used.size()) { break; } if (idxs.size() >= n_ubatch) { break; } }
return ubatch_add(idxs, idxs.size(), false);}它从扁平下标顺序取连续的一段,长度最多 n_ubatch。注意 seq_eqs 参数传的是 false:每个 token 独立算作一个序列集,ubatch_add 里 n_seqs = idxs.size(),n_seq_tokens = n_tokens / n_seqs = 1。这意味着统一 KV 模式下每个 ubatch 的形状是「 个序列 × 1 个 token」,即使里面有多条序列的多个 token,它们的每序列 token 数也不被要求相等。
为什么统一 KV 不要求等量?因为统一 KV 只有一条流,find_slot 在 n_stream == 1 时走的是「扁平一段」的路径:n_tokens = ubatch.n_tokens、n_seqs = 1,只要连续区间里有这么多空单元就放得下,不需要按序列做等量对齐。等价地,连续批处理的「每轮解码每条序列出一个 token」在统一 KV 下被简化成了「一串 token 连着算」,位置正确性与掩码正确性由每个 token 自己的 pos 与 seq_id 保证。
这种模式的代价是:形状多样性高。每轮解码若有 5 个请求,n_tokens = 5;下一轮 8 个请求,n_tokens = 8;预填充时 512、1024、2048 混着来。每一次形状变化都意味着 ggml 图要重建或至少缓冲区要重分配。所以 llama.cpp 在解码路径上常常把「同一形状的连续几次 decode」放在一起,图复用计数 n_reused 才可能上去;具体到图复用条件,见 llama.cpp 源码完全拆解(六):图构建与注意力。
split_equal:常规路径的「公平切分」
非统一 KV 是 llama.cpp 的常规配置(默认 kv_unified = false),每条序列有自己的连续 KV 流。split_equal 的规则是:每个 ubatch 里,每个参与序列集的 token 数相同,且不同序列集互不相交。
它的实现分三步,全部围绕 used、seq_set、seq_set_map 展开:
第一步:挑选参与的序列集。 从第一个未使用的 token 开始扫,每当遇到一个新的序列集,检查它与已选中的序列集是否「有交集」(位集按位与是否非空)。有交集就跳过,无交集才收进 cur_seq_set。当 cur_seq_set.size() > n_ubatch 时停止——因为一个序列集在 ubatch 里至少要占 1 个 token,超过 n_ubatch 个序列集就必然装不下。
sequential = true 时还额外要求「序列 id 递增」:
bool add = true;for (uint32_t s = 0; s < cur_seq_set.size(); ++s) { if (!(cur_seq_set[s] & seq_set[i]).none()) { add = false; break; }}if (sequential) { add = add && (cur_seq_set.empty() || batch.seq_id[i][0] == last_seq_id + 1);}「递增」有什么好处?它保证同一序列集内的 token 在原始批次里是连续的——这在注意力掩码、位置检查与流式回传里都更方便,尤其当多模态图像 token 与文本 token 混排时,递增条件会让同类 token 尽量归并到一起。代价是「遇到一个乱序 token 就跳过它」,如果整个批次乱序严重,参与的序列集会很少,每个 ubatch 装的 token 就少。这通常不是问题,因为 llama.cpp 的调用方(common/batch、服务端的 server-context)在组装 batch 时本身就按序列 id 排序。
第二步:等量扩展。 对每个选中的序列集,维护一个指针 cur_idx[s] 指向该序列集下一个未用 token。每轮从每个序列集各取一个 token 追加到 idxs_per_seq[s],然后用 (idxs_per_seq[0].size() + 1) * n_seqs > n_ubatch 判断下一轮是否超限。注意 +1:这是「如果再加一轮,总 token 数会是多少」的预判,在超限前停下,保证每个序列集的 token 数严格一致。
这里有一个隐含的细节:cur_idx[s] 初始化时会跳过已经用过的 token(while (used[seq_set_map[cur_seq_set[s]][cur_idx[s]]]) ++cur_idx[s];)。所以同一个序列集在第二个、第三个 ubatch 里继续取 token 时,会从上次停下的地方接着走。
第三步(本例中传入 n_keep_tail = 0,因此不生效):尾部保留。 当调用方希望「每个序列的最后 个 token 不被拆到两个 ubatch」时(某个需要尾部窗口的编码、或者 DFlash 一类需要保留尾部的模型),n_keep_tail 会起作用:装不下的序列集会整体退回(把它们的 token 重新标记为未使用),只保留能在本 ubatch 里跑完或还剩 个 token 的序列集。如果所有序列集都违规(剩余 token 比 少又没跑完),就把第一个序列集单独成全——要么在本 ubatch 里跑完,要么截短到只剩 个尾部 token 留给下一个 ubatch。
最后是拼接。 按序列集的顺序把所有 idxs_per_seq[s] 首尾相接:
std::vector<int32_t> idxs;for (uint32_t s = 0; s < n_seqs; ++s) { idxs.insert(idxs.end(), idxs_per_seq[s].begin(), idxs_per_seq[s].end());}return ubatch_add(idxs, n_seqs, true); // equal_seqs = true所以一个由 3 条序列、每条 4 个 token 组成的 ubatch,内存里是 [s0t0, s0t1, s0t2, s0t3, s1t0, ..., s2t3],即「先序列 0 的全部,再序列 1 的全部」。这不一定是原始 batch 的顺序——如果原始 batch 是交错排的(t0、t1、t2 各来自不同序列),batch_idxs 就会记录真实来源,后面 out_ids 会修正输出行的映射。
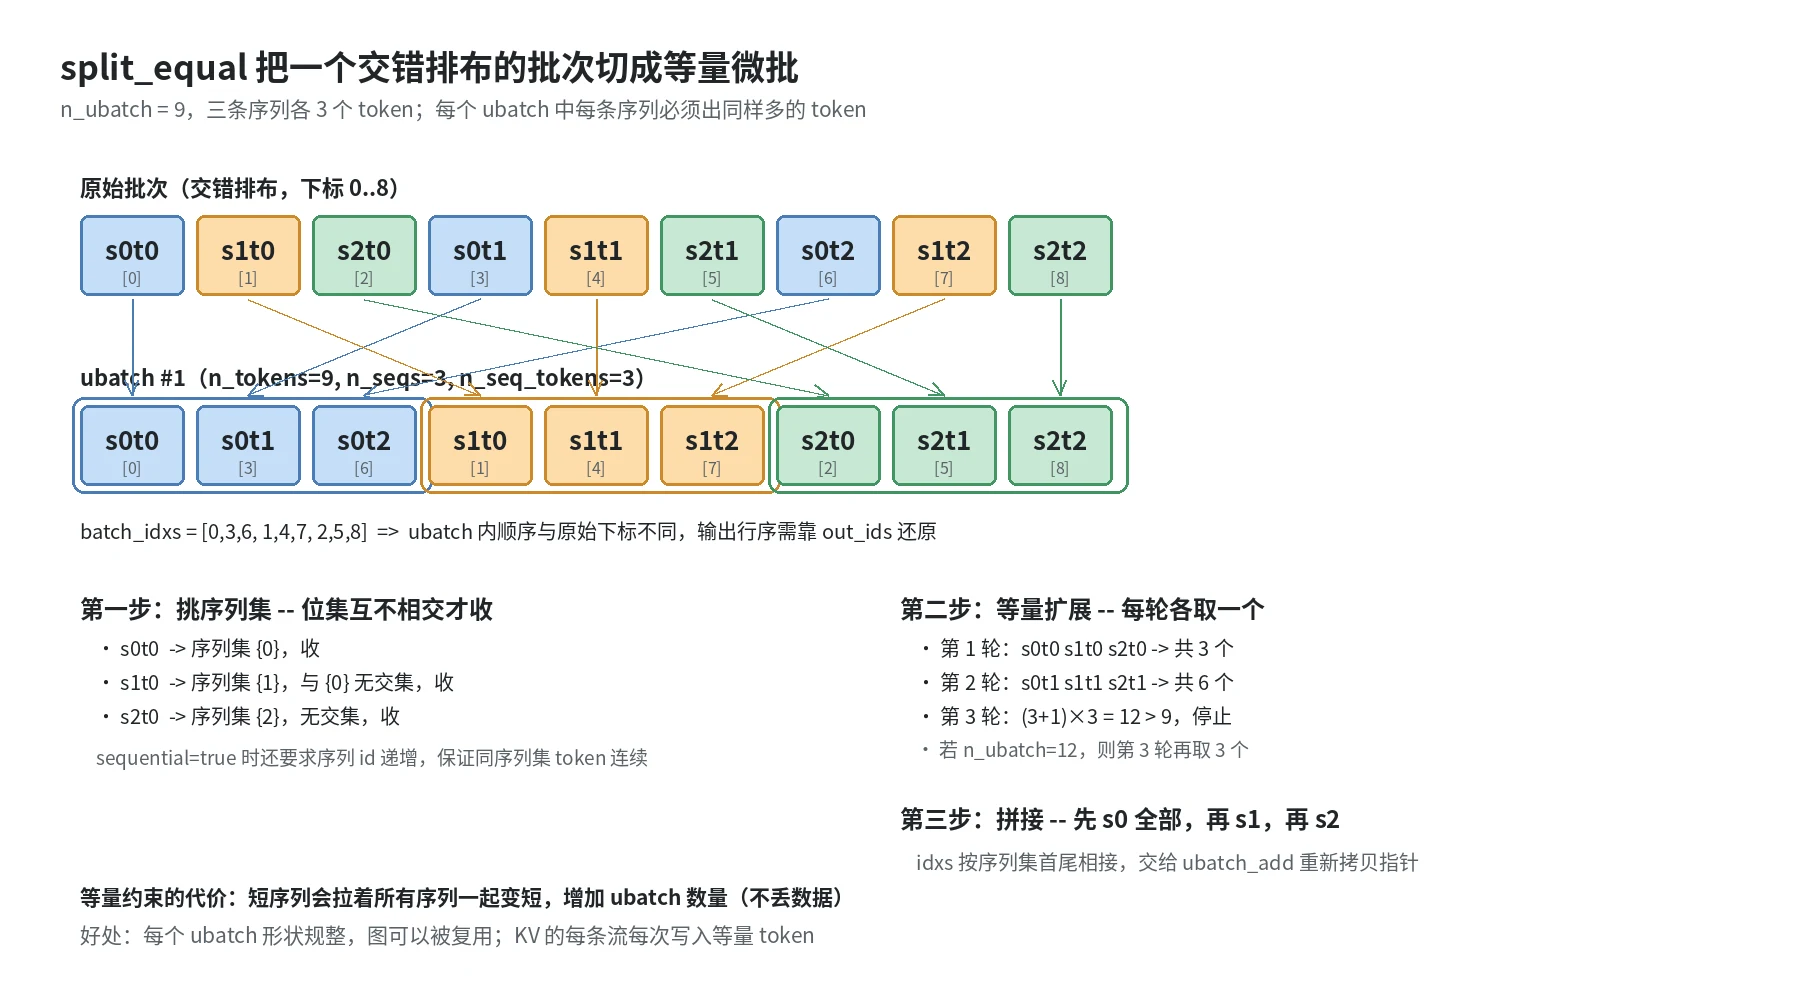
上图展示了一个典型的 trace:原始 batch 里有序列 {0}、{1}、{2} 三种 token,前三个 token 分别是它们的第一个 token。split_equal 把它们全部选中,之后逐轮各取一个,最终形成 [s0t0,s0t1,s0t2, s1t0,s1t1,s1t2, s2t0,s2t1,s2t2]。图的下半部分是第二个 ubatch(继续取剩下的 token)。由于 n_ubatch 恰好能装下 9 个 token,第一轮就装完了全部。
如果 n_ubatch = 6,第一轮只会取 6 个(每个序列 2 个),第二轮再取剩下的 3 个。这时候第二轮中每个序列集只剩 1 个 token,cur_idx 会指向它们各自的下一个 token,没问题。
如果某个序列集只剩 1 个 token,但另一个序列集还有 5 个,第二轮仍然只能给每个序列集取 1 个,剩下的 4 个要第三轮。这就是 split_equal 的「公平但有浪费」:短序列会拉着所有序列一起变短,因为它要求每轮等量。这个浪费在解码(每序列每轮就 1 个 token)时不存在;在预填充(不同 prompt 长度不一)时确实存在,但预填充通常长 prompt 占大头,短 prompt 的浪费有限;而且 llama.cpp 的服务端在组装 batch 时会对 prompt 长度相近的 slot 做分组(can_batch_with 与 get_available_slot),部分缓解了这个问题。server-context 那一层如何分组,见 llama.cpp 源码完全拆解(八):服务化与调度。
split_seq:整条序列必须落在同一个 ubatch
split_seq 是为 embd_all = true 的场景准备的。embd_all 在 decode 里这样定义:
const bool output_all = cparams.embeddings;const bool embd_all = output_all || !cparams.causal_attn;即:要么在算嵌入(每个 token 都要输出),要么模型用的是非因果注意力(双向注意力——编码器模型、重排模型、部分多模态编码器)。非因果注意力的每个 token 都要看到它所在整条序列的全部 token,所以一条序列不能被拆到两个 ubatch。
split_seq 的做法是:
- 从第一个未用 token 出发,记下它的序列集
cur_seq_set; - 向后扫描,只收「序列集是当前序列集的子集」的 token。子集关系意味着新 token 不引入新序列——它要么属于当前序列(单序列情况)、要么属于当前序列的超集之一(共享前缀情况);
- 一旦遇到引入了新序列的 token 就停下;
- 收满
n_ubatch个也停下。
auto cur_seq_set = seq_set[cur_idx];while (true) { idxs.push_back(cur_idx); used[cur_idx] = true; ++n_used; if (idxs.size() >= n_ubatch) break;
do { ++cur_idx; } while (cur_idx < get_n_tokens() && (used[cur_idx] || ((cur_seq_set & seq_set[cur_idx]) != seq_set[cur_idx])));
if (cur_idx == get_n_tokens()) break; cur_seq_set = seq_set[cur_idx];}return ubatch_add(idxs, 1, true); // n_seqs = 1n_seqs 固定为 1:即使 cur_seq_set 位集里有多条序列(共享前缀),这个 ubatch 也按单序列组装,因为所有 token 属于同一段 KV 流(多条序列共享同一份 KV)。equal_seqs = true 是为了让后续代码按「每条序列 token 数相同」来理解这个 ubatch,n_seq_tokens = n_tokens。
这个函数没有「回退重分配」的逻辑。如果一个序列集在这批里超过 n_ubatch 个 token,while 循环会在收满时停下——那这条序列就被拆成多个 ubatch 了,与「整条序列同一个 ubatch」的目标矛盾。这是有意的:非因果注意力的调用方必须保证 n_ubatch >= 最长序列长度。decode 开头有一条 GGML_ASSERT:
GGML_ASSERT((cparams.causal_attn || cparams.n_ubatch >= n_tokens_all) && "non-causal attention requires n_ubatch >= n_tokens");即非因果注意力下每个 llama_decode 的总 token 数不能超过 n_ubatch,调用方只能一条一条送。所以 split_seq 在正常路径上总能一次吃完一个序列集;它与 split_simple 的区别只是「按序列集而不是按扁平顺序」切。
嵌入路径也有同样的约束:output_reserve 里按 n_batch 而不是 n_ubatch 分配输出缓冲,但 decode 不会主动限制嵌入批次大小,所以这里 GGML_ASSERT 中的 n_ubatch >= n_tokens 分支只在 !causal_attn 时强制,output_all 时的嵌入计算由 embd_all 选择 split_seq,但若某条序列本身比 n_ubatch 大,就会在 split_seq 里被拆开——这类模型的嵌入通常由用户设置 n_ubatch 足够大来避免,服务端池化路径也按 n_ubatch 分块。
ubatch_add:重排之后的所有指针都要「修一遍」
三个 split_* 最后都调用 ubatch_add(idxs, n_seqs, equal_seqs)。传入的 idxs 是「按 ubatch 内顺序排列的原始 token 下标」,ubatch_add 负责把它变成一份自洽的 llama_ubatch:为每个 token 重新分配 token id、嵌入、位置、序列、输出,并把所有指针都指到自己的内存。
它必须自己做内存,不能复用 balloc 里的 token_vec / pos / seq_id_data,原因是:balloc 只在一次 llama_decode 的生命周期里存在,且其数组是按原始批次索引的;ubatch 需要在后续的 apply()、set_inputs()、graph_compute() 中独立存活,还可能被 mctx 持有直到下一轮。所以 ubatch_add 为每个 ubatch 分配一个 std::shared_ptr<data_t>,把所有数组放进去:
auto udata = std::make_shared<llama_ubatch::data_t>();udata->token.resize(n_tokens);udata->embd.resize(n_embd_all);udata->embd_state.resize(n_state_all);udata->pos.resize(n_pos_all);udata->n_seq_id.resize(n_tokens);udata->seq_id.resize(n_tokens);udata->seq_id_unq.resize(0);udata->seq_idx.resize(LLAMA_MAX_SEQ, -1);udata->output.resize(n_tokens);udata->type.resize(mixed ? n_tokens : 0);udata->batch_idxs = idxs; // 记录原始下标随后一个循环把每个下标 idxs[i] 的数据拷到新位置 i:
for (size_t i = 0; i < idxs.size(); ++i) { if (use_token) udata->token[i] = batch.token[idxs[i]]; ... for (size_t j = 0; j < n_pos_per_embd; ++j) { udata->pos[j*n_tokens + i] = batch.pos[j*batch.n_tokens + idxs[i]]; } udata->n_seq_id[i] = batch.n_seq_id[idxs[i]]; udata->output[i] = batch.logits[idxs[i]]; for (int s = 0; s < udata->n_seq_id[i]; ++s) { udata->seq_id_data.push_back(batch.seq_id[idxs[i]][s]); } ...}位置数组的索引要单独看。 原 batch.pos 是段优先布局,batch.pos[j*batch.n_tokens + idxs[i]] 是新布局同段位置的正确来源;新数组的 pos[j*n_tokens + i] 把 段搬到新位置。两个 n_tokens 不一样:前者是原批次的 batch.n_tokens,后者是本 ubatch 的 n_tokens。这一步是整段代码里最容易写错的地方之一,写反了就会让 M-RoPE 把图像位置读错,表现为多模态理解质量下降而不是报错。
第二级指针的修复单独占用一段循环:
llama_seq_id * seq_id_ptr = udata->seq_id_data.data();for (size_t i = 0; i < idxs.size(); ++i) { udata->seq_id[i] = seq_id_ptr; seq_id_ptr += udata->n_seq_id[i];}因为 seq_id_data 在循环里不断 push_back,std::vector 可能扩容并移动内存,所以不能在 push 的同时保存 &seq_id_data.back()。正确做法是先全部 push 完,再统一计算每行的起始地址。这种「两遍法」在 C++ 里处理「指针指向正在增长的容器」时是标准做法,llama.cpp 里许多类似的地方也采用同一思路。
seq_id_unq 与 seq_idx: 遍历 seq_set_unq 位集,把置位序列 id 依次追加进 seq_id_unq,并在 seq_idx 里记录它的下标。seq_idx[seq_id] 是后面 decode 里做池化嵌入提取时的索引:
const llama_seq_id seq_id = ubatch.seq_id_unq[s];const int32_t seq_idx = ubatch.seq_idx[seq_id];embd_seq_out[seq_id].resize(n_embd_out);ggml_backend_tensor_get_async(backend_embd, t_embd, embd_seq_out[seq_id].data(), (n_embd_out*seq_idx)*sizeof(float), n_embd_out*sizeof(float));即:池化嵌入在 GPU 上按「本 ubatch 的第 seq_idx 个序列」排列,seq_idx 把「原始序列 id」映射到「本 ubatch 内的序列槽」。这个映射之所以必要,是因为一个 ubatch 可能只包含原始批次的一小部分序列(split_equal 第二轮只含少数序列),序列 id 与槽位不再一一对应。
prepare:只找位置不写单元,以及为什么必须整体成功
init_batch 切出全部 ubatch 之后,调用 prepare(ubatches):
llama_kv_cache::slot_info_vec_t llama_kv_cache::prepare( const std::vector<llama_ubatch> & ubatches) { llama_kv_cache::slot_info_vec_t res;
struct state_t { slot_info sinfo; std::vector<uint32_t> v_heads_old; std::vector<llama_kv_cells> v_cells; }; std::vector<state_t> states; bool success = true;
for (const auto & ubatch : ubatches) { // 只找合适的位置,暂不修改单元 const auto sinfo_new = find_slot(ubatch, false); if (sinfo_new.empty()) { success = false; break; }
res.push_back(sinfo_new);
// 把单元的旧状态存入恢复栈 state_t state = { sinfo_new, v_heads, {} }; ... }
...}要点有三个。
第一,find_slot(ubatch, false) 的第二参数 cont = false。 这个参数控制「找不到连续区间时,是否把碎片拼起来」。prepare 不传 cont=true,因为这只是预演,没必要为了预演去做碎片拼接(拼接会改变 slot_info 的 strm 分布,使恢复变复杂)。真正 apply 时的 find_slot 也不传 cont=true 用于常规路径,cont 只在某些特定的重试路径里使用。
第二,每个 ubatch 找到位置后,旧单元的 pos、seq 归属、序列流头指针都要备份。 因为 find_slot 虽然只「找」不「写」,但 find_slot 的 cont=true 路径和某些「把已有 token 平移」的操作会改状态;prepare 选择最简单的方式:前后完全隔离——先备份,然后全部 apply_ubatch 一遍,最后恢复。这等价于「尝试性执行」,即使 apply_ubatch 改动了很多东西,结束时也一定会复原。
第三,任何一个 ubatch 失败即整批失败。 不存在「前两个 ubatch 放了、第三个放不下,就只跑前两个」的降级。为什么?因为 init_batch 的调用语义是「这一批 token 要么全处理、要么全不处理」:调用方会认为 llama_decode 返回非零时整个批次未生效。如果允许部分成功,调用方在重试时就会重复写前两个 ubatch,KV 里出现重复位置;如果不允许,调用方只能整批减少批次大小(服务端做的是 n_batch /= 2 重试),代价是丢掉一部分吞吐,但状态是确定的。
具体地,apply_ubatch 在写单元时还会做两件事:
- 对被覆盖的非空单元(统一 KV 或环形复用情况下,一个位置可能已被别的 token 用过),记录
seq_pos_max_rm[seq_id] = max(...); - 写完所有单元后,对每个被覆盖的序列,把
[pos_min, pos_max]内小于被覆盖位置的所有单元删除(purge),以维持「一个序列在缓存里的位置区间是连续的」这条不变式。
这条不变式的来源是 llama.cpp PR #13746 讨论中提出的「位置区间内不能有洞」约束——注意力掩码与 RoPE 的假设都依赖它。prepare 的恢复栈之所以必须保存 llama_kv_cells(而不只是 v_heads),就是因为 apply_ubatch 的 purge 可能删除大量单元,恢复必须把单元结构(位置、序列占用)完整还原。
执行侧:输出行序的还原与 batch_idxs 的最终用途
切分、预演、执行都完成后,decode 要做一件事:让调用方按原始批次顺序拿结果。这个过程分三层:
第一层,out_ids。 ubatch_add 在拷贝 output 标志的同时,把「本 ubatch 中哪些行是输出」记录到 out_ids(所有 ubatch 共享同一个 out_ids,按 ubatch 的出现顺序追加)。decode 在末尾用它检查输出数量:
auto & out_ids = balloc->get_out_ids();GGML_ASSERT(out_ids.size() == (size_t) n_outputs);第二层,output_ids。 建立「原始行号 → logits 缓冲行号」的反查表:
for (int64_t i = 0; i < n_outputs; ++i) { output_ids[out_ids[i]] = i;}logits 缓冲区是按 ubatch 内顺序填的:第一个 ubatch 中第一个输出行在缓冲区第 0 行,第二个 ubatch 的第一个输出行紧随其后。而调用方给的 llama_get_logits_ith(ctx, i) 里 i 指向原始批次。output_ids 正是这两套编号的桥。
第三层,output_swaps。 当 out_ids 本身不是单调递增时(比如统一 KV 下 split_simple 恰好按顺序、或者非统一 KV 下 split_equal 的重排让输出顺序变了),代码用选择排序把 out_ids 排成 [0,1,2,...] 的样子,同时记录每次交换:
std::swap(out_ids[i], out_ids[j_min]);output_swaps.push_back({ i, j_min });这些交换不在采样时执行,而是在调用方读取 logits 时懒执行。这样做的原因是:采样通常只关心少数几行的 logits,懒交换可以把实际交换次数降到最少。文件注释说得很直白——这是「mostly relevant for recurrent models atm」。
batch_idxs 的最终用途在嵌入提取分支:
bool extract_all_idxs = extract_layer_inputs(res, n_tokens_prev, ubatch.n_tokens);...if (extract_all_idxs) { const auto & batch_idxs = ubatch.data->batch_idxs; embd_batch_idxs.insert(embd_batch_idxs.end(), batch_idxs.begin(), batch_idxs.end());}在需要逐层输入嵌入的模型里(MTP 钩子批次、EAGLE-3 / DFlash 提取目标特征),每个 ubatch 的嵌入行要按实际来源映射回原始批次,供投机解码的验证阶段配对。
三种策略的实际表现:什么时候会浪费
用一个具体算例把三种策略的差异摆出来。假设有一批次,4 条序列,每条 5 个 token,n_ubatch = 8,n_stream > 1:
- split_equal:第一轮挑选 4 个序列集(全部不相交),每轮各取 1 个,一共能取 2 轮(8 个 token,
(2+1)*4=12 > 8所以在第 2 轮后停),形成[8 token × 2 ubatch]。剩下的 12 个 token 构成第二个批次单元:第一轮取 4 个序列集,每序列 1 个,8 个 token 用完;第二个 ubatch 同样 8 个 token;最后剩 4 个 token,第三轮取 4 个序列集,每个 1 个——结果 3 个 ubatch。 - split_simple(假想统一 KV):直接 8、8、4,形状不均匀但总 ubatch 数相同。
- split_seq:整条序列不能被拆分,每条 5 个 token 都能整除
n_ubatch之外不强制要求,实际上会得到 4 个 ubatch( 个空位无法装下第二个序列)。
从这个例子能看出,split_equal 的「公平」在等量序列上表现良好;但若 4 条序列长度是 5、5、5、1,split_equal 的第二轮就只给每条序列 1 个(因为第 4 条只剩 1 个),第一轮每序列 1 个、第二轮每序列 1 个,剩给第三轮的是 4 条序列各 4、4、4、0 个,第三轮无法凑到 4 个序列集(第 4 条没了),所以只能让前 3 条进第三轮、每条 2 个((2+1)*3=9 > 8),第四轮再处理最后 2、2、2 个 → 仍然 5 个 ubatch。split_simple 只需要 个 ubatch。
这就是 split_equal 在「长短混排」时的浪费:短序列会形成新的「轮次」,每轮的 token 数被 n_ubatch / 序列集数 压低。但这只是 ubatch 数量增多,并没有丢数据,位置与序列正确性由每个 ubatch 自带的 pos、seq_id 保证。
实际 llama.cpp 服务端在预填充时通常把 prompt 长度接近的 slot 分到同一轮(见 server-context 的批组装逻辑),因此长短混排不如「一次塞满所有 slot」常见;单流解码时每条序列每个 ubatch 也就 1 个 token,不会出现浪费。
与站内其他框架的对照
llama.cpp 这套「一份扁平 batch 切成若干 ubatch」的思路与 vLLM、SGLang 的调度结构有本质不同,值得对照着看。
vLLM 的 V1 调度器直接把请求按「每轮出 1 个 token」组织成 ScheduledSequenceGroup,每个请求在本轮要追加 1 个 token(预填充是若干块),InputBatch 负责把不同请求的「本轮 token」拼成一份 token_ids 与 positions 的扁平 buffer。它没有显式的 n_ubatch 概念——调度器本身就是切分器:准入阶段决定 max_num_seqs、块预算,准入后的请求就是本轮的 ubatch,形状固定为「 条序列 × 1 个 token」或「若干预填充请求的组合」。对照阅读可参考 vLLM 源码完全拆解(二十五):请求准入的五层关卡 和 KV Cache 的页粒度:128 token 一块的账,以及五个推理框架为什么选了五个不同答案。
SGLang 的调度器走的是「PrefillAdder 预算 KV、切分长提示、组装 Prefill Batch」的路子,ForwardBatch 承载本轮要跑的所有 token;对于超出 KV 预算的 prompt,它会切分成多个 extend 请求,每个请求下一次处理一段。这与 llama.cpp 的 split_equal 在目的上相似——都是「让长 prompt 不独占一轮」——但 SGLang 的切分在调度器层面完成,llama.cpp 的切分在上下文层完成:调用方只管递扁平 batch,切分是上下文对调用方透明地做的。可参考 SGLang 源码完全拆解(四):PrefillAdder 如何预算 KV、切分长提示并组装 Prefill Batch。
更贴切的对照是 vLLM 的 Dual Batch Overlap 与 SGLang 的 Two-batch Overlap——它们「一次前向切成两半、一半算、一半等通信」的切法,在概念上与 ubatch 切分相似(都把一轮逻辑执行切成多个可独立推进的段),但目的不同:后两者是为了重叠通信与计算,而 ubatch 切分是为了适应固定形状的计算图。可参考 vLLM 源码完全拆解(二十七):Dual Batch Overlap 与 SGLang 源码完全拆解(二十二):Two-batch Overlap。
还有一种对照值得注意:vLLM 的 max_num_batched_tokens 与 llama.cpp 的 n_batch 名字很像,但语义不同。前者衡量「一个调度轮次能装多少 token」,后者衡量「一次 llama_decode 调用能装多少 token」。在 llama.cpp 里,一次 llama_decode 调用的输入由服务端 update_slots 组装,可能包含多个 slot 的解码 token 与一段 prompt;n_batch 是这条链路上单次调用能承受的总量。而 n_ubatch 是 n_batch 之下、GPU 图执行单元的上限。换句话说,llama.cpp 的切分是两次:服务端在组装 batch 时受 n_batch 约束,上下文在切成 ubatch 时受 n_ubatch 约束。
切分对参数选择的影响
最后给一组实用结论:读者在调参时看到的 -b、-ub 两个参数分别影响这条链路的不同环节。
-b(n_batch)决定一次 llama_decode 的逻辑容量,直接影响:
- 服务端能一次塞进多少 prompt token;
- 图复用率——
n_batch越大,每次 decode 包含的形状越多样,图复用越难,但单次调用能吞的 token 更多; - 错误回滚粒度——失败时回滚的是整个
llama_decode涉及的序列位置。
-ub(n_ubatch)决定每次图计算实际能装下的 token 数,直接影响:
- 计算缓冲区大小(按
n_ubatch预留,注意力中间量是大头); - 长 prompt 被切成的段数(
split_equal或split_simple切成几轮); split_seq模式下必须满足的硬约束(非因果注意力要求n_ubatch >= n_tokens)。
两个参数的经验取值:默认情况下 n_batch = n_ubatch = 512 或 2048(随版本与设备而异),预填充时增大 n_batch 可以提升吞吐,但 n_ubatch 别跟着盲目变大——它直接决定显存峰值;解码时 n_batch 只需要覆盖「最大并发数 × 1」,n_ubatch 也只需 ≥ 该值即可。对显存较小的设备,缩 n_ubatch 换取更大 n_batch(更多并发、更少 KV 碎片)往往是正确的取舍。
小结
把这一篇的要点压成几条:
第一,切分不在调用方,在上下文与记忆模块之间。 调用方递进来的是扁平 llama_batch(或新的 llama_batch_ext),llama_context::decode 通过 llama_batch_allocr 做校验与规范化,然后交给 llama_memory_i::init_batch 做切分。切分策略的选择权在记忆模块,因为只有它知道 n_stream 与容量结构。
第二,三种策略各有适用面。 split_simple 适合统一 KV 的扁平顺切;split_equal 适合非统一 KV 的「序列集不相交 + 等量」;split_seq 适合「整条序列必须同批」的非因果注意力与嵌入计算。split_equal 的尾部保留机制(n_keep_tail)为需要尾部窗口的模型提供额外保证。
第三,ubatch_add 负责所有指针的修复。 位置段优先布局在两份不同 n_tokens 之间搬运,seq_id 的两级指针采用「先 push 完再算起点」的两遍法,batch_idxs 为后续行序还原与嵌入提取留存原始下标。
第四,prepare 的「预演 + 恢复」是正确性保证。 全部 ubatch 必须同时装得下,任何一个失败即整批失败,不留半截状态。恢复栈保存单元内容,使 purge 也能被完整还原。
第五,输出侧的还原是懒执行的。 output_ids 提供反查表,output_swaps 记录选择排序过程中的交换,在读取 logits 时才真正执行。
下一篇进入 llama.cpp 源码完全拆解(二十六):词嵌入与输出头——llama_context::get_embeddings 如何把图输出里的 logits 与嵌入按原始顺序交还给调用方。这一篇讲了切分之后「哪个 ubatch 里放了什么」,下一篇要讲切分之后的结果如何被 output_ids、output_swaps 与 embd 缓冲区还原回调用方视角的编号——也就是 llama_get_logits_ith、llama_get_embeddings_ith、池化嵌入与逐层输入这几条路径的完整实现。
参考资料
- llama.cpp 官方仓库(src/ 与 ggml/ 源码)
src/llama-batch.cpp:llama_batch_allocr的init、三套split_*、ubatch_add、llama_batch_compatsrc/llama-batch.h:llama_ubatch、llama_batch_ext与llama_batch_allocr接口src/llama-context.cpp:decode主循环、process_ubatch、graph_params与输出行序还原src/llama-kv-cache.cpp:init_batch的策略选择、prepare的预演与find_slotsrc/llama-memory.h:llama_memory_i与llama_memory_context_i接口src/llama-cparams.h:n_batch、n_ubatch、kv_unified等运行时参数tests/test-batch.cpp:llama.cpp 自带的批次切分单元测试- llama.cpp Issue #13746 讨论:KV 缓存位置区间的连续不变式
- Efficient Memory Management for Large Language Model Serving with PagedAttention
- vAttention: Dynamic Memory Management for Serving LLMs without PagedAttention
- M-RoPE: Multimodal Rotary Position Embedding and Modality-Agnostic Embeddings(Qwen2-VL)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



