


llama.cpp 源码完全拆解(十八):slot 与 prompt cache 的复用账——RAM 状态缓存、FIFO 淘汰与 checkpoint 附录
引言:前面讲的是「怎么复用」,这一篇讲「复用的东西存在哪、怎么被丢掉」
llama.cpp 源码完全拆解(四):llama_context 与记忆系统 与 llama.cpp 源码完全拆解(八):服务化与调度 已经把服务端的复用逻辑讲到了调用边界:get_available_slot 按最长公共前缀挑 slot,pre_decode 用 n_past 决定从哪个 token 开始算,前缀不连续时用 --cache-reuse 做 KV 平移,前缀对不上时从 slot 的检查点链表里恢复。那两篇回答的是「请求进来之后,哪些 token 可以不算」。
这一篇往下挖一层,回答三个那两个调用点背后的问题:
prompt_save到底把什么东西序列化成了一个字节数组?为什么它是「与 block、radix 树无关的另一种前缀缓存」,而不是 PagedAttention 的亲戚?server_prompt_cache这个内存在 RAM 里的缓存区,凭什么在用户只给了「8192 MiB」这一个数字的情况下,同时管住字节数和 token 数两本账?淘汰规则为什么是 FIFO 而不是 LRU?--slot-save-path存到磁盘的那个文件,为什么在状态数据后面还追加一段「检查点附录与草稿状态附录」?恢复时凭什么决定要不要把草稿数据丢掉?
这三件事都属于「复用的东西存在哪、又在哪里被丢掉」:一个存在进程内存里,一个存在磁盘上,一个在 kv_unified 模式下被主动清空。把它们串起来看,llama.cpp 的 slot 复用机制才算完整。
GPU 显存内的前缀复用可以对照 vLLM 源码完全拆解(四):KVCacheManager 如何分配、复用与回收物理 Block 与 SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环:那两套是在 GPU 显存里按块或按前缀树节点直接复用;llama.cpp 的 RAM 级缓存则是在 GPU 显存之外再开一层,以「整段序列状态」为粒度做整存整取。不同层次的取舍,下面会逐条落到代码上。
复用的最小单位:一段序列状态,而不是一个块
prompt_save 存了什么
server_slot::prompt_save 只有十行左右,但每个字段都值得看一眼。以下以当前主线的字段为准(字段名与结构在近期版本中保持一致):
bool prompt_save(server_prompt_cache & prompt_cache) const { if (prompt.tokens.size() == 0) { return false; }
const size_t cur_size_tgt = llama_state_seq_get_size_ext(ctx_tgt, id, LLAMA_STATE_SEQ_FLAGS_NONE); const size_t cur_size_dft = ctx_dft ? llama_state_seq_get_size_ext(ctx_dft, id, LLAMA_STATE_SEQ_FLAGS_NONE) : 0;
const size_t cur_size = cur_size_tgt + cur_size_dft;
auto * cur = prompt_cache.alloc(prompt, cur_size_tgt, cur_size_dft); if (cur == nullptr) { return false; }
llama_state_seq_get_data_ext(ctx_tgt, cur->data.main.data(), cur_size_tgt, id, LLAMA_STATE_SEQ_FLAGS_NONE); if (ctx_dft) { llama_state_seq_get_data_ext(ctx_dft, cur->data.drft.data(), cur_size_dft, id, LLAMA_STATE_SEQ_FLAGS_NONE); } return true;}四个关键点:
- 先问大小,再分配,再写入。
llama_state_seq_get_size_ext先返回「这条 seq_id 当前占用的序列状态有多少字节」,缓存器按这个精确大小分配两块std::vector<uint8_t>,随后llama_state_seq_get_data_ext把数据写进去。这种「两段式」是 llama.cpp 状态序列化一贯的风格:llama_state_get_size/llama_state_get_data也是这么用的,目的是避免调用方猜大小。 - 粒度是整段序列,而不是其中某一段。
LLAMA_STATE_SEQ_FLAGS_NONE表示「取整条 seq_id 的所有单元」,包含从pos_min到pos_max每个单元里这条序列的 K、V(以及其它记忆类型里对应序列的循环状态等)。它没有「只取某一段位置」的能力——这一点直接决定了 RAM 缓存的命中率上限:缓存条目只能在get_common_prefix长度处被截取使用(见下一节),因为它是一整段。 - 目标模型与草稿模型两本账。开启投机解码时
ctx_dft非空,草稿模型自己的 KV 也要存。两本账分开存、分开算大小,这样恢复时只要其中一本失败就整条作废——原因很实在:草稿模型的 KV 必须与目标模型的 KV 严格对齐,单独恢复一本只会让后续验证阶段算出错误的 logits。 - 分配失败就直接返回 false。
alloc允许失败(例如条目本身超出缓存上限),失败时prompt_save什么也不做;调用方对此是宽松的——只是没缓存上,不影响请求本身。
这段代码回答了一个容易被误解的问题:llama.cpp 的 RAM 级 prompt cache 和 PagedAttention 不是同一个物种。PagedAttention 把 KV 拆成固定大小的物理块,按块分配、按块回收、按逻辑块表映射;llama.cpp 的 RAM 缓存不关心块,它把「一条序列此刻的全部状态」看成一个不透明的字节数组整体搬进 RAM。前者以块为最小单位,后者以序列状态为最小单位。
为什么是序列状态,而不是拷贝块
要回答这个问题,得先看 llama.cpp 记忆层能不能「单独拷一段」。记忆层(llama_memory_i,在 llama.cpp 源码完全拆解(四):llama_context 与记忆系统 中讲过)的接口里有 seq_rm、seq_cp、seq_keep 之类的操作,理论上可以在同一个 context 内把一段 KV 从 seq A 复制到 seq B。但服务端的 RAM 缓存要解决的是跨时间的问题:slot 被别的请求占用了,原来的 KV 还在 GPU 里,必须先把「这一段 KV 的完整语义状态」搬到别处,之后再把 slot 腾出来给别的请求用,最后还得能把状态搬回来。
如果把 KV 块整块拷到另一个「影子 slot」里,那么影子 slot 也占着同样多的 GPU 显存——这没有解决显存问题,只是换了个地方。搬到 RAM 才是真正释放 GPU 显存。而 llama_state_seq_get_data_ext 恰好就是「把一个 seq_id 的全部状态序列化成一段字节」的接口,天然适合跨 GPU 搬运。
代价也很明确:恢复是整段恢复,不能只恢复缓存条目的前一半。prompt_load 把条目原样搬回 slot:llama_state_seq_set_data_ext 写入的字节数与条目保存时完全一致,prompt 里的 token 列表也是完整的。截断发生在之后的 pre_decode:它重新计算 n_past,用 slot.prompt.tokens.keep_first(n_past) 截 token 簿记,再用 slot.mem.seq_rm(slot.id, slot.prompt.tokens.pos_next(), -1) 把超出 LCP 的 KV 单元真正删掉。于是「在某个前缀处再分叉」被拆成「先整段恢复、再问记忆层删尾部」两步,恢复路径不做任何长度判断,判断全部集中在调度循环里。
下图是 llama.cpp 官方给 --cache-reuse 做的说明图,它展示的正是这一层复用中「被复用的单位」长什么样:上一段已缓存的 prompt(AAABCCCCDDDEEF GGHHHITIxxx)与新 prompt(AAACCCCEEGGITIyyy)之间既有相同前缀,也有插入内容造成的错位;相同的字符块通过位置平移被保留,只有新字符和新位置需要重算。RAM 级缓存则是把这种「平移」省掉更狠的一刀——整段序列根本不需要重算,直接搬家:
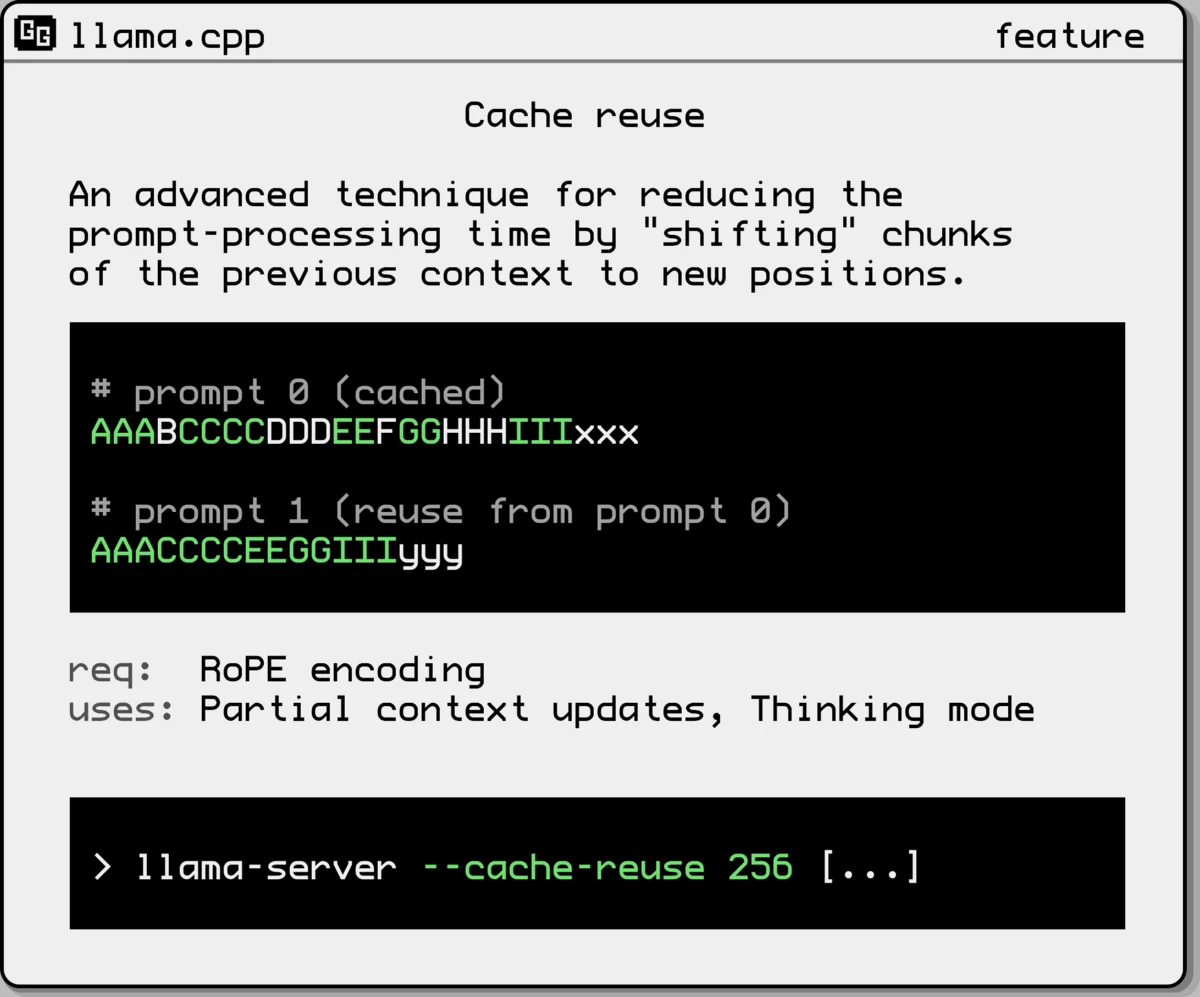
图源:llama.cpp 官方文档中 --cache-reuse 的说明卡片(ggml.ai)。
RAM 级缓存区:字节与 token 两本账
数据结构
server_prompt_cache 的定义只有几十行(tools/server/server-task.h),但它是整个复用体系里最值得细读的部分:
struct server_prompt_data { std::vector<uint8_t> main; std::vector<uint8_t> drft;
size_t size() const { return main.size() + drft.size(); }};
struct server_prompt_cache_state { server_prompt prompt; server_prompt_data data;
size_t size() const { size_t res = data.size(); for (const auto & ckpt : prompt.checkpoints) { res += ckpt.size(); } return res; }};
struct server_prompt_cache { server_prompt_cache(int32_t limit_size_mib, size_t limit_tokens) { this->limit_size = 1024ull*1024ull*(limit_size_mib < 0 ? 0 : limit_size_mib); this->limit_tokens = limit_tokens; }
std::list<server_prompt_cache_state> states;
size_t limit_size = 0; // in bytes, 0 = no limit size_t limit_tokens = 0; // in tokens, 0 = no limit ...};几个设计细节:
- 条目里同时存「prompt(token 列表 + 检查点)」与「data(字节)」。 token 列表是匹配用的索引,字节是恢复用的本体。检查点也一起进条目,而且它的体积被计入
size()——这解释了为什么一个长 prompt 的条目可能比「token 数 × 每 token 字节数」要大不少:检查点本身的 KV 快照也是显存状态的字节拷贝,每 token 平均体积的估算里会被一并摊入。 std::list而不是std::vector。 淘汰规则是「从头部弹出、向尾部追加」,只在两端操作,用链表最自然。注意alloc()返回的是&states.back(),这个指针在后续 push 新条目时不会失效(链表节点地址稳定),调用方可以安全地拿它继续写入。limit_size_mib传负值视为「无上限」(limit_size = 0表示不限)。这是从--cache-ram -1这条命令行来的:用户想关掉上限。
alloc:先查重、再腾地方
alloc() 是缓存区里最长的一个函数,做的事可以分成四步。
第一步,查重:
// first check if the current state is contained fully in the cachefor (auto it = states.begin(); it != states.end(); ++it) { const int cur_lcp_len = it->prompt.tokens.get_common_prefix(prompt.tokens); if (cur_lcp_len == (int) prompt.tokens.size()) { SRV_TRC("%s", " - prompt is already in the cache, skipping\n"); return nullptr; }}条件是「新条目的所有 token 都是某个已有条目的前缀」——即新条目完全被一个更长(或等长)的已有条目覆盖。此时没有存的价值:将来有人要这段前缀,用更长的那条恢复后截断即可。注意这个判断允许已有条目比新条目更长,这正是整段状态「多存不怕」的思路:长的能代替短的。
第二步,计算体积并做单条限流:
size_t checkpoints_size = 0;for (const auto & ckpt : prompt.checkpoints) { checkpoints_size += ckpt.size();}
const size_t state_size_new = state_size_tgt + state_size_dft + checkpoints_size;
// skip over-limit entries to avoid disturbing the cacheif (limit_size > 0 && state_size_new > limit_size) { SRV_WRN(" - prompt state size %.3f MiB exceeds cache size limit %.3f MiB, skipping\n", ...); return nullptr;}「单条就比整个上限还大」时不插入缓存、也不淘汰任何已有条目(注释的原话是 avoid disturbing the cache)。这是个很有保护意识的细节:如果一条超大 prompt 让缓存把所有已有条目都挤掉,结果自己又没填进去或者很快被替换,等于白白损失了整个缓存。
第三步,清掉被新条目包含的旧条目,再为字节配额腾地方:
// remove any cached prompts that are fully contained in the current promptfor (auto it = states.begin(); it != states.end();) { const int len = it->prompt.tokens.get_common_prefix(prompt.tokens); if (len == (int) it->prompt.tokens.size()) { it = states.erase(it); } else { ++it; }}
if (limit_size > 0) { // make room before allocating the new vectors to avoid breaching the limit while (!states.empty() && size() + state_size_new > limit_size) { states.pop_front(); }}这两个循环合起来就是一种「前缀覆盖」的淘汰规则:新条目比旧条目长,就把旧条目作废。好处是缓存在「同一段会话在持续增长」的场景下不会膨胀成大量互为前缀的碎片;坏处也很明显——如果新条目插入失败(单条超限、或者内存不足),旧的、覆盖范围更短的那条已经在前面被删掉了。这是「长覆盖短」策略的固有代价,服务端接受它,因为这些条目本来在 RAM 里,重新算一次的成本远低于真 GPU 显存错误。
第四步,分配,并在内存不足时收缩上限:
std::vector<uint8_t> state_data_tgt;std::vector<uint8_t> state_data_dft;
try { state_data_tgt.resize(state_size_tgt); state_data_dft.resize(state_size_dft);} catch (const std::bad_alloc & e) { SRV_ERR("failed to allocate memory for prompt cache state: %s\n", e.what());
limit_size = std::max<size_t>(1, 0.4*size()); SRV_WRN(" - cache size limit reduced to %.3f MiB\n", limit_size / (1024.0 * 1024.0));
update(); return nullptr;}std::bad_alloc 不直接失败放弃,而是把上限降到当前的 40%,先 update() 清掉多余的条目,再返回失败、等下一轮再试。这个「自适应收缩」在台式机上少见,但在嵌入式、低内存 Linux 容器里非常实用:--cache-ram 是一个固定数字,实际可用内存却受宿主机与其它进程影响,收缩让缓存不会因为一次 bad_alloc 把服务器整个拖死。
load:LCP + 双阈值 + 保留「不糟蹋大条目」
load() 决定了从缓存里取哪一条。核心规则写在循环里:
const int lcp_best = prompt.tokens.get_common_prefix(tokens_new);
float f_keep_best = prompt.tokens.size() > 0 ? float(lcp_best) / prompt.tokens.size() : -1.0f;float f_sim_best = float(lcp_best) / tokens_new.size();
auto it_best = states.end();
for (auto it = states.begin(); it != states.end(); ++it) { const int lcp_cur = it->prompt.tokens.get_common_prefix(tokens_new); const float f_keep_cur = float(lcp_cur) / it->prompt.tokens.size(); const float f_sim_cur = float(lcp_cur) / tokens_new.size();
// don't trash large prompts if (f_keep_cur < 0.25f) { continue; }
if (f_keep_best < f_keep_cur && f_sim_best < f_sim_cur) { f_keep_best = f_keep_cur; f_sim_best = f_sim_cur; it_best = it; }}两个指标的分母不同:
f_keep = LCP / 条目长度,衡量「这条条目里有多大比例被用到」。越小说明恢复之后要截掉越多,越浪费。f_sim = LCP / 新请求长度,衡量「新请求能省掉多少」。越大说明恢复越有用。
选择条件是两者同时严格上升——不是取 f_keep 最大,也不是取 f_sim 最大,而是取在二维上「帕累托前进」的那一条。这是一个容易看漏的地方:如果只看 f_sim,一条很短的条目(例如只含 system prompt)会经常被选中,恢复它之后新请求后半段还要从头算;如果只看 f_keep,一条很长但只剩开头匹配的条目会被反复选中。两者都要求意味着每换一次候选,都必须在「别浪费已存的」和「尽量省新请求的」这两个方向上同时更好。
f_keep < 0.25 的「don’t trash large prompts」是硬性抛弃线:恢复一条条目之后立刻要砍掉 75% 以上的 KV,得不偿失——那 25% 不到的部分用 n_past 直接重算,可能还要比「恢复整段再截断」便宜。这个 0.25 是经验值,没有对应的命令行参数,写死在代码里。
基线 f_keep_best 初值是当前 slot 已有的 LCP 比例(slot 里 prompt.tokens 可能本身就是空,此时初值为 -1,代表「任何缓存条目都更好」)。这样比较的对象是「不恢复、就用当前 slot 的状态继续算」。
恢复本身是四步:先 llama_state_seq_set_data_ext 把目标与草稿字节分别写回(两次写入都要严格返回「写入字节数 == 原字节数」,任何一次不等都直接 return false,并且条目不被移出缓存),再把条目的 prompt 整体 std::move 给 slot,最后 data.clear(); shrink_to_fit() 释放字节缓冲、states.erase(it_best) 移除条目。注意草稿字节写回失败时只打 WRN,但同样 return false——这说明服务端把「目标与草稿必须一起恢复成功」当作硬性不变量,与 prompt_save 里两本账分开存但共同失效的对偶关系一致。取出即删除:RAM 级缓存在取用时会把条目移出缓存,这是它与「只读缓存」类结构最大的使用差别——条目一旦被恢复,就进入了 slot 的 prompt,如果之后又被打断、需要再存回来,那要等 get_available_slot 那条「f_keep < 0.5 就 save」的规则再次触发。
update:字节配额与 token 配额的双重压舱
void server_prompt_cache::update() { if (limit_size > 0) { while (!states.empty() && size() > limit_size) { states.pop_front(); } }
// average size per token const float size_per_token = std::max<float>(1.0f, float(size()) / (std::max<size_t>(1, n_tokens())));
// dynamically increase the token limit if it can fit in the memory limit const size_t limit_tokens_cur = limit_size > 0 ? std::max<size_t>(limit_tokens, limit_size/size_per_token) : limit_tokens;
if (limit_tokens > 0) { while (!states.empty() && n_tokens() > limit_tokens_cur) { states.pop_front(); } }}这里有三个值得展开的点:
- 两个上限用
std::max合成一个有效的 token 上限。用户给出limit_tokens(来自n_ctx)是「token 维度」的愿望;limit_size/size_per_token是从当前实测的「每 token 字节」推出来的「这一块内存理论上最多能装多少 token」。std::max取两者较大的那个作为有效上限,结果是:字节上限是硬约束(第一条 while 已经砍到size() <= limit_size),token 上限是软约束,但在「条目实际体积很小」时会自动被抬高到内存允许的最大 token 数。这解释了为什么命令行里--cache-ram与n_ctx同时在场时,有时候 token 上限看起来没被遵守——字节配额已经先砍掉了足够多。 - 淘汰方向是
pop_front,即 FIFO(按插入时间),不是 LRU。states的push_back只在alloc末尾发生,erase只在alloc的前缀覆盖、load的取用与update的淘汰里发生,没有任何「取用后挪到队尾」的操作。取用即删除这一点让 LRU 变得没必要:命中条目直接被搬进 slot 了,已经不在缓存里,不存在「刚用过的留在队首」的问题。剩下没被用到的条目,按插入时间最老的先被淘汰,接近「最久没被新条目覆盖」的意思。 size_per_token至少为 1。这个下界不是为了精度,而是为了避免size() == 0且n_tokens() == 0时的除零或除出极小值。limit_tokens_cur的下界由此保证不会因为一条稀疏的小条目而跌到荒谬的低值。
RAM 缓存的命中率上限:为什么 f_keep >= 0.25 是个结构性约束
前文讲了 load 的 0.25 抛弃线。把它与 FIFO 淘汰规则放在一起,可以估算一条 RAM 缓存的实际命中上限。
假设缓存里有 条目、每条长度服从某分布,且请求与缓存条目的公共前缀长度平均为 。一条请求能命中某条目的概率条件是该条目与新请求的 LCP 至少达到条目长度的 25%。如果缓存条目都比新请求长(比如缓存了昨天一整段长文档),那么 LCP 最多等于新请求长度,而 f_keep = 新请求长度 / 条目长度,只有在「新请求长度至少是条目长度 25%」时才会被采用——一条很短的追问无法用一条很长的缓存条目,因为恢复后要截掉 75% 以上,代码认为这「糟蹋」了大条目。
这与 SGLang 的 RadixAttention 形成鲜明对比:后者用前缀树,节点按「被多少个请求引用」计数,短的公共前缀可以命中树上任何一条更长的路径,不需要关心「恢复后要截掉多少」。在「共享一段长 system prompt + 各种短追问」这种最常见的工作流里,SGLang 的缓存几乎全部命中,llama.cpp 的 RAM 缓存只能命中「system prompt + 追问」组合里已经完整出现过的那几条——也就是用户反复问同样问题的场景。
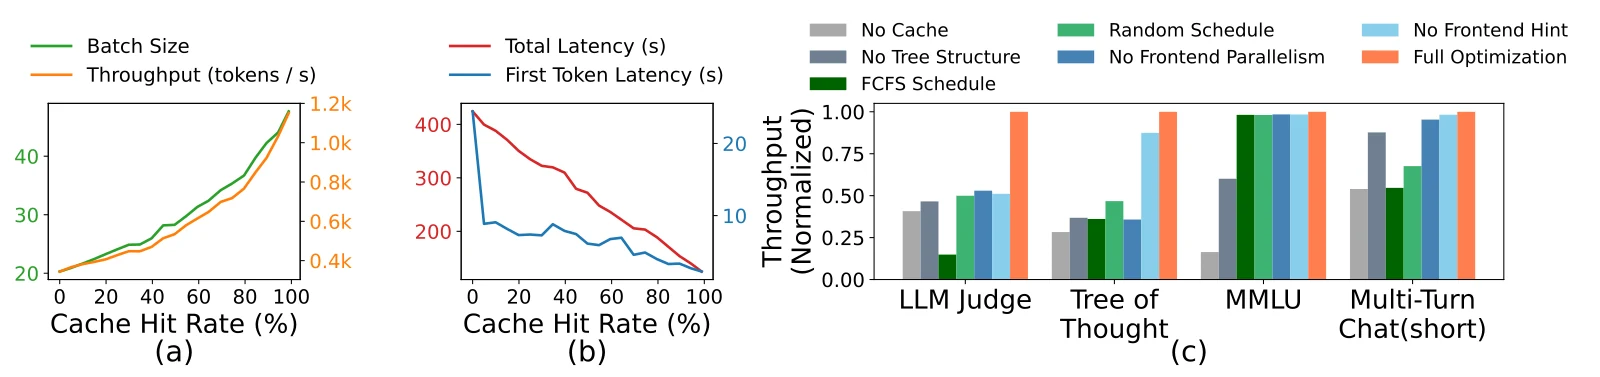
图源:SGLang 论文(arXiv:2312.07104)Figure 8。这张消融图给出的口径与本节的命中率讨论正好互照:前缀缓存带来的 n_prompt_cached 占比、开启树状复用与关闭时的吞吐差距。llama.cpp 的 server_prompt_cache 在指标上也以「跳过的 prompt token 比例」衡量,但它的命中边界是「整段前缀与条目开头一致」,而不是「任意前缀可挂到树上」——这个差别在低并发、固定 prompt 的部署里影响不大,在多租户、短追问场景下会大幅拉低这个比例。
这不意味着 llama.cpp 的设计错了。它的目标部署是端侧或小规模多用户,请求集相对固定、prompt 结构性也更强;0.25 这条线保护的是「不要为了一条几乎全新的请求去搬动一段巨大的字节数组」,在 RAM 带宽有限的机器上,搬运成本和截断成本都可能超过「直接重算这一段」的成本。
为什么是 RAM 而不是 GPU
回到与 vLLM / SGLang 的对照。SGLang 的 HiCache 把 KV 分成 GPU 池、宿主内存池、外部存储三级,前缀树跨层维护;vLLM 的 KV Connector 把块直接通过 NIXL 之类通道传给另一个实例。llama.cpp 的 RAM 级缓存看起来简单得多,其实在定位上很接近 HiCache 的宿主层——都是「GPU 之外的一层、按 token 前缀可检索」。区别在于:
- 检索结构:HiCache 用分层前缀树对同一批页做跨请求命中判定,命中的粒度是页;llama.cpp 用线性
std::list+get_common_prefix,命中的粒度是「一整段状态」。 - 写回策略:HiCache 在层间做预取与写回流水;llama.cpp 只在两个点写:slot 即将被别的请求占用且
f_keep < 0.5、LRU 选中的 slot 即将被覆盖。恢复在get_available_slot里一次性完成。 - 代价:llama.cpp 的 RAM 条目一旦取出就删除,命中率依赖「之后不再被打断」,而 HiCache 的条目可以反复命中。
这种取舍在端侧与 CPU 为主的场景里是合理的:llama.cpp 的大多数部署是「单机、少量并发、prompt 长度中等」,前缀树带来的页级命中收益不足以抵消实现与多后端适配的复杂度;而「整段状态」与 llama_state_seq_get_data_ext 完全对齐,不需要额外维护任何块表。
一个容易忽略的语义:state 的单位是「每 token 多少字节」
llama_state_seq_get_size_ext 返回的字节数不是「KV 张量总大小」的简单复制。一个 f16 KV、GQA 结构、32 层、8 个 KV head、head_dim 128 的模型,纯 KV 的理论体积是:
这里第一个 2 是 K 与 V 两份,第二个 2 是 f16 的字节宽度。按这个数,8192 token 的条目光 KV 就要 1 GiB,--cache-ram 的默认 8192 MiB 大约够放 7 到 8 条这样的条目——实际能放几条取决于检查点、草稿模型状态、以及 KV 量化(-ctk q8_0 之类)把每 token 字节数压到多少。这解释了为什么 RAM 缓存的容量规划不能按「token 数」直接估:同一个 --cache-ram 8192,在 f16 KV 与 q4_0 KV 下能容纳的 prompt 总长度差出数倍。
llama_state_seq_get_data_ext 也不是把上述 KV 原样 memcpy 出来:它走的是 llama.cpp 内部的状态序列化格式,按序列把每个单元的 K、V 以及其它记忆类型(循环状态、卷积状态等)的字节写进去,并在头部记录版本、模型尺寸、序列位置区间等信息。set_data_ext 读回时会校验这些头部字段,任何不匹配都会导致恢复失败。因此 RAM 缓存与槽位存档都不能跨模型、跨 n_ctx、跨 KV 量化类型复用——它们只保证「同一个 context 生命周期内的状态搬运」。
槽位存档文件:磁盘上的状态、检查点与草稿
保存格式
--slot-save-path 打开之后,server_task_type::slot_save 依次写三段,任何一段失败都直接 send_error 而不继续:
- 主体:
slot->prompt.tokens.serialize()把 token 列表打包,再调用llama_state_seq_save_file(ctx_tgt, filepath, slot->id, tokens, n)。这个接口是「整体重写」(不带std::ios::app),头部由 llama 自己写,包含序列 id、token 数、状态字节等。 - 检查点附录:
save_slot_checkpoints以追加模式打开同一个文件,写magic = 0x504b4353 "SCKP"、version = 1、count,然后对每个检查点依次写n_tokens / pos_min / pos_max和data_tgt / data_dft / data_spec三块缓冲(每块先写 64 位长度)。 - 草稿状态附录:
save_slot_draft同样追加,写magic = 0x54464453 "SDFT"、version = 1,内容是当前时刻的草稿上下文状态(llama_state_seq_get_data_ext(ctx_dft, ...))与common_speculative_get_state返回的投机状态。如果两个都是空,就不写这一段。
这三段的分工很关键:主体里只有目标上下文,草稿上下文的「当前状态」不在主体里,而是在草稿附录的尾部;检查点附录里则同时带了每个检查点的目标、草稿与投机三块数据。恢复时,llama_state_seq_load_file 只读主体,剩下两段由服务端自己解析。
检查点附录的头部与逐条字段(省略了 ckpt_write 类的低层封装与日志):
const uint32_t magic = SLOT_CKPT_MAGIC; // 0x504b4353 "SCKP"const uint32_t version = SLOT_CKPT_VERSION; // 1const uint32_t count = (uint32_t) slot.prompt.checkpoints.size();ckpt_write(ofs, &magic, sizeof(magic), n_written);ckpt_write(ofs, &version, sizeof(version), n_written);ckpt_write(ofs, &count, sizeof(count), n_written);for (const auto & cur : slot.prompt.checkpoints) { ckpt_write(ofs, &cur.n_tokens, sizeof(cur.n_tokens), n_written); ckpt_write(ofs, &cur.pos_min, sizeof(cur.pos_min), n_written); ckpt_write(ofs, &cur.pos_max, sizeof(cur.pos_max), n_written); ckpt_write_buf(ofs, cur.data_tgt, n_written); ckpt_write_buf(ofs, cur.data_dft, n_written); ckpt_write_buf(ofs, cur.data_spec, n_written);}几个格式层面的要点:
magic与version让附录可以被「跳过」。加载侧先读 offset 之后的 12 字节头,magic不符就直接return 0,表示「这个文件没有附录」——这覆盖了「用户手动用旧版本保存的文件」与「写附录时进程被杀」两种情况。version不符则打 WRN 后同样忽略。主状态已经由llama_state_seq_load_file读进 slot,不受影响。- 每块缓冲前有一个 64 位长度,读取前先与文件剩余字节比较。
ckpt_read_buf的注释写得很明白:the size field may be corrupted。文件被截断时长度字段可能是一个巨大的数,先算n_avail - n_read再决定resize(n),可以避免按坏长度去分配内存。 - 每个检查点带位置区间与 token 数。位置区间
[pos_min, pos_max]是恢复时的对齐依据:加载侧用size_up_to_pos把位置换算成 token 下标,n_past被重新抬到it->n_tokens。 data_spec是检查点里的第三块。它为投机解码实现自带的状态(例如 eagle3 的延迟边界g_embd行)留了位置;非投机模型下它为空,序列化时只写一个 0 长度。- 草稿检查点与目标检查点并列在同一段里。加载时的兼容性检查很有意思:
// the slot file does not check the draft context - test-load one draft checkpoint, drop the draft data if it does not fitif (ctx_dft != nullptr && !checkpoints.empty() && !checkpoints.back().data_dft.empty()) { const bool ok = checkpoints.back().load_dft(ctx_dft, slot.id, LLAMA_STATE_SEQ_FLAGS_PARTIAL_ONLY); llama_memory_seq_rm(llama_get_memory(ctx_dft), slot.id, -1, -1); if (!ok) { SLT_WRN(slot, "draft context checkpoint data in '%s' does not match the draft context - dropped\n", ...); for (auto & cur : checkpoints) { cur.clear_dft(); } }}用 LLAMA_STATE_SEQ_FLAGS_PARTIAL_ONLY「试装」最后一个带草稿数据的检查点,装不上就把所有检查点的草稿数据统统清空。为什么是「试装一个」而不是「逐个验证」?因为同一个 slot 文件里的草稿检查点来自同一次会话的同一个草稿模型上下文,草稿上下文的形状参数(层数、头数、维度)对所有检查点都一样;最后一个装不上,等于所有都装不上。注意试装之后无论成功失败都要 seq_rm 清掉草稿槽位——试装会把状态写进草稿上下文,清掉是为了不让这个临时写入混进后续的真实恢复。清空草稿数据而不是让整个文件恢复失败,理由是:目标模型的检查点仍然有效,没有草稿数据时投机验证会回退到普通路径,只是少了一种加速,而不是整个存档不能用。
- 恢复时
id_task = -1的特殊语义:槽位文件里加载回来的检查点标记为id_task = -1,意思是「不是某次具体任务创建的」。create_checkpoint清理时有一条规则「同一次任务内太密集的旧检查点会被删,除非是当前 task 建的」,id_task == -1的检查点不参与这种「同任务内太密」的清理,因为它们的来源已经丢失,无法判断是不是同一次任务。 - 草稿附录「只存当前状态」,不存历史。
save_slot_draft里只有一块data_dft一块data_spec,与检查点里的逐点快照不同;它对应 slot 在保存瞬间的草稿上下文,是草稿侧唯一的「当前时点」快照。恢复时load_slot_draft会先seq_rm清掉草稿槽位再整体写回,与 RAM 缓存里「目标与草稿一起恢复」的逻辑一致。
槽位存档与 RAM 缓存的分工
同样是「把 KV 状态搬到别处」,槽位文件与 server_prompt_cache 的目标并不相同,比较一下能看清设计边界:
| 维度 | RAM 级 prompt cache | 槽位存档文件 |
|---|---|---|
| 存在哪 | 进程内存(std::list) | 用户指定目录下的二进制文件 |
| 谁来写 | get_available_slot 在 slot 将被覆盖时自动写 | 调用方主动 POST /slots/{id}?action=save |
| 谁来读 | get_available_slot 自动挑最匹配的条目 | 调用方主动 action=restore,指定 slot id |
| 生命周期 | 由 --cache-ram 字节上限与 FIFO 淘汰控制 | 不受缓存配额约束,直到有人删除 |
| 附带内容 | 目标状态 + 草稿状态 + 检查点链表 | 目标状态 + 检查点附录 + 草稿状态附录 |
| 兼容性检查 | 检查点随条目一起恢复,不检查模型是否变了 | 草稿检查点试装失败即只清草稿、保留目标 |
| 淘汰 | 自动(字节/ token / 前缀覆盖) | 不淘汰,由调用方管理 |
这个对比能解释两件事:
- 槽位存档不适合当「缓存」用。它的读取必须由调用方指定 slot id,服务端不做任何「这条存档最适合哪个新请求」的判定。如果把它堆满目录当缓存,服务端根本不会去用——它是一个会话持久化接口,而不是一层存储层级。
- RAM 缓存也不适合当「存档」用。条目取出即删除,而且会被新条目按前缀覆盖——一个只在昨天出现过一次的 prompt 在今天请求类似内容时很可能已经在缓存里找不到了。想让一段会话长期可恢复,应该用槽位存档,而不是依赖 RAM 缓存。
为什么不存「每个检查点对应的 token 列表」
检查点里没有 token 列表,只有位置区间与 n_tokens。这条选择与前面讲的 server_tokens 抽象有关:n_tokens 是序列在 token 维度上的长度,位置 pos_min / pos_max 是位置维度(含 M-RoPE 的多模态场景下,一个 token 可以占多 pos,二者不等价)。保存 token 列表会让文件体积按 prompt 长度成倍增长,而位置区间与 n_tokens 已经足够在恢复时把检查点落到某个 n_past 上——size_up_to_pos(pos_next) 就是干这个的。
代价是精度:如果两次加载之间的 prompt 在检查点位置之前被修改过,那么恢复的位置会对不上。槽位存档的定位是「同一条会话的暂停与继续」,修改 prompt 超出了它的语义契约,因此不做额外校验。
存档的失败模式:半截文件、旧模型、旧量化
磁盘存档比 RAM 缓存更容易遇到「读不出来」的情况,因为文件会跨进程、跨部署、跨版本。代码里有三处对应的防护:
- 附录解析失败就忽略附录。
load_slot_checkpoints读count字段后,如果后续某个检查点的某个长度字段超界或数据不完整,函数直接返回 0,表示「没有可用的检查点」;主状态已经在此前读进 slot,不受影响。这保护的是「写到一半被 kill」的场景——写检查点附录时进程被中断,文件尾部是不完整的数据,不能因此让整次恢复失败。 - 草稿状态单独试装。前文已讲过,草稿检查点的形状参数不匹配时,只清掉
data_dft,保留data_tgt。这里的data_dft不只是每个检查点上的那块,还包括common_prompt_checkpoint::data_spec——投机解码实现自带的状态(例如 eagle3 的延迟边界g_embd行)也一起清。 - 恢复位置被重新约束。
load_slot_checkpoints读出的检查点会被重新挂到slot.prompt.checkpoints上,但n_past不由文件决定,而是由size_up_to_pos(pos_next)在当前 slot 的 token 列表里重新索引。这意味着文件里的位置区间只是「提示」,真正的对齐在pre_decode里完成。若前后两次会话的 prompt 在检查点之前改过,n_past会落到一个和文件预期不同的位置,进而可能恢复到一个「内容对得上、语义不对」的状态——这是存档系统的固有边界,使用时应把它当作会话快照而不是任意可撤销的回滚点。
另外,--slot-save-path 目录在磁盘上没有配额概念。一个「每条请求都存档」的客户端会在几小时内堆出几十 GB 的文件;服务端不做任何清理,全部由调用方负责。
kv_unified 与空闲 slot 清仓
一个 buffer,按位置段共享
--kv-unified(命令行里的 -kvu)决定 KV 缓存是「每个 slot 各占一段固定区间」还是「一个共享 buffer 按活动位置动态分配」。两种模式的行为差异在这一篇里尤其明显:
- 非 unified:每个 slot 在初始化时就把
n_ctx / n_parallel的单元划给自己。一个 slot 清空自己的 prompt,只是把那一段里的内容删掉,别的 slot 用不到那一段——所以空闲 slot 的显存不会因此变得可复用。 - unified:所有 slot 共享同一个
llama_context的位置空间。一个 slot 清空之后,它腾出来的单元可以被其它 slot 立即分配,前提是位置段足够连续。
代码里对这一点有一句非常直白的注释(在 init 里处理 --cache-idle-slots 时):
if (params_base.kv_unified) { SRV_TRC("%s", "idle slots will be saved to prompt cache and cleared upon starting a new task\n");} else { // without a unified KV cache, clearing a slot frees no reusable room, so we only // publish a RAM-cache copy of idle slots (their KV stays in VRAM) [TAG_IDLE_SLOT_CLEAR] SRV_TRC("%s", "idle slots will be saved to prompt cache upon starting a new task\n");}两种模式的行为区别可以总结成一张表:
| 模式 | 空闲 slot 的处理 | 显存是否真的释放 | 后续能否被别的 slot 复用 |
|---|---|---|---|
| unified | 存入 RAM 缓存 + 清空 slot | 是 | 是(位置段重新进入分配池) |
| 非 unified | 存入 RAM 缓存,slot 原样保留 | 否 | 否(但那一段显存本来就归它) |
注意这个 --cache-idle-slots 的「存 + 清」动作不在请求结束时触发,而是在下一个任务被 launch 时、对所有非处理中的 slot 执行(process_single_task 里 SERVER_TASK_TYPE_COMPLETION 分支末尾,带 [TAG_IDLE_SLOT_CLEAR] 注释的那段循环)。换句话说,slot 在生成完成之后的空闲期里仍然保留着 KV;只有当新请求进来、需要腾位时,服务端才一次性把所有 idle slot 快照一遍、在 unified 模式下清掉。这个时机选择避免了「每个请求结束都要搬一次状态」的频繁开销,也让「同一个用户紧接着追问」能在未清空之前直接复用 slot 内的 KV,完全不走 RAM 缓存。
--cache-idle-slots 默认打开,但它要求 --cache-ram 非零,否则在 init 时被禁用并打印警告:
if (params_base.cache_idle_slots) { if (params_base.cache_ram_mib == 0) { SRV_WRN("%s", "--cache-idle-slots requires --cache-ram, disabling\n"); params_base.cache_idle_slots = false; } ...}原因也很实在:清空 slot 意味着「显存里的 KV 没了」,如果又不往 RAM 里存一份,那下一次有人用同一段前缀就得从头算——这比保留 KV 还亏。所以「清空」这个动作必须伴随「存进 RAM」,而 RAM 级缓存由 --cache-ram 控制。
try_clear_idle_slots:一次只清一个
解码时遇到显存不足,调度循环会调 try_clear_idle_slots:
bool try_clear_idle_slots() { bool res = false;
if (!params_base.kv_unified) { return res; }
for (auto & slot : slots) { if (slot.is_processing()) { continue; }
if (slot.prompt.n_tokens() > 0) { SRV_WRN("purging slot %d with %zu tokens\n", slot.id, slot.prompt.tokens.size()); slot.prompt_clear(); res = true; // clear slots one by one break; } }
return res;}函数里有两处刻意为之:
- 只在 unified 模式有效。前面已经解释:非 unified 模式清空一个 slot 不会释放任何「可再分配」的空间,因此调用直接空转返回 false。这意味着非 unified 模式下遇到显存不足,只有缩小批大小这一条路。
- 一次只清一个 slot。清空之后
break,返回 true,让调度循环尝试重新llama_decode;如果仍不足,下一轮再清下一个。这比「一次性清到够为止」更保守:每清一次都先试试解码能不能过,避免把不必要的会话状态清掉。这里有一个值得注意的边界——这条「抢救路径」并不保证先存进 RAM 缓存:只有--cache-idle-slots打开时,服务端才会在新任务 launch 时把 idle slot 先存再清;如果关闭了它,try_clear_idle_slots清掉的 KV 就真没了,下次同一个前缀还得从头算。所以对「前缀复用很重要、显存又比较紧」的部署,--cache-idle-slots与--cache-ram应该同时保留开启,让「清空」总是有「先存」兜底。
prompt_clear() 的实现就是 mem.seq_rm(id, -1, -1) 加 prompt.clear():删掉这个 seq_id 在整个位置空间里的所有单元,清掉 token 列表与检查点链表。注意这里没有「先存 RAM 再清」——能不能先存,取决于调用 try_clear_idle_slots 的上下文里 --cache-idle-slots 与 prompt_cache 是否已经处理过。在当前主线里,空闲 slot 的「存 RAM → 清空」是在收到新任务时由 --cache-idle-slots 那条路径完成的;try_clear_idle_slots 是解码失败时的抢救路径,它的语义是「实在不够就清」,没有 RAM 存取作为前置条件。
n_ctx_slot():每张牌的尺寸
unified 模式下还有一个用户最容易踩的坑:-c(总上下文)与 --kv-unified-per-slot(单 slot 上限)的关系。
// context size of a single slot, capped by --kv-unified-per-slot and by the training context of the modelint n_ctx_slot() const { int res = llama_n_ctx_seq(ctx_tgt);
if (params_base.kv_unified_per_slot > 0) { res = std::min(res, params_base.kv_unified_per_slot); }
return std::min(res, llama_model_n_ctx_train(model_tgt));}llama_n_ctx_seq() 直接返回 llama_context 构造时算好的 n_ctx_seq(见 llama.cpp 源码完全拆解(四):llama_context 与记忆系统):unified 模式下它等于整个 -c,非 unified 模式下等于 -c / n_seq_max 再按 256 向上取整、并把 n_ctx 反推成它的整数倍。因此在 unified 模式下 n_ctx_slot() 的第一项就是整个共享池的大小,所有 slot 理论上都能用满。--kv-unified-per-slot 是一个附加的单 slot 上限,用来在不需要那么多上下文的部署里避免一个长请求把整个共享池吃光。最后还要跟模型的训练上下文 n_ctx_train 取小——这条保证了一旦 RoPE 的外推没有正确配置,服务端会明确报出「slot context 超过训练上下文」的警告而不是静默产出垃圾输出。
init 里对 --kv-unified-per-slot 还有一处有意思的提示:当它比共享池还大时,缓存容量根本不会被它约束,代码会警告「cap has no effect, slots are limited to …」。这避免了用户误以为「设了 128K 就能服务 128K 请求」,实际却被 -c 卡在更小的值上。
一个 buffer 的真实代价:位置连续性与前缀命中的相互拉扯
unified 模式并不是「没有任何代价的共享」。既然所有 slot 共用一个位置空间,那么当 slot A 的前缀在位置 0..6143、slot B 的前缀在位置 7000..9000 时,A 的后缀如果想复用 B 的某段,位置就必须被「平移」到 A 的后缀之后——这正是 --cache-reuse 的 KV 平移所做的事。没有开启 n_cache_reuse 时,跨 slot 的复用只能发生在当前位置区间恰好连续的场合;否则即便 token 相同,位置上的 K/V 也无法直接拿来用,只能重算。
由此可以得到一个与直觉相反但很重要的结论:统一 KV 池提升的是「显存利用率」,不是「前缀命中率」。显存利用率提升来自「空闲 slot 清空后位置段可被任何 slot 重新分配」,而前缀命中率取决于「相同前缀是否恰好落在可复用的位置上」以及「slot 选择是否把请求交给了持有该前缀的 slot」。后者由 --slot-prompt-similarity 决定,与 unified 与否无关。两者一起调,效果才是叠加的;只开 unified 而不设 slot_prompt_similarity,前缀复用的收益仍然受限于「新请求恰好被 LRU 分到某个 slot」这种偶然性。
非 unified 模式的「位置连续」问题则被固定分区绕开了:每个 slot 有自己的 0..n_ctx_slot 位置区间,前缀总在固定的位置上,跨请求复用只需要看 token 是否相同。代价是分区内部的碎片无法被其它 slot 使用——一个只用了几百 token 的 slot 仍然占着整段显存。这两种模式的取舍,与 PagedAttention 的「逻辑块表 vs 固定分区」问题本质上是同一类,只是 llama.cpp 把粒度从「页」放大到了「整个 slot 的位置区间」。
一条请求在缓存体系里的完整旅程
把前面三节拼成一条时间线,以「用户 A 发来一段 8000 token 的 prompt,其中前 6000 token 与上一次请求相同」为例:
- 选 slot:
get_available_slot按 LCP 相似度扫过空闲 slot,找到持有这 6000 token 前缀的那一个,此时f_sim = 6000 / 8000 = 0.75,超过默认阈值 0.10 就会优先选中它。若找不到,走 LRU,被选中的 idle slot 会被--cache-idle-slots安排先prompt_save再清空;get_available_slot里另有一条独立规则:当本次 LCP 选择要挤掉该 slot 一半以上的原有上下文(f_keep < 0.5),也先存一份。 - RAM 级比对(如果 slot 本身已经空了):
prompt_load从states里挑在f_keep与f_sim上同时前进的那一条,恢复两本(main + drft)状态数据,erase取出条目。 - 组 batch:
pre_decode重新计算n_past = get_common_prefix(...),并把它按n_tokens_shared、n_decision_first、alora_invocation_start三项钳住;n_cache_reuse > 0时对剩余不连续片段尝试 KV 平移。 - 前缀对不上部分:进入检查点恢复路径,从 slot 的检查点链表里找
pos_min < 阈值且pos_max <= pos_next的最后一条,load_tgt/load_dft回填。 - 解码失败:
try_clear_idle_slots在 unified 模式下清一个空闲 slot,或缩小批大小重试。 - 存档:
slot_save任务依次写主体、检查点附录、草稿状态附录;之后再slot_restore时做草稿检查点兼容性试装。
如果用一张图描述这个体系在 token 维度上的三类「容量账本」,可以这样理解:GPU 显存里的 KV(最热、最小)、RAM 级缓存里的整段状态(次热、按字节与 token 双约束、FIFO 淘汰)、磁盘存档里的状态与检查点附录(最冷、按会话粒度、人控)。三层之间的搬运只发生在有限几个点:prompt_save / prompt_load、slots_save / slots_restore、try_clear_idle_slots。这种「少量同步点 + 大块搬运」的设计与 HiCache 的流水线式写回正好互补:前者实现简单、可读性强,每 token 的额外元数据几乎为零;后者在大规模多模型场景下命中率高,但要维护跨层前缀树与一致性。
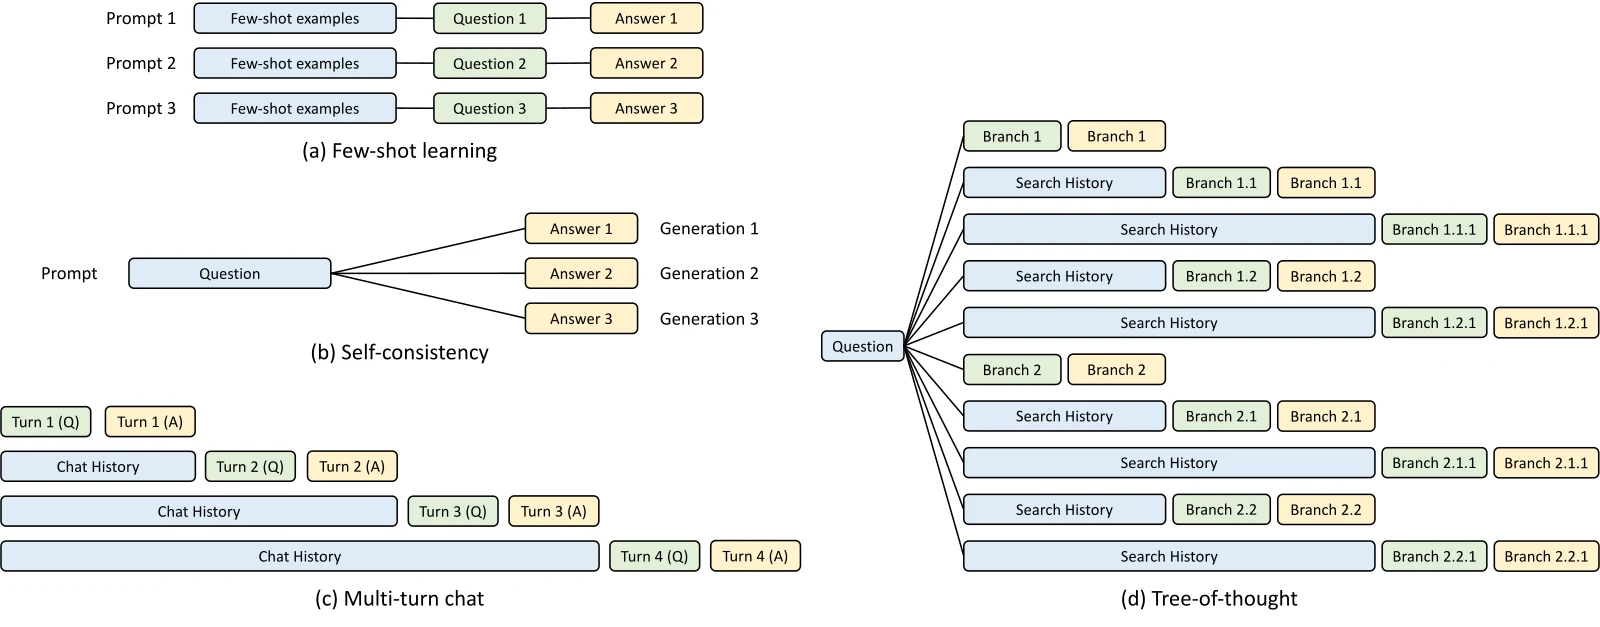
图源:SGLang 论文(arXiv:2312.07104)Figure 9,KV cache sharing 示例。可共享的片段包括 few-shot 示例、self-consistency 中的问题、多轮对话历史与思维树中的搜索历史。把它与 llama.cpp 的 std::list 对照,能看到「按可共享片段做树状索引」与「按整段序列状态做线性列表」在复用范围与实现成本上的分野:SGLang 能把多种工作流里的「蓝色片段」都挂到树上被反复命中,llama.cpp 只能命中「新请求的整段前缀与某个缓存条目开头完全一致」的那一种。
调参与坑
这一节把散落在代码里的默认值与用户最容易误解的地方收在一起,方便部署时对照。
--cache-ram 与 n_ctx 谁管谁
--cache-ram是字节配额(默认 8192 MiB),硬约束,update第一条 while 保证size() <= limit_size。n_ctx通过构造函数的limit_tokens进入,是 token 软上限;它会被limit_size / size_per_token抬高到内存允许的值,因此不要指望n_ctx能在字节充足时严格限制缓存条目数量。- 用户想把缓存「关掉」,
--cache-ram 0。--cache-idle-slots会被同时禁用。
--slot-prompt-similarity 不是「相似度」
默认值 0.10 在命令行文档里,但更准确的理解是:它是选 slot 时要求的最低 LCP 占比。设为 0 时这条路径完全关闭,请求只能按 id_slot 或 LRU 分配。把这个值调高(例如 0.5)会让服务端更愿意等待或重算,而不是把请求塞进一个「有一定可能命中」的 slot。它不控制 server_prompt_cache 的选择阈值——那里的 0.25 f_keep 线是写死的。
哪些记忆类型支持 --cache-reuse
pre_decode 里有两句很关键的判断:
const bool can_cache_reuse = llama_memory_can_shift(llama_get_memory(ctx_tgt)) && !slot.prompt.tokens.has_mtmd;llama_memory_can_shift 问的是记忆层:「你能不能把一段 KV 从一个位置整体平移到另一个位置?」这要求位置编码可以由 K 直接推出 V 的旋转关系(典型是 RoPE,平移等价于对 K 做额外的旋转),纯因果注意力的纯 RoPE 模型支持;SWA(滑动窗口注意力)、循环状态(Mamba / RWKV 类)、以及一些混合记忆不支持。多模态 prompt 被显式排除,因为图片的 chunk 在 server_tokens 里以 LLAMA_TOKEN_NULL 占位,平移时位置连续性会断在 chunk 边界上。日志里会打印「cache reuse is not supported - ignoring n_cache_reuse = N」,看到这条就说明该降级——但 get_common_prefix 的线性复用仍在生效。
指标:n_prompt_tokens_cache 而不是「命中率」
/slots 端点返回每个 slot 的 n_prompt_tokens_cache(来自 slot.stats.n_prompt_cached),它记录「这条请求 prefill 时直接跳过的 token 数」,不是百分比。全局口径在 server_metrics 里分成两个字段:prompt 桶只统计实际送进解码的 prompt token,被缓存跳过的那些单独累加到 n_prompt_cached。源码注释写得很清楚:only processed tokens, cached ones are counted separately below。因此「命中率」需要自己算:
按请求采样计算。把这个比值和 --slot-prompt-similarity 的阈值、--cache-ram 的淘汰频率放在一起看,才能判断「缓存条目很多、但每条只命中一小段」的情况是否发生。只看缓存条目数或只看内存占用,都会高估缓存的实际收益。
--ctx-checkpoints 的 32 是默认值,不是最佳值
--ctx-checkpoints N 默认 32。create_checkpoint 里两条清理规则会跟它联动:同任务内相邻很近的检查点会被删(checkpoint_min_step)、链表满了从头部淘汰。32 个检查点在长 prompt 场景下通常足够,但对「同一条 slot 上反复追问同一段长文档」的工作流,调大这个数可以让命中点更密;代价是每个检查点的 KV 快照体积以及 RAM 级缓存条目的体积都会被计入 server_prompt_cache_state::size(),从而加速缓存淘汰。
一次真实的缓存命中:日志里能看见什么
把 TRC 级别的日志打开(-v,或 -lv 4 / --log-verbosity 4),一次典型的前缀命中会打印出这样几行,可以拿来对照上文的每一条规则:
selected slot by LCP similarity, f_sim_best = 0.750 (> 0.100 thold), f_keep = 0.857 - looking for better prompt, base f_keep = -1.000, f_sim = 0.000 - prompt with length 7168, lcp = 6144, f_keep = 0.857, f_sim = 0.750 - found better prompt with f_keep = 0.857, f_sim = 0.750new prompt, n_ctx_slot = 32768, n_keep = 0, task.n_tokens = 8192slot 0: n_past = 6144prompt cache update took 1.37 ms逐行对应:
- 第一行来自
get_available_slot:f_sim_best是「新请求的公共前缀占比」,f_keep是「这条 slot 原有上下文在这次请求里被保住的比例」。f_keep = 0.857大于 0.5,所以这条 slot 不会被先存进缓存,而是直接拿来用。 - 中间三行来自
prompt_load:基线f_keep = -1.000是因为 slot 已经被--cache-idle-slots清空:prompt.tokens.size() == 0时初值被显式设为-1.0f,表示「空 slot 下任何缓存条目都更好」;候选条目 7168 长、LCP 6144,两项指标都比基线大,因此被选中。 n_past = 6144由pre_decode二次算出:条目被keep_first(6144)截断后与input_tokens的公共前缀正好吻合。- 最后一行来自
prompt_cache->update()的耗时记录,在每次alloc/erase之后都会打印。
如果这次是 --cache-reuse 256 的场景,还会多出这样的日志:reusing chunk with size 1024, shifting KV cache [6144, 7168) -> [6208, 7232)。它说明有一段 1024 token 的后缀被 seq_rm + seq_add 平移到了新位置,n_past 在循环里被逐步抬高。
两个反直觉的默认值
读完缓存与槽位两条代码路径后,有两个默认值很值得单独记住,因为它们直接决定了「默认配置下缓存收益有多大」。
第一个是 --slot-prompt-similarity 的默认 0.10。它意味着默认情况下服务端会按 LCP 选 slot,而不仅仅是 LRU。这与很多人的印象相反:不少人会以为 llama.cpp 的 slot 分配是纯轮询或纯 LRU,前缀复用完全靠「同一个 slot 碰到同一个请求」的运气。实际代码里 LCP 选择是默认开启的,阈值低到 0.1——一条新请求只要与某个空闲 slot 有 10% 的公共前缀就会优先交给它。把阈值调到 0 才会关闭 LCP 选择。对「多个用户的 prompt 共享同一段超长 system prompt」的场景,这个默认值就已经提供了很大一部分收益;把它调到 0.3 以上,则会让「短前缀 + 长差异」的请求更少被塞进某个看起来沾边、实际命中不深的 slot。
第二个是 --cache-idle-slots 默认开启、但只能在 --cache-ram 非零时生效。这意味着默认的 8192 MiB 让「空闲 slot 清仓进 RAM」这件事一直在发生:一个 slot 的用户生成完毕、slot 回到 idle 状态,下一次有新任务时,服务端会先把这个 slot 的 prompt 存进 RAM 缓存,再让新请求进来。长期运行的多用户服务因此能维持几百 MB 的缓存条目池,命中率取决于请求前缀的重叠度。如果客户端在短时间内在同一 slot 上反复问同样的问题,服务端实际上很少真的去重算 prefill。
--cache-ram 0 之外,还有哪些方式让缓存失效
除了「字节耗尽」这条正常路径,用户行为会主动让缓存失去作用:
- 切换模型。
server_prompt_cache的生命周期与server_context绑定,换模型意味着重启进程或重新load_model,缓存被整体丢弃;slots_restore时如果模型架构变过,检查点附录里的位置区间仍然能解析,但load_tgt会因为状态格式不一致而失败。 - 改
--ctx-checkpoints。检查点是缓存条目体积的一部分,size()里包含它们。把--ctx-checkpoints调大以后,同样长度的 prompt 条目会变得更大,更快撞上字节上限,从而更频繁地触发淘汰。 - 切换
--kv-unified。unified 与非 unified 不是「运行时可调项」,而是llama_context构造参数,所以换模式等于重启。重启后旧的检查点附录仍然存在,但 unified 下 slot 间的位置段布局已经不同,恢复出来的状态未必符合预期的位置分布;实践上换模式后应清空--slot-save-path下的文件。 - 多模态输入。
server_tokens以LLAMA_TOKEN_NULL标记图片占位,get_common_prefix在遇到不同图片时会返回第一个图片的位置。这意味着同一段文字 prompt 在图片之前的部分仍然可以命中,但图片本身之后的 KV 全部作废——这与「图片用 hash 在 radix 树节点上做键」的 SGLang 做法不同,llama.cpp 只能用「图片之前的纯文本前缀」来复用。
与 vLLM、SGLang 的三层缓存对照
把前面各部分拼成一张横向表,三套系统处理「KV 复用」的层次边界会很清楚:
| 层次 | llama.cpp | vLLM(V1) | SGLang |
|---|---|---|---|
| GPU 内复用单元 | 整段序列状态内的位置段,按 seq_cp / seq_add 平移 | 物理块 + 逻辑块表,前缀 hash 命中即块复用 | 前缀树节点 + 引用计数,页级共享 |
| GPU 外一层 | RAM 级 server_prompt_cache,整段状态字节 | CPU 卸载 / KV Connector 传输到远端实例 | HiCache 宿主池,前缀树跨层 |
| 持久化 | 槽位存档(状态 + 检查点附录 + 草稿附录),由用户驱动 | 无内建(需外部系统) | L3 外部存储(HiCache) |
| 命中判定 | 线性 LCP + f_keep >= 0.25 + 双指标帕累托前进 | 前缀 hash 精确匹配(块粒度) | 前缀树路径匹配(页粒度) |
| 淘汰 | FIFO,字节硬上限 + token 软上限 + 前缀覆盖 | 块级 LRU + 引用计数 | 树节点 LRU + 引用计数 |
| 跨请求复用范围 | 同 slot 内为主,跨 slot 靠 --slot-prompt-similarity 调度 | 全局(同一实例内) | 全局(同实例,HiCache 下跨实例) |
这张表暴露出 llama.cpp 在「跨请求」维度上的结构性缺失:GPU 外的 RAM 缓存与 GPU 内的前缀复用都是以 slot 为单位的。跨 slot 的复用只有两条路——--slot-prompt-similarity 把请求调度到「已经含着相同前缀」的 slot(前提是那个 slot 空闲),以及 --cache-reuse 的 KV 平移(前提是记忆层支持 shift,且中间没有多模态块)。没有任何一种机制能让两个同时在跑的请求共享同一段前缀 KV。
对端侧和单用户部署,这完全够用:一个用户同时只跑一两条对话,跨 slot 共享没有意义。对多租户部署,这是需要知道的上限——当并发很高、每个请求都带相同的 system prompt 时,llama.cpp 的 prefill 会把这些 system prompt 重算很多遍,因为同时活跃的 slot 之间无法共享。这也是 SGLang / vLLM 的 RadixAttention / PagedAttention 前缀命中在服务端场景里能拿到更高收益的根本原因。
小结
三句话概括这一篇:
- RAM 级 prompt cache 的粒度是「整段序列状态」,由
llama_state_seq_get_data_ext产生的字节块组成;它与 PagedAttention 的不同在于「序列状态 vs 物理块」,因此命中判定只能用线性get_common_prefix,命中后只能整段恢复再截断。 - 缓存区同时管字节与 token 两本账,字节硬、token 软;淘汰是 FIFO(取用即删除,无需 LRU),并在前缀覆盖规则下清理被新条目完全覆盖的旧条目;内存不足时上限自适应收缩而不是让进程崩溃。
- 磁盘存档在状态数据之后追加检查点与草稿检查点两段附录,加载时对草稿附录做兼容性试装,不匹配就只清掉草稿、保留目标检查点,让恢复尽量不因为一个可选组件失败而整体作废;
kv_unified模式下空闲 slot 才真正「清空腾房」,非 unified 模式下清空没有可复用空间,只能靠批大小调节兜底。
下一篇将沿 tools/server/ 继续展开:server_tokens 的多模态占位与 mtmd 输入如何进入 slot 的调度账本,以及它在 n_cache_reuse 平移路径上为什么必须被排除。
参考资料
- llama.cpp 源码:tools/server/server-task.h(server_prompt_cache / server_prompt_cache_state)
- llama.cpp 源码:tools/server/server-task.cpp(server_prompt_cache::alloc / load / update)
- llama.cpp 源码:tools/server/server-context.cpp(get_available_slot / prompt_save / prompt_load / try_clear_idle_slots)
- llama.cpp 源码:tools/server/server-common.cpp(server_tokens::get_common_prefix / pos_next / keep_first)
- llama.cpp 源码:common/common.h(common_prompt_checkpoint 与 prompt utils)
- llama.cpp 官方文档:tools/server/README.md 中的 cache 与 slot 参数说明
- SGLang: Efficient Execution of Structured Language Model Programs(arXiv:2312.07104)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



