


llama.cpp 源码完全拆解(十四):mul_mat_vec_q——解码时一条量化权重如何被 dp4a 逐块点积
从 CPU 的那次 mul_mat 说起
上一篇拆了 ggml-cpu 里一次 mul_mat:量化权重按块解包、点积分给线程池、结果按行归并。那是 llama.cpp 在没有 GPU 时的样子。现在把同一件事搬到显卡上:一个 token 进来,模型的每一层都要做一次「量化权重矩阵 × 一条激活向量」,7B 模型一层几千万个权重,整个 decode step 要把几 GB 的权重量从显存搬到 SM 上,乘加的次数却少得可怜。
这种形状下,通用 GEMM 库没有优势,Tensor Core 也使不上劲——MMA 指令处理的是「一大块矩阵乘一大块矩阵」,而这里是一个向量。llama.cpp 的答案是一族专门的 kernel:mul_mat_vec_q,简称 MMVQ。它在 ggml/src/ggml-cuda/mmvq.cu 里,一千六百多行,模板参数按量化类型、批大小、是否融合展开成上百个编译实例。
这一篇只讲这一个 kernel。要回答的问题很具体:
- 量化权重在显存里是怎么排的,一个线程一次到底读进来几个字节;
- 激活为什么要先量化成
q8_1,d和s两个 half 各自承担什么; dp4a这条指令为什么能把四个 int8 乘加压成一次操作,0x0F0F0F0F掩码在做什么;- Q4_0、Q4_K、Q6_K 三种典型格式的点积分别怎么写,K-quant 的 min 项为什么要单独累加;
nwarps、rows_per_block、small_k、halve_iters这些看起来像玄学的参数,各自在解决什么形状问题;- 融合路径(gate、bias、SwiGLU)把哪些算子塞进了同一个 kernel,MoE 的
mul_mat_id又是怎么复用同一套代码。
第七篇已经讲过 MMVQ 在 mul_mat 分派链里的位置和它相对 MMQ 的取舍;这一篇往下钻,钻进 kernel 内部。
解码的形状:一次前向里 99% 的权重只被用一次
先把账算清楚。以 7B 模型、Q4_K 量化为例,权重总量大约 3.5 到 4 GB。解码阶段每个 step 只处理一个新 token(忽略投机解码的多 token 情形),Transformer 每一层要做的是:
- QKV 投影、输出投影、FFN 的 gate/up/down 三块,全部是「权重矩阵 × 一条向量」;
- 注意力本身是「一条 query 对历史 KV」,那是另一类 kernel,不在这一篇的范围。
矩阵乘的算术强度可以写成「每读一个字节的权重能做多少次乘加」。Q4_K 平均每个权重 4.5 bit,即 0.5625 字节;一次乘加算 2 FLOP,于是强度约为 FLOP/byte。H100 这一级别的卡,FP16 峰值算力与 HBM 带宽的比值(ridge point)在 100 FLOP/byte 上下。3.6 距离 100 差了两个数量级,结论很直接:解码时的矩阵乘是纯带宽问题,SM 的乘加单元大部分时间在等数据。
这解释了两件事。
第一,为什么不能「先把权重反量化成 FP16,再交给 cuBLAS」。反量化要先读 4-bit 权重、写 2 字节的 FP16 权重,再让 GEMM 读一遍;写回和二次读取都是纯增的显存流量,而计算量并没有变。对一个带宽受限的算子,这是最坏的选择。
第二,为什么 MMVQ 不做 shared memory 分块。MMQ 那一类 GEMM kernel 把权重 tile 搬进 SRAM,是为了让同一个权重元素被多个 token 复用;解码时只有一个 token,复用次数是 1,搬进 SRAM 只是多一次拷贝。MMVQ 索性让每个线程直接从显存(经过 L2)读自己负责的那几个量化块,在寄存器里解包、点积、累加。
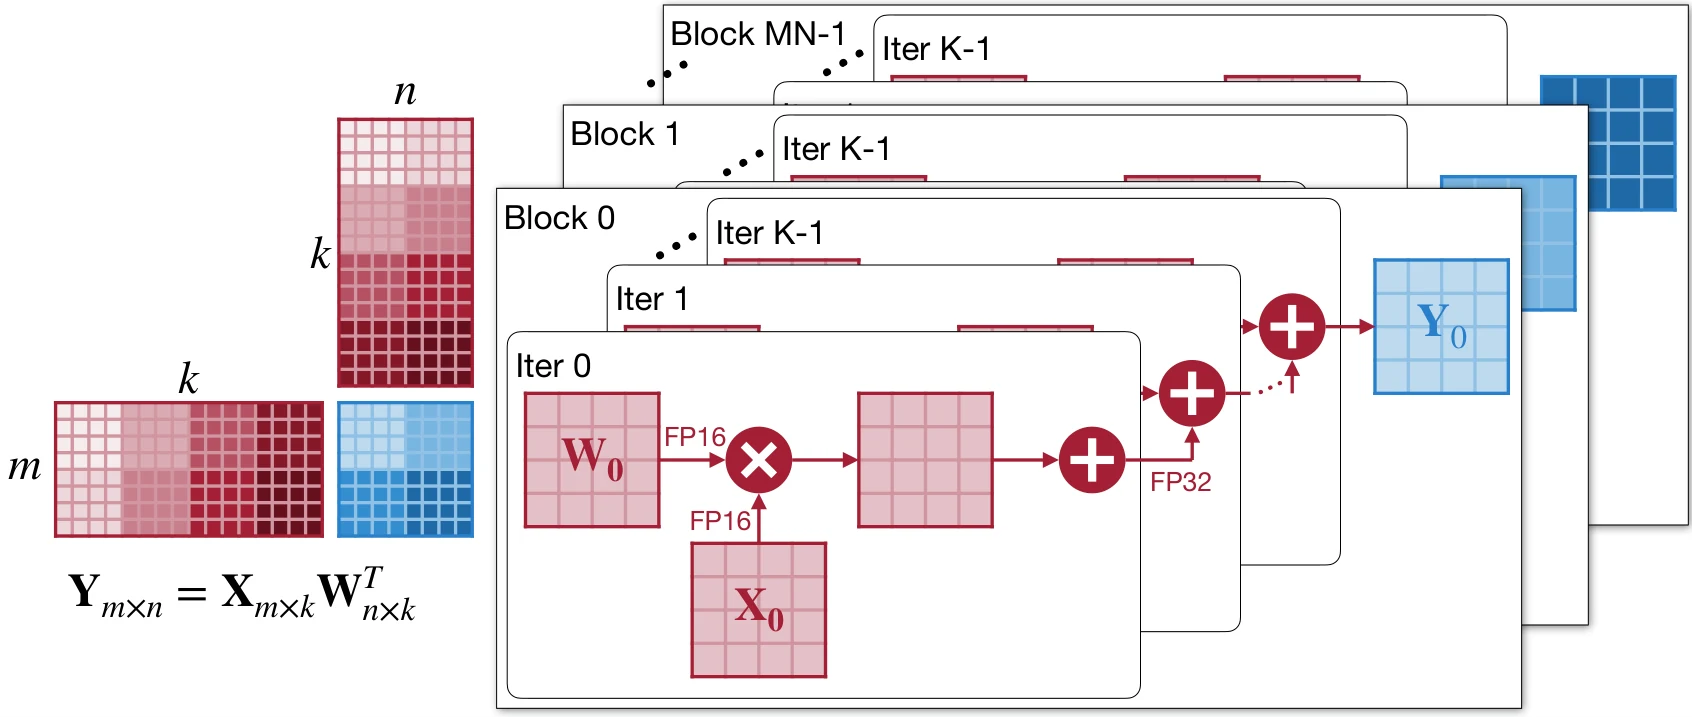
图里这个结构值得对着 MMVQ 看一遍:标准的 GEMM 把 m(输出行)和 n(batch 列)铺成二维 block,k 方向在循环里顺序推进。解码时 m 是输出通道数(几千到上万),n 是 1,k 是隐藏维(几千)。也就是说,网格在 m 方向铺得很宽,每个 block 只处理一列,k 循环很长——这正是 mul_mat_vec_q 的 blockIdx.x 与 k 循环的对应关系。
分派:什么时候轮到 MMVQ
ggml-cuda.cu 里的 ggml_cuda_mul_mat 是一串顺序判断,MMVQ 排在 MMF 和 MMQ 之间:
if (ggml_cuda_should_use_mmvf(...)) { ggml_cuda_mul_mat_vec_f(...); return; }if (ggml_cuda_should_use_mmf(...)) { ggml_cuda_mul_mat_f(...); return; }if (ggml_cuda_should_use_mmvq(src0->type, cc, ne11)) { ggml_cuda_mul_mat_vec_q(ctx, src0, src1, nullptr, dst); return;}if (ggml_cuda_should_use_mmq(src0->type, cc, ne11, /*n_experts=*/0)) { ggml_cuda_mul_mat_q(ctx, src0, src1, nullptr, dst); return;}ggml_cuda_mul_mat_cublas(ctx, src0, src1, dst);判据本身很短:
bool ggml_cuda_should_use_mmvq(enum ggml_type type, int cc, int64_t ne11) { if (!ggml_is_quantized(type)) return false; // k-quants cost more to decode and mvq redoes that per column, so MMQ wins sooner. if (GGML_CUDA_CC_IS_NVIDIA(cc) && cc == GGML_CUDA_CC_ADA_LOVELACE) { switch (type) { case GGML_TYPE_Q2_K: return ne11 <= 4; case GGML_TYPE_Q3_K: return ne11 <= 6; default: return ne11 <= MMVQ_MAX_BATCH_SIZE; } } if (GGML_CUDA_CC_IS_NVIDIA(cc) && cc == GGML_CUDA_CC_BLACKWELL) { switch (type) { case GGML_TYPE_Q4_K: return ne11 <= 5; case GGML_TYPE_Q5_K: return ne11 <= 6; case GGML_TYPE_Q6_K: return ne11 <= 7; default: return ne11 <= MMVQ_MAX_BATCH_SIZE; } } ... return ne11 <= MMVQ_MAX_BATCH_SIZE; // 8}三个细节:
- 只有量化权重才走 MMVQ。FP16/BF16 权重走 MMF(tensor core 的向量版)或 cuBLAS,量化是这条路径的前提。
- 批大小上限硬编码为 8(
mmvq.cu顶部的#define MMVQ_MAX_BATCH_SIZE 8)。到 9 列激活时,MMQ 或 cuBLAS 更划算。 - 不同架构、不同量化类型的阈值不一样。Ada 上 Q2_K 只允许 4 列,Blackwell 上 Q4_K 只允许 5 列。注释给的理由是「k-quants 解码更贵,而 MMVQ 每一列都要重做一次解码」——这句话是理解整个 kernel 取舍的钥匙,后面会展开。
MoE 的 mul_mat_id 走另一套阈值 get_mmvq_mmid_max_batch(type, cc),同样是逐架构、逐类型调出来的:Turing 之后的 NVIDIA 上,IQ2/IQ3 系列只允许 4 个 token,Q2_K 是 7,Q4_K 是 5,Q6_K 是 5,其余类型可以到 8。Ada、Volta、Pascal 又各有一张表。这些数字不是推导出来的,是 benchmark 扫出来的分界点。
权重的排法:块、超级块,以及一个线程读多少
MMVQ 的内层循环完全由量化格式决定。llama.cpp 的量化格式分两代:老式的「块」(Q4_0、Q5_1、Q8_0 等,32 个权重一块),和 k-quants 的「超级块」(Q2_K 到 Q6_K,256 个权重一块,内部再分 16 或 32 个一组的子块)。
先看两个结构体(ggml/src/ggml-common.h):
#define QK4_0 32typedef struct { ggml_half d; // delta,这一块 32 个权重的统一 scale uint8_t qs[QK4_0 / 2]; // 16 字节,32 个 4-bit 量化值} block_q4_0; // 18 字节 / 32 权重 = 4.5 bit
#define QK_K 256typedef struct { uint8_t scales[12]; // 8 个 6-bit scale + 8 个 6-bit min,压进 12 字节 uint8_t qs[128]; // 256 个 4-bit 量化值 ggml_half2 dm; // d(super-block scale)与 dmin(min 的 scale)} block_q4_K; // 144 字节 / 256 权重 = 4.5 bitQ4_0 是「对称量化」:权重近似成 , 取 ,存成无符号的 ,计算时统一减 8。Q4_K 是「非对称」:每个子块有自己的 6-bit scale 和 6-bit min,还原公式是
其中 、 是子块的 6-bit 参数, 是 4-bit 量化值。多出来的 min 项让 Q4_K 在同样 4.5 bit 下能表达带偏移的分布,代价是点积里要多算一项 。
vecdotq.cuh 里为每种格式定义了一个编译期常量 VDR(vec dot ratio),注释写得很清楚:
// VDR = vec dot ratio, how many contiguous integers each thread processes// when the vec dot kernel is called#define VDR_Q4_0_Q8_1_MMVQ 2#define VDR_Q4_K_Q8_1_MMVQ 2#define VDR_Q6_K_Q8_1_MMVQ 2以 Q4_0 为例,qk = 32、qi = 4(一个块在「int 单位」下的长度:16 字节 = 4 个 int)、vdr = 2。kernel 里每个线程算出的 kqs 是
const int kqs = vdr * (tid % (qi/vdr)); // 0, 2, 4, 6 轮流qi/vdr = 2,即两个线程负责一个 Q4_0 块:线程 A 取 qs 的前 8 字节(16 个 nibble),线程 B 取后 8 字节。每个线程一次读 8 字节权重,解出 16 个 4-bit 值,正好够做 4 次 dp4a。k-quants 的 qk = 256、qi = 32、vdr = 2,于是 qi/vdr = 16——16 个线程负责一个 256 权重的超级块,每个线程仍然是 8 字节、16 个 nibble。
这条「每个线程每轮处理 16 个权重」的规律不是巧合:8 字节的权重刚好能用两个 32-bit 寄存器装下,16 个权重刚好能用 4 个 dp4a 吃完,寄存器和指令数都整齐。
激活的量化:为什么是 q8_1,而不是 q8_0
权重量化之后,激活也必须量化到整数域,才能用整数点积指令。llama.cpp 选的是 q8_1:
#define QK8_1 32typedef struct { union { struct { ggml_half d; ggml_half s; }; // d = scale, s = d * sum(q) ggml_half2 ds; }; int8_t qs[QK8_1];} block_q8_1; // 36 字节 / 32 个 int8和常见的 q8_0 相比,q8_1 多了一个 s:它是这一块 32 个 int8 之和乘以 d。为什么需要它?
- 对称格式(Q4_0)需要减掉量化零点 :,后一项就需要 ,而
s = d \cdot \sum q_y,直接乘s即可。 - 非对称格式(Q4_K、Q5_K、Q6_K)有 min 项:需要 去乘子块的 min。
如果没有 s,每个块都要在 kernel 里把 32 个 int8 再加一遍,等于把刚刚算过的和重算一次。量化阶段顺手存下来,kernel 里就是一次 half 转 float 的乘法。
量化本身是一个独立的 pre-pass kernel(quantize.cu):
static __global__ void quantize_q8_1(const float * x_ptr, void * vy_ptr, ...) { const float xi = i0 < ne00 ? x[i03*s03 + i02*s02 + i01*s01 + i00] : 0.0f; float amax = fabsf(xi); float sum = xi;
amax = warp_reduce_max<QK8_1>(amax); sum = warp_reduce_sum<QK8_1>(sum);
const float d = amax / 127.0f; const int8_t q = amax == 0.0f ? 0 : roundf(xi / d);
y[ib].qs[iqs] = q; if (iqs > 0) return; y[ib].ds = make_half2(d, sum);}一个 warp 的 32 个 lane 正好覆盖一个 QK8_1 块,所以 amax 和 sum 都用 warp shuffle 归约,不需要 shared memory 和 __syncthreads。d 取 amax/127,是把浮点范围映射到 int8 的对称区间;s 存的是原始浮点的和,而不是量化后再求和——两者只在舍入意义上差一点,但用原始和更准。
还有一个容易被忽略的细节:host 端在调用前会把激活的行宽补齐到 512 的倍数。
const int64_t ne10_padded = GGML_PAD(ne10, MATRIX_ROW_PADDING); // 512ggml_cuda_pool_alloc<char> src1_q8_1(ctx.pool(), ne13*ne12 * ne11*ne10_padded * sizeof(block_q8_1)/QK8_1);padding 的作用是让 kernel 里可以按块无条件读取,不必对最后一列做谓词判断。padding 出来的部分会被量化成 0(i0 < ne00 ? ... : 0.0f),点积结果不受影响。
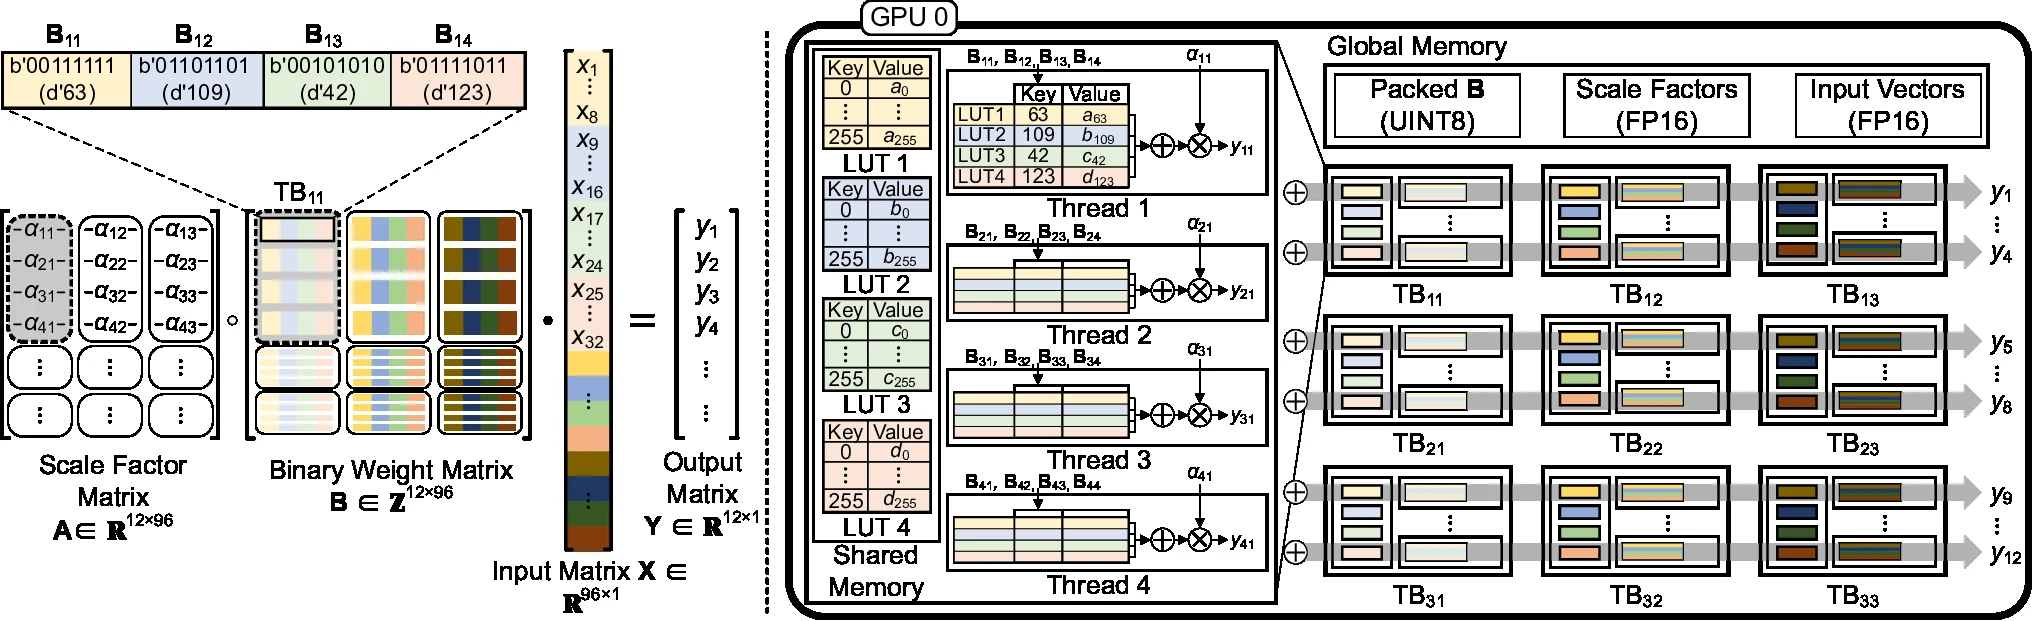
这张图来自另一条技术路线(nuQmm,group-wise 量化权重 + tensor core),但线程与数据的对应关系和 MMVQ 是同一类问题:谁负责哪几个量化值、scale 在哪一级回乘、哪些中间量必须留在寄存器里。区别在于 MMVQ 没有 tensor core 的 fragment 布局,全部靠 dp4a 的 4 路 int8 点积。
dp4a:一条指令吃完 4 组 int8 乘加
整篇 kernel 的算力都用在一个 PTX 指令上:dp4a(cuda.dp4a),在 CUDA C++ 里通过 __dp4a 内建函数暴露,llama.cpp 包了一层:
static __device__ __forceinline__ int ggml_cuda_dp4a(const int a, const int b, int c) { ... asm("dp4a.s32.s32 %0, %2, %3, %1;" : "=r"(c) : "r"(a), "r"(b), "r"(c)); return c;}dp4a.s32.s32 d, a, b, c 的语义是:把 32 位的 a 和 b 各自拆成 4 个 8-bit 有符号整数,两两相乘得到 4 个乘积,求和,再加上 32 位的 c,结果写回 d。也就是
一条指令完成 4 次乘加,而且不需要把 int8 扩展成 32 位再乘——这就是它比「逐元素 int 乘法 + 累加」快得多的原因。它从 Turing 开始成为 NVIDIA 推理卡的标准指令(更老的 Pascal 只能退回逐元素乘加),在 AMD 上对应的是 sdot4 / sudot4,common.cuh 里的 ggml_cuda_dp4a 按架构分别用内建函数或内联汇编实现。本质上,它把一个 32 位寄存器当成四个 int8 并行处理,一条指令完成四次乘加。
注意它的一个硬约束:操作数是有符号 int8。而 4-bit 权重解出来的 nibble 是无符号的 0..15。kernel 里没有对每个 nibble 做符号扩展,而是保持无符号,再用常数偏移去「纠正」:
- Q4_0 的真实量化值是
q - 8(对称量化的零点)。于是 第一项直接用无符号 nibble 与有符号 int8 做dp4a(nibble 在 0..15 范围内,作为 int8 解释仍然正确),第二项用q8_1里的s乘常数 8 减掉。 - Q6_K 的量化值范围是
-32..31,6 bit 存成无符号0..63。把它拆成低 4 位(0..15)和高 2 位(0..3),拼成0..63,再减 32: 第一项用拼好的vil | vih做dp4a,第二项用dp4a(0xE0E0E0E0, u, ...)一次减掉——0xE0作为 int8 是 -32。
这是整个 kernel 里最巧妙的一处:把「符号」从数据里搬到常数里。数据侧永远是「干净的无符号 nibble」,符号信息通过 d、s 和常数偏移在循环末尾一次性处理,循环体内没有任何分支和转换。
一次 vec_dot 的解剖:以 Q4_0 为例
vec_dot_q4_0_q8_1 的调用约定是:给定一个权重块编号 kbx 和一个块内偏移 iqs,算这一小块(16 个权重)与对应激活的点积。
static __device__ __forceinline__ float vec_dot_q4_0_q8_1( const void * __restrict__ vbq, const block_q8_1 * __restrict__ bq8_1, const int & kbx, const int & iqs) {
const block_q4_0 * bq4_0 = (const block_q4_0 *) vbq + kbx;
int v[VDR_Q4_0_Q8_1_MMVQ]; int u[2*VDR_Q4_0_Q8_1_MMVQ];
#pragma unroll for (int i = 0; i < VDR_Q4_0_Q8_1_MMVQ; ++i) { v[i] = get_int_b2(bq4_0->qs, iqs + i); // 16 个 nibble u[2*i+0] = get_int_b4(bq8_1->qs, iqs + i); // 低 nibble 对应的 int8 u[2*i+1] = get_int_b4(bq8_1->qs, iqs + i + QI4_0); // 高 nibble 对应的 int8 }
return vec_dot_q4_0_q8_1_impl<VDR_Q4_0_Q8_1_MMVQ>(v, u, bq4_0->d, bq8_1->ds);}get_int_b2 按 16 位读再拼成 32 位,因为 qs 只保证 2 字节对齐。两个 int(v[0]、v[1])共 8 字节、16 个 nibble。QI4_0 = 4,所以 u[2i+1] 读的是 qs 的后半段。
点积本体:
template <int vdr> static __device__ __forceinline__ float vec_dot_q4_0_q8_1_impl( const int * v, const int * u, const float & d4, const half2 & ds8) {
int sumi = 0;
#pragma unroll for (int i = 0; i < vdr; ++i) { const int vi0 = (v[i] >> 0) & 0x0F0F0F0F; const int vi1 = (v[i] >> 4) & 0x0F0F0F0F;
sumi = ggml_cuda_dp4a(vi0, u[2*i+0], sumi); sumi = ggml_cuda_dp4a(vi1, u[2*i+1], sumi); }
const float2 ds8f = __half22float2(ds8);
// second part effectively subtracts 8 from each quant value return d4 * (sumi * ds8f.x - (8*vdr/QI4_0) * ds8f.y);}逐行读:
vi0 = (v[i] >> 0) & 0x0F0F0F0F:取低 nibble,得到 4 个值。vi1 = (v[i] >> 4) & 0x0F0F0F0F:取高 nibble。- 两次
dp4a:一次做 4 个低 nibble,一次做 4 个高 nibble。vdr = 2,循环两轮,共 4 次dp4a,处理 16 个权重。 - 结果修正:
d4是权重块的 scale,ds8f.x = d(激活 scale),ds8f.y = s = d·Σq_y。常数8*vdr/QI4_0 = 8*2/4 = 4,即每轮减去 4 个值的零点(dp4a一轮处理 4 个 int8,两轮共 8 个)。等价于 。
注意最后 8*vdr/QI4_0 这个常数:它是编译期算出来的,vdr 越大,减去的项也按比例变大。这种「把块大小写进常数」的写法在每个格式的 impl 里反复出现。
Q4_K 稍复杂一点,因为它有 min 项:
static __device__ __forceinline__ float vec_dot_q4_K_q8_1_impl_vmmq( const int * v, const int * u, const uint8_t * sc, const uint8_t * m, const half2 & dm4, const float * d8) {
float sumf_d = 0.0f; float sumf_m = 0.0f;
#pragma unroll for (int i = 0; i < QR4_K; ++i) { // QR4_K = 2 个子块 const int v0i = (v[0] >> (4*i)) & 0x0F0F0F0F; const int v1i = (v[1] >> (4*i)) & 0x0F0F0F0F;
const int dot1 = ggml_cuda_dp4a(v1i, u[2*i+1], ggml_cuda_dp4a(v0i, u[2*i+0], 0)); const int dot2 = ggml_cuda_dp4a(0x01010101, u[2*i+1], ggml_cuda_dp4a(0x01010101, u[2*i+0], 0));
sumf_d += d8[i] * (dot1 * sc[i]); sumf_m += d8[i] * (dot2 * m[i]); }
const float2 dm4f = __half22float2(dm4); return dm4f.x*sumf_d - dm4f.y*sumf_m;}两个点积同时进行:dot1 是权重 nibble 与激活的乘积和;dot2 用常数 0x01010101(每个字节为 1)与激活做 dp4a,得到的就是 。这就是 q8_1 里 s 的另一种用法:如果 s 已经存了和,dot2 可以被 s/d 代替;但在 k-quant 的 impl 里,作者选择用一次额外的 dp4a 直接算出和,常数乘法的延迟比「从 half 里解出 s、再乘常数」低,而且在展开之后和主 dp4a 处于同一发射队列。
sc[i] 和 m[i] 是子块的 6-bit scale 与 min,在调用前从 scales[12] 里按位拼出来,写法刻意做成「分支无关」:
const int j = bq8_offset/2;const int jm = j & 1;const uint32_t hi = (uint32_t) -(int32_t) (j >= 2);aux[0] = (uint16_t) (((s0 & 0x3f3f) & ~hi) | ((((s4 >> 0) & 0x0f0f) | ((s0 & 0xc0c0) >> 2)) & hi));aux[1] = (uint16_t) (((s2 & 0x3f3f) & ~hi) | ((((s4 >> 4) & 0x0f0f) | ((s2 & 0xc0c0) >> 2)) & hi));注释写明这样写是为了让 nvcc 把它们提出 ncols_dst 循环——如果写成 if (j >= 2),编译器会因为分支而不能跨迭代复用;换成 hi 掩码的算术写法后,这堆位运算只依赖 iqs 和 bq8_offset,在多列循环外可以只算一次。
Q6_K 则展示了另一类修正:
const int vil = (vl[j] >> (4*i)) & 0x0F0F0F0F;const int vih = ((vh[j] >> (4*i)) << 4) & 0x30303030; // 高 2 位移到 bit4-5
// (vil | vih) - 32 for each byte, the - 32 is done by the second dp4asumi = ggml_cuda_dp4a(vil | vih, u[VDR_Q6_K_Q8_1_MMVQ*i + j], sumi);sumi = ggml_cuda_dp4a(0xE0E0E0E0, u[VDR_Q6_K_Q8_1_MMVQ*i + j], sumi);高 2 位掩码 0x30303030 只保留 bit4、bit5,拼上低 4 位就构成 0..63 的无符号值;第二行 dp4a(0xE0E0E0E0, ...) 每个字节减 32。
三个格式放在一起,模式很清楚:
| 格式 | 数据侧修正 | 常数侧补偿 | 额外项 |
|---|---|---|---|
| Q4_0 | nibble 保持 0..15 | - 8 × s | 无 |
| Q4_K | nibble 保持 0..15 | - dmin × m × Σq_y | 子块 scale、子块 min |
| Q6_K | 0..63 | dp4a(0xE0...) 的 -32 | 子块 scale |
| 格式 | 每块权重数 | 每线程每轮权重 | 每块字节 | 子块数 | 修正项 |
|---|---|---|---|---|---|
| Q4_0 | 32 | 16 | 18 | 1 | 减 8 |
| Q4_K | 256 | 16 | 144 | 8 | 减 min |
| Q6_K | 256 | 16 | 210 | 16 | 减 32 |
kernel 的形状:nwarps、rows_per_block 与 K 的切分
mul_mat_vec_q 的 grid 是三维的:
const dim3 block_nums(nblocks, nchannels_dst, nsamples_or_ntokens);const dim3 block_dims(warp_size, nwarps, 1);blockIdx.x选输出行(rows_per_block * blockIdx.x起);blockIdx.y选权重矩阵的「通道」(普通矩阵乘里是 1,MoE 里是专家编号);blockIdx.z选样本/序列;- 线程块内部是
(warp_size, nwarps),threadIdx.y是 warp 编号,threadIdx.x是 lane。
关键在 K 方向怎么切。kernel 里每个线程的起点是:
const int tid = warp_size*threadIdx.y + threadIdx.x;const int row0 = rows_per_cuda_block*blockIdx.x;const int blocks_per_row_x = ncols_x / qk;constexpr int blocks_per_iter = vdr * nwarps*warp_size / qi;
for (int kbx = tid / (qi/vdr); kbx < blocks_per_row_x; kbx += blocks_per_iter) { const int kby = kbx * (qk/QK8_1); const int kqs = vdr * (tid % (qi/vdr)); ...}以 Q4_K、nwarps=4、warp_size=32、qi=32、vdr=2 代入:blocks_per_iter = 2*4*32/32 = 8,即整个线程块每轮吃掉 8 个超级块(2048 个权重);qi/vdr = 16,即 16 个线程一组覆盖一个超级块;128 个线程正好 8 组。kby = kbx * (256/32) = kbx * 8,每个超级块对应 8 个 q8_1 块。
这样切分的好处是:每个线程的 K 方向负载是均等的,且相邻线程读的是相邻的 8 字节。一个 warp 的 32 个 lane 会读到 2 个连续的超级块(16 lane 一个),合并访问可以打满 128 字节的 cache line——虽然每个 lane 只读 8 字节,但 16 个 lane 合起来正好 128 字节,对齐时一次 L2 事务就能覆盖。
nwarps 和 rows_per_block 都没有运行期分支,而是编译期常量,来源是一张按架构分档的参数表:
static constexpr __host__ __device__ int calc_nwarps( ggml_type type, int ncols_dst, mmvq_parameter_table_id table_id, bool small_k = false, bool halve_iters = false) { if (table_id == MMVQ_PARAMETERS_GENERIC) { switch (ncols_dst) { case 1: case 2: case 3: case 4: return 4; case 5: case 6: case 7: case 8: return 2; default: return 1; } } ...}以通用表为例:
| ncols_dst | nwarps | K 的分工 | 解释 |
|---|---|---|---|
| 1 | 4 | K 切成 4 份给 4 个 warp | 一个 token 时,靠 warp 级并行填满 SM |
| 2-4 | 4 | 每列仍由 4 warp 协作 | 列数少,K 并行仍然划算 |
| 5-8 | 2 | 每列 2 warp | 列数多了,列内并行让位给列间并行 |
| >8 | — | 不走 MMVQ | 交给 MMQ |
这里的取舍是「并行度从哪来」。解码时每行输出只有一次 K 归约,K 很长(几千),单靠一个 warp 串行扫 K 会浪费 SM;把 K 切给 4 个 warp,每个 warp 只扫 1/4,最后归约一次,延迟直接降下来。但当 batch 有 8 列时,列本身就是 8 份独立工作,再把每列切 4 份就有 32 份归约和 32 份 partial sum,同步成本超过收益,于是退到 2 warp。
rows_per_block 是另一半:
static constexpr __host__ __device__ int calc_rows_per_block( ggml_type type, int ncols_dst, int table_id, bool small_k = false, int nwarps = 1) { ... switch (ncols_dst) { case 1: if (small_k) return nwarps; if (table_id == MMVQ_PARAMETERS_GB10) { return type == GGML_TYPE_IQ2_S || type == GGML_TYPE_IQ3_S ? 2 : 1; } return table_id == MMVQ_PARAMETERS_GENERIC && mmvq_two_rows_ncols1(type) ? 2 : 1; case 2: ... case 8: return 2; default: return 1; }}small_k 是一个运行期判断,编译期展开成两个 kernel 实例:
const auto should_use_small_k = [&](int c_ncols_dst) { const int nwarps = calc_nwarps(type, c_ncols_dst, table_id); // K 很短时,把一个 block 的线程挪去多算几行,别让它们闲着 return nwarps > 1 && blocks_per_row_x < nwarps * blocks_per_iter_1warp;};它解决的是「K 太短、warp 没活干」的问题。如果 ncols_x 只有 1024(4 个超级块),4 个 warp 每个只能分到 1 个块,剩下的线程全在空转;此时把 rows_per_block 提到 nwarps,让每个 warp 去算一行,反而更划算。这个判断只在 host 端做一次,kernel 里没有分支。
低比特类型在 ncols_dst == 1 时默认 rows_per_block = 2,注释写得很直白:
// Low bit types load few weight bytes per thread, a second row per block// shares the q8_1 loads and adds memory parallelism.Q1_0、Q2_K、Q3_K、IQ1_S、IQ1_M 这些格式,每个线程一轮只读很少的权重字节,瓶颈不在解包而在「等待显存」。多算一行,等于把两条独立的读请求塞进同一个 block,提高 memory-level parallelism,同时 q8_1 的激活读取还能被两行共享。
最后是 Ada/Hopper 上的 __launch_bounds__:
template <ggml_type type, int ncols_dst, bool has_fusion, bool small_k = false, bool halve_iters = false>__launch_bounds__(calc_nwarps(type, ncols_dst, get_device_table_id(), small_k, halve_iters)*ggml_cuda_get_physical_warp_size(), 1)static __global__ void mul_mat_vec_q(...)__launch_bounds__(maxThreadsPerBlock, minBlocksPerMultiprocessor) 的第二个参数是 1,意思是「每个 SM 至少能放一个这样的 block」。它让编译器知道线程块的上限,从而决定寄存器预算:MMVQ 的寄存器用量很大(tmp[ncols_dst][rows_per_block]、v、u、各种指针),如果不给上限,编译器可能为了更高的 occupancy 把寄存器压得太低,导致 spill。
归约与写出:为什么 shared memory 只用了一半
一个线程块里,nwarps 个 warp 各自算出了同一行的部分和。归约分两步:
__shared__ float tmp_shared[nwarps-1 > 0 ? nwarps-1 : 1][ncols_dst][rows_per_block][warp_size];
if (threadIdx.y > 0) { for (int j = 0; j < ncols_dst; ++j) for (int i = 0; i < rows_per_block; ++i) tmp_shared[threadIdx.y-1][j][i][threadIdx.x] = tmp[j][i];}__syncthreads();if (threadIdx.y > 0) return; // warp 0 留下来做归约
dst += sample_dst*stride_sample_dst + channel_dst*stride_channel_dst + row0;
for (int j = 0; j < ncols_dst; ++j) for (int i = 0; i < rows_per_block; ++i) { for (int l = 0; l < nwarps-1; ++l) tmp[j][i] += tmp_shared[l][j][i][threadIdx.x]; tmp[j][i] = warp_reduce_sum<warp_size>(tmp[j][i]); if (threadIdx.x == i && (rows_per_block == 1 || uint32_t(row0 + i) < stride_col_dst)) dst[j*stride_col_dst + i] = result; }几个细节:
- shared memory 只存
nwarps-1份。warp 0 的 partial sum 留在寄存器里,不用写出去也不读回来,省掉一份 shared 流量和一次读写往返。 - warp 0 的 lane 直接做向量归约。每个 lane 拿到的是「同一行、同一列、同一 K 切片」在其它 warp 的部分和,加上自己的,再用
warp_reduce_sum把 32 个 lane 的 K 切片加起来。整个归约没有第二次__syncthreads,因为写 shared 的 warp 已经 return 了。 - 写出只用
threadIdx.x == i的 lane。rows_per_block最多是 2,所以只有 lane 0 和 lane 1 真正写dst,其它 lane 的结果在warp_reduce_sum里已经被合并。这避免了「32 个 lane 同时写同一地址」的竞争,也省掉一次if (lane==0)之外的判断。 row0 + i < stride_col_dst的谓词只在rows_per_block == 2时需要,防止最后一行越界。
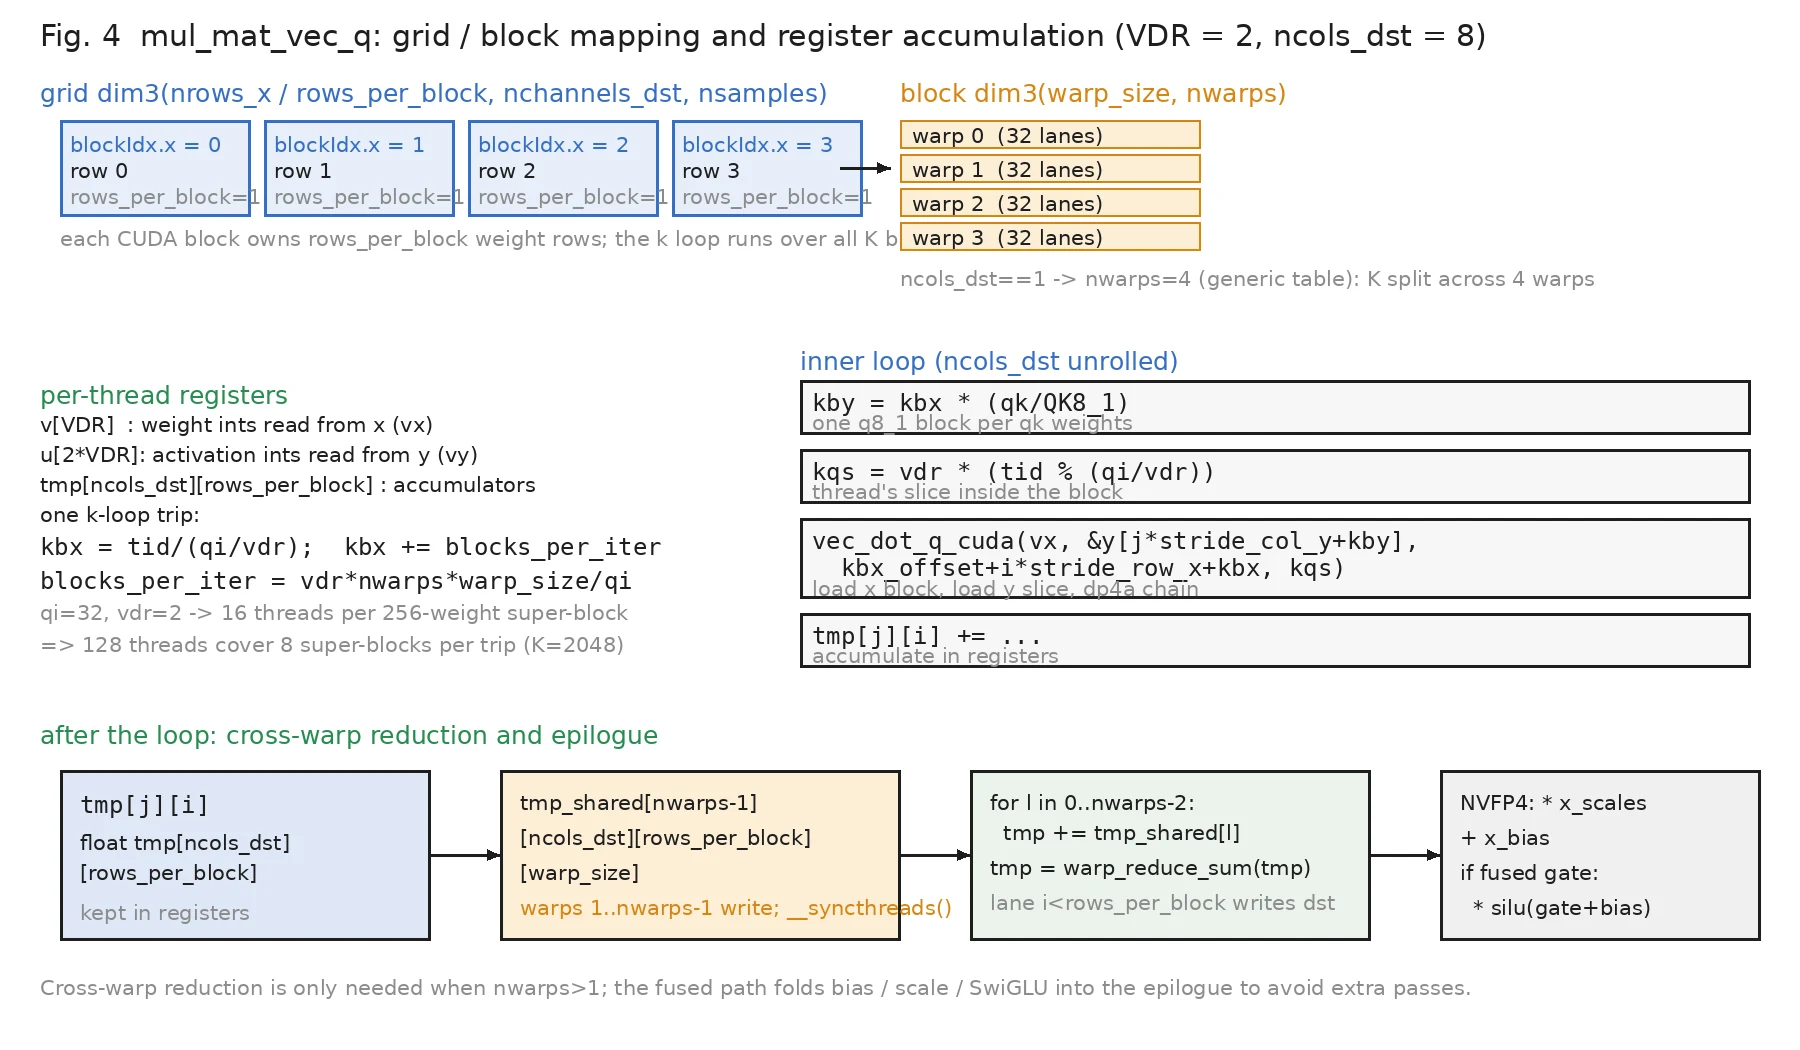
这张图把一次 launch 的生命周期串起来:grid 在行方向铺开,block 内 nwarps 个 warp 分 K,寄存器里累加,shared 里汇总,warp 0 做最终归约,epilogue 里再叠 bias、scale 和 GLU。图里没有画出的部分是 ncols_dst 循环:它把上述流程对每一列重复一遍,列与列之间共享同一份权重读取(但各自解码,这一点下一节展开)。
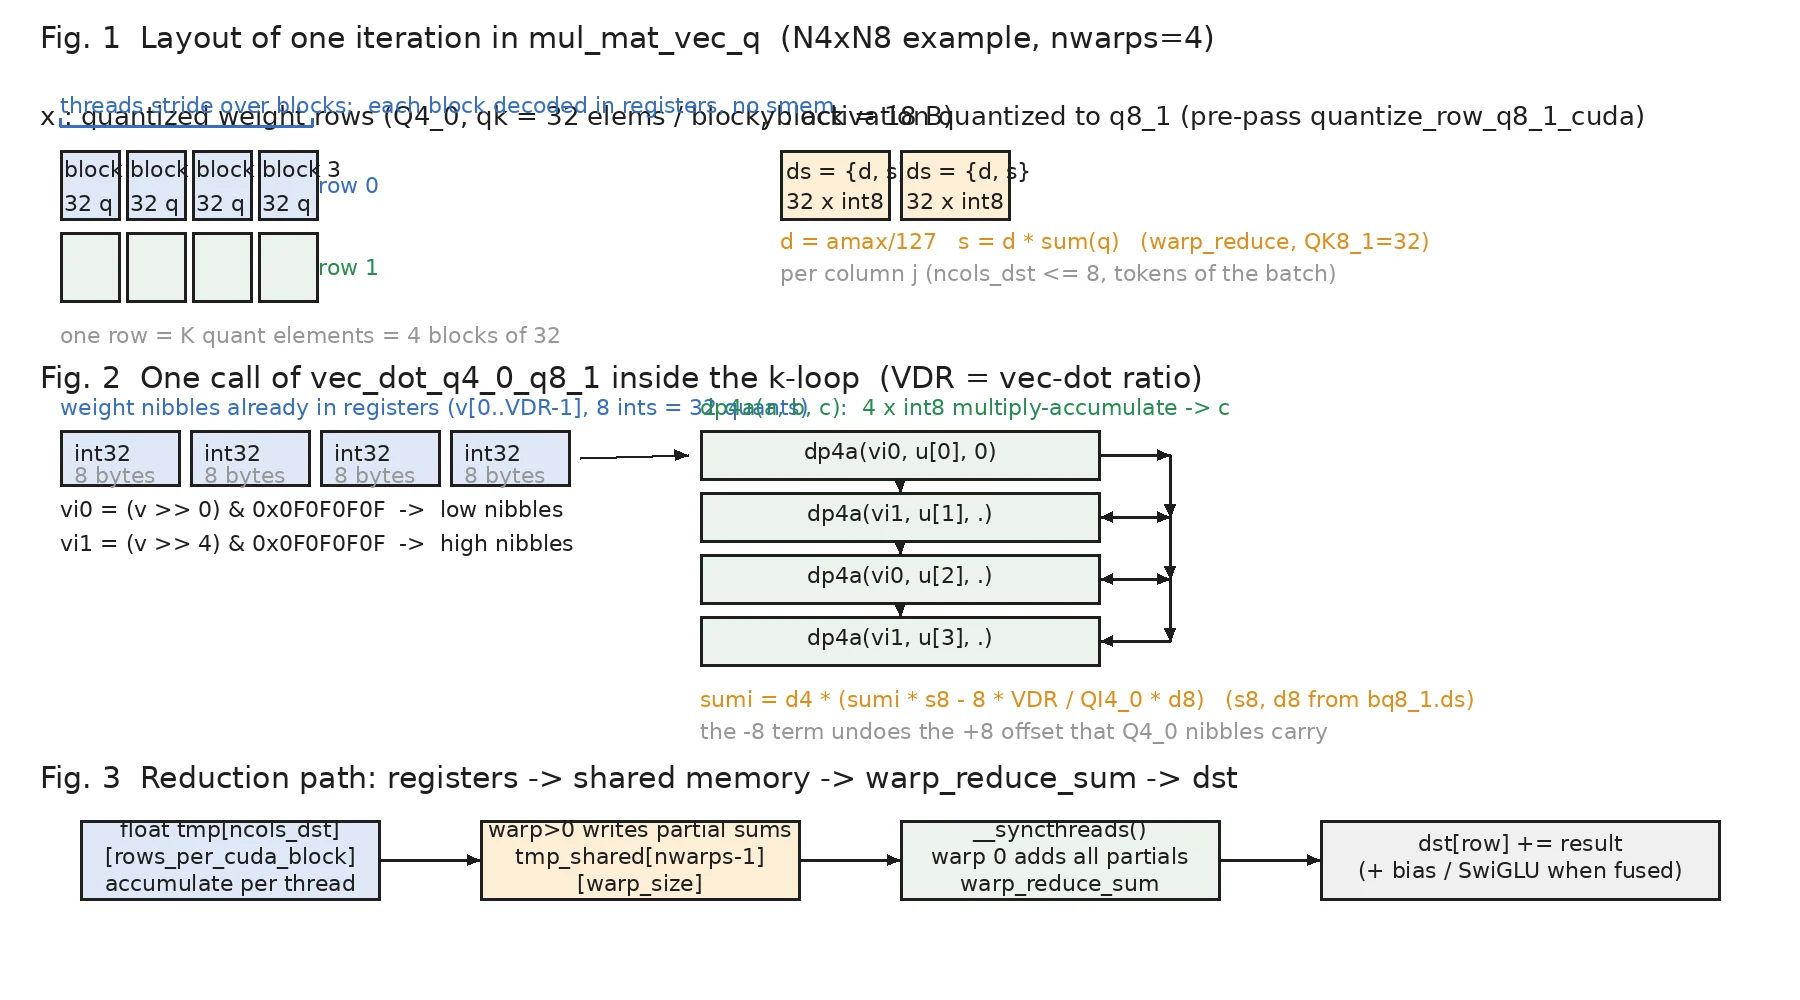
前面那张布局图则给出了更微观的对应关系:一个 block 负责 rows_per_block 行;一个 warp 的 32 个 lane 按 qi/vdr 分组覆盖量化块;每个线程的 v、u、tmp 三组寄存器分别对应权重、激活和累加器。
融合:把 gate、bias 和 SwiGLU 塞进同一个 kernel
FFN 的常见写法是 down(silu(gate(x)) * up(x))。朴素实现是三次矩阵乘加一个逐元素 GLU,中间结果要写回显存再读出来。对解码这种带宽受限的场景,中间激活只有几千个 float(几十 KB),流量不大,但三次 kernel launch 和两次 global memory 往返的延迟是实打实的。
mul_mat_vec_q 支持把 gate 的权重读取和 up 的结果在同一个 kernel 里算完,并在 epilogue 里直接做 GLU:
struct ggml_cuda_mm_fusion_args_device { const void * gate; const void * x_bias; const void * gate_bias; const void * x_scale; const void * gate_scale; ggml_glu_op glu_op; float glu_limit; const void * shared_up; const void * shared_gate; float * shared_dst; uint32_t shared_stride_col_dst;};这段结构体的字段说明了它能融合的东西:gate 权重、两个 bias、NVFP4 的 per-expert scale、GLU 类型与 clamp 上限,以及 MoE 共享专家的 up/gate/dst。对应到 epilogue:
if (threadIdx.x == i && (rows_per_cuda_block == 1 || uint32_t(row0 + i) < stride_col_dst)) { float result = tmp[j][i]; if constexpr (has_fusion) { if constexpr (type == GGML_TYPE_NVFP4) result *= x_scales; result += x_biases[j]; if (use_gate) { float gate_value = tmp_gate[j][i]; if constexpr (type == GGML_TYPE_NVFP4) gate_value *= gate_scales; gate_value += gate_biases[j]; switch (active_glu) { case GGML_GLU_OP_SWIGLU: result *= ggml_cuda_op_silu_single(gate_value); break; case GGML_GLU_OP_GEGLU: result *= ggml_cuda_op_gelu_single(gate_value); break; case GGML_GLU_OP_SWIGLU_OAI: result = ggml_cuda_op_swiglu_oai_single(gate_value, result); break; case GGML_GLU_OP_SWIGLU_CLAMP:result = ggml_cuda_op_swiglu_clamp_single(gate_value, result, glu_limit); break; default: result = result * gate_value; break; } } } dst[j*stride_col_dst + i] = result;}注意 tmp_gate 和 tmp 是同时累加的:内层循环里对每个 vec_dot 调用两次,一次读 vx(up 权重),一次读 vgate(gate 权重)。所以融合并不减少权重流量——gate 的权重本来就要读——它省的是「把 up 结果写出去、再读回来做 GLU」这一趟,以及一次 launch。
融合的判定在 ggml-cuda.cu 的图优化阶段,不是用户开关:
static bool ggml_cuda_should_fuse_mul_mat_vec_q(const ggml_tensor * tensor) { ... bool use_mul_mat_vec_q = ggml_is_quantized(src0->type) && !bad_padding_clear && src1->type == GGML_TYPE_F32 && dst->type == GGML_TYPE_F32 && src1->ne[1] <= MMVQ_MAX_BATCH_SIZE; // fusion is not universally faster on Pascal const int cc = ggml_cuda_info().devices[ggml_cuda_get_device()].cc; if (cc <= GGML_CUDA_CC_PASCAL) return false; if (tensor->op == GGML_OP_MUL_MAT && dst->ne[1] != 1) return false; if (tensor->op == GGML_OP_MUL_MAT_ID && dst->ne[2] > get_mmvq_mmid_max_batch(src0->type, cc)) return false; return use_mul_mat_vec_q;}条件很严:
src1->ne[1] == 1(普通矩阵乘)或 MoE 的ne2在上限内,即「一次只有一个 token 的列」;- Pascal 及更老的卡不融合(寄存器压力和指令延迟不划算);
bad_padding_clear的情形不融合。这个条件值得单独说:kernel 会把src0的 padding 清零,如果src0是另一个张量的视图、且 buffer 是临时计算缓冲,清零会破坏别人的数据,只能退回非融合路径或 cuBLAS。
MoE 的共享专家还有一条额外的融合:一个 MoE 层通常有「路由专家」和「共享专家」两组 FFN,拓扑相同、权重不同。ggml_cuda_match_shared_expert 会在图里找到这两组 MUL_MAT_ID + MUL_MAT_ID + GLU 的模式,把共享专家的最后一次 blockIdx.y 复用同一个 kernel launch:
const bool shared_expert = has_fusion && fusion.shared_up && blockIdx.y == gridDim.y - 1;const uint32_t channel_dst = shared_expert ? 0 : blockIdx.y;if (shared_expert) { vx = fusion.shared_up; dst = fusion.shared_dst; stride_col_dst = fusion.shared_stride_col_dst;}也就是说 grid 的 y 维是 n_experts + 1:前 n_experts 个 block 处理路由专家,最后一个处理共享专家。共享专家对所有 token 都生效,所以它的 channel_dst 固定为 0。这个设计把「共享专家」从一次单独的 launch 变成一个额外的 grid 切片,省掉一次 kernel 和一次调度。
MoE:一个 warp 一个 token 的专用 kernel
MoE 的 mul_mat_id 和普通矩阵乘的区别在于:每个 token 被路由到不同的专家,权重矩阵按 ids 间接索引。如果直接复用 mul_mat_vec_q,blockIdx.y 是专家编号,ncols_dst 是 token 数,但每个专家看到的 token 数不一样,grid 会在「专家 × 全部 token」上铺开,大量 block 做无效功。
mmvq.cu 另有一个专用 kernel:
// Dedicated MoE multi-token kernel.// Grid: (ceil(nrows_x / c_rows_per_block), nchannels_dst)// Block: (warp_size, ncols_dst) - each warp handles one token independently.// No shared memory reduction needed since each warp works alone.template <ggml_type type, int c_rows_per_block, bool has_fusion = false>static __global__ void mul_mat_vec_q_moe(...)三处关键差异:
- block 形状是
(warp_size, ncols_dst),threadIdx.y不再是「第几个 K 切片」,而是「第几个 token」。一个 warp 独立负责一个 token 的整行点积,K 不再跨 warp 切分。 - 不需要 shared memory 归约。一个 warp 内部用
warp_reduce_sum就能完成 K 归约,没有跨 warp 的部分和,也就没有__syncthreads。 rows_per_block = 2固定,注释说这是调参结果:
constexpr int rows_per_block = 2; // 2 gives best perf based on tuningconst dim3 block_nums(nblocks_rows, nchannels_dst + (fusion.shared_up != nullptr));const dim3 block_dims(warp_size, ncols_dst);为什么 MoE 反而要「一个 warp 一个 token」?因为 MoE 的并行度来源不同:路由专家有几十上百个,每个专家只处理少量 token,grid 的 y 维已经提供了大量并行 block;此时再把 K 切给多个 warp,只会让每个 warp 的 K 更短、归约更多,不划算。一个 warp 扫完整行,延迟由 K 决定,但不同专家/不同 token 的 warp 之间完全独立,SM 的占用率由 grid 规模保证。
代价是:ncols_dst 个 token 共享同一组权重时,每个 token 的 warp 都要各自解码一遍权重。这正是 MoE 下 get_mmvq_mmid_max_batch 阈值更保守的原因——token 越多,重复解码越多,超过阈值就该换 MMQ(它把权重解码摊到一个 tile 的所有列上)。
多个 token 时,MMVQ 到底亏在哪
把 ncols_dst 个 token 放进同一个 kernel 后,内层循环长这样:
for (int kbx = ...; kbx < blocks_per_row_x; kbx += blocks_per_iter) { for (int j = 0; j < ncols_dst; ++j) { for (int i = 0; i < rows_per_block; ++i) { tmp[j][i] += vec_dot_q_cuda(vx, &y[j*stride_col_y + kby], kbx_offset + i*stride_row_x + kbx, kqs); } }}注意 vec_dot_q_cuda 的第一个参数是 vx,每次调用都会重新读一遍权重块并解码。虽然这些读大概率命中 L1/L2(同一个 block 内 ncols_dst 次访问同一地址),但解包、位运算、scale 查表是实打实的指令,ncols_dst 越大,这部分重复计算越多。
MMQ 的做法相反:权重 tile 搬进 shared memory 后只解一次,所有列共用。所以分界点取决于「解码成本 / 权重字节」与「列数」的比值:
- Q4_0 这样的简单格式,解码就是两次移位和掩码,重复 8 次也不贵,阈值可以到 8;
- Q2_K/Q3_K 这类格式,每个超级块要拆 6-bit scale、处理 min、做多次
dp4a修正,解码成本高得多,Ada 上 Q2_K 只允许 4 列、Q3_K 只允许 6 列; - Blackwell 上 Q4_K 也只允许 5 列——新一代卡的 MMQ 相对更快,MMVQ 的窗口反而更窄。
这也是为什么 should_use_mmvq 的注释要写「k-quants cost more to decode and mvq redoes that per column」。它解释的不是一个实现细节,而是整张阈值表的来源。
同样的取舍在其它系统里表现为「主循环里要不要放反量化」。W8A8 的主循环只有 tensor core 操作,反量化全部在 epilogue 里,循环体短、流水顺;W4A16 和 W4A4 则必须把权重的解包塞进主循环,循环体变长,反过来又决定了它们对 batch 尺寸的敏感度。MMVQ 属于后一种,区别只是它连 epilogue 里的「乘 scale」都尽量提前算进了常数。
性能直觉:一次 decode step 到底在等什么
以上所有设计最终落到一个数字上:一次 decode step 的耗时 ≈ 权重字节数 / 有效带宽。
以 7B Q4_K 为例,权重约 3.9 GB。A100 80GB 的 HBM 峰值约 2.0 TB/s,按有效带宽 80% 估算就是 1.6 TB/s,一步的理想下界约 2.4 ms;H100 的峰值约 3.35 TB/s,下界降到 1.5 ms 左右。实际 decode step 还要加上 K 归约、激活量化、采样与 CPU 调度,通常在 4 到 8 ms 之间。这个区间里,MMVQ kernel 本身占比最大的一直是「读权重」。
几件事对带宽的有效利用率影响最大:
- 合并访问。相邻 lane 读相邻块,16 lane 覆盖 128 字节。kernel 里用
kqs = vdr * (tid % (qi/vdr))把线程和块内偏移绑定,就是为了让连续线程拿到连续地址。 - K 并行度。
nwarps决定同一时刻有多少个独立的读请求在飞;warp 太少,MLP 不够,延迟暴露;warp 太多,归约和寄存器压力上来。 - 寄存器而非 shared。权重块只读一次、马上解码成寄存器,不进 shared memory,省掉的是一次写 shared + 读 shared。
- 融合。bias、scale、GLU 在 epilogue 里做,省掉中间激活的 global 往返。
- L2 命中。多 token 时,
ncols_dst次访问同一权重块,如果 L2 能装下这个 block 的工作集,重复解码的「读」是便宜的,贵的只是指令;这也是 MMVQ 在 8 列以内仍然不亏的原因之一。
反过来,这些优化都不改变一个事实:解码是带宽受限的,再多的算术优化也压不下一整个数量级。真正的数量级来自别的地方——投机解码让一步产出多个 token(详见 vLLM 投机解码)、专家并行把权重摊到多张卡、量化继续往低比特走(见 GGUF 完全拆解 中 k-quants 的块布局)。MMVQ 只是把这些手段用足之后,那个「最后一公里」的 kernel。
一次 launch 的参数账:4096×4096 的 Q4_K 层
把前面的规则套到一个具体形状上,会看得更清楚。假设某一层的权重是 4096 行 × 4096 列,Q4_K 量化,单 token 解码,A100(warp_size=32、通用参数表):
qk = 256,blocks_per_row_x = 4096/256 = 16个超级块;vdr = 2、qi = 32,nwarps = 4,blocks_per_iter = 2*4*32/32 = 8;rows_per_block = 1(Q4_K 不在mmvq_two_rows_ncols1名单里),所以 grid.x = 4096;- 每个线程负责
16/8 = 2轮,每轮 16 个权重,共 32 个权重; - 线程总数 = 4096 个 block × 128 线程 = 524288;524288 × 32 = 16777216,正好等于 4096 × 4096。
这组数字说明两件事。第一,每个线程的活非常少:32 个权重、8 次左右的 dp4a,其余时间都在等内存。第二,线程数远大于权重元素数除以每线程权重数以外的任何并行维度——没有多余的并行度可以挖,只能靠提高单线程的访存效率。
再看每个 block 的访存:128 个线程、每轮 8 个超级块,每个超级块 144 字节,一轮读 1152 字节权重;两轮共 2304 字节。16 个 lane 覆盖一个超级块里的 128 字节 qs 段,因为块是按 144 字节紧密排列、qs 前面还有 12 字节的 scales,这段 128 字节通常跨两个 cache line。block_q4_K 把 qs 放成连续的 128 字节、scales 和 dm 单独放在块头,正是为了让主循环只扫这一段连续数据;12 字节的 scales 和 4 字节的 dm 每块只读一次,由 16 个 lane 共享(命中 L1 后就是广播),不会打断主访问流。
同一层在 Hopper 上还有个小优化:PDL(Programmatic Dependent Launch)。quantize_q8_1 在结尾调用 ggml_cuda_pdl_lc()(cudaTriggerProgrammaticLaunchCompletion),mul_mat_vec_q 在开头调用 ggml_cuda_pdl_sync()(cudaGridDependencySynchronize)。前一个 kernel 还没完全退出时,后一个就可以开始启动、加载参数;真正读 y 之前再同步一次。对一个只有几十微秒的 kernel,launch 延迟和尾部气泡是实打实的占比,PDL 把这部分重叠掉了。这段代码只在 GGML_CUDA_USE_PDL 且 __CUDA_ARCH__ >= Hopper 时编译进去,老卡上就是空函数。
正确性上的几个坑
kernel 里有几处看起来与性能无关、但少一个就会算错的细节。
权重行的补齐。MATRIX_ROW_PADDING = 512,权重张量的最后一维会被补到 512 的倍数:
if (ne0 % MATRIX_ROW_PADDING != 0) { size += ggml_row_size(tensor->type, MATRIX_ROW_PADDING - ne0 % MATRIX_ROW_PADDING);}这样 K 循环可以无条件按块读,不会在最后一块越界。代价是 padding 区域的字节必须为 0,否则会被当成真实权重参与点积。对持久化的权重,GGUF 文件里这些字节本来就是 0;对临时计算出来的量化权重(比如运行期量化的激活转成权重),代码要显式清零:
if (ggml_backend_buffer_get_usage(src0->buffer) == GGML_BACKEND_BUFFER_USAGE_COMPUTE) { const size_t size_data = ggml_nbytes(src0); const size_t size_alloc = ggml_backend_buffer_get_alloc_size(src0->buffer, src0); if (size_alloc > size_data) { CUDA_CHECK(cudaMemsetAsync((char *) src0->data + size_data, 0, size_alloc - size_data, stream)); }}这也是 bad_padding_clear 那个判据的由来:如果 src0 是视图、清零会破坏视图背后的真实数据,就只能放弃 MMVQ,退回不会写 src0 的路径。
激活的补齐与 stride。激活按 ne10_padded = GGML_PAD(ne10, 512) 补齐后量化,之后所有 stride 都用补齐后的值:
const int64_t s11 = ne10_padded / QK8_1;kernel 里的 kby 和 stride_col_y 都基于这个值。如果这里用了未补齐的 ne10,y[j*stride_col_y + kby] 会读到上一列的数据——结果不会崩,但数值是错的。这类错误很难在单元测试里发现,只能靠形状推导。
MoE 的 ids 与 fastdiv。mul_mat_id 的 blockIdx.y 是「输出通道」,要映射到权重矩阵的专家编号,需要查 ids。kernel 里对两种情况分开处理:
channel_x = shared_expert ? 0 : ncols_dst == 1 && ids ? ids[channel_dst] : fastdiv(channel_dst, channel_ratio);channel_y = ncols_dst == 1 && ids ? fastmodulo(channel_dst, nchannels_y) : channel_dst;单 token 时直接查表;多 token 时 channel_ratio 是整数倍关系,用 fastdiv / fastmodulo(预计算倒数)代替除法。MoE 的 grid 在每个 step 都会变,除法在热路径上,这个替换不是微优化,而是必要的。
alignment。get_int_b2 假设 2 字节对齐、get_int_b4 假设 4 字节对齐。block_q4_0 的 qs 紧跟在 2 字节的 d 后面,所以只能按 2 字节读;block_q8_1 的 qs 前面是 4 字节的 ds,可以按 4 字节读。这些假设写在函数注释里,改布局时必须一起改,否则在严格对齐的架构上会触发 misaligned access。
和其他框架里对应物对照
同样的「量化权重 × 向量」问题,各个框架给出的答案差别很有意思:
| 框架 | 解码矩阵乘 | 特点 |
|---|---|---|
| llama.cpp(本项目) | mul_mat_vec_q | dp4a + 寄存器累加,按量化格式和架构各一套参数表 |
| Marlin(vLLM 等) | W4A16 GEMM | tensor core 的 MMA 指令,权重重排成 MMA fragment 布局,batch 更大时更有优势;见 Marlin 完全拆解 |
| QServe | W4A8 GEMM | 激活也量化到 int8,GEMM 用 tensor core,逐通道精调与 progressive 量化降低 W4A8 误差 |
| TensorRT-LLM | fused QGEMM / FMHA | 构建期与运行期两层拆分,解码路径使用专门的低延迟 GEMM |
这些路径的共同点是「尽量用 tensor core」,而 llama.cpp 的 MMVQ 选择「dp4a + 寄存器」。原因不是技术选择上的偏好,而是使用场景:
- llama.cpp 的目标是消费级与边缘设备(笔记本、Mac、手机、Jetson),老卡甚至没有
dp4a,dp4a的可用性远高于 tensor core; - 量化格式是 GGUF/k-quants,块内布局是为 CPU SIMD 与
dp4a设计的,搬到 MMA fragment 需要额外的重排; - 解码时 batch 很小,tensor core 的利用率低,MMA 的优势发挥不出来。
当这些前提变化时——比如在数据中心卡上做大 batch 服务——MMVQ 就会被 MMQ(或者其它框架的 tensor core 路径)取代,这也是 should_use_mmvq 阈值存在的意义。
读 mmvq.cu 的入口顺序
如果要把这一千六百行从头读一遍,推荐的顺序不是从上往下,而是从调用链倒推:
ggml-cuda.cu的ggml_cuda_mul_mat:看清楚 MMVQ 在分派链的位置和判据;ggml_cuda_mul_mat_vec_q:host 端 wrapper,看清量化、padding、stride 和 layout 的换算;mul_mat_vec_q_switch_type→mul_mat_vec_q_switch_ncols_dst→mul_mat_vec_q_switch_fusion:三层模板分派,每一层对应一个「编译期常量」,读到这里就明白为什么 kernel 有上百个实例;calc_launch_params/calc_nwarps/calc_rows_per_block:参数表与 shape 的关系;mul_mat_vec_q本体:grid/block 映射、K 循环、归约、epilogue;mul_mat_vec_q_moe:MoE 专用版本,对比看差异;vecdotq.cuh里对应格式的vec_dot_*_q8_1:点积的具体实现。
按这个顺序,每一层都能回答「上一层为什么这样调用」,不会在模板分派里迷失。
为什么没有「预先重排成最优布局」
一个常见的疑问是:既然 k-quants 的块布局是为 dp4a 设计的,为什么不干脆在加载时把权重重排成「每个线程一轮读 128 字节连续」的完美布局,彻底消除跨 cache line?
ggml 里确实有 repack 机制(ggml-cuda 的 mmq 路径对部分格式支持 repack),但 MMVQ 没有走这条路,原因有几个:
- repack 需要额外的显存副本。7B 模型 4 GB 权重,再存一份同等大小的副本,显存占用接近翻倍;对消费级卡来说,能不能装下模型比几个百分点的带宽利用率更重要。
- repack 需要额外的加载时间和显存峰值,在 llama.cpp 的「启动快、显存省」的设计目标下不划算。
- 16 lane 读连续的 144 字节,会跨 1 到 2 个 128 字节的 cache line;跨出去的那部分字节大概率被相邻 lane 组或相邻 block 用到,实际浪费远小于「每块都多读 128 字节」的最坏估计。
MMQ 之所以更愿意做重排,是因为它对同一个权重 tile 要服务多列,重排的收益被列数放大;MMVQ 只有一两列,收益不抵成本。这又是一个「形状决定实现」的例子。
小结
mul_mat_vec_q 是 llama.cpp 在解码场景下的核心 kernel,它的设计可以压缩成几条原则:
- 带宽是唯一的约束:不做 shared memory 分块,权重读一次、在寄存器里解码一次,算完就走;
- 格式决定循环:块大小、VDR、子块数都在编译期固化,循环体内没有分支;
- 符号搬到常数里:nibble 永远是无符号的,零点、min、偏移通过
s和dp4a常数修正; - 并行度按形状调整:K 长时切 K,列多时切列,K 短时多算几行,全部在 host 端决定、编译期展开;
- 能融合就融合:gate、bias、scale、GLU 在 epilogue 里做,省一次 launch 和一趟激活往返。
理解了这五条,再看 mmvq.cu 里那些看似随意的数字——nwarps=4、rows_per_block=2、Q2_K 只许 4 列——它们都是这些原则在具体架构和量化格式上的落点,而不是玄学。
下一篇将转向 llama.cpp 的另一条解码路径:mul_mat_vec_f,即 FP16/BF16 权重在没有量化时的向量乘,以及它与 tensor core 的取舍。
参考资料
- llama.cpp CUDA 后端源码(ggml/src/ggml-cuda)
- llama.cpp ggml-common.h:量化块结构定义
- NVIDIA PTX ISA:dp4a 指令说明
- nuQmm: Quantized MatMul for Efficient Inference of Large-Scale Generative Language Models (arXiv:2206.09557)
- QServe: W4A8KV4 Quantization and System Co-design for Efficient LLM Serving (arXiv:2405.04532)
- Marlin: Mixed Auto-Regressive Linear kernel(llm-awq 仓库)
- llama.cpp Pull Request #1684:k-quants 引入与困惑度对比
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



