


llama.cpp 源码完全拆解(八):服务化与调度——server-context 如何把一次前向变成多用户服务
引言:前七篇讲「一次前向怎么算」,这一篇讲「多个用户怎么排队」
前七篇把 llama.cpp 的执行侧从下到上讲完了:第一篇铺开整张源码地图,第二篇讲 ggml 的惰性张量与调度器的切图,第三篇讲 GGUF 装载与张量放置,第四篇讲 llama_context 与记忆系统(KV 缓存、单元记账、槽位分配、掩码构造),第五篇讲采样与语法约束,第六篇讲 llama-graph 如何把模型结构翻译成 ggml 图,第七篇讲后端与 kernel(mmq、flash-attn、CPU repack)。
这七篇有一个共同的前提:一个 llama_context、一条序列、一次 llama_decode。真实的部署场景不是这样。一台跑 llama-server 的机器上同时有几十个用户,各自发来不同长度的 prompt,各自以不同的速度消费流式输出;有的请求刚进来要处理几千 token 的 prefill,有的请求正在逐 token 生成;显存里只有一块 KV 缓存,服务器要决定「这一轮把哪些 slot 的哪些 token 拼进同一个 batch」。这套逻辑既不在 ggml 里,也不在 llama_context 里,它在 tools/server/ 目录下。
这一篇要回答的问题:
- 一个 HTTP 请求从进入进程到拿到第一个 token,中间经过几个线程、几次队列传递?
--parallel到底并行的是什么?「slot」是一个什么样的数据结构,它凭什么能承载一条独立的对话?- 连续批处理(continuous batching)在 llama.cpp 里的最小形态是什么样:谁来组装 batch、谁来回收 slot?
- 多序列共享前缀的场景下,KV 缓存怎么复用?llama.cpp 没有 radix tree,它用什么记账?
- 上下文写满时(
n_ctx溢出),服务器如何决定「丢掉谁的历史」? - 流式输出、stop string、部分 UTF-8 这些看起来是「接口层」的问题,为什么会影响调度循环?
站内已有 连续批处理完全拆解:Orca 的迭代级调度与选择性批处理 从 Orca 论文的角度讲过调度理论,也有 vLLM 源码完全拆解(三):Scheduler.schedule 如何分配 Token 预算与 KV Block 与 SGLang 源码完全拆解(三):Scheduler 请求状态机如何闭环 两个工业级调度器的实现。这一篇补的是第三个视角:一个以 CPU 与端侧为主战场、没有块表也没有 radix tree 的最小服务实现——它的调度循环短到可以在一屏里看完骨架,但每个设计决策都能对上前面几篇讲过的底层机制。
进程与线程拓扑:谁在等谁
先把 tools/server/ 的文件摊开。与本文直接相关的有五个:server.cpp(约 260 KB,HTTP 路由注册与 CLI 入口)、server-context.cpp(约 258 KB,服务核心:server_context_impl、server_slot、调度循环)、server-task.cpp(约 66 KB,请求参数的 JSON 解析与响应格式化)、server-http.cpp(约 36 KB,基于 cpp-httplib 的传输层)、server-queue.cpp(约 22 KB,任务队列与主循环)。
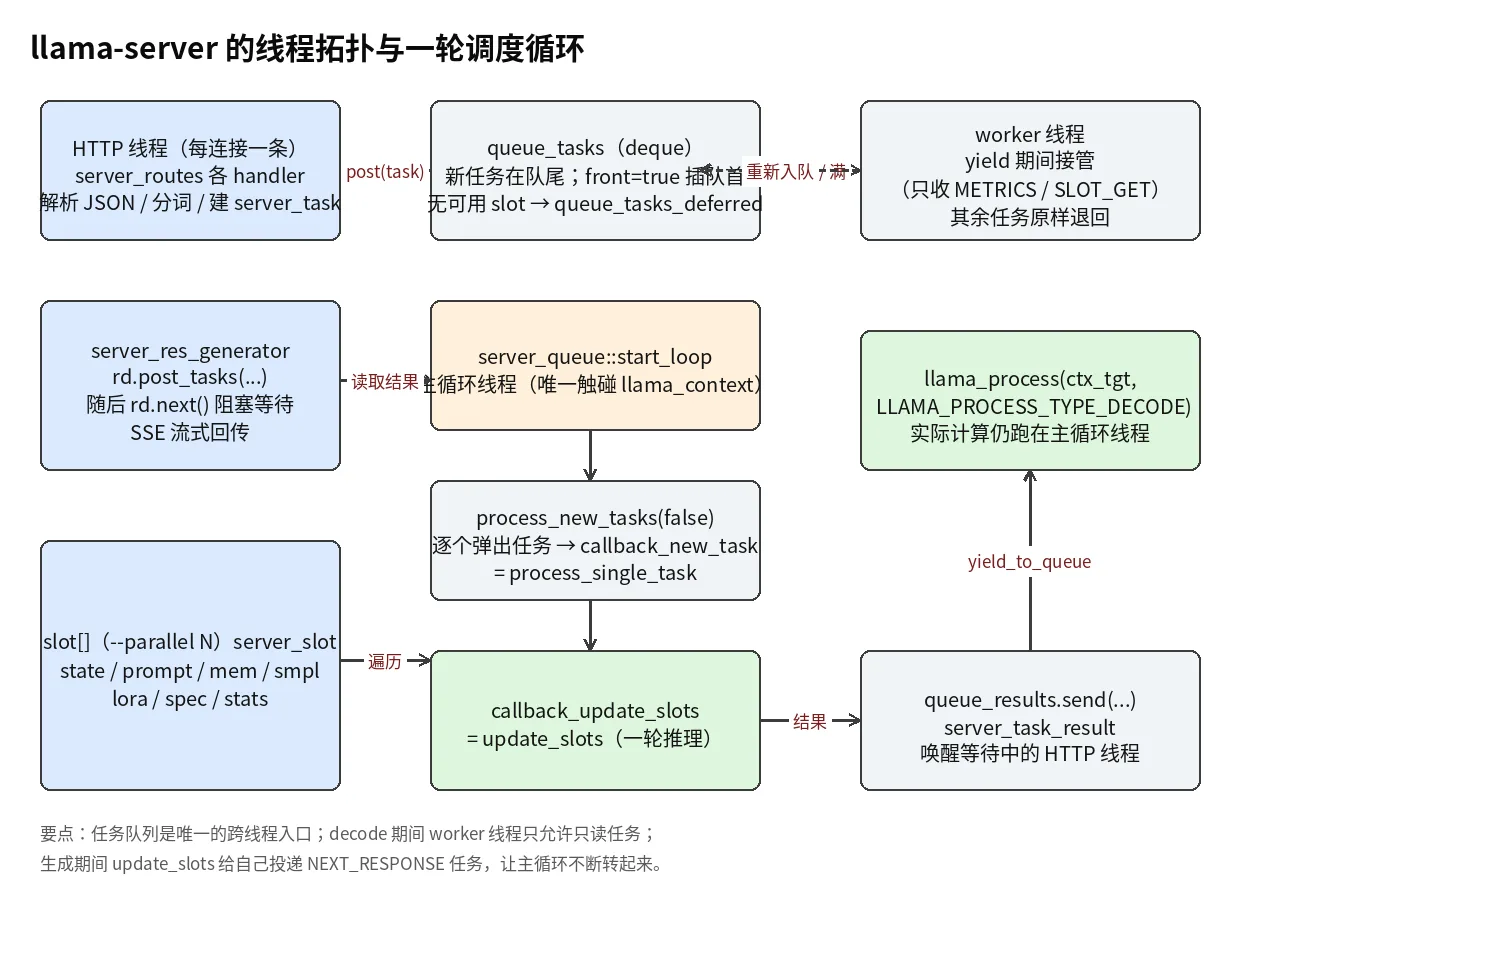
和 vLLM、SGLang 那种「一个进程内多进程/多线程分工、多个 EngineCore」的结构不同,llama-server 的并发模型非常克制:一个 llama_context、一个主循环线程、一组 HTTP 线程。理解这套服务的关键,是搞清楚「一次 llama_decode 到底在哪个线程上跑」,以及「GPU 在算的时候,谁来接新请求」。
三套队列:tasks、results 与 deferred
server_queue(server-queue.h)里挂着三个 std::deque<server_task>:
| 队列 | 用途 |
|---|---|
queue_tasks | 主任务队列,按到达顺序排队,支持从队首插入(高优先级) |
queue_tasks_deferred | 暂缓队列:当前没有可用 slot 时,请求先到这里等 |
queue_tasks_unhandled | 让位期间的「退回件」:worker 线程试探性取走的任务 |
任务与结果的传递是两套独立队列:queue_tasks 负责「活儿」,server_response 负责「结果」。每个请求在入队时会用 add_waiting_task_id 登记自己的 task id,然后阻塞在 recv() 上等结果;update_slots 侧产出 token 后,用 queue_results.send(...) 把 server_task_result 对象投进结果队列,唤醒等待中的 HTTP 线程。「任务队列 + 结果队列 + 等待 id 集合」这套模式,本质上是一个进程内的 actor 系统:HTTP 线程只做协议适配,所有接触 llama_context 的动作都被收敛到主循环线程。
main loop:start_loop 的五步循环
server_context::start_loop() 只有一行实质代码——把控制权交给 server_queue::start_loop(idle_sleep_ms),其中 idle_sleep_ms 来自 --sleep-idle-seconds 参数(睡眠机制后面再讲)。主循环的骨架是:
void server_queue::start_loop(int64_t idle_sleep_ms) { running = true; // ... while (true) { if (process_new_tasks(false)) { break; // terminate }
// all tasks in the current loop is processed, slots data is now ready callback_update_slots();
// wait for new tasks (max 1s), then check sleeping condition while (true) { /* ... */ } }}process_new_tasks把queue_tasks里的任务逐个取出,交给注册进来的callback_new_task——它就是server_context_impl::process_single_task。注意锁的粒度:取出任务的那一刻就lock.unlock(),因为回调里可能会再生产新任务(例如launch_slot_with_task失败时给自己发错误结果),拿着锁调用会死锁。- 队列排空后,调用
callback_update_slots——它就是server_context_impl::update_slots,也就是「这一轮推理」。整个服务只有一个地方调用llama_decode,就是这里。 - 之后进入等待:没有新任务就最多睡 1 秒,醒来检查一次「闲置降级」(sleeping)条件。
update_slots 内部还有一条自我驱动的细节:只要有任意一个 slot 还在处理中,它就给自己投递一个 SERVER_TASK_TYPE_NEXT_RESPONSE 任务:
} else { SRV_DBG("%s", "posting NEXT_RESPONSE\n");
server_task task(SERVER_TASK_TYPE_NEXT_RESPONSE); task.id = queue_tasks.get_new_id(); queue_tasks.post(std::move(task));}这个任务的处理函数是空的(case SERVER_TASK_TYPE_NEXT_RESPONSE: { // do nothing }),唯一作用是让主循环的等待条件立刻满足,从而马上回到 update_slots 再跑一轮。「一个空任务当心跳」是这套循环最省事的地方:生成期间主循环永远不会真正休眠,而所有跨线程的通信(新请求、取消、指标查询)都通过任务队列被自然地插进每轮迭代之间。
worker 线程与 yield_to_queue:解码期间还能收指标
llama_decode 可能跑上百毫秒,如果这期间主循环线程被完全占用,/metrics 之类的只读请求就要排队等。为此 server_queue 额外维护了一个 worker 线程,通过 yield_to_queue 实现「算力的让位」:
void server_queue::yield_to_queue(std::function<void()> && work) { // ... { std::unique_lock<std::mutex> lock(mutex_tasks); GGML_ASSERT(!worker.busy && "yield_to_queue() cannot be nested"); worker.busy = true; worker.yielding = true; } worker.cv.notify_one();
// run the work on the current thread, so that all ggml compute stays on the same thread std::exception_ptr exception; try { work(); } catch (...) { exception = std::current_exception(); } // ...}调用方的用法是 queue_tasks.yield_to_queue([&]() { ret = llama_process(...); }):计算仍然跑在调用线程(主循环线程)上——源码注释特意说明,这是为了保证所有 ggml 计算留在同一条线程上(多后端调度器与 CUDA 流都有线程绑定假设)。与此同时,worker 线程开始消费新任务,但它只接受只读任务:
// while yielding, an encode / decode is running and only reading the server state is safeif (is_yielding && task.type != SERVER_TASK_TYPE_METRICS && task.type != SERVER_TASK_TYPE_SLOT_GET) { SRV_DBG("decoding, decline task, id_task = %d\n", task.id); return false;}被拒收的任务不会丢:进 queue_tasks_unhandled,等让位结束时按原顺序 push_front 回主队列。这条「让位期间只读、其余原样退回」的规则,把并发正确性问题压缩成了一句话:任何会改动 slot 状态的任务,只能在主循环线程上执行。
sleeping:闲置时把模型请出显存
--sleep-idle-seconds(默认 -1,即关闭)打开后,主循环会在闲置超过阈值的时刻进入 sleeping 状态:设置 sleeping = true,依序调用回调链(on_sleeping_state 注册的回调按注册顺序通知,离开时逆序);服务端借此把 llama_context 和模型卸载,只留下缓存的 /props、/models 响应;下一次请求到达时 wait_until_no_sleep() 先把模型装载回来再处理。对 HTTP 侧而言,server_res_generator 在构造时就会 wait_until_no_sleep()——「睡眠是传输层不可见的」,请求只是变慢,不会失败。
任务模型:一次 HTTP 请求被翻译成什么
server_task_type 的十五种任务
server_task(server-task.h)是任务队列里流动的唯一对象。它有一个 type 字段,取值来自 server_task_type,一共十五种:
enum server_task_type { SERVER_TASK_TYPE_COMPLETION, // /completion、/v1/chat/completions 等生成类 SERVER_TASK_TYPE_EMBEDDING, // /v1/embeddings SERVER_TASK_TYPE_RERANK, // /rerank SERVER_TASK_TYPE_DECISION, // /systemone:从候选中选一个 SERVER_TASK_TYPE_INFILL, // /infill:代码填充 SERVER_TASK_TYPE_CANCEL, // 取消某个在途请求 SERVER_TASK_TYPE_CONTROL, // 对在途请求的实时控制 SERVER_TASK_TYPE_NEXT_RESPONSE, // 循环自驱的心跳(见第二节) SERVER_TASK_TYPE_METRICS, // /metrics SERVER_TASK_TYPE_SLOT_GET, // GET /slots SERVER_TASK_TYPE_SLOT_SAVE, // POST /slots 的 save 动作 SERVER_TASK_TYPE_SLOT_RESTORE, // POST /slots 的 restore 动作 SERVER_TASK_TYPE_SLOT_ERASE, // POST /slots 的 erase 动作 SERVER_TASK_TYPE_GET_LORA, // 查询已装载的 LoRA adapter SERVER_TASK_TYPE_SET_LORA, // 动态设置 LoRA 的缩放};这张表本身就是一张「服务端功能地图」:除了生成、嵌入、重排这些推理任务,还有四个维护类任务(NEXT_RESPONSE/METRICS/SLOT_GET/SLOT_*)和两个管理类任务(LoRA 的查询与设置)。把「功能」统一建模成「任务」,是这套队列机制能成立的前提——无论请求来自 HTTP 还是来自服务器自己(心跳、指标),都走同一条入队、调度、回传路径。
server_task 里与调度直接相关的字段:
| 字段 | 作用 |
|---|---|
id | 任务编号,由 queue_tasks.get_new_id() 分配;结果回传时按它路由 |
id_slot | 客户端指定要用的 slot(-1 表示不指定) |
id_target | CANCEL 任务用来指向「要取消哪个任务」 |
id_parent / child_tasks | 父子任务:n_cmpl > 1 时的并行采样 |
n_tokens_shared | 父子任务共享前缀的 token 数 |
params | task_params:请求级参数(见下) |
tokens | server_tokens:已经分好词的输入(可能含多模态占位) |
decision / slot_action / set_lora | 各专用任务自己的载荷 |
task_params:请求级参数落在哪
task_params 是请求参数结构体(server-task.cpp 负责解析 JSON 到它)。与调度、KV 管理直接相关的几个:
stream:是否流式;return_progress:流式时是否回传 prompt 处理进度。cache_prompt(默认 true):是否复用上一条 prompt 已算过的前缀。n_keep/n_discard:上下文写满做 context shift 时,头部保留多少、中段最多丢弃多少(0表示丢n_left/2)。n_predict:本请求最多生成多少 token(-1 表示不限;与全局-n取更严格者)。n_cmpl:同一 prompt 并行采样几个结果——这就是父子任务的来源。n_cache_reuse:--cache-reuse的值。大于 0 时,允许把「与缓存里旧 prompt 相同的片段」通过 KV 位置平移搬到新位置上复用,而不是从头重算。speculative:投机解码参数;sampling:采样参数(common_sampler链)。
一个容易忽略的点:n_keep、n_discard、n_cache_reuse 这些参数不是「推理时再看」,而是被调度循环在每轮 pre_decode 里消费的——它们决定了 KV 缓存里哪些位置会被删、哪些会被平移。
优先级与 defer:没有 slot 时请求去哪里
任务队列支持插队:post(task, front = true) 把任务放进队首(例如取消/控制类任务需要尽快执行)。更重要的机制是 defer:
case SERVER_TASK_TYPE_COMPLETION: ... server_slot * slot = get_available_slot(task); if (slot == nullptr) { // if no slot is available, we defer this task for processing later queue_tasks.defer(std::move(task)); break; }当 get_available_slot 找不到空闲且兼容的 slot(--parallel 上限已满,或请求指定了 id_slot 但那个 slot 正忙),任务不会被拒绝,而是进 queue_tasks_deferred。每当有 slot 释放,release() 的回调会调用 queue_tasks.pop_deferred_task(id_slot)——它优先挑选指定使用该 slot 的暂缓任务,没有才退回取队首。这与 vLLM 「无块可用就抢占(preemption)」的策略形成鲜明对照:llama.cpp 选择了不抢占,把压力前移到队列——已经开始的请求从不为新请求让路,新请求要么等,要么在 prefix 复用上占便宜。
父子任务:n_cmpl 并行的分流
n_cmpl > 1 时,handle_completions_impl 会给主任务挂上若干子任务:
if (task.params.n_cmpl > 1) { int n_children = task.params.n_cmpl - 1; for (int j = 0; j < n_children; j++) { task.add_child(task.id, rd.get_new_id()); }}add_child 复制父任务的 tokens 与参数,并给每个子任务一个不同的采样种子(seed += child_tasks.size() + 1),保证多个候选不是同一条轨迹。调度上,父任务占用的 slot 会先独立把 prompt 算一遍(launch_slots_with_parent_task 要确保同时有足够的空闲 slot 接纳所有 child,否则整组一起 defer),prompt 处理完成后,decode() 的收尾阶段把父 slot 的完整状态复制给每个子 slot:
// all children slots should already launched by launch_slots_with_parent_task()// copy state to the child slotsfor (auto & child : children) { slot.copy_state_to(*child); child->state = SLOT_STATE_DONE_PROMPT;}子 slot 的状态随后进入 DONE_PROMPT,各自从同一份 KV 出发独立生成。这就是「多序列共享 KV 的分支策略」在 llama.cpp 里的答案:不是块表引用计数,也不是 radix tree,而是「父 slot 算好之后整份复制」——复制的是 common_memory 里的 KV 数据(slot.mem 的拷贝构造)和 prompt/采样的簿记。代价是额外的显存:每个 child 都要一份自己的 KV。
slot:服务端的「会话所有权」
server_slot 的字段地图
server_slot 是服务端最核心的运行时对象(定义在 server-context.cpp 顶部)。可以把它理解成一条对话的上下文所有权:谁持有 slot,谁就拥有这段 KV、这套采样参数、这份流式输出状态。主要成员按职责分组:
| 分组 | 成员 | 说明 |
|---|---|---|
| 身份与状态 | id、state、i_batch | slot 编号;当前状态;当前批次里代表本 slot 的 token 下标(-1 表示不在本批) |
| 上下文与记忆 | ctx_tgt / ctx_dft、mem(common_memory) | 目标模型与草稿模型的上下文;mem 是对 KV/循环状态的封装 |
| 请求与参数 | task(unique_ptr<server_task>)、n_ctx、n_keep、n_predict_max | 当前绑定的任务;本 slot 的上下文上限(--kv-unified-per-slot 也会钳制);请求级保留长度与生成上限 |
| prompt 簿记 | prompt(server_prompt)、last_nl_pos、truncated | server_prompt = server_tokens + checkpoint 链表;最后一次换行位置(增量输出用);是否发生过 context shift |
| 生成产物 | generated、generated_tokens、generated_token_probs、n_sent_text、has_next_token、stopping_word | 已生成文本/token/概率;已发送字符数(处理部分 UTF-8);是否还有下一 token;命中的停止词 |
| 采样与 LoRA | smpl(common_sampler_ptr)、sampled、lora、alora_invocation_start | 采样器链;最新采样出的 token;本请求挂载的 LoRA 及 aLoRA 激活起点 |
| 投机解码 | spec、spec_draft、spec_draft_q、spec_prompt、spec_i_batch、spec_ckpt、spec_is_replay | 草稿 token、草稿分布、验证在批内的下标、检查点与回放标志 |
| 统计 | stats(server_slot_stats)、t_print_last、n_gen_last | 供 /slots 与日志用的吞吐统计 |
这里最值得单独记住的是 prompt。它不只存 token 列表:
struct server_prompt { server_tokens tokens; std::list<common_prompt_checkpoint> checkpoints; ...};server_tokens 承载「这条 slot 当前 KV 里到底有哪些 token、位置怎么排」;checkpoints 是上下文检查点链表——每一轮处理 prompt 时按策略打点,保存「到某个位置为止的 KV 状态快照」与投机解码状态。前缀不匹配时,服务端会尝试把某个 checkpoint 恢复回 KV,而不是全部重算。这是下一节的主角。
六个状态的状态机
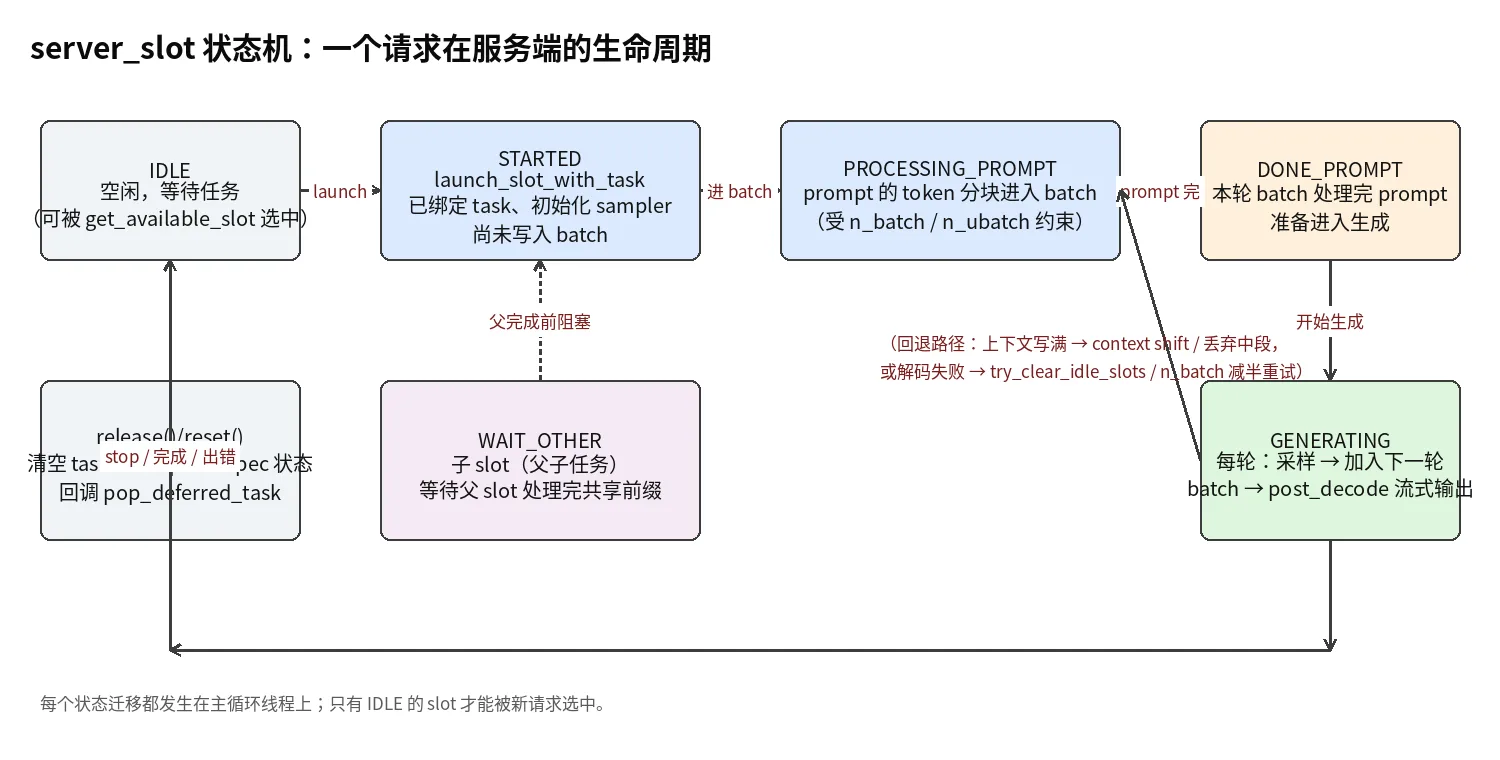
slot_state 只有六个值,迁移规则却不简单:
SLOT_STATE_IDLE:空闲。只有这个状态的 slot 会被get_available_slot选中。SLOT_STATE_STARTED:launch_slot_with_task成功后进入——任务已绑定、sampler 已初始化,但还没进 batch。SLOT_STATE_PROCESSING_PROMPT:prompt 的 token 正在分块进 batch(每轮受n_batch约束)。SLOT_STATE_DONE_PROMPT:prompt 这一大段处理完,准备采样第一个 token。SLOT_STATE_GENERATING:逐 token 生成中;每轮采样出的 token 会被handle_last_sampled_token加进下一轮 batch。SLOT_STATE_WAIT_OTHER:子 slot 专用——n_cmpl的子任务刚被 launch,要等父 slot 把共享前缀处理完、复制状态过来,才能开始生成。
迁移发生在主循环里:STARTED → PROCESSING_PROMPT 在 pre_decode 组装批次时完成;PROCESSING_PROMPT → DONE_PROMPT 由「本批里该 slot 的 prompt token 已全部处理」触发;DONE_PROMPT → GENERATING 在 post_decode 里采样前落定;任何 stop、完成、出错都会经由 release() 回到 IDLE。
launch_slot_with_task:一次请求如何进入 slot
这个函数(server-context.cpp)是「HTTP 请求 → slot」的唯一入口。流程按顺序做四件事:
- LoRA 处理:请求带 per-request LoRA 时,对比 slot 现有 LoRA;如果变了且
lora_should_clear_cache判定不兼容,清空 prompt(因为 LoRA 换了,旧 KV 不再有效)。若是 aLoRA(按调用字符串激活的 adapter),会在 prompt token 里从后往前扫描激活串,找到最后一次出现的位置作为alora_invocation_start——激活点之前的 KV 保持原样,之后要重算。 - token 校验:
task.tokens.validate(ctx_tgt)拒绝越界 token。 - 采样器初始化:
common_sampler_init(model_tgt, task.params.sampling)按请求参数构造采样器链;若启用后端采样(backend_sampling),把 sampler 指针注册给上下文(llama_set_sampler),让采样在 GPU 侧完成;否则在 CPU 采样。 - 状态落位:
n_predict_max记录生成上限;slot.task = make_unique<server_task>(move(task))——任务对象被移进 slot;slot.state置为is_child() ? WAIT_OTHER : STARTED。
release/reset:一次生成的收尾
slot.release() 在发完最终响应后调用,做三件事:先触发 callback_on_release(回调里会 pop_deferred_task,把等待中的下一批请求放进队列)、再 callback_on_reset,最后 reset() 清空运行态——task_prev = std::move(task); task.reset();、stats = {}、llama_set_sampler(ctx_tgt, id, nullptr)、清空投机草稿与多模态 batch。注意 reset() 不清 prompt:这条 slot 的 KV 缓存和 token 记录保留下来,供下一条请求的前缀复用——这正是服务端「缓存不随请求结束而释放」的设计前提。
槽位选择与前缀复用:服务端怎么「记便宜账」
launch 之前还有一步:到底把这个请求交给哪个 slot。这一步决定了后续能不能白捡一段已经算好的 KV,因此值得单独讲。
get_available_slot:三种挑法
server_slot * get_available_slot(const server_task & task) { server_slot * ret = nullptr; bool update_cache = false;
// 1) 客户端指定了 id_slot,就用它 if (task.id_slot != -1) { ret = get_slot_by_id(task.id_slot); if (ret) { // a busy slot is returned untouched, the caller defers the task if (ret->is_processing()) { return ret; // 忙 → 交给调用方 defer } } }
// 2) 按「最长公共前缀占比」挑相似度最高的空闲 slot if (slot_prompt_similarity != 0.0f) { float f_sim_best = 0; for (server_slot & slot : slots) { if (slot.is_processing()) continue; const auto & tokens = slot.prompt.tokens; if (tokens.empty()) continue;
const size_t lcp_len = tokens.get_common_prefix(task.tokens); const float f_sim_cur = float(lcp_len) / task.tokens.size();
if (f_sim_cur > f_sim_best && f_sim_cur > slot_prompt_similarity) { f_sim_best = f_sim_cur; ret = &slot; } } }
// 3) 还没选中 → 取空闲里最久未使用的那个 if (ret == nullptr) { const auto free_slots = get_free_slots(1, -1); if (!free_slots.empty()) { ret = free_slots[0]; update_cache = true; } } ...}三条路径的优先级与动机:
-
客户端指定
id_slot:把「会话粘性」交给调用方。注意一个细节——如果指定的 slot 正忙,函数直接把忙的 slot 返回给调用方,由调用方defer,而不是换一个空闲 slot。语义是明确的:用户要的就是这个 slot,宁等不换。 -
LCP 相似度(
--slot-prompt-similarity,默认0):按最长的公共前缀 token 数 / 新请求 token 数打分,选相似度最高且过阈值的空闲 slot。这是 llama.cpp 版的「前缀亲和调度」:与其把请求丢给随便一个空 slot,不如交给「已经含着相同前缀 KV」的那个。代码里还留了一手:const float f_keep = (f_sim_best*task.tokens.size()) / ret->prompt.tokens.size();// if we are about to lose a large portion of the existing context - save it in the prompt cacheif (f_keep < 0.5f) {update_cache = true;}f_keep衡量「新请求要占掉这个 slot 原有上下文的多少」。如果新请求会挤掉一半以上原有的 prompt,就在复用之前先把旧 prompt 存进 prompt cache,免得白白浪费。 -
LRU 兜底:都没命中就取最久未使用的空闲 slot,并标记
update_cache = true。
最后一段决定了「要不要动 prompt cache」:
if (ret) { update_cache = update_cache && prompt_cache; // cache prompts only for the tasks that reuse them update_cache = update_cache && !task.is_stateless();
if (update_cache) { ret->prompt_save(*prompt_cache); if (!ret->prompt_load(*prompt_cache, task.tokens)) { ret->prompt_clear(); } prompt_cache->update(); }}两个门控:prompt_cache 只在配置了 --prompt-cache 类参数时存在;is_stateless()(embedding / rerank)的任务不复用状态,因此既不读写缓存也不做前缀复用。这与第三节里 cache_prompt && !is_stateless() 的条件是同一条规则的两次出现。
前缀复用的两条路:公共前缀与 KV 平移
真正决定「省多少计算」的逻辑在 pre_decode 组装 prompt 时:
if (slot.task->params.cache_prompt && !slot.task->is_stateless()) { // reuse any previously computed tokens that are common with the new prompt n_past = slot.prompt.tokens.get_common_prefix(input_tokens);
// the children start from the shared prefix, do not go past it if (slot.task->n_tokens_shared > 0) { n_past = std::min(n_past, slot.task->n_tokens_shared); } ... if (slot.alora_invocation_start > 0) { n_past = std::min(n_past, slot.alora_invocation_start - 1); }n_past 就是「新请求可以直接跳过的 token 数」。它被三件事钳住:
- 父子任务的共享前缀:child 只允许复用到父 slot 交付的共享前缀为止。
- decision 任务的首个读取位置:输出要从 batch 里读,所以那个位置必须重新评估。
- aLoRA 激活点:激活串之前不缓存(因为激活之后 LoRA 权重变了,前面的 KV 不能保持)。
第二条件是 n_cache_reuse(--cache-reuse N):当公共前缀不连续、中间有「洞」时,llama.cpp 能把缓存里的 KV 平移到新位置上复用:
// reuse chunks from the cached prompt by shifting their KV cache in the new positionif (can_cache_reuse && n_cache_reuse > 0) { size_t head_c = n_past; // cache size_t head_p = n_past; // current prompt
while (head_c < slot.prompt.tokens.size() && head_p < input_tokens.size()) { size_t n_match = 0; while (head_c + n_match < slot.prompt.tokens.size() && head_p + n_match < input_tokens.size() && slot.prompt.tokens[head_c + n_match] == input_tokens[head_p + n_match]) { n_match++; }
if (n_match >= (size_t) n_cache_reuse) { const int64_t kv_shift = (int64_t) head_p - (int64_t) head_c; slot.mem.seq_rm (slot.id, head_p, head_c); slot.mem.seq_add(slot.id, head_c, head_c + n_match, kv_shift); ... } else { head_c += 1; } }}机制是:从 n_past 开始向后扫,找长度不小于 n_cache_reuse 的匹配块;对每个匹配块,用 seq_rm 先清掉目标位置上的旧内容,再用 seq_add(pos, shift) 把源位置的 KV 整体平移到新偏移上(shift 是新旧位置之差;这正是第四篇讲过的 K-shift / RoPE 位置平移)。于是「插入了一段新内容、但后半段仍相同」的场景不必重算后半段。代价是只对支持平移的记忆类型有效——纯因果注意力可以用 RoPE 平移位置,SWA 与循环状态则不行,所以代码里先有:
const bool can_cache_reuse = llama_memory_can_shift(llama_get_memory(ctx_tgt)) && !slot.prompt.tokens.has_mtmd; // 多模态不行:图像块的位置语义特殊这套机制和 SGLang 的 RadixAttention 是同一目标的两条实现路线:后者用前缀树做跨 slot、跨请求的全局复用与 LRU 淘汰;llama.cpp 没有全局前缀树,只有每个 slot 自己那一份 prompt 记录,复用限于「同一 slot 的新旧请求之间」,外加一个可选的磁盘 prompt cache。下面这张 RadixAttention 的示意图可以把两者的差别看得很直观:
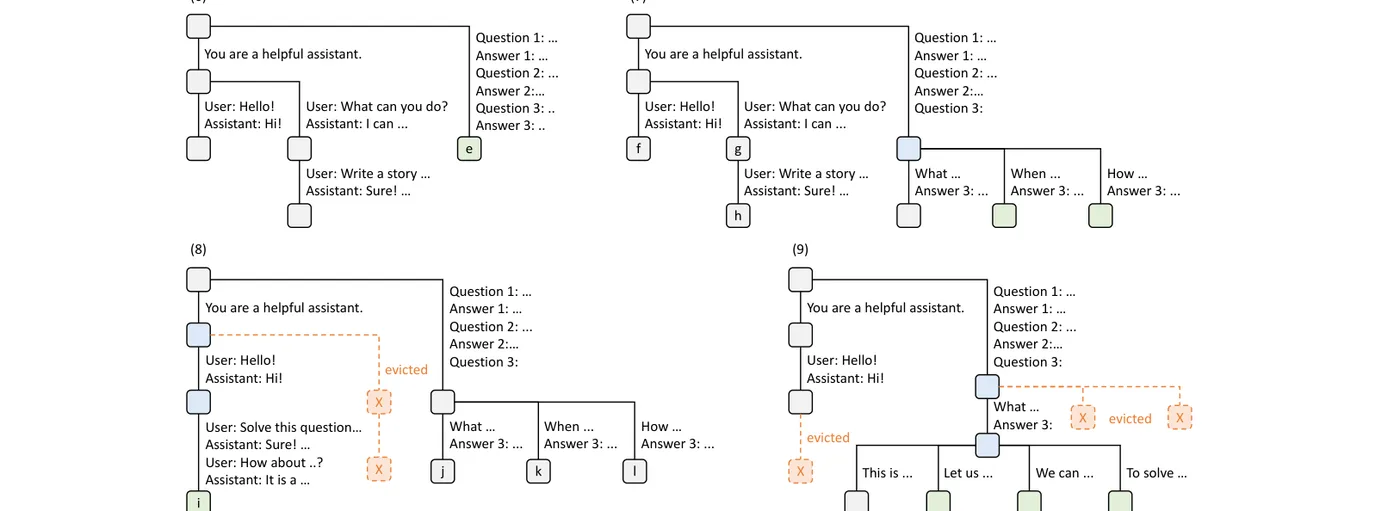
RadixAttention 把「可复用前缀」表示成一棵树,多个请求的 KV 共享同一批节点、按引用计数回收;llama.cpp 则把「可复用」压缩成一条线性 token 列表 + 一次 LCP 比较。线性列表换来的是实现的极简和多后端的统一,代价是复用范围小、只能同 slot 内复用。
checkpoint:不重算整段 prompt 的退路
即便前缀不匹配,llama.cpp 还有第二道保险:上下文检查点。create_checkpoint 在 prompt 处理过程中按策略打点,保存目标模型(与草稿模型)在某个位置区间的 KV 状态,并连同投机解码状态一起存:
auto & cur = slot.prompt.checkpoints.emplace_back();cur.id_task = id_task;cur.update_pos(slot.prompt.n_tokens() - n_tokens_cur, pos_min, pos_max);cur.update_tgt(ctx_tgt, slot.id, LLAMA_STATE_SEQ_FLAGS_PARTIAL_ONLY);cur.update_dft(ctx_dft, slot.id, LLAMA_STATE_SEQ_FLAGS_PARTIAL_ONLY);// stash the draft's speculative state with the checkpointcommon_speculative_get_state(spec.get(), slot.id, cur.data_spec);数量与间距由 --ctx-checkpoints 与 checkpoint_min_step 控制,代码里有两条清理规则:同一次任务内太密集的旧检查点会被删(除非是当前 task 建的),队列满了就从头淘汰。前缀不匹配时,调度循环会在链表里从后往前找第一个满足条件(pos_min < 阈值 且 pos_max <= pos_next)的检查点:
const auto it = std::find_if( slot.prompt.checkpoints.rbegin(), slot.prompt.checkpoints.rend(), [&](const auto & cur) { if (cur.pos_max > pos_next) return false; return cur.pos_min < pos_min_thold || cur.pos_min == 0; });if (!do_reset) { it->load_tgt(ctx_tgt, slot.id, LLAMA_STATE_SEQ_FLAGS_PARTIAL_ONLY); ... pos_next = std::min(pos_next, std::max(it->pos_min + 1, it->pos_max)); n_past = std::min(slot.prompt.tokens.size_up_to_pos(pos_next), (size_t) it->n_tokens);}阈值 pos_min_thold 与 SWA 有关:n_swa > 0 时取 pos_eval - n_swa + 2,否则取 pos_eval。含义是——只有覆盖范围足够「靠后」的检查点才有用:滑窗注意力只看最近 n_swa 个位置,更早的检查点恢复出来也没意义。找不到合适检查点就 do_reset = true,把 n_past 和 pos_next 归零,退回全量重算。
还有一个细节:检查点会被「前移的位置」作废。位置一旦被平移或被截断,检查点里记录的区间就与新位置对不上,所以代码在确定 pos_next 之后会扫一遍链表,删掉所有 pos_max > pos_next 的条目。
批组装:pre_decode 如何把多个 slot 拼成一个 batch
update_slots 在一次迭代里做三件事:pre_decode() 组装 batch、循环分块 decode()、对每块 post_decode()。其中最复杂的是 pre_decode,它要在一轮之内同时回答:
- 哪些 slot 的上下文写满了,需要先做 context shift?
- 已经在生成的 slot 们,各自要写什么 token 进 batch?
- 有没有空闲 slot 可以顺带处理 prompt(连续批处理的入口)?
- 新 prompt 中有多少 token 可以跳过(前缀复用/检查点恢复)?
上下文平移:写满时的丢弃策略
每个 slot 在进入组装前先过一次「容量体检」:
iterate(slots, [&](server_slot & slot) { if (slot.state == SLOT_STATE_GENERATING && slot.prompt.n_tokens() + 1 >= slot.n_ctx) { if (!params_base.ctx_shift) { ...报错并 release... } if (slot.task->is_parent() || slot.task->is_child()) { ...「context shift cannot be used for shared prompt」... }
// Shift context int n_keep = slot.task->params.n_keep < 0 ? slot.task->n_tokens() : slot.task->params.n_keep; if (add_bos_token) n_keep += 1; n_keep = std::min(slot.n_ctx - 4, n_keep);
const int n_left = slot.prompt.n_tokens() - n_keep; int n_discard = slot.task->params.n_discard ? slot.task->params.n_discard : (n_left / 2); n_discard = std::clamp(n_discard, 0, std::max(0, n_left - 1));
slot.mem.seq_rm (slot.id, n_keep, n_keep + n_discard); slot.mem.seq_add(slot.id, n_keep + n_discard, slot.prompt.tokens.pos_next(), -n_discard); ... slot.truncated = true; }});逐条解释这套「丢中段、留两头」的策略:
n_keep:保留 prompt 开头多少个 token(默认取「请求原始 prompt 的长度」——也就是把用户原始输入整段留住),BOS 额外 +1;再钳到n_ctx - 4,给尾部至少留 4 个位置。n_discard:中段最多丢多少。默认丢一半(n_left / 2),并钳到「至多丢到只剩 1 个」。seq_rm+seq_add(shift = -n_discard):不是删除 KV 再重算,而是把n_keep + n_discard之后的所有位置整体向前平移n_discard。平移后 RoPE 相对位置全部改变——这依赖第四篇讲过的can_shift(纯因果注意力可用)。- 父/子 slot 禁止 shift:因为共享前缀的 KV 被复制给了多个 slot,平移会破坏其他 slot 的副本。这也解释了为什么
n_cmpl模式下长对话更早触顶。 - 丢弃后
slot.truncated = true,服务端会把它带进输出(告诉客户端「上下文被截断了」)。
与 vLLM 的对照:vLLM 在显存不足时抢占请求(recompute/swap),llama.cpp 的等价手段是「就地丢弃中段 + 平移」。它更省事,但代价是历史信息真的丢了——被丢弃的那段对话模型再也看不到。
generating 与 drafting:先安排已经在跑的请求
体检之后是按序组装。第一批进 batch 的是正在生成的 slot:
batch.clear();auto & slot_batched = batch.slot_batched;
std::vector<server_slot *> generating;std::vector<server_slot *> drafting;
iterate(slots, [&](server_slot & slot) { if (slot.state != SLOT_STATE_GENERATING) return;
// check if we can batch this slot with the previous one if (!slot_batched) { slot_batched = &slot; } else if (!slot_batched->can_batch_with(slot)) { return; // 不相容 → 本轮不进同一批 }
generating.push_back(&slot); if (spec) { ...准备投机草稿参数... }});两个概念先讲清楚:
-
slot_batched:本批次第一个 slot 会成为这一批的「代表」。batch.slot_batched的作用见update_slots——它承载 batch 级的 LoRA 与 embeddings 开关(common_set_adapter_lora(ctx_tgt, slot_batched->lora)、llama_set_embeddings(ctx_tgt, ...))。一次 decode 只能挂一套 LoRA,这就是can_batch_with存在的根本原因。 -
can_batch_with的相容条件:bool can_batch_with(server_slot & other_slot) const {// a joint decision head reads the whole batchif (!task->decision.order.empty() || !other_slot.task->decision.order.empty()) return false;return task->type == other_slot.task->type&& inp_embd.size() == other_slot.inp_embd.size()&& are_lora_equal(lora, other_slot.lora);}任务类型一致、输入嵌入(
inp_embd,多模态或 MTP 的输入向量)规模一致、LoRA 集合一致,三者皆满足才能合并。注意条件里没有「序列长度一致」——因为批内每个 token 的 KV 位置是各自记录的,这本来就是连续批处理能成立的原因。
接着处理投机解码:
if (spec) { const int n_draft_max = slot.get_n_draft_max(); if (n_draft_max > 0) { if (!slot.spec_draft.empty()) { // 有上一轮的残留草稿 → 复用 if (use_ckpt_tgt) { GGML_ASSERT(!slot.spec_ckpt.empty()); } } else { slot.spec_ckpt.update_pos(slot.prompt.n_tokens(), ...); ... common_speculative_get_draft_params(spec.get(), slot.id) = { /* .drafting = */ true, /* .n_max = */ n_draft_max, /* .pos0 = */ slot.prompt.tokens.pos_next(), /* .id_last = */ slot.sampled, /* .prompt = */ &slot.spec_prompt, /* .result = */ &slot.spec_draft, ... }; drafting.push_back(&slot); } }}
// generate the actual drafts (if any)if (!drafting.empty()) { queue_tasks.yield_to_queue([&]() { common_speculative_draft(spec.get()); });}get_n_draft_max 先算「还能塞下几颗草稿」:以 n_ctx - prompt.tokens - 2 为上限(留 2 个位置给上下文平移),再受 n_remaining() - 1(剩余生成长度)约束。草稿生成本身跑在 yield_to_queue 里——生成期间还能收指标请求。
添加 prompt:连续批处理的位置
生成侧的 token 都进 batch 之后,才是新 prompt 的处理:
int32_t n_batch = llama_n_batch(ctx_tgt);int32_t n_ubatch = llama_n_ubatch(ctx_tgt);
// next, batch any pending prompts without exceeding n_batchif (params_base.cont_batching || batch.size() == 0) { bool add_ok = true; // false means the batch is full, skip remaining slots
iterate(slots, [&](server_slot & slot) { if (!add_ok || batch.size() >= n_batch) { return; // batch is full, skip remaining slots } ...两个开关点:
cont_batching || batch.size() == 0:--cont-batching(默认开)允许「本轮已有生成 token」时继续往批里塞 prompt 块;关掉它就退化成「要么整批都是 prompt、要么整批都在生成」的老式批处理。batch.size() >= n_batch:逻辑批次上限。注意这是逻辑批;物理上update_slots还会按llama_n_batch()切块调用 decode(后面讲)。
进批的 slot 逐个走「首次进批」初始化:
if (slot.state == SLOT_STATE_STARTED) { slot.stats.update_prompt_start(); slot.state = SLOT_STATE_PROCESSING_PROMPT; SLT_TRC(slot, "new prompt, n_ctx_slot = %d, n_keep = %d, task.n_tokens = %d\n", ...); int n_past = 0; // 可复用多少 token ...然后是一串拒收条件,每一个都对应一条 SLO 边界:
| 条件 | 处理 | 含义 |
|---|---|---|
input_tokens.empty() | 发空响应并释放 | 空 prompt 没有意义 |
!can_split() && n_tokens > n_ubatch | 报错 ERROR_TYPE_SERVER | 不能分块的场景(如某些池化类型),prompt 超出物理批装不下 |
!can_split() && n_tokens > n_ctx | 报错 ERROR_TYPE_EXCEED_CONTEXT_SIZE | 同上,超出上下文 |
can_split() && n_tokens >= n_ctx | 报错「try increasing it」 | 可分块但 prompt 本身超过 slot 上下文 |
decision 且 n_tokens - n_decision_first > n_batch | 报错 | decision 的输出要从一个 batch 里读,不能跨批 |
can_split() 的意义:它决定「prompt 能不能分块慢慢消化」。纯生成任务当然可以;embedding/rerank 只有在池化类型为 LAST、或因果 reranker、或 decision 任务时才允许切块——因为这些任务的输出只能从最后一个 token 的位置读取,分块必须保证「最后一块里含最后一个位置」。
n_past:从哪开始算
拒收检查之后,就是上一节细讲过的前缀复用部分。把整条链串起来看:
n_past = get_common_prefix(prompt.tokens, input_tokens) // 线性 LCP → min(…, n_tokens_shared) // 子 slot 只到共享前缀 → min(…, n_decision_first) // decision 的首读位置 → min(…, alora_invocation_start - 1) // aLoRA 激活点之前 → (可选)n_cache_reuse 的 KV 平移复用,继续抬高 n_past → (不匹配时)checkpoint 恢复,把 n_past 拉到检查点覆盖的范围 → 都不行则 n_past = 0,全量重算之后 pos_next 由 slot.prompt.tokens.pos_next(n_past) 推出,并算出 pos_eval 与 pos_min_thold(SWA 判别阈值)。这条链的每一环都能在「更省重算」和「更正确」之间权衡,而且每一环的代价都可测:注释里 [TAG_PROMPT_LOGITS]、[TAG_CHECKPOINTS_FIX_POS_MIN] 这些标签就是团队记录边界条件的习惯。
最后是真正把 token 塞进 batch 的部分(server_batch::add),并更新 slot.i_batch(本 slot 在本批里的代表 token 下标)。i_batch 是 post_decode 采样时的定位锚点:一个 slot 在一批里的所有 token,采样只发生在它最后(或指定)的那个位置上。
decode:一次前向与它的失败回退
update_slots 拿到组装好的 batch 后,按 n_batch 分块执行。每个分块的流程是:
batch.render(off, n_tokens); // 把逻辑 batch 的 [off, off+n_tokens) 渲染成 common_batch 视图bool ok = decode(n_batch, off);if (ok) { off_next = off + n_tokens; n_batch = llama_n_batch(ctx_tgt); // 恢复原始批大小} else { continue; // 用缩小后的 n_batch 重试同一位置}post_decode(n_tokens, off);decode() 内部有两处设计值得拆开看。第一,计算通过 yield 让出:
int ret = 0;queue_tasks.yield_to_queue([&]() { ret = llama_process(ctx_tgt, LLAMA_PROCESS_TYPE_DECODE, batch.view.get()); if (ret == 0 && has_output) { llama_synchronize(ctx_tgt); }});has_output 表示这一批里有 slot 需要读采样结果——需要同步等待;否则可以让后续 kernel 继续异步执行。这就是第二节讲过的「计算留在主线程、worker 只收只读任务」的执行方式。
第二,失败的分类与回退:
if (ret != 0) { std::string err; if (n_batch == 1 && ret == 1) err = "Context size has been exceeded."; if (ret == -1) err = "Invalid input batch."; if (ret < -1) err = "Compute error.";
if (!err.empty()) { ...对所有在处理的 slot 报错、release、prompt_clear... // stop, do not retry with smaller batch size throw std::runtime_error(err); }
// retry with half the batch size to try to find a free slot in the KV cache if (!try_clear_idle_slots()) { n_batch /= 2; } SRV_WRN("failed to find free space in the KV cache, retrying with smaller batch size, ..."); return false; // retry with the updated n_batch}两种失败泾渭分明:
- 致命错误(上下文真的溢出、批非法、计算错误)→ 立刻报错并终止本轮,不缩批重试。
- KV 空间不足(返回值不属于上述三类)→ 先尝试
try_clear_idle_slots():在kv_unified模式下清空一个空闲 slot 的 prompt 缓存(一次只清一个,代码注释里写得很直白:「clear slots one by one」);清不出空间才把n_batch减半重试。这就是 llama.cpp 的「内存压力调节阀」:不抢占活跃请求,而是(一)回收空闲 slot 的缓存、(二)缩小批大小。
值得留意 decode() 尾部的两件事:投机解码的批量处理(common_speculative_process(spec, batch.view),同样在 yield 里跑);以及父 slot 完成后给子 slot 复制状态——n_cmpl 的分支就发生在这里(见下节)。
post_decode:从 logits 到流式输出
post_decode 是「采样与回传」阶段。输入是本轮的 (off, n_tokens) 与 batch 视图,输出是「哪些 slot 收到了什么 token、要不要继续」。它的骨架是三段 iterate(slots, ...):常规采样、投机解码验证、以及收尾清理。
常规路径:采样、接受、输出
iterate(slots, [&](server_slot & slot) { // 提前量:prompt 处理进度回传 if (slot.state == SLOT_STATE_PROCESSING_PROMPT || slot.state == SLOT_STATE_DONE_PROMPT) { if (slot.task->params.stream && slot.task->params.return_progress) { send_partial_response(slot, {}, true); } }
if (!is_inside_view(slot.i_batch)) { return; // 本 slot 的代表 token 不在这一子块里 }
if (slot.state == SLOT_STATE_DONE_PROMPT) { // embedding / rerank / decision 在此收尾并释放 slot ... slot.state = SLOT_STATE_GENERATING; if (slot.can_speculate()) { common_speculative_begin(spec.get(), slot.id, slot.prompt.tokens.get_text_tokens()); } } else if (slot.state != SLOT_STATE_GENERATING) { return; }
if (slot.can_speculate() && !slot.spec_draft.empty()) { return; // 交给投机路径采样 }
const int tok_idx = slot.i_batch - off; // 子块内的下标 llama_token id = common_sampler_sample(slot.smpl.get(), slot.ctx_tgt, tok_idx); slot.i_batch = -1; common_sampler_accept(slot.smpl.get(), id, true); ...可以读出三条规则:
is_inside_view与tok_idx:逻辑批被分块执行,每个 slot 的代表 token 只会在其中一块里出现;tok_idx把它换算成子块内偏移交给采样器从 logits 里取。DONE_PROMPT → GENERATING的转换点就在这里,而且投机解码的common_speculative_begin也在这一刻调用——草稿引擎需要知道「这条序列进入生成阶段了」。- 有草稿时常规采样被跳过,留到第二段统一处理。
采样之后是输出三连:process_token(判断是否命中停止条件)、print_timings_tg(生成速度统计)、必要时 send_final_response + release()。process_token 返回 false 表示该 slot 该结束了——这正是「一次迭代只跑一块、但随时可能释放某个 slot」的收口点。
投机路径:接受、回滚与检查点恢复
第二段 iterate 才是投机解码的核心。它做四件事:
// 1) 采样并接受(按是否启用 rejection 走不同分支)std::vector<llama_token> accepted;if (!synth_probs.empty()) { accepted = server_sample_and_accept_synth(...); // 合成分布直接接受} else if (slot.spec_is_replay && slot.use_spec_rejection()) { accepted = server_accept_replay(...);} else if (use_rejection) { accepted = common_sampler_sample_and_accept_n_rejection(...);} else { accepted = common_sampler_sample_and_accept_n(...);}
// 2) 计算需要回滚几个 tokenconst uint32_t n_rollback = slot.spec_draft.size() + 1 - accepted.size();const bool use_ckpt_tgt = ctx_tgt_seq_rm_type == COMMON_CONTEXT_SEQ_RM_TYPE_FULL || (ctx_tgt_seq_rm_type == COMMON_CONTEXT_SEQ_RM_TYPE_RS && n_rollback > llama_n_rs_seq(ctx_tgt));
// 3) 部分接受 → 恢复检查点,把 KV 退回到草稿前if (n_rollback > 0) { if (use_ckpt_tgt) { slot.spec_is_replay = true; slot.spec_draft = std::move(accepted); ckpt.load_tgt(slot.ctx_tgt, slot.id, LLAMA_STATE_SEQ_FLAGS_PARTIAL_ONLY); if (slot.ctx_dft) ckpt.load_dft(slot.ctx_dft, slot.id, LLAMA_STATE_SEQ_FLAGS_PARTIAL_ONLY); slot.mem.seq_rm(slot.id, ckpt.pos_max + 1, -1); slot.prompt.tokens.keep_first(ckpt.n_tokens); common_sampler_copy(smpl_save.get(), slot.smpl.get()); return; }}
// 4) 接受:把 prompt 回退到草稿前,插入已接受的 tokenslot.prompt.tokens.keep_first(slot.prompt.n_tokens() - n_draft);slot.prompt.tokens.insert({ids.begin(), ids.end() - 1});slot.sampled = ids.back(); // 最后一个 token 作为下一轮起点slot.mem.seq_rm(slot.id, slot.prompt.tokens.pos_next(), -1);几个关键设计点:
- 四种接受策略并存:合成分布(
synth_probs,某些草稿器直接给分布)、回放(spec_is_replay)、rejection sampling(温度 > 0 时,use_spec_rejection = temp > 0.0f)、以及最朴素的 sample-and-match。注释说明回放与 rejection 的关系:「at temp 0 both p and q are point masses, so rejection is the same as sample-and-match」——温度 0 时拒绝采样退化为「逐位比对」。 n_rollback与检查点:草稿只被部分接受时,多算的 KV 必须退回。use_ckpt_tgt判断「当前上下文是否只能用检查点做回滚」——COMMON_CONTEXT_SEQ_RM_TYPE_FULL表示支持完整序列回滚(不需要检查点),RS表示循环状态(只支持有限长度回滚),回滚量超过上限时同样要用检查点。这就是第三节里 checkpoint 同时存data_spec的原因:回滚不仅要恢复 KV,还要恢复草稿端的投机状态。- 接受后的 prompt 簿记:
keep_first(n_tokens - n_draft)把上一轮草稿尾巴砍掉,再插入「已接受的 token 去掉最后一个」;slot.sampled = ids.back()是下一轮的输入;seq_rm(pos_next, -1)把 KV 里多算的部分删干净。这三步构成「一次投机解码的收尾事务」——顺序错了就会KV/簿记不一致。
统计与子 slot 激活
接受之后,每个被接受的 token 都走一次 process_token(保证 stop string、EOS、长度上限都对每个 token 生效),并累计 n_accepted_per_pos(按草稿位置统计接受率,供 /slots 观察草稿质量)。
父 slot 完成 prompt 后的 children 激活则写在 decode() 末尾:
for (auto & slot : slots) { if (slot.state == SLOT_STATE_DONE_PROMPT && slot.task->is_parent()) { std::vector<server_slot *> children; for (auto & other : slots) { if (other.state == SLOT_STATE_WAIT_OTHER && slot.task->id == other.task->id_parent) { children.push_back(&other); } } for (auto & child : children) { GGML_ASSERT(slot.task->n_tokens_shared == 0); slot.copy_state_to(*child); child->state = SLOT_STATE_DONE_PROMPT; } }}注意 GGML_ASSERT(slot.task->n_tokens_shared == 0):只有「child 完全继承父 prompt」时才能整份复制状态;如果 child 有自己的 prompt、只共享前 N 个 token,状态就不能照搬(那需要更细的 KV 切分)——断言把这种情形显式挡在门外。这也是与 SGLang 的关键差异:SGLang 的 fork 语义(共享前缀引用计数)能支持「部分共享」,llama.cpp 只能全量复制或全量不共享。
process_token 与流式输出的三个细节
每个被接受的 token 都会走一次 process_token(server-context.cpp:1976),它是「token → 文本 → 停止判断」的关口。三个细节值得单独讲,因为它们解释了为什么「看起来是接口层」的问题会深深嵌进调度循环:
第一,未完成 UTF-8 必须压住不发。 一个汉字在 UTF-8 里是三个字节,而 token 的切分通常与字符边界不一致:
// check if there is incomplete UTF-8 character at the endbool incomplete = validate_utf8(slot.generated.text) < slot.generated.text.size();
if (!incomplete) { size_t pos = std::min(slot.n_sent_text, slot.generated.text.size()); const std::string str_test = slot.generated.text.substr(pos); ...}只要累积文本的末尾构成不完整的多字节字符,本轮就不做停止词检测、不发新内容——n_sent_text 记录「已经发出去多少字节」,等下一个 token 补齐字符后再一并发送。这是流式接口正确性的硬约束:否则客户端会在 SSE 流里收到半个汉字。
第二,停止词可能横跨多个 token。 所以搜索范围不是「新 token 的文本」,而是从 n_sent_text 开始的全部未发送文本:
size_t stop_pos = slot.find_stopping_strings(str_test, token_str.size(), true);if (stop_pos != std::string::npos) { slot.generated.truncate(pos + stop_pos); // 砍掉停止词及其后 pos = std::min(slot.n_sent_text, slot.generated.text.size());} else if (slot.has_next_token && !llama_vocab_is_eog(vocab, result.tok)) { stop_pos = slot.find_stopping_strings(str_test, token_str.size(), false); send_text = stop_pos == std::string::npos;}find_stopping_strings 的第三个参数区分两种语义:true 表示「这是全停检查」,找到就截断;false 表示「部分匹配检查」——如果 str_test 的尾部可能是一个更长的停止词的前缀(例如停止词是 </s> 而现有文本以 < 结尾),本轮也压住不发,等下一个 token 来判断。这就是「部分前缀缓存」的一般化:不止多字节字符,停止词也可能跨界。
第三,EOS 与预算、上下文、缩进的收口都写在这里。 例如上下文耗尽:
// if context shifting is disabled, make sure that we don't run out of contextif (!params_base.ctx_shift && slot.prompt.n_tokens() + 1 >= slot.n_ctx) { slot.truncated = true; slot.stop = STOP_TYPE_LIMIT; slot.has_next_token = false;}注意条件是 !params_base.ctx_shift:开 ctx_shift 的情况下这里不拦,让 pre_decode 的平移逻辑接手;关掉平移才在这里提前停止。生成预算同理(!slot.has_budget() → STOP_TYPE_LIMIT),n_indent(要求每行至少缩进 N 个空白)也在这里以「把最后一行砍掉」的方式生效。slot.stop 取值来自 stop_type 枚举(EOS/WORD/LIMIT),最终会带进响应体。
流式输出:结果如何回到 HTTP 线程
post_decode 的所有输出都经由 send_partial_response / send_final_response 两个函数。它们做的事很短:组装 server_task_result_cmpl_partial(含 text_to_send、可选的 token 概率、timings),然后 queue_results.send(...)。HTTP 线程侧则在 server_res_generator::set_next 里循环调用 rd.next(...),把每一条结果格式化成 OAI SSE(或 Anthropic SSE / Responses SSE)并写回 socket;如果长时间没有新结果,就按 sse_ping_interval 发一个 SSE 注释行(:\n\n)保持连接。
一个容易被忽略的连接点:set_next 的 should_stop 会检查客户端是否断开。一旦断开,reader 停止等待并触发任务取消——在途的 slot 通过 SERVER_TASK_TYPE_CANCEL 或等待队列里的清理逻辑被释放,不至于把显存耗在已消失的客户端上。这条链把「HTTP 连接生命周期」与「KV 资源生命周期」绑定在一起,是服务端资源安全的关键一环。
多序列与共享前缀:父子的分叉与回收
到这里,服务端的四个阶段都讲完了。把它们串回「多序列」这个主题上,llama.cpp 的答案可以总结成一张「所有权表格」:
| 场景 | 机制 | 复用范围 | 代价 |
|---|---|---|---|
| 同一 slot 的新旧请求 | get_common_prefix + n_cache_reuse 的 KV 平移 | 同一 slot 内 | 复用点之前的 KV 必须已被保留(release() 不清 prompt) |
| 请求之间「谁用哪个 slot」 | --slot-prompt-similarity 的 LCP 打分 + LRU 兜底 | 空闲 slot | 相似度不足时依旧全量重算 |
| 打散的前缀片段 | 上下文检查点(create_checkpoint / load_tgt) | 同一 slot 内 | 检查点的显存开销;SWA 下阈值更苛刻 |
n_cmpl 并行采样 | 父 slot 算完 prompt 后 copy_state_to 全量复制 | 只在复制时刻一次 | 每个 child 各持一份 KV |
| 空闲 slot 的缓存 | --cache-idle-slots 存进 prompt cache / prompt_clear | 磁盘缓存条目 | 存取与匹配成本 |
| 显存吃紧 | try_clear_idle_slots + n_batch 减半 | —— | 前者丢掉空闲 slot 的缓存,后者牺牲时延 |
这张表和 SGLang / vLLM 的设计取向形成了有意思的三角:
- vLLM:PagedAttention 让 KV 以固定块被任意序列共享,配引用计数与写时复制;调度以「块预算」为第一约束。
- SGLang:在 vLLM 的块内存基础上加 RadixAttention,前缀以树形全局复用,LRU 淘汰,缓存命中率成为核心指标。
- llama.cpp:没有块表、没有全局树,复用是「slot 私有的线性前缀 + 检查点 + 可选平移」三件套。换来的是:实现小、可移植(CPU 也要能跑)、单机延迟低。
前两者把「复用」当作集群级资源来经营,llama.cpp 把「复用」当作 slot 级优化来做。理解了这一点,就能理解为什么 llama-server 的调度循环可以短到几百行,而 vLLM 的 Scheduler 要处理块表、抢占与 waterfall。 站内已有 vLLM 源码完全拆解(三):Scheduler.schedule 如何分配 Token 预算与 KV Block 与 SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环 分别讲透了这两条路线,可以对照阅读。
小结
八篇下来,llama.cpp 的这条「从一次前向到多用户服务」的链路可以总结成六条判断:
第一,任务队列是整个服务端唯一的跨线程入口。 HTTP 线程只做协议适配与分词,把工作封装成 server_task 入队;所有会改动 slot 与 llama_context 的处理都发生在主循环线程上。NEXT_RESPONSE 心跳、defer 暂缓队列、yield_to_queue 的只读 worker,这三个机制合起来保证了「只有一个线程碰模型状态」这个不变量。
第二,slot 是「会话所有权」,不是「请求」。 release() 之后 prompt 与 KV 都留着,属于 slot 而不是请求。因此「前缀复用」在 llama.cpp 里天然是「slot 内跨请求」的——这也是它和 vLLM/SGLang 的分水岭。
第三,批组装是一条按优先级排序的流水线。 先体检(context shift),再安排生成侧(generating/drafting),最后在 cont_batching 允许时塞 prompt,并受 n_batch 预算约束。can_batch_with(类型、embeddings、LoRA)是硬门槛,其余维度都是自由的。
第四,前缀复用的每一环都有明确的钳制项。 n_tokens_shared(父子)、n_decision_first(decision)、alora_invocation_start(aLoRA)依次压住 n_past;不匹配时交给 --cache-reuse 的 KV 平移或检查点恢复;都不行就全量重算,且有 do_reset 显式兜底。
第五,失败路径是「不抢占」的。 空间不足先清空闲 slot 缓存、再减半批大小重试;上下文写满用 ctx_shift 丢中段并平移;父/子 slot 不允许 shift(共享副本会毁掉)。所有失败都对应明确的错误类型,不做静默降级。
第六,接口语义(UTF-8、停止词、SSE、断开检测)是调度循环的一部分。 不完整的 UTF-8、跨 token 的停止词前缀会直接决定「本轮发不发」;客户端断开通过 should_stop 反向影响资源回收。读推理框架源码时,把接口层当「壳子」会漏掉这一类真实约束。
至此,llama.cpp 子系列的八个模块——整体架构、ggml 计算图与内存分配器、GGUF 装载与 mmap、llama_context 与记忆系统、采样管线与语法约束、图构建与注意力、后端与 kernel、服务化与调度——已经形成完整闭环:一次请求从分词进入 slot、被图构建翻译成 ggml 图、由后端切分执行、再经采样与流式输出回到客户端,这条主干上已无断层。以下方向属于可选补篇,不影响主线理解:
沿 tools/server/ 的其余部分继续展开:路由层的全部端点与鉴权、多模态输入(mtmd)如何进入 slot、以及 server_res_generator 与 SSE/Responses/Anthropic 三种响应格式的适配细节。另一个值得对照的方向是第四篇留下的 checkpoint 存储:--slot-save-path 的磁盘格式(含检查点附录与草稿状态)与 SGLang 的 HiCache 在分层缓存上的差异。本站的推理框架源码系列会继续沿路线图推进下一个框架,llama.cpp 这一部分的内容以本篇收束。
参考资料
- llama.cpp 官方仓库(ggml-org/llama.cpp)
- llama-server 服务核心 tools/server/server-context.cpp
- 服务端私有结构 server_slot 与 server_batch(tools/server/server-context.h)
- 任务模型与参数解析 tools/server/server-task.h 与 server-task.cpp
- 任务队列与主循环 tools/server/server-queue.h 与 server-queue.cpp
- HTTP 传输层 tools/server/server-http.cpp
- llama-server 参数与服务端点文档 tools/server/README.md
- 上下文与记忆系统 src/llama-context.cpp 与 src/llama-memory.h
- KV 缓存实现 src/llama-kv-cache.cpp 与 src/llama-kv-cells.h
- SGLang:Efficiently Programming Large Language Models using SGLang(RadixAttention 与前缀复用)
- Efficient Memory Management for Large Language Model Serving with PagedAttention(vLLM 论文)
- Orca: A Distributed Serving System for Transformer-Based Generative Models(迭代级调度原始论文)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



