


llama.cpp 源码完全拆解(九):投机解码——一条序列里的草稿、验证与 KV 裁剪
为什么 llama.cpp 的投机解码长得和别人不一样
投机解码(speculative decoding)的基本逻辑在站内已经拆过很多遍:用一个小而快的草稿模型连续猜出 个 token,再让大模型一次性并行验证这批 token,接受最长的一段正确前缀,从而把「 次串行解码」压缩成「1 次并行前向」。原理本身不复杂,可参考 EAGLE 完全拆解 与 Medusa 完全拆解 里的接受规则推导。
但把这套逻辑落进 llama.cpp 时,会撞上一个非常具体的问题:草稿模型产生的 个 token,KV 该往哪里放?
vLLM、SGLang、TensorRT-LLM 这类框架的回答是「开一块独立的草稿 KV 池」,因为它们的 KV 缓存本来就是按 block 分页、按请求动态分配的,多开一本账并不困难。前面拆 vLLM 时看到的 draft_model_runner、SGLang 的 DraftWorker、TensorRT-LLM 的 one-model 统一 worker,都属于这一类思路,可见 vLLM 源码完全拆解(十):投机解码、SGLang 源码完全拆解(十一):投机解码 与 TensorRT-LLM 源码完全拆解(十):投机解码。
llama.cpp 不行。它最主流的用法是单 context、单序列:一个 llama_context 里只有一块连续增长的 KV 缓存,没有 block 表,没有分页,也没有独立的草稿池。更麻烦的是,它还必须把这种「一条序列」的模型扩展到 llama-server 的多用户并发服务场景——n_parallel 个 slot 同时在生成。
于是 llama.cpp 给出了一个很有代表性的答案:把草稿 token 直接追加进同一条序列的同一份 KV 缓存,验证完毕后用区间删除把不该留下的部分裁掉。
这句话里藏了三个技术点,也是本篇要彻底讲透的三件事:
- 同一份 KV 里怎么区分「草稿」和「已确认」——靠
seq_id与位置区间(pos)记账,而不是靠两套缓存; - 验证之后怎么回滚——
llama_memory_seq_rm支持「删掉某序列在 区间内的 KV」,这恰好是投机解码需要的原语,但它并非所有后端都支持,于是又派生出 checkpoint 降级路径; - 一套系统里怎么同时装下 11 种草稿器——从独立的 draft 模型、EAGLE-3、MTP,到完全不需要模型的 n-gram 查表,都由
common/speculative.cpp的一组common_speculative_impl子类统一抽象。
这一篇接在 llama.cpp 源码完全拆解(四):llama_context 与记忆系统 和 llama.cpp 源码完全拆解(八):服务化与调度 之后。如果你对 llama.cpp 那套 llama_memory_i 抽象、slot 状态机还不熟,建议先看那两篇;本篇只在下游用到它们时才回指。
llama.cpp 投机解码的系统地图
在进入代码之前,先把整套机制的角色摆清楚。llama.cpp 的投机解码横跨三个文件、三种角色,边界划分得相当干净:
| 角色 | 文件 | 职责 | 是否知道「这是投机解码」 |
|---|---|---|---|
| 草稿器抽象层 | common/speculative.cpp | 生成草稿 token、记录接受统计、维护每个草稿器的私有状态 | 是,这是它的全部工作 |
| 目标模型 | src/llama-context.cpp | 一个 batch 里并行前向目标模型的 个 token | 否,它只看到「一个长度为 的 batch」 |
| 服务调度层 | tools/server/server-context.cpp | 决定何时起草、如何把草稿拼进 batch、验证后如何回滚 slot 状态 | 是,它负责记账与回滚 |
这个划分的关键在于目标模型完全不知道自己在做投机解码。llama.cpp 的核心库没有「verify」这种概念:验证就是把 个 token 当成一次普通的 batch decode 塞进去,拿到 组 logits,仅此而已。所以推理框架的「投机解码支持」在 llama.cpp 里其实只是 common 层与 server 层的一层编排,核心库只需要提供一个能力:能删除某个序列在某个位置区间内的 KV。
这个能力就是 llama_memory_seq_rm。它的签名是:
bool llama_memory_seq_rm(llama_memory_t mem, llama_seq_id seq_id, llama_pos p0, llama_pos p1);语义是:删除 seq_id 这条序列在位置区间 [p0, p1) 内的 KV。传 -1 表示「不限」,所以 llama_memory_seq_rm(mem, id, -1, -1) 是删掉整条序列,llama_memory_seq_rm(mem, id, p, -1) 是删掉从 p 到结尾的全部。
投机解码需要的正是区间中间挖洞这种形态:草稿的 个 token 落在 ,验证后可能只接受前 个,那么需要删掉的是 这一段尾巴,而保留 。
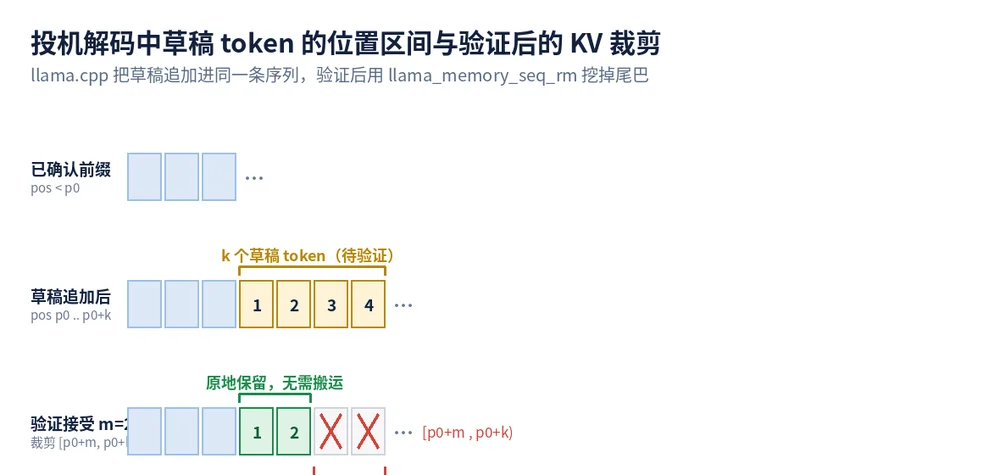
上图是整篇的骨架:草稿 token 被追加进同一条序列的位置区间 ,验证接受 个后,只需删掉 这一段。注意被接受的 个 token 的 KV 原地保留——这是 llama.cpp 方案最省事的地方,它不需要把「正确的 KV」搬来搬去。
seq_id:一份 KV 缓存里的多路记账
要理解「为什么可以直接追加」,得先回到 llama.cpp 的 KV 缓存结构。
llama_context 里维护的 llama_kv_cache 本质上是一个按 cell 组织的大数组,每个 cell 存一个位置的 K/V 向量。每个 cell 上挂着一个 seq_id 集合——这是 llama.cpp KV 缓存最核心的抽象:一个 cell 可以被多条序列共享。前缀共享就是靠这个实现的:两条请求共享同一个 prompt 前缀时,前缀部分的 cell 上会同时挂着两个 seq_id,物理上只存一份。
这个设计在 llama.cpp 源码完全拆解(四):llama_context 与记忆系统 里详细拆过,这里只取它对投机解码的两个推论:
推论一:同一条序列的位置必须连续且唯一。
因为 llama_memory_seq_rm 是按 (seq_id, pos) 定位的,一条序列在某个 pos 上只能有一个 cell。所以草稿 token 不能「另起一段位置」写进去,只能老老实实接在 pos_next() 后面。这就是为什么服务层拼 batch 时,草稿 token 的位置是逐个递增的:
// tools/server/server-context.cpp — server_slot::handle_last_sampled_tokenauto pos0 = prompt.tokens.pos_next();
add_ok &= batch.add(id, sampled, pos0++, true, false);for (auto token : spec_draft) { add_ok &= batch.add(this->id, token, pos0++, true, false);}sampled 是上一步采样出的、已经确定的那个 token,它占 pos0;紧接着 个草稿 token 占 pos0+1 到 pos0+k。一次 batch 里同时放进「1 个确定的 token + 个待验证的草稿 token」,总共 个。
推论二:草稿模型必须是独立的 context。
草稿模型当然不能和目标模型共用同一份 KV 缓存——它有自己的权重、自己的层数、自己的 hidden size。所以 llama.cpp 用了两个 llama_context:ctx_tgt 与 ctx_dft。两者各自的 KV 缓存里,同一条序列(同一个 seq_id)各自维护自己的位置记账。这就解释了为什么服务层要同时追踪 ctx_tgt_seq_rm_type 和 ctx_dft_seq_rm_type——两边的回滚能力可能不同,需要分别判断。
于是「同一份 KV 缓存里放下草稿」这个说法要精确一点:草稿与目标序列共用的是各自 context 内的同一份 KV 缓存,区别只体现在 pos 区间的记账上。目标模型的 KV 里, 是还没确认的草稿;草稿模型的 KV 里,同一区间是草稿模型自己的前向留下的痕迹。两者都要在验证后被裁剪到一致的状态。
11 种草稿器:一套抽象,五种来源
llama.cpp 支持多少种草稿来源?看这张表:
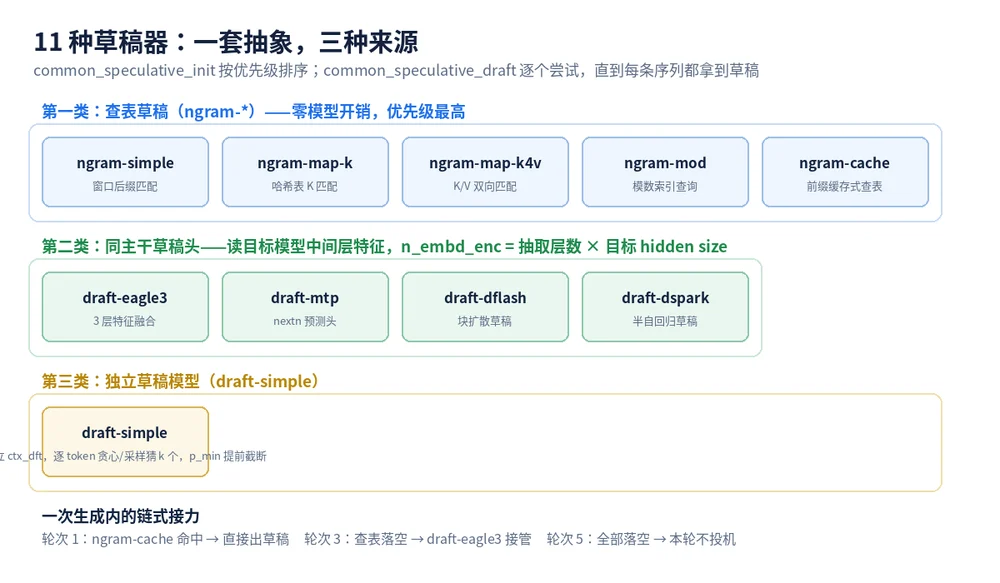
const std::map<std::string, common_speculative_type> common_speculative_type_from_name_map = { {"none", COMMON_SPECULATIVE_TYPE_NONE}, {"draft-simple", COMMON_SPECULATIVE_TYPE_DRAFT_SIMPLE}, {"draft-eagle3", COMMON_SPECULATIVE_TYPE_DRAFT_EAGLE3}, {"draft-mtp", COMMON_SPECULATIVE_TYPE_DRAFT_MTP}, {"draft-dflash", COMMON_SPECULATIVE_TYPE_DRAFT_DFLASH}, {"draft-dspark", COMMON_SPECULATIVE_TYPE_DRAFT_DSPARK}, {"ngram-simple", COMMON_SPECULATIVE_TYPE_NGRAM_SIMPLE}, {"ngram-map-k", COMMON_SPECULATIVE_TYPE_NGRAM_MAP_K}, {"ngram-map-k4v", COMMON_SPECULATIVE_TYPE_NGRAM_MAP_K4V}, {"ngram-mod", COMMON_SPECULATIVE_TYPE_NGRAM_MOD}, {"ngram-cache", COMMON_SPECULATIVE_TYPE_NGRAM_CACHE}};11 种,可以归成三大类:
第一类:独立草稿模型(draft-simple)。 最经典的做法——另加载一个小模型 ctx_dft,用贪心或采样逐 token 猜 个。draft-simple 是 llama.cpp 里最通用、也最容易理解的一种。
第二类:同主干草稿头(EAGLE-3、MTP、DFlash、DSpark)。 这一类的草稿不是独立的完整模型,而是挂在目标模型上的一个小「头」。EAGLE-3 与 MTP 在站内都拆过(EAGLE-3 完全拆解、MTP 完全拆解),DFlash 与 DSpark 是扩散式草稿(见 DFlash 块扩散解码 和 DSpark)。它们的共同点是需要读目标模型的中间层特征,所以 ctx_dft 不是一个独立模型,而是一个窄得多的小网络。
第三类:查表草稿(ngram-*)。 完全不需要任何模型。ngram-simple 用滑动窗口在历史文本里找 个 token 的后缀匹配,直接抄后续 token 当草稿;ngram-map-k 用哈希表做同样的事;ngram-cache 则维护一份更像「前缀缓存」的哈希结构。这一类延迟极低、内存占用极小,在「输入里有大量重复片段」的场景(如代码编辑、文档问答)里收益意外地高。
值得一提的是,llama.cpp 目前不支持树形草稿。对比 Medusa 完全拆解 里的多头候选树——一次前向验证多条候选路径,llama.cpp 的草稿始终是一条线性链:
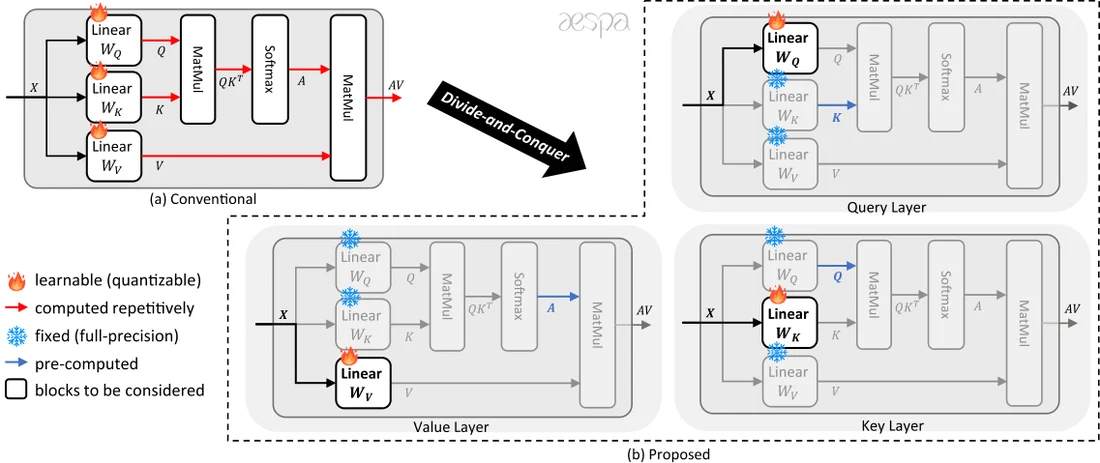
图源:Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads(arXiv 2402.08958)。Medusa 用多个头并行给出不同候选,形成树形投机;而 llama.cpp 由于「同一条序列的位置必须连续唯一」这一约束(见前文推论一),无法让一棵候选树共享同一份 KV——这是它的架构边界,也是它换来实现简洁的代价。
这 11 种可以在一次运行里叠加使用。common_speculative_init 会按优先级把用户请求的类型展开成一个有序列表:
// this list here defines the priority of the speculators// the one with highest priority are listed firstadd_config_if_enabled(COMMON_SPECULATIVE_TYPE_NGRAM_SIMPLE);add_config_if_enabled(COMMON_SPECULATIVE_TYPE_NGRAM_MAP_K);add_config_if_enabled(COMMON_SPECULATIVE_TYPE_NGRAM_MAP_K4V);add_config_if_enabled(COMMON_SPECULATIVE_TYPE_NGRAM_MOD);add_config_if_enabled(COMMON_SPECULATIVE_TYPE_NGRAM_CACHE);
add_config_if_enabled(COMMON_SPECULATIVE_TYPE_DRAFT_SIMPLE);add_config_if_enabled(COMMON_SPECULATIVE_TYPE_DRAFT_EAGLE3, params.draft.ctx_dft != nullptr);add_config_if_enabled(COMMON_SPECULATIVE_TYPE_DRAFT_MTP, params.draft.ctx_dft != nullptr);add_config_if_enabled(COMMON_SPECULATIVE_TYPE_DRAFT_DFLASH, params.draft.ctx_dft != nullptr);add_config_if_enabled(COMMON_SPECULATIVE_TYPE_DRAFT_DSPARK, params.draft.ctx_dft != nullptr);优先级「查表类在前、模型类在后」。为什么这个顺序? 因为查表类几乎零开销——如果 n-gram 能命中,就没必要启动一次草稿模型前向。而四个草稿头类型的 add_config_if_enabled 第二参数是 params.draft.ctx_dft != nullptr,没有加载草稿 context 就自动跳过——这形成一个优雅的降级链:用户没配 -md 时,模型类草稿器全部不可用,但 n-gram 类仍然能工作。
common_speculative_draft 的调度逻辑正好实现了这个「接力」语义:
for (auto & impl : spec->impls) { impl->draft(dparams); ... for (llama_seq_id seq_id = 0; seq_id < (llama_seq_id) dparams.size(); ++seq_id) { auto & dp = dparams[seq_id]; if (!dp.drafting) { continue; }
auto & result = *dp.result;
// a new draft has been sampled if (dp.drafting && !result.empty()) { dp.drafting = false; // 这条序列已经有草稿了,后面的 impl 不再碰它 ... spec->impl_last[seq_id] = impl.get(); ... } if (dp.drafting) { n_drafting++; } } if (n_drafting == 0) { break; } // 所有序列都拿到草稿了,提前退出}dparams[seq_id].drafting 这个布尔就是接力棒:前一个 impl 没产出草稿时保持 true,交给下一个 impl;一旦产出草稿就置 false,后面的 impl 跳过这条序列。spec->impl_last[seq_id] 记下「这条序列的草稿是谁给的」,验证结束后的 common_speculative_accept 才能把接受数反馈给正确的实现。
这套「链式草稿」设计解释了 llama.cpp 一个很容易被忽略的行为:同一次生成里,不同轮次可以换草稿器。第一轮 n-gram 命中、快速给出草稿;第三轮 n-gram 落空、draft-model 接管。对用户是透明的,统计里则分开累加。
草稿 context 是怎么装配出来的
四种「同主干草稿头」都要求 ctx_dft 存在,而它们的 context 装配方式和独立草稿模型并不相同:
common_params params_dft = common_base_params_to_speculative(params);
auto mparams_dft = common_model_params_to_llama(params_dft);auto cparams_dft = common_context_params_to_llama(params_dft);if (spec_mtp) { cparams_dft.ctx_type = LLAMA_CONTEXT_TYPE_MTP;}cparams_dft.n_rs_seq = 0;
const common_fit_extra_model extra = { /*.path_model =*/ params_dft.model.path.c_str(), /*.mparams =*/ &mparams_dft, /*.cparams =*/ &cparams_dft, /*.shares_model =*/ !has_draft, // an MTP context runs on the weights of the main model};两个分支值得对照:
MTP 路径把 ctx_type 设为 LLAMA_CONTEXT_TYPE_MTP,并且 shares_model = !has_draft——MTP context 直接跑在主模型的权重上。这符合 MTP 的定义:多 token 预测头本就是目标模型的组件(见 MTP 完全拆解),它不需要另一套权重,只需要一个独立的 context 来持有「预测未来 token」时的 KV 记账。这也解释了 has_spec 的判定里为什么 MTP 可以单独成立:
const bool has_draft = params.speculative.has_dft();const bool spec_mtp = std::find(params_base.speculative.types.begin(), params_base.speculative.types.end(), COMMON_SPECULATIVE_TYPE_DRAFT_MTP) != params_base.speculative.types.end();const bool has_spec = has_draft || spec_mtp;has_draft(有没有 -md 指定的草稿模型文件)与 spec_mtp(有没有请求 MTP 类型)是或的关系——只用 MTP 时不需要额外模型文件。
cparams_dft.n_rs_seq = 0 这一行前面已经提过:草稿 context 不需要可逆状态,因为它的 KV 每轮重建。把它显式清零而不是留给默认值,是一个「明确声明不需要」的写法。
还有一个细节:草稿 context 装配完成后,服务层要把它回填进参数里,草稿器实现才能拿到它:
if (has_draft && model_dft == nullptr) { SRV_ERR("failed to load draft model, '%s'\n", params_dft.model.path.c_str()); return false;}
if (ctx_dft == nullptr) { SRV_ERR("%s", "failed to create MTP context\n"); return false;}
params_base.speculative.draft.ctx_tgt = ctx_tgt;params_base.speculative.draft.ctx_dft = ctx_dft;注意两个失败检查的分工:has_draft 为真但 model_dft == nullptr 说明模型文件加载失败;ctx_dft == nullptr 则说明 context 创建失败——这在 MTP 路径上是真实可能发生的(因为 MTP 不加载模型文件,只创建 context)。错误信息「failed to create MTP context」正是为后一种情况准备的。
回填之后,草稿器就同时握有两个 context 的指针。ctx_tgt 供四种草稿头抽取目标特征用,ctx_dft 供所有草稿器做草稿前向用——draft-simple 只用后者,而 EAGLE-3 / MTP / DFlash / DSpark 两个都要。
draft-simple:最通用的一种草稿器
讲透一个具体实现,才能看清抽象层的每个虚函数到底在干什么。选 draft-simple,因为它最不依赖特殊模型结构。
它的类定义只带几个成员:
struct common_speculative_impl_draft_simple : public common_speculative_impl { common_params_speculative_draft params;
common_batch batch;
// zero row at the draft input width, stands in for target embeddings the draft cannot read std::vector<float> zeros; bool zeros_warned = false;
std::vector<common_sampler_ptr> smpls; std::vector<common_params_sampling> smpls_cfg; ...};batch 是草稿模型自己的输入 batch,smpls 是每条序列一个采样器——这一点很重要,因为多用户服务下不同 slot 的温度、top-k 都不一样,采样器不能共用。
构造函数里有三件事值得看。第一件是词表兼容性检查:
const bool vocab_cmpt = common_speculative_are_compatible(llama_get_model(ctx_tgt), llama_get_model(ctx_dft));if (!vocab_cmpt) { SPC_ERR("%s", "the target and draft vocabs are not compatible\n"); throw std::runtime_error("draft model vocab type must match target model to use speculation");}common_speculative_are_compatible 的检查比想象中严格。它不只看词表大小,而是逐项核对:词表类型(BPE / SentencePiece / …)必须一致;add_bos / add_eos 行为必须一致,且 BOS/EOS 的 token id 必须相同;词表大小差不能超过 SPEC_VOCAB_MAX_SIZE_DIFFERENCE;最后从 SPEC_VOCAB_CHECK_START_TOKEN_ID 开始逐个 token 比对文本内容:
for (int i = SPEC_VOCAB_CHECK_START_TOKEN_ID; i < std::min(n_vocab_tgt, n_vocab_dft); ++i) { const char * token_text_tgt = llama_vocab_get_text(vocab_tgt, i); const char * token_text_dft = llama_vocab_get_text(vocab_dft, i);
if (std::strcmp(token_text_tgt, token_text_dft) != 0) { SPC_DBG("draft model vocab must match target model ... token %d content differs - target '%s', draft '%s'\n", ...); return false; }}为什么必须这么严? 因为投机解码的正确性依赖一个前提:草稿模型给出的 token id,在目标模型眼里是同一个 token。如果两者对 id=1024 的解释不同(一边是「的」,一边是「the」),那么把草稿 token 直接喂给目标模型验证,验证的就是一个语义上毫无关系的 token,接受率会崩、甚至可能因为特殊 token 语义差异导致输出异常。这类 bug 在工程上极难定位,所以 llama.cpp 选择在初始化阶段直接拒绝,而不是「尽力而为」。
第二件是采样器的构造。注意草稿器默认只用 TOP_K:
smpls.resize(n_seq);for (auto & smpl : smpls) { common_params_sampling params; params.no_perf = false; params.top_k = 10; params.samplers.assign(1, COMMON_SAMPLER_TYPE_TOP_K);
smpl.reset(common_sampler_init(llama_get_model(ctx_dft), params));}为什么草稿端只要 top-k、不带温度? 因为草稿端有两条路:走拒绝采样(rejection sampling)时,草稿必须给出完整的候选分布 ,由服务层调 spec_retune 按目标模型的温度重建采样器;走采样-匹配(sample-and-match)时,草稿只需要给出一个「最有希望的 token」,接受规则退化成「草稿 token 是否等于目标模型采样出的 token」。默认的 top-k=10 采样器服务的是后者——它给一个略有随机性的候选,同时 common_sampler_get_candidates 还能返回候选分布供调试打印。
第三件是行宽不匹配的兜底:
// mtmd input is projected by the target encoder, a draft with a different width cannot read it// it gets zeros instead, keeping its positions contiguousconst size_t n_embd = t.embd.n_rows * t.embd.n_embd;const bool same_width = n_embd == zeros.size();if (!same_width && !zeros_warned) { SPC_WRN("target embeddings of size %zu do not fit the draft input width %zu, " "the draft receives zero rows for them and drafts after multimodal input will be poor\n", ...); zeros_warned = true;}const llama_embd embd = same_width ? t.embd : llama_embd{ zeros.data(), 1, zeros.size() };batch.add_embd(embd, t.pos.data(), t.seq_id, output);多模态输入下,图像 embedding 由目标模型的视觉编码器投影出来,其维度是目标模型的 n_embd_inp,草稿模型未必相同。这时 llama.cpp 的选择是:位置照常占住,内容填零。宁可让草稿质量变差(并明确警告「drafts after multimodal input will be poor」),也不能让位置出现空洞——因为位置一旦不连续,后面所有按 pos 的记账、回滚全都失效。这是一个典型的「保正确性、牺牲质量」的工程取舍。
process() 虚函数负责把目标模型刚跑完的 batch「镜像」给草稿模型。它只输出最后一个 token:
// copy the entries to a batch owned by the draft context, only the last token is outputbatch.clear();const int32_t n_tokens = batch_in.size();for (int32_t k = 0; k < n_tokens; ++k) { const auto & t = batch_in.tokens[k]; const bool output = k == n_tokens - 1; ...}为什么只要最后一个 token 的输出? 草稿模型不需要重现整个前向,它只需要把 KV 推进到与目标模型相同的状态,然后知道「当前最后一个位置的 hidden state 用来预测下一个 token」。前面那些 token 的 logits 完全没用,算出来也不读——llama.cpp 通过 output 标志位让后端跳过它们的 logits 计算,省掉一部分开销。
真正的草稿循环在 draft() 里,它的形状是「外层逐轮、内层逐序列」:
int i = 0;while (n_drafting > 0) { int i_batch = 0; batch.clear();
for (llama_seq_id seq_id = 0; seq_id < (llama_seq_id) n_seq; ++seq_id) { if (!drafting[seq_id]) { continue; }
auto * smpl = smpls[seq_id].get(); const llama_token id_sampled = common_sampler_sample(smpl, ctx_dft, i_batch, true); ++i_batch;
const auto * cur_p = common_sampler_get_candidates(smpl, true);
// add drafted token for each sequence const llama_token id = dparams.at(seq_id).result_q ? id_sampled : cur_p->data[0].id;
// only collect very high-confidence draft tokens if (cur_p->data[0].p < params.p_min) { drafting[seq_id] = false; n_drafting--; continue; } ... } ...}这里有两个精妙之处。
其一:多条序列在同一个草稿 batch 里并行推进。 while (n_drafting > 0) 的每一轮,都会把所有还在起草的序列各取一个 token,凑成一个 batch 一次前向——这就是草稿模型侧的「连续批处理」。i_batch 是这条序列在当前 batch 里的行号,用来取对应的 logits。
其二:p_min 提前裁剪。 每采一个草稿 token,都检查它的概率是否低于阈值 params.p_min。低于就立刻停止这条序列的起草,不再往下猜。
为什么用「概率」而不是「固定长度」来截断? 因为投机解码的收益是有条件的:接受 个草稿 token 换来的加速,必须大于草稿本身的开销与 宽度前向的额外代价。如果草稿模型的第 3 个 token 概率只有 0.05,那它被接受的概率极低,继续猜第 4、5 个只会白烧草稿算力、并且拉长验证 batch。p_min 让草稿长度变成自适应的:模型有信心时就多猜几个,没信心时就少猜。这比 EAGLE 早期的固定 更贴近实际——EAGLE-2 后来引入「动态草稿树」也是同一个动机,可对照 EAGLE-2 完全拆解。
顺带一提,spec_retune 处理的是拒绝采样路径:
static void spec_retune( std::vector<common_sampler_ptr> & smpls, std::vector<common_params_sampling> & cfg, const llama_model * model, llama_seq_id seq_id, float temp, uint32_t seed) { ... if (cur.temp == temp && cur.seed == seed) { return; // 配置没变,不重建采样器 } ... sparams.temp = cur.temp; // must be explicit, the default reseeds at random; mixed so it differs from the target's sparams.seed = cur.seed == LLAMA_DEFAULT_SEED ? cur.seed : cur.seed ^ 0x85ebca6bu; sparams.samplers = { COMMON_SAMPLER_TYPE_TOP_K, COMMON_SAMPLER_TYPE_TEMPERATURE };
smpls[seq_id].reset(common_sampler_init(model, sparams));}两处细节:温度+种子没变就直接返回,避免每轮重建采样器;种子做了一次 ^ 0x85ebca6b 的混淆——注释说得很清楚,「mixed so it differs from the target’s」,即让草稿采样和目标任务采样用不同的随机流,否则两者的随机性会产生相关性,破坏拒绝采样的数学前提。
EAGLE-3:让草稿头读目标模型的中间层特征
draft-simple 的草稿模型只看 token,不看目标模型的内部状态。EAGLE-3 反过来:它的草稿头必须读目标模型若干中间层的 hidden state。
struct common_speculative_impl_draft_eagle3 : public common_speculative_impl { common_params_speculative_draft params; common_batch batch; // decoder input, (token, g_embd) pairs common_batch batch_enc; // encoder input, built from the extracted target features
std::vector<common_sampler_ptr> smpls; std::vector<llama_sampler *> backend_chains; // backend sampler chain per seq
int32_t n_embd_dec = 0; // draft hidden size int32_t n_embd_enc = 0; // target_layer_ids_n * target_hidden_size int32_t n_embd_tgt = 0; // target model hidden size int32_t n_layer_tgt = 0; // target model layer count
const int32_t * target_layer_ids = nullptr; // model_dft's extract layer indices uint32_t target_layer_ids_n = 0; ...};维度关系一眼可见:编码器输入宽度 n_embd_enc 等于「抽取层数 × 目标模型 hidden size」——因为要把多层特征拼在一起喂给草稿头。抽取层数被硬性限定为 3:
target_layer_ids = llama_model_target_layer_ids (model_dft);target_layer_ids_n = llama_model_target_layer_ids_n(model_dft);if (target_layer_ids_n != 3) { throw std::runtime_error("draft model is not eagle3 (expected 3 extract layers, got " + std::to_string(target_layer_ids_n) + ")");}为什么是三? EAGLE-3 的原始设计里,草稿头融合低、中、高三层特征来获得既有局部细节又有全局语义的表示。llama.cpp 把这个数量写死在 GGUF 元数据里(草稿模型的 target_layer_ids 数组),初始化时不匹配直接抛异常——又是一个「宁可早失败」的取舍。
接下来是「打开特征抽取开关」的部分,这是 llama.cpp 支持 EAGLE 类草稿的关键机制:
// turn on extraction of the target layers' hidden statesfor (uint32_t k = 0; k < target_layer_ids_n; ++k) { if (target_layer_ids[k] < n_layer_tgt) { llama_set_embeddings_layer_inp(ctx_tgt, (uint32_t) target_layer_ids[k], true); } else if (target_layer_ids[k] == n_layer_tgt) { llama_set_embeddings_nextn(ctx_tgt, true, /*masked*/ false); } else { GGML_ABORT("EAGLE3: target layer id %d exceeds target n_layer %d", target_layer_ids[k], n_layer_tgt); }}
// turn on extraction of the draft model's pre-norm hidden state// (used both for the encoder output g_embd and the decoder pre-norm output).llama_set_embeddings_nextn(ctx_dft, true, /*masked*/ true);llama_set_embeddings_layer_inp 让目标模型在跑完第 层后,把该层的输入 hidden state 额外输出到 ctx_tgt 的一个缓冲里。target_layer_ids[k] == n_layer_tgt 这个分支很讲究——最后一个抽取点落在「第 层之后」,也就是 nextn(next-token prediction 额外层)的输入。
注意最后一行对草稿模型也开了 nextn 且 masked = true。注释说明它用于取「pre-norm hidden state」——masked 语义是不推进主状态、只旁路抽取(避免抽取动作本身污染草稿模型的正向计算)。这个细节对熟悉 llama.cpp 源码的读者很关键:nextn 抽取在草稿模型侧是「只读」的。
还有一个工程优化值得单说:
// offload draft sampling to the backendbackend_chains.assign(n_seq, nullptr);if (this->params.backend_sampling) { for (llama_seq_id seq_id = 0; seq_id < (llama_seq_id) n_seq; ++seq_id) { llama_sampler * chain = llama_sampler_chain_init(llama_sampler_chain_default_params()); llama_sampler_chain_add(chain, llama_sampler_init_top_k(10));
if (!llama_set_sampler(ctx_dft, seq_id, chain)) { SPC_WRN("backend offload failed for seq_id=%d; using CPU sampler\n", (int) seq_id); llama_sampler_free(chain); chain = nullptr; } backend_chains[seq_id] = chain; }}当 backend_sampling 打开,采样动作被 llama_set_sampler 挂到草稿 context 上,由图执行时在设备侧完成,而不是「前向结束 → 回传 logits 到 CPU → CPU 采样 → 再喂回 GPU」这一趟往返。草稿端每轮 次采样,这个往返在 大时相当可观;把 top-k 采样下沉到后端是典型的「消灭同步点」优化。失败时优雅降级回 CPU 采样器并告警,不影响正确性。
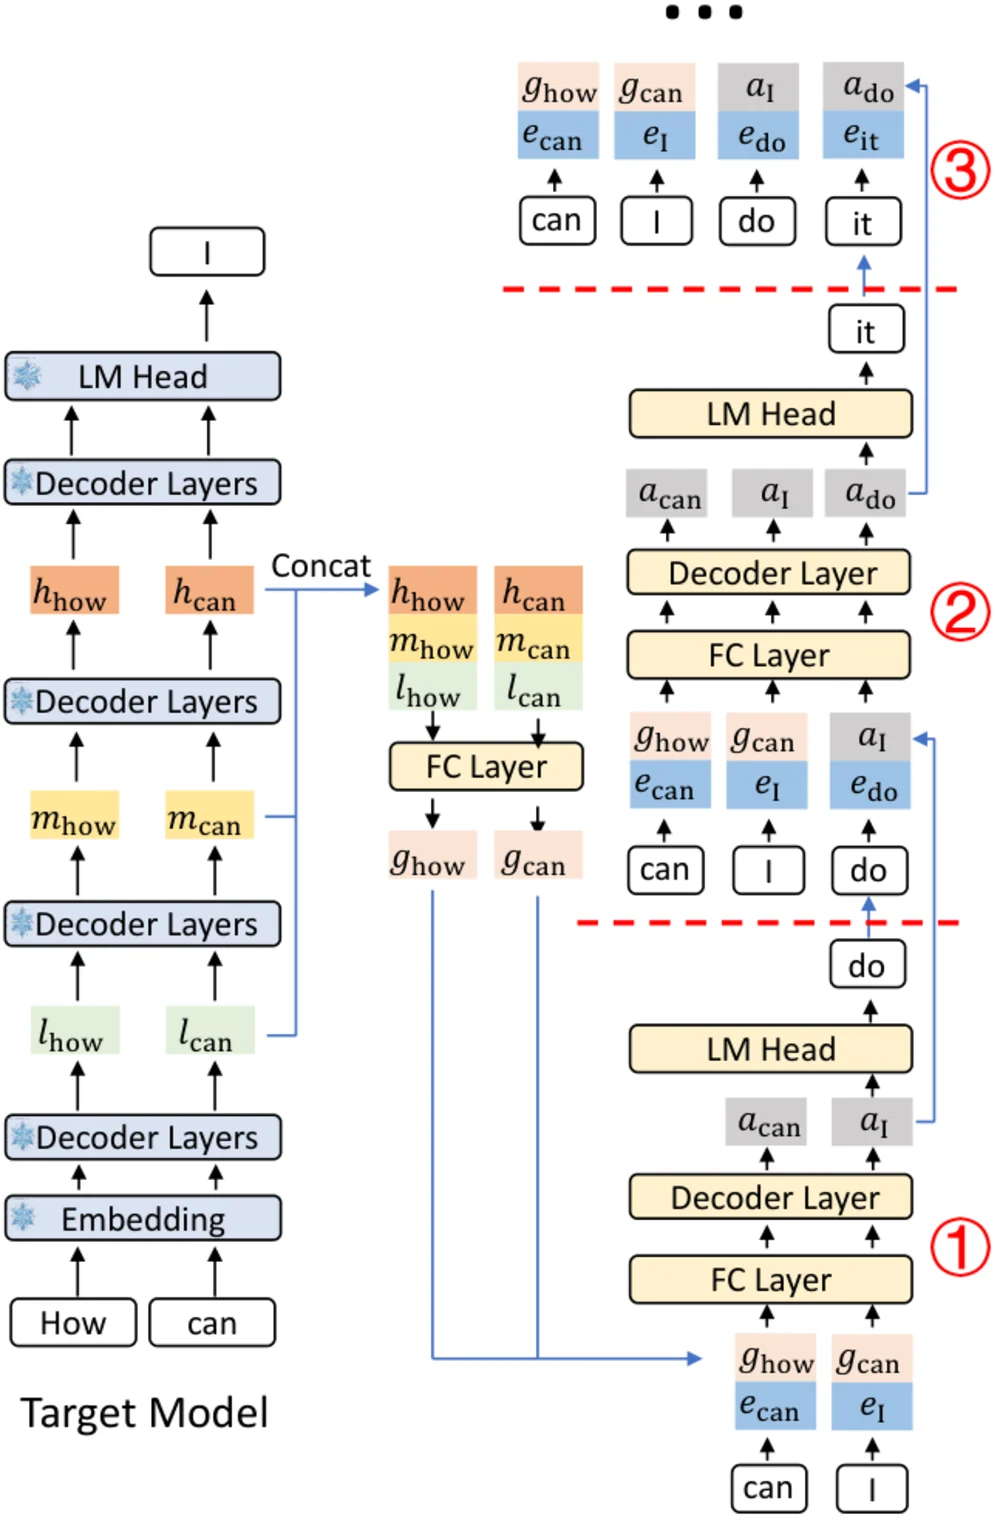
上图是 EAGLE-3 的原始设计(来自 EAGLE-3 论文):目标模型的低、中、高三层 hidden state 被抽取出来拼接,送入草稿头。llama.cpp 的 n_embd_enc = target_layer_ids_n * n_embd_tgt 正是图中这条拼接路径的宽度。对照 EAGLE 完全拆解 里讲过的「特征不确定性」动机,可以看出 llama.cpp 把 EAGLE 的核心机制原样搬进了推理侧,只是把训练相关的部分留在 GGUF 元数据里由草稿模型自带。
不过 llama.cpp 的实现比论文更细致的地方在于延迟边界(deferred boundary)的处理。先看这段注释:
// So the last training pos of each process() call is *deferred* to whichever next call has// ...// pending_g_last [n_embd_dec] ┐ the deferred boundary's (g, pos). Set by问题出在 process() 与 draft() 的对接上。EAGLE 草稿头需要「上一个位置的目标模型特征 」和「这个位置的输入 token」成对出现。但 llama.cpp 收到的 batch 是分 ubatch 送的:一次前向可能被拆成好几个 ubatch,而草稿头需要的 是某个 ubatch 的最后一行。如果直接按 ubatch 边界对齐,就会出现「特征和 token 错位一格」。
llama.cpp 的解法是把每个 process() 调用的最后一个位置往后推(defer):
// [per-seq] deferred boundary statestd::vector<std::vector<float>> pending_g_last;std::vector<llama_pos> pending_pos_last;pending_g_last 存着「还没配对的 」,等到下一次 process() 或 draft() 调用时,用那次的第一个 token 和它配对,写入草稿模型的 KV:
// cross-ubatch bridge — complete the prior ubatch's deferred boundary....batch.set_embd(idx, { pending_g_last[seq_id].data(), 1, (size_t) n_embd_dec });这就是注释里「cross-ubatch bridge」的含义:用一次延迟配对,跨过 ubatch 边界。verify_g / verify_pos_first / verify_g_rows 则保存最近一次 process() 的编码器输出快照,供验证阶段按实际接受数 取回正确的 行:
// [per-seq] snapshot of the most recent process()'s encoder outputstd::vector<std::vector<float>> verify_g; // [n_seq][n_rows * n_embd_dec]std::vector<llama_pos> verify_pos_first; // [n_seq] — pos of verify_g[seq][0]std::vector<int32_t> verify_g_rows; // [n_seq] — number of rows为什么需要快照? 因为验证结果 是运行时才知道的——接受 2 个还是 3 个,取决于目标模型的采样。而草稿模型的 KV 必须精确推进到「接受 个之后」的状态,才能保证下一轮草稿的起点正确。快照让这个「按需取行」成为可能,而不必重算编码器输出。
最后还有一个可序列化的状态接口:
// (optional) serialize/restore per-seq internal state (e.g. eagle3's deferred boundary).virtual bool get_state(llama_seq_id /*seq_id*/, std::vector<uint8_t> & /*data*/) const { return false; }virtual void set_state(llama_seq_id /*seq_id*/, const std::vector<uint8_t> & /*data*/) {}// we only need to stash the deferred boundary's g_embd row for recurrent/hybrid targets:bool get_state(llama_seq_id seq_id, std::vector<uint8_t> & data) const override { ... const std::vector<float> & g = pending_g_last[seq_id];注意注释里的限定条件——「for recurrent/hybrid targets」。对循环架构或混合架构(如 Mamba、Jamba 这类带 SSM 层的模型),KV 缓存状态不是「按位置追加」这么简单,状态是一整块递归量;此时延迟边界那行 没法靠位置重建,必须显式序列化。common_speculative_get_state / set_state 就是为这类模型准备的逃生舱,让状态能在 checkpoint 存取时一起带上。
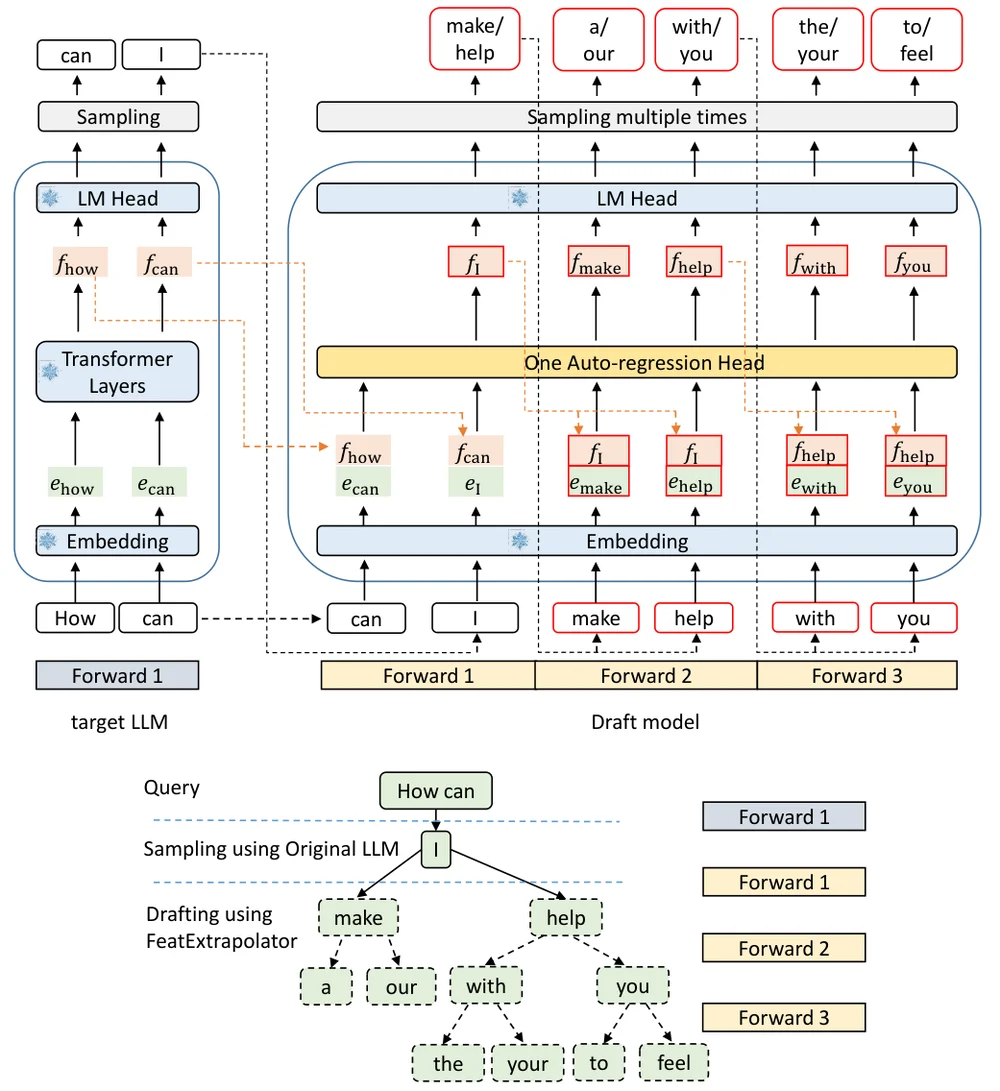
图源:EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty(arXiv 2401.15077)。EAGLE 指出「用特征预测特征」会引入不确定性,因此改为让草稿头直接消费目标模型的已确定特征——这正是 llama.cpp
target_layer_ids抽取机制的理论基础。
回滚的三种能力等级:为什么需要 checkpoint
前面反复提到 ctx_tgt_seq_rm_type,现在把它讲清楚。llama.cpp 在初始化时会探测目标 context 到底支持哪一档回滚:
common_context_seq_rm_type common_context_can_seq_rm(llama_context * ctx) { auto * mem = llama_get_memory(ctx); if (mem == nullptr) { return COMMON_CONTEXT_SEQ_RM_TYPE_NO; }
if (llama_n_rs_seq(ctx) > 0) { COM_TRC("%s", "the context supports bounded partial sequence removal\n"); return COMMON_CONTEXT_SEQ_RM_TYPE_RS; }
common_context_seq_rm_type res = COMMON_CONTEXT_SEQ_RM_TYPE_PART;
llama_memory_clear(mem, true);
// eval 2 tokens to check if the context is compatible std::vector<llama_token> tmp; tmp.push_back(0); tmp.push_back(0);
int ret; { common_batch batch = common_batch_get_one(ctx, tmp); std::vector<float> zeros; common_batch_set_zero_state(batch, llama_get_model(ctx), zeros); ret = llama_process(ctx, LLAMA_PROCESS_TYPE_DECODE, batch.get()); } if (ret != 0) { COM_ERR("llama_process() failed: %d\n", ret); res = COMMON_CONTEXT_SEQ_RM_TYPE_NO; goto done; }
// try to remove the last tokens if (!llama_memory_seq_rm(mem, 0, 1, -1)) { COM_TRC("%s", "the context does not support partial sequence removal\n"); res = COMMON_CONTEXT_SEQ_RM_TYPE_FULL; goto done; }
done: llama_memory_clear(mem, true); llama_synchronize(ctx);
return res;}这段代码是「用真实前向来探测后端能力」的典型案例,值得逐段读:
- 先看有没有
mem。没有记忆模块的 context(比如纯 embedding 用途)直接判NO。 - 再看
llama_n_rs_seq(ctx) > 0。这是一个由使用者预先声明的量:调用llama_context_default_params()后设置cparams.n_rs_seq = N,表示「这个 context 需要支持最多删除尾部 个位置」。need_n_rs_seq()的定义揭示了它什么时候非零:
uint32_t need_n_rs_seq() const { bool needs_rs_seq = std::any_of(types.begin(), types.end(), [&](auto t) { return t == COMMON_SPECULATIVE_TYPE_DRAFT_MTP || t == COMMON_SPECULATIVE_TYPE_DRAFT_EAGLE3 || t == COMMON_SPECULATIVE_TYPE_DRAFT_DFLASH || t == COMMON_SPECULATIVE_TYPE_DRAFT_DSPARK; });
return needs_rs_seq ? draft.n_max : 0u;}「RS」是 reversible state 的意思——只有 MTP / EAGLE3 / DFlash / DSpark 这四种「同主干草稿头」需要它,因为它们的草稿模型侧也维护着与目标模型逐位置对齐的状态,回滚必须两边同时发生且代价很低。取值就是 draft.n_max:只需要能删掉「最多一轮草稿长度」的尾巴,不需要任意区间删除。
- 如果没有 RS,就做真实探测:清空记忆、跑一个 2 token 的假 batch(token id 全 0,附带 zero state),然后尝试
llama_memory_seq_rm(mem, 0, 1, -1)——删掉位置 1 到结尾。删得掉就是PART(支持任意区间部分删除),删不掉就是FULL(只能整条序列删除),前向失败则是NO。
为什么要真跑一次? 因为「支不支持部分删除」取决于后端实现与 KV 类型。FlashAttention 风格的 KV、滑窗 KV、循环 KV 对区间删除的支持各不相同,而 API 层没有问询接口。既然没有,就用一次最小代价的前向去实测——一个 2 token 的假 batch 代价可以忽略,但换来的是运行时确定的能力判断,而不是「假设它支持」然后在中途 crash。
三档能力对应的回滚策略完全不同:
| 能力等级 | seq_rm_type | 回滚手段 | 代价 |
|---|---|---|---|
| 可区间删除 | RS | 直接 llama_memory_seq_rm(mem, id, ckpt.pos_max + 1, -1),无需保存状态 | 最低 |
| 可部分删除但非 RS | PART | 直接 seq_rm 删尾部区间 | 低 |
| 只能整条删除 | FULL | 必须提前存 checkpoint,回滚时整条恢复再删 | 高(要存/取 KV 状态) |
| 不支持删除 | NO | 根本不能启用投机解码 | — |
服务层初始化时就把两边的等级探测出来:
ctx_tgt_seq_rm_type = common_context_can_seq_rm(ctx_tgt);if (ctx_tgt_seq_rm_type == COMMON_CONTEXT_SEQ_RM_TYPE_NO) { SRV_WRN("%s", "speculative decoding not supported by this context\n");}
if (ctx_tgt_seq_rm_type == COMMON_CONTEXT_SEQ_RM_TYPE_FULL) { SRV_TRC("%s", "speculative decoding will use checkpoints\n");}
// try speculative decodingif (ctx_tgt_seq_rm_type != COMMON_CONTEXT_SEQ_RM_TYPE_NO) { try { spec.reset(common_speculative_init(params_base.speculative, params_base.n_parallel)); } catch (const std::exception & e) { SRV_ERR("failed to initialize speculative decoding context: %s\n", e.what()); ... }}
if (ctx_dft) { ctx_dft_seq_rm_type = common_context_can_seq_rm(ctx_dft);}两行日志把语义说得很清楚:不支持删除就完全关掉投机解码(而不是带病运行),只能整条删除就启用 checkpoint 路径。注意草稿模型那边的 n_rs_seq 被显式清零:
auto cparams_dft = common_context_params_to_llama(params_dft);if (spec_mtp) { cparams_dft.ctx_type = LLAMA_CONTEXT_TYPE_MTP;}cparams_dft.n_rs_seq = 0;为什么草稿模型不需要 RS? 因为草稿模型的 KV 状态在每一轮验证后整体重建——它本来就只服务草稿,丢掉一段重算比维护可逆状态更省事。目标模型不行,它的 KV 里有大量用户长前缀,整条重建代价太高。这个不对称是 llama.cpp 设计里的一个关键取舍。
checkpoint 的实现
common_prompt_checkpoint 是「整条序列状态」的容器:
struct common_prompt_checkpoint { int64_t n_tokens;
// (optional) id of the task that created the checkpoint int id_task = -1;
llama_pos pos_min; llama_pos pos_max;
std::vector<uint8_t> data_tgt; std::vector<uint8_t> data_dft;
// (optional) speculative-decoding implementation state stashed with the checkpoint // (e.g. eagle3's deferred-boundary g_embd row) std::vector<uint8_t> data_spec; ...};三个数据块:data_tgt 与 data_dft 分别是目标/草稿 context 的序列状态,data_spec 是草稿器自己的私有状态(正是前面 EAGLE-3 的延迟边界那行 )。保存与恢复直接调用 llama.cpp 的状态序列化 API:
void common_prompt_checkpoint::update_tgt( llama_context * ctx, llama_seq_id seq_id, llama_state_seq_flags flags) { if (ctx == nullptr) { return; }
const size_t ckpt_size = llama_state_seq_get_size_ext(ctx, seq_id, flags);
data_tgt.resize(ckpt_size);
const size_t n = llama_state_seq_get_data_ext(ctx, data_tgt.data(), ckpt_size, seq_id, flags); if (n != ckpt_size) { GGML_ABORT("checkpoint size mismatch: expected %zu, got %zu\n", ckpt_size, n); }}注意 flags 传的是 LLAMA_STATE_SEQ_FLAGS_PARTIAL_ONLY:
// work only with partial states, such as SWA KV cache or recurrent cache (e.g. Mamba)#define LLAMA_STATE_SEQ_FLAGS_PARTIAL_ONLY 1这个 flag 是 checkpoint 能实用的关键。 如果保存「整条序列的完整 KV」,一个 32K 上下文的 7B 模型每层每头都要存,checkpoint 会膨胀到几百 MB,每轮草稿都存一次完全不现实。PARTIAL_ONLY 只保存容易丢失、无法重建的那部分状态(滑窗 KV、循环状态),体积小得多。恢复时,其余部分靠重算补回来。
恢复接口对称:
bool common_prompt_checkpoint::load_tgt( llama_context * ctx, llama_seq_id seq_id, llama_state_seq_flags flags) const { if (ctx == nullptr) { return true; }
if (data_tgt.empty()) { return true; }
const size_t n = llama_state_seq_set_data_ext(ctx, data_tgt.data(), data_tgt.size(), seq_id, flags); return n == data_tgt.size();}完整的一轮:从起草到回滚
把前面所有部件串起来,llama-server 的一次投机解码轮次是这样走的。第一步:判断哪些 slot 可以起草。
// tools/server/server-context.cpp — update_slots 中iterate(slots, [&](server_slot & slot) { if (slot.state != SLOT_STATE_GENERATING) { return; } ... if (spec) { common_speculative_get_draft_params(spec.get(), slot.id).drafting = false;
const bool use_ckpt_tgt = ctx_tgt_seq_rm_type == COMMON_CONTEXT_SEQ_RM_TYPE_FULL; const bool use_ckpt_dft = ctx_dft_seq_rm_type == COMMON_CONTEXT_SEQ_RM_TYPE_FULL;
const int n_draft_max = slot.get_n_draft_max();
if (n_draft_max > 0) { GGML_ASSERT(slot.can_speculate());
// stale candidates: a replay never reads them, a new draft refills them slot.spec_draft_q.clear();
if (!slot.spec_draft.empty()) { // we have a previous (partial) draft to reuse if (use_ckpt_tgt) { GGML_ASSERT(!slot.spec_ckpt.empty()); } } else { ... slot.spec_ckpt.update_pos( slot.prompt.n_tokens(), llama_memory_seq_pos_min(llama_get_memory(ctx_tgt), slot.id), llama_memory_seq_pos_max(llama_get_memory(ctx_tgt), slot.id));
if (use_ckpt_dft) { slot.spec_ckpt.update_dft(ctx_dft, slot.id, LLAMA_STATE_SEQ_FLAGS_PARTIAL_ONLY); }
slot.spec_prompt = slot.prompt.tokens.get_text_tokens(); ... drafting.push_back(&slot); } } }});三件事同时发生:预算草稿长度、在 FULL 路径上先存 checkpoint、把序列挂进 drafting 列表。草稿长度的预算是 get_n_draft_max():
int get_n_draft_max() const { GGML_ASSERT(task);
if (!can_speculate()) { return 0; }
// determine the max draft that fits the current slot state // note: slot.prompt is not yet expanded with the `id` token sampled above // also, need to leave space for 1 extra token to allow context shifts int n_draft_max = n_ctx - prompt.n_tokens() - 2;
if (n_remaining() > 0) { n_draft_max = std::min(n_draft_max, n_remaining() - 1); }
SLT_DBG(*slot, "max possible draft: %d\n", n_draft_max);
return n_draft_max;}两个约束取最小值:上下文剩余空间(n_ctx - n_tokens - 2,那个 -2 是给采样出的 token 和一次上下文 shift 留的余量)与本次请求剩余的最大生成数(n_remaining() - 1)。注意 n_max 是上界——真正的草稿长度还受草稿器内部逻辑(如 draft-simple 的 p_min 截断)影响。
第二步:跑草稿器。前面讲过的链式接力在这里触发:
// generate the actual drafts (if any)if (!drafting.empty()) { queue_tasks.yield_to_queue([&]() { common_speculative_draft(spec.get()); });}yield_to_queue 把草稿生成让给队列——这一点在多用户场景下很重要:草稿是 CPU/GPU 上的一段独立计算,把它塞进任务队列而不是内联执行,调度器才有机会把别的 slot 的活儿排在它前面。这与 llama.cpp 源码完全拆解(八):服务化与调度 里讲的任务队列模型是同一套机制。
第三步:拼验证 batch。这一步的细节在 handle_last_sampled_token() 里,前面已经贴过那段位置递增的代码。这里补上 batch 索引的记账:
GGML_ASSERT(spec_i_batch.empty());
spec_i_batch.push_back(batch.size());for (size_t i = 0; i < spec_draft.size(); i++) { spec_i_batch.push_back(batch.size() + i + 1);}spec_i_batch 存的是「草稿 token 在当前 batch 里的行号」。为什么要显式记?因为 batch 里还有别的 slot 的 token——目标是多用户共享一次前向。验证阶段必须知道自己的 个草稿 token 落在第几行,才能去取对应的 logits。
第四步:验证并决定接受几个。这是核心:
// save the original draft sizeconst size_t n_draft = slot.spec_draft.size();
GGML_ASSERT(n_draft > 0);
// batch indices of the draft tokens, used to get the token probabilities belowauto spec_i_batch = std::move(slot.spec_i_batch);
// verify and try to accept the draft{ common_sampler_ptr smpl_save(common_sampler_clone(slot.smpl.get()));
GGML_ASSERT(spec_i_batch.size() == n_draft + 1); GGML_ASSERT(slot.spec_draft_q.empty() || (slot.spec_draft_q.size() == slot.spec_draft.size())); const auto & synth_probs = common_speculative_get_synth_probs(spec.get());
// drafters that fill no distribution fall back here const bool use_rejection = slot.use_spec_rejection() && !slot.spec_draft_q.empty();
std::vector<llama_token> accepted; if (!synth_probs.empty()) { // synthetic acceptance replaces verification entirely, so it comes first accepted = server_sample_and_accept_synth( slot.smpl.get(), slot.ctx_tgt, spec_i_batch, slot.spec_draft, synth_probs, slot.spec_synth_rng, slot.spec_is_replay); } else if (slot.spec_is_replay && slot.use_spec_rejection()) { accepted = server_accept_replay(slot.smpl.get(), slot.ctx_tgt, spec_i_batch, slot.spec_draft); } else if (use_rejection) { accepted = common_sampler_sample_and_accept_n_rejection(slot.smpl.get(), slot.ctx_tgt, spec_i_batch, slot.spec_draft, slot.spec_draft_q); } else { accepted = common_sampler_sample_and_accept_n(slot.smpl.get(), slot.ctx_tgt, spec_i_batch, slot.spec_draft); } ...}四条分支对应四种验证语义,值得逐一说明。
分支一:合成接受(synthetic acceptance)。synth_probs 非空说明用户显式配了 --speculative-synth-* 参数——这是 llama.cpp 提供的一个纯基准测试模式:不看真实匹配,直接按给定的概率序列接受草稿。它存在的意义是给性能测试提供可控的接受率,让「接受率 0.8 时吞吐多少」这种问题可以被稳定复现,而不必依赖某个具体语料的实际命中率。注释写得很直白:「synthetic acceptance replaces verification entirely」。
分支二:重放(replay)。spec_is_replay 为真说明这是上一轮因 FULL 路径回滚而重跑的一轮。为什么会重跑?看后面的回滚代码——FULL 路径下部分接受需要「恢复 checkpoint + 删除尾巴 + 截断 prompt + 恢复采样器」:
// partial acceptance is not supported by the context -> truncate the draft and restore the stateslot.spec_is_replay = true;slot.spec_draft = std::move(accepted);
const auto & ckpt = slot.spec_ckpt;...GGML_ASSERT(ckpt.load_tgt(slot.ctx_tgt, slot.id, LLAMA_STATE_SEQ_FLAGS_PARTIAL_ONLY));
if (slot.ctx_dft) { GGML_ASSERT(ckpt.load_dft(slot.ctx_dft, slot.id, LLAMA_STATE_SEQ_FLAGS_PARTIAL_ONLY));}
slot.mem.seq_rm(slot.id, ckpt.pos_max + 1, -1);
slot.prompt.tokens.keep_first(ckpt.n_tokens);common_sampler_copy(smpl_save.get(), slot.smpl.get());
return;注意最后那个 return——处理完回滚就直接返回,本轮不再走正常的接受流程。下一轮进来时 spec_is_replay 为真,于是用 server_accept_replay:
static std::vector<llama_token> server_accept_replay( common_sampler * smpl, llama_context * ctx, const std::vector<int32_t> & idxs, const llama_tokens & draft) { GGML_ASSERT(idxs.size() == draft.size() + 1);
std::vector<llama_token> result; result.reserve(idxs.size());
for (size_t i = 0; i < draft.size(); ++i) { // the token is discarded - the call is what advances the sampler over this position common_sampler_sample(smpl, ctx, idxs[i]); common_sampler_accept(smpl, draft[i], true); result.push_back(draft[i]); }
const llama_token id = common_sampler_sample(smpl, ctx, idxs[draft.size()]); common_sampler_accept(smpl, id, true); result.push_back(id);
return result;}注释里那句『the token is discarded - the call is what advances the sampler over this position』说明了重放的本质:决策已经在上一次做过了,重放只是为了把采样器的内部状态推进到正确位置,所以采出来的 token 直接丢掉、用上次已经接受的 draft[i] 覆盖。这样两次决策必然一致,回滚不会引入非确定性。
这里还藏着一个很实际的正确性问题:回滚必须连采样器一起回滚。采样器里可能有 RNG 状态、有语法约束的 FSM 状态(GBNF)、有惩罚/DRY 的历史窗口。如果只回滚 KV 而不回滚采样器,重放时采出的 token 可能和第一次不同,导致「同一段文本生成两次结果不同」这种极难排查的 bug。common_sampler_clone / common_sampler_copy 这对 API 就是为此存在的。
分支三与分支四:拒绝采样 vs 采样-匹配。区别在 use_rejection:只有当请求温度 且草稿器填了候选分布 spec_draft_q 时才走拒绝采样:
// at temp 0 both p and q are point masses, so rejection is the same as sample-and-matchbool use_spec_rejection() const { return task && task->params.sampling.temp > 0.0f;}注释把温度 0 的退化讲透了:温度 0 时草稿分布 和目标分布 都是单点质量(point mass,即 argmax 的 one-hot),此时 要么是 1 要么是 0,拒绝采样与「采样-匹配」完全等价。所以温度 0 时没必要走更贵的拒绝路径。
拒绝采样的接受规则本身是标准形式,llama.cpp 的实现里有两个工程细节值得看:
// Accept a drafted token with probability min(1, p/q), else draw from norm(max(0, p - q)).// Preserves the target distribution exactly, and accepts more often than matching does when the// draft samples instead of taking its argmax.std::vector<llama_token> common_sampler_sample_and_accept_n_rejection(...) { ... // draws come from the sampler's own stream, so they stay independent of what was drafted std::uniform_real_distribution<float> uni(0.0f, 1.0f); ... const bool masked = !grammar_first && grammar_should_apply(gsmpl); if (masked) { cand.assign(cur_p->data, cur_p->data + cur_p->size); llama_token_data_array arr = { cand.data(), cand.size(), -1, false }; llama_sampler_apply(gsmpl->grmr, &arr); }
// a candidate the grammar rejects carries no probability, whatever the target thinks auto p_raw = [&](size_t k) { return masked && cand[k].logit == -INFINITY ? 0.0f : cur_p->data[k].p; };
// masking drops probability mass, so rescale what is left or the residual is over-weighted float p_sum = 0.0f; if (masked) { for (size_t k = 0; k < cur_p->size; ++k) { p_sum += p_raw(k); } }
const float p_norm = masked && p_sum > 0.0f ? 1.0f/p_sum : 1.0f;两个细节:随机数取自采样器自己的流(注释:『so they stay independent of what was drafted』),保证接受决策与草稿过程独立;语法掩码后要重归一化 (注释:『masking drops probability mass, so rescale what is left or the residual is over-weighted』)——如果不重新归一化,被语法禁止的 token 的概率质量会凭空消失,残差分布 就被过度加权,最终采样分布会偏。这是一个非常容易写错、且错了以后只表现为「结构化输出场景下质量略降」的隐蔽 bug。
第五步:回滚 KV。接受数定下来后:
GGML_ASSERT(accepted.size() >= 1);
const uint32_t n_rollback = slot.spec_draft.size() + 1 - accepted.size();
const bool use_ckpt_tgt = ctx_tgt_seq_rm_type == COMMON_CONTEXT_SEQ_RM_TYPE_FULL || (ctx_tgt_seq_rm_type == COMMON_CONTEXT_SEQ_RM_TYPE_RS && n_rollback > llama_n_rs_seq(ctx_tgt));n_rollback 是「要删掉几个位置的 KV」。注意 RS 路径的条件判断:只有当回滚量超过了预留的 n_rs_seq 时,才退化到 checkpoint 路径。也就是说 RS 的快路径覆盖了绝大多数轮次(回滚量 一轮草稿长度),只有异常情况才走慢路径。这个「预留足够容量让快路径覆盖常态」的思路,和 n_rs_seq = draft.n_max 的取值完全对应。
第六步:反馈接受数。最后一个动作是把结果告诉草稿器:
common_speculative_accept(spec.get(), slot.id, accepted.size() - 1);
slot.spec_draft = std::move(accepted);accepted.size() - 1 是「接受的草稿 token 数」——accepted 里最后那个元素是目标模型自己采出来的新 token,不是草稿,所以减 1。common_speculative_accept 内部把这个数分发给所有草稿器:
void common_speculative_accept(common_speculative * spec, llama_seq_id seq_id, uint16_t n_accepted) { common_speculative_impl * impl = spec->impl_last[seq_id];
if (impl == nullptr) { GGML_ASSERT(n_accepted == 0); return; }
{ common_time_meas tm(impl->t_accept_us, !impl->gen_perf);
if (impl->n_acc_tokens_per_pos.size() < n_accepted) { impl->n_acc_tokens_per_pos.resize(n_accepted, 0); }
for (size_t i = 0; i < n_accepted; ++i) { impl->n_acc_tokens_per_pos[i]++; }
if (n_accepted > 0) { impl->n_acc_drafts++; impl->n_acc_tokens += n_accepted; }
impl->accept(seq_id, n_accepted, false); impl->n_call_accept++; }
// accept with the rest of the implementations, using is_other == true for (auto & impl_other : spec->impls) { if (impl_other.get() != impl) { impl_other->accept(seq_id, n_accepted, true); } }}impl_last[seq_id] 取出「这条序列的草稿是谁给的」,先给它统计并调用 accept(..., is_other=false);然后其余所有实现也用 is_other=true 收到同一个接受数。为什么要通知「没出草稿的那些实现」? 因为它们的状态也必须与目标模型保持一致——比如 ngram-cache 要更新它的历史,EAGLE-3 要推进延迟边界。如果只通知出草稿的那一个,别的草稿器的内部位置记账就会漂移,下一次轮到它们时起点就错了。is_other 参数让实现自己决定「作为旁观者时该做什么、不该做什么」。
n_acc_tokens_per_pos[i] 的累加统计的是「第 个草稿位置被接受了多少次」。这个向量直接回答了「草稿长度该开多大」——如果第 1 个位置接受率 0.9、第 5 个位置只有 0.1,那么 里有 4 个位置基本是白猜的。统计输出正是基于它:
std::string str_stats;if (impl->n_call_accept > 0) { const double mean = 1.0 + (double) impl->n_acc_tokens / (double) impl->n_call_accept; std::ostringstream tmp; tmp << std::fixed << std::setprecision(3); for (size_t i = 0; i < impl->n_acc_tokens_per_pos.size(); ++i) { if (i > 0) { tmp << ", "; } tmp << (double) impl->n_acc_tokens_per_pos[i] / (double) impl->n_call_accept; } ... str_stats = ", #mean acc len = " + oss.str() + ", #acc rate/pos = (" + tmp.str() + ")";}mean = 1.0 + n_acc_tokens / n_call_accept —— 那个 1.0 就是目标模型每轮必然产出的那一个 token。所以「平均接受长度 2.8」意味着每轮前向平均产出 2.8 个 token,这是判断投机解码是否划算最直接的指标。
n-gram 草稿器:不花算力换草稿
三种来源里,n-gram 类是最容易被忽视、但在特定场景收益很高的一类。它们的共同思想是:不训练任何模型,直接在历史文本里找重复片段。
以 ngram-mod 为例,它的实现只有几十行。构造函数里建一个固定大小的哈希表:
common_speculative_impl_ngram_mod( const common_params_speculative & params, uint32_t n_seq) : common_speculative_impl(COMMON_SPECULATIVE_TYPE_NGRAM_MOD, n_seq, params.ngram_mod.n_max) , params(params.ngram_mod) , mod(params.ngram_mod.n_match, 4*1024*1024) , verbose(std::getenv("LLAMA_TRACE") != nullptr) { static_assert(sizeof(llama_token) == sizeof(common_ngram_mod::entry_t));
SPC_TRC("%s", "adding speculative implementation 'ngram-mod'\n"); SPC_TRC("- n_match=%d, n_max=%d, n_min=%d\n", this->params.n_match, this->params.n_max, this->params.n_min); SPC_TRC("- mod size=%zu (%.3f MB)\n", mod.size(), (float)(mod.size_bytes())/1024/1024);
if (this->params.n_match < 16) { SPC_WRN("ngram_mod n_match=%d is too small - poor quality is possible, " "see: https://github.com/ggml-org/llama.cpp/pull/19164\n", this->params.n_match); }
sinfos.resize(n_seq);}static_assert(sizeof(llama_token) == sizeof(common_ngram_mod::entry_t)) 是一个很有 llama.cpp 风格的声明:token 类型和哈希表条目类型必须同宽,这样查表时可以直接做位运算,不需要转换。n_match 是匹配窗口长度,默认上限 4*1024*1024 个条目。构造时还做了参数合法性检查——n_match < 16 会警告,并附上具体的 PR 链接,说明这是个被实测踩过的坑(窗口太小则匹配到的都是噪声)。
真正的工作在 begin():
void begin(llama_seq_id seq_id, const llama_tokens & prompt) override { auto & sinfo = sinfos[seq_id];
sinfo.i_last = 0; sinfo.n_draft_last = 0;
const size_t n = mod.get_n(); if (prompt.size() < n) { return; }
for (size_t i = 0; i < prompt.size() - n; ++i) { mod.add(prompt.data() + i); }
sinfo.i_last = prompt.size() - n;
const double f = (double)mod.get_used() / (double)mod.size(); SPC_TRC("ngram_mod occupancy = %zu/%zu (%.2f)\n", mod.get_used(), mod.size(), f);
constexpr double f_thold = 0.25; if (f > f_thold) { SPC_WRN("ngram_mod occupancy %.2f exceeds threshold (%.2f) - resetting\n", f, f_thold);
mod.reset(); }}这里有三点设计:
其一,只索引 prompt,不索引生成内容。 mod.add(prompt.data() + i) 在 begin() 里跑一次,把整个 prompt 的所有 -gram 灌进哈希表。生成过程中产生的 token 不再入表。
为什么? 因为生成的 token 是尚未被验证的推测产物——如果把它们也加进表,用它们查出来的草稿就是「用幻觉喂幻觉」,会形成自我强化的错误。而且生成内容一旦被后续轮次回滚,表里就留下了不存在的片段。把索引范围限制在「已经确定的 prompt」上,从根本上避免了这个问题。这也解释了为什么 common_speculative_impl_ngram_simple 的 process() 是空实现:
bool process(const common_batch & /*batch*/) override { // TODO: implement草稿阶段的 ngram 类实现不消费 batch,因为它们不需要任何前向结果——这使它们的开销真正接近于零。
其二,占用率超阈值就整体重置。
constexpr double f_thold = 0.25;if (f > f_thold) { SPC_WRN("ngram_mod occupancy %.2f exceeds threshold (%.2f) - resetting\n", f, f_thold);
mod.reset();}哈希表占用超过 25% 就清空重来。为什么不渐进淘汰? 因为 ngram 表的价值在于「最近的、相关的文本」。当表填到 1/4 满,说明积累的历史已经远超当前请求所需;继续往里塞只会让命中率稀释到无意义的水平。整体重置是 O(1) 的粗粒度策略,便宜且有效。25% 这个数也反映了设计意图:留出足够的空槽以维持低冲突率,而不是把表用到满。
其三,sinfo.i_last 记录已索引到的位置,这样同一序列继续推进时可以增量补索引,不必重复扫描整个 prompt。注意增量补索引还有分块节流:
// add new ngrams in chunksif (sinfo.i_last + 32 < cur_len) { for (size_t i = sinfo.i_last; i < cur_len - n; ++i) { mod.add(prompt.data() + i); }
sinfo.i_last = cur_len - n;}只有「落后超过 32 个 token」才补索引。为什么要节流? 因为生成过程中每轮 prompt 只增长几个 token,如果每轮都补,就是每轮几十次哈希写入的小开销;攒到 32 个再一次性补,摊薄了调用开销。这是典型的「批量化小操作」优化。
草稿生成的核心逻辑在 draft_one(),它揭示了一个容易被忽略的细节——草稿的前 个 token 是直接抄 prompt 的:
result.resize(n + params.n_max);for (size_t i = 0; i < n - 1; ++i) { result[i] = prompt.at(cur_len - n + 1 + i);}result[n - 1] = dparams.id_last;
for (int i = 0; i < params.n_max; ++i) { const llama_token token = mod.get(result.data() + i); if (token == common_ngram_mod::EMPTY) { if (i < params.n_min) { result.clear(); return; }
result.resize(n + i); break; } result[n + i] = token;}哈希表的查询是基于滑动窗口逐步推进的:先填好长度为 的查询键(前 个来自 prompt 末尾,第 个是刚采样的 token),查一次得到下一个 token,把它接到键尾再查下一次——如此滚动 轮。这就是「用 -gram 匹配续写」的标准形态。
n_min 与 n_max 分工明确:n_max 是能猜多长,n_min 是至少猜多长。如果查表在第 步就落空,result.clear() 直接放弃整条草稿——猜得太短就不值得验证,省下这次前向。只有猜到 以上才接受一个短草稿。
然后是一个清理步骤,把内部拼接用的 个前缀 token 切掉:
// only return the m tokens that were draftedfor (size_t i = 0; n + i < result.size(); ++i) { result[i] = result[n + i];}result.resize(result.size() - n);
// store length of drafted n-gram for later acceptance analysissinfo.n_draft_last = result.size();其四,自适应重置——这是 n-gram 类最聪明的一处设计。
void accept(llama_seq_id seq_id, uint16_t n_accepted, bool is_other) override { if (is_other) { return; }
auto & sinfo = sinfos[seq_id];
// compute acceptance fraction if we have a recorded draft length if (sinfo.n_draft_last > 0) { const double f_acc = (double)n_accepted / (double)sinfo.n_draft_last; if (f_acc < 0.25) { sinfo.n_low++; if (sinfo.n_low >= 5) { if (verbose) { SPC_TRC("low acceptance streak (%d) - resetting ngram_mod\n", sinfo.n_low); }
mod.reset(); sinfo.n_low = 0; sinfo.i_last = 0; } } else { sinfo.n_low = 0; } }}三个阈值构成一个完整的自适应回路:
- 接受率低于 25% 判定为「这次草稿质量差」,
n_low计数加一; - 连续 5 轮如此 才动手重置——单轮的坏运气不该触发重置,那是噪声;
- 重置时把
i_last归零,下一次begin()会重新索引整个 prompt。
为什么要连续 5 轮? 因为 n-gram 命中本身有随机性——某几轮恰好没匹配上是正常的。用连续计数做迟滞(hysteresis),把「偶然波动」和「真的不匹配」区分开。这个 n_low >= 5 与 f_acc < 0.25 的双阈值,和 begin() 里那个 occupancy > 0.25 的整体重置形成互补:前者针对质量退化,后者针对容量饱和。两个维度各自自治,不需要任何中心化调参。
还要注意 accept() 开头那个 if (is_other) { return; }——n-gram 草稿器明确忽略旁观者通知。因为它没有需要同步的内部位置状态(它的状态只依赖 prompt,而 prompt 由服务层维护)。对比 EAGLE-3 必须处理 is_other,这个差异正好印证了前面说的「is_other 让实现自己决定该做什么」。
n-gram 草稿器的价值场景很具体:输入里存在大量可复制的片段。典型例子是代码编辑(用户贴一段代码让你改,输出大部分与输入重合)、文档问答(答案常是原文摘录)、以及多轮对话里反复引用上文。在这些场景里,n-gram 的草稿命中率可以相当高,而它的开销比一次草稿模型前向低几个数量级。反过来,在开放式创作类任务里它基本无效——这也解释了为什么它是「接力链的第一棒」而不是唯一方案。
统计、调参与实测口径
llama.cpp 的统计输出集中在 common_speculative_print_stats,它按实现逐个打印:
SPC_TRC("statistics %16s: #calls(b,g,a) = %4zu %6zu %6zu, #gen drafts = %6zu, #acc drafts = %5zu, #gen tokens = %6zu, #acc tokens = %5zu%s%s\n", common_speculative_type_to_str(impl->type).c_str(), impl->n_call_begin, impl->n_call_draft, impl->n_call_accept, impl->n_gen_drafts, impl->n_acc_drafts, impl->n_gen_tokens, impl->n_acc_tokens, str_stats.c_str(), str_perf.c_str());每个字段的含义:
| 字段 | 含义 |
|---|---|
#calls(b,g,a) | begin / draft / accept 的调用次数 |
#gen drafts | 成功产出草稿的轮次(有草稿就算,不管接不接受) |
#acc drafts | 至少有 1 个 token 被接受的轮次 |
#gen tokens | 草稿器一共猜了多少 token |
#acc tokens | 其中被接受的有多少 |
#mean acc len | 每轮平均产出 token 数(含目标模型那一个) |
#acc rate/pos | 每个草稿位置的接受率 |
dur(b,g,a) | begin / draft / accept 各阶段累计耗时(毫秒) |
这些数字是调参的唯一依据。几个实用的判断:
#acc tokens / #gen tokens是草稿命中率。 低于 0.5 说明草稿质量不行,应该换草稿器或降 。#acc rate/pos的衰减速度决定 。 如果第 1 位 0.85、第 2 位 0.6、第 3 位 0.3、第 4 位 0.15,那n_max = 3附近是甜点;设成 5 只会多烧草稿算力和验证宽度。这与 EAGLE-2 完全拆解 里「动态草稿树按置信度分配预算」是同一个优化方向,只是 llama.cpp 用的是静态阈值 + 运行时 截断的组合,实现简单得多。dur(b,g,a)揭示瓶颈在哪。 如果g(draft)耗时占比很高,说明草稿模型本身太慢或太大,投机解码的加速会被吃掉——这正是「草稿模型要小」这条经验法则的量化体现。#acc drafts / #calls(a)反映轮次效率。 如果这个比值很低,说明大量轮次的草稿全被拒,只有目标模型那一个 token 产出,等于白做了草稿与验证。
关于实测口径,有几个容易混淆的点:
第一,llama.cpp 报的是 decode 阶段的加速,不含 prefill。mean acc len 是 decode 每轮产出,而 prefill(处理 prompt 的那次前向)长度不受投机解码影响。所以长上下文场景下整体吞吐提升会被 prefill 摊薄。
第二,投机解码的收益强依赖草稿模型与目标模型的「同族性」。用同系列、训练数据接近的小模型做草稿,接受率天然更高;用不相关的小模型,接受率会低到负收益。common_speculative_are_compatible 那套严格的词表检查就是这条经验的代码化。
第三,n_parallel 与投机解码的关系。前面读到 common_speculative_get_output_limits 会按 n_parallel 缩放输出数与 n_outputs_max:
common_speculative_output_limits common_speculative_get_output_limits( int32_t n_batch, int32_t n_parallel, int32_t n_draft) { const int64_t per_seq = 1 + (int64_t) std::max(0, n_draft); const int64_t total = (int64_t) n_parallel * per_seq;
return { /* .total = */ (int32_t) std::min<int64_t>(n_batch, total), /* .per_seq = */ (int32_t) std::min<int64_t>(n_batch, per_seq), };}每个序列要 个输出,总输出数是 n_parallel × (1+k),再被 n_batch 封顶。这两个值被写进 context 参数:
params_base.n_outputs_max = output_limits.total;params_base.n_outputs_max_per_seq = output_limits.per_seq;含义是:后端要预留足够的输出缓冲,让一个 batch 里所有 slot 的草稿 token 都能拿到 logits。如果不预留,多用户并发下投机解码会因输出缓冲不足而失败。这是一个「并发度 × 投机深度」共同决定显存预留的典型例子——它的代价是 n_outputs_max 越大,logits 缓冲越大。所以投机解码在多用户场景下会显著增加中间激活的内存占用,这一点在容量规划时不能忽略。
第四,RS 预留的代价。cparams.n_rs_seq = params.speculative.need_n_rs_seq() 意味着 context 要为「最多删除尾部 个位置」留出能力。对于滑窗类后端,代价可能是额外的状态副本;这也是为什么 need_n_rs_seq 只对需要它的四种草稿头返回非零——不需要就完全不预留。
小结
把 llama.cpp 投机解码的机制串起来:
-
KV 与位置记账:草稿 token 直接追加进同一条序列的同一份 KV 缓存,位置从
pos_next()连续递增。目标模型不知道自己在做投机解码,它只看到一个长度 的普通 batch。这依赖llama_memory_seq_rm提供的区间删除原语——[p0, p1)语义恰好匹配「删掉未接受的草稿尾巴,原地保留已接受部分」。 -
按能力协商的回滚:
common_context_can_seq_rm用一次 2-token 真实前向实测后端能力,分出RS/PART/FULL/NO四档。FULL路径必须提前用common_prompt_checkpoint保存PARTIAL_ONLY状态,回滚时整条恢复再删尾巴,并通过spec_is_replay在下一轮重放以保持采样器状态一致。RS 路径只在回滚量超过预留n_rs_seq时退化到 checkpoint。 -
一套抽象承载 11 种草稿器:
common_speculative_impl的五个虚函数把「刷新 / 消费 batch / 起草 / 接受 / 状态序列化」抽干净,draft-simple、draft-eagle3、draft-mtp、draft-dflash、draft-dspark与五种ngram-*各自实现。common_speculative_draft的接力循环让它们在同一次生成的不同轮次轮流接管。 -
EAGLE-3 的延迟边界:因为 ubatch 会把一次前向切开,草稿头需要的「目标特征 + 输入 token」对会错位一格,llama.cpp 用
pending_g_last把每个process()的最后一行推迟到下一次调用才配对,即 cross-ubatch bridge;verify_g快照则让验证阶段能按实际接受数 精确取回特征行。 -
验证的四种语义:合成接受(基准测试用)、重放(回滚后重跑)、拒绝采样(,含语法掩码后的重归一化)、采样-匹配(温度 0 时的等价退化)。全部经由
common_sampler_*完成,且采样器状态必须随 KV 一起回滚。 -
统计是调参依据:
#mean acc len、#acc rate/pos、dur(b,g,a)分别回答「每轮产出多少」「草稿长度该设多大」「瓶颈在哪」,而n_outputs_max的缩放揭示了「并发度 × 投机深度」对显存预留的要求。
与 vLLM / SGLang / TensorRT-LLM 的对比可以浓缩成一句:那些框架的投机解码是在分页 KV 池之上再加一套草稿账本,而 llama.cpp 是在单序列连续 KV 之上用位置区间做减法。前者灵活、支持复杂草稿结构(树形草稿、多草稿并行),但要维护两套内存管理;后者受限于「位置必须连续唯一」这一约束(所以不支持树形草稿),但实现极简、且天然与 n_parallel 的 slot 模型兼容。取舍的根源在于底层 KV 缓存抽象不同——这正是 vAttention 完全拆解 里讨论的「分页 KV vs 连续 KV」之争在投机解码上的一次具体投影。
下一篇将讨论 llama.cpp 的 grammar 与结构化输出路径:GBNF 语法如何编译成状态机、采样子系统里 common_sampler_apply 如何在 logits 上做掩码,以及投机解码与语法约束同时开启时的交互——这一篇里已经看到 common_sampler_sample_and_accept_n_rejection 里的 grammar_first 分支,下一篇会把它彻底展开。
参考资料
- llama.cpp 仓库(ggml-org/llama.cpp)
- llama.cpp 投机解码实现:common/speculative.cpp
- llama.cpp 投机解码接口:common/speculative.h
- llama.cpp 服务端调度实现:tools/server/server-context.cpp
- llama.cpp 公共接口与 llama_memory_seq_rm 语义:include/llama.h
- EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty
- EAGLE-2: Faster Inference of Language Models with Dynamic Draft Trees
- EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test
- Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads
- Fast Speculative Decoding in llama.cpp(PR #19164 相关讨论)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



