


llama.cpp 源码完全拆解(二):ggml 计算图与内存分配器——惰性张量、生命周期复用与跨后端切图
本篇是 llama.cpp 子系列的第二篇。上一篇建立的是整张地图:ggml/ 是自包含的张量库,张量是惰性的图节点而不是数据的持有者,后端通过「注册表 → 设备 → 缓冲区类型 → 缓冲区」四层句柄描述,ggml_backend_sched 负责把一张图切到多个设备上执行。那篇对这些机制只做了概述,并承诺这一篇要把「惰性张量」与「切图」落到真实代码上。
这个承诺不是修辞。理解 ggml 的计算图与分配器,是理解 llama.cpp 后续一切模块的前提:为什么 llama_decode 的形状一变就要重新建图、为什么 n_ubatch 与 n_seq_max 要参与启动时的显存预留、为什么 -ngl 之外的 -ot(张量卸载)能在混合设备上工作、为什么 pipeline parallel 下每个 token 会多出一份图副本——这些问题的答案全部落在 ggml-alloc.c 和 ggml-backend.cpp 这两个文件里。它们加起来不到 4000 行 C 代码,却决定了 llama.cpp 的内存上限与执行形态。
本篇沿三条线展开。第一条是数据结构:ggml_tensor、ggml_context、ggml_cgraph 三个结构体逐字段解读,看清「惰性」在代码里到底意味着什么。第二条是静态内存分配:ggml_gallocr 如何在图执行之前就为每个中间张量算出地址,以及它用什么样的生命周期分析把峰值内存压下来。第三条是跨后端切图:ggml_backend_sched 的五个 pass 如何决定每个算子跑在哪里、跨设备拷贝插在哪里。最后把三条线合到一次真实的 llama_decode 上,看这套机制在实际推理时的完整形态。
ggml_tensor:一个图节点的全部字段
先看 ggml/include/ggml.h 里的结构体定义。它是 ggml 一切机制的地基,值得逐字段读:
struct ggml_tensor { enum ggml_type type;
struct ggml_backend_buffer * buffer;
int64_t ne[GGML_MAX_DIMS]; // number of elements size_t nb[GGML_MAX_DIMS]; // stride in bytes: // nb[0] = ggml_type_size(type) // nb[1] = nb[0] * (ne[0] / ggml_blck_size(type)) + padding // nb[i] = nb[i-1] * ne[i-1]
// compute data enum ggml_op op;
// op params - allocated as int32_t for alignment int32_t op_params[GGML_MAX_OP_PARAMS / sizeof(int32_t)];
int32_t flags;
struct ggml_tensor * src[GGML_MAX_SRC];
// source tensor and offset for views struct ggml_tensor * view_src; size_t view_offs;
void * data;
char name[GGML_MAX_NAME];
void * extra; // extra things e.g. for ggml-cuda.cu
char padding[8];};常量在头文件里写死:GGML_MAX_DIMS 为 4,GGML_MAX_SRC 为 10,GGML_MAX_OP_PARAMS 为 64 字节,GGML_MAX_NAME 为 64(release 构建下 GGML_MAX_NAME 取 64,debug 构建会放宽到更长以便看图调试)。
先看最反直觉的一个字段:data 可以为 NULL。 当用户调用 ggml_mul_mat(ctx, weight, x) 时,返回的张量已经是一个完整的结构体:形状算好了、op 标记为 GGML_OP_MUL_MAT、src[0] 与 src[1] 指向两个输入,但 data 是空指针——没有任何一个字节被计算或分配。这是「惰性」最具体的含义:张量在构建期只是一条待执行的指令记录。数据要等到 ggml_gallocr_alloc_graph() 把地址填进 data、后端把图跑完才出现。
ne 与 nb 是一对容易混淆的字段。 ne[i] 是第 i 维的元素个数,nb[i] 是第 i 维的字节步长。ggml 的维度是「列优先」风格:ne[0] 是最内层(通常对应矩阵的列数,即每行有多少个连续元素),ne[1] 是行数。头文件注释里的三行公式说明了步长的递归构造:nb[0] 是一个元素类型的字节数(对量化类型来说是一个量化块的字节数),nb[1] 是「走一行跳过多少字节」——注意其中的 + padding:当一行结束的位置不满足行对齐要求时(例如 CUDA 上要求 16 字节对齐),ggml 会在行尾插入填充字节,nb[1] 因此可能大于 nb[0] * ne[0]。这个 padding 是很多 kernel 里「非连续访存」分支存在的直接原因。
op 与 op_params 描述这条指令。 op 是一个约 100 个取值的枚举(GGML_OP_MUL_MAT、GGML_OP_RMS_NORM、GGML_OP_ROPE、GGML_OP_FLASH_ATTN_EXT……),op_params 是 64 字节的参数区,算子特有参数按 int32_t 对齐塞在这里。以 GGML_OP_ROPE 为例,它记录了 n_dims、mode、n_ctx_orig、freq_base、freq_scale、ext_factor 等参数;以 GGML_OP_SCALE 为例,它存放一个 float 的缩放系数。参数被统一转成 32 位整数存储,读取时用 ggml_get_op_params_f32() 这类辅助函数还原——这是纯 C 环境里省内存、避免联合体细节的一种工程妥协。
src[GGML_MAX_SRC] 是不定长的输入列表。 十个槽位中未使用的部分为 NULL。绝大多数量子只用 1 到 3 个输入,但为 MoE 与融合算子预留了余量。图的有效结构就靠这个数组表达:谁依赖谁,全在这里。
view 机制藏在 view_src 与 view_offs 里。 调用 ggml_view_1d/2d/3d() 或 ggml_reshape_*() 时,不会产生新的数据区,而是产生一个「新的张量结构体 + 指向原张量的指针 + 字节偏移」。读取时 view_src 告诉分配器「我的数据和这个张量是同一块」,view_offs 告诉它偏移多少。这个机制让 reshape/transpose/slice 全部是零成本的——它们是图上的一道「门」,而不是一次内存拷贝。后文会看到,分配器的 view 复用逻辑正是围绕这两个字段写的最复杂的一段代码。
flags 是四个布尔语义的位域:GGML_TENSOR_FLAG_INPUT(该张量是图的外部输入,用户会往里面写数据)、GGML_TENSOR_FLAG_OUTPUT(该张量是图的输出,用户要读)、GGML_TENSOR_FLAG_PARAM(该张量是一个参数/权重,参与梯度图判定)、GGML_TENSOR_FLAG_COMPUTE(该张量必须被真实计算,而不是只在图中出现)。这四个 flag 直接决定分配器行为:OUTPUT 的张量永不释放,INPUT 的张量会被优先分配以免被覆盖,COMPUTE 决定节点是否真正进入执行序列——ggml_build_forward_order() 构建的图不设 COMPUTE,就是「只排拓扑序、不执行」的用法。
buffer 记录数据所在的后端缓冲区。 分配完成后,data 指针指向该缓冲区内的某一偏移,buffer 反向指回缓冲区句柄。为什么两个都要有?因为 data 只够定位数据,而释放、跨设备拷贝、能力查询都需要知道「这块内存在哪个设备上」。调度器判断张量属于哪个后端时,读的就是 buffer(后文第五节的 pass 1 会展开)。
与 PyTorch 张量对照,ggml 张量少了三样东西——没有 autograd 元数据(无 grad_fn、无 requires_grad,训练能力通过 ggml_build_backward_expand 手工构建反向图实现)、没有设备抽象层(设备信息外置到 buffer)、没有引用计数(生命周期由图分配器统一管理,而不是 Python 的对象引用)。少了这三样,sizeof(struct ggml_tensor) 能被压到几百字节,一个 8192 token 的预填充图有几万个中间张量也只是几兆字节的元数据——这是 llama.cpp 能在消费级机器上跑起来的隐形前提。
ggml_context:只装元数据的对象池
张量结构体本身存在哪里?答案不在张量里,而在 ggml_context。它的定义同样在 ggml.c 内:
struct ggml_context { size_t mem_size; void * mem_buffer; bool mem_buffer_owned; bool no_alloc;
int n_objects;
struct ggml_object * objects_begin; struct ggml_object * objects_end;};ggml_context 是一个仅用于元数据的对象池:创建时一次性分配一块内存(mem_buffer,大小由 ggml_init_params.mem_size 指定),随后每创建一个张量或计算图,就从池里切走一块、挂到 objects_begin 链表上。张量结构体与名字字符串住在这里,名称、形状、图结构也住在这里;张量的数据不在这里。
分离是刻意的。看 ggml_new_tensor_impl() 的分支就明白:当 no_alloc 为 true 时,函数只创建结构体、跳过数据分配。llama.cpp 在上下文构造时把所有上下文都建为 no_alloc = true(llama_context 里 ggml_init_params 的 no_alloc 传的就是 true),数据内存只由两类来源供应:一是装载期一次性分配的权重缓冲区,二是执行期由 ggml_gallocr 分配的中间张量缓冲区。上下文只负责「结构生命周期」,分配器负责「数据生命周期」,两者的生命周期尺度完全不同:结构随批次重建而重建,数据缓冲区在 reserve 之后反复重用。
这个设计还解释了 llama.cpp 里「多个 context」的存在。llama_context::sched_reserve() 会为图构建准备一个专门的 context,采样器有自己独立的 context(采样缓冲、候选 logits 的临时内存),KV 缓存也会创建一个 context 来装它的视图张量。它们各自的 mem_size 是估算出来的:图 context 的大小随 max_nodes(最坏图节点数)增长,这是启动日志里「llama_context: graph nodes = …」一类数字的来源。
一个对象的布局在内存里长这样:ggml_object 头部记录类型、大小与链表指针,紧接着是对象负载。ggml_object 与 ggml_tensor 的头部尺寸是固定的(GGML_OBJECT_SIZE、GGML_TENSOR_SIZE),名称字符串的长度按需追加。这带来一个实际后果:mem_size 耗尽时 ggml 不会自动扩容,而是 GGML_ASSERT 直接失败——所以 llama.cpp 用 graph_max_nodes() 预估最坏图的节点数,把 context 开得足够大。如果哪次运行遇到「failed to initialize graph」这类报错,经常是某个批次的形状超出了预留估算。
ggml_cgraph:拓扑排序、哈希去重与引用计数
张量建好了,怎么变成一张可执行的图?答案在 ggml_cgraph 里。这个结构体在私有头文件 ggml/src/ggml-impl.h 中定义:
struct ggml_cgraph { int size; // maximum number of nodes/leafs/grads/grad_accs int n_nodes; // number of nodes currently in use int n_leafs; // number of leafs currently in use
struct ggml_tensor ** nodes; // tensors with data that can change if the graph is evaluated struct ggml_tensor ** grads; // the outputs of these tensors are the gradients of the nodes struct ggml_tensor ** grad_accs; // accumulators for node gradients struct ggml_tensor ** leafs; // tensors with constant data int32_t * use_counts;// number of uses of each tensor, indexed by hash table slot
struct ggml_hash_set visited_hash_set;
enum ggml_cgraph_eval_order order;
// an optional identifier that can be utilized to recognize same graphs if two non-zero values match // a value of 0 means it is not set and should be ignored uint64_t uid;};几个字段值得逐一说明。
nodes 与 leafs 是两类张量。 注释写得很清楚:nodes 是「数据在求值时会变化的张量」,leafs 是「常量数据」。划分标准在遍历时确定:一个张量如果 op == GGML_OP_NONE 且不带 PARAM 标志,它就是一个叶子(没有产生它的算子,例如用户直接创建的输入张量、ggml_new_tensor 出来的权重视图);其余都进 nodes。关键约定:nodes 数组本身就是一个合法的执行顺序——ggml_build_forward_expand() 之后的 graph->nodes[0..n_nodes) 已经是拓扑序,可以直接按顺序执行。这不是巧合,是下一段要讲的遍历算法直接保证的性质。
use_counts 是给分配器用的引用计数。 它不是张量自己的字段,而是一张与哈希表槽位平行的数组:use_counts[slot] 记录该张量被下游引用了多少次。分配器用这个数字实现生命周期管理——一个中间张量在被创建后,每被一个后来者消费一次就减一,减到零且没有 view 引用时就可以回收。为什么放在图里而不是张量里?因为同一个张量可能参与多张图(例如 llama_context 里跨 ubatch 复用的图),引用计数是「相对于某张图」的量,不属于张量本身。
visited_hash_set 保证遍历不重复。 它是一个开放寻址的指针哈希表,键是 ggml_tensor * 指针本身。遍历从输出张量出发递归访问所有 src,每个张量第一次访问时插入哈希表并分配一个编号(槽位),再次遇到时直接从表里查出「已访问」,跳过——这保证了①同一张量在 nodes/leafs 里只出现一次,②共享子表达式(多个下游引用同一个中间结果)不会被重复计算。哈希表的容量通过 ggml_hash_set_new() 创建,容量不足时 GGML_HASHSET_FULL 会触发断言——所以 ggml_new_graph_custom() 创建的图有一个 size 上限,llama.cpp 里对应的是 graph_max_nodes() 算出来的最坏节点数。
order 决定访问 src 的顺序。 枚举有三个取值:GGML_CGRAPH_EVAL_ORDER_LEFT_TO_RIGHT、GGML_CGRAPH_EVAL_ORDER_RIGHT_TO_LEFT,以及 GGML_CGRAPH_EVAL_ORDER_COUNT。遍历时按这个顺序挑选 src 槽位。为什么需要顺序可调?因为某些算子(例如融合的 ggml_mul_mat 与后续加法)在「先访问左输入还是右输入」上会产生不同的相邻节点排布,而相邻节点的后端归属和内存分配质量都受此影响。llama.cpp 默认使用从左到右,order 字段为特殊场景留了开关。
uid 是「同图识别」的标识。 每次 ggml_backend_sched_split_graph() 会调用 ggml_graph_next_uid() 给图打上一个新编号。调度器把它当作「这张图和新一张图是不是同一个结构」的快速判据——后面讲图复用时会回到这里。
遍历算法:一次后序遍历完成五件事
图的构建入口是 ggml_build_forward_expand(),它直接调 ggml_build_forward_impl() → ggml_visit_parents_graph()。后者的骨架是:
static size_t ggml_visit_parents_graph(struct ggml_cgraph * cgraph, struct ggml_tensor * node, bool compute) { if (node->op != GGML_OP_NONE && compute) { node->flags |= GGML_TENSOR_FLAG_COMPUTE; }
const size_t node_hash_pos = ggml_hash_find(&cgraph->visited_hash_set, node); GGML_ASSERT(node_hash_pos != GGML_HASHSET_FULL);
if (ggml_bitset_get(cgraph->visited_hash_set.used, node_hash_pos)) { return node_hash_pos; // 已访问,直接返回槽位 }
// This is the first time we see this node in the current graph. cgraph->visited_hash_set.keys[node_hash_pos] = node; ggml_bitset_set(cgraph->visited_hash_set.used, node_hash_pos); cgraph->use_counts[node_hash_pos] = 0;
for (int i = 0; i < GGML_MAX_SRC; ++i) { const int k = /* 按 order 选择槽位 */; struct ggml_tensor * src = node->src[k]; if (src) { const size_t src_hash_pos = ggml_visit_parents_graph(cgraph, src, compute); cgraph->use_counts[src_hash_pos]++; // 引用计数 +1 } }
if (node->op == GGML_OP_NONE && !(node->flags & GGML_TENSOR_FLAG_PARAM)) { cgraph->leafs[cgraph->n_leafs++] = node; // 叶子 } else { cgraph->nodes[cgraph->n_nodes++] = node; // 节点 }
return node_hash_pos;}这段不到 40 行的递归,一次完成五件事:
第一,标记 COMPUTE。 只有真正要执行的图才打这个标志;ggml_build_forward_order() 走的路径 compute = false,图只用来排序。
第二,去重。 哈希表命中即返回(同时把槽位编号返回给上层,供引用计数使用),避免共享子表达式被展开多次。
第三,计数。 每个张量第一次被访问时 use_counts 归零,随后每有一个下游访问它(无论来自同一节点还是不同节点)加一。遍历结束后,整个图的引用关系统计完毕。
第四,分类。 后序遍历意味着父节点在子节点之后入队——所以 nodes 数组天然是拓扑序。这个顺序有一个容易忽略的细节:它是「深度优先、后序」的拓扑序,而不是「按层次」的拓扑序。对分配器来说两种都合法,但 DFS 顺序的局部性更好——相邻执行的节点往往共享输入,内存复用率更高。
第五,命名。 未被命名的节点和叶子会被自动命名为 node_%d、leaf_%d,方便在 GGML_SCHED_DEBUG 日志里定位。看图调试时,ggml_backend_sched_print_assignments() 打印的就是这些名字。
ggml_build_forward_select() 是一个变体:给定一组输出张量,只为其中某一个设 compute = true,其余只参与排序——这是「同一张图、不同输出头」的场景(比如同时要 logits 和 last hidden state,但这次只算 logits)。
为什么需要静态分配器:三个约束的交汇
图有了拓扑序,下一步是给每个中间张量分配内存。任何推理运行时都必须回答这个问题,而各家的答案差异很大。先看 PyTorch 的做法作对照:caching allocator 在每次分配请求到来时,从空闲块池里找一块合适的显存,用完由记录的 stream 顺序判断何时归还。它是「边跑边分配」的流式模式,优点是不需要预知未来,代价是分配/释放有开销,且需要依赖运行时(CUDA/驱动)的动态管理。
llama.cpp 不能走这条路,原因有三,且缺一不可。
其一,多后端必须共享一套分配逻辑。 ggml 支持 CPU、CUDA、Metal、Vulkan 等十几个后端,其中相当一部分(如某些移动端 GPU API)根本没有提供「运行时分配」的便捷接口,或者分配的代价高到不可接受。如果每个后端各写一套动态分配器,代码量和出错面积都无法控制。静态分配把「算地址」与「分配」解耦:ggml_gallocr 先在纯软件层面把每个张量要放在哪个缓冲区的哪个偏移算出来,再让每个后端只需实现「给我一块 N 字节的缓冲区」这一个动作。
其二,图要被反复重放。 一次 decode 和下一次 decode 的图结构完全一样,形状也一样(这正是 can_reuse 的前提)。如果每次执行都重新分配,就等于把同一份计算做了两遍。静态分配器一次 reserve、之后每次只做「重置计数器 + 按记录填地址」——ggml_gallocr_alloc_graph() 的后半段就是这么做的,全程没有一次真正的分配调用。
其三,CUDA Graph 与 Graph 捕获需要地址稳定。 捕获一张 CUDA Graph 意味着把 GPU 指令流录下来,之后按原样重放。重放时所有显存地址必须与捕获时相同——任何一次动态分配都会改变地址,导致图失效。这不仅适用于 llama.cpp 的 ggml-cuda 路径,也是 vLLM/SGLang 使用 CUDA Graph 时必须固定 KV 缓存地址的同一条物理约束(可参考站内对 SGLang CUDA Graph 与编译路径 的拆解)。
所以问题变成:在不知道运行时数据、只知道图结构的前提下,怎样算出每个中间张量需要多少内存、放在什么地址,同时让总内存尽量小? 这正是 ggml-alloc.c 的内容。它的输入是一张完整的 ggml_cgraph,输出是一张「地址表」——每个张量对应一个 buffer_id + offset。
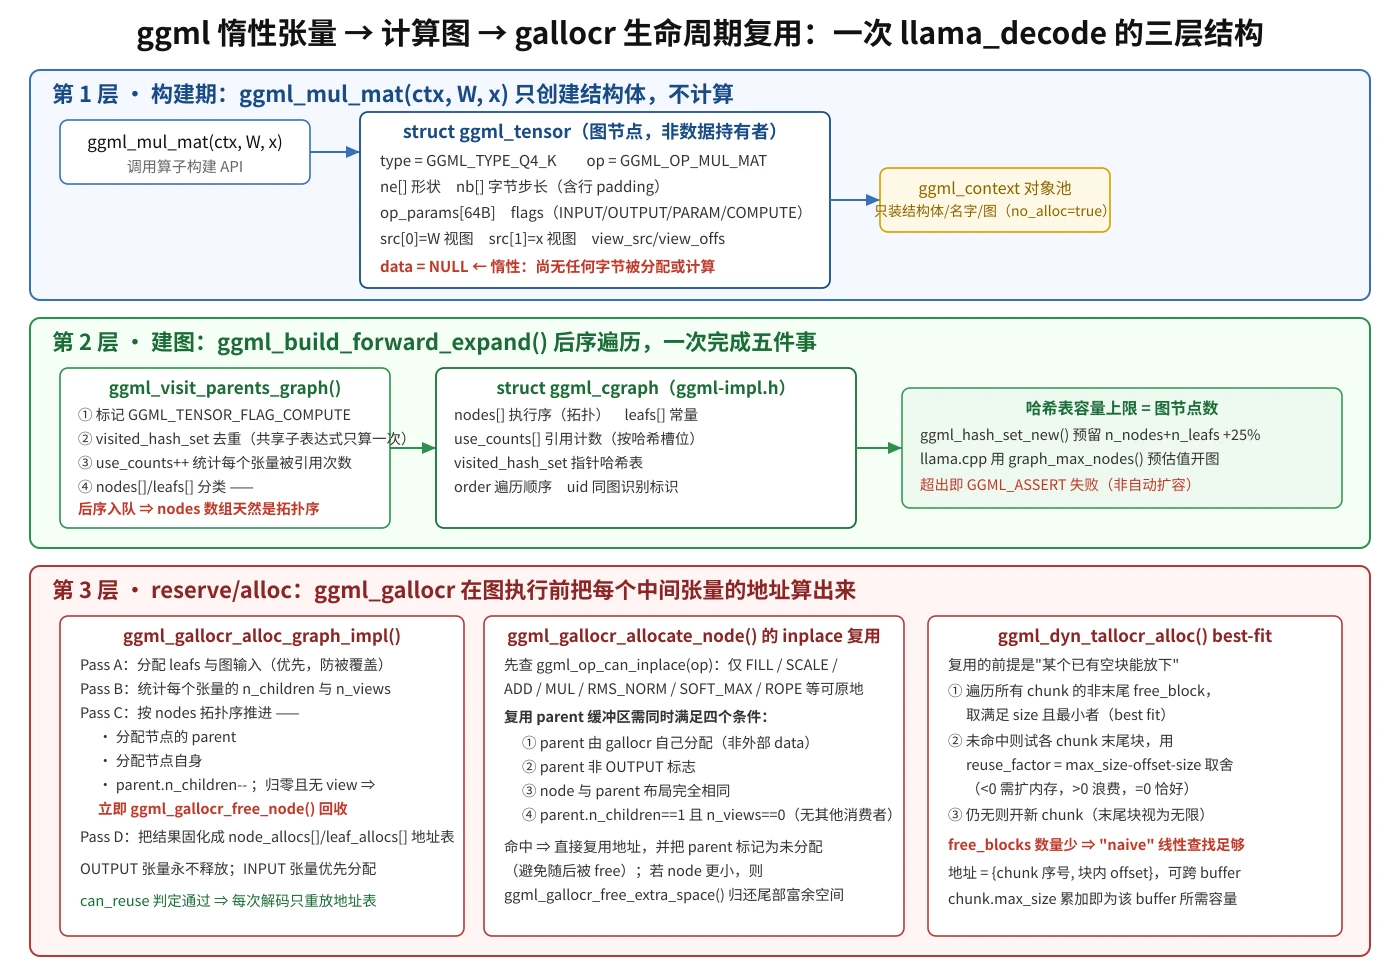
ggml_gallocr:把图的地址全部提前算好
要理解这个分配器,先看它内部的数据结构。ggml-alloc.c 里与分配决策直接相关的有四个:
struct hash_node { int n_children; // 该张量被多少个图节点引用 int n_views; // 该张量被多少个 view 引用 int buffer_id; // 分配到的缓冲区编号 struct buffer_address addr; // {chunk, offset} bool allocated;};
struct tensor_alloc { int buffer_id; struct buffer_address addr; size_t size_max; // 0 = 预分配/未使用/view};
struct node_alloc { struct tensor_alloc dst; // 节点自身的分配 struct tensor_alloc src[GGML_MAX_SRC]; // 各输入张量的分配};
struct ggml_gallocr { ggml_backend_buffer_type_t * bufts; // [n_buffers] struct vbuffer ** buffers; // [n_buffers] struct ggml_dyn_tallocr ** buf_tallocs; // [n_buffers] int n_buffers;
struct ggml_hash_set hash_set; struct hash_node * hash_values; // [hash_set.size]
struct node_alloc * node_allocs; // [n_nodes] int n_nodes;
struct leaf_alloc * leaf_allocs; // [n_leafs] int n_leafs;};几个字段的含义值得展开。hash_node 是「每个张量的分配状态」,用哈希表按张量指针索引。n_children 与 n_views 是生命周期分析的全部输入——它们的值在分配过程中动态递减,归零就是「这个张量可以释放」的信号。node_alloc/leaf_alloc 是「输出」:reserve 完成后,每个图节点保存着自身与所有输入的 (buffer_id, offset),这就是「地址表」。llama.cpp 之后每次执行新的一批时,ggml_gallocr_alloc_graph() 直接照着这张表把 tensor->data 回填,不做任何重新计算。
一个 gallocr 可以有多个缓冲区(n_buffers),对应不同后端的不同缓冲区类型。这正是跨设备分配的实现方式:图中跑在 CUDA 上的节点与跑在 CPU 上的节点,各自被分配到对应后端的内存池里,一个分配器统管全局。
内存池的内部:chunk、free_block 与 best-fit
缓冲区内部的空间怎么管理?答案是每个缓冲区配一个 ggml_dyn_tallocr(dynamic tensor allocator)。它的结构很朴素:
struct free_block { size_t offset; size_t size;};
struct tallocr_chunk { struct free_block free_blocks[MAX_FREE_BLOCKS]; int n_free_blocks; size_t max_size;};
struct ggml_dyn_tallocr { size_t alignment; size_t max_chunk_size; struct tallocr_chunk * chunks[GGML_VBUFFER_MAX_CHUNKS]; int n_chunks; ...};一个 chunk 是一块「几乎连续」的内存(跨多个实际 buffer 时通过虚拟 buffer 拼接,见下文),内部用 free_blocks 数组记录所有空闲段,按 offset 升序排列。max_size 记录这块 chunk 历史上用到的最高水位——重新分配缓冲区时按它来定容量。
分配函数 ggml_dyn_tallocr_alloc() 做三件事:
第一步,优先在已有空闲块里找 best-fit。 代码遍历所有 chunk 中除末尾块以外的 free_blocks,挑出「能放下且剩余最小」的那个。注释里有一句关键的辩护:// this is a very naive implementation, but for our case the number of free blocks should be very small——它用的是 O(n) 线性扫描而不是平衡树之类的结构,因为图中的空闲块数量天然很小(同一时刻活跃的中间张量数量有限,释放后相邻块还会合并)。这是一个典型的「理解负载特征后选择朴素实现」的工程决策。
第二步,找不到合适块时试各 chunk 的末尾块,用 reuse_factor 取舍。 末尾块是特殊的:它后面是 chunk 的未分配边界,继续往后扩就能容纳更大的请求。但「扩多少」有代价,代码用了一个巧妙的度量:
int64_t reuse_factor = chunk->max_size - block->offset - size;// reuse_factor < 0 : 需要额外分配的内存// reuse_factor = 0 : 恰好用满现有空闲区域// reuse_factor > 0 : 会有多余内存闲置挑选规则是:若所有候选项都导致扩容(reuse_factor < 0),选「扩容需求最小」的;若存在恰好装下或有余量的候选,选「闲置最小」的。这个看似绕口的逻辑实际上是在回答「扩展 chunk 边界,还是浪费已有块」这个取舍。注意 max_size 的更新发生在分配之后(chunk->max_size = MAX(chunk->max_size, addr.offset + size)),也就是说「已使用水位」只增不减——这正是 reserve 阶段能测算出「该缓冲区至少需要多大」的来源。
第三步,实在没有就开新 chunk。 新 chunk 的初始大小取请求大小(对齐后),并且被标记为「末尾块」,其 max_size 可以被后续分配继续撑大。
用一张表总结 chunk 容量与缓冲区分配的关系:
| 概念 | 作用 |
|---|---|
free_block | chunk 内一段可复用的连续空闲区域 |
tallocr_chunk.max_size | 该 chunk 的历史水位(用于定缓冲区大小) |
ggml_dyn_tallocr.max_chunk_size | 单个 chunk 的增长上限(超过则开新 chunk) |
ggml_vbuffer | 把多个 chunk 组织成一个后端缓冲区的包装 |
ggml_vbuffer 是本版代码里较新的一层:ggml_vbuffer_alloc() 按 buf_tallocs 记录的 chunk 尺寸向对应后端申请缓冲区(ggml_backend_buft_alloc_buffer),ggml_vbuffer_tensor_alloc() 把 buffer_address 翻译成真实地址并写入 tensor->data 与 tensor->buffer。多 chunk 的存在使单个逻辑缓冲区可以分散在多个物理分配里(例如后端有单次分配上限时),对上层不可见。
生命周期分析:三段循环 + 引用计数
真正让内存「省下来」的是 ggml_gallocr_alloc_graph_impl()。它的流程分三段:
第一段,分配所有 leaf 与外部输入。 graph->leafs[] 里的张量(权重、常量)逐个走 ggml_gallocr_allocate_node()。紧接着遍历所有节点,把带 GGML_TENSOR_FLAG_INPUT 标志的张量与「被 INPUT 消费者引用的 src」也先分配掉。注释说明了这个顺序的原因:输入张量会被用户写入(set_inputs),必须保证它们不会在后续分配中被复用覆盖。
第二段,统计引用计数。 对每个节点:若节点本身是 view,则其 view_src->n_views += 1;对每个 src,则 src->n_children += 1。这就是全部统计——不需要遍历整图做复杂分析,一次线性扫描就够了。
第三段,主循环:按拓扑序推进并即时释放。 这段代码是整个分配器的心脏,展开读:
for (int i = 0; i < graph->n_nodes; i++) { struct ggml_tensor * node = graph->nodes[i]; int buffer_id = get_node_buffer_id(node_buffer_ids, i);
// allocate parents (only leafs need to be allocated at this point) for (int j = 0; j < GGML_MAX_SRC; j++) { struct ggml_tensor * parent = node->src[j]; if (parent == NULL) continue; ggml_gallocr_allocate_node(galloc, parent, buffer_id); }
// allocate node ggml_gallocr_allocate_node(galloc, node, buffer_id);
// update parents for (int j = 0; j < GGML_MAX_SRC; j++) { struct ggml_tensor * parent = node->src[j]; if (parent == NULL) continue; struct hash_node * p_hn = ggml_gallocr_hash_get(galloc, parent); p_hn->n_children -= 1;
if (p_hn->n_children == 0 && p_hn->n_views == 0) { if (ggml_impl_is_view(parent)) { struct ggml_tensor * view_src = parent->view_src; struct hash_node * view_src_hn = ggml_gallocr_hash_get(galloc, view_src); view_src_hn->n_views -= 1; if (view_src_hn->n_views == 0 && view_src_hn->n_children == 0 && view_src_hn->allocated) { ggml_gallocr_free_node(galloc, view_src); } } else if (p_hn->allocated) { ggml_gallocr_free_node(galloc, parent); } } }}换成自然的语言:按执行顺序走一遍图;每到达一个节点,先确保它的输入有地址(第一次遇到时分配),再给自己要一块地址,最后「消费」掉所有输入——每消费一个,该输入的 n_children 减一;一旦某个输入的所有消费者都已执行完(n_children == 0)且没有 view 挂在上面(n_views == 0),它的内存立刻归还给内存池,可以被后面任意一个张量复用。
这套机制的效果是「峰值内存」而不是「总和内存」。举个具体例子:假设一个分支计算产生了一个 16MB 的中间张量,它只被下一个算子消费一次,那么它存在的时间窗口就是「这两个算子之间」,后面的算子分配新内存时直接复用这 16MB。在一层 Transformer 中,像 attention 的中间分数(score)、FFN 的中间激活(gate/up 的输出)都符合「单一消费者」模式,逐层复用后,显存占用由「所有中间张量之和」降为「单层最宽处」——在 4096 维、8192 token 的模型上这个差距是几十倍。
值得注意的是三个边界条件。其一,GGML_TENSOR_FLAG_OUTPUT 的张量永不释放:ggml_gallocr_free_node() 开头就有注释 // graph outputs are never freed,因为用户要读它。其二,view 张量自身不占内存(ggml_impl_is_view 检查),它随 view_src 的归还而失效;因此释放判断要区分「parent 是 view」的情况,先把 view_src 的 n_views 减掉,再看 view_src 是否满足「无子、无 view、已分配」三条件。其三,INPUT 张量同样会参与引用计数,但它们的分配时机被提前到第一段,避免被复用覆盖——「先分配」与「后释放」两个保护合起来保证了输入张量的数据在整批执行期间有效。
inplace 复用:比「跨张量复用」更激进的一步
上面的释放-复用发生在不同张量之间:A 死了,B 才能用 A 的空间。还有一步更激进:某些算子可以直接把输出写在输入的地址上,连一次分配都不发生。
判定清单在 ggml_op_can_inplace() 里,返回 true 的算子包括 FILL(填充)、SCALE(缩放)、DIAG_MASK_ZERO/DIAG_MASK_INF(掩码填充)、ADD/ADD_ID/ADD1/SUB/MUL/DIV(逐元素运算)、SQR/SQRT/LOG(一元运算)、UNARY、ROPE/ROPE_BACK、SILU_BACK、RMS_NORM/RMS_NORM_BACK、CLAMP、SOFT_MAX/SOFT_MAX_BACK。共同特点是「逐元素或逐行操作、输出与输入同形状、读到某个位置时不需要后续位置的旧值」——这类算子天然满足原地计算的安全性(SOFT_MAX 除外需要注意行最大值扫描,但 ggml 的实现先做归约再写回,同行的读写可以复用同一块)。
真正的复用决策在 ggml_gallocr_allocate_node() 里,它对每个 src 依次检查四个条件:
// try to reuse a parent's buffer (inplace)if (ggml_op_can_inplace(node->op)) { for (int i = 0; i < GGML_MAX_SRC; i++) { struct ggml_tensor * parent = node->src[i]; if (parent == NULL) continue;
// 条件一:parent 的数据必须由 gallocr 分配(外部数据不能动) if (!ggml_gallocr_is_own(galloc, parent)) continue;
// 条件二:parent 不能是图输出 if (parent->flags & GGML_TENSOR_FLAG_OUTPUT || ...) continue;
// 条件三:node 与 parent 的布局必须完全相同 if (!ggml_are_same_layout(node, parent)) continue;
struct hash_node * p_hn = ggml_gallocr_hash_get(galloc, parent); // 条件四:parent 只有这一个消费者,且没有任何 view 挂着 if (p_hn->n_children == 1 && p_hn->n_views == 0) { ... 复用 parent 的地址 ... } }}条件三「布局相同」是 ggml_are_same_layout() 的语义:形状、步长、类型全一致。为什么必须?因为原地写要求输出的每个位置与输入的重叠语义逐位对齐——如果输出是转置或 reshape,地址复用会写出错误结果。条件四「n_children == 1」排除了「parent 还要被别的节点读」的情形:原地写会覆盖 parent,只有确定这是它最后一次被读取才安全。
命中复用后,代码把 node 的 buffer_id 与 addr 直接抄给 parent,然后:
p_hn->allocated = false; // avoid freeing the parent把 parent 标记为「未分配」——这样主循环稍后递减 n_children 到零时就不会去释放这块内存(它现在由 node 持有)。若 node 比 parent 小(例如对一个大 buffer 做切片写入的算子),还会调 ggml_gallocr_free_extra_space():把父张量地址后段「parent_size - node_size」的富余空间立即归还给内存池。这两个细节合起来说明一个原则:地址复用必须精确到字节,多占的部分要还回去,否则就会白白吃掉后续本可复用的空间。
view 张量还有一条特殊复用链,代码里的注释叫「reusing view parent」:当 parent 是 view、且该 view 是 view_src 的唯一 view、view_src 本身无其他消费者、且 view_src->data == parent->data 时,node 可以直接接管 view_src 的地址(而不是 view 的)。这种情况出现在「先 reshape、再做逐元素操作」的模式里——reshape 是 view,逐元素操作想复用,就必须追溯到真正的数据所有者也即 view_src。这段代码是分配器里最绕的地方,但它的存在使「reshape → 归一化 → 缩放」这类常见链完全没有额外分配。
reserve、alloc 与 realloc:三件事各管一段
分配器的对外接口只有三个重要函数,对应三个不同频率的操作:
ggml_gallocr_reserve() 在启动期调用一次(准确说是每个形状组合一次)。它执行完整的生命周期分析与地址规划,把结果固化到 node_allocs[]/leaf_allocs[],并按算出的需求大小真正分配后端缓冲区(ggml_vbuffer_alloc)。为了给哈希表足够的空间,它先算 min_hash_size = n_nodes + n_leafs 并加 25% 余量,必要时重建哈希表。若某个 buffer 所需容量超过当前已分配的容量,就整体重新分配该缓冲区(ggml_vbuffer_free + ggml_vbuffer_alloc)——注意这里是「整块重来」,因为地址表在 reserve 阶段就固化了,中途扩容会让已固化的 offset 失效。
ggml_gallocr_alloc_graph() 在每批执行前调用。它先问 ggml_gallocr_needs_realloc():「这张图的节点数、叶子数、每个 dst/src 的尺寸上限,与 reserve 时记录的是否一致?」只有当 n_buffers == 1(单缓冲区场景)时才允许自动重新 reserve,多缓冲区场景下直接返回 false,要求调用方显式重来。检查通过后,它做的全部工作是:重置每个 vbuffer 的分配游标(ggml_vbuffer_reset),然后按地址表把 tensor->data 逐个回填(ggml_gallocr_init_tensor)。全程零分配、零分析、零哈希操作——这就是「图复用 + 静态分配」组合省下的东西:每步解码省掉一次全图内存规划。
ggml_gallocr_needs_realloc() 的判据也值得留意。它逐个节点比对:talloc->size_max >= node_size 是否仍成立(对 dst 与每个 src 都查)。若之前没有分配过(buffer_id < 0)而现在需要分配,也判为需要 realloc。换句话说,触发重新规划的只有「形状相关的事实变化」,而不是数据本身的变化。这与上一节讲的「形状必须唯一确定图结构」是同一约束在分配器侧的投影。
到这里,ggml-alloc.c 的机制已经完整:哈希表上挂引用计数、拓扑序推进中即时释放、逐元素算子原地复用、view 链追溯复用、以及 reserve 一次固化的地址表。把这些放回 llama.cpp 的语境里:一个 70B 模型在 8192 token 的批上跑解码,这些机制决定了中间张量缓冲区被压到多少 MB,也决定了换一段上下文长度时要不要重新规划。
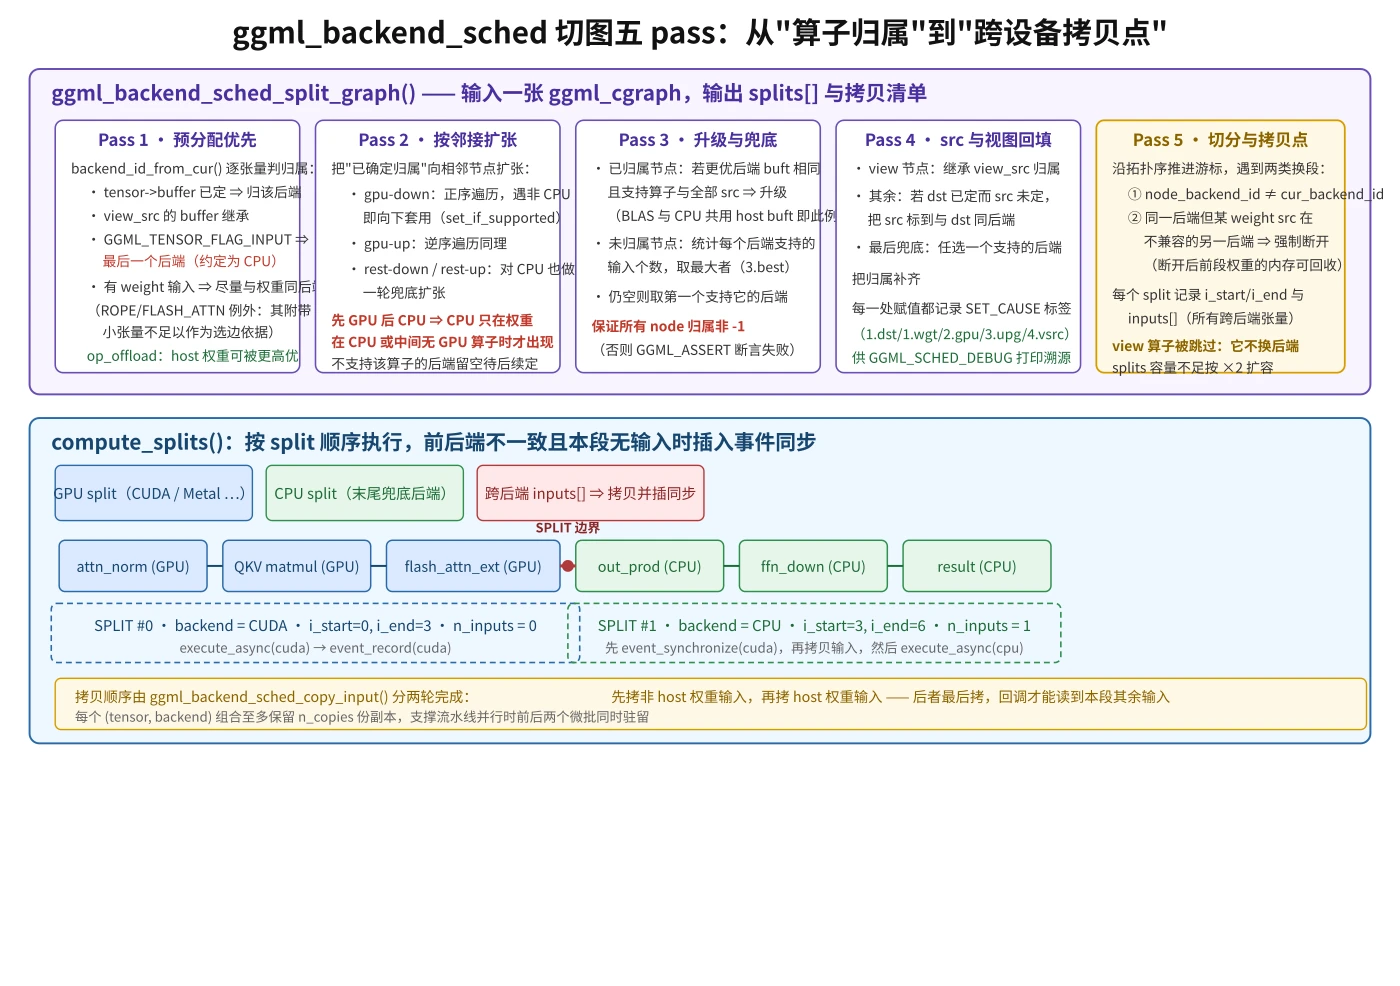
ggml_backend_sched:一张图怎么跑到多块设备上
分配器解决了「内存从哪来」,调度器解决「每条指令在哪执行」。这两个问题在架构上是分开的,但代码上是耦合的——ggml_backend_sched 的 galloc 成员就是一个 ggml_gallocr,调度器把「每个节点的后端归属」交给分配器,分配器再按归属把节点放进对应后端的内存池。
调度器的核心数据结构:
struct ggml_backend_sched_split { int backend_id; // 这一段跑在哪个后端 int i_start; // 起始节点编号(含) int i_end; // 结束节点编号(不含) struct ggml_tensor ** inputs; // 需要拷进这段的所有跨后端张量 int n_inputs; int inputs_capacity; struct ggml_cgraph graph; // 这一段的图视图};
struct ggml_backend_sched { bool is_reset; bool is_alloc;
int n_backends; ggml_backend_t backends[GGML_SCHED_MAX_BACKENDS]; ggml_backend_buffer_type_t bufts[GGML_SCHED_MAX_BACKENDS]; ggml_gallocr_t galloc;
// hash map of the nodes in the graph struct ggml_hash_set hash_set; int * hv_tensor_backend_ids; // [hash_set.size] struct ggml_tensor ** hv_tensor_copies; // [hash_set.size][n_backends][n_copies]
int * node_backend_ids; // [graph_size] int * leaf_backend_ids; // [graph_size]
int * prev_node_backend_ids; // [graph_size] int * prev_leaf_backend_ids; // [graph_size]
struct ggml_cgraph graph; // copy of the graph with modified inputs
struct ggml_backend_sched_split * splits; int n_splits; int splits_capacity;
// pipeline parallelism support int n_copies; int cur_copy; int next_copy; ggml_backend_event_t events[GGML_SCHED_MAX_BACKENDS][GGML_SCHED_MAX_COPIES]; struct ggml_tensor ** graph_inputs; int n_graph_inputs; ... ggml_backend_sched_copy_callback callback_copy; ...};三组字段值得先解释,因为后文全部围绕它们展开。
hv_tensor_backend_ids 是「每个张量归属哪个后端」的哈希表,与 hv_tensor_copies 配合。后者是一个三维数组 [tensor][backend][copy]:同一个张量在不同的后端上可能需要一份副本(跨设备时数据必须实际搬过去),在流水线并行(n_copies > 1)时还会为每个微批各留一份,避免前后两批互相覆盖。宏定义把索引计算压缩成一行:
#define tensor_id_copy(id, backend_id, copy_id) \ sched->hv_tensor_copies[(id) * sched->n_backends * sched->n_copies + \ (backend_id) * sched->n_copies + (copy_id)]node_backend_ids 与 leaf_backend_ids 是切图后的「归属表」,与图的 nodes[]/leafs[] 下标平行。它们与分配器的 node_buffer_ids 是同一个东西——ggml_backend_sched_split_graph() 算完之后,直接把这个数组喂给 ggml_gallocr_reserve_n()。
splits[] 是最终产物。切图的结论不是「每个节点一个后端」,而是「连续的一段节点属于同一后端」——因为同一后端的连续节点可以合并成一次图执行调用,减少后端切换与同步开销。每个 split 记录区间与需要拷贝进来的输入。
切图的核心函数是 ggml_backend_sched_split_graph(),它由五个 pass 组成。下面逐个展开。
Pass 1:从「已经确定的事实」出发
第一个 pass 做的判断在 ggml_backend_sched_backend_id_from_cur() 里,它对每个张量(先 leafs 后 nodes)回答一个问题:这张张量的后端归属是否已经由别的事实唯一确定了? 代码里按优先级依次检查四类事实:
// 1. 张量已经在某个缓冲区里(预分配)int cur_backend_id = ggml_backend_sched_backend_from_buffer(sched, tensor, tensor);if (cur_backend_id != -1) { SET_CAUSE(tensor, "1.dst"); return cur_backend_id; }
// 2. view:继承 view_src 的归属if (tensor->view_src != NULL) { cur_backend_id = ggml_backend_sched_backend_from_buffer(sched, tensor->view_src, tensor); if (cur_backend_id != -1) { SET_CAUSE(tensor, "1.vsrc"); return cur_backend_id; }}
// 3. 图输入:归最后一个后端(约定为 CPU)if (tensor->flags & GGML_TENSOR_FLAG_INPUT) { cur_backend_id = sched->n_backends - 1; SET_CAUSE(tensor, "1.inp"); return cur_backend_id;}
// 4. 有 weight 输入:尽量与权重同后端for (int i = 0; i < GGML_MAX_SRC; i++) { const struct ggml_tensor * src = tensor->src[i]; if (src->buffer != NULL && src->buffer->usage == GGML_BACKEND_BUFFER_USAGE_WEIGHTS) { int src_backend_id = ggml_backend_sched_backend_from_buffer(sched, src, tensor); ... SET_CAUSE(tensor, "1.wgt%d", i); return src_backend_id; }}四类事实里最核心的是第四类:权重在哪个后端,算子就在哪个后端。这是 llama.cpp 卸载策略(-ngl)的落地机制——用户说「把 N 层放到 GPU」,实际就是把那几层的权重张量分配到 GPU 缓冲区,调度器看到「这个算子的权重在 GPU 上」就把它派给 GPU。反过来也成立:权重留在 host 内存(mmap 映射的 CPU 内存)的层,其算子自然落到 CPU。
第 3 类事实里那句「最后一个后端(假定为 CPU)」是一条架构约定,写死在代码里。它决定了图输入(token id、位置、attn mask)总是先在 CPU 上准备好,需要时再拷贝到 GPU——这与 vLLM/SGLang 把输入直接构造成 GPU 张量的做法不同,原因在于 llama.cpp 的后端列表里 CPU 永远存在且永远排在最后,作为兜底。
第 4 类事实里还有一个例外处理,代码注释写得很清楚:
// skip ROPE since the rope freqs tensor is too small to choose a backend based on itallow = allow && tensor->op != GGML_OP_ROPE;// skip FLASH_ATTN_EXT since the sinks tensor is too small to choose a based based on itallow = allow && tensor->op != GGML_OP_FLASH_ATTN_EXT;为什么这两个算子要被排除?因为它们除主输入外还带一个极小的附属张量:ROPE 的 freqs 表(几 KB)与 flash attention 的 sinks 张量。如果按「有 weight 输入就跟随」的规则,这两个小张量的位置会决定整个算子的归属——而它们的放置位置往往与主计算无关,把 ROPE 或 attention 拖到错误的设备上,代价远大于收益。这是一个典型的「规则要留例外」的例子,而例外是通过排除小张量来界定的。
还有一个 op_offload 分支:当权重在 host 内存、而某个更高优先级后端既支持该算子又声明「乐意卸载此算子」(ggml_backend_offload_op)时,把算子派给那个后端。它的用途是「权重留在内存、算力送到加速器」——例如某些加速卡通过 PCIe 直接读 host 内存的场景。
每个归属决定都伴随一个 SET_CAUSE() 调用,打上 1.dst、1.wgt0、1.off 这样的标签。这些标签在 GGML_SCHED_DEBUG 模式下会打印,使「为什么这个算子被放在这块卡上」可以逐条溯源。这个设计对调试卸载策略非常实用——当 -ngl 行为不符合预期时,看日志里每个算子的 cause 比读代码快得多。
Pass 2:把归属向邻居扩张
第一轮结束后,仍然有大量节点归属未定(没有权重输入、也不是输入的中间张量)。第二个 pass 的做法是按图顺序把已知归属「传染」给相邻节点:
// expand gpu backends (i.e. non last prio) up and down, ignoring cpu// thus, cpu will never be used unless weights are on cpu, or there are no gpu ops between cpu ops代码里有四段几乎相同的循环:gpu-down(正序)、gpu-up(逆序)、rest-down、rest-up。前两段只对「非 CPU 后端」的归属做扩张,后两段则对包括 CPU 在内的所有归属再做一轮。这个顺序体现了优先级:
先把 GPU 的归属向上下铺开,CPU 只在扩张后仍无归属时才接管。 注释里那句话说得很直接:除非权重在 CPU 上、或者两个 CPU 算子之间根本没有 GPU 算子,否则 CPU 不会被选中。这个规则的效果是把分散的 GPU 算子「连成块」——理想情况下,整层 Transformer 都在 GPU 上执行,只在一层结束、下一层开始处(如果那层的权重在 CPU)才切回 CPU。
扩张函数 ggml_backend_sched_set_if_supported() 在赋值前会问后端「你支持这个算子吗」(ggml_backend_supports_op)。不支持就留空、不强行赋值——这让后端能力差异自然地表现为「归属待定」,而不是错误。这也解释了为什么扩张要跑四遍:某些算子只有特定后端支持(如某个 flash attention 变体),它们会在多轮扩张中逐步找到合适的位置。
Pass 3:升级与兜底
第三个 pass 处理两类剩余情况。
第一类:已归属节点能否升级到更高优先级后端。 代码里「更高优先级」的判据不只是后端序号,还要求缓冲区类型相同:
// upgrade nodes to higher prio backends with compatible buffer types// if the tensor is already in the same buffer type (*) as another higher priority backend,// we should move it there注释里还补充了为什么用「缓冲区类型相同」这个严格条件(而不是更宽松的「所有人都支持」):因为宽松条件验证慢。而实际中这个严格条件的命中率并不低,注释给的例子是「多个后端可以共用 host 内存,具有相同的缓冲区类型(例如 BLAS 和 CPU)」——CPU 与 BLAS 后端都用 host 内存,一个原本落在 CPU 上的算子如果 BLAS 也支持,就能升级到 BLAS,用更快的实现而不需要任何数据搬移。这与 -ot 把 FFN 权重放到 BLAS/CPU 的组合场景直接相关。
第二类:仍无归属的节点,选择「输入支持最多」的后端。 遍历所有后端,对每个后端数一数「这个节点有多少个输入在该后端上(或该后端的缓冲区类型可接受)」,取最大者。这个启发式规则的目标是最小化跨后端拷贝:如果 3 个输入里有 2 个在 CUDA 上,那把节点放 CUDA 只需要拷 1 个输入。
pass 3 之后还有一层保底:若某节点依然没有归属,就取「第一个支持它的后端」,并断言归属必定非 -1。这保证了后续切图不会遇到未定义状态。
Pass 4:src 与 view 的回填
第四个 pass 把归属信息补齐到「所有张量」:
- view 节点继承
view_src的归属。view 本身不占内存(它只是数据的一个窗口),因此不能独立于数据源而存在——归属必须与 view_src 一致,否则分配器无法在正确的位置开窗。 - dst 已定而 src 未定时,把 src 标到 dst 同后端。这是「输出在哪,输入就在哪」的方向补全——它的合理性在于:如果 dst 已经被判定在这块设备上执行,那么 src 待定意味着计算图尚未决定输入放哪,把输入拉到 dst 处是最省拷贝的选择。
- 最后再用「第一个支持它的后端」兜底。
每个赋值同样记录 SET_CAUSE(4.vsrc 等)。这个 pass 完成后,node_backend_ids 与 leaf_backend_ids 的每个元素都非 -1,可以进入切图。
Pass 5:切分与拷贝点
第五个 pass 把「逐节点归属」翻译成「连续区间 + 拷贝清单」。核心循环:
int i_split = 0;struct ggml_backend_sched_split * split = &sched->splits[0];
// find the backend of the first split, skipping view opsint i = 0;for (; i < graph->n_nodes; i++) { struct ggml_tensor * node = graph->nodes[i]; if (!ggml_is_view_op(node->op)) { split->backend_id = tensor_backend_id(node); break; }}split->i_start = 0;split->n_inputs = 0;int cur_backend_id = split->backend_id;
for (; i < graph->n_nodes; i++) { struct ggml_tensor * node = graph->nodes[i]; if (ggml_is_view_op(node->op)) continue; // view 不参与切分
const int node_backend_id = tensor_backend_id(node); GGML_ASSERT(node_backend_id != -1);
// 判定是否要在此处断段 bool need_new_split = false; if (node_backend_id == cur_backend_id && split->n_inputs > 0) { for (int j = 0; j < GGML_MAX_SRC; j++) { struct ggml_tensor * src = node->src[j]; if (src == NULL) continue; // 检查是否有权重位于「不同且不兼容」的后端 if (src->buffer != NULL && src->buffer->usage == GGML_BACKEND_BUFFER_USAGE_WEIGHTS) { int src_backend_id = tensor_backend_id(src); if (src_backend_id != cur_backend_id && !ggml_backend_sched_buffer_supported(sched, src, cur_backend_id)) { need_new_split = true; break; } } } }
if (node_backend_id != cur_backend_id || need_new_split) { split->i_end = i; i_split++; // ... 扩容 splits 数组 ... split = &sched->splits[i_split]; split->backend_id = node_backend_id; split->i_start = i; split->n_inputs = 0; cur_backend_id = node_backend_id; }
// 收集本段需要拷入的输入 for (int j = 0; j < GGML_MAX_SRC; j++) { ... }}这段代码里有两个不太直观但很重要的设计。
其一,view 算子被完全跳过。 ggml_is_view_op(node->op) 为真时直接 continue,既不参与断段判断,也不推进 i。原因在上一节讲过:view 不占内存、不执行计算(它只是一次指针偏移),把它当作执行节点会制造大量零长度的段。跳过之后,view 前后的节点在切分意义上变成「相邻」,这正是我们想要的。
其二,断段有两种触发,第二种更容易被忽略。 第一种是 node_backend_id != cur_backend_id(后端切换),这是显然的。第二种是「同一后端,但某个权重输入位于不兼容的另一后端」——注释里的理由非常具体:
// check if a weight is on a different and incompatible backend// by starting a new split, the memory of the previously offloaded weights can be reused为什么这种情况要断段?因为如果不断,这段 split 就需要把这个跨后端的权重拷进来;而断段会让前一段的权重内存被回收。ggml_backend_sched_alloc_splits() 按 split 逐个分配缓冲区,前一段用过的区域可以给后一段复用——所以「提前断开」换来的是内存节省,代价是多一次后端切换与同步。这是一个明确的工程取舍,代码选择了「省内存」。
收集输入的逻辑紧随其后:对每个 src,若 src_backend_id != split->backend_id(数据在别的后端上),就把它加进 split->inputs[],并用 tensor_id_copy() 在目标后端上取/建一份副本。splits 数组容量不足时按 2 倍扩容(realloc + 清零新增部分),这是标准的动态数组模式。
切图结束后,n_splits 个区间就绪,每个区间带一份「需要拷入的张量清单」。这份清单是运行时的执行剧本。
执行:按 split 顺序跑,必要时插同步
执行函数是 ggml_backend_sched_compute_splits()。它的结构就是「按 split 顺序遍历」:
for (int split_id = 0; split_id < sched->n_splits; split_id++) { struct ggml_backend_sched_split * split = &splits[split_id]; int split_backend_id = split->backend_id; ggml_backend_t split_backend = sched->backends[split_backend_id];
// 若本段无输入、且与上一段后端不同 → 先同步上一段 if (split->n_inputs == 0 && prev_backend_id >= 0 && prev_backend_id != split_backend_id) { if (sched->events[prev_backend_id][sched->cur_copy] != NULL) { ggml_backend_event_synchronize(sched->events[prev_backend_id][sched->cur_copy]); } else { ggml_backend_synchronize(sched->backends[prev_backend_id]); } }
// 拷贝输入:先非 host 权重,再 host 权重 for (int input_id = 0; input_id < split->n_inputs; input_id++) { if (!ggml_backend_sched_is_host_weight(split->inputs[input_id])) { ggml_backend_sched_copy_input(sched, split, split->inputs[input_id]); } } for (int input_id = 0; input_id < split->n_inputs; input_id++) { if (ggml_backend_sched_is_host_weight(split->inputs[input_id])) { ggml_backend_sched_copy_input(sched, split, split->inputs[input_id]); } }
// 执行本段 enum ggml_status ec = ggml_backend_graph_compute_async(split_backend, &split->graph); if (ec != GGML_STATUS_SUCCESS) return ec;
// 记录本段事件 if (sched->events[split_backend_id][sched->cur_copy] != NULL) { ggml_backend_event_record(sched->events[split_backend_id][sched->cur_copy], split_backend); } prev_backend_id = split_backend_id;}三个细节值得说明。
同步的时机是有讲究的:只有当「本段没有输入需要拷贝」且「后端与上一段不同」时才插同步。为什么?因为如果本段有输入要拷,拷贝动作本身就会与上一段的写入形成依赖,后端实现(或拷贝路径)会处理这个顺序;而没有输入时,两段之间通过同一个缓冲区发生了隐式依赖(分配器可能让两段复用同一块内存),必须显式同步才能保证上一段读完。注释里写的理由正是这一条:the allocator may have reused buffer regions across splits。
拷贝的顺序分两轮:先拷所有非 host 权重输入,再拷 host 权重输入。后者的理由在代码注释里也写了——host 权重最后拷,这样拷贝回调(callback_copy)才能读到本段的其余输入。callback_copy 是给上层(llama.cpp)插入自定义逻辑的钩子,它需要完整的输入视图才能做出正确决策,所以顺序被刻意固定。
事件(event)机制是流水线并行的基础。每个后端为每个 copy 保有一个 ggml_backend_event_t;一段执行完就 event_record,下一段在执行前 event_synchronize。在 n_copies == 1 时这套机制与简单同步等价;在 n_copies > 1(pipeline parallel)时,前后两个微批各自使用不同的 copy 槽位,事件让「第 N 批的 GPU 段」与「第 N+1 批的 CPU 段」真正并行,而不是互相等待。
把这一段与上一节对照,一张图在多设备上的完整生命周期就清楚了:split_graph() 决定切在哪、galloc 决定每段的内存从哪个池子来、compute_splits() 按顺序执行并在边界处搬数据与同步。三个环节各自有独立的调试开关(GGML_SCHED_DEBUG 打印归属与切分、GGML_ALLOCATOR_DEBUG 打印分配、后端自身的日志打印 kernel 执行),合起来构成完整的可观测性。
图复用判定:什么时候能重放,什么时候必须重建
跨后端执行讲完,回到 llama.cpp 主流程里最关键的一个判断:新的一批数据来了,能不能继续用上一批的那张图?
这个判断由 llm_graph_result::can_reuse(gparams) 与它调用的 llm_graph_params::allow_reuse(other) 共同完成。判定条件分成四组,逐组都要通过:
bool allow_reuse(const llm_graph_params & other) const { // 组 1:ubatch 的形状与序列结构 bool can_reuse_ubatch = ubatch.equal_seqs() == other.ubatch.equal_seqs() && ubatch.n_tokens == other.ubatch.n_tokens && ubatch.n_seq_tokens == other.ubatch.n_seq_tokens && ubatch.n_seqs == other.ubatch.n_seqs && ubatch.n_seqs_unq == other.ubatch.n_seqs_unq && ubatch.is_mixed() == other.ubatch.is_mixed() && // 组 2:数据载体一致(都是 token,或都是 embedding) ((!ubatch.token && !other.ubatch.token) || (!ubatch.embd && !other.ubatch.embd) || (ubatch.token && other.ubatch.token && ubatch.embd && other.ubatch.embd)) && (!ubatch.embd_state == !other.ubatch.embd_state); ...}组 1 是形状:token 总数、序列数、每个序列分到的 token 数、去重后的序列数、是否混合批次。这些数值共同决定了注意力张量的形状、mask 的构造方式与 KV 的索引范围。
组 2 是数据载体:一个批次要么喂 token id(由 ubatch.token 非空标识),要么喂已经算好的 embedding(ubatch.embd)。两者不能混用——因为图里对应的输入张量类型不同(整数 vs 浮点),形状也可能不同。embd_state 的有无同样要一致,它关系到 embedding 输入是否携带额外状态。
组 3 只在 equal_seqs 为真时生效,逻辑是逐位比较参与序列的 id:
// when we split the batch using "equal_seqs" we have to verify that the// participating sequences are the same// the reason is because the set of attention streams would be different// for different sequencesif (can_reuse_ubatch && ubatch.equal_seqs()) { if (!ubatch.data) { // 旧 ubatch 不拥有自己的数据 → 无法保证仍然存活 → 无法比较序列 id can_reuse_ubatch = false; } else { for (uint32_t s = 0; s < ubatch.n_seqs_unq; ++s) { can_reuse_ubatch &= ubatch.seq_id_unq[s] == other.ubatch.seq_id_unq[s]; } }}这条注释把「为什么序列 id 相同如此重要」讲得很清楚:不同的序列集合意味着不同的注意力流(attention streams)。在 llama.cpp 的记忆模型里,每个序列有自己的 KV 范围;批次里的 seq_id 决定了注意力要读哪些 KV 段、以及 mask 的稀疏结构。换了序列集合,这些结构全变,图也就不是同一张图了。代码里还处理了一个边角情况——如果旧 ubatch 不持有自己的数据(!ubatch.data),就无法保证这些 id 仍然可读,保守地判定不能复用。
组 4 是输出与采样器:
if (n_outputs != other.n_outputs) return false;if (!samplers_equal(samplers, other.samplers)) return false;n_outputs 决定哪些位置的 logits 被计入输出张量;采样器链(sampler chain,包括 temperature、top-k、grammar 等)决定采样相关节点的构成。任何一个变了,图的结构就可能不同——尤其采样器,它是会真正改变图中节点集合的(grammar 约束会引入 bitmask 计算节点)。可参考站内对 SGLang 采样与语法约束闭环 的拆解,那里的 logits 变换链与 llama.cpp 的 sampler chain 是同一个问题在两个框架里的不同实现。
allow_reuse 之外,llm_graph_result::can_reuse() 还要把所有输入张量逐个问一遍:
bool llm_graph_result::can_reuse(const llm_graph_params & params) { if (!this->params.allow_reuse(params)) { ... return false; }
bool res = true; for (auto & input : inputs) { const bool cur = input->can_reuse(params); res = res && cur; } return res;}每个 llm_graph_input_* 都有自己的 can_reuse 逻辑,检查的是「这个输入张量的形状与含义是否还能用」。其中最关键的是 llm_graph_input_attn_kv::can_reuse(),它进一步调用 can_reuse_kq_mask(...)——KQ mask 的形状随序列长度与位置分布变化,是图复用最常被打破的地方(在上下文继续增长或序列长度变化时)。把「输入张量可用性」与「参数一致性」分开检查的好处是:形状层面的复用判断与拓扑层面的复用判断解耦,任何一侧不满足都能快速拒绝。
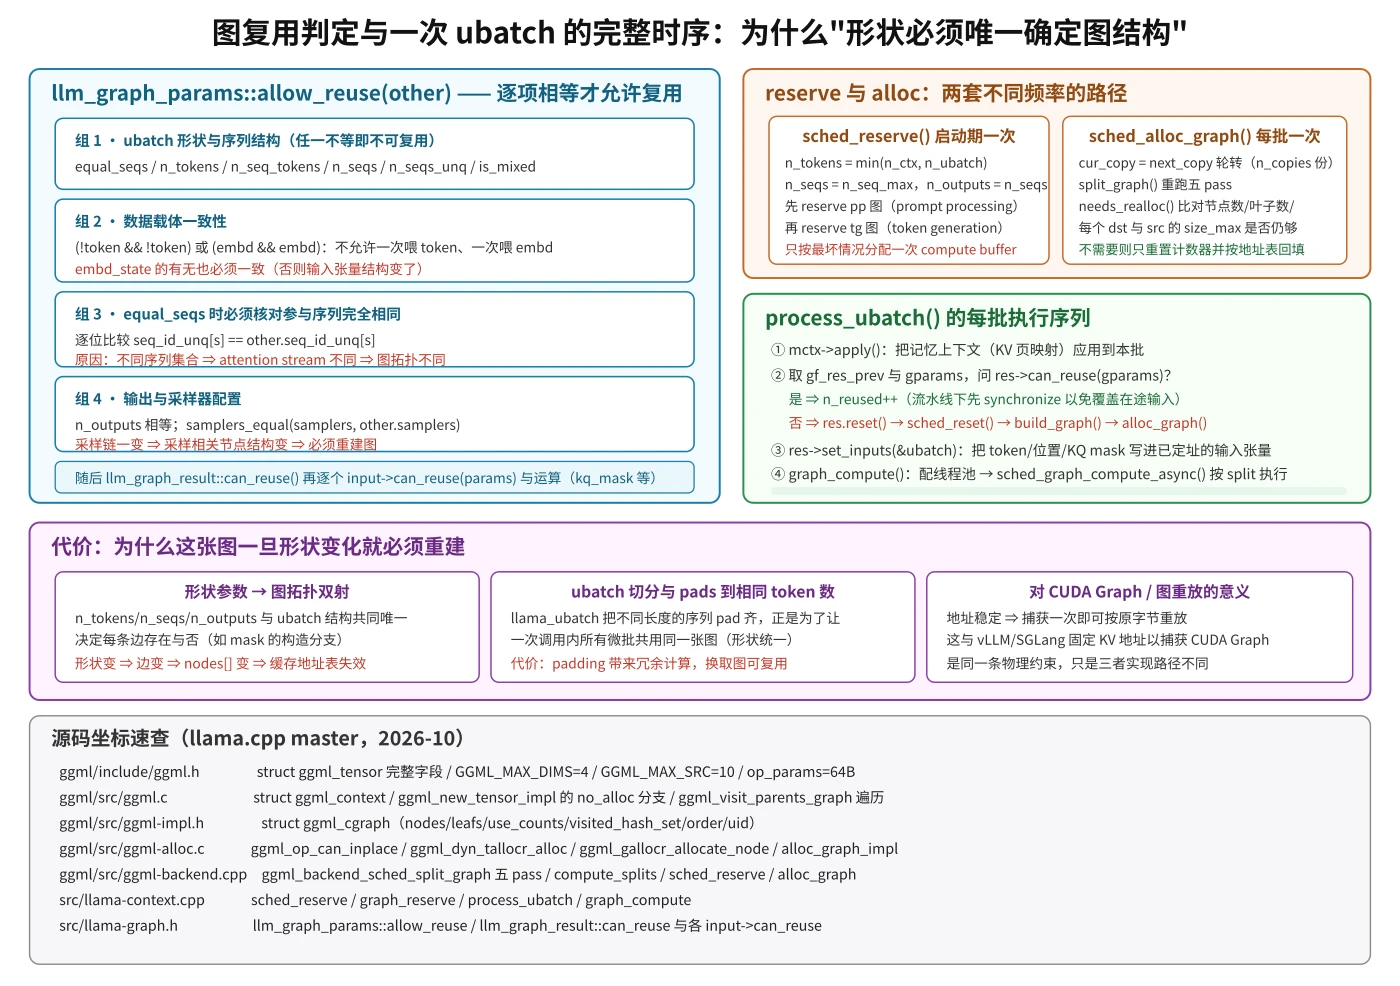
落到一次 llama_decode:三层机制如何合流
前面三节分别讲了分配器、调度器与复用判定。把这三层放回 llama_context::process_ubatch(),就能看清它们如何合流。这个函数是每批执行的实际入口,其结构是:
llm_graph_result * llama_context::process_ubatch(const llama_ubatch & ubatch, llm_graph_type gtype, llama_memory_context_i * mctx, ggml_status & ret) { if (mctx && !mctx->apply()) { ... return nullptr; }
auto * res = get_gf_res_prev(); auto * gf = res->get_gf();
// the new graph parameters // in order to correctly reuse a graph, it's full topology has to be uniquely // determined by these parameters const auto gparams = graph_params(res, ubatch, mctx, gtype);
if (!graph_reuse_disable && gf_res_prev_active == res && res->can_reuse(gparams)) { // 复用路径 if (cparams.pipeline_parallel) { // 流水线下上一批可能还在 GPU 上跑,set_inputs 会覆盖它正在读的输入 ggml_backend_sched_synchronize(sched.get()); } n_reused++; } else { // 重建路径 gf_res_prev_active = nullptr; res->reset();
ggml_backend_sched_reset(sched.get()); ggml_backend_sched_set_eval_callback(sched.get(), cparams.cb_eval, cparams.cb_eval_user_data);
gf = model.build_graph(gparams); if (!gf) { ... return nullptr; }
if (!ggml_backend_sched_alloc_graph(sched.get(), gf)) { ... return nullptr; }
gf_res_prev_active = res; }
res->set_inputs(&ubatch);
const auto status = graph_compute(res->get_gf(), ubatch.n_tokens > 1); ...}这段代码里每一行都能对应到前面讲过的机制:
mctx->apply() 是记忆上下文的应用:把「本批涉及哪些序列、各自 KV 范围在哪」告诉记忆模块,准备出本次前向所需的 KV 视图。这就是 attention 输入张量(llm_graph_input_attn_kv)的数据来源,也是 can_reuse 检查的对象之一。
graph_params(...) 构造参数包,包含架构、超参、上下文参数、ubatch、图类型(prompt processing 还是 token generation)、调度器句柄、记忆上下文等。注释里那句「为了让图能被正确复用,其完整拓扑必须由这些参数唯一确定」是整个复用机制的设计纲领——allow_reuse 检查的所有字段都在这个参数包里。
复用路径只做三件事:流水线时同步、n_reused++、继续往下走。没有建图、没有分配、没有切图。这就是「图重放」的全部内容。
重建路径走完整链条:重置调度器状态(sched_reset,让 hash 映射与 splits 失效并清空)、重新设置评估回调、重新构建图(build_graph,走 llama-graph.cpp 里的模型特定逻辑)、重新分配与切图(sched_alloc_graph,内部调用 split_graph 五 pass 与 ggml_gallocr_alloc_graph)。
res->set_inputs(&ubatch) 是复用与重建两条路径的共同尾步:把 token id、位置、KV 索引、KQ mask 等数据写进已定址的输入张量。这正是分配器「先分配输入张量」那一步为什么必要——它们必须已经有效地址,才能在此处被写入。
graph_compute() 则是最后的执行:
ggml_status llama_context::graph_compute(ggml_cgraph * gf, bool batched) { int n_threads = batched ? cparams.n_threads_batch : cparams.n_threads; ggml_threadpool_t tp = batched ? threadpool_batch : threadpool;
if (backend_cpu != nullptr) { auto * reg = ggml_backend_dev_backend_reg(ggml_backend_get_device(backend_cpu)); auto * set_threadpool_fn = (decltype(ggml_backend_cpu_set_threadpool) *) ggml_backend_reg_get_proc_address(reg, "ggml_backend_cpu_set_threadpool"); if (set_threadpool_fn) set_threadpool_fn(backend_cpu, tp); }
for (const auto & set_n_threads_fn : set_n_threads_fns) { set_n_threads_fn.second(set_n_threads_fn.first, n_threads); }
copy_experts.reset();
auto status = ggml_backend_sched_graph_compute_async(sched.get(), gf); ...}这里出现了两层线程池抽象:CPU 后端通过 ggml_backend_reg_get_proc_address 拿到「设置线程池」的扩展函数并注入(因为 CPU 后端是唯一使用 ggml 自建线程池的后端),其他后端则通过注册表里收集到的 set_n_threads_fns 逐个设置线程数。batched 参数区分了「这一批是 prompt processing(多 token)还是 token generation(单 token)」——两者使用不同的线程数配置,因为批处理的并行度与解码的并行度需求完全不同。
把整个过程压缩成一句话:每次 llama_decode 先问「图能不能复用」,能复用就直接对着已有的地址表写输入然后执行,不能复用就走一遍建图→切图→分配→执行;无论哪条路,中间张量的内存都由 gallocr 提前算好,跨设备的数据搬移都由 splits[] 的输入清单驱动。
为什么这张图这么”僵硬”:代价与权衡
讲到这里,一个自然的疑问是:为什么 llama.cpp 要接受「形状必须唯一确定图结构」这个约束?把它与 vLLM/SGLang 的 eager 执行对照,代价与收益都很清楚。
收益一:零规划开销的重放。 ggml_gallocr_alloc_graph() 在复用路径上的开销是按地址表回填指针,几十到几百个张量各写一次 data,微秒量级。如果换成运行时动态分配,每步解码都要跑一遍完整的生命周期分析(对 8192 token、几十层的图,那是几万次哈希查找与指针操作)。对解码这种「每步只生成一个 token、但每步都要跑完整模型」的场景,这笔开销占总时间的比例不小。
收益二:地址稳定,使 CUDA Graph 捕获成为可能。 捕获一张 CUDA Graph 要求所有显存地址在执行间保持不变。ggml 的静态分配天然给出这个保证——只要形状不变,地址表不变,图就能被捕获并重放。这与 vLLM/SGLang 捕获 CUDA Graph 的动机完全相同,只是后者需要额外保证 KV 块的地址固定(通过预分配固定尺寸的 block pool 实现),而 llama.cpp 因为整个计算缓冲区都是预留的,约束更容易满足。
收益三:跨设备切分可以在规划期一次完成。 归属判定、切图、拷贝点确定全部发生在建图之后、执行之前。运行时只需要按剧本搬数据。如果做运行时动态派发,每个算子都要现场问「谁来执行、数据在哪、要不要拷」,那正是很多框架里调度开销的来源。
代价同样明确:
代价一:形状一变就要重建。 批大小从 4 变成 5、上下文再加一个 token、序列集合变化——任何一种都触发完整重建。llama.cpp 的对策是 ubatch 切分与 pad:把一个批次切成多个形状相同的微批(llama_ubatch 的构造就是为了让同一批内的微批形状统一),并把不同长度的序列 pad 到相同 token 数。这解释了为什么 graph_reserve() 里会出现「把 n_tokens 向上取整到 n_seqs 的倍数」这一步:
if (n_tokens % n_seqs != 0) { n_tokens = ((n_tokens + (n_seqs - 1)) / n_seqs) * n_seqs; // round to next multiple of n_seqs}代价二:padding 带来冗余计算。 形状统一靠 pad 实现,pad 出来的位置仍然要参与计算(虽然结果被丢弃)。在序列长度差异很大的批次里,这个浪费可能相当可观。llama.cpp 的取舍是:宁可多算一点,也要保住图复用。这与 vLLM 的 PagedAttention 可以逐序列精确分配形成对照——后者用分页解决了变长问题,代价是更复杂的内存管理。
代价三:能力查询成为热路径。 因为归属判定依赖「后端是否支持某算子」,ggml_backend_supports_op 在切图时会被反复调用。llama.cpp 的对策是后端把支持列表预处理成查表结构,把查询做成 O(1)。这属于「把复杂度移到初始化期」的同一思路。
一句话总结这套取舍:llama.cpp 用初始化期的完整规划,换取运行期的零决策执行。 这个选择与它的目标场景(单机、消费级硬件、批大小小、解码占主导)高度匹配;而在服务器上跑高并发大 batch 的场景里,同样的僵硬约束就会成为瓶颈——这恰好解释了为什么 vLLM 与 SGLang 走了另一条路。站内对 vAttention 用 CUDA 虚拟内存保住连续 KV Cache 的拆解展示了第三种可能:在保持地址连续稳定的同时,让映射本身可以动态调整,把「稳定」与「灵活」的冲突进一步化解。
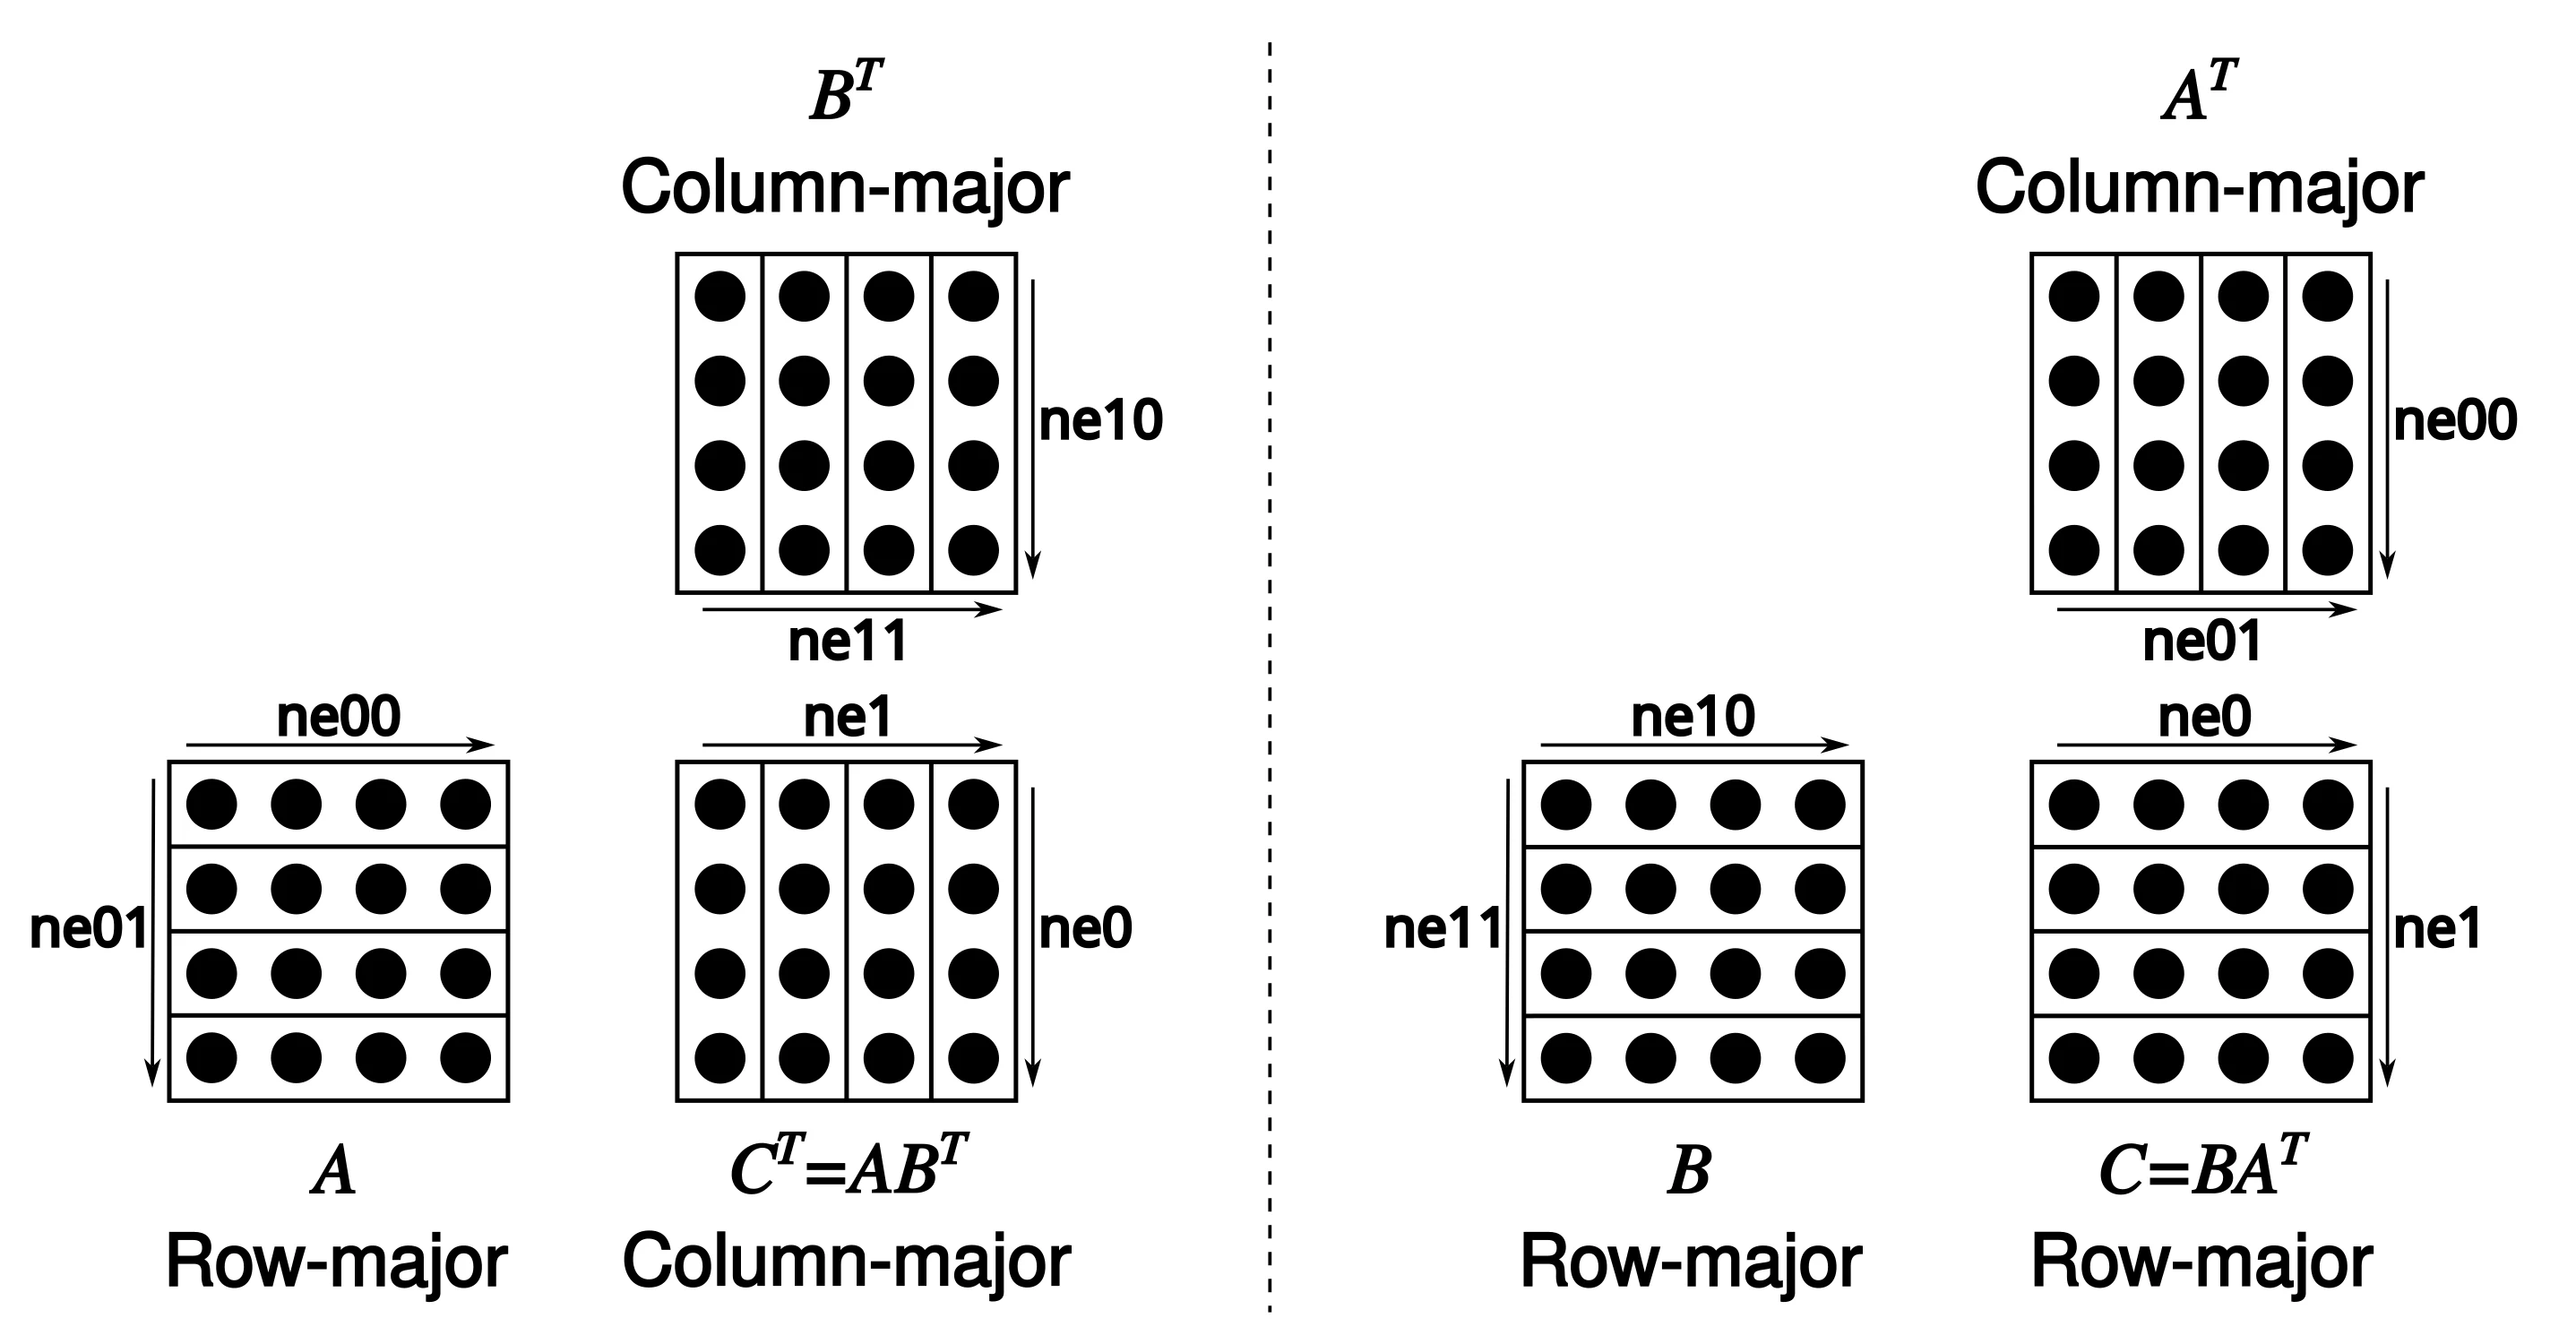
上图(来源:llama.cpp 官方仓库 media/matmul.png)是 ggml 里一次量化矩阵乘的布局示意。它与本篇的关系在于:图中那些「按块存储的权重」正是 ggml_tensor 的 type 字段可以取 GGML_TYPE_Q4_K 之类的直接原因,也是分配器计算 ggml_nbytes() 时必须按块尺寸而非元素尺寸来算的原因——一个 Q4_K 张量的字节数由 ne[0]/256 * 块大小 决定,而不是 ne[0] * 4 bit。分配器对量化类型是完全无感知的:它只问缓冲区类型「这个张量要多少字节」,具体的块布局交给算子实现。
小结
本篇沿 ggml/include/ggml.h、ggml/src/ggml.c、ggml/src/ggml-alloc.c、ggml/src/ggml-backend.cpp 与 src/llama-context.cpp 走完了 llama.cpp 的图与内存这两条主线,核心结论有六条:
第一,ggml_tensor 是图节点而不是数据持有者。data 在构建期是空指针,形状、算子、输入列表、view 来源在结构体里描述清楚;ggml_context 只管理这些结构体与名字,不管理数据。
第二,ggml_cgraph 的 nodes[] 数组天然是拓扑序,因为它由一次后序遍历生成;use_counts[] 与 visited_hash_set 分别是引用计数与去重表,前者给分配器用、后者保证共享子表达式只被访问一次。
第三,ggml_gallocr 做的是「静态内存分配」而非「动态分配」。它按拓扑序扫描图、用 n_children/n_views 做生命周期分析、在张量死亡瞬间归还内存,把显存占用从「全部中间张量之和」压到「单层峰值」;对逐元素算子还会做原地复用,并通过 free_extra_space 把富余部分精确归还。
第四,ggml_backend_sched 用五个 pass 完成跨设备切图:从预分配事实出发判定归属、向邻居扩张、升级与兜底、回填 src 与 view、最后按归属连续性与权重兼容性切出 splits 与拷贝清单。compute_splits() 按 splits 顺序执行,在边界处搬输入、插事件同步。
第五,图复用的判定条件分为形状、数据载体、序列集合、输出与采样器四组,任何一组不通过都必须重建图。这条规则的物理含义是「图拓扑由这些参数唯一确定」,而它的工程代价是「形状一变就要重建」,对策是 ubatch 切分与 pad。
第六,这套设计的核心取舍是用初始化期的完整规划换运行期的零决策执行。收益是重放零开销、地址稳定(利于 CUDA Graph)、切分一次算好;代价是形状僵硬、padding 冗余、能力查询进热路径。理解这条取舍,就理解了 llama.cpp 与 vLLM/SGLang 在架构上的根分歧。
下一篇进入 llama.cpp 源码完全拆解(三):GGUF 与量化在装载侧的落地——沿 llama-model-loader.cpp 看 GGUF 的元数据字典与张量信息表如何被解析、llama-mmap.cpp 的三种装载模式如何影响权重的常驻行为、llama_model 如何按 -ngl/-ot/--split-mode 把张量分配到设备与缓冲区类型、以及 llama_prepare_model_devices 的设备枚举与去重策略。站内已有 GGUF 完全拆解:一个文件里的张量布局、k-quants 块量化与元数据字典 从文件字节层面讲过格式,那一篇讲文件长什么样,下一篇讲 llama.cpp 怎么把它读进来并放对地方。再往后是 llama_context 与记忆(llama_memory_i 与 llama-kv-cache.h 的 slot_info 与序列操作)、计算图构建(llama-arch.cpp 与 llm_graph_context 构件)、后端与 kernel、采样器,最后是 tools/server/ 的服务化调度。
参考资料
- llama.cpp 官方仓库(ggml/ 与 src/ 源码)
ggml/include/ggml.h:张量结构、算子枚举与图 APIggml/include/ggml-backend.h:后端注册、缓冲区类型与调度器接口ggml/src/ggml-alloc.c:生命周期分析与静态分配器实现ggml/src/ggml-backend.cpp:ggml_backend_sched切图五 pass 与执行ggml/src/ggml.c:ggml_context对象池与图遍历实现src/llama-context.cpp:sched_reserve、graph_reserve、process_ubatch与graph_compute- llama.cpp 官方文档:后端与多 GPU 使用
- llama.cpp 官方文档:添加新模型架构的步骤
- FlashAttention 论文:IO 感知的精确注意力计算
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



