


vLLM 源码完全拆解(二十八):结构化输出的语法约束——从 JSON Schema 到 GPU 上的位掩码,以及五个推理框架的草稿剪枝与跳跃
模型吐出 JSON 的时候,偶尔会多一个逗号、少一个引号,或者把 "temperature" 写成 "temperture"。对一次聊天影响不大,对程序解析就是直接报错。于是推理框架里多了一类组件:结构化输出(structured output),也叫约束解码(constrained decoding)。它不是微调模型让它”听话”,而是在采样前动一点手脚:把当前不合法的那部分词表直接堵死,使模型从第一步到最后一步都只能生成符合约束的 token。
本文沿着 vLLM V1 的实现,把这台机器的每一个零件拆开:JSON Schema 怎么变成语法、语法在哪个线程里编译、位掩码在哪个进程里生成、怎么和投机解码的草稿对齐、又怎么在多个并行 rank 之间保持一致。最后把 SGLang、TensorRT-LLM、llama.cpp 和 DeepInfer 拉过来做横向对照,重点是两个工程问题:草稿 token 要不要剪,以及确定性的字符串要不要让模型跳过。
为什么约束解码值得单独拆一篇
先界定问题。语言模型每一步输出的是词表上的一个概率分布,采样器从这个分布里挑 token。所谓约束,就是在每个位置上定义”哪些 token 可以出现”。这个定义来自一种形式语言:JSON Schema、正则表达式、上下文无关文法(CFG),或者”只能在某几个固定字符串里选一个”。
把这些约束”解释”成逐 token 的合法性判断,中间要穿过三层抽象:
- 字符串层:JSON Schema 描述的是字符串应满足的结构。
- 文法层:结构语言(正则、CFG)可以判断一个前缀能否继续延伸。
- token 层:词表里的 token 是字节序列,不一定与文法的最小单位对齐。
前两层在 CPU 上做,第三层要把结果送到 GPU,和 logits 对齐。每一层都有自己的坑。
历史上最朴素的实现是”逐 token 试一遍”:对每个候选 token,把它解码成字符串,喂进文法状态机,看能不能走通。词表动辄十几万,每生成一个 token 就要试十几万次,开销无法接受。
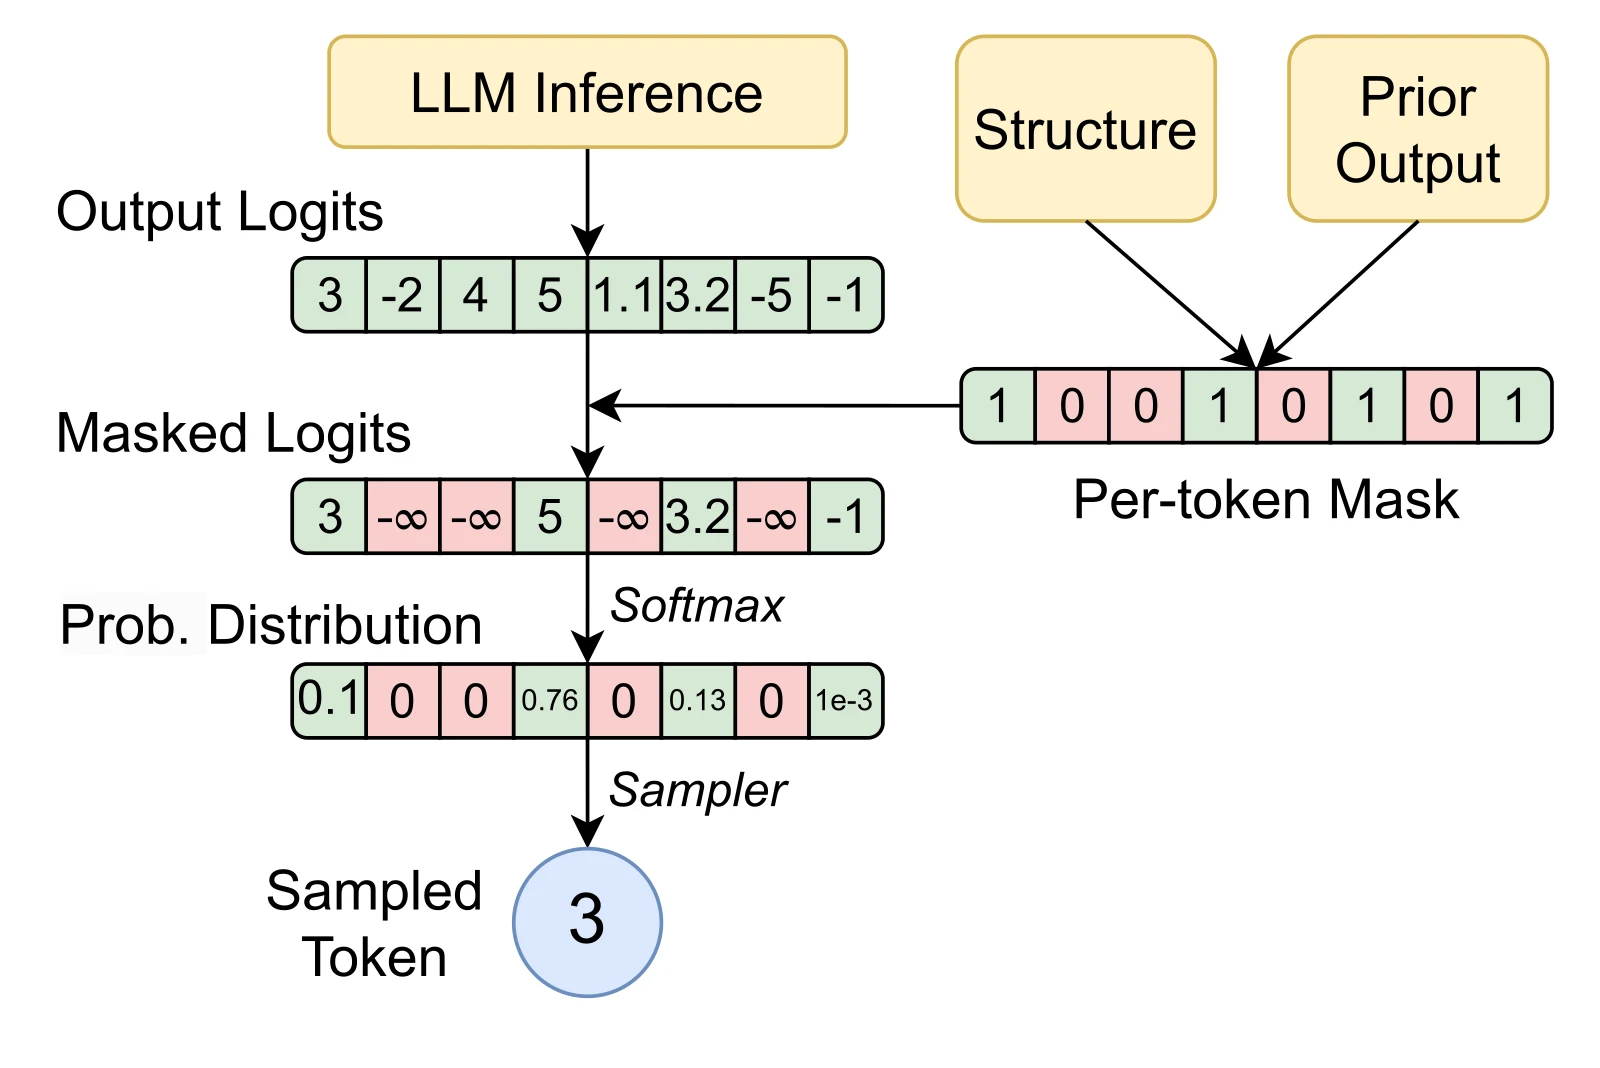
图:约束解码的”逐 token 掩码”基线(来源:arXiv:2411.15100)
2024 年 11 月,MLC 团队发布 XGrammar(arXiv:2411.15100),核心观察是:大量 token 在当前文法状态下是否合法,与上下文无关。XGrammar 把词表切成”上下文无关 token”和”上下文相关 token”,前者可以预先算好并缓存,后者才在运行时检查。
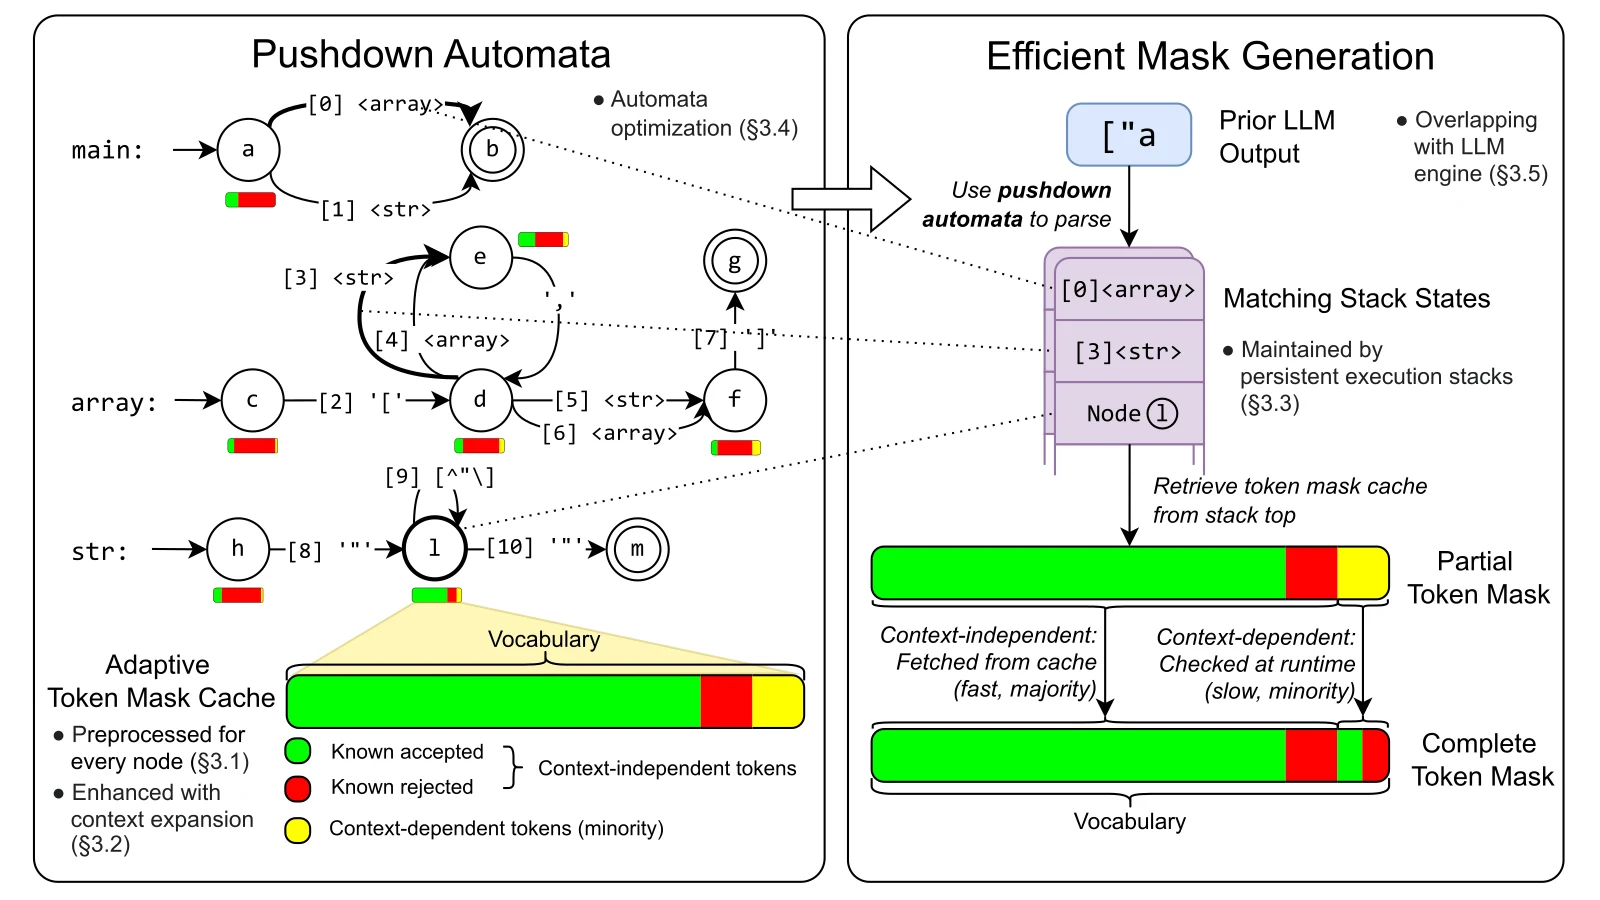
图:XGrammar 论文总体思路(来源:arXiv:2411.15100)
vLLM 并不自己实现这些文法引擎。XGrammar、Guidance、Outlines 都作为可选后端接入,vLLM 负责的是推理框架这一侧的工程:调度、异步、批处理、并行、与投机解码和推理模式的耦合。这正是本文要讲的部分:真正有框架味道的那一半。
三层抽象:Schema、元语法、Token 掩码
从约束到”下一步允许哪些 token”
约束解码的经典视角是一个自动机。正则对应确定性有限自动机(DFA),CFG 对应下推自动机(PDA)。给定已生成的前缀 ,当前状态为 ,对词表中每个 token ,如果把 的解码文本接在 后面能否在文法中继续走通,决定了 的合法性。
把所有合法 token 编码成一个 0/1 位向量,长度等于词表大小 ,在第 位置为 1 表示允许。位向量压缩成 个 32 位整数,这就是位掩码(token bitmask)。采样前,把所有不允许的位置的 logit 置为 :
之后照常做 softmax 和采样,于是被采样出来的 token 必然合法。注意这里发生的是”重归一化”:原本概率质量分配给非法 token 的部分,会被按比例分给合法 token。这解释了为什么约束解码会让某些输出看起来”被逼出来的”——在文法只剩一条路的时候,模型别无选择。
位掩码的存储格式
vLLM 后端接口里的 allocate_token_bitmask(max_num_seqs) 一次性分配 (seqs, (V+31)//32) 的 int32 张量,初值全部为 -1(二进制全 1,表示全部允许)。后端往某一行里写”拒绝”位时,是把对应位清零而不是置 1。以 XGrammar 为例,fill_next_token_bitmask 写入的语义就是”不允许的 token 对应位为 0”。Guidance 后端则调用 llguidance_torch.fill_next_token_bitmask,Outlines 后端使用 guide.write_mask_into——三者写出来的是同一套位布局。
这个”全 1 表示允许 + 清零表示拒绝”的约定很重要:一个尚未约束的请求行只需要保持全 1,不需要任何后端参与。这在”推理模型先思考、再输出结构化答案”的场景里会成为关键机制(见后文”推理模式的特殊处理”)。
缓存的是”某一状态下的一整行掩码”
XGrammar 的加速来自一个很朴素的观察:文法自动机在某个状态 下,“哪些 token 合法”只取决于 本身,与”怎么到达 “无关。于是可以对常见状态预计算整行掩码。论文把词表按当前状态细分为三类:
- 上下文无关且被接受:不论后续上下文如何都合法,可以预先缓存;
- 上下文无关且被拒绝:不论后续上下文如何都不合法,可以预先缓存;
- 上下文相关:必须运行时检查。
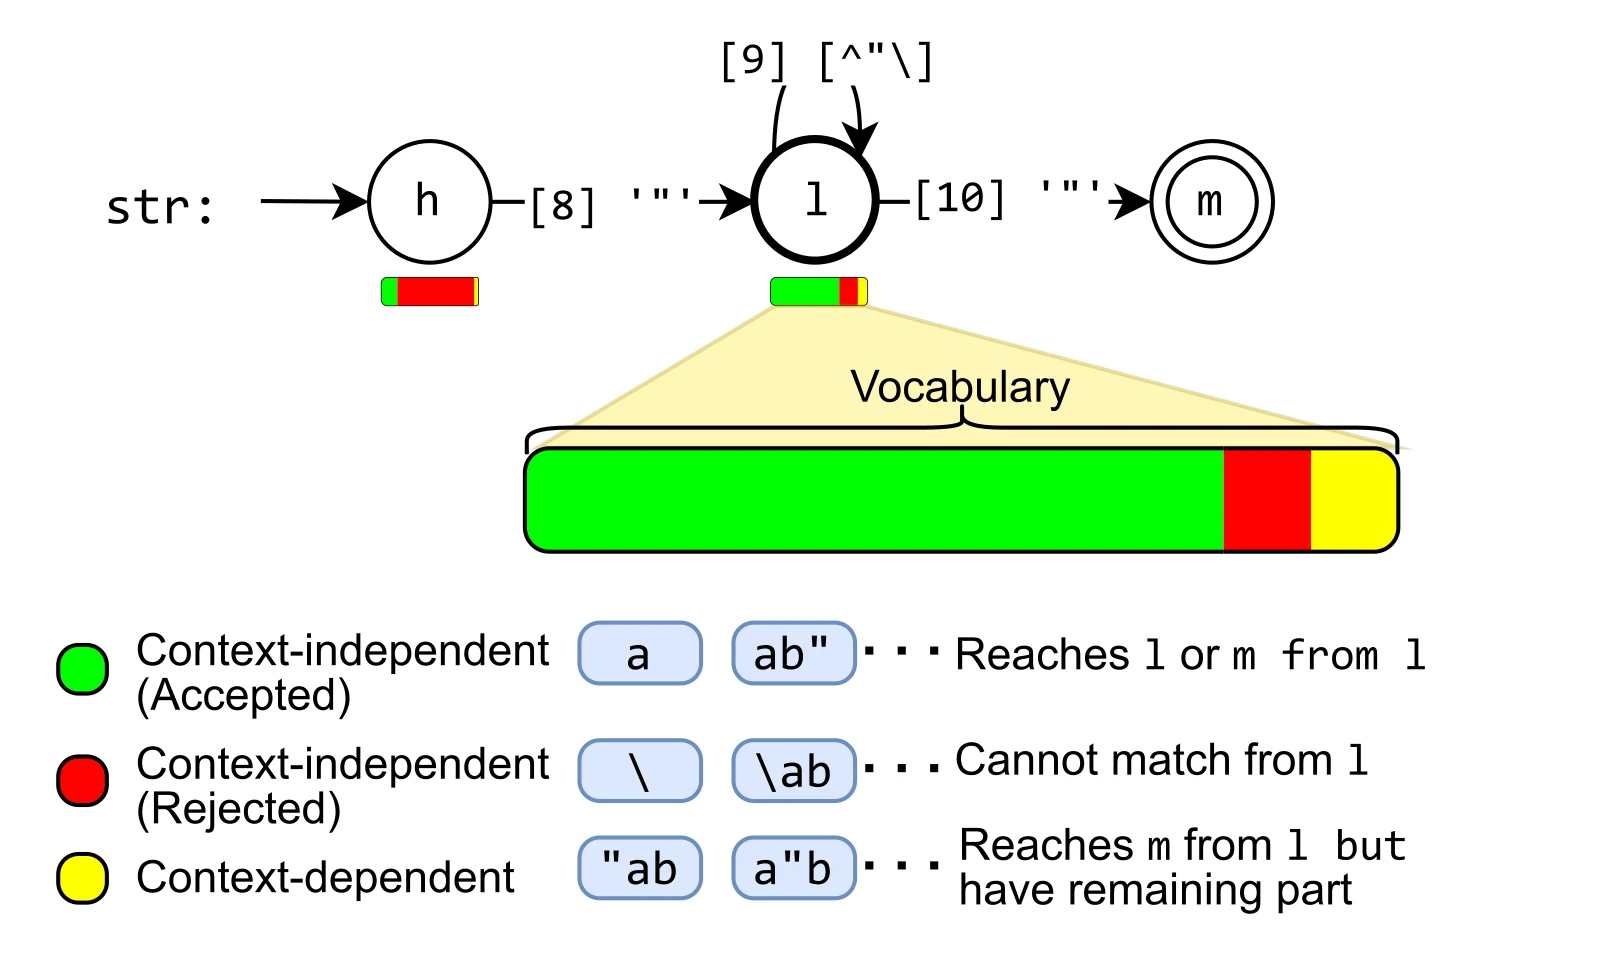
图:XGrammar 的 token 掩码缓存分类(来源:arXiv:2411.15100)
缓存的实际形状是一棵”状态 → 位掩码”的映射树,内存占用随文法状态数量和词表大小线性增长。XGrammar 论文还设计了一种自适应存储格式:在接受占多数的状态里,只存”被拒绝”和”上下文相关”的稀疏集合;在拒绝占多数的状态里,反过来只存”被接受”和”上下文相关”的集合。这样大多数状态的缓存体积远小于 字节。vLLM 在 XgrammarBackend._create_compiler 里把这个缓存的大小上限暴露成 VLLM_XGRAMMAR_CACHE_MB,按 MB 配置;底层 GrammarCompiler(cache_enabled=True, cache_limit_bytes=...)。
这也解释了一个常见困惑:为什么同一个 schema 的第一个请求 TTFT 很高,后续请求却很快?因为第一个请求承担了文法编译与缓存填充的代价,后续请求只要命中同一 schema 的编译缓存、并在运行中命中”状态 → 掩码”缓存,边沿开销就只剩”取行 + 拷贝到 GPU”。
三种后端,三种文法引擎
vLLM 目前支持的几个后端,分别来自三个团队的开源文法引擎:
| 后端 | 底层引擎 | 文法模型 | 特点 |
|---|---|---|---|
| xgrammar | XGrammar(MLC) | 改进的上下文无关文法引擎 | 默认首选,编译快、开销低 |
| guidance | llguidance(Guidance AI) | CFG(Lark 语法),带 token 级快速前进 | 支持 jump-forward 式加速 |
| outlines | outlines-core | Schema → 正则 → DFA | 编译慢但对简单结构稳 |
| lm-format-enforcer | LF Enforcer | 前缀树式 JSON | 已弃用,v0.35 移除 |
对同一个约束,不同后端的结果可能略有不同,比如正则语法:XGrammar 和 Guidance 用 Rust 风格的正则,LM Format Enforcer 用 Python re 语法,“哪些 token 被允许”会因此不同。vLLM 的文档对此有明确警告:切换后端可能改变输出。
请求入口:后端选择与校验
一个请求带着 structured_outputs 参数进来(OpenAI 兼容接口上表现为 response_format、guided_json 之外的新 structured_outputs 字段),SamplingParams 的校验流程要做三件事:选后端、验内容、记下来。
“auto” 的决策链
默认 backend="auto"。这个”auto”不是”随机挑一个”,而是一条有明确优先级的决策链,位于 SamplingParams._validate_structured_outputs:
- 如果请求参数里已经固定了
_backend,且引擎初始化时指定了别的后端,直接报错——一个引擎只支持一个后端,不支持请求级选择。 - Mistral Tekken 分词器 + Lark 语法:走
guidance。原因在注释里写得很清楚:llguidance 从 mistral-common 取 tokenizer,永远不会让一个正则匹配到特殊 token,而 XGrammar 对 Mistral 分词器不声明任何特殊 token,正则里的.可能匹配到[TOOL_CALLS]或[INST]这样的特殊 token。 - 其余情况先试 xgrammar:调用
validate_xgrammar_grammar。若通过,锁定xgrammar。 - 若 XGrammar 校验失败(不支持的 JSON Schema 特性等),进入回退:若 schema 含有 guidance 不支持的特性或分词器是 Mistral 的非 Tekken 版本,回退到
outlines;否则回退到guidance。如果 guidance 也不支持该分词器,报错。 - 标记
_backend_was_auto = True,允许复用的 SamplingParams 在不同请求间保持同一后端。
这里有一个容易忽略的细节:选择结果被写回请求参数对象(self.structured_outputs._backend)。这正是为了”复用 SamplingParams”的情形:同一个参数对象被多个请求拿去用,如果每次都重新选,可能出现同一引擎前后不一致。vLLM 用 _backend_was_auto 标记”这个值是我自动填的,引擎配置是 auto 时允许被覆盖”,否则视作用户显式指定。
内容校验:宁可在前端报 400,也不要在引擎里崩
校验函数在进入引擎前还做了一批”提前拒绝”:
choice为空列表 → 报错。空选择集没有任何合法 token,文法引擎会陷入死锁。grammar是空字符串或全空白 → 报错。json为空字符串 → 报错。json_object = False→ 报错(要么不设这个字段,要么设 True)。- 正则包含 NUL 字节
\x00→ 报错。NUL 在正则里没有意义,而”正则转文法”这条路通常不处理它;提前报错就是干净的 400,而不是”auto 模式悄悄换后端”。 - 深度嵌套的 JSON Schema → 用
check_json_nesting提前拒绝,避免后端在遍历或转换 schema 时递归过深。 - 扩散语言模型直接用结构化输出 → 报错。扩散模型是对整块 canvas 并行去噪,不是从左到右逐 token 采样,文法状态机需要的”下一个 token 从当前状态出发”不成立。
这些规则组合起来体现一个原则:能在前端拦下的错误,绝不留到 engine core。因为 engine core 里的报错意味着一个 worker 进程里的异常,处理起来远比 HTTP 400 贵。
core 里的语法管理器
进入 engine core 后,真正管理语法生命周期的是 StructuredOutputManager,位于 vllm/v1/structured_output/。它是一个引擎级组件,在 EngineCore.__init__ 里构造,然后注入 Scheduler。
为什么是”引擎级”而不是”请求级”
因为有三块共享资源:
- backend 实例:XGrammar 后端持有两个
GrammarCompiler(一个过滤了特殊 token 用于 JSON,一个保留部分特殊 token 用于 structural tag),编译器内部有按 schema 哈希的缓存。多个请求共享同一个编译器,可以命中同一 schema 的编译结果。 - 分词器:后端需要分词器把词表转成 XGrammar 的
TokenizerInfo。 - 位掩码缓冲区:
_grammar_bitmask按max_num_seqs × (1 + num_speculative_tokens)分配,整个引擎复用一块,随批大小不断复用。
引擎级管理器的直接后果是:一个引擎同时只支持一个后端。grammar_init 会检查 request_backend != self.backend_name,一旦发现请求解析到别的后端就抛出 VLLMValidationError。前端的”auto 选后端”和 core 的”一个引擎一个后端”是对齐的——前端已经保证同一引擎内的请求解析到同一后端。如果用户显式配置了不同后端,就必须拆成不同的引擎实例。
grammar_init:编译在输入处理线程里
EngineCore 在 _initialize_kv_caches 之后会起一个输入处理线程,负责把 EngineCoreRequest 变成内部 Request 对象。Request.from_engine_core_request 里判断 request.use_structured_output,如果为真,就调用 structured_output_manager.grammar_init(req)。
这里的线程模型值得说明:语法编译是 CPU 密集的(解析 Schema、构造文法、把每个 token 预映射到文法自动机),放在输入处理线程而不是调度器线程,是为了让编译与 GPU 前向并行。grammar_init 内部的注释写了两点:
- “no race condition”:
grammar_init只在输入处理线程被调用;管理器对每个请求独立,编译是异步执行的; - “Scheduler always checks grammar compilation status before scheduling request”:调度器在调度之前不会直接看编译”完成没”,而是看请求状态是否从
WAITING_FOR_STRUCTURED_OUTPUT_GRAMMAR提升到了WAITING。
异步编译:一个 Future,不是一个锁
grammar_init 有两种路径:
- 异步(默认):
grammar = self.executor.submit(self._create_grammar, request),request.structured_output_request.grammar = grammar(一个Future)。executor是一个ThreadPoolExecutor,线程数取 CPU 核数的一半(注释:“这些任务是 CPU 密集的,不是 I/O 密集的,默认的 CPU×5 太多了”)。 - 同步(
external_launcher模式):直接调用_create_grammar,异常先塞进一个已完成的Future;若调度器检查时发现是Exception,就给这个请求报错。
为什么 external_launcher 要关掉异步?注释给出的理由是:在 external_launcher 模式下每个 TP rank 各有一个调度器,而异步编译会让 WAITING_FOR_STRUCTURED_OUTPUT_GRAMMAR → WAITING 的状态转移在不同 rank 上发生在不同时刻,这就破坏了 external launcher 依赖的确定性假设。
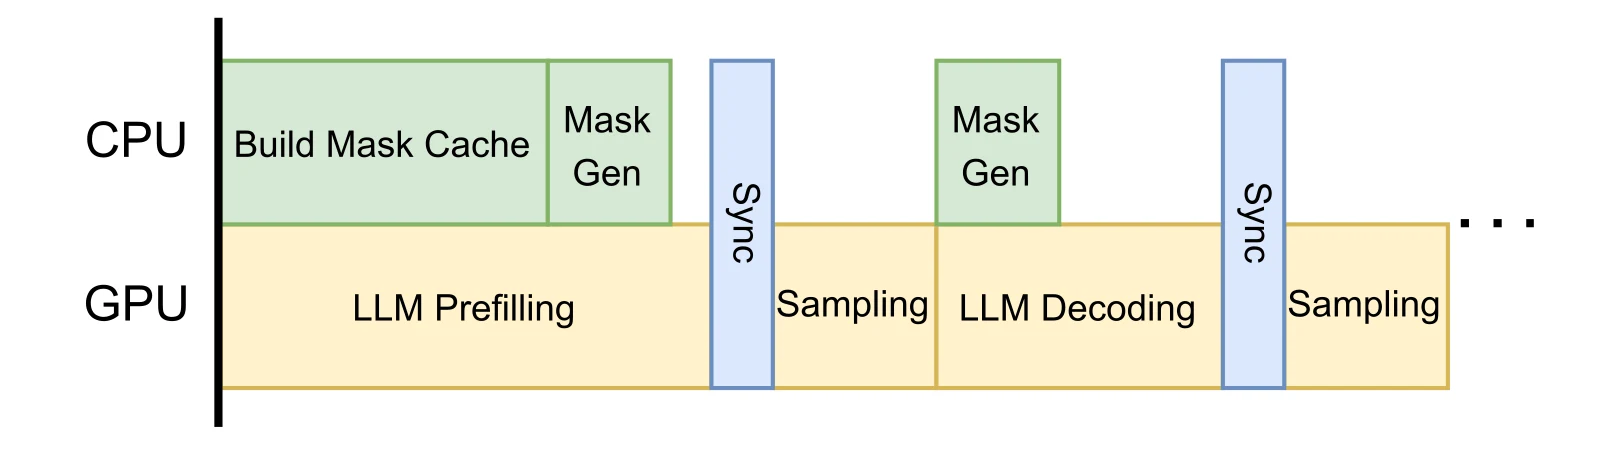
图:文法计算与 GPU 执行的重叠设计(来源:arXiv:2411.15100)
调度器如何”等”语法
Scheduler.schedule() 在遍历等待请求时,会为每个请求调用 _update_waiting_for_remote_kv 一类状态提升函数。WAITING_FOR_STRUCTURED_OUTPUT_GRAMMAR 分支的逻辑非常短:
elif request.status == RequestStatus.WAITING_FOR_STRUCTURED_OUTPUT_GRAMMAR: struct_output_req = request.structured_output_request if not struct_output_req or struct_output_req.grammar is None: return False if isinstance(struct_output_req.grammar, Exception): self.grammar_compile_error_reqs[request.request_id] = RequestError(...) return False request.status = RequestStatus.WAITINGrequest.structured_output_request.grammar 是一个 property,内部调用 _check_grammar_completion():如果 _grammar 是 Future 且 done(),就 result();如果抛出异常,把异常对象本身存进 _grammar。因此调度器看到的 grammar is None 就意味着”还在编译”,isinstance(..., Exception) 意味着”编译失败”。
这种设计的精妙之处在于:每步调度只做一次”是否完成”的检查,不阻塞。批里其他已经就绪的请求照常被调度,未就绪的请求继续留在队列里。编译失败的请求被单独记录在 grammar_compile_error_reqs 里,之后在 update_from_output 阶段作为该请求的 RequestError 上报,只失败这一个请求(code="validation_error"),不影响同批其他请求。
_is_blocked_waiting_status 把三种状态归为”阻塞等待”:等语法、等远程 KV、等流式输入。这类请求不占 KV 块,也不进入批统计。
这里有一笔值得单独算的账:一个”等语法”的请求会保留它已经预填的那部分 KV。_holds_kv_blocks 的注释特意说明,“状态为 WAITING 或 PREEMPTED 但 num_computed_tokens > 0 的请求,同样持有 KV 块”。所以编译慢不会让请求从零开始,但它会让这块 KV 在等待期间一直占用显存,和其他请求争抢页池。当并发很高、语法编译线程又因为 CPU 抢占而变慢时,这种现象会以”显存不够 → 抢占 → 其他请求被打回 WAITING”的方式外溢。这就是为什么 vLLM 把 grammar_init 的线程数限制在 CPU 核数的一半:不是为了省 CPU,而是为了让语法编译不与位掩码填充、输入处理抢同一批核。
编译失败、超时与”毒 grammar”
“编译失败”在推理框架里不是一个可以简单抛出 500 的事件,因为同批还有别的请求在跑,而且失败的 schema 很可能是同一个恶意或错误 schema 被一万个请求重复提交。vLLM 与 SGLang 在这里的处理方向一致、粒度不同:
- vLLM:
Future里存的是异常对象;调度器检查时把它转成该请求的RequestError(code="validation_error"),在update_from_output阶段只失败这一个请求。失败结果不缓存,下一个带同样 schema 的请求会重新编译、重新失败。 - SGLang:
GrammarManager.get_ready_grammar_requests在一个时间窗口内轮询 grammar queue;超时请求被记为 failed,并调用grammar_backend.set_cache(req.grammar_key, InvalidGrammarObject("Grammar preprocessing timed out"))。后续同 key 的请求命中缓存,直接以”失败的 grammar”返回,不再排队编译。这就是”毒 grammar”防护:坏 schema 不会反复拖垮编译线程。
两种做法的取舍很清楚:vLLM 不缓存失败,实现简单,但面对重复恶意 schema 时会反复付出编译代价;SGLang 缓存失败,能挡住重复提交,但需要额外的超时轮询与跨 rank 同步逻辑(all_gather_object 取就绪交集、失败并集,再沿 PP 链传播)。SGLang 还在 get_cached_or_future_value 命中时 copy() 一份 matcher 给新请求,避免多个请求共享同一个可变文法状态;vLLM 则是每个请求各建一个 XgrammarGrammar,底层只共享不可变的 CompiledGrammar 与编译器缓存。前者省一次”从 schema 到 matcher”的构造,后者省掉状态复制的正确性风险。
位掩码的生命周期:从调度器到 GPU
只在”要采样”的请求上生成
位掩码生成不是每步都做。Scheduler.schedule() 在更新调度统计时,维护一个汇总字段:
scheduler_output.has_structured_output_requests |= ( request.use_structured_output and not request.is_prefill_chunk)关键条件是 not request.is_prefill_chunk。为什么预填块不行?因为预填阶段一个请求可能被切成多个 chunk,中间 chunk 的最后一个 token 并不会被采样;预填期间的文法不应该被推进,也不应该生成位掩码。而 is_prefill_chunk 的定义是”已计算的 token 数小于请求总 token 数加输出占位符数”,也就是”还没到要产生输出的那一步”。
get_grammar_bitmask:在调度之后、GPU 执行之前
EngineCore.step 里,schedule() 返回后立刻:
future = self.model_executor.execute_model(scheduler_output, non_block=True)grammar_output = self.scheduler.get_grammar_bitmask(scheduler_output)...model_output = future.result()if model_output is None: model_output = self.model_executor.sample_tokens(grammar_output)这里值得留意执行顺序:GPU 前向先被异步发起,位掩码随后在 CPU 上生成,最后才执行采样。这是把 CPU 上的文法计算和 GPU 上的前向重叠起来的具体形态。XGrammar 论文里讲的”把文法计算与 GPU 执行重叠”,在 vLLM 中变成了这几行代码。
在有异步调度的情况下(is_async_scheduling),还会出现更复杂的情况:pending_structured_output_tokens 为真时,本 step 的采样必须推迟——因为要等上一轮的草稿 token 结果,知道哪些草稿被接受之后,才能生成对应位置的位掩码。这种情况下 deferred_scheduler_output 被保存,等到拿到 take_draft_token_ids 之后,先 update_draft_token_ids_in_output 修正调度输出,再调用 get_grammar_bitmask,最后 sample_tokens。
grammar_bitmask() 内部:批次 × 位移的块状布局
位掩码的实际生成在 StructuredOutputManager.grammar_bitmask()。它的输入是三个东西:
requests:所有请求对象,structured_output_request_ids:本批被调度、且不在预填块中的结构化输出请求 id,顺序由调度器决定,scheduled_spec_decode_tokens:每个请求本步被调度的投机 token。
输出是一个 numpy 的 int32 数组,按”每个请求占一个固定宽度块”的方式排布:
max_num_spec_tokens = self.vllm_config.num_speculative_tokensis_diffusion = self.vllm_config.model_config.is_diffusionmask_stride = max_num_spec_tokens + (0 if is_diffusion else 1)mask_stride 是每个请求的行数。开投机解码时,每个请求需要 行:一行给”当前状态下的下一个 token”,再加 行给 个草稿位置各自的状态。扩散模型没有”bonus token”,所以是 行而不是 行。
整块缓冲区大小是 max_batch_size * mask_stride,但实际返回时只截取前 len(structured_output_request_ids) * mask_stride 行,以 numpy() 返回。返回 numpy 而不是 torch tensor 的原因写在代码里:numpy 的序列化比 tensor 便宜得多,这块数据要经过 IPC 送到 worker 进程。
两种填充路径:串行与并行
位掩码的”填充”(对每个请求、每一行调用后端 fill_bitmask)有两种路径,以 len(structured_output_request_ids) > fill_bitmask_parallel_threshold(默认 128)且 num_spec_tokens == 0 为切换条件:
- 大 batch、无投机:并行路径。按每 16 条请求分一批,提交到
executor_for_fillmask(线程数取min(cpu/2, 8))。每条请求只需要”当前状态”的一行,逻辑简单,天然适合并行。 - 其他情况:串行路径。每条请求内部要按 token 顺序推进文法状态,因为草稿位置的位掩码依赖前一个草稿位置被接受后的文法状态,这是一条链,不适合跨请求并行以外的方式。
我读这段代码时感受到一个设计上的取舍:并行只用在结构最简单的地方。不是”哪里都可以并行就并行”,而是”只有无投机解码、纯解码批的稳态才值得为并行付出额外复杂度”。小批、投机解码、推理模式等场景统一走串行路径,代码路径少、语义明确。
串行路径的核心:一行一行往前推,再滚回去
串行路径的算法用伪代码写出来是:
for req in structured_output_requests: base = 本请求在缓冲区中的起始行 spec = 调度给本请求的投机 token(去掉 -1 填充) grammar_start, constraint_start = _get_constraint_bounds(req, spec)
rows = spec + [bonus] # bonus 是下一行"正常解码"的位掩码 advanced = 0 # 本请求推进多少次文法 blocked = False # 一旦遇到非法或填充,后续全部"全允许"
for i, tok in enumerate(rows): apply = i >= constraint_start fill_row(grammar, base + i, apply, masked_ids if i < constraint_start else ()) if blocked: continue if tok == -1: blocked = True # 投机填充,后面不再推进 elif i >= grammar_start: if grammar.accept_tokens([tok]) and not grammar.is_terminated(): advanced += 1 else: blocked = True # 草稿非法或文法终止,后面不再推进
if advanced > 0: grammar.rollback(advanced) # 状态回到本步开始处这段代码处理了投机解码与文法的四个耦合点:
- 草稿位置的位掩码必须”预演”。给第 个草稿位置生成掩码时,文法已经被前 个草稿推进了几步。这正是”如果前面几个草稿都被接受,第 个位置允许什么”。
- -1 是填充哨兵。N-gram、部分投机后端对未被接受的草稿位置填
-1。strip_speculative_padding把第一个负数及其之后全部切掉,保证文法只看到真实 token。 - 文法一旦终止或拒绝草稿,后续行全部”全允许”,因为后面的草稿是验证器的事——如果验证器接受了某个草稿但文法会拒绝它,说明这个草稿”理论上”不该出现,验证器不会接受它。把位掩码行置为全允许,不会产生额外错误,只是不再依赖文法。
- 最后必须 rollback。位掩码生成是”如果……就……”的预演,不应改变请求的真实文法状态。推进了
advanced步就回滚advanced步。这一步在代码里写作grammar.rollback(state_advancements),出现在grammar_bitmask()末尾。
这也是为什么 XGrammar 后端构造 GrammarMatcher 时传入 max_rollback_tokens=self.num_speculative_tokens:文法引擎只保留最近 步的回滚栈, 就是草稿数。用更小的回滚栈能让 matcher 状态更轻;用更大会浪费内存。这个参数和 vLLM 的投机配置是同一个来源。
推理模式的特殊处理:思考和输出之间的那道闸
推理模型(例如 DeepSeek-R1 系列、Qwen 的 thinking 模式)会先思考、再输出答案。一个自然的需求是:思考阶段不约束,答案阶段才约束。但”思考结束”是由模型自己生成的 token 决定的,这个 token 本身是否合法,也要由文法来判断。
_get_constraint_bounds() 处理的就是这个边界。它返回一个 ConstraintBounds(grammar_start, constraint_start):从 constraint_start 开始的行才真正应用文法;grammar_start 是文法开始”看”token 的位置。两者相等意味着”从这一位起,文法开始起作用”;grammar_start 比 constraint_start 早一位,意味着”有一位 token 既是推理结束标记又是第一个内容 token”(比如工具调用起始 token)——这一位要按内容文法来判断。
默认的无推理请求返回 _CONSTRAINED_FROM_START (0, 0);无投机 token 的推理请求返回 _NO_SPEC_TOKENS (1, 1)——即本步唯一的”下一 token”位置需要由文法判断。
如果文法拒绝某个”隐式推理结束 token”作为第一个内容 token(例如,工具调用起始 token 在 schema 里不能作为开头),这个 token 会被加入 masked_reasoning_end_ids,在推理阶段就被掩码掉。否则采样到它就会直接产生非法输出。这个集合每请求只计算一次(structured_req.masked_reasoning_end_ids 缓存),因为文法在推理结束前不推进,集合是固定的。
GPU 侧:apply_grammar_bitmask
位掩码到了 GPU worker 进程,由 gpu_model_runner 在采样前应用:
if grammar_output is not None: apply_grammar_bitmask(scheduler_output, grammar_output, self.input_batch, logits)sample_output = self._sample(logits, spec_decode_metadata)apply_grammar_bitmask 里最核心的是两件事:对齐和拷贝。
行对齐:位掩码的行 ≠ logits 的行
调度器生成的位掩码行顺序由 num_scheduled_tokens 的顺序决定;而 logits 的行顺序是 input_batch.req_ids。并且投机解码让 logits 的行数不是批大小:每个请求的 logits 行数等于 1 + 该请求被调度的草稿数。所以代码先建立一个映射:
cumulative_offset = 0for batch_index, req_id in enumerate(input_batch.req_ids): logit_index = batch_index + cumulative_offset cumulative_offset += len(spec_tokens.get(req_id, ())) if req_id in struct_out_req_ids: struct_out_req_batch_indices[req_id] = logit_index这行 logit_index = batch_index + cumulative_offset 就是投机解码下”第 个请求的 logits 从哪一行开始”的算法:排在它前面的每个请求,都多贡献了若干草稿行。
然后创建一个形状为 (logits.shape[0], mask_width) 的 int32 张量,初值 -1,把每条结构化请求块(1 + 草稿数 行)拷贝到它对应的位置,其余行保持全允许——非结构化请求的行也在这里得到”干净”的位掩码。这个排序是纯 CPU 循环,但每步只遍历批内的请求数,不遍历词表。
异步拷贝与 index 张量
排序好的张量用 pin_memory=True 分配,然后 sorted_bitmask_tensor.to(logits.device, non_blocking=True) 拷贝到 GPU。再根据”是否需要挑出部分行”决定要不要传 indices:
- 若所有 logits 行都是结构化输出请求(
len(out_indices) == logits.shape[0]),无需 indices,掩码直接对齐; - 否则创建一个
out_indices的 index 张量,用async_tensor_h2d非阻塞上传,供 XGrammar 的apply_token_bitmask_inplace(logits, bitmask, indices=...)只处理这些行。
CPU 路径(例如 CPU 后端的 vLLM)还有一个特例:旧版 XGrammar 的 CPU kernel 要求 float32 logits,代码会把 logits 转成 float32、应用掩码、再转回原 dtype。
这里我注意到一个反复出现的工程原则:凡是能省一次同步的,都省。位掩码整块拷贝是非阻塞的;indices 上传是非阻塞的;甚至 apply_token_bitmask_inplace 本身在 XGrammar 里也是直接在内核里把 logits 的拒绝位置改成 -inf,不需要另一个 kernel 输出结果再拷回。
与投机解码的三处耦合
投机解码改变了”每一步只有一个 token 要被验证”的前提,结构化输出必须在三处适配:
1. 草稿剪枝:trim_spec_tokens
草稿 token 从 draft 模型产生,在验证之前会先进入调度器。对结构化输出请求,Scheduler.update_draft_token_ids 会调用 structured_output_manager.trim_spec_tokens(request, spec_token_ids)。这一步做两件事:
- 去掉
-1填充; - 用
grammar.validate_tokens(...)得到”草稿序列里能被文法接受的最长前缀”,然后保留这个前缀再加一个 token:prefix + spec[grammar_start : grammar_start + len_validated + 1]。
为什么”再多留一个”?因为草稿序列中第一个非法 token 本身仍然要被验证器采样。验证器要对每个草稿位置给出”接受/拒绝”的结果,并在被拒绝的位置采出一个替代 token。这个替代 token 的位置必须也参与文法判断——它的位掩码行由上面的”串行填充”算法生成。如果草稿被剪到只保留合法前缀,那么”第一个非法位置”的 logits 行会被当作”bonus 行”,并处于文法已经推进过所有前序合法草稿后的状态,正好是合法替代 token 的分布。
这就是注释里那句 “Trim structured-output padding and grammar-invalid suffixes” 背后的机制。它不是单纯修剪,而是为了给替代 token 留一个干净的行。
2. update_draft_token_ids_in_output:占位符回填
异步调度下,草稿 token 的 CPU 拷贝发生在下一 step。如果本 step 已经按”草稿数 = N”排好了位掩码和 logits 布局,而实际草稿被文法剪短了(例如只保留了 2 个而不是 4 个),就需要在 update_draft_token_ids_in_output 里把 spec_token_ids 补齐到原来的长度,用 -1 占位,并在 num_invalid_spec_tokens 里记下每个请求的填充数量。这样:
- logits 行数和位掩码行数保持一致;
- 采样器能看到”这里应该是草稿但后来被判定非法”,从而跳过;
- 投机统计里,这些草稿不计入”提出但被拒绝”的计数(
adj_draft_tokens的调整)。
3. 推理阶段的草稿掩码
推理阶段,constraint_start > 0 的那些行需要只掩码”隐式推理结束 token”——即 masked_ids 参数。具体写法在 _fill_bitmasks 里:
self._grammar_bitmask[index].fill_(self._full_mask) # 全允许if masked_ids: row = self._grammar_bitmask[index].numpy().view(np.uint32) for token_id in masked_ids: row[token_id >> 5] &= ~np.uint32(1 << (token_id & 31))(token_id >> 5) 是第几行 int32,(token_id & 31) 是行内第几位。这是标准的位运算操作。masked_reasoning_end_ids 集合通常只有一两个 token,所以这个循环很短。
在 grammar_bitmask() 里,推理阶段的草稿行还面临一个额外的挑战:草稿可能跨越”推理结束”的边界。某条草稿序列可能前几步还在推理、第 步是推理结束、之后都是内容。_get_constraint_bounds(request, spec_tokens) 会在草稿序列上做一次二分回溯:从最后向前逐步弹出,直到推理仍未结束,以此决定 constraint_start,然后每行按 i >= constraint_start 决定是否应用内容文法。这部分逻辑依赖推理解析器(ReasoningParser)提供的 is_reasoning_end_streaming;推理解析器在 vLLM 里是可插拔的,structured_outputs_config.reasoning_parser 指定。
跨 rank 一致性:为什么位掩码必须”处处相同”
在 TP / PP / EP 并行里,同一个请求的状态必须在所有参与计算的 rank 上完全相同,否则可能出现一个 rank 跳过某个 token、另一个 rank 不跳过,导致 logits 分布不一致或通信错位。
位掩码在哪个 rank 生成?在 vLLM 中,Scheduler 只存在于每个 engine core 进程;在 TP 情况下只有一个 engine core(多个 rank 通过 worker 执行),在 DP 情况下每个 DP rank 有自己的 engine core 和调度器。因此 TP/PP 场景下位掩码”只生成一次”,天然一致。真正的问题出现在两个调度器都需要看到的场景:DP attention、external launcher、以及 P/D 分离的 prefill/decode 两端。
external_launcher:同步编译
前面提到的 _use_async_grammar_compilation 是一个明确的一致性开关。开启外部署模式时,每个 TP rank 各有一个调度器,异步编译会造成状态提升的时序差异。vLLM 的处理是:同步编译。这样每个 rank 在收到请求后,编译完才进入调度,所有 rank 的 WAITING_FOR_STRUCTURED_OUTPUT_GRAMMAR → WAITING 转移在同一个时点发生。
DP:位掩码的确定性要求
在 DP 场景下,每个 DP rank 自行编译语法、自行生成位掩码。只要文法引擎是确定性的,结果就一致。SGLang 的 GrammarManager 对此处理得更显式:跨 DP/TP rank 用 all_gather_object 同步”哪些语法就绪、哪些失败”,取 ready 的交集和 failed 的并集,再把结果沿 PP 链逐级传播。这样各 rank 的语法队列状态保持一致,后续调度保持一致。
vLLM 的调度器在 DP 下通过 DPCoordinator 协调批,每个 DP rank 有自己的 StructuredOutputManager;位掩码由各 rank 在自己的 EngineCore.step 里生成。因为编译是同步结果(每个 rank 自己编译),而位掩码基于”已接受 token 的文法状态”,只要各 rank 的 token 序列一致,位掩码就一致。
采样之后的文法推进:accept_tokens
位掩码决定”下一步允许哪些 token”。采样之后,被选中(或被验证器接受)的 token 需要写进文法,让状态往前走。这在 Scheduler.update_from_output 里:
if new_token_ids and not self.structured_output_manager.accept_tokens( request, new_token_ids): logger.error("Unexpected: grammar rejected tokens %s for request %s", ...) request.status = RequestStatus.FINISHED_ERROR request.resumable = False stopped = Trueaccept_tokens 有四个需要注意的点:
- 只对结构化输出请求生效(
use_structured_output检查)。 - 推理阶段的
grammar_start处理:若grammar_start > len(new_token_ids),说明本步还没有到达内容阶段,直接返回 True(不推进文法)。 - 若
grammar_start落在新 token 内,说明本步包含了推理结束 token,先structured_req.reasoning_ended = True把状态锁死,此后所有判断都走”已结束推理”的路径。 - 推进失败是一个”不该发生”的错误。因为位掩码机制保证每个采样出来的 token 都是合法的,验证器接受的草稿也是合法的。
accept_tokens返回 False 只会在后端 bug、或某些边界情形(比如 XGrammar 的override_stop_tokens与文法的交互)下出现。vLLM 的处理是记录错误并终止请求,不恢复。
这里有一个值得单独强调的设计:采样和推进的职责分离。采样器不知道文法,文法管理器不知道采样。两者通过”位掩码 → 采样 → token → 推进”的流水线衔接。这种分离使得更换采样器(惩罚、logit 处理器、水印)不影响文法,也使得更换文法引擎不影响采样。
后端差异:三个引擎的行为对比
vLLM 用统一接口 StructuredOutputGrammar 抽象文法。接口只有很少几个方法:
accept_tokens(request_id, tokens):推进,返回是否全部接受;返回 False 时必须不改变状态。validate_tokens(tokens):不推进,返回可接受的最长前缀。rollback(n):回滚 步。fill_bitmask(bitmask, idx):把当前状态的位掩码写进第idx行。is_terminated():是否到达文法终点。reset():重置。
三个后端对这几个方法的实现,暴露了它们底层的差异:
XGrammarGrammar
accept_tokens 逐个 token matcher.accept_token,如果中途失败,回滚已经接受的数量并返回 False。validate_tokens 用”接受 + 回滚”模拟:逐个接受,遇到失败或终止就停,最后整体 rollback(len(accepted))。fill_bitmask 调用 matcher.fill_next_token_bitmask。is_terminated 是缓存字段 _is_terminated。
XGrammar 的 matcher 是”上下文无关文法引擎 + 持久化栈”,它的 accept_token 对特殊 token 的处理很敏感。vLLM 的 XgrammarBackend 因此维护两个编译器:compiler(从词表里过滤掉所有特殊 token,用于 JSON)和 full_vocab_compiler(保留部分特殊 token,用于 structural tag;Lark 文法也走它)。两份编译器共享 TokenizerInfo 的 metadata,但词表不同。
GuidanceGrammar(llguidance)
accept_tokens 先找 EOS 位置:如果 EOS 出现在中间就返回 False;如果已经终止就返回 True。然后 ll_matcher.try_consume_tokens(tokens),若返回的 token 数不等于输入长度,说明有非法 token,回滚并返回 False。
有一个 rollback_lag 字段很有意思:
if eos_index is not None and num_tokens == eos_index and self.ll_matcher.is_stopped(): self.rollback_lag = 1 self.terminated = Truellguidance 在”接受状态”(is_stopped)时遇到 EOS,会自动消耗 EOS 并终止,但包装层的 EOS 还没有被消耗。rollback_lag = 1 就是为了记录”内部比外部多接受了一个 token”,rollback(n) 时只回滚 n - rollback_lag 步。这是一个典型的”两个状态机对同一个 EOS 的解释不同”的适配层细节。
Guidance 的 validate_tokens 会先 strip_speculative_padding,再调 ll_matcher.validate_tokens(tokens),返回 num_tokens,截取前缀。它的 fill_bitmask 调用 llguidance_torch.fill_next_token_bitmask。
OutlinesGrammar
Outlines 的底层是 outlines_core.Guide,即 JSON Schema → 正则 → DFA。accept_tokens 先找 EOS:若 EOS 在末尾,先检查 guide.accepts_tokens(tokens),再逐个 guide.advance(t),如果遇到了 EOS,还要用 guide.is_finished() 判断是否在终态;在终态接受 EOS 才算成功,否则回滚。
Outlines 的 validate_tokens 有点特殊:逐个 token 检查 guide.accepts_tokens(accepted),但必须在接受每个 token 后判断,因为 accepts_tokens 检查的是”这一串 token 能否被接受”,而且只检查当前路径,不检查”接受之后是否进入死状态”。accept_tokens 里也有一段注释专门讲这个:guide.advance() 除了接受当前 token,还会检查接受后的状态是不是死状态(即无路可走),因此验证时需要在 accept 之后判断。
validate_tokens 里还有一个”EOS 在末尾”的语义:如果 tokens 的最后一个是 EOS,_is_finished_after(accepted) 会检查推入 EOS 前的状态是否已经是终态。这个细节在投机解码里很重要:草稿末位的 EOS 只有在文法已经到达”可以结束”的状态时才合法。
横向对照:草稿阶段的五种文法接入方式
vLLM 的处理是”把文法当作草稿的过滤器”:非法草稿剪掉,保留一个位置让验证器采样替代 token。它的假设是”草稿验证比文法更便宜”,所以让验证器来处理不合法草稿。
但这不是唯一做法。把另外四个框架拉过来对比,会看到同一个”草稿 × 文法”问题被切在了四个不同的工程边界上。
TensorRT-LLM:带草稿的位掩码——文法状态在验证后回滚
TensorRT-LLM 的 GuidedDecoder(tensorrt_llm/_torch/pyexecutor/guided_decoder.py)接口上比 vLLM 多出两个方向:EAGLE-3 与 MTP 草稿生成器都会主动调用它(eagle3.py、mtp.py 中的 add_draft_batch / execute_draft_batch),而不仅仅是验证器侧使用。
它的核心数据结构是 token_mask:主机端 [max_num_sequences * (max_num_draft_tokens + 1), ceil(V/32)] 的 CPU 张量,再配一块 GPU 上的同名张量,bitmask_size = ceil(vocab_size_padded / 32)。_build() 的循环思路与 vLLM 很像——初始化或推进 matcher、fill_next_token_bitmask 填 CPU 行、然后整块拷贝到 GPU——但多了两条 vLLM 没有的规则:
- “没有合法后继”判定:填完一行后调用
_has_valid_token(offset),检查这一行是否允许至少一个 token。若为全 0,说明文法走到了死状态。对主模型请求直接raise ValueError,对草稿请求则置is_draft_terminated并停止后续草稿位置的引导。这一步 vLLM 没有做显式检查,因为 vLLM 的文法状态理论上不允许出现”全非法”。 - 草稿的推进计账:
num_advanced_tokens[slot]记录本次 build 里 matcher 一共推进了几步(包括草稿位置),num_guided_tokens记录本次填了几行,num_advanced_draft_tokens记录草稿循环中总共推进了几步。is_draft_terminated是每请求的草稿状态门。
这两个计数直接对应两个回滚时机,也是 TensorRT-LLM 这套设计最有意思的地方:
def _rollback_rejected_tokens(requests): # 验证之后、下一次草稿循环的第一个 build 之前调用 num_accepted_tokens = 1 + req.num_accepted_draft_tokens num_rollback_tokens = self.num_advanced_tokens[slot] - num_accepted_tokens if num_rollback_tokens < 0: raise ValueError(...) self.grammar_matchers[slot].rollback(num_rollback_tokens)
def _rollback_draft_tokens(requests): # 草稿循环结束后、目标模型的 build 之前调用 self.grammar_matchers[slot].rollback(self.num_advanced_draft_tokens[slot]) self.num_advanced_draft_tokens[slot] = 0 self.is_draft_terminated[slot] = False第一处回滚处理的是”验证器接受的草稿数量少于文法预演推进的步数”:文法在填位掩码时把每条被引导的草稿都推进了,验证后只保留 1 + num_accepted_draft_tokens 步,其余要回滚。第二处回滚处理的是”草稿循环内部的临时推进”:草稿循环里每一步的 execute_draft_batch 都会让 matcher 往前走,但这些草稿尚未经过目标模型验证,所以草稿循环结束时统一回滚掉,把文法状态恢复到”已知的最后一个被验证 token”之后。
add_draft_batch 里还有一个细节:num_accepted_draft_tokens = min(num_accepted_tokens, num_advanced_tokens[slot]) - 1。当启用 overlap scheduler 时,草稿里可能包含 EOS,且 EOS 之后的目标 token 仍被验证器接受。取最小值保证回滚不会超过实际被推进的步数;减 1 是因为 num_accepted_tokens 里包含 bonus token,而 bonus token 正是”下一个正常采样位置”,它尚未被 matcher 推进。
和 vLLM 的”预演 + rollback 一段就完事”相比,TensorRT-LLM 用三本计数账本(advanced / guided / advanced_draft)把”草稿引导”和”目标验证”之间的对账写得很显式。代价是代码里要维护三个时间点的回滚调用:草稿循环结束、验证之后、以及草稿循环内每一步的累积。收益是:草稿端也能用位掩码,而不是让 draft 模型自由发散,再由目标模型拒掉——这在 EAGLE-3 这种”草稿树本就有多分支”的场合尤其重要,因为它减少了无效草稿的验证开销。
llama.cpp:文法在”目标验证”这一侧生效,草稿不推进文法
llama.cpp 的 server 投机解码走 common_sampler 链。grammar 是链上的一个采样器,它在 apply 时把词表里非法的 token 的候选概率清零;文法采样器自己维护一个 llama_grammar 状态机,accept 时把 token 喂进去。
草稿端(draft model 生成)用的是独立的采样器链。common/speculative.cpp 里初始化 draft 采样器时:
params.samplers.assign(1, COMMON_SAMPLER_TYPE_TOP_K);smpl.reset(common_sampler_init(llama_get_model(ctx_dft), params));只有 top-k,没有 grammar。因此草稿模型自由发散,不受文法约束;草稿只负责”快速产生候选”。验证端则用 slot 自己的采样器链(smpl,包含 grammar)对目标模型的 logits 逐位置 common_sampler_sample(smpl, ctx, idxs[i]);如果草稿被接受,则 common_sampler_accept(smpl, draft[i], is_replay_target),其中 is_replay_target 只在 replay 的最后一个目标 token 上为 true。
这一段代码里有一行注释非常准确地概括了设计:
// synthetic draft tokens do not advance grammar or reasoning state// the last replay token is from the target and must advance bothconst bool is_replay_target = is_replay && i + 1 == draft.size();common_sampler_accept(smpl, draft[i], is_replay_target);也就是说,合成草稿被接受时不推进文法状态,因为推进文法状态会让”草稿位置”这个虚拟位置的合法性影响到下一次目标采样;只有目标模型真正产出的 token 才推进。这样,草稿阶段的文法状态始终与”已验证的 token 序列”保持一致,不会出现”草稿被拒,但文法已经走过去了”的回滚问题。llama.cpp 用”晚推进”绕开了 vLLM 和 TensorRT-LLM 都必须面对的 rollback 账。
代价也很直接:草稿阶段不受文法约束,会浪费一部分验证计算在”文法必然拒绝”的草稿上。这与 vLLM 的”预演 + 回滚”是两种不同的代价分配:vLLM 把代价放在 CPU 侧(每步多生成几行掩码、多一次 rollback),换来 GPU 侧验证更干净;llama.cpp 把代价放在 GPU 侧(更多草稿被拒),换 CPU 侧只有一条采样器链。在 llama-server 里,llama_grammar 和投机解码属于两个独立组件,由 server 的批次组装串联。
SGLang:一套完整的 GrammarManager,外加(曾有的)jump-forward
SGLang 的 GrammarManager 与 vLLM 的 StructuredOutputManager 职责相似,但有几个显著差异:
- 缓存复用:
grammar_backend.get_cached_or_future_value(key, ...)以(类型, schema 字符串)为 key 缓存已编译的语法对象;命中后直接copy()一份给新请求,未命中则提交编译并进入grammar_queue。 - 跨 rank 同步:每步开始调度时,PP0 的 DP/TP rank 用
all_gather_object同步”就绪集合”与”失败集合”,取 ready 交集、failed 并集;再沿 PP 链逐级传播。 - 轮询而非 Future 完成检查:
get_ready_grammar_requests在一个时间窗口内轮询 grammar queue,超过SGLANG_GRAMMAR_MAX_POLL_ITERATIONS的超时请求被记为失败,并写入缓存一个InvalidGrammarObject,后续同 key 的请求直接失败而不重复编译(避免”毒 grammar”反复被排队)。 - 重叠能力声明:
batch.spec_algorithm.supports_grammar_overlap(),如果投机算法在verify()里能通过grammar_barrier推进 FSM(与目标前向重叠),则不强制关闭 overlap;否则need_grammar_sync会强制关闭 overlap 以保证文法推进发生在目标前向之后。
jump-forward:SGLang 较早的版本(v0.4.1 及之前)在调度器里有一段 scheduler.py 的 batch.check_for_jump_forward:对每个请求调用 grammar.try_jump_forward(tokenizer),如果 XGrammar 的 find_jump_forward_string() 给出一个确定性的字符串(例如 {"name": " 这类由 schema 唯一决定的前缀),就直接把它塞进 output_ids,然后重新分词,让文法状态跳过这一段。这个机制由 --disable-jump-forward 关闭,并在调度阶段(prepare_for_decode 之前)执行。实现上的关键点是重新分词:跳过的字符串按 token 边界切分,可能和原来的 token 序列交错,所以需要”取公共前缀、回滚文法、再重新接受”——这就是 jump_and_retokenize。
后续版本(v0.4.6 及之后的调度器)里这一段调度器侧的 jump-forward 不再出现在 scheduler.py。BaseGrammarObject 的接口里,try_jump_forward / jump_forward_str_state / jump_and_retokenize 仍然保留;xgrammar_backend.py 里也保留着 try_jump_forward、jump_forward_str_state、jump_and_retokenize 三个实现。这说明相关协议和 XGrammar 侧的能力还在,但何时调用、由谁调用,在不同版本里发生了变化。
jump-forward 的原理值得单独说清楚:文法在某些状态下会”被迫”输出一段确定性的字符串。例如 JSON 里紧跟字段名之后的 ": " 分隔符,在 any_whitespace=False 时由 schema 唯一确定。既然这段字符串是强制的,模型完全没有必要一步一步采样它,直接跳过就行。跳过不但省 token 步数,还让确定性前缀不再消耗模型的”注意力”。
DeepInfer:文法引擎相同,但把”填掩码 + 应用掩码”做成两段可异步的流水
DeepInfer 的结构化输出(deepinfer/structure_output/)底层引擎同样是 XGrammar,接口是 so_args={"schema_type", "schema", ...},支持 regex、json、ebnf 三种(README 与 examples/_structured_output.py 都给出了用法),但它对 vLLM 的两个环节做了不同的工程化:
1. 文法构建从调度路径里彻底移出,做成未来的 matcher 池。 SOMatcherBuilder 用一个 ThreadPoolExecutor(可选 CPU 亲和绑定)持有唯一的 XGrammarCompiler(num_threads=2、可选缓存),build(so_args, replay_tokens) 返回一个 XGrammarMatcherFuture;调用方只 submit / pump 两个方法,worker 线程只填 future,不能碰调度逻辑。这与 vLLM 的 grammar_init + executor.submit 目标一致,但把”构建 matcher + 回放 replay tokens + 产出可用 matcher”打包成一个可轮询对象,超时/释放都会转成 aborted_matcher,而不是抛异常——这样调度器不需要处理异常类型,只需要看 is_aborted()。
2. 位掩码的应用内核自带”步”语义。 deepinfer/model_executor/layers/tilelang_ops/structure_output.py 里的 apply_token_bitmask_by_step_inplace(logits, bitmask, indices, ftp, step) 用 TileLang 写。它的参数说明里有两个 vLLM 没有的概念:
ftp(first packed row):[num_requests]的 int32,记录每个请求在 logits 中的首行;step:每个请求要应用的掩码行相对首行的偏移。
把这两个参数组合起来,“第 个请求的第 个位置”就落在 logits[ftp[j] + step] 上,对应 bitmask[j]。ftp 为 None 时退化为”indices 直接寻址 logits 与掩码行”。参考实现的注释写得很清楚:logits_end = int(ftp[request_idx + 1]),“如果下一个请求还没填,一直应用到末尾”。这比 vLLM 的”把掩码重排到与 logits 对齐”少一次主机侧重排,直接用 GPU 侧的偏移寻址;代价是 kernel 需要两个额外的索引张量,并且要求调用方自己维护 ftp。
3. Trigger 与 bound:约束不必从第一个 token 开始。 XGrammarMatcher 支持 trigger_tokens(触发 token 序列,用 KMP 自动机线性扫描)和 bound_token_id(约束边界 token)。在触发之前,matcher 处于”未约束”状态,只记录 trigger 的匹配进度;_progress_history 保留最近 MAX_ROLLBACK_TOKENS 步的进度,使得草稿失败回滚时 trigger 的匹配状态也能回滚。这是 vLLM 的 ConstraintBounds(推理结束位置)的泛化版本:vLLM 只针对”推理结束”这一个 token 做闸,DeepInfer 用一条可回滚的 KMP 序列来定义边界,适用于工具调用、结构化前缀出现在任意位置的情形。rollback 里还要单独扣减 tokens_after_eos 与 tokens_in_matcher 两本账,因为 EOS 后 matcher 可能已经停止(EOS 之前的 token 在 matcher 里,EOS 之后的在包装层的 mask_after_eos 里)。
简而言之:vLLM 把复杂度放在调度器侧(单后端、异步编译、草稿行对齐),DeepInfer 把复杂度放在 matcher 的生命周期侧(future、trigger、回滚账)与内核侧(带 step 的掩码应用)。两者的文法引擎相同,但”文法状态在哪一层被持有”给出了不同的工程答案。
后端切换时要注意什么
读完几套实现之后,我把”实际使用时容易踩的坑”总结成几条:
- 一个引擎一个后端。
StructuredOutputManager.grammar_init会拒绝解析到不同后端的请求;如果确实需要不同后端,必须拆成不同引擎。前端的”auto”和 core 的这一限制是配套的。 - 分词器状态必须与服务端一致。
skip_tokenizer_init打开时不能使用结构化输出(需要在 CPU 上分词),SamplingParams校验会直接报错。 - 语法编译是 CPU 密集的,线程池不要开太大。vLLM 把
grammar_init的线程数限制在 CPU 核数的一半,理由是这些任务是 CPU 密集的,和 I/O 密集的默认假设不同。语法编译线程过载会和输入处理线程、位掩码填充线程争 CPU,直接拉高 TTFT。 - “先推理、后约束”需要显式配置推理解析器。没有
reasoning_parser时,结构化输出会从第一个 token 就开始约束,推理内容也会被文法绑住,模型会”想不出”东西来。 - 投机解码的草稿数要和文法回滚栈对齐。XGrammar 的
max_rollback_tokens来自投机配置;如果草稿数大于回滚能力,rollback会抛异常。vLLM 用的是同一个配置,所以正常不会出问题;如果手工改过其中一处,就需要同步。 - jump-forward 不总是收益。确定性前缀跳过之后,位置编码、注意力掩码、缓存都需要”跳”一段;对于长前缀,省的是模型步数;对于短前缀,重分词的开销可能超过收益。历史上 SGLang 用
--disable-jump-forward来控制,就是因为部分模型/分词器组合下并不划算。
一句话说清楚”零开销”是什么意思
论文与博客在宣传结构化输出时常说”near-zero overhead”,读源码后需要拆开来理解。它至少包含四层:
- 编译零阻塞:语法编译不在调度关键路径上,
grammar_init放到输入处理线程,调度器只做一次Future.done()检查;SGLang、DeepInfer 同样把构建移出调度路径。 - 位掩码生成可重叠:CPU 生成、GPU 前向、GPU 采样三者在不同流上重叠(XGrammar 论文的 Figure 8,也就是 vLLM 中
execute_model先异步发起、再get_grammar_bitmask的那几行)。 - 位掩码应用是”原地”的:
apply_token_bitmask_inplace把被拒绝的 logit 直接设为-inf,不需要额外 kernel 输出结果再拷回。 - 草稿预演让投机命中率下降有限:草稿按文法预演,非法部分被提前剪掉或标为终止,验证器不需要为”文法必然拒绝”的草稿浪费验证步。
这四层分别对应四个不同的失败点:第 1 层失败会导致 TTFT 抖动,第 2 层失败会让 TPOT 回到”文法计算串行在前向前面”的老状态,第 3 层失败会多出一次内存往返,第 4 层失败会让投机解码的优势在结构化输出请求上几乎归零。生产环境里如果用 per-request metrics 看到”结构化输出请求的 decode 速度比非结构化请求低得离谱”,基本可以先从第 2、4 层查起。
小结
约束解码在推理框架里不是一个”加个插件”就能完成的功能。它把三样东西耦合在一起:
- 文法引擎:CPU 上判断 token 合法性,XGrammar、Guidance、Outlines 三个引擎各有擅长的语法和不同的性能特征;
- 调度器:决定哪些请求要位掩码、在什么时点生成、如何与投机解码的草稿布局对齐;
- GPU 侧采样器:把位掩码落到 logits 上,并且要和 index 张量的异步上传、投机解码的多行布局对齐。
vLLM 的工程思路,我把它概括成三点:
- 异步优先,非阻塞等待:语法编译放输入处理线程,调度器只做”完成没”的判断,不阻塞;
- 一引擎一后端:编译器和分词器都是重资源,共享它们意味着只能有一个后端;前端的 auto 选择必须与之配套;
- 把文法当作草稿的过滤器而不是验证器:非法草稿被剪到合法前缀 + 一个替代位置,验证器只处理合法草稿;代价是每步需要”预演推进 + 回滚”的位掩码生成。
而 SGLang 在早期版本里选了另一条路:让文法替模型跳过确定性的前缀(jump-forward),这在 schema 结构性强、确定性前缀长的场景里非常划算,但在重分词和长前缀的场景里需要仔细权衡。TensorRT-LLM 把位掩码推进到草稿循环内部,让草稿模型也受文法约束,再用三本推进账在验证后回滚;llama.cpp 让文法只在目标验证侧生效,草稿端用独立的 top-k 采样器,靠”晚推进”绕开回滚;DeepInfer 则把 matcher 构建做成可轮询的 future,把掩码应用做成带 step 偏移的 TileLang 内核。五种实现,五个不同的”代价放在哪一层”的答案。
下一篇将讨论 vLLM 的 GuidedDecoding 扩展语法与多约束组合,以及这些文法引擎在 schema 与 tokenizer 版本变化下的缓存失效策略(VLLM_XGRAMMAR_CACHE_MB、LLGuidance 的 serialize_guidance_grammar 缓存键、以及 Outlines 的 disk cache),把”同一个 schema 被一万个请求请求到”这件事的缓存账算清楚。
参考资料
- vLLM 源码:
vllm/v1/structured_output/__init__.py、backend_types.py、backend_xgrammar.py、backend_guidance.py、backend_outlines.py、utils.py;vllm/v1/core/sched/scheduler.py、vllm/v1/worker/gpu_model_runner.py、vllm/v1/engine/core.py、vllm/sampling_params.py、vllm/config/structured_outputs.py(vLLM 项目主分支) - vLLM 文档:Structured Outputs,https://docs.vllm.ai/en/latest/features/structured_outputs.html
- Dong et al., XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models, arXiv:2411.15100,https://arxiv.org/abs/2411.15100
- Geng et al., Generating Structured Outputs from Language Models: Benchmark and Studies, arXiv:2501.10868,https://arxiv.org/abs/2501.10868
- Guidance AI / llguidance:https://github.com/guidance-ai/llguidance
- Outlines,https://github.com/dottxt-ai/outlines;outlines-core,https://github.com/dottxt-ai/outlines-core
- SGLang 源码:
python/sglang/srt/constrained/xgrammar_backend.py、grammar_manager.py、base_grammar_backend.py;v0.4.1 分支的scheduler.py与schedule_batch.py(jump-forward 相关) - TensorRT-LLM 源码:
tensorrt_llm/_torch/pyexecutor/guided_decoder.py、tensorrt_llm/_torch/speculative/eagle3.py、mtp.py - llama.cpp 源码:
common/sampling*与tools/server中 grammar 与投机解码的衔接 - 站内延伸:CUDA Graph 的桶与垫:五个推理框架如何把动态解码批塞进静态图、GLM-5.3 推理全链路(十四):MTP 的三段前向——草稿、验证与 draft_extend 的算子与通信账、DeepInfer 源码拆解(三十八):采样内核的微观账——基数筛选、两级定点采样与残差并行的 TileLang 实现、SGLang 源码完全拆解(二十四):可观测性
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



