


llama.cpp 源码完全拆解(六):图构建与注意力——llama-graph 如何把模型结构翻译成 ggml 图
引言:谁把”一层 Transformer”翻译成了算子序列
读过任何一份推理框架源码的人都会经过同一个困惑时刻:模型权重已经装在显存里了、KV 缓存也已经分配好了、调度器也知道这一批要算哪些 token 了——可是这些信息并不会自动变成 GPU 上的计算。中间必然有一步,把「模型结构 + 这一批数据 + 运行参数」翻译成一串具体的算子调用。这一步叫建图(graph construction),在 llama.cpp 里由 src/llama-graph.cpp(4265 行)与 src/llama-graph.h(1463 行)承担。
它在整个引擎里的位置,可以用一张简化的数据流来看:
llama_decode(llama_context) │ ├── 批处理构建 llama-batch.cpp 把 token 组织成 ubatch ├── 记忆更新 llama-kv-cache.cpp 分配 KV 槽位、算 k_idxs ├── 【建图】 llama-graph.cpp 模型结构 → ggml 算子序列 ← 本篇 ├── 图分配与切分 ggml-backend.cpp gallocr 内存规划 + 多后端切图 ├── 图执行 ggml-backend sched 逐个节点 dispatch 到设备 └── 输出回传 llama-context.cpp logits / embedding 拷出值得先建立一个直觉:建图不是”跑模型”,它只是”把要跑的东西写下来”。整个 llama-graph.cpp 里几乎没有一次真正的数值计算——所有 ggml_mul_mat、ggml_soft_max、ggml_rope_ext 调用都只是在图上记录一个节点。真正的计算发生在后面 ggml_backend_sched_graph_compute 的时候。之所以要这样两段式,第(二)篇已经讲过答案:只有先把整张图写下来,才可能做内存复用规划、多后端切分、图复用这些优化。
这一篇要回答的就是「怎么写下来」这件事,以及围绕它的一整套工程约束:
- 模型结构的描述信息(层数、头数、RoPE 参数……)怎么被组织成一个「建图参数包」?
- 把所有模型架构共用逻辑收拢起来的
llm_graph_context提供了哪些构件? - 具体的模型(以 Llama 与 DeepSeek 为例)写出来的建图代码是什么样?注意力与 MoE 这两块最复杂的部分怎么落到 ggml 算子上?
- 建完的图凭什么可以被复用?形状一变就得重建,边界在哪里?
前置回顾:前五篇讲到了哪里
这个系列到目前走过了五篇,每篇解决一个层次的问题,读第六篇之前先把它们串一遍:
- 第(一)篇 整体架构与模块全景:把 llama.cpp 的仓库地形摸了一遍。核心结论是
ggml/是一个自包含的张量库,src/是引擎层,tools/是应用层;引擎层里llama_model持有只读的东西(超参、词表、权重),llama_context持有可变的东西(调度器、记忆、输出缓冲)。 - 第(二)篇 ggml 计算图与内存分配器:讲清了「惰性张量」到底是什么——张量是图上的节点而不是数据持有者。
ggml_build_forward_expand把节点挂进ggml_cgraph,ggml-alloc.c用两条生命周期(ggml_new_graph_custom的图生命周期与ggml_gallocr的分配生命周期)为中间结果复用内存。 - 第(三)篇 GGUF 装载、mmap 与张量放置:一个
.gguf文件如何变成设备上的权重,-ngl/-ot/--split-mode如何决定张量落在哪个 backend 的哪个 buffer type。 - 第(四)篇 llama_context 与记忆系统:
llama_memory_i抽象了「KV 缓存」与「循环状态」两类记忆,slot_info与seq_rm/seq_cp/seq_keep/seq_add/seq_div支撑多序列批处理,KV 缓存可以量化存储。 - 第(五)篇 采样管线与语法约束:logits 如何经采样器链变成 token。
把这五篇连起来看,会发现中间缺了一环:第二篇讲的是 ggml 这个「通用图库」怎么工作,第三、四篇讲的是权重和 KV 缓存在哪、怎么记,第五篇讲的是图跑完之后的事。可是——「Llama 的一层 Transformer 到底长什么样、是谁把它写成 ggml 的算子序列的」这个问题,一直没正面回答。 第(一)篇只给了一个名字:llama-graph,说它是「模型结构与 ggml 图之间的中间层」。
这一篇就补这一环,把第(一)篇地图上的「计算图构建」格子真正填满,也为后面「后端与 kernel」那一篇铺好路——因为 kernel 优化针对的正是这一篇构建出来的那些 ggml 节点。
llm_graph_params:一次建图的输入契约
先看建图的输入。llama.cpp 把「建一张图需要知道的一切」打包成一个结构体 llm_graph_params,定义在 src/llama-graph.h 里。这个设计的关键在于:建图函数不再是某个模型对象的成员函数,而是一个只依赖参数包的纯过程。模型架构知道自己该怎么建图(通过 llama_arch 分派),但建图过程本身不需要回头去摸 llama_model 或 llama_context 的成员。
参数包里的五类信息
llm_graph_params 的字段可以分成五类,每一类解决一个不同的问题。
第一类:模型规模与超参。 arch(架构枚举,如 LLM_ARCH_LLAMA、LLM_ARCH_DEEPSEEK2)、hparams(llama_hparams,层数、头数、KV 头数、RoPE 类型、归一化 epsilon、专家数等)、cparams(llama_cparams,运行时参数:上下文长度、RoPE 频率缩放、YaRN 参数、池化类型等)。注意 hparams 和 cparams 是按值复制进来的,不是指针——原因在 llm_graph_params 的注释里写得很清楚:图要被复用时,输入必须自己带着这些参数,否则会指向上一批已经释放的 llm_graph_params,造成 stack-use-after-return。这是一个典型的「为了复用而放弃引用」的工程决策。
第二类:这一批数据。 llama_ubatch ubatch——注意注释写着 // note: intentionally make a copy,同样是按值复制。ubatch 描述这一批 token:有多少 token、有多少序列、每个 token 属于哪些序列、哪些 token 需要输出 logits、token id 还是原始 embedding。它是建图时唯一会「逐次变化」的模型无关信息。
第三类:图的类型。 llm_graph_type gtype,枚举值区分这一次建图是为了什么:预填充、解码、预填充后紧接着解码(LLM_GRAPH_TYPE_PREFILL / LLM_GRAPH_TYPE_DECODER / LLM_GRAPH_TYPE_DECODER_MTP),还是纯粹的嵌入计算或池化。为什么要区分?因为同一个模型在不同场景下会建出结构不同的图——比如嵌入模型(BERT 类)走的是池化路径,而生成模型走的是 logits 路径;再比如 MTP(多 token 预测)需要在解码图中额外接一个 nextn 层。用 gtype 在入口处分流,比在每个模型文件里写一堆 if 要干净。
第四类:外部依赖的句柄。 这些是「建图需要用到、但不属于模型结构本身」的东西:
ggml_backend_sched_t sched——ggml 的后端调度器,负责把一张图切到多个设备上。建图时每一次ggml_build_forward_expand都是挂到这个调度器所管辖的图里。ggml_backend_t backend_cpu——CPU 后端。注释里有一句很诚实的话:// TODO: needed by build_attn_mha, figure out a way to remove?,说明目前的实现里注意力建图还硬依赖 CPU 后端做某些事情(历史遗留),这是一个尚未清理干净的耦合点。const llama_adapter_cvec * cvec与const llama_adapter_loras * loras——控制向量与 LoRA 适配器。它们让建图时能在权重上「临时叠加」一个低秩修正。const llama_memory_context_i * mctx——这一批对应的记忆上下文。这是注意力建图的关键输入,因为它提供「K/V 视图」与「KV 位置索引」。const llama_cross * cross——编码器-解码器架构(如 T5)的编码器输出。const llama_moe_cache * moe_cache——MoE 专家缓存(这一篇会讲)。const llama_prec_policy * prec_policy——精度策略,用于混合精度的算子选择。const llama_hadamard * hdmd——Hadamard 旋转相关的权重折叠信息,用于某些量化/压缩模型的等价变换。
第五类:输出与回调。 n_outputs(需要输出 logits 的 token 数)、llm_graph_cb cb(建图过程中的回调,供调试和 profiler 使用)、llm_graph_result * res(建图结果对象,图的容器),以及 std::map<llama_seq_id, llama_sampler *> samplers——这一项只有在「采样进图」(把采样步骤也编译进计算图,避免 logits 拷回 CPU)时才非空。
为什么要有 allow_reuse
参数包里最值得单独拿出来讲的是 allow_reuse 方法。它的作用是:判断「用另一组参数建出来的图,是否与当前这组参数建出来的图拓扑完全相同」。如果拓扑相同,就可以直接重用上一批的图,跳过整个建图过程。
它不是简单比较指针或批大小,而是逐项检查:
bool allow_reuse(const llm_graph_params & other) const { // 先检查 ubatch bool can_reuse_ubatch = ubatch.equal_seqs() == other.ubatch.equal_seqs() && ubatch.n_tokens == other.ubatch.n_tokens && ubatch.n_seq_tokens == other.ubatch.n_seq_tokens && ubatch.n_seqs == other.ubatch.n_seqs && ubatch.n_seqs_unq == other.ubatch.n_seqs_unq && ubatch.is_mixed() == other.ubatch.is_mixed() && ( /* token/embd 二选一,且不能一边有一边无 */ (!ubatch.token && !other.ubatch.token) || (!ubatch.embd && !other.ubatch.embd) || (ubatch.token && other.ubatch.token && ubatch.embd && other.ubatch.embd) ) && (!ubatch.embd_state == !other.ubatch.embd_state); ...}几个判据值得逐条解释:
n_tokens相同:直接决定所有激活张量的形状。equal_seqs()相同:这关系到注意力流的组织方式。equal_seqs是 llama.cpp 对「一批里每条序列长度完全相等」这种特殊情况的快速路径(典型场景是纯解码批处理,每条序列都只贡献 1 个 token)。如果这一批和上一批一个走equal_seqs一个不走,注意力算子的输入形状会不同。- 当
equal_seqs为真时,还要逐个比对序列 id:因为每条序列会形成一条独立的 attention stream,序列集合不同,attention mask 的维度就不同。代码里还专门处理了!ubatch.data的边界:如果这批数据不归自己持有,就无法保证它还有效,于是保守地判定不可复用。 token/embd的互斥检查:一个 ubatch 要么带 token id 要么带原始 embedding,两批必须同类。n_outputs相同:决定最后要裁剪出多少行 logits,影响inp_out_ids与尾部的图结构。samplers相同且samplers.size() > 0时,还要比对每个 token 的output标志与seq_id[0]——因为采样进图时,图上会接采样算子,采样器集合不同结构就不同。- 最后是一长串
cparams的比较(embeddings、pooling_type、RoPE 参数、nextn_layer_offset等)。
这个方法的工程含义是:llama.cpp 把「图能不能复用」这个问题转化成了一次廉价的字段比较。如果复用,省下的是整个建图过程(几十次 ggml_* 调用与张量创建),最典型的收益是在高并发解码场景——每条序列每步只生成一个 token,形状长期稳定,图可以长时间复用。
llm_graph_context:构件库与建图上下文
参数包准备好了,接下来是「谁拿着参数包建图」。答案是一个叫 llm_graph_context 的结构体(src/llama-graph.h:1015)。理解它,就理解了 llama.cpp 建图设计的核心取舍。
它为什么叫「context」而不是「builder」
llm_graph_context 的构造函数做的事情很朴素:把参数包里的字段展开成一批 const 成员,然后两个指针就从结果对象里取出来:
llm_graph_context::llm_graph_context(const llm_graph_params & params) : arch (params.arch), hparams (params.hparams), cparams (params.cparams), ubatch (params.ubatch), n_embd (hparams.n_embd), n_layer (hparams.n_layer()), n_layer_nextn (hparams.n_layer_nextn), n_rot (hparams.n_rot()), n_ctx (cparams.n_ctx), n_head (hparams.n_head()), n_head_kv (hparams.n_head_kv()), n_embd_head_k (hparams.n_embd_head_k()), n_embd_k_gqa (hparams.n_embd_k_gqa()), n_embd_head_v (hparams.n_embd_head_v()), n_embd_v_gqa (hparams.n_embd_v_gqa()), n_expert (hparams.n_expert), n_expert_used (cparams.warmup ? hparams.n_expert : hparams.n_expert_used()), ... n_tokens (ubatch.n_tokens), n_outputs (params.n_outputs), ... res (params.res), ctx0 (res->get_ctx()), gf (res->get_gf()) { res->set_params(params); }两个细节值得停下来看。
第一,n_expert_used 有个 warmup 分支:cparams.warmup ? hparams.n_expert : hparams.n_expert_used()。意思是「预热阶段所有专家都参与」。为什么?因为 llama.cpp 在启动预热(warmup)时希望把所有专家路径的 kernel 都编译/加载一遍,如果只走 Top-K 选中的少数专家,其余专家的 kernel 在第一次真正用到时才会被 CUDA 模块加载,造成首请求抖动。让 n_expert_used == n_expert 就能让预热图覆盖全部专家。这是一个「把冷启动成本前置」的决策。
第二,ctx0 与 gf 不是新建的,而是从 res 里取的:ctx0 = res->get_ctx(),gf = res->get_gf()。这说明图容器(llm_graph_result)的生命周期比建图上下文更长——图复用成立的前提正是如此:上一批建好的 gf 与它驻留的 ctx_compute 必须活到下一批,下一批如果判定可复用,就直接跳过建图、只更新输入张量的值(set_inputs)。
所谓「context」,指的是它是一组共享的建图环境:一个内存上下文(ggml_context * ctx0,所有张量从这里分配元数据)、一张图(ggml_cgraph * gf,所有节点挂在这里)、一份只读的模型规模快照、一份本批数据快照。所有 build_* 方法都在这套环境里「往里加节点」。
构件库:一次建图能用的全部积木
llm_graph_context 的公开方法就是建图构件库。按职责可以分成四组,我把 llama-graph.h 里声明的全部构件按组列出来。
A. 通用算子构件(跨架构共用)
| 构件 | 作用 | 关键点 |
|---|---|---|
build_lora_mm(w, cur) | 带 LoRA 的矩阵乘 | 先算 w @ cur,再把每个 LoRA 的 B @ (A @ cur) 按 scale 加上去 |
build_lora_mm_id(w, w_s, cur, ids) | 带 LoRA 的「按行路由矩阵乘」 | 给 MoE 用:每个 token 按自己的专家 id 取权重 |
build_norm(cur, mw, mb, type, il) | 归一化 | LLM_NORM/LLM_NORM_RMS/LLM_NORM_GROUP 三选一,再乘 mw、加 mb |
build_ffn(...) | 前馈网络(稠密) | up/gate/down 三层 + 激活 + 门控类型 |
build_moe_ffn(...) | 前馈网络(MoE) | 路由、Top-K、专家矩阵乘、加权求和 |
build_cvec(cur, il) | 控制向量 | 在指定层上叠加一个控制向量 |
build_hadamard_input(w, cur) | Hadamard 折叠权重的输入侧变换 | 特定压缩模型需要 |
build_moe_cache_slots(...) | MoE 缓存槽位 | 从缓存读专家权重时用 |
B. 输入构件(往图里插「待填充」的输入张量)
build_inp_embd、build_inp_pos、build_inp_attn_scale、build_inp_out_ids、build_inp_mean、build_inp_cls、build_inp_cross_embd、build_inp_pos_bucket_enc、build_inp_pos_bucket_dec。这些方法的命名规律是 build_inp_xxx,它们的公共模式是:新建一个张量 → cb() 打点 → ggml_set_input() 标记为输入 → 登记到 res 的输入列表 → 返回张量。
C. 注意力构件
build_attn_mha(底层 MHA 构造)与 8 个 build_attn 重载(分别对应「无缓存」「KV 缓存」「仅 K 缓存」「DSA 稀疏」「iSWA 混合记忆」等组合),以及配套的 build_attn_inp_no_cache、build_attn_inp_kv、build_attn_inp_k。
D. 输出构件
build_pooling(嵌入模型的池化)、build_logits、build_sampling(采样进图)、build_dense_out(nextn 稠密输出头)、build_rs(循环状态,Mamba/RWKV 类)。
这份构件库的存在,是 llama.cpp 能支持一百多个模型架构的直接原因。我在 src/models/ 里数了一下,.cpp 文件超过 140 个。新加一个架构,大部分工作是「选构件、排顺序、连起来」,而不是重写算子。
建图的公共节奏
所有架构的建图函数都遵循同一套节奏,写出来大致是:
1. 取权重指针(从 layer 结构体中按名字取到对应张量)2. build_inp_embd() 得到 inpL(token → hidden state)3. build_inp_pos() 得到位置张量(RoPE 用)4. for il in 0..n_layer-1: a. 可选:控制向量 / 层输入采集 b. 注意力子层:norm → q/k/v 投影 → RoPE → 写 KV → 注意力 → 输出投影 → 残差 c. FFN 子层:norm → (稠密 FFN | MoE FFN) → 残差5. 输出侧:norm → build_logits() 或 build_pooling()这套节奏本身不是 llama.cpp 发明的——它就是 Transformer 的结构。llama.cpp 的价值在于把它参数化了:每一层的差异被收拢成「层权重指针 + hparams 字段」,而建图代码本身是数据驱动的循环。
llm_graph_result:图的容器与复用的载体
构件往哪里挂?答案是 llm_graph_result(src/llama-graph.h:1379 附近)。它是一张图的「外壳」,持有:
buf_compute_meta:一块按max_nodes预算出来的元数据缓冲。注意reset()里这段:
buf_compute_meta.resize(ggml_tensor_overhead()*max_nodes + ggml_graph_overhead_custom(max_nodes, false));ggml_init_params params = { /*.mem_size =*/ buf_compute_meta.size(), /*.mem_buffer =*/ buf_compute_meta.data(), /*.no_alloc =*/ true,};ctx_compute.reset(ggml_init(params));gf = ggml_new_graph_custom(ctx_compute.get(), max_nodes, false);no_alloc = true 是第二篇讲过的关键设定:这个 context 只分配张量的元数据(形状、类型、步长),不分配实际数据。数据由 ggml_gallocr 在调度阶段统一规划。max_nodes 是一个预先算好的节点数上界——因为 no_alloc 上下文的内存是静态这块 buffer,节点数超了就会崩,所以必须提前预算。
inputs:一个llm_graph_input_i的数组,就是这一篇后面要重点讲的「图输入」。fused_nodes:被融合的节点列表,用于把多个算子合并成一个(减少 kernel 启动)。hdmd_inputs:Hadamard 变换的输入缓存,避免同一对(cur, rot)重复变换。- 一组输出张量指针:
t_inp_tokens、t_inp_embd、t_logits、t_embd、t_embd_pooled、t_h_nextn、t_layer_inp[]、t_sampled[]、t_candidates[]。 params:上一批的参数包副本——复用判断就靠它。
set_outputs 做的事情是把上面这些指针逐个 ggml_set_output,告诉 ggml「这些张量的数据必须留在可访问的缓冲区里,不能被内存规划复用掉」。这对应第二篇讲的分配器语义。
复用判断的聚合
真正的复用入口是 llm_graph_result::can_reuse:
bool llm_graph_result::can_reuse(const llm_graph_params & params) { if (!this->params.allow_reuse(params)) { if (debug > 1) { LLAMA_LOG_DEBUG("%s: cannot reuse graph due to incompatible graph parameters\n", __func__); } return false; } bool res = true; for (auto & input : inputs) { const bool cur = input->can_reuse(params); res = res && cur; } return res;}这里是两级判断:先看参数包(allow_reuse),再看每一个图输入自己的 can_reuse。为什么需要第二级?因为有些输入张量的形状不仅取决于 ubatch 的字段,还取决于记忆上下文的状态。最典型的是注意力的 KV 索引张量——它的形状是 [n_batch](没问题),但内容与「这批 token 落在 KV 缓存的哪些物理位置」有关;而 kq_mask 的形状却依赖 n_kv(KV 缓存里已经有多少个位置),这个值会随批次变化。所以 llm_graph_input_attn_kv::can_reuse 必须自己判断:如果我这一批看到的 n_kv 和上一批不同,掩码张量的形状就不同,图不能复用。
看 llm_graph_input_attn_kv 里的注释,能读到另一个设计动机:
// note: these have to be copies because in order to be able to reuse a graph, its inputs// need to carry these parameters with them. otherwise, they can point to freed// llm_graph_params from a previous batch, causing stack-use-after-returnconst llama_hparams hparams;const llama_cparams cparams;const llama_kv_cache_context * mctx;「为了能复用图,输入必须自己带着这些参数」,所以 hparams/cparams 又一次按值复制进输入对象。整个 llm_graph 子系统里到处是这种「复制换生命周期安全」的写法,它们都是同一个约束的产物:图的寿命可能远长于建图时那一批的参数对象。
从 token 到 hidden state:嵌入、位置与输出裁剪
现在进入具体构件。这一节讲三个「入口侧」的输入构件,它们是每一张图的开头。
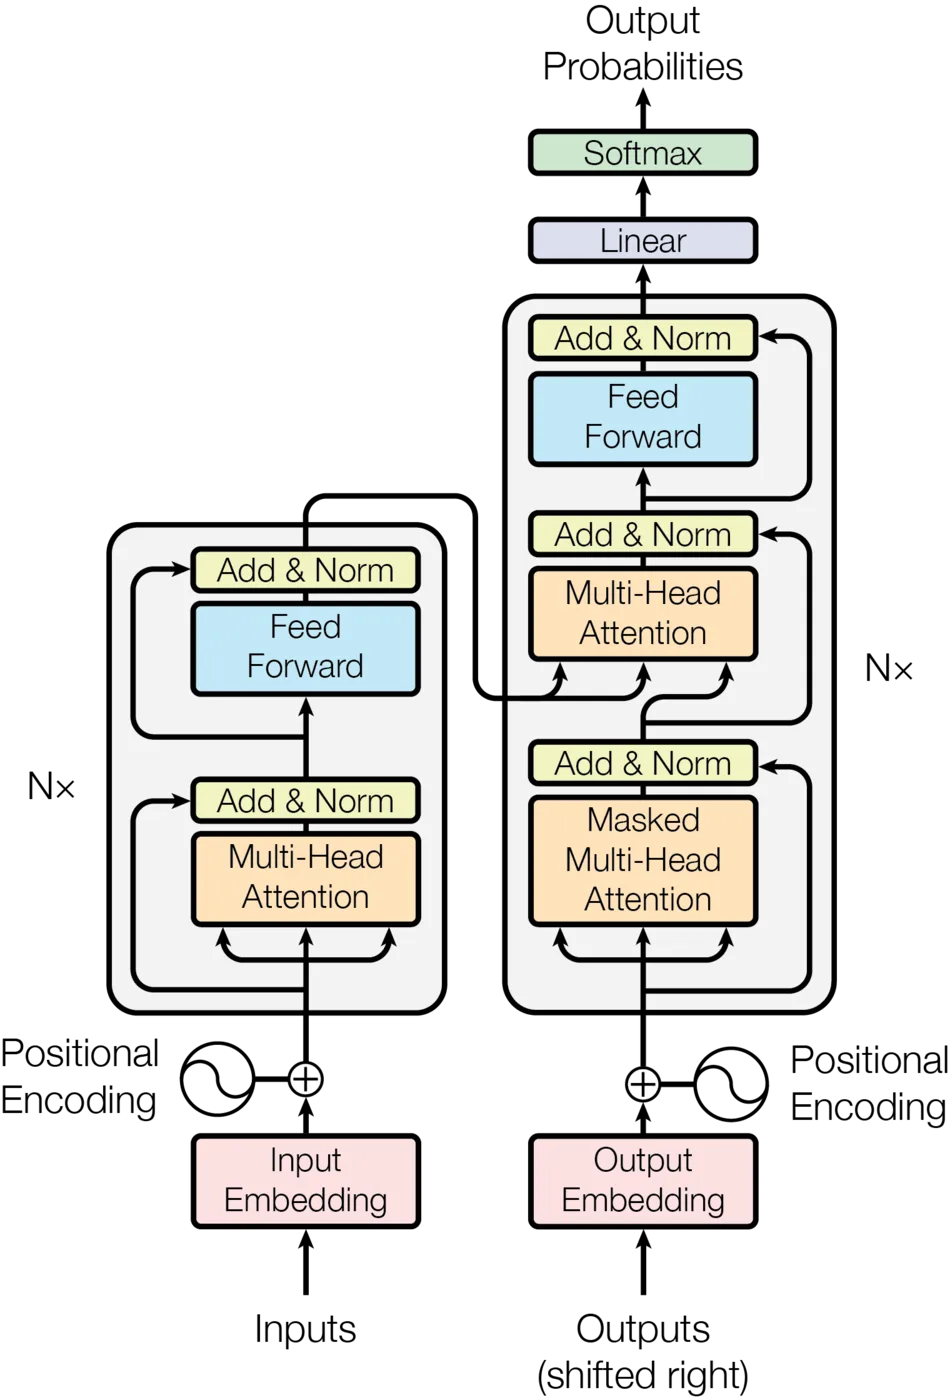
在展开之前,先把「一张图要产出什么」对齐到注意力的标准结构上。llama.cpp 建出来的图,最终目的就是实现下图的这套计算(缩放点积注意力与多头注意力的原始定义,来自 2017 年 Vaswani 等人的 Transformer 论文):
图中的每一步在 llama.cpp 里都对应明确的构件:MatMul(Q,K) 对应 ggml_mul_mat(ctx0, k, q);Scale 对应建图时算出的 kq_scale;Mask (opt.) 对应 llm_graph_input_attn_kv 里的 self_kq_mask;SoftMax 对应 ggml_soft_max_ext;MatMul(·,V) 对应 ggml_mul_mat(ctx0, v, kq)。多头版本里那个被反复强调的 h 个并行分支,在 llama.cpp 里由张量的 n_head 维度承载——一次矩阵乘覆盖全部头,不需要 Python 里那种循环。图片来源:Attention Is All You Need(arXiv:1706.03762)。
build_inp_embd:三条路径与一次 select
嵌入查表看起来是最简单的操作:ggml_get_rows(ctx0, tok_embd, inp_tokens)。但 llama.cpp 的 build_inp_embd 有近 180 行,因为它要同时处理三种输入来源:
// we have 3 standard paths to produce the input embeddings for the first layer:// - embd0: extract from the token embeddings weight (`tok_embd`) using the input token ids// - embd1: pass raw embeddings, skipping the `tok_embd`// - embd2: mixed path of both tokens ids + raw embeddings (if supported)embd0:token id 路径。给一批 token id,用GET_ROWS从词嵌入矩阵里取出对应行。这是标准文本生成路径。embd1:原始向量路径。直接传入[n_embd_inp, n_tokens]的 float 矩阵,跳过查表。用于多模态(视觉编码器输出已经是向量)、embedding API(调用方直接给向量)等场景。embd2:混合路径。一批里既有 token id 也有原始向量,两者拼在一起。
为什么要用「select」而不是在不同场景下建不同的图? 代码里的注释和引用(PR #18550)给了答案:
const int idx = ubatch.is_mixed() ? 2 : ubatch.token ? 0 : 1;ggml_tensor * cur = ggml_build_forward_select(gf, inps.data(), has_mixed ? 3 : 2, idx);ggml_build_forward_select 是 ggml 的一个特殊构造,实现只有十来行(ggml/src/ggml.c):
struct ggml_tensor * ggml_build_forward_select( struct ggml_cgraph * cgraph, struct ggml_tensor ** tensors, int n_tensors, int idx) { GGML_ASSERT(idx >= 0 && idx < n_tensors);
for (int i = 0; i < n_tensors; i++) { ggml_build_forward_impl(cgraph, tensors[i], true, i == idx ? true : false); }
return tensors[idx];}关键在最后一个参数:它一路传到 ggml_visit_parents_graph(cgraph, node, compute),而那个函数的第一行是
if (node->op != GGML_OP_NONE && compute) { node->flags |= GGML_TENSOR_FLAG_COMPUTE;}于是语义就清楚了:所有分支都会被访问、都会作为节点挂进图,但只有选中分支的节点会被打上 GGML_TENSOR_FLAG_COMPUTE 标志——执行阶段只跑带这个标志的节点。这就是「把多条分支都建进图,但运行时只执行选中的那一条」。这样一来,无论这一批是 token 还是 embedding,图的拓扑是一样的——复用判断就不需要因为输入类型不同而失效。这是「用一点建图冗余换取复用稳定性」的交易。
代码里甚至为此让 token 缩放也走同样的路径(scale_tok 那一小段),注释写着「applied after the select so that the graph is the same for any batch contents」(在 select 之后应用,这样图对任何批内容都一样)。代价也在代码里写明了:set_rows 写入的是输入的一份副本(ggml_dup),因为「select 的各分支不能共享张量」。这些细节都是同一个目标下的取舍——形状与拓扑的一致性优先于单批的执行效率。
还有一个细节值得一提:
// we use ggml_build_forward_order to make the GET_ROWS ops stick at the beginning of the compute graph// this way the embeddings remain in the host buffer, and the GET_ROWS run before any other computationsembd0 = ggml_get_rows(ctx0, tok_embd, inp->tokens);ggml_build_forward_order(gf, embd0);ggml_build_forward_order 强制把 GET_ROWS 节点排到图的最前面。为什么?因为 tok_embd(词嵌入矩阵)往往很大,如果它留在 CPU/host 缓冲区(比如 -ngl 没把 embedding 层放到 GPU),让 GET_ROWS 最先执行意味着取出的 embedding 只需传输很小的一块到 GPU,而不是把整个词嵌入矩阵搬过去。这是一个纯粹的数据搬运优化——排序即优化。对应的 PR 是 #18599。
另外,n_embd_inp != n_embd 时要 ggml_pad:某些模型(如带 deepstack 的多模态模型)输入嵌入维度大于主干维度,需要补零对齐。
build_inp_pos 与位置编码的入口
位置张量的构造很短:
ggml_tensor * llm_graph_context::build_inp_pos() const { auto inp = std::make_unique<llm_graph_input_pos>(hparams.n_pos_per_embd(), hparams.rope_section_order); auto & cur = inp->pos; cur = ggml_new_tensor_1d(ctx0, GGML_TYPE_I32, (int64_t)n_tokens*hparams.n_pos_per_embd()); ggml_set_input(cur); cb(cur, "inp_pos", -1); res->add_input(std::move(inp)); return cur;}关键点是 n_pos_per_embd():每个 token 对应的位置值不止一个。M-RoPE(多模态 RoPE)需要为每个 token 提供时间、高度、宽度三个位置分量;某些 2D/3D 位置编码也有类似需求。所以位置张量长度是 n_tokens * n_pos_per_embd,而不是 n_tokens。位置值在运行时由 set_input 填充——因为每个 token 的绝对位置取决于它在序列中的偏移,而偏移是 KV 缓存决定的,建图时未知。
build_inp_out_ids:为什么只算一部分行
ggml_tensor * llm_graph_context::build_inp_out_ids() const { ... cur = ggml_new_tensor_1d(ctx0, GGML_TYPE_I32, n_outputs); ...}inp_out_ids 是「这批 token 里哪些需要 logits」的索引列表。预设场景(比如一次 1000 token 的预填充)里,通常只有最后一个 token 需要输出 logits;训练或投机解码验证场景可能需要全部。如果算全部 logits,最后那次 lm_head 矩阵乘的规模是 [n_tokens, n_vocab]——n_vocab 动辄十几万,这是全图最贵的一次矩阵乘。
所以 llama.cpp 用 ggml_get_rows 在输出前把 hidden state 裁剪成只有 n_outputs 行,再乘 lm_head。代价是要多一次 GET_ROWS(搬 n_outputs 行 hidden state),收益是把矩阵乘从 [n_tokens, n_embd] × [n_embd, n_vocab] 缩到 [n_outputs, n_embd] × [n_embd, n_vocab]。在纯解码批处理里 n_tokens == n_outputs,两者相等;在长预填充里差距是数量级的。这个裁剪点在建图时由 crop_before_nextn/crop_after_nextn 两个判断决定放在 nextn 层的前面还是后面。
llm_graph_result 里 t_layer_inp 数组也是同一类「按需保留」的设计:某些研究场景(要拿到每一层的输入做探针)才需要把中间张量标成输出;否则它们只是通往下一层的中间结果,算完即可被复用(内存规划器会覆盖掉)。
注意力建图:从 Q/K/V 到分页 KV 的拼接视图
注意力是整个建图子系统里最复杂的一块,也是最值得细看的地方。原因有两点:一是它必须把KV 缓存的物理布局接进图(这与第(四)篇讲的记忆系统直接咬合),二是它面对的后端实现差异最大(FlashAttention 与非 FlashAttention 两条路)。
build_attn_mha:两条实现路径
build_attn_mha(llama-graph.cpp:2896)拿到已经投影好的 q、k、v(形状分别是 [n_embd_head_q, n_head_q, n_tokens]、[n_embd_head_k, n_head_k, n_tokens]、[n_embd_head_v, n_head_v, n_tokens]),加上掩码、bias、sink 和 MLA 解码矩阵,输出注意力的结果。
在开始逐行读 build_attn_mha 之前,先看一眼多头注意力本身的结构,后面代码里所有的 permute、张量维度编号都能在这里找到对应:
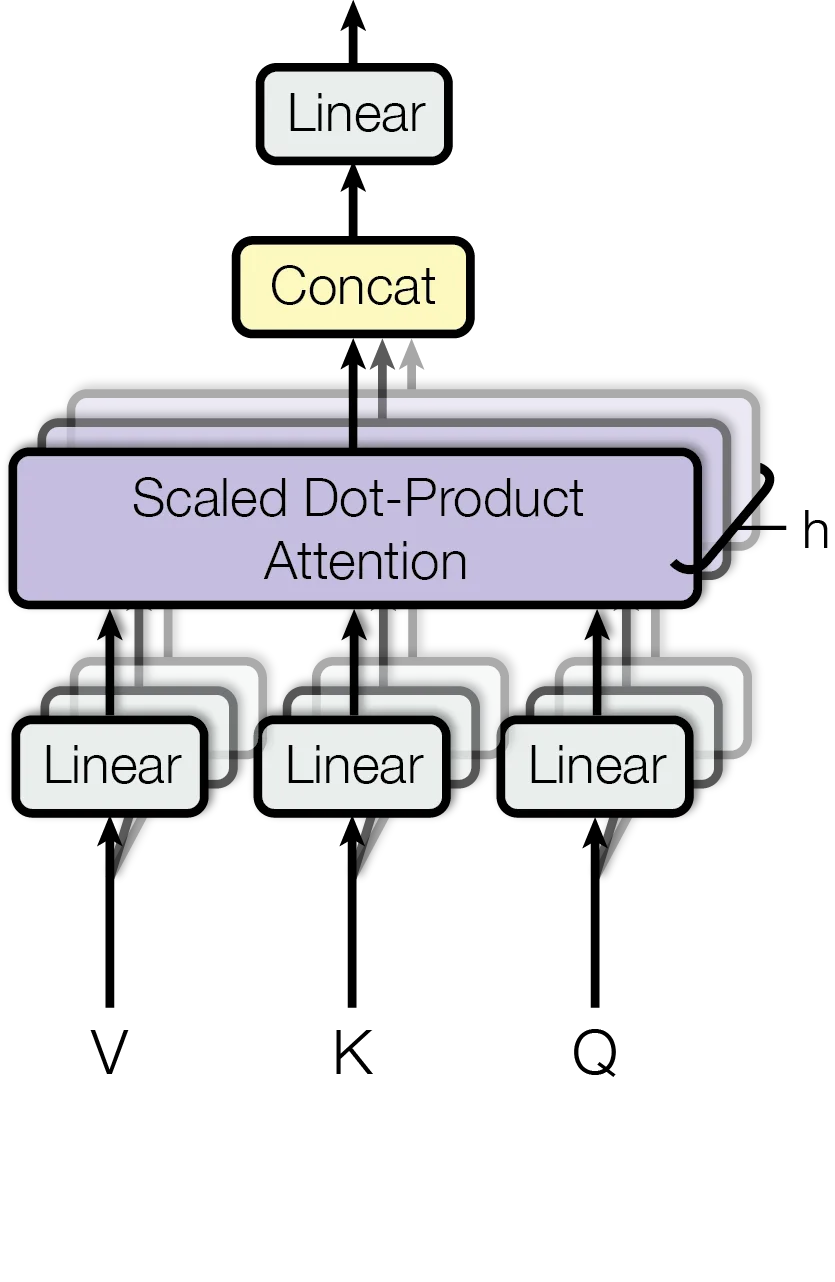
这张图解释了建图代码里几个看起来”多余”的动作:build_qkv 返回的 Q/K/V 张量形状是 [n_embd_head, n_head, n_tokens]——把”按头切分”这件事编码成了张量的第 1 维,所以不需要显式的切分与循环;最后那一次 ggml_reshape_2d 把 [n_embd_head, n_head] 两个维度合并回去,对应的就是图中最后的 Concat 与输出投影。图片来源:Attention Is All You Need(arXiv:1706.03762)。
第一条路:FlashAttention。 判断条件很短:
const bool use_flash_attn = cparams.flash_attn && kq_b == nullptr;只要用户开了 -fa(cparams.flash_attn)且没有 KQ bias(ALiBi 类相对位置偏置),就走 ggml_flash_attn_ext。注意有一个断言:GGML_ASSERT(kq_b == nullptr && "Flash attention does not support KQ bias yet")——FlashAttention kernel 目前不支持额外的加性 bias 张量,所以两者互斥。
走这条路时要做几件准备工作:
- 转置 V:
if (v_trans) v = ggml_transpose(ctx0, v);。v_trans的判定是v->nb[1] > v->nb[2],也就是「V 当前是转置布局」。为什么要检查?因为 KV 缓存里的 V 到底以什么布局存储,取决于缓存实现(第(四)篇讲的v_trans标志)。不同布局访问效率不同,需要统一成 FlashAttention kernel 期望的形式。 - 类型转换:如果 K 或 V 是 F32,转成 F16。FlashAttention kernel 的原生精度是 F16/BF16,F32 输入会走更慢的路径甚至不支持。注释里点明了一种典型场景:
this can happen when KV cache is not used (e.g. an embedding model with non-causal attn)。 - 设置 kernel 提示:三行关键调用——
cur = ggml_flash_attn_ext(ctx0, q, k, v, kq_mask, kq_scale, hparams.f_max_alibi_bias, hparams.attn_soft_cap ? hparams.f_attn_logit_softcapping : 0.0f);res->add_fused_node({LLM_FUSED_OP_FLASH_ATTN, cur, il});
ggml_flash_attn_ext_add_sinks(cur, sinks);GGML_ASSERT(n_kv_max >= 0 && n_kv_max <= INT32_MAX);ggml_flash_attn_ext_set_n_kv_max(cur, static_cast<int32_t>(n_kv_max));ggml_prec_set_acc(cur, GGML_PREC_F32);add_fused_node 登记这是一个「融合算子」——后面后端侧会据此做特殊处理(比如把 KV 写入和注意力融合成一个 kernel)。add_sinks 接上 attention sink(第(四)篇讲过:给 softmax 分母加一个始终参与的虚拟位置,解决长上下文里注意力被首 token 吸走的问题)。set_n_kv_max 告诉 kernel「KV 长度最多是多少」——这是一个形状提示,用于 kernel 侧的静态分块。ggml_prec_set_acc(cur, GGML_PREC_F32) 则是强制累加精度为 F32,避免半精度累加的数值漂移。
- MLA 解码(
v_mla):这一小段有一个非常有意思的注释,记录了一次真实的性能取舍。
if (v_mla) {#if 0 // v_mla can be applied as a matrix-vector multiplication with broadcasting across dimension 3 == n_tokens. // However, the code is optimized for dimensions 0 and 1 being large, so this is inefficient. cur = ggml_reshape_4d(ctx0, cur, v_mla->ne[0], 1, n_head, n_tokens); cur = ggml_mul_mat(ctx0, v_mla, cur);#else // It's preferable to do the calculation as a matrix-matrix multiplication with n_tokens in dimension 1. // The permutations are noops and only change how the tensor data is interpreted. cur = ggml_permute(ctx0, cur, 0, 2, 1, 3); cur = ggml_mul_mat(ctx0, v_mla, cur); cb(cur, "fattn_mla", il); cur = ggml_permute(ctx0, cur, 0, 2, 1, 3); cur = ggml_cont(ctx0, cur); // Needed because ggml_reshape_2d expects contiguous inputs.#endif}v_mla 是 MLA(Multi-head Latent Attention)的「吸收」优化用到的上投影矩阵。MLA 把 K/V 压缩到一个低维 latent 向量,注意力在 latent 空间算完之后要重新投影回完整的 V 维度(V 的 head 维度就是 latent 维度),这一步需要一个矩阵乘。两种写法数学等价:一种把 n_tokens 放在第 3 维(每次只乘一行 → 实际退化成矩阵-向量乘,GPU 利用率低),另一种把它放在第 1 维(变成矩阵-矩阵乘,能吃满 tensor core)。代码保留了 #if 0 的旧版本和注释说明,把「为什么换写法」这件事留在了代码里——这是很好的工程注释实践。ggml_permute 在这里是零开销的(只改张量的步长解释,不动数据),最后的 ggml_cont 则是为了满足 ggml_reshape_2d 对连续性的要求。
第二条路:非 FlashAttention 朴素实现。 如果没开 FlashAttention,就老老实实建一列算子:
ggml_tensor * kq = ggml_mul_mat(ctx0, k, q);cb(kq, "kq", il);
// note: this op tends to require high floating point range// while for some models F16 is enough, for others it is not, so we default to F32 hereggml_prec_set_acc(kq, GGML_PREC_F32);kq 的累加精度默认 F32,注释解释了为什么:这个算子的数值范围大,有些模型 F16 够用有些不够,所以保守取 F32。然后依次可能叠加:
- Grok 的特殊 softcap:
kq = 30 * tanh(kq / 30),代码展开成了三步(缩放 → tanh → 缩回)。 - 通用的 logit softcap(
hparams.attn_soft_cap):Gemma 2 等模型用来压制 logits 幅度的机制,同样是scale → tanh → scale三步。 - 加 KQ bias(
kq_b):ALiBi 或 T5 的相对位置偏置。 - softmax:
ggml_soft_max_ext(ctx0, kq, kq_mask, kq_scale, hparams.f_max_alibi_bias),后面再接ggml_soft_max_add_sinks(kq, sinks)。 - V 的连续性处理:
if (!v_trans) { v = ggml_cont(ctx0, ggml_transpose(ctx0, v)); }——注释直接写着// note: avoid this branch(「避免走这个分支」),因为这个cont会产生一次真实的数据搬运。能保持v_trans = true就保持,这是布局选择的动因。 - 最终乘:
ggml_mul_mat(ctx0, v, kq),然后可选v_mla解码,再permute+cont把多个 stream 的结果合并回二维。
最后有一个和 offload 有关的细节:
if (!cparams.offload_kqv) { // all nodes between the KV store and the attention output are run on the CPU ggml_backend_sched_set_tensor_backend(sched, cur, backend_cpu);}--no-kv-offload 时,注意力输出及之前的所有节点都强制跑在 CPU 上。这里的实现方式是直接给张量指定后端——因为 KV 缓存在 CPU 内存里的话,把 K/V 搬到 GPU 反而更慢,不如就地算。这是「数据在哪就在哪算」的直接表达。
stream 维度:k->ne[3] 是什么
build_attn_mha 开头有一段很容易被忽略但很重要的代码:
// split the batch into streams if neededconst auto n_stream = k->ne[3];
// the stream dim steps over one stream's worth of dim-2 (tokens): (ne[2]/n_stream) rows of stride nb[2].// q->nb[3]/n_stream only equals that for a contiguous q; nope-only MLA (glm5-next) passes a permuted// q_absorbed where nb[3] != ne[2]*nb[2], so using nb[3] read another head's queries for streams s >= 1.q = ggml_view_4d(ctx0, q, q->ne[0], q->ne[1], q->ne[2]/n_stream, n_stream, q->nb[1], q->nb[2], q->nb[2]*(q->ne[2]/n_stream), 0);q = ggml_permute(ctx0, q, 0, 2, 1, 3);ne[3] 是 K 张量的第 4 维——在 llama.cpp 里这个维度承载的是注意力流(stream)。什么时候一批里有多个 stream?回看第(四)篇:llama.cpp 支持「一个 ubatch 里多条长度不等的序列」。这类批次不能简单地当成一个大连通块算注意力(那会让序列 A 的 token 看到序列 B 的 token),所以要把它们拆成若干条独立流:每条流有自己的掩码,注意力在流内进行。equal_seqs 批处理(所有序列等长)只产生 1 条流,混合长度批次会产生 n_seqs 条流。
上面的 ggml_view_4d 把 Q 从「三维」重解释为「四维」,把 ne[2](token 维)拆成 (ne[2]/n_stream, n_stream) 两块。注意注释里那段关于 nb[3] 的警告:作者的初版写法用了 q->nb[3]/n_stream 作为新视图的步长,这在 Q 连续时是对的,但对某些模型的 MLA 路径(permuted 的 q_absorbed)是错的——按错误的步长切片会读到别的 head 的 Q。这是一个真实修过的 bug,注释把踩坑过程留了下来。这类注释在 llama.cpp 源码里密度很高,是阅读时的重要线索。
图输入:KV 视图如何接进图
这是整个注意力建图里最优雅的一步。注意力算子需要 K 和 V,但 K/V 不在图上——它们在 KV 缓存里,位置由调度器决定。llama.cpp 的解法是建图时只放一个”空壳”输入张量,运行时再把它指向缓存里的真实数据。承担这件事的是 llm_graph_input_attn_kv(llama-graph.h:339):
class llm_graph_input_attn_kv : public llm_graph_input_i {public: llm_graph_input_attn_kv(const llama_hparams & hparams, const llama_cparams & cparams, const llama_kv_cache_context * mctx) : ... {}
void set_input(const llama_ubatch * ubatch) override; bool can_reuse(const llm_graph_params & params) override;
ggml_tensor * get_k_idxs() const { return self_k_idxs; } ggml_tensor * get_v_idxs() const { return self_v_idxs; } ggml_tensor * get_kq_mask() const { return self_kq_mask_cnv; }
ggml_tensor * self_k_idxs = nullptr; // I64 [n_batch] ggml_tensor * self_v_idxs = nullptr; // I64 [n_batch] or [n_batch*n_embd_v_gqa]
ggml_tensor * self_kq_mask = nullptr; // F32/F16 [n_kv, n_batch/n_stream, 1, n_stream] ggml_tensor * self_kq_mask_cnv = nullptr; // [n_kv, n_batch/n_stream, 1, n_stream] ... const llama_kv_cache_context * mctx;};三个张量构成完整的契约:
self_k_idxs / self_v_idxs:形状 [n_batch] 的 I64 索引数组。这一批的每个 token,它的 K/V 要写进 KV 缓存的哪个物理槽位。建图时它只是一个 ggml_set_input 的占位符;运行时 set_input(ubatch) 调用 mctx->get_k_idxs(...) 之类的接口把调度器算好的槽位号填进去。K 和 V 分别有各自的索引数组是因为K 和 V 可以存在不同的缓存结构里(量化类型可能不同,或者 V 走了 v_trans 布局)。
self_kq_mask:形状 [n_kv, n_batch/n_stream, 1, n_stream] 的掩码。四个维度分别是:KV 位置数、每条流的 query 数、无用的 1、流数。这个张量承载了两件事——因果性(query 只能看自己及之前的 KV)和流隔离(第 s 条流的 query 只能看第 s 条流的 KV)。它也是运行时填充的,因为「哪些位置有有效 KV」取决于批次开始前缓存里已经存了什么。
self_k_rot / self_v_rot:用于 KV 的旋转/变换(注释写着 // note: assumes v_rot^2 == I,即变换的平方等于恒等——说明这是一个自逆变换,用于某种等价的基变换)。
build_attn_inp_kv 的构造很简短:
llm_graph_input_attn_kv * llm_graph_context::build_attn_inp_kv() const { return (llm_graph_input_attn_kv *) res->add_input( std::make_unique<llm_graph_input_attn_kv>(hparams, cparams, mctx));}注意这里没有新建任何 ggml 张量。张量的创建推迟到了 set_input 里。为什么?因为 kq_mask 的形状依赖 n_kv,而 n_kv 在 set_input 之前还在变。这样的设计让「图的结构」与「输入的形状」解耦:图的骨架可以提前建好,输入张量在填充数据的时刻才按当时的真实形状创建。
K/V 的拼接视图:分页 KV 怎么变成一个张量
注意力算子(无论 Flash 还是朴素)需要一个形状规整的 k/v 张量。可是 KV 缓存在物理上是分页的、非连续的(第(四)篇讲过分页与 cell 的概念)。怎么把「一堆散落的物理页」变成「一个逻辑上连续的 K 张量」?
答案是在 set_input 里用一个 ggml_view 把缓存张量按索引重排成视图,而不是真的做数据搬运。llama_kv_cache_context 提供的 cpy_k/cpy_v 接口负责「把新算出的 K/V 写进指定槽位」(图上有对应的写算子),而 get_k/get_v 则提供一个「按当前批次需要的位置组织好的视图」。
代码里能看到写 KV 的动作也是图节点:
if (!mctx_cur->get_v_trans()) { ggml_build_forward_expand(gf, mctx_cur->cpy_k(ctx0, k_cur, k_idxs, il)); ggml_build_forward_expand(gf, mctx_cur->cpy_v(ctx0, v_cur, v_idxs, il));} else { ggml_build_forward_expand(gf, mctx_cur->cpy_k(ctx0, k_cur, k_idxs, il));}这说明 KV 写入本身就是计算图的一部分——它不是一个”外部副作用”,而是一个 ggml 节点(底层是 GGML_OP_CPY 或 SET_ROWS)。这么做的好处是后端调度器能一起排程:KV 写入和后续的矩阵乘可以在同一个流上重叠,且写入的目标地址是图的一部分,内存规划器能正确处理它。注意 v_trans 为真时只写 K 不写 V——因为 V 的转置视图本身就是写入位置(有些缓存实现让 V 直接以转置布局存储,写入算子隐含了转置)。
这一小节的结论可以概括成一句:llama.cpp 把「KV 缓存的物理管理」和「注意力算子的数据需求」用一层视图与索引间接层解耦了。记忆系统负责分配与记账,图这边负责「给我这批 token 需要的 K/V 视图」,两者通过 k_idxs/v_idxs/kq_mask 三个输入张量交换信息。
MoE 建图:从路由到分组专家矩阵乘
稠密 FFN 的建图是直白的(build_ffn:up → 门控/激活 → down),MoE 则要解决三个额外问题:路由怎么算、每个专家只处理一部分 token 怎么表达、专家权重怎么按 token 取用。
路由:门控函数与 ggml_argsort_top_k
先看 MoE 层的整体结构,这是理解后面所有路由代码的前提:
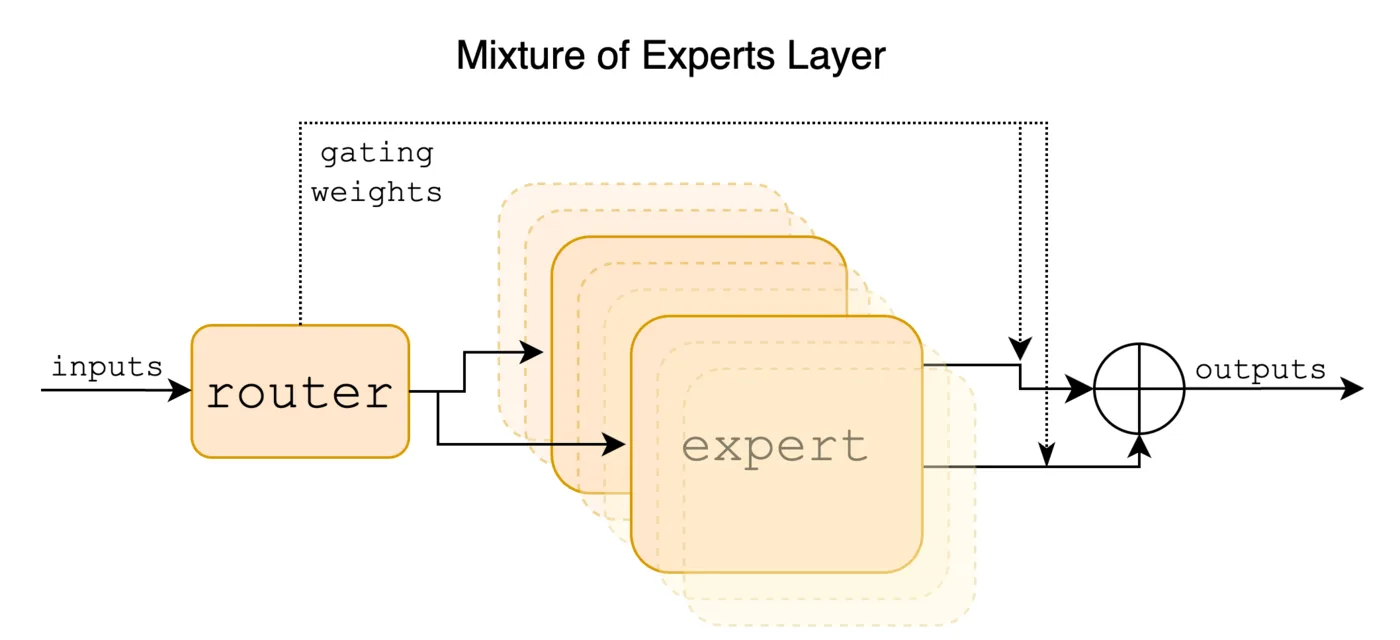
图里的四个要素——Router(门控)、Top-K 选择、专家前向、加权求和——在 build_moe_ffn 里依次对应:门控矩阵乘 build_lora_mm(gate_inp, cur)、ggml_argsort_top_k、build_lora_mm_id(每个专家一次矩阵乘)、最后的 ggml_mul + 逐个 ggml_add 聚合。图中「Router」输出的那排权重正是代码里 weights 张量的来源。图片来源:Mixtral of Experts(arXiv:2401.04088)。
build_moe_ffn 的第一步是算出每个 token 的专家分布。门控矩阵乘产出 [n_expert, n_tokens] 的分数:
ggml_tensor * logits = nullptr;
if (probs_in == nullptr) { logits = build_lora_mm(gate_inp, cur); // [n_expert, n_tokens] if (gating_op == LLAMA_EXPERT_GATING_FUNC_TYPE_SQRT_SOFTPLUS) { ggml_prec_set_acc(logits, GGML_PREC_F32); } cb(logits, "ffn_moe_logits", il);} else { logits = probs_in; // 调用方已经算好路由(投机解码等场景)}
if (gate_inp_b) { logits = ggml_add(ctx0, logits, gate_inp_b); cb(logits, "ffn_moe_logits_biased", il);}probs_in 非空意味着调用方传入已经算好的路由分数,跳过门控矩阵乘。这是给「一次前向处理多个候选 token」的场景(投机解码的验证批、MTP)留的口子——那些场景下路由结果可以复用,不必重算。
接下来按 gating_op 算门控概率:
switch (gating_op) { case LLAMA_EXPERT_GATING_FUNC_TYPE_SOFTMAX: probs = ggml_soft_max(ctx0, logits); break; case LLAMA_EXPERT_GATING_FUNC_TYPE_SIGMOID: probs = ggml_sigmoid(ctx0, logits); break; case LLAMA_EXPERT_GATING_FUNC_TYPE_SOFTMAX_WEIGHT: probs = logits; break; case LLAMA_EXPERT_GATING_FUNC_TYPE_SQRT_SOFTPLUS: probs = ggml_sqrt(ctx0, ggml_softplus(ctx0, logits)); break;}四种门控对应不同模型族:Softmax 是 Mixtral/Qwen-MoE 一类的经典做法;Sigmoid 是 DeepSeek-V3 的改动(用 sigmoid 逐专家独立打分,而非在专家之间做竞争性的归一化);SQRT_SOFTPLUS 是较新模型的变体。门控函数的选择直接改变「专家之间是否竞争」这件事——softmax 让专家抢概率质量,sigmoid 让每个专家独立决定自己「开多大」。
DeepSeek V3 的选择偏置是接下来一个关键分支,注释写得很清楚:
// add experts selection bias - introduced in DeepSeek V3// leave probs unbiased as it's later used to get expert weightsggml_tensor * selection_probs = probs;if (exp_probs_b != nullptr) { selection_probs = ggml_add(ctx0, probs, exp_probs_b); cb(selection_probs, "ffn_moe_probs_biased", il);}注意这里分出了两个张量:probs(无偏置,用于最后的加权)与 selection_probs(带偏置,只用于 Top-K 选择)。这正是 DeepSeek-V3 负载均衡机制的精确定义——偏置只影响「谁被选中」,不影响「选中后权重多大」。如果实现时误用了同一个张量,模型行为会偏。代码里还有更多架构特例:Llama4 的 sigmoid 只在 Top-K 之后应用(注释直接引用了 meta-llama 的 moe.py 行号),GroveMoE 又有自己的 sigmoid 位置。
分组路由(DeepSeek-V3 的 expert group)是这一段最复杂的部分:
if (hparams.n_expert_groups > 1 && n_tokens > 0) { const int64_t n_exp_per_group = n_expert / hparams.n_expert_groups;
ggml_tensor * selection_groups = ggml_reshape_3d(ctx0, selection_probs, n_exp_per_group, hparams.n_expert_groups, n_tokens);
// 每组取前 2 高的分数并求和,作为该组的组分数 ggml_tensor * group_scores = ggml_argsort_top_k(ctx0, selection_groups, 2); group_scores = ggml_get_rows(ctx0, ggml_reshape_4d(ctx0, selection_groups, 1, selection_groups->ne[0], selection_groups->ne[1], selection_groups->ne[2]), group_scores); group_scores = ggml_sum_rows(ctx0, ggml_reshape_3d(ctx0, group_scores, ...));
// 选出 n_group_used 个组 ggml_tensor * expert_groups = ggml_argsort_top_k(ctx0, group_scores, hparams.n_group_used);
// 未选中组的分数全部置为 -inf,之后 Top-K 自然只会落在选中的组里 selection_probs = ggml_get_rows(ctx0, selection_groups, expert_groups); selection_probs = ggml_set_rows(ctx0, ggml_fill(ctx0, selection_groups, -INFINITY), selection_probs, expert_groups); selection_probs = ggml_reshape_2d(ctx0, selection_probs, n_expert, n_tokens);}DeepSeek-V3 有 256 个路由专家,分成 8 组(每组 32 个)。机制是:先选组、再选专家。组分数是组内 Top-2 分数之和(这个细节来自 DeepSeek 官方实现,代码注释里直接引了 HF 上 modeling_deepseek.py 的行号)。选出 n_group_used 个组之后,把其他组的分数填成 -INFINITY——用一个 ggml_fill + ggml_set_rows 的组合实现「掩码」。
为什么需要分组?原文的动机是通信与局部性:在大规模专家并行下,如果路由完全自由,一个 token 的 K 个专家可能散落在任意 rank 上,通信量不可控。分组后约束「K 个专家只能从少数几个组里选」,让专家在设备上的布局与路由有结构对应。这是「算法机制为系统代价让路」的典型例子。
Top-K 选择本身:
ggml_tensor * selected_experts = selected_experts_in;if (selected_experts == nullptr) { selected_experts = ggml_argsort_top_k(ctx0, selection_probs, n_expert_used); // [n_expert_used, n_tokens] cb(selected_experts->src[0], "ffn_moe_argsort", il);}cb(selected_experts, "ffn_moe_topk", il);用的是 ggml_argsort_top_k。注意 cb(selected_experts->src[0], ...) 打点的是它的源张量而不是结果——因为 argsort_top_k 在多数后端实现里是「先排序得到索引,再取前 K」,打点源张量才能看到完整的排序输出。selected_experts_in 又是那个「调用方传入路由」的口子。
权重:取回、归一化与 clamp
probs = ggml_reshape_3d(ctx0, probs, 1, n_expert, n_tokens);
ggml_tensor * weights = ggml_get_rows(ctx0, probs, selected_experts); // [1, n_expert_used, n_tokens]cb(weights, "ffn_moe_weights", il);
if (gating_op == LLAMA_EXPERT_GATING_FUNC_TYPE_SOFTMAX_WEIGHT) { weights = ggml_reshape_2d(ctx0, weights, n_expert_used, n_tokens); weights = ggml_soft_max(ctx0, weights); // 只在选中的 K 个之间做 softmax weights = ggml_reshape_3d(ctx0, weights, 1, n_expert_used, n_tokens);}
if (norm_w) { weights = ggml_reshape_2d(ctx0, weights, n_expert_used, n_tokens); ggml_tensor * weights_sum = ggml_sum_rows(ctx0, weights); // [1, n_tokens] // Avoid division by zero, clamp to smallest number representable by F16 weights_sum = ggml_clamp(ctx0, weights_sum, 6.103515625e-5, INFINITY); weights = ggml_div(ctx0, weights, weights_sum); weights = ggml_reshape_3d(ctx0, weights, 1, n_expert_used, n_tokens);}if (w_scale != 0.0f && w_scale != 1.0f) { weights = ggml_scale(ctx0, weights, w_scale);}三处细节:
reshape_3d(..., 1, n_expert, n_tokens)再get_rows,是为了让selected_experts的索引落在第 1 维(n_expert维)上。ggml 的GET_ROWS按「第 1 维的索引」取行,所以必须先 reshape 把专家维搬到第 1 维、并在前面加一个长度为 1 的维度。结果就是[1, n_expert_used, n_tokens]。多出来的那个前导 1 是为了后面广播乘。ggml_clamp(weights_sum, 6.103515625e-5, INFINITY):这个常数是 F16 的最小正规数()。注释写着「Avoid division by zero」。为什么要用 F16 的表示下限而不是某个抽象的小数?因为权重张量本身可能是 F16 存储的,如果 clamp 到一个更小的值,除完之后可能溢出成 inf 或 nan。这是一个由数据类型反推出来的常数,很好地说明了数值实现必须贴着存储格式思考。SOFTMAX_WEIGHT分支只在选中的 K 个权重之间再做一次 softmax,而不是在全专家上。这是「先选后归一」与「先归一后选」的语义差别。
专家矩阵乘:build_lora_mm_id 与两条路径
权重算完之后调用 ggml_build_forward_expand(gf, weights) ——注释写着 //call early so that topk-moe can be used(提前展开,让下面的 topk-MoE 融合能用上)。然后分两条路:
if (gate_up_exps) { // 合并路径:一次 mul_mat_id,再切成 gate 与 up 两个视图 ggml_tensor * gate_up = build_lora_mm_id(gate_up_exps, cur, selected_experts, up_exps_s, slots); // [n_ff*2, n_expert_used, n_tokens]
const int64_t n_ff = gate_up->ne[0] / 2; cur = ggml_view_3d(ctx0, gate_up, n_ff, gate_up->ne[1], gate_up->ne[2], gate_up->nb[1], gate_up->nb[2], 0); up = ggml_view_3d(ctx0, gate_up, n_ff, gate_up->ne[1], gate_up->ne[2], gate_up->nb[1], gate_up->nb[2], n_ff * gate_up->nb[0]);} else { // 分开路径:gate 与 up 各一次 mul_mat_id up = build_lora_mm_id(up_exps, cur, selected_experts, up_exps_s, slots); cur = build_lora_mm_id(gate_exps, cur, selected_experts, gate_exps_s, slots);}build_lora_mm_id 是「带 LoRA 的按 id 矩阵乘」——它内部最终落到 ggml_mul_mat_id。这个方法解决的核心问题是:有 n_expert 个权重矩阵,每个 token 只走其中 K 个,怎么一次算完?
答案是「先按专家分组,再批量矩阵乘」。后端的 mul_mat_id kernel 会先把 token 按路由表重排成按专家分组的连续区间,然后对每个被用到的专家做一次批量矩阵乘。这样,「每个 token 一次小矩阵乘」变成「每个专家一次较大的矩阵乘」,GPU 利用率大幅提升。分组的重排过程本身也是有代价的(一次 gather),所以只有当 K 个专家覆盖的 token 数足够多、且专家数不是特别大时才划算。
两种做法的对比可以用一张矩阵乘示意图说清:图中左侧是权重矩阵、右侧是激活矩阵,而 mul_mat_id 做的事就是把「右侧的行」按专家分组重排、并把「左侧的列块」按路由表挑选出来:
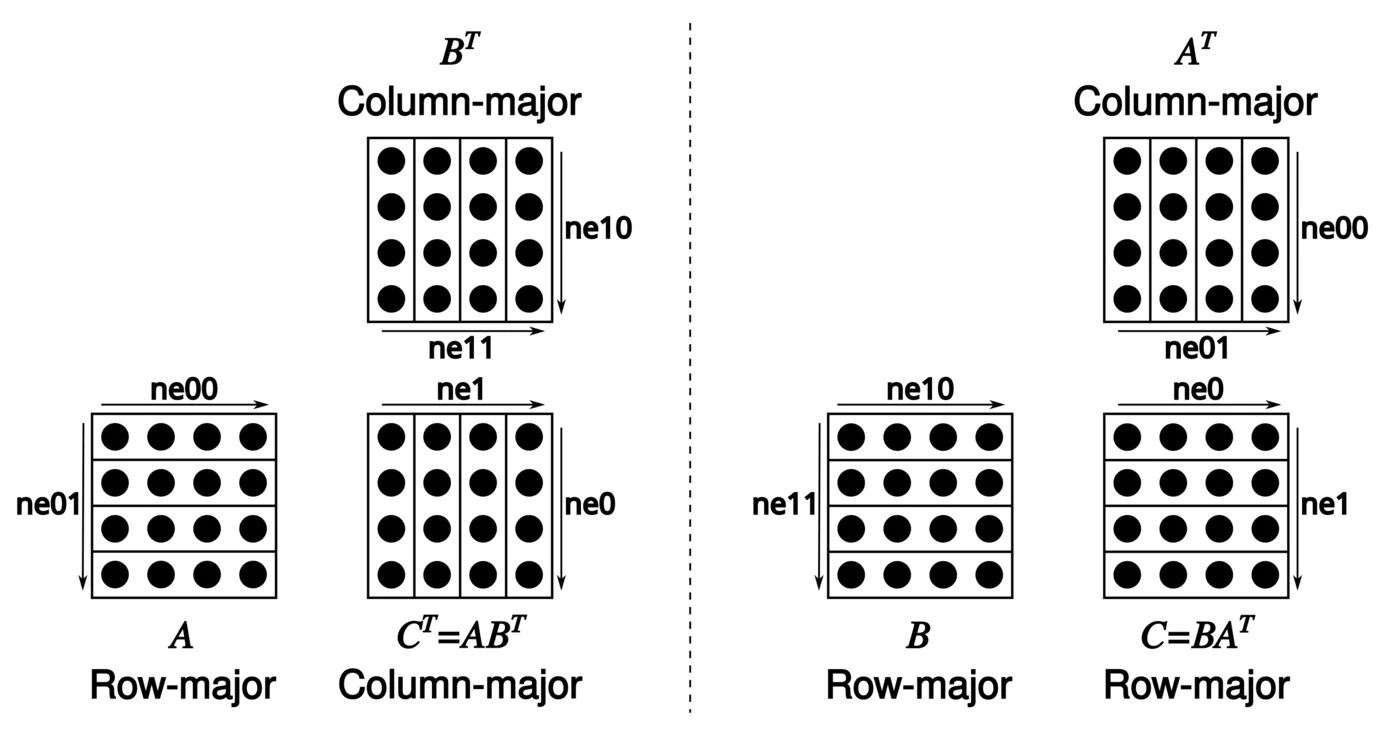
把图中 B 的列分组这件事想清楚,就能理解 mul_mat_id 相对「逐专家循环」省下了什么:循环写法里每个专家只有零星几列参与计算(矩阵乘退化成矩阵-向量乘,tensor core 利用率极低),而分组之后每个专家的列是连续的、可以一次吃完。图片来源:llama.cpp 官方仓库 media/matmul.png。
两条路径的存在是因为有些模型的 gate 与 up 权重在文件里是拼在一起的(gate_up_exps),这种情况下用一次 mul_mat_id 算出一个 [n_ff*2, ...] 的张量,再用两个 ggml_view_3d(零拷贝的切片视图)分出 gate 与 up。好处是少一次矩阵乘的调度与一次权重的读取;代价是视图的步长必须与权重的排布严格对应,写错就读到另一半数据。
slots 是 build_moe_cache_slots 的返回值,后面单独讲。
激活:一个 switch 里的 20 种模型口味
算完 gate/up,接下来是激活。这里的 switch (type_op) 有七个 case,每个 case 又带架构特例:
case LLM_FFN_SILU: if (gate_exps) { if (il >= 0) { const float limit = hparams.swiglu_clamp_exp[il]; constexpr float eps = 1e-6f; if (limit > eps) { if (arch == LLM_ARCH_MAPLE || arch == LLM_ARCH_DEEPSEEK4 || arch == LLM_ARCH_GLM5_NEXT || ... ) { cur = ggml_swiglu_clamp(ctx0, cur, up, limit); } else { up = ggml_clamp(ctx0, up, -limit, limit); ggml_tensor * gate_act = ggml_silu(ctx0, cur); gate_act = ggml_clamp(ctx0, gate_act, -INFINITY, limit); cur = ggml_mul(ctx0, gate_act, up); } } } } if (has_gate) { cur = ggml_swiglu_split(ctx0, cur, up); } else { cur = ggml_silu(ctx0, cur); } break;这里的 swiglu_clamp_exp[il] 是逐层的 SwiGLU 钳位阈值,作用是压制激活值上界(防止数值溢出,也用于某些模型训练期的稳定性)。注意实现上分了两种:有专门 ggml_swiglu_clamp 算子的模型走融合路径,其余模型用「clamp up + silu + clamp gate_act + mul」四步拼出来——融合算子的收益是一次 kernel 而不是四次,但只在少数架构上实现了。
其余 case 各有来头:LLM_FFN_SITU(注释直接写出公式 situ(gate, up) = beta*tanh(gate/beta)*sigmoid(gate) * lb*tanh(up/lb))、LLM_FFN_GELU(走 ggml_geglu_split)、LLM_FFN_SWIGLU_OAI_MOE(注释里留着两个魔数 alpha = 1.702f、limit = 7.0f,还带着 // TODO: move to hparams?)、LLM_FFN_RELU 与 LLM_FFN_RELU_SQR。最后一个 case 里有一条罕见的 GGML_ABORT:
case LLM_FFN_RELU_SQR: if (has_gate) { // TODO: add support for gated squared relu GGML_ABORT("fatal error: gated squared relu not implemented"); }llama.cpp 对未实现的组合直接 abort 而不是静默降级——这是有意的策略:宁可拒绝加载也不给出错误结果。对使用者来说,这意味着某些模型组合暂时不能用,但不会得到一个「看起来能跑、结果全错」的模型。
激活之后是 down 投影,然后有一个被注释解释得很清楚的精度设定:
experts = build_lora_mm_id(down_exps, cur, selected_experts, down_exps_s, slots);if (arch == LLM_ARCH_MISTRAL4 || arch == LLM_ARCH_MELLUM) { // src1 can exceed F16 range ggml_prec_set_src(experts, GGML_PREC_F32, 1);}ggml_prec_set_src(..., 1) 把第二个输入(这里是被乘的激活值)的精度提到 F32,注释说明原因是「src1 会超出 F16 范围」。这又是一个「由数值范围反推的精度决策」。
聚合:为什么用一串 view + add 而不是 sum_rows
最后一步是把 K 个专家的输出加权聚合:
ggml_tensor * cur_experts[LLAMA_MAX_EXPERTS] = { nullptr };const uint32_t n_expert_used_il = hparams.n_expert_used(il);
for (uint32_t i = 0; i < n_expert_used_il; ++i) { cur_experts[i] = ggml_view_2d(ctx0, experts, n_embd, n_tokens, experts->nb[2], i*experts->nb[1]); ggml_build_forward_expand(gf, cur_experts[i]);}
// aggregate expertsggml_tensor * moe_out = cur_experts[0];for (uint32_t i = 1; i < n_expert_used_il; ++i) { moe_out = ggml_add(ctx0, moe_out, cur_experts[i]); ggml_build_forward_expand(gf, moe_out);}experts 的形状是 [n_embd, n_expert_used, n_tokens]。这里用 ggml_view_2d 沿第 1 维(专家维)切出 K 个 [n_embd, n_tokens] 视图,然后逐个 ggml_add 相加。
为什么不用一个 ggml_sum_rows 求和?因为后端对「若干个二维张量相加」这种模式有专门的优化(多条流并行读、向量化累加),而 sum_rows 在「沿第 1 维归约」时的访存模式未必好。代码注释还留了一条重要线索:
// order the views before the adds// Use per-layer n_expert_used to bound the graph even during warmup (avoids// the large-add-nodes issue for uniform arches; for Puzzle the per-layer// value is correct). ref: https://github.com/ggml-org/llama.cpp/pull/14753两点:一是先把所有 view 节点展开、再加 add 节点(顺序影响调度);二是 n_expert_used 取逐层值 hparams.n_expert_used(il) 而不是全局值——因为 warmup 阶段全局 n_expert_used 被设成了 n_expert(前面讲过),如果这里也用全局值,就会建出 n_expert 个 add 节点,把图撑爆。这是一个由 warmup 策略反推出来的建图约束——两个看似无关的决策耦合在了一起。
专家缓存:slots 与 llama_moe_cache
build_moe_cache_slots 与 llama_moe_cache 是较新加入的机制。MoE 模型的问题是:专家参数占显存的大头,但每次只有少数专家被用到。以 DeepSeek-V3 的口径来说,671B 总参数里绝大部分在专家中,而每个 token 只激活其中一小部分——这就是「大参数量、小激活量」的来源。如果能只把活跃专家搬进显存,显存占用可以降一个层级。
llama_moe_cache 维护一组「显存槽位」,每个槽位放一个专家。build_moe_cache_slots 的返回值是「这次选中的专家对应到缓存里的哪个槽位」:
// the slots of the selected experts in the MoE cache, nullptr if the experts of the layer are not read from the cacheggml_tensor * build_moe_cache_slots( ggml_tensor * selected_experts, ggml_tensor * up_exps, ggml_tensor * gate_exps, ggml_tensor * down_exps, ggml_tensor * gate_up_exps, int il) const;slots 被当作路由表传给 build_lora_mm_id(最后一个参数)。于是 ggml_mul_mat_id 看到的 n_expert 不再是「模型有多少专家」,而是「缓存有几个槽位」——专家总数可以远超槽位数。这是一个用间接寻址换取显存占用的设计:多一次槽位查表,换来的是专家权重可以按需换入换出。
它与第(三)篇讲的 -ot 思路一致,但粒度更细:-ot 按「层」决定驻留,MoE 缓存按「专家个体」决定驻留。对 MoE 模型来说,后者的粒度才是对的——同一层里的 256 个专家活跃度差异极大,按层整块驻留会浪费大量显存。
一个具体例子:Llama 与 DeepSeek 的建图代码
前面讲的都是构件。这一节看真实模型怎么把这些构件排起来,素材是 src/models/llama.cpp(248 行,是全仓库最简洁的建图实现之一)与 src/models/deepseek2.cpp。
Llama:一个模板化的建图函数
src/models/llama.cpp 的建图函数是一个模板——embed 是一个编译期参数,同一份代码实例化出两个版本:
template <bool embed>void llama_model_llama::graph(llm_graph_context & ctx) const { ... }embed = true 时建的是「嵌入模型」的图(输出 pooled embedding,不接 lm_head),embed = false 时是生成模型的图。用模板而不是运行时分支,好处是未使用的那半代码不进入编译产物,运行时也零开销。
函数开头是四个输入构件:
inpL = build_inp_embd(model.tok_embd);
// inp_pos - contains the positionsggml_tensor * inp_pos = build_inp_pos();
using inp_attn_type = std::conditional_t<embed, llm_graph_input_attn_no_cache, llm_graph_input_attn_kv>;
inp_attn_type * inp_attn = nullptr;if constexpr (embed) { inp_attn = build_attn_inp_no_cache();} else { inp_attn = build_attn_inp_kv();}
const float kq_scale = hparams.f_attention_scale == 0.0f ? 1.0f/sqrtf(float(n_embd_head)) : hparams.f_attention_scale;
ggml_tensor * inp_out_ids = build_inp_out_ids();注意 inp_attn_type 用 std::conditional_t 在编译期选择注意力输入类型:生成模型用 llm_graph_input_attn_kv(有 KV 缓存),嵌入模型用 llm_graph_input_attn_no_cache(没有缓存,K/V 就是本批 token 自己)。kq_scale 的默认值是 ——这是标准缩放点积注意力里的缩放因子, 是每个头的维度;如果模型配置里显式给了 f_attention_scale 就用配置值。
主循环是标准的 Transformer 层循环:
for (int il = 0; il < n_layer; ++il) { res->t_layer_inp[il] = inpL; ggml_tensor * inpSA = inpL;
// norm cur = build_norm(inpL, model.layers[il].attn_norm, NULL, LLM_NORM_RMS, il);
// self-attention { ggml_tensor * rope_factors = model.get_rope_factors(cparams, il); auto [Qcur, Kcur, Vcur] = build_qkv(model.layers[il], cur, n_embd_head, n_head, n_head_kv, il);
Qcur = ggml_rope_ext(ctx0, Qcur, inp_pos, rope_factors, n_rot, rope_type, n_ctx_orig, freq_base, freq_scale, ext_factor, attn_factor, beta_fast, beta_slow); Kcur = ggml_rope_ext(ctx0, Kcur, inp_pos, rope_factors, ...);
if (hparams.use_kq_norm) { // Llama4TextL2Norm Qcur = ggml_rms_norm(ctx0, Qcur, hparams.f_norm_rms_eps); Kcur = ggml_rms_norm(ctx0, Kcur, hparams.f_norm_rms_eps); }
cur = build_attn(inp_attn, model.layers[il].wo, ..., Qcur, Kcur, Vcur, nullptr, nullptr, nullptr, kq_scale, il); }
if (il == n_layer - 1 && inp_out_ids) { cur = ggml_get_rows(ctx0, cur, inp_out_ids); inpSA = ggml_get_rows(ctx0, inpSA, inp_out_ids); }
ggml_tensor * ffn_inp = ggml_add(ctx0, cur, inpSA); ...}几点值得读:
build_qkv返回结构化绑定:auto [Qcur, Kcur, Vcur] = build_qkv(...)。llama.cpp 把这个三件套打包成一个llm_graph_qkv结构返回,而不是三个 out 参数——现代 C++ 的用法让调用点很干净。- RoPE 用
ggml_rope_ext:一次调用里塞了 12 个参数(位置、频率因子、旋转维度、RoPE 类型、原始上下文长度、base 频率、频率缩放、YaRN 的 ext_factor/attn_factor/beta_fast/beta_slow)。为什么这么多?因为 llama.cpp 要在一个算子里同时支持 RoPE 的多种变体(标准 RoPE、NTK 缩放、YaRN、Llama3 的分频段缩放)。rope_factors就是 Llama3 那种逐层不同的频率因子(不同层的 RoPE base 不一样),model.get_rope_factors(cparams, il)从模型配置里取出来,Llama2 类模型返回nullptr。 use_kq_norm分支:Llama4 对 Q/K 额外做一次 RMSNorm(注释// Llama4TextL2Norm)。这说明「同一个架构文件要覆盖同一家族的不同代际」——加一个布尔开关比新写一个架构文件划算。- 输出裁剪的位置:
if (il == n_layer - 1 && inp_out_ids)发生在最后一层注意力的残差之前,而且cur与inpSA都要裁。为什么两个都要裁?因为接下来是ggml_add(cur, inpSA)—— 如果只裁一个,两个张量的行数不匹配,加法会失败。这是一个容易忽略的成对裁剪。
FFN 部分展示了 MoE 与稠密如何在同一份代码里分叉:
// feed-forward network (non-MoE)if (model.layers[il].ffn_gate_inp == nullptr) { cur = build_norm(ffn_inp, model.layers[il].ffn_norm, NULL, LLM_NORM_RMS, il); cur = build_ffn(cur, model.layers[il].ffn_up, ..., model.layers[il].ffn_up_s, model.layers[il].ffn_gate, ..., model.layers[il].ffn_gate_s, model.layers[il].ffn_down, ..., model.layers[il].ffn_down_s, NULL, LLM_FFN_SILU, LLM_FFN_PAR, il);} else { // MoE branch cur = build_norm(ffn_inp, model.layers[il].ffn_norm, NULL, LLM_NORM_RMS, il); cur = build_moe_ffn(cur, model.layers[il].ffn_gate_inp, model.layers[il].ffn_up_exps, model.layers[il].ffn_gate_exps, model.layers[il].ffn_down_exps, nullptr, n_expert, n_expert_used, LLM_FFN_SILU, true, hparams.expert_weights_scale, LLAMA_EXPERT_GATING_FUNC_TYPE_SOFTMAX, il, nullptr, nullptr, model.layers[il].ffn_up_exps_s, model.layers[il].ffn_gate_exps_s, model.layers[il].ffn_down_exps_s);}cur = ggml_add(ctx0, cur, ffn_inp);判据是 ffn_gate_inp == nullptr —— 门控矩阵存在就是 MoE 层,不存在就是稠密层。这意味着 llama.cpp 用权重是否存在来决定图结构,而不是查一个布尔标志。好处是「权重装载与图构建的一致性由数据本身保证」;坏处是如果权重装载出错(比如某个张量没被加载),图会静默走错分支。这类「用数据存在性编码结构」的写法在 llama.cpp 里很常见。
LLM_FFN_PAR 是门控类型——表示 gate 与 up 是并行两个矩阵(ggml_swiglu_split 的形式),与之相对的是顺序形式(先 gate 再 up,中间夹激活)。这个区分对应不同模型族的 FFN 实现。
MoE 分支的参数里 LLAMA_EXPERT_GATING_FUNC_TYPE_SOFTMAX 是硬编码的——说明这个模板文件服务的是「Llama 家族里用 softmax 门控的 MoE 模型」。DeepSeek 那种 sigmoid 门控在自己文件里。
结尾是输出侧:
cur = build_norm(cur, model.output_norm, NULL, LLM_NORM_RMS, -1);res->t_embd = cur;
if constexpr (!embed) { // lm_head cur = build_lora_mm(model.output, cur, model.output_s); res->t_logits = cur;}res->t_embd = cur 把最后一层归一化的输出登记为「embedding 输出」(t_embd 在 set_outputs 里会被保留),res->t_logits 则是最终的 logits。这两个是 llm_graph_result 里的输出指针被真正赋值的时刻——前面所有章节讲的 llm_graph_result 设计,最终就是为这两行服务的。-1 作为层号是 llama.cpp 的约定:表示「不在层循环里」。
DeepSeek:MLA 与两条注意力输入
src/models/deepseek2.cpp(705 行)展示了 MLA 架构的建图差异。先看 DeepSeek-V3 的整体结构,尤其是 MLA 与 DeepSeekMoE 这两块:
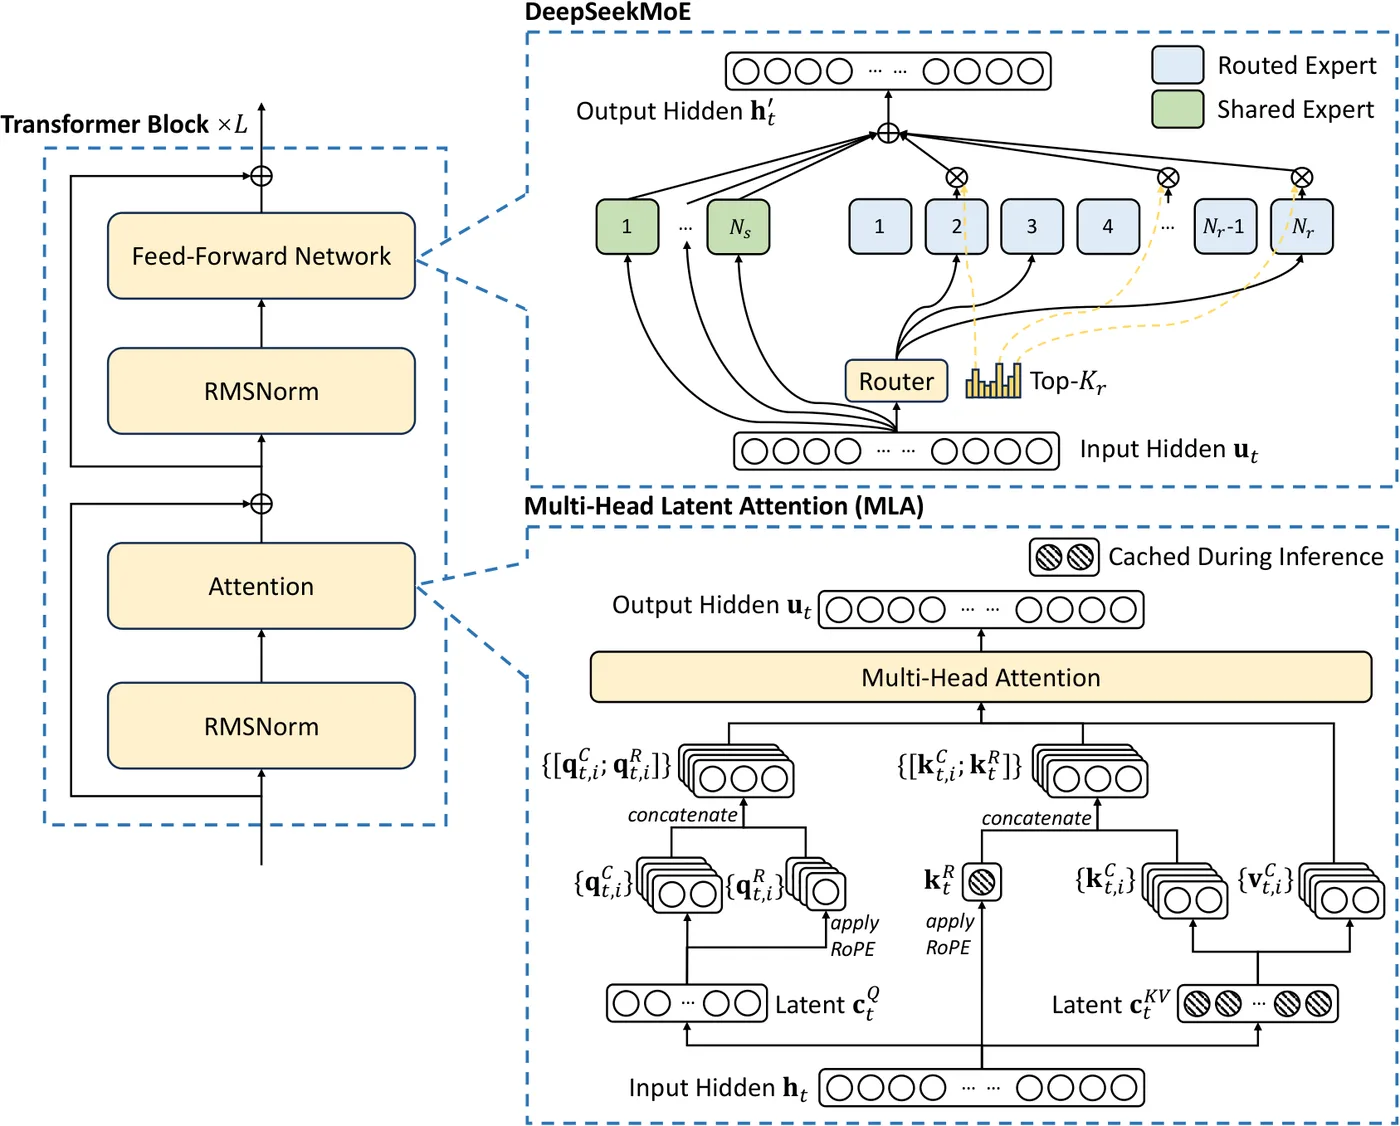
对照这张图可以看出 llama.cpp 的两处结构性取舍。第一,MLA 的 KV 压缩:图中 MLA 把 K/V 投影到一个低维的 c_KV latents,这一步让 KV 缓存的体积与头数解耦——回到代码,这就是为什么 DeepSeek 走 build_attn_inp_k(只有 K 索引)而不是 build_attn_inp_kv。第二,DeepSeekMoE 的共享专家 + 路由专家:图里 FFN 分成上下两路(共享专家恒参与、路由专家按 Top-K 选),而 build_moe_ffn 的 n_expert/n_expert_used 与 exp_probs_b 参数正是用来表达「哪些是路由专家、如何做无辅助损失的负载均衡」。图片来源:DeepSeek-V3 Technical Report(arXiv:2412.19437)。
最直观的一处是注意力输入的选择:
auto * inp_attn_kv = !is_mla ? build_attn_inp_kv() : nullptr;auto * inp_attn_k = is_mla ? build_attn_inp_k() : nullptr;MLA 走的是 llm_graph_input_attn_k(只有 K 索引,没有 V),而不是标准的 attn_kv。为什么?
这是因为 MLA 的「吸收」优化(Absorption)。回顾 MLA 的机制:它把 K/V 压缩成低维 latent(c_kv),注意力计算在 latent 空间进行。关键是 V 的变换可以吸收进输出投影矩阵——也就是说,如果只缓存 latent 形式的 K(c_kv),V 的信息可以从中恢复,不需要单独缓存完整的 V。这样 KV 缓存的体积就与完整 MHA 的 V 缓存脱钩了,MLA 的缓存占用优势正是来自这里。
llm_graph_input_attn_k 就是为这种「只缓存 K」的架构准备的(llama-graph.h:381,注释里引了 PR #19067)。它比 attn_kv 少了 self_v_idxs 和 self_v_rot——因为根本没有 V 要索引。
DeepSeek 的 FFN 建图还有一个门控函数上的区别:
ggml_tensor * moe_out = build_moe_ffn(cur, ..., n_expert, n_expert_used, LLM_FFN_SILU, hparams.expert_weights_norm, ..., ...hparams.expert_weights_norm 是从模型配置读出来的而不是硬编码——因为 DeepSeek 的不同版本对权重归一化的开关不同,而且这个值会随模型一起从 GGUF 元数据里读进来。对比 Llama 文件里硬编码的 true,可以看出不同架构文件对「配置化程度」的处理不一致——这是仓库演进过程中自然形成的差异。
还有一个 nextn 层相关的片段:
ggml_tensor * head_norm_w = layer.nextn.shared_head_norm;GGML_ASSERT(head_norm_w && "GLM4 MTP: missing both nextn.shared_head_norm and output_norm");cur = build_norm(cur, head_norm_w, nullptr, LLM_NORM_RMS, -1);MTP(Multi-Token Prediction)层是 DeepSeek-V3 的一个特性:模型除了主输出头外还有一个「预测下一个再下一个 token」的头,用于投机解码时提供草稿。llama.cpp 把它作为 nextn 层的一部分建进图(n_layer_nextn 就是这类层的数量)。这里那条断言值得注意:用 GGML_ASSERT 而不是静默回退,与前面 GGML_ABORT 的策略一致——模型与实现不匹配时宁可拒绝。
把两个文件的写法对照起来,可以看出一条清晰的分工线:llama-graph.cpp 提供与架构无关的构件,src/models/*.cpp 只负责声明「这个架构有哪些张量、按什么顺序排、用什么门控」。148 个模型文件之所以能维护,正是因为这层分工:新架构作者不需要懂 ggml,只需要照着最相似的已有架构改张量名单与循环顺序。
图复用与形状约束
前面几节都提到了「复用」,这一节把它讲完。
复用的判据汇总
一次 llama_decode 进来,llama_context::process_ubatch(llama-context.cpp:1507)会做这个判断:
if (!graph_reuse_disable && gf_res_prev_active == res && res->can_reuse(gparams)) { ... // 复用:跳过建图,只填充输入}三个条件:
!graph_reuse_disable:用户可以全局关闭图复用(调试用)。gf_res_prev_active == res:复用必须发生在同一张图容器上(res是上一次建图的那个结果对象)。res->can_reuse(gparams):也就是前面讲的两级判断——参数包allow_reuse+ 每个输入的can_reuse。
判断通过后的动作只有一件事:set_inputs(ubatch),即把所有输入张量按新的批次数据填充。图结构不动,ggml_gallocr 也不用重新规划(因为形状没变)。
形状为什么是硬约束
ggml 的图在 no_alloc 上下文里构建,张量的形状在建图时就固化在元数据里。第二篇讲过,ggml_gallocr 的内存规划是基于图上所有张量的形状和生命周期做的。如果某一批的 n_tokens 变了,所有激活张量的形状都变,整张图必须重建、内存必须重规划。
于是 llama.cpp 在上下文初始化时就把最大的形状算出来,预分配好(第(四)篇讲的 llama_context 初始化预算),运行时只允许「小于等于」的批次。这就是为什么建图代码里到处是 graph_reserve、ubatch_reserve、n_kv_max 这类命名——它们都是「把形状提前钉死」的工程手段。
ggml_flash_attn_ext_set_n_kv_max 是最典型的一例:它把「KV 长度上界」作为元数据挂在张量上,让 kernel 可以用静态分块(n_kv_max 决定分块数),代价是实际 KV 长度短于上界时会有些冗余计算。这是「形状固定」换「kernel 效率」的交易。
什么会让复用失效
把 allow_reuse 的检查项反过来说,就是「什么改动会导致图重建」:
n_tokens变化(最根本的:预填充和解码的形状完全不同)。n_seqs/n_seqs_unq/equal_seqs变化(注意力流的组织变了)。- token/embd 输入类型切换(走不同的 select 分支)。
n_outputs变化(输出裁剪的行数变了)。- 采样器集合变化(采样进图时图上会多出节点)。
cparams里影响图结构的参数变化(RoPE 参数、池化类型、nextn_layer_offset等)。- 某个输入的
can_reuse返回 false——最有代表性的就是kq_mask的n_kv变了:KV 缓存里已存的位置数变化会改变掩码张量的形状。
这里的实际影响是:纯解码场景复用率极高(每步一个 token,形状稳定),混合批次(同时有预填充和解码)复用率低(形状每次都不同)。这也解释了 llama.cpp 为什么要做 equal_seqs 这条快速路径——它让「多条序列同时解码」这一最常见的高并发场景保持形状稳定,从而让图复用真正生效。
与 vLLM/SGLang 的对照
vLLM 与 SGLang 走的是相反的路:eager 模式下一个算子调用立即执行,不存在”图重建”的成本,因此形状可以自由变化(每条请求自己的 KV 长度都没关系)。它们对付调度开销的手段是 CUDA Graph(第(十)二篇与 SGLang 篇讲过:解码整图捕获重放、prefill 分段图 + 形状分桶)。形状分桶本质上就是「把形状空间离散化成有限的几桶,每桶一张捕获好的图」——这是对同一个问题(形状动态 vs 图静态)的另一种解法。
llama.cpp 的解法更「静态」:一张图,形状上界固定,复用时只换输入。代价是形状必须提前预算、内存预留偏保守;收益是零重建开销、零捕获开销、且天然适配「一张图切到多个后端」。这两种路线的差异根植于第(一)篇讲过的定位差异:llama.cpp 面向单机/端侧(内存与设备固定、批量小、形状收敛),vLLM/SGLang 面向数据中心(设备多、批量大、形状发散)。
小结
这一篇把 llama.cpp 的图构建子系统从参数包到具体模型代码拆了一遍。核心结论有六条。
第一,建图是一个”纯过程”,输入是一个自给自足的参数包。 llm_graph_params 把模型规模、本批数据、图类型、外部句柄、输出回调五类信息打包成一个按值传递的结构体,建图函数因此不需要回头访问 llama_model 或 llama_context。hparams/cparams/ubatch 都刻意做成副本——因为图的寿命可能远长于这一批的参数对象,用引用会踩 stack-use-after-return。
第二,llm_graph_context 是一套”构件库 + 共享环境”。 它把参数展开成一堆 const 成员(还顺手做了 warmup 时全专家参与的预处理),并提供四组构件:通用算子(build_lora_mm/build_norm/build_ffn)、输入(build_inp_*)、注意力(八个 build_attn 重载)、输出(build_logits/build_pooling)。ctx0 与 gf 从 llm_graph_result 取来而不是新建——这是图复用能成立的前提。
第三,“输入”是被显式建模的一等公民。 每个 build_inp_* 都遵循同一套模式:新建张量 → 打点 → ggml_set_input → 登记进 res->inputs。其中最典型的是注意力的 llm_graph_input_attn_kv:它把「K/V 槽位索引」和「KV 掩码」抽象成三个占位张量,运行时用 set_input 填充。建图时不知道 KV 会落在哪里,所以图上放一个壳——这是整套设计里最关键的一层解耦。
第四,注意力建图的两条路与一个 stream 维度。 build_attn_mha 按 cparams.flash_attn && kq_b == nullptr 分流:FlashAttention 路径做转置/类型归一后调用 ggml_flash_attn_ext,并设置 n_kv_max、attention sink 与 F32 累加精度;朴素路径则老老实实建 mul_mat → softcap → bias → softmax → mul_mat 一列算子。k->ne[3] 是注意力流维度,混合长度批次会被拆成多条流,每条流有独立的掩码。
第五,MoE 建图的核心是”先把路由算清楚,再按 id 批量矩阵乘”。 门控函数(softmax/sigmoid/sqrt-softplus)决定专家之间是否竞争;DeepSeek-V3 的选择偏置被刻意拆成 probs(用于加权)与 selection_probs(用于选择)两个张量;专家分组用 -INFINITY 掩码实现;权重归一化用 F16 最小正规数做 clamp。最后 build_lora_mm_id 落到 ggml_mul_mat_id,用「按专家分组重排 + 批量矩阵乘」替代逐专家的循环。
第六,图复用是一次廉价的字段比较,形状是硬约束。 复用判据分两级:参数包的 allow_reuse(比对 ubatch 形状、序列集合、输出数、采样器、cparams)与每个输入的 can_reuse(比对各自关心的形状变化,比如 n_kv)。通过之后只做一件事:set_inputs。之所以必须如此,是因为 ggml 在 no_alloc 上下文里建图时就把形状固化进了元数据,形状一变整张图与内存规划都要重来。纯解码场景复用率极高,混合批次复用率低——这也解释了 equal_seqs 快速路径存在的意义。与 vLLM/SGLang 的对照是:后者用 CUDA Graph + 形状分桶解决同一个问题,本质是把形状空间离散化成有限的几桶。
一句话概括这一篇:llama-graph 是”模型结构”与”算子序列”之间的编译器,它的输入契约、构件库、输入抽象与复用判据,共同构成了 llama.cpp 支持一百多个模型架构而代码不爆炸的全部秘密。
下一篇进入 llama.cpp 源码完全拆解(七):后端与 kernel——这一篇建出来的图,最终要由 ggml_backend_sched 切分到 CPU/GPU 上执行。下一篇会沿 ggml-cuda/ 目录拆解量化矩阵乘(mmq.cu)、FlashAttention 的 CUDA 实现(flash-attn.cu)、CPU 侧的指令集特化与权重 repack,以及调度器的拷贝回调与 MoE 优化。此外,MoE 专家并行与 DeepEP 通信在站内已有专文,可参考 SGLang 源码完全拆解(十七):DP Attention 与专家并行;KV 缓存的量化存储与量化块布局,可参考 GGUF 完全拆解:一个文件里的张量布局、k-quants 块量化与元数据字典 与 KIVI 完全拆解:非对称 2-bit KV Cache 量化。
参考资料
- llama.cpp 官方仓库(ggml-org/llama.cpp)
- llama-graph 建图核心源码 src/llama-graph.cpp
- 建图接口与构件声明 src/llama-graph.h
- Llama 架构建图实现 src/models/llama.cpp
- DeepSeek 架构建图实现 src/models/deepseek2.cpp
- llama_context 中 process_ubatch 与图复用入口 src/llama-context.cpp
- Attention Is All You Need(缩放点积注意力与多头注意力的原始论文)
- DeepSeek-V3 Technical Report(MLA 与 DeepSeekMoE 架构)
- Mixtral of Experts(稀疏 MoE 层结构与 Top-2 路由)
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity
- llama.cpp 官方文档:ggml 后端与多 GPU 使用
- ggml 张量库仓库(ggml-org/ggml)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



