


llama.cpp 源码完全拆解(一):整体架构与模块全景——ggml 后端抽象、llama_model/llama_context 与图构建
前面十八篇把 SGLang 的运行时从请求入口一路拆到了弹性 EP 与故障恢复,vLLM 侧则用十六篇建立了从 add_request 到 detokenizer 的完整路径。两个框架都建立在同一个前提上:模型在启动时被加载进显存,算子在 GPU 上通过高度特化的 kernel 执行,KV 缓存是一块被显式管理的显存区域。这套前提在处理 70B 级别模型的服务器上成立,但在另一个场景里完全不成立——单机、消费级显卡、甚至没有显卡,模型是以 4 bit 量化块的形式躺在磁盘文件里,内存装不下全部权重,必须做内存映射与按需换入。
llama.cpp 就是为后一个场景写出来的。它 2023 年 3 月由 Georgi Gerganov 在 GitHub 上发布,最初的动机是让 LLaMA 权重能在 MacBook 的 Apple Silicon 芯片上跑起来,随后扩展成一个覆盖 CPU、CUDA、Metal、Vulkan、SYCL、ROCm、CANN 等十余种后端的推理运行时。它与 vLLM、SGLang 最本质的区别不在调度算法,而在算子层是自己实现的:vLLM 把 torch.nn.Linear 交给 PyTorch 和 cuBLAS,SGLang 同样如此,而 llama.cpp 从张量库 ggml 开始都是自研的。这个选择决定了它的全部架构形态——一套自定义计算图、一套自定义内存分配器、一套自定义量化格式、一套跨后端调度器。
本篇是 llama.cpp 子系列的第一篇,目标不是讲透某个模块,而是画出整张地图:仓库里有哪些目录、各层职责边界在哪、一次 llama_decode 调用如何从 Python 侧的用户代码一路走到 CPU 上一个 AVX2 点积指令。后面几篇会依次深入 ggml 的计算图与分配器、GGUF 文件格式与量化块布局、llama_model 的张量装载与内存映射、KV 缓存与上下文管理、采样器,以及 server 的多序列调度。
为什么需要一张”分层地图”
读一个几十万行的 C/C++ 仓库,最容易失败的路径是从 main() 开始逐行读。llama.cpp 的主仓库根目录下同时存在 src/、ggml/、common/、tools/、examples/、conversion/、gguf-py/ 七个源码相关目录,加上 tests/、benches/、ci/ 等辅助目录,如果不先建立”谁依赖谁”的直觉,很快就会在 llama_model_loader、ggml_backend_sched、llama_context::process_ubatch 这几个名字之间迷路。
先给出依赖方向。llama.cpp 的代码组织是严格分层的,上层可以调用下层的公开头文件,反向依赖只通过少数几个回调(例如 ggml_backend_reg_get_proc_address 查询的 CPU 线程池设置函数)实现:
tools/ (server, cli, llama-bench, quantize, mtmd ...) | 依赖common/ (CLI 参数解析、对话模板、采样链组装、日志) | 依赖src/ (llama.h 公开 API + llama_* 内部实现) | 依赖ggml/ (张量库:ggml.h 核心 + ggml-backend.h 后端抽象 + 各后端目录) | 依赖无(ggml 是自包含的,可以被单独复制到其他项目使用)ggml/ 是唯一一个可以脱离 llama.cpp 独立工作的层。它的公开头文件只有 ggml/include/ggml.h(核心张量与算子)和 ggml/include/ggml-backend.h(后端注册、设备、调度器),对应实现在 ggml/src/ggml.c、ggml/src/ggml-alloc.c、ggml/src/ggml-backend.cpp 等文件里。llama.cpp 官方仓库把 ggml 作为子目录内联维护(历史上曾拆分成独立的 ggml-org/ggml 仓库,现在主开发仍在 llama.cpp 的 ggml/ 目录内进行),这意味着两者的版本是同步演进的——这也是为什么读 llama.cpp 时必须整个仓库一起看,不能假设 ggml 是一个稳定的外部库。
src/ 层是 llama.cpp 的”业务逻辑”,它做三件 ggml 完全不关心的事:把 GGUF 文件里的权重装载成 ggml 张量、把 Transformer 的层结构翻译成一张 ggml 计算图、管理 KV 缓存与序列。common/ 与 tools/ 是应用层,llama-server 的 HTTP 接口、连续批处理、多序列管理都在 tools/server/ 里,而不是在 src/ 里——这一点和 vLLM、SGLang 差别很大,后两者把服务化能力作为核心设计目标放在引擎内部。
ggml 的两个核心抽象
llama.cpp 与 PyTorch 生态的分野,在 ggml 的头文件里就能看清。ggml.h 是纯 C 的 API(约 11.6 万字节,含大量算子声明与量化类型定义),ggml-backend.h 则是 C++ 风格的句柄体系。理解 ggml 只需要抓住两个抽象:张量是惰性的,后端是可插拔的。
惰性张量与计算图
ggml.h 里的张量结构体与 PyTorch 的 eager 张量有本质区别。一个 ggml_tensor 记录形状(ne[4])、步长(nb[4])、数据类型(GGML_TYPE_Q4_K 这样的量化类型也是合法类型)、指向数据的 data 指针,以及一个 op 字段表示”这个张量是由哪个算子产生的”和一个 src[GGML_MAX_SRC] 数组表示输入张量。当用户调用 ggml_mul_mat(ctx, a, b) 时,返回的张量没有任何数据被计算,它只是一个标记了 GGML_OP_MUL_MAT、输入指向 a 和 b 的节点。真正的计算发生在把整张图交给后端执行的时候。
这个设计直接决定了四个后果,后面每一篇都会反复用到:
- 内存可以提前规划。因为图在执行前是完整的,分配器能算出每个中间张量的生命周期,做重叠复用,这就是
ggml-alloc.c里ggml_gallocr的工作。 - 图可以被反复重放。CUDA Graph、Metal 的 command buffer 复用都建立在同一张图结构不变的前提上。
- 图可以按后端切分。一个图节点被分配给哪个后端是在执行前决定的,切分点就是跨设备拷贝点。
- 形状必须在构建时确定。这是 llama.cpp 用
llama_ubatch统一形状、以及所有序列被 pads 到相同 token 数的根本原因——图的结构由形状参数唯一决定,形状一变就要重建。
ggml_context 是张量与图元数据的分配器,它不管理张量数据本身,只管理张量结构体、字符串(算子名、张量名)和图结构体。llama.cpp 在 llama_context 构造时会创建若干个 context:一个用于构建当前批次的图,一个用于采样,一个用于 KV 缓存(ggml-backend.h 中的 ggml_context_ptr 就是为此设计的 RAII 包装)。
后端抽象:注册表、设备、缓冲区类型
ggml-backend.h 定义的句柄体系用四层描述一个可插拔的执行环境:
| 句柄 | 含义 | 典型实例 |
|---|---|---|
ggml_backend_reg_t | 一个后端注册表项,承载后端的名字与函数表 | CUDA、Metal、Vulkan、CPU、RPC |
ggml_backend_dev_t | 注册表里的一个设备 | 某块具体的 GPU、CPU、RPC 远端 |
ggml_backend_buffer_type_t | 该设备上分配缓冲区的类型描述 | 设备显存、主机 pinned 内存、mmap 的权重区 |
ggml_backend_buffer_t | 实际分配出来的缓冲区 | 一块显存切片 |
设备被划分为五类,ggml-backend.h 里的枚举是 GGML_BACKEND_DEVICE_TYPE_CPU、GGML_BACKEND_DEVICE_TYPE_GPU、GGML_BACKEND_DEVICE_TYPE_IGPU(集成显卡,在设备枚举时会被去重,避免同一颗芯片被多个后端各报一次)、GGML_BACKEND_DEVICE_TYPE_ACCEL(加速器)和 GGML_BACKEND_DEVICE_TYPE_META。最后一个是 llama.cpp 用来实现多卡张量并行的特殊构造:它把一组真实设备包装成一个逻辑设备,让上层代码可以像对待单设备一样对待一组 GPU。
每个后端在初始化时通过 ggml_backend_register 把自己挂进全局注册表,ggml_backend_load_all() 会扫描构建产物目录下的所有后端动态库并全部加载(llama_backend_init 里就是这么做的)。上层查询能力用的是一组统一接口:ggml_backend_dev_supports_op 问”这个算子你能执行吗”,ggml_backend_dev_buffer_type 问”你的缓冲区怎么分配”,ggml_backend_reg_get_proc_address 用来取得后端特有的扩展函数。
这个设计的实际意义在于:“一张图跑在混合设备上”是默认能力,而不是特例。llama.cpp 支持同时使用 CUDA GPU、CPU 和远端 RPC 服务器,甚至允许用 -ot 参数把指定的张量模式(比如所有 FFN 权重)强制放到指定后端。支持这一点的机制是 ggml_backend_sched——不是后端,而是一个”后端的后端”。
ggml_backend_sched:跨设备调度的核心
ggml_backend_sched 是 llama.cpp 架构里最容易被低估的组件。它不是简单地把图丢给一个后端,而是完成了四件事:切图、分配、插入拷贝、执行。
切图的依据是每个节点的”优选后端”。llama.cpp 在构建图时会为张量标注权重张量应该放在哪个设备上(这是模型装载阶段 llama_prepare_model_devices 与张量分配策略共同决定的信息),调度器随后从上到下遍历整张图,遇到节点归属发生变化的地方就断开,形成一个”切分(split)“。每个切分内的所有节点必须在同一个后端上执行。
切分之后是缓冲区规划。ggml_backend_sched_reserve 用一个”测量图(measure graph)“跑一遍完整的分配流程,把每个后端需要的计算缓冲区大小定下来,之后真实执行时直接复用这块缓冲区。这正是 llama_context::graph_reserve 做的事——它构造一个虚拟的 ubatch(balloc.ubatch_reserve(n_tokens/n_seqs, n_seqs)),用最坏情形形状跑一次 model.build_graph,再调用 ggml_backend_sched_reserve 把缓冲区定死。头文件里 graph_reserve 的注释写得很明确:这是为了”预留最坏情况的计算缓冲区(allocate worst-case compute buffers)”。
跨切分的张量必须搬运,这就是 ggml_backend_sched 会在图里插入 GGML_OP_CPY 节点的原因。默认做法是把张量复制到目标后端的缓冲区,llama.cpp 通过 ggml_backend_sched_set_copy_callback 注册了一个自定义回调 llama_context::sched_copy_experts,用来优化 MoE 场景:只复制 MUL_MAT_ID 实际用到的专家行,而不是整个专家权重张量。这是”调度器不只是调度,还能参与语义优化”的一个典型例子。
最后是执行。ggml_backend_sched_graph_compute_async 按切分顺序依次调用各后端的 graph_compute。由于切分之间可能有依赖,默认是串行的;但当后端支持异步提交(CUDA、Metal)时,可以借助事件做流水重叠——llama_context::graph_compute 里那段”pipeline parallelism 下前一个 async 计算可能还在跑,必须先同步再写输入张量”的注释,说的就是这个边界。
llama_model 与 llama_context:职责怎么切
进入 src/ 层,第一个要建立的概念是模型与上下文的分离。这个分离在 PyTorch 生态里也存在(nn.Module 与 KVCache),但 llama.cpp 把边界划得更硬:
// src/llama-model.h(结构体成员摘录,示意)struct llama_model { llama_hparams hparams; // 层数、头数、头维、RoPE 类型、专家数等超参 llama_vocab vocab; // 词表与分词规则 std::vector<llama_layer> layers; // 每层的权重张量句柄 + 层类型标记 std::vector<llama_device> devices; // 权重的归属设备列表 ggml_type type_k, type_v; // K/V 的存储类型(可量化) // ...};llama_model 持有不可变的、只读的东西:超参、词表、权重张量、设备分配。它在 llama_model_load_from_file 时构造,之后不再改变(LoRA adapter 是例外,它挂在 context 侧)。权重张量通常通过 mmap 直接映射到文件页,这意味着模型的物理内存占用是惰性的——只有被访问过的页才会真正读进 RAM 或显存,进程退出时随页缓存释放,多个进程可以共享同一份页缓存。这就是为什么 llama.cpp 能在 16 GB 内存的机器上”加载”一个 20 GB 的 GGUF 文件而不立刻 OOM。
llama_context 持有可变的、每个会话独立的东西。src/llama-context.h 里的成员表很长,按职责可以分成五组:
- 计算基础设施:
llama_cparams(运行时参数:n_ctx、n_batch、n_ubatch、线程数、RoPE 缩放、KV 类型)、ggml_backend_sched_ptr sched(调度器)、backend_ptrs/backend_buft/backend_buf_exp_size(各后端的缓冲区规划结果)、threadpool与threadpool_batch(CPU 侧的线程池句柄,解码用单 token 线程数、预填充用批量线程数)。 - 内存与缓存:
llama_memory_ptr memory(抽象的”上下文记忆”,KV 缓存是它的一种实现)、llama_moe_cache_ptr moe_cache(MoE 专家权重缓存)、mem_storage(每序列的设备端状态副本,用于快速 state save/load)。 - 输出缓冲:
buffer_view<float> logits(形状[n_outputs][n_vocab])、buffer_view<float> embd(池化前的嵌入)、embd_seq(按序列池化后的嵌入)、output_ids与output_swaps(批次位置到输出缓冲行的映射与重排)。 - 适配器:
cvec(控制向量)与loras(LoRA 权重)。 - 图复用状态:
gf_res_prev(两个llm_graph_result_ptr的数组,分别对应”有输出”和”无输出”两类批次,llama-context.h的注释指出这样做是为了让 CUDA Graph 缓存键不同)、gf_res_reserve、graph_reuse_disable(环境变量LLAMA_GRAPH_REUSE_DISABLE)、n_reused(复用计数)。
KV 缓存的容量是这些运行时参数里最常被算错的一项。对常规多头注意力模型,缓存大小是
其中 是层数、 是 KV 头数(GQA 下远小于查询头数)、 是头维、 是上下文长度,系数 2 对应 K 与 V 两份。以 Llama-3.1-8B 为例,、、、、dtype 为 fp16,代入得到约 1 GiB——这还没算每个序列的缓存是独立分配的:llama.cpp 的 n_seq_max 与 n_ctx_seq 决定了”总上下文预算如何在序列间切分”,默认 n_ctx 是所有序列共享的总量(对应 cparams.kv_unified),而开启统一 KV 池后每个序列可用长度是动态的。把 type_k/type_v 换成量化类型(如 Q8_0)能让这个数字直接减半再减半,代价是注意力的近似误差——这一步在长上下文场景里往往比调批次大小更能决定”能不能跑起来”。
注意 memory 的类型是 llama_memory_i,而不是 llama_kv_cache。src/llama-memory.h 里对这个接口的定义是”批次处理期间管理记忆上下文的接口,按记忆类型各自实现”,注释里列举了 llama_kv_cache_context、llama_kv_cache_iswa_context 等实现。接口的核心方法只有四个:init_batch(把输入批次切成 ubatch 并校验能装下)、init_full(模拟全满缓存,用于分配最坏情况缓冲区)、init_update(处理待执行的 shift/copy)、以及返回的 llama_memory_context_i 上的 next / apply / get_ubatch / get_status。头文件里有一句非常关键的设计约束:只有 llama_memory_i::apply() 允许改动记忆与记忆上下文。
这个抽象是 llama.cpp 近年来最重要的结构演进之一。它把 KV 缓存从”一个大的 K/V 张量”升级成了”一类记忆”,从而允许混合记忆类型(llama-memory-hybrid.cpp 组合两种记忆)、循环状态记忆(llama-memory-recurrent.cpp,对应 RWKV/Mamba 这类没有 KV 缓存的架构)、以及带滑动窗口的缓存(llama-kv-cache-iswa.cpp)。接口上还有两个回调值得一提:layer_filter_cb 用来筛掉不参与缓存的层,layer_reuse_cb 用来让某些层复用其他层的缓存空间——这是层间 KV 共享(如 YOCO 类结构)的挂载点。
从 llama_decode 到 GPU:一次前向的完整路径
地图画完之后,用一次真实的调用走一遍。外部调用 llama_decode(ctx, batch) 进入 llama_context::decode,其主干在 src/llama-context.cpp 里大约 200 行,可以分成六个阶段。
第一阶段:批处理校验与 allocr 初始化。 decode 首先确认 context 有 memory(没有则退化为 encode),检查 token 数非零、嵌入维度匹配输入维度。随后决定 output_all(cparams.embeddings 为真时全部 token 都要输出)和 embd_all(非因果注意力必须把整条序列放进同一个 ubatch)。最后把批次交给 llama_batch_allocr:balloc->init(batch_inp, vocab, output_all)。这个 allocr 负责把外部的扁平 llama_batch 展开成内部表示、生成位置、解析序列 ID、校验位置连续性,并把结果缓存起来供本次及后续复用(llama_context 成员里的 balloc 注释写着”复用 batch_allocr 以避免不必要的内存分配”)。
第二阶段:内存更新与 ubatch 切分。 紧接着是 memory_update(false),处理上一轮留下的 shift/copy 操作。然后进入主循环,每轮调用 memory->init_batch(*balloc, cparams.n_ubatch, embd_all) 取下一个 ubatch。根据返回状态分三种情况:LLAMA_MEMORY_STATUS_SUCCESS 表示有新数据要处理,LLAMA_MEMORY_STATUS_NO_UPDATE 表示这个 ubatch 不需要更新记忆(例如纯解码且缓存已就位),失败则返回负值。这个循环的存在意味着一次 llama_decode 内部可能执行多次图计算——当输入批次(n_batch)大于单个 ubatch 容量(n_ubatch)时必须切分,这正是分块预填充在 llama.cpp 里的形态。
第三阶段:图复用或重建。 对每个 ubatch,process_ubatch 决定是复用上一轮的图还是重建。判断条件是 gf_res_prev_active == res && res->can_reuse(gparams),其中 gparams 由 graph_params(res, ubatch, mctx, gtype) 生成。头文件里的注释说明了复用成立的前提:图的结构必须由这组参数唯一决定。如果形状、序列数、输出数、记忆上下文任何一项变了,就必须走重建路径:ggml_backend_sched_reset、ggml_backend_sched_set_eval_callback、model.build_graph(gparams)、ggml_backend_sched_alloc_graph。这里有个容易被忽视的正确性细节:复用路径下如果开启了 pipeline parallelism,必须先 ggml_backend_sched_synchronize,否则上一轮还在读的输入张量会被这一轮覆盖。
第四阶段:写入输入并执行。 res->set_inputs(&ubatch) 把 token id、位置、序列信息、输出标记写进图上被标记为输入的那些张量,然后 graph_compute(res->get_gf(), ubatch.n_tokens > 1)。graph_compute 做两件准备动作——给 CPU 后端设置线程池、给所有后端设置线程数(批量用 n_threads_batch,单 token 用 n_threads)——然后调用 ggml_backend_sched_graph_compute_async。注意这里把”是否批量”作为参数传下去,就是为了在预填充和逐 token 解码之间切换线程策略:解码时并行度不足,线程开太多反而因为同步开销掉性能。
第五阶段:取回输出。 图算完之后,从 llm_graph_result 里取出 t_logits、t_embd 等输出张量的指针,用 ggml_backend_sched_get_tensor_backend 问出这些张量实际落在哪个后端,再用 ggml_backend_tensor_get_async 异步拷回主机侧的 logits 缓冲区,偏移量是 n_outputs_prev * n_vocab。注意”异步”两个字:拷贝是排进流里的,真正的同步发生在后续需要数据的时候(例如采样前)。output_ids 与 output_swaps 负责把图里的输出行序映射回批次的原始顺序,因为经过 ubatch 切分与 padding 之后,两者的顺序未必一致。
第六阶段:错误回滚。 如果 process_ubatch 返回空指针,decode 会做一件很讲究的事:遍历失败 ubatch 的所有 token,按序列统计最小位置 pos_min[s],然后对每个受影响的序列调用 memory->seq_rm(s, pos_min[s], -1),把该位置之后的所有缓存条目删掉。这是因为部分 ubatch 可能已经成功写入缓存,如果不回滚,下次调用就会看到一个”半截状态”的序列。返回值也做了区分:2 表示被 abort(已处理的 ubatch 会保留在记忆里),-2 表示分配失败,-3 表示计算失败。llama.h 里 llama_decode 的注释完整列出了这套返回码语义,包括”返回 1 表示找不到 KV 槽位,请减小批次或增大上下文”这一条——这正是上下文长度耗尽时用户看到的那个错误。
把这段路径写成骨架,调用顺序与关键返回值一目了然:
// src/llama-context.cpp(主干骨架,省略日志与断言)int llama_context::decode(const llama_batch_ext & batch_inp) { if (!memory) { return encode(batch_inp); // 无记忆的 context 退化为编码器 } // 1. 形状与输出策略 const bool output_all = cparams.embeddings; const bool embd_all = output_all || !cparams.causal_attn; if (!balloc->init(batch_inp, vocab, output_all)) { return -1; // 批次无效 } GGML_ASSERT(n_tokens_all <= cparams.n_batch); sched_reserve(); // 必要时重建调度器与计算缓冲区 memory_update(false); // 处理上一轮遗留的 shift / copy
// 2. ubatch 切分循环:一次 decode 可能执行多次图计算 while (true) { mctx = memory->init_batch(*balloc, cparams.n_ubatch, embd_all); if (!mctx) return -2; // 分配失败 if (mctx->get_status() == LLAMA_MEMORY_STATUS_NO_UPDATE) { // 本 ubatch 不需要更新记忆,直接推进 } llama_ubatch ubatch = mctx->get_ubatch();
// 3. 图复用 or 重建 + 执行 ggml_status status; const auto * res = process_ubatch( ubatch, ctx_type_to_graph_type(cparams.ctx_type), mctx.get(), status); if (!res) { // 失败回滚:按序列最小位置裁剪已写入的缓存 const auto pos_max = std::numeric_limits<llama_pos>::max(); for (int s = 0; s < LLAMA_MAX_SEQ; ++s) { if (pos_min[s] != pos_max) memory->seq_rm(s, pos_min[s], -1); } switch (status) { case GGML_STATUS_ABORTED: return 2; case GGML_STATUS_ALLOC_FAILED: return -2; case GGML_STATUS_FAILED: return -3; default: break; } } // 4. 回传输出(异步拷贝到 host buffer) auto * t_logits = res->get_logits(); if (logits.data && t_logits && n_outputs > 0) { ggml_backend_t be = ggml_backend_sched_get_tensor_backend(sched.get(), t_logits); ggml_backend_tensor_get_async(be, t_logits, logits.data + n_outputs_prev * n_vocab, 0, n_outputs * n_vocab * sizeof(float)); } if (!mctx->next()) break; // 没有下一个 ubatch 就收尾 } return 0;}三个细节值得对着这段代码再强调一次。第一,sched_reserve() 放在主循环之前:调度器的重建只在 LoRA 变化、采样器变化、注意力类型变化等场景才需要,正常推理路径下它会因为 sched_need_reserve 为假而直接返回。第二,memory_update(false) 的参数 optimize 在解码路径下是 false,而在缓存空间告急重试的路径下是 true(decode 中段的那个 if (memory_update(true)) 分支),差别在于是否允许做代价较高的缓存整理。第三,n_outputs 在进入 process_ubatch 之前就被设好,因为在图构建阶段就要知道输出张量的行数——这正是 llama-context.h 里那句注释”needs to happen before the graph is built”的含义。
这段路径里有一个 llama.cpp 特有的概念需要单独点出:llama_ubatch。src/llama-batch.h 里它的注释第一句是”keep this struct lightweight”。它的字段包括 n_tokens、n_seq_tokens、n_seqs、n_seqs_unq、n_pos,以及一组指针:token([n_tokens])、embd([n_embd, n_tokens],用于直接注入嵌入)、pos([n_tokens*n_pos])、n_seq_id 与 seq_id(每个 token 属于哪些序列)、output(每个 token 是否输出)、type(混合批次里标记该行是 token 还是 embd)。它的形状约束是”每个序列的 token 数相同”(n_seq_tokens 对全部 n_seqs 一致),这就是为什么批次里的短序列需要 padding,也是图结构能被形状参数唯一确定的前提。
n_pos 这个字段值得展开一点:它表示每个 token 有几个位置,常规文本模型是 1,而 M-RoPE 类多模态模型是 3(顺序位置、图像内的 y、图像内的 x),is_pos_2d() 判断的就是这种情况。pos 数组的排布是”所有行的第 0 段、所有行的第 1 段……”这样的分段结构,而不是按 token 连续——这是为了在图里把三段位置分别喂给三组 RoPE 算子。
ggml 的算子层与后端实现
图构建完之后,真正干活的是后端。ggml/src/ 下的目录结构直接反映了这套抽象的落地方式:
ggml/src/├── ggml.c # 核心张量与算子构建(图侧)├── ggml.cpp├── ggml-alloc.c # 计算图内存分配器(ggml_gallocr)├── ggml-backend.cpp # 调度器 ggml_backend_sched├── ggml-backend-reg.cpp # 后端注册表与动态加载├── ggml-backend-dl.cpp # 动态库加载├── ggml-backend-meta.cpp # META 设备(多卡张量并行的逻辑设备)├── ggml-quants.c # 量化块的解量化与量化(参考实现)├── gguf.cpp # GGUF 读写├── ggml-cpu/ # CPU 后端├── ggml-cuda/ # NVIDIA CUDA├── ggml-metal/ # Apple Metal├── ggml-vulkan/ # Vulkan├── ggml-sycl/ # Intel SYCL├── ggml-hip/ # AMD ROCm/HIP├── ggml-cann/ # 华为昇腾├── ggml-opencl/ ggml-zdnn/ ggml-zendnn/ (更多加速器后端)├── ggml-blas/ # BLAS 加速(Accelerate / OpenBLAS)└── ggml-rpc/ # RPC 后端(跨机器卸载)每个后端目录都要实现同一组东西:设备的初始化与查询、缓冲区类型与分配、算子支持性判断(supports_op)、以及最核心的 graph_compute。后端的规模差异极大:ggml-cuda/ggml-cuda.cu 约 26 万字节,ggml-cpu/ggml-cpu.c 约 13 万字节,而 ggml-vulkan/ggml-vulkan.cpp 接近 89 万字节——Vulkan 需要大量胶水代码来描述管线与内存屏障,而 CUDA 可以依赖更简洁的编程模型。所有 CUDA kernel 集中在 ggml-cuda/ 的 *.cu 文件里,按算子拆分(mmq.cu 是量化矩阵乘、flash-attn.cu 是注意力、norm.cu 是归一化等),每个 kernel 针对不同量化类型的”点积/矩阵乘”组合做实例化——这是 llama.cpp 在 GPU 侧最重要的性能来源,下一篇之外的后续篇章会专门拆。
ggml-alloc.c 里的 ggml_gallocr 是图执行的内存规划器。它不分配具体后端上的缓冲,而是算出”每个张量需要在哪个 buffer 的哪个偏移”,并利用张量生命周期做复用:两个生命周期不重叠的中间张量可以共享同一段空间。对于自回归解码这种形状固定、每步重放同一张图的场景,规划结果只需算一次。头文件里 ggml_backend_sched_reserve 与 ggml_backend_sched_alloc_graph 的分工也是这个思路:前者算一次,后者每步用规划结果直接摆位。
权重装载:GGUF、mmap 与 4 bit 块
llama.cpp 与 PyTorch 生态的另一个大分野是模型文件格式。它不用 safetensors 或 pickle,而是自定义的 GGUF(GPT-Generated Unified Format),并且把量化后的权重直接存进文件。这一点决定了整个装载路径的形态。
src/llama-model-loader.cpp(约 8 万字节)负责从 GGUF 读取元数据字典、张量信息表与张量数据。它支持把单个模型拆成多个文件(splits),支持按需读取(lazy_mode,对大张量按行惰性读取,需要 mmap 配合),支持键值覆盖(kv_overrides,用来在不重新转换模型的前提下改元数据),以及张量缓冲区类型覆盖(tensor_buft_overrides,即 -ot 参数的落地)。
值得强调的是,llama.cpp 里不存在一个”把量化权重还原成 fp16 再算”的步骤。矩阵乘 kernel 直接吃量化块:ggml-cuda/mmq.cu 里的 kernel 按块解出缩放因子与整数权重,在寄存器里与激活值做乘加。这也是 ggml 把量化类型定义成”张量类型”而非”存储优化”的原因——量化是一等公民,贯穿从文件格式到算子实现的整条链路,而不是加载期的预处理。
src/llama-mmap.cpp 提供跨平台的 mmap/mlock 抽象,llama_supports_mmap() 与 llama_supports_mlock() 都是通过它查询的。三种装载模式在 llama.h 的枚举里写得很清楚:LLAMA_LOAD_MODE_MMAP(内存映射)、LLAMA_LOAD_MODE_MLOCK(强制常驻内存,避免被交换出去)、LLAMA_LOAD_MODE_MMAP_MLOCK(两者结合,适合权重需要频繁访问的机器),以及新增的 LLAMA_LOAD_MODE_DIRECT_IO(绕过页缓存直接读,适合一次性大模型加载后不重复访问的场景)。默认的 AUTO 会依据设备能力自动选择。
mmap 路径的实际收益不只是”省内存”。因为 GGUF 里的量化权重是紧凑的块结构(例如 Q4_K 每 256 个权重一组,带 6 bit 与 4 bit 混合的缩放因子),文件布局与内存布局一致,mmap 之后不需要任何反序列化或重排,张量可以直接指向映射区。数据按页换入:只有当图执行真正读到某个权重块时,对应的页才从磁盘进入内存。这让”模型比内存大”变成了可工作的状态——代价是每步解码可能触发缺页中断,性能取决于磁盘。
量化为什么能省这么多空间而不至于毁掉模型,可以用一条简单公式看清误差的量级。把权重按块做均匀量化时,块内每个权重 被映射到整数 再缩放回去:
其中 是块的缩放因子, 是零点偏移, 是取整, 与 由比特数决定(例如 4 bit 时是 0 与 15)。取整带来的误差 在块内近似均匀分布,于是
这里 是量化步长, 是比特数。这条公式解释了两个现象:比特数每降 1,误差方差涨 4 倍(因为 大致随 变化),所以从 8 bit 降到 4 bit 的退化远小于从 4 bit 降到 2 bit;而块越小、缩放因子越密, 就越小——这正是 k-quants 把块从 32 个权重扩大到 256 个权重的同时,在块内再分层存储缩放因子(用 6 bit 存上层缩放、4 bit 存下层残差)的原因:块变大是为了减少缩放因子的存储开销,分层则是为了不让块变大导致 变粗。理解这条权衡,就能理解为什么上表里同为 4 bit 的 Q4_K_M 明显强于 Q4_0。
量化格式的设计是 llama.cpp 性能的关键。ggml-quants.c 实现的是参考版(标量)的量化与解量化,真实前向则由各后端提供向量化版本。llama.cpp 历史上的量化体系演化出了三类:legacy(Q4_0、Q4_1、Q5_0、Q5_1、Q8_0,每 32 个权重一块,块内共享一个缩放因子,Q4_1 额外多一个最小值偏移)、k-quants(Q2_K 到 Q6_K,块大小提升到 256,块内分层存储缩放因子与最小值,用更少比特描述更高精度的缩放)、以及 i-quants(IQ1_S 到 IQ4_NL 一族,使用码本/查表与更激进的比特分配)。存储类型是张量的属性,llama_model 里的 type_k / type_v 甚至允许把 KV 缓存本身也以量化类型存储(对应 --cache-type-k / --cache-type-v 参数),这是长上下文场景下省显存的主要手段。
量化误差随比特数的下降有多陡,可以从公开的实测数据看清。2026 年 1 月有一篇对 llama.cpp 量化方案的统一评测(针对 Llama-3.1-8B-Instruct,见参考资料),给出了同一模型在 F16 与各量化档位下的基准表现。下面是其中一组关键数字(GSM8K、HellaSwag、IFEval、MMLU、TruthfulQA mc2 的均值,以及困惑度 PPL):
| 方案 | 约比特 | 体积缩减 | 均值分数 | PPL |
|---|---|---|---|---|
| F16(基线) | 16 | — | 69.47 | 7.32 |
| Q3_K_S | 3 | 77.23% | 65.49 | 8.96 |
| Q3_K_M | 3 | 75.03% | 68.07 | 7.96 |
| Q3_K_L | 3 | 73.14% | 68.78 | 7.81 |
| Q4_0 | 4 | 71.03% | 67.98 | 7.74 |
| Q4_K_S | 4 | 70.83% | 69.17 | 7.62 |
| Q4_K_M | 4 | 69.41% | 69.15 | 7.56 |
| Q5_K_M | 5 | 64.35% | 69.36 | 7.40 |
| Q6_K | 6 | 58.98% | 69.23 | 7.35 |
| Q8_0 | 8 | 46.87% | 69.41 | 7.33 |
读这张表要注意两点。第一,“约比特”不等于实际比特:Q3_K_S 的存储密度接近 3 bit,但它的均值分数比 Q4_K_S 低 3.7 分,而 Q4_K_S 与 Q4_K_M 的分数几乎相同(69.17 与 69.15)、比特率也几乎相同(70.83% 与 69.41% 的体积缩减),这说明该档位下缩放因子的排布方式差异比比特数差异更重要。第二,Q4_K 系列在 4 bit 档位把损失压到了接近 F16 的水平(69.17 对 69.47),而老式的 Q4_0 在同一比特档只到 67.98,这是 k-quants 相比 legacy 量化的核心收益。
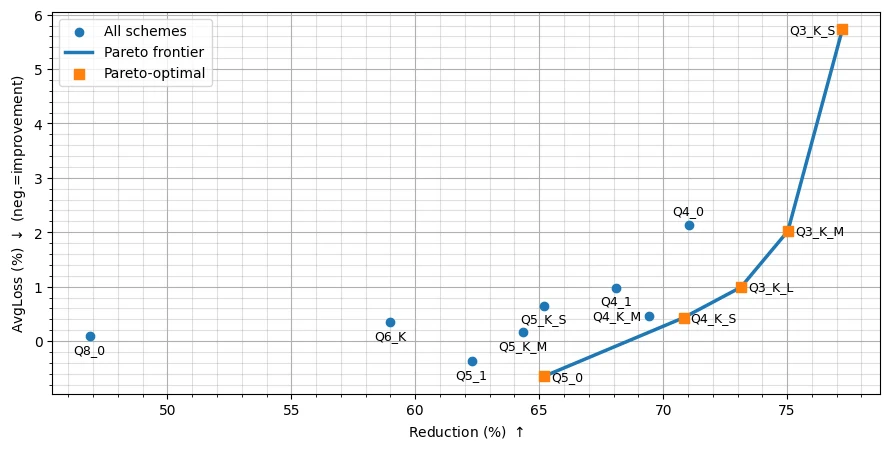
上图是该评测中的图 1,横轴是压缩程度、纵轴是相对 F16 的平均分数损失。曲线在 4 bit 附近出现明显的”拐点”形状:从 F16 降到 8 bit 再到 5 bit,损失几乎可以忽略;跨过 4 bit 之后斜率陡然变陡,3 bit 及以下开始出现显著退化,Q3_K_S 是其中最激进也最吃亏的一档。这个形状解释了为什么社区默认推荐 Q4_K_M:它在”拐点”刚过的位置拿到了接近无损的质量,同时把体积压到 F16 的 70% 左右。
计算图构建:模型结构到 ggml 图
src/llama-graph.cpp 约 15 万字节,src/llama-graph.h 约 5 万字节,是 llama.cpp 里最大的单个职责模块。它做的事是把一个具体的模型结构(Llama、Qwen、DeepSeek、Gemma、Mixtral……)翻译成一张 ggml 计算图。
llama.cpp 支持上百种模型架构,全部集中登记在 src/llama-arch.cpp(约 9.5 万字节)里:每种架构有一份 llm_arch_info,描述它的张量名列表、张量类型约束与超参映射。llama-arch.h 约 2.7 万字节,定义 llama_layer(一层的权重句柄集合,从 attn_norm 到 ffn_down 一应俱全)、llama_layer_filter(哪些张量在量化/装载时需要特殊处理)等结构。这两个文件合起来是 llama.cpp 的”模型注册中心”,新增一个模型架构的入口就在这里——docs/development/HOWTO-add-model.md 是官方给出的添加模型的步骤说明。
所有架构的计算图走的是同一套构建框架,由 llm_graph_context(在 llama-graph.h 里)提供可复用的构件:build_norm、build_attn、build_ffn、build_moe_ffn、build_inp_embd、build_inp_pos、build_kv 等。具体架构的实现只负责按顺序调用这些构件,把层与层之间的连接关系写出来。这一层抽象是 llama.cpp 能快速跟进新模型的根本原因:DeepSeek 的 MLA、Qwen 的偏置注意力、Gemma 的 GeGLU、Mixtral 的稀疏 MoE 都是通过在这里注册新的构建函数实现的,而不是改动底层算子。
图构建的产物是一个 llm_graph_result。llm_graph.h 里它封装的是”本次前向需要输出的张量集合”——get_logits()、get_embd()、get_h_nextn()(MTP/next-n 预测所需的隐状态)等访问器都在这里。llama_context 每次调用 build_graph 都会得到一个新的 llm_graph_result,但底层 ggml_cgraph 的结构可能被复用(can_reuse(gparams) 判断的就是这个)。
CPU 后端:llama.cpp 真正的主战场
讨论 llama.cpp 的性能时,注意力几乎总被 CUDA 吸引,但实际上它的设计重心在 CPU。原因很直接:这是它区别于 vLLM/SGLang 的定位所在——在没有 GPU 的机器上、在 Apple Silicon 的统一内存上、在只有集成显卡的笔记本上跑模型。
ggml-cpu/ 目录是为此存在的。它做的事情包括:为每种数据类型实例化向量化的点积与矩阵乘(vec_dot 系列,用 AVX2、AVX512、NEON、SVE、RVV 等指令集各写一份)、把大矩阵乘切成适合多线程的瓦片、处理非连续访存与转置、以及一个”重打包(repack)“机制:把量化权重在加载后重排成对特定指令集更友好的布局,换取推断速度。ggml-cpu.c 约 13 万字节,其中很大一部分是这些指令集特化路径。
CPU 后端支持的能力查询是动态的:ggml_backend_dev_supports_op 会根据当前指令集与张量类型回答”这个算子我能不能高效执行”,调度器据此决定哪些层留在 CPU、哪些交给 GPU。这也是 -ngl(n-gpu-layers)这类参数背后的机制——它是”把多少层放到 GPU 后端”的简称。
Apple Silicon 上还有一条独立路径:Metal。它同样是 ggml 后端(ggml-metal/),但因为 macOS 上内存与显存统一,权重可以直接映射,不需要像 CUDA 那样把权重显式搬到显存——llama_prepare_model_devices 里对设备类型的枚举与去重逻辑,很大程度上就是为了在”同一颗芯片被 Metal 与 CPU 后端同时报告”时避免重复选择。
服务化与工具层:工具才是产品
tools/ 目录里放着 llama.cpp 真正的对外产品。tools/server/(含 ui/,一个独立的 Web 界面工程)提供 HTTP 服务与 OpenAI 兼容接口;tools/cli/ 是交互式命令行;tools/llama-bench/ 是性能基准工具;tools/quantize/ 负责把 F16 GGUF 量化成各种低比特格式;tools/imatrix/ 用重要性矩阵做量化校准;tools/mtmd/ 处理多模态投影器;tools/gguf-split/(注:gguf-split 同时存在于根目录与 tools/ 下)拆分大模型文件;tools/perplexity/ 计算困惑度;tools/export-lora/ 导出 LoRA 权重;tools/rpc/ 是 RPC 后端的服务端;tools/fit-params/ 与 tools/tuning/ 做参数拟合与自动调优。
这个”业务在 tools 而不在 src”的分层,与 vLLM/SGLang 把调度器与服务逻辑放在引擎核心的做法形成鲜明对比。它带来一个重要的阅读后果:llama.cpp 的连续批处理、多序列并行、prompt cache 复用都在 tools/server/ 里,而不在 llama_context 里。llama_context 本身只提供 llama_batch 里的 seq_id 二维结构来表达”一个批次里的 token 属于哪些序列”,把”哪些序列该被放进同一个批次”的策略完全交给上层。这个设计让 llama.cpp 的引擎层保持极简,同时把调度策略的复杂度推给应用——后续讲 server 调度时会详细展开这个取舍的代价与好处。
common/ 目录则是这些工具的共享底座:命令行参数解析(common/arg.cpp 是一份巨大的参数表)、对话模板(common/chat.cpp 处理 chat template 与工具调用)、采样链组装、日志与进度条。如果你打算自己写一个基于 llama.cpp 的应用,common/ 是最值得先读的部分,因为它展示了官方推荐的 API 使用顺序。
与 vLLM/SGLang 的架构对照
把这张地图和前面两个系列对照,差异可以归到一张表里:
| 维度 | vLLM / SGLang | llama.cpp |
|---|---|---|
| 算子实现 | PyTorch + cuBLAS + 特化 kernel | 自研 ggml,每个后端各写一套 |
| 权重格式 | safetensors(HF 格式) | GGUF,权重可直接量化存储 |
| 显存/内存管理 | 启动时预分配 KV 池,PagedAttention 式分页 | KV 缓存由 llama_memory_i 抽象,支持混合/循环类型 |
| 计算图 | eager 执行 + torch.compile 编译 | 显式构建 ggml 图,形状驱动、图可复用 |
| 跨设备 | 张量并行/流水并行由框架实现 | ggml_backend_sched 切图 + 自动插拷贝 |
| 服务调度 | 引擎内置调度器 | 引擎极简,调度在 tools/server/ |
| 主要场景 | 服务器多并发、大显存 GPU | 单机、消费级硬件、无 GPU 或统一内存 |
这张表里最关键的一行是”计算图”。vLLM 的 eager 模式意味着每个算子调用即执行,调度开销由 CUDA Graph 与编译来摊平;llama.cpp 的显式图意味着结构先确定、执行后发生,这天然适合”图复用 + 后端切分”,但也带来形状必须固定的代价。理解了这一点,就能理解为什么 llama.cpp 里到处都是 ubatch_reserve、graph_reserve、can_reuse 这类命名——它们都是”把形状固定下来”的工程手段。
站内已有对 vLLM 与 SGLang 引擎层的完整拆解,可参考 vLLM 源码完全拆解(一):整体架构与模块全景 与 SGLang 源码完全拆解(一):整体架构、进程拓扑与请求数据流,与本篇对照阅读能更快看出三者在分层上的不同取舍。另外本篇多次提到的 GGUF 文件格式与 k-quants 块布局,站内已有专文拆过,可参考 GGUF 完全拆解:一个文件里的张量布局、k-quants 块量化与元数据字典——那篇从文件字节层面讲清了本篇只做概述的部分。
阅读路径建议
如果按本篇的地图继续往下读,推荐的顺序是:
- ggml 核心与计算图(下一篇):
ggml.h的张量结构体与算子注册、ggml.c的图构建 API、ggml-alloc.c的生命周期复用、ggml-backend.cpp的调度器实现细节。这一篇会讲清”惰性张量”和”切图”在代码里的样子。 - GGUF 与量化:文件格式、元数据键、k-quants 的块结构、量化的实现路径(若单独成篇)。站内已有 GGUF 专文,可能与其部分重叠,届时会以 llama.cpp 装载侧的实现为主而非文件格式规范。
- llama_model 与装载:
llama-model-loader.cpp如何解析张量表、mmap 与 lazy 模式如何生效、llama_prepare_model_devices的设备选择与去重策略、张量到设备与缓冲区类型的分配算法(含-ngl、-ot、--split-mode的落地)。 - llama_context 与记忆:
llama-context.h的完整成员解读、llama_memory_i接口与各实现(KV、iSWA、hybrid、recurrent)、llama-kv-cache.h里的slot_info与序列操作(seq_rm/seq_cp/seq_keep/seq_add/seq_div)。 - 计算图构建:
llama-graph.h的llm_graph_context构件、llama-arch.cpp的架构注册、以 Llama 与 DeepSeek 两个架构为例逐层展开图构建。 - 后端与 kernel:CPU 的指令集特化与 repack、CUDA 的
mmq/flash-attnkernel、ggml_backend_sched的拷贝回调与 MoE 优化。 - 采样与输出:
llama-sampler.cpp(约 15 万字节)的采样链设计、grammar 约束、与llama_context采样缓冲的交互。 - server 调度与应用层:
tools/server/的连续批处理、slot 管理、prompt cache 复用策略,以及common/的参数与模板体系。
小结
本篇建立的是 llama.cpp 的分层地图,核心结论有五条:
第一,llama.cpp 与 vLLM/SGLang 的根本差异在算子层自研。ggml/ 是一个自包含的张量库,它带来的是完全的控制权——可以自定义量化格式、自定义内存布局、自定义跨设备调度——代价是每一种硬件都要自己实现算子。
第二,ggml 的两个核心抽象是惰性张量与可插拔后端。张量是图节点而非数据持有者,这使内存规划、图重放、后端切分都成为可能;后端通过”注册表 → 设备 → 缓冲区类型 → 缓冲区”四层句柄描述,“一张图跑在混合设备上”是默认能力。
第三,llama_model 与 llama_context 的边界是只读与可变的边界。前者持有超参、词表、mmap 进来的权重与设备分配;后者持有调度器、记忆、输出缓冲、适配器与图复用状态。KV 缓存被抽象成 llama_memory_i,不再是”一个张量”,因此可以支持混合记忆、循环状态与滑动窗口。
第四,一次 llama_decode 的路径是校验 → allocr → 记忆更新 → ubatch 切分 → 图复用/重建 → 写输入 → 调度器执行 → 回传输出 → 错误回滚。其中 ubatch 切分意味着一次调用可能执行多次图计算,图复用成立的前提是形状参数唯一确定图结构,错误回滚则要求按序列最小位置裁剪缓存。
第五,llama.cpp 的服务化在 tools/ 而不在 src/。引擎层只提供用 seq_id 表达的多序列批次,连续批处理与缓存复用策略归应用层,这与 vLLM/SGLang 把调度器放在引擎核心的做法形成对照,也解释了两者在代码组织上的全部差异。
下一篇进入 llama.cpp 源码完全拆解(二):ggml 的计算图与内存分配,沿 ggml.h 的张量结构、ggml.c 的算子构建、ggml-alloc.c 的生命周期复用与 ggml-backend.cpp 的调度器实现,把本篇只做了概述的”惰性张量”与”切图”落到真实代码上。
参考资料
- llama.cpp 官方仓库(ggml-org/llama.cpp)
- ggml 张量库仓库(ggml-org/ggml)
- Which Quantization Should I Use? A Unified Evaluation of llama.cpp Quantization on Llama-3.1-8B-Instruct(arXiv:2601.14277)
- HOWTO-add-model:向 llama.cpp 添加新模型架构的官方步骤
- llama.cpp 多 GPU 与设备分配文档(docs/multi-gpu.md)
- llama.cpp 构建与后端选项文档(docs/build.md)
- llama.cpp 本地推理性能调优建议(docs/development/token_generation_performance_tips.md)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



