


vLLM 源码完全拆解(二十七):Dual Batch Overlap——两个线程、两条流与一次 yield,如何把专家通信藏进计算里
MoE 推理的账本里,有一类时间最刺眼:计算本身很快,但跨卡搬运 token 的 all-to-all 很长。DeepSeek 在推理系统里早就注意到了这一点,官方文档里把它概括为「双批重叠」(dual-batch overlap):把一批请求切成两半,一半在算专家 GEMM 的时候,另一半在做 dispatch,另一半在 combine 的时候,这一半再开始算。vLLM 把这个思路落进了 --enable-dbo,并在后续版本里持续做工程化改造。
这篇文章沿着 vLLM 当前主干源码,一块一块拆开 DBO:为什么需要它、批次怎么被切开、两个线程如何在一行 yield 上交换、两条 CUDA 流上的事件如何保证正确性、CUDA Graph 如何捕获这样一张「两个线程交替发射」的图,以及这套机制在哪里被拦住、在哪些条件下会退回普通路径。文中出现的算子、缓冲与账本,会在需要时链回本系列已经讲过的对应文章。
背景:Wide-EP 部署里,通信凭什么占据关键路径
从「专家并行 + 数据并行」说起
DeepSeek 风格的稀疏 MoE 模型有两本书要算:一本是稀疏专家激活,另一本是 KV 缓存。以 DeepSeek-R1 为例,671B 总参数里每次前向只激活约 37B;同时 MLA 的低秩投影在张量并行下会被每个 rank 各自复制一份,TP 越大,有效 KV 缓存越小。
专家并行(Expert Parallel,EP)把专家摊到多个 rank 上,每个 rank 只持有自己那份专家。前向时,每个 token 按路由结果被发往持有对应专家的 rank,算完再收回来。这样每个 rank 都能把显存几乎全部用于 KV 缓存和专家权重。再叠加数据并行(DP),注意力层在 DP 组内复制、专家层在 EP 组内切分,就是 vLLM 文档里说的 Wide-EP:注意力计算按 DP rank 各自独立,MoE 的 token 在 EP 组里全局交换。
Wide-EP 的收益是显存与批次规模,代价是 MoE 层前后多出了通信:每一层都要做一次 dispatch(token 按专家发出去)和一次 combine(结果按 token 收回来)。EP 规模越大,参与 all-to-all 的 rank 越多,拓扑越复杂,这段通信的绝对时长就越可观。
通信为什么很难被「异步」掉
按理论,all-to-all 应该可以和计算重叠:一边发、一边算。但落到单卡上的执行序列里,这条路并不平坦:
- dispatch 的结果是专家 GEMM 的输入。没有 dispatch 完成,本地专家无活可干。
- combine 的输入是专家 GEMM 的输出。GEMM 没做完,combine 无从发起。
- 同一时刻,一个微批的通信与另一个微批的计算可以并行,但单个微批内部这个链条无法拆开。
所以,真正能重叠的不是「一个微批的通信与它自己的计算」,而是「两个微批」——A 批在通信时,B 批在计算;B 批在通信时,A 批在计算。这就是双批重叠的全部动机。vLLM 的设计文档 docs/design/dbo.md 开篇也是这样写的:DBO 的核心动机是把 MoE 层稀疏的 all-to-all 与周围的计算重叠起来,目前只面向 DP+EP 部署。
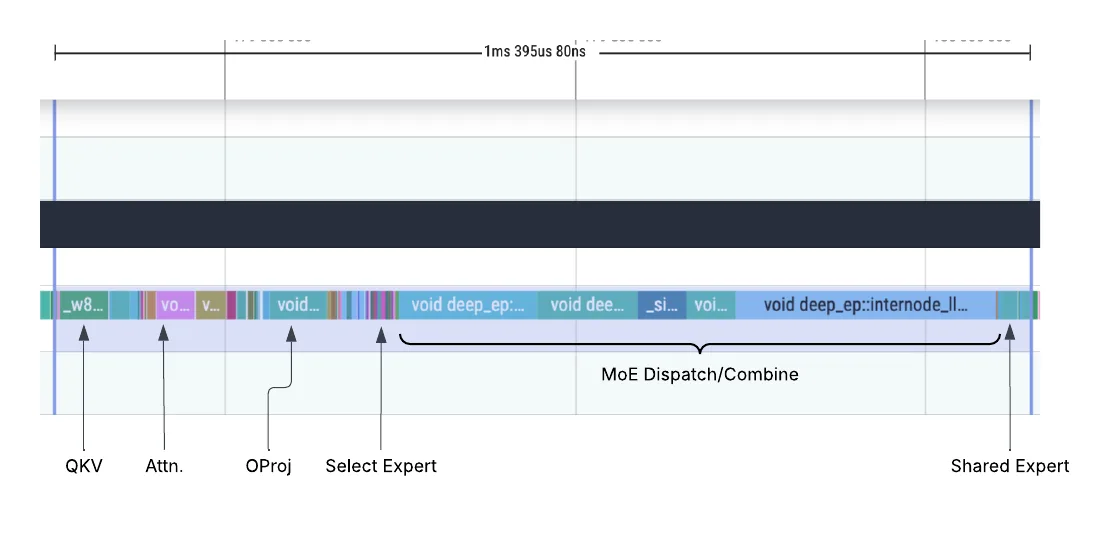
上图是 vLLM 官方博客里一份 DeepSeek 解码负载的 profiler trace。横轴是时间,每个格子是一个流上的算子。可以看到 QKV、Attn、OProj、Select 这些计算算子都很短,但 MoE Dispatch/Combine 那一段拉得很长——即使这一批的计算量很小,通信仍按自己的节奏走完。在 EP 规模较大的部署里,这段通信往往就是把 GPU 利用率压在低位的主要因子。
关键数字:阈值与开关
DBO 的配置集中在 ParallelConfig 里,逻辑非常简单:
# vllm/config/parallel.py(节选)enable_dbo: bool = Falseubatch_size: int = 0 # 手动指定微批数dbo_decode_token_threshold: int = 32 # 纯解码批的启用门槛dbo_prefill_token_threshold: int = 512 # 含 prefill 批的启用门槛
@propertydef use_ubatching(self): return self.enable_dbo or self.ubatch_size > 1
@propertydef num_ubatches(self): return 2 if self.enable_dbo else self.ubatch_size--enable-dbo 等价于「启用双批」,num_ubatches 固定为 2;--ubatch-size N 则允许把批次切成 N 份(ubatching.py 里有 _NUM_UBATCHES: int = 2 的默认值,运行时会被实际微批数覆盖,说明主线仍把双批作为默认形态)。两个阈值决定了「多小的批不值得切」:纯 decode 批至少 32 个 token、含 prefill 的批至少 512 个 token 才会被切开。配置校验里还有一条硬约束:两个阈值都不得小于微批数,否则切完会出现空批。
这组数字背后是一笔很朴素的账:切批本身有开销——多一次 DP 协调的 all-reduce、多一次元数据切分、多两个线程的调度、多一份流与事件的同步。批太小,重叠省下的时间还不够付这些账。
总览:DBO 的四个角色
按 vLLM 设计文档的划分,DBO 只动三处代码位置,外加一组工具类:
| 角色 | 文件 | 职责 |
|---|---|---|
GPUModelRunner | vllm/v1/worker/gpu_model_runner.py | 判断本步是否切批、切在哪里、把注意力元数据切成 N 份 |
UBatchWrapper | vllm/v1/worker/gpu_ubatch_wrapper.py | 为微批开线程、管理 UBatchContext 与 CUDA Graph |
UBatchContext | vllm/v1/worker/ubatching.py | 乒乓 yield 的上下文:CPU 事件、GPU 事件、两条流 |
FusedMoEModularKernel | vllm/model_executor/layers/fused_moe/modular_kernel.py | 在 prepare/finalize 处插入 dbo_yield 与 recv hook |
调度器(Scheduler)完全不知道自己被切了——切批发生在模型执行器的入口,SchedulerOutput 仍然是「这一步要跑哪些 token」。这个边界选择很重要:调度器继续用一个批次做预算与 KV 记账,而 GPU 侧把同一个批次拆成两半交替执行。KV 的分配、块表、采样逻辑都不需要感知微批的存在,需要感知的只有注意力层的元数据与 MoE 的通信缓冲。
第一步:切还是不切——DP 组里的集体投票
为什么必须全组一致
当 EP 组横跨多个 DP rank,每个 rank 的路由结果不同,dispatch 的目标 rank 也不同。一次 all-to-all 是一个集体操作,所有 rank 必须同时发起、同时完成。如果 rank 0 把批次切成两半、rank 1 不切,那么 rank 0 发出的两段 dispatch 会与 rank 1 的单次 dispatch 对不上号。
所以 DBO 的第一条铁律是:所有 DP rank 对「是否切批」必须给出一致答案。实现方式是一次 CPU 上的 all-reduce。
# vllm/v1/worker/gpu/dp_utils.py(节选)tensor = torch.zeros(7, dp_size, dtype=torch.int32, device="cpu")tensor[0][dp_rank] = num_tokenstensor[1][dp_rank] = desired_batch_desc.cg_mode.valuetensor[2][dp_rank] = uniform_token_count or 0tensor[3][dp_rank] = max_query_len or -1tensor[4][dp_rank] = int(allow_ubatching) # 本 rank 的投票tensor[5][dp_rank] = num_reqstensor[6][dp_rank] = int(allow_skip_drafts)get_dp_group().cpu_all_reduce_(tensor)7 行 int32 的小张量在 CPU 上做一次求和型 all-reduce,把每个 rank 的意图直接抹成全局可见。求和之后,torch.all(allow_ubatching_across_dp == 1) 就是「所有 rank 都同意切批」;任何一个 rank 投反对票,结果就不为 1,全组都不切。这里选 CPU 而不是 NCCL,是因为这个决策直接决定后续要发多少个 kernel、走哪条执行路径,CPU 必须马上拿到结果;7 个数的一趟 CPU all-reduce 代价在微秒级,相对一步前向可以忽略。关于这类并行协调的细节,可参考 AllReduce 完全拆解:Ring、树算法与 NCCL——张量并行推理的通信账单从哪来。
谁在投反对票
allow_ubatching 来自 GPUModelRunner._allow_microbatching()。它做一件很具体的事:拒绝切开「读者正在等写者」的批次。
def _allow_microbatching(self, num_reqs, num_scheduled_tokens_np) -> bool: if not self.parallel_config.use_ubatching or num_reqs < 2: return True computed = self.input_batch.num_computed_tokens_cpu[:num_reqs] query_lens = num_scheduled_tokens_np[:num_reqs] readers = np.flatnonzero( (query_lens > (self.reorder_batch_threshold or 1)) & (computed > 0) ) if readers.size == 0: return True
for block_table in self.input_batch.block_table.block_tables: block_size = block_table.block_size table = block_table.get_numpy_array() start = computed // block_size stop = (computed + query_lens + block_size - 1) // block_size ... for reader in readers: whole = computed[reader] // block_size if np.isin(table[reader, :whole], written).any(): return False return True这段代码处理的是前缀缓存与写者的时间差。设想同一批里有两个请求:请求 A 是长 prefill,正在往一组 KV 块里写;请求 B 命中了前缀缓存,它的历史 KV 有一部分正好落在 A 这一拍才写的那组块里。整批一起跑时,这一步先写 KV、再做注意力,B 读到的是 A 刚刚写好的块,正确。但切成两半后,如果 B 在前半段、A 在后半段,B 的注意力就会去读一组尚未被填写的块。
代码的做法是:找出「读历史」请求(有 query 且已经算过 token,说明它不是首段 prefill),对每个读请求,把它已经完成的整块(whole)拿出来,和本批所有请求将要写的块集合 written 求交。交集非空就返回 False,全组在这一步不切批。注意只检查「整块」:读请求的末尾可能落在半满的块里,那是它自己的私有块,它会先写后读,不构成竞态。
这是一个典型的「正确性优先于性能」的 veto:切批只是机会主义优化,遇到写读耦合就退回整批执行,代价是一步的通信没有被藏住,收益是结果永远与不开 DBO 时一致。
投票通过之后的第二道闸:空微批不能进图
即便所有 rank 都同意切,还要处理一种边界:某个 rank 的第二个微批可能是空的。
ubatch_utils.py 里保留了一个 is_last_ubatch_empty() 辅助函数:
def is_last_ubatch_empty(orig_num_tokens, padded_num_tokens, num_ubatches): return (padded_num_tokens // num_ubatches) * (num_ubatches - 1) >= orig_num_tokens按这个函数的定义,如果把全局 pad 后的 token 数均分,第一份已经装下了本 rank 的全部真实 token,第二个微批就是空的。设计文档的表述是「若某个 rank 在 pad 后第二个微批为空,则放弃切批,所有 rank 都不切」,当前主线的执行路径则不同:注释里写明「Empty microbatches run as dummy batches.」——空微批仍要参与 all-to-all,只是走 dummy 路径,不产生真实的专家负载;切分本身是全局约定,不能因为一个 rank 没货就临阵变卦。is_last_ubatch_empty() 这个函数还留在工具模块里,当前主线的 gpu_model_runner.py 已不再调用它,读源码时不要把它当作执行路径上的真正闸门。
真正被拦住的是 CUDA Graph:
if 2 * int(num_tokens_across_dp.min()) < ubatch_desc.num_tokens: # 如果有 rank 的第二个微批为空,就不用 CUDA Graph 跑 ubatch_desc = None最小值乘 2 若仍小于图桶的 token 数,说明 pad 之后必有一边是空的。图桶是按「每个微批都有真实 token」的形状捕获与回放的,空微批与图桶的假设不匹配,于是这一步退回 eager 的线程路径。切批继续、图回放放弃——这是当前代码的选择,而不是整体放弃切批。
空微批的代价确实存在:本 rank 的第二个微批没有计算,DP 组内的负载不均会被进一步放大,慢微批拖住快微批。所以它更像一个「允许但尽量避免」的兜底,而不是理想路径。
Pad 到最大,而非各扫门前雪
所有 rank 决定切批后,token 数不是各自为政,而是统一 pad 到全局最大:
# Expert all-to-all requires every rank to split and pad equally.# Empty microbatches run as dummy batches.ubatch_num_tokens = int(num_tokens_across_dp.max())原因和投票的动机一样:all-to-all 是集体的,各 rank 的微批必须能对位。rank 0 有 900 个 token 切成 450+450,rank 1 有 600 个 token——它也要把 token 补到 450+450 对齐,第二段的 150 个 pad 行走 dummy 路径,dispatch 里不产生真实的专家负载。pad 本身是一种浪费,但比切不对位要多花一次集合通信便宜得多。
第二步:切在哪——UBatchSlice 的两种索引
一个批次在 GPU 侧有两套坐标:请求维(第几个请求)和 token 维(扁平化后的第几个 token)。切批既要回答「请求切在哪里」,也要回答「token 切在哪里」。vLLM 用一个很小的数据结构把两者绑在一起:
@dataclassclass UBatchSlice: request_slice: slice # 这个微批覆盖哪些请求 token_slice: slice # 这个微批覆盖哪些扁平化 token
def is_empty(self): return self.request_slice.start == self.request_slice.stop \ or self.token_slice.start == self.token_slice.stop
@property def num_tokens(self): return self.token_slice.stop - self.token_slice.startmaybe_create_ubatch_slices() 的核心是三个数:按 token 数均分得到切点,按累积 token 数 cu_num_tokens 反查请求边界,最后把最后一个微批 pad 到全局长度。
split_point = int(num_tokens_padded) // num_ubatchestoken_split_points = [split_point * i for i in range(1, num_ubatches)]
cu_num_tokens = np.zeros(len(num_scheduled_tokens) + 1, dtype=np.int32)np.cumsum(num_scheduled_tokens, dtype=np.int32, out=cu_num_tokens[1:])
all_points = token_split_points + [int(cu_num_tokens[-1])]for end_token in all_points: token_slice = slice(start_token, end_token) req_start = int(np.searchsorted(cu_num_tokens, start_token, side="right") - 1) req_stop = int(np.searchsorted(cu_num_tokens, end_token, side="left")) ubatch_slices.append(UBatchSlice(slice(req_start, req_stop), token_slice)) start_token = end_token两步都是 searchsorted:
req_start取的是「包含start_token的那个请求」(side="right"减一,恰好落在边界上时取边界前的请求);req_stop取的是「从end_token开始或之后的第一个请求」(side="left"),所以第end_token个 token 属于的请求不归本微批。
结果是一个半开区间:[req_start, req_stop) 中的请求,与 [start_token, end_token) 中的 token 重叠。一个请求可能被两个微批同时覆盖——这就是切分发生在请求内部的情况,下面专门处理。
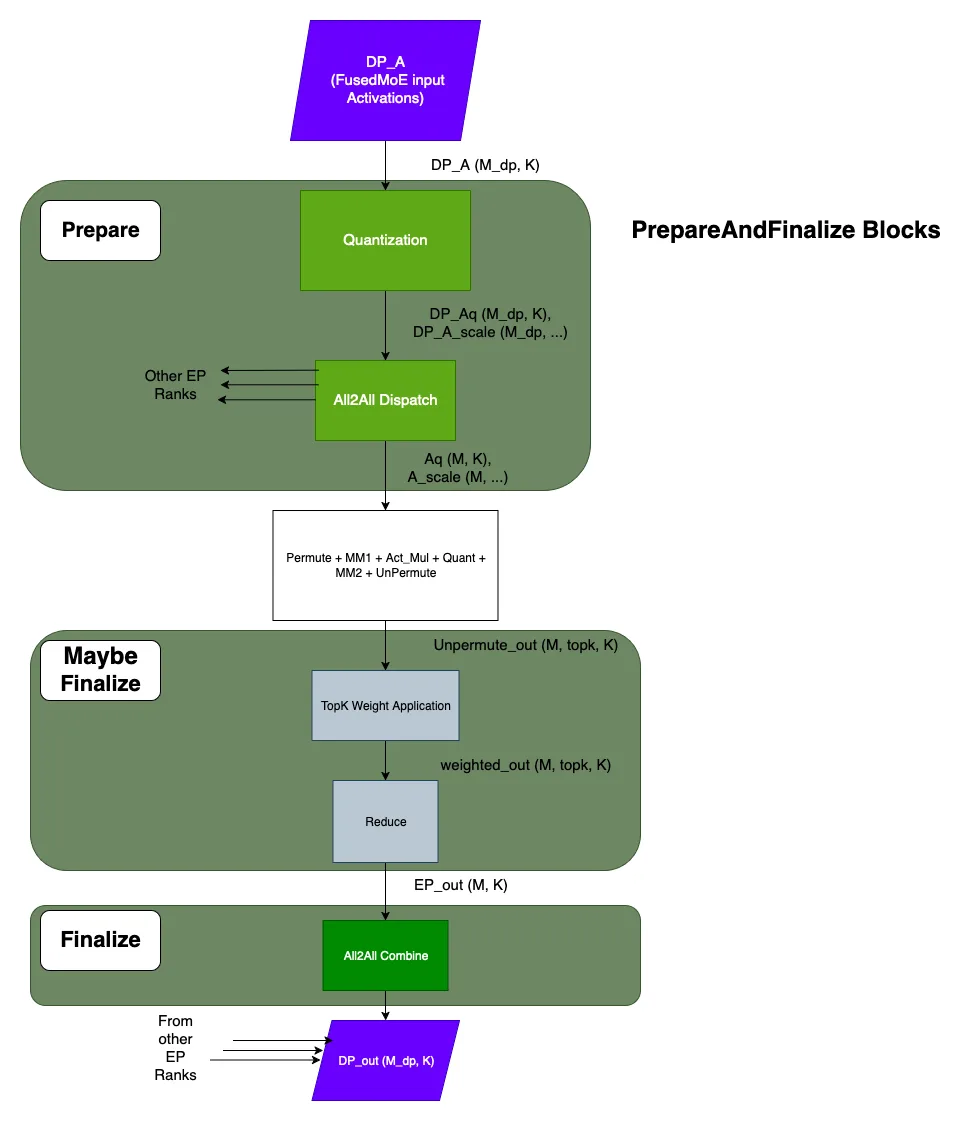
下图是 MoE 模块化内核 prepare/finalize 的块图,理解后文 FusedMoEModularKernel 在何处插入 yield 会容易得多:量化 → all-to-all dispatch → permute + MM1 + 激活 + MM2 + unpermute → finalize(top-k 权重应用),而 DBO 的交换点就在「all-to-all」这两块的前后。
对 pad 的专门处理
最后一个微批要覆盖到 num_tokens_padded,因为切片是在 DP pad 之前计算的:
def _pad_out_ubatch_slices(ubatch_slices, num_total_tokens, num_reqs_padded): last_slice = ubatch_slices[-1] return ubatch_slices[:-1] + [UBatchSlice( slice(last_slice.request_slice.start, num_reqs_padded), slice(last_slice.token_slice.start, num_total_tokens), )]于是存在两份切片:ubatch_slices(真实 token)和 ubatch_slices_padded(含 pad)。模型输入、slot mapping、DP 元数据都用 padded 版以保证各微批形状一致;注意力元数据则按图模式选择——FULL CUDA Graph 回放时用 padded 版(图里的形状必须与捕获时完全一致),否则用真实版(避免注意力去读不存在的 pad token)。
第三步:注意力元数据怎么跟着切
模型前向只有一份输入,但注意力层需要知道自己这一半覆盖了哪些请求、哪些 token。split_attn_metadata() 把一份 CommonAttentionMetadata 切成 N 份,每份对应一个 UBatchSlice。
需要切的字段只有四个:query_start_loc(每个请求在扁平输入里的起点)、seq_lens(每个请求的上下文总长)、block_table_tensor(每个请求的块表)、slot_mapping(每个 token 写到哪个 KV 槽)。其余字段(max_query_len、num_actual_tokens 等)重新计算。
splits_first_request = first_tok > start_locs[first_req]splits_last_request = last_tok < start_locs[last_req + 1] - 1
query_start_loc_cpu = slice_query_start_locs(start_locs, request_slice)query_start_loc = slice_query_start_locs(attn_metadata.query_start_loc, request_slice)
if splits_first_request: tokens_skipped = first_tok - start_locs[first_req] query_start_loc[1:] -= tokens_skipped # 首请求只保留后半段
seq_lens = attn_metadata.seq_lens[request_slice]
if splits_last_request: tokens_skipped = start_locs[last_req + 1] - token_slice.stop query_start_loc[-1] -= tokens_skipped # 末请求只保留前半段 seq_lens = seq_lens.clone() seq_lens[-1] -= tokens_skipped这里有两个细节值得展开。
首请求与末请求被切开时,语义要各自修正。 切点可能落在一个请求的中间——最常见的是长 prefill 被 chunked prefill 切开后再被 DBO 切一刀。splits_first_request 表示本微批的第一个请求是从上一个微批延续来的,它的 query 不是从头开始的,所以 query_start_loc 要整体减去跳过的 token 数,让扁平输入从 0 重新计起。
seq_lens 在切末请求时要改,且必须 clone。 seq_lens 是 KV 层面的账:每个请求这一步结束时上下文有多长。如果末请求只跑了前半段 prefill,它的 seq_lens 就不应包含后半段。注意这里对 seq_lens 做了 clone(),原因写在注释里:seq_lens 有可能是 CUDA Graph 捕获时的持久缓冲,原地改会破坏下一条请求的元数据。query_start_loc 没有 clone,因为 slice_query_start_locs 通过切片减运算生成了新张量——代价上与图兼容性之间做了取舍,注释也明确写了「会破坏 cudagraph 兼容性」。
还有一个容易忽略的点:max_seq_len 故意用 max(max(seq_lens_cpu_upper_bound), attn_metadata.max_seq_len) 来保守求值,保留捕获时设置的覆盖值,好让滑窗注意力层在回放时选中正确的 kernel。
第四步:UBatchContext——乒乓 yield 的机器
切好批、切好元数据、切好输入之后,执行落在 UBatchWrapper 里。它给每个微批开一个线程,每个线程持有自己的 UBatchContext。整个 DBO 的心跳就是这个类。
它持有什么
class UBatchContext: def __init__(self, id, comm_stream, compute_stream, forward_context, ready_barrier, cpu_wait_event, cpu_signal_event, gpu_comm_done_event, gpu_compute_done_event, schedule="default", token_offset=0): ... self.current_stream = compute_stream self.recv_hook = None四类同步原语,正好对应 CPU 与 GPU 两个世界:
| 原语 | 层面 | 作用 |
|---|---|---|
cpu_wait_event / cpu_signal_event | CPU(threading.Event) | 「轮到我了」的交接棒 |
gpu_comm_done_event / gpu_compute_done_event | GPU(torch.Event) | 本微批的通信流/计算流做完没有 |
compute_stream | GPU 流 | 本微批的计算工作 |
comm_stream | GPU 流 | 所有微批共用的一条通信流 |
注意 comm_stream 由 wrapper 在构造时创建一次、两个微批共用;compute_stream 是主线程当前的计算流,两个微批也共用。两个世界交错的那条线,就在于「哪个微批当前持有 current_stream」。
进入与退出
def __enter__(self): _THREAD_ID_TO_CONTEXT[threading.get_ident()] = self.id _CURRENT_CONTEXTS[self.id] = self self.ready_barrier.wait() # 所有线程就位 self.cpu_wait_event.wait() # 等我被唤醒 self.cpu_wait_event.clear() self._restore_context() # 装上我自己的 ForwardContext self.update_stream(self.compute_stream) return selfForwardContext 是 vLLM 的全局上下文(注意力元数据、slot mapping、DP 元数据都在里面)。两个线程共享一个 Python 进程,这个全局变量只能有一个值,所以谁在跑,谁就把自己的上下文装回去,跑完再交棒。
clear() 的时机也很讲究:等待用的 Event 在进入时清掉,所以在 yield 里「先 signal 对方、再 wait 自己」的顺序下,不会出现「对方还没睡就又被我唤醒」的丢失唤醒(lost wakeup)。
交接棒:_cpu_yield
def _cpu_yield(self): assert forward_context._forward_context == self.forward_context assert current_stream() == self.current_stream assert not self.cpu_wait_event.is_set()
self.cpu_signal_event.set() # 叫醒对方 self.cpu_wait_event.wait() # 自己睡下 self.cpu_wait_event.clear() self._restore_context()代码注释写得很直白:「正确性关键:同一时刻只能有一个线程在跑。」三句断言就是这条规则的守卫。
这里有一个值得停下来想的点:为什么使用 threading.Event 而不是把模型拆成独立进程?因为 ForwardContext、torch.cuda 的当前流、环境变量、CUDA Graph 的捕获都在同一个进程里;线程是最廉价的方式,可以共享这些状态,代价就是 GIL。
乒乓的完整形态
yield_() 保存当前流、叫醒对方、睡下、醒来后恢复流:
def yield_(self): self.current_stream = current_stream() self._cpu_yield() self.update_stream(self.current_stream)而带流切换的版本才是 DBO 的关键——它让「计算 → 通信」的交接带着两件事:本微批的计算流记录一个完成事件,唤醒对方后切到通信流并等计算完成。
def yield_and_switch_from_compute_to_comm(self): assert current_stream() == self.compute_stream self._signal_compute_done() # 在 compute_stream 上 record self._cpu_yield() # 叫醒另一个微批去算 assert self.current_stream == self.compute_stream self.update_stream(self.comm_stream) self._wait_compute_done() # comm_stream 等 compute_stream
def yield_and_switch_from_comm_to_compute(self): assert current_stream() == self.comm_stream self._signal_comm_done() self._cpu_yield() assert self.current_stream == self.comm_stream self.update_stream(self.compute_stream) self._wait_comm_done()为什么 CPU 这边先交棒、再在 GPU 流上等待?因为 GPU 的命令是异步排进流的,CPU 不需要等 GPU。真正需要串行的是 CPU 上的发射顺序——哪些 kernel 先被排进哪条流。先叫醒对方,让对方在它自己的 compute_stream 上把计算 kernel 排进去,再回来在自己的流上等事件,就形成了 GPU 上「我的通信在跑、对方的计算在跑」的并发画面。
全局访问器与 recv hook
模型层的代码不持有 UBatchContext 引用,它通过一组全局函数访问「当前线程的上下文」:
_THREAD_ID_TO_CONTEXT: dict = {}
def _register_ubatch_function(func): def wrapper(*args, **kwargs): if len(_THREAD_ID_TO_CONTEXT) > 0: ctx = _CURRENT_CONTEXTS[_THREAD_ID_TO_CONTEXT[threading.get_ident()]] func(ctx, *args, **kwargs) return wrapper
dbo_yield = _register_ubatch_function(UBatchContext.yield_)dbo_yield_and_switch_from_compute_to_comm = _register_ubatch_function( UBatchContext.yield_and_switch_from_compute_to_comm)如果当前线程没有注册上下文(DBO 没开,或不在微批线程里),dbo_yield 就是一个空操作。这让模型层代码可以无条件地在关键位置写 dbo_yield(),而不需要到处加 if。
recv hook 是另一个关键的全局机制:
def dbo_register_recv_hook(recv_hook): ctx_idx = _THREAD_ID_TO_CONTEXT[threading.get_ident()] next_ctx = _CURRENT_CONTEXTS[(ctx_idx + 1) % _NUM_UBATCHES] next_ctx.recv_hook = recv_hook
def maybe_run_recv_hook(self): if self.recv_hook is not None: self.recv_hook() self.recv_hook = None当前线程把「接收我的 dispatch 结果」这个动作挂到对方的上下文上。对方在某处调用 dbo_maybe_run_recv_hook() 时,顺手替我执行这个等待。换句话说,hook 让「别人做别的事的时候,帮我把我自己的通信收掉」。
第五步:MoE 层里的三段接力
所有 dbo_yield 都落在 FusedMoEModularKernel 与 DeepEP 的 prepare/finalize 模块里。按时间顺序,一个微批经过三次交接:
- dispatch 之前:
dbo_yield_and_switch_from_compute_to_comm(),让出 CPU,自己切到通信流并发 dispatch kernel; - 对方跑到需要收结果的地方:
dbo_maybe_run_recv_hook(),执行我挂上去的接收逻辑; - combine 之前:
dbo_yield_and_switch_from_compute_to_comm(),重复一次。
第 1 段:dispatch 前的交接
previous_event = dbo_get_previous_event(self.buffer.capture)
# 我们在这之前 yield:dispatch kernel 会阻塞 CPU,先把另一个微批的计算排进队列dbo_yield_and_switch_from_compute_to_comm()_dbo_record_stream(tokens, token_scales, rank_topk_ids, rank_topk_weights)
(..., handle, event) = self.buffer.dispatch( x=token_data, ..., async_finish=self.async_prepare and not dbo_enabled(), allocate_on_comm_stream=False,)
a2a_idx = dbo_current_ubatch_id()self.handles[a2a_idx] = handle
dbo_switch_to_compute_sync()return lambda: self._receiver(event, ...)三件事需要讲清:
previous_event = dbo_get_previous_event(self.buffer.capture) 在 yield 之前取。注释解释了为什么:DeepEP 需要一个「开始之前已经完成」的事件来做 stream 内部的依赖排序;如果放在 yield 之后取,CPU 上已经被对方插入了计算命令,这个事件会把对方的计算尾巴也算进来,导致重叠失效。
async_finish=self.async_prepare and not dbo_enabled()——DBO 开启时,dispatch 不走 DeepEP 的异步完成模式,而是走 DBO 自己的 hook 机制。两套异步不能叠加,否则「谁等谁、在哪条流上等」会乱。
self.handles[a2a_idx] = handle——DeepEP 的 dispatch 返回一个 handle,combine 时按它匹配。两个微批并发执行意味着会有两个 handle 同时在飞,所以要按微批 id 分开存。这是典型「单线程假设被打破后必须显式记账」的改动。
dbo_switch_to_compute_sync() 在 dispatch kernel 入队之后立刻切回计算流并等通信完成,这样后续在计算流上的量化、专家 GEMM 都正确地排在 dispatch 之后。
_dbo_record_stream:缓存分配器的跨流生命周期
这是最容易出错、也最容易在生产中被忽略的类型:PyTorch 的缓存分配器按流回收内存块。一个张量在通信流上分配(DeepEP 的输出),却在计算流上被读;分配器只记录「这个块属于通信流」,一旦通信流上的引用释放,就可能被分给下一个需求。下一个需求恰好是另一个微批在计算流上的一次分配——于是它在用一块被别的流读着的内存。
def _dbo_record_stream(*tensors): """Mark tensors allocated on the other DBO stream as used by this one.""" if not dbo_enabled(): return stream = current_stream() for t in tensors: if t is not None: t.record_stream(stream)record_stream 告诉分配器「这块内存在这条流上也用过了,等这条流到了某个同步点再回收」。它的开销很小,但省掉它就会出现随机的、难以复现的结果错乱。
第 2 段:接收结果与挂 recv hook
dispatch 返回的 lambda 就是 receiver:它等 DeepEP 的事件、处理 topk ids 的 -1、按需在 dispatch 后量化。这个 receiver 在多线程路径下被挂到对面:
hook, receiver = (prepare_ret if isinstance(prepare_ret, tuple) else (None, prepare_ret))if hook is not None: if dbo_enabled(): dbo_register_recv_hook(hook) # 挂到对方上下文 dbo_yield() # 让对方先跑 else: hook()注意这里同时挂 hook 又 yield——挂完就睡,让对方在它的路径上 dbo_maybe_run_recv_hook() 时把我的等待执行掉。
DeepEP 低延迟后端用的是另一套:low_latency_combine 返回 recv_hook,由 dbo_maybe_run_recv_hook() 在同一微批路径上执行。也就是说,超低延迟模式下 vLLM 利用的是 DeepEP 内核自己已经分好的接收阶段,DBO 只负责把它们排进合适的时间点。
第 3 段:combine 前再交一次棒
previous_event = dbo_get_previous_event(self.buffer.capture)dbo_yield_and_switch_from_compute_to_comm()_dbo_record_stream(fused_expert_output)
combined_x, _, event = self.buffer.combine( x=fused_expert_output, handle=handle, topk_weights=None, previous_event=previous_event, async_finish=do_async and not dbo_enabled(),)dbo_switch_to_compute()
if do_async: def _receiver(): if event.event is not None: event.current_stream_wait() dbo_switch_to_comm() output.copy_(combined_x, non_blocking=True) dbo_yield_and_switch_from_comm_to_compute() return _receiver结构与第 1 段对称:交棒 → 发 combine → 切回计算流。最后那一段 receiver 里,拷贝回 output 发生在通信流上,拷贝完再交棒回计算流——这样「写回模型的输出张量」这件事留在通信流上,不占计算流的关键路径。
共享专家:在被让出的空档里干活
DeepSeek 的 MoE 层有共享专家,它的输入不经过 all-to-all,是纯本地计算。DBO 把它的执行安排在「通信正在飞」的那段时间里:
def _maybe_apply_shared_experts(self, shared_experts, shared_experts_input): if shared_experts is not None: assert self.prepare_finalize.supports_async() shared_experts(shared_experts_input, SharedExpertsOrder.MK_INTERNAL_OVERLAPPED)在 _finalize 中,finalize_async() 返回后先立即调用共享专家,再处理 combine 的 hook/receiver——共享专家的 MLP 计算和 combine 通信在时间上重叠了。
完整时间线:用设计文档的记号画一遍
vLLM 设计文档给了当前实现的调度记号,原文如下(S = 共享专家,A0 = MLA qkv 投影,A1 = 核心注意力 + o_proj + MoE gate,D = dispatch,C = combine):
# Comp: |-A0₀-A1₀-||-MLP₁-||-S₁-MLP₀-||-S₀-A0₁-A1₁-|# Comm: |----D₁---||--D₀--||----C₁---||-----C₀-----|# Order: D₁ send, A0₀, A1₀, D₁ recv, D₀ send, MLP₁, D₀ recv,# C₁ send, S₁, MLP₀, C₁ recv, C₀ send, S₀, A0₁, A1₁, C₀ recv.逐段对着看:
- 最开始是
D₁ send:微批 1 先发它自己的 dispatch。这里「谁先发」不重要,两个线程的先后只取决于 CPU 的调度,关键是两者一开始就错开。 A0₀, A1₀:微批 0 在计算流上做 qkv、注意力、gate——通信飞的时候,计算填补。D₁ recv:微批 1 的 dispatch 结果到了(由微批 0 的 hook 或微批 1 自己来收)。D₀ send、MLP₁:微批 0 开始 dispatch;微批 1 的专家 MLP 开始。D₀ recv、C₁ send、S₁、MLP₀:微批 0 的 dispatch 收到;微批 1 开始 combine;微批 1 的共享专家可以顺带算(S₁);微批 0 的专家 MLP 开始。C₁ recv、C₀ send、S₀、A0₁, A1₁、C₀ recv:收尾,微批 1 收 combine,微批 0 发 combine 后开始它的下一层注意力,微批 0 再收 combine。
注意一个顺序上的小心思:在通信流上,D₀ 在 C₁ 之前发出(先 dispatch 后 combine),而在计算流上 S₁ 和 MLP₀ 被安排在中间。两条流上的事件没有严格的一一对应——只要每一条流内部顺序正确、跨流的等待点正确,就能构造出更大的重叠面积。这也是为什么 DBO 的实现必须细到「哪一条流、哪个事件」,而不是一句「发个 all-to-all 就异步了」。
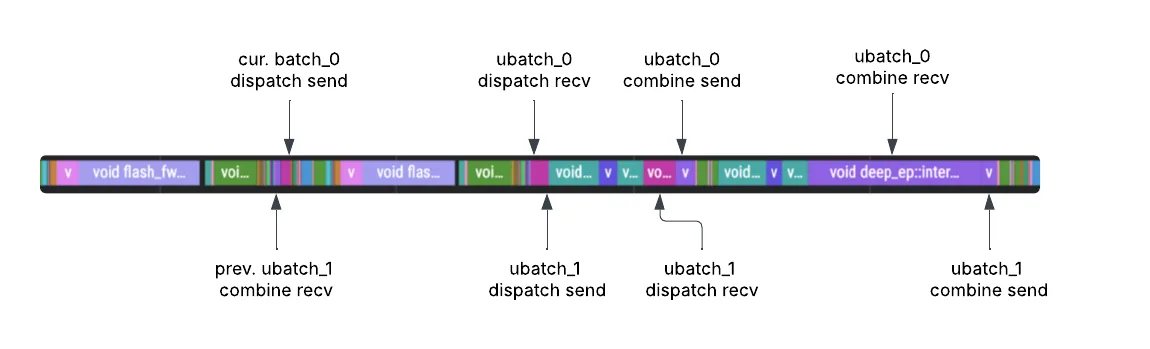
这张图是官方博客里 DBO 开启后的 profiler trace。上半部分是当前微批(ubatch_0),下半部分是上一个微批(ubatch_1)。可以读出的关键信息:
- 同一时刻,两条通道上都各有活:一边
dispatch send,另一边dispatch recv或combine send; cur. batch_0与prev. ubatch_1交错——正是「当前微批还没算完,上一个微批的通信还在收尾」;void deep_ep:inter...这类内核(DeepEP 的 internet 通信内核)出现在上下两个通道里,说明通信内核在两个微批之间交替,而不是串行排队。
第六步:UBatchWrapper——线程与图的管理者
UBatchWrapper 是包在模型外面的一个「可调用对象」,对 GPUModelRunner 基本透明。runner 仍然把一次完整前向的输入塞给它,它自己决定要不要拆成两个线程跑。
__call__ 的分支
def __call__(self, *args, **kwargs): forward_context = get_forward_context() ubatch_slices = forward_context.ubatch_slices cudagraph_runtime_mode = forward_context.cudagraph_runtime_mode
if ubatch_slices is None: if cudagraph_runtime_mode is CUDAGraphMode.FULL: if forward_context.batch_descriptor.num_tokens in self.cudagraphs: cudagraph_runtime_mode = CUDAGraphMode.NONE if cudagraph_runtime_mode in (CUDAGraphMode.NONE, CUDAGraphMode.PIECEWISE): return self.runnable(*args, **kwargs) return self.cudagraph_wrapper(*args, **kwargs) ...这个 ubatch_slices is None 分支里的第一段逻辑非常细小但很重要:如果某个形状已经捕获过 ubatched 的图,那么同一形状 非 ubatched 的运行不能再走图捕获——因为 FULL 图按形状只保存一份,ubatched 版占了那个位置。此时强行 cudagraph_wrapper() 会尝试在正常运行时捕获一张新图,这是不能接受的(运行时捕获意味着停下来等编译)。处理方式是退回 eager。
每微批的输入切片与 DP 元数据
compute_stream = torch.cuda.current_stream()
ubatch_dp_metadata = []for ubatch_slice in ubatch_slices: ubatch_num_tokens_across_dp = torch.tensor( [ubatch_slice.num_tokens] * dp_size, device="cpu", dtype=torch.int32) ubatch_dp_metadata.append(DPMetadata.make( self.vllm_config.parallel_config, ubatch_slice.num_tokens, ubatch_num_tokens_across_dp))DPMetadata 记录的是「每个 DP rank 在这一步有多少 token」,TP 层的 all-reduce 融合与 DP 的负载均衡都读它。切批之后,每个微批要有自己的一份——因为在微批的视角里,DP 组内的 token 数就是「我这个微批的 token 数」,假设所有 rank 同样切分(前面已经 pad 到一致了)。
_slice_model_inputs() 再按 token_slice 切 input_ids、positions、inputs_embeds、intermediate_tensors。positions 有一个细节:MRoPE(多模态旋转位置编码)的 positions 是二维 [3, num_tokens],第二种情况按列切,否则按第一维切。
跑微批
@torch.inference_mode()def _ubatch_thread(results, model, ubatch_metadata): torch.accelerator.set_device_index(self.device) with ubatch_metadata.context: model_output = model(input_ids=..., positions=..., ...) results.append((ubatch_metadata.context.id, model_output))
with override_forward_context(None): threads = [threading.Thread(target=_ubatch_thread, args=(results, model, m)) for m in ubatch_metadata] for t in threads: t.start() self.ready_barrier.wait() # 等所有线程进入上下文 ubatch_metadata[0].context.cpu_wait_event.set() # 唤醒第一个 for t in threads: t.join()override_forward_context(None) 把主线程的全局上下文清掉——因为马上要由各微批线程各自装载。ready_barrier 在 __enter__ 里被所有线程等一次,确保两个线程都完成了上下文装载与流设置,主线程才开始「发第一棒」。主线程只会发第一棒;之后的每一棒都靠微批线程在 yield 里互相传递。
所有线程结束后,torch.cat(sorted_results, dim=0) 按微批 id 排序拼回完整输出;如果模型返回的是元组(例如 EAGLE-3 草稿需要收集 aux hidden states),会逐分量拼接,保持结构一致。
线程安全与顺序:为什么主线程要 join
看上去主线程只发一棒、然后 join,什么都没「管」。但它必须等所有线程结束才能返回输出,因为模型输出是按微批 id 拼起来的,而微批的执行顺序是动态的——谁先结束不一定。sorted(results) 按 id 排序正好解决了这一点。
第七步:CUDA Graph——一条图里放两个线程的乒乓
这一步是 DBO 最难的部分,也是「能不能在生产里用」的分水岭。
CPU 侧每发射一个 kernel 都要走 Python、torch、驱动的路径;decode 时一个 token 一步,kernel 数几百个,CPU 开销会直接暴露为 GPU 空转。vLLM 用 FULL CUDA Graph 把整步前向捕获成一张图回放,绕开 CPU。但 DBO 是「两个线程交替发射」——怎么捕获?
捕获流程
_capture_ubatches() 的注释已经把四步说得很清楚,这里对着代码:
@torch.inference_mode()def _capture_ubatch_thread(results, ubatch_metadata): torch.accelerator.set_device_index(self.device) with torch.cuda.stream(ctx.compute_stream): _ = torch.cuda.current_blas_handle() with torch.cuda.stream(ctx.comm_stream): _ = torch.cuda.current_blas_handle() with ctx: # 进上下文、等障碍、被唤醒 model_output = model(...) results.append((ctx.id, model_output))第一步:每个线程先在自己两条流上都初始化 CUDA 上下文。current_blas_handle() 会触发 cuBLAS 的惰性初始化。这必须在捕获之前、在正确的设备上下文下完成——否则捕获图时第一个线程触发初始化会在图中插入初始化调用,或者更糟,在错误的流上初始化。
第二步与第三步在 torch.cuda.graph(...) 里完成:
with torch.cuda.graph(cudagraph.cudagraph, stream=compute_stream, pool=self.graph_pool): ubatch_metadata[0].context.cpu_wait_event.set() # 发第一棒 for thread in ubatch_threads: thread.join() sorted_results = [value for position, value in sorted(results)] result = _cat_ubatch_outputs(sorted_results) cudagraph_metadata.outputs = result get_offloader().join_after_forward()第四步:把图与它的元数据存进 self.cudagraphs[num_tokens]。
捕获期间,两个线程照常执行 yield 乒乓——只是这时 GPU 上不实际执行 kernel,而是在记录。关键前提是乒乓的 CPU 交接不依赖 GPU 的返回值:yield 只操作 threading.Event 和 torch.cuda.Event 的 record/wait,不读回 GPU 数据,不做 item() 或 synchronize()。如果模型代码在中间做了任何 host 同步,捕获就会卡死或行为错误。这也解释了为什么 _register_ubatch_function 里的 dbo_yield 可以在图里「被记录为」空——它们本来就不发射任何 GPU 命令,图里只记录流上的内核和事件。
stream=compute_stream 指定了捕获的主流,pool=self.graph_pool 让 DBO 的图与常规图共享内存池,减少显存碎片。共享专家与 pre-capture 预取相关的 offloader 在捕获前后分别 sync_prev_onload() 与 join_after_forward(),防止拷贝流上的工作跨进图边界,造成未 join 的流错误。
回放
elif num_tokens in self.cudagraphs and cudagraph_runtime_mode is CUDAGraphMode.FULL: cudagraph_metadata = self.cudagraphs[num_tokens] get_offloader().sync_prev_onload() cudagraph_metadata.cudagraph.replay() return cudagraph_metadata.outputs回放本身不需要任何多线程与 CPU 同步。图中已经录下了两条流上的全部内核与事件等待顺序——CUDA 图回放时会按捕获时的流拓扑重建依赖。这就是设计文档那句「一旦捕获过,就可以无需多线程与 CPU 同步地回放」。
只捕获 FULL,且只在均匀解码时捕获
allow_microbatching = ( self.parallel_config.use_ubatching and cudagraph_runtime_mode == CUDAGraphMode.FULL and uniform_decode and check_ubatch_thresholds(config=..., num_tokens=batch_desc.num_tokens, uniform_decode=uniform_decode))三个限定:
- 只有 FULL 图支持;PIECEWISE 图(把图切段、段间留出 CPU 可介入的边界)与多线程乒乓不兼容。
- 只有均匀解码(每个请求恰好排一个 token)才捕获微批图。decode 是 DBO 收益最直接的场景:每步 token 少、通信占比高。
- 超过阈值才捕获——阈值太低的形状图数量爆炸、收益又不明显。
其余形状仍然捕获非微批版本;到了运行时若形状对不上,UBatchWrapper 里那段 num_tokens not in self.cudagraphs 分支会退到线程执行(eager 或 piecewise)。这也是 vLLM 博客里所说「DBO 支持 prefill,但 prefill 侧主要靠 eager 线程路径」的原因。
为什么 DBO 只支持 FULL 图
如果只从实现细节去找,会看到「DBO 的图必须在 UBatchWrapper 里整体捕获」。从系统层面,原因更直接:PIECEWISE 图的核心价值是在图段之间让出 CPU,让调度器做下一批准备;而 DBO 本来就要在 CPU 上乒乓。两者叠加会让「谁在图内、谁在图外」变得难以推理;而且 PIECEWISE 的段边界是按单个线程设计的,无法容纳两个线程的交错。想更完整地理解两种图模式,可参考 vLLM 源码完全拆解(十二):piecewise compilation 与 CUDA Graph——消灭 kernel 调度开销的两层机制 以及专门讨论跨框架桶与 pad 的 CUDA Graph 的桶与垫:五个推理框架如何把动态解码批塞进静态图。
第八步:SM 的分配——把通信和计算真正隔到不同 SM 上
到这一步,DBO 已经让「两个微批」在时间上重叠了。但还有一层资源争用:通信内核(DeepEP)和计算内核(专家 GEMM)都要占用 SM。如果两者同时启动,它们会互相抢 SM,导致两条流上的 kernel 都拖慢,重叠变成「互相伤害」。
vLLM 用 SMControlContextManager 解决:
class SMControlContextManager: def __init__(self, comm_sms, set_comm_sms, set_compute_sms): device = torch.accelerator.current_device_index() total_sms = num_compute_units(device) assert comm_sms < total_sms self.total_sms = total_sms self.compute_sms = total_sms - comm_sms ... def __enter__(self): self.set_comm_sms(self.comm_sms) self.set_compute_sms(self.compute_sms) def __exit__(self, ...): self.set_comm_sms(self.total_sms) self.set_compute_sms(self.total_sms)进入上下文时,通信内核的 SM 上限设为 comm_sms,计算内核的上限设为 总 SM - comm_sms;退出时恢复全员。
comm_sms 的取值有两条路径:
comm_sms = envs.VLLM_DBO_COMM_SMS # 默认 20...max_sms_used = all2all_manager.max_sms_used()if max_sms_used is not None: comm_sms = min(comm_sms, max_sms_used)- DeepEP 高吞吐(HT)管理器没有覆写
max_sms_used(),继承基类返回None——含义是「可能用满 GPU」,于是保留默认VLLM_DBO_COMM_SMS = 20; - DeepEP 低延迟(LL)的
max_sms_used()直接返回 0——低延迟模式完全靠 RDMA,不用 SM; - 若
comm_sms为 0,set_comm_sms/set_compute_sms都不生效,也就不做隔离。
set_comm_sms 调 all2all_manager.set_num_sms(),落到 DeepEP 的 Buffer.set_num_sms();set_compute_sms 调 DeepGEMM 的 set_num_sms()(当前只对 DeepGEMM 做了支持,代码里留了 TODO)。
这里有一处值得仔细看的设计约束:
def set_num_sms(self, num_sms: int): # 缓冲区是按创建时的 kernel 配置分配的,所以只能减、不能增 if num_sms > self.num_sms: num_sms = self.num_sms deep_ep.Buffer.set_num_sms(num_sms)DeepEP 的缓冲区大小与 QoS 状态在 kernel 创建时确定,运行期只能调低 SM 数。这与 DBO 的做法正好合拍:DBO 只需要「通信只占一小部分 SM」,让计算跑在其余 SM 上。
还有一个来自 ROCm 的坑,vLLM 在代码里直接写了出来:
rocm_deepep_ht_dbo = (current_platform.is_rocm() and parallel_config.enable_dbo and parallel_config.all2all_backend == "deepep_high_throughput")if rocm_deepep_ht_dbo: comm_sms = 0 # 为 HT 预留 CU 会破坏 DP+EP 的生成精度ROCm 上的 DeepEP HT 在 DBO 下如果给通信单独留出 CU,会破坏 DP+EP 解码结果的正确性(注释的原话是 corrupts DP+EP generation accuracy),所以干脆不隔离,保证正确性。
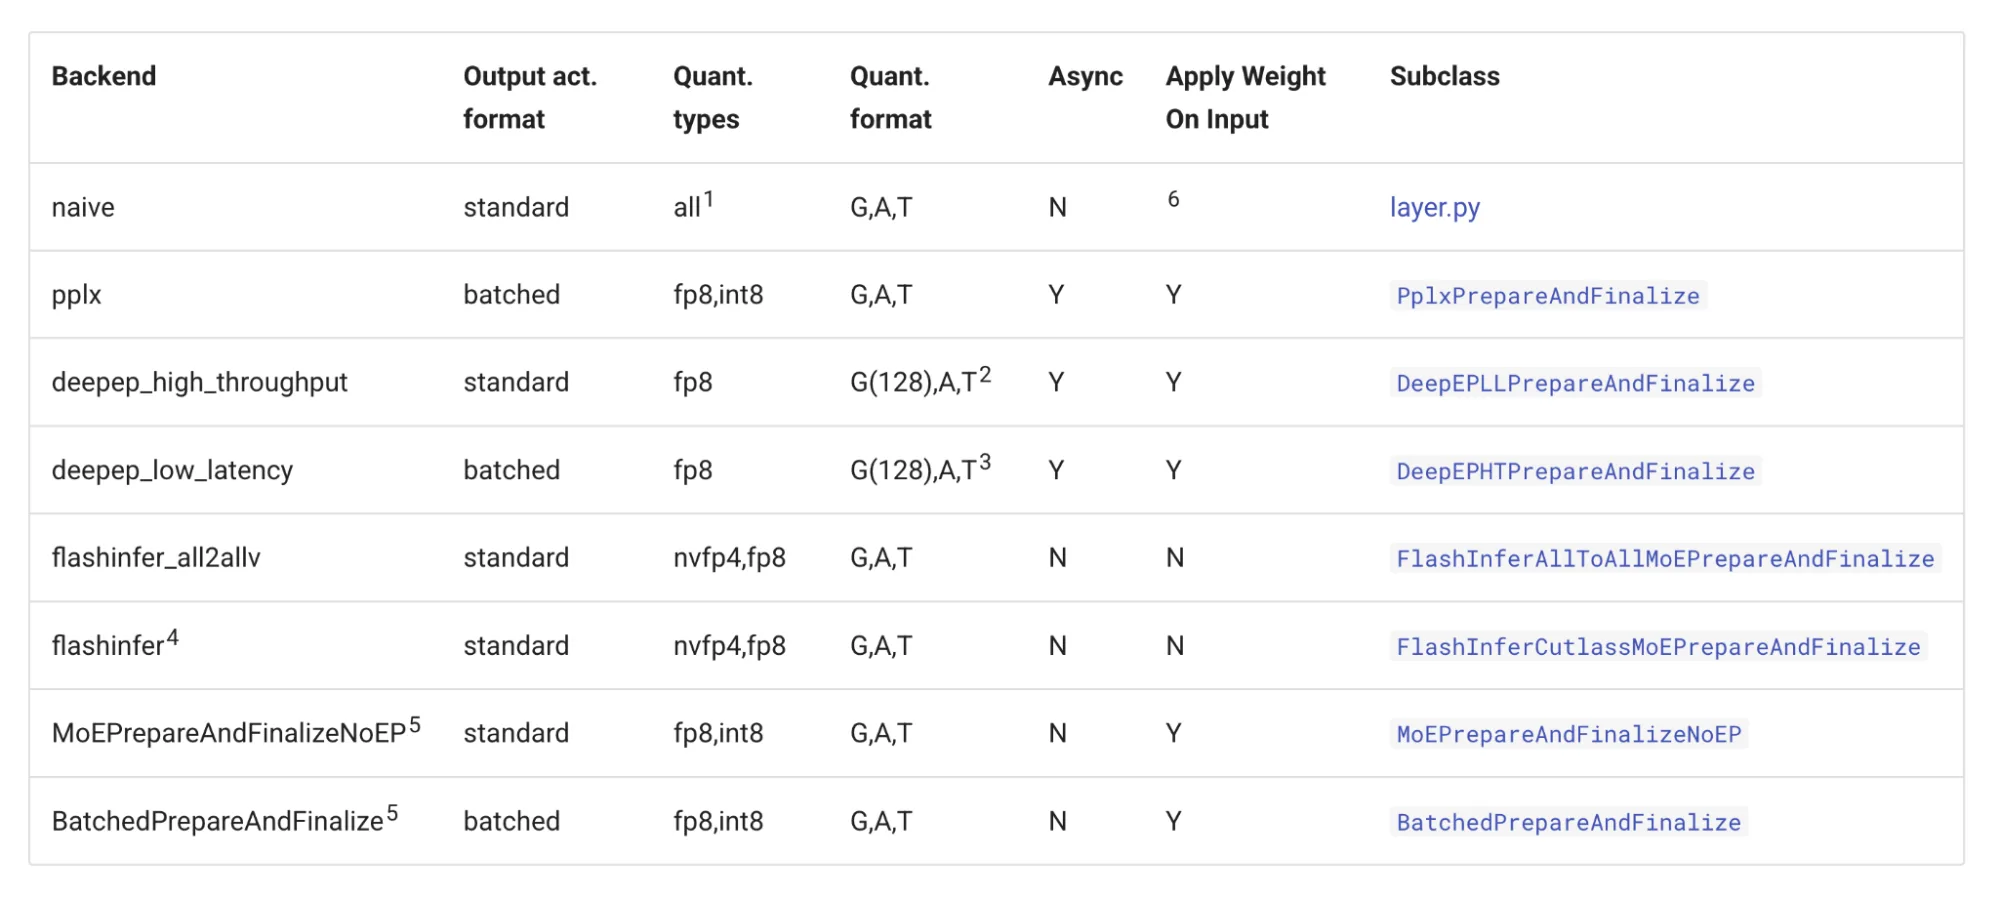
下图来自 vLLM MoE 内核文档,列出了各 all-to-all 后端的输出激活格式(standard / batched)以及对应的 prepare/finalize 实现。理解 DBO 的 SM 隔离为什么只对 DeepEP 生效,需要先知道不同后端是不同的人写的、有完全不同的内部结构:
工程细节:几处容易踩的坑
1. 事件必须与流绑定
UBatchContext._signal_compute_done() 在 compute_stream 上 record 事件,_wait_compute_done() 让 comm_stream 等它。如果误把两个微批的同一类事件混在一起,就会出现「我在等对方的事件、对方在等我的事件」的活锁。代码里所有事件都是「本微批的通信完成/计算完成」,配对关系从 make_ubatch_contexts 里初始化时就固定了。
2. ROCm 下通信工作区必须同步
DeepEP HT 在 ROCm 上会复用 Buffer 内部的通信工作区:
def _sync_dbo_comm_if_needed(self): if self.sync_dbo_comm and dbo_enabled(): torch.cuda.current_stream().synchronize()如果不让上一个微批的 HT 内核结束,下一个微批就会复用一份还在被读的工作区。代价是整流的同步,但在 ROCm 上这是换取正确性的必要成本。
3. 模型输出的拼接顺序
_cat_ubatch_outputs() 以「按微批 id 排序后的结果」拼接,而不是按线程结束先后顺序。如果不排序,输出行序就会随机乱掉——采样拿到的 logits 行会对应错误的请求,结果表现为「答案串台」这种极其隐蔽的错误。
4. 当 ubatching 被否决时,避免捕获新图
abort/mis-vote 的路径(ubatch_slices is None 但形状已在 self.cudagraphs 里)必须手动把 runtime mode 降为 NONE。否则会进 cudagraph_wrapper,在运行时触发捕获——一个本该是 eager 的执行变成了一次缓慢的图捕获,甚至打断服务。
5. 只让「纯解码」走图捕获
前面提到 uniform_decode 的限制。混合批(含 prefill)走线程路径,positions 的二维处理、is_padding 的切片都在这条路径上验证过;而 FULL 图捕获只要均匀解码,形状单一、路径简单。
何时不用 DBO:设计约束一览
把散落在各处的条件收拢起来,DBO 的适用边界大致如下:
| 约束 | 位置 | 含义 |
|---|---|---|
| DP size > 1 | DP 协调入口 | 单卡没有 all-to-all,也就没有重叠对象 |
| EP 开启 | SMControlContextManager | 仅对专家并行有 SM 隔离 |
| all2all 后端为 DeepEP | 设计文档与 all2all_manager | 其他后端没有对应的 set_num_sms 与 hook 机制 |
| 读历史请求不能与同批写者重叠 | _allow_microbatching | 前缀缓存命中与 in-flight prefill 共存时退整批 |
| 空微批不进 CUDA Graph | sync_cudagraph_and_dp_padding | 空微批会走 dummy 批,但图桶按非空形状捕获 |
| 超过 token 阈值 | check_ubatch_thresholds | 小批次切了不划算 |
| 图捕获仅均匀解码 | 捕获条件 | 混合批走线程路径 |
| 不支持 GDN/线性注意力 | 元数据构造处断言 | 状态型层不能按 token 切片 |
| ROCm 上 HT 后端不做 SM 隔离 | create_sm_control_context | 精度优先 |
其中 GDN / 线性注意力这一条值得单独说。线性注意力(如 Gated Delta Net)不存 KV 缓存,而是按请求维护一份递推状态;它的注意力元数据构造器(GDNAttentionMetadataBuilder、Mamba2AttentionMetadataBuilder 等)拿到 ubid(微批 id)时会直接断言 UBatching not supported with GDN or linear attn yet。也就是说,这类层的元数据是整体构造、不能按微批拆分的,DBO 遇到它们只能整批执行。
与站内其他机制的对照
DBO 的工程意义可以概括为「让推理执行器同时握住两本账」:一本是批次切分后各微批的输入形状与注意力元数据,另一本是两条流之间的依赖与 SM 配额。真正让它在服务里稳下来的,不是重叠本身,而是这些记账做对了。
- SGLang 的 Twobatch Overlap 同样把一批切成两半,但它切在 EP 通信层(
batch_overlap),以 micro-batch 的 fork/join 来让 dispatch 与本地专家计算错位;DBO 切在模型执行器入口,并以线程乒乓贯穿整个模型前向,包含注意力与共享专家。可参考 SGLang 源码完全拆解(二十二):Two-batch Overlap——一次前向切成两半,让通信藏进计算背后。 - DeepSeek 公开的 profile 数据文档里,预填充与解码都使用两个 micro-batch 来重叠计算与 all-to-all;解码时 RDMA 消息发出后全部 SM 归还计算,系统等计算结束后再收通信。可参考 DeepSeek-V3/R1 推理系统完全拆解:跨节点专家并行、双批重叠与负载均衡。
- 通信本身的内核与缓冲是 DeepEP 提供的,dispatch/combine 的内核结构、两类模式(HT 与 LL)的差异,可参考 DeepEP 完全拆解:DeepSeek 开源通信库如何把 MoE 推理的 dispatch/combine 压到硬件极限。
把三者放在一起看,DBO 的「不同」不在于重叠的思想,而在于它把这项工作完全放进了推理框架的执行器层,并且与 CUDA Graph、DP 协调、前缀缓存这些框架层机制做了深度咬合。也正因为如此,它是这套框架源码里少有的「多线程 + 多流 + 图捕获」三重交织的模块。
如何观察它是否真的在工作
在源码层面验证 DBO 是否生效,可以从三个地方看:
- 调度日志:
Running batch with cudagraph_mode: ..., should_ubatch: %s这一行 debug 日志会打出每一步should_ubatch的值。频繁出现False说明投票没通过或被阈值拦住。 - 元数据切分日志:
ubatch_slices: %s, ubatch_slices_padded: %s会打印每个微批的请求与 token 区间,可以直接看出一个长 prefill 是否被切开。 - Profiler:开启 DBO 后,应在 profiler 上看到两条流上交替出现的
dispatch send/dispatch recv/combine send/combine recv,正如官方 trace 里的cur. batch_0与prev. ubatch_1。Nsight Systems 中按 flow 观察两条流之间的 event 依赖,可以直接看到「计算等通信」的地方是否被填满。关于 profiler 的使用方法,可参考 GPU 推理性能分析完全指南:用 torch.profiler、Nsight Systems 与 Nsight Compute 逐层定位瓶颈。
启动命令的形态与设计文档一致,必须同时打开 DP 与 EP:
vllm serve deepseek-ai/DeepSeek-V2-Lite --trust-remote-code \ --data-parallel-size 2 --enable-expert-parallel --enable-dbo \ --all2all-backend deepep_low_latency解码为主的负载选 deepep_low_latency(RDMA 驱动、不占 SM);预填充为主的负载选 deepep_high_throughput(吃 SM、与计算争资源,此时 SM 隔离的作用才会体现)。
小结
DBO 的全部逻辑可以压成一条链:
- 决策:DP 组用一次 7 元 CPU all-reduce 统一投票,任何 rank 的 veto(典型是写读耦合)都会让全组退回整批,保证与不开 DBO 时结果一致;空微批不取消切批,只让它退回 eager。
- 切分:按 token 均分、按累积和反查请求边界,得到
UBatchSlice——一个请求可以被两个微批各覆盖一半。注意力元数据随之切出 query 起点、序列长度、块表与槽映射四件事。 - 执行:每个微批一个线程,各自持有上下文与「CPU 交接棒 + 两条流上的事件」;在 MoE 层的 dispatch/combine 前后用
yield_and_switch_from_compute_to_comm交棒,用recv_hook让对方替自己收结果。 - 隔离:进入 SM 控制上下文后,通信与计算被分配到互不相交的 SM 子集,避免重叠变成互相抢资源。
- 固化:以 FULL CUDA Graph 捕获两张流上的乒乓,回放时不再需要线程与 CPU 同步。
这套设计的代价也清楚:必须 DP>1 且 EP 开启、必须走 DeepEP、只捕获均匀解码的图、遇到前缀缓存与 in-flight prefill 的耦合会整批。它的收益也明确:DeepSeek 部署里的 MoE dispatch/combine 不再独占关键路径,官方博客记录的 H200 解码吞吐从约 1.5k tokens/s 提升到 2.2k tokens/s(多节点、IB + ConnectX-7),并把 DBO for decode 列为主要贡献之一。
对于读源码的路径,DBO 是一个很好的练习:它横跨调度器之下的执行器、模型层、MoE 内核层与通信库四层,而且每一层的改动都有明确的「为什么」。从 gpu_ubatch_wrapper.py 的 __call__ 开始逆向读,先看一个 UBatchSlice 从 runner 生成、到 metadata 切片、再到两条流上的内核,最后读 ubatch_utils.py 里那几段「什么时候不该切」的判断,整条链路就串起来了。
参考资料
- vLLM Dual Batch Overlap 设计文档
- vLLM Large Scale Serving: DeepSeek @ 2.2k tok/s/H200 with Wide-EP
- vLLM v1/worker/ubatching.py 源码
- vLLM v1/worker/gpu_ubatch_wrapper.py 源码
- vLLM v1/worker/ubatch_utils.py 源码
- vLLM v1/worker/gpu/dp_utils.py 源码
- vLLM fused_moe/prepare_finalize/deepep_ht.py 源码
- vLLM fused_moe/modular_kernel.py 源码
- DeepEP GitHub 仓库
- vLLM 并行配置 ParallelConfig 源码
- DeepSeek 公开的推理 profile 数据说明(双 micro-batch 重叠策略)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



