


llama.cpp 源码完全拆解(二十一):递归状态缓存——Mamba、RWKV 与混合模型的「KV Cache」长什么样
在 llama.cpp 的源码系列里,前面几篇反复围绕一个对象展开:llama_kv_cache。它的基本单位是「格」(cell)等于「token 位置」,一条序列占有哪一段位置、每个位置存哪一层哪一头的 K/V,前缀缓存、checkpoint、状态存取都以位置为坐标。这个模型对所有基于注意力的模型都成立,因为注意力的输出取决于「看哪些位置」,所以只要位置还在,KV 就必须在。
但模型世界里并不只有注意力。Mamba、RWKV、以及 Qwen3-Next、Kimi Linear、MiniMax-01 这类混合架构,引入了「递归层」:它不保存每个 token 的 K/V,而是把一个不断被覆盖的固定大小状态向前推。序列第 10000 个 token 的输出,只取决于「推到第 10000 步时的状态」,和 10000 个历史位置都没有直接关系。对这层内存,按 token 位置分页、按位置做前缀匹配、按位置回滚,这些 KV Cache 的经典动作要么失去意义,要么需要换一套语义。
llama.cpp 为它单独准备了一个子系统:llama_memory_recurrent。这个类只有一千三百多行,却包含了递归推理的很多「麻烦事」:每序列只有一格、复制时要先找新格子、共享状态怎么记住来源、投机解码要回滚几步怎么办、异构缓存怎么读、混合模型里注意力和递归两种内存怎么分工。这一篇就从 llama_memory_recurrent 和它的调用方出发,把这套逻辑逐段拆开。
需要先说的是:这篇文章讲的不是一个论文算法,而是 llama.cpp 内部一个类。它的「设计」不是从论文里抄来的,而是在一次次适配 Mamba、RWKV、Qwen3-Next、Kimi Linear 等模型的过程中被逐步打磨出来的工程结构。要读懂它,得先把「递归层到底需要什么样的缓存」这个问题讲清楚。
从 KV Cache 到递归状态:缓存的对象变了
注意力层需要什么
先把注意力层的缓存要求写清楚,后面才能看清递归层缺了什么。一个标准的自注意力层在 decode 时做的事是:
其中 是当前位置的查询, 是历史每个位置的键值。要让 和全量重算时一致,就必须保存所有 的 。于是缓存的大小是「层数 × 长度 × 头数 × 维度」,随着 线性增长。
这个结构有两个隐含性质,直接决定了 KV Cache 子系统的全部设计:
- 格与 token 位置一一对应。位置 的 K/V 只能有一个,且永远对应 token 。要复用前缀,只要看「这串位置在缓存里还在不在」。
- 不同位置互不依赖,拷贝就是搬家。把第 100 到 200 号位置的 K/V 复制给另一条序列,就是逐位置复制,任意顺序都行,写时复制(COW)与引用计数都建立在「一格可以被多条序列共享」之上。
递归层需要什么
递归层(State Space Model,SSM)把历史压进一个固定大小的状态。以 Mamba-2 为例,每个头的状态是一个 的矩阵,每来一个 token 做一次:
这里的 都是当前 token 算出来的输入, 是模型参数。注意两点:第一, 只依赖状态;第二,这个状态是就地覆盖的,算出新状态之后旧状态就没用了(除了为了回滚才需要保留几步)。所以缓存大小与序列长度无关,每条序列只需要一份状态,换一条序列只是换一格。
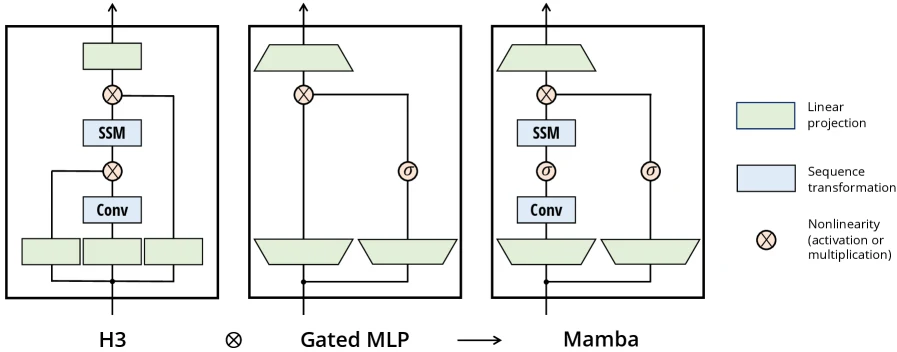
图 1 是 Mamba 论文里的块结构示意:输入先经过卷积,再进入选择性 SSM,最后与门控分支相乘。整条序列的信息被压进那个固定大小的递归状态,状态沿序列逐步更新,长度则完全不进入缓存的账本。
这个差别听上去只是省内存,实际上推翻了 KV Cache 的两条隐含性质:
- 格与位置不再一一对应。一格存的是「某条序列推到现在为止的第几步」,它不属于任何历史位置。同一个序列连续追加 token,都落在同一格里。
- 历史位置不可寻址。你没法说「把第 100 到 200 号位置的状态复制出来」,因为它们已经不在缓存里了。所以递归缓存天然只能做「当前状态」的复制,不能做部分区间复制。
llama.cpp 把这种「格 = 一份完整序列状态,位置只是最后一次写入的终点」的语义,称作递归缓存(recurrent cache)。它和 KV Cache 共用同一个抽象接口 llama_memory_i,但内部实现完全是另一套。
一个常被忽略的第三个缓存:卷积状态
真正的递归层往往还带一个小卷积。Mamba 的块在进入 SSM 之前,会先对输入做一层一维卷积(深度可分离卷积,卷积核长度 ,通常为 4)。要让 decode 与全量重算一致,必须记住每个通道最近 个输入,这就是卷积状态(conv state)。
卷积状态的大小是 ,也和序列长度无关,但它有一个值得注意的性质:它只依赖最近几个 token,不依赖整个历史。Kimi Linear 这类 KDA(Kernelized Delta Attention)层的卷积状态同理,而且它同时有 Q、K、V 三路,每路各自存最近 个时间步的输入,所以 n_embd_r 里要装下三路历史,这也是 KDA 的卷积状态行比 Mamba 更长的原因。
这个「短期记忆」和 SSM 的「长期记忆」性质完全不同,下一节会看到,llama.cpp 在实现里把两者都当成一类「每层一格的状态」来处理,只在拷贝语义上做了微妙区分。
一句话概括:把「每序列一份状态」塞进「每位置一格」的旧框架
这个子系统的核心思想可以用一句话概括:沿用 llama_kv_cells 那套「格 + 序列集合」的簿记结构,把每一格的含义从「一个 token 位置」改成「一份完整的序列状态」,再用 src/src0 两个字段记录「这一格是从哪一格拷过来的」,以便在下一批写入前先把旧状态搬到新格里。
为什么说这是「旧框架」?因为前面几篇讲的 llama_kv_cache 也是用 llama_kv_cells 来记录每个位置的 pos、所属序列集合 seq_id、引用等。递归缓存直接复用了同样的格子结构,但格子里的 pos 只记录「最后一格 token 的位置」,seq_id 集合表示「哪些序列共享这一格的状态」,另外多了 tail(每条序列自己的尾部格子)和 src/src0(拷贝链)。
对比一下就更清楚了:
| 对比项 | llama_kv_cache | llama_memory_recurrent |
|---|---|---|
| 一格代表什么 | 一个 token 位置的 K/V | 一份完整的序列递归状态(R/S 两行) |
| 格数 | n_ctx(按位置编号,每层一套张量) | n_seq_max(默认至少 1) |
| 前缀复用 | 按位置前缀匹配 | 只有「整段共享」一种复用 |
| 部分删除 | 任意区间 seq_rm | 只支持整段删除,或凭快照做有限回滚 |
| 状态大小 | 每层随长度线性增长 | 每层 ,与长度无关 |
| 张量布局 | [k_head, n_embd_k, n_ctx],n_ctx 为第二维 | [n_embd_r/s, n_rows],n_rows = cells × (1 + n_rs_seq) |
| 张量名 | cache_k_l0 等 | cache_r_l0、cache_s_l0 |
这张表最重要的两行是第三、第四行。递归缓存没有前缀的概念:一条序列的当前状态是它一路推过来的结果,如果你想复用另一条序列的状态,只能把整格共享过去(seq_cp),不能只复用「前 100 个 token 的状态」。这也意味着 seq_rm 对递归缓存来说,要么整条序列删掉,要么什么都别动。
理解了这一点,后面的代码就都能对照上:find_slot 不是找空位,而是「找空格的搬运函数」;state_write 不是把区间写出去,而是「把整条序列当前那格写出去」;seq_rm 处理部分删除时只看 p0,因为部分区间在递归缓存里没有物理意义。
数据结构:mem_cell、r_l/s_l 与 n_rs_seq
mem_cell:比 KV 缓存的格子多两个字段
打开 llama-memory-recurrent.h,格子定义如下:
struct mem_cell { llama_pos pos = -1; int32_t src = -1; // used to know where states should be copied from int32_t src0 = -1; // like src, but only used when setting the inputs (allowing to copy once) int32_t tail = -1;
std::set<llama_seq_id> seq_id;
bool has_seq_id(const llama_seq_id & id) const { ... } bool is_empty() const { return seq_id.empty(); } bool is_same_seq(const mem_cell & other) const { return seq_id == other.seq_id; }};逐字段解释:
pos:这条序列最后一次写入的 token 位置。对递归状态来说它更多是用来做连续性检查(last_pos == cell.pos + n_seq_tokens)以及对外的位置查询,不是寻址坐标。seq_id:哪些序列共享这一格的状态。这里的共享不是写时复制,而是真的同一个状态:seq_cp之后两条序列都指向同一格,之后其中一条继续推理时才触发「分离」。src:这一格的数据「应该从哪一格拷来」。在一次find_slot中,所有被重排过的格子都把src指向自己的来源,等下次find_slot时先按src把数据搬过来。src0:对外暴露的「稳定来源」,供构建计算图时生成输入索引。tail:每条序列自己的「尾巴格」。注意cells[seq_id].tail这个写法:格数是n_seq_max,而序列号也小于n_seq_max,所以格子 0..n_seq_max-1 本身被征用来存放「每条序列的尾巴指针」。这在逻辑上有点绕,但代码里确实是这么用的:cells[seq_id]读的是序列seq_id的元数据格,它的tail指向真正存放该序列状态的那一格。
两层张量:r_l 与 s_l
const uint32_t n_rows = mem_size * (1 + n_rs_seq);ggml_tensor * r = ggml_new_tensor_2d(ctx, type_r, hparams.n_embd_r(), n_rows);ggml_tensor * s = ggml_new_tensor_2d(ctx, type_s, hparams.n_embd_s(), n_rows);ggml_format_name(r, "cache_r_l%d", i);ggml_format_name(s, "cache_s_l%d", i);r_l 是卷积状态(R 代 recurrence short memory),s_l 是 SSM 状态(S 代 state)。每层一张二维张量:行是 n_embd_r(或 n_embd_s)维的状态,列是 n_rows。n_rows 等于「格数 × (1 + 回滚快照数)」,默认 n_rs_seq = 0 时就是「格数」。
n_embd_r 和 n_embd_s 是在 llama-hparams.cpp 里按架构算的:
uint32_t llama_hparams::n_embd_r() const { if (wkv_head_size != 0) { return token_shift_count * n_embd; } // RWKV if (n_shortconv_l_cache != 0) { return n_embd * (n_shortconv_l_cache - 1); } // LFM2 if (n_embd_head_kda != 0) { // Kimi KDA const uint32_t d_inner = n_head() * n_embd_head_kda; // 32 * 128 = 4096 return 3 * (ssm_d_conv > 0 ? ssm_d_conv - 1 : 3) * d_inner; } const uint32_t n_conv = (ssm_d_conv > 0 ? ssm_d_conv - 1 : 0) * (ssm_d_inner + 2*ssm_n_group*ssm_d_state); return n_conv; // Mamba}
uint32_t llama_hparams::n_embd_s() const { if (wkv_head_size != 0) { return n_embd * wkv_head_size; } if (n_embd_head_kda != 0) { return n_embd_head_kda * n_embd_head_kda * n_head(); } if (n_embd_head_la != 0) { return n_embd_head_la * n_embd_head_la * n_head(); } // MiniMax-01 return ssm_d_state * ssm_d_inner; // Mamba}注释里已经点出了两个典型大小:若取一组典型 Mamba-2 配置(d_state=128, d_inner=2048, n_head=64), 行是 128×2048 = 262144 个元素;Kimi KDA 的 行则是 128×128×32 = 524288 个元素,正好是前者的两倍。卷积状态更夸张:KDA 的 n_embd_r 是 3 × 3 × 4096 = 36864,比 Mamba 的 3 × (2048 + 2×8×128) 还要大好几倍。这说明混合模型的递归缓存并不像直觉那样「很小」,它对每层一份、每序列一份的账本要单独算。
注意这里还有 p_l:某些模型(如带 PLE——Per-Layer Embedding——的模型)需要一个单独的卷积历史,因为它在设备间必须镜像而不能和 r 共用一行。构造函数里给每个 buffer 类型开了张量上下文,并按 ple_conv_state() > 0 ? 3u : 2u 预留了每层张量数。
n_rs_seq:为投机解码准备的快照数
n_rs_seq 是这类缓存最新的一个参数:每条序列允许保留多少个回滚快照。默认 0 表示不保留;大于 0 时,每层张量的列数从 mem_size 扩成 mem_size × (1 + n_rs_seq),也就是给每条序列额外留 n_rs_seq 份历史状态。
它由 common_params_speculative::need_n_rs_seq() 根据投机解码方法自动设置:
uint32_t need_n_rs_seq() const { bool needs_rs_seq = std::any_of(types.begin(), types.end(), [&](auto t) { return t == COMMON_SPECULATIVE_TYPE_DRAFT_MTP || t == COMMON_SPECULATIVE_TYPE_DRAFT_EAGLE3 || t == COMMON_SPECULATIVE_TYPE_DRAFT_DFLASH || t == COMMON_SPECULATIVE_TYPE_DRAFT_DSPARK; }); return needs_rs_seq ? draft.n_max : 0u;}也就是草稿长度 n_max。道理很直接:投机解码一次前向要吃掉 个草稿 token,验证后可能只接受前 个。对 KV Cache,被拒绝的草稿 K/V 直接删掉即可;对递归状态,状态已经「推过去了」,要退回去只能靠事先留下的快照。所以每条序列至少要能回到「接受 个 token 之后」的状态, 共 个终点,对应 个回滚快照。
这是一个很有意思的设计:递归缓存不能「局部撤销」,只能「回到快照」。n_rs_seq 就是为了这种语义准备的。
构造:格数、行数、按层过滤与设备
构造函数做的事不多,但每一行都有信息量:
head = 0;size = mem_size;used = 0;this->n_rs_seq = n_rs_seq;rs_idx.assign(n_seq_max, 0);cells.clear();cells.resize(mem_size);mem_size 由模型层传入,默认是 std::max(1u, cparams.n_seq_max):每条序列至少一格。这个选择很合理:一份状态就是一个连续格,只有一条序列时只需要第 0 格,即使 --parallel 1 也不能让它为 0。
接下来按层建张量,逐层调用 model.dev_layer(i) 判断放 CPU 还是 GPU:
for (int i = 0; i < n_layer; i++) { if (filter && !filter(i)) { LLAMA_LOG_DEBUG(...); continue; } ggml_backend_buffer_type_t buft = ggml_backend_cpu_buffer_type(); if (offload) { auto * dev = model.dev_layer(i); buft = ggml_backend_dev_buffer_type(dev); } ...}filter 是层过滤器。它来自混合内存 llama_memory_hybrid:注意力层和递归层不在一张表里,递归缓存只负责 is_recr(il) 为真的层。模型层还会按架构传入不同的过滤器,比如 Qwen4EXP 的 MTP 草稿上下文只能持有注意力层,递归过滤器就必须返回 false。
设备选择直接跟随 dev_layer(i),也就是和权重、KV 一样按层放置:同一层的递归状态和权重放在同一张卡上。这一点对混合模型尤其重要,因为混合层的注意力部分和递归部分必须同步。
最后:
ggml_backend_buffer_clear(buf, 0); // 避免 padding 中的 NaN递归状态不像 K/V 那样可以随便覆盖,它会被读进图并参与运算。如果某格从未被写过,读出来应该是 0 而不是未初始化的垃圾值,否则 Mamba 层的 dt_softplus 和后续卷积会污染输出。
拷贝链 src 与 src0:为什么需要两个字段
递归缓存最反直觉的设计是两个「来源」字段。要理解它,得先明白一次 find_slot 里发生了什么:一批 ubatch 里每条序列都要把自己的状态从一个格搬到另一个格,但搬运不能立刻做,因为目标格可能还存着另一条序列的旧状态。
src:本批搬运计划
find_slot 对每条序列做四件事:找到它的尾格、必要时把分享出去的尾格分离到空格、把目标格重排到 [min, max] 连续区间、更新尾部指针。重排靠交换格子实现:
for (uint32_t s = 0; s < n_seqs; ++s) { const int32_t dst_id = s + min; const int32_t src_id = cells[ubatch.seq_id[i][0]].tail; if (dst_id != src_id) { std::swap(dst_cell.pos, src_cell.pos); std::swap(dst_cell.src, src_cell.src); std::swap(dst_cell.seq_id, src_cell.seq_id); for (uint32_t j = 0; j < size; ++j) { /* 修正所有 tail 指针 */ } }}重排之后,代码给每个被用到的格子打上来源标记:
for (int i = min; i <= max; ++i) { if (cells[i].src < 0) { cells[i].src0 = rs_z; // 空状态:从零格拷 } else { cells[i].src0 = cells[i].src; // 非空:保留原来的来源 } cells[i].src = i; // avoid moving or clearing twice}src = i 这一行的含义是「这一格数据已经在本格了,以后若被重排,来源就是自己」。下次 find_slot 再发生交换时,src 会被一起 swap 跟随数据走,最后真正执行拷贝时按这个字段找来源。
为什么不立刻拷贝? 两个原因。第一,一次 find_slot 可能在准备阶段被调用两次(prepare() 先在 find_slot 上试探,再恢复原来的 cells 快照),真正执行发生在 apply()。第二,拷贝本身是一张 ggml 图里的 ggml_get_rows,不是 C++ 侧的 memcpy,所以需要在建图时按「拷贝索引」批量完成,而不是逐条序列做。用一个字段记住「数据将来该从哪来」,就能让建图阶段只做一次 gather。
这里还有一个小细节:d_cell.src 和 src_cell.src 是一起 swap的,而 src 本身又是在下一次 find_slot 时覆盖为 i。也就是说,src 只在两次 find_slot 之间有意义,它的生命周期是「上一次安排 -> 这一次执行」。
src0:本轮图里要建的输入索引
src0 的作用不同。它是 s_copy() 返回给计算图的东西:
int32_t llama_memory_recurrent_context::s_copy(int i) const { const uint32_t cell_idx = i + mem->head; const int32_t src0 = mem->cells[cell_idx].src0; if (mem->n_rs_seq == 0) { return src0; } uint32_t idx = 0; if (!mem->cells[cell_idx].seq_id.empty()) { const llama_seq_id seq = *mem->cells[cell_idx].seq_id.begin(); if (seq >= 0 && (size_t) seq < mem->rs_idx.size()) { idx = mem->rs_idx[seq]; mem->rs_idx[seq] = 0; // reset rollback idx } } return (int32_t)(idx * mem->size) + src0;}在没有回滚快照时,它直接返回 src0。有快照时,它返回 快照序号 × 格数 + src0,也就是把输入索引从「主面」挪到「第 idx 个快照面」。并且它在读完之后立刻把 rs_idx[seq] 清零:每个回滚序号只消费一次,下一次用就是默认的主面。
这个「读一次就清零」的设计,是为了处理「同一批中有多条序列,但只有一条需要回滚」的情况:所有序列都走同一个 gather,只有那一条的索引被临时改到快照面,读完立刻恢复。这里也隐含了一个前提:回滚只在一条序列上发生。如果两条序列同时要求回滚,s_copy 只会取 *seq_id.begin() 那一条,另一次回滚就会被吞掉。这在当前实现里是可接受的,因为 llama.cpp 的投机解码一次只处理一条序列的回滚。
rs_z:为什么要一个「零格」
find_slot 最后一段:
std::vector<int32_t> refcounts(size, 0);for (size_t i = 0; i < size; ++i) { const int32_t src = cells[i].src; if (src >= 0) { refcounts[src] += 1; }}rs_z = -1;for (int i = min; i <= max; ++i) { if (refcounts[i] == 0) { rs_z = i; break; }}for (int i = min; i <= max; ++i) { if (cells[i].src < 0) { GGML_ASSERT(rs_z >= 0); cells[i].src0 = rs_z; } else { cells[i].src0 = cells[i].src; } cells[i].src = i;}新序列第一次出现时,它的状态格是空的(seq_id 为空,pos=-1)。一个空格如果要被读进图,它的内容不应是该格历史的「残留数据」,而应该是一个干净的零状态:Mamba 和 RWKV 的状态都从零开始。
rs_z 就是被选中当作「零格」的那一格:在本次用到的区间 [min, max] 里,找一个没有被其他格当作来源的格,先把它清零,再让它作为所有「新序列」的拷贝来源。refcounts 的作用是避免选中一个「别人正在从它拷数据」的格,因为那样会毁掉正在进行的拷贝链。
图 2 把这一节的全部簿记画成了一张对照图:左边是 KV Cache「格 = 位置」的语义,右边是递归缓存「格 = 整段序列状态」的语义;下方是 find_slot 在一次批次内的三步搬运——共享格分离、重排到 [min, max]、在图里按 src0 做一次 gather。
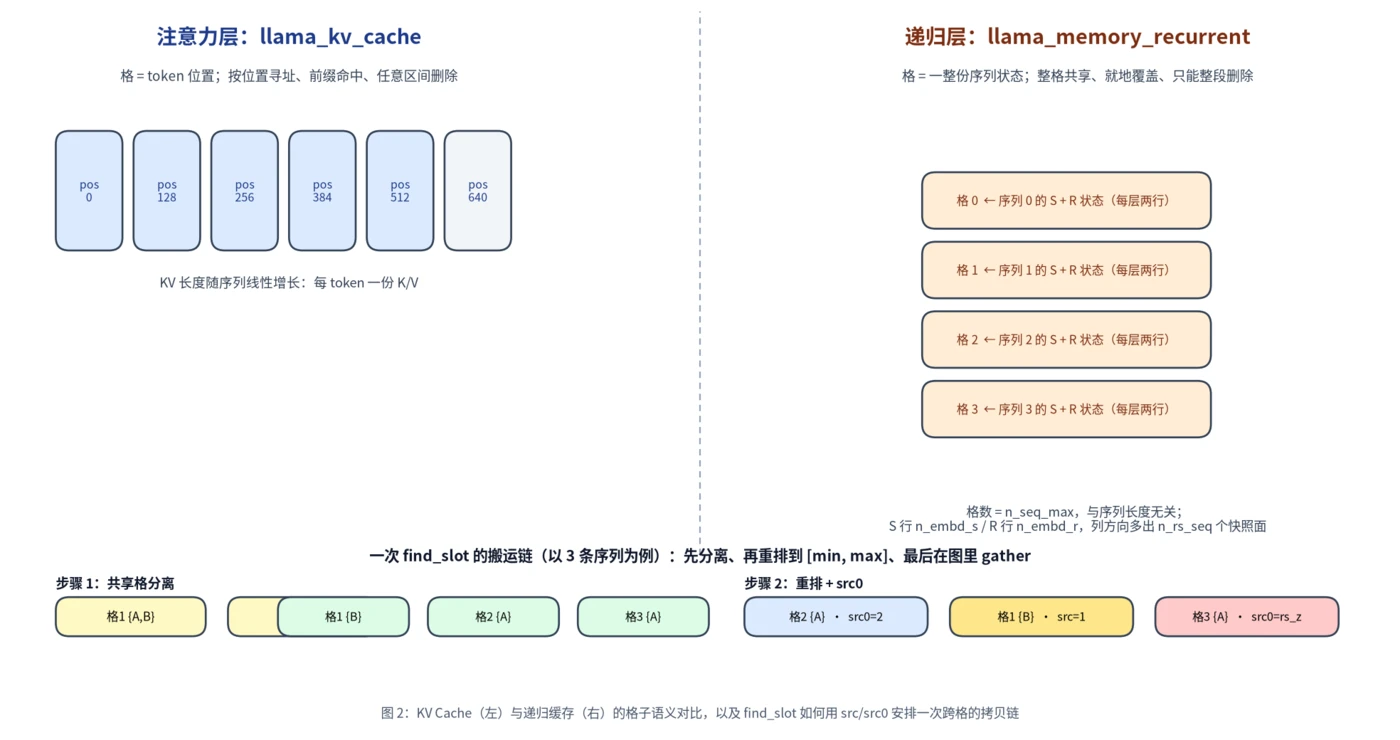
新序列的递归状态不是「空」的,而是「零」,而零状态必须有一个确切的物理位置,否则 ggml_get_rows 就没有合法的来源行可读。图 2 下方中间那格的 src0=rs_z 就是这个零格。
计算图侧:build_rs 如何把一格状态变成一次 gather
状态缓存在 C++ 侧只管簿记,真正动数据的是图里的三个算子:一次清零、一次 gather、一次 scatter 回写。
llama-graph.cpp 中的 build_rs:
ggml_tensor * states = ggml_reshape_2d(ctx0, s, state_size, s->ne[1]);
// Clear a single state which will then be copied to the other cleared states.ggml_tensor * state_zero = ggml_view_1d(ctx0, states, state_size*(rs_zero >= 0), rs_zero*states->nb[1]*(rs_zero >= 0));ggml_build_forward_expand(gf, ggml_scale_inplace(ctx0, state_zero, 0));
const int64_t i0 = n_rs - state_copy->ne[0];ggml_tensor * states_all = ggml_get_rows(ctx0, states, state_copy);逐段解释:
view_1d截出零格那一行,ggml_scale_inplace(..., 0)把它清零。清空之后,states_all的 gather 就可以把新序列的来源指向这一行。ggml_get_rows(states, state_copy):按state_copy这张索引表(每格一个整数)把n_rs行状态取出来,形成一个「本批所有序列的输入状态」张量,形状是{state_size, n_rs}。- 输出:
ggml_tensor * output_states = get_state_rows ? get_state_rows(ctx0, states, state_copy_main) : ggml_view_2d(ctx0, states_all, state_size, n_seqs, states_all->nb[1], 0);ggml_build_forward_expand(gf, output_states);
ggml_tensor * states_extra = ggml_view_2d(ctx0, states_all, state_size, n_rs - n_seqs, states_all->nb[1], (n_seqs - i0)*states_all->nb[1]);ggml_build_forward_expand(gf, ggml_cpy(ctx0, states_extra, ggml_view_2d(ctx0, s, state_size, (n_rs - n_seqs), s->nb[1], (rs_head + n_seqs)*s->nb[1])));output_states是前n_seqs行,也就是本批里实际参与前向的每条序列的状态,被交给模型层当输入。states_extra是本批里「只是为了保留而被带上来的额外状态」。为什么会有额外状态?因为s_copy的索引表长度是n_rs,不只包含本批序列,还包含「本批没用到但需要保留在head..head+n区间内的状态」。它们被原样再写回物理缓存,保证「本批之前就已经在区间的那些格」数据不丢。get_state_rows是模型层可选提供的回调:Mamba-2 用它做ggml_ssm_scan,直接从缓存行出发,而不是从 gather 后的拷贝出发,避免了一次大拷贝。值得注意的是,回调成立的前提是「扫描内核自己负责把最终状态写回缓存」,否则 gather 的意义就只剩下给调用方准备输入,输出还需要另一条写回路径。
这里的 state_copy 就是 llm_graph_input_rs 的输入张量,它在 set_input 时被填充:
void llm_graph_input_rs::set_input(const llama_ubatch * ubatch) { const int64_t n_rs = mctx->get_n_rs(); if (s_copy) { int32_t * data = (int32_t *) s_copy->data; // assuming copy destinations ALWAYS happen ONLY on the cells between head and head+n for (uint32_t i = 0; i < n_rs; ++i) { data[i] = mctx->s_copy(i); } }}s_copy(i) 返回的是 src0(或其快照面偏移),n_rs = max - min + 1,所以「拷贝目标只可能落在 head..head+n 区间」这个假设成立。
读回:Mamba-2 的 get_ssm_rows 与扫描快照
Mamba-2 的层不使用 gather 后的拷贝,而是直接用缓存行:
auto get_ssm_rows = [&](ggml_context * ctx, ggml_tensor * states, ggml_tensor * ids) { ggml_tensor * ssm = ggml_reshape_4d(ctx, states, d_state, head_dim, n_head, state_slots); return ggml_ssm_scan(ctx, ssm, x, dt, A, B, C, ids, K);};这里 states 是 states_all 的视图,state_slots 是张量第二维长度 n_rows(含快照面)。ggml_ssm_scan 的 ids 就是 state_copy_main(每条序列去读哪一行),K 是快照数加一:
const int64_t K = cparams.n_rs_seq > 0 ? (int64_t) cparams.n_rs_seq + 1 : 1;CUDA 侧的 ssm_scan 内核在扫描每个 token 时把中间状态写进不同的快照面:
// Slot 0 is the final state written below; slots 1..K-1 are rollback snapshots.const int64_t slot = n_tok - 1 - i;if (K > 1 && slot > 0 && slot < K) { float * s_snapshot_warp = (float *) ((char *) s_warp + slot * s_slot_bytes); for (int j = 0; j < c_factor; j++) { s_snapshot_warp[WARP_SIZE * j + lane] = state[j]; }}处理完第 个 token 后的状态,会被写到第 n_tok - 1 - i 个快照面。反过来读:快照面 存的是「处理了 个 token 之后」的状态。以一次 4 个 token 的草稿前向为例,面 0 是最终状态(4 个 token),面 1 是 3 个 token 后的状态,面 2 是 2 个 token 后的状态,面 3 是 1 个 token 后的状态。
这正好对上投机解码的接受计数:若验证接受了 个草稿 token,seq_rm 算出的回退步数是 rollback = n_tok - j,于是 rs_idx[seq] = n_tok - j,读的就是「接受 个 token 后」的那一面。主面 0 仍会在同一次 scan 里被写成完整的最终状态,两者互不覆盖。
这里还有一个值得注意的 kernel 融合:ggml_cuda_try_ssm_scan_cache_fusion 会识别「scan 之后紧跟一个把快照写回缓存视图的 cpy」的模式,直接让内核自己写缓存,跳过那个 cpy。限制条件之一就是 n_seqs != 1 时不融合,因为多序列时「一个序列读的行可能正是另一个序列本轮要写的行」。这是一个非常实际的正确性问题。
卷积状态没有 ssm_scan 这样的语义,它的快照是用循环直接写的:
const int64_t n_written = std::min<int64_t>(n_seq_tokens, K);for (int64_t slot = 0; slot < n_written; ++slot) { ggml_tensor * last_conv = ggml_view_3d(ctx0, conv_x, d_conv - 1, ..., (n_seq_tokens - slot) * conv_x->nb[0]); ggml_build_forward_expand(gf, ggml_cpy(ctx0, last_conv, ggml_view_2d(ctx0, conv_states_all, row_count, n_seqs, conv_states_all->nb[1], ((size_t) slot * mem_size + kv_head) * row_size)));}这里用 (n_seq_tokens - slot) 作为偏移,得到的正是「处理了 n_seq_tokens - slot 个 token 之后」的卷积历史;把它写到第 slot 面,与 ssm_scan 的「面 对应 步」完全一致。每个快照面在列方向偏移 slot * mem_size 行。
回滚:seq_rm 只能整段删,n_rs_seq 才能有限回退
对递归缓存来说,seq_rm 的区间不是「逐位置删除」:真正有影响的只有尾格。代码先处理整段删除,再处理「区间盖住尾部」的部分回退。
const bool rm_all = p0 == 0 && p1 == std::numeric_limits<llama_pos>::max();if (rm_all) { set_rs_idx(seq_id, 0); }
// models like Mamba or RWKV can't have a state partially erased at the end// of the sequence because their state isn't preserved for previous tokens注释写得很直接。但紧接着有一大段「部分回退」的特殊处理:
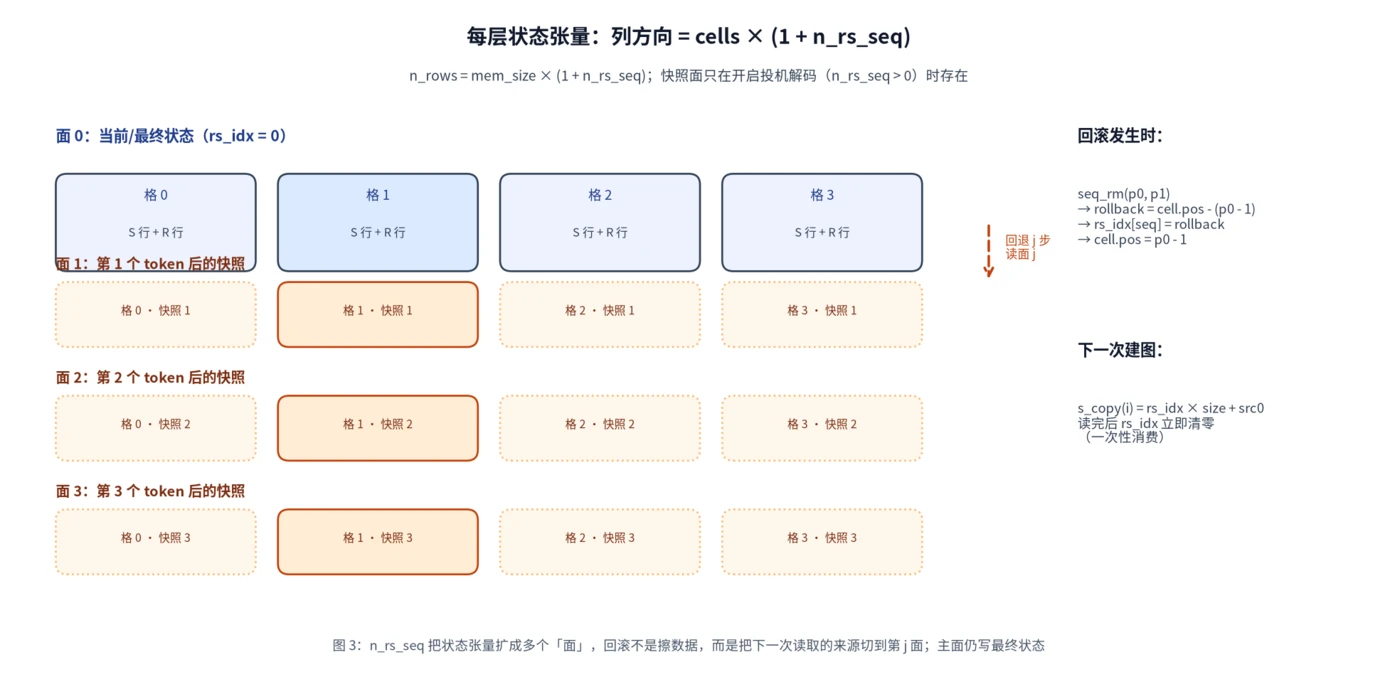
if (0 < p0 && p0 <= cell.pos && p1 > cell.pos) { if (cell.seq_id.size() > 1) { return false; } // 共享格不能只给一条序列回退 if (is_empty()) { cell.pos = p0 - 1; return true; } // 没层的草稿上下文只动 pos const llama_pos rollback = cell.pos - (p0 - 1); const bool pending = rs_idx[seq_id] != 0; if (!pending && rollback >= 1 && rollback <= (llama_pos) n_rs_seq) { set_rs_idx(seq_id, (uint32_t) rollback); cell.pos = p0 - 1; return true; } return false;}这段逻辑做的事情是:如果调用方要求把序列从 p0 开始截断(p1 大于当前尾位置),而且回退步数在 n_rs_seq 以内,就把 rs_idx[seq_id] 设成回退步数,并把 pos 改成 p0 - 1。物理状态并没有被擦除:下一次 find_slot 时 s_copy 会从对应快照面读状态,主面最终会被覆盖成真正需要的前缀状态。
有四个约束值得单独讲:
cell.seq_id.size() > 1时拒绝。共享格只允许整段删除,因为回滚一条序列而另一条仍在使用同一格时,你无法决定物理面应该跟着谁。这与站内 前缀共享的扇出难题 讲过的「共享导致的写时复制」是同一类问题,只是递归缓存里状态是不可分割的整体,无法按位置拆开,所以干脆拒绝。is_empty()时只改pos。当层过滤器把所有层都过滤掉(比如纯注意力层的 MTP 草稿上下文),递归缓存在逻辑上仍要维护位置信息,但不需要物理状态。这时回退只是把pos改小。pending时拒绝。rs_idx的语义是「下一次读时用哪个快照面」,而且读一次就被清零。如果在上次回滚之后、还没真正读之前又来了第二次回滚,那么第一次回滚的意图会被覆盖。代码选择直接拒绝第二次回滚,让调用方自己处理(一般是干脆全删)。- 滚回步数必须在
[1, n_rs_seq]内。超过n_rs_seq的回滚意味着要回到一个没被保留的状态,只能拒绝。
这四条约束合起来说明一件事:递归缓存的「回滚」不是一种独立的操作,而是一种「延迟应用的状态源切换」。这个模型很聪明,但也把「每次回滚只能发生一次、只能发生在不共享的序列上」写成了隐式前提。
另外,seq_add 和 seq_div 在递归缓存里也只需要改 pos:
// for Mamba-like or RWKV models, only the pos needs to be shiftedif (0 <= seq_id && seq_id < (int64_t) size) { const int32_t tail_id = cells[seq_id].tail; if (tail_id >= 0) { auto & cell = cells[tail_id]; if (cell.has_seq_id(seq_id) && p0 <= cell.pos && cell.pos < p1) { cell.pos += shift; } }}这正好体现了「位置只是元数据」这一点:对递归状态而言,位置平移不会改变内容。
用图 3 可以更直观地理解这个机制:状态张量在列方向被切成「面 0 + 若干个快照面」,回滚不是去擦除数据,而是把「下一次读取的来源」切到第 面——主面仍然承载最终状态。
状态存取:整条序列的当前状态如何落盘
KV 缓存的 state_write 可以只写一段区间,因为它是按位置管理的。递归缓存的 state_write 则必须先把「逻辑当前状态」映射到「物理行」,因为当前状态可能还在快照面里:
const uint32_t cell_id = rs_idx_cur * size + (cell.src >= 0 ? cell.src : (int32_t) i);if (cell_ranges_data.empty() || cell_ranges_data.back().second != cell_id) { cell_ranges_data.emplace_back(cell_id, cell_id + 1);} else { cell_ranges_data.back().second++;}这里出现了一个易错的细节:cell_ranges_data 存的是连续物理行区间。如果两条相邻的逻辑格恰好物理行连续(比如 size + 0, size + 1),它们就会被合并成一个区间,然后一次性 write_tensor 写出。但如果它们都在主面,0, 1 也会被合并,没问题;如果它们在快照面,size, size+1 也会被合并。这个合并依赖一个前提:逻辑格与物理行在这个区间内是同序的,而 find_slot 里的重排保证了 [min, max] 区间是连续的,所以这个假设成立。
还有一段防御性代码:
} else if (rs_idx_cur != seq_rs_idx) { GGML_ABORT("cannot write shared recurrent state with different rollback indices");}当 seq_id = -1(写全部序列)且某格被多条序列共享时,如果这些序列的 rs_idx 不一致,就没法决定「写到快照面 1 还是 2」,只能中止。
写入数据时的 R/S 两段循环没有特别复杂的地方,但 s_trans 字段值得一说:
const uint32_t s_trans = 0;目前递归缓存总是写成非转置布局,读取时直接拒绝转置格式。而 KV Cache 里 V 的转置只在「不开 FlashAttention」时才发生:那时注意力 kernel 需要按 token 维度连续读取 V,把 V 布局转成 [n_ctx, n_embd_v] 后每次取一段连续行;递归状态没有这种访存模式,所以不需要转置。
混合模型:llama_memory_hybrid 如何把两套缓存缝起来
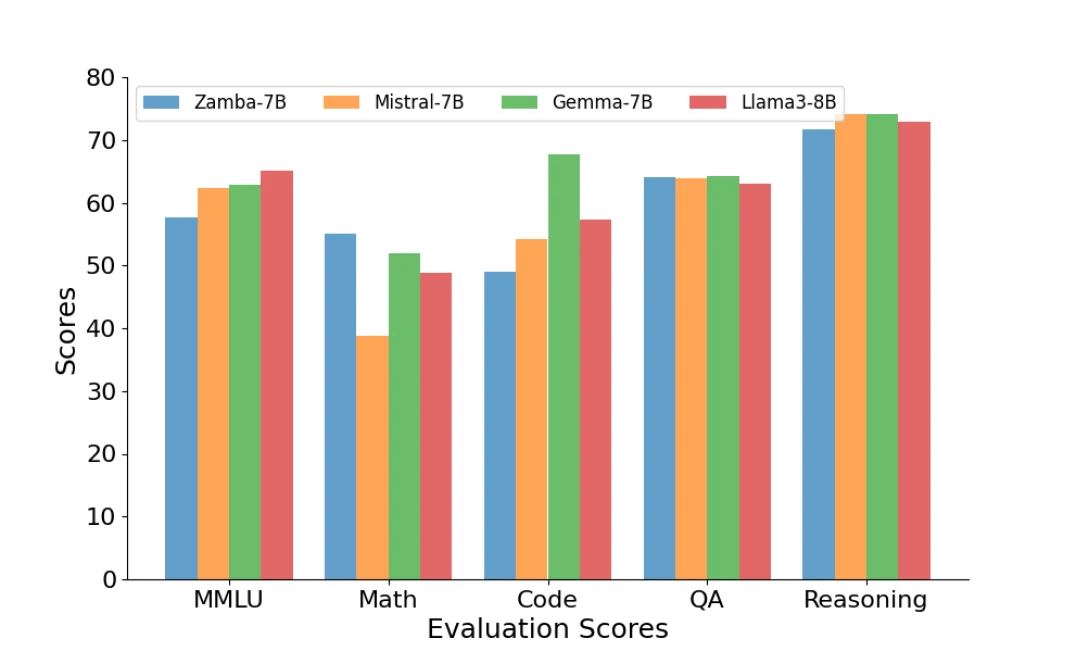
Zamba 这类模型是混合架构的代表:在一个 Transformer 主干里,把大部分注意力层换成 Mamba 层,只保留少数几层自注意力。图 4 展示了它的块级结构组合方式——Mamba 块与注意力块按固定模式交错,这正是 llama_memory_hybrid 要应对的「一层一个样」的布局。
混合模型的每一层要么是注意力层,要么是递归层。llama.cpp 用 llama_memory_hybrid 把两者合并成同一个 llama_memory_i。同族还有两个变体:面向 SWA 混合层的 llama_memory_hybrid_iswa,以及面向带稀疏索引器的混合层的 llama_memory_hybrid_idx;它们沿用同一套「两份内存 + 过滤器」的组合方式,只是把注意力那一半换成更专门的 KV 实现。
构造函数里两份内存是一起建的:
mem_attn(std::make_unique<llama_kv_cache>(model, type_k, type_v, ..., filter_attn == nullptr ? [&](int32_t il){ return !hparams.is_recr(il); } : filter_attn)),mem_recr(new llama_memory_recurrent(model, type_r, type_s, offload, rs_size, n_seq_max, n_rs_seq, filter_recr == nullptr ? [&](int32_t il){ return hparams.is_recr(il); } : filter_recr))filter_attn 收集所有非递归层,filter_recr 收集所有递归层。注意 filter_attn 还会被进一步定制:比如 Nemotron-H 的注意力过滤器是 !is_recr(il) && n_ff(il) == 0,也就是只把「既非递归、又没有 FFN」的层交给注意力缓存。过滤器只是决定「哪一层归哪本账」,具体组合必须结合该模型自己的层布局来读。
init_batch 的顺序值得注意:
// prepare the recurrent batches firstif (!mem_recr->prepare(ubatches)) { ... return FAILED_PREPARE; }
auto heads_attn = mem_attn->prepare(ubatches);if (heads_attn.empty()) { ... return FAILED_PREPARE; }先准备递归缓存,再准备注意力缓存。 递归缓存的 prepare() 只做一次完整的 find_slot 试探并恢复,不分配任何槽位;注意力缓存的 prepare() 会真正分配槽位、记录 sinfos_attn。两者都依赖同一个 ubatch 分割。把递归缓存放在前面,是为了在一个「可能失败但不会留下副作用」的阶段先把不可行的批划分挡掉。
seq_pos_min 和 seq_pos_max 这两个查询的合并方式也反映了异构语义:
llama_pos llama_memory_hybrid::seq_pos_min(llama_seq_id seq_id) const { // the min of the total cache is the max of the two caches' min values return std::max(mem_attn->seq_pos_min(seq_id), mem_recr->seq_pos_min(seq_id));}llama_pos llama_memory_hybrid::seq_pos_max(llama_seq_id seq_id) const { // the max of the total cache is the min of the two caches' max values return std::min(mem_attn->seq_pos_max(seq_id), mem_recr->seq_pos_max(seq_id));}一条混合序列的「最小覆盖位置」必须是两边都覆盖到了的位置,所以取 max;最大位置取 min 同理。这条规则看起来别扭,但它是唯一能保证「在这个区间内两类层都有有效状态」的合并方式。
seq_rm 在混合缓存里的写法很有意思,它不是简单地两边都删,而是先删递归缓存,失败就整体放弃:
bool llama_memory_hybrid::seq_rm(llama_seq_id seq_id, llama_pos p0, llama_pos p1) { // Try removing from the recurrent cache first since it may fail. If it does // fail, the cache will not have been mutated. if (!mem_recr->seq_rm(seq_id, p0, p1)) { return false; } return mem_attn->seq_rm(seq_id, p0, p1);}注释解释了理由:递归缓存的 seq_rm 会失败(比如要求删一个它做不到的部分区间,或者共享格要单独回退),失败时它本身不会改动任何状态;而注意力缓存一旦被删就无法撤销。所以用一个「先删难删的那边」的顺序,至少保证失败时两边都不动。
但这里有一个必须说清的边界:这个顺序只保证「失败时原子」,不保证「成功时两侧等价」。当递归侧返回成功、却因为区间没有盖住尾格而静默无操作时,注意力侧仍会照常删除该区间,两侧的位置账本就出现了一个缝隙。llama.cpp 的实际调用路径只对「整条序列」或「尾部区间」使用 seq_rm,所以这个缝隙没有暴露出来;如果要在这个接口之上做新的缓存策略,必须自己守住这条约束。
这也解释了为什么 seq_rm 在递归缓存里对做不到的部分区间是返回失败而不是静默忽略:返回值是混合缓存能否推进删除的闸门。对于纯递归模型(Mamba、RWKV),失败直接意味着调用方必须整条删除;对于混合模型,失败意味着两边都不动。这是本节最值得记住的一点:失败在这里是一种契约,而不是错误。
state_write 和 state_read 则串行地把两套状态都写出去/读回来,读失败时回滚两边:
try { mem_recr->state_read(io, seq_id, flags); }catch (...) { mem_attn->state_clear(seq_id); // a failed restore leaves the sequence empty in both caches throw;}这一点对 server 的 prompt cache 非常关键:混合模型存进 RAM 的 checkpoint 必须包含递归状态,否则恢复出来的序列「位置对了但状态是旧的」,输出就会漂移。
一个算例:48 层混合模型的一条序列,缓存到底多大
用一个具体的例子把上面的账算清楚。假设一个 48 层的混合模型:12 层是 full attention,36 层是带短卷积的线性注意力(gated delta net 一类的结构)。,线性注意力的 head 数 ,,卷积核 。再假设我们开 --parallel 4、n_ctx_seq = 8192,没有投机解码(n_rs_seq = 0)。
注意力部分:12 层,KV 头数假设与 query 头一致或经过 GQA,这里取 ,。FP16 下每层每 token 是 字节,四条序列共 个 token,合计 64 MiB,12 层约 768 MiB。
递归部分:36 层,每层 S 行 个 FP32 元素,约 1 MiB;R 行 个元素,约 72 KiB。每层约 1.07 MiB,36 层约 38.5 MiB。格子数等于 n_seq_max = 4,所以整块递归缓存约 154 MiB。
在这个配置下,递归缓存约为注意力缓存的五分之一。但要注意两件事:第一,递归缓存的大小与上下文长度无关,n_ctx_seq 翻倍只会让注意力部分翻倍;第二,递归状态的大小按 head 数与 head 维的平方增长,层数或 head 数一多,它就会迅速接近、甚至超过注意力缓存。
如果这里打开 EAGLE-3 草稿,n_max = 3,则 n_rs_seq = 3,每张张量多 3 倍列,递归缓存从约 154 MiB 涨到约 616 MiB,已经接近注意力部分的 768 MiB。这是投机解码在混合模型上的隐性代价,值得在部署时留意。
与站内其他框架的对照
递归缓存的「每序列一格」在别的框架里是怎么做的?
vLLM 的混合缓存由 KVCacheCoordinator 管,它把注意力层、滑窗层、Mamba 层放在同一个页池里,但每种层有自己的 spec 计算法。Mamba 层的「状态」在 vLLM 里也被映射为「页」,只是每页存的是「每个请求槽位的一份完整状态」,而不是 token KV。站内文章 vLLM 源码完全拆解(二十三):混合 KV Cache 的组账本 详细拆解了这套分组机制,和 llama.cpp 的 llama_memory_hybrid 目的相同,只是 vLLM 靠页池统一管理,llama.cpp 靠两个独立对象拼起来。
SGLang 的 ReqToTokenPool、KVPool 也有类似的「槽位 + 页」结构;对递归层,SGLang 同样为每个请求槽位单独维护一份状态,而不是按 token 分页。它在思路上和 llama.cpp 的「每序列一格」一致,区别在于状态池的分配器和前缀树的记账方式不同。
DeepInfer 把注意力 KV 池与状态缓存分开记账,并专门讨论了状态在长上下文下的截断与重放。站内 DeepInfer 源码完全拆解(三):KV 内存与 SWA 有界重放 讲了另一套「有界重放」的方案。
横向来看,回滚与快照是各框架都绕不过去的点:投机解码的每一步验证都可能部分失败,而递归状态一旦被推过去就无法局部撤销。llama.cpp 的做法是「在列方向多开几个面,读的时候按索引切面」,实现成本极低——没有额外的分配器、没有额外的拷贝,只是索引里多乘一个 size;代价是回滚步数被固定为草稿长度,且一次只能回滚一条序列。把快照放进页分配器的框架则更灵活,但每次验证都要多做一次页级记账,且页大小与草稿长度的对齐会引入新的取舍。
在「状态缓存是否要参与前缀共享」这一点上,各框架其实也分成了两派:参与共享的框架能把递归状态和注意力 KV 一起做前缀命中,但必须处理写时复制;不参与的框架则干脆让递归状态每序列独占一份,换来实现上的简单。
读这套代码时最容易踩的五个坑
把上面各节串起来,这段代码里有几处「读第一遍容易误判」的地方,单独列出来:
cells[seq_id].tail不是「第 seq_id 条序列的格子」。tail字段本身就是一个格子的指针,而cells[seq_id]访问的是被征用的元数据格。把它理解成「索引 = 序列号、内容 = 该序列尾格」就顺了。find_slot会修改cells,prepare()会把它改回去。prepare()在试探前拷贝cells/used/head,试探失败或成功后都恢复原状,真正的变更发生在apply()。如果只在prepare()之后打印cells,看到的是「旧世界」,容易误以为搬运没有生效。src与src0的时间性不同。src是「上一批留下的搬运计划」,会在下一次find_slot结束时被覆盖成i;src0才是本批图要用的索引。在 debug 时先看src0,再看src的当前值,否则会看到一堆src == i的格,误以为「没有拷贝」。- 快照面的编号方向与直觉相反。面号越大,表示越早的状态;面 0 永远是最终状态。写测试时如果拿「面 1 等于第 1 步」去断言,必然失败。
rs_idx是「一次性」的。s_copy每读一次就清零,因此任何在set_input之前反复调用s_copy的调试代码都会把回滚意图消耗掉。要在调试时观察回滚,应该在set_input之后读s_copy张量本身,而不是再调s_copy(i)。
这五点合起来说明一个事实:这套缓存的「状态」分三层——C++ 侧的格子簿记、图里的索引张量、设备上的张量行。看到任何异常,先问「我读的是哪一层」,再去对源码。
为什么不用统一的「页」抽象
一个自然的疑问是:既然 KV Cache 已经有一套分页机制,为什么不把递归状态也做成「一种特殊的页」,让所有层共用一套分配器?这样前缀树、引用计数、卸载都可以复用。
统一抽象的好处很明显,但递归状态与页抽象之间有三处结构性冲突:
- 格与页的语义不同。KV 的一页是「一段位置上的 K/V」,页内的数据是并行的、可任意访问的;递归状态的一格是「一条序列的全部历史压缩」,它是一个整体,不能拆成两页。vLLM 的做法是给状态单独定义一种 spec、映射到「每个槽位一份状态」的页,但分配器的记账仍然是特殊处理的。
- 共享语义不同。KV 页的共享是「多个引用指向同一页 + 写时复制」,因为注意力是只读历史;递归状态的共享是「两个序列指向同一格」,其中一个继续推理时必须先把状态复制出去(
find_slot的第一步),否则另一条序列的历史就被污染了。 - 回滚语义不同。KV 页可以按位置删掉一段,前缀树重新挂载即可;递归状态只能整格删除或退回快照面。这两者用同一套页 API 表达,必须引入「页有不同种类」的概念,相当于抽象已经被打破。
llama.cpp 的选择是:保持 llama_memory_i 这一层接口统一,再往下完全分开实现。KVCacheCoordinator 那类统一页池的做法,代价是把语义分支下沉到分配器里;分开实现的做法,代价是混合缓存需要 llama_memory_hybrid 这层胶水,且要在 seq_rm 这种「一边能做、一边不能做」的操作上做闸门。两种设计都合理,选哪种更多取决于是否要跨模型共享前缀树与卸载路径。
状态存取与序列操作的边界
前面提到 state_write 的两个细节——物理行映射与共享格的回滚序号一致性——它们共同说明了一件事:递归缓存的状态存取以「序列」为单位,而不是以「位置区间」为单位。混合模型的 state_write 会把两套缓存串行地写出,两套的格式不同、对齐方式也不同,读回时必须严格按同样的顺序解析;如果递归侧读失败,代码会清空注意力侧已恢复的序列再抛出异常,避免出现「位置对了、状态是旧的」这种最难排查的半恢复状态。
把这一节的结论放到 server 的 prompt cache 上看:缓存条目实际上由「注意力 KV + 递归状态」两部分组成,只要其中一部分缺失,这个条目就不能被安全复用。这一点在把 checkpoint 存到磁盘、再跨进程恢复时尤其要小心:两套状态的长度、序列位置与快照面编号必须一起恢复、一起校验。
序列操作的另一条边界是 seq_cp。递归缓存里它做的是「让目标序列指向源序列的同一格」,而不是逐位置复制;seq_keep 则把其余序列的状态全部释放。混合模型上这两个操作对两侧同时生效,所以复制一条混合序列之后,两边的状态是同一时刻的同一状态,不存在「KV 比状态新」的窗口。
小结
把这一路拆下来,llama_memory_recurrent 的设计可以归纳为三句话:
- 复用格子结构,改变格子的含义。一格不再是一个 token 位置,而是一份完整的序列递归状态;位置只是元数据,「共享」意味着整格共享。
- 拷贝靠
src/src0延迟到图里执行。find_slot只在 C++ 侧整理搬运计划,真正的拷贝由build_rs中的ggml_get_rows完成,这样每一批只有一次 gather,而不是每条序列一次。 - 回滚靠额外的「快照面」与「一次性索引」。
n_rs_seq在张量列方向展开成若干个面,rs_idx记录「这次读哪个面」,s_copy读一次即清零;seq_rm只在限定条件下支持回退,其余情况一律拒绝。
这三点之外,混合内存 llama_memory_hybrid 的职责是用「取 max / 取 min」的合并方式,把注意力和递归两种语义差异大的缓存压到同一个接口之上。它的若干隐式约束(seq_pos_min/max 取交集、seq_cp/seq_add 对两侧同时生效、seq_rm 以递归缓存为闸门且只在整段与尾部两种用法下保持两侧一致)是这套设计留下的边界,理解它们对排查混合模型的缓存问题很有帮助。
下一篇将讨论 llama.cpp 的 llama_memory_hybrid_idx——在混合模型里再加一层「稀疏索引器」缓存时,三套内存如何协同记账,以及 Qwen4EXP 这类带索引器缓存的混合模型在解码时如何把三种缓存同时接到一次前向里。
把规则压缩成一张速查表
最后把散落在各节的判据收拢成一张表,方便在读源码时对照:
| 场景 | 递归缓存的反应 | 依据 |
|---|---|---|
| 新序列第一次进批 | 从 rs_z 零格拷贝,pos 设为最后 token | find_slot 的 src0 = rs_z |
| 多条序列共享同一格 | 继续推理的那条先分离到空格,再写新状态 | find_slot 的 seq_meta.tail 检查 |
请求删整条序列(p0=0, p1=∞) | 释放格、rs_idx 归零 | seq_rm 的 rm_all 分支 |
| 请求删中间一段(不盖住尾部) | 无实际影响,尾格保留 | seq_rm 只对尾格生效 |
| 请求从尾部回退 步 | 仅当 j <= n_rs_seq 且格不共享且无 pending 时接受 | seq_rm 的部分回退分支 |
| 要求位置平移 | 只改 pos,不改数据 | seq_add / seq_div |
| 复制一条序列 | 目标序列指向源格,不复制数据 | seq_cp |
| 状态写盘 | 按「当前逻辑面」映射物理行,连续行合并写出 | state_write 的 cell_ranges_data |
这张表里最容易被忽略的是「删中间一段不盖住尾部」这一行:它不是错误,也不是拒绝,而是一个静默的无操作。对混合缓存来说,这个无操作会造成「注意力侧删了、递归侧没删」的缝隙,因此 seq_rm 在 llama.cpp 内部只被用于整段删除与尾部截断;在这两种用法下,两侧的语义才是一致的。
参考资料
- llama.cpp 官方仓库
- llama-memory-recurrent.h / llama-memory-recurrent.cpp 源码
- llama-memory-hybrid.cpp 源码
- llama-graph.cpp 中 build_rs 与 graph input 代码
- Mamba: Linear-Time Sequence Modeling with Selective State Spaces(arXiv:2312.00752)
- Zamba: A Compact 7B SSM Hybrid Model(arXiv:2405.16712)
- llama.h 中 llama_memory_seq_rm/cp/add 与 llama_n_rs_seq 的 API 定义
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



