


TensorRT-LLM 源码完全拆解(二十五):GenerationExecutor 的三根队列——请求如何跨进 worker 世界,结果又如何回到调用者
从 PyExecutor 之外的那层说起
前面二十多篇里,TensorRT-LLM 的 PyExecutor、调度器、KV Cache、注意力后端、采样器、投机解码都已经逐一拆过。这些组件回答的是「一次前向内部怎么跑」。但只要把视角从 PyExecutor.step() 往上抬一层,就会遇到另一组问题:用户调用 LLM.generate() 时,请求是怎样从 Python 主进程进入 GPU worker 的?为什么 TensorRT-LLM 的 LLM 对象背后有时是一个进程,有时是一组 MPI rank,有时又是 Ray 集群?结果为什么能一边生成一边流式返回,而不是等整段序列结束再给?worker 崩溃时,已经阻塞在 result() 上的调用者为什么不会永久挂死?
这些问题的答案都在 tensorrt_llm/executor/ 这一层,核心类是 GenerationExecutor。它不是另一个调度器,也不参与 kernel 计算;它是引擎的边界对象:向上承接 LLM API 的 token 与采样参数,向下把请求送进 PyExecutor,并把引擎产生的增量结果翻译成调用者可消费的 GenerationResult。TensorRT-LLM 的 LLM、trtllm-serve、trtllm-bench 都通过它接触引擎,因此这一层设计得好不好,直接决定了流式延迟、故障行为和部署拓扑。
这一篇沿着 tensorrt_llm/executor/executor.py、proxy.py、worker.py、base_worker.py 和 ipc.py 的源码,把这条边界完整拆开。重点不在「有哪些类」,而在三件事:
- 部署形态如何被选择:同一份
LLM代码,为什么在 TP1、TP8、Ray、外部mpirun下会走不同的进程结构; - 请求与结果如何配对:
client_id、GenerationRequest、GenerationResult与 worker 内部request_id之间是什么关系; - 故障如何被传播:哪些错误只杀一条请求,哪些错误会杀死整个引擎,关闭顺序为什么必须写成现在这样。
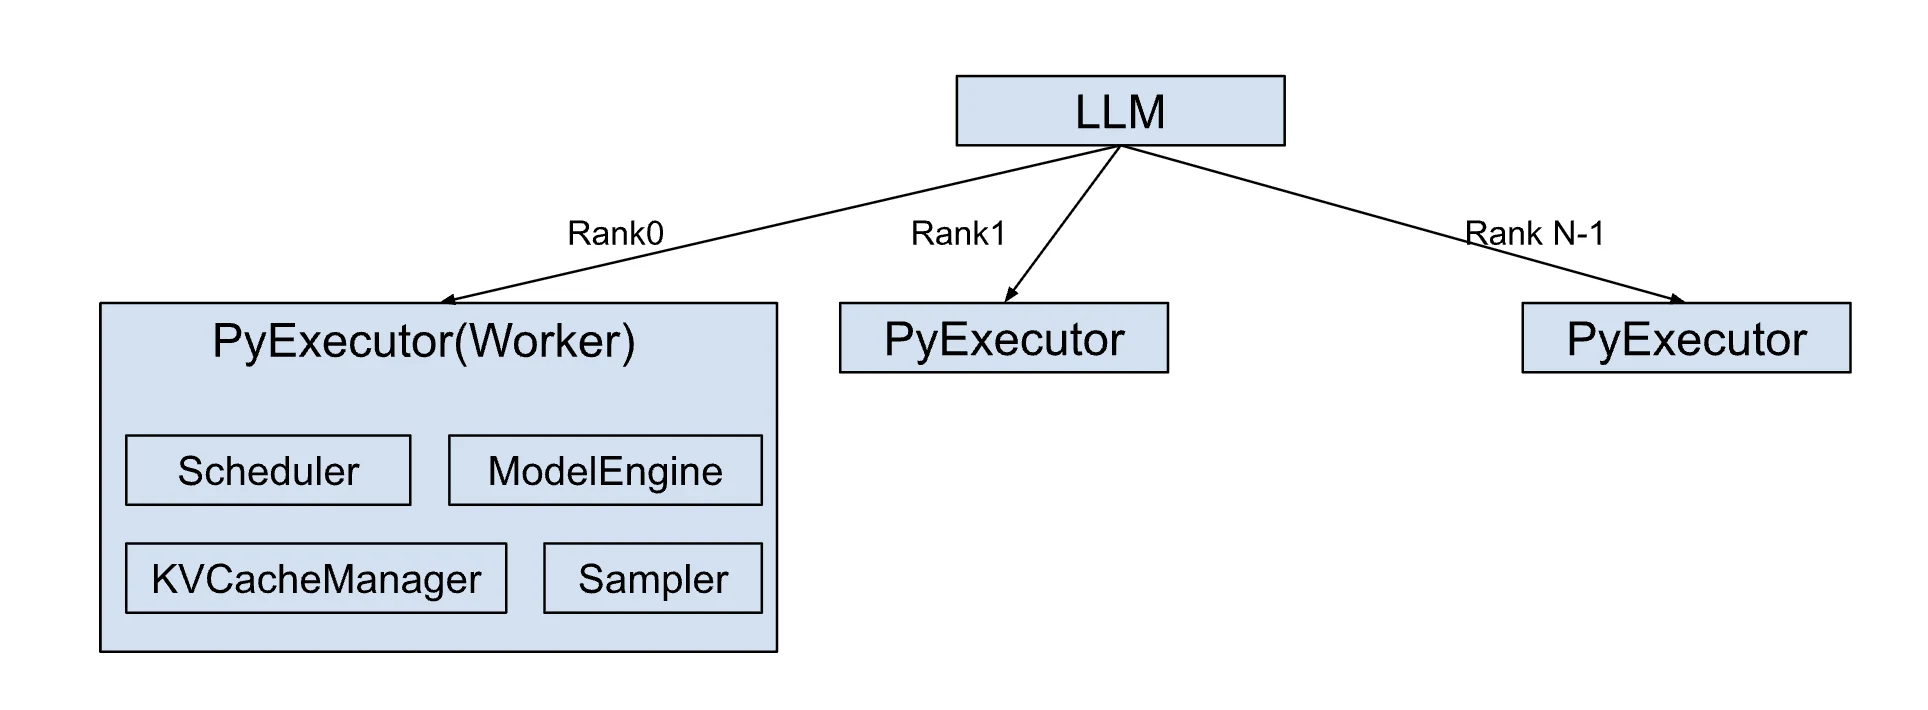
上图是 NVIDIA 官方架构文档给出的分层:最上方是 LLM API 与 serving 入口,中间是 executor/runtime 的边界,下面才是模型执行与 kernel。本文讨论的正是中间那条常被忽略、却决定了请求如何跨越进程的接缝。官方文档见 TensorRT-LLM Architecture Overview。
三层边界:LLM、GenerationExecutor、PyExecutor
先把三个名字摆清楚,否则读源码时很容易把「executor」和「engine」混为一谈。
- LLM(或
BaseLLM):面向用户的 API 层。它负责 prompt 预处理、tokenize、采样参数校验、多模态输入打包,然后调用self._executor.generate_async(...)。它不关心请求最终跑在几张卡上。 - GenerationExecutor:本文的主角。它是「请求/结果」这一层的抽象,负责把
GenerationRequest送进引擎、维护GenerationResult的生命周期、分发结果、传播错误、管理进程与队列。 - PyExecutor:真正的执行引擎。它包含调度器、KV Cache Manager、ModelEngine、Sampler 等,
step()一次推进一批请求。前面系列文章拆的就是它。
BaseLLM.generate_async 的最后一段是关键衔接点:
result = self._executor.generate_async( prompt_token_ids, sampling_params=sampling_params, lora_request=lora_request, prompt_adapter_request=prompt_adapter_request, streaming=streaming, kv_cache_retention_config=kv_cache_retention_config, disaggregated_params=disaggregated_params, trace_headers=trace_headers, postproc_params=_postproc_params, multimodal_params=multimodal_params, scheduling_params=scheduling_params, conversation_params=conversation_params, cache_salt=cache_salt, arrival_time=arrival_time, encoder_input_token_ids=encoder_input_token_ids, priority=priority,)return RequestOutput._from_generation_result( result, prompt, self.tokenizer, post_processor_hook=self._post_processor_hook,)注意两点。第一,到了这一层,prompt 已经是 token id,不再是原始文本,tokenizer 的职责已经结束;第二,RequestOutput 只是 GenerationResult 的一层 API 包装,真正可等待的句柄是 GenerationResult。这也是 TensorRT-LLM 与 vLLM 在接口上的一个差异:vLLM 的 RequestOutput 本身就是流式对象,TensorRT-LLM 则把「引擎结果句柄」和「用户输出对象」分成两层,中间由 executor 负责搬运。
GenerationExecutor 的抽象方法只有两个:
class GenerationExecutor(ABC): @abstractmethod def submit(self, request: GenerationRequest) -> GenerationResult: pass
@abstractmethod def abort_request(self, request_id: int) -> None: pass所有部署形态的差异,最终都被压缩成「submit() 把请求放到哪里、GenerationResult 从哪里取结果」。generate_async() 和同步 generate() 则是基类提供的语法糖:前者构造 GenerationRequest 并调用 submit(),后者对一批 prompt 逐个调用 generate_async(),再逐个 result()。这解释了一个容易误解的行为:同步 generate() 并不是一次真正的批量提交,它只是把多个异步请求先发出去,再按顺序收结果;批量调度发生在 PyExecutor 内部,而不是 API 层。
is_llm_executor 是构造时传入的一个布尔值,作用不大但很容易看漏。它只影响基类的迭代统计句柄是否初始化:True 时初始化 _iter_stats_result 和 _iter_kv_events_result 这两个单例;proxy 创建 worker 时传 False,LLM 创建顶层 executor 时传 True。这样可以避免每个 worker 都维护一份前端根本不会读取的统计对象。
三层职责可以压缩成一张表:
| 层 | 关心的问题 | 不关心的问题 |
|---|---|---|
| LLM / BaseLLM | prompt 如何变成 token、采样参数、流式开关 | 进程拓扑、KV 块、CUDA Graph |
| GenerationExecutor | 请求送到哪个进程、结果如何回来、错误如何传播 | 一次前向如何调度、kernel 如何选 |
| PyExecutor | 每步跑哪些请求、KV 如何分配、模型如何前向 | 调用者在哪个进程、结果如何序列化 |
同一份 LLM,为什么会长出五种进程结构
GenerationExecutor.create() 是整层的「总装开关」。它不是一个简单的工厂方法,而是一棵按环境变量、并行规模、启动方式分叉的决策树。读懂这棵决策树,就能解释部署时看到的进程数量与队列方向。
核心分支按优先级排列如下:
@staticmethoddef create(model_world_size=1, world_size=0, mpi_session=None, reuse_mpi_comm=False, return_logits=False, postproc_worker_config=None, is_llm_executor=None, hf_model_dir=None, tokenizer=None, llm_args=None, **args): if world_size == 0: world_size = mpi_world_size()
# 1) 多前端挂载模式:不拥有引擎,只连接到已运行的 worker attach_env = os.getenv("TLLM_EXECUTOR_ATTACH_INFO") if attach_env: return GenerationExecutorFrontendProxy(...)
# 2) Ray 编排 if llm_args.orchestrator_type == "ray": return GenerationExecutor._create_ray_executor(...)
# 3) 外部 mpirun / mpi4py 派生 worker mpirun_launch = external_mpi_comm_available(model_world_size) spawn_workers = need_spawn_mpi_workers(model_world_size) if spawn_workers or (mpirun_launch and reuse_mpi_comm): if llm_args.orchestrator_type == "rpc": return GenerationExecutor._create_rpc_executor(...) return GenerationExecutor._create_ipc_executor(..., use_worker=False)
# 4) TP1 的单进程特例 if return_logits or enable_worker_single_process_for_tp1(): return GenerationExecutor._create_ipc_executor(..., use_worker=True)
# 5) 普通单机 / 单卡:默认仍拆 proxy + worker if platform.system() != "Windows": return GenerationExecutor._create_ipc_executor(..., use_worker=False) return GenerationExecutorFrontendProxy # Windows 走 ProcessPoolExecutorSession下面逐个解释每一档的动机。
3.1 单进程 Worker:不是默认,而是两个特例
GenerationExecutorWorker 同时继承 RpcWorkerMixin 和 BaseWorker,而 BaseWorker 又继承 GenerationExecutor。也就是说,worker 自己也可以扮演 executor:请求不跨进程,submit() 直接把请求塞进本地 PyExecutor,GenerationResult 直接由 worker 的响应线程投递。
这条路径只在两种情况下默认启用:
return_logits=True:需要把 context logits 整体搬回 Python 侧时,跨进程 IPC 的序列化成本过高;- 环境变量
enable_worker_single_process_for_tp1()为真:开发者调试 TP1 时希望所有东西在一个进程里,方便打断点。
源码对这条路径的注释写得很直白:TP1 的单进程 worker 会损害流式生成性能。原因并不玄妙:流式返回要求每个 step 的结果尽快离开 GPU 进程;单进程模式下,Python 主线程既要负责 HTTP/生成循环,又要等待引擎,CPU 上的调度与解码会和 GPU 前向争抢同一个 GIL。拆出 worker 进程后,rank0 的响应线程可以持续把结果推给 proxy,主进程只负责消费队列。
所以「单卡就应该单进程」是一个直觉陷阱。TensorRT-LLM 在 Linux 上即使只有一张 GPU,默认也会拆出 proxy 与 worker 两个进程,正是为了让流式输出不被主进程的 Python 工作拖慢。
3.2 IPC Proxy:请求队列 + 结果队列 + 启动状态队列
默认路径创建 GenerationExecutorProxy。它的构造顺序值得按源码走一遍,因为其中包含了几处必须保持顺序的初始化:
# 1. 先选 MPI 会话:自己拉起 worker,还是绑定外部已存在的 worker 世界if mpi_session is None: if mpi_process_pre_spawned: self.mpi_session = create_mpi_comm_session(model_world_size) else: self.mpi_session = MpiPoolSession(n_workers=model_world_size)else: validate_session_world_size(mpi_session, model_world_size) self.mpi_session = mpi_session
# 2. 建三根队列self.request_queue = IpcQueue(is_server=True, name="proxy_request_queue")self.result_queue = FusedIpcQueue(is_server=True, socket_type=zmq.PULL, name="proxy_result_queue")self.worker_init_status_queue = IpcQueue(is_server=True, socket_type=zmq.ROUTER, name="worker_init_status_queue")
# 3. 通过 MpiPoolSession.submit(worker_main, ...) 拉起 worker 世界# 4. 等 worker 的 READY,再建 RPC client 与错误监控线程# 5. 启动结果分发线程三根队列的分工必须分清:
| 队列 | 方向 | socket 类型 | 用途 |
|---|---|---|---|
request_queue | proxy → rank0 worker | PAIR;多前端时为 PUSH/PULL | 正向请求、取消、profile 控制 |
result_queue | rank0 worker → proxy | PAIR;开 postproc 并行时为 PULL | 增量响应、错误响应、结束哨兵 |
worker_init_status_queue | worker → proxy,proxy 回 ACK | ROUTER/DEALER | 启动握手、worker 进程身份 |
result_queue 在普通模式下是 PAIR,因为只有 rank0 worker 一个生产者;一旦启用 num_postprocess_workers > 0,结果会由多个后处理进程分别写回,因此改成 PULL,让多个 PUSH 端连接。这个 socket 类型的变化不是风格问题:PAIR 只允许一对一,多个生产者同时写会直接破坏消息边界。
request_queue 在单前端模式下也是 PAIR,但在多前端模式下变成 PUSH/PULL:rank0 worker 绑定 PULL 端,所有前端进程都作为 PUSH 端连接。这样才能让多个 trtllm-serve 前端共享同一个引擎。
3.3 启动握手:为什么 READY 之前还要先发进程身份
_start_executor_workers() 通过 mpi_session.submit(worker_main, ...) 把 worker 世界拉起来,然后进入 _wait_for_executor_workers_ready()。这个等待循环同时做三件事:
- 轮询
worker_init_status_queue,收到消息后立刻回"ACK"; - 识别
WORKER_PROCESS_IDENTITIES_SIGNAL,把每个 rank 的 pid 登记到WorkerProcessMonitor; - 在等待期间持续检测 worker 是否已经死亡。
worker 侧的顺序是刻意安排的:
mpi_comm().barrier()worker_process_identities = mpi_comm().allgather( capture_worker_process_identity(mpi_rank()))
# 先发身份,再构造 backend。模型加载可能持续几分钟,# 外部 kill 掉的 worker 未必能走完 MPI future。if is_leader and worker_process_identities_signal is not None: identities_msg = (worker_process_identities_signal, None, worker_process_identities) worker_init_status_queue.notify_with_retry(identities_msg)
worker = worker_cls(...) # 这里才真正 create_py_executor、加载权重
ready_msg = (ready_signal, None, worker_process_identities)worker_init_status_queue.notify_with_retry(ready_msg)为什么身份要先于 READY 发送?因为模型构造可能非常慢,而 proxy 需要一个独立于 MPI future 的存活信号。如果 worker 在加载权重时被 OOM killer 杀掉,MPI future 可能永远不会完成;此时 proxy 只能靠 pid 级别的 WorkerProcessMonitor 发现「这个进程已经没了」,从而快速失败,而不是一直等到 READY 超时。这是「初始化阶段」与「运行阶段」两类故障检测必须分开的典型例子。
还有一个容易被忽略的细节:add_done_callback(mpi_done_callback) 必须在 READY 之后才注册。如果 future 已经完成,add_done_callback 会同步执行回调,把引擎标记为 dead;而 _fail_initialization() 需要先 shutdown_abort() 再标记 dead,顺序反了会让 MPI_Abort 的升级路径失效,导致持有权重的 rank 卡死。源码注释把这一点写得很清楚,说明这是踩过坑之后固定下来的顺序。
3.4 RPC Proxy、Ray 与多前端挂载
orchestrator_type="rpc" 时走 GenerationExecutorRpcProxy:进程模型与 IPC proxy 类似,但请求/结果不再走本地 ZMQ,而是通过 RPC 通道;适合 worker world 已经在别处启动、前端只想远程调用的场景。
orchestrator_type="ray" 时走 RayExecutor。Ray 自己负责 actor 的放置、重启与资源调度,TensorRT-LLM 只保留「请求如何送到 rank0、结果如何聚合」的逻辑。官方文档给出的 Ray 编排结构如下:
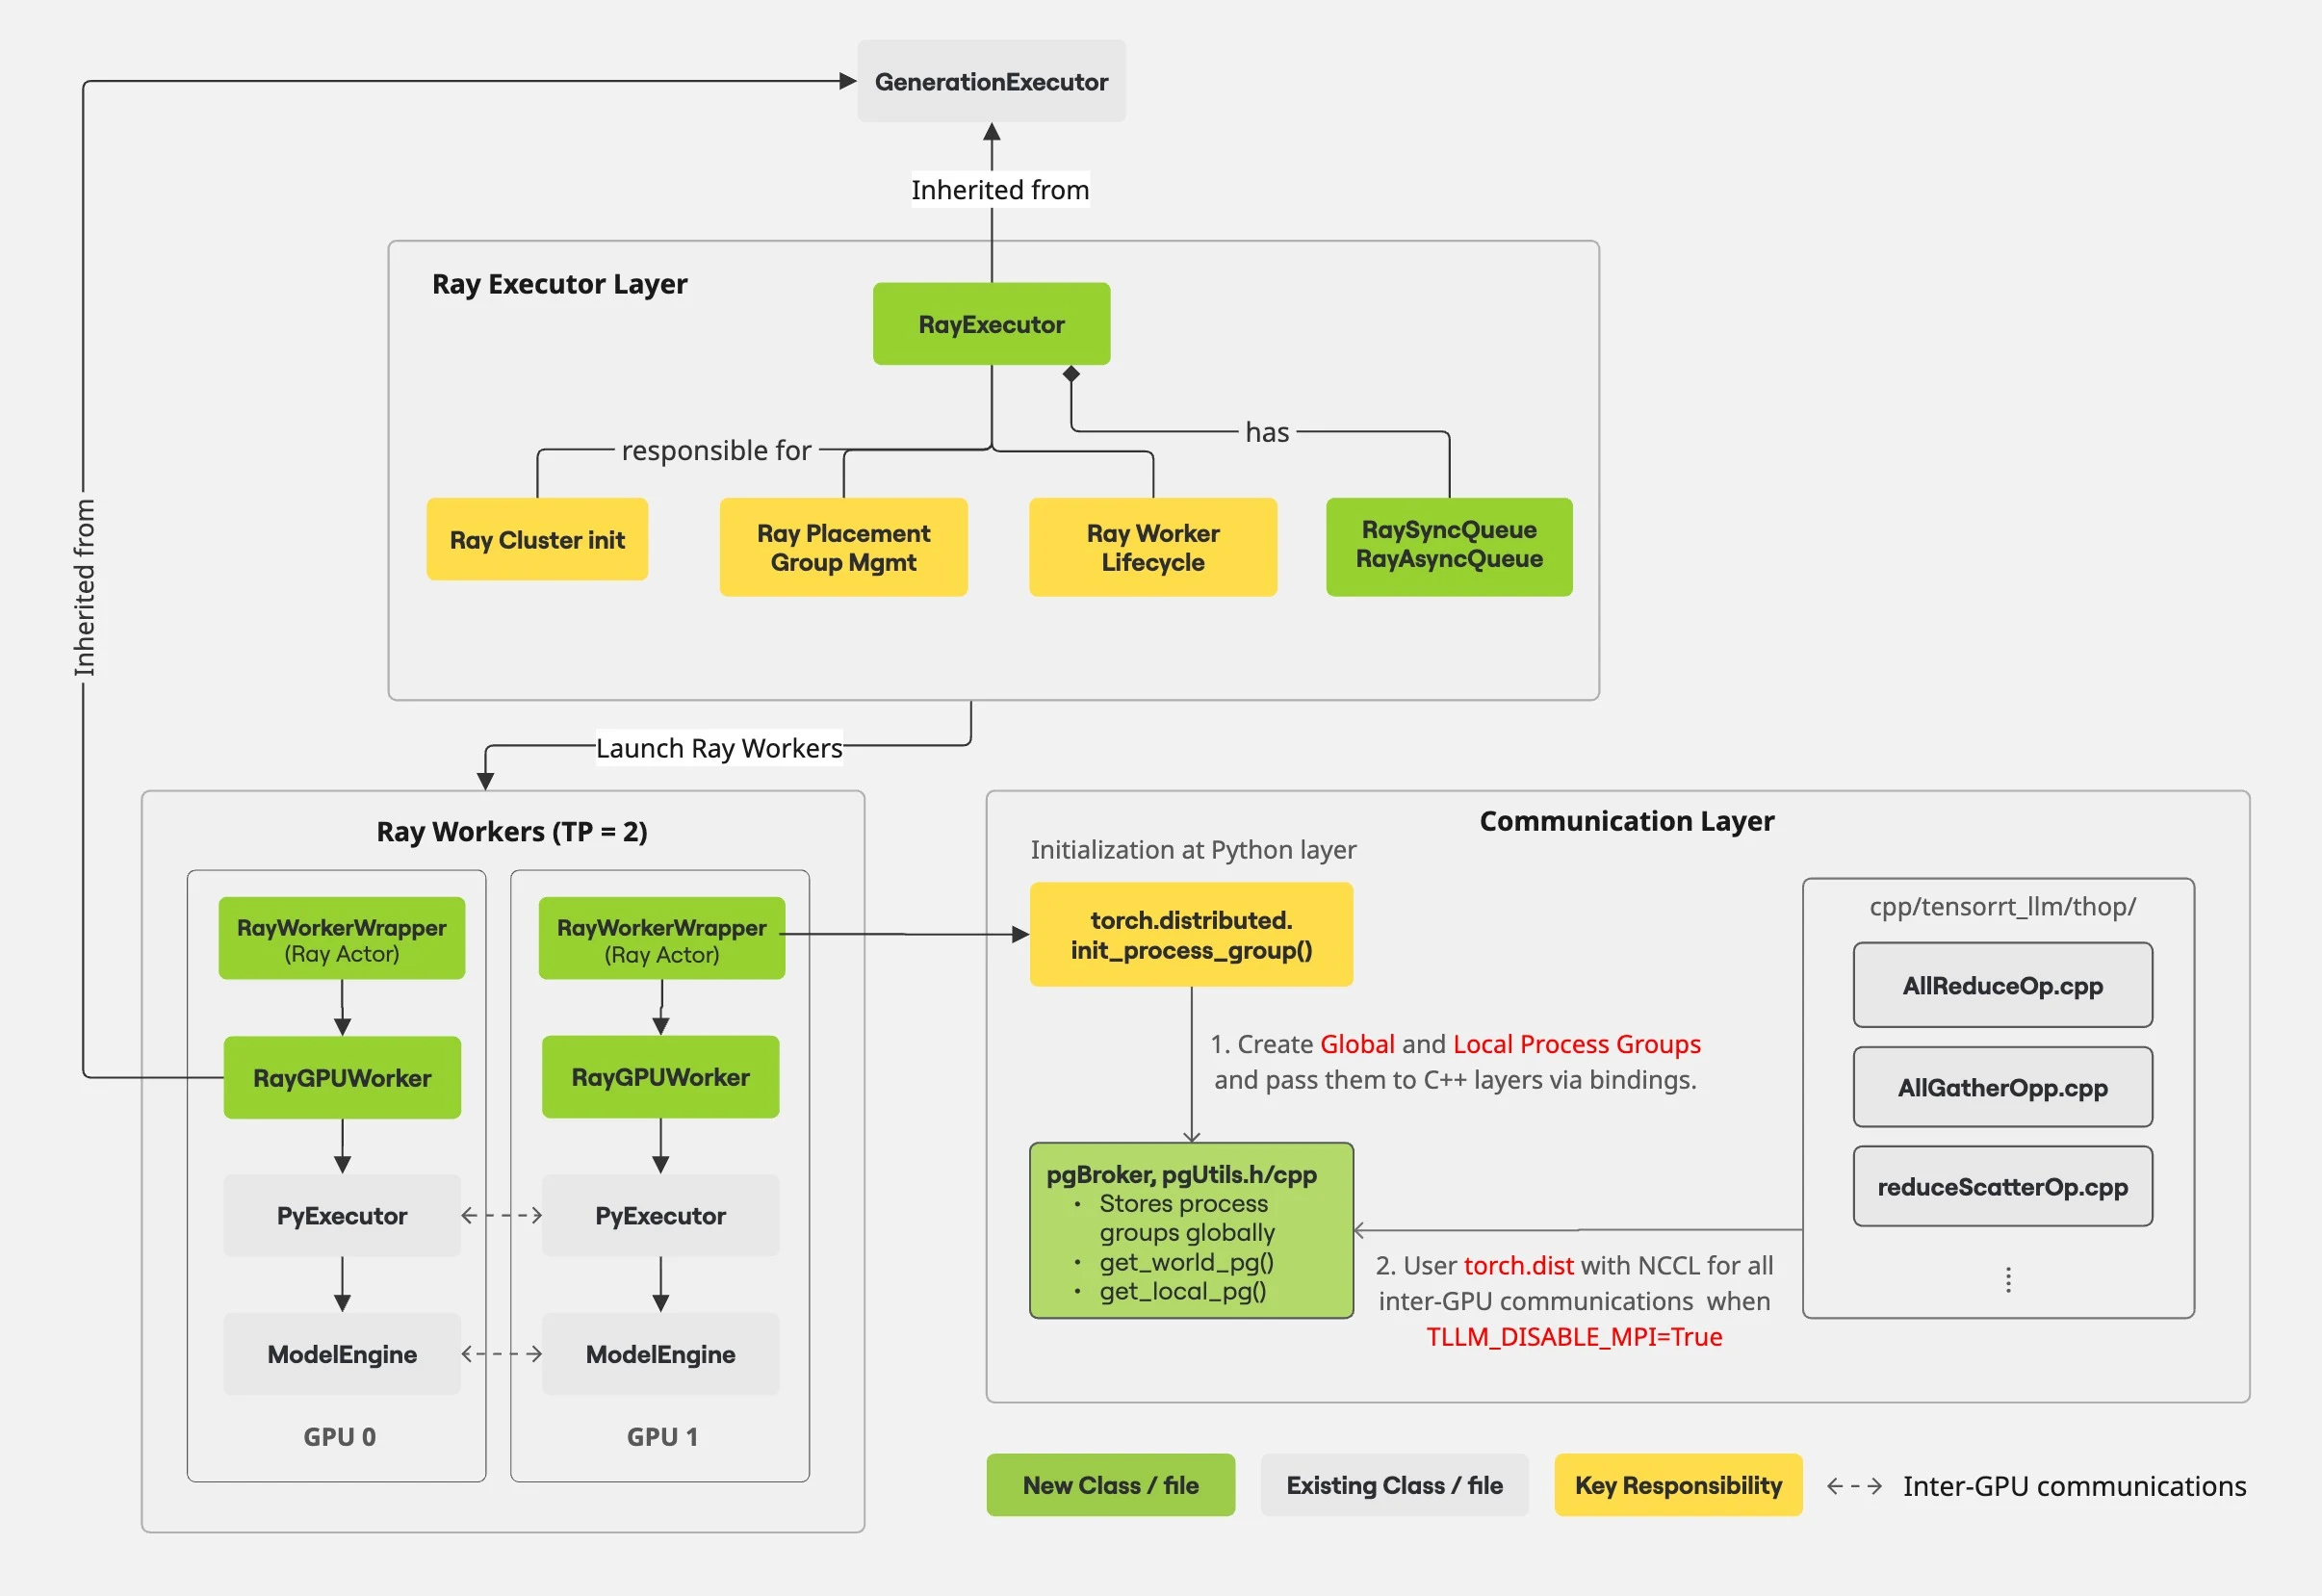
图中可以看到,Ray 路径下 driver、worker actor 与引擎进程是三层分离的;TensorRT-LLM 不再自己维护 MPI pool,而是把 worker 的生命周期交给 Ray。这也是为什么 collective_rpc 的多 rank 能力只在 RPC/Ray 路径完整支持,而 IPC proxy 对多 rank 只放行 sleep、wakeup 这类在 rank 内部自行协调的方法。
多前端挂载(num_serve_frontends > 1)是另一条独立分支。启动器 proxy 先创建一个共享 IPC 目录与 32 字节 HMAC key,rank0 worker 绑定唯一的请求入口,每个前端绑定自己的结果 lane;TLLM_EXECUTOR_ATTACH_INFO 通过环境变量把地址和 key 交给被 trtllm-serve 拉起的子进程。挂载进程走 GenerationExecutorFrontendProxy,它刻意跳过 GenerationExecutorProxy.__init__,因此不会创建 MPI session、不会拉起 worker、也不会注册发送 shutdown 哨兵的 atexit 钩子。引擎的所有权只属于启动器前端,挂载前端只拥有自己的请求通道和结果通道;关闭时它只 abort 自己的请求,不发送 None 哨兵。
为了让 worker 知道把结果送回哪个前端,client_id 的高位被用来编码 frontend id:
def _get_next_client_id(self) -> int: return namespace_client_id(self._frontend_id, super()._get_next_client_id())worker 侧再用 frontend_lane_index(response.client_id, len(lanes)) 选出对应的 PUSH lane。把路由信息塞进 ID 而不是单独维护映射表,好处是无状态:worker 只要看到 client_id 就能决定去向,不需要和 proxy 同步一张会过期的表。
到此,五种形态可以放在一张表里:
| 形态 | 进程结构 | 适用场景 | 关键限制 |
|---|---|---|---|
| 单进程 Worker | 1 个进程 | TP1 调试、return_logits | 流式性能较差 |
| IPC Proxy | 前端进程 + MPI worker world | Linux 默认、单机多卡 | 多 rank 的 collective_rpc 受限 |
| RPC Proxy | 前端 + 远程 worker | worker 已由外部启动 | 依赖 RPC 通道 |
| Ray Executor | driver + Ray actors | 集群编排、弹性伸缩 | 依赖 Ray 运行时 |
| Frontend Proxy | 多个前端 + 共享 worker | 多前端共享同一引擎 | 只有启动器拥有引擎生命周期 |
一次 submit 的全部账本:client_id、GenerationRequest 与 GenerationResult
真正需要逐行读的是 proxy 的 submit()。它是整个边界层里并发最敏感的一段代码:
def submit(self, request: GenerationRequest) -> GenerationResult: # 引擎已死:拒绝新工作,立即失败 if self._engine_dead or self._fatal_error is not None: raise EngineDeadError(self._fatal_error)
self._start_dispatch_threads() # 首次提交时启动结果分发线程
request.set_id(self._get_next_client_id()) logprob_params = self._get_logprob_params(request)
result = GenerationResult( request, background_error_handler=self._handle_background_error, executor=self, disaggregated_params=request.disaggregated_params, logprob_params=logprob_params) self._results[request.id] = result
# 关闭 submit 与 death 之间的竞态 if self._engine_dead or self._fatal_error is not None: self._results.pop(request.id, None) raise EngineDeadError(self._fatal_error)
with nvtx_range_debug("request_queue.put"): self._send_request(request)
self._handle_background_error() return result这段代码有三个必须理解的顺序。
4.1 先登记结果,再发送请求
GenerationResult 必须在 request_queue.put() 之前登记进 self._results。原因在于结果分发线程的动作:它从 result_queue 收到一条响应后,用 client_id 去 self._results 里找对应的结果对象的队列。如果请求先被发送、worker 的响应先回来,而结果对象还没登记,分发线程就会因找不到 client_id 而丢弃响应——请求从此永远等不到结果。分布式系统中「先登记、后发送」是消费端可见性的必要条件。
登记之后又立刻再检查一次引擎是否死亡,是为了关闭另一个窗口:错误监控线程的 _mark_engine_dead() 会对当时 _results 的快照做一次性遍历,把 EngineDeadError 塞进每个待决结果。如果请求恰好在「登记完成」与「快照发生」之间插入,它会漏掉这次广播,永远阻塞在一个已经没有生产者的队列上。所以 submit() 在登记之后、发送之前再检查一遍,并在命中时把刚登记的条目删掉再抛错。
GenerationResult 的 client_id 其实就是 request.id,而 worker 内部还有另一个 id——PyExecutor 的 request_id。worker 维护映射 _client_id_to_request_id,用于取消请求。两个 id 的分工很清楚:client_id 属于边界层,用来配对请求与结果;request_id 属于引擎层,用来在调度器里标识一条序列。DeepInfer 系列里也能看到相似的双 id 设计,这是所有带前端的推理引擎绕不开的一层。
4.2 参数只传一次
GenerationResult.__init__ 中有一个很容易被忽略的字段:
# Avoid duplicate transmission of sampling_params for a request.# SamplingParams is needed to create dummy results on postprocess workers.self._params_transmitted = Falseworker 侧在第一次发送某个 client_id 的响应时,会调用 _get_params_for_first_rsp() 把 sampling_params、postproc_params、disaggregated_params 一并带上;之后把 _params_transmitted 置位,后续响应不再携带这三份参数。如果没有这个标志,一条生成长 4096 token 的请求,每一步都要序列化一遍完整的采样参数、后处理参数与分离式参数,这些字段在 100 个并发请求、每步几十毫秒的节奏下就是一笔持续不断的固定开销。边界层的优化往往不是算子层面的,而是「哪些东西不需要重复过线」。
_get_logprob_params() 只在 prompt_logprobs 不为空时才构造参数,并且会把 drop_context_logits 提前算好:只要用户没有显式请求 context logits,或者启用了后处理并行(此时 logits 会被后处理进程接管),就不会把 logits 放进响应。这是一种「默认不传大对象」的策略,与许多框架把 logits 一律回传的做法不同。
4.3 可选的请求批量发送
默认情况下,_send_request() 直接 request_queue.put(request)。但如果设置了环境变量 TRTLLM_PROXY_BATCH_REQUESTS=1,则会走 _RequestSender:
class _RequestSender: MAX_BATCH_SIZE = 1024
def send(self, payload: bytes) -> None: with self._cond: if self._closed: return if self._thread is None: self._thread = threading.Thread(target=self._run, daemon=True, name="proxy_request_sender") self._thread.start() self._pending.append(payload) self._cond.notify()
def _run(self) -> None: while True: with self._cond: while not self._pending and not self._closed: self._cond.wait() batch = [self._pending.popleft() for _ in range(min(len(self._pending), self.MAX_BATCH_SIZE))] self._request_queue.put(batch)它的设计取舍写在源码注释里,值得完整理解。在批量模式下,每条请求由调用线程先 pickle 成 bytes,再交给后台发送线程成批发送。这样做的收益是:一个突发请求(例如前端一次收到几百条 prompt)只需要一次 receive、一次 HMAC 校验,worker 再逐条 unpickle;代价是发送线程必须先拿到 GIL 才能发送,在 trtllm-serve 的 asyncio 事件循环繁忙时,单条请求最多要等到解释器的切换间隔(默认 5 ms)才被送出。
把三个参数放在一起看,就能判断什么时候该打开它:
- 请求突发强、单条延迟要求宽松的服务:开启收益明显;
- 延迟敏感、请求稀疏的交互式服务:不建议开启,5 ms 的 GIL 等待对首 token 延迟是实打实的。
另外,一旦开启,request_queue 的写入者就变成了发送线程;shutdown 的 None 哨兵也必须由同一个线程发送,否则 ZMQ socket 会被两个线程同时写,属于未定义行为。源码里 _close_request_sender(send_sentinel=...) 正是为了保证这一点。
4.4 worker 侧如何接住请求
rank0 worker 在 worker_main() 里完成 READY 之后进入主循环:
for req in _incoming_requests(request_queue): if isinstance(req, CancellingRequest): worker.abort_request(req.id) elif isinstance(req, StartProfileRequest): ... send_profile_ack("start", ack_err, req) elif isinstance(req, StopProfileRequest): ... elif isinstance(req, GenerationRequest): try: worker.submit(req) except RequestError as e: worker._await_response_helper.temp_error_responses.put( ErrorResponse(req.id, e, req.id))_incoming_requests() 是哨兵协议的入口:
while (msg := request_queue.get()) is not None: if isinstance(msg, list): for payload in msg: yield pickle.loads(payload) else: yield msgNone 就是「关闭引擎」的哨兵。取消请求(CancellingRequest)与 profile 控制请求(StartProfileRequest、StopProfileRequest)跟生成请求共用同一根队列,因此它们的顺序被天然保证:取消必然在该请求之后被处理。这比另外维护一根取消通道要简单,也避免了「取消先于请求到达」的乱序问题。
worker.submit() 内部抛出的 RequestError 不会让 worker 退出,而是转成 ErrorResponse 放进 temp_error_responses。下一次响应分发时,process_responses() 会把这些错误响应拼进结果批次,由 proxy 分发回对应 client_id。这里体现了一个重要边界:请求级错误在 worker 内部就被转译成结果,不经过致命错误通道。
BaseWorker.submit() 还做了一件事:只允许 rank0 提交请求。其他 rank 调用会直接抛出 RuntimeError,并提示用户用 if __name__ == "__main__": 保护入口。这是多进程 + spawn 场景下的经典问题:每个子进程都会重新执行模块顶层,如果顶层建 LLM,就会同时出现多个 rank0。把这条检查写进 submit(),相当于给出了一个明确的报错,而不是让用户面对莫名其妙的 MPI 死锁。
从 request 到 engine request:worker 内部的第二次登记
proxy 把请求送到 rank0 之后,worker 还要把「边界请求」翻译成「引擎请求」。BaseWorker.submit() 是第二次登记:
def submit(self, request: GenerationRequest) -> GenerationResult: self.start() # 首次提交时启动响应线程
if self.rank != 0: raise RuntimeError("Only rank 0 can submit requests. ...")
client_id = request.id if request.id is not None else self._get_next_client_id() if request.id is None: request.set_id(client_id)
logprob_params = self._get_logprob_params(request) result = GenerationResult( request, background_error_handler=self._handle_background_error, executor=self, disaggregated_params=request.disaggregated_params, logprob_params=logprob_params) self._results[client_id] = result
enqueued = False try: request_id = self._enqueue_request(request) enqueued = True finally: if not enqueued: self._results.pop(client_id, None)
self._client_id_to_request_id[client_id] = request_id self._handle_background_error() return result这段代码与 proxy 的 submit() 结构几乎一一对应,但目的不同:proxy 的 _results 用来分发跨进程结果,worker 的 _results 用来在本地生成响应、计算 logprobs、以及决定 postproc 路由。两边都保存一份 GenerationResult,是因为两边都需要一个「按 client_id 找队列」的索引;worker 侧的这份还多承担了「把采样参数附在第一次响应上」的职责。
_enqueue_request() 负责真正的翻译。它做的事情比看起来多:
executor_request = tllm.Request( client_id=request.id, input_token_ids=prompt_token_ids, max_tokens=_deduce_max_tokens(request), streaming=request.streaming, sampling_config=request.sampling_params._get_sampling_config(), end_id=-1 if request.sampling_params.ignore_eos else request.sampling_params.end_id, output_config=request.sampling_params._get_output_config(), return_all_generated_tokens=False, guided_decoding_params=request.sampling_params._get_guided_decoding_params(), bad_words=request.sampling_params._get_bad_words(), stop_words=[] if request.sampling_params.ignore_eos else request.sampling_params._get_stop_words(), embedding_bias=request.sampling_params.embedding_bias, lora_config=lora_config, multimodal_input=multimodal_input, mrope_config=None, kv_cache_retention_config=request.kv_cache_retention_config, context_phase_params=context_phase_params, encoder_input_token_ids=request.encoder_input_token_ids, type=request_type, disagg_request_id=disagg_request_id, cache_salt=request.cache_salt, priority=request.priority)这里有五个知识点值得展开。
第一,max_tokens 的推导不是简单的默认值。 _deduce_max_tokens() 会先减去 output prefix 的长度(如果用户用 decoder_output_token_prefix 预填了输出),再考虑 CP(context parallel)的切分:prompt 在 CP 下会被切成 len(prompt_token_ids) / cp_size 行,因此可用长度是 max_seq_len - splited_prompt_len。如果这个值小于等于 0,它会直接拒绝请求,而不是悄悄截断 prompt。错误信息按「请求级总量」报告,而不是按单个 CP rank 的算术报告,因为用户看到的应该是 max_seq_len * cp_size。这是一个非常实际的边界条件:在长上下文 + CP 部署下,用户指定的 max_tokens 经常大于实际可用空间,框架必须明确告诉用户,而不是生成一个语义被截断的结果。
第二,LoRA 在 worker 侧加载,而不是在 proxy 侧。 _load_lora_adapter() 把 adapter 加载到本地缓存,然后构造 tllm.LoraConfig 与 py_lora_path。每个 rank 独立从磁盘读 adapter,PeftCacheManager.add_request_peft() 再把它挂进缓存。为什么不让 proxy 加载一次、广播给所有 rank?因为 adapter 可能很大,广播要走集合通信;而磁盘读取在每个 rank 上并行发生,反而更快,且不占用请求通道。代价是同一个 adapter 被读 N 次,适合「adapter 数量多、单个不大」的服务形态。
第三,prompt token id 有两种形态。 如果请求从跨进程通道来,可能带一个 int32 buffer(_prompt_token_ids_i32);如果在本进程内构造,就只有 list[int]。源码优先把 int32 buffer 交给 C++ Request 构造函数,避免在持 GIL 的 submit 线程上做一次 O(ISL) 的 Python list 拷贝和逐元素 nanobind 转换。对于 32K prompt,这个差别非常明显。这里的原则与前面「参数只传一次」一致:能避免的线性开销,不要留在关键路径上。
第四,多模态输入在边界处会被拆成两份。 multimodal_input 走 C++ runtime 的 binding;multimodal_data 则作为 Python 动态属性 py_multimodal_data 挂在 request 上,给 PyTorch 侧使用。源码在设置 py_multimodal_data 之前会把 request.multimodal_params.multimodal_input 置为 None,避免同一份数据被序列化两次。这与前面「参数只传一次」是同一种工程直觉,只是对象从采样参数变成了图像张量。
第五,PyTorch 后端特有的字段被挂在动态属性上。 py_original_end_id、py_num_logprobs、py_lora_path、py_return_routed_experts、py_logits_post_processors 等,都是 Python 侧附加到 tllm.Request 对象上的属性,而不是 C++ binding 的正式字段。源码注释解释了原因:把 logits_processor 这类 Python 对象塞进 C++ binding 会导致 PyCapsule pickle 问题,跨进程时无法序列化。这就是 TensorRT-LLM 在「C++ 契约 + Python 执行」混合架构下必然要接受的裂缝:一部分能力只能通过 Python 侧旁路传递。
_client_id_to_request_id[client_id] = request_id 是取消链路的枢纽。用户调用 GenerationResult.abort() 时,proxy 收到的是 client_id,于是发送 CancellingRequest(client_id);worker 的 abort_request(client_id) 用这张表换成引擎的 request_id,再调用 engine.cancel_request(request_id)。如果请求已经完成,表里没有条目,worker 只打一条 warning 并返回。取消是异步的,proxy 不会等待取消生效;真正的资源释放在 PyExecutor 的下一步调度中完成。
响应线程的启动也藏着一个细节:
def start_thread(self, thread: ManagedThread): if not self.engine.can_enqueue_requests(): return if thread.is_alive(): return if thread.ident is not None: # 已经退出过:要么是 shutdown 时的正常 stop, # 要么是引擎事件循环崩溃;重启会掩盖后者,导致 peer rank 挂死 err = getattr(self.engine, "_event_loop_error", None) if err is not None: raise RequestError(str(err)) from err return thread.start()await_response_thread 不是在 worker 构造时启动的,而是在第一次 submit() 时通过 start() 惰性启动。这样做的好处是:如果引擎从未收到请求,就没有必要创建一个空转的轮询线程。坏处是「线程已退出」与「线程从未启动」必须区分:如果事件循环崩溃导致线程退出,再次 start() 会把崩溃掩盖成一次正常重启,而其他 rank 可能还卡在集合通信里。所以源码用 thread.ident is not None 判断「曾经启动过」,并在这种情况下抛出 RequestError,让上层知道引擎已经不可用。
结果如何逆流:两种 handler 与一次批量唤醒
worker 侧的 AwaitResponseHelper 是一个可调用对象,被 ManagedThread 反复执行。它每次调用 engine.await_responses(timeout=0.1),把引擎产出的 tllm.Response 列表转成用户可见的结果。这个类有两个实现分支,因为「单进程 worker」与「IPC worker」的结果投递方式完全不同:
class HandlerKind(enum.Enum): unknown = 0 single_process_worker = 1 ipc_batched = 2
def _resolve_handler_kind(self): has_ipc_queues = (self.worker.result_queue is not None or self.worker.postproc_queues is not None or self.worker.frontend_result_queues is not None) if not has_ipc_queues: return HandlerKind.single_process_worker return HandlerKind.ipc_batched判断依据是「worker 有没有结果队列」。这比传一个布尔参数更稳健,因为队列是在 worker_main() 里根据部署模式设置的,handler 只需要观察现状。
6.1 先过滤空响应,再拼上延迟到达的提交错误
def process_responses(self, responses): responses = [r for r in responses if r is not None]
while True: try: responses.append(self.temp_error_responses.get_nowait()) except Empty: break
return responsesawait_responses() 可能返回 None 占位,必须先过滤。temp_error_responses 是 worker 在 submit() 抛 RequestError 时写入的错误队列;把这些错误拼进同一批响应,意味着「提交失败」和「执行失败」对调用者呈现为同一种结果:GenerationResult 的队列里收到一条错误,result() 抛出 RequestError。调用者不需要知道错误发生在边界内还是引擎内。
6.2 单进程路径:直接写进 GenerationResult 的队列
def handle_for_worker(self, responses): event_loop = None async_queues = [] for response in responses: queue = self.worker.return_queue(response.client_id) if not response.has_error(): response = _maybe_wrap_response(self.worker, response)
if isinstance(queue, _SyncQueue): queue.put_nowait(response) async_queues.append(queue) event_loop = event_loop or queue.loop else: queue.put(response)
if response.has_error() or response.result.is_final: self.worker._pop_result(response.client_id)
if async_queues: _SyncQueue.notify_many(event_loop, async_queues)return_queue() 的逻辑是:如果 worker 注册了中心化的 result_queue,就写到那里;否则直接写进该 client_id 对应的 GenerationResult.queue。单进程路径下没有中心化队列,所以每个请求各自一个队列。
这里的关键是 _SyncQueue 的批量唤醒。GenerationResult 在构造时根据当前线程有没有事件循环选择队列类型:
if has_event_loop(): self.aqueue = AsyncQueue() self.queue = self.aqueue.sync_qelse: self.queue = Queue() self.aqueue = None同步消费者拿到的是标准 queue.Queue;异步消费者拿到的是 AsyncQueue.sync_q,它底层是一个 asyncio 队列的同步视图。如果每条响应都调用一次 notify,一个 batch 里有 64 条响应就会唤醒事件循环 64 次;_SyncQueue.notify_many() 把这些通知合并成一次,事件循环被唤醒后一次性取走所有可用结果。这是流式服务里非常典型的「批量通知」优化,和前面请求批量发送是同一个思路的两端。
_pop_result() 只在 is_final 或 has_error 时调用,避免每个增量 token 都做一次字典删除。_maybe_wrap_response() 则在需要时把 LogProbsResult 与请求级性能指标包进 ResponseWrapper,不改变底层响应的类型。
6.3 IPC 路径:先分桶,再批量过线
IPC 路径的处理函数是 handle_for_ipc_batched()。它比单进程路径多做了三件事:错误类型转换、后处理分桶、以及按前端 lane 分拣。
def handle_for_ipc_batched(self, responses): postproc_batches = ([[] for _ in range(num_postprocess_workers)] if self.enable_postprocprocess_parallel else None) rsp_batch = []
for response in responses: if isinstance(response, ErrorResponse): pass elif self.worker._has_background_error(): response = self.worker._create_error_response(response) elif response.has_error(): response = ErrorResponse(response.client_id, response.error_msg, response.request_id) else: response = _maybe_wrap_response(self.worker, response)
_send_rsp(self.worker, response, postproc_batches=postproc_batches, rsp_batch=rsp_batch)
if postproc_batches: for wid, batch in enumerate(postproc_batches): if batch: self.worker.postproc_queues[wid].put(batch)
if rsp_batch: if (lanes := self.worker.frontend_result_queues) is not None: for frontend_id, sub_batch in enumerate( bucket_responses_by_frontend(rsp_batch, len(lanes))): if sub_batch: lanes[frontend_id].put(sub_batch) else: self.worker.result_queue.put(rsp_batch)为什么必须把 tllm.Response 转成 ErrorResponse?源码注释给出的原因是:带错误的 tllm.Response 无法被序列化。这是 C++ 绑定对象跨进程序列化的限制;错误信息必须降级成一个纯 Python 的 NamedTuple,才能通过 ZMQ 的 pickle 通道。
后处理分桶用的是 response.client_id % num_postprocess_workers,而不是随机分配。原因是增量 detokenize 依赖同一个请求之前的 CompletionOutput;只有把同一个 client_id 固定映射到同一个后处理进程,后者才能维护该请求的解码状态。这是一个「哈希分片 + 有状态 worker」的经典约束:分片函数必须稳定,扩容时不能改变已有请求的归属,否则状态会断裂。TensorRT-LLM 选择按 client_id 取模,简单且稳定;代价是后处理进程数量变化时,存量请求无法迁移。
_send_rsp() 的路由优先级也值得记住:
- 如果启用了后处理并行,且响应不是带直连路由的
ErrorResponse,优先进 postproc 队列; - 否则如果有
frontend_result_queues,按frontend_lane_index(client_id)送到对应前端 lane; - 否则如果有
result_queue,追加到rsp_batch,最后一次性put; - 如果都没有,直接写进该请求的
GenerationResult.queue。
ErrorResponse 在「有直连路由」时会绕过 postproc,直接走结果队列。原因是 PostprocWorker 会读取 input.rsp.result,而错误响应没有这个字段;让它走直连队列,proxy 的 demux 会把它当成终止信号处理。代价是它可能超过同一请求更早的、仍在 postproc 队列里的响应;proxy 在收到错误时会 pop 掉该 client_id,随后迟到的正常响应会因找不到结果而被丢弃,只留下一条 benign 的 warning。这种「错误快于正常响应」的乱序是被接受的,因为错误本身已经终止了请求。
6.4 proxy 侧:分发线程是结果的总出口
proxy 的 dispatch_result_task() 是一个由 ManagedThread 驱动的循环:
def dispatch_result_task(self) -> bool: if (res := self.result_queue.get()) is None: return False
async_queues = [] event_loop = None
def process_res(res): result = self._results.get(res.client_id) if result is None: return queue = result.queue if isinstance(queue, _SyncQueue): queue.put_nowait(res) async_queues.append(queue) event_loop = event_loop or queue.loop else: queue.put(res)
if (is_llm_response(res) and res.result.is_final) or isinstance(res, ErrorResponse): self._results.pop(res.client_id, None)
res = res if isinstance(res, list) else [res] for i in res: if i is None: return False process_res(i)
if async_queues: _SyncQueue.notify_many(event_loop, async_queues) return True它与 worker 的 handle_for_ipc_batched() 构成一对镜像:worker 负责把结果按 client_id 打包成 batch,proxy 负责拆包并按 client_id 找到调用者的队列。两边都用 notify_many 做一次批量唤醒,避免每个 token 一次事件循环调度。
res is None 是 worker 发出的关闭哨兵。pre_shutdown() 在关闭请求发送端时会发送一个 None,分发线程读到它就直接返回 False,ManagedThread 随之退出。这里也有一个容易忽略的边界:如果 worker 已经崩溃,哨兵永远不会到达,分发线程会永远阻塞在 result_queue.get()。所以 shutdown() 在 _engine_dead 为真时只给分发线程一个 5 秒的 join 上限,超时后直接泄漏这个 daemon 线程,而不是让整个进程卡死。这是「正确性优先于资源整洁」的典型取舍:进程即将退出,泄漏一个线程比永久挂起可接受得多。
result is None 的分支同样重要。请求可能已经因为错误被 pop,或者已经被用户 abort;此时 worker 的迟到响应会找不到结果。源码选择静默丢弃,而不是抛 KeyError。如果把这里改成断言,abort 场景下几乎必然崩溃,因为 abort 是异步的,worker 在收到取消前还会产出若干条响应。
故障传播:一条请求的死与整个引擎的死必须分开
边界层最重要的一条设计原则是:请求级错误不能升级为引擎级错误,引擎级错误也不能只影响一条请求。TensorRT-LLM 用两个不同的异常类型和两条不同的传播路径来保证这件事。
7.1 两类错误
_handle_background_error() 根据错误对象的类型分流:
def _handle_background_error(self, error=None): if error is not None: if isinstance(error, RequestError): # 单请求错误,可以被捕获后忽略 ... elif isinstance(error, str): # 单请求错误,字符串形式 error = RequestError(error) else: # 后台线程或进程的严重错误 self._set_fatal_error(error) self.shutdown() raise error
if self._error_queue.empty(): return
try: e = self._error_queue.get_nowait() ... if isinstance(e, str): e = RequestError(e) elif not isinstance(e, BaseException): e = RuntimeError(repr(e)) if not isinstance(e, RequestError): self._set_fatal_error(e) self.shutdown() raise e except Empty: pass判断标准不是「错误来自哪里」,而是「错误对象是什么类型」。RequestError 表示「这条请求不合法或执行失败」,例如 max_tokens 超出上下文、adapter 加载失败、请求被引擎拒绝;字符串会被包装成 RequestError,因为跨进程通道里的错误信息往往已经退化成字符串。其他任何异常都被视为系统级错误:CUDA OOM、worker 进程崩溃、事件循环异常、MPI 通信失败。系统级错误会先记录为 _fatal_error,再触发 shutdown(),最后重新抛出。
这里有一个重要的顺序:先记录 fatal error,再 shutdown。因为 shutdown() 内部会调用 _handle_background_error() 做收尾;如果不先记录,收尾阶段的二次错误会覆盖原始错误,用户看到的就不是根因。_set_fatal_error() 本身也只保留第一条错误:
def _set_fatal_error(self, error): if self._fatal_error is None: self._fatal_error = error logger.error(f"Fatal engine error recorded: {repr(error)}")注释承认存在一个很窄的 TOCTOU 竞争:两个线程可能同时通过 is None 检查,最终记录的是其中一条错误。但因为两条都是 fatal、都会触发 shutdown,这个竞争只影响日志里显示哪条错误,不影响行为。这种「明确写出可接受竞争」的注释,比假装没有竞争更有价值。
7.2 健康检查不能顺手触发阻塞式关闭
基类的 check_health() 与 _handle_background_error() 不同:它不抛异常,只返回布尔值,并且会排空整个错误队列,确保排在 RequestError 后面的 fatal error 不会被延迟到下一次检查才被发现。proxy 重写了它,原因很实际:基类版本在发现 fatal error 时调用 shutdown(),而 shutdown() 会阻塞等待 MPI future;如果 health check 是从事件循环线程调用的,整个 HTTP 服务会被卡住。proxy 版本因此只调用 pre_shutdown()(非阻塞),把阻塞式清理留给真正的 shutdown 路径。
def check_health(self): if self.doing_shutdown or self._fatal_error is not None: return False if self._drain_error_queue(): return self._fatal_error is None and not self.doing_shutdown if self._check_mpi_workers(): return False return True_drain_error_queue() 只处理系统级错误;RequestError 被跳过,因为它不影响引擎健康。_check_mpi_workers() 同时检查本地 pid 监控和 MPI future,覆盖「进程还活着但 future 已完成」与「future 还没完成但进程已经消失」两种死法。
7.3 引擎死亡时,所有待决请求必须立刻醒过来
worker 崩溃最可怕的后果不是崩溃本身,而是调用者阻塞在一个永远不会再有生产者的队列上。TensorRT-LLM 用 EngineDeadError 广播来解决:
def _mark_engine_dead(self, error=None): if self._engine_dead: return self._engine_dead = True dead_error = EngineDeadError(error) for result in list(self._results.values()): try: result.queue.put(dead_error) except Exception: pass release = getattr(getattr(self, 'mpi_session', None), 'release_exit_joins', None) if release is not None: try: release() except Exception: passGenerationResult._result_step() 收到 EngineDeadError 时,会把它记为 _terminal_error、置 _done = True,然后抛出。之后再调用 result() 或 aresult(),会直接重新抛出同一条错误,而不会重新阻塞。这个「粘性终止错误」的设计非常重要:很多框架的 future 在失败后再次 get() 会再次等待;TensorRT-LLM 选择让失败永久可见。
_mark_engine_dead() 用 queue.put() 而不是 put_nowait(),注释解释得很清楚:异步路径的 _SyncQueue 需要 put() 才能正确唤醒等待中的事件循环,put_nowait() 只对同步队列有效。它还顺手调用 release_exit_joins(),因为解释器退出时会先 join 非 daemon 线程,再执行 atexit;如果 pool manager 线程卡住,必须在用户代码还活着的时候解除登记,否则进程会挂死在退出阶段。
worker 死亡的通知有两条路径:MPI future 的 add_done_callback 是事件驱动的,进程一退出就触发;_error_monitor_loop 每 5 秒轮询一次,是兜底。源码明确把事件驱动称为「延迟敏感路径」,把轮询称为「backstop」。远程 MPI 会话(RemoteMpiCommSessionClient)没有本地 future,只能靠轮询,因此它的故障发现延迟最多 5 秒。这个差异在多前端或跨机部署时会影响故障恢复时间,值得在运维层面知道。
7.4 shutdown 的顺序为什么必须写成这样
pre_shutdown() 是「通知阶段」,shutdown() 是「等待与清理阶段」。前者可以在任意线程调用,后者是阻塞的。
def pre_shutdown(self): if not self.workers_started: return if self.doing_shutdown: return self.doing_shutdown = True
self._worker_process_monitor.close() self._shutdown_event.set() # 叫醒 error monitor self._abort_all_requests() # 给所有待决请求发 abort
send_sentinel = (not self.mpi_futures or any(not f.done() for f in self.mpi_futures)) self._close_request_sender(send_sentinel=send_sentinel)send_sentinel 的条件值得细读。它要覆盖两种情况:
- 没有任何 future:
RemoteMpiCommSessionClient的 worker 在另一个进程里,submit()返回空列表;如果不发哨兵,worker 永远收不到关闭信号,proxy 的分发线程会一直阻塞在result_queue.get()。 - 至少有一个 future 还活着:正常本地 worker,需要通知其退出。
如果所有 future 都已完成(worker 已经全死了),就不需要发哨兵;发了也没人收,反而可能在已关闭的 socket 上抛错。
shutdown() 的顺序是:
1. 若 workers 未启动:关闭请求发送端,清理多前端 IPC 目录,返回2. 若尚未 pre_shutdown:先调用它3. 等待 MPI futures: - engine_dead:最多等 5 秒,跳过仍未完成的 future - 正常:所有 future 共用一个 180 秒 deadline - 超时则把引擎标记为 dead,走 dead-engine 路径4. join error monitor(最多 5 秒)5. 停止并 join dispatch_result_thread(dead 时最多 5 秒)6. 关闭 profile control 单线程执行器(wait=True)7. 关闭 RPC client8. 关闭 request/init/result/resource-governor/profile-ack 队列9. 清理多前端 IPC 目录10. 若拥有 MPI session: - engine_dead:abandon(),不 join 死掉的世界 - 正常:shutdown()11. 最后再调用一次 _handle_background_error(),处理收尾阶段的新错误第 3 步的两个 timeout 是整段代码里最有信息量的地方。正常关闭给 180 秒,是因为大引擎的权重释放、进程组销毁、NCCL 通信器拆除可能确实很慢;引擎已死时只给 5 秒,是因为任何 join 死 worker 的操作都可能永久阻塞。源码没有试图「优雅地」等一个已经崩溃的世界,而是明确区分「可等待」与「不可等待」。
第 6 步之所以要 wait=True,是因为 start_profile / stop_profile 的 ZMQ 操作被固定在一个单线程执行器上。如果直接关闭 socket,正在等待 worker ACK 的 profile 调用会踩到已关闭的队列。这个执行器的存在本身就是为了满足 ZMQ 的线程安全约束:socket 不能被多个线程同时访问,而 FastAPI 的线程池不保证同一个请求落在同一个线程上。把「所有 profile 控制流量」钉到一个专用线程,是用一个线程换取正确性。
第 10 步的 abandon() 与 shutdown() 的区别同样重要。shutdown() 会 join pool manager 与 worker 进程;如果 worker 已经崩溃,join 会永远阻塞。abandon() 只放弃会话,不等待。源码在 _mark_engine_dead() 里还会调用 release_exit_joins(),进一步确保解释器退出时不会卡在非 daemon 线程上。这些看起来琐碎的清理,实际上是「推理服务能正常重启」与「进程必须被 kill -9」之间的差别。
7.5 初始化失败为什么不能走普通 shutdown
_fail_initialization() 是专门为启动阶段准备的:
def _fail_initialization(self, error, cause=None): root_cause = cause if cause is not None else error try: self._abort_owned_session(root_cause) except Exception as abort_error: logger.error(...) finally: self._set_fatal_error(root_cause) if not self.doing_shutdown: self.pre_shutdown() raise error from cause顺序是「先 abort,再 mark」。如果反过来,_mark_engine_dead() 会调用 release_exit_joins(),把 pool 标记为 dead,从而让 shutdown_abort() 内部的阻塞式 shutdown 变成非阻塞,MPI_Abort 的升级路径就失效了。结果是非 leader rank 卡在初始化集合通信里,继续持有权重,直到作业被外部杀掉。源码把这一点写在注释里,并用 finally 保证即使 abort 抛错也会完成 mark,避免清理失败掩盖原始初始化错误。
启动路径还有一个专门的检测函数 _detect_worker_death_during_init(),它只检测、不记录、不清理。原因与上面相同:检测函数如果顺手调用 _check_mpi_workers(),就会触发 mark,破坏 abort 的顺序。因此初始化等待循环使用一个「纯检测」版本,把「发现」与「处理」分开。这种拆分在并发代码里很常见,但 TensorRT-LLM 把它写成了两个独立函数,而不是靠一个布尔参数控制副作用,可读性更好。
后处理并行:另一条结果分叉路
结果并不总是从 worker 直接回到调用者。当用户设置 num_postprocess_workers > 0 时,worker 会把原始响应送到一组后处理进程,由它们做增量 detokenize、stop string 检测、logprobs 组装,再写回结果通道。这条路径与主结果路径共用同一根 result_queue,但在 socket 类型与写入者数量上都发生了改变。
8.1 后处理进程是怎么被拉起的
worker_main() 在 rank0 上启动后处理池:
postproc_worker_pool = ProcessPoolExecutor( max_workers=postproc_worker_config.num_postprocess_workers)for i in range(num_postprocess_workers): fut = postproc_worker_pool.submit( postproc_worker_main, result_queues[i].address, proxy_result_addrs, postproc_worker_config.postprocess_tokenizer_dir, PostprocWorker.default_record_creator, postproc_worker_config.post_processor_hook, ) postprocess_worker_futures.append(fut)每个后处理进程接收三样东西:属于自己的输入队列地址、结果 lane 的地址列表、以及可选的独立 tokenizer 目录。源码在 fork 之前显式调用了一次 gc.collect(),注释写得很具体:
A reused worker process may still hold cyclic garbage from the LLM it hosted before, including CUDA objects. Collect it here: a forked postprocess worker that finalizes them aborts on CUDA.
这是一个非常值得记住的工程细节。在外部 mpirun 启动的长期 worker 进程里,同一个 OS 进程可能先后承接过多个 LLM 实例;如果上一个实例留下的循环垃圾里包含 CUDA 对象,fork 出来的后处理子进程在解释这些对象析构时会触发 CUDA abort。显式 GC 一次,把风险留在父进程里,是成本极低的预防措施。这类问题不会在代码层面暴露,只会在特定部署形态下偶发,因此必须靠注释和纪律保留。
8.2 为什么每个后处理进程有自己的 tokenizer
postprocess_tokenizer_dir 是独立的配置项,而不是复用主 worker 的 tokenizer。原因是主 worker 的 tokenizer 可能来自 trust_remote_code=True 的自定义类,无法跨进程 pickle;后处理进程干脆自己从目录再加一份。源码在 _start_executor_workers() 里也做了对应处理:
# Strip the tokenizer from worker_kwargs to avoid MPI pickle failures.# Tokenizers using trust_remote_code=True reference classes in the dynamic# 'transformers_modules' namespace that cannot be deserialized on remote nodes.# The tokenizer is not needed by workers; it is only consumed by the proxy / rank-0 leader.mpi_worker_kwargs = {k: v for k, v in worker_kwargs.items() if k != 'tokenizer'}这里有两个取舍叠在一起:一方面,tokenizer 只被 rank0 与后处理进程使用,其他 rank 根本不需要;另一方面,带 trust_remote_code 的 tokenizer 无法被 MPI 反序列化。与其试图让所有 rank 都能加载 tokenizer,不如直接不传,让 rank0 从本地目录自行构造。这是「减少跨进程依赖」的又一个实例,和前面参数只传一次、多模态输入只传一份是同一类思路。
8.3 后处理进程的输入需要一份「假的 GenerationResult」
后处理进程需要 sampling_params 来构造一个用于增量解码的临时结果对象。但完整地跨进程传一遍 GenerationResult 代价太高,所以 _send_rsp_to_postproc() 只传一个 PostprocWorker.Input,其中采样参数由 _get_params_for_first_rsp() 决定是否附带:
def _get_params_for_first_rsp(worker, client_id): res = worker._results.get(client_id, None) assert res is not None if not res._params_transmitted: res._params_transmitted = True return res.sampling_params, res.postproc_params, res.disaggregated_params return None, None, None这就是 4.2 节提到的「参数只传一次」的具体应用。后处理进程在收到第一次输入时用这些参数建立本地状态,后续输入不再携带。需要注意,_params_transmitted 是在 worker 侧设置的,而不是后处理进程侧;worker 是唯一的决策者。
8.4 分桶与跨请求顺序
pid = response.client_id % num_postprocess_workers 把同一个请求固定到一个进程。这一约束保证了增量解码状态的一致性,但也带来一个副作用:一个慢请求会拖慢同桶里所有请求的后处理进度。对延迟敏感的服务,后处理进程数量应该足够多,让桶内请求数保持在较低水平;或者干脆不启用后处理并行,把 tokenizer 工作留在 proxy 主进程。
顺带说明一个容易混淆的点:后处理并行时的 result_queue 在 proxy 侧是 PULL,而 worker 侧每个后处理进程各自 PUSH 到同一个地址。如果某个后处理进程崩溃,它负责的桶里的请求会永久得不到最终结果。TensorRT-LLM 并没有为这种情况单独设计恢复路径,故障最终会通过 worker 世界的 future 死亡或前端超时暴露出来。这说明后处理并行是一个性能选项,不是可靠性选项;需要更强容错的部署不应依赖它。
分离式部署:executor 只负责把「角色」送进去
TensorRT-LLM 支持 Prefill/Decode 分离(P/D disaggregation),而 executor 层在这件事里的角色常被误解。它不负责搬运 KV,也不负责选择哪台机器做 Decode;它只负责把请求的「角色」与交接参数送进 worker,并保证结果和取消仍然按同一条 client_id 账本回来。
上图来自 NVIDIA 官方的分离式服务技术博客。Context 实例负责处理 prompt、生成首 token 并产出 KV;Generation 实例接收 KV 后继续解码。对 executor 来说,这两类请求走的是同一根 request_queue,区别只在 GenerationRequest.disaggregated_params 里携带的 request_type。
在 BaseLLM.generate_async() 里,如果请求是 context_only,会把 sampling_params.max_tokens 强制设为 1:
is_ctx_only = (disaggregated_params is not None and disaggregated_params.request_type == "context_only")if is_ctx_only: sampling_params.max_tokens = 1 self._configure_bart_decoder_prefix(sampling_params)为什么是 1 而不是 0?因为引擎的调度与 KV 分配逻辑要求一条请求至少产出一个 token;max_tokens=1 让 Context 实例完成一次前向、把 KV 写进缓存,然后以「正常结束」的姿态退出,而不是走一条特殊的零 token 路径。这个细节把 P/D 的角色差异压缩成了普通的采样参数,避免在 executor 与 PyExecutor 里增加分支。
worker 侧则把角色翻译成 C++ 的 RequestType:
request_type = tllm.RequestType.REQUEST_TYPE_CONTEXT_AND_GENERATIONdisagg_request_id = 0
if request.disaggregated_params is not None: request_type = request.disaggregated_params.get_request_type() disagg_request_id = request.disaggregated_params.disagg_request_id if request_type == tllm.RequestType.REQUEST_TYPE_GENERATION_ONLY: context_phase_params = request.disaggregated_params.get_context_phase_params()context_phase_params 里包含 KV 接收端需要的信息。executor 只把它挂到 tllm.Request 上,真正的 KV 传输由 batch_manager 里的 cacheTransceiver 与格式化器完成。这条分工线很重要:executor 是控制面的入口,KV 数据面在引擎内部。因此排查 P/D 问题时,如果请求根本没被 worker 接收,应该看 executor 的队列与 client_id;如果请求被接收但 KV 传不过去,应该看 cache transceiver 与网络,而不是继续盯 executor。
这也解释了为什么 P/D 场景下 GenerationResult 依然能正常工作:无论 Context 还是 Generation,client_id 的登记、结果的打包、错误的广播都走同一套代码。executor 不需要知道这条请求最终在哪台机器上完成,它只需要保证「从哪个 client_id 进来,就从哪个队列出去」。
官方实现与部署细节见 Disaggregated Serving in TensorRT-LLM 与 Disaggregated Serving 文档。
与站内其他框架的对照
边界层最容易看出不同框架的设计哲学,因为这一层不涉及算子,只涉及结构选择。下面从四个维度横向对照。
| 维度 | TensorRT-LLM | vLLM V1 | SGLang | llama.cpp | DeepInfer |
|---|---|---|---|---|---|
| 边界形态 | proxy + MPI worker world,三根 IPC 队列 | 前端进程 + 引擎进程,ROUTER/PULL | 三段式,反分词独立进程 | 同进程多线程 | 同进程,CP 跨进程 |
| 结果投递 | rank0 打包 batch,proxy 拆包分发 | 引擎侧直接分发 | tokenizer 进程转发 | 线程内条件变量 | 进程内队列 |
| 多 rank RPC | IPC 只放行 sleep/wakeup;完整能力在 Ray/RPC | 不适用 | 通过 DP/EP 内部协调 | RPC 后端 | 内部协调 |
| 引擎死亡语义 | EngineDeadError 广播到所有待决结果 | 引擎死亡 → 所有请求失败 | 类似 | 进程退出 | 引擎内错误传播 |
这张表里最有意思的一行是「多 rank RPC」。TensorRT-LLM 的 IPC proxy 只允许 rank0 接收 collective_rpc,并且只放行 sleep、wakeup 这类在 rank 内部自行协调的方法;其余多 rank 方法必须走 Ray。原因是 IPC 通道只有一根 request queue,而 collective_rpc 要广播到所有 rank,需要另一套同步机制。vLLM 没有这个问题,因为它的执行器抽象从一开始就假设可以访问所有 rank;SGLang 则把多 rank 协调放进调度器内部。这不是孰优孰劣,而是「边界层承担多少并行语义」的不同选择。
另一个对照是「结果是否经过中心化打包」。TensorRT-LLM 的 rank0 会把一个 step 的所有响应打包成一个 list 再 put 一次,proxy 再拆包;vLLM 的引擎进程直接对每个请求的结果队列写入;llama.cpp 在同进程里通过条件变量唤醒等待线程。TensorRT-LLM 的选择在多请求并发时减少了 ZMQ 消息数量与 HMAC 校验次数,代价是 rank0 侧的打包延迟——一个 step 中最慢的结果决定整批过线时间。这与它的批量请求发送是成对的设计,追求的是「单位请求的固定开销最小」,而不是「第一个 token 最快」。
站内已有文章拆过 vLLM、SGLang、llama.cpp、DeepInfer 的前端-引擎边界,可参考 前端与引擎之间的那道进程边界:vLLM、SGLang、TensorRT-LLM、llama.cpp、DeepInfer 如何把一次请求交给 GPU。那一篇从「请求如何跨越边界」横向比较,本篇则进一步深入到 TensorRT-LLM 边界层内部的队列、登记与故障语义,两者可以对照阅读。
工程边界与已知取舍
把这一层的设计逐条列出,可以总结出几条反复出现的取舍。
第一,流式延迟与 CPU 开销的对抗。 拆出 worker 进程是为了不让主进程的 Python 工作拖慢结果投递;批量发送请求是为了减少单位请求的固定开销;批量通知是两端共同的优化。但这三项优化都建立在「请求足够密集」的前提上。对低频、单用户、首 token 延迟敏感的场景,批量发送反而有害,单进程模式反而可能更简单。部署时应当根据实际负载选择,而不是默认全开。
第二,id 的双重身份带来了路由能力,也带来了约束。 client_id 同时承担「请求配对」与「前端 lane 路由」两个职责,高位编码 frontend id,低位是自增计数器。这个设计让 worker 无需查表就能决定响应去向,但也限制了 client_id 的位宽使用:前端数量与计数器共享 64 位空间。namespace_client_id() 在计数器接近位宽边界时会做一次重编码(no-op),保证不会溢出到 frontend id 的位段。这种位级复用在高并发长生命周期服务里需要格外小心。
第三,故障语义是「宁可快失败,不可永等待」。 引擎死亡时,所有待决 GenerationResult 立即收到 EngineDeadError;分发线程在 dead 状态下只等 5 秒就放弃;MPI 会话在 dead 状态下直接 abandon();远程 worker 死亡最多 5 秒被发现。这些选择的共同目标是「不要让调用者阻塞在一个已经不可恢复的世界里」。代价是清理不彻底——线程可能泄漏、会话可能被放弃、部分 CUDA 资源可能来不及释放。对需要长期运行的服务,这种「泄漏优于挂死」的策略会通过进程重启来兜底,而不是在进程内做完美的清理。
第四,Python 与 C++ 的混合契约必然有裂缝。 py_* 动态属性、ErrorResponse 的序列化降级、tokenizer 的跨进程剔除、多模态数据的两份拆分,都是这一类裂缝的表现。它们不会出现在高层 API 里,但会影响每一个试图在 executor 层做扩展的人。如果要在 worker 侧加自定义逻辑,需要先确认它是否会被 pickle、是否会经过 C++ binding、是否在每个 rank 上都可用。
第五,部署形态的选择不应留给用户猜。 create() 的决策树在大部分情况下会给出合理默认值,但它也意味着「同样的 LLM(...) 在 TP1 与 TP8、在本地与 mpirun、在 Ray 与非 Ray 下行为不同」。日志里那几行 Orchestrator is creating ... executor 值得在部署初期检查一遍,确认实际走的是预期的路径。如果发现 using single process worker for TP1 的警告,却期望流式性能,就应该关掉那个开关。
小结
TensorRT-LLM 的 GenerationExecutor 不是「引擎之上的一层薄封装」,而是把推理引擎变成一个可部署服务的完整边界层。它做了五件事:
- 选择部署形态:单进程、IPC proxy、RPC proxy、Ray、多前端挂载,同一份
LLM代码在不同环境下被组装成不同进程结构; - 维护请求账本:
client_id先登记后发送、参数只传一次、int32 token buffer 旁路、PyTorch 动态属性旁路; - 搬运结果:worker 打包、proxy 拆包、两端
notify_many、后处理分桶与前端 lane 路由; - 区分故障:
RequestError只杀一条请求,fatal error 杀整个引擎并广播EngineDeadError; - 有序关闭:先通知、后等待;可等待的等 180 秒,已死的只等 5 秒,不可恢复的会话直接放弃。
如果只记一句话:这一层的全部复杂度都来自「请求与结果必须严格配对,而它们之间隔着一个可能随时死掉的进程世界」。 上面所有的队列、登记、超时与广播,都是在为这个不变量服务。
下一篇回到引擎内部更细的一层,讨论 TensorRT-LLM 的 ResourceManager 如何管理 KVCacheManager、PEFT 缓存与调度资源,以及这些资源在 create_py_executor 的装配线里是如何被一次性建好、又如何在 shutdown 时按顺序释放的。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



