


DeepInfer 源码完全拆解(一):整体架构与模块全景——DeepSeek 官方推理引擎如何接管 V4.1-Flash
引言:为什么第五个框架是 DeepInfer
在系统阅读推理框架源码的这条线上,本站已经走过了 vLLM、SGLang、llama.cpp 与 TensorRT-LLM 四个框架:从 vLLM 源码完全拆解(一):整体架构与模块全景 建立调度器与块管理器的心智模型,到 SGLang 源码完全拆解(一):整体架构、进程拓扑与请求数据流 理解 RadixAttention 与重叠调度,再到 llama.cpp 源码完全拆解(一):整体架构与模块全景 的 ggml 图执行,以及 TensorRT-LLM 源码完全拆解(一):整体架构与模块全景 中构建期消失、PyTorch 后端接管推理引擎的转变。这四个框架各自代表了一条技术路线,但它们有一个共同的盲点:它们都是”通用”推理框架,服务的是任意 Transformer 模型的通用形态。
DeepInfer 不一样。它是 DeepSeek 官方开源的推理框架,用官方原文来说,是”驱动 DeepSeek 大规模生产服务的高性能推理框架”(the high-performance inference framework that powers DeepSeek’s large-scale production services)。它只服务一个模型家族——当前版本支持 DeepSeek-V4.1-Flash——但为了把这一个模型在 SM100 GPU 与 Ascend 950 NPU 上压榨到极限,它把一整套只有自家才有的东西直接焊进了引擎:FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect 这些官方 kernel 库,DSpark 投机解码与置信度调度验证,SWA 有界重放,异步调度,以及 batch-invariant 推理与确定性采样。
换句话说,前面四个框架教的是”通用引擎如何兼容各种模型”,DeepInfer 教的是”一个模型为了自己的极速推理,会把引擎做成什么样”。这条轴线上很多设计决策在通用框架里是没法做的,因为通用框架必须对模型形状保持无知,而 DeepInfer 可以对 V4.1-Flash 的每一层结构做特化。理解这种特化在哪里、代价是什么,是本系列要回答的核心问题。
本篇作为框架总览,目标是画地图而不是追函数:先讲清楚 DeepInfer 的定位与它和 vLLM/SGLang/TensorRT-LLM 的血缘关系,再走一遍仓库地形与模块划分,然后沿”一次请求如何穿过引擎”的主线把各模块串起来,最后给出推荐的源码阅读路径。后续篇章会逐个模块展开——调度器与异步重叠、KV 内存与 SWA 有界重放、MoE 专家并行与 EPLB、DSpark 投机解码、TileLang 特化 kernel、结构化输出与确定性采样。
血缘关系:它站在谁的肩上,又在哪里分道扬镳
读一个不熟悉的推理框架,最快的切入方式是先搞清楚它从哪里长出来。DeepInfer 的仓库里到处是答案:deepinfer/engine/llm_engine.py、deepinfer/entrypoints/llm.py、deepinfer/sampling_params.py、deepinfer/sequence.py、deepinfer/config.py 这些文件的头部都带着同一行注释:
# Derived from vLLM; modified by DeepSeek.README 的致谢段落也直接写明:DeepInfer 最初主要构建在 vLLM 之上,并从 SGLang 与 TensorRT-LLM 中获得了额外灵感。
但”派生自 vLLM”不等于”vLLM 换皮”。把两者对照着看,能清楚看到 DeepSeek 改造的方向:
第一,调度器搬进了 C++,且只留一个驱动进程。 在 vLLM V1 里,调度逻辑是 Python 的 Scheduler.schedule(),块管理是 Python 的 KVCacheManager,两者跑在 EngineCore 进程里但都还是 Python 对象。DeepInfer 把这些全部下沉到 csrc/engine/:scheduler.hpp 里是完整的 C++ Scheduler 类,block_manager.hpp 是 C++ 的块管理器,Python 侧只通过 deepinfer._C.engine 这个 pybind 扩展拿到 Scheduler、BlockManager、SchedulerOutputs、SequenceMetadata、SequenceMetadataPool、FlopsEstimator 等类型。调度这一步是每个 decode step 都要走的路径,把它从 Python 挪到 C++,省下的是每步几毫秒的 Python 对象开销——在单请求毫秒级解码的目标下,这不是优化,是必要条件。
第二,调度与执行是解耦的、异步的。 DeepInfer 有一组开关叫零开销调度(zero-overhead scheduling,代码里统一缩写为 ZOS),由环境变量 DEEPINFER_ZERO_OVERHEAD_SCHEDULING 控制。它的效果是:第 步的 decode 结果不在第 步就处理完,而是延后到第 步的 forward 期间再去 post-process,让 CPU 侧的簿记和 GPU 侧的计算真正重叠起来。这一点 SGLang 用 Overlap Scheduler 做过类似的事,但 DeepInfer 的做法更激进——它连”上一步到底采样出了哪些 token”都要在下一步里用 GPU→CPU 拷回来的 seqlens_q 去修正,才能确定下一步该算多长。这套机制后面会用一整篇拆。
第三,只服务一个模型,所以可以彻底特化。 这是最根本的差异。deepinfer/model_executor/models/v4_modules/ 目录下有 23 个文件专门描述 V4.1-Flash 的层结构:mla_attn.py(MLA 注意力)、index_attn.py(稀疏注意力的索引器)、compress.py(KV 压缩)、cross_layer.py(跨层共享拓扑)、yoco.py(YoCo 解码器)、engram.py(条件记忆)、mhc_ops.py(流形约束超连接)。这些是模型结构级的知识,通用框架必须把它们抽象成配置,而 DeepInfer 直接把它们写成模块。
第四,kernel 来自官方库而非社区实现。 README 明确列出它用的 kernel 库:FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect,外加自定义的 TileLang kernel(放在 deepinfer/model_executor/layers/tilelang_ops/)。这些库是 DeepSeek 自己开源并维护的,本站已有几篇拆解过它们——DeepGEMM 完全拆解、DeepEP 完全拆解,以及 TileLang 完全拆解。DeepInfer 是把这些散落的库焊成一个完整引擎的那层胶水。
第五,它是离线推理的开放版本,不是完整的服务栈。 这点必须说清楚,否则读者会困惑于”为什么找不到 HTTP server”。README 的”Required for a complete inference service (not included in this release)“一节明确列出三样没开源的东西:KV cache 系统、VE/Prefill/Decode 分离(引擎侧大部分功能已实现)、以及 prefill 与 decode 两侧跨数据并行副本的负载均衡。也就是说,线上 DeepSeek 服务里还有一套独立的外围系统,DeepInfer 开源的是”引擎内核”这一块。它的入口是 deepinfer/entrypoints/llm.py 里的 LLM 类,一个离线批处理接口,对应 vLLM 的 LLM 而非 AsyncLLMEngine。
把这五条放在一起,DeepInfer 的定位就清楚了:它是把 vLLM 的骨架、SGLang 与 TensorRT-LLM 的经验、DeepSeek 自家的模型结构知识与 kernel 库,压缩成一个只为自家模型服务的极速引擎。
仓库地形:九个顶层目录
git clone 之后看到的顶层结构是这样:
| 目录 | 内容 | 读它的价值 |
|---|---|---|
deepinfer/ | 主 Python 包:引擎、worker、模型执行、输出约束 | 主体,绝大多数篇章都在这里 |
csrc/ | C++/CUDA 源码与 pybind 绑定:调度器、块管理、输入准备 | 理解性能关键的调度与元数据路径 |
deep_cluster/ | 硬件与拓扑抽象(NVIDIA/Ascend/CPU、NUMA 绑定) | 理解它为什么能同时跑 SM100 与 Ascend 950 |
vendor/ | 第三方子模块(git submodule) | FlashMLA/DeepGEMM/DeepEP 等库的落点 |
eval/ | 评测脚本:aime、gpqa、hle 等 | 精度验证口径 |
examples/ | 离线推理示例、sweep 压测脚本、yoco 示例 | 上手与复现 benchmark |
tests/ | 单元与分布式测试 | 想改代码时的回归网 |
scripts/ | 构建与工具脚本 | 环境搭建 |
doc/ | 文档与图片(含官方 pareto 曲线图) | 性能口径 |
deepinfer/ 内部的模块划分是理解全局的关键:
deepinfer/├── engine/ # LLMEngine、EngineArgs、EngineType、统计与 profile├── entrypoints/ # LLM 离线入口├── worker/ # Worker、ModelRunner、CacheEngine、CUDA Graph Runner├── model_executor/ # 模型定义、层实现、并行、EPLB、TileLang 算子├── ve/ # Vision Encoder / 多模态预处理(VE 即视觉编码侧)├── structure_output/ # 结构化输出的编译器、匹配器与掩码├── distributed/ # 共享内存广播等进程间通信├── npu_ops/ # Ascend NPU 算子└── hugging_face/ # HF tokenizer / 配置适配对照 vLLM 的结构读这个表,能看出几处刻意的不一样:
- vLLM 有独立的
core/目录放 Scheduler 与 KVCacheManager,DeepInfer 没有——它们去了csrc/engine/。 - vLLM 的多模态处理分散在
multimodal/与model_executor/models/里,DeepInfer 单独拆出一个ve/,把视觉编码侧(Vision Encoder 的前处理、图像处理器、张量输入准备)独立成模块。这对应它支持的DeepSeek-V4.1-Flash的多模态能力,也对应 README 里 VE 与 Prefill/Decode 分离并列的那句”未包含”。 - vLLM 的结构化输出用
xgrammar与outlines两个第三方库,DeepInfer 自建了structure_output/,内含compiler.py(把正则/JSON Schema/EBNF 编译成语法)、mask.py(生成 logits 掩码)、matcher.py与so_matcher_builder.py(有限状态机推进)。同时环境变量里还有DEEPINFER_XGRAMMAR_*一组开关,说明它也保留了 xgrammar 路径。两条路径都存在这件事本身值得在结构化输出那一篇里讲清楚。 worker/里有两个 CUDA Graph Runner:cuda_graph_runner.py与dflash_cuda_graph_runner.py。第二个是给 DFlash(块扩散草稿)单独准备的,普通框架不会有这种东西。
核心抽象:Sequence、Block、Scheduler 与 Worker
不管读哪个推理框架,先把四五个核心抽象认全,后面所有代码都能挂在它们身上。DeepInfer 的核心抽象如下。
Sequence 与 SequenceMetadata。 deepinfer/sequence.py 里的 Sequence 承载一个请求的完整状态:token id 列表、状态(等待/运行/完成)、采样参数、KV 块表、生成了多少 token 等。与之配套的是 C++ 侧的 SequenceMetadata——每个 step 只为”这一步被调度到的序列”构造一份元数据(seqlen_q、seqlen_k、是否最后一个 prefill chunk 等),放到 SequenceMetadataPool 里,用完归还。这是典型的对象池设计:decode 每步都要新建几百个元数据对象,如果每步都让 Python 分配一遍,GC 压力会直接反映在步时间上。
BlockManager 与 state_manager。 块管理器有两个实例:BlockManager(cache_config.num_gpu_blocks) 管 KV 块,state_manager = BlockManager(cache_config.num_state_seqs) if cache_config.bytes_of_state_per_seqs > 0 else None 管”状态槽位”。第二本账是 DeepInfer 特有的——V4.1-Flash 这类带循环/压缩状态的模型(比如 YoCo、mHC、压缩注意力)需要额外的工作状态内存,它和 KV 块一样需要分配、引用计数、回收,所以复用了同一套块管理器实现。环境变量 DEEPINFER_NUM_STATE_SLOTS_RATIO(默认 1.2)控制状态槽位相对请求数的倍率。
Scheduler。 调度器在 C++(csrc/engine/scheduler.hpp,1300 行上下),通过 pybind 暴露 schedule(sequence_metadata_pool)。它持有 waiting 与 running 两个序列队列,内部再分为 _schedule_prefill 与 _schedule_decode 两条路径,产出物是统一结构 SchedulerOutputs:本步调度的序列、是否 prefill、本步 total token 数、本步结束的序列、seqlens_q、以及一族 clone/zero 指令(clone_states、clone_blocks、zero_states)。最后一项是写时复制的钩子——当调度决定抢占或分支时,C++ 侧只登记”哪些状态/块需要克隆”,真正的设备侧拷贝由 Python 侧拿到 SchedulerOutputs 后统一发起。
SchedulerOutputs 上还挂着一组统计量,由 pybind 暴露:sum_seqlen_qxk、max_seqlen_k、min_seqlen_k、attn_tflops、total_tflops、num_cached_tokens_gpu。这些都来自 C++ 侧的 FlopsEstimator——它按模型元数据(层数、头数、隐维)对该步的注意力 FLOPs 做估算,调度器用它来做负载判断。把算力估算做进调度器,是”面向自家模型特化”才能有的奢侈:通用框架不知道模型内部结构,估不出这么细的数。
Worker 与 ModelRunner。 deepinfer/worker/worker.py 的 Worker 是每个 GPU 上的执行体。它持有 model_runner(model_runner.py,前向与采样的组织者)与 gpu_cache(cache_engine.py 管理的一整块显存 KV 池)。关键接口只有一个:execute_model_step()。Worker 分成 driver worker(rank 0,还额外持有引擎回调 EngineCallbacks,负责在采样前调用 pre_sampler_sync_fn)与 slave worker(纯执行)。WorkerBase(worker/base.py)承担所有 worker 共有的初始化:进程组建立、NUMA 绑定、显存 profiling、cache engine 初始化等——_bind_numa 出现在 base 而非 worker,说明它是所有角色共享的部署优化。
LLMEngine。 deepinfer/engine/llm_engine.py 的 LLMEngine 是引擎本体:持有 tokenizer、worker 组、scheduler、block_manager、state_manager、request_output_pool,对外暴露 add_request、abort_request、step()。它的 EngineType 有 NORMAL、PROMPT、COMPLETION 等取值——这是为 P/D 分离预留的角色划分:prompt 引擎只做 prefill(assert scheduler_outputs.prompt_run, "Prompt engines should not perform decoding"),completion 引擎只做 decode,NORMAL 引擎两者都做。README 说 P/D 分离”引擎侧大部分功能已实现”,这一行断言就是证据。
一次请求如何穿过引擎:step 的完整解剖
把请求从入口走到输出,只需要看三处:entrypoints/llm.py 的 LLM.generate、llm_engine.py 的 LLMEngine.step 与 worker.py 的 Worker.execute_model_step。
对外入口 LLM 是个离线批处理器:收一批 prompt,逐条 add_request,然后循环 step() 直到没有未完成请求,从返回的 RequestOutput 指针数组里取文本。注意这里的返回类型是 np.ndarray[np.uint64]——一串 uint64 指针,指向 C++ 侧 RequestOutputPool 里分配的对象。为什么不用 Python 对象直接返回?因为 step 是热路径,把输出对象留在池里、只传指针,可以把对象构造与析构的开销压到最低;代价是生命周期规则变得严格:step() 返回的输出”下一个 step 会被自动回收”,调用方想留用必须显式 pool.clone()。这类”指针 + 池 + 延迟释放”的组合在 DeepInfer 里反复出现,属于它性能文化的缩影。
LLMEngine.step() 的主干顺序如下(对应源码里的 cpu_timer 分段):
step(): 1. schedule:cpp -> self.scheduler.schedule(sequence_metadata_pool) 2. schedule:clone -> 若有 clone_states/clone_blocks/zero_states, 调用 worker 在默认流上克隆/清零,登记到 deferred_release 3. schedule:post -> post_schedule(scheduler_outputs)(子类扩展点) 4. prompt 步的 SO 簿记 -> 结构化输出请求在最后一个 prefill chunk 准备 matcher 5. decode 步且存在 copy_state -> do_copy_state()(KV 落盘钩子) 6. multi_modal_fetch -> 多模态输入拉取,失败请求直接 abort 7. _execute_model_async_step -> _run_workers("execute_model_step", ...) 8. stats/计数第 7 步把 seq_metadata_list 与 scheduler_outputs 交给 driver worker,由它run_workers 广播到所有 worker。接下来是 Worker.execute_model_step——整个引擎最核心的一段,注释里写明它是一轮固定编排:
execute_model_step(is_prompt, is_placeholder, seq_metadata_list, scheduler_outputs): 1. forward 当前步: driver 先算 seqlens 修正(ZOS 下要用上一步采样的结果修正本步的 q/k 长度) model_runner.execute_main_model(seq_metadata_list, gpu_cache, metadata_zos) 2. post process 上一步:_post_process_step(self.prev_step_state) 3. sample 当前步: 若本步有 d2h 修正,先同步事件,用修正后的 seqlens_q 更新 CPU 侧元数据 model_runner.execute_sample(...) pre_sampler_sync 回调(driver)→ 释放上一步延后的资源 4. prompt 步 / 非 ZOS:当场 post_process 本步并返回输出; ZOS 的 decode 步:把本步状态存进 prev_step_state,留给下一步处理这就是零开销调度(ZOS)的全部机制:一个 decode step 的三件事(前向、后处理、采样)被重新排序成”前向本步 → 后处理上一步 → 采样本步 → 延后本步后处理”,让 CPU 侧的后处理(把输出写回调度器、更新序列状态)与下一步的 GPU 前向重叠。为什么可以这样重排而结果不变?因为下一步前向需要的输入只有”上一步采样出了哪些 token”,而采样结果在 ZOS 下通过一条 GPU→CPU 的拷贝路径(seqlens_q 的 d2h)在下一步前向前拿到。代价是每步多一次小拷贝和多一层”修正”—_correct_seqlens_qk 会把 metadata_zos.remap(本步批次对上一步批次的映射)拷到 CPU,据此修正 q/k 长度。这套机制的正确性边界很窄,SGLang 用 Overlap Scheduler 做过同样性质的事,可以对照 SGLang 源码完全拆解(六):Overlap Scheduler 如何重叠 CPU 调度与 GPU 执行 一起读。
另一处值得注意的设计是 DeferredRelease:每一步产出的资源(序列元数据、输出指针、clone 后的 unpin 列表)不立即释放,而是收集起来,在下一次 pre_sampler_sync 时释放——那时这些资源对应的 GPU 工作已经完成,释放动作与 GPU 计算重叠。它还专门用 clone_done_evt 记录克隆完成事件,在释放前 synchronize(),避免把还在用的块归还池子。这类”延迟一拍释放”的账法,与站内拆过的前缀共享扇出问题里”引用计数 + 写时复制”的记账是同一个主题,可参考 前缀共享的扇出难题:同前缀请求同时涌入时,KV Cache 复用的账怎么记。
空步也是步:placeholder 与数据平行的 lockstep
step() 的末尾有一句容易读漏的判断:_execute_model_async_step 把 is_placeholder=scheduler_outputs.is_empty() 传给 worker。也就是说,当调度器这一步没调度出任何序列时,引擎照样走一遍执行流程——worker 构造一条占位序列(model_runner._placeholder_seq_metadata(is_prompt)),照常前向、照常采样,只是产出被丢弃。
为什么不干脆跳过?因为 DeepInfer 是数据并行(Attention DP)部署:多个 DP rank 各自持有完整的注意力权重与调度器,但 MoE 层需要跨 rank 做 all-to-all(DeepEP 的 dispatch/combine),EPLB 的统计还依赖周期性的 EP all_gather。这些集合通信要求所有 rank 同步进入——如果某个 rank 因为队列空就跳过一步,其余 rank 会在集合通信上等到超时。占位步保证所有 rank 的步数一致,把”队列空”变成一个代价可控的伪步。这是数据并行服务里很经典的约束,站内讨论过的 DP 路由与负载均衡(BalanceRoute 完全拆解:大规模 LLM 数据并行服务如何在线负载均衡)面对的是同一类问题:DP 副本之间必须对齐,只是对齐的代价不同——BalanceRoute 在外层做均衡,DeepInfer 在引擎内部用空步兜底。
六条特化:DeepInfer 与通用框架的差异清单
总览的任务是把差异点列全,细节留给后续篇章。以下六条是 DeepInfer 相对通用框架最有辨识度的设计。
一、异步调度:把 CPU 移出关键路径
前面拆过的 ZOS 是这条的第一层。第二层在 scheduler.hpp 的 update_mtp_runtime 与 mtp_varlen.hpp 里:DeepInfer 在运行时用实测数据反推 kernel 耗时估计。SamplerRuntimeEstimator 用一个 9 槽滑窗维护采样耗时的中位数(至少 5 个样本才给出估计),ForwardRuntimeEstimator 则维护”归一化残差”的中位数——即 (forward_ms - baseline_ms) / graph_size,用来拟合 forward 启动曲线随 batch/graph size 的斜率,先按 graph size 聚合取中位数、再对中位数取中位数,各 graph size 等权。这些估计值被调度器用来决定下一步该用多大的 CUDA Graph、验证多长的草稿。用实测中位数而不是理论公式来喂调度决策,是一种很”生产环境”的做法:硬件、驱动、负载都会漂移,固定系数会失准。
二、SWA 有界重放:把 prefill 的一段后缀重算,换取更小的 KV
README 给出的配置是 DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact 加 DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140。它的机制是:对带滑窗注意力(SWA)的模型,prefill 时不再对整个 prompt 计算并保留全量 KV,而是只重放一段有界后缀——保留的尾部必须覆盖 SWA 窗口加上最大回溯长度(DEEPINFER_MAX_BACKTRACKING_TOKENS,其下界由草稿长度决定)。环境变量注释里把约束写得非常明确:启用截断时 KEEP_TOKENS 默认 0,即必须显式设置,否则等于没配。
截断模式有两档:mask(用掩码把不可见位置屏蔽掉)与 compact(把物理布局压紧,不再为被截断的位置存 KV)。两者必须数值等价,DeepInfer 为此专门提供了一套两级验证:L1 是 examples/yoco/yoco_equiv.py mask-compact,单机秒级、不加载权重,直接比对 SWA 枢轴、可见 key、store slot 与压缩 key 区间这些元数据;L2 用固定 teacher-forcing 轨迹逐元素比对 logprob 与 top-K,并要求模型是”兼容的 V4.1 HF YoCo checkpoint”(满足 n_prefill_layer < n_layer 约束),且除截断模式外所有环境变量必须一致。这套”元数据级 + 数值级”双重等价验证,说明截断不是近似,而是同一语义的两种实现。想理解它服务的模型结构,可以先读本站的 YOCO 完全拆解:Decoder-Decoder 架构如何让 KV Cache 只存一次 和 DeepSeek-V4.1-Flash 推理侧完全拆解:890 字节/token 的 KV Cache 是怎么压出来的——后者讲的 SWA 有界重放,正是这里的引擎实现。
三、投机解码:DSpark 与置信度调度验证
DeepInfer 内置的投机解码不是外挂草稿模型,而是模型自带的 MTP 头。开关是 DEEPINFER_ENABLE_MTP_VARLEN=1,草稿长度上限由 DEEPINFER_USE_NEXTN_DECODE 控制(默认 5)。“VARLEN”这个词是关键:不同请求在这一步接受多少草稿 token 是不一样的,所以验证前向的 batch 形状是变长的——input_metadata/dflash.py、tilelang_ops/schedule_mtp_varlen.py、mtp_info_pool.py、store_mtp_info 这些模块合起来处理这件事,连 worker 里都有独立的 dflash_cuda_graph_runner.py,因为变长形状需要与常规解码分桶不同的 CUDA Graph 策略。
置信度调度则对应环境变量 DEEPINFER_DFLASH_CONFIDENCE_HEAD_TEMPERATURE——它支持每个草稿位一个温度值,参数个数必须与 DEEPINFER_USE_NEXTN_DECODE 一致,否则初始化直接报错。机制与站内拆过的 DSpark 一致,见 DSpark:半自回归生成与置信度调度的投机解码;MTP 主干则见 MTP 完全拆解:多 token 预测如何让 DeepSeek 自带草稿模型。至于 examples/yoco/README.md 里那句”置信度挂在每轮最后一个 token 上、并滞后一轮”,是这种逐位置信度设计的直接推论,也是任何想复现的人必须注意的时序细节。
四、并行策略:Attention DP、balanced CP 与 MoE EP + EPLB
README 的一句话是”Parallelism: Attention DP / balanced CP, MoE EP + EPLB”。拆开看:
- Attention DP:注意力层做数据并行,即不同的请求副本各自持有完整的注意力权重与自己的 KV;对应
deepinfer/model_executor/parallel_utils/parallel_state.py里的PG(parallel group 集合)以及communication_op.py。 - Balanced CP:上下文并行(context parallel)按”均衡”方式切分序列维。调度器里有个细节泄了底:
cp_align = cp_size > 1 ? cp_size * 2 : 1,而前向工作量分配是(max_num_batched_tokens - num_batched_tokens) / cp_align * cp_align——token 预算必须按 CP 粒度对齐,因为 CP 切分要求序列长度可均分。prepare_cp_mirror算子是另一处证据:CP 下的镜像准备。 - MoE EP + EPLB:专家并行 + 专家负载均衡器。
deepinfer/model_executor/eplb/policy.py的注释把术语定得很清楚:logical expert(模型定义的专家)与 physical expert(GPU 上实际放置的副本,数量 = logical + redundant)。冗余专家默认为 32(DEEPINFER_OVERRIDE_NUM_EXTRA_EXPERTS),且这只是下界——引擎会把”路由专家数 + 冗余数”向上取整到能被ep_size整除,backbone 与 DFlash 分别取整。重排算法是逐层独立的贪婪放置:目标是让”各步各 rank 负载峰值之和”最小,实现上给每个候选放置算分数再选当前最优。
EP 的通信依赖 DeepSeek 自家的 DeepEP 库——dispatch/combine 两种内核的结构见下图,机制细节可参考 DeepEP 完全拆解:DeepSeek 开源通信库如何把 MoE 推理的 dispatch/combine 压到硬件极限:
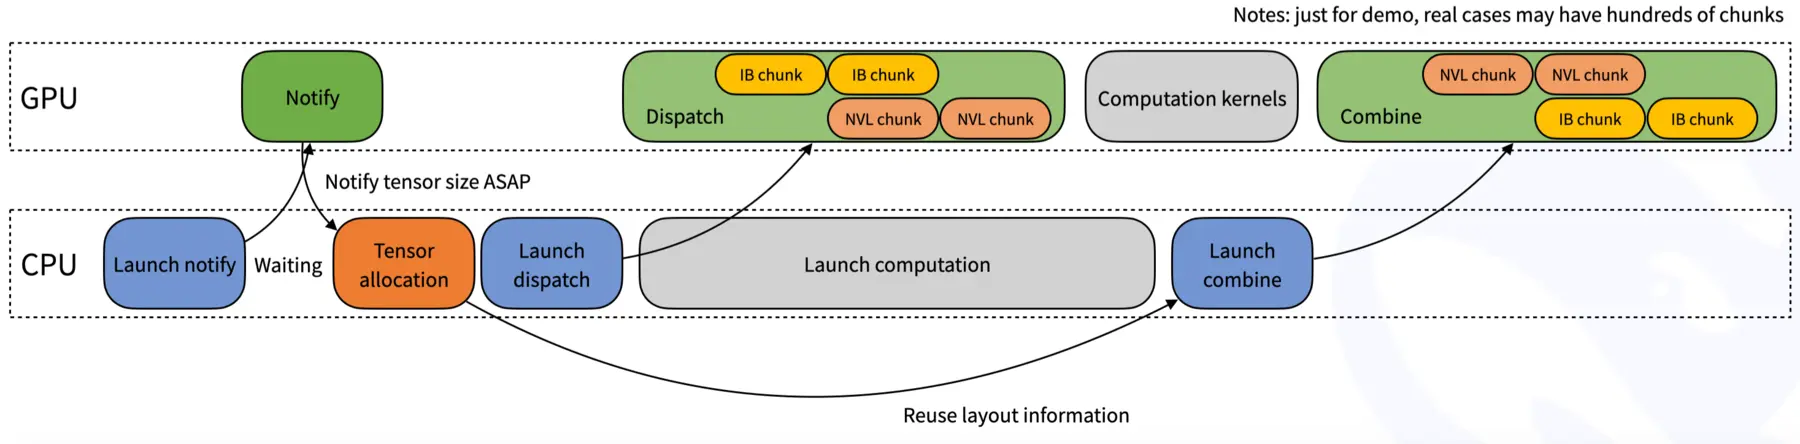
(图源:DeepEP 官方仓库 figures/normal.png)
调度器侧还有一组环境变量专门服务 EPLB:DEEPINFER_MOE_LB_STAT_INTERVAL(默认 128 步统计一次)、DEEPINFER_EXPERT_COUNT_WINDOW_SIZE(默认 100)、DEEPINFER_REARRANGEMENT_STEP_INTERVAL、DEEPINFER_REARRANGE_AFTER_PREFILL_IN_NORMAL_ENGINE(是否在 prefill 之后立刻重排)、以及调试用的 DEEPINFER_FORCE_IMBALANCE_RATIO(人为制造不平衡)与 DEEPINFER_SHOW_EPLB_DETAIL。这套开关的密度说明 EPLB 在线上是常态开启的运维机制,不只是论文演示。DeepSeek 线上系统的 EP + 三个负载均衡器设计,可回看 DeepSeek-V3/R1 推理系统完全拆解:跨节点专家并行、双批重叠与负载均衡;SGLang 侧的 EPLB 实现见 SGLang 源码完全拆解(十七):DP Attention 与专家并行。
五、确定性:batch-invariant 推理与确定性采样
这是通用框架基本不提供的性质,而 DeepInfer 把它做成了开关:
DEEPINFER_BATCH_INVARIANT=1(仅 NVIDIA):不同 batch 组成下模型输出保持一致。为什么 batch 会影响数值结果?因为 GEMM 的规约顺序、批内 token 的排列会改变累加次序,浮点加法不满足结合律,结果就会有 ulp 级差异。批量不变推理的要求是:把 kernel 的规约顺序与批大小解耦——哪怕 batch=1 和 batch=64 混着跑,同一个 prompt 的输出也必须逐位一致。这在生产环境里有实际意义:缓存/校验基准、回归测试、以及”同输入必须同输出”的 SLA。- 确定性采样:
DEEPINFER_BATCH_INVARIANT=1加DEEPINFER_ENABLE_MTP_VARLEN=0,再给SamplingParams传固定的seq_seed,相同输入 token 与采样参数就产生相同输出。注意必须关掉 MTP——投机解码的草稿长度受运行时估计影响,会引入非确定性,这两条要求是互斥的。
数值一致性的底层问题(浮点加法为什么不可结合、规约顺序如何影响结果)在站内已有专门拆解:浮点数与数值稳定性:从 IEEE 754 到 FP8 的 LLM 精度世界。
六、kernel 与硬件:官方库 + 双平台
kernel 侧的证据链很直白:README 点名 FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect 五个官方库,外加自研的 TileLang 算子目录。其中 tilelang_ops/ 有两个平行子目录 cuda/ 与 asc/——同一组逻辑算子(compress、load_paged_kv_cache、store_kv_cache、swa_index、fused_sample、schedule_mtp_varlen 等)各写一份 CUDA 版与昇腾版,共享 ops.py 的接口层。这是”双平台”承诺在代码层面的落实方式:不是把算子抽象成统一 DSL 再靠编译器, 而是承认两个平台的差异,各写各的、接口统一。
FlashMLA 的 kernel 调度策略(warp 分工与流水)如下图,它的实现思路与站内拆过的 MLA、DSA 系列直接相关:
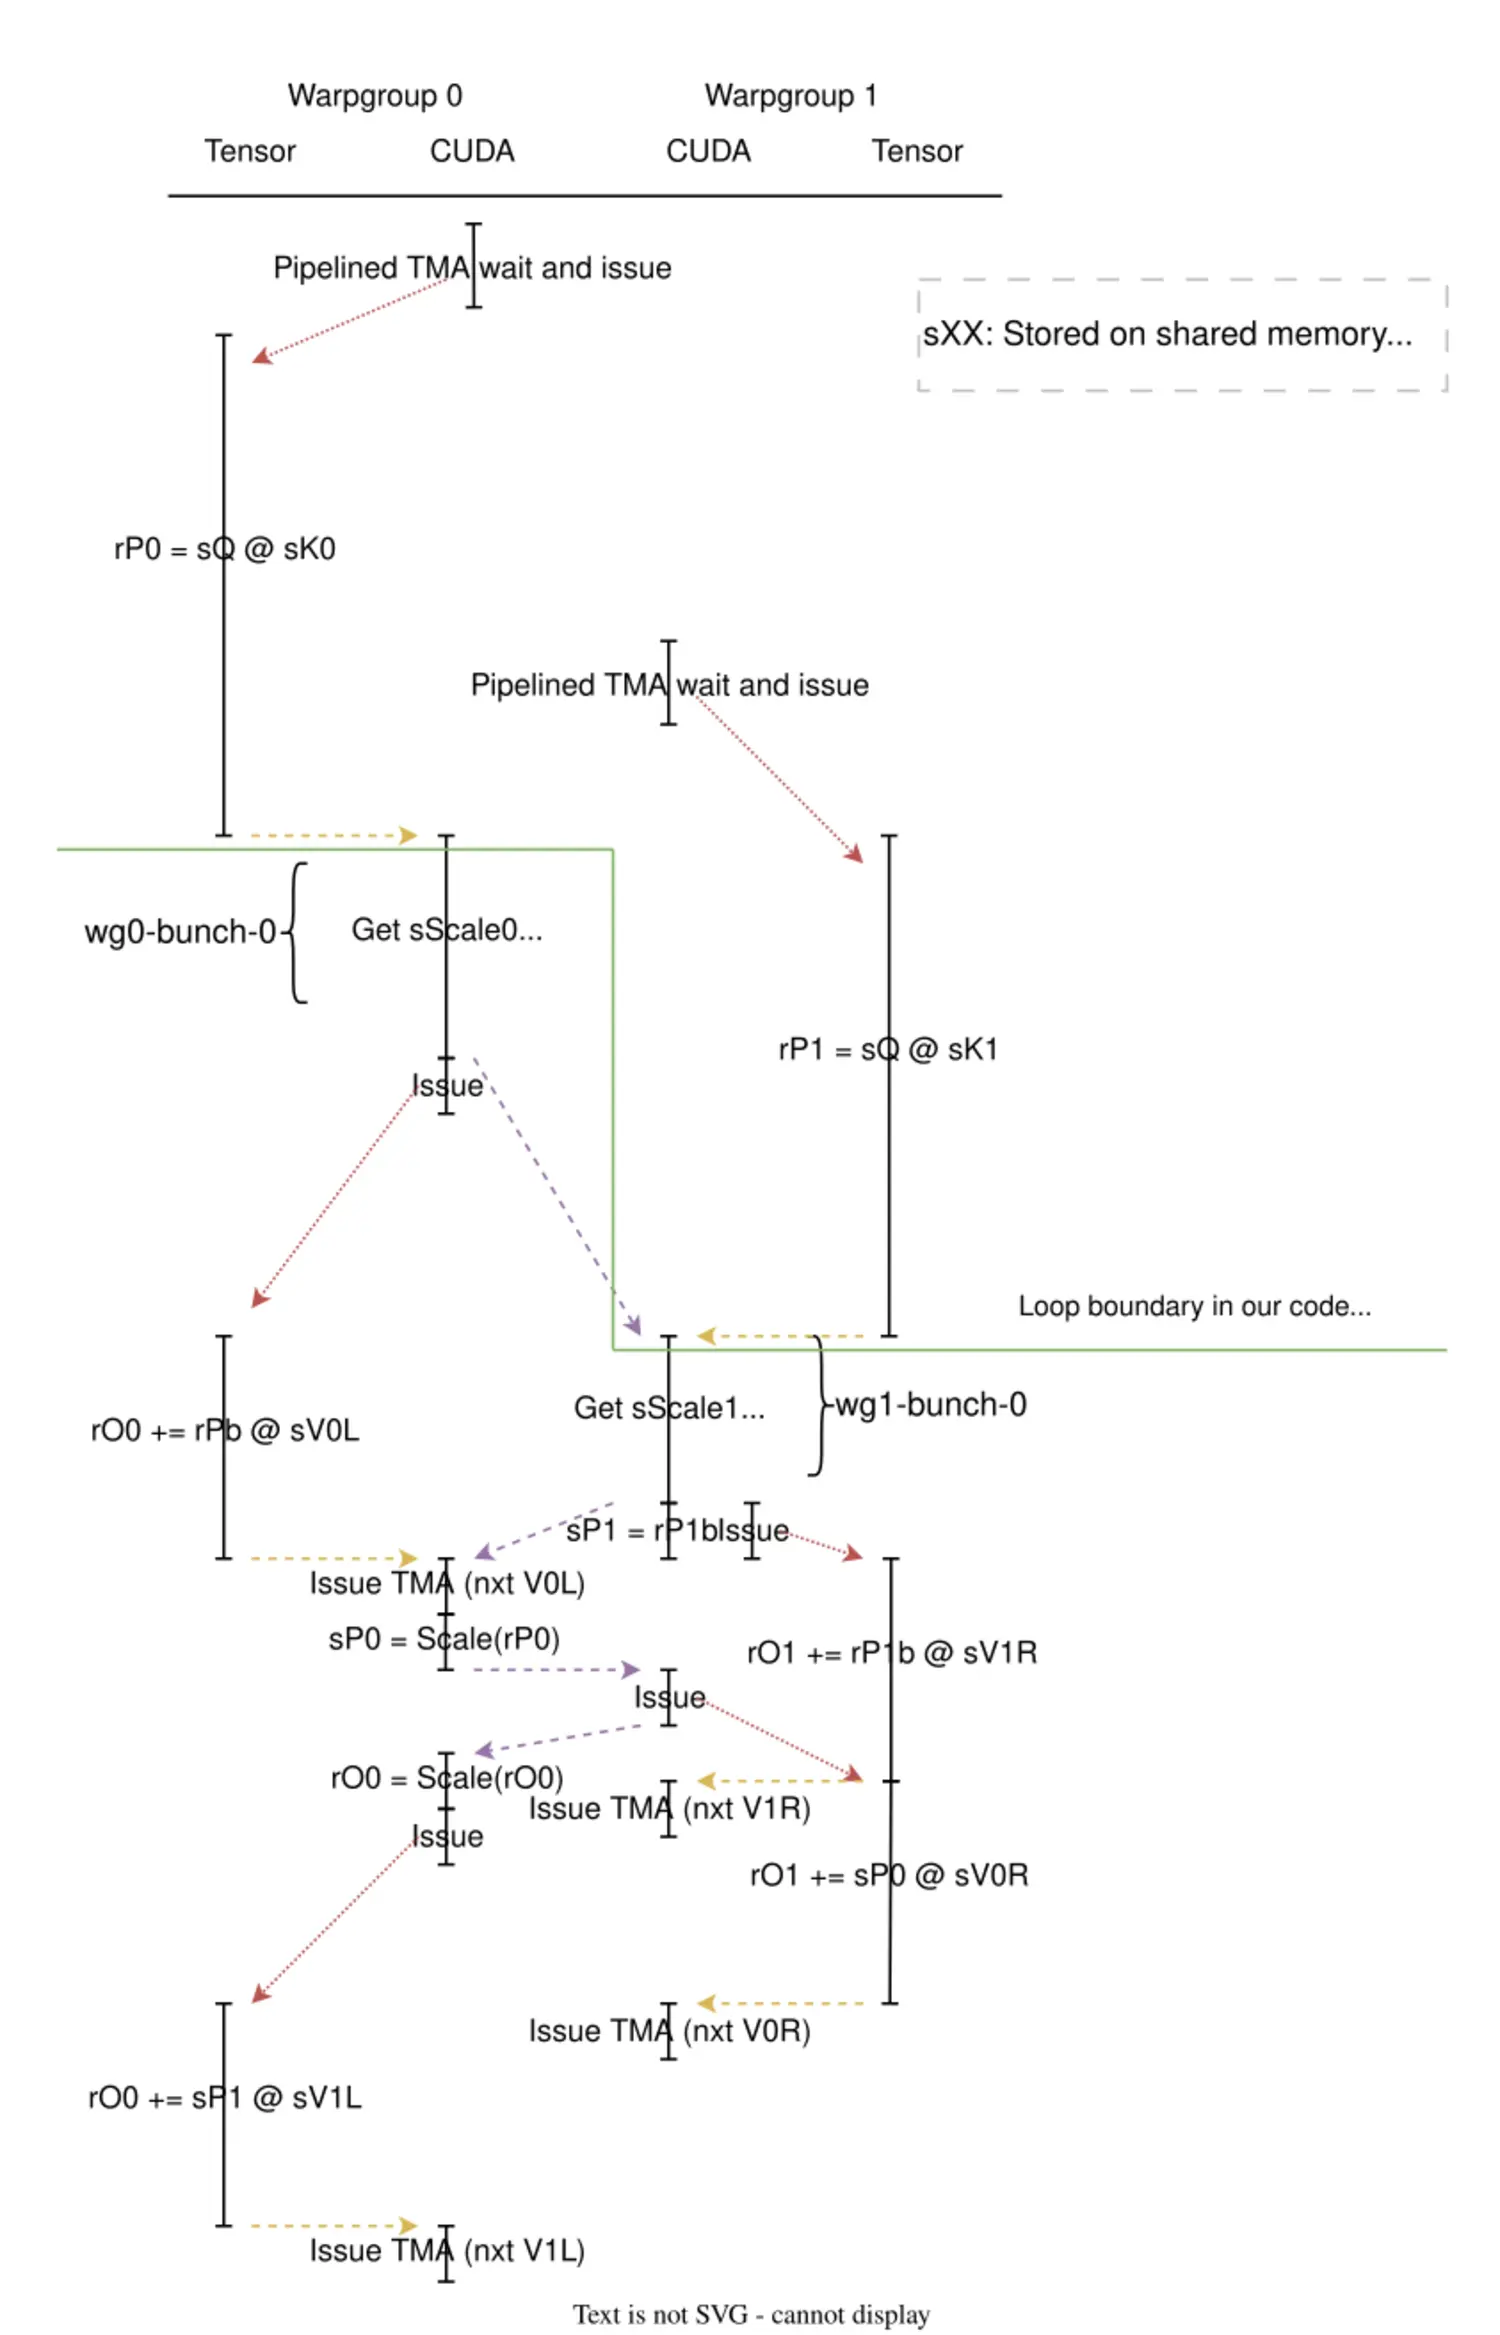
(图源:FlashMLA 官方仓库 docs/assets/MLA Kernel Sched.drawio.svg)
模型侧的模块也全部对应站内已拆解的文章:v4_modules/mla_attn.py(MLA 注意力,见 MLA 完全拆解)、v4_modules/index_attn.py(稀疏注意力索引器,见 DSA 稀疏注意力完全拆解:从 DeepSeek-V3.2 的闪电索引器到 vLLM 的算子实现)、v4_modules/compress.py(KV 压缩)、v4_modules/cross_layer.py(跨层共享拓扑,见 DeepSeek-V4 混合注意力完全拆解:CSA + HCA + 滑窗)、v4_modules/engram.py(条件记忆,见 Engram 完全拆解:条件记忆——MoE 之外的第二条稀疏轴)、v4_modules/mhc_ops.py 与 hc_blocks.py(流形约束超连接,见 mHC 完全拆解:流形约束超连接),以及 models/vision_encoder/ 与 models/deepseek_vl.py(多模态,见 DeepSeek-OCR 完全拆解:光学上下文压缩)。把这些文件名和文章对上,读者会发现一件事:DeepInfer 是这些公开技术的”总装厂”——所有前作拆过的东西,在这里被装进同一个引擎、共用同一个调度器与内存账本。
结构化输出:自建编译器与 xgrammar 的双路径
结构化输出(constrained decoding)把生成限制在正则、JSON Schema 或 EBNF 语法之内:每一步采样前,把所有”会破坏语法”的 token 从 logits 里屏蔽掉。DeepInfer 的接口是给 SamplingParams 传 so_args={"schema_type": ..., "schema": ...},示例见仓库的 examples/_structured_output.py。
实现上它同时保留两条路径。自建的部分在 deepinfer/structure_output/:
compiler.py:把正则/JSON/EBNF 编译成语法结构;matcher.py与so_matcher_builder.py:有限状态机式的匹配器与它的构建器——SOMatcherBuilder在LLMEngine里是懒构造的,属性访问到才创建,代码注释给了理由:“get_idle_cpus 在 CPU 配额不足的机型上直接 raise,不消费 SO 的部署不应为此启动失败”。构建并发由DEEPINFER_SO_BUILDER_CPUS(默认 4)控制;mask.py:把当前状态允许的 token 集合变成 logits 掩码,由采样侧应用。
另一条路径是 xgrammar,由一组环境变量控制:DEEPINFER_XGRAMMAR_DEBUG、DEEPINFER_XGRAMMAR_TIMEOUT(默认 20,语法编译超时)、DEEPINFER_XGRAMMAR_DISABLE_CACHE、DEEPINFER_XGRAMMAR_CACHE_LIMIT_BYTES(默认 10 GiB)。两条路径并存本身是工程信号:自建实现服务自家主路径(可控、可特化、能做成 TileLang 算子——tilelang_ops/*/structure_output.py 就在那里),第三方库作为备份与对照。本站拆过的 vLLM 与 SGLang 结构化输出分别走 xgrammar 与 outlines/xgrammar(见 vLLM 源码完全拆解(十四):结构化输出 与 SGLang 源码完全拆解(十):Sampling、Grammar 与结构化输出),对照着读能看出三家的取舍差异。
SO 的生命周期管理也藏在 step() 里,而且写得非常防守。调度器为每个 SO 请求维护 so_status 与 so_matcher:prefill 的最后一个 chunk 到来时,如果 so_status == 0 且 matcher 就绪,就把它推到状态 1(开始约束);否则——注释原话是”SO 簿记 bug 只判死本请求”——直接把请求置为 FINISHED_SO_FAILED 当步回收,同时把 so_status 置 -1 让本步采样器早退。连”依赖采样器把 -1 写回账本”这条路径都不可信(注释说 _get_so_mask 的快路径可能吞掉 -1),所以选择主动杀死单请求而不是污染整批。这种”单请求失败不影响整批、且失败路径要显式走完”的写法,是长时间运行的生产引擎必须有的韧性设计。
与四个框架的对照
把 DeepInfer 放回它自己的坐标系里,五家的差异可以压进一张表:
| 维度 | vLLM V1 | SGLang | llama.cpp | TensorRT-LLM | DeepInfer |
|---|---|---|---|---|---|
| 调度器位置 | Python(EngineCore 进程) | Python(Scheduler 进程) | C++(server-context 队列) | Python(CapacityScheduler) | C++(pybind 暴露给 Python) |
| KV 管理 | Python KVCacheManager + PagedAttention | RadixCache 前缀树 + 页池 | slot + 图内 KV | KVCacheManager(两级池) | 两本块账(KV 块 + 状态槽)+ 索引器配额 |
| 图执行 | piecewise CUDA Graph + torch.compile | 解码整图 + prefill 分段图 | 无(逐图执行) | 静态形状 CUDA Graph 为主 | 幂次+等宽混合分桶、ZOS 下共享输入缓冲、DFlash 独立图 |
| 投机解码 | 外挂草稿模型/EAGLE/n-gram | EAGLE/草稿 worker | 自身实现的投机采样 | one-model worker | DSpark/MTP 变长验证 + 置信度调度 |
| 结构化输出 | xgrammar/outlines | xgrammar | GBNF | 内置 guide | 自建 compiler/matcher + xgrammar 双路径 |
| 目标模型 | 任意 | 任意 | 任意(GGUF) | 任意 | 仅 DeepSeek-V4.1-Flash |
| 服务形态 | 完整在线服务 | 完整在线服务 | 完整 server | 完整服务栈 | 离线引擎(KV 系统、P/D 分离编排、DP 负载均衡未开源) |
表里最”扎眼”的一行是最后一列的目标模型:其余四家都在为”任意模型”做兼容层,DeepInfer 把这层成本全部省下来换成特化。理解了这一列,前面所有机制——两本块账、变长验证、SWA 有界重放、batch-invariant、双平台算子——就都能归位到同一条主线:知识越具体,优化越激进。反面也同样成立:这套引擎不能直接拿来跑别的模型,它就是 V4.1-Flash 的专属座舱。
执行侧的两个关键机制:形状分桶与显存预算
CUDA Graph 的尺寸桶与”预热-缓存”闭环
decode 是每步都要跑一次前向的场景,逐步 launch 几十上百个 kernel 的开销会直接吃掉延迟预算,所以 CUDA Graph 几乎是所有推理框架的标配——站内已有 CUDA Graph 完全拆解:从逐次 Kernel Launch 到可重放推理执行图 讲透通用原理。DeepInfer 的特别之处在于图尺寸集合的构造方式与选择逻辑。
worker/cuda_graph_runner.py 里的 build_graph_batch_sizes(max_size, interval) 用两段式规则生成桶:先从 1 开始按 2 的幂次递增(1、2、4、8……)直到 interval,之后以固定宽度 interval 均匀铺到 max_size,最后补上 max_size 本身。默认 interval 由 DEEPINFER_CUDAGRAPH_BATCH_SIZE_INTERVAL 给出(默认 8)。这个混合策略的动机很直接:小 batch 时 batch 数变化带来的相对开销大,用 2 的幂次把分辨率做细;大 batch 时相对开销小,用固定宽度避免桶数爆炸(桶数越多,捕获/预热图的内存与时间成本越高)。DFlash 有独立的一套,间隔由 DEEPINFER_DFLASH_CUDAGRAPH_BATCH_SIZE_INTERVAL 控制——变长验证的形状变化比常规解码更剧烈,桶策略不能共用。
真正的选择发生在 model_runner._prepare_input。它先判断是否可用图:run_cuda_graph = not is_prompt and self.use_cuda_graph and bool(self.cuda_graph_runner.graphs)——prefill 不跑图(形状太长太杂),DEEPINFER_ENFORCE_EAGER 可强制关掉图,而 use_cuda_graph 本身在构造时就排除了 PROMPT 引擎(self.parallel_config.engine_type != EngineType.PROMPT)。然后 cuda_graph_runner.select(total_q) 按本步真实 token 数挑一个 ≥ 它的桶,差出来的部分用填充序列补齐:
seq_metadata_list + self.cuda_graph_runner.padding_seq_metadata_list[: graph_size - total_q]也就是说,桶比真实 batch 大的部分是拿”空转的 padding 序列”填满的,图只按固定形状重放,多余算力白白浪费但不影响正确性——这是 CUDA Graph 与动态批处理之间的经典权衡,DeepInfer 通过加密桶(让浪费的比例可控)来缓解。
这里还有两个细节值得记下来。其一,CudaGraphData 的 docstring 写着”Source tensors are on CPU, or share device tensor storage under ZOS”——ZOS 之下,图的输入张量不是每次从 CPU 拷进设备缓冲,而是与设备侧张量共享存储,省掉了 H2D 拷贝。这就是 ZOS 的另一层收益:它不只是把 CPU 后处理挪出关键路径,还顺带让 CUDA Graph 的输入准备变便宜。其二,test/baseline 之外还有一个 decode_perf_cache.py:DecodePerfCache 把实测的 decode 性能曲线按 {time_unit, model, batch_sizes, parallel_config} 的哈希键缓存到磁盘(目录 DEEPINFER_DECODE_PERF_CACHE_DIR,TTL 由 DEEPINFER_DECODE_PERF_CACHE_TTL_SEC 控制,默认一小时),跨进程复用——下次启动时调度器不必重新做一遍预热扫描,直接把上次的曲线读回来。它甚至专门把 time_unit: "ms" 写进哈希输入,注释说明是为了和旧的 SPS 缓存区分开。把”性能曲线”当作可缓存的产物,是生产引擎才会有的设计。
显存预算:KV 池、状态池与每字节的来路
worker/cache_engine.py(978 行,头部同样标着 derived from vLLM)负责把显存切成 KV 池和状态池。它的预算函数写得像一份账本:
KVSTORE_GRAIN = 128,注释明确:“kvstore 落盘粒度:只在 token 数为 128 的倍数处落盘”。落盘对齐到 128 token 的边界,意味着缓存卸载的单元是固定大小的段,而不是任意长度。_kv_bytes_per_token(kv_lora_rank, rope_head_dim, per_n_cast, use_fp4)直接算出每个 token 的 KV 字节数,并按use_fp4选择V41_FP4_FORMAT或V41_FORMAT两种布局,还用assert kv_lora_rank + rope_head_dim == layout.num_elements与assert per_n_cast == layout.elements_per_sf校验布局常量自洽。这解释了本站另一篇里”890 字节/token”这个数字的来路——它不是一个约定值,而是这个函数在当前量化布局下的返回值(详见 DeepSeek-V4.1-Flash 推理侧完全拆解)。_state_bytes(head_dim, num_state_token)算的是[num_state_token, 2, head_dim]的 fp32 状态字节数。注意这里的形状[N, 2, head_dim]:每个 token 位置存两组 head_dim 向量,这是循环/压缩类状态(YoCo、KDA 一类的固定循环状态)的典型布局。站内 Kimi Delta Attention 完全拆解:固定循环状态如何替代不断增长的 KV Cache 讲的就是这类状态的机制。_align_to_multiple(numerator, denominator, alignment)与_get_from_attn_index_configs处理对齐与一致性校验:后者遍历所有带attn_index的注意力层,对每层取候选值并要求结果处处一致(assert result in (0, candidate)),注释也留了口子——“不同量化方式会有一些区别”。索引器自己的 KV 也有独立的字节开销,DEEPINFER_INDEX_ATTN_MEMORY_LIMIT(默认 10 GiB)就是为它设的上限。
把这些拼起来,DeepInfer 的显存账本至少有三本:主 KV 池(按 _kv_bytes_per_token 算)、状态池(按 _state_bytes 算,容量由 DEEPINFER_NUM_STATE_SLOTS_RATIO 放大)、索引器内存(受 DEEPINFER_INDEX_ATTN_MEMORY_LIMIT 限制)。三本账分别对应 block_manager、state_manager 与索引器的配额检查——这就是为什么 LLMEngine.__init__ 里要有两个 BlockManager 实例。通用框架通常只有一本账,因为它们的模型没有状态池与索引器这两类额外内存。想对比另一种记账思路,可以读 vAttention 完全拆解:用 CUDA 虚拟内存保住连续 KV Cache(按需映射物理页)与 TensorRT-LLM 源码完全拆解(十五):显存与缓冲管理(把 KV 池、workspace 与图缓冲装进同一份预算)。
性能口径:官方 benchmark 与它的实测方法
README 给出的两张 pareto 图是官方性能口径的锚点。先看吞吐形态:
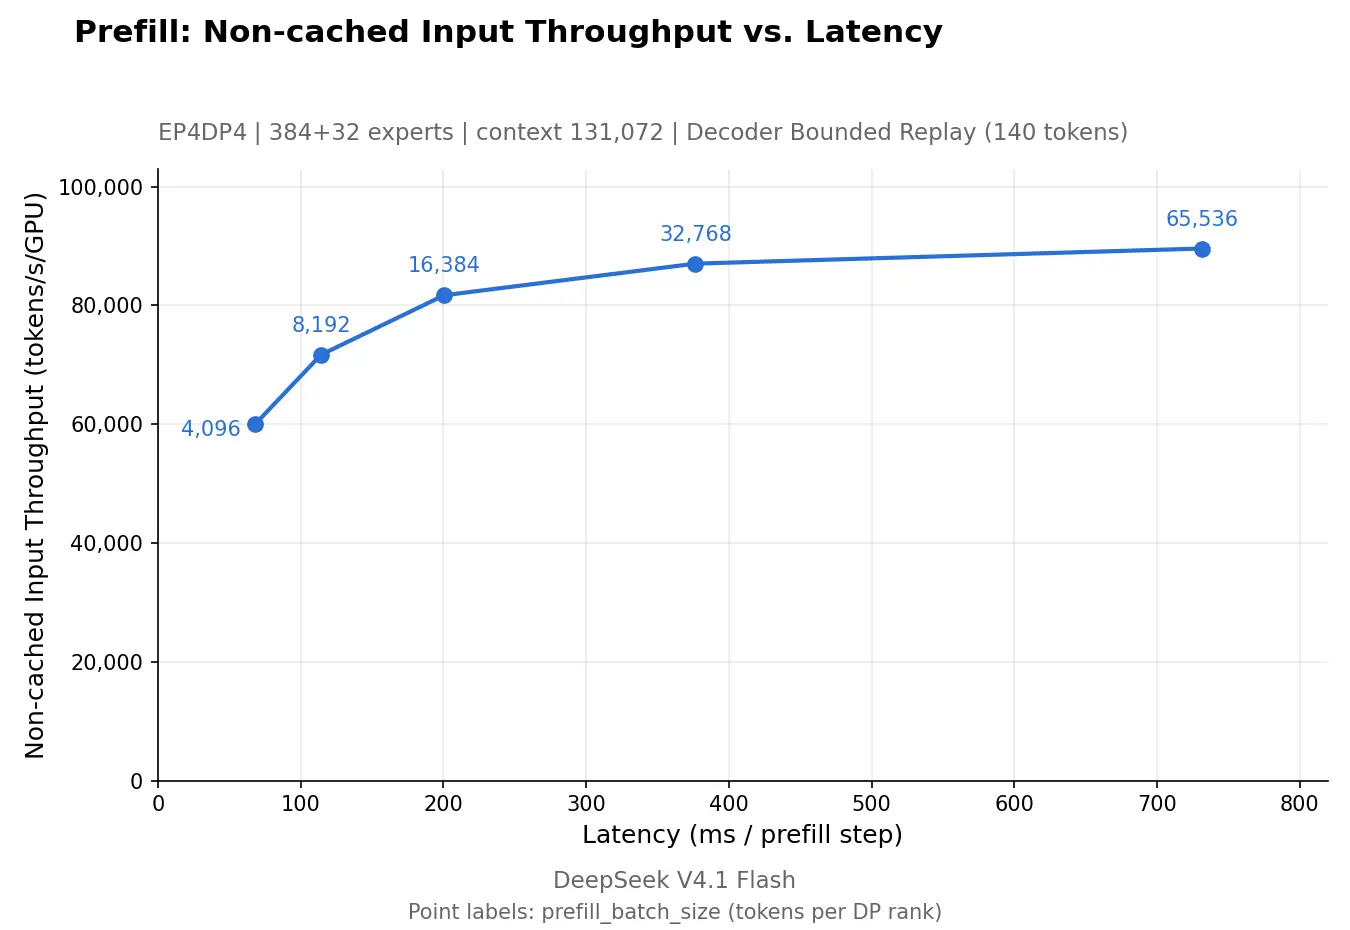
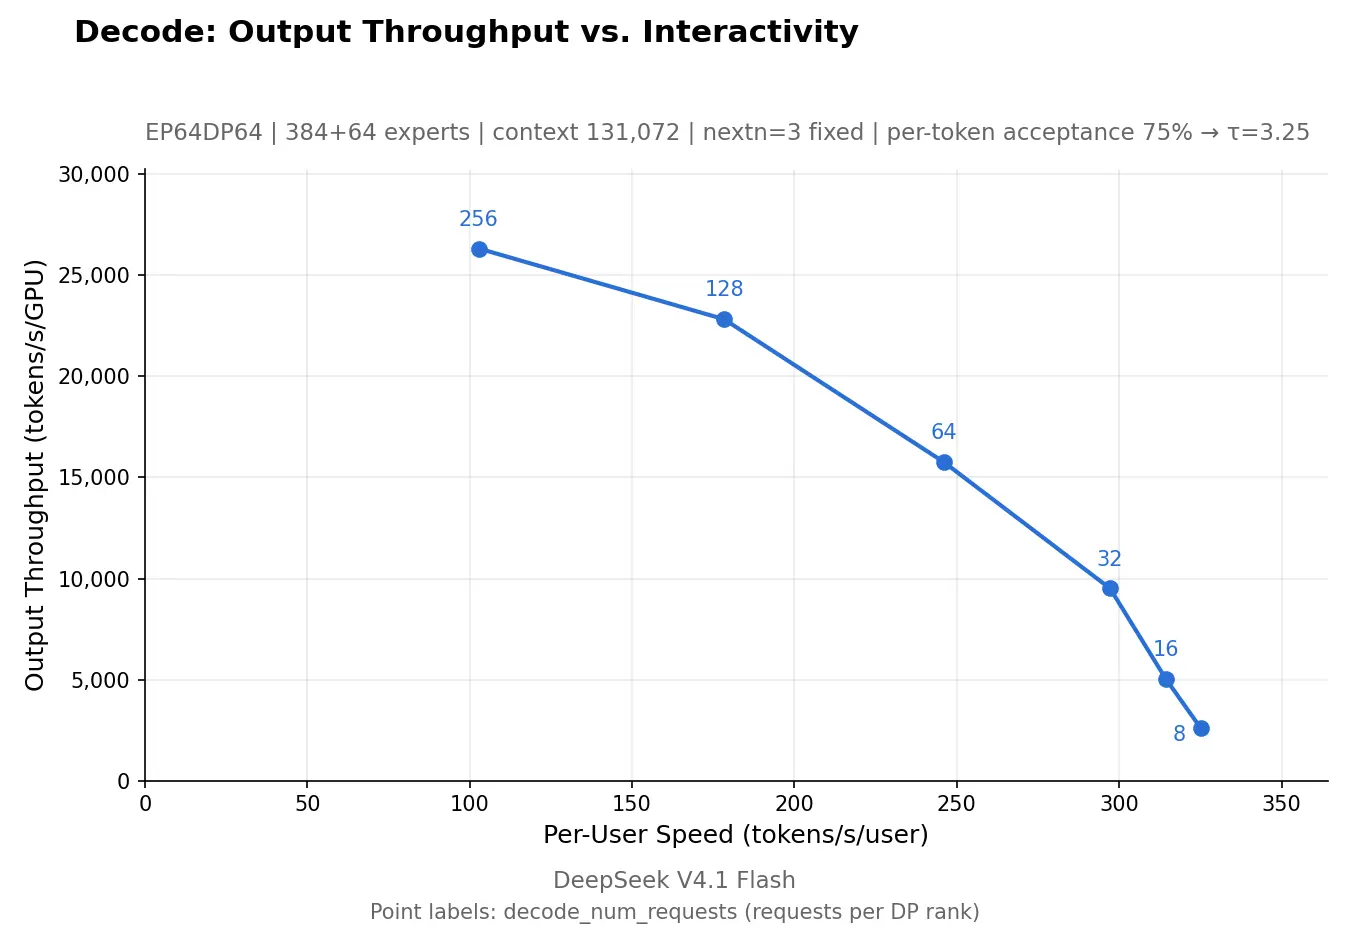
(图源:DeepInfer 官方仓库 doc/images;测试配置为 prefill 4 张 SM100 GPU、decode 64 张 SM100 GPU,各自在同一个 scale-up 域内)
比曲线本身更值得读的是 examples/README.md 里对测法的交代,因为多数字节差异都藏在口径里:
- prefill 与 decode 解耦测量。
--prefill_batch_size与--non_cached_tokens只影响 prefill 段的 chunk 大小与后缀长度;--decode_num_requests只控制 decode 批大小。两个阶段唯一的耦合是 decode 复用 prefill 产生的共享前缀 KV,所以整批请求按max(N, K)构造——当N > K时,下标超过K的请求max_tokens=1,最后一个 prefill chunk 产出首 token 后立刻完成、在第一次 decode 调度前就被移出running,永远不进 decode 批。 - 吞吐按”全接受”记账。decode 吞吐的公式是
avg_SPS × decode_num_requests × (1 + nextn) / --cp,即假定每个请求每步产出1 + nextn个 token,不管真实接受率是多少。所以 64 个请求、nextn=5 的一步计 384 个 token。这是投机解码 benchmark 里常见的口径选择,读数字时必须知道它衡量的是”上限吞吐”而非”实际吞吐”。 - 测量窗口要避让干扰。prefill 吞吐取跳过 5 个 warmup chunk 后最后 11 个样本形成的 10 个稳态区间;decode 的
avg_SPS取跳过 50 个 warmup 步与 60 个带日志的步之后、decode profiler 挂上之前的最后 61 个满批样本形成的 60 个区间。会与 EPLB 统计 flush(EP all_gather,抖动十几毫秒)撞上的区间整段丢弃再平均——benchmark 特意把DEEPINFER_MOE_LB_STAT_INTERVAL设为 10,让 prefill 的日志段也能带上真实 moe_lb 值。同时还会打印干净区间里最慢的单步max_step,正常情况下应该接近1000 / avg_SPS。 - profiler 只用于看算子构成。
PROFILE=1时 trace 里必然含 2 个满 chunk prefill 步与 3 个稳态 decode 步,但步时间里包含 profiler 的即时开销(bsz=1 时膨胀可达近 50%),出 trace 后还有 ~7-11% 的残留减速,所以任何测量都不能排在 profiler 之后,也不能拿 trace 里的步时间反推 SPS。 - 数值回归是硬约束。PPL 基线存在
tests/models/offline_decode_ppl.json,按平台/负载为键(与传入的模型目录无关),每个 DP rank 一组样本,验证时逐样本精确比对。多机运行时刷新与验证按节点切分,黄金基线在跨节点文件锁下写入。长 PPL 的配置是 16389 token 输入、4096 token 输出、nextn=5。
这套口径信息量很大:它同时说明了官方图的横纵轴是什么、数字在什么条件下得到、以及哪些数字不能拿来用。对想复现的人来说,这比曲线本身更重要。
推荐的源码阅读路径
按”先结构后代码、先粗后细”的次序,五步能建立完整心智模型:
README.md→examples/README.md:先读功能清单与 benchmark 口径,知道这个引擎承诺什么、数字怎么来的。半小时,收益最大。deepinfer/engine/llm_engine.py(约 1030 行):从LLMEngine.__init__看它持有哪些对象(这就是全局对象图),再读step()看主干顺序,最后读_process_model_outputs与pre_sampler_sync看输出回传与延迟释放。本篇的抽象表基本来自这一段。deepinfer/worker/worker.py(283 行):execute_model_step的四步编排是理解 ZOS 的唯一入口,配合worker/zos_status.py里的WorkerStepState与MetadataZOS(数据类定义本身就把字段语义写在 docstring 里)一起读。csrc/engine/scheduler.hpp与csrc/engine/pybind_scheduler.cpp:C++ 侧不必逐行读。先读 pybind 文件——它列出了 Python 能看到的全部能力面(schedule、process_outputs、add_sequence、abort_sequence、get_num_preempted_seqs等),再按需回到 hpp 看_schedule_prefill/_schedule_decode的具体算术。deepinfer/model_executor/models/v4_modules/:进模型层前先读builder.py(130 行)与cross_layer.py。builder.py的_build_block会告诉你模型是怎么被拼出来的、哪些层共享 KV 源、哪些层共享索引器的k_proj,这几条共享关系决定了后面所有注意力与 KV 内存代码的行为。
想先补背景再进源码的读者,可以按这条线走:MLA(MLA 完全拆解)→ 稀疏注意力索引器(DSA 稀疏注意力完全拆解)→ 混合注意力与跨层复用(DeepSeek-V4 混合注意力完全拆解)→ KV 压缩(DeepSeek-V4.1-Flash 推理侧完全拆解)→ MoE 通信(DeepEP 完全拆解)→ 调度与重叠(SGLang Overlap Scheduler)。读完这些再打开 DeepInfer,代码里几乎不会出现陌生的概念。
工程上的坑与边界
总览的价值有一部分在于提前标出”不知道会踩的坑”。以下几条来自代码注释与环境变量的显式约束,都是实打实的边界条件。
- ZOS 的正确性依赖元数据修正。开启零开销调度后,本步的 q/k 长度要用上一步采样的结果修正,修正路径是
_correct_seqlens_qk加一次 d2h 拷贝。这意味着任何绕过这条路径、直接相信调度器算出的seqlens_k的下游代码都会错。worker 里的注释也点明了:MetadataZOS的remap_cpu是”本步 H2D 的源、同时充当 CPU 侧 fresh/previous 分派输入”,两件事共用一份 pinned 内存,改一处要考虑另一处。 - YoCo 截断与抢占的交互。
step()里在克隆块之前有一句注释:“NOTE 开启 yoco 截断时,允许抢占导致的结果变化”。截断模式下 KV 只保留了有界后缀,一旦发生抢占需要重算,结果可能与不抢占时不同——这是可接受的既定行为,而非 bug。任何把”同输入必同输出”当作硬要求的场景(确定性采样),必须同时考虑这一条。 - 确定性采样与投机解码互斥。前文已述:要确定性就必须
DEEPINFER_ENABLE_MTP_VARLEN=0,因为变长验证的草稿长度由运行时估计决定。 - CUDA Graph 与显存的耦合。
entrypoints/llm.py的注释直接给出排障提示:开 CUDA Graph 时若遇到CUDA error: an illegal memory access was encountered,很可能是图捕获时 OOM,解决办法是调低gpu_memory_utilization再试。因为图捕获阶段会一次性吃下所有桶的输入/输出缓冲,峰值显存远高于运行时。 - 形状约束。CP 相关的 token 预算必须按
cp_align = cp_size * 2对齐,--cp必须整除ep_size,冗余专家数会被向上取整到能整除ep_size的值。这些不是可选的调优参数,是不满足就跑不起来的硬约束。同理,启用 YoCo 截断时DEEPINFER_YOCO_PREFILL_KEEP_TOKENS必须显式设置(默认 0),且保留长度必须覆盖 SWA 窗口加最大回溯长度。 - 多机运行的记账分裂。PPL 基线的刷新与验证在多机下按节点切分,每个节点只更新/比对它自己持有的 rank,黄金基线在跨节点文件锁下写入。
--output(另存候选基线)只支持单机——多机下候选文件必然缺别的节点的 rank,脚本会直接报错并提示用默认路径。 - 平台差异。Ascend 路径有自己的调试环境变量(
ASCEND_LAUNCH_BLOCKING=1让算子同步执行以便读栈、ASCEND_SLOG_PRINT_TO_STDOUT=1输出 CANN 日志),DEEPINFER_ENGRAM_FORCE_GPU_STORAGE在 Ascend 上被强制打开。batch-invariant 与确定性采样目前都标注为 NVIDIA only。
本系列的后续规划
按”每进入一个新框架先发总览、再逐模块展开”的规则,DeepInfer 系列的路线图如下:
- 本篇:整体架构与模块全景。
- 异步调度与 ZOS:
Worker.execute_model_step的编排、seqlens修正、ForwardRuntimeEstimator/SamplerRuntimeEstimator如何把实测耗时喂回调度。 - KV 内存与 SWA 有界重放:
cache_engine.py的显存池、两本块账(KV 块 + 状态槽)、YoCo mask/compact 的等价性与验证方法。 - MoE 专家并行与 EPLB:logical/physical expert 的放置算法、冗余专家的取整规则、DeepEP dispatch/combine 在引擎侧的组织方式。
- 投机解码:DSpark/MTP 变长验证、DFlash CUDA Graph、置信度头温度参数的语义与时序。
- TileLang 特化算子与双平台:
tilelang_ops/cuda与asc的对应关系、共享接口层ops.py的设计。 - 结构化输出与确定性:
structure_output/的编译器与匹配器、xgrammar 路径并存的边界、batch-invariant 的实现约束。
下一篇讨论异步调度与 ZOS,重点回答三个问题:为什么”延后一拍”能换来重叠、seqlens_q 的 GPU→CPU 修正路径如何保证正确、以及运行时耗时估计为什么必须用中位数而不是均值。
参考资料
- DeepInfer 官方仓库(README 与功能清单)
- DeepInfer 官方示例与 benchmark 口径说明
- DeepInfer YoCo mask/compact 等价性验证说明
- DeepInfer llm_engine.py 源码
- DeepInfer worker.py 与 execute_model_step
- DeepInfer scheduler.hpp(C++ 调度器实现)
- DeepInfer pybind_scheduler.cpp(Python 能力面)
- DeepInfer environ.py(全部 DEEPINFER_* 环境变量)
- DeepInfer EPLB policy.py(专家放置算法)
- DeepInfer mtp_varlen.hpp(运行时耗时估计器)
- DeepInfer V4.1 模型构建器 builder.py
- DeepSeek-V4.1-Flash-1017 模型卡
- FlashMLA 官方仓库(MLA kernel)
- DeepEP 官方仓库(MoE dispatch/combine)
- DeepGEMM 官方仓库(FP8 GEMM 内核)
- TileLang 官方仓库(tile 级内核 DSL)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



